

ASUS Ascent GX10 သည် NVIDIA GB10 Superchip ပတ်လည်ရှိ core build ကို လိုက်နာထားပြီး Arm v9.2-A CPU complex ကို integrated Blackwell graphics နှင့် 128GB unified LPDDR5x memory တို့ဖြင့် တွဲဖက်အသုံးပြုထားသည်။ NVIDIA သည် platform ကို FP4 AI compute ၏ 1 petaFLOP အထိ အဆင့်သတ်မှတ်ပြီး model fine-tuning ကို 200 billion parameters အထိ ပံ့ပိုးပေးသည်။ CPU နှင့် GPU ဆက်သွယ်မှုကို NVLink-C2C မှတစ်ဆင့် ကိုင်တွယ်ပြီး system တစ်လျှောက်တွင် coherent memory access ကို ခွင့်ပြုသည်။
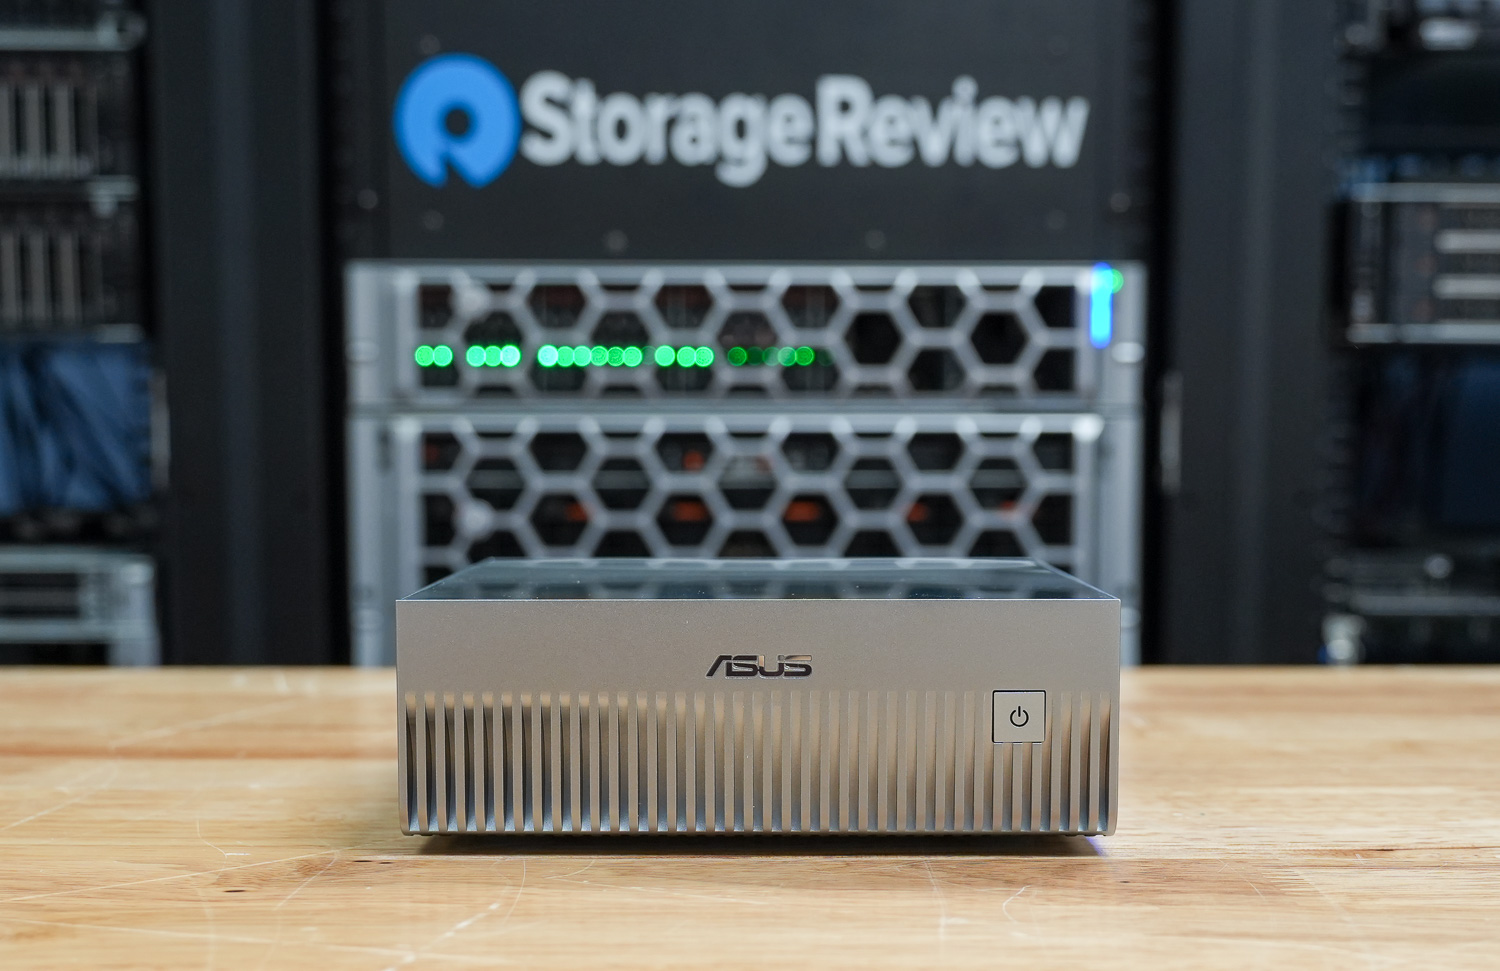
ASUS သည် ထိုဟာ့ဒ်ဝဲကို ကျစ်လစ်ပြီး ချောမွေ့သော 150 x 150 x 51 mm ကိုယ်ထည်ထဲသို့ ထည့်သွင်းထားပြီး အလေးချိန် 1.48 kg (Dell နှင့် GIGABYTE ဗားရှင်းများထက် အနည်းငယ်ပိုမြင့်ပြီး အနည်းငယ်ပိုလေးသည်)၊ Stellar Grey ဖြင့် အပြီးသတ်ထားသည်။ အခြားမော်ဒယ်များကဲ့သို့ပင် ၎င်းကို 240W ပြင်ပအဒက်တာဖြင့် ပါဝါပေးထားသည်။
သိုလှောင်မှု ရွေးချယ်စရာများတွင် 1TB နှင့် 2TB PCIe 4.0 NVMe ဖွဲ့စည်းပုံများမှ 4TB PCIe 5.0 NVMe ဗားရှင်းအထိ အမျိုးမျိုးရှိသည်။ ကွန်ရက်ချိတ်ဆက်မှုတွင် 10G Ethernet နှင့် NVIDIA ConnectX-7 SmartNIC ပေါင်းစပ်မှုအပြင် AW-EM637 မော်ဂျူးမှတစ်ဆင့် WiFi 7 နှင့် Bluetooth 5.4 တို့ ပါဝင်သည်။ နောက်ဘက်ချိတ်ဆက်မှုတွင် DisplayPort 2.1 alternate mode ပါရှိသော USB 3.2 Gen 2×2 Type-C port သုံးခု၊ 180W PD input ပါရှိသော USB Type-C port တစ်ခု၊ HDMI 2.1၊ 10G LAN၊ ConnectX-7 port နှင့် Kensington lock slot တစ်ခု ပါဝင်သည်။
ASUS က အခြားရောင်းချသူတွေနဲ့ နှိုင်းယှဉ်ရင် GB10 ပလက်ဖောင်းတစ်ဝိုက်မှာ အအေးပေးစနစ်၊ သိုလှောင်မှုနဲ့ ချိတ်ဆက်မှုတွေကို ဘယ်လိုပေါင်းစပ်ထားလဲဆိုတာနဲ့ ရေရှည်အလုပ်ပမာဏတွေအောက်မှာ သူ့ရဲ့စွမ်းဆောင်ရည်က တိုင်းတာနိုင်တဲ့နည်းလမ်းတွေနဲ့ ကွာခြားမှုရှိမရှိ ကြည့်ရအောင်။
ASUS Ascent GX10 သတ်မှတ်ချက်များ
| specification | ASUS Ascent GX10 (GB10) |
|---|---|
| အရွယ်အစားနှင့်အလေးချိန် | |
| အမြင့် | အတွက် 2 |
| width | အတွက် 5.9 |
| အနက် | အတွက် 5.9 |
| အလေးချိန် | 3.26 ပေါင် |
| processor ကို | |
| ပရိုဆက်ဆာအမျိုးအစား | NVIDIA GB10 (Grace Blackwell Superchip) (20 Cores) |
| ပေါင်းစပ်ဂရပ်ဖစ် | NVIDIA Blackwell GPU (ပေါင်းစပ်ထားသည်) |
| မှတ်ဉာဏ် | |
| memory အမျိုးအစား | LPDDR5x (ပေါင်းစည်းထားသော စနစ် မှတ်ဉာဏ်) |
| မှတ်ဉာဏ် Configuration | 128 GB LPDDR5x၊ ပေါင်းစည်းထားသော စနစ်မှတ်ဉာဏ် |
| မှတ်ဉာဏ် Bandwidth | ၂၇၃ GB/s (၈၅၃၃ MT/s) |
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | |
| ထောကျပံ့ OS ကို | NVIDIA DGX OS |
| ပြင်ပပေါက်များနှင့် အပေါက်များ | |
| Network Ports များ | RJ45 တစ်ခု (10GbE) NVIDIA ConnectX-7 NIC (200G × 2 QSFP) |
| USB port | USB 3.2 Gen 2×2 Type-C (20Gbps) သုံးခု PD in ပါရှိသော USB 3.2 Gen 2×2 Type-C တစ်ခု |
| ဗီဒီယို ပို့တ်(များ) | HDMI 2.1a တစ်ခု |
| ပါဝါအဒက်တာပေါက် | USB Type-C (PD IN) |
| လုံခြုံရေး slot | ကင်းဆင်တန်သော့တစ်ခု |
| ကြိုးမဲ့ | |
| ဝိုင်ဖိုင် | WiFi 7 (AW-EM637၊ 2×2) |
| ဘလူးတုသ် | ဘလူးတုသ် ၅.၀ |
| သိုလှောင်ခြင်း | |
| သိုလှောင်မှုရွေးချယ်စရာများ | M.2 NVMe PCIe 5.0: 4TB M.2 NVMe PCIe 4.0: 1TB / 2TB |
| ပါဝါစ Adapter ကို | |
| ပုံစံ | ၂၄၀ ဝပ် ပြင်ပ အဒက်တာ (USB Type-C) |
ASUS Ascent GX10 ဒီဇိုင်းနှင့် တည်ဆောက်မှု
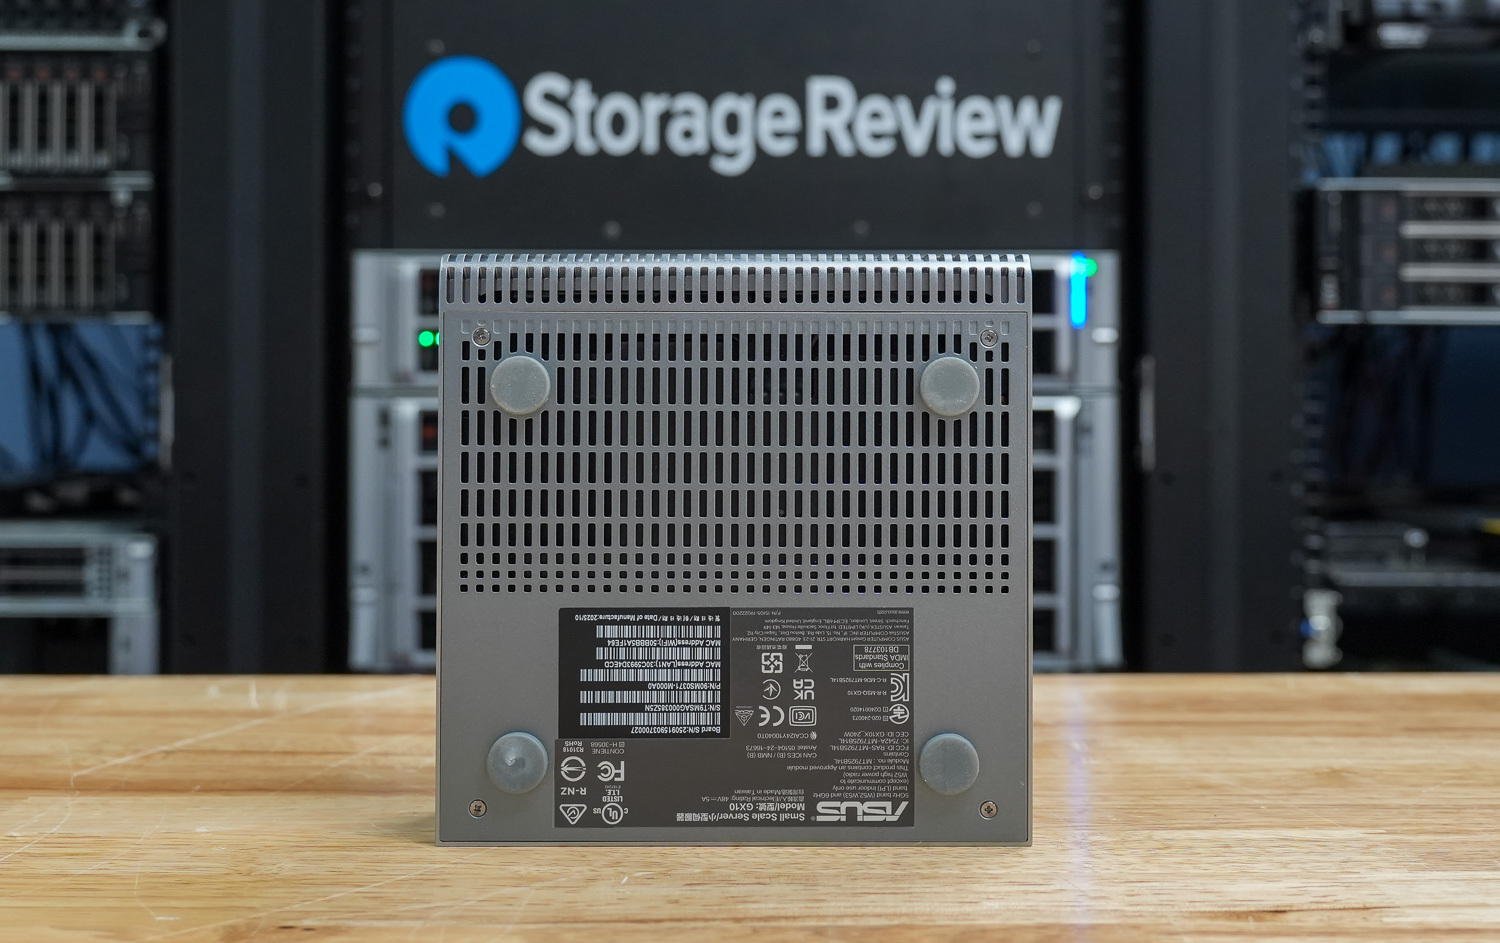
ASUS Ascent GX10 သည် အခြား Spark-based စနစ်များတွင် ကျွန်ုပ်တို့မြင်တွေ့ခဲ့ရသည့် ပုံမှန်ကျစ်လစ်သော 150 x 150 mm footprint ကို ဆက်လက်ထိန်းသိမ်းထားပြီး အမြင့် 51 mm နှင့် အလေးချိန် 1.48 kg ရှိသည်။ အတွင်းပိုင်းကို ကြယ်တာရာမီးခိုးရောင်ဖြင့် အပြီးသတ်ထားပြီး ဓာတ်ခွဲခန်းကိုဦးတည်သည့် reference unit ထက် ချောမွေ့သော desktop appliance တစ်ခုနှင့် ပိုတူသည်။
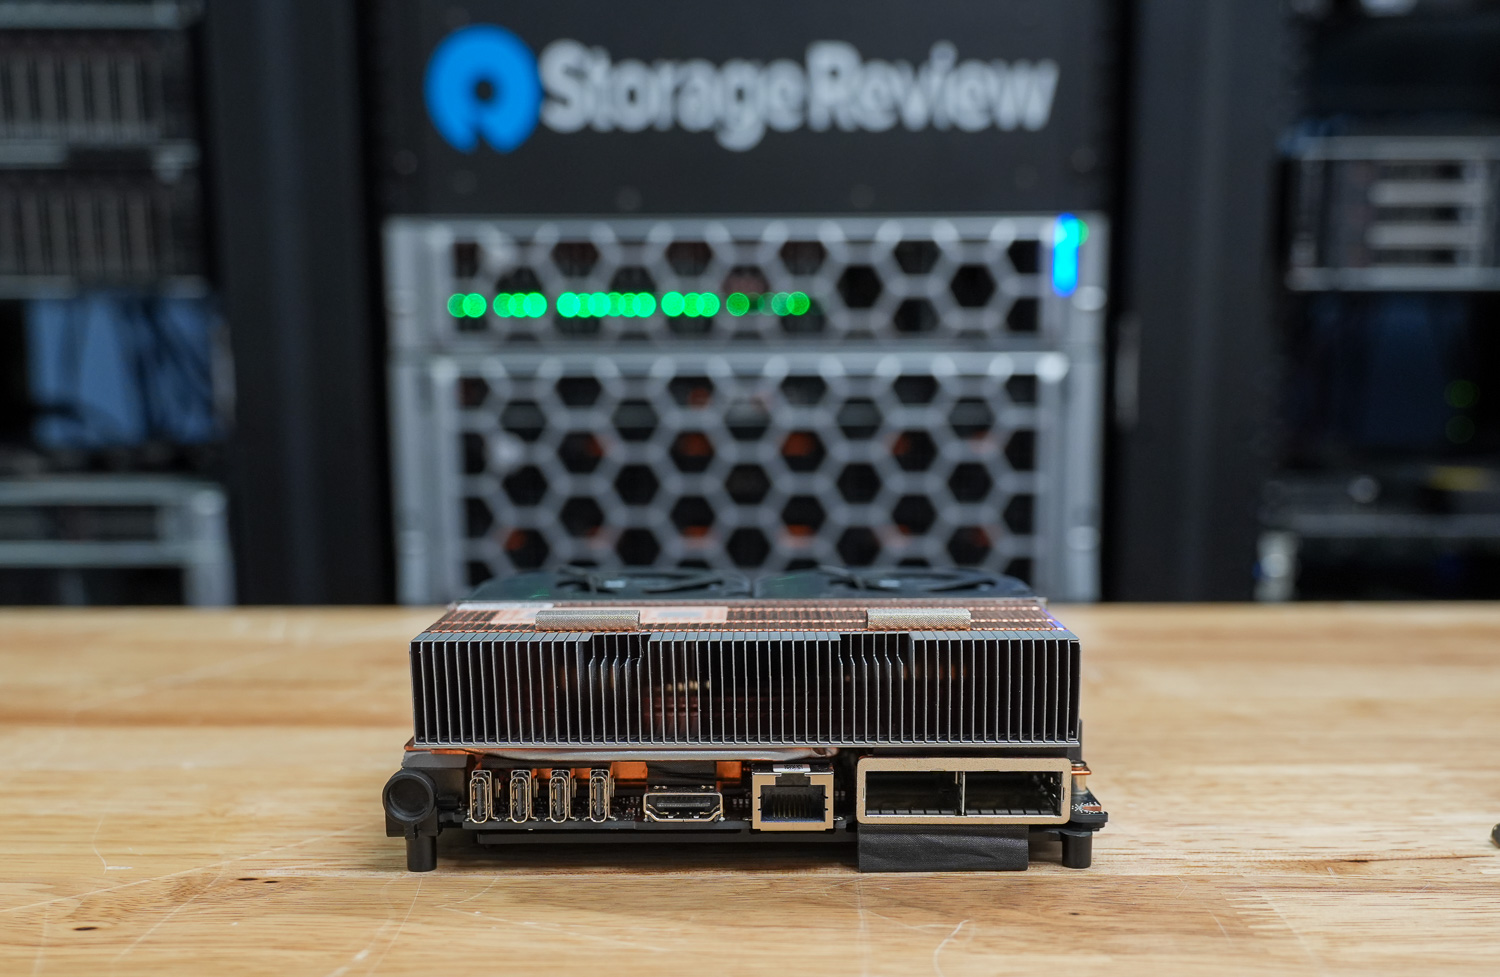
ရှေ့မျက်နှာပြင်ကို ယူနစ်တစ်ခုလုံးရဲ့ အကျယ်ကို ဆန့်ထုတ်ထားတဲ့ ဒေါင်လိုက်လေဝင်ပေါက်တွေနဲ့ လွှမ်းမိုးထားပြီး ASUS လိုဂိုငယ်လေးတစ်ခုနဲ့ grille ပုံစံနဲ့ လိုက်ဖက်တဲ့ စတုရန်းပါဝါခလုတ်တစ်ခုပါရှိပါတယ်။ ASUS က ပါဝါခလုတ်ထဲမှာ ပါဝါညွှန်ပြကိရိယာတစ်ခု ထည့်သွင်းထားတာကလည်း ထူးခြားပါတယ်။ ဒီလိုပြောရတာ ထူးဆန်းတယ်လို့ ထင်ရပေမယ့် GB10 စနစ်အများစုမှာ ပါဝါညွှန်ပြကိရိယာ လုံးဝမပါဝင်ပါဘူး။
အဓိကချိတ်ဆက်မှုအားလုံးကို စနစ်၏နောက်ကျောတွင် တည်ရှိပြီး ASUS သည် ရရှိနိုင်သောနေရာကို ကောင်းစွာအသုံးချသည်။ USB 3.2 Gen 2×2 Type-C port သုံးခုသည် DisplayPort alternate mode ဖြင့် 20 Gbps ကို ပံ့ပိုးပေးသည့်အပြင် PD 3.1 EPR မှတစ်ဆင့် 180W အထိ ပံ့ပိုးပေးသည့် ပါဝါထည့်သွင်းမှုအတွက် ရည်စူးထားသော စတုတ္ထမြောက် USB Type-C port တစ်ခုဖြစ်သည်။ display output အတွက် HDMI 2.1 port တစ်ခု တပ်ဆင်ထားသည်။
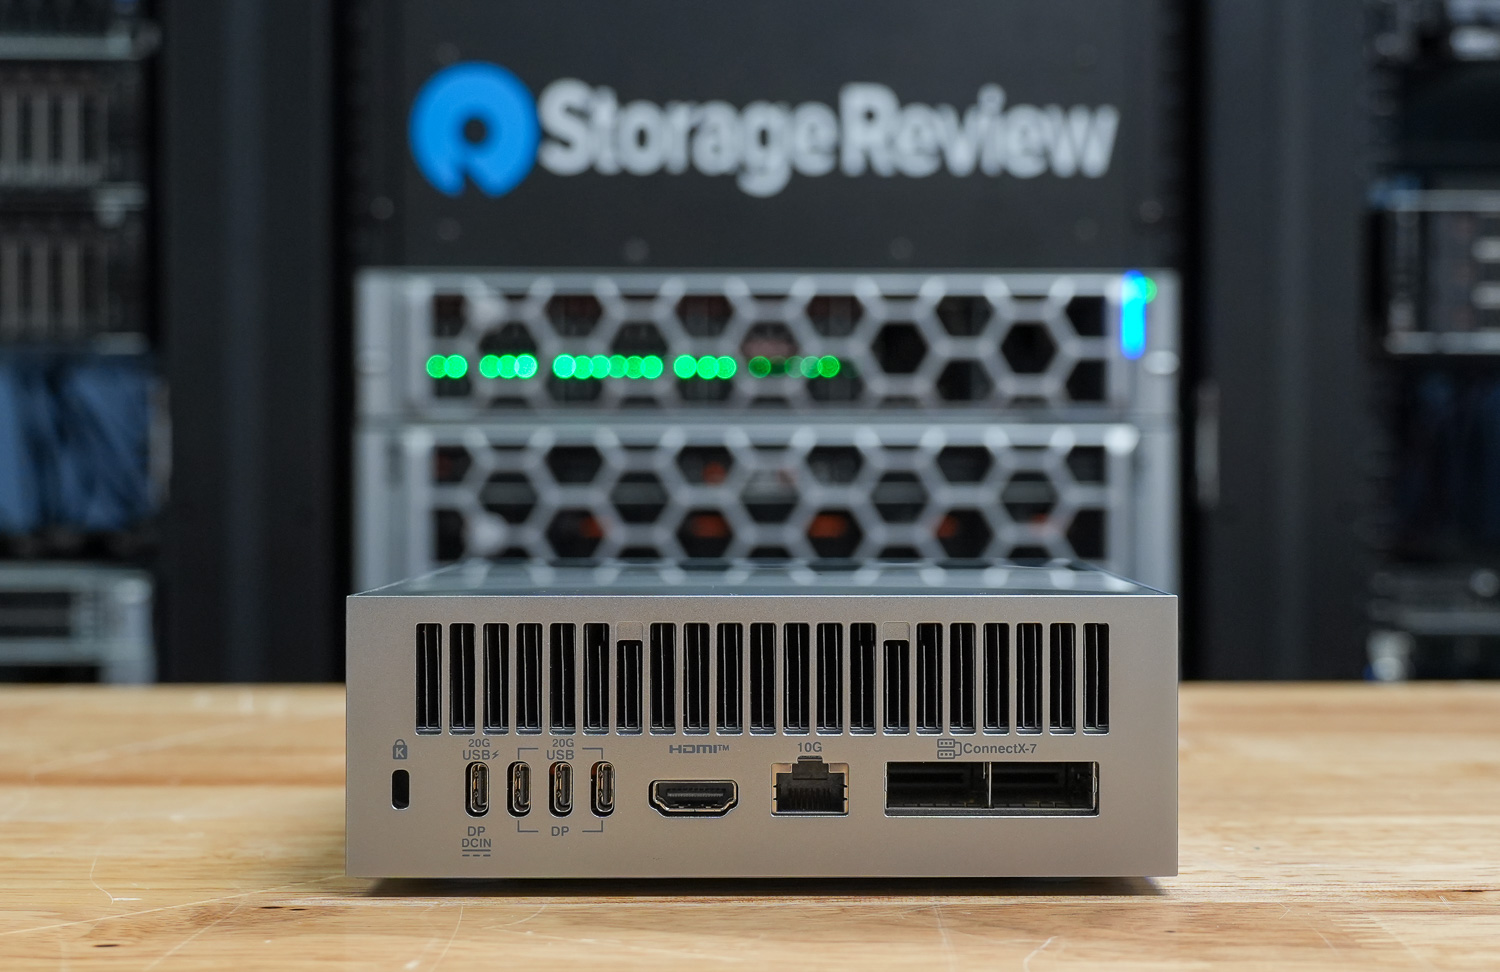
ကွန်ရက်ချိတ်ဆက်မှု ရွေးချယ်စရာများတွင် 10G LAN port နှင့် NVIDIA ConnectX-7 NIC တို့ ပါဝင်ပြီး bandwidth မြင့်မားသော data လွှဲပြောင်းမှုများကို ပြုလုပ်နိုင်စေပြီး စနစ်များစွာကို ချိတ်ဆက်နိုင်စေပါသည်။ ၎င်းတွင် ပုံမှန် Kensington lock slot လည်း ပါရှိသည်။
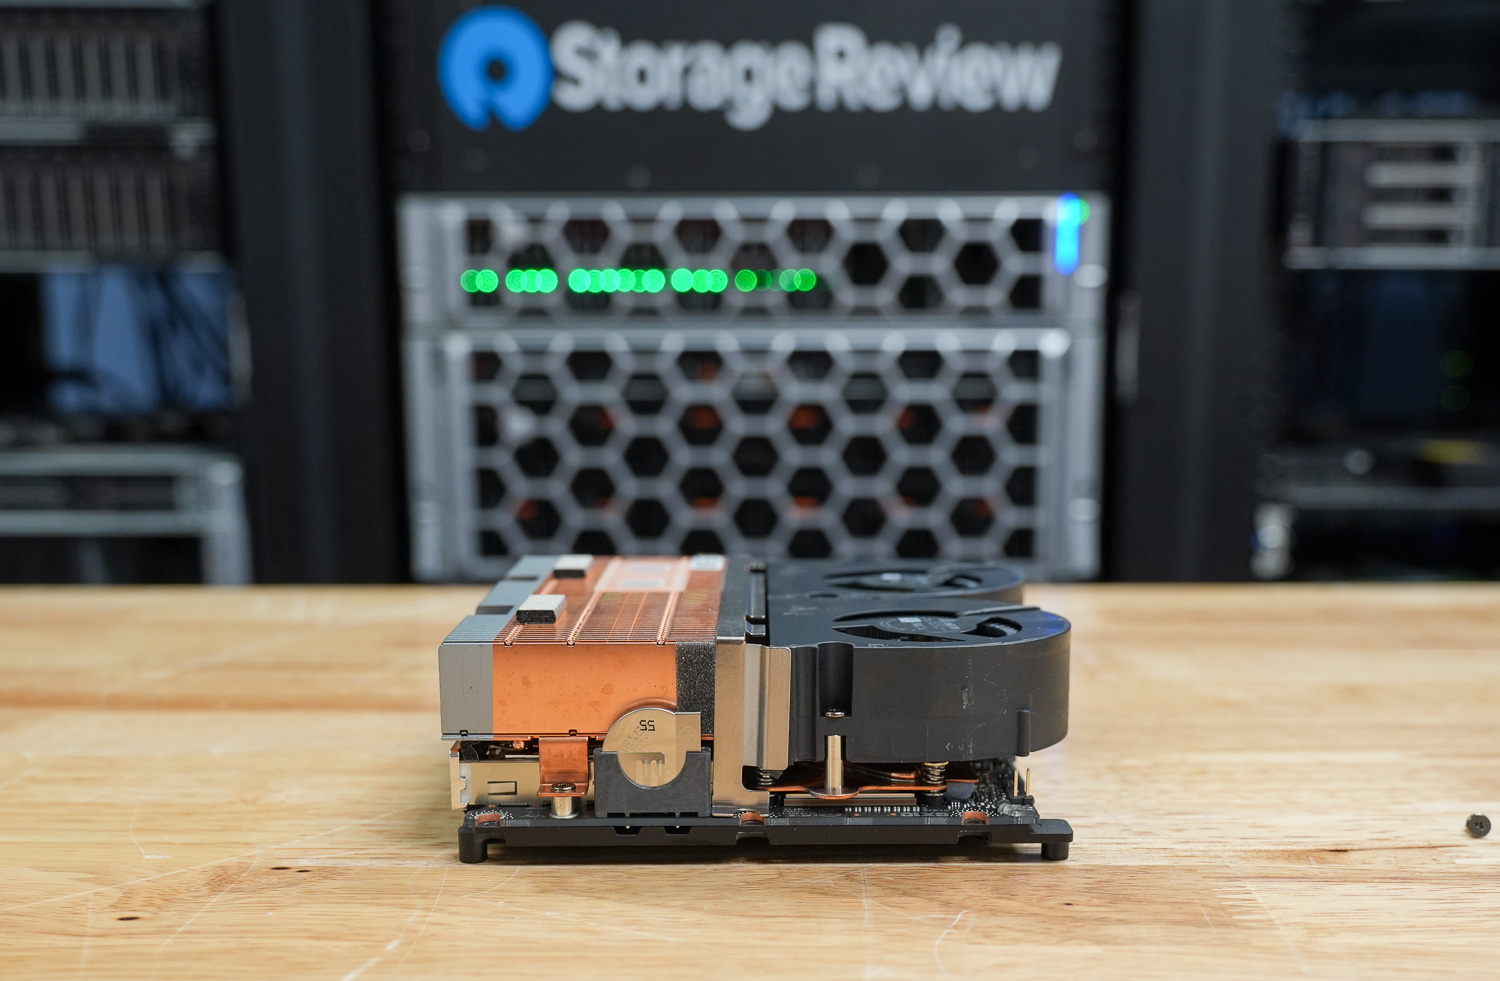
အတွင်းပိုင်းမှာ GX10 ဟာ NVIDIA ရဲ့ GB10 Grace Blackwell Superchip ပေါ်မှာ အလုပ်လုပ်ပြီး Arm v9.2-A CPU နဲ့ integrated Blackwell graphics တွေကို တွဲဖက်အသုံးပြုထားပါတယ်။ 128 GB LPDDR5x unified memory နဲ့ ကျောထောက်နောက်ခံပြုထားတာကြောင့် CPU နဲ့ GPU တွေဟာ သီးခြား memory domain တွေမှာ အလုပ်လုပ်မယ့်အစား pool တစ်ခုတည်းကို မျှဝေအသုံးပြုကြပါတယ်။ အဲဒီ setup ဟာ ဒီ system တွေအတွက် တည်ဆောက်ထားတဲ့ AI workloads အမျိုးအစားတွေအတွက် အရေးကြီးပါတယ်။
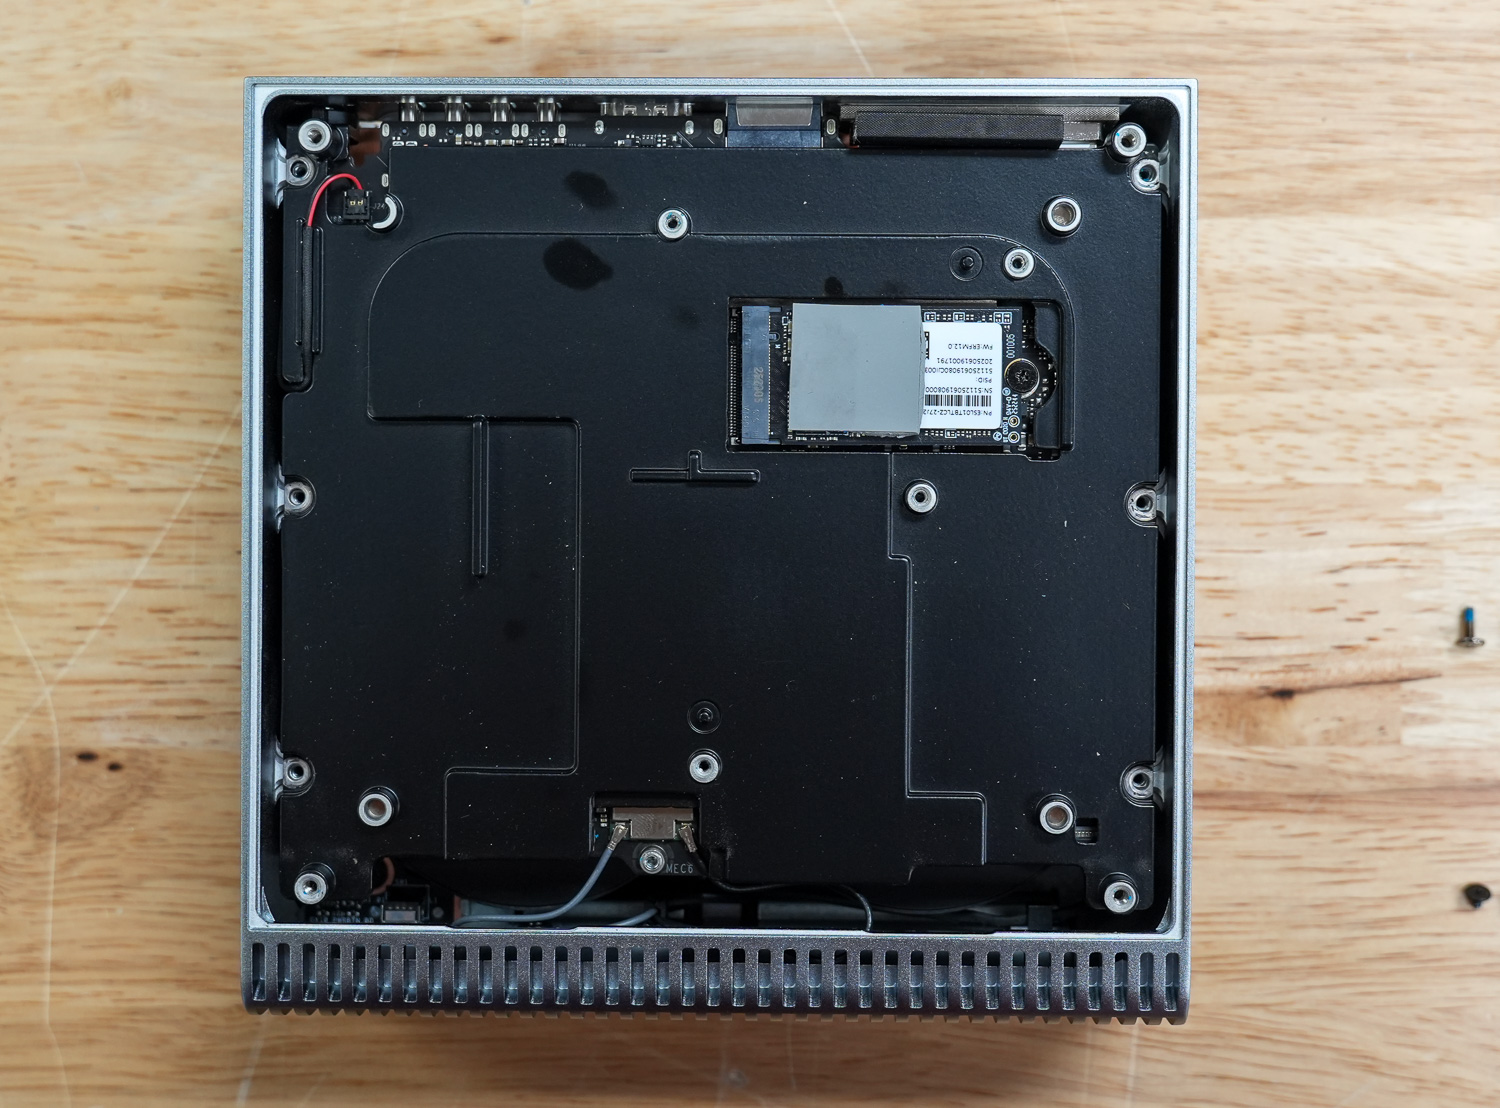
သိုလှောင်မှုကို M.2 2242 NVMe slot မှတစ်ဆင့် ရရှိမည်ဖြစ်ပြီး 1 TB နှင့် 2 TB PCIe 4.0 drives များမှ 4 TB PCIe 5.0 configuration အထိ ရွေးချယ်နိုင်ပါသည်။ ပါဝါကို 240 W အထိ အဆင့်သတ်မှတ်ထားသော USB-C PD 3.1 EPR adapter မှတစ်ဆင့် ထောက်ပံ့ပေးပြီး 180 W အထိ ပါဝါပေးပါသည်။ တစ်ချိန်တည်းမှာပင်၊ ကြိုးမဲ့နည်းပညာတွင် Bluetooth 5.4 ပါရှိသော Wi-Fi 7 module နှင့် wired networking အတွက် built-in 10G Ethernet တို့ ပါဝင်သည်။
ASUS Ascent GX10 အပူချိန်စမ်းသပ်ခြင်း
ASUS Ascent GX10 အတွင်းရှိ အစိတ်အပိုင်းများ၏ အပူပေးမှုကို စမ်းသပ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် ၎င်းတို့ကို Founders Edition နှင့် Dell၊ Acer နှင့် GIGABYTE ကဲ့သို့သော OEM များနှင့် နှိုင်းယှဉ်ခဲ့ပါသည်။ ကျွန်ုပ်တို့၏ Spark Thermal Testing စာတမ်းတွင် ဤအကြောင်းကို ပိုမိုနက်ရှိုင်းစွာ လေ့လာခဲ့ပါသည် ။
stack တစ်လျှောက်မှာ၊ ကျွန်ုပ်တို့သည် workload အတွက် အဆင့်သုံးဆင့်ဖြင့် သတ်မှတ်ထားသော အချိန်ကာလတစ်ခုအတွင်း component များကို စောင့်ကြည့်ခဲ့ပြီး တစ်နာရီခန့်ကြာ utilization ကို မြှင့်တင်ပေးခဲ့ပါသည်။ ၎င်းက device ကို ရှည်လျားသောကာလများနှင့် workload အဆင့်အမျိုးမျိုးတွင် အသုံးပြုနေသည်ကို ကျွန်ုပ်တို့ မြင်တွေ့နိုင်စေခဲ့ပါသည်။ ကျွန်ုပ်တို့သည် CPU၊ GPU၊ network၊ NVMe အပူချိန်နှင့် စုစုပေါင်းပါဝါသုံးစွဲမှုကို စောင့်ကြည့်ခဲ့ပါသည်။
CPU အပူချိန်
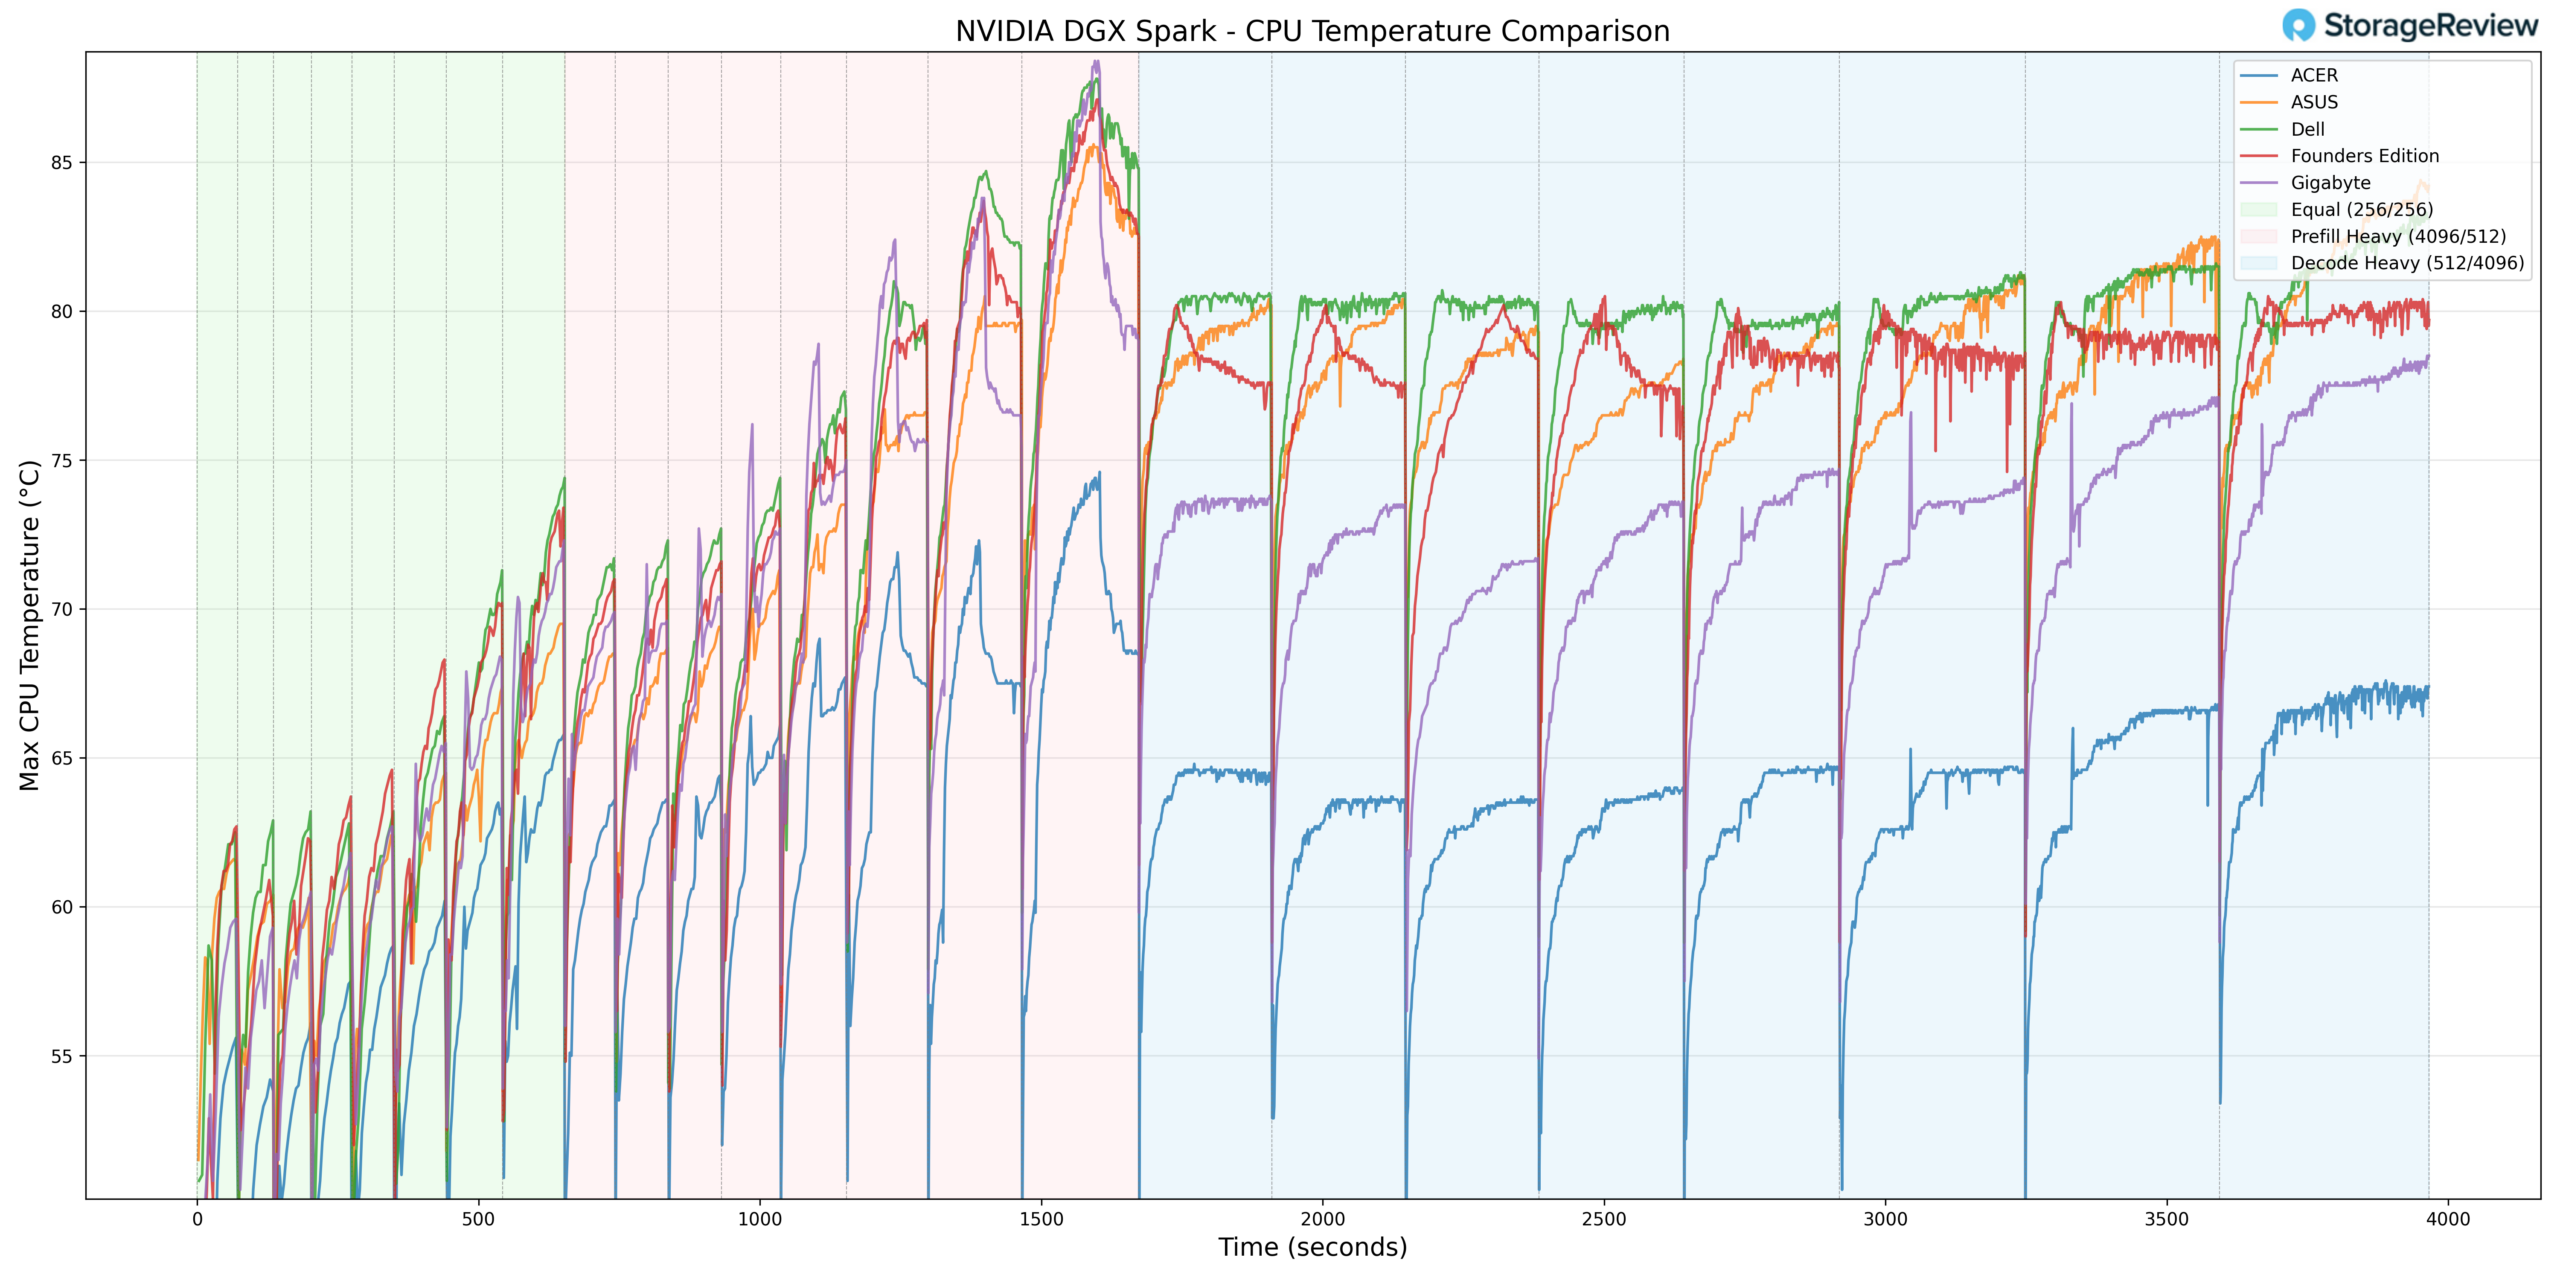
CPU အပူချိန်စမ်းသပ်မှုအတွင်း၊ Prefill Heavy အဆင့်တွင် ASUS စနစ်သည် အမြင့်ဆုံးအပူချိန် 87.3°C သို့ ရောက်ရှိခဲ့သည်။ ၎င်းသည် ASUS ကို burst-heavy အကူးအပြောင်းများအတွင်း နှိုင်းယှဉ်မှုအစု၏ အပေါ်ပိုင်းအလယ်တွင် ထားရှိသော်လည်း အုပ်စု၏ အမြင့်ဆုံးထိပ်များအောက်တွင် အနည်းငယ်နိမ့်သည်။
workload သည် Equal ISL/OSL သို့ ကူးပြောင်းပြီးနောက် Decode Heavy အဖြစ်သို့ ပြောင်းလဲသွားသည်နှင့်အမျှ CPU အပူချိန်များသည် ဆက်လက်မြင့်တက်နေမည့်အစား တည်ငြိမ်သွားခဲ့သည်။ စဉ်ဆက်မပြတ် decoding လုပ်ဆောင်ချက်သည် ထိန်းချုပ်ထားသော အပူအလွှာအတွင်းတွင် ရှိနေခဲ့ပြီး 87.3°C အမြင့်ဆုံးသည် အပူပြည့်ဝမှုကို ကြာရှည်စွာ ဖြစ်ပေါ်စေခြင်းထက် ကာလတို ramp လုပ်ဆောင်ချက်နှင့် ဆက်စပ်နေကြောင်း ညွှန်ပြနေသည်။
အောက်ဆုံးအဆင့်မှာ CPU ဟာ အားလပ်ချိန် ဒါမှမဟုတ် ပေါ့ပါးတဲ့ ဝန်အားအခြေအနေတွေမှာ အနည်းဆုံး အပူချိန် 38.8°C ရှိခဲ့ပါတယ်။ ဒီအခြေခံစံနှုန်းက စနစ်ဟာ တွက်ချက်မှုဖိအား မြင့်မားနေချိန်မရှိတဲ့အခါ အပူထိရောက်စွာ ပျံ့နှံ့မှုကို ထင်ဟပ်စေပါတယ်။
အလုံးစုံသော် ASUS သည် မြင့်မားသော်လည်း ထိန်းချုပ်ထားသော burst CPU thermal များကို တည်ငြိမ်သော sustained-load အပြုအမူဖြင့် သရုပ်ပြခဲ့သည်။
GPU အပူချိန်
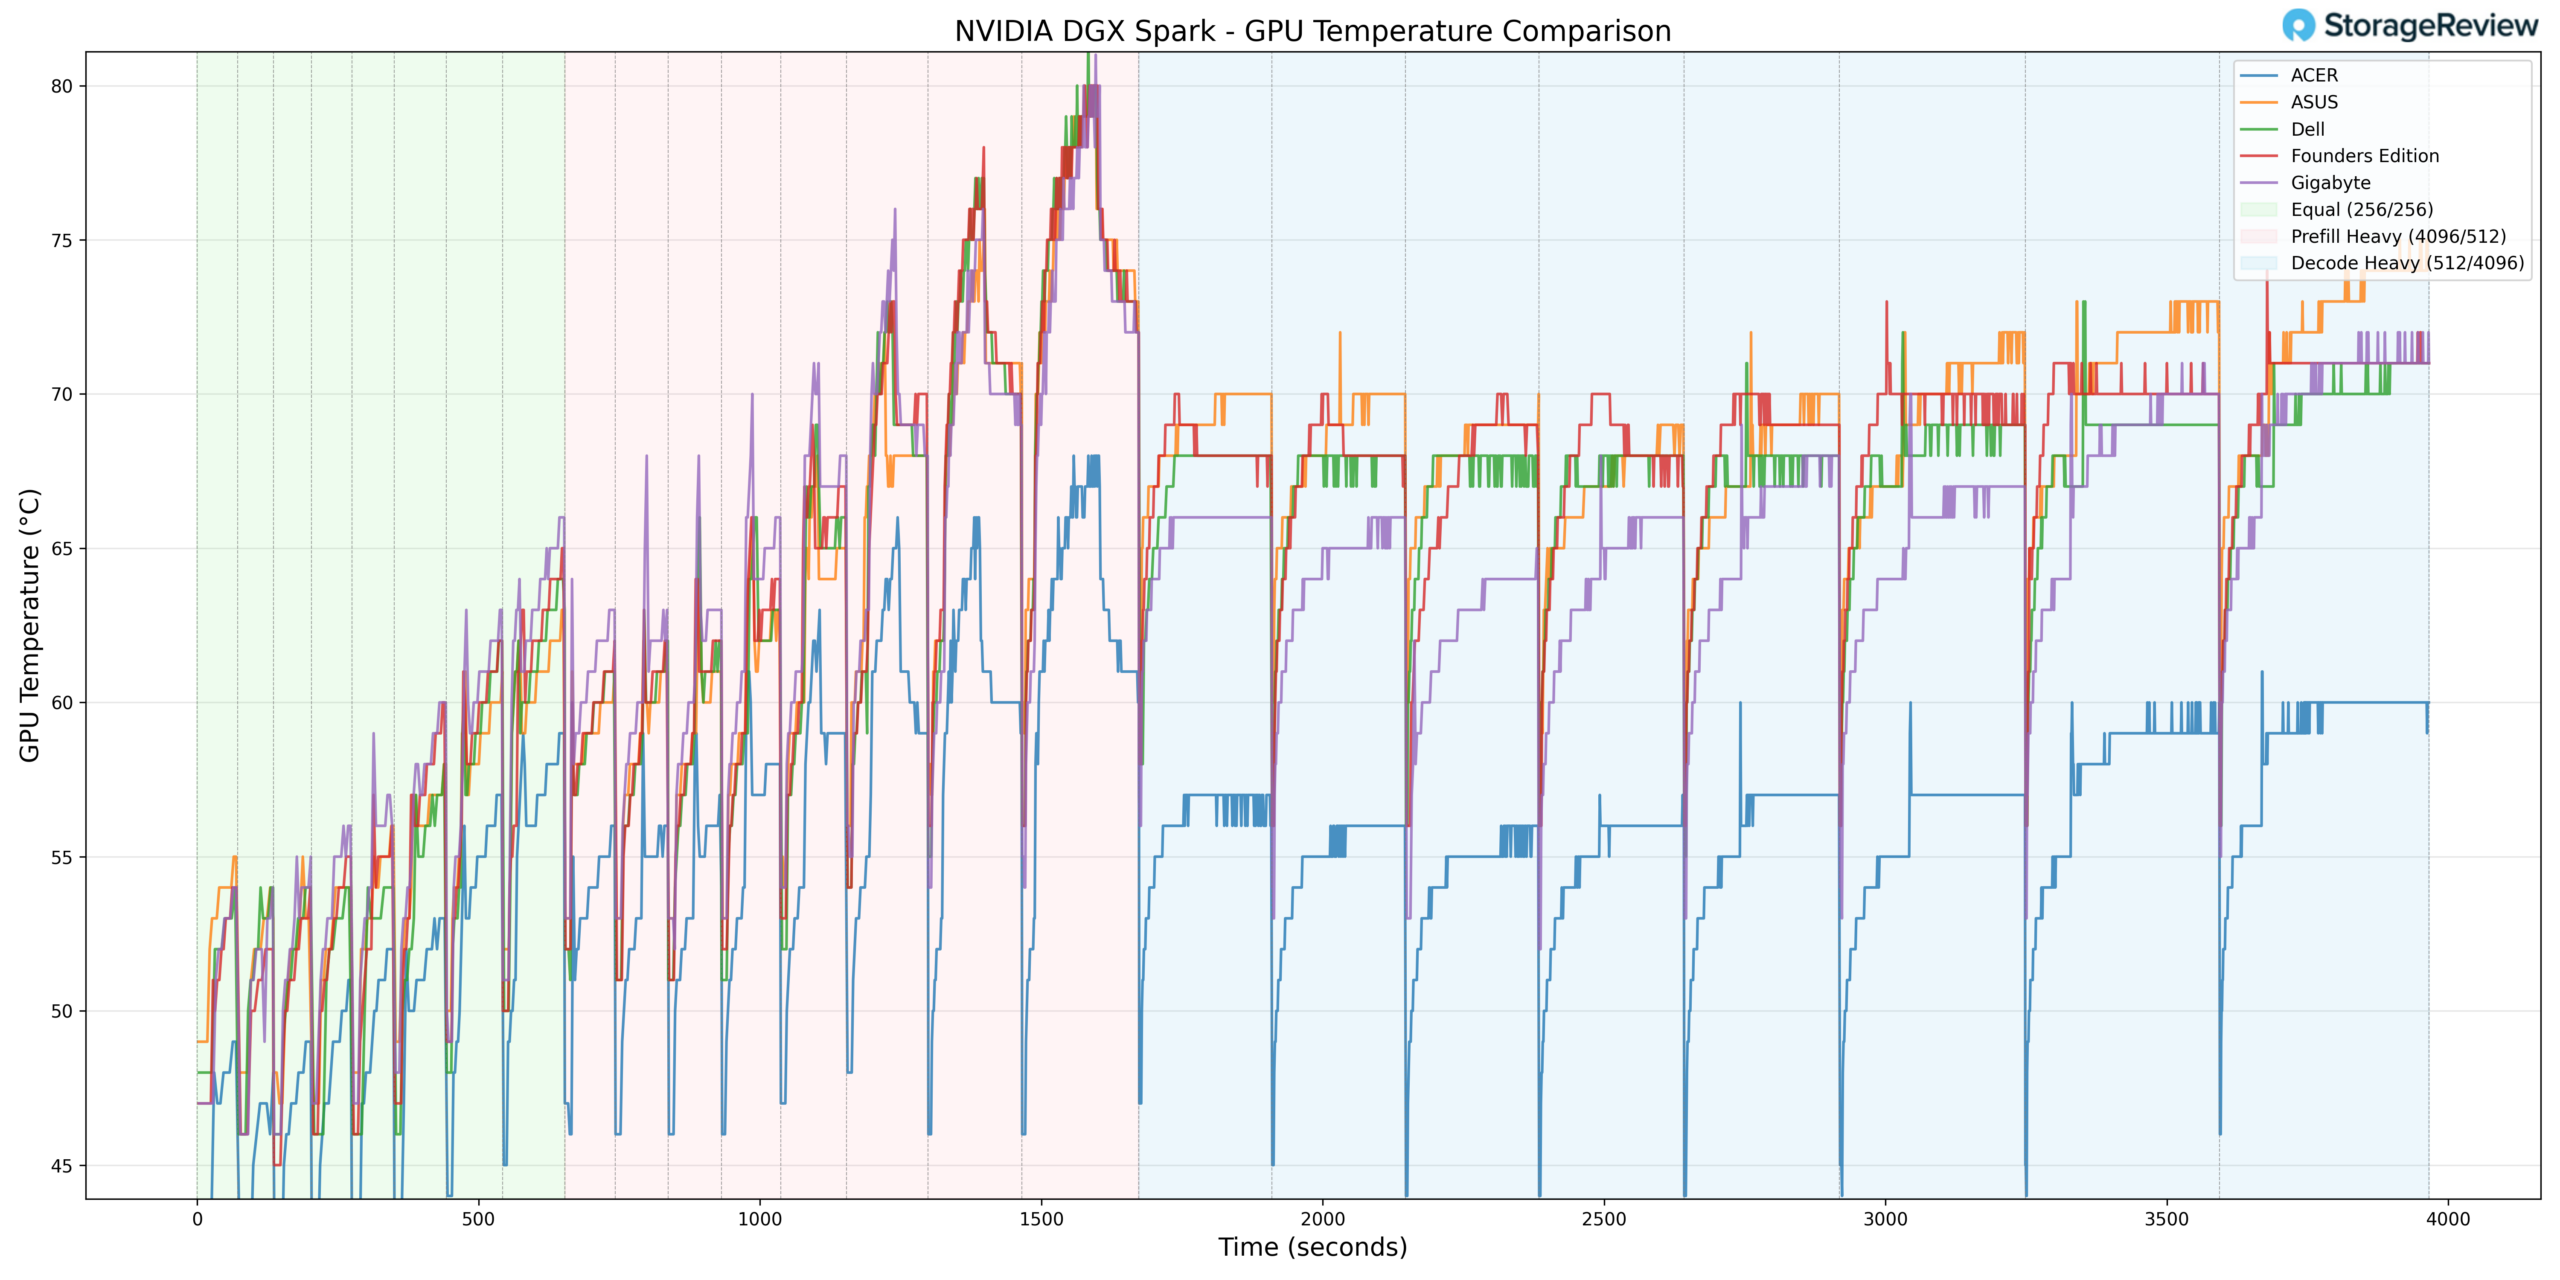
GPU အပူချိန်များသည် အလားတူပုံစံအတိုင်း လိုက်လာခဲ့သည်။ Prefill Heavy အရှိန်မြှင့်မှုအတွင်း GPU သည် အမြင့်ဆုံးအပူချိန် 82°C သို့ ရောက်ရှိခဲ့သည်။ ၎င်းသည် ASUS ကို အမြင့်ဆုံးပေါက်ကွဲမှုအခြေအနေများတွင် ပြိုင်ဘက်အချို့ထက် အနည်းငယ်ပိုပူစေသော်လည်း GB10 ပလက်ဖောင်းအတွက် မျှော်မှန်းထားသော လည်ပတ်မှုကန့်သတ်ချက်များအတွင်းတွင် ရှိနေဆဲဖြစ်သည်။
လုပ်ဆောင်ချက်သည် Equal ISL/OSL နှင့် Decode Heavy အဆင့်များအဖြစ်သို့ ပြောင်းလဲလာသည်နှင့်အမျှ GPU အပူချိန်များသည် တည်ငြိမ်နေခဲ့သည်။
GPU သည် ပေါ့ပါးသောအဆင့်များတွင် အနည်းဆုံး အပူချိန် 38°C ကို မှတ်တမ်းတင်ခဲ့ပြီး၊ ၎င်းသည် stack ၏ ကျန်အပိုင်းများနှင့် ကိုက်ညီသော solid idle thermal ဝိသေသလက္ခဏာများကို ညွှန်ပြနေသည်။
အားလုံးကို ခြုံငုံကြည့်လျှင် ASUS သည် ခန့်မှန်းနိုင်သော အပူချိန်ကို ထိန်းသိမ်းထားစဉ်တွင် ပြင်းထန်သော burst GPU အသုံးပြုမှုကို ခွင့်ပြုခဲ့သည်။
NVMe အပူချိန်
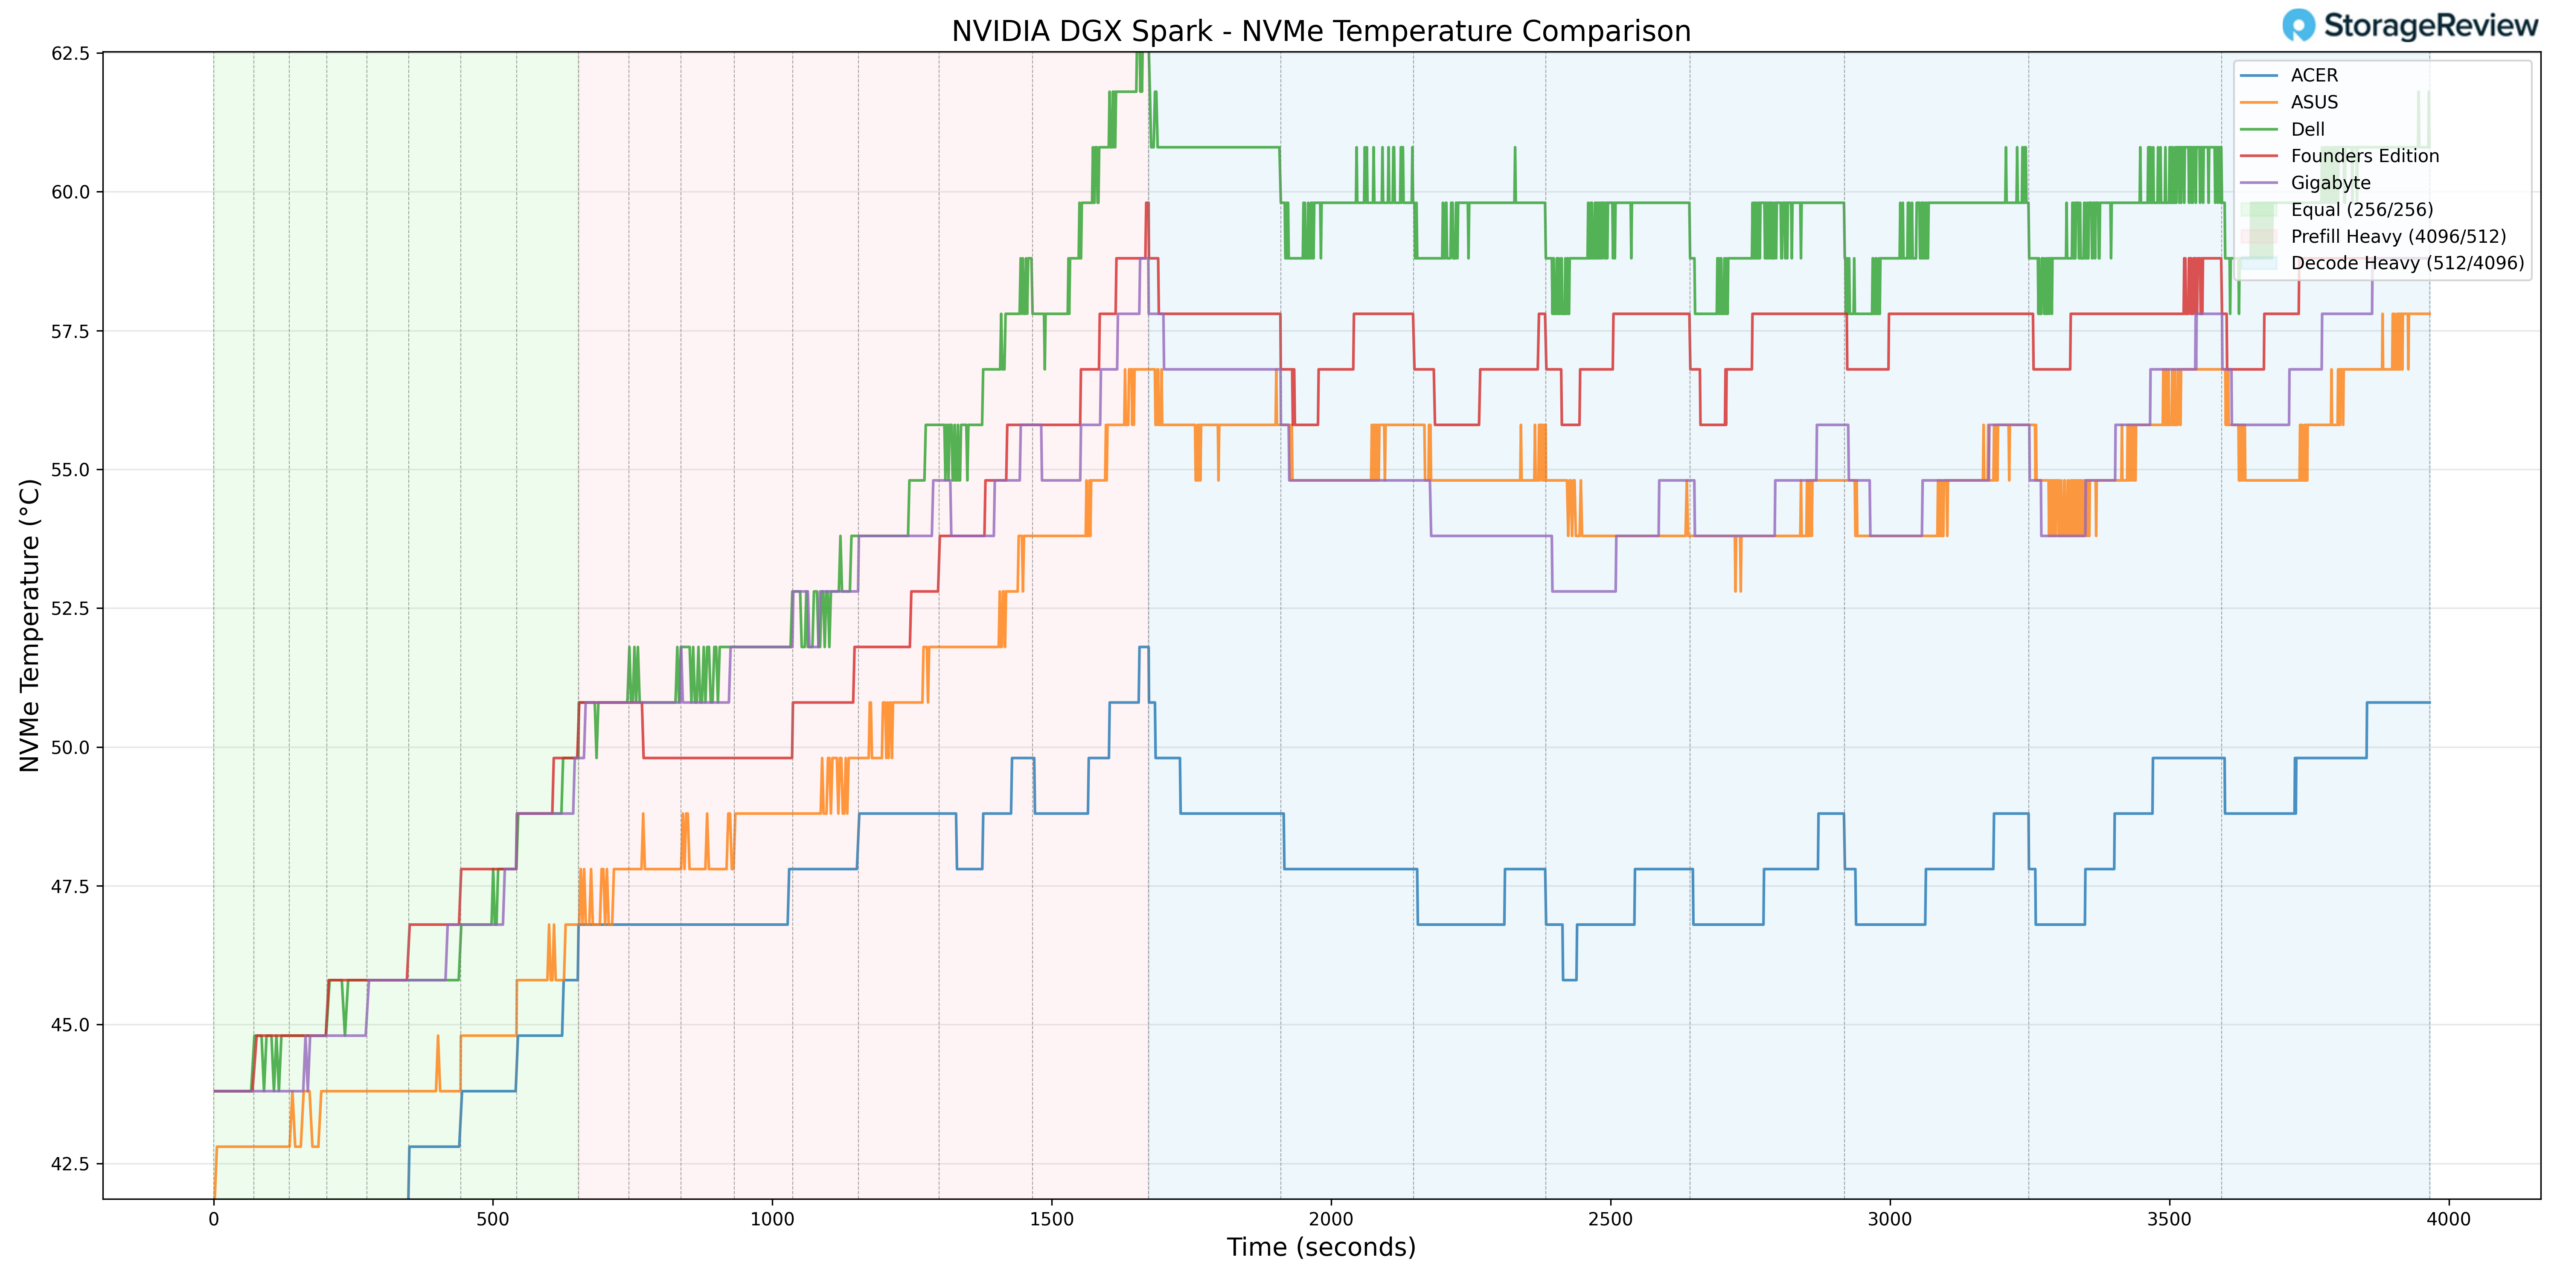
သိုလှောင်မှုအပူချိန်များကို ကောင်းမွန်စွာ စီမံခန့်ခွဲထားပါသည်။ NVMe drive သည် workload များသောအဆင့်များတွင် အမြင့်ဆုံးအပူချိန် 56.8°C သို့ ရောက်ရှိခဲ့ပြီး အဖြစ်များသော throttling thresholds အောက်တွင် သက်တောင့်သက်သာရှိနေခဲ့ပါသည်။ ၎င်းသည် သိုလှောင်မှု subsystem ပတ်လည်ရှိ chassis အတွင်း ထိရောက်သော လေစီးဆင်းမှု သို့မဟုတ် အပူချိန်ဒီဇိုင်းကို ညွှန်ပြနေပါသည်။
ပိုမိုပေါ့ပါးသောအဆင့်များအတွင်း NVMe အပူချိန်သည် အနည်းဆုံး 37.8°C အထိ ကျဆင်းသွားခဲ့ပြီး အခြားစနစ်များ၏ အားလပ်ချိန်အပူချိန်များနှင့် နီးကပ်စွာ ကိုက်ညီပြီး အနားယူချိန်တွင် သိုလှောင်မှုသည် အပူချိန်ကန့်သတ်ချက်မရှိကြောင်း ခိုင်မာစေသည်။
အလုံးစုံသော် ASUS သည် ဝန်အောက်တွင် ပိုမိုသင့်တင့်သော NVMe အပူချိန်ပရိုဖိုင်များထဲမှ တစ်ခုကို ထိန်းသိမ်းထားနိုင်သည်။
NIC အပူချိန်
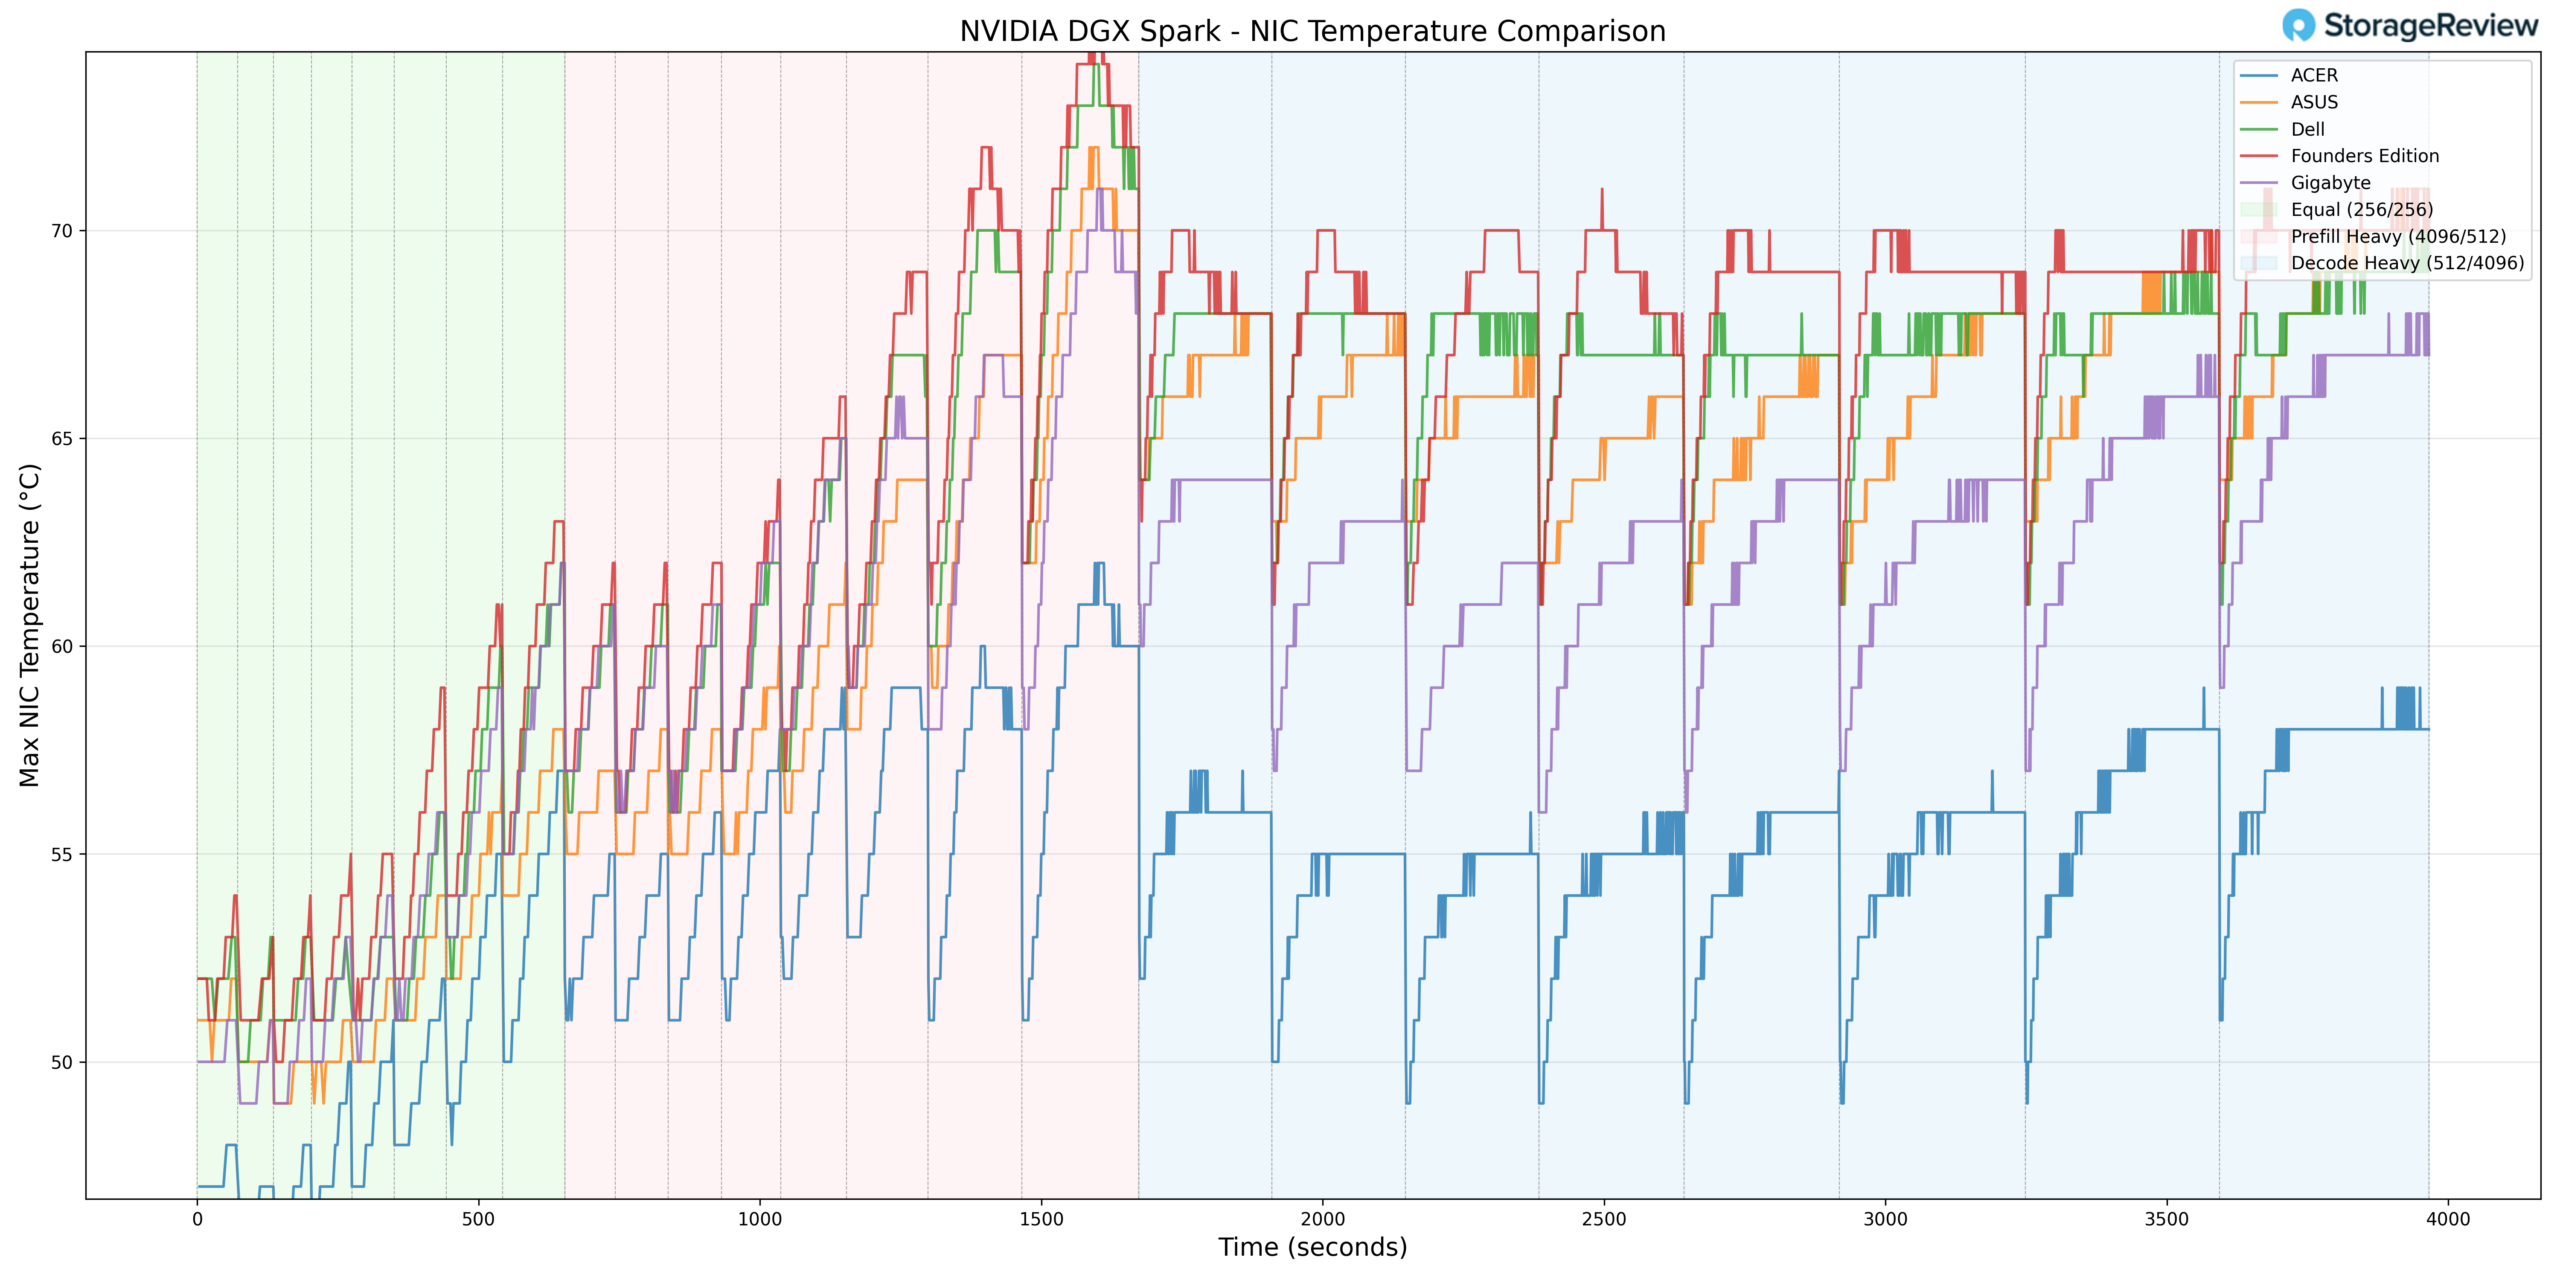
NIC thermals များသည် လှုပ်ရှားမှုများသောအဆင့်များတွင် 73°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ ၎င်းသည် ASUS ကို network throughput အခြေအနေအမြင့်ဆုံးတွင် stack ၏ ပိုနွေးသောတစ်ဝက်တွင် ထားရှိသော်လည်း ပုံမှန်လည်ပတ်မှုခံနိုင်ရည်အတွင်းတွင် ရှိနေဆဲဖြစ်သည်။
မှတ်တမ်းတင်ထားသော အနိမ့်ဆုံး NIC အပူချိန်မှာ ပေါ့ပါးသော အလုပ်ပမာဏများအတွင်း ၄၁°C ရှိပြီး မျှော်လင့်ထားသည့် အခြေခံအပြုအမူကို ထင်ဟပ်စေသည်။
NIC များ၏ Thermal scaling ကို system load နှင့် အချိုးကျစွာ ခြေရာခံခဲ့ပြီး မူမမှန်သော အတက်အကျများကို မပြသခဲ့ပါ။
GPU ပါဝါသုံးစွဲမှု
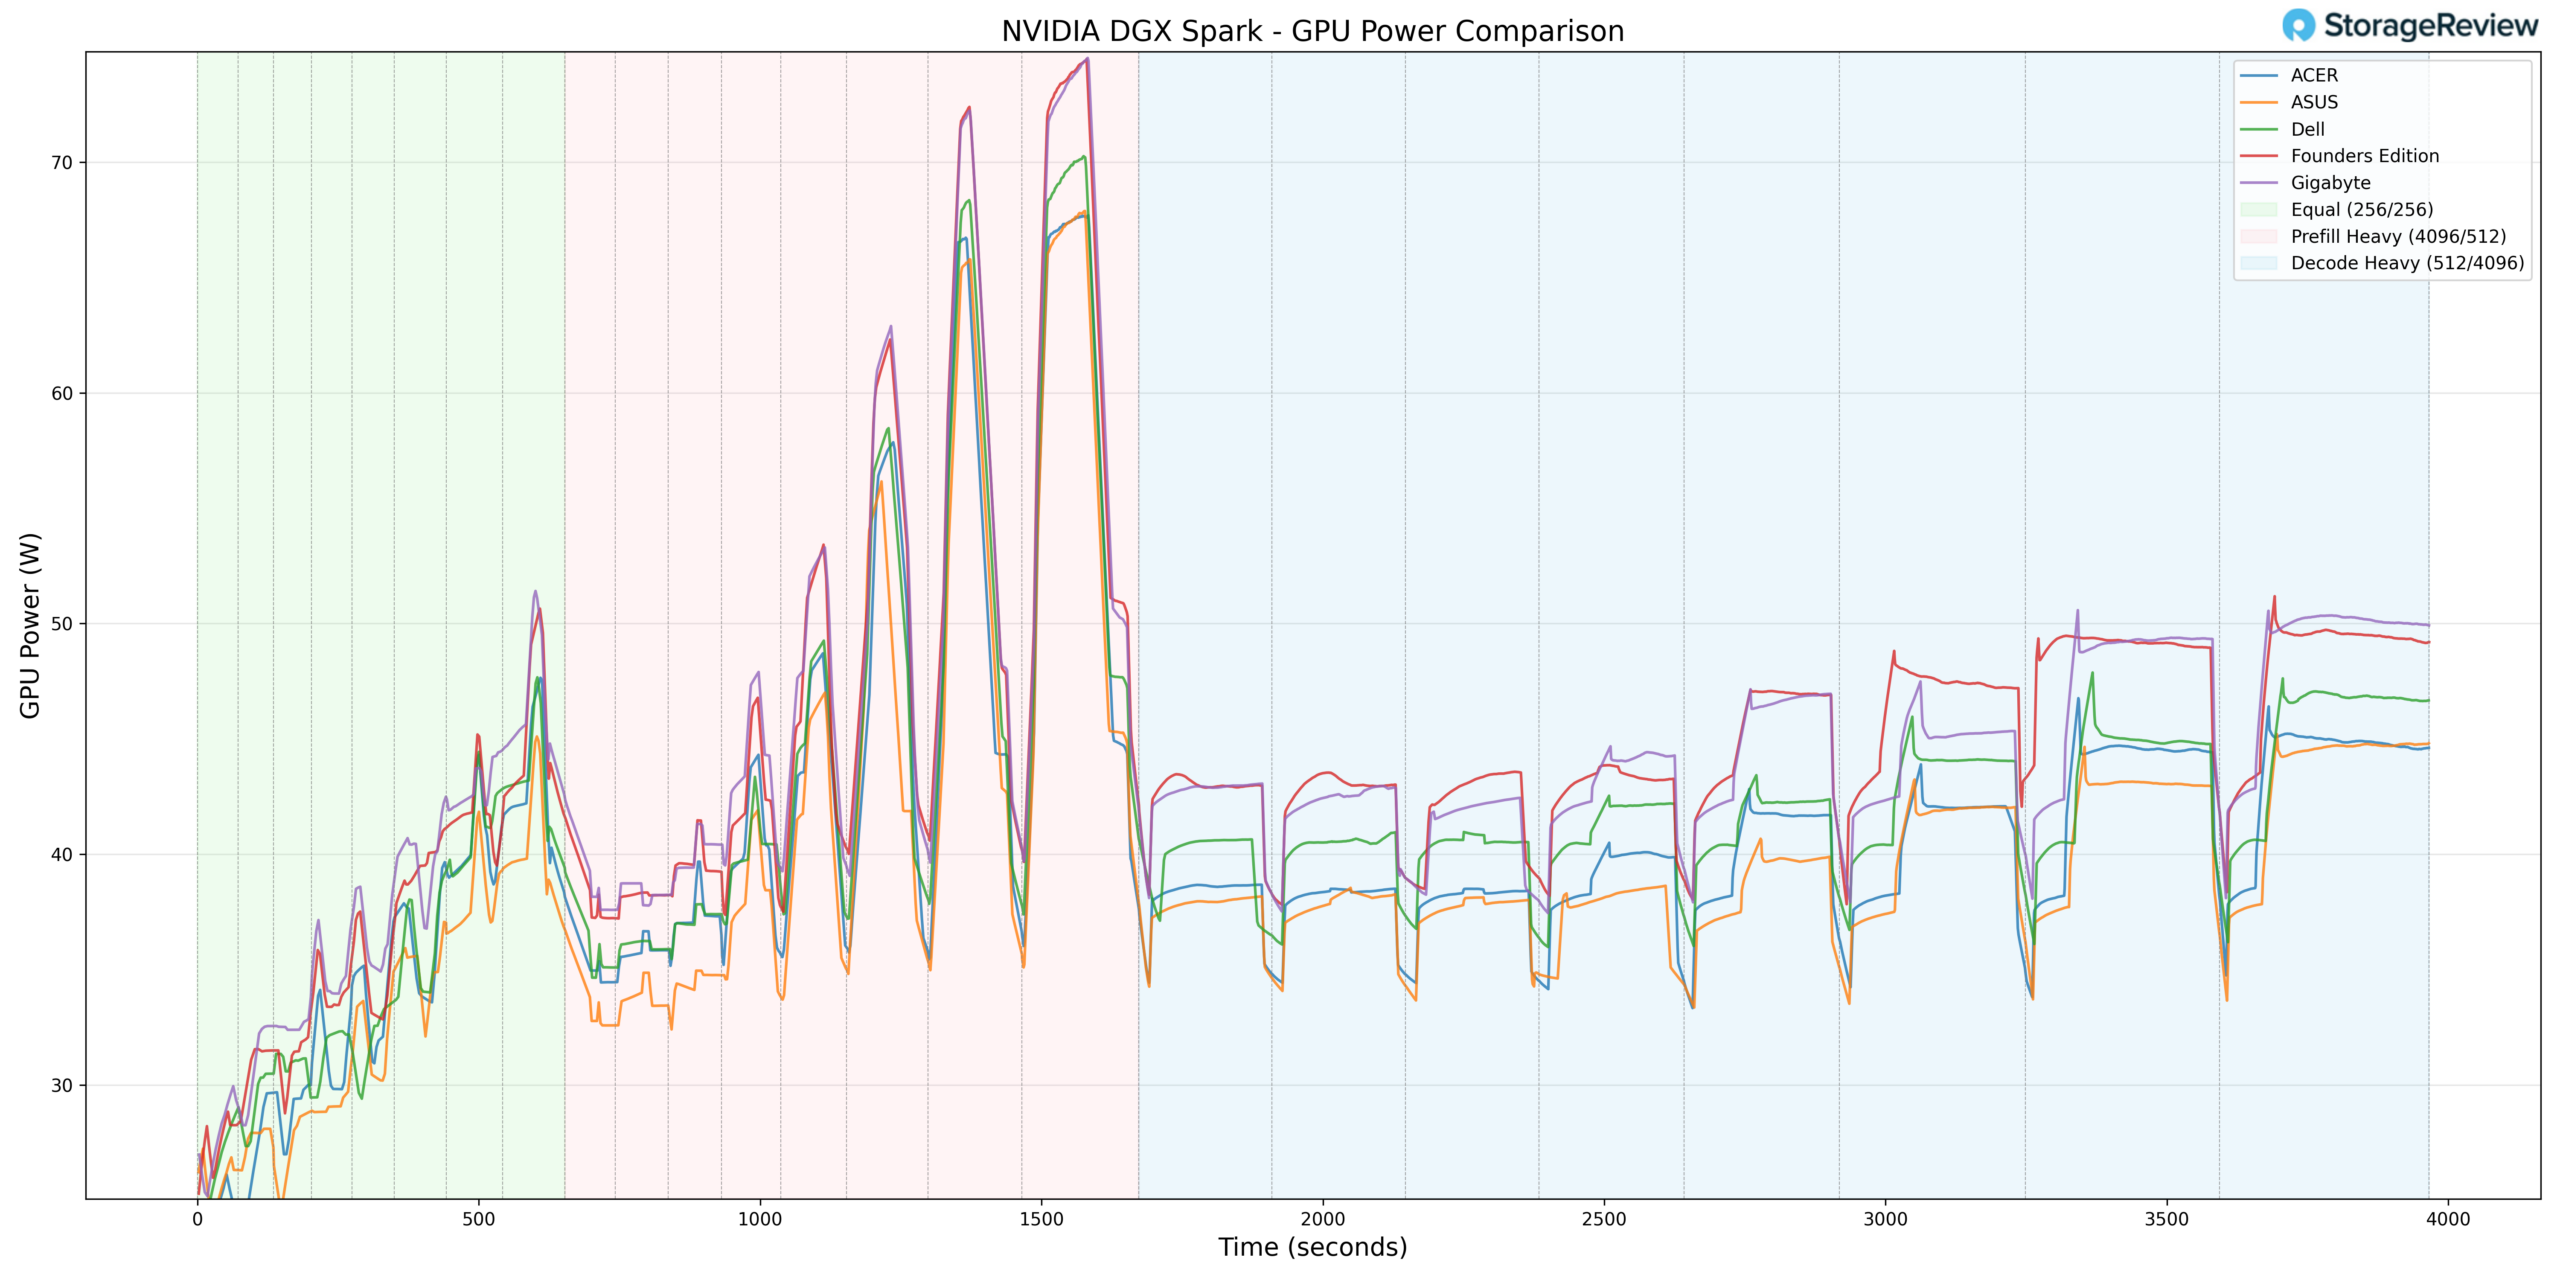
Prefill Heavy အကူးအပြောင်းများအတွင်း GPU ပါဝါသုံးစွဲမှုသည် 69.77W တွင် အမြင့်ဆုံးသို့ ရောက်ရှိခဲ့သည်။ အုပ်စုရှိ အချို့သော မြင့်မားသော အကောင်အထည်ဖော်မှုများနှင့် နှိုင်းယှဉ်ပါက ASUS သည် အမြင့်ဆုံး တွေ့ရှိရသည့် ပါဝါအဆင့်အောက်တွင် အနည်းငယ် လည်ပတ်ခဲ့သည်။
ဒီပါဝါအပြုအမူက စနစ်ရဲ့ ဟန်ချက်ညီတဲ့ အပူချိန်ပရိုဖိုင်ကို ရှင်းပြရာမှာ အထောက်အကူပြုပါတယ်။ GPU အပူချိန်ဟာ burst phases တွေအတွင်းမှာ 82°C အထိ ရောက်ရှိခဲ့ပေမယ့်၊ အမြင့်ဆုံးဆွဲအားစနစ်တွေနဲ့ နှိုင်းယှဉ်ရင် အနည်းငယ်နိမ့်တဲ့ peak power allocation က ASUS ဟာ GPU ကို စမ်းသပ်ထားတဲ့ စနစ်တွေထဲမှာ အကောင်းဆုံးအဆင့်ကို တွန်းအားပေးနေတာ မဟုတ်ဘူးဆိုတာကို ညွှန်ပြနေပါတယ်။
Decode workloads များကို စဉ်ဆက်မပြတ်လုပ်ဆောင်နေစဉ်အတွင်း၊ ပါဝါသုံးစွဲမှုသည် workload demand နှင့်အညီ တည်ငြိမ်ပြီး တသမတ်တည်း ခန့်မှန်းနိုင်သော ပါဝါစီမံခန့်ခွဲမှုကို ထင်ဟပ်စေသည်။
အပူချိန်အကျဉ်းချုပ်
CPU၊ GPU၊ NVMe နှင့် NIC စောင့်ကြည့်မှုတစ်လျှောက်တွင် ASUS GB10 သည် ထိန်းချုပ်ထားသော burst thermals နှင့် ယှဉ်ပြိုင်နိုင်သော sustained-load တည်ငြိမ်မှုကို သရုပ်ပြခဲ့သည်။ Prefill-heavy transitions အတွင်း CPU သည် 87.3°C နှင့် GPU သည် 82°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး NVMe သည် 57°C အောက်တွင်ရှိနေခဲ့ပြီး NIC သည် 73°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ GPU ပါဝါသုံးစွဲမှုသည် 69.77W တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး stack တွင် အမြင့်ဆုံးတွေ့ရှိရသော ပါဝါ ceilings အောက်တွင် အနည်းငယ်နိမ့်ကျနေခဲ့သည်။
အလုံးစုံသော် ASUS သည် ဟန်ချက်ညီသော အပူချိန်အကောင်အထည်ဖော်မှုကို တင်ပြထားပြီး၊ တည်ငြိမ်သော ရေရှည်စွမ်းဆောင်ရည်နှင့် အသင့်အတင့် ပါဝါခွဲဝေမှုကို ထိန်းသိမ်းထားစဉ်တွင် ပြင်းထန်သော ပေါက်ကွဲမှုစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပါသည်။
ASUS Ascent GX10 စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
ASUS Ascent GX10 ကို အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Spark ယူနစ်များကို စမ်းသပ်ခဲ့ပြီး၊ ၎င်းသည် ဘာသာစကားကြီးများအတွက် အကျယ်ပြန့်ဆုံး အသုံးပြုထားသော high-throughput inference နှင့် serving engine ဖြစ်သည့် vLLM Online Serving benchmark ကို အသုံးပြုခဲ့သည်။ vLLM online serving benchmark သည် လည်ပတ်နေသော vLLM server သို့ concurrent request များပေးပို့ခြင်းဖြင့် လက်တွေ့ကမ္ဘာ production workloads များကို တုပပြီး စုစုပေါင်း total token throughput (tokens per second)၊ ပထမဆုံး token သို့ရောက်ရှိချိန်နှင့် output token တစ်ခုလျှင် အချိန်အပါအဝင် အဓိက metrics များကို load အခြေအနေအမျိုးမျိုးတွင် တိုင်းတာသည်။
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတွင် dense architectures မှ micro-scaling data types အထိ မော်ဒယ်အမျိုးမျိုး ပါဝင်သည်။ ၎င်းသည် workload scenarios သုံးမျိုးဖြစ်သည့် Equal ISL/OSL၊ Prefill Heavy နှင့် Decode Heavy တို့တွင် စွမ်းဆောင်ရည်ကို အကဲဖြတ်ခဲ့သည်။ ဤ scenarios များသည် balanced input နှင့် output loads များမှ compute-intensive prompt processing နှင့် memory-bandwidth-bound token generation အထိ ကွဲပြားသော real-world serving patterns များကို ကိုယ်စားပြုသည်။
ASUS Ascent GX10 အပြင်၊ Dell၊ Acer နှင့် GIGABYTE မှ OEM စနစ်များနှင့်အတူ NVIDIA Founders Edition Spark ကို ရည်ညွှန်းချက်အဖြစ် benchmark လုပ်ခဲ့ပါသည်။ ၎င်းက ASUS ၏ရလဒ်များကို ပိုမိုကျယ်ပြန့်သော ယှဉ်ပြိုင်မှုရှုခင်းအတွင်း ထည့်သွင်းနိုင်စေပြီး ၎င်းသည် မည်သည့်နေရာတွင် ဦးဆောင်နေသည်၊ မည်သည့်နေရာတွင် လိုက်မီနေသည် သို့မဟုတ် မတူညီသော မော်ဒယ်များနှင့် workload အမျိုးအစားများကို လိုက်မီနေသည်ကို နားလည်နိုင်စေခဲ့ပါသည်။
GPT-OSS-120B
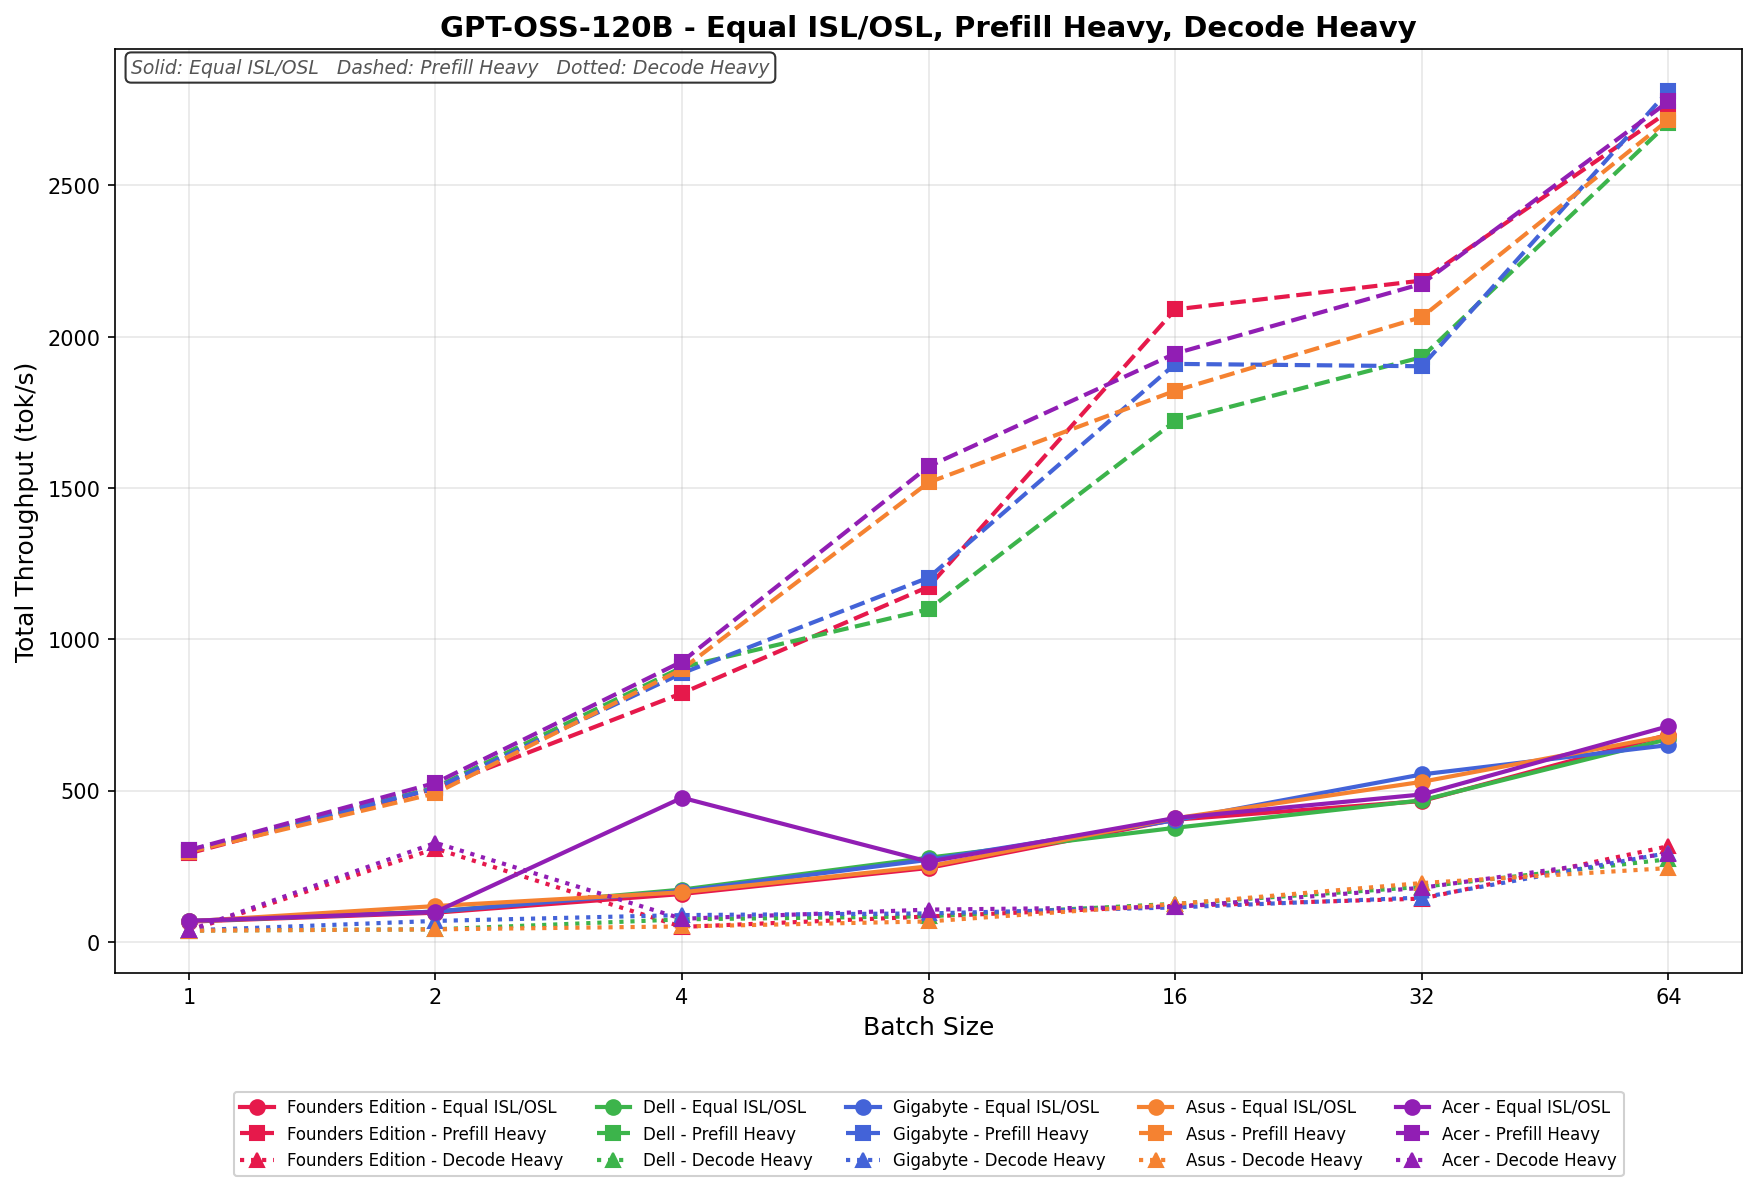
Equal ISL/OSL မှာ ASUS Spark ဟာ batch 1 မှာ 70 tok/s မှ batch 64 မှာ 680 tok/s အထိ တိုးမြှင့်နိုင်ပါတယ်။ batch sweep တစ်လျှောက်မှာ တိုးချဲ့မှုဟာ တည်ငြိမ်ပြီး linear ဖြစ်ပြီး နှစ်ဆတိုးတိုင်းမှာ တသမတ်တည်း တိုးတက်မှုရှိပါတယ်။ ထက်မြက်တဲ့ တိုးတက်မှု ဒါမှမဟုတ် ရပ်တန့်မှုတွေ မရှိပါဘူး၊ ပြီးတော့ batch 4 ကနေစပြီး throughput ဟာ ခန့်မှန်းထားသလို တိုးလာပြီး အလယ်အလတ်နဲ့ အထက် batch အရွယ်အစားတွေမှာ ပိုမိုကျယ်ပြန့်တဲ့ OEM နယ်ပယ်နဲ့ နီးကပ်စွာ ချိန်ညှိထားပါတယ်။
Prefill Heavy သည် ၂၉၀ tok/s မှစတင်ပြီး အသုတ် ၆၄ တွင် ၂၇၀၀ tok/s အထိ မြင့်တက်လာသည်။ အသုတ် ၈ တွင် တိုးတက်မှုမှာ အရှိန်အဟုန်ဖြင့် ရှိနေပြီး throughput မှာ ၁၅၀၀ tok/s ကို ကျော်လွန်ကာ အသုတ် ၁၆ နှင့် ၃၂ တွင် သန့်ရှင်းစွာ ဆက်လက်တိုးချဲ့နေသည်။ ကွေးညွှတ်မှုသည် regression point မရှိဘဲ ချောမွေ့နေပြီး ခိုင်မာသော၊ ကြီးမားသော အသုတ်ထိရောက်မှုနှင့် တည်ငြိမ်သော၊ မြင့်မားသော throughput အပြုအမူကို ပြသနေသည်။
Decode Heavy သည် batch 1 တွင် 45 tok/s မှ batch 64 တွင် 260 tok/s အထိရှိသည်။ batch အရွယ်အစားနည်းခြင်းသည် batch 1 နှင့် 2 အကြား အနည်းငယ်ကွဲပြားမှုကို ပြသသော်လည်း throughput သည် batch 4 တွင် တည်ငြိမ်ပြီး batch 16 မှစ၍ တသမတ်တည်း တိုးချဲ့လာသည်။ batch 32 မှ 64 အထိ တိုးလာမှုသည် သိသာထင်ရှားပြီး မြင့်မားသော တစ်ပြိုင်နက်တည်းလုပ်ဆောင်သည့်အခါ ထိရောက်သော decode scaling ကို ထင်ဟပ်စေသည်။
အလုံးစုံသော် ASUS သည် workload အမျိုးအစားသုံးမျိုးလုံးတွင် ပိုမိုကျယ်ပြန့်သော Spark ဂေဟစနစ်နှင့် အလွန်နီးကပ်စွာ လိုက်လံဆောင်ရွက်ပါသည်။
GPT-OSS-20B
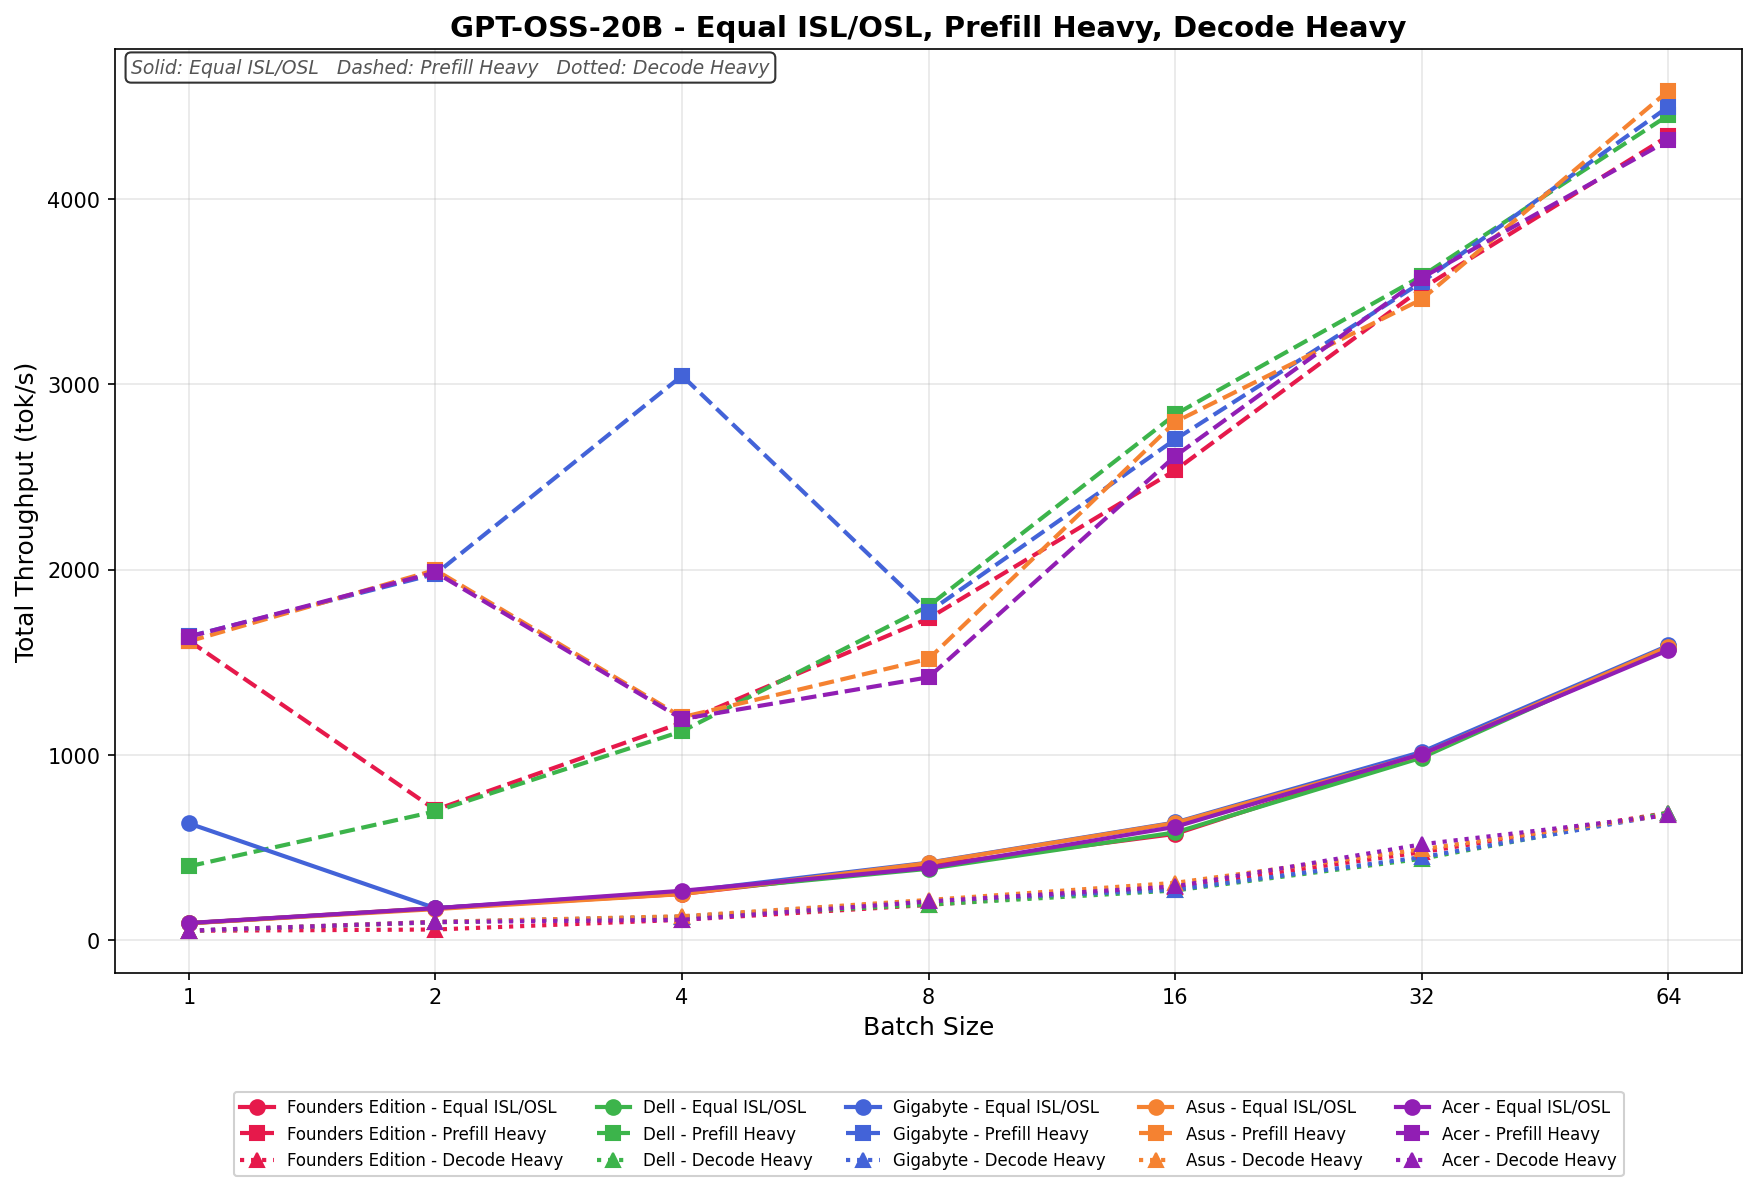
Equal ISL/OSL မှာ ASUS Spark ဟာ batch 1 မှာ 90 tok/s မှ batch 64 မှာ 1,600 tok/s အထိ တိုးမြှင့်နိုင်ပါတယ်။ throughput ဟာ sweep တစ်လျှောက်မှာ တဖြည်းဖြည်း တိုးလာပြီး batch 8 ကနေစပြီး အထူးသဖြင့် clean linear scaling ရှိလာမှာပါ။ အမြတ်အစွန်းတွေဟာ နှစ်ဆတိုးတိုင်းမှာ တသမတ်တည်းရှိနေပြီး curve မှာ concurrency တိုးလာတာနဲ့အမျှ မတည်ငြိမ်မှု ဒါမှမဟုတ် regression မရှိပါဘူး။
Prefill Heavy သည် အသုတ် ၁ တွင် 1,650 tok/s မှစတင်ပြီး အသုတ် ၂ တွင် 2,000 tok/s အထိ မြင့်တက်လာပြီးနောက် အသုတ် ၄ တွင် ကျဆင်းသွားပြီး မြှင့်တင်မှု အားကောင်းလာပါသည်။ အသုတ် ၈ မှစ၍ ထုတ်လုပ်မှုပမာဏသည် အဆက်မပြတ် မြင့်တက်လာပြီး အသုတ် ၆၄ တွင် 4,550 tok/s အထိ ရောက်ရှိခဲ့ပါသည်။
Decode Heavy သည် batch 1 တွင် 60 tok/s မှ batch 64 တွင် 700 tok/s အထိရှိသည်။ တိုးချဲ့မှုသည် sweep တစ်လျှောက်တွင် တဖြည်းဖြည်းနှင့် တသမတ်တည်းဖြစ်ပြီး နှစ်ဆတိုးတိုင်းတွင် ခန့်မှန်းနိုင်သော အကျိုးအမြတ်များရှိသည်။ အထင်ရှားဆုံးတိုးတက်မှုသည် batch 16 နှင့် 64 အကြားတွင် ဖြစ်ပေါ်ပြီး throughput သည် မြင့်တက်ခြင်း သို့မဟုတ် ကျဆင်းခြင်းမရှိဘဲ တဖြည်းဖြည်းတိုးတက်လာသည်။
Qwen3 ကုဒ်ဒါ 30B A3B FB8
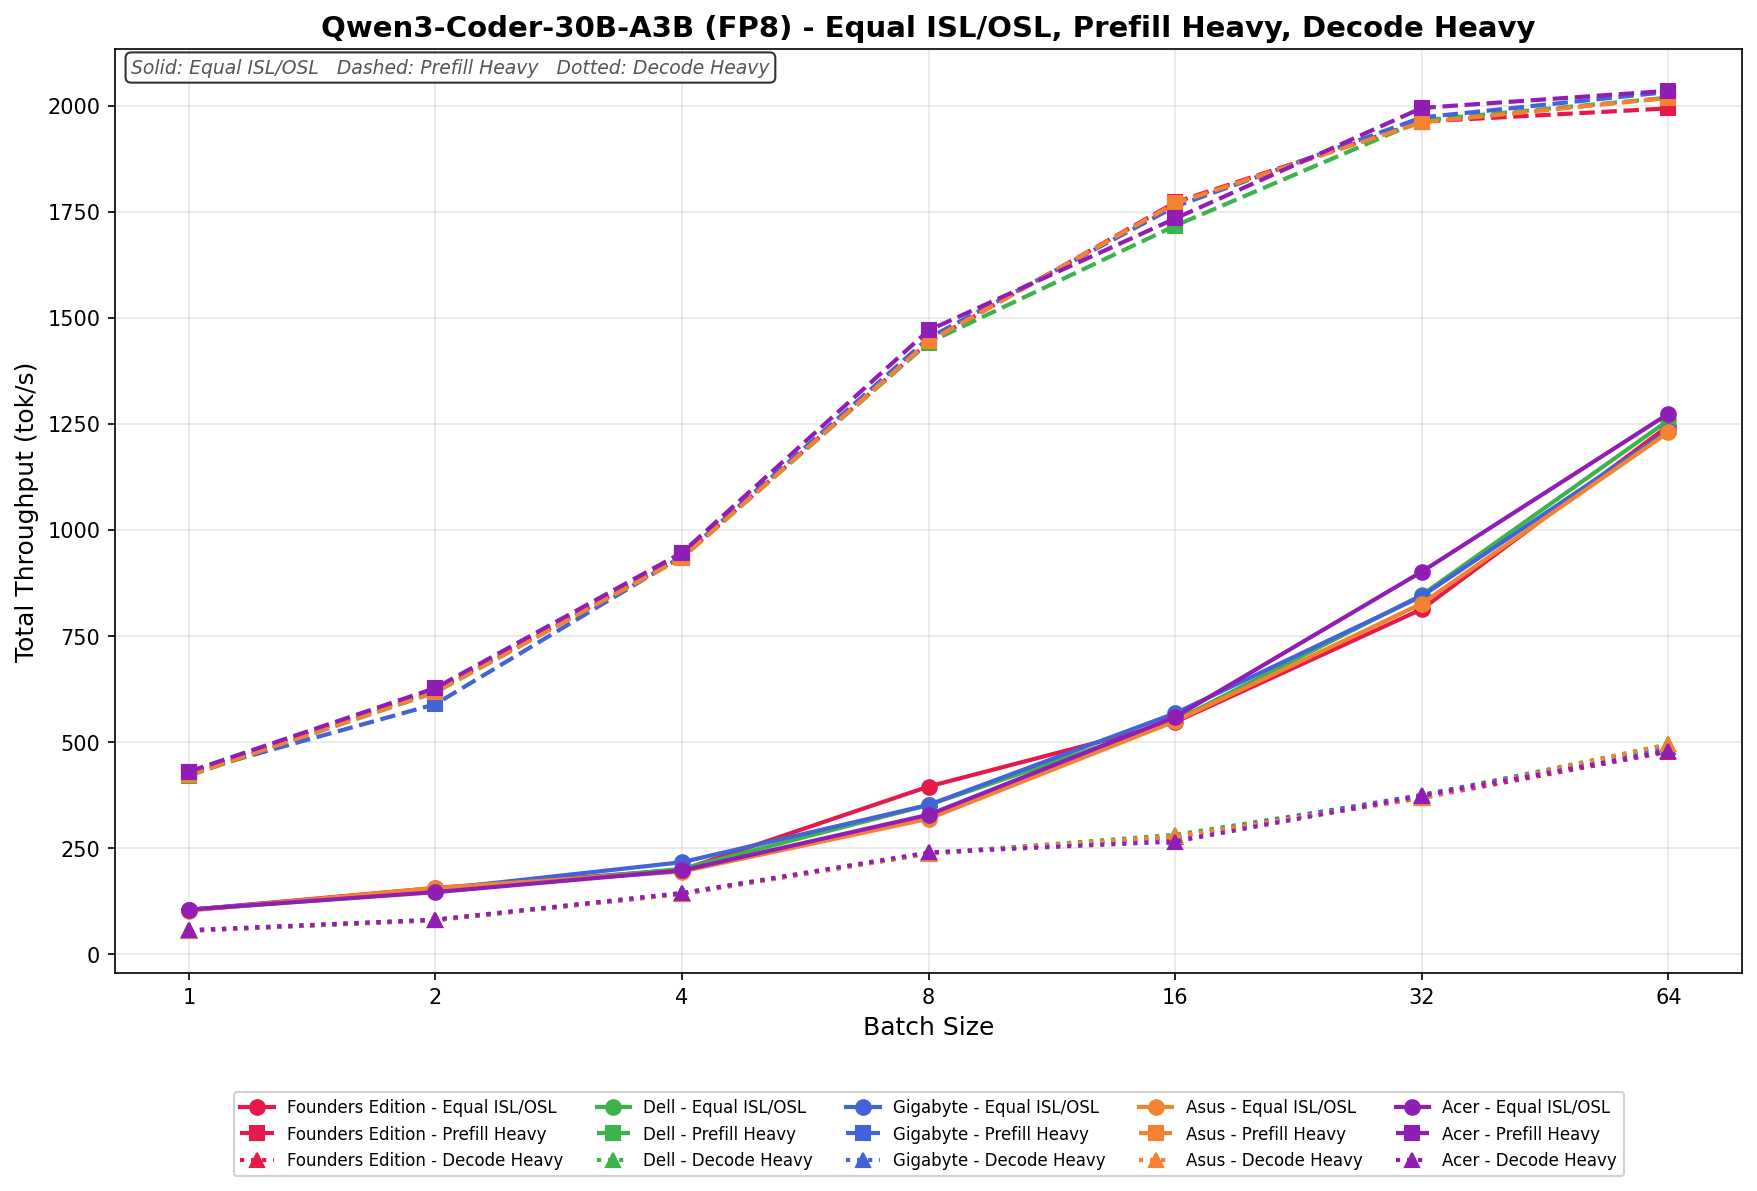
Equal ISL/OSL မှာ ASUS Spark ဟာ batch 1 မှာ 100 tok/s မှ batch 64 မှာ 1,230 tok/s အထိ တိုးမြှင့်လာပါတယ်။ throughput ဟာ sweep တစ်လျှောက်မှာ တဖြည်းဖြည်း တိုးလာပြီး batch 4 ကနေစပြီး clean linear growth လည်း ရှိလာပါပြီ။
Prefill Heavy သည် ၄၂၀ tok/s မှစတင်ပြီး အသုတ် ၆၄ တွင် ၂,၀၀၀ tok/s အထိ မြင့်တက်လာသည်။ အသုတ်တစ်ခုလုံးတွင် တိုးချဲ့မှုသည် ချောမွေ့ပြီး ခန့်မှန်းရလွယ်ကူသည်။ အကြီးမားဆုံးခုန်ပျံကျော်လွှားမှုသည် အသုတ် ၄ နှင့် ၈ အကြားတွင် ဖြစ်ပေါ်ပြီး throughput သည် ၉၄၀ tok/s ခန့်မှ ၁၄၅၀ tok/s အထိ ရွေ့လျားသည်။
Decode Heavy သည် batch 1 တွင် 60 tok/s မှ batch 64 တွင် 490 tok/s အထိရှိသည်။ scaling သည် တဖြည်းဖြည်းနှင့် တသမတ်တည်းဖြစ်ပြီး ကျဆင်းမှု သို့မဟုတ် ပုံမှန်မဟုတ်မှုများ မရှိပါ။ throughput ကို နှစ်ဆတိုးတိုင်း ခန့်မှန်းခြေအားဖြင့် တိုးလာပြီး batch 16 မှ အထက်သို့ အထင်ရှားဆုံး အကျိုးအမြတ်များ ဖြစ်ပေါ်ပြီး ပိုမိုမြင့်မားသော တပြိုင်နက်တည်းတွင် decode scaling ထိရောက်မှုကို ထင်ဟပ်စေသည်။
Qwen3 ကုဒ်ဒါ 30B A3B Base
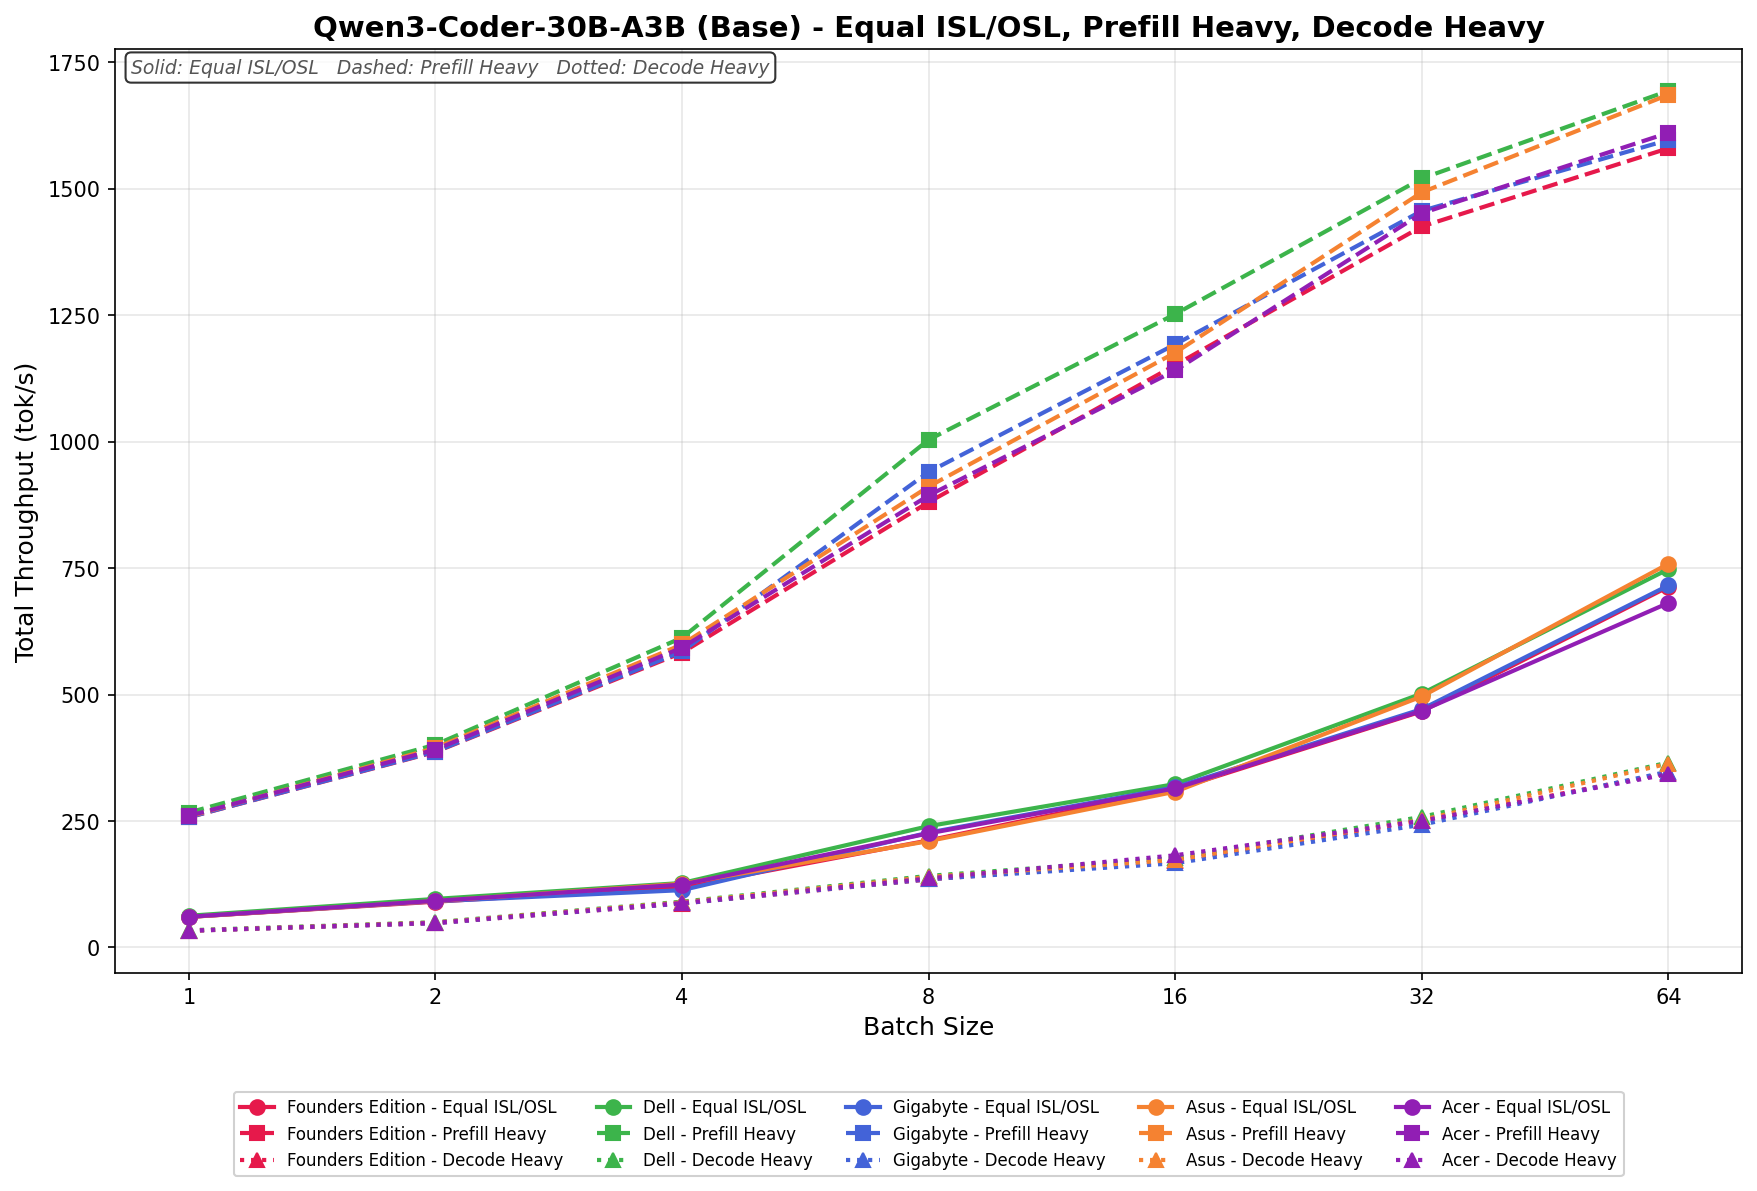
Equal ISL/OSL မှာ ASUS Spark ဟာ batch 1 မှာ 60 tok/s မှ batch 64 မှာ 750 tok/s အထိ တိုးမြှင့်နိုင်ပါတယ်။ throughput ဟာ sweep တစ်လျှောက်မှာ တဖြည်းဖြည်း တိုးလာပြီး batch 8 ကနေစပြီး အထူးသဖြင့် clean linear scaling ရှိလာမှာပါ။
Prefill Heavy သည် ၂၆၀ tok/s မှစတင်ပြီး အသုတ် ၆၄ တွင် ၁၆၈၀ tok/s အထိ မြင့်တက်လာသည်။ အသုတ်လိုက် တိုးချဲ့မှုတစ်လျှောက်လုံး ချောမွေ့ပြီး တိုးတက်လာသည်။ အသိသာဆုံး အရှိန်မြှင့်မှုသည် အသုတ် ၄ နှင့် ၈ အကြားတွင် ဖြစ်ပေါ်ပြီး throughput သည် ၆၀၀ tok/s ခန့်မှ ၉၀၀ tok/s အထိ ခုန်တက်သွားသည်။
Decode Heavy သည် batch 1 တွင် 30 tok/s မှ batch 64 တွင် 360 tok/s အထိရှိသည်။ ချဲ့ထွင်ခြင်းသည် တဖြည်းဖြည်းနှင့် တသမတ်တည်းဖြစ်ပြီး၊ batch အရွယ်အစားနည်းသောအခြေအနေများတွင် မမှန်သောအပြုအမူမရှိပါ။
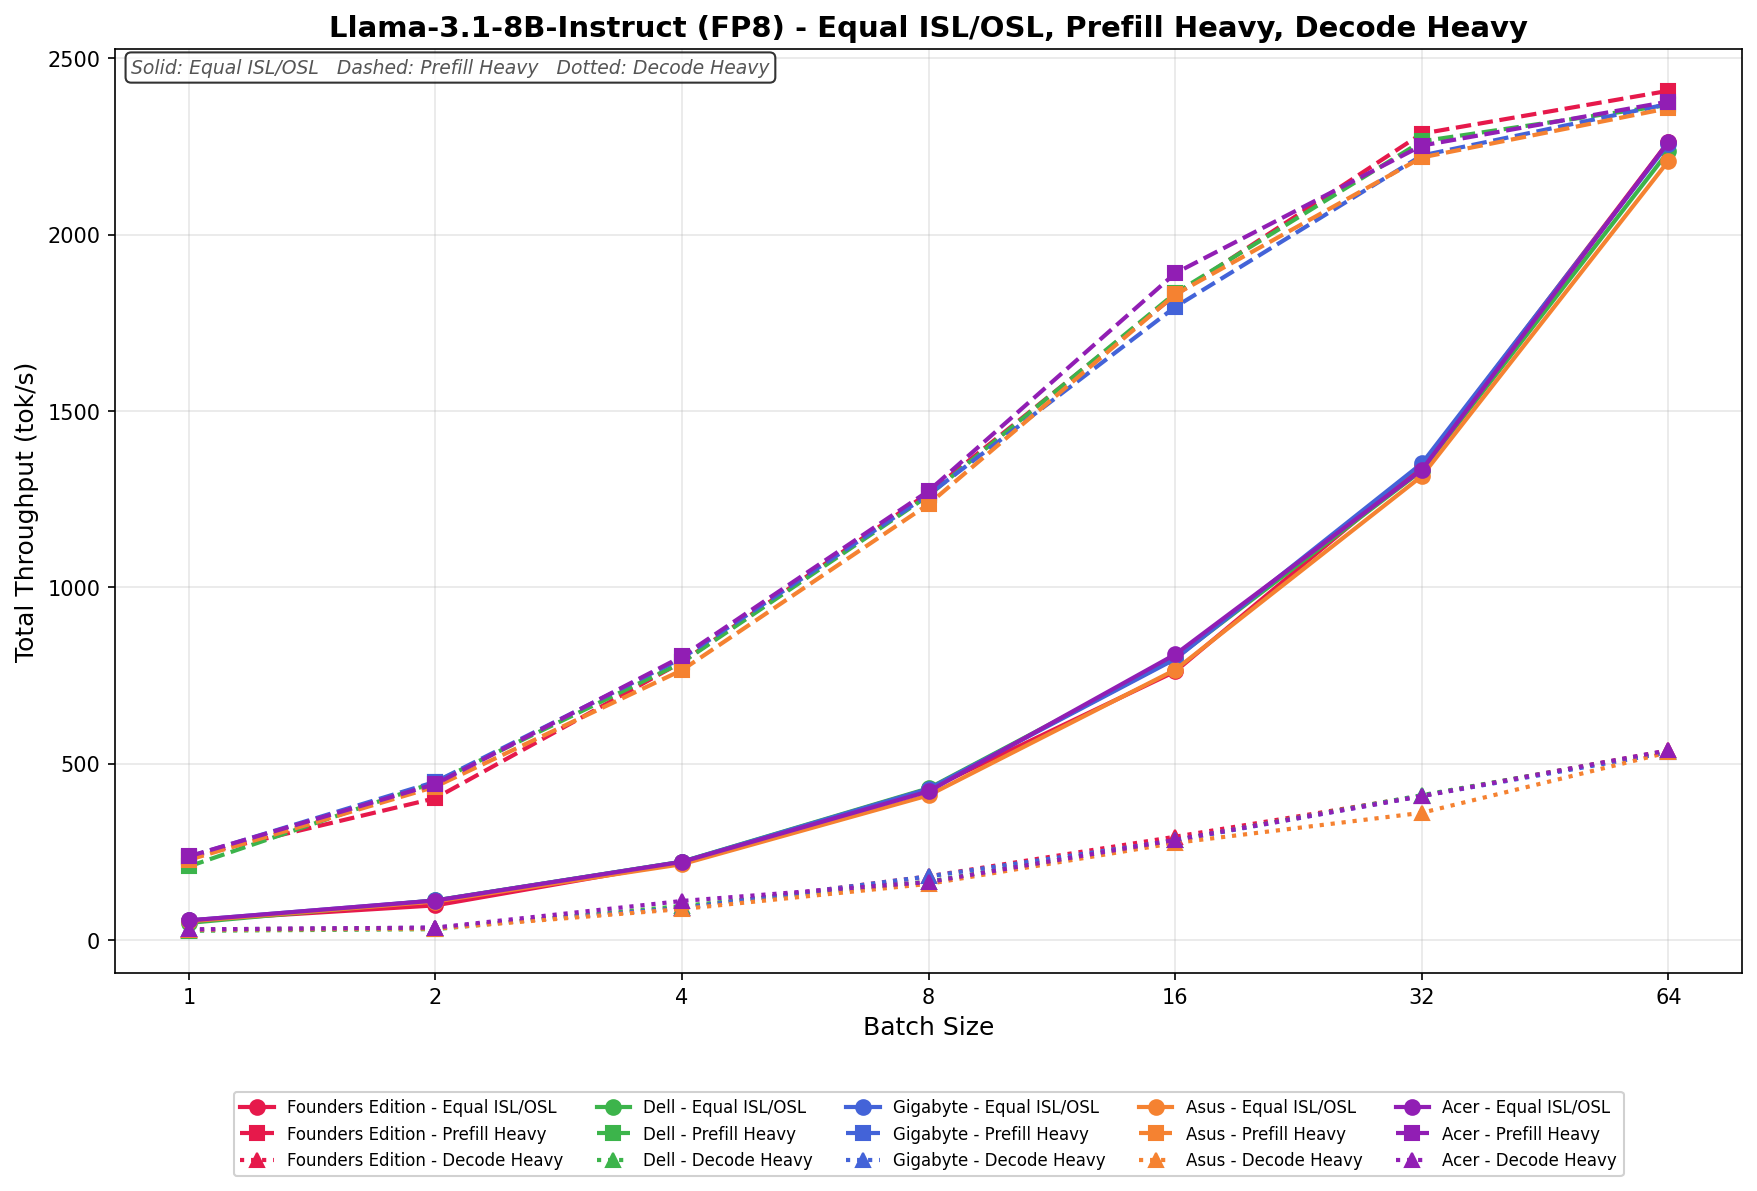
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
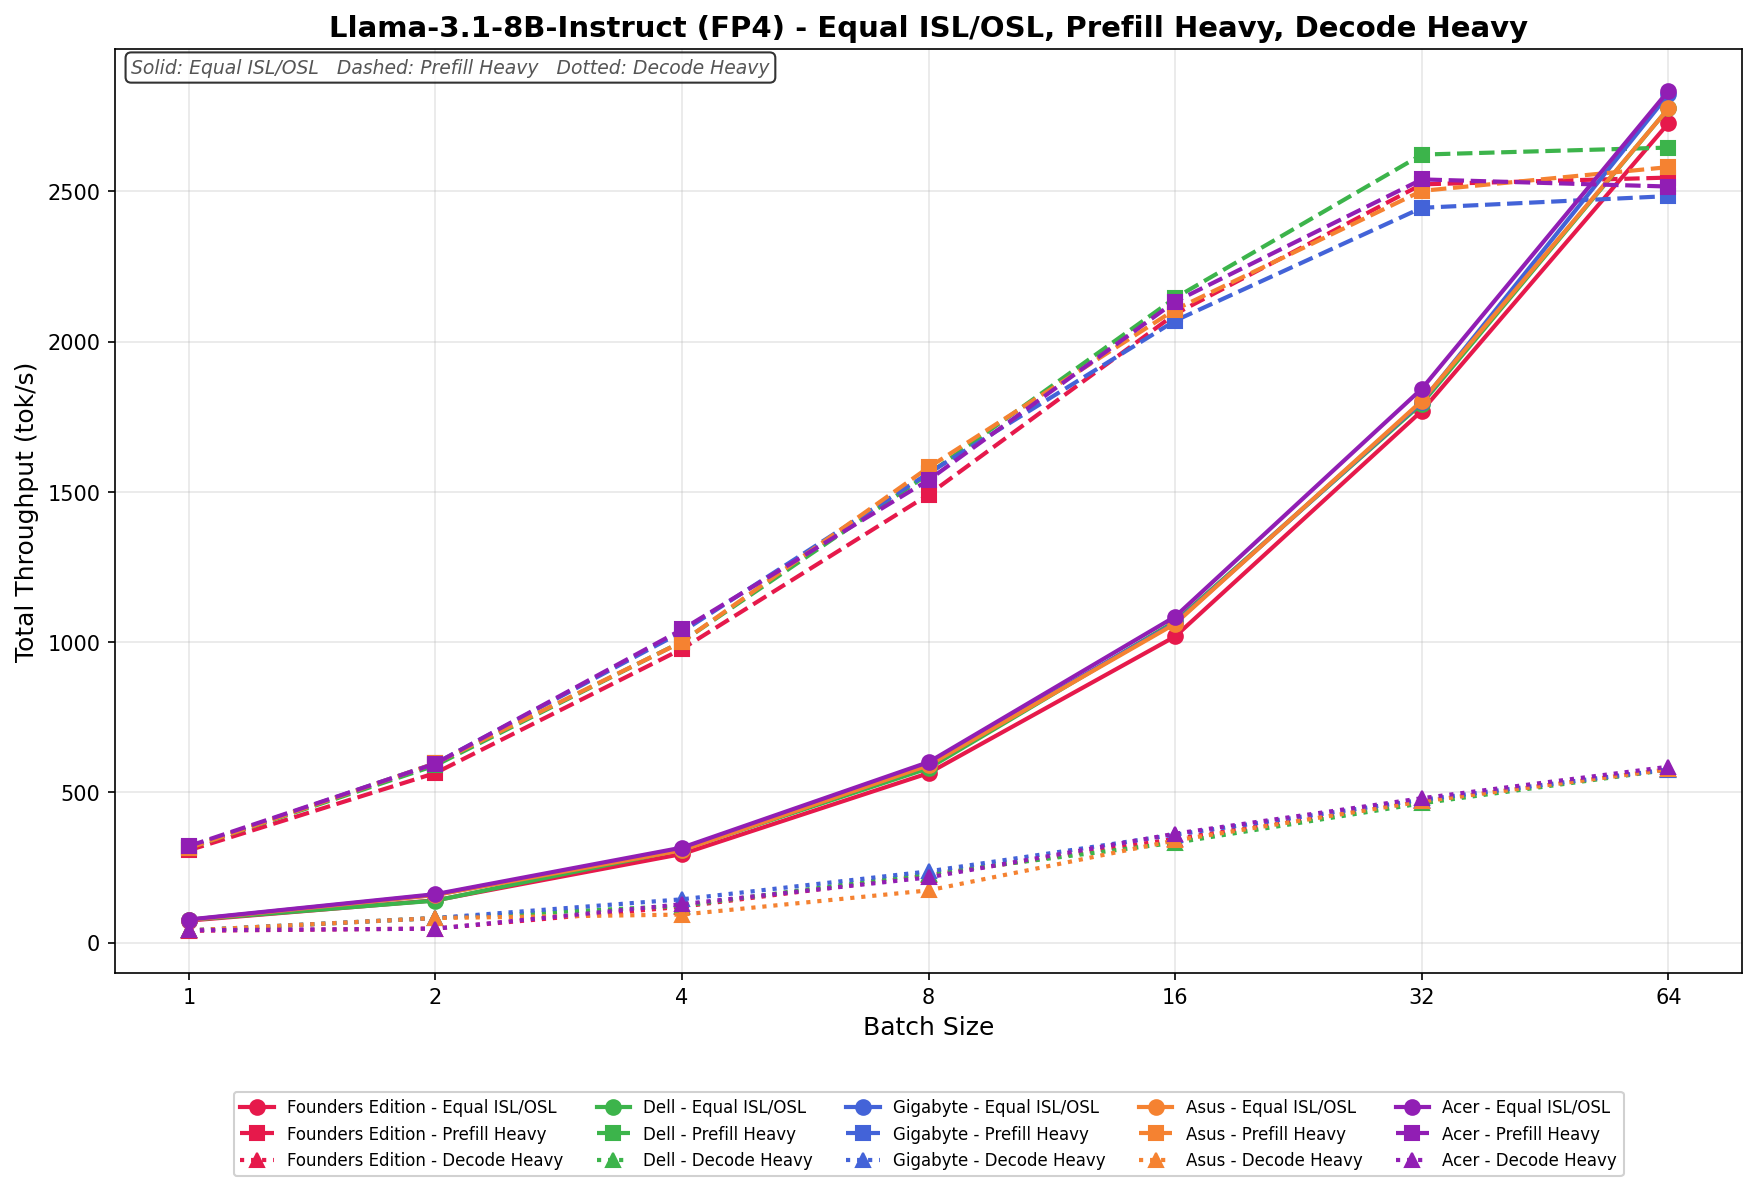
Equal ISL/OSL မှာ ASUS Spark ဟာ batch 1 မှာ tok/s 70 မှ batch 64 မှာ tok/s 2,750 အထိ တိုးလာပါတယ်။ တိုးတက်မှုက တည်ငြိမ်နေပြီး batch 16 ကနေစပြီး တစ်ပြိုင်နက်တည်း တိုးတက်လာတာနဲ့အမျှ အထူးသဖြင့် ခိုင်မာတဲ့ တိုးချဲ့မှုတစ်ခု ဖြစ်လာပါတယ်။
Prefill Heavy သည် 300 tok/s မှစတင်ပြီး batch 64 တွင် 2,550 tok/s အထိ မြင့်တက်လာသည်။ ချိန်ညှိမှုသည် သန့်ရှင်းပြီး linear ဖြစ်ပြီး နှစ်ဆတိုးတိုင်းတွင် တသမတ်တည်းတိုးတက်မှုများရှိပြီး မြင့်မားသော batch အရွယ်အစားများတွင် မတည်ငြိမ်မှုမရှိပါ။
Decode Heavy သည် batch sweep တစ်လျှောက်တွင် ၄၀ tok/s မှ ၅၈၀ tok/s အထိ ရှိသည်။ Throughput သည် တဖြည်းဖြည်းနှင့် ခန့်မှန်းနိုင်သောအတိုင်း တိုးလာပြီး batch 16 နောက်ပိုင်းတွင် အကြီးမားဆုံး အကျိုးအမြတ်များ ဖြစ်ပေါ်သည်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
Equal ISL/OSL မှာ ASUS Spark ဟာ batch 1 မှာ 50 tok/s မှ batch 64 မှာ 2,200 tok/s အထိ တိုးမြှင့်နိုင်ပါတယ်။ တိုးတက်မှုဟာ ချောမွေ့ပြီး linear ဖြစ်ပြီး batch 16 ထက်ကျော်လွန်တဲ့အခါ တစ်ပြိုင်နက်တည်း တိုးတက်လာတာနဲ့အမျှ အရှိန်အဟုန် မြင့်မားလာပါတယ်။
Prefill Heavy သည် 220 tok/s မှစတင်ပြီး batch 64 တွင် 2,350 tok/s အထိ မြင့်တက်လာသည်။ တိုးချဲ့မှုသည် sweep တစ်လျှောက်တွင် သန့်ရှင်းပြီး တသမတ်တည်းရှိပြီး နှစ်ဆတိုးတိုင်းတွင် ခန့်မှန်းနိုင်သော တိုးတက်မှုများနှင့် တည်ငြိမ်သော high-batch အပြုအမူရှိသည်။
Decode Heavy သည် ၃၀ tok/s မှ ၅၃၀ tok/s အထိ ရှိသည်။ ထုတ်လုပ်မှုပမာဏသည် အသုတ်အရွယ်အစားအလိုက် တဖြည်းဖြည်းတိုးလာပြီး အကြီးမားဆုံးအကျိုးအမြတ်များသည် အသုတ် ၁၆ မှစ၍ ပေါ်လာသည်။
GPU တိုက်ရိုက်သိုလှောင်မှု
Spark မှာ ကျွန်တော်တို့ ပြုလုပ်ခဲ့တဲ့ စမ်းသပ်မှုတွေထဲက တစ်ခုကတော့ MagnumIO GPU Direct Storage (GDS) စမ်းသပ်မှုပါ။ GDS ဆိုတာ NVIDIA မှ တီထွင်ထားတဲ့ လုပ်ဆောင်ချက်တစ်ခုဖြစ်ပြီး NVMe drives တွေ ဒါမှမဟုတ် တခြားမြန်နှုန်းမြင့် storage devices တွေမှာ သိမ်းဆည်းထားတဲ့ data တွေကို access လုပ်တဲ့အခါ GPU တွေကို CPU ကိုကျော်ပြီး လုပ်ဆောင်နိုင်စေပါတယ်။ CPU နဲ့ system memory ကနေတစ်ဆင့် data တွေကို routing လုပ်မယ့်အစား GDS က GPU နဲ့ storage device အကြား တိုက်ရိုက်ဆက်သွယ်မှုကို ဖြစ်စေပြီး latency ကို သိသိသာသာ လျှော့ချပေးပြီး data throughput ကို တိုးတက်စေပါတယ်။
ASUS က Ascent GX10 ထဲမှာ Phison ESL04TBTLCZ 1TB Gen4 SSD ကို အသုံးပြုထားပါတယ်။ ဒါက ကျွန်တော်တို့ စမ်းသပ်ဖူးသမျှ 1TB GB10 platform တစ်ခုတည်းပါပဲ၊ ဒါပေမယ့် ကျွန်တော်တို့ မြင်တွေ့ခဲ့ရတာတွေအရ ဒီ SSD ဟာ PCIe Gen4 ဖြစ်ရုံသာမက write speed အနှေးဆုံးလည်း ဖြစ်ပါတယ်။
GPU Direct Storage ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU ဟာ ကြားခံအဖြစ်လုပ်ဆောင်ပြီး latency ကိုတိုးစေပြီး အဖိုးတန် system resource တွေကို သုံးစွဲစေတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါတယ်။ GPU Direct Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ တိုက်ရိုက်ဒေတာတွေကို ရယူနိုင်အောင် လုပ်ပေးခြင်းအားဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီတိုက်ရိုက်လမ်းကြောင်းက ဒေတာရွေ့လျားမှု overhead ကို လျော့ကျစေပြီး ဒေတာလွှဲပြောင်းမှုတွေကို ပိုမိုမြန်ဆန်ထိရောက်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPU Direct Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
ထို့အပြင်၊ GDS သည် ဗီဒီယိုလုပ်ဆောင်ခြင်း၊ သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်း သို့မဟုတ် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းကဲ့သို့သော ဒေတာအစုအဝေးကြီးများကို streaming လုပ်ခြင်းပါဝင်သည့် workloads များအတွက် အထူးအကျိုးရှိပါသည်။ CPU အပေါ် မှီခိုမှုကို လျှော့ချခြင်းဖြင့် GDS သည် ဒေတာရွှေ့ပြောင်းမှုကို အရှိန်မြှင့်ပေးပြီး အခြားအလုပ်များအတွက် CPU အရင်းအမြစ်များကို လွတ်လပ်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
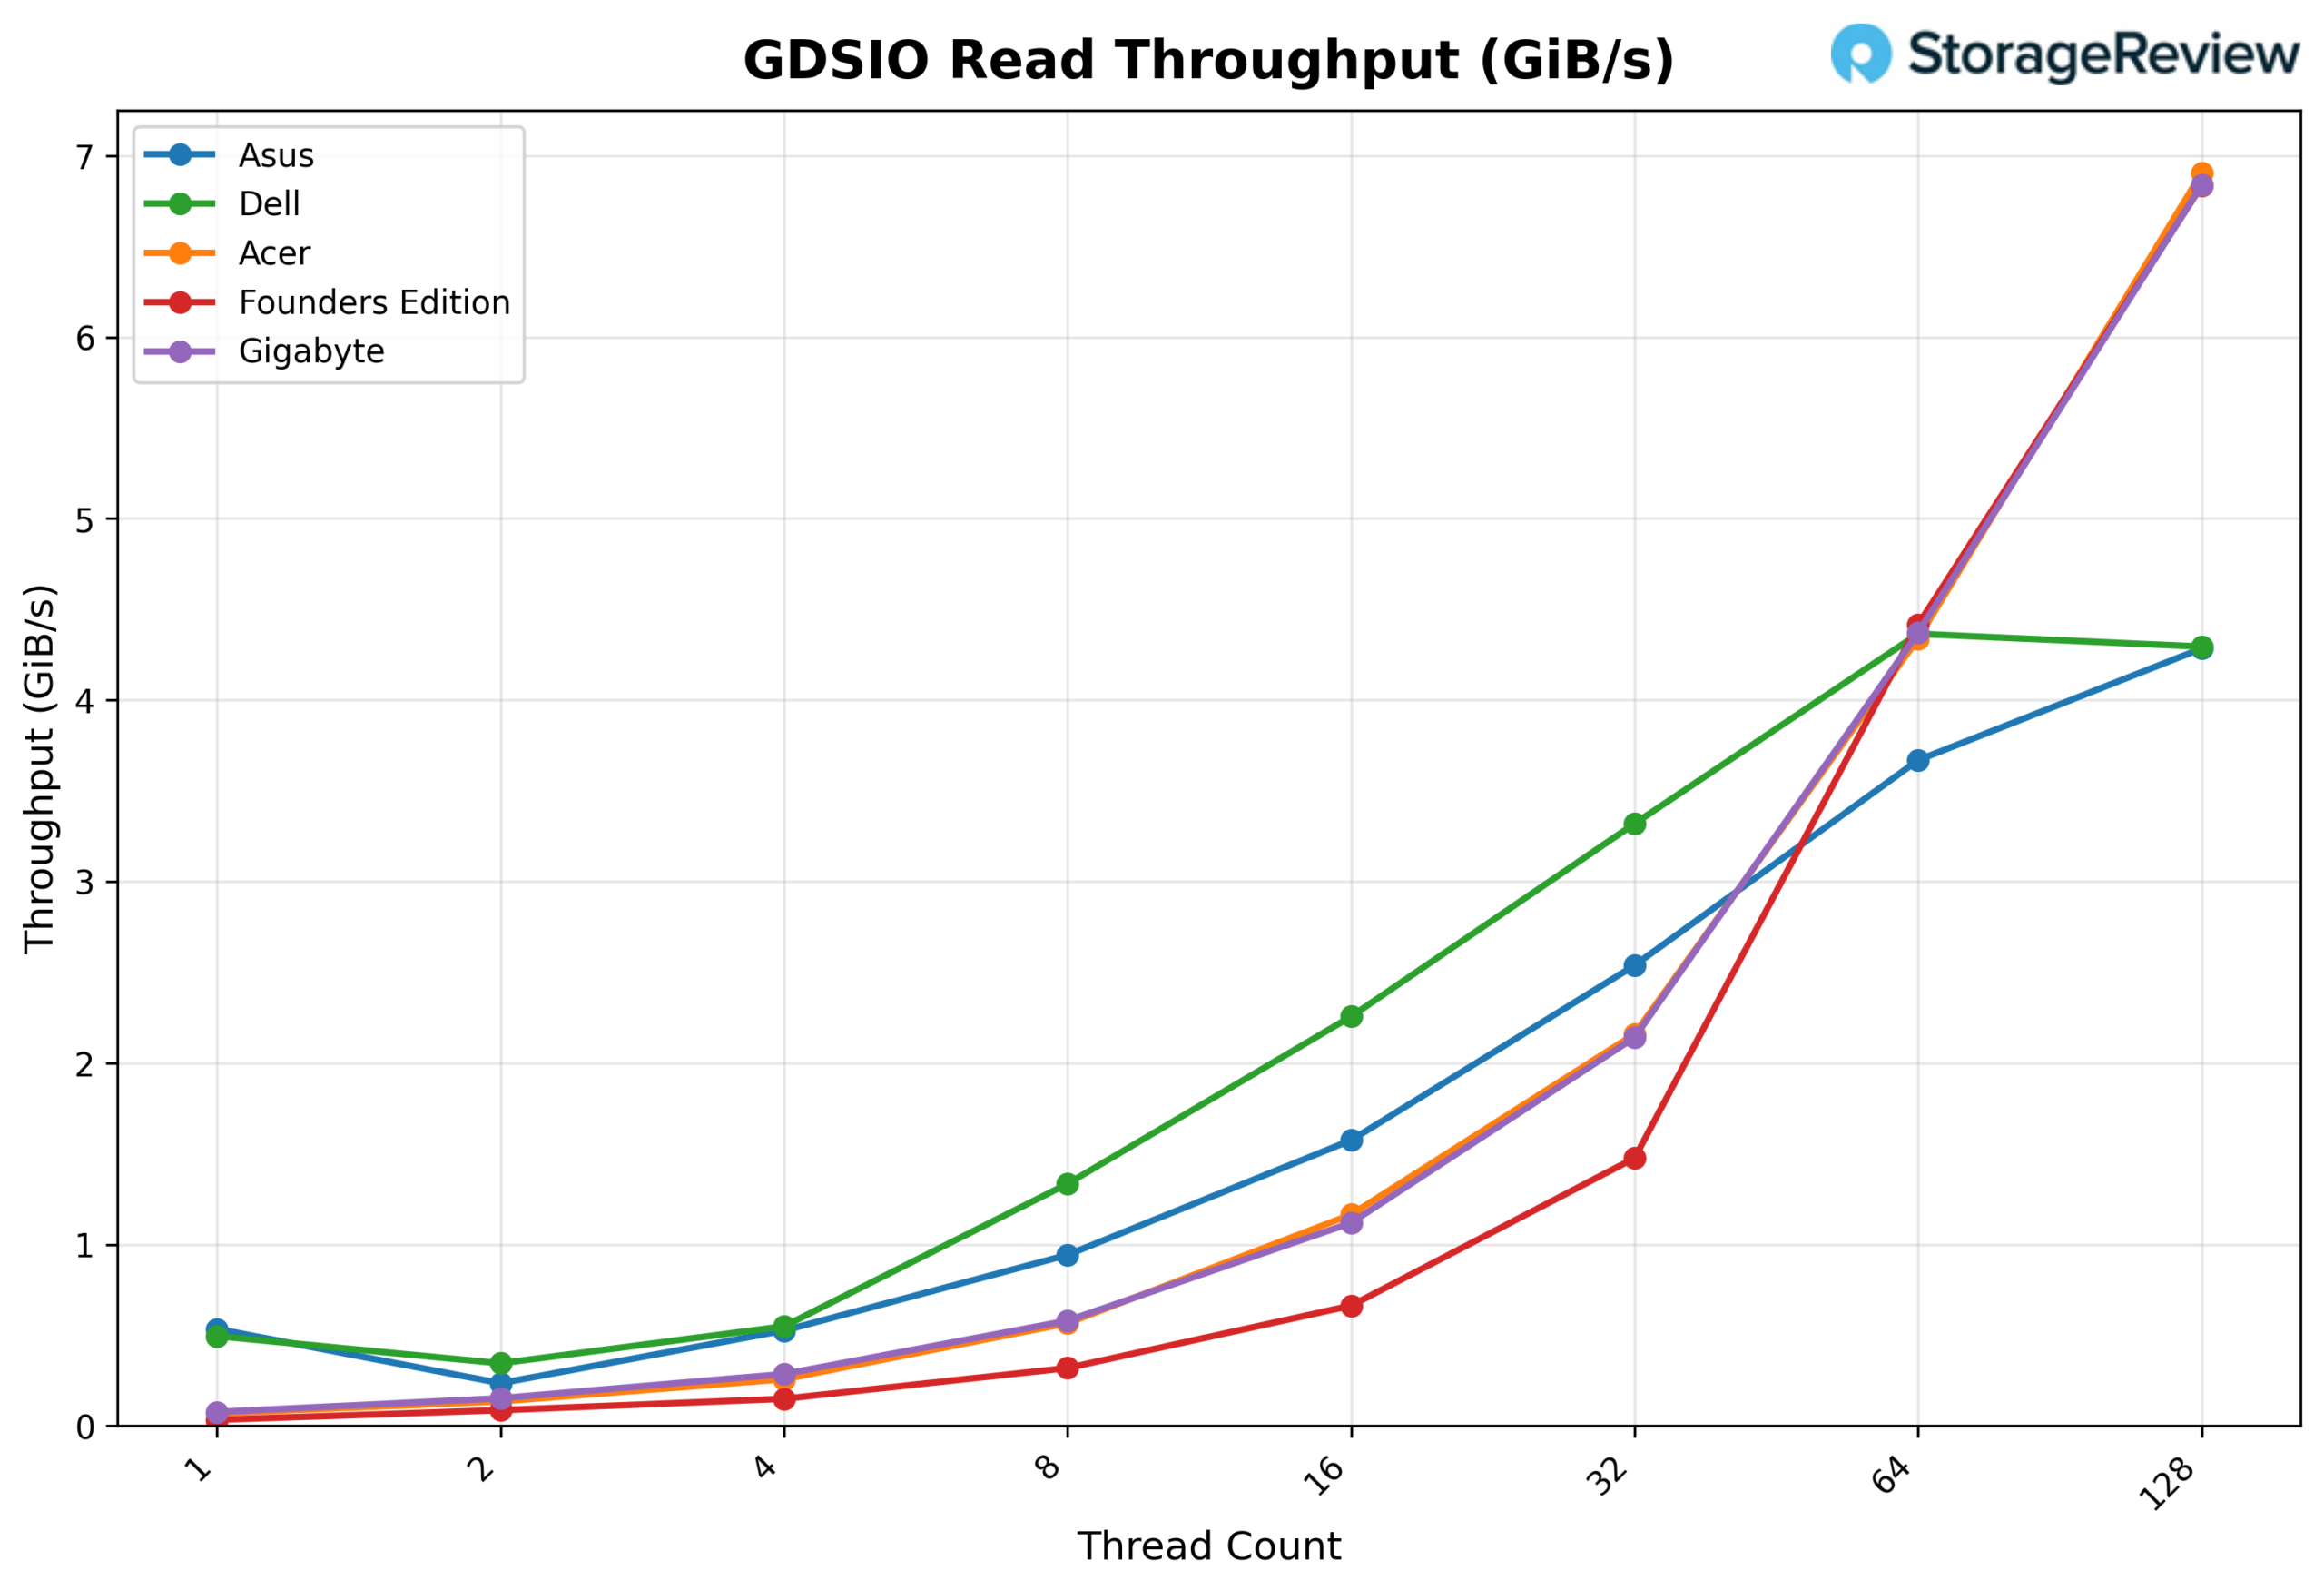
GDSIO ဖတ်ရှုမှုပမာဏ ၁၆k
GDSIO Read Throughput 16K ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread 1 မှာ 0.53 GiB/s ကနေစတင်ပေမယ့် ရလဒ်တွေအရ အောက်ပိုင်းမှာ ကွဲပြားမှုအချို့ရှိပြီး thread 2 ခုဟာ 0.23 GiB/s ရှိပြီး thread 4 မှာ 0.52 GiB/s အထိပြန်တက်လာပါတယ်။ Throughput ဟာ thread 8 ခု (0.94 GiB/s) နဲ့ thread 16 ခု (1.57 GiB/s) မှာ တည်ငြိမ်တဲ့ scaling ကိုပြန်လည်စတင်ပြီး thread 32 ခု (2.54 GiB/s) မှာ ပိုမိုတက်ကြွစွာတိုးတက်လာပါတယ်။ thread 64 ခု (3.67 GiB/s) မှာ scaling ဟာအားကောင်းနေဆဲဖြစ်ပြီး thread 128 ခုမှာ 4.28 GiB/s မှာအမြင့်ဆုံးရောက်ရှိပြီး အစောပိုင်းအဆင့်မတက်ဘဲ အပေါ်သို့ဆက်လက်ရွေ့လျားနေတာကိုပြသပါတယ်။
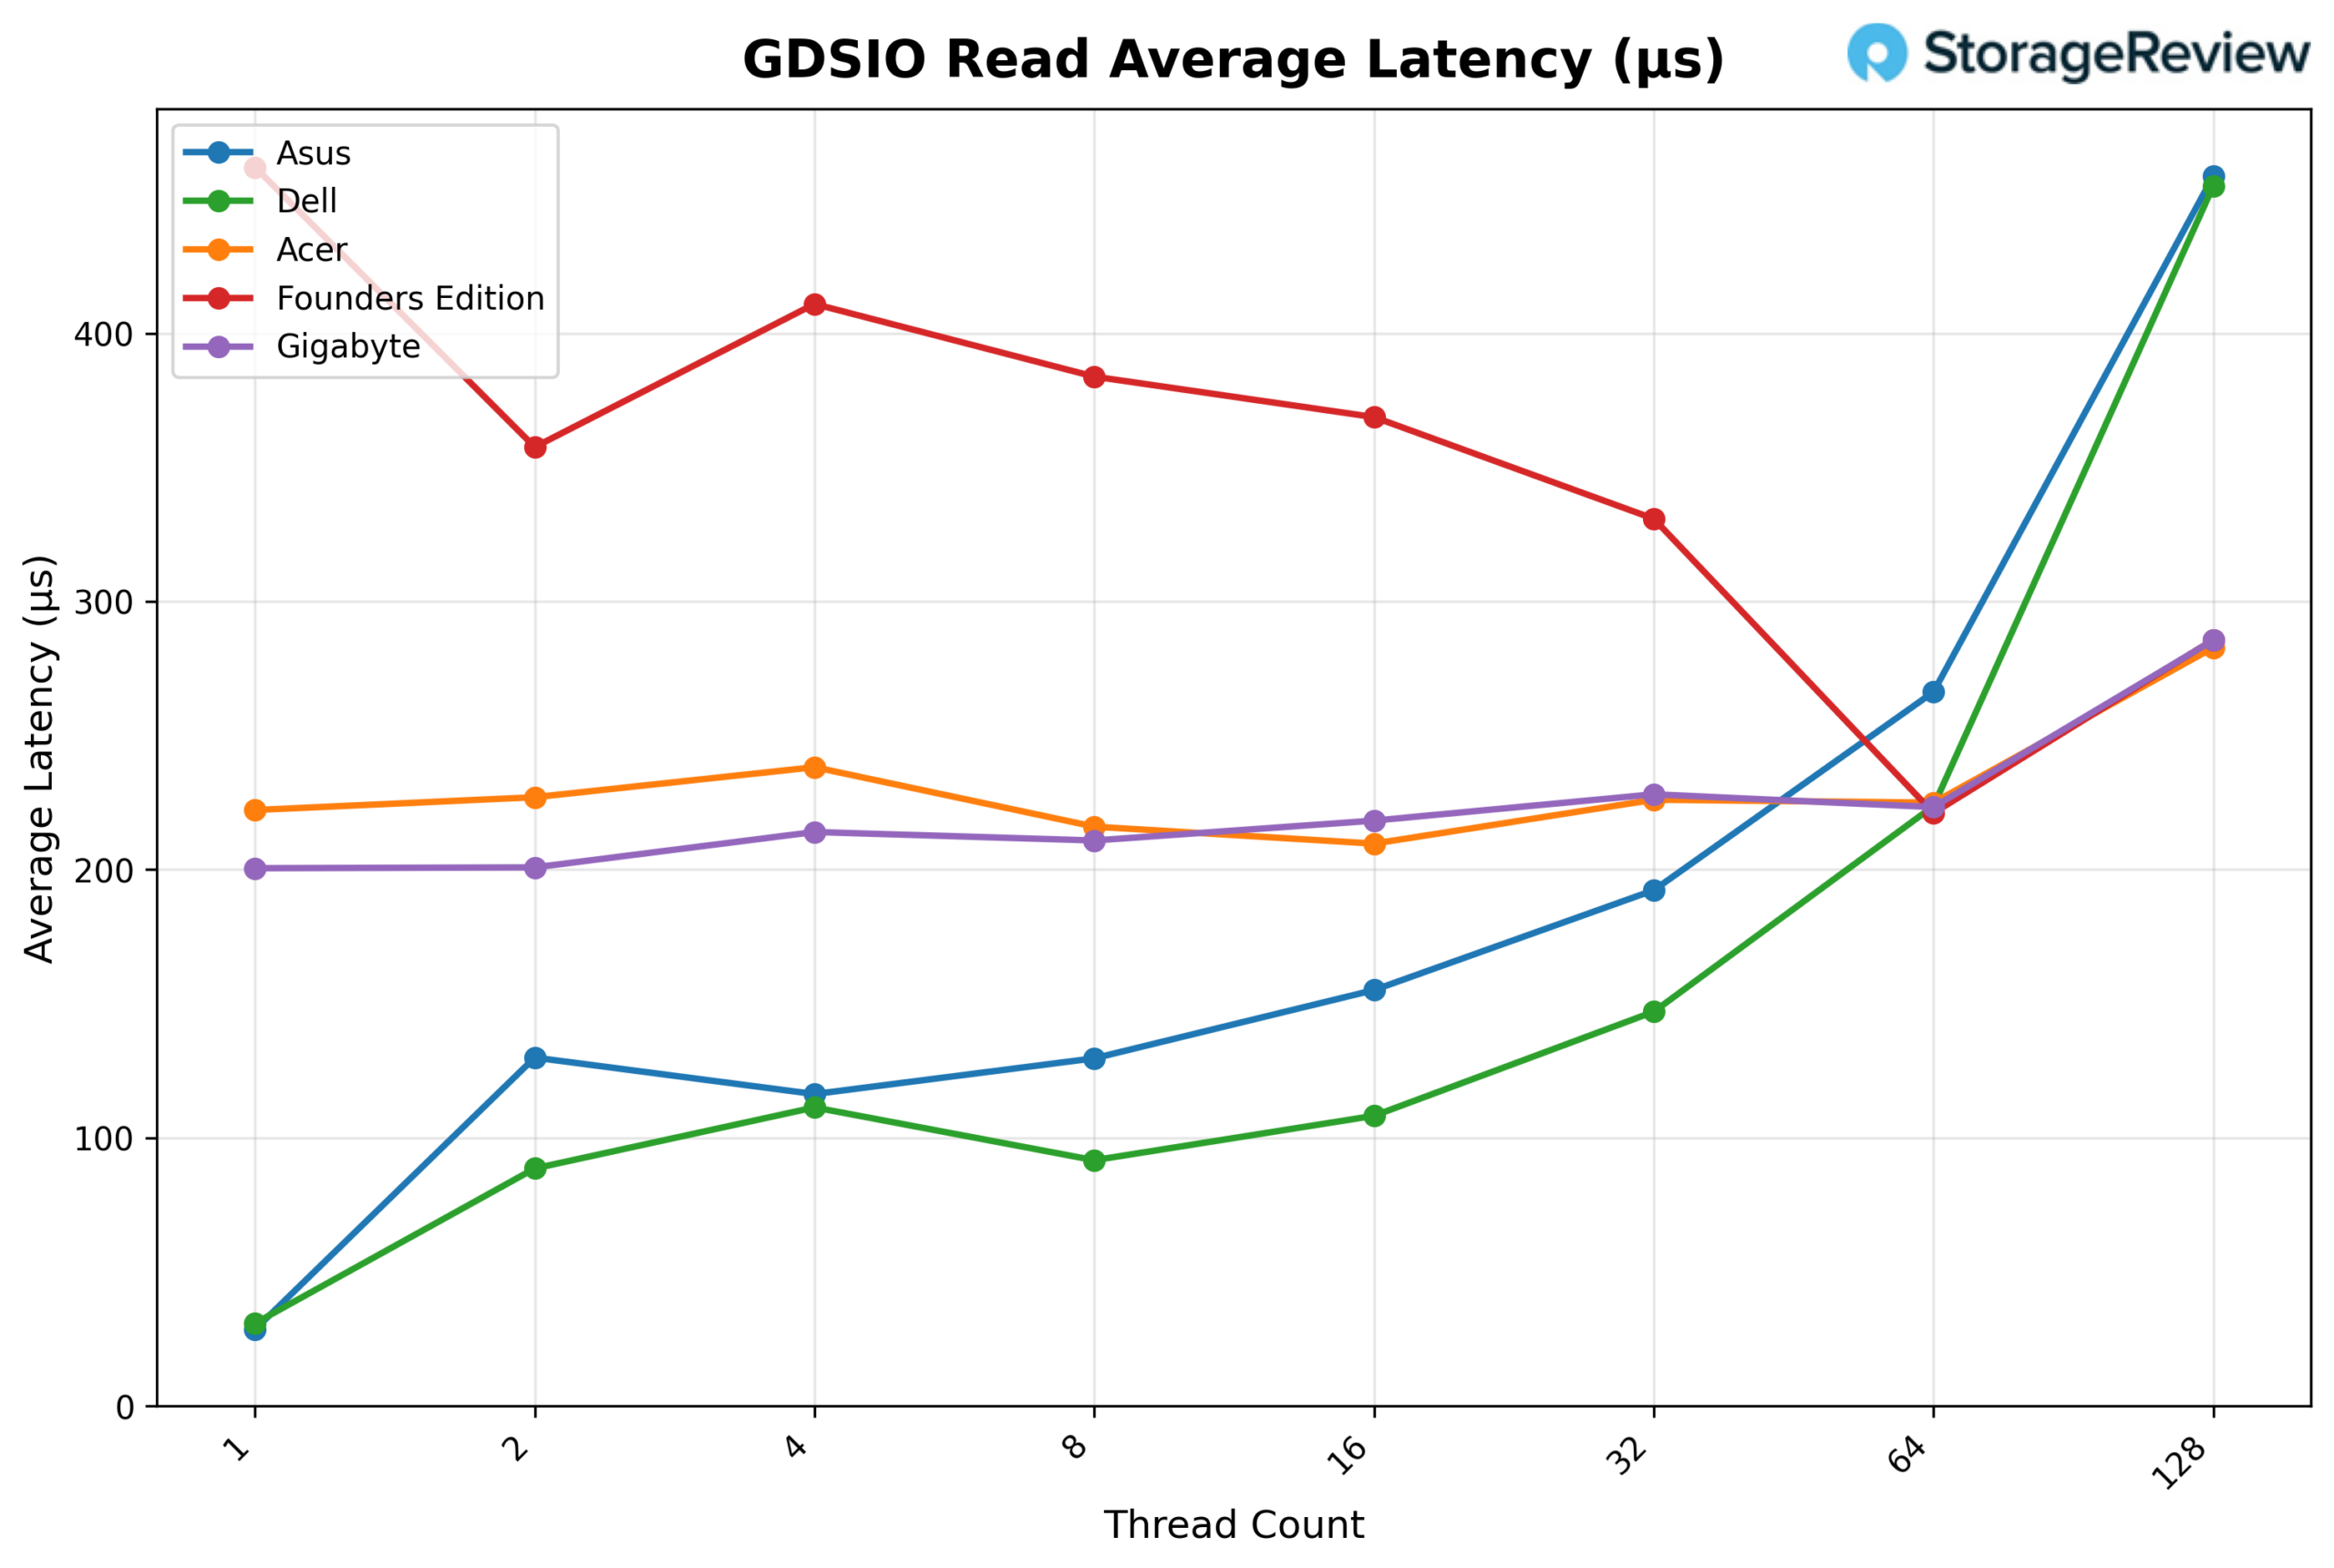
GDSIO ဖတ်ရှုမှု ပျမ်းမျှ နှောင့်နှေးမှု 16K
GDSIO Read Average Latency (16K) ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread ၁ ခုမှာ ၀.၀၃ ms လောက်ကနေစပြီး thread ၂ ခု (၀.၁၃ ms) နဲ့ thread ၄ ခု (၀.၁၂ ms) မှာ နိမ့်နေပါသေးတယ်။ Latency ဟာ thread ၈ ခု (၀.၁၃ ms) နဲ့ thread ၁၆ ခု (၀.၁၆ ms) မှာ အနည်းငယ်တက်လာပြီးနောက် thread ၃၂ ခု (၀.၁၉ ms) နဲ့ thread ၆၄ ခု (၀.၂၇ ms) မှာ မြင့်တက်လာပါတယ်။ thread ၁၂၈ ခုမှာ latency ၀.၄၆ ms အထိရောက်ရှိပြီး throughput မှာတွေ့ရတဲ့ scaling အပြုအမူနဲ့ ကိုက်ညီအောင် full sweep မှာ အတော်လေးနိမ့်နေပါသေးတယ်။
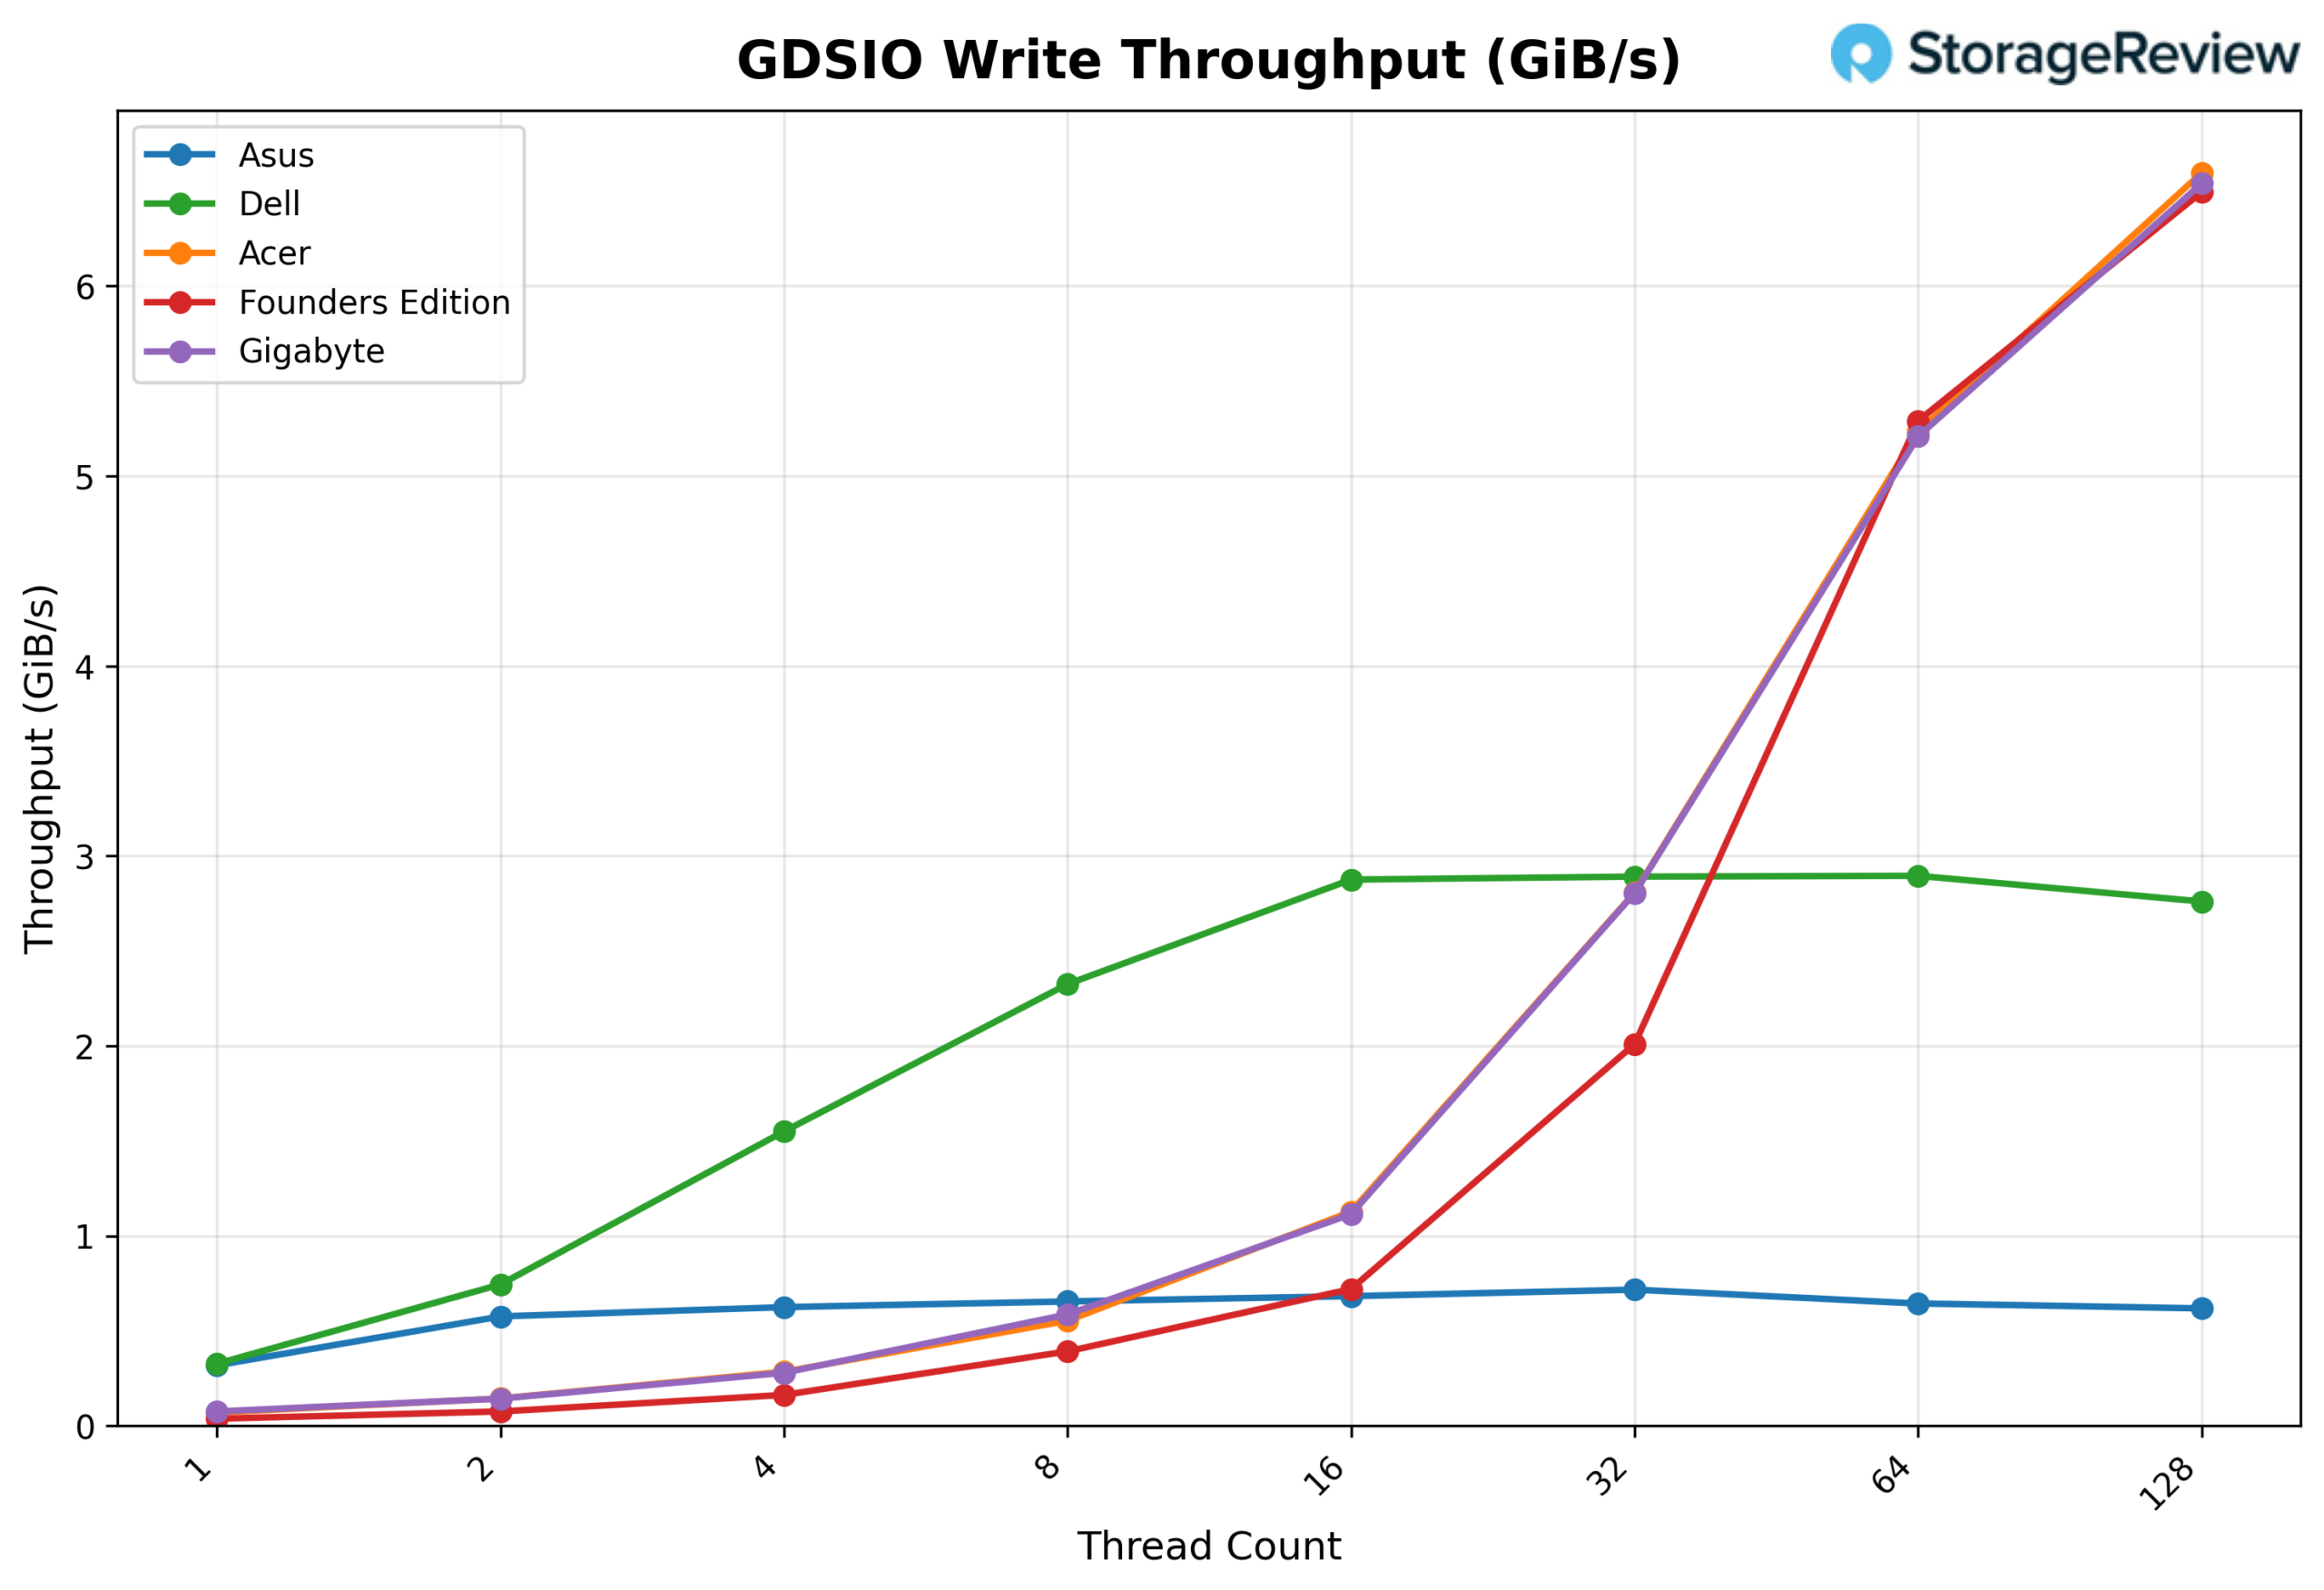
GSDIO ရေးသားမှုပမာဏ ၁၆K
GDSIO Write Throughput 16K ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread 1 ခုမှာ 0.32 GiB/s ကနေစတင်ပြီး thread 2 ခုမှာ 0.58 GiB/s နဲ့ thread 4 ခုမှာ 0.62 GiB/s အထိ တိုးလာပါတယ်။ စွမ်းဆောင်ရည်ဟာ thread 8 ခု (0.65 GiB/s) နဲ့ thread 16 ခု (0.68 GiB/s) မှာ ဆက်လက်မြင့်တက်နေပြီး thread 32 ခု (0.72 GiB/s) မှာ အသင့်အတင့်အမြင့်ဆုံးကို ရောက်ရှိနေပါတယ်။ thread 64 ခု (0.64 GiB/s) နဲ့ thread 128 ခု (0.62 GiB/s) မှာ အနည်းငယ်ကျဆင်းသွားပြီး thread sweep ရဲ့ အပေါ်ပိုင်းမတိုင်ခင်မှာ platform ဟာ write saturation point ကို ရောက်ရှိနေပြီဆိုတာကို ညွှန်ပြနေပါတယ်။
GDSIO ရေးသားမှုပျမ်းမျှနှောင့်နှေးမှု 16K
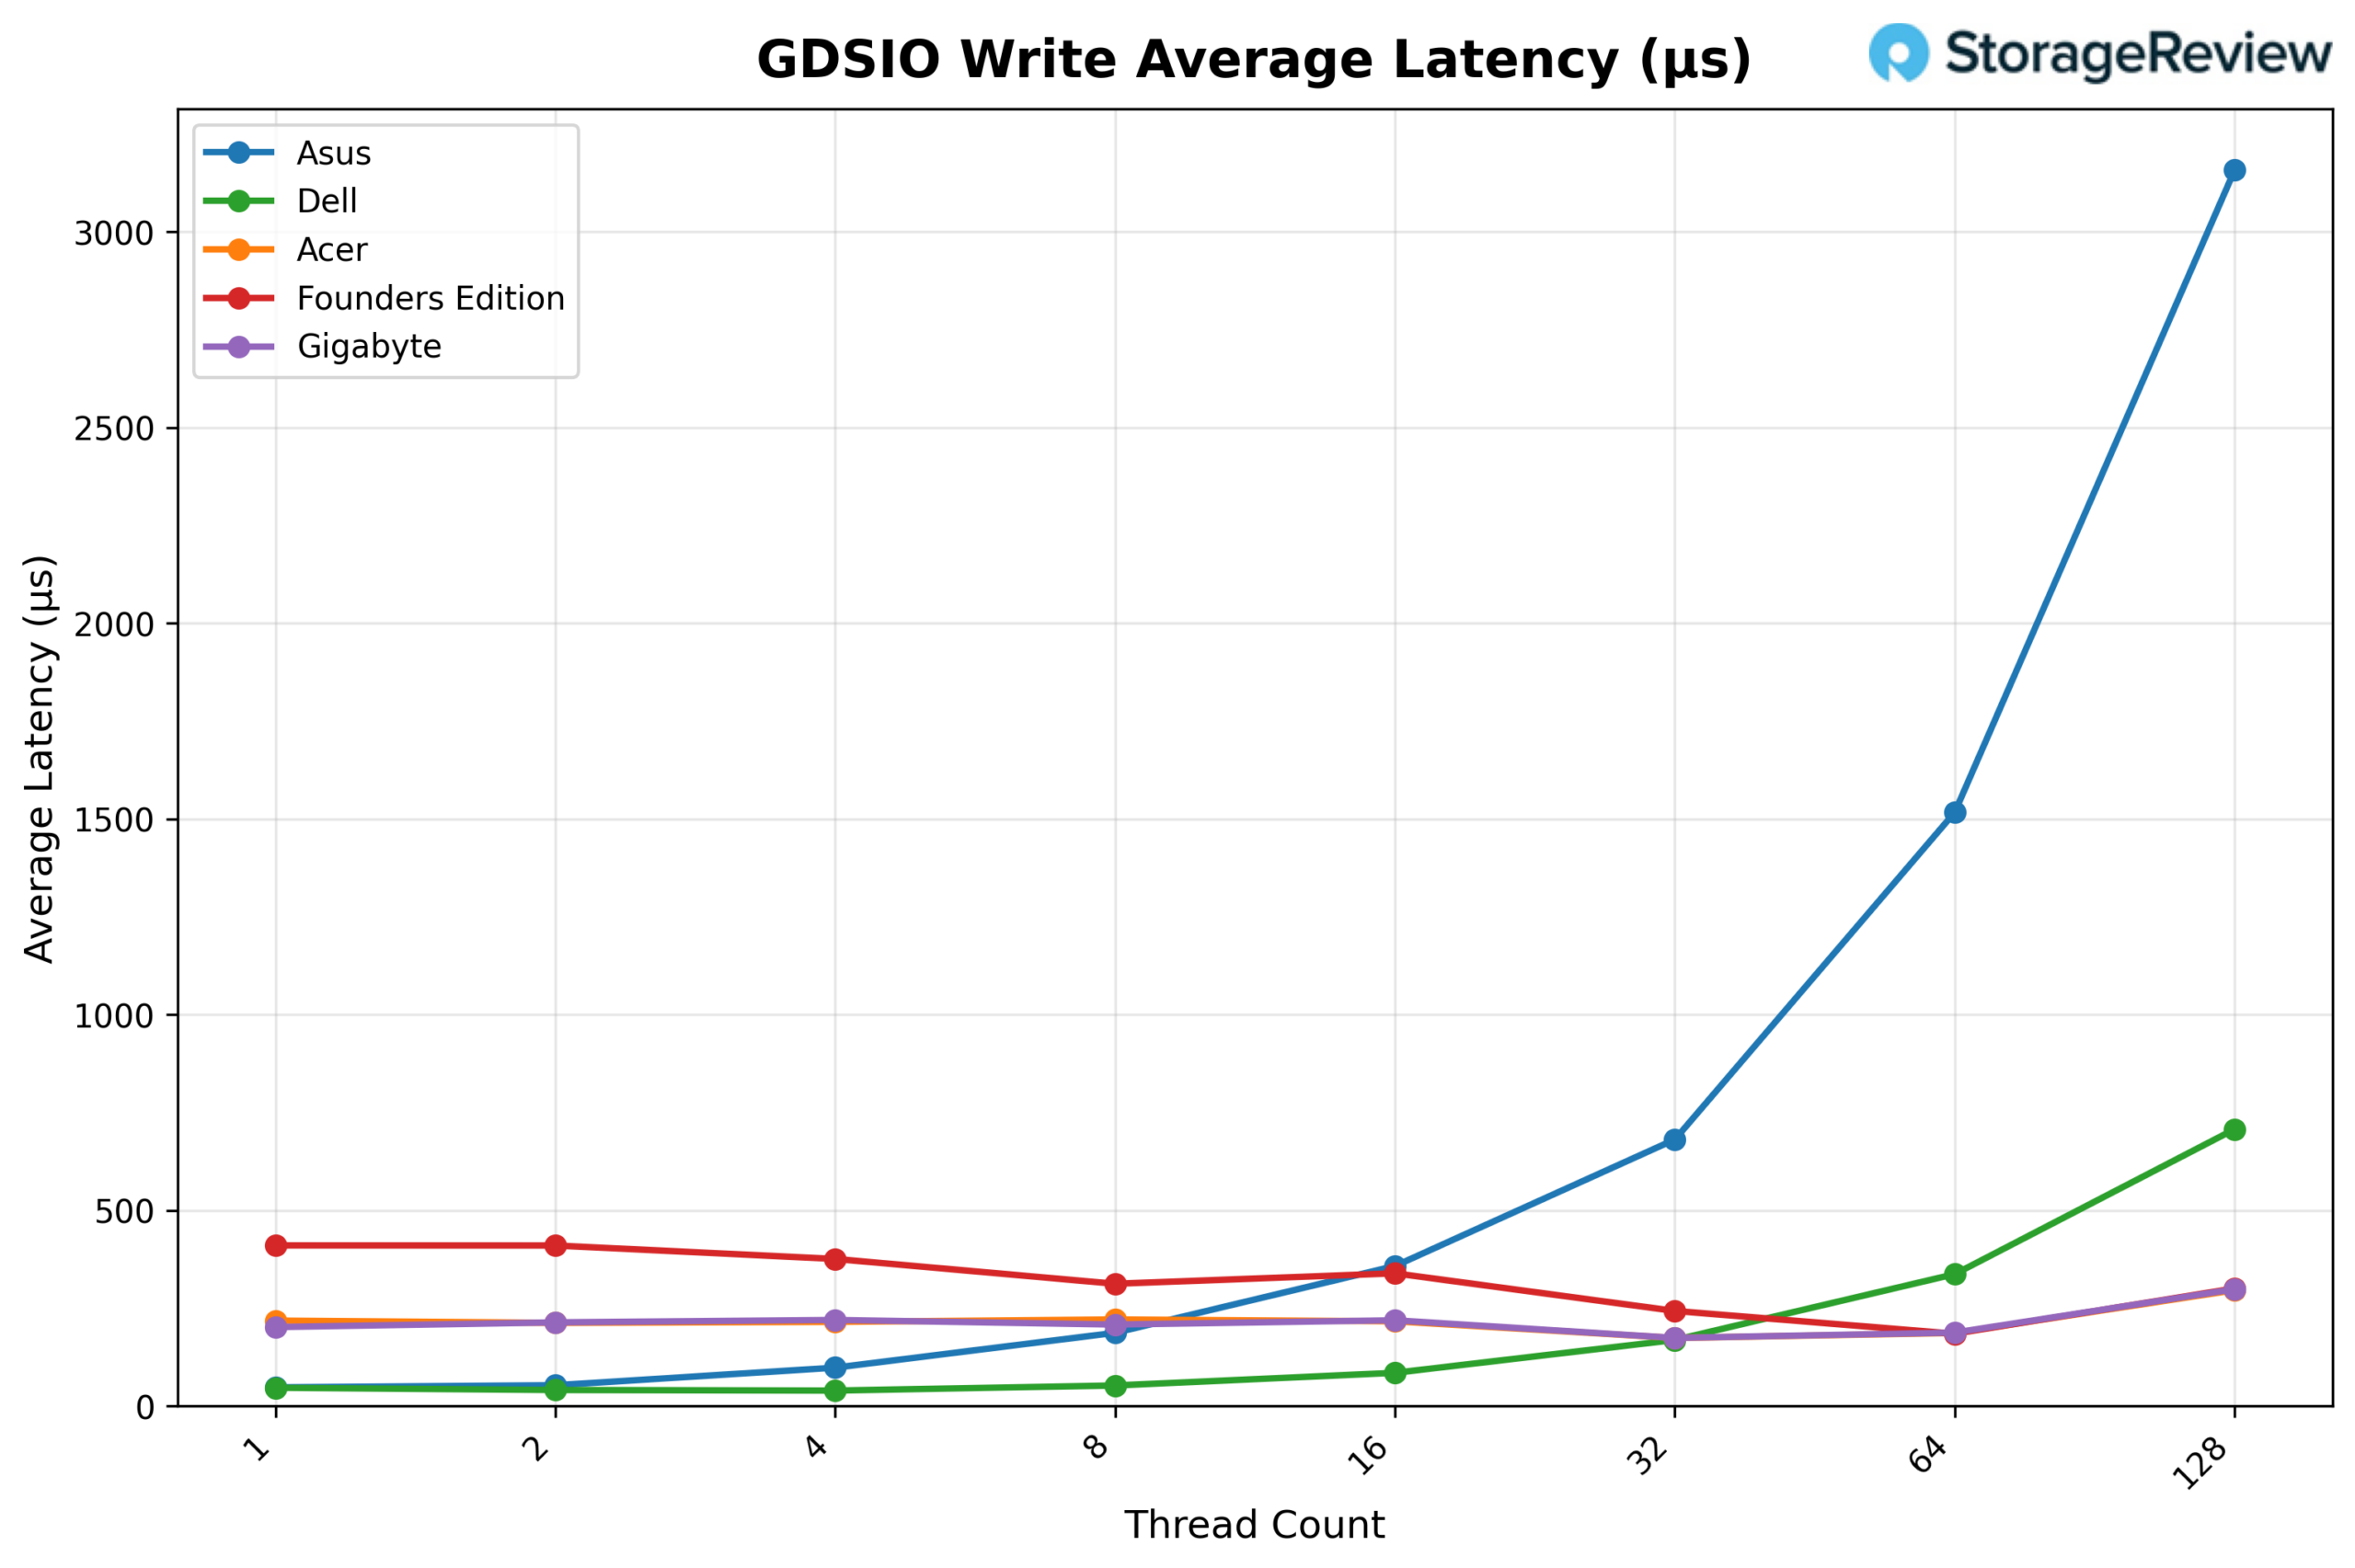
GDSIO Write Average Latency (16K) ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread ၁ ခုမှာ ၀.၀၅ ms လောက်ကနေစပြီး thread ၂ ခု (၀.၀၅ ms) နဲ့ thread ၄ ခု (၀.၁၀ ms) မှာ အလွန်နည်းနေပါတယ်။ Latency ဟာ thread ၈ ခု (၀.၁၉ ms) နဲ့ thread ၁၆ ခု (၀.၃၆ ms) မှာ အနည်းငယ်တက်လာပြီး thread ၃၂ ခု (၀.၆၈ ms) နဲ့ thread ၆၄ ခု (၁.၅၂ ms) မှာ မြင့်တက်လာပါတယ်။ thread ၁၂၈ ခုမှာ latency က ၃.၁၆ ms အထိရောက်ရှိပြီး ၁M ရလဒ်တွေနဲ့ နှိုင်းယှဉ်ရင် အတော်လေး တည်ငြိမ်နေပေမယ့် thread အရေအတွက် ပိုများတဲ့အခါ throughput plateau မြင့်တက်လာတာနဲ့ ကိုက်ညီပါတယ်။
GDSIO ဖတ်ရှုမှုပမာဏ 1M
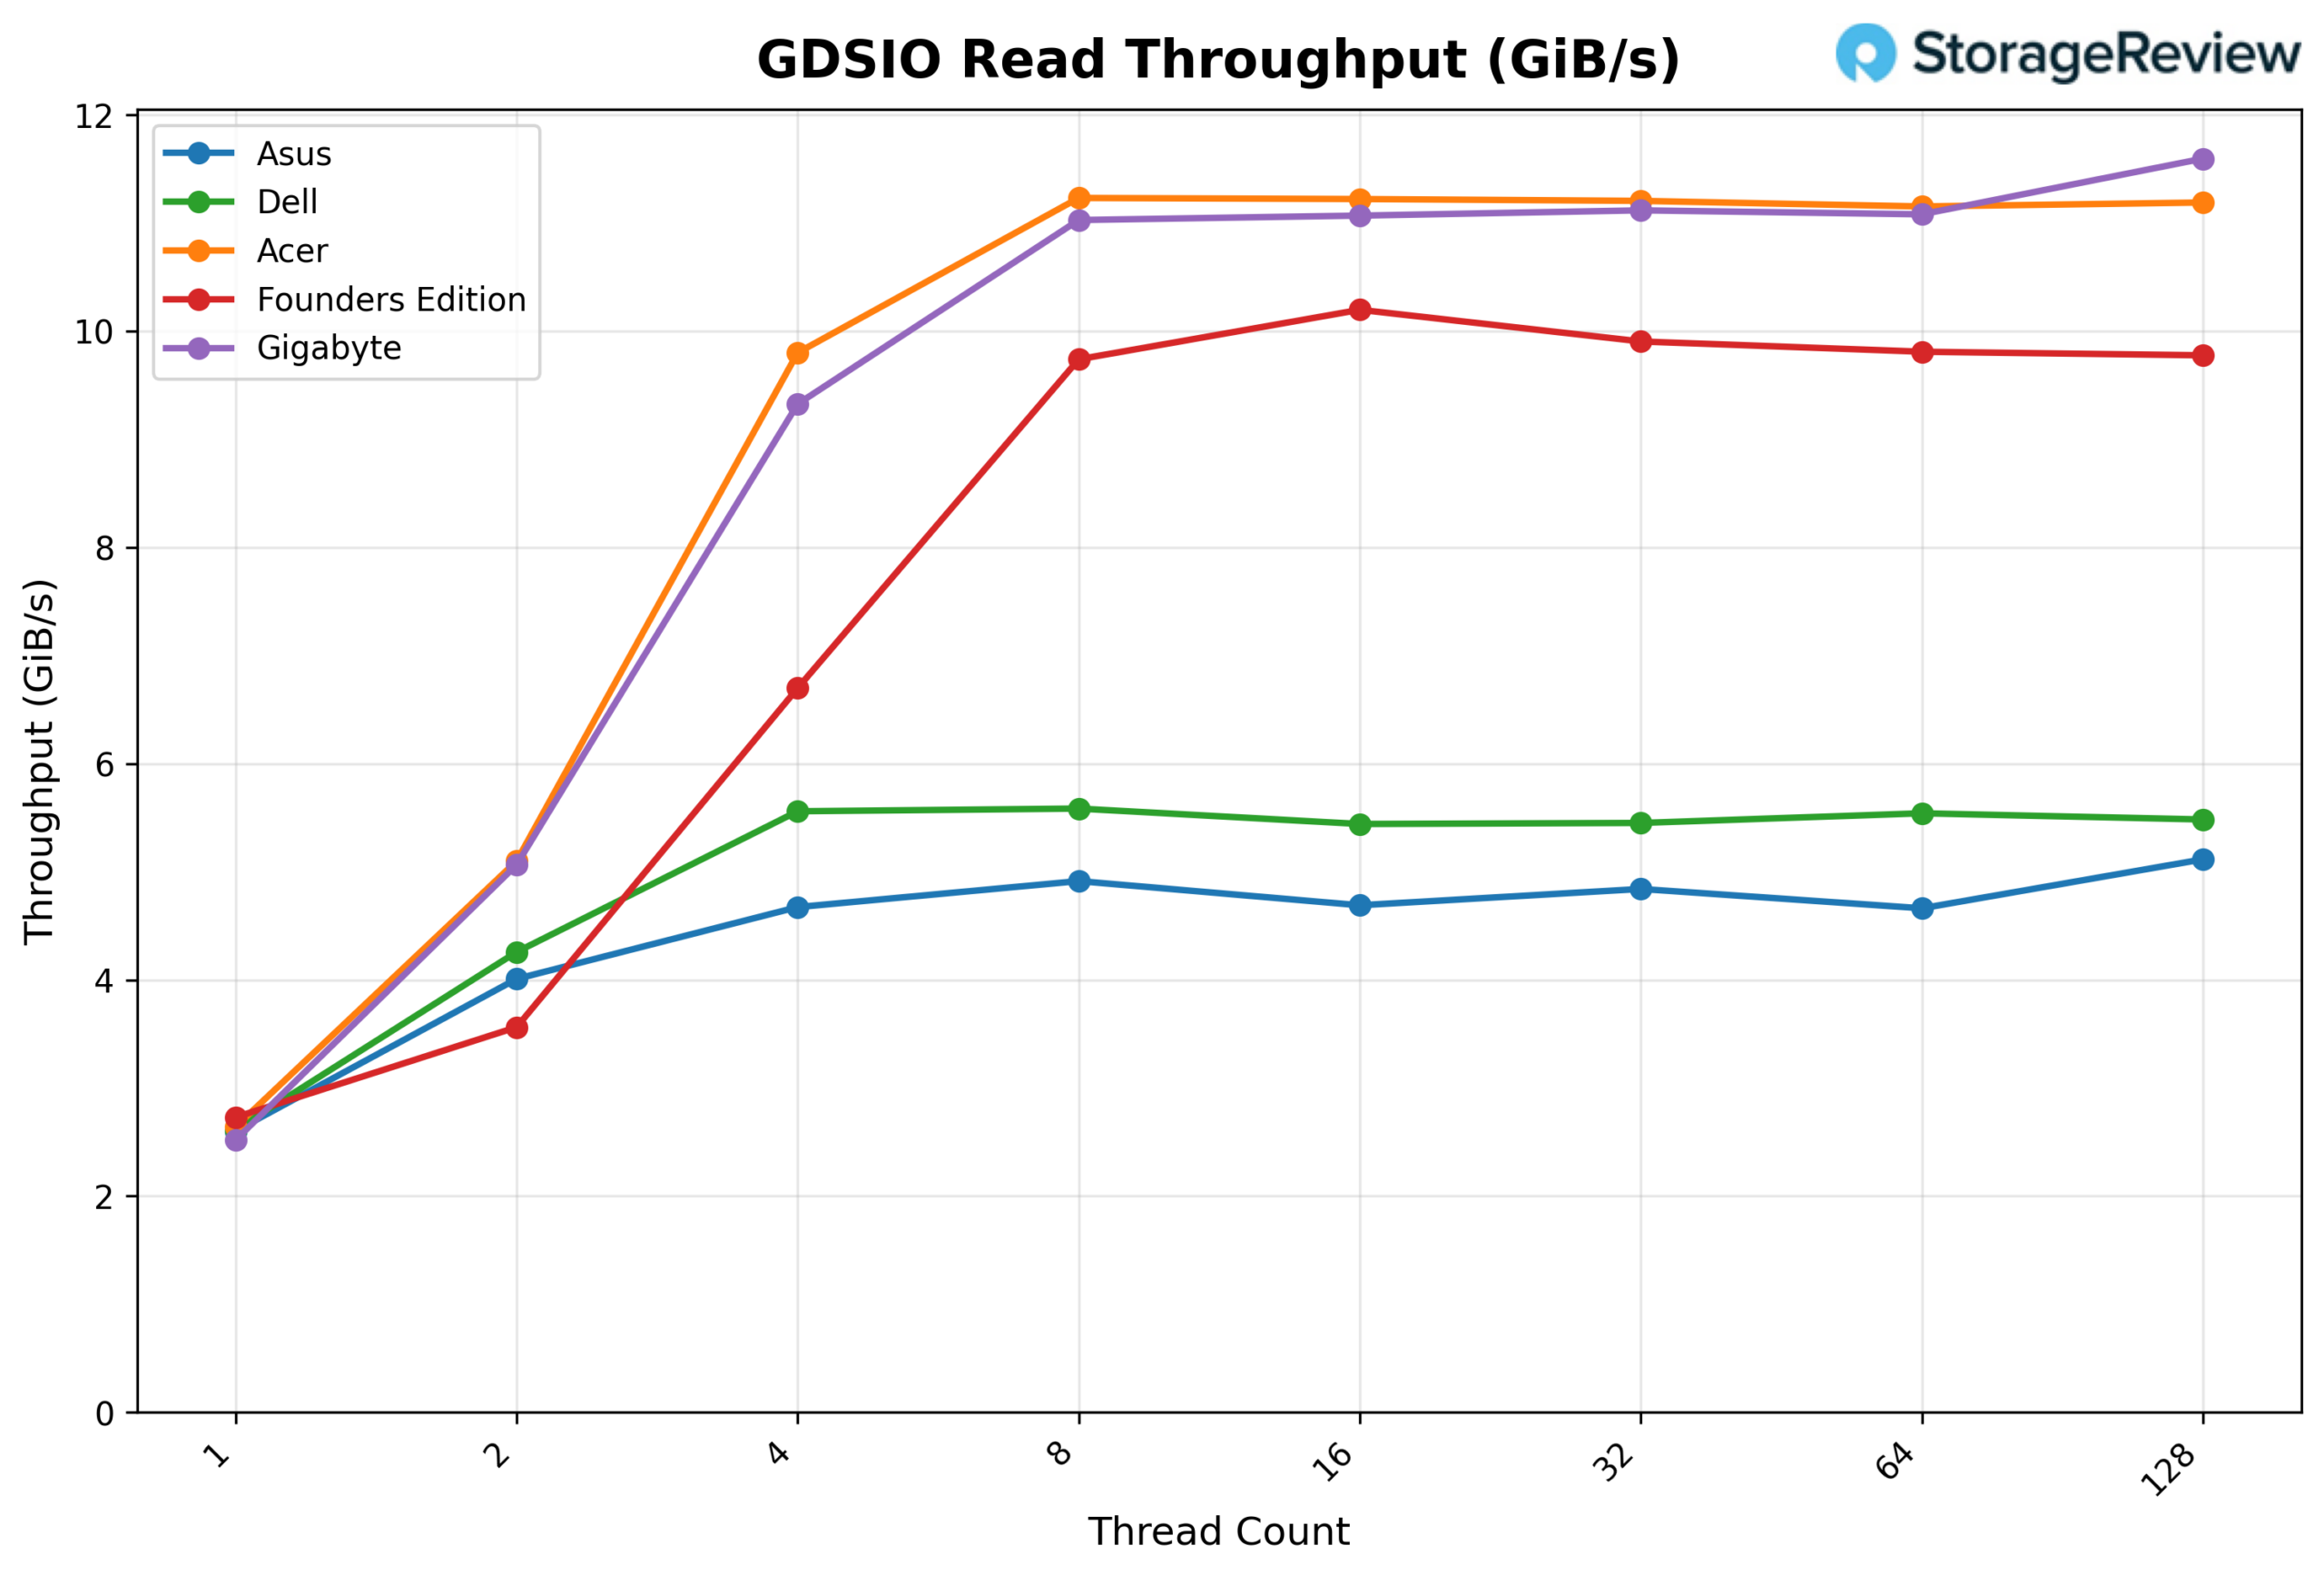
GDSIO Read Throughput 1M ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread တစ်ခုမှာ 2.60 GiB/s ကနေစတင်ပြီး thread နှစ်ခုမှာ 4.01 GiB/s အထိ သိသိသာသာ ခုန်တက်သွားပါတယ်။ စွမ်းဆောင်ရည်ဟာ thread လေးခု (4.67 GiB/s) နဲ့ thread ရှစ်ခု (4.91 GiB/s) မှာ ဆက်လက်မြင့်တက်နေပြီး အဲဒီနောက်မှာ platform ဟာ ထိရောက်စွာ ပြည့်နှက်သွားပါတယ်။ Thread ဆယ့်ခြောက်ခု (4.69 GiB/s)၊ thread ၃၂ ခု (4.84 GiB/s) နဲ့ thread ပေါင်း ၆၄ ခု (4.66 GiB/s) မှာ throughput ဟာ တသမတ်တည်းရှိနေပြီး တည်ငြိမ်တဲ့ နှုန်းထားကို ပြသနေပါတယ်။ thread ဆယ့်ရှစ်ခုမှာ throughput ဟာ 5.12 GiB/s အထိ ရောက်ရှိပြီး sweep မှာ အမြင့်ဆုံး တွေ့ရှိရတဲ့ ရလဒ်ကို အမှတ်အသားပြုပါတယ်။
GDSIO ဖတ်ရှုမှု ပျမ်းမျှ နှောင့်နှေးမှု 1M
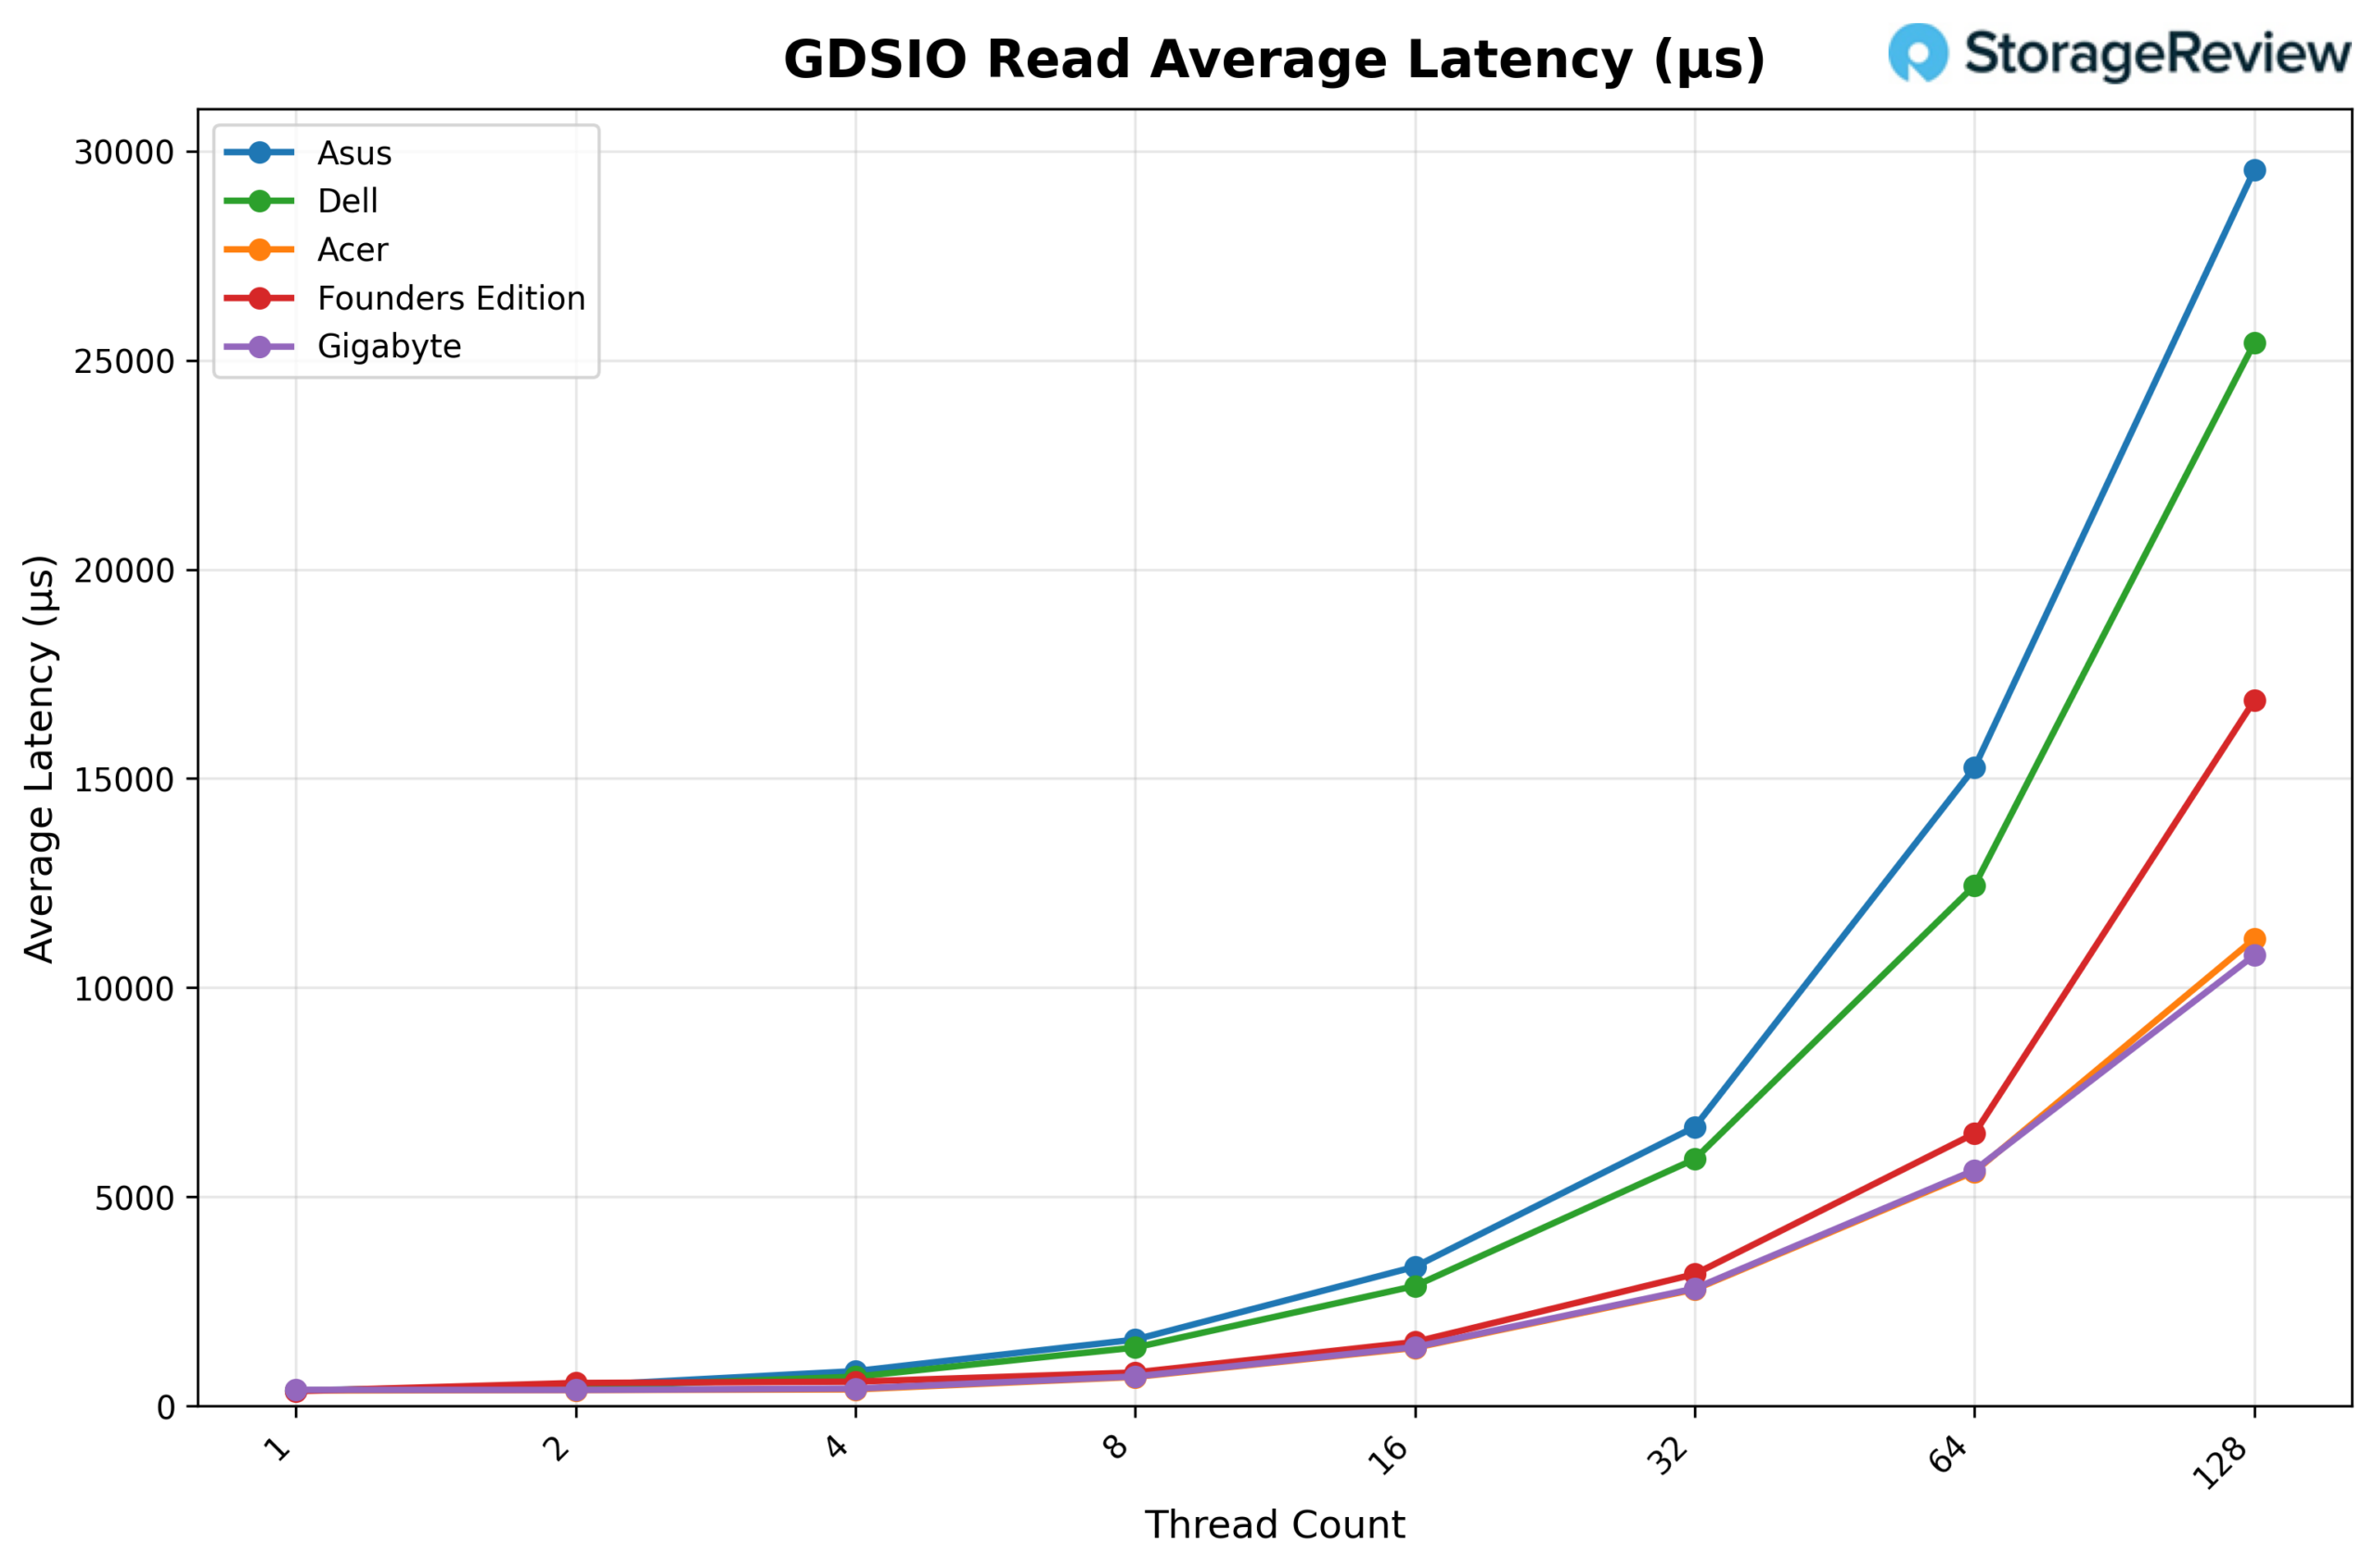
GDSIO Read Average Latency (1M) ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread 1 မှာ 0.38ms လောက်ကနေစပြီး thread 2 (0.49ms) နဲ့ thread 4 (0.84ms) မှာ နိမ့်နေပါသေးတယ်။ Latency ဟာ တစ်ပြိုင်နက်တည်းဖြစ်ပေါ်မှုနဲ့အတူ တိုးလာပြီး thread 8 မှာ 1.59ms၊ thread 16 မှာ 3.33ms နဲ့ thread 32 မှာ 6.67ms အထိ မြင့်တက်လာပါတယ်။ thread 64 (15.26ms) မှာ အတက်ဘက်လမ်းကြောင်းက ဆက်လက်ရှိနေပြီး thread 128 မှာ 29.54ms အထိ ရောက်ရှိခဲ့ပြီး အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းဖြစ်ပေါ်မှုအဆင့်တွေနဲ့ ကိုက်ညီပေမယ့် throughput ကတော့ အများအားဖြင့် ထိန်းသိမ်းထားပါတယ်။
GDSIO ရေးသားမှုပမာဏ 1M
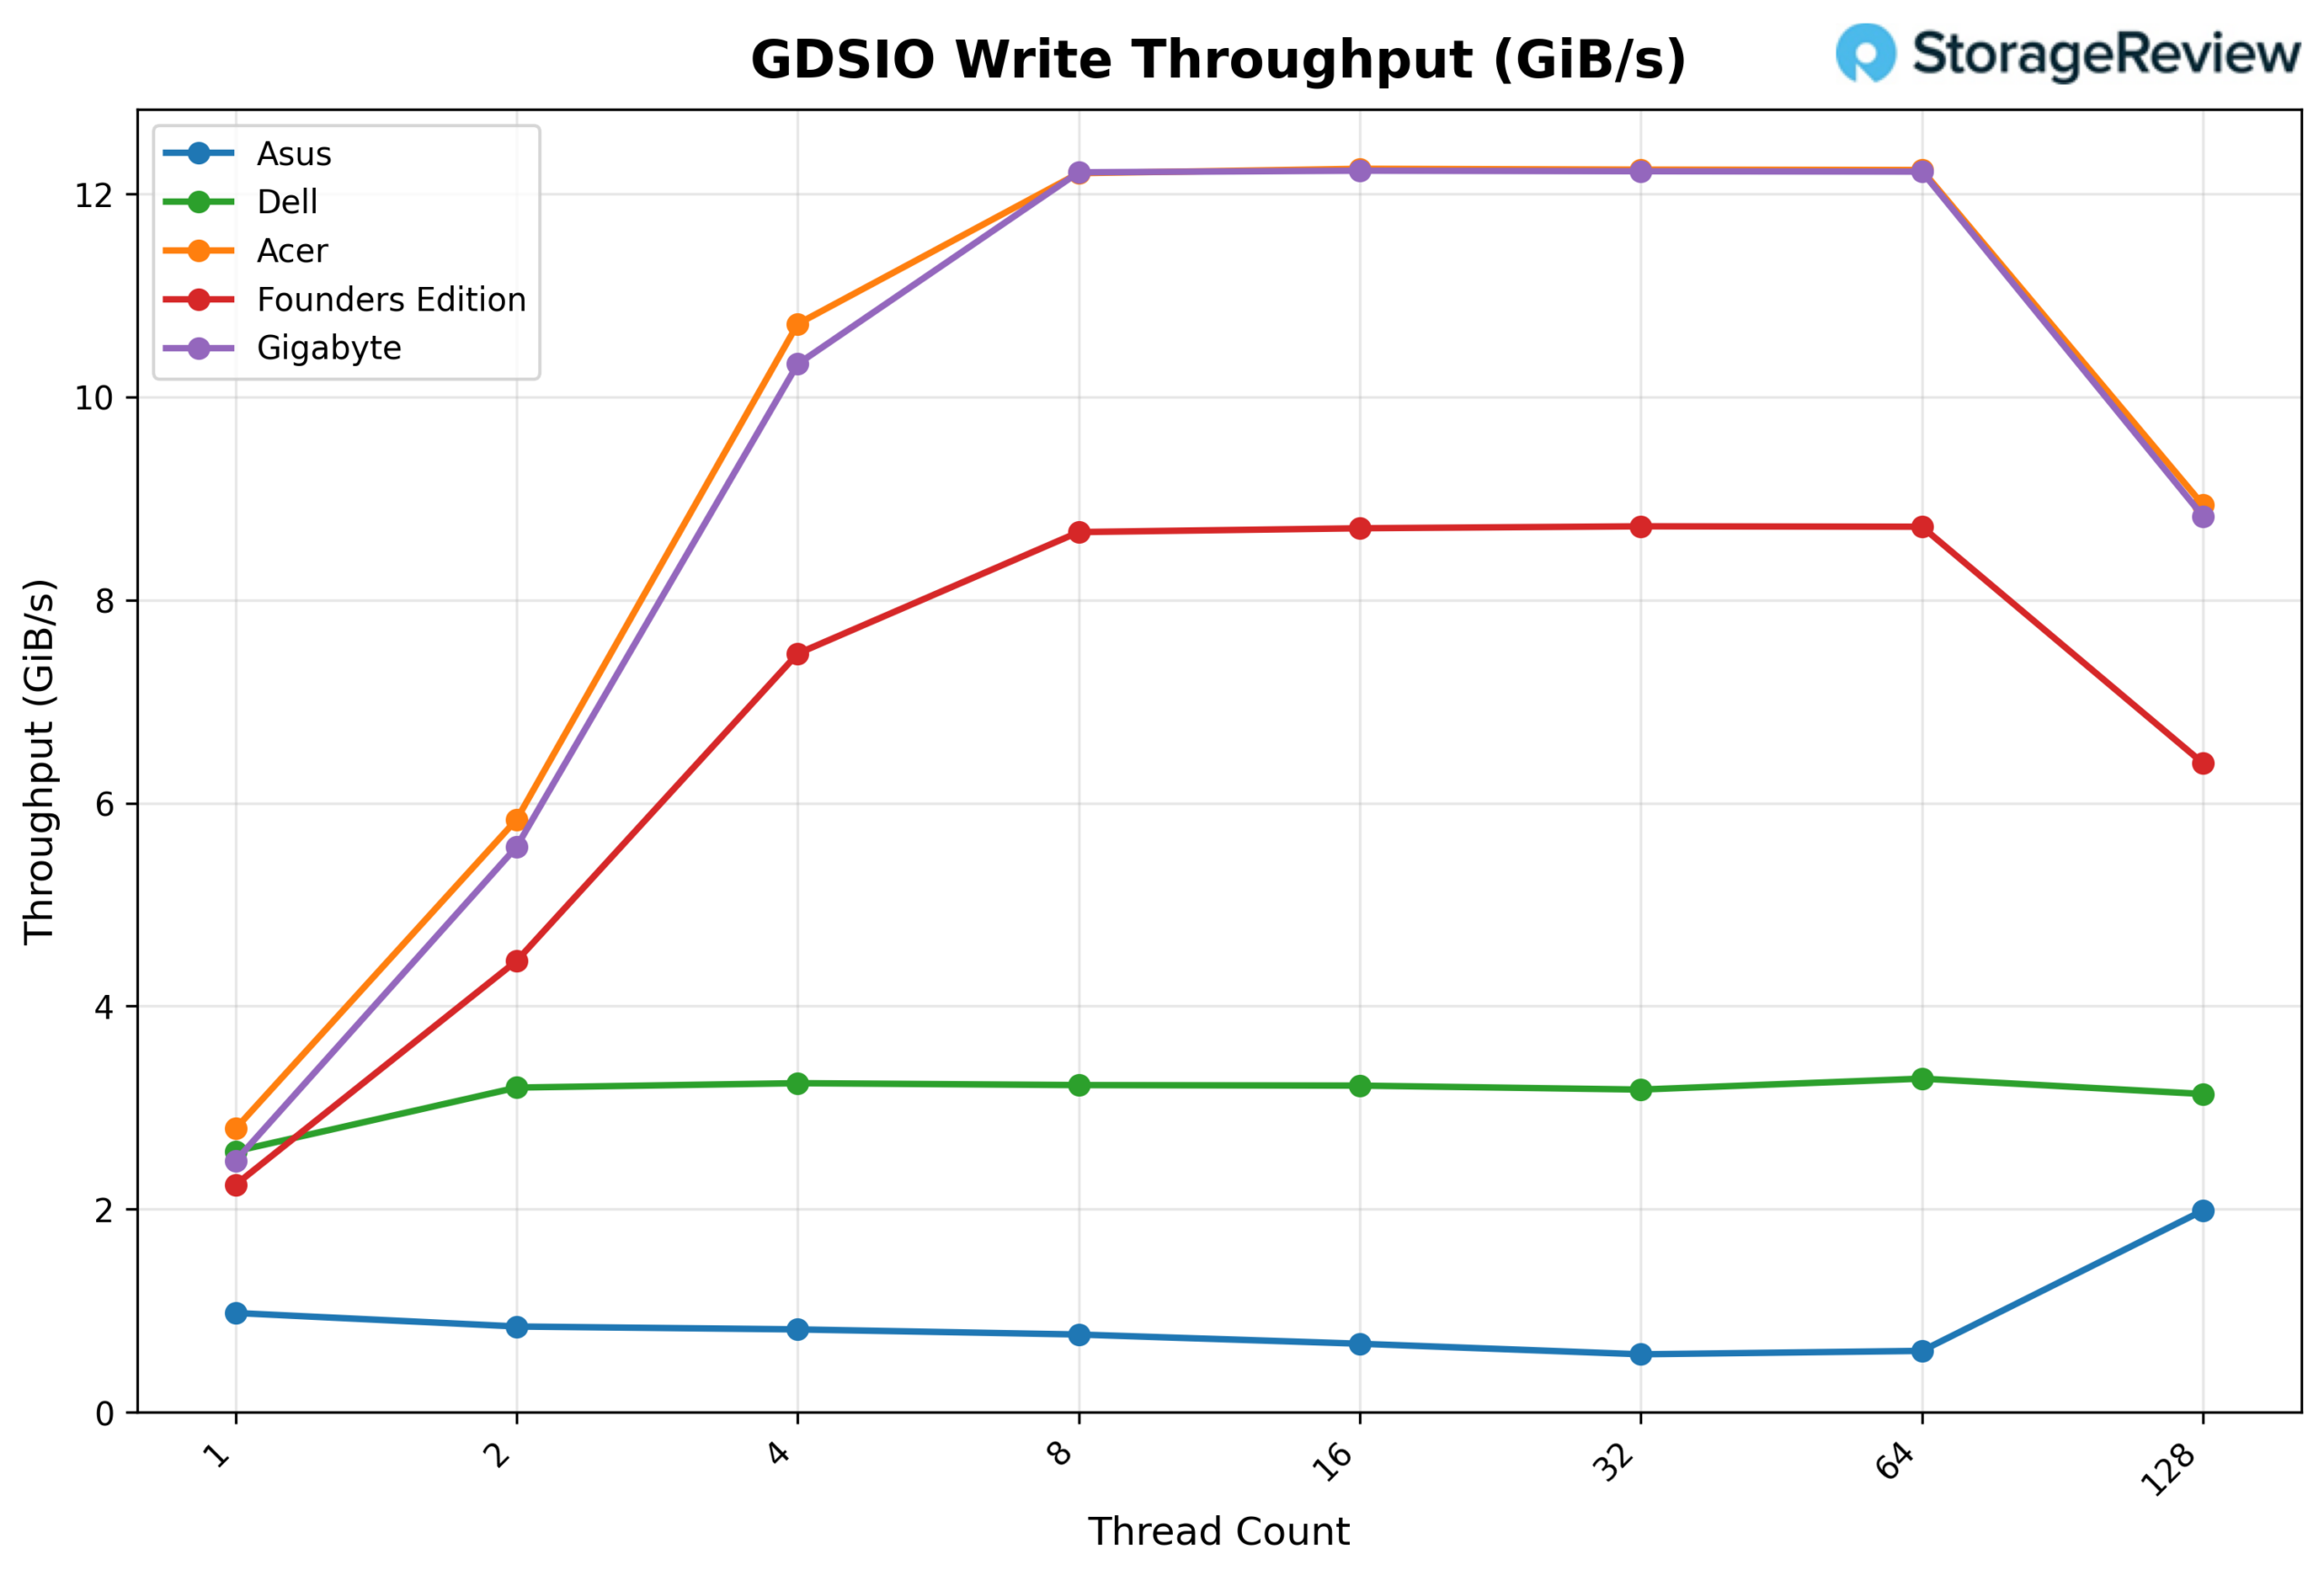
GDSIO Write Throughput 1M ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread 1 မှာ 0.98 GiB/s ကနေစတင်ပြီး thread 2 ခု (0.85 GiB/s) နဲ့ thread 4 ခု (0.82 GiB/s) မှာကျဆင်းသွားပြီးနောက် thread 8 ခု (0.77 GiB/s) နဲ့ thread 16 ခု (0.68 GiB/s) မှာဆက်လက်ကျဆင်းသွားပါတယ်။ thread 64 ခု (0.61 GiB/s) မှာအနည်းငယ်ပြန်လည်ကောင်းမွန်လာပြီးနောက် thread 32 ခု (0.57 GiB/s) မှာစွမ်းဆောင်ရည်ဆက်လက်ကျဆင်းသွားပါတယ်။ thread 128 ခုမှာ throughput 1.99 GiB/s အထိမြင့်တက်လာပေမယ့် ಒಟ್ಟಾರೆ write scaling pattern က sweep တစ်လျှောက်မှာသိသာထင်ရှားတဲ့ပြိုင်ဆိုင်မှုကိုညွှန်ပြနေပါတယ်။
GDSIO ရေးသားမှုပျမ်းမျှ နှောင့်နှေးမှု 1M
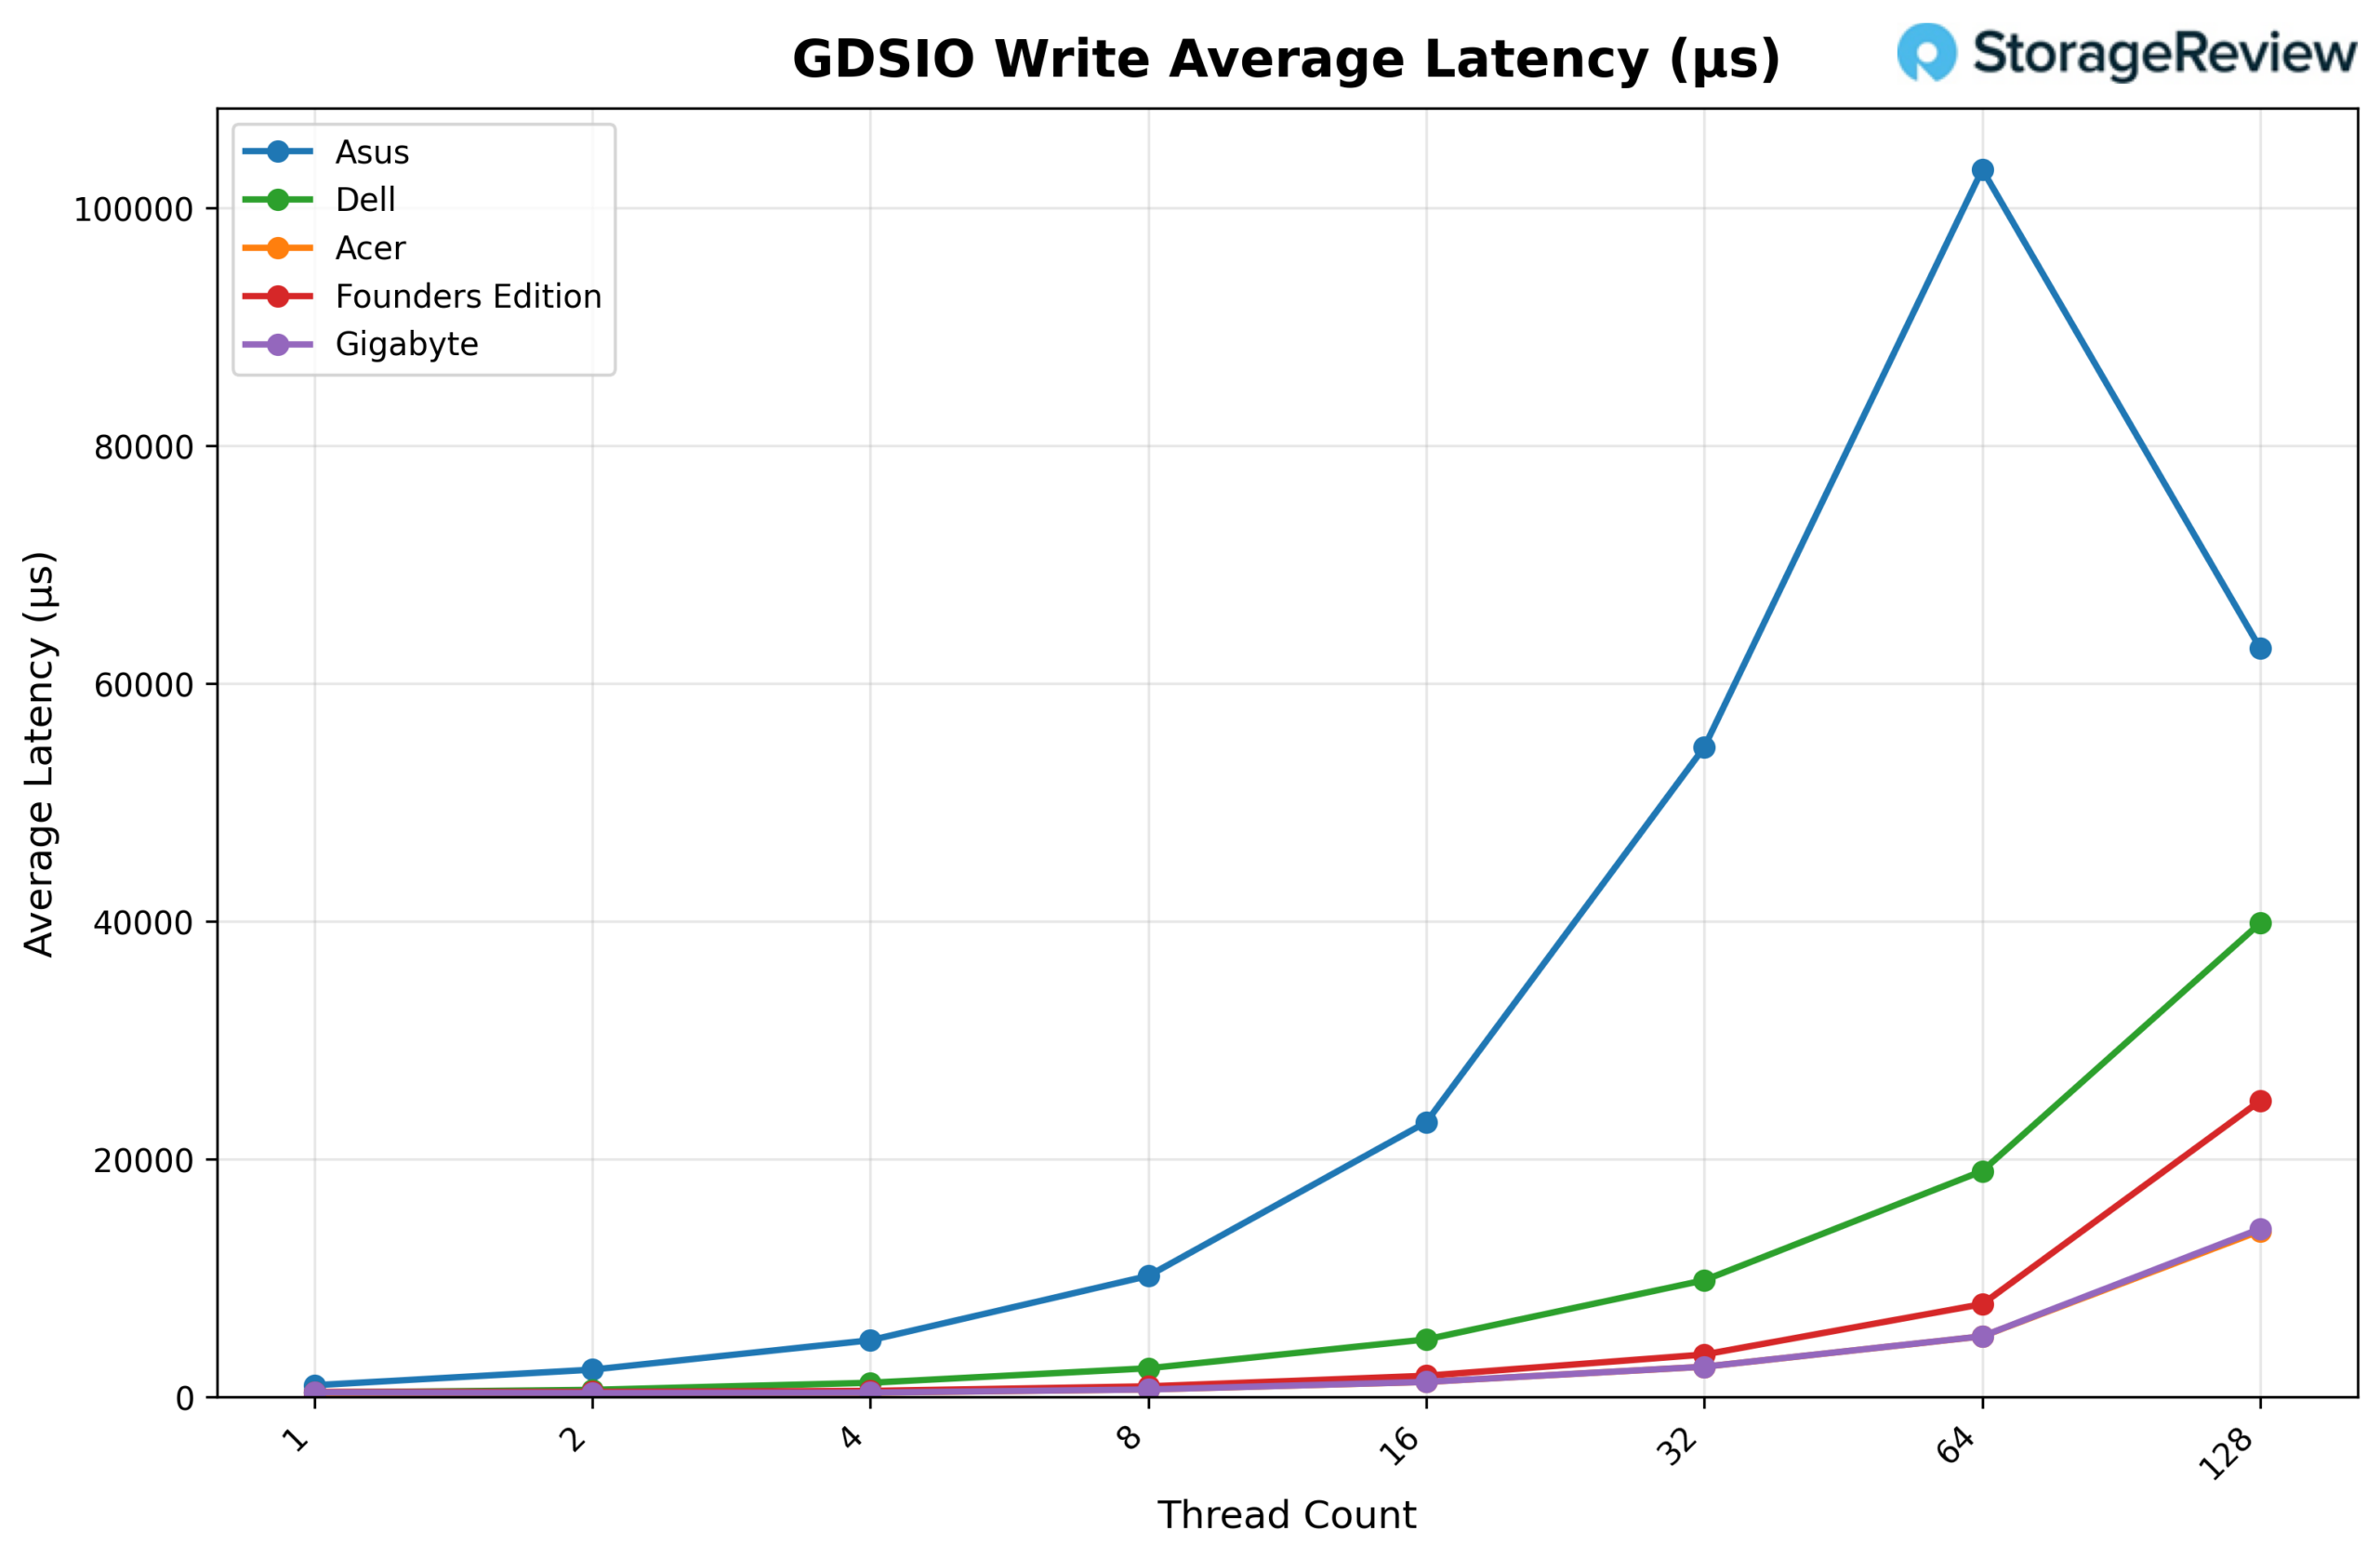
GDSIO Write Average Latency (1M) ကိုကြည့်မယ်ဆိုရင် ASUS ဟာ thread 1 မှာ 1.00ms လောက်ကနေစပြီး thread 2 မှာ 2.31ms နဲ့ thread 4 မှာ 4.78ms အထိ မြင့်တက်လာပါတယ်။ တစ်ပြိုင်နက်တည်းလုပ်ဆောင်နိုင်မှု မြင့်တက်လာတာနဲ့အမျှ Latency ဟာ သိသိသာသာ မြင့်တက်လာပြီး thread 8 မှာ 10.19ms၊ thread 16 မှာ 23.12ms နဲ့ thread 32 မှာ 54.67ms အထိ ရောက်ရှိလာပါတယ်။ thread 64 (103.25ms) မှာ အတက်ဘက်လမ်းကြောင်းဟာ သိသိသာသာ ဆက်လက်တည်ရှိနေပြီး thread 128 မှာ 62.97ms အထိ ပြန်လည်ကျဆင်းသွားကာ အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းလုပ်ဆောင်နိုင်မှုမှာ တွေ့ရှိရတဲ့ တစ်စိတ်တစ်ပိုင်း throughput ပြန်လည်ကောင်းမွန်လာမှုနဲ့ ကိုက်ညီပါတယ်။
ကောက်ချက်
ASUS Ascent GX10 သည် NVIDIA ၏ GB10-based Spark platform ကို အခြေခံထားသည့် နောက်ထပ်ဗားရှင်းတစ်ခုဖြစ်ပြီး stack တစ်လျှောက်တွင် ကျွန်ုပ်တို့စမ်းသပ်ခဲ့သည့် underlying board နှင့် silicon ပေါ်တွင် အခြေခံထားသည်။ ဆိုလိုသည်မှာ core compute လုပ်ဆောင်ချက်သည် အများအားဖြင့် တသမတ်တည်းရှိပြီး vLLM စမ်းသပ်မှုတွင် GX10 သည် GPT-OSS၊ Qwen3-Coder နှင့် Llama 3.1 မော်ဒယ်များတစ်လျှောက် အခြား Spark စနစ်များနှင့် အနီးကပ်ခြေရာခံနိုင်ခဲ့သည်။ Scaling လုပ်ဆောင်ချက်သည် ကြိုတင်ခန့်မှန်းနိုင်ခဲ့ပြီး Prefill-heavy throughput အားကောင်းပြီး batch size မြင့်မားသောအခါတွင် တည်ငြိမ်သော gains များဖြင့် ရှိနေခဲ့သည်။
အပူချိန်အရ GX10 သည် burst phase များအတွင်း အုပ်စု၏ နွေးထွေးသောဘက်သို့ ရွေ့လျားခဲ့ပြီး CPU သည် 87.3°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး GPU သည် 82°C တွင် ကြာရှည်သော workloads များအောက်တွင် တည်ငြိမ်သွားခဲ့သည်။ NVMe နှင့် NIC thermals များသည် မျှော်မှန်းထားသော လည်ပတ်မှုအတိုင်းအတာအတွင်း ရှိနေခဲ့ပြီး set တွင် အနိမ့်ဆုံး peak နံပါတ်များ မပါဝင်သည့်တိုင် chassis သည် လေစီးဆင်းမှုကို လုံလောက်စွာ ကိုင်တွယ်နေကြောင်း ညွှန်ပြနေသည်။
GPU Direct Storage သည် အသိသာဆုံး ကွဲလွဲမှုအမှတ်ဖြစ်ပြီး ပါဝင်သော 1TB Gen4 SSD ၏ အဓိကလွှမ်းမိုးမှုခံရသည်။ Read scaling သည် လုပ်ဆောင်နိုင်သော်လည်း အုပ်စု၏ အောက်ဆုံးသို့ ရောက်ရှိခဲ့ပြီး write throughput သည် အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းတွင် latency မြင့်မားခြင်းဖြင့် စောစီးစွာ ရပ်တန့်သွားခဲ့သည်။ ပိုမိုကောင်းမွန်သော SSD သည် ဤယူနစ်တွင် သိသိသာသာ အထောက်အကူဖြစ်စေပါလိမ့်မည်။
Spark စနစ်အားလုံးသည် တူညီသော board နှင့် GB10 Superchip ကို မျှဝေအသုံးပြုကြသောကြောင့် စွမ်းဆောင်ရည်ကွာခြားချက်များသည် တဖြည်းဖြည်းချင်း ဖြစ်ပေါ်လာပါသည်။ လက်တွေ့တွင် ဆုံးဖြတ်ချက်ချခြင်းသည် raw compute စွမ်းရည်ထက် storage configuration၊ thermals၊ physical design နှင့် vendor alignment တို့အပေါ် မူတည်ပါသည်။
ထုတ်ကုန်စာမျက်နှာ – ASUS Ascent GX10
ဦးဆောင်သူစာရင်း- ASUS Ascent GX10 သည် ကျွန်ုပ်တို့၏ ဒေသတွင်း AI အတွက် အကောင်းဆုံး ဒက်စ်တော့များ စာရင်းတွင် စမ်းသပ်ထားသော အစိတ်အပိုင်းတစ်ခုဖြစ်သည်။


 အမေဇုံ