

Comino ကတော့ မသိသေးသူတွေအတွက် အရည်အအေးပေးဆာဗာတွေမှာ နယ်ပယ်တစ်ခုကို ထွင်းထုထားပြီး စွယ်စုံရပြီး ထိရောက်တဲ့ workstation တွေနဲ့ server တွေကို ဖန်တီးနေတဲ့ ကုမ္ပဏီတစ်ခုပါ။ ဒီသုံးသပ်ချက်မှာ Comino Grando Server နဲ့ Workstation ရဲ့ flagship system တွေကို လေ့လာကြည့်ပါမယ်။ ဒီစနစ်တွေကို ၁၉ လက်မ rack-mountable unit အနေနဲ့ရော standalone desktop အနေနဲ့ပါ လုပ်ဆောင်နိုင်အောင် ဒီဇိုင်းထုတ်ထားပြီး high-performance computing လိုအပ်ချက်အမျိုးမျိုးကို ဖြည့်ဆည်းပေးပါတယ်။ data analysis၊ graphic design၊ gaming ဒါမှမဟုတ် တခြားခက်ခဲတဲ့ အလုပ်တွေပဲဖြစ်ဖြစ် ဒီဆာဗာတွေကို စွမ်းဆောင်ရည်၊ ယုံကြည်စိတ်ချရမှုနဲ့ အအေးပေးစနစ်တွေကို ပေးစွမ်းနိုင်အောင် တည်ဆောက်ထားပါတယ်။
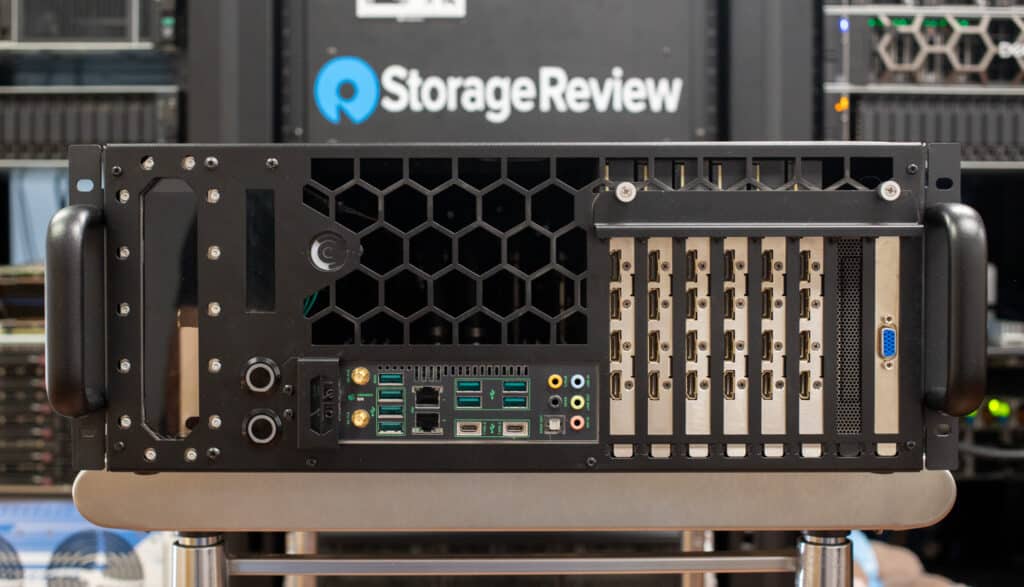
Comino Grando 6x NVIDIA 4090 စနစ်
ဤ Grando စနစ်များ၏ “အေးမြသောအချက်” ကို ချဲ့ကားပြောရန် မဖြစ်နိုင်ပါ။ ၎င်းတို့သည် ပါဝါနှင့် စွမ်းဆောင်ရည်ကို ထုတ်ဖော်ပြသပြီး အကောင်းဆုံးအပူချိန်ကို ထိန်းသိမ်းရန် ခေတ်မီအရည်အအေးပေးနည်းပညာများကို ချောမွေ့စွာပေါင်းစပ်ထားသည်။ ၎င်းသည် ပင်ပန်းသောအလုပ်များအောက်တွင်ပင် အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို သေချာစေပြီး အေးမြမှုကို တိုက်ရိုက်နှင့် ပုံဆောင်သဘောဆောင်သော ဂုဏ်သတ္တိတစ်ခုဖြစ်စေသည်။ အအေးပေးပလက်ဖောင်းဒီဇိုင်းသည် အရည်အအေးပေးခြင်းမရှိပါက မဖြစ်နိုင်သော GPU သိပ်သည်းဆများကိုလည်း ဖြစ်စေသည်။ ဥပမာအားဖြင့် Grando Server တွင် Comino သည် NVIDIA 4090 GPU ခြောက်ခုကို ဘေးချင်းယှဉ်ထားနိုင်ပြီး လေဖြင့်အအေးပေး၍မရပါ။ အရည်အအေးပေးဒီဇိုင်းသည် slot အကျယ်တစ်ခုရှိပြီး stock air-cooled အပိုင်းသည် နှစ်ဆအကျယ်ရှိသည်။
Server နှင့် Workstation မော်ဒယ်များကို အလွန်စိတ်ကြိုက်ပြင်ဆင်နိုင်ပြီး အစွမ်းထက်သော multi-core processors (AMD Threadripper PRO)၊ 1TB အထိ မန်မိုရီဖွဲ့စည်းပုံများနှင့် ကြီးမားသော သိုလှောင်မှုစွမ်းရည်များ အပါအဝင် ရွေးချယ်စရာများစွာကို ပေးဆောင်ပါသည်။ အသုံးပြုသူများသည် NVIDIA RTX A6000 (48GB), NVIDIA RTX 6000 ADA (46GB), NVIDIA H100 (80GB), NVIDIA A100 (80GB), NVIDIA L40s (48GB) နှင့် NVIDIA RTX 4090 (24GB) အပါအဝင် ထိပ်တန်းပရော်ဖက်ရှင်နယ် GPU ခြောက်ခုအထိ ထည့်သွင်းရန် ရွေးချယ်ခွင့်လည်း ရှိပါသည်။ ၎င်းသည် Comino Grando ကို ပါဝါနှင့် ယုံကြည်စိတ်ချရမှုကို ကတိပြုသည့် ခိုင်မာသော ကွန်ပျူတာဖြေရှင်းချက်များကို ရှာဖွေနေသော ပရော်ဖက်ရှင်နယ်များနှင့် စီးပွားရေးလုပ်ငန်းများအတွက် ခိုင်မာသောရွေးချယ်မှုတစ်ခု ဖြစ်စေပါသည်။
Comino ရဲ့ အရည်အအေးပေးစနစ်နှစ်ခုကို စမ်းသပ်ခွင့်ရခဲ့ပါတယ်။ Grando Server ကနေစပြီး ကျွန်တော်တို့ရဲ့ configuration မှာ NVIDIA RTX 4090 ခြောက်လုံး တပ်ဆင်ထားပါတယ်။ ဒါ့အပြင် AMD ရဲ့ Threadripper PRO 5995WX CPU ( Lenovo ThinkStation P620 ထဲမှာ မြင်တွေ့ခဲ့ရတဲ့ 64-core processor )၊ 512GB DDR5 DRAM၊ 2TB NVMe SSD နဲ့ ပါဝါပြတ်တောက်မှုတွေကို ခံနိုင်ရည်ရှိစေဖို့ redundancy အတွက် 1600W PSU လေးလုံးလည်း တပ်ဆင်ထားပါတယ်။
Comino မှ ကျွန်ုပ်တို့လက်ခံရရှိခဲ့သော ဒုတိယစနစ်ဖြစ်သည့် Workstation iteration ကို NVIDIA A100 professional GPU လေးခု၊ Threadripper Pro 3975WX processor (36 cores, 64 threads, turbo speed up to 4.2 GHz), 512GB DDR5 DRAM နှင့် 2TB NVMe SSD တို့ဖြင့် မီးမောင်းထိုးပြထားသည်။ ဤတစ်ခုမှာ တိတ်ဆိတ်ငြိမ်သက်သော လုပ်ဆောင်ချက်များအတွက် ဒီဇိုင်းထုတ်ထားသော်လည်း အထဲက GPU တွေကို ထည့်သွင်းစဉ်းစားလျှင် အံ့သြစရာကောင်းလောက်အောင် ကောင်းမွန်ပါသည်။
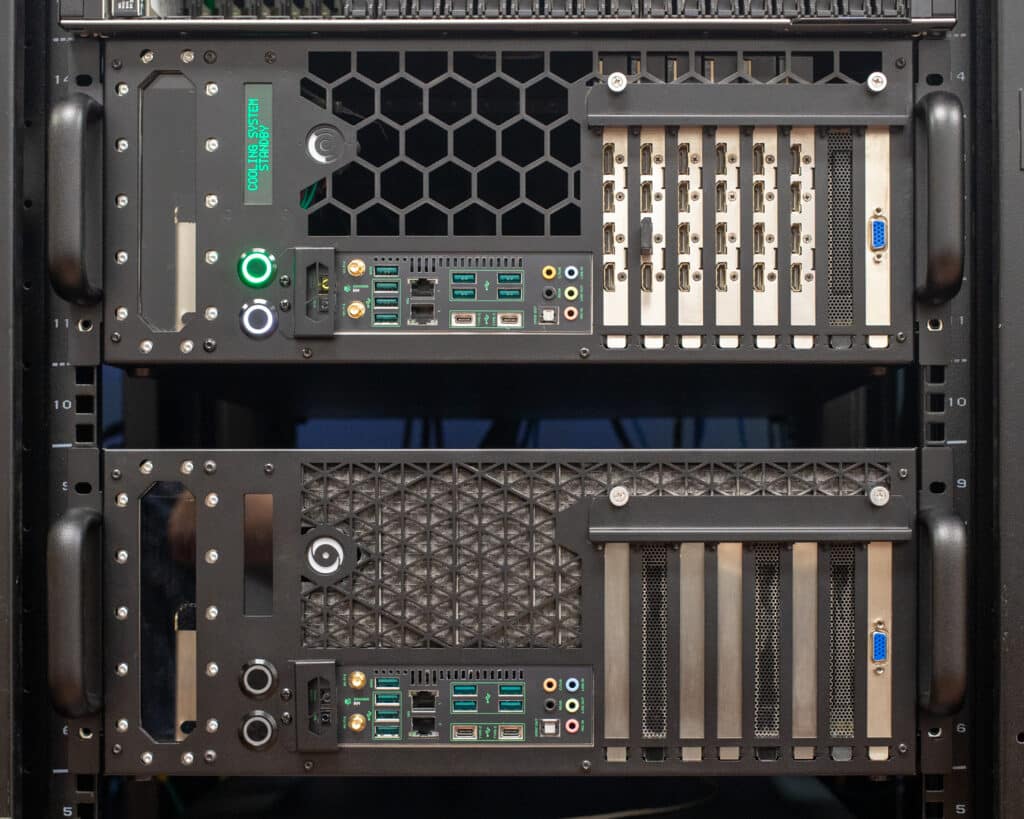
Comino Grando အရည်ဖြင့်အအေးပေးထားသော GPU စနစ်များ
အထက်တွင်ဖော်ပြခဲ့သည့်အတိုင်း မော်ဒယ်နှစ်ခု၏ အဓိကကွာခြားချက်မှာ ၎င်းတို့၏ GPU နှင့် CPU စွမ်းရည်များဖြစ်ပြီး ၎င်းတို့၏ပစ်မှတ်ထားသော အပလီကေးရှင်းအခြေအနေများလည်း ကွဲပြားပါသည်။ Server မော်ဒယ်ရှိ 5995WX CPU သည် core အရေအတွက် မြင့်မားသောကြောင့် parallel processing task များအတွက် အလွန်သင့်လျော်ပါသည်။ ၎င်းသည် တစ်ပြိုင်နက်တည်း အလုပ်များစွာကို ကိုင်တွယ်ရန် အရေးကြီးသည့် server ပတ်ဝန်းကျင်များတွင် စွမ်းဆောင်ရည်ကို သိသိသာသာ မြှင့်တင်ပေးပါသည်။
ဆန့်ကျင်ဘက်အနေနဲ့ ပါဝါအားကောင်းနေဆဲဖြစ်ပေမယ့် Workstation ရဲ့ 3975WX ကတော့ core နည်းပါးစွာသာ ပေးစွမ်းနိုင်တာကြောင့် application အမျိုးမျိုးမှာ ဟန်ချက်ညီတဲ့ စွမ်းဆောင်ရည် လိုအပ်တဲ့နေရာမှာ workstation အသုံးပြုမှုနဲ့ ကိုက်ညီပါတယ်။ GPU ရွေးချယ်မှုက ဒီနှစ်ခုကို ပိုပြီး ခွဲခြားသိမြင်စေပါတယ်။ RTX 4090s တွေဟာ ဂရပ်ဖစ် rendering မှာ ခေတ်မီပြီး ပြင်းထန်တဲ့ ဂရပ်ဖစ်တွက်ချက်မှု လိုအပ်တဲ့ အလုပ်တွေအတွက် အသင့်တော်ဆုံးဖြစ်ပြီး NVIDIA A100s (တစ်ခုစီမှာ 40GB memory တပ်ဆင်ထားပြီး deep learning နဲ့ သိပ္ပံနည်းကျ ကွန်ပျူတာတွက်ချက်မှုအတွက် ဖန်တီးထားပါတယ်။)
Comino Grando အစိတ်အပိုင်းများနှင့် တည်ဆောက်မှု
အစပိုင်းမှာ ပို့ဆောင်ရေး မတော်တဆမှုတစ်ခု (ဆာဗာဟာ ပို့ဆောင်ရေးထရပ်ကားပေါ်ကနေ ပြုတ်ကျခဲ့တာ - ကျွန်တော်တို့ကြောင့် မဟုတ်ပါဘူး၊ ကျွန်တော် ကျိန်ဆိုပါတယ်!) ရှိခဲ့ပေမယ့် Comino ရဲ့ ပြည့်စုံတဲ့ထုပ်ပိုးမှုက စနစ်ရဲ့ တည်တံ့ခိုင်မြဲမှုကို ထိန်းသိမ်းထားနိုင်ခဲ့ပါတယ်။ ဒီခံနိုင်ရည်ရှိမှုဟာ တစ်စိတ်တစ်ပိုင်းအားဖြင့် ၎င်းရဲ့ ကျစ်လျစ်ပြီး ရေအအေးပေးစနစ် ဒီဇိုင်းကြောင့်ဖြစ်ပြီး သယ်ယူပို့ဆောင်ရေးအတွင်း ပျက်စီးမှုအန္တရာယ်ကို လျှော့ချပေးပါတယ်။ ဒီစနစ်ကို ကွန်ဗင်းရှင်းတွေမှာ ပြသခဲ့ပြီး အမေရိကန်တစ်ဝှမ်းက နည်းပညာကျွမ်းကျင်သူတွေက ခွဲခြမ်းစိတ်ဖြာခဲ့တာကြောင့် ခရီးသွားလာခြင်းရဲ့ ဟောင်းနွမ်းမှုနဲ့ မစိမ်းပါဘူး။
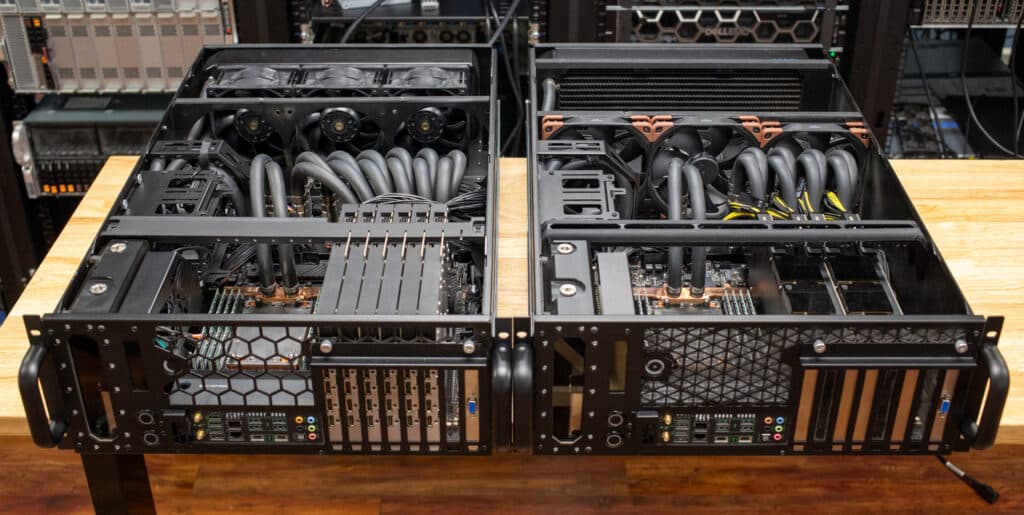
Comino Grando 6x 4090 (ဘယ်ဘက်) နှင့် 4x A100 (ညာဘက်)
Grando Server မော်ဒယ်ကို ဖွင့်လိုက်တဲ့အခါ ပါဝါကြိုးတွေ၊ သံလမ်းတွေနဲ့ ကြိုတင်ဖြည့်ထားတဲ့ အအေးပေးစနစ်အကြောင်း သတိပေးချက်တစ်ခု၊ ပြုပြင်ထိန်းသိမ်းမှုအတွက် ကိရိယာတွေနဲ့ အရင်းအမြစ်တွေ ပါဝင်တဲ့ ကောင်းမွန်စွာ စီစဉ်ထားတဲ့ အတွင်းပိုင်းကို ကျွန်တော်တို့ တွေ့ရှိခဲ့ပါတယ်။ ဆာဗာရဲ့ ရှေ့မျက်နှာစာမှာ RTX 4090 ခြောက်လုံး ပါဝင်ပြီး ချောမွေ့ပြီး ထိရောက်တဲ့ ဒီဇိုင်းအတွက် ရေဘလောက်တွေကြောင့် တစ်ခုချင်းစီကို slot တစ်ခုတည်းနဲ့ ပိုင်းခြားထားပါတယ်။ ဒီသေးငယ်တဲ့ ယူနစ်တွေရဲ့ ပါဝါကို ထည့်သွင်းစဉ်းစားရင် ဒီ setup က စိတ်ဝင်စားစရာပါပဲ။
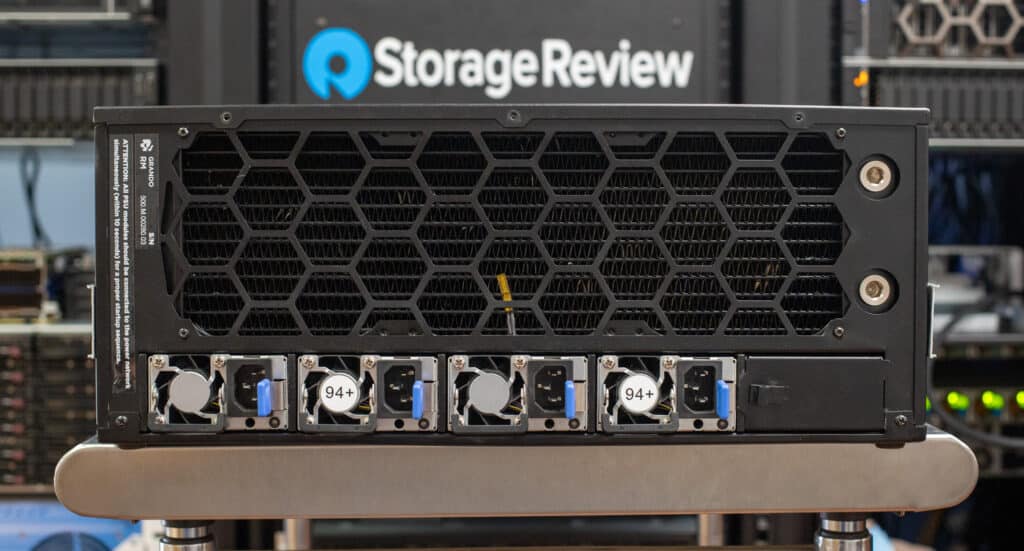
Comino Grando ဆာဗာ နောက်ဘက်
မော်ဒယ်နှစ်ခုစလုံးသည် နီးပါးတူညီသော case များကိုအသုံးပြုထားသည်။ အတွင်းပိုင်းတွင် အအေးပေးစနစ်ဖွဲ့စည်းပုံမှလွဲ၍ ၎င်းတို့သည် အတူတူပင်ဖြစ်သည်။ အခြားနည်းဖြင့်မဖော်ပြထားပါက၊ ကျွန်ုပ်တို့သည် layout အပိုင်းအတွက် Server iteration ကိုအာရုံစိုက်ပါမည်။ ရှေ့ panel ချိတ်ဆက်မှုတွင် တိုက်ရိုက်အသံစနစ်ပေါင်းစပ်မှုအတွက် audio in/out jack များ၊ peripheral ချိတ်ဆက်မှုအတွက် USB port များစွာနှင့် ကျယ်ပြန့်သော device အမျိုးမျိုးနှင့် ချိတ်ဆက်နိုင်စေရန် networking port များအပါအဝင် အပို I/O ရွေးချယ်မှုများ ပါဝင်သည်။ မော်ဒယ်နှစ်ခုစလုံးသည် Comino ၏ မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော computing hardware အတွက် ဒီဇိုင်းအတွေးအခေါ်နှင့်အညီ ပြုပြင်ထိန်းသိမ်းမှုနှင့် အသုံးပြုသူအပြန်အလှန်ဆက်သွယ်မှုအတွက် အလွယ်တကူဝင်ရောက်နိုင်မှုကို အလေးပေးဖော်ပြသည်။
ဆာဗာ၏ ရှေ့ panel ၏ ဘယ်ဘက်အစွန်ဆုံးတွင် LED display တစ်ခုရှိပြီး ပန့်များ၊ လေအပူချိန်၊ အအေးခံအပူချိန်နှင့် ပန်ကာအမြန်နှုန်းဆိုင်ရာ အချက်အလက်များအပါအဝင် အသုံးဝင်သော telemetry data အမျိုးမျိုးကို ပေးပါသည်။ မီနူးကို လမ်းညွှန်ရန် အအေးခံမော်ဂျူးပေါ်ရှိ မီးလင်းသောခလုတ်များဖြင့် လွယ်ကူချောမွေ့စေပြီး အချက်အလက်များကို scroll လုပ်ရန် တိုတောင်းသော ဖိထားပါ (၂ စက္ကန့်အောက်)။ PB2 ကို ကြာကြာနှိပ်ထားပါ (၂ စက္ကန့်ကျော်) သည် Commands၊ Service (Settings) နှင့် Event Log အပါအဝင် မီနူး branch များကို ဝင်ရောက်ကြည့်ရှုနိုင်စေပြီး setting များနှင့် system diagnostics များကို ပိုမိုထိန်းချုပ်နိုင်စေပါသည်။ အလုံးစုံပြောရလျှင် interface သည် လွယ်ကူပြီး backlit ခလုတ်များဖြင့် မြှင့်တင်ထားသော မီနူးများဖြင့် အလွယ်တကူ လမ်းညွှန်နိုင်ပါသည်။
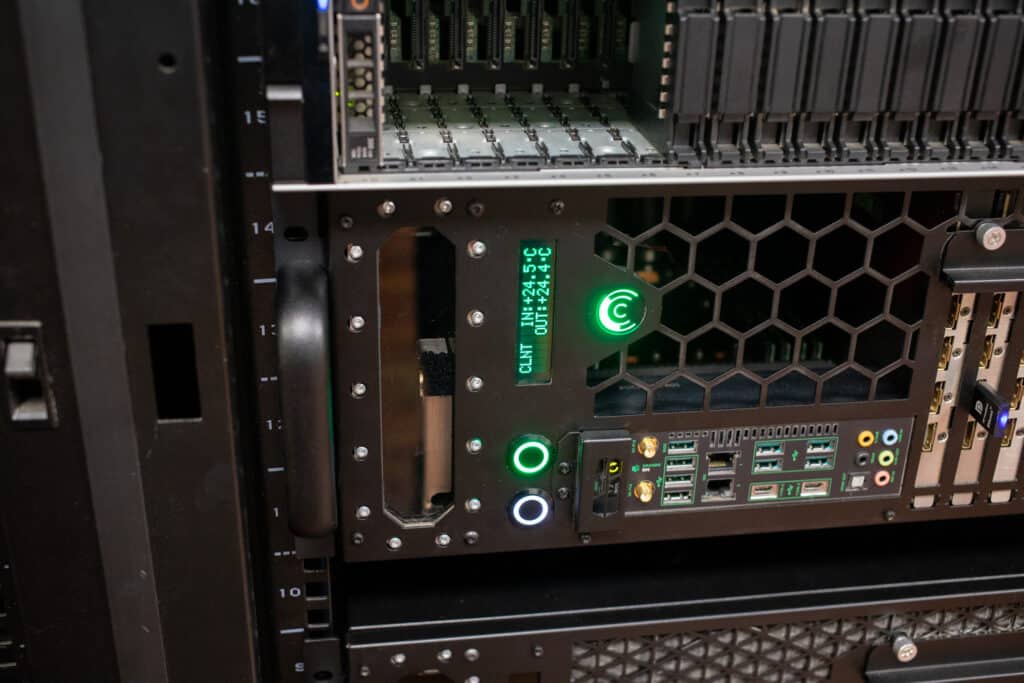
Comino Grando အရည်ဖြင့်အအေးပေးထားသော GPU စနစ် Telemetry Display
အပေါ်ဘက် panel ကိုဖွင့်လိုက်တဲ့အခါ ကျွန်တော်တို့ရဲ့အာရုံကို ပထမဆုံးဖမ်းစားခဲ့တာက ခေတ်မီဆန်းပြားမှုနဲ့ တစ်ပြေးညီဖြစ်မှုကိုပြသတဲ့ အရည်ပြွန်ပါ။ GPU တွေနဲ့ SSD တွေထားရှိတဲ့ chassis ဧရိယာတွေကို ဖုံးလွှမ်းထားတဲ့ support bar ကိုလည်း ဆွဲဆောင်နိုင်ခဲ့ပါတယ်။ ပို့ဆောင်နေစဉ်အတွင်း အာရုံခံနိုင်တဲ့ အစိတ်အပိုင်းတွေရဲ့ ရွေ့လျားမှုကို သိသိသာသာ လျှော့ချပေးပြီး ကောင်းမွန်တဲ့အခြေအနေမှာ ရောက်ရှိစေမှာပါ။
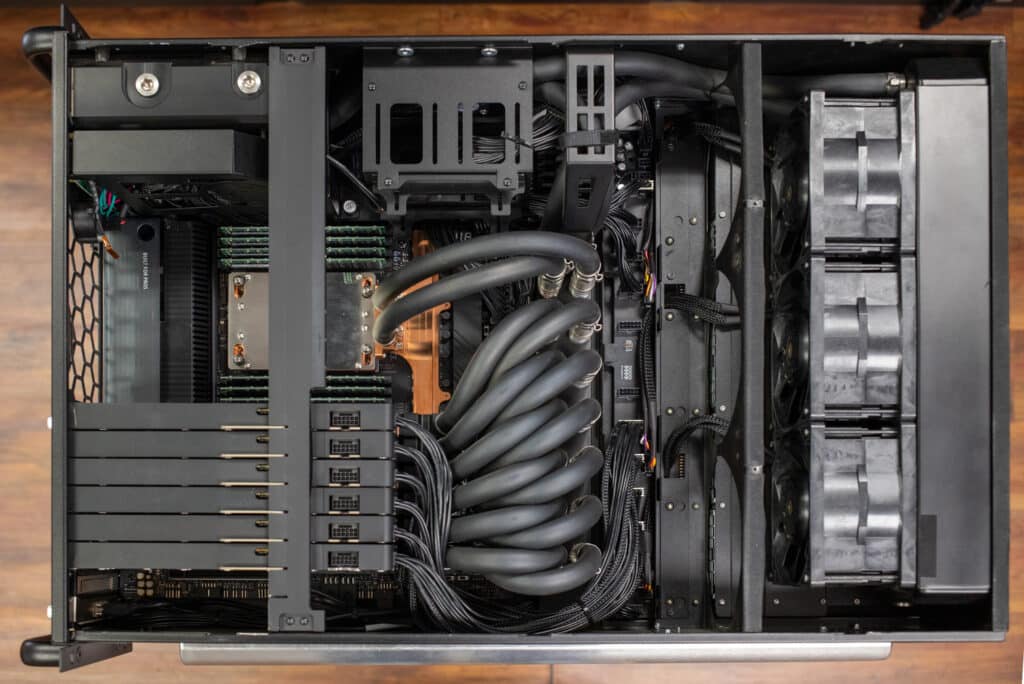
Comino Grando 6x 4090 စနစ်အတွင်းခန်း
စနစ်၏အလယ်ဗဟိုတွင် ရေဖြန့်ဖြူးရေးဘလောက်ကြီးတစ်ခုရှိပြီး အေးသောအရည်နှင့် ပြန်လည်စီးဆင်းသောလမ်းကြောင်းနှစ်မျိုးလုံးကို ပေးစွမ်းသည်။ ၎င်းတို့အားလုံးကို ရေယိုစိမ့်ခြင်းမရှိသော အမြန်ဖြုတ်နိုင်သော ချိတ်ဆက်မှုများဖြင့် ချိတ်ဆက်ထားပြီး Comino ၏ အရည်အသွေးမြင့် အင်ဂျင်နီယာစွမ်းရည်ကို ပြသနေသည်။
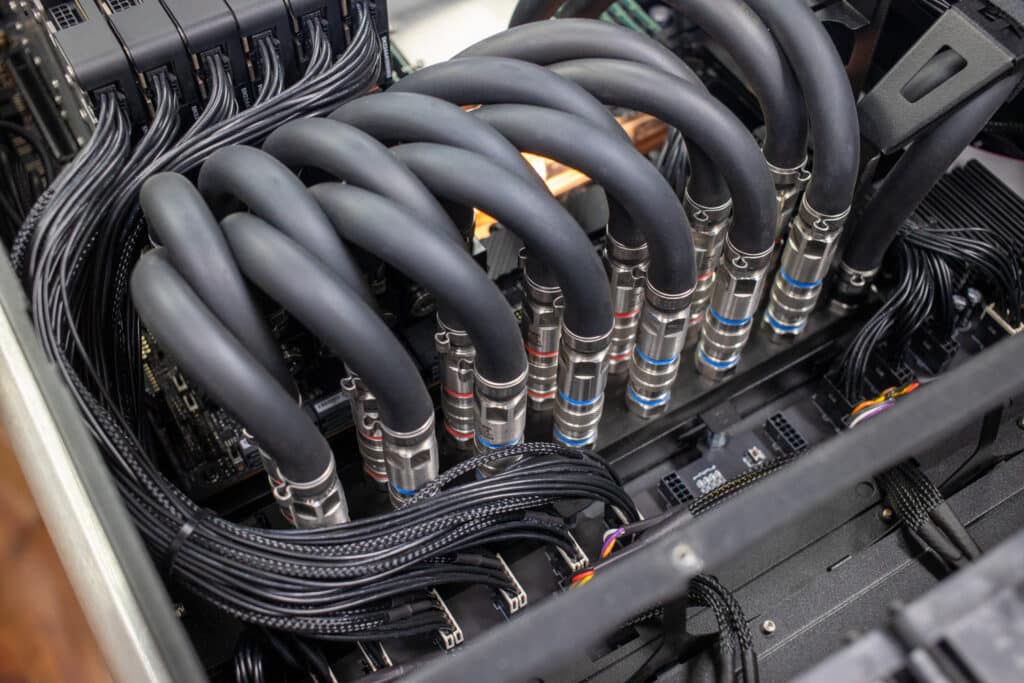
Comino Grando 6x 4090 Manifold
Grando Server အတွင်းရှိ NVIDIA RTX 4090 GPU ခြောက်လုံးကို ကိုယ်ပိုင် Comino အအေးပြားများဖြင့် ဖုံးအုပ်ထားပြီး ဆာဗာအတွင်းရှိ နေရာလွတ်ကို အများဆုံးရရှိစေရန် အလွန်ကျစ်လျစ်သောပုံစံဖြင့် စီစဉ်ထားပြီး ယူနစ်တစ်ခုစီကို ထိရောက်စွာ အအေးပေးနိုင်ကြောင်း သေချာစေသည်။ Workstation မော်ဒယ်တွင် NVIDIA A100 GPU လေးခုကို အသုံးပြုထားသည်။
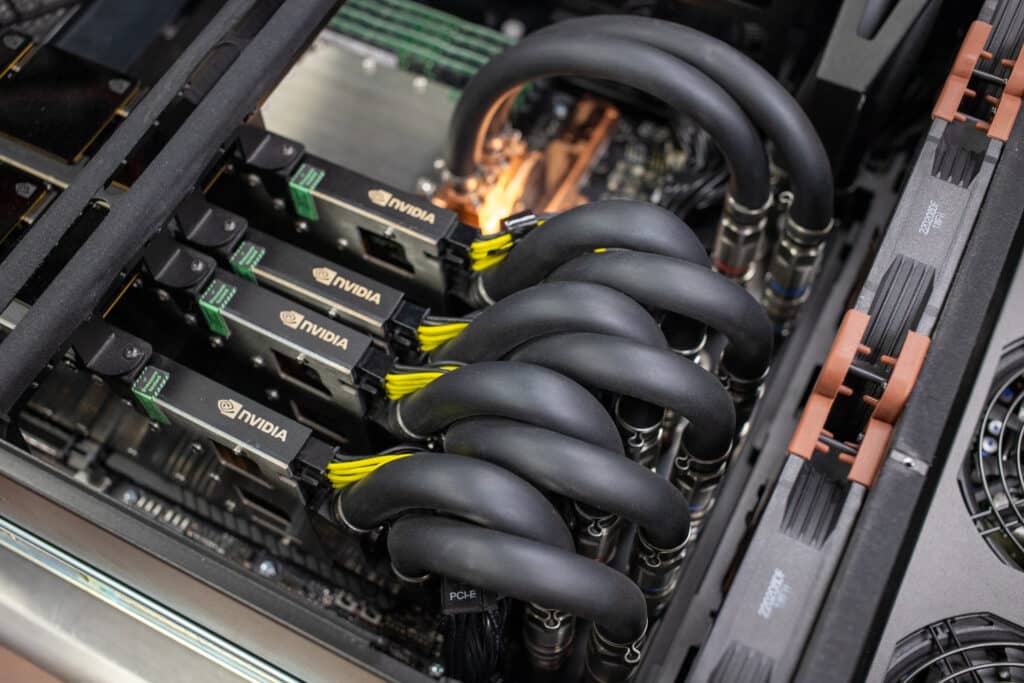
Comino Grando 4x A100 Manifold
နှစ်ခုစလုံးကို ဆာဗာအတွင်း ထောင့်မှန်ကျစွာ လည်ပတ်သည့် ထိန်းသိမ်းမှုကွင်းကို အသုံးပြု၍ လုံခြုံစွာ ချိတ်ဆက်ထားသည်။ ၎င်းသည် GPU များကို တည်ငြိမ်စေပြီး ချိန်ညှိပေးကာ ရွေ့လျားနေစဉ်အတွင်း ၎င်းတို့၏ဖွဲ့စည်းပုံဆိုင်ရာ တည်တံ့မှုကို ထိန်းသိမ်းပေးသည်။
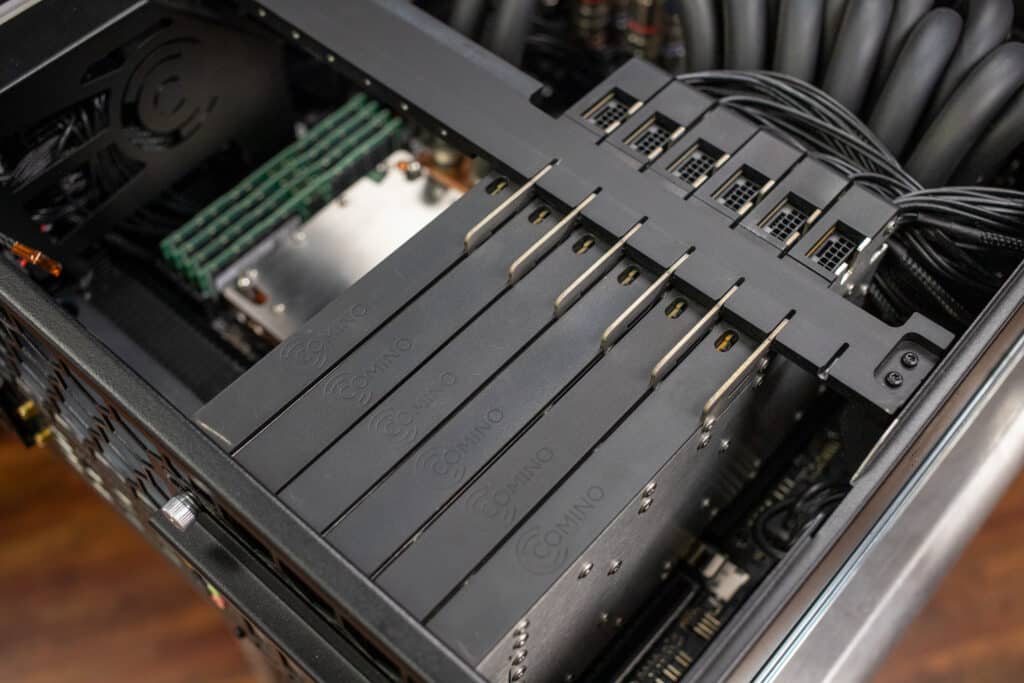
Comino Grando GPU အအေးပြားများ
GPU တစ်ခုကို ဖြုတ်လိုက်တဲ့အခါ Comino ရဲ့ custom cold plate design ပါတဲ့ Gigabyte NVIDIA RTX 4090 ကတ်တွေက အတော်လေး လေးပါတယ်။ GPU မှာ တပ်ဆင်ထားတဲ့ heatsink ကြောင့်လည်း ဖြစ်နိုင်ပါတယ်။
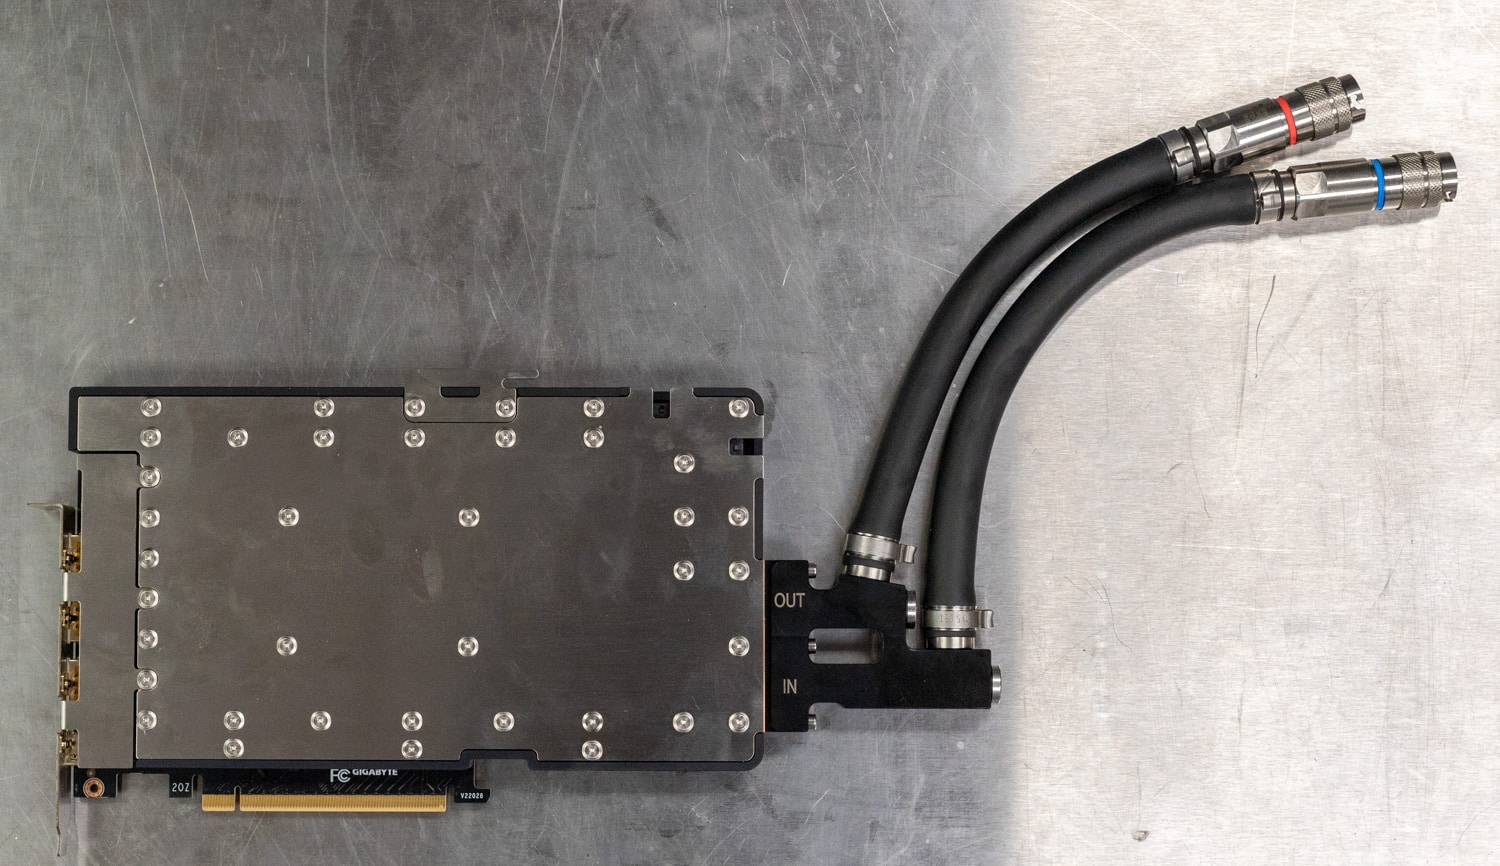
ရေဖြန့်ဖြူးရေးဘလောက်သို့ ပြန်သွားသော ကတ်တစ်ခုစီရှိ ဆက်စပ်ပစ္စည်းများသည် ရေစက်မပါသော ချိတ်ဆက်မှုများဖြစ်ပြီး ကတ်များကို နေရာတိုင်းတွင် အရည်ယိုစိမ့်မှုမရှိဘဲ ဝန်ဆောင်မှုအတွက် ဖယ်ရှားနိုင်သည်။ ၎င်းတို့တွင် တွဲဆက်မျက်နှာပြင်တွင် အကြွင်းအကျန်အနည်းငယ်သာရှိသော်လည်း စနစ်မှ ချိတ်ဆက်မှုဖြုတ်ပြီးနောက်တွင်သာဖြစ်သည်။
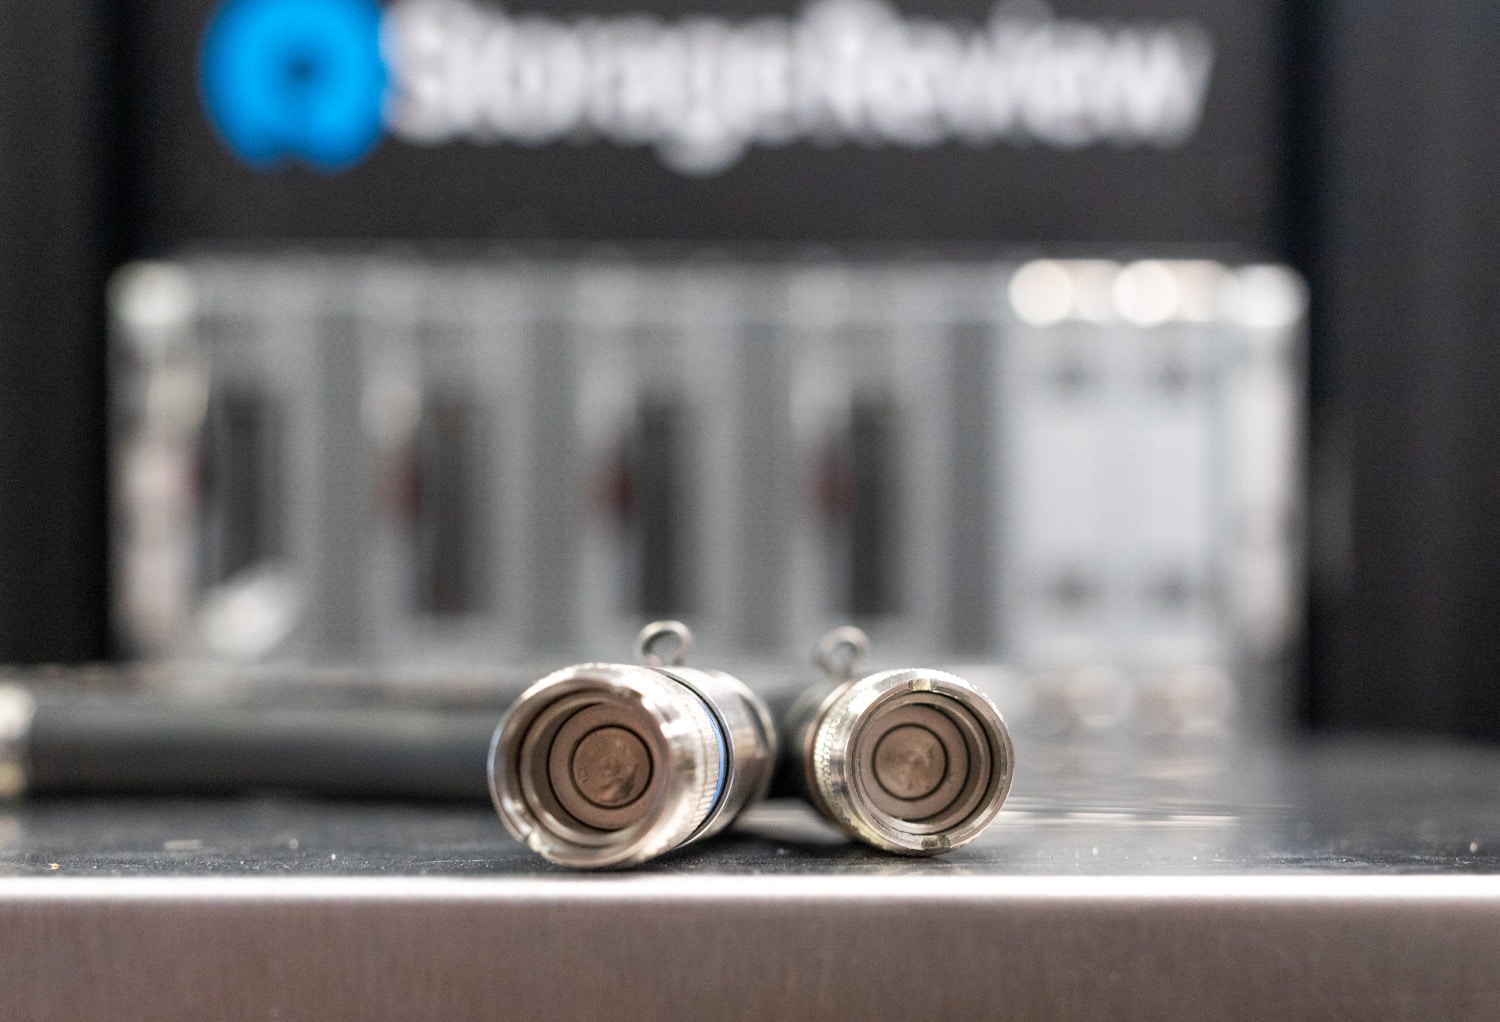
ဖြန့်ဖြူးရေးဘလောက်တွင်လည်း အလားတူဆက်စပ်ပစ္စည်းများ ရှိပါသည်။
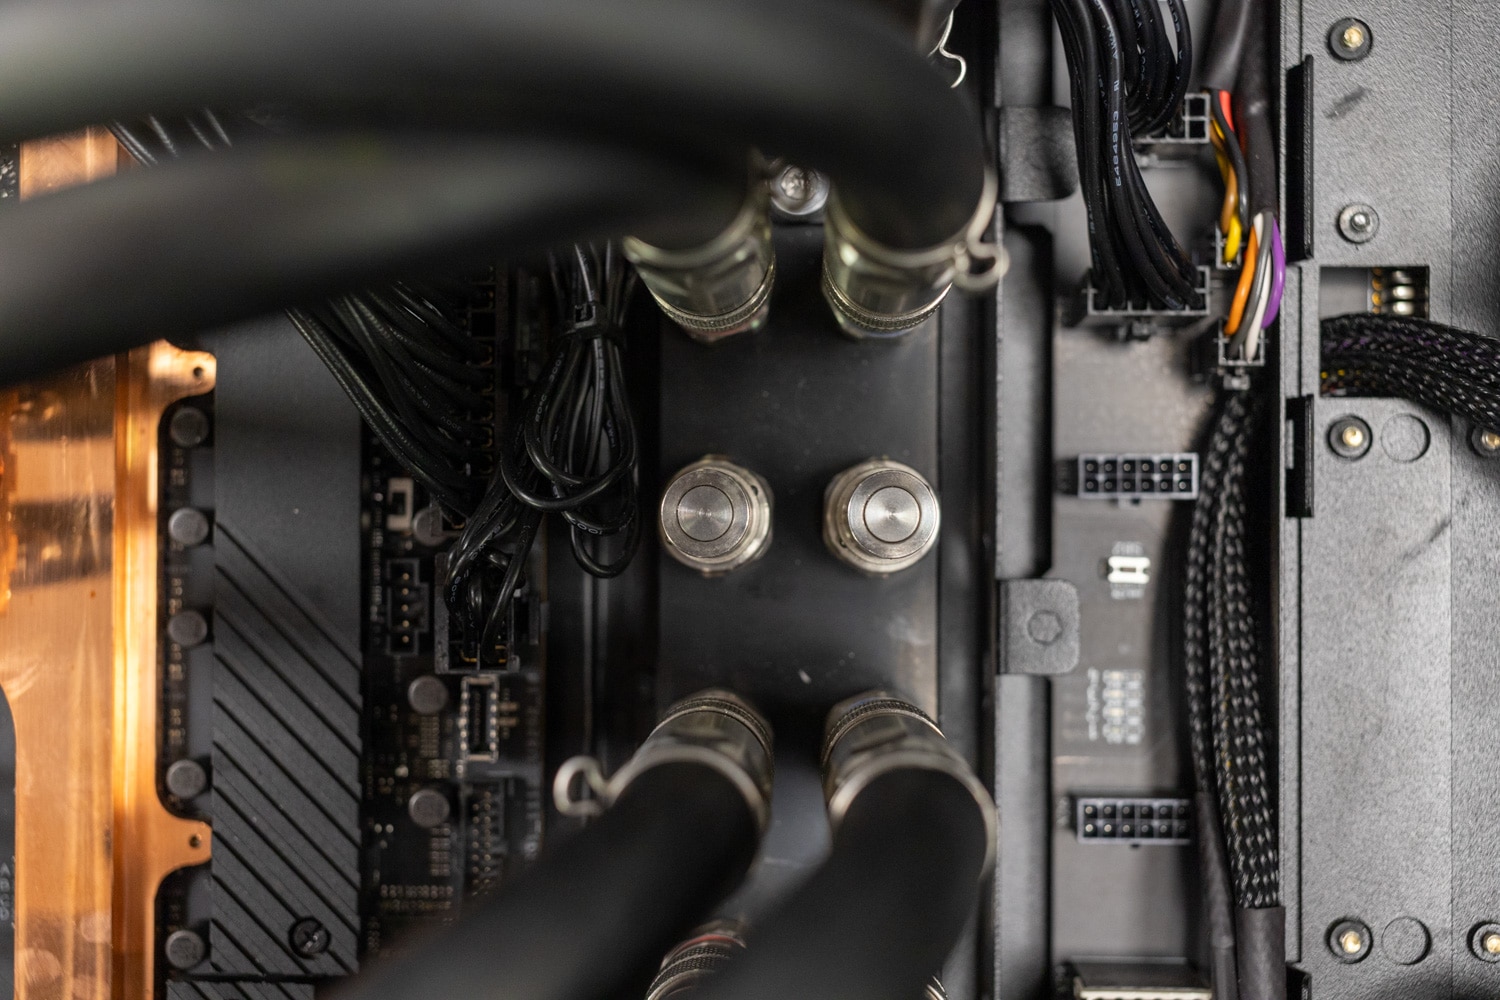
CPU နှင့် ဗို့အားထိန်းညှိကိရိယာများတွင် အအေးပေးပိုက်များနှင့် တိုက်ရိုက်ချိတ်ဆက်ထားသော အအေးပြားတစ်ခုပါရှိပြီး ၎င်းတို့ကို အေးမြစေပြီး ပြင်းထန်သောအလုပ်များအောက်တွင် ပိတ်ဆို့မှုများကို ရှောင်ရှားနိုင်သည်။ CPU ကို နှစ်ဖက်စလုံးတွင် စုစုပေါင်း 512GB ရှိသော DRAM slot များ အပြည့်အဝထည့်သွင်းထားသည်။
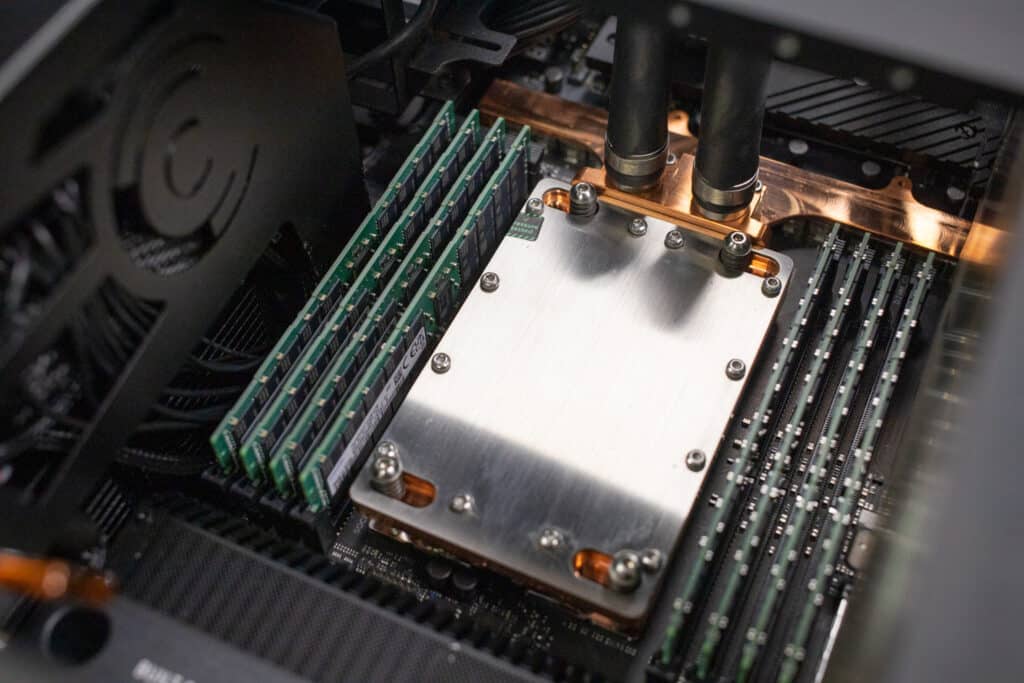
Comino Grando CPU အအေးပြား
စနစ်နှစ်ခုလုံးမှာ အပူထုတ်ဖို့အတွက် အနောက်ဘက်မှာ ကြီးမားတဲ့ ရေတိုင်ကီတစ်ခု ပါရှိပေမယ့် ပလက်ဖောင်းနှစ်ခုကြား အကြီးမားဆုံး ကွာခြားချက်ကတော့ ပန်ကာဖွဲ့စည်းပုံနဲ့ ಒಟ್ಟಾರೆဆူညံသံပါ။ စနစ်နှစ်ခုလုံးက အလွန်တိတ်ဆိတ်ပေမယ့် Workstation ဖွဲ့စည်းပုံကတော့ ပိုမိုတိတ်ဆိတ်ပြီး ပန်ကာစနစ် အားနည်းပါတယ်။
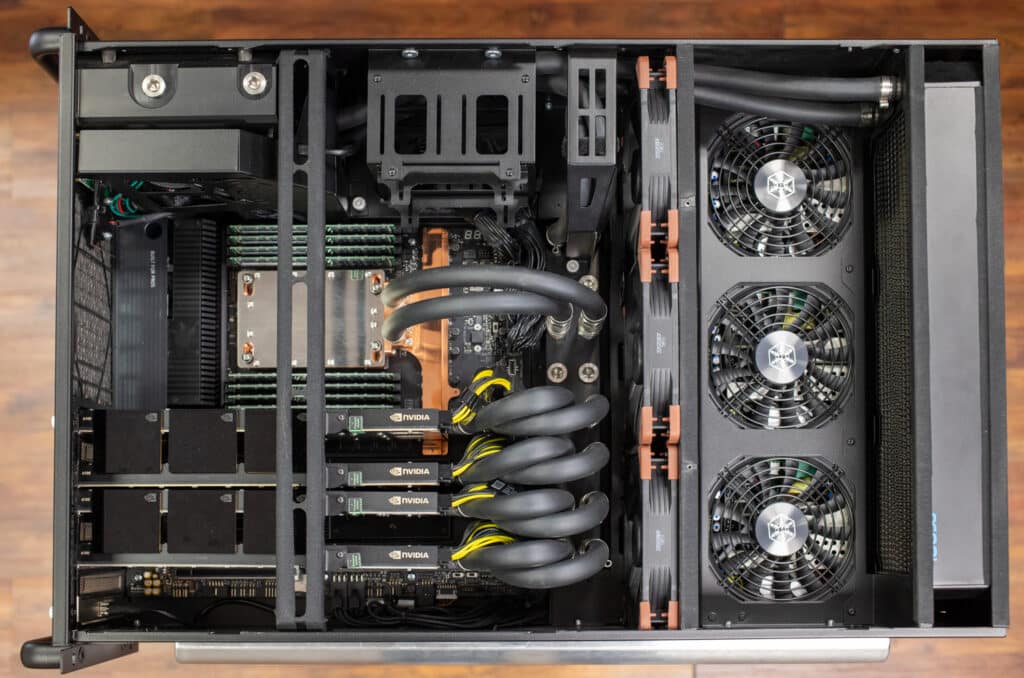
Comino Grando 4x A100 Workstation အတွင်းပိုင်း
ဒီဇိုင်းပိုင်းအရဆိုရင် ကျွန်တော်တို့မှာ ရှိတဲ့ တစ်ခုတည်းသော ညည်းညူချက်က I/O port တွေကို ရှေ့ဘက်မှာထားပြီး power input တွေကို နောက်ဘက်မှာ ထားဖို့ပါပဲ။ rack mount data center ပတ်ဝန်းကျင်မှာ ဒီဒီဇိုင်းက စိန်ခေါ်မှုတစ်ရပ် ဖြစ်စေပါတယ်။ စင်ပေါ်မှာ ရှိနေတဲ့ motherboard ကို အသုံးပြုခြင်းအားဖြင့် Comino မှာ ရွေးချယ်စရာတွေ အများကြီးပဲ ရှိပါတယ်။ အလွန်ကောင်းမွန်စွာ စဉ်းစားထားတဲ့ ဒီဇိုင်းမှာ အသားတင်ရလဒ်က အနည်းငယ် စိတ်အနှောင့်အယှက်ဖြစ်စရာပါပဲ။
Comino Grando အဝေးထိန်းစီမံခန့်ခွဲမှု
Grafana ကို Comino Grando Server ကို စီမံခန့်ခွဲရန်အတွက် အသုံးချထားပြီး၊ dashboard များမှတစ်ဆင့် real-time data visualization ကို ပေးစွမ်းသည့် အစွမ်းထက် open-source analytics နှင့် monitoring solution အဖြစ် ဆောင်ရွက်ပေးသည်။ ၎င်းသည် data source အမျိုးမျိုးနှင့် ပေါင်းစပ်ထားပြီး alerting၊ multi-tenant support နှင့် API access ကဲ့သို့သော feature များကို ပေးဆောင်သောကြောင့် system performance ကို ခြေရာခံခြင်းနှင့် ရောဂါရှာဖွေခြင်းအတွက် လက်တွေ့ကျသည်။
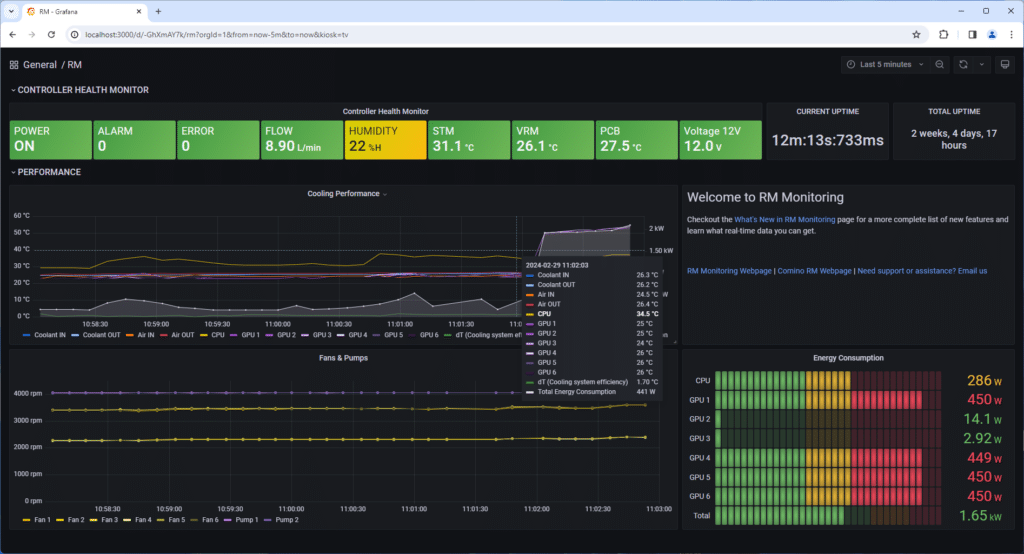
အထွေထွေအချက်အလက်ဒိုင်ခွက်ကိုကြည့်လျှင် Grafana သည် Comino Grando တွင် အပူချိန်စီမံခန့်ခွဲမှုအတွက် အအေးပေးအရည်စီးဆင်းမှုနှုန်း၊ ပတ်ဝန်းကျင်စိုထိုင်းဆအဆင့်၊ System Management (STM)၊ Voltage Regulator Module (VRM) နှင့် Printed Circuit Boards (PCB) ကဲ့သို့သော အရေးကြီးသောအစိတ်အပိုင်းများ၏ အပူချိန်များကဲ့သို့သော အချိန်နှင့်တပြေးညီ မက်ထရစ်များကို ပြသသည်။
၎င်းသည် စွမ်းအင်သုံးစွဲမှုကိုလည်း စောင့်ကြည့်ပေးပြီး ဤအဆင့်မြင့်ဆာဗာကို စီမံခန့်ခွဲရန်အတွက် မရှိမဖြစ်လိုအပ်သော CPU နှင့် GPU ပါဝါသုံးစွဲမှုကဲ့သို့သော အစိတ်အပိုင်းတစ်ခုချင်းစီ၏ အသုံးပြုမှုကိုလည်း ပြသပေးပါသည်။ အင်တာဖေ့စ်သည် ပြသထားသော ဤအရေးကြီးသော အချက်အလက်အားလုံးကို အလွယ်တကူ သုံးစွဲနိုင်သောပုံစံဖြင့် ထိရောက်စွာ ပေါင်းစည်းပေးပါသည်။ ၎င်းသည် ဆာဗာ၏ စွမ်းဆောင်ရည်နှင့် ယုံကြည်စိတ်ချရမှုကို အကောင်းဆုံးအဆင့်တွင် ထိန်းသိမ်းထားစဉ်တွင် စီမံခန့်ခွဲသူများအား မည်သည့်အလားအလာရှိသော ပြဿနာများကိုမဆို ကြိုတင်ဖြေရှင်းရန် လက်တွေ့လုပ်ဆောင်နိုင်သော အသိအမြင်များကို ပေးစွမ်းပါသည်။
Comino Grando သတ်မှတ်ချက်များ
| ဂရန်ဒို ဆာဗာ | ဂရန်ဒို ဝပ်စတေရှင် | |
|---|---|---|
| စီပီယူ | Threadripper Pro W5995WX | Threadripper Pro 3975WX |
| သိုးထီး | 512GB RAM ကို | 512GB RAM ကို |
| GPU ကို | ၆X NVIDIA RTX 4090 | ၄X A100 |
| PSU | 1600w PSU ၄ လုံး | ၃ x ၁၀၀၀ SFX-L PSU |
| သိုလှောင်ခြင်း | 2TB NVMe | 2TB NVMe |
ကော်မီနို ဂရန်ဒို ဖျော်ဖြေမှု
Comino Grando စနစ်များ၏ ဖွဲ့စည်းပုံနှစ်ခု—ဆာဗာနှင့် အလုပ်စက်—ကြား စွမ်းဆောင်ရည်ကို နှိုင်းယှဉ်ရန်အတွက် ကျွန်ုပ်တို့သည် rendering၊ computation နှင့် data processing စွမ်းရည်များအပါအဝင် ကွန်ပျူတာစွမ်းဆောင်ရည်၏ ရှုထောင့်အမျိုးမျိုးကို အကဲဖြတ်သည့် benchmark အမျိုးမျိုးကို အသုံးပြုခဲ့ပါသည်။ benchmark များတွင် Blender 4.0၊ Luxmark၊ OctaneBench၊ Blackmagic RAW Speed Test၊ 7-zip Compression နှင့် Y-Cruncher တို့ ပါဝင်ပြီး တစ်ခုချင်းစီကို ကွန်ပျူတာပတ်ဝန်းကျင်အမျိုးမျိုးတွင် ဤစနစ်များ၏ သီးခြားအားသာချက်များကို အကဲဖြတ်ရာတွင် ၎င်း၏သက်ဆိုင်မှုအတွက် ရွေးချယ်ခဲ့ပါသည်။
Blender ၂.၆၅
Blender သည် မော်ဒယ်လ်၊ အန်နီမေးရှင်း၊ သရုပ်ဖော်ခြင်းနှင့် ပုံဖော်ခြင်း ပရောဂျက်များအတွက် ပြီးပြည့်စုံသော open-source 3D ဖန်တီးမှုအစုံတစ်ခုဖြစ်သည်။ Blender benchmarks များသည် ရှုပ်ထွေးသော မြင်ကွင်းများကို ပုံဖော်ရာတွင် စနစ်တစ်ခု၏ စွမ်းဆောင်ရည်ကို အကဲဖြတ်ပြီး ၎င်းသည် visual effects၊ အန်နီမေးရှင်းနှင့် ဂိမ်းဖွံ့ဖြိုးတိုးတက်ရေးတို့တွင် ပရော်ဖက်ရှင်နယ်များအတွက် အရေးကြီးသော ရှုထောင့်တစ်ခုဖြစ်သည်။ ဤ benchmark သည် CPU နှင့် GPU rendering စွမ်းရည်များကို တိုင်းတာပြီး ၎င်းတို့သည် high-end graphics processing နှင့် computational tasks များအတွက် ဒီဇိုင်းထုတ်ထားသော server များနှင့် workstation များအတွက် သက်ဆိုင်သည်။
| Blender 4.0 (တစ်မိနစ်လျှင် နမူနာများ၊ များလေ ပိုကောင်းလေ) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| ဘီလူး (CPU) | 568.02 | 334.40 |
| အမှိုက်ဆိုင် (CPU) | 386.53 | 231.90 |
| စာသင်ခန်း (CPU) | 293.91 | 174.21 |
| Blender 4.0 GPU စမ်းသပ်မှုများ | ||
| မိစ္ဆာ (GPU) | 5,880.71 | 1,656.34 |
| အမှိုက်ဆိုင် (GPU) | 2,809.36 | 1,137.73 |
| စာသင်ခန်း (GPU) | 2,895.54 | 953.46 |
ရလဒ်များက Grando Server ၏ rendering တွင် ခိုင်မာသောစွမ်းဆောင်ရည်ကို မီးမောင်းထိုးပြနေပြီး၊ ၎င်း၏ မြင့်မားသောပါဝါရှိသော CPU နှင့် သာလွန်ကောင်းမွန်သော GPU စနစ်ထည့်သွင်းမှုကြောင့်ဟု ဆိုနိုင်သည်။ Grando Workstation သည် အထူးသဖြင့် အသေးစိတ် 3D မော်ဒယ်လ်နှင့် rendering လိုအပ်သော ပရော်ဖက်ရှင်နယ် setting များတွင် အံ့သြဖွယ်ကောင်းလောက်အောင် စွမ်းဆောင်ရည်ကောင်းမွန်သော်လည်း၊ server ၏ configuration ကို ပိုမိုတောင်းဆိုမှုများသော graphics processing task များအတွက် ဒီဇိုင်းထုတ်ထားသည်။ စွမ်းဆောင်ရည်ကွာခြားချက်များသည် high-end rendering အလုပ်များအတွက် server ၏ အသင့်ဖြစ်မှုကို ထင်ဟပ်စေပြီး၊ ရက်အကန့်အသတ်ရှိသော သို့မဟုတ် ရှုပ်ထွေးသော rendering လိုအပ်ချက်များရှိသော ပရောဂျက်များအတွက် အဖိုးတန်ကိရိယာတစ်ခုကို ပေးဆောင်သည်။
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်ကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် တိကျသော အလင်း simulation သည် အရေးကြီးပါသည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| ဟောလ်ဘန်ချ် | 240,303 | 92,156 |
| အစားအသောက်များ | 98,459 | 27,194 |
Grando Server ရဲ့ စွမ်းဆောင်ရည်က အဆင့်မြင့် 6x RTX 4090 GPU စနစ်ထည့်သွင်းမှုကြောင့် ထူးခြားတဲ့ ray tracing စွမ်းရည်တွေကို ပြသနေပါတယ်။ Grando Workstation က အသေးစိတ် ဗိသုကာပုံစံ မြင်သာမှု လိုအပ်တဲ့ အလုပ်တွေအတွက် အထူးသဖြင့် အကျိုးရှိစေမယ့် သိသာထင်ရှားတဲ့ စွမ်းရည်တွေကို ပြသထားပေမယ့် Server မော်ဒယ်ကတော့ ပိုပြီး ပြင်းထန်တဲ့ rendering အလုပ်တွေအတွက် ရည်ရွယ်ထားပါတယ်။ ဒီခြားနားချက်က ray tracing စွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင် လုပ်ဆောင်ဖို့ အရေးကြီးပြီး render လုပ်ထားတဲ့ မြင်ကွင်းတွေမှာ ထိရောက်မှုနဲ့ လက်တွေ့ကျမှုကို သေချာစေတဲ့ ပရောဂျက်တွေအတွက် server ရဲ့ သင့်တော်မှုကို အလေးပေးဖော်ပြပါတယ်။
OctaneBench
OctaneBench သည် အစွမ်းထက်ပြီး ရေပန်းစားသော GPU-accelerated ray tracing renderer တစ်ခုဖြစ်သည့် OctaneRender ကို အသုံးပြု၍ GPU များ၏ rendering စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ content creation၊ architectural visualization နှင့် visual effect များတွင် လုပ်ဆောင်နိုင်စွမ်းကို အကဲဖြတ်ရန်အတွက် အရေးကြီးပြီး rendering speed သည် productivity နှင့် project timelines များကို တိုက်ရိုက်သက်ရောက်မှုရှိသည်။
| OctaneBench | kernel | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|---|
| အတွင်းဖြစ်သော | သတင်းအချက်အလက် ချန်နယ်များ | 275.25 | 68.05 |
| အတွင်းဖြစ်သော | တိုက်ရိုက်အလင်းရောင် | 826.70 | 244.65 |
| အတွင်းဖြစ်သော | လမ်းကြောင်း ခြေရာခံခြင်း | 1,065.47 | 297.89 |
| စိတ်ကူး | သတင်းအချက်အလက် ချန်နယ်များ | 156.00 | 36.22 |
| စိတ်ကူး | တိုက်ရိုက်အလင်းရောင် | 642.48 | 191.03 |
| စိတ်ကူး | လမ်းကြောင်း ခြေရာခံခြင်း | 785.45 | 232.82 |
| ATV | သတင်းအချက်အလက် ချန်နယ်များ | 431.21 | 73.74 |
| ATV | တိုက်ရိုက်အလင်းရောင် | 896.54 | 220.35 |
| ATV | လမ်းကြောင်း ခြေရာခံခြင်း | 1,130.18 | 273.55 |
| သေတ္တာ | သတင်းအချက်အလက် ချန်နယ်များ | 222.37 | 51.48 |
| သေတ္တာ | တိုက်ရိုက်အလင်းရောင် | 789.55 | 224.08 |
| သေတ္တာ | လမ်းကြောင်း ခြေရာခံခြင်း | 885.74 | 254.17 |
| စုစုပေါင်းရမှတ် | 8,106.94 | 2,168.02 | |
Grando Server သည် OctaneBench စမ်းသပ်မှုများတွင် ထူးချွန်ပြီး GPU အရှိန်မြှင့်တင်မှုမှ အကျိုးကျေးဇူးရရှိသည့် တောင်းဆိုမှုများသော rendering workflow များအတွက် ၎င်း၏ထူးခြားသောသင့်လျော်မှုကို ညွှန်ပြနေသည်။ သိသာထင်ရှားသော rendering စွမ်းရည်များကို ပေးဆောင်သော်လည်း Grando Workstation ကို ပရော်ဖက်ရှင်နယ်ပတ်ဝန်းကျင်များတွင် စွမ်းဆောင်ရည်နှင့် ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို ဟန်ချက်ညီအောင် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသည်။ ဤစွမ်းဆောင်ရည်ကွာခြားချက်သည် ပြိုင်ဘက်ကင်းသော rendering မြန်နှုန်းများလိုအပ်သော အထူးပြုလုပ်ငန်းတာဝန်များအတွက် server ၏ဒီဇိုင်းကို အလေးပေးဖော်ပြပြီး ပိုမိုထိရောက်သော ပရောဂျက်ပြီးမြောက်မှုများကို ပံ့ပိုးပေးသည်။
Blackmagic RAW မြန်နှုန်းစမ်းသပ်မှု
Blackmagic RAW မြန်နှုန်းစမ်းသပ်မှုသည် အရည်အသွေးမြင့် ဗီဒီယိုဖော်မတ်များအတွက် လုပ်ဆောင်မှုအမြန်နှုန်းကို တိုင်းတာပေးပြီး ဗီဒီယိုထုတ်လုပ်ရေးနှင့် တည်းဖြတ်ရေးတွင် ဆာဗာများနှင့် အလုပ်ရုံများအတွက် မရှိမဖြစ်လိုအပ်သော ရှုထောင့်တစ်ခုဖြစ်သည်။ ၎င်းသည် စနစ်များသည် RAW ဗီဒီယိုဖိုင်များကို မည်သို့စီမံခန့်ခွဲပြီး မီဒီယာထုတ်လုပ်မှုပတ်ဝန်းကျင်များတွင် လုပ်ငန်းစဉ်ထိရောက်မှုနှင့် ထုတ်လုပ်နိုင်စွမ်းကို မည်သို့အကျိုးသက်ရောက်စေသည်ကို အကဲဖြတ်သည်။
| Blackmagic RAW မြန်နှုန်းစမ်းသပ်မှု | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| 8K CPU | 132 FPS | 135 FPS |
| 8K CUDA | 345 FPS | 309 FPS |
Grando Server နှင့် Workstation တို့သည် Blackmagic RAW Speed Test တွင် ကောင်းမွန်သောစွမ်းဆောင်ရည်ကို ပြသထားပြီး CUDA-accelerated task များတွင် server သည် အနည်းငယ်သာလွန်ကောင်းမွန်ပါသည်။ ဆိုလိုသည်မှာ Server မော်ဒယ်သည် လေးလံသောဗီဒီယိုတည်းဖြတ်ခြင်းနှင့် processing များပါဝင်သော workflow များအတွက် (အထူးသဖြင့် GPU acceleration မှ အကျိုးကျေးဇူးရရှိသော workflow များအတွက်) အနည်းငယ်ပိုမိုကောင်းမွန်သောစွမ်းဆောင်ရည်ကို ပေးစွမ်းပါသည်။ သို့သော် Workstation သည် ဗီဒီယိုလုပ်ဆောင်ခြင်းဆိုင်ရာ task များအတွက် သိသာထင်ရှားသောစွမ်းရည်များကို ပေးစွမ်းနေဆဲဖြစ်ပြီး မီဒီယာထုတ်လုပ်မှုအတွက် ၎င်း၏ပြည့်စုံသောတည်ဆောက်မှုကို သရုပ်ပြပါသည်။
7-zip Compression
7-zip Compression benchmark သည် စနစ်တစ်ခု၏ data compression နှင့် decompression ကို ကိုင်တွယ်ရာတွင် ထိရောက်မှုကို စမ်းသပ်ပြီး ၎င်းသည် dataset ကြီးများကို စီမံခန့်ခွဲခြင်းနှင့် storage ကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်ခြင်းအတွက် အရေးကြီးပါသည်။ ဤ benchmark သည် data-intensive operations များတွင် server များနှင့် workstation များ၏ စွမ်းဆောင်ရည်ကို ထင်ဟပ်စေပြီး data manipulation တွင် မြန်နှုန်းနှင့် ထိရောက်မှုမှာ အရေးကြီးပါသည်။
| 7-Zip ဖိသိပ်မှု စံနှုန်း (မြင့်လေ ပိုကောင်းလေ) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| လက်ရှိ CPU အသုံးပြုမှု | 3,379% | 3,439% |
| လက်ရှိ အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| လက်ရှိခဲ့သည် Rating | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ရလဒ်အနေဖြင့် CPU အသုံးပြုမှု | 3,362% | 3,406% |
| ရလဒ်အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ရလဒ်အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ဖိသိပ်ခြင်း | ||
| လက်ရှိ CPU အသုံးပြုမှု | 6,015% | 6,286% |
| လက်ရှိ အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| လက်ရှိခဲ့သည် Rating | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ရလဒ်အနေဖြင့် CPU အသုံးပြုမှု | 6,053% | 6,269% |
| ရလဒ်အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ရလဒ်အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| စုစုပေါင်း အဆင့်သတ်မှတ်ချက် | ||
| စုစုပေါင်း CPU အသုံးပြုမှု | 4,708% | 4,837% |
| စုစုပေါင်း အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| စုစုပေါင်း အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
7-zip Compression benchmark မှ ရလဒ်များအရ Grando Server နှင့် Workstation တို့သည် data compression နှင့် decompression task များကို ကိုင်တွယ်ရာတွင် စွမ်းဆောင်ရည်မြင့်မားသော စွမ်းဆောင်ရည်ရှိသူများအဖြစ် ပြသနေပါသည်။ ၎င်းတို့၏ စွမ်းဆောင်ရည်သည် စနစ်များသည် data ပမာဏများစွာကို ထိရောက်စွာ စီမံခန့်ခွဲနိုင်ကြောင်း ညွှန်ပြနေပြီး၊ ၎င်းတို့၏ CPU configuration များကို အနည်းငယ်ကွဲပြားမှုများဖြင့် ထင်ဟပ်နေပါသည်။ ဤစွမ်းရည်များသည် စနစ်များ၏ အရေးကြီးသော data စီမံခန့်ခွဲမှု task များအတွက် သင့်လျော်မှုကို မီးမောင်းထိုးပြနေပြီး၊ ထိရောက်သော storage နှင့် retrieval process များကို သေချာစေသည်။
Y-Cruncher
Y-Cruncher သည် စနစ်တစ်ခု၏ ရှုပ်ထွေးသော သင်္ချာလုပ်ဆောင်ချက်များကို ကိုင်တွယ်နိုင်စွမ်းကို စမ်းသပ်သည့် တွက်ချက်မှုဆိုင်ရာ စံနှုန်းတစ်ခုဖြစ်ပြီး Pi ကို ဂဏန်းထရီလီယံအထိ တိကျစွာ တွက်ချက်ပေးပါသည်။ ဤစံနှုန်းသည် အထူးသဖြင့် သိပ္ပံနည်းကျသုတေသနနှင့် ပြင်းထန်သော ဂဏန်းတွက်ချက်မှုလိုအပ်သော သရုပ်ဖော်မှုများတွင် အသုံးပြုရန် ဆာဗာများနှင့် အလုပ်စခန်းများ၏ တွက်ချက်မှုစွမ်းအားကို ညွှန်ပြသည်။
| Y-Cruncher (စုစုပေါင်း တွက်ချက်ချိန်) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| ၅၀ ဘီလီယံ ဂဏန်းများ | 11.023 စက္ကန့် | 11.759 စက္ကန့် |
| ၅၀ ဘီလီယံ ဂဏန်းများ | 28.693 စက္ကန့် | 32.073 စက္ကန့် |
| ၅၀ ဘီလီယံ ဂဏန်းများ | 61.786 စက္ကန့် | 69.869 စက္ကန့် |
| ၅၀ ဘီလီယံ ဂဏန်းများ | 130.547 စက္ကန့် | 151.820 စက္ကန့် |
| ၅၀ ဘီလီယံ ဂဏန်းများ | 353.858 စက္ကန့် | 425.824 စက္ကန့် |
| ၅၀ ဘီလီယံ ဂဏန်းများ | 788.912 စက္ကန့် | 971.086 စက္ကန့် |
Y-Cruncher benchmark က Grando Server ရဲ့ အနည်းငယ်သာလွန်ကောင်းမွန်တဲ့ တွက်ချက်မှုစွမ်းရည်တွေကို ဖော်ပြနေပြီး၊ အလွန်တောင်းဆိုမှုများတဲ့ အလုပ်တွေအတွက် စိတ်ကြိုက်ပြင်ဆင်ထားပါတယ်။ Grando Workstation က သိပ္ပံနဲ့ ခွဲခြမ်းစိတ်ဖြာမှုဆိုင်ရာ အသုံးချမှုအမျိုးမျိုးအတွက် သင့်တော်တဲ့ သိသာထင်ရှားတဲ့ တွက်ချက်မှုစွမ်းအားကို ပေးစွမ်းနိုင်ပေမယ့်၊ server ကို အမြင့်ဆုံးတွက်ချက်မှုစွမ်းဆောင်ရည်လိုအပ်တဲ့ အခြေအနေတွေအတွက် အထူးကောင်းမွန်အောင် ပြုလုပ်ထားပါတယ်။ ဒါက Server ရဲ့ ရှုပ်ထွေးတဲ့ simulation တွေနဲ့ ခွဲခြမ်းစိတ်ဖြာမှုတွေကို ပံ့ပိုးပေးရာမှာ၊ တွက်ချက်မှုဆိုင်ရာ အလုပ်တွေကို ပိုမိုမြန်ဆန်ပြီး ထိရောက်စွာ လုပ်ဆောင်နိုင်အောင် အထောက်အကူပြုရာမှာ အခန်းကဏ္ဍကို အလေးပေးဖော်ပြနေပါတယ်။
Geekbench 6
Geekbench 6 သည် CPU နှင့် GPU များ၏ တွက်ချက်မှုစွမ်းဆောင်ရည်ကို တိုင်းတာပေးပြီး single-core နှင့် multi-core စွမ်းရည်များနှင့် ဂရပ်ဖစ်ပရိုဆက်ဆာစွမ်းအားတို့ကို လွှမ်းခြုံထားသည်။ ဤစံနှုန်းသည် သရုပ်ဖော်မှုများ၊ အချက်အလက်ခွဲခြမ်းစိတ်ဖြာမှုနှင့် ဂရပ်ဖစ်ပုံဖော်ခြင်းအပါအဝင် အလုပ်အမျိုးမျိုးတွင် ဆာဗာများနှင့် workstation များ၏ အလုံးစုံတွက်ချက်မှုစွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက် မရှိမဖြစ်လိုအပ်သည်။
| Geekbench 6 (မြင့်လေ ပိုကောင်းလေ) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| CPU Single-Core | 2,127 | 2,131 |
| CPU Multi-Core | 21,621 | 20,411 |
| GPU ကို | 294,894 | 193,447 |
Geekbench 6 ရလဒ်များက Grando Server နှင့် Workstation iteration များအကြား CPU single-core စွမ်းဆောင်ရည်တွင် တူညီမှုနီးပါးရှိကြောင်း ပြသနေပြီး single-threaded processing ကို အားကိုးသော အလုပ်များတွင် နှိုင်းယှဉ်နိုင်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြနေသည်။ သို့သော် Grando Server သည် multi-core နှင့် အထူးသဖြင့် GPU စမ်းသပ်မှုများတွင် သာလွန်ကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ပြသနေပြီး ပိုမိုရှုပ်ထွေးသော၊ parallel processing အလုပ်များနှင့် ပိုမိုပြင်းထန်သော graphical computations များကို ကိုင်တွယ်နိုင်စွမ်းကို ထင်ဟပ်စေသည်။ ၎င်းသည် server ၏ ခိုင်မာသော multi-threaded application များနှင့် high-end graphics processing လိုအပ်သော ပတ်ဝန်းကျင်များအတွက် သင့်လျော်မှုကို ညွှန်ပြနေပြီး compute နှင့် graphics-intensive workflows များတွင် ထုတ်လုပ်နိုင်စွမ်းကို မြှင့်တင်ပေးသည်။
Cinebench R23
Cinebench R23 သည် CPU ၏ rendering စွမ်းရည်ကို single-core နှင့် multi-core စွမ်းဆောင်ရည်ကို အဓိကထား၍ တိုင်းတာသည်။ ၎င်းသည် server သို့မဟုတ် workstation သည် content creation၊ 3D rendering နှင့် အခြား CPU-intensive tasks များတွင် မည်မျှကောင်းမွန်စွာ လုပ်ဆောင်နိုင်သည်ကို အကဲဖြတ်ရန်အတွက် မရှိမဖြစ်လိုအပ်သော benchmark တစ်ခုဖြစ်သည်။ MP Ratio (multi-core performance ratio) သည် system တစ်ခုသည် ၎င်း၏ multiple core များကို မည်မျှထိရောက်စွာ အသုံးချသည်ကို ထိုးထွင်းသိမြင်စေသည်။
| Cinebench R23 (မြင့်လေ ပိုကောင်းလေ) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| CPU Multi-Core | 73,556 | 49,534 |
| CPU Single-Core | 1,484 | 1,468 |
| MP အချိုး | 49.56x | 33.75x |
ဤနေရာတွင် Grando Server သည် multi-core စမ်းသပ်မှုများတွင် Workstation ထက် သာလွန်ကောင်းမွန်ပြီး parallel processing မှ အကျိုးကျေးဇူးရရှိသည့် လိုအပ်ချက်များသော rendering task များကို ကိုင်တွယ်ဖြေရှင်းနိုင်စွမ်းကို ပြသနေသည်။ single-core ရလဒ်များတွင် အနည်းငယ်ကွာခြားချက်က multiple core များမလိုအပ်သော task များတွင် အလားတူထိရောက်မှုများကို ညွှန်ပြနေသည်။ Server မော်ဒယ်၏ MP Ratio မြင့်မားခြင်းက multi-core အသုံးပြုမှုတွင် ၎င်း၏ကျွမ်းကျင်မှုကို ပြသနေပြီး rendering နှင့် simulation project များတွင် ရှုပ်ထွေးသော၊ multi-threaded application များကို ကိုင်တွယ်ရာတွင် ကျွမ်းကျင်စေသည်။
Cinebench ၂
Cinebench 2024 သည် ရိုးရာ CPU benchmark များနှင့်အတူ GPU စွမ်းဆောင်ရည်ကို ပေါင်းစပ်ခြင်းဖြင့် ၎င်း၏ 2023 counterpart ၏ အတိုင်းအတာကို တိုးချဲ့ထားသည်။ ဤပြည့်စုံသော ဗျူဟာသည် လက်ရှိ 3D အကြောင်းအရာဖန်တီးမှုနှင့် rendering လုပ်ဆောင်ချက်များ၏ တင်းကျပ်သော လိုအပ်ချက်များကို စီမံခန့်ခွဲရာတွင် စနစ်တစ်ခု၏ ကျွမ်းကျင်မှုကို အကဲဖြတ်ရန်အတွက် မရှိမဖြစ်လိုအပ်သည်။ ၎င်းသည် ၎င်း၏ တွက်ချက်မှုနှင့် ဂရပ်ဖစ် rendering စွမ်းရည်များအပေါ် အားလုံးပါဝင်သော ရှုထောင့်ကို ပေးဆောင်သည်။
| Cinebench ၂၀၂၄ (မြင့်လေ ပိုကောင်းလေ) | Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x 4090) | Grando Workstation (TR 3975WX၊ 512GB၊ 4x A100) |
|---|---|---|
| GPU ကို | 140,842 | 52,829 |
| CPU Multi-Core | 4,430 | 2,817 |
| CPU Single-Core | 90 | 89 |
| MP အချိုး | 49.49x | 31.73x |
Grando Server သည် GPU နှင့် CPU multi-core benchmarks များတွင် အထင်ကြီးလောက်သော စွမ်းဆောင်ရည်ကို ပြသထားပြီး အရင်းအမြစ်များစွာကို အသုံးပြုသည့် ရှုပ်ထွေးသော rendering task များကို ကိုင်တွယ်ရာတွင် ၎င်း၏ အားသာချက်ကို ညွှန်ပြနေသည်။ ဆန့်ကျင်ဘက်အနေဖြင့် Grando Workstation သည် အထူးသဖြင့် Server မော်ဒယ်နှင့် နှိုင်းယှဉ်ပါက ၎င်း၏ ဗိသုကာနှင့် configuration ကို ထည့်သွင်းစဉ်းစားလျှင် ချီးကျူးဖွယ်ကောင်းသော စွမ်းဆောင်ရည်ကို ပြသထားသည်။ စနစ်နှစ်ခုကြားရှိ CPU single-core ရမှတ်များသည် multi-core processing ကို များစွာမှီခိုခြင်းမရှိသော task များအတွက် နှိုင်းယှဉ်နိုင်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြနေသည်။ နောက်ဆုံးအနေဖြင့် 49.49x ၏ MP Ratio ရမှတ်သည် Server မော်ဒယ်၏ multi-core configuration ကို အမြင့်ဆုံးဖြစ်အောင် လုပ်ဆောင်ရာတွင် ကျွမ်းကျင်မှုကို အလေးပေးဖော်ပြပြီး အကောင်းဆုံးစွမ်းဆောင်ရည်နှင့် အမြန်နှုန်းရရှိရန် မြင့်မားသော CPU နှင့် GPU throughput လိုအပ်သော တောင်းဆိုမှုများသော ပရောဂျက်များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။
Virtualized Desktop စွမ်းဆောင်ရည်
စနစ်တစ်ခုလုံးရဲ့ စွမ်းဆောင်ရည်ကို ကြည့်ရှုတဲ့ benchmark တွေအပြင်၊ တစ်ခုချင်းစီမှာ သီးသန့် 4090 GPU ပါတဲ့ virtual desktop ခြောက်ခုကို မျှဝေဖို့အတွက် Grando Server စနစ်ကို virtualize လုပ်ချင်ပါတယ်။ Windows Server 2022 Standard ကို ဖြန့်ကျက်ပြီး virtual machine (VM) ခြောက်ခုကို setup လုပ်ခဲ့ပါတယ်၊ GPU တစ်ခုစီအတွက် တစ်ခုစီပါ၊ ဒါကြောင့် tasks တွေကို ထိရောက်စွာ ဖြန့်ဝေနိုင်ပြီး system ရဲ့ စစ်မှန်တဲ့ စွမ်းရည်တွေကို စမ်းသပ်နိုင်ပါတယ်။
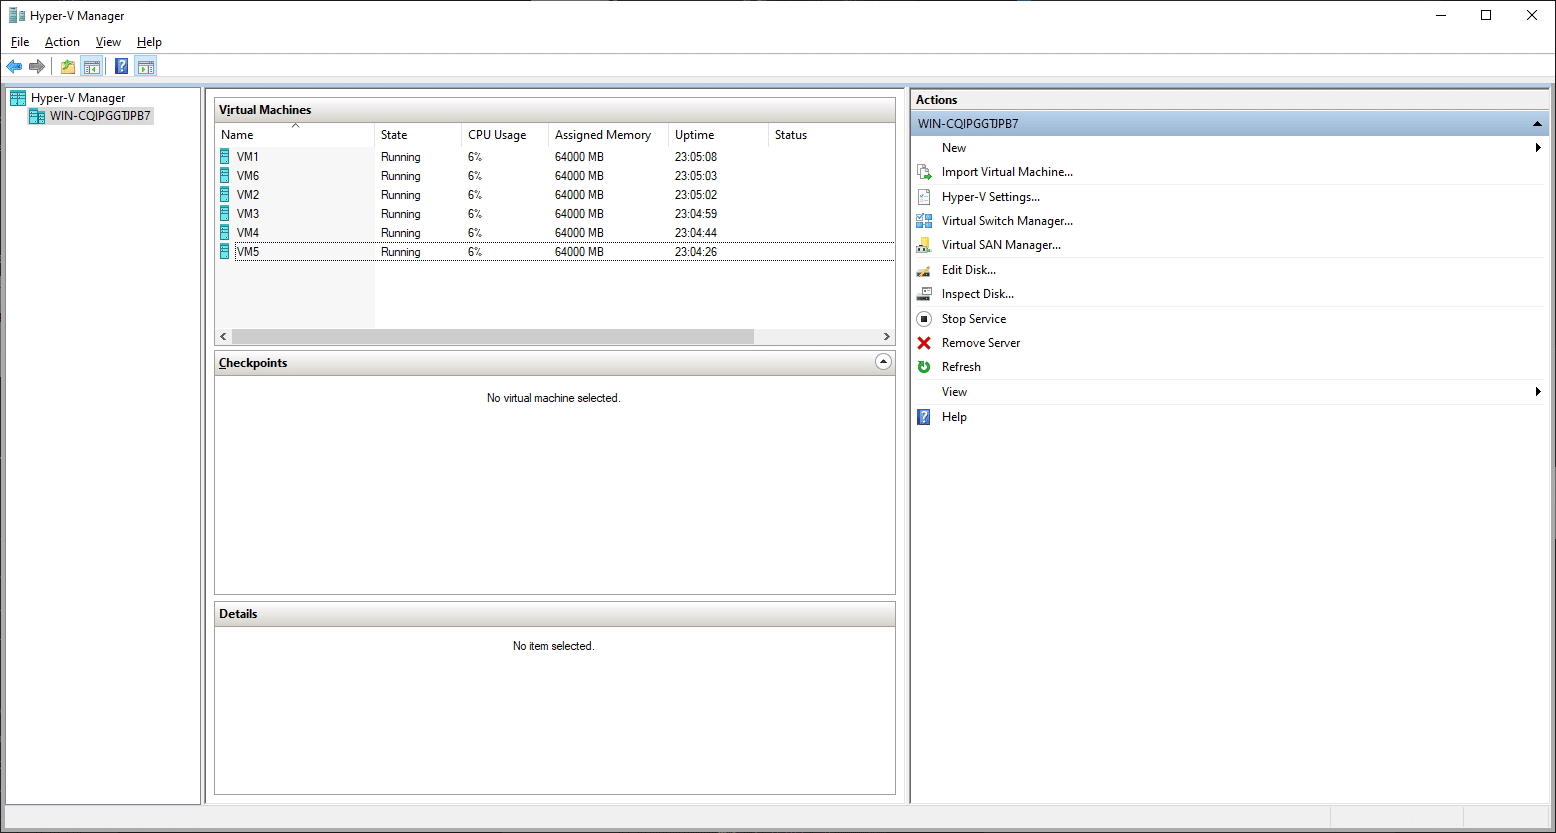
RTX 4090 GPU တစ်ခုစီအတွက် VM တစ်ခု တည်ဆောက်ခြင်းဖြင့်၊ ကျွန်ုပ်တို့သည် သီးသန့် workstation တစ်ခုကို တုပသည့် သီးခြားပတ်ဝန်းကျင်တစ်ခုကို ဖန်တီးပေးပြီး GPU တစ်ခုစီ၏ စွမ်းဆောင်ရည်ကို အာရုံစိုက် အကဲဖြတ်နိုင်စေပါသည်။ အောက်တွင် passthrough လုပ်ငန်းစဉ်၏ powershell လုပ်ငန်းစဉ်ကို ဖော်ပြထားသည်။
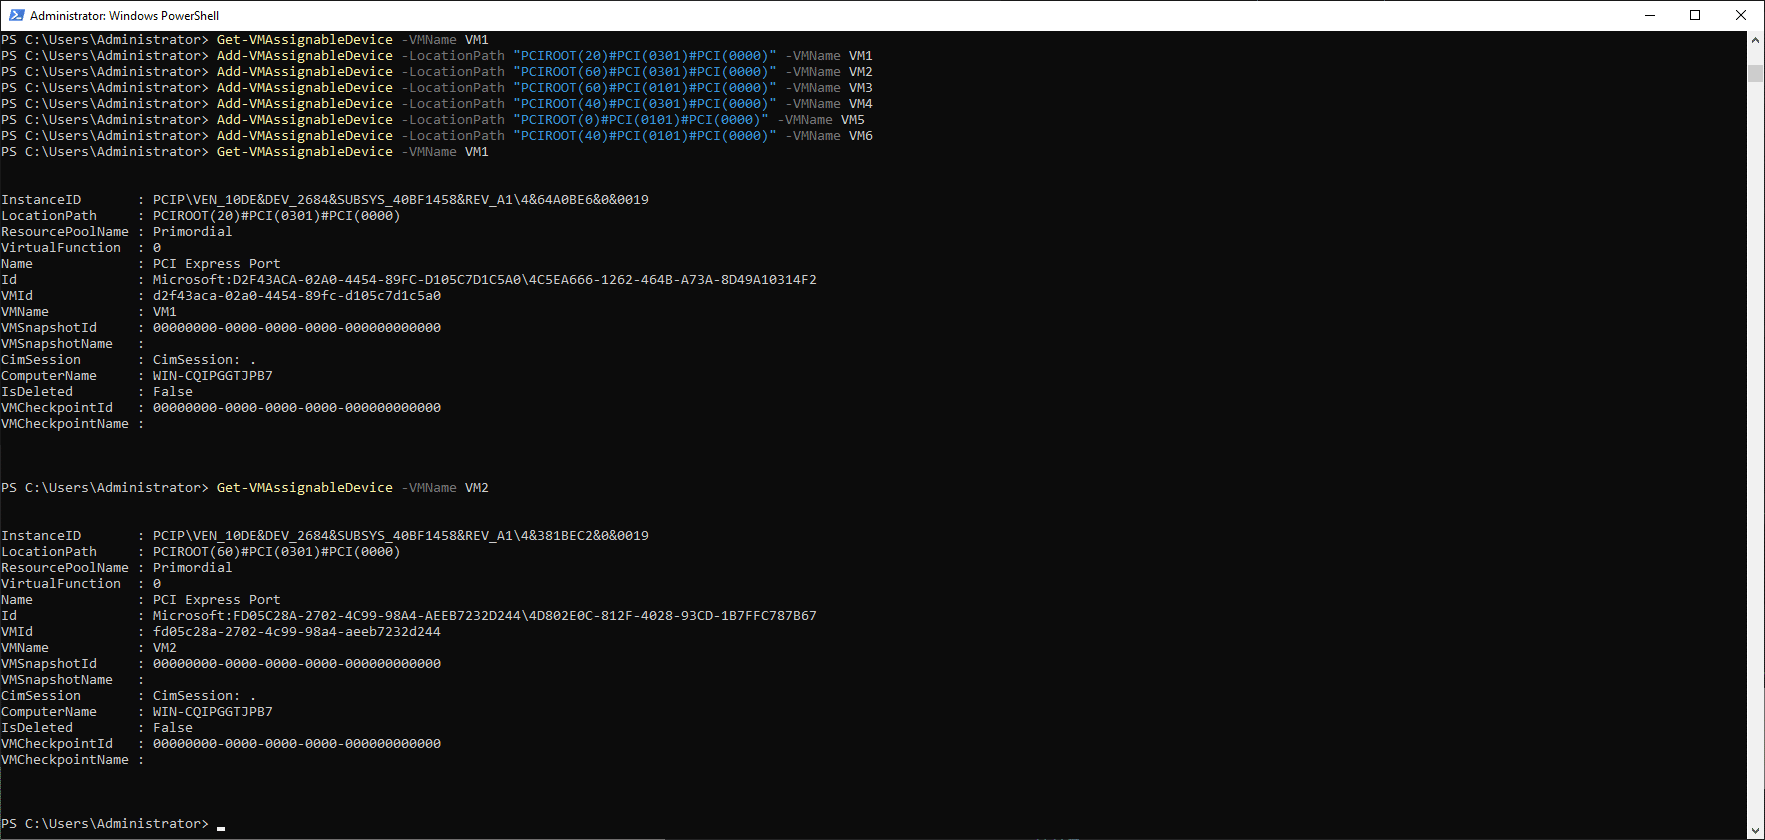
ဒီ setup ဟာ multi-GPU စနစ်မှာ အားသာချက်တွေနဲ့ အလားအလာရှိတဲ့ အတားအဆီးတွေကို ဖော်ထုတ်ဖို့အတွက်လည်း အသုံးဝင်ပါတယ်၊ ဘာလို့လဲဆိုတော့ shared resources တွေရဲ့ ဝင်ရောက်စွက်ဖက်မှုမရှိဘဲ card တစ်ခုစီရဲ့ စွမ်းဆောင်ရည်ကို သီးခြားစီ အကဲဖြတ်နိုင်စေလို့ပါ။
LuxMark
LuxMark benchmark ရလဒ်များသည် Hallbench တွင် ရမှတ် ၃၈,၅၉၉ မှ ၄၀,၇၉၇ အထိ ခိုင်မာသော အကွာအဝေးကို ပြသထားသည်။ ၎င်းသည် စွမ်းဆောင်ရည်တွင် ထူးခြားသော တသမတ်တည်းရှိကြောင်း ပြသနေပြီး၊ လုပ်ငန်းလည်ပတ်မှု အတက်အကျများ သို့မဟုတ် VM-သီးသန့် ဖွဲ့စည်းမှုများကြောင့် အနည်းငယ် ကွဲပြားမှုများ ရှိနိုင်သည်။ အမြင့်ဆုံးရမှတ်များ (VM1 နှင့် VM4) သည် အစားအသောက်အမျိုးအစားအတွက် အလားတူ ray tracing လုပ်ငန်းများအတွက် RTX 4090 GPU များ၏ အမြင့်ဆုံးစွမ်းဆောင်ရည်စွမ်းရည်ကို မီးမောင်းထိုးပြသည်။
အလုံးစုံသော် ဤရလဒ်များသည် Comino server ၏ GPU တစ်ခုတည်းကို အသုံးပြု၍ high-end computing task များအတွက် စွမ်းဆောင်ရည်ကို ပြသနေပြီး၊ တစ်ပြိုင်နက်တည်း workload များစွာတွင် ပါဝါနှင့် တိကျမှု နှစ်မျိုးလုံးကို ပေးဆောင်ပါသည်။ စုစုပေါင်းရမှတ်ကို standalone client system စွမ်းဆောင်ရည်နှင့် နှိုင်းယှဉ်ကြည့်သောအခါ၊ သီးခြားစနစ် ၆ ခုသည် အလွန်ကောင်းမွန်စွာ လုပ်ဆောင်နိုင်ခဲ့သည်။ ကျွန်ုပ်တို့သည် Hallbench တွင် ၂၄၁,၁၈၃ မှတ်နှင့် Food တွင် ၁၀၃,၃၉၉ မှတ်ကို တိုင်းတာခဲ့ပြီး standalone ရလဒ် ၂၄၀,၃၀၃ မှတ်နှင့် ၉၂,၁၅၆ မှတ် အသီးသီး ရရှိခဲ့ပါသည်။
| Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x NVIDIA RTX 4090) | ဟောလ်ဘန်ချ် | အစားအသောက်များ |
| စုစုပေါင်း | 241,183 | 103,399 |
| VM1 | 40,797 | 17,370 |
| VM2 | 38,599 | 17,415 |
| VM3 | 40,363 | 16,898 |
| VM4 | 40,651 | 17,129 |
| VM5 | 40,138 | 17,111 |
| VM6 | 40,635 | 17,476 |
Cinebench ၂
Cinebench 2024 benchmark သည် virtualized environment အောက်တွင် GPU တစ်ခုချင်းစီသည် ရှုပ်ထွေးသော rendering tasks များကို မည်သို့ကိုင်တွယ်သည်ကို အကဲဖြတ်နိုင်စေပါသည်။ ဤ workload တွင် အဓိကအာရုံစိုက်မှုမှာ GPU ဖြစ်သည်၊ အဘယ်ကြောင့်ဆိုသော် ကျွန်ုပ်တို့သည် ရရှိနိုင်သော host CPU resources များကို VM တစ်ခုချင်းစီသို့ အပြည့်အဝ ပံ့ပိုးပေးခြင်း မပြုခဲ့ပါ။ ဤနေရာတွင် ကျွန်ုပ်တို့သည် စုစုပေါင်း GPU ရမှတ် 183,348 pts ကို တိုင်းတာခဲ့ပြီး client system သည် 140,842 pts ရရှိခဲ့သည်။
| Grando ဆာဗာ (TR W5995WX၊ 512GB၊ 6x NVIDIA RTX 4090) | ||||
| GPU ကို | CPU (မာလ်တီ ကော်ပတ်စ်) | CPU (တစ်ခုတည်းသော core) | လွှတ်တော်အမတ်အချိုး | |
| စုစုပေါင်း | 183,348 မှတ် | 2,333 မှတ် | 487 မှတ် | 4.78x |
| VM1 | 31,178 မှတ် | 394 မှတ် | 82 မှတ် | 4.83x |
| VM2 | 30,925 မှတ် | 392 မှတ် | 81 မှတ် | 4.81x |
| VM3 | 29,406 မှတ် | 384 မှတ် | 81 မှတ် | 4.74x |
| VM4 | 30,816 မှတ် | 391 မှတ် | 81 မှတ် | 4.81x |
| VM5 | 30,440 မှတ် | 386 မှတ် | 81 မှတ် | 4.76x |
| VM6 | 30,583 မှတ် | 386 မှတ် | 81 မှတ် | 4.75x |
GPU ရမှတ်များသည် ၂၉,၄၀၆ မှ ၃၁,၁၇၈ အထိရှိပြီး စွမ်းဆောင်ရည် မြင့်မားမှုကို ပြသနေသည်။ CPU multi-core ရမှတ်များကို ၃၈၄ မှ ၃၉၄ အကြား တင်းကျပ်စွာ အုပ်စုဖွဲ့ထားပြီး single-core ရမှတ်များသည် ၈၁ မှ ၈၂ အထိ ရှိပြီး VM အားလုံးတွင် ပြင်းထန်သော အလုပ်များကို ထိရောက်စွာ ကိုင်တွယ်ဖြေရှင်းနိုင်သည့် ဆာဗာ၏ စွမ်းရည်ကို ပြသနေသည်။
multi-core မှ single-core စွမ်းဆောင်ရည်အချိုး (MP အချိုး) သည် 4.74x မှ 4.83x အထိ အနည်းငယ်ကွဲပြားပြီး multi-threaded rendering task များကို အကျိုးပြုသည့် processing power ၏ မျှတသော ဖြန့်ဖြူးမှုကို ထင်ဟပ်စေသည်။ ရမှတ်များကိုယ်တိုင်ကမူ အလုံးစုံအားဖြင့် ဤရလဒ်များသည် Comino Grando Server ၏ virtualized environment တွင် ခိုင်မာသောစွမ်းဆောင်ရည်ကို ပြသနေပြီး ထိရောက်မှုနှင့် အမြန်နှုန်းသည် အဓိကကျသည့် 3D rendering နှင့် computational task များအတွက် အလွန်သင့်လျော်စေသည်။
Blender ၂.၆၅
Blender benchmark အတွင်း VM တစ်ခုစီသည် မတူညီသော scene သုံးခုဖြစ်သည့် Monster၊ Junkshop နှင့် Classroom တို့တွင် တသမတ်တည်း စွမ်းဆောင်ရည်ကို ပြသခဲ့သည်။ VM6 သည် Monster scene တွင် အမြင့်ဆုံးရမှတ် ၅,၉၄၉ ဖြင့် ထင်ရှားပြီး VM resource allocation သို့မဟုတ် workload handling တွင် အနည်းငယ်ကွဲပြားမှုကြောင့် ဖြစ်နိုင်သည့် စွမ်းဆောင်ရည်တွင် အနည်းငယ်ကွဲလွဲမှုကို ညွှန်ပြသည်။ Junkshop scene ရမှတ်များသည် အတော်လေးနီးကပ်ပြီး VM5 သည် အနိမ့်ဆုံးရမှတ် ၂,၆၅၆ ဖြင့် ပြသသည်။ Classroom scene ရလဒ်များသည် ပိုမိုကွဲပြားပြီး VM2 သည် အမြင့်ဆုံးရမှတ် ၂,၈၆၈ ဖြင့် ရရှိပြီး geometry ကြွယ်ဝသော scene များကို ကိုင်တွယ်ရာတွင် ကွဲပြားမှုများကို ညွှန်ပြသည်။
ဤရလဒ်များကို Blender တွင် workload ကို ချဲ့ထွင်နိုင်ခြင်းမရှိသော virtualized မဟုတ်သော Server နှင့် နှိုင်းယှဉ်သောအခါ၊ ကျွန်ုပ်တို့သည် စွမ်းဆောင်ရည်နှင့် အသုံးပြုမှုတွင် များစွာပိုမိုကောင်းမွန်သည်ကို တွေ့ရှိရပါသည်။ client system သည် Monster တွင် 5,881၊ Junkshop တွင် 2,809 နှင့် Classroom တွင် 2,896 ဖြင့် ထိပ်ဆုံးမှ ရပ်တည်ခဲ့ပြီး ကျွန်ုပ်တို့၏ Windows HyperV ဖြန့်ကျက်မှုတွင် စုစုပေါင်း Monster တွင် 34,729၊ Junkshop တွင် 16,270 နှင့် Classroom တွင် 16,836 ရရှိခဲ့သည်။
| Blender 4.0 – Grando Server (TR W5995WX, 512GB, 6x NVIDIA RTX 4090) |
||||
| ဧရာမသတ္တဝါကြီး | အမှိုက်ဆိုင် | စာသင်ခန်း | ||
| စုစုပေါင်း | 34,726 | 16,270 | 16,836 | |
| VM1 | 5,773 | 2,764 | 2,791 | |
| VM2 | 5,766 | 2,748 | 2,868 | |
| VM3 | 5,741 | 2,716 | 2,750 | |
| VM4 | 5,828 | 2,683 | 2,810 | |
| VM5 | 5,669 | 2,656 | 2,837 | |
| VM6 | 5,949 | 2,703 | 2,780 | |
ကောက်ချက်
Comino Grando Server နှင့် Workstation တို့သည် GPU-driven performance system များကို မှန်ကန်စွာလုပ်ဆောင်ခြင်း၊ data analysis၊ AI research နှင့် graphic-intensive tasks များကဲ့သို့သော လိုအပ်ချက်မြင့်မားသော နယ်ပယ်များကို ဖြည့်ဆည်းပေးခြင်း၏ အကောင်းဆုံး ဥပမာများဖြစ်သည်။ NVIDIA RTX 4090s ခြောက်လုံးဖြင့် configure လုပ်ထားသော Server မော်ဒယ်သည် လေးလံသော computing work များအတွက် ဒီဇိုင်းထုတ်ထားသော powerpower တစ်ခုဖြစ်ပြီး AMD ၏ Threadripper PRO 5995WX CPU နှင့် 512GB DDR5 memory တို့ဖြင့် ဖြည့်စွက်ထားသည်။ ဤ configuration သည် parallel processing နှင့် high-speed data manipulation လိုအပ်သော server environment များအတွက် အကောင်းဆုံးရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။
ဆန့်ကျင်ဘက်အနေနဲ့ core-purpure အနည်းငယ်နည်းပေမယ့် Workstation မော်ဒယ်က NVIDIA A100 GPU လေးခုနဲ့ ညီမျှခြင်းကို ဟန်ချက်ညီစေပြီး အသေးစိတ် 3D modeling နဲ့ deep learning tasks တွေမှာ သူ့ရဲ့ ကျွမ်းကျင်မှုကို ပြသနေပါတယ်။ ဒီစနစ်ဒီဇိုင်းက အနည်းငယ်ကွဲပြားပြီး ပိုမိုတိတ်ဆိတ်တဲ့ လုပ်ဆောင်ချက်ကို ခွင့်ပြုပေးပါတယ်။ ဒါပေမယ့် တရားမျှတစွာပြောရရင် လေအေးပေးစက်နဲ့ လည်ပတ်တဲ့ server တွေနဲ့ နှိုင်းယှဉ်ရင် ကျွန်တော်တို့ရဲ့ ဓာတ်ခွဲခန်းမှာ နှစ်ခုစလုံးက အလွန်တိတ်ဆိတ်ပါတယ်။
စွမ်းဆောင်ရည်အရ၊ benchmark ရလဒ်များက ရှင်းလင်းသောပုံရိပ်ကို ပုံဖော်ပေးသည်- Grando Server သည် OctaneBench နှင့် Blender 4.0 ကဲ့သို့သော GPU-intensive စမ်းသပ်မှုများတွင် ထူးချွန်ပြီး high-end rendering အလုပ်များကို လွယ်ကူစွာလုပ်ဆောင်နိုင်စွမ်းကို မီးမောင်းထိုးပြသည်။ ၎င်း၏ စိတ်ကြိုက် CPU-GPU ဟန်ချက်ညီမှုဖြင့် workstation ဗားရှင်းသည် professional application အမျိုးမျိုးအတွက် စွယ်စုံရမှုကို ပေးစွမ်းသည်။ 7-zip Compression နှင့် Y-Cruncher benchmarks များက သက်သေပြသည့်အတိုင်း စနစ်နှစ်ခုလုံး၏ ကြီးမားသော dataset များကို စီမံခန့်ခွဲရာတွင် မြန်နှုန်းနှင့် ထိရောက်မှုသည် ယနေ့ခေတ် data-driven ရှုခင်းတွင် အရေးကြီးသော အားသာချက်တစ်ခုဖြစ်သည့် data-intensive လုပ်ငန်းဆောင်တာများကို ကိုင်တွယ်နိုင်စွမ်းကို ပေါ်လွင်စေသည်။
6x 4090 စနစ်ကို VDI box အဖြစ်ပြောင်းလဲလိုက်တဲ့အခါ စနစ်တွေရဲ့ ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို ပိုမိုပေါ်လွင်စေခဲ့ပါတယ်။ အဲဒီမှာ တသမတ်တည်းရှိတဲ့ စွမ်းဆောင်ရည်ကိုလည်း ကျွန်တော်တို့ မြင်တွေ့ခဲ့ရပါတယ်။ ဆိုလိုတာက အဖွဲ့အစည်းတစ်ခုဟာ ဒီစနစ်တွေထဲက ဘယ်စနစ်ကိုမဆို သီးသန့် GPU access ရှိတဲ့ remote desktop များစွာကို ပံ့ပိုးပေးဖို့ ထိထိရောက်ရောက် ခွဲဝေပေးနိုင်ပါတယ်။ ဒီအသုံးပြုမှုကို liquid cooling plates တွေက အပြည့်အဝ အထောက်အကူပြုပြီး ဒီလို GPU density မျိုးမျိုးကို single box ထဲမှာ ထည့်သွင်းဖို့ တစ်ခုတည်းသော နည်းလမ်းပါပဲ။
အလုံးစုံပြောရရင် ဒီ Comino Grando စနစ်တွေဟာ ကျွန်တော်တို့မြင်ဖူးသမျှထဲမှာ အထင်ကြီးစရာအကောင်းဆုံးတွေထဲက တစ်ခုပါ။ ဟုတ်ကဲ့၊ အရည်နဲ့အအေးပေးတဲ့ enterprise server ရွေးချယ်စရာတွေ အများကြီးရှိပါတယ်၊ ဒါပေမယ့် အဲဒါက ဒီမှာရည်မှန်းချက်မဟုတ်ပါဘူး။ ဒီ Comino စနစ်တွေဟာ configuration (client နဲ့ enterprise GPU options) နဲ့ rack density/efficiency မှာ အလွန်အမင်းပြောင်းလွယ်ပြင်လွယ်ရှိမှုနဲ့ ပတ်သက်ပါတယ်။ ဒီကဏ္ဍတွေမှာ အလုံးစုံစွမ်းဆောင်ရည်က အလွန်အထင်ကြီးစရာကောင်းပြီး Comino Grando စနစ်တွေကို ၂၀၂၄ ခုနှစ်ရဲ့ အကောင်းဆုံးဆုရှင်တွေထဲက တစ်ခုအဖြစ် သတ်မှတ်ပါတယ်။


 အမေဇုံ