

DapuStor J5060 SSD သည် ဒေတာအသုံးပြုမှုများသောပတ်ဝန်းကျင်များတွင် စွမ်းအင်ချွေတာသောသိုလှောင်မှုအတွက် တိုးပွားလာသောဝယ်လိုအားကိုဖြည့်ဆည်းရန် ဒီဇိုင်းထုတ်ထားသော မြင့်မားသောစွမ်းရည်၊ လုပ်ငန်းသုံး NVMe drive တစ်ခုဖြစ်သည်။ ၎င်းသည် 3D Enterprise QLC NAND Flash ကိုအခြေခံထားပြီး စံ U.2 15mm form factor တွင်တည်ရှိသော PCIe 4.0 x4 interface with NVMe 1.4a ကိုထောက်ပံ့ပေးသည်။ ဤ drive ကို ဖတ်ရှုစွမ်းဆောင်ရည်နှင့် terabyte တစ်ခုလျှင်ကုန်ကျစရိတ်မရှိမဖြစ်လိုအပ်သောအခြေအနေများအတွက် ဒီဇိုင်းထုတ်ထားသည်။ ၎င်းသည် cloud infrastructure၊ AI inference၊ big data platform များနှင့် write operations များရှားပါးသော သို့မဟုတ် ခန့်မှန်းနိုင်သော intelligent manufacturing pipelines ကဲ့သို့သော application များအတွက် အလားအလာရှိသောသင့်လျော်စေသည်။
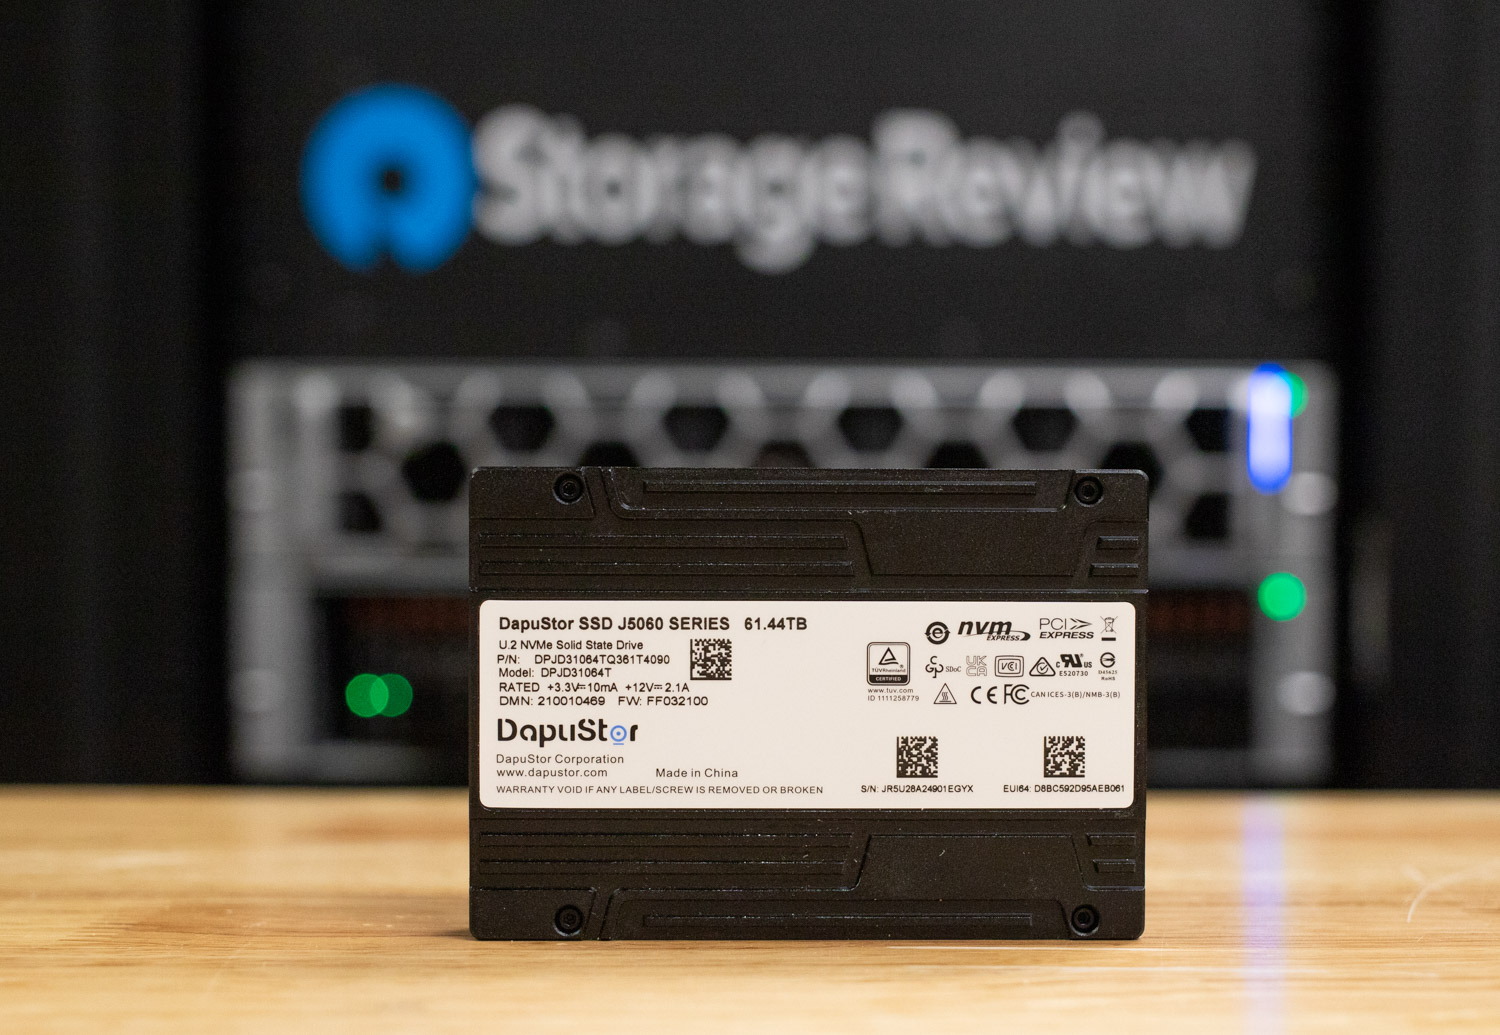
DapuStor J5060 အင်္ဂါရပ်များနှင့် စွမ်းဆောင်ရည်ပရိုဖိုင်
61.44TB အထိ သိုလှောင်နိုင်စွမ်းများ တိုးချဲ့နိုင်သောကြောင့် J5060 သည် ရုပ်ပိုင်းဆိုင်ရာ သိပ်သည်းဆနှင့် ပါဝါသုံးစွဲမှုကို ထိန်းချုပ်ထားစဉ် သိုလှောင်မှုကို ပေါင်းစည်းလိုသော အဖွဲ့အစည်းများအတွက် စိတ်ဝင်စားဖွယ်ကောင်းသော ဖြေရှင်းချက်တစ်ခုကို ပေးစွမ်းပါသည်။ single U.2 drive တွင်ရှိသော ဤစွမ်းရည်အဆင့်သည် multi-petabyte dataset များကို စီမံခန့်ခွဲသည့် hyperscale နှင့် enterprise environment များအတွက် အထူးသဖြင့် သက်ဆိုင်ပြီး၊ rack space နှင့် စွမ်းအင်ထိရောက်မှုသည် အမှန်တကယ် အကန့်အသတ်များဖြစ်သည်။ J5060 တွင် dual-port support၊ advanced power loss protection နှင့် flash-level voltage optimization ကဲ့သို့သော enterprise-grade features များ ပါဝင်သောကြောင့် high-availability deployments များတွင် data integrity နှင့် stability ကို သေချာစေရန် ကူညီပေးပါသည်။
၎င်း၏စွမ်းဆောင်ရည်နှင့် ပတ်သက်၍ J5060 ကို ဖတ်ရှုမှုများပြားသော workloads များအတွက် သတ်မှတ်ထားသည်။ ၎င်းတွင် 7,300MB/s အထိ sequential read throughput ရှိပြီး 1.5 million 4K random read IOPS အထိ ပံ့ပိုးပေးပြီး QLC-based drive အတွက် အားကောင်းသည်။ သို့သော် ၎င်း၏ write စွမ်းဆောင်ရည်မှာ သိသိသာသာ အကန့်အသတ်ရှိပြီး 16KB random writes အတွက် 30K IOPS သာရှိပြီး ဤကန့်သတ်ချက်သည် ကျွန်ုပ်တို့၏ workload testing တစ်လျှောက်လုံးတွင် တသမတ်တည်းဖြစ်သည်။ drive ၏ write bandwidth ကို 3,000MB/s တွင် အဆင့်သတ်မှတ်ထားသည်။ သို့သော် ၎င်းသည် ရေရှည် သို့မဟုတ် မြင့်မားသော depth write လုပ်ဆောင်ချက်များအောက်တွင် ကောင်းစွာ မခံနိုင်သောကြောင့် ရောနှော သို့မဟုတ် write-intensive tasks များအတွက် ၎င်း၏သင့်လျော်မှုကို ထိခိုက်စေနိုင်သည်။
QLC NAND ကိုအသုံးပြုခြင်းဖြင့် DapuStor သည် ဤမြင့်မားသောစွမ်းရည်များကို ကုန်ကျစရိတ်နည်းပါးစွာဖြင့် ပေးပို့နိုင်သော်လည်း အပေးအယူများလည်းရှိပါသည်။ ငါးနှစ်တာကာလအတွင်း ခံနိုင်ရည်အား 0.5 DWPD (Drive Writes Per Day) သာရှိသောကြောင့် J5060 သည် write volume နည်းသော read-centric application များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။ မကြာခဏ checkpointing လုပ်ခြင်း၊ transaction logging သို့မဟုတ် active caching ပါဝင်သည့် workload များသည် drive ၏ခံနိုင်ရည်ကို ဖိအားပေးပြီး write performance တွင် ကန့်သတ်ချက်များကို ဖော်ထုတ်နိုင်သည်။
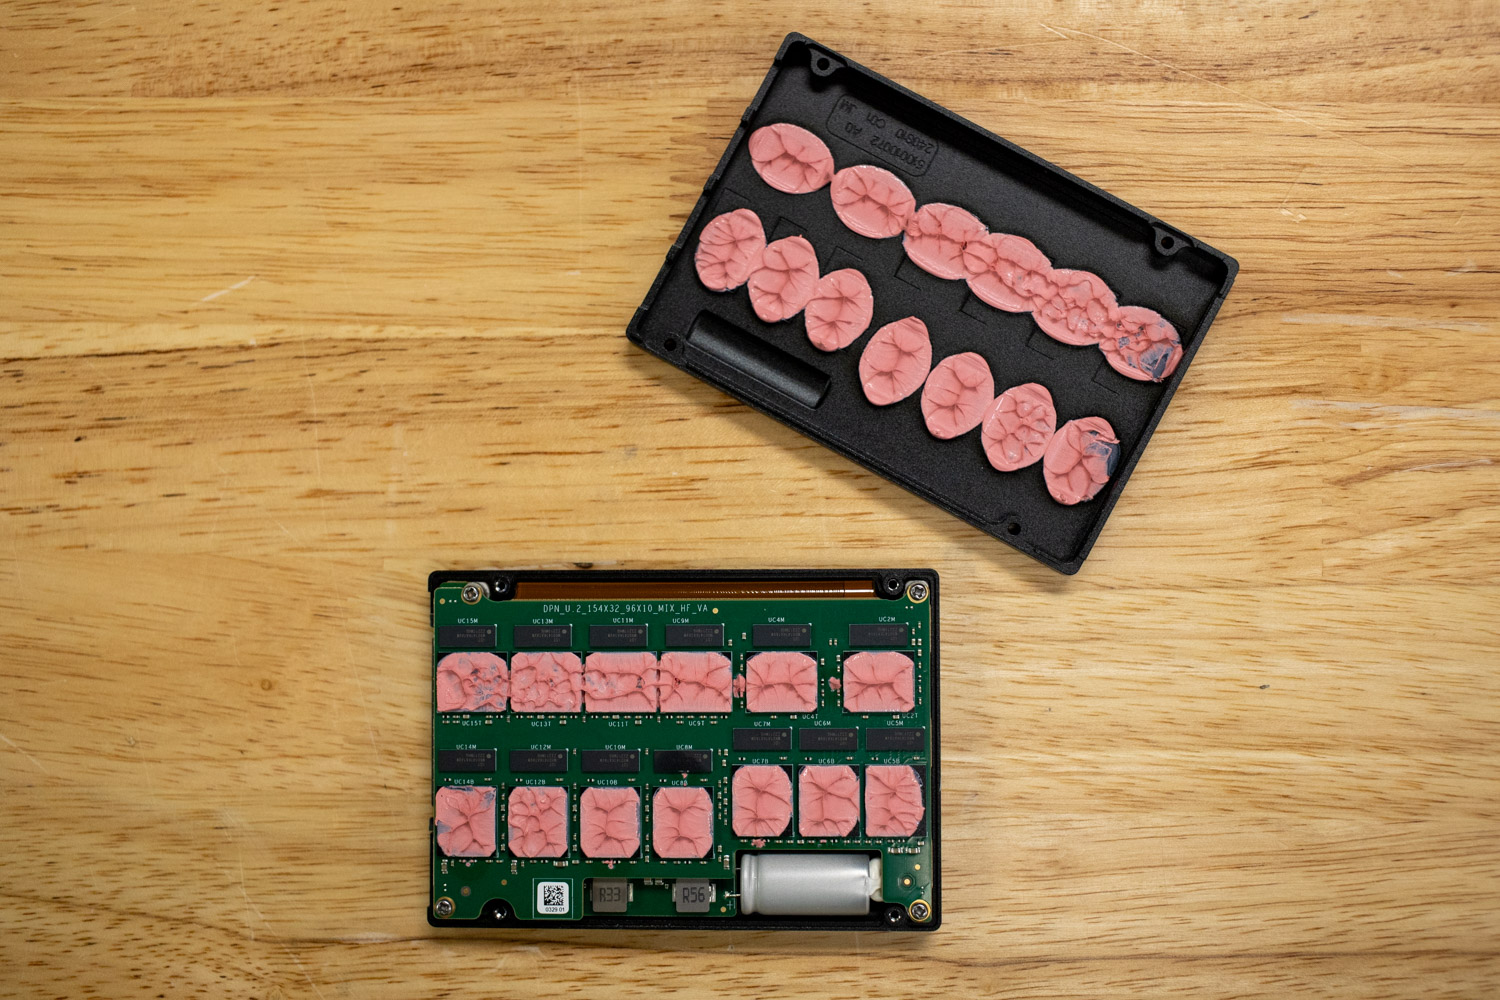
ပါဝါအတွက်၊ drive သည် ဖတ်ရှုသည့်အခါတွင် ဝပ် ၁၂ ခန့်၊ ရေးသားသည့်အခါတွင် ဝပ် ၂၃ အထိနှင့် အားလပ်ချိန်တွင် ဝပ် ၅ သာ အသုံးပြုပါသည်။ ဤကိန်းဂဏန်းများသည် ခေတ်မီ enterprise data center ၏ မျှော်လင့်ချက်များနှင့် ကောင်းစွာ ကိုက်ညီပါသည်၊ အထူးသဖြင့် terabyte တစ်ခုလျှင် ပါဝါသည် စိုးရိမ်စရာ တိုးပွားလာနေသည့် မြင့်မားသော သိပ်သည်းဆ ဖြန့်ကျက်မှုများအတွက်ဖြစ်သည်။
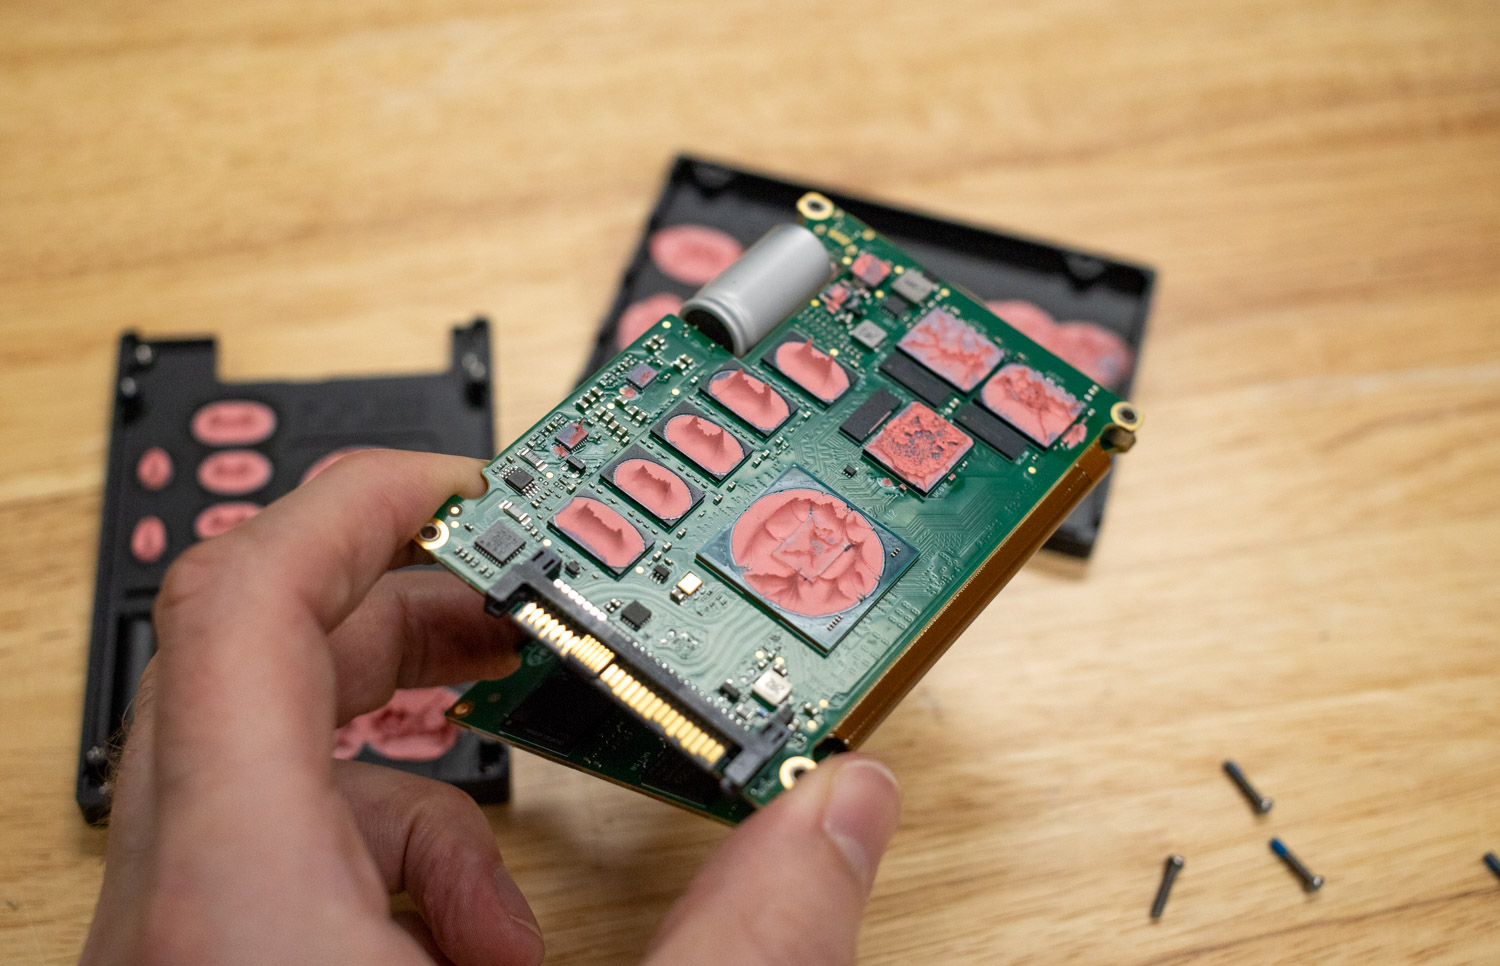
ဤသုံးသပ်ချက်တွင်၊ ကျွန်ုပ်တို့သည် 61.44TB မော်ဒယ်ကို အာရုံစိုက်ပြီး ပေါင်းစပ်ထားသော နှင့် application-aligned workloads များမှတစ်ဆင့် ၎င်း၏ လက်တွေ့ကမ္ဘာစွမ်းဆောင်ရည်ပရိုဖိုင်ကို စစ်ဆေးပါမည်။
DapuStor J5060 သတ်မှတ်ချက်များ
| J5060 | |
|---|---|
| စွမ်းရည် (တီဘီ) | 61.44 |
| form ကို Factor | U.2 15mm |
| interface | PCIe 4.0 x4၊ NVMe 1.4a၊ နှစ်ပေါက် ထောက်ပံ့ပေးထားသည် |
| ဖတ်/ရေး Bandwidth (128K) MB/s | 7400 / 3000 |
| ကျပန်းဖတ်/ရေး (4KB) K IOPS | ၁၅၀၀ / ၃၀ (၁၆KB) |
| 4K Random Latency (အမျိုးအစား။) R/W µs | ၇ (၄KB) / ၁၂ (၁၆KB) |
| 4K စဉ်ဆက်မပြတ် နှောင့်နှေးမှု (ပုံစံ) R/W µs | ၇ (၄KB) / ၁၂ (၁၆KB) |
| ရိုးရိုးပါဝါ (W) | 23 |
| အားလပ်ချိန် ပါဝါ (W) | 5 |
| Flash အမျိုးအစား | 3D Enterprise QLC NAND Flash |
| တည်မြဲခြင်း | ၀.၆ DWPD |
| MTBF | 2 သန်းနာရီ |
| Uber | ဖတ်ရှုမှု 10^17 bits လျှင် 1 sector |
| အာမခံချက် | ၄ နှစ် |
DapuStor J5060 စွမ်းဆောင်ရည်
စစ်ဆေးရေးဂိတ်
AI လေ့ကျင့်ရေးပတ်ဝန်းကျင်များတွင် Dapustor J5060 SSD ၏ လက်တွေ့ကမ္ဘာစွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Data and Learning Input/Output (DLIO) benchmark tool ကို အသုံးပြုခဲ့ပါသည် ။ Argonne National Laboratory မှ တီထွင်ထားသော DLIO ကို deep learning workloads များတွင် I/O ပုံစံများကို စမ်းသပ်ရန် အထူးဒီဇိုင်းထုတ်ထားသည်။ ၎င်းသည် storage system များသည် checkpointing၊ data ingestion နှင့် model training ကဲ့သို့သော စိန်ခေါ်မှုများကို မည်သို့ကိုင်တွယ်ဖြေရှင်းသည်ကို ထိုးထွင်းသိမြင်စေပါသည်။ အောက်ပါဇယားတွင် drive နှစ်ခုစလုံးသည် checkpoints ၉၉ ခုတွင် လုပ်ငန်းစဉ်ကို မည်သို့ကိုင်တွယ်ဖြေရှင်းသည်ကို ဖော်ပြထားသည်။ machine learning model များကို လေ့ကျင့်ပေးသည့်အခါ၊ checkpoints များသည် model ၏အခြေအနေကို ပုံမှန်သိမ်းဆည်းရန်နှင့် အနှောင့်အယှက်များ သို့မဟုတ် ပါဝါပြတ်တောက်မှုများအတွင်း တိုးတက်မှုဆုံးရှုံးမှုကို ကာကွယ်ရန်အတွက် မရှိမဖြစ်လိုအပ်ပါသည်။ ဤသိုလှောင်မှုဝယ်လိုအားသည် အထူးသဖြင့် ရေရှည် သို့မဟုတ် ပြင်းထန်သော workloads များအောက်တွင် ခိုင်မာသောစွမ်းဆောင်ရည် လိုအပ်ပါသည်။
ဤလုပ်ငန်းအတွက် ရွေးချယ်ထားသော ပလက်ဖောင်းမှာ Ubuntu 22.04.02 LTS ကို အသုံးပြုထားသော ကျွန်ုပ်တို့၏ Dell PowerEdge R760 ဖြစ်သည်။ ကျွန်ုပ်တို့သည် ၂၀၂၄ ခုနှစ်၊ ဩဂုတ်လ ၁၃ ရက်နေ့တွင် ထွက်ရှိခဲ့သော DLIO benchmark version 2.0 ကို အသုံးပြုခဲ့သည်။ ကျွန်ုပ်တို့၏ စနစ်ဖွဲ့စည်းပုံကို အောက်တွင်ဖော်ပြထားသည်-
- Intel Xeon Gold 6430 (32-Core, 2.1GHz) ၂ ခု
- 16 x 64GB DDR5-4400 မှတ်ဉာဏ်
- 480GB Dell BOSS SSD
- စီးရီးကြိုးများ Gen5 JBOF
- 61.44TB Dapustor J5060
- ၆၁.၄၄TB Solidigm D5-P5336
ကျွန်ုပ်တို့၏ benchmarking သည် လက်တွေ့ကမ္ဘာအခြေအနေများကို ထင်ဟပ်စေရန်အတွက်၊ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုကို LLAMA 3.1 405B model architecture ပေါ်တွင် အခြေခံခဲ့ပါသည်။ model parameters၊ optimizer states နှင့် layer states များကို ဖမ်းယူရန် torch.save() ကို အသုံးပြု၍ checkpointing ကို အကောင်အထည်ဖော်ခဲ့ပါသည်။ ကျွန်ုပ်တို့၏ setup သည် 8-GPU system တစ်ခုကို simulate လုပ်ခဲ့ပြီး 4-way tensor parallel နှင့် 2-way pipeline parallel processing တို့ပါဝင်သော hybrid parallelism strategy ကို GPU ရှစ်ခုတွင် ဖြန့်ဝေထားပါသည်။ ဤ configuration သည် checkpoint sizes 1,636GB ကို ရရှိစေခဲ့ပြီး ခေတ်မီ large language model training လိုအပ်ချက်များကို ကိုယ်စားပြုပါသည်။
အလုံးစုံသော် Dapustor J5060 သည် စမ်းသပ်မှု၏ အစောပိုင်းအဆင့်တွင် ခိုင်မာသော တသမတ်တည်းရှိမှုကို ပြသခဲ့ပြီး ပထမဆုံး စစ်ဆေးရေးဂိတ် ၃၃ ခုအတွက် အချိန်များသည် ၅၇၅.၆၆ စက္ကန့်ခန့်တွင် ရှိနေခဲ့သည်။ 5060J သည် ဒရိုက်ကို ပထမဆုံးအကြိမ် မဖြည့်မီ ပိုမိုမြင့်မားသော စွမ်းဆောင်ရည်ကို ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ အခြားတစ်ဖက်တွင်၊ Solidigm P5336 သည် J5060 ထက် အစပိုင်းတွင် နှေးကွေးသော်လည်း စမ်းသပ်မှု ဆက်လက်လုပ်ဆောင်သည်နှင့်အမျှ တသမတ်တည်းရှိသော စွမ်းဆောင်ရည်ကို ပြသခဲ့သည်။
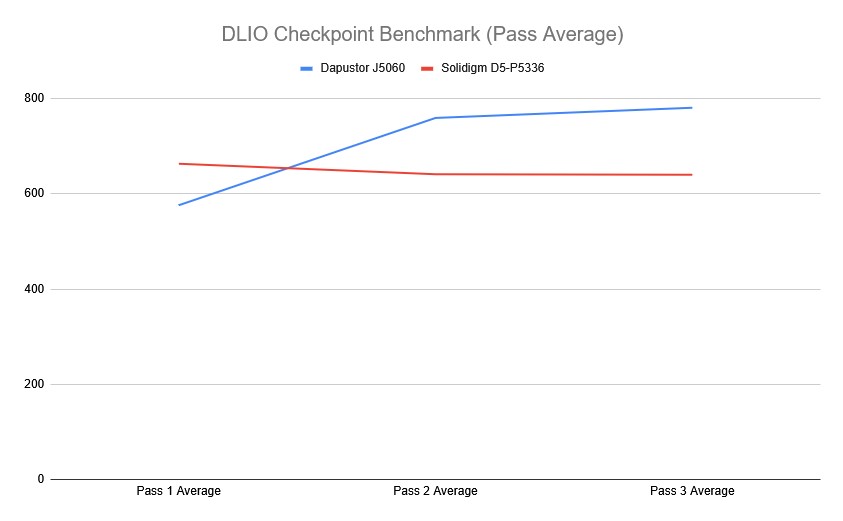
ပျမ်းမျှအားဖြင့် ထည့်သွင်းစဉ်းစား လျှင် Dapustor J5060 သည် ၇၆၉.၄၄ စက္ကန့ ်ဖြင့် ပြီးဆုံးခဲ့ပြီး Solidigm P5336 သည် ၆၄၀.၁၇ စက္ကန့ ်ဖြင့် ပြီးဆုံးခဲ့သည် ။ ၎င်းသည် စစ်ဆေးရေးဂိတ်များကို ပိုမိုမြန်ဆန်စွာ သိမ်းဆည်းရာတွင် Solidigm P5336 ကို ဦးဆောင်စေသည်။
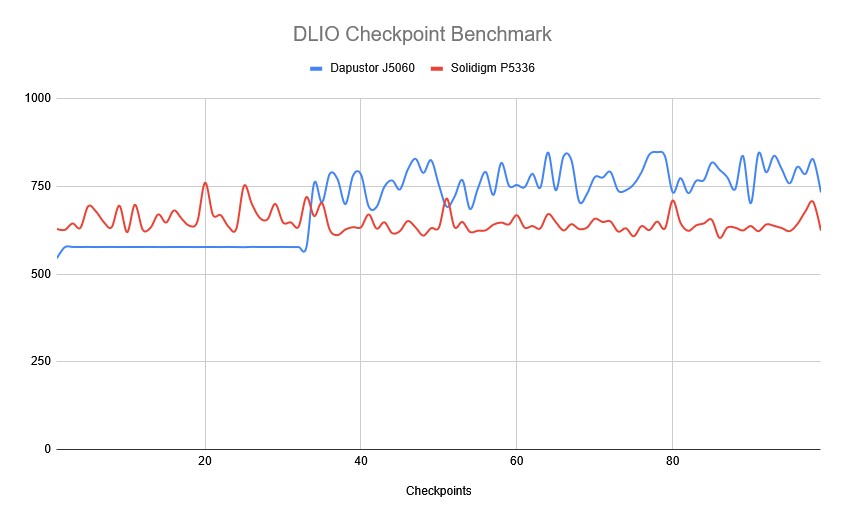
အလုံးစုံပြောရရင် Dapustor J5060 ဟာ တိုတောင်းတဲ့လုပ်ဆောင်ချက်တွေကို ကောင်းကောင်းကိုင်တွယ်နိုင်ပေမယ့် မိနစ် ၃၀ ကျော်ကြာတဲ့အထိ ကြာရှည်စွာရေးသားဖို့တော့ ရုန်းကန်နေရပါတယ်။ တစ်ချိန်တည်းမှာပဲ Solidigm P5336 ဟာ ကြာရှည်တဲ့အလုပ်တွေမှာ တသမတ်တည်းစွမ်းဆောင်ရည်အတွက် ပိုကောင်းတဲ့ drive တစ်ခုဖြစ်ပါတယ်။ Dapustor J5060 ရဲ့ ရေးသားမှုစွမ်းဆောင်ရည် အားနည်းတာကို စမ်းသပ်မှုဆက်လက်လုပ်ဆောင်လာတာနဲ့အမျှ checkpointing speed ယိုယွင်းလာတဲ့အခါ ထင်ရှားပါတယ်။
GPU တိုက်ရိုက်သိုလှောင်မှု
GPU Direct Storage ဆိုသည်မှာ CPU နှင့် system memory ကိုကျော်ဖြတ်၍ storage device များနှင့် GPU များအကြား တိုက်ရိုက်ဒေတာလွှဲပြောင်းနိုင်စေသည့် နည်းပညာတစ်ခုဖြစ်သည်။ ရိုးရာဒေတာလွှဲပြောင်းမှုတွင် ဒေတာကို storage မှ CPU ၏ memory ထဲသို့ ဖတ်ရှုပြီးနောက် GPU ၏ memory သို့ ကူးယူသည်။ ဤလုပ်ငန်းစဉ်တွင် ဒေတာမိတ္တူများစွာပါဝင်သောကြောင့် latency တိုးလာပြီး စွမ်းဆောင်ရည်လျော့ကျစေသည်။ CPU သည် storage နှင့် GPU အကြား ဒေတာလွှဲပြောင်းမှုကို ကိုင်တွယ်ရန် လိုအပ်သောကြောင့် bottleneck အဖြစ် လုပ်ဆောင်သည်။ GDS သည် storage device များအား GPU ၏ memory သို့ ဒေတာနှင့် မှ ဒေတာများကို တိုက်ရိုက်လွှဲပြောင်းခွင့်ပြုခြင်းဖြင့် ဤ bottleneck ကို ဖယ်ရှားပေးသည်။
ကျွန်ုပ်တို့သည် read နှင့် write workloads နှစ်ခုလုံးတွင် အောက်ပါ parameters များ၏ ပေါင်းစပ်မှုတိုင်းကို စနစ်တကျ စမ်းသပ်ခဲ့ပါသည်-
- ဘလောက်အရွယ်အစားများ: 1M၊ 128K၊ 16K
- IODpth: ၁၂၈၊ ၆၄၊ ၃၂၊ ၁၆၊ ၈၊ ၄၊ ၁
ကျွန်ုပ်တို့၏ GDSIO ရလဒ်များကို ပြန်လည်သုံးသပ်သည့်အခါ 61.44TB Dapustor J5060 နှင့် Solidigm P5336 တို့၏ ဖတ်ရှုခြင်းနှင့် ရေးခြင်းစွမ်းဆောင်ရည်ကို စစ်ဆေးပါသည်။
GDSIO စဉ်ဆက်မပြတ်ဖတ်ရှုမှုစွမ်းဆောင်ရည်
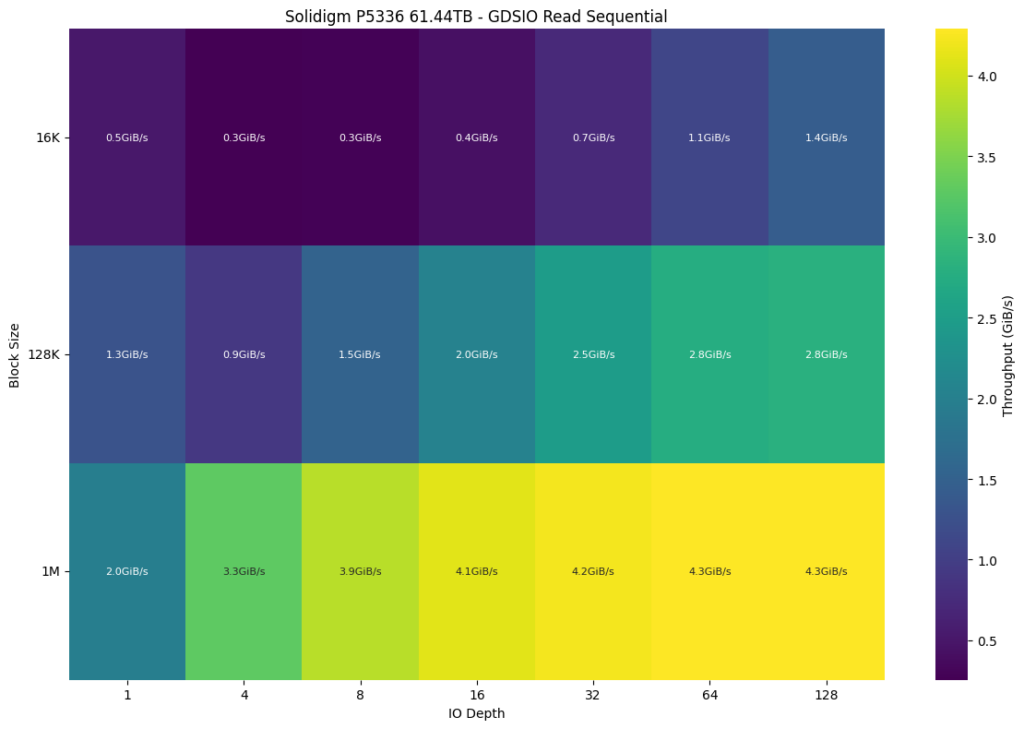
Dapustor J5060 သည် IO အနက် ၆၄ နှင့် ၁၂၈ ရှိသော 1M block အရွယ်အစားတွင် အမြင့်ဆုံးဖတ်ရှုမှု 4.2 GiB/s ရရှိသည်။ အသေးဆုံး block အရွယ်အစား (16K) တွင်၊ IO အနက်တိုးလာသည်နှင့်အမျှ စွမ်းဆောင်ရည်သည် 0.1 GiB/s မှ 0.8 GiB/s အထိရှိသည်။ ၎င်းသည် အကောင်းဆုံး throughput အတွက် IO အနက်မြင့်မားသော block အရွယ်အစားကြီးများကို ဦးစားပေးကြောင်း ရှင်းရှင်းလင်းလင်းပြသသည်။ block အရွယ်အစားကြီးများတွင် အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို ရရှိပြီး အစုလိုက်ဒေတာလွှဲပြောင်းမှုများကို ကိုင်တွယ်ရာတွင် drive ၏ထိရောက်မှုကို ညွှန်ပြသည်။
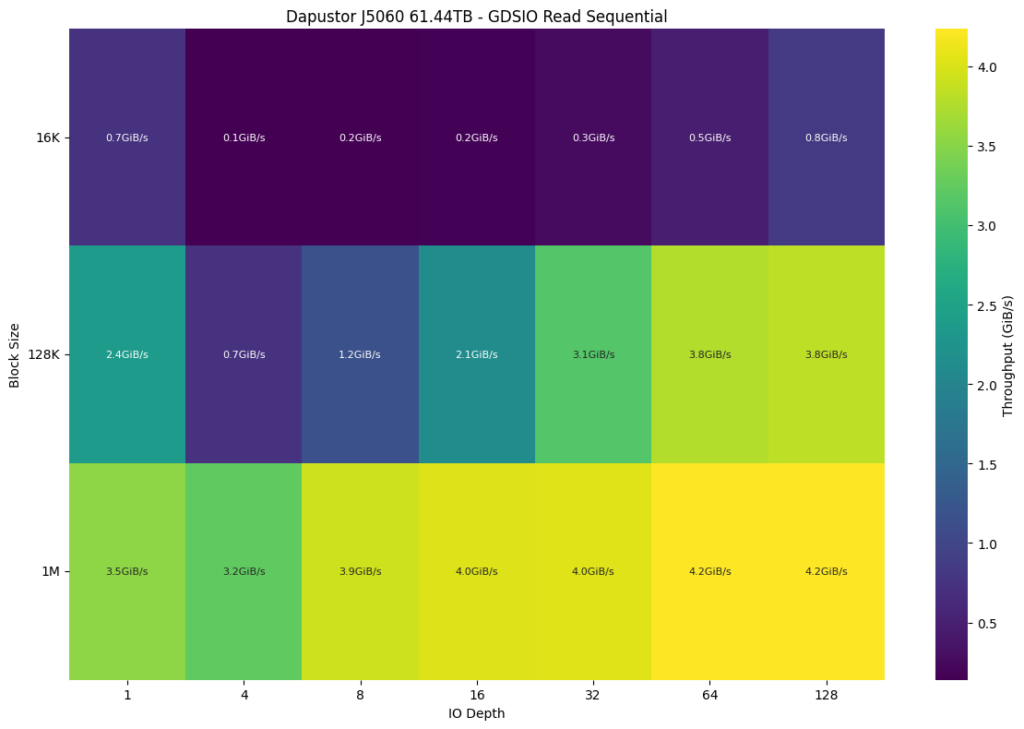
နှိုင်းယှဉ်ကြည့်လျှင် Solidigm P5336 သည် တူညီသော block size (1M) တွင် အလားတူ အမြင့်ဆုံး throughput 4.3 GiB/s သို့ ရောက်ရှိခဲ့သော်လည်း IO depth 32 တွင် ထိုစွမ်းဆောင်ရည်ကို အစောပိုင်းတွင် ရရှိခဲ့ပြီး မြင့်မားသော IO depths များတွင် တသမတ်တည်း ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ ၎င်းသည် Solidigm P5336 အတွက် IO depths ပိုမိုကျယ်ပြန့်သော အပိုင်းအခြားတွင် block အရွယ်အစားကြီးများကို ကိုင်တွယ်ရာတွင် အနည်းငယ်ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြနေသည်။
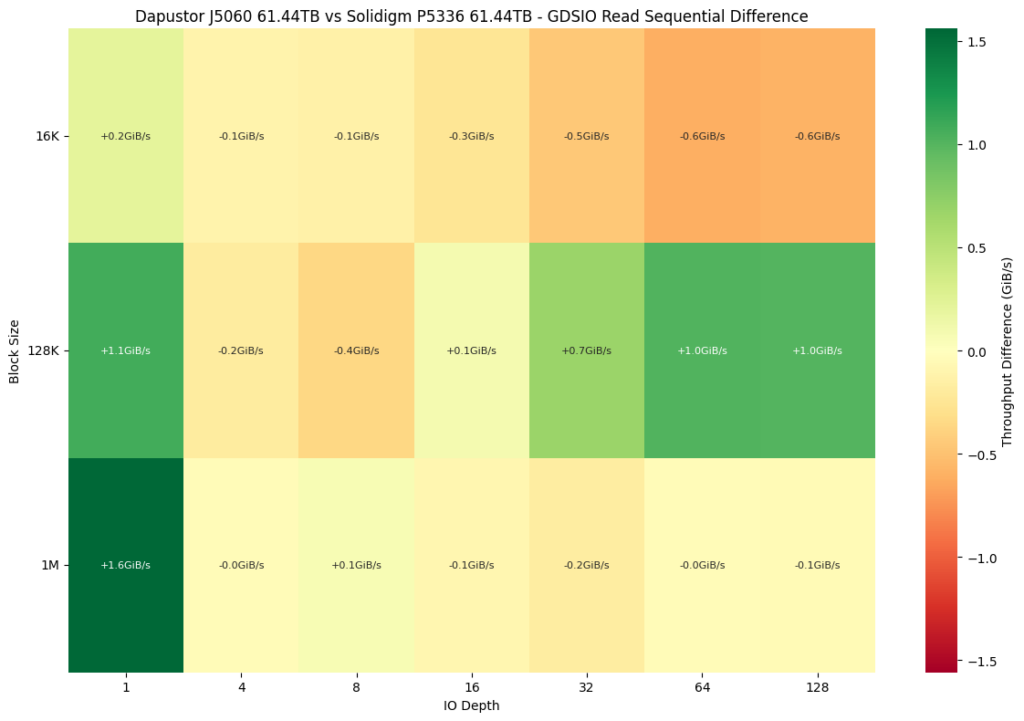
ပိုမိုကောင်းမွန်သော နှိုင်းယှဉ်ချက်အမြင်ပေးနိုင်ရန်အတွက်၊ drive နှစ်ခုလုံးကို နှိုင်းယှဉ်သည့် differential chart တစ်ခုရှိပါသည်။ အစိမ်းရောင်ရှိသော block သည် Dapustor SSD ၏ အားသာချက်ကို ပြသပြီး spectrum ၏ အနီရောင်ဘက်သို့ ရွေ့လျားနေသော block သည် အားနည်းချက်ကို ပြသသည်။ ဤနေရာတွင် J5060 သည် IO အနက် ၄ မှ ၈ အထိမှလွဲ၍ 128K block အရွယ်အစားတွင် P5336 ထက် သာလွန်သည်။ သို့သော်၊ block အရွယ်အစား 16K နှင့် 1M ရှိသော IO အနက်များ ပိုမိုမြင့်မားသောအခါတွင် throughput ကျဆင်းမှုများကို သတိပြုမိပြီး ထိုအခြေအနေများတွင် ထိရောက်မှုနည်းပါးကြောင်း ညွှန်ပြသည်။
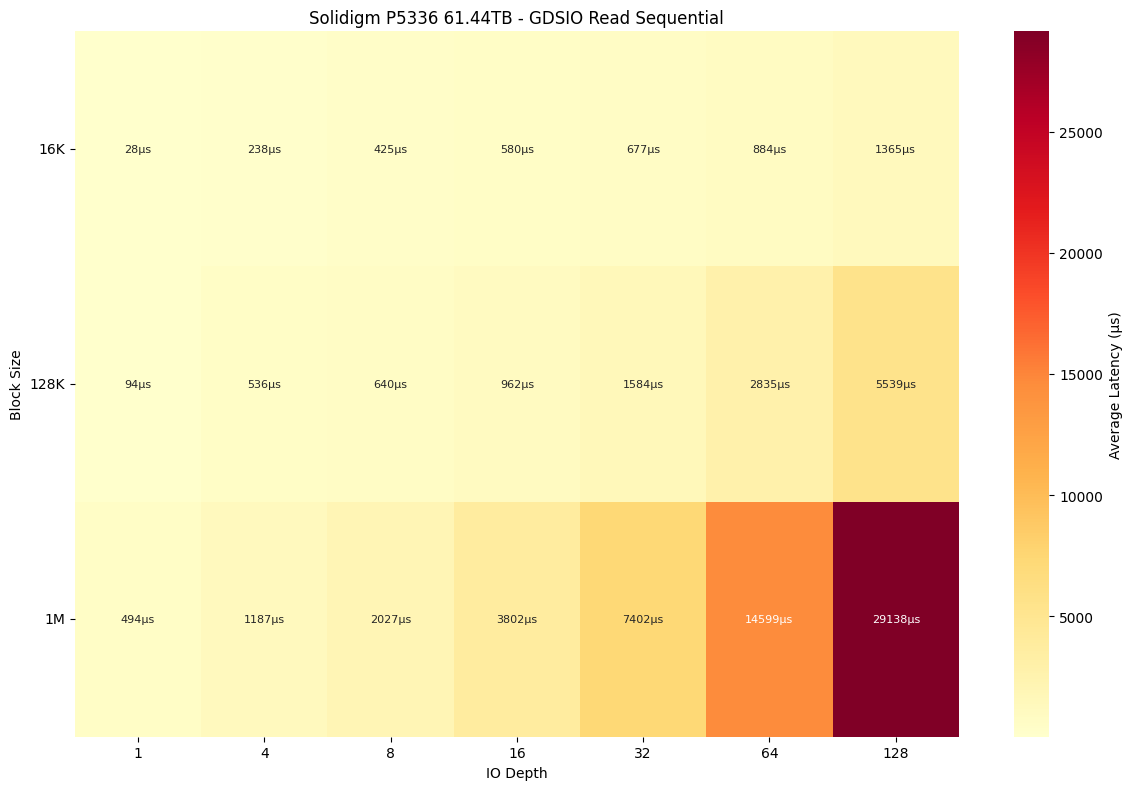
အစဉ်လိုက်ဖတ်ရှုချိန် နှိုင်းယှဉ်ချက်တွင်၊ Solidigm P5336 သည် block အရွယ်အစားနှင့် IO အနက်အားလုံးနီးပါးတွင် Dapustor J5060 ထက် latency နိမ့်ကျမှုကို အဆက်မပြတ်ထိန်းသိမ်းထားသည်။ 16K block အရွယ်အစားတွင်၊ queue အနက်တိုးလာသည်နှင့်အမျှ ကွာဟချက်သည် ပိုမိုထင်ရှားလာသည်- J5060 သည် အနက် 128 တွင် 2,329 μs တွင် အမြင့်ဆုံးရောက်ရှိပြီး P5336 သည် 1,365 μs တွင် နိမ့်ကျနေသည်။ 128K တွင်၊ Solidigm သည် အနက်အများစုကို ထပ်မံဦးဆောင်နေပြီး၊ အနက် 128 တွင် မြင့်မားသောဝန်များ (J5060 တွင် 4,080 μs နှင့် P5336 တွင် 5539 μs) မှလွဲ၍။ 1M block အရွယ်အစားတွင်၊ drive နှစ်ခုစလုံးသည် မျှော်လင့်ထားသည့်အတိုင်း latency တိုးလာသော်လည်း P5336 သည် အနည်းငယ်ပိုမိုကောင်းမွန်စွာ ထိန်းချုပ်ထားပြီး အမြင့်ဆုံး queue အနက်တွင် 29,138 μs နှင့် 29,512 μs ရှိသည်။
GDSIO အဆက်မပြတ်ရေးသားမှုစွမ်းဆောင်ရည်
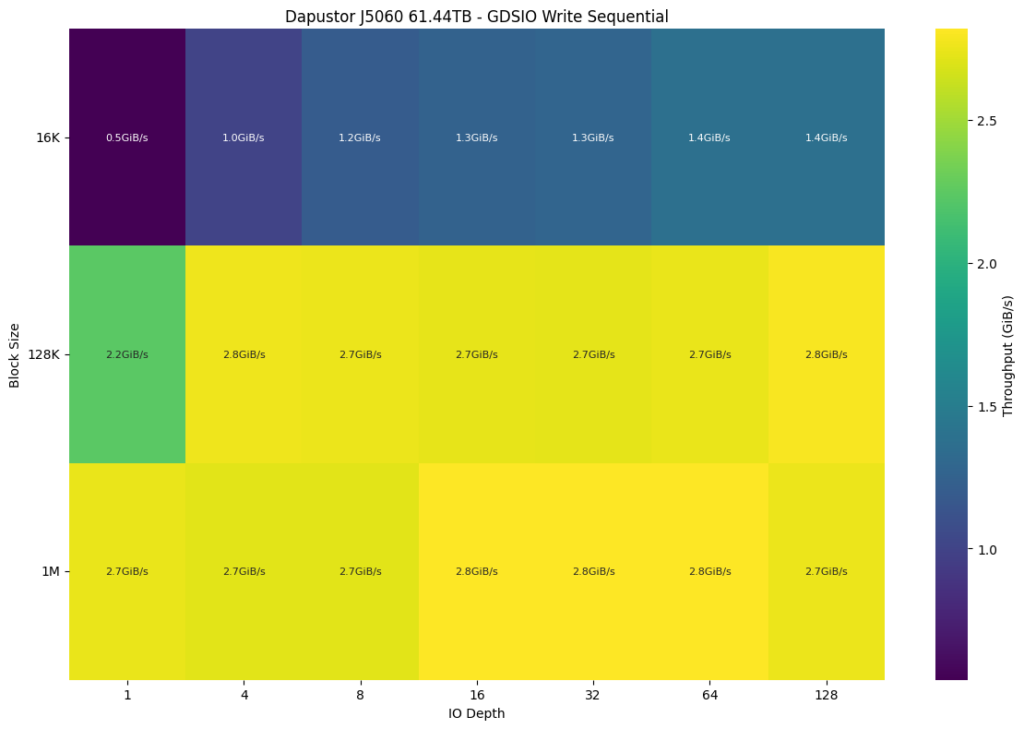
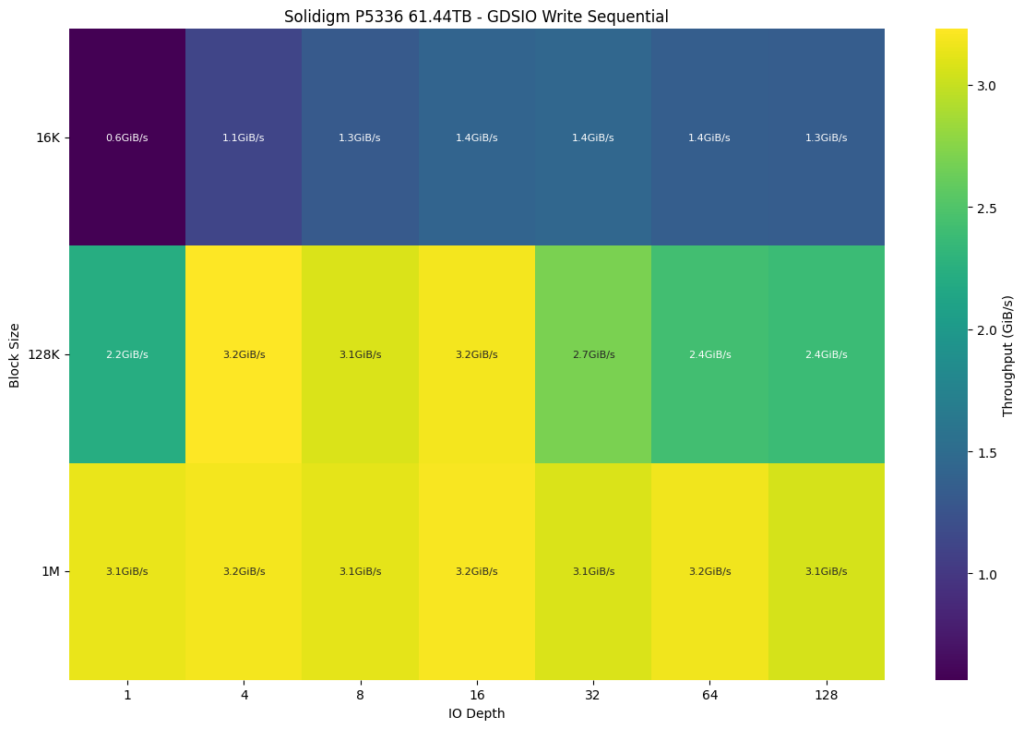
Dapustor J5060 သည် IO အနက်အားလုံးတွင် 128K နှင့် 1M block အရွယ်အစားများအတွက် 2.7 မှ 2.8 GiB/s အထိ တသမတ်တည်း ရေးသားမှုနှုန်းကို ပြသထားသည် (128K မှလွဲ၍ 1 IO အနက်အရွယ်အစားသည် 2.2GiB/s ရှိသည်။) 16K block အရွယ်အစားများအတွက် စွမ်းဆောင်ရည်သည် IO အနက်ပေါ် မူတည်၍ 0.5 GiB/s မှ 1.4 GiB/s အထိ ရှိပြီး IO အနက်မြင့်မားသောအခါတွင် 1.4 GiB/s ဖြင့် အမြင့်ဆုံးရောက်ရှိသည်။
နှိုင်းယှဉ်ကြည့်လျှင်၊ Solidigm P5336 သည် 128K နှင့် 1M block size များတွင် ပိုမိုကောင်းမွန်စွာ စွမ်းဆောင်ရည်ရှိပြီး 3.2GiB/s ဖြင့် အမြင့်ဆုံးရောက်ရှိသည်။ block size ငယ်များအတွက် (16K)၊ Solidigm P5336 သည် IO depths 16 မှ 64 တွင် 1.4 GiB/s အမြင့်ဆုံးရောက်ရှိကာ ပိုမိုမြင့်မားသော စွမ်းဆောင်ရည်ကို ပြသသည်။ ၎င်းသည် ရေးသားခြင်းလုပ်ဆောင်ချက်များအတွင်း block size ငယ်များဖြင့် Solidigm P5336 သည် အနည်းငယ်ပိုမိုထိရောက်ကြောင်း ညွှန်ပြသည်။
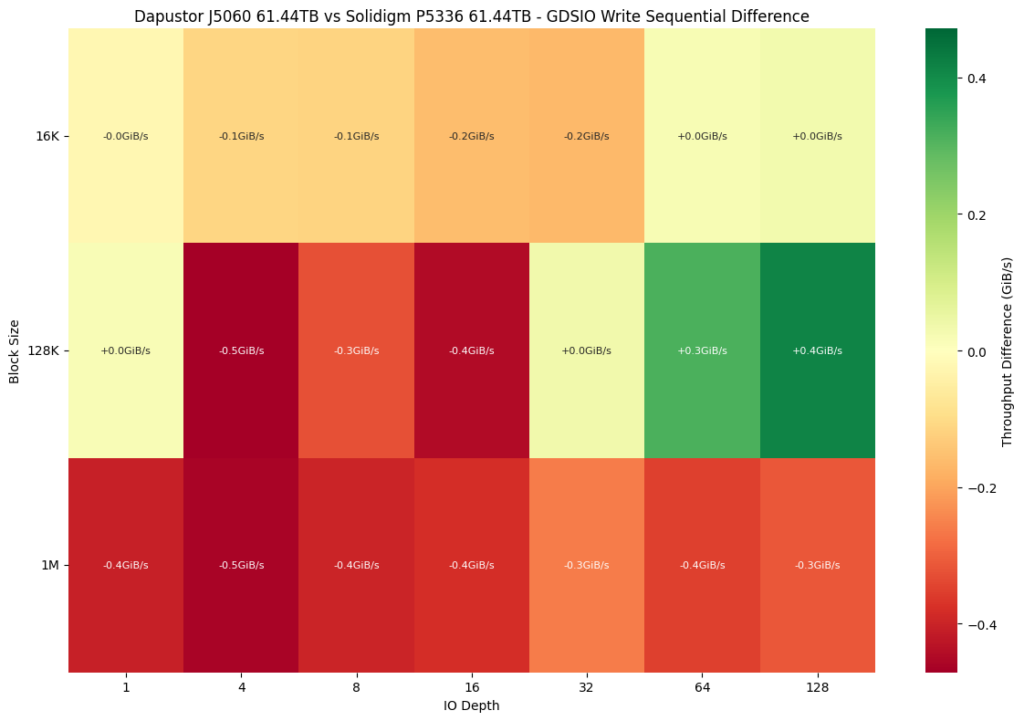
ကွဲပြားသောရှုထောင့်သို့ ရွေ့လျားသွားလျှင်၊ Dapustor J5060 နှင့် Solidigm P5336 ၏ ရေးသားစွမ်းဆောင်ရည်ကြားတွင် ပိုမိုကြီးမားသော ကွာဟချက်ကို ကျွန်ုပ်တို့တွေ့ရသည်။ ကျွန်ုပ်တို့၏ throughput နှိုင်းယှဉ်ချက်အရ J5060 သည် IO အနက်အားလုံးတွင် အထူးသဖြင့် block အရွယ်အစားကြီးများ (1M) တွင် အများစုနေရာများတွင် P5336 ထက် နောက်ကျနေကြောင်း ပြသသည်။ Throughput ကျဆင်းမှုများသည် IO အနက် ၄ ခုတွင် -0.5 GiB/s အထိရောက်ရှိသည်။ 128K block အရွယ်အစားများဖြင့် IO အနက်ပိုမိုမြင့်မားသောအခါ စွမ်းဆောင်ရည်တိုးတက်မှုများရှိသော်လည်း၊ ၎င်းတို့သည် ပိုမိုကျယ်ပြန့်သော စွမ်းဆောင်ရည်နိမ့်ကျမှုကို ချေဖျက်ရန် လုံလောက်သော အရေးမပါလှပါ။
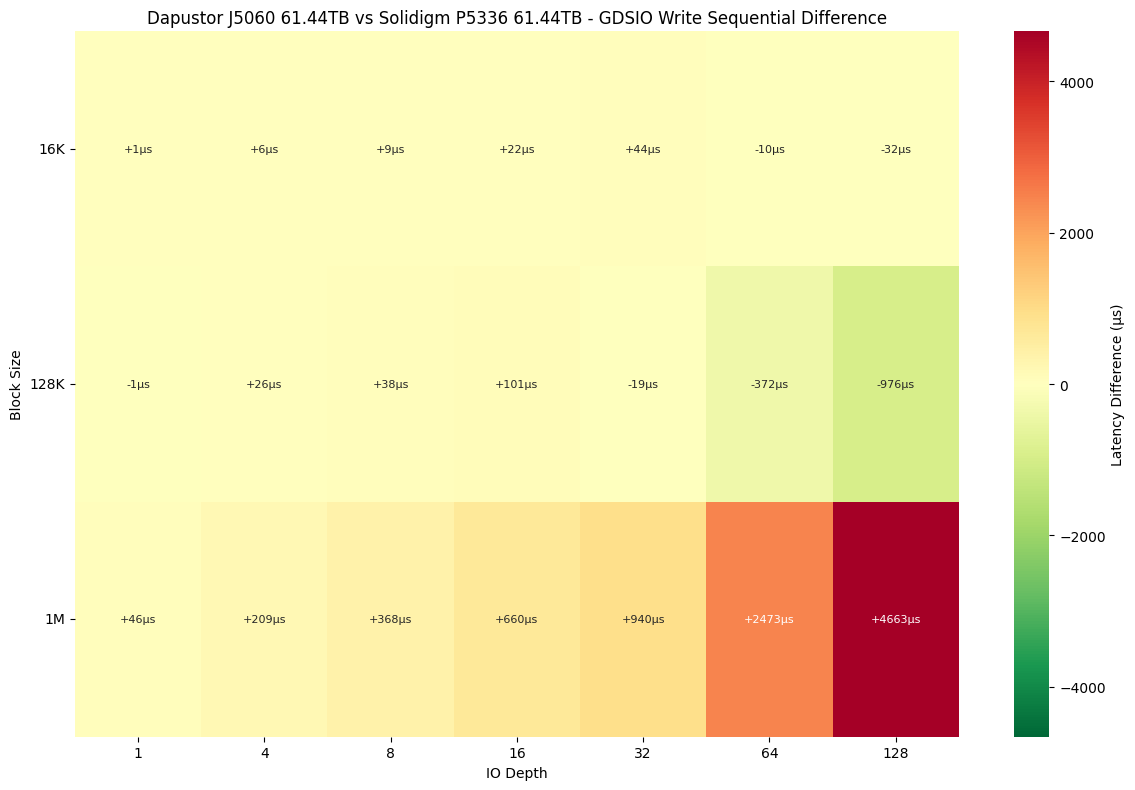
Dapustor J5060 နှင့် Solidigm P5336 အကြား အစဉ်လိုက်ရေးသားမှု latency ကို နှိုင်းယှဉ်သောအခါ၊ drive နှစ်ခုစလုံးသည် 16K ကဲ့သို့သော block အရွယ်အစားငယ်များတွင် အလားတူအပြုအမူကို ပြသပြီး၊ Solidigm သည် IO အနက်နိမ့်များတွင် အနည်းငယ်အားသာချက်ရှိပြီး Dapustor သည် အနက်မြင့်များတွင် (64 နှင့် 128) ကွာဟချက်ကို ပိတ်ပေးသည်။ 128K block အရွယ်အစားများတွင် Solidigm သည် queue အနက်နိမ့်များတွင် ထပ်မံဦးဆောင်နေသော်လည်း Dapustor သည် IO အနက်တိုးလာသည်နှင့်အမျှ latency နိမ့်ကျမှုကို အဆက်မပြတ်ပေးစွမ်းနိုင်ပြီး၊ load အောက်တွင် scaling ပိုမိုကောင်းမွန်ကြောင်း ညွှန်ပြသည်။ သို့သော်၊ 1M block အရွယ်အစားများဖြင့် Solidigm သည် IO အနက်အားလုံးတွင် latency အားသာချက်ကို ရှင်းရှင်းလင်းလင်းထိန်းသိမ်းထားပြီး လေးလံသော sequential write workloads များအောက်တွင် response time များကို သိသိသာသာမြန်ဆန်စွာပြသသည်။ အလုံးစုံပြောရလျှင် Solidigm သည် ပိုမိုတသမတ်တည်းလုပ်ဆောင်နိုင်ပြီး Dapustor ၏အစွမ်းသတ္တိကို အလတ်စား block များနှင့် queue များတွင် ပိုမိုမြင်သာစေသည်။
FIO လုပ်ငန်းပမာဏ အနှစ်ချုပ်
Flexible I/O Tester (FIO) သည် workload scenarios အမျိုးမျိုးအောက်တွင် storage devices များ၏ စွမ်းဆောင်ရည်ကို တိုင်းတာရန် အသုံးပြုသည့် industry-standard benchmarking tool တစ်ခုဖြစ်သည်။ ၎င်း၏ ဘက်စုံအသုံးပြုနိုင်မှုနှင့် ယုံကြည်စိတ်ချရမှုအတွက် ယုံကြည်စိတ်ချရသော FIO သည် လက်တွေ့ကမ္ဘာအခြေအနေများကို တုပပြီး SSD ၏ စွမ်းရည်များနှင့် စွမ်းဆောင်ရည်ကန့်သတ်ချက်များအကြောင်း ထိုးထွင်းသိမြင်မှုများကို ပေးစွမ်းသည်။ StorageReview သည် FIO ကို အသုံးပြု၍ workload patterns၊ block sizes နှင့် queue depths များတစ်လျှောက် throughput၊ latency နှင့် IOPS တို့ကို တိုင်းတာသည့် ပြည့်စုံသော ခွဲခြမ်းစိတ်ဖြာမှုများကို ပေးဆောင်သည်။
အသုံးချသော အလုပ်ဝန်များ-
- 128K အစဉ်လိုက် ဖတ်ရှုခြင်းနှင့် ရေးခြင်း
- 64K ကျပန်းဖတ်ရှုခြင်းနှင့် ရေးသားခြင်း
- 16K ကျပန်းဖတ်ရှုခြင်းနှင့် ရေးသားခြင်း
- 4K ကျပန်းဖတ်ရှုခြင်းနှင့် ရေးသားခြင်း
ဤအလုပ်ပမာဏများသည် ကြီးမားသော အစဉ်လိုက်လွှဲပြောင်းမှုများ၊ ဒေတာဘေ့စ်များ၏ ပုံမှန်အားဖြင့် များပြားသော ကျပန်း I/O နှင့် virtualized ပတ်ဝန်းကျင်များတွင် အဖြစ်များသော small-block ကျပန်းဝင်ရောက်ခွင့်များ အပါအဝင် ကျယ်ပြန့်သော enterprise အသုံးပြုမှုကိစ္စရပ်များကို ကိုယ်စားပြုသည်။
ဤစွမ်းဆောင်ရည်အပိုင်းတွင် Dapustor J5060 ၏ အဓိကပေါင်းစပ် workloads များတွင် စွမ်းဆောင်ရည်ကို အကျဉ်းချုပ်ဖော်ပြထားပြီး ၎င်းတွင် block size အမျိုးမျိုးနှင့် queue depth အမျိုးမျိုးတွင် sequential နှင့် random read/write operations များ ပါဝင်သည်။ မက်ထရစ်များကို parsed fio output မှ တိုက်ရိုက်ထုတ်ယူပြီး bandwidth (MB/s)၊ IOPS နှင့် latency percentiles 99.9999% အထိ ပါဝင်ပြီး load အောက်ရှိ throughput နှင့် tail အပြုအမူ နှစ်မျိုးလုံးကို ထိုးထွင်းသိမြင်စေပါသည်။
128K ဆင့်ကဲဖတ်ရှုခြင်းနှင့် ရေးခြင်းစွမ်းဆောင်ရည်
| မောင်း | Thread/IO အနက် | အသားဖြူ (MB/s) | IOPS | 99.0% | 99.9% | 99.99% |
|---|---|---|---|---|---|---|
| Dapustor J5060 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 7,482 | 57,081 | 1.66 ms | 2.02 ms | 2.83 ms |
| Solidigm P5336 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 7,479 | 57,057 | 1.51 ms | 1.66 ms | 1.81 ms |
| Dapustor J5060 ရေးသားရန် | ၈ တန်/၃၂ ကွက် | 3,023 | 23,063 | 0.69 ms | 0.69 ms | 0.70 ms |
| Solidigm P5336 ရေးသားခြင်း | ၈ တန်/၃၂ ကွက် | 3,364 | 25,669 | 2.67 ms | 3.48 ms | 4.42 ms |
Dapustor J5060 သည် 128K တွင် အထင်ကြီးလောက်စရာ sequential read performance ကို ပေးစွမ်းနိုင်ပြီး percentile မြင့်မားသောအခြေအနေများတွင်ပင် latency control ဖြင့် 7.48GB/s အထိ ရောက်ရှိသည်။ Solidigm P5336 နှင့် နှိုင်းယှဉ်ပါက J5060 ၏ throughput သည် အခြေခံအားဖြင့် အတူတူပင်ဖြစ်သည် (7.48GB/s vs. 7.47GB/s)။ သို့သော် Solidigm သည် latency consistency တွင် အနည်းငယ်သာ အားသာချက်ရှိပြီး tail latency အနည်းငယ် နိမ့်ကျသည်ကို ပြသသည်။
128K sequential writes (QD16) မှာ J5060 ဟာ latency အလွန်နည်းတဲ့ 3,023MB/s စွမ်းဆောင်ရည်နဲ့ ခိုင်မာတဲ့ စွမ်းဆောင်ရည်ကို ရရှိပါတယ်။ ဒါပေမယ့် Solidigm P5336 ကတော့ latency သိသိသာသာ မြင့်မားပေမယ့် 99.99% percentile (Dapustor ရဲ့ သိသိသာသာ နိမ့်တဲ့ 0.70ms ထက် 4.42ms) မှာ latency သိသိသာသာ မြင့်မားပါတယ်။ ဒါက J5060 ဟာ latency-sensitive sequential write scenarios တွေအတွက် ပိုမိုအားကောင်းတဲ့ ကိုယ်စားလှယ်လောင်းတစ်ဦးဖြစ်ကြောင်း ညွှန်ပြနေပါတယ်။
64K ကျပန်းဖတ်ရှုခြင်းနှင့် ရေးခြင်းစွမ်းဆောင်ရည်
| မောင်း | IO အနက် | အသားဖြူ (MB/s) | IOPS | 99.0% | 99.9% | 99.99% |
|---|---|---|---|---|---|---|
| Dapustor J5060 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 7,475 | 114,058 | 20.05 ms | 21.89 ms | 25.82 ms |
| Solidigm P5336 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 7,472 | 114,014 | 21.36 ms | 21.89 ms | 22.68 ms |
| Dapustor J5060 ရေးသားရန် | ၈ တန်/၃၂ ကွက် | 534 | 8,151 | 574.6 ms | 708.8 ms | 742.39 ms |
| Solidigm P5336 ရေးသားခြင်း | ၈ တန်/၃၂ ကွက် | 857 | 13,070 | 196.1 ms | 208.6 ms | 221.24 ms |
64K ကျပန်းဖတ်ရှုမှုများ (QD256) တွင် Dapustor J5060 သည် 7.4GB/s နီးပါး throughput နှင့် ကောင်းမွန်စွာထိန်းချုပ်ထားသော latency ဖြင့် အထူးကောင်းမွန်ပါသည်။ Solidigm ၏ရလဒ်များသည် အနီးကပ်တူညီပြီး (7.47GB/s) အမြင့်ဆုံး percentile latency အနည်းငယ်ပိုကောင်းပါသည်။ drive နှစ်ခုစလုံးသည် ဤနေရာတွင် အလွန်ကောင်းမွန်စွာလုပ်ဆောင်ပြီး လက်တွေ့ကွာခြားချက်အနည်းငယ်သာရှိသည်။
64K random မှာ write performance က J5060 မှာ သိသိသာသာ ရုန်းကန်နေရတဲ့ အခြေအနေပါ။ throughput က 534MB/s အထိ သိသိသာသာ ကျဆင်းသွားပြီး latency က သိသိသာသာ မြင့်တက်လာပါတယ် (99.99%)။ နှိုင်းယှဉ်ကြည့်မယ်ဆိုရင် Solidigm P5336 က J5060 ထက် သိသိသာသာ စွမ်းဆောင်ရည် ပိုကောင်းပြီး 857MB/s ပေးစွမ်းနိုင်ပြီး latency (percentile တစ်ခုတည်းမှာ 221.24ms) သိသိသာသာ နည်းပါးတာကြောင့် latency နဲ့ ရေရှည် write throughput ကို အာရုံခံနိုင်တဲ့ application တွေအတွက် ပိုပြီး သင့်တော်ပါတယ်။
16K ကျပန်းဖတ်ရှုခြင်းနှင့် ရေးခြင်းစွမ်းဆောင်ရည်
| မောင်း | IO အနက် | အသားဖြူ (MB/s) | IOPS | 99.0% | 99.9% | 99.99% |
|---|---|---|---|---|---|---|
| Dapustor J5060 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 7,430 | 453,461 | 5.28 ms | 6.39 ms | 8.16 ms |
| Solidigm P5336 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 7,431 | 453,527 | 5.01 ms | 5.21 ms | 5.47 ms |
| Dapustor J5060 ရေးသားရန် | ၈ တန်/၃၂ ကွက် | 531 | 32,404 | 143.65 ms | 149.94 ms | 181.40 ms |
| Solidigm P5336 ရေးသားခြင်း | ၈ တန်/၃၂ ကွက် | 847 | 51,724 | 57.9 ms | 65.8 ms | 71.8 ms |
16K ကျပန်းဖတ်ရှုမှု workload (QD256) တွင် Dapustor သည် 453K IOPS နှင့် ထိန်းချုပ်ထားသော latency ဖြင့် အလွန်ကောင်းမွန်သော ရလဒ်များကို ရရှိသည်။ Solidigm P5336 သည် ဤစွမ်းဆောင်ရည်ကို အခြေခံအားဖြင့် ထင်ဟပ်စေပြီး latency တွင် Dapustor ထက် အနည်းငယ်သာလွန်သည် (5.47ms vs. 99.99%)၊ ကျပန်းဖတ်ရှုမှု များပြားသော အခြေအနေများတွင် Solidigm အတွက် latency တသမတ်တည်း အနည်းငယ်ပိုမိုကောင်းမွန်ကြောင်း ညွှန်ပြသည်။
Dapustor SSD ရဲ့ 16K random write performance ဟာ 32K IOPS အထိ သိသိသာသာ ကျဆင်းသွားပြီး latency ကတော့ 181.4ms (99.99%) အထိ မြင့်တက်လာပါတယ်။ ဒီမှာလည်း Solidigm ဟာ Dapustor drive ထက် သိသိသာသာ သာလွန်ကောင်းမွန်ပြီး 51.7K IOPS နဲ့ latency profile (71.8ms at 99.99%) သိသိသာသာ တိုးတက်ကောင်းမွန်လာတာကြောင့် latency-sensitive random write workloads တွေအတွက် Solidigm ရဲ့ အားသာချက်ကို ပေါ်လွင်စေပါတယ်။
4K ကျပန်းဖတ်ရှုခြင်းနှင့် ရေးခြင်းစွမ်းဆောင်ရည်
| မောင်း | IO အနက် | အသားဖြူ (MB/s) | IOPS | 99.0% | 99.9% | 99.99% |
|---|---|---|---|---|---|---|
| Dapustor J5060 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 6,941 | 1,694,464 | 1.43 ms | 1.58 ms | 1.79 ms |
| Solidigm P5336 ဖတ်ရန် | ၈ တန်/၃၂ ကွက် | 3,994 | 975,108 | 2.31 ms | 2.41 ms | 2.64 ms |
| Dapustor J5060 ရေးသားရန် | ၈ တန်/၃၂ ကွက် | 131 | 31,923 | 143.65 ms | 145.75 ms | 179.31 ms |
| Solidigm P5336 ရေးသားခြင်း | ၈ တန်/၃၂ ကွက် | 197 | 48,030 | 58.5 ms | 64.2 ms | 68.7 ms |
Dapustor J5060 ရဲ့ အထူးခြားဆုံးအချက်ကတော့ 4K random read scenario ဖြစ်ပြီး QD256 မှာ အမြင့်ဆုံးစွမ်းဆောင်ရည် 1.69 million IOPS ကျော်ရှိပြီး latency အလွန်နည်းပါးပါတယ်။ နှိုင်းယှဉ်ကြည့်မယ်ဆိုရင် Solidigm P5336 က သိသိသာသာ နောက်ကျကျန်နေပြီး percentile အားလုံးမှာ latency သိသိသာသာ မြင့်မားပြီး 975K IOPS သာ စီမံခန့်ခွဲနိုင်ပါတယ်။ intensive small-block random reads တွေအတွက် Dapustor J5060 က အကောင်းဆုံးရွေးချယ်မှုပါပဲ။
ကံမကောင်းစွာပဲ၊ J5060 ရဲ့ 4K random write စွမ်းဆောင်ရည်ဟာ သိသိသာသာ ကျဆင်းသွားပြီး latency မြင့်မားတဲ့ (179.31ms at 99.99%) နဲ့ 131MB/s နဲ့ 31.9K IOPS သာ ထုတ်လုပ်ပေးပါတယ်။ Solidigm SSD ဟာ ဒီအခြေအနေကို ပိုမိုအဆင်ပြေစွာ ကိုင်တွယ်ဖြေရှင်းနိုင်ပြီး 197MB/s၊ 48K IOPS နဲ့ tail latency (68.7ms at 99.99%) သိသိသာသာ နိမ့်ကျပါတယ်။ Solidigm မှာလည်း latency မြင့်တက်မှုတွေ ကြုံတွေ့နေရပေမယ့် 4K random write workloads တွေအတွက်တော့ ပိုမိုအားကောင်းတဲ့ drive တစ်ခု ဖြစ်နေဆဲပါ။
ကောက်ချက်
အဆုံးစွန်အားဖြင့် DapuStor J5060 သည် သိုလှောင်မှုသိပ်သည်းဆနှင့် terabyte တစ်ခုလျှင်ကုန်ကျစရိတ်ကို ရေရှည်ရေးသားစွမ်းဆောင်ရည်ထက် ဦးစားပေးသည့် ဖတ်ရှုမှုများပြားသော workloads များအတွက် ဒီဇိုင်းထုတ်ထားသော မြင့်မားသောစွမ်းရည်ရှိသော enterprise QLC SSD တစ်ခုဖြစ်သည်။ 61.44TB အထိရှိသော စွမ်းရည်များနှင့် PCIe Gen4 interface ဖြင့် ၎င်းသည် content delivery networks၊ cloud archives သို့မဟုတ် ကြီးမားသော sequential reads နှင့် ရံဖန်ရံခါ writes များအပေါ် မှီခိုနေရသော AI inference systems များကဲ့သို့သော ပတ်ဝန်းကျင်များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။
အဲဒီရည်မှန်းချက်ကို စိတ်ထဲမှာထားပြီး J5060 ကို လက်တွေ့မှာ ဘယ်လိုစွမ်းဆောင်ရည်ရှိလဲဆိုတာ သိရအောင် စမ်းသပ်မှုအမျိုးမျိုးကို ပြုလုပ်ခဲ့ပါတယ်၊ အထူးသဖြင့် Solidigm P5336 နဲ့ ယှဉ်ရင်ပေါ့။ J5060 က ကောင်းမွန်တဲ့ sequential read performance ကို ပေးစွမ်းပြီး high-density storage ကို ပေးစွမ်းတာကြောင့် read များတဲ့ပတ်ဝန်းကျင်မှာ ကောင်းကောင်းအလုပ်လုပ်နိုင်ပါတယ်။ အချို့ကိစ္စတွေမှာ၊ အထူးသဖြင့် IO depth နိမ့်ပြီး block size ကြီးတဲ့အခြေအနေတွေမှာ J5060 က Solidigm P5336 ထက် သာလွန်ပါတယ်။ ဒီအခြေအနေတွေမှာ သူ့ရဲ့ latency နဲ့ throughput က block ကြီးကြီးဖတ်တဲ့စွမ်းဆောင်ရည်ကို ဦးစားပေးတည်ဆောက်ထားတယ်ဆိုတာ ပြသနေပါတယ်။
သို့သော်၊ ရေးသားမှုလုပ်ဆောင်ချက်ကို ထည့်သွင်းစဉ်းစားသောအခါ စွမ်းဆောင်ရည်သည် သိသိသာသာ ထိခိုက်ခံရသည်။ IOPS၊ latency နှင့် throughput အပါအဝင်၊ ရေးသားမှု မက်ထရစ်တိုင်းနီးပါးတွင် J5060 သည် အဆက်မပြတ် စွမ်းဆောင်ရည် နိမ့်ကျနေသည်။ ဤအားနည်းချက်သည် latency မြင့်မားပြီး throughput ပြားချပ်သွားသည့် IO အနက်မြင့်မားသောနေရာများနှင့် block အရွယ်အစားကြီးသောနေရာများတွင် sequential write pressure အောက်တွင် အထင်ရှားဆုံးဖြစ်သည်။ AI နှင့်ဆက်စပ်သော checkpointing workloads များအတွင်း၌ပင် J5060 သည် စတင်အားကောင်းသော်လည်း စွမ်းဆောင်ရည်တွင် လျင်မြန်စွာ ကျဆင်းသွားပြီး ရေရှည်ရေးသားမှု တည်ငြိမ်မှုပြဿနာများကို အချက်ပြသည်။
ဖတ်ရှုမှုများပြားပြီး စွမ်းရည်မြင့်မားသော လိုအပ်ချက်များရှိသော အဖွဲ့အစည်းများအတွက် J5060 သည် ရှင်းလင်းသောတန်ဖိုးကို ပေးစွမ်းနိုင်သော်လည်း ၎င်း၏ကန့်သတ်ချက်များသည် ရောနှောထားသော သို့မဟုတ် ရေးသားရန် အလွန်အမင်းလိုအပ်သော workloads များအတွက် ရောင်းချရန် ပိုမိုခက်ခဲစေသည်။


 အမေဇုံ