

Datrium က “open convergence” ကို ပေးစွမ်းပြီး အဲဒါက သူတို့ခေါ်တဲ့ next generation of converged infrastructure ပါ။ enterprise IT နယ်ပယ်မှာ ရောင်းချသူတွေရှိသလောက် convergence မှာ riff တွေ အများကြီးရှိနိုင်ပြီး Datrium ကလည်း infrastructure ဘယ်လိုပုံစံရှိနိုင်မလဲဆိုတာ သူတို့ရဲ့အမြင်ကို မြှင့်တင်ဖို့ မရှက်ပါဘူး။ Datrium ရဲ့အမြင်အရ compute၊ primary storage၊ secondary storage နဲ့ cloud တို့ဟာ storage class တစ်ခုချင်းစီအတွက် silo မပါဘဲ scalable ဖြစ်ပြီး manage လုပ်ရလွယ်ကူတဲ့ မြင့်မားတဲ့ resilient configuration တစ်ခုမှာ ပေါင်းစပ်ထားတာကို မြင်တွေ့ရပါတယ်။ ထို့အပြင် data call အများစုဟာ on-board flash cache ပါတဲ့ compute node တွေကို ထိမှန်မှာဖြစ်လို့ Datrium ဟာ data node တွေဆီကို သွားစရာမလိုဘဲ အံ့မခန်းစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပါတယ်။ ဒါက အမြင့်ဆုံး 32K read and write bandwidth မှာ 200GB/s နဲ့ 16GB/s နဲ့ 18M IOPS 4K random read ကို ရရှိစေပါတယ်။
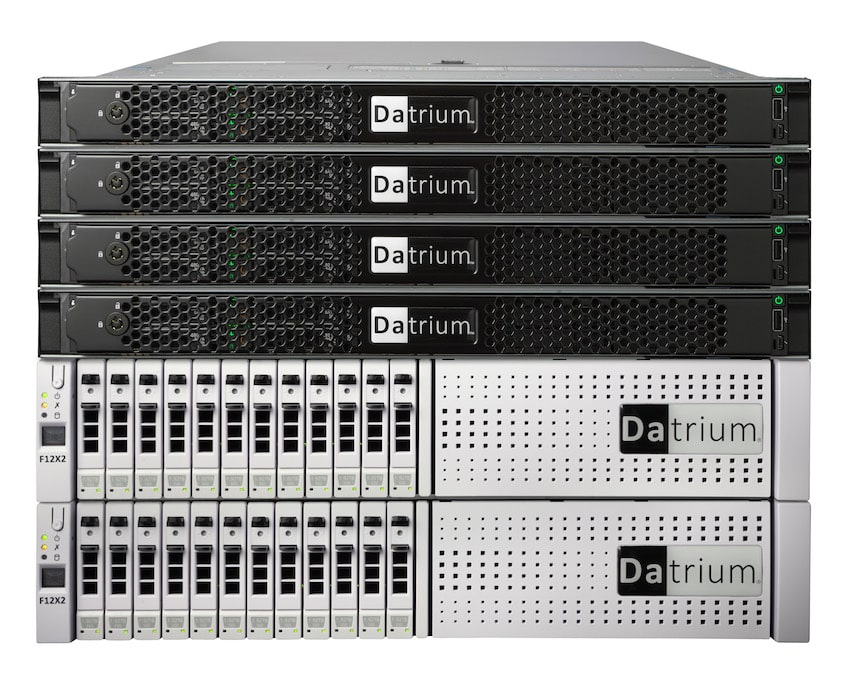
အခြေခံအားဖြင့် Datrium ကို DVX စနစ်ဖြင့် ဖွဲ့စည်းထားသော compute node များနှင့် storage node များဖြင့် ဖွဲ့စည်းထားသည်။ Compute node များကို Datrium မှ ထောက်ပံ့ပေးနိုင်သည်၊ သို့မဟုတ် ဖောက်သည်များသည် ၎င်းတို့၏ကိုယ်ပိုင်ရှိပြီးသား server infrastructure ကို အသုံးချနိုင်သည်။ Compute node များသည် IO processing ကို ကိုင်တွယ်ပြီး flash ပေါ်တွင် cache ကို local တွင် သိမ်းဆည်းထားသည်။ Flash သည် ကုန်ကျစရိတ်နည်းသော၊ စွမ်းရည်မြင့် SATA drive များမှသည် စွမ်းဆောင်ရည်မြင့် NVMe အထိ မည်သည့်အရာမဆို ဖြစ်နိုင်သည်။ flash ဆိုင်ရာ ဆုံးဖြတ်ချက်သည် workload ပေါ်တွင် လုံးဝမူတည်ပြီး ဖောက်သည်၏ လိုအပ်ချက်များနှင့် ကိုက်ညီစေရန် ချိန်ညှိနိုင်သည်။ persistent data များသည် data node များပေါ်တွင် ရှိနေသောကြောင့် compute node များသည် stateless ဖြစ်ပြီး data ဆုံးရှုံးမှု သို့မဟုတ် ပျက်စီးမှုအန္တရာယ်မရှိဘဲ offline ဖြစ်နိုင်ပြီး n-1 availability ကို ထိန်းသိမ်းထားသည်။ Datrium သည် vSphere 5.5-6.5၊ Red Hat 7.3၊ CentOS 7 1611 နှင့် bare metal Docker 1.2 အပါအဝင် environment အမျိုးမျိုးကို ပံ့ပိုးပေးသည်။
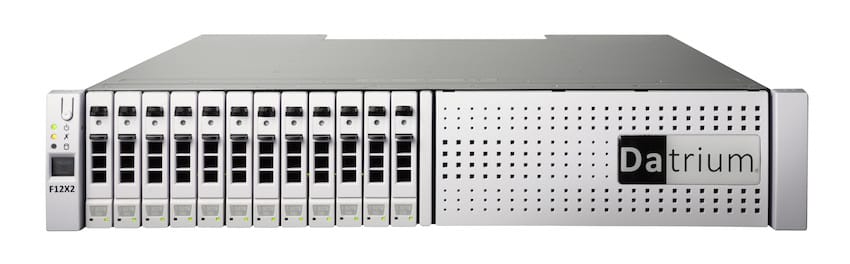
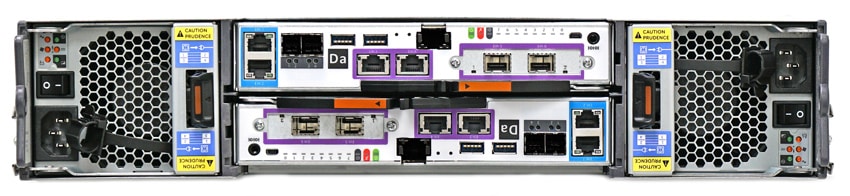
ဒေတာ node များသည် ဒေတာ၏ အမြဲတမ်းမိတ္တူများကို ထိန်းသိမ်းထားနိုင်ပြီး disk သို့မဟုတ် flash configuration များဖြင့် ရရှိနိုင်ပါသည်။ Datrium DVX အတွင်းရှိ ဒေတာများကို အမြဲတမ်း compressed လုပ်ထားပြီး global deduped လုပ်ကာ double fault tolerance ဖြင့် erasure code လုပ်ထားသည်။ Datrium သည် DVX အတွင်း encryption၊ snapshots နှင့် replication များကိုလည်း ပေးဆောင်သည်။ ဒေတာ node များသည် processing အားလုံးအတွက် compute node များအပေါ် မှီခိုနေရပြီး storage system ကို dual hot-swappable controllers များမှတစ်ဆင့် IO ပေးပို့ရန် လွတ်လပ်စွာထားရှိပေးသည်။ ဒေတာ node များတွင် mirrored၊ battery-backed NVRAM နှင့် load balancing နှင့် path failover ပါရှိသော high-speed Ethernet networking တို့ ပါဝင်သည်။ Datrium မှ နောက်ဆုံးပေါ် node များတွင် Flash End-to-End ပါရှိသော DVX ပါဝင်သည်။ ဆိုလိုသည်မှာ compute node များတွင် flash ရှိပြီး all-flash DVX data node များဖြစ်သည်။ F12X2 data node တွင် 16TB အသုံးပြုနိုင်သော storage (12×1.92TB SSDs) ရှိပြီး 2-6x data reduction နှင့် 25GbE networking ကို ပံ့ပိုးပေးသည့် 32-96TB အထိ ထိရောက်သော capacity ရှိသည်။ နောက်ဆုံးပေါ် compute node CN2100 တွင် Skylake CPU အသစ်များ၊ NVMe ပံ့ပိုးမှုနှင့် 25GbE ကွန်ရက်အထိ ထည့်သွင်းထားသည်။
ဒီသုံးသပ်ချက်က တစ်နည်းနည်းနဲ့ ထူးခြားပါတယ်၊ ဘာလို့လဲဆိုတော့ ကျွန်တော်တို့မှာ Dell PowerEdge C6320 compute node ၃၂ ခုနဲ့ Datrium DVX all-flash data node ၁၀ ခုနဲ့ configure လုပ်ထားတဲ့ Datrium test environment တစ်ခုကို အဝေးကနေ ဝင်ရောက်ကြည့်ရှုနိုင်လို့ပါ။
- Dell PowerEdge C6320 ဆာဗာ ၃၂ လုံး
- VMware ESXi 6.0 Update3 ကို ထည့်သွင်းပြီးပါပြီ
- Dual Xeon CPU E5-2697 v4 CPU များ
- 128GB မှတ်ဉာဏ်
- ဒေတာကက်ရှ်အဖြစ် 4 x 1.92TB Samsung PM863a SSD
- ၂ x 10Gb/s NIC (စီမံခန့်ခွဲမှု/ဒေတာ)
- ကွန်ရက်ဖွဲ့စည်းပုံ
- core switch ပေါ်ရှိ F12X2 Data-node ၁၀ ခု
- TOR switch ၈ ခုတွင် Compute-node ၃၂ ခု
- TOR switch တစ်ခုစီတွင် core switch သို့ 160Gbps uplink ရှိသည်။
စီမံခန့်ခွဲမှု
DVX ကို HTML5-based user interface ဖြင့် browser မှတစ်ဆင့် သို့မဟုတ် VMware vCenter plug-in အနေဖြင့် စီမံခန့်ခွဲပါသည်။ DVX UI ၏ အခြေခံအုတ်မြစ်တစ်ခုလုံးသည် ရိုးရှင်းမှုပေါ်တွင် မူတည်ပြီး ရိုးရာနည်းလမ်းဖြင့် သိုလှောင်မှုကို စီမံခန့်ခွဲရန် မလိုအပ်ပါ။ သိုလှောင်မှု ပံ့ပိုးပေးခြင်းမှသည် ထပ်တူပြုခြင်းစီမံခန့်ခွဲမှုအထိ အရာအားလုံးသည် တူညီသော UI မှ ဖြစ်ပေါ်သည်။
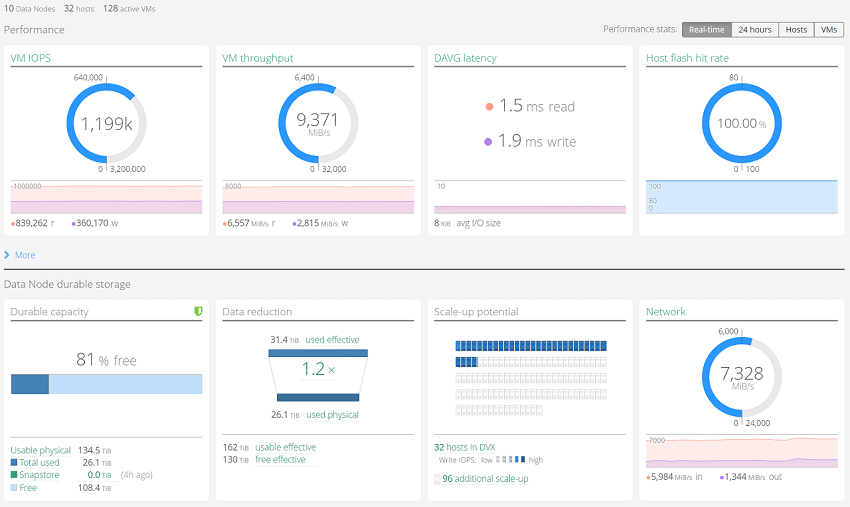
လျင်မြန်စွာကြည့်လိုက်ရုံဖြင့် အသုံးပြုသူများသည် cluster VM IOPS၊ throughput၊ network transfer speeds အပြင် Datrium ပျမ်းမျှ read/write latency နှင့်ပတ်သက်သည့် စွမ်းဆောင်ရည်အချက်အလက်များကို host flash hit rates များနှင့်အတူ ရှာဖွေနိုင်ပါသည်။ Datrium DVX platform ၏ အဆင့်ဆင့်ဖွဲ့စည်းပုံကို ထည့်သွင်းစဉ်းစားပါက host များနှင့် underlying data node များအကြား စွမ်းဆောင်ရည်အဆင့်များကို စစ်ဆေးခြင်းသည် အလုံးစုံစွမ်းဆောင်ရည်ကို တိုင်းတာရာတွင် အထောက်အကူဖြစ်စေပါသည်။ စွမ်းဆောင်ရည် မက်ထရစ်များအပြင်၊ snapshot space နှင့်အတူ စုစုပေါင်းဒေတာခြေရာကိုပြသသည့် စုစုပေါင်းအသုံးပြုနိုင်သောစွမ်းရည်အပြင် လက်ရှိဒေတာလျှော့ချမှု မက်ထရစ်များကိုလည်း ပံ့ပိုးပေးထားပါသည်။
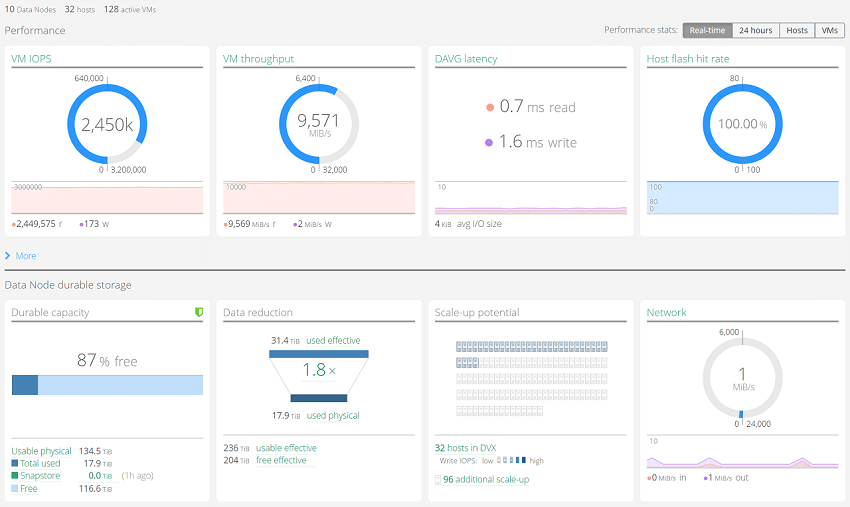
အထက်ပါ screenshot များတွင် မှတ်သားထားရမည့် စိတ်ဝင်စားဖွယ်အချက်တစ်ခုမှာ network traffic (တစ်ခုမှာ 4K random-write activity နှင့် နောက်တစ်ခုမှာ read activity ကိုပြသထားသည်) ဖြစ်သည်။ Datrium DVX သည် read activity အတွက် host-side flash ကို အသုံးပြုပြီး data-node များထံ write activity ကို commit လုပ်သောကြောင့် network speed များဖြင့် ဖော်ပြထားသောအရာကို သင်တွေ့မြင်နိုင်သည်။ ကျွန်ုပ်တို့၏ 4K random test တွင် network activity ကို 7.3GB/s ဖြင့် တိုင်းတာခဲ့ပြီး internal-host flash မှ data ကို ဆွဲထုတ်ခဲ့သော ကျွန်ုပ်တို့၏ read test တွင် network traffic မရှိခဲ့ပါ။
performance benchmark
ဒီလောက်ကြီးမားတဲ့ cluster ရဲ့ စွမ်းဆောင်ရည်ကို တိုင်းတာဖို့အတွက်၊ ဖြန့်ကျက်ရလွယ်ကူမှုနဲ့ vdbench VM ရာပေါင်းများစွာမှာ စွမ်းဆောင်ရည်ဒေတာတွေကို စုစည်းပေးနိုင်တဲ့ စွမ်းရည်ကြောင့် VMware ကနေ HCIBench ကို ရွေးချယ်ခဲ့ပါတယ်။ cluster ကြီးတစ်ခုအတွက်၊ ဒီ tool က enterprise storage ကို တိုင်းတာဖို့ အသုံးများတဲ့ workloads တွေကို မြန်မြန်ဆန်ဆန် မြှင့်တင်ပေးနိုင်သလို user-defined repeating pattern ရှိတဲ့ data တွေနဲ့လည်း အလုပ်လုပ်နိုင်အောင် ခွင့်ပြုပေးပါတယ်။ data-reduction services ပေးနေတဲ့ platform တွေအတွက်၊ user တွေကို real-world အခြေအနေတွေနဲ့ ပိုနီးစပ်တဲ့ စွမ်းဆောင်ရည်ကို ပြသနိုင်ဖို့ အခွင့်အရေးပေးပါတယ်။ ဒီကိစ္စမှာ၊ ကျွန်တော်တို့ရဲ့ workloads တစ်ခုချင်းစီအတွက် 2:1 compression setting ကို အသုံးပြုခဲ့ပါတယ်။ benchmarks အားလုံး၊ compression၊ deduplication နဲ့ inline erasure coding တွေ လည်ပတ်နေတာကို သတိပြုသင့်ပါတယ်။ တစ်နည်းအားဖြင့် benchmarks အားလုံးကို real-world operating condition အပြည့်နဲ့ ပြုလုပ်ခဲ့ပါတယ်။
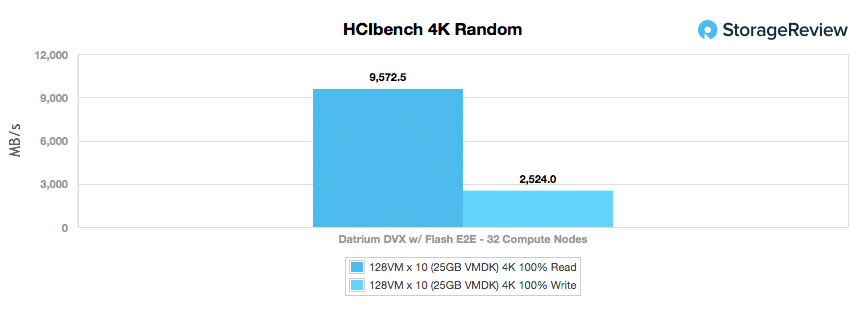
ကျွန်ုပ်တို့ရဲ့ HCIbench 4K မှာ fully random 4K workload profile နဲ့ peak random throughput ကို လေ့လာကြည့်ပါတယ်။ Datrium DVX ဟာ 9.5725GB/s read နဲ့ 2.524GB/s write ရရှိခဲ့ပါတယ်။
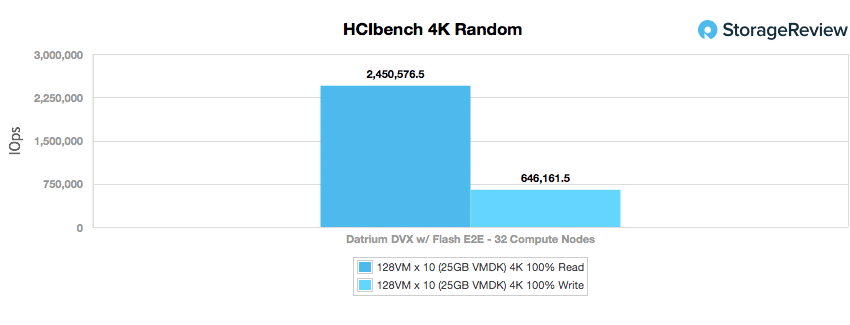
နောက်တစ်ခုကတော့ တူညီတဲ့ 4K profile မှာရှိတဲ့ peak I/O ကို ကြည့်ကြရအောင်။ ဒီမှာ Datrium DVX မှာ IOPS read ၂.၄၅ သန်းကျော်နဲ့ IOPS write ၆၄၆,၁၆၂ ရှိတဲ့ အထင်ကြီးစရာကောင်းတဲ့ ပြသမှုတစ်ခု ရှိခဲ့တယ်။
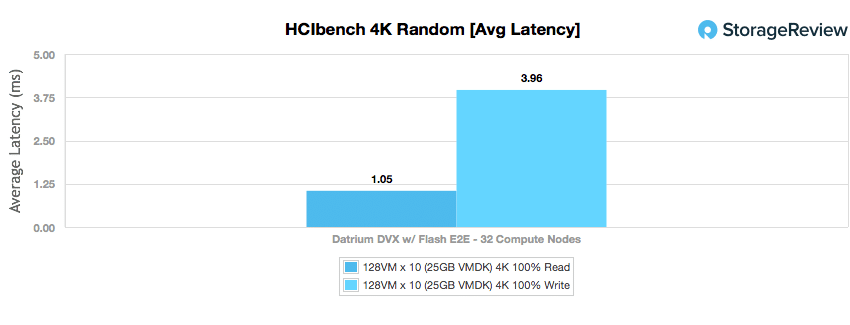
နောက် metric ကတော့ fully random 4K workload profile ရဲ့ average latency ကို ကြည့်ပါတယ်။ sub-millisecond latency မဟုတ်ပေမယ့် DVX ဟာ အထင်ကြီးလောက်စရာ 1.05ms read နဲ့ 3.96ms write တွေကို ရရှိခဲ့ပါတယ်။
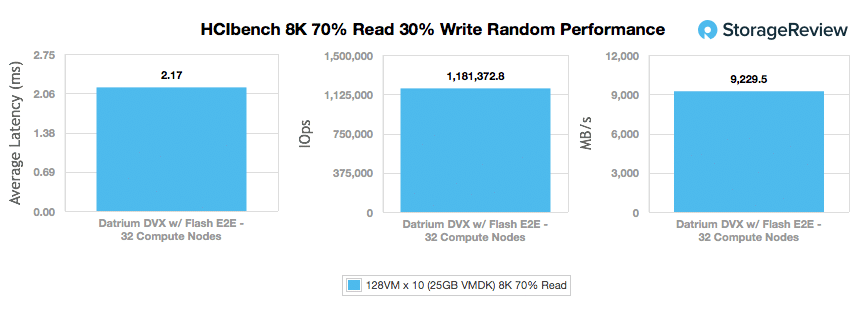
ကျွန်ုပ်တို့ရဲ့ နောက်ထပ်စမ်းသပ်မှုက ဖတ်ရှုမှု ၇၀% နဲ့ ရေးသားမှု ၃၀% ရောနှောထားတဲ့ ပိုကြီးတဲ့ 8K ကျပန်းဒေတာပရိုဖိုင်ကို ကြည့်ရှုပါတယ်။ ဒီမှာ DVX ရဲ့ throughput က 9,229.5GB/s ပါ။ အမြင့်ဆုံး I/O အချိန်မှာ DVX ဟာ IOPS ၁.၁၈ သန်းကျော်ကို ရောက်ရှိနိုင်ခဲ့ပါတယ်။ 8K 70/30 latency က 2.17ms သာ ရှိပါတယ်။
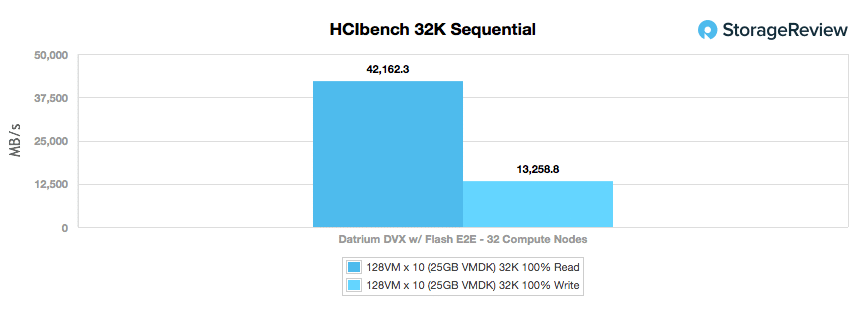
နောက်ဆုံး workload သည် 32K sequential read and write profile ပါဝင်သည့် peak bandwidth focus သို့ ပြောင်းသွားသည်။ ဤနေရာတွင် DVX သည် ကြီးမားသော 42.16GB/s read နှင့် 13.26GB/s write ကို ရရှိနိုင်သည်။
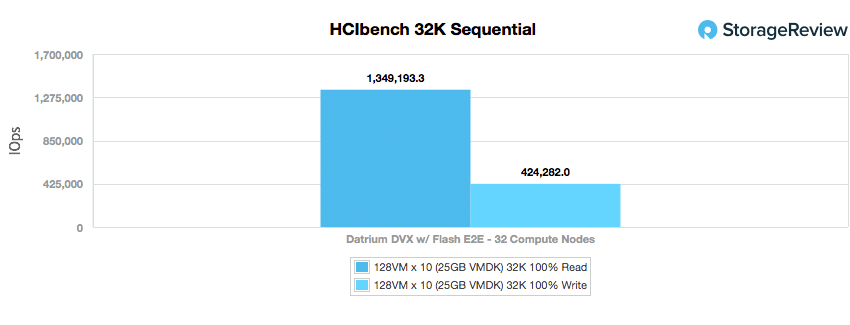
တူညီသော workload အတွက် peak I/O ကိုကြည့်လျှင် DVX သည် 1.349 သန်းကျော် IOPS read နှင့် 424,282 IOPS write ဖြင့် အထင်ကြီးလောက်စရာ ကိန်းဂဏန်းများကို ဆက်လက်ပြသနေပါသည်။
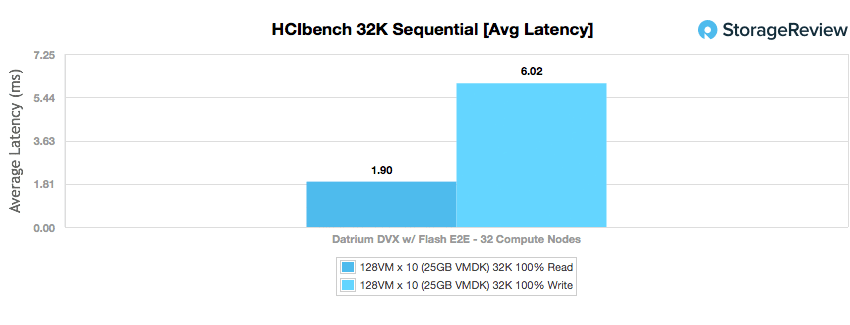
DVX ဟာ 32K စမ်းသပ်မှုမှာ မြင့်မားတဲ့ ဂဏန်းတွေအားလုံးနဲ့ဆိုရင် 1.9ms read နဲ့ 6.02ms write ဆိုတဲ့ latency အတော်လေးနိမ့်တဲ့ စွမ်းဆောင်ရည်နဲ့ အမြင့်ဆုံးရောက်ခဲ့ပါတယ်။
converged platform တစ်ခုဖြစ်တဲ့အတွက် CPU utilization ဟာ ထည့်သွင်းစဉ်းစားရမယ့် အရေးကြီးတဲ့အချက်တစ်ချက်ဖြစ်ပါတယ်။ ဘာဖြစ်လို့လဲဆိုတော့ storage overhead အချို့ဟာ workload တွေကို လည်ပတ်ဖို့အတွက် အသုံးပြုထားတဲ့ system တွေကနေ လာတာကြောင့်ပါ။ workload တစ်ခုချင်းစီအတွင်း platform ကို စောင့်ကြည့်နေစဉ်မှာ cluster တစ်ခုလုံးရဲ့ စွမ်းဆောင်ရည် (ညီမျှခြင်းရဲ့ နှစ်ဖက်စလုံး) ကို ကျွန်ုပ်တို့ ကြည့်ရှုခဲ့ပါတယ်၊ vdbench ကို အသုံးပြုနေတဲ့ HCIbench workers တွေနဲ့ cluster တစ်ခုလုံးမှာ ပျံ့နှံ့နေတဲ့ storage VM တွေရဲ့ overhead တွေ အပါအဝင်ပါ။
များပြားလှသော sequential write activity (အလုပ်အများစုကို flash node များထံ တိုက်ရိုက် offload လုပ်သည့်) အတွင်းတွင်၊ ကျွန်ုပ်တို့သည် စုစုပေါင်း system resource များကို အသုံးပြုသည့်ပမာဏ၏ ၄၀% အောက်သာ တွေ့ရှိခဲ့ရပါသည်။ 4K random read workload ကဲ့သို့ များပြားလှသော read activity အတွင်းတွင် ဤ metric သည် ၆၀% ကျော်အထိ မြင့်တက်လာခဲ့ပါသည်။ ထို့ကြောင့် system သည် workload ကို ဝန်ဆောင်မှုပေးပြီး VM များသည် workload ကို အသုံးပြုနေသည့်တိုင်၊ အခြား application များနှင့် workload များအတွက် CPU resource များ၏ ၆၀% ကျန်ရှိနေပြီး အဆိုးဆုံးအခြေအနေမှာ ၄၀% အထိ ကျဆင်းသွားခဲ့ပါသည်။ ထို့ကြောင့် Insane Mode ကို လည်ပတ်နေချိန်တွင် (ပုံမှန်အားဖြင့် 20% max host utilization) inline data service အပြည့်အစုံဖြင့် အဆိုးဆုံးအခြေအနေတွင်၊ Datrium platform တွင် system resource အများအပြား ကျန်ရှိနေပါသေးသည်။
ကောက်ချက်
Datrium DVX မိသားစုကို နောက်ဆုံးပေါ် storage နှင့် compute resources မျိုးဆက်ကို ပံ့ပိုးပေးရန် အပ်ဒိတ်လုပ်ထားပါသည်။ ဤကိစ္စတွင်၊ compute node များတွင် flash cache နှင့် persistent storage အတွက် all-flash data node များပါဝင်သော end-to-end flash configuration ကို ကျွန်ုပ်တို့ ကြည့်ရှုခဲ့ပါသည်။ Datrium ၏ “open convergence” platform တွင် ပိုမိုရင့်ကျက်သော ထုတ်ကုန်များတွင် ယေဘုယျအားဖြင့် တွေ့ရလေ့ရှိသော data services များလည်း ပါဝင်သည်။ Datrium DVX ဖြင့် data များကို အမြဲတမ်း compressed လုပ်ထားပြီး global deduped လုပ်ကာ double fault-tolerance ဖြင့် erasure code လုပ်ထားသည်။ ဖောက်သည်များသည် Datrium ၏ compute node များကို အသုံးပြုရန် ရွေးချယ်နိုင်သော်လည်း ဤသုံးသပ်ချက်တွင်ကဲ့သို့ပင်၊ ၎င်းသည် မလိုအပ်ပါ (ကျွန်ုပ်တို့၏ စမ်းသပ်မှုသည် Dell PowerEdge node ၃၂ ခုကို အသုံးပြုခဲ့သည်)။ ဤ compute node များသည် IO processing နှင့် cache ကို အနည်းဆုံး overhead 20% အထိ ကိုင်တွယ်ပါသည်။ သို့သော် storage performance ပိုမိုလိုအပ်သော instance များအတွက် DVX ကို Insane Mode တွင်ထားနိုင်ပြီး DVX သည် compute resources များ၏ 40% အထိ အသုံးပြုနိုင်မည်ဖြစ်သည်။
စွမ်းဆောင်ရည်ပိုင်းမှာတော့ Datrium DVX က ပိုကြီးတဲ့ပတ်ဝန်းကျင်မှာ တကယ်လုပ်နိုင်တာကို အကောင်းဆုံးထင်ဟပ်စေမယ့် HCIbench benchmarks တွေကို ရွေးချယ်ခဲ့ပါတယ်။ အစကတည်းက all-flash DVX က အထင်ကြီးလောက်စရာ ကိန်းဂဏန်းတွေကို ပြသနိုင်ခဲ့ပါတယ်။ 4K benchmarks တွေမှာ DVX က 9.57GB/s ကျော်၊ 2.45 million IOPS read နဲ့ 2.52GB/s ကျော်၊ 646K IOPS write ရရှိခဲ့ပါတယ်။ DVX က ဒီကိန်းဂဏန်းတွေကို 1.05ms read နဲ့ 3.96ms write လောက်ပဲ latency နဲ့ပဲ ရယူနိုင်ခဲ့ပါတယ်။ 8K 70% read 30% write ကို ပြောင်းလိုက်တဲ့အခါ DVX က 9.2GB/s ကျော်၊ 1.18 million IOPS ကျော်၊ latency 2.17ms ပဲ ရှိပါတယ်။ ကျွန်ုပ်တို့ရဲ့ 32K sequential စမ်းသပ်မှုမှာ DVX ဟာ အံ့သြဖွယ်ကောင်းတဲ့ 42.16GB/s read နဲ့ 1.349 million IOPS ကို ရရှိခဲ့ပြီး latency 1.9ms ရှိပါတယ်။
Datrium ရဲ့ spin on convergence ဟာ ထူးခြားတဲ့ လုပ်ဆောင်ချက်တစ်ခုပါ။ localized flash နဲ့ compute node တွေကနေ “ကျန်တဲ့” CPU ကို အသုံးချတာက အဓိပ္ပာယ်ရှိပေမယ့် TCO အကျိုးကျေးဇူးအားလုံးအတွက် persistent storage အတွက် flash ကို သိမ်းဆည်းထားနိုင်ဆဲပါ။ ဒီလုပ်ဆောင်ချက်ကို လုပ်ဆောင်ဖို့ အဓိကမောင်းနှင်အားကတော့ DVX စနစ်က ပေးစွမ်းတဲ့ storage စွမ်းဆောင်ရည်တွေဖြစ်ပြီး data node တွေမှာ flash ကနေ အများဆုံးရယူဖို့ အရေးကြီးပါတယ်။ စွမ်းဆောင်ရည်ပိုလိုအပ်သူတွေအတွက် compute node တွေမှာ NVMe storage ကို လျှော့ချဖို့ လွယ်ကူပါတယ်။ ဒါပေမယ့် ကျွန်တော်တို့က ဈေးသက်သာတဲ့ option နဲ့ ကောင်းကောင်းလုပ်ဆောင်နိုင်ခဲ့တာ ထင်ရှားပါတယ်။ ဒါပေမယ့် resiliency မပါဘဲ စွမ်းဆောင်ရည်က ဘာမှ အဓိပ္ပာယ်မရှိပါဘူး။ DVX နဲ့ compute node တွေဟာ stateless ဖြစ်ပြီး N-1 server failure tolerance model ကို ပံ့ပိုးပေးပါတယ်။ ဆိုလိုတာက ကျွန်တော်တို့ရဲ့ test config မှာ server ၃၂ ခုထဲက ၃၁ ခု ဆုံးရှုံးနိုင်ပြီး data အားလုံးကို ရရှိနိုင်ပါသေးတယ်။ server အားလုံး ဆုံးရှုံးသွားရင်တောင် DVX က data ရဲ့ authoritative copy ကို compute node တွေမှာမဟုတ်ဘဲ data node တွေမှာ သိမ်းဆည်းပြီး ကာကွယ်ထားတဲ့အတွက် data တွေ ဆုံးရှုံးမှာ မဟုတ်ပါဘူး။
အဆုံးစွန်အားဖြင့် Enterprise IT တွင် ပေါင်းစည်းထားသော အခြေခံအဆောက်အအုံကဲ့သို့ စိတ်လှုပ်ရှားဖွယ်ကောင်းသော အရာ မရှိပါ။ ထိုရူပါရုံကို အကောင်အထည်ဖော်ရန် နည်းလမ်းများစွာရှိသော်လည်း Datrium သည် DVX အတွက် ၎င်းတို့၏ ကမ်းလှမ်းချက်ကို စုစည်းထားပြီး ၎င်းတွင် အလွန်ကောင်းမွန်သော စွမ်းဆောင်ရည်ပရိုဖိုင်နှင့်အတူ နက်ရှိုင်းသောဒေတာစီမံခန့်ခွဲမှုဝန်ဆောင်မှုများ ပါဝင်သည်။ သို့သော် ပေါင်းစည်းထားသော နယ်ပယ်တွင် အနည်းငယ်သာ စွမ်းဆောင်ရည်နှင့် အင်္ဂါရပ်နှစ်မျိုးလုံးကို အကောင်အထည်ဖော်ခဲ့ပြီး Datrium ၏ DVX ကို လူအုပ်ကြားတွင် ထင်ရှားစွာထင်ရှားသော ကောင်းမွန်စွာ တပ်ဆင်ထားသော ကမ်းလှမ်းချက်တစ်ခု ဖြစ်စေသည်။


 အမေဇုံ