

Dell ရဲ့ PowerEdge R7x0 series server တွေဟာ data center တွေရဲ့ အုတ်မြစ်တစ်ခုဖြစ်ပြီး သူတို့ရဲ့ ထူးခြားတဲ့ တည်ဆောက်မှု အရည်အသွေး၊ ဂရုတစိုက် ဒီဇိုင်း၊ စွမ်းဆောင်ရည်၊ သိပ်သည်းဆနဲ့ ယုံကြည်စိတ်ချရမှုတို့အတွက် နာမည်ကြီးပါတယ်။ ဒီ server တွေဟာ ပြောင်းလဲနေတဲ့ လိုအပ်ချက်တွေကို ဖြည့်ဆည်းဖို့ အဆက်မပြတ် တိုးတက်ပြောင်းလဲလာခဲ့ပါတယ်။ အခုဆိုရင် Dell PowerEdge R770 ကို မိတ်ဆက်လိုက်တဲ့အခါ series ဟာ သိသိသာသာ ခုန်ပျံကျော်လွှားမှုတစ်ခု ဖြစ်လာပါတယ်။
R770 သည် Intel ၏ Xeon 6 ပရိုဆက်ဆာမိသားစုအသစ်ကို ပွဲဦးထွက်ပြသခဲ့ပြီး Xeon 6500 နှင့် 6700 P နှင့် E core ပရိုဆက်ဆာများ ပါဝင်သည်။ ၎င်းသည် Dell ၏ ၎င်း၏ mainstream server လိုင်းတွင် OCP Data Center Modular Hardware System (DC MHS) စံနှုန်းကို ပထမဆုံးအကြိမ် အပြည့်အဝအသုံးပြုခြင်းဖြစ်သည်။ ဤပြောင်းလဲမှုနှစ်ခုပေါင်းစပ်ခြင်းဖြင့် စွမ်းဆောင်ရည်နှင့် ဒီဇိုင်းအတွေးအခေါ်တွင် သိသာထင်ရှားသော တိုးတက်ပြောင်းလဲမှုကို ကတိပြုပါသည်။
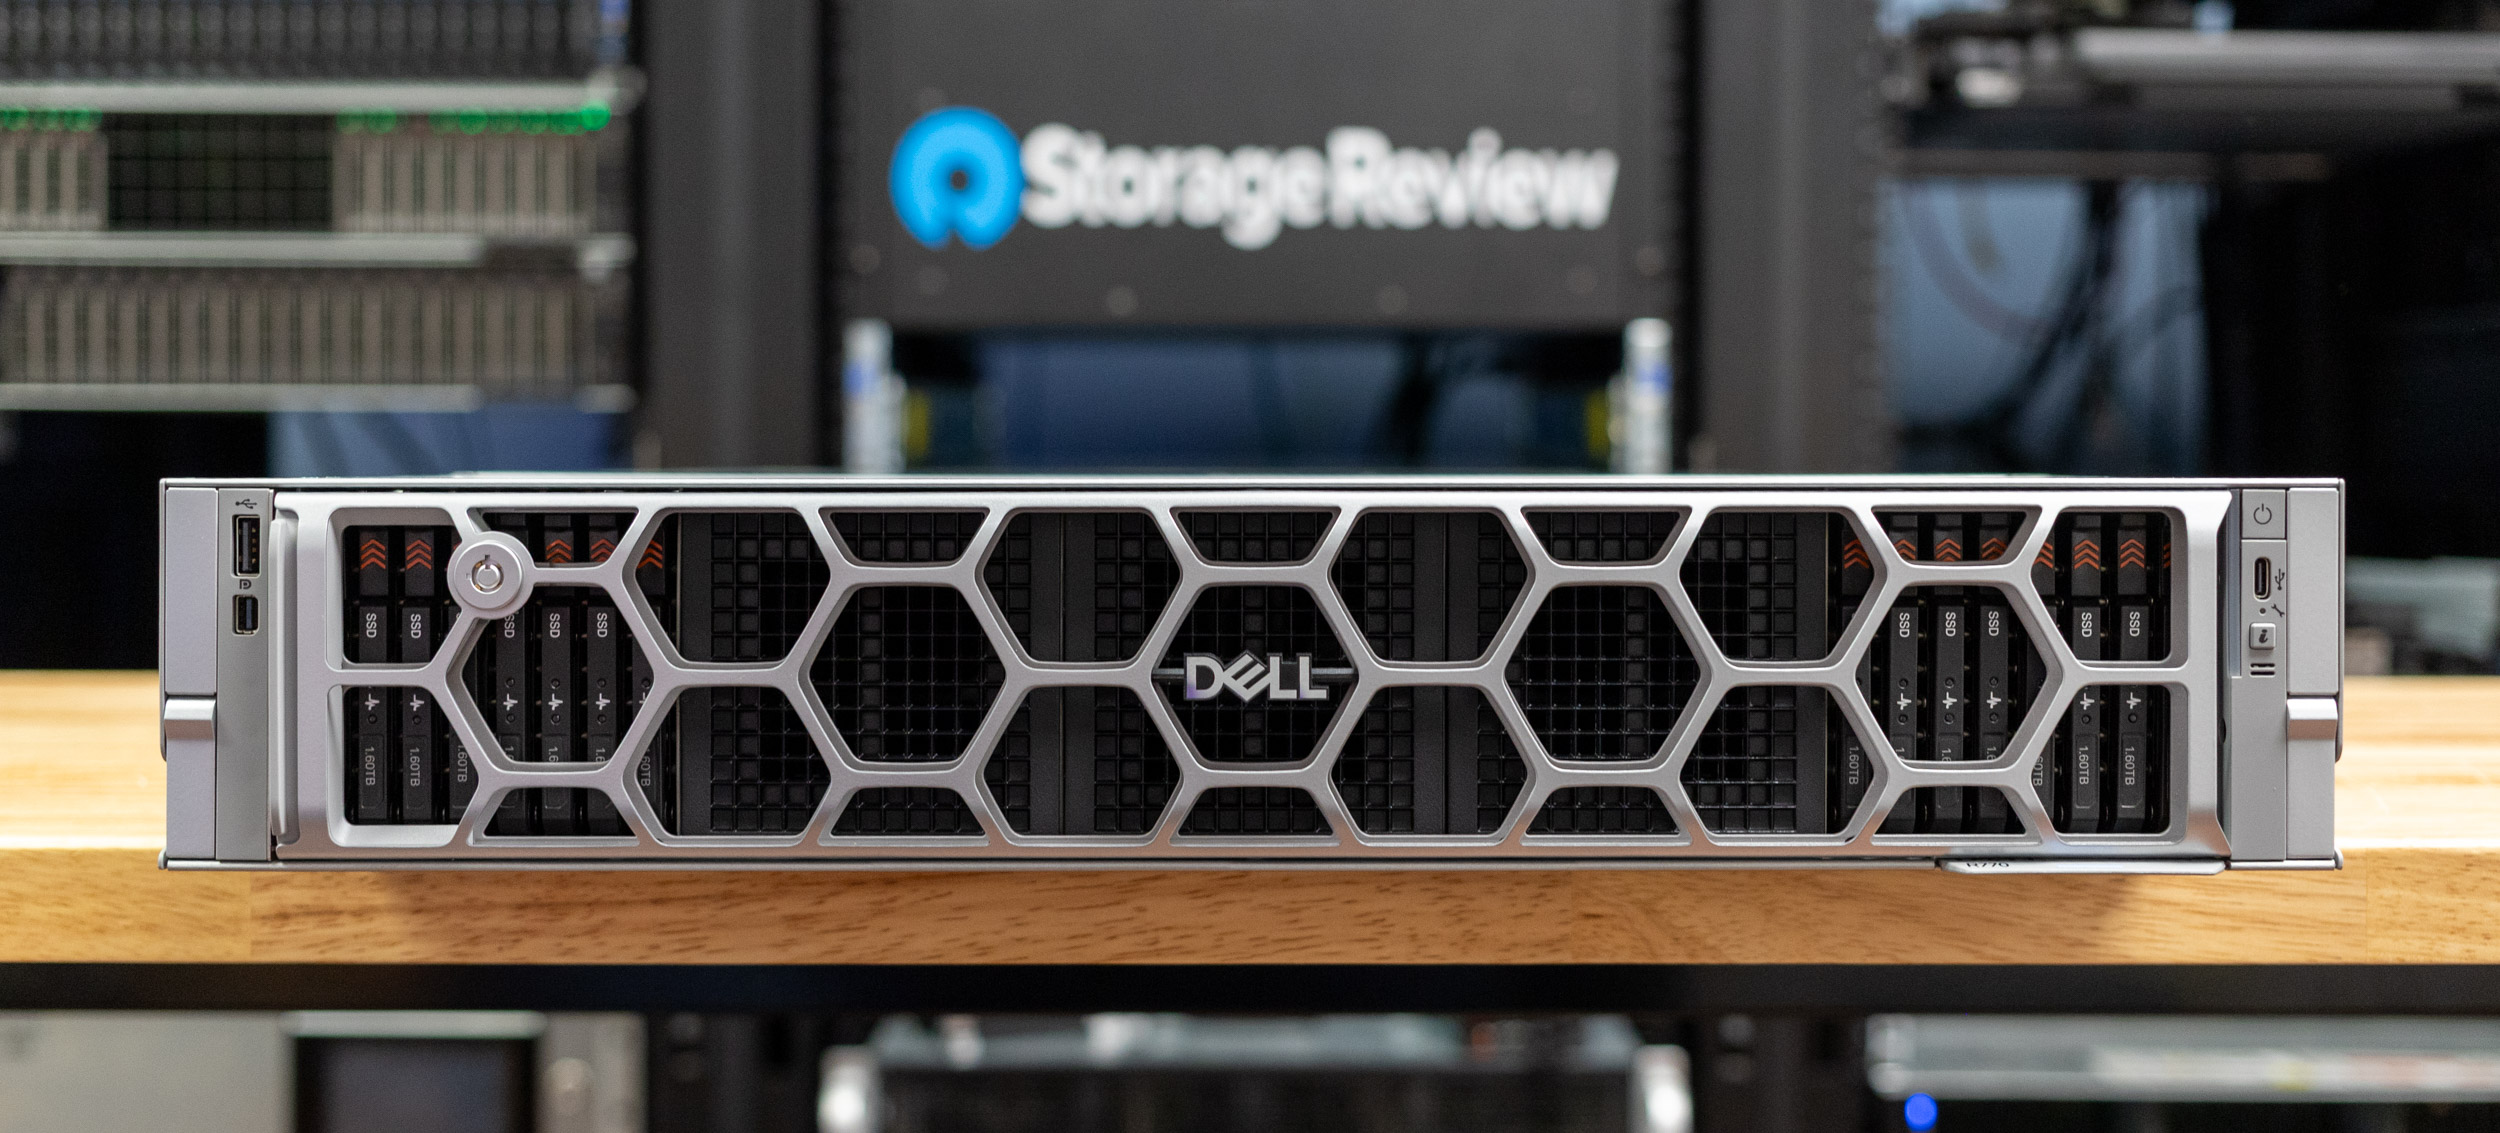
ခေတ်မီဒေတာစင်တာလိုအပ်ချက်များကိုဖြည့်ဆည်းပေးခြင်း
R770 ကို စတင်မိတ်ဆက်ခြင်းသည် ဒေတာစင်တာများသည် ဖိအားများ တိုးပွားလာနေချိန်တွင် ဖြစ်ပေါ်လာခြင်းဖြစ်သည်။ အလုပ်ဝန်များသည် ပိုမိုကွဲပြားပြီး တောင်းဆိုမှုများ များပြားလာပါသည်။ ဒေတာ၏ စဉ်ဆက်မပြတ် တိုးတက်မှုသည် ခိုင်မာသော ခွဲခြမ်းစိတ်ဖြာမှုများနှင့် ဒေတာဘေ့စ်များအတွက် လိုအပ်ချက်ကို ပိုမိုမြင့်မားစေပါသည်။ ရှုပ်ထွေးသော မော်ဒယ်များကို လေ့ကျင့်ပေးခြင်းမှသည် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းအထိ၊ အတုဥာဏ်ရည်သည် အထူးပြုအသုံးချမှုတစ်ခု မဟုတ်တော့ဘဲ သိသာထင်ရှားသော တွက်ချက်မှုစွမ်းအားနှင့် အထူးပြု အရှိန်မြှင့်တင်မှု လိုအပ်သည့် အဓိက စီးပွားရေးမောင်းနှင်အားတစ်ခု ဖြစ်လာပါသည်။
တစ်ချိန်တည်းမှာပင်၊ စွမ်းအင်ထိရောက်မှုနှင့် ပိုင်ဆိုင်မှုစုစုပေါင်းကုန်ကျစရိတ်ကို အကောင်းဆုံးဖြစ်အောင်လုပ်ဆောင်ခြင်းတို့ကို အထူးအာရုံစိုက်လျက်ရှိသည်။ ထို့အပြင်၊ စက်မှုလုပ်ငန်းသည် ဆန်းသစ်တီထွင်မှုကို မြှင့်တင်ရန်၊ အပြန်အလှန်လုပ်ဆောင်နိုင်စွမ်းကို မြှင့်တင်ရန်နှင့် ရောင်းချသူ lock-in ကို လျှော့ချရန် ပွင့်လင်းသောစံနှုန်းများကို ပိုမိုရှာဖွေလာကြသည်။ R770 တွင် ၎င်း၏ ပရိုဆက်ဆာရွေးချယ်မှုအသစ်များနှင့် OCP DC MHS ကို အသုံးပြုခြင်းဖြင့် ဤစိန်ခေါ်မှုများကို တိုက်ရိုက်ဖြေရှင်းရန် ဒီဇိုင်းထုတ်ထားသည်။
Intel Xeon 6 P-Core ပရိုဆက်ဆာများ
R770 ပရိုဆက်ဆာသည် Intel Xeon 6 series ပရိုဆက်ဆာများကို အသုံးပြုထားပြီး 6700 နှင့် 6500 series အပါအဝင် Socket E2 (LGA4710-2) platform ပေါ်တွင် တည်ဆောက်ထားသော Performance နှင့် Efficiency cores များကို ပေါင်းစပ်ထားသည်။ ဤသုံးသပ်ချက်အတွက်၊ ကျွန်ုပ်တို့သည် P series SKUs များကို အထူးအာရုံစိုက်ပါသည်။
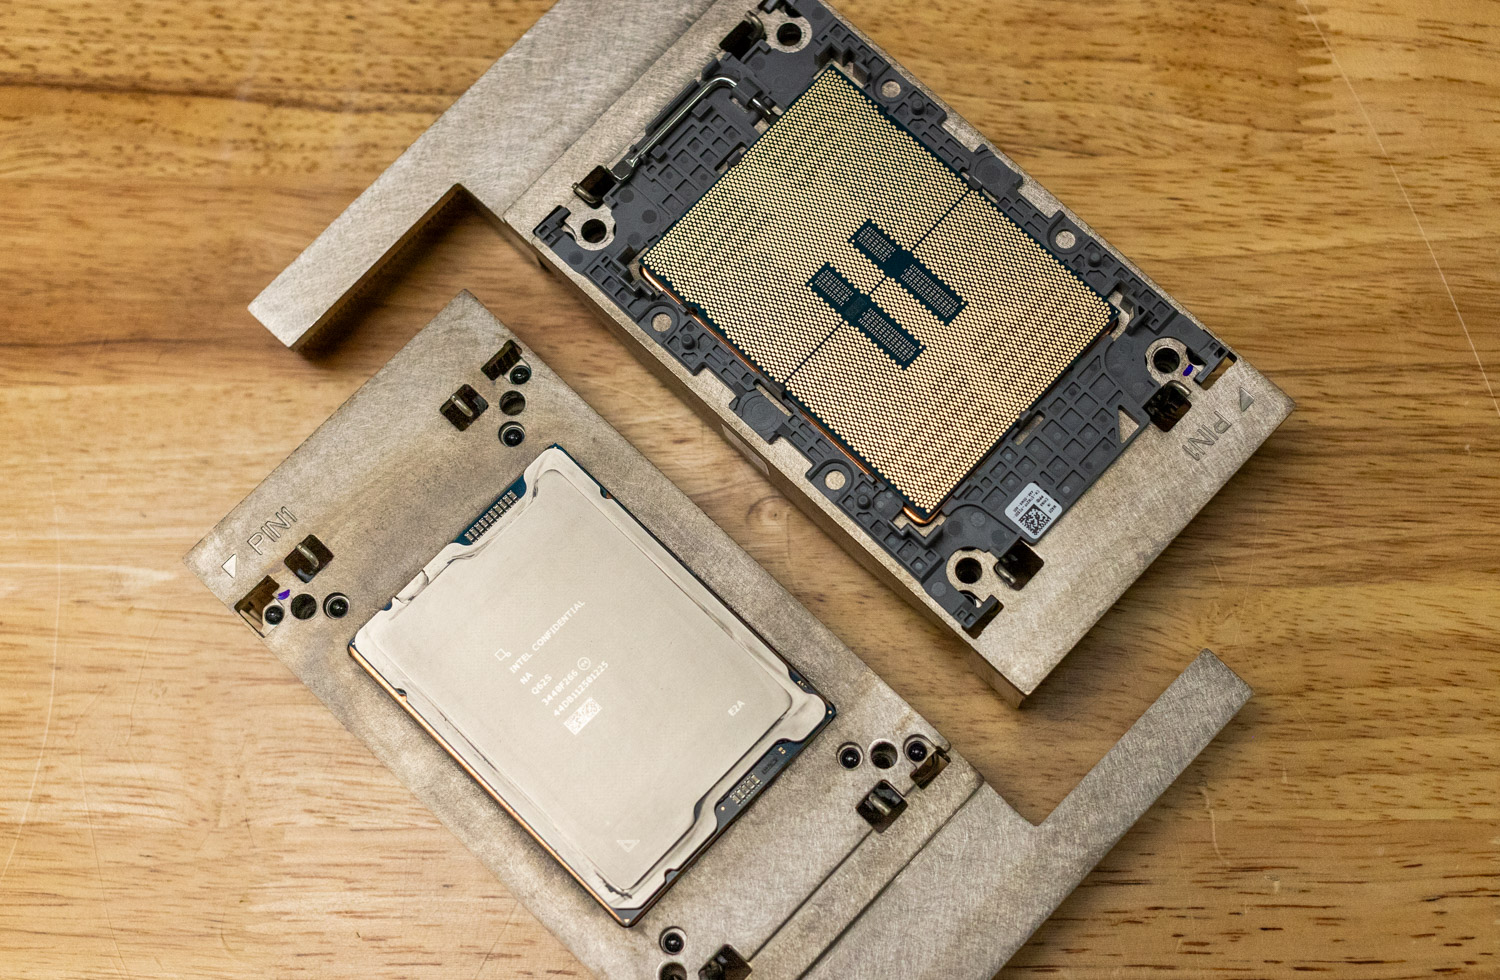
Intel သည် ဤပရိုဆက်ဆာများကို tile-based ဒီဇိုင်းကို အသုံးပြု၍ တည်ဆောက်ထားပြီး I/O tile များကို compute tile တစ်ခု သို့မဟုတ် နှစ်ခုနှင့် ပေါင်းစပ်ထားသည်။ ၎င်းသည် စီးရီးအတွင်း scalability ကို ခွင့်ပြုပေးပြီး compute tile နှစ်ခုကို အသုံးပြု၍ P-core (XCC) ၈၆ ခုအထိ ရောက်ရှိစေပြီး single compute tile များဖြင့် P-core ၄၈ ခု (HCC) သို့မဟုတ် P-core ၁၆ ခု (LCC) အထိ ရောက်ရှိစေသည်။
ယခင်မျိုးဆက် Sapphire နှင့် Emerald Rapids Processors များနှင့် နှိုင်းယှဉ်ပါက ဤပရိုဆက်ဆာများ၏ အဓိကကွာခြားချက်မှာ Xeon 6 ပရိုဆက်ဆာအားလုံးတွင် built-in accelerator များ ရရှိနိုင်ခြင်းဖြစ်သည်။ ၎င်းတွင် crypto နှင့် compression အတွက် Intel QuickAssist Technology၊ data movement အတွက် Intel Data Streaming Accelerator၊ database နှင့် analytics acceleration အတွက် Intel In-Memory Analytics Accelerator နှင့် network processing efficiency အတွက် Intel Dynamic Load Balancer တို့ ပါဝင်သည်။
မန်မိုရီနှင့် I/O bandwidth ကိုလည်း သိသိသာသာ အဆင့်မြှင့်တင်မှုများ ပြုလုပ်ထားပါသည်။ Xeon 6700/6500 P-core စီးရီးသည် 8-channel DDR5 မန်မိုရီကို ပံ့ပိုးပေးပါသည်။ ၎င်းတို့သည် 8,800 MT/s အထိ အမြန်နှုန်းကို ပေးစွမ်းနိုင်သည့် Multiplexed Rank DIMM (MRDIMM) အတွက် လမ်းခင်းပေးပါသည်။ I/O ကဏ္ဍတွင် ဤပရိုဆက်ဆာများသည် PCIe 5.0 နှင့် CXL 2.0 ကို ပံ့ပိုးပေးပါသည်။ dual-socket configuration များတွင်၊ ပလက်ဖောင်းသည် socket တစ်ခုလျှင် PCIe လမ်းကြောင်း ၈၈ ခု (စုစုပေါင်း လမ်းကြောင်း ၁၇၆ ခု) အထိ ပေးစွမ်းနိုင်ပါသည်။
P-core နှင့် E-core ကွဲပြားမှုများရှိနေသော်လည်း Xeon 6 မိသားစုသည် instruction set များ၊ BIOS၊ drivers များ၊ OS/application support နှင့် RAS features များတွင် ባህሪያዊဖြစ်မှုကို ထိန်းသိမ်းထားပြီး deployment အမျိုးအစားအမျိုးမျိုးတွင် integration နှင့် management ကို ရိုးရှင်းစေသည်။ P-core variants များသည် per-core per-core per-performance၊ AI acceleration၊ high memory bandwidth နှင့် substantial I/O များသော workloads များအတွက် ရည်ရွယ်ပါသည်။ တောင်းဆိုမှုများသော databases များ၊ HPC simulations များ၊ advanced analytics နှင့် ကျယ်ပြန့်သော AI applications များကို စဉ်းစားပါ။
Dell PowerEdge R770 သတ်မှတ်ချက်များ
| specification | Dell PowerEdge R770 |
| processor ကို | ပရိုဆက်ဆာတစ်ခုလျှင် E-core ၁၄၄ ခု သို့မဟုတ် P-core ၈၆ ခုအထိ ပါဝင်သော Intel Xeon 6 ပရိုဆက်ဆာနှစ်ခု |
| မှတ်ဉာဏ် | DDR5 DIMM slot ၃၂ ခု၊ RDIMM အများဆုံး 8 TB ကို ပံ့ပိုးပေးသည်၊ 6400 MT/s အထိ အမြန်နှုန်း၊ မှတ်ပုံတင်ထားသော ECC DDR5 DIMM များကိုသာ ပံ့ပိုးပေးသည် |
| သိုလှောင်မှု ထိန်းချုပ်ကိရိယာများ | အတွင်းပိုင်း Boot: Boot Optimized Storage Subsystem (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2 NVMe SSDs သို့မဟုတ် M.2 Interposer board (DC-MHS): 2 x M.2 NVMe SSDs သို့မဟုတ် USB, အတွင်းပိုင်း controllers: ရှေ့ PERC H965i, ရှေ့ PERC H975i, ရှေ့ PERC H365i |
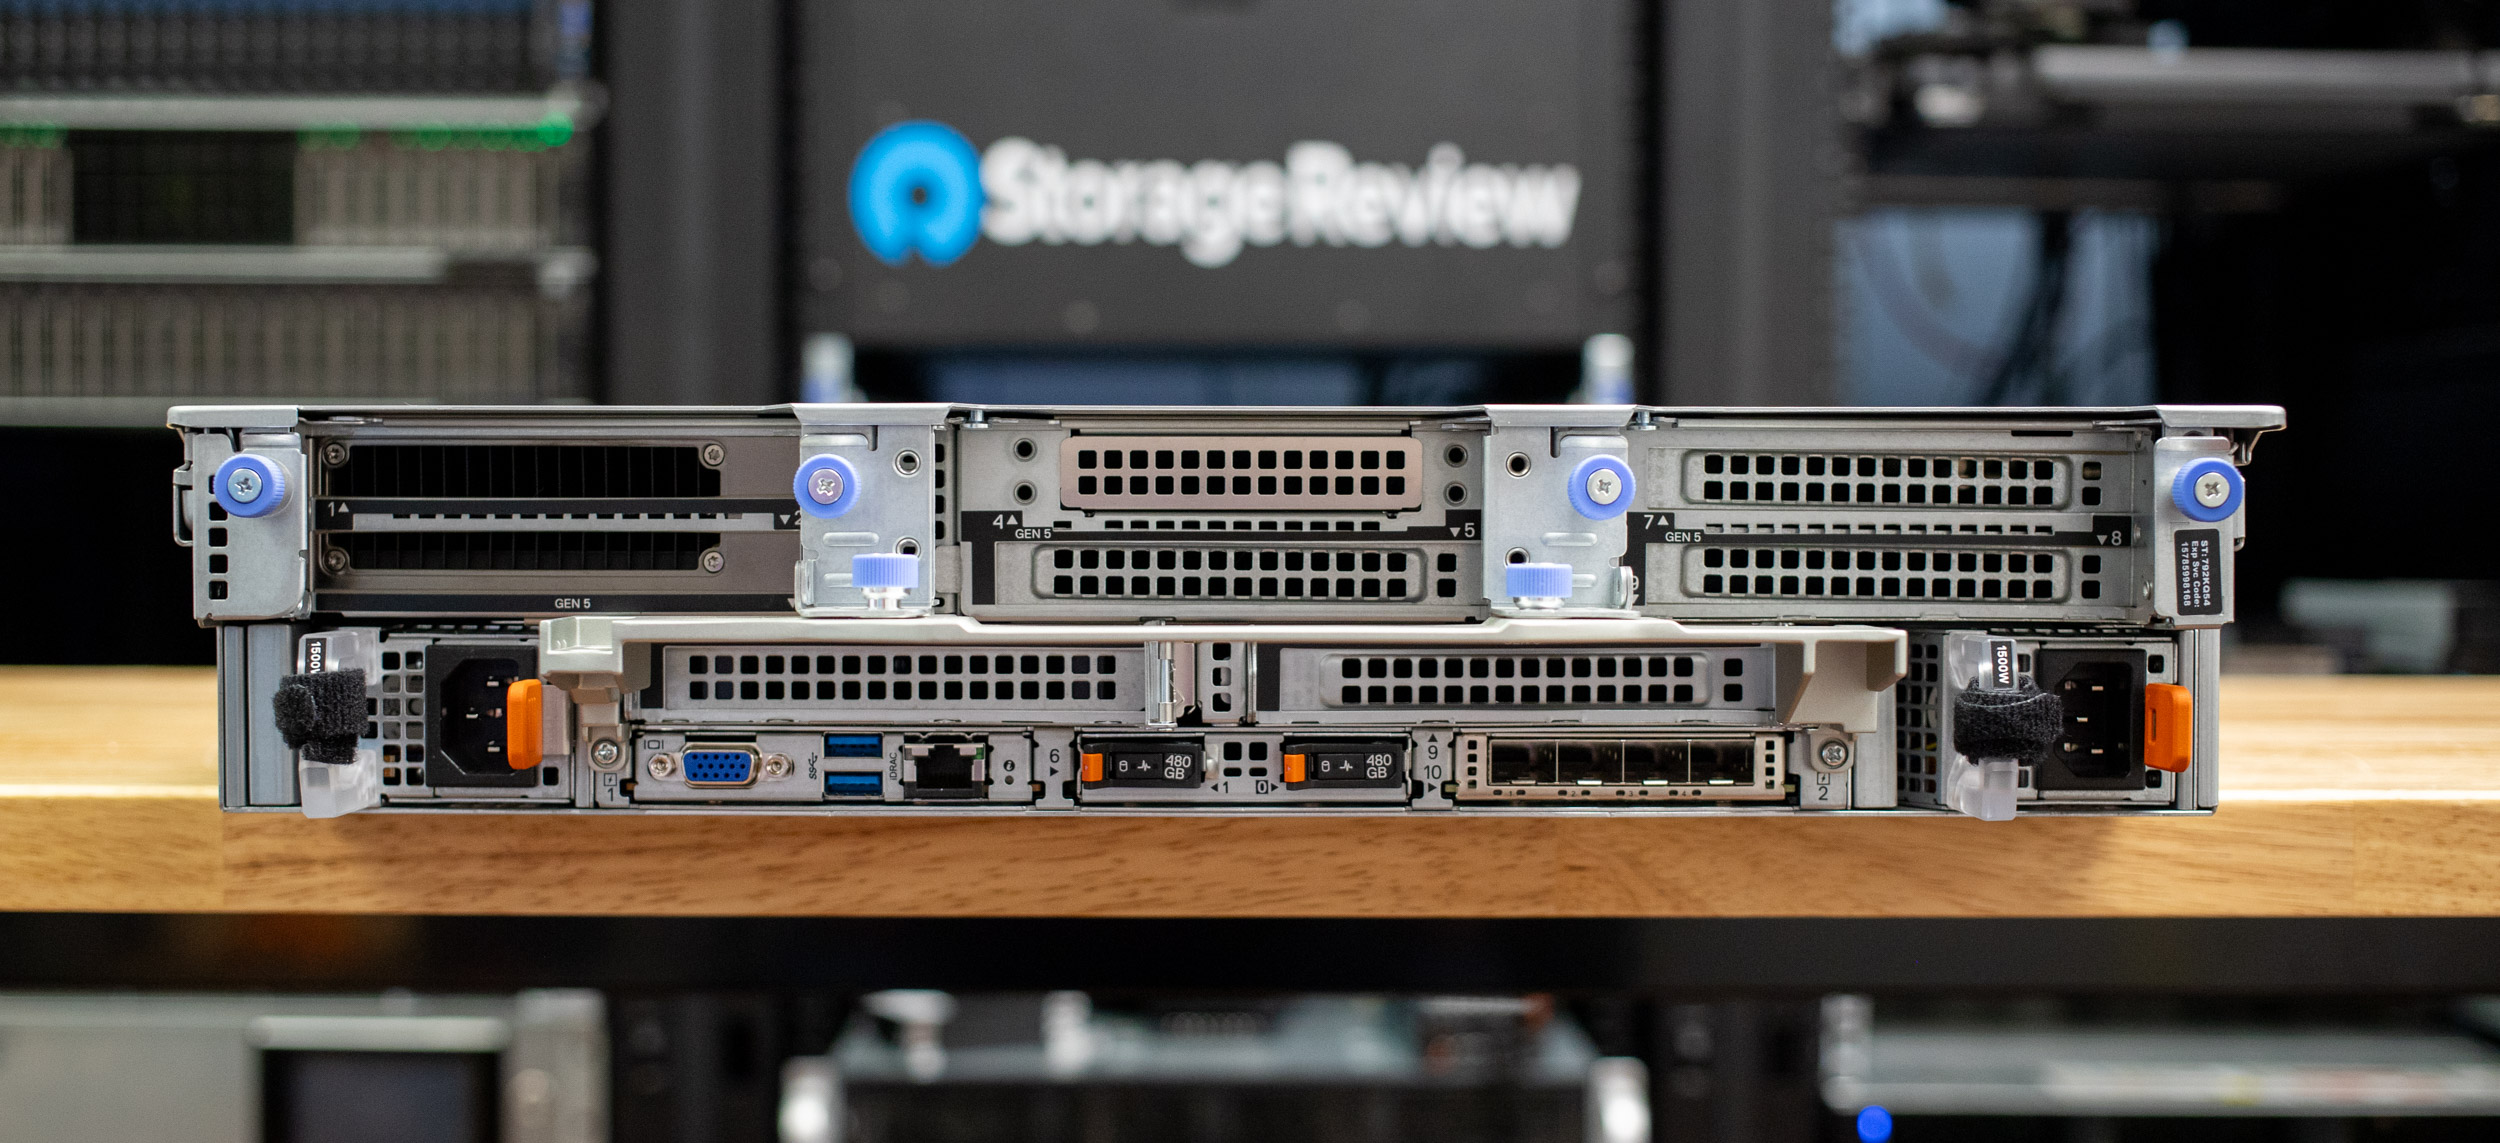
| ရှေ့နှင့်နောက်ဘက်ပင်လယ်အော်များ |
|
| Hot Swap ပါဝါထောက်ပံ့မှုများ |
|
| အအေးခံရွေးချယ်မှုများ | လေဖြင့်အအေးပေးခြင်းနှင့် တိုက်ရိုက်အရည်ဖြင့်အအေးပေးခြင်း (DLC သည် rack ဖြေရှင်းချက်တစ်ခုဖြစ်ပြီး လည်ပတ်ရန် rack manifolds နှင့် အအေးပေးဖြန့်ဖြူးရေးယူနစ် (CDU) လိုအပ်သည်) |
| ပရိသတ်များ | စွမ်းဆောင်ရည်မြင့် ငွေရောင် (HPR SLVR) ပန်ကာများ/စွမ်းဆောင်ရည်မြင့် ရွှေရောင် (HPR GOLD) ပန်ကာများ၊ ပူပြင်းစွာလဲလှယ်နိုင်သော ပန်ကာ ၆ လုံးအထိ |
| ရှုထောင့်နှင့်အလေးချိန် | အမြင့် – ၈၆.၈ မီလီမီတာ (၃.၄၂ လက်မ)၊ အနံ – ၄၈၂ မီလီမီတာ (၁၈.၉၇ လက်မ)၊ အလေးချိန် – ၂၈.၅၃ ကီလိုဂရမ် (၆၂.၈၉ ပေါင်)၊ အနက် (နောက်ဘက် I/O ဖွဲ့စည်းမှုအတွက်) – bezel ပါလျှင် ၈၀၂.၄၀ မီလီမီတာ (၃၁.၅၉ လက်မ)၊ bezel မပါလျှင် ၈၀၁.၅၁ မီလီမီတာ (၃၁.၅၆ လက်မ)၊ အနက် (ရှေ့ I/O ဖွဲ့စည်းမှုအတွက်) – bezel မပါလျှင် ၈၁၄.၅၂ မီလီမီတာ (၃၂.၀၇ လက်မ) |
| form ကို Factor | ဆာဗာ 2U ထိန်သိမ်း |
| ထည့်သွင်းထားသော စီမံခန့်ခွဲမှု | iDRAC၊ iDRAC Direct၊ Redfish ပါဝင်သော iDRAC RESTful API၊ RACADM CLI၊ iDRAC Service Module (iSM)၊ NativeEdge Endpoint၊ NativeEdge Orchestrator |
| bezel | ရွေးချယ်နိုင်သော လုံခြုံရေးဘောင် |
| လုံခွုံရေး | ကုဒ်ဝှက်စနစ်ဖြင့် လက်မှတ်ရေးထိုးထားသော firmware၊ Data at Rest Encryption (local သို့မဟုတ် external key management ပါရှိသော SED များ)၊ Secure Boot၊ Secured Component Verification (Hardware integrity check)၊ Silicon Root of Trust၊ System Lockdown၊ System Lockdown (iDRAC10 Enterprise သို့မဟုတ် Datacenter လိုအပ်သည်)၊ Chassis Intrusion Detection၊ TPM 2.0 FIPS၊ CC-TCG အသိအမှတ်ပြုလက်မှတ် |
| ကွန်ယက်ရွေးစရာများ |
|
| GPU ရွေးချယ်စရာများ | ၆ x ၇၅ W FHHL အထိ သို့မဟုတ် ၂ x ၃၅၀ W DWFL အထိ |
| ဆိပ်ကမ်းများ | ရှေ့ပေါက်များ- USB 2.0 Type C ပေါက် ၁ ခု၊ USB 2.0 Type A ပေါက် ၁ ခု (ရွေးချယ်နိုင်သည်)၊ Mini-DisplayPort ၁ ခု (ရွေးချယ်နိုင်သည်)၊ DB9 Serial ပေါက် ၁ ခု (ရှေ့ I/O ဖွဲ့စည်းမှုပါရှိသည်)၊ iDRAC စီမံခန့်ခွဲမှုအတွက် သီးသန့် ethernet ပေါက် ၁ ခု၊ နောက်ပေါက်များ- iDRAC စီမံခန့်ခွဲမှုအတွက် သီးသန့် ethernet ပေါက် ၁ ခု၊ VGA ၁ ခု၊ USB 3.1 Type A ပေါက် ၂ ခု၊ အတွင်းပိုင်းပေါက်များ- USB 3.1 Type A ပေါက် ၁ ခု |
| PCIe |
|
| လည်ပတ်မှုစနစ်များနှင့် Hypervisor များ | Canonical Ubuntu Server LTS၊ Hyper-V ပါဝင်သော Microsoft Windows Server၊ Red Hat Enterprise Linux၊ SUSE Linux Enterprise Server၊ vSphere ပါဝင်သော VMware |
OCP DC MHS ဖြင့် မော်ဂျူလာဆန်မှုကို လက်ခံကျင့်သုံးသည့် Dell PowerEdge R770

Server/DC-MHS – OpenComputer မှ ရင်းမြစ်
Dell PowerEdge R770 သည် ၎င်း၏ ရုပ်ပိုင်းဆိုင်ရာ ဒီဇိုင်းနှင့် အစိတ်အပိုင်း ဗိသုကာတွင် သိသာထင်ရှားသော တိုးတက်မှုများနှင့် ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို မိတ်ဆက်ပေးထားပြီး Open Compute Project ၏ Data Center Modular Hardware System (OCP DC MHS) စံနှုန်းကို အသုံးပြုထားသည်။
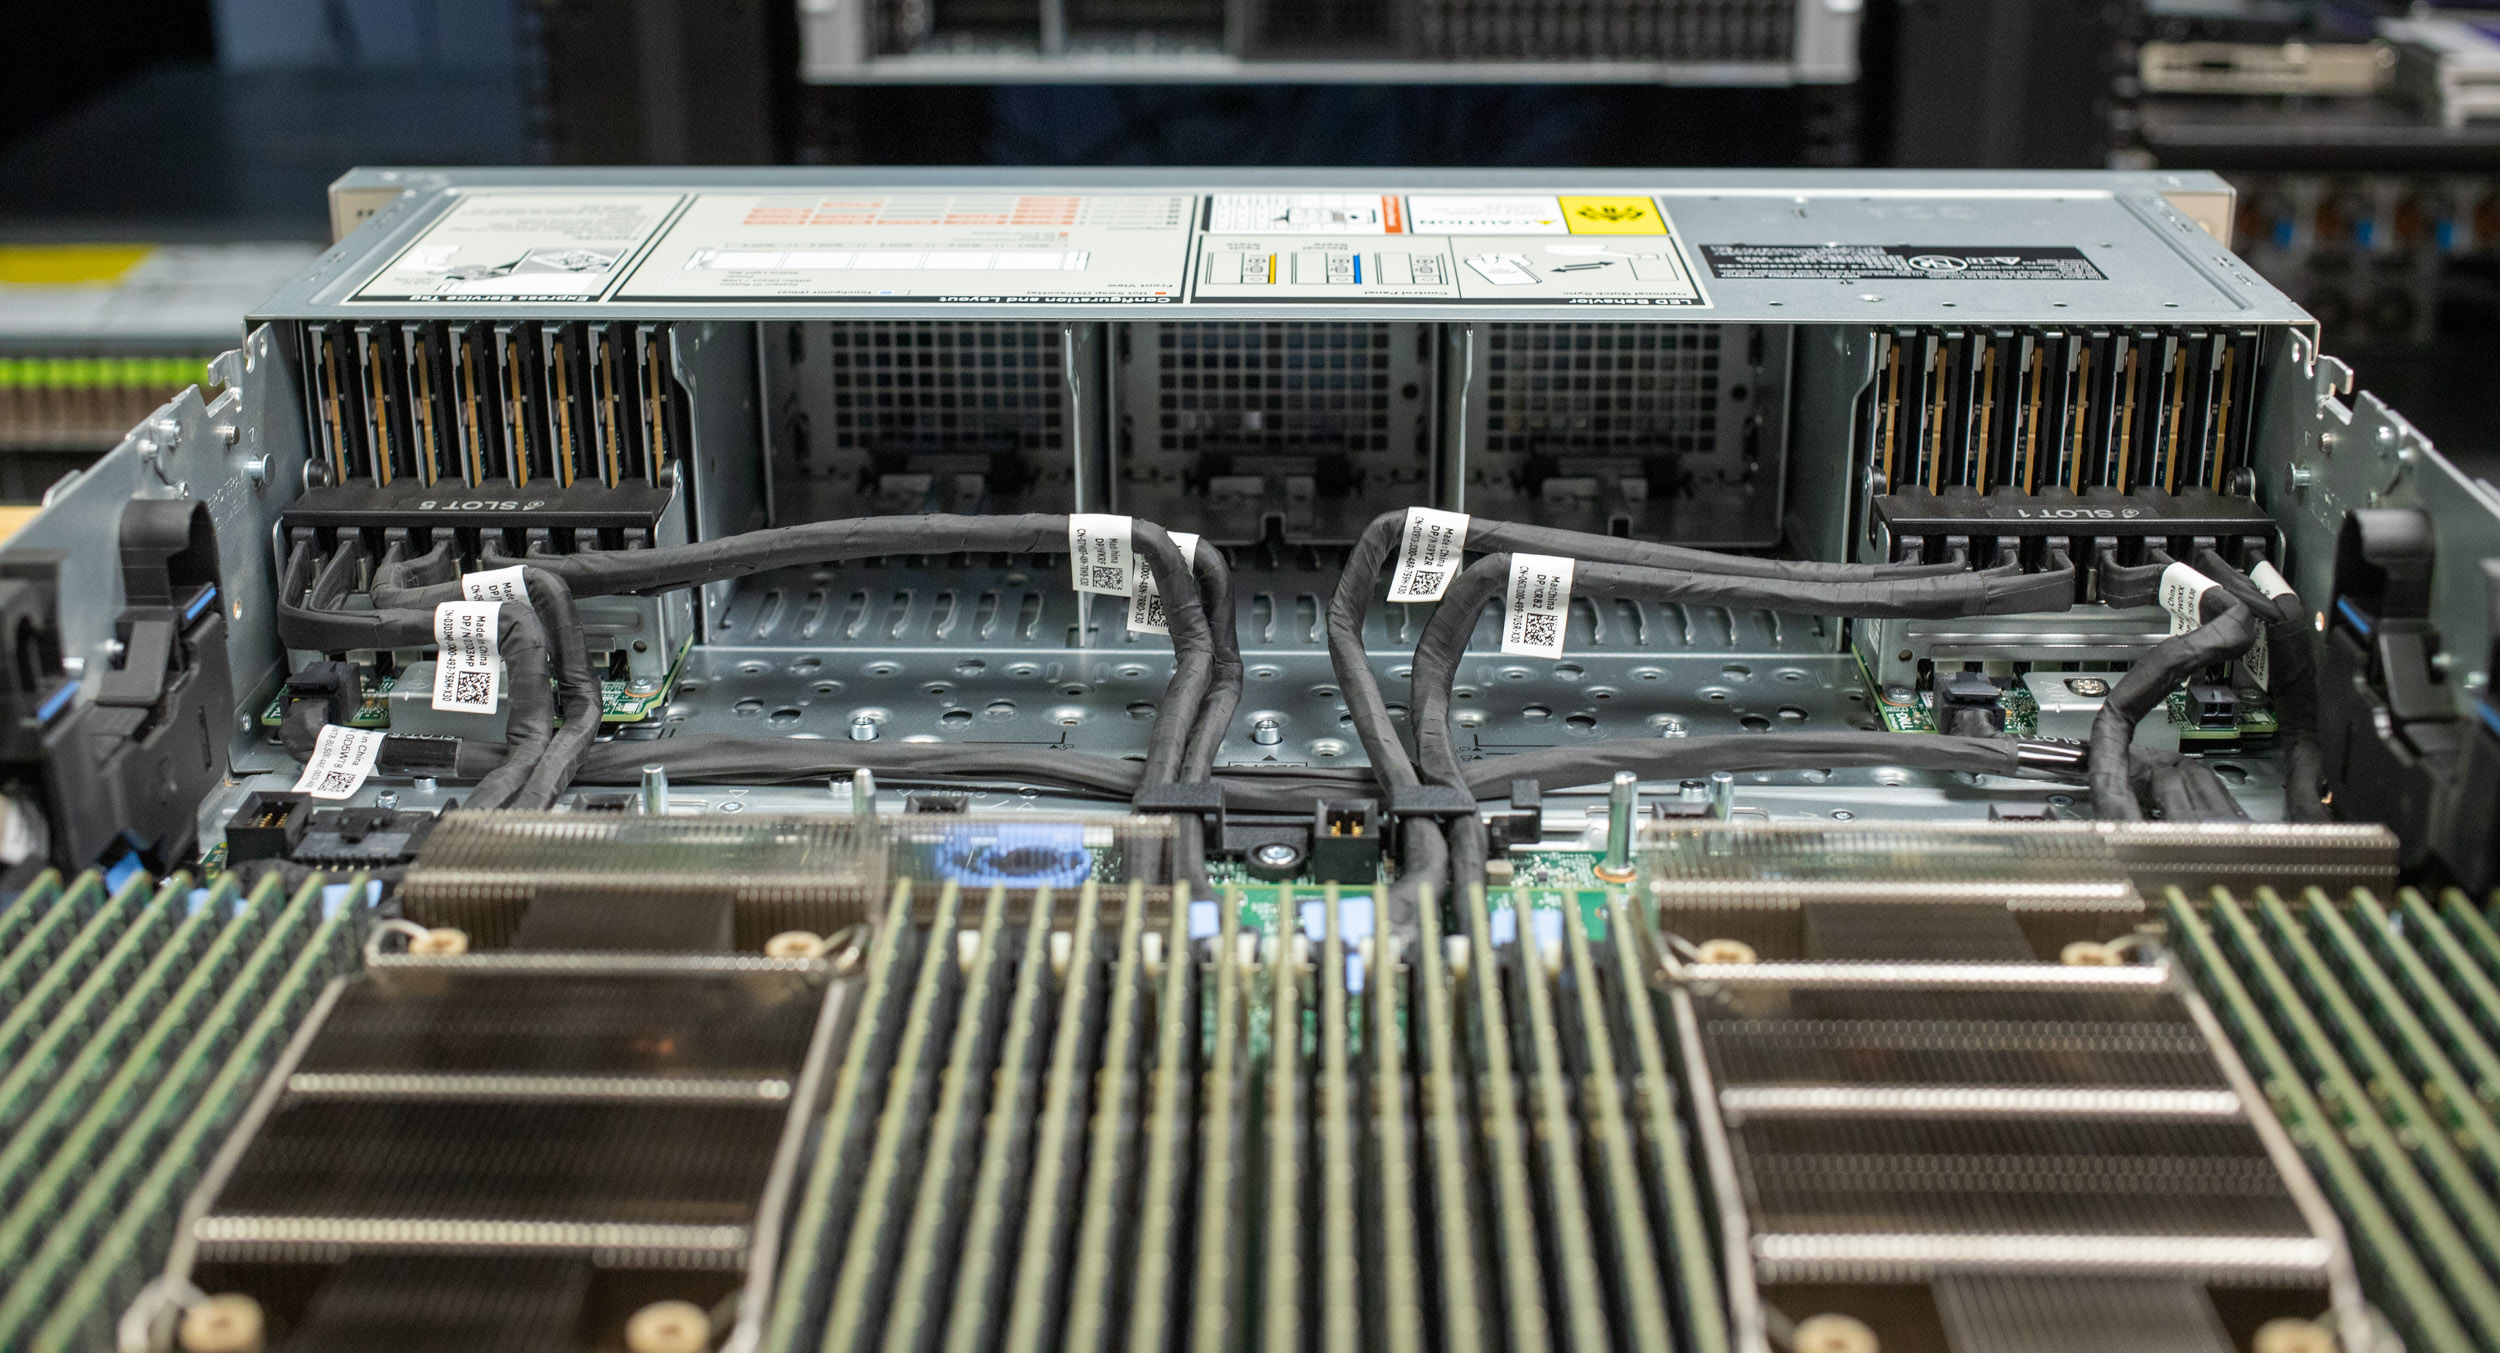
R7x0 စီးရီး၏ အမွေအနှစ်ကို ဆက်လက်ထိန်းသိမ်းထားသော R770 သည် မတူညီသော ဖြန့်ကျက်မှုလိုအပ်ချက်များကို ဖြည့်ဆည်းရန် ကျယ်ပြန့်သော ဖွဲ့စည်းမှုရွေးချယ်မှုများကို ပေးဆောင်ပါသည်။ ဤလိုင်းအတွက် သိသာထင်ရှားသော ပထမဆုံးအချက်မှာ ရိုးရာ Rear I/O ဖွဲ့စည်းမှုနှင့် Front I/O Cold Aisle Accessible ဖွဲ့စည်းမှုအကြား ရွေးချယ်မှုဖြစ်ပြီး မတူညီသော ဒေတာစင်တာ အပြင်အဆင်များနှင့် ဝန်ဆောင်မှုပေးနိုင်မှု လိုအပ်ချက်များအတွက် ပိုမိုပြောင်းလွယ်ပြင်လွယ်ရှိစေပါသည်။ သိုလှောင်မှုရွေးချယ်မှုများသည်လည်း အနည်းဆုံး သို့မဟုတ် လုံးဝမရှိသော compute-focused node များမှသည် storage-centric workloads များအတွက် ထူးခြားသော E3.S drives ၄၀ ကို ပံ့ပိုးပေးသည့် high-density configurations များအထိ တူညီစွာ စွယ်စုံရရှိပါသည်။
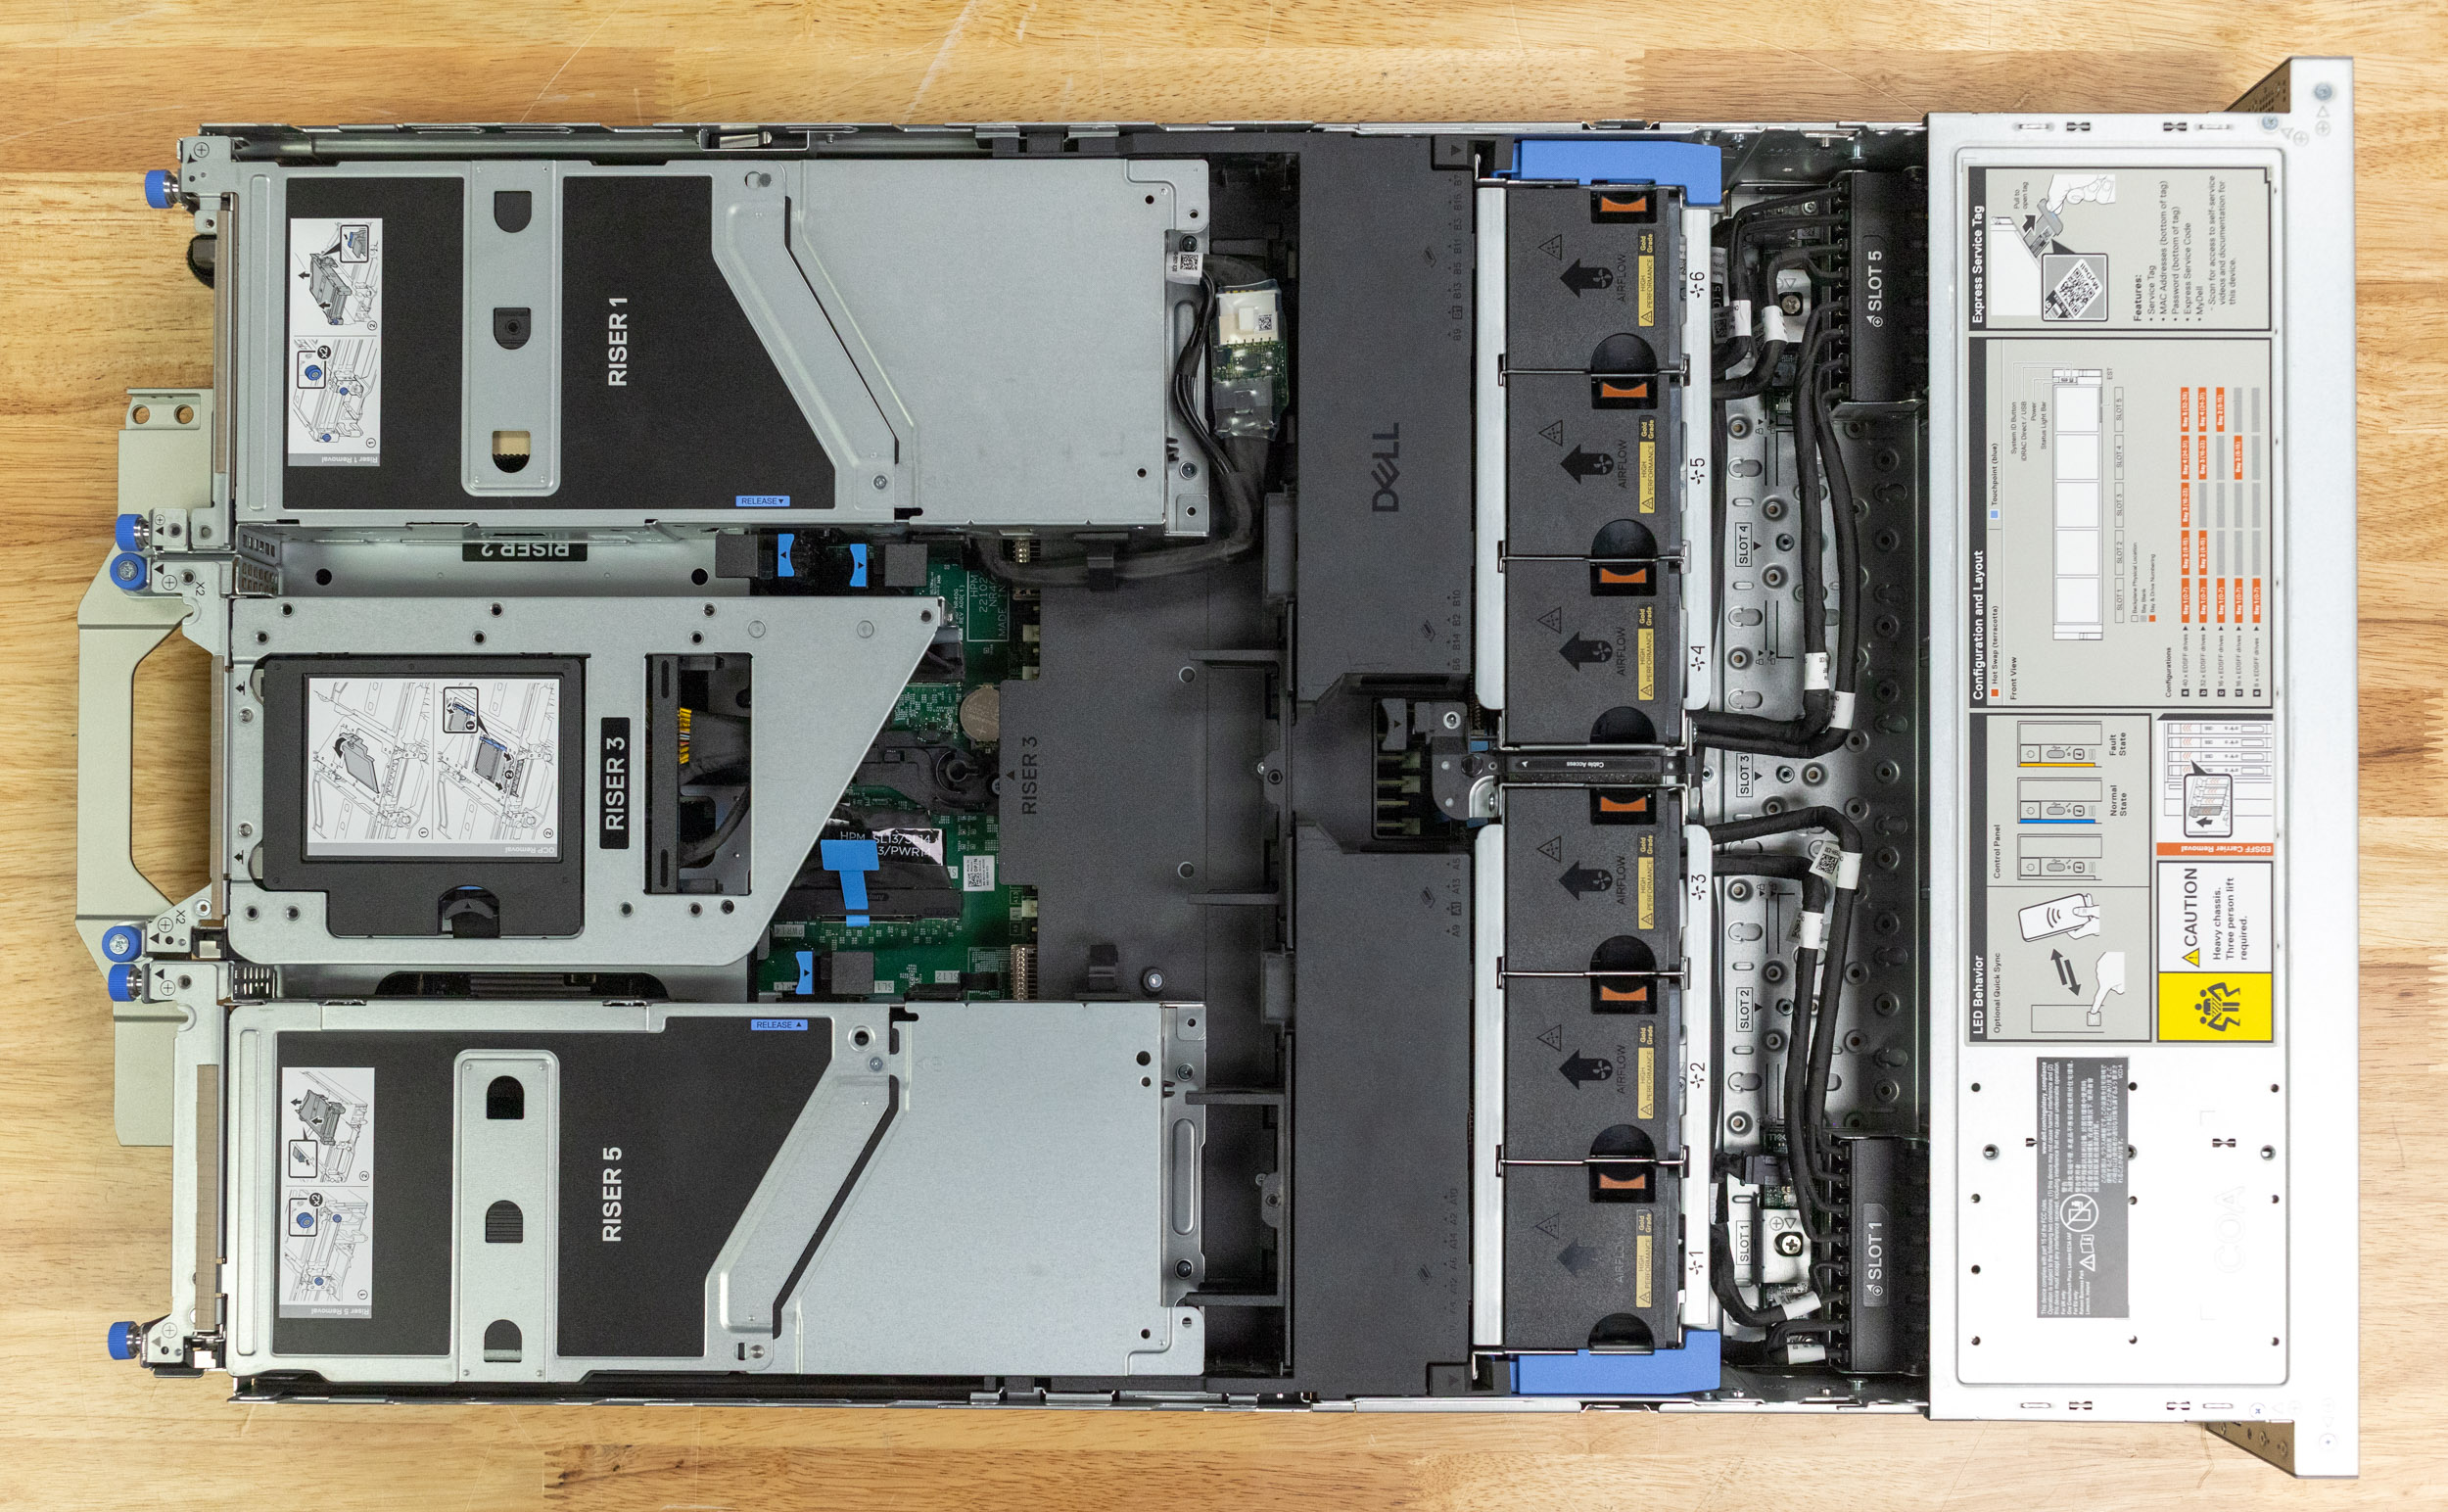
အထူးသဖြင့် AI နှင့် HPC အတွက် အရှိန်မြှင့်ကွန်ပျူတာလိုအပ်ချက် တိုးပွားလာမှုကို ဖြေရှင်းရန်အတွက် R770 တွင် ခိုင်မာသော ချဲ့ထွင်နိုင်စွမ်းများ ပါရှိသည်။ ကိုယ်ထည်နှင့် riser configuration ပေါ် မူတည်၍ server သည် Gen 5 x16 Full-Height, Full-Length (FHFL) PCIe ကတ်ခြောက်ကတ်အထိ ထည့်သွင်းနိုင်သည်။ ထို့အပြင်၊ dual-width GPU နှစ်ခု တပ်ဆင်မှုကိုလည်း ပံ့ပိုးပေးသောကြောင့် အလုပ်အမျိုးမျိုးအတွက် စွမ်းဆောင်ရည်မြင့် platform တစ်ခု ဖြစ်လာစေသည်။ ကွန်ရက်ချိတ်ဆက်မှု ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို OCP 3.0 mezzanine slot များမှတစ်ဆင့် ပံ့ပိုးပေးထားပြီး configuration ပေါ်မူတည်၍ x8 သို့မဟုတ် x16 ကတ်များကို ပံ့ပိုးပေးသည်။
Dell သည် ဝန်ဆောင်မှုပေးနိုင်မှုနှင့် ယုံကြည်စိတ်ချရမှုကို မြှင့်တင်ရန် ရည်ရွယ်သည့် ဒီဇိုင်းပြုပြင်မှုများစွာကိုလည်း အကောင်အထည်ဖော်ခဲ့သည်။ အဓိက ဥပမာတစ်ခုမှာ Boot Optimized Storage Solution (BOSS) ကတ်၏ တိုးတက်ပြောင်းလဲမှုဖြစ်သည်။ ယခင်က ကြိုးများမှတစ်ဆင့် ချိတ်ဆက်ထားပြီး PCIe riser တွင် ထည့်သွင်းထားသော R770 ရှိ BOSS controller ကို ယခုအခါ motherboard နှင့် တိုက်ရိုက်ချိတ်ဆက်နိုင်သော OCP-standardized ကတ်အဖြစ် အကောင်အထည်ဖော်ထားပြီး ကြိုးရှုပ်ထွေးမှုများကို ဖယ်ရှားပေးပါသည်။ ဤ BOSS controller အသစ်တွင် ပိုမိုမြန်ဆန်သော NVMe M.2 drives များပါဝင်ပြီး boot devices များအတွက် အကောင်းဆုံးလည်ပတ်မှုအပူချိန်နှင့် စွမ်းဆောင်ရည်ကို သေချာစေရန် heatsinks များ ပါဝင်သည်။ နည်းပညာရှင်များအတွက် နောက်ထပ်သိမ်မွေ့သော်လည်း လက်တွေ့ကျသော တိုးတက်မှုတစ်ခုမှာ NVRAM ကို ရှင်းလင်းခြင်းကဲ့သို့သော လုပ်ဆောင်ချက်များအတွက် ရိုးရာ jumpers များမှ ပိုမိုအသုံးပြုရလွယ်ကူသော DIP switches များသို့ ရွှေ့ပြောင်းခြင်းဖြစ်သည်။
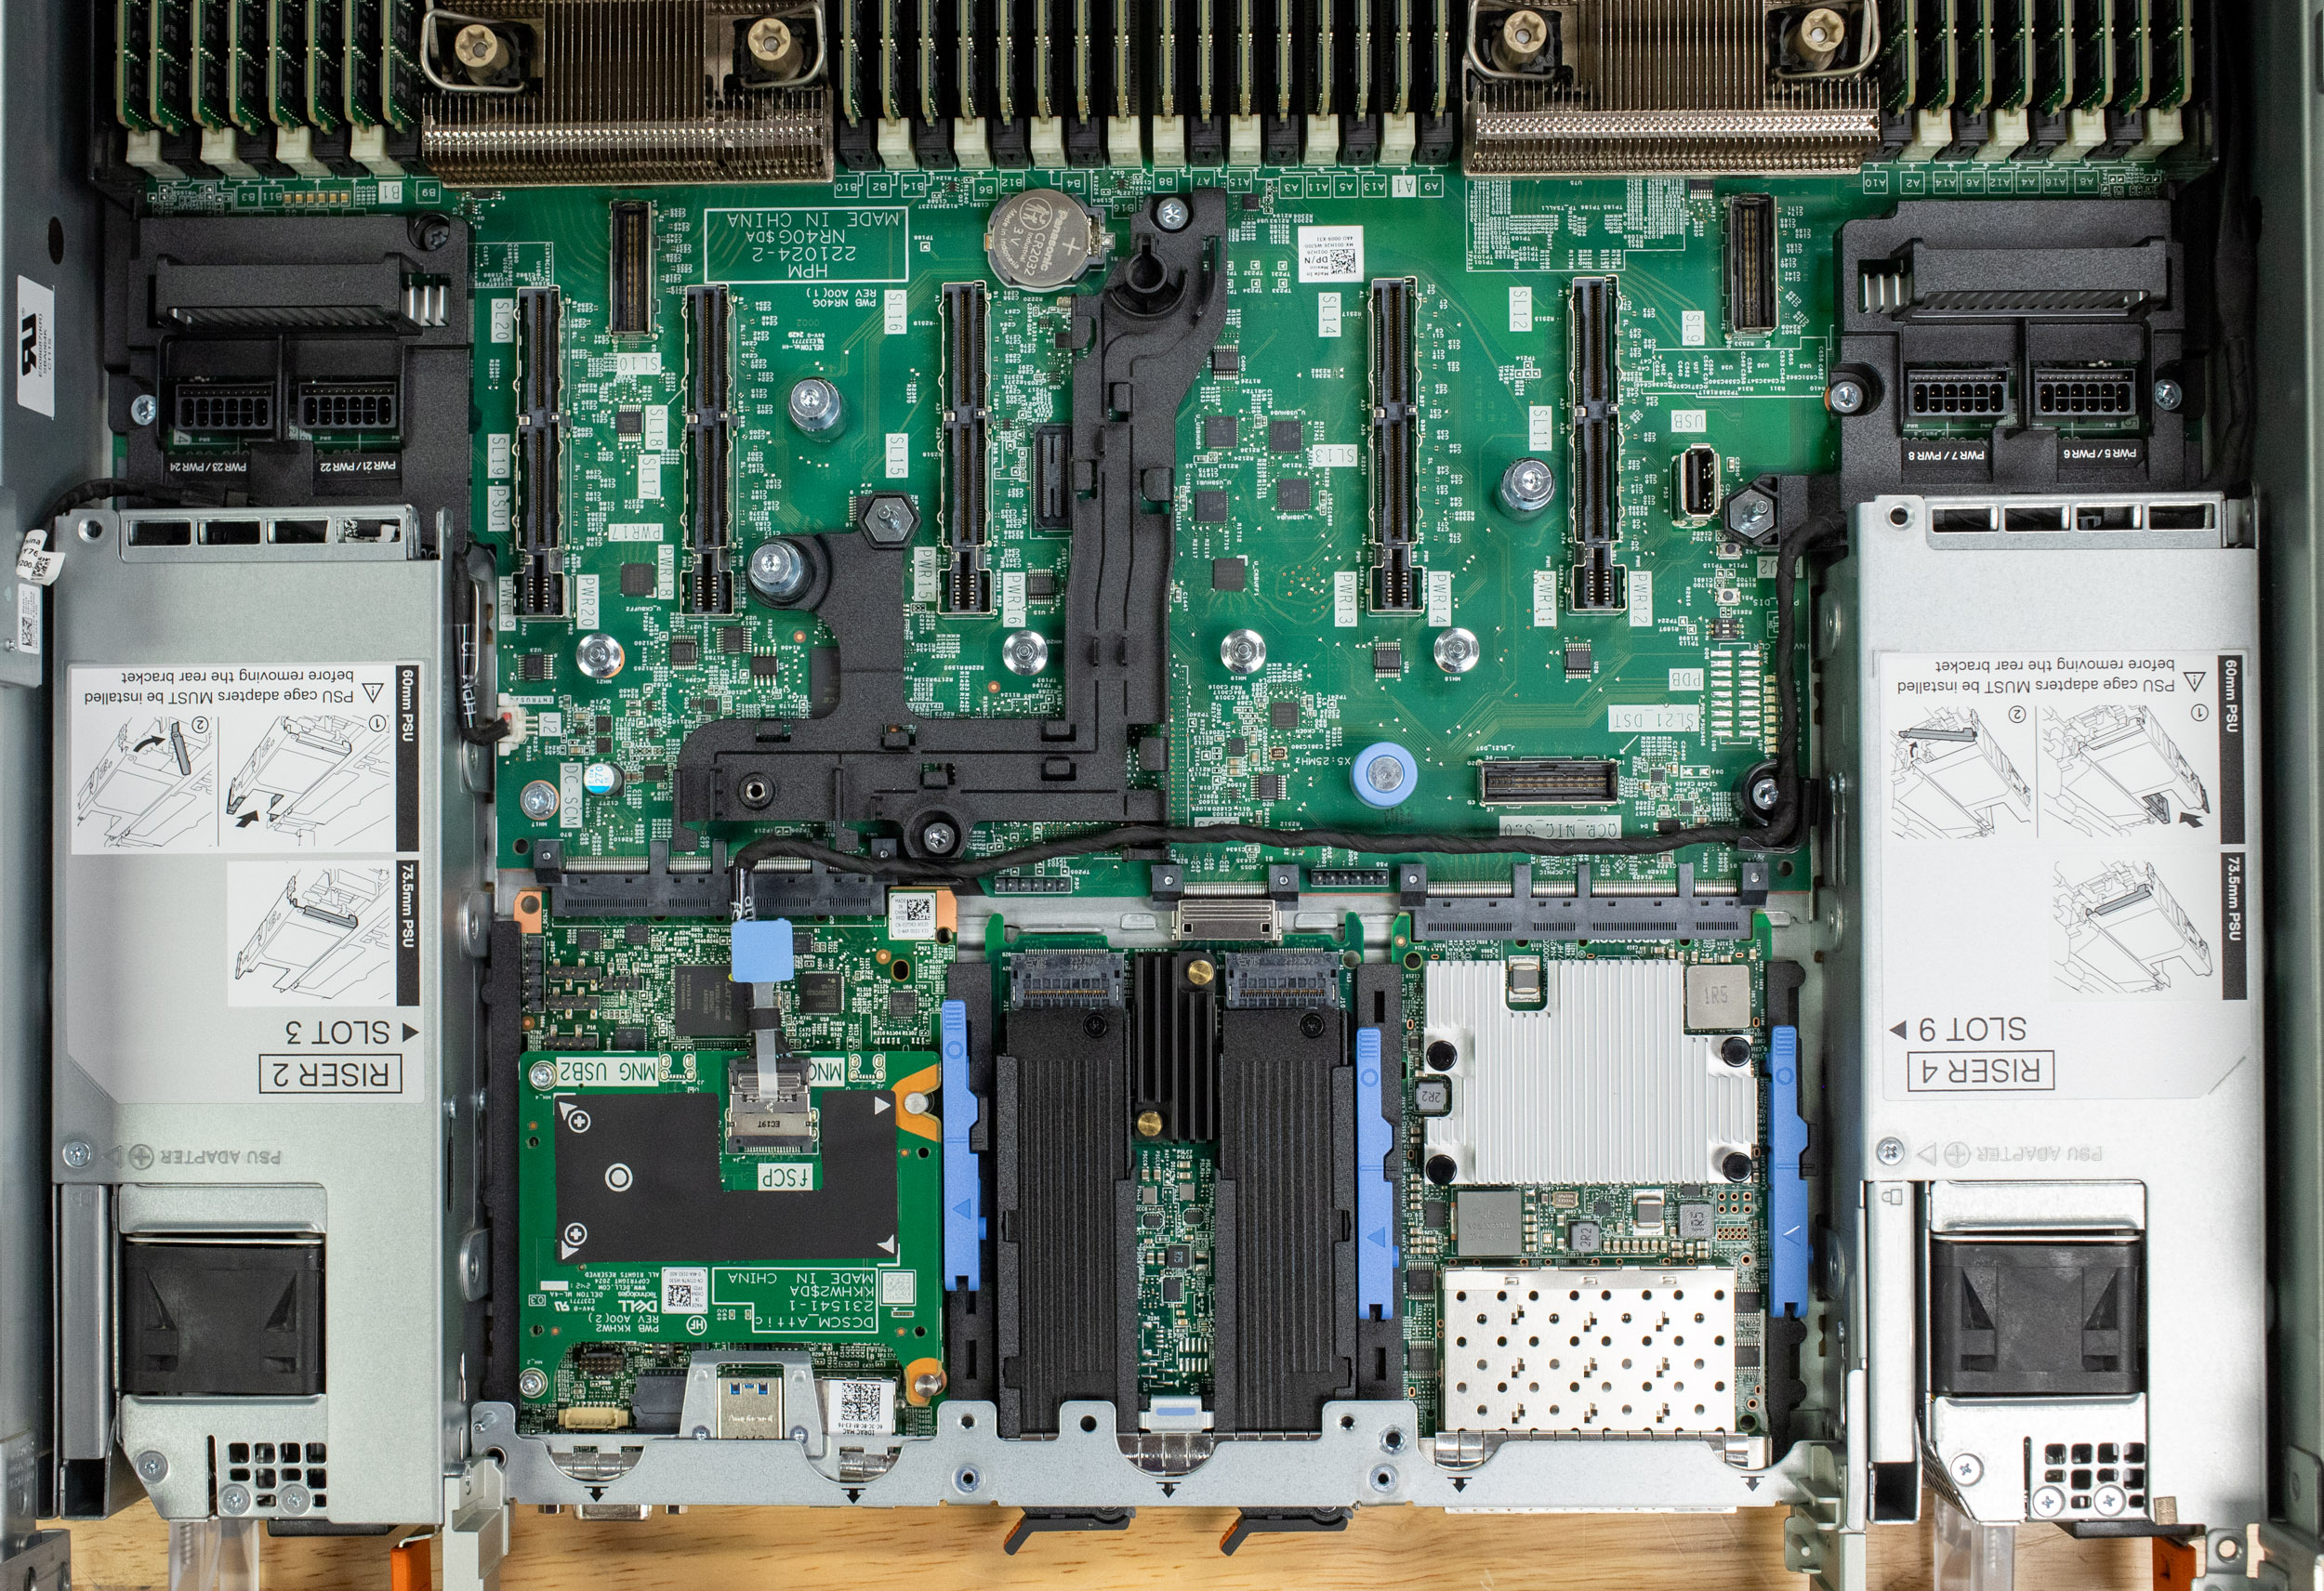
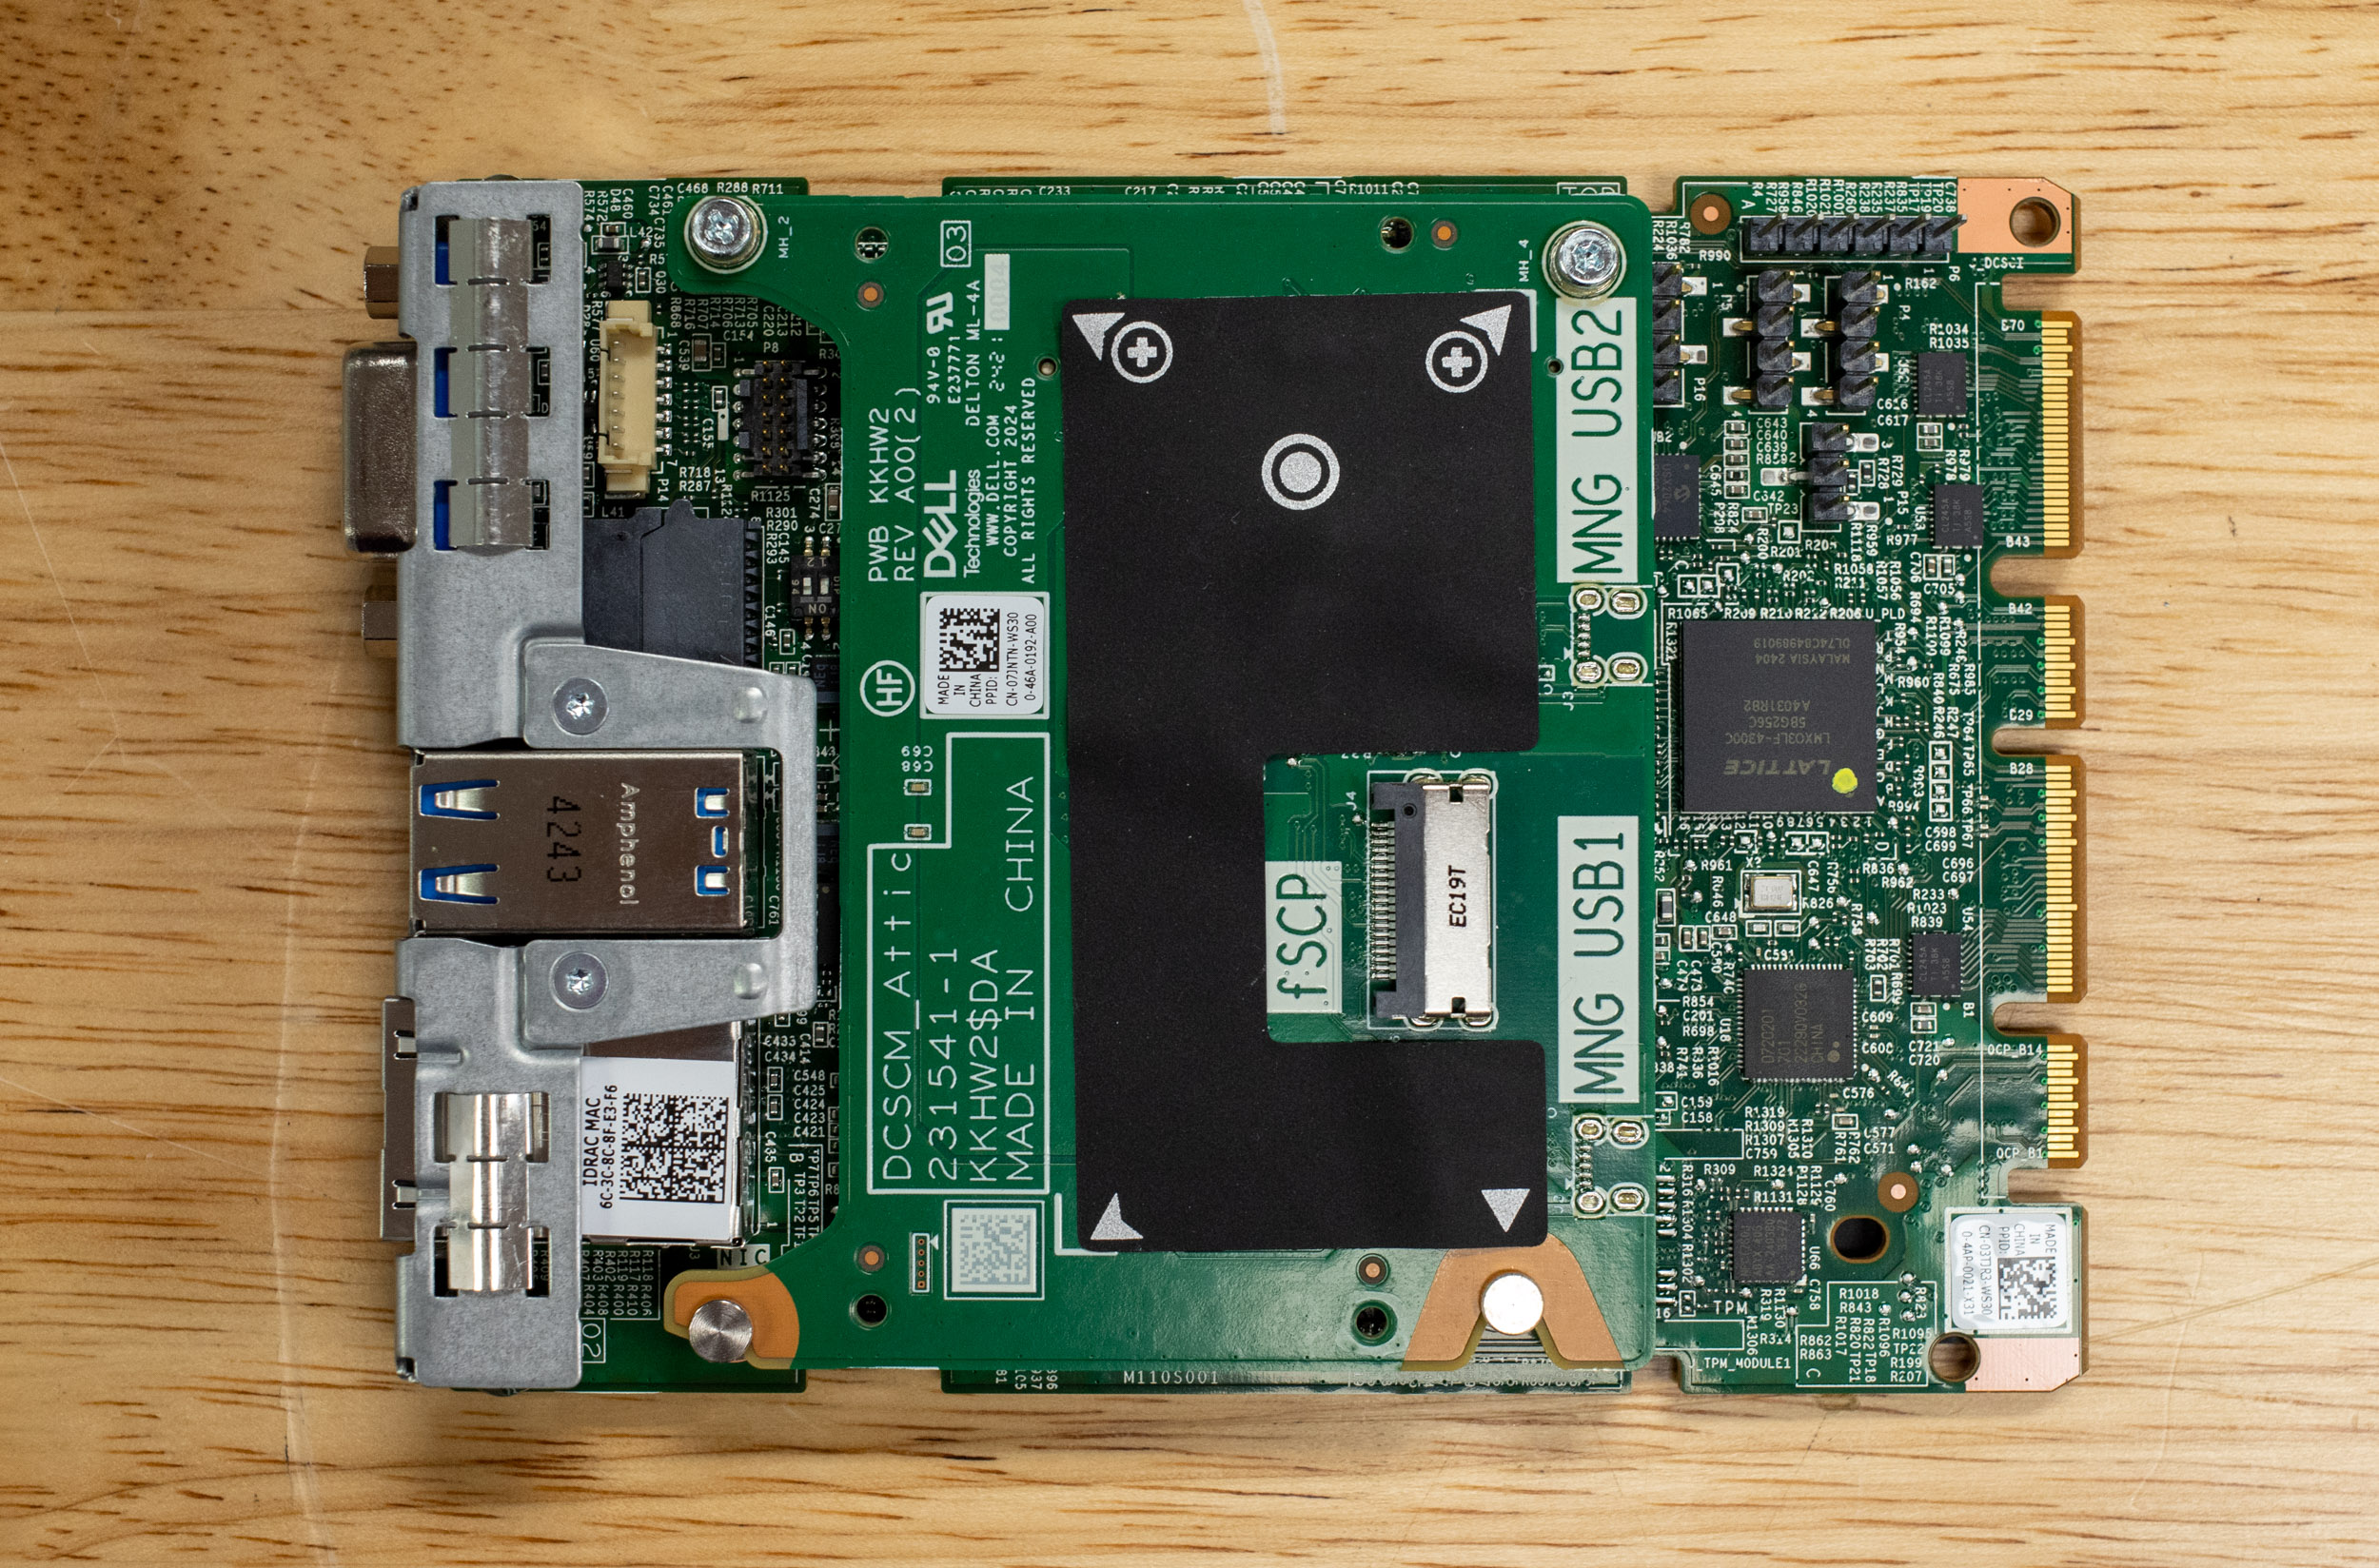
အထင်ရှားဆုံး ဗိသုကာပြောင်းလဲမှုမှာ OCP DC MHS စံနှုန်းကို အပြည့်အဝလက်ခံကျင့်သုံးခြင်းဖြစ်သည်။ Dell သည် ယခင်မျိုးဆက်များတွင် OCP အစိတ်အပိုင်းများကို စတင်ထည့်သွင်းခဲ့ပြီး အထူးသဖြင့် OCP 3.0 network adapter slots များကို လက်ခံကျင့်သုံးခဲ့သည်။ R770 သည် ဤအရာထက် များစွာပို၍ မြင့်မားသည်။ အဓိကအစိတ်အပိုင်းများသည် ယခုအခါ OCP သတ်မှတ်ချက်များနှင့် ကိုက်ညီပြီး riser slots များကဲ့သို့သော အစိတ်အပိုင်းများ၊ ယခု M-XIO connectors များ ပါဝင်သည်။ M-XIO connector သည် riser ကတ်များအတွက် စံသတ်မှတ်ထားသော interface ကို ပံ့ပိုးပေးပြီး ပြောင်းလွယ်ပြင်လွယ်ရှိမှုနှင့် အဆင့်မြှင့်တင်နိုင်စွမ်းကို မြှင့်တင်ပေးသည်။ iDRAC ကို OCP DC-SCM (Server Control Module) အဖြစ်လည်း အကောင်အထည်ဖော်ထားသည်။
ထို့အပြင်၊ R770 သည် GPU များနှင့် backplanes ကဲ့သို့သော peripheral ချိတ်ဆက်မှုများအတွက် PICPWR power connector အသစ်ကို မိတ်ဆက်ပေးထားသည်။ ဤ connector သည် သိသာထင်ရှားသော ထပ်လောင်းပေါင်းထည့်မှုတစ်ခုဖြစ်ပြီး power delivery ကို ရိုးရှင်းစေပြီး inline power monitoring ကို ပေါင်းစပ်ထည့်သွင်းထားသည်။


ဤနက်ရှိုင်းသောပေါင်းစပ်မှုသည် မတူညီသော subsystem များတစ်လျှောက် interface များနှင့် form factor များကို စံသတ်မှတ်ပေးသည်။ Dell သည် အသုံးပြုသူများသည် အာမခံချက်ရှိသော compatibility နှင့် support အတွက် အတည်ပြုထားသော component များကိုသာ စွဲကိုင်သင့်ကြောင်း အလေးပေးပြောကြားသော်လည်း၊ အခြေခံစံသတ်မှတ်ခြင်းသည် အစိတ်အပိုင်းများစွာကို နောင်တွင် compliant system များတစ်လျှောက်တွင် ပိုမိုအသုံးပြုသူအတွက် ဝန်ဆောင်မှုပေးနိုင်ပြီး အပြန်အလှန်လဲလှယ်နိုင်သော အလားအလာရှိစေသည်။
စီမံခန့်ခွဲမှုနှင့် iDRAC
Dell PowerEdge R770 သည် အင်္ဂါရပ်များစွာပါဝင်ပြီး လူကြိုက်များသော iDRAC 9 ပေါ်တွင် နောက်မျိုးဆက် iDRAC 10 ဖြင့် တည်ဆောက်ထားပြီး Data Center Secure Control Module (DC-SCM) နှင့် ချောမွေ့စွာ ပေါင်းစပ်ခြင်းဖြင့် စနစ်စီမံခန့်ခွဲမှုကို မြှင့်တင်ပေးပါသည်။ ဤပေါင်းစပ်မှုသည် firmware update များနှင့် configuration management များကို ချောမွေ့စေပြီး data center များတစ်လျှောက်တွင် တသမတ်တည်းနှင့် တိုးချဲ့နိုင်သော လုပ်ငန်းလည်ပတ်မှုများကို သေချာစေသည်။ iDRAC 10 သည် အဆင့်မြင့် automation နှင့် monitoring စွမ်းရည်များကိုလည်း ပံ့ပိုးပေးသောကြောင့် IT administrator များအနေဖြင့် စွမ်းဆောင်ရည် သို့မဟုတ် ယုံကြည်စိတ်ချရမှုကို မထိခိုက်စေဘဲ ကြီးမားသော ဖြန့်ကျက်မှုများကို ထိရောက်စွာ စီမံခန့်ခွဲနိုင်စေပါသည် ။
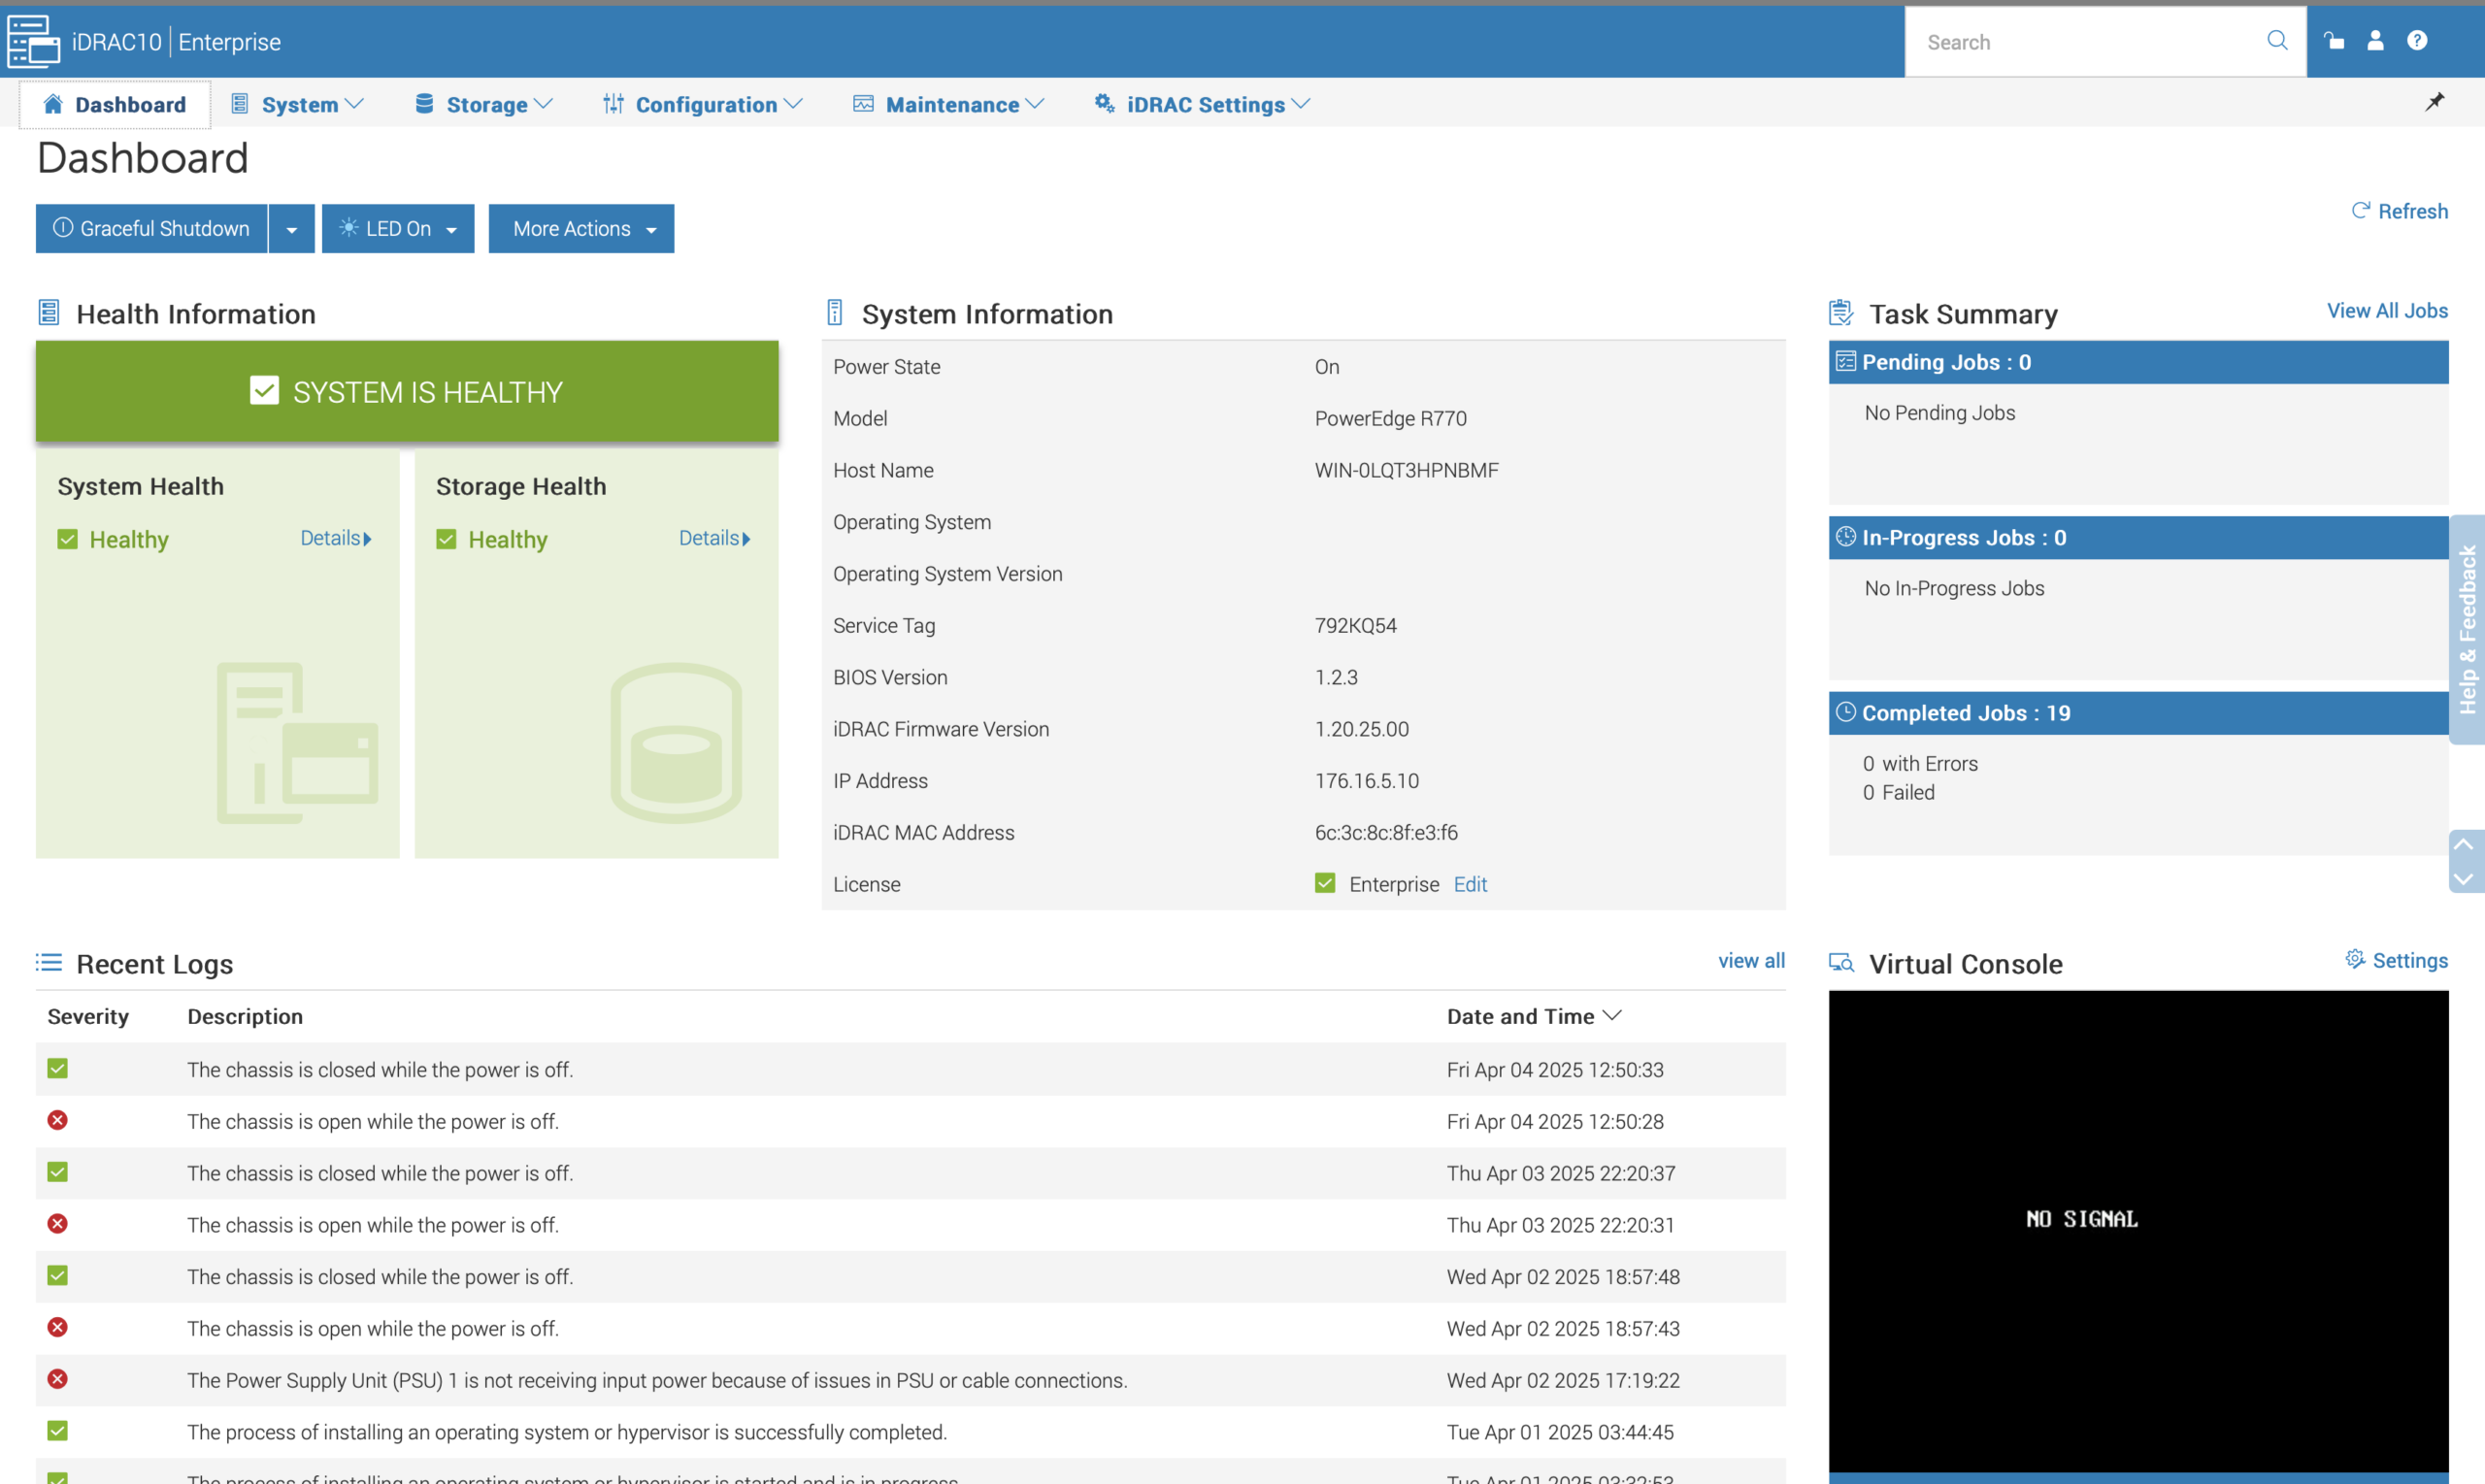
လုံခြုံရေးသည် R770 ၏ စီမံခန့်ခွဲမှုအင်္ဂါရပ်များ၏ အခြေခံအုတ်မြစ်ဖြစ်ပြီး Dell သည် ခိုင်မာသော pre-boot နှင့် boot အတည်ပြုခြင်းယန္တရားများကို အကောင်အထည်ဖော်ထားသည်။ ဆီလီကွန်အခြေခံ Root of Trust နည်းပညာကို အသုံးပြုထားသော iDRAC 10 သည် BIOS နှင့် iDRAC အပါအဝင် firmware အားလုံးကို အကောင်အထည်ဖော်မှုမပြုမီ ကုဒ်ဝှက်စနစ်ဖြင့် အတည်ပြုထားကြောင်း သေချာစေသည်။ ဤမပြောင်းလဲနိုင်သော ဟာ့ဒ်ဝဲအခြေခံ လုံခြုံရေးအစီအမံသည် malware ကျူးကျော်ဝင်ရောက်မှုနှင့် ထောက်ပံ့ရေးကွင်းဆက်တိုက်ခိုက်မှုများမှ ကာကွယ်ပေးပြီး စနစ်လည်ပတ်မှုများအတွက် လုံခြုံသောအခြေခံအုတ်မြစ်ကို ပံ့ပိုးပေးသည်။ ထို့အပြင်၊ R770 တွင် ပေါ်ပေါက်လာသော ကုဒ်ဝှက်ခြိမ်းခြောက်မှုများကို လျော့ပါးစေရန် quantum-safe booting protocols များကို ထည့်သွင်းထားပြီး အရေးကြီးသော အခြေခံအဆောက်အအုံများကို ကာကွယ်ရာတွင် ၎င်း၏အခန်းကဏ္ဍကို ပိုမိုခိုင်မာစေသည် ။

Dell ရဲ့ ထောက်ပံ့ရေးကွင်းဆက်လုံခြုံရေးအပေါ် ကတိကဝတ်ကို R770 ရဲ့ ဒီဇိုင်းမှာ ထင်ရှားစွာတွေ့မြင်နိုင်ပြီး၊ ပြည့်စုံတဲ့ ယုံကြည်စိတ်ချရတဲ့ စိစစ်အတည်ပြုခြင်းလုပ်ငန်းစဉ်ကို အသုံးပြုထားပါတယ်။ ဟာ့ဒ်ဝဲအစိတ်အပိုင်းတစ်ခုစီကို ထုတ်လုပ်မှုအတွင်း ထည့်သွင်းထားတဲ့ ကုဒ်ဝှက်လက်မှတ်တွေကို အသုံးပြုပြီး တင်းကျပ်တဲ့ အတည်ပြုမှုကို ခံယူပါတယ်။ ဒီလုပ်ငန်းစဉ်က ခွင့်ပြုထားတဲ့ firmware နဲ့ အစိတ်အပိုင်းတွေကိုသာ အသုံးပြုကြောင်း သေချာစေပြီး၊ ခွင့်ပြုချက်မရှိဘဲ ပြုပြင်မွမ်းမံခြင်း သို့မဟုတ် အတုအပ အစိတ်အပိုင်းတွေနဲ့ ဆက်စပ်နေတဲ့ အန္တရာယ်တွေကို လျှော့ချပေးပါတယ်။
AI စက်ရုံများ၏ အုတ်မြစ်ချခြင်း
R770 ကို GPU နှင့် Chassis configuration အများအပြားဖြင့် မှာယူနိုင်ပြီး AI workloads အမျိုးမျိုးအတွက် စွယ်စုံသုံး platform တစ်ခုဖြစ်စေသည်။ ဤပြောင်းလွယ်ပြင်လွယ်ရှိမှုနှင့် ၎င်း၏ခိုင်မာသော storage နှင့် networking စွမ်းရည်များသည် AI Factories များတွင် AI solution များကို ဖြန့်ကျက်နေသော အဖွဲ့အစည်းများအတွက် ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။ AI factories ဆိုသည်မှာ AI မော်ဒယ်များကို ဖန်တီးခြင်း၊ လေ့ကျင့်ခြင်းနှင့် ဖြန့်ကျက်ခြင်းအတွက် လိုအပ်သော infrastructure နှင့် tools များကို ရည်ညွှန်းသည်။ ဤစက်ရုံများသည် အလိုအလျောက်ယာဉ်များနှင့် robotics ကဲ့သို့သော အဆင့်မြင့်စနစ်များ တီထွင်ရာတွင် မရှိမဖြစ်လိုအပ်သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့သည် ကြီးမားသော dataset များကို ထိရောက်စွာ စီမံဆောင်ရွက်ရန် လိုအပ်သော computational power နှင့် data pipelines များကို ပံ့ပိုးပေးသောကြောင့်ဖြစ်သည်။
အလိုအလျောက်ယာဉ်များနှင့် ရိုဘော့တစ်စနစ်များ တီထွင်ရာတွင် လက်တွေ့ကမ္ဘာအခြေအနေများကို ထင်ဟပ်စေသည့် ကျယ်ပြန့်သော လေ့ကျင့်ရေးဒေတာများ လိုအပ်ပါသည်။ NVIDIA ၏ Cosmos NIM သည် ဤနယ်ပယ်တွင် သိသာထင်ရှားသော တိုးတက်မှုတစ်ခုဖြစ်ပြီး developer များအား World Foundational Models ကဲ့သို့သော ရုပ်ပိုင်းဆိုင်ရာ AI စနစ်များ ဖန်တီးခြင်းနှင့် ဖြန့်ကျက်ခြင်းတို့ကို အရှိန်မြှင့်တင်ရန် အစွမ်းထက်သော toolkit တစ်ခုကို ပေးဆောင်ပါသည်။
ကမ္ဘာ့ဖောင်ဒေးရှင်းပုံစံများကို နားလည်ခြင်း
ကမ္ဘာ့အုတ်မြစ်မော်ဒယ်များ (WFM) များသည် လက်တွေ့ကမ္ဘာပတ်ဝန်းကျင်ကို တုပပြီး မတူညီသောထည့်သွင်းမှုများအပေါ်အခြေခံ၍ တိကျသောရလဒ်များကို ခန့်မှန်းသည့် ခေတ်မီသော အာရုံကြောကွန်ရက်များဖြစ်သည်။ သီးခြားတာဝန်များကို အာရုံစိုက်သည့် ရိုးရာ AI မော်ဒယ်များနှင့်မတူဘဲ၊ WFM များသည် ရူပဗေဒနှင့် နေရာဒေသဂုဏ်သတ္တိများအပါအဝင် ရုပ်ပိုင်းဆိုင်ရာကမ္ဘာ၏ ဒိုင်းနမစ်ကို နားလည်သည် ။ ၎င်းတို့သည် စာသားညွှန်ကြားချက်များ၊ ရုပ်ပုံများ သို့မဟုတ် အခြားထည့်သွင်းမှုဒေတာများမှ ဗီဒီယိုများကို ထုတ်ပေးနိုင်ပြီး ရွေ့လျားမှု၊ အားနှင့် နေရာဒေသဆက်နွယ်မှုများကို တိကျစွာကိုယ်စားပြုနိုင်သည်။
NVIDIA Cosmos NIM များ- ကမ္ဘာ့အခြေခံမော်ဒယ်များအတွက် ခြေလှမ်းတစ်ခု
NVIDIA ရဲ့ Cosmos NIM တွေဟာ World Foundational Models တွေရရှိဖို့အတွက် အရေးကြီးတဲ့ခြေလှမ်းတစ်ခုပါပဲ။ ဒါတွေက အဖွဲ့အစည်းတွေနဲ့ AI ဓာတ်ခွဲခန်းတွေကို synthetic training data တွေထုတ်လုပ်နိုင်စေပြီး ဒီ AI model တွေကို train လုပ်ဖို့ လိုအပ်တဲ့ data တွေကို ထိရောက်စွာ ချိန်ညှိပေးနိုင်ပါတယ်။ Cosmos Predict model ကို ကျွန်တော်တို့ ဖြန့်ကျက်ခဲ့ပါတယ်၊ ဒါက text ဒါမှမဟုတ် video prompts တွေကနေ ကမ္ဘာ့အခြေအနေကို ထုတ်ပေးပြီး frame တွေကို predict လုပ်ခြင်းအားဖြင့် continuous motion ကို synthesize လုပ်တဲ့ generalist model တစ်ခုပါ။
ဒါတွေကတော့ ကျွန်တော်တို့ရဲ့ ဓာတ်ခွဲခန်းရဲ့ ဓာတ်ပုံတစ်ပုံတည်းနဲ့ Cosmos နဲ့ ဖန်တီးနိုင်ခဲ့တဲ့ စိတ်ဝင်စားစရာကောင်းတဲ့ ရလဒ်တွေပါ။ အပြစ်အနာအဆာကင်းတာ မဟုတ်ပေမယ့် ဓာတ်ပုံတစ်ပုံတည်းကနေ ဘာတွေရနိုင်လဲဆိုတာကတော့ အရမ်းအထင်ကြီးစရာပါပဲ။
NVIDIA H100 ကဲ့သို့သော မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော GPU များကို ပံ့ပိုးပေးနိုင်သည့် R770 ၏စွမ်းရည်နှင့် ၎င်း၏ခိုင်မာသောသိုလှောင်မှုနှင့် ကွန်ရက်ချိတ်ဆက်မှုစွမ်းရည်များသည် AI ဖြေရှင်းချက်များကို ဖြန့်ကျက်လိုသော အဖွဲ့အစည်းများအတွက် ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခုဖြစ်စေသည်။
R770 ၏ စွမ်းရည်များကို အသုံးချခြင်းဖြင့် အဖွဲ့အစည်းများသည် Cosmos NIM ကဲ့သို့သော AI မော်ဒယ်များကို ထိရောက်စွာ လေ့ကျင့်ပေးနိုင်ပြီး အလိုအလျောက်ယာဉ်များနှင့် ရိုဘော့တစ်စနစ်များ ဖွံ့ဖြိုးတိုးတက်မှုကို အရှိန်မြှင့်တင်ပေးနိုင်ပါသည်။ R770 ၏ စွမ်းဆောင်ရည်နှင့် တိုးချဲ့နိုင်မှုသည် AI မော်ဒယ်လေ့ကျင့်မှုအတွက် လိုအပ်သော အချက်အလက်များစွာကို ကိုင်တွယ်ရန်အတွက် အကောင်းဆုံးပလက်ဖောင်းတစ်ခုဖြစ်စေပြီး ၎င်း၏ ဘက်စုံအသုံးပြုနိုင်မှုကြောင့် AI workloads အမျိုးမျိုးကို ပံ့ပိုးပေးနိုင်စေပါသည်။
GPU တိုက်ရိုက်သိုလှောင်မှု
GPU Direct Storage သည် CPU နှင့် system memory ကိုကျော်ဖြတ်၍ storage devices များနှင့် GPUs များအကြား တိုက်ရိုက်ဒေတာလွှဲပြောင်းနိုင်စေသည့် နည်းပညာတစ်ခုဖြစ်သည်။ ရိုးရာဒေတာလွှဲပြောင်းမှုတွင် ဒေတာကို storage မှ CPU ၏ memory သို့ ဖတ်ရှုပြီးနောက် GPU ၏ memory သို့ ကူးယူသည်။ ဤလုပ်ငန်းစဉ်တွင် ဒေတာမိတ္တူများစွာပါဝင်သောကြောင့် latency တိုးလာပြီး စွမ်းဆောင်ရည်လျော့ကျစေသည်။ CPU သည် bottleneck အဖြစ်ဆောင်ရွက်ပြီး storage နှင့် GPU အကြား ဒေတာလွှဲပြောင်းမှုကို ကိုင်တွယ်ရန် လိုအပ်ပါသည်။ GDS သည် storage devices များအား GPU ၏ memory သို့ ဒေတာနှင့် မှ ဒေတာများကို တိုက်ရိုက်လွှဲပြောင်းခွင့်ပြုခြင်းဖြင့် ဤ bottleneck ကို ဖယ်ရှားပေးသည်။
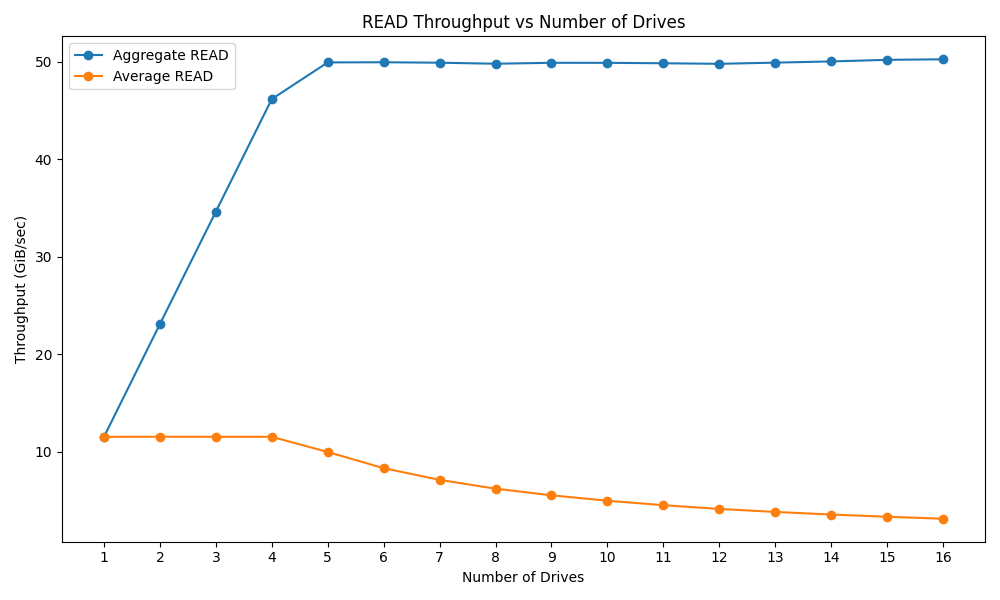
ကျွန်ုပ်တို့သည် drive ၁၆ ခုပါဝင်သော storage system တွင် GDSIO workload analysis တစ်ခုကို ပြုလုပ်ခဲ့ပြီး storage စွမ်းဆောင်ရည်နှင့် PCIe Gen 5 GPU ကို ပြည့်နှက်စေနိုင်သည့် ၎င်း၏စွမ်းရည်ကို နားလည်ရန် အသုံးပြုသည့် drive အရေအတွက်ကို တဖြည်းဖြည်းတိုးမြှင့်ပေးခဲ့ပါသည်။
GDSIO Read ဇယားက KIOXIA CD8P SSD အရေအတွက်တိုးလာခြင်းက r770 မှာ စုစုပေါင်းနဲ့ ပျမ်းမျှဖတ်ရှုမှုပမာဏကို ဘယ်လိုအကျိုးသက်ရောက်စေတယ်ဆိုတာကို ဖော်ပြထားပါတယ်။ အစပိုင်းမှာတော့ drive အရေအတွက် တစ်ခုကနေ လေးခုအထိ တိုးလာတာနဲ့အမျှ စုစုပေါင်းဖတ်ရှုမှုပမာဏဟာ 50.2 GiB/sec လောက်အထိ မြန်မြန်ဆန်ဆန် မြင့်တက်လာပါတယ်။ ဒါက စနစ်ဟာ PCIe Gen 5 x16 ကို data loading အတွက် drive သုံးခုကနေ လေးခုအထိပဲ ပြည့်နှက်စေနိုင်တယ်ဆိုတာကို ညွှန်ပြနေပါတယ်။ drive ငါးခုထက်ကျော်လွန်ရင် စုစုပေါင်းဖတ်ရှုမှုပမာဏ ရပ်တန့်သွားပြီး နောက်ထပ် drive တွေ သိသိသာသာ တိုးတက်မလာဘူးဆိုတာကို ညွှန်ပြနေပါတယ်။ တစ်ချိန်တည်းမှာပဲ drive တစ်ခုစီရဲ့ ပျမ်းမျှဖတ်ရှုမှုပမာဏဟာ drive ၄ ခုအထိ တည်ငြိမ်နေပေမယ့် drive တွေ ထပ်ထည့်လာတာနဲ့အမျှ ကျဆင်းသွားပါတယ်။ ဒီလိုကျဆင်းမှုဟာ drive တွေပိုများလာတာနဲ့အမျှ ရရှိနိုင်တဲ့ PCIe bus bandwidth ကို မျှဝေသုံးစွဲပြီး တစ်ဦးချင်း drive ဖတ်ရှုမှုတွေ လျော့နည်းသွားတာကြောင့် ဖြစ်ပါတယ်။
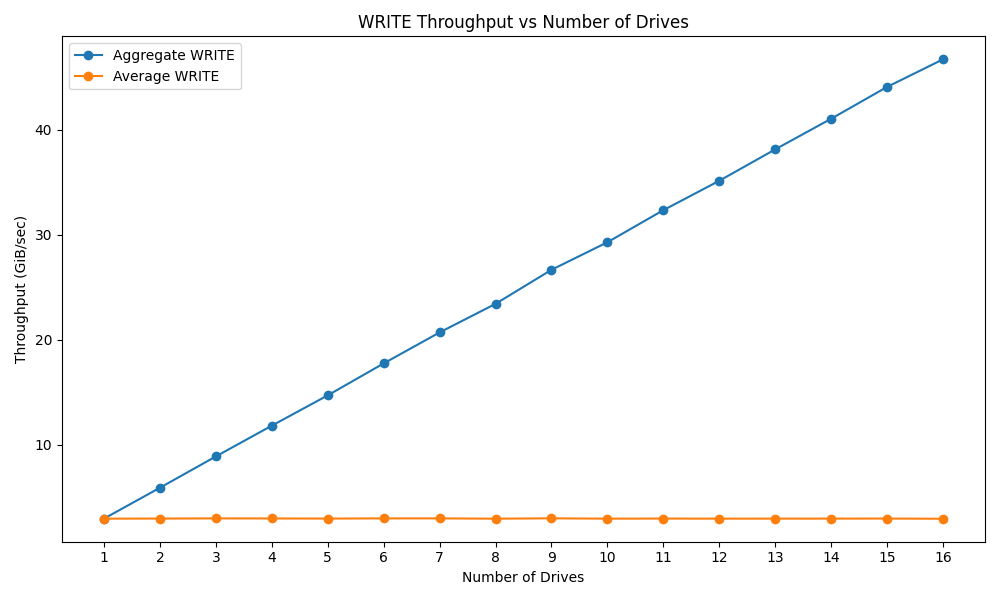
ဆန့်ကျင်ဘက်အနေနဲ့ ဒီ drive တွေရဲ့ write performance က သူတို့ရဲ့ read performance ထက် အများကြီးနိမ့်ပါတယ်။ 46.7GiB/s write bandwidth ရရှိဖို့ drive ၁၆ ခုလုံး တပ်ဆင်ခဲ့ရပြီး drive တွေရဲ့ ပျမ်းမျှ write က တသမတ်တည်းရှိနေပါတယ်။ KIOXIA CD8 portfolio မှာ write-performance capacities နိမ့်ကျနေတာကြောင့် high-capacity version တွေ ဒါမှမဟုတ် တခြား PCIe Gen5 SSD တွေက ပိုကောင်းပါလိမ့်မယ်။
Dell PowerEdge R770 ကို နှိုင်းယှဉ်ခြင်း
စံနှုန်းသတ်မှတ်ချက်များနှင့်ပတ်သက်၍ R770 သည် Dell ၏ flagship mainline system ဖြစ်သောကြောင့် မတူညီသောပတ်ဝန်းကျင်များစွာတွင် ဖြန့်ကျက်အသုံးပြုသွားမည်ဖြစ်သည်။ ထို့ကြောင့် ဤ platform သည် မတူညီသောပတ်ဝန်းကျင်များတွင် မည်သို့လုပ်ဆောင်သည်ကို အကြံဥာဏ်ပေးရန်အတွက် ကျွန်ုပ်တို့သည် ဤ platform အတွက် ပြည့်စုံသော စံနှုန်းသတ်မှတ်ချက်များကို လုပ်ဆောင်ခဲ့ပါသည်။ Lenovo ThinkSystem SR630 V4 ကို ထိပ်တန်း E-core နှင့် P-core CPU များအကြား ကွာခြားချက်ကို ပြသရန် စမ်းသပ်မှုအချို့တွင် နှိုင်းယှဉ်ခဲ့ပါသည်။
System Configuration
- CPU ကို: ၂x Intel Xeon 6787P (တစ်ခုလျှင် 86 cores)
- ရမ်: 32x Micron 64 GB Dual-Rank DDR5 6400 MT/s စုစုပေါင်း မှတ်ဉာဏ်: 2TB
- စွမ်းအင်ထောက်ပံမှု: ဒယ်လ်တာ ၁၅၀၀ ဝပ် ၂ ခု
- GPU ကို: TGI benchmark အတွက် NVIDIA H100 ၁ ခု၊ ကျန်ရှိသော စမ်းသပ်မှုများအတွက် NVIDIA L4 ၁ ခု
- NIC: DELL BRCM 4P 25G SFP 57504S OCP NIC
- BOSS ကတ်: BOSS-N1 DC-MHS ဒစ်ခ်များ ၀ နှင့် ၁ SK hynix 480 GB Dell NVMe ISE PE9010 RI M.2 480GB
- ဒစ်ခ်များ- ၀-၅ လက်မ Backplane ၁: Samsung 6.4 TB၊ Dell NVMe PM1745 MU E3.S 6.4TB
AI လုပ်ငန်းဝန်စွမ်းဆောင်ရည်
စာသားထုတ်လုပ်ခြင်းဆိုင်ရာ ကောက်ချက်ချမှု စံနှုန်း
Text Generation Inference (TGI) သည် Hugging Face မှ တီထွင်ထားသော မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော LLM inference server တစ်ခုဖြစ်သည်။ ၎င်းကို LLM များ၏ ဖြန့်ကျက်မှုနှင့် သုံးစွဲမှုကို အကောင်းဆုံးဖြစ်အောင် ဒီဇိုင်းထုတ်ထားပြီး ထုတ်လုပ်မှုပတ်ဝန်းကျင်များအတွက် အကောင်းဆုံးရွေးချယ်မှုတစ်ခုဖြစ်စေသည်။ TGI သည် open-source LLM အမျိုးမျိုးကို ပံ့ပိုးပေးပြီး tensor parallelism၊ token streaming နှင့် continuous batching ကဲ့သို့သော အင်္ဂါရပ်များကို ပေးဆောင်ပြီး ၎င်း၏စွမ်းဆောင်ရည်နှင့် ထိရောက်မှုကို မြှင့်တင်ပေးပါသည်။

စာသားထုတ်လုပ်ခြင်းဆိုင်ရာ ကောက်ချက်ချခြင်း – QwQ 32B
TGI ရဲ့ benchmarking feature ကို မတူညီတဲ့ configuration တွေနဲ့ workload တွေအောက်မှာ သူ့ရဲ့စွမ်းဆောင်ရည်ကို အကဲဖြတ်ဖို့အတွက် အသုံးပြုပါတယ်။ TGI ရဲ့ benchmarking feature က production setting မှာ LLM တွေကို ဝန်ဆောင်မှုပေးရာမှာ ရှုပ်ထွေးမှုတွေကို ထည့်သွင်းစဉ်းစားတဲ့အတွက် လက်တွေ့ကမ္ဘာရဲ့ စွမ်းဆောင်ရည်ကို ပိုမိုတိကျစွာ ကိုယ်စားပြုပေးပါတယ်။
LLM များကို အသုံးပြု၍ စာသားများ ထုတ်ပေးခြင်းတွင် အဓိကအဆင့်နှစ်ဆင့် ပါဝင်သည်- prefill အဆင့်နှင့် decode အဆင့်။ prefill အဆင့်သည် ကနဦးအဆင့်ဖြစ်ပြီး LLM သည် လိုအပ်သော အလယ်အလတ်ကိုယ်စားပြုမှုများကို ထုတ်လုပ်ရန် input prompt ကို လုပ်ဆောင်သည်။ ဤအဆင့်သည် မော်ဒယ်မှတစ်ဆင့် single forward pass တွင် input prompt တစ်ခုလုံးကို စီမံဆောင်ရွက်ခြင်းကြောင့် တွက်ချက်မှုအရ အလွန်အမင်း အာရုံစိုက်ရသည်။
ကြိုတင်ဖြည့်သွင်းခြင်းအဆင့်တွင်၊ input prompt ကို tokenized လုပ်၍ LLM မှ လုပ်ဆောင်နိုင်သော format သို့ပြောင်းလဲသည်။ ထို့နောက် LLM သည် input tokens များအကြောင်း အချက်အလက်များကို သိမ်းဆည်းသည့် KV cache ကို တွက်ချက်သည်။ KV cache သည် output tokens များထုတ်လုပ်ခြင်းကို လွယ်ကူချောမွေ့စေသည့် အရေးကြီးသော data structure တစ်ခုဖြစ်သည်။
ဆန့်ကျင်ဘက်အနေနဲ့၊ decode အဆင့်ဟာ prefill အဆင့်အတွင်း ထုတ်လုပ်လိုက်တဲ့ အလယ်အလတ်ကိုယ်စားပြုမှုတွေအပေါ် အခြေခံပြီး LLM က output token တွေကို တစ်ခုချင်းစီထုတ်ပေးတဲ့ autoregressive လုပ်ငန်းစဉ်တစ်ခုဖြစ်ပါတယ်။ decode အဆင့်ဟာ prefill အဆင့်အတွင်း ထုတ်လုပ်လိုက်တဲ့ KV cache ပေါ်မှာ အများကြီးမူတည်ပြီး ညီညွတ်ပြီး နောက်ခံအခြေအနေနဲ့ သက်ဆိုင်တဲ့ output token တွေကို ထုတ်လုပ်ဖို့အတွက် လိုအပ်တဲ့ context ကို ပံ့ပိုးပေးပါတယ်။
ကြိုတင်ဖြည့်သွင်းခြင်းအဆင့်
batch size ၁ မှ ၃၂ အထိ တိုးလာသည်နှင့်အမျှ မော်ဒယ်သုံးခုလုံးအတွက် latency တိုးလာသည်။ DeepSeek-R1-Distill-Qwen-32 B ၏ latency သည် batch size ၁ တွင် ၂၉.၉၇ ms မှ batch size ၃၂ တွင် ၇၆.၉၅ ms အထိ တိုးလာသည်။ အလားတူပင် GEMMA-3-27B-IT နှင့် Qwen/QwQ-32B အတွက် latency သည် အသီးသီး ၅၁.၈၄ ms နှင့် ၂၉.၉၀ ms မှ ၇၉.၅၈ ms နှင့် ၇၆.၃၀ ms အထိ တိုးလာသည်။
ဆန့်ကျင်ဘက်အနေနဲ့၊ batch size တိုးလာတာနဲ့အမျှ token rate သိသိသာသာတိုးတက်လာပါတယ်။ batch size 1 မှာ model သုံးမျိုးအတွက် token rate တွေက တစ်စက္ကန့်ကို 192.95 မှ 334.46 အထိရှိပါတယ်။ batch size 32 မှာ DeepSeek-R1-Distill-Qwen-32B၊ GEMMA-3-27B-IT နှင့် Qwen/QwQ-32B တို့အတွက် တစ်စက္ကန့်ကို 4158.67၊ 4021.40 နှင့် 4194.13 အထိ အသီးသီးမြင့်တက်လာပါတယ်။
| အသုတ်အရွယ်အစား | DeepSeek-R1-Distill-Qwen-32B | GEMMA-3-27B-IT | Qwen/QwQ-32B | |||
|---|---|---|---|---|---|---|
| latency (ms) | တိုကင်နှုန်း | latency (ms) | တိုကင်နှုန်း | latency (ms) | တိုကင်နှုန်း | |
| 1 | 29.97 | 333.64 | 51.84 | 192.95 | 29.90 | 334.46 |
| 2 | 30.21 | 662.09 | 52.55 | 380.61 | 29.95 | 667.80 |
| 4 | 32.40 | 1234.72 | 52.62 | 760.12 | 32.12 | 1245.47 |
| 8 | 36.98 | 2163.46 | 52.66 | 1519.19 | 36.69 | 2180.66 |
| 16 | 51.63 | 3125.50 | 60.96 | 2624.64 | 51.29 | 3147.61 |
| 32 | 76.95 | 4158.67 | 79.58 | 4021.40 | 76.30 | 4194.13 |
ကုဒ်ဖြုတ် အဆင့်
prefill အဆင့်နှင့်မတူဘဲ၊ decode အဆင့်အတွင်း latency သည် မတူညီသော batch အရွယ်အစားများတွင် တည်ငြိမ်နေပါသည်။ ဥပမာအားဖြင့်၊ batch အရွယ်အစား ၂ မှ ၃၂ အထိ တိုးလာသည်နှင့်အမျှ DeepSeek-R1-Distill-Qwen-32 B ၏ latency သည် ၂၇.၁၄ ms မှ ၂၉.၅၂ ms အထိ ရှိပါသည်။
decode အဆင့်မှာ token rate တိုးလာတာနဲ့အမျှ batch size တိုးလာတာနဲ့အမျှ တိုးတက်ကောင်းမွန်လာပေမယ့် prefill အဆင့်လောက်တော့ သိသိသာသာ မရှိပါဘူး။ batch size 1 မှာ DeepSeek-R1-Distill-Qwen-32B နဲ့ Qwen/QwQ-32B အတွက် တစ်စက္ကန့်ကို token ၃၆-၃၇ ခန့်နဲ့ GEMMA-3-27B-IT အတွက် တစ်စက္ကန့်ကို token ၃၃.၉၆ ရှိပါတယ်။ batch size ၃၂ မှာ token rate တွေက တစ်စက္ကန့်ကို ၁၀၈၃.၈၃၊ ၈၇၃.၃၉ နဲ့ ၁၀၈၄.၈၉ အသီးသီး တိုးလာပါတယ်။
| အသုတ်အရွယ်အစား | DeepSeek-R1-Distill-Qwen-32B | GEMMA-3-27B-IT | Qwen/QwQ-32B | |||
|---|---|---|---|---|---|---|
| latency (ms) | တိုကင်နှုန်း | latency (ms) | တိုကင်နှုန်း | latency (ms) | တိုကင်နှုန်း | |
| 1 | 27.24 | 36.71 | 29.45 | 33.96 | 27.24 | 36.71 |
| 2 | 27.14 | 73.70 | 30.80 | 64.93 | 27.14 | 73.69 |
| 4 | 27.50 | 145.46 | 31.33 | 127.65 | 27.47 | 145.62 |
| 8 | 27.91 | 286.61 | 32.54 | 245.83 | 27.90 | 286.78 |
| 16 | 28.31 | 565.07 | 34.71 | 460.92 | 28.44 | 562.56 |
| 32 | 29.52 | 1083.83 | 36.64 | 873.39 | 29.50 | 1084.89 |
ကြိုတင်ဖြည့်သွင်းခြင်းအဆင့်သည် initial hidden state များနှင့် key-value cache များကို input prompt တစ်ခုလုံးအတွက် တွက်ချက်ပေးသောကြောင့် ၎င်းသည် မျှော်လင့်ထားသည့်အတိုင်းဖြစ်သည်။ အဘယ်ကြောင့်ဆိုသော် ၎င်းသည် GPU ကို ကောင်းစွာ ပြည့်စေနိုင်သောကြောင့်ဖြစ်ပြီး ကြီးမားသော၊ batched operations များကို တစ်ပြိုင်နက်တည်း လုပ်ဆောင်နိုင်သောကြောင့်ဖြစ်သည်။ prompt ကို လုပ်ဆောင်ပြီးနောက်၊ မော်ဒယ်သည် token အသစ်များကို ယေဘုယျအားဖြင့် တစ်ကြိမ်လျှင် တစ်ခုစီ ထုတ်လုပ်ပေးသည်။ အဆင့်တိုင်းတွင်၊ မော်ဒယ်သည် ယခင် token နှင့် cache လုပ်ထားသော hidden state များကိုယူပြီး နောက် token ကို ထုတ်လုပ်သည်။ ဤအဆင့်သည် token တစ်ခုချင်းစီကို ထိရောက်စွာ လုပ်ဆောင်သောကြောင့်၊ batch size သည် မကြာခဏ သေးငယ်သောကြောင့် GPU ကို မကြာခဏ အသုံးမပြုဖြစ်ပါ။
Procyon AI ကွန်ပျူတာအမြင်စံနှုန်း
လက်တွေ့ကမ္ဘာ စက်မြင်နိုင်စွမ်းဆိုင်ရာ လုပ်ငန်းများကို အသုံးပြု၍ Procyon AI Computer Vision Benchmark သည် CPU များ၊ GPU များနှင့် AI accelerator များတစ်လျှောက် AI inference စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ၎င်းသည် TensorRT၊ OpenVINO၊ SNPE၊ Windows ML နှင့် Core ML ကဲ့သို့သော inference engine များစွာကို ပံ့ပိုးပေးပြီး ထိရောက်မှု၊ လိုက်ဖက်ညီမှုနှင့် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဆိုင်ရာ ထိုးထွင်းသိမြင်မှုများကို ပေးစွမ်းသည်။
Procyon AI Computer Vision Benchmark ရလဒ်များသည် ခိုင်မာသော AI inference စွမ်းဆောင်ရည်ကိုလည်း ပြသနေပါသည်။ စနစ်သည် MobileNet V3 သည် 20.64 ms နှင့် ResNet 50 သည် 22.42 ms ဖြင့် inference အချိန်နည်းပါးစွာ ရရှိခဲ့သည်။ Inception V4 နှင့် DeepLab တို့သည် အသီးသီး 65.23 ms နှင့် 41.37 ms ဖြင့် လည်ပတ်ပြီး ပိုမိုရှုပ်ထွေးသော vision workloads များကို ထိရောက်စွာ ကိုင်တွယ်ဖြေရှင်းပေးပါသည်။ အဓိက အရာဝတ္ထု ထောက်လှမ်းမှု မော်ဒယ် YOLO V3 ကို 37.80 ms ဖြင့် စီမံဆောင်ရွက်ခဲ့ပြီး real-time AI applications များအတွက် အလွန်သင့်လျော်စေပါသည်။ computationally intensive super-resolution မော်ဒယ် REAL-ESRGAN သည် 1,159.22 ms မှတ်တမ်းတင်ခဲ့ပြီး ကျွန်ုပ်တို့အား ಒಟ್ಟಾರೆ AI Computer Vision ရမှတ် 81 မှတ် ရရှိခဲ့သည်။
| AI ကွန်ပျူတာအမြင် (ကြာချိန်နည်းလေ ပိုကောင်းလေ) (ရမှတ်မြင့်လေ ပိုကောင်းလေ) | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) |
|---|---|
| MobileNet V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 20.64 ms |
| ResNet 50 ပျမ်းမျှ ကောက်ချက်ချချိန် | 22.42 ms |
| စတင်ခြင်း V4 ပျမ်းမျှ ကောက်ချက်ချချိန် | 65.23 ms |
| DeepLab ပျမ်းမျှ ကောက်ချက်ချချိန် | 41.37 ms |
| YOLO V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 37.80 ms |
| REAL-ESRGAN ပျမ်းမျှ ကောက်ချက်ချချိန် | 1,159.22 ms |
| AI ကွန်ပျူတာအမြင် ಒಟ್ಟಾರೆရမှတ် | 81 |
Hammer DB TPROC-C
ကျွန်ုပ်တို့သည် ဂိုဒေါင် ၅၀၀ တွင် OLTP workloads များကို simulate လုပ်ရန် HammerDB TPROC-C benchmark ကို အသုံးပြု၍ လူကြိုက်များသော open-source database လေးခုဖြစ်သည့် MariaDB 11.4.4၊ MySQL 8.4.4၊ MySQL 5.7.44 နှင့် PostgreSQL 17.2 တို့၏ စွမ်းဆောင်ရည်ကိုလည်း အကဲဖြတ်ခဲ့ပါသည်။
MariaDB သည် အထူးသဖြင့် dual-socket configuration များတွင် ထိပ်တန်းစွမ်းဆောင်ရည်ရှိသူအဖြစ် ပေါ်ထွက်လာခဲ့ပြီး ထိရောက်စွာ ချဲ့ထွင်နိုင်ခဲ့ပြီး အမြင့်ဆုံး transaction throughput ကို ရရှိခဲ့သည်။ MySQL 8.4.4 သည် legacy 5.7.44 ဗားရှင်းထက် သိသာထင်ရှားသော တိုးတက်မှုများကို ပြသခဲ့ပြီး မကြာသေးမီက ထုတ်ဝေမှုများတွင် တိုးတက်မှုများကို အလေးပေးဖော်ပြခဲ့သည်။ PostgreSQL 17.2 သည် တသမတ်တည်း စွမ်းဆောင်ရည်ကို ပေးစွမ်းခဲ့သော်လည်း MariaDB နှင့် MySQL 8.4.4 ထက် အနည်းငယ် နောက်ကျကျန်နေခဲ့သည်။ MariaDB သည် single socket တွင် TPM ၃.၁၅ သန်းနှင့် dual socket တွင် TPM ၅.၈ သန်း ပေးစွမ်းခဲ့ပြီး အခြေအနေနှစ်ခုလုံးတွင် ကျန်အရာများထက် သာလွန်ကောင်းမွန်ခဲ့သည်။
စွမ်းဆောင်ရည် နှိုင်းယှဉ်ဇယား (တစ်မိနစ်လျှင် ငွေပေးငွေယူများ၊ TPM)
| ဒေတာဘေ့စ်အင်ဂျင် | တစ်ခုတည်းသော ပလပ်ပေါက် TPM | နှစ်ပေါက်ပါ TPM |
|---|---|---|
| MariaDB ၁၁ | 3,150,000 | 5,800,000 |
| က MySQL 8.4.4 | 2,850,000 | 5,150,000 |
| PostgreSQL ၁၁ | 2,700,000 | 4,900,000 |
| က MySQL 5.7.44 | 2,300,000 | 4,250,000 |
R770 ရဲ့ CPU တစ်ခုလျှင် cores ၈၆ ခု (ဦးစားပေး cores များ ရောနှောထားခြင်း) အပါအဝင် အစွမ်းထက်တဲ့ hardware ရှိနေပေမယ့်လည်း socket နှစ်ခုလုံးမှာ ဖြန့်ဝေတဲ့အခါ database တွေထဲက ဘယ် database မှ သိသာထင်ရှားတဲ့ စွမ်းဆောင်ရည် တိုးတက်မှုကို မပြသခဲ့ပါဘူး။ ဒါက core locality ပိုကောင်းပြီး memory latency လျော့နည်းတာကြောင့် single-socket execution အတွက် open-source database တွေရဲ့ ဘုံဦးစားပေးမှုကို ထင်ဟပ်စေပါတယ်။
ဤရလဒ်များကို ထောက်ရှုခြင်းအားဖြင့် R770 သည် instance တစ်ခုတည်းကို ချဲ့ထွင်ခြင်းထက် virtualized environment တွင် database instances များစွာကို လည်ပတ်ရန်အတွက် ပိုမိုသင့်လျော်ပါသည်။ စနစ်၏ ဗိသုကာလက်ရာသည် မြင့်မားသောသိပ်သည်းဆ၊ ရောနှောထားသော database workload ကို ပံ့ပိုးပေးရန်အတွက် အကောင်းဆုံးဖြစ်ပြီး၊ စွမ်းဆောင်ရည်နှင့် ထိရောက်မှု cores နှစ်မျိုးလုံးကို အသုံးပြု၍ instances များစွာတွင် တသမတ်တည်း throughput ကို ပေးဆောင်ပါသည်။
7-Zip
လူကြိုက်များသော 7-Zip utility ၏ built-in memory benchmark သည် compression နှင့် decompression task များအတွင်း system ၏ CPU နှင့် memory ၏ စွမ်းဆောင်ရည်ကို တိုင်းတာပြီး system သည် data-intensive operations များကို မည်မျှကောင်းမွန်စွာ ကိုင်တွယ်နိုင်သည်ကို ညွှန်ပြသည်။
7-Zip benchmark မှာ compression tasks တွေနဲ့ ပတ်သက်လာရင် Dell system ဟာ Lenovo (224.313 GIPS) ထက် rating (266.425 GIPS) ပိုများပြီး Dell က CPU usage အနည်းငယ် နိမ့်ကျတာကို ပြသခဲ့ပါတယ်။ ဒါပေမယ့် Lenovo ဟာ decompression မှာ Dell ထက် rating မြင့်မားပြီး (288.457 GIPS vs. 256.154 GIPS) CPU usage အနည်းငယ် ပိုများပါတယ်။ Dell မှာ overall total rating (261.290 GIPS) အနည်းငယ် ပိုများပြီး compression နဲ့ decompression tasks နှစ်ခုလုံးမှာ overall efficiency ပိုကောင်းတာကို ပြသခဲ့ပါတယ်။
| 7-Zip ဖိသိပ်ခြင်း & decompress | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| ချုံ့ခြင်း – လက်ရှိ CPU အသုံးပြုမှု | 5267% | 5064% |
| ချုံ့ခြင်း – လက်ရှိ အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ချုံ့ခြင်း – လက်ရှိအဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ချုံ့ခြင်း – ရလဒ်အနေဖြင့် CPU အသုံးပြုမှု | 5270% | 5156% |
| ချုံ့ခြင်း – ရလဒ် အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ချုံ့ခြင်း – ရလဒ်အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ချုံ့ခြင်း – လက်ရှိ CPU အသုံးပြုမှု | 5623% | 6184% |
| ဖိသိပ်ခြင်း – လက်ရှိ အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ဖိသိပ်မှုလျှော့ချခြင်း – လက်ရှိအဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ချုံ့ခြင်း - ရလဒ်အနေဖြင့် CPU အသုံးပြုမှု | 5627% | 6205% |
| ဖိသိပ်ခြင်း – ရလဒ် အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| ဖိသိပ်မှုလျှော့ချခြင်း – ရလဒ်အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| စုစုပေါင်း – စုစုပေါင်း CPU အသုံးပြုမှု | 5448% | 5681% |
| စုစုပေါင်း – စုစုပေါင်း အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
| စုစုပေါင်း – စုစုပေါင်း အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် |
y-cruncher
y-cruncher သည် ၂၀၀၉ ခုနှစ်တွင် စတင်မိတ်ဆက်ခဲ့သော လူကြိုက်များသော benchmarking နှင့် stress-testing application တစ်ခုဖြစ်သည်။ ဤစမ်းသပ်မှုသည် multi-threaded ဖြစ်ပြီး scalable ဖြစ်ပြီး Pi နှင့် အခြား constant များကို trillions of digits အထိ တွက်ချက်သည်။ ဤစမ်းသပ်မှုတွင် မြန်လေ ပိုကောင်းလေဖြစ်သည်။ ဤဆော့ဖ်ဝဲသည် high-core count platform များကို စမ်းသပ်ရာတွင် အလွန်ကောင်းမွန်ပြီး single နှင့် dual-socket platform များအကြား compute အားသာချက်များကို ပြသခဲ့သည်။
Y-cruncher benchmark ရလဒ်များက Dell PowerEdge R770 သည် P-core CPU များကို အသုံးချပြီး E-core CPU များပါသည့် Lenovo ThinkSystem SR630 V4 အကြား စွမ်းဆောင်ရည် သိသိသာသာ ကွာဟချက်ကို ပြသနေပြီး အထူးသဖြင့် dataset အရွယ်အစား တိုးလာသည်နှင့်အမျှဖြစ်သည်။ ၎င်းသည် မည်သည့်စနစ်က ပိုကောင်းသည်ထက် ဤ workload အောက်တွင် CPU အမျိုးအစားများ မည်သို့နှိုင်းယှဉ်သည်ကို ပြသခြင်းအပေါ် ပိုမိုအာရုံစိုက်ပါသည်။
တွက်ချက်မှုသေးငယ်သော တွက်ချက်မှုများအတွက် Dell စနစ်သည် Pi ၏ ဂဏန်း ၁ ဘီလီယံကို ၂.၇၅၃ စက္ကန့်အတွင်း တွက်ချက်နိုင်ခဲ့ပြီး Lenovo သည် ၅.၉၉၇ စက္ကန့်ဖြင့် နှစ်ဆကျော်ကြာခဲ့သည်။ အလုပ်ပမာဏ တိုးလာသည်နှင့်အမျှ ကွာဟချက် ပိုမိုကျယ်ပြန့်လာသည်။ ဂဏန်း ၁၀ ဘီလီယံတွင် Dell သည် ၃၄.၈၇၃ စက္ကန့်ဖြင့် ပြီးမြောက်ခဲ့ပြီး Lenovo ၏ ၈၁.၀၄၆ စက္ကန့်အချိန်ထက် ထက်ဝက်အောက် လျော့နည်းခဲ့သည်။ ဂဏန်း ၅၀ ဘီလီယံအမှတ်ဖြင့် Dell သည် ၎င်း၏အားသာချက်ကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး ၂၂၁.၂၅၅ စက္ကန့်ဖြင့် အလုပ်ကို ပြီးမြောက်ခဲ့ပြီး Lenovo သည် ၄၇၆.၈၂၆ စက္ကန့်ကြာခဲ့ပြီး Dell ကို ၅၃% ပိုမိုမြန်ဆန်စေခဲ့သည်။
ဂဏန်း ၁၀၀ ဘီလီယံတွင် Lenovo သည် ၎င်း၏ လက်ရှိ 512GB RAM ဖွဲ့စည်းမှုပုံစံကြောင့် စမ်းသပ်မှုကို အပြီးသတ်နိုင်ခဲ့ခြင်း မရှိပါ။ 2TB RAM ဖြင့် Dell သည် အလုပ်ပမာဏကို ထိရောက်စွာ ကိုင်တွယ်ခဲ့ပြီး ၄၉၁.၇၃၇ စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့သည်။
| Y-cruncher (ကြာချိန်နည်းလေ ပိုကောင်းလေ) | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| 1 ဘီလီယံ | 2.753 စက္ကန့် | 5.997 စက္ကန့် |
| 2.5 ဘီလီယံ | 7.365 စက္ကန့် | 17.573 စက္ကန့် |
| 5 ဘီလီယံ | 16.223 စက္ကန့် | 37.793 စက္ကန့် |
| 10 ဘီလီယံ | 34.873 စက္ကန့် | 81.046 စက္ကန့် |
| 25 ဘီလီယံ | 99.324 စက္ကန့် | 220.025 စက္ကန့် |
| 50 ဘီလီယံ | 221.255 စက္ကန့် | 476.826 စက္ကန့် |
| 100 ဘီလီယံ | 491.737 စက္ကန့် |
Blender OptiX
open-source 3D modeling application တစ်ခု။ ဤ benchmark ကို Blender Benchmark utility ကို အသုံးပြု၍ လုပ်ဆောင်ခဲ့သည်။ ရမှတ်သည် တစ်မိနစ်လျှင် နမူနာများဖြစ်ပြီး မြင့်လေ ပိုကောင်းလေဖြစ်သည်။
Blender benchmark ရလဒ်များအရ Dell PowerEdge R770 သည် Lenovo ThinkSystem SR630 V4 ထက် အထူးသဖြင့် CPU rendering တွင် စွမ်းဆောင်ရည်အားသာချက်ရှိကြောင်း ထင်ရှားစွာပြသထားသည်။ CPU Monster မြင်ကွင်းတွင် Dell သည် တစ်မိနစ်လျှင် နမူနာ ၁,၇၀၆.၀၀၂ ခု ရရှိခဲ့ပြီး Lenovo ၏ တစ်မိနစ်လျှင် နမူနာ ၁,၄၃၂.၀၉ ခုထက် ၁၉% သာလွန်ခဲ့သည်။ CPU Junkshop စမ်းသပ်မှုသည် ဤကွာဟချက်ကို ပိုမိုအလေးပေးဖော်ပြခဲ့ပြီး Dell သည် တစ်မိနစ်လျှင် နမူနာ ၁,၁၆၉.၃၇၀ ခု ရရှိခဲ့ပြီး Lenovo ၏ တစ်မိနစ်လျှင် နမူနာ ၉၁၄.၇၅ ခုထက် ၂၈% သာလွန်ခဲ့သည်။ အလားတူပင် Dell သည် CPU Classroom စမ်းသပ်မှုတွင် တစ်မိနစ်လျှင် နမူနာ ၇၉၁.၄၇၅ ခု ရရှိခဲ့ပြီး Lenovo သည် တစ်မိနစ်လျှင် နမူနာ ၆၅၆.၆၈ ခု ရရှိခဲ့ပြီး ၂၀% ကွာခြားချက်ရှိသည်။
Lenovo စနစ်တွင် GPU မရှိခြင်းကြောင့် GPU-based rendering တွင်လည်း ပါဝင်နိုင်ခြင်း မရှိခဲ့ပေ။ Dell ၏ NVIDIA L4 သည် Monster အတွက် 1,895.71 Samples/Min၊ 950.42 Samples/Min နှင့် Classroom အတွက် 968.43 Samples/Min ရမှတ်များ ရရှိထားသည်။
| Blender CPU Benchmark | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| CPU Monster (Blender 4.3) | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် |
| CPU Junkshop (Blender 4.3) | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် |
| CPU အတန်းခန်း (Blender 4.3) | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် |
| GPU Monster (Blender 4.3) | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် | (gpu မပါ) |
| GPU Junkshop (Blender 4.3) | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် | (gpu မပါ) |
| GPU အတန်း (Blender 4.3) | နမူနာ ၉၆၈.၄၃၂ ခု/မိနစ် | (gpu မပါ) |
Cinebench R23
Cinebench R23 benchmark tool သည် Cinema 4D engine ကို အသုံးပြု၍ ရှုပ်ထွေးသော 3D မြင်ကွင်းတစ်ခုကို render လုပ်ခြင်းဖြင့် စနစ်၏ CPU စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ၎င်းသည် single-core နှင့် multi-core စွမ်းဆောင်ရည်ကို တိုင်းတာပြီး 3D rendering လုပ်ငန်းများကို ကိုင်တွယ်ရာတွင် CPU ၏ စွမ်းရည်များကို ပြည့်စုံစွာ မြင်တွေ့နိုင်စေပါသည်။
Cinebench R23 မှာ benchmark ရလဒ်တွေက Dell PowerEdge R770 နဲ့ Lenovo ThinkSystem SR630 V4 တို့ရဲ့ CPU စွမ်းဆောင်ရည်မှာ သိသာထင်ရှားတဲ့ ကွာခြားချက်တွေကို မီးမောင်းထိုးပြနေပါတယ်။ အထူးသဖြင့် processor တစ်ခုစီရဲ့ core အရေအတွက်ကို ထည့်သွင်းစဉ်းစားရင်ပေါ့။ 2x Intel Xeon 6780E processors (144 cores per processor) တပ်ဆင်ထားတဲ့ Lenovo ThinkSystem SR630 V4 ဟာ CPU Multi-Core စမ်းသပ်မှုမှာ Dell ရဲ့ 74,710 points နဲ့ နှိုင်းယှဉ်ရင် 99,266 points နဲ့ Dell ထက်သာလွန်ကောင်းမွန်ခဲ့ပါတယ်။ ဒီကွာခြားချက်က Dell ရဲ့ 2x Intel Xeon 6787P processors (86 cores per processor) နဲ့ နှိုင်းယှဉ်ရင် core count (288 total core) ပိုများတာကြောင့် multi-core စွမ်းဆောင်ရည်ကို ကန့်သတ်ထားတဲ့အတွက် Lenovo ရဲ့ multi-core စွမ်းဆောင်ရည်ကို ကန့်သတ်ထားပါတယ်။
CPU Single-Core စမ်းသပ်မှုတွင် Dell သည် ရမှတ် ၁,၂၇၂ မှတ်ဖြင့် ပိုမိုကောင်းမွန်စွာ စွမ်းဆောင်ရည်ပြသခဲ့ပြီး Lenovo ၏ ၈၉၄ မှတ်ထက် ကျော်လွန်ခဲ့ပြီး core အရေအတွက် နည်းပါးသော်လည်း Dell ၏ single-threaded စွမ်းဆောင်ရည်သာလွန်ကောင်းမွန်ကြောင်း ပေါ်လွင်စေခဲ့သည်။
| Cinebench R23 | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| CPU Multi-Core | 74,710 မှတ် | 99,266 မှတ် |
| CPU Single-Core | 1,272 မှတ် | 894 မှတ် |
| MP အချိုး | 58.74 က x | 111.00 က x |
Cinebench ၂
Cinebench 2024 သည် GPU စွမ်းဆောင်ရည် အကဲဖြတ်ခြင်းကို ထည့်သွင်းခြင်းဖြင့် R23 ၏ benchmark စွမ်းရည်များကို တိုးချဲ့ပေးသည်။ ၎င်းသည် CPU စွမ်းဆောင်ရည်ကို ဆက်လက်စမ်းသပ်သော်လည်း GPU ၏ rendering task များကို ကိုင်တွယ်နိုင်စွမ်းကို တိုင်းတာသည့် စမ်းသပ်မှုများလည်း ပါဝင်သည်။
ဒီ အပ်ဒိတ်လုပ်ထားတဲ့ benchmark မှာ Dell PowerEdge R770 ဟာ GPU စွမ်းဆောင်ရည်အတွက် 12,996 မှတ် ရရှိခဲ့ပြီး GPU အရှိန်မြှင့်ထားတဲ့ rendering task တွေကို ကိုင်တွယ်နိုင်စွမ်းကို မီးမောင်းထိုးပြခဲ့ပါတယ်။ Lenovo ThinkSystem SR630 V4 မှာ သီးသန့် GPU မပါဝင်တာကြောင့် GPU ရမှတ် မရရှိပါဘူး။
CPU Multi-Core စမ်းသပ်မှုတွင် Lenovo သည် ၂၈၈၄ မှတ်ရရှိခဲ့ပြီး Dell ၏ ၂၈၃၁ မှတ်ထက် အနည်းငယ်သာလွန်ခဲ့ပြီး Lenovo ၏ multi-core စွမ်းဆောင်ရည်တွင် အနည်းငယ်သာလွန်ကြောင်း ညွှန်ပြနေသည်။ CPU Single-Core အတွက် Dell သည် Lenovo ထက် ၇၁ မှတ်ရရှိခဲ့ပြီး Lenovo ၏ ၅၃ မှတ်နှင့် နှိုင်းယှဉ်ပါက core နည်းသော်လည်း Dell ၏ single-core စွမ်းဆောင်ရည်မြင့်မားမှုကို ပြသနေသည်။
| Cinebench R24 | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| GPU ရမှတ် | 12,996 မှတ် | |
| CPU Multi-Core | 2,831 မှတ် | 2,884 မှတ် |
| CPU Single-Core | 71 မှတ် | 53 မှတ် |
| MP အချိုး | 39.77 က x | 54.43 က x |
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
Geekbench 6 benchmark ရလဒ်များက Dell PowerEdge R770 နှင့် Lenovo ThinkSystem SR630 V4 အကြား သိသာထင်ရှားသော စွမ်းဆောင်ရည်ကွာခြားချက်များကို ပြသနေပါသည်။ CPU Single-Core စမ်းသပ်မှုတွင် Dell သည် Lenovo ထက် ရမှတ် ၁,၇၉၇ ဖြင့် သာလွန်ကောင်းမွန်ခဲ့ပြီး Lenovo မှာ ၁၁၇၃ ရရှိခဲ့ကာ Dell ၏ single-core စွမ်းဆောင်ရည်တွင် ၅၃% တိုးတက်မှုကို ညွှန်ပြနေပါသည်။
CPU Multi-Core စမ်းသပ်မှုတွင် Dell သည် 15,880 ဖြင့် ထပ်မံဦးဆောင်ခဲ့ပြီး Lenovo သည် 13,868 ရမှတ်ရရှိခဲ့ပြီး Dell အား multi-core စွမ်းဆောင်ရည်တွင် 14% အားသာချက်ရရှိစေခဲ့သည်။ ၎င်းသည် Dell ၏ Intel Xeon 6787P ပရိုဆက်ဆာများသည် အထူးသဖြင့် multiple core များမှ အကျိုးကျေးဇူးရရှိသော အလုပ်များတွင် သာလွန်ကောင်းမွန်သော အလုံးစုံတွက်ချက်မှုစွမ်းအားကို ပေးစွမ်းနိုင်ကြောင်း ညွှန်ပြနေသည်။
GPU OpenCL စမ်းသပ်မှုက NVIDIA L4 GPU ကြောင့် ရမှတ် ၁၄၈,၇၃၀ ရရှိခဲ့တဲ့ Dell ရဲ့ အားသာချက်ကို ပိုမိုပေါ်လွင်စေခဲ့ပါတယ်။
| Geekbench 6 (မြင့်လေ ပိုကောင်းလေ) | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| CPU Single-Core | 1,797 | 1,173 |
| CPU Multi-Core | 15,880 | 13,868 |
| GPU OpenCL ရမှတ် | 148,730 | (gpu မပါ) |
Blackmagic RAW မြန်နှုန်းစမ်းသပ်မှု
Blackmagic RAW Speed Test သည် Blackmagic RAW codec ကို အသုံးပြု၍ ဗီဒီယိုပြန်ဖွင့်ခြင်းနှင့် တည်းဖြတ်ခြင်းတွင် စနစ်တစ်ခု၏ စွမ်းရည်များကို တိုင်းတာရန် ဒီဇိုင်းထုတ်ထားသော စွမ်းဆောင်ရည် benchmarking tool တစ်ခုဖြစ်သည်။ ၎င်းသည် စနစ်တစ်ခုသည် မြင့်မားသော resolution ဗီဒီယိုဖိုင်များကို မည်မျှကောင်းမွန်စွာ decode လုပ်၍ ဖွင့်နိုင်သည်ကို အကဲဖြတ်ပြီး CPU နှင့် GPU-based processing နှစ်မျိုးလုံးအတွက် frame rate များကို ပေးပါသည်။
CPU-based စမ်းသပ်မှုတွင် Dell PowerEdge R770 သည် 141 FPS ရရှိခဲ့ပြီး 120 FPS ရရှိခဲ့သော Lenovo ThinkSystem SR630 V4 ထက် သာလွန်ခဲ့သည်။ ၎င်းသည် Dell စနစ်သည် Lenovo ထက် CPU-based ဗီဒီယိုလုပ်ဆောင်ခြင်းကို ပိုမိုထိရောက်စွာ ကိုင်တွယ်ကြောင်း ညွှန်ပြသည်။ GPU-based စမ်းသပ်မှုအတွက် Dell PowerEdge R770 သည် 157 FPS ရရှိခဲ့ပြီး NVIDIA GPU ပါဝင်မှုကြောင့် အကျိုးကျေးဇူးရရှိခဲ့သည်။
| Blackmagic RAW မြန်နှုန်းစမ်းသပ်ခြင်း (မြင့်လေ ပိုကောင်းလေ) | Dell PowerEdge R770 (Intel Xeon 6787P 2x | 2TB Ram) | Lenovo ThinkSystem SR630 V4 (Intel Xeon 6780E ၂ ခု | 512GB Ram) |
|---|---|---|
| FPS CPU | 141 FPS | 120 FPS |
| FPS CUDA | 157 FPS | 0 FPS (GPU မရှိ) |
Blackmagic ဒစ်ခ် မြန်နှုန်းစမ်းသပ်ခြင်း
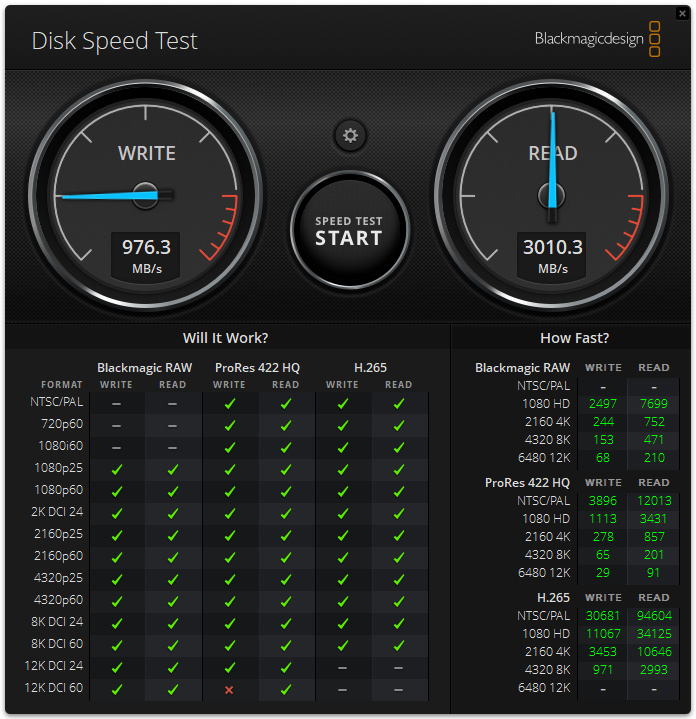
Blackmagic Disk Speed Test သည် drive တစ်ခု၏ read နှင့် write speed များကို benchmark လုပ်ပြီး၊ အထူးသဖြင့် ဗီဒီယိုတည်းဖြတ်ခြင်းလုပ်ငန်းများအတွက် ၎င်း၏စွမ်းဆောင်ရည်ကို ခန့်မှန်းသည်။ ၎င်းသည် 4K သို့မဟုတ် 8K ဗီဒီယိုကဲ့သို့သော resolution မြင့်မားသော content များအတွက် ၎င်းတို့၏ storage သည် လုံလောက်သော မြန်နှုန်းရှိကြောင်း အသုံးပြုသူများအား သေချာစေရန် ကူညီပေးသည်။
Blackmagic speed test မှာ mirrored SK hynix 480GB Dell NVMe ပါတဲ့ Dell PowerEdge R770 boss card ဟာ read speed 3,010.3 MB/s နဲ့ write speed 976.3 MB/s ရရှိခဲ့ပါတယ်။
ကောက်ချက်
Dell PowerEdge R770 သည် Open Compute Project ၏ Data Center Modular Hardware System စံနှုန်းနှင့် ခေတ်မီသော hardware ကို လက်ခံကျင့်သုံးခြင်းကြောင့် ကျွန်ုပ်တို့အား အမှန်တကယ် စိတ်လှုပ်ရှားစေပါသည်။ OCP DC MHS ပေါင်းစပ်မှုသည် မော်ဂျူလာစွမ်းရည် မြှင့်တင်ခြင်း၊ ဝန်ဆောင်မှု ပိုမိုကောင်းမွန်လာခြင်းနှင့် စံသတ်မှတ်ချက် တိုးမြှင့်ခြင်းဖြင့် ကုန်ကျစရိတ်များ လျှော့ချနိုင်ခြင်း အပါအဝင် အကျိုးကျေးဇူးများစွာကို ယူဆောင်လာပါသည်။ ဤဒီဇိုင်းအတွေးအခေါ်သည် iDRAC ကို OCP DC-SCM အဖြစ် အကောင်အထည်ဖော်ခြင်းမှသည် port များအထိ စနစ်၏ ရှုထောင့်အားလုံးတွင် ထင်ရှားပါသည်။
R770 သည် အထင်ကြီးလောက်သော သိုလှောင်မှုစွမ်းရည်များကိုလည်း ကြွားဝါပြီး 2U chassis တစ်ခုတည်းတွင် E3.S drives ၄၀ အထိ ပံ့ပိုးပေးသောကြောင့် သိုလှောင်မှုများစွာပါဝင်သော workloads များအတွက် အကောင်းဆုံးဖြေရှင်းချက်တစ်ခုဖြစ်သည်။ ထို့အပြင်၊ server ၏ ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို Front I/O Cold Aisle Accessible configuration အပါအဝင် configuration အမျိုးမျိုးအတွက် ၎င်း၏ ပံ့ပိုးမှုကြောင့် ပိုမိုမြှင့်တင်ထားပြီး မတူညီသော data center layouts များနှင့် ဝန်ဆောင်မှုပေးနိုင်မှု လိုအပ်ချက်များအတွက် ပိုမိုပြောင်းလွယ်ပြင်လွယ်ရှိစေပါသည်။
GPU အများအပြားနှင့် Intel ၏ Xeon 6 Performance core CPU များကို ပံ့ပိုးပေးထားသောကြောင့် R770 သည် ခေတ်မီဒေတာစင်တာများ၏ လိုအပ်ချက်များကို ဖြည့်ဆည်းရန် သင့်လျော်သော စွမ်းအားပြည့်ပြီး စွယ်စုံသုံးဆာဗာပလက်ဖောင်းတစ်ခုဖြစ်သည်။ ၎င်း၏ ခေတ်မီဟာ့ဒ်ဝဲ၊ မော်ဂျူလာဒီဇိုင်းနှင့် ခိုင်မာသောလုံခြုံရေးအင်္ဂါရပ်များကြောင့် R770 သည် AI၊ HPC နှင့် ရိုးရာလုပ်ငန်း workloads များကို ဖြန့်ကျက်လိုသော အဖွဲ့အစည်းများအတွက် ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။

ဦးဆောင်သူစာရင်း- Dell PowerEdge R770 သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံးဆာဗာများ ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Intel 2U Server ဆုကို ရရှိထားသည်။


 အမေဇုံ