

System DRAM သည် AI တွင် အထူးသဖြင့် CPU inferencing တွင် အရေးကြီးသော အခန်းကဏ္ဍမှ ပါဝင်သည်။ AI application များ ပိုမိုရှုပ်ထွေးလာသည်နှင့်အမျှ ပိုမိုမြန်ဆန်ပြီး ပိုမိုထိရောက်သော memory solution များအတွက် လိုအပ်ချက်သည် ပိုမိုအရေးပါလာပါသည်။ AI တွင် system DRAM ၏ အရေးပါမှုကို CPU inferencing နှင့် memory channel များစွာအသုံးပြုခြင်း၏ အရေးပါသော အခန်းကဏ္ဍကို အဓိကထား၍ ကျွန်ုပ်တို့ လေ့လာလိုပါသည်။
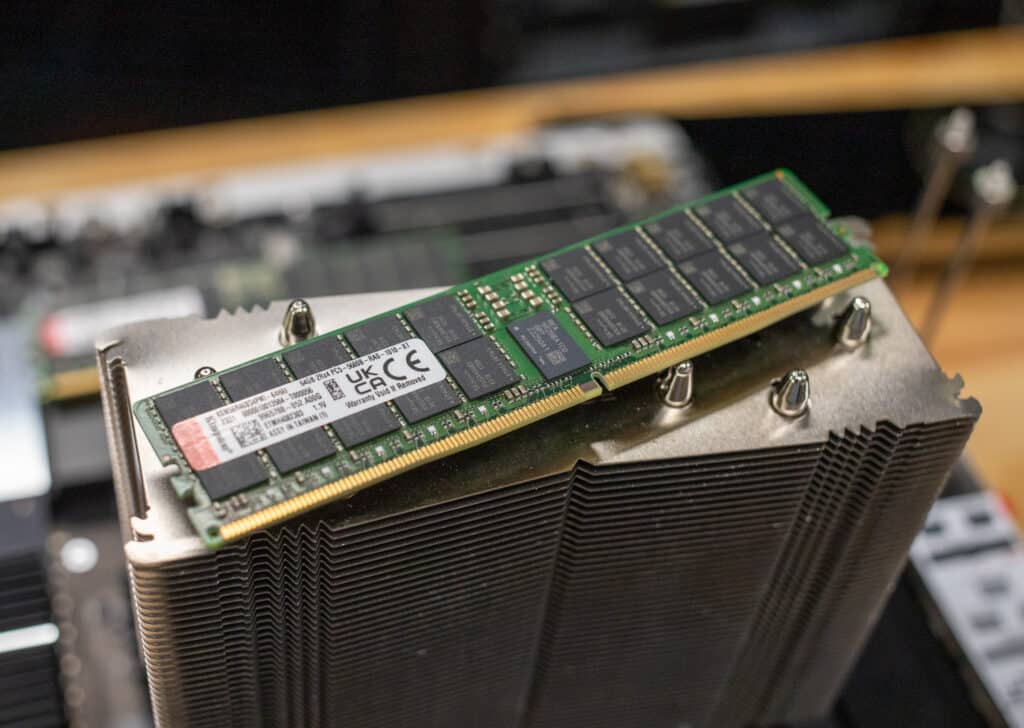
Kingston KSM56R46BD4PMI-64HAI DDR5
AI မှာ System DRAM ရဲ့ အရေးပါမှု
System DRAM သည် AI စနစ်များရှိ ဒေတာအတွက် အဓိကဗဟိုချက်ဖြစ်သည်။ ဒေတာကို CPU မှ အမြန်ဝင်ရောက်နိုင်ရန် ယာယီသိမ်းဆည်းထားပြီး ဒေတာများကို လျင်မြန်စွာ လုပ်ဆောင်နိုင်စေပါသည်။
၎င်းသည် ကြီးမားသောဒေတာစုများကို မြန်ဆန်ထိရောက်စွာကိုင်တွယ်ခြင်းသည် အားသာချက်တစ်ခုသာမက မရှိမဖြစ်လိုအပ်ချက်တစ်ခုဖြစ်သည့် AI အပလီကေးရှင်းများတွင် အထူးအရေးကြီးပါသည်။ AI စွမ်းရည်များ မြှင့်တင်ရာတွင် System DRAM ၏ ဘက်စုံအခန်းကဏ္ဍကို အနီးကပ်လေ့လာကြည့်ပါမည်။
- မြန်နှုန်းနှင့် ထိရောက်မှု- AI အယ်လဂိုရစ်သမ်များ၊ အထူးသဖြင့် ကောက်ချက်ချရာတွင် ဒေတာအမြောက်အမြားကို စီမံဆောင်ရွက်ရန်အတွက် မြန်နှုန်းမြင့်မှတ်ဉာဏ် လိုအပ်ပါသည်။ System DRAM သည် ဤမြန်နှုန်းကို ပေးစွမ်းပြီး နှောင့်နှေးမှုကို လျှော့ချပေးပြီး စနစ်စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးပါသည်။
- စွမ်းရည်- ခေတ်မီ AI အပလီကေးရှင်းများသည် မှတ်ဉာဏ်စွမ်းရည် ကြီးမားသော လိုအပ်ပါသည်။ စွမ်းရည်မြင့် DRAM သည် သိုလှောင်မှုကိရိယာများမှ ဒေတာရယူခြင်း၏ နှေးကွေးသောလုပ်ငန်းစဉ်ကို ရှောင်ရှားရန် ပိုမိုကြီးမားသောဒေတာစုများကို မှတ်ဉာဏ်တွင် လုပ်ဆောင်နိုင်ကြောင်း သေချာစေသည်။
- ယုံကြည်စိတ်ချရမှု- AI တွင် ဒေတာများ၏ တည်တံ့ခိုင်မြဲမှုသည် အလွန်အရေးကြီးပါသည်။ System DRAM သည် ၎င်း၏ အမှားပြင်ဆင်နိုင်စွမ်းဖြင့် ဒေတာပျက်စီးမှုကို အနည်းဆုံးဖြစ်စေပြီး တိကျမှု အလွန်အရေးကြီးသော အပလီကေးရှင်းများတွင် မရှိမဖြစ်လိုအပ်ပါသည်။
- တိုးချဲ့နိုင်မှု- AI မော်ဒယ်များသည် ပိုမိုရှုပ်ထွေးလာသည်နှင့်အမျှ မှတ်ဉာဏ်အရင်းအမြစ်များကို တိုးချဲ့နိုင်စွမ်းသည် အလွန်အရေးကြီးလာပါသည်။ System DRAM သည် တိုးတက်ပြောင်းလဲနေသော AI အပလီကေးရှင်းများ၏ တိုးပွားလာသော လိုအပ်ချက်များနှင့် ၎င်းတို့၏ တိုးပွားလာသော ဒေတာလိုအပ်ချက်များကို လိုက်လျောညီထွေဖြစ်စေရန် လိုအပ်သော တိုးချဲ့နိုင်မှုကို ပေးဆောင်ပါသည်။
- Bandwidth: System DRAM ၏ bandwidth မြင့်မားခြင်းက ဒေတာလွှဲပြောင်းမှုနှုန်းကို ပိုမိုမြန်ဆန်စေပြီး ဒေတာကို ပိုမိုမြန်ဆန်စွာ ဝင်ရောက်ကြည့်ရှုနိုင်စေပါသည်။ ၎င်းသည် ရှုပ်ထွေးသော အာရုံကြောကွန်ရက်များကို လေ့ကျင့်ပေးခြင်းနှင့် ကြီးမားသော ဒေတာလုပ်ဆောင်ခြင်း လုပ်ငန်းများကို စီမံခန့်ခွဲခြင်းအတွက် အထူးအကျိုးရှိပါသည်။
CPU တွက်ချက်မှုနှင့် DRAM
ဉာဏ်ရည်တုတွင်၊ CPU inferencing – ခန့်မှန်းချက်များ သို့မဟုတ် ဆုံးဖြတ်ချက်များချရန် လေ့ကျင့်ထားသော မော်ဒယ်ကို အသုံးပြုသည့် လုပ်ငန်းစဉ် – နှင့် DRAM ၏ အခန်းကဏ္ဍတို့သည် AI အပလီကေးရှင်းများ၏ ထိရောက်မှုနှင့် အမြန်နှုန်းကို သိသိသာသာ လွှမ်းမိုးသည့် အရေးကြီးသော အစိတ်အပိုင်းများ ဖြစ်သည်။ ဤအဆင့်သည် ကြီးမားသော dataset များကို လျင်မြန်စွာ ဝင်ရောက်ကြည့်ရှုပြီး လုပ်ဆောင်ရန် လိုအပ်သောကြောင့် မှတ်ဉာဏ်-များစွာ အသုံးပြုရသည်။ ပါဝင်ပတ်သက်သော ဒေတာ၏ ရှုပ်ထွေးသော သဘောသဘာဝနှင့် အရွယ်အစားကြောင့် စနစ်မှတ်ဉာဏ်အပေါ် အထူးသဖြင့် တောင်းဆိုမှုများသည်။
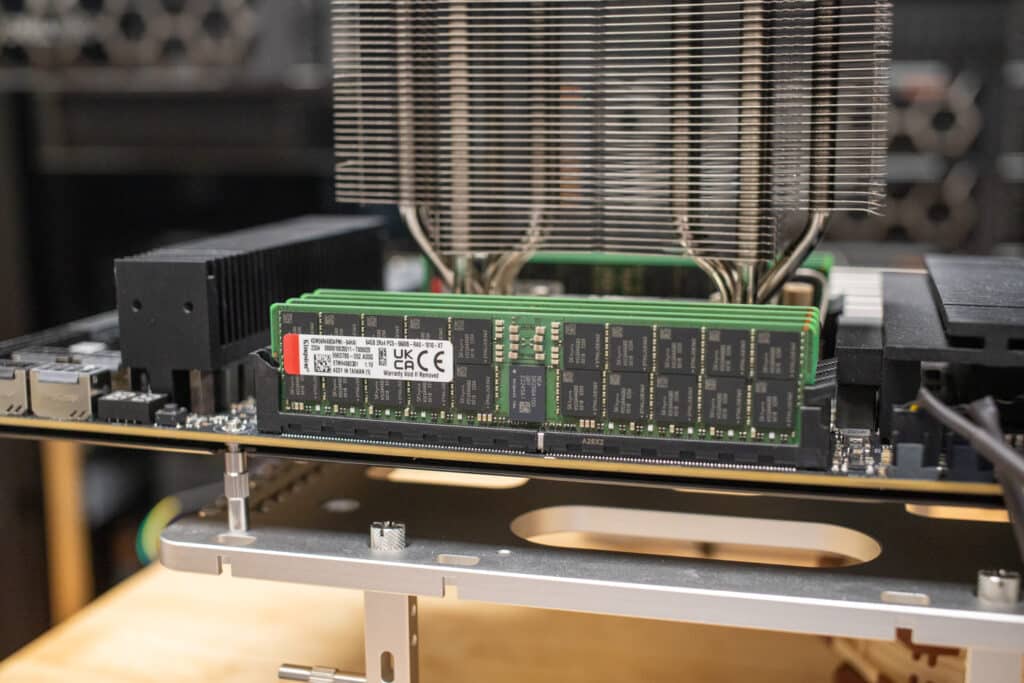
DRAM သည် AI လုပ်ဆောင်ချက်များအတွက် CPU inferencing ကို အကောင်းဆုံးဖြစ်အောင်လုပ်ဆောင်ရာတွင် အဓိကကျသော မြှင့်တင်မှုများစွာမှတစ်ဆင့် အရေးပါသောအခန်းကဏ္ဍမှ ပါဝင်ပါသည်။ ပထမအချက်အနေဖြင့် ၎င်းသည် CPU inferencing တွင် မြန်ဆန်သော ဒေတာလုပ်ဆောင်ခြင်းနှင့် ဆုံးဖြတ်ချက်ချခြင်းအတွက် မရှိမဖြစ်လိုအပ်သော မြင့်မားသော data throughput ရရှိရန် လိုအပ်သော bandwidth ကို ပံ့ပိုးပေးပါသည်။ ဤ throughput တိုးလာခြင်းသည် ရှုပ်ထွေးသောအလုပ်များတွင် ပိုမိုမြန်ဆန်သောစွမ်းဆောင်ရည်ကို တိုက်ရိုက်ပြောင်းလဲပေးပါသည်။
ထို့အပြင်၊ CPU နှင့်နီးကပ်စွာဒေတာသိမ်းဆည်းခြင်းဖြင့် system DRAM သည် ဒေတာကိုဝင်ရောက်ကြည့်ရှုရန်အချိန်ကို သိသိသာသာလျှော့ချပေးပြီး ယေဘုယျအားဖြင့် တွက်ချက်မှုနှောင့်နှေးမှုကို အနည်းဆုံးဖြစ်စေသည်။ ဤနီးကပ်မှုသည် မြန်ဆန်ပြီး တုံ့ပြန်မှုကောင်းသောစနစ်ကို ထိန်းသိမ်းရန်အတွက် အရေးကြီးပါသည်။ နောက်ဆုံးအနေဖြင့်၊ ဒေတာကို မြန်ဆန်စွာလုပ်ဆောင်ပြီး ဝင်ရောက်ကြည့်ရှုချိန်များ တိုတောင်းလာသည်နှင့်အမျှ CPU တွက်ချက်မှုလုပ်ငန်းများအတွက် လိုအပ်သော အလုံးစုံပါဝါကို သိသိသာသာလျှော့ချပေးပါသည်။ ၎င်းသည် ပိုမိုစွမ်းအင်ချွေတာသောလုပ်ငန်းဆောင်တာများကိုဖြစ်ပေါ်စေပြီး AI အပလီကေးရှင်းများအတွက် ပိုမိုရေရှည်တည်တံ့ပြီး ကုန်ကျစရိတ်သက်သာသောပတ်ဝန်းကျင်ကို သေချာစေသည်။
မှတ်ဉာဏ်ချန်နယ်များစွာ၏ အခန်းကဏ္ဍ
AI အပလီကေးရှင်းများ၏ စွမ်းဆောင်ရည်ကို သတ်မှတ်ရာတွင် စနစ်မှတ်ဉာဏ်ဗိသုကာသည် မရှိမဖြစ်လိုအပ်သော အစိတ်အပိုင်းတစ်ခုဖြစ်သည်။ မှတ်ဉာဏ်ချန်နယ်များစွာကို အသုံးပြုခြင်းသည် အဝေးပြေးလမ်းမကြီးကို ချဲ့ထွင်ခြင်းနှင့်တူသည် - ၎င်းသည် တစ်ပြိုင်နက်တည်း ဒေတာအသွားအလာ ပိုမိုများပြားစွာ စီးဆင်းမှုကို လွယ်ကူချောမွေ့စေပြီး စနစ်တစ်ခုလုံး၏ စွမ်းဆောင်ရည်ကို သိသိသာသာ မြှင့်တင်ပေးသည်။ ချန်နယ်များစွာကို အသုံးပြုခြင်းဖြင့် AI လုပ်ငန်းဆောင်တာများကို မည်သို့အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်နိုင်သည်ကို ဤနေရာတွင် ဖော်ပြထားသည်-
- Bandwidth တိုးလာခြင်း- Channel များစွာသည် memory bandwidth ကို တိုးစေသည်။ ၎င်းသည် AI application များအတွက် အရေးကြီးပါသည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့သည် တစ်ပြိုင်နက်တည်း ပိုမိုများပြားသော data များကို process လုပ်၍ analyze လုပ်နိုင်ပြီး inference time များကို ပိုမိုမြန်ဆန်စေသောကြောင့်ဖြစ်သည်။
- Parallel Processing: ချန်နယ်များစွာဖြင့် အချက်အလက်များကို parallel ဖြင့် လုပ်ဆောင်နိုင်ပြီး ဒေတာအစုအဝေးကြီးများပါဝင်သည့် AI တွက်ချက်မှုများကို သိသိသာသာ မြန်ဆန်စေသည်။
- ပိတ်ဆို့မှုများ လျှော့ချခြင်း- မှတ်ဉာဏ်ချန်နယ်များစွာသည် စနစ်ပိတ်ဆို့မှုများကို လျှော့ချရာတွင် အထောက်အကူပြုသည်။ မှတ်ဉာဏ်ဝန်ကို ဖြန့်ဝေခြင်းဖြင့် ချန်နယ်တစ်ခုစီကို ပိုမိုထိရောက်စွာ လည်ပတ်နိုင်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးပါသည်။
ဒေတာစစ်ဆေးပါ
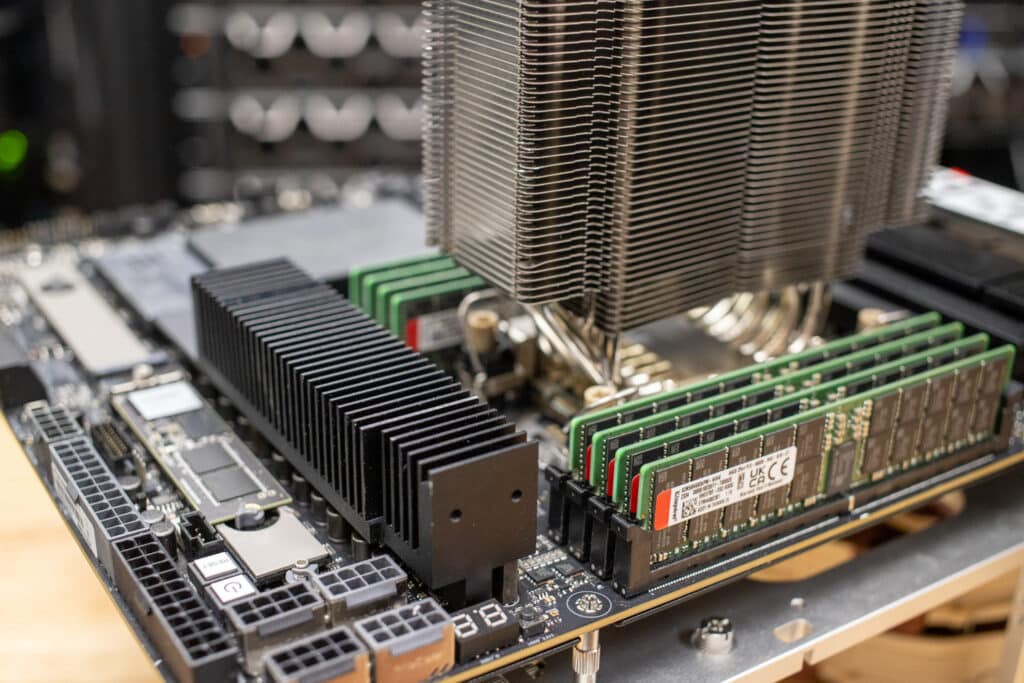
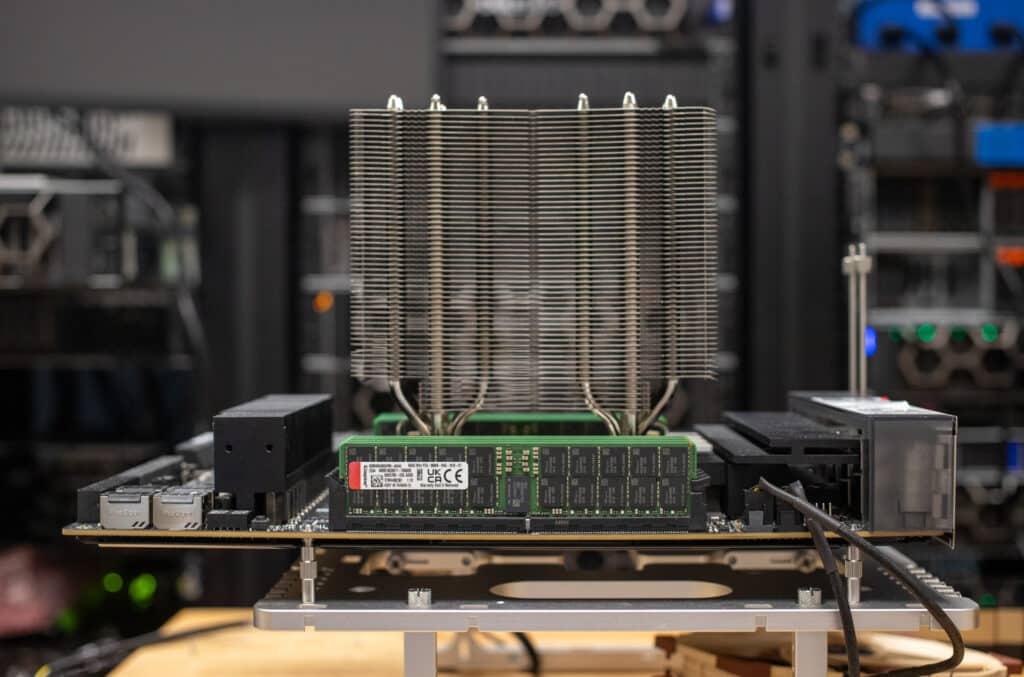
AI စနစ်များ၊ အထူးသဖြင့် CPU inferencing တွင် DRAM ၏ အားသာချက်များကို အတည်ပြုရန်အတွက်၊ ကျွန်ုပ်တို့သည် Kingston KSM56R46BD4PMI-64HAI DDR5 မှတ်ဉာဏ်မော်ဂျူး ရှစ်ခုကို channel configuration အမျိုးမျိုးတွင် အသုံးပြု၍ စမ်းသပ်မှုများစွာကို ပြုလုပ်ခဲ့ပါသည်။
| KSM48R40BD4TMM-64HMR 64GB 2Rx4 8G x 80-Bit PC5-4800 CL40 မှတ်ပုံတင်ထားသော EC8 288-Pin DIMM | KSM56R46BD4PMI-64HAI 64GB 2Rx4 8G x 80-Bit PC5-5600 CL46 မှတ်ပုံတင်ထားသော EC8 288-Pin DIMM | |
| လွှဲပြောင်းမြန်နှုန်း | 4800 MT / s နဲ့ | 5600 MT / s နဲ့ |
| CL (IDD) | သံသရာ 40 | သံသရာ 46 |
| အတန်းစက်ဝန်းအချိန် (tRCmin) | ၁၆ ns (မိနစ်) | ၁၆ ns (မိနစ်) |
| Active/Refresh Command Time (tRFCmin) သို့ Refresh လုပ်ပါ | ၁၆ ns (မိနစ်) | ၁၆ ns (မိနစ်) |
| အတန်းတက်ကြွချိန် | ၁၆ ns (မိနစ်) | ၁၆ ns (မိနစ်) |
| တန်းကြိုတင်အားသွင်းချိန် | ၁၆ ns (မိနစ်) | ၁၆ ns (မိနစ်) |
| UL အဆင့်သတ်မှတ်ချက် | ၉၄ ဗို့ – ၀ | ၉၄ ဗို့ – ၀ |
| Operating အပူချိန် | ၀ ဒီဂရီစင်တီဂရိတ်မှ +၉၅ ဒီဂရီစင်တီဂရိတ်အထိ | ၀ ဒီဂရီစင်တီဂရိတ်မှ +၉၅ ဒီဂရီစင်တီဂရိတ်အထိ |
| သိုလှောင်ခြင်းအပူချိန် | -55 C +100 ကို C | -55 C +100 ကို C |
အခြေခံတစ်ခုချမှတ်ရန်အတွက် CPU ၏ သီးခြားစွမ်းရည်များကို တိုင်းတာသည့် အာရုံစိုက်ထားသော CPU benchmark များနှင့် Geekbench စမ်းသပ်မှုများကို ကျွန်ုပ်တို့ စတင်ခဲ့ပါသည်။ မှတ်ဉာဏ်နှင့် သိုလှောင်မှုအပါအဝင် စနစ်တစ်ခုလုံးကို အလေးအနက်ထားရန်၊ ၎င်း၏ တင်းကျပ်သော လိုအပ်ချက်များအတွက် y-cruncher ကို ရွေးချယ်ခဲ့ပါသည်။ ဤချဉ်းကပ်မှုသည် အလွန်အမင်းအခြေအနေများအောက်တွင် စနစ်တစ်ခုလုံး၏ စည်းလုံးမှုနှင့် ခံနိုင်ရည်ကို အကဲဖြတ်နိုင်စေပြီး အလုံးစုံစွမ်းဆောင်ရည်နှင့် တည်ငြိမ်မှု၏ ရှင်းလင်းသောပုံရိပ်ကို ပေးစွမ်းပါသည်။
အဆုံးစွန်အားဖြင့်၊ ဤရလဒ်များသည် AI အပလီကေးရှင်းများတွင် system DRAM နှင့် memory channel အရေအတွက်သည် တွက်ချက်မှုအမြန်နှုန်း၊ ထိရောက်မှုနှင့် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို မည်သို့တိုက်ရိုက်အကျိုးသက်ရောက်စေသည်ဆိုသည့် တိကျသောဒေတာကို ပံ့ပိုးပေးပါလိမ့်မည်။
Geekbench 6
ပထမဆုံးအနေနဲ့ Geekbench 6 က overall system performance ကို တိုင်းတာပေးတဲ့ cross-platform benchmark တစ်ခုပါ။ Geekbench Browser မှာ သင်လိုချင်တဲ့ system နဲ့ နှိုင်းယှဉ်မှုတွေကို ရှာတွေ့နိုင်ပါတယ် ။ ရမှတ်မြင့်လေ ပိုကောင်းလေပါပဲ။
| Geekbench 6 | ကင်းစတန် DDR5 2 လိုင်းများ |
ကင်းစတန် DDR5 4 လိုင်းများ |
ကင်းစတန် DDR5 8 လိုင်းများ |
| CPU စံနှုန်း: Single-Core ဖြစ်သည် |
2,083 | 2,233 | 2,317 |
| CPU စံနှုန်း: Multi-Core ပါ |
14,404 | 18,561 | 19,752 |
Kingston DDR5 အတွက် Geekbench 6 ရလဒ်များသည် ၂၊ ၄ နှင့် ၈-channel setup များကို နှိုင်းယှဉ်သောအခါ ကွဲပြားမှုအမျိုးမျိုးကို ပြသသည်။ single-core စမ်းသပ်မှုများတွင် ရမှတ်များသည် ချန်နယ်နှစ်ခုဖြင့် ၂,၀၈၃ မှ ချန်နယ်ရှစ်ခုဖြင့် ၂,၃၁၇ အထိ အနည်းငယ်သာ တိုးလာပြီး ချန်နယ်အရေအတွက် တိုးလာသည်နှင့်အမျှ တစ်ဦးချင်း core လုပ်ဆောင်ချက်များအတွက် ထိရောက်မှုနှင့် throughput တိုးတက်လာကြောင်း ညွှန်ပြသည်။ သို့သော် အထင်ရှားဆုံး စွမ်းဆောင်ရည် တိုးတက်မှုကို multi-core စမ်းသပ်မှုများတွင် တွေ့ရှိရပြီး ချန်နယ်နှစ်ခုဖြင့် ၁၄,၄၀၄ မှ ချန်နယ်ရှစ်ခုဖြင့် ၁၉,၇၅၂ အထိ မြင့်တက်လာသည်။
y-cruncher
y-cruncher သည် multi-threaded နှင့် scalable program တစ်ခုဖြစ်ပြီး Pi နှင့် အခြားသင်္ချာ constant များကို trillions digits အထိ တွက်ချက်နိုင်သည်။ ၂၀၀၉ ခုနှစ်တွင် စတင်မိတ်ဆက်ချိန်မှစ၍ y-cruncher သည် overclocker များနှင့် hardware ဝါသနာရှင်များအတွက် ရေပန်းစားသော benchmarking နှင့် stress-testing application တစ်ခု ဖြစ်လာခဲ့သည်။ ဤစမ်းသပ်မှုတွင် မြန်လေ ပိုကောင်းလေဖြစ်သည်။
| y-cruncher (စုစုပေါင်း တွက်ချက်ချိန်) |
ကင်းစတန် DDR5 2 လိုင်းများ |
ကင်းစတန် DDR5 4 လိုင်းများ |
ကင်းစတန် DDR5 8 လိုင်းများ |
| ဂဏန်း ၁ ဘီလီယံ | 18.117 စက္ကန့် | 10.856 စက္ကန့် | 7.552 စက္ကန့် |
| ဂဏန်း ၁ ဘီလီယံ | 51.412 စက္ကန့် | ၃၀ စက္ကန့် | ၃၀ စက္ကန့် |
| ဂဏန်း ၁ ဘီလီယံ | 110.728 စက္ကန့် | ၃၀ စက္ကန့် | ၃၀ စက္ကန့် |
| ဂဏန်း ၁ ဘီလီယံ | 240.666 စက္ကန့် | ၃၀ စက္ကန့် | ၃၀ စက္ကန့် |
| ၂၅ ဘီလီယံ ဂဏန်းများ | 693.835 စက္ကန့် | ၃၀ စက္ကန့် | N / A |
ချန်နယ် ၂၊ ၄ နှင့် ၈ တို့တွင် y-cruncher benchmark သည် ချန်နယ်အရေအတွက် တိုးလာသည်နှင့်အမျှ တွက်ချက်မှုအမြန်နှုန်းတွင် ရှင်းလင်းပြတ်သားပြီး တသမတ်တည်း တိုးတက်မှုကို ပြသသည်။ Pi ၏ ဂဏန်း ၁ ဘီလီယံကို တွက်ချက်ရန်အတွက် စုစုပေါင်းတွက်ချက်ချိန်သည် ချန်နယ်နှစ်ခုဖြင့် ၁၈.၁၁၇ စက္ကန့်မှ ချန်နယ်ရှစ်ခုဖြင့် ၇.၅၅၂ စက္ကန့်အထိ သိသိသာသာ လျော့ကျသွားသည်။
တွက်ချက်ချိန်လျှော့ချခြင်း၏ ဤလမ်းကြောင်းသည် စမ်းသပ်ထားသော စကေးအားလုံးတွင် ဆက်လက်တည်ရှိနေပြီး ချန်နယ် ၂ ခုမှ ၄ ခုသို့ ရွေ့လျားသောအခါ ဂဏန်း ၂၅ ဘီလီယံ တွက်ချက်ချိန်သည် ၆၉၃.၈၃၅ စက္ကန့်မှ ၃၉၆.၉၉၇ စက္ကန့်သို့ ကျဆင်းသွားသည်။
3DMark – CPU ပရိုဖိုင်
3DMark ရှိ CPU Profile စမ်းသပ်မှုသည် thread အရေအတွက်အမျိုးမျိုးတွင် processor ၏စွမ်းဆောင်ရည်ကို တိကျစွာတိုင်းတာပြီး DDR5 RAM channel များ၏ configuration အမျိုးမျိုးသည် CPU workload handling နှင့် efficiency ကို မည်သို့အကျိုးသက်ရောက်စေသည်ကို အသေးစိတ်ကြည့်ရှုနိုင်စေပါသည်။ ဤစမ်းသပ်မှုသည် DDR5 RAM channel setup အမျိုးမျိုးကိုအသုံးပြုသည့်အခါ memory-intensive operations များနှင့် multi-threaded applications များတွင် စွမ်းဆောင်ရည်ကွာခြားချက်များကို နားလည်ရန်အတွက် အကျိုးရှိပါသည်။
| 3DMark – CPU ပရိုဖိုင် – ရမှတ်များ | |||
| ကြိုးအရေအတွက် | ကင်းစတန် DDR5 2 လိုင်းများ |
ကင်းစတန် DDR5 4 လိုင်းများ |
ကင်းစတန် DDR5 8 လိုင်းများ |
| မက်စ်ချည်များ | 15,822 | 15,547 | 15,457 |
| 16 ချည် | 10,632 | 9,515 | 10,367 |
| 8 ချည် | 4,957 | 6,019 | 5,053 |
| 4 ချည် | 3,165 | 3,366 | 3,323 |
| 2 ချည် | 1,726 | 1,765 | 1,781 |
| ၃ ချည် | 907 | 911 | 884 |
Kingston DDR5 RAM အတွက် 3DMark CPU Profile ရမှတ်များသည် အနည်းငယ်ရှုပ်ထွေးသော ရုပ်ပုံကို ပြသပြီး အကောင်းဆုံး channel အရေအတွက်သည် thread အရေအတွက်နှင့် သီးခြား workload ပေါ် မူတည်၍ ကွဲပြားနိုင်ကြောင်း ညွှန်ပြသည်။
thread အရေအတွက် အများဆုံးတွင်၊ channel နှစ်ခု (၁၅,၈၂၂) ဖြင့် ရမှတ်များ အမြင့်ဆုံးဖြစ်ပြီး channel ပိုများလာသည်နှင့်အမျှ အနည်းငယ် လျော့ကျသွားသည်၊ ၎င်းသည် အပို channel များသည် parallel task များအတွက် အကျိုးကျေးဇူး မပေးပါဟု ညွှန်ပြသည်။ သို့သော် thread ရှစ်ခုတွင်၊ 4-channel configuration သည် အမြင့်ဆုံးရမှတ် (၆,၀၁၉) ရရှိပြီး အပို channel များသည် အလယ်အလတ်အဆင့် parallelism ကို ကိုင်တွယ်ရာတွင် တိုးတက်ကောင်းမွန်လာသည့် sweet spot ကို ညွှန်ပြသည်။ thread အရေအတွက် နည်းသော (၄၊ ၂ နှင့် ၁ thread) တွင် channel configuration အားလုံးတွင် ရမှတ်များ အလားတူဖြစ်သည်။
ဤရလဒ်များက ချန်နယ်များ ပိုမိုများပြားလာခြင်းသည် အချို့သော multi-threaded လုပ်ဆောင်ချက်များကို အကျိုးပြုနိုင်သော်လည်း၊ သက်ရောက်မှုသည် task ၏ သဘောသဘာဝနှင့် စနစ်၏ ဗိသုကာပုံစံပေါ် မူတည်၍ ကွဲပြားကြောင်း အကြံပြုထားသည်။ ဆိုလိုသည်မှာ အသုံးပြုမှုတိုင်းအတွက် ချန်နယ်များ ပိုမိုများပြားလာခြင်းသည် အမြဲတမ်း ပိုကောင်းသည်မဟုတ်ပါ။
AI တွက်ချက်မှုအပေါ် DRAM Channel ၏ အကျိုးသက်ရောက်မှု
စမ်းသပ်မှုအားလုံးကို UL Labs Procyon Benchmark မှတစ်ဆင့် Intel OpenVINO API ကို အသုံးပြု၍ Intel Xeon w9-3475X CPU တွင် ပြုလုပ်ခဲ့သည်။
ထိပ်တန်းရောင်းချသူများထံမှ AI inference engine အမျိုးမျိုးကို ထည့်သွင်းထားသော UL Procyon AI Inference Benchmark သည် hardware setup များနှင့် လိုအပ်ချက်အမျိုးမျိုးကို ဖြည့်ဆည်းပေးပါသည်။ benchmark ရမှတ်သည် on-device inferencing စွမ်းဆောင်ရည်၏ အဆင်ပြေပြီး စံသတ်မှတ်ထားသော အနှစ်ချုပ်ကို ပေးစွမ်းသည်။ ၎င်းက ကျွန်ုပ်တို့အား in-house solution များ မလိုအပ်ဘဲ လက်တွေ့ကမ္ဘာအခြေအနေများတွင် hardware setup အမျိုးမျိုးကို နှိုင်းယှဉ်ခွဲခြားနိုင်စေပါသည်။
FP32 မှာ ရလဒ်တွေက အမှားအယွင်း အနားသတ်အတွင်းမှာပဲ ရှိနေပေမယ့် INT ကို ရွှေ့လိုက်တဲ့အခါ အလုံးစုံရမှတ်ထက် အသေးစိတ်ရမှတ်တွေကို ကြည့်တဲ့အခါ စိတ်ဝင်စားစရာကောင်းလာပါတယ်။
နံပါတ်ကြီးရင် အလုံးစုံရမှတ်ပိုကောင်းပြီး နံပါတ်ငယ်ရင် အကြိမ်ရေပိုကောင်းတယ်။
ပထမတစ်ခုက FP32 Precision ပါ။
| FP ၆ | ||
| စေ့စပ်သေချာခြင်း | ၁ ချန်နယ် | ၁ ချန်နယ် |
| ယေဘုယျအားရမှတ် | 629 | 630 |
| MobileNet V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 0.81 | 0.77 |
| ResNet 50 ပျမ်းမျှ ကောက်ချက်ချချိန် | 1.96 | 1.82 |
| စတင်ခြင်း V4 ပျမ်းမျှ ကောက်ချက်ချချိန် | 6.93 | 7.31 |
| DeepLab V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 6.27 | 6.17 |
| YOLO V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 12.99 | 13.99 |
| REAL-ESRGAN ပျမ်းမျှ ကောက်ချက်ချချိန် | 280.59 | 282.45 |
နောက်တစ်ခုကတော့ FP16 Precision ပါ။
| FP ၆ | ||
| စေ့စပ်သေချာခြင်း | ၁ ချန်နယ် | ၁ ချန်နယ် |
| ယေဘုယျအားရမှတ် | 645 | 603 |
| MobileNet V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 0.81 | 0.76 |
| ResNet 50 ပျမ်းမျှ ကောက်ချက်ချချိန် | 1.91 | 1.94 |
| စတင်ခြင်း V4 ပျမ်းမျှ ကောက်ချက်ချချိန် | 7.11 | 7.27 |
| DeepLab V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 6.27 | 7.13 |
| YOLO V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 12.93 | 15.01 |
| REAL-ESRGAN ပျမ်းမျှ ကောက်ချက်ချချိန် | 242.24 | 280.91 |
နောက်ဆုံးတော့ INT
| INT | ||
| စေ့စပ်သေချာခြင်း | ၁ ချန်နယ် | ၁ ချန်နယ် |
| ယေဘုယျအားရမှတ် | 1,033 | 1004 |
| MobileNet V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 0.71 | 0.73 |
| ResNet 50 ပျမ်းမျှ ကောက်ချက်ချချိန် | 1.48 | 1.48 |
| စတင်ခြင်း V4 ပျမ်းမျှ ကောက်ချက်ချချိန် | 4.42 | 4.47 |
| DeepLab V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 4.33 | 4.99 |
| YOLO V3 ပျမ်းမျှ ကောက်ချက်ချချိန် | 5.15 | 5.12 |
| REAL-ESRGAN ပျမ်းမျှ ကောက်ချက်ချချိန် | 122.40 | 123.57 |
DRAM စွမ်းဆောင်ရည်နှင့် နှောင့်နှေးမှု
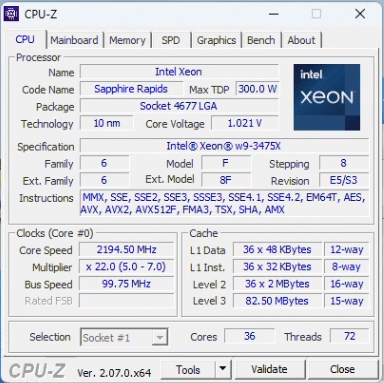
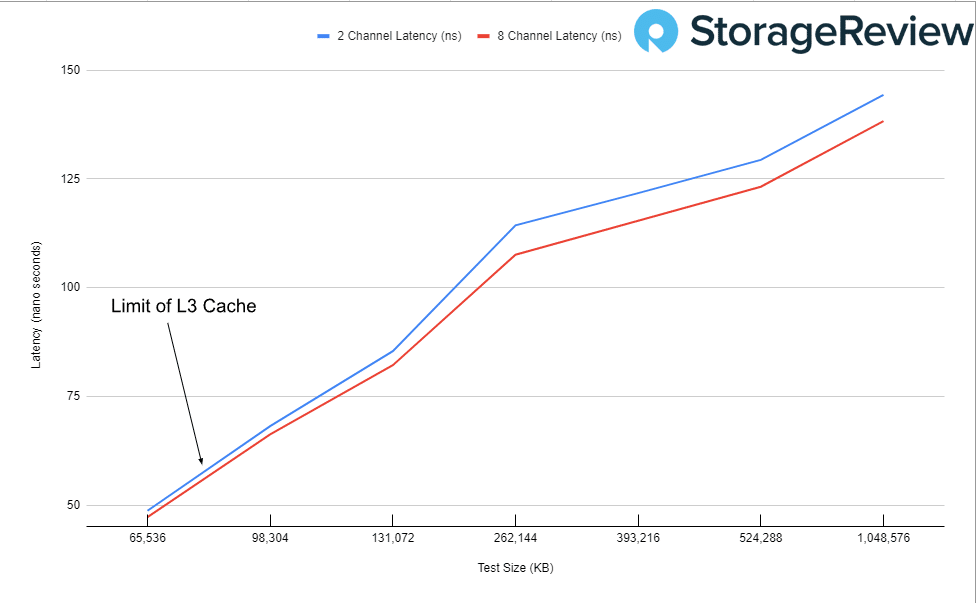
ပထမဦးစွာ 2-channel နှင့် 8-channel DRAM configuration ၏ latency ကို ကြည့်ပါမည်။ ကျွန်ုပ်တို့သည် CPU နှင့် memory တစ်ခုလုံးကို profile လုပ်ခဲ့သော်လည်း ကျွန်ုပ်တို့၏အာရုံစိုက်မှုတစ်ခုတည်းမှာ CPU Cache မှ DRAM သို့ကူးပြောင်းခြင်းဖြစ်သည်။ ကျွန်ုပ်တို့၏ Xeon W9-3475X CPU တွင် L3 cache 82.50MB သာရှိသောကြောင့်၊ ထိုကူးပြောင်းမှု၏အစတွင် ဇယားကိုကျွန်ုပ်တို့ထုတ်ယူခဲ့သည်။
| စမ်းသပ်အရွယ်အစား (KB) | ၂ ချန်နယ် bandwidth |
၈ ချန်နယ် နှောင့်နှေးမှု (ns)
|
| 65,536 | 48.70080 | 47.24411 |
| 98,304 | 68.16823 | 66.25920 |
| 131,072 | 85.38640 | 82.16685 |
| 262,144 | 114.32570 | 107.57450 |
| 393,216 | 121.74860 | 115.40340 |
| 524,288 | 129.38970 | 123.22100 |
| 1,048,576 | 144.32880 | 138.28380 |
ဤတွင်၊ ချန်နယ်များထပ်ထည့်ခြင်းသည် latency ကို အနည်းငယ်သာတိုးတက်စေသည်ကို ကျွန်ုပ်တို့တွေ့မြင်နိုင်သည်။
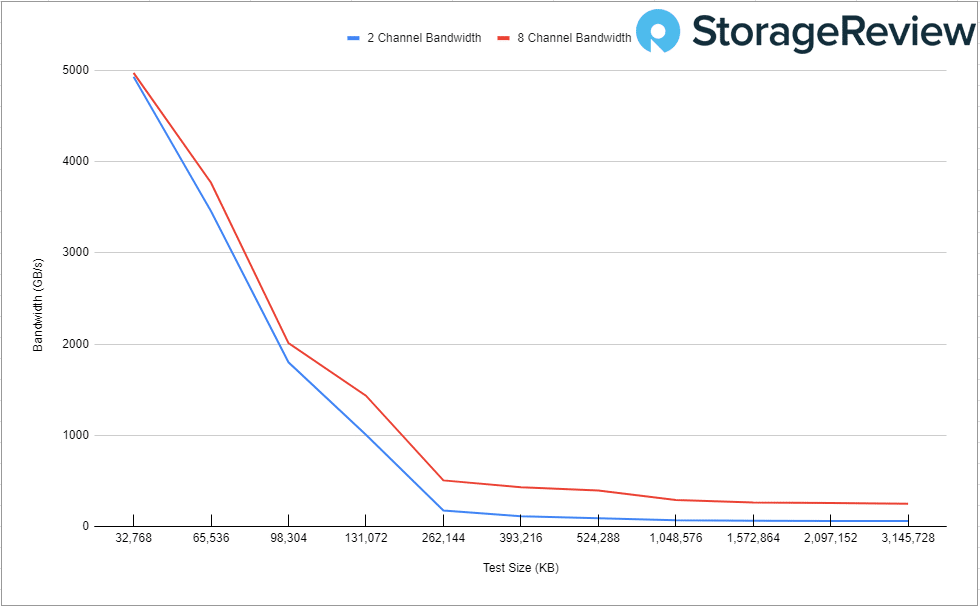
AVX512 ညွှန်ကြားချက်များတွင် bandwidth အကြောင်းဆက်သွားလျှင် 2-channel နှင့် 8-channel အကြား bandwidth တွင် သိသာထင်ရှားသော ကွာခြားချက်ကို ကျွန်ုပ်တို့တွေ့မြင်နိုင်ပါသည်။ ဤနေရာတွင် Delta သည် 2 နှင့် 8 channel အကြား စွမ်းဆောင်ရည်ကို ဖော်ပြသည်။
| စမ်းသပ်အရွယ်အစား (KB) AVX512 | ၈ ချန်နယ် လှိုင်းအကျယ် (GB/s) | ၈ ချန်နယ် လှိုင်းအကျယ် (GB/s) | ဒယ်လ်တာ (GB/s ကွာခြားချက်) |
| 65,536 | 3,455.28 | 3,767.91 | -312.63 |
| 98,304 | 1,801.88 | 2,011.83 | -209.95 |
| 131,072 | 1,009.21 | 1,436.50 | -427.28 |
| 262,144 | 178.52 | 508.65 | -330.13 |
| 393,216 | 114.76 | 433.91 | -319.15 |
| 524,288 | 94.81 | 396.90 | -302.09 |
| 1,048,576 | 71.12 | 293.26 | -222.13 |
| 1,572,864 | 66.98 | 267.44 | -200.46 |
| 2,097,152 | 65.08 | 262.50 | -197.42 |
| 3,145,728 | 63.63 | 253.12 | -189.50 |
ကောက်ချက်
အကျဉ်းချုပ်အားဖြင့် system DRAM သည် AI စနစ်များ၏ ဗိသုကာပုံစံတွင် အထူးသဖြင့် CPU inferencing တွင် အုတ်မြစ်ချပေးသည့် အုတ်မြစ်တစ်ခုဖြစ်သည်။ မြန်နှုန်းမြင့်၊ ယုံကြည်စိတ်ချရသော နှင့် ကျယ်ပြန့်သော memory ကို ပံ့ပိုးပေးနိုင်စွမ်းသည် မရှိမဖြစ်လိုအပ်ပါသည်။ ထို့အပြင်၊ memory channel များစွာကို အသုံးပြုခြင်းသည် bandwidth တိုးမြှင့်ခြင်း၊ parallel processing ကို ဖွင့်ခြင်းနှင့် bottleneck များကို လျှော့ချခြင်းဖြင့် AI application များ၏ စွမ်းဆောင်ရည်ကို သိသိသာသာ မြှင့်တင်ပေးနိုင်ပါသည်။ AI သည် ဆက်လက်တိုးတက်ပြောင်းလဲလာသည်နှင့်အမျှ system DRAM ကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်ခြင်းသည် အမြင့်ဆုံးအဆင့် စွမ်းဆောင်ရည်နှင့် ထိရောက်မှုကို သေချာစေရန် အဓိကအာရုံစိုက်မှုတစ်ခုအဖြစ် ဆက်လက်ရှိနေမည်ဖြစ်သည်။
Jordan Ranous မှ လှုံ့ဆော်ပေးသော AI မှ ထုတ်လုပ်ထားသော ရုပ်ပုံ
ထို့အပြင်၊ စမ်းသပ်မှုဒေတာသည် ဤအယူအဆကို အားဖြည့်ပေးပြီး မြှင့်တင်ထားသော မှတ်ဉာဏ်ဖွဲ့စည်းမှုများ၏ လက်တွေ့အကျိုးကျေးဇူးများကို ပြသနေပါသည်။ AI နှင့် အချက်အလက်လုပ်ဆောင်ခြင်း၏ နယ်နိမိတ်များကို ကျွန်ုပ်တို့ တွန်းအားပေးသည်နှင့်အမျှ စနစ်မှတ်ဉာဏ်၏ မဟာဗျူဟာမြောက် မြှင့်တင်မှုသည် နောက်မျိုးဆက် AI ဆန်းသစ်တီထွင်မှုနှင့် လက်တွေ့ကမ္ဘာအသုံးချမှုကို ပံ့ပိုးရာတွင် အလွန်အရေးကြီးလာမည်ဖြစ်သည်။


 အမေဇုံ