

Lenovo ThinkSystem SR650 V4 သည် cloud ဝန်ဆောင်မှုများ၊ ဆက်သွယ်ရေးနှင့် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော computing (HPC) ကဲ့သို့သော စက်မှုလုပ်ငန်းများ၏ လိုအပ်ချက်များကို ဖြည့်ဆည်းရန် ဒီဇိုင်းထုတ်ထားသော ပြောင်းလွယ်ပြင်လွယ်ရှိပြီး အစွမ်းထက်သော 2-socket၊ 2U rack server တစ်ခုဖြစ်သည်။ scale-out workloads များအတွက် အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်ခြင်းဖြစ်စေ၊ high-density compute ဖြင့် သင့်ဒေတာစင်တာကို အနာဂတ်တွင် ပိုမိုကောင်းမွန်အောင် လုပ်ဆောင်ခြင်းဖြစ်စေ SR650 V4 သည် ၎င်း၏ရှေ့ပြေးဖြစ်သော SR650 V3 ထက် အဓိပ္ပာယ်ရှိသော အဆင့်မြှင့်တင်မှုများကို ပေးဆောင်ပါသည်။

Lenovo SR650 V4 နှင့် SR650 V3 အကြား ကွာခြားချက်များ
processors
SR650 V4 မှာ processor စွမ်းရည်တွေက ပိုပြီးသိသာထင်ရှားတဲ့ အဆင့်မြှင့်တင်မှုတွေထဲက တစ်ခုပါ။ SR650 V3 က 4th Gen Intel Xeon Scalable Processors တွေကို အားကိုးခဲ့ပေမယ့် SR650 V4 မှာတော့ Intel Xeon 6 platform (ယခင်က “Granite Rapids” လို့ ကုဒ်နာမည်ပေးထားတယ်) ကို မိတ်ဆက်ပေးထားပါတယ်။ ကျွန်ုပ်တို့ရဲ့ သုံးသပ်ချက်မှာ compute-intensive workloads တွေအတွက် သီးသန့်ဒီဇိုင်းထုတ်ထားတဲ့ P-core (Performance-core) architecture ကို အဓိကထားပါတယ်။ V4 က socket တစ်ခုလျှင် P-core ၈၆ ခုအထိ (thread ၁၇၂ ခုအထိ) ပါဝင်တဲ့ processor တစ်ခု ဒါမှမဟုတ် နှစ်ခုကို ပံ့ပိုးပေးပြီး core speed မြင့်မားစွာ (4 GHz အထိ) နဲ့ TDP 350W အထိ ရရှိစေပါတယ်။
ဤအကူးအပြောင်းသည် အဖွဲ့အစည်းများအား server တစ်ခုလျှင် ပိုမိုတောင်းဆိုမှုများသော application များကို ကိုင်တွယ်နိုင်စေပြီး ၎င်းတို့၏ ရုပ်ပိုင်းဆိုင်ရာ footprint ကို လျှော့ချပေးပါသည်။ ဤဗိသုကာလက်ရာသည် virtualization နှင့် လေးလံသော database operations များအတွက် ခိုင်မာသောအခြေခံအုတ်မြစ်ကို ဖန်တီးပေးပါသည်။ ထို့အပြင်၊ V4 ၏ဗိသုကာလက်ရာသည် processor တစ်ခုလျှင် PCIe 5.0 lanes ၈၈ ခုအထိရှိသော ကြီးမားသော PCIe bandwidth ကို ပံ့ပိုးပေးပြီး ခေတ်မီမြန်နှုန်းမြင့် networking adapter များနှင့် NVMe storage array များကို ပိတ်ဆို့မှုများမရှိဘဲ ထောက်ပံ့ပေးရန်အတွက် မရှိမဖြစ်လိုအပ်ပါသည်။
| CPU ကိုမော်ဒယ် | cores / Threads | base ဘောင် | မက်စ် တာဘို | L3 ကက်ရှ် | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 336 ကို MB | 350 ဒဗလျူ |
| 6781P | 80 / 160 | 2.0 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 336 ကို MB | 350 ဒဗလျူ |
| 6767P | 64 / 128 | 2.4 GHz အမြန်နှုန်း | 3.9 GHz အမြန်နှုန်း | 336 ကို MB | 350 ဒဗလျူ |
| 6761P | 64 / 128 | 2.5 GHz အမြန်နှုန်း | 3.9 GHz အမြန်နှုန်း | 336 ကို MB | 350 ဒဗလျူ |
| 6760P | 64 / 128 | 2.2 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 320 ကို MB | 330 ဒဗလျူ |
| 6747P | 48 / 96 | 2.7 GHz အမြန်နှုန်း | 3.9 GHz အမြန်နှုန်း | 288 ကို MB | 330 ဒဗလျူ |
| 6745P | 32 / 64 | 3.1 GHz အမြန်နှုန်း | 4.3 GHz အမြန်နှုန်း | 336 ကို MB | 300 ဒဗလျူ |
| 6741P | 48 / 96 | 2.5 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 288 ကို MB | 300 ဒဗလျူ |
| 6740P | 48 / 96 | 2.1 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 288 ကို MB | 270 ဒဗလျူ |
| 6737P | 32 / 64 | 2.9 GHz အမြန်နှုန်း | 4.0 GHz အမြန်နှုန်း | 144 ကို MB | 270 ဒဗလျူ |
| 6736P | 36 / 72 | 2.0 GHz အမြန်နှုန်း | 4.1 GHz အမြန်နှုန်း | 144 ကို MB | 205 ဒဗလျူ |
| 6732P | 32 / 64 | 3.8 GHz အမြန်နှုန်း | 4.3 GHz အမြန်နှုန်း | 144 ကို MB | 350 ဒဗလျူ |
| 6731P | 32 / 64 | 2.5 GHz အမြန်နှုန်း | 4.1 GHz အမြန်နှုန်း | 144 ကို MB | 245 ဒဗလျူ |
| 6730P | 32 / 64 | 2.5 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 288 ကို MB | 250 ဒဗလျူ |
| 6724P | 16 / 32 | 3.6 GHz အမြန်နှုန်း | 4.3 GHz အမြန်နှုန်း | 72 ကို MB | 210 ဒဗလျူ |
| 6714P | 8 / 16 | 4.0 GHz အမြန်နှုန်း | 4.3 GHz အမြန်နှုန်း | 48 ကို MB | 165 ဒဗလျူ |
| 6530P | 32 / 64 | 2.3 GHz အမြန်နှုန်း | 4.1 GHz အမြန်နှုန်း | 144 ကို MB | 225 ဒဗလျူ |
| 6527P | 24 / 48 | 3.0 GHz အမြန်နှုန်း | 4.2 GHz အမြန်နှုန်း | 144 ကို MB | 255 ဒဗလျူ |
| 6521P | 24 / 48 | 2.6 GHz အမြန်နှုန်း | 4.1 GHz အမြန်နှုန်း | 144 ကို MB | 225 ဒဗလျူ |
| 6520P | 24 / 48 | 2.4 GHz အမြန်နှုန်း | 4.0 GHz အမြန်နှုန်း | 144 ကို MB | 210 ဒဗလျူ |
| 6517P | 16 / 32 | 3.2 GHz အမြန်နှုန်း | 4.2 GHz အမြန်နှုန်း | 72 ကို MB | 190 ဒဗလျူ |
| 6515P | 16 / 32 | 2.3 GHz အမြန်နှုန်း | 3.8 GHz အမြန်နှုန်း | 72 ကို MB | 150 ဒဗလျူ |
| 6511P | 16 / 32 | 2.3 GHz အမြန်နှုန်း | 4.2 GHz အမြန်နှုန်း | 72 ကို MB | 150 ဒဗလျူ |
| 6507P | 8 / 16 | 3.5 GHz အမြန်နှုန်း | 4.3 GHz အမြန်နှုန်း | 48 ကို MB | 150 ဒဗလျူ |
| 6505P | 12 / 24 | 2.2 GHz အမြန်နှုန်း | 4.1 GHz အမြန်နှုန်း | 48 ကို MB | 150 ဒဗလျူ |
မှတ်ဉာဏ်
မှတ်ဉာဏ်နှင့်ပတ်သက်၍ SR650 V4 သည် V3 ၏စွမ်းရည်များကို သိသိသာသာတိုးတက်စေပြီး subsystem စွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်စေသည်။ ၎င်းသည် DDR5 မှတ်ဉာဏ်အမြန်နှုန်းကို 6400 MHz (ချန်နယ်တစ်ခုလျှင် DIMM တစ်ခု) အထိ ပံ့ပိုးပေးပြီး ယခင်မျိုးဆက်၏ 4800 MHz ကန့်သတ်ချက်ထက် သိသိသာသာ ခုန်တက်သွားသည်။ စနစ်တွင် ပရိုဆက်ဆာတစ်ခုလျှင် မှတ်ဉာဏ်ချန်နယ်ရှစ်ခုတွင် စီစဉ်ထားသော DIMM slot ၃၂ ခု (ပရိုဆက်ဆာတစ်ခုလျှင် ၁၆ ခု) ပါရှိသည်။ ၎င်းသည် bandwidth-hungry application များအတွက် 8000 MHz အထိ အမြန်နှုန်းဖြင့် လည်ပတ်နိုင်သော standard RDIMM များ၊ 3DS RDIMM များနှင့် Multiplexed Rank DIMM အသစ်များ (MRDIMM များ) ကို ပံ့ပိုးပေးသည်။ 256GB 3DS RDIMM များကို အသုံးပြုခြင်းဖြင့် server သည် စုစုပေါင်းစနစ်မှတ်ဉာဏ် 8TB ကို ပံ့ပိုးပေးသည်။

ထို့အပြင်၊ V4 သည် CXL 2.0 (Compute Express Link) မှတ်ဉာဏ်တိုးချဲ့မှုအတွက် ပံ့ပိုးမှုကို မိတ်ဆက်ပေးသည်။ စီမံခန့်ခွဲသူများသည် E3.S drive bays (အထူးသဖြင့် E3.S 2T form factor) တွင် CXL မှတ်ဉာဏ်မော်ဂျူး ၁၂ ခုအထိ ထည့်သွင်းနိုင်သည်။ ၎င်းသည် စနစ်အား ရိုးရာပရိုဆက်ဆာနှင့် တွဲဖက်ထားသော ကန့်သတ်ချက်များထက် မန်မိုရီစွမ်းရည်နှင့် bandwidth ကို တိုးချဲ့နိုင်စေပြီး နောက်မျိုးဆက် workloads အတွက် compute latency ကို လျှော့ချပေးပြီး မန်မိုရီနည်းပါးစွာ ရပ်တန့်ခြင်းဖြင့် စုစုပေါင်းပိုင်ဆိုင်မှုကုန်ကျစရိတ် (TCO) ကို လျှော့ချပေးသည်။
သိုလှောင်ခြင်း
Lenovo SR650 V4 သိုလှောင်မှုစွမ်းရည်များသည် မြင့်မားသောစွမ်းဆောင်ရည် NVMe သိပ်သည်းဆနှင့် ပြောင်းလွယ်ပြင်လွယ်ရှိသော ပုံစံအချက်များဆီသို့ ပြောင်းလဲမှုကို သရုပ်ပြသည်။ ရိုးရာ ၃.၅ လက်မနှင့် ၂.၅ လက်မ drives များကို ပံ့ပိုးပေးနေစဉ်တွင် V4 သည် E3.S NVMe ပုံစံအချက်အတွက် ကြီးမားသော ပံ့ပိုးမှုကို မိတ်ဆက်ပေးသည်။ စနစ်သည် 32x E3.S 1T drives သို့မဟုတ် 12x E3.S 2T drives အထိ ထားရှိနိုင်ပြီး ရိုးရာ U.2 SSDs များနှင့် နှိုင်းယှဉ်ပါက ပိုမြင့်သော သိပ်သည်းဆနှင့် ပိုမိုကောင်းမွန်သော အပူချိန်စီမံခန့်ခွဲမှုကို ပေးစွမ်းသည်။

အရေးကြီးသည်မှာ V4 သည် oversubscription (1:1) မပါဘဲ တိုက်ရိုက် NVMe ချိတ်ဆက်မှုကို ပံ့ပိုးပေးသောကြောင့် PCIe lane sharing ကြောင့် မြန်နှုန်းမြင့် storage ပိတ်ဆို့မှု မဖြစ်စေပါ။ M.2 hot-swap boot drive ရွေးချယ်စရာများ ပါဝင်ခြင်းက ဝန်ဆောင်မှုပေးနိုင်မှုကို ပိုမိုမြှင့်တင်ပေးပါသည်။
Network
ကွန်ရက်ချိတ်ဆက်မှုအတွက် SR650 V4 တွင် သီးသန့် OCP 3.0 slot နှစ်ခုပါရှိပြီး နှစ်ခုစလုံးသည် PCIe Gen 5 x16 ကို ပံ့ပိုးပေးသည်။ ၎င်းသည် စံ PCIe riser slot များကို အသုံးမပြုဘဲ redundant၊ မြန်နှုန်းမြင့်ကွန်ရက် (ဥပမာ၊ dual-port 200GbE သို့မဟုတ် single-port 400GbE) ကို ဖွင့်ပေးသည့် အဓိကအဆင့်မြှင့်တင်မှုတစ်ခုဖြစ်သည်။ PCIe 5.0 သို့ ကူးပြောင်းခြင်းသည် သီအိုရီဆိုင်ရာ bandwidth (32 GT/s vs. 16 GT/s) ကို နှစ်ဆတိုးစေပြီး V4 သည် အလိုအပ်ဆုံး cloud နှင့် AI ကွန်ရက်အသွားအလာကို ကိုင်တွယ်နိုင်စွမ်းရှိစေသည်။

ပါဝါနှင့်အအေး
SR650 V4 သည် တိုက်တေနီယမ်နှင့် ပလက်တီနမ် စွမ်းဆောင်ရည်အဆင့်များဖြင့် ရရှိနိုင်သော 800W မှ 3200W အထိ မြှင့်တင်ထားသော ပါဝါထောက်ပံ့မှု ရွေးချယ်စရာများကို ပေးဆောင်ပါသည်။ စနစ်သည် သတ်မှတ်ထားသော ဒေတာစင်တာ လိုအပ်ချက်များနှင့် ကိုက်ညီစေရန် -48V DC နှင့် HVAC/HVDC ရွေးချယ်စရာများကိုလည်း ပံ့ပိုးပေးပါသည်။

TDP မြင့်မားသော ပရိုဆက်ဆာများနှင့် မှတ်ဉာဏ်မှ အပူကို စီမံခန့်ခွဲရန်အတွက် Lenovo သည် Neptune liquid-cooling options များကို မိတ်ဆက်ပေးထားသည်။ “Compute Complex Neptune Core Module” သည် open-loop liquid cooling ကို အသုံးပြု၍ ပရိုဆက်ဆာများ၊ မှတ်ဉာဏ်နှင့် ဗို့အားထိန်းညှိကိရိယာများမှ အပူကို ဖယ်ရှားပေးပြီး server အပူ၏ 80% ကျော်ကို ဖမ်းယူနိုင်ပြီး datacenter အအေးပေးစရိတ်များကို သိသိသာသာ လျှော့ချပေးနိုင်သည်။
အလုံးစုံသော် SR650 V4 သည် ခေတ်မီစီးပွားရေးလုပ်ငန်းပတ်ဝန်းကျင်များအတွက် စွမ်းဆောင်ရည်၊ သိပ်သည်းဆနှင့် အပူချိန်ထိရောက်မှုတို့တွင် ခိုင်မာသောခုန်ပျံကျော်လွှားမှုကို ပေးစွမ်းသည်။
Lenovo ThinkSystem SR650 V4 သတ်မှတ်ချက်များ
| specification | အသေးစိတ် |
|---|---|
| System ကိုအသေးစိတ်ဖော်ပြချက် | |
| form ကို Factor | 2U စင် |
| processor ကို | Intel Xeon 6700/6400-series (P-cores) ၂ ခုအထိ၊ CPU တစ်ခုလျှင် cores ၈၆ ခုအထိ၊ TDP 350W အထိ |
| မှတ်ဉာဏ် | DIMM slot ၃၂ ခု (processor တစ်ခုလျှင် ၁၆ ခု); TruDDR5 RDIMM များကို 6400 MHz အထိနှင့် MRDIMM များကို 8000 MHz အထိ ပံ့ပိုးပေးသည် |
| Memory ချဲ့ခြင်း။ | E3.S 2T form factor (12x DIMM အထိ) ရှိ CXL 2.0 မှတ်ဉာဏ်မော်ဂျူးများကို ပံ့ပိုးပေးသည် |
| မှတ်ဉာဏ် အများဆုံး | 8TB စနစ်မှတ်ဉာဏ်အထိ (256GB 3DS RDIMM များကို အသုံးပြု၍) |
| ဒစ်ခ်ဒရိုက်ဘေးများ | တပ်ဦး: ၂၄x ၂.၅ လက်မ NVMe/SAS/SATA၊ ၁၆x ၃.၅ လက်မ SAS/SATA သို့မဟုတ် ၃၂x E3.S NVMe အထိ အလယ် 8x 2.5″ အထိ ရိုးရှင်းစွာ လဲလှယ်နိုင်သည် နောက်ဘက်: ၂.၅ လက်မ သို့မဟုတ် ၃.၅ လက်မ အရွယ် ၈ ခုအထိ hot-swap လုပ်နိုင်သည် |
| သိုလှောင်မှု ထိန်းချုပ်ကိရိယာ | ၃၆x onboard NVMe port များအထိ (1:1 ချိတ်ဆက်မှု)၊ RAID/HBA ပံ့ပိုးမှု |
| ကွန်ယက်မျက်နှာပြင်များ | PCIe 5.0 x16 host interface ပါရှိသော OCP 3.0 SFF slot နှစ်ခု |
| PCI ချဲ့ထွင်မှု slot များ | PCIe 5.0 slot ၁၀ ခုအထိ (နောက်ဘက်)၊ ရှေ့ PCIe slot များကို ရွေးချယ်နိုင်သည် |
| GPU အထောက်အပံ့ | အကျယ်တစ်ခုတည်းရှိသော GPU ၈ ခု သို့မဟုတ် အကျယ်နှစ်ခုရှိသော GPU ၃ ခုအထိ |
| ဆိပ်ကမ်းများ | တပ်ဦး: ပြင်ပရောဂါရှာဖွေရေးပေါက်၊ ရွေးချယ်နိုင်သော USB နှင့် Mini-DP နောက်ဘက်: USB 3.0 ၂ ခု၊ VGA ၁ ခု၊ RJ-45 စီမံခန့်ခွဲမှု ၁ ခု၊ ရွေးချယ်နိုင်သော serial |
| အအေး | hot-swap ပန်ကာ ၆ ခုအထိ (N+1 ထပ်ဆောင်း)၊ ရွေးချယ်နိုင်သော Neptune အရည်အအေးပေးမော်ဂျူးများ |
| Power ကထောက်ပံ့ရေး | hot-swap redundant AC/DC power supplies နှစ်ခုအထိ (800W–3200W) |
| စနစ်များ စီမံခန့်ခွဲမှု | XClarity Controller 3 (XCC3); ရွေးချယ်နိုင်သော XCC3 Premier |
| လုံခြုံရေးအင်္ဂါရပ်များ | TPM 2.0၊ PFR ယုံကြည်မှုအမြစ် (NIST SP800-193)၊ ကိုယ်ထည်ထိုးဖောက်မှု၊ သော့ခတ်နိုင်သော bezel |
| လည်ပတ်မှုစနစ်များ | မိုက်ခရိုဆော့ဖ် ဝင်းဒိုးဆာဗာ၊ RHEL၊ SLES၊ Ubuntu ဆာဗာ |
| အာမခံချက် | ၃ နှစ် အခြေခံအာမခံ (ပြင်ဆင်နိုင်သည်) |
| ရှုထောင့် | အမြင့် ၈၇ မီလီမီတာ (၃.၄ လက်မ) x အနံ ၄၄၀ မီလီမီတာ (၁၇.၃ လက်မ) x အနက် ၈၀၀ မီလီမီတာ (၃၁.၅ လက်မ) |
| အလေးချိန် | အများဆုံးအလေးချိန်- 38.8 ကီလိုဂရမ် (85.5 ပေါင်) |
Lenovo ThinkSystem SR650 V4 ဒီဇိုင်းနှင့် တည်ဆောက်မှု
Lenovo ThinkSystem SR650 V4 သည် ၎င်း၏ ရုပ်ပိုင်းဆိုင်ရာ အဖုံးကို ထိရောက်စွာ အသုံးပြုထားပြီး အစိတ်အပိုင်း သိပ်သည်းဆနှင့် လေစီးဆင်းမှုနှင့် ဝန်ဆောင်မှုပေးနိုင်မှုကို ဟန်ချက်ညီအောင် ပြုလုပ်ပေးသည့် စံ 2U ပလက်ဖောင်းတစ်ခုဖြစ်သည်။ ကိုယ်ထည်သည် အမြင့် ၃.၄ လက်မ၊ အနံ ၁၇.၃ လက်မနှင့် အနက် ၃၁.၅ လက်မ ရှိပြီး အများဆုံး အလေးချိန် ၈၅.၅ ပေါင် ရှိသည်။ ဤအတိုင်းအတာများကြောင့် အခြား 2U enterprise server များနှင့် တစ်ပြေးညီ ကိုက်ညီစေပြီး မြင့်မားသော စွမ်းဆောင်ရည်ရှိသော CPU များ၊ သိပ်သည်းသော မှတ်ဉာဏ် ဖွဲ့စည်းမှုများနှင့် ပြောင်းလွယ်ပြင်လွယ် သိုလှောင်မှု backplanes များအတွက် လုံလောက်သော အနက်ကို ပေးစွမ်းသည်။
Lenovo ရဲ့ တည်ထောင်ထားတဲ့ ThinkSystem စက်မှုလုပ်ငန်းသုံး ဒီဇိုင်းကို ချက်ချင်းမှတ်မိနိုင်ပြီး မာကျောတဲ့ သံမဏိကိုယ်ထည်နဲ့ ရှင်းလင်းပြီး လုပ်ဆောင်နိုင်စွမ်းရှိတဲ့ အညွှန်းတွေ ပါဝင်ပါတယ်။ အတွင်းပိုင်း အပြင်အဆင်က သန့်ရှင်းပြီး ရည်ရွယ်ချက်ရှိရှိ လုပ်ဆောင်ထားပြီး ဖြောင့်တန်းတဲ့ လေစီးဆင်းမှု၊ မော်ဂျူလာ အစိတ်အပိုင်းဇုန်တွေနဲ့ ပုံမှန်ဝန်ဆောင်မှုအတွက် ကိရိယာမလိုဘဲ ဝင်ရောက်အသုံးပြုနိုင်မှုတွေကို အလေးပေးပါတယ်။ အလုံးစုံတည်ဆောက်ပုံက ခိုင်ခံ့ပြီး ကောင်းမွန်စွာ ဒီဇိုင်းထုတ်ထားတယ်လို့ ခံစားရပြီး အလှအပဆိုင်ရာ ဆွဲဆောင်မှုထက် ဒေတာစင်တာပတ်ဝန်းကျင်မှာ စဉ်ဆက်မပြတ်လည်ပတ်ဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ ပလက်ဖောင်းတစ်ခုကို ထင်ဟပ်စေပါတယ်။
တပ်ဦး Panel ကို
ရှေ့ panel ကို အလွန် configure လုပ်နိုင်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ test system မှာ 8-bay 2.5-inch drive backplane တပ်ဆင်ထားပေမယ့် chassis က အနည်းဆုံး အားထုတ်မှုနဲ့ bay ၁၆ ခု ဒါမှမဟုတ် ၂၄ ခုအထိ အလွယ်တကူ ချိန်ညှိနိုင်ပါတယ်။ ဖောက်သည်တွေဟာ ပိုမိုမြင့်မားတဲ့ raw capacity အတွက် 3.5-inch bays ဒါမှမဟုတ် မြင့်မားတဲ့ performance NVMe density အတွက် အသစ်ထွက် E3.S backplane options တွေကိုလည်း ရွေးချယ်နိုင်ပါတယ်။ AnyBay support က SAS၊ SATA နဲ့ NVMe drives တွေကို drive cage တစ်ခုတည်းမှာ အတူယှဉ်တွဲတည်ရှိနိုင်စေပြီး mixed-storage deployments တွေအတွက် သိသာထင်ရှားတဲ့ flexibility ကို ပေးစွမ်းပါတယ်။

ရှေ့ panel တွင် မရှိမဖြစ်လိုအပ်သော operator control များ ပါဝင်သည်- power ခလုတ်၊ ID ခလုတ်နှင့် system health နှင့် network activity ကိုညွှန်ပြသည့် status LED များ ပါဝင်သည်။ pull-out information tab သည် XCC network access label နှင့် serial number ကို အမြန်ဝင်ရောက်ခွင့်ပေးသည်။ optional local connectivity တွင် crash-cart access အတွက် Mini DisplayPort နှင့် USB port များ ပါဝင်ပြီး “lights-out” data center များတွင် troubleshooting အတွက် အလွန်တန်ဖိုးရှိပါသည်။
နောက်ဘောင်
ကိုယ်ထည်၏နောက်ဘက်ကို အမြင့်ဆုံး I/O သိပ်သည်းဆအတွက် ဒီဇိုင်းထုတ်ထားသည်။ riser configuration ပေါ်မူတည်၍ PCIe Gen 5 slot ၁၀ ခုအထိ ထည့်သွင်းနိုင်သည်။ OCP 3.0 slot နှစ်ခုပါဝင်ခြင်းကြောင့် GPU သို့မဟုတ် storage controller များကဲ့သို့သော အခြား add-in ကတ်များအတွက် စံ PCIe riser များကို လွတ်လပ်စေသည်။
ချဲ့ထွင်ခြင်းအပြင်၊ နောက်ဘက် panel တွင် onboard BMC management network port၊ USB-A port နှစ်ခုနှင့် local console access အတွက် VGA output တစ်ခုပါရှိသည်။ dual hot-swap power supplies များကို နောက်ဘက်တွင် တပ်ဆင်ထားသောကြောင့် လေစီးဆင်းမှု သို့မဟုတ် ချဲ့ထွင်မှု အပြင်အဆင်များကို မထိခိုက်စေဘဲ ဝန်ဆောင်မှုပေးနိုင်မှုကို ထိန်းသိမ်းထားသည်။
internal
အတွင်းပိုင်းတွင် အပြင်အဆင်သည် သန့်ရှင်းပြီး လေစီးဆင်းမှုအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသည်။ CPU socket နှစ်ခုဘေးတွင် DIMM slot ၃၂ ခု ပါရှိပြီး ကိုယ်ထည်၏ ရှေ့ဘက်ရှိ မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော hot-swap ပန်ကာခြောက်လုံးမှ အတားအဆီးမရှိ အအေးပေးစနစ်ကို ထိန်းသိမ်းရန် စီစဉ်ထားသည်။ ပန်ကာများသည် ကိရိယာမပါဘဲ အလွယ်တကူ အစားထိုးနိုင်ပြီး ပန်ကာဗန်းတစ်ခုလုံးကို ကိရိယာမပါဘဲ ဖြုတ်တပ်နိုင်သည်။ ဗန်းကိုဖယ်ရှားခြင်းဖြင့် AnyBay သိုလှောင်မှုဧရိယာသို့ အတားအဆီးမရှိ တိုက်ရိုက်ဝင်ရောက်နိုင်စေပြီး ဝန်ဆောင်မှု၊ အဆင့်မြှင့်တင်မှုများနှင့် backplane ပြောင်းလဲမှုများကို ရိုးရှင်းစေသည်။

CPU နှင့် မှတ်ဉာဏ်သို့ လေစီးဆင်းမှုပိတ်ဆို့ခြင်းမှ ရှောင်ရှားရန် သိုလှောင်ကြိုးများကို ကိုယ်ထည်၏ဘေးတစ်လျှောက်တွင် သပ်ရပ်စွာ သွယ်တန်းထားသည်။ Neptune အရည်အအေးပေးမော်ဂျူးများကို အသုံးပြုသည့် ပုံစံများအတွက်၊ အတွင်းပိုင်းအပြင်အဆင်သည် အအေးပေးကွင်းများကို လိုက်လျောညီထွေဖြစ်စေရန် အနည်းငယ်ပြောင်းလဲသွားသော်လည်း၊ core ဝန်ဆောင်မှုပေးနိုင်မှုမှာ မြင့်မားနေဆဲဖြစ်သည်။ M.2 boot drive မော်ဂျူးကို လေ baffle သို့မဟုတ် drive cage တွင် တပ်ဆင်ထားသောကြောင့် အခြားအစိတ်အပိုင်းများကို မဖယ်ရှားဘဲ အလွယ်တကူ ဝင်ရောက်အသုံးပြုနိုင်သည်။
XClarity ထိန်းချုပ်ကိရိယာ ၃
SR650 V4 တွင် XClarity Controller 3 (XCC3) အသစ် ပါရှိသည်။ ဤစီမံခန့်ခွဲမှုအင်ဂျင်သည် ယခင်မျိုးဆက်များထက် သိသာထင်ရှားသော စွမ်းဆောင်ရည်အဆင့်မြှင့်တင်မှုကို ပေးစွမ်းပြီး boot time ပိုမိုမြန်ဆန်ခြင်းနှင့် ပိုမိုတုံ့ပြန်မှုကောင်းသော HTML5 interface တို့ဖြင့် ပေးစွမ်းသည်။ Platform Resource Manager သည် ပါဝါနှင့် အပူချိန်အခြေအနေဆိုင်ရာ အသေးစိတ် telemetry ကို ပေးစွမ်းပြီး administrator များအား datacenter စွမ်းဆောင်ရည်ကို အကောင်းဆုံးဖြစ်အောင် ကူညီပေးသည်။
XCC3 သည် remote control (KVM)၊ virtual media mounting နှင့် firmware updates များ အပါအဝင် remote management functions အမျိုးမျိုးကို ပံ့ပိုးပေးပါသည်။ interface သည် လွယ်ကူပြီး system health၊ active events နှင့် hardware inventory တို့၏ dashboard view ကို ပေးစွမ်းပါသည်။ automation အတွက် XCC3 သည် Redfish REST APIs များကို အပြည့်အဝ ပံ့ပိုးပေးပါသည်။
Lenovo ThinkSystem SR650 V4 စွမ်းဆောင်ရည်
ဤအပိုင်းသည် Blender၊ y-cruncher၊ vLLM နှင့် Phoronix မှ benchmark ရလဒ်များကို စစ်ဆေးသည်။ Intel Xeon 6740P processors များတပ်ဆင်ထားသော Lenovo ThinkSystem SR650 V4 တွင် ကနဦးစမ်းသပ်မှုကို ပြုလုပ်ခဲ့ပြီး platform ၏ စွမ်းဆောင်ရည်ကို အာရုံစိုက်သော P-core architecture နှင့် CPU-bound workloads များအောက်တွင် overall throughput ကို အကဲဖြတ်နိုင်စေခဲ့သည်။ ပြန်လည်သုံးသပ်မှု၏ အလယ်တွင် GPU-accelerated testing ကို ဖွင့်ရန် system configuration ကို ကျွန်ုပ်တို့ ချိန်ညှိခဲ့သည်။ အသွင်ကူးပြောင်းမှုသည် ရိုးရှင်းပြီး Lenovo ၏ GPU enablement upgrade kit ဖြင့် အထောက်အကူဖြစ်စေခဲ့ပြီး ၎င်းတွင် high-performance ပန်ကာများ၊ upgrade လုပ်ထားသော heatsinks၊ ပြန်လည်ပြင်ဆင်ထားသော airflow shroud နှင့် high-power accelerators များကို ပံ့ပိုးပေးရန် ဒီဇိုင်းထုတ်ထားသော GPU-capable risers များ ပါဝင်သည်။ တပ်ဆင်ခြင်းသည် သိသာထင်ရှားသော chassis ပြောင်းလဲမှုများ မလိုအပ်ဘဲ ရှိပြီးသား system layout နှင့် သန့်ရှင်းစွာ ပေါင်းစပ်ထားသည်။
အဆင့်မြှင့်တင်ထားသော အအေးပေးစနစ်နှင့် လေစီးဆင်းမှု အစိတ်အပိုင်းများကို တပ်ဆင်ထားပြီးနောက်၊ ကျွန်ုပ်တို့သည် NVIDIA L40S GPU တစ်ခုတည်းကို ပလက်ဖောင်းတွင် ထည့်သွင်းခဲ့သည်။ ၎င်းက တည်ငြိမ်သော အပူချိန်နှင့် တသမတ်တည်း စနစ်အပြုအမူကို ထိန်းသိမ်းထားစဉ်တွင် Blender GPU rendering နှင့် inference-focused benchmarks ကဲ့သို့သော GPU-accelerated workloads များကို ထည့်သွင်းရန် စမ်းသပ်မှုကို တိုးချဲ့နိုင်စေခဲ့သည်။ အဆင့်မြှင့်တင်မှု၏ modular သဘောသဘာဝသည် SR650 V4 ၏ ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို မီးမောင်းထိုးပြပြီး ထိရောက်မှုကို အခြေခံသော CPU configuration မှ ရောနှောတွက်ချက်မှု workloads များအတွက် သင့်လျော်သော balanced CPU+GPU ပလက်ဖောင်းသို့ အလွယ်တကူ ပြောင်းလဲနိုင်စေပါသည်။
Lenovo ThinkSystem SR650 V4 ဖွဲ့စည်းပုံ-
- CPU ကို: Intel Xeon 6740P ၂ ခု
- မှတ်ဉာဏ်: 1TB RAM
- သိုလှောင်မှု: ၄ x ၉၆၀GB SSD များ
- GPU ကို: NVIDIA L40S
Blender ၂.၆၅
Blender သည် open-source 3D modeling application တစ်ခုဖြစ်သည်။ ဤ benchmark ကို Blender Benchmark utility ကို အသုံးပြု၍ လုပ်ဆောင်ခဲ့သည်။ ရမှတ်ကို တစ်မိနစ်လျှင် နမူနာများဖြင့် တိုင်းတာပြီး မြင့်မားသောတန်ဖိုးများသည် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြသည်။
Blender CPU benchmark မှာ Lenovo ThinkSystem SR650 V4 ဟာ မြင်ကွင်းအားလုံးမှာ ခိုင်မာတဲ့ rendering စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပြီး Monster မှာ တစ်မိနစ်ကို sample ၁၁၃၆.၉၉ ခု၊ Junkshop မှာ တစ်မိနစ်ကို sample ၇၀၇.၆၀ ခု နဲ့ Classroom မှာ တစ်မိနစ်ကို sample ၅၆၂.၅၃ ခု ရရှိထားပါတယ်။ ရလဒ်တွေက dual Intel Xeon 6740P processors တွေကနေ ရရှိတဲ့ multithreaded scaling အားကောင်းမှုကို ထင်ဟပ်စေပြီး မြင်ကွင်းရှုပ်ထွေးမှု တိုးလာတာနဲ့အမျှ စွမ်းဆောင်ရည် တသမတ်တည်း ရှိနေပါတယ်။
| Blender CPU (တစ်မိနစ်လျှင် နမူနာများ၊ မြင့်လေ ပိုကောင်းလေ) | Lenovo ThinkSystem SR650 V4 (Intel Xeon 6740P ၂ လုံး၊ 1TB RAM) |
|---|---|
| ဧရာမသတ္တဝါကြီး | 1136.99 |
| အမှိုက်ဆိုင် | 707.60 |
| စာသင်ခန်း | 562.53 |
Blender CPU no SMT benchmark မှာ SR650 V4 ဟာ rendering throughput မှာ သိသိသာသာ မြင့်တက်လာတာကို ပြသနေပြီး Monster မှာ တစ်မိနစ်ကို sample ၄၆၈၆.၄၀၊ Junkshop မှာ ၂၂၂၃.၉၆ နဲ့ Classroom မှာ ၂၃၈၅.၉၈ အထိ ရောက်ရှိခဲ့ပါတယ်။ GPU ရလဒ်တွေက CPU-only rendering နဲ့ နှိုင်းယှဉ်ရင် throughput သိသိသာသာ မြင့်မားတဲ့ throughput ကို ပေးစွမ်းနိုင်တဲ့ စနစ်ရဲ့ ရှုပ်ထွေးတဲ့ rendering workloads တွေကို အရှိန်မြှင့်နိုင်စွမ်းကို မီးမောင်းထိုးပြနေပါတယ်။
| Blender CPU (SMT မပါဝင်ပါ) (တစ်မိနစ်လျှင် နမူနာများ၊ ပိုများလေ ပိုကောင်းလေ) | Lenovo ThinkSystem SR650 V4 (Intel Xeon 6740P ၂ လုံး၊ 1TB RAM) |
|---|---|
| ဧရာမသတ္တဝါကြီး | 4686.40 |
| အမှိုက်ဆိုင် | 2223.96 |
| စာသင်ခန်း | 2385.98 |
y-cruncher
y-cruncher သည် Pi နှင့် အခြားသင်္ချာကိန်းသေများကို ထရီလီယံဂဏန်းများအထိ တွက်ချက်ပေးသည့် multithreaded၊ scalable program တစ်ခုဖြစ်သည်။ ၂၀၀၉ ခုနှစ်တွင် စတင်မိတ်ဆက်ချိန်မှစ၍ ၎င်းသည် overclocker များနှင့် hardware ဝါသနာရှင်များအတွက် ရေပန်းစားသော benchmarking နှင့် stress-testing application တစ်ခု ဖြစ်လာခဲ့သည်။
y-cruncher မှာ Lenovo ဟာ ပြဿနာအရွယ်အစား တိုးလာတာနဲ့အမျှ ရှင်းလင်းစွာ ချိန်ညှိနိုင်ပြီး platform ရဲ့ ခိုင်မာတဲ့ multithreaded compute စွမ်းဆောင်ရည်နဲ့ memory bandwidth ကို မီးမောင်းထိုးပြပါတယ်။ dual Intel Xeon 6740P processors နဲ့ 1TB RAM တို့နဲ့ system ဟာ 1B-digit Pi တွက်ချက်မှုကို စက္ကန့် ၂၀ ကျော်အတွင်း ပြီးမြောက်စေပြီး စက္ကန့် ၃၆၂ စက္ကန့်အတွင်း 25B digits အထိ တသမတ်တည်း စွမ်းဆောင်ရည်ကို ထိန်းသိမ်းထားပါတယ်။ ရလဒ်တွေအရ CPU နဲ့ memory pressure တည်ငြိမ်မှုအောက်မှာ ခန့်မှန်းနိုင်တဲ့ ချိန်ညှိမှုကို ပြသနေပြီး SR650 V4 ဟာ လေးလံတဲ့ သင်္ချာ workloads တွေနဲ့ stress-testing scenarios တွေအတွက် သင့်တော်ပါတယ်။
| Y-Cruncher (စုစုပေါင်း တွက်ချက်ချိန်) | Lenovo ThinkSystem SR650 V4 (Intel Xeon 6740P ၂ လုံး၊ 1TB RAM) |
|---|---|
| 1 ဘီလီယံ | 20.715 ့ |
| 2.5 ဘီလီယံ | 44.412 ့ |
| 5 ဘီလီယံ | 81.937 ့ |
| 10 ဘီလီယံ | 152.743 |
| 25 ဘီလီယံ | 362.566 |
vLLM အွန်လိုင်းဝန်ဆောင်မှု LLM ကောက်ချက်ချမှုစွမ်းဆောင်ရည်
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine ဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များအောက်တွင် ဤ inference engine ၏ လက်တွေ့ကမ္ဘာ serving စွမ်းရည်များကို တိုင်းတာသည့် စွမ်းဆောင်ရည် အကဲဖြတ်ကိရိယာတစ်ခုဖြစ်သည်။ ၎င်းသည် request rate၊ input/output အရှည်များနှင့် concurrent client အရေအတွက် အပါအဝင် configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workloads များကို simulate လုပ်သည်။ benchmark သည် throughput (တစ်စက္ကန့်လျှင် token များ)၊ ပထမဆုံး token မှအချိန်နှင့် output token တစ်ခုလျှင်အချိန် (TPOT) အပါအဝင် အဓိက metrics များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM သည် မတူညီသော load condition များအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
ကျွန်ုပ်တို့သည် မတူညီသော ဗိသုကာပုံစံများ၊ parameter scales များနှင့် quantization strategies များကို လွှမ်းခြုံထားသော မော်ဒယ်အစုံတစ်လျှောက် inference performance ကို စမ်းသပ်ခဲ့ပြီး မတူညီသော concurrency profiles များအောက်တွင် throughput ကို အကဲဖြတ်ခဲ့သည်။
သိပ်သည်းသော မော်ဒယ် စွမ်းဆောင်ရည်
Dense မော်ဒယ်များသည် ရိုးရာ LLM ဗိသုကာကို လိုက်နာပြီး၊ ၎င်းတွင် ကန့်သတ်ချက်များနှင့် activation အားလုံးကို inference လုပ်စဉ်အတွင်း အသုံးပြုသောကြောင့် ၎င်းတို့၏ sparse counterparts များထက် computationally intensive processing ကို ပိုမိုဖြစ်ပေါ်စေသည်။ မော်ဒယ်စကေးများနှင့် quantization ဗျူဟာများတစ်လျှောက် စွမ်းဆောင်ရည်လက္ခဏာများကို ပြည့်စုံစွာအကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Llama 3.1 8B မိသားစုမှ multiple dense မော်ဒယ် configuration များကို benchmark လုပ်ခဲ့သည်။
လာမာ ၃.၁ ၈ဘီ တိကျမှု FP၈
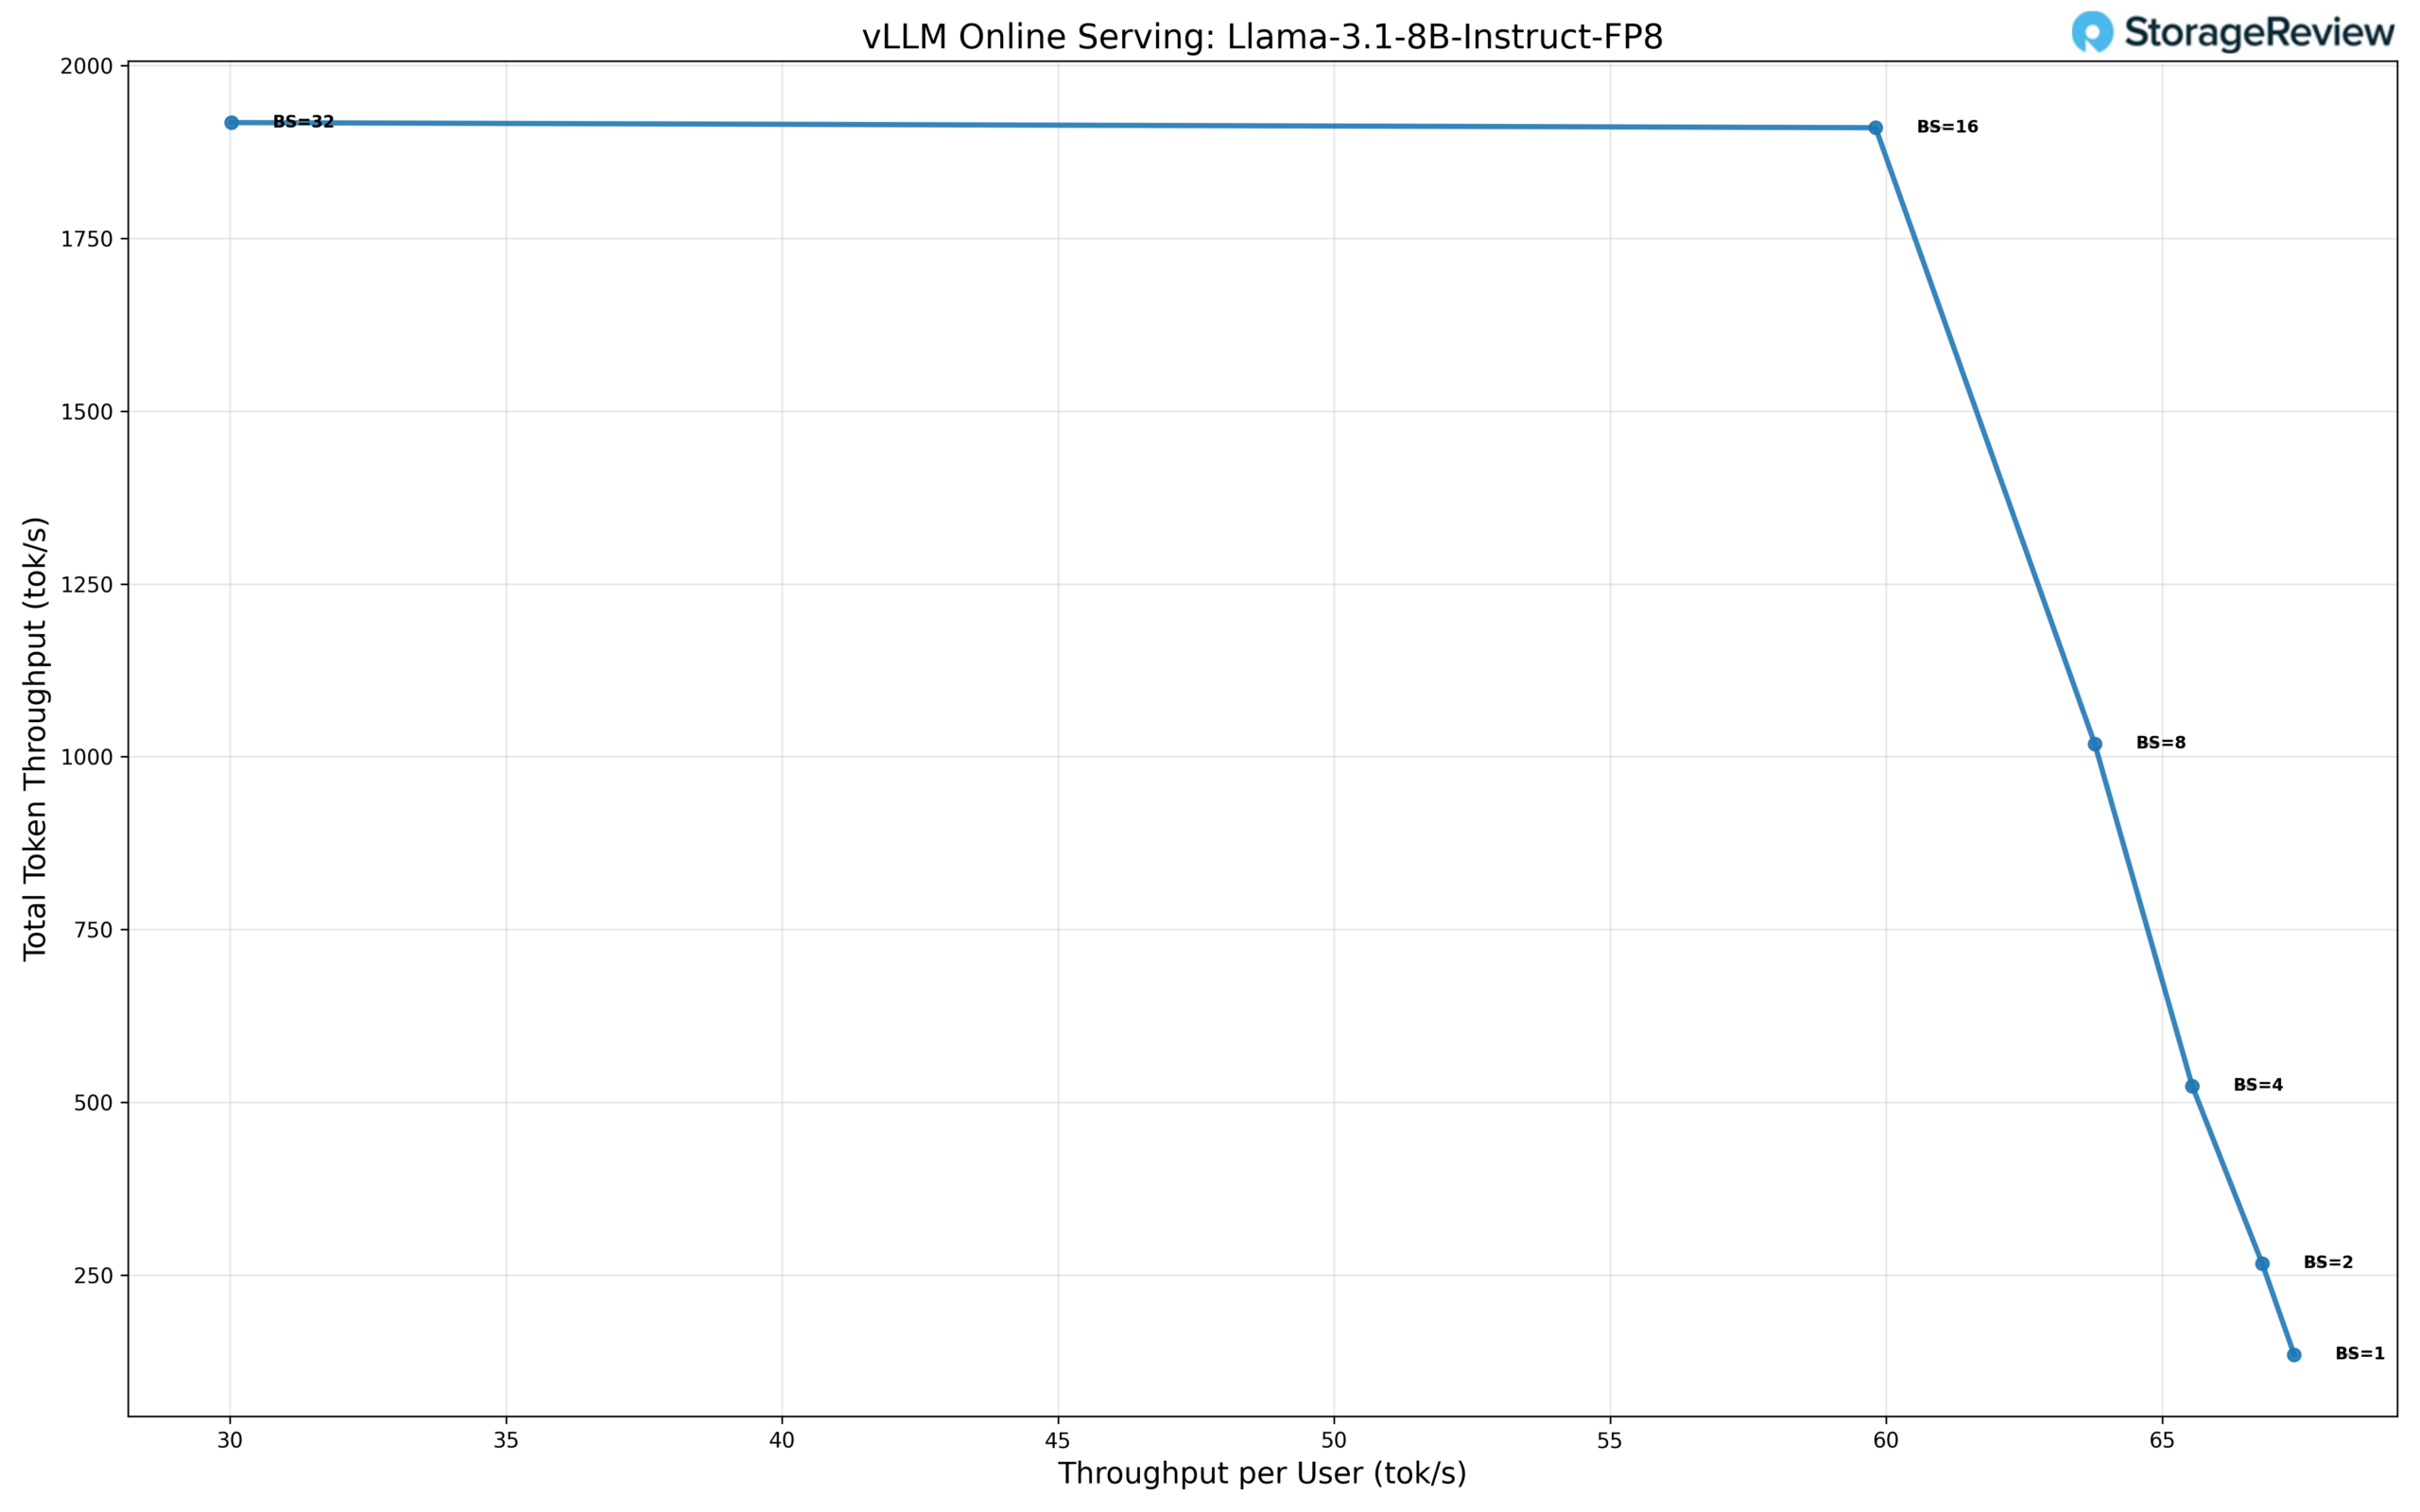
FP8 တိကျမှုတွင် လုပ်ဆောင်နေသော Llama 3.1 8B မော်ဒယ်သည် standard-precision configuration နှင့် ကွဲပြားသော scaling profile ကိုပြသပြီး အလယ်အလတ် concurrency အဆင့်များတွင် ထိရောက်မှုကို ဦးစားပေးပြီး batch အရွယ်အစား မြင့်မားသော off peak throughput ကို ရောင်းဝယ်ဖောက်ကားသည်။ single-user concurrency (BS=1) တွင် မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးလျှင် 67.8 tok/s ပေးစွမ်းပြီး စုစုပေါင်း throughput 135.6 tok/s နှင့် TPOT 3.1 ms ခန့်ရှိကာ full precision နှင့် နှိုင်းယှဉ်ပါက single-stream baseline နိမ့်ကျစေသည်။
အသုတ်အရွယ်အစားတိုးလာသည်နှင့်အမျှ စုစုပေါင်း throughput သည် လျင်မြန်စွာတိုးလာပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput သည် ထိန်းချုပ်ထားသောနည်းလမ်းဖြင့် ကျဆင်းသွားသည်။ BS=2 တွင် throughput သည် စုစုပေါင်း 271 tok/s အထိတိုးလာပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ tok/s 66.8 ဖြစ်သည်။ BS=4 တွင် စုစုပေါင်း throughput သည် 523 tok/s အထိရောက်ရှိပြီး BS=8 တွင် မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးချင်းစီ၏ tok/s 63.6 tok/s ဖြင့် 1,017 tok/s ကို ပေးဆောင်သည်။ ဤနိမ့်ကျသော concurrency အဆင့်များတစ်လျှောက်တွင် latency သည် တည်ငြိမ်နေဆဲဖြစ်ပြီး FP8 သည် ပေါ့ပါးသော multi-user inference scenarios များအတွက် သင့်လျော်စေသည်။
မော်ဒယ်သည် စုစုပေါင်း throughput 1,918 tok/s ကို ထိန်းသိမ်းထားပြီး၊ အသုံးပြုသူတစ်ဦးလျှင် 60.0 tok/s ရှိသည်။ BS=32 တွင်၊ စုစုပေါင်း throughput သည် ခန့်မှန်းခြေအားဖြင့် 1,920 tok/s တွင် ရပ်တန့်သွားပြီး၊ အသုံးပြုသူတစ်ဦးလျှင် throughput သည် 30.0 tok/s သို့ ကျဆင်းသွားသည်။ ဤ throughput သည် FP8 configuration သည် စံသတ်မှတ်ထားသော တိကျမှုထက် စော၍ ၎င်း၏ saturation point သို့ ရောက်ရှိပြီး အမြင့်ဆုံး aggregate throughput ထက် ထိရောက်မှုနှင့် ခန့်မှန်းနိုင်မှုကို ဦးစားပေးကြောင်း ညွှန်ပြသည်။
အလုံးစုံသော် FP8 သည် BS=1 မှ BS=16-32 တွင် အမြင့်ဆုံးအထိ စုစုပေါင်း throughput 14x ခန့် တိုးလာပါသည်။ Latency သည် BS=16 အထိ တသမတ်တည်းရှိနေပြီးနောက် မြင့်မားသော concurrency တွင် throughput နှင့်အတူ flatten ဖြစ်လာပြီး FP8 ကို အလွန်အမင်း batch scaling ထက် balanced၊ latency-sensitive inference workloads အတွက် လက်တွေ့ကျသော ရွေးချယ်မှုတစ်ခုအဖြစ် မီးမောင်းထိုးပြပါသည်။
လာမာ ၃.၁ ၈ဘီ စံ တိကျမှု
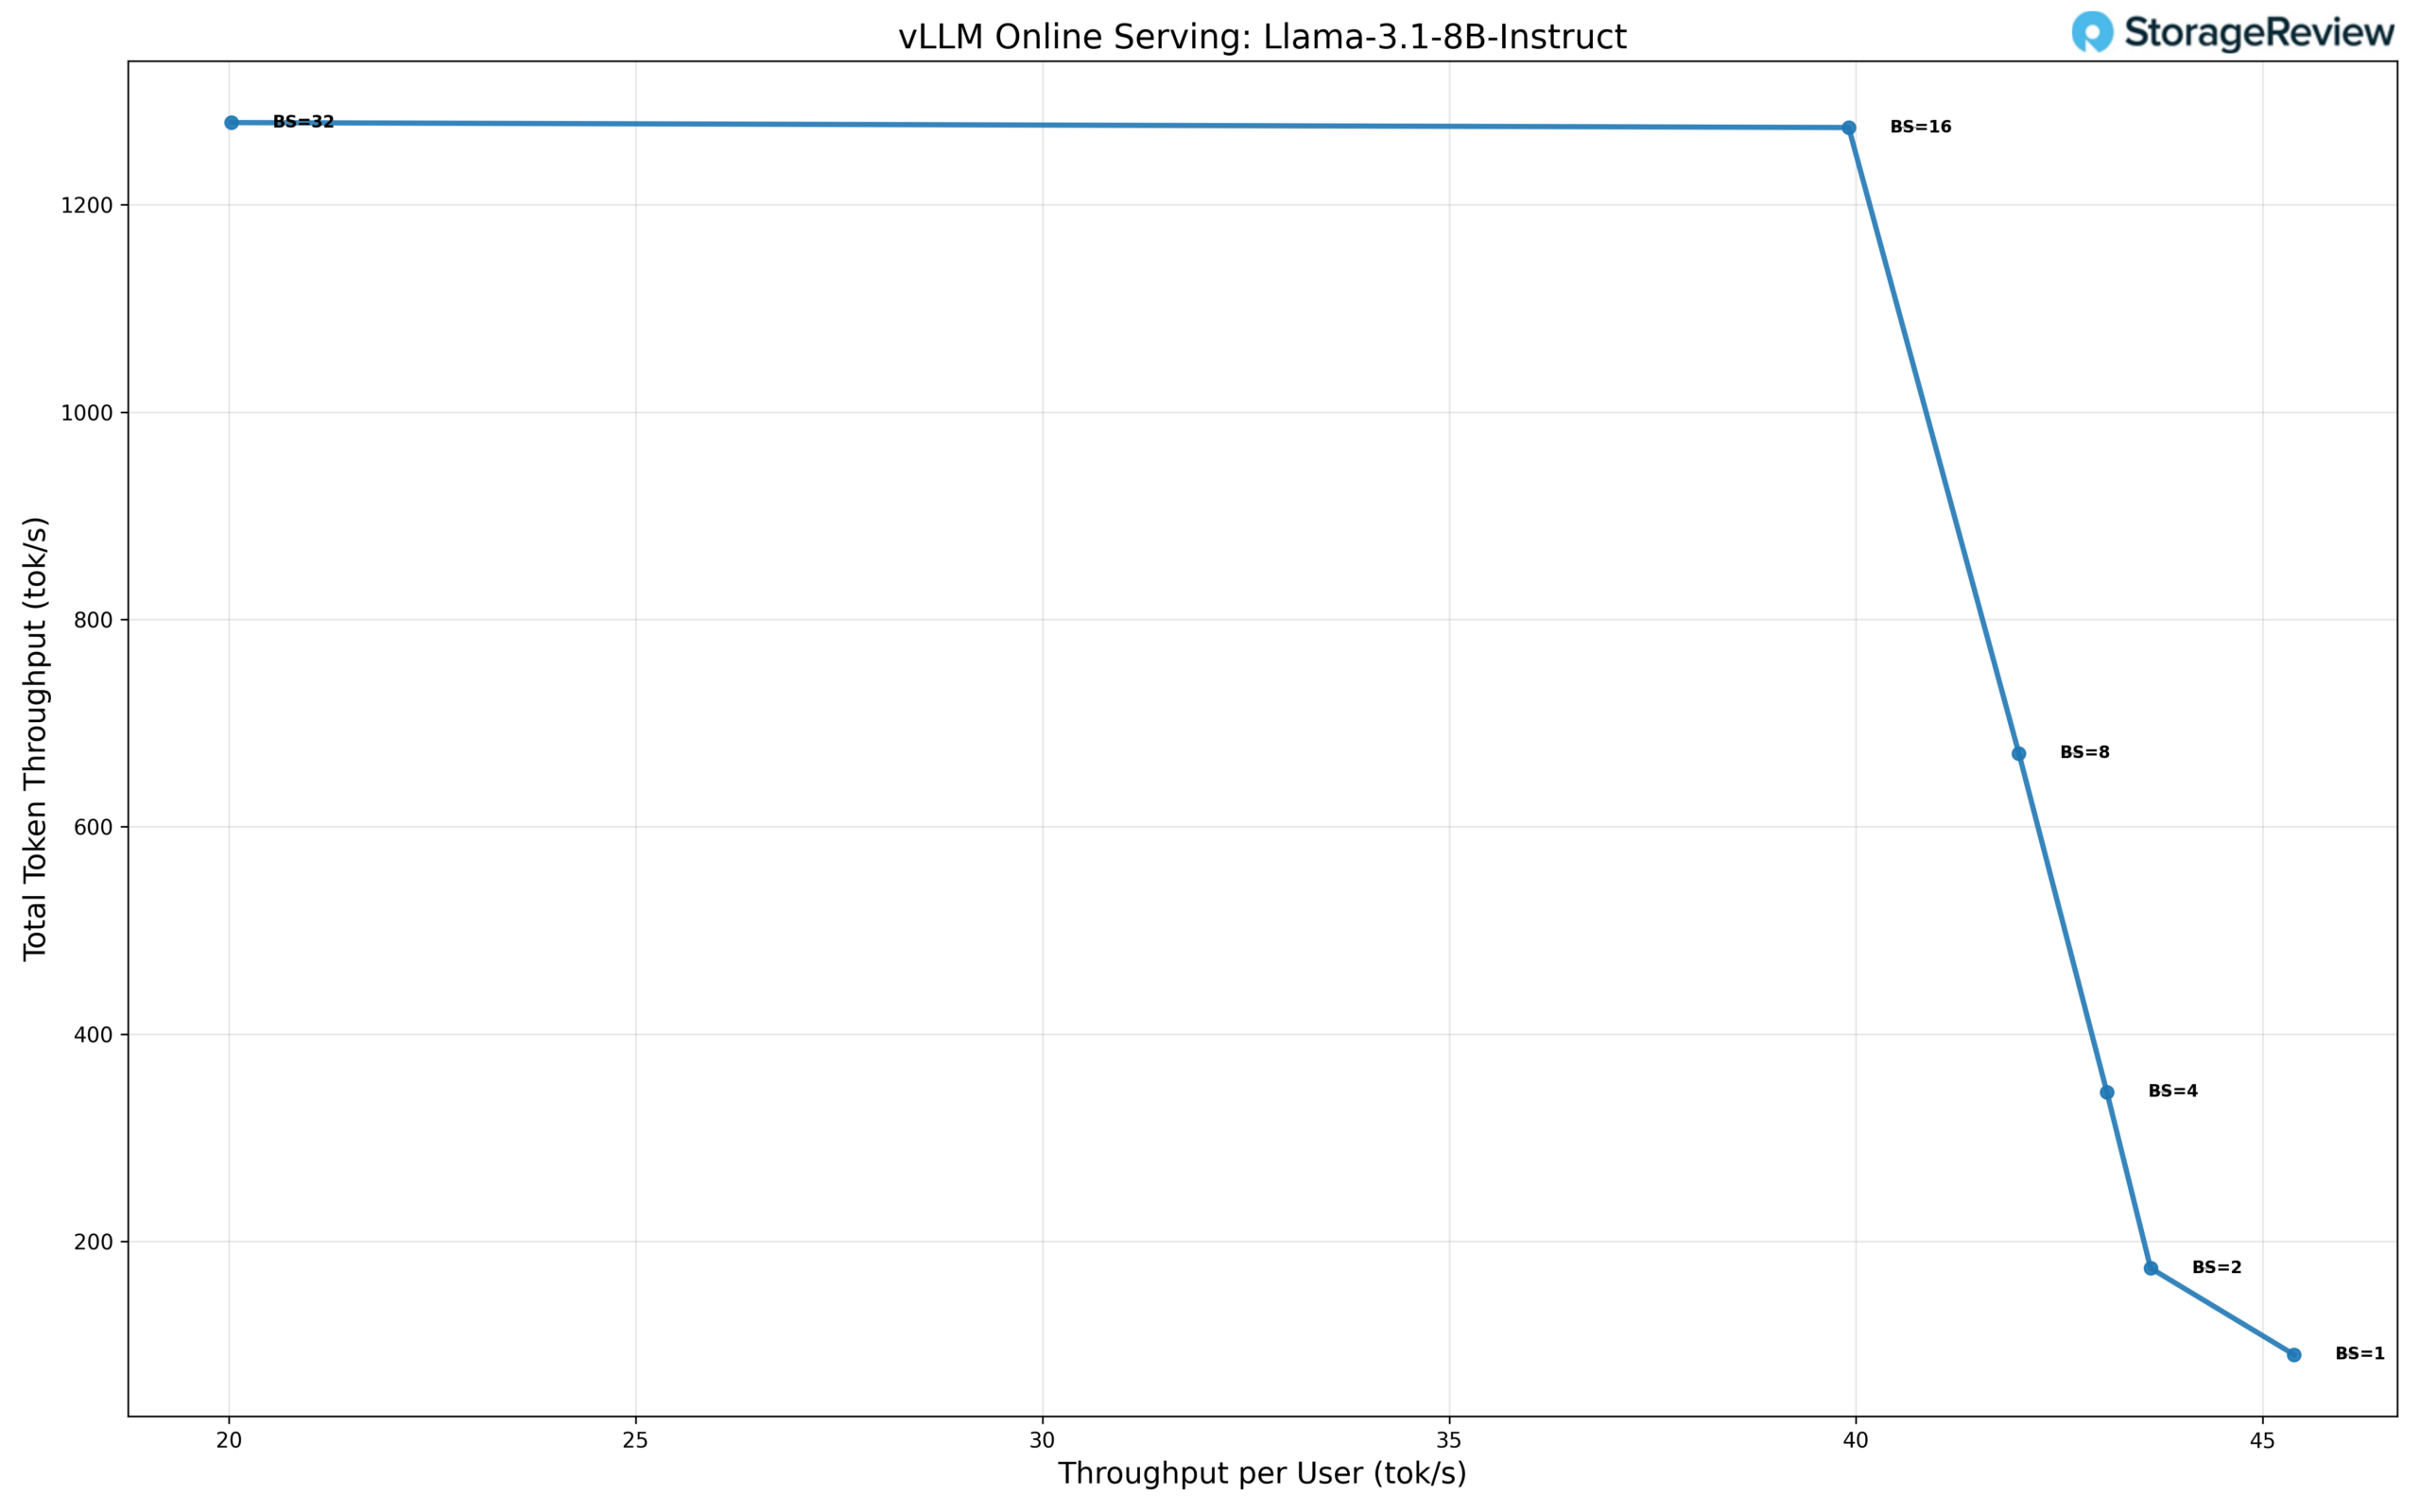
စံသတ်မှတ်ထားသော တိကျမှုတွင်၊ Llama 3.1 8B မော်ဒယ်သည် နိမ့်သော concurrency အဆင့်များတွင် ခန့်မှန်းနိုင်သော scaling အပြုအမူကို ပြသထားပြီး၊ batch အရွယ်အစားသေးငယ်သော အသုံးပြုသူတစ်ဦးချင်းစီ၏ စွမ်းဆောင်ရည်မြင့်မားပြီး concurrency မြင့်တက်လာသည်နှင့်အမျှ စုစုပေါင်း throughput တဖြည်းဖြည်း တိုးလာပါသည်။ single-user လုပ်ဆောင်ချက် (BS=1) တွင်၊ မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးချင်းစီအတွက် ခန့်မှန်းခြေအားဖြင့် 45.8 tok/s ပေးစွမ်းပြီး စုစုပေါင်း throughput 91.6 tok/s ရရှိစေပြီး latency-sensitive workloads အတွက် ခိုင်မာသော အခြေခံတစ်ခုကို တည်ဆောက်ပေးပါသည်။
တစ်ပြိုင်နက်တည်းအသုံးပြုမှုတိုးလာသည်နှင့်အမျှ စုစုပေါင်း throughput သည် ထိရောက်စွာ ချိန်ညှိနိုင်သော်လည်း အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput သည် တဖြည်းဖြည်း ကျဆင်းသွားသည်။ BS=2 တွင် စုစုပေါင်း throughput သည် 176 tok/s အထိ မြင့်တက်လာပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ tok/s 44.0 tok/s နှင့် BS=4 တွင် throughput သည် 344 tok/s အထိ ရောက်ရှိပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ tok/s 43.0 tok/s အထိ ရောက်ရှိသည်။ ဤအပြုအမူသည် BS=8 အထိ ဆက်လက်ဖြစ်ပေါ်နေပြီး မော်ဒယ်သည် စုစုပေါင်း throughput 672 tok/s ကို ထိန်းသိမ်းထားကာ အသုံးပြုသူတစ်ဦးချင်းစီ၏ သိသာထင်ရှားသော ယိုယွင်းပျက်စီးမှုမရှိဘဲ ကောင်းမွန်သောအသုံးပြုမှုကို ညွှန်ပြနေသည်။
BS=16 မှတစ်ဆင့် ချိန်ညှိမှုဆက်လက်ပြုလုပ်နေပြီး စုစုပေါင်း throughput သည် ခန့်မှန်းခြေအားဖြင့် 1,280 tok/s တွင် အမြင့်ဆုံးရောက်ရှိကာ အသုံးပြုသူတစ်ဦးလျှင် 40.0 tok/s ရှိသည်။ BS=32 တွင် စုစုပေါင်း throughput သည် 1,280 tok/s တွင် ထိရောက်စွာ တသမတ်တည်းရှိနေသော်လည်း အသုံးပြုသူတစ်ဦးလျှင် throughput သည် 20.0 tok/s အထိ ကျဆင်းသွားကာ execution pipeline ၏ saturation ကို အချက်ပြသည်။ ဤ throughput နိမ့်ကျမှုသည် စံတိကျမှုတွင် မော်ဒယ်သည် BS=16 ဝန်းကျင်တွင် ၎င်း၏ အကောင်းဆုံးလည်ပတ်မှုအမှတ်သို့ ရောက်ရှိပြီး throughput နှင့် responsiveness ကို ဟန်ချက်ညီစေကြောင်း အကြံပြုထားသည်။
အလုံးစုံသော် စံသတ်မှတ်ထားသော တိကျမှုသည် BS=1 မှ ၎င်း၏ အမြင့်ဆုံးအဆင့်အထိ စုစုပေါင်း throughput တွင် ၁၄ ဆခန့် တိုးလာပြီး အလယ်အလတ် concurrency အဆင့်များမှတစ်ဆင့် user တစ်ဦးချင်းစီ၏ စွမ်းဆောင်ရည် တည်ငြိမ်ပါသည်။ ဤပရိုဖိုင်သည် စံသတ်မှတ်ထားသော တိကျမှုကို ရန်လိုသော batch expansion ထက် တသမတ်တည်း latency နှင့် ခန့်မှန်းနိုင်သော scaling ကို ဦးစားပေးသည့် ဖြန့်ကျက်မှုများအတွက် သင့်လျော်စေသည်။
မော်ဒယ်စွမ်းဆောင်ရည် နည်းပါးခြင်း
Sparse model များ၊ အထူးသဖြင့် Mixture of Experts (MoE) architectures များသည် language model များကို ထိရောက်စွာ ချိန်ညှိရန်အတွက် ပေါ်ထွက်လာသော ချဉ်းကပ်မှုတစ်ခုဖြစ်သည်။ ဤ architectures များသည် token တစ်ခုလျှင် parameter အစုအဝေးတစ်ခုကိုသာ အသက်သွင်းနေစဉ်တွင် မြင့်မားသော total parameter count များကို ထိန်းသိမ်းထားပြီး၊ active parameter တစ်ခုလျှင် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်သည်။
Qwen3-Coder-30B-A3B FP8 စွမ်းဆောင်ရည်
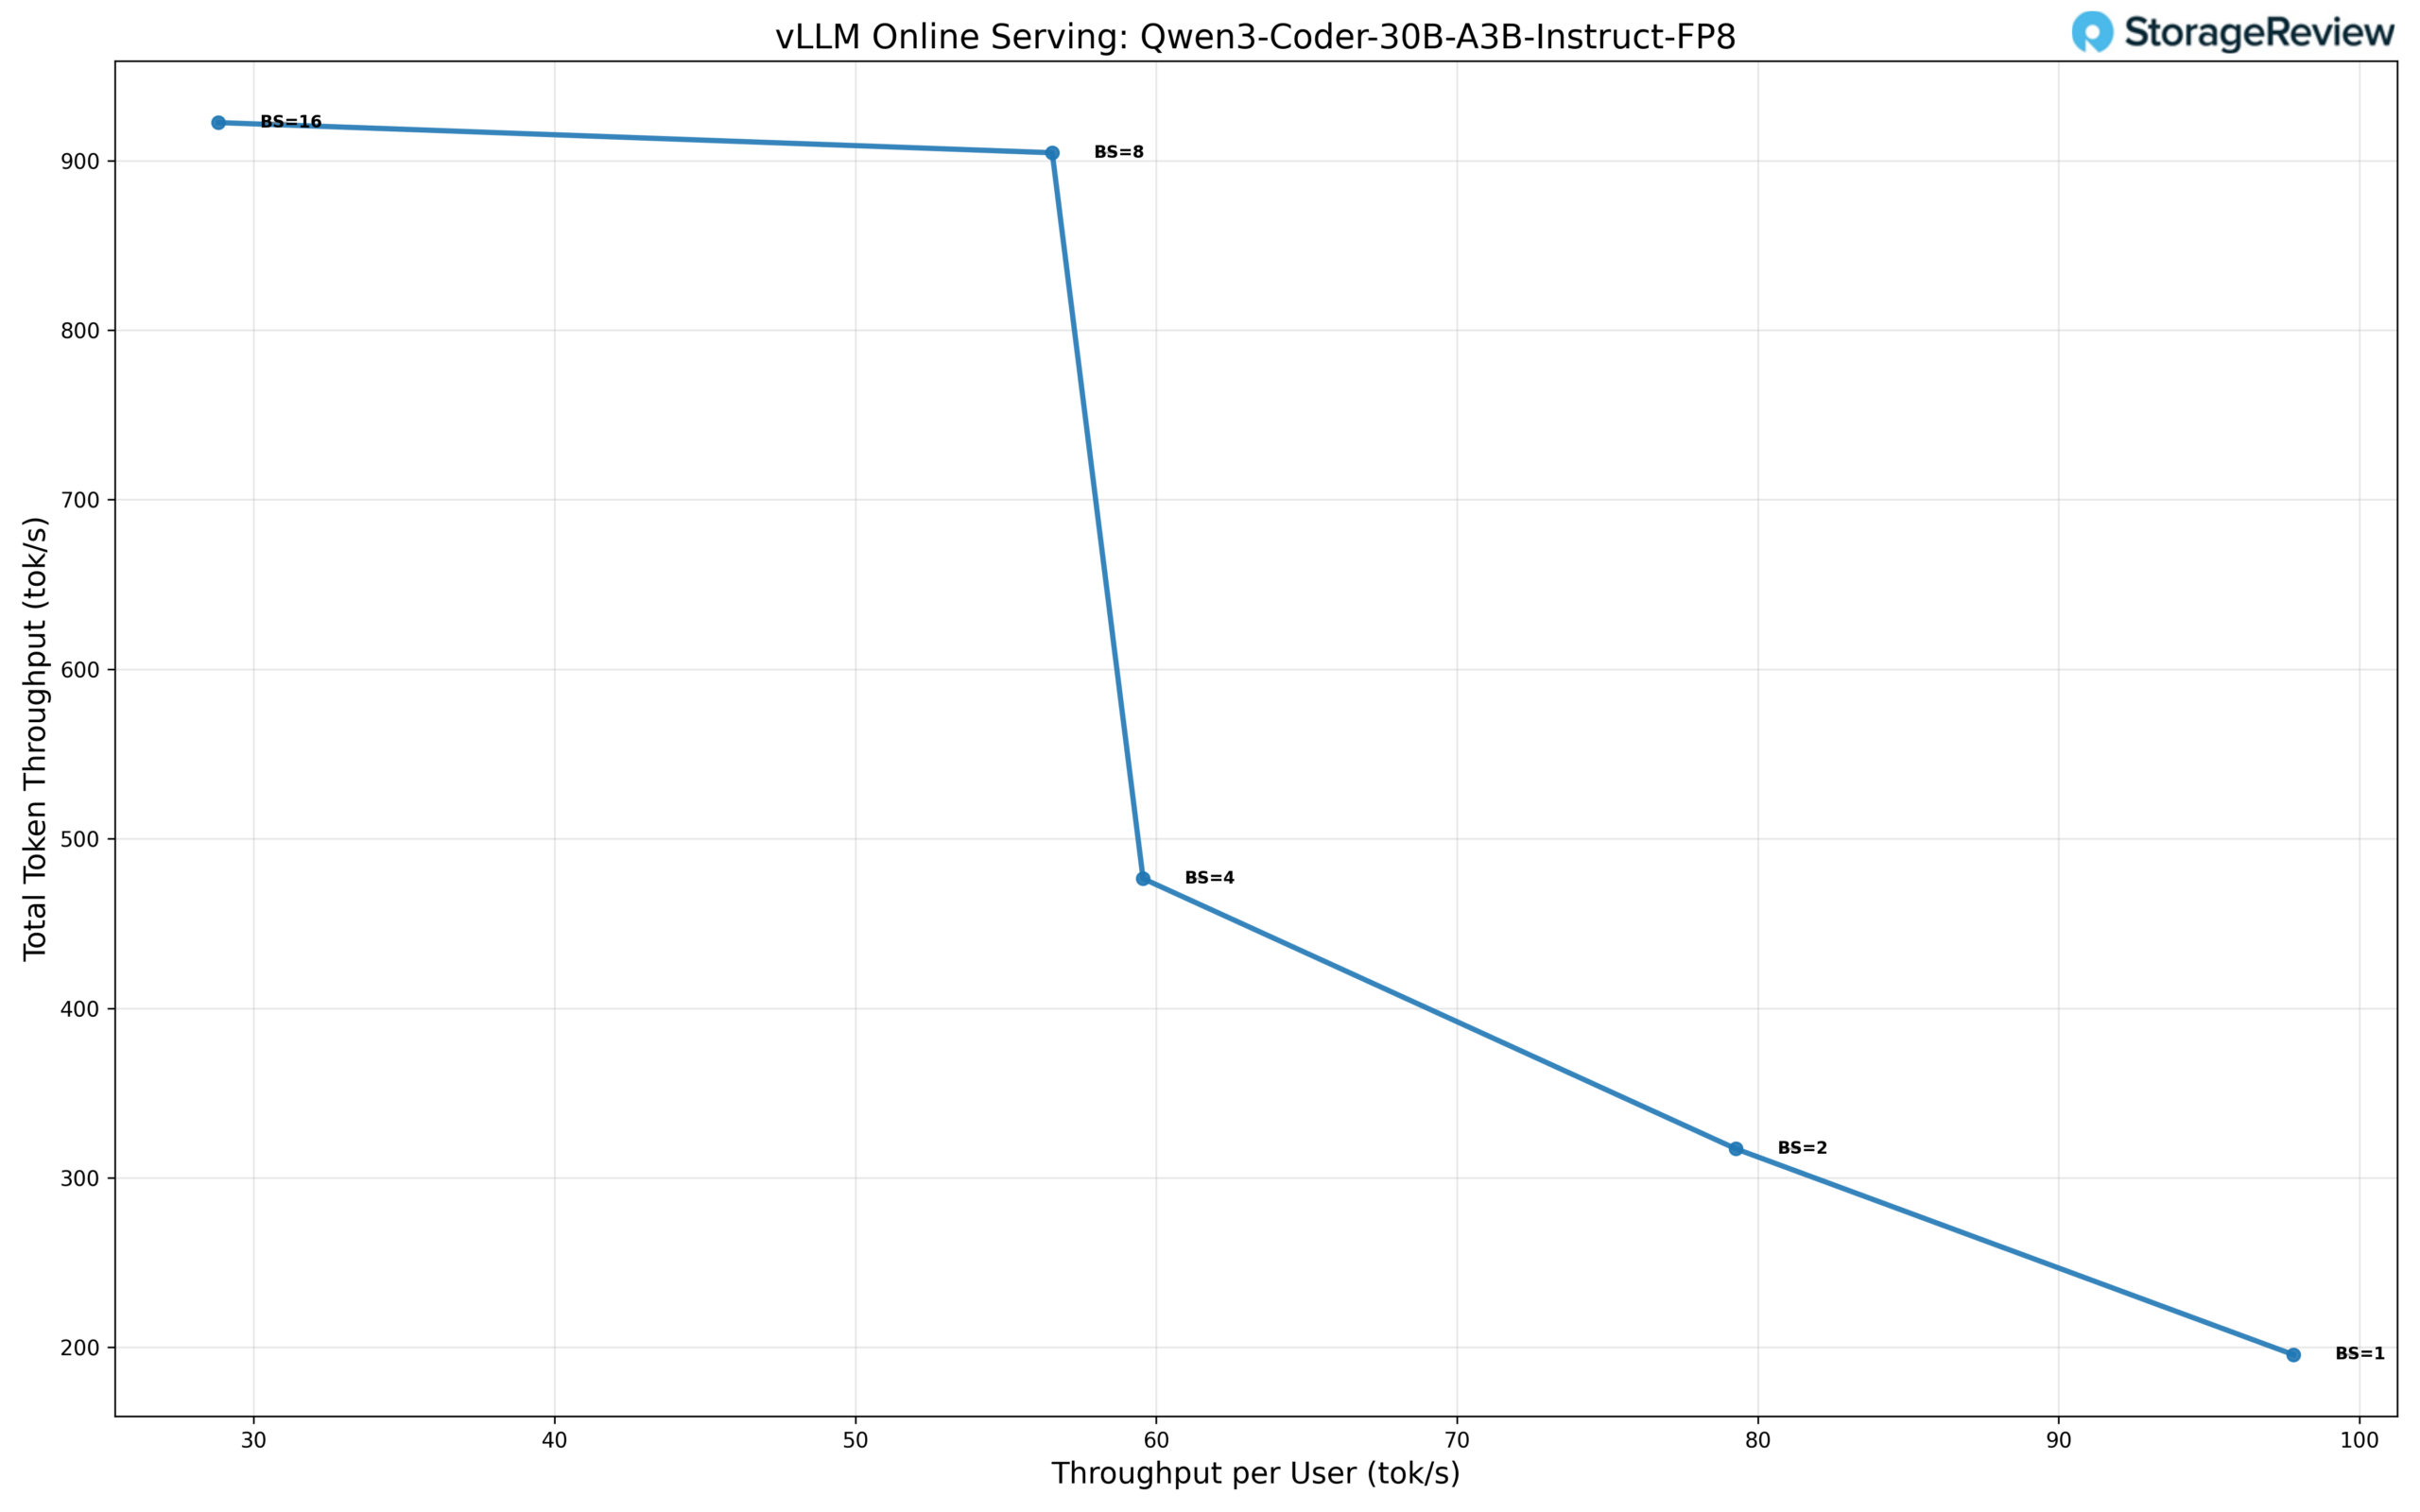
FP8 တိကျမှုဖြင့် လုပ်ဆောင်နေသော Qwen3-Coder-30B-A3B မော်ဒယ်သည် အလယ်အလတ် တစ်ပြိုင်နက်တည်း လုပ်ဆောင်မှုအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော scaling profile ကို ပြသထားပြီး၊ မော်ဒယ်ငယ်များထက် စော၍ saturation သို့ ရောက်ရှိနေစဉ်တွင် user တစ်ဦးလျှင် စွမ်းဆောင်ရည် မြင့်မားစွာ ပေးဆောင်ပါသည်။ single-user operation (BS=1) တွင်၊ မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၉၈ ခန့် ရရှိပြီး စုစုပေါင်း throughput ၁၉၆ tok/s ရရှိကာ code-generation workloads အတွက် မော်ဒယ်၏ အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်မှုကို ထင်ဟပ်စေသည့် မြင့်မားသော single-stream baseline ကို တည်ဆောက်ပေးပါသည်။
တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှုများ တိုးလာသည်နှင့်အမျှ စုစုပေါင်း throughput သည် ထိရောက်စွာ ချိန်ညှိနိုင်သော်လည်း အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput သည် ထိန်းချုပ်ထားသောပုံစံဖြင့် ကျဆင်းသွားသည်။ BS=2 တွင် စုစုပေါင်း throughput သည် 317 tok/s အထိ မြင့်တက်လာပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ tok/s 79 ရှိပြီး BS=4 တွင် မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးချင်းစီ၏ tok/s 59 ဖြင့် စုစုပေါင်း throughput 477 tok/s ကို ပေးစွမ်းသည်။ ဤရလဒ်များသည် အသုံးပြုသူတစ်ဦးချင်းစီ၏ တုံ့ပြန်မှုတွင် ရုတ်တရက် ယိုယွင်းပျက်စီးခြင်းမရှိဘဲ အနိမ့်မှအလယ်အလတ် batching မှတစ်ဆင့် ရရှိနိုင်သော compute resources များကို ထိရောက်စွာအသုံးပြုခြင်းကို ပြသသည်။
မော်ဒယ်သည် BS=8 တွင် ၎င်း၏ အမြင့်ဆုံး စုစုပေါင်း throughput သို့ ရောက်ရှိပြီး စုစုပေါင်း throughput 905 tok/s ခန့်ကို ထိန်းသိမ်းထားပြီး အသုံးပြုသူတစ်ဦးလျှင် tok/s 56 ရှိသည်။ BS=16 မှတစ်ဆင့် အနည်းငယ် ဆက်လက်တိုးချဲ့နေပြီး စုစုပေါင်း throughput သည် 920 tok/s အထိ အနည်းငယ်တိုးလာပြီး အသုံးပြုသူတစ်ဦးလျှင် throughput သည် 29 tok/s အထိ ကျဆင်းသွားကာ inference pipeline ၏ ပြည့်ဝမှုကို ညွှန်ပြသည်။ ဤအချက်အပြင်၊ ထပ်ဆောင်း concurrency သည် စုစုပေါင်း throughput တွင် အနည်းဆုံး အကျိုးအမြတ်များကို ပေးစွမ်းပြီး အသုံးပြုသူတစ်ဦး၏ စွမ်းဆောင်ရည်ကို သိသိသာသာ သက်ရောက်မှုရှိသည်။
အလုံးစုံသော် Qwen3-Coder-30B-A3B FP8 သည် BS=1 မှ BS=16 တွင် အမြင့်ဆုံးအဆင့်အထိ စုစုပေါင်း throughput ကို ၄.၇× ခန့် တိုးလာစေပါသည်။ Latency နှင့် throughput ဝိသေသလက္ခဏာများသည် ဤ configuration သည် per-request per-performance မြင့်မားရန် လိုအပ်သည့် အလယ်အလတ် multi-user coding workloads များအတွက် အသင့်တော်ဆုံးဖြစ်ကြောင်း အကြံပြုထားသည်။ သို့တိုင်၊ အလွန်အမင်း batch scaling သည် အဓိကရည်ရွယ်ချက်မဟုတ်ပါ။
မိုက်ခရိုစကေးလိုက်ခြင်း ဒေတာအမျိုးအစား စွမ်းဆောင်ရည်
Microscaling သည် ကြီးမားသော parameter အုပ်စုများတွင် uniform quantization အစား အလေးချိန်များ၏ သေးငယ်သော block များတွင် fine-grained scaling factor များကို အသုံးချသည့် အဆင့်မြင့် quantization ချဉ်းကပ်မှုကို ကိုယ်စားပြုသည်။ NVIDIA ၏ NVFP4 format သည် ဤနည်းပညာကို 8-32 တန်ဖိုးများရှိသော microscale block တစ်ခုစီသည် scaling factor အဖြစ် ပုံမှန် exponent တစ်ခုကို မျှဝေသည့် blocked floating-point ကိုယ်စားပြုမှုမှတစ်ဆင့် အကောင်အထည်ဖော်သည်။ ဤ granular ချဉ်းကပ်မှုသည် 4-bit ကိုယ်စားပြုမှုကို ရရှိနေစဉ်တွင် ဂဏန်းသင်္ချာတိကျမှုကို ထိန်းသိမ်းထားပြီး transformer architectures အတွက် အရေးကြီးသော dynamic range ကို ထိန်းသိမ်းထားသည်။ format သည် NVIDIA ၏ Tensor Core architecture နှင့် ပေါင်းစပ်ထားပြီး matrix လုပ်ဆောင်ချက်များအတွင်း on-the-fly decompression ဖြင့် ထိရောက်သော mixed-precision တွက်ချက်မှုကို ဖြစ်စေသည်။
GPT-OSS-20b စွမ်းဆောင်ရည်
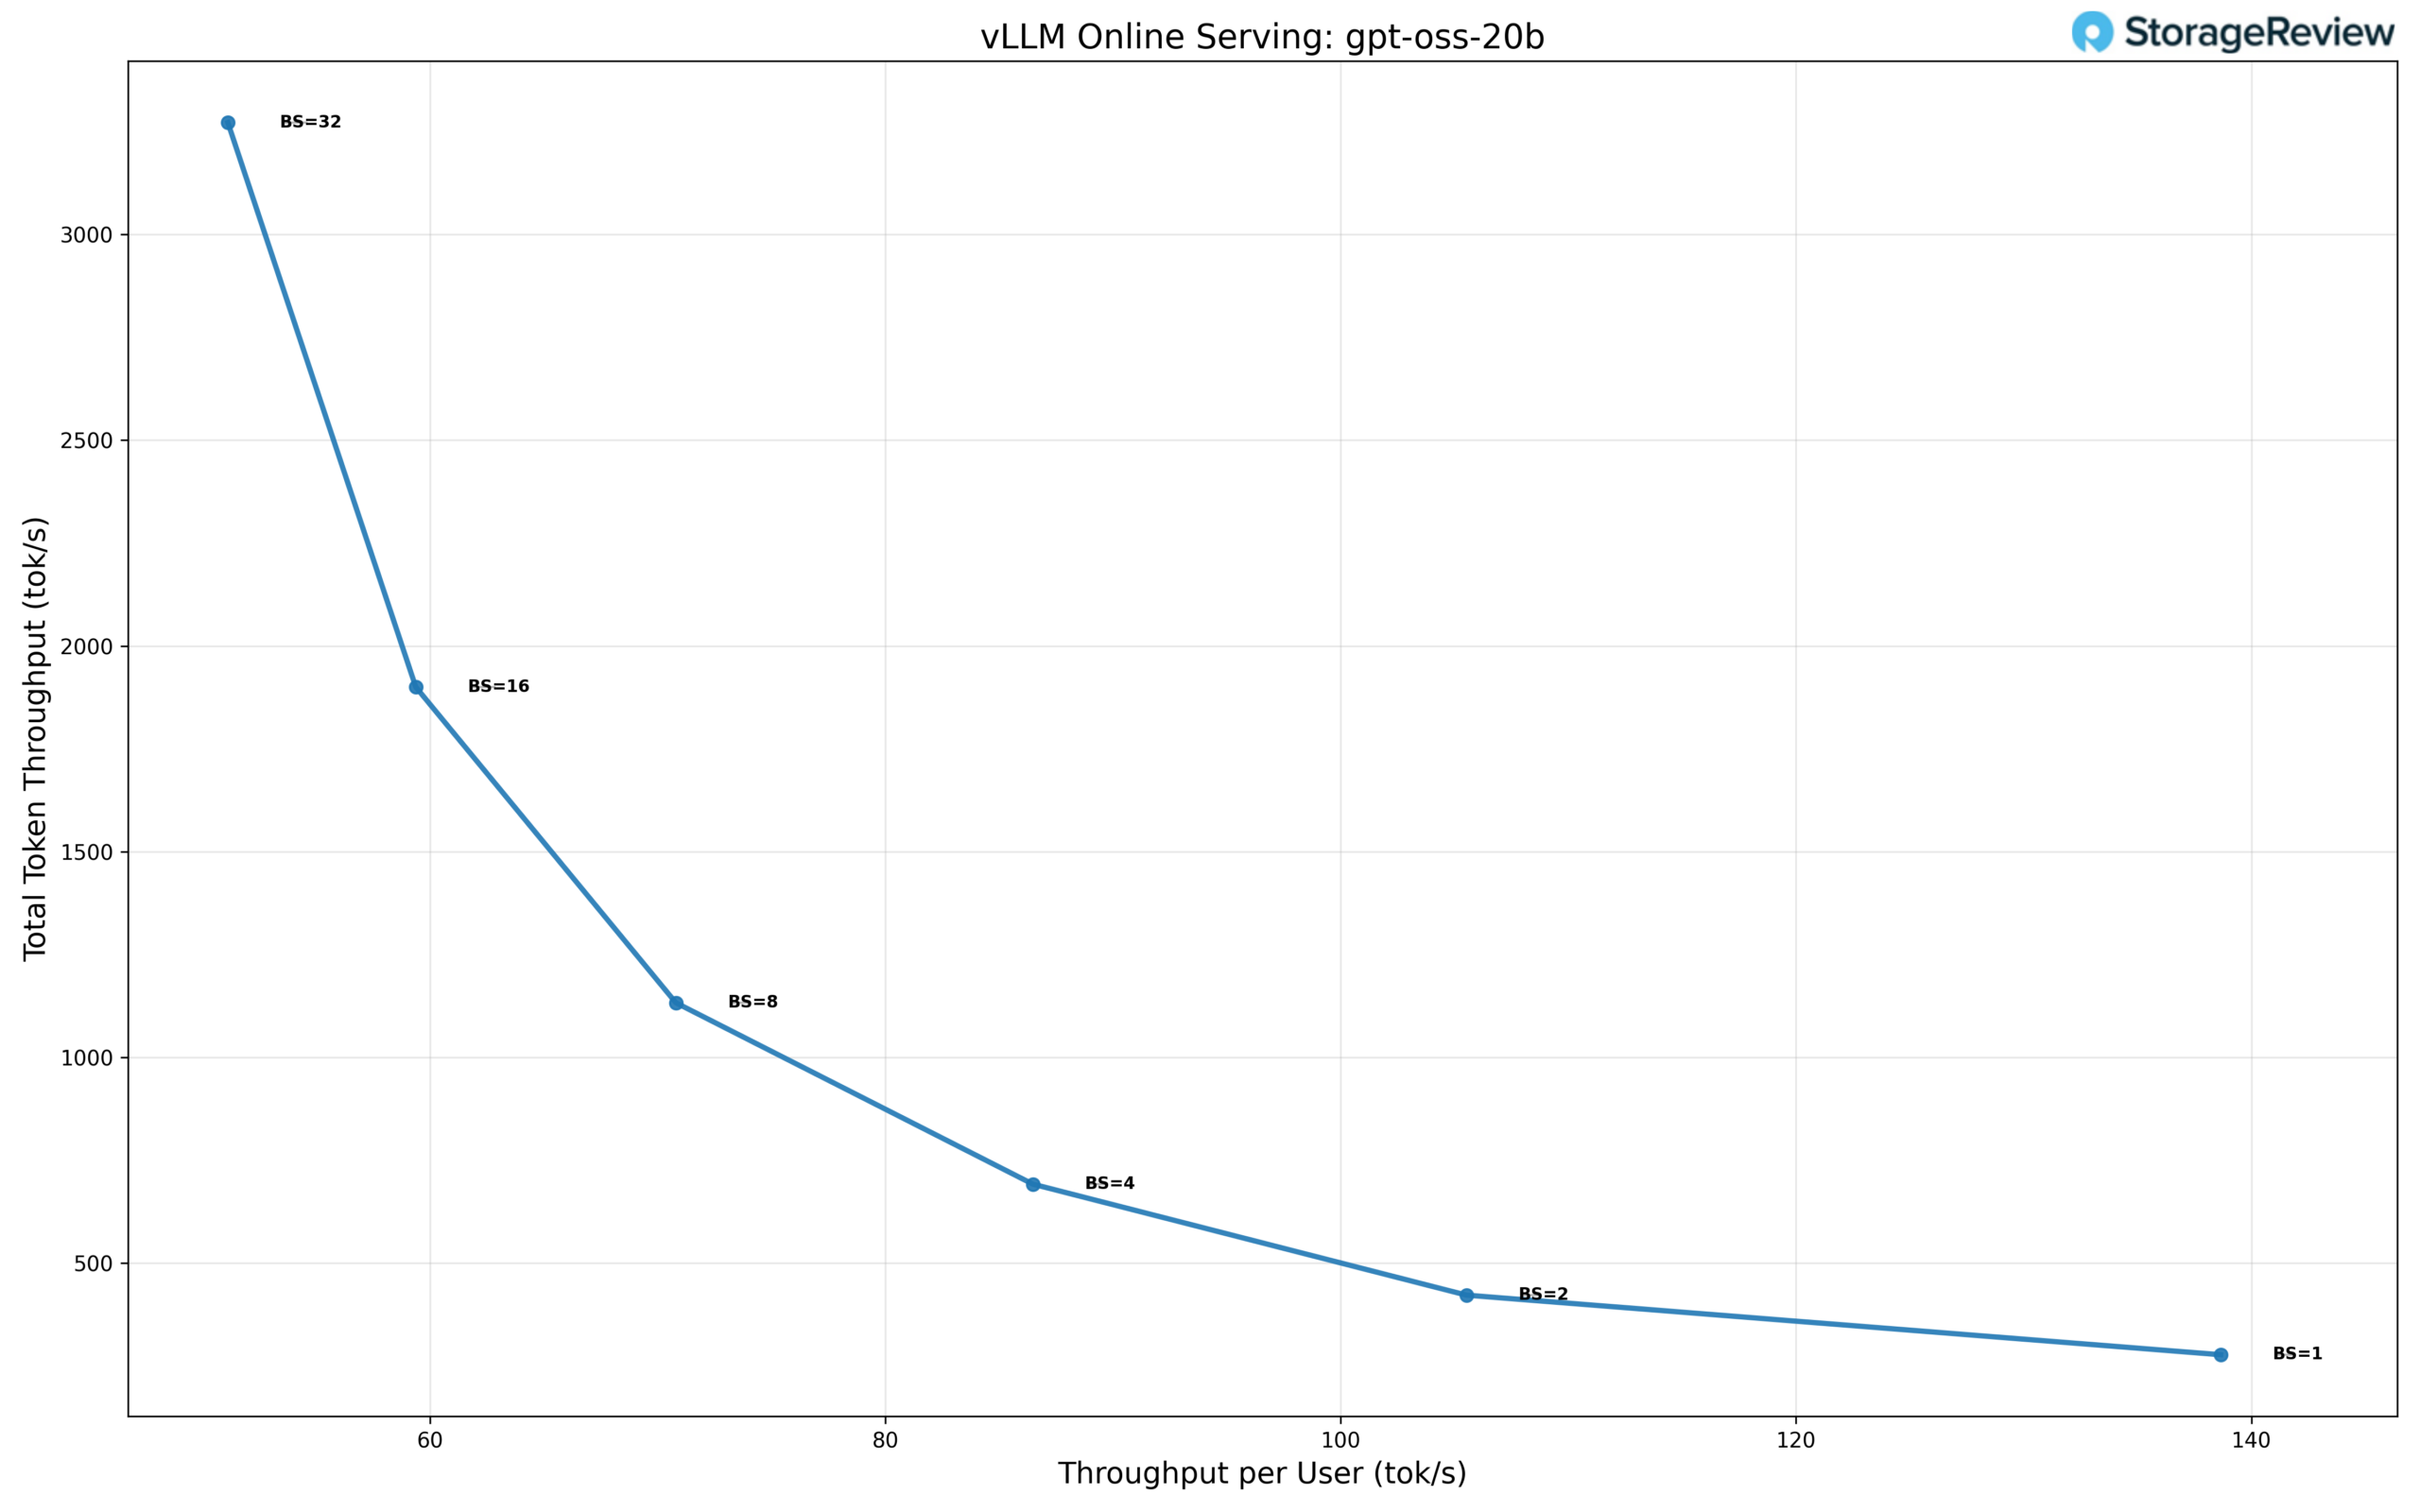
gpt-oss-20b မော်ဒယ်သည် တိုးလာသော concurrency အဆင့်များတွင် ခိုင်မာသော scaling ဝိသေသလက္ခဏာများကို ပြသထားပြီး၊ အထူးသဖြင့် batch အရွယ်အစားကြီးများတွင် မြင့်မားသော aggregate throughput ရှိသည်။ single-user concurrency (BS=1) တွင်၊ မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးလျှင် ခန့်မှန်းခြေအားဖြင့် 138 tok/s ပေးစွမ်းပြီး စုစုပေါင်း 276 tok/s ရရှိကာ single-stream inference အတွက် ခိုင်မာသော baseline ကို တည်ဆောက်ပေးသည်။
တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှုများ တိုးလာသည်နှင့်အမျှ စုစုပေါင်း throughput သည် တက်ကြွစွာ တိုးချဲ့လာပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput သည် မျှော်လင့်ထားသည့်အတိုင်း ကျဆင်းသွားသည်။ BS=2 တွင် စုစုပေါင်း throughput သည် 420 tok/s အထိ မြင့်တက်လာပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput မှာ 105 tok/s ရှိပြီး BS=4 တွင် စုစုပေါင်း throughput မှာ 690 tok/s အထိ ရောက်ရှိပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput မှာ 86 tok/s ရှိသည်။ ဤတည်ငြိမ်သောတိုးတက်မှုသည် အနိမ့်မှအလယ်အလတ် batching မှတစ်ဆင့် ရရှိနိုင်သော compute resource များကို ထိရောက်စွာအသုံးပြုခြင်းကို ညွှန်ပြသည်။
BS=8 မှတစ်ဆင့် တိုးချဲ့မှုဆက်လက်ပြုလုပ်နေပြီး၊ မော်ဒယ်သည် အသုံးပြုသူတစ်ဦးလျှင် tok/s 70 ဖြင့် စုစုပေါင်း throughput 1,120 tok/s ခန့်ရရှိကာ၊ BS=16 တွင် စုစုပေါင်း throughput 1,900 tok/s အထိတိုးလာပြီး အသုံးပြုသူတစ်ဦးလျှင် tok/s 60 ရှိသည်။ ဤရလဒ်များသည် gpt-oss-20b သည် တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှုများ မြင့်တက်လာသည့်တိုင် အသုံးပြုသူတစ်ဦးလျှင် စွမ်းဆောင်ရည်ကို အတော်လေးမြင့်မားစွာ ထိန်းသိမ်းထားနိုင်ကြောင်း ပြသနေပြီး၊ ၎င်းသည် multi-user ဝန်ဆောင်မှုပေးသည့် အခြေအနေများအတွက် အလွန်သင့်လျော်စေသည်။
မော်ဒယ်သည် BS=32 တွင် ၎င်း၏ အမြင့်ဆုံး စုစုပေါင်း throughput သို့ ရောက်ရှိပြီး စုစုပေါင်း throughput 3,250 tok/s ခန့်ကို ပေးစွမ်းနိုင်ပြီး အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput မှာ 50 tok/s အထိ ကျဆင်းသွားသည်။ ၎င်းသည် တစ်ဦးတည်းအသုံးပြုသူစွမ်းဆောင်ရည်နှင့် နှိုင်းယှဉ်ပါက စုစုပေါင်း throughput တွင် 11.8× တိုးလာမှုကို ကိုယ်စားပြုသည်။ batch size မြင့်မားသောအခါတွင် အသုံးပြုသူတစ်ဦးချင်းစီ၏ throughput ဆက်လက်ကျဆင်းနေသော်လည်း၊ အလုံးစုံ scaling စွမ်းဆောင်ရည်မှာ အားကောင်းနေဆဲဖြစ်ပြီး မော်ဒယ်သည် အစောပိုင်း saturation point နှင့် မတွေ့ဆုံဘဲ ပိုမိုမြင့်မားသော concurrency မှ အကျိုးကျေးဇူးရရှိကြောင်း ညွှန်ပြနေသည်။
အလုံးစုံသော် gpt-oss-20b သည် မြင့်မားသော single-user စွမ်းဆောင်ရည်နှင့် ခိုင်မာသော batch scaling တို့ကို ပေါင်းစပ်ထားသော balanced scaling profile ကို ပြသထားသည်။ ၎င်းသည် တုံ့ပြန်မှုကောင်းသော individual inference နှင့် ပိုမိုလေးလံသော multi-user load အောက်တွင် မြင့်မားသော aggregate throughput နှစ်မျိုးလုံး လိုအပ်သော deployments များအတွက် ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။
Phoronix စံနှုန်းများ
Phoronix Test Suite သည် OpenBenchmarking.org မှတစ်ဆင့် စမ်းသပ်မှုပရိုဖိုင် ၄၅၀ ကျော်နှင့် စမ်းသပ်မှုအစုံ ၁၀၀+ ကို ပံ့ပိုးပေးသည့် open-source၊ အလိုအလျောက် benchmarking ပလပ်ဖောင်းတစ်ခုဖြစ်သည်။ ၎င်းသည် dependencies များထည့်သွင်းခြင်းမှသည် စမ်းသပ်မှုများကို လုပ်ဆောင်ခြင်းနှင့် ရလဒ်များစုဆောင်းခြင်းအထိ အရာအားလုံးကို ကိုင်တွယ်ဆောင်ရွက်ပေးပြီး စွမ်းဆောင်ရည်နှိုင်းယှဉ်ခြင်း၊ hardware validation နှင့် စဉ်ဆက်မပြတ်ပေါင်းစပ်မှုအတွက် အသင့်တော်ဆုံးဖြစ်စေသည်။
တိုက်ရိုက်ကြည့်ရှုနိုင်သော မှတ်ဉာဏ် bandwidth
SR650 V4 သည် မန်မိုရီ bandwidth 369.6GB/s ကို ပေးစွမ်းနိုင်ခဲ့ပြီး ဒေတာများစွာ အသုံးပြုရသော workloads များအတွက် ကောင်းမွန်သော throughput ကို ပြသခဲ့ပြီး ကျန်းမာသော multi-channel မန်မိုရီစွမ်းဆောင်ရည်ကို အတည်ပြုပေးခဲ့သည်။
7-Zip ချုံ့ခြင်း
MIPS ၅၈၄,၄၉၉ ဖြင့် စနစ်သည် အလွန်ကောင်းမွန်သော compression နှင့် decompression စွမ်းဆောင်ရည်ကို ပြသခဲ့ပြီး၊ ခိုင်မာသော multi-core စွမ်းဆောင်ရည်နှင့် ခိုင်မာသော integer compute စွမ်းရည်ကို ထင်ဟပ်စေပါသည်။
Kernel စုစည်းမှု
server သည် allmod kernel တည်ဆောက်မှုကို ၂၅၆.၁၇၅ စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့ပြီး၊ ၎င်းသည် parallel compilation နှင့် developer workflows များကို ထိရောက်စွာ ကိုင်တွယ်နိုင်စွမ်းကို မီးမောင်းထိုးပြသည့် လေးစားဖွယ်ရလဒ်တစ်ခုဖြစ်သည်။
Apache Web Server ဖြစ်သည်
61,654 R/s တွင် SR650 V4 သည် ခိုင်မာသော web-serving စွမ်းဆောင်ရည်ကို ပြသခဲ့ပြီး front-end hosting သို့မဟုတ် lightweight virtualization stacks များအတွက် သင့်လျော်သော မြင့်မားသော request throughput ကို ထိန်းသိမ်းထားနိုင်ခဲ့သည်။
OpenSSL အတည်ပြုခြင်း
တစ်စက္ကန့်လျှင် ဘိုက် ၇၁၂.၆ ဘီလီယံ ရရှိခြင်းဖြင့် ဤပလက်ဖောင်းသည် ခိုင်မာသော ကုဒ်ဝှက်စနစ် အတည်ပြုခြင်း စွမ်းဆောင်ရည်ကို ပြသခဲ့ပြီး လုံခြုံစိတ်ချရသော၊ လက်မှတ်များစွာ အသုံးပြုသည့် လုပ်ငန်းဆောင်တာများအတွက် CPU ၏ စွမ်းရည်ကို အတည်ပြုပေးပါသည်။
| Phoronix စံနှုန်းများ | Lenovo ThinkSystem SR650 V4 |
|---|---|
| stream | 369,58.3 MB / s |
| 7- ZIP | 584,499 MIPS |
| Kernel Compile (allmod) | 256.175 စက္ကန့် |
| Apache (တစ်စက္ကန့်လျှင် တောင်းဆိုမှုများ) | တစ်စက္ကန့်လျှင် ၉၄,၃၄၇.၅၂ ရူပီး |
| SSL ကိုဖွင့်ပါ | ၇၁၂,၆၃၃,၇၇၆,၉၉၀ ဘိုက်/စက္ကန့် |
ကောက်ချက်
ThinkSystem SR650 V4 ဟာ CPU လဲလှယ်မှုတစ်ခုတည်းမဟုတ်တဲ့အတွက် အရေးကြီးတဲ့ platform refresh အမျိုးအစားဖြစ်ပါတယ်။ Lenovo ဟာ ဒီမျိုးဆက်ကို အသုံးပြုပြီး လက်တွေ့ကမ္ဘာမှာ ဖြန့်ကျက်မှုတွေကို ကန့်သတ်ထားတဲ့ နယ်ပယ်တွေမှာ အဓိပ္ပာယ်ရှိတဲ့ တိုးတက်မှုတွေ ဖော်ဆောင်ခဲ့ပါတယ်။ ဥပမာ memory bandwidth၊ PCIe lane availability၊ storage density နဲ့ လိုအပ်ချက်တွေ ပြောင်းလဲလာတာနဲ့အမျှ configuration ကို လိုက်လျောညီထွေဖြစ်အောင် လုပ်ဆောင်နိုင်စွမ်းတွေ ပါဝင်ပါတယ်။ Intel Xeon 6 ကို ပြောင်းရွှေ့လိုက်တာကြောင့် core option တွေ ပိုမိုများပြားလာပြီး socket တစ်ခုစီအတွက် I/O headroom ပိုမိုများပြားလာပြီး MRDIMM support ပါဝင်တဲ့ ပိုမြန်တဲ့ DDR5 နဲ့ optional CXL expansion အပါအဝင် platform လုပ်ဆောင်ချက်တွေက SR650 V4 ကို workload တွေ ပိုမိုများပြားလာတာနဲ့အမျှ သက်ဆိုင်မှုရှိအောင် ဆက်လက်လုပ်ဆောင်နိုင်စေပါတယ်။
သိုလှောင်မှုဘက်တွင်၊ U.2 နှင့် ကျွန်ုပ်တို့၏ ပြန်လည်သုံးသပ်ချက် configuration အကန့်အသတ်ရှိသော်လည်း၊ Lenovo ၏ E3.S သို့ တွန်းအားပေးမှုသည် 1:1 ချိတ်ဆက်မှုနှင့် သန့်ရှင်းသော အပူချိန်လက္ခဏာများဖြင့် ပိုမိုမြင့်မားသော NVMe သိပ်သည်းဆကို ပေးဆောင်ပြီး ခေတ်မီအခြေခံအဆောက်အအုံများ တည်ဆောက်နေပုံနှင့် ကိုက်ညီပါသည်၊ အထူးသဖြင့် local flash ပိုမိုလိုချင်သော virtualization stack များနှင့် GPU များကို raw compute ကဲ့သို့ပင် အရေးပါသော AI-adjacent pipelines များအတွက်ဖြစ်သည်။ dual OCP 3.0 Gen5 x16 slot များသည်လည်း လက်တွေ့ကျသော အဆင့်မြှင့်တင်မှုတစ်ခုအဖြစ် ရောက်ရှိလာသည်- accelerators၊ storage သို့မဟုတ် specialty adapters များအတွက် သီးသန့်ထားရှိလိုသော PCIe slot များကို မစွန့်လွှတ်ဘဲ လေးနက်သော networking ကို ဖြန့်ကျက်နိုင်သည်။
SR650 V3 ကိုသုံးနေပြီး မန်မိုရီအမြန်နှုန်း၊ PCIe headroom သို့မဟုတ် NVMe density ကြောင့် အကန့်အသတ်ရှိတယ်လို့ ခံစားရရင် SR650 V4 ဟာ ဆွဲဆောင်မှုရှိတဲ့ ခြေလှမ်းတစ်ခုပါပဲ။ SR650 လိုင်းကို ရေပန်းစားစေခဲ့တဲ့ ဝန်ဆောင်မှုပေးနိုင်မှုနဲ့ configurability ကို ထိန်းသိမ်းထားသလို IT အဖွဲ့တွေ အခက်တွေ့စေမယ့် platform runway မျိုးကိုပါ ထည့်သွင်းပေးထားပါတယ်။ virtualization cluster တစ်ခုတည်ဆောက်နေတာပဲဖြစ်ဖြစ်၊ scale-out service တွေကို ခေတ်မီအောင်လုပ်နေတာပဲဖြစ်ဖြစ်၊ balanced CPU/GPU node တစ်ခုကို တည်ဆောက်နေတာပဲဖြစ်ဖြစ်၊ SR650 V4 ဟာ အရေးကြီးတဲ့ box တွေကို စစ်ဆေးပြီး နောက်လာမယ့်အရာတွေအတွက် နေရာချန်ထားပေးပါတယ်။
ဦးဆောင်သူစာရင်း- ဤနေရာတွင်စမ်းသပ်ထားသော L40S သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Enterprise GPU များ ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Mainstream Inference GPU ကို ရရှိထားသည်။


 အမေဇုံ