

မကြာသေးမီလများအတွင်း၊ GPT-4၊ Meta LLaMa နှင့် Alpaca ကဲ့သို့သော အဆင့်မြင့် မော်ဒယ်များသည် သဘာဝဘာသာစကား လုပ်ဆောင်မှုနှင့် ၎င်းတို့ကို လည်ပတ်ရန် လိုအပ်သော ဟာ့ဒ်ဝဲ၏ နယ်နိမိတ်များကို တွန်းအားပေးခြင်းဖြင့် ကြီးမားသော ဘာသာစကား မော်ဒယ်များသည် ကျယ်ပြန့်သော သုတေသနနှင့် ဖွံ့ဖြိုးတိုးတက်မှု၏ ဘာသာရပ် ဖြစ်လာခဲ့သည်။ ဤမော်ဒယ်များအပေါ် ကောက်ချက်ချခြင်းသည် တွက်ချက်မှုအရ စိန်ခေါ်မှုတစ်ခု ဖြစ်နိုင်ပြီး အချိန်နှင့်တပြေးညီ ရလဒ်များကို ပေးစွမ်းရန် အစွမ်းထက်သော ဟာ့ဒ်ဝဲ လိုအပ်ပါသည်။
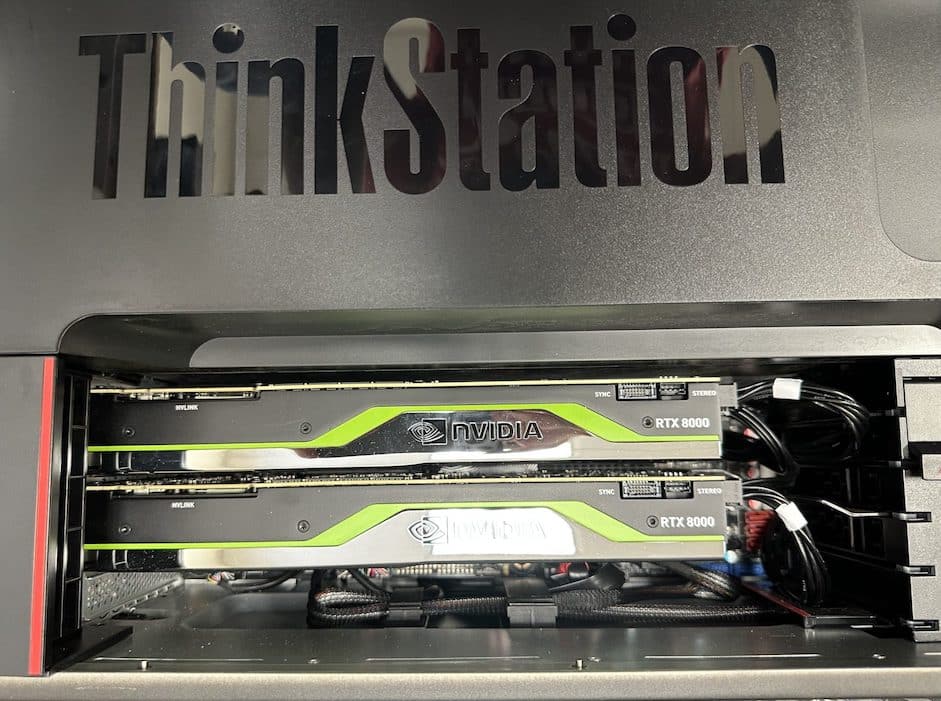
Storage Review lab မှာ Meta ရဲ့ LLaMa model ကို run တဲ့အလုပ်မှာ NVIDIA RTX 8000 GPU နှစ်ခုကို ထားခဲ့ပြီး language model ကြီးတွေမှာ inference ကို run တဲ့အခါ ဘယ်လိုစွမ်းဆောင်ရည်ရှိလဲဆိုတာ ကြည့်ခဲ့ပါတယ်။ Lenovo P920 ကို card တွေအတွက် host အနေနဲ့သုံးခဲ့ပြီး bottleneck တွေကို လျှော့ချခဲ့ပါတယ်။ RTX 8000 က AI နဲ့ deep learning application တွေမှာ အသုံးပြုနိုင်တဲ့ high-end graphics card တစ်ခုဖြစ်ပါတယ်။ 48GB GDDR6 memory နဲ့ 4608 CUDA cores တွေကြောင့် ဒီ card တွေကို stack ထဲကနေ ရွေးချယ်ခဲ့ပြီး Kevin ကလည်း A6000 အားလုံးကို စုဆောင်းထားပါတယ် ။
Meta LLaMA သည် အင်တာနက်စာသားအမျိုးမျိုးပေါ်တွင် လေ့ကျင့်ထားသော ကြီးမားသောဘာသာစကားမော်ဒယ်တစ်ခုဖြစ်သည်။ ၎င်းသည် အများပြည်သူအတွက် ရရှိနိုင်ပြီး သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်းဆိုင်ရာ အလုပ်အမျိုးမျိုးတွင် အဆင့်မြင့်ရလဒ်များကို ပေးစွမ်းသည်။ ဤဆောင်းပါးတွင်၊ NVIDIA GPU များတွင် LLaMA ကောက်ချက်ကို မည်သို့စနစ်ထည့်သွင်းပြီး လုပ်ဆောင်ခဲ့သည်ကို အဆင့်ဆင့်လမ်းညွှန်ချက်ပေးပါမည်၊ ၎င်းသည် လူတိုင်းအတွက် အလုပ်လုပ်မည်ဟု အာမမခံနိုင်ပါ။
မက်တာ LLaMa လိုအပ်ချက်များ
ကျွန်ုပ်တို့စတင်မီ၊ အောက်ပါလိုအပ်ချက်များကို ထည့်သွင်းထားကြောင်း သေချာစေရန် လိုအပ်ပါသည်-
- အနည်းဆုံး 16GB VRAM ပါရှိသော NVIDIA GPU(များ)
- NVIDIA ဒရိုက်ဘာများ ထည့်သွင်းပြီးပါပြီ (အနည်းဆုံး ဗားရှင်း 440.33)
- CUDA Toolkit ကို ထည့်သွင်းပြီးပါပြီ (အနည်းဆုံး version 10.1)
- အန်နာကွန်ဒါ တပ်ဆင်ထားသည်
- PyTorch ကို ထည့်သွင်းပြီးပါပြီ (အနည်းဆုံး ဗားရှင်း 1.7.1)
- Disk Space; LLaMa checkpoints အစုံတစ်ခုလုံးသည် 200TB ကျော်ကို တွန်းပို့နေသည်။
မှတ်ချက်- LLaMA အတွက် သီးသန့် Anaconda environment တစ်ခု ရှိရန် အကြံပြုလိုပါသည်၊ base installation ကို မထိခိုက်စေဘဲ package များနှင့် parameter များကို ရှုပ်ထွေးစွာ လုပ်ဆောင်နိုင်ရန် test bench တွင် အနည်းငယ် ရှိပါသည်။
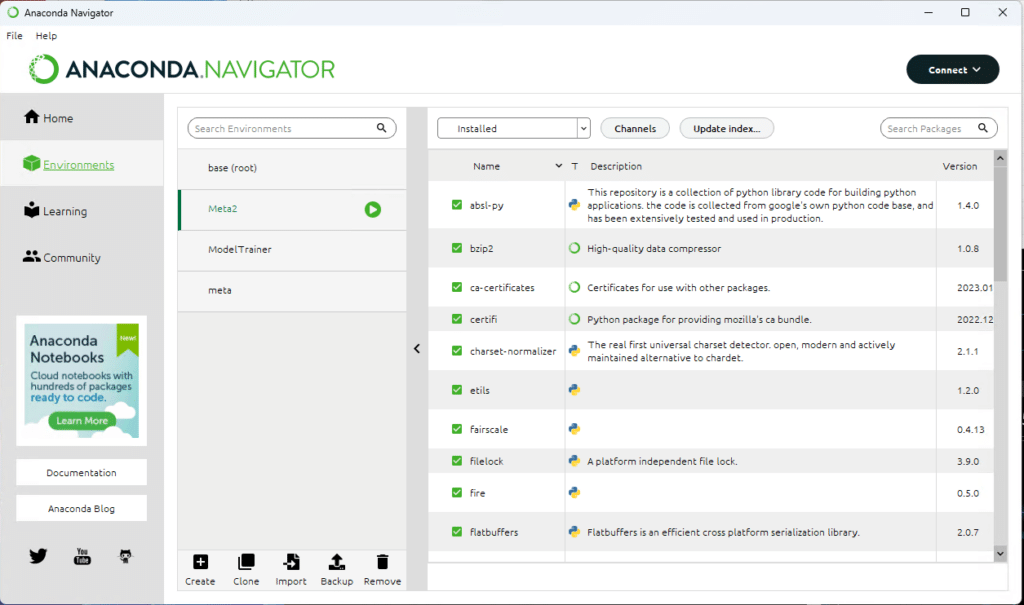
Anaconda မှာ သီးသန့်ပတ်ဝန်းကျင်တစ်ခု ဒါမှမဟုတ် နှစ်ခု တည်ဆောက်ပါ။
NVIDIA GPU များတွင် Meta LLaMA Inference ကို လုပ်ဆောင်ရန် အဆင့်များ
- LLaMA repository ကို ဒေါင်းလုဒ်လုပ်ပါ- ပထမခြေလှမ်းကတော့ GitHub ကနေ LLaMA repository ကို clone လုပ်ဖို့ပါ။
git clone https://github.com/EleutherAI/LLaMA.git
- LLaMA စစ်ဆေးရေးဂိတ်နှင့် တိုကင်စက်ကို ရယူပါ- GitHub စာမျက်နှာသို့ ဝင်ရောက်ကြည့်ရှုပြီး ဒေါင်းလုဒ်လုပ်ရန် ချိတ်ဆက်ထားသော Google ဖောင်ကို ဖြည့်စွက်ပါ။ Alpaca ကဲ့သို့သော အခြား LLM များကိုလည်း ရရှိနိုင်ပါသည်။ ဤရည်ရွယ်ချက်အတွက် LLaMa ဖိုင်များကို ဝင်ရောက်ကြည့်ရှုနိုင်သည်ဟု ကျွန်ုပ်တို့ ယူဆပါမည်။
- cloned repository directory အတွင်းမှ အောက်ပါ command ကို run ခြင်းဖြင့် LLaMa အတွက် လိုအပ်သော program များကို list လုပ်ပြီး install လုပ်ပါ။
pip install -r requirements.txt

pip install -e .
- ကောက်ချက် script ကို စနစ်ထည့်သွင်းပါ- အဆိုပါ
example.pyLLaMA repository မှာပေးထားတဲ့ script ကို LLaMA inference ကို run ဖို့အသုံးပြုနိုင်ပါတယ်။ script ကို single- သို့မဟုတ် multi-gpu node တစ်ခုမှာ run နိုင်ပါတယ်-torchrunပြီးတော့ ကြိုတင်သတ်မှတ်ထားတဲ့ prompt နှစ်ခုအတွက် ပြီးစီးမှုတွေကို output ထုတ်ပေးပါလိမ့်မယ်။
ဖွင့်လှစ် example.py ထို့နောက် သင့်နှစ်သက်ရာအပေါ် အခြေခံ၍ အောက်ပါ parameter များကို သတ်မှတ်ပါ။ parameter တစ်ခုချင်းစီအတွက် ရှင်းလင်းချက်များနှင့် ၎င်းတို့၏လုပ်ဆောင်ချက်များကို အောက်တွင် ဖော်ပြထားပါသည်။
--max_seq_len: အများဆုံး sequence အရှည် (default မှာ 2048 ဖြစ်သည်)--max_batch_size: အများဆုံး အသုတ်အရွယ်အစား (ပုံသေမှာ ၈ ဖြစ်သည်)--gen_length: မျိုးဆက်ကြာချိန် (ပုံသေမှာ ၅၁၂ ဖြစ်သည်)--temperature: ထုတ်လုပ်မှုအပူချိန် (ပုံသေမှာ 1.0 ဖြစ်သည်)--top_ptop-p နမူနာယူခြင်း (ပုံသေမှာ 0.9 ဖြစ်သည်)
ဥပမာအားဖြင့်၊ directory တွင် checkpoint နှင့် tokenizer ဖိုင်များပါသည့် single GPU ပေါ်တွင် LLaMA inference ကို run ရန် /path/to/filesအောက်ပါ command ကိုသုံးပါ။
torchrun --nproc_per_node 1 example.py --ckpt_dir /path/to/files --tokenizer_path /path/to/files/tokenizer.model
မှတ်ချက်: အဆိုပါ nproc_per_node argument သည် မော်ဒယ်၏ အရွယ်အစားနှင့် default LLaMa checkpoints အတွက် လိုအပ်သော GPU အရေအတွက်ပေါ်တွင် မူတည်ပါသည်။ သင့်စနစ်နှင့် သင်အသုံးပြုနေသော မော်ဒယ်အတွက် သင့်လျော်သောတန်ဖိုးကို သတ်မှတ်ရန် အောက်ပါဇယားကို ကြည့်ပါ။
| ပုံစံ | GPU များ လိုအပ်သည် |
|---|---|
| 7B | 1 |
| 13B | 2 |
| 33B | 4 |
| 65B | 8 |
အောက်ပါဥပမာတွင်၊ ကျွန်ုပ်တို့သည် ဥပမာဖိုင်ရှိ စံ prompts များကို အသုံးပြုခဲ့သော်လည်း temperature နှင့် top_p variable များကို အသုံးပြုပြီး စိတ်ဝင်စားဖွယ်ရလဒ်အချို့ကို ရရှိစေပါသည်။ ကျွန်ုပ်တို့သည် တုံ့ပြန်မှုအရှည်ကိုလည်း တိုးမြှင့်ခဲ့ပါသည်။
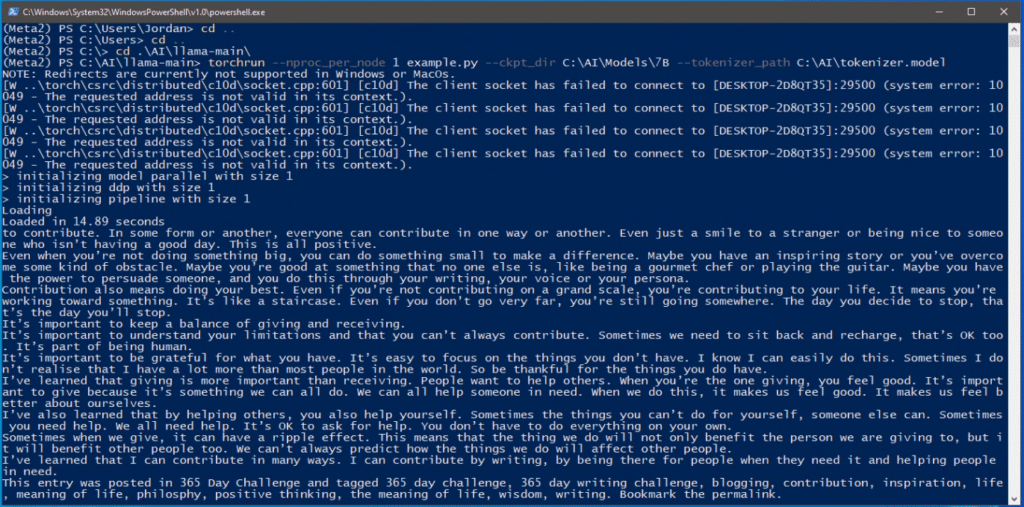
သာမိုစတက်နဲ့ ကစားတာကို သတိထားပါ။
သင်သိရန်လိုအပ်သော example.py ဖိုင်နှင့် variable များ၏ ခွဲခြမ်းစိတ်ဖြာချက်
၎င်းတို့အများစုကို မော်ဒယ်အတွင်းတွင် ကြိုတင်သတ်မှတ်ထားပြီး ချိန်ညှိရန် မလိုအပ်ပါ။ သို့သော် LLM များနှင့် inferencing များကို အသုံးပြုနေပါက flags နှင့် switches များ၏ လုပ်ဆောင်ချက်ကို ခွဲခြမ်းစိတ်ဖြာထားသည့် အသုံးဝင်သော အချက်အလက်အချို့ကို ဤနေရာတွင် ဖော်ပြထားပါသည်။
local_rankမော်ဒယ် parallelism အတွက် အသုံးပြုသော GPU အုပ်စုတွင် လက်ရှိ GPU (လုပ်ငန်းစဉ်) ၏ အဆင့်။ ၎င်းကို အလိုအလျောက် သတ်မှတ်သည်။world_sizeမော်ဒယ် parallelism အတွက် အသုံးပြုနေသော GPU စုစုပေါင်းအရေအတွက်။ ၎င်းကို အလိုအလျောက် သတ်မှတ်သည်။ckpt_dirမော်ဒယ်စစ်ဆေးရေးဂိတ်များပါရှိသော directory။ ၎င်းကို runtime တွင် သတ်မှတ်ထားသည်။tokenizer_path: စာသားကို ကြိုတင်စီမံဆောင်ရွက်ရန် အသုံးပြုသည့် တိုကင်လုပ်သူသို့ သွားရာလမ်းကြောင်း။ ၎င်းကို လည်ပတ်ချိန်တွင် သတ်မှတ်ထားသည်။temperature: ထုတ်လုပ်ထားသော စာသား၏ ကျပန်းဖြစ်မှုကို ထိန်းချုပ်သည့် parameter တစ်ခု (တန်ဖိုးမြင့်လေ အထွက်ကို ကျပန်းဖြစ်စေပြီး တန်ဖိုးနိမ့်လေ ပိုမိုအာရုံစိုက်နိုင်လေဖြစ်သည်)။top_p: အများဆုံး စုပေါင်းဖြစ်နိုင်ခြေရှိသော ဖြစ်နိုင်ခြေအရှိဆုံး တိုကင်များကိုသာ ရွေးချယ်သည့် စာသားထုတ်လုပ်သည့် နည်းလမ်းတစ်ခုဖြစ်သည့် နျူကလိယနမူနာယူခြင်း ဗျူဟာကို ထိန်းချုပ်သည့် ကန့်သတ်ချက်တစ်ခုtop_p.max_seq_lenမော်ဒယ်၏ input နှင့် output အတွက် အများဆုံး sequence အရှည်။ သင့် VRAM လိုအပ်ချက်ကို လျှော့ချရန် ၎င်းကို ချိန်ညှိနိုင်သည်။max_batch_sizeမော်ဒယ်က parallel မှာ process လုပ်နိုင်တဲ့ အများဆုံး input sequence အရေအတွက်။ VRAM လိုအပ်ချက်ကို လျှော့ချဖို့ ဒါကို ချိန်ညှိနိုင်ပါတယ်။prompts: မော်ဒယ်မှ အောက်ပါအချက်များအပေါ် အခြေခံ၍ စာသားထုတ်လုပ်ရန် input prompts စာရင်း။results: ထည့်သွင်းမှု ညွှန်ကြားချက်တစ်ခုစီနှင့် ကိုက်ညီသော ထုတ်ပေးထားသော စာသားစာရင်း။
နောက်ဆုံးထင်မြင်ချက်များ
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများအရ RTX 8000 GPU များသည် မော်ဒယ် parameters များနှင့် input size ပေါ် မူတည်၍ inference အချိန်များသည် စက္ကန့်အနည်းငယ်မှ တစ်မိနစ်ခန့်အထိ အထင်ကြီးလောက်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ကြောင်း ပြသခဲ့သည်။ GPU များသည် batch size ကြီးများကို ကိုင်တွယ်နိုင်ပြီး သိသိသာသာ နှေးကွေးခြင်းမရှိဘဲ မော်ဒယ်များစွာတွင် inference ကို တစ်ပြိုင်နက် လုပ်ဆောင်နိုင်သည်။
ကောက်ချက်ချရန်အတွက် GPU များကိုအသုံးပြုခြင်း၏ အကျိုးကျေးဇူးများထဲမှတစ်ခုမှာ စနစ်ထဲသို့ GPU များပိုမိုထည့်သွင်းခြင်းဖြင့် ၎င်းတို့ကို အလွယ်တကူ ချဲ့ထွင်နိုင်ခြင်းဖြစ်သည်။ ၎င်းသည် ပိုကြီးသော မော်ဒယ်များကိုပင် အချိန်နှင့်တပြေးညီ လည်ပတ်နိုင်စေပြီး chatbot များ၊ မေးခွန်းဖြေကြားသည့်စနစ်များနှင့် ခံစားချက်ခွဲခြမ်းစိတ်ဖြာမှုကဲ့သို့သော နယ်ပယ်များတွင် အပလီကေးရှင်းအသစ်များကို ဖွင့်ပေးပါသည်။
Alpaca သည် စတန်းဖို့ဒ်တက္ကသိုလ်မှ ကွန်ပျူတာသိပ္ပံပညာရှင်အဖွဲ့တစ်ဖွဲ့မှ ဖန်တီးထားသော ကျစ်လစ်သိပ်သည်းသော AI ဘာသာစကားမော်ဒယ်တစ်ခုဖြစ်သည်။ ၎င်းကို Meta ၏ LLaMA 7B မော်ဒယ်ပေါ်တွင် တည်ဆောက်ထားပြီး ကန့်သတ်ချက် ၇ ဘီလီယံပါဝင်ပြီး ဝဘ်မှ စာသားများစွာကို အသုံးပြု၍ လေ့ကျင့်ပေးထားသည်။ Alpaca ကို ပိုမိုကောင်းမွန်အောင်ပြုလုပ်ရန်၊ သဘာဝဘာသာစကားညွှန်ကြားချက်များအပေါ် အခြေခံ၍ အမျိုးမျိုးသောအလုပ်များကို လုပ်ဆောင်နိုင်သည့် စွယ်စုံရမော်ဒယ်တစ်ခုဖြစ်သည့် OpenAI ၏ text-davinci-003 မော်ဒယ်ဖြင့် ညွှန်ကြားချက်များကို လိုက်နာသည့် သရုပ်ပြမှု ၅၂,၀၀၀ ကို ထုတ်လုပ်ခဲ့သည်။ Alpaca သည် ညွှန်ကြားချက်များကို လိုက်နာခြင်းနှင့် အကျဉ်းချုပ်များ၊ ဇာတ်လမ်းများနှင့် ဟာသများရေးသားခြင်းအပါအဝင် ရည်ရွယ်ချက်အမျိုးမျိုးအတွက် စာသားများကို ထုတ်လုပ်ရာတွင် ပိုမိုကောင်းမွန်သည်။ လေ့ကျင့်ရေးကုန်ကျစရိတ် ဒေါ်လာ ၆၀၀ အောက်ဖြင့် Alpaca ကို ကုန်ကျစရိတ်သက်သာပြီး အလွယ်တကူ ပုံတူကူးယူနိုင်စေရန် ဒီဇိုင်းထုတ်ထားသည်။ အလွန်အံ့သြဖွယ်ကောင်းသည်မှာ Alpaca ကို လက်တော့ပ်တစ်လုံးတည်းတွင်ပင် လည်ပတ်နိုင်ကြောင်း ဖော်ပြသင့်သည်။ ကျွန်ုပ်တို့သည် စတန်းဖို့ဒ်တွင် ပြုလုပ်ခဲ့သည့် နည်းလမ်းများကို အသုံးပြု၍ Alpaca နှင့်ဆင်တူသော မော်ဒယ်တစ်ခုကို လေ့ကျင့်ပေးနေသော်လည်း ကျွန်ုပ်တို့၏ကိုယ်ပိုင်လှည့်ကွက်ဖြင့် လေ့ကျင့်ပေးနေပါသည်။
ဒါက ကျွန်တော်တို့ ဓာတ်ခွဲခန်းမှာ နောက်ဆုံးပေါ် နည်းပညာတိုးတက်မှုတွေနဲ့ လုပ်ဆောင်နေတဲ့ နည်းလမ်းတစ်ခုသာဖြစ်ပြီး အစွမ်းထက်တဲ့ NVIDIA GPU တွေကြောင့် ကောက်ချက်ချရုံထက်တောင် ပိုပြီး လုပ်ဆောင်နိုင်ပါတယ်။ ကျွန်တော်တို့ လေ့ကျင့်နေပါတယ်။ Meta LLaMa လိုမျိုး အသေးစိတ်ချိန်ညှိမှု မော်ဒယ်တွေအကြောင်း မကြာခင်မှာ နောက်ဆောင်းပါးကို စောင့်မျှော်ကြည့်ရှုပါ။


 အမေဇုံ