

NVIDIA DGX Spark အကြောင်းပြောတဲ့အခါတိုင်း အချက်နှစ်ချက်က အရင်ဆုံးပေါ်လာလေ့ရှိပါတယ်။ ပထမအချက်ကတော့ ခေါင်းစဉ်သတ်မှတ်ချက်ပါ။ ဒေါ်လာ ၄၀၀၀ လောက်တန် desktop box ထဲမှာ unified memory 128 GB ပါဝင်ပါတယ်။ လွန်ခဲ့တဲ့ နှစ်နှစ်လောက်ကတောင် အင်ဂျင်နီယာတစ်ယောက်ရဲ့စားပွဲပေါ်မှာ ထားဖို့ မဖြစ်နိုင်ဘူးလို့ ထင်ခဲ့မိပါတယ်။ ဒုတိယအချက်ကတော့ unit ရဲ့နောက်ဘက်မှာ 200 GB network ပါဝင်တာပါ။ desktop appliance မှာ တကယ့် datacenter-class fabric ရှိနေတာက လူတွေကို ရှေ့ကိုတိုးစေတာပါ။ ဘာလို့လဲဆိုတော့ ဒါက single-box workstation ထက်ပိုမြန်တဲ့ တစ်ခုခုကို ဆိုလိုတာပါ။ Sparks ကို ချိတ်ဆက်ပြီး ရုပ်ပိုင်းဆိုင်ရာ ပုံတူပွားနိုင်စွမ်းကို ဆိုလိုပါတယ်။ အရင်က rack ထဲမှာပဲ သီးသန့်တည်ရှိခဲ့တဲ့ multi-node setup အမျိုးအစားပါ။
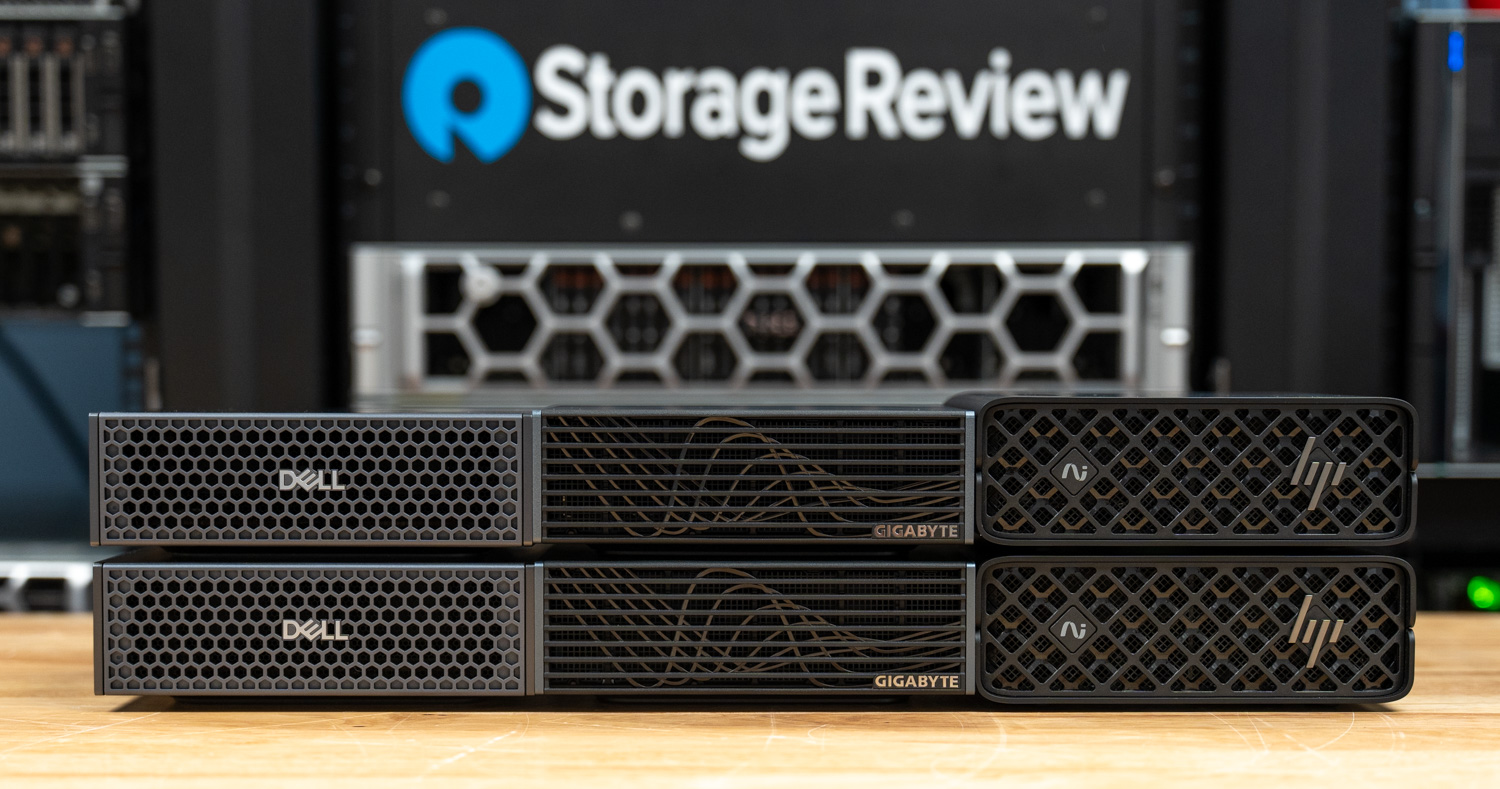
ဤသုံးသပ်ချက်သည် ထိုစွမ်းရည်ကို စစ်ဆေးသည်။ ကျွန်ုပ်တို့တွင်ရှိသော OEM Spark အကောင်အထည်ဖော်မှုသုံးခုလုံးတွင် ဖြန့်ဝေထားသော ကောက်ချက်ချမှုကို 200 Gb fabric ပေါ်တွင် ချိတ်ဆက်ထားသော two-node cluster များအဖြစ် တွဲဖက်ထားပြီး model variants များနှင့် workload shape သုံးခုကို ဖြတ်ကျော်၍ နှိုင်းယှဉ်ပါသည်။ NVIDIA ၏ default အကြံပြုချက်နှင့် ကွဲပြားသော box နှစ်ခုကြားတွင် model ကို မည်သို့ခွဲဝေထားသည်ကိုလည်း ကျွန်ုပ်တို့ ရည်ရွယ်ချက်ရှိရှိ ရွေးချယ်မှုပြုလုပ်ပြီး data ဖြင့် ကာကွယ်ပါသည်။ သို့သော် ယင်းတို့မပြုလုပ်မီတွင်၊ အောက်ပါအရာအားလုံးကို ပုံဖော်ပေးသည့် context အပိုင်းနှစ်ပိုင်းရှိသည်- clustering ကို ဦးစွာဖြစ်နိုင်စေသော network နှင့် လူတစ်ဦးသည် ၎င်းကို အသုံးပြုရန် သို့မဟုတ် အသုံးမပြုလိုသည့် အကြောင်းရင်းများ။
၂၀၀ GB အထည်
ကျွန်ုပ်တို့ရဲ့ မူရင်း DGX Spark သုံးသပ်ချက်မှာ networking implementation ကို အသေးစိတ်ဖော်ပြထားပေမယ့် အခြေခံအချက်တွေကိုတော့ ပြန်လည်ဖော်ပြသင့်ပါတယ်၊ ဘာလို့လဲဆိုတော့ ဒီသုံးသပ်ချက်မှာပါတဲ့ အရာအားလုံးက သူတို့အပေါ်မှာ မူတည်နေလို့ပါ။ Spark တိုင်းရဲ့ နောက်ဘက်မှာ NVIDIA ConnectX-7 SmartNIC နဲ့ မောင်းနှင်တဲ့ QSFP56 cages နှစ်ခု ပါရှိပါတယ်။ စာရွက်ပေါ်မှာဆိုရင် cages နှစ်ခုက aggregate connectivity 400 GB ကို အကြံပြုထားပေမယ့် PCIe က အဓိက အမြင့်ဆုံးပါ။ ConnectX-7 က Gen5 x4 links နှစ်ခုရဲ့ နောက်ကွယ်မှာ ရှိနေပြီး cages တွေကို ဘယ်လိုချိတ်ဆက်ထားပါစေ platform က အသုံးပြုနိုင်တဲ့ bandwidth 200 GB အထိ ရှိပါတယ်။ QSFP56 cage တစ်ခုတည်းက box က support လုပ်တဲ့ 200 Gb အပြည့်အဝကို ပေးစွမ်းနိုင်တာကြောင့် ဒုတိယ port က throughput အပိုအစား topology flexibility အတွက် ရှိနေတာပါ။
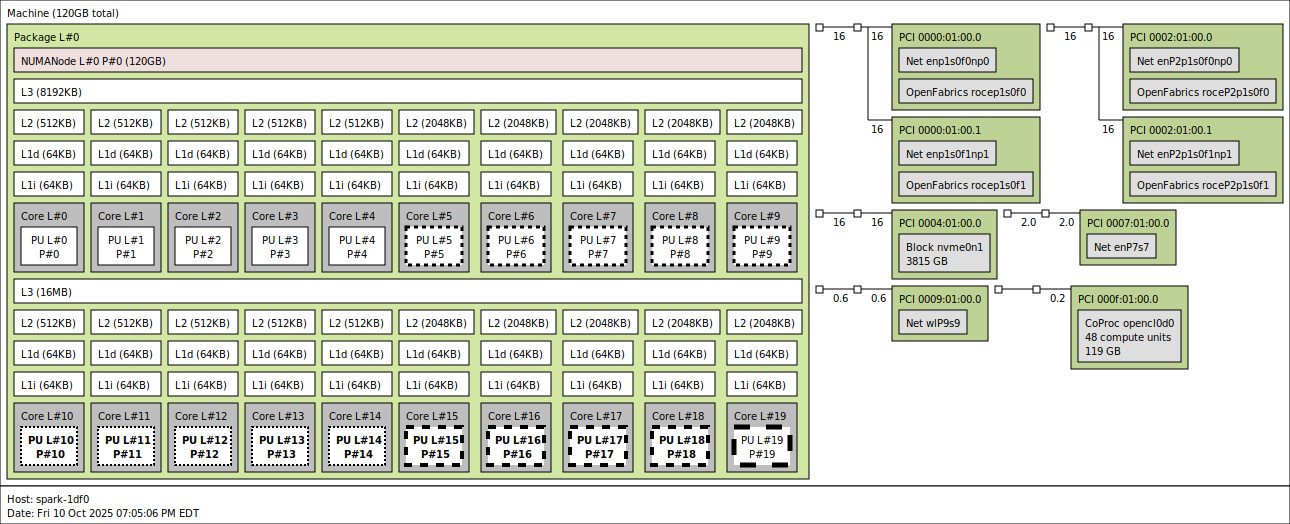
အဲဒီပြောင်းလွယ်ပြင်လွယ်ရှိမှုဟာ အသုံးများတဲ့ configuration သုံးခုမှာ ပေါ်လာပါတယ်။ အရိုးရှင်းဆုံးကတော့ Spark-to-Spark link ကို တိုက်ရိုက်အသုံးပြုတဲ့ 200 GB port တစ်ခုတည်းဖြစ်ပြီး NVIDIA ရဲ့ အတည်ပြုထားတဲ့ two-node setup က သတ်မှတ်ထားတဲ့အတိုင်းဖြစ်ပြီး ဒီသုံးသပ်ချက်အတွက် ကျွန်တော်တို့ဘာတွေအသုံးပြုခဲ့လဲဆိုတာပါ။ ဒုတိယတစ်ခုကတော့ switch မပါဘဲ cluster လုပ်ဖို့ Sparks ကြားမှာ ring-like topology ကို တည်ဆောက်ထားတဲ့ 100 Gb port နှစ်ခုပါ။ တတိယတစ်ခုကတော့ cage တစ်ခုက clustering အတွက် peer Spark ကိုသွားပြီး နောက်တစ်ခုက NVMe-oF မှတစ်ဆင့် high-speed storage ကိုသွားတဲ့ split-role configuration တစ်ခုဖြစ်ပါတယ်။ အလုပ်လုပ်တဲ့ dataset က Spark ရဲ့ internal NVMe မှာ မဆန့်တဲ့အခါ အသုံးဝင်ပါတယ်။
NVIDIA က Spark ကို အဲဒီကွန်ရက်ကို ဘယ်လိုအသုံးပြုလဲဆိုတာနဲ့ တိုက်ရိုက်ချိတ်ဆက်ထားတဲ့ configuration သုံးမျိုးနဲ့ ရောင်းချပါတယ်။ တစ်ဦးချင်း desktop အလုပ်အတွက် Spark တစ်ခုတည်း၊ stretched မော်ဒယ်တွေအတွက် 200 Gb fabric ပေါ်မှာ တိုက်ရိုက်ချိတ်ဆက်ထားတဲ့ validated two-Spark cluster တစ်ခုနဲ့ ဒီနှစ် GTC မှာ two-node ကန့်သတ်ချက်ကို ကျော်လွန်ဖို့ user တွေရဲ့ တောင်းဆိုမှုကို တုံ့ပြန်တဲ့အနေနဲ့ NVIDIA က လူသိရှင်ကြား ပြသခဲ့တဲ့ four-unit configuration တစ်ခု။ dual-Spark configuration ဟာ NVIDIA တက်ကြွစွာ ဈေးကွက်တင်နေတဲ့ configuration တစ်ခုဖြစ်ပြီး စာဖတ်သူအများစုက အမှန်တကယ် ဖြန့်ကျက်မယ့် configuration တစ်ခုဖြစ်ပြီး ဒီ hardware ပေါ်မှာ production-style inference အတွက် ကျိုးကြောင်းဆီလျော်တဲ့ အထက်ဆုံး bound ကို ကိုယ်စားပြုတယ်လို့ ကျွန်တော်တို့ ယုံကြည်ပါတယ်။ ဒီ review က end-to-end benchmarking လုပ်ထားတဲ့ configuration တစ်ခုလည်း ဖြစ်ပါတယ်။
ဘာကြောင့် Cluster Sparks ကို ပထမဆုံးအနေနဲ့ ဖြစ်ပေါ်စေတာလဲ
Sparks ကို cluster လုပ်ရတဲ့ ထင်ရှားတဲ့ အကြောင်းရင်းက cluster တိုင်းလိုပဲ အတူတူပါပဲ။ 128 GB box တစ်ခုတည်းနဲ့ အရေးကြီးတဲ့ model အားလုံးကို မသိမ်းဆည်းနိုင်ပါဘူး။ 120B-parameter model ကို box နှစ်ခုမှာ တိုးချဲ့လိုက်ခြင်းအားဖြင့် တခြားနည်းနဲ့ မကိုက်ညီတဲ့ workloads class တစ်ခုကို ဖွင့်လှစ်ပေးပါတယ်။ အဲဒါက အဓိကအသုံးပြုမှုကိစ္စဖြစ်ပြီး အများဆုံး demo လုပ်ခံရတဲ့ ကိစ္စပါ။
ဒီ platform မှာ NVIDIA ရဲ့ တကယ့် customer base အတွက် ပိုအရေးကြီးတဲ့ အကြောင်းရင်းကတော့ သင်ယူမှုပါပဲ။ NVIDIA က Spark ကို entry point အနေနဲ့ ထားရှိပါတယ်။ သူတို့ရဲ့ official documentation , sample notebooks နဲ့ partner playbooks တွေက ဒီ box ကို teaching appliance အနေနဲ့ သဘောထားပါတယ်။ local chat interface နောက်မှာ pre-built model တစ်ခု တည်ဆောက်တာကနေ hosted endpoint နဲ့ coding assistant ကို run တာအထိ၊ fine-tuning လုပ်တဲ့ model အသေးစားလေးတွေကနေ PyTorch နဲ့ JAX မှာ end-to-end application တွေ တည်ဆောက်တာအထိ အရာအားလုံးအတွက် first class guides တွေ ပါဝင်ပါတယ်။ အဓိကအချက်ကတော့ CUDA kernel ကို တစ်ခါမှ မရေးဖူးတဲ့သူတစ်ယောက်က သူတို့ရဲ့ desk မှာ သုညကနေ အလုပ်လုပ်တဲ့ AI workflow တစ်ခုအထိ တစ်ပတ်အတွင်း ရောက်ရှိနိုင်တယ်ဆိုတာပါပဲ။ ML မဟုတ်တဲ့ field မှာရှိတဲ့ engineer တွေအတွက်လည်း အတူတူပါပဲ။ သူတို့ အပြည့်အဝ ထိန်းချုပ်နိုင်တဲ့ sandbox တစ်ခု လိုချင်တဲ့ self-contained sandbox နှစ်ခုပါတဲ့ two-spark cluster က အဲဒီ teaching surface ကို multi-node territory အထိ တိုးချဲ့ပေးပါတယ်။ အဲဒီလူဟာ tensor parallelism, pipeline parallelism နဲ့ collective communication libraries တွေ ဘယ်လိုအလုပ်လုပ်လဲဆိုတာကို သင်ယူနိုင်ပါပြီ။ တကယ့် bottleneck တွေကို ဖော်ထုတ်နိုင်တဲ့ network လည်း ရှိပါတယ်။
NVIDIA ရဲ့ ကိုယ်ပိုင်ရပ်တည်ချက်မှာ ထင်ရှားစွာ ပျောက်ဆုံးနေတာကတော့ Spark ဟာ production inference serving အတွက်ဖြစ်တယ် ဆိုတဲ့ အခိုင်အမာပြောဆိုချက်ပါ။ Jensen ဟာ လွန်ခဲ့တဲ့နှစ်အနည်းငယ်အတွင်း keynote တိုင်းလိုလိုမှာ hardware-software co-design အကြောင်း ပြောဆိုခဲ့ပြီး ဒီမူက ဒီမှာ အကျုံးဝင်ပါတယ်။ NVIDIA platform တိုင်းကို workload shape တစ်ခုအတွက် optimize လုပ်ထားပြီး Spark ကို traffic ကို serving လုပ်ဖို့မဟုတ်ဘဲ individual exploration နဲ့ learning အတွက် optimize လုပ်ထားပါတယ်။ ကျွန်ုပ်တို့ရဲ့ ယခင် Spark reviews တွေမှာ platform ဟာ inference task အများစုမှာ memory-bandwidth ကို အလွန်အမင်းကန့်သတ်ထားပြီး network က cluster လုပ်လိုက်တာနဲ့ အဲဒီကန့်သတ်ချက်ကို ပိုမိုကောင်းမွန်စေတယ်ဆိုတာ ပြသခဲ့ပြီးဖြစ်ပါတယ်။ 200 Gb link တစ်ခုတည်းဟာ desktop အတွက် အထင်ကြီးစရာကောင်းပေမယ့် single chassis အတွင်းမှာ PCIe Gen5 x16 connection ထက် သိသိသာသာ နှေးကွေးပြီး NVLink-bridged datacenter GPU တစ်စုံမှာ သန့်ရှင်းစွာအလုပ်လုပ်တဲ့ collective communication pattern တွေဟာ 200 Gb fabric ကို latency penalties တွေမပါဘဲ transplant မလုပ်ပါဘူး။
NVIDIA က တရားဝင်ထောက်ပံ့ပေးထားတဲ့ configuration ကို Sparks နှစ်ခုအထိ ကြာမြင့်စွာ ကန့်သတ်ထားရတဲ့ အကြောင်းရင်းအစစ်အမှန်ဖြစ်ပြီး GTC မှာ လေးခုပါ သရုပ်ပြမှုဟာ အော်ဂဲနစ်ထုတ်ကုန်တိုးချဲ့မှုထက် အသုံးပြုသူဝယ်လိုအားကို တုံ့ပြန်တဲ့အကြောင်းရင်းလည်း ဖြစ်ပါတယ်။ software stack ကို node လေးခု ဒါမှမဟုတ် ရှစ်ခုမှာ လည်ပတ်တာကို ဘာမှမတားဆီးနိုင်ဘဲ အသုံးပြုသူတွေနဲ့ outlet အများအပြားက cluster ကြီးတွေကနေ ရလဒ်တွေကို ထုတ်ပြန်ခဲ့ကြပါတယ်။ အဲဒီစမ်းသပ်မှုတွေကနေ ရရှိတဲ့ စွမ်းဆောင်ရည်ကိန်းဂဏန်းတွေက ယေဘုယျအားဖြင့် ကျေနပ်စရာမကောင်းပါဘူး- inter-node fabric က အဓိကကုန်ကျစရိတ်ဖြစ်လာပြီး စုပေါင်းစွမ်းဆောင်ရည်က သိသိသာသာ ကျဆင်းသွားပြီး အဲဒီအပြင် အဲဒီ configuration တွေရဲ့ နောက်ဆုံးအပိုင်းမှာ per-user throughput ဟာ cluster ကို တရားမျှတစေဖို့ လုံလောက်တဲ့ အရွယ်အစားရှိတဲ့ မည်သည့်မော်ဒယ်အတွက်မဆို single-digit tokens per second အပိုင်းအခြားထဲကို ကျဆင်းသွားနိုင်ပါတယ်။ အဲဒီအချိန်မှာ setup ဟာ serving platform တစ်ခုထက် learning lab တစ်ခုအနေနဲ့ လုပ်ဆောင်နိုင်ပါတယ်။
ဒါတွေအားလုံးက ပယ်ချဖို့ ရည်ရွယ်တာ မဟုတ်ပါဘူး။ Clustering Sparks ဟာ ဒေါ်လာထောင်ပေါင်းများစွာတန်တဲ့ datacenter hardware တွေရဲ့ နောက်ကွယ်မှာ ပိတ်မိနေတဲ့ distributed inference နဲ့ training အတွက် intuition တစ်ခု တည်ဆောက်ဖို့ အမှန်တကယ် အကောင်းဆုံးနည်းလမ်းတစ်ခုဖြစ်ပြီး pipeline bubbles တွေကို တကယ်မြင်နိုင်ခြင်း၊ bottleneck တွေကို လျှော့ချနိုင်ခြင်း၊ နဲ့ သင်ပိုင်ဆိုင်တဲ့ system မှာ parallelism trade-off တွေကို လျှော့ချနိုင်ခြင်းရဲ့ ပညာရေးဆိုင်ရာတန်ဖိုးဟာ အရေးကြီးပါတယ်။ ကျွန်ုပ်တို့ရဲ့ နောက်ဆက်တွဲအစီအစဉ်ကတော့ dual-Spark cluster တစ်လျှောက်မှာ 1B-parameter အသေးစား ဒါမှမဟုတ် sub-1 B model တစ်ခုကို သုညကနေ စတင်လေ့ကျင့်ပေးခြင်းအားဖြင့် ဒီထက်ပိုပြီး လုပ်ဆောင်ဖို့ဖြစ်ပြီး၊ တကယ့် distributed pre-training run တစ်ခု လုပ်ဆောင်တဲ့ အခြေအနေတွေကို တတ်နိုင်သမျှ အနီးစပ်ဆုံး ထင်ဟပ်စေဖို့ ရွေးချယ်ထားတဲ့ setup တစ်ခုနဲ့၊ ဒါကြောင့် ဒီ cluster class က ဘယ်နေရာမှာ အဓိပ္ပာယ်ရှိလဲ၊ မသင့်တော်လဲဆိုတာကို ကျွန်ုပ်တို့ အတိအကျ ပြသနိုင်ပါတယ်။ အဲဒီ project က လက်ရှိမှာ နောက်ကွယ်မှာ ရှိနေပြီး သင်မြင်ပြီးသား တခြား coverage တွေကို လုပ်ဆောင်နေပြီး ကျွန်ုပ်တို့ရဲ့ 800 Gb lab core switch အသစ် ရောက်ရှိလာဖို့ optics တွေကို စောင့်နေပါတယ်။ lab build ပြီးသွားရင် ပြန်လည်ကြည့်ရှုဖို့ မျှော်လင့်ပါတယ်။
အောက်ပါတို့သည် dual-Spark configuration သည် အကာကွယ်ဆုံးသော use case ကို အဓိကထားဖော်ပြထားသည်- box နှစ်ခုလုံးလိုအပ်လောက်အောင် ကြီးမားသော model များ၏ distributed inference၊ ကျွန်ုပ်တို့တွင်ရှိသော OEM implementations သုံးခုလုံးတွင် benchmark လုပ်ထားသည်။ per-model နံပါတ်များဆီသို့ မသွားမီ၊ နောက်အပိုင်းတွင် NVIDIA ၏ကိုယ်ပိုင် documentation တွင် default လုပ်လေ့ရှိသော tensor-parallel configuration ထက် pipeline-parallel configuration အောက်တွင် ထိုနံပါတ်များကို အဘယ်ကြောင့် report လုပ်ရကြောင်း ရှင်းပြပါမည်။
စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
Tensor Parallel မဟုတ်ဘဲ Pipeline Parallel ကို ဘာကြောင့် ကျွန်ုပ်တို့ အစီရင်ခံတာလဲ။
NVIDIA မှထုတ်ဝေထားသော DGX Spark လမ်းညွှန်များ နှင့် ၎င်းတို့၏ရည်ညွှန်းပစ္စည်းအများစုသည် Spark box နှစ်ခုတွင် မော်ဒယ်တစ်ခုကို မည်သို့ scale လုပ်ရမည်ကိုဖော်ပြရန် tensor parallelism (TP) ကို အားကိုးအားထားပြုပါသည်။ TP သည် matrix multiplication တိုင်းကို GPU နှစ်ခုလုံးတွင် ပိုင်းခြားထားသောကြောင့် layer တစ်ခုစီသည် device နှစ်ခုလုံးတွင် တစ်ပြိုင်နက်တည်း run ပြီး partial result များကို attention နှင့် MLP block တစ်ခုစီပြီးနောက် all-reduce မှတစ်ဆင့် ပေါင်းစပ်ထားသည်။ Pipeline parallelism (PP) သည် မတူညီသောလမ်းကြောင်းကို ယူသည်- ၎င်းသည် မော်ဒယ်ကို layer အလိုက် ထက်ဝက်ဖြတ်ပြီး ပထမတစ်ဝက်ကို box တစ်ခုပေါ်တွင်နှင့် ဒုတိယတစ်ဝက်ကို အခြားတစ်ခုပေါ်တွင်ထားပြီးနောက် ၎င်းတို့အကြား activation များကို stream လုပ်သည်။ request တစ်ခုစီသည် full model မှတစ်ဆင့် ဆက်လက်စီးဆင်းနေသော်လည်း မည်သည့်အချိန်တွင်မဆို box တစ်ခုသာ ပေးထားသော token အတွက် တွက်ချက်မှုကို လုပ်ဆောင်နေပြီး အခြားတစ်ခုသည် နောက် microbatch တွင် အလုပ်လုပ်နေသည်။
အပေးအယူလုပ်ရမယ့်အချက်က ဝါယာကြိုးပေါ်က ဘာတွေဖြတ်သွားလဲဆိုတာပေါ် မူတည်ပါတယ်။ dual-Spark stack က ConnectX-7 200 GbE link မှတစ်ဆင့် စနစ်နှစ်ခုကို ချိတ်ဆက်ပေးပြီး network link အတွက် မြန်ပေမယ့် Spark တစ်ခုတည်းထဲက memory bandwidth နဲ့ ယှဉ်ရင် နှေးပါတယ်။ TP ရဲ့ all-reduce က transformer layer တစ်ခုစီကို နှစ်ကြိမ် fire လုပ်တာကြောင့် TP=2 ကို run နေတဲ့ 80-layer model က output ရဲ့ token တစ်ခုစီအတွက် cross-box exchange ၁၆၀ ကို generate လုပ်ပေးပြီး အဲဒီ exchange တိုင်းက နောက် computation ကို block လုပ်ပါတယ်။ PP=2 က model ရဲ့ တစ်ဝက်နှစ်ခုကြားက seam မှာ token တစ်ခုစီကို တစ်ကြိမ်ပဲ hands off activation လုပ်ပါတယ်။ non-trivial latency ရှိတဲ့ 200 GbE link မှာ အဲဒီကွာခြားချက်က ကျန်တာအားလုံးကို လွှမ်းမိုးထားပါတယ်။
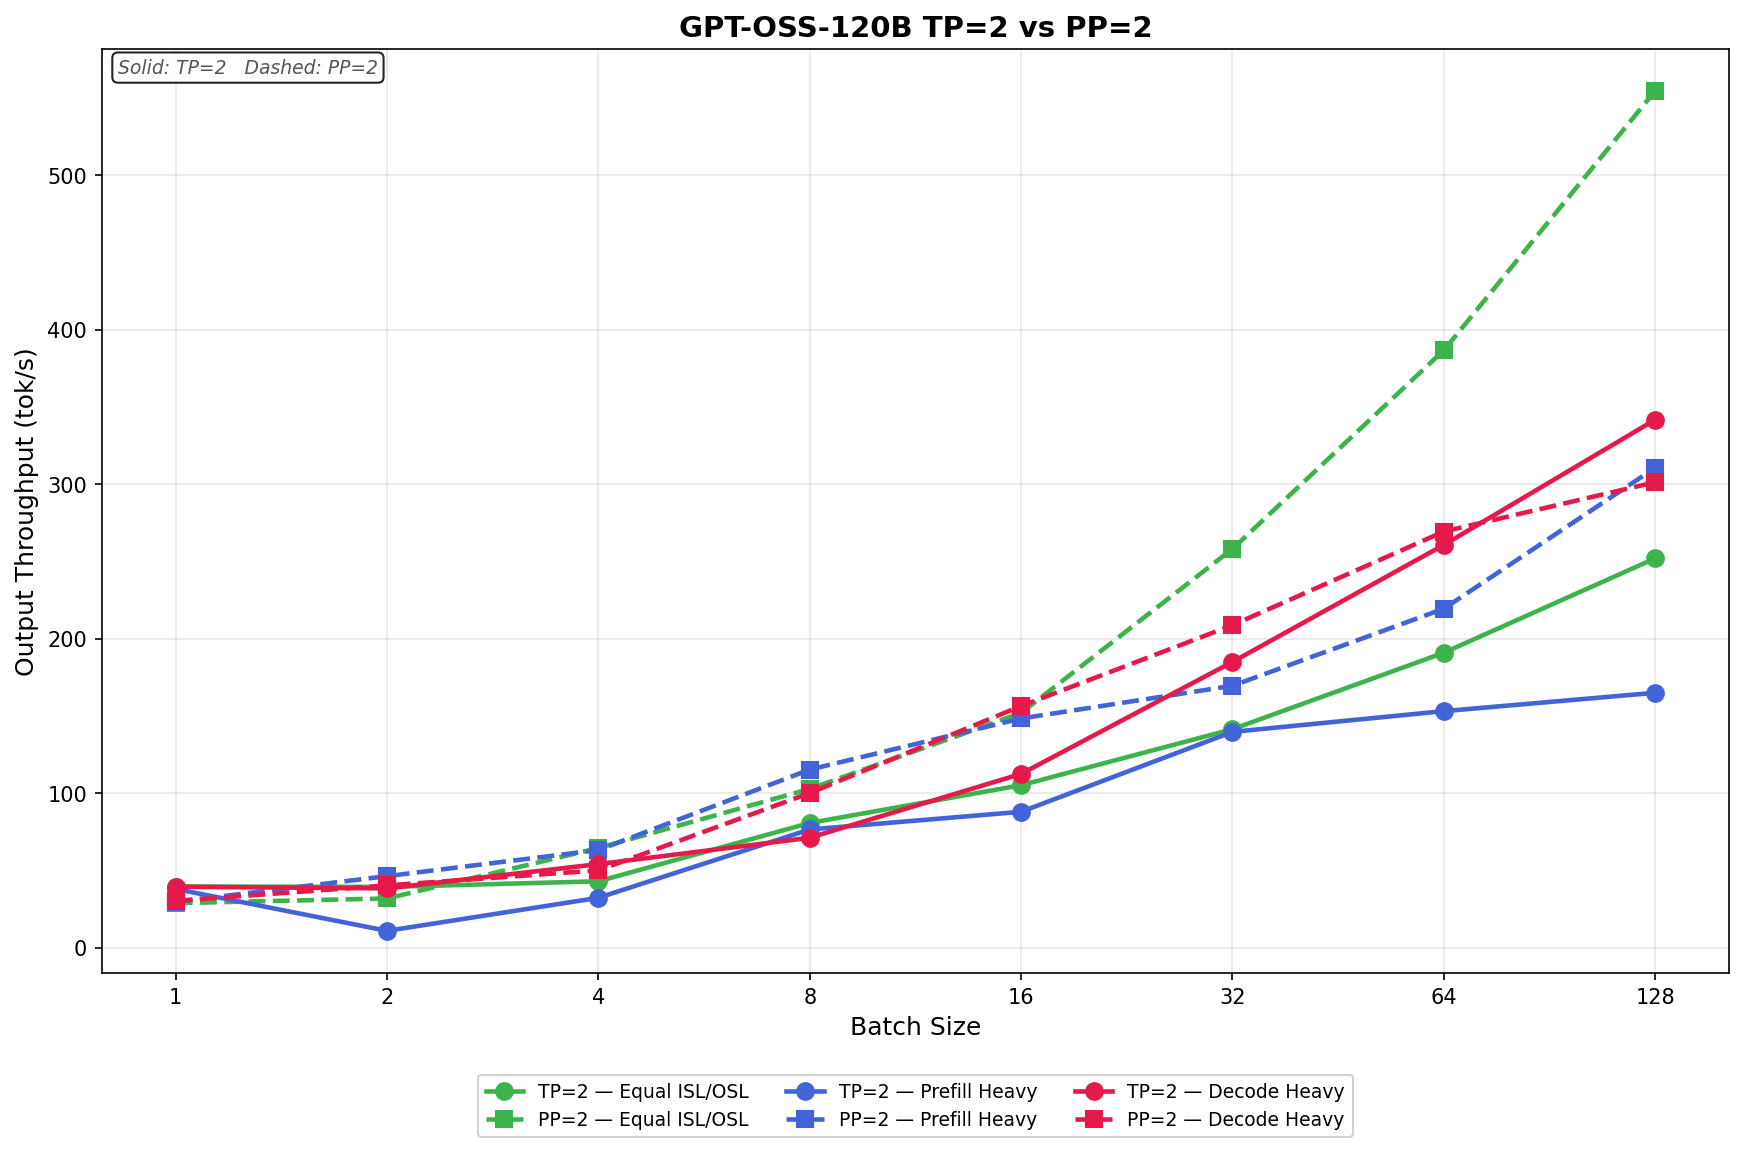
ကျွန်ုပ်တို့ရဲ့ GPT-OSS-120B တိုင်းတာမှုတွေက ဒီအချက်ကို ရှင်းရှင်းလင်းလင်း သက်သေပြနေပါတယ်။ workload က ဘယ် strategy ရဲ့ overhead ကိုမှ ဖုံးကွယ်ဖို့ အလွန်ပါးလွှာတဲ့ batch size 1 မှလွဲရင် PP=2 က ဦးဆောင်ပြီး တစ်ပြိုင်နက်တည်း လုပ်ဆောင်မှုတွေ တိုးလာတာနဲ့အမျှ ထိန်းသိမ်းထားပါတယ်။ Equal ISL/OSL workload မှာ TP=2 က batch size 128 မှာ 252.01 tok/s အထိ ရောက်ရှိပြီး PP=2 က hardware တစ်ခုတည်းမှာ 554.69 tok/s အထိ မြင့်တက်ကာ 2.20x အားသာချက်ရှိပါတယ်။ Prefill Heavy ကလည်း PP=2 က 310.63 tok/s နဲ့ အဆုံးသတ်ပြီး TP=2 က 164.99 tok/s နဲ့ အဆုံးသတ်ပါတယ်။ Decode Heavy scenario က သုံးခုထဲမှာ အနီးစပ်ဆုံးဖြစ်ပေမယ့် PP=2 က batch size 8 ကနေ batch size 64 အထိ ဦးဆောင်နေဆဲဖြစ်ပြီး batch size 128 မှာ အသင့်အတင့် ဦးဆောင်မှုကိုသာ ပေးစွမ်းနိုင်ပြီး ရှည်လျားတဲ့ 8K output က pipeline bubble cost ကို မြင့်တက်စေပါတယ်။
TP=2 မှာ အနိုင်ရတဲ့ ကျဉ်းမြောင်းတဲ့ window ရှိပါတယ်။ scenario တိုင်းမှာ batch size 1 မှာ TP ဟာ သေးငယ်ပေမယ့် တကယ့် အားသာချက်ကို ပေးစွမ်းပါတယ်- Equal မှာ tok/s 39.55 vs 28.79 tok/s၊ Prefill Heavy မှာ 37.97 vs 29.60 နဲ့ Decode Heavy မှာ 39.42 vs 30.28။ request တစ်ခု flight လုပ်နေချိန်မှာ idle pipeline stage ကို အလုပ်ရှုပ်နေစေမယ့် second microbatch မရှိတာကြောင့် PP ဟာ step တိုင်းမှာ empty slot တစ်ခုအတွက် ပေးချေပြီး TP ဟာ ရှိပြီးသား token တစ်ခုတည်းမှာ GPU နှစ်ခုလုံးကို အသုံးပြုနိုင်ပါတယ်။ ဒါက NVIDIA ရဲ့ TP လမ်းညွှန်ချက်ကို တည်ဆောက်ထားတဲ့ စနစ်ပါ- ပထမဆုံးနဲ့ တစ်ခုတည်းသော request မှာ latency က aggregate throughput ထက် ပိုအရေးကြီးတဲ့ interactive single-stream serving ပါ။ deployment တစ်ခုဟာ chat-style ဖြစ်ပြီး box တစ်ခုကို user တစ်ယောက်နဲ့ tight TTFT targets တွေနဲ့ဆိုရင် TP=2 က မှန်ကန်တဲ့ call ဖြစ်ပြီး ဒါက NVIDIA ရဲ့ Spark ကို ဘယ်လိုမြင်လဲဆိုတာနဲ့လည်း ကိုက်ညီပါတယ်။
အခြေခံအဆောက်အအုံကို အတိုင်းအတာတစ်ခုအထိ ဝန်ဆောင်မှုပေးသော workloads များအတွက်၊ batched inference နှင့် concurrent requests များစွာပါဝင်သည့်အခါ၊ Pipeline parallelism သည် box များတစ်လျှောက် scaling လုပ်သည့်အခါ အထူးသဖြင့် Expert Parallelism ကဲ့သို့သော strategy များ မပါဝင်သည့်အခါတွင် ပိုမိုသင့်လျော်ပါသည်။ 200 GbE fabric သည် compute ကို idle မလုပ်ဘဲ TP ၏ per-token all-reduce traffic ကို ထိန်းထားနိုင်မည်မဟုတ်ဘဲ၊ batch size သည် 4 သို့မဟုတ် 8 ဖြစ်သောအခါ၊ PP ၏ bubble cost သည် steady-state stream ထဲသို့ ပျောက်ကွယ်သွားပါသည်။ ထို့ကြောင့် ဤဆောင်းပါး၏ ကျန်အပိုင်းရှိ per-model number တိုင်းကို TP=1 နှင့် PP=2 ဖြင့် ဖော်ပြထားပါသည်။ ၎င်းသည် real work ပြုလုပ်ရန် တောင်းဆိုသည့်အခါ dual-Spark deployment မှ ပေးစွမ်းနိုင်သည့်အရာကို အမှန်တကယ်ကိုယ်စားပြုသည့် configuration ဖြစ်သည်။
GPT-OSS-120B ကို TP vs PP ခေါင်းစဉ်ဇယားအဖြစ် ရည်ရွယ်ချက်ရှိရှိ ရွေးချယ်ခဲ့ခြင်းမှာ ၎င်းသည် အကျယ်ဆုံးကွာဟချက်ကို ပြသသောကြောင့်ဖြစ်သည်။ သို့သော် ၎င်းသည် မော်ဒယ်အားလုံးအတွက် မှန်ကန်မှုမရှိကြောင်းနှင့် ဤ parameter များသည် မော်ဒယ်၏ parameter များပေါ်တွင် မူတည်ကြောင်းကိုလည်း ပြသလိုပါသည်။ BF16 ရှိ Llama-3.1-8B-Instruct သည် ပိုမိုရှေးရိုးစွဲသော ဇာတ်လမ်းတစ်ပုဒ်ကို ပြောပြသည်။ မော်ဒယ်သည် အလွှာတစ်ခုစီ၏ တွက်ချက်မှုသည် မြန်ဆန်ပြီး TP ၏ all-reduce traffic သည် သင့်လျော်လောက်အောင် သေးငယ်သည်။ ဆန့်ကျင်ဘက်အားဖြင့်၊ PP ၏ per-step coordination cost သည် မော်ဒယ်အရွယ်အစား မည်သို့ပင်ရှိစေကာမူ ပုံသေဖြစ်သည်။ ရလဒ်အနေဖြင့် TP=2 သည် batch sweep တစ်ခုလုံးနီးပါးတွင် ဦးဆောင်မှုကို ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ Equal ISL/OSL မှာ TP=2 ဟာ batch size 1 (23.2 vs 13.4 tok/s) ကနေ batch size 32 (388.7 vs 349.3 tok/s) အထိ ဦးဆောင်နေပြီး batch size 64 (524.8 vs 638.2 tok/s) နဲ့ batch size 128 (679.2 vs 1,047.1 tok/s) မှာသာ ထိပ်ဆုံးကို ရှုံးနိမ့်ပါတယ်။ Prefill Heavy ဟာ PP=2 က 64 နဲ့ 128 မှာ နေရာယူခင် batch size 32 မှာ TP=2 က ဦးဆောင်နေပြီး အဲဒီပုံစံအတိုင်းပါပဲ။ Decode Heavy ဟာ အဆုံးဖြတ်အရှိဆုံးပါ- TP=2 ဟာ batch size တိုင်းမှာ အနိုင်ရပြီး 366.7 tok/s နဲ့ ပြီးဆုံးပြီး PP=2 က 330.5 tok/s နဲ့ ပြီးဆုံးပါတယ်။
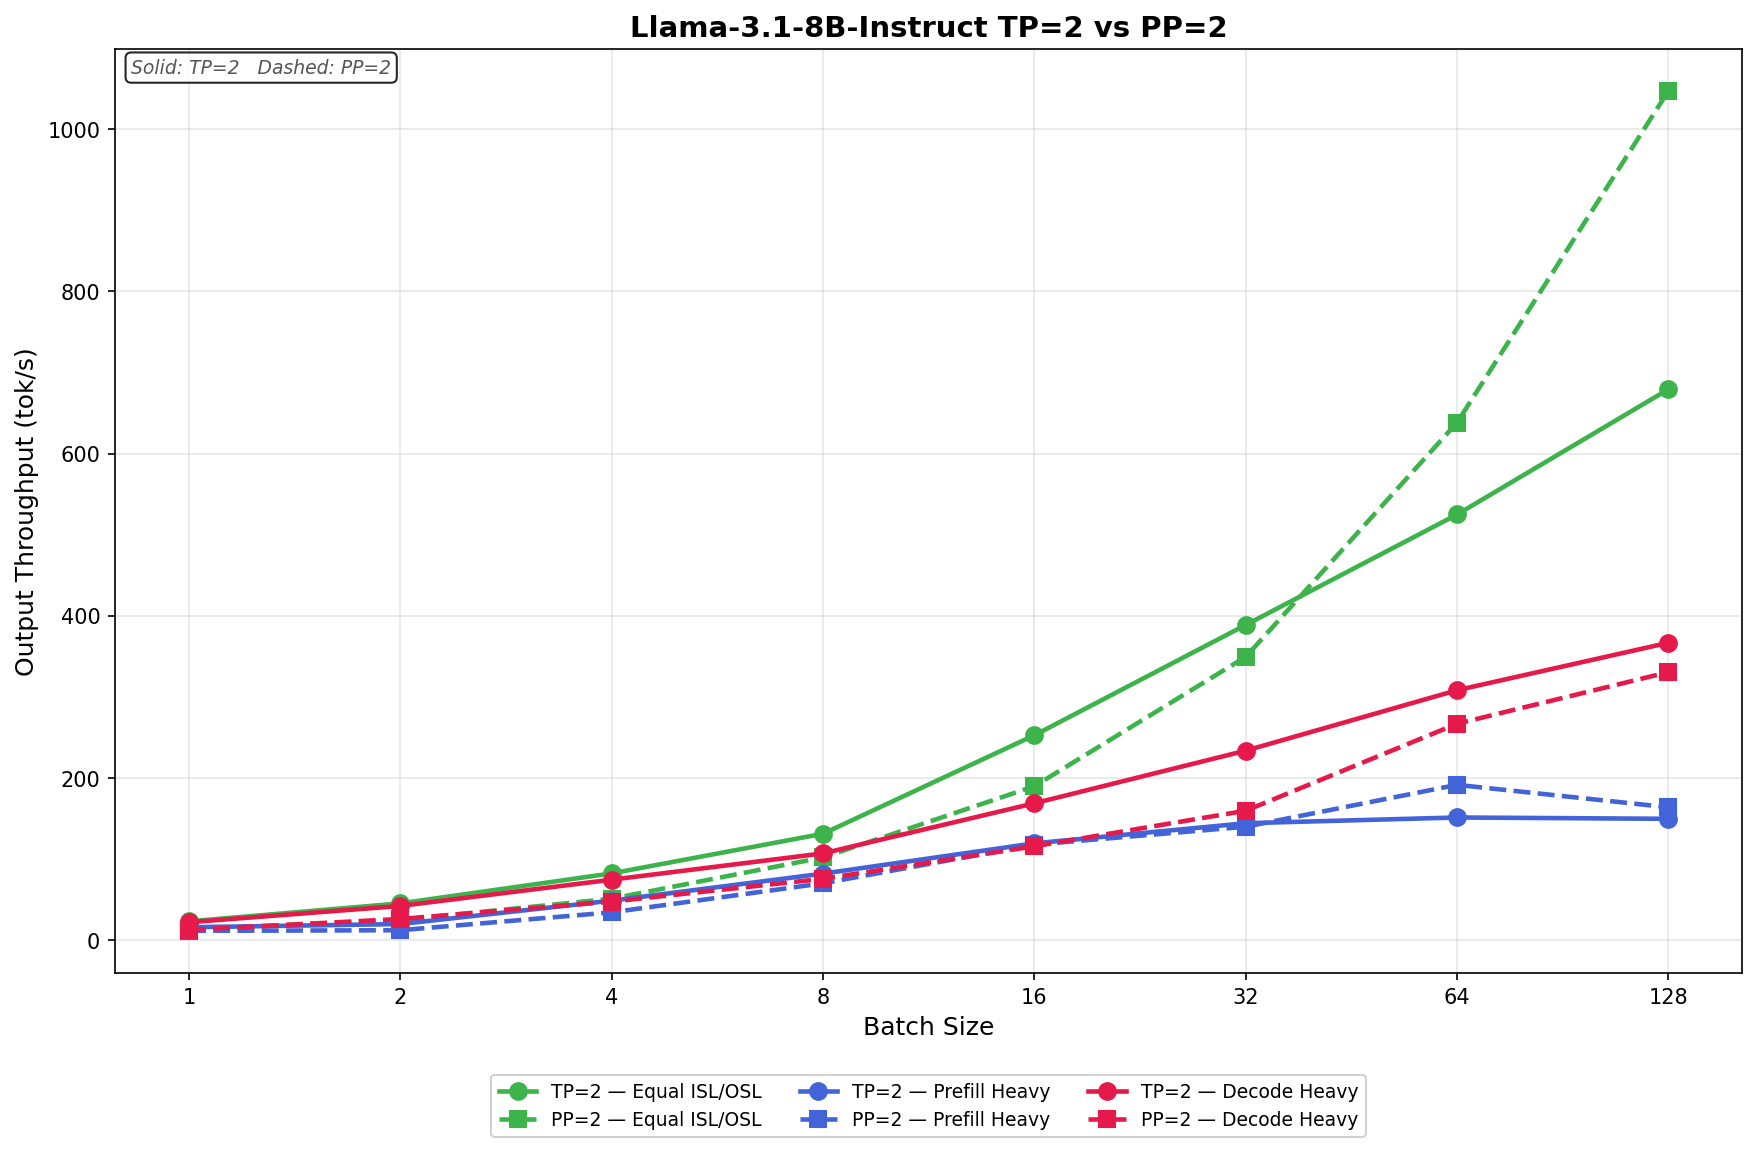
ဤတန်ပြန်ဥပမာသည် အခြေခံယန္တရားကို ဆန့်ကျင်ဘက်ဖြစ်စေမည့်အစား အားဖြည့်ပေးသည်။ PP=2 သည် batch size များသည် pipeline ကိုဖြည့်ရန်နှင့် bubble cost ကို အပြည့်အဝလျှော့ချရန် လုံလောက်သောအခါတွင်သာ အနိုင်ရပြီး မော်ဒယ်ကိုယ်တိုင်က TP ၏ per-layer all-reduce သည် ဈေးသက်သာလောက်အောင် သေးငယ်သောအခါတွင်သာ အနိုင်ရသည်။ ထို crossover point သည် ပိုမိုဝေးကွာသွားသည်။ Decode Heavy ရလဒ်သည်လည်း တသမတ်တည်းရှိသည်- output sequence ရှည်ခြင်းသည် decode အဆင့်များပိုများခြင်း၊ pipeline bubbles များ ပိုမိုအပြန်အလှန်ပေးချေခြင်းနှင့် PP အတွက် ကွာခြားချက်ကို ဖြည့်ဆည်းရန် window ငယ်ခြင်းတို့ကို ဆိုလိုသည်။ တစ်နည်းအားဖြင့် PP သည် GPT-OSS-120B တွင် batch size 128 တွင် 2.20x အနိုင်ရစေသည့် ရူပဗေဒတစ်ခုတည်းသည် 8B မော်ဒယ်တွင် ထိပ်ဆုံး batch size နှစ်ခုကိုသာ အနိုင်ရပြီး decode-heavy sweep ကို ဘယ်သောအခါမှ မအနိုင်ရရသည့် အကြောင်းရင်းကိုလည်း ရှင်းပြသည်။
GPT-OSS-120B
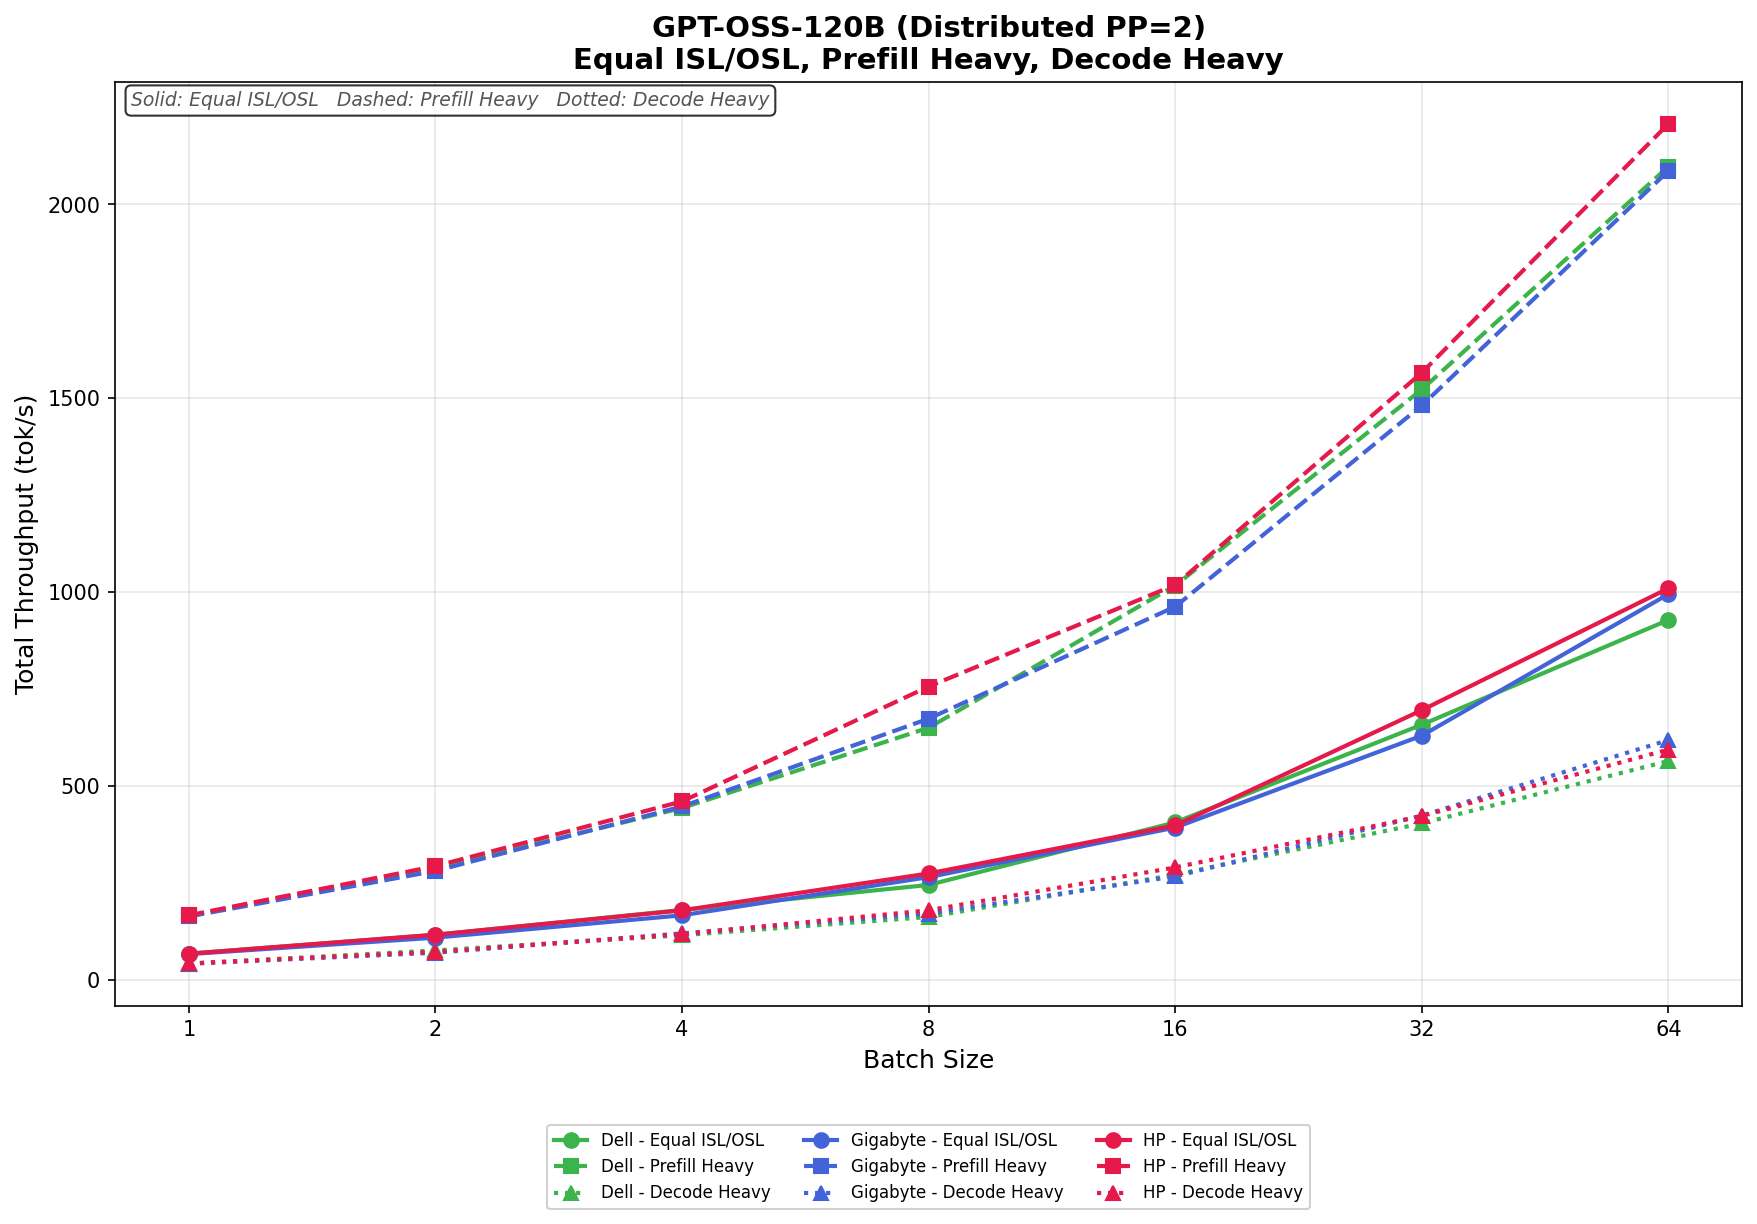
Equal ISL/OSL မှာ Dell ဟာ 67.06 tok/s ကနေစတင်ပြီး 927.93 tok/s အထိ တိုးချဲ့နိုင်ပြီး batch size 64 ရှိပါတယ်။ GIGABYTE ဟာ 65.77 tok/s ကနေ အနည်းငယ်နိမ့်ပြီး စတင်ပေမယ့် 994.53 tok/s နဲ့ ပိုမိုအားကောင်းပြီး HP ကတော့ 1,009.75 tok/s နဲ့ ထိပ်ဆုံးမှာ ဦးဆောင်နေပါတယ်။ HP ဟာ batch size 32 ကနေစပြီး ဦးဆောင်နေပြီး အများစုမှာတော့ spread က ကျဉ်းမြောင်းနေဆဲပါ။
Prefill Heavy မှာ throughput က ဘုတ်အဖွဲ့တစ်ခုလုံးမှာ ပိုပြီး တက်ကြွစွာ တိုးလာပါတယ်။ Dell က 164.42 tok/s ကနေ 2,097.80 tok/s အထိ တိုးလာပြီး GIGABYTE က 162.96 tok/s ကနေ 2,086.72 tok/s အထိ တိုးလာပြီး HP က အားအကောင်းဆုံးရလဒ်ကို ရရှိပြီး 165.95 tok/s ကနေ 2,208.16 tok/s အထိ တက်လာခဲ့ပါတယ်။ HP က batch size တိုင်းလိုလိုမှာ ဦးဆောင်နေပြီး Dell နဲ့ GIGABYTE က အထူးသဖြင့် batch size 32 နဲ့ 64 မှာ အုပ်စုလိုက် စုစည်းထားပါတယ်။
Decode Heavy မှာ decode workload အတွက် မျှော်လင့်ထားတဲ့အတိုင်း အလုံးစုံစွမ်းဆောင်ရည်က နိမ့်ကျနေပါတယ်။ Dell က 41.20 tok/s ကနေ 563.98 tok/s အထိ ရှိပြီး GIGABYTE က 40.83 tok/s ကနေ 617.96 tok/s အထိ တိုးလာပြီး HP က 41.63 tok/s ကနေ 593.56 tok/s အထိ တိုးလာပါတယ်။ GIGABYTE က batch size 64 နဲ့ အခိုင်မာဆုံး finish ရှိပြီး HP က mid-range မှာ ဦးဆောင်နေပြီး Dell က နီးစပ်နေဆဲဖြစ်ပေမယ့် concurrency မြင့်မားတဲ့နေရာမှာတော့ အနည်းငယ် နောက်ကျနေပါတယ်။
GPT-OSS-20B
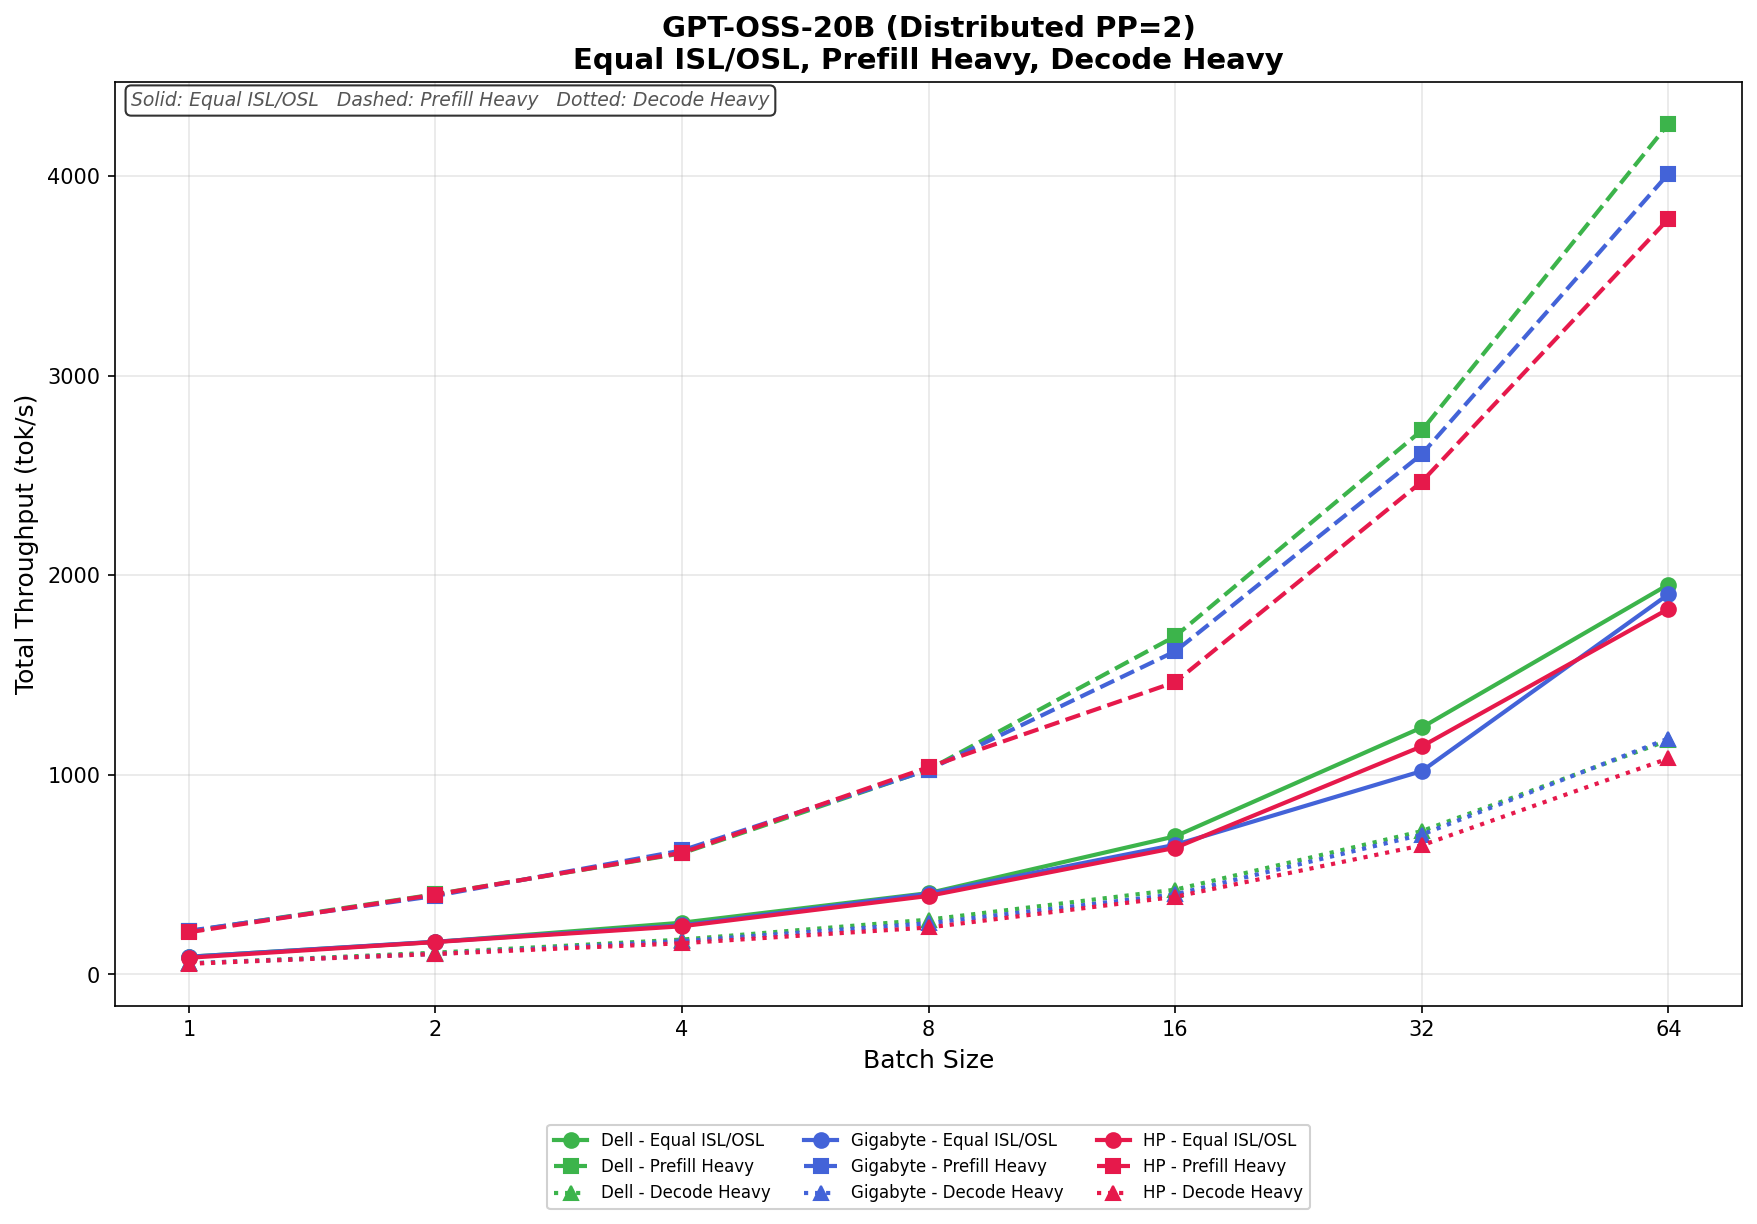
Equal ISL/OSL မှာ Dell က batch size 1 မှာ tok/s 88.73 မှ batch size 64 မှာ tok/s 1,953.55 အထိ တိုးလာပြီး အများစုကို ဦးဆောင်နေပါတယ်။ GIGABYTE ကလည်း 88.42 tok/s မှ 1,904.62 tok/s အထိ တိုးလာပြီး HP ကတော့ 83.49 tok/s မှ 1,831.45 tok/s အထိ ရှိပါတယ်။ Dell က အထူးသဖြင့် batch size 16 ကနေစပြီး အခိုင်မာဆုံး upper-end scaling ကို ထိန်းသိမ်းထားဆဲပါ။
Prefill Heavy မှာ စနစ်သုံးခုလုံးမှာ throughput ramps တွေ သိသိသာသာ မြင့်တက်လာပါတယ်။ Dell က ဒီစမ်းသပ်မှုမှာ အမြင့်ဆုံးရလဒ်ကို ပေးစွမ်းနိုင်ပြီး batch size 64 မှာ 216.05 tok/s ကနေ 4,261.96 tok/s အထိ တိုးလာပါတယ်။ GIGABYTE က 4,011.86 tok/s နဲ့ နောက်ကလိုက်ပြီး HP က 3,785.25 tok/s အထိ ရောက်ရှိပါတယ်။ စနစ်သုံးခုစလုံးဟာ batch size သေးငယ်တဲ့ batch size တွေမှာ တင်းကျပ်စွာ အုပ်စုဖွဲ့ထားဆဲဖြစ်ပေမယ့် Dell က batch size 16 မှာ ခွဲထွက်သွားပြီး sweep ရဲ့ ကျန်ရှိတဲ့အပိုင်းတွေမှာ ဦးဆောင်မှုကို တိုးချဲ့လိုက်ပါတယ်။
Decode Heavy မှာ scaling က တဖြည်းဖြည်းချင်းလုပ်ပေမယ့် platform အားလုံးမှာ အားကောင်းနေဆဲပါ။ Dell က 54.88 tok/s ကနေ 1,173.31 tok/s အထိ၊ GIGABYTE က 55.24 tok/s ကနေ 1,181.94 tok/s အထိ၊ HP က 53.20 tok/s ကနေ 1,082.23 tok/s အထိ တိုးလာပါတယ်။ GIGABYTE က အမြင့်ဆုံး batch size မှာ Dell ထက် အနည်းငယ်သာ သာလွန်ပြီး HP ကတော့ concurrency level မြင့်တဲ့ system နှစ်ခုလုံးမှာ နောက်က လိုက်နေပါတယ်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက်အခြေခံ
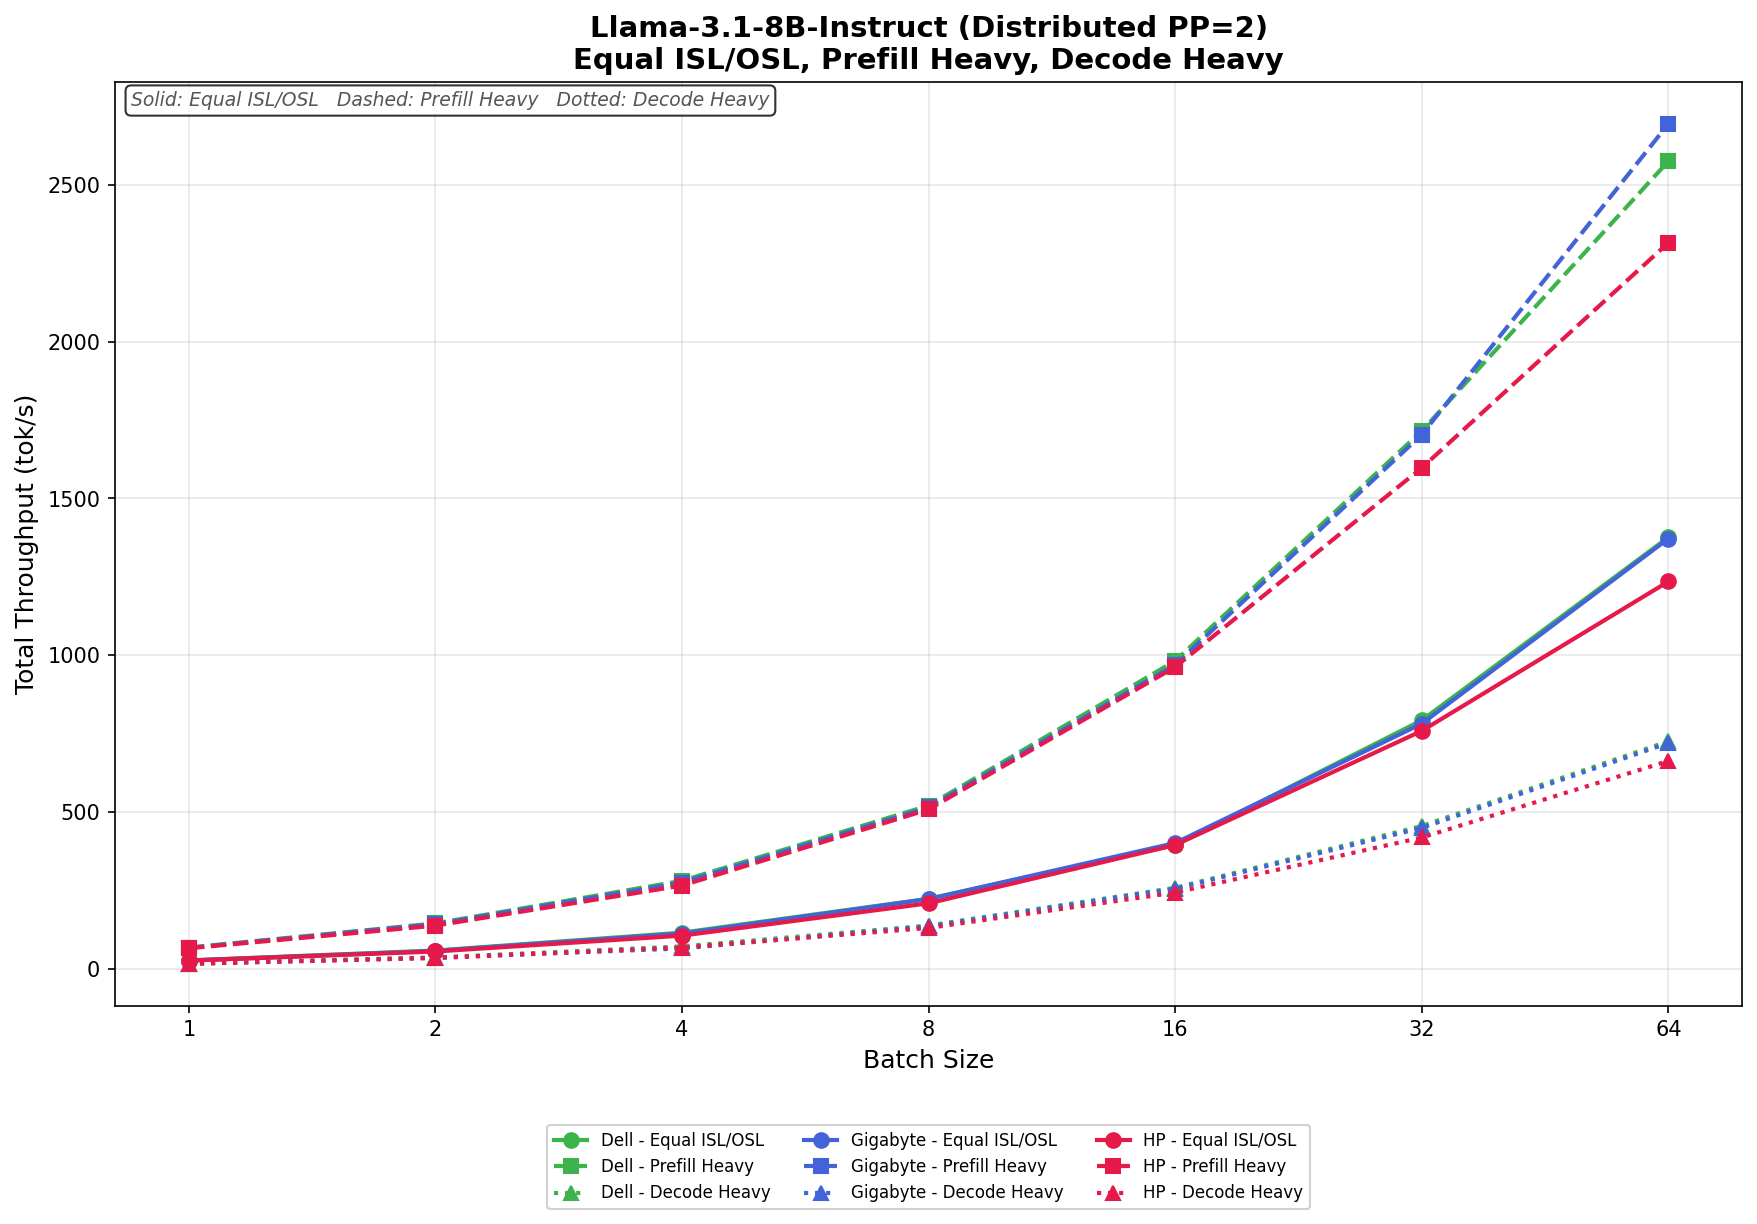
Equal ISL/OSL မှာ Dell ဟာ batch size 64 မှာ 27.69 tok/s မှ 1,376.38 tok/s အထိ တိုးလာပြီး GIGABYTE ကတော့ 27.23 tok/s မှ 1,372.27 tok/s အထိ ရှိပါတယ်။ HP ဟာ sweep တစ်လျှောက်လုံးမှာ အနည်းငယ် နောက်ကျကျန်ခဲ့ပြီး 26.89 tok/s မှ 1,235.32 tok/s အထိ တိုးလာပါတယ်။ Dell က မြင့်မားတဲ့ concurrency level တွေမှာ lead အသေးစားတစ်ခု စတင်မဖွင့်ခင်မှာ စနစ်သုံးခုစလုံးဟာ batch size 16 မှာ အလွန်နီးကပ်စွာ လိုက်လံလုပ်ဆောင်ခဲ့ပါတယ်။
Prefill Heavy မှာ batch size တွေ တက်လာတာနဲ့အမျှ throughput တွေ မြင့်တက်လာပါတယ်။ Dell က 68.60 tok/s ကနေ 2,575.25 tok/s အထိ တိုးတက်လာပြီး GIGABYTE က batch size 64 မှာ 67.49 tok/s ကနေ 2,694.25 tok/s အထိ တိုးလာတာကြောင့် အခိုင်မာဆုံးရလဒ်ကို ရရှိခဲ့ပါတယ်။ HP က 2,315.15 tok/s အထိ ရောက်ရှိခဲ့ပြီး ယှဉ်ပြိုင်နိုင်စွမ်းရှိနေဆဲဖြစ်ပေမယ့် batch size မြင့်တွေမှာ Dell နဲ့ GIGABYTE တို့နောက်မှာ အမြဲတမ်း နောက်ကျကျန်နေပါတယ်။ GIGABYTE က အထူးသဖြင့် batch size 64 နဲ့အထက်မှာ အပေါ်ဆုံးအဆင့်မှာ ဦးဆောင်နေပါတယ်။
Decode Heavy မှာ scaling ဟာ တစ်လျှောက်လုံးမှာ တည်ငြိမ်နေပါတယ်။ Dell က 17.19 tok/s ကနေ 726.22 tok/s အထိ၊ GIGABYTE က 16.96 tok/s ကနေ 720.57 tok/s အထိ၊ HP က 16.79 tok/s ကနေ 663.31 tok/s အထိ တိုးလာပါတယ်။ Dell နဲ့ GIGABYTE တို့ဟာ စမ်းသပ်မှုအများစုမှာ အတူတူပဲဖြစ်ပြီး Dell က အမြင့်ဆုံး concurrency အဆင့်တွေမှာ အနည်းငယ်သာ အားသာချက်ရှိပါတယ်။ တစ်ချိန်တည်းမှာပဲ၊ HP က batch size ကြီးတွေမှာ အနည်းငယ် နောက်ကျကျန်နေပါတယ်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
Equal ISL/OSL မှာ Dell ဟာ batch size 64 မှာ tok/s 69.71 ကနေ 2,849.20 tok/s အထိ တိုးလာပြီး GIGABYTE ကတော့ အနည်းငယ် သာလွန်နေပြီး 70.92 tok/s ကနေ 2,912.03 tok/s အထိ တိုးလာပါတယ်။ HP ကတော့ ယှဉ်ပြိုင်နိုင်စွမ်းရှိနေဆဲဖြစ်ပြီး 69.52 tok/s ကနေ 2,821.50 tok/s အထိ ရှိပါတယ်။ စနစ်သုံးခုစလုံးဟာ workload တစ်ခုလုံးမှာ တင်းကျပ်စွာ အုပ်စုဖွဲ့ထားပြီး မြင့်မားတဲ့ concurrency အဆင့်တွေမှာသာ ခွဲခြားမှုအနည်းငယ်သာ ပေါ်လာပါတယ်။
Prefill Heavy မှာ အထူးသဖြင့် batch size ကြီးတွေမှာ scaling က ပိုပြီး ပြင်းထန်လာပါတယ်။ Dell က 170.09 tok/s ကနေ 4,417.65 tok/s အထိ တိုးလာပြီး GIGABYTE က batch size 64 မှာ 173.55 tok/s ကနေ 4,767.43 tok/s အထိ တက်လာကာ အုပ်စုထဲမှာ အားအကောင်းဆုံးရလဒ်ကို ပြသပါတယ်။ HP က 170.12 tok/s ကနေ 4,214.57 tok/s အထိ တိုးလာပါတယ်။ GIGABYTE က batch size 32 ပြီးရင် field ကနေ ခွဲထွက်သွားပြီး ဒီ workload မှာ အားအကောင်းဆုံး upper-end throughput ကို ပေးစွမ်းပါတယ်။
Decode Heavy မှာ စနစ်သုံးခုစလုံးဟာ အများစုသော လှုပ်ရှားမှုတွေမှာ အနီးကပ် ညှိနှိုင်းမှု ရှိနေပြန်ပါတယ်။ Dell ဟာ 43.19 tok/s ကနေ 1,260.24 tok/s အထိ ရှိပြီး GIGABYTE ဟာ 43.53 tok/s ကနေ 1,258.05 tok/s အထိ တိုးလာပြီး HP ကတော့ 42.54 tok/s ကနေ 1,178.74 tok/s အထိ တိုးလာပါတယ်။ Dell နဲ့ GIGABYTE တို့ဟာ အသုတ်အရွယ်အစားပေါ်မူတည်ပြီး ဦးဆောင်မှုကို ထိထိရောက်ရောက် လဲလှယ်ကြပြီး HP ကတော့ အကြီးမားဆုံး concurrency အဆင့်တွေမှာ စနစ်နှစ်ခုလုံးရဲ့ နောက်မှာ အနည်းငယ် နောက်ကျကျန်နေပါတယ်။
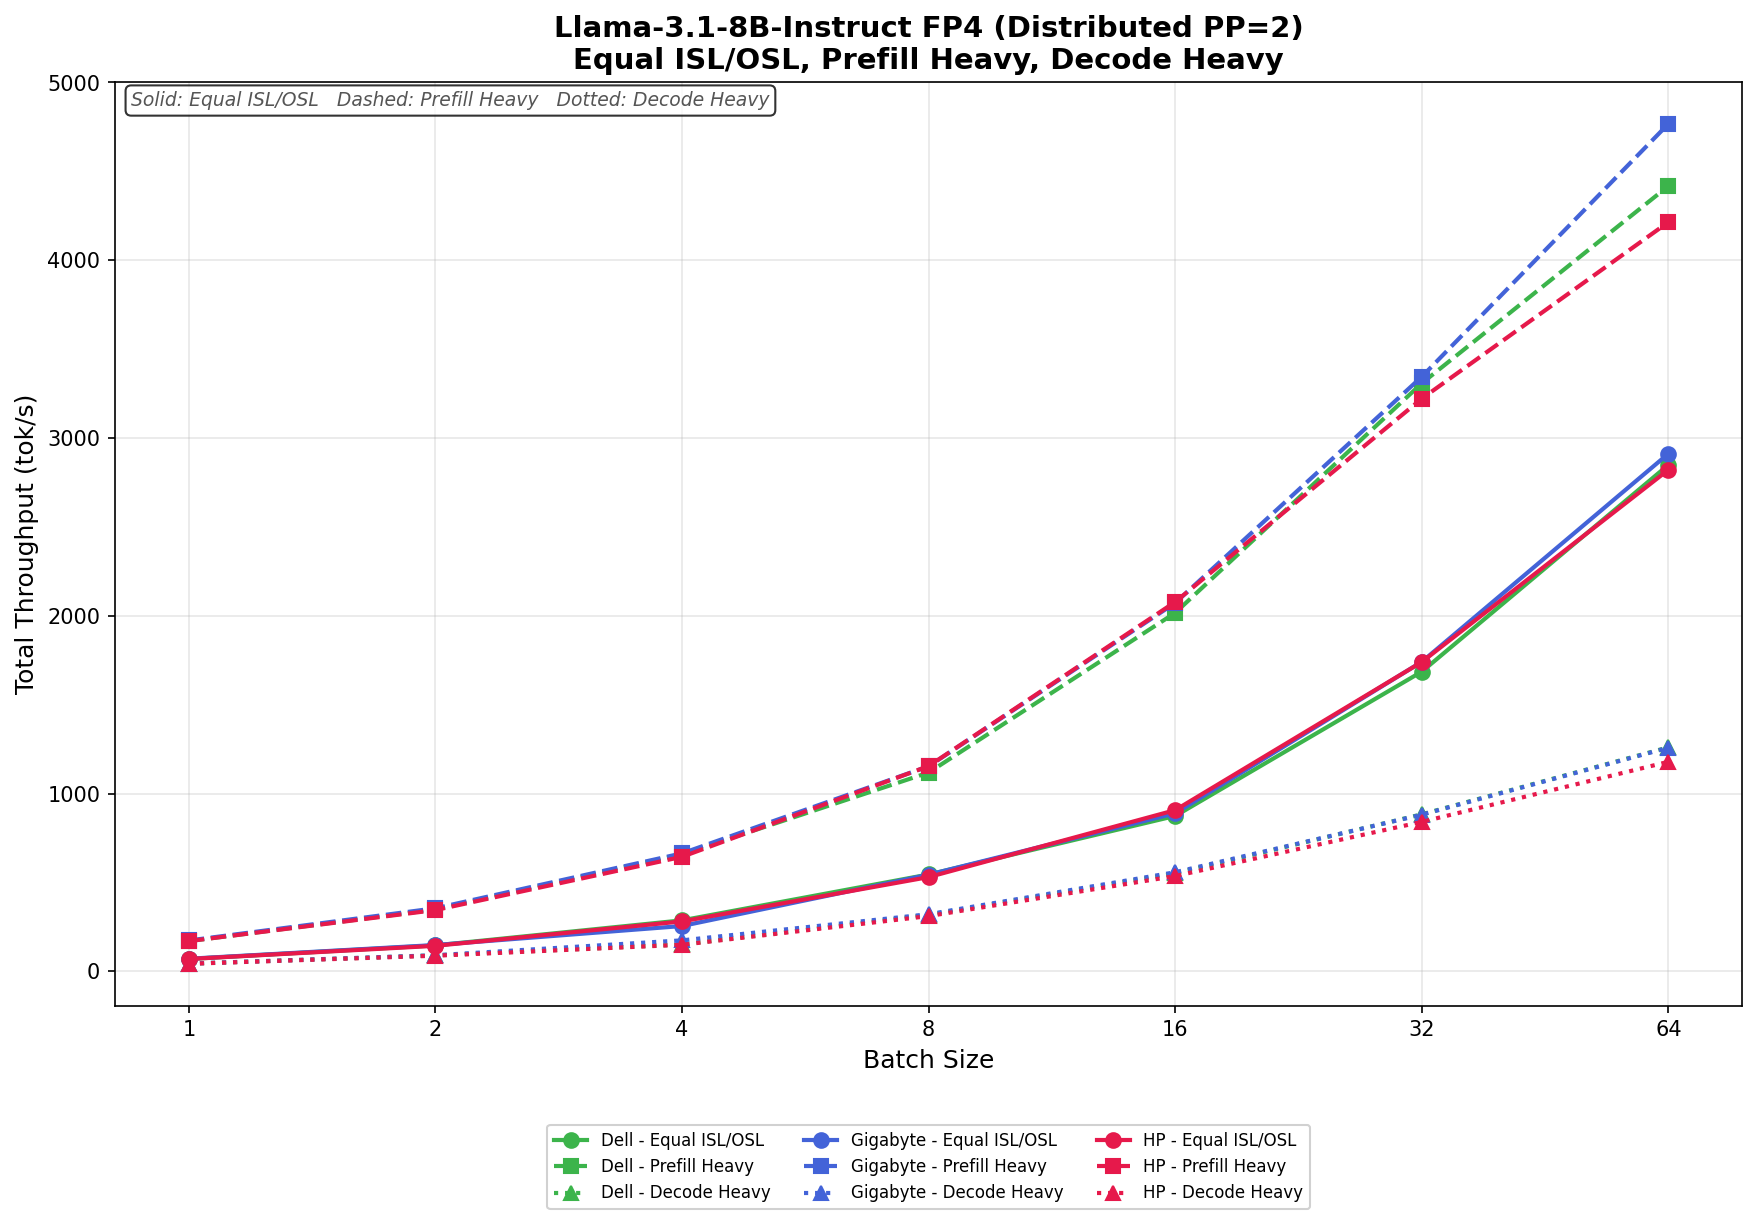
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
Equal ISL/OSL တွင်၊ Dell သည် batch size 64 တွင် 46.93 tok/s မှ 2,206.52 tok/s အထိ တိုးလာပြီး GIGABYTE သည် 46.16 tok/s မှ 2,175.44 tok/s အထိ ရှိသည်။ HP သည် 46.40 tok/s မှ 2,149.15 tok/s အထိ တိုးလာပြီး စမ်းသပ်မှုတစ်လျှောက်လုံးတွင် ಒಟ್ಟಾರೆ ပျံ့နှံ့မှုသည် ကျဉ်းမြောင်းနေဆဲဖြစ်ပြီး စနစ်သုံးခုစလုံးသည် batch size 32 တွင် scaling အပြုအမူကို ထိန်းသိမ်းထားကြသည်။
Prefill Heavy မှာ တစ်ပြိုင်နက်တည်းထုတ်လုပ်မှုတိုးလာတာနဲ့အမျှ throughput ramps တွေ ပိုမိုပြင်းထန်လာပါတယ်။ Dell ဟာ 115.85 tok/s မှ 3,794.52 tok/s အထိ တိုးတက်လာပြီး GIGABYTE ကတော့ batch size 64 မှာ 113.34 tok/s မှ 4,133.76 tok/s အထိ တိုးတက်လာကာ အားအကောင်းဆုံး အလုံးစုံရလဒ်ကို ရရှိခဲ့ပါတယ်။ HP ကတော့ 3,624.73 tok/s အထိ ရောက်ရှိခဲ့ပါတယ်။ GIGABYTE ဟာ batch size 32 ကစပြီး ပိုမိုမြင့်မားတဲ့ batch size တွေမှာ ပိုမိုထင်ရှားတဲ့ ဦးဆောင်မှုကို စတင်တည်ဆောက်လာပါတယ်။
Decode Heavy မှာ စနစ်သုံးခုဟာ မြင့်မားတဲ့ ပြိုင်တူလုပ်ဆောင်မှုတွေမှာ သေးငယ်တဲ့ ခွဲထွက်မှုတွေ မပေါ်ပေါက်ခင်မှာ ပြိုင်တူလုပ်ဆောင်မှုအဆင့်နိမ့်တွေမှာ တင်းကျပ်စွာ အုပ်စုဖွဲ့ထားပါတယ်။ Dell က 29.11 tok/s ကနေ 1,077.07 tok/s အထိ ရှိပြီး GIGABYTE က 28.64 tok/s ကနေ 1,068.92 tok/s အထိ တိုးလာပြီး HP က 28.68 tok/s ကနေ 1,000.20 tok/s အထိ တိုးလာပါတယ်။ Dell က workload အများစုမှာ ကျဉ်းမြောင်းတဲ့ ဦးဆောင်မှုကို ထိန်းသိမ်းထားနိုင်ပြီး GIGABYTE က အလွန်နီးကပ်စွာ နောက်ကျကျန်နေခဲ့ပြီး HP က ပိုကြီးတဲ့ batch size တွေမှာ အနည်းငယ် နောက်ကျကျန်နေခဲ့ပါတယ်။
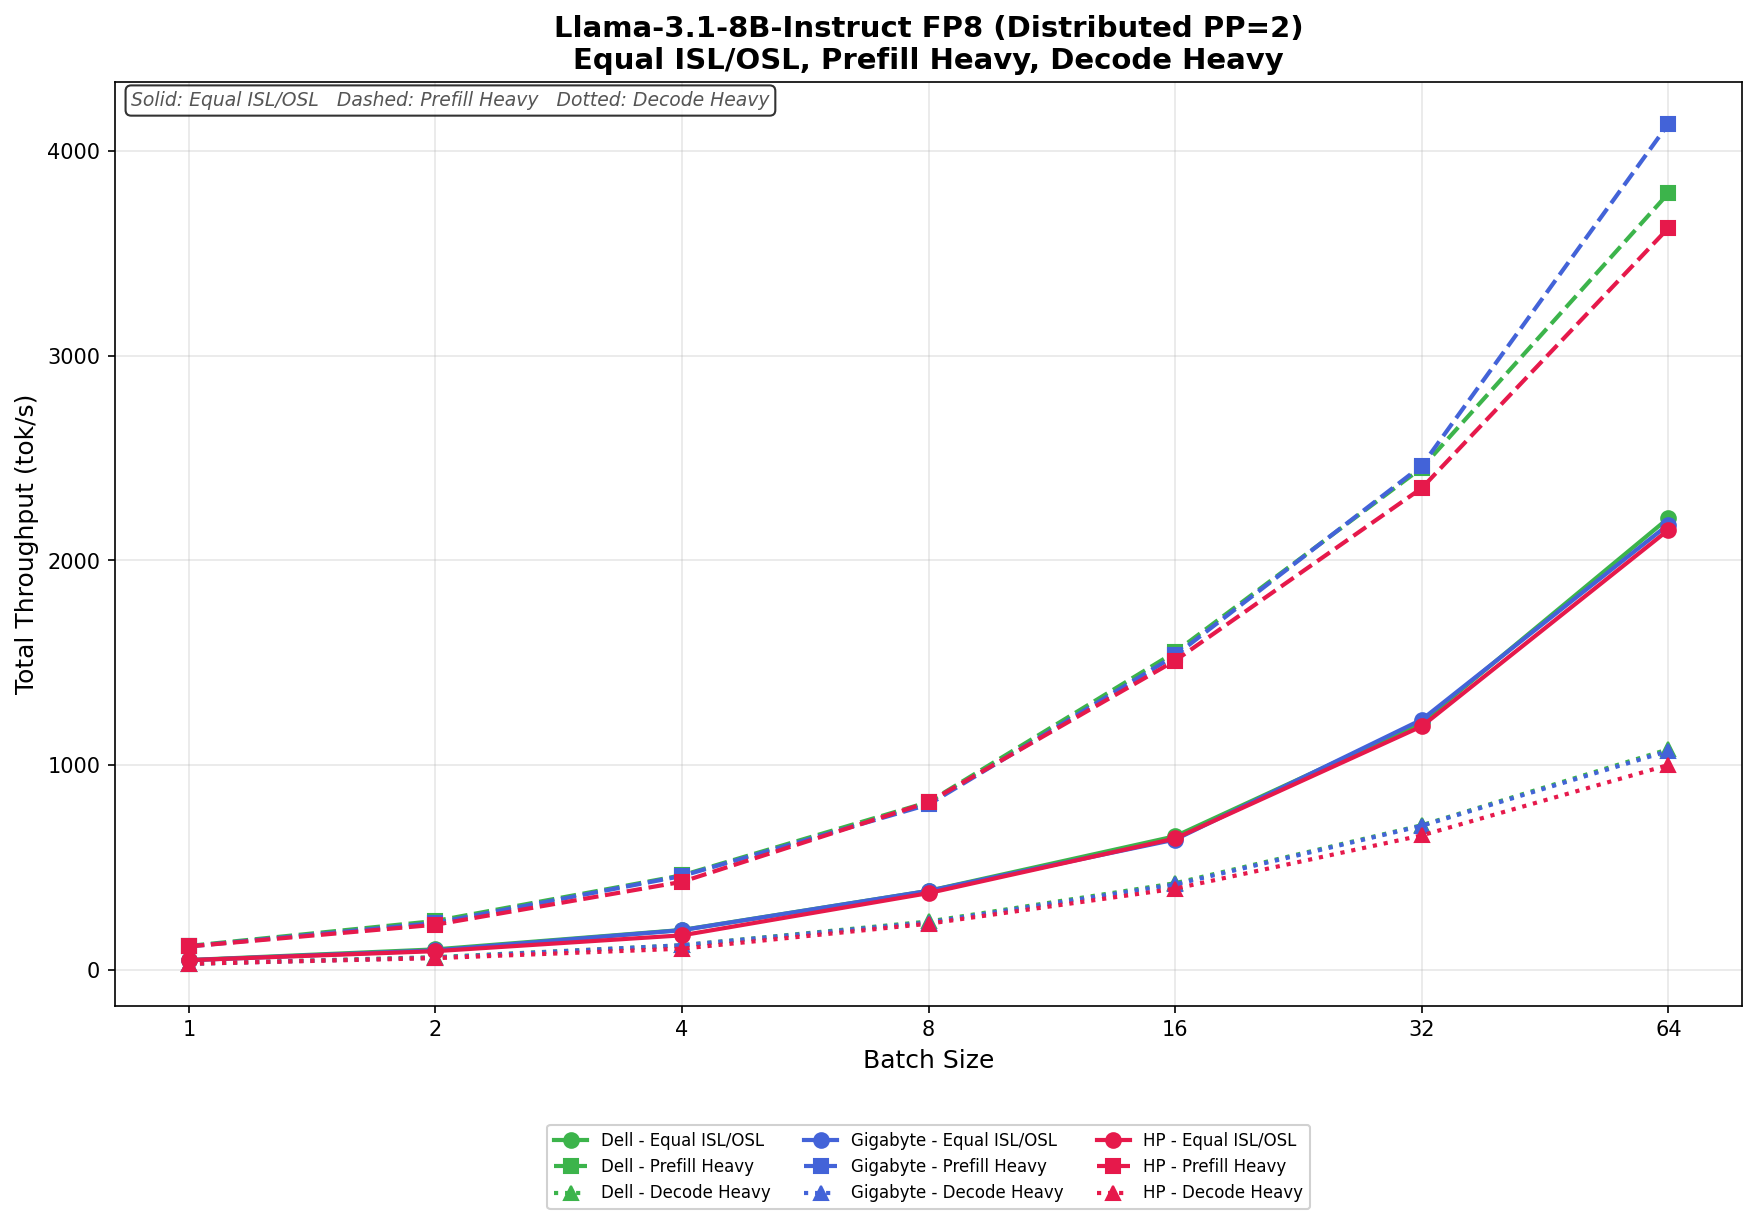
မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ
Equal ISL/OSL မှာ Dell ဟာ batch size 64 မှာ 10.41 tok/s မှ 498.56 tok/s အထိ တိုးလာပြီး GIGABYTE ကတော့ အပေါ်ပိုင်းမှာ အနည်းငယ် သာလွန်နေပြီး 9.76 tok/s မှ 509.18 tok/s အထိ တိုးလာပါတယ်။ HP ကတော့ စနစ်နှစ်ခုလုံးရဲ့ နောက်မှာ အနည်းငယ် နောက်ကျကျန်နေပြီး 9.25 tok/s မှ 477.25 tok/s အထိ ရှိပါတယ်။ စနစ်တွေကြားက ကွာဟချက်ဟာ workload တစ်လျှောက်လုံးမှာ အထူးသဖြင့် အောက်ပိုင်းနဲ့ အလယ်အလတ်တန်းစား concurrency အဆင့်တွေမှာ အတော်လေး သေးငယ်နေဆဲပါ။
Prefill Heavy မှာ စနစ်သုံးခုလုံးမှာ scaling သိသိသာသာ တိုးတက်လာပါတယ်။ Dell က ၂၅.၉၁ tok/s ကနေ ၁,၀၇၉.၁၉ tok/s အထိ တိုးလာပြီး GIGABYTE က ၂၄.၂၅ tok/s ကနေ ၁,၀၇၁.၀၇ tok/s အထိ တိုးလာပါတယ်။ HP က ၉၈၈.၈၂ tok/s အထိ ရောက်ရှိပြီး batch size က ၆၄ ဖြစ်ပါတယ်။ Dell နဲ့ GIGABYTE ကတော့ အများစုမှာ အတူတူပဲ ဖြစ်နေပြီး အမြင့်ဆုံး concurrency level မှာ Dell က အနည်းငယ် အားသာချက် ရှိပါတယ်။
Decode Heavy မှာ၊ ပိုကြီးတဲ့ မော်ဒယ်မှာ decode-focused workload အတွက် မျှော်လင့်ထားတဲ့အတိုင်း throughput က အလုံးစုံ သိသိသာသာ နိမ့်နေပါသေးတယ်။ Dell က 6.49 tok/s ကနေ 297.82 tok/s အထိ ရှိပြီး GIGABYTE က 6.10 tok/s ကနေ 297.23 tok/s အထိ တိုးလာပြီး HP က 5.77 tok/s ကနေ 276.55 tok/s အထိ တိုးလာပါတယ်။ Dell နဲ့ GIGABYTE ကတော့ စမ်းသပ်မှုတစ်လျှောက်လုံးမှာ အသာစီးရနေပြီး HP ကတော့ batch size ကြီးတွေမှာ system နှစ်ခုလုံးရဲ့ နောက်မှာ အနည်းငယ် အဆက်မပြတ် နောက်ကျနေပါတယ်။
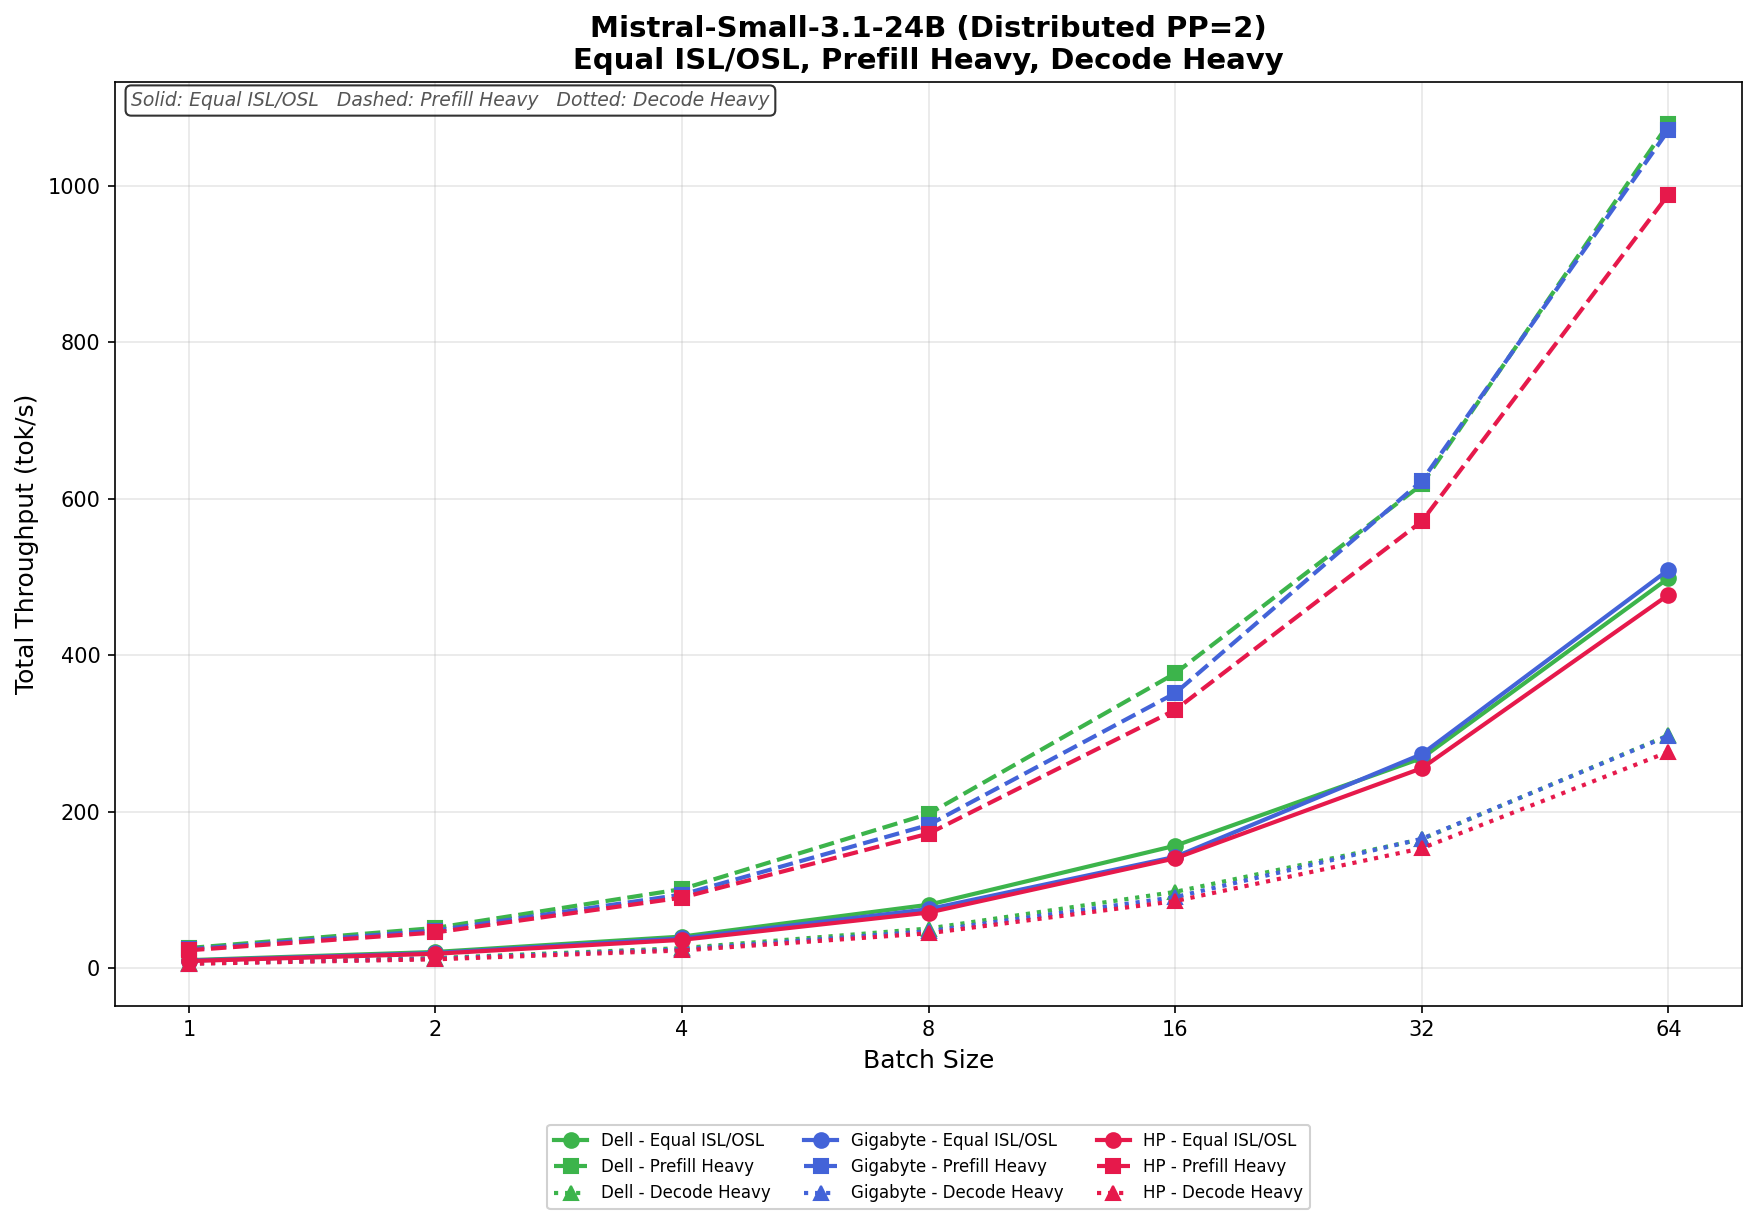
Qwen3 ကုဒ်ဒါ 30B A3B Base
Equal ISL/OSL မှာ Dell ဟာ batch size 64 မှာ 59.05 tok/s ကနေ 817.82 tok/s အထိ တိုးလာပြီး GIGABYTE ကတော့ 59.81 tok/s ကနေ 809.88 tok/s အထိ ရှိပါတယ်။ HP ကတော့ system နှစ်ခုလုံးထက် အနည်းငယ်နောက်ကျနေပြီး 56.51 tok/s ကနေ 780.21 tok/s အထိ တိုးလာပါတယ်။ Dell နဲ့ GIGABYTE တို့ရဲ့ စွမ်းဆောင်ရည်က sweep အများစုမှာ အတူတူပဲဖြစ်ပြီး batch size မြင့်တဲ့အခါ အနည်းငယ်သာ ကွဲလွဲမှုတွေ ပေါ်လာပါတယ်။
Prefill Heavy မှာ တစ်ပြိုင်နက်တည်းလုပ်ဆောင်နိုင်မှု တိုးလာတာနဲ့အမျှ throughput သိသိသာသာ မြင့်တက်လာပါတယ်။ Dell ဟာ 144.81 tok/s မှ 1,756.99 tok/s အထိ တိုးတက်လာပြီး GIGABYTE ကတော့ batch size 64 မှာ 147.55 tok/s မှ 1,862.40 tok/s အထိ တိုးတက်လာကာ အားအကောင်းဆုံး overall scaling ကို ပြသထားပါတယ်။ HP ဟာ 1,751.17 tok/s အထိ ရောက်ရှိပြီး ယှဉ်ပြိုင်နိုင်စွမ်းရှိနေဆဲဖြစ်ပေမယ့် အထက်ပိုင်းမှာတော့ တခြား system နှစ်ခုထက် အနည်းငယ်နောက်ကျနေပါတယ်။ GIGABYTE ဟာ batch size 32 လောက်ကစပြီး အသင့်အတင့် ဦးဆောင်မှုကို တည်ဆောက်ပြီး စမ်းသပ်မှုရဲ့ နောက်ဆုံးအဆင့်အထိ တိုးချဲ့လုပ်ဆောင်ပါတယ်။
Decode Heavy မှာ စနစ်သုံးခုဟာ workload အများစုတစ်လျှောက်လုံးမှာ အနီးကပ်ညှိနှိုင်းမှုရှိနေပြန်ပါတယ်။ Dell က 36.69 tok/s ကနေ 427.48 tok/s အထိရှိပြီး GIGABYTE က 36.92 tok/s ကနေ 417.42 tok/s အထိ တိုးလာပြီး HP က 35.30 tok/s ကနေ 403.32 tok/s အထိ တိုးလာပါတယ်။ decode-focused workload မှာ Dell က batch size အမြင့်ဆုံးမှာ အားသာချက်အနည်းငယ်ကို ထိန်းသိမ်းထားပေမယ့် HP က Dell နဲ့ GIGABYTE နှစ်ခုလုံးထက် အနည်းငယ်နောက်ကျနေပါတယ်။
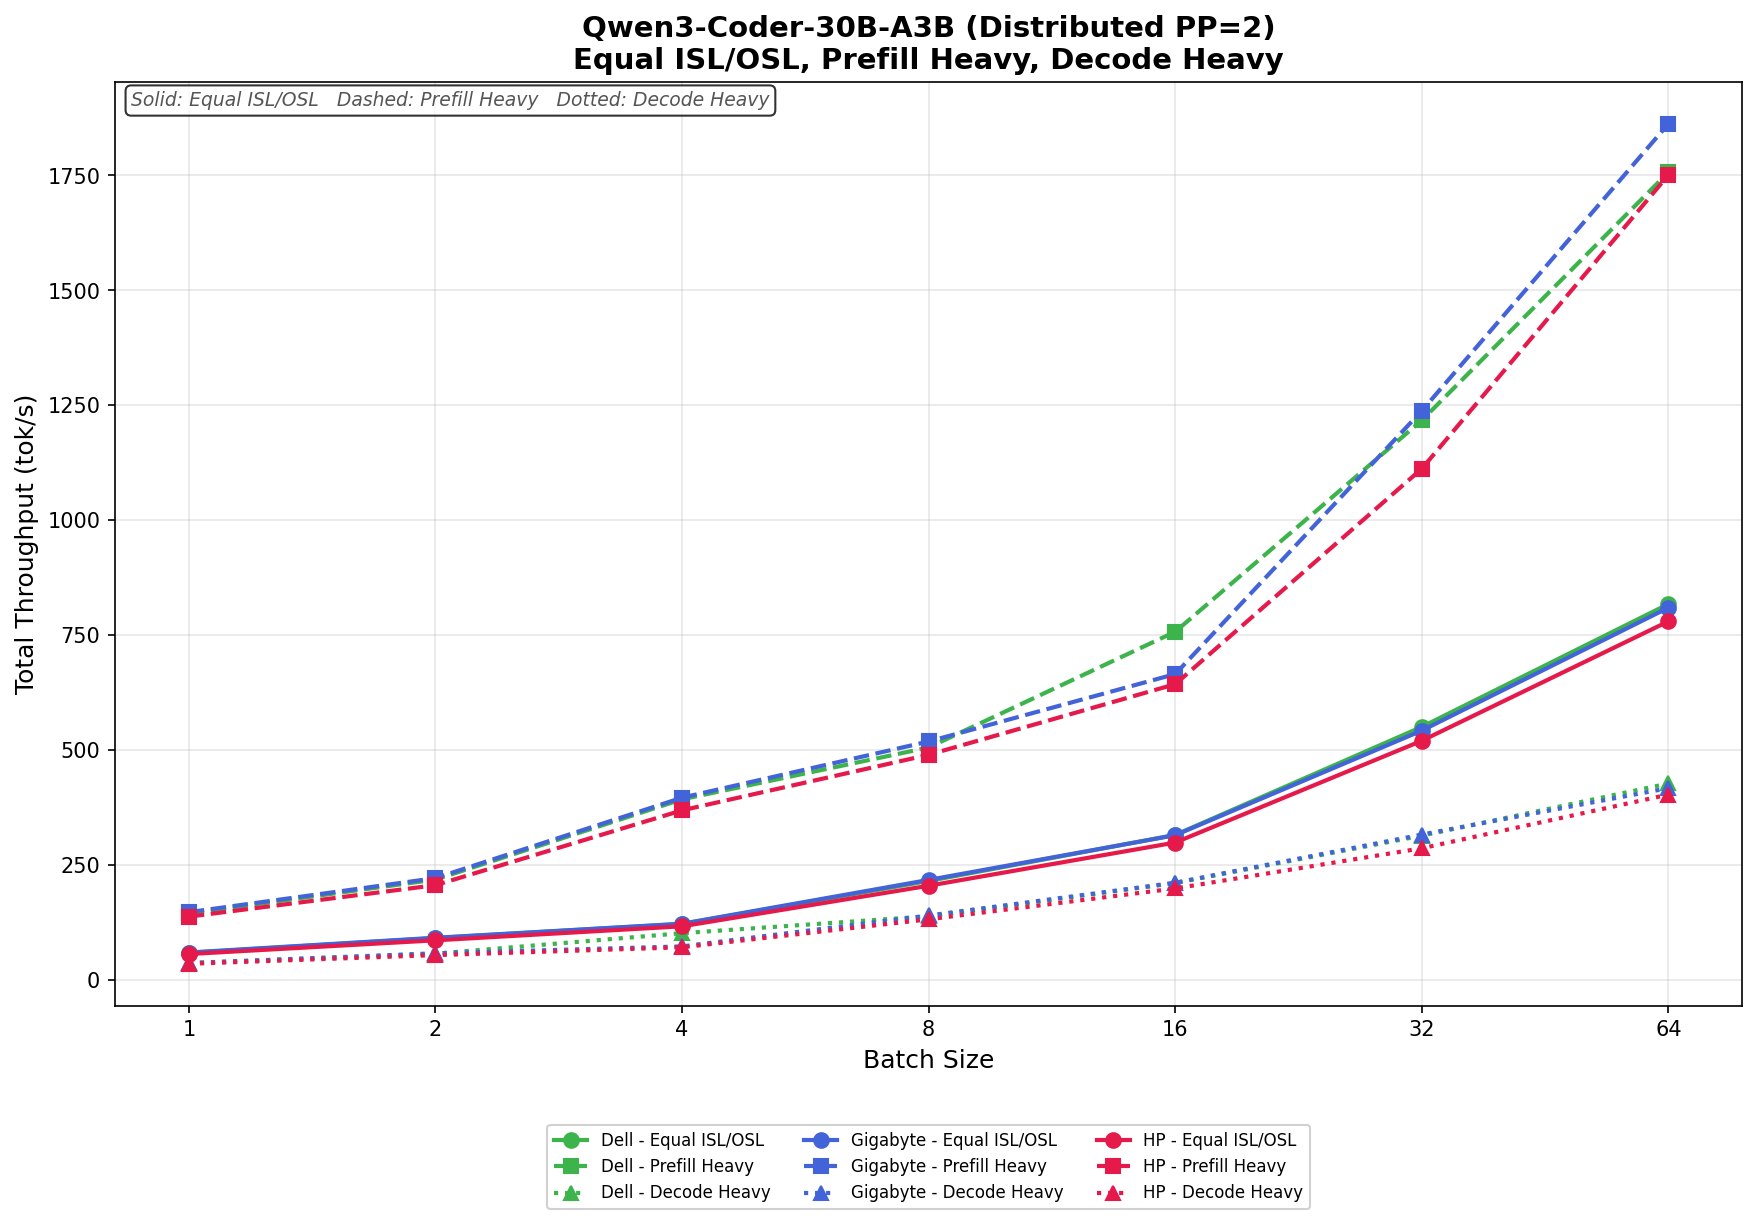
Qwen3 ကုဒ်ဒါ 30B A3B FB8
Equal ISL/OSL မှာ Dell ဟာ batch size 64 မှာ tok/s 98.65 ကနေ 1,379.26 tok/s အထိ တိုးလာပြီး GIGABYTE ကတော့ 100.20 tok/s ကနေ 1,308.79 tok/s အထိ ရှိပါတယ်။ HP ကတော့ ယှဉ်ပြိုင်နိုင်စွမ်းရှိနေဆဲဖြစ်ပြီး 97.06 tok/s ကနေ 1,354.23 tok/s အထိ တိုးလာပါတယ်။ HP ဟာ အနိမ့်နဲ့ အလတ်စား batch size အတော်များများမှာ ခဏတာ ဦးဆောင်နေပေမယ့် Dell ကတော့ အမြင့်မားဆုံး throughput နဲ့ အဆုံးသတ်သွားပါတယ်။
Prefill Heavy မှာ throughput ဟာ စနစ်သုံးခုလုံးမှာ အရှိန်အဟုန်နဲ့ တိုးလာပါတယ်။ Dell က ၂၄၀.၄၃ tok/s ကနေ ၃၀၄၁.၇၂ tok/s အထိ တိုးလာပြီး GIGABYTE က အသုတ်အရွယ်အစား ၆၄ မှာ ၂၄၅.၉၂ tok/s ကနေ ၃၀၈၈.၆၂ tok/s အထိ တိုးလာတာကြောင့် အလုံးစုံရလဒ် အကောင်းဆုံးဖြစ်ပါတယ်။ HP က ၂,၈၅၇.၈၀ tok/s အထိ ရောက်ရှိပါတယ်။ GIGABYTE က အသုတ်အရွယ်အစား ၄ ကနေစပြီး သိသာထင်ရှားတဲ့ ဦးဆောင်မှုကို တည်ဆောက်ပြီး ကျန်ရှိနေတဲ့ sweep တစ်လျှောက်လုံး ထိန်းသိမ်းထားနိုင်ပါတယ်။
Decode Heavy မှာ Dell ဟာ အလုံးစုံအားဖြင့် အားအကောင်းဆုံး upper-end scaling ကို ပိုင်ဆိုင်ထားပါတယ်။ Dell ဟာ 60.91 tok/s ကနေ 705.77 tok/s အထိ ရှိပြီး GIGABYTE ကတော့ 61.53 tok/s ကနေ 639.80 tok/s အထိ တိုးလာပြီး HP ကတော့ 59.85 tok/s ကနေ 635.25 tok/s အထိ တိုးလာပါတယ်။ HP ဟာ batch size သေးငယ်တဲ့အခါ ခေတ္တဦးဆောင်နေပေမယ့် Dell ကတော့ concurrency level ပိုများပြီး အုပ်စုထဲမှာ အားအကောင်းဆုံး decode throughput နဲ့ အဆုံးသတ်သွားပါတယ်။
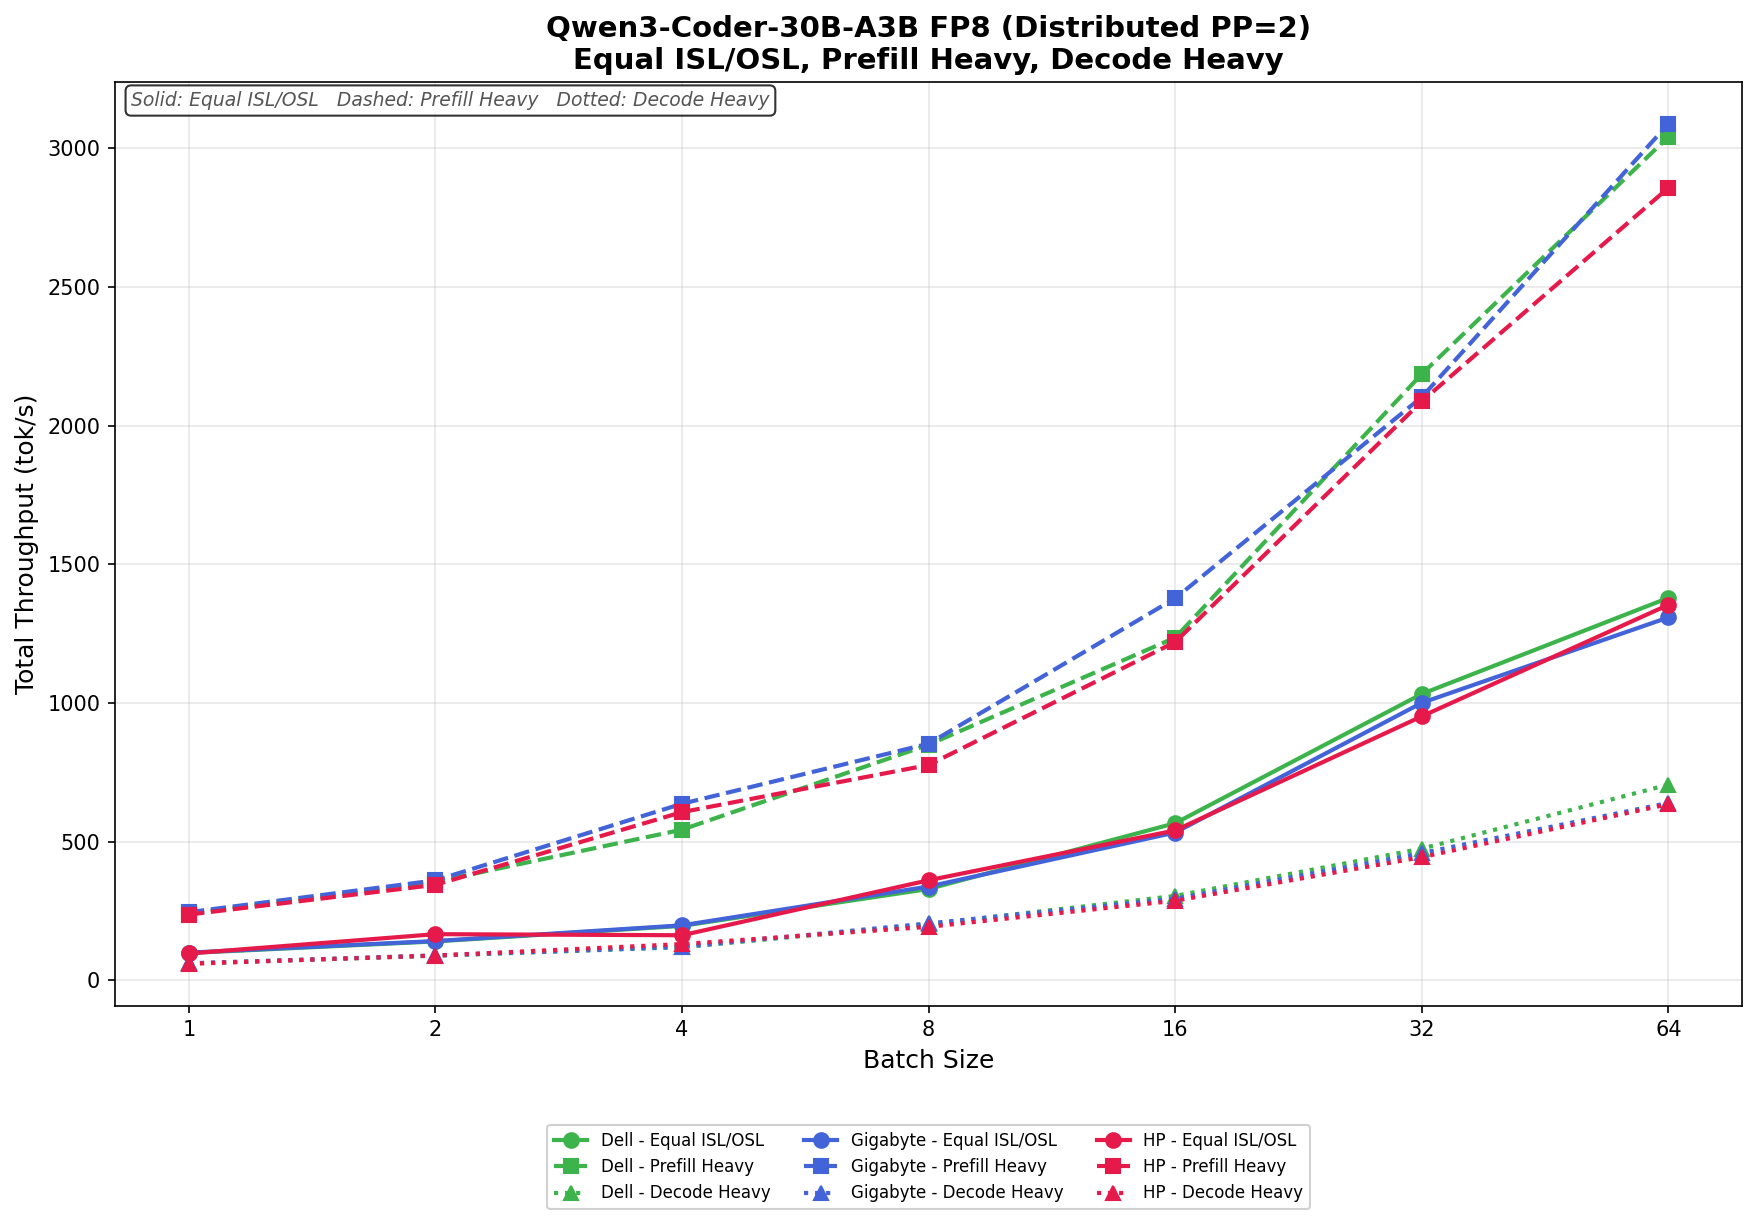
Dual Spark Systems အမြင့်ဆုံးထွက်ရှိမှု အနှစ်ချုပ်
အောက်ဖော်ပြပါဇယားတွင် Dell၊ GIGABYTE နှင့် HP dual-Spark စနစ်များတစ်လျှောက် Distributed PP=2 စမ်းသပ်မှုအတွင်း တွေ့ရှိရသည့် အမြင့်ဆုံး token output throughput ကို အကျဉ်းချုပ်ဖော်ပြထားသည်။ တန်ဖိုးတစ်ခုစီသည် စမ်းသပ်ထားသော batch size တွင် ထို workload scenario အတွက် ရရှိသော အမြင့်ဆုံးတိုင်းတာထားသော output throughput (tok/s) ကို ကိုယ်စားပြုသည်။ ထူထဲသောကိန်းဂဏန်းများသည် ထို workload scenario အတွင်း အကောင်းဆုံးစွမ်းဆောင်ရည်ရှိသော စနစ်ကို ညွှန်ပြသည်။
| ပုံစံ | ဇာတ်လမ်း (BS – ၆၄) | Dell Peak Output | GIGABYTE အမြင့်ဆုံးထွက်ရှိမှု | HP အမြင့်ဆုံးထွက်ရှိမှု |
|---|---|---|---|---|
| GPT-OSS မော်ဒယ်များ | ||||
| GPT-OSS-120B | ညီမျှသော ISL/OSL | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| GPT-OSS-120B | ကြိုတင်ဖြည့်ရန် လေးလံသော | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| GPT-OSS-120B | လေးလံသော ဒီကုဒ် | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| GPT-OSS-20B | ညီမျှသော ISL/OSL | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| GPT-OSS-20B | ကြိုတင်ဖြည့်ရန် လေးလံသော | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| GPT-OSS-20B | လေးလံသော ဒီကုဒ် | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ မော်ဒယ်များ | ||||
| Llama-3.1-8B-ညွှန်ကြားချက် | ညီမျှသော ISL/OSL | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Llama-3.1-8B-ညွှန်ကြားချက် | ကြိုတင်ဖြည့်ရန် လေးလံသော | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Llama-3.1-8B-ညွှန်ကြားချက် | လေးလံသော ဒီကုဒ် | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ-၃.၁-၈ဘီ-FP၈ | ညီမျှသော ISL/OSL | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ-၃.၁-၈ဘီ-FP၈ | ကြိုတင်ဖြည့်ရန် လေးလံသော | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ-၃.၁-၈ဘီ-FP၈ | လေးလံသော ဒီကုဒ် | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ-၃.၁-၈ဘီ-FP၈ | ညီမျှသော ISL/OSL | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ-၃.၁-၈ဘီ-FP၈ | ကြိုတင်ဖြည့်ရန် လေးလံသော | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| လာမာ-၃.၁-၈ဘီ-FP၈ | လေးလံသော ဒီကုဒ် | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Mistral နှင့် Qwen မော်ဒယ်များ | ||||
| မစ်စထရယ်-စမော-၃.၁-၂၄ဘီ | ညီမျှသော ISL/OSL | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| မစ်စထရယ်-စမော-၃.၁-၂၄ဘီ | ကြိုတင်ဖြည့်ရန် လေးလံသော | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| မစ်စထရယ်-စမော-၃.၁-၂၄ဘီ | လေးလံသော ဒီကုဒ် | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
ကောက်ချက်
ဒီစမ်းသပ်မှုအဆင့်ကနေ အသုံးဝင်ဆုံးတွေ့ရှိချက်က ဘယ် OEM က ဘယ် workload မှာ အသာရခဲ့လဲဆိုတာနဲ့ သိပ်မဆိုင်ပါဘူး။ ကျွန်တော်တို့စမ်းသပ်ခဲ့တဲ့ မော်ဒယ်အားလုံးနဲ့ workload ပုံစံအားလုံးမှာ Dell၊ GIGABYTE နဲ့ HP တို့ရဲ့ Spark implementations သုံးခုဟာ ကျဉ်းမြောင်းတဲ့ band အတွင်းမှာ စွမ်းဆောင်ရည်ပြခဲ့ပါတယ်။ သတ်မှတ်ထားတဲ့ batch size တွေမှာ leads အသေးလေးတွေ ထွက်ပေါ်လာပေမယ့် platform တစ်ခုကမှ အပြတ်အသတ်အနိုင်ရခဲ့တာမဟုတ်သလို platform ကလည်း အမြဲတမ်း နောက်မကျခဲ့ပါဘူး။ သုံးခုထဲက တစ်ခုကို ရွေးချယ်တဲ့ ဝယ်ယူသူတွေဟာ သူတို့ရဲ့ဆုံးဖြတ်ချက်ကို benchmark deltas တွေထက် chassis design၊ thermal behavior၊ warranty terms နဲ့ support relationship တွေပေါ်မှာ အခြေခံသင့်ပြီး desktop-class system တိုင်းက စဉ်ဆက်မပြတ် load အောက်မှာ ထုတ်လုပ်တဲ့ run-to-run variance နဲ့ နီးစပ်ပါတယ်။
ပိုစိတ်ဝင်စားစရာကောင်းတဲ့ ရလဒ်ကတော့ methodological ပါ။ Sparks နှစ်ခုကို ချိတ်ဆက်ထားတဲ့ 200 GbE fabric မှာ tensor parallelism နဲ့ pipeline parallelism ကြားက ရွေးချယ်မှုက OEM သုံးခုကြားက ကွာခြားချက်ထက် ပိုအရေးကြီးပြီး ကျိုးကြောင်းဆီလျော်တဲ့ concurrency မှာ batched inference အတွက် pipeline parallelism က ပိုသင့်တော်ပါတယ်။ TP=2 ရဲ့ per-layer all-reduce traffic ဟာ compute ကို idle မထားခဲ့ဘဲ ConnectX-7 link ကိုဖြတ်ပြီး trip မှာ မရှင်သန်နိုင်ပါဘူး။ PP=2 ရဲ့ pipeline bubble cost ဟာ batch က pipeline ကို ပြည့်တာနဲ့ steady-state stream ထဲကို amortize လုပ်ပါတယ်။ NVIDIA ရဲ့ documentation က ခုခံကာကွယ်နိုင်တဲ့ အကြောင်းပြချက်တစ်ခုကြောင့် TP ကို default အနေနဲ့ သတ်မှတ်ထားပါတယ်။ Spark အတွက် သူတို့ရဲ့ primary positioning က tight TTFT နဲ့ interactive single-stream serving ဖြစ်ပြီး TP=2 က outright အနိုင်ရတဲ့ တစ်ခုတည်းသော regime ပါ။ workload က chat interface ထက် infrastructure serving လုပ်သလို ထင်ရတဲ့အချိန်မှာ calculus က ပြောင်းပြန်ဖြစ်သွားပါတယ်။
ထိုပြောင်းပြန်လှန်မှုက Spark သည် အဘယ်အရာဖြစ်သည်နှင့် မဖြစ်သည်ကို အားဖြည့်ပေးသည်။ two-node Spark cluster သည် အင်ဂျင်နီယာတစ်ဦးတည်းအား ကွန်ရက်ပေါ်တွင် ဖြန့်ဝေထားသော ကောက်ချက်အပြုအမူကို အစစ်အမှန် datacenter fabric ကိုတုပနိုင်လောက်အောင် မြန်ဆန်စွာ ကိုယ်တိုင်ကိုယ်ကျ မြင်တွေ့နိုင်စေသော်လည်း ထုတ်လုပ်မှုဖြန့်ကျက်မှုများသည် စကေးတွင် လုပ်ဆောင်သော အတားအဆီးများကို ဖော်ထုတ်ရန် လုံလောက်သော ကန့်သတ်ချက်များရှိသည်။
Spark ဖွဲ့စည်းပုံကြီးများသည် ၎င်းတို့၏ကိုယ်ပိုင်သတ်မှတ်ချက်များအရ စစ်ဆေးသင့်ပြီး၊ ထိုစကေးနှင့်ကိုက်ညီသော workloads နှင့် parallelism ဗျူဟာများဖြင့် ကျွန်ုပ်တို့တွင် ထိုအလုပ်ကို roadmap ပေါ်တွင် ရှိပါသည်။ သီးခြားစီအနေဖြင့်၊ ဤတစ်ခု၏နောက်ကွယ်တွင် တန်းစီထားသော နောက်ထပ်စမ်းသပ်မှုသည် inference မှ training သို့ ပြောင်းလဲသွားသည်- dual-Spark cluster ပေါ်တွင် scratch မှ trained လုပ်ထားသော sub-1B-parameter မော်ဒယ်တစ်ခုဖြစ်ပြီး ပိုမိုကြီးမားသော စနစ်များ၏ distributed pre-training အခြေအနေများကို ထင်ဟပ်စေရန် configure လုပ်ထားသည်။ ကျွန်ုပ်တို့၏ 800 Gb lab core switch အသစ်အတွက် optics ကိုစောင့်ဆိုင်းနေစဉ်တွင် ထိုအလုပ်ကို ခေတ္တရပ်တန့်ထားပြီး core အသစ် အွန်လိုင်းဖြစ်ပြီးနောက် ၎င်းကို ထုတ်ဝေရန် မျှော်လင့်ပါသည်။


 အမေဇုံ