

Qumulo File System သည် Qumulo ၏ ထူးခြားသော software-defined distributed file system ဖြစ်ပြီး data center၊ private နှင့် public cloud တို့ကို လွှမ်းခြုံထားသည်။ ၎င်း၏ software ကို hybrid cloud အတွက် တည်ဆောက်ထားပြီး ကြိုတင် configure လုပ်ထားသော နှင့် pre-qualified industry standard hardware platform များပေါ်တွင်သာမက public cloud များစွာတွင်ပါ လည်ပတ်နိုင်စေပါသည်။ ကျွန်ုပ်တို့၏ lab တွင် Qumulo ၏ software နှင့် ၎င်း၏ အရေးအကြီးဆုံး စွမ်းရည်အချို့ကို လေ့လာခွင့်ရခဲ့ပါသည်။ ဤ review တွင် Qumulo ၏ file system နှင့် ၎င်း၏ graphical user interface (GUI) ကို လေ့လာကြည့်ပါမည်။
ဆန်းသစ်တီထွင်ရန်အတွက် အဖွဲ့အစည်းများသည် ခေတ်မီသိုလှောင်မှု၊ ဒေတာအခြေခံအဆောက်အအုံ၊ အမွေအနှစ်နှင့် cloud-based အပလီကေးရှင်းများနှင့် ဝန်ဆောင်မှုများ၊ cloud storage အပြင် unstructured data management နှင့် platform များအပေါ် မှီခိုအားထားရသည်။ သို့သော်၊ unstructured data သည် cloud သို့ ရွှေ့ပြောင်းလိုသော သို့မဟုတ် hybrid-cloud model ကို အသုံးချလိုသော ကုမ္ပဏီများအတွက် လည်ပင်းတွင် နာကျင်မှုတစ်ခု ဖြစ်လာသည်၊ အဘယ်ကြောင့်ဆိုသော် ဤကဲ့သို့သော data သည် ရရှိနိုင်သော cloud platform အများစုတွင် data silo အသစ်တစ်ခုကို ဖန်တီးပေးသောကြောင့်ဖြစ်သည်။ IT ဌာနသည် ဤအကျိုးဆက်ကို ရင်ဆိုင်နေရပြီး မကြာခဏဆိုသလို မတူညီသော file system နှစ်ခုတွင် workloads များကို စီမံခန့်ခွဲရန် ဝန်ပိနေတတ်သည်- ၎င်းတို့၏ premises တွင်တစ်ခုနှင့် cloud တွင်တစ်ခု။
သို့သော်လည်း၊ တကယ့်ပြဿနာက cloud platform တွေ ဒါမှမဟုတ် unstructured data platform တွေ မဟုတ်ပါဘူး။ cloud ကို ကူးပြောင်းဖို့အတွက် မသင့်တော်တဲ့ legacy file storage ကို ကျွန်တော်တို့ အသုံးပြုနေဆဲပါ။ Qumulo မီးမောင်းထိုးပြခဲ့သလိုပဲ IT ပြောင်းလဲသွားပြီ၊ ဒါပေမယ့် file storage ကတော့ ပြောင်းလဲမသွားသေးပါဘူး။ နောက်ဆုံးအောင်မြင်တဲ့ file storage architectures တွေကို cloud မထွန်းကားခင် ၁၅ နှစ်ကျော်က ဖန်တီးခဲ့တာပါ။ ဆန့်ကျင်ဘက်အနေနဲ့ ခေတ်မီ file storage ဟာ cloud-ready ဖြစ်သင့်ပါတယ်- unstructured data type အားလုံးကို ပေါင်းစည်းပြီး file ဘီလီယံပေါင်းများစွာအထိ တိုးချဲ့နိုင်၊ data center အများအပြားနဲ့ cloud ကိုယ်တိုင်ကို လွှမ်းခြုံထားနိုင်ရပါမယ်။ ဒါ့အပြင် real-time analytics နဲ့ API driven control တွေနဲ့ visibility နဲ့ automation ကို ပံ့ပိုးပေးပါတယ်။
Qumulo: Cloud-Ready File System
Qumulo သည် ကွဲပြားသော သိုလှောင်မှုကုမ္ပဏီအမျိုးအစားတစ်ခုအဖြစ် မိမိကိုယ်ကိုယ် ဖော်ထုတ်ကာ hybrid cloud workloads များကို ကိုင်တွယ်ဖြေရှင်းရန်နှင့် cloud-native file data ဝန်ဆောင်မှုများကို ပံ့ပိုးပေးရန် ပထမဆုံးဖိုင်စနစ်ရှိသည်ဟု ဆိုပါသည်။ ဤဆော့ဖ်ဝဲဖြင့် ကုမ္ပဏီသည် unstructured data platform များကို ပစ်မှတ်ထားပြီး builders များနှင့် developer များအတွက် application များနှင့် microservices များကို စွမ်းအားပေးပါသည်။ Qumulo file system software ကို public၊ private နှင့် hybrid cloud တို့တွင် ရရှိနိုင်ပါသည်။
Qumulo ရဲ့ software ရဲ့ အလွှာတွေမှာ အောက်ပါတို့ ပါဝင်ပါတယ်-
- ပလက်ဖောင်းများ။ လက်ရှိဟာ့ဒ်ဝဲပလက်ဖောင်းများတွင် HPE နှင့် Fujitsu နှင့် public cloud များ AWS နှင့် GCP တို့ပါဝင်သည်။ Qumulo သည် မကြာသေးမီက object data ကို အသုံးချသည့် cloud-native application များနှင့် ဝန်ဆောင်မှုများကို အသုံးချရန်အတွက် ဖိုင်မှ object သို့ data ရွှေ့ပြောင်းနိုင်စွမ်းကို ကြေညာခဲ့သည်။
- လည်ပတ်မှုစနစ်။ စံ Ubuntu Linux ကို အခြေခံထားသည်။
- Scalable Block Store (SBS)။ Qumulo ၏ အခြေခံအုတ်မြစ်။ ချဲ့ထွင်နိုင်မှု၊ သယ်ဆောင်ရလွယ်ကူမှု၊ ကာကွယ်မှုနှင့် စွမ်းဆောင်ရည်တို့ကို ဖွင့်ပေးသည်။
- ဖိုင်စနစ်။ ၎င်းသည် တိုးချဲ့နိုင်သော ဖိုင်အရေအတွက်နှင့် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော ဖိုင်လုပ်ဆောင်ချက်များကို ဖွင့်ပေးသည်။ ထို့အပြင် စွမ်းဆောင်ရည်နှင့် စွမ်းရည်ဆိုင်ရာ အချိန်နှင့်တပြေးညီ ထိုးထွင်းသိမြင်မှုကို ပေးစွမ်းသည်။
- ဒေတာဝန်ဆောင်မှုများ။ enterprise-grade tools များကို အသုံးပြု၍ Qumulo platform ရှိ ဒေတာများကို ကာကွယ်ပါ၊ လုံခြုံအောင်ထားပါ၊ စီမံခန့်ခွဲပါ။ ဤအလွှာတွင် စွမ်းရည်ငါးခုပါဝင်သည်- snapshots၊ replication၊ quotas၊ audit နှင့် role-based access control (RBAC)။
- စီမံခန့်ခွဲမှုနှင့် ပရိုဂရမ်ရေးသားနိုင်မှု။ Qumulo ပလပ်ဖောင်းဖြင့် ပေါင်းစပ်ဖြေရှင်းချက်များ တည်ဆောက်နိုင်စေပြီး စီမံခန့်ခွဲသူများသည် ၎င်းတို့၏ဒေတာဝန်ဆောင်မှုများကို အလိုအလျောက်လုပ်ဆောင်နိုင်စေပြီး စီမံခန့်ခွဲနိုင်စေပါသည်။
- ဒေတာဝင်ရောက်ခြင်းနှင့် အထောက်အထားစိစစ်ခြင်း။ စံအပလီကေးရှင်းများနှင့် လည်ပတ်မှုစနစ်များကို အသုံးပြု၍ ဒေတာများကို ဝင်ရောက်ကြည့်ရှုနိုင်စေခြင်းဖြင့် enterprise-grade လုံခြုံရေးကို သေချာစေသည်။ ဤအလွှာသည် NFS၊ SMB နှင့် FTP အပါအဝင် enterprise access protocols များကို ပံ့ပိုးပေးသည်။
ကျွန်ုပ်တို့ အဓိကထားရာနေရာမှာ ဖိုင်စနစ်ဖြစ်ပြီး၊ ၎င်းသည် ယုတ္တိဗေဒဆိုင်ရာဖွဲ့စည်းပုံများတွင် ဒေတာများကို စီစဉ်ခြင်းနှင့် ဖိုင်အရေအတွက်များစွာဖြင့် workload များကို လုပ်ဆောင်ခြင်းဆိုင်ရာ အယူအဆအပေါ် အခြေခံထားသည်။ ဖိုင်စနစ်သည် တစ်ခုတည်းသော namespace ကို တင်ပြသည့် ဖြန့်ဝေထားသော ဗိသုကာပုံစံကို အသုံးပြုသည်။ အသုံးပြုထားသော ပလက်ဖောင်းများသည် မျှဝေခြင်းမရှိသော လွတ်လပ်သော node များ၏ cluster များဖြစ်ပြီး node တစ်ခုချင်းစီသည် စွမ်းရည်နှင့် စွမ်းဆောင်ရည်ကို ပေးဆောင်သည်။ ထို့အပြင်၊ တစ်ဦးချင်း node များသည် တစ်ခုနှင့်တစ်ခု အဆက်မပြတ် ညှိနှိုင်းဆောင်ရွက်သောကြောင့် မည်သည့် client မဆို မည်သည့် node နှင့်မဆို ချိတ်ဆက်နိုင်ပြီး namespace တွင် ဖတ်ရှုရေးသားနိုင်စေပါသည်။ ဤဖွဲ့စည်းပုံသည် အလွန်စိတ်ဝင်စားဖွယ်ကောင်းသည်။ ၎င်းသည် ဖန်တီးသူများအတွက် ဒေတာသက်တမ်းစက်ဝန်းတစ်လျှောက် ရွေ့လျားနေစဉ် ဒေတာအစုံများတွင် ပူးပေါင်းဆောင်ရွက်ရန် ရည်ရွယ်သည်။ ၎င်းသည် စနစ်များသည် petabytes နှင့် ဘီလီယံပေါင်းများစွာသော ဖိုင်များအထိ တိုးချဲ့သည့်တိုင် စွမ်းဆောင်ရည်နှင့် စွမ်းရည်အသုံးပြုမှုဆိုင်ရာ အချိန်နှင့်တပြေးညီ ထိုးထွင်းသိမြင်မှုကိုလည်း ပေးစွမ်းသည်။
Qumulo File System သည် ဒေတာများကို directory များအဖြစ် စီစဉ်ပေးပြီး SMB နှင့် NFS client များထံ ဒေတာများကို တင်ပြပေးကာ protocol များတစ်လျှောက် ဒေတာများကို မျှဝေနိုင်သောကြောင့် မတူညီသော user များနှင့် application အမျိုးအစားများစွာအား တူညီသောဒေတာကို ဝင်ရောက်ကြည့်ရှုနိုင်စေပါသည်။ ဖိုင်စနစ်တွင် ထူးခြားသောဂုဏ်သတ္တိများရှိသည်- B-tree များကို အသုံးပြုခြင်းနှင့် built-in real-time data analytics engine ပါဝင်သည်။
B-trees ဖွဲ့စည်းပုံကို အသုံးပြုခြင်းဖြင့် Qumulo သည် အခြားစနစ်များတွင် ပျံ့နှံ့နေသော ပြဿနာများကို မကြုံတွေ့ရဘဲ ဖိုင်ဘီလီယံပေါင်းများစွာအထိ ချဲ့ထွင်နိုင်သည်။ B-trees များသည် ဒေတာဘလောက်များစွာကို ဖတ်ရှုရေးသားသော စနစ်များအတွက် အထူးသင့်လျော်ပါသည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့သည် ဒေတာအရေအတွက် တိုးလာသည်နှင့်အမျှ လုပ်ဆောင်ချက်တစ်ခုစီအတွက် လိုအပ်သော I/O ပမာဏကို လျှော့ချပေးသည့် “ရေတိမ်” ဒေတာဖွဲ့စည်းပုံများဖြစ်သောကြောင့်ဖြစ်သည်။ ဤဖွဲ့စည်းပုံများသည် ဖိုင်စနစ်များနှင့် ကျယ်ပြန့်သော ဒေတာဘေ့စ်အညွှန်းကိန်းများအတွက် အသင့်တော်ဆုံးဖြစ်သည်။
Qumulo File System ရဲ့ နောက်ထပ်အရေးကြီးတဲ့ အစိတ်အပိုင်းတစ်ခုကတော့ real-time analytics engine ပါဝင်တဲ့ data-aware capability ပါ။ Data awareness ဆိုတာ storage system ထဲကို multi-dimensional visibility ကို ဆိုလိုပြီး system content, activity, users နဲ့ အခြားအရာတွေအကြောင်း အစွမ်းထက်တဲ့ insights တွေကို ပေးစွမ်းပါတယ်။ Qumulo ရဲ့ real-time analytics နဲ့ storage administrator တွေဟာ throughput နဲ့ latency အပါအဝင် storage usage နဲ့ performance ကို မြန်မြန်ဆန်ဆန် စောင့်ကြည့်နိုင်ပါတယ်။ ဒီ visibility က အဖွဲ့အစည်းတွေကို သူတို့ရဲ့ unstructured data ကို ထိန်းချုပ်နိုင်အောင်၊ လက်ရှိလိုအပ်ချက်တွေကို ကြိုတင်စီမံခန့်ခွဲခြင်းအပြင် အနာဂတ် storage လိုအပ်ချက်တွေကို ပိုမိုကောင်းမွန်စွာ ခန့်မှန်းခြင်းအားဖြင့် ಒಟ್ಟಾರೆ operational နဲ့ capital cost တွေကို လျှော့ချနိုင်အောင် စွမ်းဆောင်ပေးပါတယ်။ အောက်က အပိုင်းမှာ ပြန်လည်သုံးသပ်ထားတဲ့အတိုင်း Qumulo web-UI က ဒီ visibility ကို နောက် system management level ကို ယူဆောင်လာပါတယ်။
၎င်း၏ software architecture နှင့် ၎င်း၏ သီးခြား file system ဖြင့် Qumulo သည် အဖွဲ့အစည်းများအား ယခင်က on-prem data center တစ်ခုတည်းတွင် မဖြစ်နိုင်သော စီးပွားရေးရည်မှန်းချက်များကို အောင်မြင်စေရန် ခွင့်ပြုသည်။ Qumulo ၏ အားသာချက်များထဲမှ တစ်ခုမှာ ၎င်း၏ file system ကို on-premises တွင် run ပြီးနောက် cloud တွင် တူညီသော software ကို run နိုင်ခြင်း ဖြစ်သည်။ ကုမ္ပဏီသည် scale-out file storage provider အဖြစ် လူသိများသည်။ ယခုအခါ cloud ၏ elasticity နှင့် cloud compute နှင့် cloud storage infrastructure နှစ်ခုလုံး၏ scale ကို အသုံးပြုခြင်းဖြင့် Qumulo ၏ software နှင့်အတူ data များကို ရှေ့တိုးနောက်ငင် ရွှေ့ပြောင်းရန်နှင့် data center ကို အလွယ်တကူ scale-out သို့မဟုတ် scale up လုပ်ရန် အလွန်အစွမ်းထက်စေသည်။ ဥပမာအားဖြင့် ကုမ္ပဏီများသည် ၎င်းတို့၏ on-prem app များကို cloud ထဲသို့ ရွှေ့နိုင်ပြီး ၎င်းသည် အလုပ်လုပ်ပါသည်။ ထို့အပြင် user တွင် machine learning သို့မဟုတ် AI ကဲ့သို့သော cloud service များဖြင့် အသုံးချလိုသော file data ရှိပါက Qumulo ၏ Shift လုပ်ဆောင်ချက်သည် cloud-native application innovation ကို ဝင်ရောက်ကြည့်ရှုနိုင်ရန် data ကို cloud object store သို့ ကူးယူပေးမည်ဖြစ်သည်။
အဖွဲ့အစည်းများသည် ဤအလုပ်ပမာဏများကို cloud သို့ ရွှေ့ပြောင်းသည်နှင့်အမျှ ၎င်းတို့၏ဒေတာများ မည်သို့လုပ်ဆောင်နေသည်ကိုလည်း နားလည်လိုကြသည်။ Qumulo ၏ analytics သည် hardware platform များအတွက် ပေးဆောင်သည့် အတွေ့အကြုံကို cloud တွင် တွေ့ရှိရပြီး hybrid-cloud အတွေ့အကြုံအပြည့်အဝကို ပေးဆောင်သည်။ ကုမ္ပဏီများသည် software ကို physical appliance ထဲသို့ သို့မဟုတ် cloud ထဲသို့ run ပါက software သည် အတူတူပင်ဖြစ်ပြီး GUI နှင့် စွမ်းဆောင်ရည်များ တူညီပါသည်။
အင်္ဂါရပ်များနှင့် စွမ်းရည်များအကြောင်း အသေးစိတ်သိရှိလိုပါက Qumulo ၏ ဝဘ်ဆိုက်ရှိ နည်းပညာဆိုင်ရာ စာရွက်စာတမ်းများကို ဝင်ရောက်ကြည့်ရှုရန် ကျွန်ုပ်တို့ အားပေးပါသည်။
Qumulo စွမ်းဆောင်ရည်
စွမ်းဆောင်ရည် ဖွဲ့စည်းပုံ
ကျွန်ုပ်တို့၏ 5-node cluster ရှိ Qumulo node များ၏ configuration တွင် LACP ရှိ dual 25GbE ports များပါဝင်ပြီး 480GB SATA SSD လေးခုနှင့် 6TB SATA HDD ဆယ့်နှစ်ခုစီ ပါဝင်သည်။ ကျွန်ုပ်တို့၏ storage test များအတွက် vSwitch သို့ 25G port တစ်ခုစီ သတ်မှတ်ထားသော ကျွန်ုပ်တို့၏ Dell EMC PowerEdge R740xd server ရှစ်ခုသို့ NFS share နှင့် ချိတ်ဆက်ထားသော server ရှစ်ခုအတွက် single NFS namespace တစ်ခု ပံ့ပိုးပေးခဲ့သည်။ ထို့နောက် VMware ရှိ ကျွန်ုပ်တို့၏ 16 CentOS LoadGens များကို အသုံးပြုခဲ့ပြီး တစ်ခုချင်းစီတွင် twin 125GB vDisks များ ခွဲဝေပေးထားသောကြောင့် cluster တွင် စုစုပေါင်း 4TB footprint ရှိသည်။
storage arrays တွေကို benchmarking လုပ်တဲ့အခါ application testing က အကောင်းဆုံးဖြစ်ပြီး synthetic testing က ဒုတိယနေရာမှာ ရှိပါတယ်။ တကယ့် workloads တွေရဲ့ ပြီးပြည့်စုံတဲ့ ကိုယ်စားပြုမှု မဟုတ်ပေမယ့် synthetic tests တွေက repeatability factor ရှိတဲ့ baseline storage devices တွေကို အထောက်အကူပြုပြီး ယှဉ်ပြိုင်တဲ့ solution တွေကြား apples-to-apples နှိုင်းယှဉ်မှုကို လွယ်ကူစေပါတယ်။ ဒီ workloads တွေက “four corners” tests၊ common database transfer size tests တွေအပြင် VDI environments အမျိုးမျိုးကနေ trace captures တွေအထိ testing profiles အမျိုးမျိုးကို ပေးစွမ်းပါတယ်။ ဒီ tests အားလုံးက scripting engine တစ်ခုပါဝင်တဲ့ common vdBench workload generator ကို အသုံးပြုပြီး compute testing cluster ကြီးတစ်ခုပေါ်မှာ ရလဒ်တွေကို automate လုပ်ပြီး capture လုပ်ပါတယ်။ ဒါကြောင့် flash arrays နဲ့ individual storage devices တွေ အပါအဝင် storage devices အမျိုးမျိုးမှာ တူညီတဲ့ workloads တွေကို repeat လုပ်နိုင်ပါတယ်။
Qumulo သိုလှောင်မှု array ကို large-block transfer များအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသောကြောင့် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများသည် 64K၊ 1024K နှင့် 2048K sequential transfer များကို အာရုံစိုက်ခဲ့သည်။
ကိုယ်ရေးအချက်အလက်
- ၆၄K စဉ်ဆက်မပြတ်ဖတ်ရှုမှု- ၁၀၀% ဖတ်ရှုမှု၊ ၁၆ ချည်၊ ၀-၁၂၀% iorate
- ၆၄K အစဉ်လိုက်ရေးသားမှု- ၁၀၀% ရေးသားမှု၊ ၈ ချည်၊ ၀-၁၂၀% iorate
- ၆၄K စဉ်ဆက်မပြတ်ဖတ်ရှုမှု- ၁၀၀% ဖတ်ရှုမှု၊ ၁၆ ချည်၊ ၀-၁၂၀% iorate
- ၆၄K အစဉ်လိုက်ရေးသားမှု- ၁၀၀% ရေးသားမှု၊ ၈ ချည်၊ ၀-၁၂၀% iorate
- ၆၄K စဉ်ဆက်မပြတ်ဖတ်ရှုမှု- ၁၀၀% ဖတ်ရှုမှု၊ ၁၆ ချည်၊ ၀-၁၂၀% iorate
- ၆၄K အစဉ်လိုက်ရေးသားမှု- ၁၀၀% ရေးသားမှု၊ ၈ ချည်၊ ၀-၁၂၀% iorate
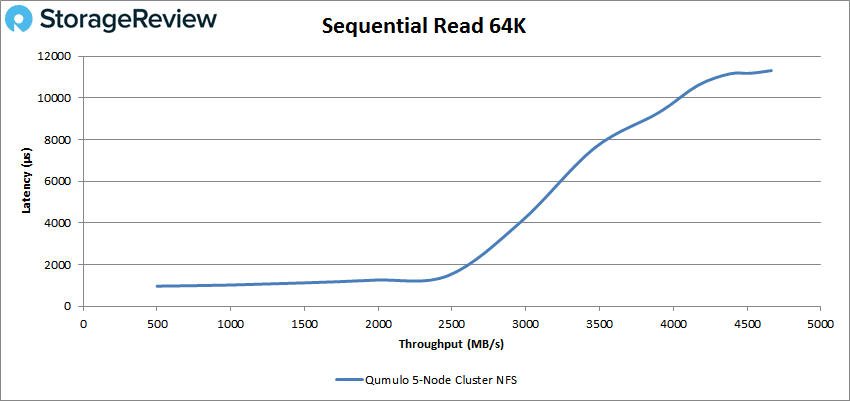
ပထမတစ်ခုကတော့ ကျွန်တော်တို့ရဲ့ 64K sequential benchmark ဖြစ်ပြီး latency 11.3ms မှာ 74,619 IOPS ဒါမှမဟုတ် 4.66GB/s ရှိပါတယ်။
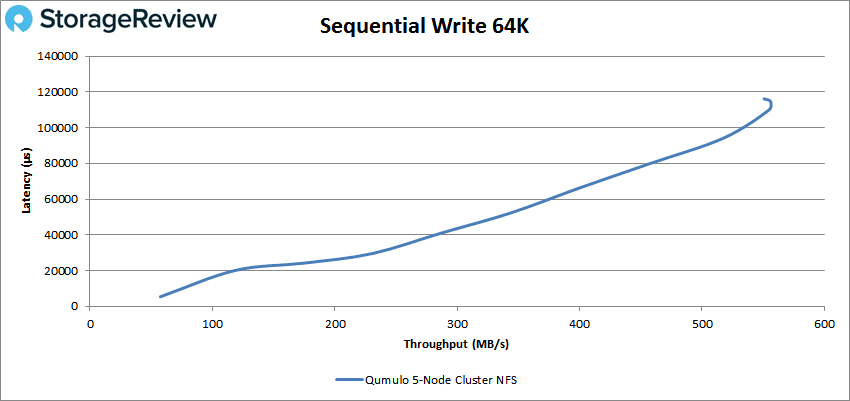
64K ရေးသားမှုသည် 110ms latency တွင် 9K IOPS သို့မဟုတ် 555MB/s အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို ရရှိခဲ့သည်။
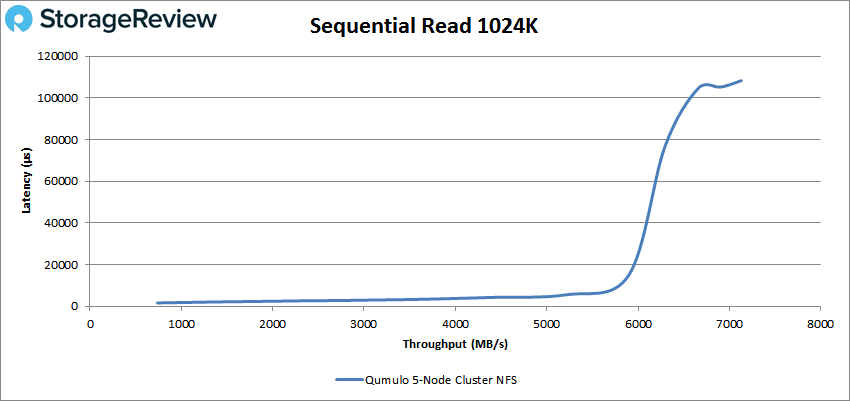
နောက်တစ်ခုကတော့ 1024K စမ်းသပ်မှုတွေကို ဆက်သွားပါမယ်။ ဖတ်ရှုမှုအတွက် 108ms latency မှာ 7,128 IOPS သို့မဟုတ် 7.13GB/s အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို တွေ့ရှိခဲ့ရပါတယ်။
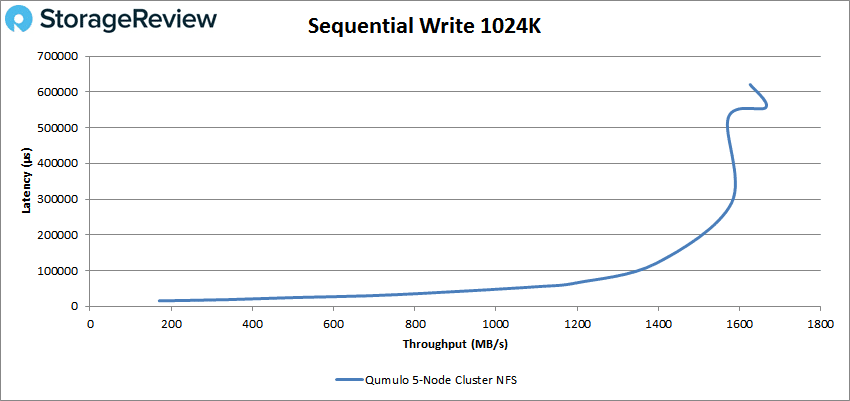
1024K ရေးသားမှုသည် အချို့ကျဆင်းသွားပြီးနောက် 557ms latency တွင် 1,670 IOPS သို့မဟုတ် 1.6GB/s အမြင့်ဆုံးကို မြင်တွေ့ခဲ့ရသည်။
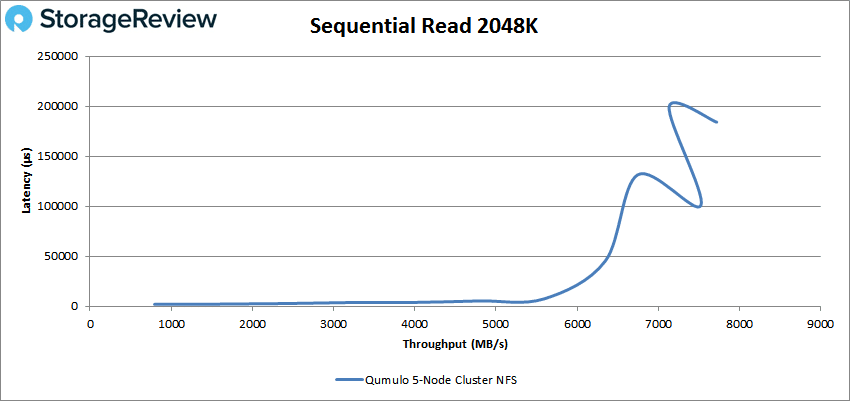
ကျွန်ုပ်တို့ရဲ့ နောက်ဆုံး sequential benchmark တွေကတော့ 2048K ပါ။ read performance မှာ 184ms latency မှာ 3,858 IOPS ဒါမှမဟုတ် 7.7GB/s အမြင့်ဆုံးကို မြင်တွေ့ခဲ့ရပါတယ်။
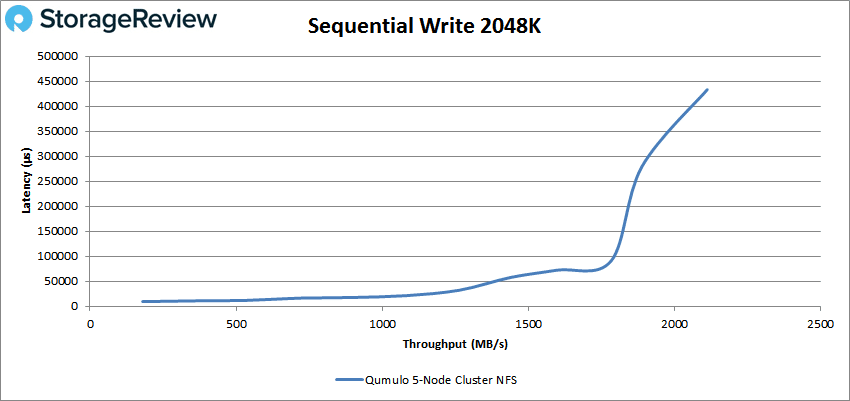
နောက်ဆုံးအနေနဲ့ ကျွန်တော်တို့ရဲ့ 2048K ရေးသားမှုမှာ 433ms latency မှာ 1,055 IOPS ဒါမှမဟုတ် 2.1GB/s အမြင့်ဆုံးကို မြင်တွေ့ခဲ့ရပါတယ်။
Qumulo ဝဘ် UI ခြုံငုံသုံးသပ်ချက်
အောက်ပါအပိုင်းတွင်၊ Qumulo ၏ ဝဘ်အသုံးပြုသူမျက်နှာပြင်နှင့် ၎င်း၏ အဓိကဖွဲ့စည်းပုံအချို့ကို ကျွန်ုပ်တို့ ခြုံငုံသုံးသပ်ထားပါသည်။ ကုမ္ပဏီသည် စီမံခန့်ခွဲသူများအနေဖြင့် ဒေတာစင်တာနှင့် cloud ပတ်ဝန်းကျင်များကို ဖြန့်ကျက်ခြင်း၊ စီမံခန့်ခွဲခြင်းနှင့် စောင့်ကြည့်ခြင်းအတွက် ဤဝဘ်အခြေပြု UI ကို ပေးဆောင်ပါသည်။
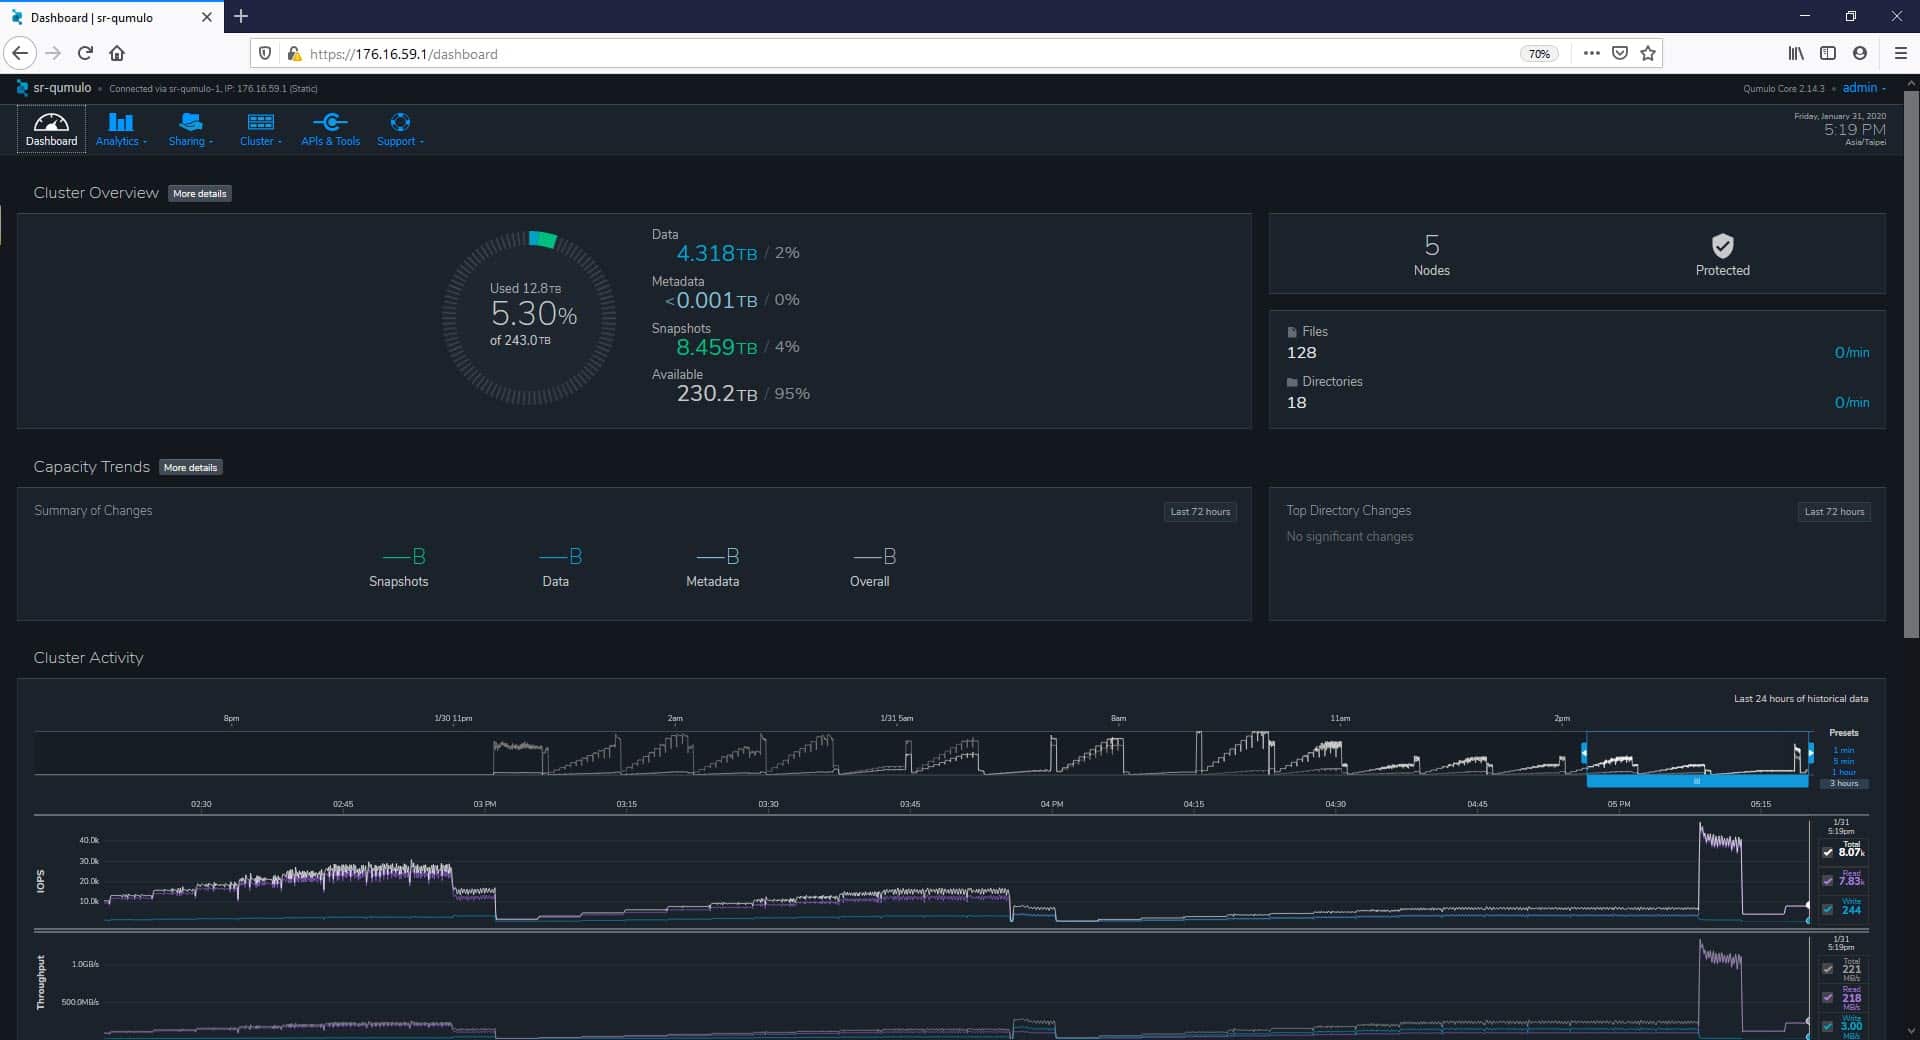
cluster ထဲကို admin အနေနဲ့ login ဝင်ပြီးရင် Dashboard စာမျက်နှာကို တိုက်ရိုက်ရောက်သွားပါလိမ့်မယ်။ ဒီအချိန်မှာ Qumulo က အဆိုပြုထားတဲ့ ထူးခြားပြီး ခေတ်မီတဲ့ Web UI ကို ချက်ချင်းသဘောပေါက်သွားပါတယ်။ ဒီ web UI မှာ tab တွေနဲ့ စနစ်တကျ စီစဉ်ထားတဲ့ အလိုလိုသိနိုင်တဲ့ menu တစ်ခု ပါဝင်ပါတယ်။ မျက်နှာပြင်ရဲ့ ဘယ်ဘက်အပေါ်ထောင့်မှာ မြင်တွေ့ရပြီး ကျွန်တော်တို့ရဲ့ infrastructure ကို deploy, manage နဲ့ monitor လုပ်ဖို့အတွက် လိုအပ်တဲ့ categories အားလုံးကို မြန်မြန်ဆန်ဆန် ထည့်သွင်းထားပါတယ်။ Main menu မှာ Dashboard, Analytics, Sharing, Cluster, API's & Tools, နဲ့ Support tabs တွေ ပါဝင်ပါတယ်။ ဒီ tabs တွေကို ညွှန်ပြပြီး UI က UI က ပေးထားတဲ့ စာမျက်နှာအမျိုးမျိုးကို ဝင်ရောက်ကြည့်ရှုဖို့ drop-down list တစ်ခုကို ပြသပေးပါတယ်။ အပေါ်ညာဘက်ထောင့်မှာ user တွေက လက်ရှိ software version, အချိန် (web browser ရဲ့ client local time အပေါ် အခြေခံပြီး) နဲ့ လက်ရှိ logged user ကို မြင်တွေ့နိုင်ပါတယ်။
သို့တိုင် Dashboard စာမျက်နှာတွင် အခြေခံအဆောက်အအုံများကို စောင့်ကြည့်ခြင်းကို လွယ်ကူချောမွေ့စေသည့် ဆွဲဆောင်မှုရှိသော UI အပြင်အဆင်ကို ကျွန်ုပ်တို့ သတိပြုမိပြီး Cluster Overview၊ Capacity Trends၊ Client Activity နှင့် real-time တွင် Cluster Activity ကဲ့သို့သော မတူညီသော အရေးကြီးသောနေရာများကို ကျွန်ုပ်တို့ လေ့လာနိုင်ပါသည်။
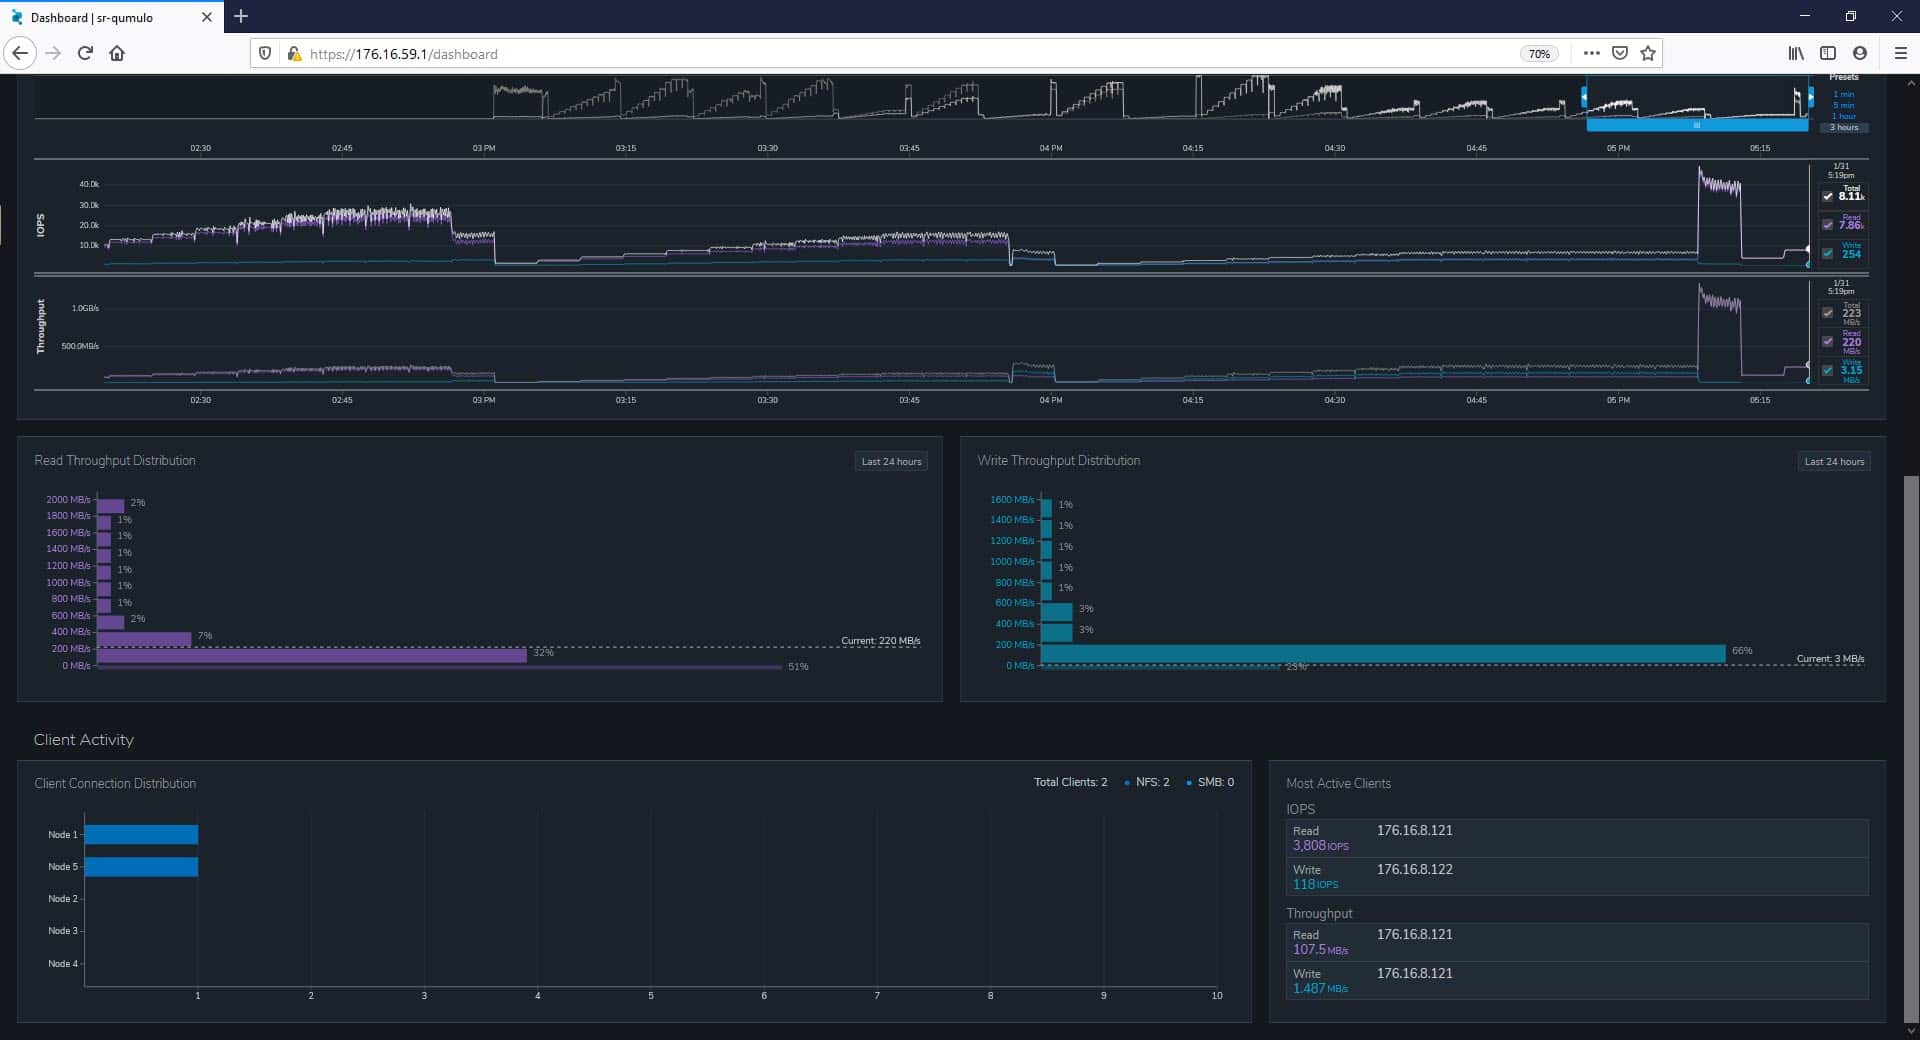
Dashboard ဧရိယာမှာရှိတဲ့ UI အကြောင်း ကျွန်တော်တို့ အထူးသဘောကျတဲ့ အယူအဆတစ်ခုကတော့ ၎င်းရဲ့ element အားလုံးနဲ့ dynamic interaction ဖြစ်တာပါပဲ။ ဥပမာအားဖြင့် Cluster Activity အောက်မှာ ကျွန်တော်တို့ စောင့်ကြည့်ချင်တဲ့ information activity ကို ၂၄ နာရီအတွင်း ရွှေ့ဖို့၊ ချဲ့ဖို့ ဒါမှမဟုတ် ကျဉ်းမြောင်းအောင်လုပ်ဖို့ အလွယ်တကူ drag လုပ်နိုင်ပါတယ်။ ဒီမှာ ၁ မိနစ်၊ ၅ မိနစ်၊ ၁ နာရီနဲ့ default ၃ နာရီကာလတွေပါတဲ့ preset တွေလည်း ရှိပါတယ်။ metrics (IOPS နဲ့ Throughput) တွေက peak data ပေါ်မူတည်ပြီး ချိန်ညှိပေးပါလိမ့်မယ်။
Dashboard စာမျက်နှာကို scroll လုပ်လိုက်ရင် Client Activity ဧရိယာကို တွေ့ပါလိမ့်မယ်။
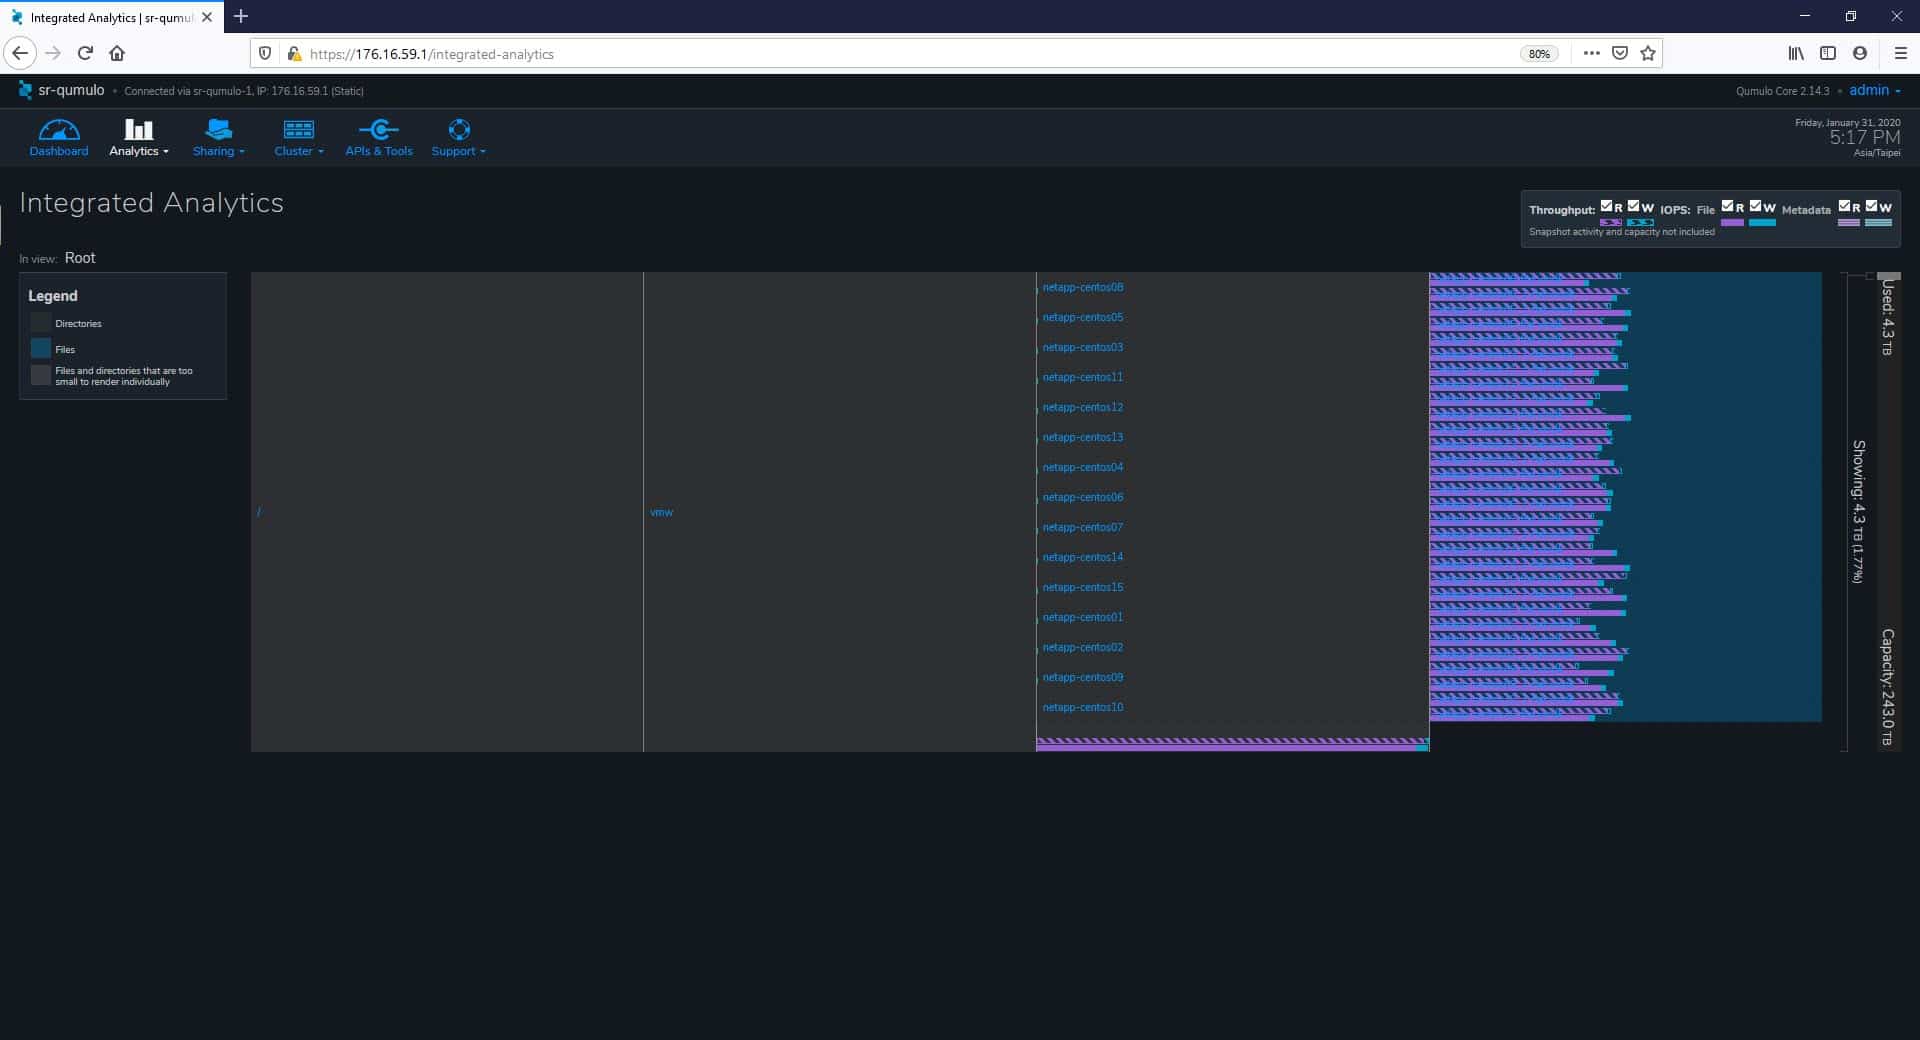
ယခု Qumulo ထင်ရှားသောနယ်ပယ်ဖြစ်သည့် analytics သို့ တန်းသွားပါမည်။ ယခင်ကဖော်ပြခဲ့သည့်အတိုင်း Qumulo သည် administrator များအား data နှင့် user များကို real-time တွင် စီမံခန့်ခွဲနိုင်စေပါသည်။ Analytics > Integrated Analytics အောက်တွင်၊ ဘယ်ဘက်ရှိ information pane ကို system ၏ resource အများဆုံးအသုံးပြုနေသော client များနှင့် directory များနှင့် file များကို actively read နှင့် write လုပ်နေသော client များဖြင့် ဖြည့်ထားသည်ကို မြင်တွေ့နိုင်ပါသည်။ ဤအချက်အလက်ကို directory သို့မဟုတ် subdirectory တစ်ခုကို နှိပ်ပြီးနောက် ပြသပါသည်။
Analytics tab အောက်မှာရှိနေတဲ့ Capacity Explorer စာမျက်နှာကို ရွှေ့လိုက်မယ်ဆိုရင် စနစ်ပေါ်မှာ capacity ဘယ်လိုဖြန့်ဝေထားလဲဆိုတာကို မြင်တွေ့နိုင်ပါတယ်။ ပထမဦးစွာ directory ရဲ့ capacity ကို အကြီးဆုံးကနေ အငယ်ဆုံးအထိ ယေဘုယျခြုံငုံသုံးသပ်ထားပါတယ်။
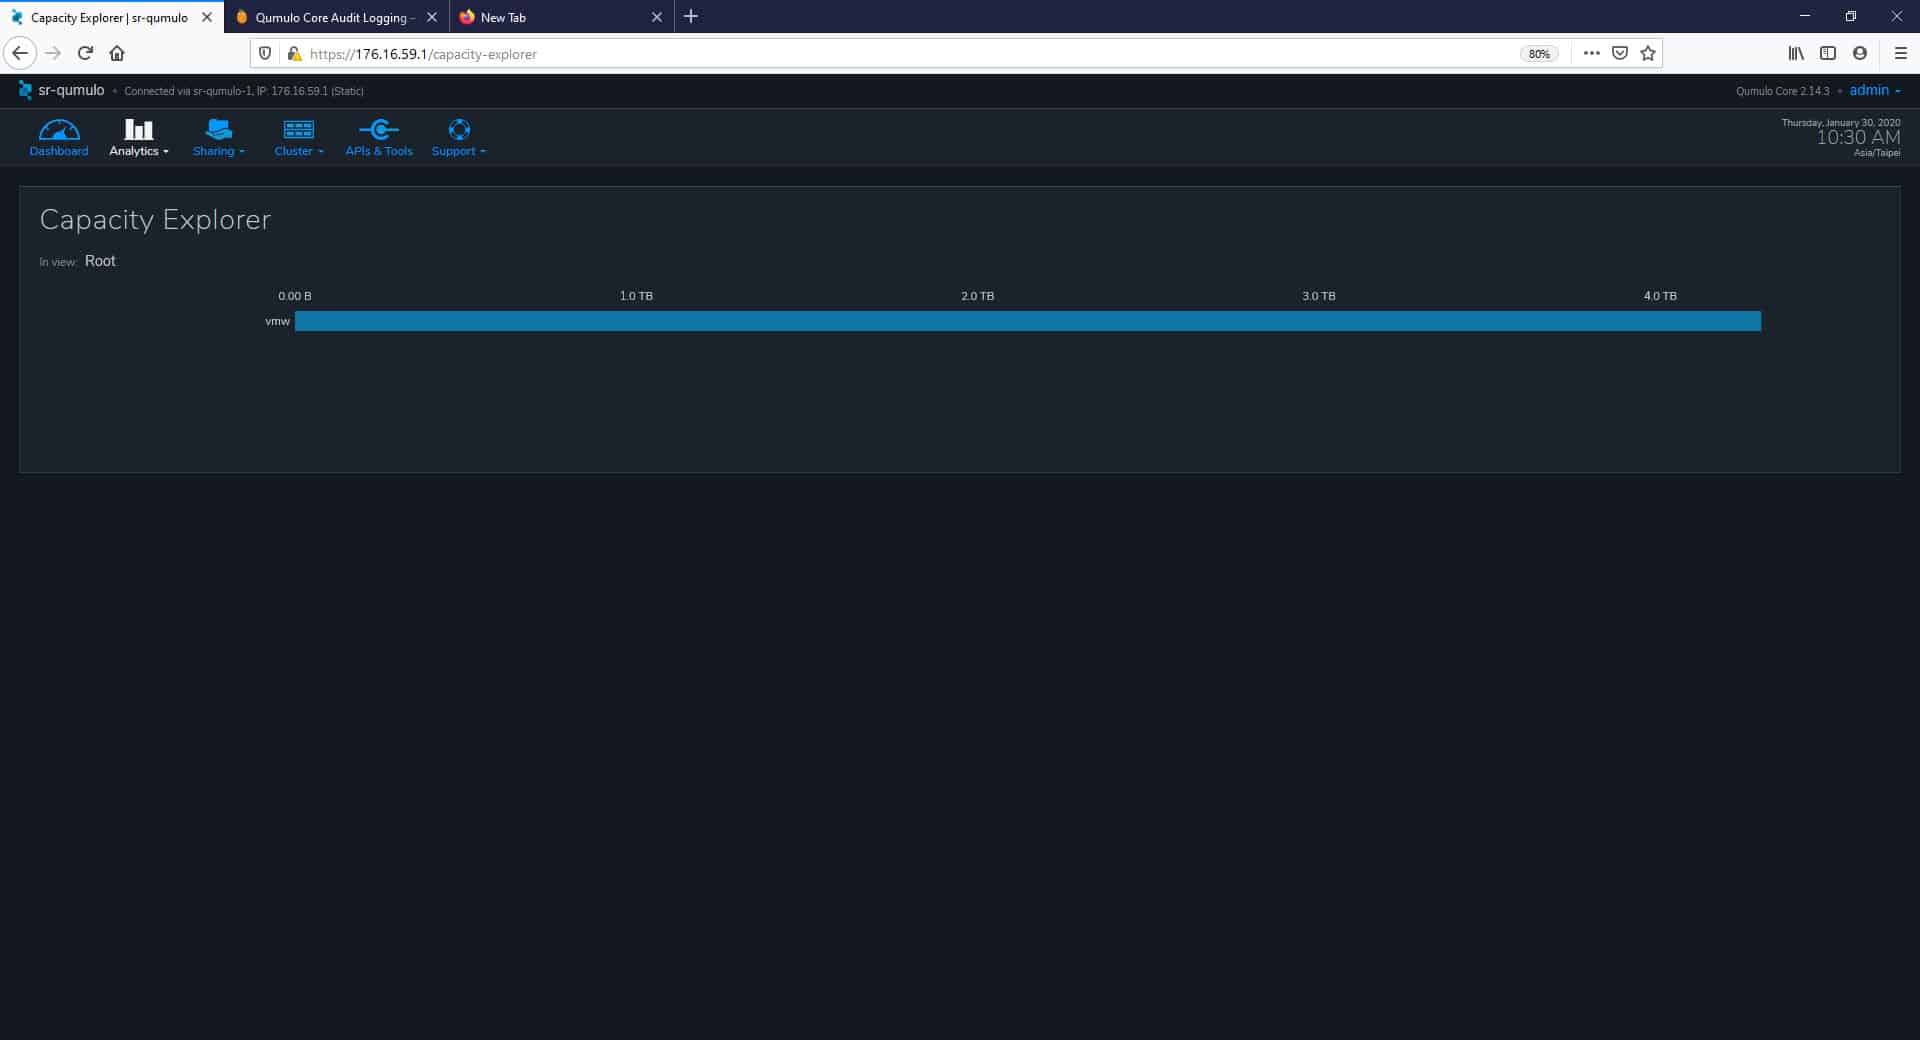
directory တစ်ခုကို နှိပ်ခြင်းအားဖြင့်၊ ကျွန်ုပ်တို့သည် ၎င်းတို့တစ်ခုစီကို ပိုမိုအသေးစိတ်ရှုထောင့်မှ တူးဖော်ကြည့်ရှုနိုင်ပါသည်။ ဥပမာအားဖြင့်၊ အောက်ပါပုံတွင် “vmw” အမည်ရှိ directory တွင်ပါဝင်သော subdirectory များကို ပြသထားသည်။
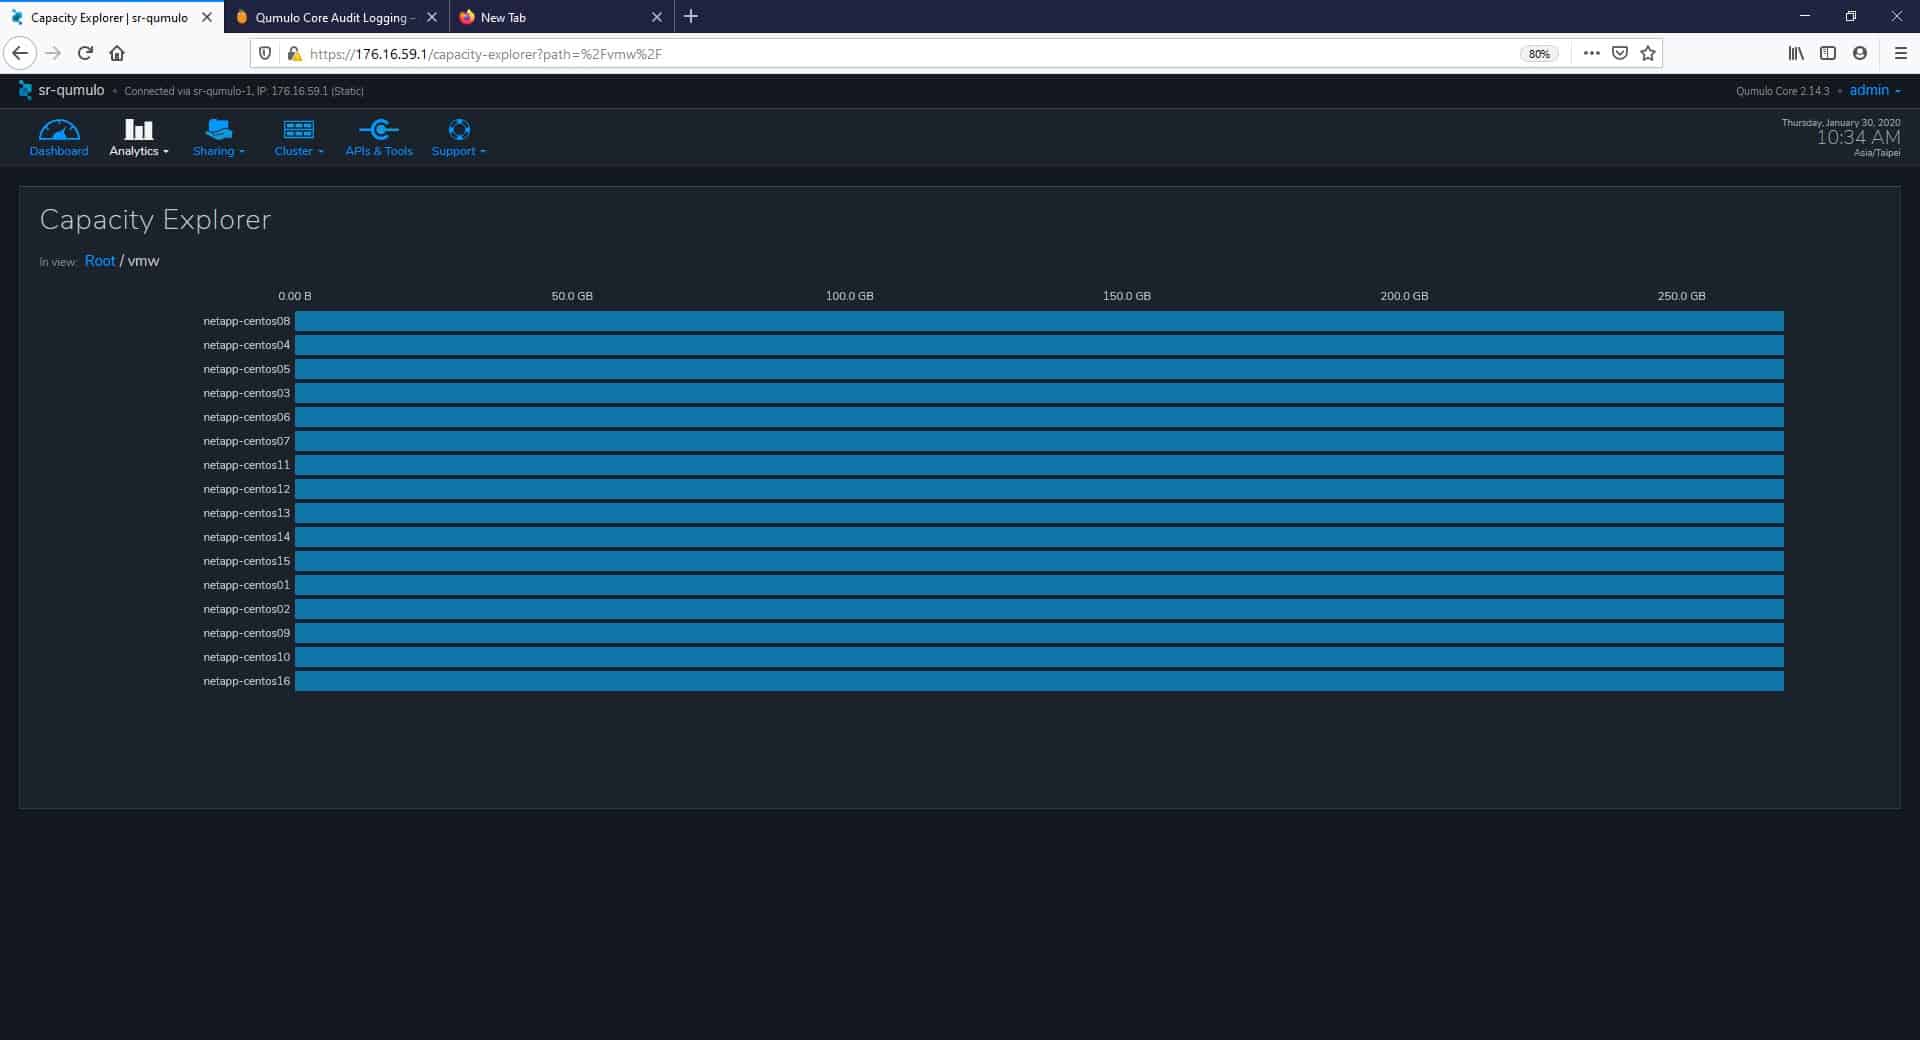
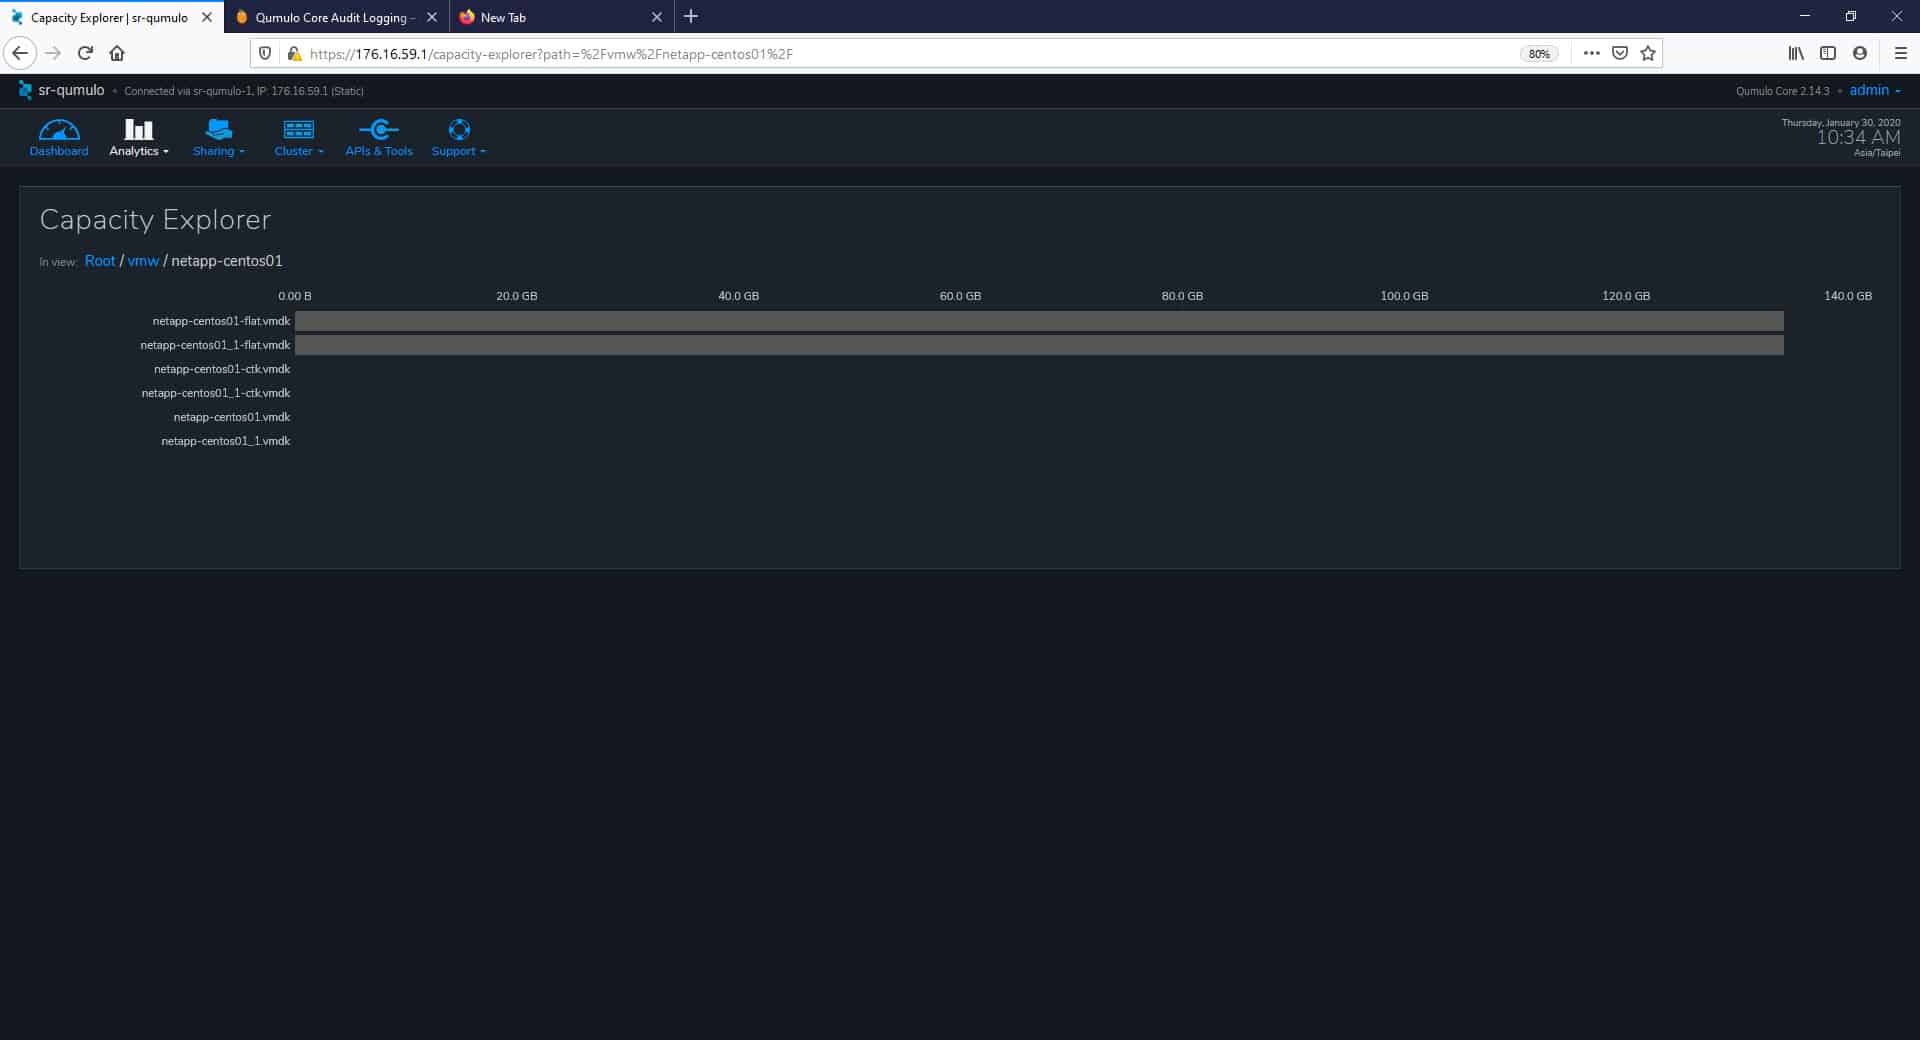
ပြီးတော့ subdirectory တွေကို ဆက်နှိပ်မယ်ဆိုရင် file level မှာ အသေးစိတ်အချက်အလက်တွေကို နောက်ဆုံးမှာ ရောက်နိုင်ပါတယ်။ ဒီတစ်ခါတော့ “netapp-centos01” လို့ခေါ်တဲ့ subdirectory ကို နှိပ်လိုက်ပါတယ်။
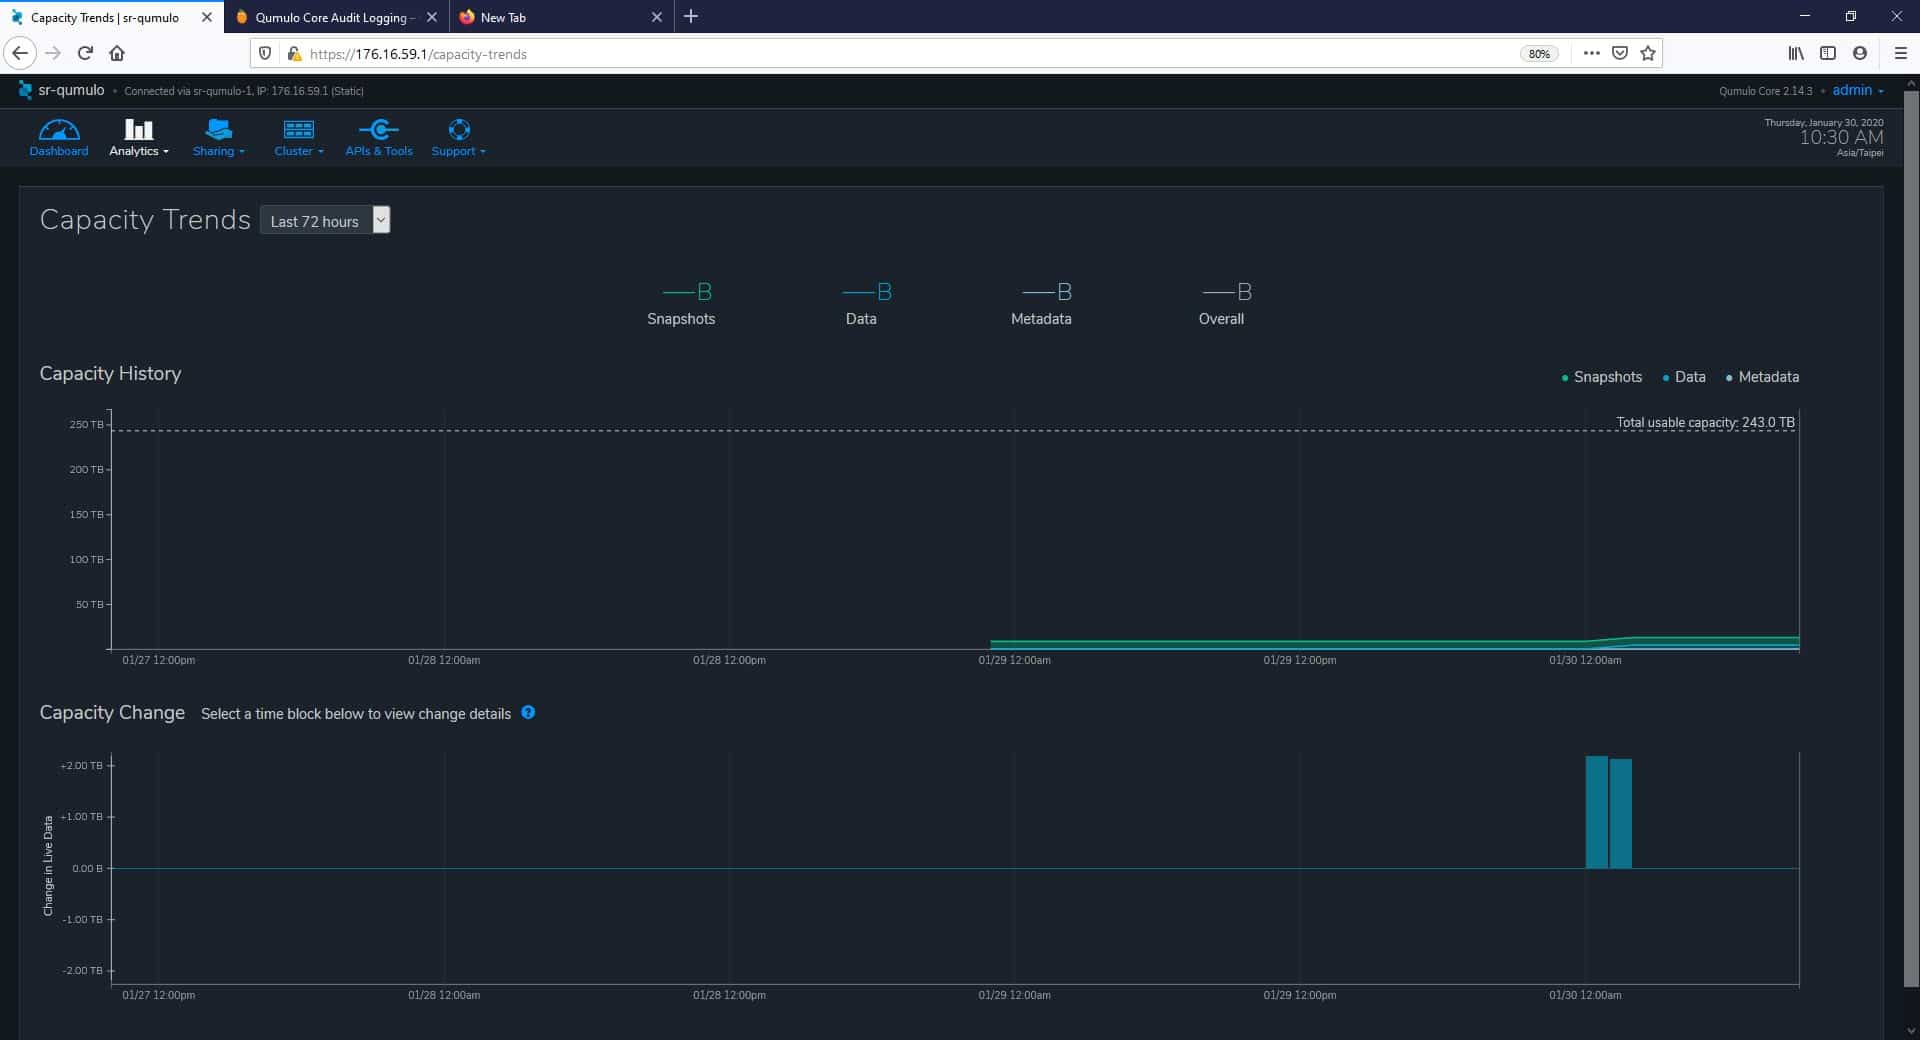
analytics အောက်ရှိ နောက်စာမျက်နှာမှာ Capacity Trends ဖြစ်သည်။ ဤနေရာမှ cluster ၏ capacity usage overtime ကို စောင့်ကြည့်စီမံခန့်ခွဲရန် လိုအပ်သော အသေးစိတ်အချက်အလက်အားလုံးကို ရယူနိုင်ပါသည်။ ဤနေရာတွင် အဓိကနယ်ပယ်နှစ်ခုမှာ Capacity History နှင့် Capacity Change တို့ဖြစ်သည်။ ဤ capacity များတွင် metadata၊ data နှင့် snapshots များ ပါဝင်သည် (Capacity Change တွင်သာ ချန်လှပ်ထားသည်)။ capacity ၏ History နှင့် ပြောင်းလဲမှုများကို ပြီးခဲ့သည့် ၇၂ နာရီ၊ ပြီးခဲ့သည့် ၃၀ ရက် သို့မဟုတ် ၅၂ ပတ်ကြာ အချိန်ဘောင်များဖြင့် လျင်မြန်စွာ filter လုပ်နိုင်သည်။ ၎င်းတို့သည် storage admin များအား cluster ကို scale အတွက် မြင်ယောင်ရန်နှင့် စီမံခန့်ခွဲရန်နှင့် capacity ပြောင်းလဲနေသော အဖြစ်အပျက်များကို စူးစမ်းလေ့လာရန် ကူညီပေးသည့် အကောင်းဆုံးရွေးချယ်မှုများဖြစ်သည်။
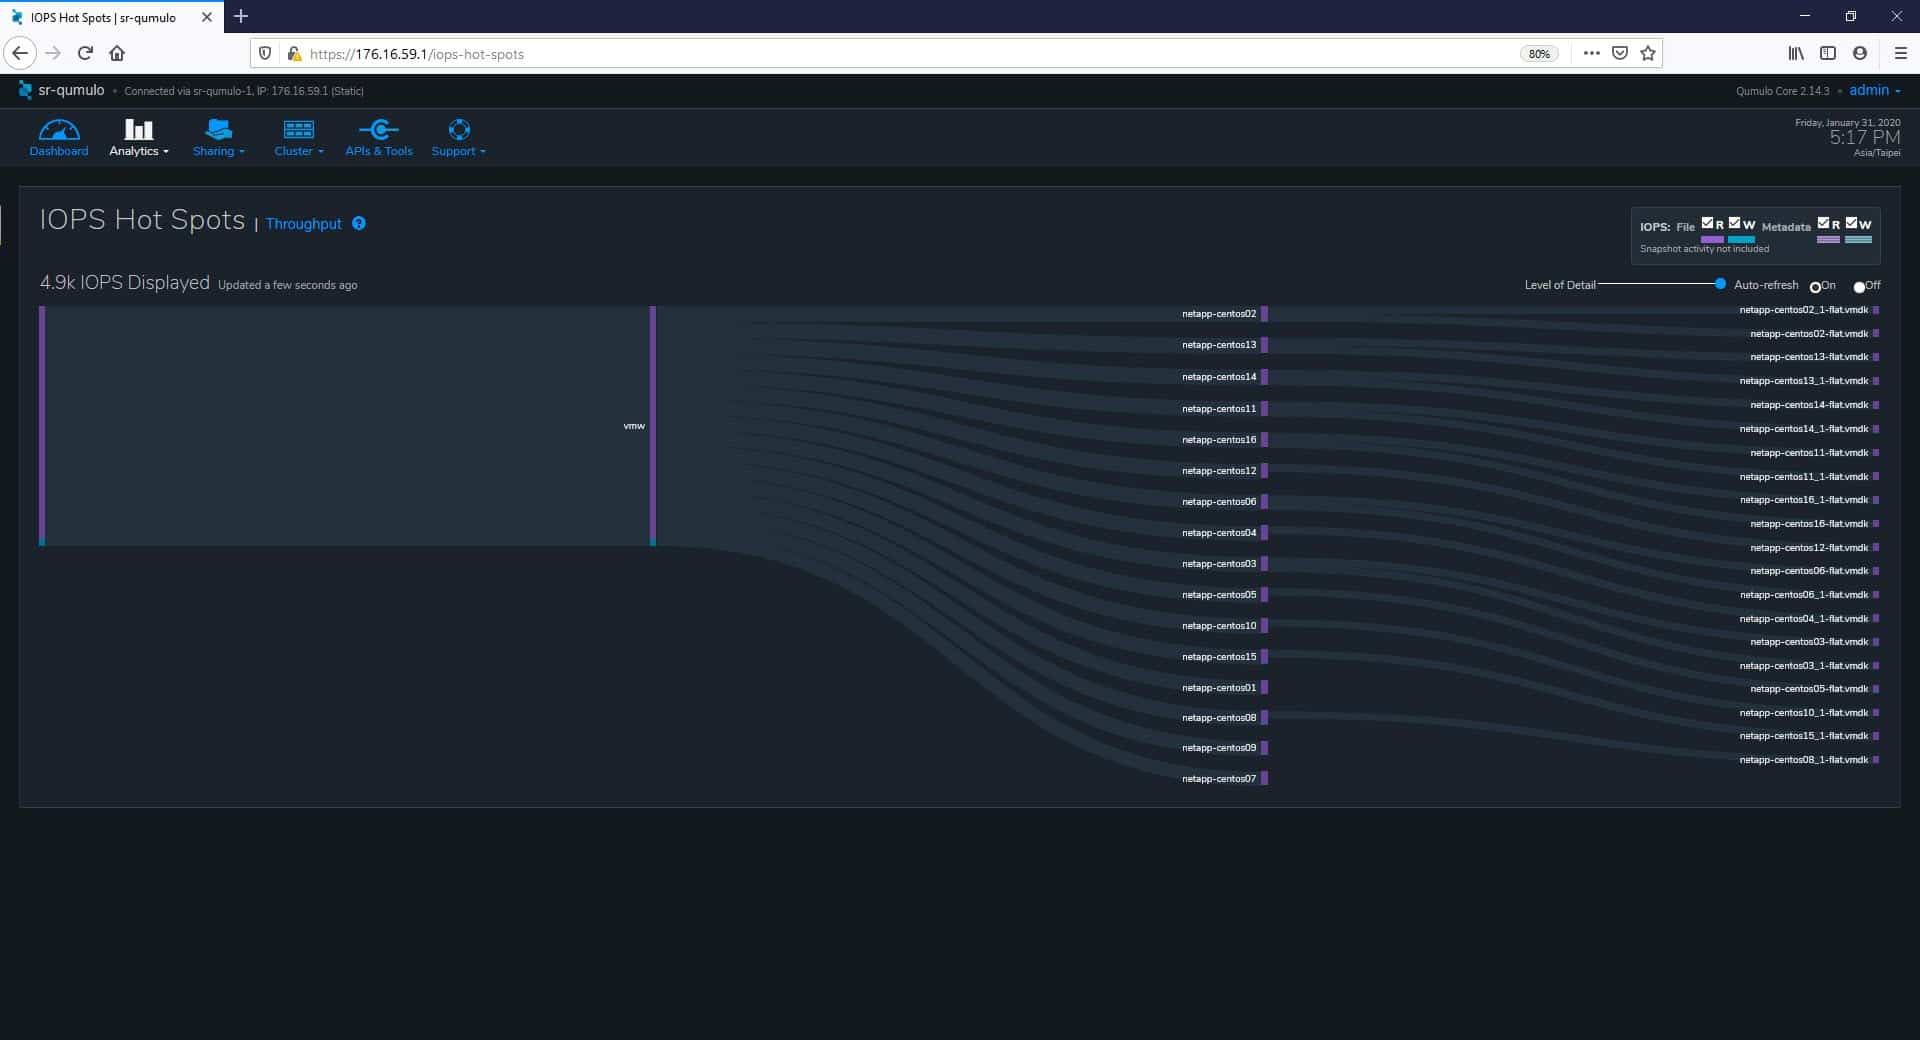
Analytics tab အောက်မှာ ကျွန်တော်တို့ လေ့လာခဲ့တဲ့ နောက်အပိုင်းကတော့ Activity ပါ။ အဲဒီမှာ Throughput Hot Spots၊ IOPS Hot Spots၊ Clients နဲ့ Paths တွေကို ရှာတွေ့နိုင်ပါတယ်။ IOPS Hot Spots စာမျက်နှာက ကျွန်တော်တို့ရဲ့ storage system မှာရှိတဲ့ input/output per second hotspots တွေကို ခွဲခြားသတ်မှတ်ပေးနိုင်ပါတယ်။ ဒီဇယားမှာ ဖိုင်တွေနဲ့ metadata အတွက် read/write လုပ်ဆောင်ချက်တွေအရ အတက်ကြွဆုံး directory တွေကို ပြသထားပါတယ်။ ဒီဒေတာရဲ့ အသေးစိတ်အဆင့်ကို ဇယားရဲ့ အပေါ်ညာဘက်မှာရှိတဲ့ slider ကို အသုံးပြုပြီး ချိန်ညှိနိုင်ပါတယ်။ Auto-refresh radio button ကနေ display ကို pause လုပ်ဖို့ အကောင်းဆုံး option တစ်ခုလည်း ရှိပါတယ်။
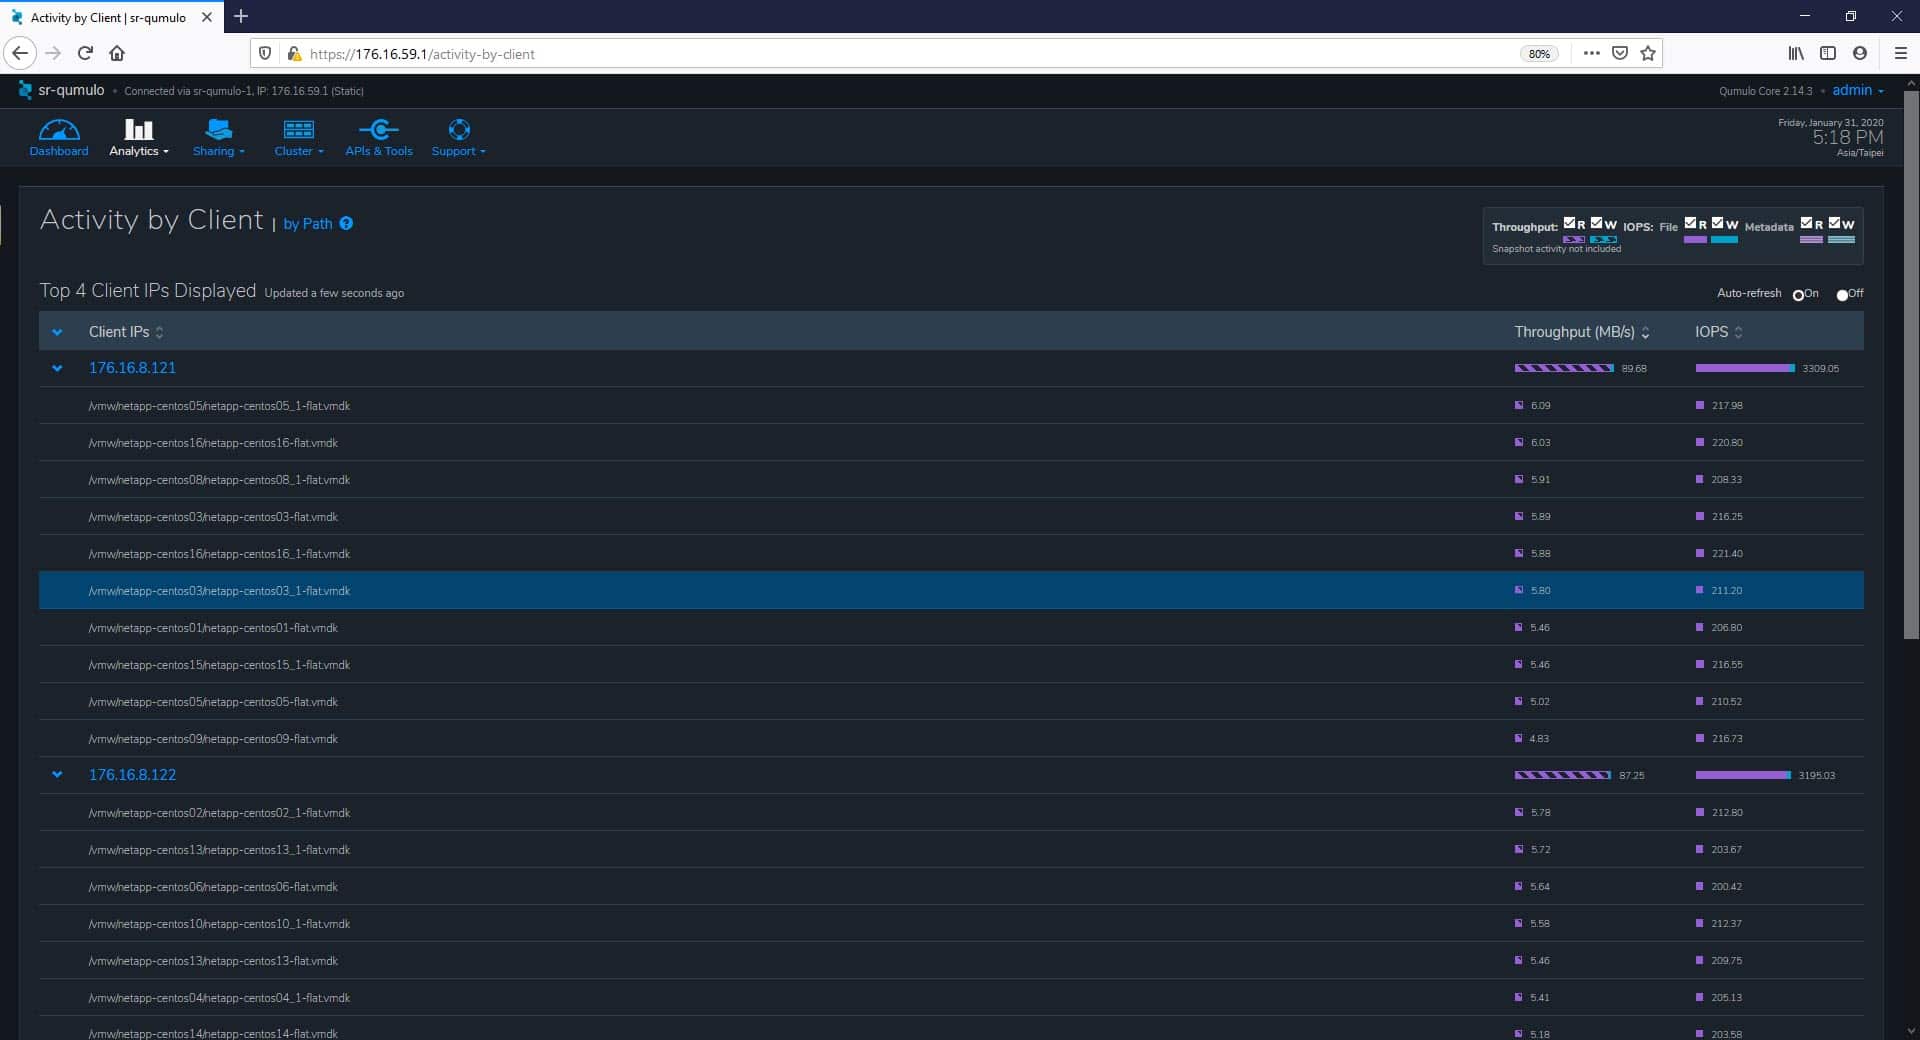
Client အလိုက် လုပ်ဆောင်ချက်တွေကိုလည်း စောင့်ကြည့်နိုင်ပါတယ်။ analytics က throughput နဲ့ IOPS အရ ဘယ် client တွေက အတက်ကြွဆုံးလဲဆိုတာကို ကြည့်နိုင်ပါတယ်။
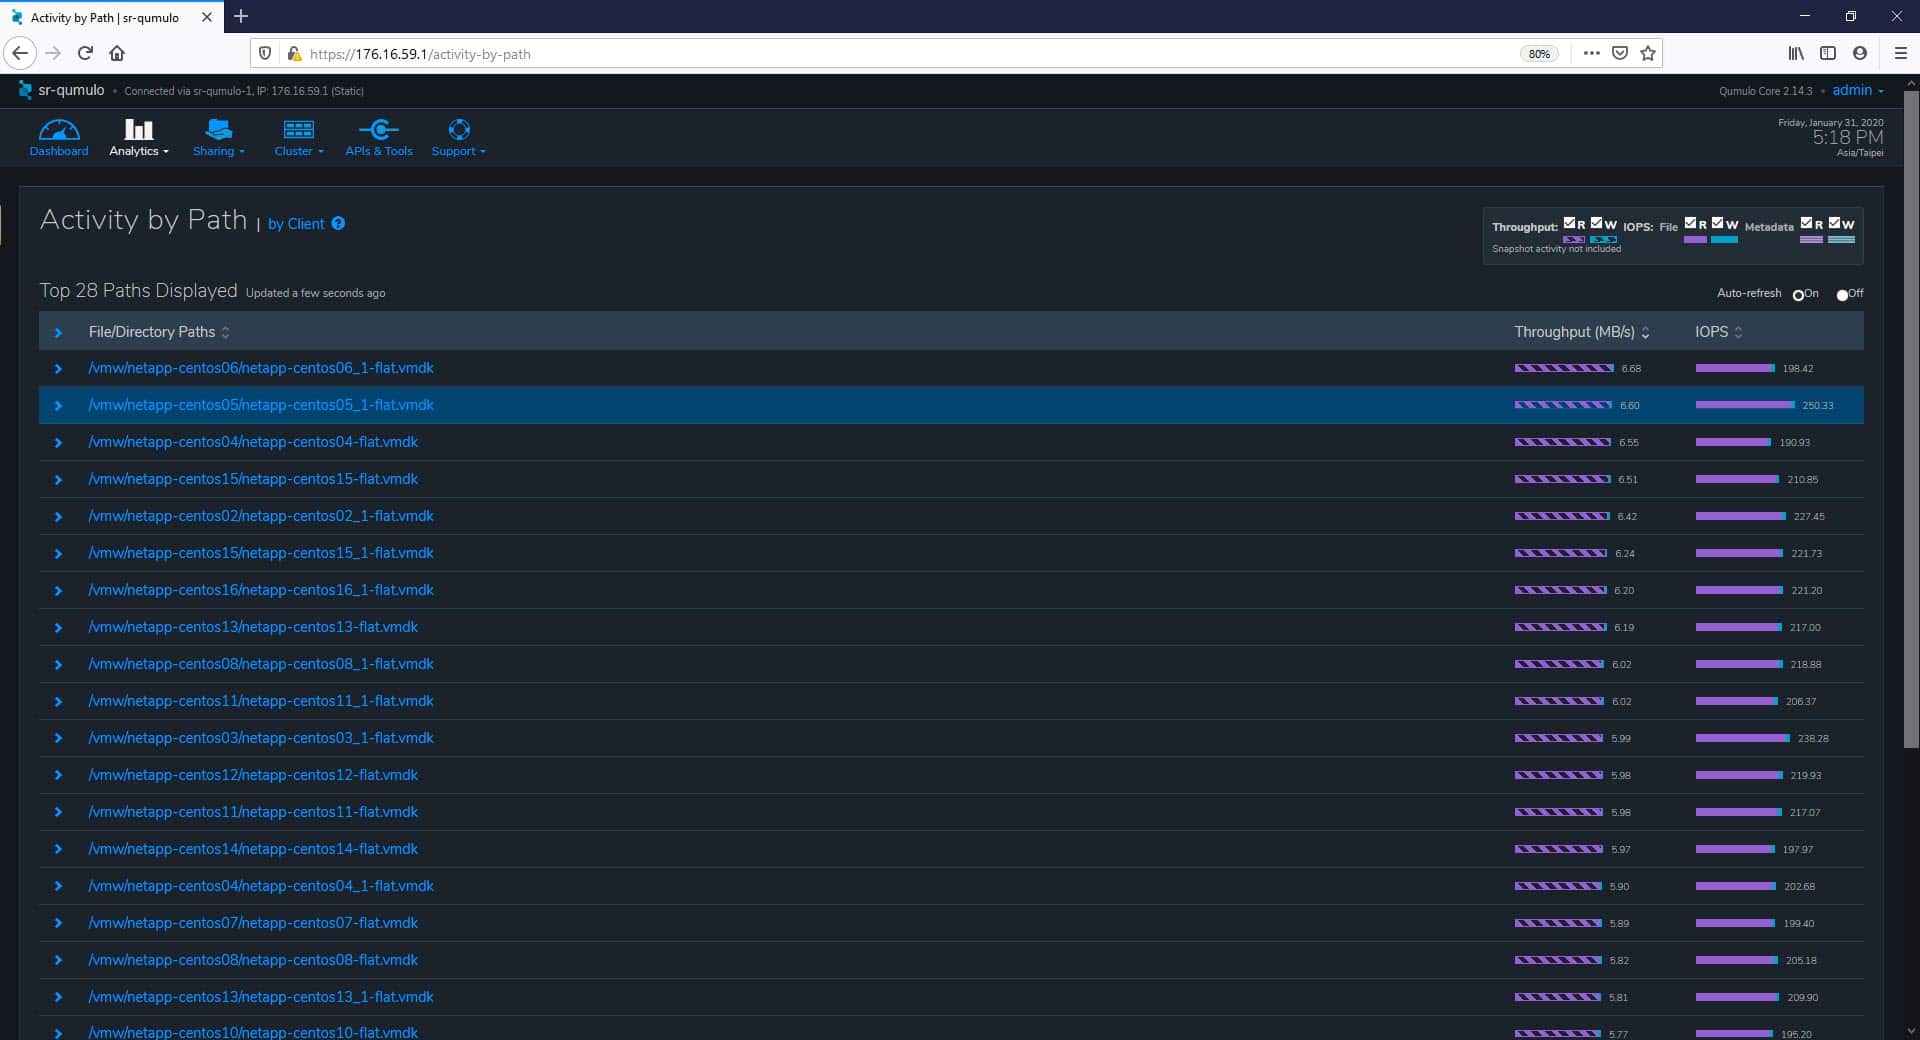
ထို့အပြင်၊ ကျွန်ုပ်တို့သည် Path မှတစ်ဆင့် cloud မှတစ်ဆင့် လုပ်ဆောင်ချက်ကို စောင့်ကြည့်ပါသည်။
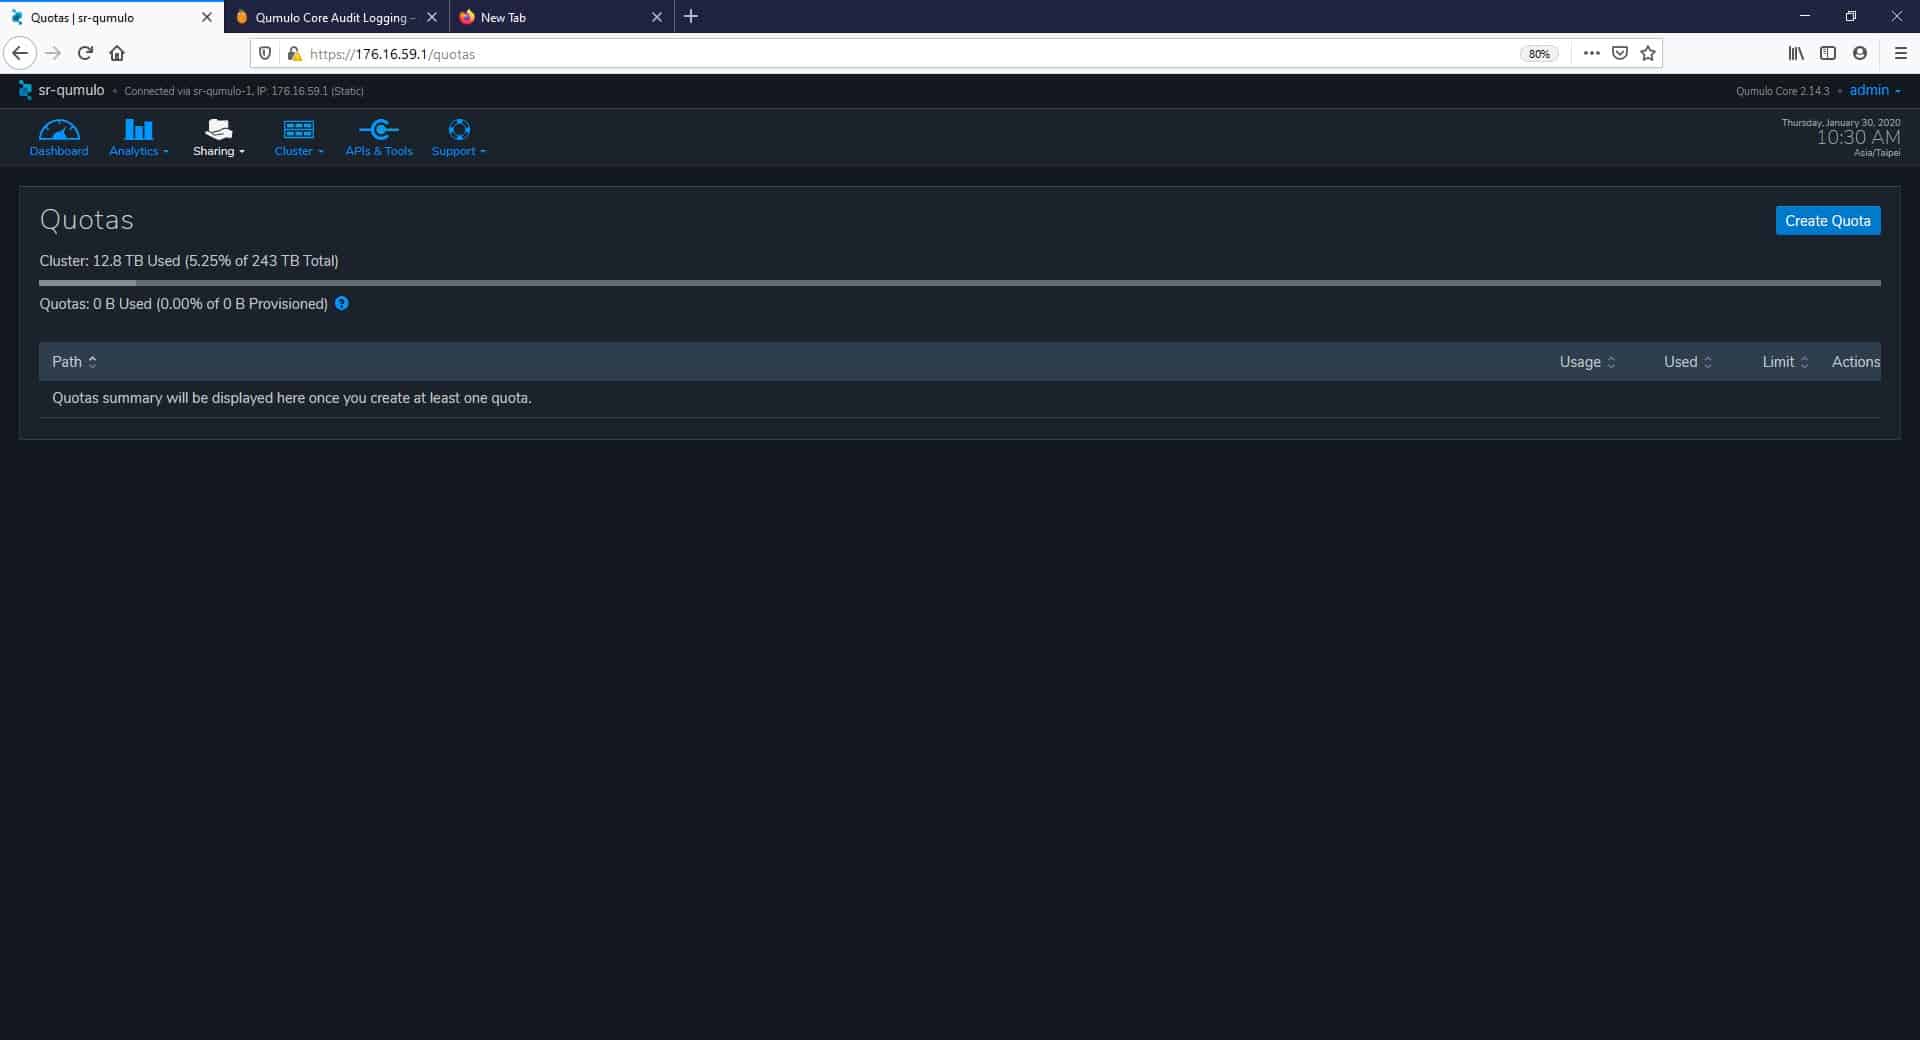
main menu ထဲက နောက် tab ကတော့ Sharing ဖြစ်ပြီး ဒီမှာ ကျွန်တော်တို့ ပထမဆုံး ခွဲခြမ်းစိတ်ဖြာတဲ့ စာမျက်နှာကတော့ Quotas ပါ။ Qumulo က real-time capacity quotas တွေကို enable လုပ်ပေးပြီး admin တွေအနေနဲ့ ပေးထားတဲ့ directory တစ်ခုကနေ file တွေအတွက် ဘယ်လောက် capacity သုံးခွင့်ပြုထားလဲဆိုတာကို သတ်မှတ်ပေးနိုင်ပါတယ်။ ဒီ page ကနေ Quotas တွေကို ဖန်တီး၊ တည်းဖြတ် ဒါမှမဟုတ် ဖျက်နိုင်ပါတယ်။
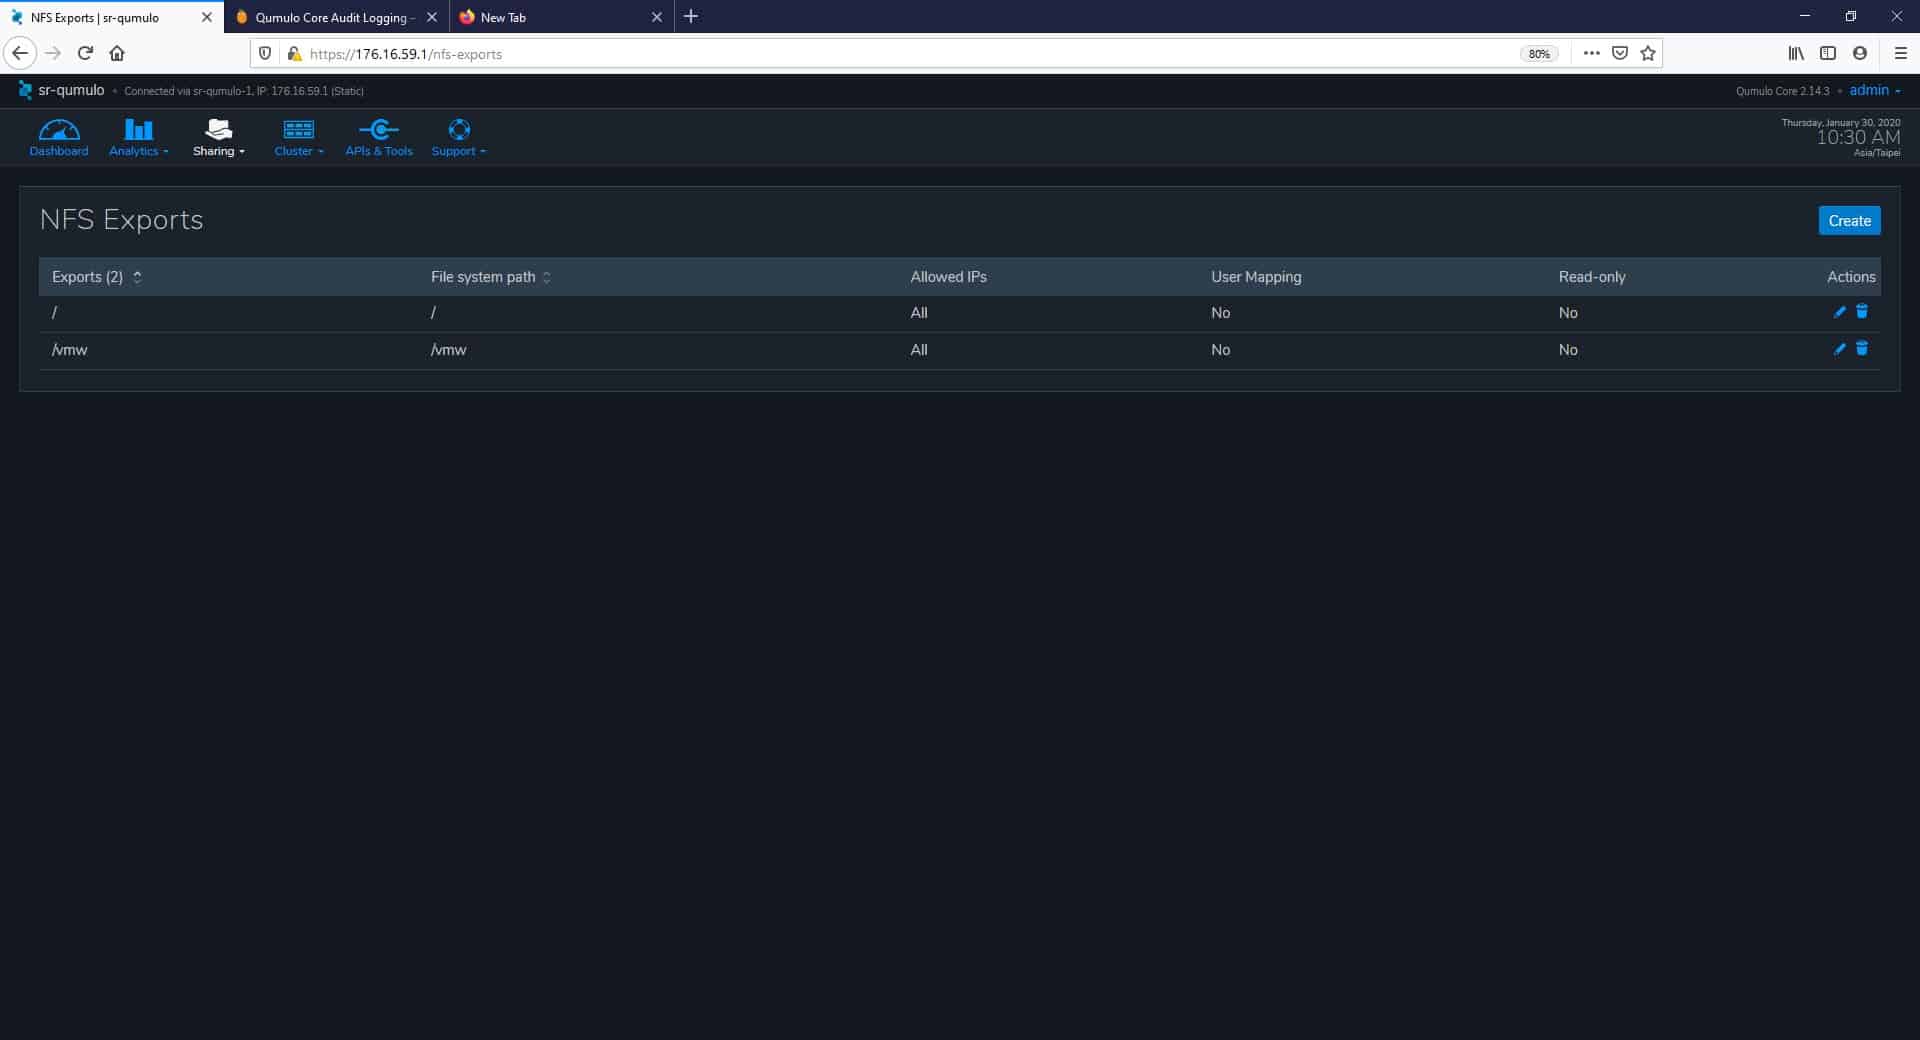
နောက်စာမျက်နှာနှစ်ခုမှာ NFS Exports နှင့် SMB Shares တို့ဖြစ်ပြီး ၎င်းတို့သည် client များအား သတ်မှတ်ထားသော directory တွင် သိမ်းဆည်းထားသော data များကို မျှဝေခွင့်ပြုသည်။ ဥပမာအားဖြင့် NFS Exports အောက်တွင်၊ ကျွန်ုပ်တို့သည် export အသစ်များကို ဖန်တီးနိုင်သည့်အပြင် ၎င်းတို့ကို တည်းဖြတ်နိုင်၊ ဖျက်နိုင်ပါသည်။
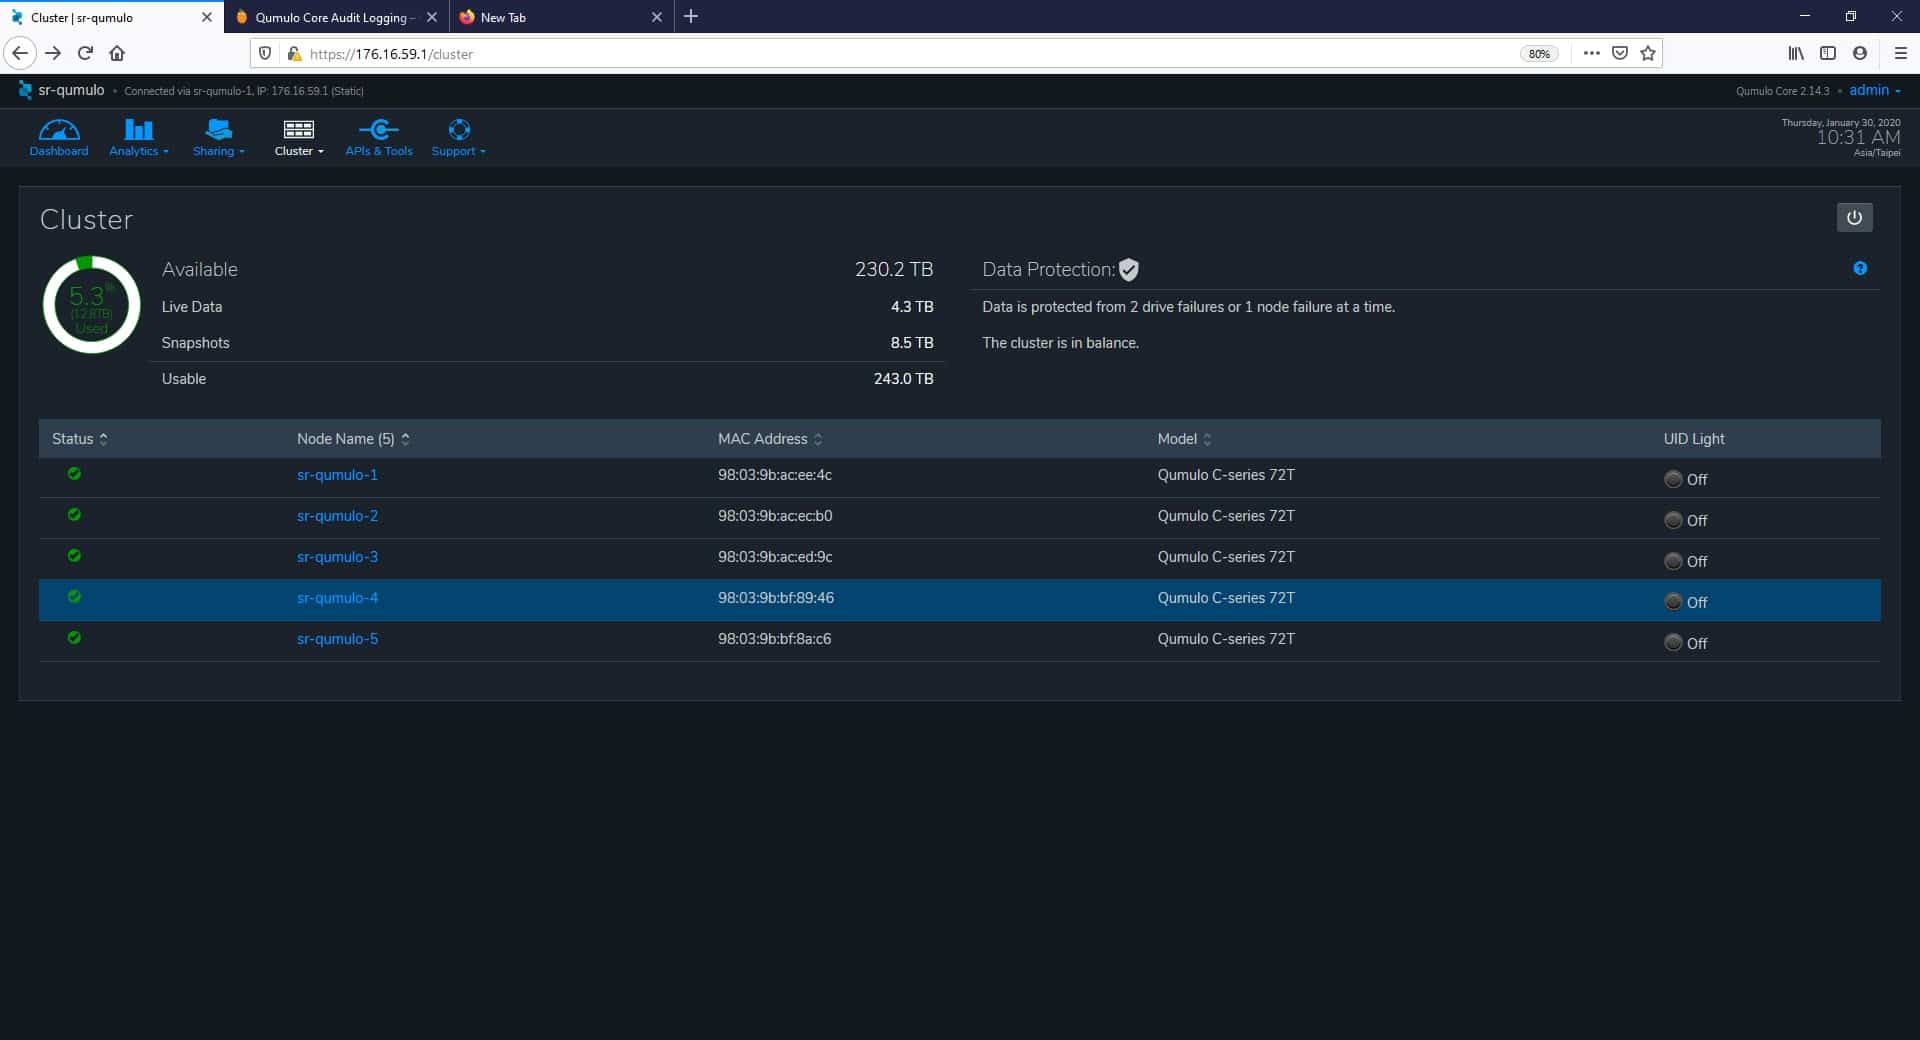
နောက်တစ်ခုကတော့ main menu မှာ Cluster ပါ။ Cluster menu အောက်မှာ cluster နဲ့ system နဲ့ သက်ဆိုင်တဲ့ configuration အမျိုးမျိုးနဲ့ option တွေကို တွေ့ရပါတယ်။ ပထမစာမျက်နှာ Overview မှာ cluster နဲ့ node တွေအကြောင်း အရေးကြီးတဲ့ capacity information တွေ ရှိပါတယ်။
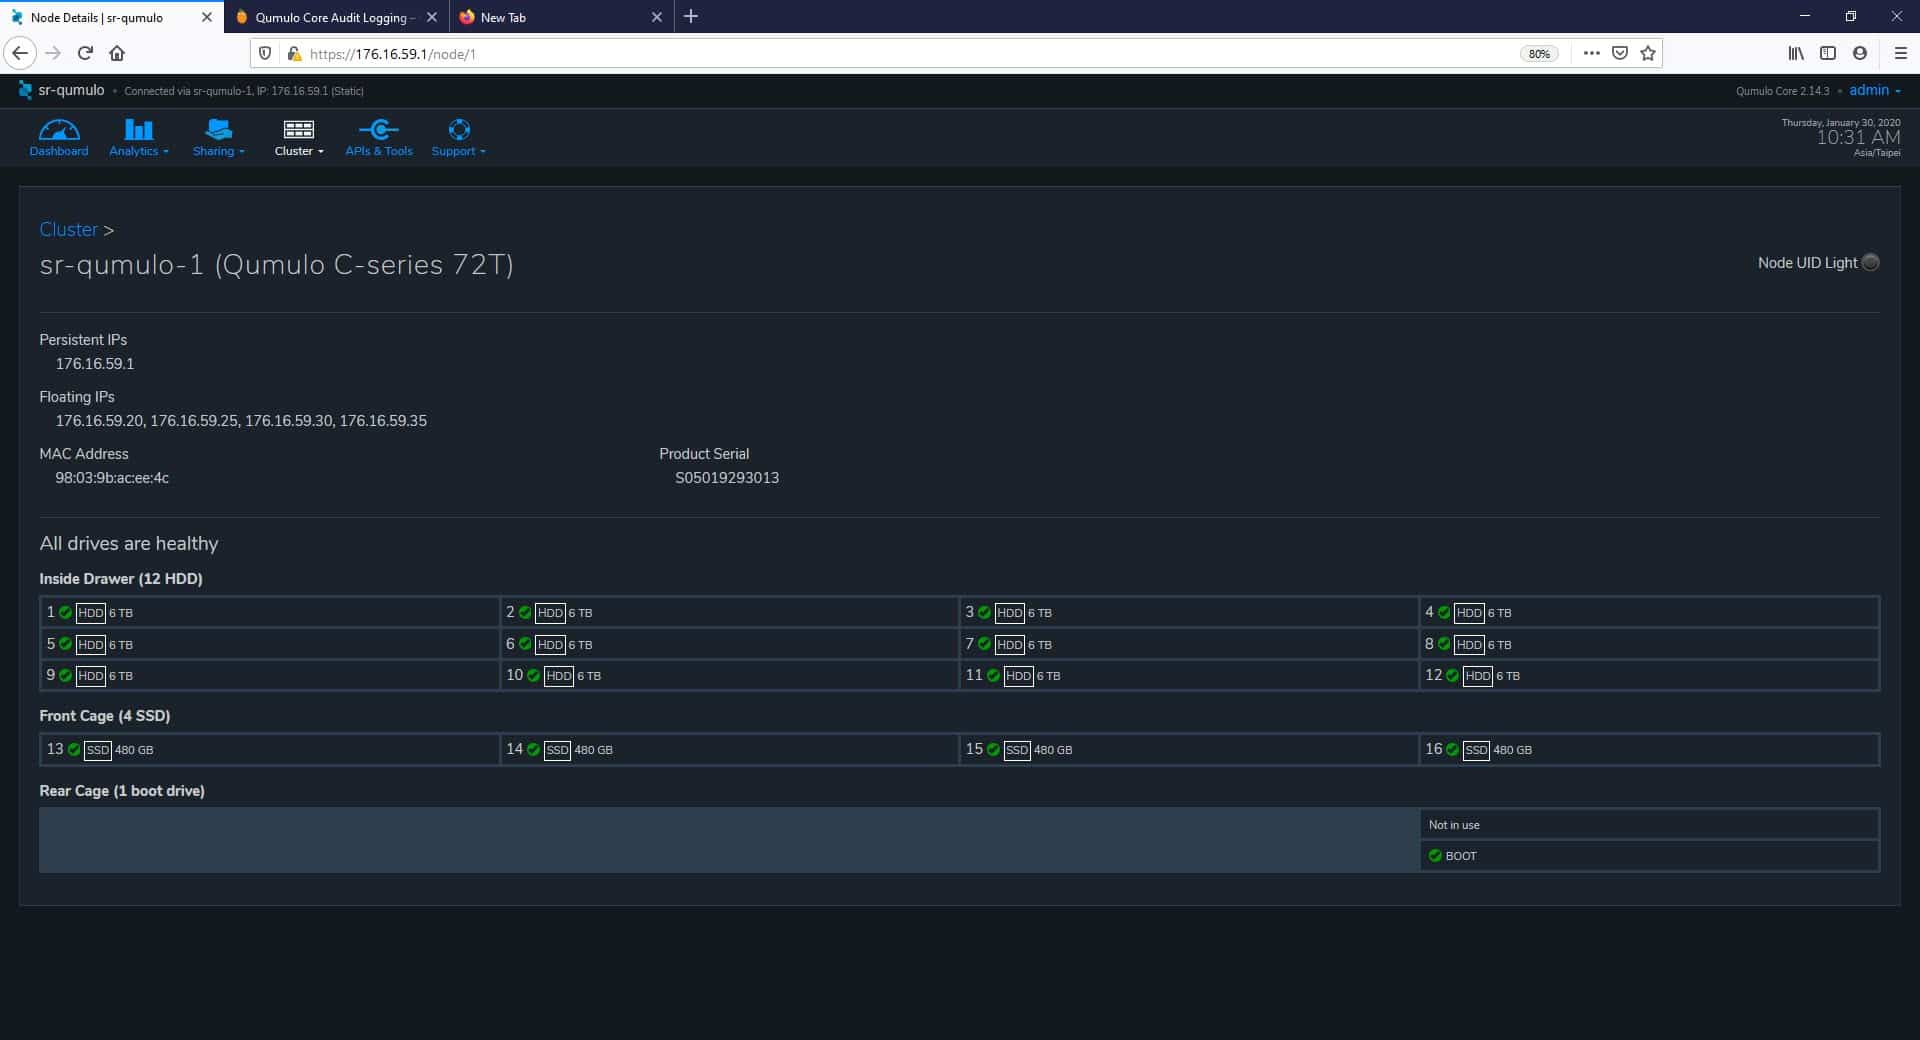
node တစ်ခုကို နှိပ်ခြင်းအားဖြင့် ပိုမိုတိကျသော hardware အသေးစိတ်အချက်အလက်များကို ကျွန်ုပ်တို့ လေ့လာနိုင်ပါသည်။ ဥပမာအားဖြင့်၊ သက်ဆိုင်ရာ network information ကို ရှာဖွေရန်နှင့် health status ကို မောင်းနှင်ရန် “sr-qumulo-1” node ကို နှိပ်ပါသည်။
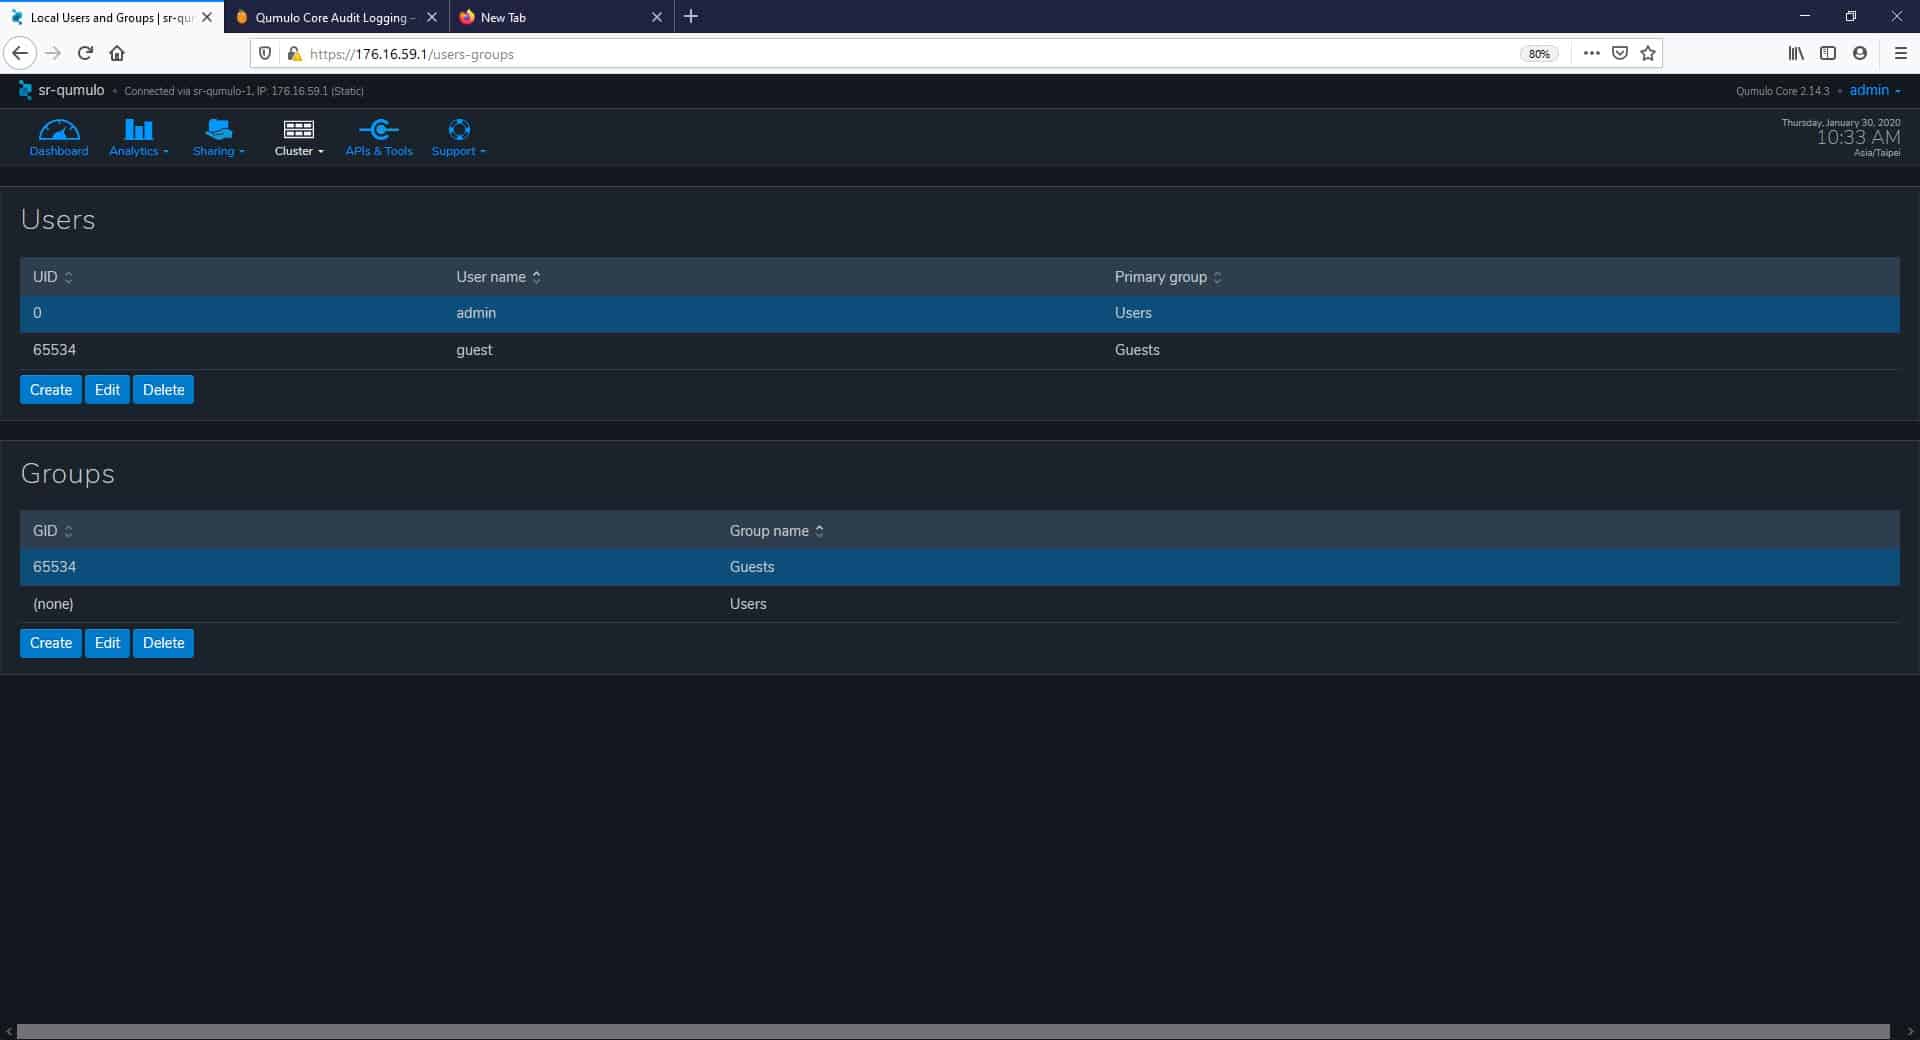
Cluster မီနူးအောက်မှာ Snapshots နဲ့ Replication လိုမျိုး အရေးကြီးတဲ့ storage features တွေကိုလည်း တွေ့ရပါတယ်။ network configuration၊ cluster ကို အမည်ပြောင်းခြင်း၊ cluster မှာ host အသစ်ထည့်ခြင်းနဲ့ အခြား option တွေလည်း ပါဝင်ပါတယ်။ FTP နဲ့ SMB protocols တွေကိုလည်း စီစဉ်ပေးပါတယ်။ နောက်ဆုံးအနေနဲ့ ဒီမီနူးမှာ authentication နဲ့ authorization ကို စီမံခန့်ခွဲနိုင်ပါတယ်။ အောက်ကပုံမှာ Local Users & Groups စာမျက်နှာကို ဥပမာအနေနဲ့ ပြသထားပါတယ်။
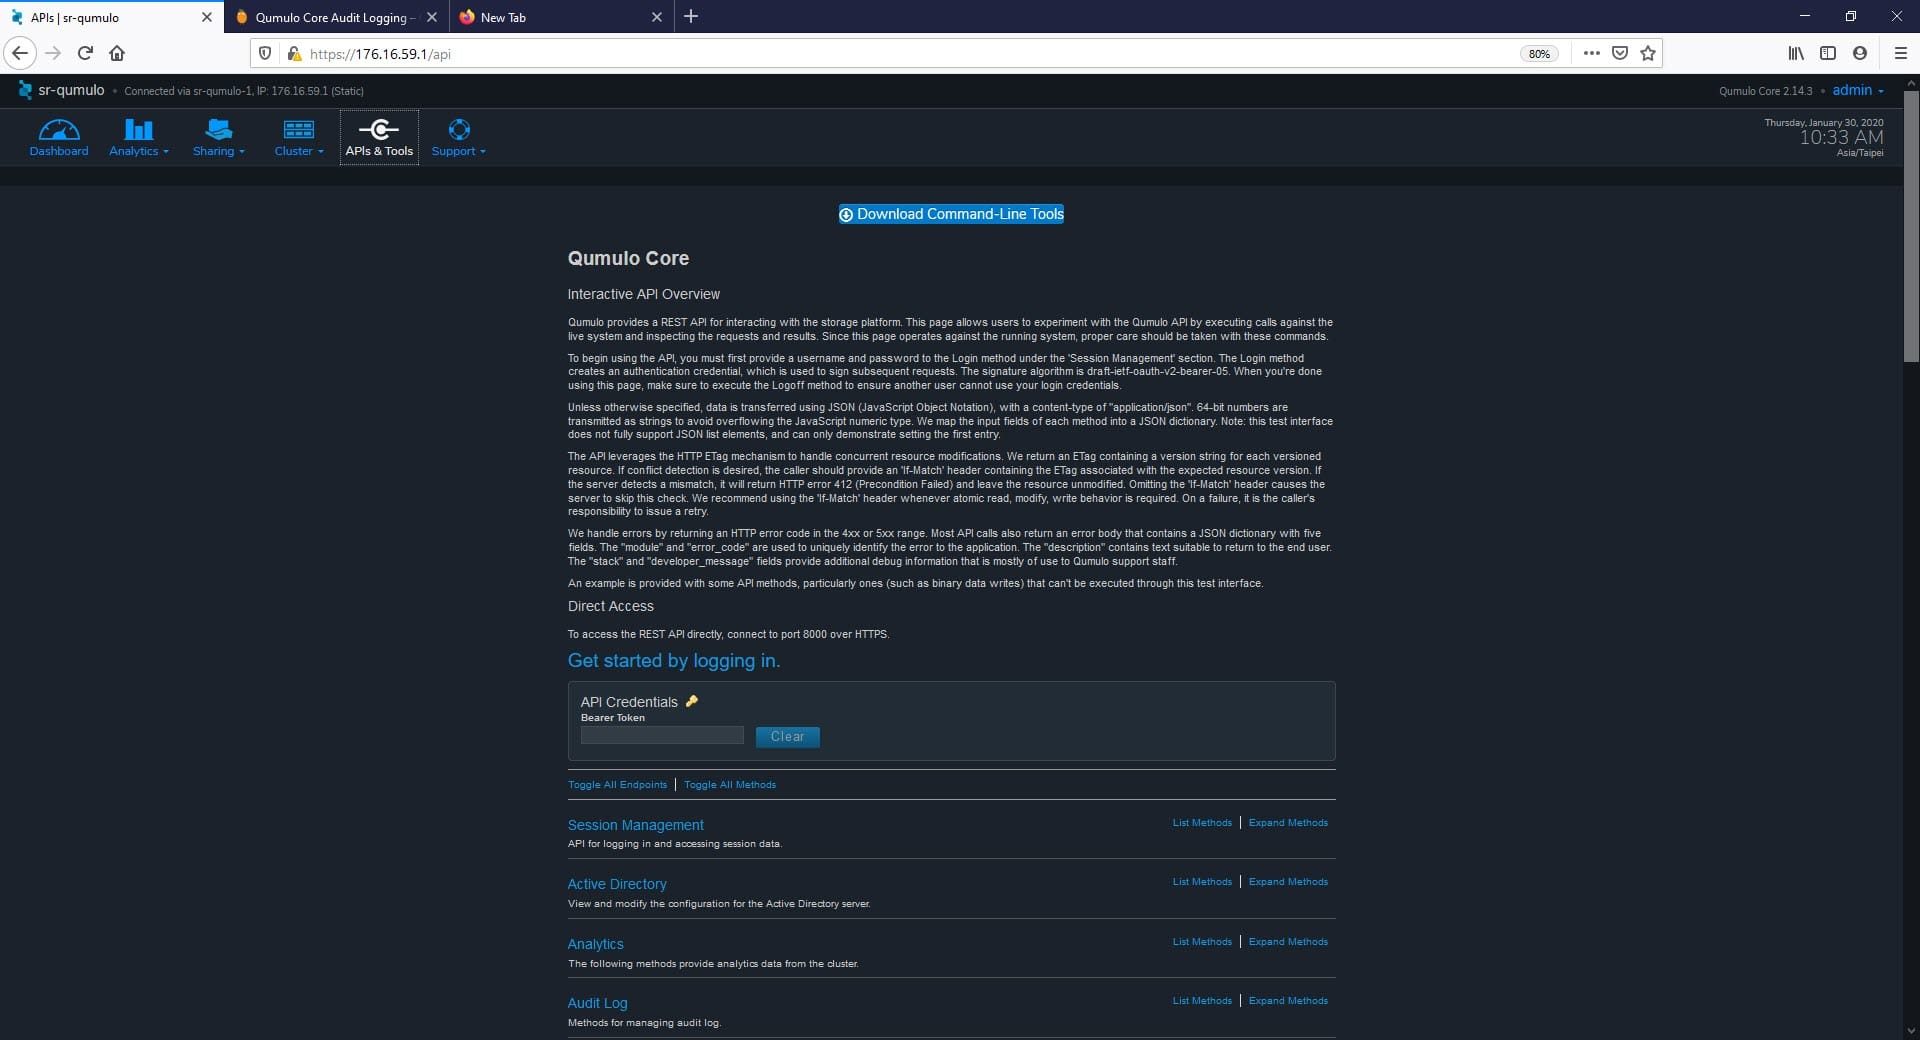
APIs & Tools tab မှ UI တွင် Qumulo Core စာမျက်နှာကို တိုက်ရိုက်ဝင်ရောက်ကြည့်ရှုနိုင်ပါသည်။ ဤနေရာတွင် Qumulo Core REST API အတွက် python client library wrappers များနှင့် CLI ကို ဒေါင်းလုဒ်လုပ်နိုင်ပါသည်။
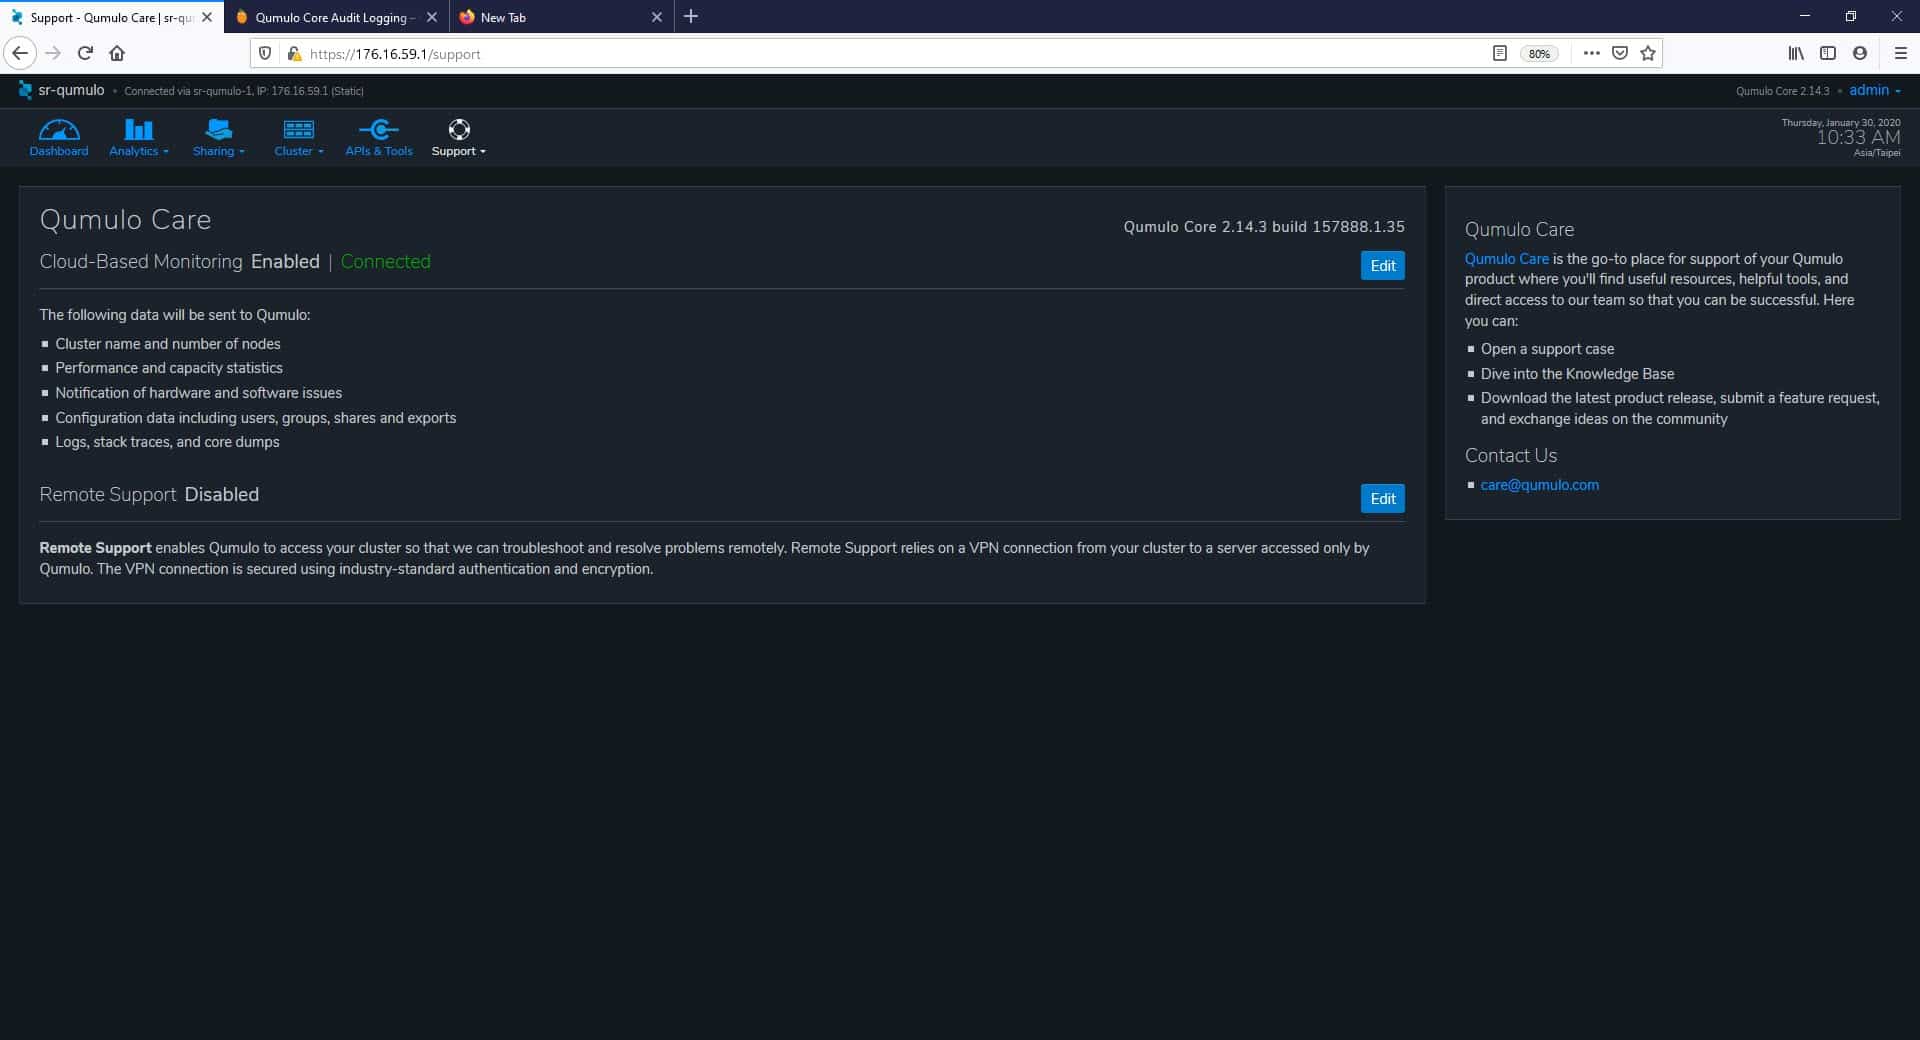
မီနူးထဲက နောက်ဆုံး tab က Support ဖြစ်ပြီး ဒီမှာ ကျွန်တော်တို့ ပထမဆုံးတွေ့တဲ့ စာမျက်နှာကတော့ Qumulo ကို data ပို့နိုင်တဲ့ cloud-based monitoring service တစ်ခုဖြစ်တဲ့ Qumulo Care ပါ။ ဒီနည်းနဲ့ Qumulo အဖွဲ့ဟာ cluster နဲ့ ဆက်စပ်နေတဲ့ ပြဿနာတွေကို ပိုမိုကောင်းမွန်စွာ ဖြေရှင်းနိုင်ပြီး မြန်ဆန်စေနိုင်ပါတယ်။
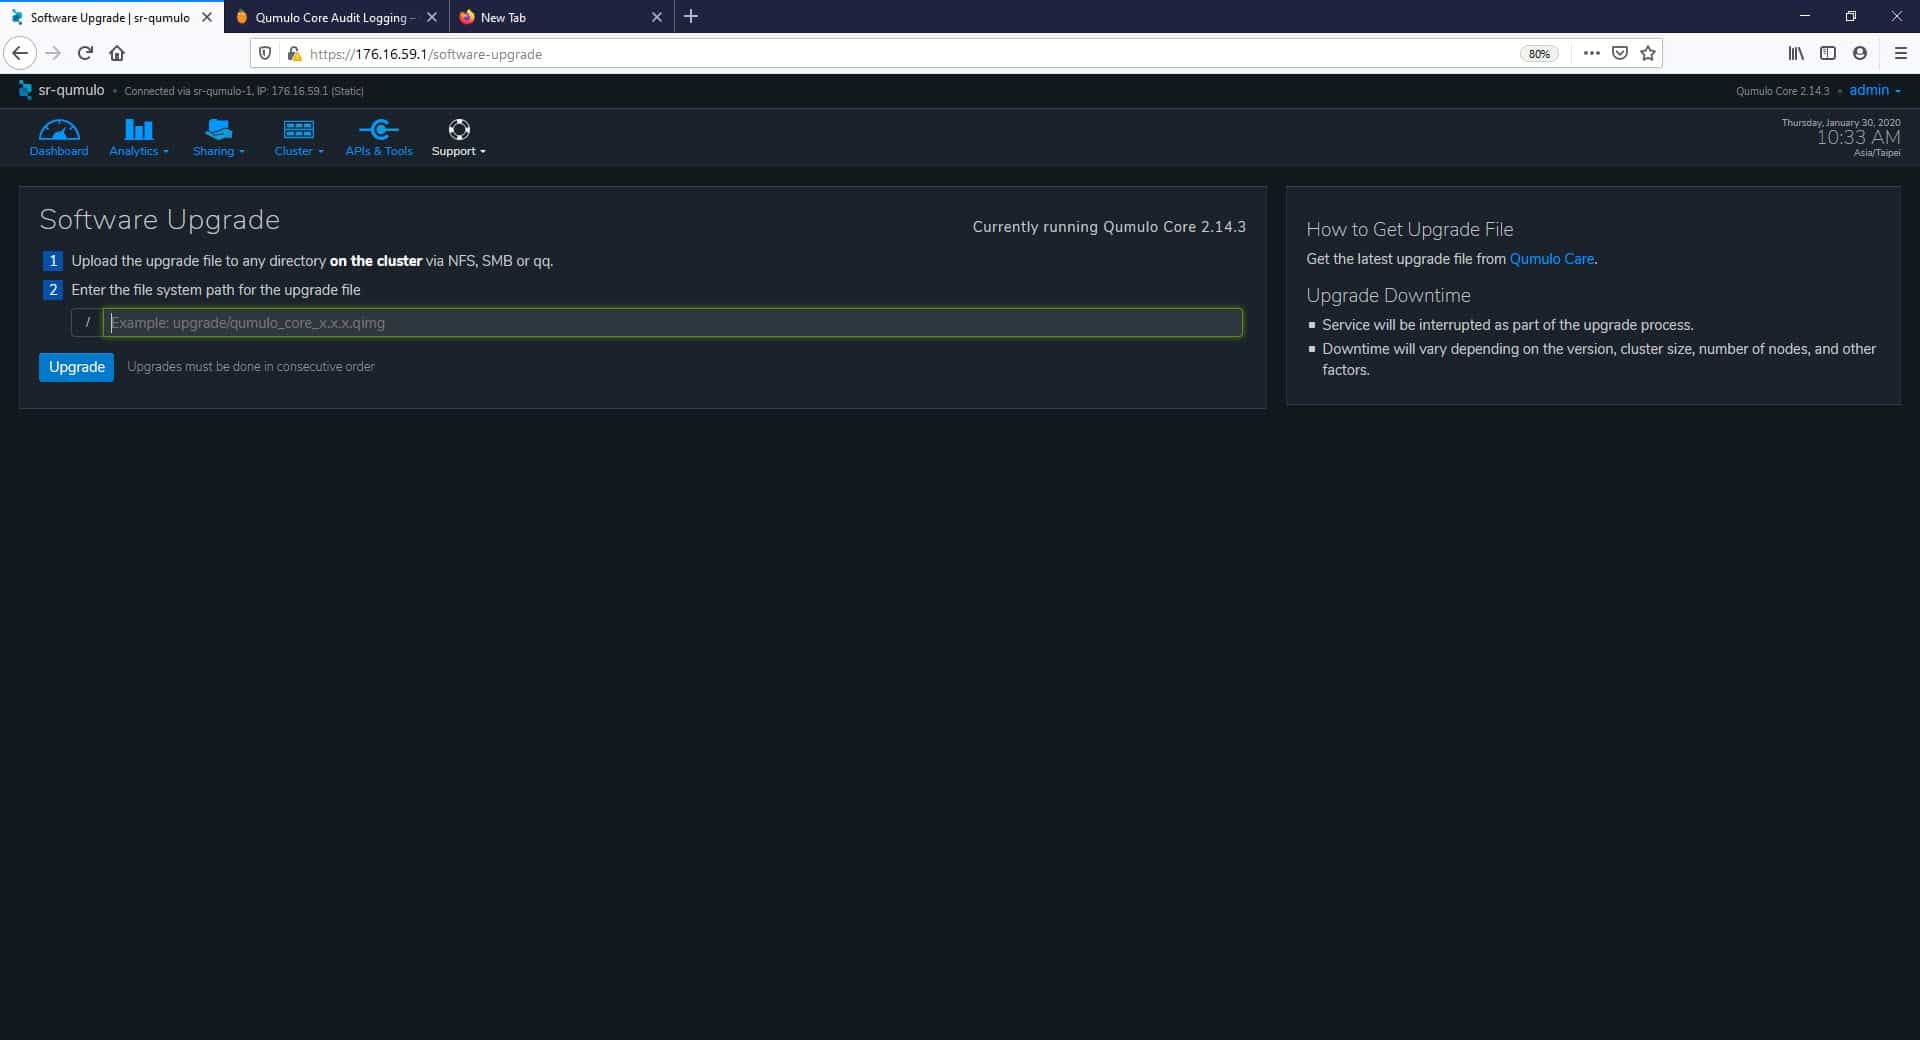
နောက်ဆုံးအနေနဲ့ မီနူးမှာ Software Upgrade စာမျက်နှာကို မြင်ရပါလိမ့်မယ်။
ကောက်ချက်
ဆန်းသစ်တီထွင်ရန်အတွက် အဖွဲ့အစည်းများသည် ရရှိနိုင်သော ဖြေရှင်းချက်များက ညံ့ဖျင်းစွာ ဝန်ဆောင်မှုမပေးနိုင်သော ဖွဲ့စည်းမထားသောဒေတာပလက်ဖောင်းများနှင့် ဒေတာ-သိရှိနိုင်သောသိုလှောင်မှုပေါ်တွင် မှီခိုနေရသည်။ ဤသုံးသပ်ချက်တွင်၊ ကျွန်ုပ်တို့သည် ပတ်ဝန်းကျင်အားလုံးတွင် ဖွဲ့စည်းမထားသောဒေတာကို ပေးဆောင်ရန် တီထွင်ထားသော Qumulo File System ကို လေ့လာခဲ့သည်။ Qumulo သည် hybrid cloud အတွက် ၎င်း၏ထူးခြားသော software-defined solution ဖြင့် ဒေတာ-သိရှိနိုင်သောသိုလှောင်မှုနှင့် cloud file data ဝန်ဆောင်မှုများ၏ ရှေ့ဆောင်များထဲမှ တစ်ခုဖြစ်သည်။
ဤဆောင်းပါး၏ နောက်ဆုံးအပိုင်းတွင်၊ ကျွန်ုပ်တို့သည် Qumulo ၏ Web-UI ကို ကြည့်ရှုခဲ့ပါသည်။ အတိတ်ကာလတွင်၊ ကျွန်ုပ်တို့သည် အလွန်ရေပန်းစားသော server နှင့် storage appliances အချို့၏ graphical user interfaces (GUI) များကို ခြုံငုံသုံးသပ်ခဲ့ပြီး ယခုတစ်ကြိမ်တွင်၊ ကျွန်ုပ်တို့သည် Qumulo ၏ လတ်ဆတ်သော GUI ကို ခြုံငုံသုံးသပ်ခွင့်ရသည့်အတွက် အလွန်စိတ်လှုပ်ရှားမိပါသည်။ ပထမတစ်ချက်ကြည့်လိုက်လျှင် ဤ GUI ၏ ကြော့ရှင်းသောဒီဇိုင်း၊ အလွန်ကောင်းမွန်သော user experience နှင့် admin ၏ နေ့စဉ်စီမံခန့်ခွဲမှုလုပ်ငန်းများတွင် မည်မျှရိုးရှင်းသည်ကို ကျွန်ုပ်တို့ သတိပြုမိပါသည်။
အလုံးစုံသော် Qumulo ၏ဆော့ဖ်ဝဲသည် ၎င်း၏ဖောက်သည်များအား ထူးကဲသောစွမ်းရည်များ၊ စောင့်ကြည့်ခြင်းနှင့် စီစဉ်ခြင်းကိရိယာများကို ပေးပါသည်။ ဆော့ဖ်ဝဲသည် cloud သို့ခရီးကို ရိုးရှင်းစေသည်။ ၎င်းသည် lift-and-shift cloud migration ဖြင့် ဒေတာရွှေ့ပြောင်းမှုကို ပံ့ပိုးပေးသည့်အပြင် ကျွန်ုပ်တို့၏အဖိုးတန်ဒေတာနှင့် ဘာတွေဖြစ်နေသည်ကို ချက်ချင်းသိရှိနိုင်ရန် အစွမ်းထက်သော real-time analytics များကို ပေးပါသည်။


 အမေဇုံ