

၂၀၂၃ ခုနှစ်တွင် Artificial Intelligence ၏ အလျင်အမြန်တိုးတက်မှုသည် ယှဉ်နိုင်စရာမရှိပါ၊ ဤကြီးကျယ်ခမ်းနားမှုအားလုံး၏ အဓိကအချက်မှာ (ဒရမ်တီးပေးပါ) Generative AI မော်ဒယ်များဖြစ်ပြီး အဓိကဥပမာတစ်ခုမှာ ChatGPT ကဲ့သို့သော Large Language Model (LLM) ဖြစ်သည်။ ဤ LLM များသည် တုံ့ပြန်မှုများပေးခြင်း၊ အကြောင်းအရာများထုတ်လုပ်ခြင်းနှင့် အလုပ်အမျိုးမျိုးတွင် အထောက်အကူပြုခြင်းဖြင့် လူသားကဲ့သို့သော စာသားများကို ဖန်တီးနိုင်စွမ်းအတွက် သိသာထင်ရှားသော အာရုံစိုက်မှုကို ရရှိခဲ့သည်။ သို့သော် နည်းပညာဆိုင်ရာ အံ့ဖွယ်အမှုတိုင်းကဲ့သို့ပင် LLM များသည် ချို့ယွင်းချက်များ ကင်းစင်သည်မဟုတ်ပါ။ တစ်ခါတစ်ရံတွင် ဤမော်ဒယ်များသည် အဓိပ္ပာယ်မရှိသော သို့မဟုတ် အကြောင်းအရာနှင့် မသက်ဆိုင်သော အပြုအမူများကို ပြသလေ့ရှိသည်။ ဓာတ်ခွဲခန်းတွင် ဤဖြစ်စဉ်ကို 'Quinn Effect' ဟု ကျွန်ုပ်တို့ခေါ်ဆိုပါသည်။
ဖန်တီးနိုင်စွမ်းရှိသော AI ဖြင့် ပုဂ္ဂိုလ်ရေးဆန်သော Quinn Effect
Quinn Effect ကို အဓိပ္ပာယ်ဖွင့်ဆိုခြင်း
Quinn Effect ကို generative AI တစ်ခုသည် ၎င်း၏ ရည်ရွယ်ထားသော လမ်းကြောင်းမှ ထင်ရှားစွာ လမ်းလွဲသွားခြင်းအဖြစ် နားလည်နိုင်ပြီး မသက်ဆိုင်သော၊ ရှုပ်ထွေးသော သို့မဟုတ် လုံးဝထူးဆန်းသော output ကို ဖြစ်ပေါ်စေပါသည်။ ၎င်းသည် တုံ့ပြန်မှုတွင် ရိုးရှင်းသော အမှားတစ်ခု သို့မဟုတ် မသင့်လျော်သော အတွေးများစီးကြောင်းအဖြစ် ပေါ်လာနိုင်သည်။
Quinn Effect ရဲ့နောက်ကွယ်က အကြောင်းရင်းတွေ
Quinn Effect ဘာကြောင့်ဖြစ်ပေါ်ရတယ်ဆိုတာကို အပြည့်အဝနားလည်ဖို့အတွက် generative AI architectures နဲ့ training data တွေရဲ့ ကမ္ဘာထဲကို ဝင်ရောက်လေ့လာရပါမယ်။ Quinn Effect ဟာ အောက်ပါတို့အပါအဝင် အမှားအယွင်းများစွာကြောင့် ဖြစ်ပေါ်နိုင်ပါတယ်။
- ထည့်သွင်းမှုတွင် မရှင်းလင်းမှု- LLM များသည် များပြားလှသောဒေတာများမှ ပုံစံများအပေါ်အခြေခံ၍ အစီအစဉ်တစ်ခုရှိ နောက်စကားလုံးကို ခန့်မှန်းရန် ရည်ရွယ်ပါသည်။ မေးခွန်းတစ်ခုသည် မရေမရာ သို့မဟုတ် မရှင်းလင်းပါက မော်ဒယ်သည် အဓိပ္ပာယ်မရှိသောအဖြေတစ်ခုကို ထုတ်ပေးနိုင်သည်။
- အကျုံးဝင်သည်- AI မော်ဒယ်တစ်ခုခုကို ၎င်း၏ လေ့ကျင့်ရေးဒေတာနှင့် အလွန်နီးကပ်စွာ စိတ်ကြိုက်ပြုလုပ်ထားသည့်အခါတွင် ဖြစ်ပွားသည်။ ထိုကဲ့သို့သောကိစ္စများတွင် မော်ဒယ်တစ်ခုသည် ၎င်း၏ လေ့ကျင့်ရေးအစုံမှ အသေးစိတ်အချက်အလက်များနှင့် ကိုက်ညီသော ရလဒ်များကို ထုတ်ပေးနိုင်သော်လည်း ယေဘုယျအားဖြင့် ယုတ္တိဗေဒ သို့မဟုတ် သက်ဆိုင်မှုမရှိပါ။
- ဆက်စပ်မှုမရှိခြင်း- လူသားများနှင့်မတူဘဲ၊ LLM များသည် ပိုမိုကျယ်ပြန့်သော အကြောင်းအရာများကို အဆက်မပြတ် မှတ်ဉာဏ် သို့မဟုတ် နားလည်မှု မရှိပါ။ စကားပြောဆိုမှုတစ်ခု ရုတ်တရက် ပြောင်းလဲသွားပါက မော်ဒယ်သည် thread ကို ဆုံးရှုံးသွားနိုင်ပြီး လမ်းကြောင်းလွဲသွားသော output များ ဖြစ်ပေါ်စေနိုင်သည်။
- ဒေတာဘက်လိုက်မှုများ- GPT ဗိသုကာလက်ရာများအပါအဝင် LLM များသည် ကျယ်ပြန့်သောဒေတာစုများမှ သင်ယူကြသည်။ ဤဒေတာစုများတွင် ဘက်လိုက်မှုများ သို့မဟုတ် အဓိပ္ပါယ်မရှိသောဒေတာများပါဝင်ပါက AI သည် ဤပုံစံများကို ပုံတူကူးယူနိုင်သည်။
- ဘာသာစကား ရှုပ်ထွေးမှု- သဘာဝဘာသာစကားသည် ရှုပ်ထွေးပြီး သိမ်မွေ့သော သိမ်မွေ့သော အဓိပ္ပာယ်ဖွင့်ဆိုချက်များဖြင့် ပြည့်နှက်နေသည်။ တစ်ခါတစ်ရံတွင် မော်ဒယ်သည် အဓိပ္ပာယ်ဖွင့်ဆိုချက်များစွာပါသော စကားလုံးများ၊ စကားစုများ သို့မဟုတ် စကားစုများကို ကိုင်တွယ်ဖြေရှင်းရပြီး မမျှော်လင့်ထားသော ရလဒ်များ ဖြစ်ပေါ်စေနိုင်သည်။
Quinn Effect ကို လျော့ပါးစေခြင်း
Quinn Effect ကို လုံးဝဖယ်ရှားပစ်ဖို့က ခက်ခဲပေမယ့်၊ ၎င်းဖြစ်ပွားခြင်းကို လျော့ပါးစေဖို့ လုပ်ဆောင်နိုင်တဲ့ အဆင့်တွေကတော့ -
- ပုံမှန် အပ်ဒိတ်များနှင့် ပြုပြင်မွမ်းမံမှုများ- ကွဲပြားပြီး အပ်ဒိတ်လုပ်ထားသော အချက်အလက်အစုများတွင် မော်ဒယ်ကို စဉ်ဆက်မပြတ် လေ့ကျင့်ခြင်းနှင့် ပြုပြင်ခြင်းသည် မတိကျမှုများကို လျှော့ချနိုင်သည်။
- တုံ့ပြန်ချက် လှည့်ကွက်များ- မော်ဒယ်လမ်းကြောင်းမှ သွေဖည်သွားသည့် ဖြစ်ရပ်များကို ဖော်ထုတ်ပြီး ပြုပြင်ရန် အသုံးပြုသူတုံ့ပြန်ချက်က ကူညီပေးသည့် စနစ်တစ်ခုကို အကောင်အထည်ဖော်ခြင်းသည် အကျိုးရှိပါသည်။
- ပိုမိုကောင်းမွန်သော အခြေအနေဆိုင်ရာ အသိပညာပေးမှု- မော်ဒယ်များ၏ အနာဂတ်ဗားရှင်းများသည် စကားပြောဆိုမှုအလှည့်အပြောင်းများထက် ပိုမိုကောင်းမွန်သော အကြောင်းအရာထိန်းသိမ်းမှုကို ခွင့်ပြုသည့် ယန္တရားများမှ အကျိုးကျေးဇူးရရှိနိုင်ပါသည်။
- မတူညီသောဒေတာအစုရင်းမြစ်များ- လေ့ကျင့်ရေးဒေတာသည် ကျယ်ပြန့်သောခေါင်းစဉ်များ၊ လေသံများနှင့် သိမ်မွေ့သောအချက်များကို လွှမ်းခြုံထားပြီး ပြည့်စုံကြောင်း သေချာစေခြင်းသည် မော်ဒယ်၏ ခိုင်မာမှုကို မြှင့်တင်ရာတွင် အထောက်အကူဖြစ်စေနိုင်သည်။
ထင်ကြေးပေးတာတွေ လုံလောက်ပါပြီ၊ မော်ဒယ်က ဘာကို "တွေး" နေတာလဲ။
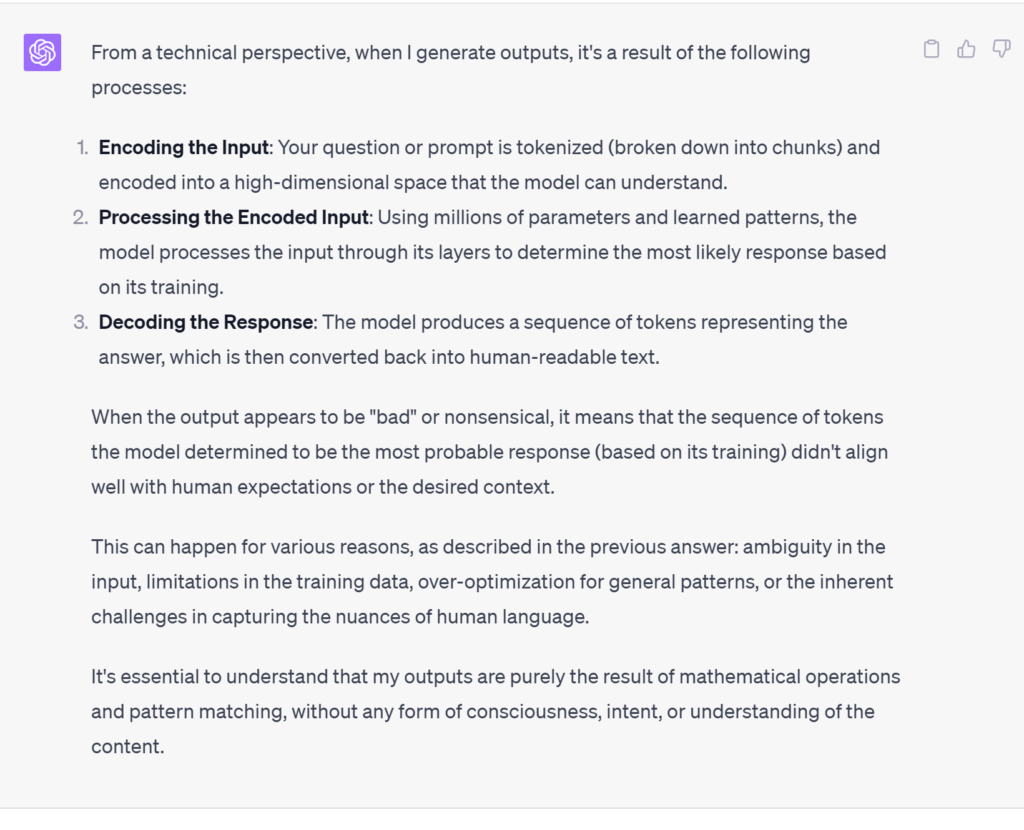
ဘာတွေဖြစ်ပျက်နေလဲဆိုတဲ့အပေါ် ChatGPT-4 ရဲ့အမြင်ကို မေးမြန်းဖို့ ကျွန်တော်တို့ ဆုံးဖြတ်လိုက်ပါတယ်။
နောက်တစ်ခုကဘာလဲ
Quinn Effect သည် အဆင့်မြင့်ဆုံး AI မော်ဒယ်များတွင်ပင် ရှိနှင့်ပြီးဖြစ်သော ချို့ယွင်းချက်များကို အလင်းပြပေးသည်။ ဤကန့်သတ်ချက်များကို အသိအမှတ်ပြုခြင်းသည် ထိုချို့ယွင်းချက်များကို နားလည်ခြင်း၊ လျော့ပါးစေခြင်း နှင့် အလားအလာရှိသော အသုံးချခြင်းအတွက် ပထမခြေလှမ်းဖြစ်သည်။ AI နယ်ပယ်သည် ၎င်း၏ အရှိန်အဟုန်ဖြင့် ကြီးထွားမှုကို ဆက်လက်လုပ်ဆောင်လာသည်နှင့်အမျှ ထိုကဲ့သို့သော ဖြစ်စဉ်များကို သတိပြုမိခြင်းသည် အသုံးပြုသူများနှင့် developer များအတွက် မရှိမဖြစ်လိုအပ်လာပြီး generative AI ကမ္ဘာတွင် မျှော်လင့်ချက်နှင့် လက်တွေ့ဘဝကြား ကွာဟချက်ကို ပေါင်းကူးပေးရန် ကူညီပေးသည်။
ထရန်စဖော်မာများ၏ ရှုပ်ထွေးမှုနှင့် ကန့်သတ်ချက်အရေအတွက်ကို ကျွန်ုပ်တို့ ဆက်လက်တိုးတက်ပြောင်းလဲလာသည်နှင့်အမျှ၊ ကျော်လွှားရမည့် ဤကဲ့သို့သော အပိုစိန်ခေါ်မှုများ ရှိလာမည်မှာ သေချာပါသည်။ သို့သော် NVIDIA တွင် ဤပြဿနာကို ကိုင်တွယ်ဖြေရှင်းရန် SDK များ ရှိသည်ကိုလည်း သတိပြုရန် အရေးကြီးပါသည် ။ နောက်အပိုင်းတွင်၊ မော်ဒယ်တစ်ခုကို အသေးစိတ်ညှိယူခြင်းနှင့် pseudo-production environment တွင် guardrails များကို အသုံးချခြင်းအကြောင်း ကျွန်ုပ်တို့ လေ့လာပါမည်။


 အမေဇုံ