

Historisch gezien ging elke opslagbewerking die door een GPU werd gelezen via de host-CPU, die het bestandssysteem beheerde, opdrachten verstuurde en de gegevens terugstuurde. Deze overhead is verwaarloosbaar bij grote sequentiële overdrachten, maar wordt een beperkende factor bij het verwerken van miljoenen bewerkingen van 512 bytes per seconde. Op FMS 2026 in Santa Clara kondigde NVIDIA nieuwe software en een branche-initiatief aan om dit knelpunt te elimineren.
De belangrijkste aankondiging betreft cuFile, een API waarmee GPU's rechtstreeks van en naar opslag kunnen lezen en schrijven. NVIDIA stelt cuFile en de volledige ondersteunende softwarestack open source beschikbaar, waarbij de code wordt gehost in de nieuwe XIO-SIG-organisatie op GitHub. Tot de oprichtende beheerders behoren Google, Intel, Meta en NVIDIA. Daarnaast heeft NVIDIA officieel Storage-Next gelanceerd, een initiatief dat al sinds GTC 2025 publiekelijk werd besproken. Storage-Next omvat nu meer dan 40 leveranciers van opslag- en flashgeheugen, zoals DDN, KIOXIA en Micron, evenals fabrikanten van controllers, koelspecialisten en standaardisatieorganisaties. Deze deelnemers werken samen aan het definiëren van hoe opslagapparaten zich moeten gedragen wanneer een GPU, in plaats van een CPU, de client is.
Het probleem: host-gemedieerde I/O
GPU-systemen werken van oudsher volgens een host-gecentreerd I/O-model. De CPU plant GPU-taken in, bereidt data voor en initieert alle overdrachten tussen de GPU en het netwerk of de opslag. Elke bewerking volgt een vaste volgorde: de GPU-kernel wordt voltooid, de controle keert terug naar de CPU, de CPU bereidt de overdracht voor en de volgende kernel wordt gestart. De kosten per bewerking, voornamelijk de overhead van het starten van de kernel en de synchronisatie tussen CPU en GPU, worden gemeten in microseconden. Hoewel deze overhead verwaarloosbaar is voor bulkoverdrachten, wordt deze significant voor fijnmazige bewerkingen.
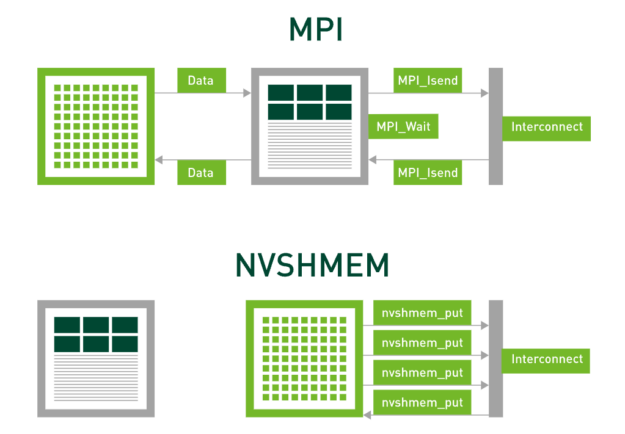
Voor GPU-naar-GPU-communicatie heeft NVIDIA de tussenkomst van de host geëlimineerd door middel van NVSHMEM, waardoor apparaatcode rechtstreeks overdrachten kan initiëren en deze kan laten overlappen met berekeningen. De impact hiervan is aanzienlijk: toen GROMACS zijn halo-uitwisselingscommunicatie van MPI naar NVSHMEM overzette, werd de communicatie uit het kritieke pad verwijderd en volledig overlappend met berekeningen.
De opslag behield het door de host gemedieerde model. Een leesbewerking van een NVMe-schijf geeft de controle nog steeds terug aan de CPU, voert het bestandssysteem uit en wacht op voltooiing. Training verdraagt dit omdat de leesbewerkingen groot en infrequent zijn. Inferentie niet. Het leveren van KV-cache-items, embeddings en vectorzoekresultaten genereert miljoenen kleine, willekeurige leesbewerkingen per seconde, waarbij de CPU bij elke bewerking betrokken is.
GPU-geïnitieerde I/O en SCADA
SCADA (scaled, accelerated data access) past het NVSHMEM-model toe op opslag, waardoor de GPU zijn eigen opslag-I/O kan initiëren en beheren.
Het onderliggende onderzoek is BaM, oftewel Big Accelerator Memory, dat werd gepubliceerd op ASPLOS 2023 door NVIDIA, IBM, de Universiteit van Illinois en de Universiteit van Buffalo. BaM demonstreerde een GPU die NVMe-schijven rechtstreeks beheert, waarbij de kleine verzoeken die over de threads worden gegenereerd, worden samengevoegd en in de cache worden opgeslagen om de schijven te kunnen blijven gebruiken zonder tussenkomst van de host. Op identieke hardware voerde BaM data-analyseworkloads 5.3 keer sneller uit dan toegang via de CPU en voerde grafiekworkloads uit vanuit flashgeheugen met tot wel 21.7 keer lagere hardwarekosten dan wanneer dezelfde gegevens in het hostgeheugen zouden worden opgeslagen.
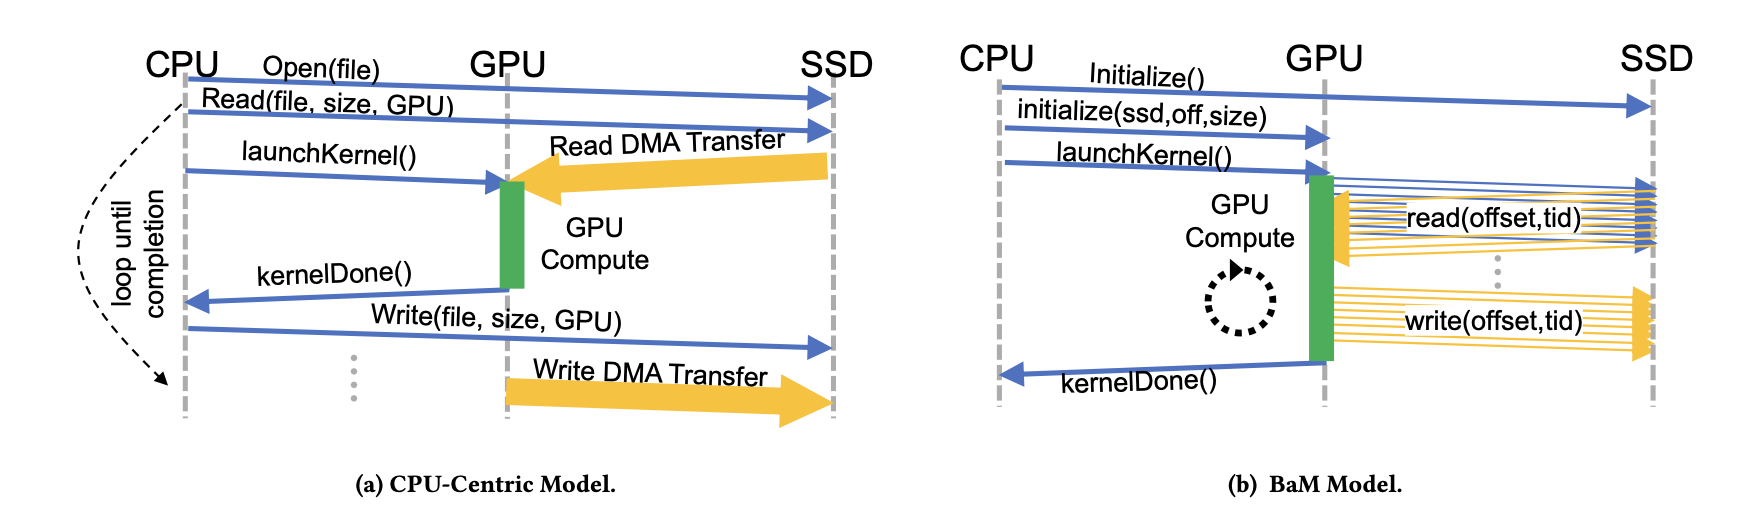
SCADA is de gecommercialiseerde vorm. Een runtime op de GPU bevindt zich tussen de threads van de kernel en de opslag. Deze bundelt verspreide kleine verzoeken tot leesbewerkingen die worden uitgevoerd vanuit een cache op de GPU of worden toegewezen aan schijven, die lokaal NVMe-geheugen of een externe opslagserver kunnen bevatten.
Directe toegang tot apparaten moet worden beperkt, omdat onbeveiligde toegang tot een gedeelde schijf ervoor kan zorgen dat de ene applicatie de gegevens van een andere applicatie kan lezen of beschadigen. NVIDIA heeft daarom geprivilegieerde niveaus in het ontwerp opgenomen. Prestatiekritieke onderdelen van een applicatie draaien zonder privileges, buiten de vertrouwde computeromgeving. Een geprivilegieerde component configureert bij de installatie beveiligde toegang tussen elke applicatie en alleen de goedgekeurde opslag, met behulp van standaard Linux-beveiligingsmechanismen. NVIDIA noemt deze scheiding en de op Linux gebaseerde interoperabiliteit als reden waarom de stack als open source wordt uitgebracht in plaats van als een gesloten CUDA-component.
Het verschil tussen SCADA en GPUDirect Storage
Elke opslagbewerking heeft een datapad (de verplaatste bytes) en een controlepad (het samenstellen, verzenden en voltooien van verzoeken). GPUDirect Storage (GDS), geïntroduceerd in 2019 en beschikbaar sinds 2021, heeft de CPU uit het datapad verwijderd: via cuFile worden gegevens via DMA tussen de schijf en het GPU-geheugen verplaatst zonder bouncebuffer in het host-RAM. Volgens de lanceringsdocumentatie van NVIDIA is de maximale snelheid van het CPU-pad op een DGX-2 50 GB/s, waarbij GDS paden kan combineren voor een bovengrens van bijna 200 GB/s. DDN, VAST, WEKA, Pure Storage en de andere grote leveranciers van AI-opslag zijn hiervoor gecertificeerd. Het controlepad blijft op de CPU: de hostsoftware bepaalt nog steeds wat er moet worden opgehaald en verstuurt elk verzoek, en de GPU is het DMA-doel in plaats van de initiator.
Bij grote overdrachtsgroottes is deze verdeling prima. Een leesbewerking van 1 MB dekt de kosten van het besturingspad tot nul. Bij 512 bytes keert de verhouding om. De vaste kosten per aanvraag domineren en de CPU raakt verzadigd ruim voordat de schijven dat doen. SCADA verplaatst het besturingspad naar de GPU, die de latentie per bewerking op dezelfde manier absorbeert als de geheugenlatentie, door honderdduizenden bewerkingen tegelijkertijd uit te voeren.
De twee bestaan naast elkaar: cuFile voor bulkoverdrachten, SCADA voor grote volumes kleine, willekeurige leesbewerkingen.
Storage-Next en het 512-byteprobleem
SCADA richt zich op de GPU-kant. Storage-Next behandelt de schijfkant, die momenteel is geoptimaliseerd voor een andere workload.
Enterprise SSD's zijn al tien jaar geoptimaliseerd voor willekeurige leesbewerkingen van 4 KB, afgestemd op de toegangspatronen van databases en virtualisatie. De meeste controllers verrichten ongeveer evenveel werk voor een leesbewerking van 512 bytes als voor een van 4 KB, waardoor verzoeken kleiner dan 4 KB de kosten van 4 KB met zich meebrengen. Toegangspatronen voor inferentie zijn nog kleiner: embeddings zijn een paar honderd bytes groot en KV-cacheblokken zijn ruim onder de kilobyte. Het verwerken hiervan vanaf schijven die geoptimaliseerd zijn voor 4 KB leidt tot een 8x leesversterking, wat bandbreedte en controllercache verspilt. Bij tientallen terabytes aan kleine objecten bepaalt die versterking of flashgeheugen geschikt is als geheugenlaag.
Storage-Next is het initiatief om schijven, controllers en systemen opnieuw te ontwerpen rondom de kleinere eenheid. Het werd publiekelijk gepresenteerd op GTC 2025, waar het al in ontwikkeling is, met als doel de 512-byte IOPS per GPU te maximaliseren onder beperkingen op het gebied van stroomverbruik en staartlatentie. Tijdens FMS voegde NVIDIA een lidmaatschapsnummer toe, meer dan 40 leveranciers van opslag en flashgeheugen, en wees SCADA aan als het raamwerk waartegen gebouwd moet worden.
Het referentieresultaat is Microns SC25-demonstratie van 230 miljoen 512-byte random-read IOPS van één server onder het SCADA-programmeermodel: 44 Micron 9650 PCIe Gen6 SSD's achter drie Broadcom PEX90000 Gen6-switches, aangestuurd door drie H100's in een H3 Platform Falcon 6048-chassis. Dit cijfer komt overeen met ongeveer 95% van de gecombineerde IOPS-waarde van 5.5 miljoen van de 44 schijven.
De samenstelling van dat getal is belangrijk. 230 miljoen leesbewerkingen van 512 bytes komen overeen met ongeveer 118 GB/s aan data, wat vier of vijf van die schijven achter elkaar zouden kunnen verwerken. De prestatie zit hem in het aantal bewerkingen. Het continu uitvoeren ervan via hostsoftware zou tientallen CPU-cores in beslag nemen, alleen al voor de afhandeling van het verzenden en voltooien van de bewerkingen, terwijl de enkele CPU van de demo in feite inactief was. Verdeeld over de meer dan honderdduizend threads van een GPU, komt de belasting neer op een paar duizend bewerkingen per thread per seconde.
De mogelijkheden van SSD's zijn nu de doorslaggevende factor. De Micron 9650, de eerste PCIe Gen6 SSD, heeft een sequentiële snelheid van 28 GB/s en een record van 5.5 miljoen random-read IOPS. Micron meldt lineaire schaalbaarheid van 1 tot 44 schijven in de demo. De GP-serie van Kioxia, een XL-Flash SSD ontworpen voor toegang tot 512 bytes , wordt ontwikkeld in het kader van Storage-Next. De Storage-Next roadmap van NVIDIA voorziet in PCIe Gen7 SSD's die elk 100 miljoen IOPS aankunnen, een doel waar controllerfabrikanten, waaronder Marvell, nu naartoe werken. Om deze aantallen te bereiken, zijn herontwerp van de controller, foutcorrectie afgestemd op kleine datastromen en standaarden voor GPU-native schijfgedrag nodig.
Koppeling aan training en inferentie
De twee paden corresponderen met twee toegangspatronen. Training is bandbreedte-intensief. Het streamt grote sequentiële shards en schrijft periodiek checkpoints van meerdere terabytes weg, gedurende welke tijd de GPU's inactief zijn. De CPU-overhead is verwaarloosbaar bij deze overdrachtsgroottes, dus GDS en de recent open-source gemaakte cuFile-stack blijven de juiste interface, gemeten in GB/s per GPU en checkpointduur.
Inferentie is IOPS-gebonden. De KV-cache, de aandachtsstatus voor elk token dat al in een conversatie is verwerkt, groeit met de contextlengte. Agentische implementaties voeren duizenden gelijktijdige conversaties uit. Dit overschrijdt al snel het GPU-geheugen en het opnieuw berekenen van verwijderde items kost meer GPU-tijd dan het teruglezen ervan. Het standaardontwerp is een gelaagde cache die gegevens overdraagt van GPU-geheugen naar systeemgeheugen naar flashgeheugen, en die wordt bijgevuld door grote hoeveelheden kleine, willekeurige leesbewerkingen. Vectorzoekopdrachten en embedding-lookups produceren hetzelfde patroon. Dit is de toegangsvorm waarop SCADA zich richt en de reden waarom NVIDIA 512 bytes IOPS noemt in plaats van bandbreedte. Het serveren van de KV-cache vanuit flashgeheugen in plaats van geheugen verhoogt het aantal contexten en gelijktijdige gebruikers dat elke GPU ondersteunt, wat de servicekosten per gebruiker bepaalt.
De hardware: Vera BlueField-4 STX en CMX
De platformlaag is NVIDIA Vera BlueField-4 STX , de rack-scale opslagarchitectuur die werd geïntroduceerd op GTC 2026 en deze week is uitgebreid. STX combineert het Vera Rubin-platform met BlueField-4-opslagprocessors, die elk Vera Arm-cores combineren met 800 Gb/s aan geïntegreerde netwerkverbindingen en ongeveer zes keer zoveel rekenkracht als BlueField-3.
Tijdens FMS publiceerde NVIDIA een benchmark voor deze cores. Een tweetraps compressie- en encryptiepipeline, representatief voor de inline dataservices-opslagsystemen die op al het verkeer van toepassing zijn, draaide op Vera met een doorvoer die tot 3.21 keer hoger lag dan die van een x86-CPU. De impliciete bewering is dat encryptie, compressie en verificatie, die momenteel x86-cores in opslagcontrollers verbruiken, met een lager energieverbruik naar Vera-silicium kunnen worden verplaatst. DOCA, NVIDIA's softwareframework voor BlueField, handhaaft het beveiligingsbeleid in het datapad. CMX Context Memory Storage , gebouwd op STX, poolt flashgeheugen achter BlueField-4 als een gedeelde KV-cachelaag voor inferentie met lange contexten. Partnersystemen van DDN, Dell, HPE, IBM, VAST Data, WEKA en anderen worden verwacht in de tweede helft van 2026.
Sluiting Gedachten
De strategische structuur is duidelijk: NVIDIA publiceert de interface die GPU's zullen gebruiken om toegang te krijgen tot de opslag, maakt de implementatie open source en organiseert meer dan 40 leveranciers om het onderliggende hardwaregedrag te standaardiseren. Het openstellen van cuFile wijkt af van NVIDIA's gebruikelijke werkwijze om deze laag binnen CUDA te houden. Maar een door GPU's geïnitieerde opslaginterface is alleen rendabel als leveranciers van schijven, controllers en arrays hierop inbouwen. Dat Intel zich als beheerder aansluit, is een belangrijk signaal. Een toonaangevende leverancier van de x86-chips in de huidige opslagsystemen ondersteunt software die is ontworpen om die chips uit het I/O-pad te verwijderen.
De demonstratie van Micron toont de haalbaarheid aan. Drie GPU's stuurden 44 Gen6-schijven aan tot ongeveer 95% van hun gecombineerde nominale capaciteit bij een blokgrootte die in de industrie tot nu toe als bijzaak werd beschouwd. Wat nu nog rest, is de uitvoering: de code op GitHub, de ontwikkeling van SCADA van framework naar ondersteunde CUDA-component, en de massale levering van SSD's die geoptimaliseerd zijn voor kleine leesbewerkingen. De bovenstaande cijfers zijn afkomstig van NVIDIA en haar partners, en niet van onafhankelijke metingen. We zullen ze testen wanneer de STX-systemen in de tweede helft van het jaar in ons lab arriveren.


 Amazon