

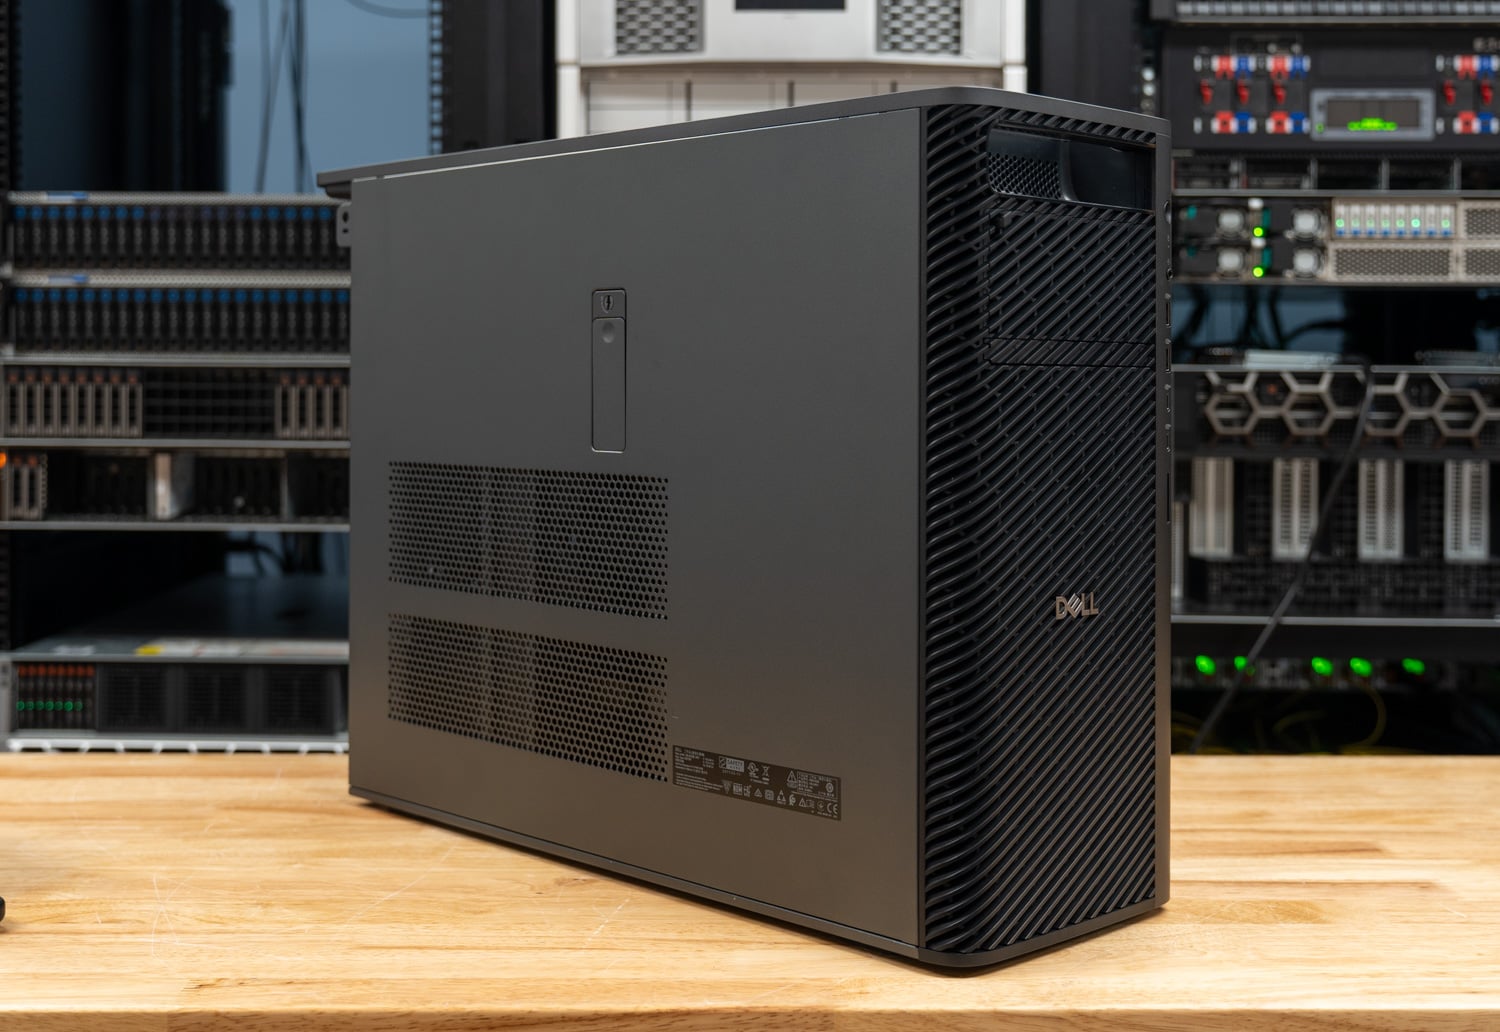
De Dell Pro Precision 9 T4 is de single-socket tower aan de top van Dell's Pro Precision-lijn, en ons testmodel is geconfigureerd voor lokale AI op een schaal die de meeste werkstations niet kunnen evenaren. Hij combineert Intel's 86-core Xeon 698X met 256 GB DDR5-6400 ECC-geheugen, twee 300W NVIDIA RTX PRO 6000 Blackwell Max-Q-videokaarten met elk 96 GB GDDR7-geheugen, twee 2 TB Gen5 SSD's en een dual-port 25GbE-adapter, gevoed door een 2400W-voeding. Op Dell.com kost deze configuratie ongeveer $ 66,600.
Key Takeaways
- Met twee GPU's wordt een model dat niet op één kaart past, toch bruikbaar. De MiniMax M2.7 met 129.3 GB genereerde 83.7 tokens per seconde voor één gebruiker wanneer deze verdeeld was over beide RTX PRO 6000-kaarten, 2.8 keer zoveel als de 30.3 tokens per seconde wanneer één kaart werd gebruikt en de rest van het model in het systeemgeheugen zat.
- De tweede GPU schaalde de servercapaciteit met een factor 1.85 tot 2.02 en de embeddingcapaciteit met een factor 1.92 op. De piekoutput van llama.cpp steeg van 582.5 naar 1,176.1 tokens per seconde op Ministral 3 3B en van 424.8 naar 787.9 op gpt-oss 120B met één server per GPU, en het embedden van een miljoen Wikipedia-passages daalde van 890 naar 464 seconden.
- Een tweede GPU verkortte een LoRA-epoch met 37 procent. Een LoRA-epoch op Ministral 3 8B duurde 31.5 minuten op één GPU en 19.7 minuten op twee, met een eindverlies van 1.169 en 1.167.
- De geheugenbandbreedte is waar de Xeon van de T4 een voorsprong neemt. STREAM Triad behaalde een snelheid van 328 GB/s, 53 procent hoger dan de Threadripper PRO 9995WX in de Precision 7875, en de T4 voltooide de OpenFOAM drivAer-berekening in 293 seconden tegenover 556 seconden en een 10-miljardcijferige y-cruncher-run in 53.9 seconden tegenover 83.7 seconden.
- De Precision 7875 blinkt uit in CPU-taken die sterk afhankelijk zijn van de processorkern. De Threadripper met 96 kernen presteerde 37 procent sneller in 7-Zip en 30 procent sneller in Blender Monster, en voltooide de LLVM-compilatie in 43.7 seconden tegenover 58.4 seconden voor de concurrentie.
Waar de Pro Precision 9 T4 zich bevindt
Dell positioneert de T4 als zijn vlaggenschip onder de single-socket tower workstations voor organisaties die maximale rekenkracht en uitbreidbaarheid nodig hebben, met AI-ontwikkeling, technische simulatie en wetenschappelijk computergebruik bovenaan de lijst met toepassingen. De T4 staat boven de Dell Pro Precision 9 T2 , die hetzelfde Granite Rapids-WS Xeon 6 workstationplatform gebruikt in een kleinere behuizing met één GPU. De T4 voegt daar de achtkanaals processoren aan toe, tot wel 86 cores, en ruimte voor maximaal vier grafische kaarten, afhankelijk van het model.
De processoropties op Dell.com beginnen bij de 12-core Xeon 634 en lopen via de 64-core Xeon 696X tot de 86-core Xeon 698X in ons testmodel, die 336 MB cache, een basisklokfrequentie van 2.0 GHz, een maximale klokfrequentie van 4.8 GHz en een vermogen van 350 W heeft. Het geheugen kan oplopen tot 4 TB DDR5 RDIMM verdeeld over 16 slots, waarvan ons testmodel er acht vult met 32 GB modules met een snelheid van 6400 MT/s. De grafische mogelijkheden beginnen bij een enkele RTX A400, en het aantal kaarten is afhankelijk van het model: de configurator van Dell biedt vier RTX A1000-kaarten, drie RTX PRO 4000 Blackwell-kaarten, twee 300W RTX PRO 6000 Max-Q-kaarten of één 600W RTX PRO 6000.
De basisconfiguratie staat op Dell.com vermeld voor $ 5,925. Onze configuratie voegt daar $ 8,300 aan toe voor de Xeon 698X, $ 15,000 voor het 256 GB geheugen en $ 30,820 voor de twee RTX PRO 6000 Max-Q videokaarten, exclusief opslag, netwerk en de 36 maanden ProSupport-upgrade die Dell automatisch toevoegt aan een configuratie van dit niveau.
Bouw en Ontwerp
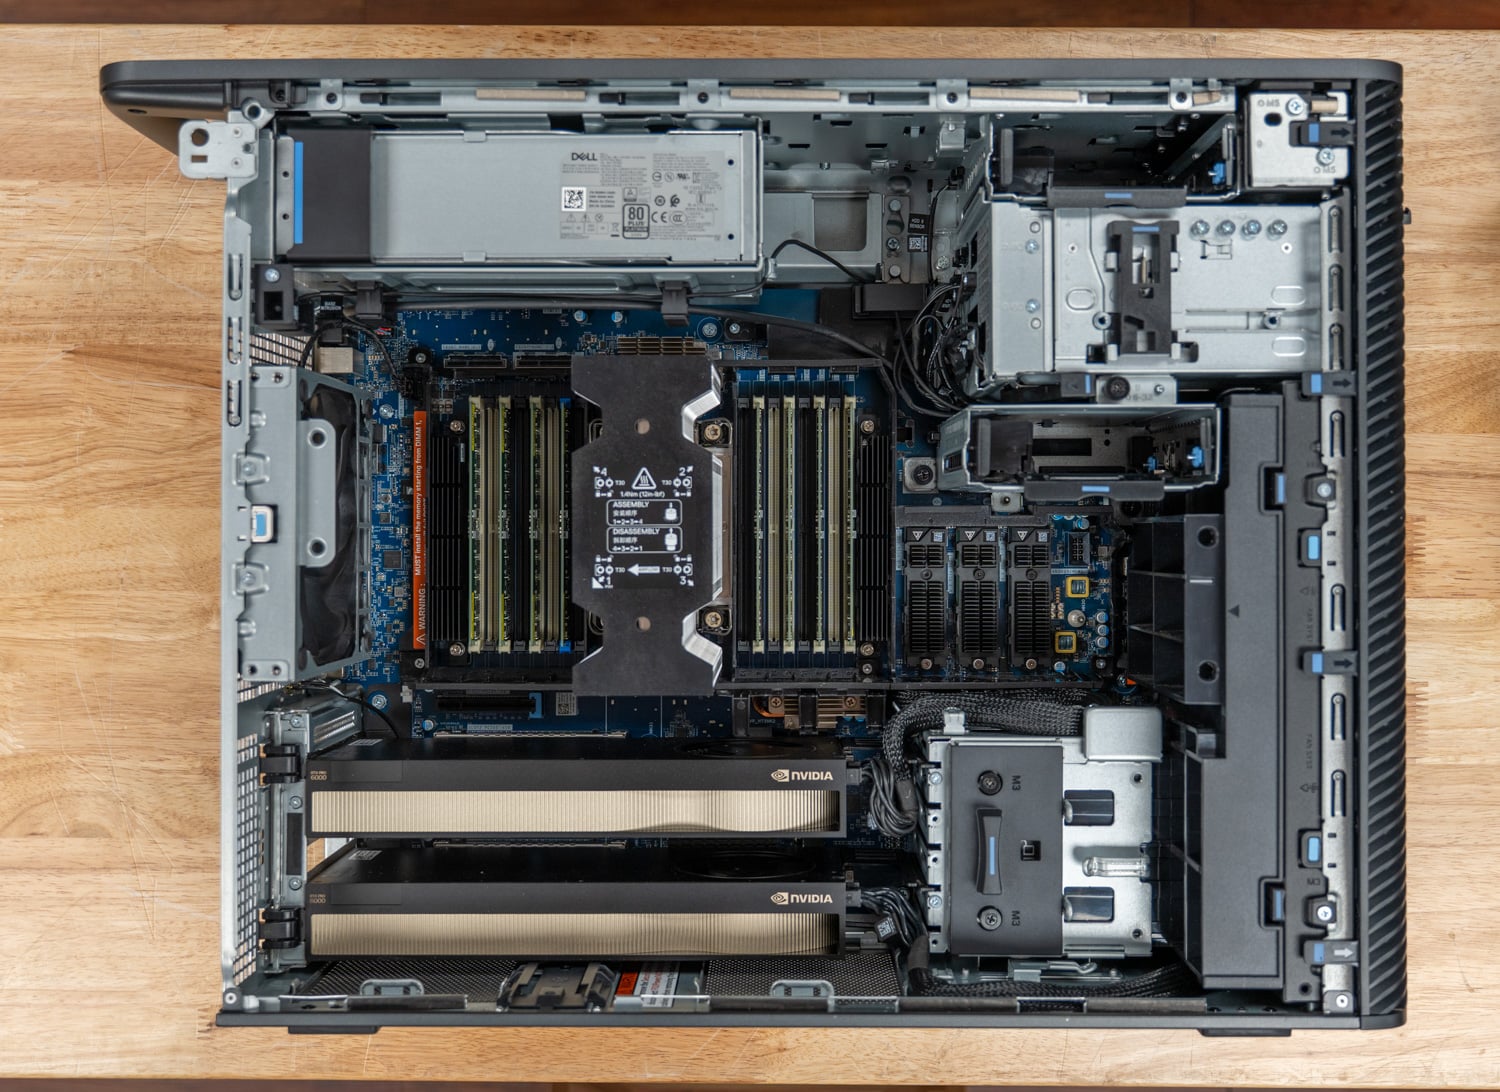
De T4 is een full-tower behuizing met een hoogte van 449.8 mm, een breedte van 203.7 mm en een diepte van 617.5 mm. Dell geeft een minimumgewicht van 24.1 kg en een maximumgewicht van 33.6 kg op, afhankelijk van de configuratie. Ons testexemplaar gebruikt de 2400W Platinum-voeding, die de configurator van Dell selecteert voor de configuratie met twee RTX PRO 6000-videokaarten. Een 1500W-voeding is de standaardvoeding voor lichtere configuraties.
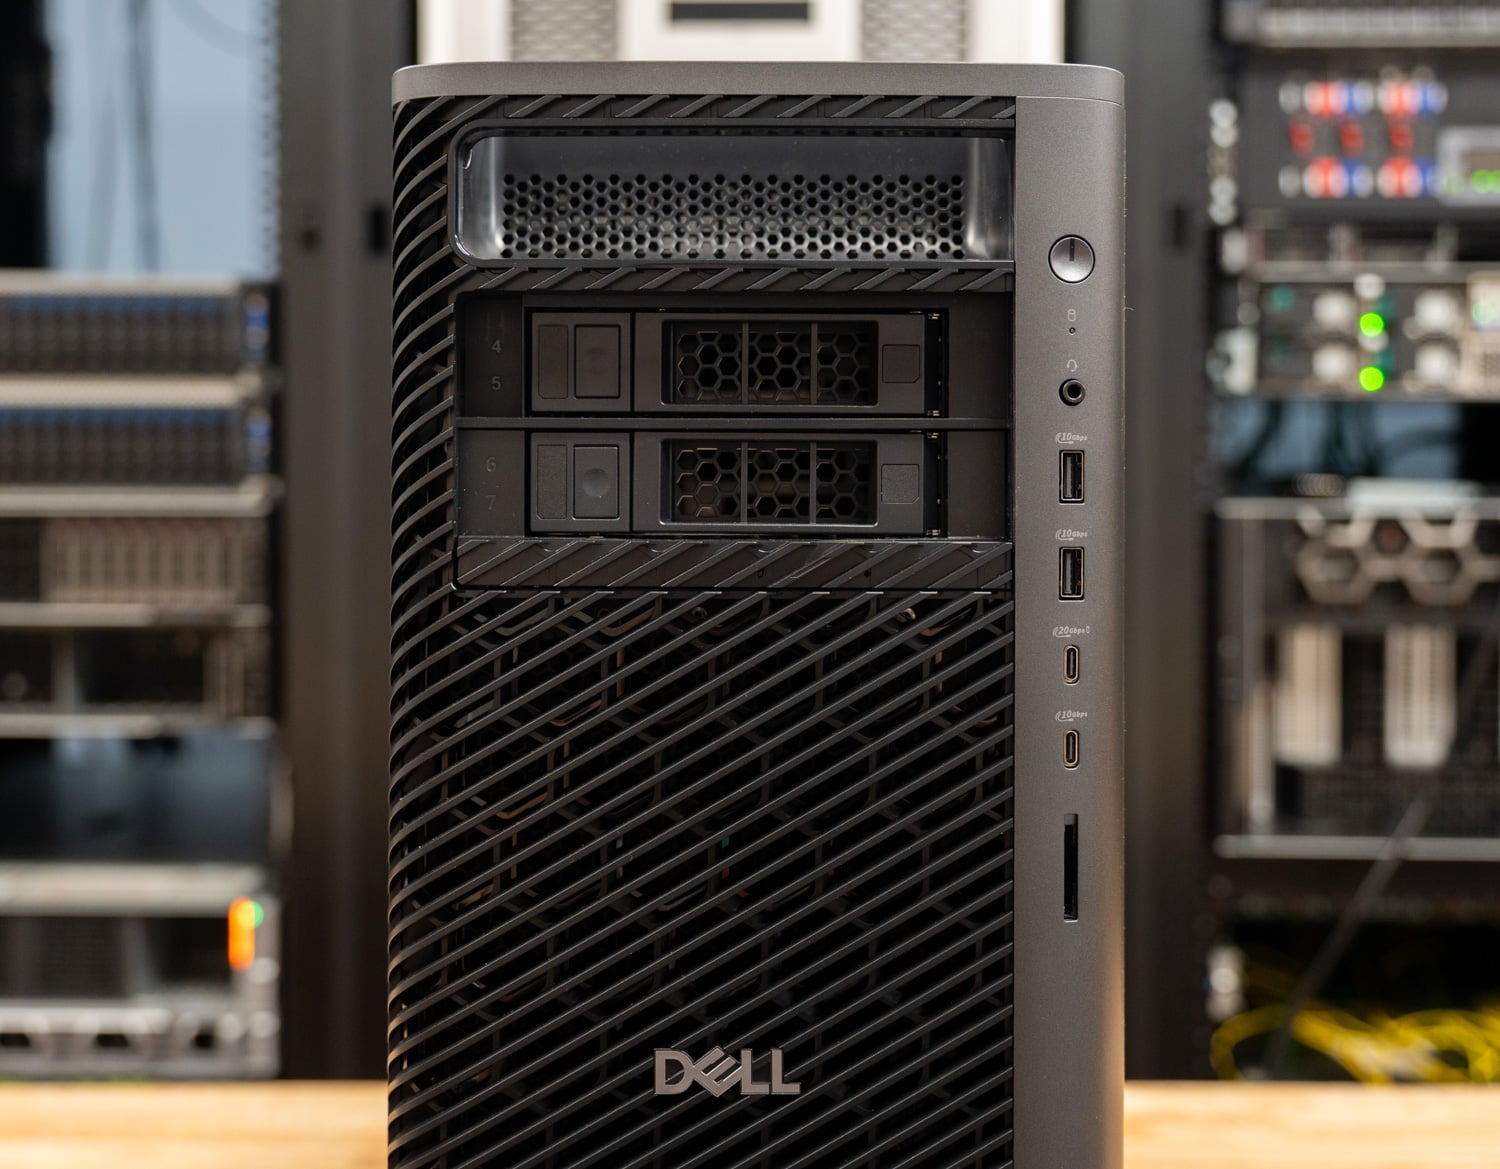
Onderhoudsgemak is een sterk punt van de T4, te beginnen met de gereedschaploze toegang via een vergrendeling aan de zijkant en een 2400W-voeding die met de hand uit de bovenkant van de achterkant van de behuizing kan worden geschoven. Alle andere onderdelen, inclusief de grafische kaarten en de SSD's, kunnen met een kruiskopschroevendraaier worden verwijderd. De blauwe markeringen van Dell geven aan welke onderdelen met de hand kunnen worden verwijderd. Het lab vond het platform gemakkelijk door een gebruiker in het veld te repareren, wat belangrijk is voor een werkstation in deze prijsklasse.
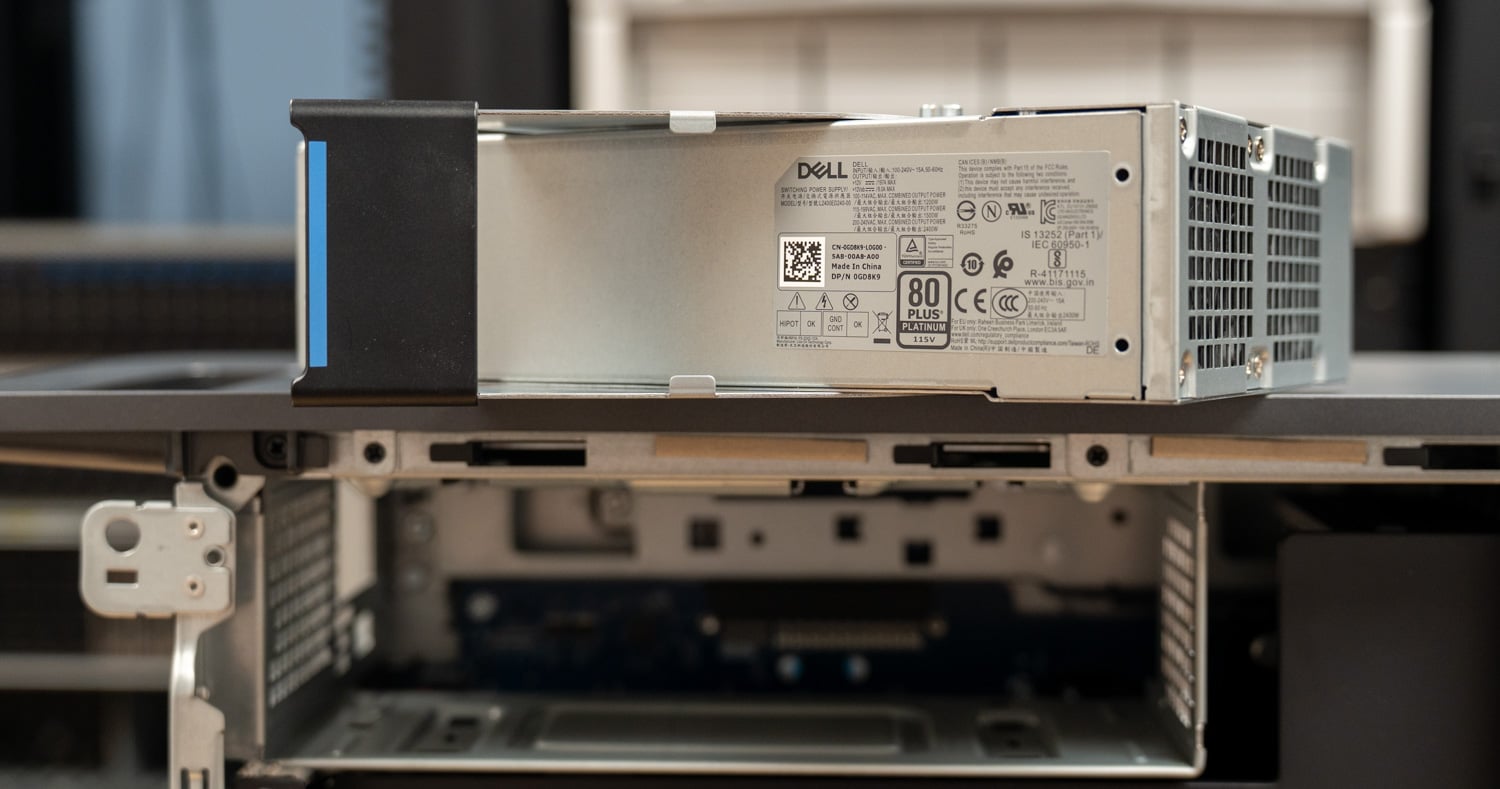
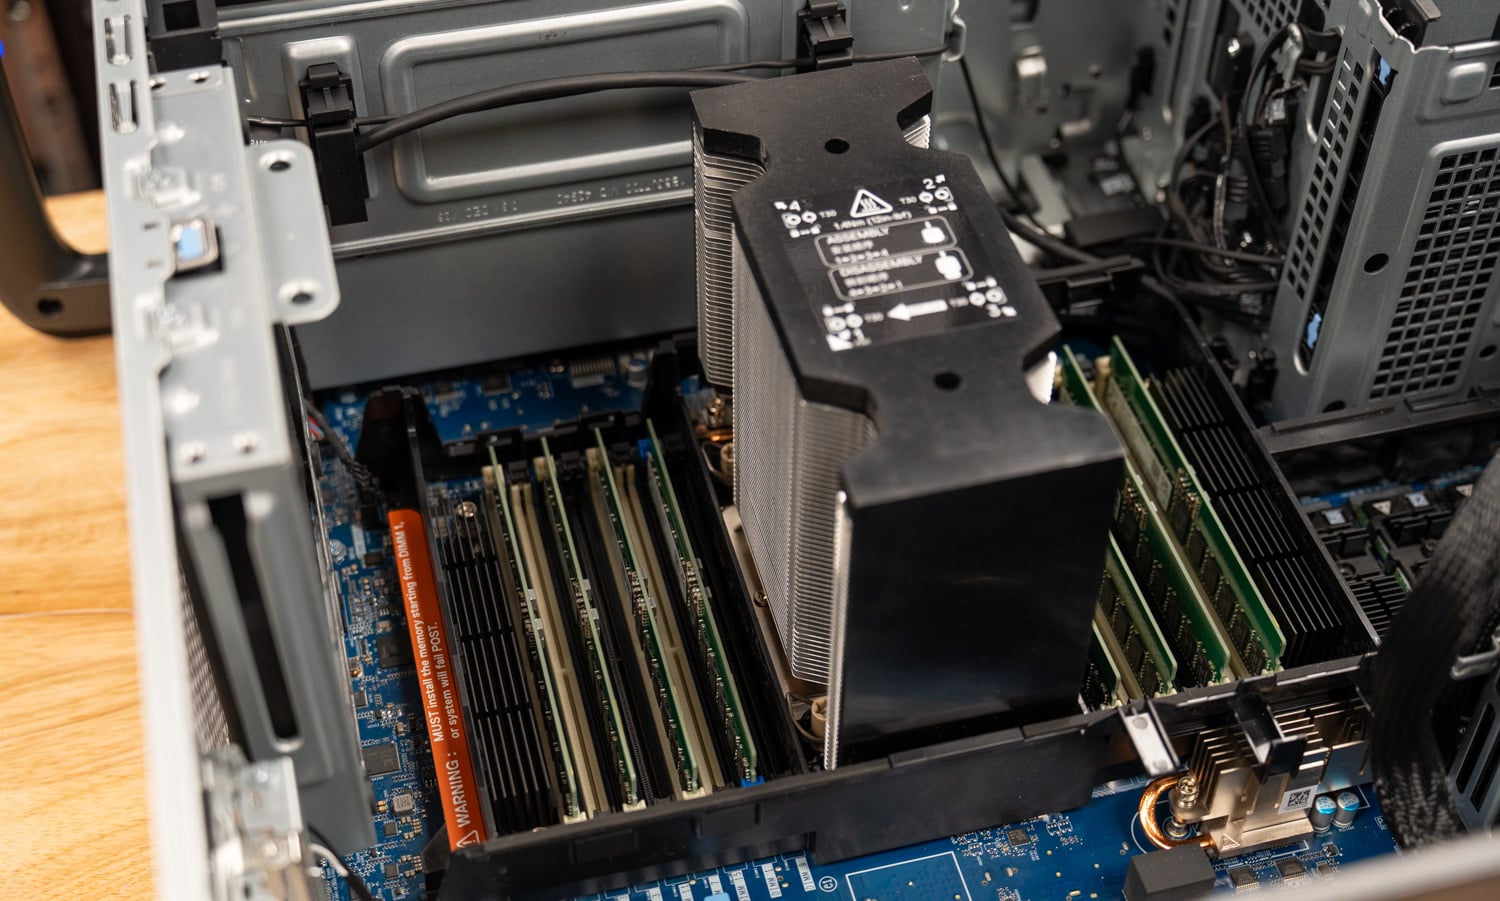
De koeling is de beste die we tot nu toe van Dell in deze towerbehuizing hebben gezien. Lucht stroomt van voor naar achter en grote, nauwsluitende kappen leiden de lucht naar beneden en over de processor en het geheugen, terwijl dit kanaal gescheiden blijft van het PCIe-gedeelte. De twee grafische kaarten van 300 W halen daardoor lucht uit een aparte stroom en nemen geen warmte over van de 350 W Xeon-processor. Met de kappen op hun plaats bevinden zich twee ventilatoren tussen de processorzone en de kaartsleuf. De behuizing heeft dezelfde blauwe aanraakpunten en kan worden verwijderd voor toegang tot het geheugen.
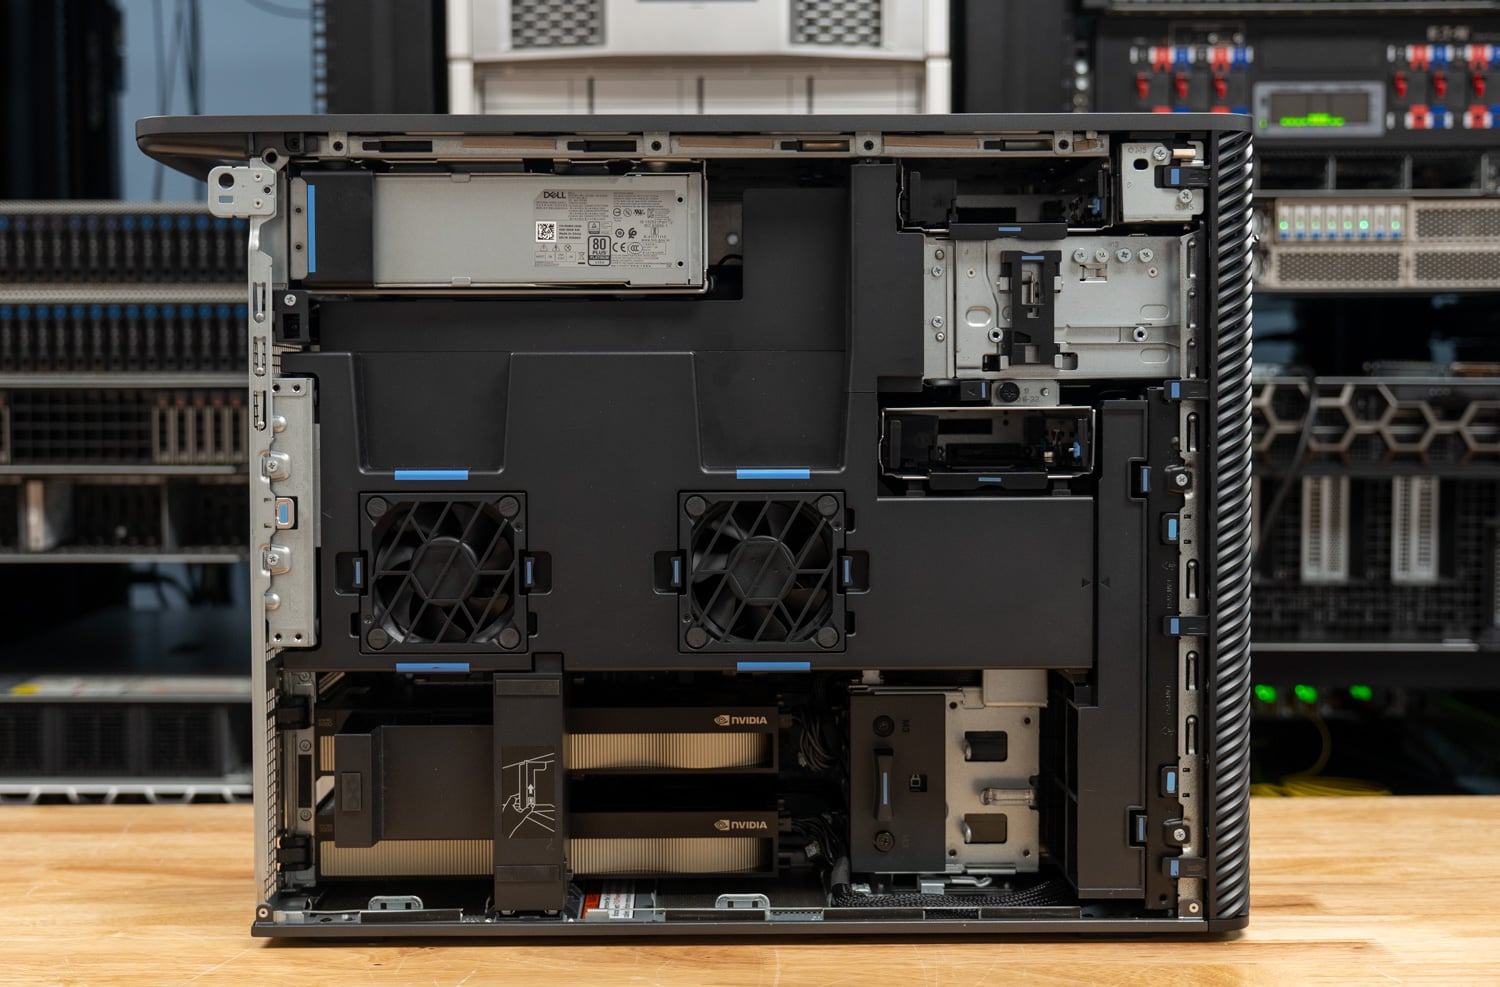
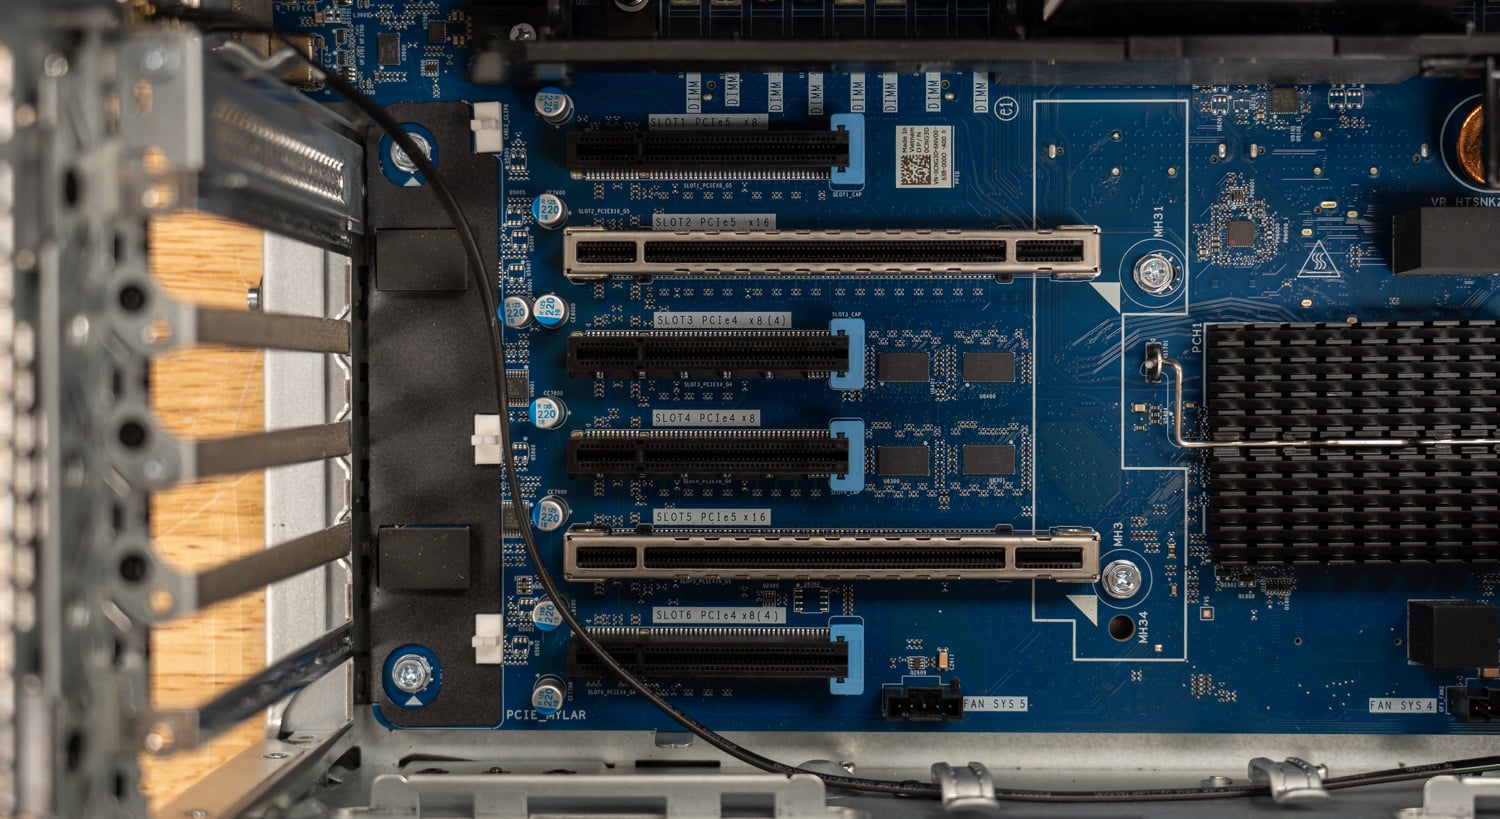
Uitbreidingsmogelijkheden zijn er via zes full-height PCIe-slots: twee Gen5 x16-slots voor de GPU's, een Gen5 x8, een Gen4 x8 en twee Gen4-slots met x8-connectoren en x4-bekabeling. Opslag is mogelijk via drie interne M.2 Gen5-slots en één Gen4-slot, twee interne 3.5-inch SATA-bays en een FlexBay aan de voorzijde met ruimte voor maximaal vier NVMe-schijven of twee 3.5-inch schijven, plus een optionele slanke optische drive. Ons testmodel start op vanaf een interne 2TB Gen5-schijf en heeft nog een 2TB Gen5-schijf in een intern M.2-slot.
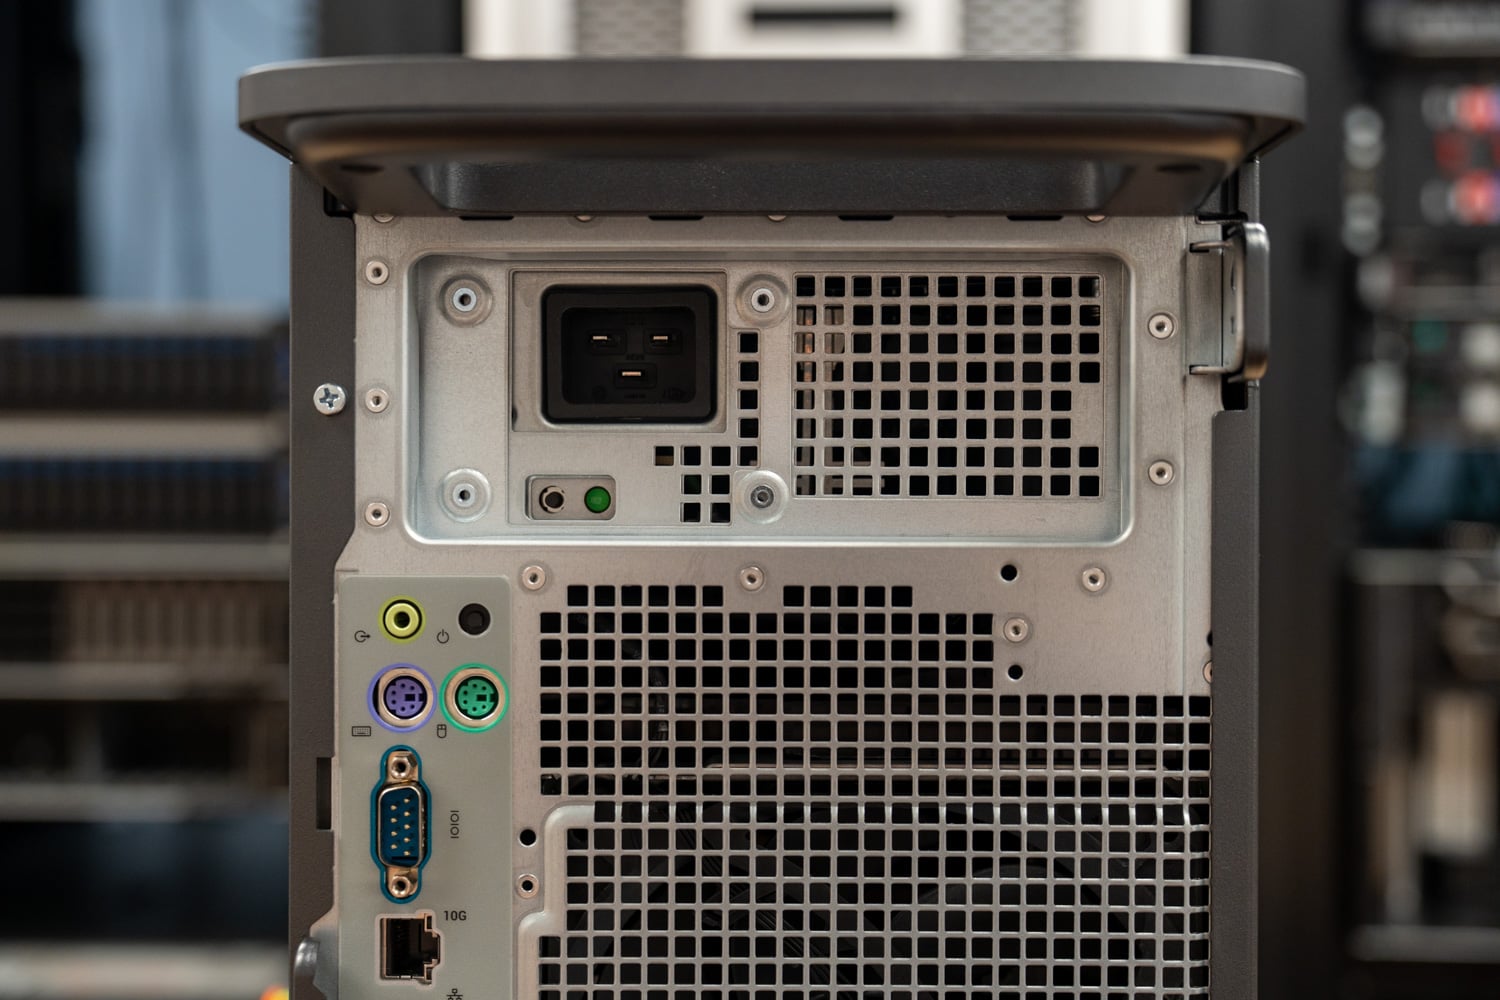
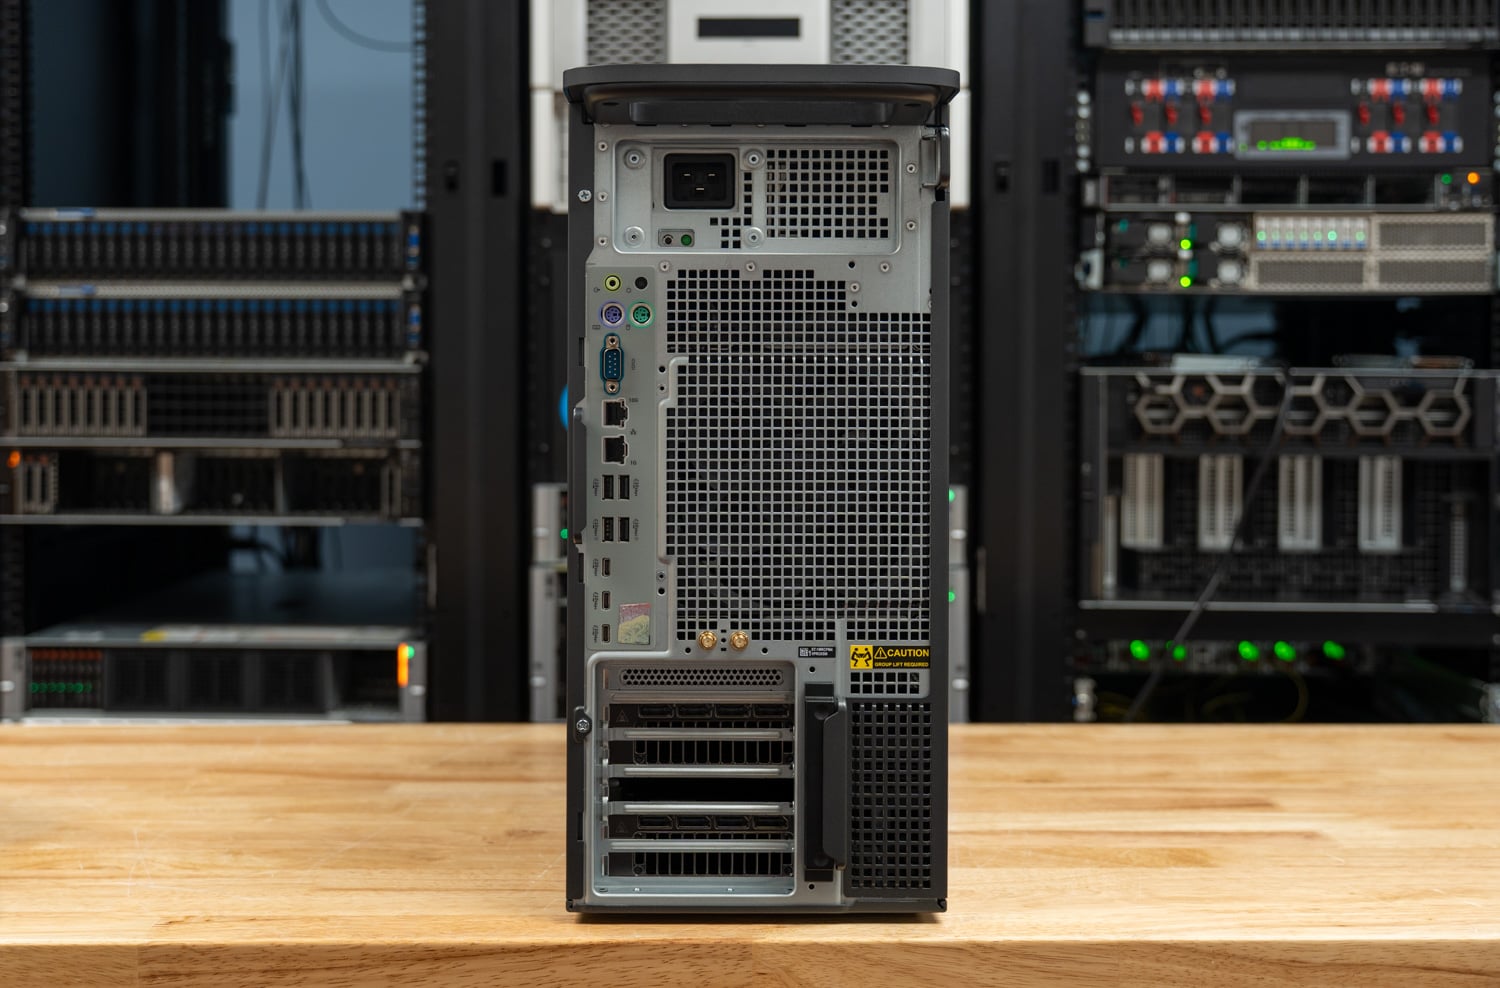
Het voorpaneel is voorzien van een hoofdtelefoonaansluiting, twee 10 Gbps USB-A-poorten, een 20 Gbps USB-C-poort met PowerShare, een 10 Gbps USB-C-poort en een optioneel SD-kaartslot. Aan de achterzijde bevinden zich 10 GbE- en 1 GbE RJ-45-poorten, vier 10 Gbps USB-A-poorten, twee 10 Gbps USB-C-poorten, een 20 Gbps USB-C-poort, een seriële poort, twee PS/2-poorten en een lijnuitgang. Ons testmodel is uitgerust met de Intel E810-XXV dual-port 25 GbE SFP28-adapter, MediaTek Wi-Fi 7 MT7925 met Bluetooth 5.4, een geheugenkaartlezer en Dell's dual USB-C-uitbreidingskaart.
De beveiliging en het beheer omvatten een TPM 2.0, Dell SafeBIOS, detectie van chassisinbraak, ondersteuning voor zelfversleutelende schijven, veilige BIOS-wissing en Intel vPro Enterprise. Dell geeft aan dat de T4 tot 85 procent gerecycled plastic bevat in belangrijke componenten, 90 procent gerecycled aluminium in de handgrepen en 11 procent gerecycled staal in de behuizing. De configuratie is ENERGY STAR-gecertificeerd.
Specificaties van de Dell Pro Precision 9 T4
| Specificaties | Dell Pro Precision 9 T4 (zoals getest) |
|---|---|
| Platform | |
| Model | Dell Pro Precision 9 T4 (PW9T4260) |
| Gegevensverwerker | Intel Xeon 698X, 86 kernen, 172 threads, 336 MB cache, 2.0 GHz basis, tot 4.8 GHz, 350 W |
| Processoropties | Xeon 634 (12 kernen) tot en met Xeon 698X (86 kernen) |
| Geheugen | 256 GB (8x 32 GB) DDR5-6400 RDIMM ECC 16 sleuven, tot 4 TB |
| grafiek | 2x NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96GB GDDR7 per stuk, 300W per stuk |
| Besturingssysteem | Windows 11 Pro voor werkstations (getest op Ubuntu 26.04.1 LTS) |
| Opslag | |
| Zoals geconfigureerd | 2x 2TB M.2 2280 Gen5 x4 TLC SED (beide in interne M.2-slots) |
| Interne sleuven | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2x 3.5-inch SATA |
| FlexBay | Tot 4 NVMe-schijven plus een optionele slanke optische schijf, of 2x 3.5-inch SATA-schijven. |
| Uitbreiding en connectiviteit | |
| PCIe slots | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 elektrisch) |
| Netwerken | Intel E810-XXV dual-port 25GbE SFP28 (uitbreidingsmodule) Ingebouwde 10GbE en 1GbE RJ-45 MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Voorpoorten | 1x USB-C 20 Gbps met PowerShare 1x USB-C 10 Gbps 2x USB-A 10Gbps Headset-aansluiting Optionele SD-kaartsleuf |
| Poorten aan de achterkant | 1x USB-C 20 Gbps 2x USB-C 10 Gbps 4x USB-A 10Gbps Serieel, 2x PS/2, lijnuitgang |
| Kracht en fysiek | |
| Laboratoriumvoedingen | 2400W Platinum (1500W optie) |
| Afmetingen | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| Gewicht | 24.1 kg tot 33.6 kg (53.1 tot 74.1 lb) afhankelijk van de configuratie |
| Garantie | ProSupport met service op locatie na diagnose op afstand, 36 maanden |
| Prijs | $5,925 basis Ongeveer $66,600 in de geconfigureerde uitvoering (Dell.com) |
Testopstelling en methodologie
We testen high-end werkstations op Linux, en alle vier de systemen in deze review draaiden Ubuntu 26.04.1 LTS met kernel 7.0.0-43, NVIDIA-stuurprogramma 595.99.02, CUDA 13, llama.cpp build b11716 en Ollama 0.40.3, met het Linux-prestatieprofiel. De resultaten zijn afkomstig van drie tools: sr-client voor lokale AI- en clientworkloads, sr-harness voor compileren, compressie, cryptografie, webservers en y-cruncher, en sr-suite r5.28 voor GROMACS, OpenFOAM, ClickHouse, Valkey en geheugenbandbreedte. Elk resultaat is de mediaan van herhaalde runs.
Alle vier systemen draaiden met de BIOS-thermische modus ingesteld op Ultra Performance, en de T4 draaide BIOS-versie 1.2.0. Voor de T4-testrun werd sr-harness 3.3 gebruikt, voor de Precision 7875 versie 3.5 en voor beide T2's versie 3.6, met dezelfde testprocedure voor al deze versies.
Elk vergelijkingssysteem is een Dell tower met RTX PRO 6000 Blackwell-graphics. De Dell Precision 7875 combineert de 96-core Threadripper PRO 9995WX met dezelfde twee RTX PRO 6000 Max-Q-kaarten en 512 GB DDR5-5600, waardoor deze het meest overeenkomt. De Dell Pro Precision 9 T2 draait op de 24-core Xeon 658X met één Max-Q-kaart, en de Dell Pro Max Tower T2 draait op de 24-core Core Ultra 9 285K met de 600W RTX PRO 6000, wat laat zien wat de hogere stroomlimiet per GPU toevoegt.
| Configuratie | CPU | Geheugen | GPU | Test Drive | BIOS thermische modus |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 kernen | 256 GB DDR5-6400 (8 kanalen) | 2x RTX PRO 6000 Max-Q (300W) | 2TB SK Hynix PCB01 Gen5 | Ultraprestaties |
| Dell Precision 7875 | Threadripper PRO 9995WX, 96 kernen | 512 GB DDR5-5600 (8 kanalen) | 2x RTX PRO 6000 Max-Q (300W) | 2TB Samsung Gen4 | Ultraprestaties |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 kernen | 128 GB DDR5-6400 (4 kanalen) | 1x RTX PRO 6000 Max-Q (300W) | Samsung PM9E1 Gen5, 2TB-schijven in een striped array. | Ultraprestaties |
| Dell Pro Max-toren T2 | Core Ultra 9 285K, 24 kernen | 128 GB DDR5-4400 (2 kanalen) | 1x RTX PRO 6000 (600W) | 2TB Samsung PM9F1 Gen4 | Ultraprestaties |
Lokale AI-prestaties
Elk systeem hier is uitgerust met minimaal één RTX PRO 6000 Blackwell met 96 GB GDDR7-geheugen. De resultaten met één GPU meten dus de kaart zelf, de maximale stroomlimiet en hoe snel het platform de kaart van data voorziet. De twee kaarten van de T4 maken hem uniek. Onze tests met twee GPU's voeren elk model op drie manieren uit, waar van toepassing: twee onafhankelijke servers, één per GPU, voor de doorvoer; één model verdeeld over beide kaarten (per laag); en, voor de MiniMax M2.7, één kaart met de rest van het model in het systeemgeheugen.
LLM-server op één GPU
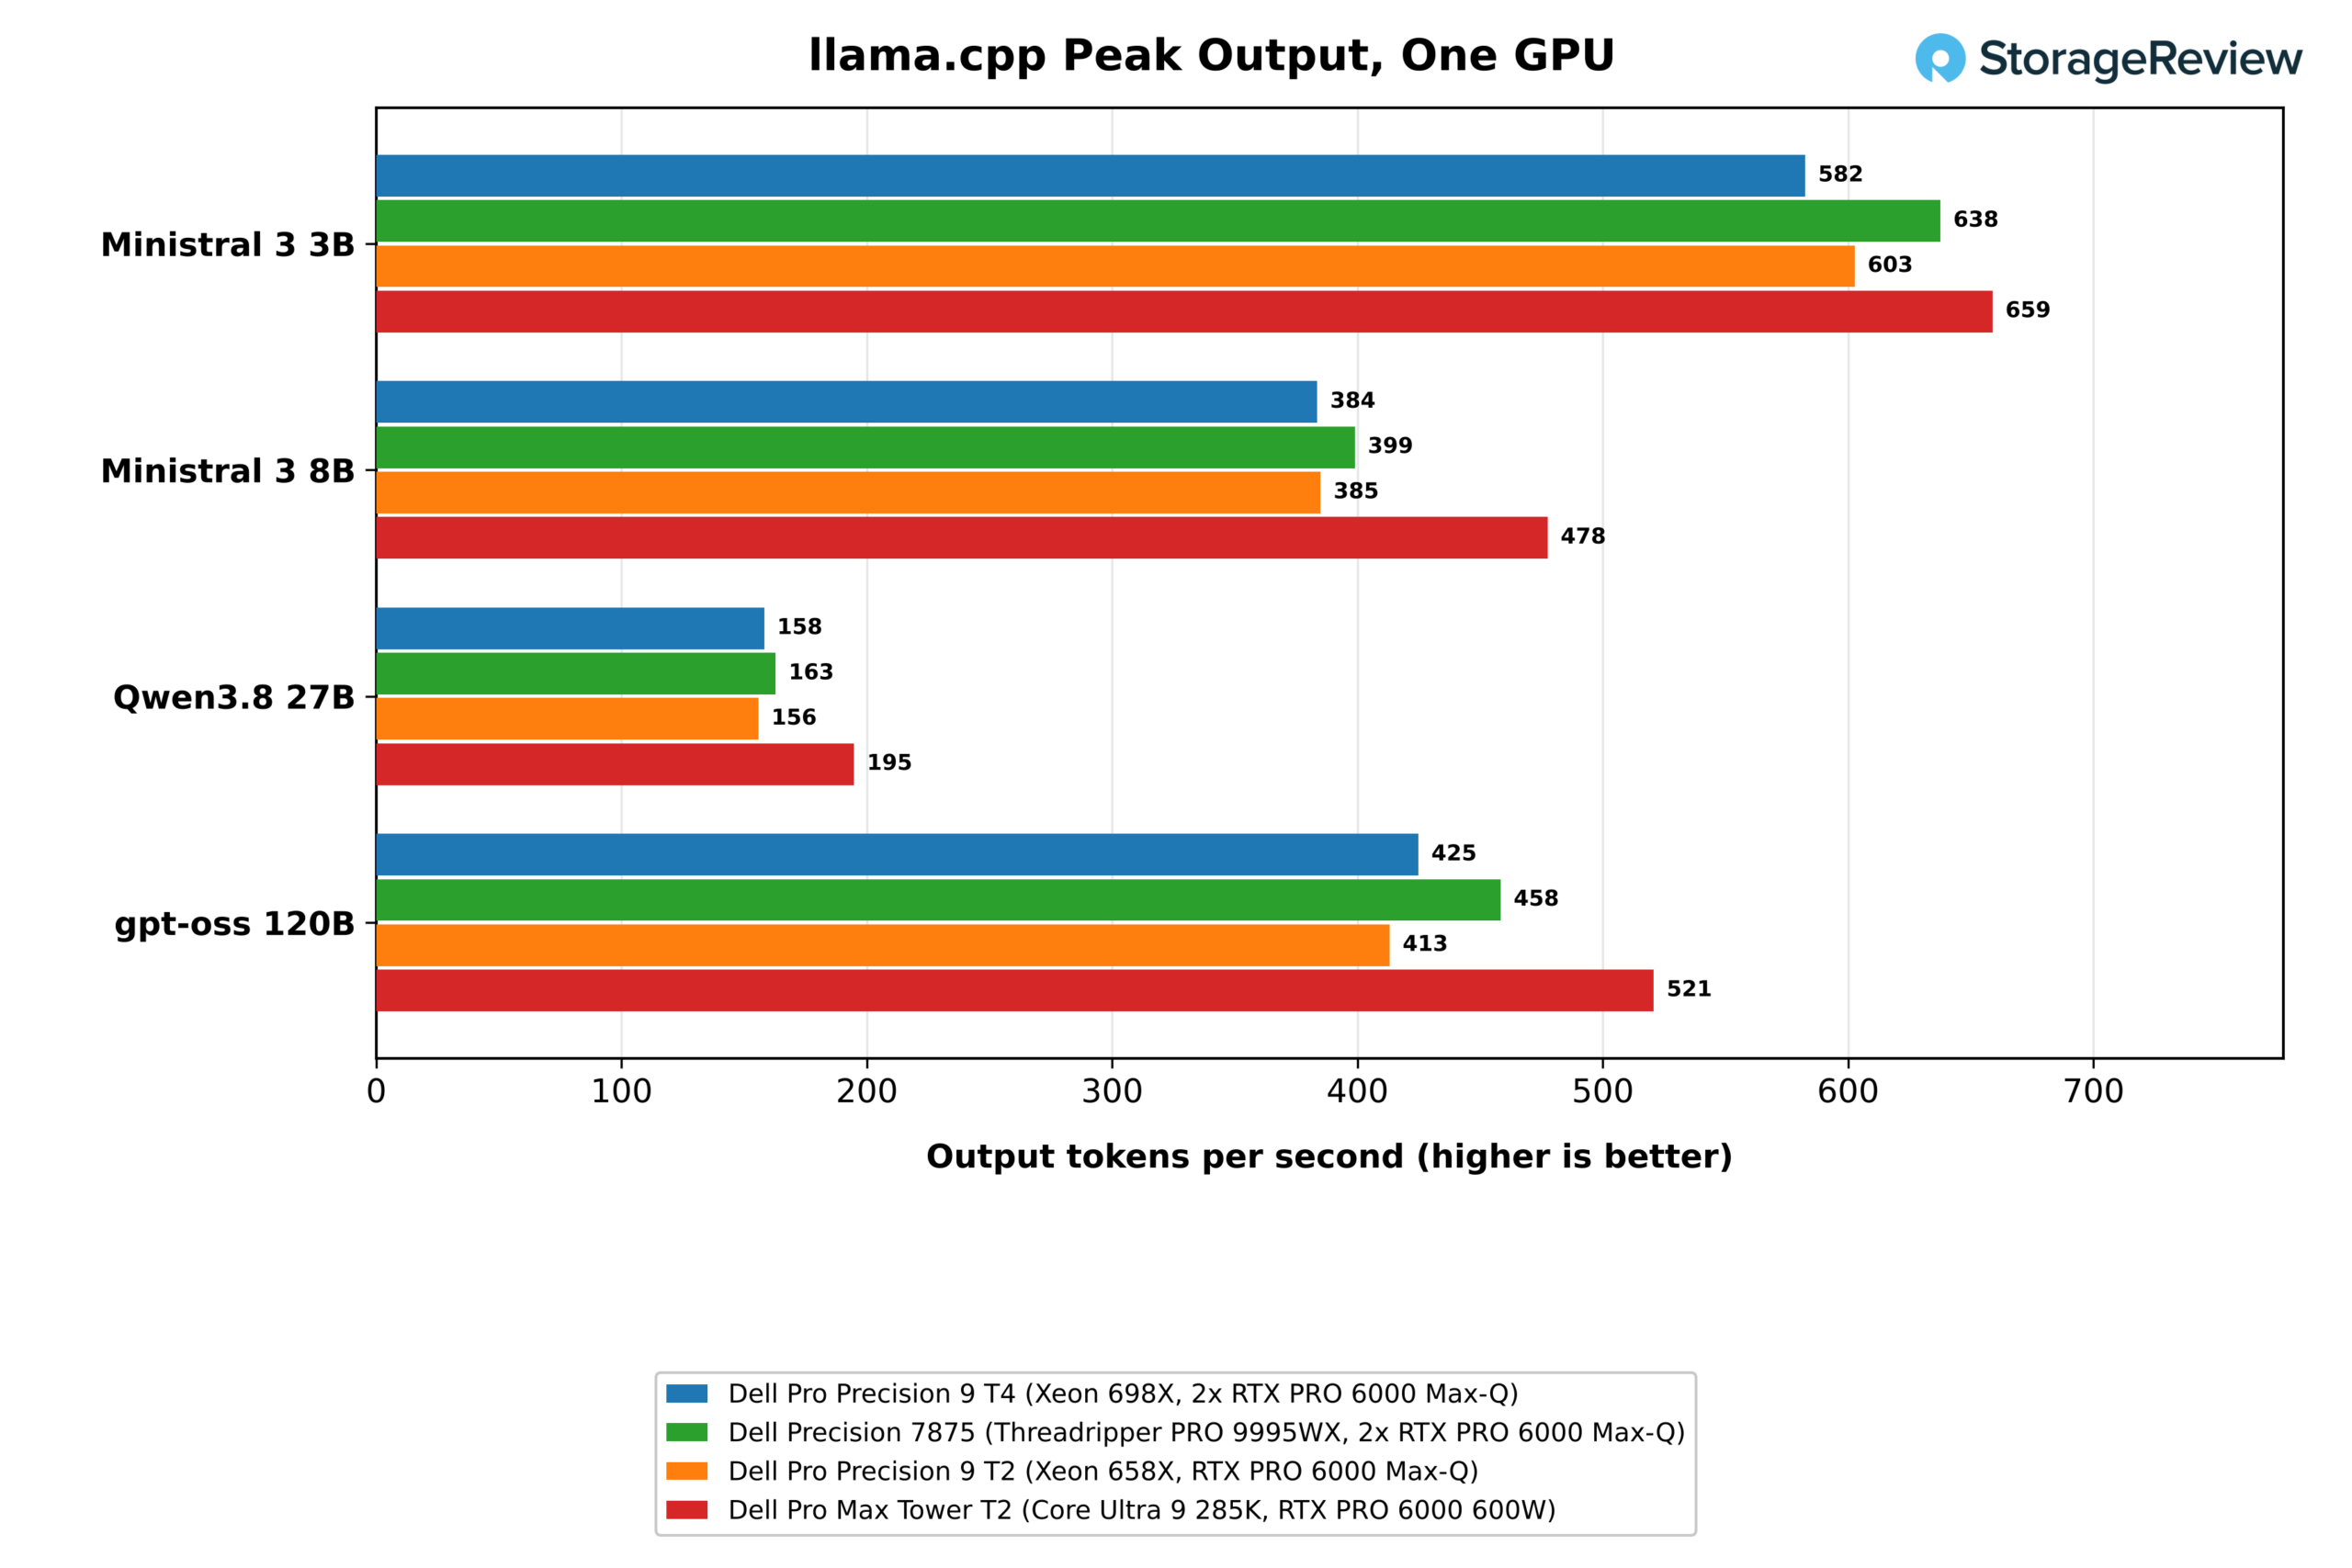
| llama.cpp server, één GPU (output tokens/s, hoe hoger hoe beter) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| Ministral 3 3B, één verzoek | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, piek | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministral 3 8B, één verzoek | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, piek | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, één verzoek | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, piek | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, één verzoek | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, piek | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, één verzoek, tijd tot eerste token (ms, lager is beter) | 1,189 | 1,181 | 1,213 | 844 |
Op één GPU presteert de T4 precies binnen de limiet van 300W. Hij genereerde 166.9 tokens per seconde voor één gebruiker op gpt-oss 120B en piekte op 424.8 tokens per seconde bij 64 gelijktijdige verzoeken. Dit ligt binnen 1 tot 9 procent van de identieke Max-Q-kaart van de Precision 7875 op alle vier de modellen en is gelijk aan de Pro Precision 9 T2. De 600W-kaart in de Pro Max Tower T2 is 13 tot 25 procent sneller op het piekvermogen van elk model en bereikt 520.7 tokens per seconde op gpt-oss 120B.
Twee GPU's: replica's en gesplitste modellen
| llama.cpp server, twee GPU's (output tokens/s, hoe hoger hoe beter) | Dell Pro Precision 9 T4 | Dell Precision 7875 |
|---|---|---|
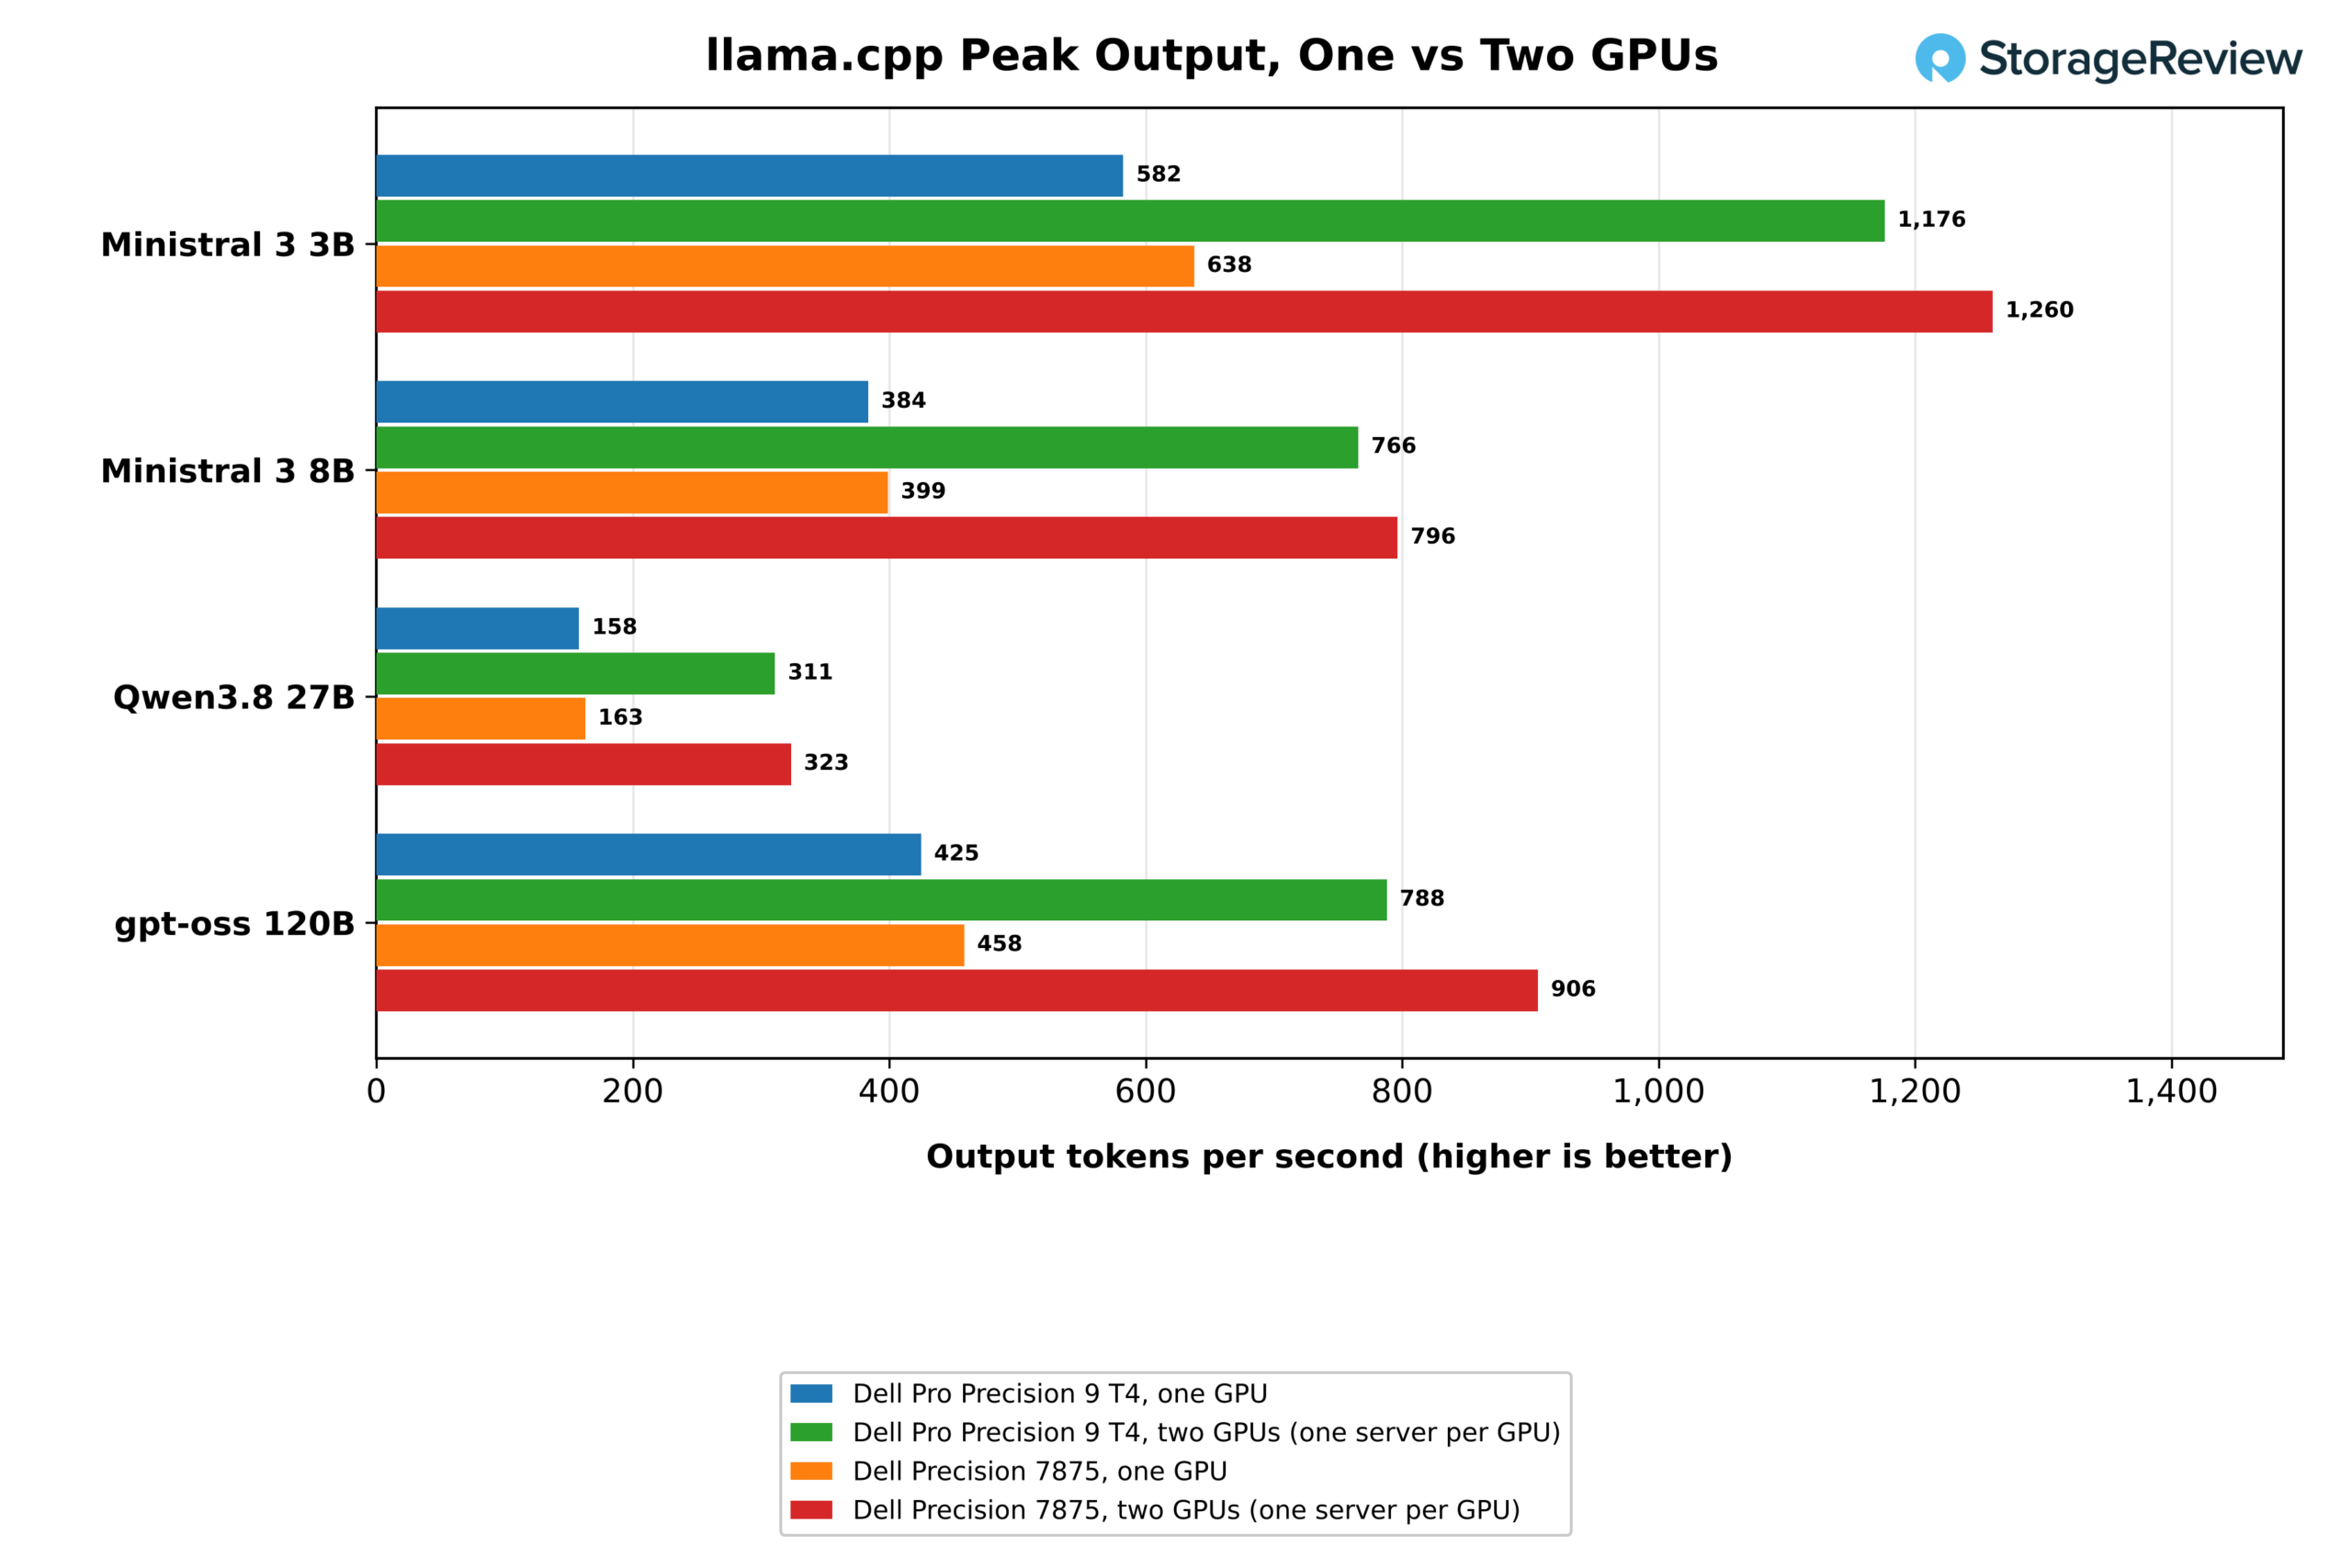
| Ministral 3 3B, piekbelasting, één server per GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, piekbelasting, één server per GPU | 765.7 | 796.4 |
| Qwen3.8 27B, piekbelasting, één server per GPU | 310.8 | 323.2 |
| gpt-oss 120B, piekbelasting, één server per GPU | 787.9 | 905.8 |
| gpt-oss 120B, één verzoek, opgesplitst per laag | 170.6 | 182.4 |
| gpt-oss 120B, piek, gesplitst per laag | 539.2 | 619.4 |
Door één server per GPU te gebruiken, werd de piekoutput van de T4 met een factor 1.85 tot 2.02 verhoogd over de vier modellen. De piekoutput steeg van 582.5 naar 1,176.1 tokens per seconde op de Ministral 3 3B, van 383.6 naar 765.7 op het 8B-model en van 158.1 naar 310.8 op de Qwen3.8 27B, een schaalvergroting van 1.97 tot 2.02 keer. gpt-oss 120B schaalde 1.85 keer naar 787.9 tokens per seconde op de T4 en 1.98 keer naar 905.8 op de Precision 7875, die zijn piek bereikte bij 128 gelijktijdige verzoeken, terwijl de T4 piekte bij 64.
Het verdelen van gpt-oss 120B over twee kaarten per laag is de langzamere manier om de tweede GPU te gebruiken wanneer het model al op één GPU past. Het leverde één gebruiker 170.6 tokens per seconde op, binnen 3 procent van wat een enkele kaart zou kunnen leveren, en piekte op 539.2 tokens per seconde, 27 procent meer dan één GPU en aanzienlijk minder dan de 787.9 tokens per seconde die twee replica's leverden. De gesplitste configuratie is vooral nuttig bij modellen die niet op één kaart passen, zoals de MiniMax M2.7.
| llama.cpp server, gpt-oss 120B, 8,192-token prompts, 1,024-token outputs | T4, één GPU | T4, twee GPU's, één server per GPU | T4, twee GPU's, gesplitst per laag | Precision 7875, twee GPU's, één server per GPU |
|---|---|---|---|---|
| 1 gelijktijdig: totale doorvoer (tokens/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 gelijktijdig: tijd tot eerste token, mediaan (ms, lager is beter) | 1,189 | 1,180 | 719 | 1,189 |
| 8 gelijktijdig: totale doorvoer (tokens/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 gelijktijdig: uitvoer per gebruiker (tokens/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 gelijktijdig: tijd tot eerste token, mediaan (ms, lager is beter) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 gelijktijdig: totale doorvoer (tokens/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 gelijktijdig: uitvoer per gebruiker (tokens/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 gelijktijdig: tijd tot eerste token, mediaan (ms, lager is beter) | 3,874 | 3,226 | 2,852 | 2,867 |
De volledige test op gpt-oss 120B laat zien hoe de tweede kaart de curve beïnvloedt, waarbij de totale doorvoer zowel prompt- als outputtokens meetelt. Eén GPU steeg van 1,502 tokens per seconde voor een enkele aanvraag naar 2,760 bij acht aanvragen en 3,823 bij 64 aanvragen, waarbij elke gebruiker 6.6 outputtokens per seconde ontving. Met één server per GPU leverden acht aanvragen 4,820 tokens op en 64 aanvragen 7,091 tokens, 1.85 keer de capaciteit van één kaart, wat neerkomt op 12.3 tokens per seconde per gebruiker. Het opsplitsen van het model resulteerde in een lagere piek van 4,853 tokens, maar leverde de eerste token voor één gebruiker op in 719 ms in plaats van 1,189 ms.

MiniMax M2.7: Een model te groot voor één kaart
| MiniMax M2.7 Q4_K_M, 129.3 GB (meer is beter, tenzij anders vermeld) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
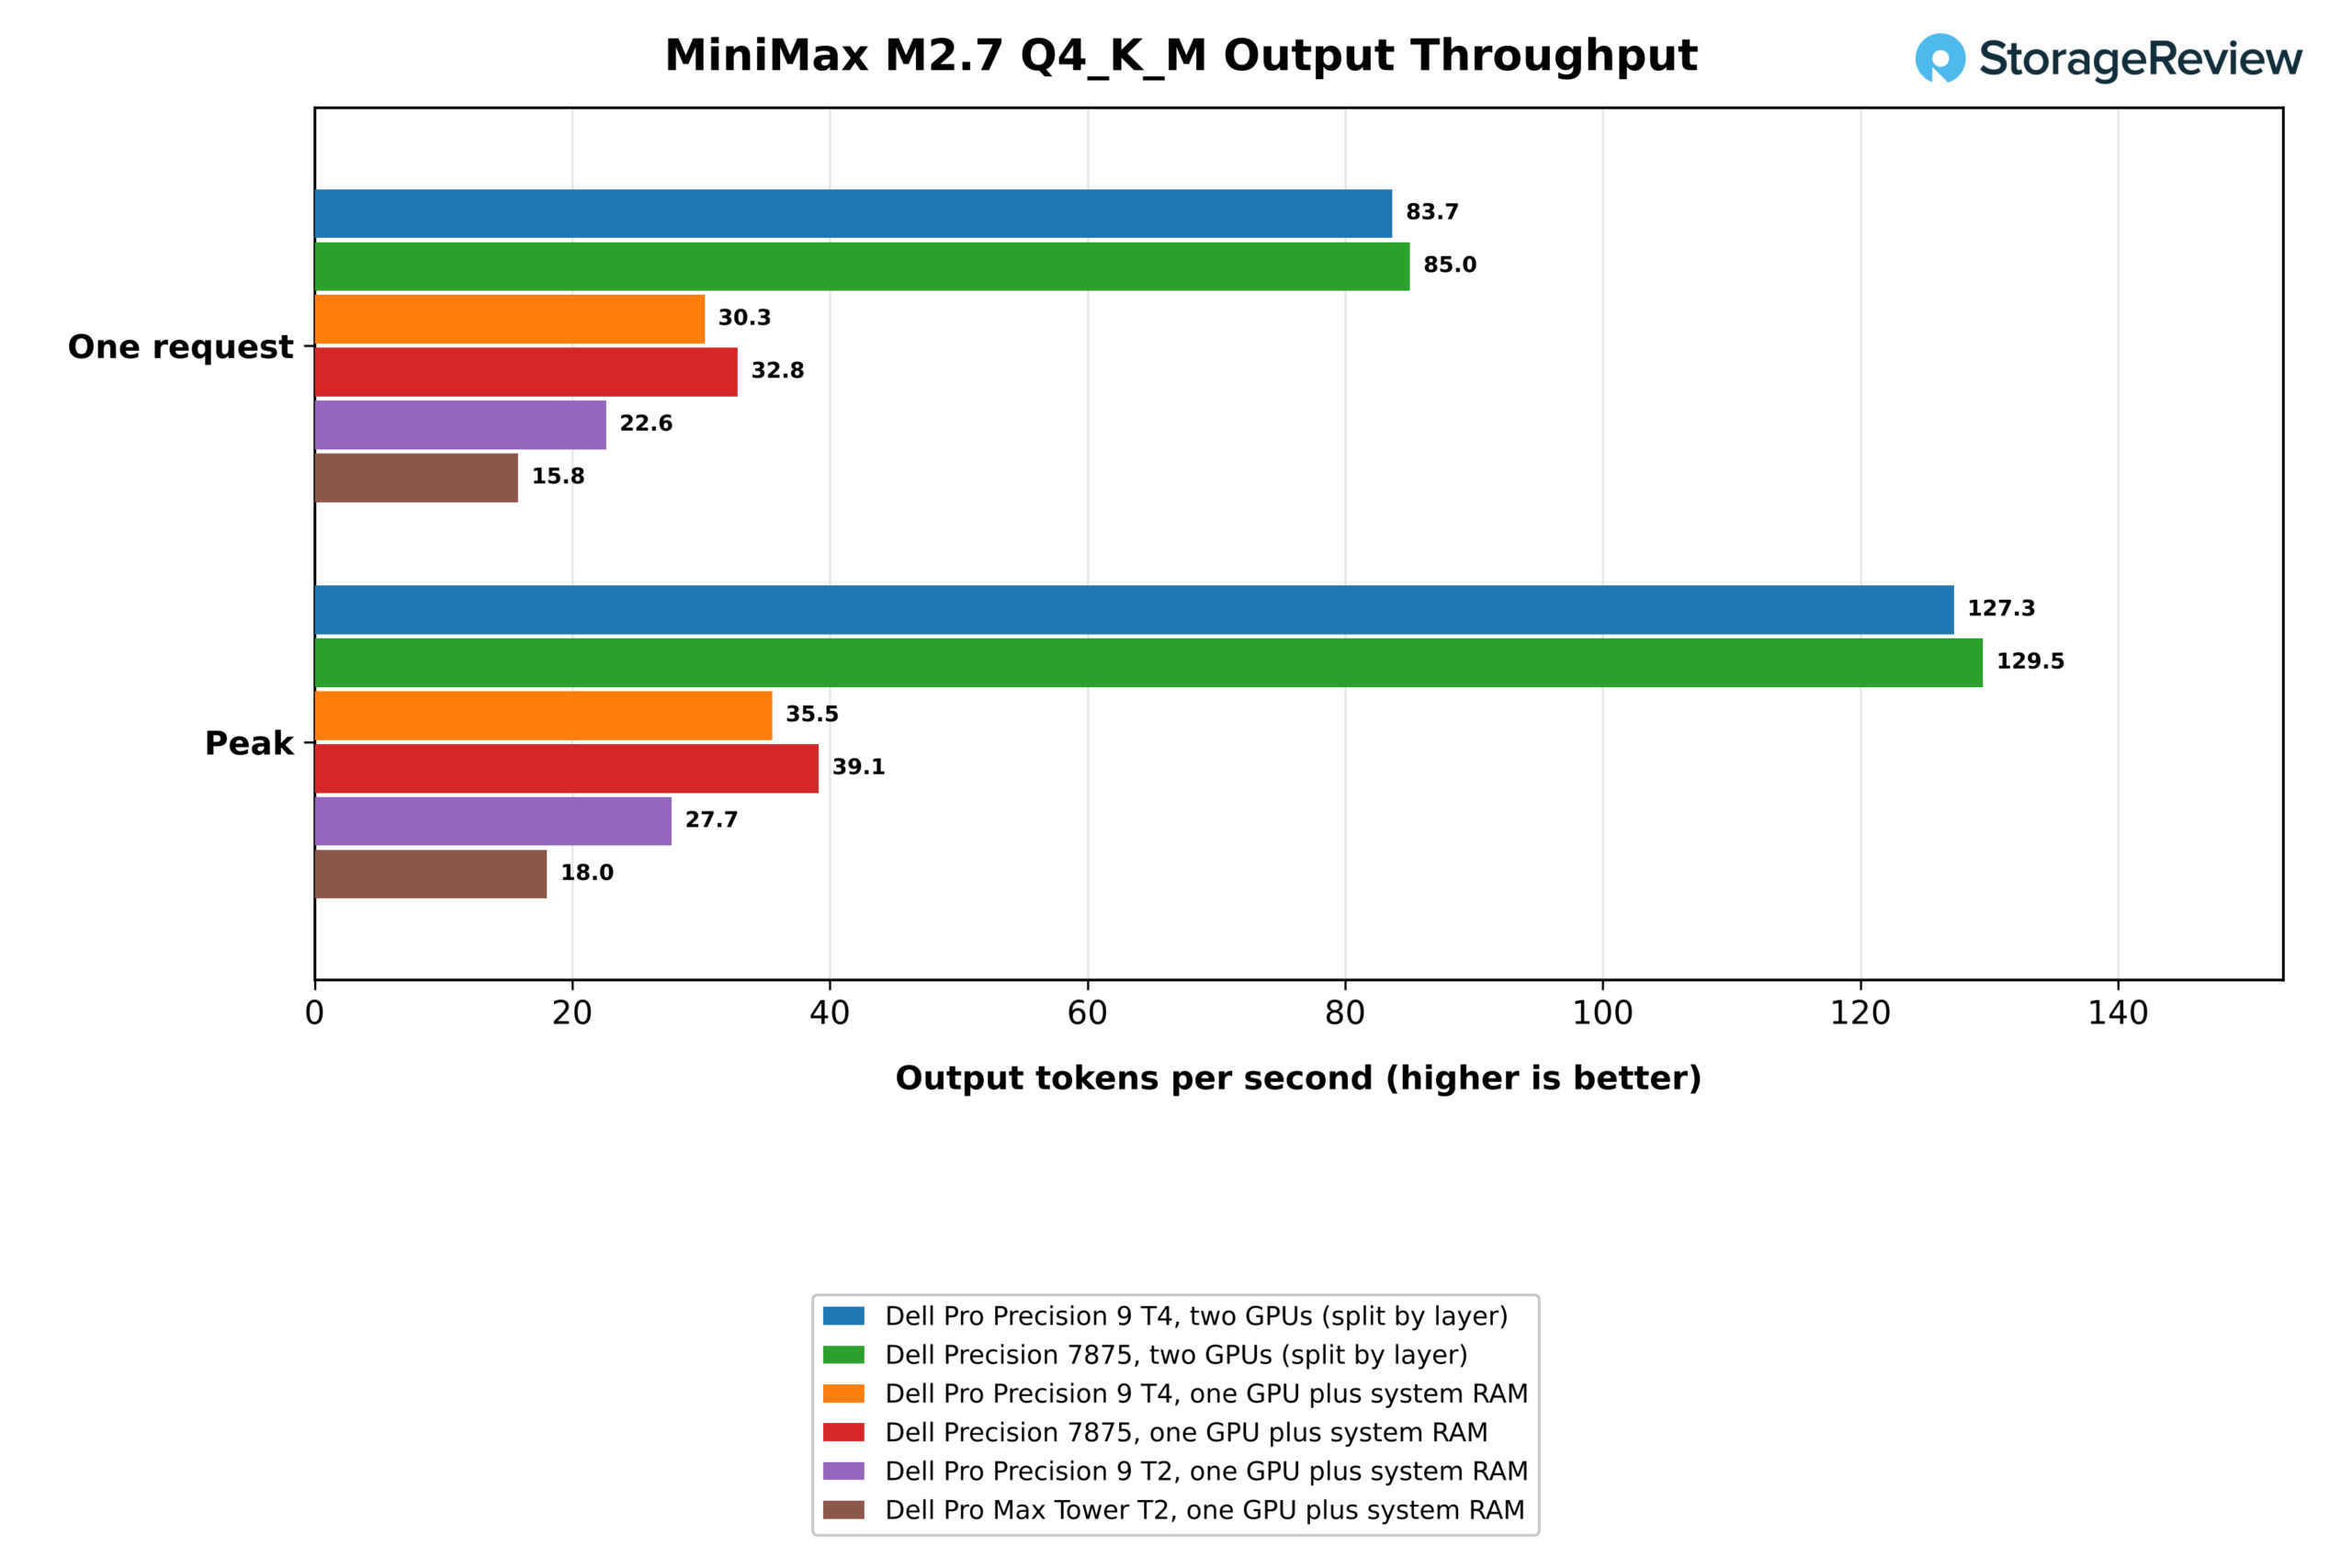
| Eén GPU plus systeem-RAM, één aanvraag (tokens/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| Eén GPU plus systeem-RAM, piek (tokens/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| Eén GPU plus systeem-RAM, tijd tot eerste token (ms, lager is beter) | 16,224 | 16,143 | 16,216 | 18,522 |
| Twee GPU's, gescheiden per laag, één verzoek (tokens/s) | 83.7 | 85.0 | Enkele GPU | Enkele GPU |
| Twee GPU's, gesplitst per laag, piek (tokens/s) | 127.3 | 129.5 | Enkele GPU | Enkele GPU |
| Twee GPU's, verdeeld per laag, tijd tot eerste token (ms, lager is beter) | 3,138 | 3,162 | Enkele GPU | Enkele GPU |
| Koude belasting, één GPU plus RAM (minder is beter) | 40.5 | 65.8 | 37.6 | 81.1 |
| Koude belasting, twee GPU's verdeeld (s, lager is beter) | 27.6 | 50.7 | Enkele GPU | Enkele GPU |
MiniMax M2.7 is een model met 230 miljard parameters, gebaseerd op een mix van experts, en onze 4-bits kwantisering neemt 129.3 GB in beslag, meer dan de 96 GB van één RTX PRO 6000. Op één kaart, met de rest in het systeemgeheugen, genereerde de T4 30.3 tokens per seconde voor één gebruiker en duurde het 16.2 seconden om het eerste token terug te geven. Verdeeld over beide kaarten genereerde de T4 83.7 tokens per seconde, 2.8 keer sneller, gaf het eerste token terug in 3.1 seconden en bereikte een piek van 127.3 tokens per seconde tegenover 35.5.
De resultaten met één GPU laten zien hoe belangrijk het hostplatform is zodra een model het systeemgeheugen bereikt. De acht kanalen DDR5-6400 van de T4 zorgen ervoor dat deze 34 procent sneller is dan de vierkanaals Pro Precision 9 T2 met 22.6 tokens per seconde en 1.9 keer sneller dan de dual-channel Pro Max Tower T2 met 15.8 tokens per seconde, ondanks het feit dat de 600W-kaart van de Pro Max Tower T2 sneller is op elk model dat erin past. De Precision 7875 was met 32.8 tokens per seconde net iets sneller dan de T4, ondanks 35 procent minder geheugenbandbreedte, dus bandbreedte alleen is niet doorslaggevend voor dit resultaat. We rapporteren de voorsprong van de 7875 zoals gemeten en hebben de oorzaak ervan niet kunnen achterhalen.
Model laden
| Ollama 0.40.3 en llama.cpp model laden (s, lager is beter) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8 GB), koud | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, warm | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9 GB), koud | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, warm | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, cold, één kopie op elke GPU | 26.47 | 35.55 | Enkele GPU | Enkele GPU |
| MiniMax M2.7 (129.3 GB), koud, één GPU plus RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, warm, één GPU plus RAM | 28.6 | 15.2 | 36.7 | 80.5 |
Bij koude testruns presteren de Gen5-schijven beter. De T4 laadt gpt-oss:120b vanaf zijn SK hynix Gen5 SSD in 15.2 seconden, net als de Pro Precision 9 T2 en ruim voor de 25.8 en 28.2 seconden van respectievelijk de Precision 7875 en de Pro Max Tower T2 met Gen4-schijven. Bij warme testruns vanuit de paginacache is de volgorde omgekeerd: de 7875 doet er 5.0 seconden over tegenover 7.5 seconden voor de T4, en het laden van een kopie op elke GPU tegelijk duurde 26.5 seconden op de T4.
Ophaalgebaseerde generatie op grote schaal
| RAG over 1,002,067 Wikipedia-passages | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
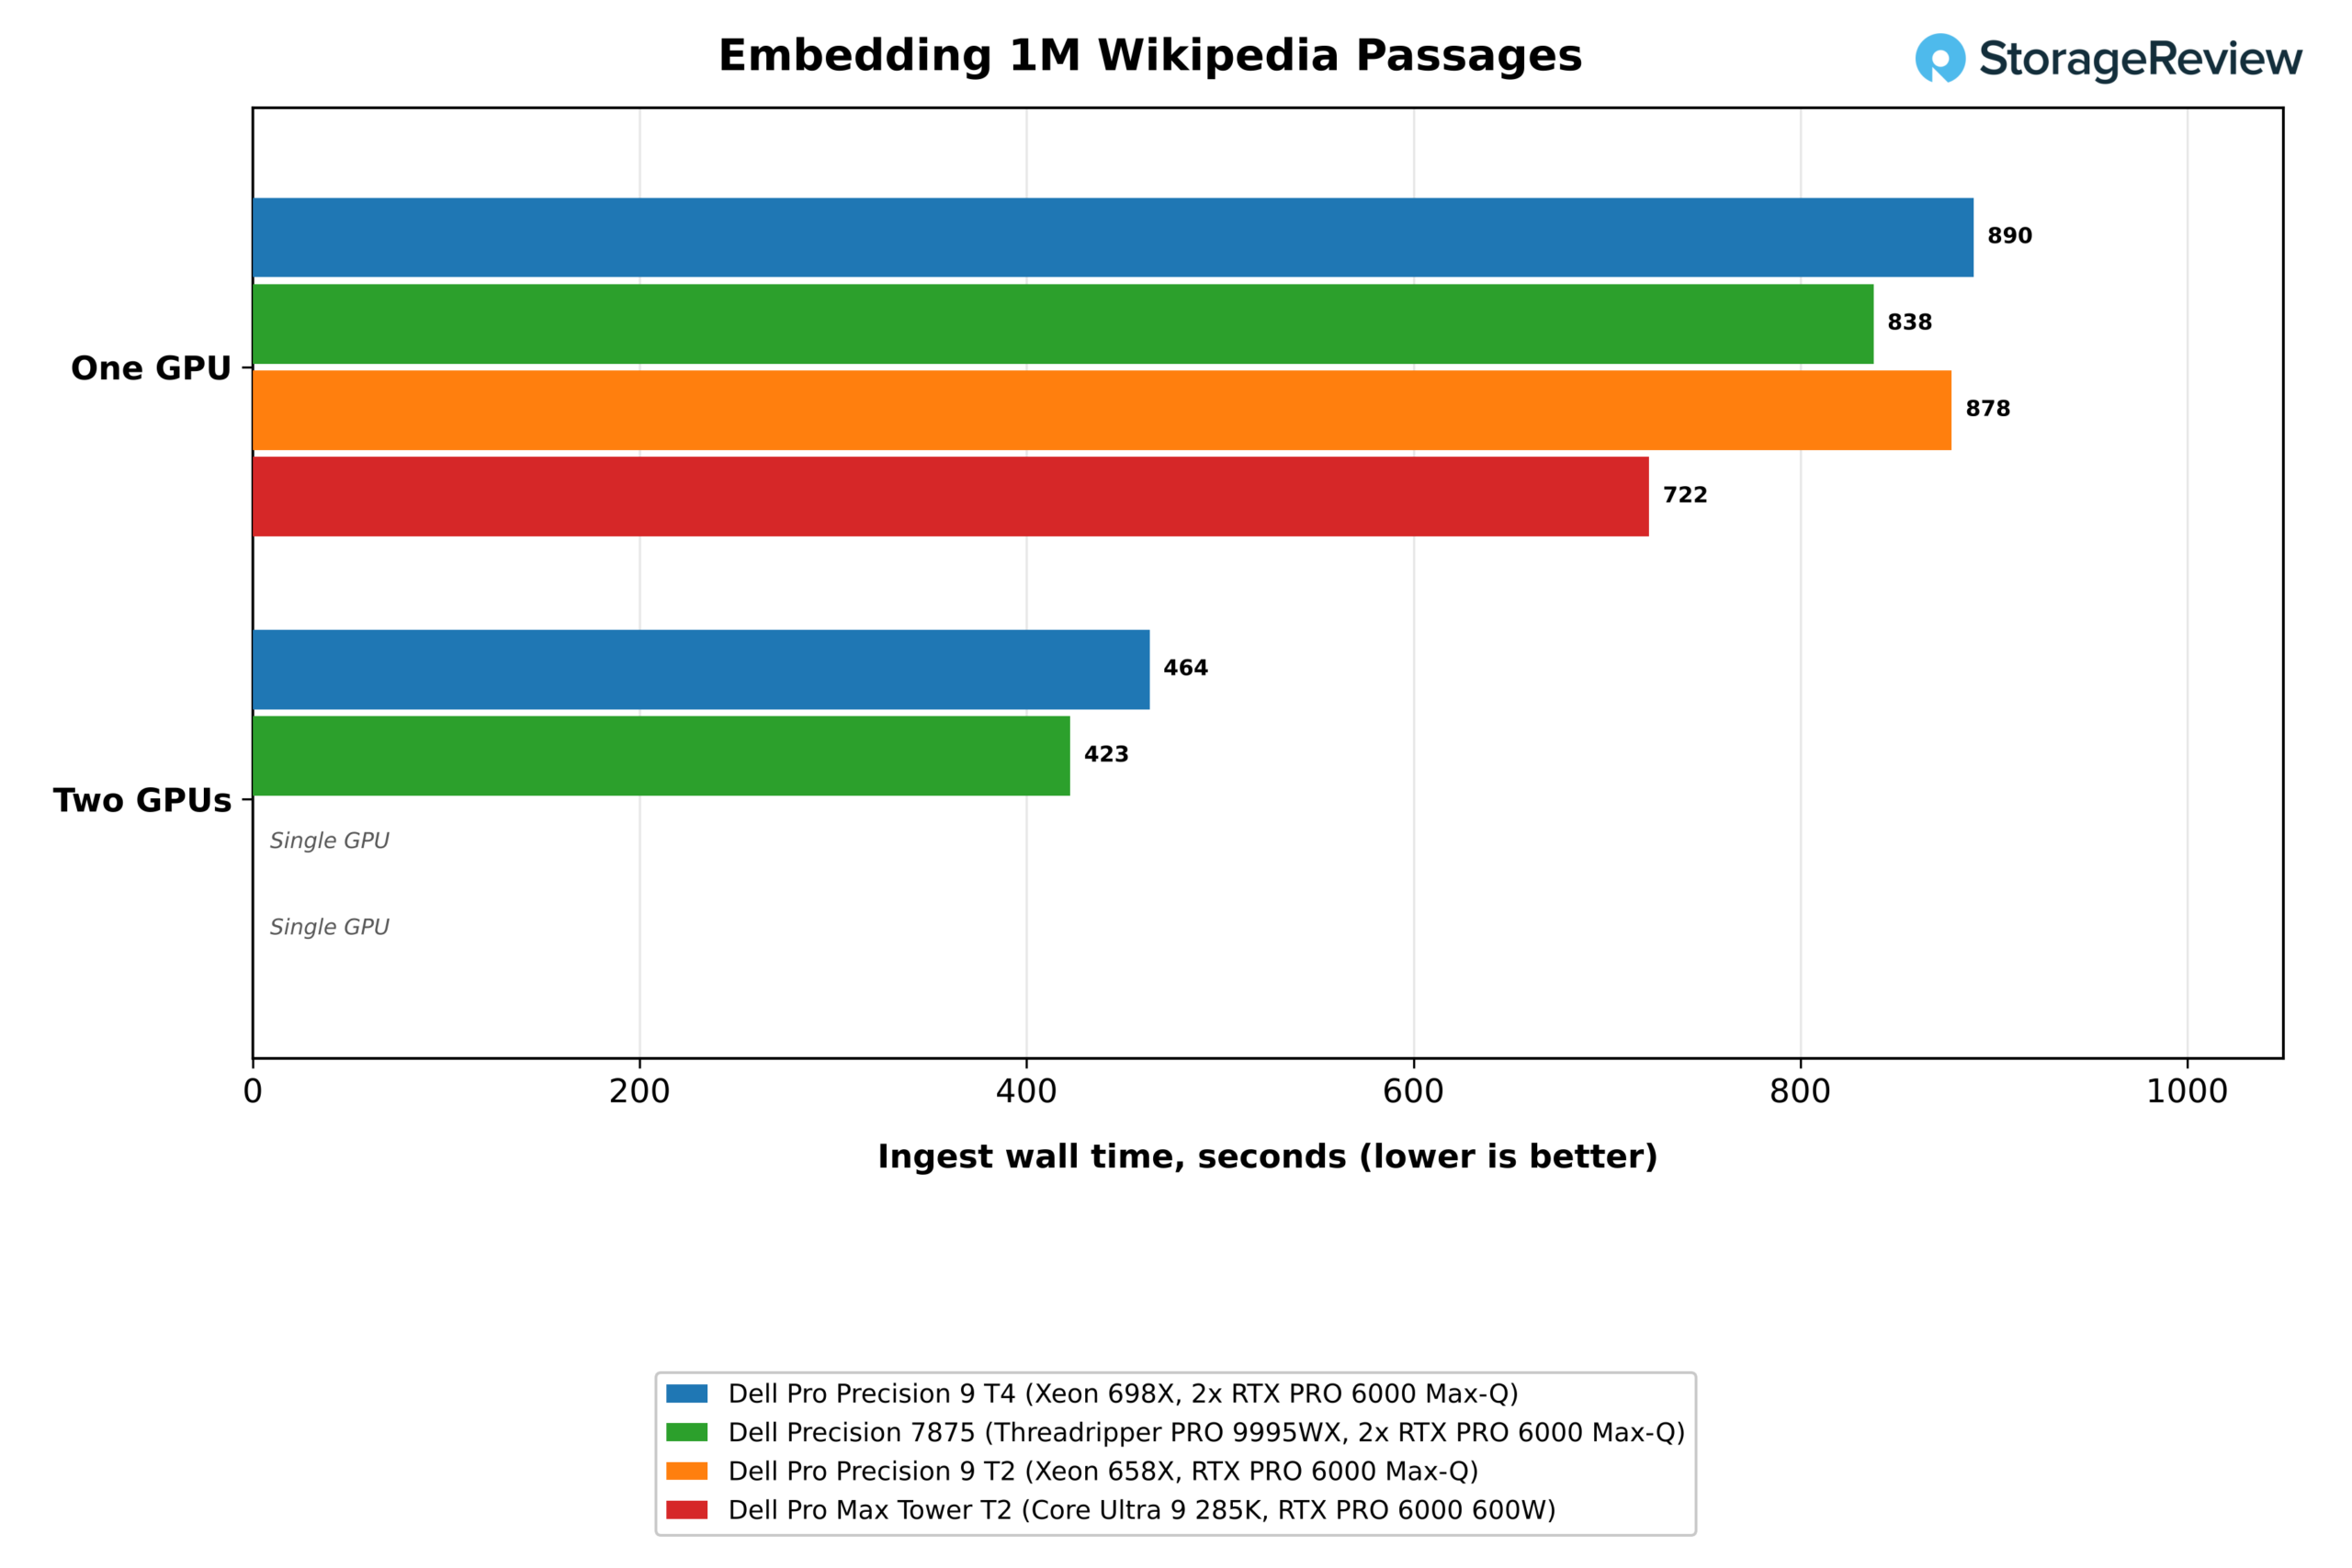
| Inbedding, één GPU (passages/s) | 1,126 | 1,196 | 1,141 | 1,388 |
| Inbedding van de verstreken tijd, één GPU (s, lager is beter) | 890 | 838 | 878 | 722 |
| Inbedding, twee GPU's (passages/s) | 2,162 | 2,371 | Enkele GPU | Enkele GPU |
| Het inbedden van de verstreken tijd, twee GPU's (s, minder is beter) | 464 | 423 | Enkele GPU | Enkele GPU |
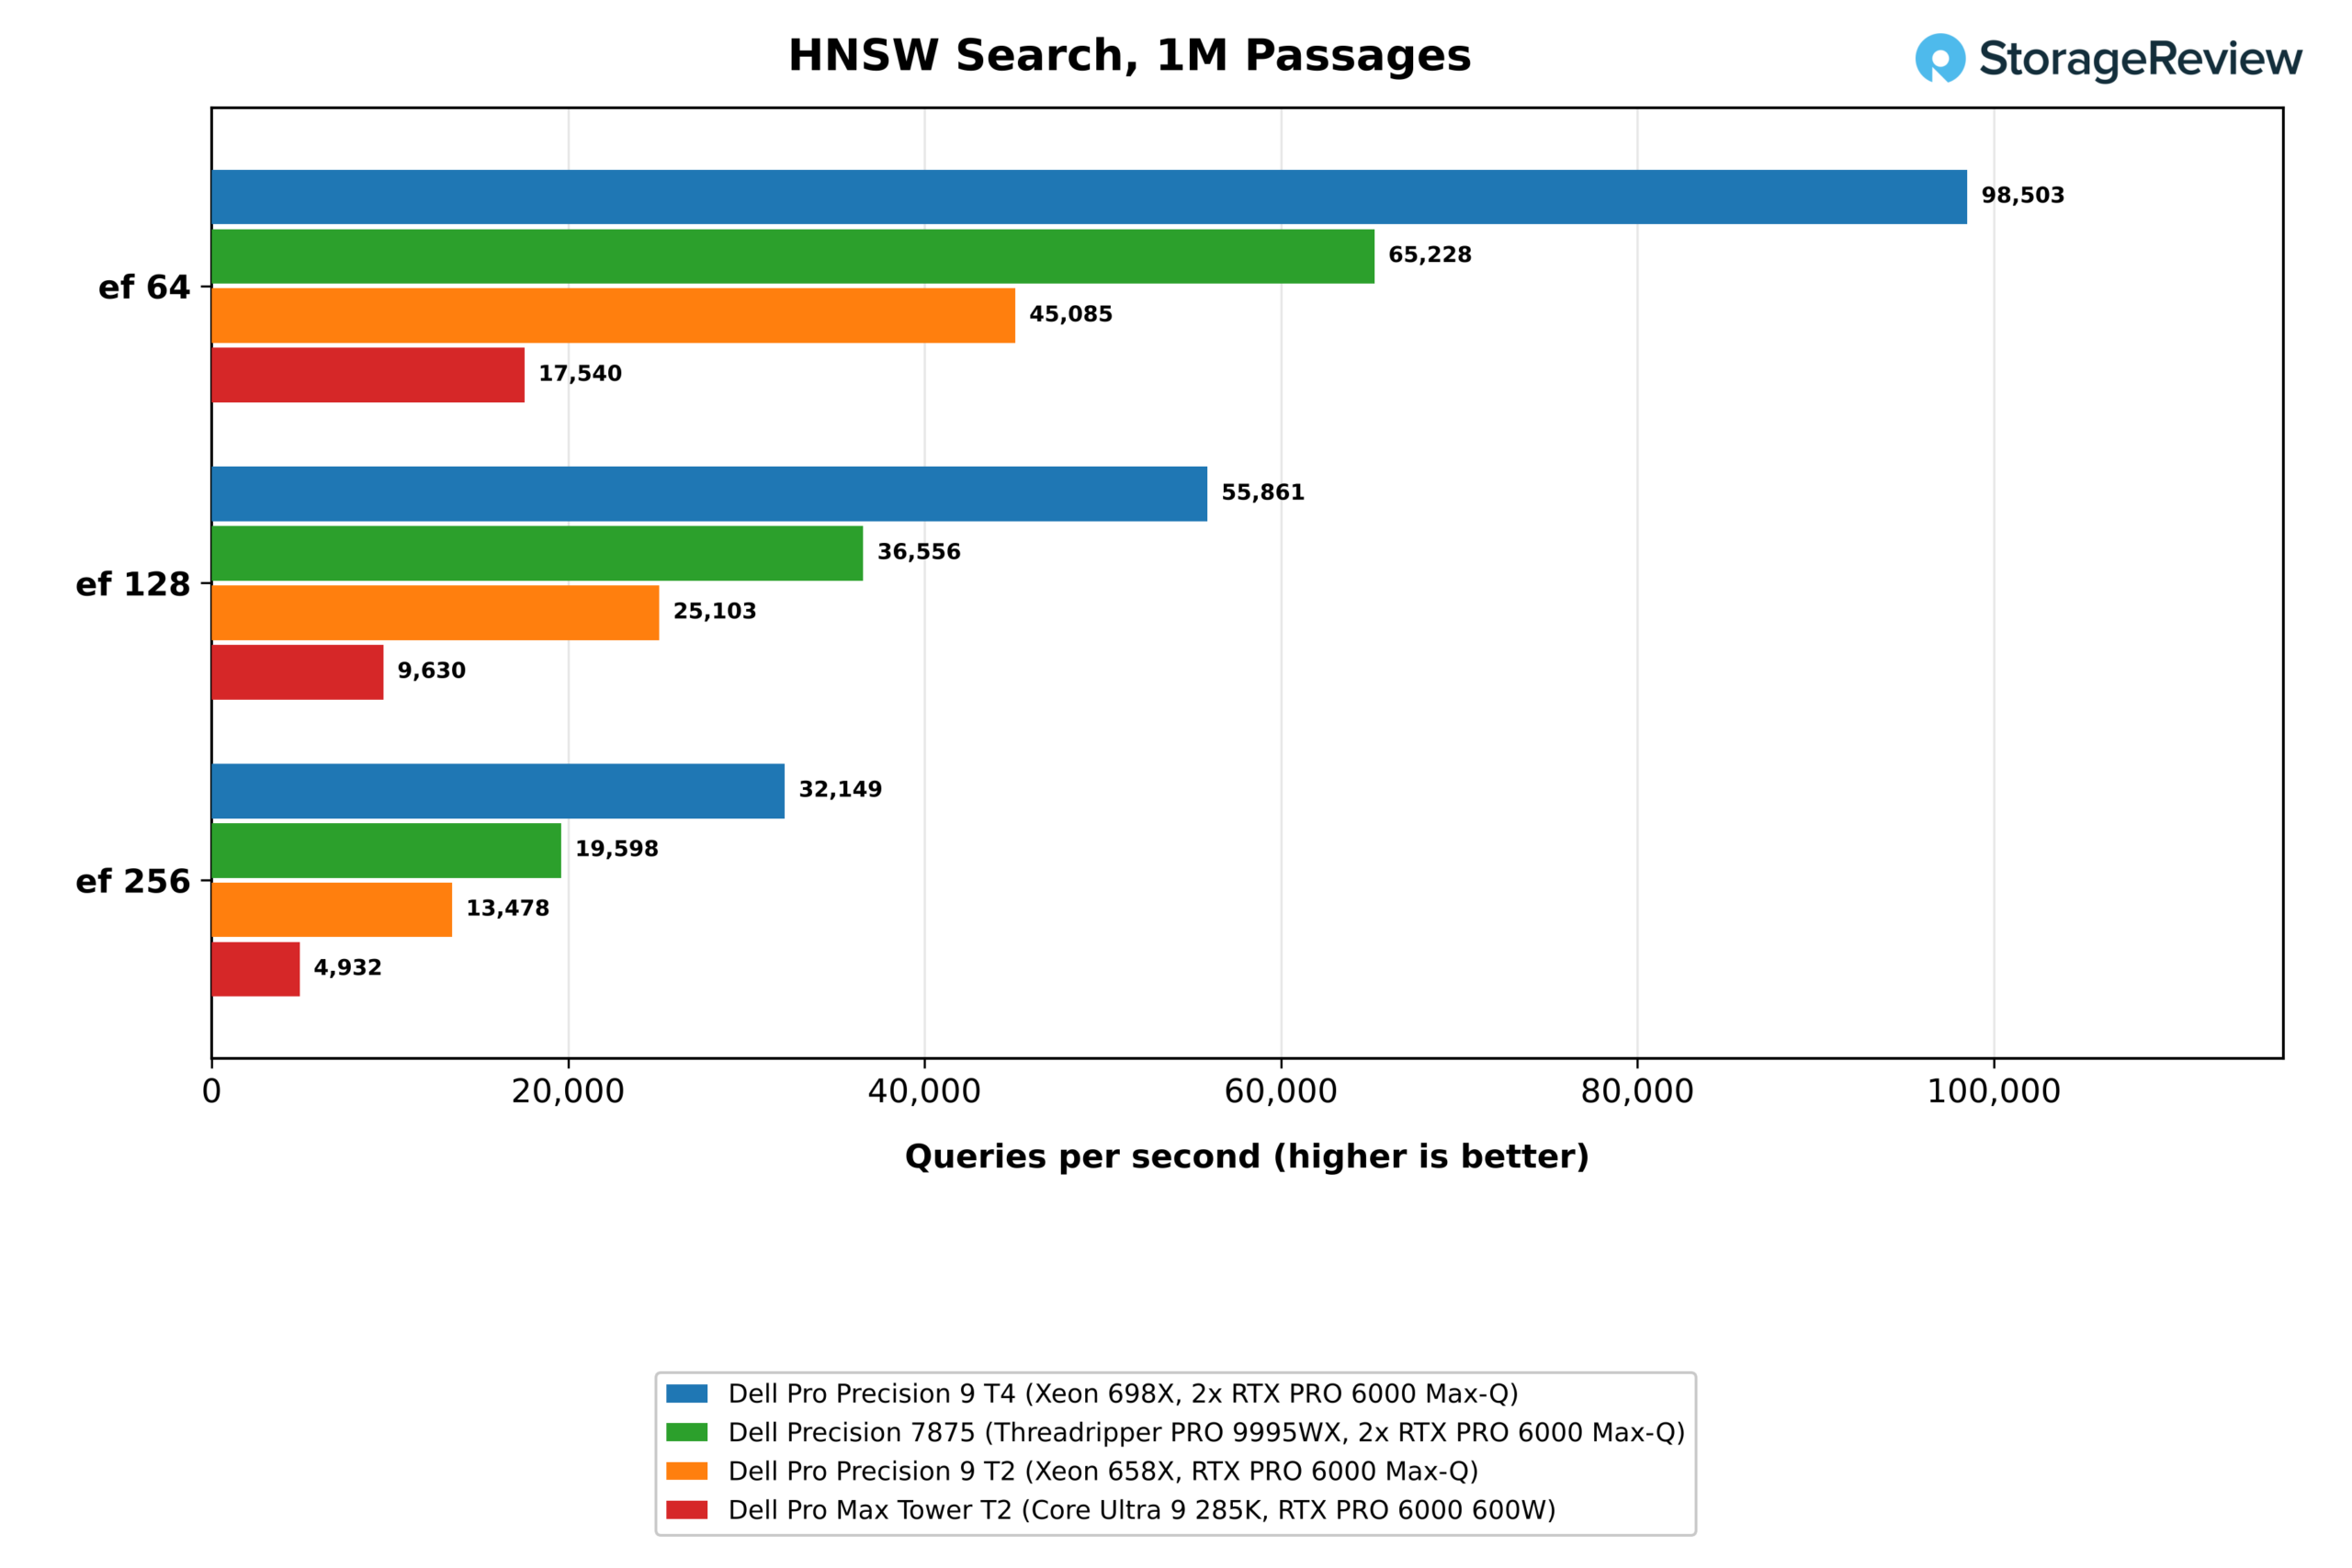
| HNSW-indexopbouw (s, lager is beter) | 27.3 | 34.8 | 46.3 | 118.6 |
| HNSW-zoekopdracht, ef 64 (queries/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| HNSW-zoekopdracht, ef 256 (queries/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 versus exacte zoekopdracht, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Vraag om te beantwoorden p50 (s, lager is beter) | 0.123 | 0.082 | 0.117 | 0.095 |
De RAG-at-scale-test verbergt SQuAD-vragen tussen een miljoen Wikipedia-passages, integreert ze met nomic-embed-text, bouwt een HNSW-index en beantwoordt ze met Phi-4-mini. Het integreren duurde 890 seconden op één T4 GPU en 464 seconden op twee, een snelheidsverbetering van 1.92x. De Precision 7875 voltooide de test in 423 seconden op twee kaarten. De 600W-kaart in de Pro Max Tower T2 is met 722 seconden de snelste GPU in deze test.
Indexopbouw en vectorzoekopdrachten worden uitgevoerd door de CPU, en dat is waar de T4 uitblinkt. De HNSW-index werd in 27.3 seconden opgebouwd, tegenover 34.8 seconden op de Precision 7875 en 118.6 seconden op de Pro Max Tower T2. De zoekopdrachten werden uitgevoerd met een snelheid van 98,503 queries per seconde bij een EF van 64, 1.51 keer sneller dan de 7875 en 5.6 keer sneller dan het Core Ultra-systeem. Bij een EF van 256 werden 32,149 queries per seconde uitgevoerd met een recall van 97.6 procent bij exacte zoekopdrachten, en de antwoorden werden gemiddeld in 0.12 seconden teruggestuurd.
Scherpstellen
| Ministral 3 8B LoRA, BF16, één epoch van Dolly 15k | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| Trainingsduur per epoch, één GPU (minuten, hoe lager hoe beter) | 31.5 | 27.2 | 30.6 | 22.3 |
| Doorvoer, één GPU (tokens/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Verlies vóór en na de training, één GPU | 1.534 tot 1.169 | 1.534 tot 1.172 | 1.534 tot 1.167 | 1.534 tot 1.167 |
| Trainingsduur per epoch, twee GPU's (minuten, hoe lager hoe beter) | 19.7 | 18.1 | Enkele GPU | Enkele GPU |
| Doorvoer, twee GPU's (tokens/s) | 2,528 | 2,754 | Enkele GPU | Enkele GPU |
| Snelheidsvoordeel dankzij de tweede GPU | 1.60x | 1.50x | Enkele GPU | Enkele GPU |
| Verlies na training, twee GPU's | 1.167 | 1.168 | Enkele GPU | Enkele GPU |
De LoRA-test met één epoch verfijnt Ministral 3 8B in BF16 op Dolly 15k over 1,849 stappen en beoordeelt 200 testvoorbeelden elke 100 stappen. Elk systeem begon met een testverlies van 1.534 en eindigde tussen 1.167 en 1.172, dus het resultaat dat ze van elkaar onderscheidt, is de tijd die de epoch duurt. Eén T4 GPU voltooide de test in 31.5 minuten met 1,584 tokens per seconde, binnen 3 procent van de Pro Precision 9 T2 op dezelfde Max-Q-kaart. De Precision 7875 deed er 27.2 minuten over en de 600W-kaart in de Pro Max Tower T2 22.3 minuten.
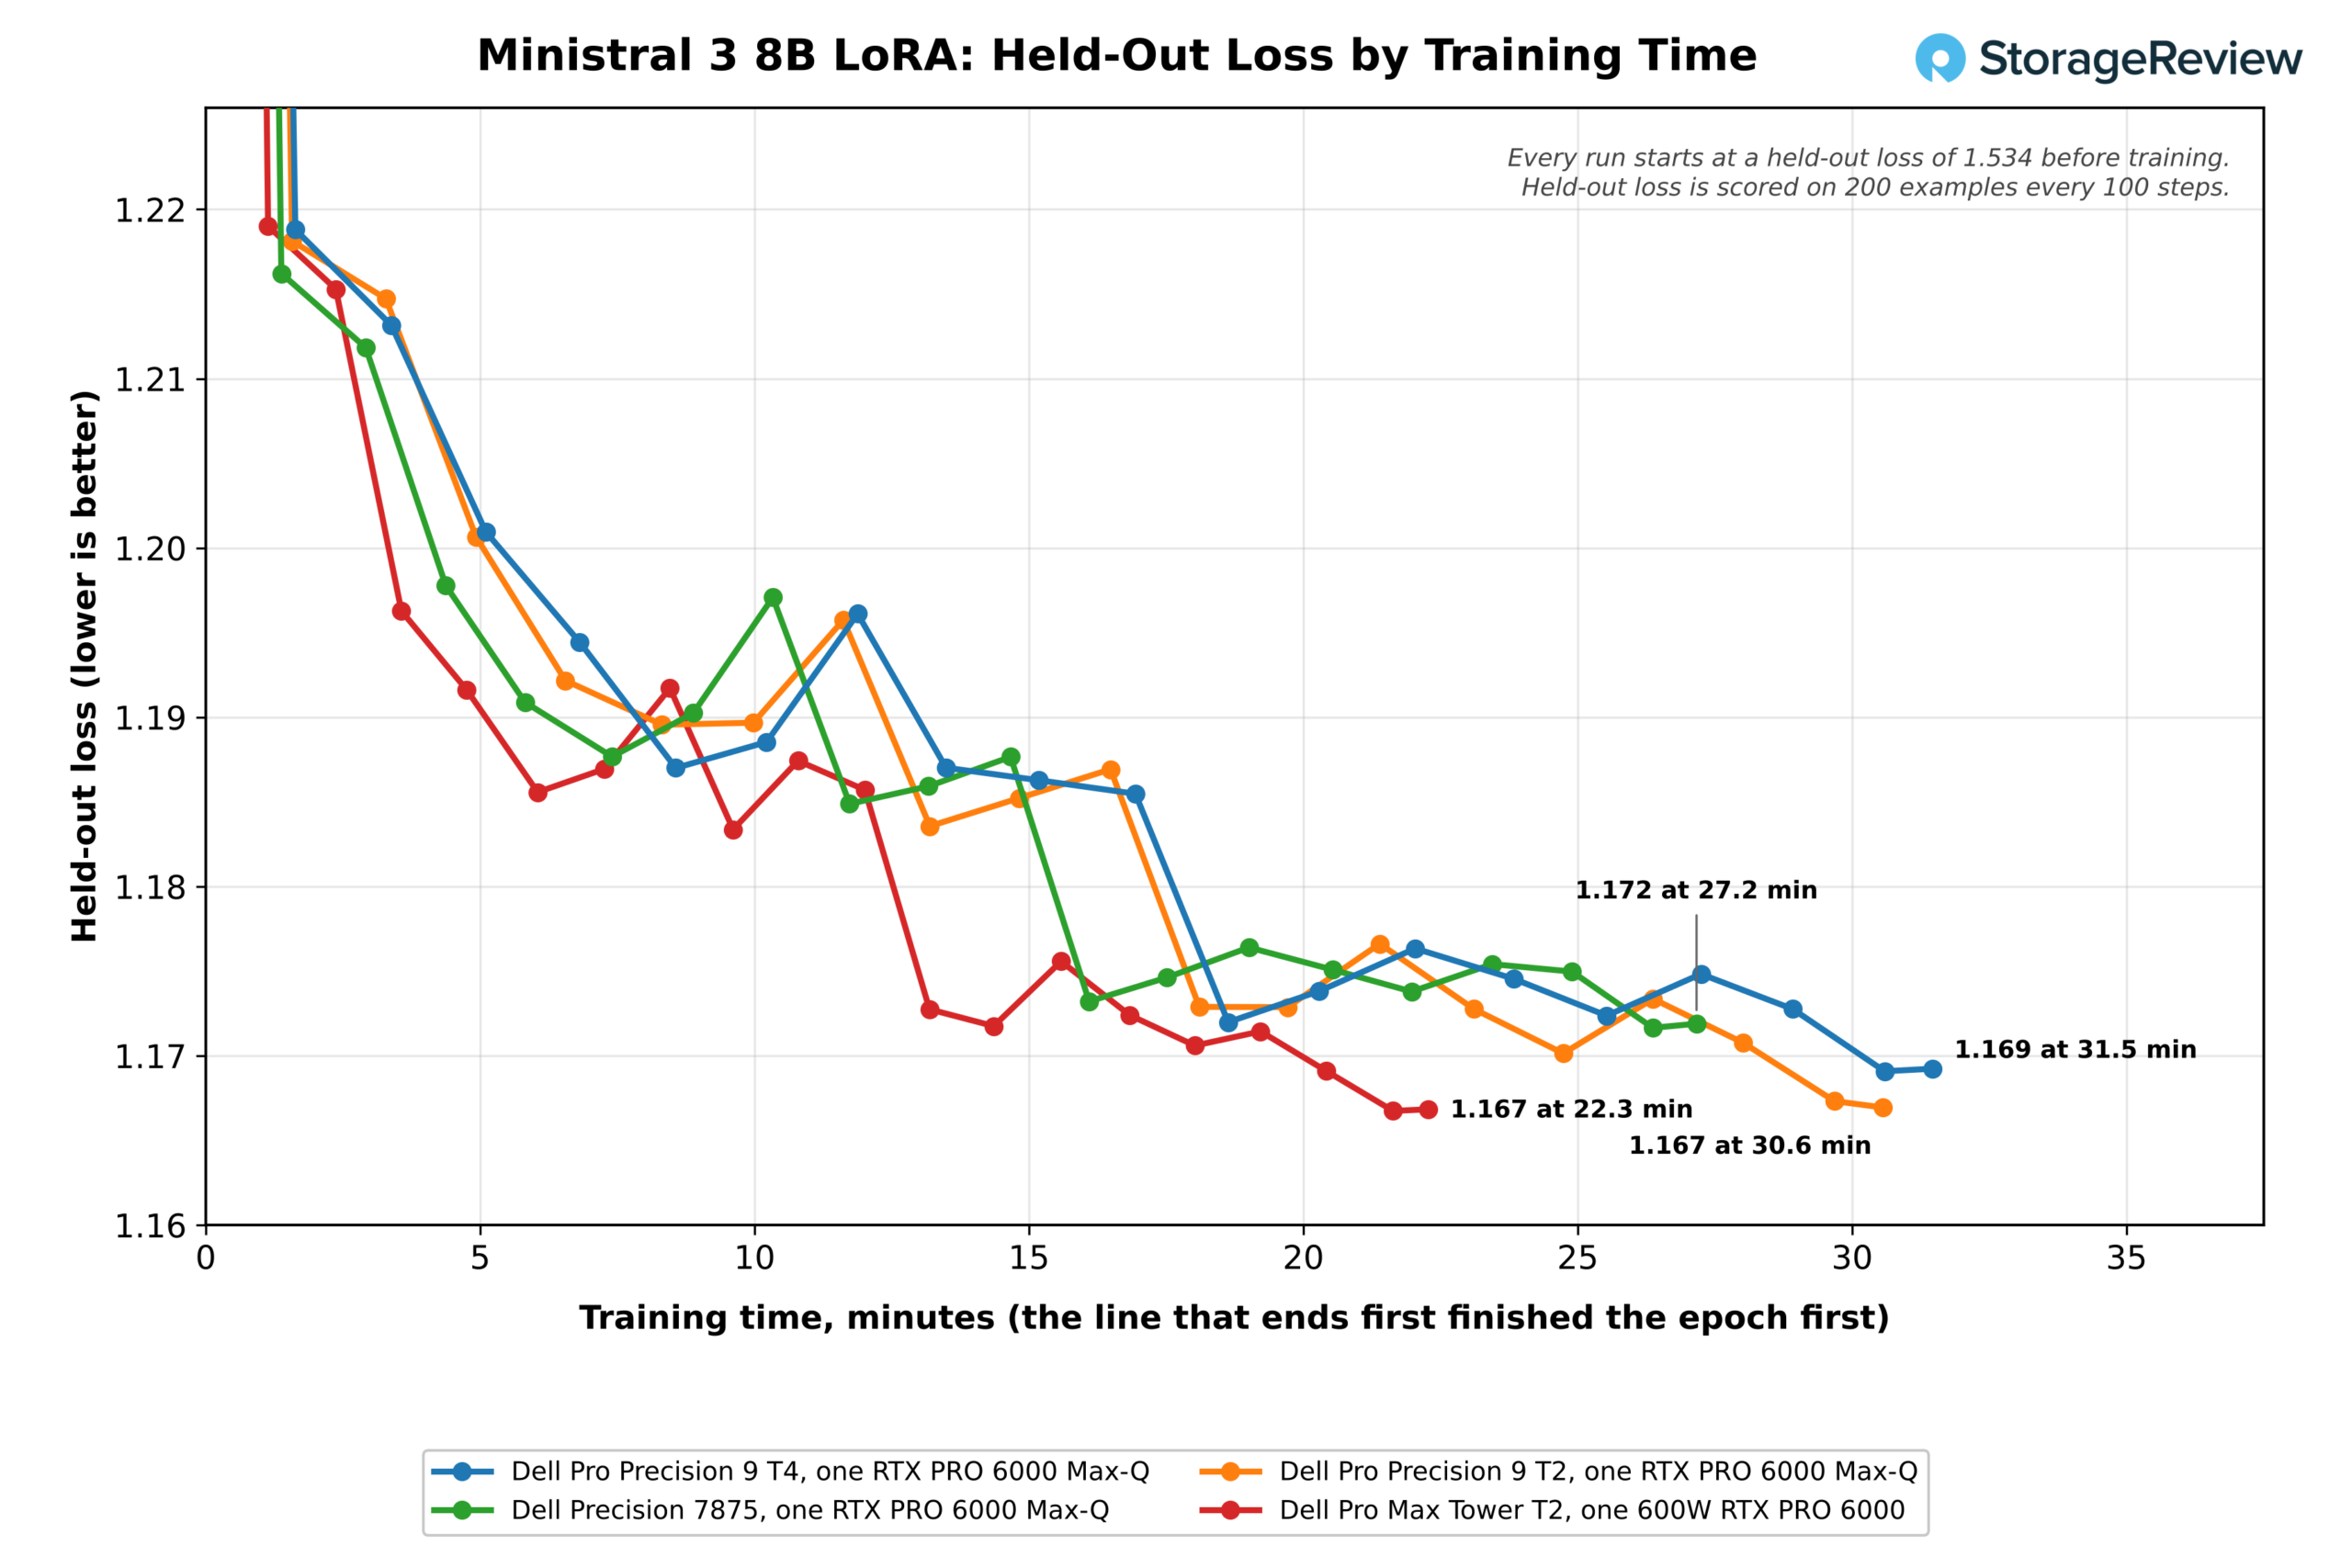
Het verlies op de T4 daalde van 1.534 naar 1.219 in de eerste 100 stappen, 1.6 minuut na aanvang van de training, en zakte vervolgens naar 1.169 gedurende de rest van de epoch. Door de tweede GPU toe te voegen, werd de epoch van de T4 teruggebracht tot 19.7 minuten bij 2,528 tokens per seconde, een snelheidsverbetering van 1.60x, waarmee de 22.3 minuten van de enkele 600W-kaart werden overtroffen. De Precision 7875 voltooide zijn epoch met twee GPU's in 18.1 minuten, een snelheidsverbetering van 1.50x, en de runs met twee GPU's eindigden met een verlies van respectievelijk 1.167 en 1.168.
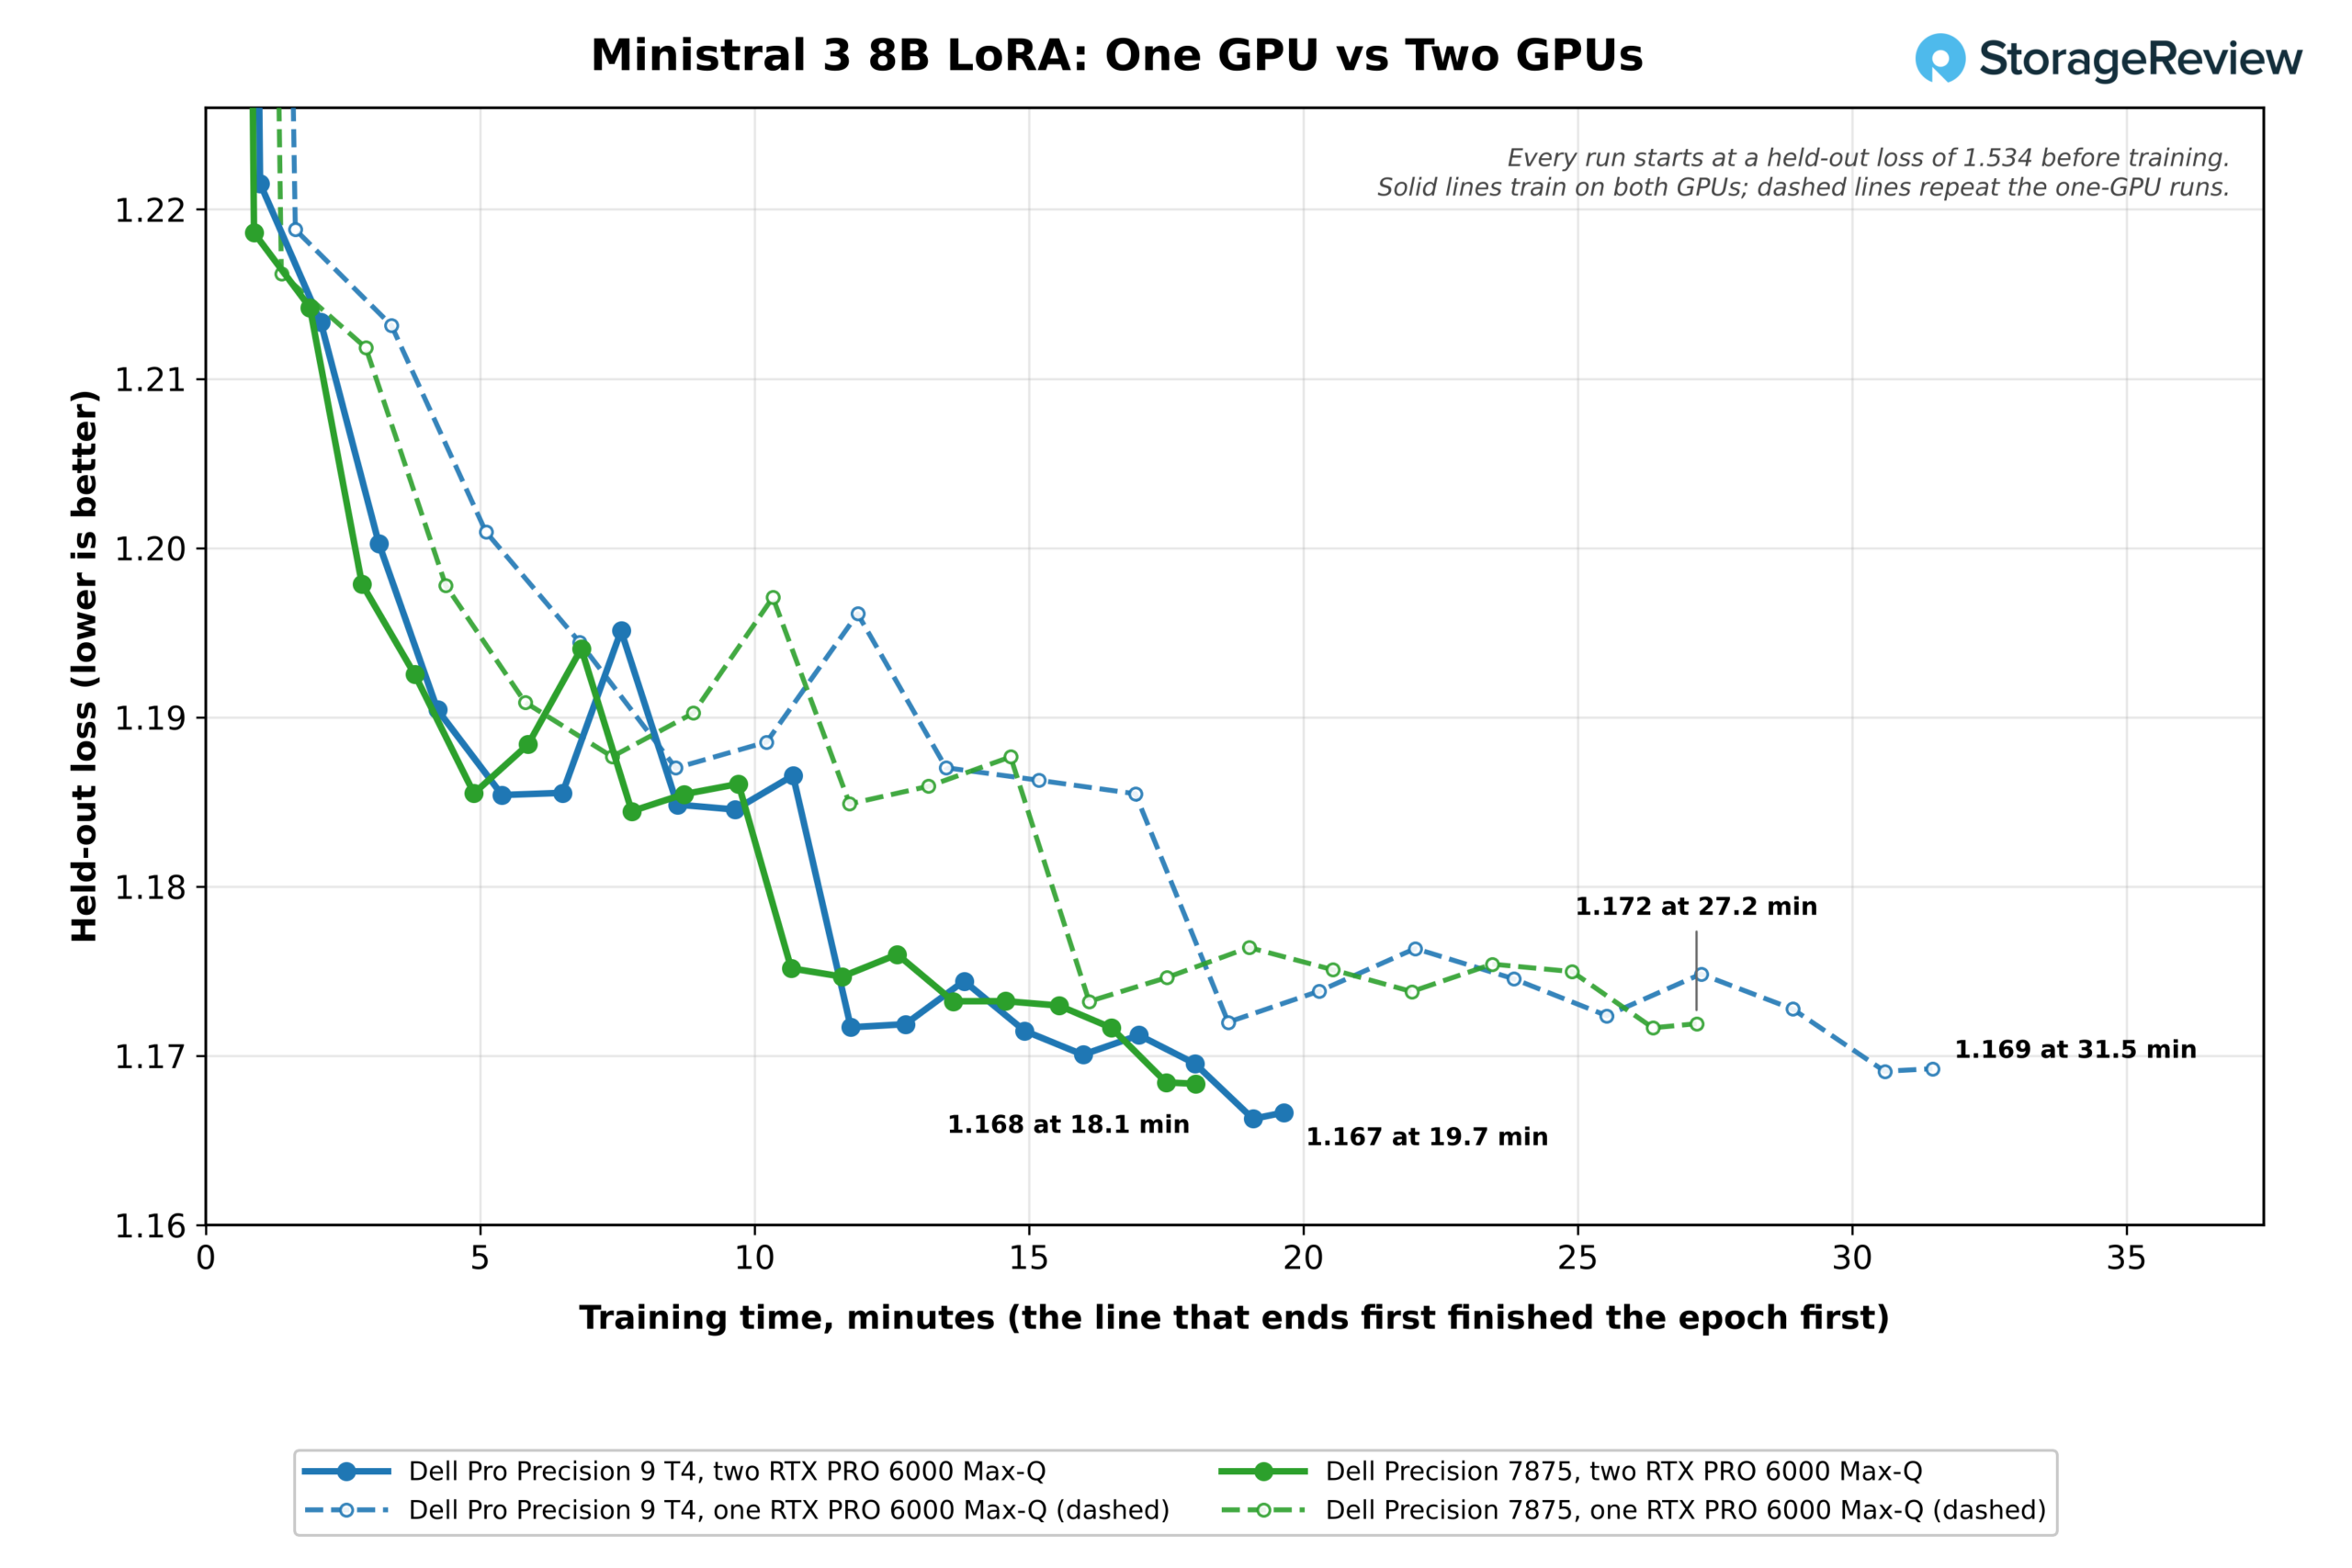
Beide kaarten werken data-parallel met twee voorbeelden per GPU en de gradiënten worden geaccumuleerd tot dezelfde globale batch van acht, over vier passes op één GPU en twee passes op een paar. De run met twee GPU's ziet dus dezelfde voorbeelden bij elke stap en komt uit op hetzelfde verlies. Met twee korte voorbeelden per GPU in elke pass hoeft de tweede kaart weinig werk te verrichten en neemt de uitwisseling van gradiënten een groter deel van elke stap in beslag. Het piekgebruik van de GPU-geheugenperiode bedroeg 19.5 GiB op één kaart en 19.7 GiB per kaart op twee, een fractie van de 96 GB op elke RTX PRO 6000.
Codeeragent, kleinschalige RAG en beeldgeneratie
| Codeeragent, RAG en beeldgeneratie (hoger is beter, tenzij anders vermeld) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| Codeeragent, gpt-oss:20b 64K, succesvolle uitvoeringen (van 3) | 3 | 2* | 2* | 2* |
| Codeeragent, gpt-oss:120b 128K, succesvolle uitvoeringen (van 3) | 3 | 3 | 3 | 3 |
| Codeeragent, gpt-oss:120b, generatiesnelheid (tokens/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20,963 passages, ingest (passages/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| RAG-antwoordgeneratie, Phi-4-mini (tokens/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024 (beelden/min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (afbeeldingen/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (afbeeldingen/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Gemarkeerd door de testsuite: een van de drie agentruns op dit systeem heeft niet alle 11 tests doorstaan.
De T4 slaagde voor elke test met de codeeragent op elk modelniveau, inclusief alle drie de gpt-oss:20b-tests in een 64K-context, waar de andere drie systemen er twee van de drie haalden. De T4 genereerde 161.5 tokens per seconde op gpt-oss:120b. Beeldgeneratie vindt plaats op één GPU, waardoor de 40.96 beelden per minuut van de T4 op FLUX.2 klein in BF16 vergelijkbaar zijn met de andere Max-Q-systemen en achterblijven bij de 600W-kaart met 54.25.
CPU-prestaties
De CPU-resultaten plaatsen de 86 Xeon-cores van de T4 tegenover de 96 Threadripper-cores van de Precision 7875, met de twee T2-processors met 24 cores als referentiepunten. De Threadripper heeft tien cores meer en biedt 192 threads tegenover de 172 van de Xeon. De T4 wint waar de geheugenbandbreedte doorslaggevend is, terwijl de 7875 wint waar het aantal cores en de kloksnelheid bepalend zijn.
Compressie, rendering en compilatie
| Test | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| 7-Zip, alle draden (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-rits, één draad (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (samples/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (monsters/min) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Classroom (voorbeelden/min) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| HandBrake SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 build (s, lager is beter) | 58.4 | 43.7 | 106.4 | 155.9 |
| Linux kernel allmodconfig (s, lager is beter) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, alle threads (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 verbindingen (verzoeken/s) | 414,468 | 467,128 | 323,567 | 153,732 |
De T4 behaalde een score van 619.8 GIPS in 7-Zip en 961.8 samples per minuut in Blender Monster, respectievelijk 2.2 en 2.4 keer zo hoog als de 24-core Pro Precision 9 T2. De Precision 7875 presteerde 37 procent beter in 7-Zip en 30 procent beter in Blender. De LLVM-build werd voltooid in 43.7 seconden tegenover 58.4 seconden, en de Linux-kernel allmodconfig-build in 264 seconden tegenover 312 seconden. De snelheid per core is het zwakke punt van de T4, met de laagste score voor 7-Zip met één thread in deze groep: 8.85 GIPS.
HandBrake's x265-codering is de uitzondering in deze tabel, en de oorzaak ligt meer bij de encoder dan bij de processor. De andere drie systemen behaalden allemaal tussen de 40.0 en 41.7 fps met 24 of 96 cores, dus x265 schaalt met deze preset niet mee met het aantal cores, en de 31.4 fps van de T4 is consistent met de lagere snelheid per core op de threads die x265 wél gebruikt. Tijdens de codering draaide de T4 gemiddeld op ongeveer 1 GHz over zijn 172 threads bij een temperatuur van 51 tot 64 °C, wat aangeeft dat het grootste deel van de chip inactief was. SVT-AV1 schaalde beter, met 159.4 fps op de T4 tegenover 255.8 fps op de 7875.


Geheugenbandbreedte, simulatie en wiskunde
| Test | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| STREAM Triad (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 drivAer, 3M cellen, oplossen (s, lager is beter) | 293 | 556 | 826 | Heeft niet afgerond |
| GROMACS benchPEP, alle kernen (ns/dag) | 1.243 | 1.034 | Niet uitvoeren | Niet uitvoeren |
| GROMACS benchMEM, 16 cores (ns/dag) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, alle cores (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU oplossing N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1 miljard cijfers (s, lager is beter) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10 miljard cijfers (s, lager is beter) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25 miljard cijfers (s, lager is beter) | 155.6 | 259.6 | Niet uitvoeren | Niet uitvoeren |
Acht kanalen DDR5-6400 geven de T4 een snelheid van 328 GB/s in STREAM Triad, 53 procent meer dan de DDR5-5600 van de Precision 7875 en 2.3 keer zoveel als de vierkanaals Pro Precision 9 T2. Bandbreedte-intensieve tests volgen: de T4 loste de OpenFOAM drivAer-test met 3 miljoen cellen op in 293 seconden, tegenover 556 seconden voor de 7875 en 826 seconden voor de Pro Precision 9 T2, terwijl de Pro Max Tower T2 de test niet binnen de limiet van 150 minuten voltooide. De T4 voltooide de test met 22.6 miljoen cellen in 6,851 seconden.

GROMACS benchPEP, de grote moleculaire dynamica-simulatie die volledig op alle cores draait, behaalde een rekentijd van 1.243 ns/dag op de T4 tegenover 1.034 op de 7875, en de LU-oplossing bereikte 1,660 GFLOPS tegenover 1,172. y-cruncher berekende 10 miljard cijfers van Pi in 53.9 seconden tegenover 83.7 op de 7875 en 25 miljard in 155.6 seconden tegenover 259.6. Dichte berekeningen die in de cache blijven, geven de voorkeur aan de Threadripper, die OpenBLAS DGEMM aanvoerde met 4,745 GFLOPS tegenover 3,664.


Databases en services
| Test | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| ClickBench hot run, 43 queries (s, lager is beter) | 3.21 | 2.88 | 4.80 | 10.44 |
| ClickBench koude test, 43 query's (lager is beter) | 6.45 | 7.09 | 6.92 | 14.22 |
| Valkey cache, SET (verzoeken/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Valkey cache, GET (verzoeken/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Stokvis, alle threads (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, lager is beter) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse voerde de 43 ClickBench-query's uit in 3.21 seconden bij hoge belasting en 6.45 seconden bij lage belasting op de T4, 0.33 seconden achter de 7875 bij hoge belasting en 0.64 seconden voor bij lage belasting. Valkey geeft de voorkeur aan snelle cores boven veel cores, en de 666,714 SET-verzoeken per seconde van de T4 blijven achter bij alle drie de vergelijkingssystemen, met de Core Ultra 9 285K in de Pro Max Tower T2 als koploper met 1.72 miljoen. Dat patroon komt overeen met de resultaten van de T4 met één thread en is het overwegen waard voor latency-intensieve services.
Met alle 172 threads geladen en de processor op een gemiddelde temperatuur van 87°C doorzocht de T4 68.21 miljoen knooppunten per seconde in Stockfish, 1.5 keer zoveel als de Pro Precision 9 T2 met 48 threads en ruim minder dan de helft van de 168.27 miljoen knooppunten per seconde van de 7875 met 192 threads. De test liep ook vast tijdens de eerste volledige run van de T4, voordat een aparte hertest dit resultaat opleverde. We rapporteren het resultaat zoals gemeten en hebben de oorzaak van de zwakke schaalbaarheid niet kunnen achterhalen.
Opslagprestaties
| fio, 25 GiB geheugenvoetafdruk (hoger is beter) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max-toren T2 |
|---|---|---|---|---|
| Sequentiële leesbewerking 128K (MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| Sequentiële schrijfsnelheid 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Willekeurige leesbewerking 4K, piek (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Willekeurige schrijfbewerkingen van 4K, piek (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*Door de testsuite gemarkeerd vanwege variatie tussen opeenvolgende runs na een herhaling.
De 2TB SK hynix Gen5 opstartschijf van de T4 haalde leessnelheden van 14,152 MB/s en schrijfsnelheden van 10,078 MB/s, ongeveer twee keer zo snel als de sequentiële leessnelheden van de Gen4-schijven in de Precision 7875 en de Pro Max Tower T2. De pieksnelheid bedroeg 2.31 miljoen willekeurige lees-IOPS en 1.83 miljoen willekeurige schrijf-IOPS. De sequentiële leessnelheid van 20,914 MB/s van de Pro Precision 9 T2 overtreft de snelheid van één Gen5 x4-link, wat past bij het testvolume van dat systeem, een striped array van Samsung PM9E1 Gen5-schijven. We hebben alleen de opstartschijf van de T4 getest; de tweede 2TB-schijf maakte geen deel uit van deze test.

Thermische prestaties en kloksnelheden onder belasting
| Dell Pro Precision 9 T4 | CPU Max (C) | CPU-gemiddelde (C) | Gemiddelde CPU-klokfrequentie (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| Blenders | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| LLVM-build | 83 | 74.5 | 2,127 |
| BLAS openen | 80 | 62.9 | 1,325 |
| LLM-medewerker | 84 | 65.0 | 924 |
| Scherpstellen | 71 | 61.2 | 854 |
| RAG op schaal | 74 | 64.4 | 987 |
| Opslag | 64 | 55.4 | 942 |
Met de BIOS in Ultra Performance-modus bereikte de Xeon 698X een piektemperatuur van 93°C in 7-Zip en 96°C in GROMACS. De kloksnelheden in de tabel zijn gemiddelden over alle 172 logische CPU's. Blender en Stockfish belasten alle threads en draaiden op 2.5 GHz tot 2.6 GHz, boven de basiskloksnelheid van 2.0 GHz van de chip. GROMACS en OpenBLAS belasten respectievelijk 64 en 86 fysieke cores en laten de resterende threads inactief rond de 0.8 GHz, vandaar de gemiddelde waarden van ongeveer 1.3 GHz. Bij GPU-gedreven taken bleef de processor koeler, met een gemiddelde temperatuur van 61°C tot 65°C tijdens LLM-serveren, finetuning en RAG, aangezien deze tests de grafische kaarten zwaar belasten.

Conclusie
De Dell Pro Precision 9 T4 is gebouwd voor lokale AI-taken, en dat blijkt wel uit de tweede RTX PRO 6000. Twee Max-Q-kaarten verhoogden de piekdoorvoer voor servering met een factor 1.85 tot 2.02 over vier modellen en de doorvoer voor embedding met een factor 1.92. Een LoRA-epoch op Ministral 3 8B werd verkort van 31.5 naar 19.7 minuten, en MiniMax M2.7, een model dat te groot is voor één kaart, werd door één gebruiker verwerkt van 30.3 naar 83.7 tokens per seconde. Op gpt-oss 120B bereikte één server per GPU een totaal van 7,091 tokens per seconde bij 64 verzoeken, terwijl het verdelen van het model over beide kaarten de eerste token voor één gebruiker in 719 ms opleverde, in plaats van 1,189 ms.

Acht kanalen DDR5-6400 gaven de Xeon 698X een voorsprong van 53 procent in geheugenbandbreedte ten opzichte van de Threadripper PRO 9995WX. Die bandbreedte zorgde ervoor dat de T4 snellere resultaten behaalde in OpenFOAM, GROMACS benchPEP, y-cruncher en HNSW-zoekopdrachten dan de Precision 7875, en de Gen5-opslag van de T4 laadde grote modellen sneller. Ook de behuizing verdient lof, met de beste koelingslay-out die we tot nu toe van Dell in deze klasse hebben gezien en gereedschaploze toegang tot de voeding.
De 7875 blijft 18 tot 38 procent voor op core-gebonden rendering, compressie en compilatie, en zelfs 60 procent voor op SVT-AV1. De snelheid per core van de Xeon bleef achter bij alle systemen in deze groep, wat bleek bij Valkey en andere licht multithreaded services. Finetuning op een enkele GPU was ook trager op de T4, waar de LoRA-epoch 31.5 minuten duurde, tegenover 27.2 minuten op de 7875 en 22.3 minuten op de 600W-kaart in de Pro Max Tower T2. Elk systeem eindigde binnen 0.005 seconde van hetzelfde achterstandsverlies.
Met een prijs van ongeveer $66,600 in de configuratie die op Dell.com wordt aangeboden, is de T4 geschikt voor teams die modellen lokaal willen beheren, integreren en verfijnen, inclusief modellen die meer dan 96 GB GPU-geheugen nodig hebben, naast geheugenintensieve simulatie en analyses op dezelfde machine. Kopers die zich voornamelijk bezighouden met rendering en compilatie zullen het Threadripper-platform sneller vinden, en kopers die slechts één GPU nodig hebben, kunnen dezelfde kaart in de kleinere Pro Precision 9 T2 krijgen.

Klassement: De Dell Pro Precision 9 T4 is uitgeroepen tot Beste Xeon Tower voor Lokale AI in ons klassement van Beste Desktops voor Lokale AI.


 Amazon