

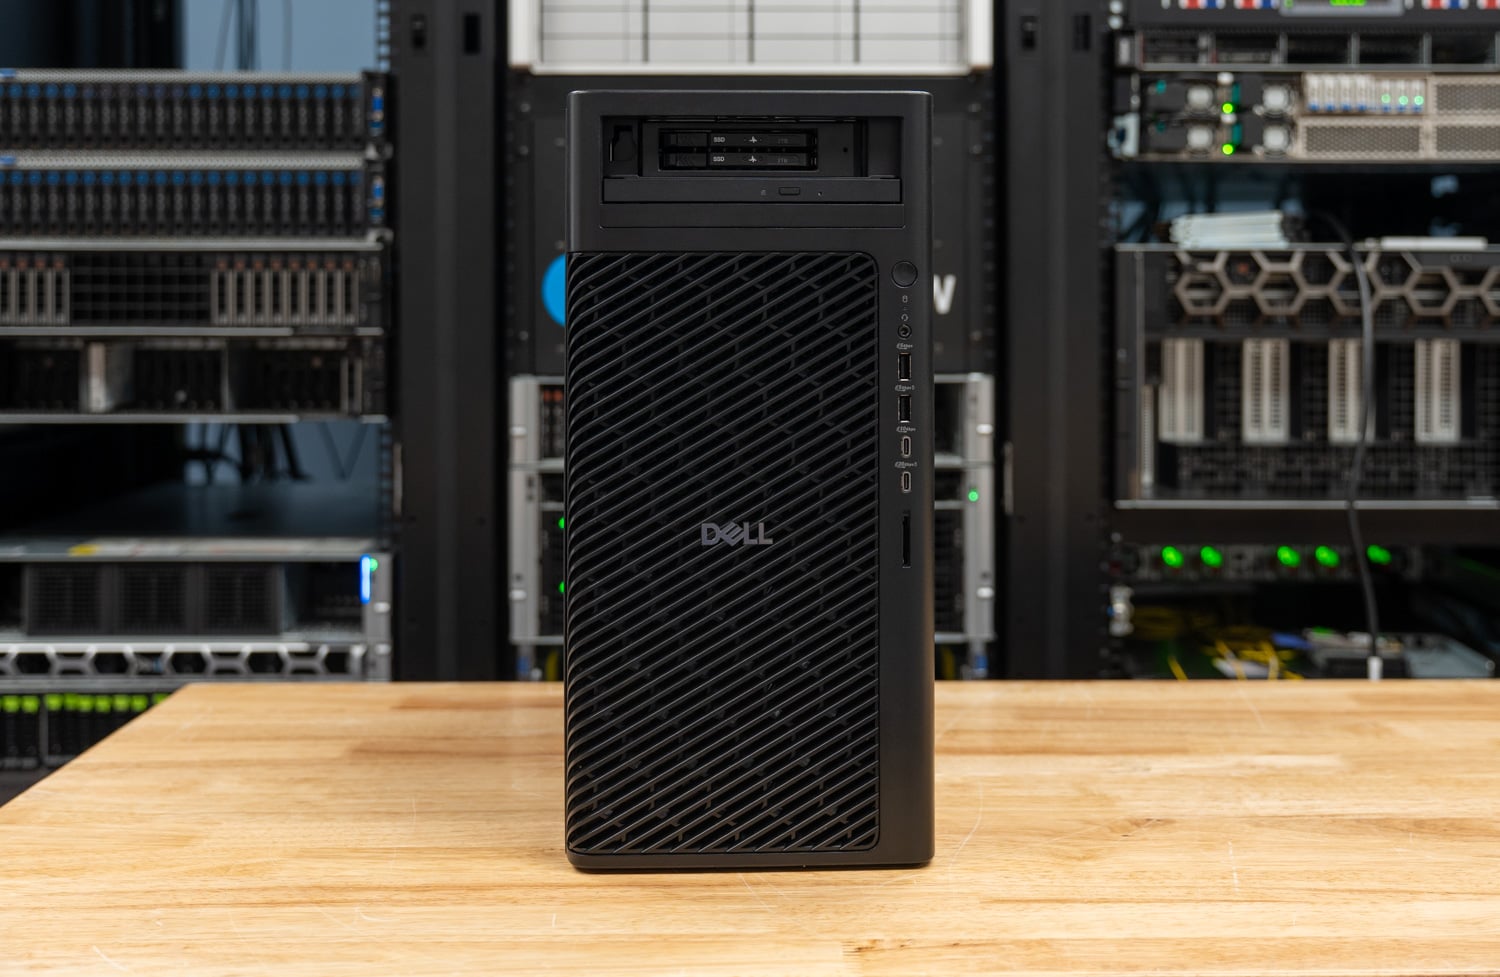
De Dell Pro Precision 9 T2 is de Xeon-versie van de tower met één GPU die we een jaar geleden hebben getest als de Dell Pro Max Tower T2 . Hij brengt twee veranderingen tegelijk met zich mee: een nieuwe naam, aangezien Dell zijn workstations weer onder het Precision-merk brengt, en een nieuw platform, waarbij Intel's Xeon 6 de Core Ultra 9 285K vervangt in dezelfde 32-liter behuizing. Ons testexemplaar was uitgerust met de 24-core Xeon 658X, 128 GB DDR5-6400 RDIMM ECC, de 300W RTX PRO 6000 Blackwell Max-Q en twee 2TB E3.S Gen5-schijven in de FlexBay aan de voorzijde. Op Dell.com is dezelfde configuratie te vinden voor ongeveer $ 28,300.
We hebben het getest als een matrix: de Pro Precision 9 T2 draaide onze volledige testsuite met de Max-Q-kaart waarmee hij werd geleverd en vervolgens nogmaals met de 600W RTX PRO 6000 Blackwell uit onze Pro Max Tower T2. De Core-gebaseerde T2 draaide beide kaarten ook, dus alle onderstaande resultaten hebben vier kolommen, waarbij elk paar één variabele isoleert: het CPU-platform of de stroomlimiet van de GPU. De testsuite is dezelfde als die op de RTX Spark-notebooks van vorige week draaide , met een paar toevoegingen die hier voor het eerst worden gebruikt.
De Xeon levert hogere doorvoersnelheid op, maar levert lagere latentie in. De Pro Precision 9 T2 behaalde een score van 12,322 in Cinebench 2026 multi-core tegenover 8,856 op de Core T2, bouwde LLVM in 140.2 seconden tegenover 182.5 seconden en las 122,233 MB/s in STREAM Triad tegenover 33,003 MB/s. De single-core Cinebench-score van 454.1 blijft echter achter bij de 285K (564.4) en de Speedometer-score van 36.8 blijft achter bij de 285K (46.3). De 600W-kaart zorgt voor een prestatieverbetering van ongeveer 7 tot 20 procent bij LLM-decodering en 20 tot 39 procent bij promptverwerking en diffusie in beide towers. In de Xeon-tower kost het de CPU 4 tot 5 procent bij taken die alle cores belasten.
Key Takeaways
- Xeon 6 is een platform met hoge doorvoersnelheid in een single-socket tower: 12,322 punten in Cinebench 2026 multi-core, 39 procent meer dan de Core Ultra 9 285K in dezelfde behuizing, 289.6 GIPS in 7-Zip tegenover 174.8, DGEMM op 1,638 GFLOPS tegenover 768, en 3.7 keer de geheugenbandbreedte dankzij vier kanalen DDR5-6400.
- De 285K heeft nog steeds de hoogste snelheid per thread: De Xeon presteert 20 procent minder goed in Cinebench single-core, 21 procent minder in Speedometer en 20 tot 31 procent minder goed in single-threaded Python, met een core-to-core latency van 56.2 ns tegenover 38.1 ns.
- De GPU bepaalt de AI-resultaten en de 600W-kaart levert stroom op basis van prompts: MLPerf Llama 3.1 8B genereert 230.9 tokens per seconde met de Max-Q en 252.8 met de 600W-kaart, terwijl de tijd tot het eerste token daalt van 0.082 naar 0.059 seconden en Qwen-Image 20B een 1024×1024 afbeelding rendert in 19.7 seconden in plaats van 26.1.
- De 600W-kaart belast de CPU van de Xeon met 4 tot 5 procent: De Cinebench multi-core score daalde van 12,322 naar 11,705 en de score voor de continue test van 30 minuten van 12,328 naar 11,764, terwijl de steady-state kloksnelheid daalde van 4,274 naar 4,178 MHz; dezelfde vervanging had geen effect op de Core T2.
- E3.S in de FlexBay, voorzien van strepen door VROC van Graid: De voorste schijfsleuf biedt plaats aan twee E3.S Gen5-schijven, een primeur voor een tower-werkstation in ons lab. Dell's RAID0-opstartoptie integreert deze in een volume van 4,097 GB met VROC van Graid Technology. De stripe leest 9,332 MB/s sequentieel en bereikt een piek van 840.1 IOPS bij willekeurige 4K-leesbewerkingen, tegenover 1.78 miljoen IOPS van de enkele Gen5 M.2 in de Core T2.
Van Pro Max naar Pro Precision
Dell heeft de naam Precision begin 2025 laten vervallen, toen alle workstations Dell Pro Max werden, maar heeft deze nu weer teruggebracht. Op 7 oktober hernoemde Dell de GB10- en GB300-desktops van Dell Pro Max naar Dell Pro Precision, en op Dell.com wordt de Pro Precision 9 T2 naast de nieuwe T4- en T6-towers onder dezelfde merknaam vermeld. Pro Max blijft behouden voor de machines met een Core-processor, dus de Core Ultra-tower die we vorig jaar hebben getest, wordt nog steeds verkocht als de Dell Pro Max Tower T2, en de Xeon-tower die hier wordt besproken, is de Dell Pro Precision 9 T2, model PW9T2260.
De T4 en T6 maakten met de naamswijziging dezelfde overstap naar de Xeon 6, en Dell positioneert de drie towers op basis van uitbreidingsmogelijkheden. De Pro Precision 9 T4 (PW9T4260) draait op dezelfde processorenlijst tot en met de 86-core Xeon 698X, voegt 16 DIMM-slots toe voor maximaal 4 TB DDR5-6400 op alle acht geheugenkanalen, en ondersteunt een enkele 600W RTX PRO 6000 of twee Max-Q-kaarten met een voeding van 1500W, met een optionele behuizing van 2400W.
De Pro Precision 9 T6 (PW9T6260) is het topmodel met zes slots, een voeding van 2400 W en ruimte voor twee RTX PRO 6000-kaarten van 600 W, drie Max-Q-kaarten of maximaal vijf RTX PRO 5000-kaarten. De T2 is het instapmodel met één GPU en vier kanalen.
De naamgeving is belangrijk omdat de twee towers er van buiten identiek uitzien. Ze delen dezelfde behuizing van 32 liter met afmetingen van 387 x 187.7 x 438 mm, dezelfde rand en FlexBay aan de voorkant, en dezelfde RTX PRO 6000 Blackwell-opties in de Dell-configurator. Het verschil zit hem dus in het moederbord. Waar de Pro Max Tower T2 de 24-core Core Ultra 9 285K combineert met vier DIMM-slots voor ongebufferd DDR5-geheugen, kiest de Pro Precision 9 T2 voor Intels Xeon 6 voor werkstations, het Granite Rapids-WS- platform dat we in juni op een los moederbord hebben getest. Deze configuratie beschikt over registered ECC-geheugen, meer PCIe-lanes en een 250W-processor in de topconfiguratie.

Dell biedt zes Xeon 6-processors aan in de Pro Precision 9 T2, van de 12-core Xeon 634 met 150W tot de 24-core 658X met 250W in ons testmodel. De overstap van de 634 naar de 658X kost $ 1,560 extra. De 658X heeft 24 cores en 48 threads met een basisfrequentie van 3.0 GHz en een turbofrequentie van 4.9 GHz, en beschikt over 144 MB L3-cache, drie keer zoveel als de 36 MB van de 285K. De chip ondersteunt AVX-512 en AMX, functies die de 285K niet heeft. De chip heeft acht DDR5-6400-kanalen en 128 Gen5-lanes. De T2-uitvoering heeft vier DIMM-slots en vijf uitbreidingsslots, terwijl de grotere T4- en T6-modellen de overige slots beschikbaar stellen.
| Platform | Dell Pro Precision 9 T2 (zoals getest) | Dell Pro Max Tower T2 (zoals getest) |
|---|---|---|
| Gegevensverwerker | Intel Xeon 658X, 24 kernen / 48 threads, 3.0 tot 4.9 GHz, 144 MB L3-geheugen, 250 W | Intel Core Ultra 9 285K, 24 kernen / 24 threads (8P + 16E), tot 5.7 GHz, 36 MB L3-geheugen, 125 W |
| Instructiesets | AVX-512, AMX | AVX2 (geen AVX-512), Intel AI Boost NPU |
| Geheugen | 4 x 32 GB DDR5-6400 RDIMM ECC (vier kanalen; maximaal 1 TB) | 4 x 32GB DDR5-4400 ECC UDIMM |
| Uitbreiding | Gen5 x16, Gen5 x4, Gen4 x16, twee Gen4 x8 (waarvan één x4 elektrisch) | Gen5 x16, één Gen4 x4 en twee Gen3 x4 |
| Opstartopslag zoals getest | 2 x 2TB E3.S Gen5 NVMe in de FlexBay aan de voorzijde, RAID0 (VROC van Graid Technology), 4,097GB | 2TB SK hynix PCB01 M.2 Gen5 (enkele schijf) |
| Interne M.2 | 3 x M.2 2280 Gen5 | 1 x Gen5 en 2 x Gen4 M.2 |
| Stroomvoorziening | 750W standaard; 500W of 1500W optioneel (1500W zoals getest) | 360W, 500W of 1500W (80 Plus Platinum) |
| Grafische weergave zoals getest | RTX PRO 6000 Blackwell Max-Q (300W) zoals geleverd; de 600W-versie is ook getest. | RTX PRO 6000 Blackwell (600W) zoals geleverd; Max-Q-kaart ook getest. |
| Chassis | 387 x 187.7 x 438 mm, 11.6 tot 21.8 kg | 387 x 187.7 x 438 mm, 8.17 tot 23 kg |
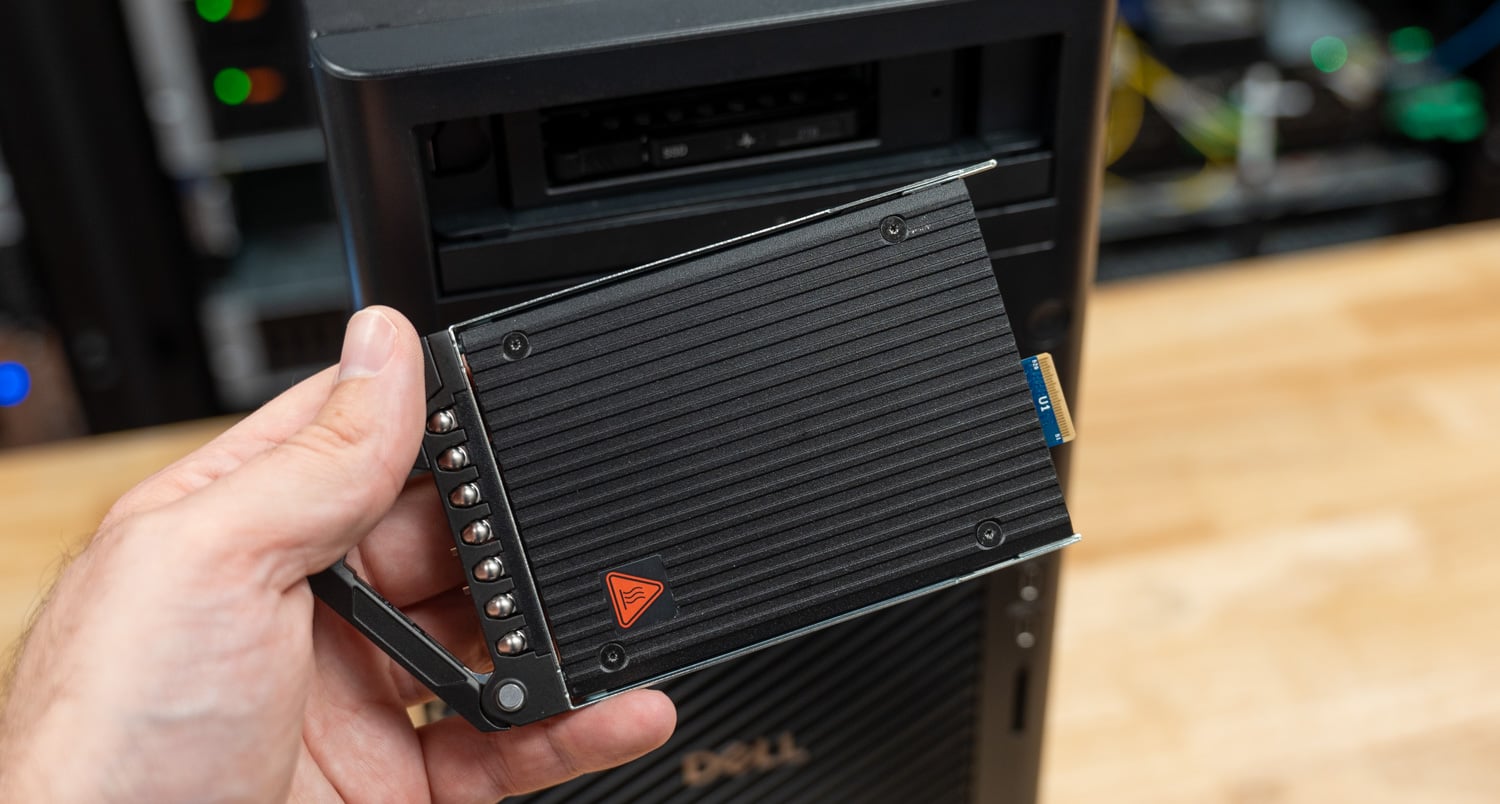
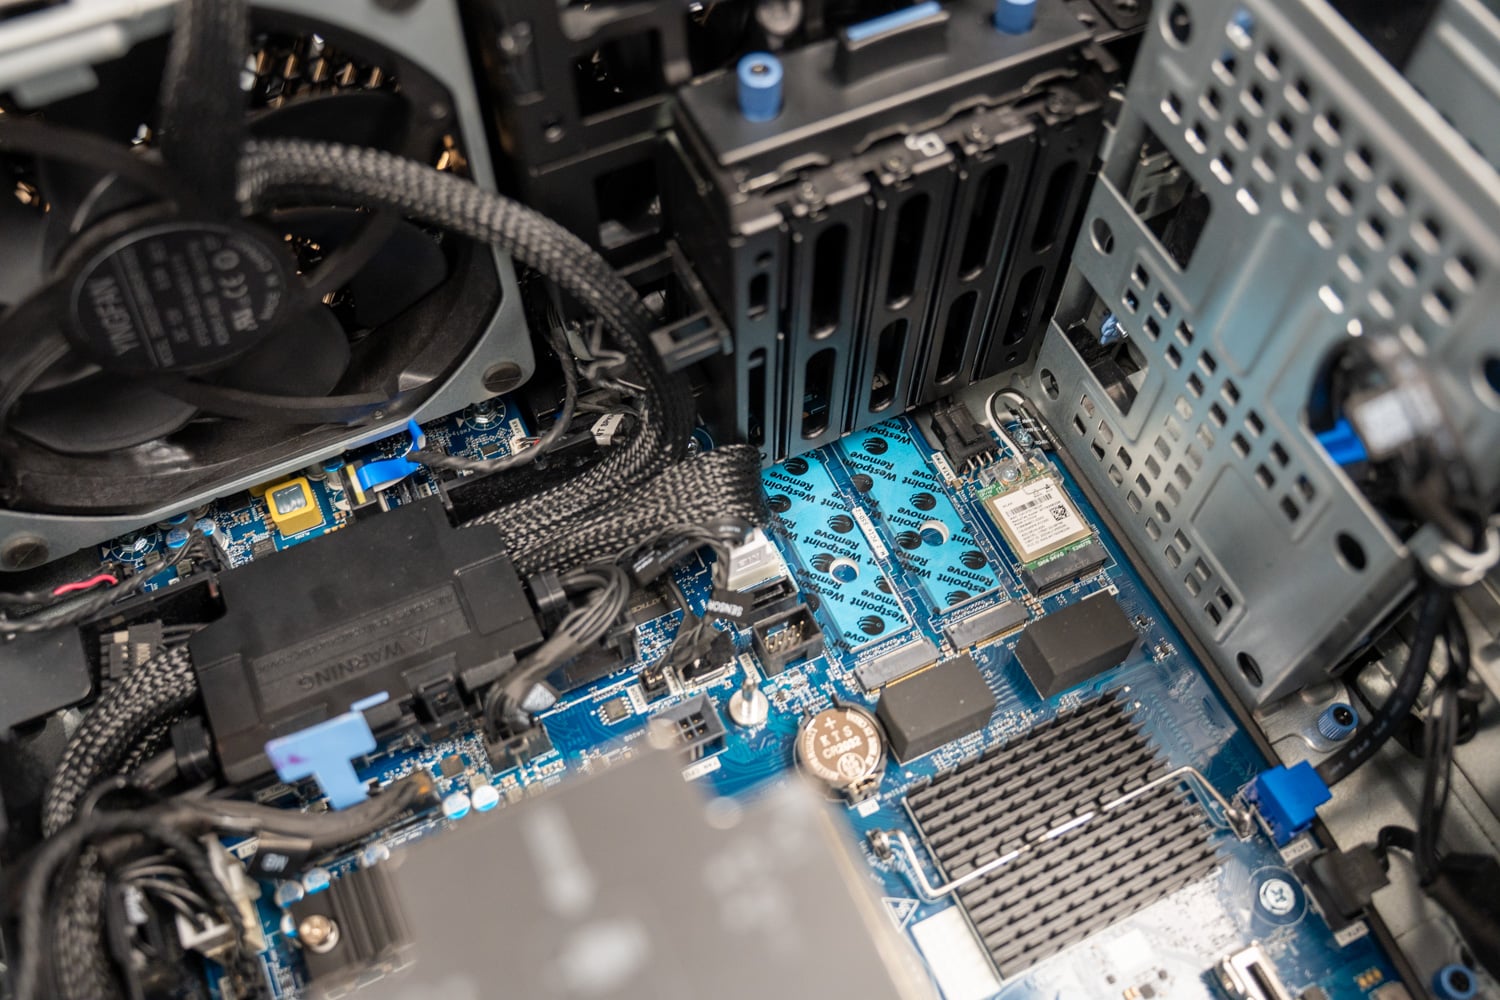
De Core T2 startte op vanaf één M.2-schijf, terwijl onze Pro Precision 9 T2 was uitgerust met Dell's FlexBay NVMe-opstartconfiguratie: twee hot-pluggable E3.S Gen5-schijven achter het voorpaneel, samengevoegd tot één volume van 4,097 GB door de RAID0-opstartoptie. E3.S is de enterprise-vormfactor waar we towerfabrikanten al langer om vragen, omdat deze de capaciteitslimiet van M.2 ruimschoots overstijgt en de schijven aan de voorkant kunnen worden verwijderd zonder de behuizing te hoeven openen. De RAID-laag is VROC van Graid Technology , de Intel VROC-code die Graid vorig jaar overnam en opnieuw lanceerde op Computex. Dit is het eerste werkstation in ons lab dat hiermee is uitgerust.

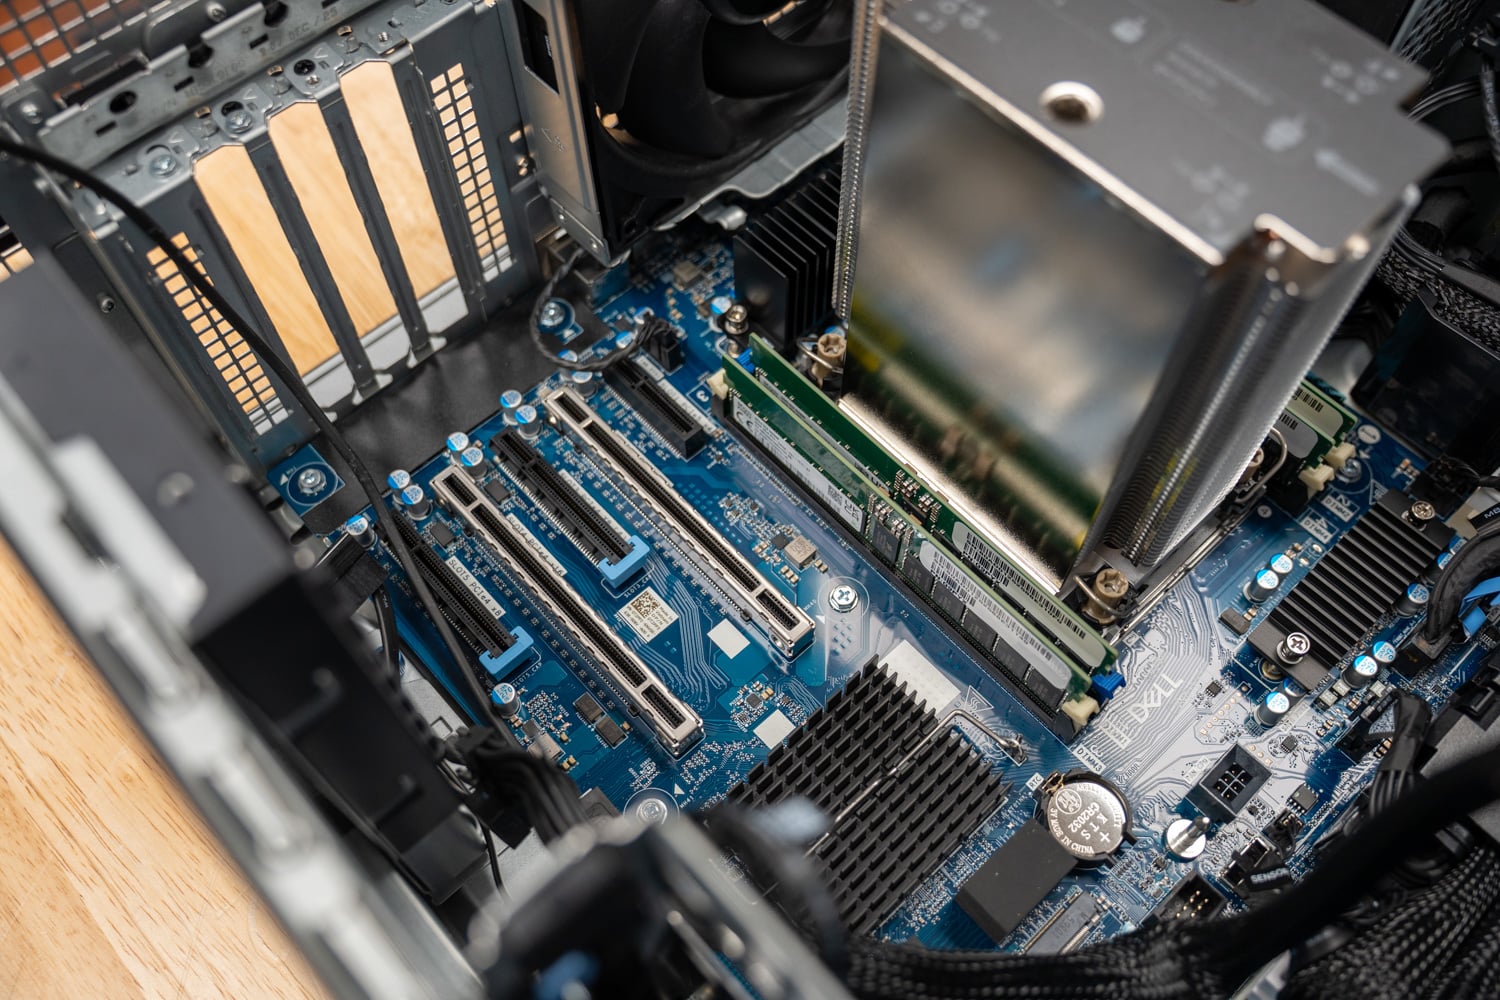
De 600W-kaart heeft iets meer ruimte nodig; de Max-Q niet. Ons exemplaar werd geleverd met een Intel E810-XXV dual-port 25GbE-adapter in het slot naast de GPU. Om de 600W RTX PRO 6000 te installeren, moesten we deze verwijderen; de koeler van de kaart neemt namelijk de ruimte van het aangrenzende slot in beslag, evenals de stroomvoorziening van dat slot. Kopers die de krachtige kaart en een snelle netwerkkaart willen, moeten de slotindeling goed overwegen voordat ze bestellen. Een voeding van 1500W is de enige verstandige keuze; ons exemplaar had de 1500W-optie, een upgrade van $40 ten opzichte van de standaard 750W-voeding.
Bouw en Ontwerp
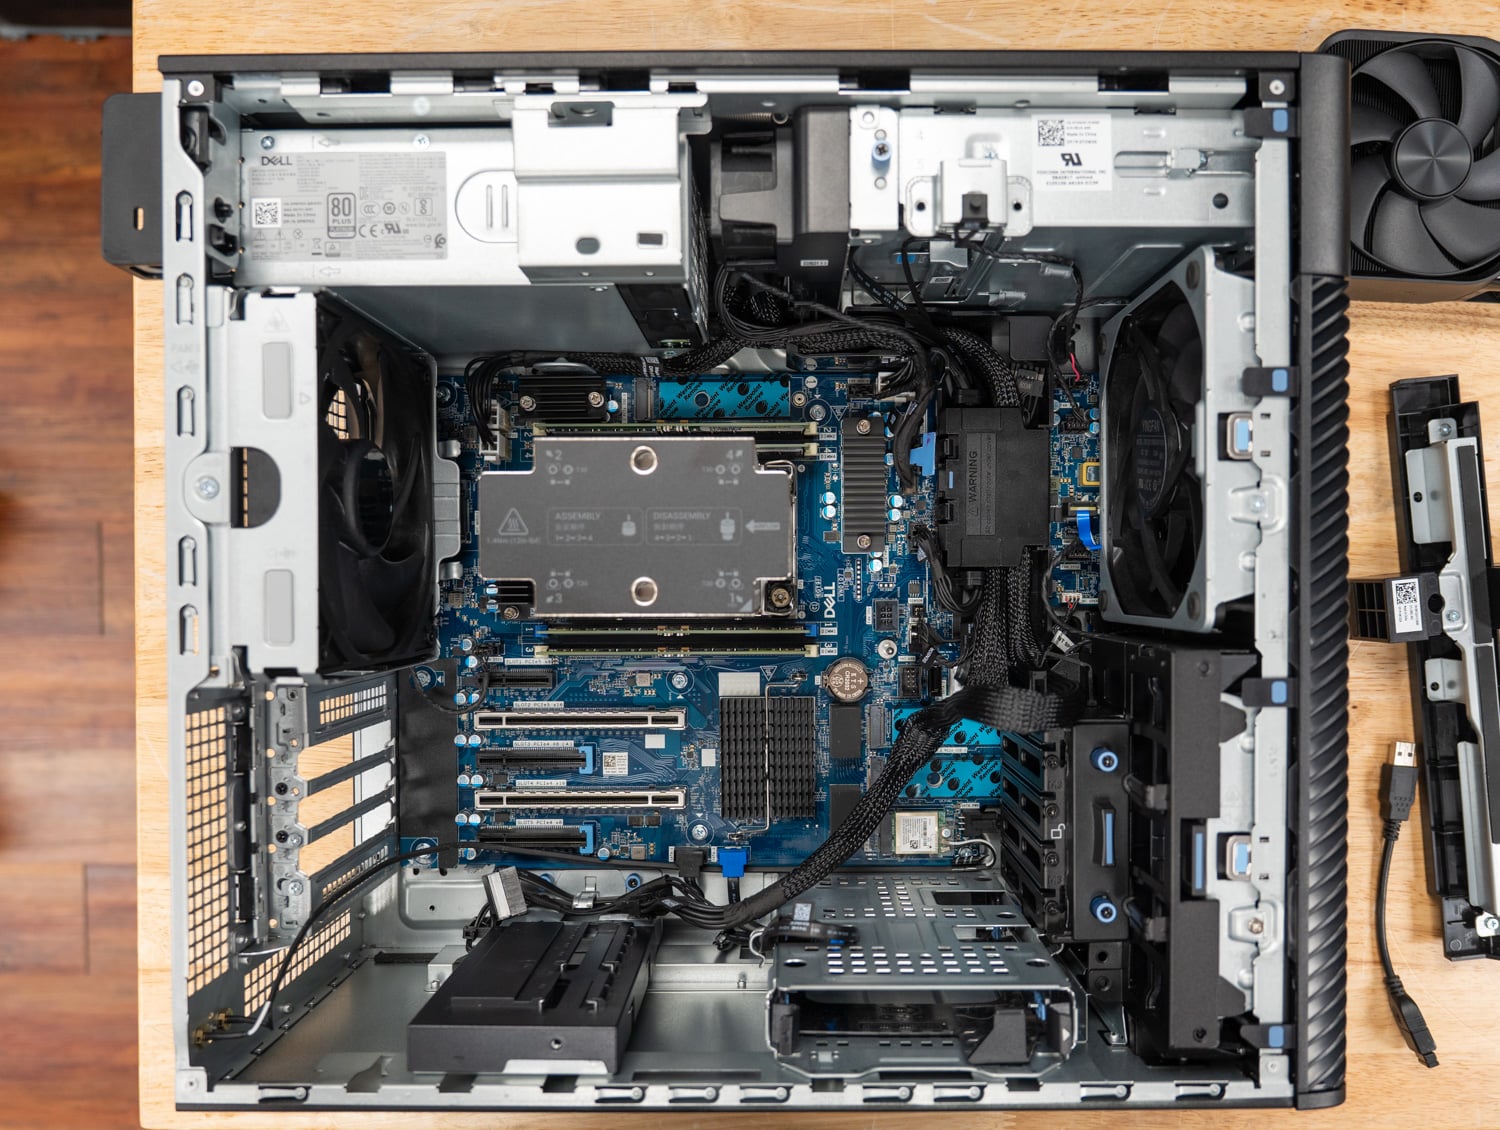
De Pro Precision 9 T2 maakt gebruik van dezelfde gereedschaploze tower als de Pro Max-versie, met een volledig dekkend gaasrooster aan de voorkant voor de luchtinlaat, een vergrendeling aan de zijkant en een vastzittende duimschroef voor het zijpaneel, en de FlexBay en optionele slanke optische drive achter de onderste rand. Dell geeft aan dat de behuizing leeg 11.6 kg weegt en geconfigureerd tot 21.8 kg. Ons exemplaar, met de 1500W-voeding, de koeler van de 658X en een grafische kaart met twee slots, zit aan de bovenkant van dat bereik.

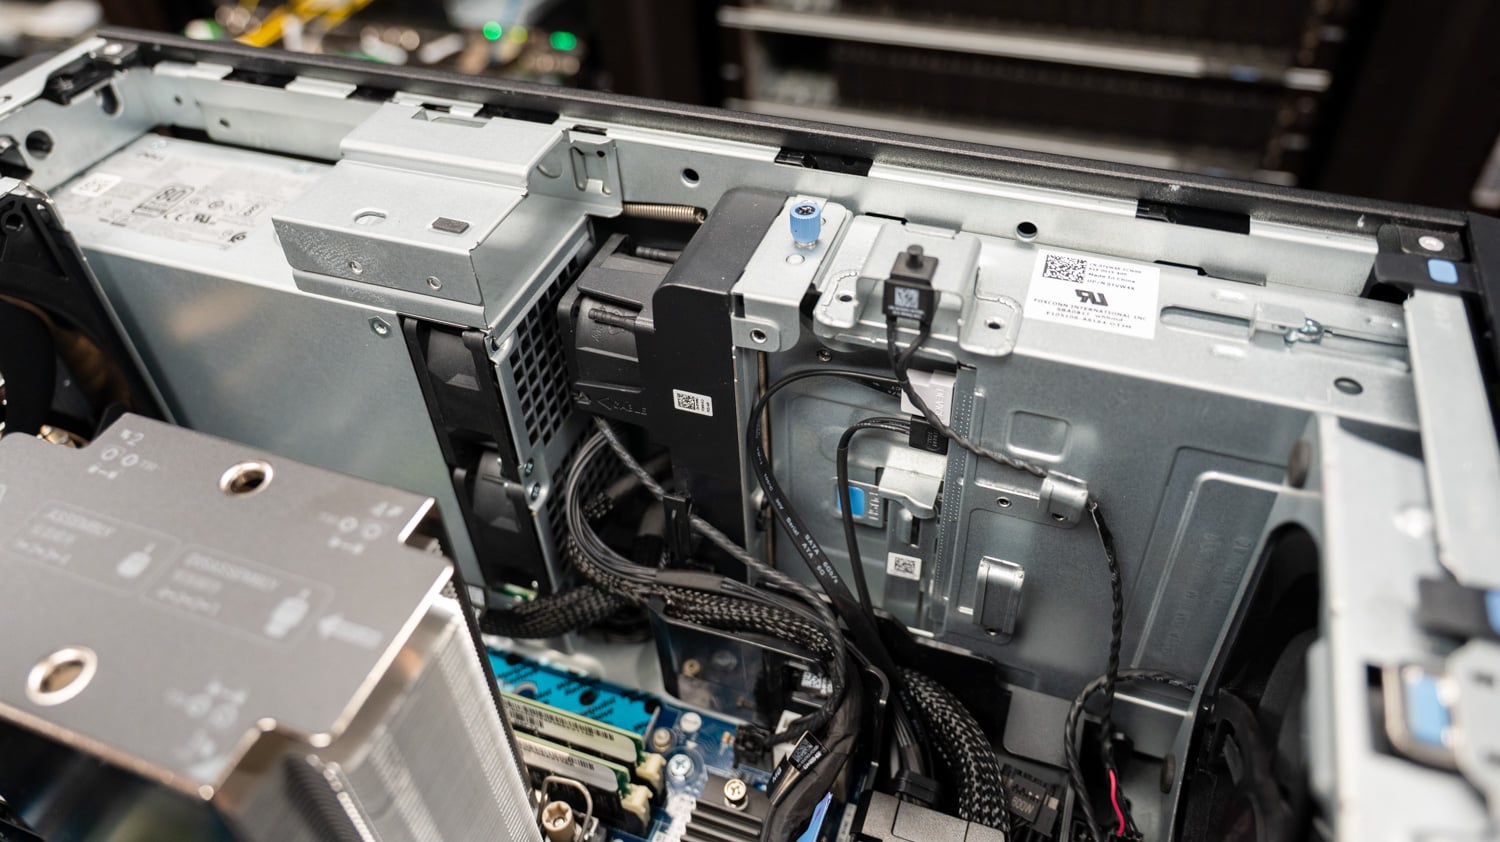
De binnenkant van de behuizing is ontworpen met het oog op luchtstroom, en Dell stuurt de lucht precies daarheen waar hij nodig is. De grote koelkap, die de DIMM's koel houdt en warme lucht van de CPU rechtstreeks uit de behuizing afvoert, heeft een ventilator die in de kap zelf is geïntegreerd. Wanneer de behuizing open is, kun je zien hoe de kap in de structurele opbouw van de behuizing past: de onderkant rust op de GPU-steunbeugel en sluit nauw aan op de zijplaat.
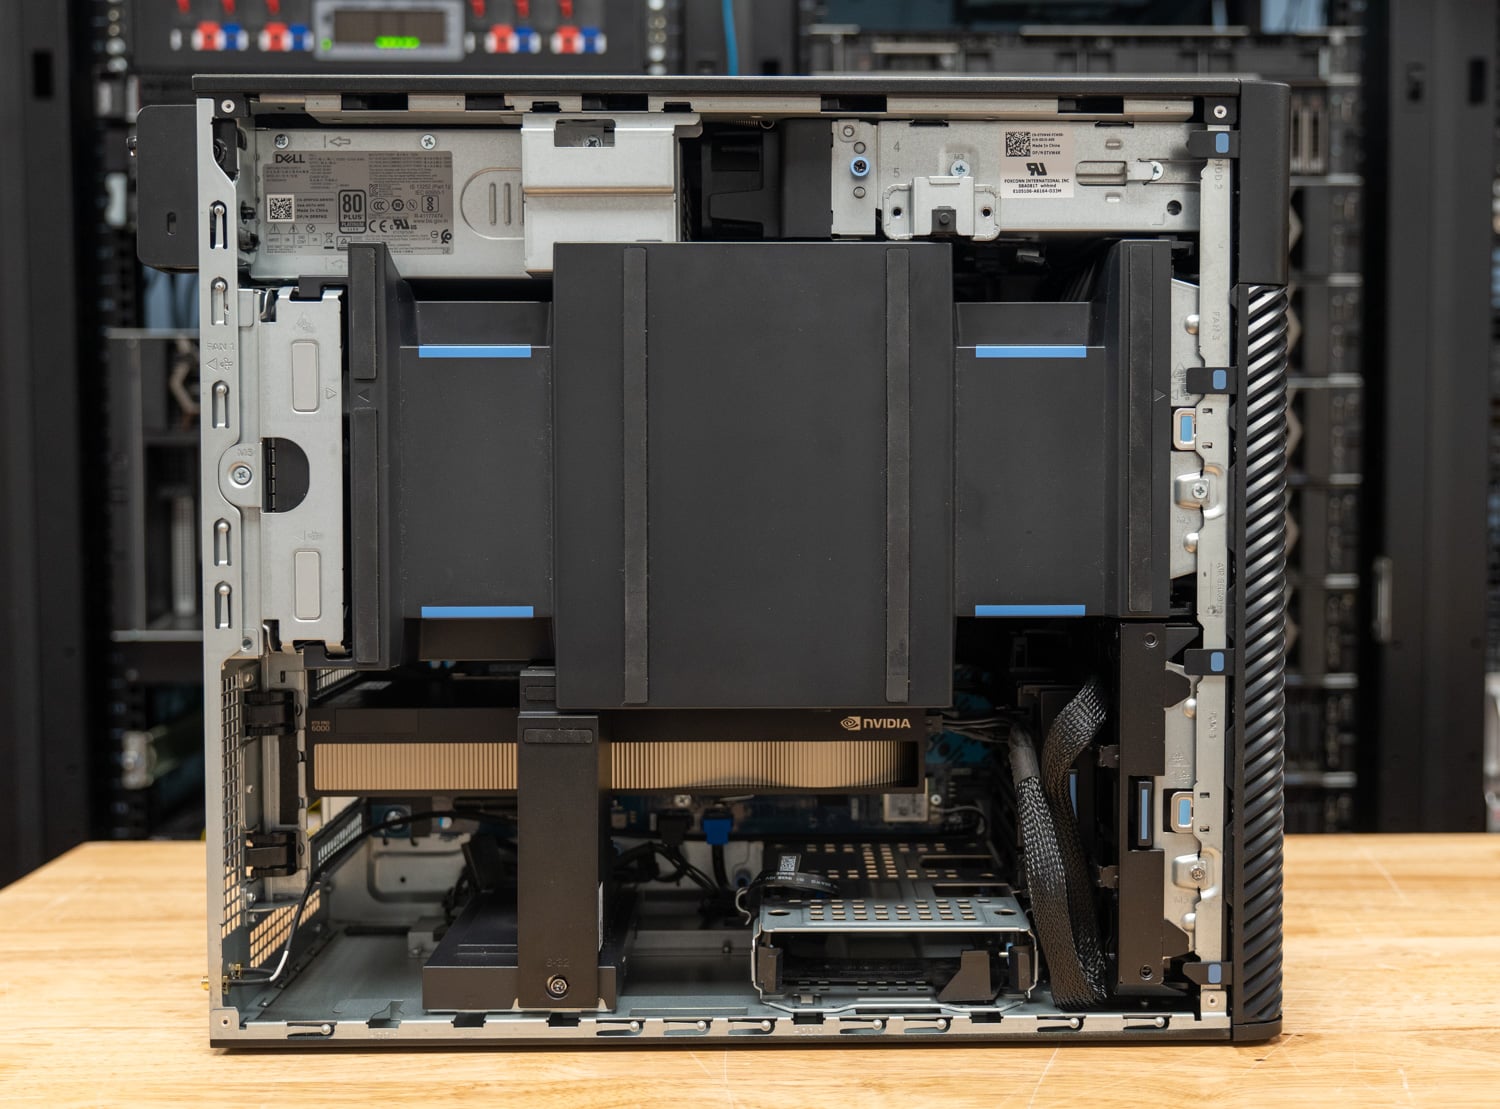
Binnenin volgt de indeling die van de Pro Max-tower: de processor en vier DIMM-slots bevinden zich boven het uitbreidingsgebied, de GPU in het Gen5 x16-slot wordt aan het uiteinde ondersteund door een bevestigingsbeugel en de voeding is aan de achterkant gemonteerd met een handgreep voor verwijdering zonder gereedschap. Alle vijf slots zijn van volledige hoogte: slot 2 is het Gen5 x16-slot voor de GPU, slot 1 is Gen5 x4 en de andere drie zijn Gen4, één x16 en twee open x8-slots, voor een netwerkkaart, een geheugenkaart of een tweede GPU. Drie interne M.2 2280 Gen5-slots en twee 3.5-inch SATA-bays bevinden zich achter de E3.S-bay aan de voorzijde.
Aan de voorzijde bevinden zich een hoofdtelefoonaansluiting, een 20 Gbps USB-C-poort met PowerShare, een 10 Gbps USB-C-poort, twee USB-A-poorten en een optioneel SD-kaartsleuf. De achterzijde is voorzien van een audio-uitgang, 20 Gbps en 10 Gbps USB-C-poorten, twee USB 2.0-poorten met SmartPower, twee 5 Gbps USB-A-poorten, 1 GbE, een sleuf voor een optionele 5 GbE-netwerkkaart of twee extra USB-A-poorten, en een optionele seriële poort. Ons testexemplaar was uitgerust met de MediaTek MT7925 Wi-Fi 7-kaart in de interne M.2 2230-sleuf en de Intel E810-XXV 25 GbE-kaart, die oorspronkelijk bedoeld was voor de 600W GPU.

Specificaties van de Dell Pro Precision 9 T2
| Specificaties | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| Platformoverzicht | |
| Processor opties | Intel Xeon 634 (12C, 150W), 636 (12C, 170W), 638 (16C, 180W), 654 (18C, 200W), 656 (20C, 210W), 658X (24C / 48T, 144MB L3, 250W) Xeon 658X zoals getest |
| Geheugen | DDR5 RDIMM ECC, 5600 of 6400 MT/s, vier slots, tot 1 TB (4 x 256 GB) 128 GB (4 x 32 GB) DDR5-6400 zoals getest |
| Grafische opties | NVIDIA RTX A400, A1000, RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600W) / 6000 Blackwell Max-Q (300W), A800 Active; AMD Radeon Pro W7400; dual- en triple-configuraties op geselecteerde kaarten RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7, zoals getest |
| Opslag | FlexBay aan de voorzijde: ruimte voor maximaal twee E3.S/NVMe-schijven plus een optionele slanke optische schijf, of één 3.5-inch SATA-sleuf. Intern: 3 x M.2 2280 Gen5 NVMe, 2 x 3.5-inch SATA RAID: Intel VMD met VROC van Graid Technology (RAID0 opstarten, interne RAID0) 2 x 2TB E3.S Gen5 NVMe in RAID0 (4,097GB) zoals getest |
| Uitbreiding | Slot 1: Gen5 x4; Slot 2: Gen5 x16; Slot 3: Gen4 x8 (x4 elektrisch, open uiteinde); Slot 4: Gen4 x16; Slot 5: Gen4 x8 (open uiteinde); M.2 2230 voor Wi-Fi |
| I / O | |
| Poorten aan de voorkant | 1 x USB-C 20 Gbps met PowerShare, 1 x USB-C 10 Gbps, 1 x USB-A 5 Gbps met PowerShare, 1 x USB-A 5 Gbps, hoofdtelefoonaansluiting, optioneel SD-kaartsleuf |
| Achterste poorten | 1 x USB-C 20 Gbps, 1 x USB-C 10 Gbps, 2 x USB 2.0 (SmartPower), 2 x USB-A 5 Gbps, audio-uitgang, 1 x RJ45 1 GbE, optionele 5 GbE- of dubbele USB-A-module, optionele seriële poort |
| Netwerken zoals getest | Intel E810-XXV DA2 dual-port 25GbE SFP28 (verwijderd voor de 600W GPU-tests); MediaTek MT7925 Wi-Fi 7, Bluetooth 5.4 |
| Kracht en fysiek | |
| Stroomvoorziening | 750W standaard; 500W of 1500W optioneel; 1500W zoals getest |
| Afmetingen | 387 x 187.7 x 438 mm (15.23 x 7.38 x 17.24 inch) |
| Gewicht | van minimaal 11.6 kg (25.57 lb) tot maximaal 21.8 kg (48.06 lb) |
| Besturingssysteem | Windows 11 Pro voor werkstations (zoals getest) of Ubuntu Linux 24.04 LTS |
| Beheer en beveiliging | Intel vPro, TPM 2.0, chassis-inbraakschakelaar, vergrendelbare frontpanelen, Kensington-slot |
| Prijs | Dell.com Basisconfiguratie $3,978 (Xeon 634, 16 GB, RTX A400, 256 GB, 750 W); circa $28,300 zoals getest (Xeon 658X, 128 GB DDR5-6400, RTX PRO 6000 Max-Q, 2 x 2 TB Gen5 FlexBay-schijven in RAID 0, 1500 W, 25 GbE, Wi-Fi 7), prijzen van Dell.com per 19 oktober 2026 |
Die prijs kent twee kanttekeningen. De configurator van Dell.com vermeldt de FlexBay-schijven als 2TB M.2 2280 Gen5-modules voor $ 1,700 per stuk, terwijl de schijven in ons exemplaar E3.S zijn. We hebben Dell gevraagd wanneer de E3.S-optie online beschikbaar komt. Dell geeft eerlijk toe dat er weinig zakelijke werkstations voor de webprijs worden gekocht, dus beschouw de $ 28,300 als een maximumprijs waar volumekortingen en contractprijzen onder vallen. Het geheugen en de GPU zijn goed voor $ 19,090, en de GPU-optie kost hetzelfde, ongeacht of je kiest voor de 300W- of de 600W-kaart.
Dell hanteert voor dit specifieke testmodel een prijs van $31,700, inclusief de E810-XXV 25GbE-adapter, Wi-Fi 7, de optische drive en drie jaar ProSupport.
Testopstelling en methodologie
Alle resultaten in deze review zijn afkomstig van sr-client 1.2, onze gescripte benchmarksuite voor Windows-clients, met het volledige testprofiel. Hierbij is gebruikgemaakt van de standaard Windows-image van Dell met de Dell-stuurprogramma's en NVIDIA-stuurprogramma 596.71 op alle vier de configuraties. De suite past overal dezelfde instellingen toe: Windows-energiemodus op 'Beste prestaties', alle timers voor slaapstand en schermuitschakeling uitgeschakeld, Windows Firewall en UAC-prompts uitgeschakeld, VBS en geheugenintegriteit ingeschakeld zoals standaard geleverd. Elk resultaat is de mediaan van herhaalde tests. De suite voert een test opnieuw uit waarvan de spreiding meer dan 2 procent bedraagt voordat deze wordt geaccepteerd.
De vier onderstaande configuraties bestaan uit twee towers en twee GPU's. De Pro Precision 9 T2 draaide de volledige testsuite met zijn Max-Q-kaart en vervolgens nogmaals met de 600W RTX PRO 6000 Blackwell uit onze Pro Max Tower T2. De Pro Max Tower T2 draaide beide kaarten achtereenvolgens, waardoor de kolommen met GPU's binnen een tower alleen verschillen in de kaart en de kolommen met towers binnen een GPU alleen verschillen in het platform. De Core T2 is uitgerust met de enkele 2TB Gen5 M.2 SSD waarmee hij werd geleverd, en de Xeon T2 met de E3.S stripe met twee schijven. De rijen met opslag en modelinformatie vergelijken deze configuraties.
| Configuratie | CPU | Geheugen | GPU | Opstartschijf | Besturingssysteem en energiemodus |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260), Max-Q | Intel Xeon 658X, 24C / 48T, 250W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300W, 96GB | 2 x 2TB E3.S Gen5 NVMe, VROC RAID0 (opstartvolume van 4,097 GB) | Windows 11 Pro voor werkstations 25H2, beste prestaties |
| Dell Pro Precision 9 T2 (PW9T2260), 600W | Intel Xeon 658X, 24C / 48T, 250W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600W, 96GB | 2 x 2TB E3.S Gen5 NVMe, VROC RAID0 (opstartvolume van 4,097 GB) | Windows 11 Pro voor werkstations 25H2, beste prestaties |
| Dell Pro Max Tower T2 (FCT2250), Max-Q | Intel Core Ultra 9 285K, 24C / 24T, 125W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300W, 96GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, optimale prestaties |
| Dell Pro Max Tower T2 (FCT2250), 600W | Intel Core Ultra 9 285K, 24C / 24T, 125W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600W, 96GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, optimale prestaties |
Hier worden verschillende tests geïntroduceerd, te beginnen met LLM serving, waarbij llama-server met vier modellen draait en de gelijktijdigheid varieert van één verzoek tot het maximale aantal verzoeken dat in het GPU-geheugen past. De test rapporteert de totale doorvoer en de doorvoer per gebruiker, de tijd tot het eerste token en de tijd per uitvoertoken. De beeldgeneratietest rendert afbeeldingen van 1024×1024 pixels met FLUX.2 klein 4B, Z-Image Turbo 6B en Qwen-Image 20B met Q4_0, Q8_0 en BF16 gewichten, en beoordeelt de gekwantiseerde uitvoer ten opzichte van BF16 met PSNR en SSIM, zodat snelheid en beeldkwaliteit hand in hand gaan. De test met de codeeragent draait nu op Crush, en de test met de agent naast de gebruiker maakt gebruik van een herziene methode waarbij de browserbenchmark beperkt blijft tot drie volledige passes.
Drie labels komen steeds terug in de tabellen, beginnend met N/A, wat betekent dat een test niet van toepassing is op de hardware: SMT single-core op de 285K, die geen SMT heeft, en de OpenBLAS top-core-class rijen op de Xeon, waarvan de 24 cores één klasse vormen. 'Partial' markeert een resultaat dat de testsuite heeft geaccepteerd met een opmerking, meestal een coding agent tier waarbij één van de drie runs de tests niet heeft gehaald. Geen van beide desktops gaf de CPU- of GPU-temperaturen door aan het sensorpad van de testsuite, dus in dit overzicht worden de gemiddelde CPU-kloksnelheden per test weergegeven in plaats van een thermische tabel.
Lokale AI-prestaties
Met 96 GB GDDR7-geheugen in elke configuratie is de modelcapaciteit gegarandeerd, en elke versie van onze lokale AI-suite draait op alle vier de varianten. De resultaten lopen daarom uiteen op basis van de GPU-vermogenslimiet: waar een test wordt beperkt door de geheugenbandbreedte, presteren de Max-Q- en 600W-kaarten vrijwel gelijk, en waar de test wordt beperkt door de rekenkracht, loopt de 600W-kaart voorop. Het CPU-platform is zelden van belang, en waar het wel van belang is, is de richting het vermelden waard.
MLPerf Client v2.0
MLPerf Client voert Llama 3.1 8B en Phi-4-mini uit met vijf promptcategorieën en rapporteert de tijd tot het eerste token en de tokenfrequentie daarna, als een geometrisch gemiddelde over de categorieën, met llama.cpp op CUDA als engine in elke configuratie. De agentscenario's voeren Llama 3.1 8B uit als data-analistagent en software-engineeragent die tools aanroepen over meerdere beurten.

| MLPerf Client v2.0 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Llama 3.1 8B, tijd tot eerste token, geometrisch gemiddelde (s, lager is beter) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, token rate, geometrisch gemiddelde (tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, tijd tot eerste token, geometrisch gemiddelde (s, lager is beter) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, token rate, geometrisch gemiddelde (tok/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| Data-analist-agent, end-to-end (s, lager is beter) | 17.5 | 15.7 | 16.2 | 14.4 |
| Data-analistagent, tokensnelheid (tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE Agent, end-to-end (s, lager is beter) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE Agent, token rate (tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
De Max-Q-kaart genereerde Llama 3.1 8B met 230.9 tokens per seconde in de Xeon-tower en 230.0 in de Core-tower, en Phi-4-mini met 345.9 en 351.0, wat betekent dat dezelfde GPU hetzelfde werk verricht. De 600W-kaart verhoogde die waarden naar 252.8 en 379.0 tokens per seconde in de Xeon-tower, een winst van ongeveer 9 procent, en verkortte de tijd tot het eerste token in Llama van 0.082 naar 0.059 seconden, een reductie van 28 procent. De promptverwerking is rekenintensief en de decodering bandbreedte-intensief. De twee kaarten delen hetzelfde geheugen, waardoor de stroomlimiet veel meer merkbaar is bij het eerste token dan bij de tokens die daarop volgen.
De agentscenario's laten zien waar het CPU-platform een rol speelt. De data-analist-agent voltooide de taak in 16.2 seconden op de Core T2 met de Max-Q-kaart en in 17.5 seconden op de Xeon T2, en de software-engineer-agent in 14.6 seconden tegenover 16.2 seconden, waarbij de tool-aanroepfasen van de Xeon in beide gevallen ongeveer 1.5 seconde langer duurden. De tokensnelheden komen binnen 1 procent overeen, dus het verschil zit hem in de tools die tussen de modelaanroepen op de CPU draaien, waar de snellere cores van de 285K de taak sneller voltooien.
Model laden
Deze test meet de tijd die een lokaal model in Ollama nodig heeft om een token te genereren, zowel in een koude (bestandscache geleegd) als in een warme (bestand al in het geheugen) toestand. De test rapporteert hoe snel het station werd gelezen tijdens de koude test, wanneer de gewichten in het GPU-geheugen arriveerden en een efficiëntiecijfer dat de leessnelheid tijdens de test vergelijkt met de sequentiële limiet van 1 MB van het station. Met 96 GB VRAM draaien alle drie de tiers: gpt-oss:20b op 12.8 GB, Qwen3.6-35B-A3B op 21.1 GB en gpt-oss:120b op 60.9 GB.

| Model laden (geheugenmapping ingeschakeld) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| gpt-oss:20b, koude lading naar eerste token (s, lager is beter) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, warm laden naar eerste token (s, lager is beter) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, aankomst in GPU-geheugen, koud (s, lager is beter) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, koud laden tot eerste token (s, lager is beter) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, warm laden tot eerste token (s, lager is beter) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, koude lading naar eerste token (s, lager is beter) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, warm laden naar eerste token (s, lager is beter) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, leesdoorvoer tijdens koude belasting (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, aankomst in GPU-geheugen, koud (s, lager is beter) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:120b laden na het wisselen van gpt-oss:20b (s, lager is beter) | 14.30 | 13.97 | 11.89 | 11.93 |
| Maximale schijfsnelheid, DiskSpd 1MB sequentiële leessnelheid (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
De Core T2 laadt elk model sneller, en dat komt door de harde schijf. gpt-oss:120b bereikte zijn eerste token in 28.54 seconden op de Core T2, tegenover 32.06 seconden op de Xeon T2. De 61 GB aan gegevens werden in 7.74 seconden in het GPU-geheugen geladen, tegenover 11.33 seconden op de Xeon T2. De enkele PCB01 verwerkte de gegevens met een snelheid van 11,633 MB/s, precies op zijn maximale DiskSpd-limiet van 11,563 MB/s, terwijl de E3.S-stripe dit deed met 9,875 MB/s, tegen een eigen limiet van 11,306 MB/s. Het RAID-volume leest grote blokken bijna net zo snel als de enkele schijf, maar houdt die snelheid niet vol via het geheugen-gemapte laadpad van Ollama.
Bij een lage belasting wordt het verschil teruggebracht tot een seconde of twee, omdat het bestand zich al in het systeemgeheugen bevindt en alleen de overdracht naar VRAM en de configuratie van llama.cpp nog nodig zijn: 27.18 seconden op de Xeon T2 tegenover 25.58 voor gpt-oss:120b, en 7.52 tegenover 6.60 voor gpt-oss:20b. De stroomlimiet van de GPU heeft, zoals verwacht, geen consistent effect op de laadtijden.
Coderingsagent
Crush, een terminal-codeeragent, stuurt een lokaal model, dat door Ollama wordt aangeboden, door een vaste codeertaak in een vastgezette repository. Er zijn maximaal drie rondes om de 11 tests van de repository te laten slagen. We rapporteren de mediane verstreken tijd van drie runs, hoeveel runs succesvol waren en de generatiesnelheid. De verstreken tijd is afhankelijk van het aantal toolaanroepen en tokens dat het model besluit te gebruiken, wat per run varieert. De generatiesnelheid is daarom een betere vergelijking van de hardwareprestaties. De test waarbij de agent naast de gebruiker draait, voert de agent en Speedometer samen uit en rapporteert hoeveel ze elkaar vertragen.

| Crush codeeragent | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Niveau S, gpt-oss:20b, 64K context | ||||
| Werktijd, mediaan (s, lager is beter) | 55.1 | 99.8 | 57.2 | 43.2 |
| Successen (van 3) | 3 | 2 | 3 | 2 |
| Generatiesnelheid (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| Niveau M, Qwen3.6-35B-A3B, 64K context | ||||
| Werktijd, mediaan (s, lager is beter) | 35.2 | 27.0 | 86.7 | 32.1 |
| Successen (van 3) | 3 | 3 | 3 | 3 |
| Generatiesnelheid (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| Niveau L, Qwen3.6-35B-A3B, 128K context | ||||
| Werktijd, mediaan (s, lager is beter) | 38.1 | 30.6 | 74.1 | 58.8 |
| Successen (van 3) | 3 | 3 | 3 | 3 |
| Generatiesnelheid (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Niveau W, gpt-oss:120b, 128K context | ||||
| Werktijd, mediaan (s, lager is beter) | 49.1 | 37.9 | 56.6 | 30.8 |
| Successen (van 3) | 3 | 3 | 3 | 3 |
| Generatiesnelheid (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| Agent naast de gebruiker (gpt-oss:20b en snelheidsmeter samen) | ||||
| Snelheidsmeter naast de agent (score) | 36.6 | 36.7 | 43.2 | 45.2 |
| Snelheidsmetervertraging (x, lager is beter) | 1.005 | 1.011 | 1.053 | 1.044 |
| Agentgeneratiesnelheid naast snelheidsmeter (tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| Agentvertraging (x, lager is beter) | 1.006 | 1.009 | 1.023 | 0.998 |
Elke configuratie voltooide alle drie de runs van de tier W-taak met gpt-oss:120b, het grootste model in de suite, met een snelheid van 160.9 tot 177.1 tokens per seconde in de Xeon-toren en 158.5 tot 174.4 in de Core-toren, waarbij de 600W-kaart in beide gevallen ongeveer 10 procent van de prestaties voor zijn rekening nam. De Qwen3.6-taken slaagden ook overal voor alle drie de runs, met een snelheid van 223 tot 253 tokens per seconde. gpt-oss:20b is het model dat problemen ondervond: de tier S-taak verloor één van de drie runs op twee van de vier configuraties, en de tier M-taak met 128 contexten (niet weergegeven) verloor overal minstens één run, een gedragspatroon dat niet verandert door de hardware.
Het tegelijkertijd uitvoeren van de agent en een browserbenchmark kost vrijwel niets op een tower-pc met een aparte GPU en 24 beschikbare cores. Speedometer vertraagde met een factor 1.005 op de Xeon T2 en met een factor 1.053 op de Core T2 wanneer de agent actief was, en de generatiesnelheid van de agent veranderde in alle gevallen met maximaal 2 procent. De Speedometer-score van de Xeon T2 van 36.6 met de agent is lager dan die van de Core T2 van 43.2 om dezelfde reden dat deze lager is wanneer de agent niet actief is: de snelheid per core van de 285K.
Retrieval-augmented generatie
Onze RAG-test integreert 20,963 SQuAD v1.1-tekstfragmenten met nomic-embed-text, haalt de vijf beste fragmenten op voor elk van de 2,000 vragen en beantwoordt er 400 met Phi-4-mini, waarbij de exacte overeenkomst en de F1-score worden gescoord ten opzichte van de referentieantwoorden. De modellen zijn klein, waardoor de test de volledige pipeline meet, inclusief de vectorzoekactie aan de CPU-zijde tussen de GPU-fasen.

| VOD | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Inname van muurtijd, 20,963 passages (s, lager is beter) | 128.5 | 125.5 | 108.1 | 103.0 |
| Inbeddingssnelheid (tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| Ophaaltijd van de query, p50 (ms, lager is beter) | 30.6 | 27.2 | 23.4 | 18.7 |
| Antwoord, Phi-4-mini tijd tot eerste token, p50 (s, lager is beter) | 0.099 | 0.087 | 0.089 | 0.083 |
| Antwoord, snelle verwerking (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| Antwoord: generatiesnelheid (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| Vraag om te beantwoorden, p50 (s, lager is beter) | 0.152 | 0.133 | 0.130 | 0.120 |
| Terugroepactie@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| Antwoord F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
De Core T2 is sneller in deze pipeline. Het verwerkte de data in 108.1 seconden tegenover 128.5 seconden op de Xeon T2 met dezelfde Max-Q-kaart, haalde de gegevens op in 23.4 ms tegenover 30.6 ms (mediaan) en beantwoordde een vraag in 0.130 seconden tegenover 0.152 seconden. Zowel het inbedden als het ophalen van gegevens hebben CPU-intensieve fasen, en die zijn in het voordeel van de 285K. De 600W-kaart verhoogde de promptverwerking met 25 tot 30 procent op beide platforms, van 20,318 naar 26,549 tokens per seconde op de Xeon T2, en de nauwkeurigheid was identiek in alle vier de configuraties, zoals verwacht mag worden met dezelfde modellen bij een temperatuur van 0.
LLM-bediening
De servertest draait llama-server met Ministral 3 3B en 8B (4,096 token prompts, 1,024 token outputs), Qwen3.8 27B en gpt-oss 120B (8,192 token prompts). De test wijst zoveel slots toe als er in het GPU-geheugen passen na de weging, en voert vervolgens de gelijktijdigheid van één verzoek uit tot die limiet is bereikt. We rapporteren de totale doorvoer (prompt- en outputtokens samen), de outputdoorvoer, de tijd tot het eerste token en de tijd per outputtoken op basis van de mediaan. Op een 96GB-kaart past gpt-oss 120B in 64 slots met 22.5 GiB KV-cache, Qwen3.8 27B in acht en de twee Ministral-modellen in vier in hun context.

| llama-server, gpt-oss 120B, 8,192-token prompts, 1,024-token outputs | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| 1 gelijktijdig: uitvoerdoorvoer (tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 gelijktijdig: tijd tot eerste token, mediaan (ms, lager is beter) | 1,241 | 918 | 1,238 | 923 |
| 1 gelijktijdig: tijd per uitvoertoken, mediaan (ms, lager is beter) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 gelijktijdig: totale doorvoer (tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 gelijktijdig: uitvoer per gebruiker (tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 gelijktijdig: tijd tot eerste token, mediaan (ms, lager is beter) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 gelijktijdig: totale doorvoer (tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 gelijktijdig: uitvoer per gebruiker (tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 gelijktijdig: tijd tot eerste token, mediaan (ms, lager is beter) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 gelijktijdig: tijd per uitvoertoken, mediaan (ms, lager is beter) | 163.0 | 141.3 | 152.7 | 126.3 |
Een enkele gebruiker ontvangt gpt-oss 120B met een snelheid van 160.6 tokens per seconde op de Max-Q-kaart en 182.7 op de 600W-kaart, waarbij het eerste token arriveert na respectievelijk 1,241 en 918 ms na een prompt van 8,192 tokens. Het belasten van de kaart met 64 gelijktijdige verzoeken verhoogde de totale doorvoer tot 3,296 tokens per seconde op de Max-Q en 3,805 op de 600W-kaart, ten koste van 5.7 en 6.6 tokens per seconde per gebruiker en een eerste tokentijd van respectievelijk 4.3 en 3.5 seconden. De curve vlakt af tussen 4 en 32 gelijktijdige verzoeken en maakt vervolgens een sprong bij 64, waar de batch de lange prompts uiteindelijk amortiseert.

| llama-server, uitvoerdoorvoer bij de hoogst mogelijke gelijktijdigheid (tok/s) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Ministraal 3 3B Redenering, 4 gelijktijdig | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministraal 3 8B Redenering, 4 gelijktijdig | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 gelijktijdig | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 64 gelijktijdig | 366.3 | 422.8 | 392.3 | 468.9 |
| Doorvoersnelheid per aanvraag (tok/s) | ||||
| Ministerieel 3 3B Redenering | 232.1 | 241.8 | 232.1 | 246.0 |
| Ministerieel 3 8B Redenering | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
De compacte Qwen3.8 27B is hier het traagste model voor één gebruiker met 54.0 tokens per seconde op de Max-Q, omdat elk token alle 27 miljard parameters doorloopt. De gpt-oss 120B, een combinatie van verschillende experts, presteert daarentegen 3.0 keer sneller, ondanks dat deze vier keer zo groot is qua schijfruimte. Het voordeel van de 600W-kaart is het grootst bij het compacte model, 24 procent bij acht gelijktijdige verzoeken, en het kleinst bij de Ministral 3B met ongeveer 7 procent. De twee towers verschillen slechts ongeveer 3 procent van elkaar, behalve bij de gpt-oss met 64 verzoeken, waar de Core T2 met beide kaarten een voorsprong had van 7 tot 11 procent. Dit betekent dat de CPU-belasting van de server bij die batchgrootte de voorkeur geeft aan de snellere cores.
Afbeelding genereren
De test voor beeldgeneratie genereert afbeeldingen van 1024×1024 pixels met drie diffusiemodellen bij drie verschillende gewichtsprecisies en rapporteert de tijd per afbeelding, de ruisreductiesnelheid en het GPU-geheugen dat de gewichten in beslag nemen. De test genereert ook dezelfde seed met een BF16-waarde en vergelijkt de Q4_0- en Q8_0-uitvoer met PSNR en SSIM, wat een indicatie geeft van de kosten van kwantisering.

| Afbeelding genereren, 1024×1024 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| FLUX.2 klein 4B, 4 stappen | ||||
| Q8_0: seconden per afbeelding (lager is beter) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: beelden per minuut | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: seconden per afbeelding (lager is beter) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8 stappen | ||||
| Q8_0: seconden per afbeelding (lager is beter) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: beelden per minuut | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: seconden per afbeelding (lager is beter) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B, 20 stappen | ||||
| Q4_0: seconden per afbeelding (lager is beter) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: seconden per afbeelding (lager is beter) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: seconden per afbeelding (lager is beter) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: beelden per minuut | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: GPU-geheugen voor gewichten (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
Diffusie is rekenintensief, en de 600W-kaart laat dat zien: Qwen-Image 20B bij Q8_0 duurde 26.1 seconden per afbeelding op de Max-Q en 19.7 seconden op de 600W-kaart in de Xeon-tower, een winst van 33 procent in afbeeldingen per minuut. Z-Image Turbo boekte een winst van 32 procent en FLUX.2 klein een winst van 21 procent. Het CPU-platform is hier irrelevant, aangezien de twee towers op elke regel binnen 1 procent verschil zaten, behalve bij het opstarten van de server, waar het RAID-volume van de Xeon T2 een paar seconden langer nodig heeft om de gewichten te laden.
| Kwantiseringsgetrouwheid ten opzichte van BF16 (zelfde seed) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| PSNR (dB, hoger is beter) / SSIM (hoger is beter) | ||||
| FLUX.2 klein 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
De rijen met getrouwheid zijn identiek voor de vier configuraties, aangezien de uitvoer afhangt van de gewichten en niet van de hardware. Q8_0 reproduceert het BF16-beeld met een SSIM van 0.938 tot 0.987 en een PSNR van 28 tot 36 dB, terwijl Q4_0 daalt naar 0.75 tot 0.79 SSIM en 18 tot 22 dB, wat een heel ander beeld geeft. Op een 96GB-kaart is er geen reden om deze modellen met een lagere geheugenlimiet dan Q8_0 te gebruiken; de BF16-gewichten van Qwen-Image passen op 45.3 GiB, en BF16 werd op alle drie de modellen even snel of iets sneller gerenderd als Q8_0, omdat het pad van Q8_0 tijd besteedt aan dequantisatie.
CPU-prestaties
De twee processors verdeelden onze CPU-testreeks duidelijk in gelijke mate. Waar een test alle cores gebruikt, wint de Xeon 658X in de meeste gevallen met 27 tot 150 procent, en hoe breder de vectoren en hoe zwaarder het geheugenverkeer, hoe groter de marge. Waar een test op één of enkele threads draait, wint de Core Ultra 9 285K met 13 tot 31 procent dankzij een 5.7 GHz P-core tegenover een 4.9 GHz Xeon-core met een hogere cache en geheugenlatentie. Het effect van de 600W GPU op de resultaten van de Xeon met alle cores wordt bij elke tabel besproken en samengevat in het gedeelte over de kloksnelheid.
Cinebench 2026 en aanhoudende belasting
Cinebench 2026 rendert een scène met Maxon's Redshift-engine op de CPU en meet de doorvoer voor één core, SMT-single-core (twee threads op één fysieke core) en meerdere cores. Vervolgens voeren we een continue lus uit die de multi-core run ongeveer 30 minuten herhaalt en vergelijken we de stabiele toestand met de eerste run.

| Cinebench 2026 (punten, hoe hoger hoe beter) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Enkele kern | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT enkelvoudige kern | 599.1 | 601.0 | Niet van toepassing (geen SMT) | Niet van toepassing (geen SMT) |
| Meerdere kernen | 12,322 | 11,705 | 8,856 | 8,838 |
| Aanhoudende lus, eerste doorgang | 12,201 | 11,731 | 8,717 | 8,788 |
| Aanhoudende lus, stabiele toestand | 12,328 | 11,764 | 8,825 | 8,844 |
| Stationaire toestand / eerste doorgang | 1.010 | 1.003 | 1.012 | 1.006 |
| Aanhoudende lus, stabiele CPU-klokfrequentie (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
De 658X behaalde een score van 12,322 in de multi-core test met de Max-Q-kaart geïnstalleerd, 39 procent meer dan de 8,856 van de 285K, en behield een score van 12,328 gedurende de 30 minuten durende test, een stabiele waarde die 1 procent hoger lag dan de eerste test. Op één core was de volgorde omgekeerd: de 285K behaalde een score van 564.4 tegenover 454.1 van de Xeon, en er waren twee threads op één Xeon-core nodig, met een score van 599.1, om de single-thread score van de 285K te overtreffen.
Door de 600W-kaart te installeren, daalde de multi-core score van de Xeon naar 11,705 en de steady-state score naar 11,764, 5 procent lager, met een steady-state kloksnelheid die daalde van 4,274 naar 4,178 MHz. De Core T2 vertoonde geen dergelijke verandering, met scores van 8,856 en 8,838. De testsuite registreerde geen CPU- of GPU-temperaturen in beide behuizingen, dus we kunnen niet zeggen of de 250W-processor het aflegt tegen de warmteontwikkeling van de 600W-kaart of tegen een gedeeld energiebudget. We kunnen alleen vaststellen dat de prestaties met de grotere kaart in de behuizing 4 tot 5 procent lager liggen bij elke all-core test.
7-Zip
De ingebouwde benchmark van 7-Zip rapporteert de doorvoer van LZMA-compressie en -decompressie in giga-instructies per seconde, eenmaal per thread en eenmaal toegewezen aan één enkele core. LZMA is afhankelijk van de doorvoer van gehele getallen, branch prediction en cache- en geheugenlatentie, waardoor het aantal cores en een snel geheugenpad meer worden beloond dan de vectorbreedte.

| 7-Zip (GIPS, hoe hoger hoe beter) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Alle draden | ||||
| Totaal | 289.6 | 288.9 | 174.8 | 175.7 |
| Comprimeren | 276.4 | 273.5 | 151.5 | 151.9 |
| Decomprimeer | 303.0 | 304.4 | 198.1 | 199.4 |
| Eén draad | ||||
| Totaal | 8.74 | 8.05 | 10.82 | 10.83 |
| Comprimeren | 8.66 | 7.80 | 9.31 | 9.31 |
| Decomprimeer | 8.83 | 8.30 | 12.33 | 12.34 |
Met 48 threads behaalde de Xeon een score van 289.6 GIPS tegenover 174.8 GIPS van de 285K met 24 threads, een voorsprong van 66 procent. De compressieprestaties waren 82 procent beter en de decompressieprestaties 53 procent. Met één thread leidde de 285K met 10.82 GIPS tegenover 8.74 GIPS, en het verschil werd groter met de 600W-kaart in de Xeon-tower, tot 8.05 GIPS, wat overeenkomt met de lagere kloksnelheden waarop die configuratie draaide.
Blender, HandBrake en LLVM
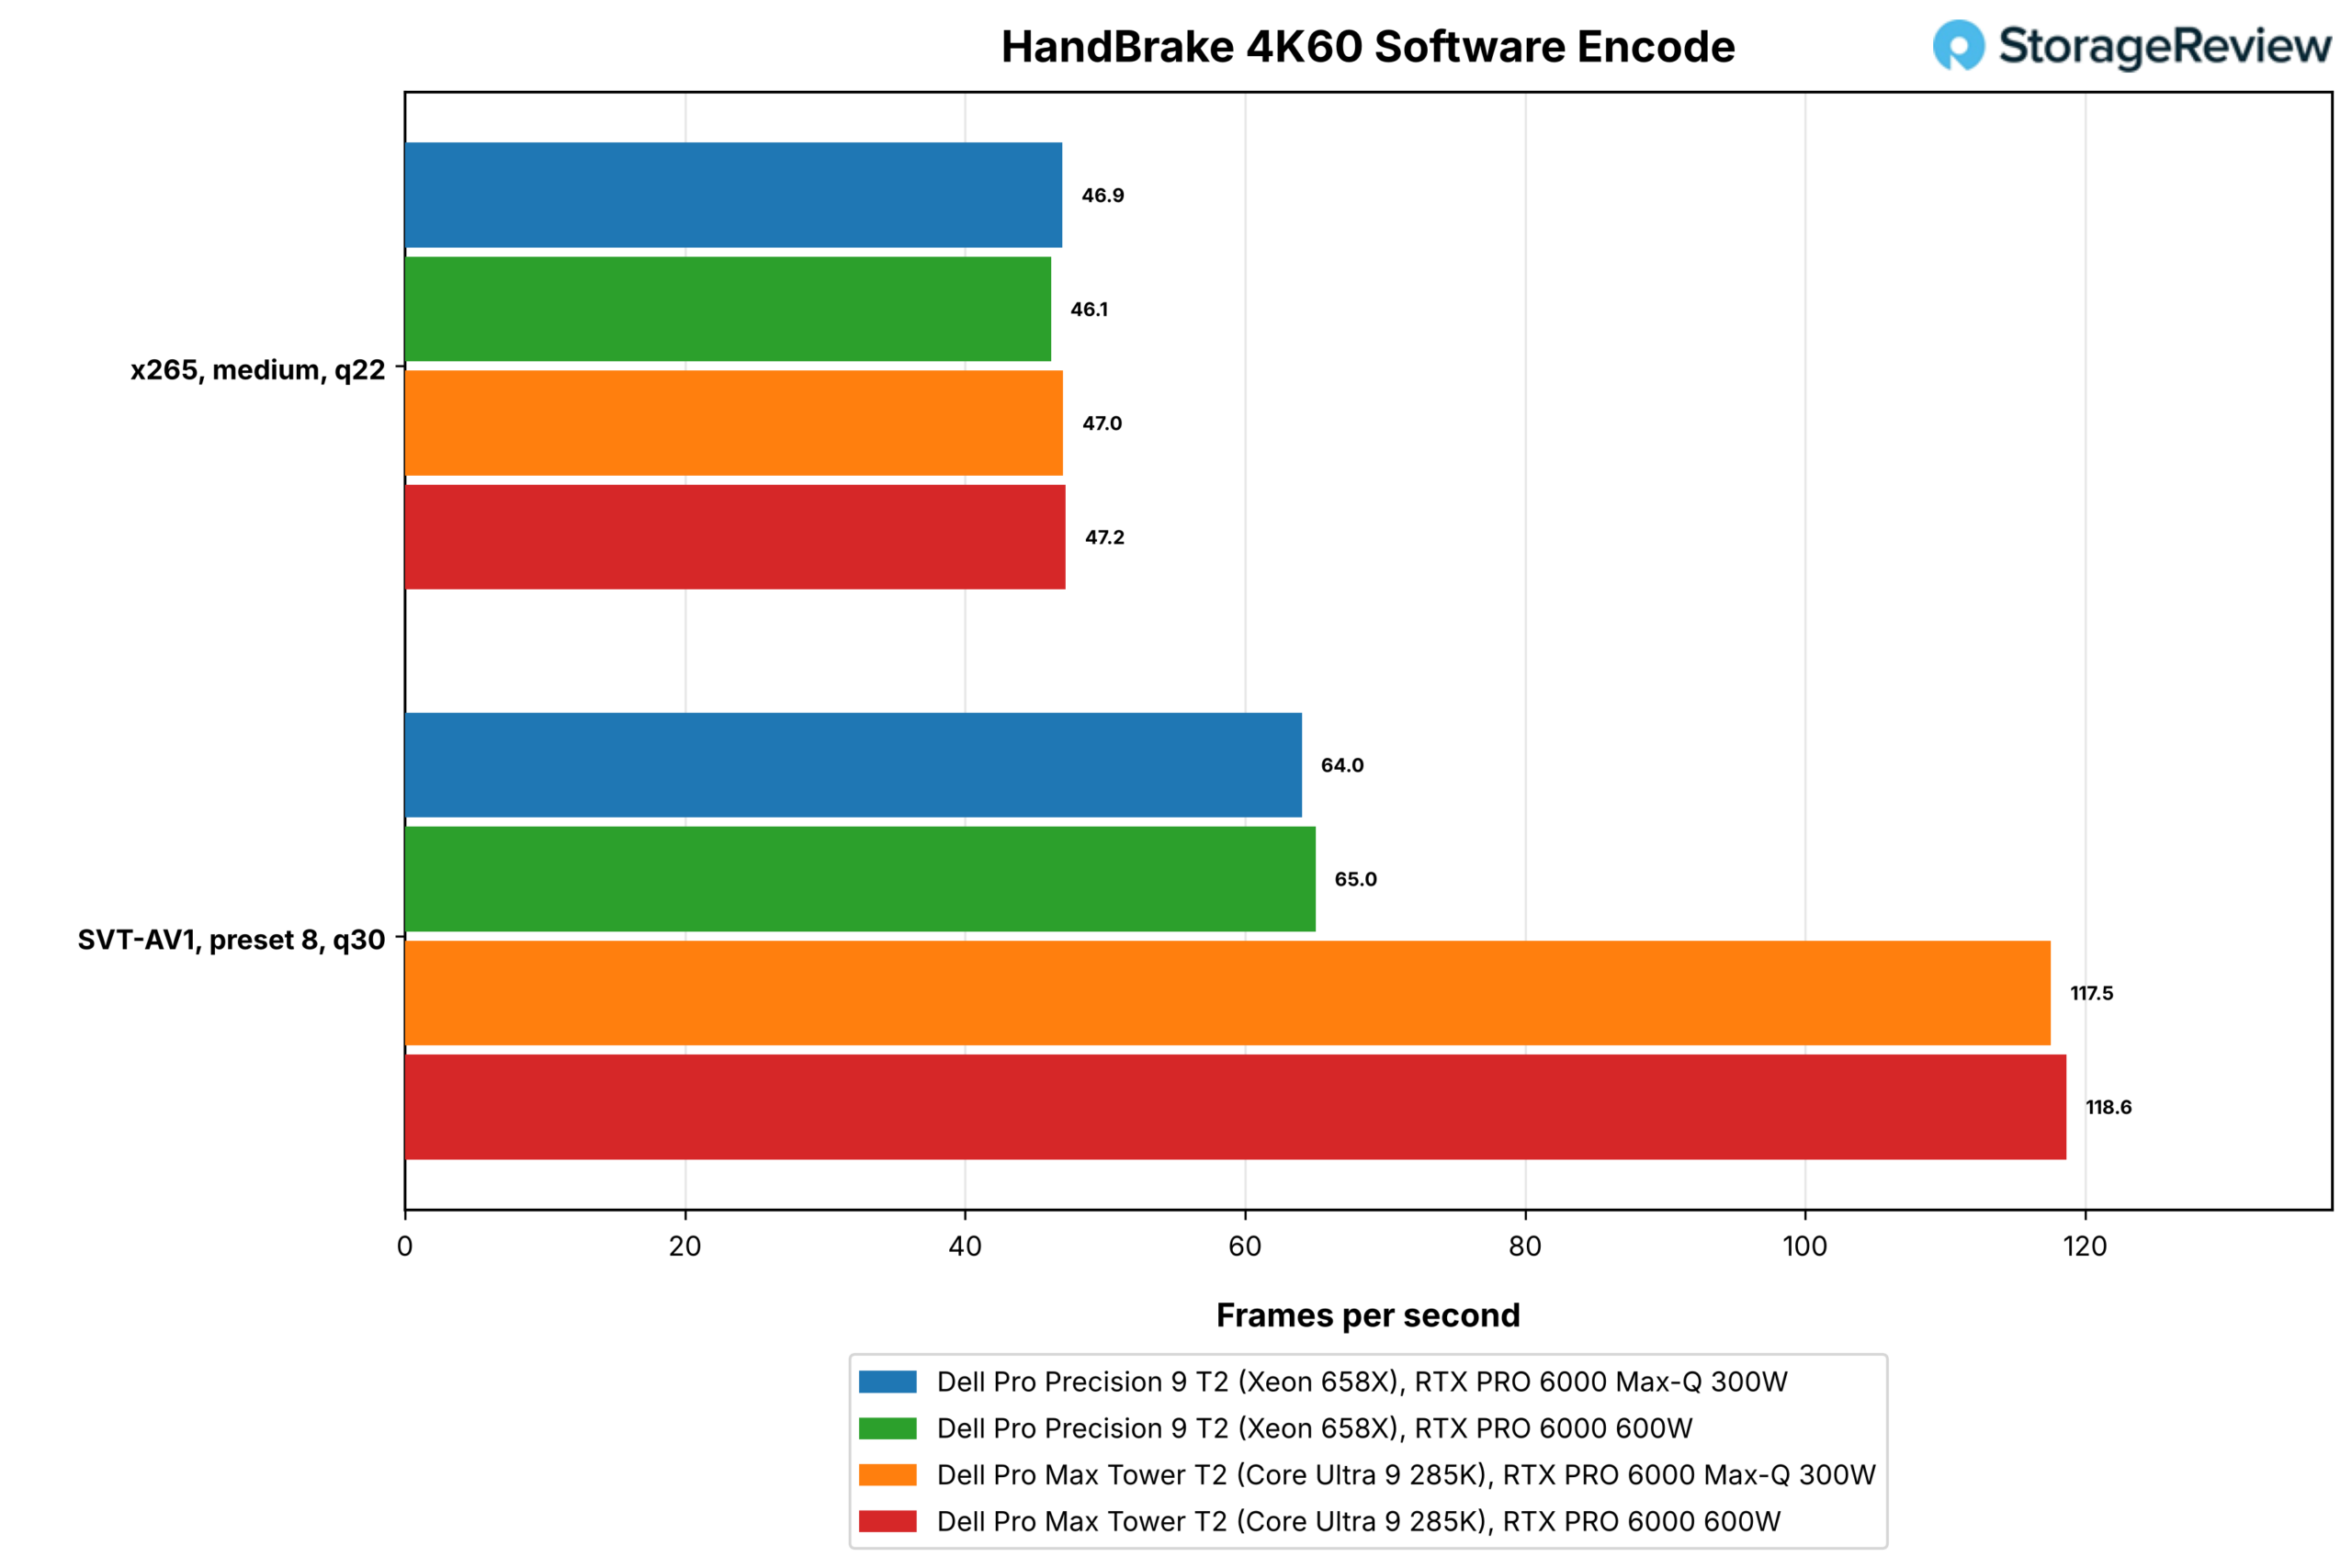
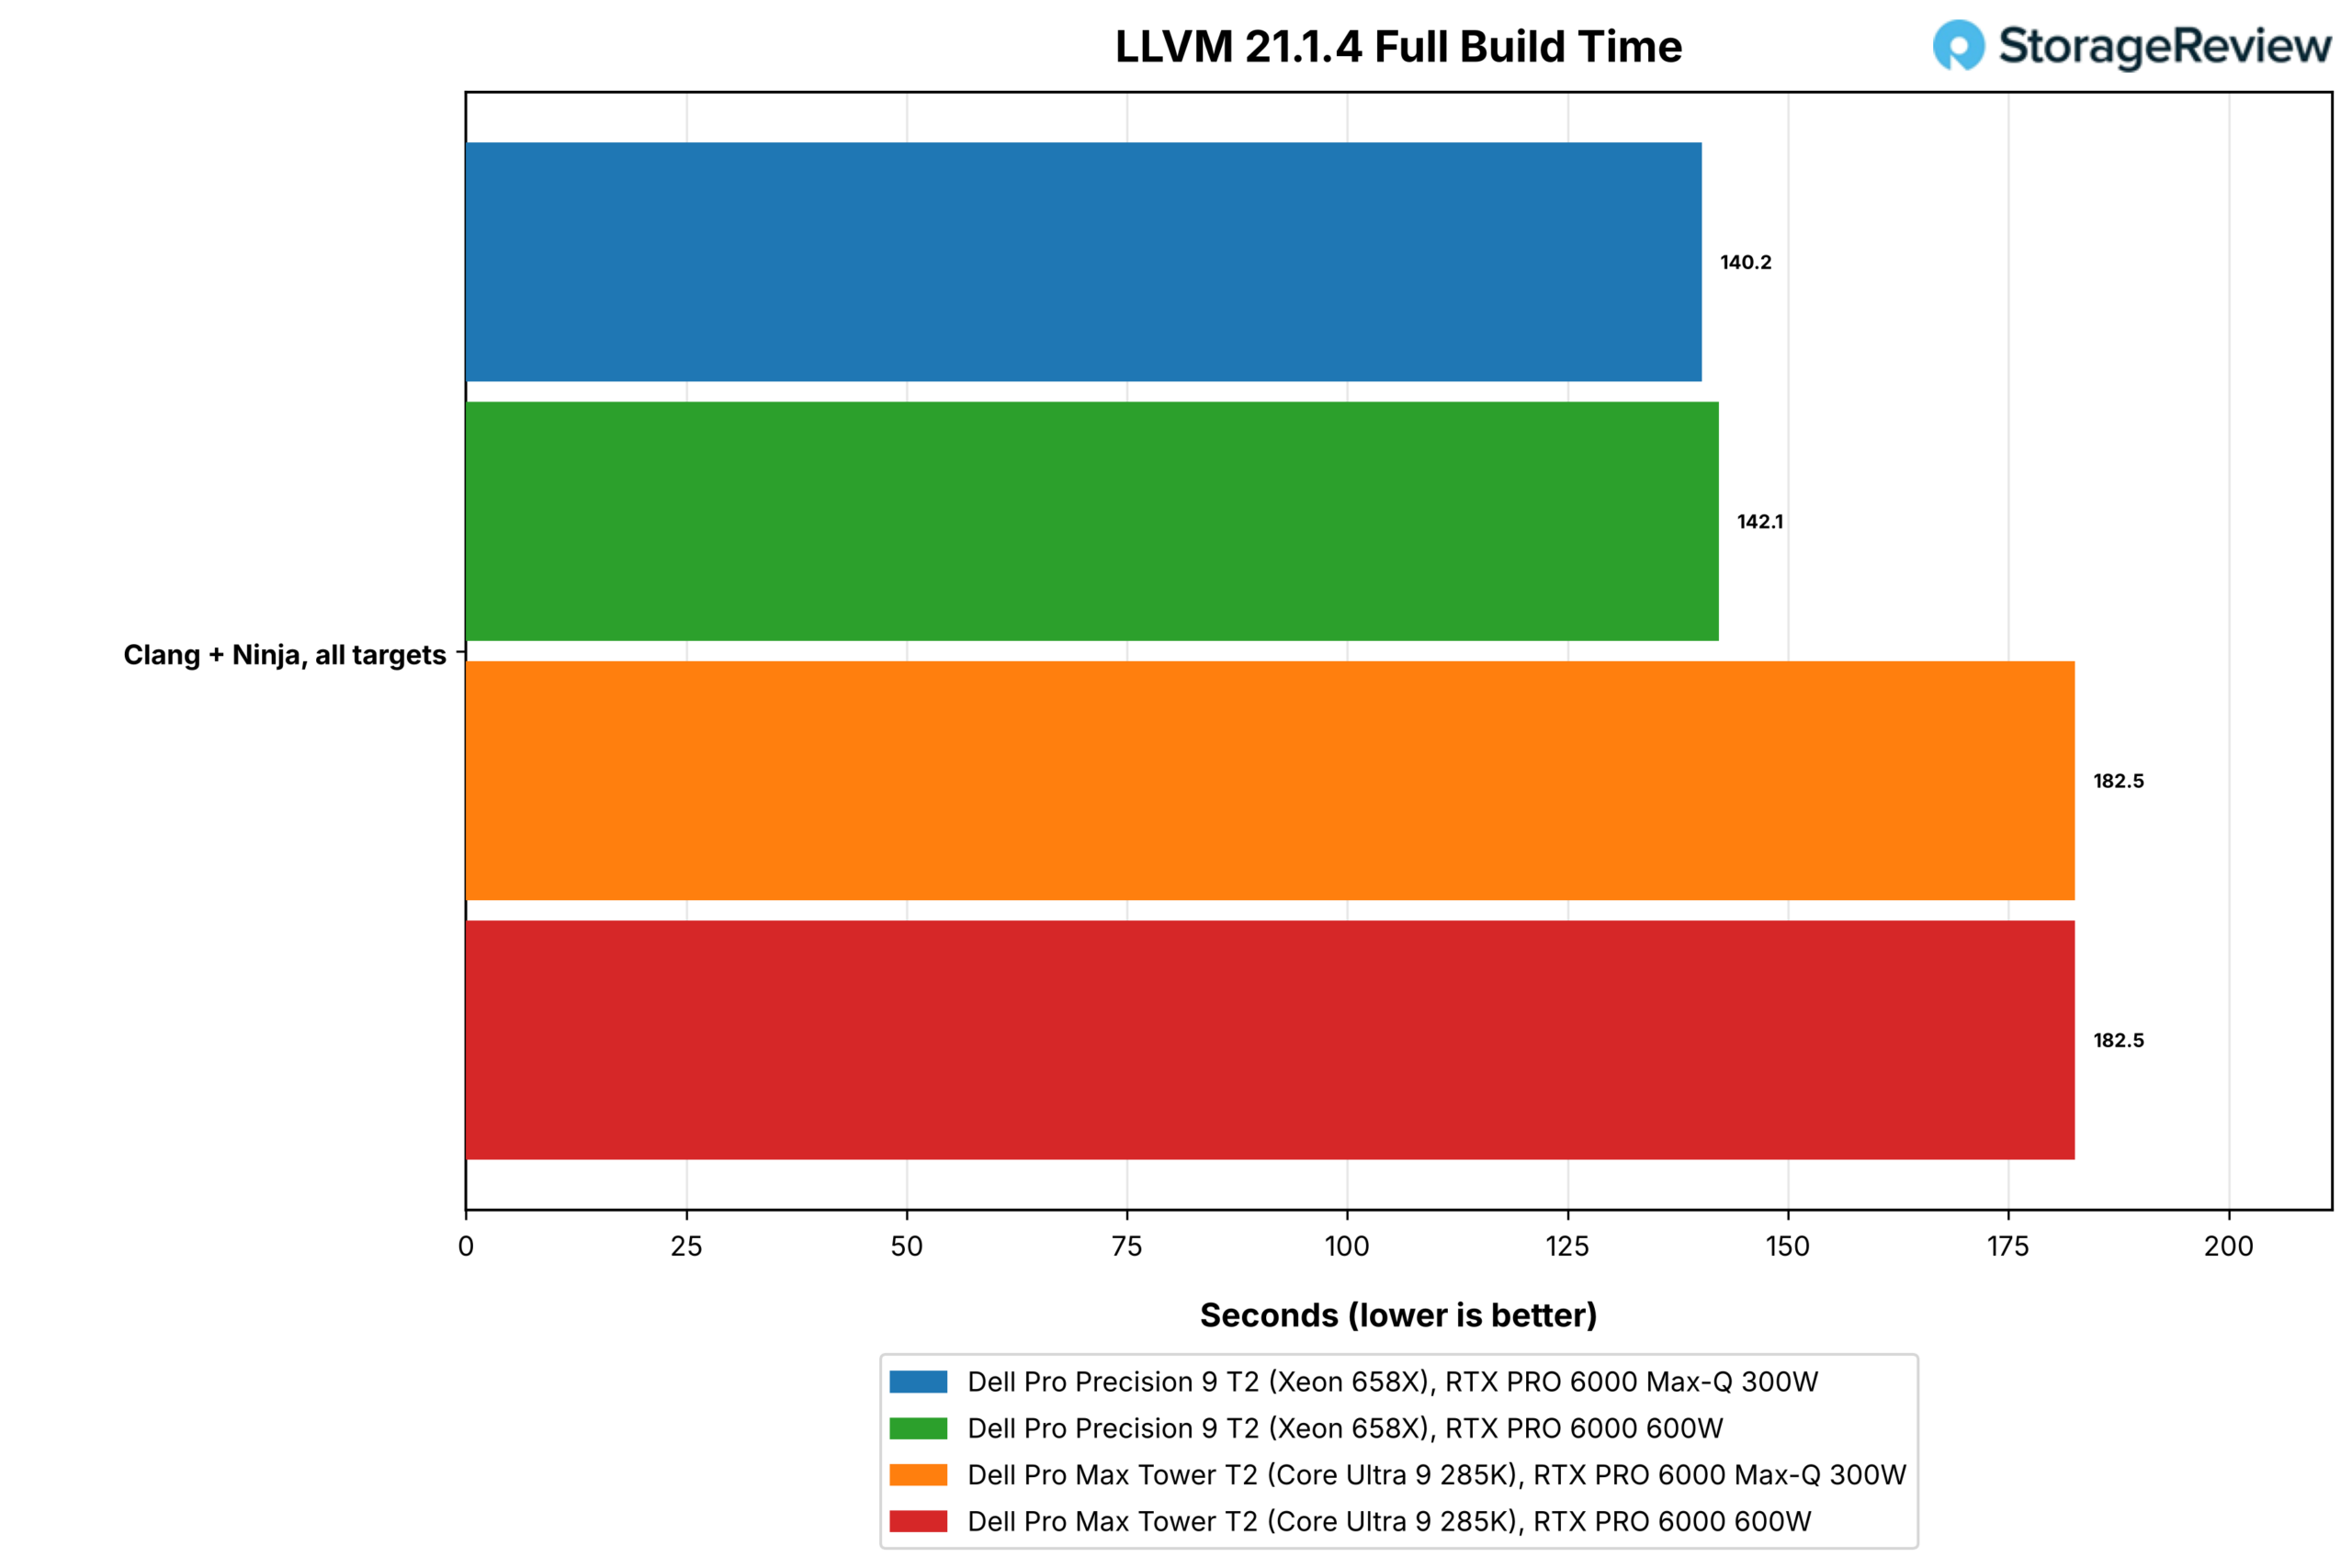
Blender 4.5 rendert de scènes Monster, Junkshop en Classroom met Cycles op de CPU. HandBrake codeert 60 seconden van een 4K60-clip in software met x265 (HEVC, medium preset, kwaliteit 22) en SVT-AV1 (preset 8, kwaliteit 30). De LLVM-test compileert de volledige LLVM 21.1.4-tree met Clang en Ninja, de langste workload die alle cores in de testsuite belast.

| Test | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Blender 4.5 Monster (samples/min, hoe hoger hoe beter) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (monsters/min) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Classroom (voorbeelden/min) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265, medium, q22 (fps, hoger is beter) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1, preset 8, q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 build (s, lager is beter) | 140.2 | 142.1 | 182.5 | 182.5 |
De Xeon renderde Monster met 366.2 samples per minuut tegenover 259.6 op de 285K, een voorsprong van 41 procent die binnen twee punten bleef voor alle drie de scènes. LLVM werd in 140.2 seconden gecompileerd tegenover 182.5 seconden op de 285K, een tijdsbesparing van 23 procent. Met de 600W-kaart geïnstalleerd daalden de Blender-scores van de Xeon met 7 tot 10 procent, de hoogste score voor deze kaart in de hele CPU-test.
HandBrake presteerde verschillend op basis van de encoderinstellingen: x265 draaide met de medium preset op 46.9 fps op de Xeon en 47.0 fps op de 285K, een gelijkspel, terwijl SVT-AV1 met preset 8 op 64.0 fps draaide op de Xeon tegenover 117.5 fps op de 285K.
We hebben een middag besteed aan het onderzoeken van dat verschil, en het blijkt een resultaat per thread te zijn. De encoder bereikt zijn maximum bij parallelismeniveau 6 met deze preset en houdt ongeveer negen logische processors bezig op de Xeon; het forceren van AVX2-kernels in plaats van AVX-512 veranderde niets (63.8 tegen 63.9 fps), en het vastzetten op één thread per fysieke core resulteerde in een vertraging van 2 procent (62.6 fps), dus noch het vectorpad, noch de SMT-scheduling is de oorzaak. Wat overblijft is de Xeon-core zelf en de interactie tussen de cores, die een gepipelinede encoder die wacht op overdrachten tussen fasen in elk frame voelt.
Stockfish, primesieve, Python en de browser
De ingebouwde benchmark van Stockfish rapporteert de zoeksnelheid van schaken in miljoenen knooppunten per seconde. Primesieve telt de priemgetallen onder de 10^12 op alle threads en onder de 10^11 op één thread. PyPerformance voert drie CPython-benchmarks (go, nbody en regex_compile) uit, die vastgezet zijn op één snelle core, en Speedometer 3.1 meet de responsiviteit van webapplicaties in Microsoft Edge.
| Test | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Stockfish-testbank, alle threads (Mnps, hoe hoger hoe beter) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfish-testbank, één thread (Mnps, hoger is beter) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12, alle schroefdraad (s, lager is beter) | 7.69 | 7.51 | 6.77 | 6.84 |
| primesieve 1e11, één draad (s, lager is beter) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, lager is beter) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, lager is beter) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, lager is beter) | 88.6 | 90.5 | 61.1 | 61.2 |
| Snelheidsmeter 3.1, Edge (score, hoe hoger hoe beter) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish behaalde met 48 threads 40.87 Mnps op de Xeon tegenover 30.10 op de 285K, en met één thread was de 285K met 1.99 tegen 1.65 de betere. Primesieve is de enige test met meerdere threads die de 285K wint, met 6.77 seconden tegen 7.69, omdat de sieve in de cache past en net zo goed schaalt met de kloksnelheid als met het aantal cores. De single-threaded tests gaan allemaal naar de 285K met een voorsprong van 13 tot 31 procent: PyPerformance met 64.8 ms tegen 91.4 ms, regex_compile met 61.1 ms tegen 88.6 ms en Speedometer met 46.3 ms tegen 36.8 ms.
Dat browsercijfer is wat een koper aan zijn bureau ervaart. Een Speedometer-score van 36.8 is in absolute termen nog steeds snel, maar het ligt een vijfde lager dan de Core-tower in dezelfde behuizing, en iedereen die voor de Xeon kiest vanwege de doorvoersnelheid moet verwachten dat de interactieve kant van de machine een stap trager zal zijn dan een Core Ultra-desktop.
GROMACS, OpenBLAS en geheugen
GROMACS voert de benchMEM moleculaire dynamica-simulatie uit op 16 cores in vier verschillende rang- en threadconfiguraties en rapporteert de gesimuleerde tijd in nanoseconden per dag voor de beste configuratie. Onze OpenBLAS-test voert een HPL-achtige LU-oplossing met dubbele precisie uit voor drie verschillende probleemgroottes en een DGEMM-matrixvermenigvuldiging op alle cores, en op de 285K nogmaals op de acht P-cores alleen; de 24 cores van de Xeon vormen één klasse, dus die rijen zijn niet van toepassing. STREAM meet de continue geheugenbandbreedte en de latentierijen meten de tijd die nodig is voor een enkele geheugentoegang en de interactie tussen cores.

| Test (hoe hoger, hoe beter) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| GROMACS benchMEM, beste lay-out (ns/dag) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, alle cores (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, alle cores (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, alle cores (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, alleen P-cores (GFLOPS) | Niet van toepassing (één kernvak) | Niet van toepassing (één kernvak) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, alle cores (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, alleen P-cores (GFLOPS) | Niet van toepassing (één kernvak) | Niet van toepassing (één kernvak) | 565.3 | 566.5 |
Dit is waar AVX-512, 144 MB L3-cache en vier kanalen DDR5-6400 samenkomen. DGEMM behaalde 1,638 GFLOPS op de Xeon tegenover 768 op de 285K, en de N=40000 LU-berekening, die 11.9 GB door het geheugen streamt, draaide op 1,659 GFLOPS tegenover 668, 2.5 keer zo snel als de Core-tower. Het resultaat van de 285K stijgt nauwelijks van N=20000 naar N=40000 omdat de bandbreedte dan beperkt wordt, terwijl de Xeon blijft schalen. GROMACS op 16 cores gaf de voorkeur aan de Xeon met een verschil van 27 procent bij 47.39 ns/dag.

| Test | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| STREAM kopiëren (MB/s, hoe hoger hoe beter) | 106,698 | 106,512 | 39,477 | 39,426 |
| STREAM-schaal (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| STREAM Toevoegen (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM Triad (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| Geheugenlatentie, 1 GiB buffer, 4 KiB pagina's (ns, lager is beter) | 148.3 | 147.8 | 135.2 | 135.4 |
| Kern-naar-kern latentie, gemiddelde van alle paren (ns, lager is beter) | 56.2 | 56.0 | 38.1 | 38.2 |
| Kern-naar-kern latentie, minimaal paar (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Kern-naar-kern latentie, maximaal paar (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad haalde snelheden van 122,233 MB/s op de Xeon T2 en 33,003 MB/s op de Core T2, 3.7 keer de bandbreedte, met vier kanalen DDR5-6400 RDIMM tegenover vier kanalen DDR5-4400 UDIMM op een platform dat de DIMM's niet kan bijbenen. De prijs hiervoor is latentie: 148.3 ns naar het geheugen op de Xeon tegenover 135.2 ns op de 285K, en gemiddeld 56.2 ns tussen cores tegenover 38.1 ns. De minimale latentie van 4.6 ns op de Xeon betreft een paar SMT-processors op één core, en de maximale latentie van 65.7 ns betreft een verbinding over het mesh-netwerk.
Gaming
SuperTuxKart 1.5 voert zijn ingebouwde benchmark uit op 1080p fullscreen met de hoogste preset en VSync uitgeschakeld. We rapporteren de gemiddelde en de stabiele framesnelheid. Bij deze resolutie heeft de GPU nog voldoende capaciteit, waardoor het resultaat de CPU volgt. De test is representatief voor de vele professionele viewports die op dezelfde manier beperkt zijn. De NVENC-pass van onze encode-test is op deze systemen niet voltooid en is daarom weggelaten.

| SuperTuxKart 1.5, 1080p Ultra, vsync uit (fps, hoe hoger hoe beter) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Gemiddelde | 304.6 | 323.2 | 359.1 | 383.5 |
| Typisch | 304 | 322 | 354 | 376 |
| Vast | 161 | 174 | 122 | 135 |
De Core T2 haalde gemiddeld 359.1 fps met de Max-Q-kaart tegenover 304.6 fps met de Xeon T2, wederom het verschil in single-thread prestaties. De Xeon-tower hield daarentegen een hogere, stabiele framerate vast van 161 fps tegenover 122 fps, met minder dips. De 600W-kaart voegde ongeveer 6 procent toe aan het gemiddelde in beide towers.
Klokken onder belasting
Geen van beide towers rapporteerde CPU- of GPU-temperaturen via het sensorpad van de testsuite. Daarom is de temperatuurtabel die we normaal publiceren hier vervangen door de gemiddelde CPU-klokfrequentie tijdens elke test. Dit getal verklaart het effect van de 600W-videokaart op de Xeon. Met de Max-Q geïnstalleerd, behield de 658X een klokfrequentie van 4,269 MHz gedurende de 30 minuten durende continue test en 4,040 tot 4,480 MHz in de kortere all-core tests. Met de 600W-videokaart in de behuizing liepen de meeste van deze tests op een lagere frequentie, tot wel 300 MHz lager, en behaalden ze allemaal lagere scores.
| Gemiddelde CPU-klokfrequentie tijdens de test (MHz) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| Aanhoudende lus | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| Stokvis | 4,291 | 3,995 | 4,749 | 4,741 |
| Blenders | 4,258 | 4,253 | 4,582 | 4,552 |
| HandBrake | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM-build | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| BLAS openen | 4,039 | 3,979 | 4,766 | 4,761 |
| STREAM | 4,321 | 4,326 | 4,687 | 4,676 |
| prime zeef | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf-client | 4,191 | 4,138 | 3,814 | 3,686 |
| Codeeragent | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM-medewerker | 4,261 | 4,169 | 4,229 | 4,209 |
| Beeldgeneratie | 4,044 | 4,008 | 3,702 | 3,837 |
| VOD | 4,178 | 4,197 | 4,172 | 4,108 |
| Super Tux Kart | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish daalde van 4,291 naar 3,995 MHz, primesieve van 4,441 naar 4,268, 7-Zip van 4,414 naar 4,307 en de sustained loop van 4,269 naar 4,182, terwijl de 285K in elke all-core test binnen 20 MHz van zichzelf bleef, ongeacht de videokaart.
De gemiddelde kloksnelheid is niet de volledige verklaring. Cinebench en Blender haalden gemiddelden die binnen 10 MHz van hun Max-Q-waarden lagen en verloren nog steeds 5 tot 10 procent, wat wijst op korte uitschieters die door het gemiddelde per test worden afgevlakt. De 658X verbruikt tot 250 W, de 600 W-kaart nog eens 600 W, en beide voeren de warmte af naar hetzelfde volume van 32 liter achter één luchtinlaat aan de voorkant; of de beperking nu de thermische capaciteit van de processor is of een stroomlimiet van het platform, is een vraag die we bij onze volgende test met externe stroom- en temperatuurmetingen zullen beantwoorden. Voorlopig moeten kopers die alle CPU-cores belasten weten dat de Max-Q-configuratie de snellere is aan de CPU-kant.
Opslagprestaties
Onze opslagtest meet de prestaties van fio op de opstartschijf met footprints van 5 GB en 25 GB, via het bestandssysteem en vervolgens weer op het onbewerkte apparaat. De resultaten van de 25 GB-test worden hier weergegeven. Op de Core T2 is de opstartschijf een enkele 2TB SK hynix PCB01 op Gen5 x4; op de Pro Precision 9 T2 zijn dit de twee E3.S Gen5-schijven in de FlexBay, gestript tot een RAID0-volume van 4,097 GB door VROC van Graid Technology. BitLocker was uitgeschakeld in alle vier de configuraties, dus de rijen in het bestandssysteem meten NTFS en de RAID-laag, niet de encryptie.


| fio, 25GB geheugenvoetafdruk, QD32 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Sequentiële leesbewerking 128K, bestandssysteem (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| Sequentiële leesbewerking 128K, onbewerkt apparaat (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| Sequentiële schrijfsnelheid 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1MB prefill-leesbewerking, QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| Willekeurige leesbewerking 4K, bestandssysteem, piek (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| Willekeurige uitlezing 4K, onbewerkt apparaat, piek (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| Willekeurige schrijfbewerkingen van 4K, piek (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Onbewerkt / willekeurig lezen van het bestandssysteem | 1.32x | 1.31x | 1.29x | 1.31x |
| Willekeurige leesbewerking 4K, 4 taken, p99 latentie (VS, lager is beter) | 506 | 485 | 183 | 185 |
| Willekeurige leesbewerking 4K, 16 taken, p99.99 latentie (VS, lager is beter) | 15,270 | 23,462 | 676 | 676 |
| Willekeurige schrijfbewerking 4K, 4 taken, p99 latentie (VS, lager is beter) | 610 | 594 | 228 | 228 |
| Maximale aandrijftemperatuur (C) | Niet van toepassing (achter RAID) | Niet van toepassing (achter RAID) | 50 | 57 |
De stripe is niet sneller dan de enkele schijf, en bij kleine blokken blijft hij er zelfs ver achter. De twee E3.S-schijven lazen 9,332 MB/s sequentieel via NTFS en 10,782 MB/s van het onbewerkte volume, tegenover 11,377 en 11,186 MB/s voor de PCB01, en schreven 6,507 MB/s tegenover 7,401 MB/s. Bij willekeurige leesbewerkingen van 4K bereikte het volume een piek van 840.1 IOPS via het bestandssysteem en 1.11 MB/s onbewerkt, tegenover 1.78 MB/s en 2.30 MB/s voor de enkele schijf, en bij willekeurige schrijfbewerkingen een piek van 557.5 IOPS tegenover 957.5. De verhouding tussen onbewerkt volume en bestandssysteem is ongeveer 1.3x op beide schijven, dus NTFS kost op beide schijven evenveel; het verschil zit hem in de VROC-laag die onder beide paden zit.
De staartlatentie is als volgt: bij 16 taken duurde de langzaamste 0.01 procent van de willekeurige leesbewerkingen 15.3 ms op het volume, tegenover 0.68 ms op de enkele schijf. De p99-leeslatentie bij 4 taken was 506 µs tegenover 183 µs. Software-RAID over twee NVMe-schijven voegt een CPU-hop toe aan elke I/O-bewerking, en de fio CPU-metingen laten dit zien: 80 procent bij de sequentiële passes tegenover 40 procent op de Core T2. Het volume verbergt ook de SMART-gegevens van de schijven, waardoor de testsuite hun temperatuur niet kon registreren.
Dat alles maakt de FlexBay niet per se een verkeerde keuze. Het biedt de T2 frontaal onderhoudbare, hot-pluggable schijven in een vormfactor die schaalbaar is tot capaciteiten die M.2 niet kan bereiken, en een opstartvolume van 4 TB met twee schijven is handig. Het betekent wel dat een koper wiens workload bestaat uit small-block random I/O, een lokale database of een zwaar gecachede modeldirectory, beter kan kijken naar een enkele E3.S-schijf zonder stripe, of naar de interne M.2-slots, waar de resultaten van de Core T2 laten zien wat één Gen5-schijf in deze behuizing presteert.
Conclusie
De Dell Pro Precision 9 T2 is de Pro Max Tower T2 met een workstationprocessor erin, en de testgegevens bevestigen dat dit precies is wat kopers kunnen verwachten. In dezelfde behuizing van 32 liter levert de Xeon 658X 39 procent meer Cinebench multi-core doorvoer, 3.7 keer de geheugenbandbreedte, een dubbele DGEMM-snelheid en een 24-core, 48-thread processor met AVX-512, AMX, registered ECC-geheugen en een uitbreidingsmogelijkheid tot 1 TB. Bij single-threaded taken, van PrimeSieve tot Python, levert hij 13 tot 31 procent in, en kopers die hun dag doorbrengen in een viewport of terminal zullen dit verschil merken.
De keuze voor de GPU is het punt dat in deze review is opgenomen om kopers inzicht te geven. De Max-Q en de 600W RTX PRO 6000-kaarten delen 96 GB geheugen en de decoderingstijden liggen 7 tot 20 procent van elkaar af. De 600W-kaart bewijst zijn voordeel door snelle verwerking, waarbij de tijd tot het eerste token met een derde of meer wordt verkort, en door diffusie, waarbij beelden 20 tot 34 procent sneller worden weergegeven.
In de Xeon-tower kost de 600W-kaart de processor bovendien 4 tot 5 procent extra bij belasting van alle cores en vereist de kaart het naastgelegen slot, wat in ons testmodel betekende dat de 25GbE-adapter verwijderd moest worden. Voor een tower waarvan de eigenaar naast lokale modellering ook CPU-renders en -simulaties uitvoert, is de door Dell meegeleverde Max-Q-kaart een evenwichtige keuze; voor iemand die modellen levert aan een team of de hele dag afbeeldingen rendert, is de 600W-kaart de extra ruimte en de 1500W-voeding zeker waard.
De E3.S in de FlexBay is de vormfactor die we al jaren in een tower wilden hebben; VROC van Graid Technology is een geloofwaardige combinatie voor de RAID-stack. Hij is weliswaar trager bij kleine willekeurige I/O dan de enkele M.2-schijf in de Core T2, maar ongeveer de helft trager bij 4K-lees- en schrijfbewerkingen. Een koper die geen RAID-opstartvolume nodig heeft, kan in plaats daarvan een enkele E3.S-schijf of de interne M.2-slots overwegen.
Aan de andere kant, nu E3.S SSD's de 60TB-grens overschrijden, krijgen gebruikers met extreme databehoeften toegang tot een compleet nieuwe wereld die voorheen externe behuizingen of het koppelen van een gedeeld opslagvolume betekende, waarbij flash-opslag de praktische beperking vormde.
De Pro Precision 9 T2 kost ongeveer $ 28,300 zoals geconfigureerd op Dell.com, nog vóór de volumekorting die de meeste zakelijke kopers krijgen. Dat is zo'n $ 4,500 meer dan een Pro Max Tower T2 met dezelfde configuratie: een 285K-processor, 128 GB DDR5-4400 ECC-geheugen, de RTX PRO 6000, een 2 TB Gen5-schijf en een 1500W-voeding kosten samen ongeveer $ 23,800. De GPU- en geheugenopties van de twee towers verschillen slechts $ 900 van elkaar. De tweede FlexBay-schijf is goed voor $ 1,700 van dat verschil, en de rest wordt bepaald door het Xeon-platform.
Wat je ervoor terugkrijgt is een tower-pc met één processor die zich onder volledige belasting gedraagt als een kleine server, met dezelfde afmetingen als een desktopcomputer. Dat is de reden waarom de naam Precision weer terug is.
Klassement: De Dell Pro Precision 9 T2 staat bovenaan als beste desktopwerkstation in ons klassement van beste desktopwerkstations , en de resultaten met de RTX PRO 6000 staan ook in ons klassement van beste zakelijke GPU's.



 Amazon