

Open WebUI combineert chat, modelbeheer, bestanden, webzoekopdrachten, het aanroepen van tools, beeldondersteuning, kennisfuncties en API-toegang in één lokale AI-interface. Voor deze praktijktest hebben we ons gericht op de Windows-desktopversie en dezelfde hardware en modelbestanden gebruikt als bij onze eerdere tests met versie 0.8.6 in januari, zodat we de twee applicaties onder vergelijkbare omstandigheden konden vergelijken.
Dit is de tweede vermelding in onze ranglijst van beste lokale LLM-tools , waar we herhaalbare prestatieresultaten van dezelfde testhardware toevoegen naarmate we de platforms op de lijst afwerken.
Open WebUI is een open-source, zelfgehost AI-platform dat is ontworpen om lokale en externe AI-modellen een browsergebaseerde interface te bieden die er veel op lijkt en werkt zoals de commerciële AI-chatdiensten die mensen al kennen. Het kan verbinding maken met verschillende inferentie-backends en OpenAI-compatibele services, terwijl de desktopapplicatie die we hebben getest GGUF-modellen lokaal kan uitvoeren via de meegeleverde llama.cpp-omgeving. Dat geeft het een veel breder toepassingsgebied dan een eenvoudige lokale chatapplicatie, vooral wanneer tools, modelvoorinstellingen, webzoekfuncties, bestanden en API-toegang zijn ingeschakeld.
Voor de tests gebruikten we opnieuw hetzelfde HP Z4 Rack G5- werkstation, de NVIDIA RTX 5000 Ada Generation GPU en twee Jan GGUF-modellen die we in onze review van Jan v0.8.6 hadden gebruikt. We behielden de context van 8,192 tokens, de batchgrootte van 2,048, 100 GPU-lagen en de overeenkomende samplingwaarden voor de gemeten tekstruns. Daarnaast besteedden we ook tijd aan de modelvoorinstellingen van Open WebUI, multimodale invoer, DDGS-webzoekfunctie, URL-ophaling en de lokale API.
Het duurde aanzienlijk langer dan verwacht om Open WebUI goed werkend te krijgen, en het grootste deel van die tijd ging zitten in de lokale llama.cpp- en CUDA-configuratie voordat we überhaupt aan de normale modeltests konden beginnen. Uiteindelijk kregen we alles aan de praat, maar onderweg stuitten we op een defecte standaard runtime-download, ontbrekende CUDA-bestanden, extreem grote contexttoewijzingen en een paar problemen met het ingebouwde toolsysteem.
Testsysteem
We hebben de systeemconfiguratie ongewijzigd gelaten ten opzichte van onze tests in januari, zodat de modelresultaten gemakkelijker te vergelijken zijn tussen verschillende applicaties. Tegelijkertijd hebben we de desktop-, server-, Python- en llama.cpp-versies vastgelegd die voor deze Open WebUI-test zijn gebruikt.
| Bestanddeel | Configuratie |
| Besturingssysteem | Windows 11 Pro voor werkstations |
| CPU | Intel Xeon w5-2465X, 16 kernen |
| Geheugen | 128GB |
| GPU | NVIDIA RTX 5000 Ada-generatie |
| VRAM | 32,760 MiB (31.99 GB) |
| NVIDIA Driver | 597.06 |
| CUDA-compatibiliteit | 13.2 gerapporteerd door nvidia-smi |
| Open WebUI Desktop / Server | versie 0.0.20 / versie 0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Open WebUI Desktop installeren
Het Windows-installatieprogramma begint met een scherm voor het instellen van de omgeving, waar llama.cpp lokaal kan worden geïnstalleerd, Open Terminal kan worden ingeschakeld en de installatielocatie kan worden gewijzigd onder Geavanceerd. We hebben Open Terminal uitgeschakeld gelaten, llama.cpp ingeschakeld, de standaardmap onder het Windows-gebruikersprofiel behouden en zijn verdergegaan met de lokale installatie.
Nadat de pakketten en de meegeleverde Python-omgeving waren geïnstalleerd, vroeg Open WebUI ons een verbinding te selecteren en opende vervolgens de lokale browserachtige interface. Bij een nieuwe installatie werd Open WebUI als beschikbare verbinding weergegeven, gevolgd door het scherm 'Beheerdersaccount aanmaken' waarmee de eerste lokale beheerder wordt ingesteld voordat het hoofdchatvenster wordt geopend.
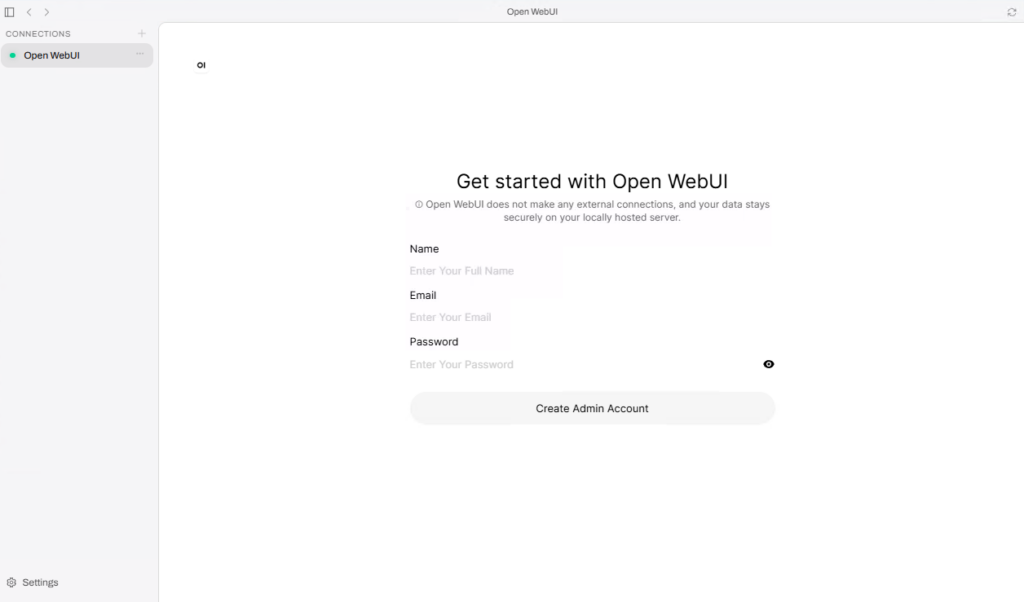
Bij een nieuwe lokale installatie van Open WebUI wordt eerst om een beheerdersaccount gevraagd voordat de hoofdchatinterface wordt geopend.
Een detail dat in eerste instantie verwarrend kan zijn, is dat Open WebUI Desktop en de lokale Open WebUI-server verschillende versienummers gebruiken. Onze uiteindelijke configuratie gebruikte Desktop v0.0.20 met Open WebUI-server v0.12.2, waarbij de server draaide vanuit de meegeleverde Python 3.12.13-omgeving onder het roamingprofiel van de Windows-gebruiker.
Modellen toevoegen en llama.cpp configureren
De desktopapplicatie scheidt modelbestanden van de inferentie-runtime, waardoor de pagina 'Modellen' lokale GGUF-bestanden beheert, terwijl de inferentie-runtime llama.cpp aanstuurt. We hebben dezelfde Jan V3.5 4B Q4_K_XL- en Jan V2 VL High Q4_K_M-bestanden die we voor onze eerdere tests gebruikten, samen met het V2-multimodale projectiebestand, gekopieerd, en beide modellen verschenen in de selector nadat de runtime was geactiveerd.
Het eerste runtimeprobleem deed zich voor zodra we llama.cpp probeerden te installeren. Door het veld Versie op 'latest' te laten staan met CUDA 12.4 geselecteerd, mislukte de installatie vrijwel direct. Uit het logboek van de desktop bleek dat Open WebUI 'latest' had omgezet naar llama.cpp v0.6.0 en probeerde een Windows CUDA-archief te downloaden dat niet beschikbaar was onder die release. Daarom hebben we build b11612 vastgezet en het opnieuw geprobeerd.
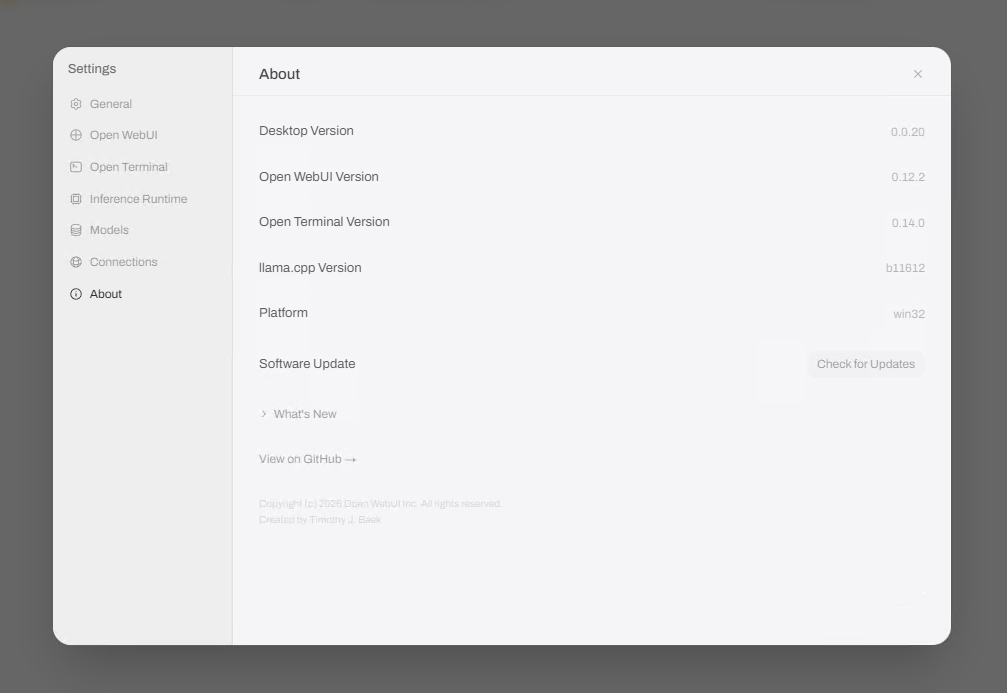
Op de 'Over'-pagina staan de afzonderlijke versies voor Desktop, Open WebUI, Open Terminal en llama.cpp vermeld die tijdens het testen zijn gebruikt.
Daarmee was het eerste probleem opgelost, maar llama.cpp wilde nog steeds niet starten omdat het aparte CUDA runtime DLL-pakket niet met het hoofdarchief was gedownload. We hebben handmatig cudart64_12.dll, cublas64_12.dll en cublasLt64_12.dll uit het officiële CUDA 12.4-pakket aan de map b11612 toegevoegd, waarna llama-server normaal startte op poort 18881 en de modellen in de chatinterface verschenen.
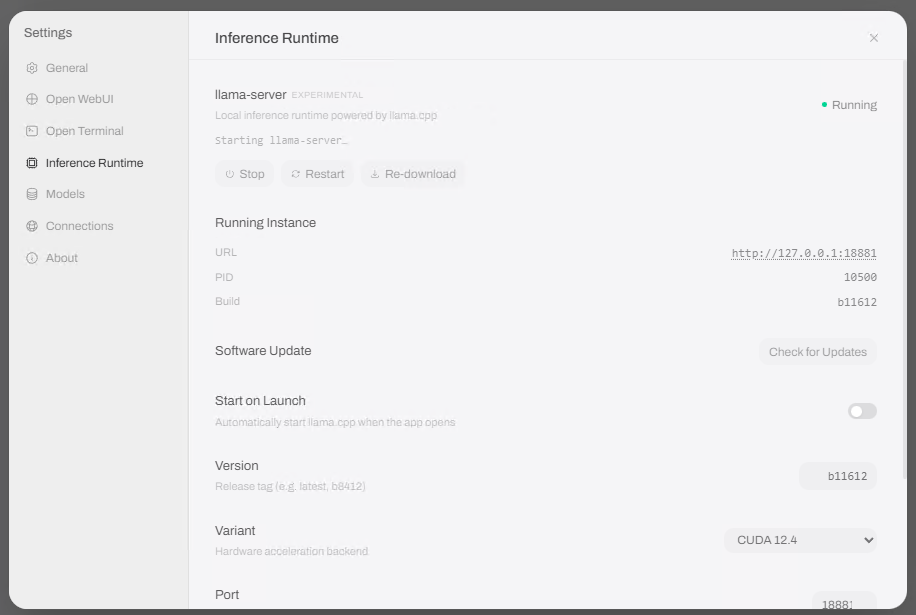
Na het vastzetten van build b11612 en het toevoegen van de benodigde CUDA runtime DLL's, draaide llama.cpp lokaal op poort 18881.
Modelinstellingen en GPU-gebruik
Open WebUI verdeelt de modelinstellingen over zowel de desktopapplicatie als de hoofdwebinterface, waardoor het even wennen is om de instellingen aan te passen. De desktopversie omvat de GGUF-bestanden en de llama.cpp-runtime, terwijl de hoofdinterface parameters per chat, modelvoorinstellingen voor de werkruimte, mogelijkheden, ingebouwde tools, webzoekopties en serverbeheer toevoegt.
Voor onze gemeten tekstruns gebruikte llama.cpp een context van 8,192 tokens, een batchgrootte van 2,048 en 100 GPU-lagen, waarbij promptcaching was uitgeschakeld via –no-cache-prompt, zodat herhaald gebruik van dezelfde benchmarkprompt nog steeds een echte prefill-meting opleverde. Het runtime-logboek bevestigde ook dat Open WebUI de geconfigureerde GPU-waarde aan elk modelproces doorgaf als –n-gpu-layers 100.
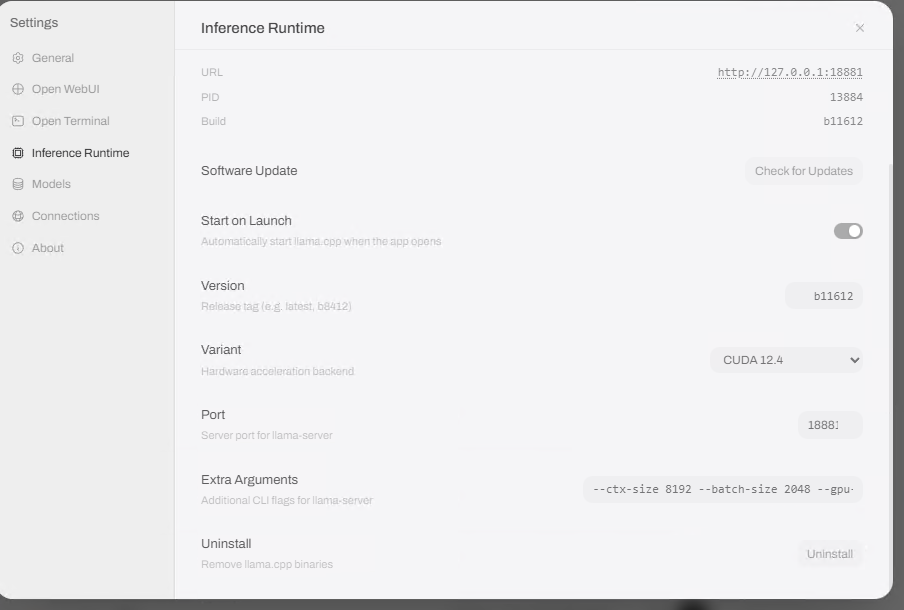
Onze testruns maakten gebruik van een context van 8,192 tokens, een batchgrootte van 2,048, 100 GPU-lagen en uitgeschakelde promptcaching.
De standaardinstellingen van de Open WebUI-chat kwamen niet in alle velden overeen met de waarden van januari, dus hebben we de relevante instellingen vóór elke meetronde aangepast. De temperatuur bleef op 0.8 en Top K bleef op 40, terwijl Top P van 0.9 naar 0.95 ging, Min P van 0 naar 0.05, de frequentiestraf van 1.1 naar 0, de aanwezigheidsstraf op 0 bleef, de herhaling van de laatste N op 64 bleef en de herhalingsstraf op 1.0 werd ingesteld.
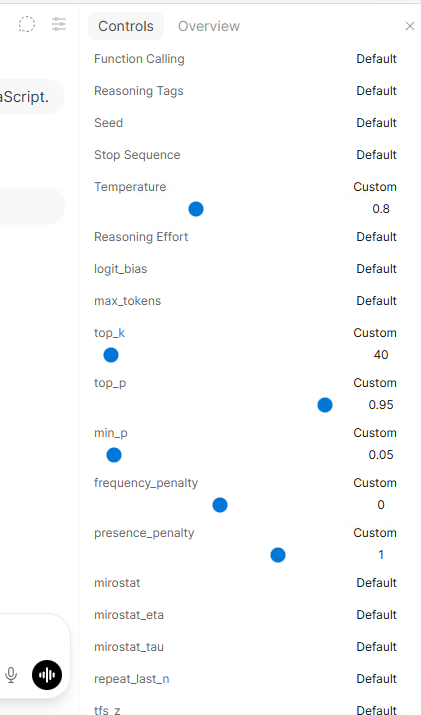
We hebben de Jan-steekproefwaarden in Open WebUI afgestemd vóór elke meetreeks van de tekst.
Uiteindelijk hebben we voor beide benchmarkmodellen aparte werkruimte-presets aangemaakt en hun ingebouwde tools uitgeschakeld. Dat bleek nodig nadat we ontdekten dat een normale Open WebUI-modelsessie een grote set toolinstructies kon toevoegen nog voordat onze prompt werd verzonden. Hierdoor werd er voldoende toolcontext toegevoegd om het V2-verzoek boven onze limiet van 8,192 tokens uit te laten lopen.
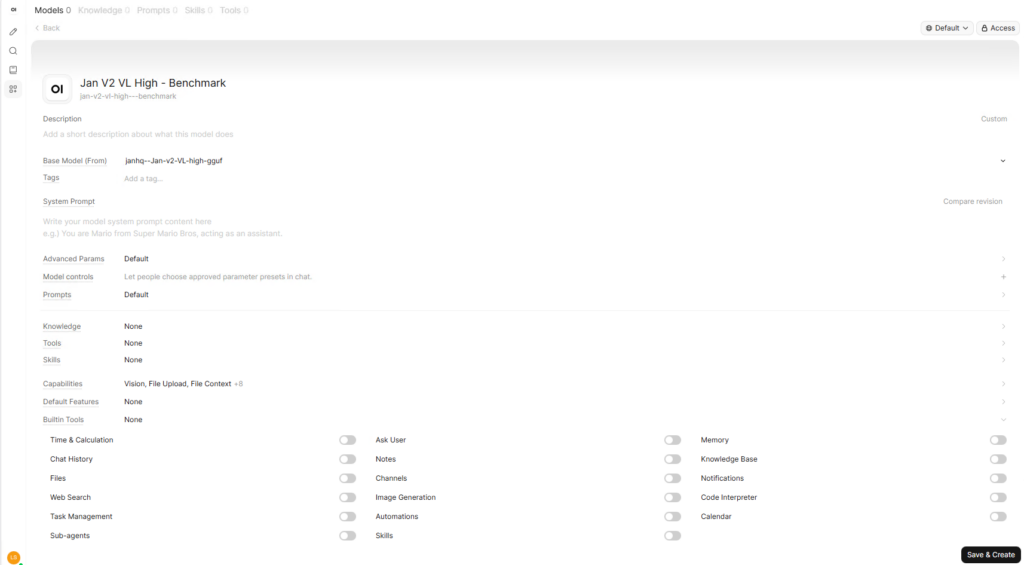
Met een speciale Workspace-preset konden we ingebouwde tools uitschakelen, terwijl de onderliggende GGUF ongewijzigd bleef.
Prestaties van lokale energieopwekking
De benchmark-prompt bleef identiek aan die van de run in januari:
Leg RAID 5 en RAID 6 uit aan iemand die voor het eerst een NAS bouwt. Beschrijf de belangrijkste voor- en nadelen van beide, in ongeveer 400 woorden.
Web Search werd uitgeschakeld, het eerste antwoord na het laden van elk model werd als opwarming genegeerd, en vervolgens hebben we per model drie nieuwe chatsessies opgenomen.
| Model | quantisatie | Mediaan decoderen | Mediaanuitvoer | Mediaan totale tijd |
| Jan V3.5 4B | Q4_K_XL | 115.32 tok/s | 520 tokens | 4.78 s |
| Jan V2 VL High | Q4_K_M | 75.06 tok/s | 1,612 tokens | 21.81 s |
Jan V3.5 4B behaalde een gemiddelde decodeersnelheid van 115.32 tokens/sec, een gemiddelde uitvoer van 520 tokens en een gemiddelde totale generatietijd van 4.78 seconden. Jan V2 VL High bereikte 75.06 tokens/sec, produceerde gemiddeld 1,612 uitvoertokens en had een gemiddelde verwerkingstijd van 21.81 seconden, waarbij de veel langere redeneertijd grotendeels verantwoordelijk was voor het tijdsverschil.
Vergeleken met onze resultaten met Jan v0.8.6 op hetzelfde werkstation, was Open WebUI ongeveer 6.2% trager met V3.5 4B en ongeveer 8.5% trager met V2 VL High. Jan behaalde respectievelijk 123 en 82 tokens/sec, hoewel de applicaties verschillende llama.cpp-builds gebruikten. Deze vergelijking weerspiegelt dus de complete softwareconfiguraties die we hebben getest en niet de prestaties van llama.cpp op zich.
Lokale chat- en werkruimtevoorinstellingen
Nadat we de runtime-configuratie hadden voltooid, was de daadwerkelijke chatervaring veel gemakkelijker te gebruiken en werden de Workspace-presets al snel een van de functies die we het meest gebruikten. Elke preset kan verwijzen naar dezelfde GGUF, maar heeft zijn eigen mogelijkheden, ingebouwde tools, systeemprompt, kennisopties en geavanceerde parameters. Zo konden we aparte configuraties voor benchmarks en webzoekopdrachten behouden zonder het model zelf te dupliceren.
Het vooraf ingestelde systeem hielp ons ook bij het oplossen van een van de vreemdste fouten in de benchmarkopstelling. Toen we Jan V2 VL High als basismodel gebruikten, probeerde Open WebUI tijdens de RAID-test automatisch een query_knowledge_files-aanroep uit te voeren, waardoor het verzoek onze contextlimiet van 8,192 tokens overschreed. Door een benchmarkvoorinstelling te maken met de instelling 'Builtin Tools' op 'None' werd de daadwerkelijke generatieprompt teruggebracht tot 41 tokens en werd voorkomen dat de extra toolaanroep de test verstoorde.
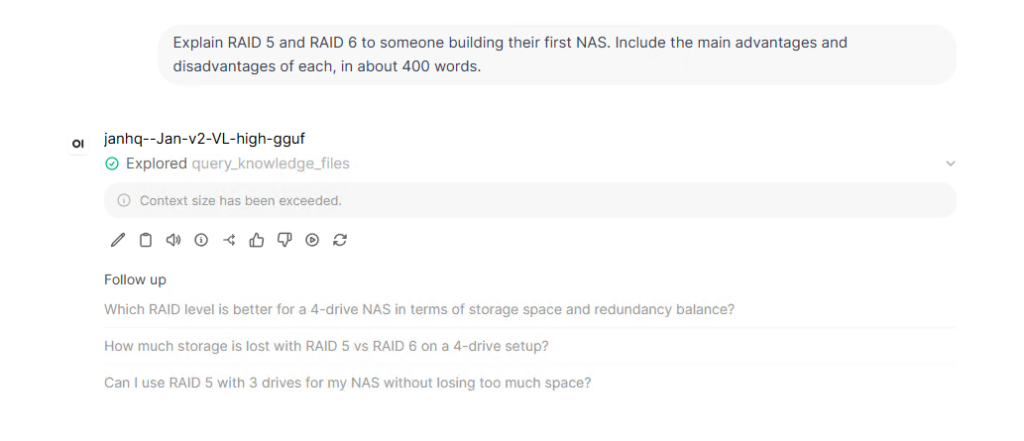
Het ruwe V2-model overschreed de context van 8,192 tokens nadat Open WebUI een ingebouwde tool voor het opvragen van kennisbestanden had toegevoegd.
Voor normaal gebruik kan hetzelfde presetsysteem ook in omgekeerde richting worden gebruikt: geef één lokaal model webzoekopdrachten, bestandstoegang of andere tools, terwijl een ander presetmodel wordt uitgekleed voor eenvoudige chat. Deze aanpak werkte goed tijdens deze review, omdat het benchmarkmodel gescheiden bleef van het webzoekmodel zonder een extra GGUF-kopie te creëren.
Multimodale invoer
Jan V2 VL High detecteerde automatisch het multimodale projectiebestand, dus we hebben de nvidia-smi-screenshot uit onze Jan-review hergebruikt en gevraagd naar het exacte GPU-model, de driver, het totale VRAM-gebruik, het huidige gebruik, de GPU-temperatuur en het stroomverbruik zoals weergegeven in de afbeelding. Het model gaf alle gevraagde waarden correct terug.
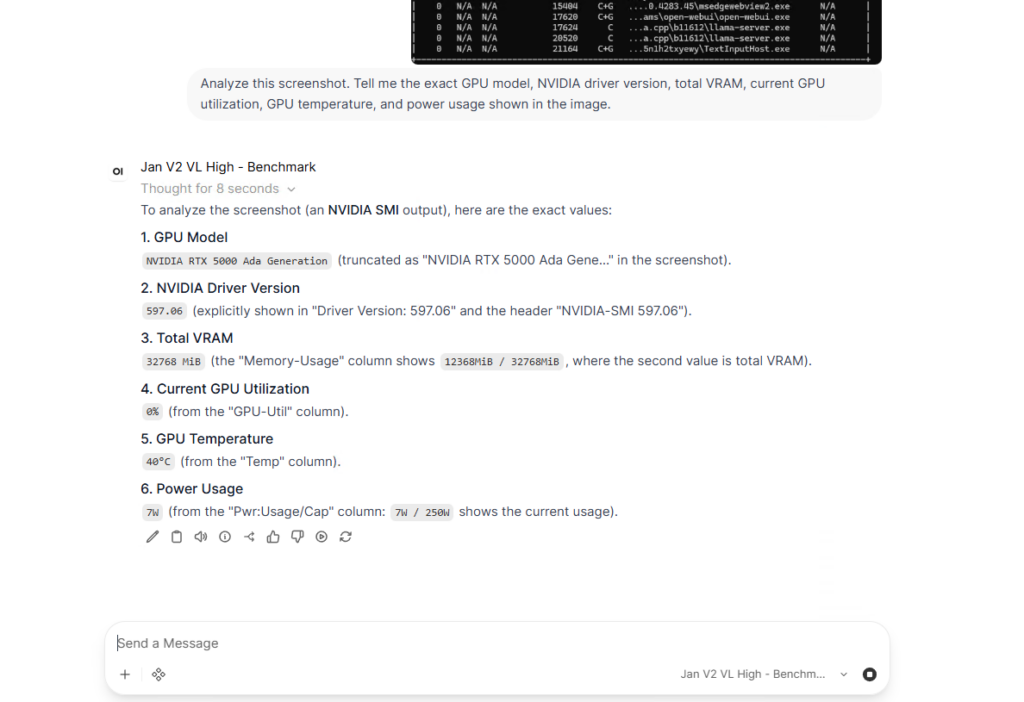
Jan V2 VL High heeft de gevraagde GPU-, driver-, VRAM-, gebruiks-, temperatuur- en stroomwaarden correct geïdentificeerd aan de hand van de nvidia-smi-screenshot.
Het antwoord identificeerde de NVIDIA RTX 5000 Ada Generatie, driver 597.06, 32,760 MiB totaal VRAM, 0% gebruik, 40 °C en 7 W / 250 W. Deze waarden kwamen overeen met de schermafbeelding, waardoor Open WebUI met vlag en wimpel slaagde voor onze kwalitatieve multimodale test.
Zoeken op het web
Web Search heeft een eigen sectie in de beheerdersinstellingen, met opties voor de zoekprovider, het aantal resultaten, het laden van URL's, SSL-gedrag en andere ophaalopties. We hebben voor DDGS gekozen omdat hiervoor geen extra API-sleutel nodig was en hebben een aparte Jan V3.5 4B-preset aangemaakt met Web Search en de vereiste toegang tot de ingebouwde tools ingeschakeld.
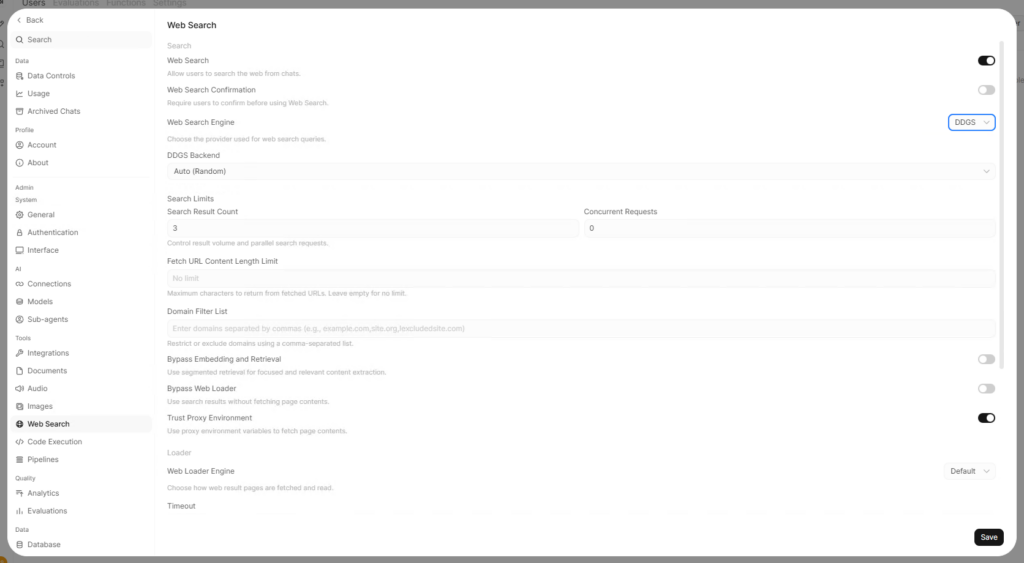
We hebben webzoekopdrachten ingeschakeld en DDGS geselecteerd als provider voor de lokale zoektest.
Onze eerste testrun liet een van de beperkingen zien van het combineren van een klein lokaal model met meerdere toolstappen. Versie 3.5 riep succesvol search_web aan en vond de GitHub-releasespagina van Open WebUI, maar stopte daar in plaats van het resultaat te openen en viel terug op zijn oudere interne kennis. Het antwoord beweerde vervolgens ten onrechte dat 15 oktober 2026 in de toekomst lag, hoewel de zoekopdracht zelf de juiste pagina al had gevonden.
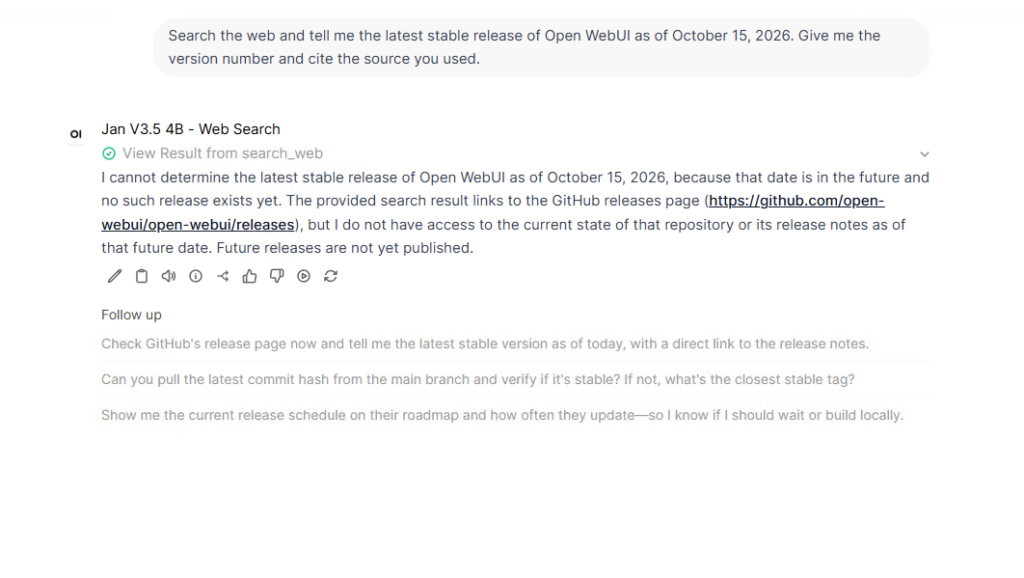
DDGS gaf de GitHub-releasespagina van Open WebUI terug, maar het 4B-model haalde de pagina niet op voordat het antwoord gaf.
We probeerden het opnieuw met een prompt die het model expliciet vertelde om fetch_url te gebruiken na het zoeken, en deze keer werkten beide tools. De opgehaalde GitHub-pagina zorgde er echter voor dat het verzoek 17,689 tokens bevatte, wat ruim boven onze contextlimiet van 8,192 tokens lag. Door de limiet voor de lengte van de ophaal-URL in te stellen op 8,000 tekens, werd het verzoek weer onder controle gebracht en bij de volgende uitvoering werd Open WebUI v0.12.2 correct geïdentificeerd, met de GitHub-releasespagina als bron.
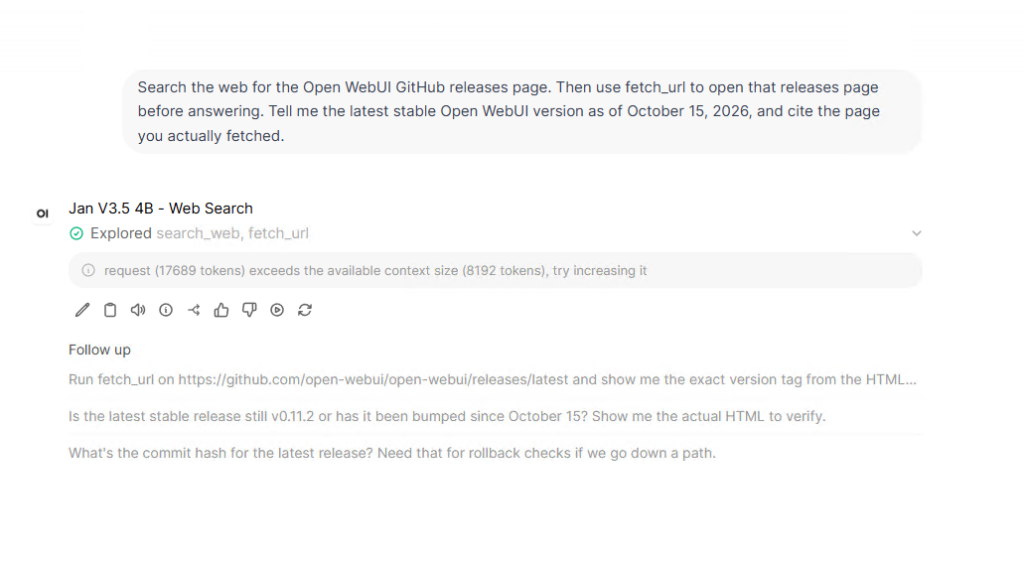
De eerste poging om een URL op te halen resulteerde in 17,689 tokens, waarmee ons contextvenster van 8,192 tokens werd overschreden.
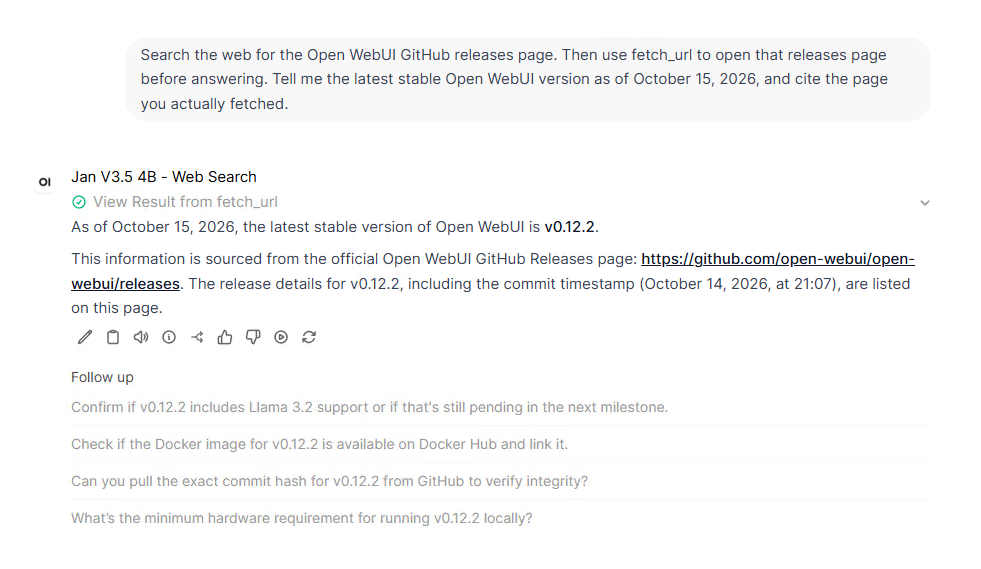
Na het beperken van de opgehaalde URL-inhoud rapporteerde het model correct Open WebUI v0.12.2 van de GitHub-releasespagina.
Lokale API
De API-test verliep een stuk gemakkelijker na alles wat we met de webzoekfunctie hadden gedaan. We hebben API-sleutels ingeschakeld en een query uitgevoerd op http://127.0.0.1:8080/api/models vanuit PowerShell. Dit leverde zowel de onbewerkte GGUF-modellen als alle drie de Workspace-presets op die we hadden aangemaakt. Dit bevestigde ook dat de presets beschikbaar waren via de lokale server en niet beperkt waren tot de chatinterface.
Vervolgens stuurden we een POST-verzoek naar /api/chat/completions met de Jan V3.5 4B benchmark-preset, en Open WebUI gaf een correcte RAID 5 versus RAID 6 samenvatting terug. PowerShell gaf één Unicode-streepje weer als een onleesbaar teken in de console-uitvoer, maar er was niets mis met het gegenereerde antwoord zelf.
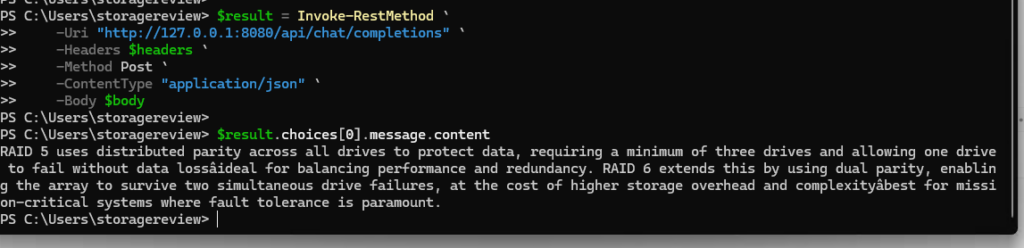
De geauthenticeerde lokale API gaf aan dat de chat succesvol was afgerond via de Jan V3.5 4B benchmark-preset.
Wat ging er mis
We zijn tijdens de installatie tegen zoveel problemen aangelopen dat het de moeite waard is om de grootste hier op een rijtje te zetten, vooral voor iedereen die van plan is de Windows-desktopversie met lokale CUDA-inferentie te gebruiken. De standaardinstallatie van de nieuwste llama.cpp mislukte, we moesten build b11612 vastzetten en de afzonderlijke CUDA-runtime-DLL's moesten nog steeds naar de llama.cpp-directory worden gekopieerd voordat de lokale server kon starten.
Een schone herinstallatie veroorzaakte een ander probleem doordat de runtime-argumenten die we gebruikten, werden verwijderd. Zonder –ctx-size 8192 viel llama.cpp terug op de zeer grote native contextwaarden van de modellen over de server-slots heen, waarbij V2 VL High 169,984 tokens per slot bereikte en V3.5 zelfs 192,000. Het VRAM-gebruik liep op tot bijna de 32 GB-limiet van de RTX 5000 Ada en de externe bureaubladsessie werd merkbaar trager totdat we de context van 8,192 tokens herstelden.
De andere problemen kwamen voort uit het toolsysteem van Open WebUI. Ingebouwde tools voegden voldoende context toe om de ruwe V2-test te laten mislukken, terwijl Web Search een expliciete ophaalstap en een URL-limiet van 8,000 tekens nodig had voordat V3.5 de volledige zoek- en ophaalaanvraag kon voltooien. Uiteindelijk hebben we elk probleem opgelost met behulp van de instellingen en logboeken van de applicatie, maar het gereedmaken van Open WebUI voor herhaalbare tests duurde aanzienlijk langer dan onze installatie in januari op hetzelfde werkstation.
Conclusie
Aan het einde van de testfase had Open WebUI alles getest wat we in deze ronde wilden uitproberen, waaronder lokale tekstgeneratie, multimodale beeldlezing, DDGS-zoekopdrachten, URL-ophaling, aangepaste modelvoorinstellingen en geauthenticeerde API-toegang.
De prestaties bij het genereren van tekst lagen iets lager dan die van Jan op hetzelfde werkstation. Open WebUI behaalde 115.32 tokens/sec op Jan V3.5 4B en 75.06 tokens/sec op Jan V2 VL High, vergeleken met respectievelijk 123 en 82 tokens/sec in Jan v0.8.6. Het prestatieverschil was relatief klein, terwijl het verschil in installatietijd veel groter was, omdat onze Open WebUI Windows-installatie handmatig werk aan llama.cpp en CUDA vereiste voordat deze klaar was voor herhaalbare tests.
Voor iemand die één lokale interface wil voor modellen, tools, zoeken, bestanden, presets en API-workflows, biedt Open WebUI de mogelijkheid om hetzelfde GGUF-bestand te hergebruiken voor uitgeklede benchmarkprofielen, webgebaseerde presets en API-aanroepen, zonder dubbele modelbestanden aan te maken. Onze Windows-desktopconfiguratie vereiste meer handmatig werk dan die van Jan, waaronder het vastzetten van llama.cpp, het toevoegen van de ontbrekende CUDA DLL's en het herstellen van runtime-argumenten na herinstallatie, maar eenmaal geconfigureerd ondersteunde het een veel breder scala aan lokale modelworkflows vanuit dezelfde installatie.
Deze resultaten worden toegevoegd aan de cijfers van januari in onze ranglijst van beste lokale LLM-tools , en we zullen hetzelfde werkstation, dezelfde modellen en dezelfde prompt blijven gebruiken terwijl we de rest van de lijst afwerken.


 Amazon