

Firma AMD opublikowała wyniki testu MLPerf Inference v6.0, pozycjonując kartę graficzną Instinct MI355X jako skalowalną platformę wnioskowania w środowiskach jedno- i wielowęzłowych oraz heterogenicznych. Zgłoszenie wykracza poza stopniowe zwiększanie wydajności, dodając nowe obciążenia, demonstrując przepustowość w skali klastra przekraczającą milion tokenów na sekundę oraz potwierdzając powtarzalność wyników w rozwijającym się ekosystemie partnerów.
Architektura CDNA 4 ukierunkowana na wnioskowanie o dużej pojemności
Procesor graficzny Instinct MI355X oparty jest na architekturze AMD CDNA 4 , zbudowanej w procesie technologicznym TSMC 3 nm | 6 nm FinFET (wykorzystuje dwuprocesową konstrukcję chipletów: matryce obliczeniowe (XCD) wykorzystują węzeł TSMC 3 nm, a matryce wejścia/wyjścia 6 nm), integrując 185 miliardów tranzystorów i obsługując formaty danych FP4 i FP6. Warto zauważyć, że dotyczy to całego układu wielochipletowego, a nie monolitycznej matrycy. Każdy procesor graficzny zawiera do 288 GB pamięci HBM3E, co umożliwia obsługę modeli do 520 miliardów parametrów na jednym urządzeniu. AMD uważa, że to połączenie gęstości obliczeniowej i pojemności pamięci jest kluczowe dla wnioskowania na dużych modelach bez nadmiernego partycjonowania modeli.
Platforma jest dostępna w konfiguracjach UBB8 z opcjami chłodzenia powietrzem i bezpośrednim chłodzeniem cieczą, co pozwala na spełnienie wymagań wdrażania w centrach danych.
Przepustowość wielowęzłowa przekracza 1 milion tokenów na sekundę
Kluczowym rezultatem tej rundy jest przekroczenie przez AMD miliona tokenów na sekundę w skali klastra. Korzystając z procesorów graficznych Instinct MI355X, AMD osiągnęło ten próg na platformie Llama 2 70B zarówno w scenariuszach serwerowych, jak i offline, a także na platformie GPT-OSS-120B w trybie offline.
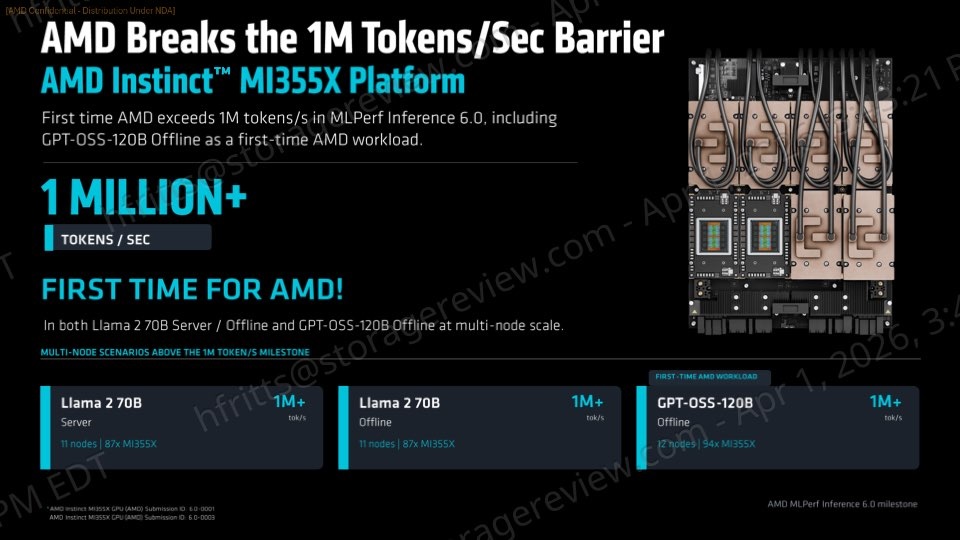
Wyniki te odzwierciedlają zmianę w kierunku oceny wydajności wnioskowania na poziomie klastra, a nie poszczególnych akceleratorów. Łączna przepustowość i czas do obsługi (TTS) są coraz częściej wykorzystywane do określania gotowości produkcyjnej dla wdrożeń AI na dużą skalę.
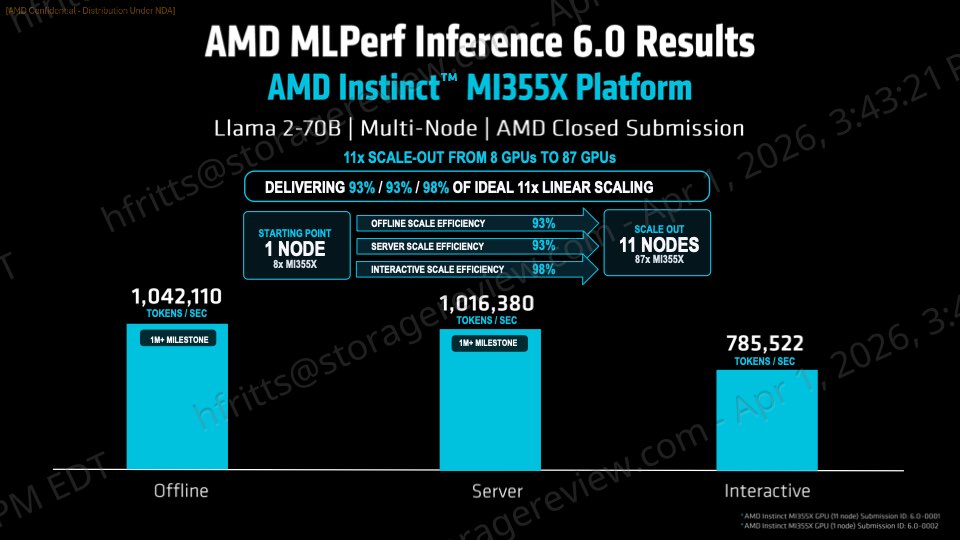
AMD wykazało również efektywne skalowanie. Na platformie Llama 2 70B konfiguracja 11 węzłów i 87 procesorów graficznych osiągnęła przepustowość ponad miliona tokenów na sekundę w scenariuszach offline, serwerowym i interaktywnym, a wydajność skalowania poziomego wahała się od 93% do 98%. Na platformie GPT-OSS-120B klaster 12-węzłowy z 94 procesorami graficznymi osiągnął podobną przepustowość, osiągając ponad 90% wydajności skalowania. Wyniki te wskazują, że wzrost wydajności przekłada się na efektywne wykorzystanie wdrożeń wykraczających poza pojedynczy system.
Zyski pokoleniowe i konkurencyjna wydajność pojedynczego węzła
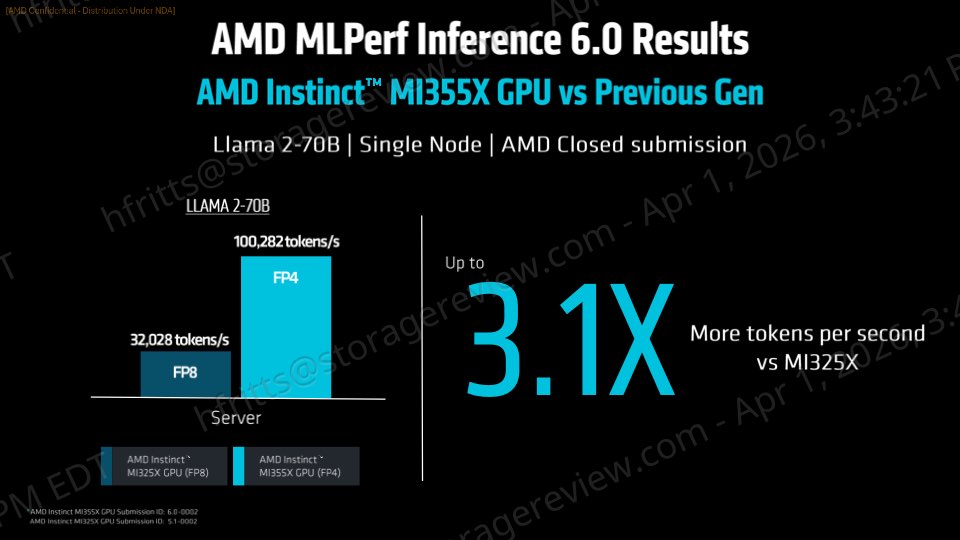
AMD odnotowało 3.1-krotny wzrost wydajności serwera Llama 2 70B w porównaniu z poprzednią generacją Instinct MI325X, osiągając 100 282 tokenów na sekundę. Poprawa ta odzwierciedla zarówno zmiany architektoniczne, jak i optymalizacje oprogramowania ROCm. Wyniki w trybie offline poprawiły się o 4.4x, a w trybie serwerowym o 4.8x w porównaniu z poprzednimi rundami. Wzrost ten jest głównie spowodowany kwantyzacją FP4.
W porównaniach pojedynczych węzłów, MI355X wykazał się konkurencyjną pozycją w porównaniu z platformami NVIDIA. Na platformie Llama 2 70B, AMD dorównało NVIDIA B200 pod względem przepustowości offline, osiągnęło niemal identyczną wydajność w trybie serwerowym i przewyższyło wydajność w trybie interaktywnym. W porównaniu z kartą Nvidia B300, GPU AMD zapewnia 92% w trybie offline, 93% w trybie serwerowym i przewyższa ją o 104% w trybie interaktywnym.
Wdrożenie modelu po raz pierwszy rozszerza zasięg
Wersja 6.0 MLPerf Inference zawiera kilka nowych obciążeń, a AMD wykorzystało tę rundę do zademonstrowania szybkiego wdrażania modelu. Po raz pierwszy zaprezentowano model GPT-OSS-120B, oparty na modelu mieszanym dla ekspertów, który uzyskał konkurencyjne wyniki w porównaniu z systemami NVIDIA zarówno w scenariuszach offline, jak i serwerowych.
Firma AMD przedstawiła również wyniki dotyczące generowania tekstu na wideo w standardzie WAN-2.2, co oznacza jej wejście w multimodalne i generatywne wnioskowanie wideo. Chociaż oficjalne zgłoszenie koncentrowało się na opóźnieniu pojedynczego strumienia, wyniki były konkurencyjne w porównaniu z wynikami istniejących platform. Strojenie po zgłoszeniu dodatkowo poprawiło wydajność, wskazując na potencjał optymalizacji w miarę rozwoju oprogramowania.
Dodatki te podkreślają, że AMD koncentruje się na wykraczaniu poza tradycyjne testy porównawcze LLM, aby obsługiwać nowe obciążenia związane ze sztuczną inteligencją.
Oprogramowanie ROCm umożliwia skalowanie i heterogeniczne wnioskowanie
AMD przypisuje znaczną część wydajności i skalowalności swojemu stosowi oprogramowania ROCm. Ulepszenia obejmują zoptymalizowane wykonywanie FP4, ulepszoną komunikację między procesorami graficznymi (GPU) w celu rozproszonego wnioskowania oraz obsługę dynamicznej dystrybucji obciążenia w środowiskach heterogenicznych.
Początkowy heterogeniczny wniosek MLPerf został opracowany z wykorzystaniem trzech modeli kart graficznych AMD Instinct: MI300X, MI325X i MI355X. Konfiguracja zgłoszona przez firmy Dell i MangoBoost osiągnęła prędkość 141 521 tokenów na sekundę na serwerze Llama 2 70B i 151 843 tokenów na sekundę na serwerze Llama 2 70B Offline.
Warto zauważyć, że platforma AMD Instinct MI355X znajdowała się w laboratorium Della w Stanach Zjednoczonych, a platformy Instinct MI300X i MI325X w Korei. Świadczy to o możliwości koordynowania systemów w różnych lokalizacjach geograficznych.
Wzrost i odtwarzalność ekosystemu
Ekosystem partnerów AMD rozszerzył się w tej rundzie MLPerf, a dziewięć firm przesłało wyniki dla różnych generacji procesorów graficznych Instinct. Wśród uczestniczących dostawców znaleźli się Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro i Red Hat.
Zgłoszenia partnerów były zbliżone do wewnętrznych wyników AMD, zazwyczaj w granicach 4%, a w niektórych przypadkach w granicach 1%. Ta spójność wskazuje, że wydajność jest powtarzalna na platformach OEM i chmurowych, co zmniejsza ryzyko wdrożenia i zwiększa pewność co do rzeczywistych rezultatów.


 Amazon