

Firma Cerebras Systems oficjalnie zaprezentowała CS-4 , czwartą generację swojej platformy superkomputerowej AI o skali wafla, przeznaczonej do zaawansowanych zadań szkoleniowych i wnioskowania o wysokiej współbieżności. System został zaprojektowany w oparciu o trzy nowo opracowane procesory Wafer Scale Engine 3 (WSE-3) Turbo, umieszczone na całkowicie przeprojektowanej platformie Nexus o konstrukcji rack-scale. Cerebras twierdzi, że system zapewnia do 30 razy większą wydajność wnioskowania niż rozwiązania oparte na GPU, co firma opiera na GPT-OSS-120B , gdzie podaje ponad 4,400 tokenów na sekundę na użytkownika, a także 10-krotny wzrost przepustowości na wat w porównaniu z poprzednią generacją CS-3.
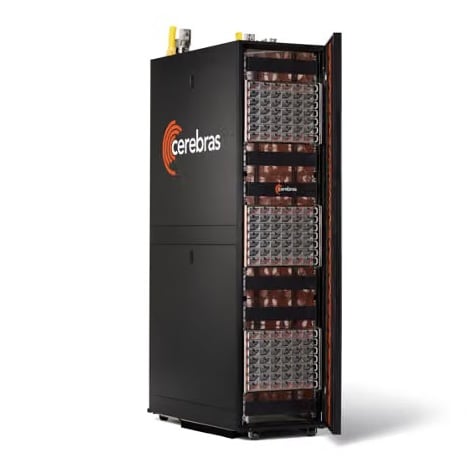
Platforma CS-4 została zaprojektowana z myślą o uwzględnieniu systemowych ograniczeń skalowalności, nieodłącznie związanych z dyskretnymi, wielowęzłowymi klastrami GPU, gdzie komunikacja między układami, straty energii w konwersji i ograniczenia termiczne często ograniczają stałą wydajność obliczeniową. Cerebras pozycjonuje platformę tak, aby obsługiwać oba skrajne zakresy obciążeń wnioskowania, zapewniając czasy reakcji poniżej milisekundy wymagane w przypadku złożonych przepływów pracy agentowych i wnioskowania interaktywnego, a jednocześnie zapewniając łączną moc potrzebną w systemach hiperskalowalnych do maksymalizacji gęstości obliczeniowej na gigawat.
Udoskonalenia w strukturze połączeń międzyprocesorowych są kluczowe dla możliwości skalowania platformy w środowisku wieloprocesorowym. CS-4 redukuje opóźnienia połączeń między waflami do zaledwie 2 mikrosekund, umożliwiając działanie struktur wielowafli z niemal monolityczną spójnością. Ta struktura o ultraniskich opóźnieniach pozwala CS-4 utrzymać prędkość generacji przekraczającą 1,000 tokenów na sekundę w modelach o ponad 10 bilionach parametrów, niwelując historyczną lukę wydajnościową, w której skalowanie liczby parametrów poważnie obniżało szybkość dostarczania interaktywnych tokenów.

Architektura Nexus Rack i plecak w skali wafla
Istotną zmianą inżynieryjną w CS-4 jest architektura platformy Cerebras Nexus, modułowa implementacja w szafie rack, oparta na niezależnych domenach obliczeniowych, zasilania i wejścia/wyjścia. Gęstość obliczeniowa jest oparta na nowo zaprojektowanym, montowanym z tyłu plecaku Wafer-Scale Backpack, który łączy się pionowo z główną macierzą zasilania. Każdy plecak to samodzielna jednostka, która mieści kolektory chłodzenia cieczą bezpośrednio do układu scalonego, stopnie konwersji mocy w punktach obciążenia, szybkie ścieżki sieciowe oraz wbudowaną elektronikę sterującą, zlokalizowaną bezpośrednio za waflem krzemowym. Dzięki odizolowaniu rdzenia obliczeniowego od głównej ramy dystrybucji zasilania, Cerebras zmniejszył liczbę komponentów systemu o 50%, zwiększył automatyzację montażu o 60% i skrócił czas wdrożenia centrum danych do zaledwie kilku godzin.

Efektywność zasilania została zwiększona dzięki przesunięciu modułów regulacji napięcia DC-DC 100 razy bliżej granicy krzemu niż w typowych implementacjach płyt serwerowych. Takie rozwiązanie punktu obciążenia zmniejsza straty rezystancyjne w sieci dystrybucji zasilania (PDN) i pozwala obudowie Nexus dostarczać dwukrotnie więcej mocy do każdego procesora WSE-3 Turbo, umożliwiając utrzymanie wyższych częstotliwości taktowania bez dławienia termicznego.

Podsystem wejścia/wyjścia został również rozbudowany o programowalny moduł Wafer I/O, który podwaja przepustowość sieci między krawędziami, jednocześnie zmniejszając opóźnienia w tranzycie. Sieć systemowa działa w dwóch trybach: standardowych interfejsach RoCE v2 (RDMA over Converged Ethernet) zapewniających połączenie z siecią o niskim opóźnieniu ze starszymi sieciami korporacyjnymi i węzłami akceleratorów innych firm oraz zastrzeżonych łączach Direct Wafer Links, które zapewniają bezpośrednie, bezprzełącznikowe ścieżki połączeń między sąsiednimi systemami w szafach i między nimi.
Specyfikacje turbosprężarek CS-4 i WSE-3
| SYSTEM CS-4 | |
| Architektura | Aktywny stelaż zasilający z trzema modułowymi plecakami komputerowymi |
| Silniki waflowe | 3x turbosprężarki WSE-3 na system |
| Obliczenia AI | 750 PFLOPS* |
| Przepustowość pamięci | 129.6 PB/s |
| Przepustowość na chipie | 160.5 PB/s |
| Przepustowość wejścia/wyjścia | 7.2 Tb/s |
| Opóźnienie wejścia/wyjścia | 2 mikrosekund |
| WSE-3 TURBO (ZA PŁYTKĘ) | |
| Tranzystory / Krzem | 4 biliony tranzystorów; 46 225 mm2, TSMC 5 nm |
| Rdzenie AI / pamięć SRAM na chipie | 900 000 rdzeni; 44 GB pamięci SRAM |
| Obliczenia AI | 250 PFLOPS* |
| Przepustowość pamięci | 43.2 PB/s |
| Przepustowość na chipie | 53.5 PB/s |
| Przepustowość wejścia/wyjścia | 2.4 Tb/s |
| *Obliczenia sztucznej inteligencji pokazane jako rozproszone w FP16 | |
Rozdzielone wnioskowanie i dostępność
Pod względem architektonicznym, CS-4 został zbudowany z natywnym wsparciem dla rozproszonych topologii wnioskowania. W środowiskach korporacyjnych i chmurowych operatorzy mogą rozdzielić fazy obliczeniowe wnioskowania, korzystając ze specjalistycznych zewnętrznych akceleratorów prefill, takich jak AMD Helios lub AWS Trainium, w celu pobierania kontekstów komunikatów i budowania stanów modeli. Związana z obliczeniami pamięć podręczna KV jest następnie kierowana przez szybkie łącza do potężnej struktury SRAM CS-4 w celu generowania tokenów autoregresyjnych z bardzo niskim opóźnieniem.
Cerebras potwierdził, że wstępne wdrożenia produkcyjne i dostawy platformy CS-4 mają rozpocząć się w tym kwartale.


 Amazon