

Stacja MSI XpertStation WS300 została zbudowana w oparciu o najnowszą architekturę DGX Station firmy NVIDIA, najwydajniejszą jak dotąd generację, umieszczając pełny węzeł GB300 Grace Blackwell Ultra obok biurka. Jego główna wartość to 20 petaflopsów mocy obliczeniowej FP4, dostarczanej przez pojedynczy procesor graficzny Blackwell Ultra połączony z 72-rdzeniowym procesorem Grace za pośrednictwem łącza NVLink-C2C o przepustowości 900 GB/s. Oba procesory korzystają z jednej spójnej puli pamięci 748 GB; 252 GB pamięci HBM3e w połączeniu z 496 GB pamięci LPDDR5X, co wystarcza do przechowywania modelu o bilionie parametrów w pamięci lokalnej.
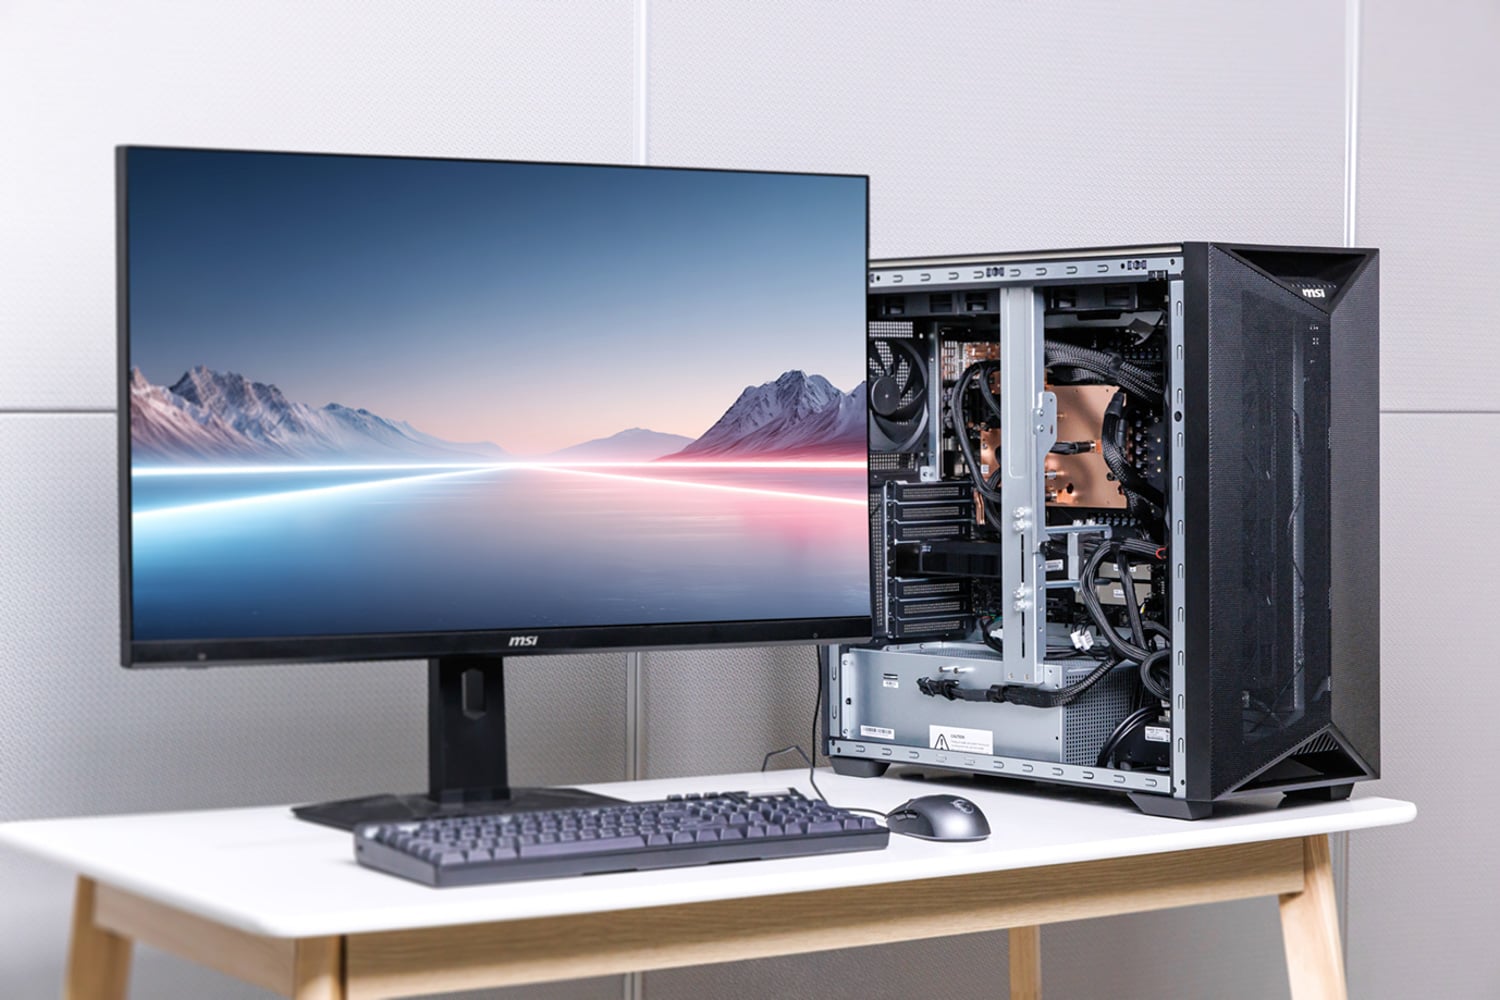
Stacja DGX obsługuje również klastrowanie wielu jednostek za pomocą karty sieciowej ConnectX-8 SuperNIC, która udostępnia dwa porty 400 GbE, zapewniając przepustowość 800 Gb/s. W rezultacie powstaje urządzenie klasy centrum danych, które może działać w domu lub biurze, a nie w serwerowni.
Specyfikacja techniczna stacji NVIDIA DGX
XpertStation WS300 to opracowana przez MSI implementacja platformy GB300 DGX Station firmy NVIDIA. NVIDIA dostarcza płytę główną Grace Blackwell Ultra i środowisko programowe, a MSI obudowę, chłodzenie cieczą, zasilanie, układ pamięci masowej, zewnętrzne wejścia/wyjścia oraz model serwisowy, które przekształcają platformę w kompletny system typu desktopside. Ponieważ procesor Grace, karta graficzna Blackwell Ultra, połączenie NVLink-C2C i sieć ConnectX-8 są stałe, prawdziwą różnicą w przypadku OEM jest to, jak skutecznie system obsługuje, zarządza i udostępnia ten sprzęt. Do testów MSI skonfigurowało ten system z czterema 2-terabajtowymi dyskami SSD Micron 4600 Gen5 M.2. Dwa dyski SSD skonfigurowano w RAID1 jako pamięć masową rozruchową, a pozostałe dwa jako oddzielne dyski SSD na potrzeby pamięci masowej lub innych zastosowań.
| Specyfikacja | Szczegóły |
|---|---|
| Architektura | |
| CPU | NVIDIA Grace, 72-rdzeniowe ramię Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300) |
| Rdzenie tensora | 5th Generation |
| Połączenie CPU-GPU | NVLink-C2C, 900 GB/s dwukierunkowy |
| Pamięć | |
| Pamięć koherentna | Do 748 GB |
| Pamięć GPU | Do 252 GB HBM3e |
| Przepustowość pamięci GPU | 7.1 TB / s |
| Pamięć procesora | Do 496 GB LPDDR5X (4 x SOCAMM) |
| Przepustowość pamięci procesora | 396 Gb / s |
| Dyski | |
| Dyski rozruchowe | 2 x M.2 2280 PCIe 5.0 x4 NVMe (podłączone do procesora), wypełnione 2 x 2TB Micron 4600 Gen5 w RAID 1 |
| Napędy rozszerzeń | 2 x M.2 2280 PCIe 5.0 x4 NVMe (podłączone do ConnectX-8), do testów wyposażone w 2 x 2 TB Micron 4600 Gen5 |
| Sieci | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (łącznie 800 Gb/s) |
| Ethernet | 1 x 10GBase-T RJ45 (Marvell AQC113) |
| Port zarządzania | 1 x 1000Base-T RJ45 (dedykowane poza pasmem) |
| Bezprzewodowy | Gniazdo M.2 2230 Key-E, PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7, Bluetooth) |
| Ekspansja | |
| Sloty PCIe | 1 x PCIe 5.0 x16 FHFL o podwójnej szerokości; 2 x PCIe 5.0 x16 FHFL o pojedynczej szerokości (sygnały x8) |
| Obsługiwane dodatkowe procesory GPU | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| Przód/Góra I/O | |
| USB | 2 x USB 3.2 Gen 2 typu A; 2 x USB 3.2 Gen 2 typu C (5 V/3 A) |
| Audio | 2 x gniazda (wyjście liniowe / mikrofonowe) |
| Tylne wejście/wyjście | |
| USB | 4 x USB 10 Gb/s typu A; 1 x Micro-USB COM (konsola szeregowa) |
| Wyświetlacz | 1 x Mini DisplayPort (wideo BMC, maks. 1024 x 768, bez DP++) |
| Audio | 3 x gniazda (wejście liniowe / wyjście liniowe / mikrofon) |
| Zarządzanie i bezpieczeństwo | |
| BMC | ASPEED AST2600 z oprogramowaniem układowym AMI MegaRAC, IPMI 2.0 i Redfish, lokalną pamięcią masową eMMC |
| Ochrona | TPM 2.0, włamanie do obudowy, sprzętowy system zaufania (ERoT) Microchip CEC1736 |
| Chłodzenie | |
| Chłodzenie cieczą | Moduł chłodzenia cieczą o mocy 1400 W dla procesora i karty graficznej, z blokami na procesorze graficznym, pamięci i ConnectX-8 |
| Grzejniki / Wentylatory | 2 grzejniki 360 mm; 1 wentylator systemowy 12025 |
| Zasilanie | |
| Zasilacz laboratoryjny | 1 x 1600 W ATX, 80 PLUS Platinum (150 x 86 x 210 mm) |
| Wejście AC | 100-114 V AC, 15 A, 47-63 Hz (maks. moc wyjściowa 1300 W); 115-240 V AC, 15-8 A, 47-63 Hz (maks. moc wyjściowa 1600 W) |
| Form Factor | |
| Wymiary | 245.7 x 529.0 x 570.4 mm (9.67 x 20.83 x 22.46 cala), szer. x wys. x gł. |
Zaprojektuj i zbuduj
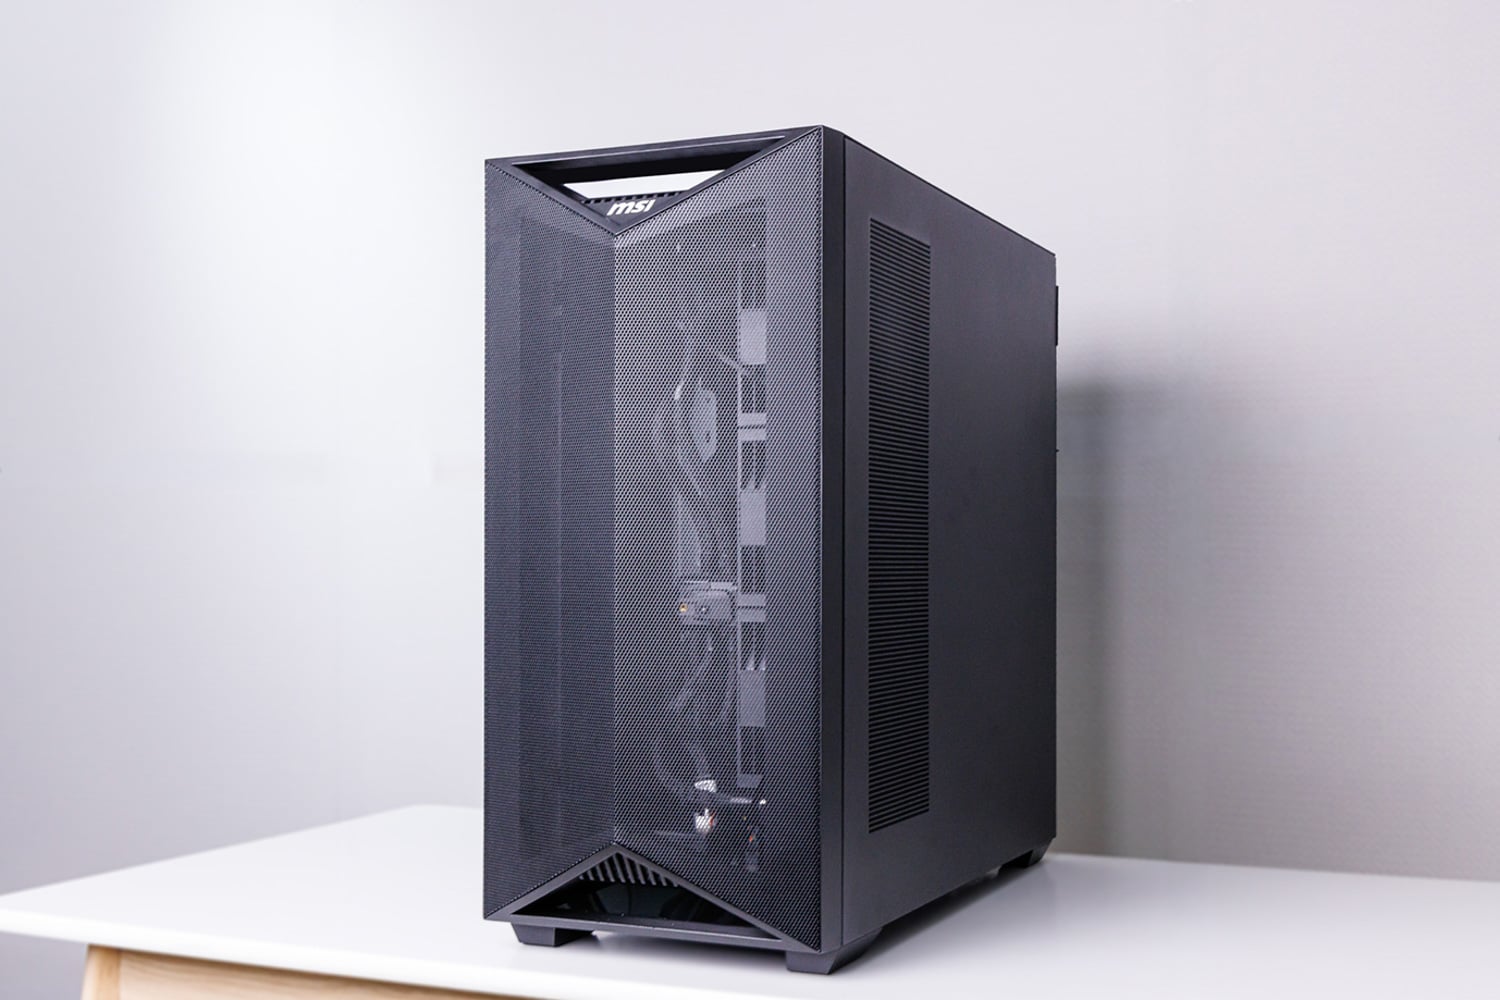
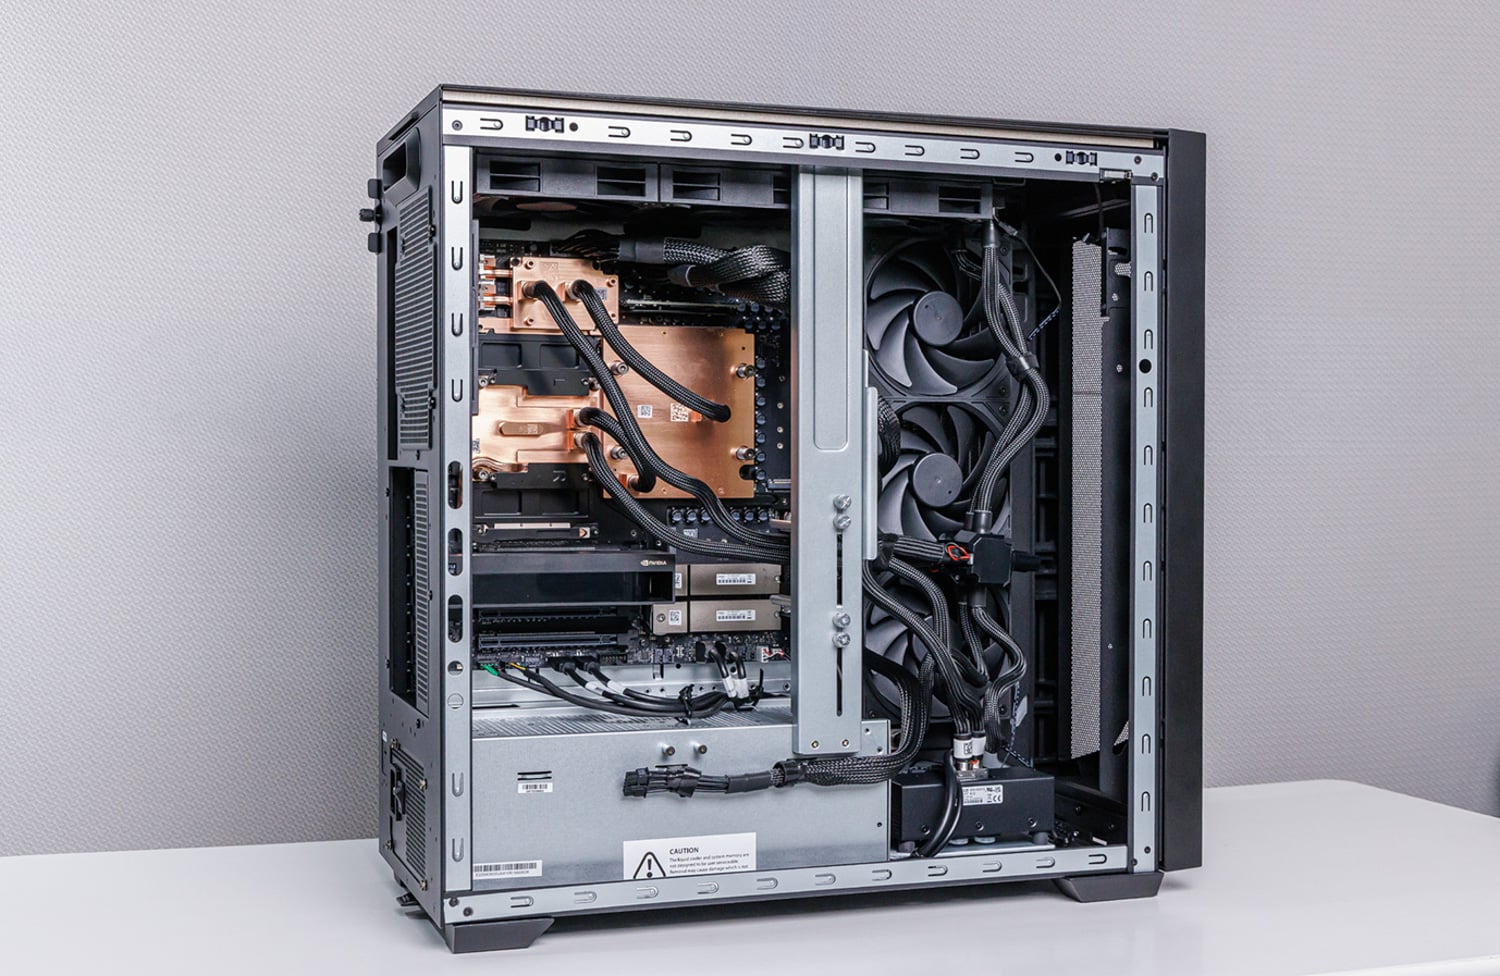
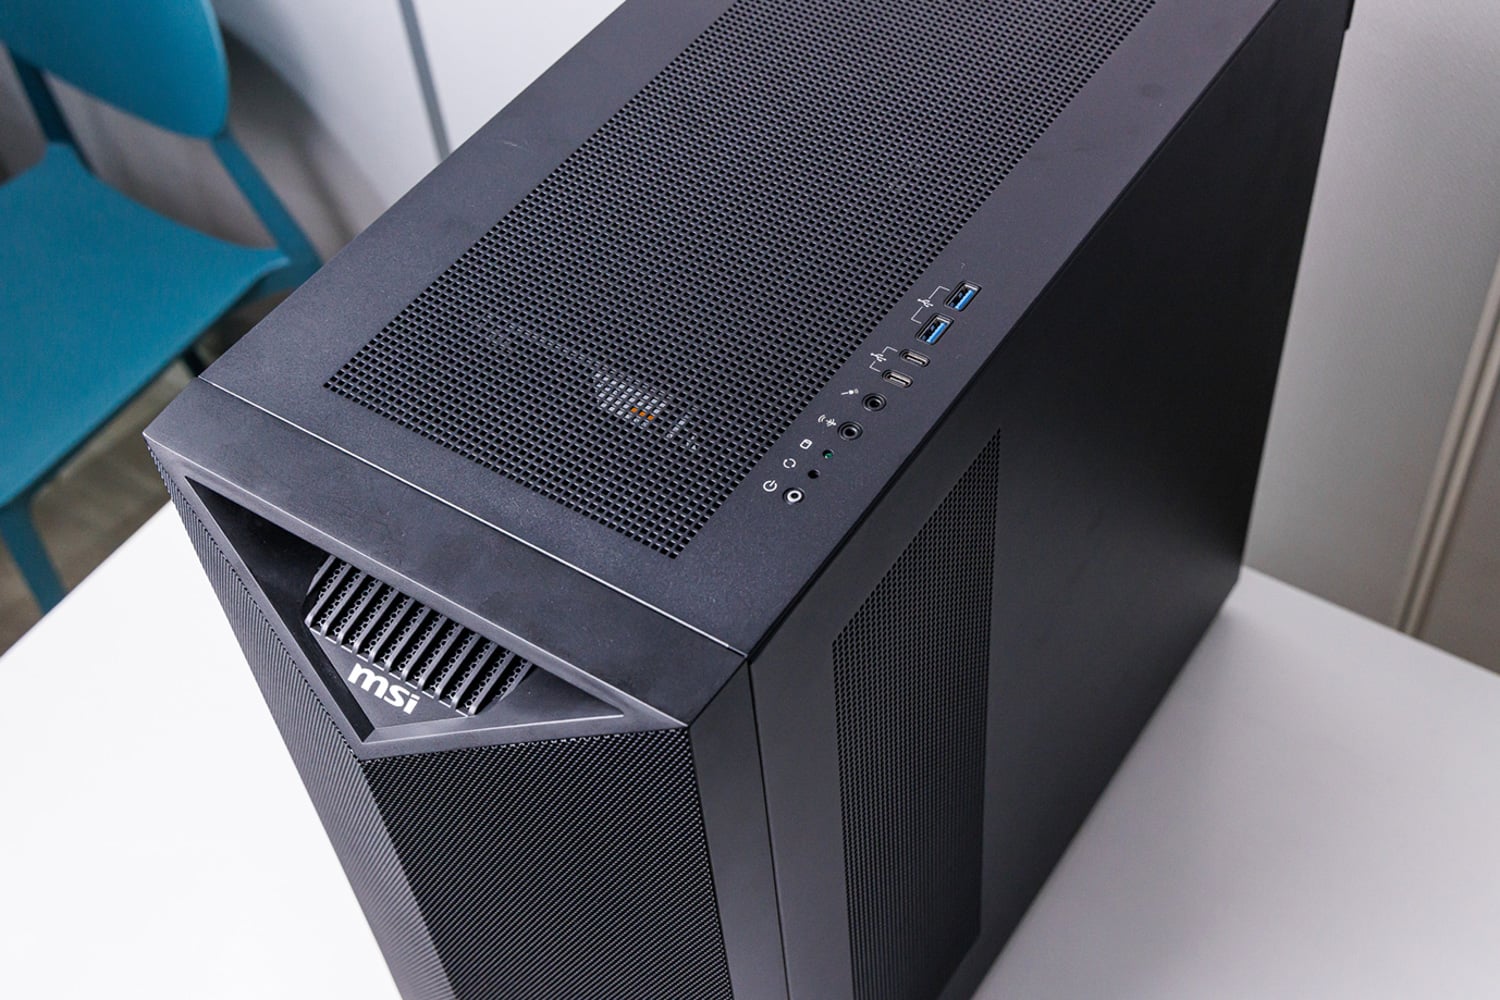
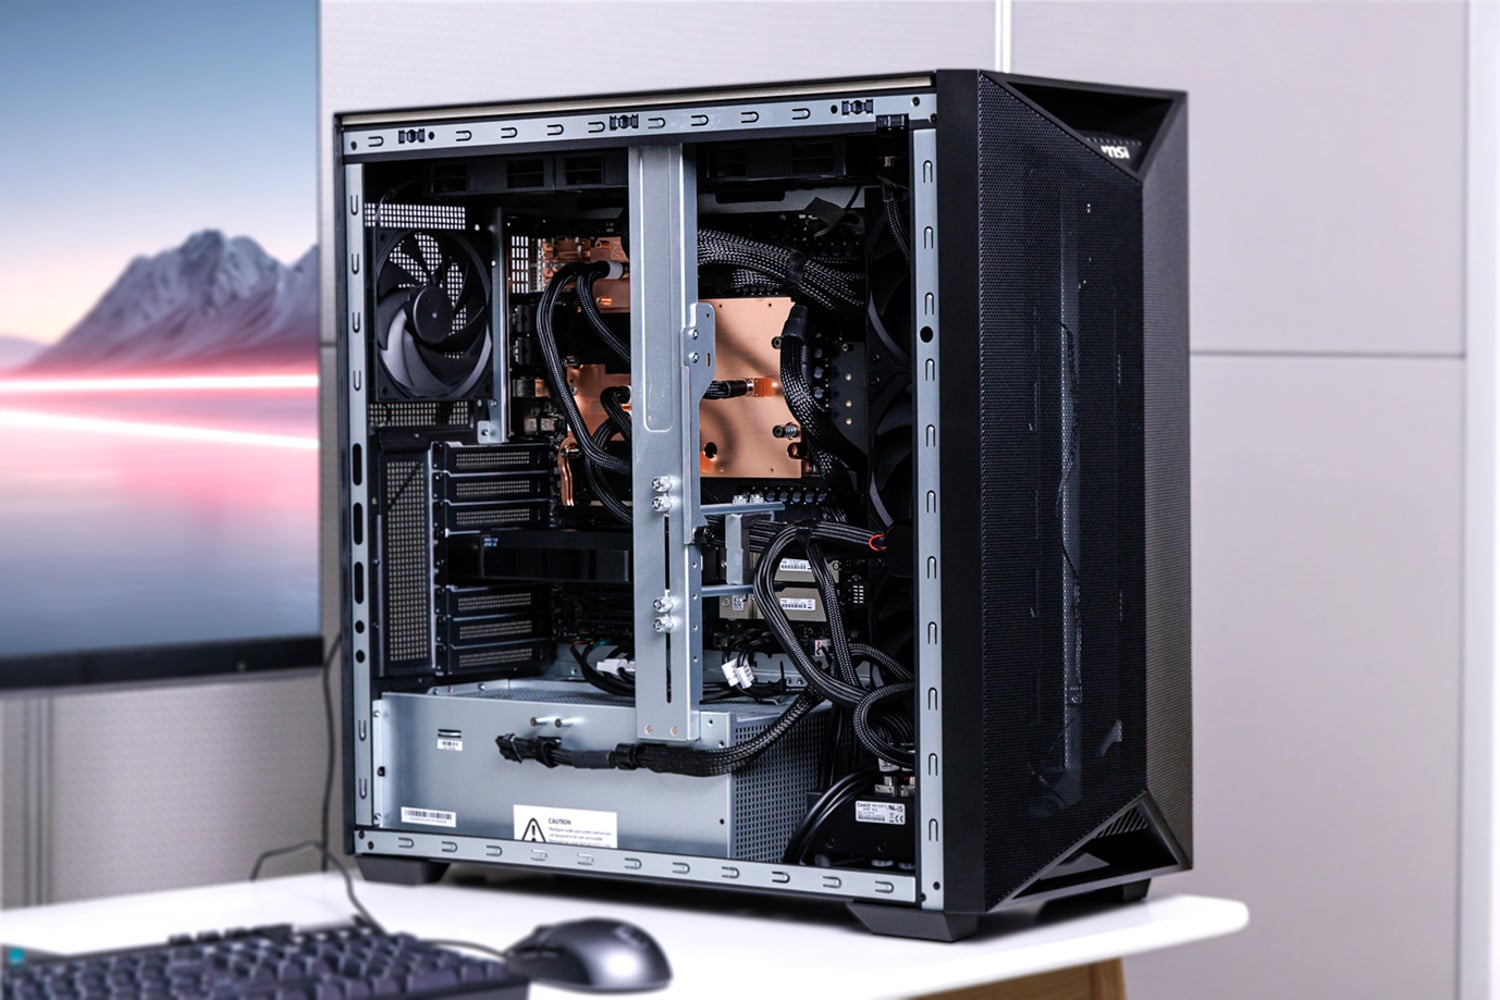
Na pierwszy rzut oka XpertStation wygląda jak standardowa, nowoczesna stacja robocza o eleganckim, profesjonalnym designie. Po zdjęciu panelu bocznego podobieństwo się kończy.
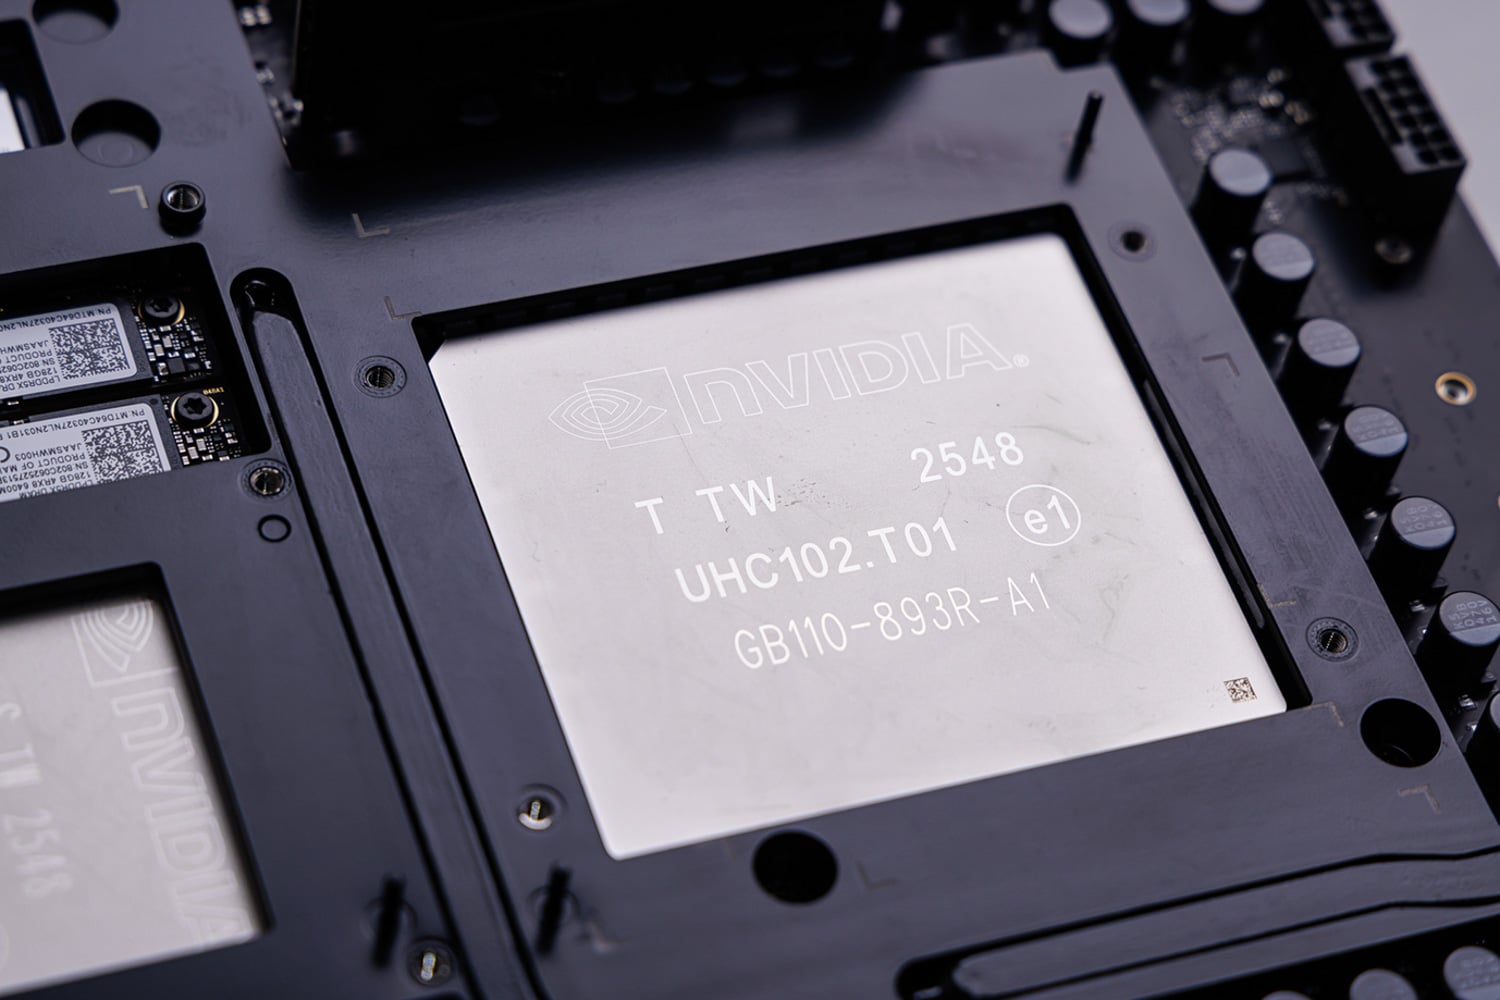
GB300 Grace Blackwell Ultra Desktop Superchip
W samym sercu WS300 znajduje się nasza gwiazda: procesor graficzny NVIDIA B300, oparty na architekturze Blackwell Ultra.
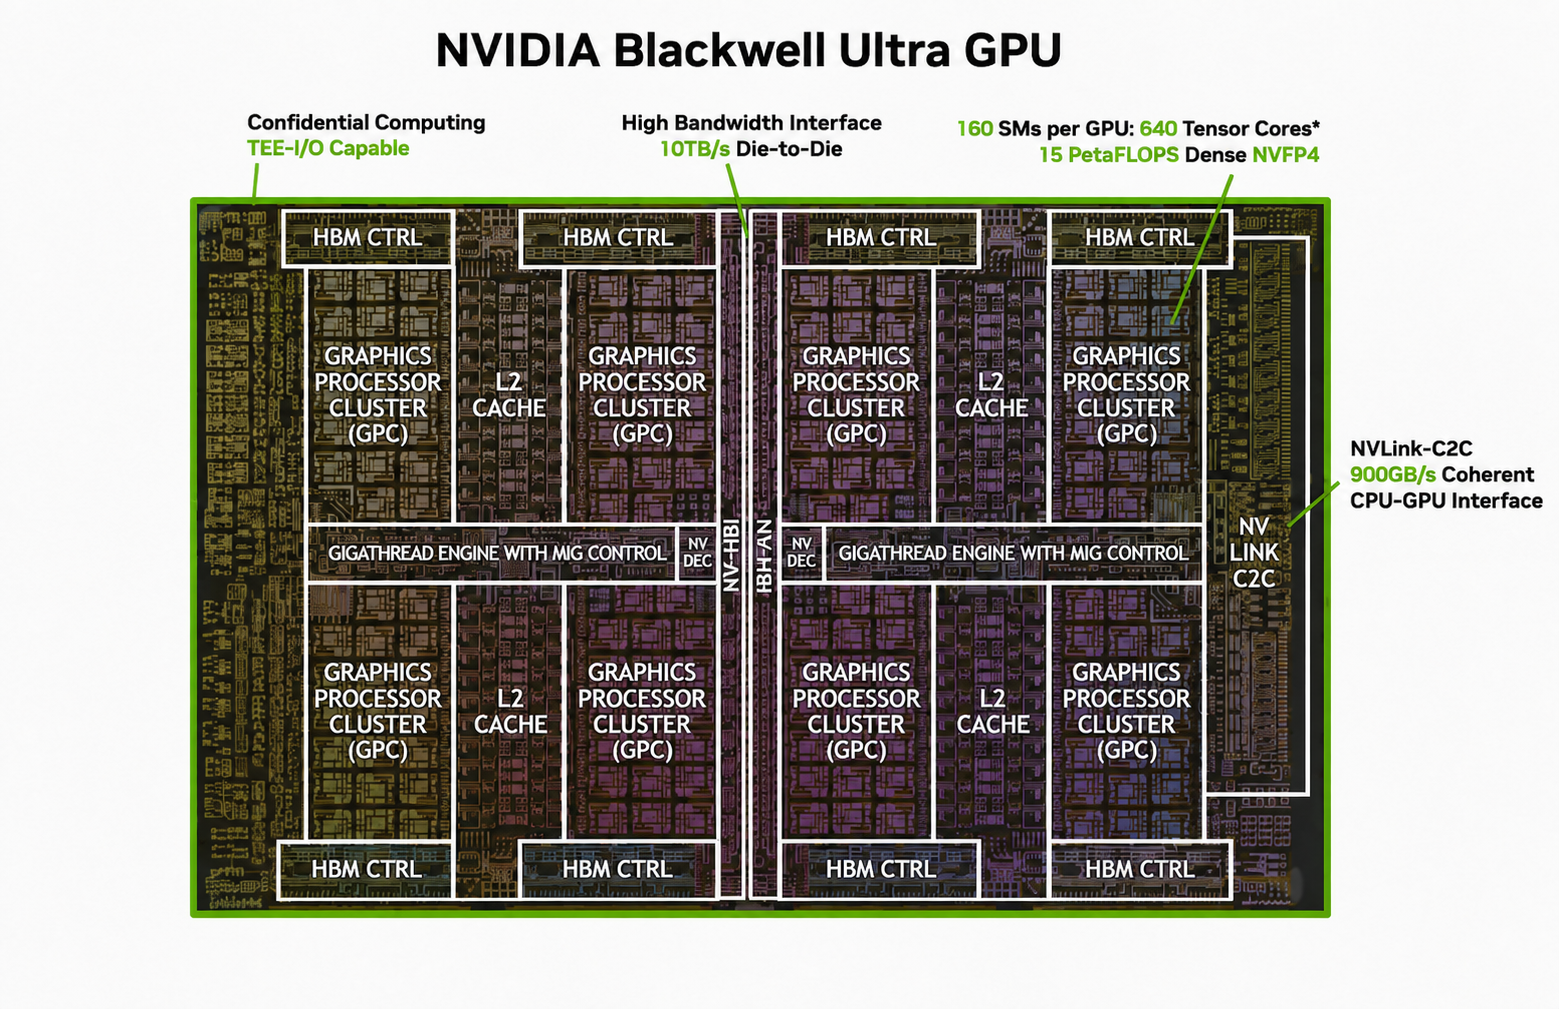
Źródło: NVIDIA, adnotacja StorageReview
B300 to jeden z najnowocześniejszych procesorów graficznych dostępnych obecnie na rynku, charakteryzujący się konstrukcją z podwójnym rdzeniem, opartą na procesie 4NP firmy TSMC. Dwa rdzenie połączone są interfejsem NV-HBI firmy NVIDIA o przepustowości 10 TB/s, co pozwala procesorowi graficznemu działać jako pojedynczy akcelerator CUDA. B300 zastosowany w stacji DGX oparty jest na 208-miliardowej konstrukcji tranzystorowej Blackwell Ultra, z maksymalnie 160 rdzeniami SM i 640 rdzeniami Tensor piątej generacji. Posiada również 252 GB pamięci HBM3e o przepustowości 7.1 TB/s. Jako element centrum danych, B300 nie posiada standardowego wyjścia wyświetlacza ani sprzętowych enkoderów NVENC. Zawiera jednak siedem silników NVDEC i siedem dekoderów nvJPEG. Procesor graficzny obsługuje również technologię MIG, co pozwala na partycjonowanie go na nawet siedem izolowanych instancji. Pod względem mocy obliczeniowej, B300 oferuje:
| Precyzja | Peak Performance |
|---|---|
| Wydajność obliczeniowa B300 | |
| Rdzeń tensora NVFP4 | 20 PFLOPS rzadki / 15 PFLOPS gęsty |
| FP8 / Rdzeń tensora FP6 | 10 PFLOPS |
| Rdzeń tensorowy INT8 | 330 TOPS |
| Rdzeń tensorowy FP16 / BF16 | 5 PFLOPS |
| Rdzeń tensora TF32 | 2.5 PFLOPS |
| FP32 | X TFTPS |
| FP64 / Rdzeń tensora FP64 | X TFTPS |
| Prędkości szczytowe są oparte na taktowaniu GPU Boost. Specyfikacje rdzenia Tensor wykorzystują rozrzedzenie, o ile nie zaznaczono inaczej. | |
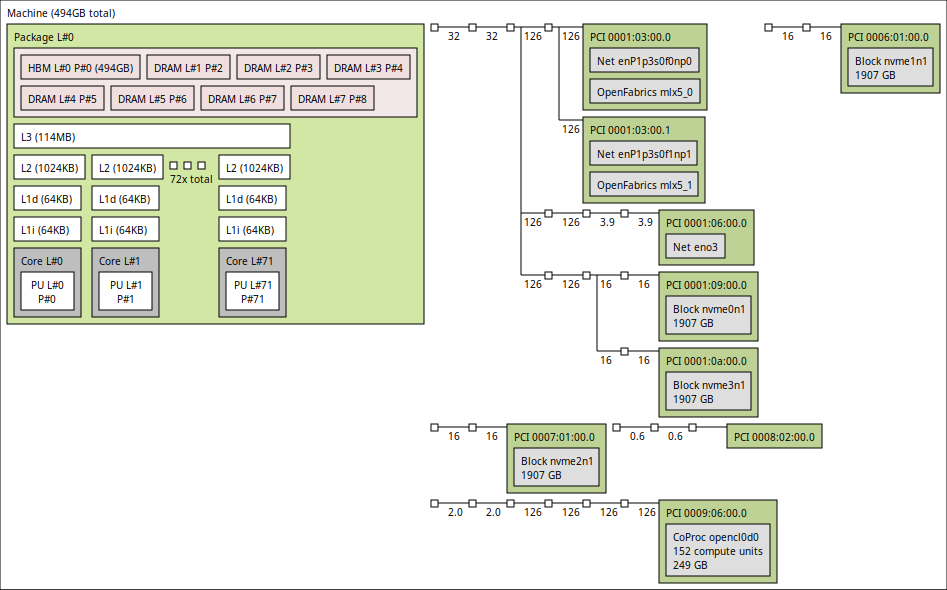
W parze z procesorem B300 znajduje się Grace, pierwszy procesor firmy NVIDIA do centrów danych. Wykorzystuje on 72 rdzenie Arm Neoverse V2, ale otaczający je procesor jest autorskim projektem firmy NVIDIA, obejmującym hierarchię pamięci podręcznej, kontrolery pamięci, systemowe wejście/wyjście, skalowalną strukturę koherencji (SCA) i interfejs NVLink-C2C. Grace udostępnia 72 rdzenie i 72 wątki sprzętowe, przy czym każdy rdzeń implementuje Armv9 z rozszerzeniami kryptograficznymi i czterema 128-bitowymi jednostkami wektorowymi SVE2. Rdzeń posiada sześciokanałowy dekoder instrukcji zdolny do obsługi do ośmiu instrukcji na cykl zegara, sześć skalarnych jednostek ALU, 64 KB pamięci podręcznej L1 instrukcji i danych oraz 1 MB prywatnej pamięci L2. Na całej powierzchni rdzenia procesor współdzieli 114 MB pamięci podręcznej L3.
Rdzenie i segmenty pamięci podręcznej L3 są połączone za pośrednictwem technologii NVIDIA Scalable Coherency Fabric, czyli siatki połączeń o przepustowości 3.2 TB/s. Technologia ta łączy również rdzenie procesora z pamięcią, systemowymi wejściami/wyjściami oraz interfejsem NVLink-C2C, zapewniając Grace przepustowość transmisji danych niezbędną do zasilania B300. W WS300 Grace obsługuje zadania po stronie procesora związane z akceleratorem: uruchamianie jądra GPU, ładowanie danych, przetwarzanie wstępne, tokenizację i orkiestrację modeli. Poniższy widok topologii daje przejrzysty obraz konstrukcji jednogniazdowej z jednym 72-rdzeniowym procesorem Grace i urządzeniami platformy połączonymi wokół niego.
Grace jest sparowana z 496 GB pamięci LPDDR5X, zapewniając przepustowość 396 GB/s. Zamiast lutować pamięć bezpośrednio do płyty głównej, DGX Station wykorzystuje cztery moduły SOCAMM. SOCAMM, czyli System-on-Chip Advanced Memory Module, pakuje pamięć LPDDR5X w kompaktową, wymienną obudowę. Pozwala to platformie zachować zalety przepustowości i energooszczędności pamięci LPDDR5X, a jednocześnie zapewnia jej łatwą obsługę. Uszkodzony moduł można wymienić bez konieczności wymiany całej płyty głównej.
Grace i B300 łączy interfejs NVLink-C2C firmy NVIDIA, czyli połączenie na poziomie pakietu, które zapewnia dwukierunkową przepustowość 900 GB/s, czyli około siedem razy więcej niż połączenie PCIe Gen5 x16. Najważniejszą różnicą jest spójność pamięci. W konwencjonalnej stacji roboczej procesor i oddzielny układ GPU utrzymują oddzielne przestrzenie pamięci, a dane są między nimi kopiowane przez PCIe. Dzięki NVLink-C2C, Grace i B300 współdzielą spójną przestrzeń adresową, umożliwiając każdemu procesorowi bezpośredni dostęp do pamięci podłączonej do drugiego.
Rezultatem jest spójna przestrzeń adresowa o pojemności 748 GB, a nie blok pamięci HBM o pojemności 748 GB. Pamięć B300 ma 252 GB pamięci HBM3e, co zapewnia przepustowość 7.1 TB/s, podczas gdy pamięć Grace dostarcza 496 GB pamięci LPDDR5X o przepustowości 396 GB/s. Dane przechowywane w pamięci Grace muszą nadal przechodzić przez łącze C2C, więc pamięć HBM pozostaje najlepszą lokalizacją dla często używanych wag modeli, tensorów i buforów. Pamięć Grace działa natomiast jako warstwa o dużej pojemności, umożliwiając obciążeniem przekraczającym 252 GB pamięci lokalnej pamięci B300 pozostanie w jednym systemie, zamiast dzielić je na wiele procesorów GPU. Wpływ przejścia do tej drugiej warstwy pamięci na wydajność zmierzymy później w części poświęconej testom.
Topologia systemu
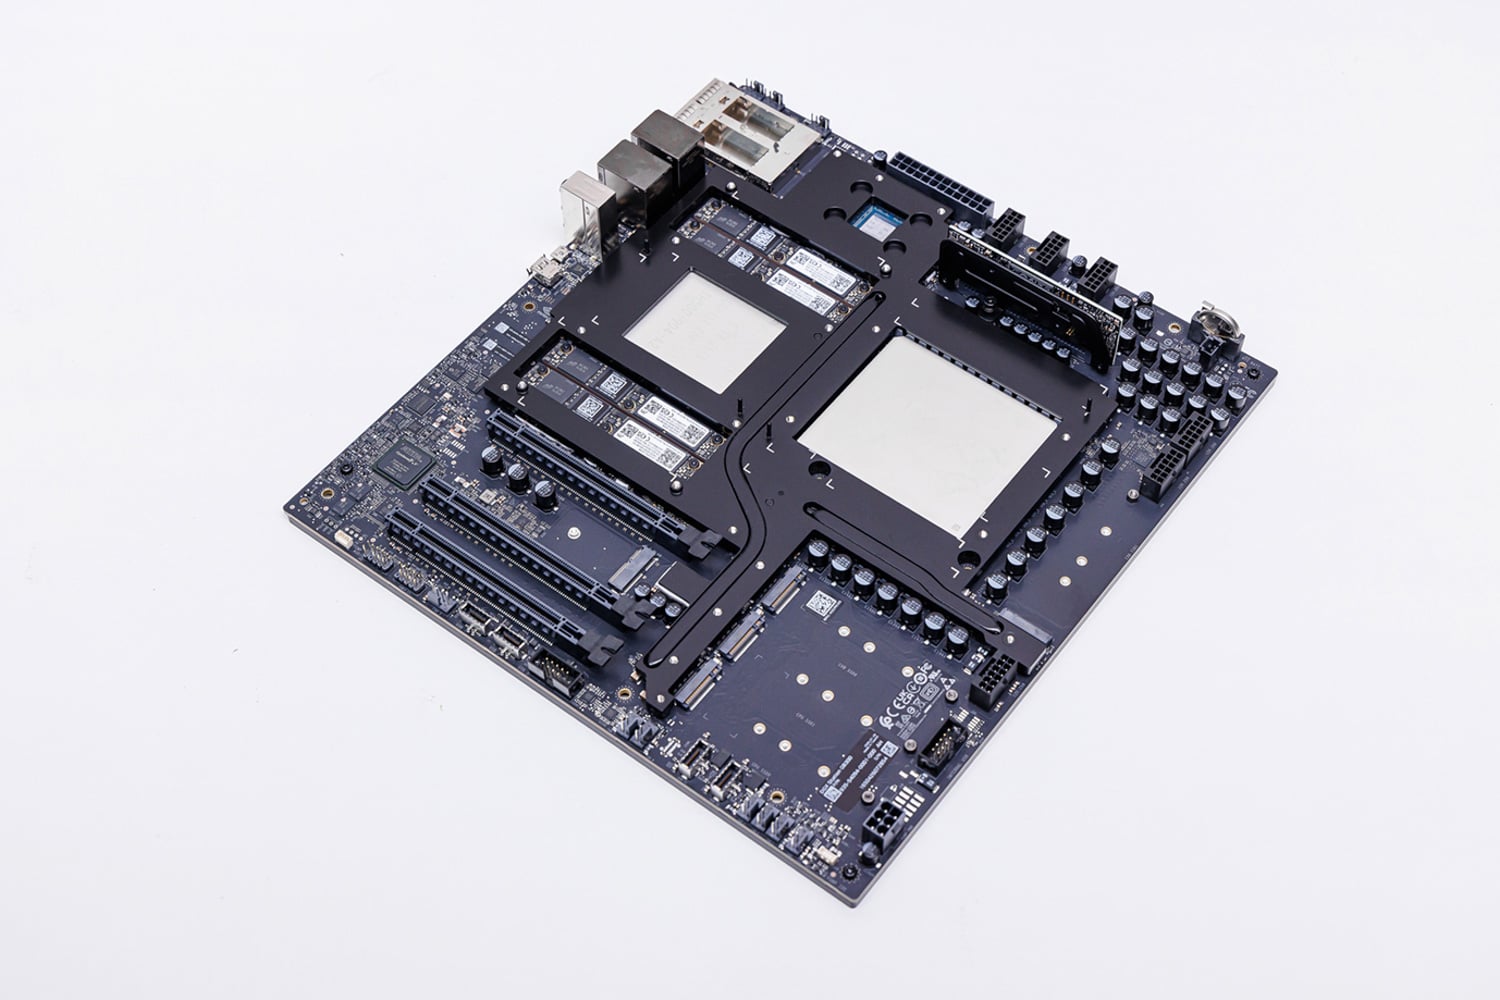
Odchodząc od obudowy GB300, schemat blokowy MSI pokazuje, jak reszta systemu łączy się wokół Grace. Procesor znajduje się w centrum topologii wejścia/wyjścia, z dwoma gniazdami PCIe 5.0 x4 M.2 podłączonymi bezpośrednio do niego. MSI wyposaża je w parę dysków SSD Micron 4600 o pojemności 2 TB skonfigurowanych w RAID 1 dla systemu operacyjnego i oprogramowania NVIDIA. Trzy pełnowymiarowe gniazda rozszerzeń również znajdują się bezpośrednio w Grace, z jednym łączem PCIe 5.0 x16 i dwoma łączami PCIe 5.0 x8.
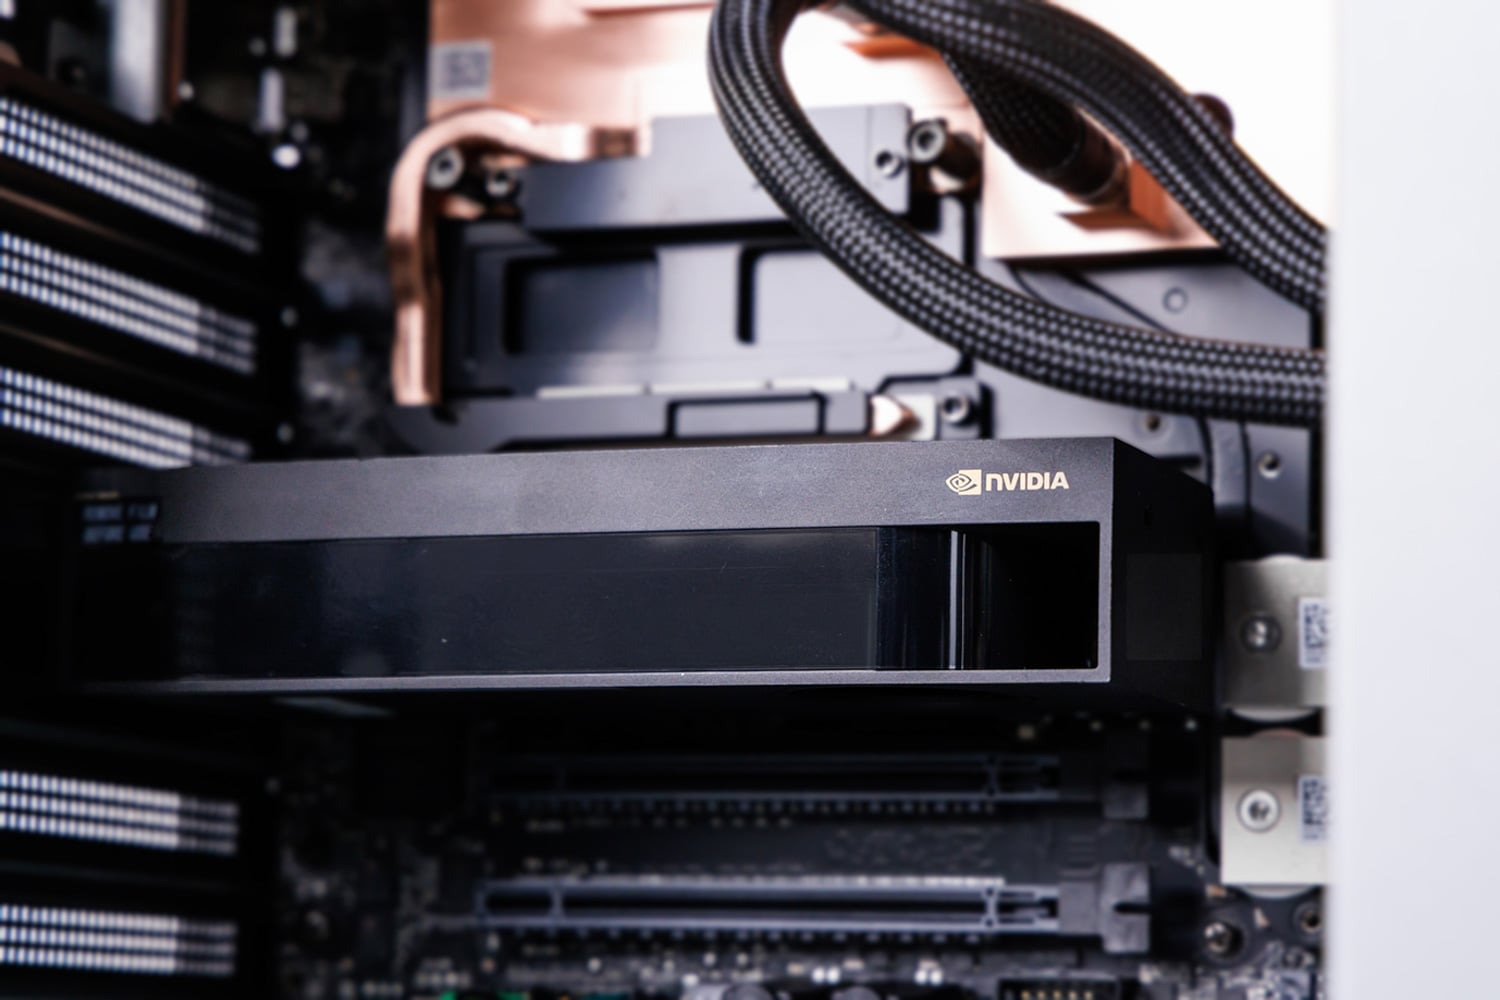
Firma MSI przygotowała również obudowę pod duży, dodatkowy procesor graficzny. Wstępnie podłączony przewód zasilający 12VHPWR jest łatwo dostępny z przodu obudowy, co eliminuje konieczność prowadzenia kolejnego kabla przez system. Pionowa metalowa listwa wzmacniająca obudowę zawiera również wspornik zapobiegający uginaniu się obudowy, umożliwiający montaż długich i ciężkich kart RTX PRO.
Kontroler USB po stronie Grace obsługuje główne porty USB z przodu i z tyłu systemu, a także kodek audio. Grace łączy się również z kontrolerem ASPEED AST2600 BMC, który zapewnia dedykowany port zarządzania 1GbE, wyjście Mini DisplayPort z ograniczeniem do 1024 x 768 oraz konsolę szeregową Micro-USB. Mini DisplayPort służy do początkowej konfiguracji i rozwiązywania problemów, a nie jako główne wyjście sygnału wideo systemu. Każdy, kto planuje używać WS300 jako konwencjonalnego komputera stacjonarnego, nadal będzie potrzebował jednej z opcjonalnych kart rozszerzeń RTX PRO.
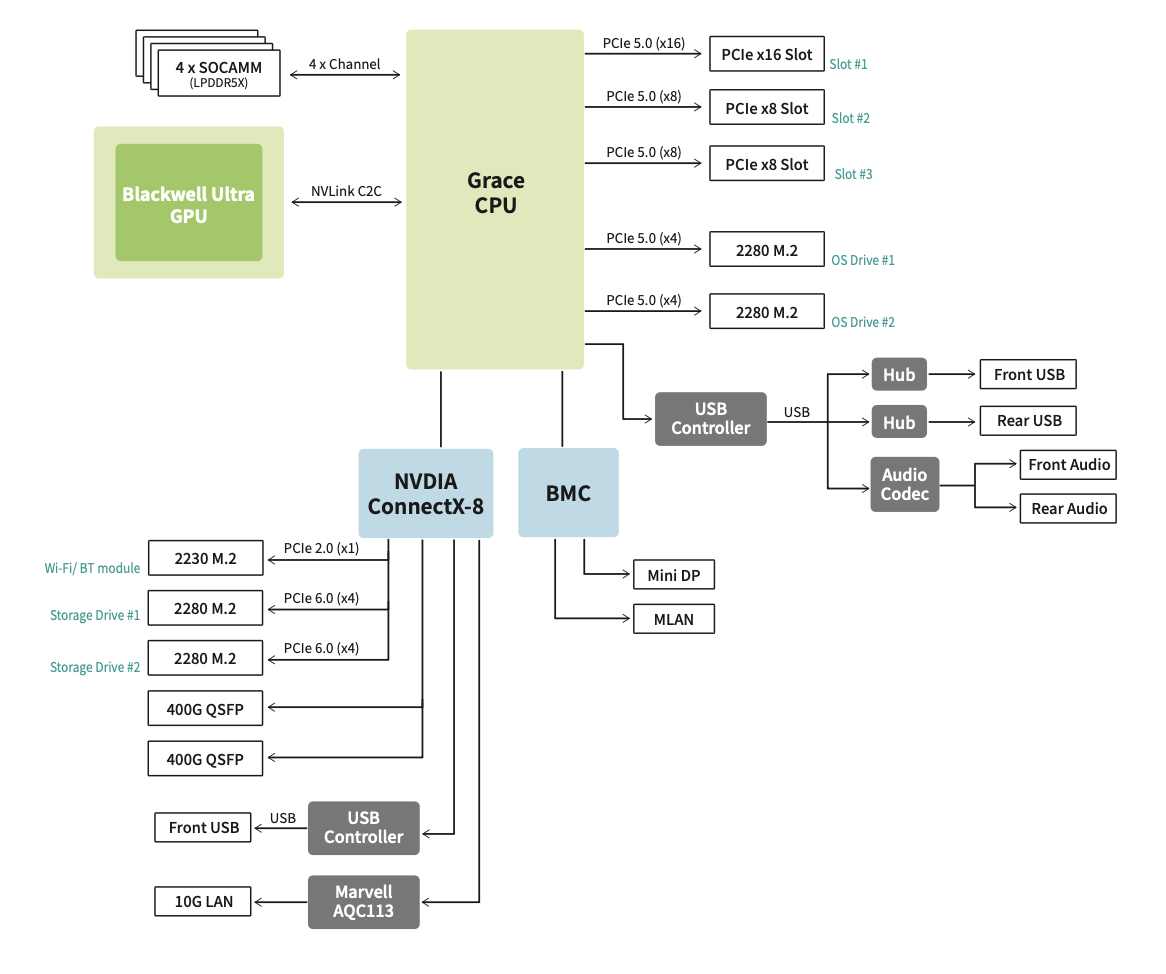
Drugą ważną gałęzią jest karta sieciowa NVIDIA ConnectX-8 SuperNIC. Jej najbardziej widoczną cechą jest para portów 400 GbE QSFP112 na tylnym panelu, zapewniających łączną przepustowość sieci do 800 Gb/s. ConnectX-8 zawiera również zintegrowany przełącznik PCIe z 48 liniami; jego łącze upstream obsługuje PCIe Gen6, ale porty downstream udostępniane urządzeniom działają w standardzie PCIe 5.0, co pozwala firmie MSI używać go jako dodatkowego koncentratora wejścia/wyjścia, a nie tylko karty sieciowej.
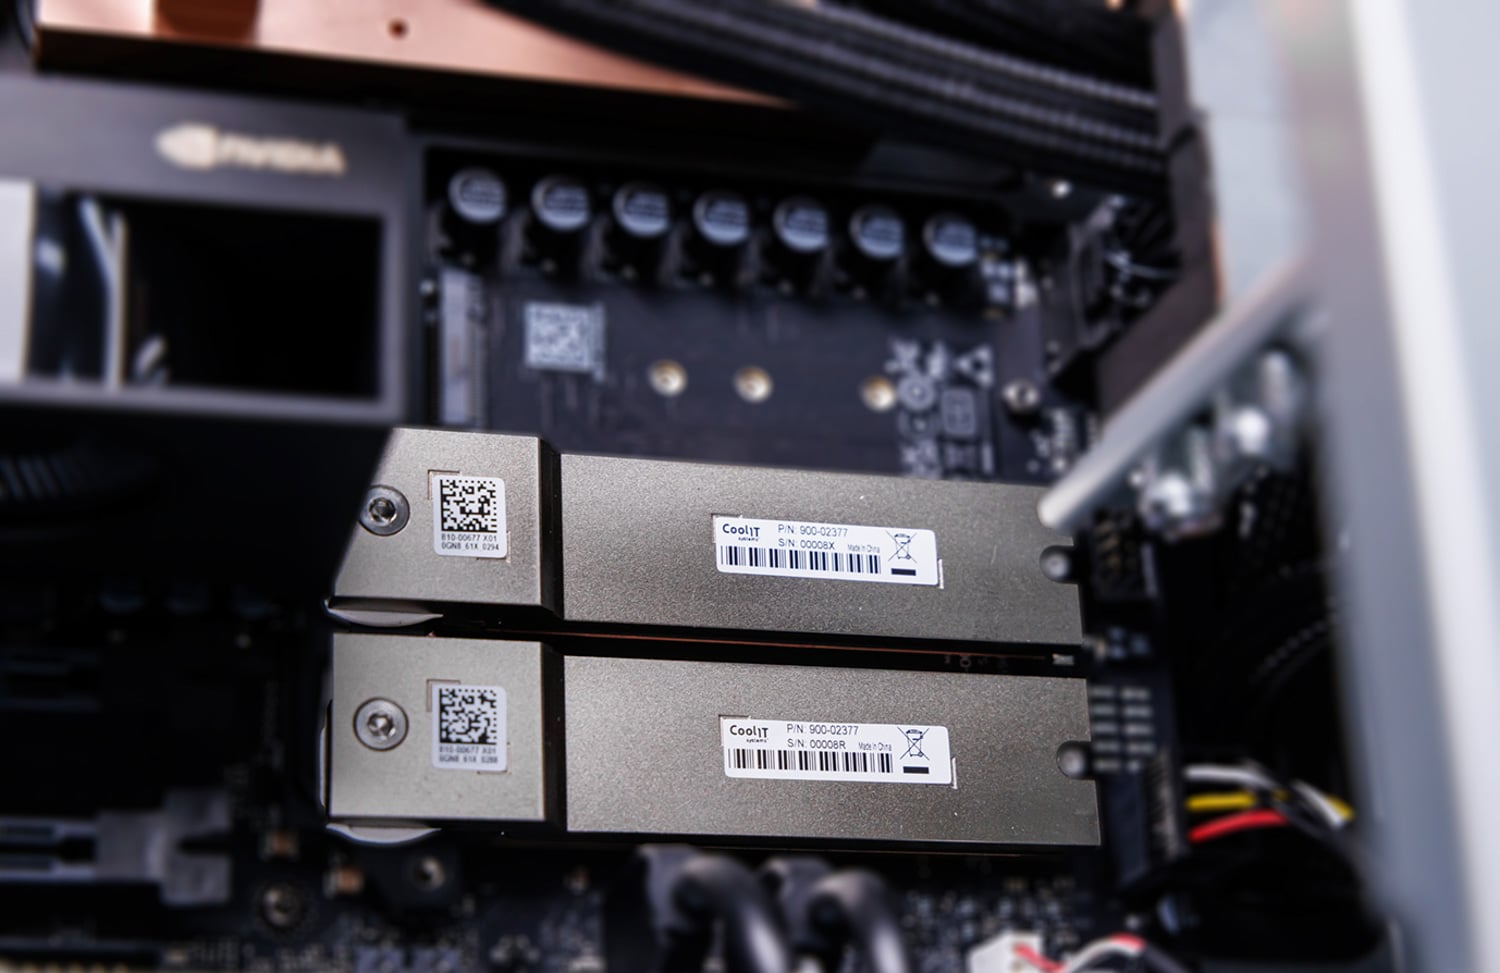
Dwa łącza PCIe 5.0 x4 z ConnectX-8 zasilają pozostałe gniazda M.2 2280, które MSI pozostawia otwarte na rozbudowę. Ta sama linia łączy również gniazdo Wi-Fi i Bluetooth M.2 2230 przez PCIe 2.0 x1, kontroler Marvell AQC113 dla portu 10GBase-T oraz drugi kontroler USB, który obsługuje dodatkową ścieżkę USB na panelu przednim.
Zasilanie i chłodzenie
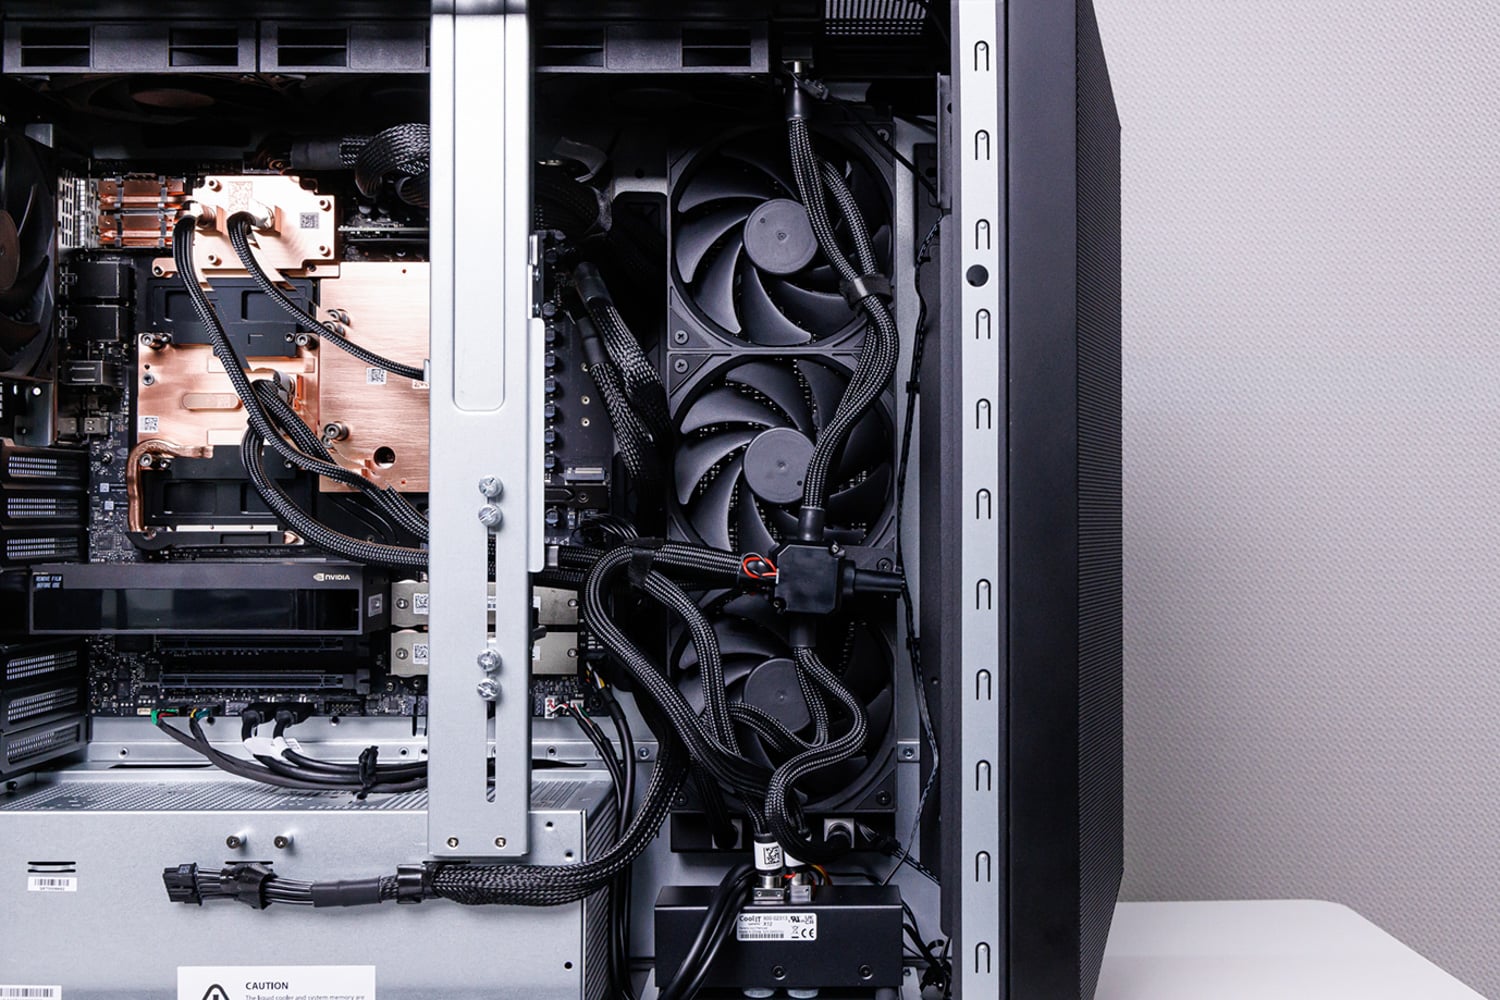
Zasilanie stacji WS300 zapewnia pojedynczy zasilacz ATX 80 PLUS Platinum o mocy 1,600 W z wejściem C19. W instalacjach w Ameryce Północnej stacja DGX wymaga dedykowanego obwodu 20 A, aby zapewnić systemowi pełną moc.
Moc 1,600 W to górny limit dla całego systemu. Grace, B300, pamięć masowa, pompy, wentylatory i opcjonalna karta RTX PRO korzystają z tego samego źródła zasilania. Dodanie wydajnej karty graficznej rozszerza możliwości WS300, ale nie pobiera ona energii z innego źródła. Gdy zarówno B300, jak i karta RTX są obciążone, muszą dzielić się dostępną mocą, co może obniżyć wydajność procesora graficznego B300.
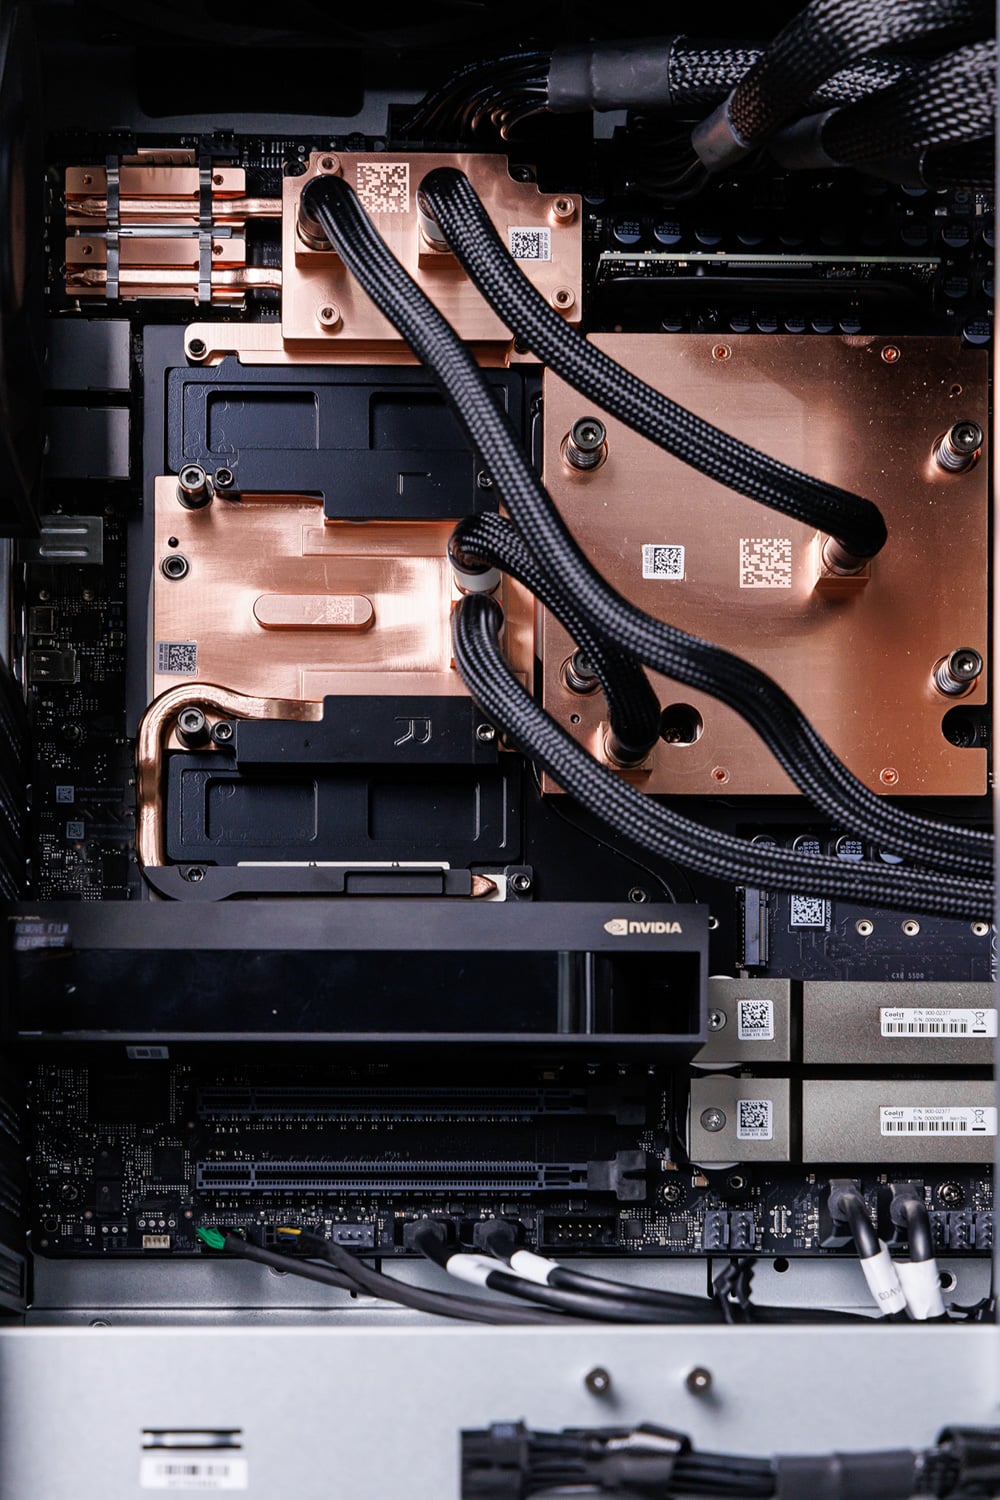
MSI radzi sobie z powstałym obciążeniem termicznym dzięki specjalnej pętli chłodzenia cieczą, obejmującej B300, procesor Grace, pamięć SOCAMM i ConnectX-8, w tym klatki optyczne. Ciepło jest odprowadzane przez dwa radiatory o średnicy 360 mm, a oddzielny wentylator o średnicy 120 mm zapewnia cyrkulację powietrza w pozostałej części obudowy. MSI szacuje moc chłodzenia na 1,400 W dla procesora i karty graficznej. Podczas naszych testów temperatura B300 osiągnęła szczyt 71°C, podczas gdy procesor nigdy nie nagrzał się powyżej 65°C, a karta graficzna pobierała 1292 W mocy.
Chlupotanie mocy
NVIDIA zarządza tym współdzielonym budżetem za pośrednictwem usługi vsloshd. W domyślnym trybie dynamicznym usługa monitoruje w czasie rzeczywistym pobór mocy modułu GB300 i opcjonalnej karty RTX PRO, dostosowując dostępny zapas mocy między nimi, zamiast narzucać każdemu urządzeniu stały limit. Zgodnie z obecną polityką, karta RTX ma priorytet, więc gdy potrzebuje więcej mocy, system najpierw obniża limit mocy GB300, a następnie podnosi limit RTX. Bez zainstalowanej karty RTX, cały budżet polityki pozostaje dostępny dla modułu GB300.
Oznacza to, że opcjonalna karta RTX PRO 6000 to nie tylko dodatkowa wydajność do B300. Gdy oba układy GPU są zajęte, moc przypisana do karty RTX pochodzi bezpośrednio z budżetu GB300 i może obniżyć taktowanie i wydajność B300.
Platforma zawiera również sprzętowy hamulec zasilania na wypadek wykrycia spadku mocy przez system. Zaobserwowaliśmy to podczas naszych testów, gdy luźne złącza zasilania powodowały, że WS300 obniżał limit mocy zamiast się wyłączyć lub kontynuował pobieranie pełnej mocy przez uszkodzone połączenie. Maszyna pozostawała online w stanie obniżonego poboru mocy do momentu rozwiązania problemu z połączeniem.
Łączność
Zanim przejdziemy do obudowy, warto rzucić okiem na przednie i tylne wejścia/wyjścia. Przednie wejścia/wyjścia składają się z dwóch portów USB 3.2 Gen 2 typu A, dwóch portów USB 3.2 Gen 2 typu C, osobnych gniazd wyjścia liniowego i mikrofonu oraz przycisków zasilania i resetowania.
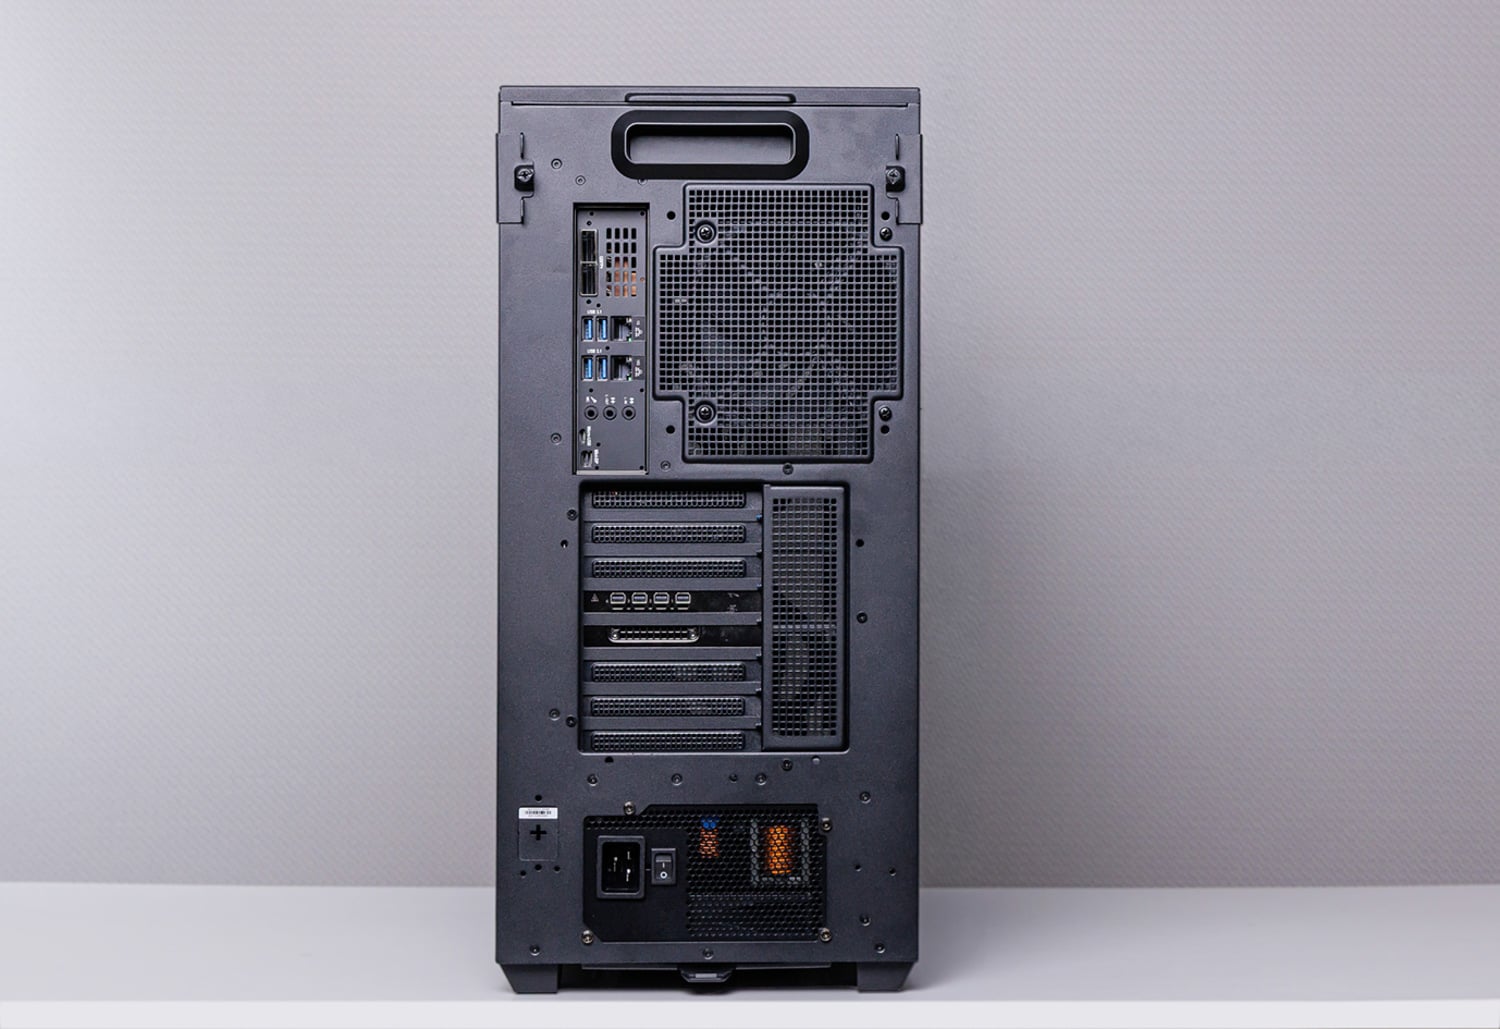
Tylny panel jest podzielony na porty łączności ze stacją roboczą i sprzęt serwerowy znajdujący się pod spodem. ConnectX-8 oferuje dwa porty 400 GbE QSFP112, oddzielny port 10GBase-T obsługuje standardową sieć hosta, a dedykowany port 1 GbE łączy się z kontrolerem BMC. Cztery porty USB typu A 10 Gb/s i trzy gniazda audio obsługują lokalne urządzenia peryferyjne. BMC udostępnia również konsolę szeregową Micro-USB i port Mini DisplayPort. Gniazdo zasilania C19 znajduje się u dołu obudowy, a moduł Wi-Fi 6E lub Wi-Fi 7 z Bluetooth można dodać poprzez wewnętrzne gniazdo M.2 2230 Key-E.
Obciążenia centrum danych na biurku
Wszystko do tej pory opisało, czym jest DGX Station; bardziej przydatnym pytaniem dla kupujących jest to, co XpertStation umożliwia zespołowi. Wartość WS300 staje się bardziej widoczna, gdy traktuje się ją jako platformę programistyczną, a nie tylko system wnioskowania o dużej pojemności. Jej procesor graficzny B300, procesor Grace, obsługa MIG, opcjonalna karta graficzna RTX PRO i stos oprogramowania dla centrów danych umożliwiają obsługę kilku przepływów pracy, które normalnie zależałyby od współdzielonego sprzętu klastrowego, na jednym węźle lokalnym.
MIG jako narzędzie programistyczne
Wyobraź sobie jednoczesne uruchamianie kilku zupełnie oddzielnych zadań na jednym GPU, z których każde jest odizolowane od pozostałych. Właśnie to robi Multi-Instance GPU (MIG): segmentuje przestrzennie procesor B300 na poziomie sprzętowym na maksymalnie siedem równych rozmiarów segmentów, czyli instancji. Każda instancja otrzymuje własny, stały przydział pamięci SM, HBM, pamięci podręcznej i przepustowości, posiada własną tożsamość urządzenia i jest postrzegana przez CUDA jako oddzielny GPU.
Dzięki temu możliwe jest opracowywanie, testowanie i weryfikowanie obciążeń wieloprocesorowych, trenowanie skryptów i opracowywanie rozwiązań dla narzędzi takich jak Dynamo, LLM-D itp.
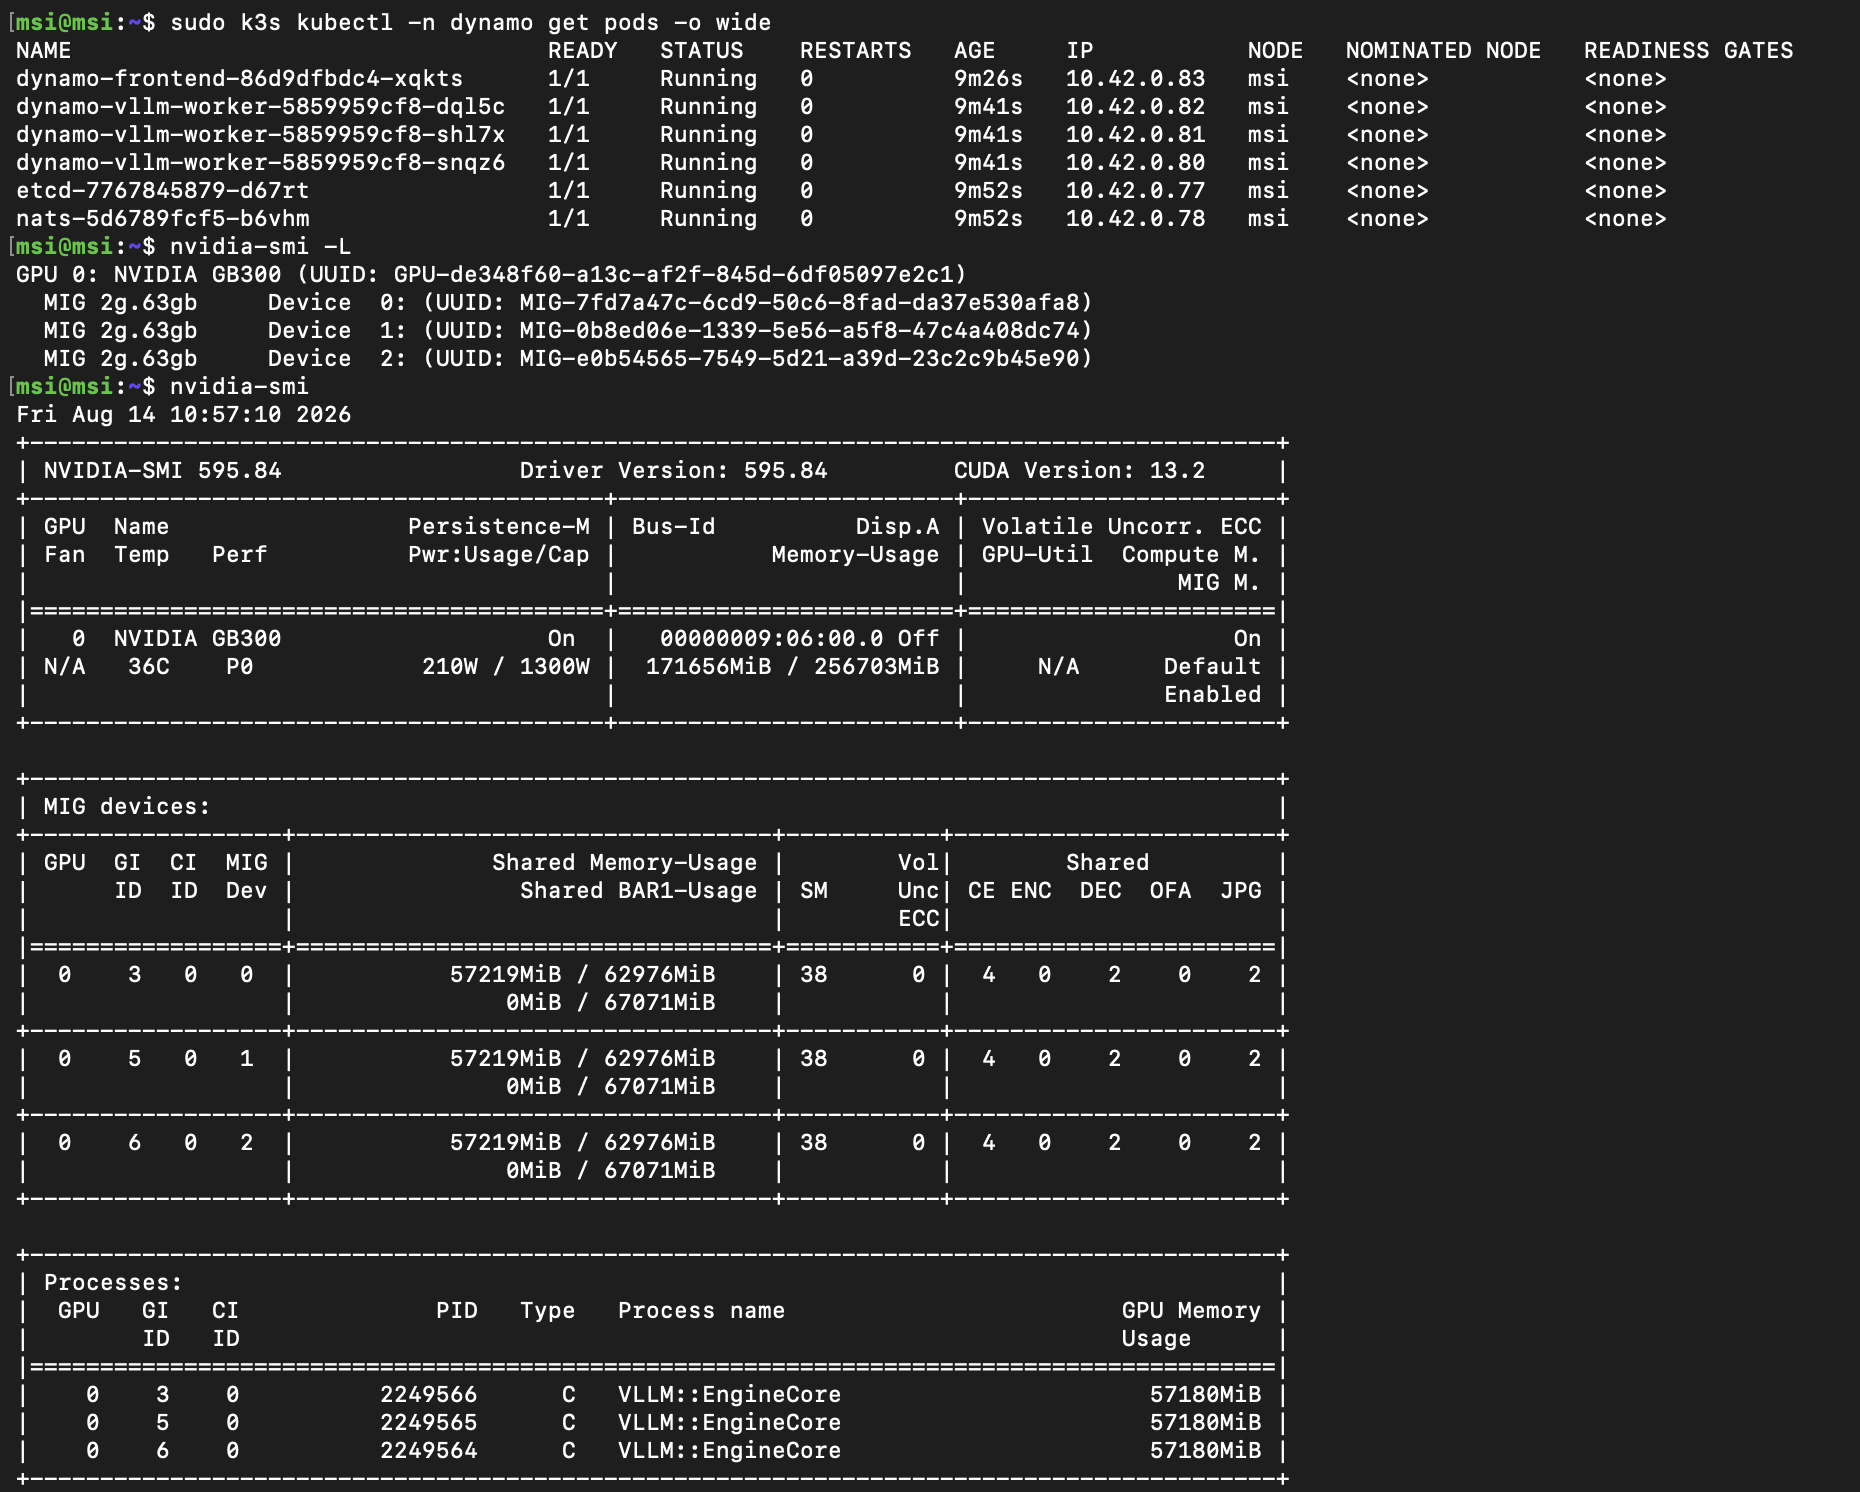
Do naszych testów skonfigurowaliśmy B300 z trzema instancjami MIG i użyliśmy ich do uruchomienia komponentów NVIDIA Dynamo na oddzielnych urządzeniach widocznych dla CUDA. Odzwierciedla to sposób, w jaki powstaje wiele naszych własnych narzędzi testowych: sprawdzenie, czy działają dokładnie tak, jak powinny, oznacza wielokrotne iterowanie na rzeczywistym sprzęcie. Posiadanie lokalnego B300, który możemy podzielić i rekonfigurować, bez konieczności planowania czasu na serwerze współdzielonym oraz bez poboru mocy, ciepła i hałasu charakterystycznego dla szafy rack w pomieszczeniu, eliminuje zaskakująco dużo narzutu związanego z tego typu iteracyjną pracą.
Isaac GR00T i fizyczna pętla sztucznej inteligencji
Innym przepływem pracy, który szczególnie dobrze pasuje do DGX Station, jest fizyczna sztuczna inteligencja.
Testowaliśmy już wcześniej ten typ przepływu pracy , ale wymagał on kilku systemów wyposażonych w różne klasy procesorów GPU. Stacja DGX łączy te dotychczas oddzielne etapy w jednym urządzeniu stacjonarnym.
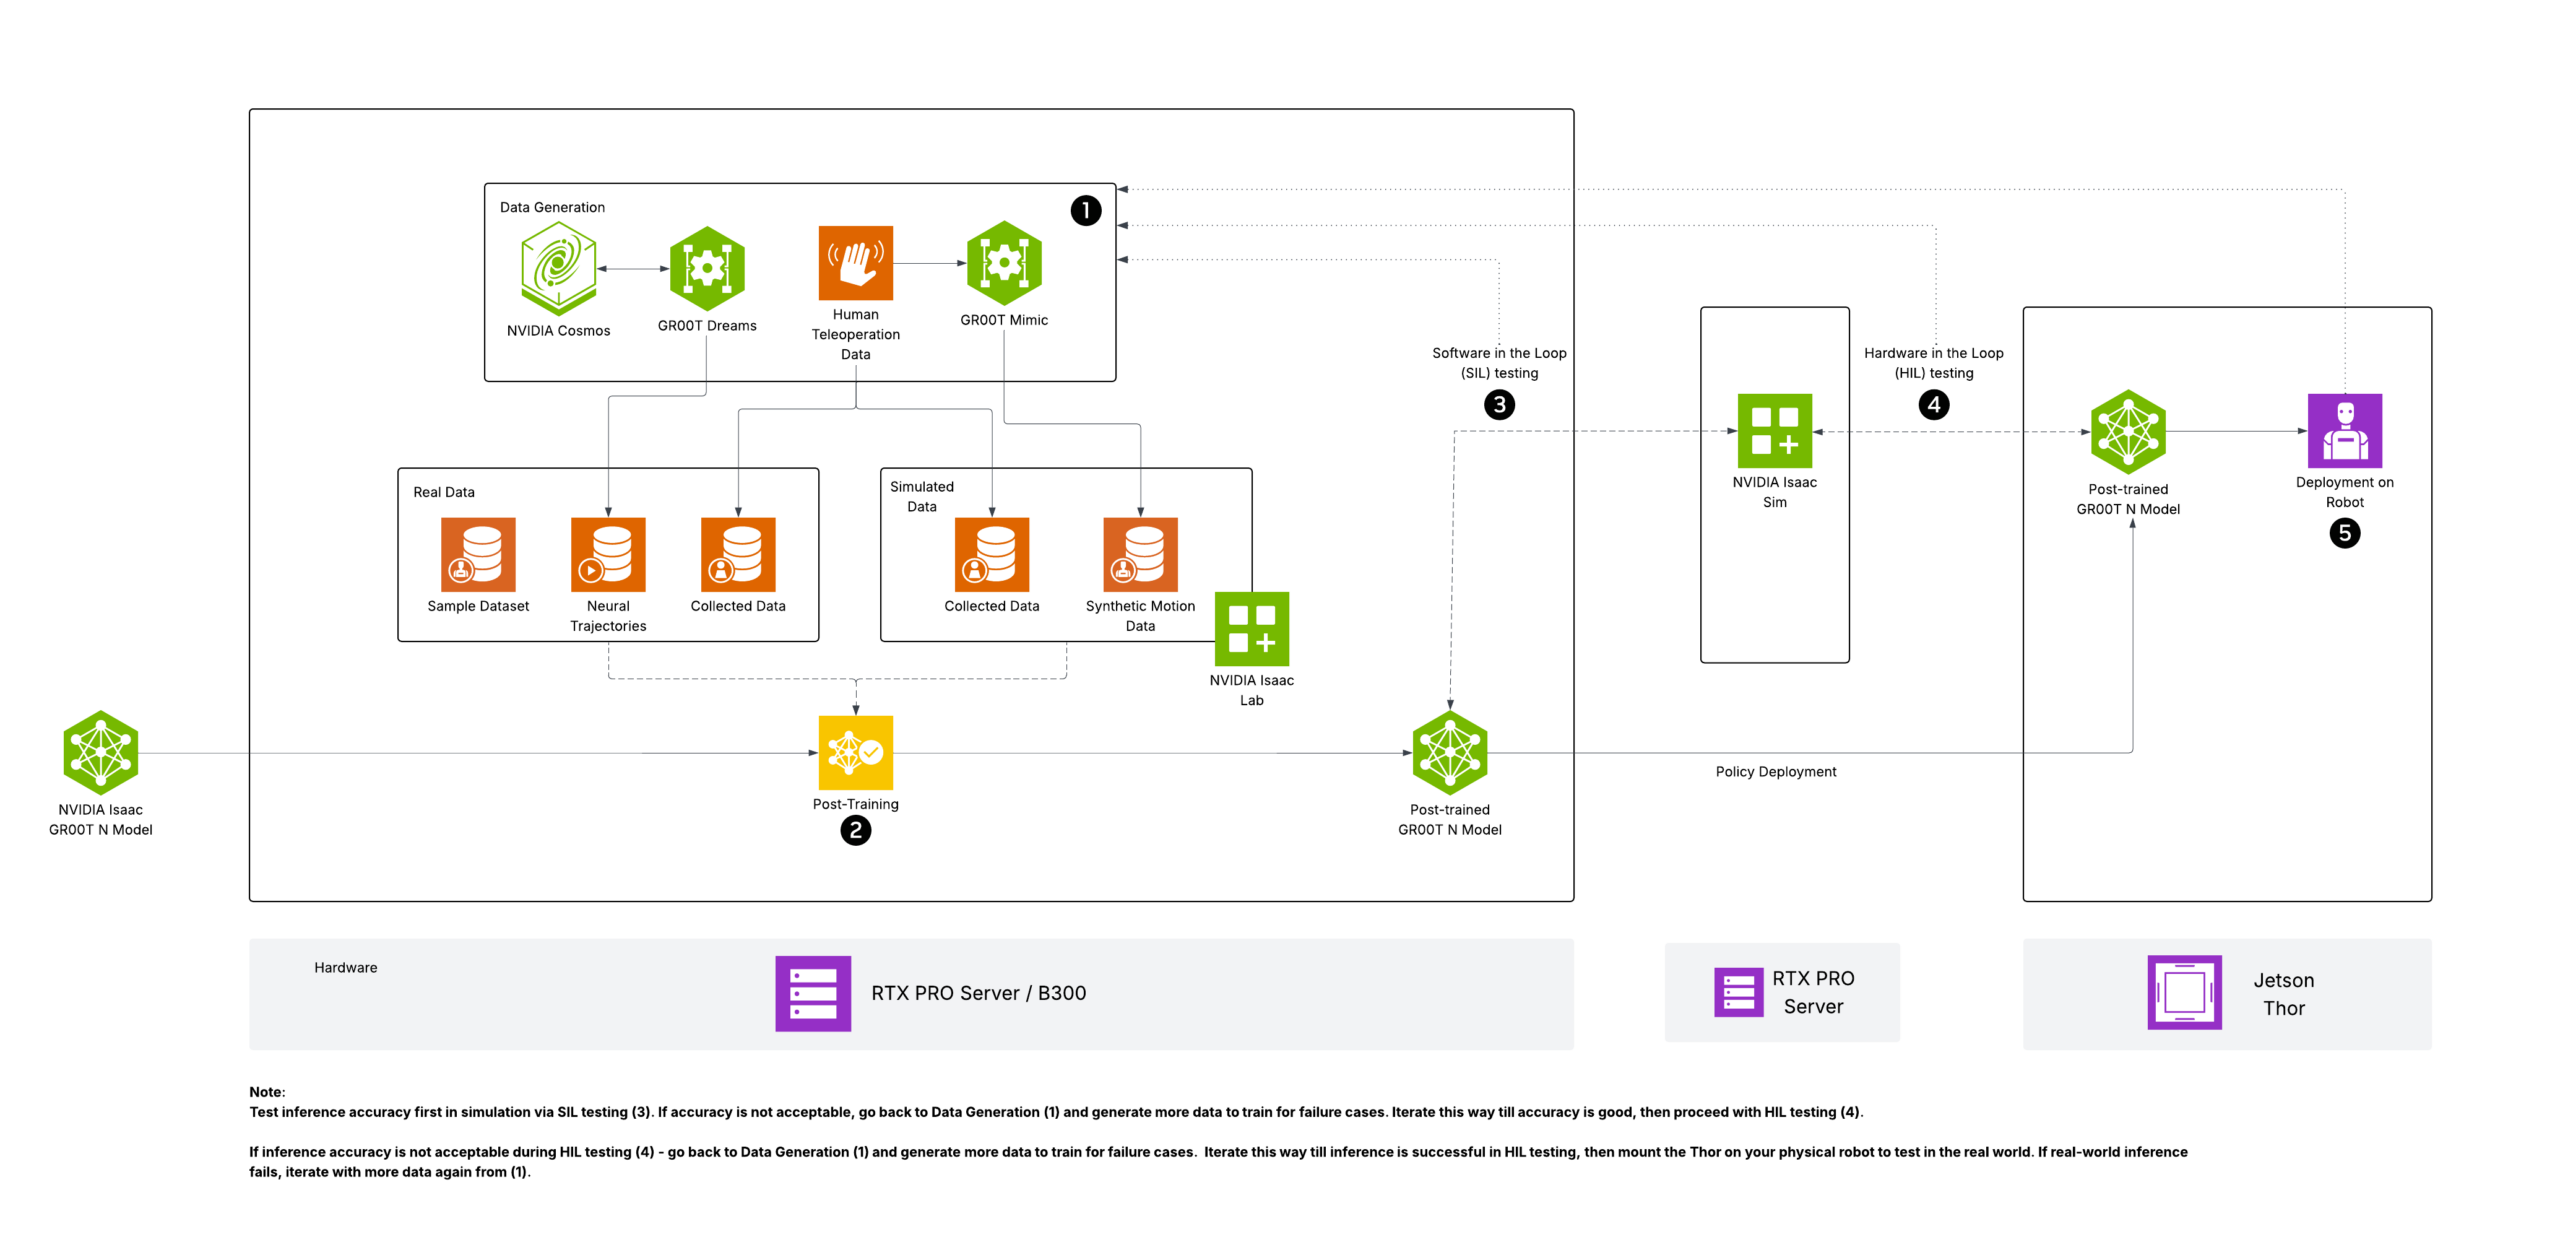
Proces rozpoczyna się od teleoperacji: operator kieruje robotem przez zadanie, aby zarejestrować niewielki zestaw demonstracji w warunkach rzeczywistych. Te przykłady trafiają następnie do procesu roboczego Isaac GR00T. Opcjonalny procesor graficzny RTX PRO obsługuje grafikę i śledzenie promieni w Isaac Sim, podczas gdy Isaac Lab i GR00T-Mimic rozszerzają oryginalne demonstracje o znacznie większy zbiór fizycznie prawdopodobnych trajektorii syntetycznych. Na koniec B300 dostraja model GR00T, wykorzystując połączony zbiór danych rzeczywistych i syntetycznych.
Źródło: NVIDIA
Po dopracowaniu, wynikową politykę można zweryfikować w symulacji, a następnie wdrożyć do robota w celu przeprowadzenia oceny w warunkach rzeczywistych. Tworzy to ścisły cykl rozwoju: przechwytuje się rzeczywistą demonstrację, odtwarza i modyfikuje ją w symulacji, ponownie trenuje model i testuje zaktualizowaną politykę na sprzęcie. W przypadku zespołów z ograniczonym dostępem do robotów, operatorów lub okien gromadzenia danych, konsolidacja symulacji, generowania danych syntetycznych i trenowania modelu w jednym systemie stacjonarnym może znacznie zmniejszyć tarcie w każdej iteracji.
Rozwój jądra Blackwell Ultra
Można jednak argumentować, że najlepszym zastosowaniem DGX Station jest optymalizacja jądra. Gdy zespół pisze jądra CUDA lub Triton dla Blackwell Ultra, nie ma lepszego sposobu niż praca na architekturze docelowej. WS300 udostępnia programistom procesor B300 i 252 GB pamięci HBM3e, umożliwiając profilowanie rzeczywistych obciążeń, inspekcję zachowania pamięci, dostrajanie ścieżek rdzenia Tensor, łączenie operacji i iterację bez konieczności rezerwowania czasu na serwerze z ośmioma procesorami GPU lub systemie rackowym.
Większe systemy nadal mają znaczenie, ale można je zarezerwować do zadań, które ich wymagają: skalowania NVLink, kolektywów NCCL, jąder komunikacyjnych, wnioskowania wieloprocesorowego i końcowej walidacji przepustowości. WS300 obsługuje lokalnie zadania jądra pojedynczego procesora graficznego, dzięki czemu te drogie, współdzielone systemy są dostępne do skalowania w celu testowania. Dla zespołu skupionego na optymalizacji Blackwell Ultra jest to niemal tak bezpośrednia maszyna programistyczna, jak oferuje rynek.
Gdyby stacja DGX została wysłana wraz z pierwszymi systemami Blackwell Ultra, podejrzewamy, że początkowy zapas zniknąłby niemal natychmiast, trafiając do laboratoriów AI, zespołów kompilatorów, deweloperów silników inferencyjnych i innych grup ścigających się z czasem w dostrajaniu oprogramowania dla B300. Nawet teraz bezpośredni dostęp do docelowego procesora graficznego może być najwyraźniejszym powodem, dla którego organizacja powinna go kupić.
Wydajność
Uwaga dotycząca testów: Testy przeprowadzono zdalnie na systemie hostowanym przez MSI, a StorageReview kontrolowało całe środowisko oprogramowania przez cały okres ewaluacji. System testowano bez zainstalowanego układu GPU RTX PRO ani żadnych innych kart rozszerzeń PCIe. Dzięki temu układ GB300 Superchip dysponował pełnym dostępnym budżetem mocy akceleratora systemu przez cały okres testów.
Maksymalna osiągalna liczba flopów Matmul (MAMF)
Po pierwsze, aby umieścić obliczenia B300 w odpowiednim kontekście, uruchomiliśmy MAMF w systemach trzech generacji Blackwell. MAMF (Maximum Achievable Matmul FLOPS) to praktyczna miara wydajności zaprojektowana do pomiaru realistycznych szczytowych operacji zmiennoprzecinkowych na sekundę, jakie można osiągnąć w akceleratorach uczenia maszynowego podczas operacji mnożenia macierzy. Oferuje ona dokładniejszy benchmark niż teoretyczny szczytowy FLOPS często podawany w specyfikacjach sprzętowych.
W ramach tego testu przeszukaliśmy każdy z 3 systemów w BF16, FP8 i NVFP4 i otrzymaliśmy najlepszy, trwały (gęsty) wynik dla każdej precyzji.
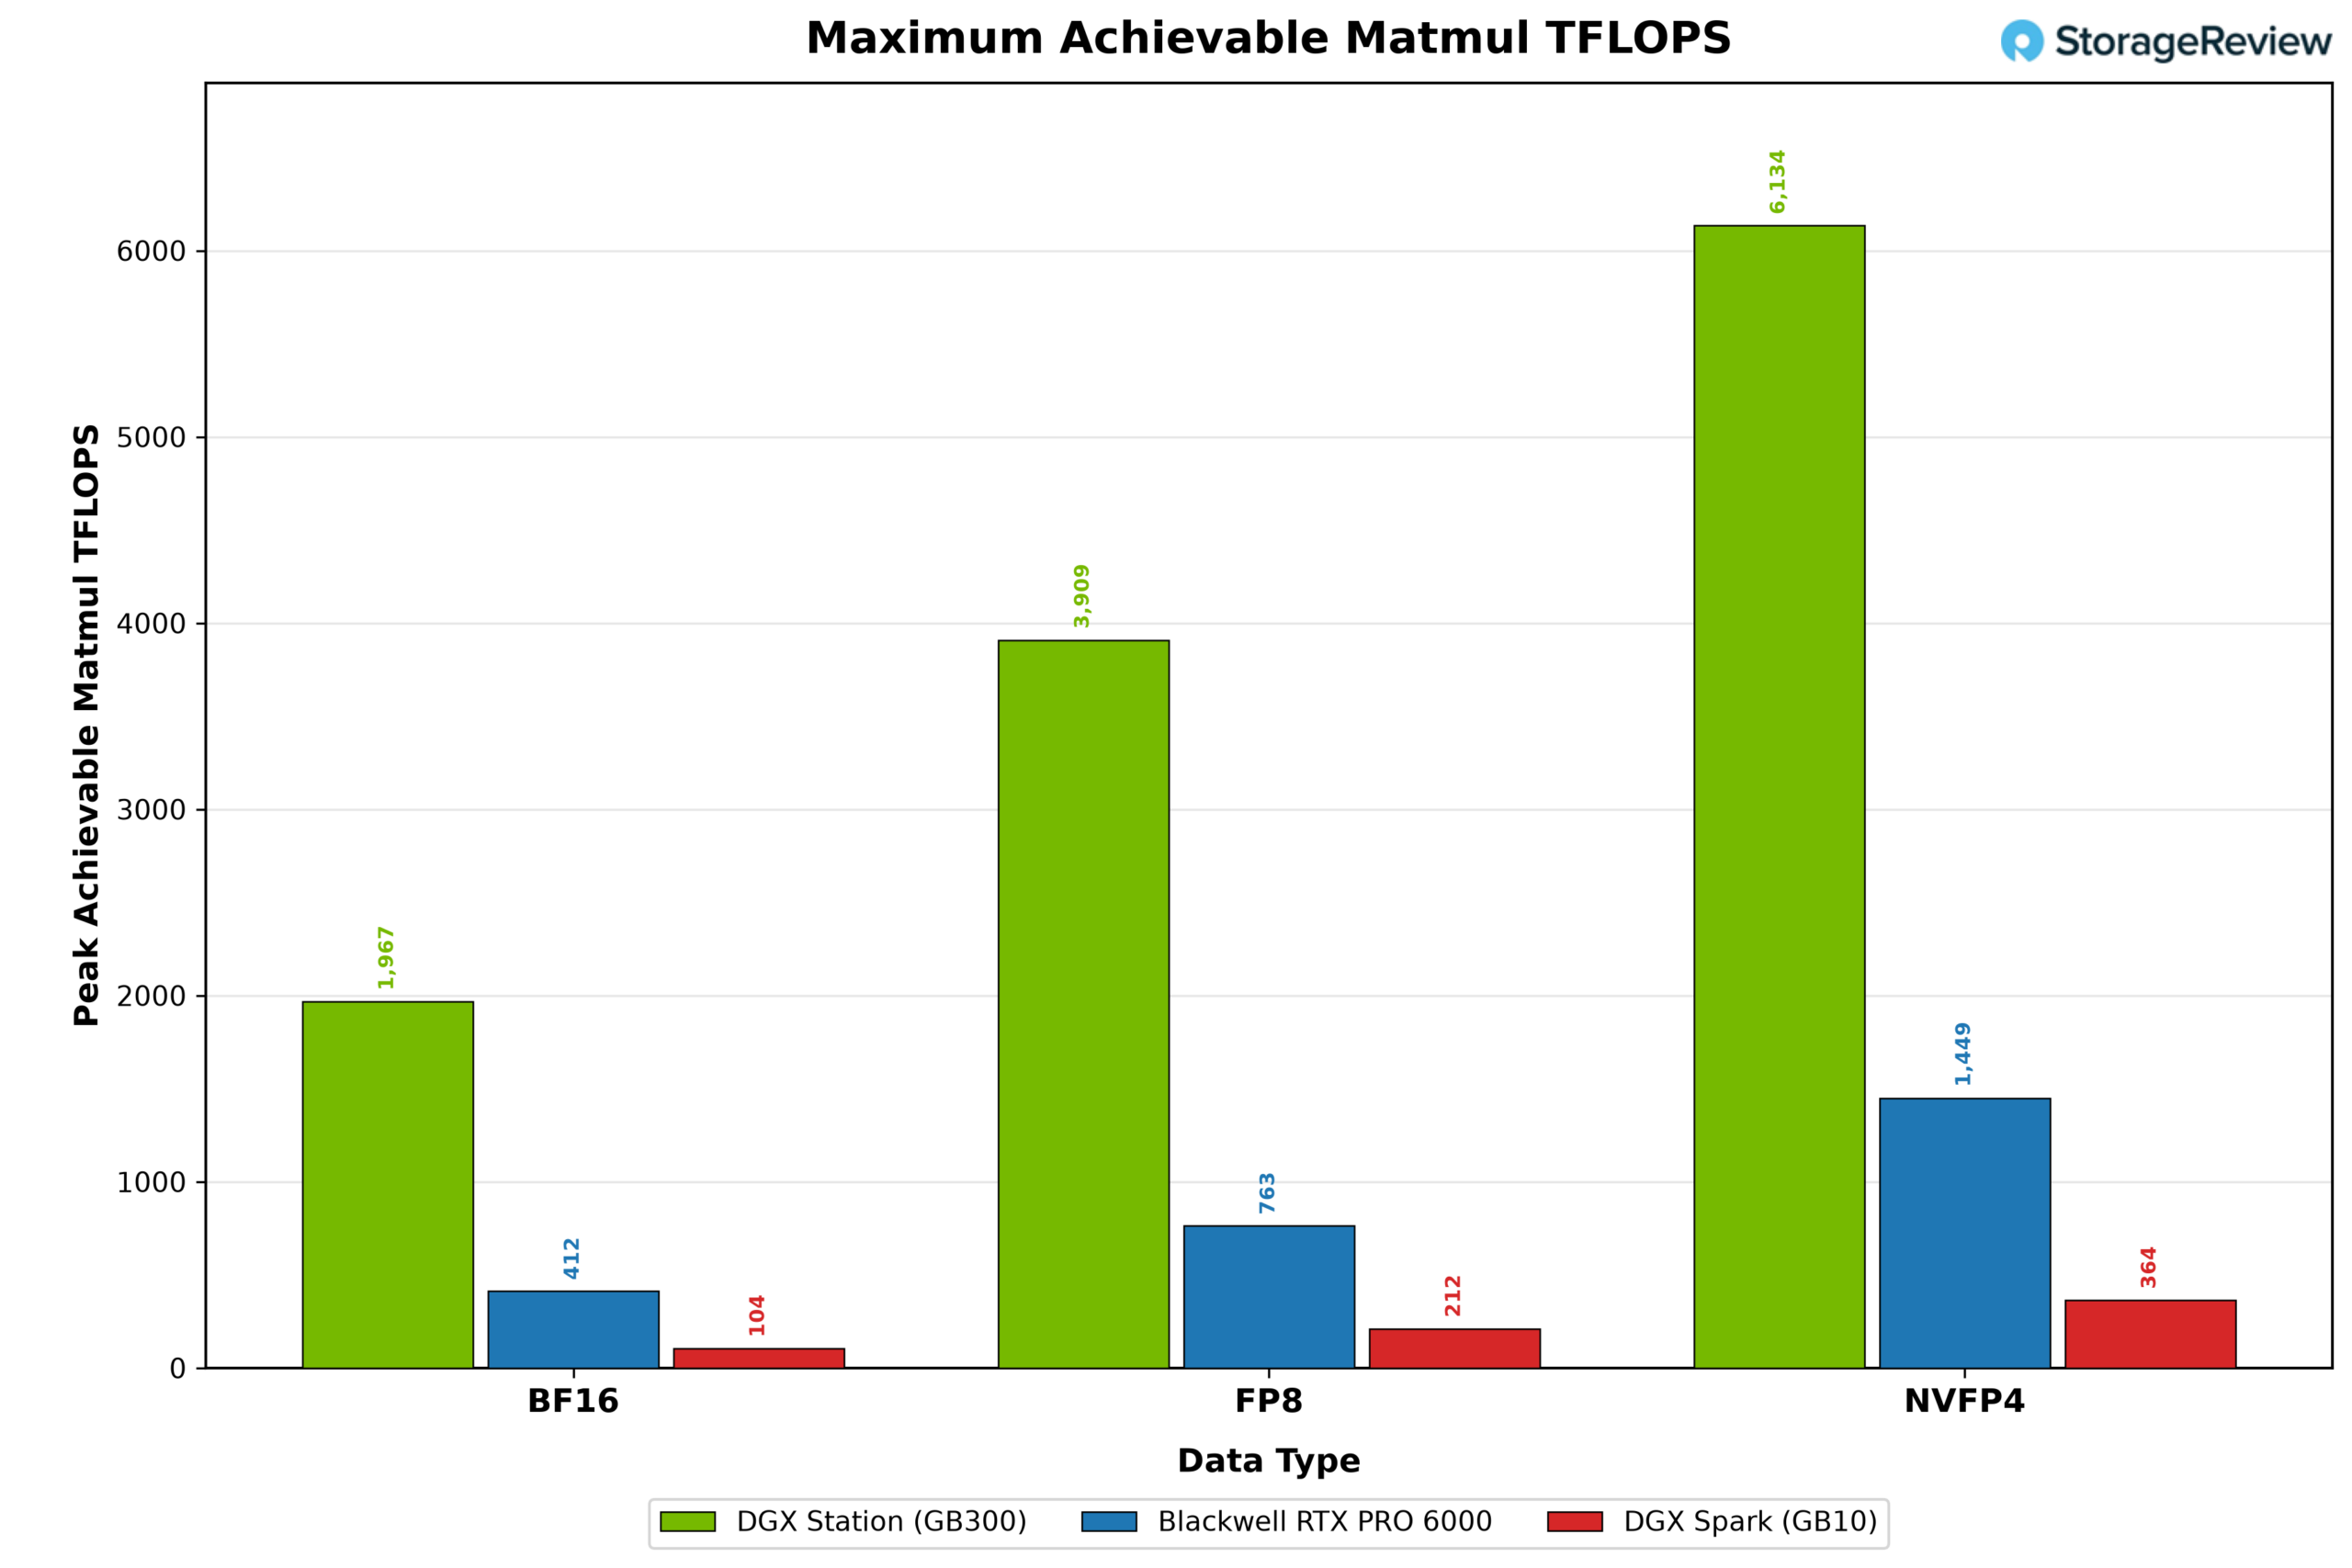
GB300 prowadzi w każdej precyzji. W BF16 osiąga 1,967 TFLOPS, w porównaniu z 412 TFLOPS w RTX PRO 6000 i 104 TFLOPS w DGX Spark . FP8 podąża za tym samym schematem: 3,909, 763 i 211 TFLOPS. NVFP4 podnosi GB300 do 6,134 TFLOPS, podczas gdy RTX PRO 6000 osiąga 1,449 TFLOPS, a Spark 364 TFLOPS. Współczynniki są niezwykle stabilne we wszystkich trzech precyzjach: GB300 ma 4-5-krotną przewagę nad RTX PRO 6000 i 17-19-krotną nad Spark, podczas gdy RTX PRO 6000 utrzymuje około 4-krotną przewagę nad Spark.
NVBandwidth
Surowa przepustowość obliczeniowa jest użyteczna tylko wtedy, gdy akcelerator może stale dostarczać dane swoim jednostkom wykonawczym. Jest to szczególnie ważne w przypadku wnioskowania AI, gdzie generowanie tokenów w fazie dekodowania jest często bardziej ograniczone przepustowością pamięci niż dostępną liczbą FLOPS.
W układzie GB300 Superchip hierarchia ta obejmuje lokalną pamięć HBM3e układu B300, pamięć LPDDR5X układu Grace oraz łącze NVLink-C2C łączące je. Narzędzie NVBandwidth firmy NVIDIA testuje różne ścieżki kopiowania w tych komponentach, pokazując zarówno dostępną przepustowość w procesorze graficznym, jak i koszt przesyłania danych między domenami pamięci procesora graficznego i procesora.
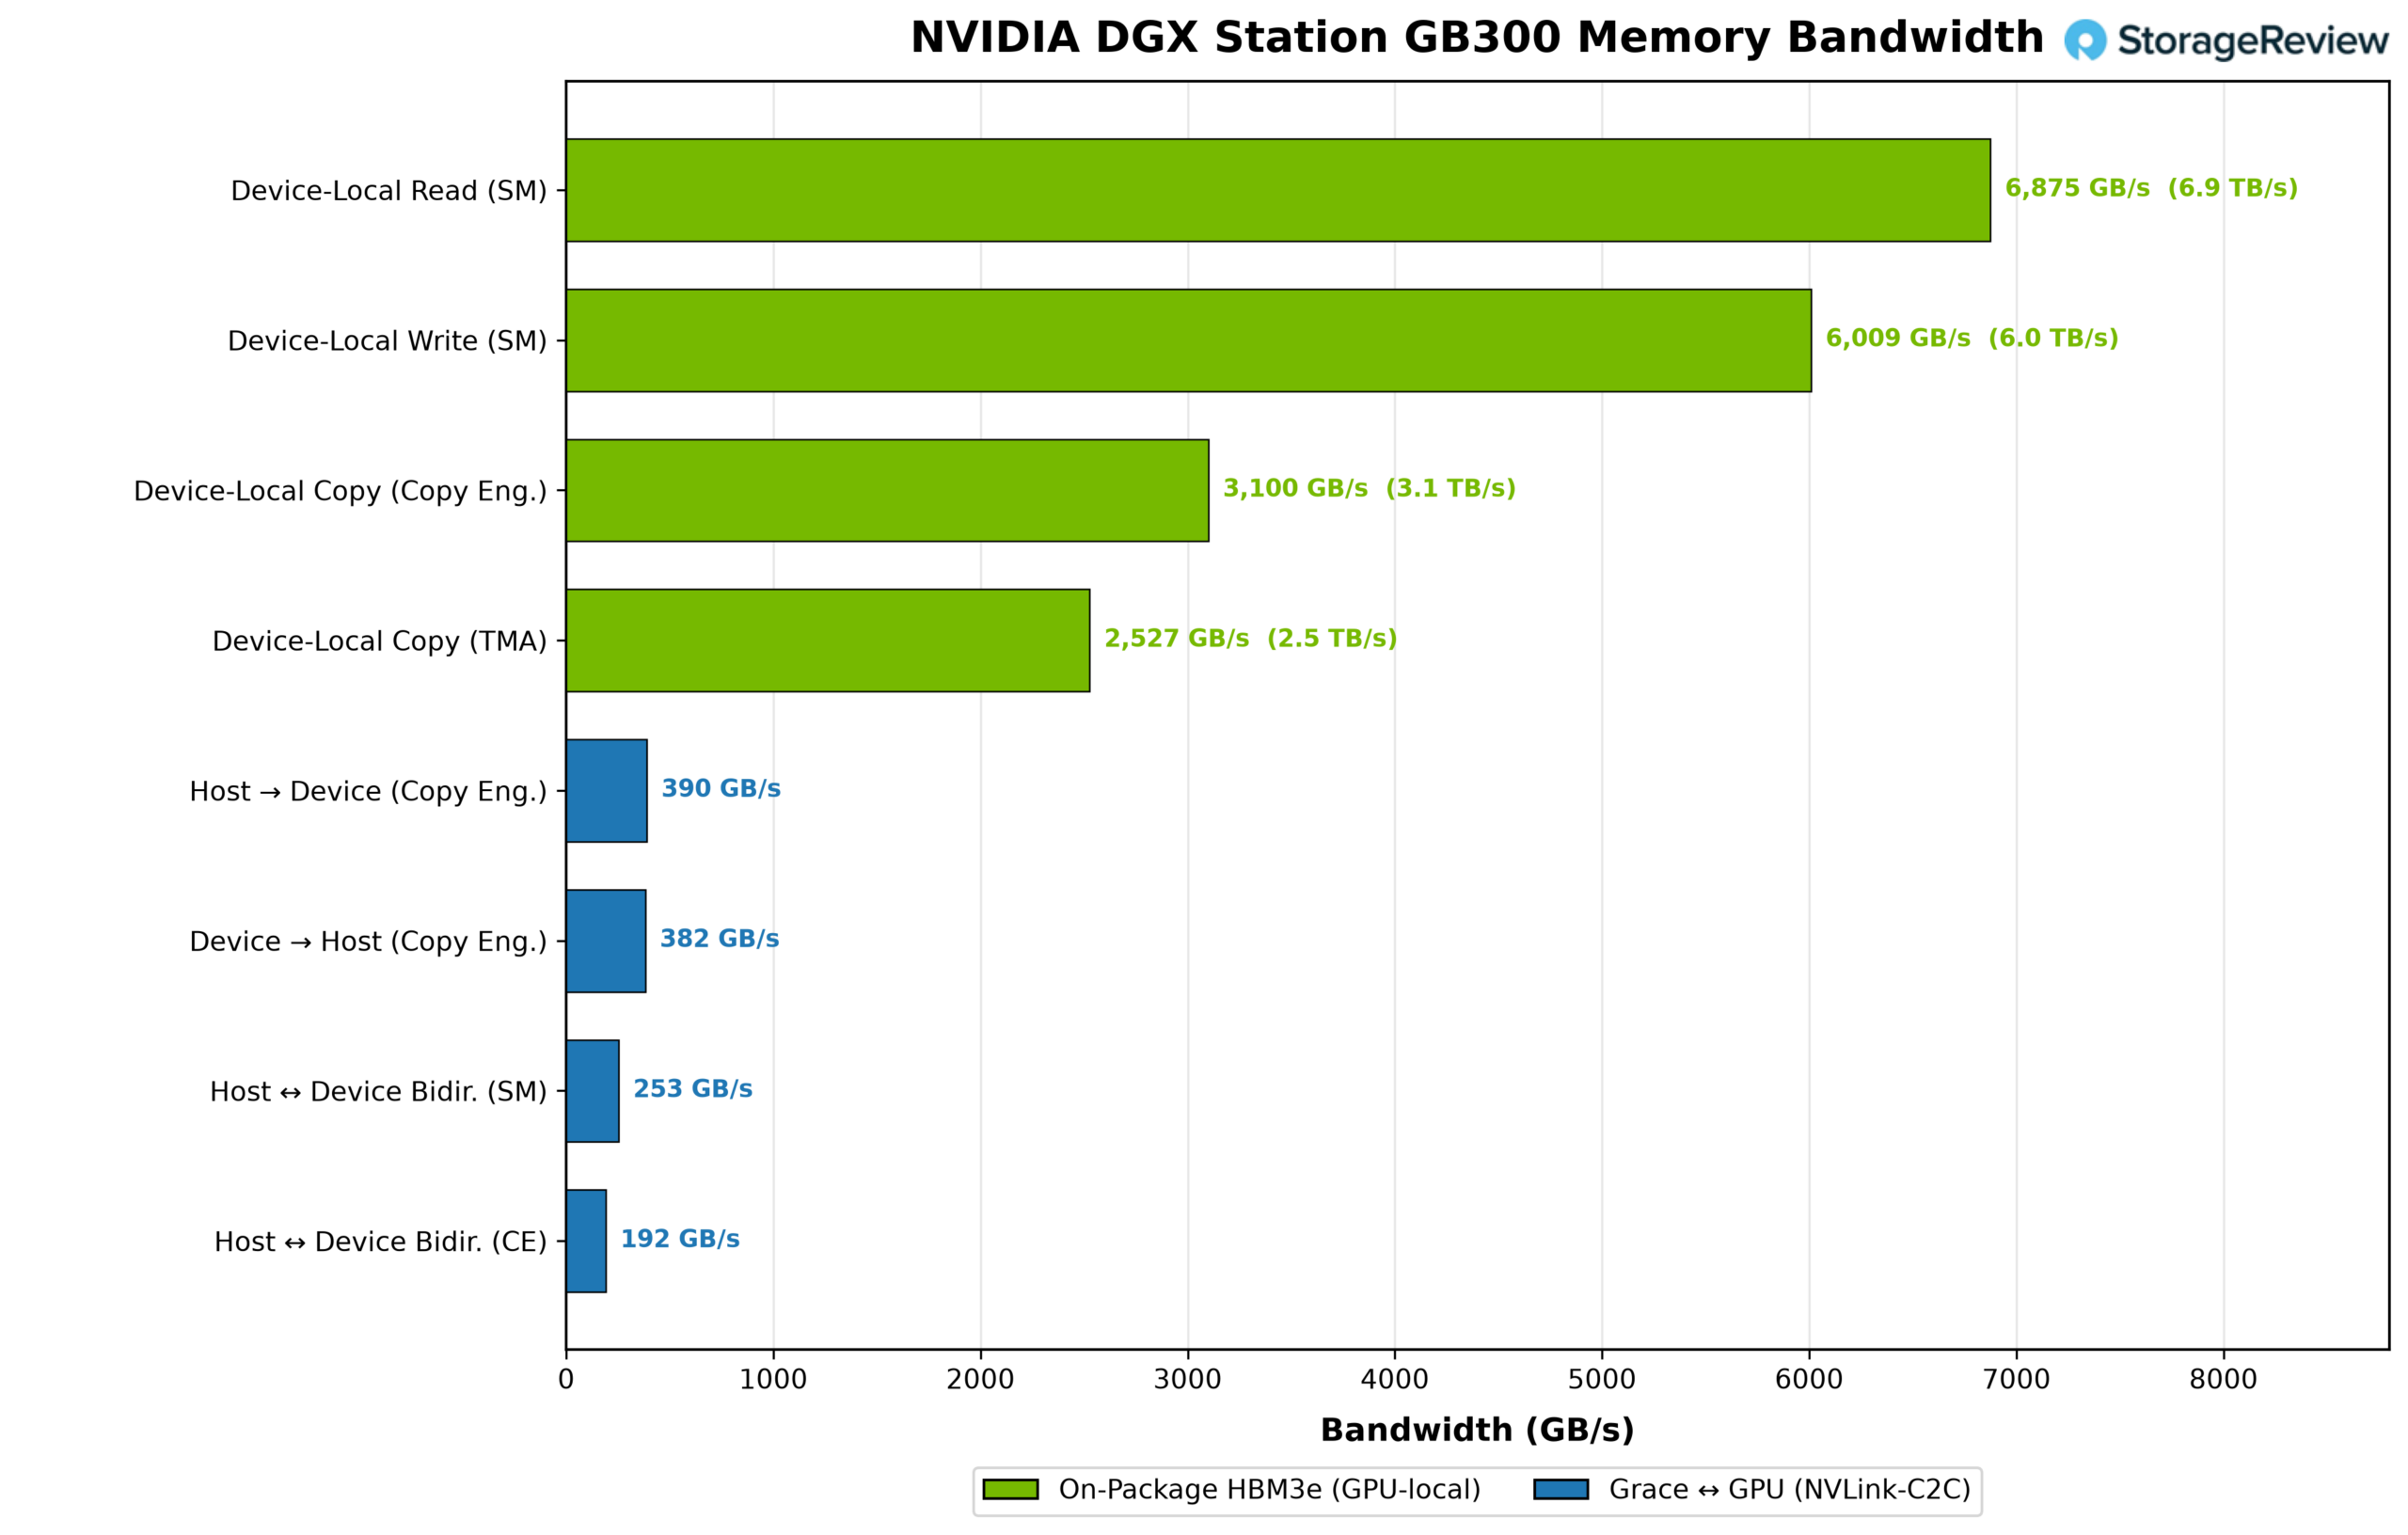
Pierwsze cztery testy mierzą ruch danych w 252 GB pamięci HBM3e procesora B300. Odczyty lokalne z urządzenia osiągają 6,875 GB/s, czyli około 6.9 TB/s, co plasuje wynik w granicach kilku procent nominalnej przepustowości pamięci GPU wynoszącej 7.1 TB/s. Zapisy lokalne z urządzenia osiągają 6,009 GB/s.
Operacje kopiowania HBM-do-HBM są niższe, ponieważ każda kopia zużywa przepustowość dwukrotnie: raz na odczyt źródła i ponownie na zapis do miejsca docelowego. Dedykowane silniki kopiujące osiągają prędkość 3,100 GB/s, a akcelerator pamięci Tensor Memory Accelerator rejestruje 2,527 GB/s.
Pozostałe testy obejmują NVLink-C2C i dostęp do 496 GB pamięci LPDDR5X w kontrolerze Grace. Transfery z pamięci Grace do kontrolera B300 HBM osiągają prędkość 390 GB/s, a transfery w przeciwnym kierunku 382 GB/s. Chociaż NVLink-C2C zapewnia do 900 GB/s spójnej przepustowości między procesorem a kartą graficzną, zmierzone transfery są ograniczone przez przepustowość pamięci LPDDR5X w kontrolerze Grace wynoszącą 396 GB/s. Transfery dwukierunkowe dodatkowo uwidaczniają to ograniczenie. Jednoczesny ruch osiąga 253 GB/s w przypadku kopii opartych na SM i 192 GB/s w przypadku silników kopiujących.
Wnioskowanie
Po przeprowadzeniu testów niskiego poziomu przechodzimy do wnioskowania LLM. W tym przypadku uwaga skupia się nie na liczbach szczytowych, ale na liczbie tokenów na sekundę, czasie do pierwszego tokena i opóźnieniu pod obciążeniem, co daje nam lepszy obraz zachowania WS300 jako systemu usług.
Zacznijmy od definiującej możliwości GB300 Superchip: obsługi modeli znajdujących się po obu stronach limitu pojemności 252 GB pamięci HBM3e w B300. To właśnie tutaj pula pamięci koherentnej o pojemności 748 GB ma największe znaczenie. Pięć punktów kontrolnych prowadzi od dwóch modeli, które bez problemu mieszczą się w pamięci HBM, przez jeden, który nominalnie mieści się w tej pamięci, ale pozostawia zbyt mało miejsca na pamięć podręczną dla środowiska wykonawczego i kwerendy kwantu (KV), aż po dwa, które muszą przenieść znaczną część swojej masy do pamięci Grace.
Uwaga: Tam, gdzie wspomniano, modele zostały uruchomione z dekodowaniem spekulatywnym w celu uzyskania wyższej przepustowości dekodowania, z wymuszoną liczbą tokenów akceptacji ustawioną na wartość tokenów dekodowania spekulatywnego. Wyniki pokazują zatem najlepszą wydajność; w rzeczywistych warunkach serwowania przepustowość jest dynamiczna i zależy od jakości tokenów dekodowania spekulatywnego.
Modele w pełni pasujące do HBM
DeepSeek v4 Flash (0731)
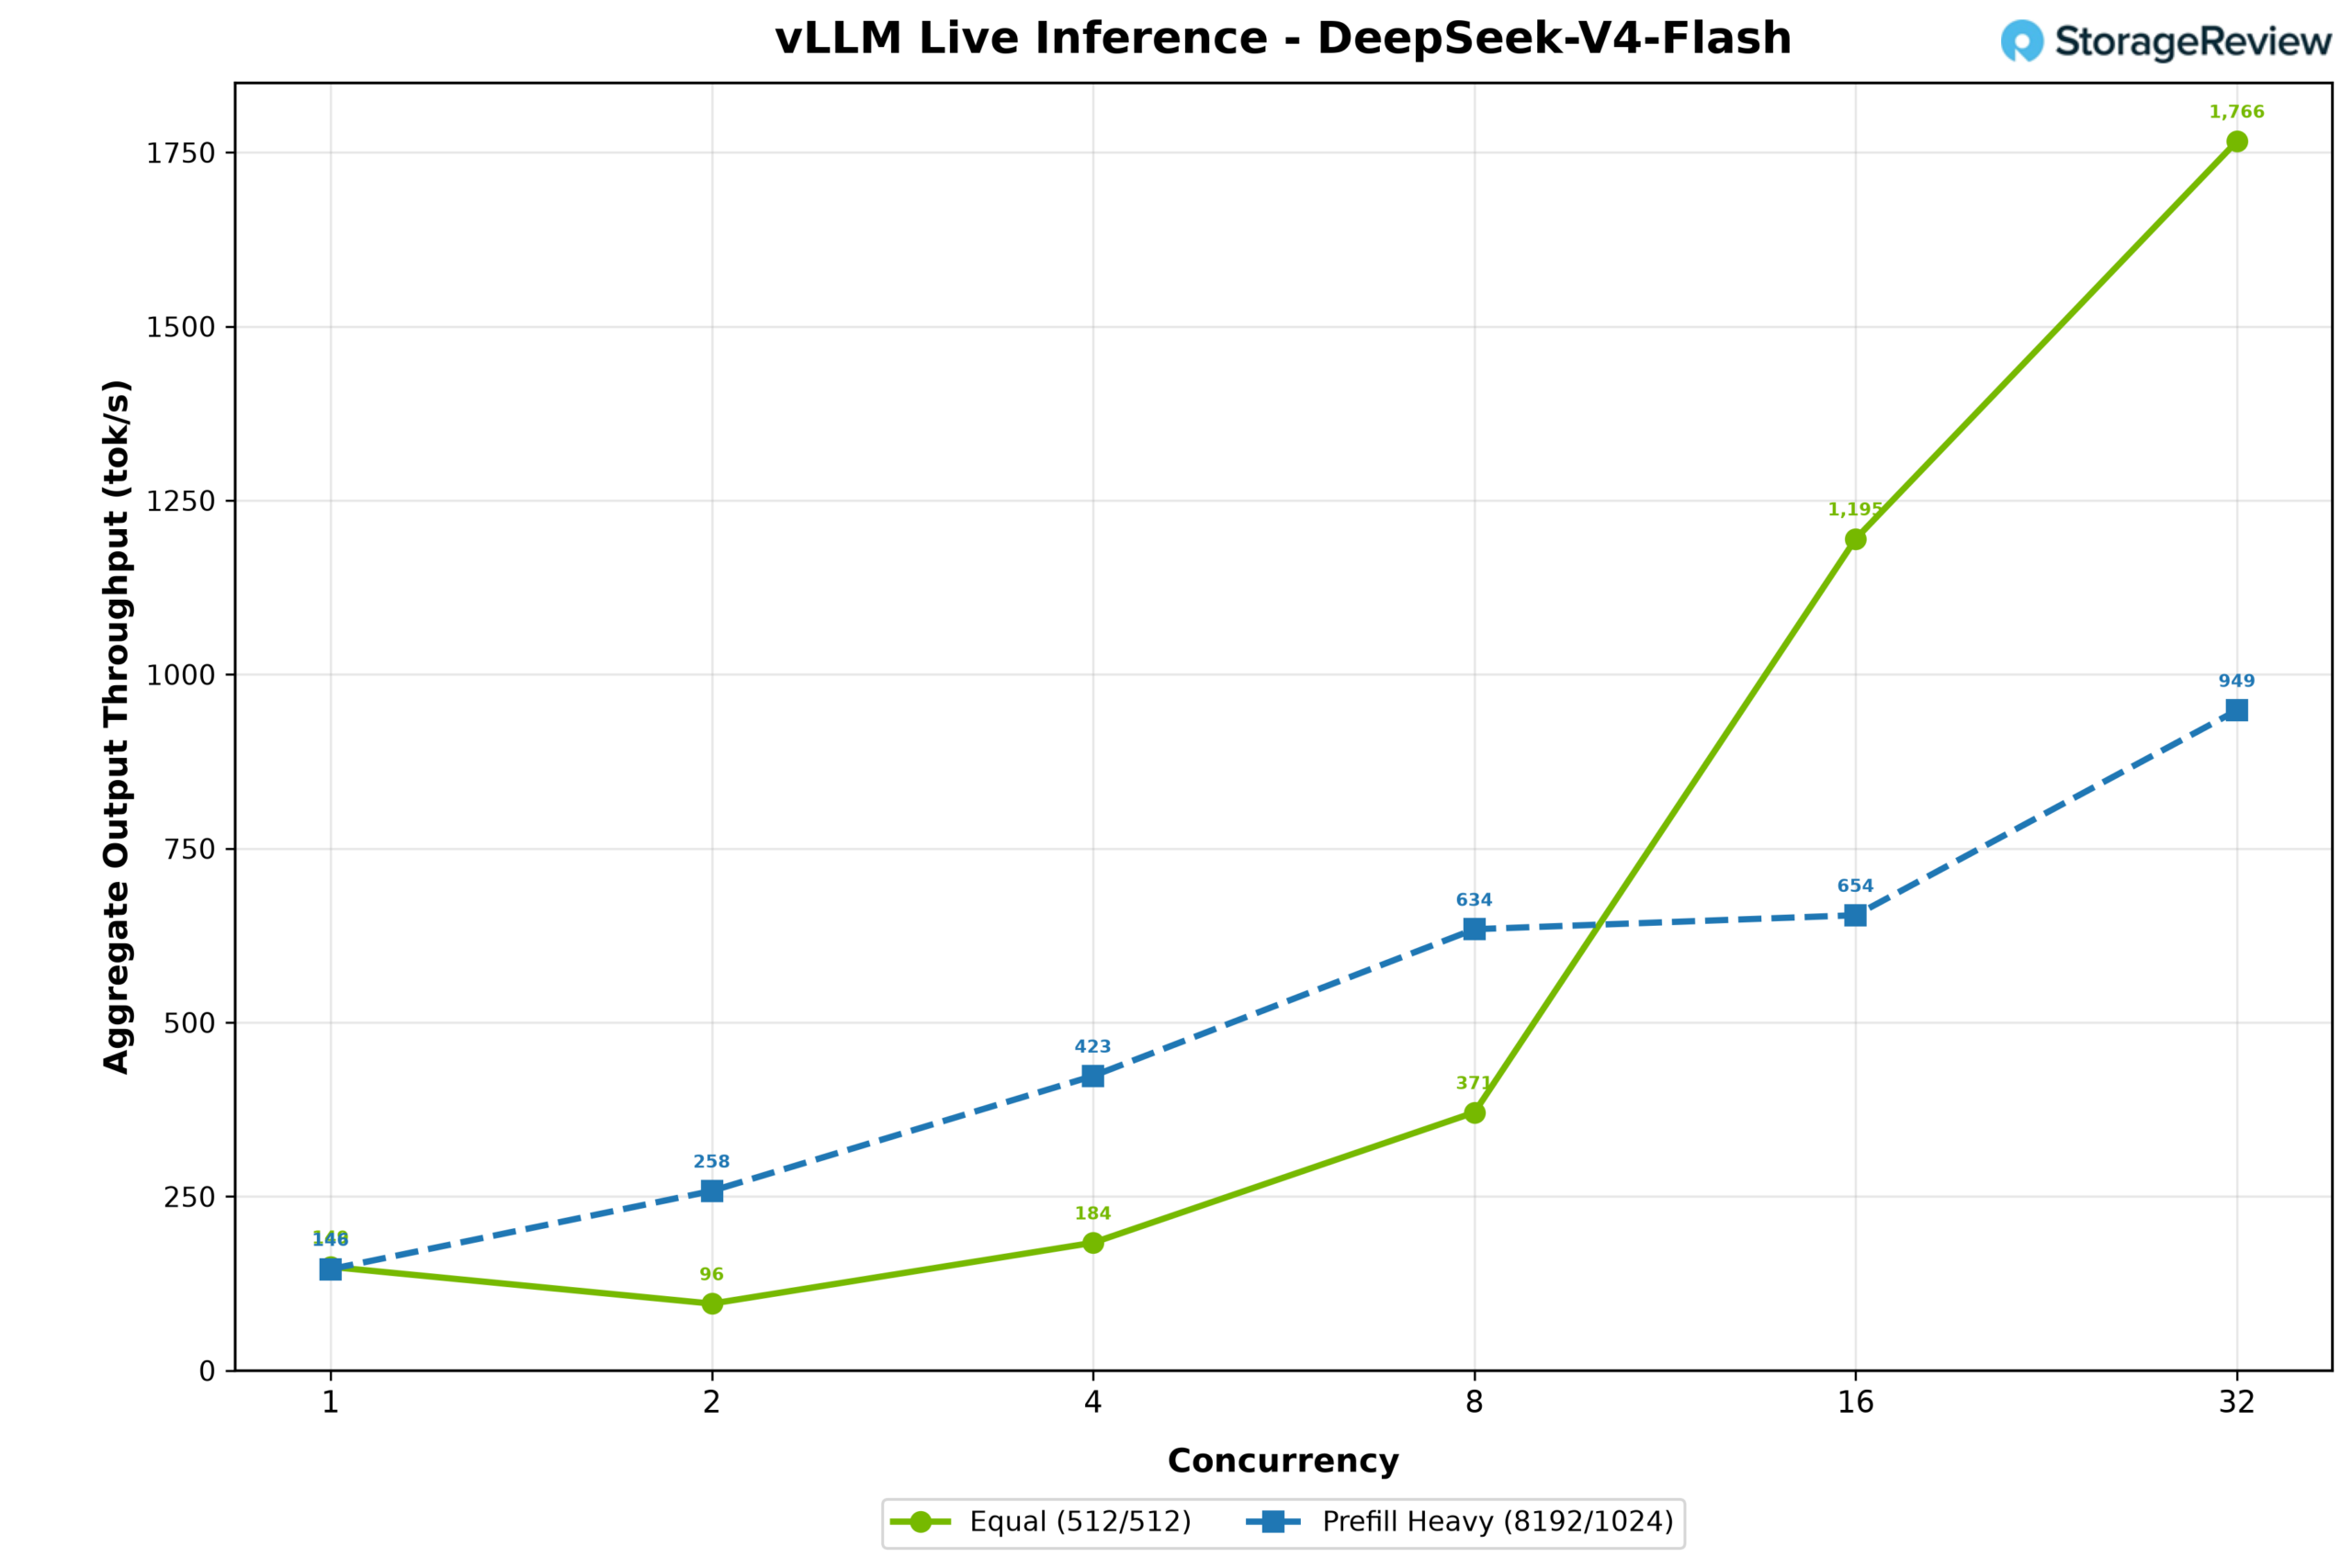
Pierwszym z nich był niezwykle popularny DeepSeek v4 Flash (0731), który wykorzystuje 14+6 GB pamięci jako natywny punkt kontrolny FP8. Model ten znany jest z bardzo wysokiej wydajności i łatwości uruchomienia, co zaobserwowaliśmy na stacji DGX. W obciążeniu 512/512 przepustowość wyjściowa wystartowała ze 149 tokenów na sekundę przy współbieżności 1, szybko rosnąc do 1,766 przy współbieżności 32. Obciążenie z dużą ilością tokenów na sekundę (prefill) wzrosło ze 146 do 949 tokenów na sekundę.
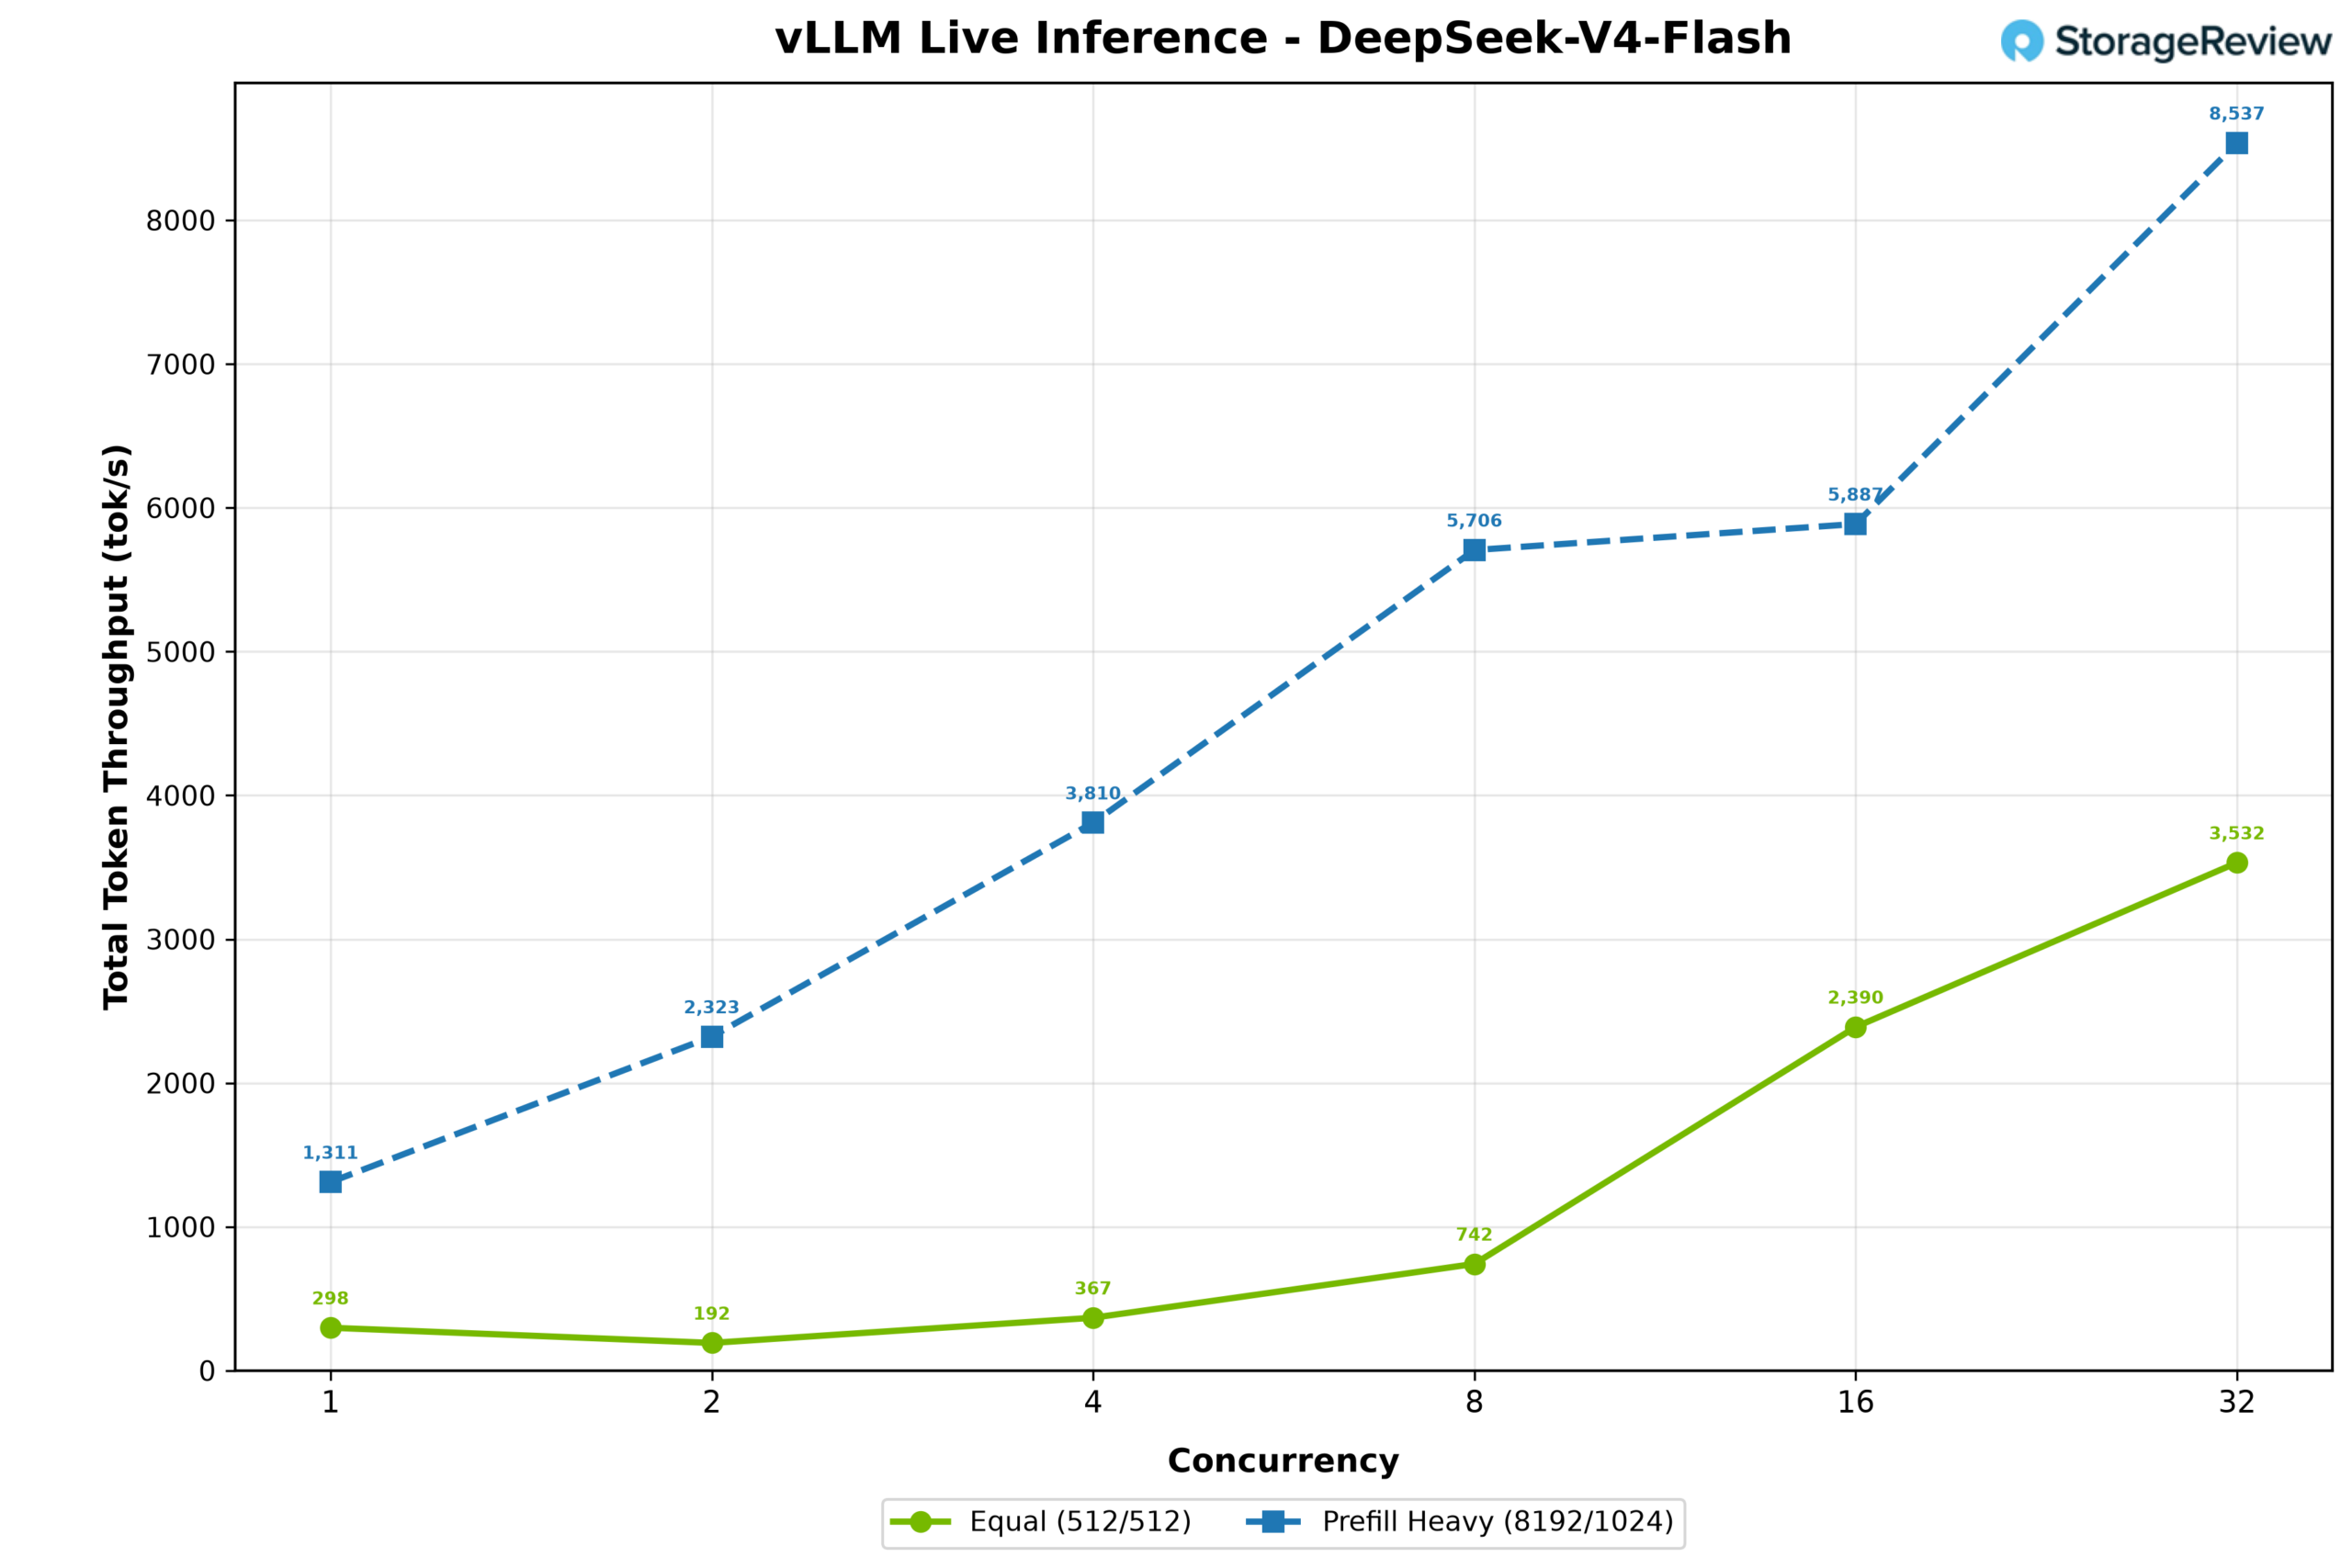
Całkowita przepustowość tokenów rosła w tempie liniowym, przy czym obciążenie pracą 512/512 wzrosło z 298 do 3,532 tokenów na sekundę, a obciążenie pracą z dużym obciążeniem wstępnym wzrosło z 1,311 do 8,537
MiniMax M2.7 (NVFP4)
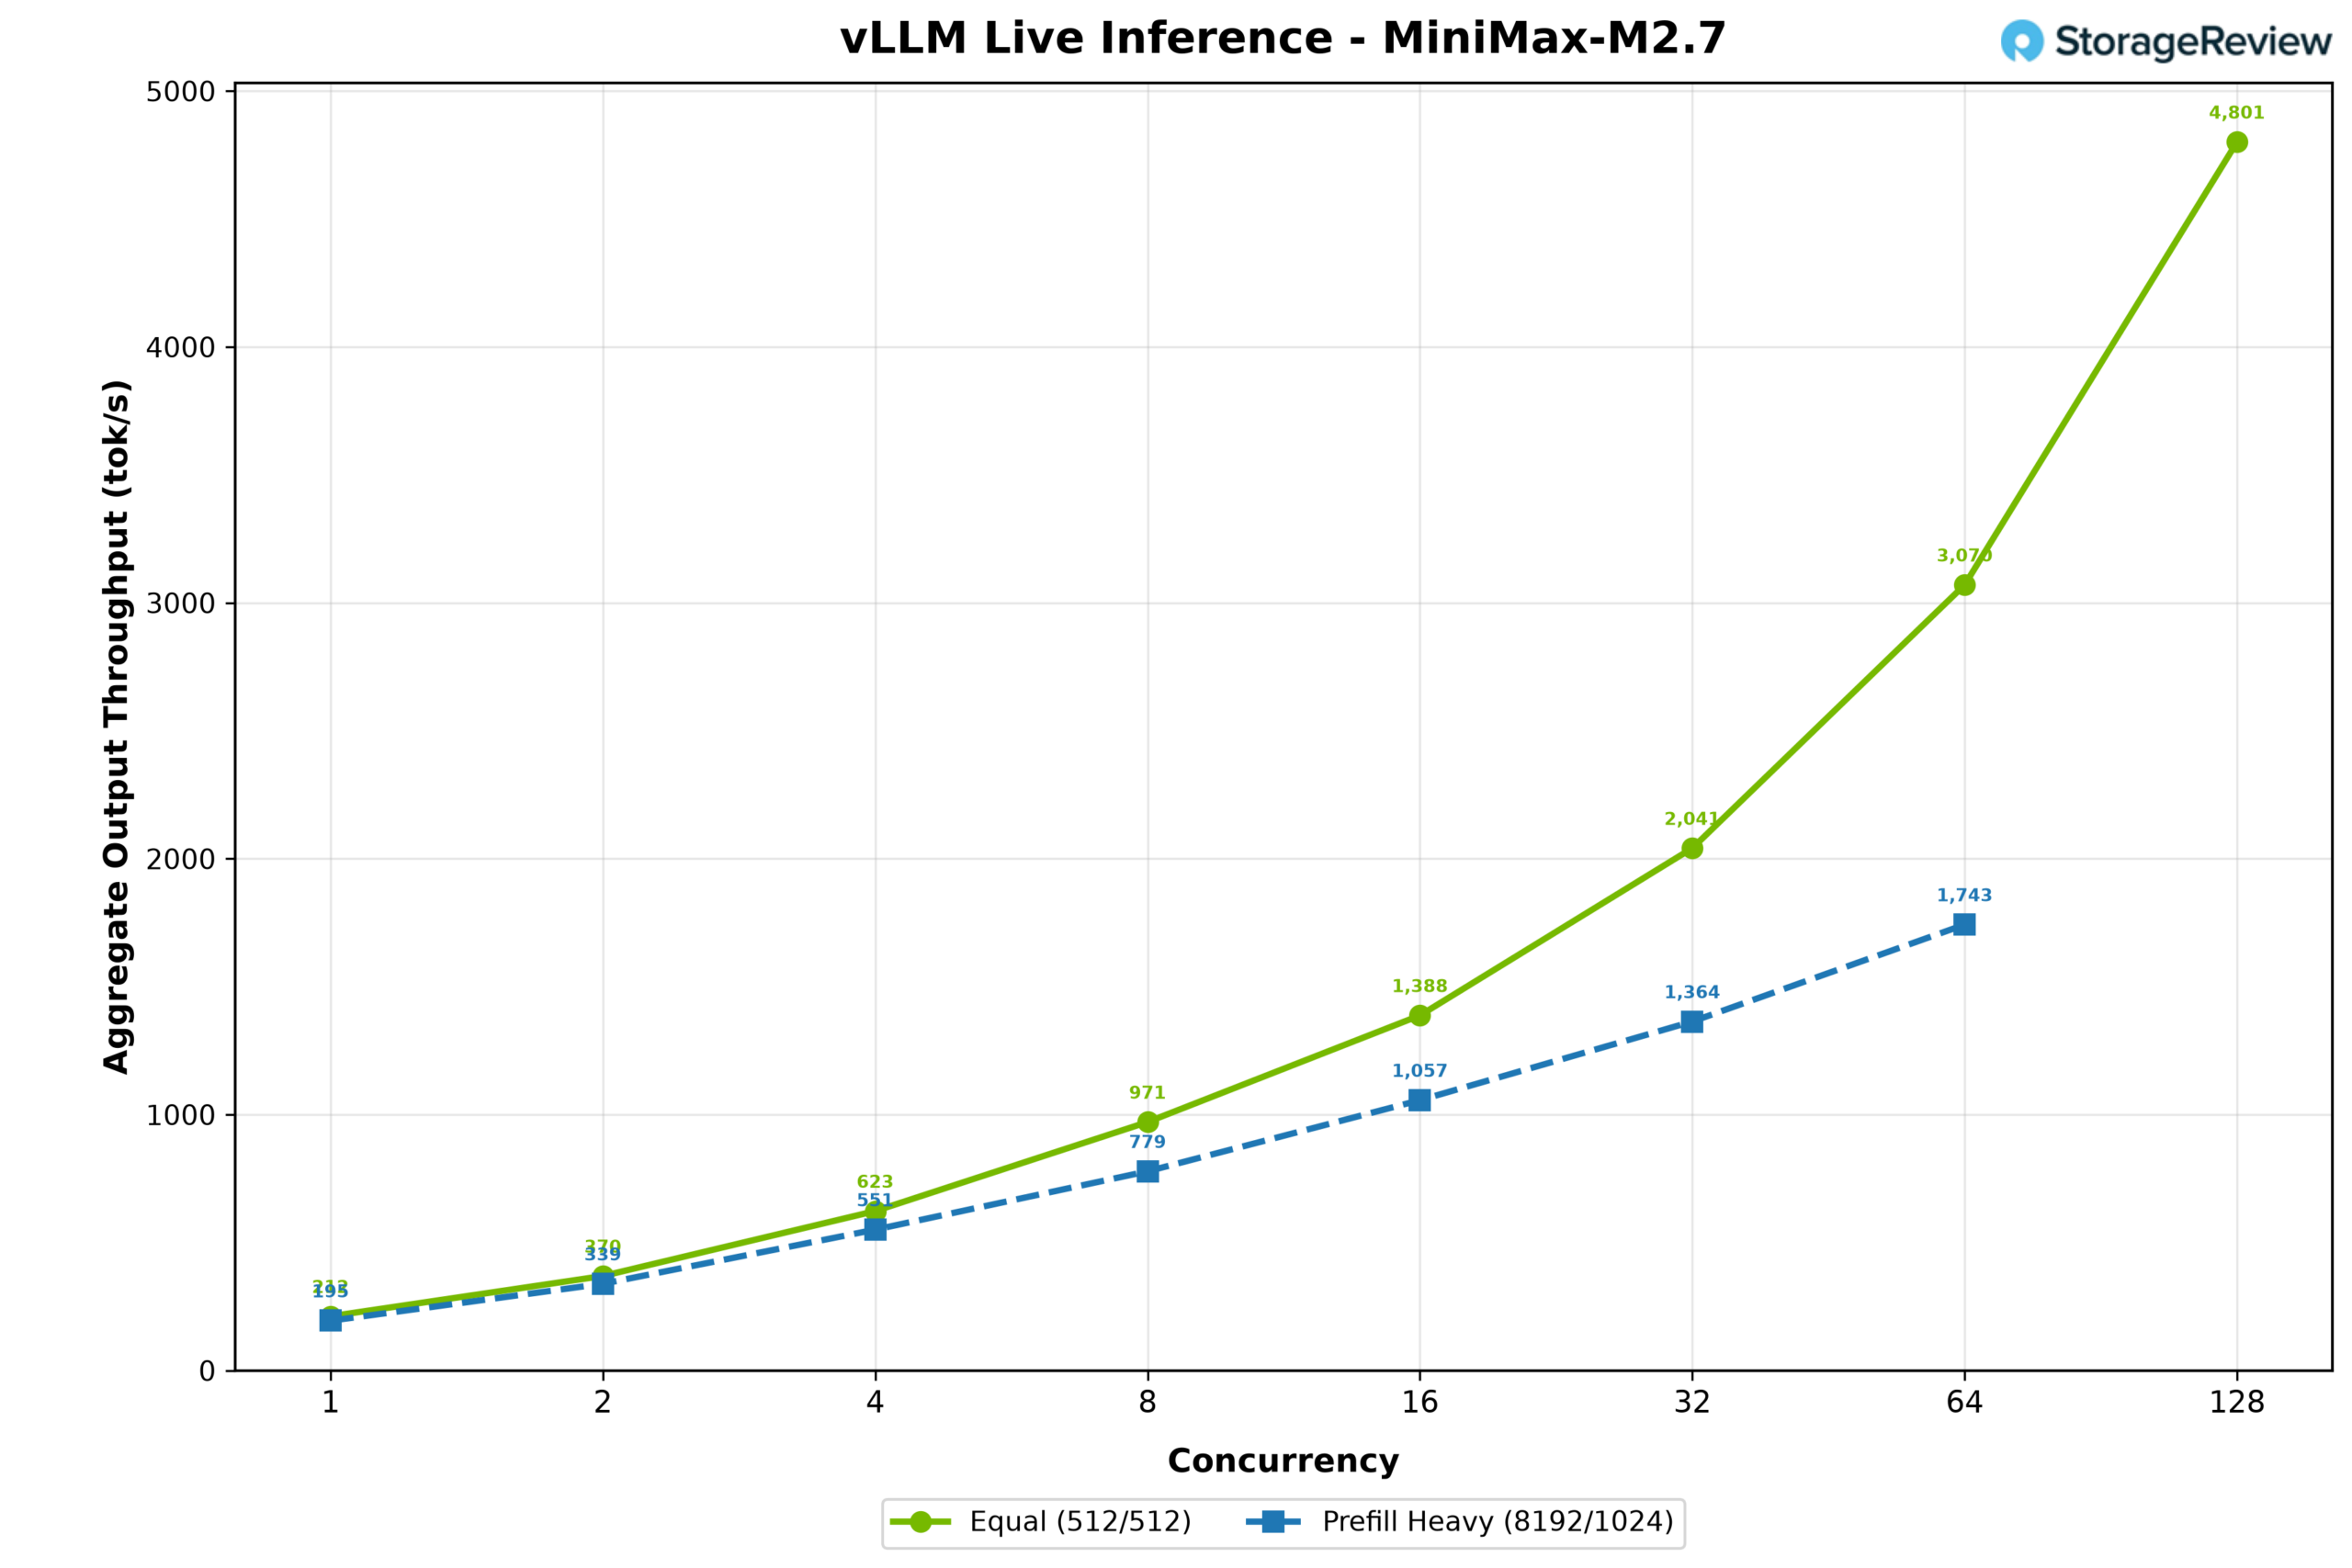
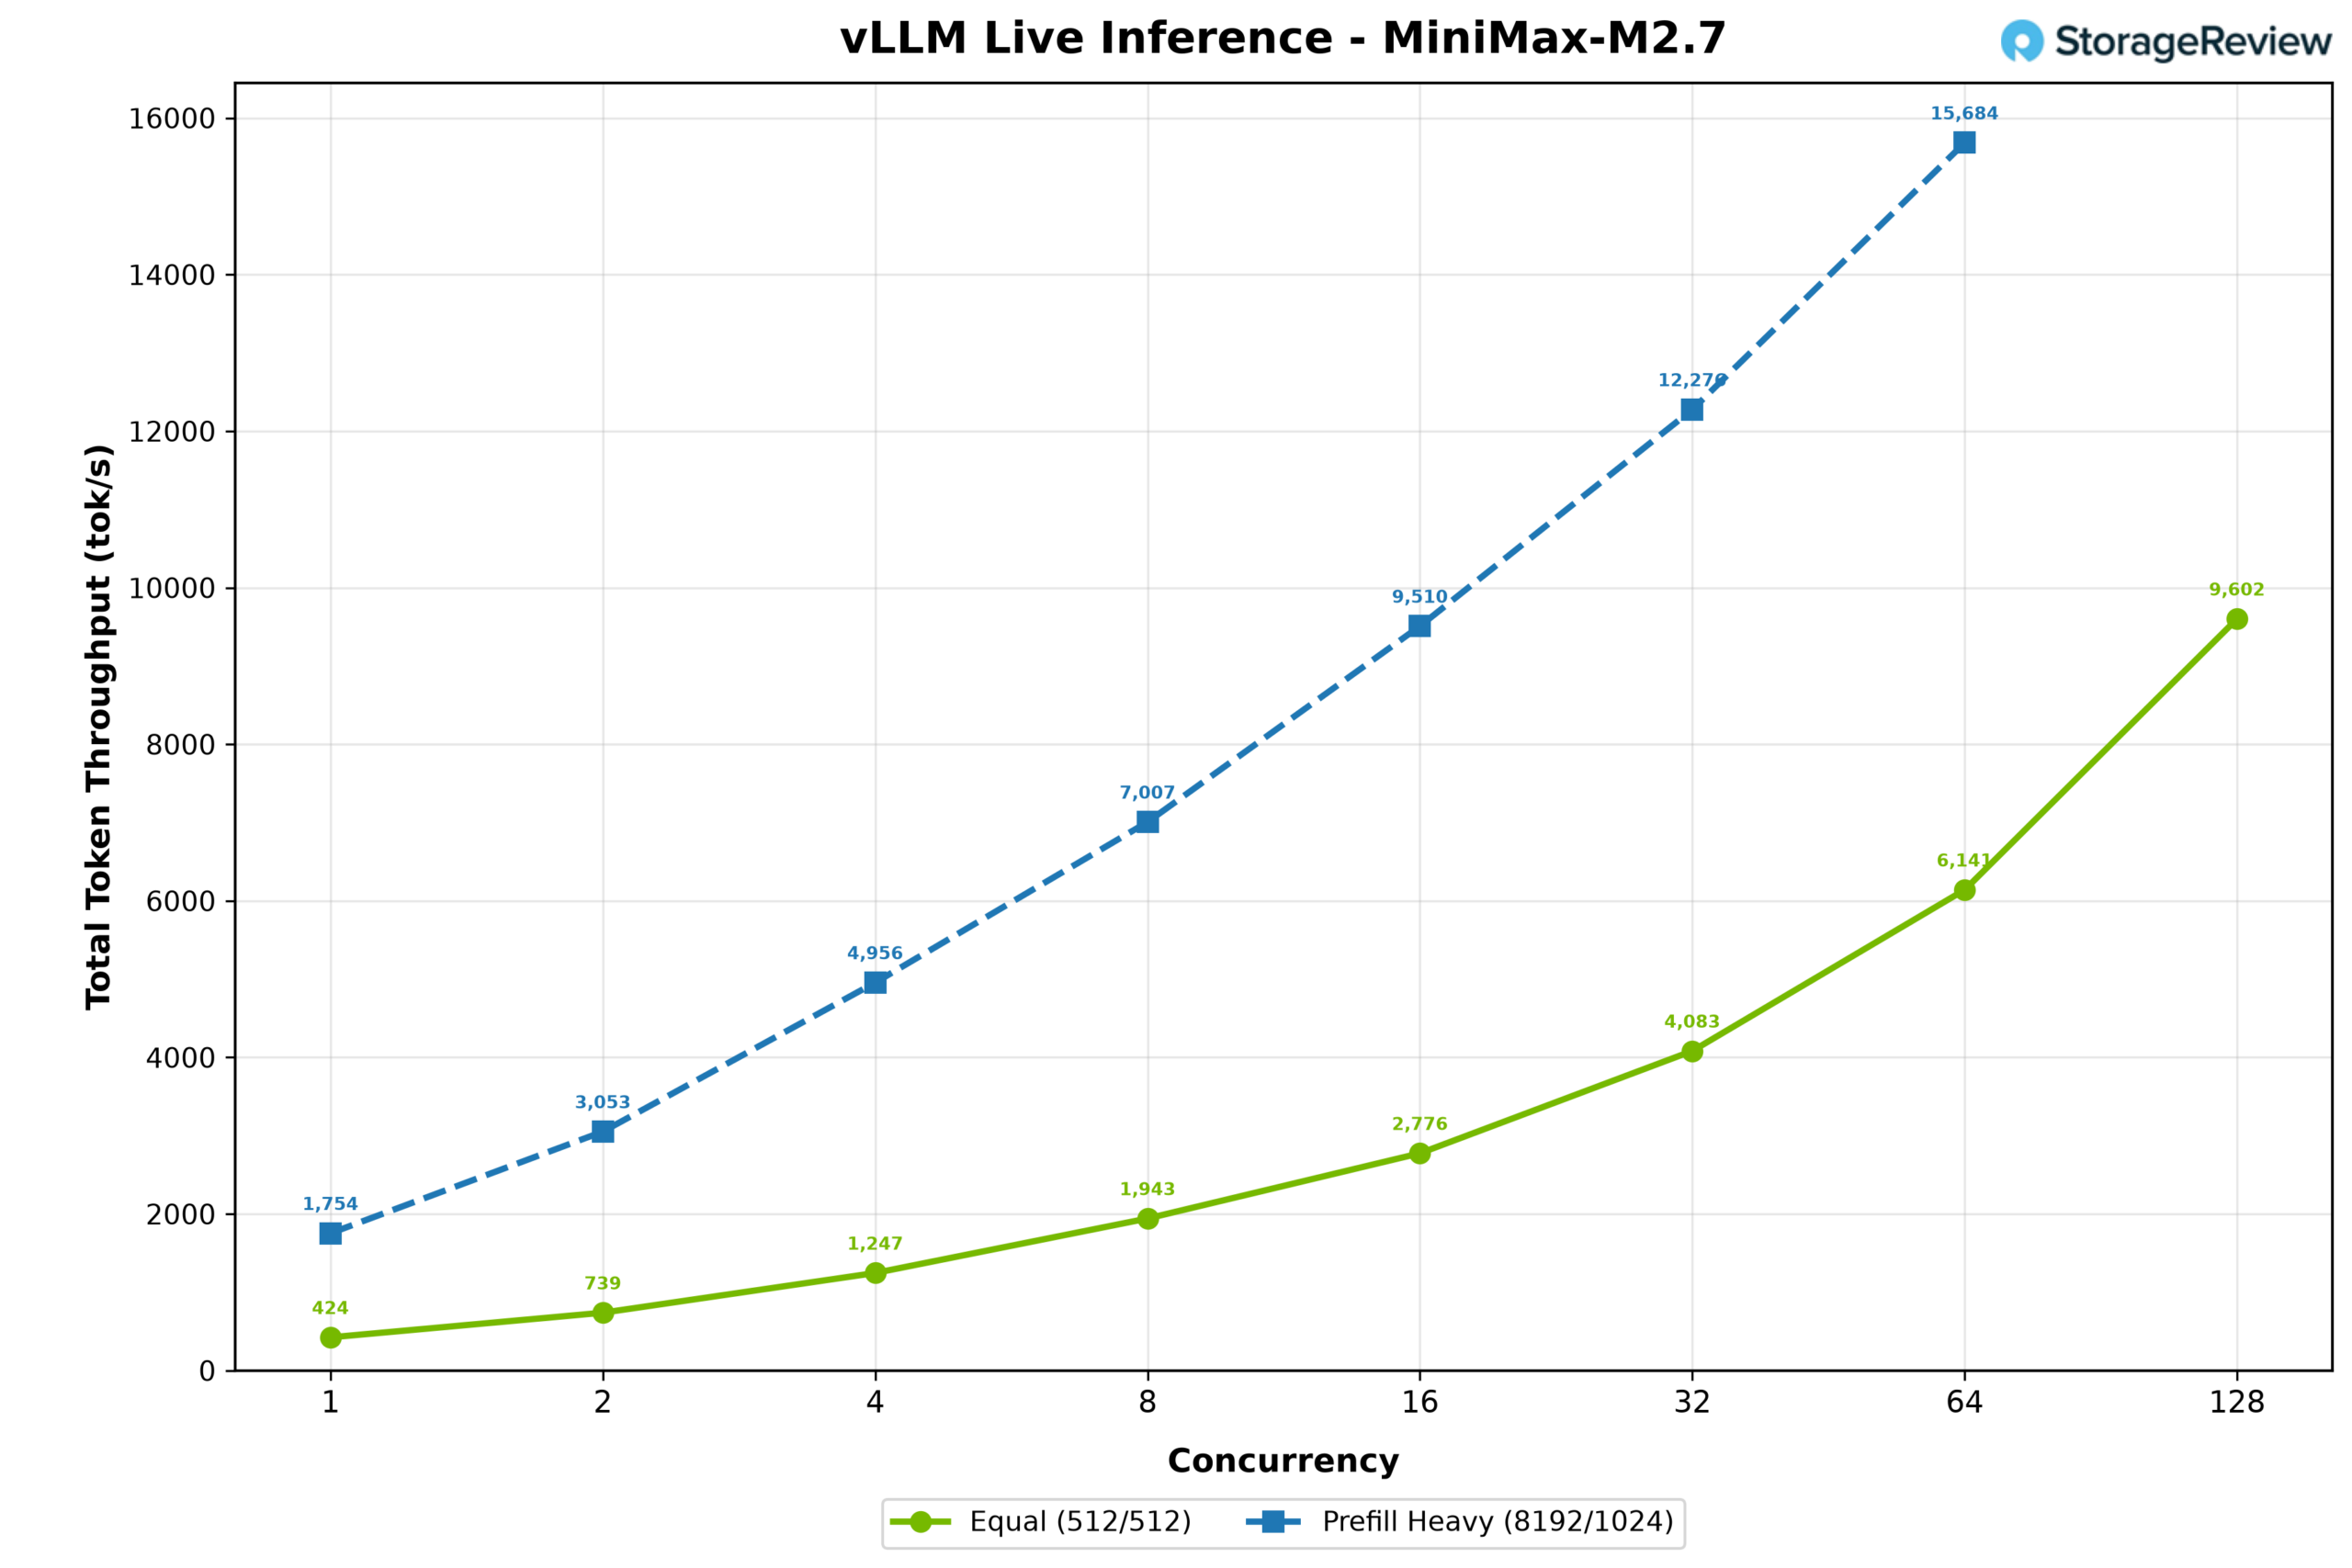
Następny w kolejce jest MiniMax M2.7, jeden z naszych ulubionych modeli, testowany z wykorzystaniem kwantowego procesora NVFP4 firmy NVIDIA, zajmujący 125 GB pamięci VRAM. W obciążeniu 512/512 przepustowość wyjściowa wystartowała ze 193 tokenów na sekundę przy współbieżności 1 i szybko wzrosła do 4,801 tokenów na sekundę przy współbieżności 128. Obciążenie intensywnie wypełniane prefillem wzrosło ze 195 tokenów na sekundę przy współbieżności 1 do 1,743 tokenów na sekundę przy współbieżności 64. Całkowita przepustowość tokenów wykazała odwrotny trend, przy czym obciążenie intensywnie wypełniane prefillem wzrosło z 1,754 do 15 684 tokenów na sekundę przy współbieżności 64, podczas gdy obciążenie 512/512 skalowało się z 424 do 9,602 tokenów na sekundę przy współbieżności 128.
Całkowita przepustowość tokenów wykazała odwrotną tendencję, przy czym obciążenie związane z wstępnym wypełnianiem wzrosło z 1,754 do 15 684 tokenów na sekundę do poziomu współbieżności 64, podczas gdy obciążenie 512/512 wzrosło z 424 do 9,602 tokenów na sekundę do poziomu współbieżności 128.
Modele, które ledwo mieszczą się w HBM
MiniMax M3 (NVFP4)
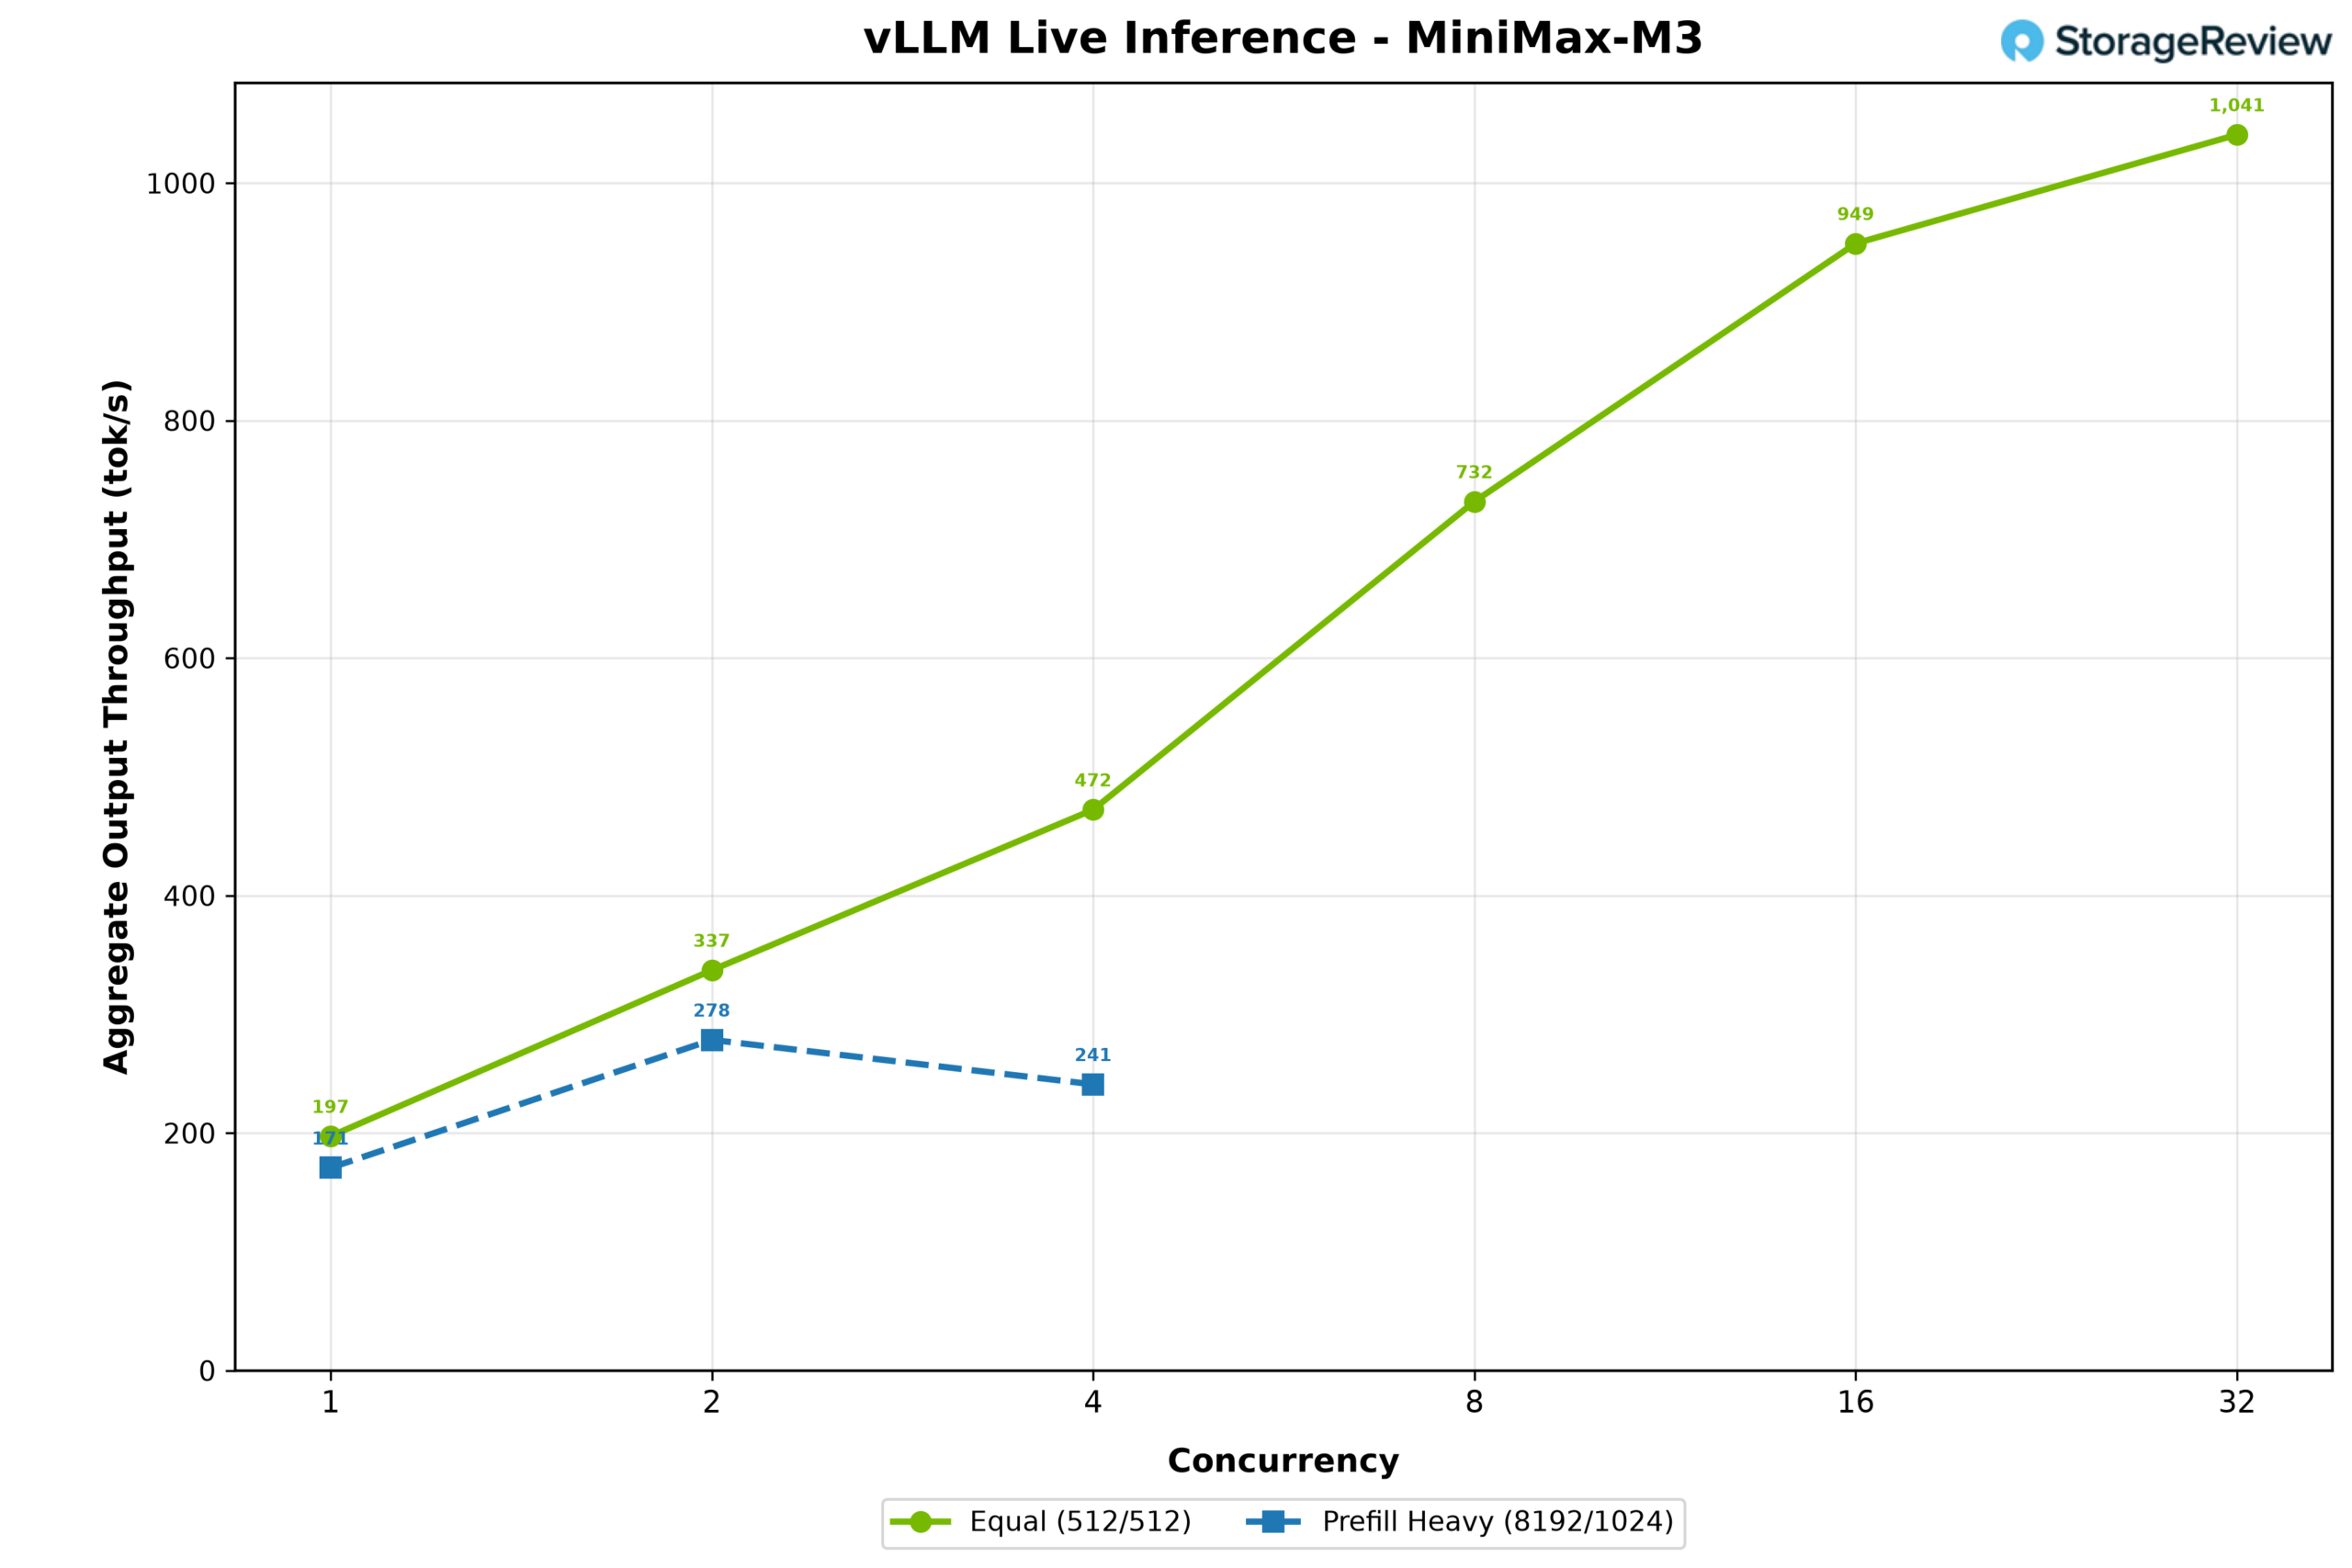
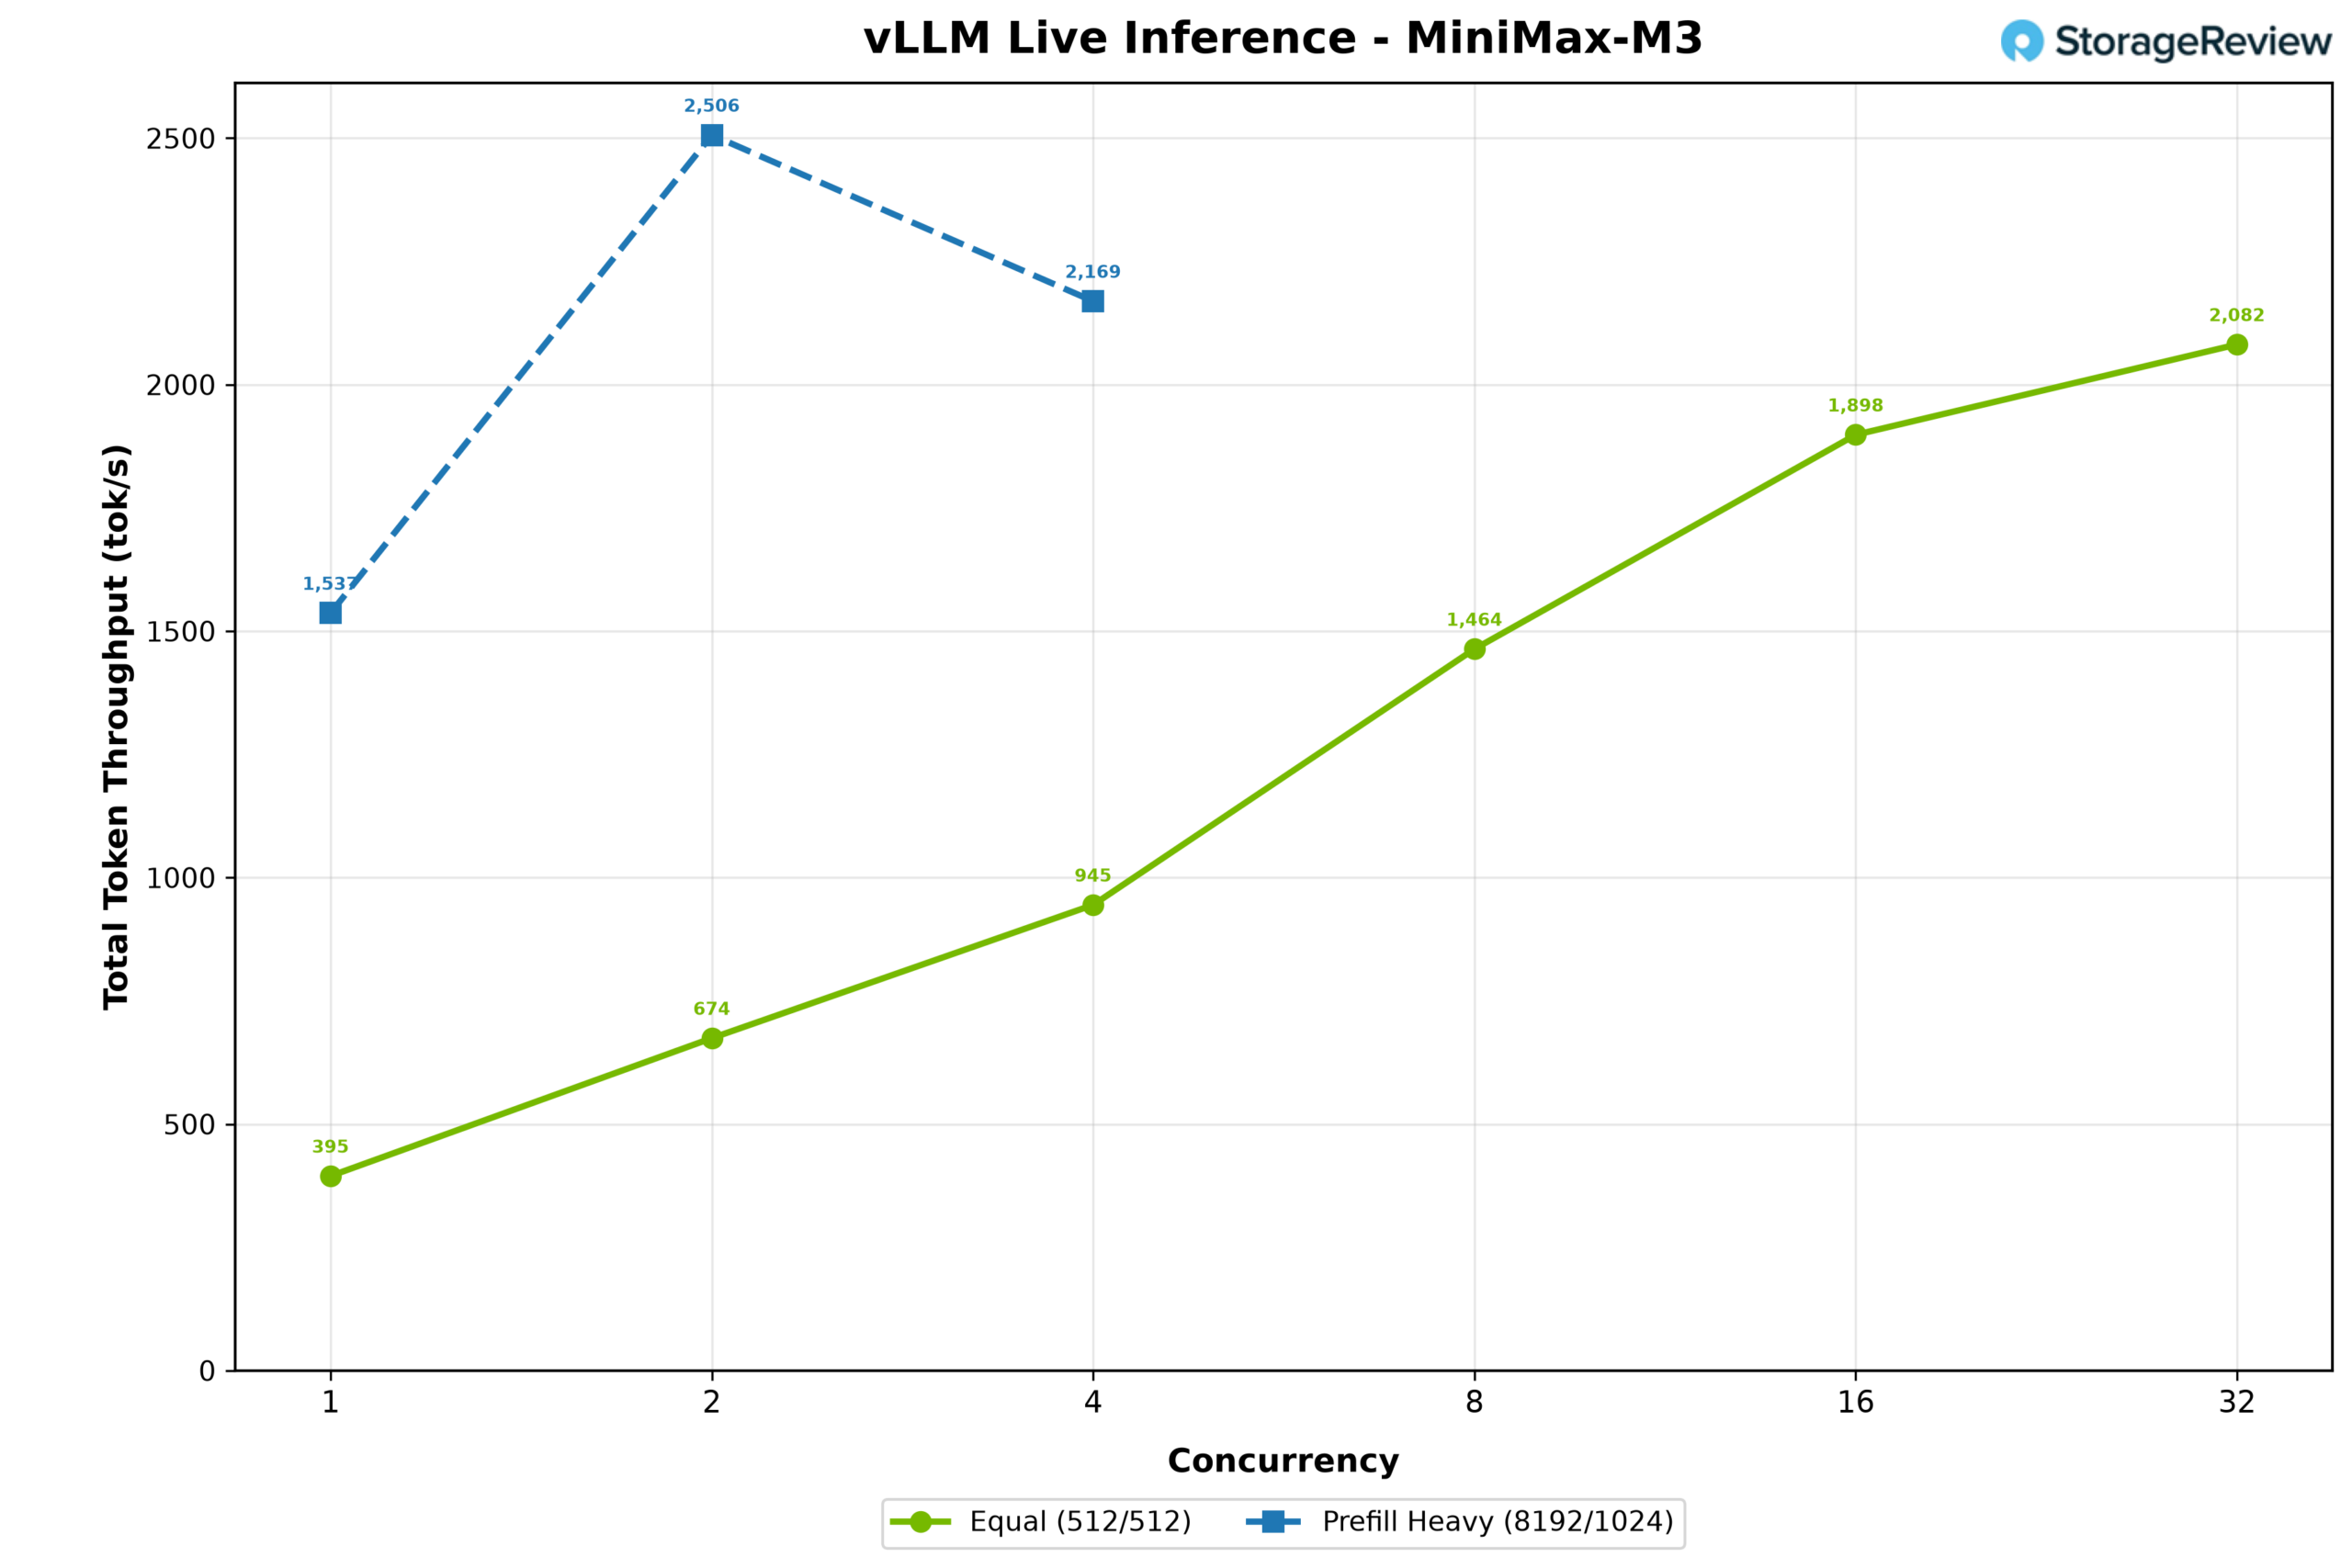
MiniMax M3 pokazuje, jak wygląda w praktyce sytuacja, gdy brakuje miejsca. Jego punkt kontrolny NVFP4 o pojemności 233 GB jest mniejszy niż 252 GB pamięci HBM w B300, ale model nadal potrzebuje miejsca na środowisko uruchomieniowe i pamięć podręczną KV. Ostatecznie zajął 223 GB pamięci HBM, a 21 GB pamięci ekspertów zostało przeniesionych do Grace. Zastosowano dekodowanie spekulatywne EAGLE3-GQA z syntetyczną długością akceptacji wynoszącą 3 tokeny. W obciążeniu 512/512 przepustowość wyjściowa wyjściowa wyniosła 197 tokenów na sekundę przy współbieżności 1 i stale rosła do 1,041 tokenów na sekundę przy współbieżności 32. Obciążenie z dużą ilością tokenów na sekundę (pre-fill) wzrosło ze 171 tokenów na sekundę przy współbieżności 1 do szczytowej wartości 278 przy współbieżności 2, po czym spadło do 241 przy współbieżności 4.
Całkowita przepustowość tokenów podążała podobnym schematem, przy czym obciążenie 512/512 wzrosło z 395 do 2,082 tokenów na sekundę, podczas gdy obciążenie z dużym obciążeniem wstępnym osiągnęło szczyt na poziomie 2,506 tokenów na sekundę przy współbieżności 2, a następnie spadło do 2,169 przy współbieżności 4
Modele nie pasujące do HBM
GLM-5.2 (NVFP4)
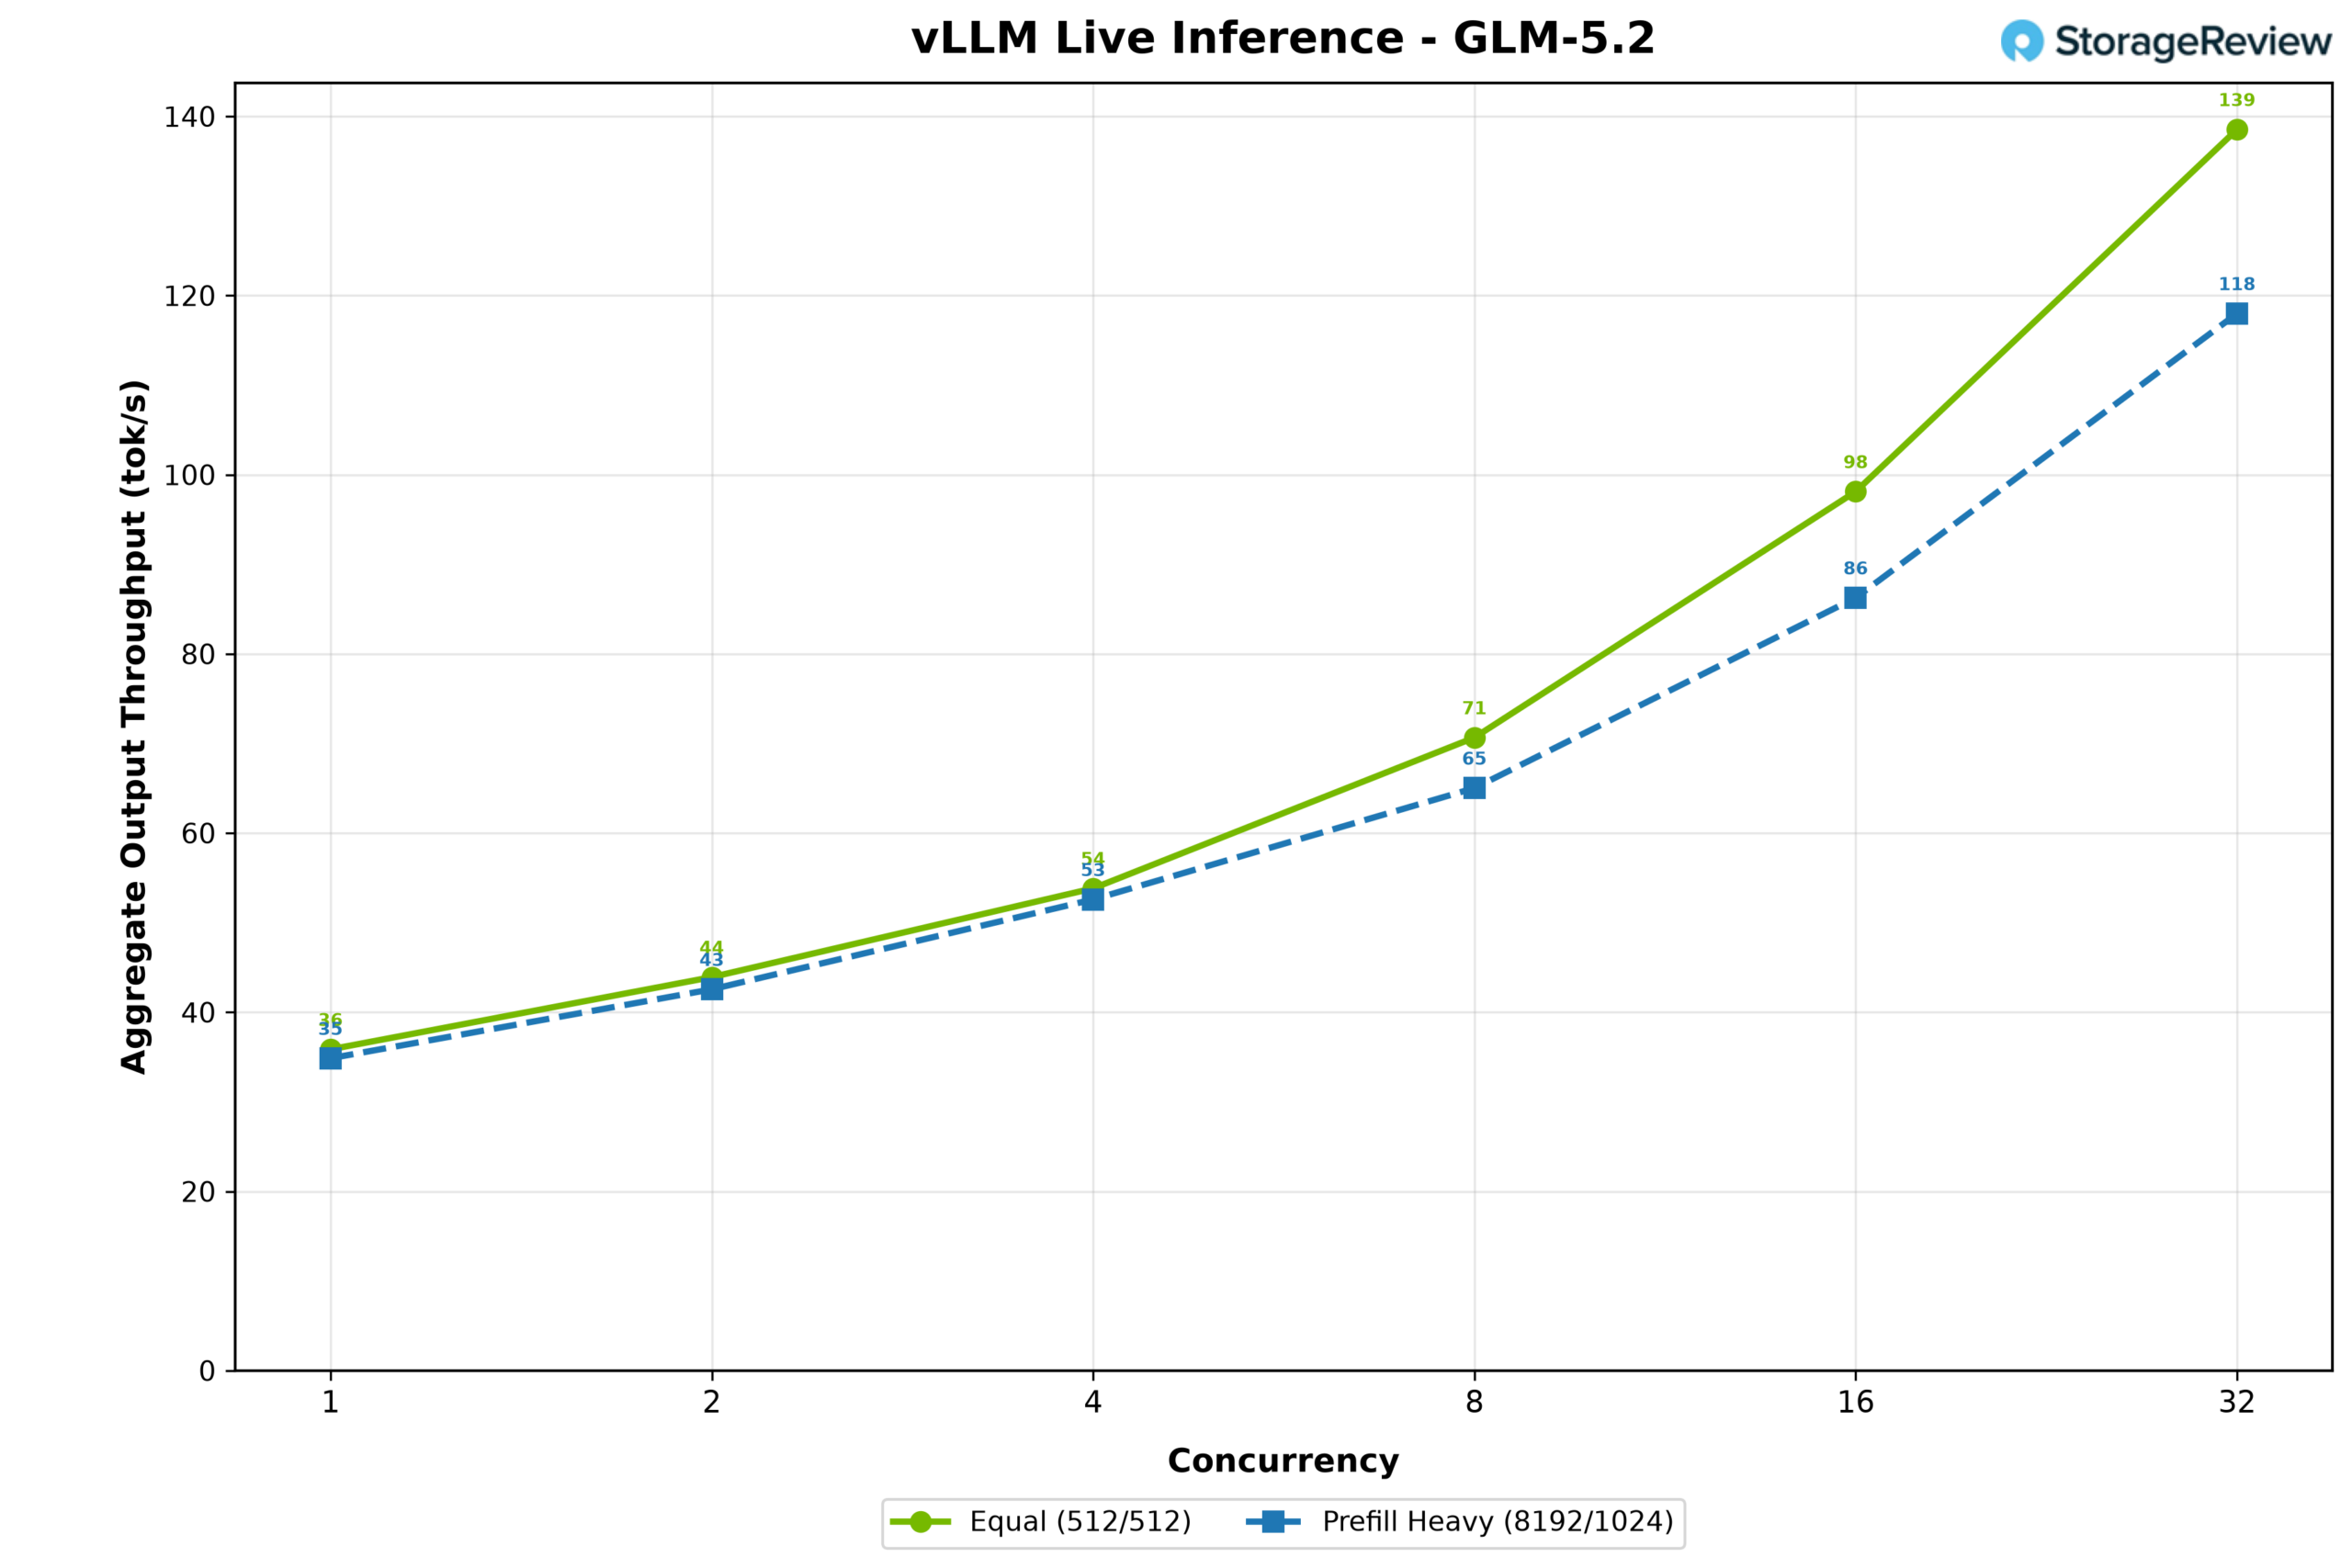
GLM-5.2 został przetestowany przy użyciu narzędzia kwantowego NVFP4 firmy NVIDIA. Jego punkt kontrolny o pojemności 433 GB wykorzystywał 218 GB pamięci HBM, a 216 GB wag eksperckich zostało przeniesionych do pamięci Grace. Zastosowano spekulatywne dekodowanie MTP z syntetyczną długością akceptacji wynoszącą 3 tokeny. Przepustowość wyjściowa w obciążeniu 512/512 wzrosła z 36 tokenów na sekundę przy współbieżności 1 do 139 przy współbieżności 32. Tuż za tym plasowało się obciążenie 8,192/1,024, którego wartość wzrosła z 35 do 118 tokenów na sekundę. Podobne wyniki dla obu profili pokazują, że generowanie było ograniczone głównie przez przenoszenie przeniesionych ekspertów między pamięcią Grace a GPU. Przeszukiwanie zakończyło się przy współbieżności 32, ponieważ nie było wystarczającej ilości pamięci HBM dla dodatkowego kontekstu.
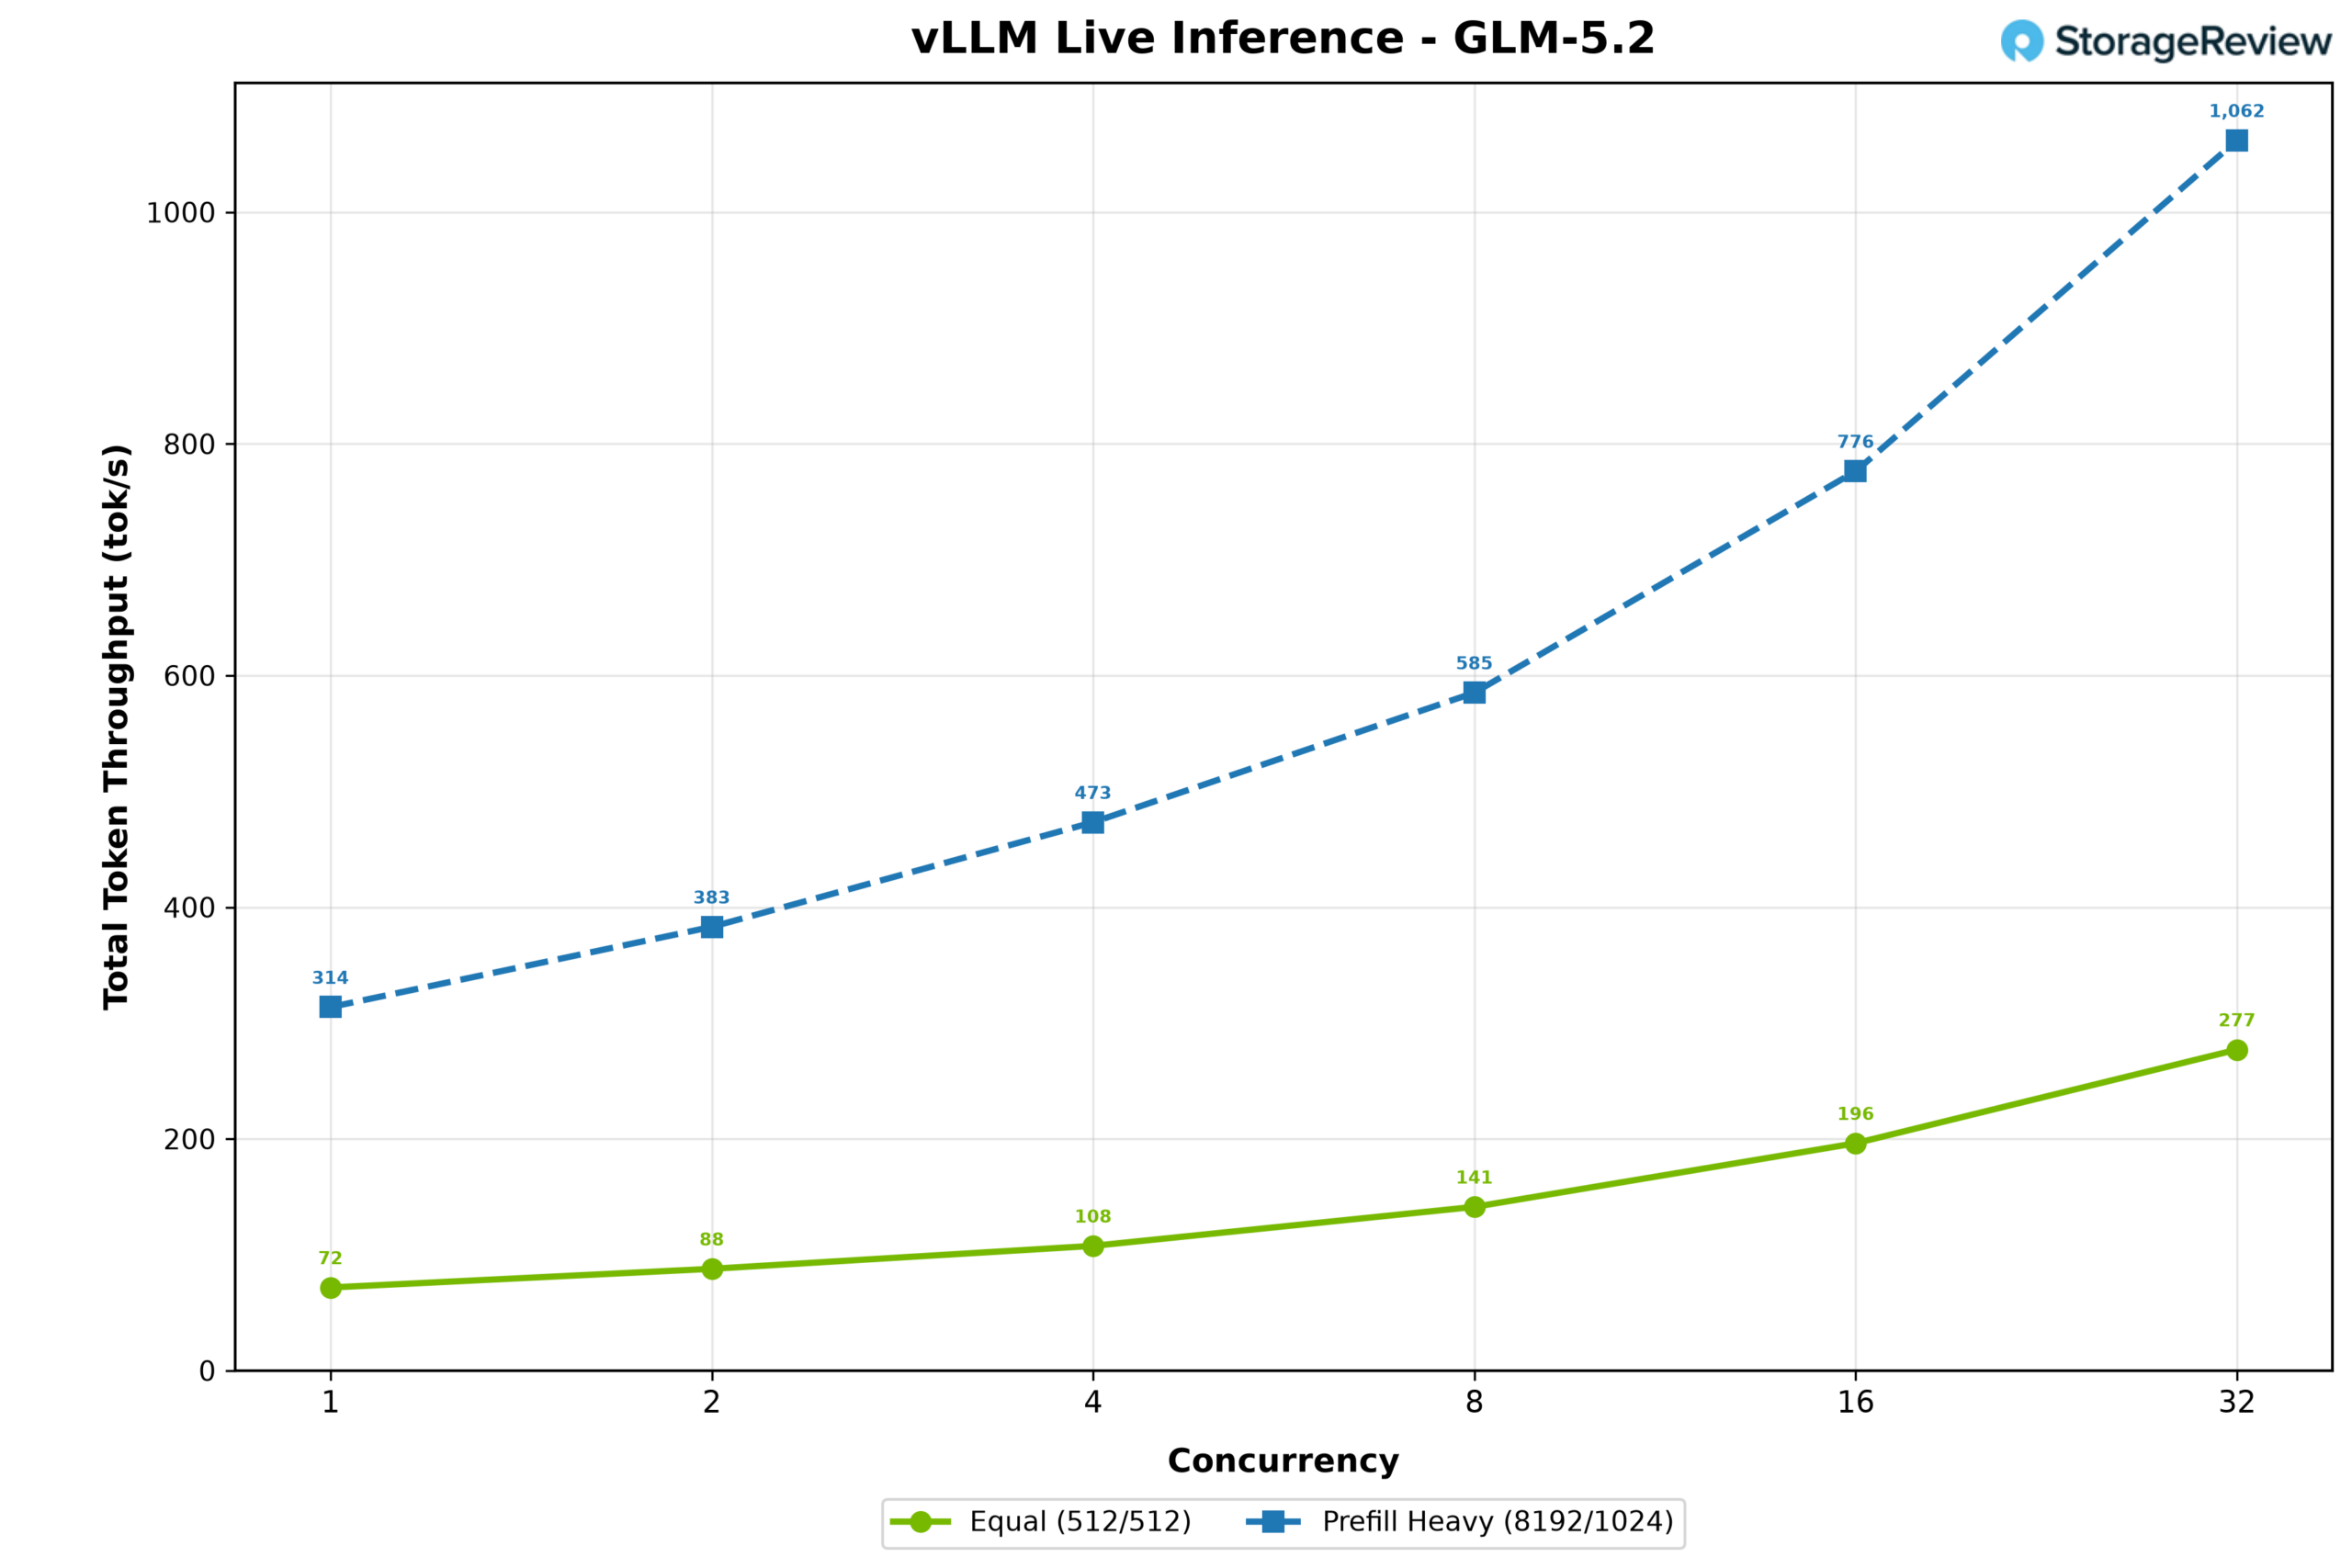
Całkowita przepustowość tokenów podążała za tym samym schematem, przy czym obciążenie 512/512 wzrosło z 72 do 277 tokenów na sekundę, a obciążenie wymagające intensywnego wypełniania z 314 do 1,062; w tym przypadku dłuższe monity ostatecznie rozdzielają oba profile, ponieważ same tokeny wstępnego wypełniania wliczają się do całkowitej liczby.
Nemotron-3-Ultra 550B (NVFP4)
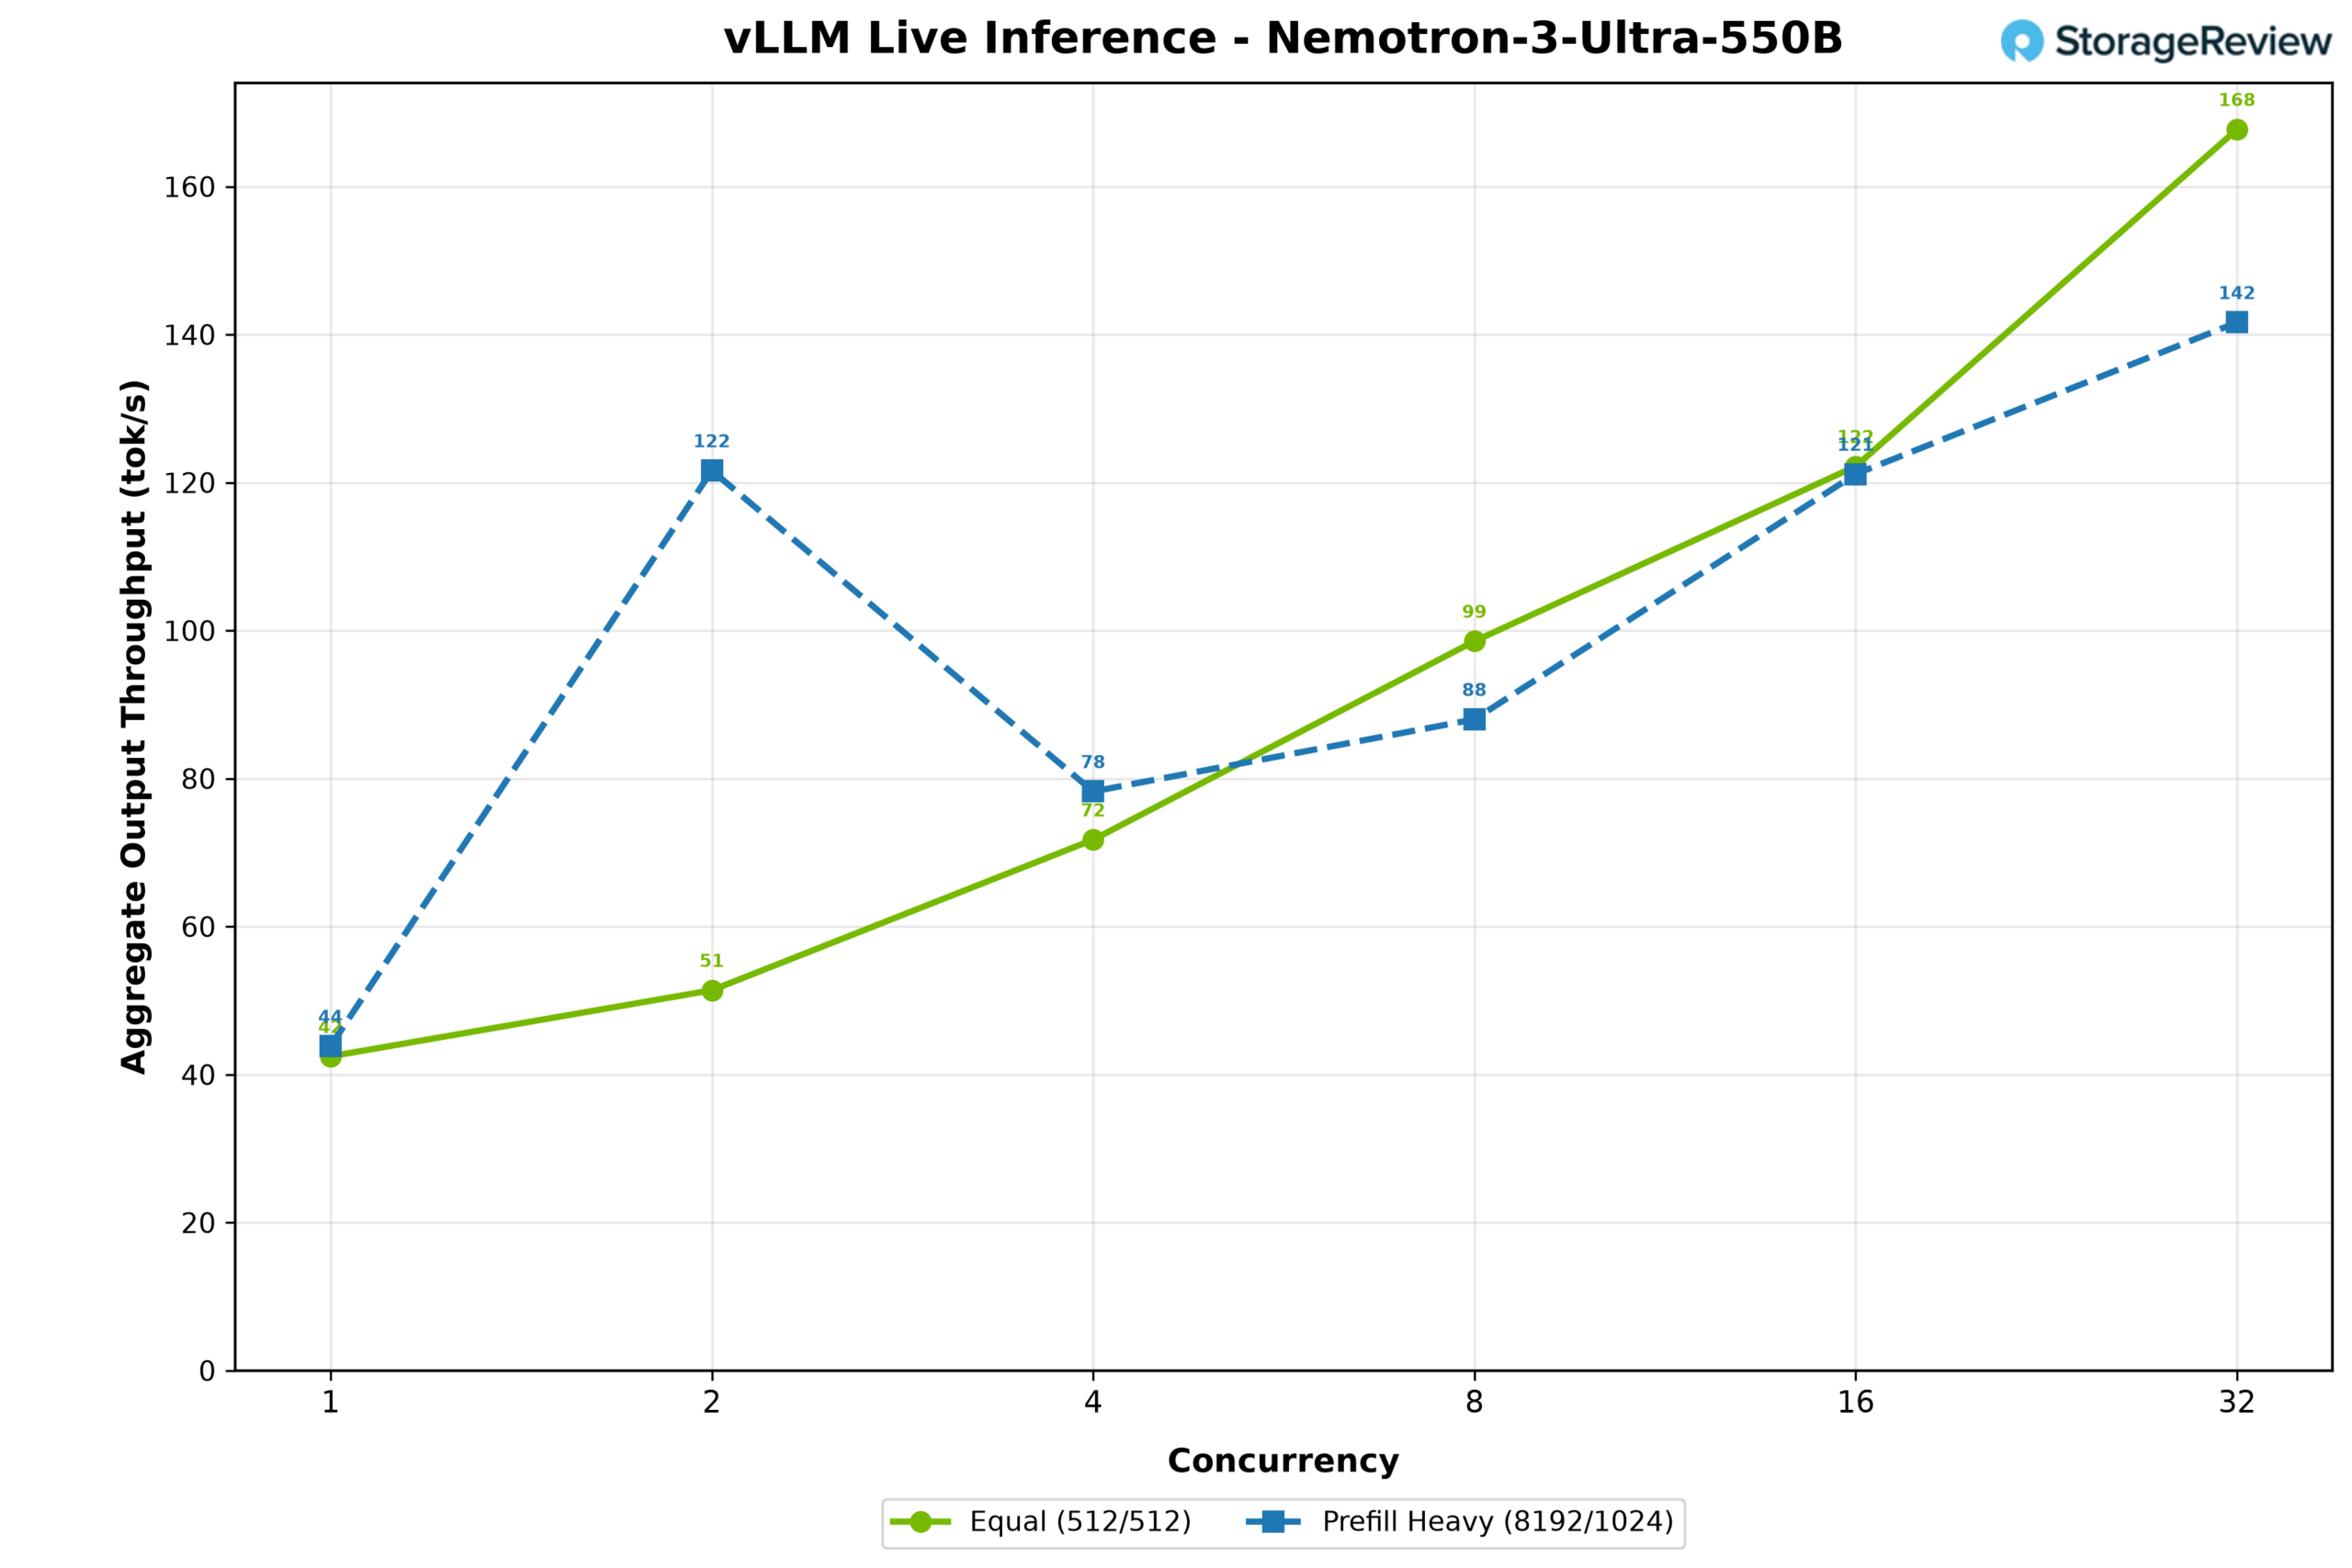
Nemotron-3-Ultra 550B to największy model, który testowaliśmy i który najbardziej bezpośrednio wykorzystuje pełną pulę koherentną. Jest to hybrydowy model NVFP4 Transformer-Mamba o pojemności 307 GB, zdecydowanie za duży dla samego HBM, z 114 GB wag przeniesionych do pamięci Grace. Zastosowano dekodowanie spekulatywne MTP z syntetyczną długością akceptacji 5 tokenów. Przepustowość wyjściowa w obciążeniu 512/512 wystartowała z 43 tokenami na sekundę przy współbieżności 1 i wzrosła do 168 przy współbieżności 32. Obciążenie z dużą ilością prefillu przedstawiło bardziej interesującą historię: przepustowość wzrosła z 44 tokenów na sekundę przy współbieżności 1 do szczytowej wartości 122 przy współbieżności 2, ale następnie spadła do 78 przy współbieżności 4, gdy długie monity zapełniły ograniczoną pamięć podręczną KV. Podobnie jak w przypadku GLM-5.2, oba profile ściśle się ze sobą śledzą, ponownie wskazując na migrację ekspertów między Grace a GPU jako czynnik ograniczający, a nie moc obliczeniową. Przeszukiwanie zakończyło się na współbieżności 32 z tego samego powodu: nie było wystarczająco dużo HBM, aby zapewnić dodatkowy kontekst.
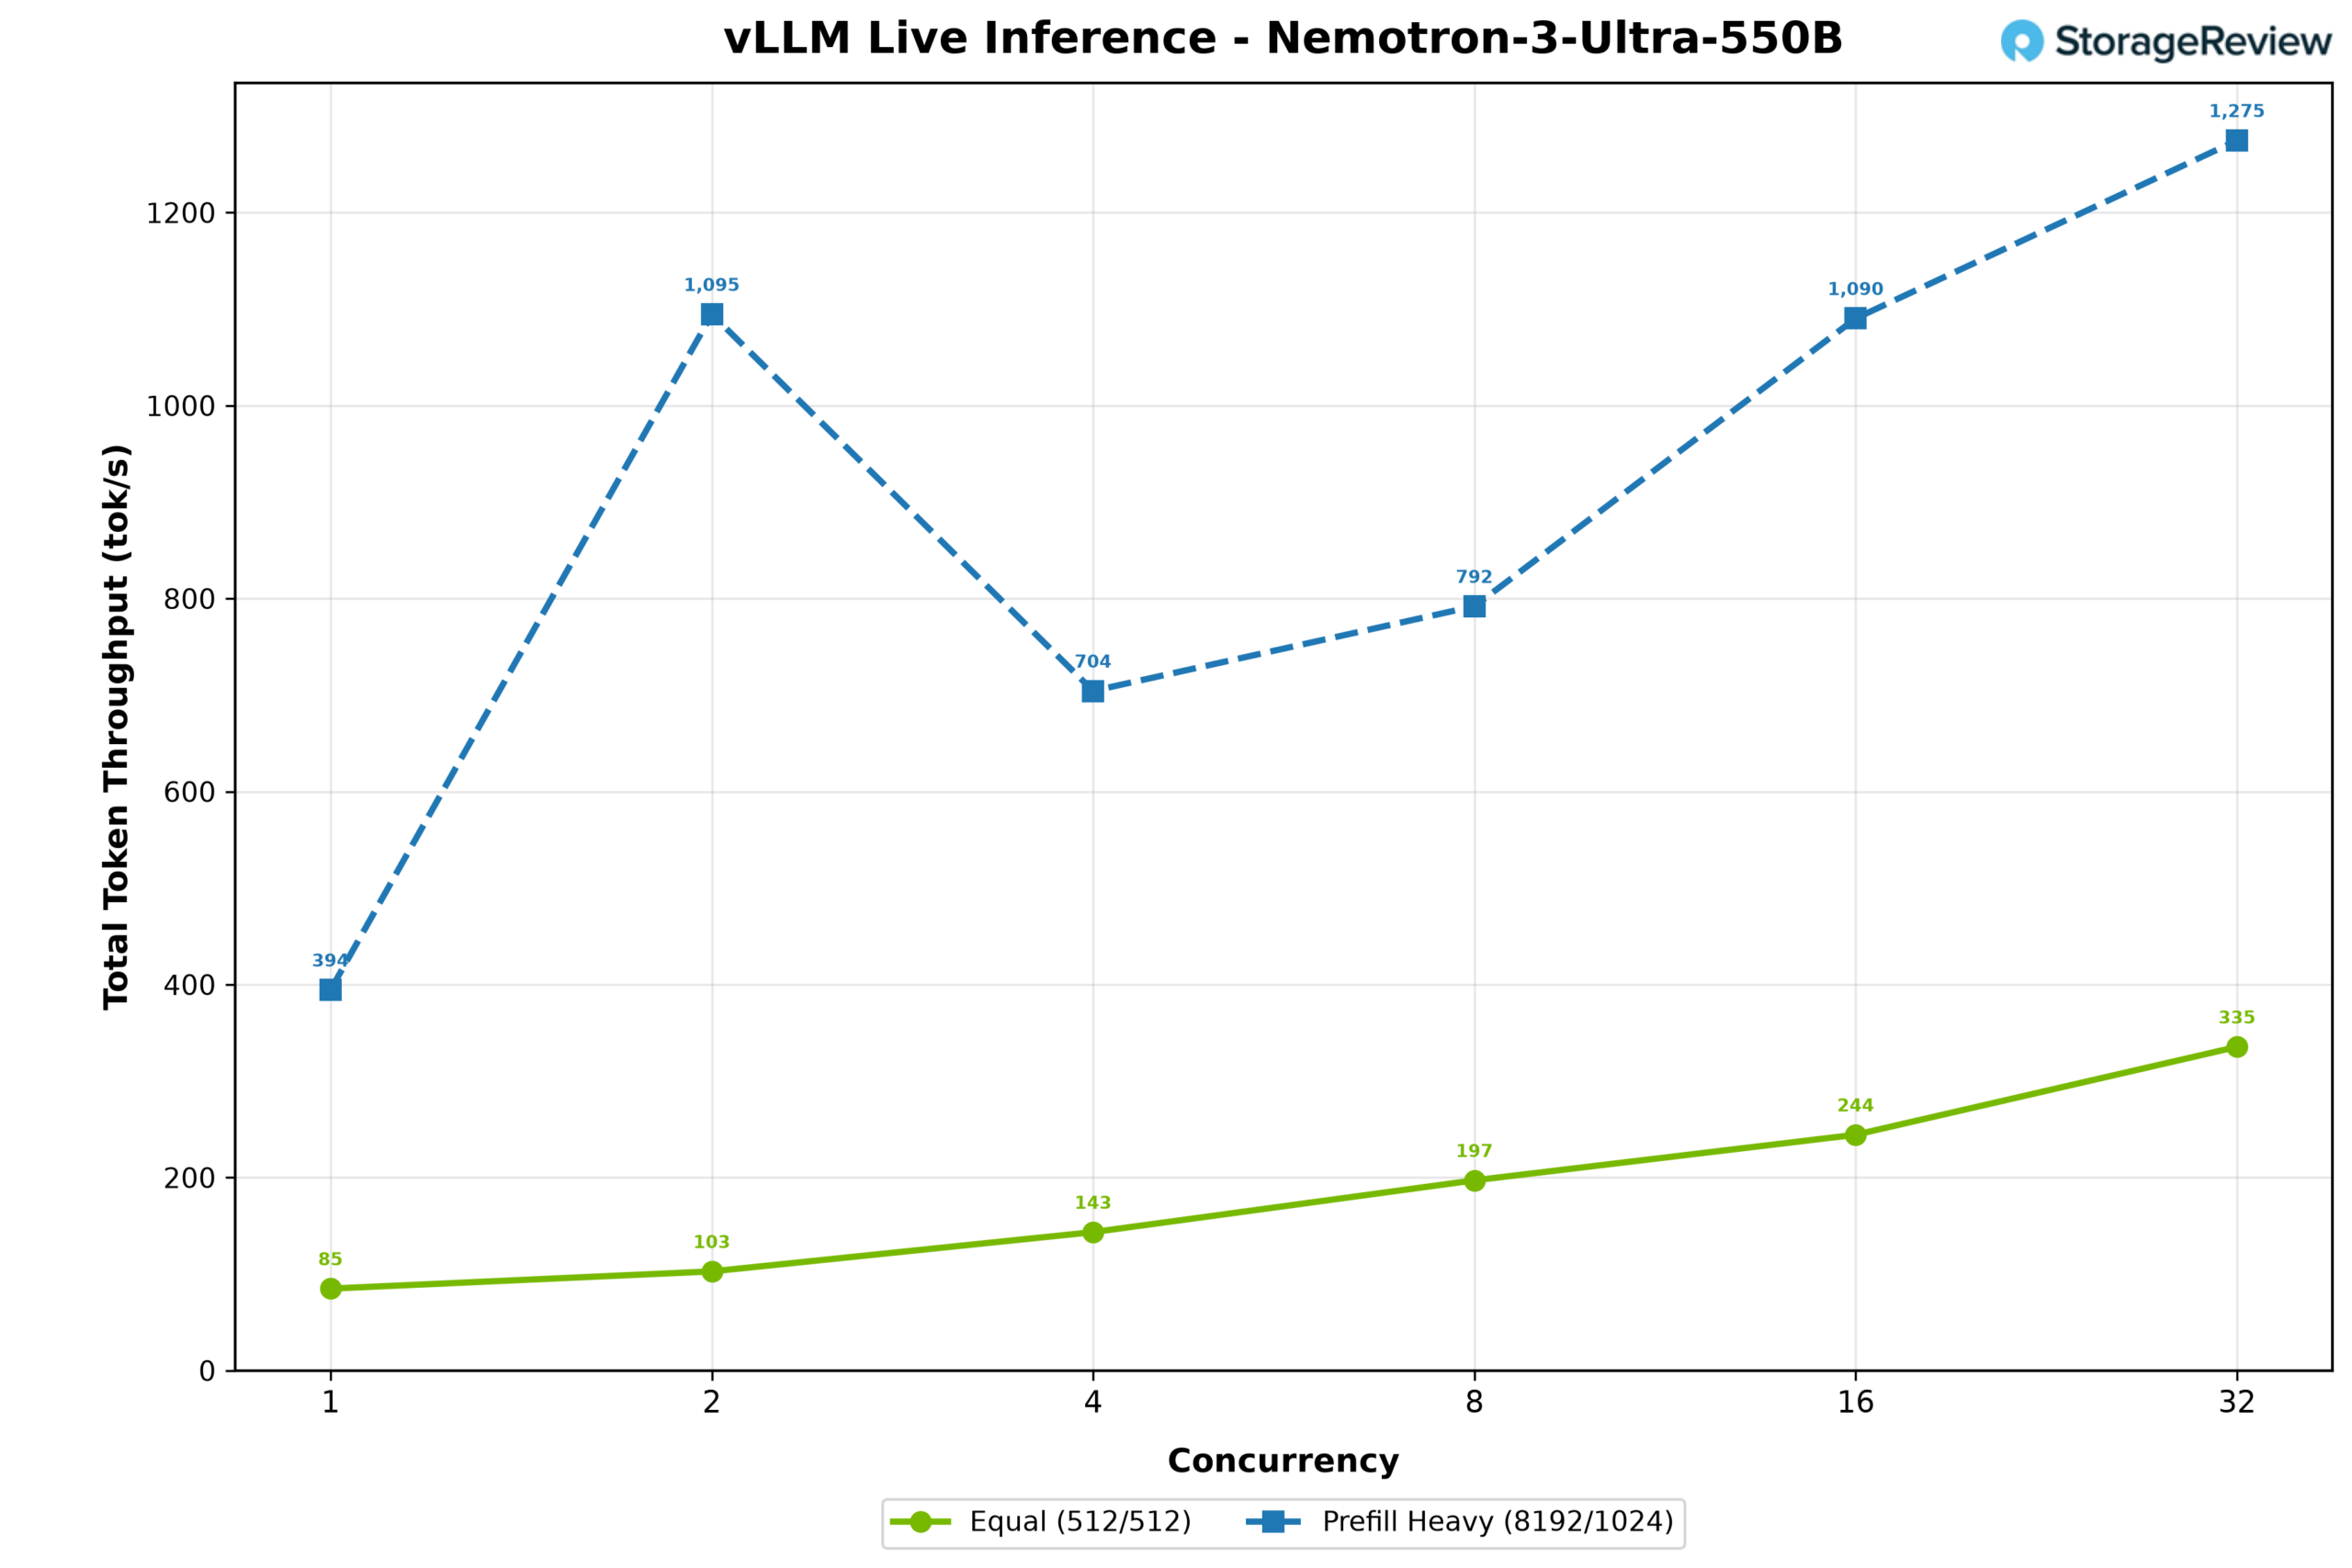
Następnie zwiększono całkowitą przepustowość tokenów, przy czym obciążenie związane z wstępnym wypełnianiem osiągnęło szczyt na poziomie 2,506 tokenów na sekundę przy współbieżności 2, a następnie spadło do 2,169 przy współbieżności 4, podczas gdy obciążenie 512/512 wzrosło z 85 do 336 tokenów na sekundę.
WS300 kontra Blackwell RTX PRO 6000 kontra DGX Spark
W tej części naszych testów wnioskowania zestawialiśmy WS300 z dwoma innymi rozwiązaniami umożliwiającymi umieszczenie Blackwell na biurku lub w jego pobliżu: Blackwell RTX PRO 6000, kartą graficzną firmy NVIDIA o mocy 600 W, zamontowaną w obudowie Dell Pro Max Tower T2, którą recenzowaliśmy wcześniej, oraz kartą DGX Spark opartą na GB10, reprezentowaną tutaj przez Acer Veriton GN100 . Każdy system uruchomił te same obciążenia wnioskowania na żywo vLLM w dwóch scenariuszach: równym obciążeniu z 512 tokenami wejściowymi i 512 tokenami wyjściowymi oraz obciążeniu o dużym stopniu wstępnego wypełniania z 8,192 tokenami wejściowymi i 1,024 tokenami wyjściowymi, przy poziomach współbieżności od 1 do 128. Sporządzono wykres łącznego wyjścia i całkowitej przepustowości dla każdego modelu, który wszystkie trzy systemy mogą obsługiwać wspólnie: GPT-OSS-20B i GPT-OSS-120B w ich natywnym MXFP4, Llama 3.1 8B w BF16, FP8 i NVFP4 oraz Mistral Small 24B i Qwen3 Coder 30B w BF16 i FP8.
GPT-OSS-20B
GPT-OSS-20B to najbardziej przyjazny test z zestawu, punkt kontrolny, który z łatwością pasuje do wszystkich trzech systemów. Przy takim samym obciążeniu, WS300 skalował się płynnie do 22 161 tokenów wyjściowych na sekundę przy 128 współbieżnych strumieniach, czyli około 2.5 razy więcej niż RTX PRO 6000 przy 9,000 i 15 razy więcej niż DGX Spark przy 1,469. Wyniki dla pojedynczego strumienia przedstawiają ten sam obraz w miniaturze: 530 tokenów na sekundę na stacji, 244 na karcie i 50 na Spark.
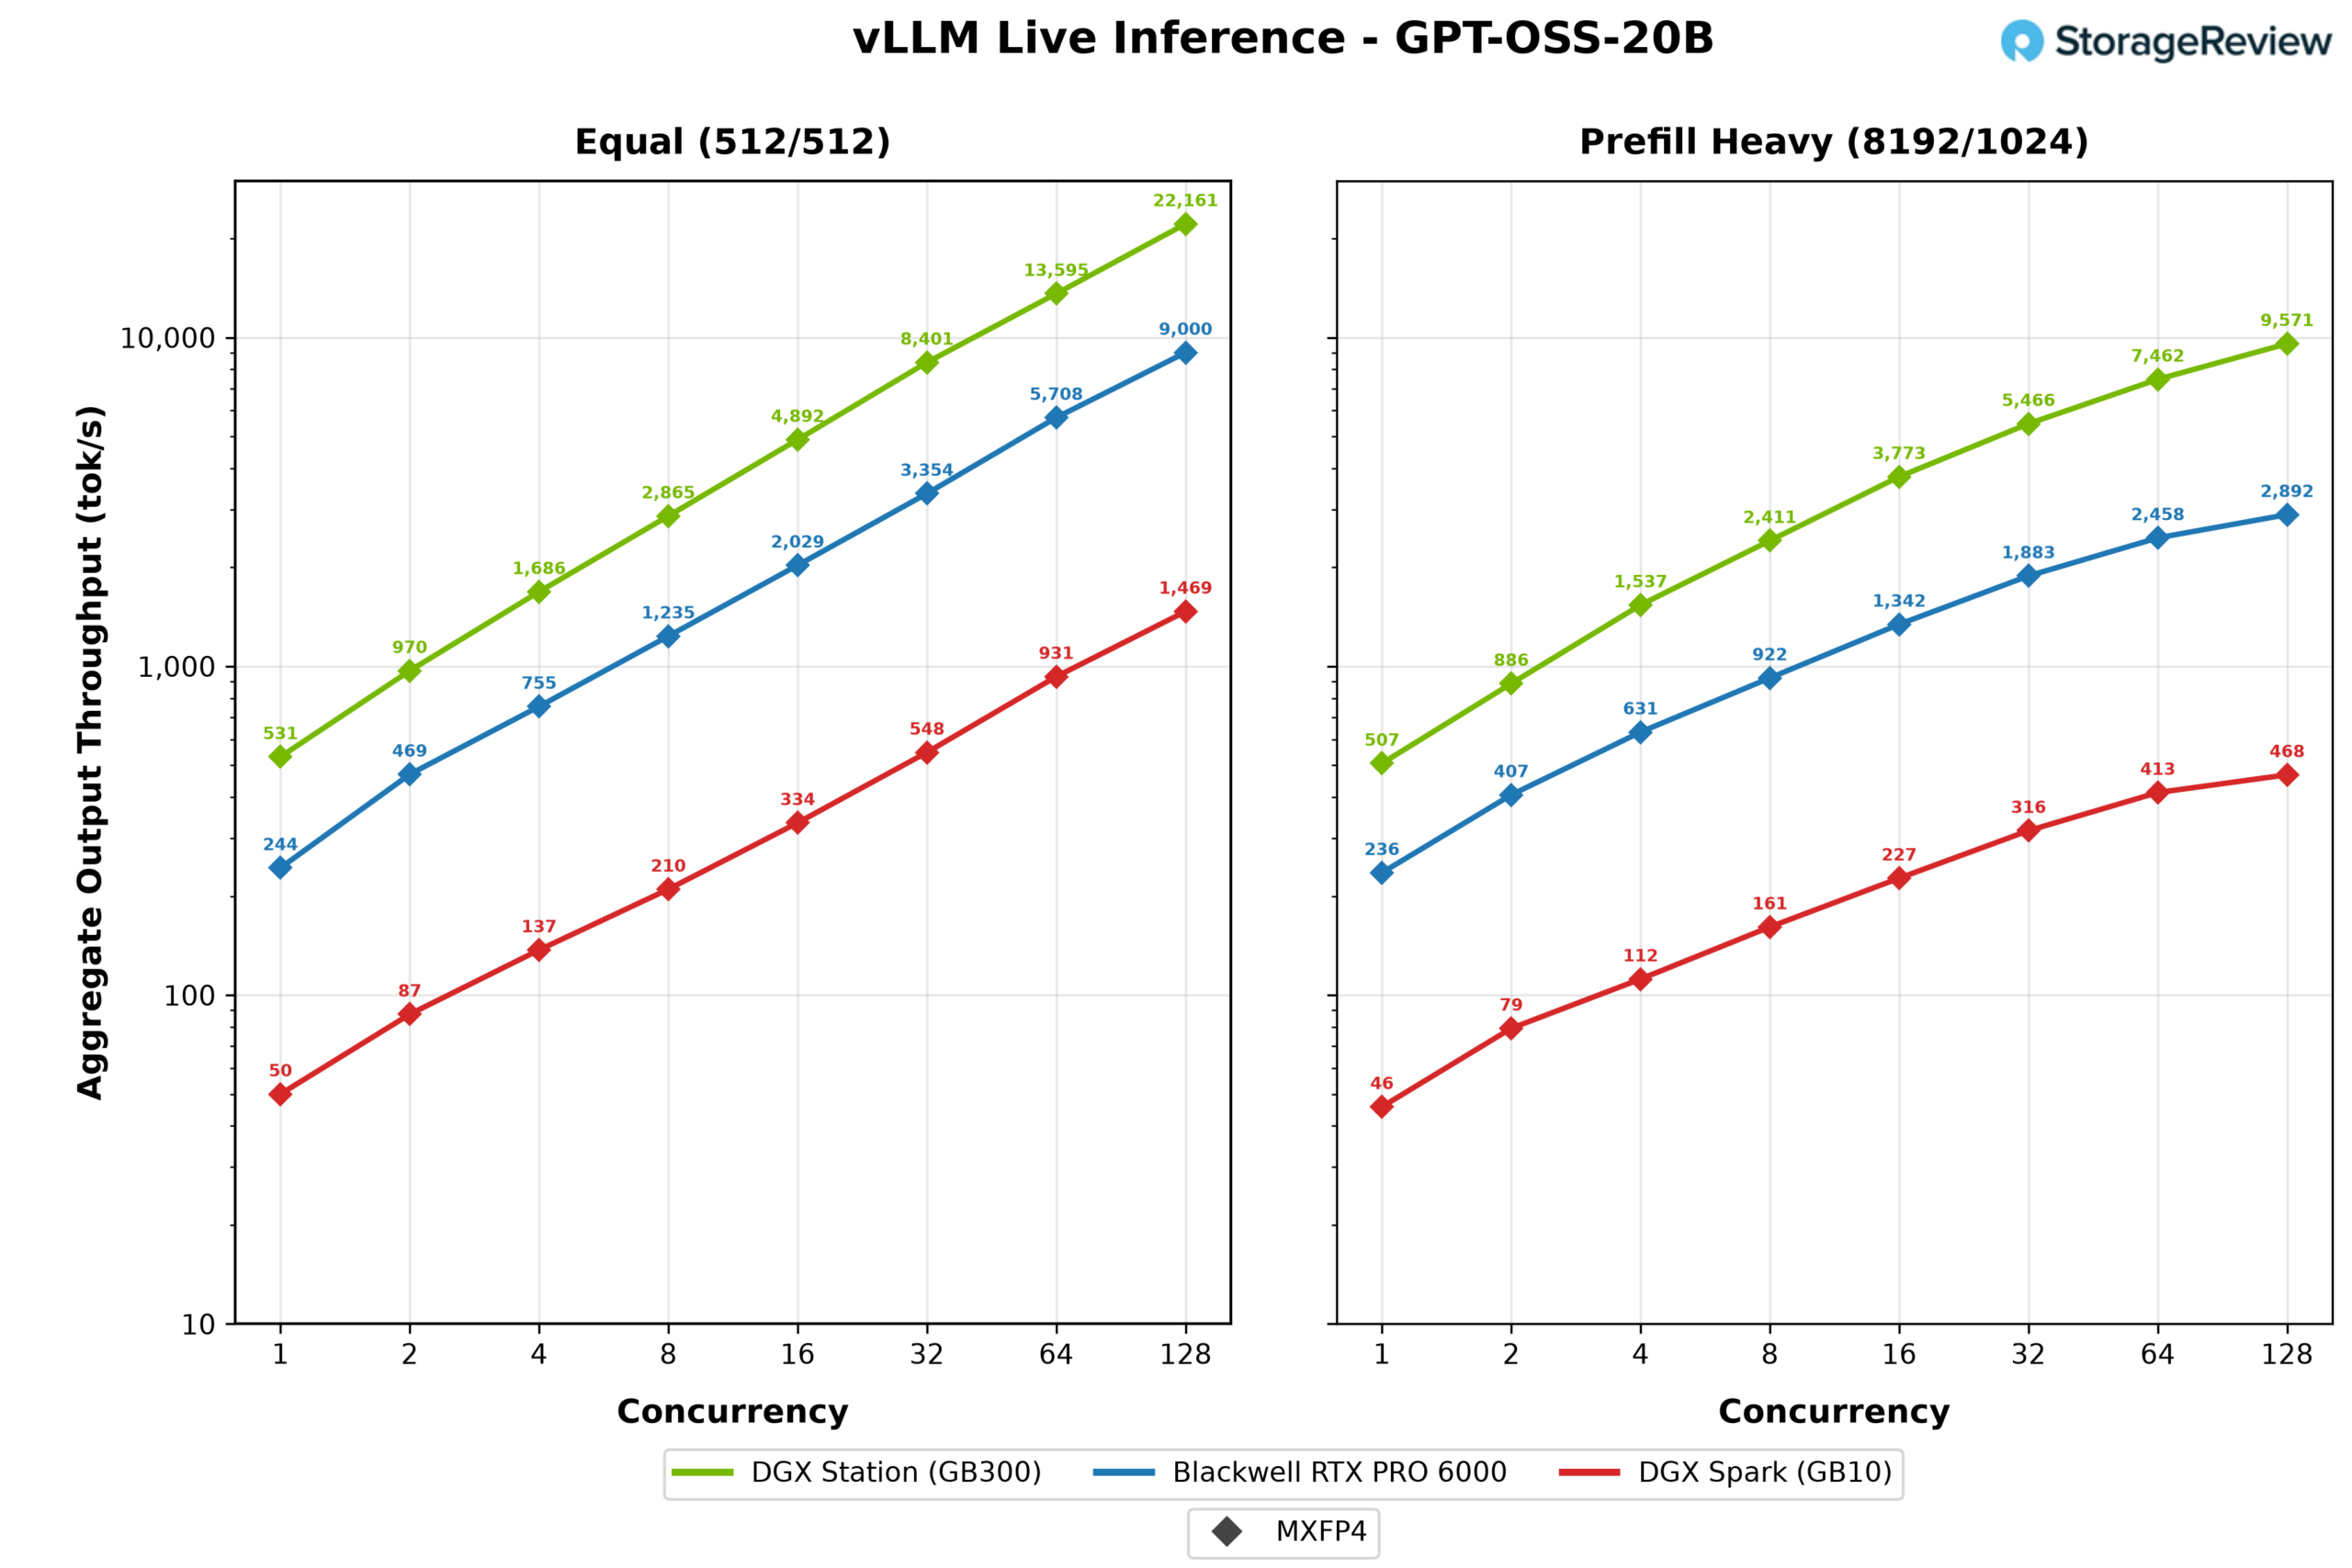
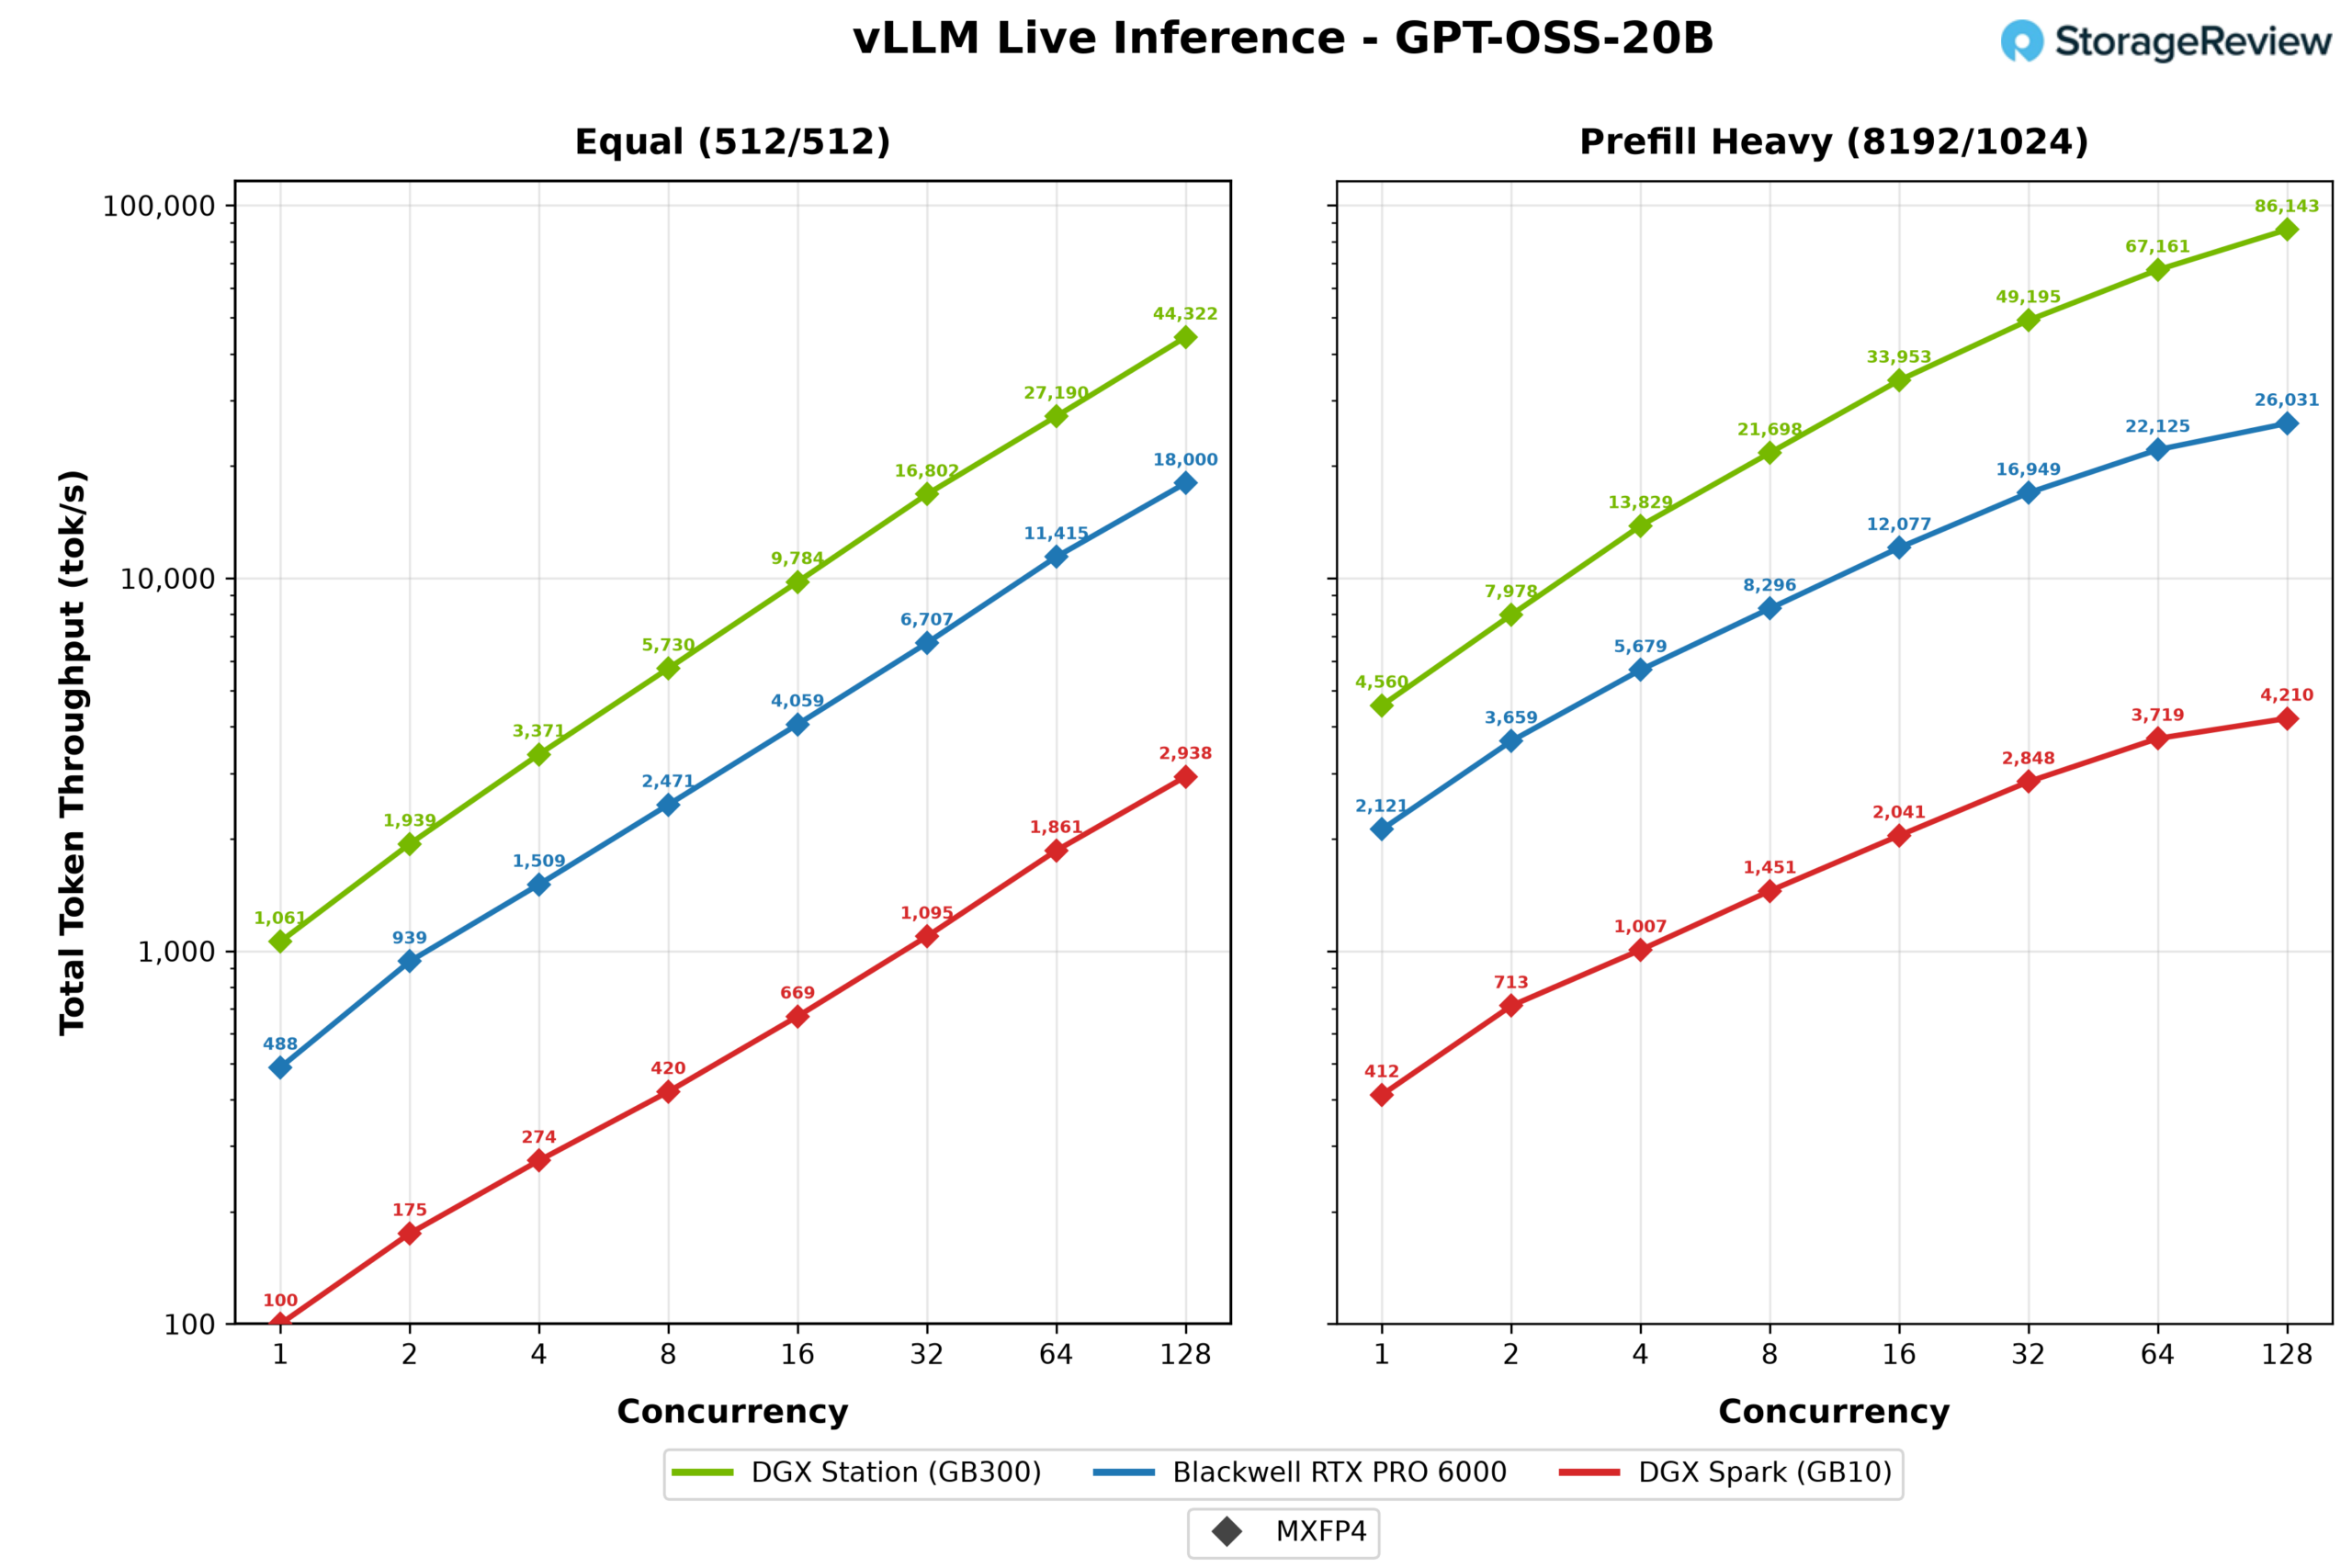
Scenariusz z dużą liczbą tokenów prefill jeszcze bardziej dzieli pole. Wysyłając 8,192 monity o tokeny, WS300 nadal dostarczał 9,572 tokeny wyjściowe na sekundę w szczytowym momencie, co daje ponad 86 000 tokenów na sekundę po zliczeniu prefillu, podczas gdy RTX PRO 6000 osiągnął 2,892, a Spark 468.
GPT-OSS-120B
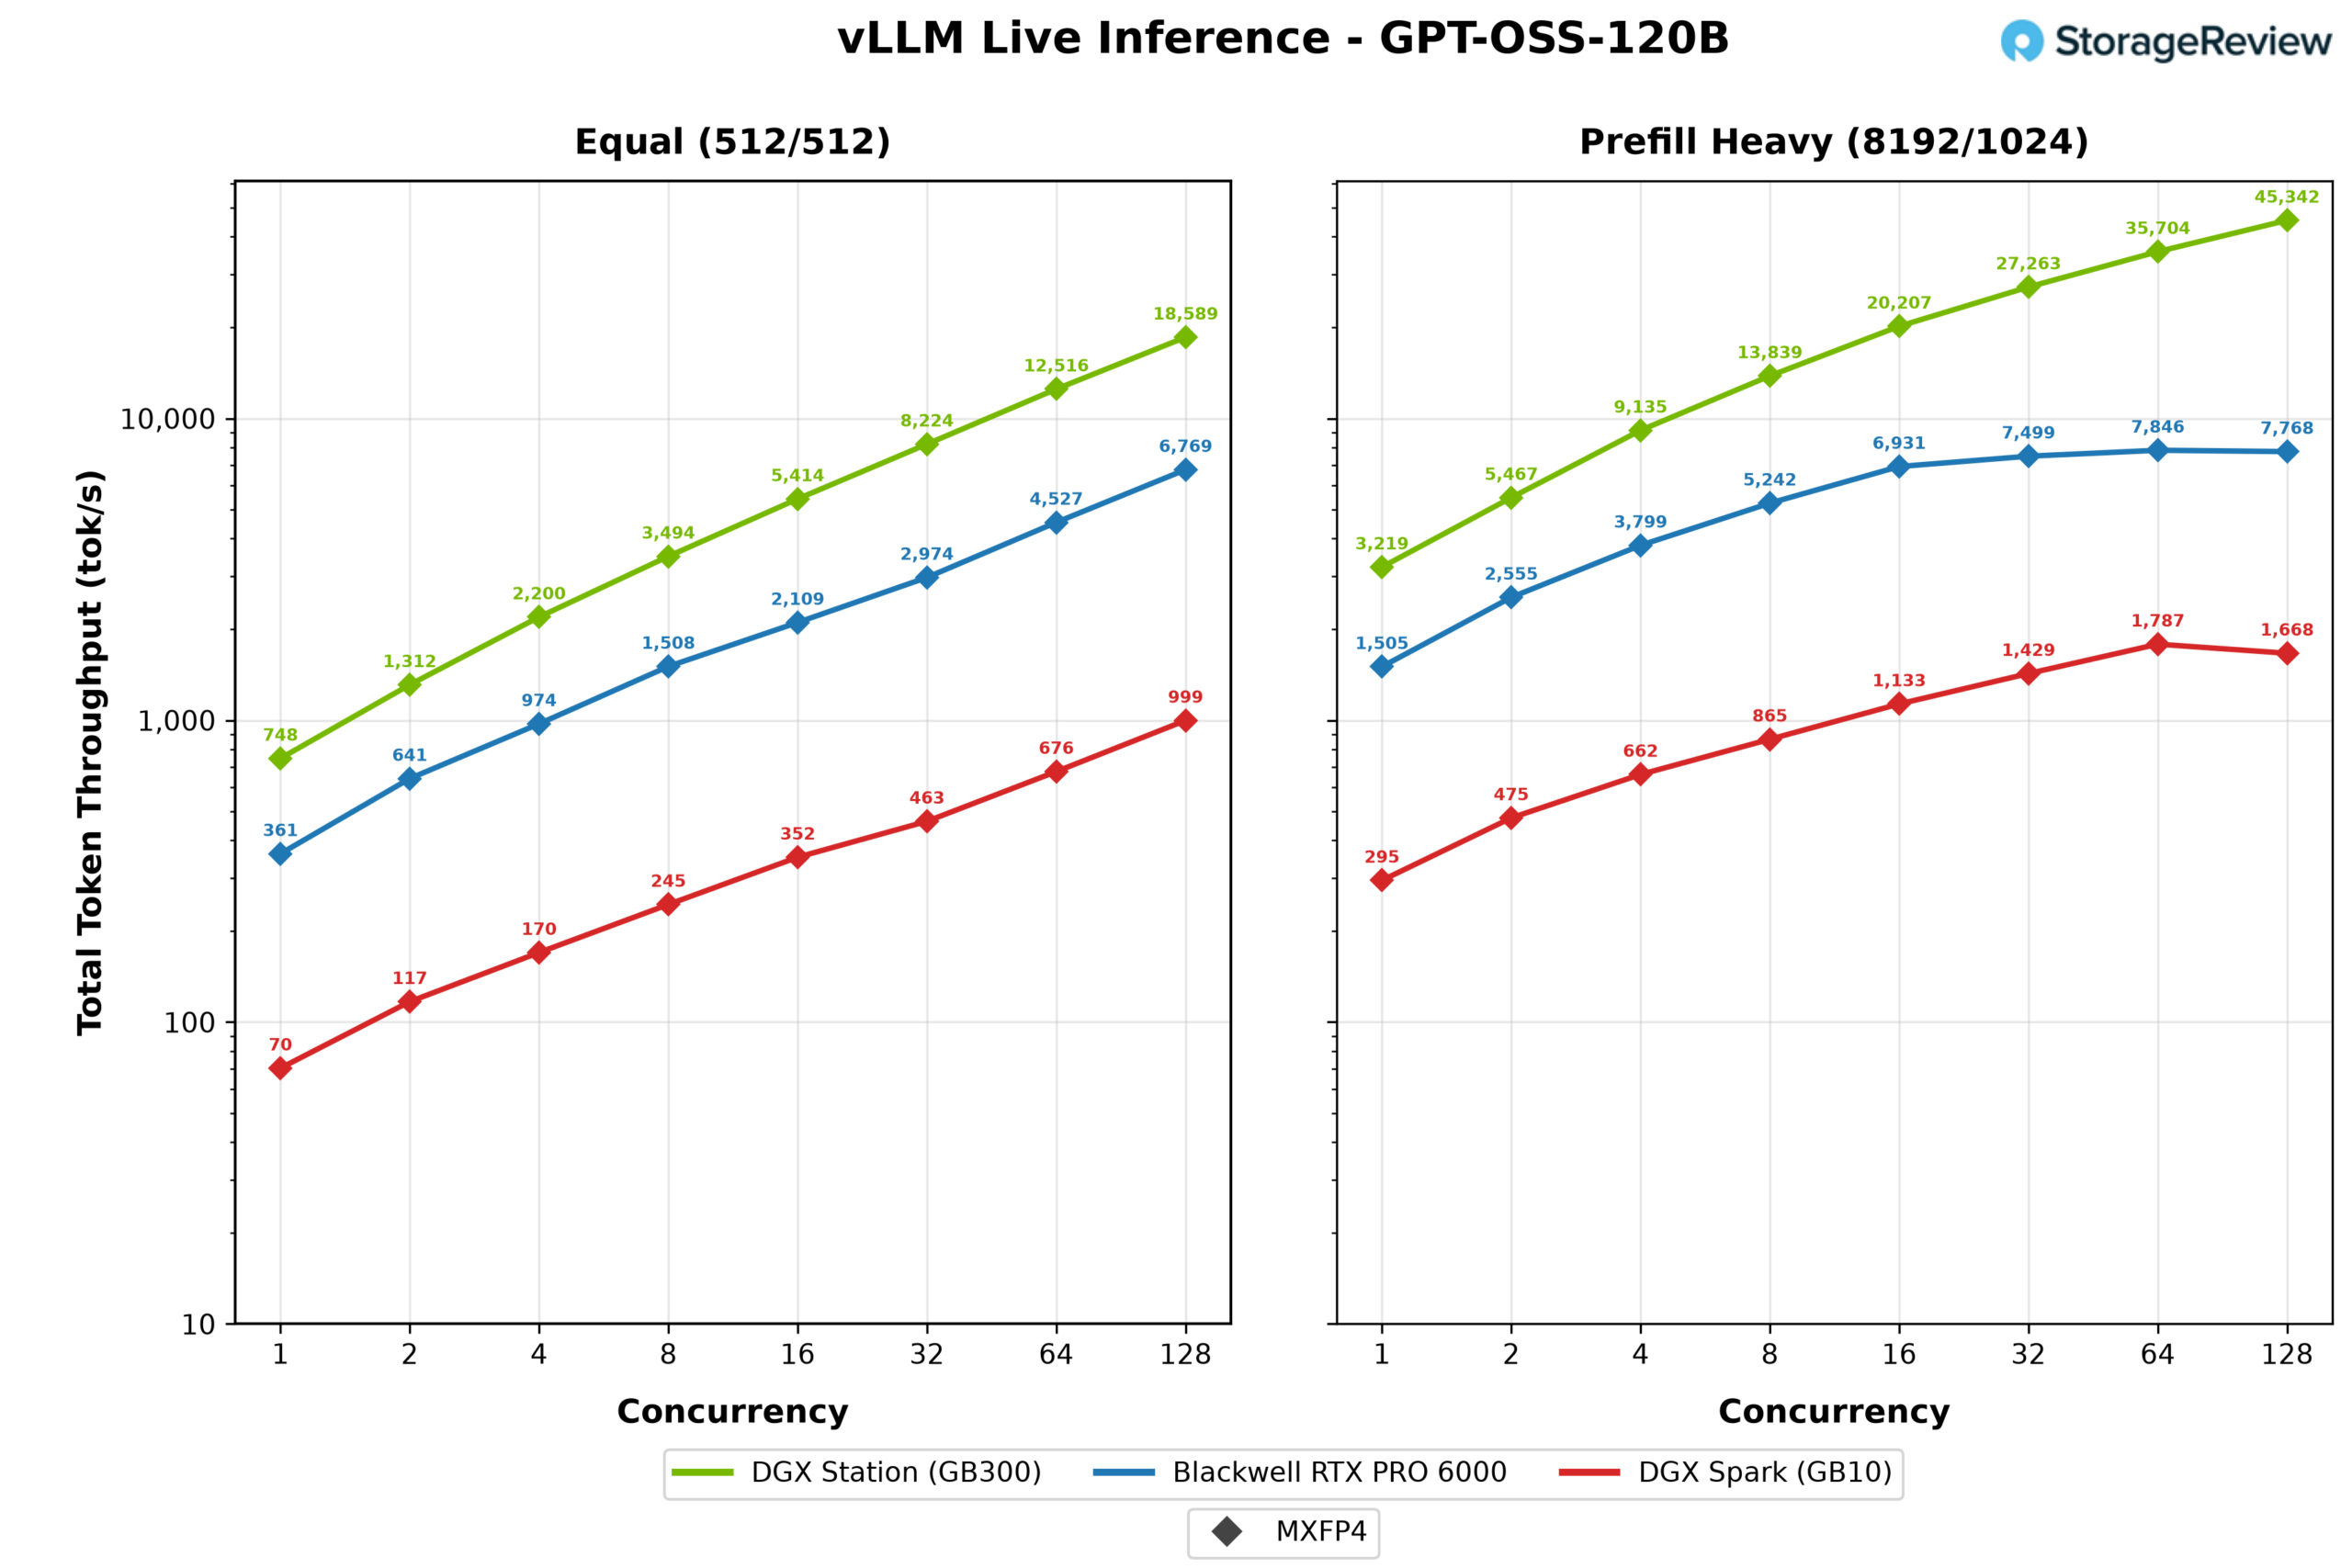
Po przejściu na GPT-OSS-120B wszystkie trzy systemy nadal mogą załadować model, ale hierarchia pamięci zaczyna mieć znaczenie. WS300 osiągnął szczytową wydajność 9,294 tokenów wyjściowych na sekundę przy takim samym obciążeniu, 2.7 razy więcej niż RTX PRO 6000 (3,384) i prawie 19 razy więcej niż DGX Spark (500).
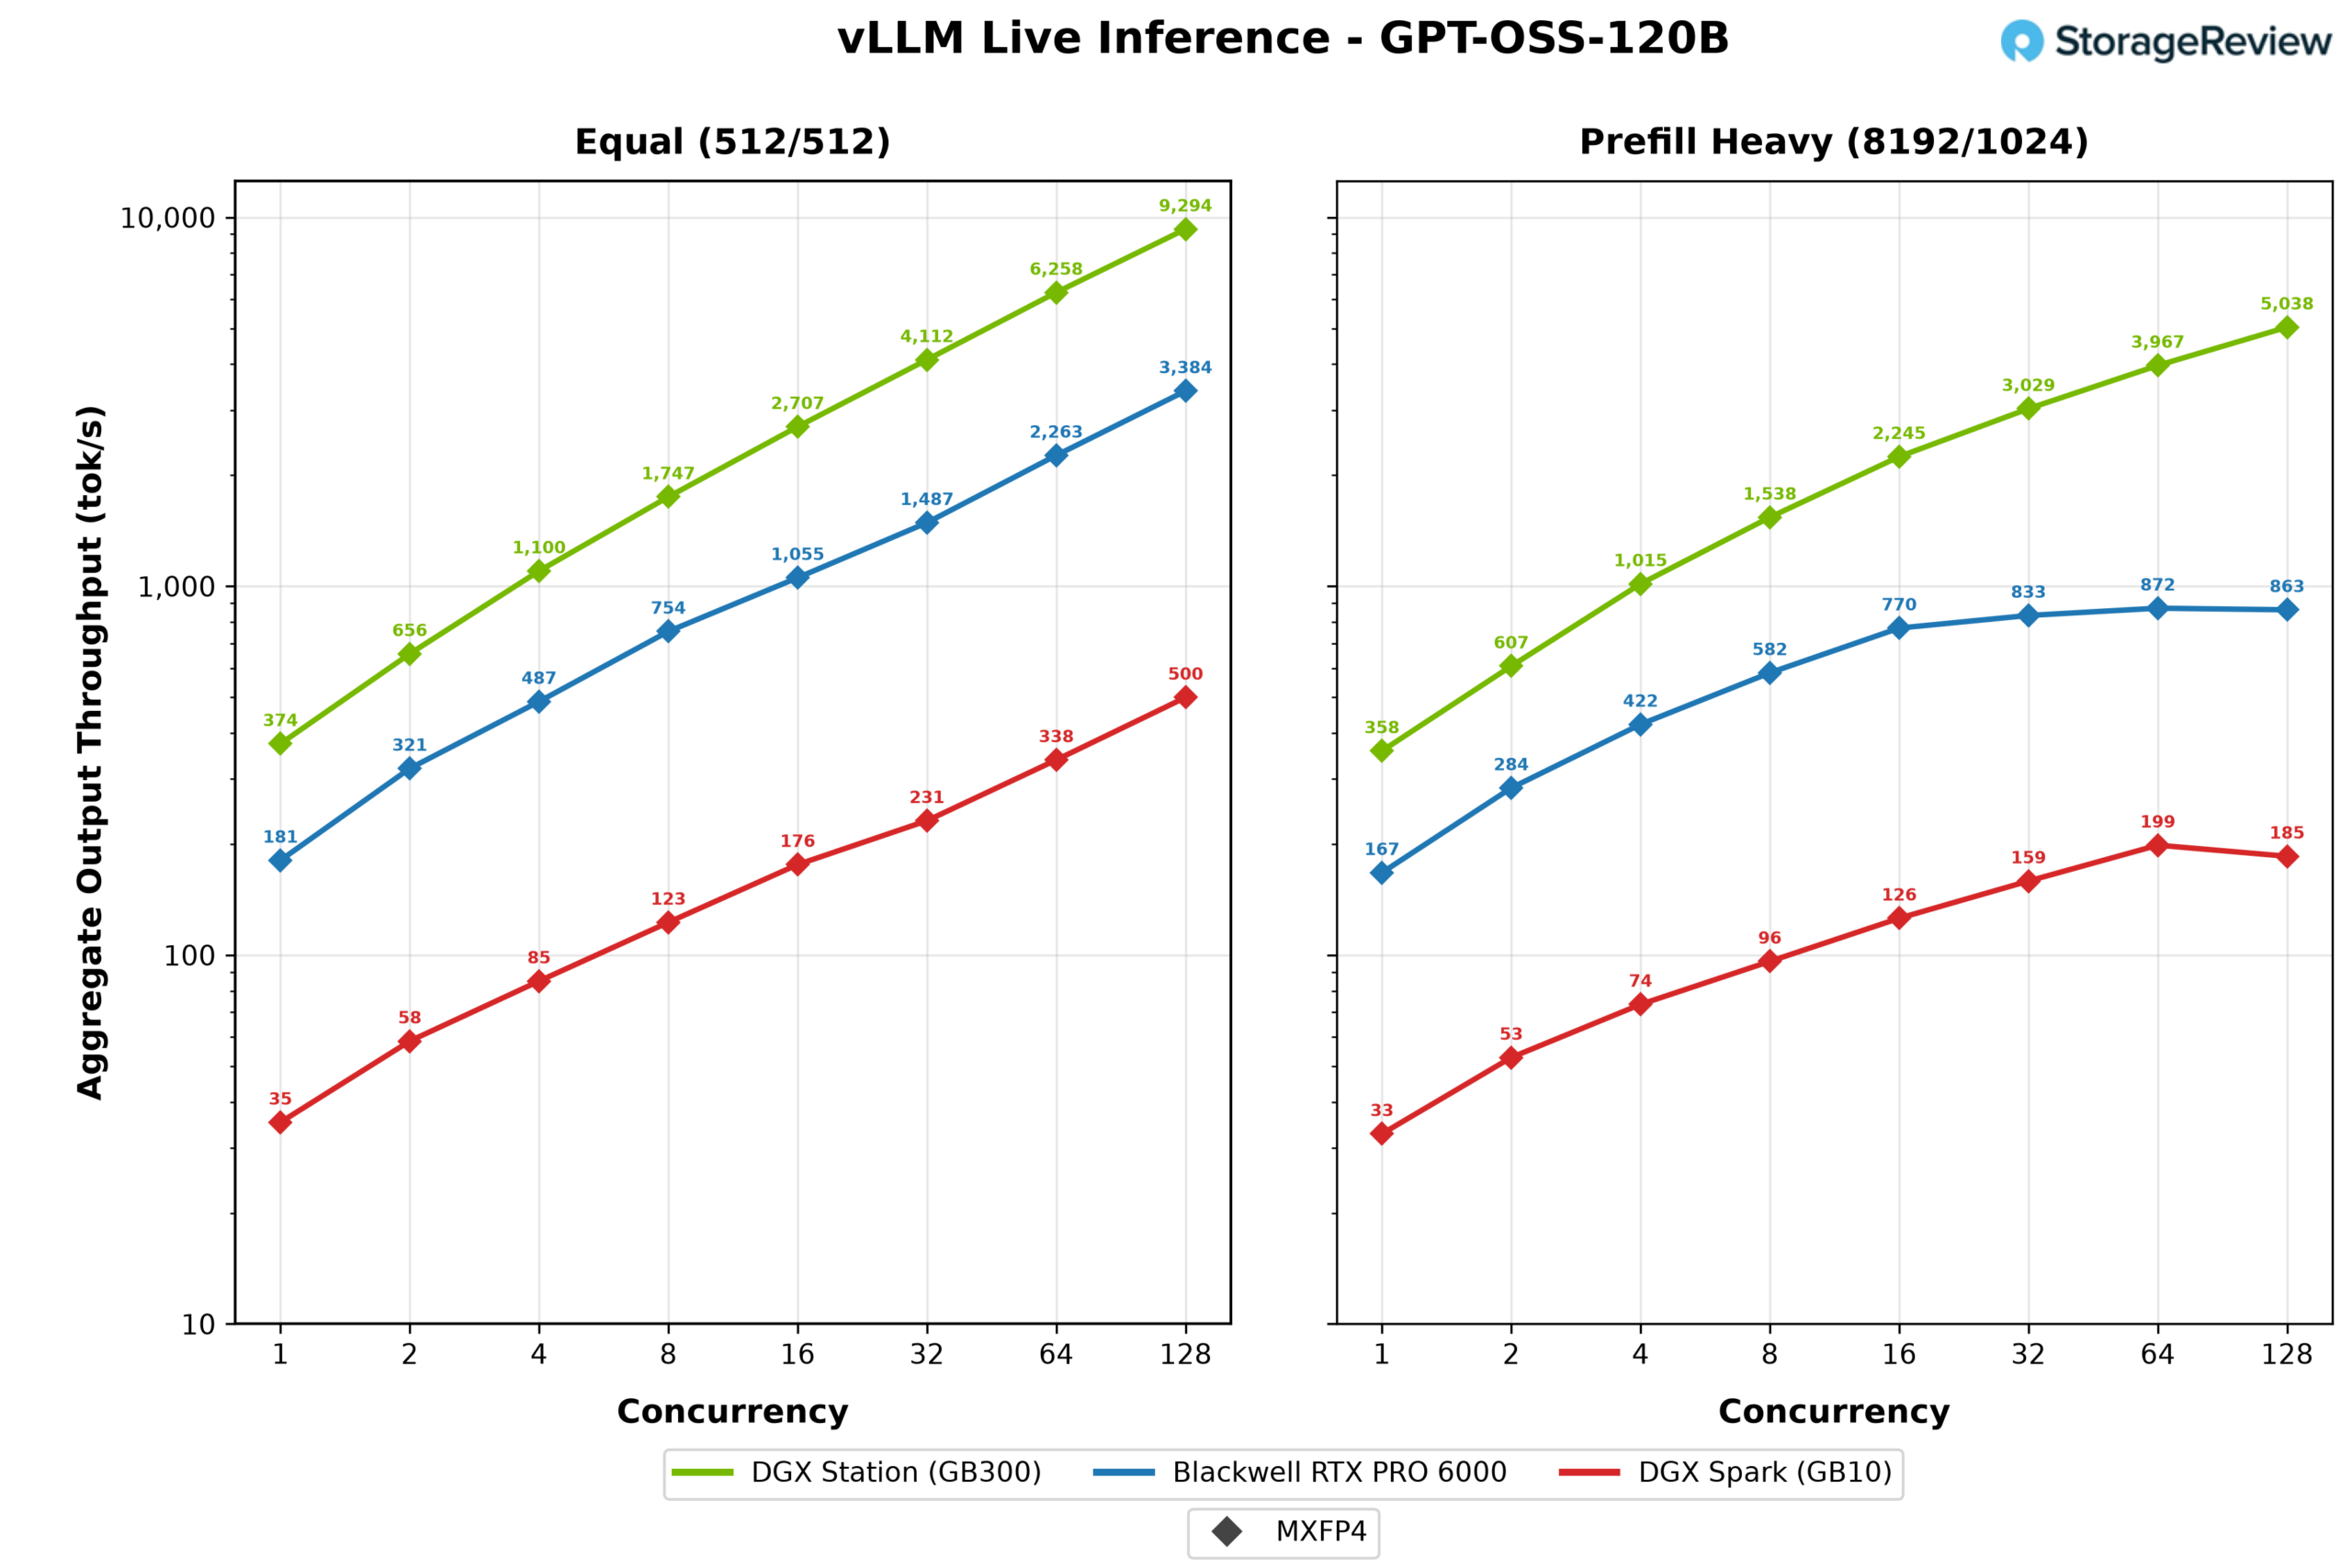
W przypadku mniejszych systemów, w których występuje duże obciążenie prefill, osiągnięto pułap, na którym osiągnęły one swoje cele. RTX PRO 6000 osiągnął 872 tokeny wyjściowe na sekundę przy 64 współbieżnych strumieniach, a Spark 199, podczas gdy WS300 nadal piął się w górę, osiągając 128 strumieni i kończąc na 5,038, co stanowi prawie 6-krotną różnicę w porównaniu z kartą. Długie komunikaty powodują wzrost pamięci podręcznej KV, a systemy z mniejszą rezerwą pamięci kończą się na długo przed Stacją.
Lama 3.1 8B
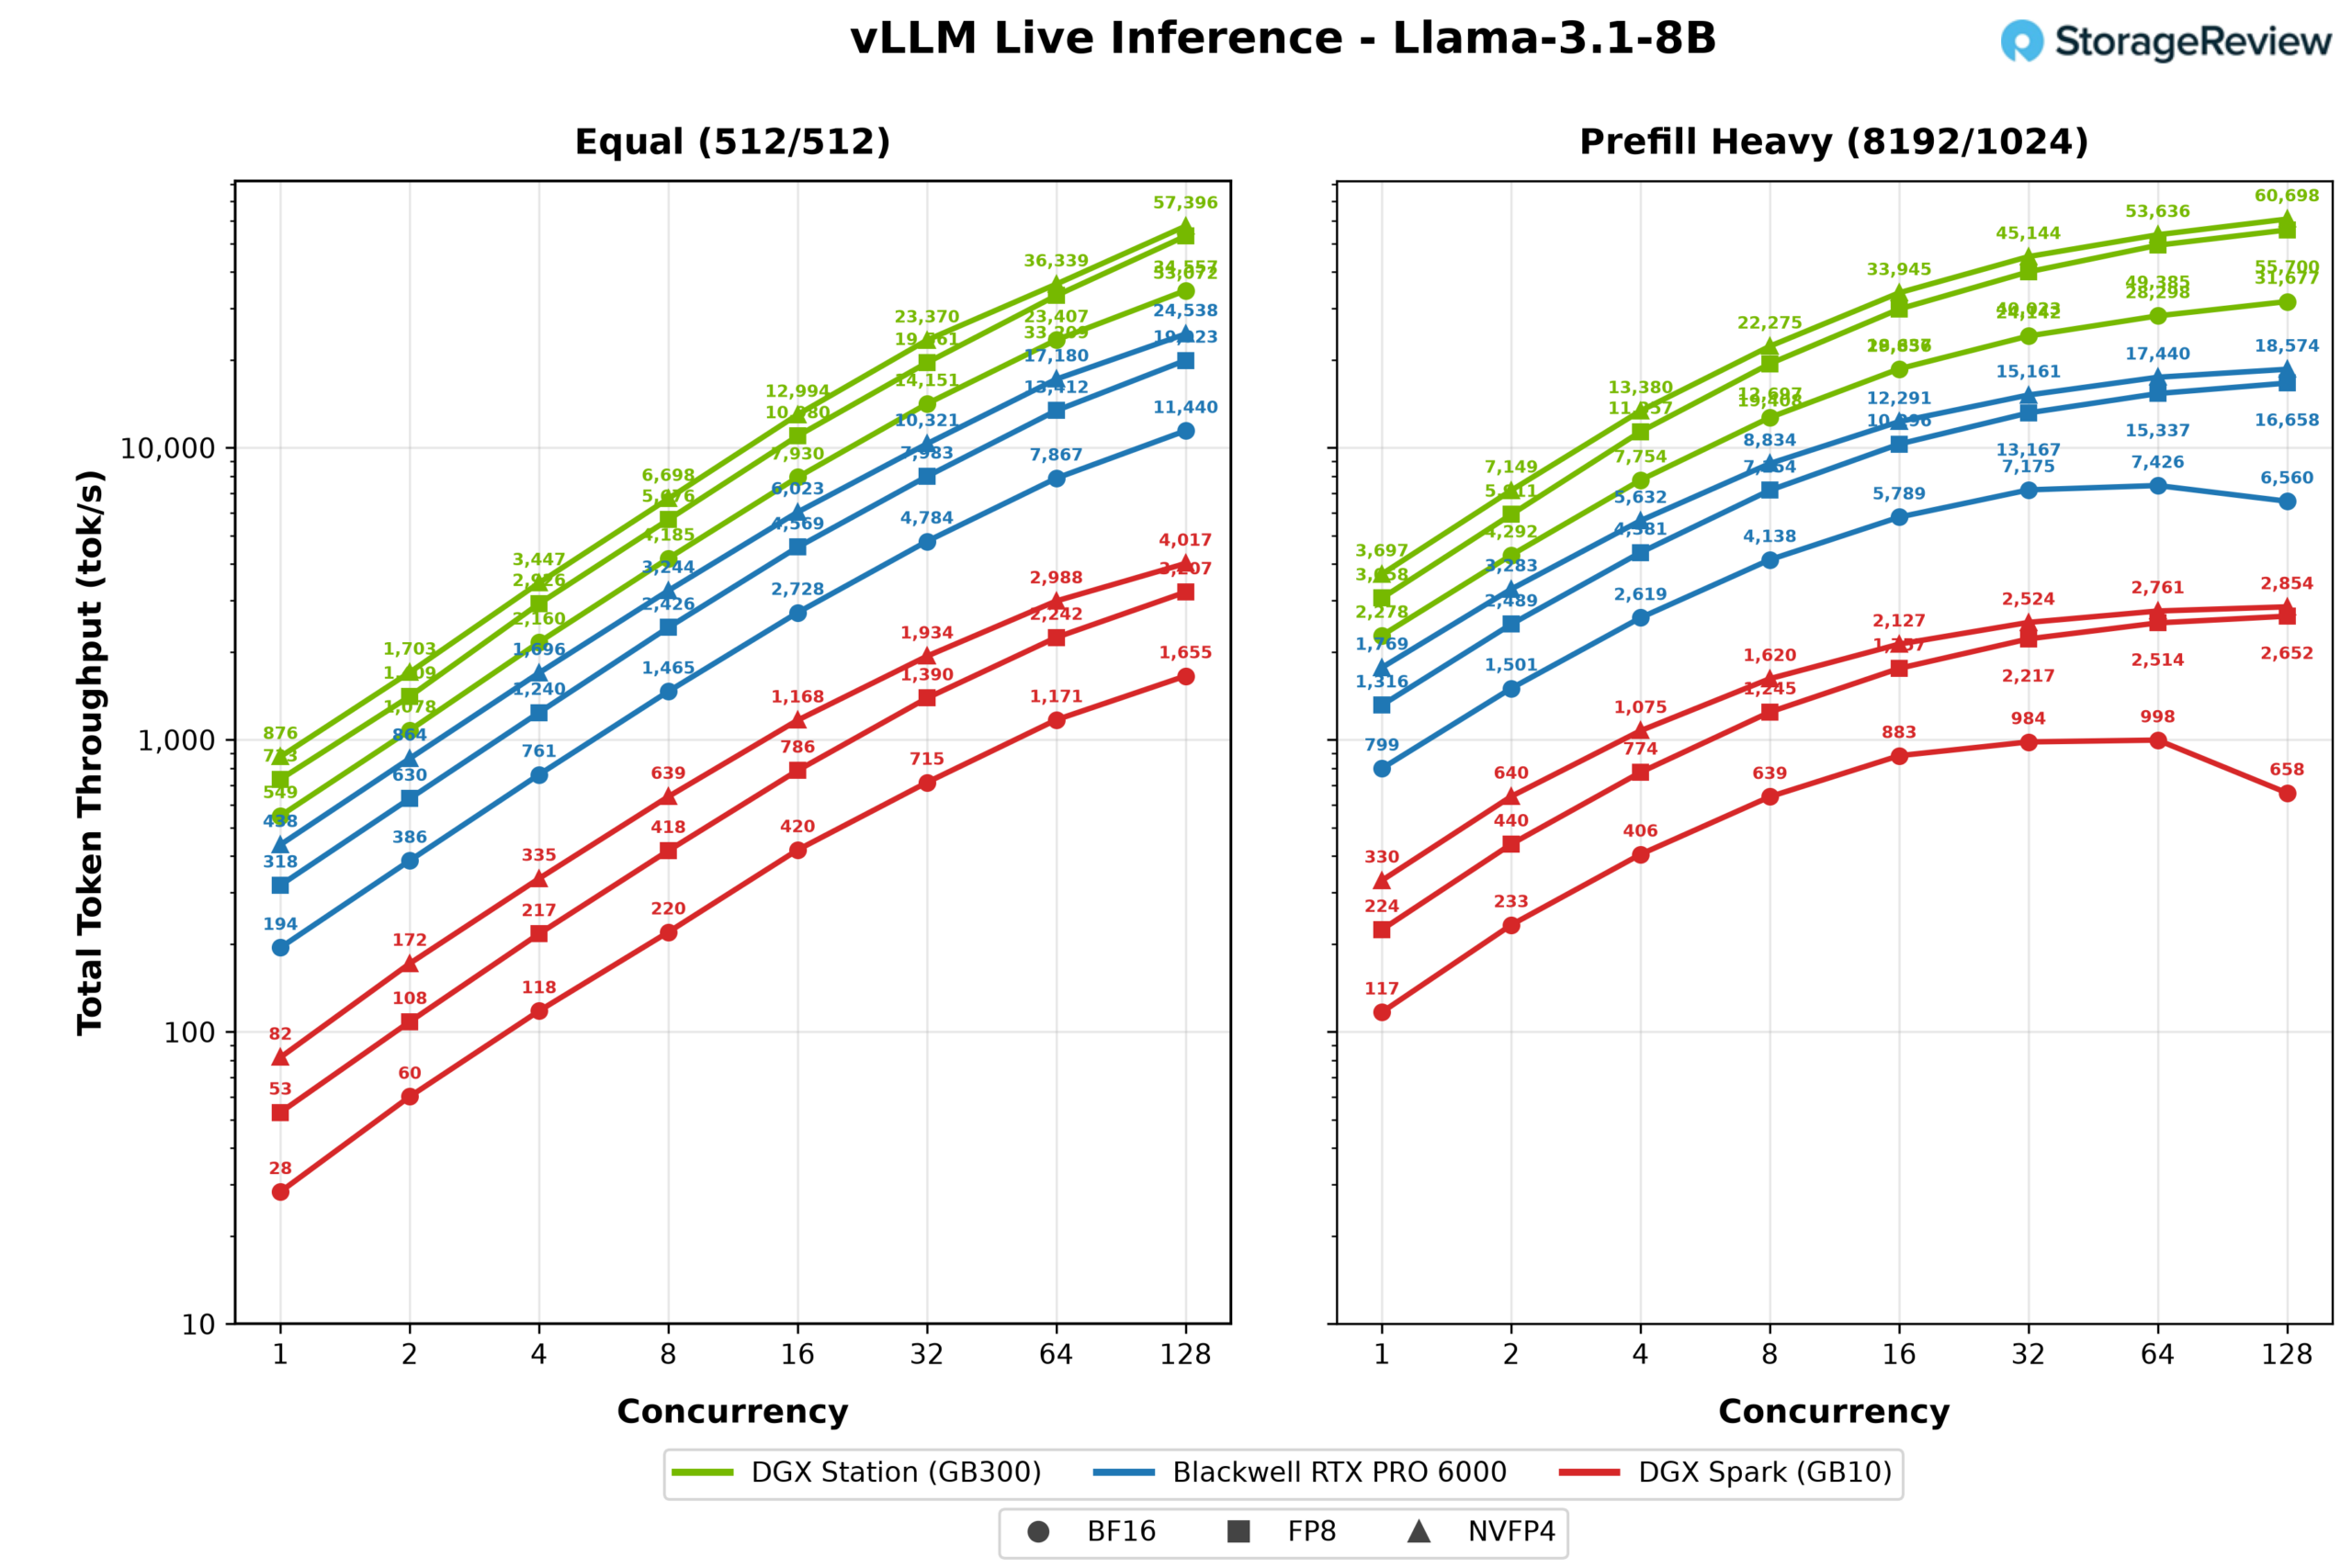
Llama 3.1 8B jest na tyle mała, że mogliśmy ją uruchomić w BF16, FP8 i NVFP4 na każdym systemie, co daje najczystszy obraz korzyści płynących z kwantyzacji na każdej maszynie. Przy 128 współbieżnych strumieniach i równym obciążeniu, WS300 zwiększył liczbę tokenów wyjściowych z 17 278 na sekundę w BF16 do 28 698 w NVFP4, co stanowi wzrost o 66 procent. RTX PRO 6000 zyskał 114 procent dzięki temu samemu wzrostowi, z 5,720 do 12 269, a DGX Spark zyskał 143 procent, z 828 do 2,009. Warto zapamiętać ten schemat: im mniejsza maszyna, tym bardziej opłacalna kwantyzacja.
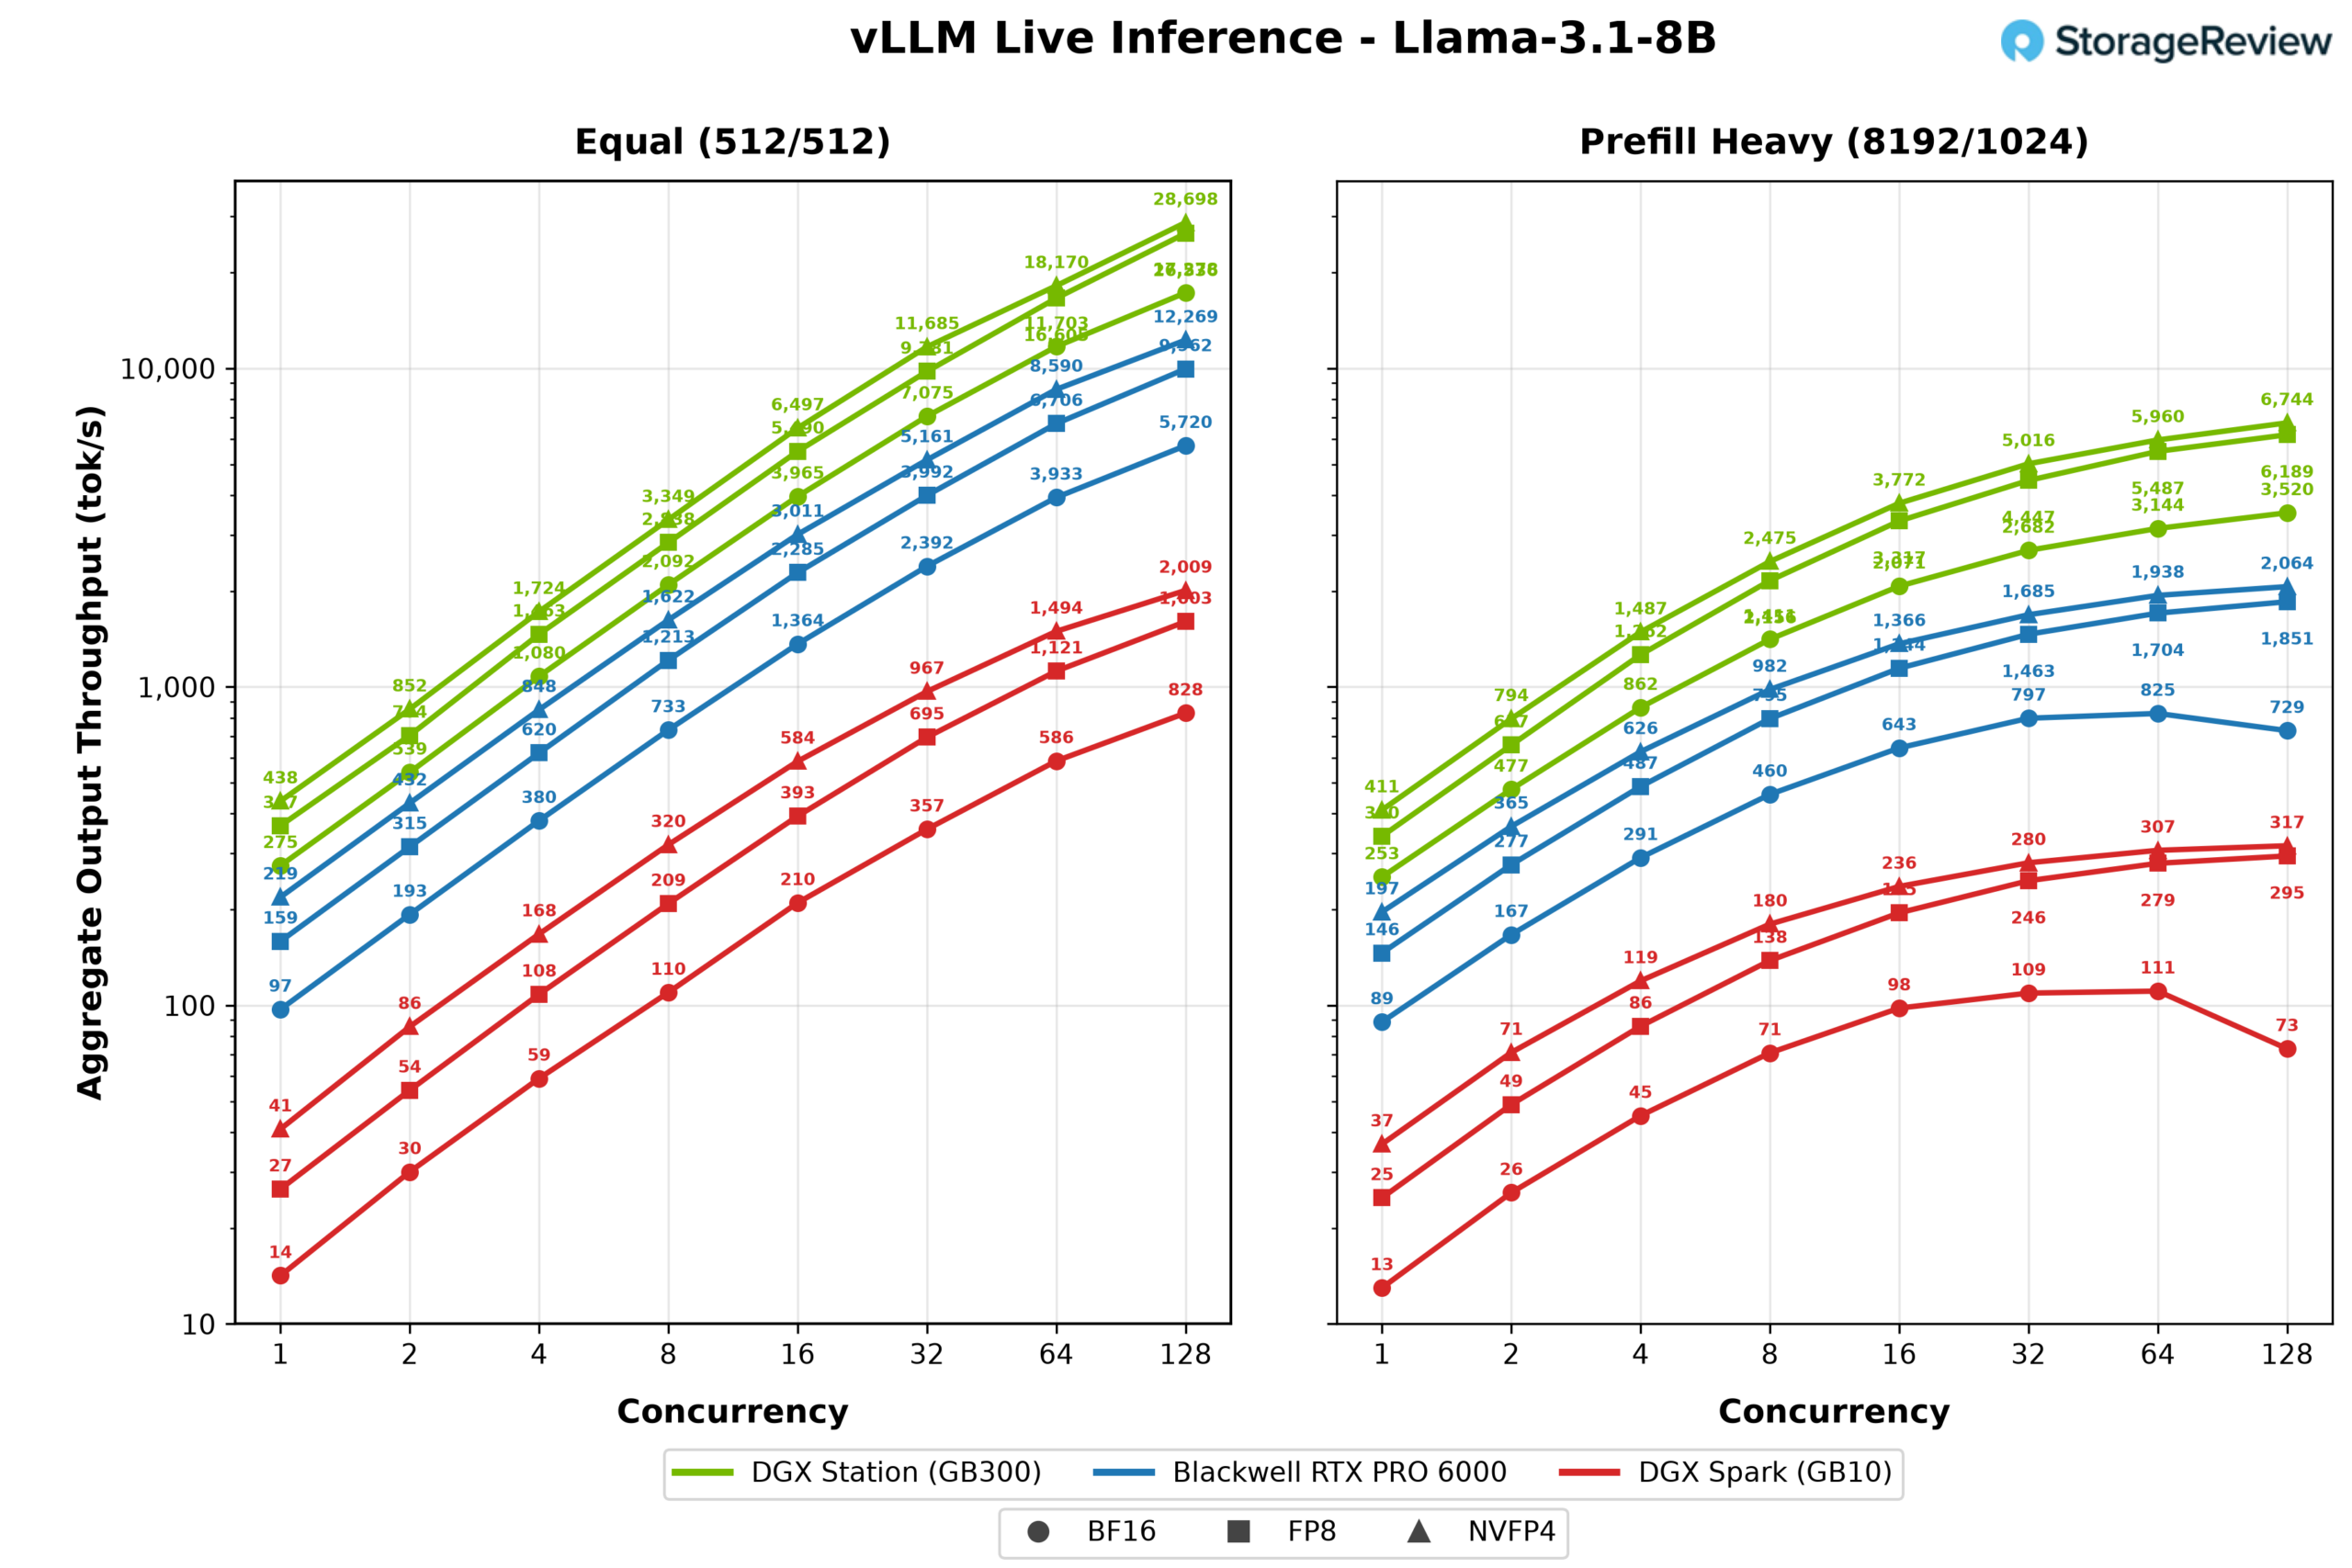
Wyniki z dużą ilością wstępnie wypełnianych tokenów kompresują całe pole, np. w przypadku WS300 maksymalna liczba tokenów wyjściowych NVFP4 wynosi 6,744, w przypadku karty jest to 2,064, a dla Spark 317.
Mistral Small 24B
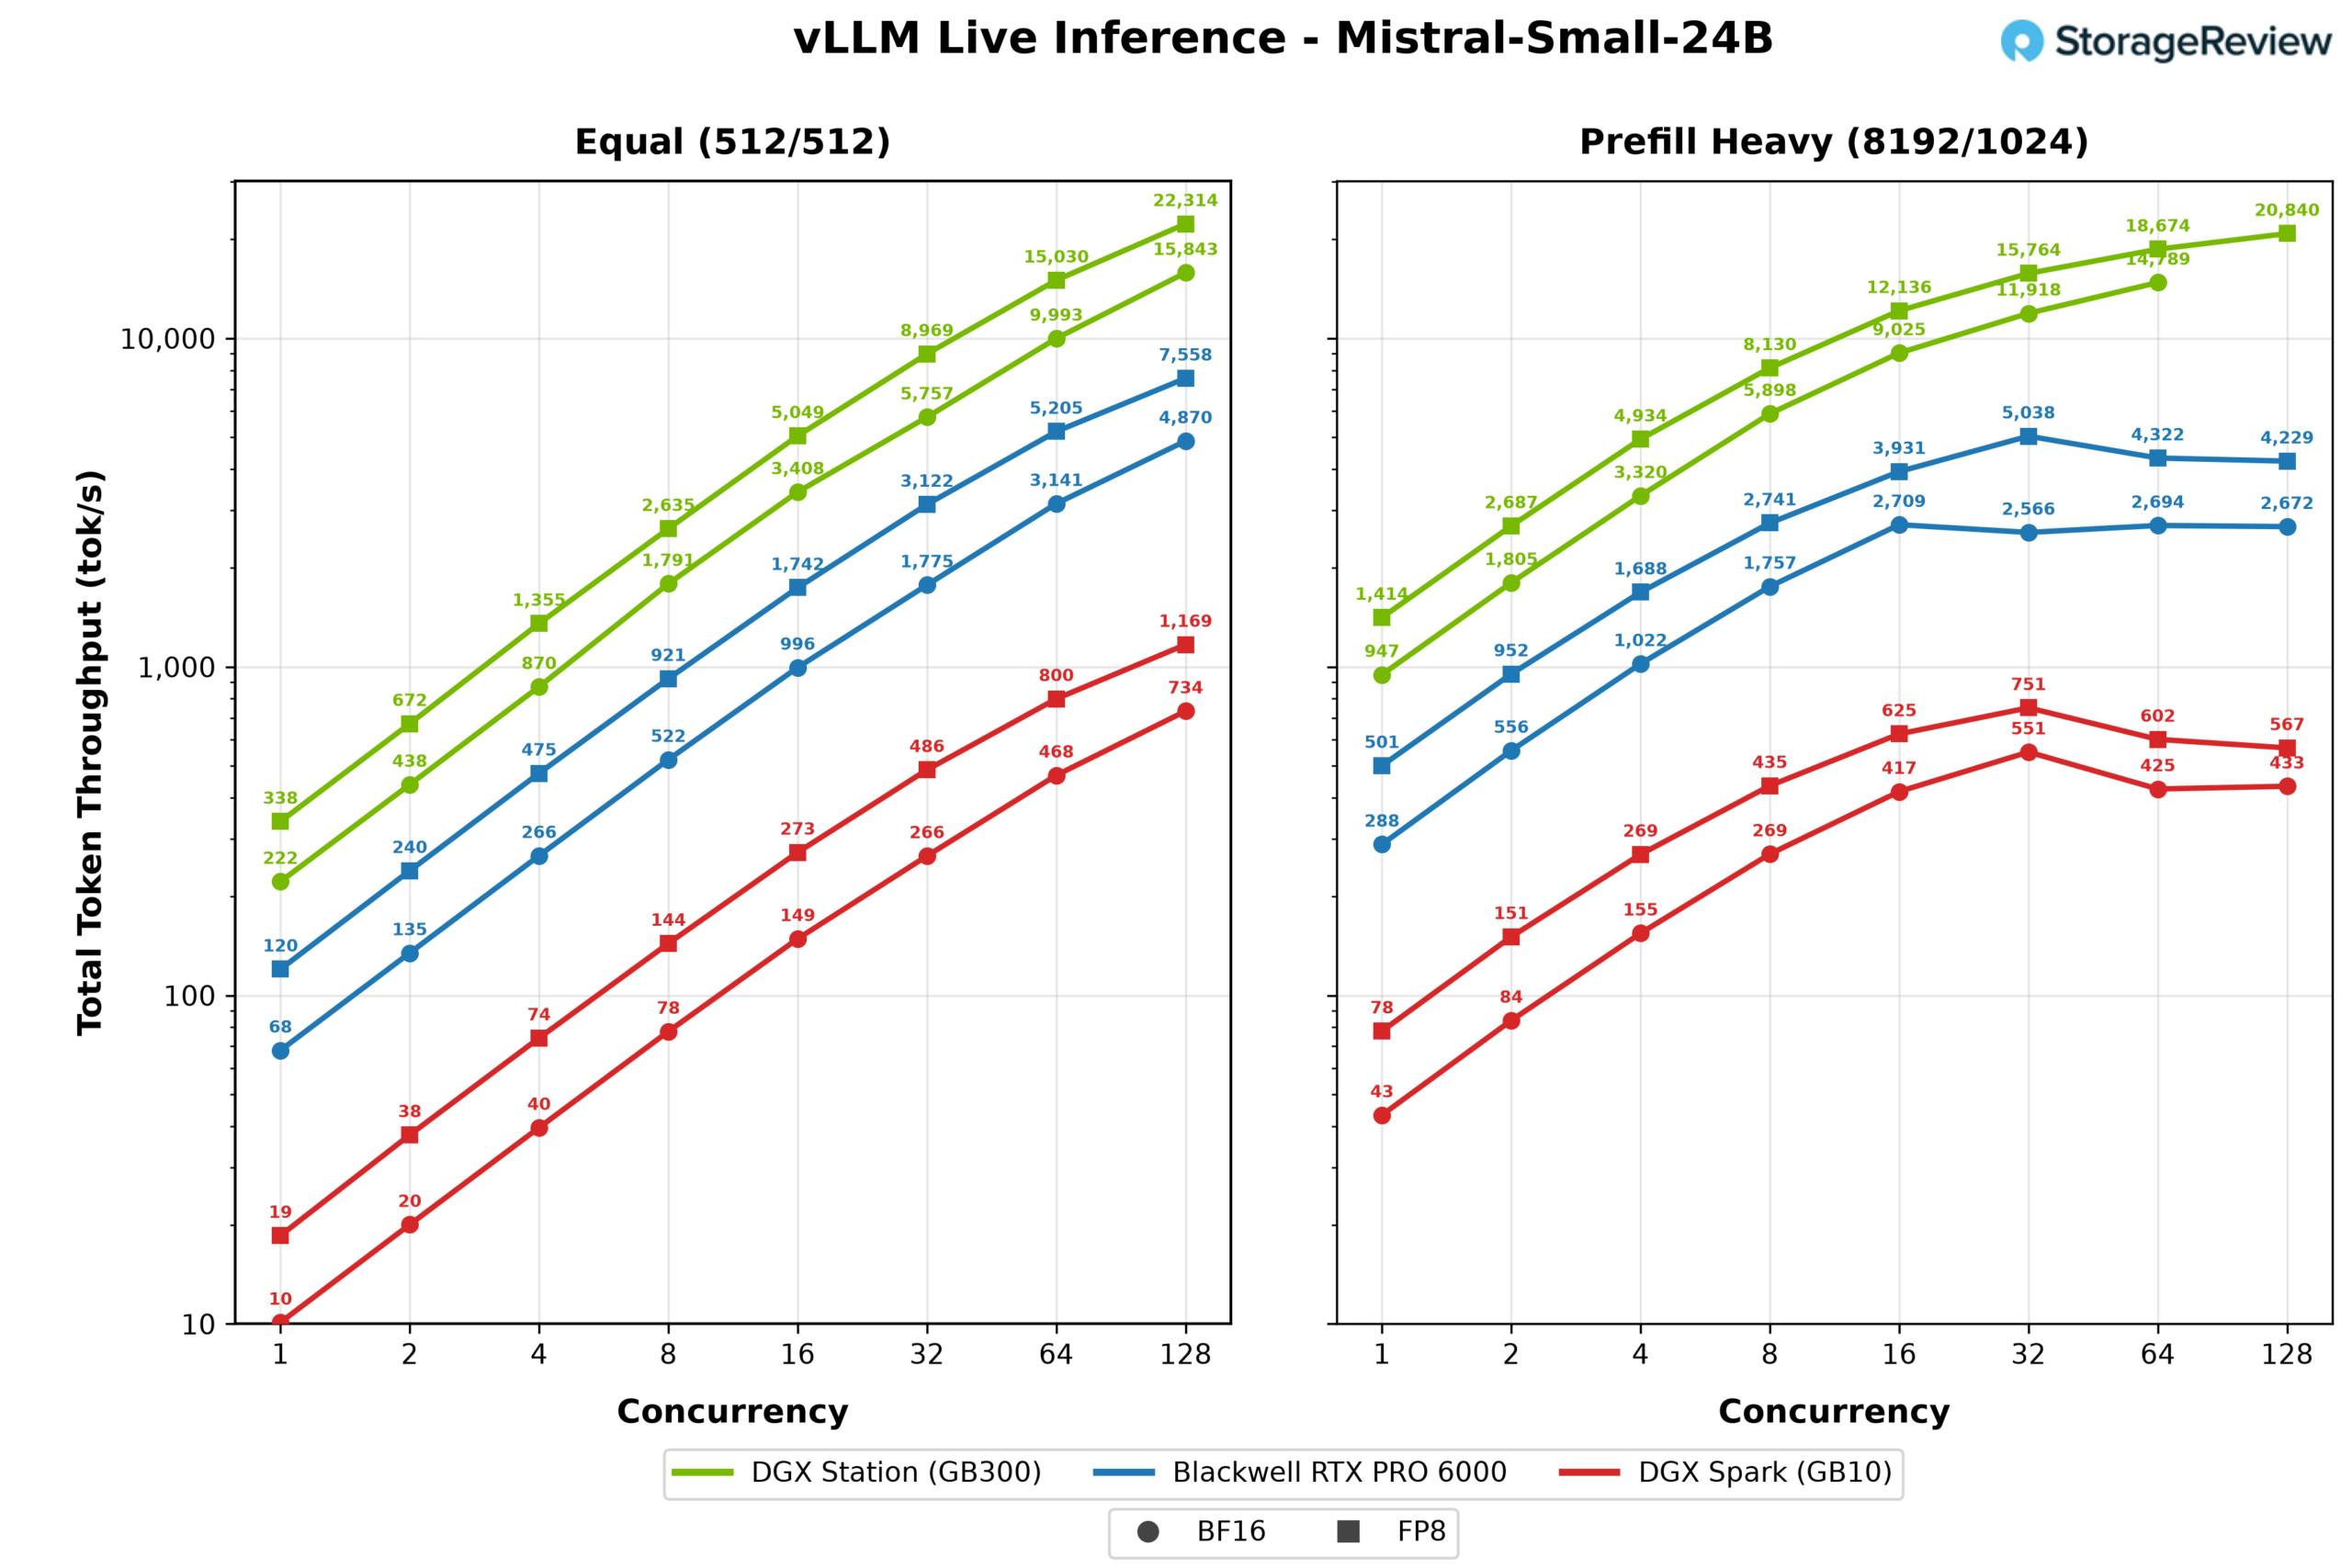
Mistral Small 24B wygenerował największe różnice w zestawie. W FP8, przy takim samym obciążeniu, WS300 osiągnął szczytową wydajność 11 157 tokenów wyjściowych na sekundę, trzy razy więcej niż RTX PRO 6000 (3,779) i 19 razy więcej niż DGX Spark (585). Przy pojedynczym strumieniu, 169 tokenów na sekundę w Stacji jest znacznie bliższe komfortowi interaktywnemu niż 9 tokenów w Spark.
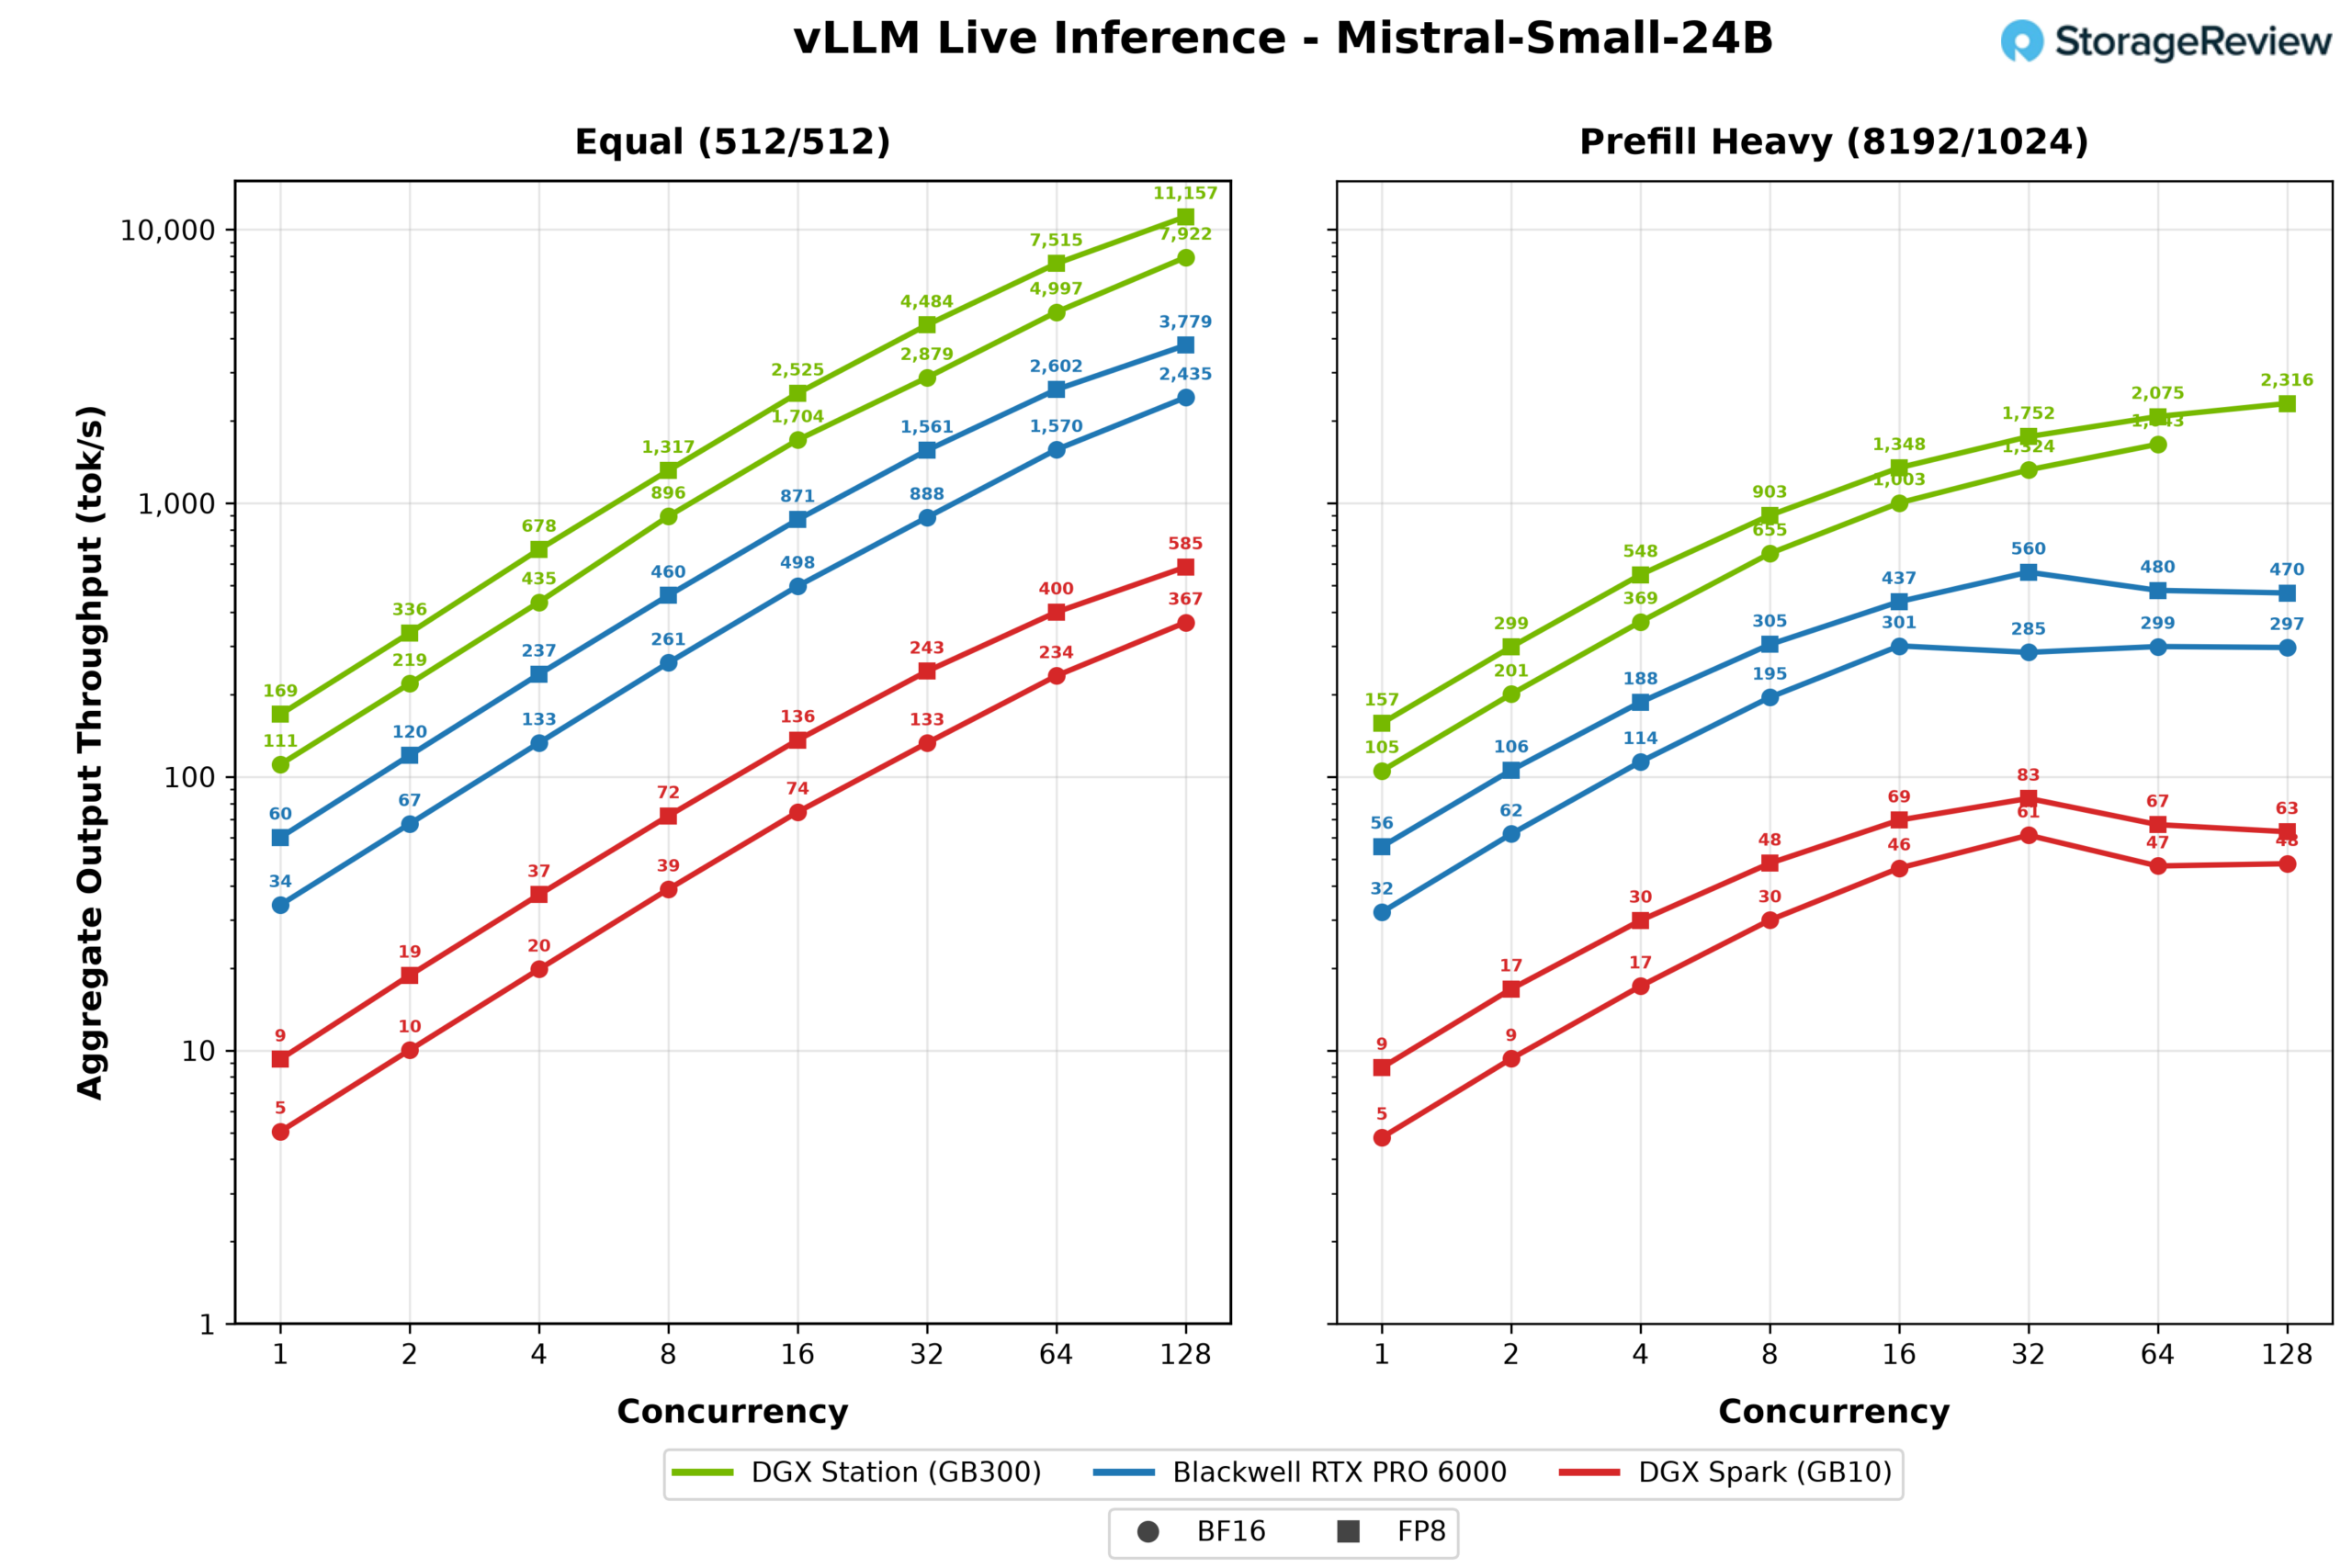
Przy dużym obciążeniu prefillem karta RTX PRO 6000 osiągnęła szczyt na poziomie zaledwie 32 równoczesnych strumieni i 560 tokenów wyjściowych na sekundę, po czym spadła, podczas gdy karta WS300 osiągnęła wynik 2,316 przy 128 strumieniach.
Koder Qwen3 30B
Qwen3 Coder 30B, model łączący w sobie funkcje eksperckie z niewielką liczbą aktywnych parametrów, to test, w którym mniejsze systemy niwelują lukę pojedynczego strumienia. Przy jednym współbieżnym żądaniu i takim samym obciążeniu, RTX PRO 6000 dostarczył 208 tokenów wyjściowych na sekundę, podczas gdy WS300 dostarczył 310 tokenów – to wynik najbardziej zbliżony do Stacji w tym porównaniu, a nawet Spark osiągnął użyteczne 55 tokenów. Przetwarzanie wsadowe przywraca normalny porządek: przy 128 strumieniach, 12 425 tokenów wyjściowych na sekundę w FP8 to 2.4 raza więcej niż w przypadku karty i prawie 16 razy więcej niż w przypadku Spark.
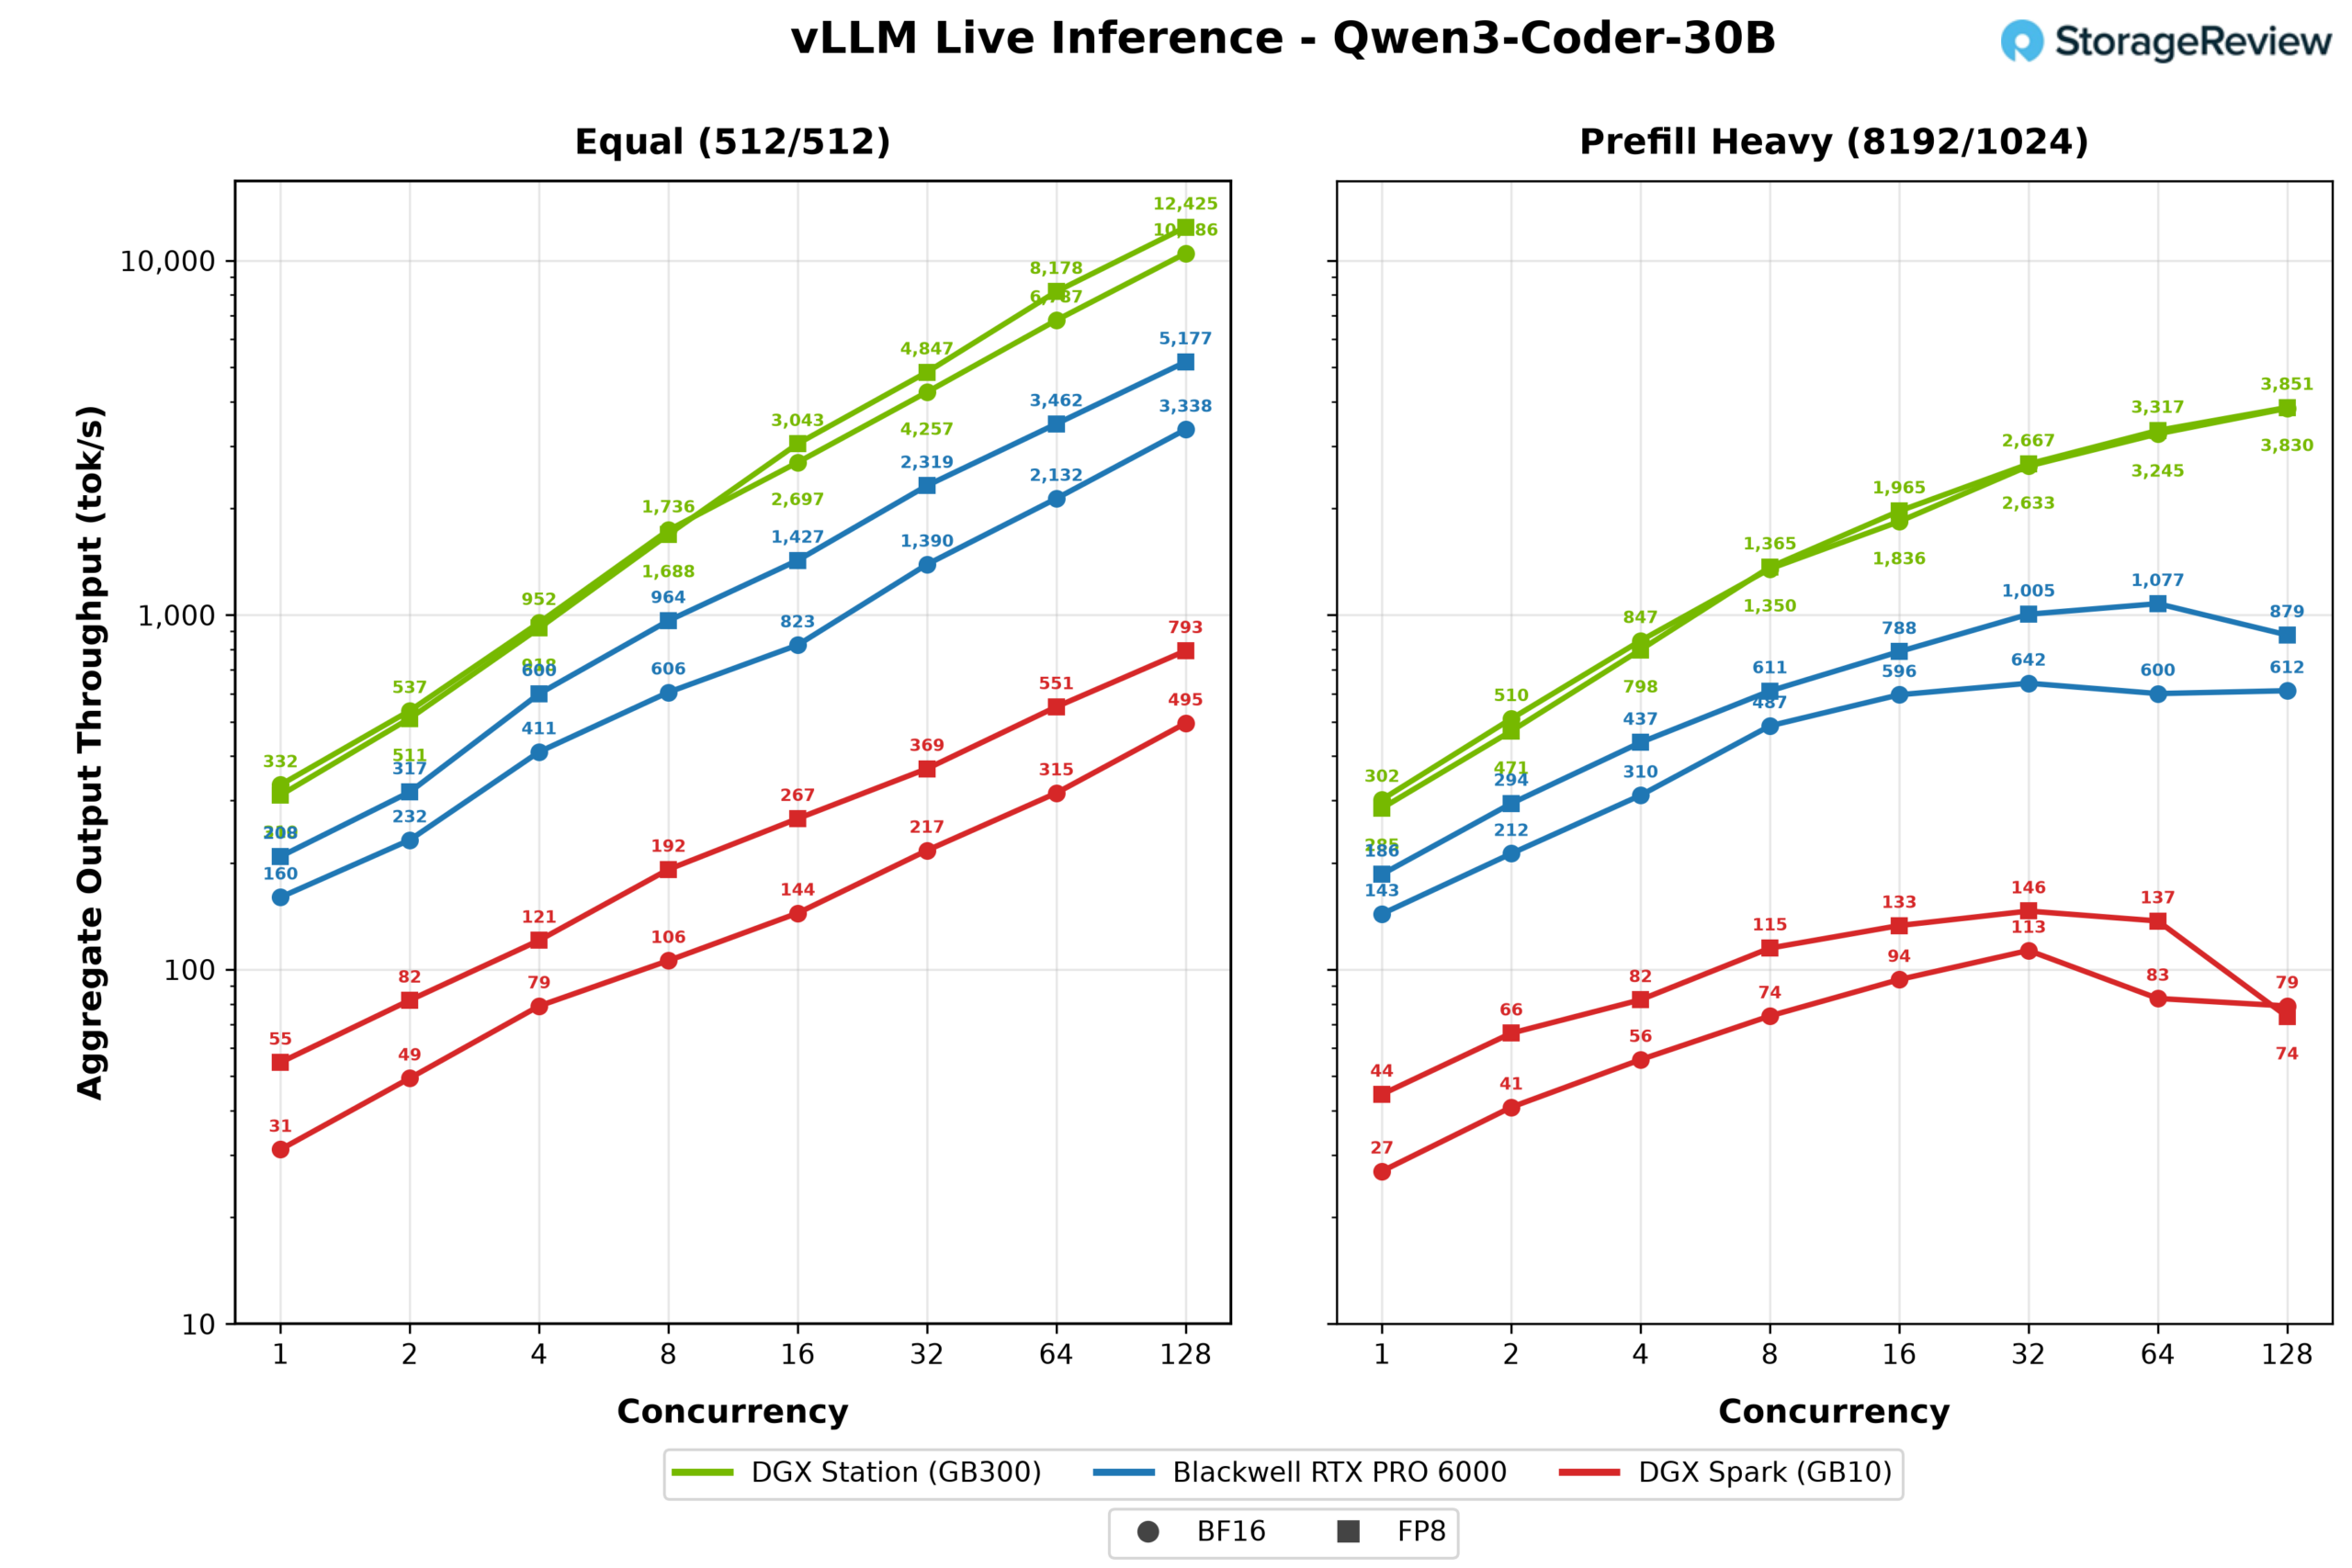
Wstępne wypełnianie przebiegało zgodnie z ustalonym schematem – WS300 osiągnął 3,851 tokenów wyjściowych na sekundę, podczas gdy karta osiągnęła szczyt na poziomie 1,077, a Spark na poziomie 146.
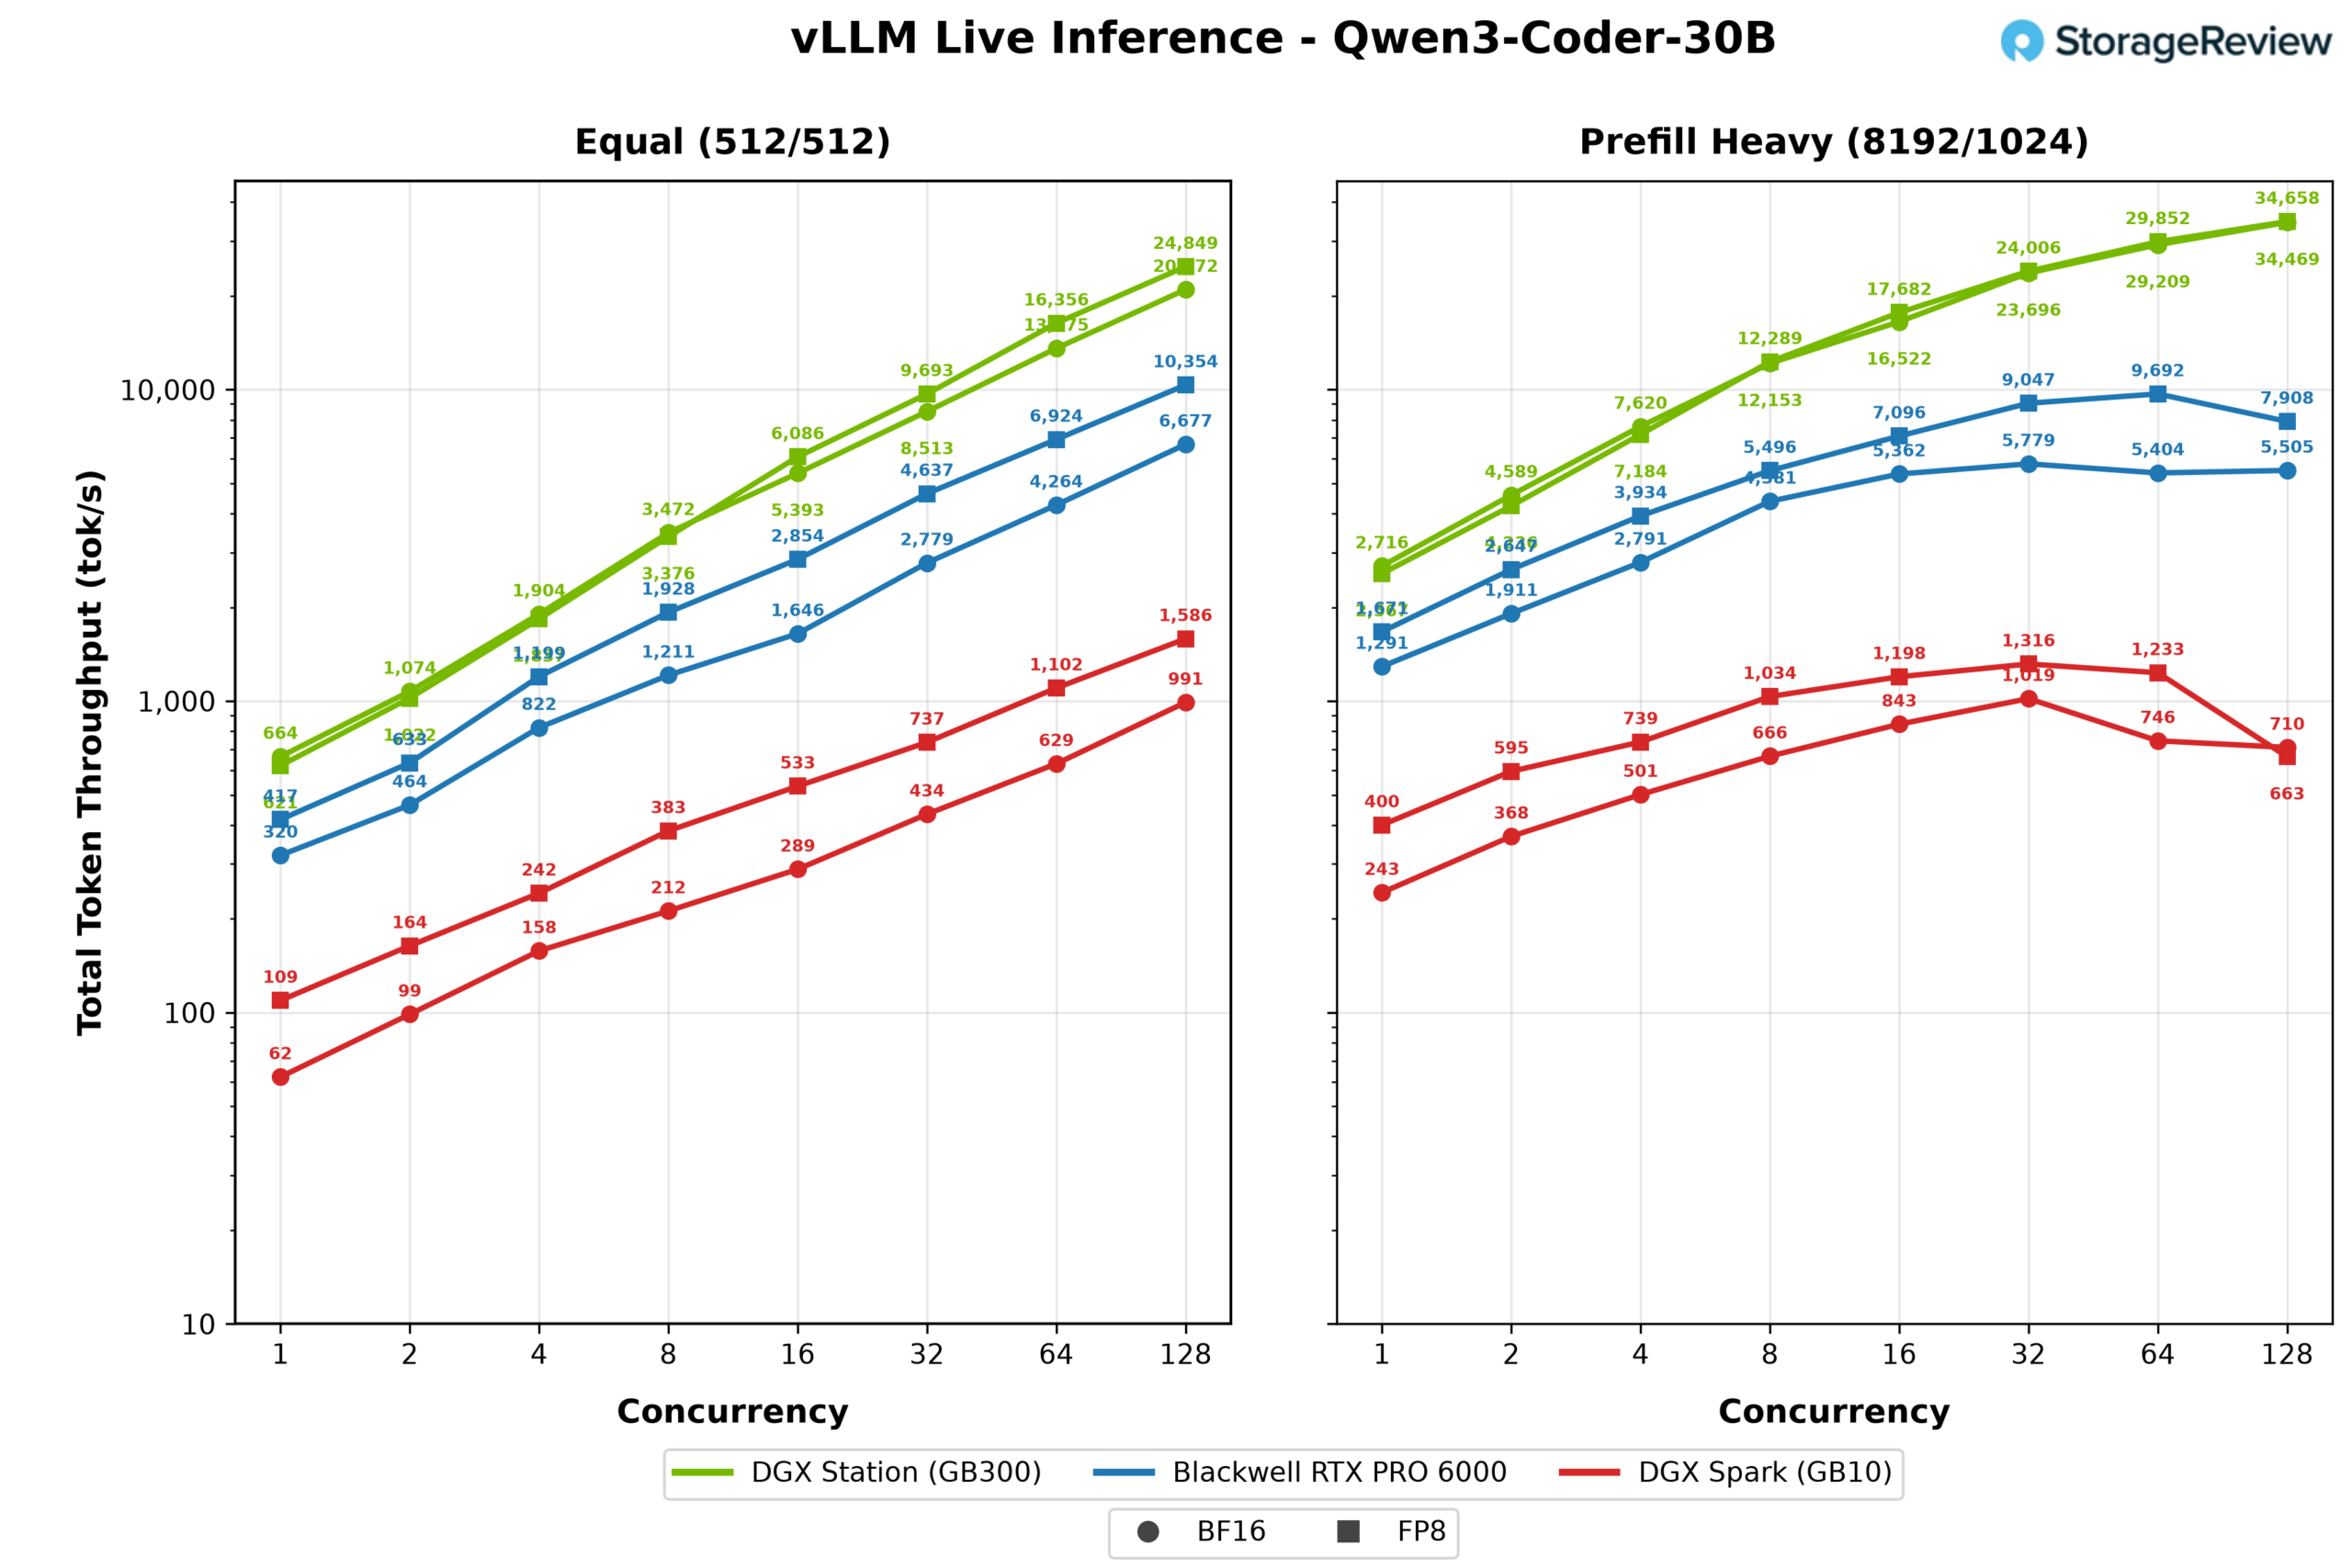
Wśród pięciu współdzielonych modeli, WS300 osiągnął od 2.3 do 3 razy większą przepustowość niż Blackwell RTX PRO 6000 i od 14 do 19 razy większą niż DGX Spark przy pełnej współbieżności, przy czym margines ten zwiększa się do 6 razy w porównaniu z kartą, gdy długie komendy obciążają pamięć podręczną KV. Wszystkie trzy maszyny korzystają z tego samego stosu CUDA i tych samych ścieżek kwantyzacji; to, co zyskuje Stacja, to pojemność pamięci i przepustowość, które są tu widoczne jako zapas współbieżności i tolerancja długiego kontekstu. Równie ważne jest to, czego te wykresy nie pokazują: żaden z modeli o skali granicznej w powyższych sekcjach nie załaduje się nawet na pozostałych dwóch systemach.
GDSIO
Nowoczesne obciążenia AI opierają się na przesyłaniu partii danych, wag modeli i punktów kontrolnych z pamięci masowej do pamięci GPU na tyle szybko, aby utrzymać akcelerator w ciągłym ruchu. Technologia NVIDIA GPUDirect Storage eliminuje tradycyjną ścieżkę dwóch kopii, w której dane są najpierw odczytywane z dysku SSD do pamięci systemowej, a następnie kopiowane do pamięci GPU.
Stacja GB300 DGX implementuje to inaczej niż konwencjonalny serwer GPU PCIe. Micron 4600 użyty w naszym teście jest podłączony do przełącznika PCIe zintegrowanego z ConnectX-8. ConnectX-8 łączy się z procesorem Grace w trybie upstream, natomiast procesor graficzny B300 łączy się z Grace przez NVLink-C2C. Dysk SSD i procesor graficzny nie znajdują się pod tym samym przełącznikiem PCIe. Ruch pamięci masowej przechodzi przez przełącznik ConnectX-8, wchodzi do głównego kompleksu PCIe Grace, przechodzi przez strukturę spójności Grace i przekracza NVLink-C2C, aby dotrzeć do HBM3e w B300.
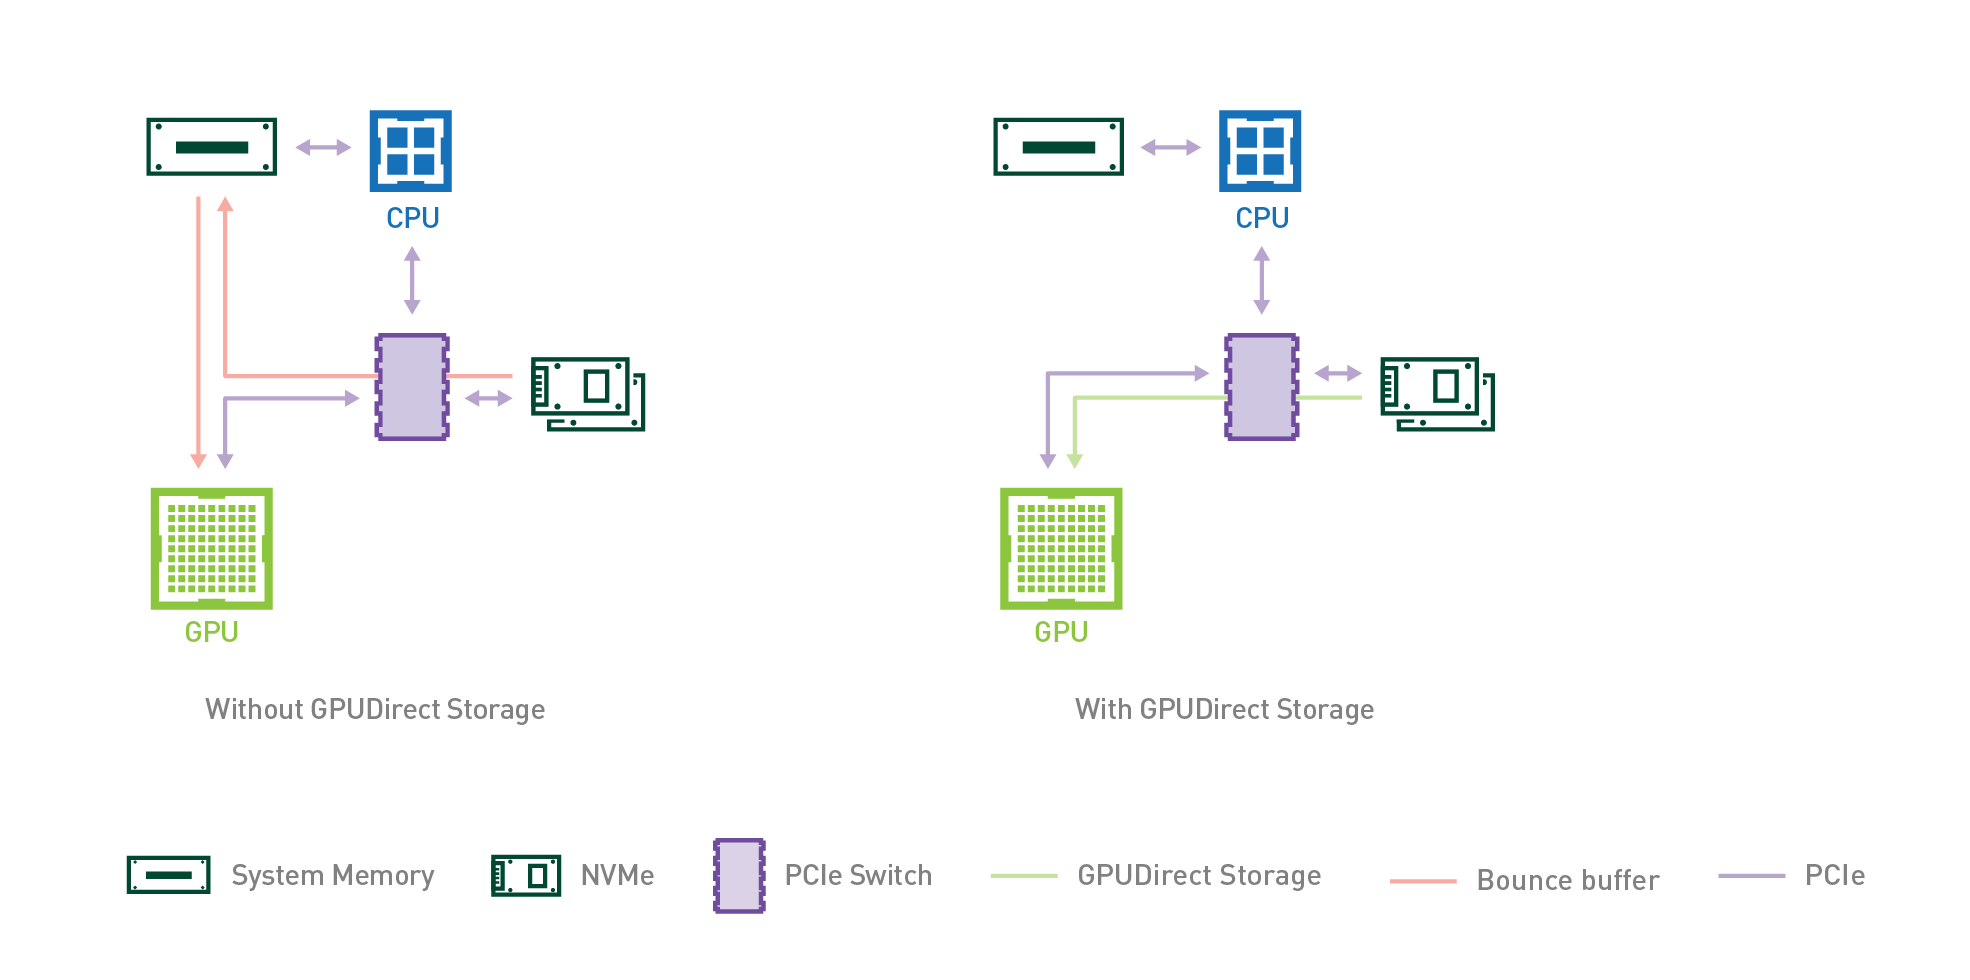
Dzięki GPUDirect Storage, cuFile rejestruje bufor przydzielony w B300 HBM3e jako źródło lub miejsce docelowe dla operacji wejścia/wyjścia pamięci masowej. Podczas odczytu kontroler Micron 4600 używa DMA do umieszczenia danych w HBM3e; podczas zapisu pobiera dane z HBM3e. Obie operacje podążają ścieżką Grace i NVLink-C2C opisaną powyżej bez umieszczania ładunku w pamięci LPDDR5X Grace. Grace nadal zarządza systemem plików i płaszczyzną sterowania NVMe, w tym przesyłaniem poleceń i translacją adresów, ale nie kopiuje danych. GPUDirect Storage eliminuje zatem etap umieszczania danych w pamięci systemowej, mimo że ruch nadal przechodzi przez Grace w drodze między dyskiem SSD a pamięcią B300. W przypadku obciążeń AI sekwencyjne odczyty odpowiadają strumieniowaniu zestawów danych, ładowaniu modeli i przywracaniu punktów kontrolnych, podczas gdy sekwencyjne zapisy odpowiadają zapisywaniu punktów kontrolnych i innym transferom z powrotem do pamięci masowej. W celu przetestowania wydajności GDSIO zmierzyliśmy wydajność pamięci masowej, wykorzystując jeden samodzielny dodatkowy dysk SSD.
Konfiguracja testowania GDSIO
- Pamięć rozruchowa: 2 x Micron 4600 2TB w RAID1
- Pamięć dodatkowa: 2 x Micron 4600 2TB
Patrząc na wydajność sekwencyjnego odczytu GDSIO, jednostka skaluje się spójnie zarówno pod względem liczby wątków, jak i rozmiaru bloku. Przy 16 KB przepustowość wzrasta z 16 MiB/s przy 1 wątku do 250 MiB/s przy 16 wątkach, osiągając 2.0 GiB/s przy 128 wątkach. Większe rozmiary bloków rosną znacznie szybciej – 256 KB osiąga 11.8 GiB/s przy 64 wątkach i osiąga szczyt 12.9 GiB/s przy 128 wątkach. Najsilniejsze wyniki występują przy 512 KB i 1 MB, gdzie przepustowość osiąga szczyt na poziomie 13.1 GiB/s, a obciążenie 1 MB osiąga ten poziom przy zaledwie 32 wątkach i utrzymuje go przez 128 wątków.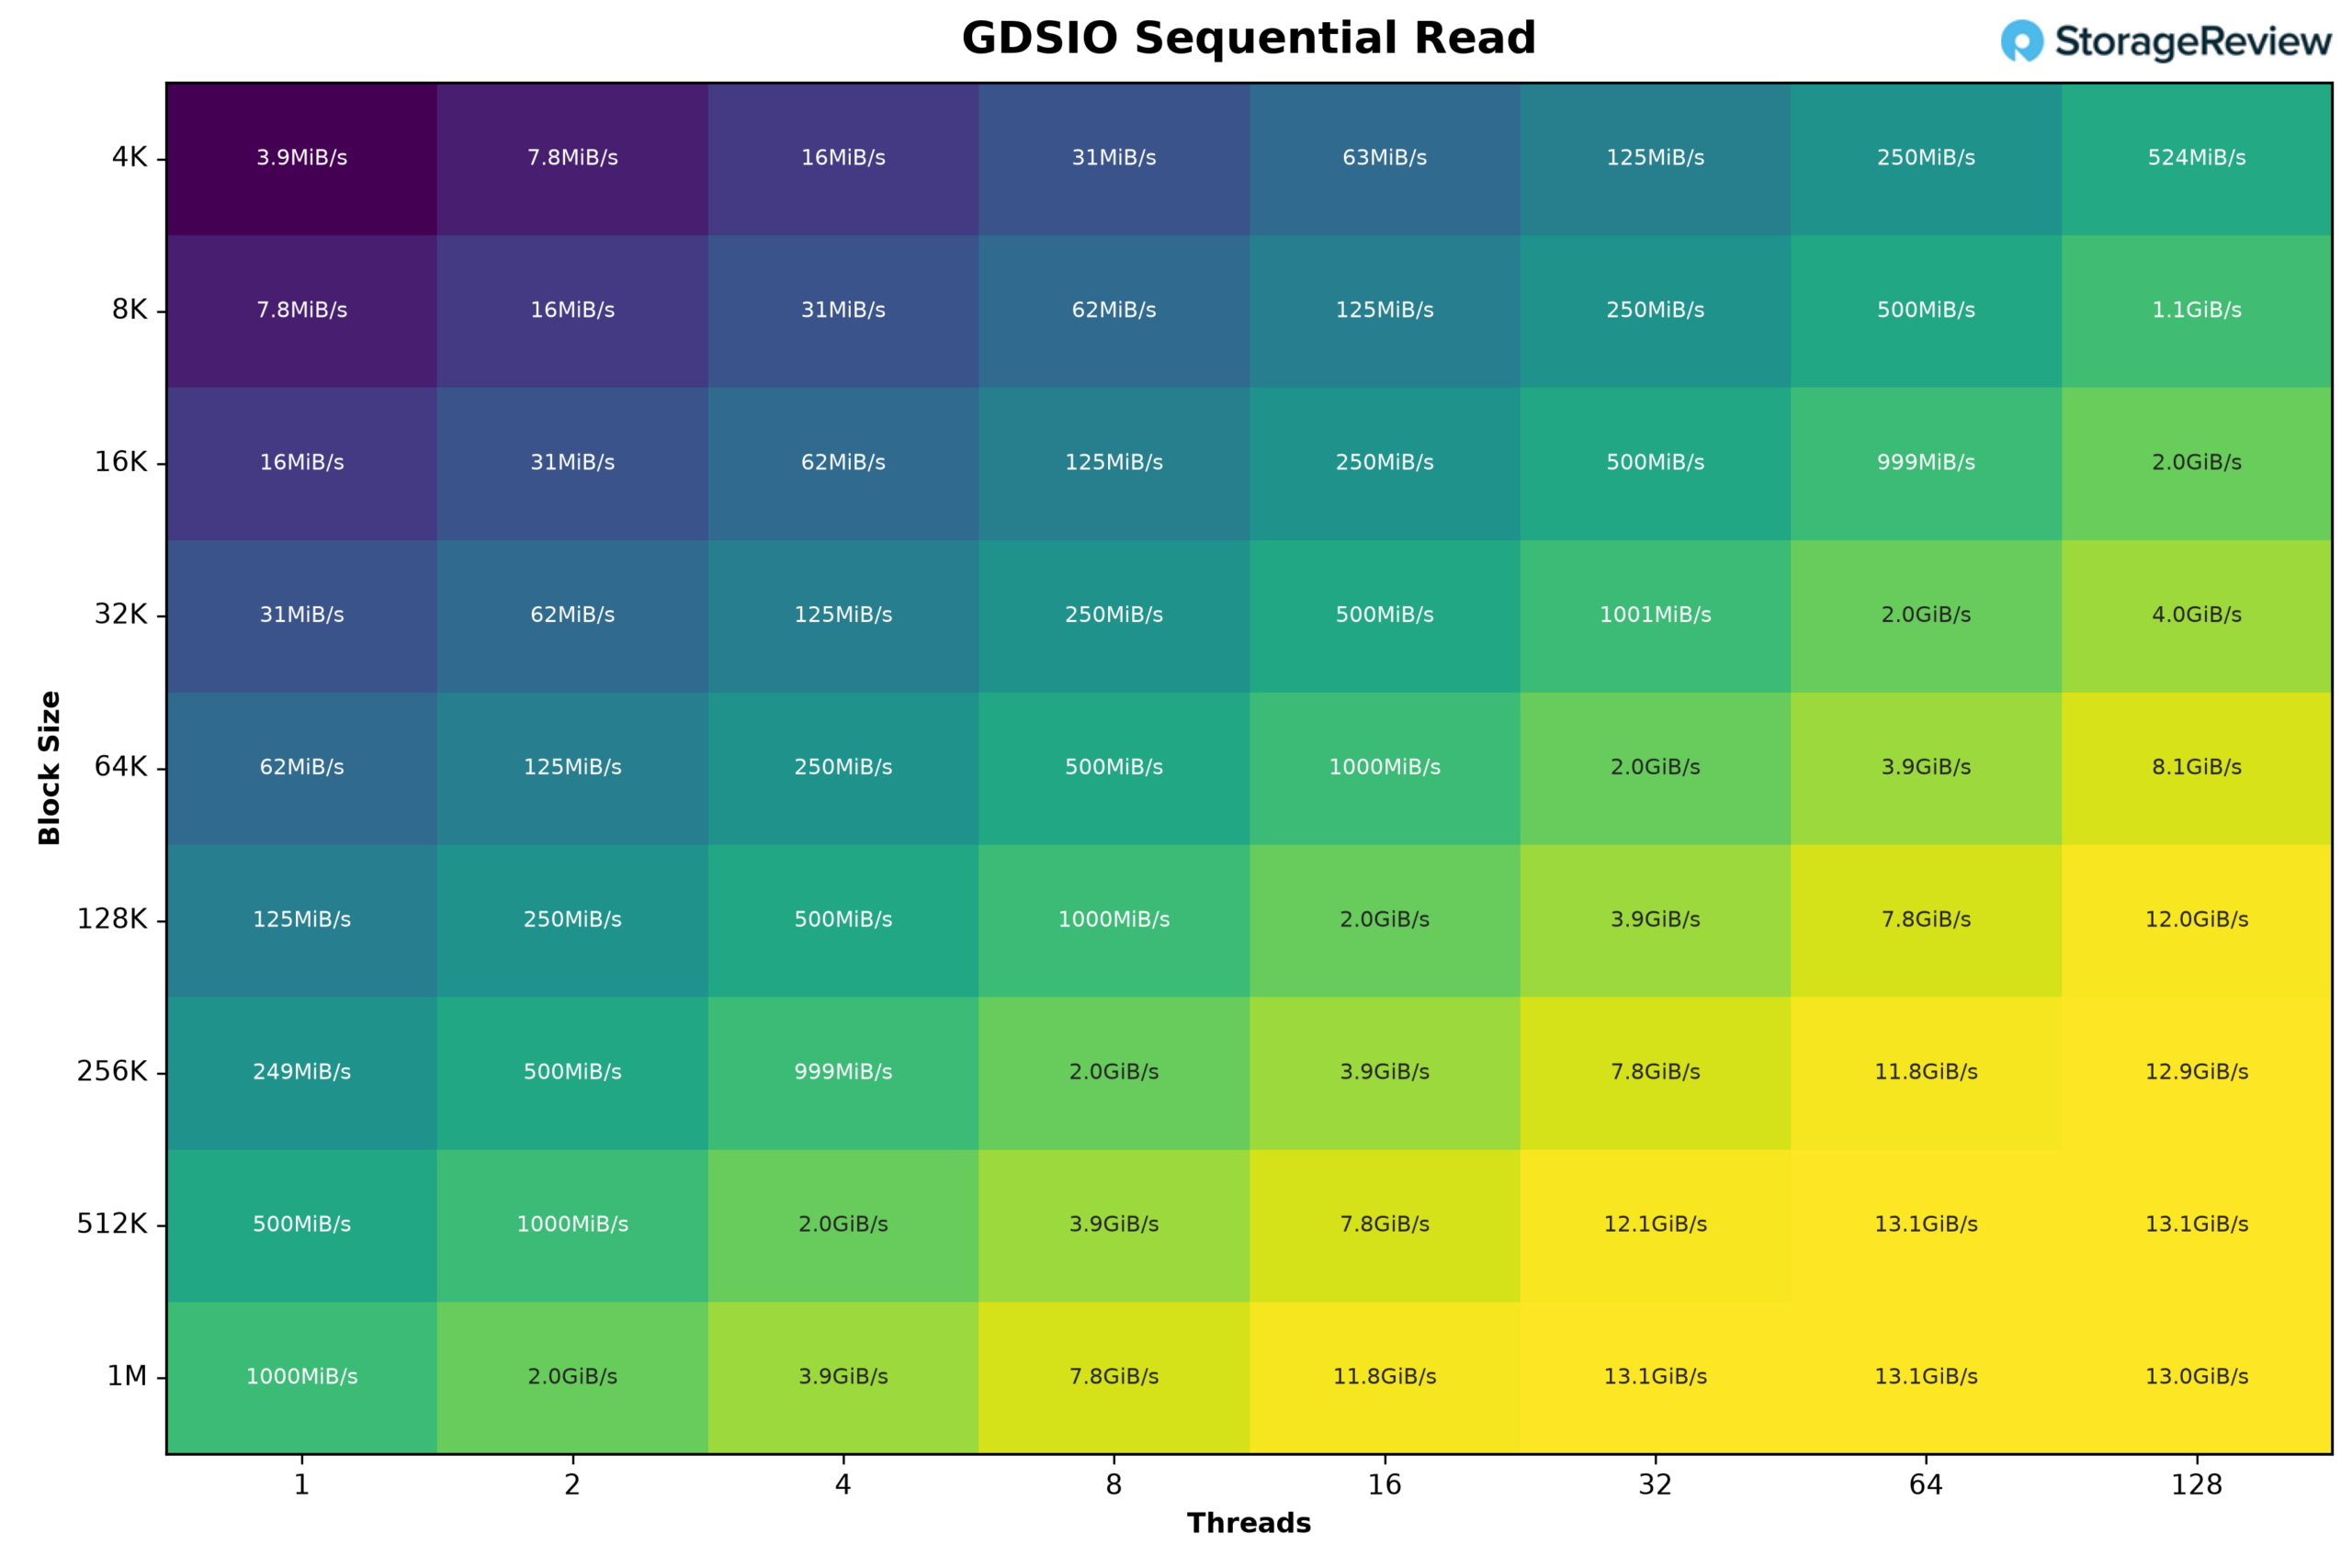
Przechodząc do wydajności zapisu sekwencyjnego GDSIO, jednostka skaluje się spójnie zarówno pod względem liczby wątków, jak i rozmiaru bloku. Przy 16 KB przepustowość wzrasta z 16 MiB/s przy 1 wątku do 250 MiB/s przy 16 wątkach, osiągając 2.0 GiB/s przy 128 wątkach. Większe rozmiary bloków rosną znacznie szybciej – 256 KB osiąga 7.5 GiB/s przy 32 wątkach i 12.0 GiB/s przy 64 wątkach. Najsilniejszy wynik uzyskuje się przy obciążeniu 1 MB, które osiąga pułap 12.0 GiB/s przy zaledwie 16 wątkach i utrzymuje tę wydajność przez 128 wątków. 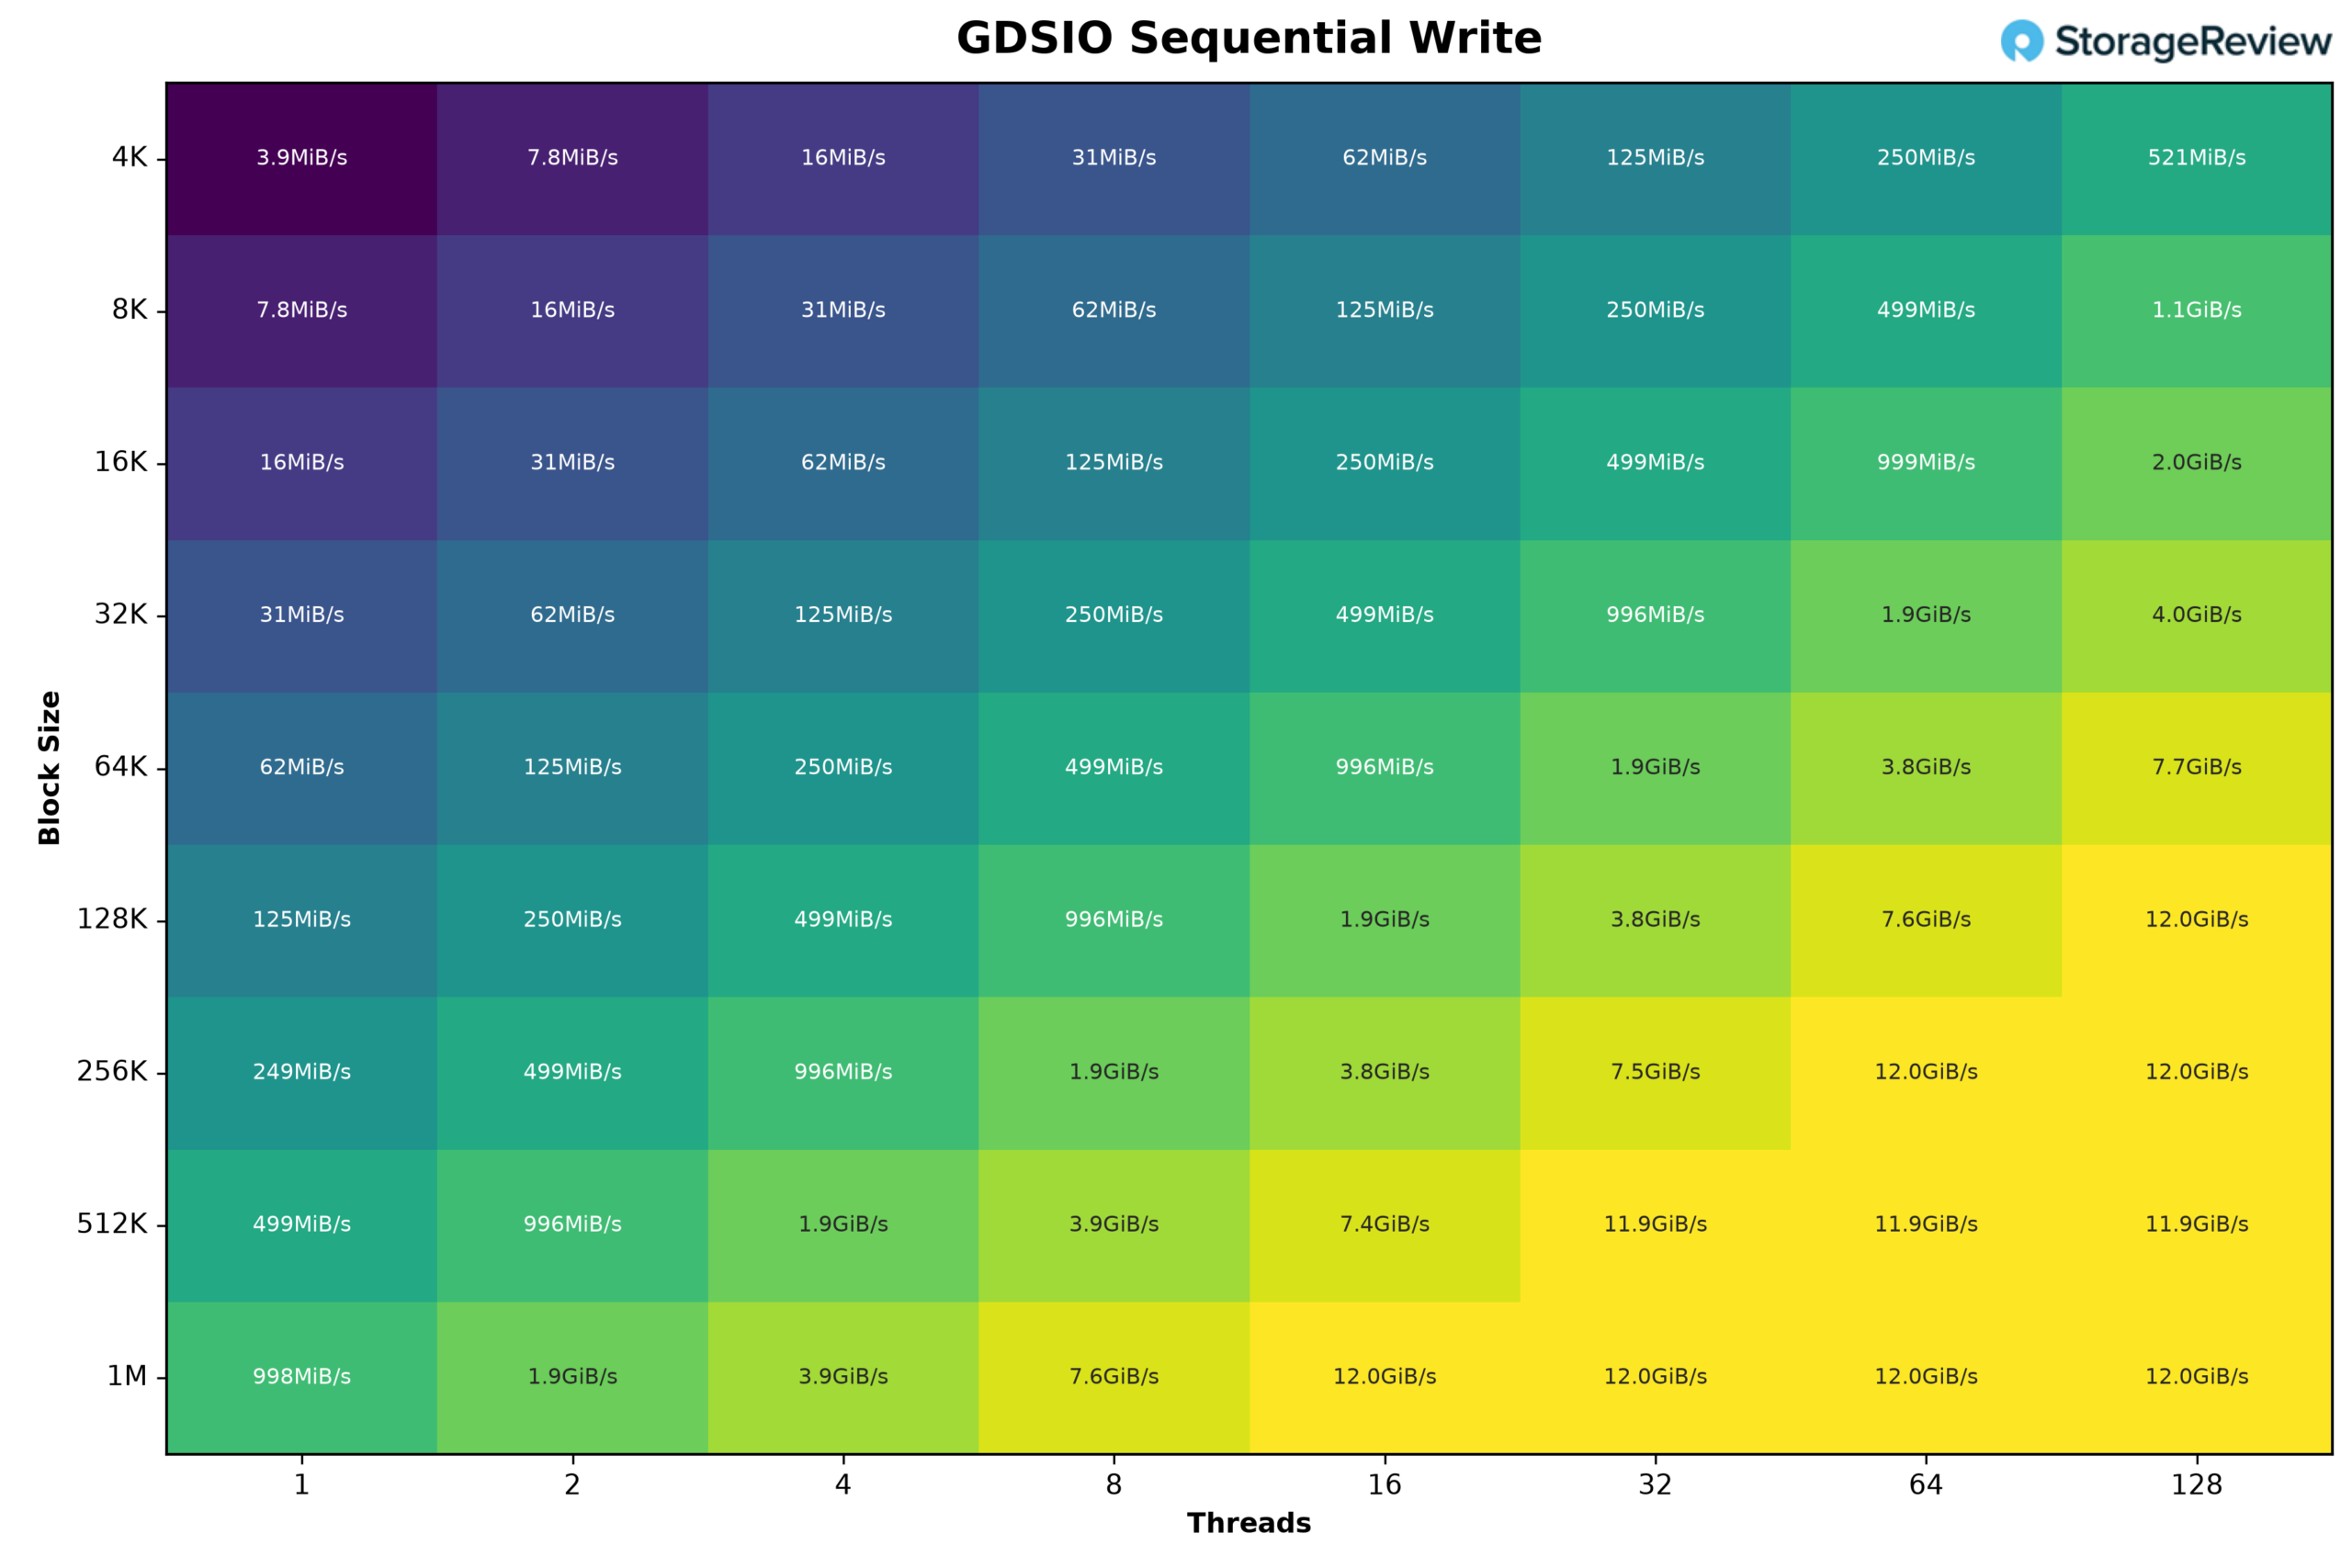
Dla kogo przeznaczony jest MSI XpertStation WS300?
WS300 jest przeznaczony dla organizacji, które potrzebują bezpośredniego dostępu do Blackwell Ultra, ale nie chcą, aby każdy eksperyment rozpoczynał się od rezerwacji klastra lub żądania chmury. Laboratoria sztucznej inteligencji, programiści silników wnioskowania, zespoły frameworków i kompilatorów, grupy robotyki oraz korporacyjne zespoły AI mogą używać go jako lokalnego węzła programistycznego dla powyższych przepływów pracy. MIG umożliwia programistom testowanie i tworzenie oprogramowania w konfiguracji z wieloma procesorami graficznymi, a BMC umożliwia zdalne zarządzanie systemem.
Ma to również sens dla doświadczonych programistów AI, którzy potrzebują systemu gotowego do pracy. Wartość to nie tylko B300. To cała platforma wokół niego: 252 GB pamięci HBM3e, Grace i 496 GB pamięci LPDDR5X, ConnectX-8, zdublowana pamięć rozruchowa, chłodzenie cieczą, zdalne zarządzanie i wsparcie MSI w jednej obudowie. Praktyczne ograniczenia to host ARM, wymóg dedykowanego obwodu 20 A oraz współdzielony budżet 1,600 W w przypadku instalacji dużej karty RTX PRO.
Maksymalne wykorzystanie możliwości stacji roboczej WS300 zależy również od oprogramowania, które ją obsługuje. Firma NVIDIA udostępnia bogaty zbiór podręczników i poradników wdrożeniowych, które mają pomóc zespołom w szybkim uruchomieniu systemu i uruchomieniu jego zasobów. W kolejnych artykułach omówimy kilka z tych narzędzi, w tym Brev, który może uprościć współdzielony dostęp do stacji roboczej i poprawić jej wykorzystanie, dzięki czemu tak kosztowne zasoby nie będą bezczynne.
Jeśli chodzi o cenę, MSI jej nie opublikowało, a maszyny tej klasy rzadko mają cenę katalogową; to ważna rozmowa z zespołem sprzedaży, a nie przycisk „Dodaj do koszyka”. Uczciwe porównanie nie dotyczy innych stacji roboczych, ale tego, za co zespół ds. sztucznej inteligencji już płaci: zarezerwowany czas klastra, zobowiązania dotyczące GPU w chmurze i koszt oczekiwania na współdzielonym sprzęcie.
Wniosek
MSI XpertStation WS300 to najwydajniejsza stacja robocza, jaką kiedykolwiek testowaliśmy, i rzadki produkt, który zmienia to, czego może dokonać pojedynczy użytkownik. Punkty kontrolne o skali pionierskiej, które normalnie znajdują się za rezerwacją klastra – GLM-5.2 o pojemności 433 GB, Nemotron-3-Ultra o 550 miliardach parametrów – ładują się i obsługują na komputerze stojącym obok biurka, w sposób prywatny i zawsze dostępny. To właśnie źródło naszego entuzjazmu dla tego systemu.
Stacja DGX jest skierowana do deweloperów: programistów jądra, którzy koncentrują się na Blackwell Ultra, zespołów zajmujących się silnikami wnioskowania i frameworkami, grup zajmujących się robotyką, które uruchamiają pełną pętlę Isaac, a także użytkowników sfrustrowanych planowaniem eksperymentów na współdzielonym sprzęcie. Poza tą niszą argumenty przemawiające za zakupem tych systemów są dość ograniczone. Host Arm wyklucza niektóre zestawy narzędzi; obwód 20 A jest wymagany do instalacji w obwodach 120 V; nie ma wyjścia wyświetlacza bez karty rozszerzeń; a stacja robocza RTX PRO 6000 kosztuje znacznie mniej, umożliwiając pracę pojedynczego użytkownika na modelach mieszczących się w jej 96 GB pamięci.
Ekonomia również ogranicza odpowiednią wielkość wdrożenia. Jeden serwer WS300 łatwo uzasadnić kosztem zarezerwowanego czasu klastra, a para na zespół nadal jest uzasadniona. Dalsze łączenie w stosy przestaje mieć sens w pewnym momencie: na przykład, gdy organizacja kupuje cztery wieże GB300, te same pieniądze są w zasięgu ośmioprocesorowego serwera B300 z większą pamięcią na GPU, gęstszym partycjonowaniem MIG i łączem NVLink między każdym GPU. Optymalnym rozwiązaniem jest jeden serwer na biurku, ewentualnie dwa w laboratorium, uzupełniające inwestycję w centrum danych.
NVIDIA dostarcza płytę bazową, więc rozróżnienie między producentami OEM sprowadza się do implementacji, a wykonanie MSI jest tutaj solidne. Pętla cieczowa o mocy 1,400 W chłodzi B300, Grace, SOCAMM i ConnectX-8, a platforma pozostała stabilna podczas testów. To dogłębne spojrzenie jest teraz opublikowane: nasza dogłębna analiza termiczna WS300 łączy dane MSI dotyczące płyty chłodzącej i radiatora z 2.8-godzinnym pomiarem, pokazującym, że rdzeń utrzymywany jest w temperaturze 60°C i płaskim taktowaniu 2.07 GHz przy pełnym obciążeniu. Budżet mocy 1,600 W jest automatycznie rozdzielany na komponenty, a kiedy testowaliśmy sprzętowy hamulec zasilania z uszkodzonym połączeniem, zamiast się wyłączyć, nastąpiło jego dławienie. Wstępnie okablowany przewód 12 VHPWR i wspornik antypoślizgowy obsługują ścieżkę rozszerzeń RTX PRO. Po przetestowaniu pierwszej stacji GB300 DGX, która do nas dotarła, możemy powiedzieć, że XpertStation WS300 stawia wysoko poprzeczkę platformie.
XpertStation WS300 jest obecnie posiadaczem gniazda na najlepszy system GB300 w naszym rankingu najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji i zajmuje czołowe miejsce w dyskusji na temat pamięci w naszym przewodniku RAM, GPU i pamięć masowa do agentowej sztucznej inteligencji .


 Amazon