

Środowisko chmurowe przechodzi obecnie znaczącą transformację. W ciągu ostatniego roku firmy o dużej skali, takie jak Amazon Web Services (AWS), Google Cloud i Microsoft Azure, znacząco zwiększyły swoje inwestycje w niestandardowe układy scalone. Rosnąca liczba firm z branży sztucznej inteligencji wchodzących na rynek układów scalonych stale rośnie.
Ten gwałtowny wzrost rozwoju chipów zmienia oblicze centrów danych, obiecując nowe poziomy wydajności, efektywności i zróżnicowania. Podczas gdy typowi producenci chipów tworzą procesory i akceleratory dla masowego odbiorcy, ci nowi gracze projektują chipy specjalnie pod kątem wymagających zadań AI.
Projekt chipa
Motywacja do tworzenia niestandardowych układów scalonych wynika z niemożności dotrzymania kroku wymaganiom hiperskalowych obciążeń chmurowych dostępnym na rynku procesorom i akceleratorom. W szczególności sztuczna inteligencja i uczenie maszynowe napędzają wzrost gęstości obliczeniowej, niższe opóźnienia i wyższe wymagania dotyczące efektywności energetycznej. Firmy hiperskalowe reagują na to, tworząc układy scalone dostosowane do swojej infrastruktury i potrzeb klientów. Nowi gracze wkraczają na rynek coraz szybciej, a procesory i akceleratory są reklamowane jako „najszybsze”, „najtańsze” lub „najlepsze” w branży.
Oczywiście, nie jest to nowe zjawisko. Dostawcy usług w chmurze od wielu lat tworzą niestandardowy sprzęt sieciowy, urządzenia pamięci masowej i serwery. Jednak projektowanie procesorów to zupełnie inna bajka.
Kim są gracze?
To nie jest pełna lista. Obecnie są to główni gracze na tym polu. Uwzględniliśmy również nowych dostawców, wnoszących swój wyjątkowy akcent do świadczenia usług opartych na sztucznej inteligencji.
AWS
Seria Graviton firmy Amazon , obecnie w czwartej generacji, wyznacza trendy w dziedzinie procesorów ARM w chmurze, oferując znaczący wzrost wydajności na wat w porównaniu z tradycyjnymi rozwiązaniami x86. AWS wprowadził również niestandardowe akceleratory AI, takie jak Inferentia i Trainium , przeznaczone do wnioskowania i trenowania obciążeń na dużą skalę.
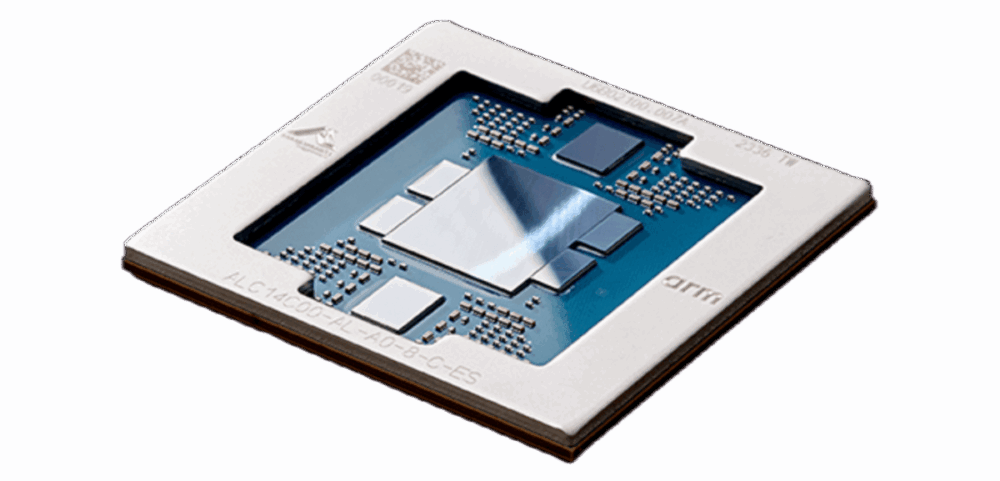
Według strony internetowej AWS, Anthropic zasugerował, że AWS będzie jego głównym partnerem szkoleniowym i będzie korzystał z AWS Trainium do szkolenia i wdrażania swoich największych modeli bazowych. Mówi się również, że Amazon zainwestuje dodatkowe 4 miliardy dolarów w Anthropic.
Tymczasem Google nadal przesuwa granice dzięki swoim procesorom Tensor Processing Units (TPU), które napędzają obecnie niektóre z największych modeli sztucznej inteligencji w produkcji. Najnowsze architektury TPU v5 i Ironwood firmy zostały zaprojektowane z myślą o masowym paralelizmie i są ściśle zintegrowane z infrastrukturą centrów danych Google.

Lazur
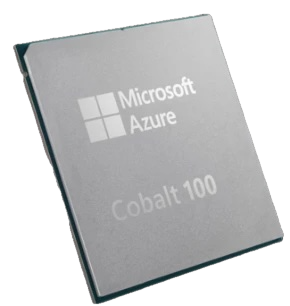
Microsoft nie pozostaje daleko w tyle, prezentując niedawno swoje niestandardowe układy sztucznej inteligencji – Azure Maia i Azure Cobalt – zoptymalizowane pod kątem sztucznej inteligencji i obciążeń ogólnego przeznaczenia. Układy te są już wdrażane w centrach danych Microsoftu, obsługując wszystko, od dużych modeli językowych po podstawowe usługi chmurowe.
Dostawcy usług komunikacyjnych nie są sami
Choć niekoniecznie są to dostawcy usług w chmurze, na rynku rozwoju układów scalonych działają również inni gracze. Firmy te również dostrzegają korzyści płynące z projektowania układów scalonych: niższe koszty, wydajność, zarządzanie i własność.
Groq
Groq oferuje platformę wnioskowania AI opartą na autorskiej jednostce przetwarzania języka (LPU) i infrastrukturze chmurowej. Oferuje wysoką wydajność przy niskich kosztach dla popularnych modeli AI.
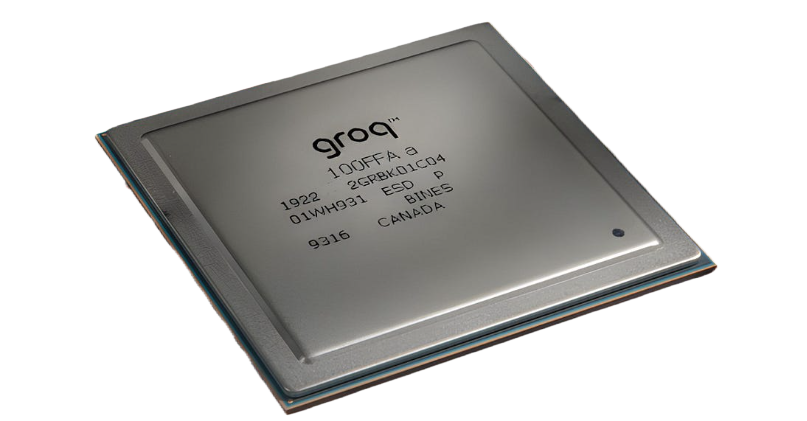
W przeciwieństwie do procesorów graficznych zaprojektowanych do grafiki, jednostka LPU jest zoptymalizowana pod kątem wnioskowania AI i zadań językowych. Groq oferuje jednostkę LPU za pośrednictwem platformy GroqCloud™ i rozwiązań lokalnych, zamiast pojedynczych układów scalonych.
Systemy SambaNova
Firma SambaNova Systems stworzyła platformę AI dostosowaną do złożonych obciążeń. Opiera się ona na systemie DataScale® i niestandardowych układach Reconfigurable Dataflow Unit (RDU) zoptymalizowanych pod kątem obliczeń przepływu danych.
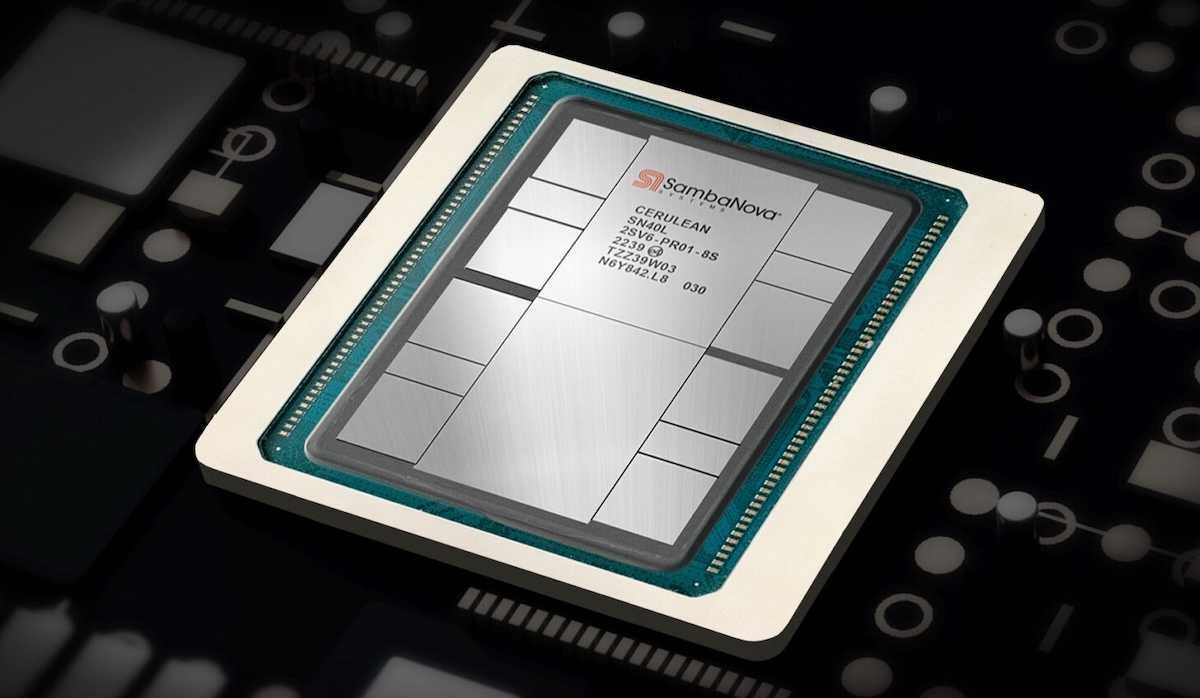
Firma oferuje wstępnie wyszkolone modele podstawowe oraz pakiet SambaNova Suite, który łączy sprzęt, oprogramowanie i modele, umożliwiając szybkie wdrażanie sztucznej inteligencji, szczególnie w finansach i opiece zdrowotnej.
mózgi
Cerebras jest znany ze swojej platformy wnioskowania i szkolenia AI, która wykorzystuje silnik Wafer-Scale Engine (WSE) . Dzięki licznym rdzeniom zoptymalizowanym pod kątem AI i wbudowanej pamięci, ten duży układ pozwala systemom Cerebras obsługiwać złożone modele, które stanowią wyzwanie dla tradycyjnego sprzętu.
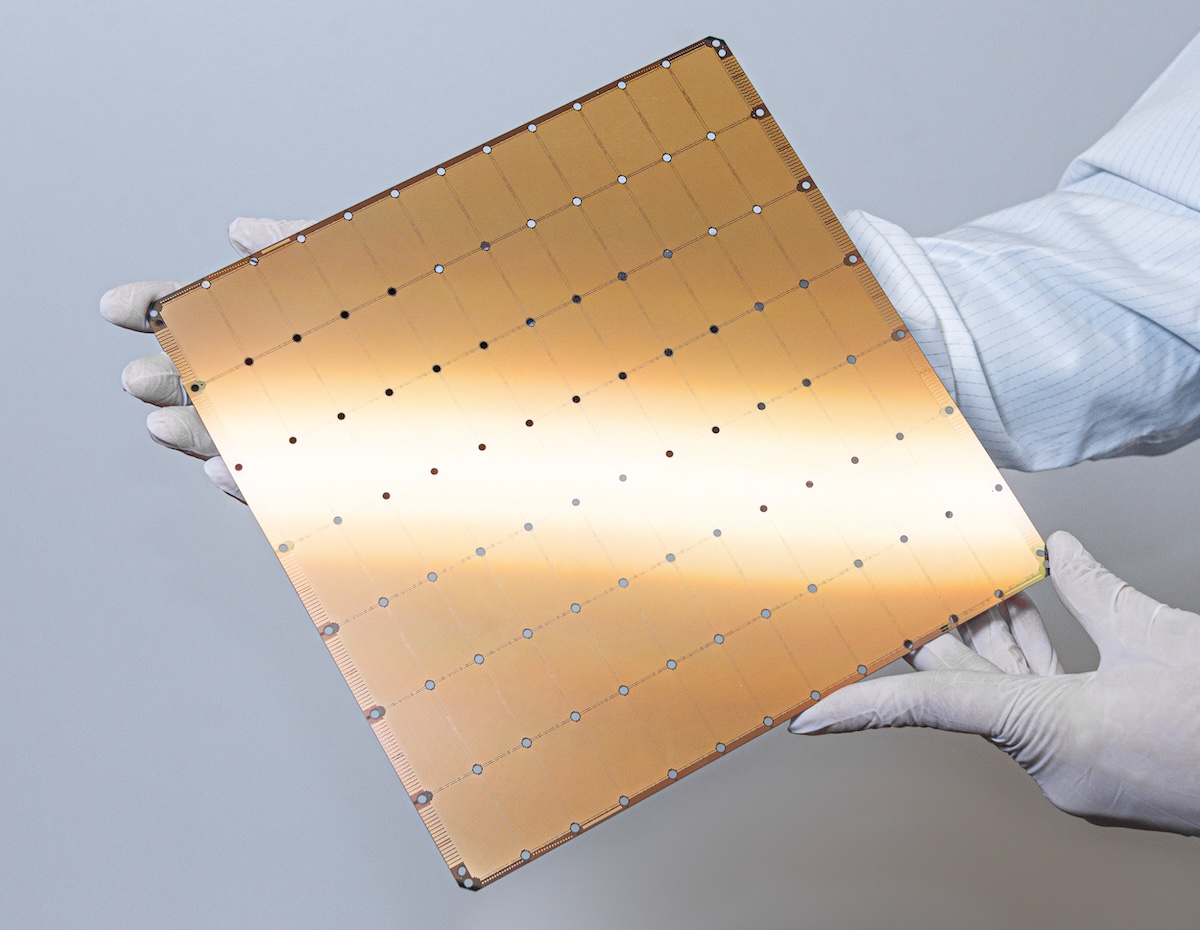
Organizacje zajmujące się badaniami medycznymi i energetyką wykorzystują systemy Cerebras na lokalnych superkomputerach, natomiast programiści mogą uzyskać dostęp do ich możliwości za pośrednictwem chmury Cerebras.
Tenstorrent
Tenstorrent rozwija zaawansowany sprzęt do sztucznej inteligencji i obliczeń o wysokiej wydajności, kierowany przez zespół specjalizujący się w architekturze komputerowej i projektowaniu układów ASIC. Ich podejście przypomina TPU Google'a, koncentrując się na otwartym sprzęcie i oprogramowaniu, i przyciągnął inwestycje od takich osobistości jak Jeff Bezos.
Płyty główne Blackhole™ PCIe tej firmy zostały zaprojektowane z myślą o skalowalnym przetwarzaniu AI i wyposażone w rdzenie RISC-V oraz pamięć GDDR6. Model Blackhole p100a zawiera procesor Blackhole Tensix i jest przeznaczony do stacjonarnych stacji roboczych.
Korzyści: wydajność, efektywność i kontrola
Niestandardowe układy scalone dają operatorom komunikacyjnym i innym graczom solidny zestaw dźwigni. Dostawcy mogą optymalizować swoje obciążenia, architekturę centrów danych oraz ograniczenia zasilania/chłodzenia, projektując układy scalone we własnym zakresie. Przekłada się to na lepszą wydajność w przeliczeniu na dolara, lepszą efektywność energetyczną i możliwość oferowania klientom zróżnicowanych usług. Strategicznie, posiadanie stosu krzemowego zmniejsza zależność od zewnętrznych dostawców, minimalizuje ryzyko w łańcuchu dostaw i umożliwia szybsze cykle innowacji. Ta zwinność stanowi przewagę konkurencyjną w świecie, w którym modele sztucznej inteligencji ewoluują z prędkością światła.
Budowa układów scalonych nie jest dla osób o słabych nerwach. Wymaga dogłębnej wiedzy inżynierskiej, znacznych nakładów inwestycyjnych oraz ścisłej współpracy z odlewniami i partnerami projektowymi. Dostawcy usług komunikacyjnych (CSP) inwestują również znaczne środki w stosy oprogramowania, kompilatory i narzędzia programistyczne, aby zapewnić dostępność i łatwość obsługi ich niestandardowego sprzętu. Efekty uboczne są odczuwalne w całej branży. Tradycyjni producenci układów scalonych, tacy jak Intel, AMD i NVIDIA, mierzą się z nową konkurencją, podczas gdy startupy i dostawcy rozwiązań IP znajdują nowe możliwości współpracy z CSP. Ruch open source w dziedzinie sprzętu, którego uosobieniem jest RISC-V, nabiera tempa, ponieważ dostawcy poszukują bardziej elastycznych i konfigurowalnych architektur.
Przyszłość krzemu w chmurze
Tempo innowacji nie wykazuje oznak spowolnienia. Wraz z rozwojem sztucznej inteligencji, analityki i przetwarzania brzegowego, oczekuje się, że dostawcy usług komunikacyjnych i hiperskalerzy będą inwestować w wysoce spersonalizowane układy scalone, jednocześnie rozszerzając swoją działalność na nowe obszary sieci, pamięci masowej i bezpieczeństwa. Następna generacja infrastruktury chmurowej będzie kształtowana w równym stopniu przez sprzęt, jak i przez oprogramowanie i usługi na niej oparte.
Ten postęp oferuje więcej opcji, lepszą wydajność i możliwość obsługi obciążeń, które wcześniej uważano za niemożliwe do wykonania dla firm i deweloperów. Dla branży oznacza to początek nowej ery, w której najwięksi dostawcy usług w chmurze staną się również jednymi z najbardziej wpływowych projektantów układów scalonych.


 Amazon