

Na początku tego roku Intel opublikował wyniki porównawcze wydajności Intel Habana Gaudi2 i NVIDIA, lidera rynku procesorów graficznych, które pokazały zaangażowanie Intela w sztuczną inteligencję i dowiodły, że nie jest to kategoria uniwersalna. Jednocześnie, w wyniku wspólnego projektu badaczy sztucznej inteligencji Intela i Microsoft Research, powstał BridgeTower, wstępnie wytrenowany multimodalny transformator realizujący najnowocześniejsze zadania wizyjno-językowe. Hugging Face zintegrował ten model ze swoją biblioteką open source do uczenia maszynowego.
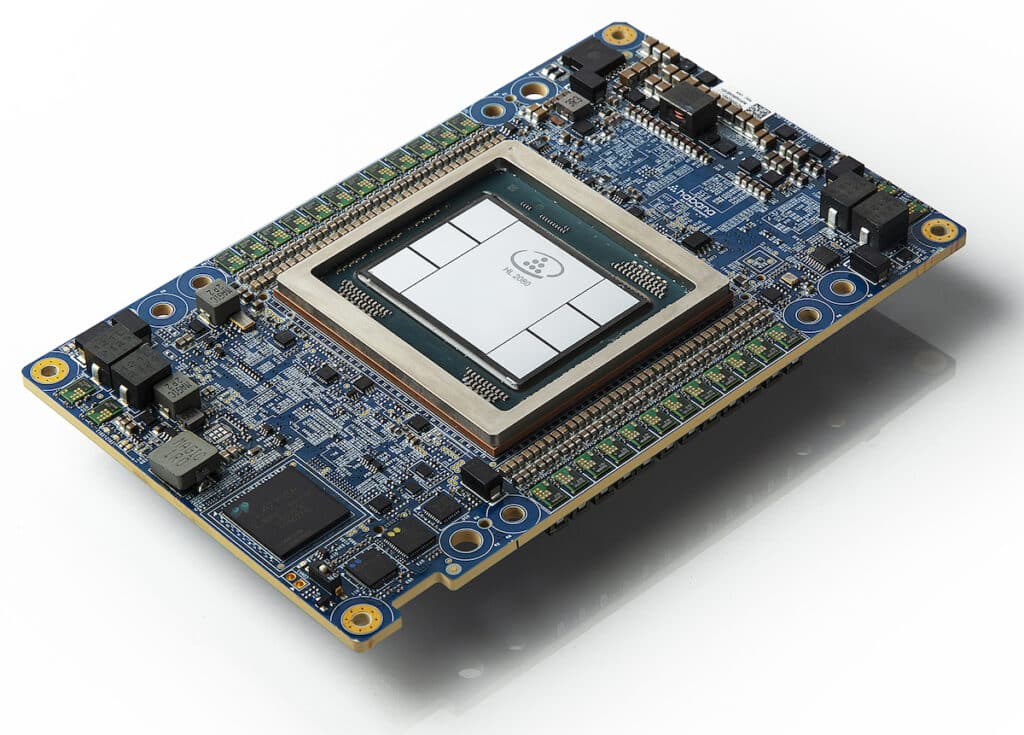
Karta Habana Gaudi2 Mezzanine (Źródło: Intel Corporation)
Firma Hugging Face opublikowała oryginalne wyniki testów porównawczych w poście na blogu na swojej stronie internetowej i zaktualizowała wyniki testów wydajności treningu AI dla procesora Habana Gaudi2 i procesora graficznego NVIDIA H100. Zgodnie z tymi wynikami, Gaudi2 przewyższył H100 w zakresie multimodalnego modelu transformatora BridgeTower, ale Gaudi2, korzystając z Optimum Habana , osiągnął 2.5-krotnie lepszą wydajność niż A100. Wyniki potwierdziły nie tylko pozycję Gaudi2 w dziedzinie sztucznej inteligencji, ale także w treningu Vision-Language.
Optimum Habana to interfejs między bibliotekami Transformers i Diffusers a procesorem Gaudi (HPU) firmy Habana. Udostępnia narzędzia umożliwiające łatwe ładowanie, trenowanie i wnioskowanie modeli w ustawieniach pojedynczych i wielu HPU dla różnych zadań downstream.
Tło BridgeTower
Modele wizyjno-językowe wykorzystują kodery unimodalne do pozyskiwania reprezentacji danych. Dane są następnie łączone lub wprowadzane do kodera międzymodalnego. BridgeTower wyróżnia się unikalnymi warstwami pomostowymi, łączącymi najwyższe warstwy koderów unimodalnych z każdą warstwą kodera międzymodalnego, umożliwiając efektywne łączenie danych wizualnych i tekstowych na różnych poziomach.
BridgeTower, wytrenowany na zaledwie 4 milionach obrazów, wyznacza nowe standardy wydajności, osiągając 78.73% dokładności w teście Visual Question Answering (VQAv2). To wynik o 1.09% lepszy od poprzedniego najlepszego modelu. W większej skali model osiąga jeszcze wyższą dokładność, wynoszącą 81.15%, przewyższając modele trenowane na znacznie większych zbiorach danych.
Jako wiodący model wizyjno-językowy, wydajność BridgeTower wynika z możliwości szybkiego ładowania danych za pomocą specjalistycznego sprzętu. Te szybkie metody ładowania danych są korzystne dla modeli wizyjnych, które często borykają się z wyzwaniami związanymi z ładowaniem danych.
Wgląd w sprzęt
Zaktualizowane testy porównawcze oparto na najnowszym sprzęcie i oprogramowaniu firm NVIDIA i Habana Labs. Procesor graficzny NVIDIA H100 Tensor Core to najnowszy i najszybszy procesor graficzny firmy INVIDIA, wyposażony w silnik Transformer Engine do specjalistycznych przebiegów i 80 GB pamięci. Wykorzystując trzecią iterację technologii Tensor Core, procesor graficzny Nvidia A100 Tensor Core jest szeroko dostępny u dostawców usług w chmurze, oferując 80 GB pamięci, co zapewnia wyższą prędkość niż jego odpowiednik z 40 GB pamięci.
Habana Labs Habana Gaudi2 to sprzęt AI drugiej generacji firmy Habana Labs, który może pomieścić do 8 jednostek HPU, każda z pamięcią 96 GB. Ma on przyjazne dla użytkownika funkcje i, w połączeniu z systemem Optimum Habana, ułatwia przenoszenie kodów opartych na Transformerach do Gaudi.
Szczegóły benchmarkingu
Test polegał na dostrojeniu modelu BridgeTower z 866 milionami parametrów i trenowaniu go w języku angielskim przy użyciu różnych technik na kilku zbiorach danych. Kolejnym krokiem było dalsze dostrajanie z wykorzystaniem zbioru danych New Yorker Caption Contest. Wszystkie platformy korzystały z tych samych ustawień i przetwarzały partie po 48 próbek każda, aby uzyskać spójne wyniki.
Wyzwaniem w tego typu eksperymentach jest czasochłonne ładowanie danych obrazowych. Optymalnie, surowe dane powinny być przesyłane bezpośrednio do urządzeń w celu dekodowania. Teraz nacisk kładzie się na optymalizację procesu ładowania danych.
Optymalizacja ładowania danych
Aby przyspieszyć ładowanie obrazu przez procesor, pomocne może być zwiększenie liczby podprocesów. Używając argumentów szkoleniowych Transformers, argument dataloader_num_workers=N może ustawić liczbę podprocesów procesora do ładowania danych. Domyślnym ustawieniem jest 0, co oznacza, że dane są ładowane przez proces główny, ale może to być nieefektywne. Zwiększenie tej wartości może poprawić szybkość, ale zwiększy również zużycie pamięci RAM. Zalecanym ustawieniem jest liczba rdzeni procesora. Najlepiej jednak najpierw poeksperymentować, aby określić optymalną konfigurację.
Test ten składał się z trzech odrębnych przebiegów:
- Przetwarzanie o mieszanej precyzji na ośmiu urządzeniach, gdzie ładowanie danych współdzieli proces z innymi zadaniami (dataloader_num_workers=0).
- Podobny przebieg, ale z dedykowanym podprocesem do ładowania danych (dataloader_num_workers=1).
- Ta sama konfiguracja, ale z dwoma dedykowanymi podprocesami (dataloader_num_workers=2).
Sprzętowo przyspieszane ładowanie danych z Optimum Habana
Aby jeszcze bardziej zwiększyć szybkość, przenieś zadania ładowania danych z procesora na urządzenia akcelerujące, takie jak jednostki HPU w Gaudi2 lub GPU w A100/H100, korzystając z potoku multimedialnego Habany. Zamiast przetwarzania obrazów wyłącznie przez procesor, zakodowane obrazy można przesyłać bezpośrednio do urządzeń w celu dekodowania i rozszerzenia. Takie podejście maksymalizuje moc obliczeniową urządzenia, ale może zwiększyć zużycie pamięci urządzenia.
Dwie skuteczne metody usprawnienia procesów szkoleniowych z wykorzystaniem obrazów to przydzielenie większej ilości zasobów do ładowania danych oraz wykorzystanie akceleratorów do przetwarzania obrazu. Podczas trenowania zaawansowanych modeli wizyjno-językowych, takich jak BridgeTower, te optymalizacje sprawiają, że Habana Gaudi2 z Optimum Habana jest znacznie szybsza niż odpowiedniki firmy NVIDIA. Habana Gaudi2 jest przyjazna dla użytkownika i wymaga jedynie kilku dodatkowych argumentów szkoleniowych.


 Amazon