

Podczas konferencji VMware Explore 2026 mieliśmy okazję porozmawiać ze Stuartem McRae, dyrektorem wykonawczym działu Enterprise Storage, Software, and Solutions Offering Group w Lenovo.
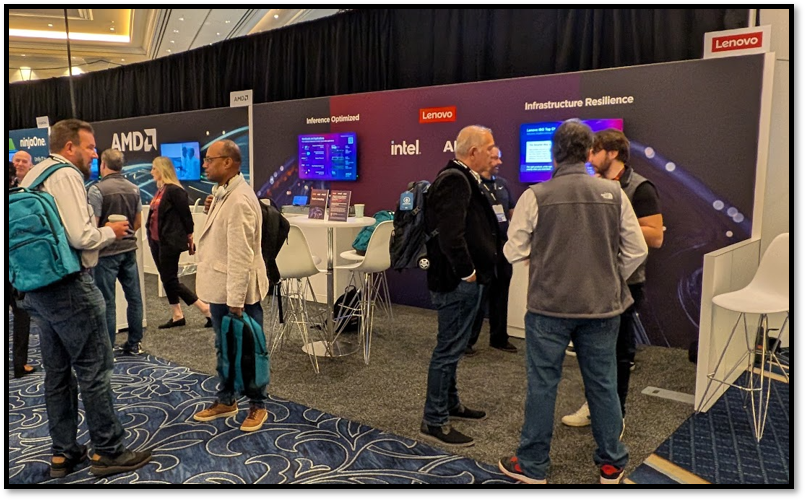
Zamiast skupiać się na konkretnym produkcie lub technologii, jak to często robimy, ta rozmowa przybrała szerszy kontekst. Omówiliśmy wszystko, od tego, jak sztuczna inteligencja zmienia opcje zakupowe, przez trwający niedobór pamięci RAM, po ożywioną debatę na temat tego, czy Teksas, czy Karolina Północna mają lepsze grille. Poniżej przedstawiamy nasze wnioski z tej dyskusji.
Powrót do On-Prem z wysokimi stawkami
We wczesnych latach rozwoju centrów danych architekci systemów z dumą hołdowali zasadzie „zbuduj to sam”. Każda infrastruktura miała swój własny, lokalny charakter, starannie złożona z preferowanych „klocków Lego” – mocy obliczeniowej, pamięci masowej i sieci. Byliśmy architektami centrów danych na zamówienie.
Jednak przedsiębiorstwa przechodzą obecnie fundamentalną przemianę. Wysokie koszty związane z generatywną sztuczną inteligencją, w połączeniu z rosnącymi i często nieprzewidywalnymi kosztami chmury publicznej, przyspieszyły powrót do infrastruktury lokalnej. Dzisiejsze środowisko wymaga natychmiastowych, przewidywalnych rezultatów, a nie architektonicznego majsterkowania.
Z naszej rozmowy z McRae wynika, że misja uległa zmianie: odchodzimy od montażu częściowego na rzecz zintegrowanych, gotowych do użycia „fabryk”, w których infrastruktura staje się niewidoczna, niezawodna i łatwa w obsłudze.
„RAM Apocalypse” to katalizator innowacji
Branża zmaga się z tym, co wielu nazywa „apokalipsą RAM”. Niestabilna mieszanka ograniczeń w dostawach pamięci DRAM i flash spowodowała gwałtowny wzrost cen surowców, przez co pamięć stała się rosnącym wąskim gardłem dla rozbudowy centrów danych. W przypadku architektury pamięci jest to moment, w którym innowacje są teraz albo nigdy.
Warstwowanie pamięci nie jest nowością, ale wcześniejsze podejścia były często technicznie wykonalne, ale podatne na problemy operacyjne, zależne od złożonych konfiguracji w warstwie systemu operacyjnego lub aplikacji. Utrudniało to ich spójne wdrażanie w zróżnicowanym środowisku korporacyjnym. Obecnie, pod przewodnictwem Lenovo i VMware, następuje przejście na integrację tej inteligencji z warstwą hiperwizora w ramach VMware Cloud Foundation (VCF). Dzięki warstwowaniu danych na dyskach NVMe w warstwie definiowanej programowo, organizacje mogą zacząć oddzielać wydajność od kosztów pamięci DRAM.
- Szeroka adopcja: Ponieważ dzieje się to na poziomie hiperwizora, nie ma potrzeby „usuwania i zastępowania” istniejących aplikacji ani przepisywania systemu operacyjnego.
- Wpływ ekonomiczny: Dzięki zoptymalizowanemu warstwowaniu organizacje oszczędzają do 45% kosztów pamięci DRAM.
„ Stare przysłowie mówi: »Kiedy jest najlepszy moment na posadzenie drzewa?« 20 lat temu. Kiedy będzie następny najlepszy moment? Jutro. Cóż, najlepszy moment na zakup serwera był rok temu… a następny najlepszy moment jest dzisiaj ” – powiedział nam McRae.
Przejście od „klocków Lego” do gotowych fabryk sztucznej inteligencji
Jesteśmy świadkami nieuniknionego zderzenia gęstości przedsiębiorstwa z koniecznością „po prostu daj mi coś, co działa”. Psychologiczna zmiana w IT jest głęboka: radość z majsterkowania ustąpiła miejsca konieczności „podejścia opartego na urządzeniach”. Dla organizacji, które chcą wdrożyć możliwości sztucznej inteligencji, złożoność procesu określania rozmiaru i walidacji jest zbyt duża, aby mogły sobie z nią poradzić samodzielnie.
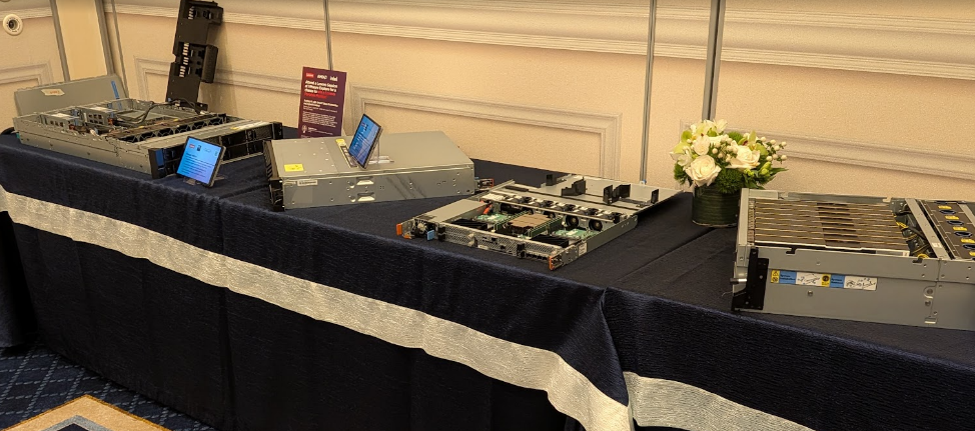
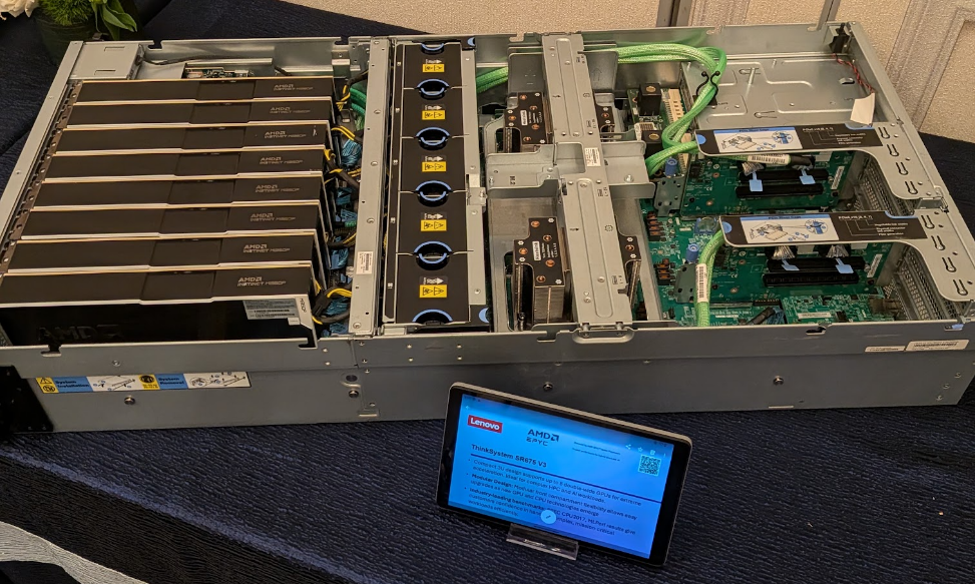
Wymusiło to powstanie hybrydowej fabryki sztucznej inteligencji (Hybrid AI Factory). Integrując sprzęt Lenovo ze stosem VCF Private AI, Lenovo zapewnia wstępnie walidowane środowisko, w którym dyski SSD, karty sieciowe i wersje oprogramowania sprzętowego gwarantują współpracę.
Ale to coś więcej niż tylko sprzęt; chodzi o zarządzanie cyklem życia i spokój ducha. W czasach, gdy bezpieczeństwo i odporność są nie do negocjacji, sprawdzony stos gwarantuje, że „elementy Lego” nie tylko będą do siebie pasować od pierwszego dnia, ale także pozostaną spójne podczas każdej kolejnej aktualizacji i poprawki. Przechodzimy od roli konstruktorów komponentów do roli nadzorców zunifikowanej, zautomatyzowanej linii produkcyjnej.
Enterprise w końcu korzysta z chłodzenia cieczą
Przez dekady chłodzenie cieczą było luksusem niszowym, domeną komputerów o wysokiej wydajności (HPC) i wyspecjalizowanych laboratoriów badawczych. Dziś jesteśmy świadkami radykalnej zmiany, ponieważ chłodzenie wodne staje się powszechnym wymogiem w przedsiębiorstwach. Ta zmiana wynika z niezmiennych praw fizyki termicznej: w miarę jak umieszczamy procesory o wysokiej gęstości i energochłonne karty graficzne w tej samej szafie, tradycyjne chłodzenie powietrzne osiągnęło swój limit.
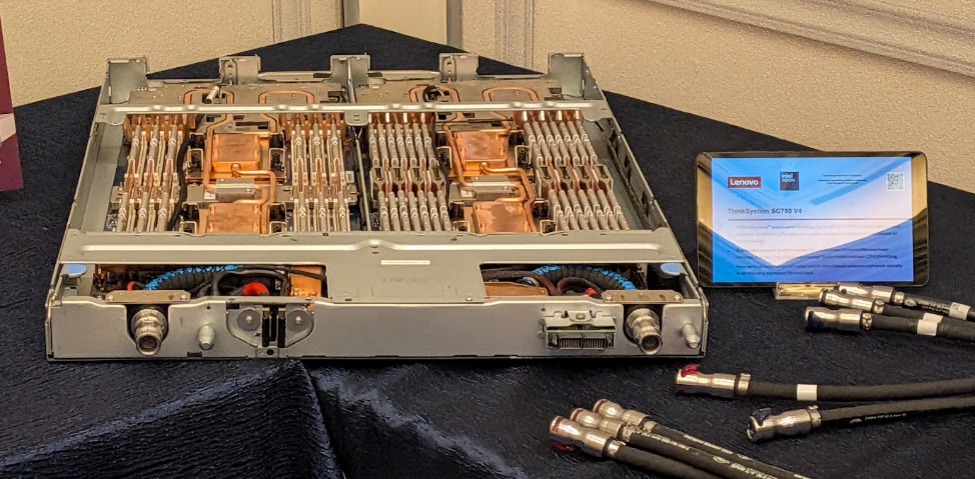
Aby zarządzać tym obciążeniem termicznym, Lenovo opracowało trzy różne architektury dla nowoczesnych centrów danych:
- Chłodzenie ciepłą wodą (Lenovo Neptune): Zaawansowane podejście polegające na bezpośrednim dostarczaniu ciepła do węzła, które pozwala na niezwykle wydajne zarządzanie ciepłem, często eliminując potrzebę stosowania energochłonnych chłodziarek.
- Chłodzenie w obiegu zamkniętym: Istotne „rozwiązanie pośrednie” dla obiektów bez istniejącej infrastruktury wodnej, wykorzystujące chłodzone cieczą radiatory, które w całości krążą wewnątrz obudowy.
- Chłodzenie powietrzem: Nadal jest to podstawa standardowych obciążeń, ale coraz częściej jest przenoszona do stref o niskiej gęstości, ponieważ większość zadań przejmuje ciecz.
Dostawa w 10 dni: logistyka jako element konkurencyjny
Na niestabilnym rynku logistyka i zakupy nie są już nudnymi funkcjami back-office; Lenovo przekształciło je w przewagę konkurencyjną. Szybkość wdrożenia stała się podstawowym miernikiem wydajności infrastruktury. Dzięki programom takim jak „Top Choice Express” i „AI Express” Lenovo oferuje 10-dniowe cykle dostaw serwerów gotowych do obsługi VCF i zoptymalizowanych pod kątem sztucznej inteligencji.
Co być może ważniejsze, Lenovo oferuje 30-dniową gwarancję ceny. Na rynku, gdzie oferty często tracą ważność w ciągu 72 godzin z powodu zmienności komponentów, ta stabilność jest strategicznym kołem ratunkowym, szczególnie dla podmiotów sektora publicznego, ograniczonych ścisłymi i sztywnymi procedurami budżetowania.
Zapotrzebowanie na stabilność sprzętową było wyraźnie odczuwalne na ostatnich wydarzeniach branżowych, nawet na konferencjach poświęconych oprogramowaniu, takich jak VMware Explore, gdzie sesje poświęcone kontroli kosztów infrastruktury szybko się zapełniły.
„ Jesteśmy jedynym dostawcą skoncentrowanym na serwerach na Explore. Obserwujemy ogromny ruch na naszym stoisku i duże zainteresowanie sprzętem… Zazwyczaj na konferencjach poświęconych oprogramowaniu nie są to sesje, które szybko się zapełniają ” – powiedział McRae.
Sztuczna inteligencja jako „krok kwantowy” w administracji systemami
Jedną z najbardziej przełomowych zmian, jakich spodziewamy się w Storage Review, jest nie sztuczna inteligencja jako obciążenie, ale jako interfejs dla samego hiperwizora. O nowym Asystencie AI firmy VMware pisaliśmy w naszym artykule o zapowiedziach VMware na tegorocznej konferencji Explore.
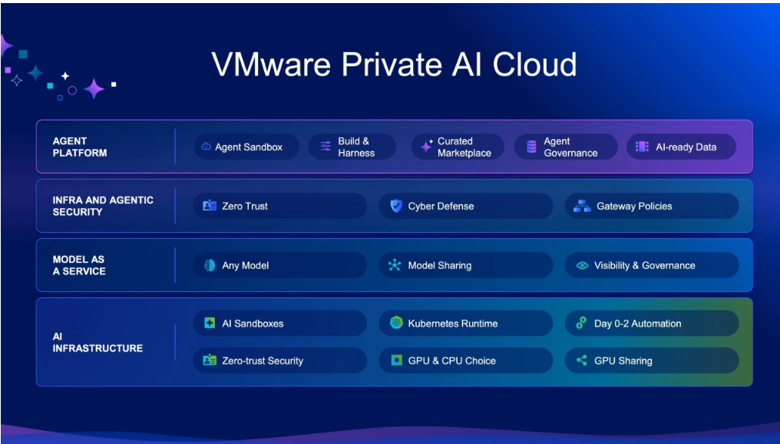
Zmierzamy w kierunku wizji „administracji w języku naturalnym”, w której tarcie między administratorem a sprzętem jest praktycznie wyeliminowane. Przekonaliśmy się o tym, testując Aipex , produkt, który oferuje to rozwiązanie dla systemów Windows, Linux i macOS. Byliśmy podekscytowani, gdy dowiedzieliśmy się, że VMware wdroży asystenta AI w VCF. Co więcej, VMware rozwija tę integrację AI, obsługując pakiety zarządzania innych firm.
Łatwo wyobrazić sobie przyszłość, w której błąd jądra lub awaria systemu nie będą już wymagać weekendowej ręcznej analizy logów. Zamiast tego administrator pyta system: „Dlaczego ta maszyna się zawiesiła?”, a asystent AI, głęboko zintegrowany ze stosem VCF, identyfikuje konkretny błąd sterownika, lokalizuje poprawkę i prosi o pozwolenie na jej wdrożenie.
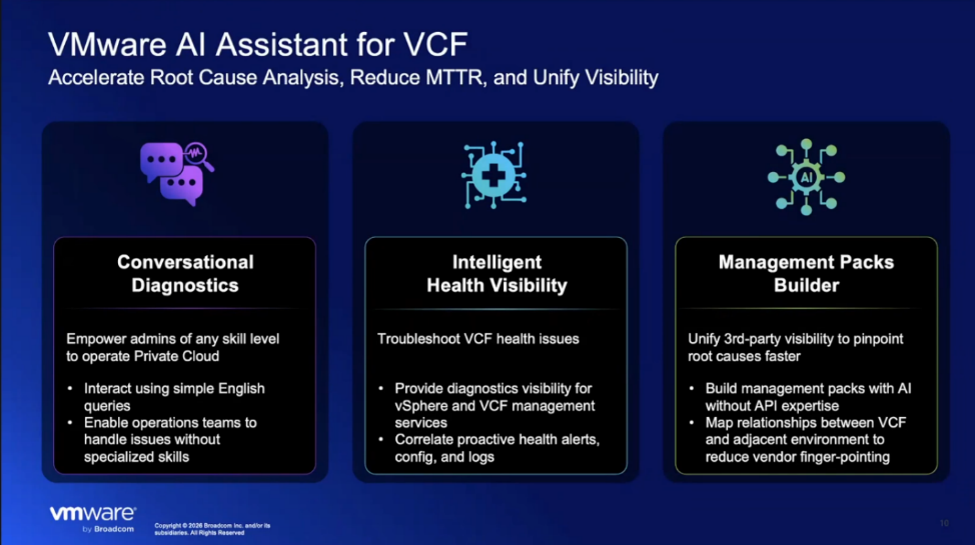
To ogromny krok naprzód, nawiązujący do początków wirtualizacji, kiedy provisioning wymagał miesięcznych konsultacji między zespołami odpowiedzialnymi za pamięć masową, sieć i serwery. Sprowadzając te złożone procesy do prostych dialogów analizowanych i wdrażanych przez sztuczną inteligencję, w końcu usuwamy barierę, która nękała IT przez dekady.
„Tak właśnie powinno być” – jak to ujął McRae.
Wnioski: Plan na kolejne trzy lata
Na zakończenie naszej rozmowy z McRae zadaliśmy mu ważne, ale trudne do odpowiedzi pytanie: Jak będzie wyglądać centrum danych za trzy lata?
Stwierdził, że plan rozwoju chmury prywatnej na najbliższe trzy lata zakłada całkowitą integrację. Możemy spodziewać się zmiany, w której VCF i vSAN staną się domyślnymi standardami, a zasoby GPU będą integrowane bezpośrednio w klastrach jako równorzędne, a nie jako wyspecjalizowane elementy odstające. Filozofia „najpierw integracja” będzie dominować, ponieważ przedsiębiorstwa będą przedkładać suwerenność danych i wydajność operacyjną nad złożoność chmury publicznej.
Ostatecznie sztuczna inteligencja to narzędzie, które wreszcie sprawi, że nasza infrastruktura stanie się „niewidzialna”. Automatyzując ręczną pracę związaną z rozwiązywaniem problemów, naprawą i dostarczaniem sprzętu, osiągamy punkt, w którym technologia pracuje dla firmy, a nie firma dla technologii. Celem nie jest już budowanie najlepszej wieży „Lego”, ale prowadzenie najbardziej wydajnej fabryki.
W końcu, gdy nalegano na wybór stylu BBQ, McRae dyplomatycznie odpowiedział, że równie mocno jak wolno wędzona wołowina z Houston i Austin lubi octowy smak grilla z Karoliny Północnej, co wołowinę z Houston i Austin. Nie skomentował grilla z Cincinnati.


 Amazon