

Firma Qumulo ogłosiła wprowadzenie Cloud AI Accelerator, nowej architektury zaprojektowanej w celu zwiększenia wydajności infrastruktury AI przedsiębiorstw poprzez eliminację wąskich gardeł w przesyle danych. Platforma prezentuje rozproszone zestawy danych zasobom GPU w czasie rzeczywistym w regionach, chmurach i środowiskach hybrydowych, bez konieczności replikacji ani tworzenia środowisk przejściowych.
Wydanie opiera się na dobrze udokumentowanej nieefektywności infrastruktury AI w przedsiębiorstwach. Powołując się na raport Cast AI „2026 State of Kubernetes Optimization Report”, Qumulo wskazuje na średnie wykorzystanie GPU w przedsiębiorstwach na poziomie około 5%, podczas gdy pozostałe 95% akcelerowanych mocy obliczeniowych pozostaje bezczynne, ponieważ dane muszą zostać przygotowane, zreplikowane i przeniesione na właściwe miejsce, zanim obciążenia będą mogły rozpocząć pracę. Prezes Qumulo, Doug Gourlay, tak ujął problem w ogłoszeniu: „Każde przedsiębiorstwo, z którym rozmawiamy, koncentruje się na dostępności GPU, ale dostępność to tylko połowa problemu. Głębszym problemem jest wykorzystanie, a winowajcą jest grawitacja danych”.
Nowe spojrzenie na rozmieszczenie danych w przypadku obciążeń AI
Tradycyjne podejścia do infrastruktury AI polegają na współlokowaniu pamięci masowej z klastrami GPU, często wykorzystując wysokowydajne systemy flash ściśle powiązane z obliczeniami. Chociaż model ten jest skuteczny podczas aktywnego trenowania lub wnioskowania, nie radzi sobie z okresami przestoju spowodowanymi przygotowywaniem danych. Tworzy on również pofragmentowane silosy pamięci masowej, ponieważ przedsiębiorstwa replikują zestawy danych w różnych środowiskach, aby utrzymać je blisko zasobów obliczeniowych.
Podejście Qumulo zmienia model poprzez oddzielenie lokalizacji danych od lokalizacji obliczeniowej. Zamiast przenosić dane do procesorów graficznych (GPU), Cloud AI Accelerator umożliwia procesorom graficznym dostęp do danych w miejscu ich przechowywania. Jest to możliwe dzięki rozproszonej strukturze danych, która zapewnia spójny dostęp do zestawów danych w czasie rzeczywistym, niezależnie od ich fizycznej lokalizacji.
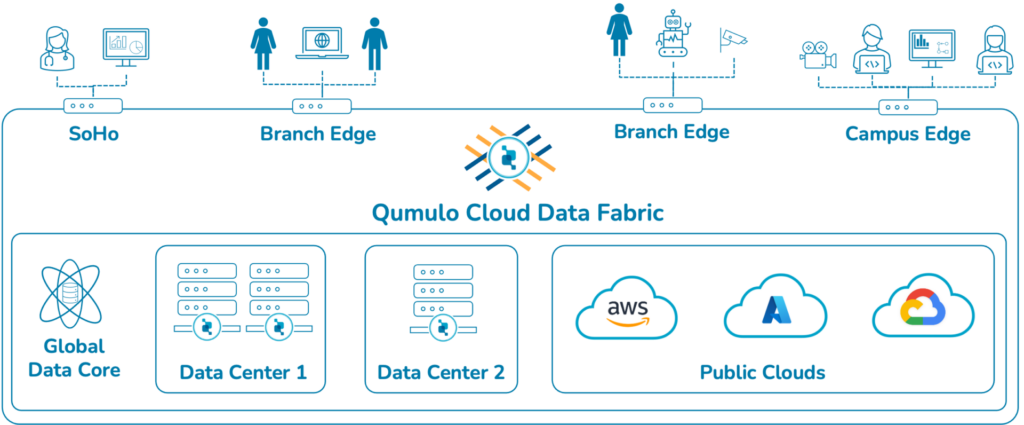
Firma określa tę funkcję jako umożliwiającą „płynność GPU”, co pozwala na planowanie obciążeń w oparciu o dostępną moc obliczeniową, a nie ograniczenia dotyczące lokalizacji danych. W praktyce umożliwia to przedsiębiorstwom korzystanie z zasobów GPU w wielu chmurach lub regionach bez konieczności wstępnego pozycjonowania danych.
Architektura: Struktura danych i warstwa buforująca
Cloud AI Accelerator to integracja trzech produktów Qumulo, które wcześniej były sprzedawane oddzielnie. Cloud Native Qumulo (CNQ) to system plików Qumulo, który działa natywnie w AWS, Azure, Google Cloud i Oracle Cloud Infrastructure. Cloud Data Fabric (CDF), uruchomiony w lutym 2025 roku, zapewnia centralne repozytorium plików i obiektów ze spójnymi pamięciami podręcznymi na brzegu sieci. NeuralCache, dodany do CDF w kwietniu 2025 roku, wykorzystuje uczenie maszynowe do predykcyjnego buforowania odczytu i zapisu, a Qumulo twierdzi, że skraca to czas ładowania danych GPU nawet o 64 procent. Sam Cloud AI Accelerator pojawił się po raz pierwszy w listopadzie 2025 roku; wydanie z 26 maja dodaje bezpośrednią łączność z Microsoft AI Foundry, AWS Bedrock i Google Vertex AI, formalizuje pozycjonowanie „płynności GPU” i łączy produkt z Cisco w celu wdrożeń hybrydowych.
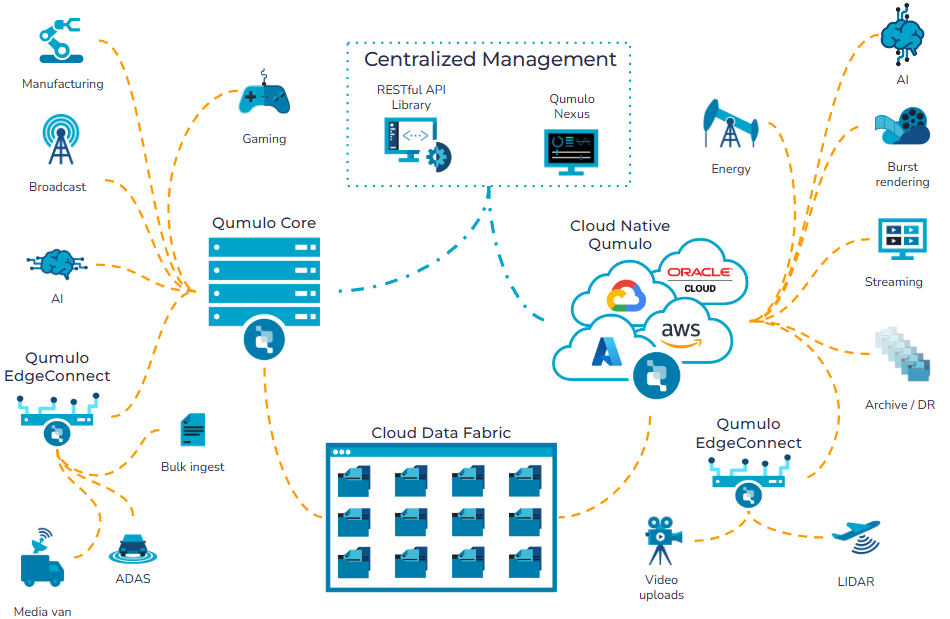
Ścieżka danych przebiega na poziomie bloku od lokalizacji źródłowych (klastry lokalne, regiony chmurowe, repliki międzyregionalne lub pamięć masowa wspierana przez CNQ S3) do pamięci podręcznej DRAM procesora akceleratora, a następnie bezpośrednio do procesorów graficznych (GPU). Architektura utrzymuje pojedyncze źródło danych w środowiskach lokalnych, brzegowych i wielochmurowych oraz eliminuje konieczność masowej replikacji, co zmniejsza zarówno obciążenie pamięci masowej, jak i złożoność synchronizacji.
Ta konstrukcja obsługuje również integrację z zarządzanymi usługami AI. Przedsiębiorstwa mogą łączyć istniejące zbiory danych bezpośrednio z platformami takimi jak Microsoft AI Foundry, AWS Bedrock i Google Vertex AI bez kopiowania danych do tych środowisk.
Wpływ operacyjny: skrócenie czasu przestoju i zmniejszenie złożoności
Podstawową korzyścią operacyjną jest eliminacja opóźnień w przygotowywaniu danych. W wielu procesach AI przygotowanie danych może trwać dni lub tygodnie, co opóźnia trenowanie modelu i zmniejsza efektywne wykorzystanie GPU. Umożliwiając natychmiastowy dostęp do zestawów danych, Cloud AI Accelerator pozwala na rozpoczęcie obciążeń, gdy tylko dostępne będą zasoby obliczeniowe.
Zmniejsza to również potrzebę utrzymywania wielu środowisk pamięci masowej. Zamiast tworzyć oddzielne silosy danych dla każdego klastra GPU lub regionu chmury, organizacje mogą działać w oparciu o jeden logiczny zestaw danych. Upraszcza to zarządzanie danymi i ogranicza rozrost infrastruktury.
Z perspektywy kosztów, model koncentruje się na wydatkach na bezczynne procesory graficzne (GPU). Eliminując konieczność wstępnego wczytywania danych do pamięci masowej podłączonej do procesora graficznego (GPU), przedsiębiorstwa mogą skrócić czas oczekiwania procesorów graficznych na dane, zwiększając tym samym ogólny zwrot z inwestycji w przyspieszone obliczenia.
Integracja Cisco dla hybrydowej infrastruktury AI
Cisco jest wspólnym partnerem rynkowym w procesie wdrażania hybrydowego, przy czym Cisco UCS zapewnia lokalną moc obliczeniową, a rozwiązania sieciowe i bezpieczeństwa Cisco obejmują infrastrukturę danych. Qumulo i Cisco wspólnie pozycjonują ofertę jako infrastrukturę, która dostosowuje się w ciągu kilku minut do zmieniającej się dostępności GPU, co ich zdaniem sprawia, że płynność GPU jest praktyczna w skali korporacyjnej.
Połączenie jest kluczowe w obu kierunkach. Zapewnia ono Qumulo sprawdzoną ścieżkę do środowisk Cisco UCS i stanowi rozwiązanie Cisco w zakresie pamięci masowej dla klientów hybrydowych rozwiązań AI, którzy chcą, aby dane pozostały lokalne, a obliczenia były skalowalne w hiperskalerach. Sieć o wysokiej przepustowości i niskich opóźnieniach jest tutaj elementem nośnym, ponieważ dostęp do danych w miejscu instalacji zależy od spójnego transportu między lokalizacjami.
Model dostępności i wdrożenia
Rozwiązanie Qumulo Cloud AI Accelerator jest już dostępne na platformach AWS, Microsoft Azure, Google Cloud i Oracle Cloud Infrastructure, z obsługą wdrożeń hybrydowych w środowiskach Cisco UCS. Qumulo i Cisco będą obecne na targach Cisco Live 2026 w Las Vegas, na stoisku nr 4018, od 31 maja do 4 czerwca, gdzie będzie można obejrzeć wspólną ofertę.
Wydanie odzwierciedla szerszą zmianę w projektowaniu infrastruktury AI w kierunku architektur skoncentrowanych na danych. Ponieważ przyspieszona moc obliczeniowa nadal przewyższa infrastrukturę, która ją zasila, poprawa wykorzystania będzie zależeć od skrócenia czasu oczekiwania procesorów graficznych na dane. Qumulo zakłada, że zapewnienie powszechnej dostępności zbioru danych, a nie mobilności, jest trwalszym rozwiązaniem niż dodawanie pamięci flash do każdego klastra GPU.


 Amazon