

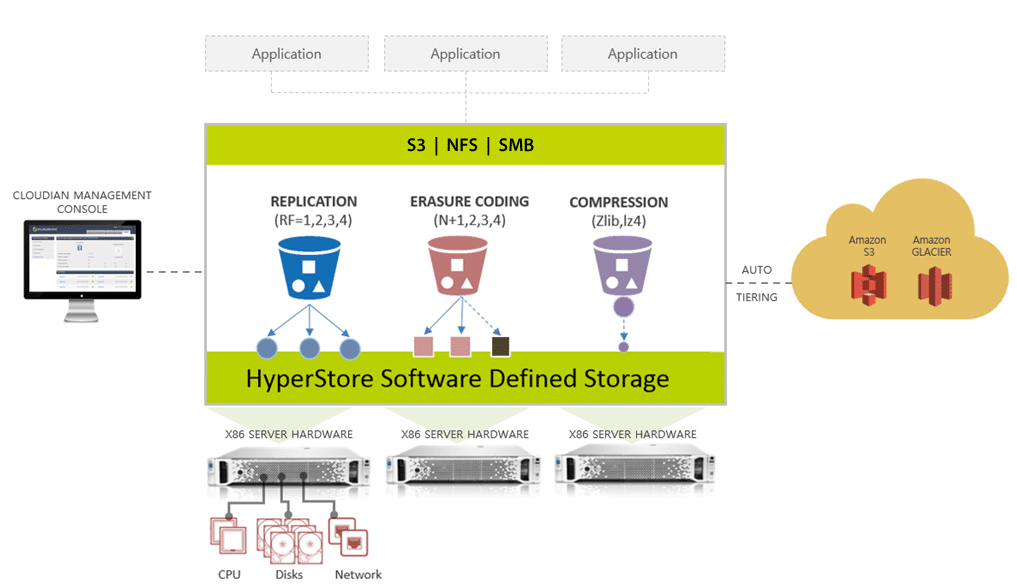
HyperStore firmy Cloudian to programowalna platforma pamięci masowej oparta na natywnym wsparciu dla API Amazon S3, z integracją z kilkoma innymi interfejsami API pamięci masowej w chmurze. Cloudian oferuje HyperStore w formie urządzeń pamięci masowej oraz rozwiązania programowego HyperStore Operating Environment dla sprzętu powszechnego użytku. Ścisła integracja HyperStore z chmurą podkreśla funkcje platformy, takie jak warstwowanie, tworzenie kopii zapasowych, replikacja, przechowywanie w chłodni i inne. Pozwala to również Cloudian na obsługę różnorodnych opcji wdrożeniowych, które wykorzystują połączenie pamięci lokalnej, zdalnej i w chmurze.
Architektura HyperStore Scale-Out rozprowadza wszystkie dane, metadane, konfiguracje i operacje w klastrze i obsługuje wdrażanie w wielu centrach danych. HyperStore wykorzystuje strumieniowanie obiektów i funkcję dynamicznego automatycznego poziomowania, aby przenosić dane między lokalną chmurą a zdalnymi usługami pamięci masowej w chmurze w skali sięgającej tysięcy serwerów i setek petabajtów danych w wielu centrach danych.
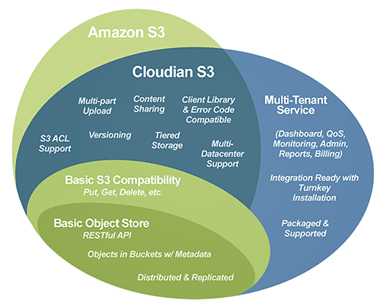
HyperStore implementuje 51 operacji wymaganych do spełnienia standardu „zaawansowanej” zgodności z Amazon S3, co pozwala programistom i administratorom wdrażać pamięć masową natywnie współpracującą z pakietem Amazon S3 SDK. HyperStore został również opracowany od podstaw z obsługą wdrożeń wielodostępnych oraz niezbędnymi funkcjami QoS, rozliczeń i raportowania, niezbędnymi dla resellerów i dostawców usług do wdrożenia platformy w środowiskach dostawców usług zarządzanych. Użytkownicy mogą również uruchamiać analitykę Hadoop bezpośrednio w oprogramowaniu i urządzeniach HyperStore.
 Jednym z zastosowań wdrożenia HyperStore jest wykorzystanie funkcji tworzenia kopii zapasowych CloudBerry. Usługę CloudBerry Managed Backup można uruchomić z serwerów Amazon EC2, integrując pamięć masową HyperStore z Amazon S3, Amazon Glacier, Google Nearline, Windows Azure, OpenStack i innymi dostawcami pamięci masowej w chmurze. Dostawcy usług korzystający z HyperStore z rozwiązaniem CloudBerry Managed Backup mogą również zapewnić użytkownikom lub klientom dostęp do danych przechowywanych w instancji HyperStore przez sieć.
Cloudian niedawno wydał Hyperstore Connect for Files. Ta nowa funkcja umożliwia natywną obsługę protokołów SMB, NFS i FTP. Oznacza to, że przechowywanie plików jest teraz oparte na technologii plug-and-play dzięki Cloudian HyperStore. Hyperstore Connect for Files działa na bazie jednego globalnego wdrożenia pamięci masowej obiektów HyperStore, co zmniejsza koszty i złożoność zarządzania. Składa się z dwóch modułów: Access Point, zaprojektowany jako bezstanowy i pełniący funkcję serwera, z którym łączą się klienci w celu konwersji plików na obiekty; oraz Global View Manager, który zapewnia globalną przestrzeń nazw i globalne blokowanie plików, umożliwiając rozproszoną współpracę w różnych lokalizacjach.
Aby przygotować ten przegląd platformy HyperStore, pracowaliśmy z HyperStore w formie urządzenia programowego, a także przeprowadziliśmy niewielką konfigurację DIY w naszym laboratorium. Urządzenie programowe może zostać użyte do utworzenia instancji HyperStore po wdrożeniu na co najmniej trzech węzłach serwerowych RedHat lub CentOS. Aktualna oferta sprzętowa Cloudian obejmuje urządzenia rackowe HyperStore FL3000 z ośmioma węzłami pamięci masowej w obudowie 3U. Każda jednostka rozszerzająca 4U może pomieścić do 480 TB pamięci. Cena katalogowa urządzenia HyperStore 12U o pojemności 576 TB z pięcioletnim wsparciem technicznym wynosi 324 000 USD.
Specyfikacje i opcje sprzętowe Cloudian HyperStore
- Obudowa µwęzła HyperStore FL3000
- Funkcja: Udostępnianie danych
- Współczynnik kształtu: 3U
- Napędy: 16 dysków SSD (2 na µwęzeł)
- Moduły: 8xµNode
- Łączność: 16x10G SFP+, 8x1Gbe IPMI
- Wymiary (dł. x szer. x wys.): 589 mm x 438.4 mm x 132.5 mm 23.2” x 17.26” x 45.21”
- Waga: 88 funtów (39.92 kg)
- Rozmiar dysku: 480 GB SSD MLC
- Zasilanie: (2) 1620 W wyjście przy 180-240 V 10.5-8 A, 50-60 Hz
- Chłodzenie: 4 wentylatory chłodzące 8 cm, 11 tys. obr./min, 4-pinowe PWM
- RohS: Zgodny
- Strefy dyskowe: 1 strefa na węzeł
- Półka rozszerzeń HyperStore
- Funkcja: Przechowywanie danych
- Współczynnik kształtu: 4U
- Napędy: 60xHDD
- Moduły: (2) moduły interfejsu SAS z możliwością wymiany na gorąco (SIM) i (4) wewnętrzne moduły interfejsu SAS z możliwością wymiany na gorąco (ISIM)
- Łączność: 2×4-portowe porty mini-SAS 6 Gb/s
- Wymiary (dł. x szer. x wys.): 1103.1 mm x 447 mm x 175.3 mm 43.43” x 17.60” x 6.90”
- Waga: 187.39 funta (85 kg) z dyskami twardymi
- Rozmiar dysku: 2, 4, 6, 8 TB SATA 7200 obr./min
- Zasilanie: (2) 1400 W zasilacze redundantne o wysokiej wydajności 200-240 V AC, 50/60 Hz
- Chłodzenie: (7+1) wirników, nadmiarowe moduły wentylatorów na system
- RohS: Zgodny
- Strefy dysków: 2 lub 4 strefy na półkę
- HyperStore FL3020 µNode
- Dyski danych na węzeł: 15
- Obsługiwane typy dysków: 2, 4, 5, 6 TB
- Maksymalna pojemność/węzeł: 30 TB, 60 TB, 75 TB, 90 TB
- Typ procesora: Intel E5-2640 V2.2GHz, 8 rdzeni
- Pamięć: 64GB
- Łączność: 2x10Gbe SFP+Port, 1x1Gbe IPMI LAN Port
- Dyski systemu operacyjnego Hyperstore: 2 dyski SSD o pojemności 480 GB
- Łączność dyskowa: 2 porty SAS 6bps
- KVM: 1 port VGA, 1 port COM i 2 porty USB 2.0 (z kluczem KVM)
- Przełącznik: Zasilanie
- HyperStore FL3050 µNode
- Dyski danych na węzeł: 30
- Obsługiwane typy dysków: 2, 4, 5, 6 TB
- Maksymalna pojemność/węzeł: 60 TB, 120 TB, 150 TB, 180 TB
- Typ procesora: Intel E5-2640 V2.2GHz, 8 rdzeni
- Pamięć: 128GB
- Łączność: 2 porty SFP+ 10Gbe, 1 port LAN IPMI 1Gbe
- Dyski systemu operacyjnego Hyperstore: 2 dyski SSD o pojemności 480 GB
- Łączność dyskowa: 2 porty SAS 6bps
- KVM: 1 port VGA, 1 port COM i 2 porty USB 2.0 (z kluczem KVM)
- Przełącznik: Zasilanie
System operacyjny i środowisko
HyperStore wykorzystuje administrację internetową do monitorowania systemu i klastra oraz zarządzania danymi, a także do udostępniania interfejsów zarządzania użytkownikami, grupami, planami taryfowymi, kontrolą jakości usług (QoS) i rozliczeniami. Dostępne są opcje API REST-full umożliwiające integrację z innymi systemami provisioningu, uwierzytelniania i rozliczeń.
System zarządzania dostępem HyperStore zapewnia użytkownikom i administratorom przepływy pracy związane z tożsamością i bezpieczeństwem, w tym zarządzanie zasadami rozliczeń i zwrotów kosztów dla dostawców usług. Obsługiwane są różne uprawnienia dla każdego użytkownika, a także konfigurowalne limity QoS dla pamięci masowej i przepustowości w chmurach wielodostępnych, zależne od grupy i użytkownika.
Wdrożenia HyperStore wykorzystują do trzech rozproszonych systemów plików: Cassandra Files System (CASSANRDA), HyperStore File System (HFS) i Erasure Code (EC). CASSANDRA służy do indeksowania metadanych, a także do optymalizacji przechowywania małych plików. HyperStore File System to warstwa przechowywania danych. Może on wykorzystywać replikację lub kodowanie erasure (EC) do przechowywania obiektów. Można wybrać metodę przechowywania dla różnych pul pamięci masowej (tzw. Bucket). EC zapewnia wysoką trwałość i dostępność danych przy minimalnym narzucie przestrzeni (nawet 20% narzutu w niektórych wdrożeniach). Wadą jest większe opóźnienie w dostępie do obiektów i konieczność intensywniejszego przetwarzania. W przypadku dużych obciążeń kopii zapasowych i archiwów powszechnie stosuje się kodowanie erasure. Replikacja jest stosowana, gdy użytkownicy wymagają szybszego dostępu, a także w przypadku replikacji międzyregionalnej. Automatyczne przejście oparte na harmonogramie (termin Cloudian oznaczający automatyczne poziomowanie) jest dostępne z magazynu HyperStore do magazynu Amazon S3, magazynu Amazon Glacier, zdalnego wdrożenia HyperStore lub usługi HyperStore innej firmy.
Szyfrowanie AES-256 po stronie serwera HyperStore chroni dane w spoczynku za pomocą szyfrowania SSL dla danych przesyłanych przez HTTPS. System plików HyperStore oferuje również trzy opcjonalne schematy kompresji: Snappy, LZ4 i Zlib. Snappy kładzie nacisk na szybkość, a nie na kompresję, z nominalną przepustowością kompresji 250 MB/s lub większą i szybkością dekompresji 500 MB/s lub większą. LZ4 charakteryzuje się niższym współczynnikiem kompresji niż Zlib, z nominalną szybkością kompresji 400 MB/s na rdzeń. Zlib oferuje średni współczynnik kompresji i szybkość przy wysokiej szybkości dekompresji.
Oprócz wbudowanych funkcji HyperStore, użytkownicy HyperStore mogą korzystać z kilku aplikacji dostępnych w CloudBerry Labs firmy Cloudian. Najbardziej znane z nich to produkty z rodziny CloudBerry Backup, ale Cloudian oferuje również aplikacje do uproszczonego zarządzania plikami w chmurze, montowania pamięci masowej w chmurze jako dysków sieciowych oraz CloudBerry Box, dwukierunkowe narzędzie podobne do Dropboxa, umożliwiające synchronizację danych między komputerami zdalnymi za pośrednictwem konta pamięci masowej w chmurze.
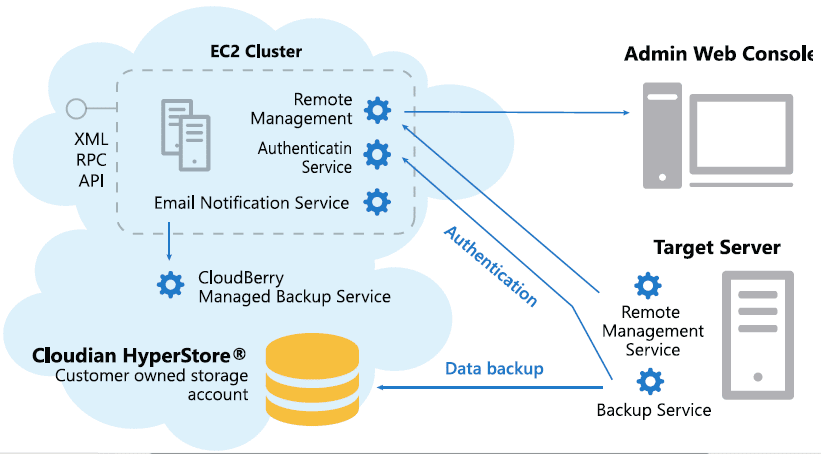
CloudBerry Backup obejmuje zaplanowane i wykonywane w czasie rzeczywistym kopie zapasowe, szyfrowanie i kompresję, ograniczanie przepustowości oraz tworzenie kopii zapasowych na poziomie bloków, a także tworzenie kopii zapasowych dla serwerów MS SQL, MS Exchange, VMware i Hyper-V. Wersja dla dostawców usług zarządzanych (Managed Service Provider) umożliwia monitorowanie historii kopii zapasowych użytkowników z poziomu panelu sterowania Managed Backup i tworzenie kont subadministratorów z ograniczonymi uprawnieniami.
Zarząd
Po zalogowaniu się jako administrator, główny ekran GUI wyświetla nam obszar u góry. Pod obszarem znajduje się zarządzana pojemność – niebieski kolor oznacza ilość wykorzystaną, a zielony ilość wolną. Bezpośrednio pod zarządzaną pojemnością znajduje się stan klastra (jak widać, aktualnie aktywne są alerty). Po prawej stronie znajdują się transakcje na sekundę i przepustowość mierzona w KB/s (na obu wykresach operacje PUT są niebieskie, a GET zielone). U dołu ekranu znajduje się liczba zarządzanych użytkowników, grup, obiektów, węzłów i centrów danych wraz z wersją oprogramowania.
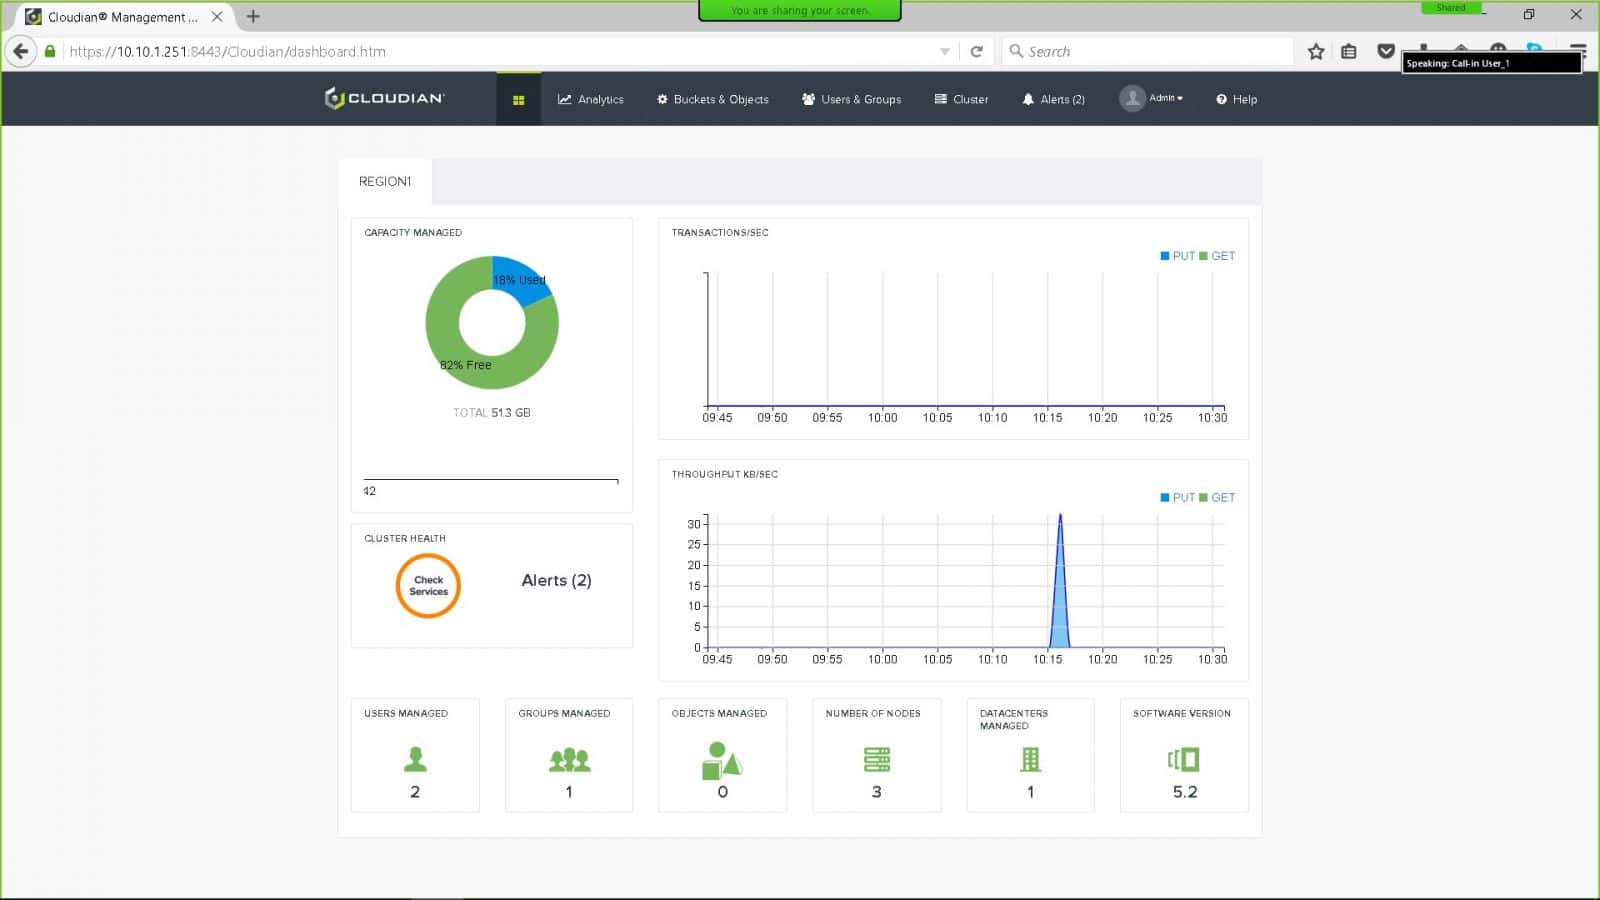
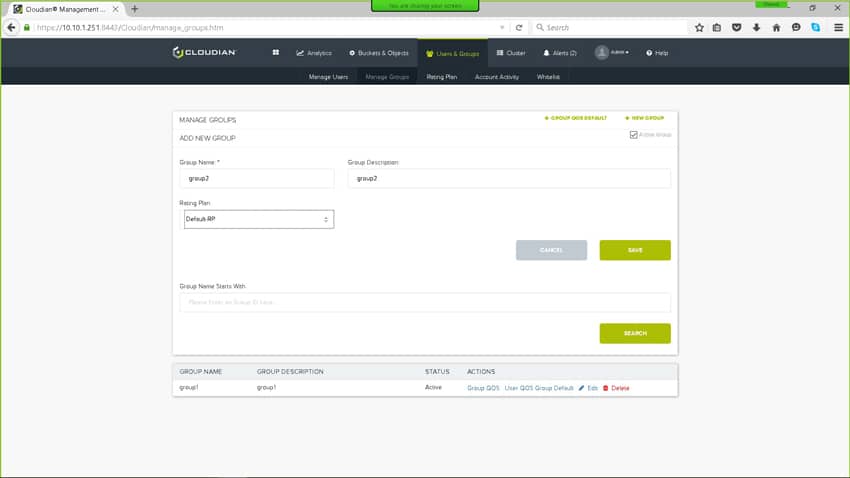
W górnej części ekranu znajdują się zakładki, takie jak ekran główny, analityka, zasobniki i obiekty, użytkownicy i grupy, klaster, alerty, ustawienia oraz pomoc. Aby skonfigurować użytkowników i grupy, administratorzy muszą kliknąć zakładkę „Użytkownicy i grupy”. Za pomocą tej zakładki można dodać nową grupę, a także określić dla niej określone ustawienia QoS.
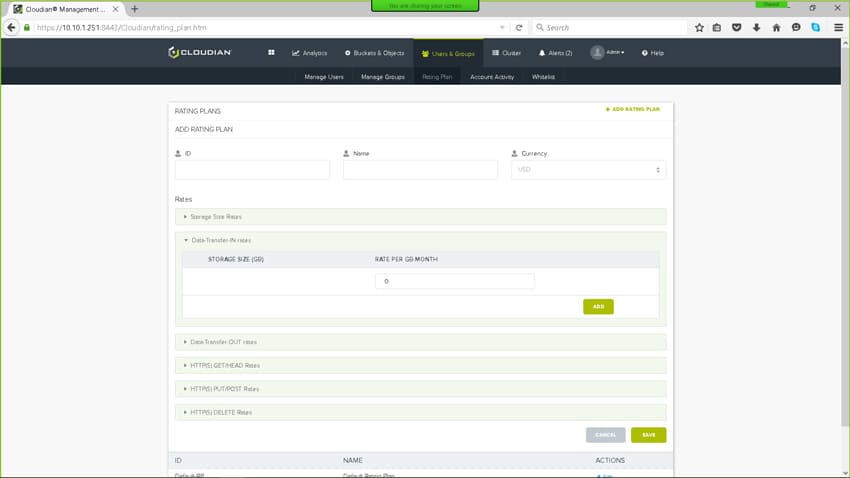
Administratorzy mogą również tworzyć plany ocen na tej karcie. Plany ocen służą do generowania raportów rozliczeniowych. Administratorzy mogą również sprawdzać aktywność konta dla określonej grupy lub użytkownika.
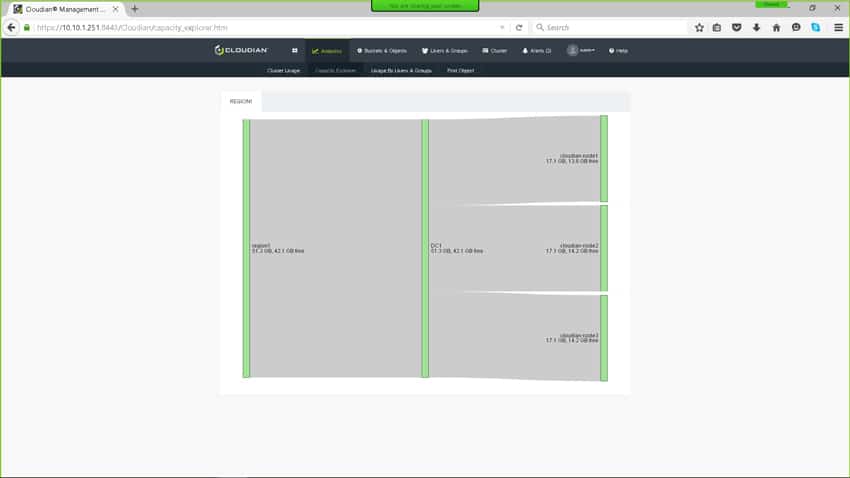
Za pomocą zakładki „Analiza” administratorzy mogą przeglądać wykorzystanie klastra, analizując takie dane, jak zużycie pojemności regionu w czasie w GB, liczbę transakcji obiektów na sekundę oraz przepustowość w KB/s. Eksplorator pojemności prezentuje wykorzystanie pojemności w formie graficznej. Również ze względów rozliczeniowych administratorzy mogą sprawdzać wykorzystanie pojemności według użytkownika. Mogą również wyszukiwać konkretne obiekty.
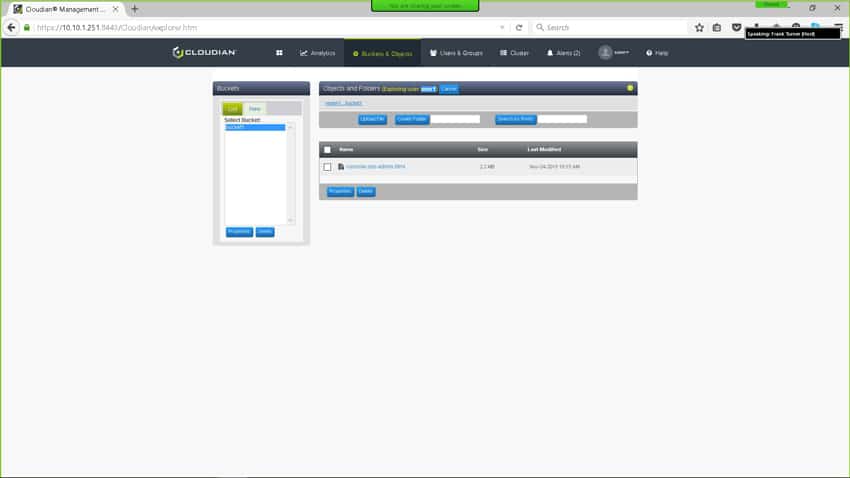
Za pomocą zakładki „Kosze i obiekty” administratorzy mogą przesyłać, tworzyć i wyszukiwać kosze i obiekty. Lista dostępnych koszy znajduje się po lewej stronie. Pod polem wyszukiwania znajduje się lista obiektów, ich rozmiar oraz data ostatniej modyfikacji.
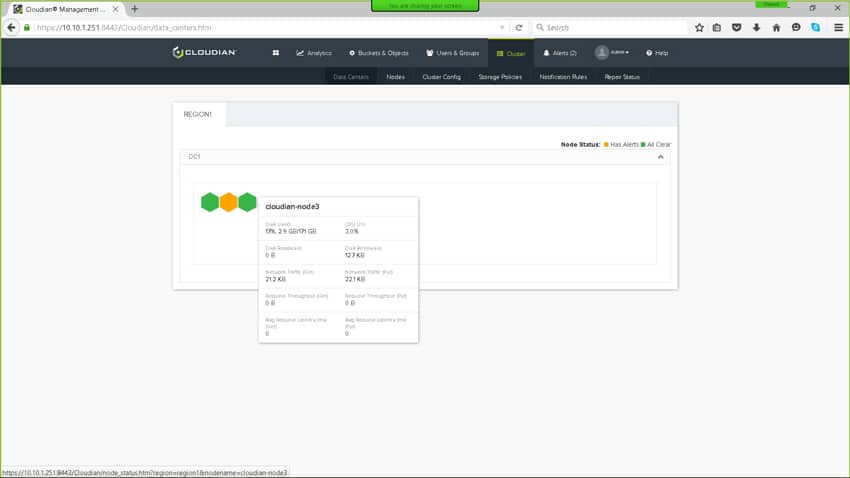
Karta Klaster oferuje administratorom kilka różnych widoków klastra. Na karcie znajduje się kilka podzakładek Centrów Danych, które pokazują klaster według regionu i jego stan – zielony oznacza przejrzystość, a bursztynowy alert (na poniższym rysunku każdy sześciokąt reprezentuje węzeł w klastrze).
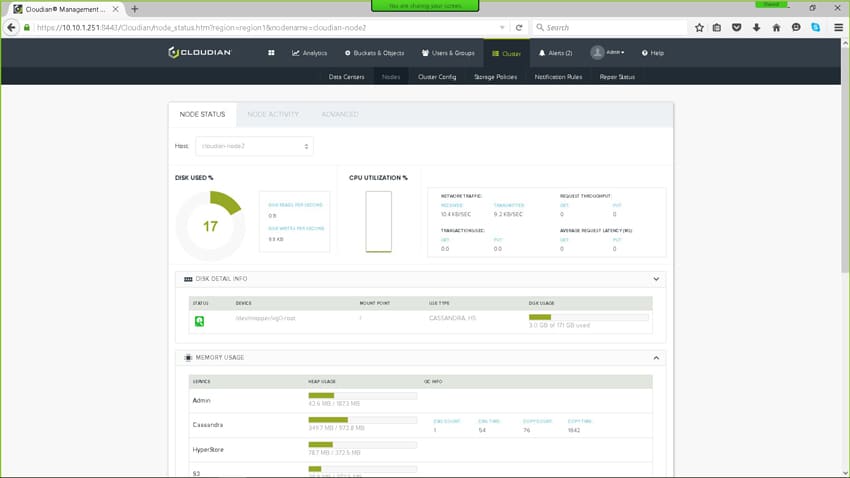
Karta Status węzłów pokazuje ogólny status, wskazując takie aspekty, jak procent zajętej przestrzeni dyskowej, procent wykorzystania procesora, szczegółowe informacje o używanych dyskach, informacje o wykorzystaniu pamięci, a także status usługi i listy zdarzeń.
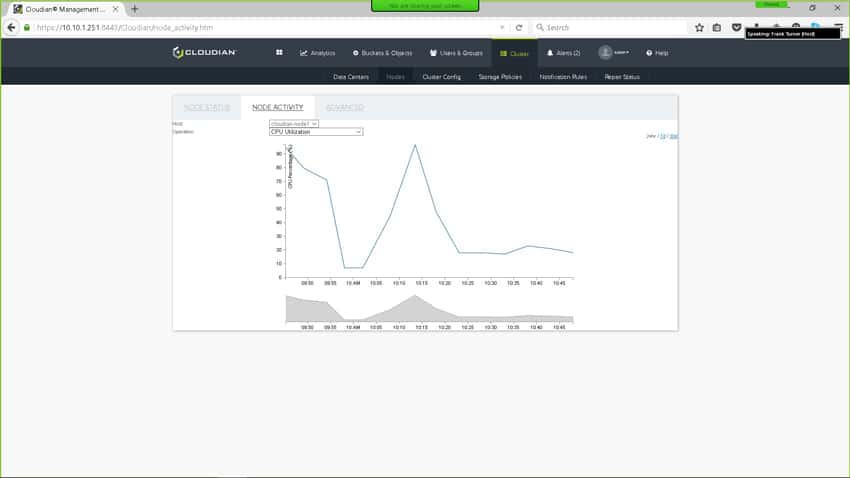
Karta Aktywność węzła zapewnia administratorom graficzną reprezentację konkretnego aspektu operacyjnego węzła. Użytkownicy mają do dyspozycji kilka opcji, w tym: wykorzystanie procesora (pokazane poniżej), dostępny dysk, odczyty z dysku, zapisy z dysku, przepustowość sieci (wychodząca), przepustowość sieci (przychodząca), transakcje (pobieranie), transakcje (wysyłanie), przepustowość żądań (pobieranie), przepustowość żądań (wysyłanie), średnie opóźnienie żądania (pobieranie), średnie opóźnienie żądania (wysyłanie), wykorzystanie pamięci administratora, wykorzystanie pamięci Cassandra, wykorzystanie pamięci HyperStore oraz wykorzystanie pamięci S3.
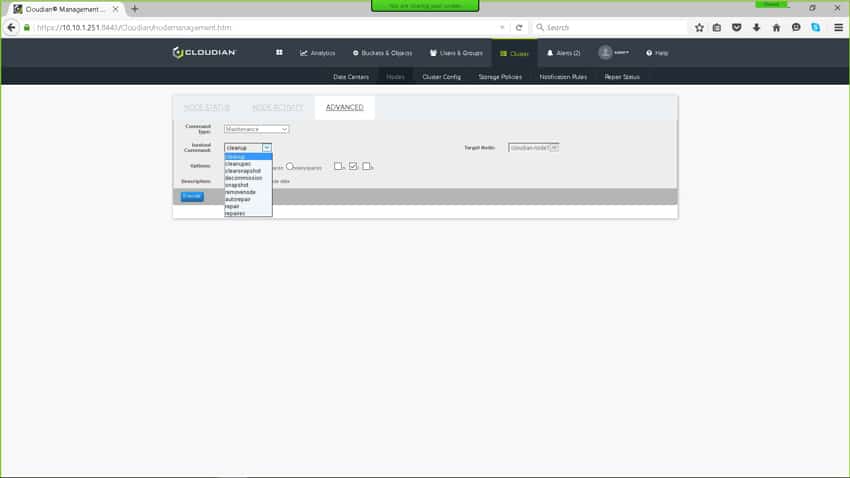
Ustawienia zaawansowane umożliwiają konserwację, wyłączanie dysków, możliwość zbierania danych diagnostycznych i odinstalowywanie węzła.
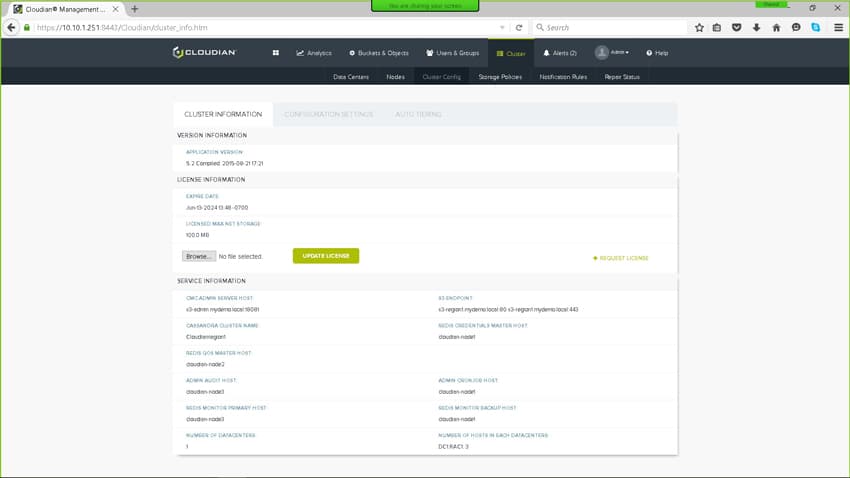
Karta Konfiguracja klastra umożliwia administratorom przeglądanie informacji o klastrze, aktualizację licencji, przeglądanie i edycję ustawień konfiguracji klastra oraz konfigurację automatycznego podziału na poziomy. W przypadku automatycznego podziału na poziomy klienci muszą posiadać jedno konto Amazon.
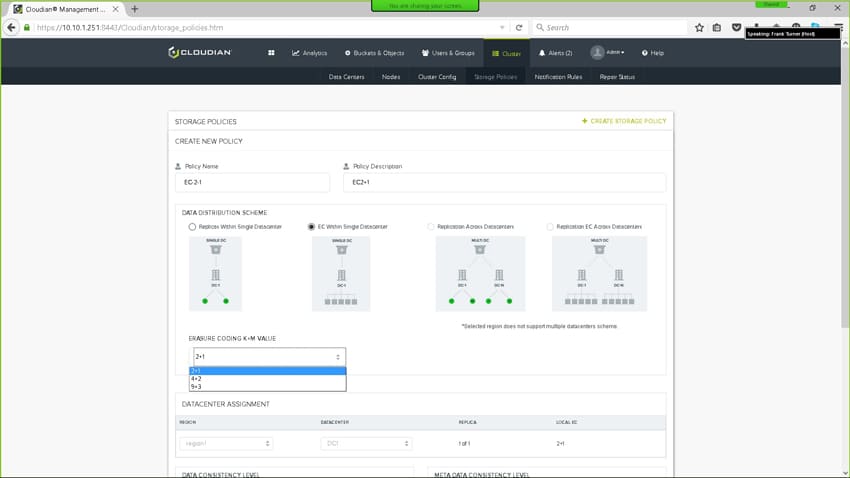
Karta „Zasady przechowywania” umożliwia administratorom skonfigurowanie zasad, w tym EC2+1. Karta ta oferuje dystrybucję danych za pomocą wskaźnika „wskaż i kliknij” oraz ekran rozwijany do wyboru wartości kodowania wymazywania K+M. Po wybraniu tych opcji administratorzy mogą przypisać centrum danych według regionu oraz centrum danych w obrębie każdego regionu. Po przypisaniu centrów danych użytkownicy mogą ustawić poziomy spójności danych i metadanych, a także widoczność grup.
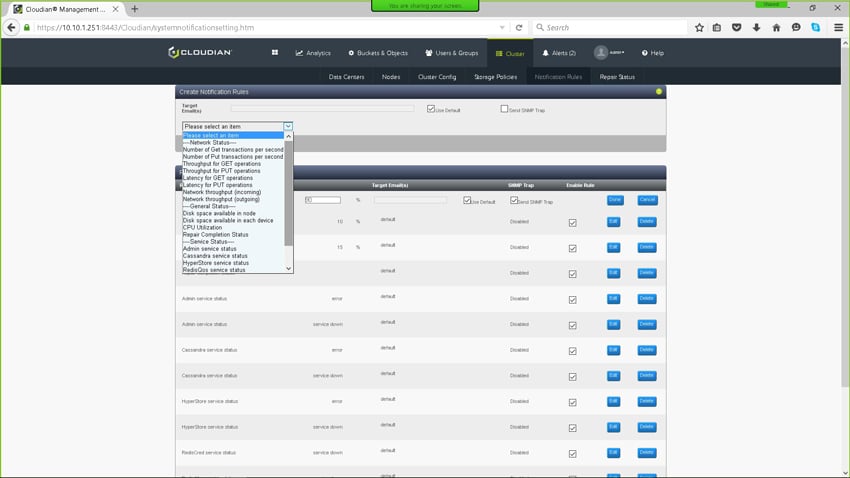
Reguły powiadomień umożliwiają wysyłanie wiadomości e-mail na określony adres dla określonych elementów w węźle. Administratorzy muszą dodać adres e-mail, na który chcą otrzymywać powiadomienia, a następnie wybrać element, o którym chcą być powiadamiani za pomocą podanych reguł. Na przykład, jeśli chcą otrzymywać powiadomienia, gdy klaster wykorzystuje ponad 90% zasobów procesora, mogą to skonfigurować na tej karcie.
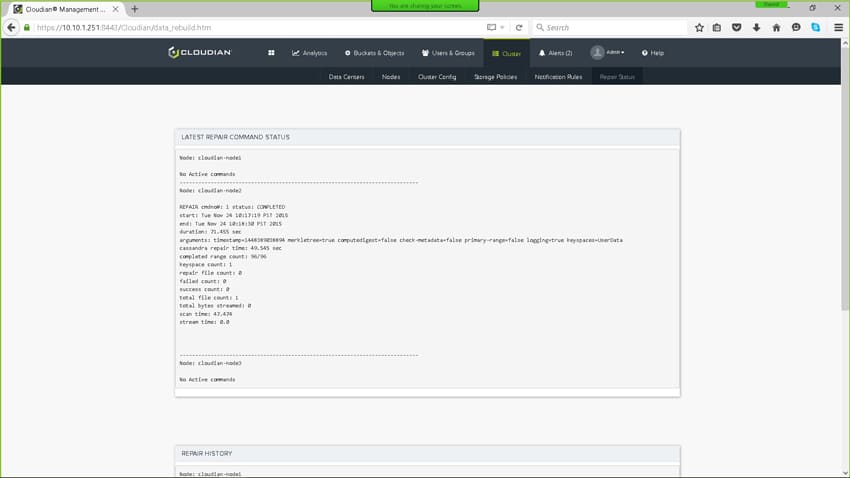
Ostatnia podzakładka w zakładce klastra pokazuje status i historię napraw.
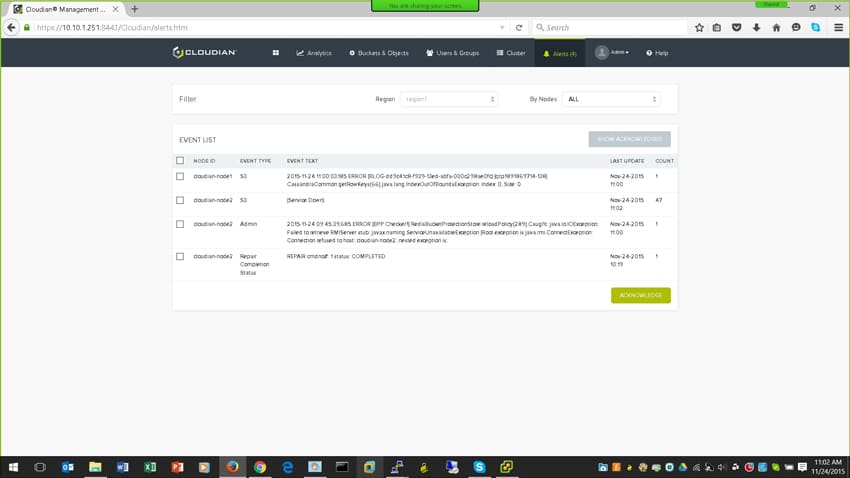
Karta Alerty wskazuje, kiedy wystąpił problem lub zmiana w systemie. Alerty można sortować według węzła lub regionu i czyścić, potwierdzając je.
Wniosek
HyperStore to platforma pamięci masowej, która stanowi przykład możliwości, jakie oferuje, oraz konwergencji powszechnie dostępnej pamięci masowej w chmurze i otwartych interfejsów API. Urządzenie programowe HyperStore umożliwia administratorom wdrożenie w pełni zgodnej z S3 obiektowej chmury pamięci masowej na standardowym sprzęcie serwerowym, z możliwością płynnej skalowalności poprzez dodawanie nowego sprzętu standardowego lub specjalnie zaprojektowanych urządzeń HyperStore.
Tworząc HyperStore od podstaw z myślą o interoperacyjności z Amazon S3 i innymi platformami chmurowymi, Cloudian może oferować klientom rozwiązania, które w pełni wykorzystują potencjał zewnętrznych dostawców chmury w zakresie warstwowania, tworzenia kopii zapasowych, replikacji i innych funkcji, bez konieczności zarządzania dwoma różnymi środowiskami pamięci masowej o różnych architekturach lub paradygmatach zarządzania. Oznacza to również, że administratorzy i użytkownicy HyperStore mogą korzystać z natywnej obsługi HyperStore dla dobrze ugruntowanego ekosystemu aplikacji S3.
Bottom Line
HyperStore przenosi wydajność i elastyczność lokalnej pamięci masowej w chmurze S3 do standardowego sprzętu, a także integruje interfejsy API, aby w pełni wykorzystać możliwości zewnętrznej pamięci masowej w chmurze od firm Amazon, Google, Microsoft i innych.
Środowisko operacyjne Cloudian HyperStore


 Amazon