

Na rynku dostępnych jest obecnie wiele opcji pamięci masowej. Większość z nich wyróżnia się różną prędkością, większą dostępnością „9” lub zróżnicowanym wsparciem dla interfejsu graficznego. Ogólnie rzecz biorąc, macierze są bardzo podobne; oferują jedynie różne ceny, wsparcie techniczne lub funkcje, które są skierowane do określonej grupy klientów. DataGravity wkroczyło na rynek, oferując coś naprawdę wyjątkowego. DataGravity nie koncentruje się na tym, jak szybko dane mogą być przechowywane lub odczytywane, ani na tym, ile dysków można zmieścić w obudowie 2U; przynajmniej na razie. DataGravity koncentruje się na zrozumieniu danych i ułatwieniu klientom ich wyszukiwania, raportowania i zapewnienia zgodności z branżowymi lub wewnętrznymi zasadami.
Zrozumienie niuansów związanych z miejscem DataGravity jest istotne. W przedsiębiorstwach często istnieją zespoły ds. analityki i bezpieczeństwa dużych zbiorów danych, których zadaniem jest wyszukiwanie i zabezpieczanie danych, ale DataGravity nie jest tym rynkiem. DataGravity jest skierowane do rynku średnich przedsiębiorstw, który w większości przypadków dysponuje ograniczonym personelem IT, ale boryka się z tymi samymi wyzwaniami związanymi z danymi, co duże przedsiębiorstwa. Dlaczego DataGravity miałoby powierzyć tak skomplikowany proces komuś, kto wydaje się słabo przygotowany do jego obsługi? Ponieważ, jak twierdzi założycielka DataGravity, Paula Long, jeśli potrafisz surfować po internecie, potrafisz korzystać z tego produktu. Automatyzacja jest kluczem do rozwiązania tych problemów.
Rodzina DataGravity Discovery Series działa poprzez zrozumienie danych w plikach. Dzięki możliwości analizy dokumentu Word, na przykład w celu sprawdzenia numerów ubezpieczenia społecznego, macierz DataGravity oferuje natychmiastowy wgląd w pliki przechowywane w firmie. DataGravity może następnie zrozumieć te dane, generować raporty i zapewnić, że poufne informacje nie zostaną udostępnione osobom nieupoważnionym. Oprócz zrozumienia danych przechowywanych w macierzy, audytowany jest cały dostęp do plików i aktywność użytkowników, co pomaga firmom spełnić wymagania dotyczące zgodności i bezpieczeństwa. To ważne rozróżnienie w zrozumieniu, czym jest DataGravity, a czym nie. DataGravity koncentruje się na tym nieustrukturyzowanym przypadku użycia danych, który jest powszechnym obszarem zastosowań dla NAS-ów i podobnych. Chociaż obsługują one iSCSI, NFS i SMB, głównym zastosowaniem DataGravity nie są typowe zastosowania biznesowe, takie jak poczta e-mail, transakcyjne bazy danych itp. Platforma może w końcu do tego dojść i prawdopodobnie tak się stanie, ale obecnie ich cel jest bardzo dobrze zdefiniowany.
Dane takie jak numery ubezpieczenia społecznego, identyfikatory pacjentów, numery telefonów, numery kart kredytowych itp. są łatwe do zdefiniowania i zrozumienia. W rzeczywistości DataGravity obsługuje wiele popularnych tagów zgodności od razu. Nie ogranicza się jednak do nich. Dla organizacji o unikalnych potrzebach, takich jak wiele firm, DataGravity oferuje edytor, który pozwala organizacjom tworzyć własne tagi. Dzięki temu użytkownicy platformy będą mogli szybko reagować na wymagania dotyczące bezpieczeństwa, zgodności i eDiscovery, specyficzne dla ich branży. Wgląd w przechowywane dane zapewnia również większą wartość biznesową, umożliwiając wyszukiwanie wszystkich informacji, oczywiście na podstawie reguł dostępu.
DataGravity oferuje macierze w kilku konfiguracjach, wykorzystując dyski twarde typu nearline do zwiększenia pojemności oraz pamięć flash jako pamięć podręczną do odczytu. Jednostki posiadają dwa kontrolery, z których każdy jest „aktywny” i wykonuje określone zadanie, które omówimy bardziej szczegółowo poniżej. Model DG1100 oferuje 18 TB pojemności dysków, a DG1200 36 TB. Model DG2200 oferuje 48 TB, a DG2400 96 TB. Obecnie dyski te nie są rozszerzalne, jednak DataGravity wyraźnie dostrzega potrzebę rozwiązania tego problemu; prawdopodobnie za pomocą półek rozszerzeń i/lub interfejsu zarządzania, który łączy wiele systemów w jeden widok zarządzania. Nasze testy w ramach tej recenzji koncentrują się wyłącznie na użyteczności; spędziliśmy dwa dni w biurze DataGravity w Nashua w stanie New Hampshire, a prace kontrolne zakończyliśmy zdalnie. Dało nam to możliwość praktycznego sprawdzenia jednostki DG1100.
Architektura
DataGravity oferuje dwa kontrolery w konfiguracji aktywny-aktywny, ale z pewnym urozmaiceniem. Zazwyczaj podwójny kontroler w konfiguracji aktywny-aktywny oznacza, że oba kontrolery są aktywne i przetwarzają dane wejścia/wyjścia. Jednak w DataGravity architektura naśladuje architekturę aktywny-pasywny, gdzie węzeł główny obsługuje dane, a węzeł inteligentny zajmuje się ich analizą. DataGravity nazywa to „aktywno-proaktywnym”. Podstawowa konfiguracja wygląda następująco: wiele GB pamięci DRAM, podtrzymywana bateryjnie pamięć NVRAM, dyski SSD na metadane i pamięć podręczną, a następnie dyski twarde typu nearline.
Z niemałą ilością danych przepływających przez pamięć DRAM i podtrzymywaną bateryjnie pamięć NVRAM, DataGravity lustrzanie kopiuje zapisy między węzłem głównym a węzłem analitycznym jako priorytet. Odbywa się to za pośrednictwem wewnętrznego mostu PCIe, oferującego komunikację o wysokiej przepustowości i niskim opóźnieniu. To szybkie łącze jest wykorzystywane w architekturze DataGravity do ciągłej ochrony i analizy danych. Dane w trakcie transmisji są lustrzanie kopiowane do momentu, aż węzeł główny będzie mógł je zapisać na dysku. Wykorzystując oba kontrolery, seria Discovery wykorzystuje główny węzeł pamięci masowej do obsługi operacji wejścia/wyjścia, a zazwyczaj bezczynny węzeł pomocniczy do pracy jako węzeł analityczny. Węzeł analityczny wykorzystuje metadane i szczegółowe zapisy lustrzanie kopiowane do tego kontrolera, zapewniając ciągłą ochronę i przetwarzanie analityczne z uwzględnieniem danych.
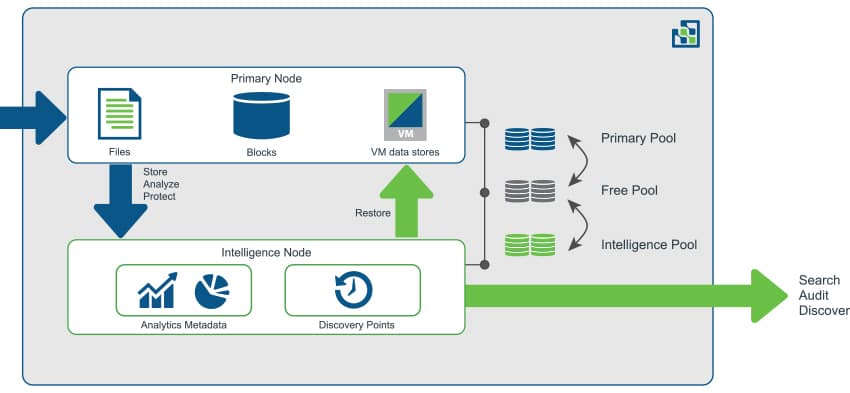
Chociaż model aktywny-aktywny (lub aktywny-proaktywny w tym przypadku) ma tę zaletę, że wykorzystuje to, za co zapłacono (w przeciwieństwie do modelu aktywnego-pasywnego, gdzie drugi węzeł pozostaje uśpiony do momentu awarii głównego), zawsze pojawia się pytanie: co z wydajnością w przypadku awarii węzła? Jeśli DataGravity potrzebuje dwóch węzłów do działania, a jeden z nich zostanie utracony, co z tego wynika dla klientów? W przypadku awarii węzła, pozostały węzeł przejmuje podstawowe funkcje produkcyjne. Użytkownicy nadal będą mogli uzyskiwać dostęp do plików i korzystać z nich tak, jak w swojej codziennej pracy. Jednak większość analiz jest zawieszona do czasu przywrócenia uszkodzonego węzła. Innymi słowy, dostępność pozostaje, ale funkcje skoncentrowane na metadanych są ograniczone do momentu przywrócenia węzła.
Użyteczność
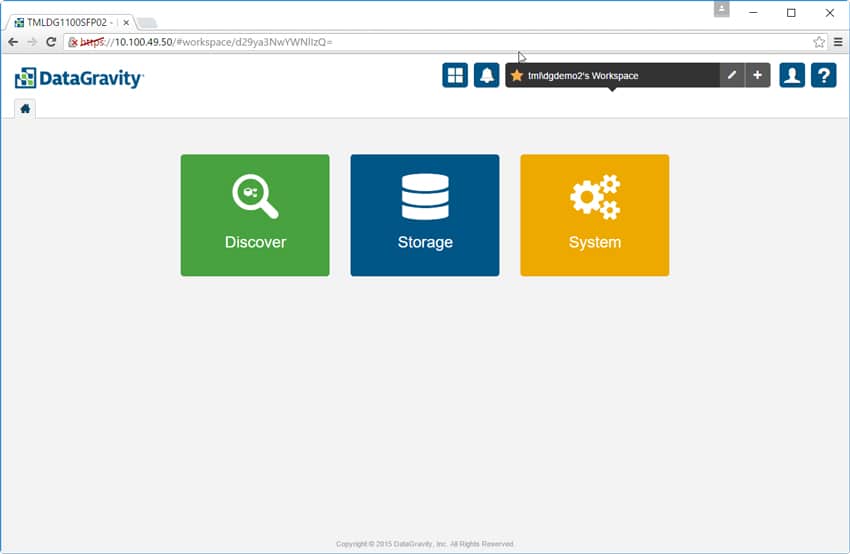
Interfejs graficzny DataGravity jest oparty na HTML 5 i charakteryzuje się bardzo prostym i użytecznym układem. Karta główna ma tylko trzy opcje do wyboru: „Odkryj”, „Pamięć masowa” lub „System”. W prawym górnym rogu znajduje się panel dostępu globalnego, który zawiera ikony pulpitu systemowego i alertów, obszaru roboczego, profilu oraz pomocy online.
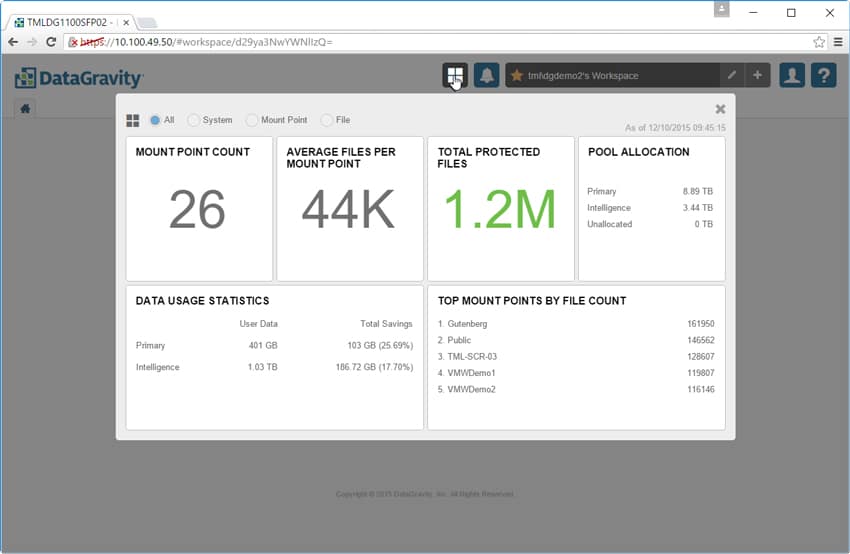
Panel systemowy umożliwia użytkownikom szybki podgląd statystyk, takich jak liczba punktów montowania, całkowita liczba chronionych plików, przydział puli i statystyki wykorzystania danych.
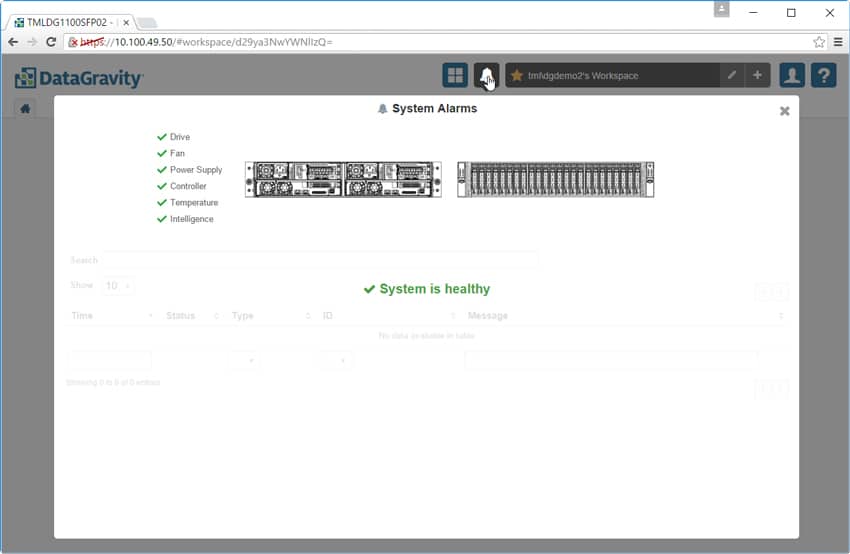
Karta alarmów systemowych działa tak, jak sugeruje jej nazwa – udostępnia użytkownikom listę alarmów i informacje o miejscu ich wystąpienia w systemie.
Po prawej stronie zakładki alarm znajduje się zakładka Obszar roboczy. Tutaj użytkownicy mogą zmieniać nazwy lub dodawać obszary robocze. Obszary robocze pozwalają użytkownikom konfigurować i zarządzać prywatnym widokiem systemu. Użytkownicy mogą konfigurować wiele obszarów roboczych w zależności od swoich potrzeb.

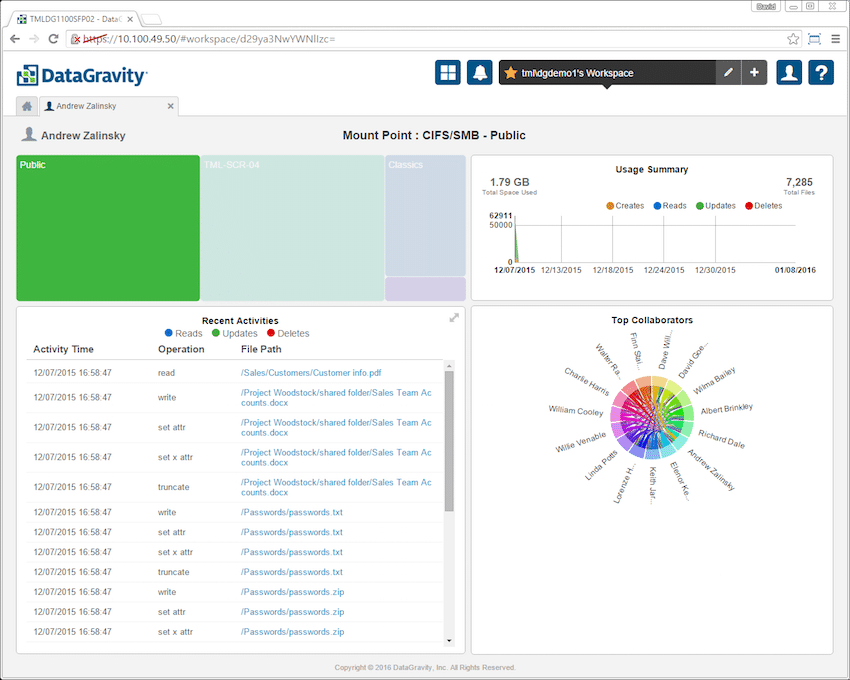
Następną ikoną jest ikona Profile. Klikając ją, autoryzowany użytkownik może zarządzać swoim profilem, subskrypcjami e-mail dla zapisanych wyszukiwań oraz wylogować się z systemu. Po zalogowaniu interfejs graficzny użytkownika udostępnia kilka kafelków, które wyświetlają informacje, takie jak podsumowanie użytkowania w czasie i ostatnia aktywność (każda z podziałem na odczyty, aktualizacje, usunięcia, a w przypadku użytkowania – również utworzone). Dostępny jest również diagram akordów, który pokazuje, z kim i w jakim charakterze współpracuje dany użytkownik.
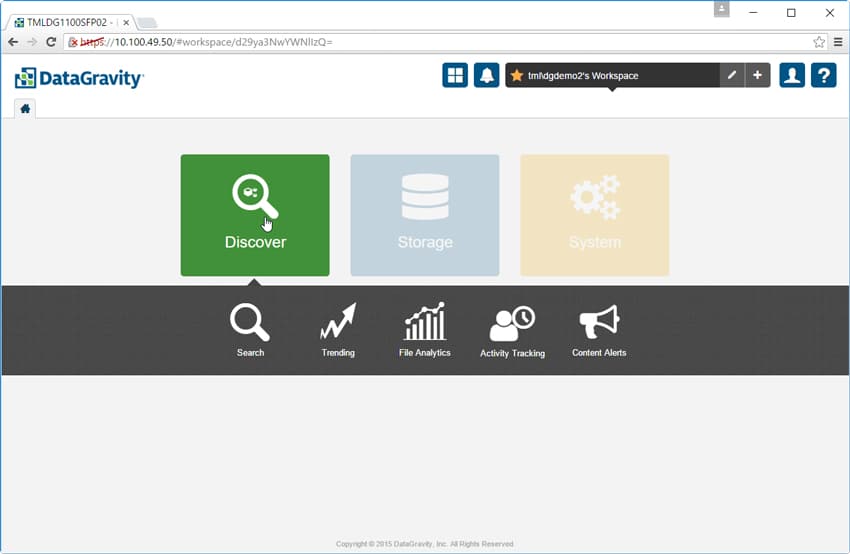
Wracając do zakładki głównej, ikona po lewej stronie to podstawa DataGravity – zakładka „Odkryj”. Kliknięcie zakładki udostępnia użytkownikom takie opcje, jak wyszukiwanie, trendy, analiza plików, śledzenie aktywności i alerty dotyczące treści.
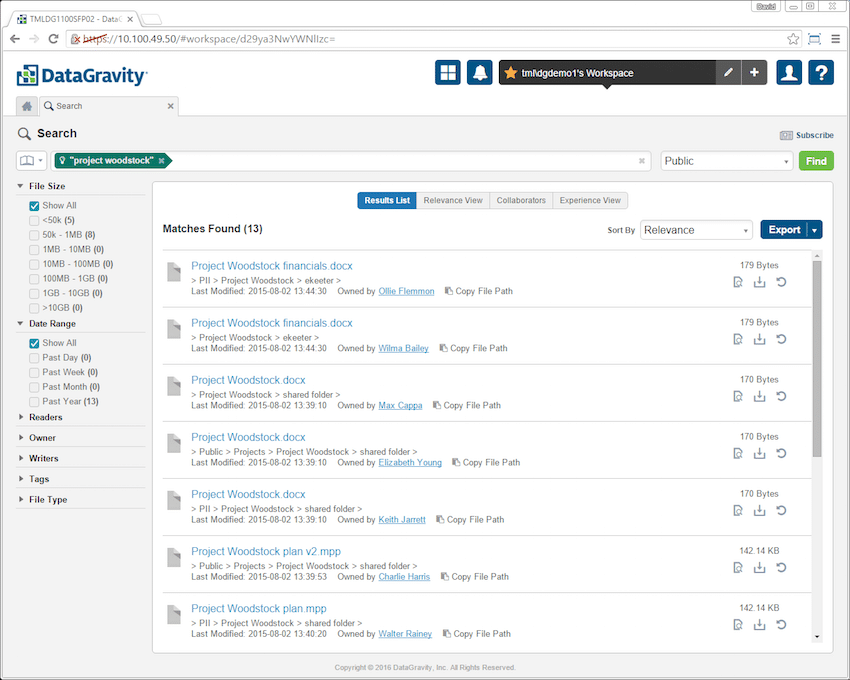
Wyszukiwanie jest takie, jak sugeruje nazwa. Pojawia się pasek wyszukiwania, a użytkownicy muszą jedynie wpisać poszukiwane słowo kluczowe lub nazwę pliku. Przed rozpoczęciem wyszukiwania użytkownicy muszą wybrać punkt montowania, w którym chcą przeprowadzić wyszukiwanie. Na poniższym obrazku wyszukiwanie dotyczy „projektu Woodstock”. Zwrócone zostały wszystkie pliki w publicznym punkcie montowania, które zawierały te hasła. Filtry po lewej stronie pozwalają na dalsze zawężenie wyników.
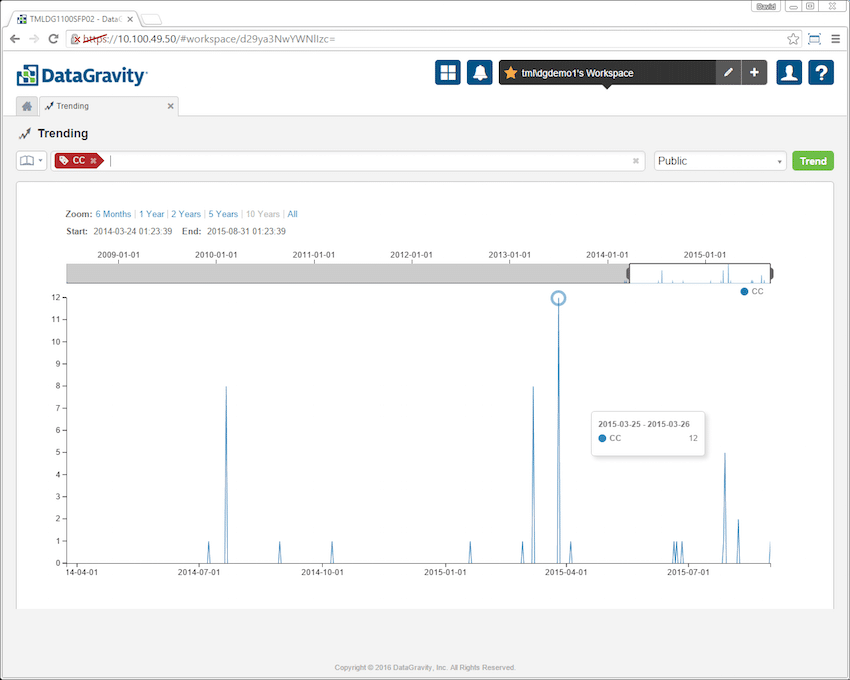
Funkcja Trending jest podobna do wyszukiwania, z tą różnicą, że tutaj użytkownicy wpisują poszukiwane słowo kluczowe lub tag, a rozwiązanie wyświetli im graficzną reprezentację danych. Pozwala to firmom śledzić, jak uzyskiwany jest dostęp do danych zarówno w plikach aktywnych, jak i usuniętych, w czasie. Na poniższym zrzucie ekranu wprowadzono tag karty kredytowej (CC) do funkcji Trending. Wyniki pokazują, jak numery kart kredytowych zmieniały się w czasie w publicznym punkcie montowania.
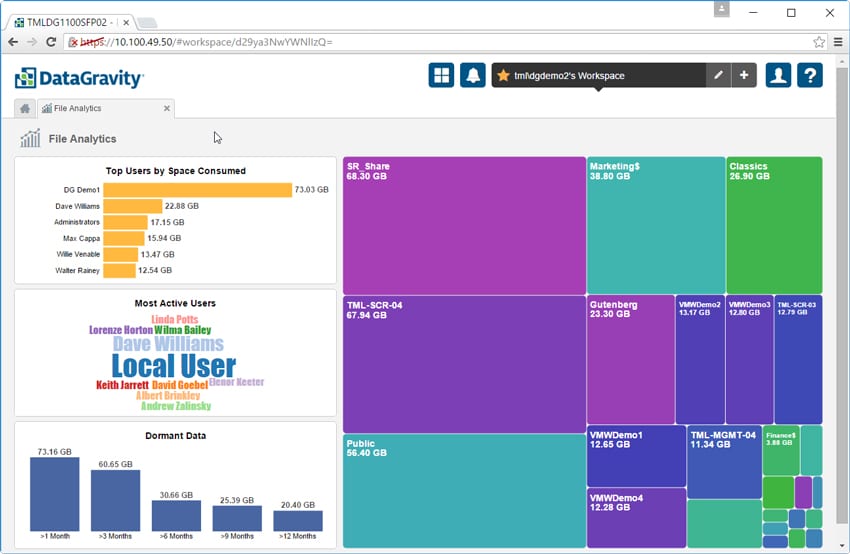
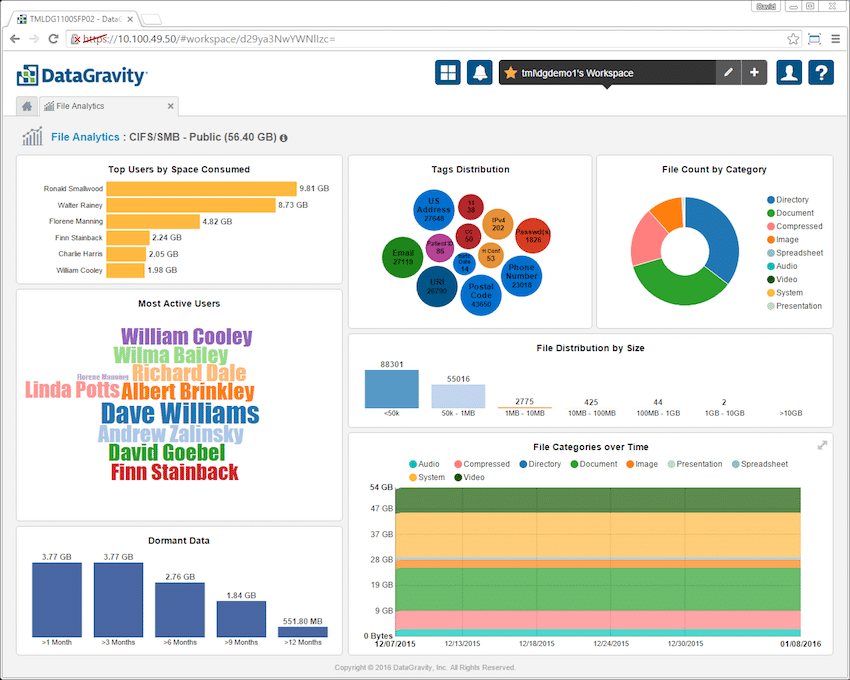
File Analytics to kolejny obszar, w którym DataGravity wyróżnia się na tle innych dostawców pamięci masowej. Za pośrednictwem tego pulpitu użytkownicy mogą łatwo przeglądać udziały plików i maszyny wirtualne reprezentowane przez kolorowe bloki po prawej stronie. Im większy udział, tym większy blok. Użytkownicy mogą również zobaczyć 10 najaktywniejszych użytkowników według zużycia miejsca na wykresie słupkowym, najbardziej aktywnych użytkowników (im bardziej aktywny użytkownik, tym większa jego nazwa), a także dane uśpione i czas ich nieaktywności, pogrupowane według kategorii 1, 3, 6, 9 i 12 miesięcy.
Kliknięcie na pojedynczy udział plików lub maszynę wirtualną pozwala na dokładniejsze rozbicie tych informacji. Po lewej stronie znajdują się informacje o najbardziej aktywnych użytkownikach (mierzone liczbą operacji odczytu/zapisu/usuwania) oraz o użytkownikach o największej liczbie miejsc w udziale lub maszynie wirtualnej. Znajduje się tam również lista uśpionych danych. Po prawej stronie znajdują się cztery dodatkowe kafelki: rozkład tagów, liczba plików według kategorii, rozkład plików według rozmiaru oraz kategorie plików w czasie. Kliknięcie każdego kafelka zapewnia więcej szczegółów.
Następna zakładka w sekcji „Odkryj” to „Śledzenie aktywności”. Jak sama nazwa wskazuje, administratorzy i użytkownicy zabezpieczeń mogą szybko sprawdzić, jaki użytkownik wykonał daną aktywność w danym okresie. Administratorzy muszą jedynie wybrać punkt montowania, który chcą przeszukać, oraz użytkownika i zakres dat.

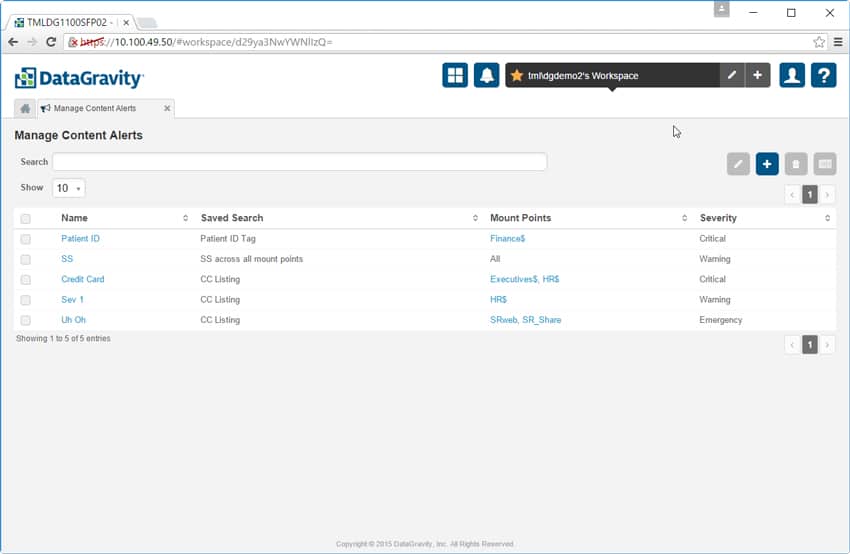
Ostatnia zakładka w sekcji „Odkryj” umożliwia administratorom zarządzanie alertami dotyczącymi treści. W poniższym przykładzie administrator skonfigurował alerty, aby otrzymywać powiadomienia o znalezieniu numerów ubezpieczenia społecznego lub kart kredytowych w postaci otwartego tekstu, w formatach niezaszyfrowanych i w miejscach, w których nie powinny się znajdować. Dzięki temu firmy mogą szybko znaleźć i przenieść krytyczne dane, które zostały umieszczone w niezabezpieczonych lokalizacjach.
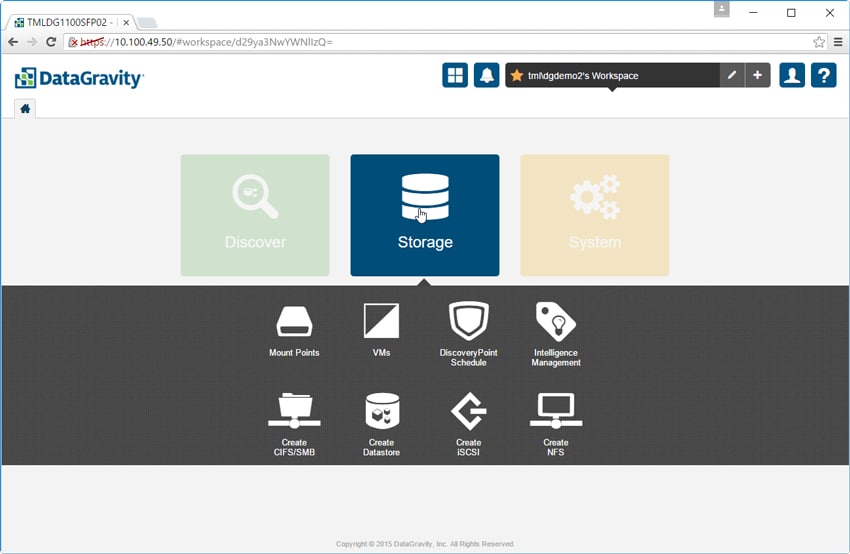
Następną główną zakładką jest zakładka „Magazyn”. Znajduje się tu 8 podzakładek: Punkty montowania, Maszyny wirtualne, Harmonogram DiscoveryPoint, Zarządzanie inteligencją, Tworzenie CIFS/SMB, Tworzenie magazynu danych, Tworzenie iSCSI i Tworzenie NFS.
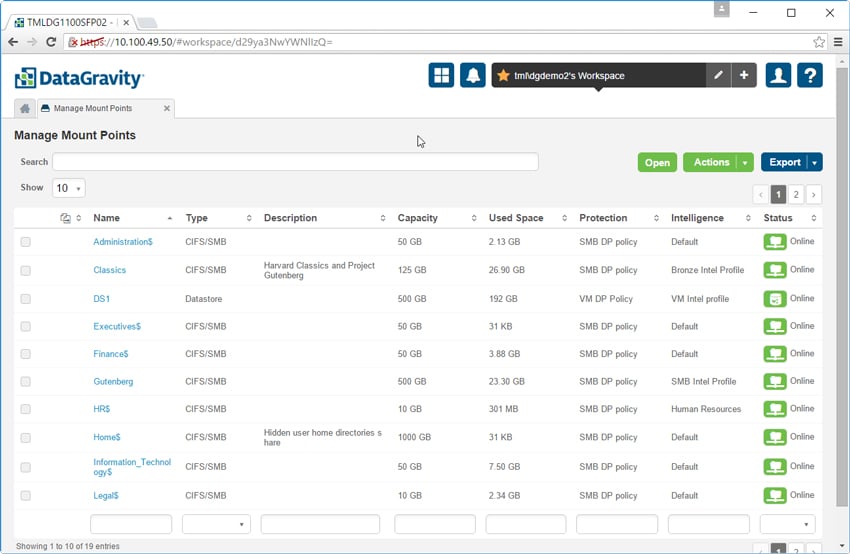
Karta Zarządzaj Punktami Montowania umożliwia użytkownikom przeglądanie ustawień każdego punktu montowania, a także tworzenie nowych. W tym miejscu użytkownicy mogą sprawdzić pojemność każdego punktu montowania (oraz jego wykorzystanie), krótki opis, politykę ochrony i status. Ustawienia każdego nowego punktu montowania utworzonego w tym miejscu można dostosować w razie potrzeby.
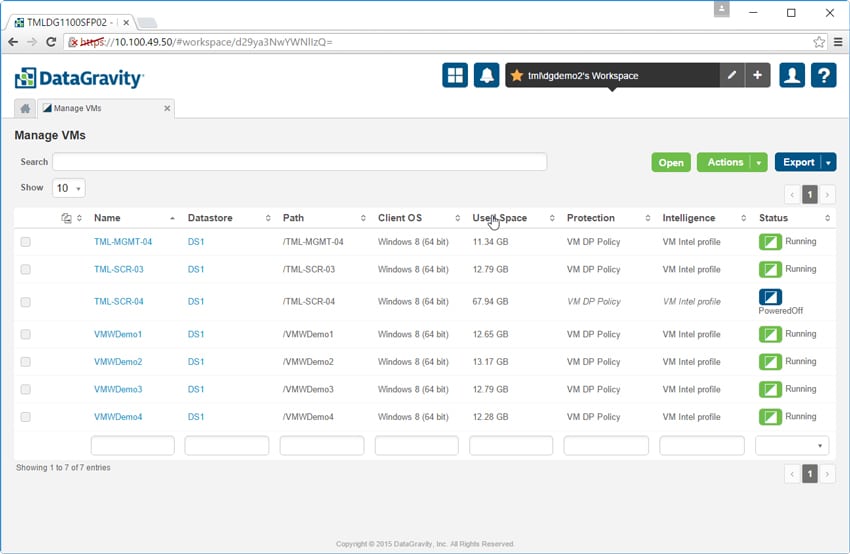
Karta „Zarządzaj maszynami wirtualnymi” jest podobna do powyższej. Umożliwia ona przeglądanie i konfigurowanie informacji o maszynach wirtualnych. Wyświetlana jest nazwa maszyny wirtualnej, jej lokalizacja, system operacyjny, używana pojemność, polityka ochrony, profil inteligencji oraz informacja o tym, czy maszyna wirtualna jest uruchomiona, czy wyłączona. Kliknięcie maszyny wirtualnej zapewnia dostęp do dodatkowych informacji.
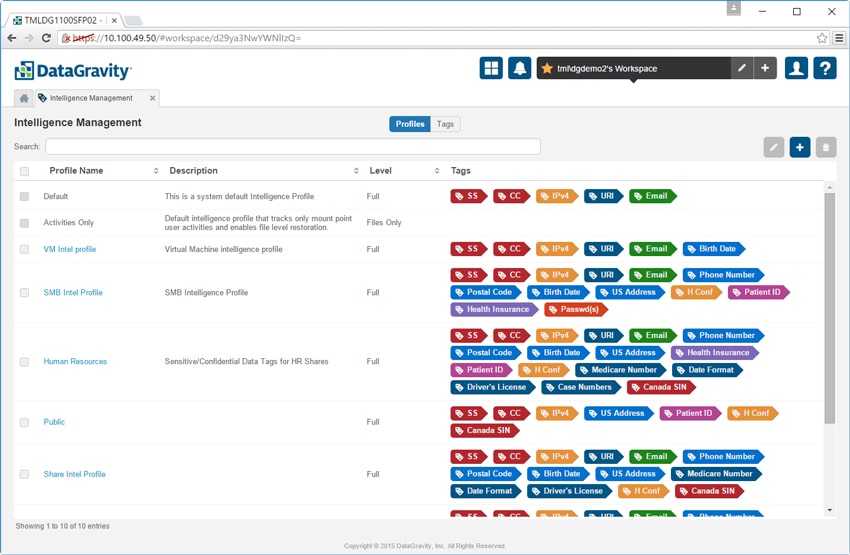
Karta Zarządzanie danymi wywiadowczymi umożliwia administratorom konfigurowanie profili danych wywiadowczych dla konkretnych przypadków użycia i stosowanie ich do punktów montowania i maszyn wirtualnych. Przycisk Tagi pozwala administratorom definiować wzorce lub frazy treści zawierające poufne dane za pomocą wbudowanego edytora wyrażeń regularnych.
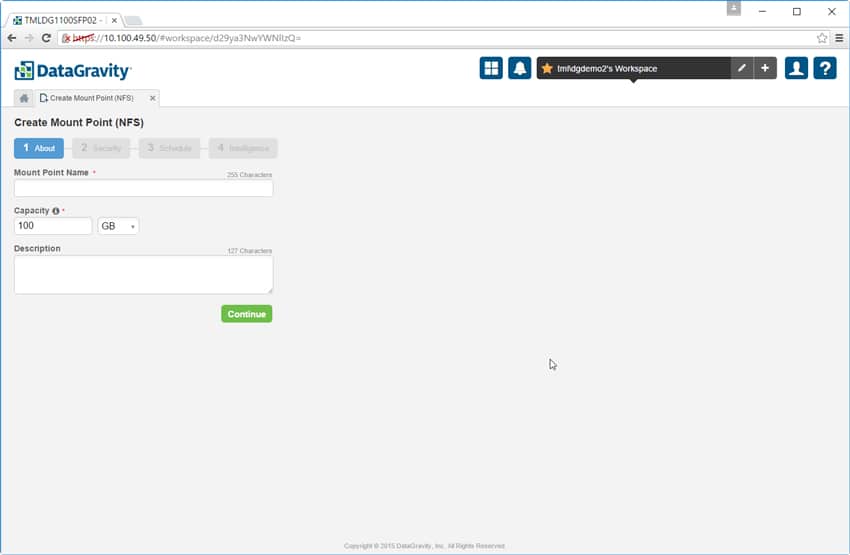
Kolejne cztery zakładki dotyczą tworzenia punktu montowania i protokołu dostępu do niego, czy to CIFS/SMB, NFS DataStore z włączoną obsługą maszyn wirtualnych, iSCSI czy NFS (jak na obrazku poniżej). Administratorzy dodają nazwę punktu montowania, dodają opis (opcjonalnie), wybierają pojemność, ustawiają politykę bezpieczeństwa, definiują harmonogram DiscoveryPoint i wybierają profil inteligencji.
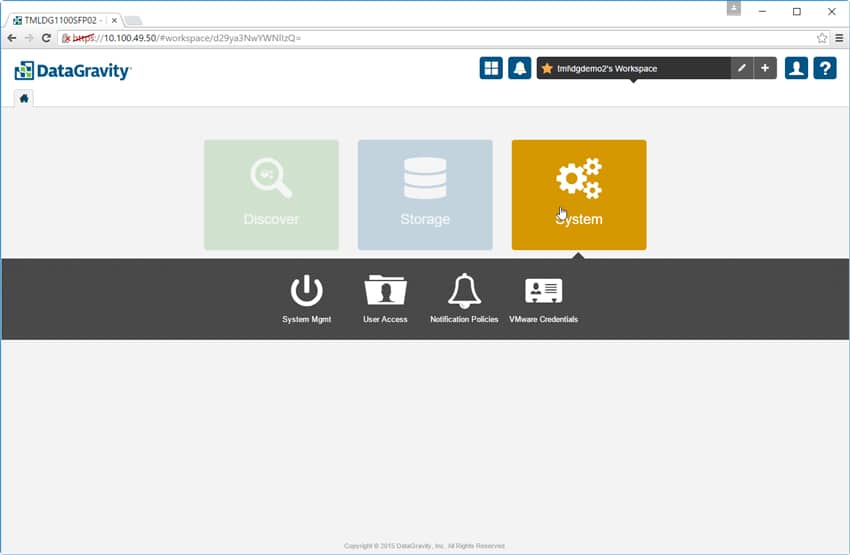
Ostatnią główną sekcją jest zakładka System. Po jej kliknięciu pojawią się cztery podzakładki: Zarządzanie systemem, Dostęp użytkowników, Zasady powiadomień i Poświadczenia VMware.
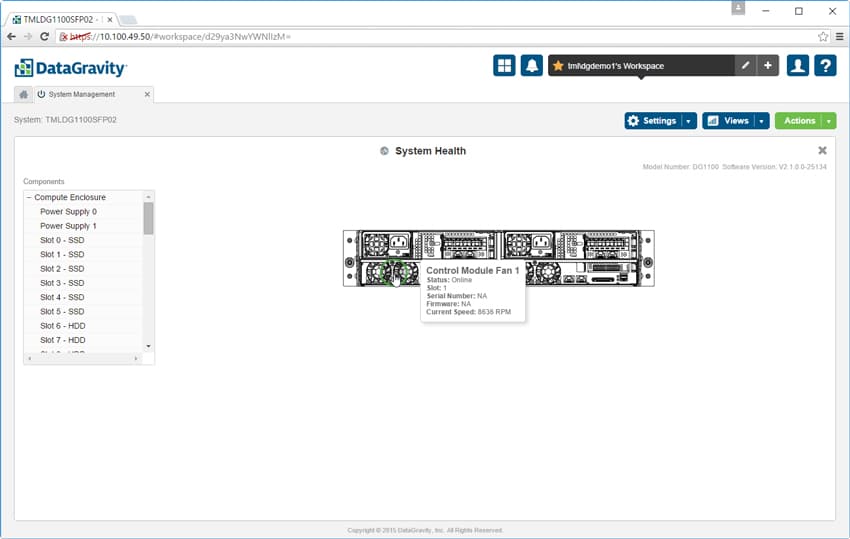
Karta Zarządzanie Systemem oferuje wiele opcji, w tym Stan Systemu, który daje wgląd w stan systemu fizycznego. Po lewej stronie znajduje się lista wszystkich komponentów rozwiązania. Po prawej stronie znajduje się graficzna reprezentacja, która po najechaniu kursorem myszy dostarczy użytkownikowi więcej informacji.
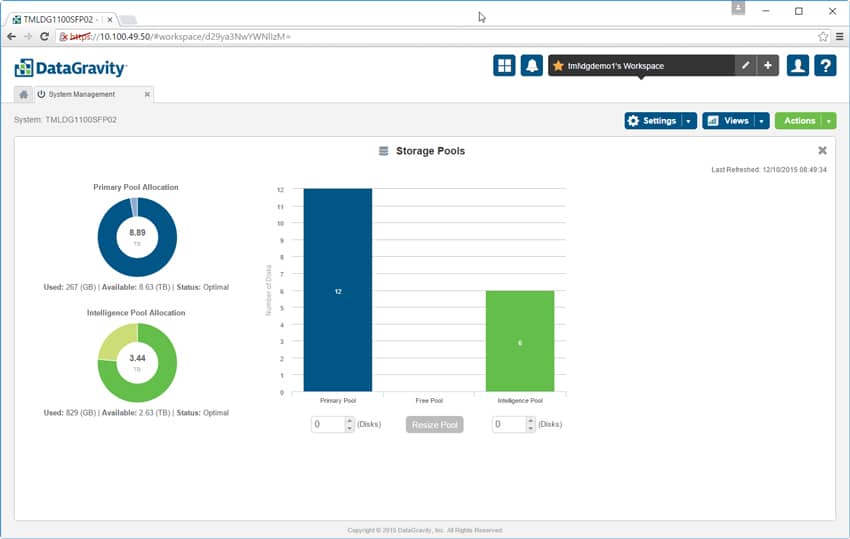
W Zarządzaniu Systemem znajduje się również sekcja Pule Magazynu Danych, która umożliwia podgląd trzech różnych pul w systemie DataGravity: puli głównej, czyli puli przydzielonej do codziennego użytku, puli inteligentnej oraz puli wolnej pamięci masowej, która nie została jeszcze przydzielona. Na tym ekranie użytkownicy mogą zmieniać rozmiary pul w razie potrzeby.
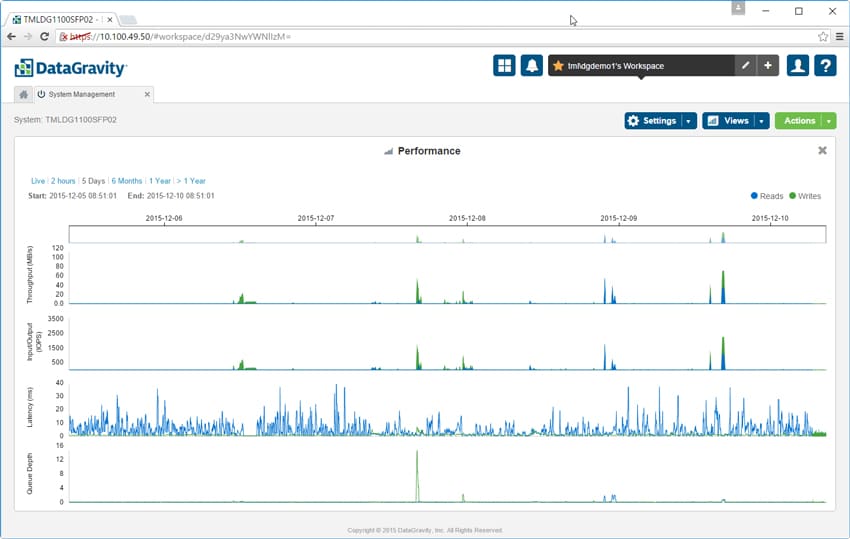
Dostępna jest również opcja podglądu wydajności systemu. Widok wydajności pokazuje zarówno odczyt, jak i zapis danych we/wy oraz szczegółowe informacje, takie jak przepustowość w MB/s, IOPS, opóźnienie i głębokość kolejki. Użytkownicy mogą przeglądać wydajność w danym okresie lub odczytywać ją w czasie rzeczywistym.
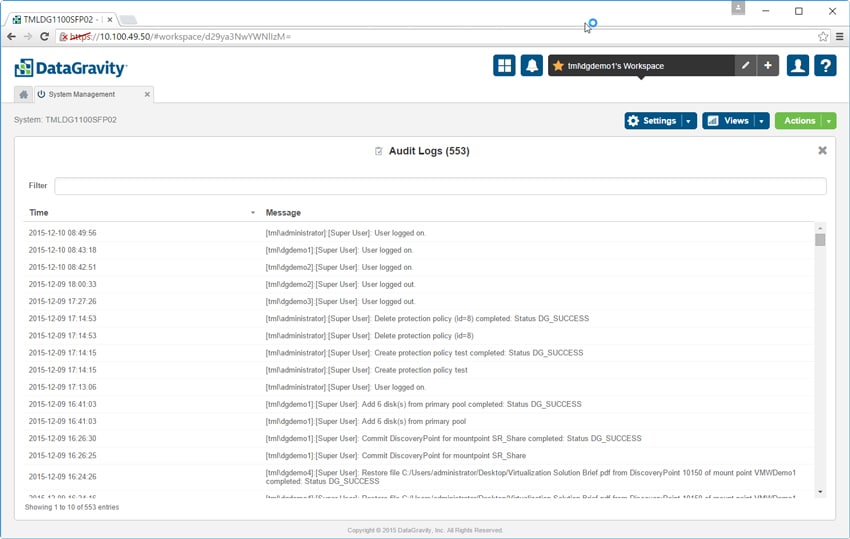
Wreszcie, w sekcji Zarządzanie systemem, administratorzy mogą przeglądać dzienniki audytu. Mogą nie tylko zobaczyć, kto się logował i co robił, ale także filtrować dzienniki, aby ułatwić dostęp do nich i przesłać je do innego systemu w celu dalszego przetwarzania.
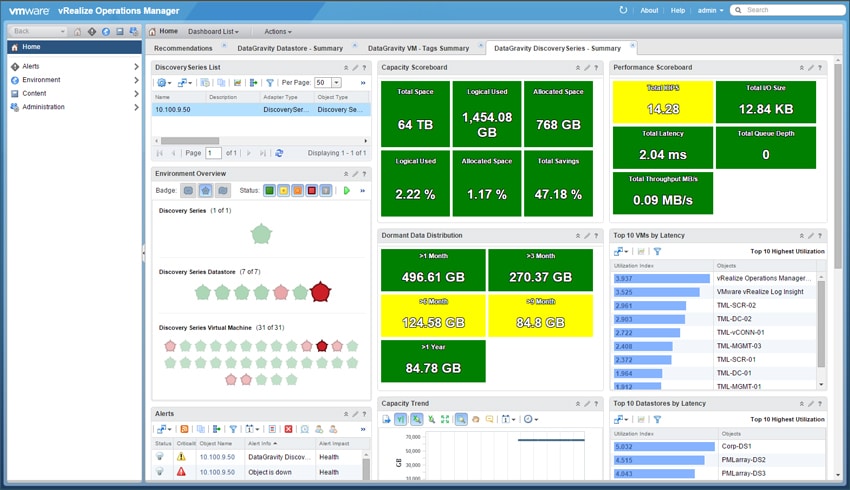
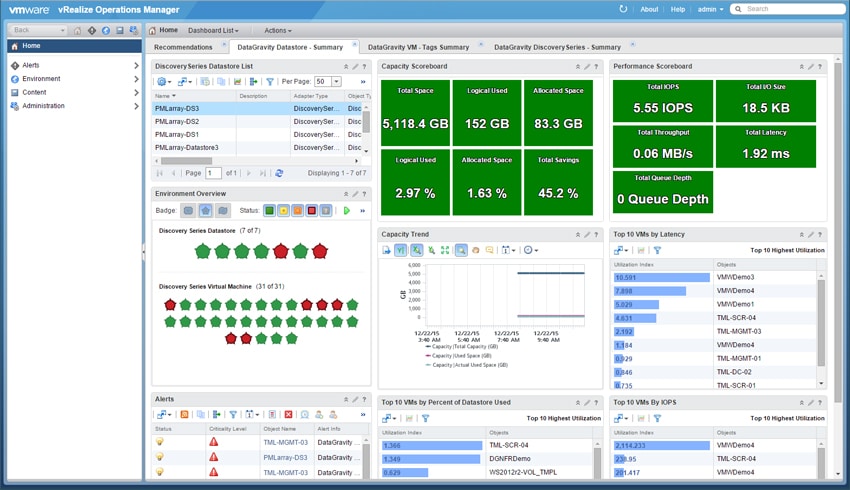
DataGravity integruje się również z VMware vRealize Operations Manager (vROPS), aby udostępnić analitykę systemu DataGravity w scentralizowanej konsoli udostępnianej przez vROPS. DataGravity nie posiada wirtualnej obecności, więc ta integracja umożliwia administratorowi wirtualizacji wgląd w system bez konieczności logowania się do interfejsu użytkownika DataGravity. Chociaż wszystkie informacje są dostępne, wizualizacje danych są ograniczone w porównaniu z interfejsem graficznym DataGravity.
Integracja vROPS wyświetla widoki podsumowujące Discovery Series, DataStore lub maszynę wirtualną. Poniżej znajduje się widok pulpitu podsumowującego Discovery Series, który pokazuje ogólną pojemność i wydajność systemu, a także opóźnienia dla magazynów danych i maszyn wirtualnych przechowywanych w systemie, wraz z oceną ryzyka dla każdego z nich.
Podczas przeglądania pulpitu nawigacyjnego DataGravity Datastore Summary wyświetlane są podobne metryki dla magazynów danych DataGravity NFS obsługujących dane.
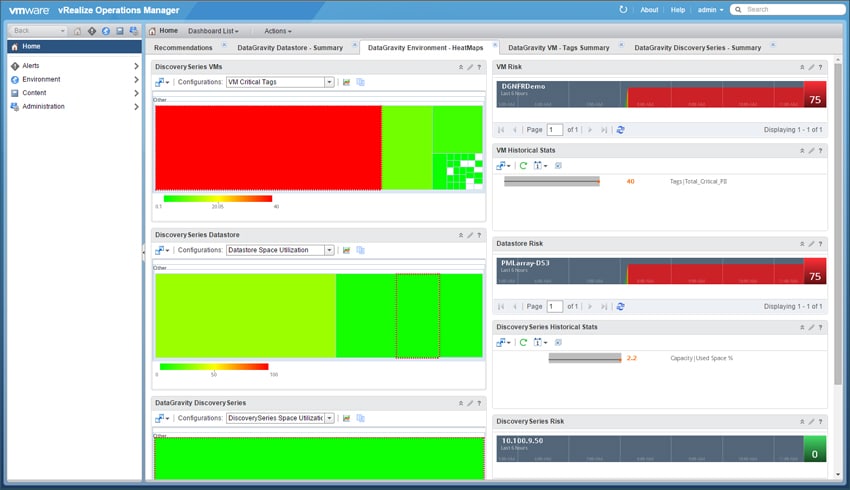
Integracja vROPS wyświetla również „mapy cieplne” wskazujące potencjalne obszary problemowe w oparciu o wstępnie zdefiniowane wartości wykorzystania przestrzeni i krytyczne znaczniki inteligencji znajdujące się w maszynach wirtualnych, magazynach danych i systemie Discovery Series.
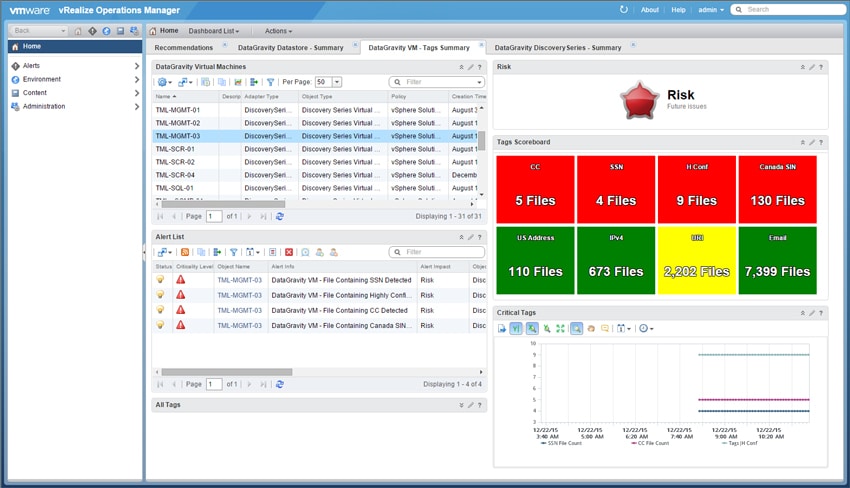
Administratorzy wirtualizacji mogą zobaczyć, jakie dane na poszczególnych maszynach wirtualnych są zagrożone. Dzięki systemowi tagowania mogą nawet dokładniej określić rodzaj zagrożonych danych.
Wniosek
Seria Discovery firmy DataGravity to macierz dyskowa, która przenosi nacisk z czystej wydajności oraz okien tworzenia kopii zapasowych i odzyskiwania na świadomość danych. Innymi słowy, DataGravity stworzyło system, który zapewnia użytkownikom wgląd we wszystkie dane za pośrednictwem łatwego w obsłudze interfejsu graficznego. System nie tylko pozwala użytkownikom zobaczyć, gdzie znajdują się ich dane w systemie, ale także oferuje im szczegółową metodę śledzenia danych, osób uzyskujących do nich dostęp oraz możliwości ujawnienia poufnych danych. DataGravity umożliwia użytkownikom oznaczanie większości typów plików, co pomaga w szybkim lokalizowaniu i monitorowaniu określonych plików danych. Może to nie tylko zwiększyć bezpieczeństwo danych firmy poprzez wykrywanie problemów (zarówno niezamierzonych, jak i złośliwych), ale także umożliwić firmie pełne wykorzystanie wszystkich przechowywanych danych dzięki zrozumieniu lokalizacji danych, dostępu, potrzeb w zakresie przechowywania i zgodności.
Zazwyczaj w StorageReview przyglądamy się sprzętowi bazowemu i testujemy jego wydajność za pomocą serii testów porównawczych. W przypadku DataGravity oprogramowanie jest najmocniejszym argumentem sprzedażowym. Chociaż firma oferuje różne pojemności od 18 TB do 96 TB i łączy w swoim rozwiązaniu pamięć RAM, pamięć NVRAM, dyski SSD i dyski twarde nearline, to podstawowy sprzęt istnieje po to, aby obsługiwać platformę analityczną DataGravity. Oczywiście cały sprzęt istnieje po to, aby obsługiwać oprogramowanie, jednak większość dostawców wykorzystuje oba te elementy w połączeniu, aby zapewnić klasyczne możliwości pamięci masowej. DataGravity nie deklaruje najwyższej wydajności ani najniższych opóźnień. Zamiast tego koncentruje się na świadomości danych i łatwości użytkowania. W tym względzie firma wyraźnie przoduje.
Zespół StorageReview udał się na miejsce, aby przetestować rozwiązanie. Ponieważ tym razem skupiliśmy się na użyteczności, nie potrzebowaliśmy fizycznego urządzenia w laboratorium do przeprowadzenia testów wydajności. Zanim dotarliśmy na miejsce, DataGravity wczytało znaczną część zawartości naszej strony internetowej do swojej macierzy, udostępniając nam dane do wyszukiwania, które znaliśmy już bardzo dobrze. Dzięki podstawowemu omówieniu systemu mogliśmy zacząć intuicyjnie korzystać z rozwiązania, aby wyszukiwać słowa kluczowe w różnych typach plików, tworzyć udziały, ponownie przypisywać pule danych, a także monitorować nasze wykorzystanie rozwiązania.
Ostatecznie to, co robi DataGravity, wyjątkowo różni się od reszty branży pamięci masowych. Doświadczony zespół postanowił najpierw rozwiązać uzasadnione problemy biznesowe, wykorzystując jako punkt zaczepienia wgląd w zgodność pamięci masowej z przepisami. Ten nacisk na inteligencję jest fundamentalny dla działalności DataGravity, która znacznie różni się od tradycyjnych zakupów pamięci masowej opartych na potrzebach pojemnościowych lub przepustowości. Chociaż podejście DataGravity ma ogromny sens w regulowanych branżach, nawet w naszym przypadku zastosowania w małych firmach odczuliśmy natychmiastowe korzyści, gdy tylko uzyskaliśmy dogłębny wgląd choćby w część naszych treści dostępnych na zewnątrz. Połącz tę wiedzę z tą samą dotyczącą katalogów domowych użytkowników, folderów współdzielonych dla grup roboczych i pozostałych zasobów biznesowych, a korzyści szybko się kumulują. DataGravity jest również bardzo intuicyjny w obsłudze, co sprawia, że idealnie nadaje się do małych lub przeciążonych działów IT.
Bottom Line
Seria Discovery firmy DataGravity umożliwia firmom pełne wykorzystanie wszystkich posiadanych danych, zapewniając jednocześnie ich bezpieczeństwo i łatwość w działaniu dzięki łatwemu w obsłudze interfejsowi. Nacisk na analitykę i przejrzystość danych jest wyjątkowy w branży pamięci masowych, co daje DataGravity istotny punkt odniesienia w branży, której często brakuje kreatywności.


 Amazon