

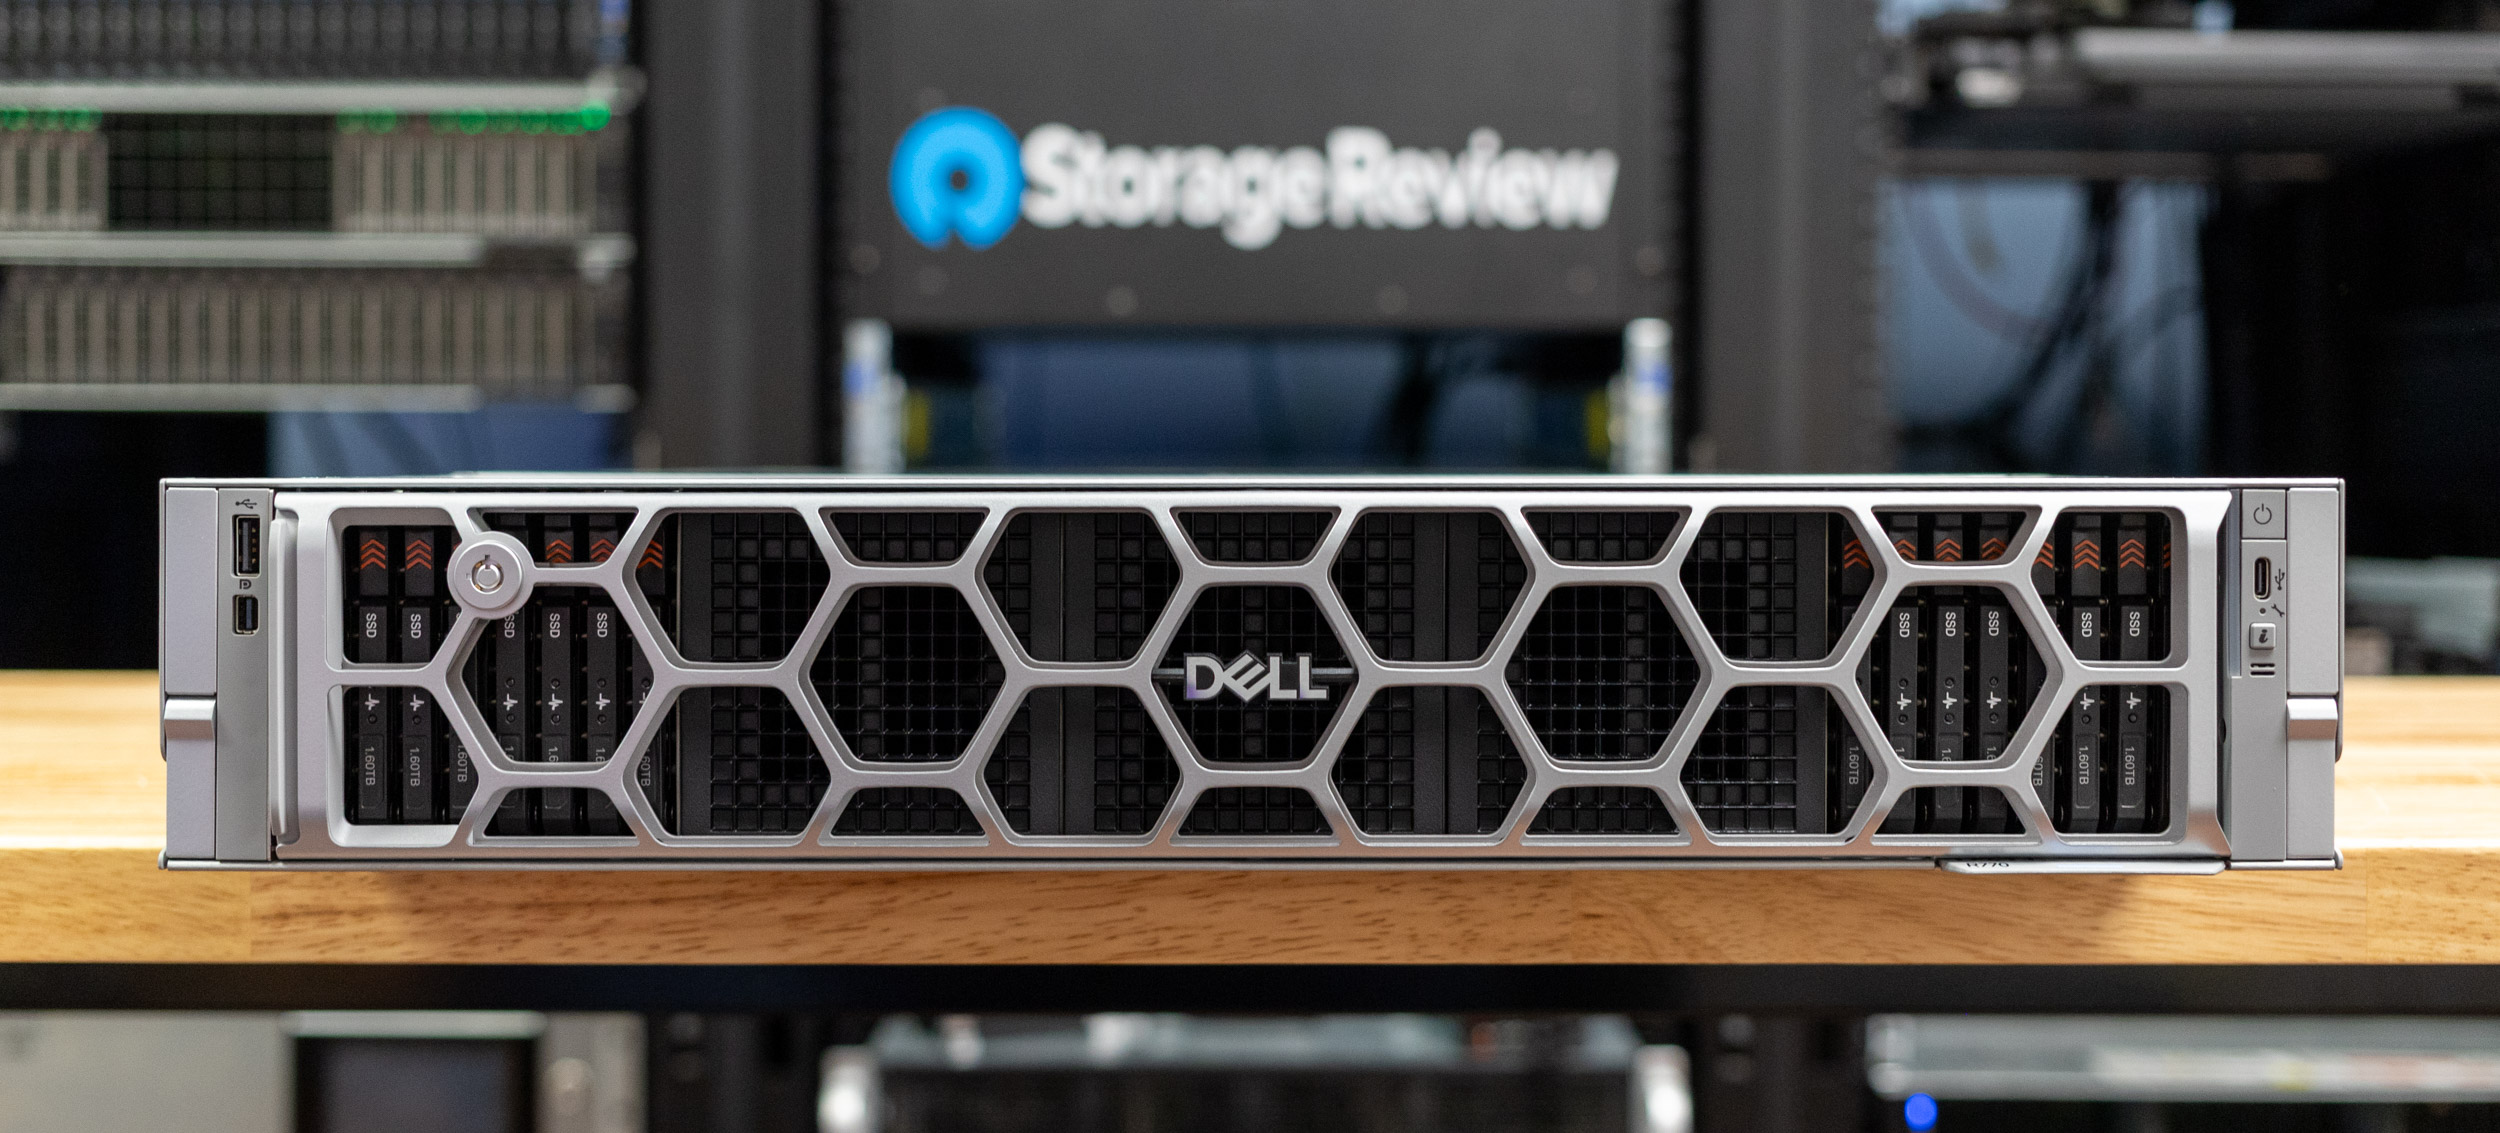
Serwery Dell PowerEdge serii R7x0 od dawna stanowią fundament centrów danych, słynąc z wyjątkowej jakości wykonania, przemyślanej konstrukcji, wydajności, gęstości i niezawodności w uniwersalnej obudowie 2U. Serwery te są stale udoskonalane, aby sprostać zmieniającym się potrzebom. Teraz, wraz z wprowadzeniem Dell PowerEdge R770, seria ta robi znaczący krok naprzód.
Model R770 debiutuje z nową rodziną procesorów Intel Xeon 6, obejmującą procesory Xeon 6500 i 6700 z rdzeniami P i E. Oznacza to pierwsze pełne wdrożenie przez firmę Dell standardu OCP Data Center Modular Hardware System (DC MHS) w jej głównej linii serwerów. Te dwie zmiany zapowiadają znaczącą ewolucję w zakresie możliwości i filozofii projektowania.
Spełnianie wymagań nowoczesnych centrów danych
Wprowadzenie na rynek modelu R770 nastąpiło w momencie rosnącej presji na centra danych. Obciążenia są coraz bardziej zróżnicowane i wymagające. Nieustanny wzrost ilości danych napędza zapotrzebowanie na solidne narzędzia analityczne i bazy danych. Od trenowania złożonych modeli po wdrażanie wnioskowania w czasie rzeczywistym, sztuczna inteligencja nie jest już niszową aplikacją, lecz kluczowym czynnikiem napędzającym biznes, wymagającym znacznej mocy obliczeniowej i specjalistycznego przyspieszenia.
Jednocześnie kładzie się duży nacisk na efektywność energetyczną i optymalizację całkowitego kosztu posiadania (CCO). Co więcej, branża coraz częściej sięga po otwarte standardy, aby wspierać innowacyjność, zwiększać interoperacyjność i potencjalnie zmniejszać uzależnienie od jednego dostawcy. Model R770, z nowymi opcjami procesora i obsługą technologii OCP DC MHS, został zaprojektowany z myślą o tym wyzwaniu.
Procesory Intel Xeon 6 P-Core
Procesor R770 wykorzystuje procesory Intel Xeon serii 6, w tym serie 6700 i 6500, z rdzeniami Performance i Efficiency zbudowanymi na platformie Socket E2 (LGA4710-2). W tej recenzji skupiamy się na jednostkach SKU serii P.
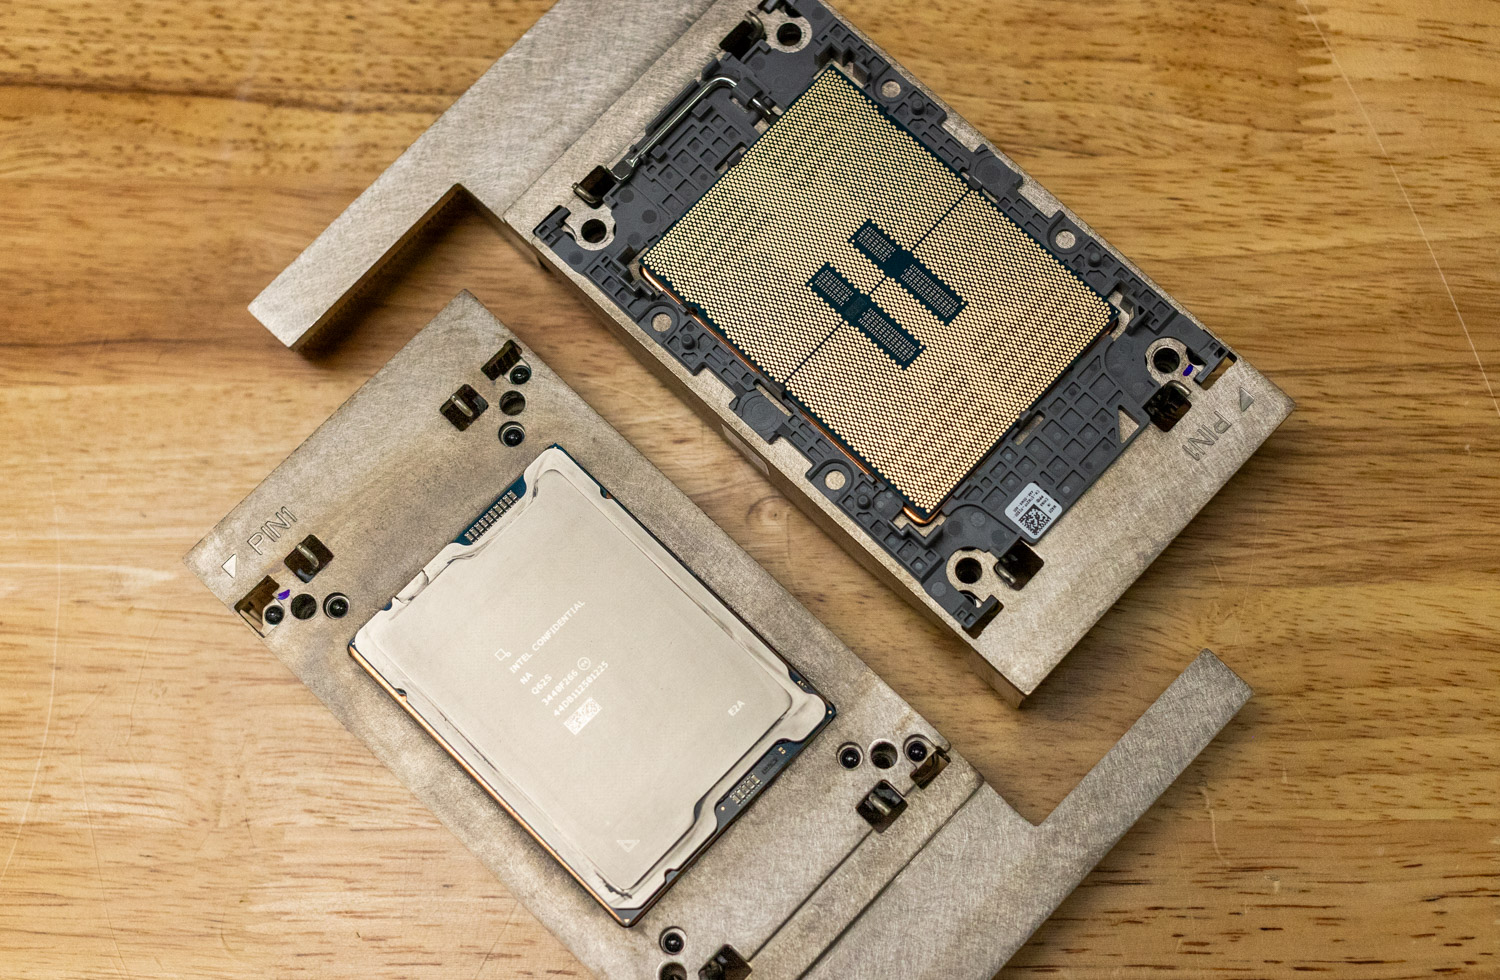
Firma Intel konstruuje te procesory w oparciu o konstrukcję kafelkową, łącząc kafelki wejścia/wyjścia z jednym lub dwoma kafelkami obliczeniowymi. Zapewnia to skalowalność w ramach serii, z konfiguracjami sięgającymi do 86 rdzeni P (XCC) przy użyciu dwóch kafelków obliczeniowych, a do 48 rdzeni P (HCC) lub 16 rdzeni P (LCC) przy użyciu pojedynczych kafelków obliczeniowych.
W porównaniu z procesorami Sapphire i Emerald Rapids poprzedniej generacji, kluczowym wyróżnikiem tych procesorów jest uniwersalna dostępność wbudowanych akceleratorów we wszystkich procesorach Xeon 6. Należą do nich: technologia Intel QuickAssist do szyfrowania i kompresji, Intel Data Streaming Accelerator do przesyłania danych, Intel In-Memory Analytics Accelerator do przyspieszenia baz danych i analiz oraz Intel Dynamic Load Balancer do zwiększenia wydajności przetwarzania sieciowego.
Pamięć i przepustowość wejścia/wyjścia również zostały znacząco ulepszone. Seria procesorów Xeon 6700/6500 P-core obsługuje 8-kanałową pamięć DDR5. Otwierają one również drogę dla pamięci Multiplexed Rank DIMM (MRDIMM), która zapewnia prędkość do 8,800 MT/s. W zakresie wejścia/wyjścia procesory te obsługują PCIe 5.0 i CXL 2.0. W konfiguracjach dwugniazdowych platforma oferuje do 88 linii PCIe na gniazdo (łącznie 176 linii).
Pomimo rozróżnienia rdzeni P i E, rodzina procesorów Xeon 6 zachowuje spójność w zakresie zestawów instrukcji, BIOS-u, sterowników, obsługi systemu operacyjnego/aplikacji oraz funkcji RAS, co upraszcza integrację i zarządzanie w różnych typach wdrożeń. Warianty z rdzeniem P są przeznaczone do obciążeń, w których wydajność na rdzeń, akceleracja AI, wysoka przepustowość pamięci i znaczne obciążenie wejścia/wyjścia mają kluczowe znaczenie; dotyczy to wymagających baz danych, symulacji HPC, zaawansowanych analiz i szerokiej gamy aplikacji AI.
Specyfikacja Dell PowerEdge R770
| Specyfikacja | Dell PowerEdge R770 |
| Procesor | Dwa procesory Intel Xeon 6 z maksymalnie 144 rdzeniami E lub 86 rdzeniami P na procesor |
| Pamięć | 32 gniazda DDR5 DIMM, obsługa modułów RDIMM maks. 8 TB, prędkość do 6400 MT/s, obsługa wyłącznie zarejestrowanych modułów ECC DDR5 DIMM |
| Kontrolerzy magazynu | Rozruch wewnętrzny: Podsystem pamięci masowej zoptymalizowany pod kątem rozruchu (BOSS-N1 DC-MHS): HWRAID 1, 2 dyski SSD M.2 NVMe lub płyta pośrednicząca M.2 (DC-MHS): 2 dyski SSD M.2 NVMe lub USB, Kontrolery wewnętrzne: Przedni PERC H965i, Przedni PERC H975i, Przedni PERC H365i |
| Zatoki przednie i tylne |
|
| Zasilacze z funkcją Hot Swap |
|
| Opcje chłodzenia | Chłodzenie powietrzem i bezpośrednie chłodzenie cieczą (DLC to rozwiązanie typu rack, które do działania wymaga kolektorów rackowych i jednostki dystrybucji chłodzenia (CDU)) |
| Fani | Wysokowydajne wentylatory Silver (HPR SLVR)/Wysokowydajne wentylatory Gold (HPR GOLD), do 6 wentylatorów z możliwością wymiany na gorąco |
| Wymiary i waga | Wysokość – 86.8 mm (3.42 cala), szerokość – 482 mm (18.97 cala), waga – 28.53 kg (62.89 funta), głębokość (dla konfiguracji tylnego wejścia/wyjścia) – 802.40 mm (31.59 cala) z ramką, 801.51 mm (31.56 cala) bez ramki, głębokość (dla konfiguracji przedniego wejścia/wyjścia) – 814.52 mm (32.07 cala) bez ramki |
| Form Factor | Serwer typu rack 2U |
| Zarządzanie osadzone | iDRAC, iDRAC Direct, interfejs API RESTful iDRAC z Redfish, interfejs wiersza poleceń RACADM, moduł usługi iDRAC (iSM), punkt końcowy NativeEdge, NativeEdge Orchestrator |
| Bezel | Opcjonalna ramka zabezpieczająca |
| Ochrona | Oprogramowanie sprzętowe podpisane kryptograficznie, szyfrowanie danych w stanie spoczynku (dyski SED z lokalnym lub zewnętrznym zarządzaniem kluczami), bezpieczny rozruch, weryfikacja bezpiecznych komponentów (kontrola integralności sprzętu), krzemowy rdzeń zaufania, blokada systemu, blokada systemu (wymaga iDRAC10 Enterprise lub Datacenter), wykrywanie włamań do obudowy, TPM 2.0 FIPS, certyfikat CC-TCG |
| Opcje sieciowe |
|
| Opcje GPU | Do 6 x 75 W FHHL lub do 2 x 350 W DWFL |
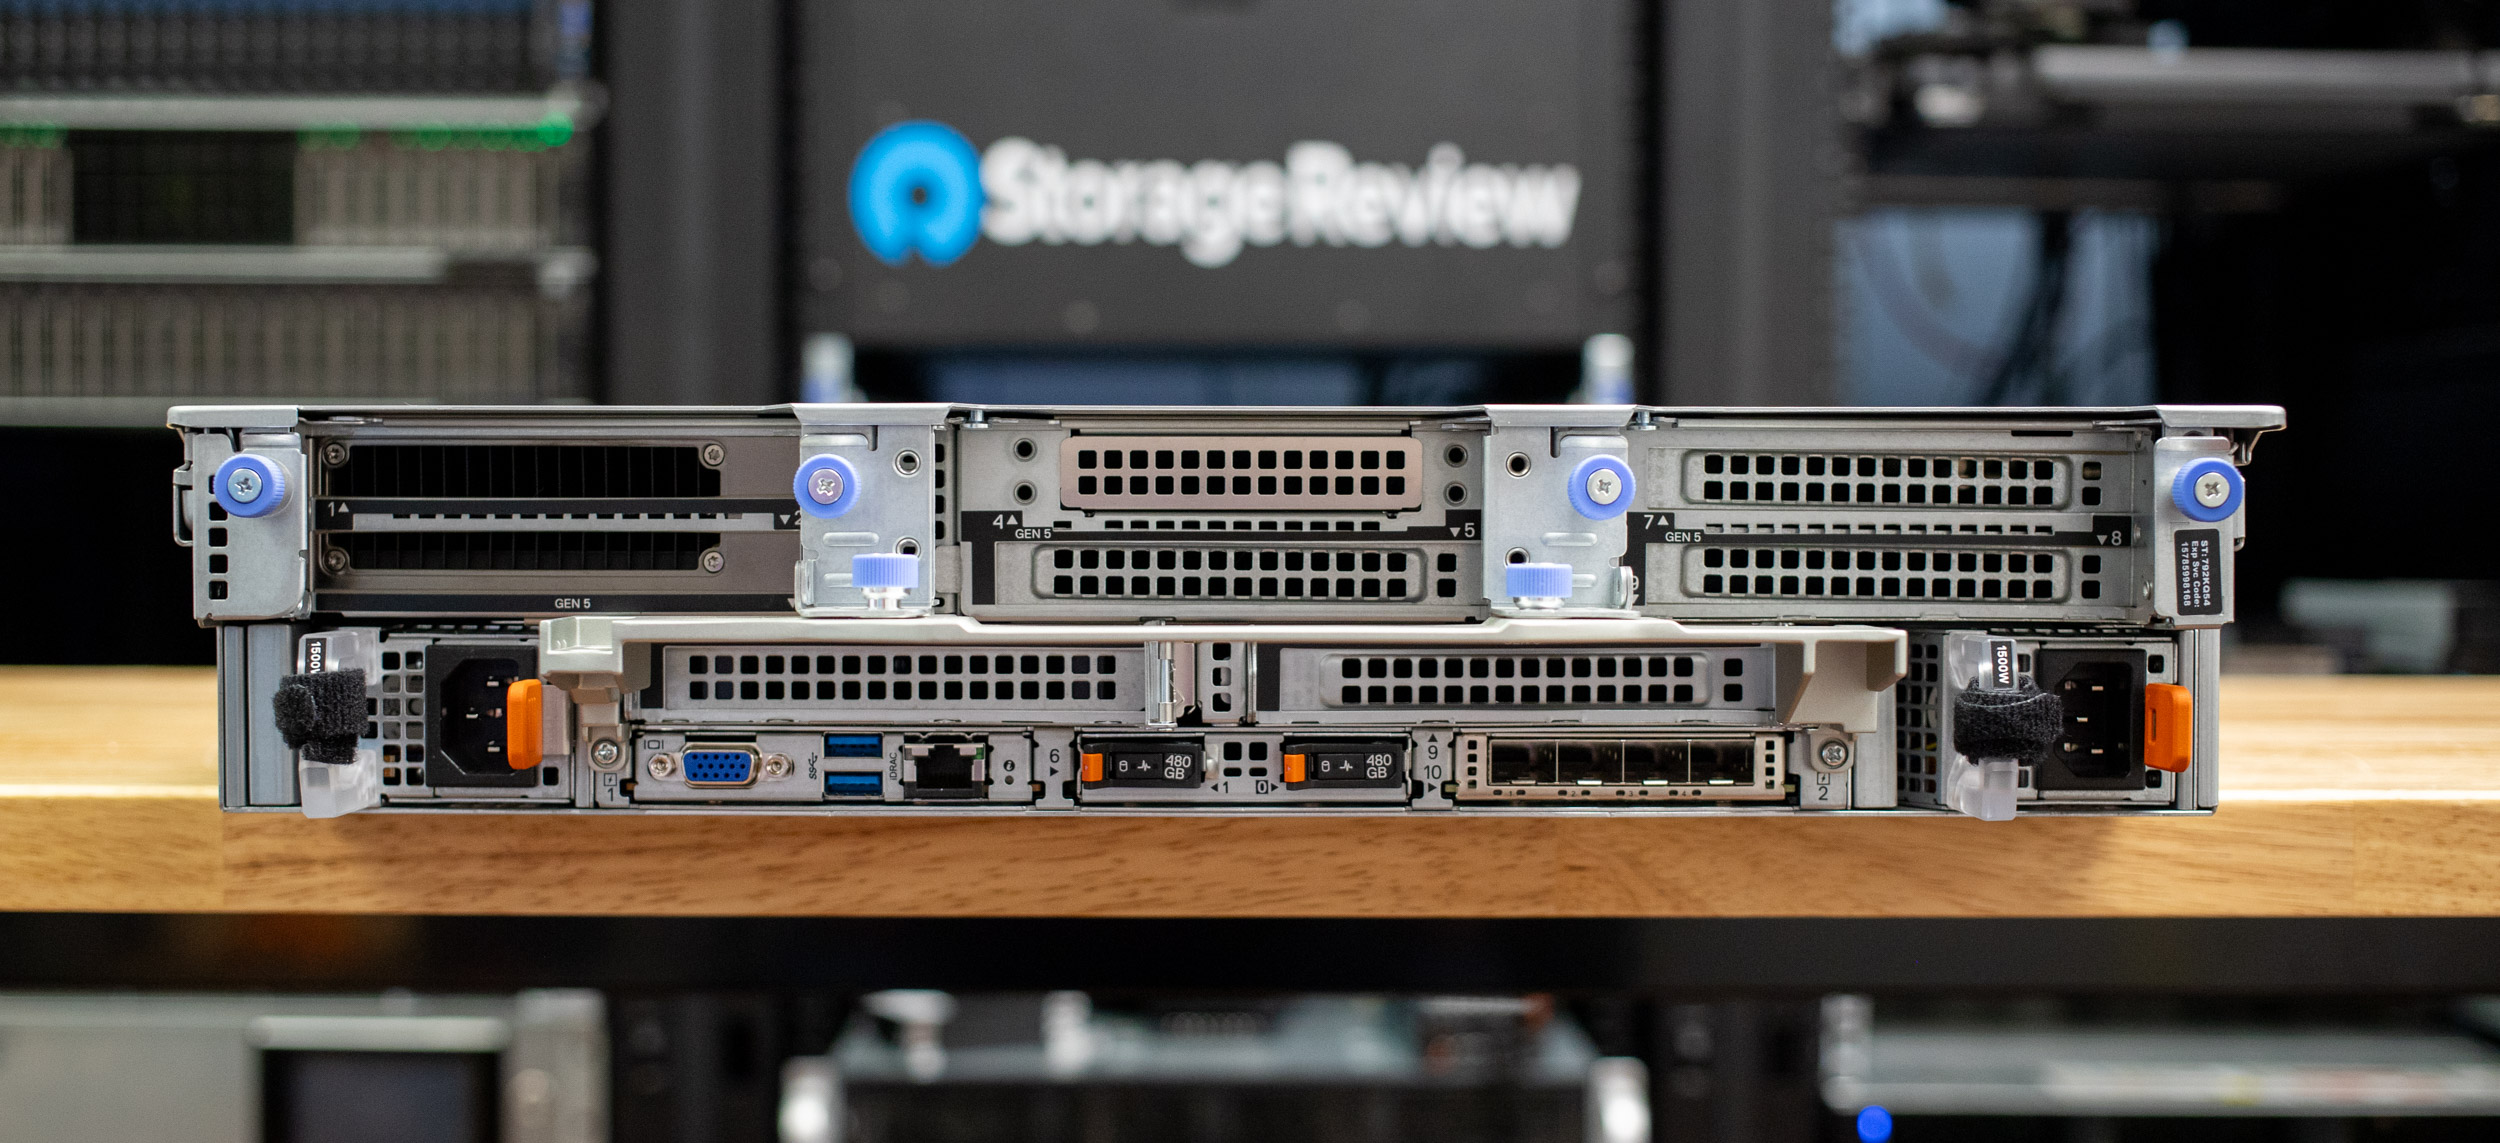
| porty | Porty przednie: 1 x port USB 2.0 typu C, 1 x port USB 2.0 typu A (opcjonalnie), 1 x Mini-DisplayPort (opcjonalnie), 1 x port szeregowy DB9 (z konfiguracją przedniego wejścia/wyjścia), 1 x dedykowany port Ethernet do zarządzania kontrolerem iDRAC; Porty tylne: 1 x dedykowany port Ethernet do zarządzania kontrolerem iDRAC, 1 x VGA, 2 x porty USB 3.1 typu A; Porty wewnętrzne: 1 x port USB 3.1 typu A |
| PCIe |
|
| Systemy operacyjne i hiperwizory | Canonical Ubuntu Server LTS, Microsoft Windows Server z Hyper-V, Red Hat Enterprise Linux, SUSE Linux Enterprise Server, VMware z vSphere |
Dell PowerEdge R770 korzysta z modułowości dzięki OCP DC MHS

Źródło z Server/DC-MHS – OpenComputer
Serwer Dell PowerEdge R770 charakteryzuje się znaczącymi udoskonaleniami i większą elastycznością pod względem konstrukcji fizycznej i architektury komponentów, dzięki zastosowaniu standardu Data Center Modular Hardware System (OCP DC MHS) projektu Open Compute Project.
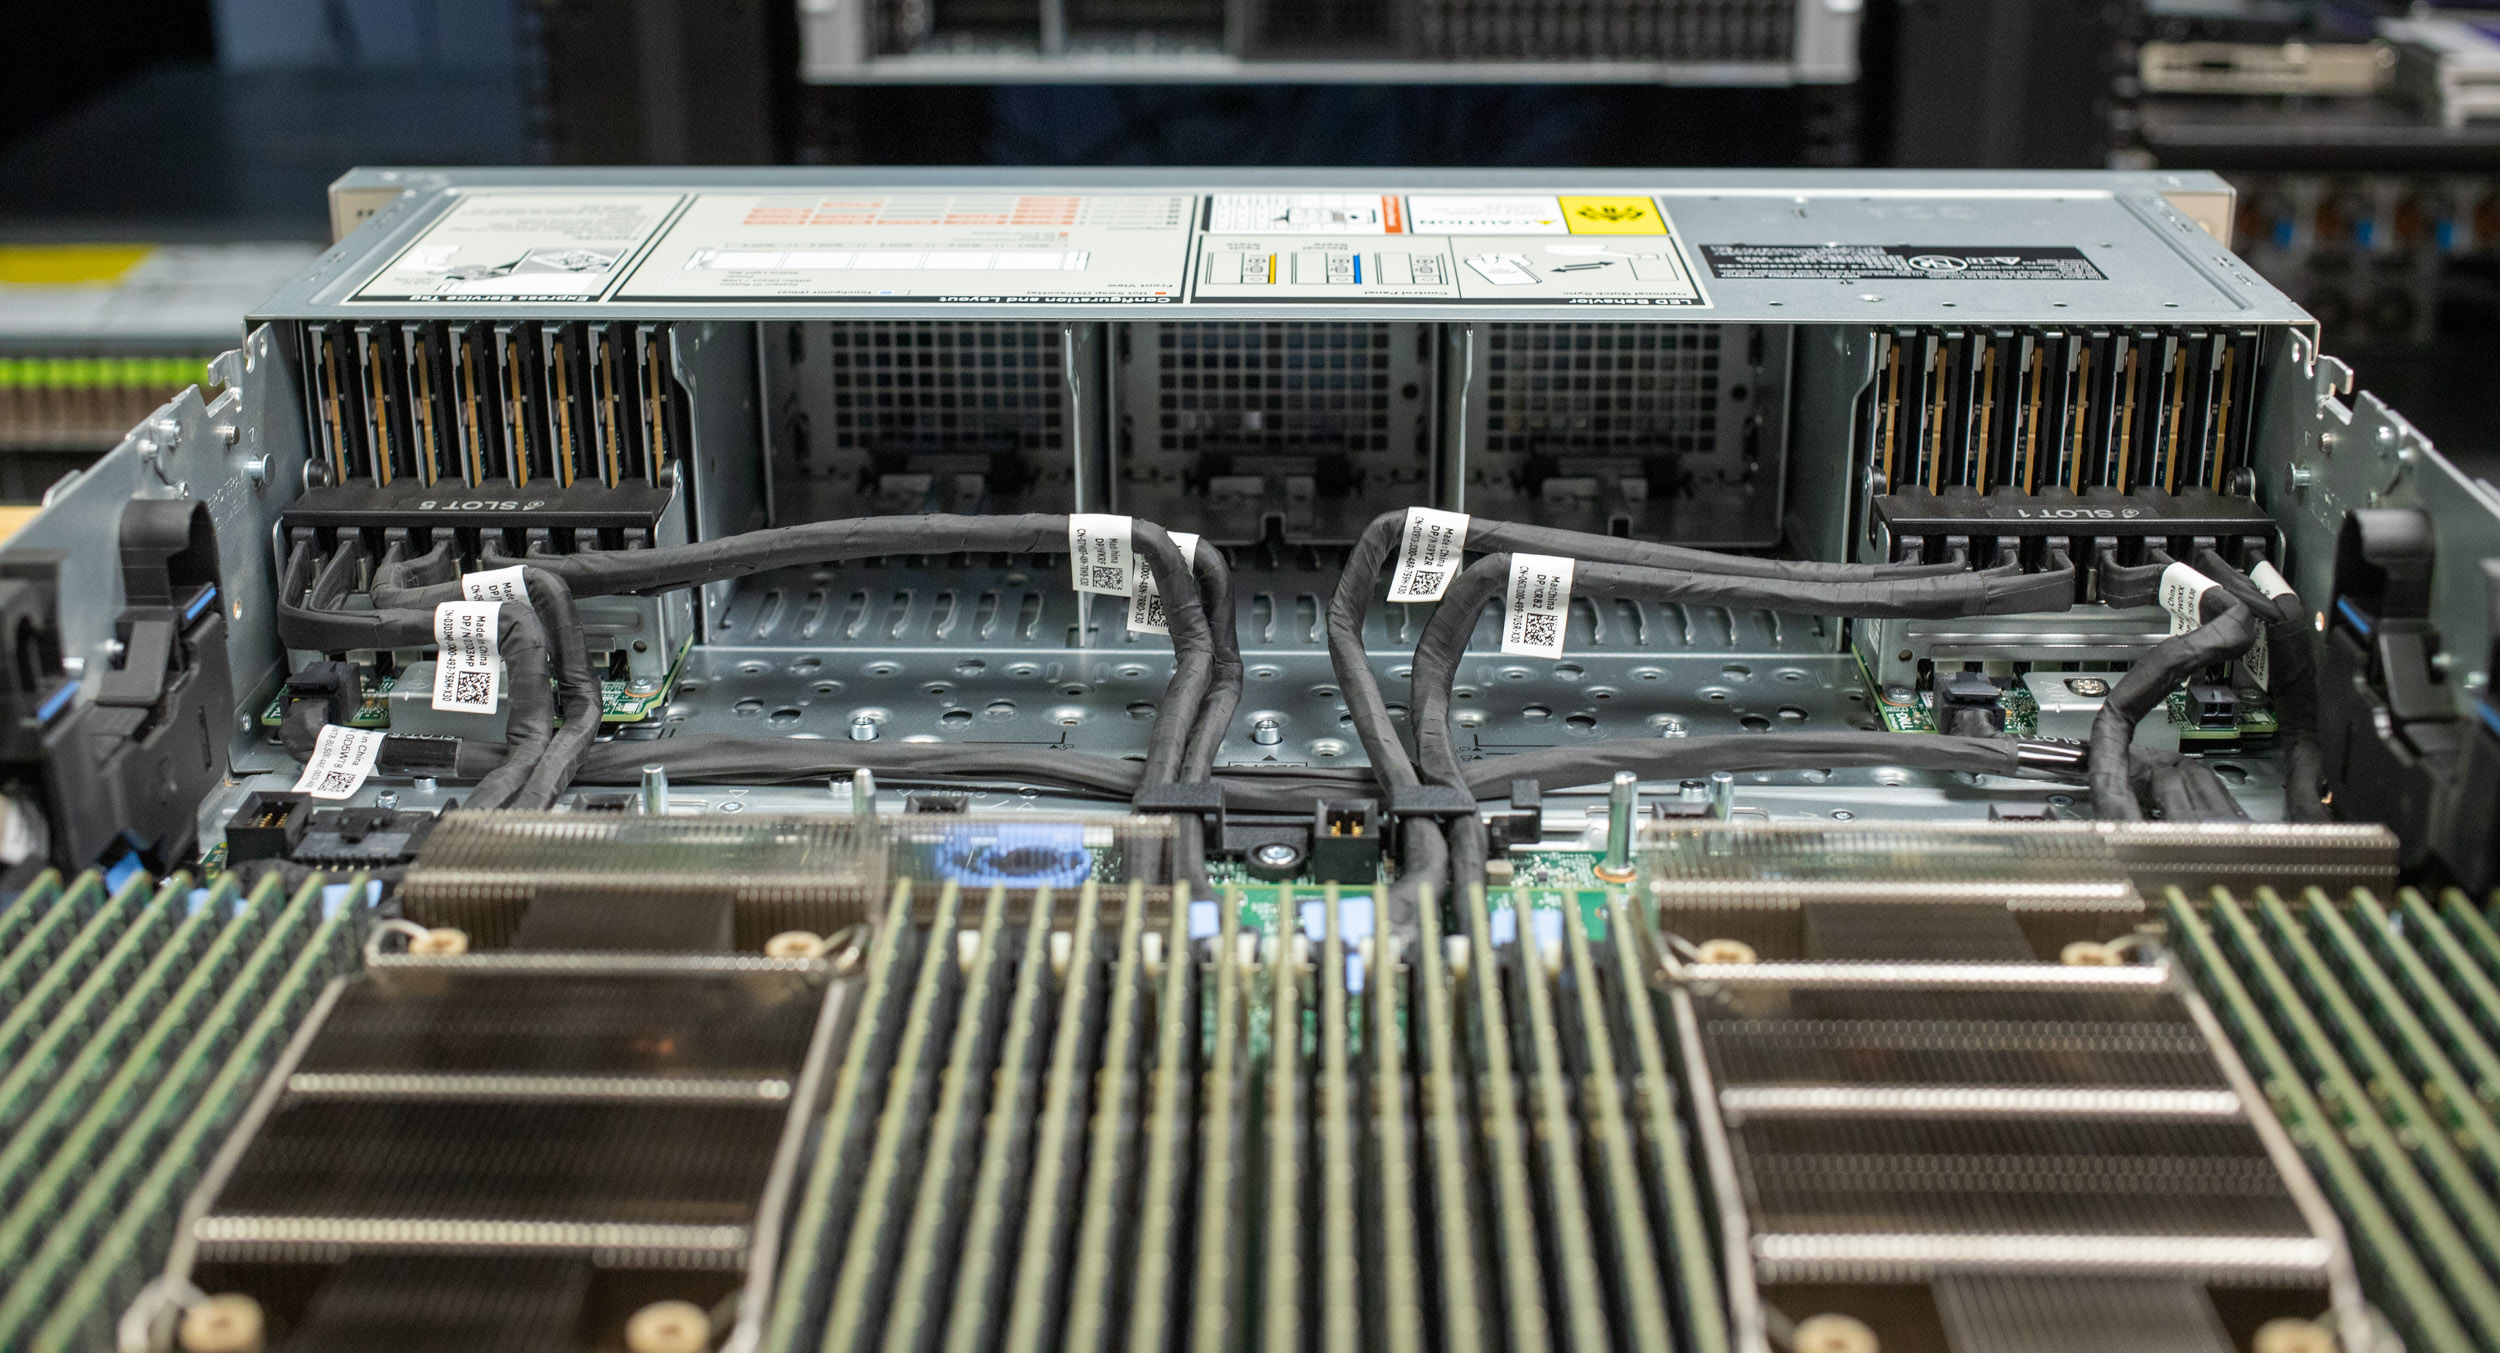
Kontynuując tradycję serii R7x0, R770 oferuje rozbudowane opcje konfiguracji, aby sprostać zróżnicowanym potrzebom wdrożeniowym. Istotną nowością w tej linii jest możliwość wyboru między tradycyjną konfiguracją Rear I/O a konfiguracją Front I/O Cold Aisle Accessible, co zapewnia większą elastyczność w różnych układach centrów danych i wymaganiach dotyczących serwisowania. Opcje pamięci masowej są równie wszechstronne, od węzłów skoncentrowanych na obliczeniach z minimalną lub zerową pamięcią lokalną, po konfiguracje o wysokiej gęstości obsługujące imponującą liczbę 40 dysków E3.S dla obciążeń skoncentrowanych na pamięci masowej.
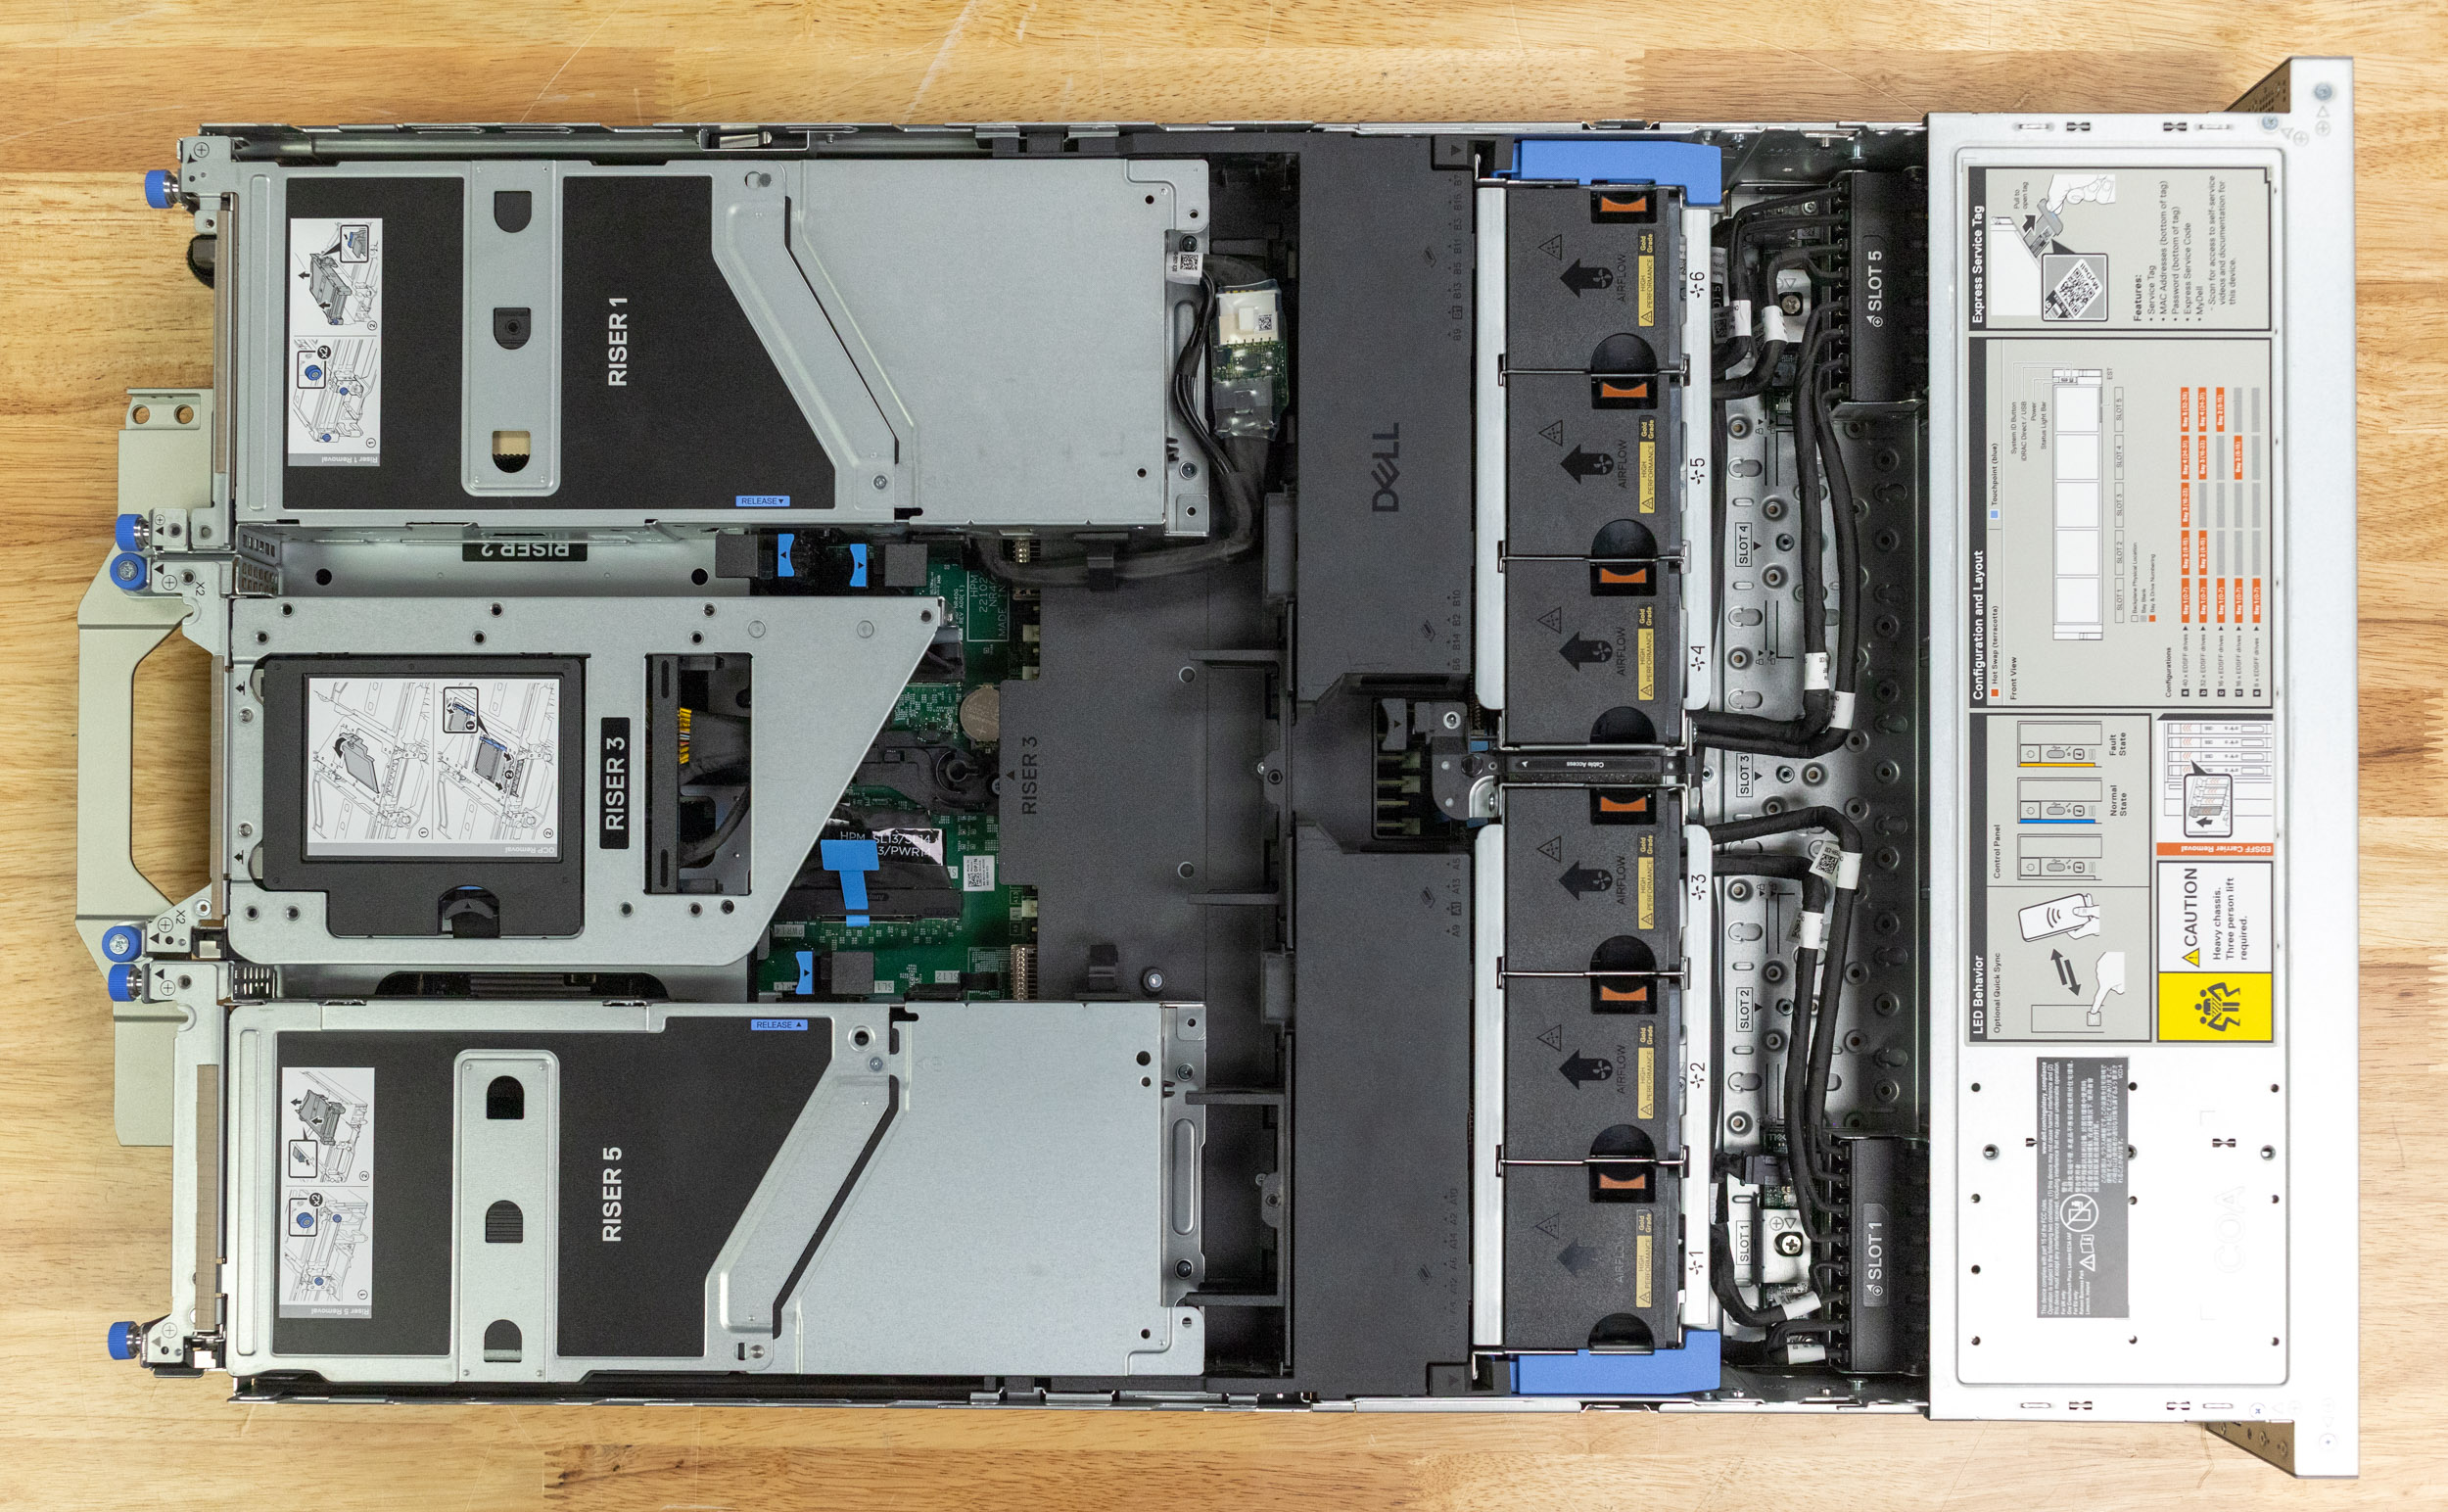
Aby sprostać rosnącemu zapotrzebowaniu na akcelerowane obliczenia, szczególnie w dziedzinie sztucznej inteligencji (AI) i HPC, serwer R770 oferuje solidne możliwości rozbudowy. W zależności od konfiguracji obudowy i risera, serwer może pomieścić do sześciu kart PCIe Gen 5 x16 o pełnej wysokości i pełnej długości (FHFL). Ponadto obsługuje instalację dwóch procesorów graficznych o podwójnej szerokości, co czyni go platformą o dużej wydajności do szerokiego zakresu zadań. Elastyczność sieci zapewniają gniazda mezzanine OCP 3.0, obsługujące karty x8 lub x16, w zależności od konfiguracji.
Firma Dell wprowadziła również szereg udoskonaleń konstrukcyjnych mających na celu poprawę łatwości serwisowania i niezawodności. Doskonałym przykładem jest ewolucja karty Boot Optimized Storage Solution (BOSS). Kontroler BOSS w R770, wcześniej podłączany za pomocą kabli i wbudowany w gniazdo PCIe, jest teraz zaimplementowany jako karta zgodna ze standardem OCP, która komunikuje się bezpośrednio z płytą główną, eliminując złożoność okablowania. Ten nowy kontroler BOSS oferuje również szybsze napędy NVMe M.2 i radiatory, aby zapewnić optymalną temperaturę pracy i wydajność urządzeń rozruchowych. Kolejnym subtelnym, ale praktycznym ulepszeniem dla techników jest przejście z tradycyjnych zworek na bardziej przyjazne dla użytkownika przełączniki DIP, umożliwiające takie funkcje, jak czyszczenie pamięci NVRAM.
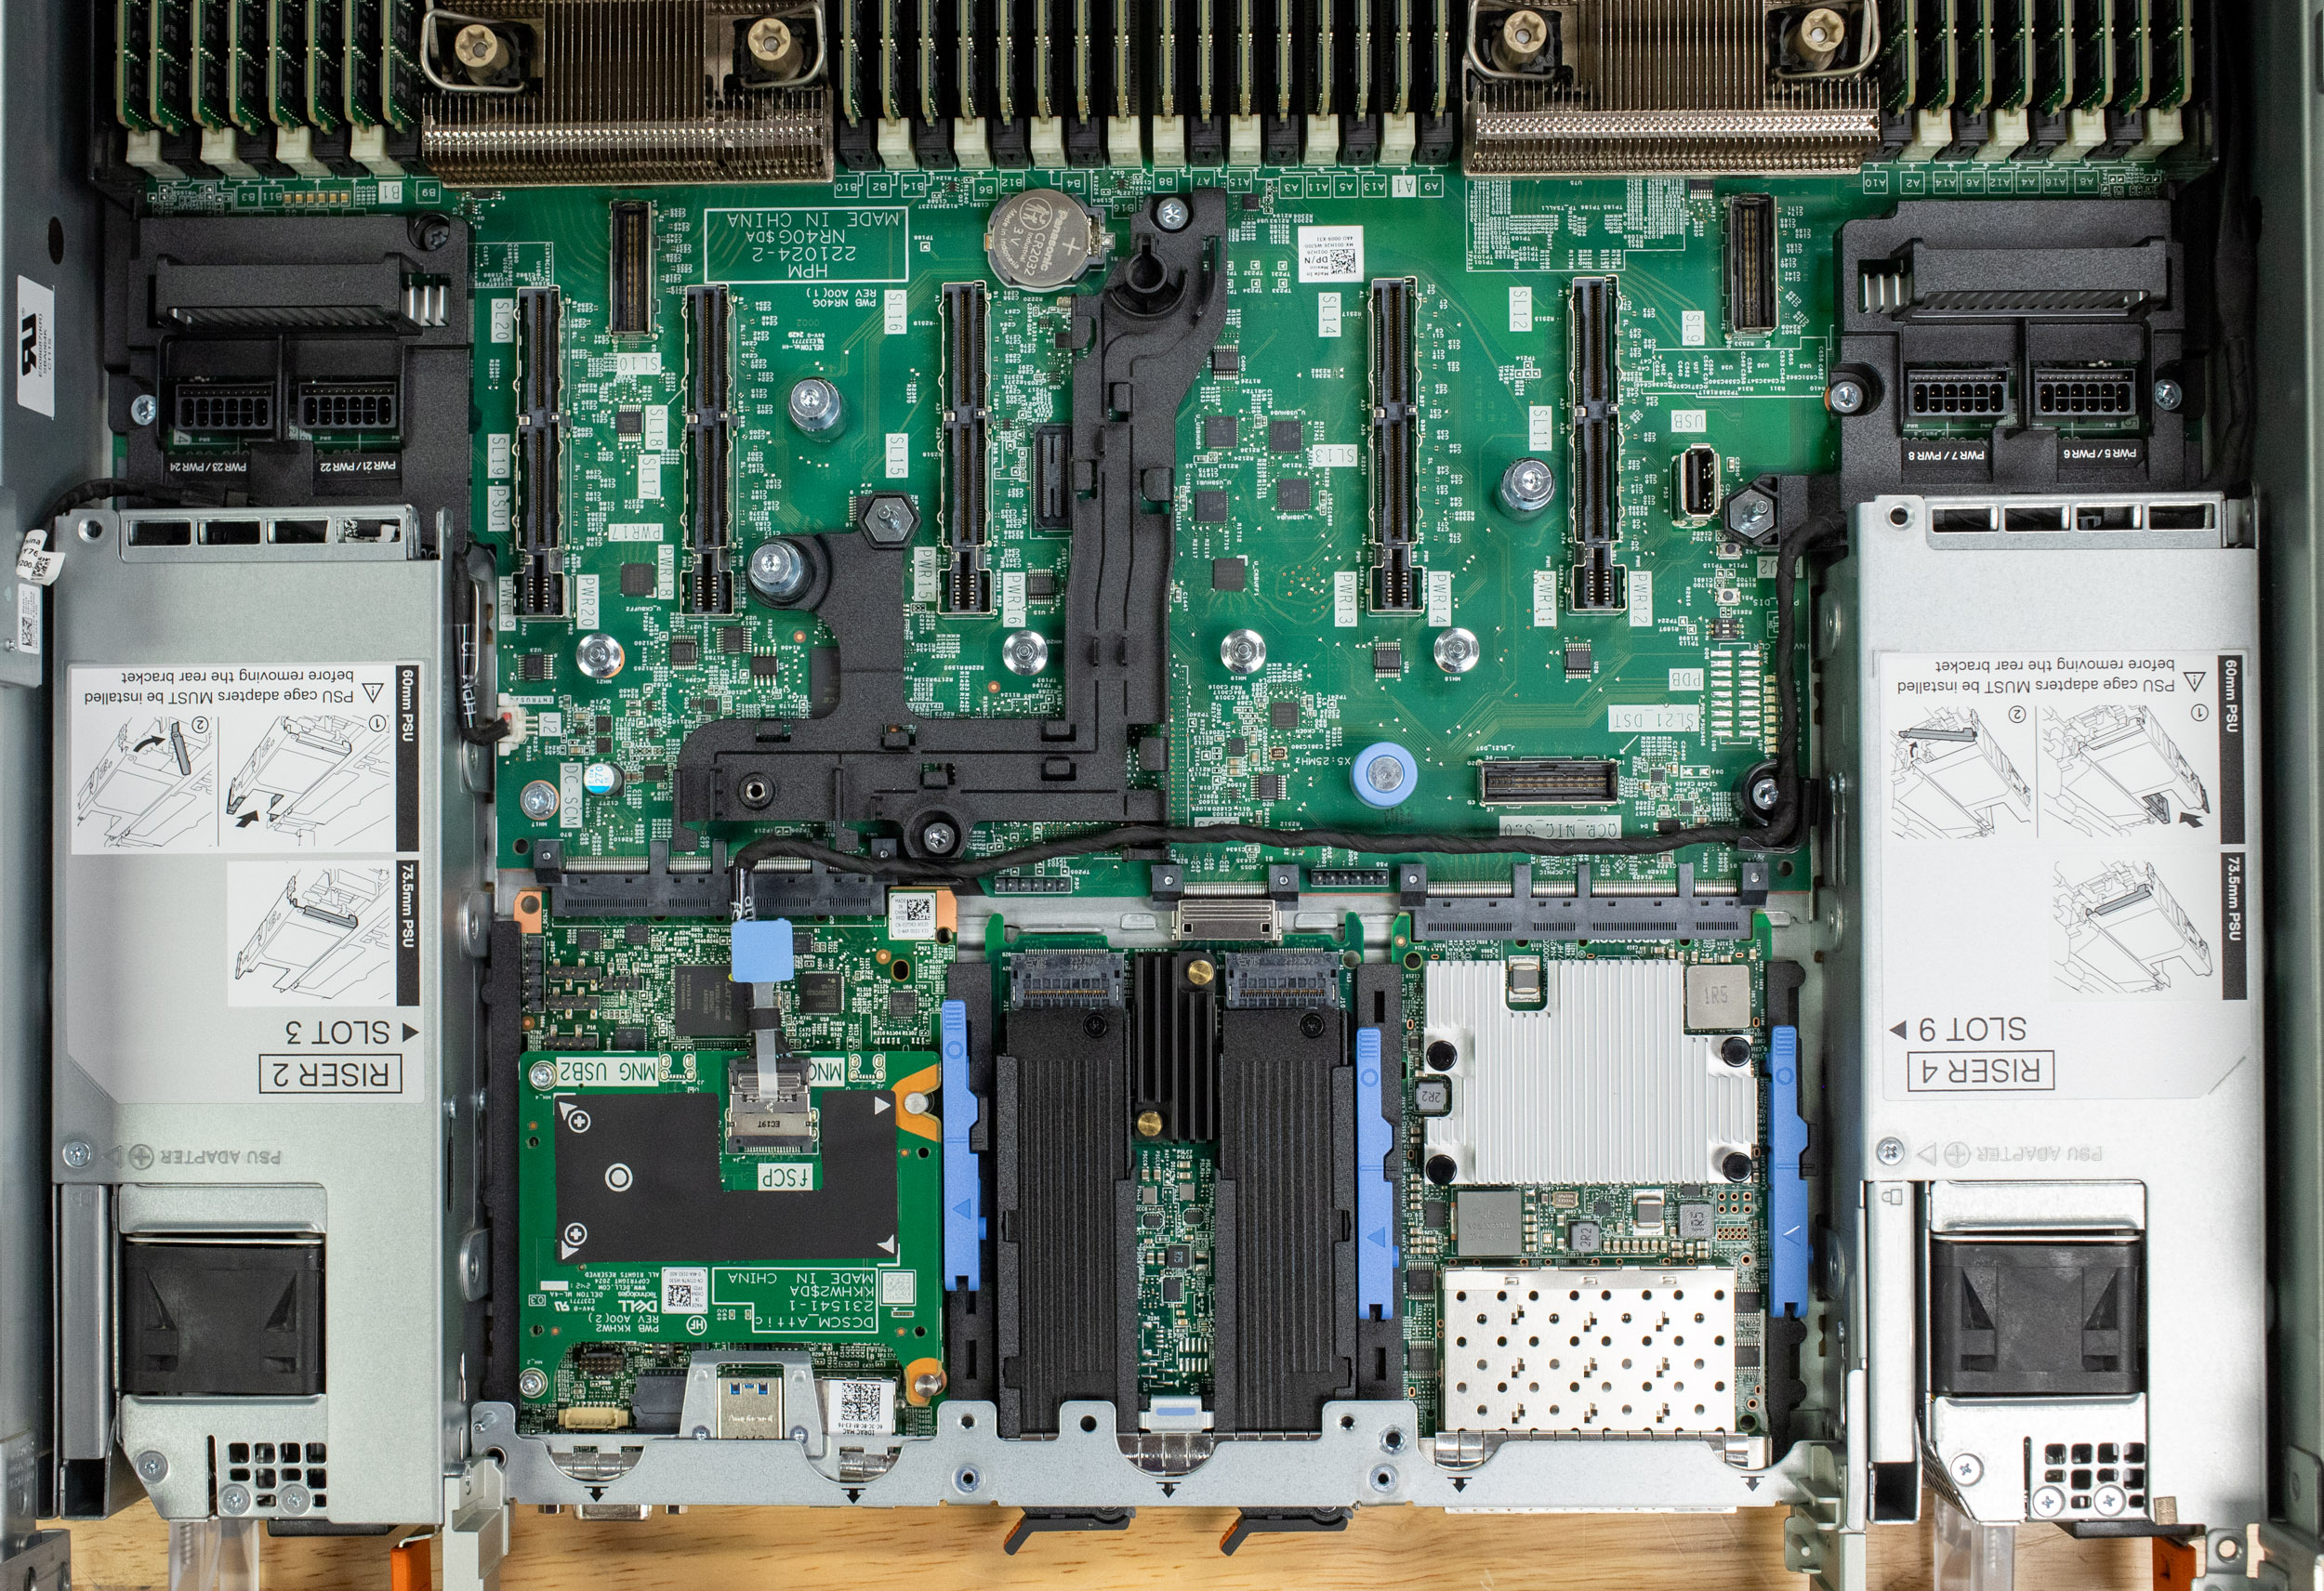
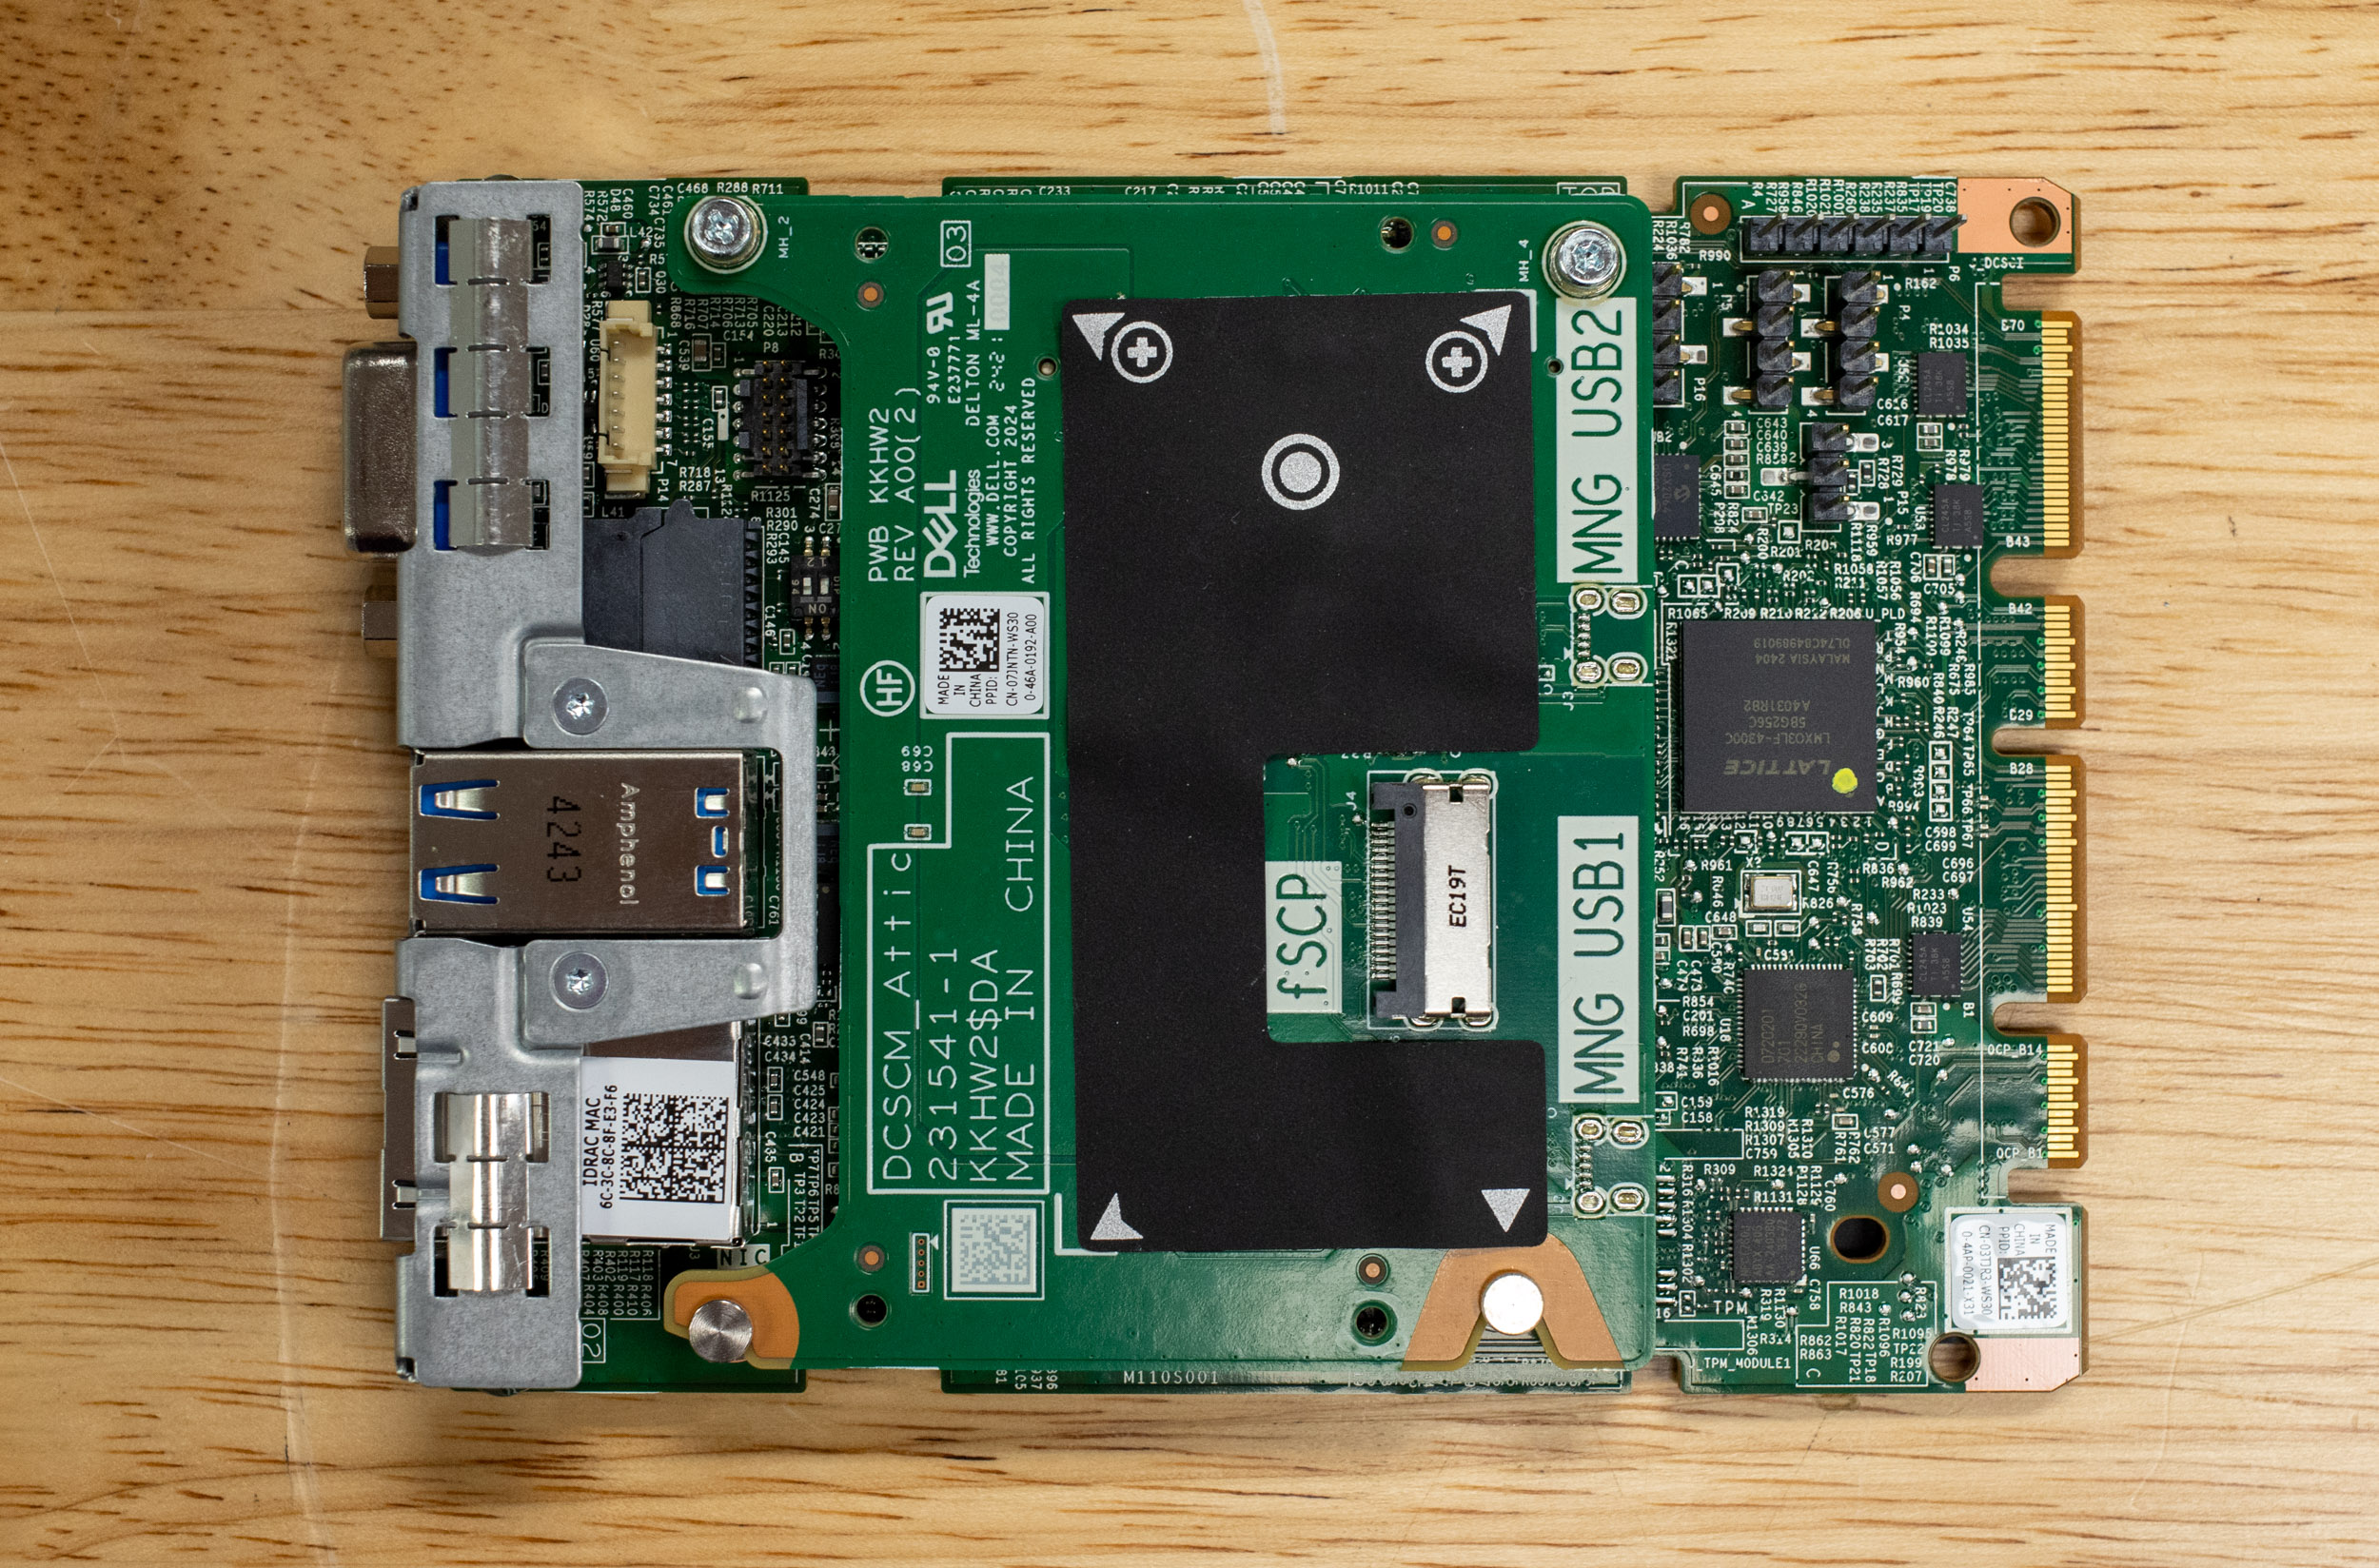
Najważniejszą zmianą architektoniczną jest pełne wdrożenie standardu OCP DC MHS. Firma Dell zaczęła wdrażać elementy OCP już w poprzednich generacjach, w szczególności poprzez zastosowanie gniazd kart sieciowych OCP 3.0. Model R770 idzie o krok dalej. Kluczowe komponenty są teraz zgodne ze specyfikacją OCP, w tym moduły procesora hosta (HPM), powszechnie znane jako płyta główna, która obejmuje elementy takie jak gniazda riser, a obecnie także złącza M-XIO. Złącze M-XIO zapewnia standardowy interfejs dla kart riser, zwiększając elastyczność i możliwości rozbudowy. Kontroler iDRAC jest również zaimplementowany jako OCP DC-SCM (Server Control Module).
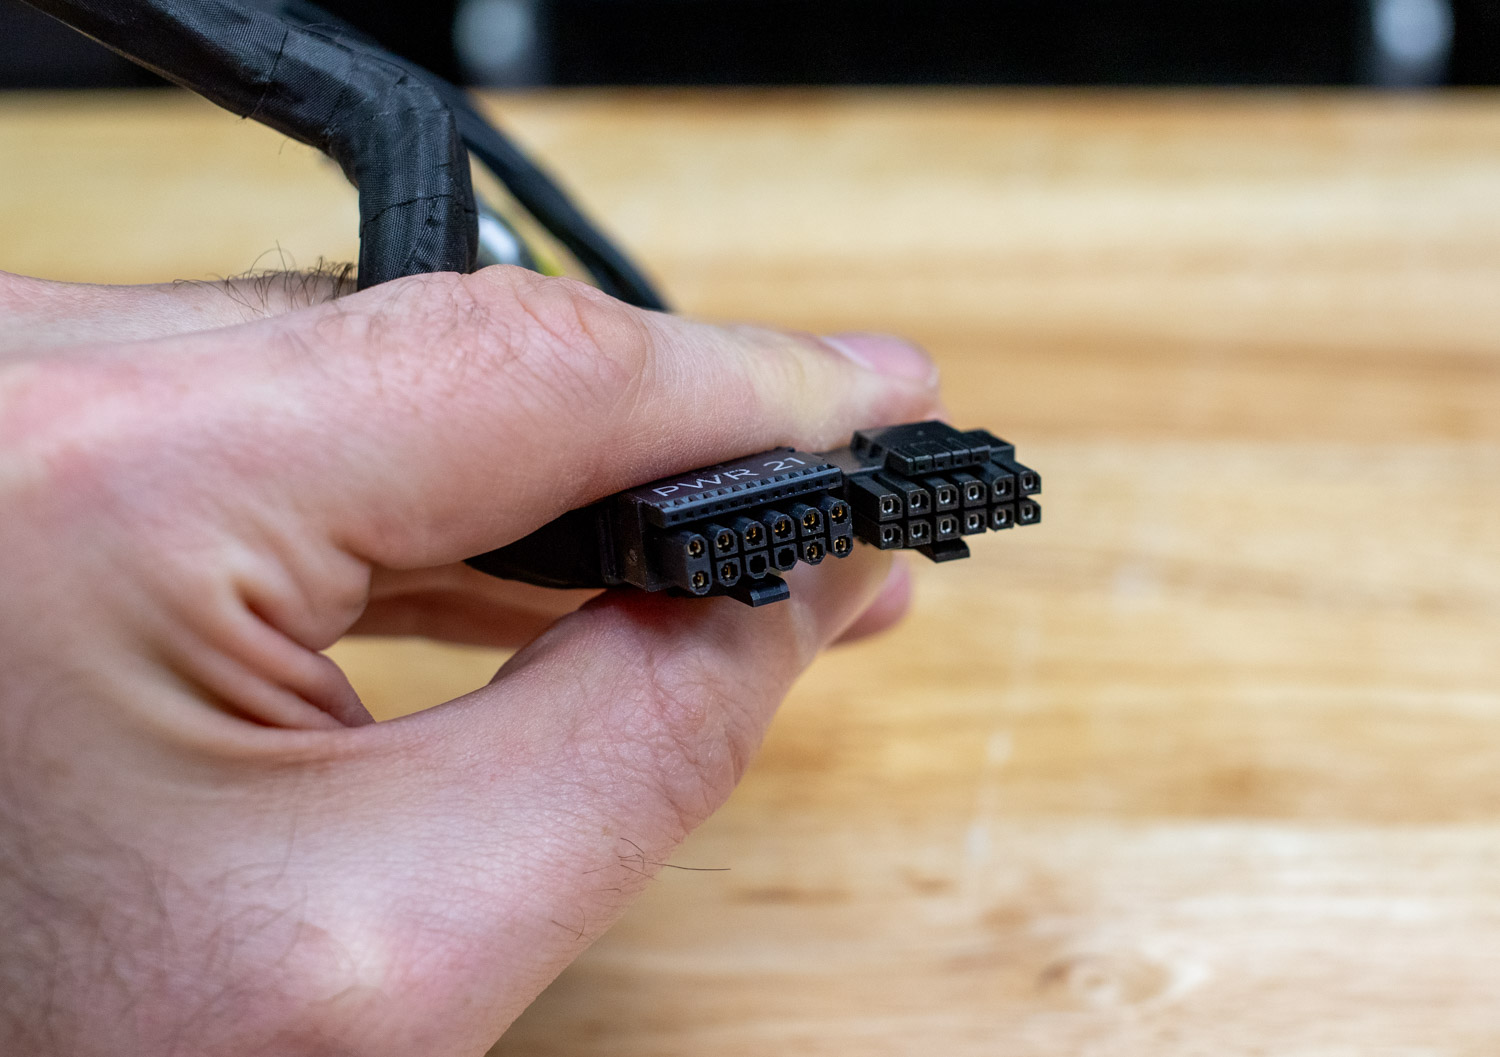
Ponadto, R770 wprowadza nowe złącze zasilania PICPWR do podłączania urządzeń peryferyjnych, takich jak karty graficzne i płyty główne. Złącze to stanowi istotny dodatek, upraszczając dostarczanie zasilania i umożliwiając monitorowanie zużycia energii.
Ta głęboka integracja standaryzuje interfejsy i formaty w różnych podsystemach. Chociaż Dell podkreśla, że użytkownicy powinni korzystać z sprawdzonych komponentów, aby zagwarantować kompatybilność i wsparcie techniczne, podstawowa standaryzacja sprawia, że wiele części jest z natury bardziej łatwych w obsłudze i potencjalnie wymiennych w przyszłości między systemami zgodnymi ze standardem.
Zarządzanie i iDRAC
Serwer Dell PowerEdge R770 bazuje na bogatym w funkcje i cenionym kontrolerze iDRAC 9, wzbogacając go o kontroler iDRAC 10 nowej generacji, który usprawnia administrowanie systemem poprzez płynną integrację z modułem Data Center Secure Control Module (DC-SCM). Integracja ta umożliwia sprawne aktualizacje oprogramowania sprzętowego i zarządzanie konfiguracją, zapewniając spójność i skalowalność działania w centrach danych. iDRAC 10 obsługuje również zaawansowane funkcje automatyzacji i monitorowania, umożliwiając administratorom IT efektywne zarządzanie wdrożeniami na dużą skalę bez obniżania wydajności i niezawodności.
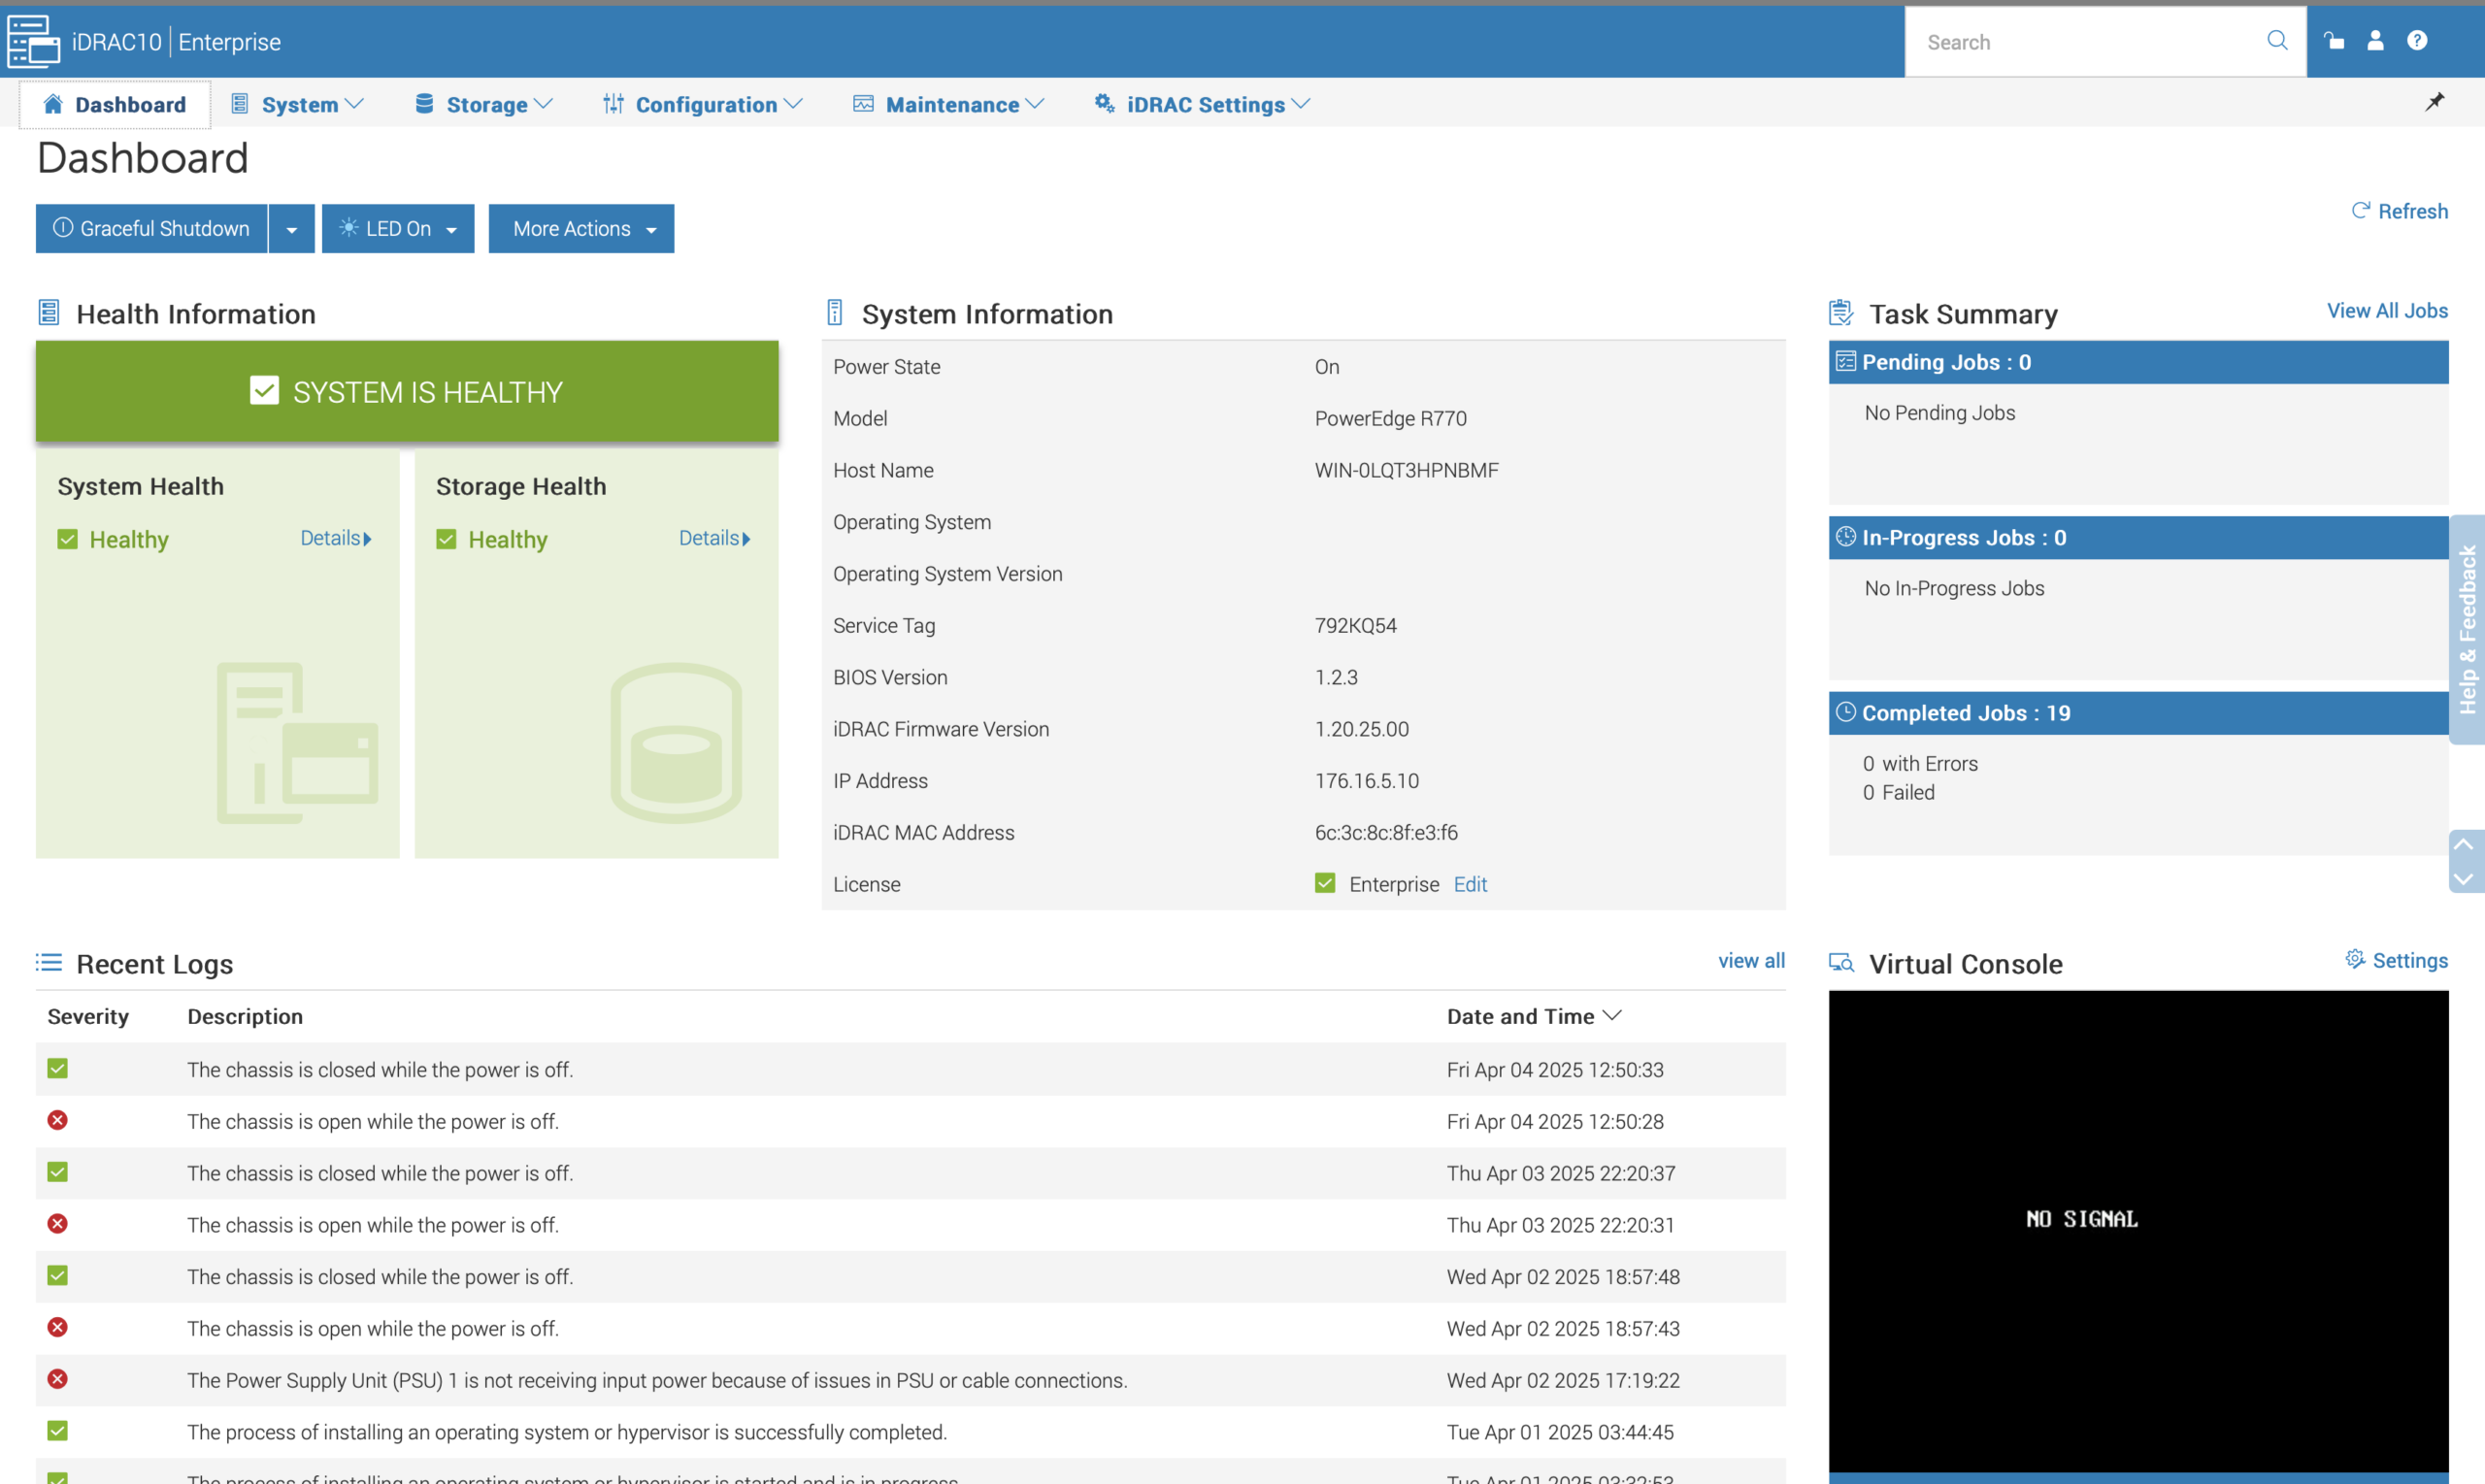
Bezpieczeństwo jest podstawą funkcji zarządzania serwerem R770, a firma Dell wdrożyła solidne mechanizmy weryfikacji przed uruchomieniem i podczas rozruchu. Wykorzystując technologię Root of Trust opartą na krzemie, kontroler iDRAC 10 gwarantuje kryptograficzną weryfikację całego oprogramowania układowego, w tym BIOS-u i kontrolera iDRAC, przed uruchomieniem. Ten niezmienny, sprzętowy mechanizm bezpieczeństwa chroni przed manipulacją złośliwym oprogramowaniem i atakami na łańcuch dostaw, zapewniając bezpieczną podstawę działania systemu. Ponadto, R770 wykorzystuje protokoły rozruchu oparte na technologii kwantowej, aby ograniczyć pojawiające się zagrożenia kryptograficzne, co dodatkowo wzmacnia jego rolę w ochronie infrastruktury krytycznej.

Zaangażowanie firmy Dell w bezpieczeństwo łańcucha dostaw jest widoczne w konstrukcji R770, która wykorzystuje kompleksowy proces uwierzytelniania oparty na łańcuchu zaufania. Każdy komponent sprzętowy przechodzi rygorystyczną weryfikację za pomocą podpisów kryptograficznych wbudowanych w procesie produkcji. Proces ten gwarantuje, że wykorzystywane jest wyłącznie autoryzowane oprogramowanie sprzętowe i komponenty, minimalizując ryzyko związane z nieautoryzowanymi modyfikacjami lub podróbkami.
Elementy konstrukcyjne fabryk AI
Platformę R770 można zamówić z wieloma konfiguracjami GPU i obudów, co czyni ją wszechstronną platformą dla szerokiego zakresu obciążeń AI. Ta elastyczność oraz solidne możliwości pamięci masowej i sieciowe czynią ją atrakcyjnym wyborem dla organizacji wdrażających rozwiązania AI w fabrykach AI. Fabryki AI odnoszą się do infrastruktury i narzędzi niezbędnych do tworzenia, trenowania i wdrażania modeli AI na dużą skalę. Fabryki te są niezbędne do rozwoju zaawansowanych systemów, takich jak pojazdy autonomiczne i robotyka, ponieważ zapewniają moc obliczeniową i potoki danych niezbędne do wydajnego przetwarzania ogromnych zbiorów danych.
Rozwój autonomicznych pojazdów i systemów robotycznych wymaga obszernych danych szkoleniowych, które odzwierciedlają rzeczywiste scenariusze. Cosmos NIM firmy NVIDIA to znaczący postęp w tej dziedzinie, oferujący programistom potężny zestaw narzędzi przyspieszających tworzenie i wdrażanie fizycznych systemów AI, takich jak World Foundational Models.
Zrozumienie modeli fundacji światowych
Modele fundamentów świata (WFM) to zaawansowane sieci neuronowe, które symulują rzeczywiste środowiska i przewidują dokładne wyniki w oparciu o różnorodne dane wejściowe. W przeciwieństwie do tradycyjnych modeli sztucznej inteligencji skoncentrowanych na konkretnych zadaniach, WFM rozumieją dynamikę świata fizycznego, w tym fizykę i właściwości przestrzenne . Potrafią generować filmy na podstawie komunikatów tekstowych, obrazów lub innych danych wejściowych, precyzyjnie odzwierciedlając ruch, siły i relacje przestrzenne.
NVIDIA Cosmos NIM: krok w stronę światowych modeli fundamentalnych
Moduły NIM Cosmos firmy NVIDIA stanowią kluczowy krok w kierunku osiągnięcia fundamentalnych modeli świata. Umożliwiają one organizacjom i laboratoriom sztucznej inteligencji generowanie syntetycznych danych treningowych, efektywnie skalując dane niezbędne do trenowania tych modeli AI. Wdrożyliśmy model Cosmos Predict , model generalistyczny, który generuje stany świata na podstawie komunikatów tekstowych lub wideo i syntetyzuje ruch ciągły poprzez przewidywanie klatek.
Oto kilka interesujących rezultatów, które udało nam się uzyskać za pomocą Cosmosa, wykorzystując tylko jedno zdjęcie naszego laboratorium. Choć nie jest ono idealne, to, co udało się uzyskać na podstawie jednego zdjęcia, jest imponujące.
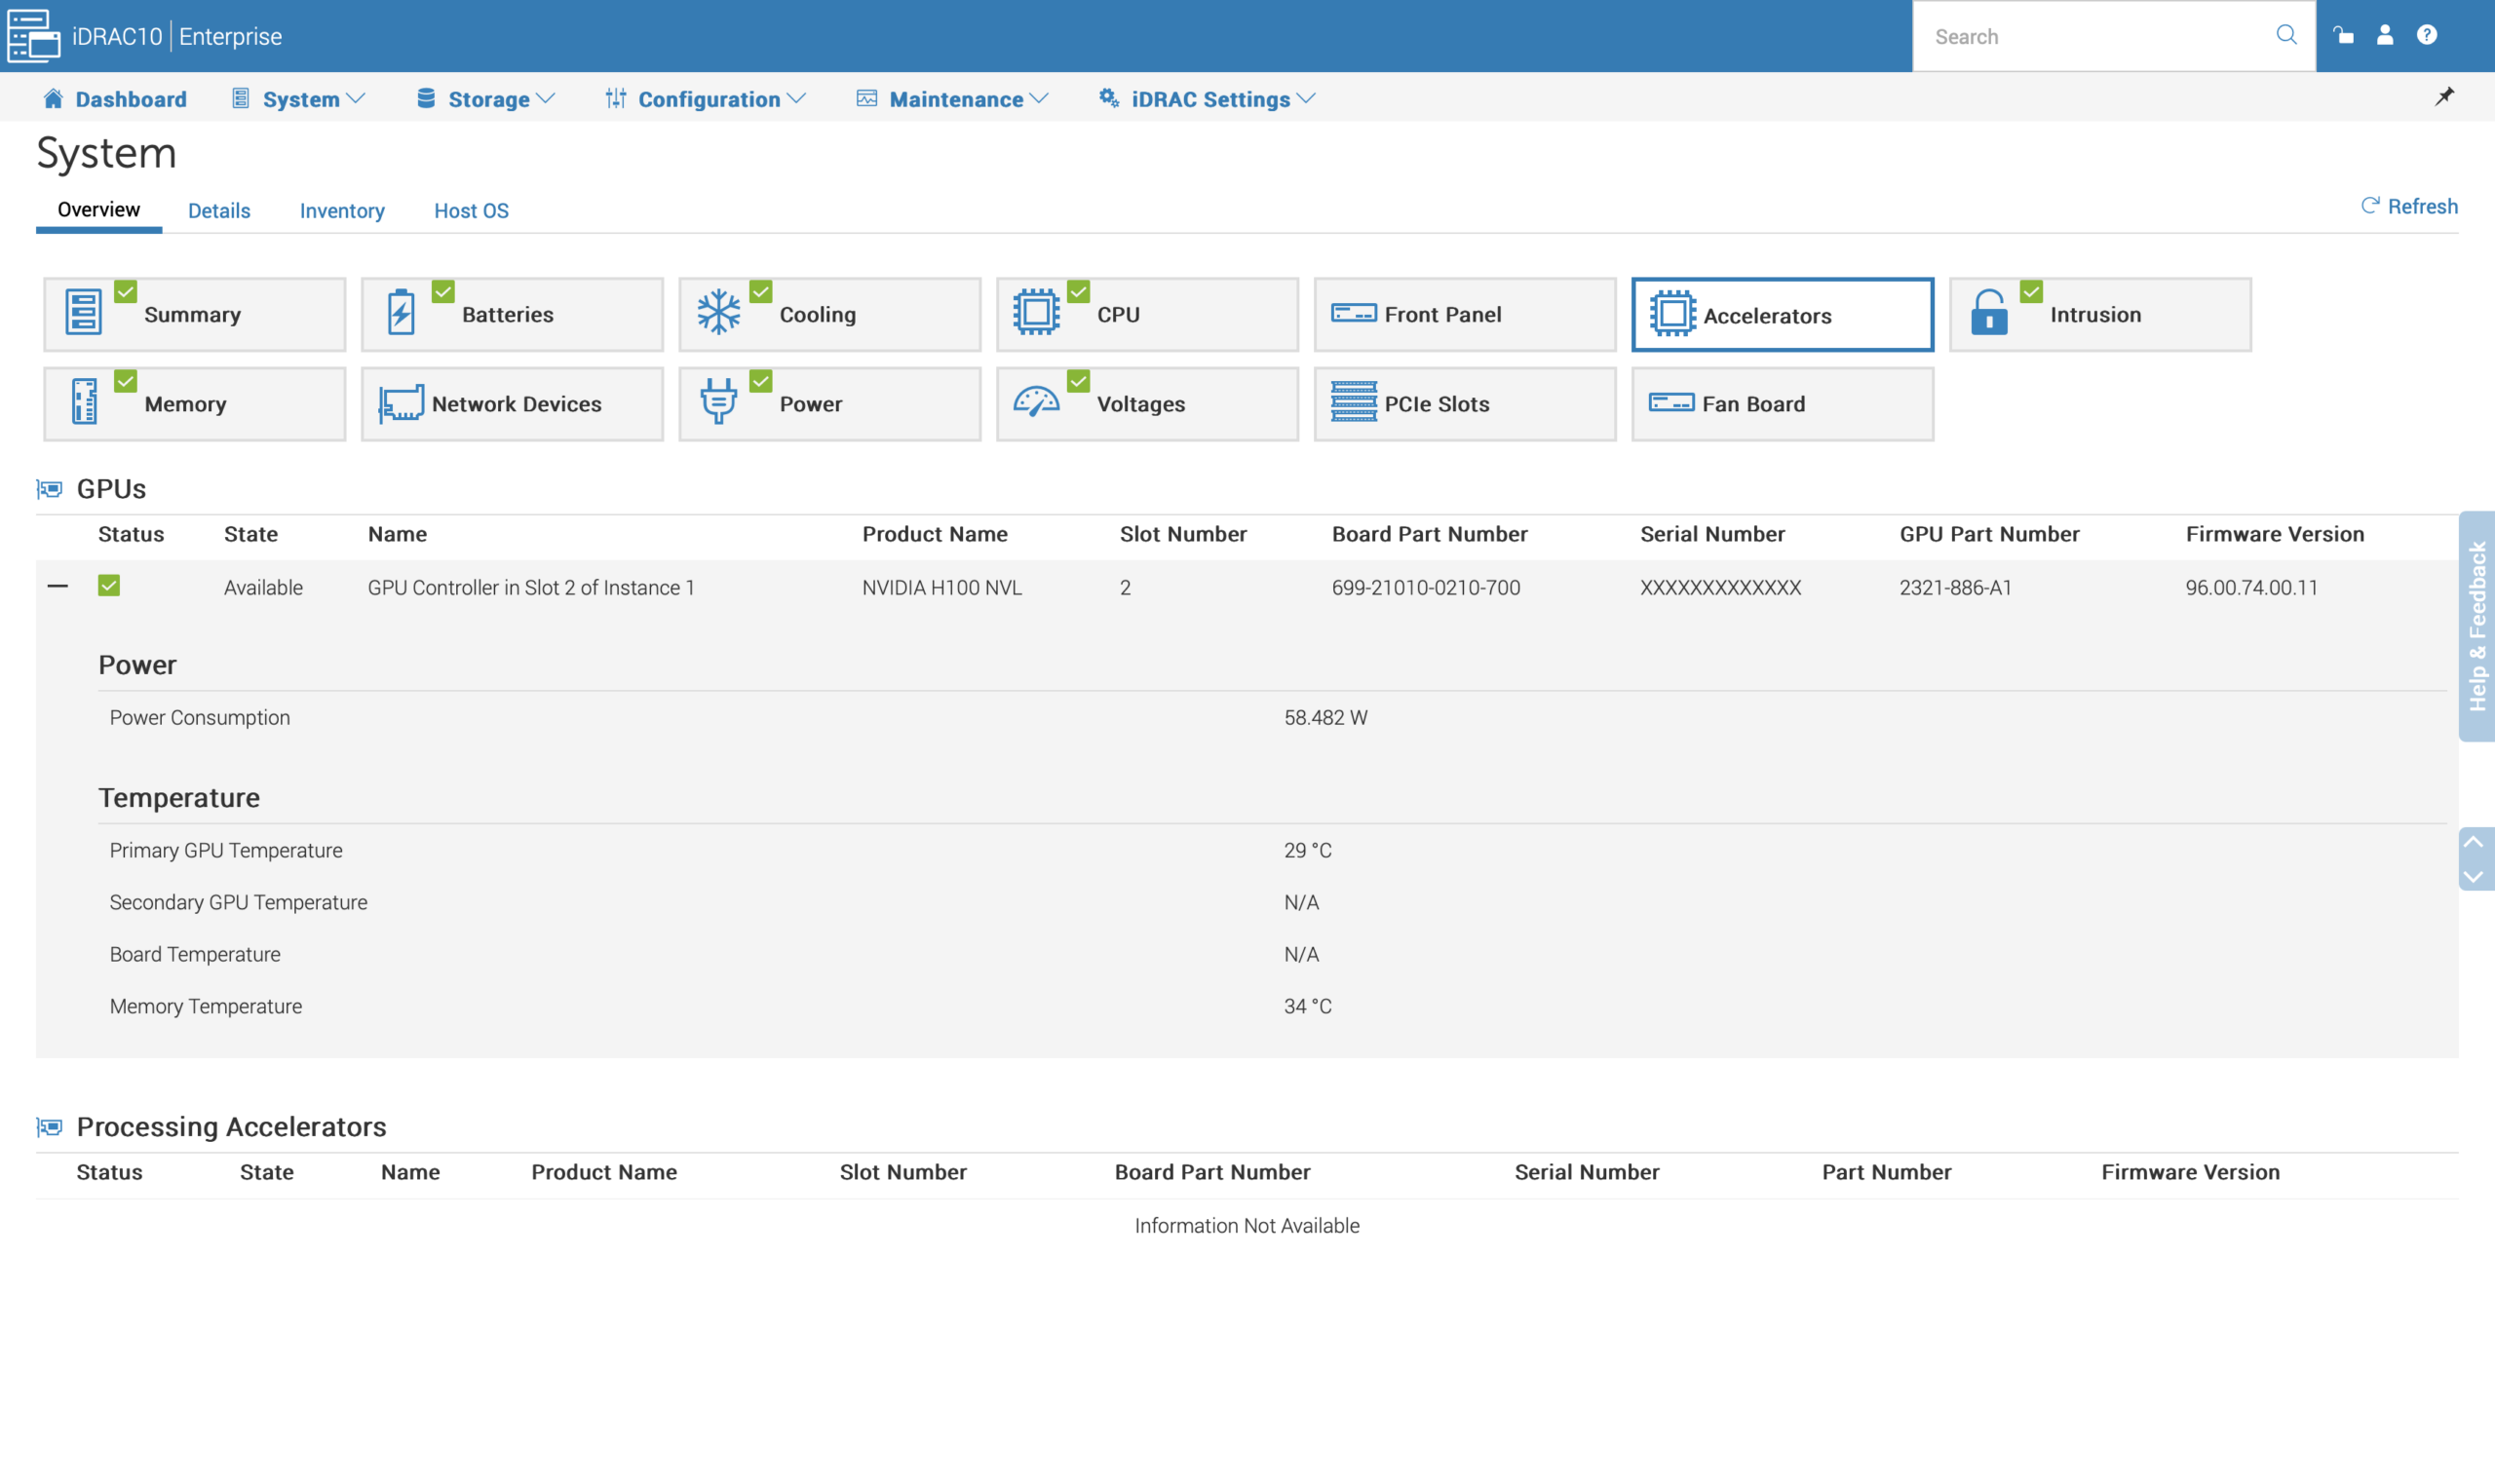
Możliwość obsługi przez R770 wydajnych procesorów graficznych, takich jak NVIDIA H100, a także jego rozbudowane możliwości w zakresie pamięci masowej i obsługi sieci sprawiają, że jest to atrakcyjny wybór dla organizacji planujących wdrożenie rozwiązań opartych na sztucznej inteligencji.
Wykorzystując możliwości platformy R770, organizacje mogą efektywnie szkolić i wdrażać modele AI, takie jak Cosmos NIM, przyspieszając rozwój pojazdów autonomicznych i systemów robotycznych. Wydajność i skalowalność platformy R770 sprawiają, że jest to idealna platforma do obsługi dużych ilości danych wymaganych do szkolenia modeli AI, a jej wszechstronność umożliwia obsługę szerokiego zakresu obciążeń AI.
Bezpośrednie przechowywanie GPU
GPU Direct Storage to technologia umożliwiająca bezpośredni transfer danych między urządzeniami pamięci masowej a procesorami graficznymi (GDS), z pominięciem procesora i pamięci systemowej. W tradycyjnym transferze danych dane są odczytywane z pamięci masowej do pamięci procesora, a następnie kopiowane do pamięci procesora graficznego (GDS). Proces ten obejmuje wiele kopii danych, co prowadzi do zwiększonego opóźnienia i spadku wydajności. Procesor (CDS) działa jako wąskie gardło, ponieważ musi obsługiwać transfer danych między pamięcią masową a procesorem graficznym. Technologia GDS eliminuje to wąskie gardło, umożliwiając urządzeniom pamięci masowej bezpośrednie przesyłanie danych do i z pamięci procesora graficznego (GDS).
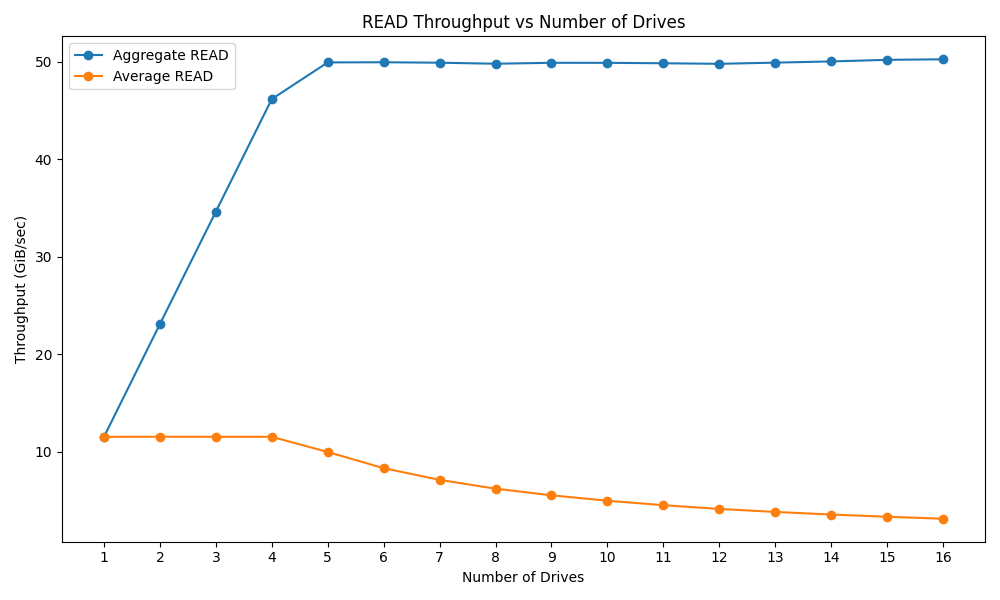
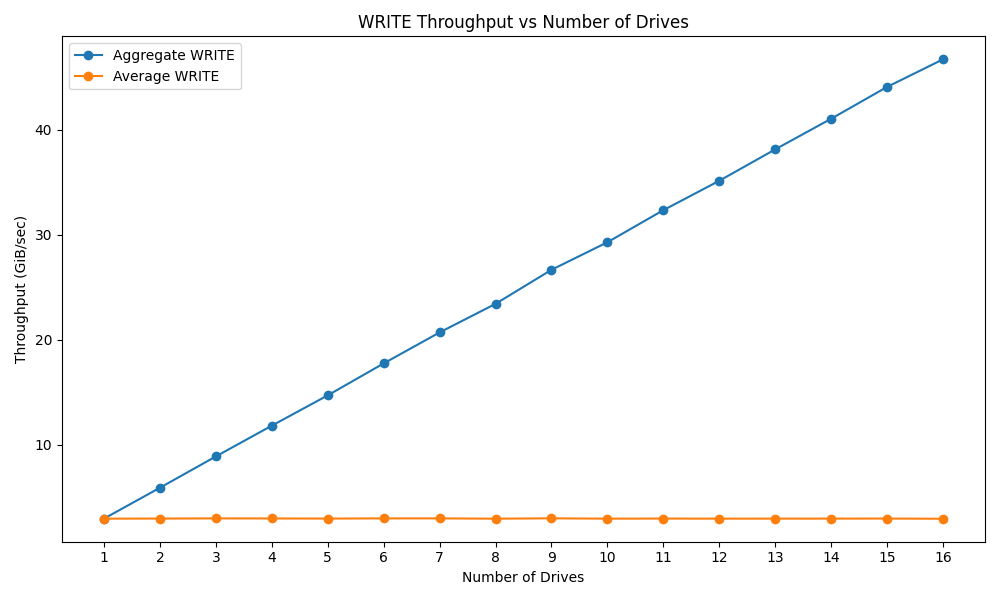
Przeprowadziliśmy analizę obciążenia GDSIO w systemie pamięci masowej składającym się z 16 dysków, stopniowo zwiększając liczbę używanych dysków, aby zrozumieć wydajność pamięci masowej i jej zdolność do nasycenia procesora graficznego PCIe Gen 5.
Wykres odczytu GDSIO ilustruje, jak zwiększenie liczby dysków SSD KIOXIA CD8P wpływa na łączną i średnią przepustowość odczytu w systemie r770. Początkowo, wraz ze wzrostem liczby dysków z jednego do czterech, łączna przepustowość odczytu szybko rośnie, osiągając około 50.2 GiB/s. Sugeruje to, że system może nasycić PCIe Gen 5 x16 zaledwie trzema do czterech dysków do ładowania danych. Powyżej pięciu dysków łączna przepustowość osiąga plateau, co wskazuje, że dodatkowe dyski nie poprawiają się znacząco. Tymczasem średnia przepustowość odczytu na dysk utrzymuje się na stałym poziomie do czterech dysków, ale następnie spada wraz z dodawaniem kolejnych dysków. Ten spadek wydajności na dysk wynika z faktu, że więcej dysków współdzieli dostępną przepustowość magistrali PCIe, a liczba odczytów z poszczególnych dysków ulega zmniejszeniu.
Natomiast wydajność zapisu tych dysków jest znacznie niższa niż wydajność odczytu. Osiągnięcie przepustowości zapisu 46.7 GiB/s zajęło wszystkim 16 dyskom, a średnia prędkość zapisu dla dysków pozostała niemal stała. Biorąc pod uwagę niższe wydajności zapisu w portfolio KIOXIA CD8, wersje o dużej pojemności lub inne dyski SSD PCIe Gen5 będą działać lepiej.
Testowanie Dell PowerEdge R770
Przechodząc do testów porównawczych, R770 to flagowy system Della, który jako taki będzie wdrażany w wielu zróżnicowanych środowiskach. Dlatego przeprowadziliśmy kompleksowy zestaw testów porównawczych dla tej platformy, aby dać wyobrażenie o jej wydajności w różnych środowiskach. W kilku testach porównaliśmy również Lenovo ThinkSystem SR630 V4, aby pokazać różnice między najnowocześniejszymi procesorami z rdzeniem E i P.
Konfiguracja systemu
- PROCESOR: 2x Intel Xeon 6787P (86 rdzeni każdy)
- RAM: 32x Micron 64 GB Dual-Rank DDR5 6400 MT/s Całkowita pamięć: 2 TB
- Zasilacze: 2x Delta 1500W
- GPU: 1x NVIDIA H100 do testu TGI, 1x NVIDIA L4 do pozostałych testów
- Karta sieciowa: Karta sieciowa DELL BRCM 4P 25G SFP 57504S OCP
- Karta BOSS: Dyski BOSS-N1 DC-MHS 0 i 1 SK hynix 480 GB Dell NVMe ISE PE9010 RI M.2 480 GB
- Dyski: 0-5 w płycie głównej 1: Samsung 6.4 TB, Dell NVMe PM1745 MU E3.S 6.4 TB
Wydajność obciążenia AI
Benchmark wnioskowania generowania tekstu
Text Generation Inference (TGI) to wydajny serwer wnioskowania LLM opracowany przez Hugging Face. Został zaprojektowany z myślą o optymalizacji wdrażania i wykorzystania LLM, co czyni go idealnym wyborem dla środowisk produkcyjnych. TGI obsługuje różne otwarte serwery LLM i oferuje funkcje takie jak paralelizm tensorów, strumieniowanie tokenów i ciągłe przetwarzanie wsadowe, które zwiększają jego wydajność i efektywność.

Wnioskowanie na podstawie generowania tekstu – QwQ 32B
Funkcja benchmarkingu TGI służy do oceny wydajności w różnych konfiguracjach i obciążeniach. Funkcja benchmarkingu TGI zapewnia dokładniejsze odwzorowanie rzeczywistej wydajności, ponieważ uwzględnia złożoność obsługi LLM w środowisku produkcyjnym.
Generowanie tekstu za pomocą LLM obejmuje dwa główne etapy: etap wstępnego wypełniania i etap dekodowania. Etap wstępnego wypełniania to krok początkowy, w którym LLM przetwarza monit wejściowy w celu wygenerowania niezbędnych reprezentacji pośrednich. Etap ten jest intensywny obliczeniowo, ponieważ obejmuje przetwarzanie całego monitu wejściowego w jednym przejściu przez model.
Na etapie wstępnego wypełniania, monit wejściowy jest tokenizowany i konwertowany do formatu, który LLM może przetworzyć. Następnie LLM oblicza pamięć podręczną KV, która przechowuje informacje o tokenach wejściowych. Pamięć podręczna KV to kluczowa struktura danych, która ułatwia generowanie tokenów wyjściowych.
Natomiast etap dekodowania to proces autoregresyjny, w którym LLM generuje tokeny wyjściowe pojedynczo, bazując na reprezentacjach pośrednich wygenerowanych na etapie wstępnego wypełniania. Etap dekodowania w dużej mierze opiera się na pamięci podręcznej KV wygenerowanej na etapie wstępnego wypełniania, która zapewnia niezbędny kontekst do generowania spójnych i kontekstowo istotnych tokenów wyjściowych.
Etap wstępnego wypełniania
Wraz ze wzrostem rozmiaru partii z 1 do 32, wzrasta opóźnienie dla wszystkich trzech modeli: opóźnienie DeepSeek-R1-Distill-Qwen-32 B wzrasta z 29.97 ms przy rozmiarze partii 1 do 76.95 ms przy rozmiarze partii 32. Podobnie opóźnienie dla GEMMA-3-27B-IT i Qwen/QwQ-32B wzrasta odpowiednio z 51.84 ms i 29.90 ms do 79.58 ms i 76.30 ms.
Natomiast szybkość transmisji tokenów znacząco wzrasta wraz ze wzrostem rozmiaru partii. Przy rozmiarze partii równym 1, szybkość transmisji tokenów dla trzech modeli waha się od 192.95 do 334.46 tokenów na sekundę. Przy rozmiarze partii równym 32, wzrasta odpowiednio do 4158.67, 4021.40 i 4194.13 tokenów na sekundę dla DeepSeek-R1-Distill-Qwen-32B, GEMMA-3-27B-IT i Qwen/QwQ-32B.
| Wielkość partii | DeepSeek-R1-Destylator-Qwen-32B | GEMMA-3-27B-IT | Qwen/QwQ-32B | |||
|---|---|---|---|---|---|---|
| Opóźnienie (ms) | Stawka tokena | Opóźnienie (ms) | Stawka tokena | Opóźnienie (ms) | Stawka tokena | |
| 1 | 29.97 | 333.64 | 51.84 | 192.95 | 29.90 | 334.46 |
| 2 | 30.21 | 662.09 | 52.55 | 380.61 | 29.95 | 667.80 |
| 4 | 32.40 | 1234.72 | 52.62 | 760.12 | 32.12 | 1245.47 |
| 8 | 36.98 | 2163.46 | 52.66 | 1519.19 | 36.69 | 2180.66 |
| 16 | 51.63 | 3125.50 | 60.96 | 2624.64 | 51.29 | 3147.61 |
| 32 | 76.95 | 4158.67 | 79.58 | 4021.40 | 76.30 | 4194.13 |
Etap dekodowania
W przeciwieństwie do etapu wstępnego wypełniania, opóźnienie podczas etapu dekodowania pozostaje względnie stabilne dla różnych rozmiarów partii. Na przykład opóźnienie DeepSeek-R1-Distill-Qwen-32 B waha się od 27.14 ms do 29.52 ms wraz ze wzrostem rozmiaru partii z 2 do 32.
Szybkość tokenów na etapie dekodowania rośnie wraz ze wzrostem rozmiaru partii, choć nie tak drastycznie, jak na etapie wstępnego wypełniania. Przy rozmiarze partii równym 1, szybkość tokenów wynosi około 36-37 tokenów na sekundę dla DeepSeek-R1-Distill-Qwen-32B i Qwen/QwQ-32B oraz 33.96 tokenów na sekundę dla GEMMA-3-27B-IT. Przy rozmiarze partii równym 32, szybkość tokenów wzrasta odpowiednio do 1083.83, 873.39 i 1084.89 tokenów na sekundę.
| Wielkość partii | DeepSeek-R1-Destylator-Qwen-32B | GEMMA-3-27B-IT | Qwen/QwQ-32B | |||
|---|---|---|---|---|---|---|
| Opóźnienie (ms) | Stawka tokena | Opóźnienie (ms) | Stawka tokena | Opóźnienie (ms) | Stawka tokena | |
| 1 | 27.24 | 36.71 | 29.45 | 33.96 | 27.24 | 36.71 |
| 2 | 27.14 | 73.70 | 30.80 | 64.93 | 27.14 | 73.69 |
| 4 | 27.50 | 145.46 | 31.33 | 127.65 | 27.47 | 145.62 |
| 8 | 27.91 | 286.61 | 32.54 | 245.83 | 27.90 | 286.78 |
| 16 | 28.31 | 565.07 | 34.71 | 460.92 | 28.44 | 562.56 |
| 32 | 29.52 | 1083.83 | 36.64 | 873.39 | 29.50 | 1084.89 |
Jest to zgodne z oczekiwaniami, ponieważ etap wstępnego wypełniania oblicza początkowe stany ukryte i pamięci podręczne wartości kluczowych dla całego monitu wejściowego, co może znacznie obciążyć procesor graficzny (GPU), ponieważ duże, wsadowe operacje mogą być wykonywane jednocześnie. Po przetworzeniu monitu model generuje nowe tokeny, zazwyczaj po jednym na raz. Na każdym kroku model pobiera poprzedni token i zbuforowane stany ukryte i generuje kolejny token. Ponieważ ten etap efektywnie przetwarza token po tokenie, rozmiar partii jest często niewielki, co często prowadzi do niedostatecznego wykorzystania procesora graficznego (GPU).
Test widzenia komputerowego Procyon AI
Wykorzystując rzeczywiste zadania z zakresu wizji maszynowej, test Procyon AI Computer Vision Benchmark ocenia wydajność wnioskowania AI na procesorach CPU, GPU i akceleratorach AI. Obsługuje wiele silników wnioskowania, takich jak TensorRT, OpenVINO, SNPE, Windows ML i Core ML, dostarczając informacji na temat wydajności, kompatybilności i optymalizacji.
Wyniki testu Procyon AI Computer Vision Benchmark również wskazują na wysoką wydajność wnioskowania AI. System osiągnął niskie czasy wnioskowania: MobileNet V3 – 20.64 ms, a ResNet 50 – 22.42 ms. Inception V4 i DeepLab działały odpowiednio z czasem 65.23 ms i 41.37 ms, skutecznie obsługując bardziej złożone obciążenia wizyjne. YOLO V3, kluczowy model detekcji obiektów, został przetworzony w 37.80 ms, co czyni go idealnym rozwiązaniem dla aplikacji AI w czasie rzeczywistym. REAL-ESRGAN, model o dużej intensywności obliczeniowej i superrozdzielczości, odnotował czas 1,159.22 ms, co dało nam ogólny wynik AI Computer Vision na poziomie 81.
| Wizja komputerowa AI (im krótszy czas trwania, tym lepiej) (im wyższy wynik, tym lepiej) | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) |
|---|---|
| Średni czas wnioskowania MobileNet V3 | 20.64 ms |
| Średni czas wnioskowania ResNet 50 | 22.42 ms |
| Średni czas wnioskowania Inception V4 | 65.23 ms |
| Średni czas wnioskowania DeepLab | 41.37 ms |
| Średni czas wnioskowania YOLO V3 | 37.80 ms |
| Średni czas wnioskowania REAL-ESRGAN | 1,159.22 ms |
| Ogólny wynik sztucznej inteligencji w zakresie widzenia komputerowego | 81 |
Hammer DB TPROC-C
Oceniliśmy również wydajność czterech popularnych baz danych typu open source — MariaDB 11.4.4, MySQL 8.4.4, MySQL 5.7.44 i PostgreSQL 17.2 — przy użyciu testu porównawczego HammerDB TPROC-C w celu symulacji obciążeń OLTP w 500 magazynach.
MariaDB okazała się najwydajniejsza, szczególnie w konfiguracjach dwugniazdowych, gdzie skalowała się efektywnie i osiągała najwyższą przepustowość transakcji. MySQL 8.4.4 wykazał znaczną poprawę w porównaniu ze starszą wersją 5.7.44, podkreślając ulepszenia wprowadzone w ostatnich wersjach. PostgreSQL 17.2 zapewniał spójną wydajność, ale nieznacznie ustępował MariaDB i MySQL 8.4.4. MariaDB osiągnęła 3.15 miliona TPM na jednym gnieździe i 5.8 miliona TPM na dwóch gniazdach, przewyższając pozostałe w obu scenariuszach.
Tabela porównania wydajności (transakcje na minutę, TPM)
| Silnik bazy danych | Moduł TPM z jednym gniazdem | Moduł TPM z dwoma gniazdami |
|---|---|---|
| MariaDB 11.4.4 | 3,150,000 | 5,800,000 |
| MySQL 8.4.4 | 2,850,000 | 5,150,000 |
| PostgreSQL 17.2 | 2,700,000 | 4,900,000 |
| MySQL 5.7.44 | 2,300,000 | 4,250,000 |
Pomimo wydajnego sprzętu R770, w tym 86 rdzeni na procesor (mieszanka rdzeni o wysokim i niskim priorytecie), żadna z baz danych nie wykazała znaczącego wzrostu wydajności po rozłożeniu na oba gniazda. Odzwierciedla to powszechne preferowanie przez bazy danych open source wykonywania zadań na jednym gnieździe ze względu na lepszą lokalizację rdzeni i mniejsze opóźnienia pamięci.
Biorąc pod uwagę te wyniki, R770 lepiej nadaje się do obsługi wielu instancji bazy danych w środowisku zwirtualizowanym niż skalowania pojedynczej instancji. Architektura systemu idealnie nadaje się do obsługi obciążeń o wysokiej gęstości i mieszanych bazach danych, wykorzystując zarówno rdzenie wydajnościowe, jak i rdzenie efektywności, aby zapewnić spójną przepustowość w wielu instancjach.
7-Zip
Wbudowany w popularny program 7-Zip test pamięci mierzy wydajność procesora i pamięci systemu podczas zadań kompresji i dekompresji, pokazując, jak dobrze system radzi sobie z operacjami wymagającymi dużej ilości danych.
W teście 7-Zip, w przypadku zadań kompresji, system Dell uzyskał wyższą ocenę (266.425 GIPS) niż Lenovo (224.313 GIPS), przy czym Dell wykazał nieco niższe obciążenie procesora. Jednak Lenovo przewyższyło Della w dekompresji, uzyskując wyższą ocenę (288.457 GIPS w porównaniu z 256.154 GIPS) i nieco wyższe obciążenie procesora. Dell uzyskał nieznacznie wyższą ogólną ocenę (261.290 GIPS), co świadczy o lepszej ogólnej wydajności zarówno w zadaniach kompresji, jak i dekompresji.
| Kompresja 7-Zip i dekompresja | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| Kompresja – bieżące użycie procesora | 5267% | 5064% |
| Kompresja – Aktualna ocena/zastosowanie | 5.061 GIPS | 4.341 GIPS |
| Kompresja – Prąd znamionowy | 266.591 GIPS | 219.840 GIPS |
| Kompresja – wynikowe użycie procesora | 5270% | 5156% |
| Kompresja – wynikowa ocena/wykorzystanie | 5.056 GIPS | 4.350 GIPS |
| Kompresja – ocena wynikowa | 266.425 GIPS | 224.313 GIPS |
| Dekompresja – bieżące użycie procesora | 5623% | 6184% |
| Dekompresja – Aktualna ocena/użycie | 4.586 GIPS | 4.688 GIPS |
| Dekompresja – Aktualna ocena | 257.909 GIPS | 289.879 GIPS |
| Dekompresja – wynikowe użycie procesora | 5627% | 6205% |
| Dekompresja – wynikowa ocena/użycie | 4.553 GIPS | 4.649 GIPS |
| Dekompresja – ocena wynikowa | 256.154 GIPS | 288.457 GIPS |
| Razem – całkowite użycie procesora | 5448% | 5681% |
| Razem – Całkowita ocena/wykorzystanie | 4.804 GIPS | 4.500 GIPS |
| Razem – Ocena całkowita | 261.290 GIPS | 256.385 GIPS |
y-cruncher
Y-cruncher to popularna aplikacja do benchmarkingu i testów obciążeniowych, która zadebiutowała w 2009 roku. Test jest wielowątkowy i skalowalny, obliczając Pi i inne stałe do bilionów cyfr. W tym teście im szybciej, tym lepiej. Oprogramowanie to znakomicie sprawdziło się w testowaniu platform o dużej liczbie rdzeni i pokazywaniu przewagi obliczeniowej między platformami jedno- i dwugniazdowymi.
Wyniki testów porównawczych Y-cruncher pokazują znaczną różnicę w wydajności między Dell PowerEdge R770, wykorzystującym procesory z rdzeniem P, a Lenovo ThinkSystem SR630 V4 z procesorami z rdzeniem E, szczególnie w miarę wzrostu rozmiaru zbioru danych. Nie chodzi tu o to, który system jest lepszy, a raczej o porównanie typów procesorów w tym obciążeniu.
W przypadku mniejszych obliczeń system Dell był już na prowadzeniu, obliczając 1 miliard cyfr liczby Pi w 2.753 sekundy, podczas gdy system Lenovo potrzebował na to ponad dwa razy więcej czasu – 5.997 sekundy. Wraz ze wzrostem obciążenia różnica rosła. Przy 10 miliardach cyfr system Dell ukończył zadanie w 34.873 sekundy, czyli o połowę krócej niż 81.046 sekundy Lenovo. Do 50 miliardów cyfr Dell utrzymał przewagę, wykonując zadanie w 221.255 sekundy, podczas gdy Lenovo potrzebowało na to 476.826 sekundy, co oznacza, że Dell był o 53% szybszy.
Przy 100 miliardach cyfr, Lenovo nie mogło ukończyć testu ze względu na obecną konfigurację 512 GB pamięci RAM. Z 2 TB pamięci RAM, Dell sprawnie poradził sobie z obciążeniem, kończąc test w 491.737 sekundy.
| Y-cruncher (krótszy czas trwania jest lepszy) | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| 1 Billion | 2.753 sekund | 5.997 sekund |
| 2.5 Billion | 7.365 sekund | 17.573 sekund |
| 5 Billion | 16.223 sekund | 37.793 sekund |
| 10 Billion | 34.873 sekund | 81.046 sekund |
| 25 Billion | 99.324 sekund | 220.025 sekund |
| 50 Billion | 221.255 sekund | 476.826 sekund |
| 100 Billion | 491.737 sekund |
Blender OptiX
Aplikacja open-source do modelowania 3D. Ten test porównawczy został przeprowadzony za pomocą narzędzia Blender Benchmark. Wynik jest liczony w próbkach na minutę, przy czym im wyższy wynik, tym lepiej.
Wyniki testów wydajnościowych Blendera pokazują wyraźną przewagę wydajnościową Dell PowerEdge R770 nad Lenovo ThinkSystem SR630 V4, szczególnie w przypadku renderowania z wykorzystaniem procesora. W teście CPU Monster Dell osiągnął 1,706.002 próbek na minutę, co stanowi 19% przewagę nad Lenovo z wynikiem 1,432.09 próbek na minutę. Test CPU Junkshop dodatkowo uwypuklił tę różnicę, gdzie Dell osiągnął 1,169.370 próbek na minutę, przewyższając Lenovo z wynikiem 914.75 próbek na minutę o 28%. Podobnie, Dell uzyskał 791.475 próbek na minutę w teście CPU Classroom, podczas gdy Lenovo pozostawało w tyle z wynikiem 656.68 próbek na minutę, co stanowi różnicę 20%.
Brak procesora graficznego w systemie Lenovo oznaczał również, że nie mógł on uczestniczyć w renderowaniu opartym na procesorze graficznym. W tym przypadku NVIDIA L4 firmy Dell osiągnęła wynik 1,895.71 próbek/min dla trybu Monster, 950.42 próbek/min oraz wynik Classroom wynoszący 968.43 próbek/min.
| Test wydajności procesora Blendera | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| Potwór procesora (Blender 4.3) | 1,706.002 próbek/min | 1432.09 próbek/min |
| CPU Junkshop (Blender 4.3) | 1,169.370 próbek/min | 914.75 próbek/min |
| Klasa CPU (Blender 4.3) | 791.475 próbek/min | 656.68 próbek/min |
| Potwór GPU (Blender 4.3) | 1,895.712 próbek/min | (bez GPU) |
| GPU Junkshop (Blender 4.3) | 950.424 próbek/min | (bez GPU) |
| Klasa GPU (Blender 4.3) | 968.432 próbek/min | (bez GPU) |
Cinebench R23
Narzędzie testowe Cinebench R23 ocenia wydajność procesora systemu poprzez renderowanie złożonej sceny 3D za pomocą silnika Cinema 4D. Mierzy wydajność pojedynczego i wielordzeniowego procesora, zapewniając kompleksowy obraz możliwości procesora w zakresie obsługi zadań renderowania 3D.
W teście Cinebench R23 wyniki testów wydajności wskazują na znaczące różnice w wydajności procesora między Dell PowerEdge R770 a Lenovo ThinkSystem SR630 V4, zwłaszcza biorąc pod uwagę liczbę rdzeni na procesor. Lenovo ThinkSystem SR630 V4, wyposażony w dwa procesory Intel Xeon 6780E (144 rdzenie na procesor), uzyskał wynik 2 99,266 punktów lepszy od Della w teście wielordzeniowym CPU, w porównaniu z 74,710 2 punktami Della. Różnica ta odzwierciedla przewagę Lenovo w obciążeniach wielowątkowych, dzięki większej liczbie rdzeni (łącznie 288 rdzeni) w porównaniu z dwoma procesorami Intel Xeon 6787P Della (86 rdzeni na procesor), co ogranicza jego wydajność wielowątkową.
W teście pojedynczego rdzenia procesora Dell uzyskał lepszy wynik, uzyskując 1,272 punkty, przewyższając tym samym Lenovo z wynikiem 894 punktów, co podkreśla lepszą wydajność jednowątkową Della pomimo mniejszej liczby rdzeni.
| Cinebench R23 | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| Procesor wielordzeniowy | 74,710 pkt | 99,266 pkt |
| Procesor jednordzeniowy | 1,272 pkt | 894 pkt |
| Współczynnik MP | 58.74 x | 111.00 x |
Cinebench 2024
Cinebench 2024 rozszerza możliwości testowania R23, dodając ocenę wydajności GPU. Nadal testuje wydajność CPU, ale zawiera również testy mierzące zdolność GPU do obsługi zadań renderowania.
W tym zaktualizowanym teście Dell PowerEdge R770 uzyskał 12 996 punktów za wydajność GPU, co potwierdza jego zdolność do obsługi zadań renderowania akcelerowanego przez GPU. Lenovo ThinkSystem SR630 V4 nie ma dedykowanego GPU, więc nie uzyskał wyniku GPU.
W teście wielordzeniowym procesora Lenovo uzyskało 2,884 punkty, nieznacznie przewyższając wynik Della z 2,831 punktami, co wskazuje na niewielką przewagę Lenovo w wydajności wielordzeniowej. W teście jednordzeniowym procesora Dell przewyższył Lenovo, uzyskując 71 punktów, w porównaniu z 53 punktami Lenovo, co świadczy o wyższej wydajności Della w teście jednordzeniowym, pomimo mniejszej liczby rdzeni.
| Cinebench R24 | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| Wynik GPU | 12,996 pkt | |
| Procesor wielordzeniowy | 2,831 pkt | 2,884 pkt |
| Procesor jednordzeniowy | 71 pkt | 53 pkt |
| Współczynnik MP | 39.77 x | 54.43 x |
Geekbench 6
Geekbench 6 to wieloplatformowy benchmark mierzący ogólną wydajność systemu. Przeglądarka Geekbench pozwala porównać z nim dowolny system.
Wyniki testów Geekbench 6 pokazują wyraźne różnice w wydajności między Dell PowerEdge R770 a Lenovo ThinkSystem SR630 V4. W teście pojedynczego rdzenia procesora Dell przewyższył Lenovo, uzyskując wynik 1,797, podczas gdy Lenovo uzyskało 1,173, co oznacza 53% poprawę wydajności pojedynczego rdzenia w przypadku Della.
W teście wielordzeniowym procesora Dell ponownie przewodził z wynikiem 15 880, podczas gdy Lenovo uzyskało 13 868, co dało Dellowi 14% przewagę w wydajności wielordzeniowej. Sugeruje to, że procesory Intel Xeon 6787P firmy Dell zapewniają wyższą ogólną moc obliczeniową, szczególnie w zadaniach wymagających wielu rdzeni.
Test GPU OpenCL dodatkowo uwydatnił przewagę firmy Dell, która dzięki procesorowi graficznemu NVIDIA L4 uzyskała wynik 148 730.
| Geekbench 6 (im wyższy wynik, tym lepiej) | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| Procesor jednordzeniowy | 1,797 | 1,173 |
| Procesor wielordzeniowy | 15,880 | 13,868 |
| Wynik OpenCL GPU | 148,730 | (bez GPU) |
Test prędkości Blackmagic RAW
Blackmagic RAW Speed Test to narzędzie do testowania wydajności, zaprojektowane do pomiaru możliwości systemu w zakresie odtwarzania i edycji wideo z wykorzystaniem kodeka Blackmagic RAW. Ocenia, jak dobrze system potrafi dekodować i odtwarzać pliki wideo o wysokiej rozdzielczości, podając liczbę klatek na sekundę dla przetwarzania zarówno z wykorzystaniem procesora (CPU), jak i karty graficznej (GPU).
W teście opartym na procesorze, Dell PowerEdge R770 osiągnął 141 kl./s, przewyższając Lenovo ThinkSystem SR630 V4, który uzyskał 120 kl./s. Oznacza to, że system Dell radzi sobie z przetwarzaniem wideo opartym na procesorze wydajniej niż Lenovo. W teście opartym na procesorze graficznym, Dell PowerEdge R770 uzyskał 157 kl./s, co jest korzystne dzięki obecności układu graficznego NVIDIA.
| Test prędkości Blackmagic RAW (im wyższy tym lepszy) | Dell PowerEdge R770 (2x Intel Xeon 6787P | 2TB pamięci RAM) | Lenovo ThinkSystem SR630 V4 (2 x Intel Xeon 6780E | 512 GB pamięci RAM) |
|---|---|---|
| Procesor FPS | 141 FPS | 120 FPS |
| FPS CUDA | 157 FPS | 0 FPS (bez GPU) |
Test szybkości dysku Blackmagic
Test prędkości dysku Blackmagic Disk Speed Test porównuje prędkość odczytu i zapisu dysku, szacując jego wydajność, szczególnie w przypadku edycji wideo. Pomaga użytkownikom upewnić się, że ich pamięć masowa jest wystarczająco szybka do obsługi treści o wysokiej rozdzielczości, takich jak wideo 4K lub 8K.
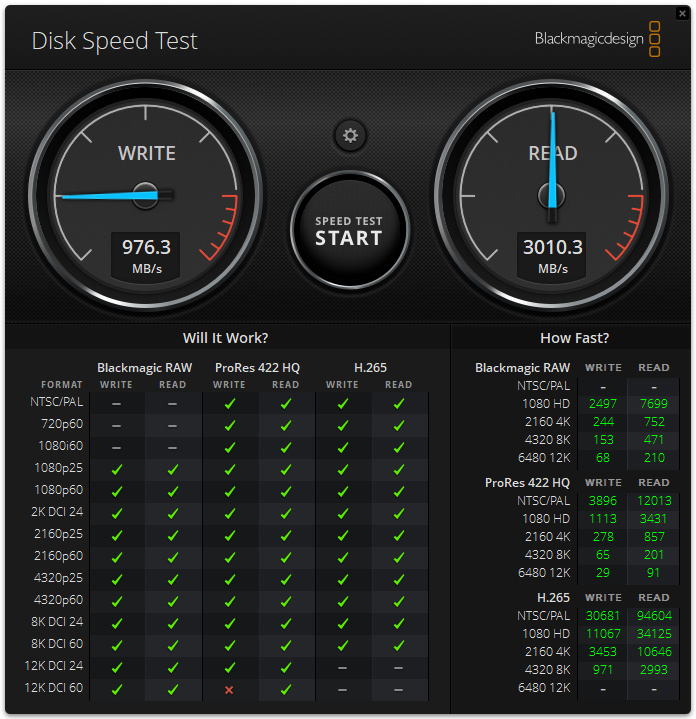
W teście szybkości Blackmagic karta graficzna Dell PowerEdge R770 z lustrzanym interfejsem SK hynix 480GB Dell NVMe osiągnęła prędkość odczytu wynoszącą 3,010.3 MB/s i prędkość zapisu wynoszącą 976.3 MB/s.
Wniosek
Serwer Dell PowerEdge R770 naprawdę nas ekscytuje, napędzany przez wdrożenie standardu Data Center Modular Hardware System projektu Open Compute Project oraz najnowocześniejszy sprzęt. Integracja OCP DC MHS przynosi liczne korzyści, w tym zwiększoną modułowość, łatwość serwisowania i potencjalnie niższe koszty dzięki zwiększonej standaryzacji. Ta filozofia projektowania jest widoczna we wszystkich aspektach systemu, od implementacji kontrolera iDRAC jako OCP DC-SCM, po porty.
Serwer R770 oferuje również imponujące możliwości pamięci masowej, obsługując do 40 dysków E3.S w jednej obudowie 2U, co czyni go idealnym rozwiązaniem do obciążeń wymagających dużej pojemności pamięci masowej. Dodatkowo, elastyczność serwera jest dodatkowo zwiększona dzięki obsłudze różnych konfiguracji, w tym konfiguracji Front I/O Cold Aisle Accessible, co zapewnia większą elastyczność w różnych układach centrów danych i wymaganiach dotyczących serwisowania.
Dzięki obsłudze szerokiej gamy procesorów graficznych i procesorów Intel Xeon 6 Performance, R770 to prawdziwie potężna i wszechstronna platforma serwerowa, doskonale dostosowana do wymagań nowoczesnych centrów danych. Najnowocześniejszy sprzęt, modułowa konstrukcja i solidne funkcje bezpieczeństwa sprawiają, że R770 jest atrakcyjną opcją dla organizacji, które chcą wdrażać rozwiązania AI, HPC i tradycyjne obciążenia korporacyjne.


 Amazon