

Dwie rzeczy zazwyczaj pojawiają się jako pierwsze, gdy rozmowa schodzi na temat NVIDIA DGX Spark. Pierwsza to specyfikacja: 128 GB zunifikowanej pamięci w obudowie desktopowej za około 4,000 dolarów – liczba, która wydawałaby się nieprawdopodobna do postawienia na biurku inżyniera jeszcze dwa lata temu. Druga to sieć 200 GB z tyłu urządzenia. Obecność prawdziwej infrastruktury klasy centrum danych w urządzeniu desktopowym skłania do refleksji, ponieważ oznacza to coś więcej niż szybszą, jednostanowiskową stację roboczą. Oznacza to możliwość łączenia urządzeń Spark i fizycznej replikacji, czyli konfigurację wielowęzłową, która kiedyś była dostępna wyłącznie w szafie rack.
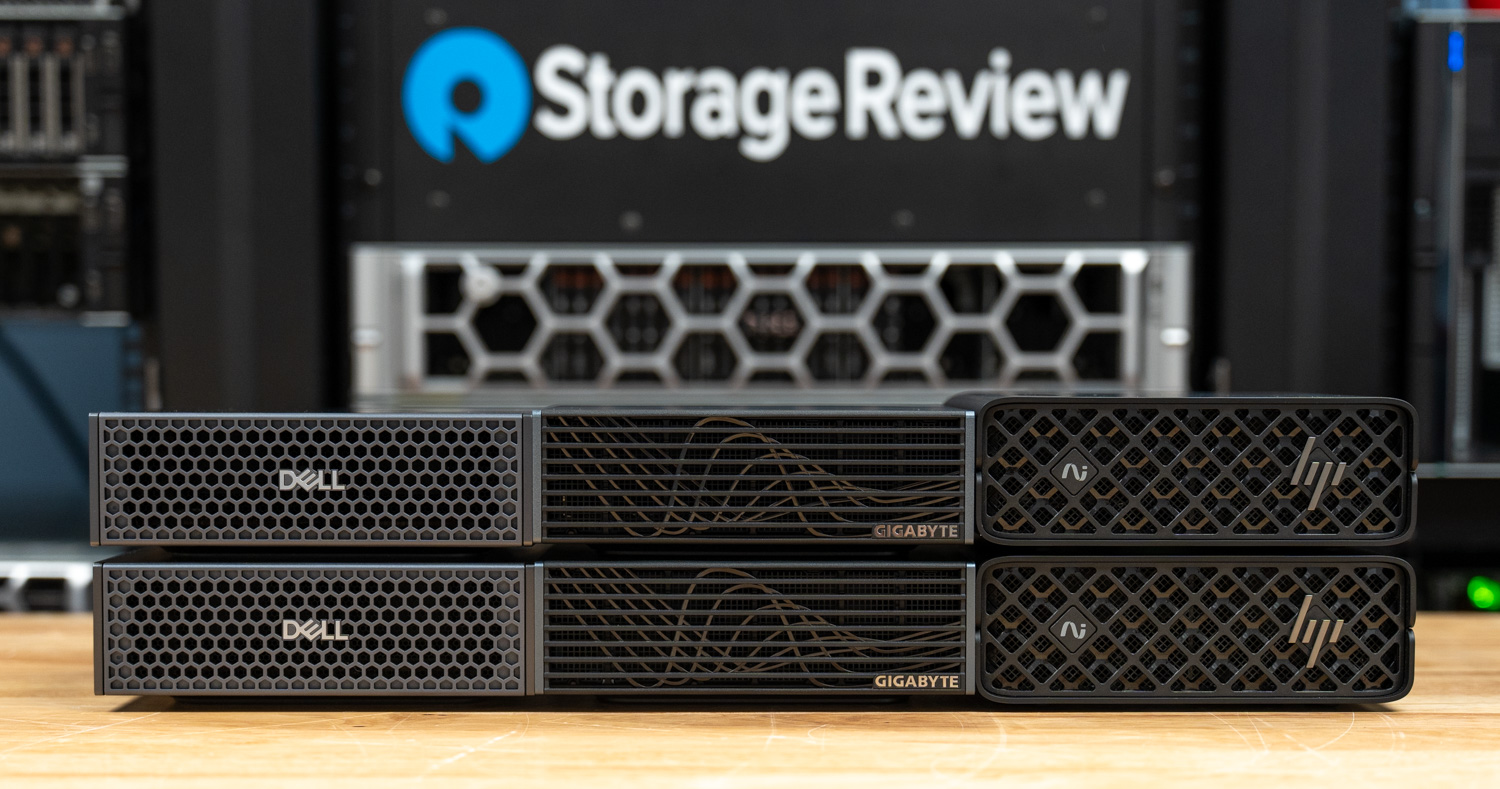
Niniejsza recenzja analizuje tę możliwość. Przeprowadzamy testy rozproszonego wnioskowania we wszystkich trzech dostępnych implementacjach OEM Spark, sparowanych w dwuwęzłowe klastry połączone przez 200-gigabitową sieć, a także w różnych wariantach modeli i trzech konfiguracjach obciążeń. Dokonujemy również świadomego wyboru metodologicznego dotyczącego podziału modelu między dwiema skrzynkami, który odbiega od domyślnej rekomendacji firmy NVIDIA, i uzasadniamy go danymi. Zanim jednak to nastąpi, dwa elementy kontekstu wpływają na wszystko, co następuje: sieć, która w ogóle umożliwia klastrowanie, oraz powody, dla których dana osoba może lub nie chcieć z niej korzystać.
200 GB Fabric
Wdrożenie sieci omówiliśmy szczegółowo w naszej oryginalnej recenzji DGX Spark, ale podstawy warto powtórzyć, ponieważ wszystko w tej recenzji od nich zależy. Z tyłu każdego Sparka znajdują się dwie klatki QSFP56 napędzane przez zintegrowaną kartę sieciową NVIDIA ConnectX-7 SmartNIC. Teoretycznie dwie klatki sugerują łączną przepustowość 400 GB, ale prawdziwym limitem jest PCIe: ConnectX-7 działa za parą łączy Gen5 x4, a platforma oferuje maksymalnie 200 GB użytecznej przepustowości, niezależnie od sposobu podłączenia klatek. Pojedyncza wypełniona klatka QSFP56 zapewnia już pełne 200 Gb obsługiwane przez urządzenie, więc drugi port służy raczej elastyczności topologicznej niż dodatkowej przepustowości.
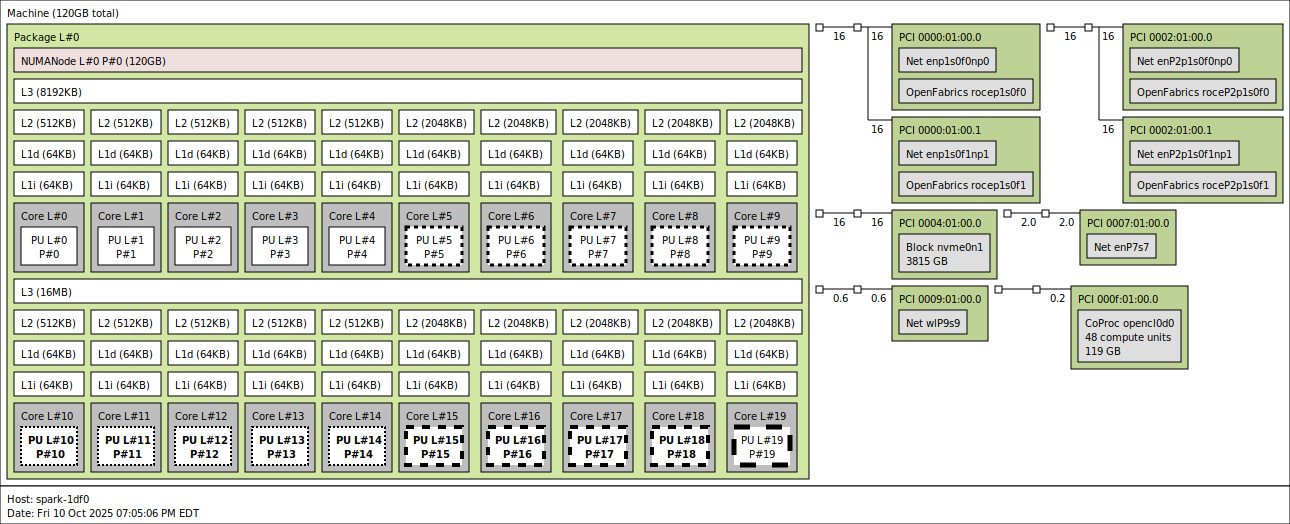
Ta elastyczność przejawia się w trzech typowych konfiguracjach. Najprostsza to pojedynczy port 200 GB używany jako bezpośrednie łącze Spark-to-Spark, co jest specyfikacją zweryfikowanej konfiguracji dwuwęzłowej firmy NVIDIA i co wykorzystaliśmy w tej recenzji. Druga to dwa porty 100 GB, tworzące topologię pierścieniową między serwerami Spark, aby utworzyć klaster bez przełącznika. Trzecia to konfiguracja z podziałem ról, w której jedna klatka jest połączona z równorzędnym serwerem Spark w celu klastrowania, a druga z szybką pamięcią masową przez NVMe-oF, co jest przydatne, gdy roboczy zestaw danych nie mieści się w wewnętrznym interfejsie NVMe serwera Spark.
NVIDIA sprzedaje Spark w trzech konfiguracjach, które bezpośrednio odwzorowują sposób wykorzystania sieci. Pojedynczy Spark do pracy na komputerach stacjonarnych, sprawdzony klaster z dwoma Sparkami, połączony bezpośrednio przez 200-gigabitową sieć dla modeli rozciągniętych, oraz, od tegorocznej konferencji GTC, konfiguracja z czterema jednostkami, którą NVIDIA publicznie zademonstrowała w odpowiedzi na zapotrzebowanie użytkowników na przekroczenie limitu dwóch węzłów. Konfiguracja z dwoma Sparkami jest aktywnie promowana przez NVIDIA, jest tą, którą większość czytelników faktycznie wdroży i która naszym zdaniem reprezentuje rozsądny górny limit dla wnioskowania w stylu produkcyjnym na tym sprzęcie. Jest to również konfiguracja, którą niniejsza recenzja testuje kompleksowo.
Dlaczego Cluster Sparks jest w ogóle godny uwagi?
Oczywistym powodem klastrowania Sparks jest to samo, co w przypadku każdego innego klastra: pojedyncza jednostka 128 GB nie pomieści wszystkich istotnych modeli. Rozciągnięcie modelu o 120-bajtowych parametrach na dwie jednostki otwiera klasę obciążeń, które inaczej by się nie zmieściły. To jest główny przypadek użycia i to właśnie on jest najczęściej demonstrowany.
Mniej oczywistym powodem, a prawdopodobnie ważniejszym dla faktycznej bazy klientów firmy NVIDIA na tej platformie, jest nauka. NVIDIA pozycjonuje Spark jako punkt wejścia. Oficjalna dokumentacja , przykładowe notatniki i podręczniki partnerów traktują to urządzenie jako narzędzie edukacyjne. Zawierają one najwyższej klasy przewodniki dotyczące wszystkiego, od uruchamiania wstępnie zbudowanego modelu za lokalnym interfejsem czatu, przez uruchamianie asystenta kodowania na hostowanym punkcie końcowym, po dostrajanie małych modeli i tworzenie aplikacji end-to-end w PyTorch i JAX. Chodzi o to, że ktoś, kto nigdy w życiu nie napisał jądra CUDA, może przejść od zera do działającego przepływu pracy AI przy swoim biurku w weekend, i to samo dotyczy inżynierów w dziedzinie innej niż ML, którzy chcą mieć samowystarczalną piaskownicę, nad którą mają pełną kontrolę. Klaster z dwoma Sparkami rozszerza tę powierzchnię edukacyjną na terytorium wielowęzłowe: ta sama osoba może teraz dowiedzieć się, jak faktycznie zachowują się paralelizm tensorów, paralelizm potoków i biblioteki komunikacji zbiorowej, z siecią, która jest na tyle realna, że ujawnia prawdziwe wąskie gardła.
W pozycjonowaniu firmy NVIDIA wyraźnie brakuje jednak stwierdzenia, że Spark służy do obsługi inferencji produkcyjnych. Jensen mówił o współprojektowaniu sprzętowo-programowym w niemal każdym wystąpieniu z ostatnich kilku lat i ta zasada ma zastosowanie również w tym przypadku. Każda platforma NVIDIA jest zoptymalizowana pod kątem określonego kształtu obciążenia, a Spark jest zoptymalizowany pod kątem indywidualnej eksploracji i uczenia się, a nie obsługi ruchu. Nasze poprzednie recenzje Spark pokazały już, że platforma ma duże ograniczenia przepustowości pamięci w przypadku większości zadań inferencyjnych, a sieć tylko pogłębia to ograniczenie, gdy tylko zostanie uruchomiona klastrowanie. Pojedyncze łącze 200 Gb, choć imponujące dla komputera stacjonarnego, jest znacząco wolniejsze niż połączenie PCIe Gen5 x16 w jednej obudowie, a zbiorcze wzorce komunikacji, które działają bezproblemowo w parze procesorów graficznych w centrum danych połączonych mostkiem NVLink, nie przenoszą się na infrastrukturę 200 Gb bez ponoszenia realnych kar za opóźnienia.
To jest prawdziwy powód, dla którego NVIDIA tak długo ograniczała oficjalnie wspieraną konfigurację do dwóch urządzeń Spark i dlaczego demonstracja czterech jednostek na GTC była odpowiedzią na zapotrzebowanie użytkowników, a nie organicznym rozszerzeniem produktu. Nic nie stoi na przeszkodzie, aby stos oprogramowania działał na czterech lub ośmiu węzłach, a wielu użytkowników i punktów sprzedaży opublikowało wyniki z większych klastrów. Dane dotyczące wydajności uzyskane z tych eksperymentów generalnie nie są pochlebne: struktura międzywęzłowa staje się dominującym kosztem, a łączna wydajność gwałtownie spada, a co gorsza, przepustowość na użytkownika na końcu tych konfiguracji może spaść do jednocyfrowego zakresu tokenów na sekundę dla dowolnego modelu wystarczająco dużego, aby uzasadnić budowę klastra. W tym momencie konfiguracja jest funkcjonalnie laboratorium edukacyjnym, a nie platformą serwerową.
Nic z tego nie oznacza odrzucenia. Clustering Sparks to naprawdę doskonały sposób na rozwinięcie intuicji w zakresie rozproszonego wnioskowania i szkolenia, które w przeciwnym razie byłoby zablokowane przez sprzęt centrów danych wart setki tysięcy dolarów. Wartość edukacyjna możliwości rzeczywistego dostrzeżenia bąbelków potokowych, wąskich gardeł w modelu all-reduction i kompromisów w zakresie paralelizmu w posiadanym systemie jest znacząca. Nasz własny plan kontynuacji zakładał rozwinięcie tego tematu poprzez wytrenowanie od podstaw małego modelu 1B-parametrowego lub sub-1B w klastrze z dwoma klastrami Spark, z konfiguracją dobraną tak, aby jak najwierniej odzwierciedlała warunki, w jakich działa rzeczywisty rozproszony przebieg wstępnego treningu, abyśmy mogli dokładnie pokazać, gdzie ta klasa klastrów ma sens, a gdzie nie. Ten projekt jest obecnie odłożony na później, podczas gdy pracujemy nad innymi materiałami, które mogliście już zobaczyć, i czekamy na pojawienie się specyfikacji naszego nowego przełącznika rdzeniowego laboratoryjnego 800 Gb. Spodziewamy się do niego powrócić, gdy tylko budowa laboratorium się ustabilizuje.
Poniżej skupimy się na przypadku użycia, w którym konfiguracja dual-Spark jest najbardziej uzasadniona: rozproszone wnioskowanie modeli wystarczająco dużych, by wymagać obu procesorów, testowane we wszystkich trzech dostępnych implementacjach OEM. Zanim przejdziemy do danych dla poszczególnych modeli, w następnej sekcji wyjaśnimy, dlaczego podajemy te wartości dla konfiguracji równoległej potoku, a nie konfiguracji równoległej tensorowej, która zazwyczaj jest domyślnie stosowana w dokumentacji firmy NVIDIA.
Test wydajności
Dlaczego raportujemy równoległość rurociągu, a nie równoległość tensora
Opublikowane przez firmę NVIDIA przewodniki DGX Spark i większość jej materiałów referencyjnych opierają się na paralelizmie tensorowym (TP), aby opisać skalowanie modelu na dwóch maszynach Spark. TP rozdziela każde mnożenie macierzy na oba procesory GPU, dzięki czemu każda warstwa działa jednocześnie na obu urządzeniach, a częściowe wyniki są łączone poprzez redukcję all-reduce po każdym bloku uwagi i MLP. Paralelizm potokowy (PP) podąża inną ścieżką: dzieli model na pół warstwami, umieszcza pierwszą połowę na jednej maszynie, a drugą na drugiej, a następnie przesyła aktywacje między nimi. Każde żądanie nadal przepływa przez pełny model, ale w danym momencie tylko jedna maszyna wykonuje obliczenia dla danego tokena, podczas gdy druga pracuje nad kolejną mikropartią.
Kompromis sprowadza się do tego, co przesyłane jest przez kabel. Podwójny stos Spark łączy oba systemy za pomocą łącza ConnectX-7 200 GbE, które jest szybkie jak na łącze sieciowe, ale wolne w porównaniu z przepustowością pamięci w pojedynczym stosie Spark. Tryb all-reduce w TP uruchamia dwa razy na warstwę transformatora, więc 80-warstwowy model z TP=2 generuje 160 wymian między skrzynkami dla każdego pojedynczego tokena wyjściowego, a każda z tych wymian blokuje kolejne obliczenia. PP=2 przekazuje aktywacje tylko raz na token, na styku dwóch połówek modelu. Na łączu 200 GbE z nietrywialnym opóźnieniem ta różnica dominuje nad wszystkim innym.
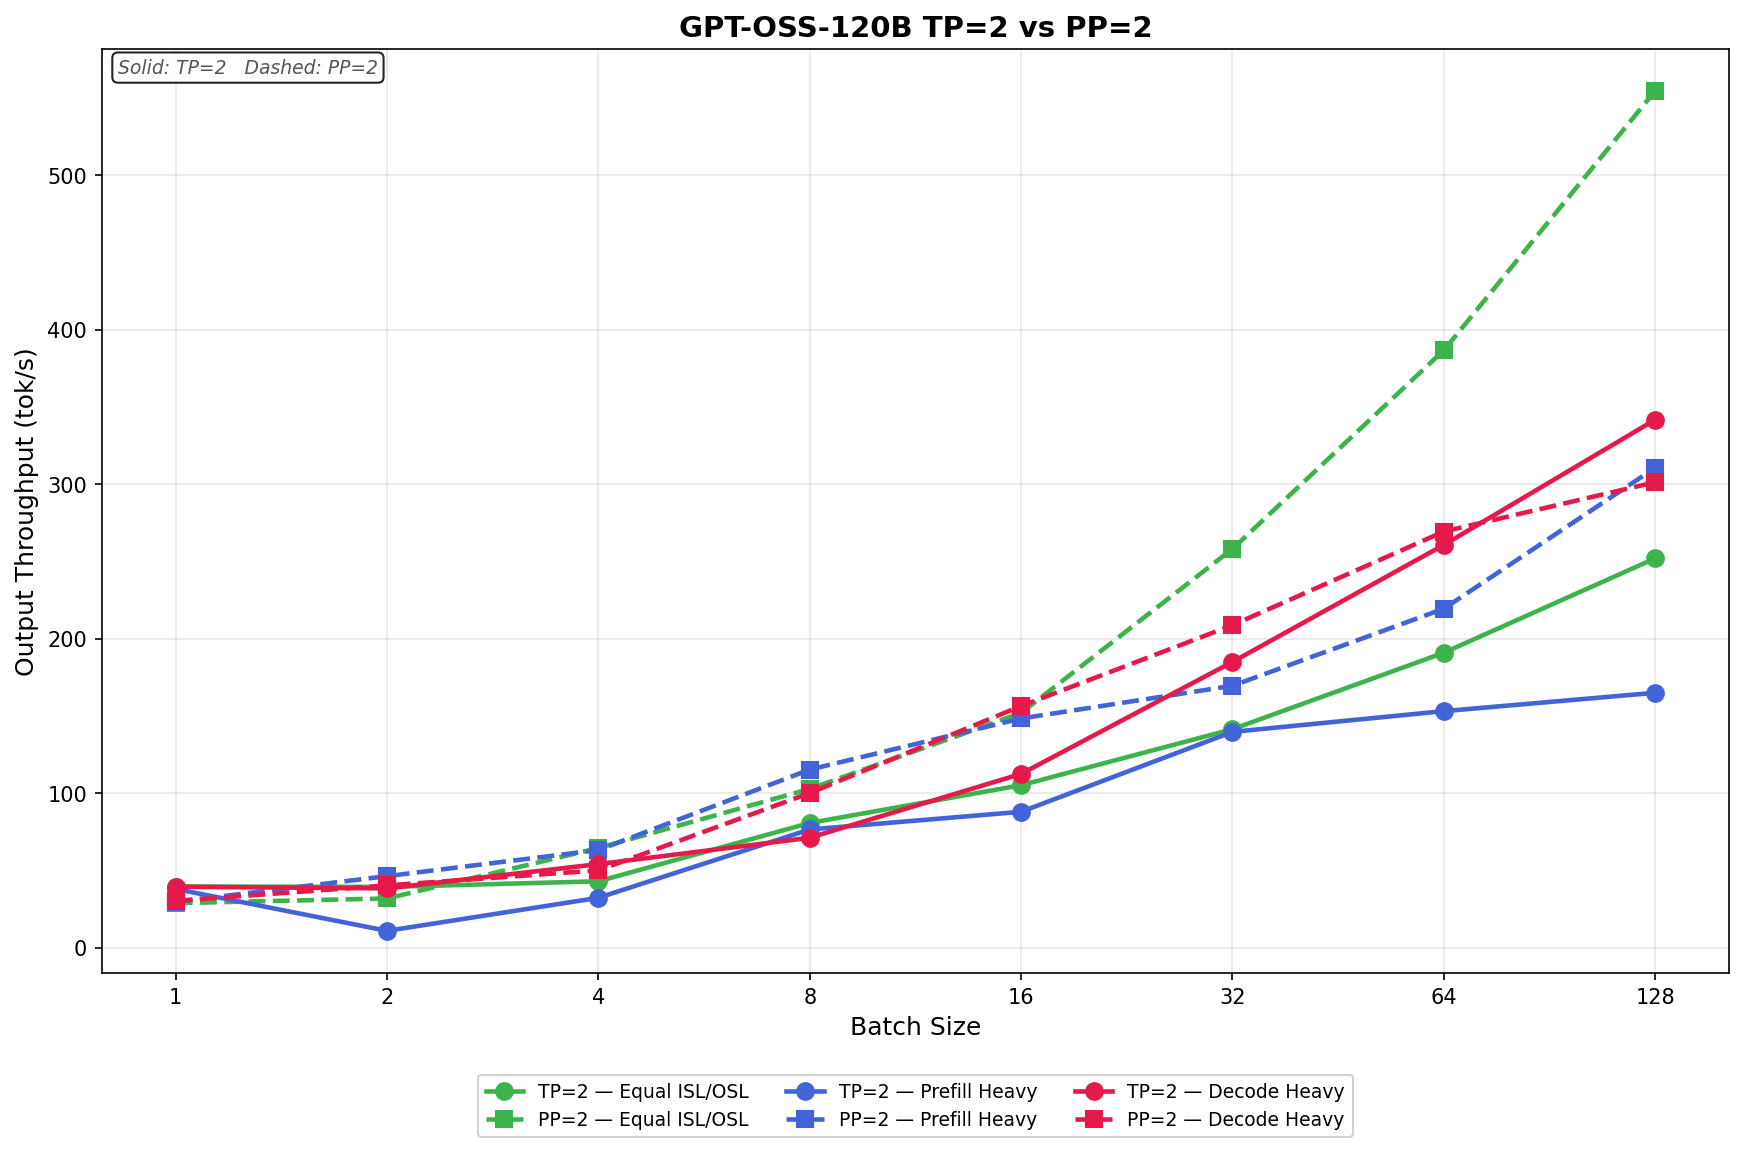
Nasze pomiary GPT-OSS-120B wyraźnie to potwierdzają. Poza rozmiarem partii 1, gdzie obciążenie jest zbyt małe, aby ukryć narzut każdej ze strategii, PP=2 przejmuje prowadzenie i utrzymuje je wraz ze wzrostem współbieżności. W obciążeniu Equal ISL/OSL, TP=2 osiąga 252.01 tok/s przy rozmiarze partii 128, podczas gdy PP=2 wzrasta do 554.69 tok/s na tym samym sprzęcie, co daje 2.20-krotną przewagę. Ten sam kształt ma scenariusz Prefill Heavy, gdzie PP=2 kończy z wynikiem 310.63 tok/s, a TP=2 ze 164.99 tok/s. Scenariusz Decode Heavy jest najbardziej zbliżony z tych trzech, ale PP=2 nadal prowadzi od rozmiaru partii 8 do rozmiaru partii 64, oddając jedynie niewielką przewagę przy rozmiarze partii 128, gdzie długi wynik 8K zwiększa koszt bańki potokowej.
TP=2 ma wąskie okno, w którym wygrywa. Przy rozmiarze partii 1 w każdym scenariuszu, TP zapewnia niewielką, ale realną przewagę: 39.55 tok/s w porównaniu z 28.79 tok/s w Equal, 37.97 w porównaniu z 29.60 w Prefill Heavy i 39.42 w porównaniu z 30.28 w Decode Heavy. Przy jednym żądaniu w locie nie ma drugiego mikrobatcha, który utrzymywałby zajęty etap bezczynnego potoku, więc PP płaci za pusty slot na każdym kroku, podczas gdy TP może korzystać z obu GPU na jedynym istniejącym tokenie. To jest właśnie system, dla którego opracowano wytyczne NVIDIA dotyczące TP: interaktywne serwowanie pojedynczego strumienia, gdzie opóźnienie pierwszego i jedynego żądania ma większe znaczenie niż łączna przepustowość. Jeśli wdrożenie ma charakter czatu, z jednym użytkownikiem na urządzenie i ścisłymi celami TTFT, TP=2 jest właściwym wyborem, co jest również zgodne z tym, jak NVIDIA postrzega Spark.
W przypadku obciążeń obsługujących infrastrukturę na dużą skalę, z wnioskowaniem wsadowym i wieloma współbieżnymi żądaniami, paralelizm potokowy jest lepszym rozwiązaniem przy skalowaniu między serwerami, zwłaszcza gdy strategie takie jak paralelizm ekspercki nie są stosowane. Sieć 200 GbE nie jest w stanie obsłużyć ruchu All-Reduce TP per token bez pozostawiania zasobów obliczeniowych bezczynnymi, a gdy rozmiar wsadu osiągnie 4 lub 8, koszt buforowy PP znika w strumieniu stanu ustalonego. Dlatego w dalszej części artykułu każda wartość dla modelu jest podawana z TP=1 i PP=2. To konfiguracja, która faktycznie odzwierciedla to, co wdrożenie dual-Spark może zaoferować w przypadku rzeczywistej pracy.
Celowo wybraliśmy GPT-OSS-120B jako główny wykres TP vs PP, ponieważ pokazuje on największą różnicę. Chcemy jednak również pokazać, że nie dotyczy to wszystkich modeli i że te parametry zależą od parametrów modelu. Llama-3.1-8B-Instruct z BF16 przedstawia znacznie bardziej konserwatywny obraz. Model jest na tyle mały, że obliczenia każdej warstwy są szybkie, a ruch TP w trybie all-reduce jest odpowiednio niewielki. Natomiast koszt koordynacji na krok w PP jest stały, niezależnie od rozmiaru modelu. W rezultacie TP=2 utrzymuje prowadzenie przez niemal cały cykl wsadowy. W systemie Equal ISL/OSL, TP=2 prowadzi od rozmiaru partii 1 (23.2 w porównaniu z 13.4 tok/s) do rozmiaru partii 32 (388.7 w porównaniu z 349.3 tok/s), tracąc przewagę jedynie przy rozmiarze partii 64 (524.8 w porównaniu z 638.2 tok/s) i rozmiarze partii 128 (679.2 w porównaniu z 1,047.1 tok/s). Tryb Prefill Heavy działa w ten sam sposób, z TP=2 na czele do rozmiaru partii 32, zanim PP=2 przejmie kontrolę przy 64 i 128. Tryb Decode Heavy jest najbardziej decydujący: TP=2 wygrywa przy każdym rozmiarze partii, kończąc na 366.7 tok/s w porównaniu z 330.5 tok/s dla PP=2 przy rozmiarze partii 128.
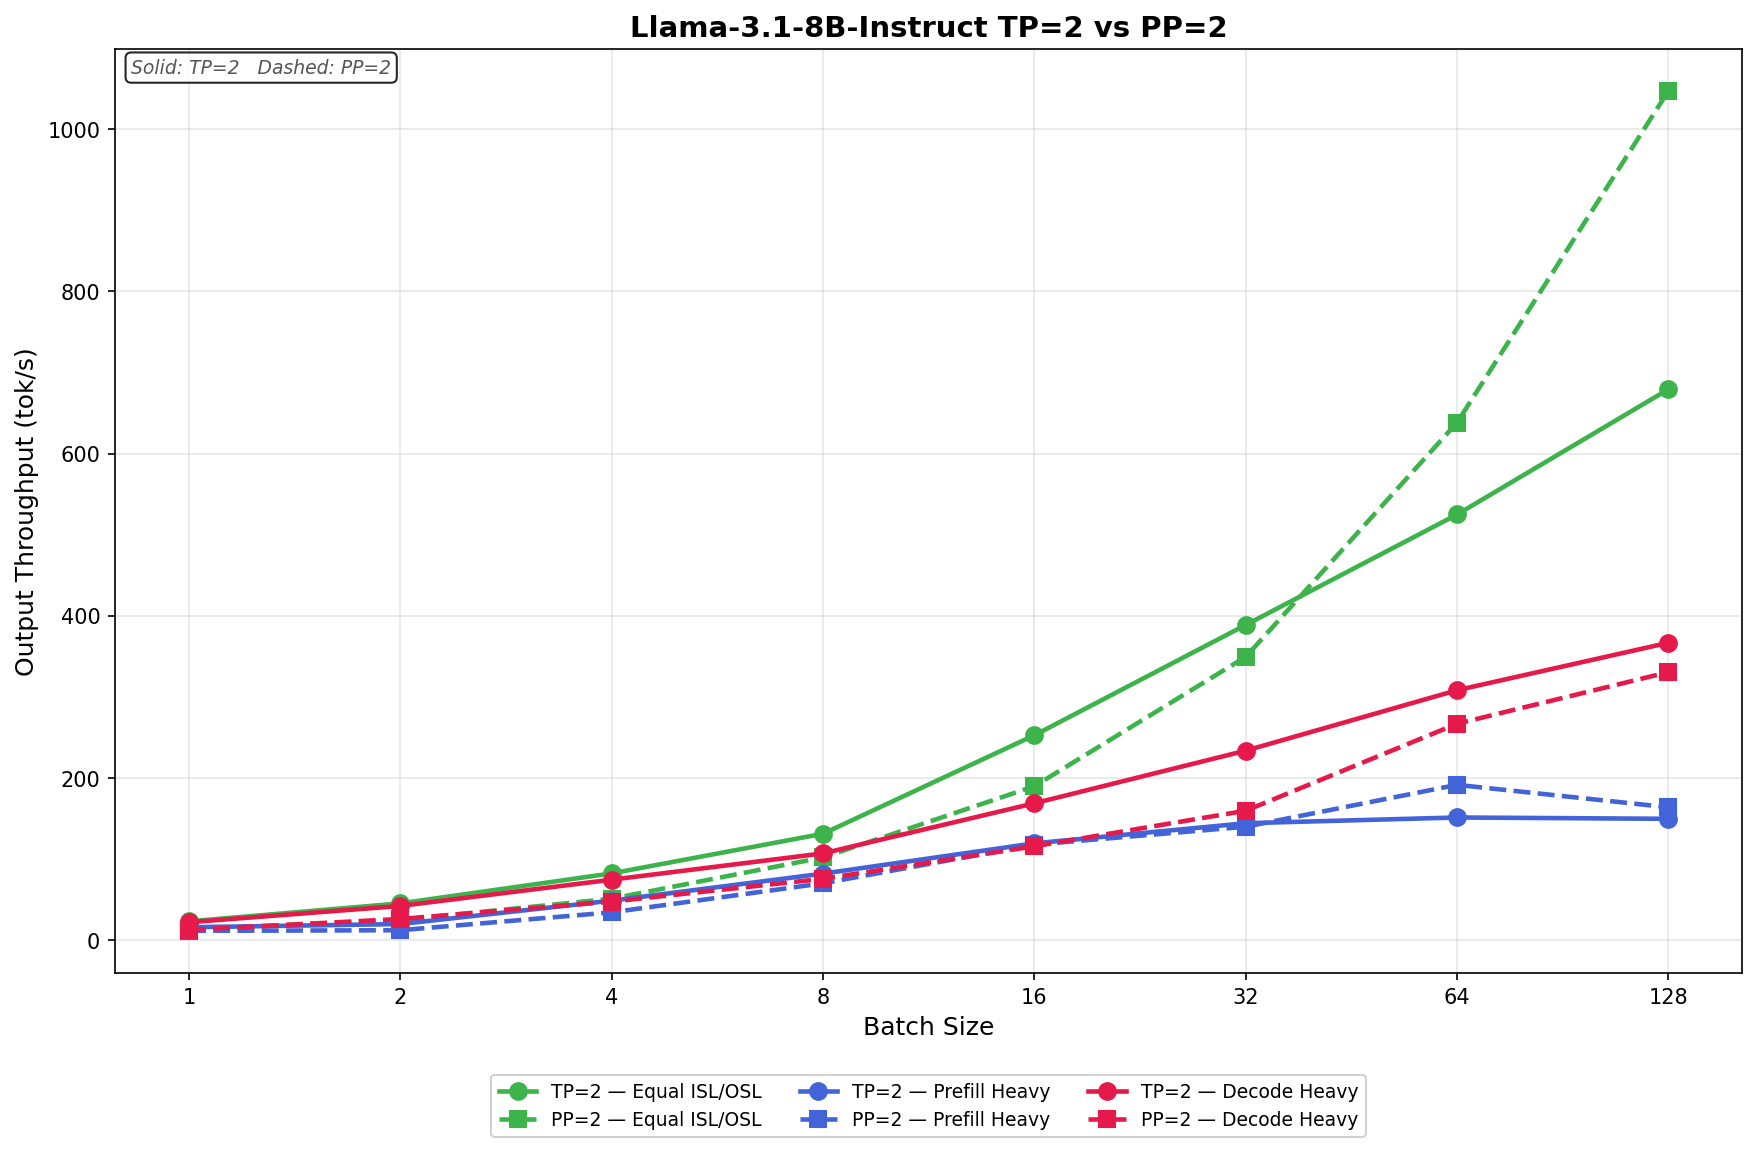
Ten kontrprzykład wzmacnia, a nie zaprzecza, podstawową mechanikę. PP=2 wygrywa tylko wtedy, gdy rozmiary partii są wystarczająco duże, aby wypełnić potok i w pełni zamortyzować koszt bąbelka, a sam model jest na tyle mały, że redukcja all-redukcji na warstwę TP jest tania; ten punkt przecięcia jest przesuwany dalej. Wynik „Decode Heavy” jest również spójny: dłuższe sekwencje wyjściowe oznaczają więcej kroków dekodowania, więcej bąbelków potoku opłacanych jeden po drugim i mniejsze okno czasowe dla PP na zrekompensowanie różnicy. Innymi słowy, ta sama fizyka, która daje PP 2.20-krotną przewagę nad GPT-OSS-120B przy rozmiarze partii 128, wyjaśnia również, dlaczego wygrywa on tylko w dwóch największych rozmiarach partii w modelu 8B i nigdy nie wygrywa w trybie „decode-heavy”.
GPT-OSS-120B
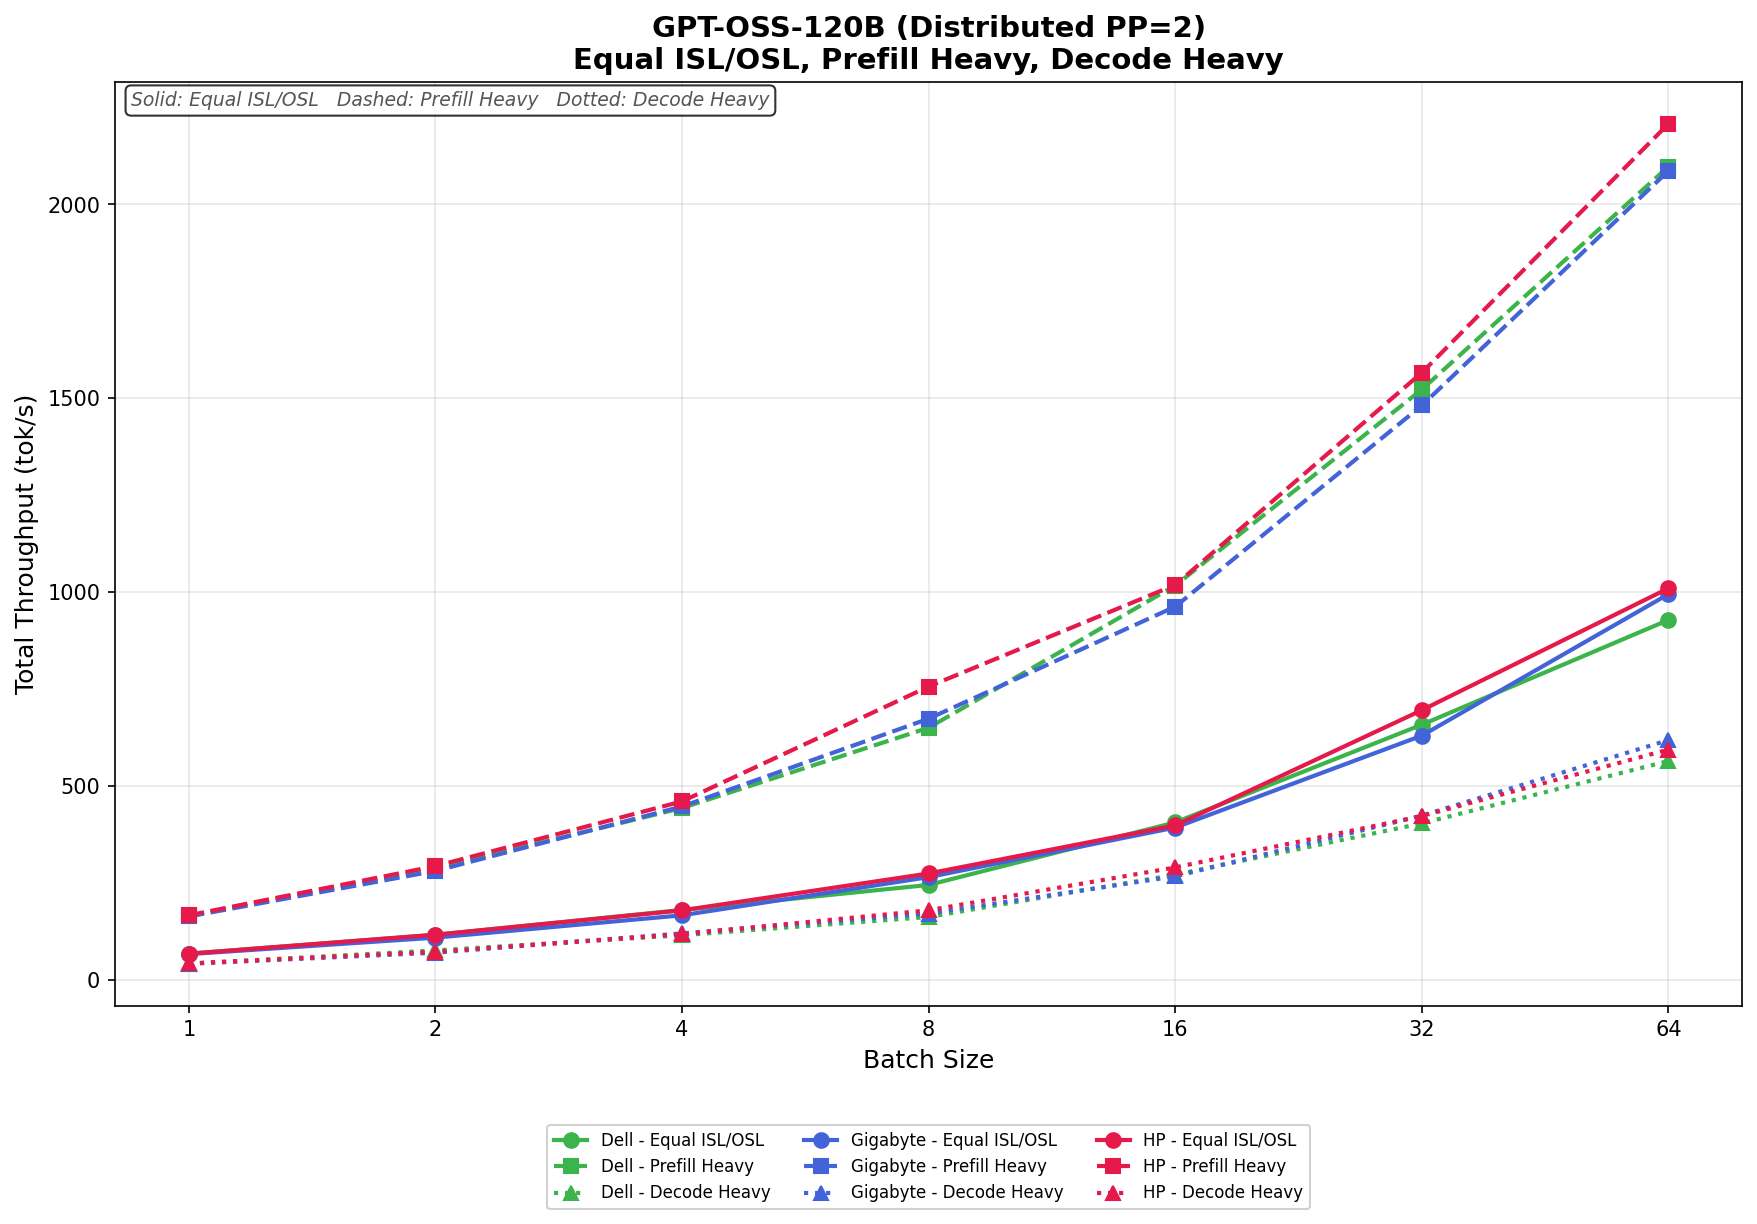
W Equal ISL/OSL, Dell zaczyna od 67.06 tok/s i skaluje do 927.93 tok/s przy rozmiarze partii 64. GIGABYTE zaczyna nieco niżej z 65.77 tok/s, ale kończy lepiej z wynikiem 994.53 tok/s, podczas gdy HP prowadzi w grupie na szczycie z wynikiem 1,009.75 tok/s. Różnica pozostaje niewielka przez większość okresu testowego, a HP wyprzedza od rozmiaru partii 32.
W trybie Prefill Heavy przepustowość rośnie znacznie bardziej dynamicznie we wszystkich obszarach. Dell skaluje ze 164.42 tok/s do 2,097.80 tok/s, GIGABYTE ze 162.96 tok/s do 2,086.72 tok/s, a HP odnotowuje najlepszy wynik, rosnąc ze 165.95 tok/s do 2,208.16 tok/s. HP prowadzi w niemal każdej wielkości partii, podczas gdy Dell i GIGABYTE pozostają blisko siebie, szczególnie w przypadku wielkości partii 32 i 64.
W trybie Decode Heavy ogólna wydajność jest niższa, zgodnie z oczekiwaniami dotyczącymi obciążenia dekodowania. Dell osiąga wyniki od 41.20 tok/s do 563.98 tok/s, GIGABYTE od 40.83 tok/s do 617.96 tok/s, a HP od 41.63 tok/s do 593.56 tok/s. GIGABYTE ma najsilniejszy wynik przy wielkości partii 64, podczas gdy HP prowadzi w średnim zakresie, a Dell utrzymuje się blisko, ale nieznacznie traci przy wyższej współbieżności.
GPT-OSS-20B
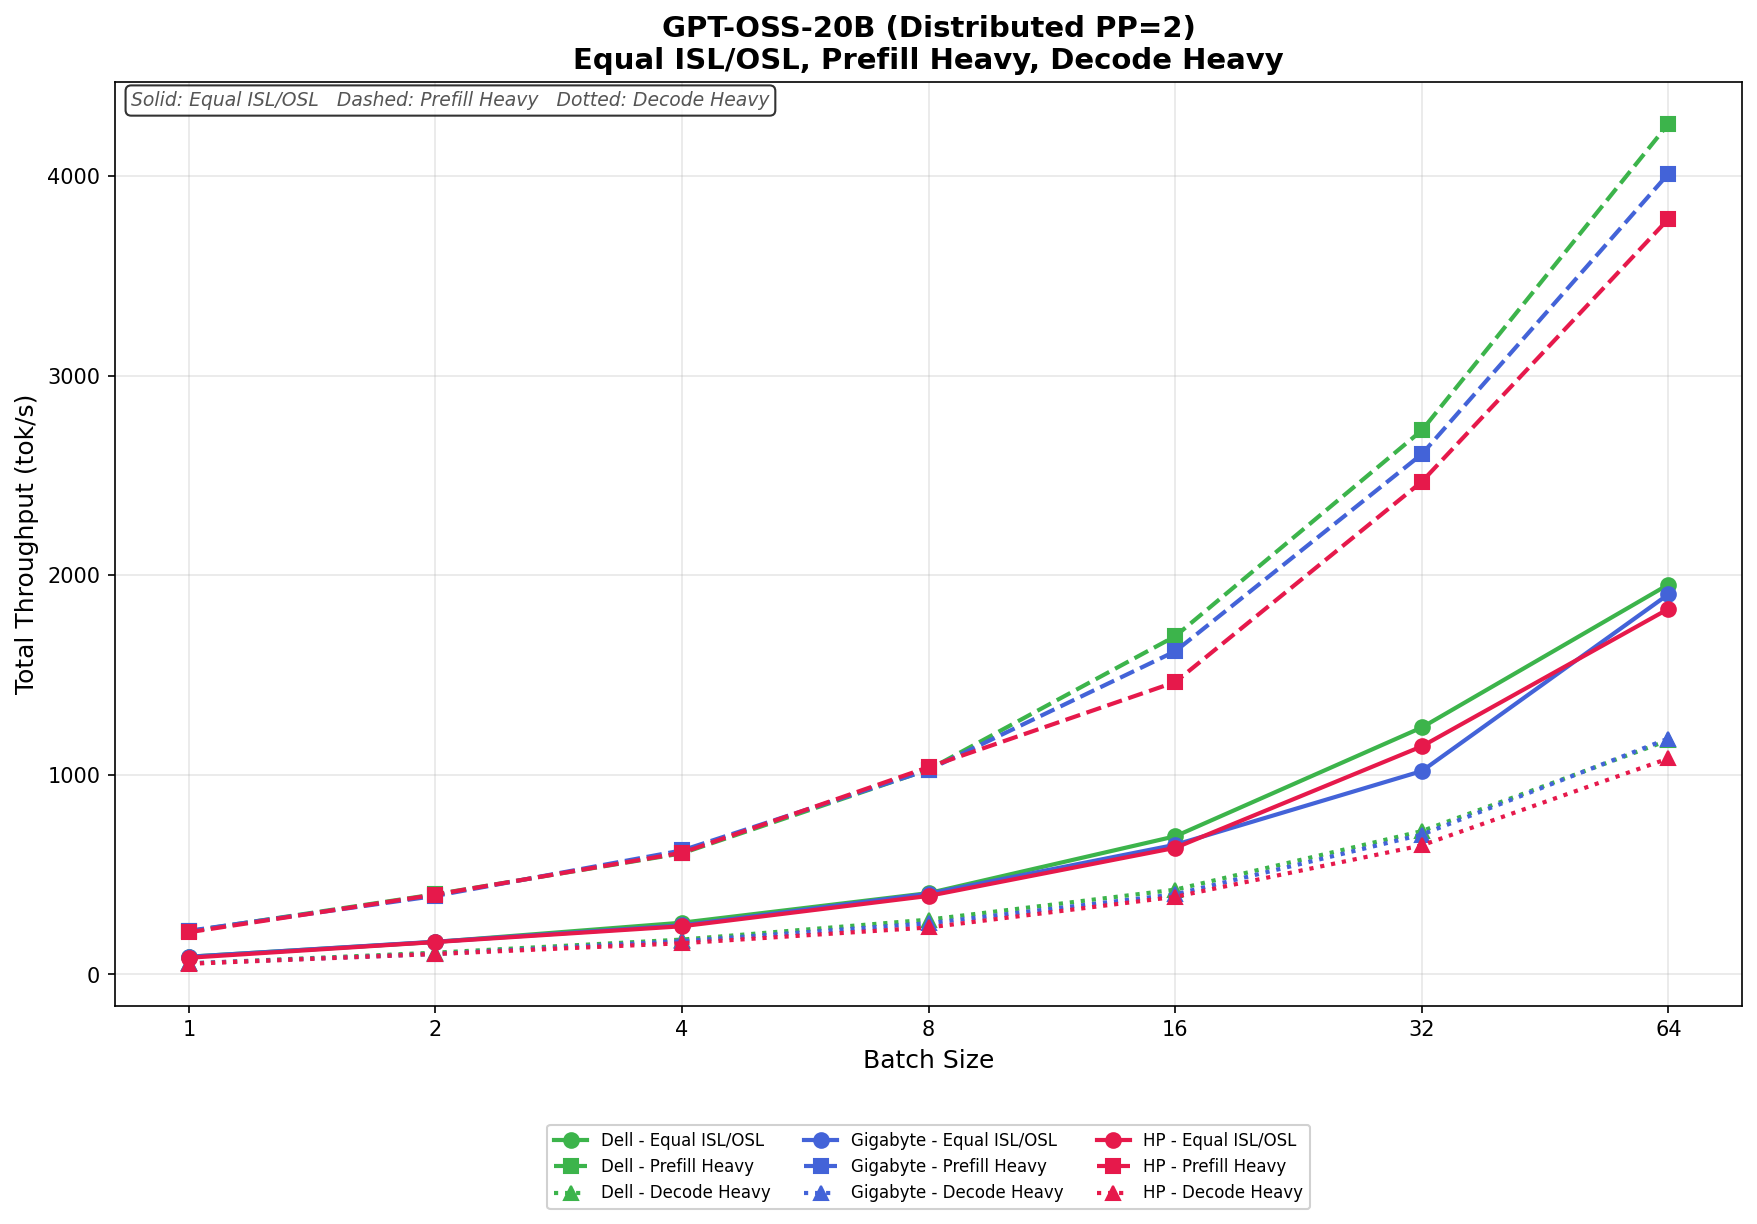
W przypadku Equal ISL/OSL, Dell prowadzi w większości, skalując z 88.73 tok/s dla partii o rozmiarze 1 do 1,953.55 tok/s dla partii o rozmiarze 64. Tuż za nim plasuje się GIGABYTE, zwiększając wydajność z 88.42 tok/s do 1,904.62 tok/s, podczas gdy HP plasuje się w przedziale od 83.49 tok/s do 1,831.45 tok/s. Dell utrzymuje najwyższą ogólną skalowalność w górnym zakresie, szczególnie od partii o rozmiarze 16 wzwyż.
W trybie Prefill Heavy przepustowość gwałtownie rośnie we wszystkich trzech systemach. Dell uzyskał najwyższy wynik w tym teście, skalując się z 216.05 tok/s do 4,261.96 tok/s przy rozmiarze partii 64. GIGABYTE plasuje się na drugim miejscu z wynikiem 4,011.86 tok/s, a HP osiąga 3,785.25 tok/s. Trzy systemy pozostają ściśle zgrupowane przy mniejszych rozmiarach partii, ale Dell zaczyna się oddzielać przy rozmiarze partii 16 i powiększa swoją przewagę w pozostałej części testu.
W Decode Heavy skalowanie jest bardziej stopniowe, ale pozostaje silne na wszystkich platformach. Dell skaluje od 54.88 tok/s do 1,173.31 tok/s, GIGABYTE skaluje od 55.24 tok/s do 1,181.94 tok/s, a HP rośnie z 53.20 tok/s do 1,082.23 tok/s. GIGABYTE minimalnie wyprzedza Dell pod względem największej wielkości partii, podczas gdy HP ustępuje obu systemom pod względem wyższych poziomów współbieżności.
Llama 3.1 8B Instrukcja bazy
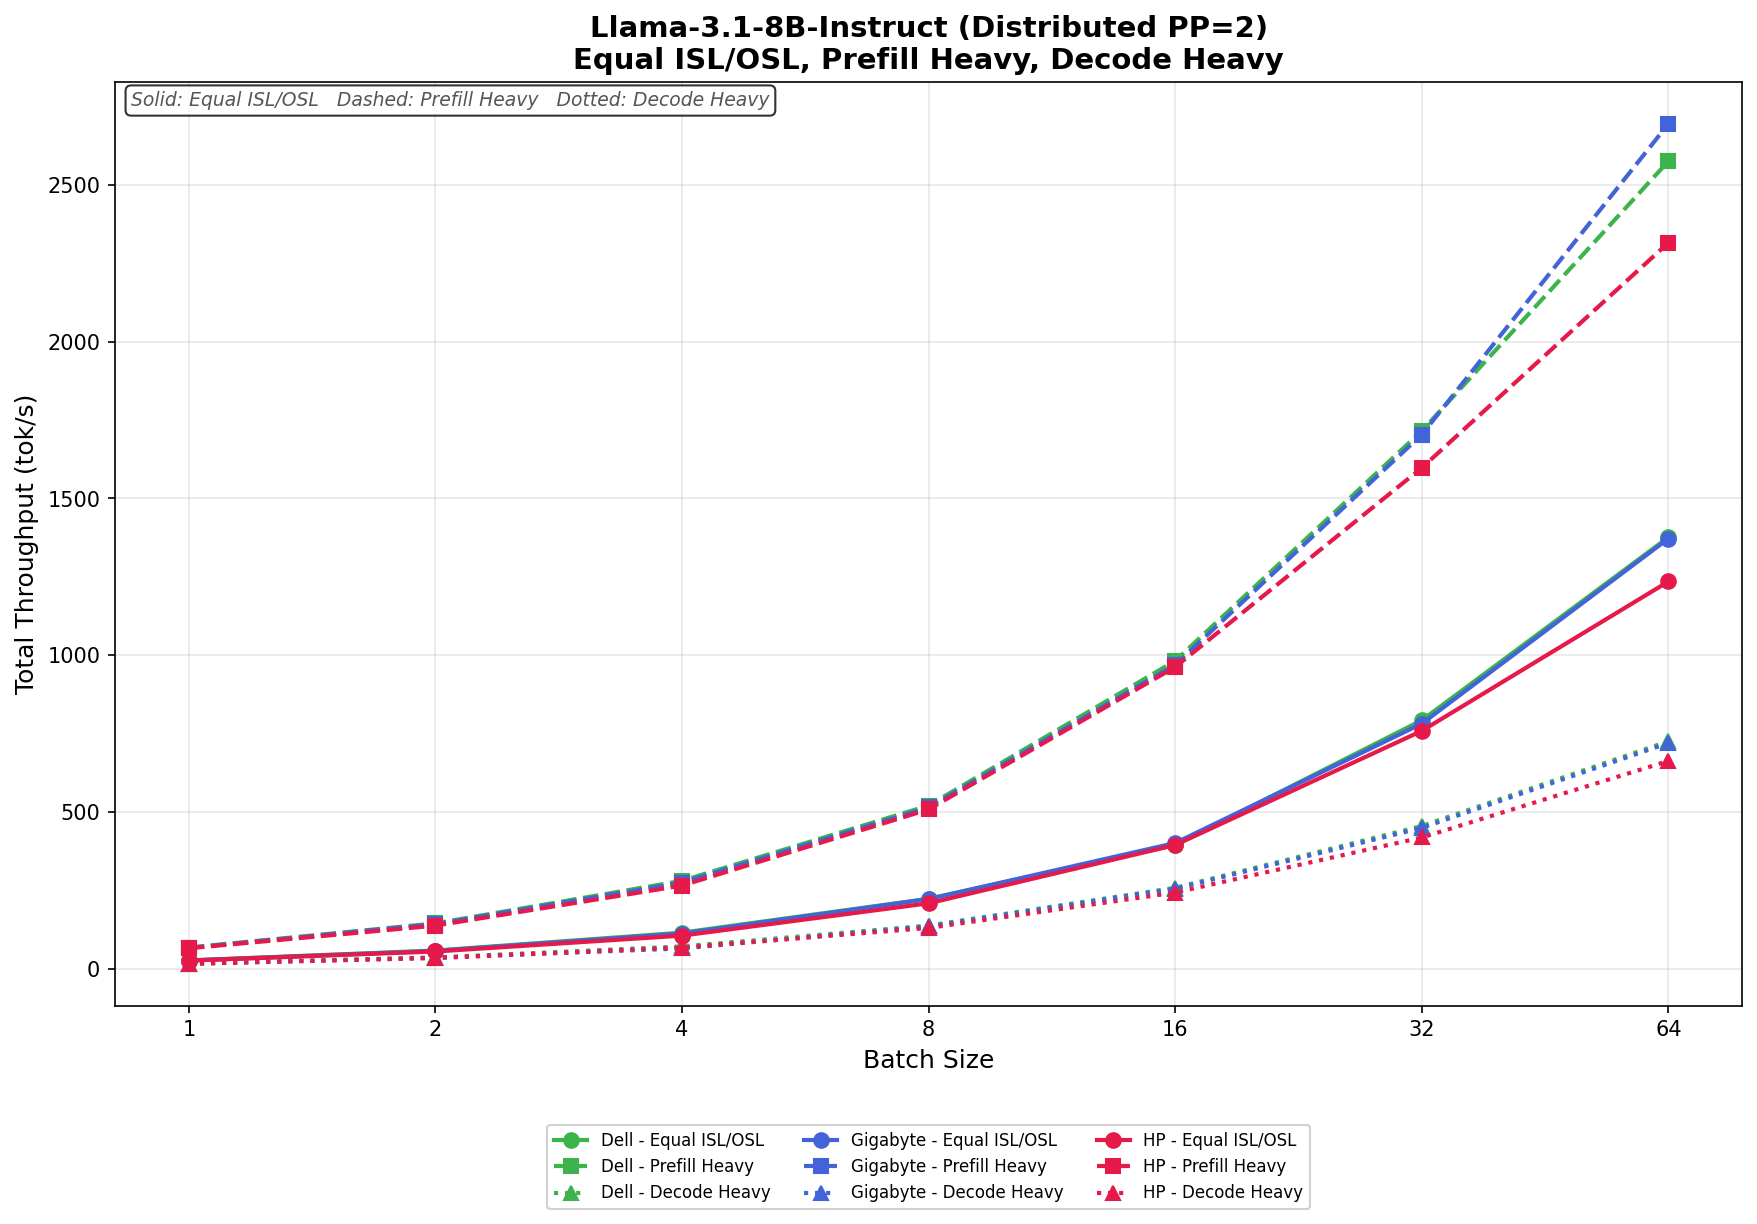
W teście Equal ISL/OSL firma Dell skaluje wydajność z 27.69 tok/s do 1,376.38 tok/s przy rozmiarze partii 64, nieznacznie wyprzedzając firmę GIGABYTE, której wydajność waha się od 27.23 tok/s do 1,372.27 tok/s. HP nieznacznie traci w całym teście, skalując z 26.89 tok/s do 1,235.32 tok/s. Wszystkie trzy systemy śledzą bardzo zbliżone wyniki w rozmiarze partii 16, zanim firma Dell zacznie zyskiwać niewielką przewagę przy wyższych poziomach współbieżności.
W trybie Prefill Heavy przepustowość dynamicznie rośnie wraz ze wzrostem wielkości partii. Dell zwiększa ją z 68.60 tok/s do 2,575.25 tok/s, podczas gdy GIGABYTE ostatecznie osiąga najlepszy wynik, skalując z 67.49 tok/s do 2,694.25 tok/s przy wielkości partii 64. HP osiąga 2,315.15 tok/s, pozostając konkurencyjnym, ale konsekwentnie ustępując Dellowi i GIGABYTE przy większych wielkościach partii. GIGABYTE przejmuje prowadzenie w górnym zakresie, szczególnie w przypadku wielkości partii 64 lub większych.
W teście Decode Heavy skalowanie pozostaje stabilne w całym zakresie. W przypadku Della skala waha się od 17.19 tok/s do 726.22 tok/s, w przypadku GIGABYTE od 16.96 tok/s do 720.57 tok/s, a w przypadku HP od 16.79 tok/s do 663.31 tok/s. Dell i GIGABYTE pozostają niemal identyczne przez większość testu, przy czym Dell ma niewielką przewagę przy najwyższych poziomach współbieżności. Jednocześnie HP nieznacznie traci przy większych partiach danych.
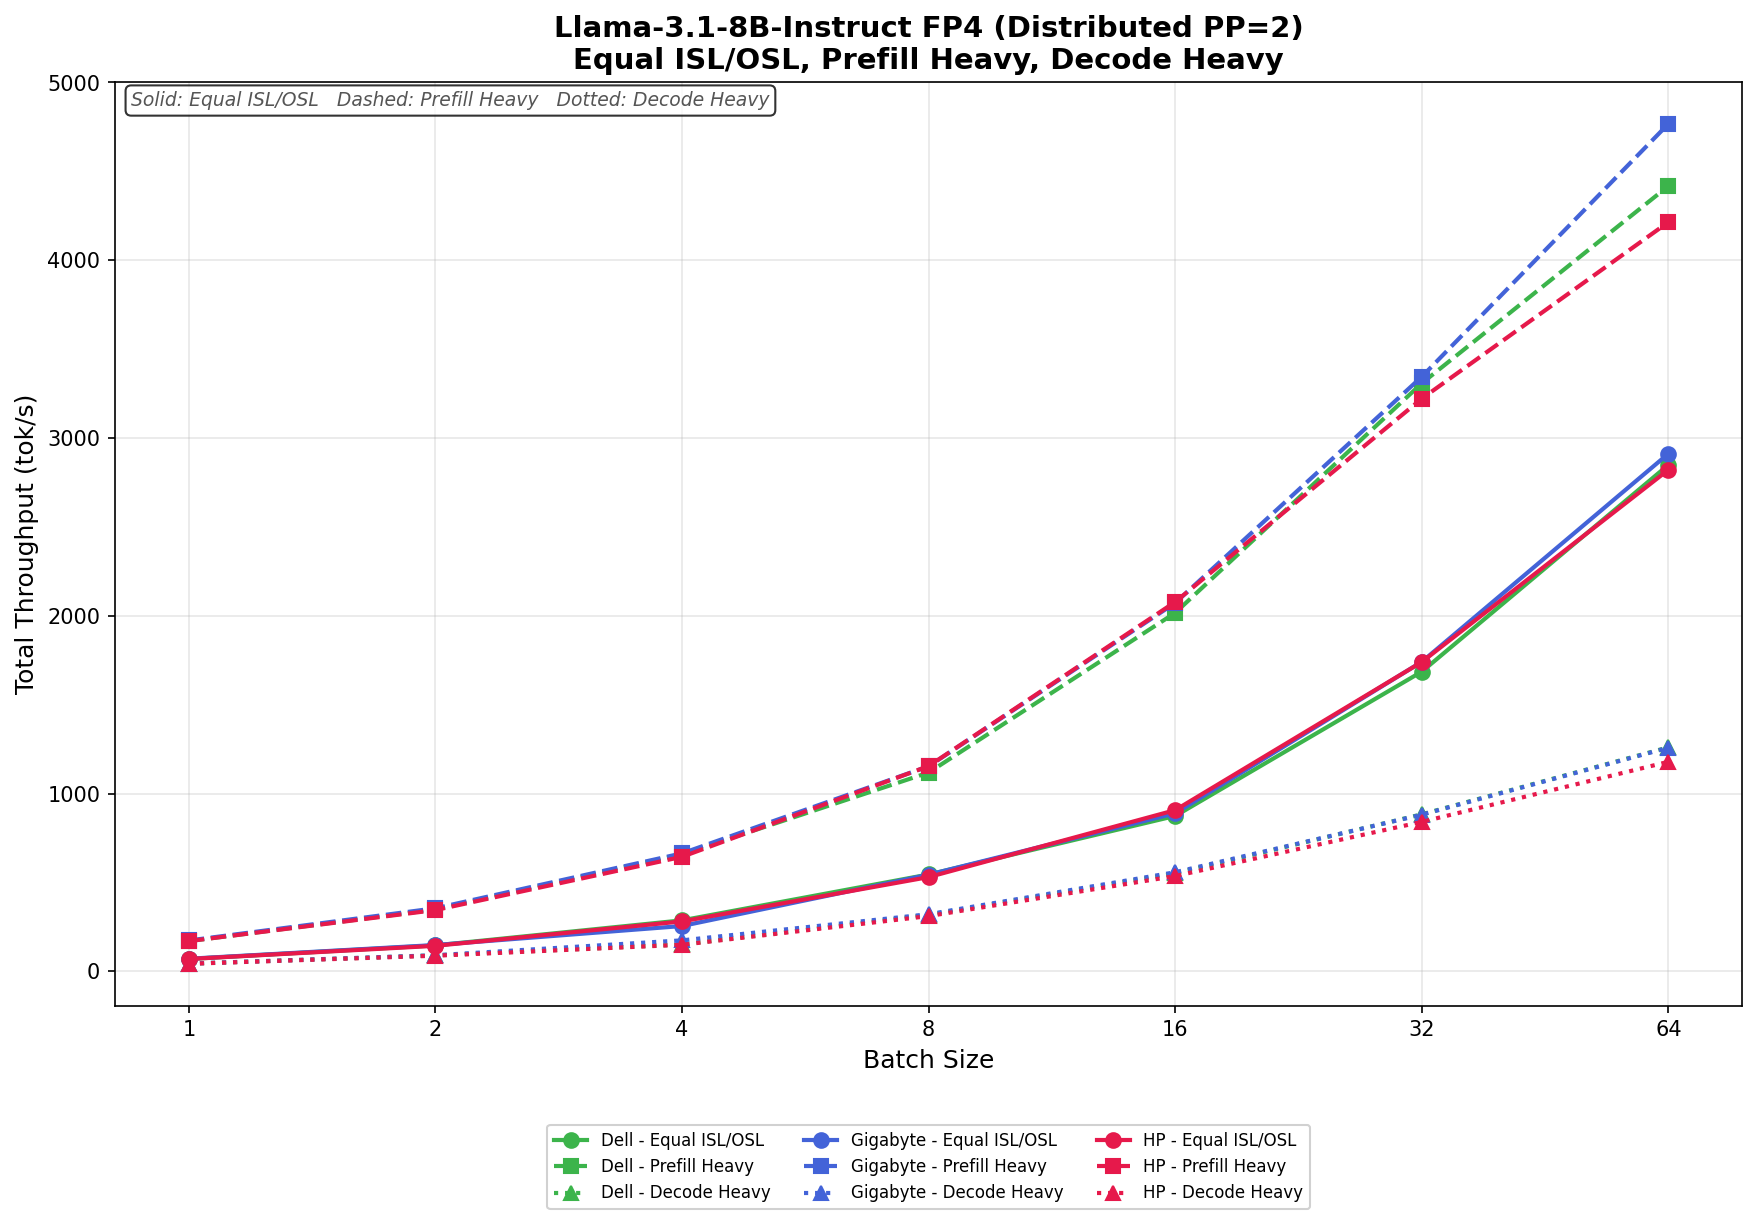
Llama 3.1 8B Instrukcja FP4
W Equal ISL/OSL, Dell skaluje się z 69.71 tok/s do 2,849.20 tok/s przy rozmiarze partii 64, podczas gdy GIGABYTE nieznacznie wyprzedza, rosnąc z 70.92 tok/s do 2,912.03 tok/s. HP pozostaje konkurencyjny, osiągając wyniki od 69.52 tok/s do 2,821.50 tok/s. Te trzy systemy pozostają ściśle zgrupowane w całym obciążeniu, a jedynie niewielka separacja pojawia się przy wyższych poziomach współbieżności.
W trybie Prefill Heavy skalowanie staje się znacznie bardziej agresywne, szczególnie przy większych partiach danych. Dell zwiększa wydajność ze 170.09 tok/s do 4,417.65 tok/s, podczas gdy GIGABYTE osiąga najlepszy wynik w grupie, ze 173.55 tok/s do 4,767.43 tok/s przy partii 64. HP skaluje ze 170.12 tok/s do 4,214.57 tok/s. GIGABYTE zaczyna oddzielać się od konkurencji po partii 32, zapewniając najwyższą przepustowość w górnym zakresie obciążenia.
W Decode Heavy wszystkie trzy systemy ponownie pozostają ściśle powiązane przez większość czasu trwania testu. W przypadku Della wartość waha się od 43.19 tok/s do 1,260.24 tok/s, w przypadku GIGABYTE od 43.53 tok/s do 1,258.05 tok/s, a w przypadku HP wzrasta z 42.54 tok/s do 1,178.74 tok/s. Dell i GIGABYTE wymieniają się przewagą w zależności od wielkości partii, podczas gdy HP nieznacznie ustępuje obu systemom przy najwyższych poziomach współbieżności.
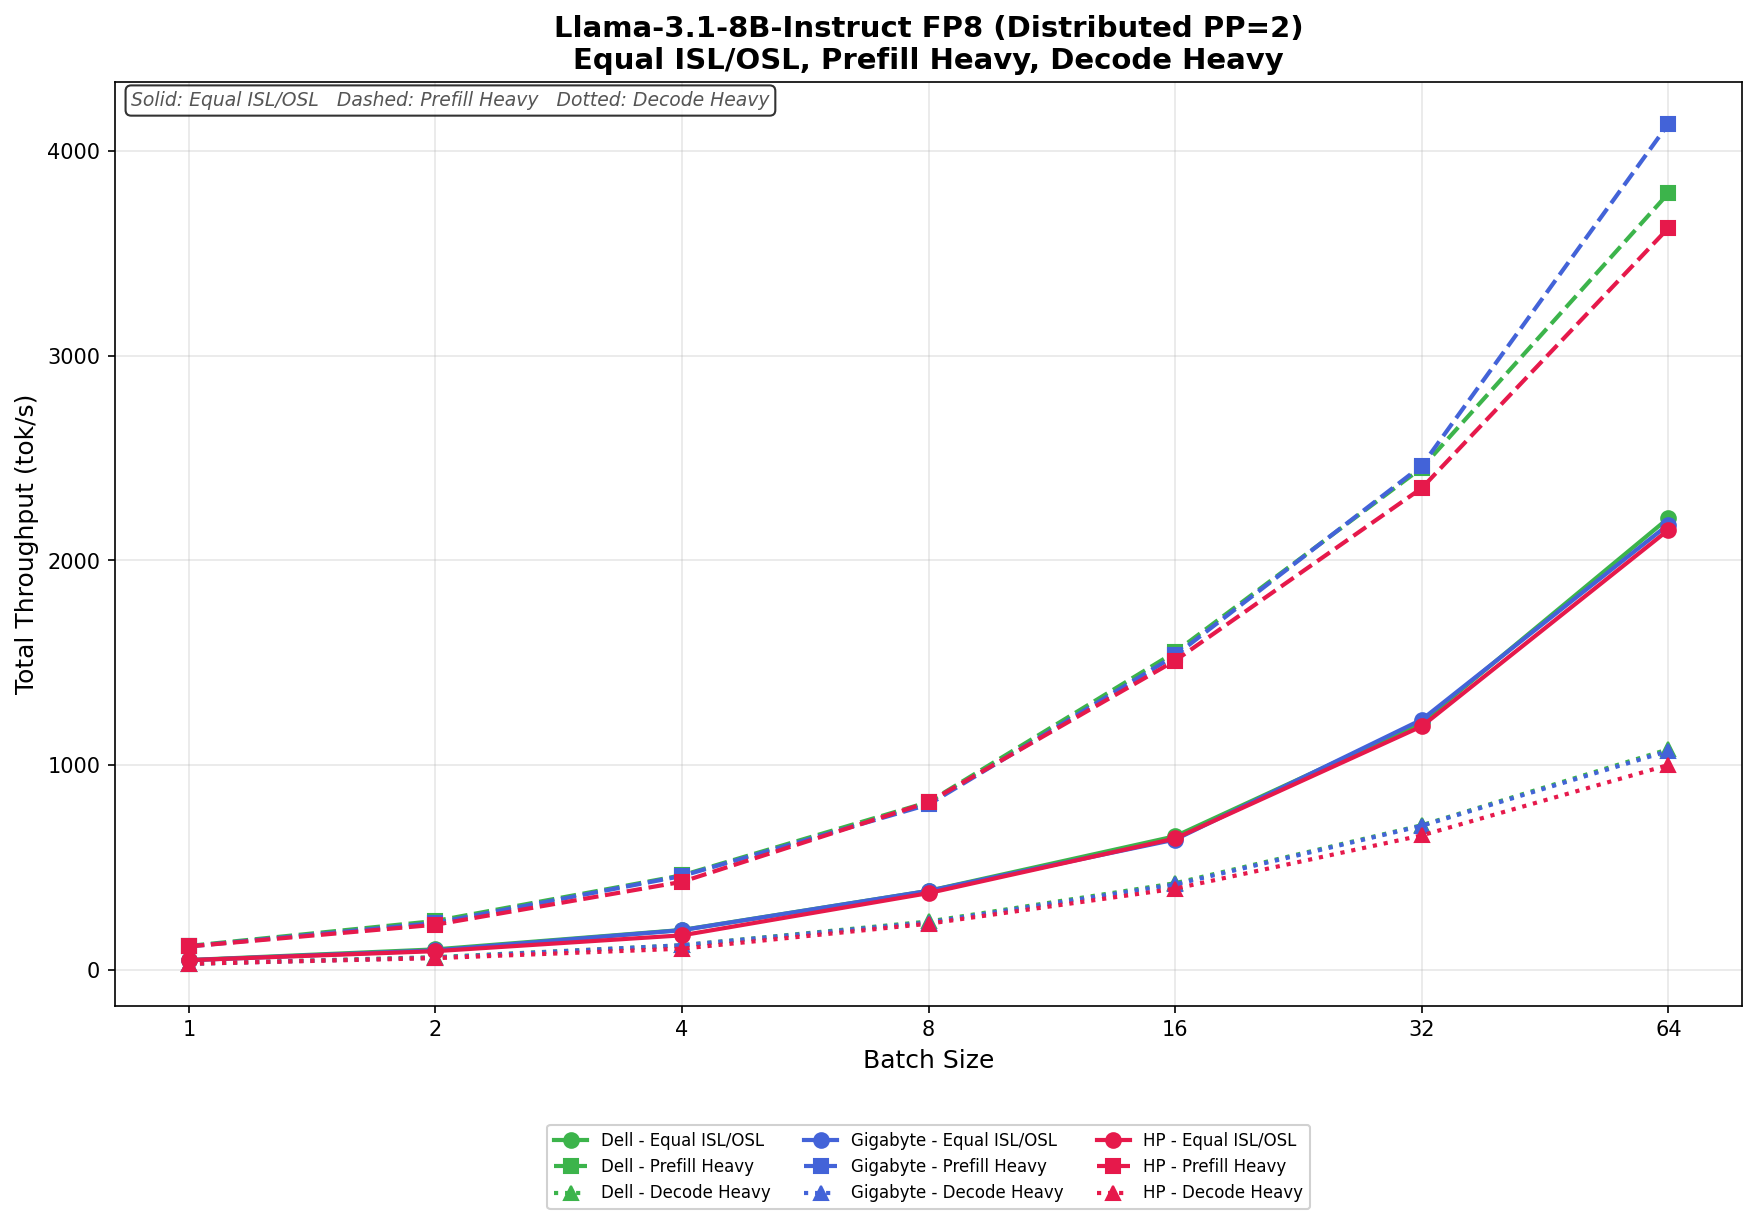
Llama 3.1 8B Instrukcja FP8
W teście Equal ISL/OSL, Dell skaluje się z 46.93 tok/s do 2,206.52 tok/s przy rozmiarze partii 64, podczas gdy GIGABYTE od 46.16 tok/s do 2,175.44 tok/s. HP plasuje się tuż za nim, zwiększając się z 46.40 tok/s do 2,149.15 tok/s. Ogólny rozrzut pozostaje niewielki w całym teście, a wszystkie trzy systemy utrzymują niemal identyczne zachowanie skalowania do rozmiaru partii 32.
W trybie Prefill Heavy przepustowość rośnie bardziej agresywnie wraz ze wzrostem współbieżności. Dell rośnie ze 115.85 tok/s do 3,794.52 tok/s, podczas gdy GIGABYTE osiąga najlepszy wynik, skalując się ze 113.34 tok/s do 4,133.76 tok/s przy rozmiarze partii 64. HP osiąga 3,624.73 tok/s. GIGABYTE zaczyna zyskiwać coraz wyraźniejszą przewagę przy większych rozmiarach partii, szczególnie od rozmiaru partii 32 wzwyż.
W Decode Heavy trzy systemy pozostają ściśle zgrupowane przy niskich poziomach współbieżności, zanim pojawią się niewielkie separacje przy wysokiej współbieżności. W przypadku Della wartości wahają się od 29.11 tok/s do 1,077.07 tok/s, w przypadku GIGABYTE od 28.64 tok/s do 1,068.92 tok/s, a w przypadku HP wzrastają z 28.68 tok/s do 1,000.20 tok/s. Dell utrzymuje niewielką przewagę w większości obciążeń, GIGABYTE pozostaje tuż za nim, podczas gdy HP nieznacznie traci przy większych rozmiarach partii.
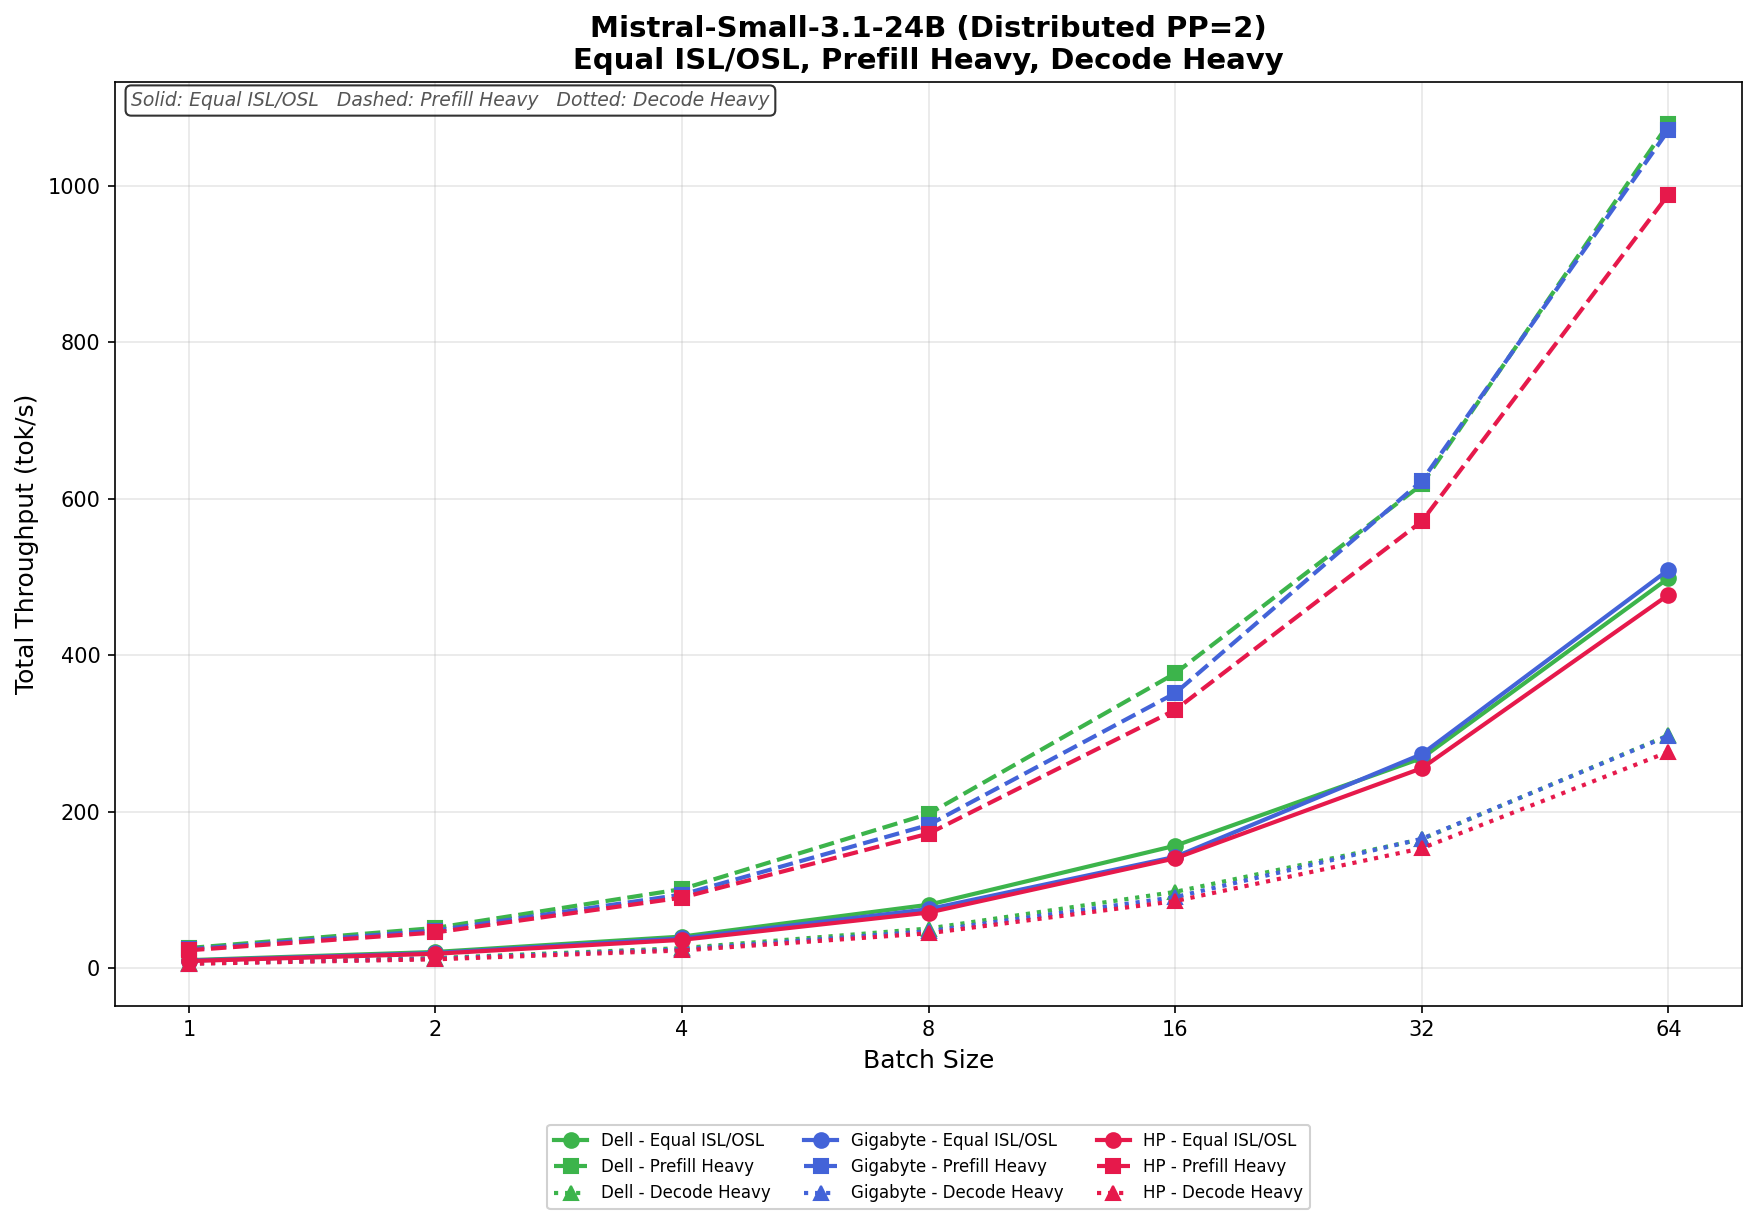
Mistral Small 3.1 24V
W Equal ISL/OSL, Dell skaluje się z 10.41 tok/s do 498.56 tok/s przy rozmiarze partii 64, podczas gdy GIGABYTE nieznacznie wyprzedza w górnym zakresie, zwiększając wydajność z 9.76 tok/s do 509.18 tok/s. HP nieznacznie ustępuje obu systemom, osiągając wyniki od 9.25 tok/s do 477.25 tok/s. Różnica między systemami pozostaje stosunkowo niewielka w całym zakresie obciążenia, szczególnie przy niższych i średnich poziomach współbieżności.
W trybie Prefill Heavy skalowanie znacznie się poprawia we wszystkich trzech systemach. Wydajność Dell wzrasta z 25.91 tok/s do 1,079.19 tok/s, podczas gdy GIGABYTE skaluje się z 24.25 tok/s do 1,071.07 tok/s. HP osiąga 988.82 tok/s przy rozmiarze partii 64. Dell i GIGABYTE pozostają niemal identyczne przez większość czasu trwania testu, przy czym Dell ma niewielką przewagę na najwyższym poziomie współbieżności.
W teście Decode Heavy przepustowość pozostaje ogólnie znacznie niższa, zgodnie z oczekiwaniami dla obciążenia skoncentrowanego na dekodowaniu w większym modelu. W przypadku Della zakres wynosi od 6.49 tok/s do 297.82 tok/s, w przypadku GIGABYTE od 6.10 tok/s do 297.23 tok/s, a w przypadku HP wzrasta z 5.77 tok/s do 276.55 tok/s. Dell i GIGABYTE idą łeb w łeb w całym teście, podczas gdy HP konsekwentnie nieznacznie ustępuje obu systemom przy większych partiach.
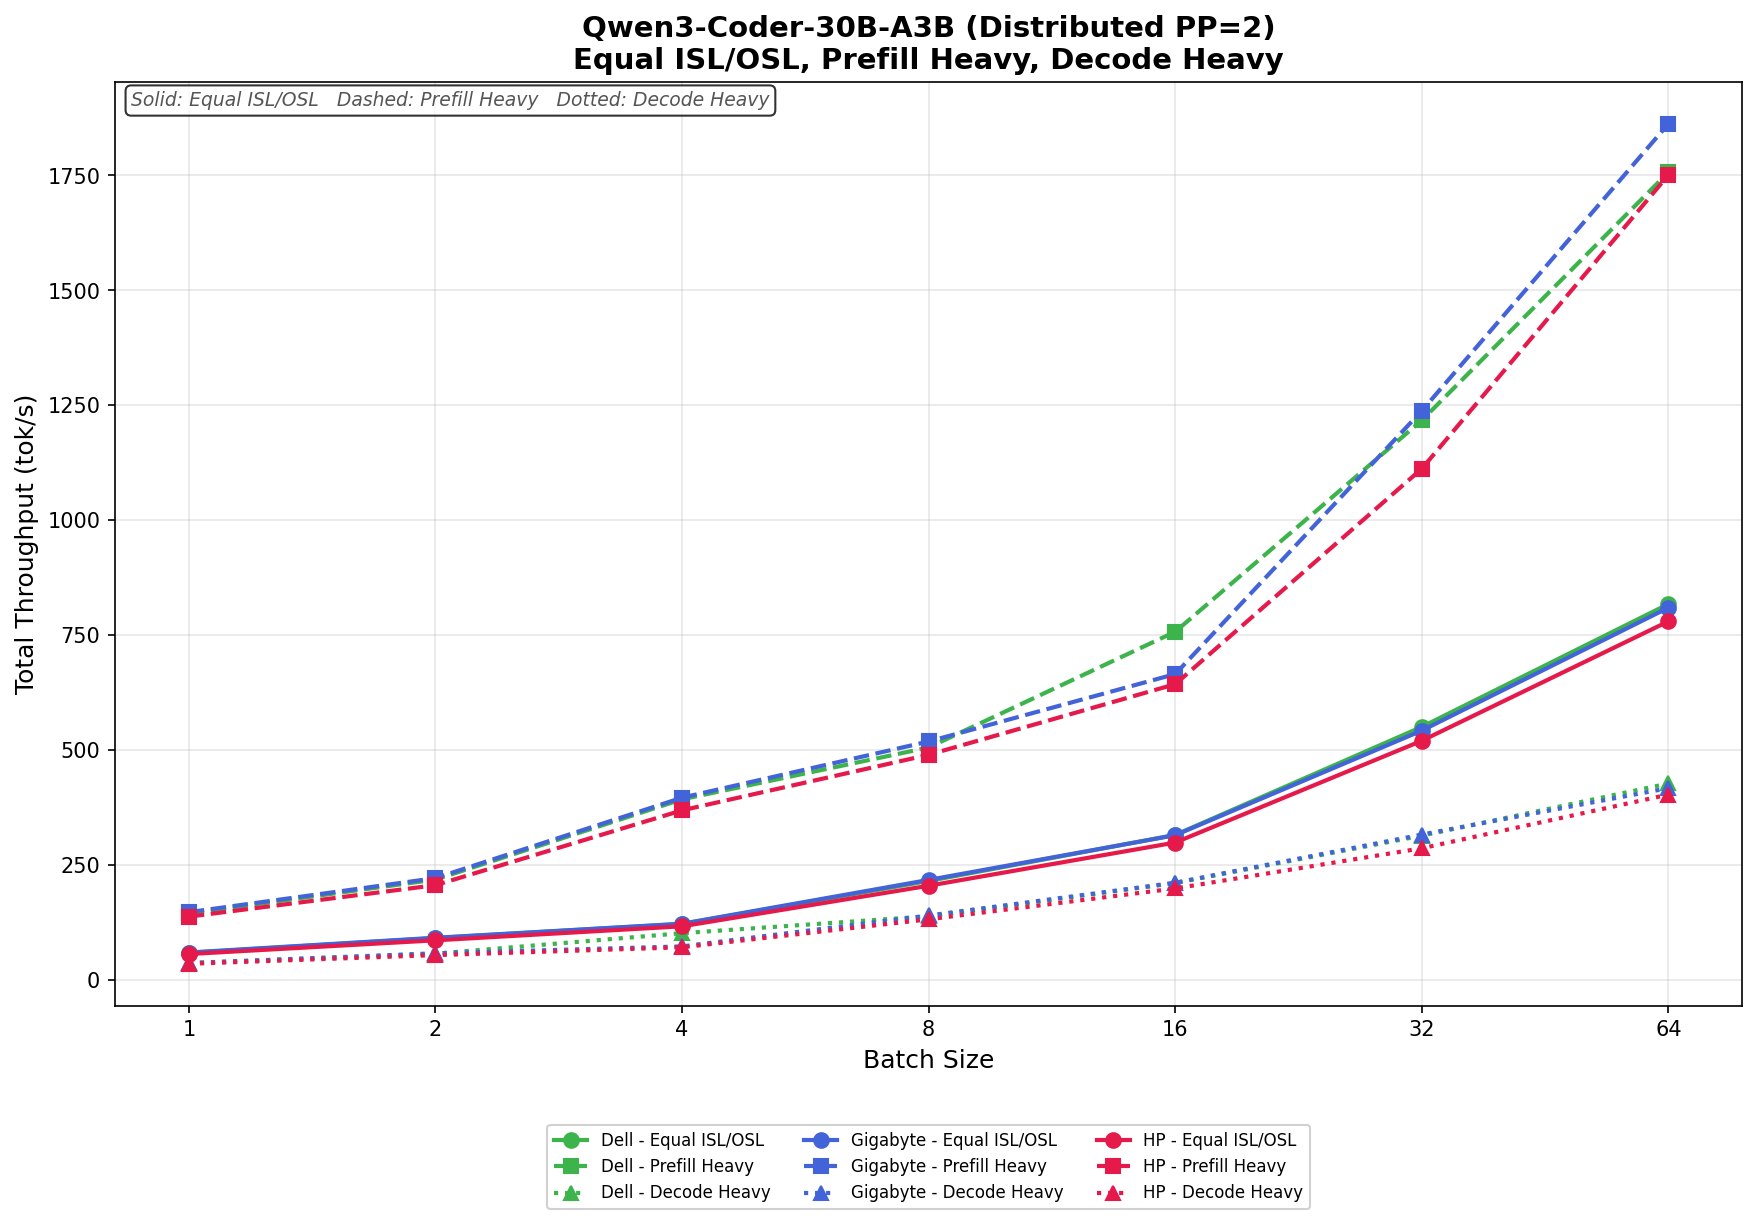
Koder Qwen3 30B A3B Base
W teście Equal ISL/OSL, Dell skaluje wydajność z 59.05 tok/s do 817.82 tok/s przy rozmiarze partii 64, podczas gdy GIGABYTE od 59.81 tok/s do 809.88 tok/s. HP nieznacznie ustępuje obu systemom, zwiększając wydajność z 56.51 tok/s do 780.21 tok/s. Wydajność między Dell i GIGABYTE pozostaje niemal identyczna przez większość testów, z niewielkimi różnicami pojawiającymi się przy większych rozmiarach partii.
W trybie Prefill Heavy przepustowość znacząco rośnie wraz ze wzrostem współbieżności. Dell zwiększa przepustowość ze 144.81 tok/s do 1,756.99 tok/s, podczas gdy GIGABYTE odnotowuje najwyższą ogólną skalowalność, wzrastając ze 147.55 tok/s do 1,862.40 tok/s przy rozmiarze partii 64. HP osiąga 1,751.17 tok/s, pozostając konkurencyjnym, ale nieznacznie w tyle za dwoma pozostałymi systemami w górnym przedziale. GIGABYTE uzyskuje niewielką przewagę, zaczynając od rozmiaru partii 32 i utrzymuje ją do ostatniego etapu testu.
W trybie Decode Heavy, trzy systemy ponownie pozostają ściśle powiązane przez większość obciążenia. W przypadku Della przepustowość waha się od 36.69 tok/s do 427.48 tok/s, w przypadku GIGABYTE od 36.92 tok/s do 417.42 tok/s, a w przypadku HP wzrasta z 35.30 tok/s do 403.32 tok/s. Dell utrzymuje niewielką przewagę przy największych rozmiarach partii, podczas gdy HP pozostaje nieznacznie w tyle zarówno za Dellem, jak i GIGABYTE w obciążeniu skoncentrowanym na dekodowaniu.
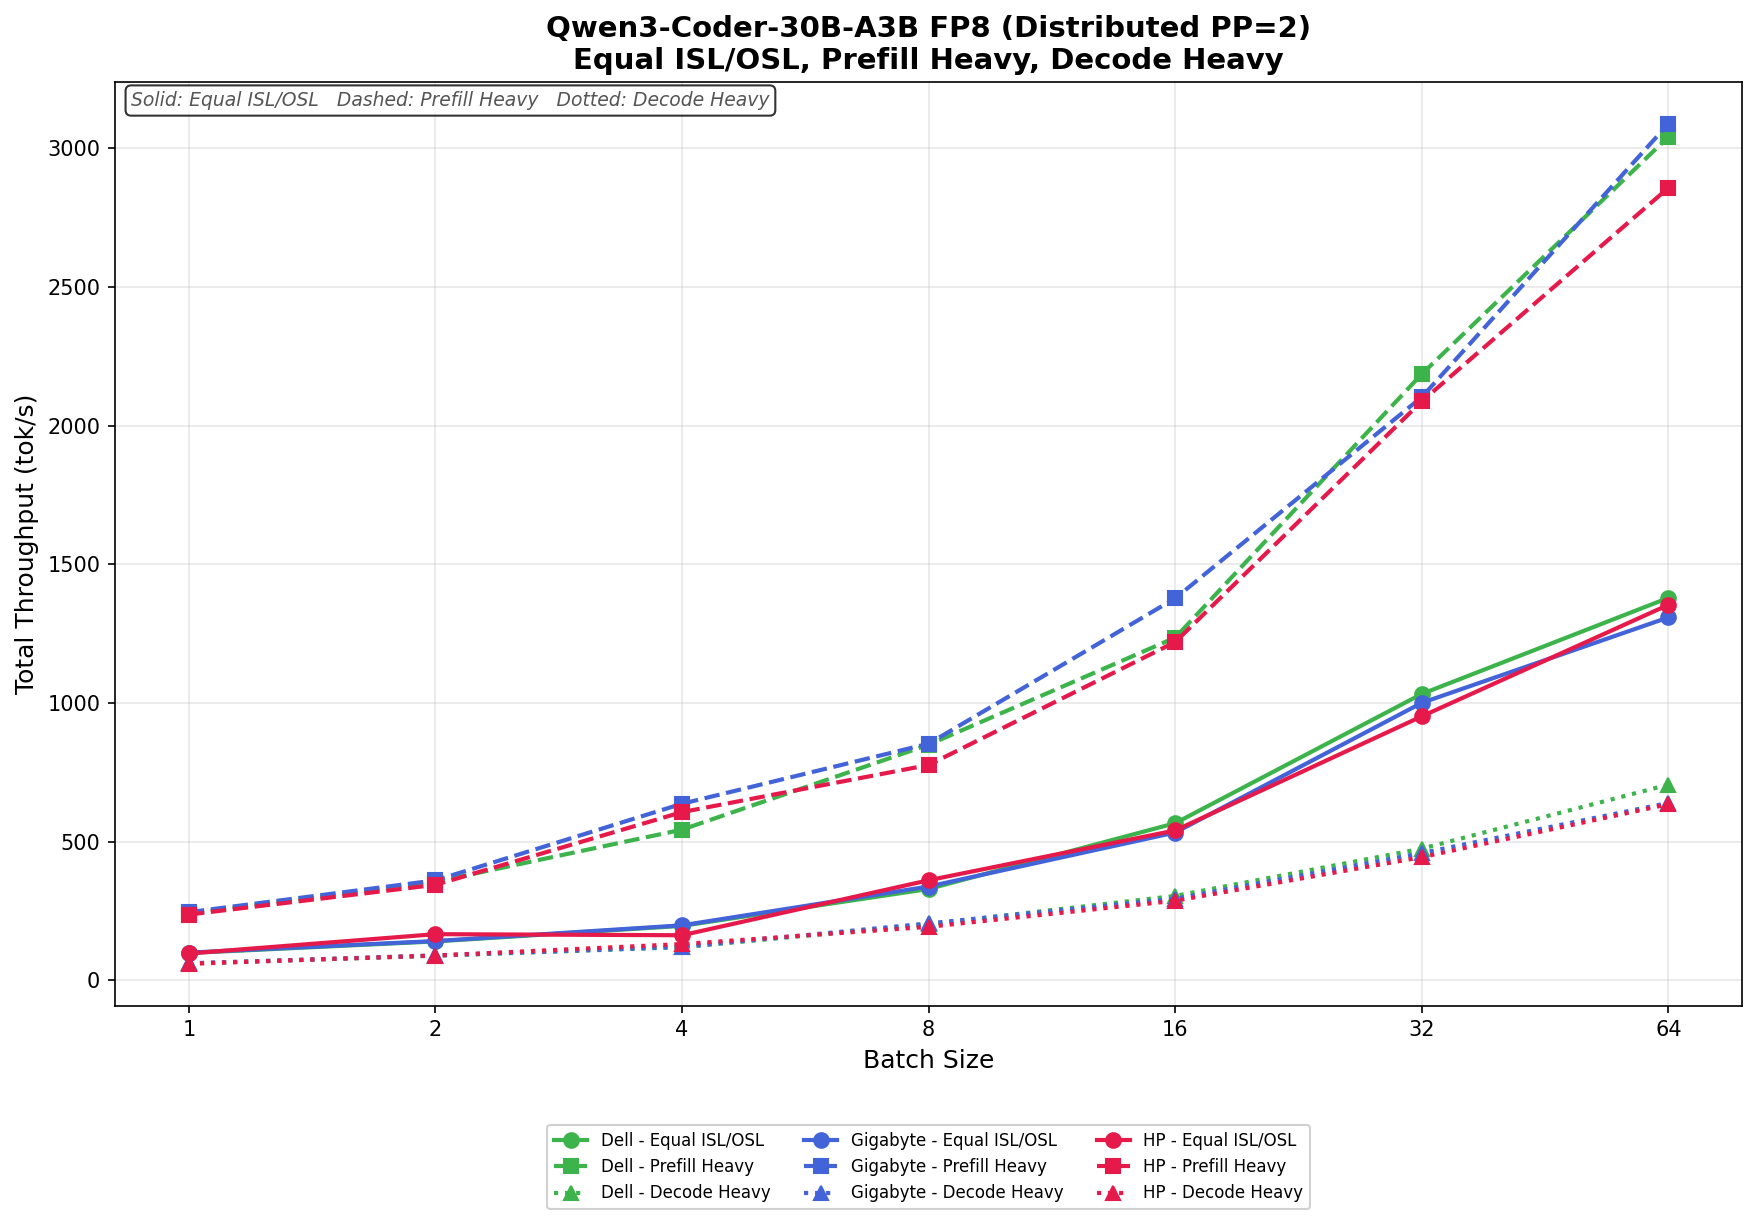
Koder Qwen3 30B A3B FB8
W Equal ISL/OSL, Dell skaluje z 98.65 tok/s do 1,379.26 tok/s przy rozmiarze partii 64, podczas gdy GIGABYTE od 100.20 tok/s do 1,308.79 tok/s. HP pozostaje konkurencyjny, zwiększając się z 97.06 tok/s do 1,354.23 tok/s. HP na krótko prowadzi w kilku mniejszych i średnich rozmiarach partii, jednak Dell kończy z najwyższą ogólną przepustowością w górnym zakresie.
W trybie Prefill Heavy przepustowość dynamicznie skaluje się we wszystkich trzech systemach. Dell rośnie z 240.43 tok/s do 3,041.72 tok/s, podczas gdy GIGABYTE osiąga najlepszy wynik, skalując z 245.92 tok/s do 3,088.62 tok/s przy rozmiarze partii 64. HP osiąga 2,857.80 tok/s. GIGABYTE zyskuje wyraźną przewagę, począwszy od rozmiaru partii 4 i utrzymuje ją do końca cyklu testowego.
W kategorii Decode Heavy, Dell utrzymuje najwyższą ogólną skalowalność w górnym zakresie. Dell osiąga zakres od 60.91 tok/s do 705.77 tok/s, GIGABYTE od 61.53 tok/s do 639.80 tok/s, a HP od 59.85 tok/s do 635.25 tok/s. HP na krótko prowadzi przy mniejszych partiach danych, ale Dell wyprzedza go przy wyższych poziomach współbieżności, kończąc z najwyższą przepustowością dekodowania w grupie.
Podsumowanie szczytowej mocy wyjściowej systemów Dual Spark
Poniższa tabela podsumowuje szczytową przepustowość wyjściową tokenów zaobserwowaną podczas testów rozproszonego PP=2 w systemach Dell, GIGABYTE i HP dual-Spark. Każda wartość reprezentuje najwyższą zmierzoną przepustowość wyjściową (tok/s) osiągniętą dla danego scenariusza obciążenia przy testowanej wielkości partii. Pogrubione wartości wskazują system o najwyższej wydajności w danym scenariuszu obciążenia.
| Model | Scenariusz (BS – 64) | Moc szczytowa Dell | GIGABYTE Maksymalna moc wyjściowa | Moc szczytowa HP |
|---|---|---|---|---|
| Modele GPT-OSS | ||||
| GPT-OSS-120B | Równy ISL/OSL | 463.97 tok/s | 497.26 tok/s | 504.88 tok/s |
| GPT-OSS-120B | Wstępnie wypełnij ciężki | 419.56 tok/s | 417.34 tok/s | 441.63 tok/s |
| GPT-OSS-120B | Dekodowanie ciężkie | 451.18 tok/s | 494.37 tok/s | 474.85 tok/s |
| GPT-OSS-20B | Równy ISL/OSL | 976.77 tok/s | 952.31 tok/s | 915.72 tok/s |
| GPT-OSS-20B | Wstępnie wypełnij ciężki | 852.39 tok/s | 802.37 tok/s | 757.05 tok/s |
| GPT-OSS-20B | Dekodowanie ciężkie | 938.65 tok/s | 945.55 tok/s | 865.78 tok/s |
| Modele lam | ||||
| Llama-3.1-8B-Instrukcja | Równy ISL/OSL | 689.53 tok/s | 687.48 tok/s | 618.87 tok/s |
| Llama-3.1-8B-Instrukcja | Wstępnie wypełnij ciężki | 515.45 tok/s | 539.27 tok/s | 463.39 tok/s |
| Llama-3.1-8B-Instrukcja | Dekodowanie ciężkie | 581.43 tok/s | 576.91 tok/s | 531.07 tok/s |
| Lama-3.1-8B-FP4 | Równy ISL/OSL | 1427.39 tok/s | 1458.86 tok/s | 1413.51 tok/s |
| Lama-3.1-8B-FP4 | Wstępnie wypełnij ciężki | 884.22 tok/s | 954.23 tok/s | 843.57 tok/s |
| Lama-3.1-8B-FP4 | Dekodowanie ciężkie | 1008.98 tok/s | 1007.23 tok/s | 943.73 tok/s |
| Lama-3.1-8B-FP8 | Równy ISL/OSL | 1105.42 tok/s | 1089.85 tok/s | 1076.68 tok/s |
| Lama-3.1-8B-FP8 | Wstępnie wypełnij ciężki | 759.50 tok/s | 827.40 tok/s | 725.51 tok/s |
| Lama-3.1-8B-FP8 | Dekodowanie ciężkie | 862.33 tok/s | 855.81 tok/s | 800.78 tok/s |
| Modele Mistral i Qwen | ||||
| Mistral-Mały-3.1-24B | Równy ISL/OSL | 249.77 tok/s | 255.09 tok/s | 239.09 tok/s |
| Mistral-Mały-3.1-24B | Wstępnie wypełnij ciężki | 216.01 tok/s | 214.38 tok/s | 197.92 tok/s |
| Mistral-Mały-3.1-24B | Dekodowanie ciężkie | 238.44 tok/s | 237.97 tok/s | 221.41 tok/s |
Wniosek
Najbardziej wartościowy wniosek z tej rundy testów ma niewiele wspólnego z tym, który producent OEM uzyskał przewagę w danym obciążeniu. We wszystkich testowanych przez nas modelach i konfiguracjach obciążeń, trzy implementacje Spark od Dell, GIGABYTE i HP działały w wąskim zakresie. Niewielkie przewagi pojawiały się przy określonych wielkościach partii, ale żadna platforma nie wygrała od razu i żadna nie pozostawała konsekwentnie w tyle. Kupujący, wybierając jedną z tych trzech platform, powinni kierować się konstrukcją obudowy, zachowaniem termicznym, warunkami gwarancji i relacjami z działem wsparcia, a nie różnicami w testach porównawczych, które są zbliżone do rozbieżności między wynikami, jakie każdy system klasy desktop generuje przy stałym obciążeniu.
Bardziej interesujący wynik ma charakter metodologiczny. W przypadku struktury 200 GbE łączącej dwa urządzenia Spark, wybór między paralelizmem tensorowym a paralelizmem potokowym ma większe znaczenie niż jakakolwiek różnica między trzema producentami OEM, a w przypadku wnioskowania wsadowego przy dowolnej rozsądnej współbieżności, paralelizm potokowy jest lepszym rozwiązaniem. Ruch all-reduce w modelu TP=2 na warstwę nie przetrwa podróży przez łącze ConnectX-7 bez pozostawienia obliczeń bezczynnych, a koszt bańki potokowej w modelu PP=2 amortyzuje się w strumieniu stanu ustalonego, gdy tylko wsad zapełni potok. Dokumentacja firmy NVIDIA domyślnie ustawia TP z uzasadnionego powodu: ich głównym założeniem dla Spark jest interaktywne serwowanie pojedynczego strumienia z krótkim czasem reakcji (TTFT), co jest jedynym rozwiązaniem, w którym TP=2 zdecydowanie wygrywa. W momencie, gdy obciążenie przypomina infrastrukturę serwującą, a nie interfejs czatu, rachunek się odwraca.
Ta inwersja podkreśla, czym Spark jest, a czym nie jest. Dwuwęzłowy klaster Spark to platforma programistyczna i edukacyjna, która pozwala pojedynczemu inżynierowi na własne oczy zobaczyć zachowanie rozproszonego wnioskowania w sieci, wystarczająco szybko, aby naśladować rzeczywistą infrastrukturę centrum danych, a jednocześnie na tyle ograniczone, aby ujawnić wąskie gardła, z którymi zmagają się wdrożenia produkcyjne na dużą skalę.
Większe konfiguracje Spark warto analizować osobno, z obciążeniami i strategiami paralelizmu dostosowanymi do tej skali, i mamy to już w planie działania. Oddzielnie, kolejny eksperyment, który czeka w kolejce po tym, przechodzi od wnioskowania do trenowania: model o parametrach poniżej 1 mld, trenowany od podstaw w klastrze z dwoma serwerami Spark, skonfigurowany tak, aby odzwierciedlał rozproszone warunki wstępnego treningu znacznie większych systemów. Prace te zostały wstrzymane do czasu, aż będziemy czekać na parametry optyczne dla naszego nowego laboratoryjnego przełącznika rdzeniowego o pojemności 800 Gb, i spodziewamy się opublikować je, gdy nowy rdzeń będzie już online.


 Amazon