

Wysoka dostępność przestała być luksusem w centrach danych i stała się elementem standardowego planowania odporności. Małe firmy i serwery brzegowe korzystają obecnie z systemów POS, monitoringu i współdzielonej pamięci masowej, które generują koszty w każdej minucie awarii. Jednak klasyczne rozwiązanie, czyli macierz korporacyjna z dwoma kontrolerami, ma rozmiar i cenę dostosowaną do centrum danych, a nie do szafy serwerowej czy szafy ściennej. To niedopasowanie sprawiło, że mniejsze działy IT dysponują kopiami zapasowymi i migawkami do ochrony danych, ale nie zapewniają ciągłości działania: serwer NAS z jednym kontrolerem, nawet jeśli jest dobrze zbudowany, pozostaje pojedynczym punktem awarii.
Wysoka dostępność nie jest nowością dla QNAP, który oferuje rozwiązania sprzętowe z dwoma kontrolerami i ścieżki odzyskiwania oparte na replikacji. W systemie QuTS hero h6.0 zmienia się wydajność. Nowy menedżer wysokiej dostępności (High Availability Manager) wbudowuje klaster w system operacyjny na zwykłym sprzęcie, umożliwiając dwóm identycznym jednostkom NAS utworzenie klastra aktywno-pasywnego za jednym adresem IP. Dzięki temu, gdy jedna jednostka ulegnie awarii, druga przejmuje jej funkcje, a klienci tego praktycznie nie zauważają. Dla organizacji starającej się zoptymalizować inwestycje w IT, jest to wysoka dostępność (HA) kosztem drugiego serwera NAS, a nie infrastruktury drugiej klasy.
Oto, o co chodzi: aby sprawdzić, jak to działa w praktyce, zbudowaliśmy w laboratorium klaster HA z dwóch systemów QNAP TS-h765eU z dyskami twardymi Seagate IronWolf Pro i dyskami SSD QNAP E1.S jako pamięcią podręczną, a następnie przystąpiliśmy do jego naprawy w taki sam sposób, w jaki awarie występują w lokalizacjach brzegowych. W trakcie transferu wyłączyliśmy zasilanie aktywnego węzła. Zerwaliśmy jego połączenie sieciowe, nie naruszając sygnału pulsu. W obu przypadkach pytanie było to samo: czy transfer plików przetrwa i jak wygląda odzyskiwanie danych po powrocie uszkodzonego węzła?
Przegląd QNAP TS-h765eU
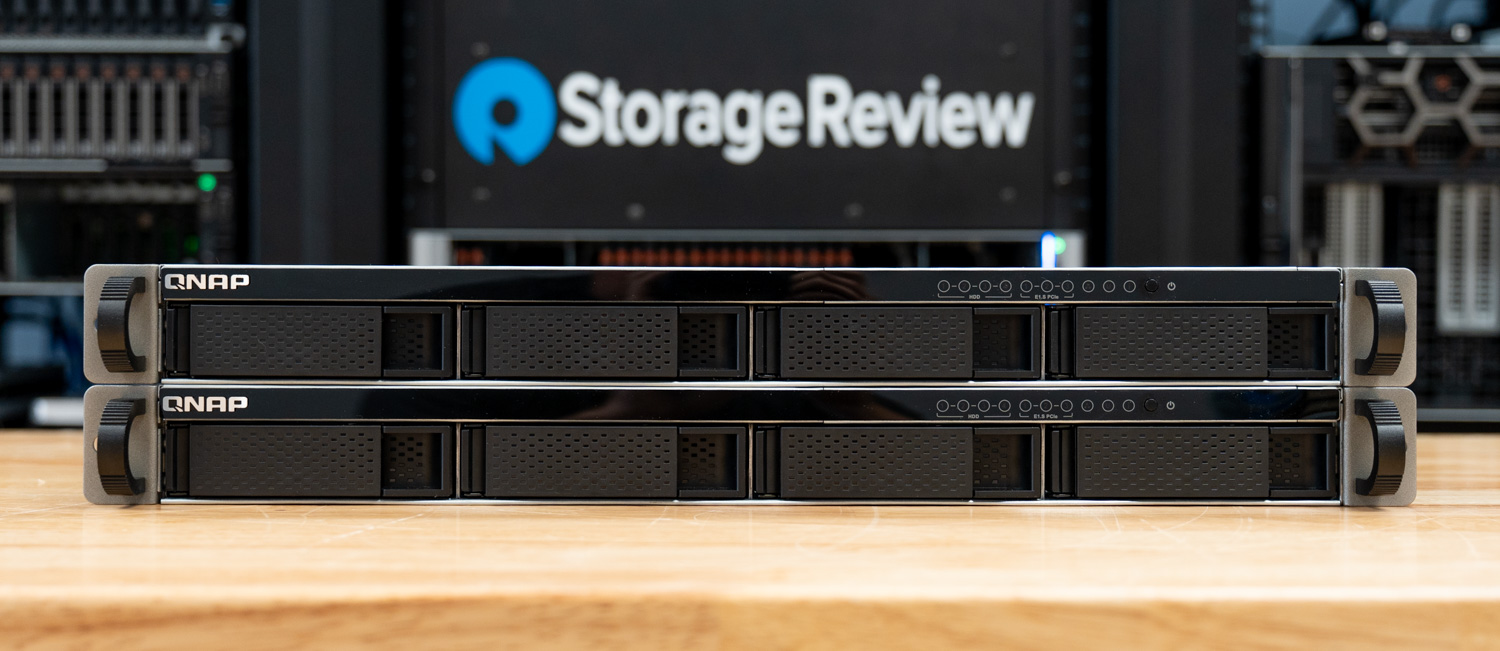
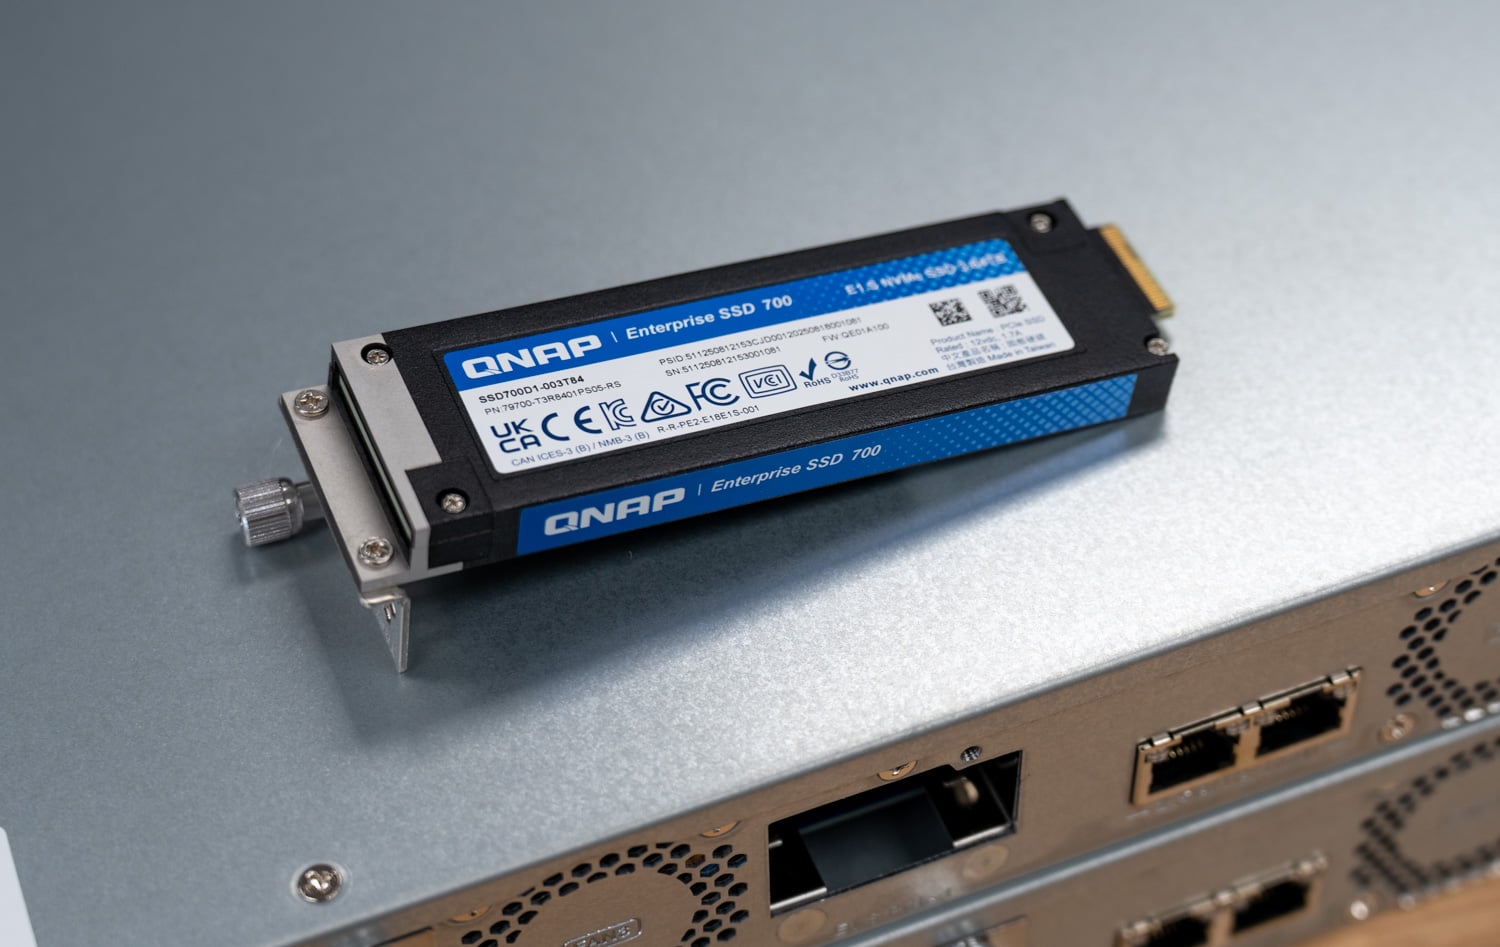
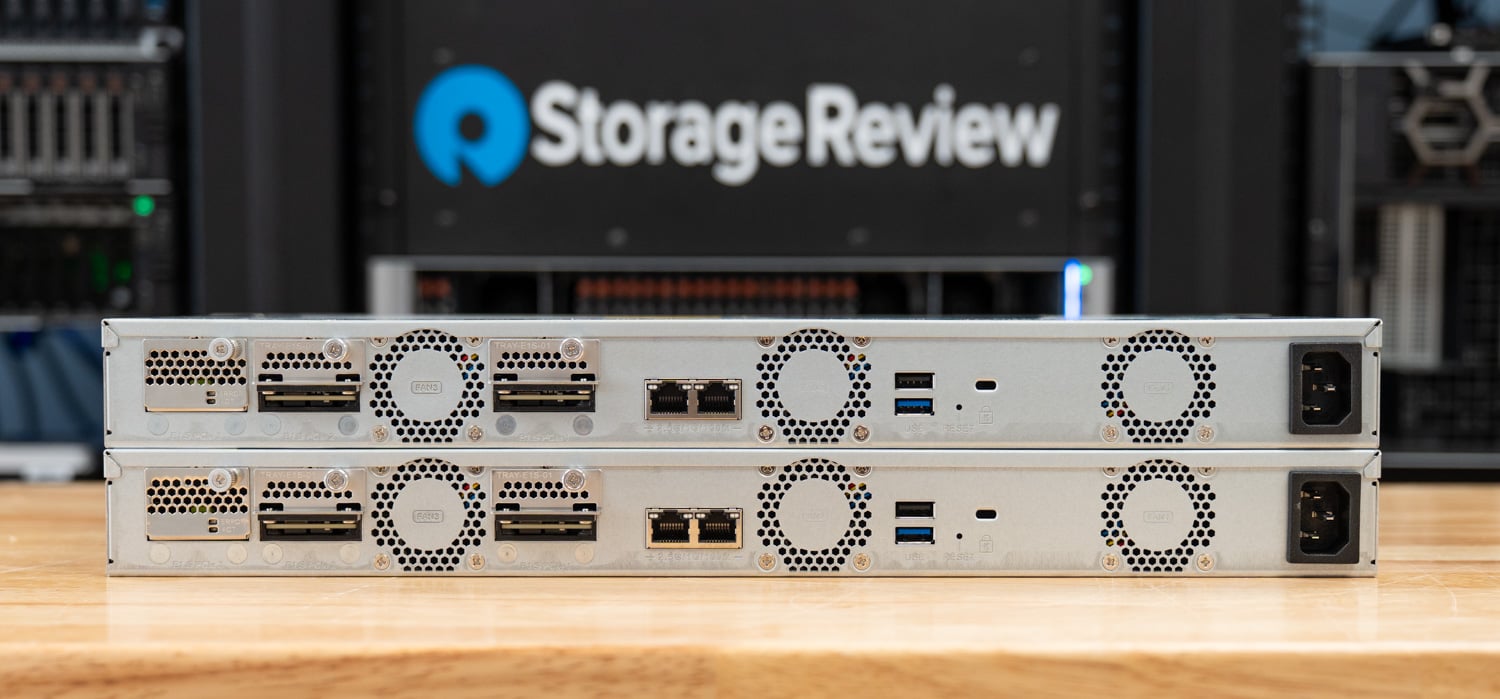
TS-h765eU to interesujący wybór jako element konstrukcyjny HA właśnie ze względu na stosunkowo prostą konstrukcję. Obudowa to NAS o małej głębokości 1U, montowany w szafie rack, o głębokości zaledwie 292.1 mm (12 cali), zaprojektowany z myślą o małych szafach multimedialnych, ściennych szafach sieciowych i wdrożeniach brzegowych, gdzie obudowa o pełnej głębokości nie będzie pasować. Każda jednostka oferuje cztery 3.5-calowe wnęki na dyski SATA z przodu oraz trzy gniazda E1.S/M.2 PCIe NVMe z tyłu, co nadaje jej hybrydowy charakter: dysk obrotowy dla pojemności, pamięć flash dla buforowania lub szybkich warstw.
Firma QNAP określiła go również jako model dostaw długoterminowych z gwarancją dostępności do roku 2031, co ma znaczenie dla organizacji stosujących standaryzację platformy w różnych lokalizacjach.
Wewnątrz TS-h765eU działa czterordzeniowy procesor Intel Atom x7405C o taktowaniu do 3.4 GHz, w połączeniu z 8 GB pamięci DDR5 (z możliwością rozbudowy do 16 GB) z funkcją In-Band ECC. Sieć obsługuje dwa porty 2.5 GbE, a 10 GbE można uzyskać, zamieniając zatokę E1.S na moduł QNAP QXG-ES10G1T.
| Specyfikacja | QNAP TS-h765eU |
|---|---|
| CPU | Intel Atom x7405C czterordzeniowy, do 3.4 GHz |
| Pamięć | 8 GB DDR5, z możliwością rozbudowy do 16 GB (In-Band ECC) |
| wnęki na napędy | 4 x 3.5-calowe SATA |
| Gniazda Flash | 3 x E1.S / M.2 PCIe NVMe |
| Sieci | 2 x 2.5 GbE, 10 GbE przez opcjonalny moduł QXG-ES10G1T E1.S |
| Form Factor | Obudowa do montażu w szafie 1U o małej głębokości, 292.1 mm (12 cali) |
| System operacyjny | QuTS hero h6.0 (oparty na systemie plików ZFS) |
| Dostępność: | Długoterminowy model dostaw do 2031 r. |
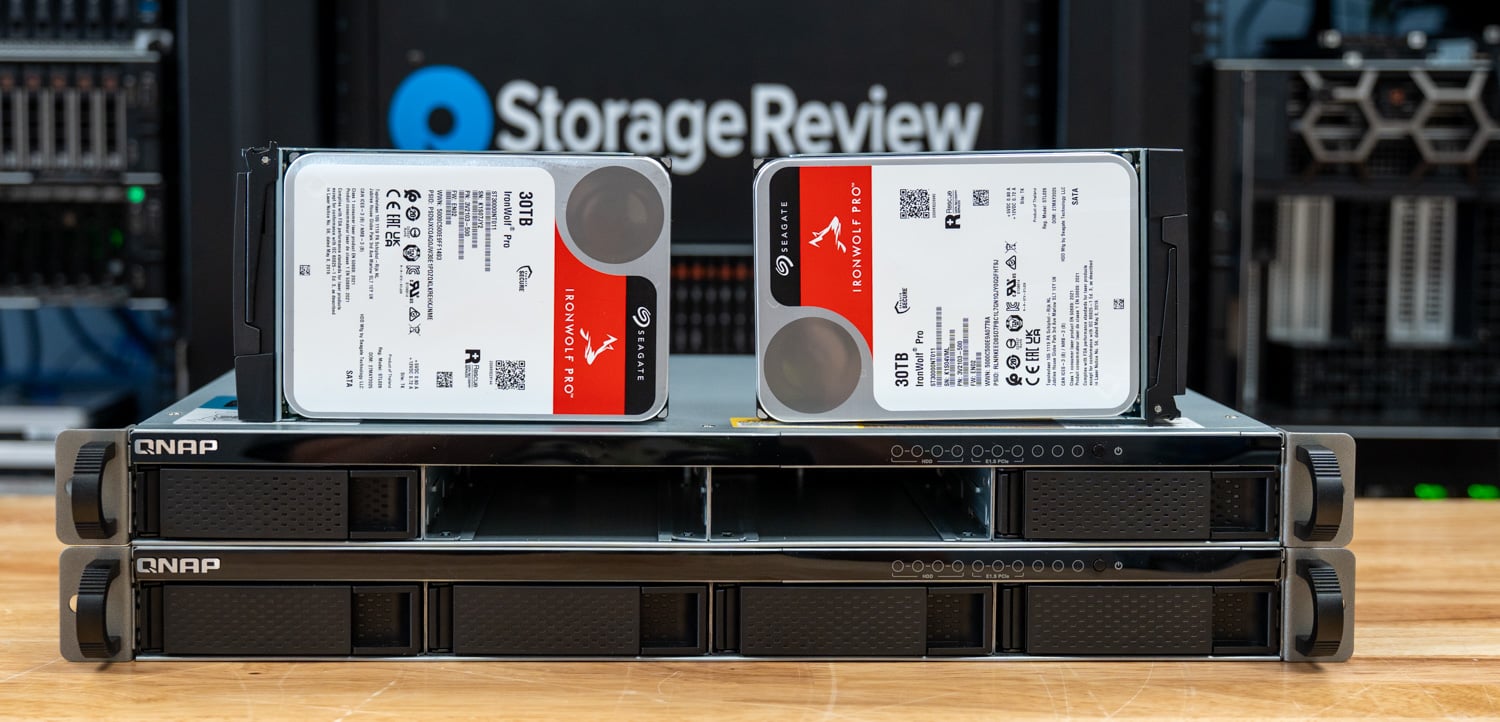
Na potrzeby tej oceny każdy węzeł został wyposażony w cztery dyski twarde Seagate IronWolf Pro o pojemności 30 TB (ST30000NT011) w puli pamięci masowej RAID 5 oraz dwa dyski QNAP SSD700 E1.S o pojemności 3.84 TB (SSD700D1-003T84) w macierzy RAID 0 jako pamięć podręczną. W obu systemach działał system QuTS hero h6.0.0.3500 z programem High Availability Manager 2.0.421.
QuTS hero h6.0 i architektura menedżera HA
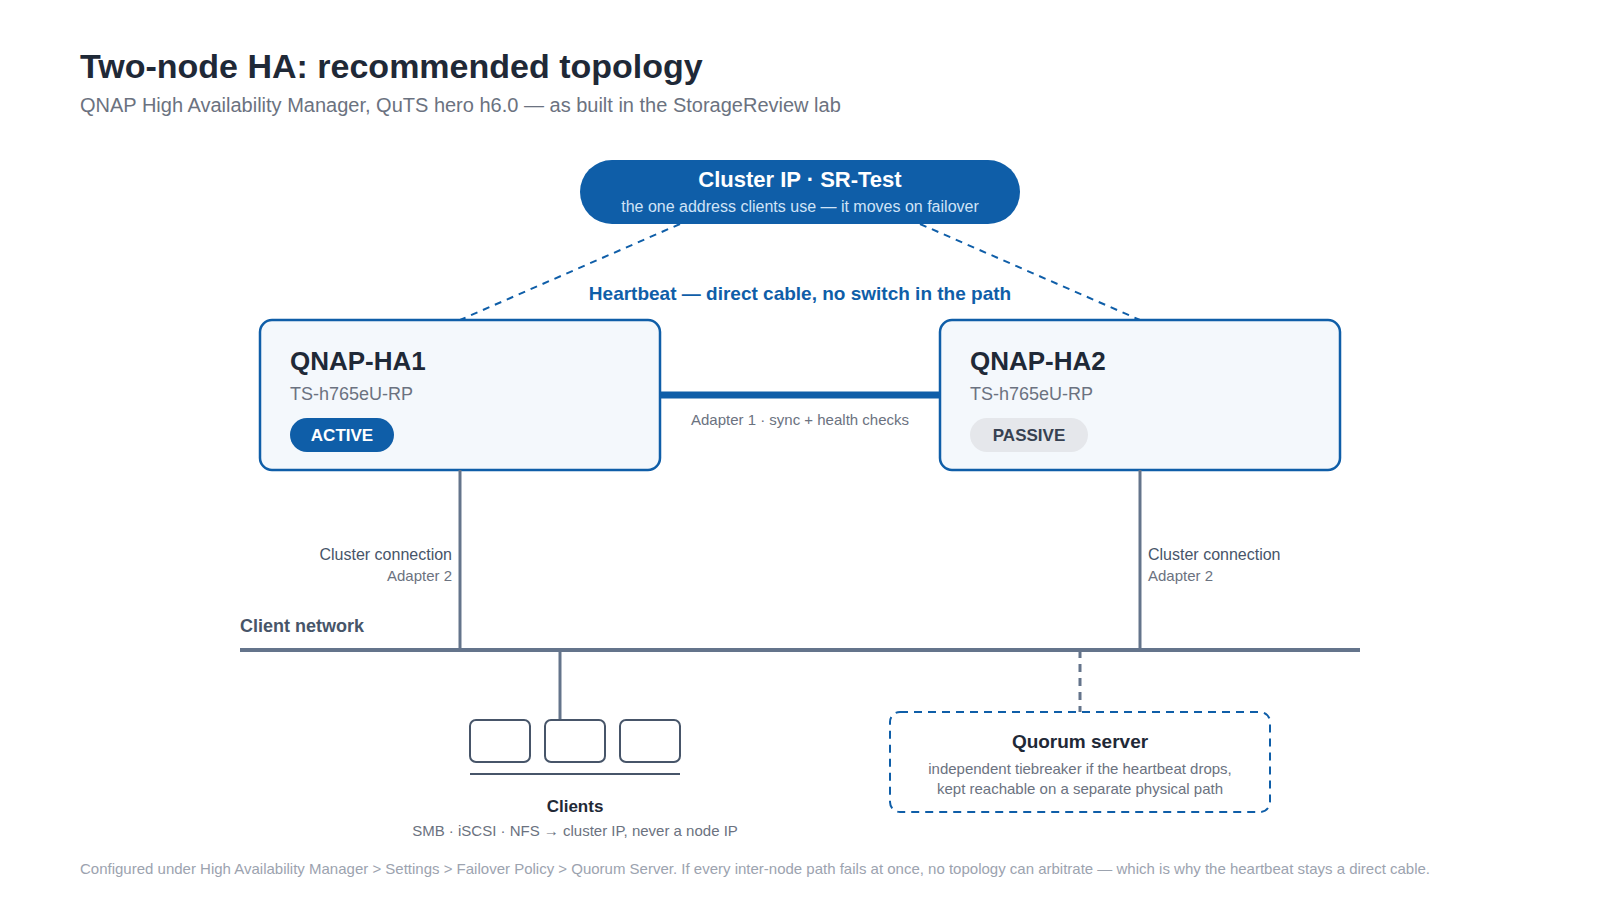
Menedżer Wysokiej Dostępności (High Availability Manager) to główna funkcja systemu QuTS hero h6.0, implementująca klasyczny układ aktywny-pasywny. Jeden serwer NAS, węzeł aktywny, obsługuje wszystkie dane i usługi. Drugi serwer NAS, węzeł pasywny, stale synchronizuje się z węzłem aktywnym za pośrednictwem dedykowanego połączenia Heartbeat i jest gotowy do przejęcia kontroli. Klienci nigdy nie komunikują się bezpośrednio z żadnym z węzłów; zamiast tego klaster prezentuje pojedynczy adres IP i nazwę hosta, a węzeł, który jest aktualnie aktywny, odpowiada na nie. W przypadku przełączenia awaryjnego, adres IP klastra przekierowuje ruch w zapleczu, dzięki czemu nie ma potrzeby przekierowywania mapowanych dysków, inicjatorów iSCSI ani zadań tworzenia kopii zapasowych.
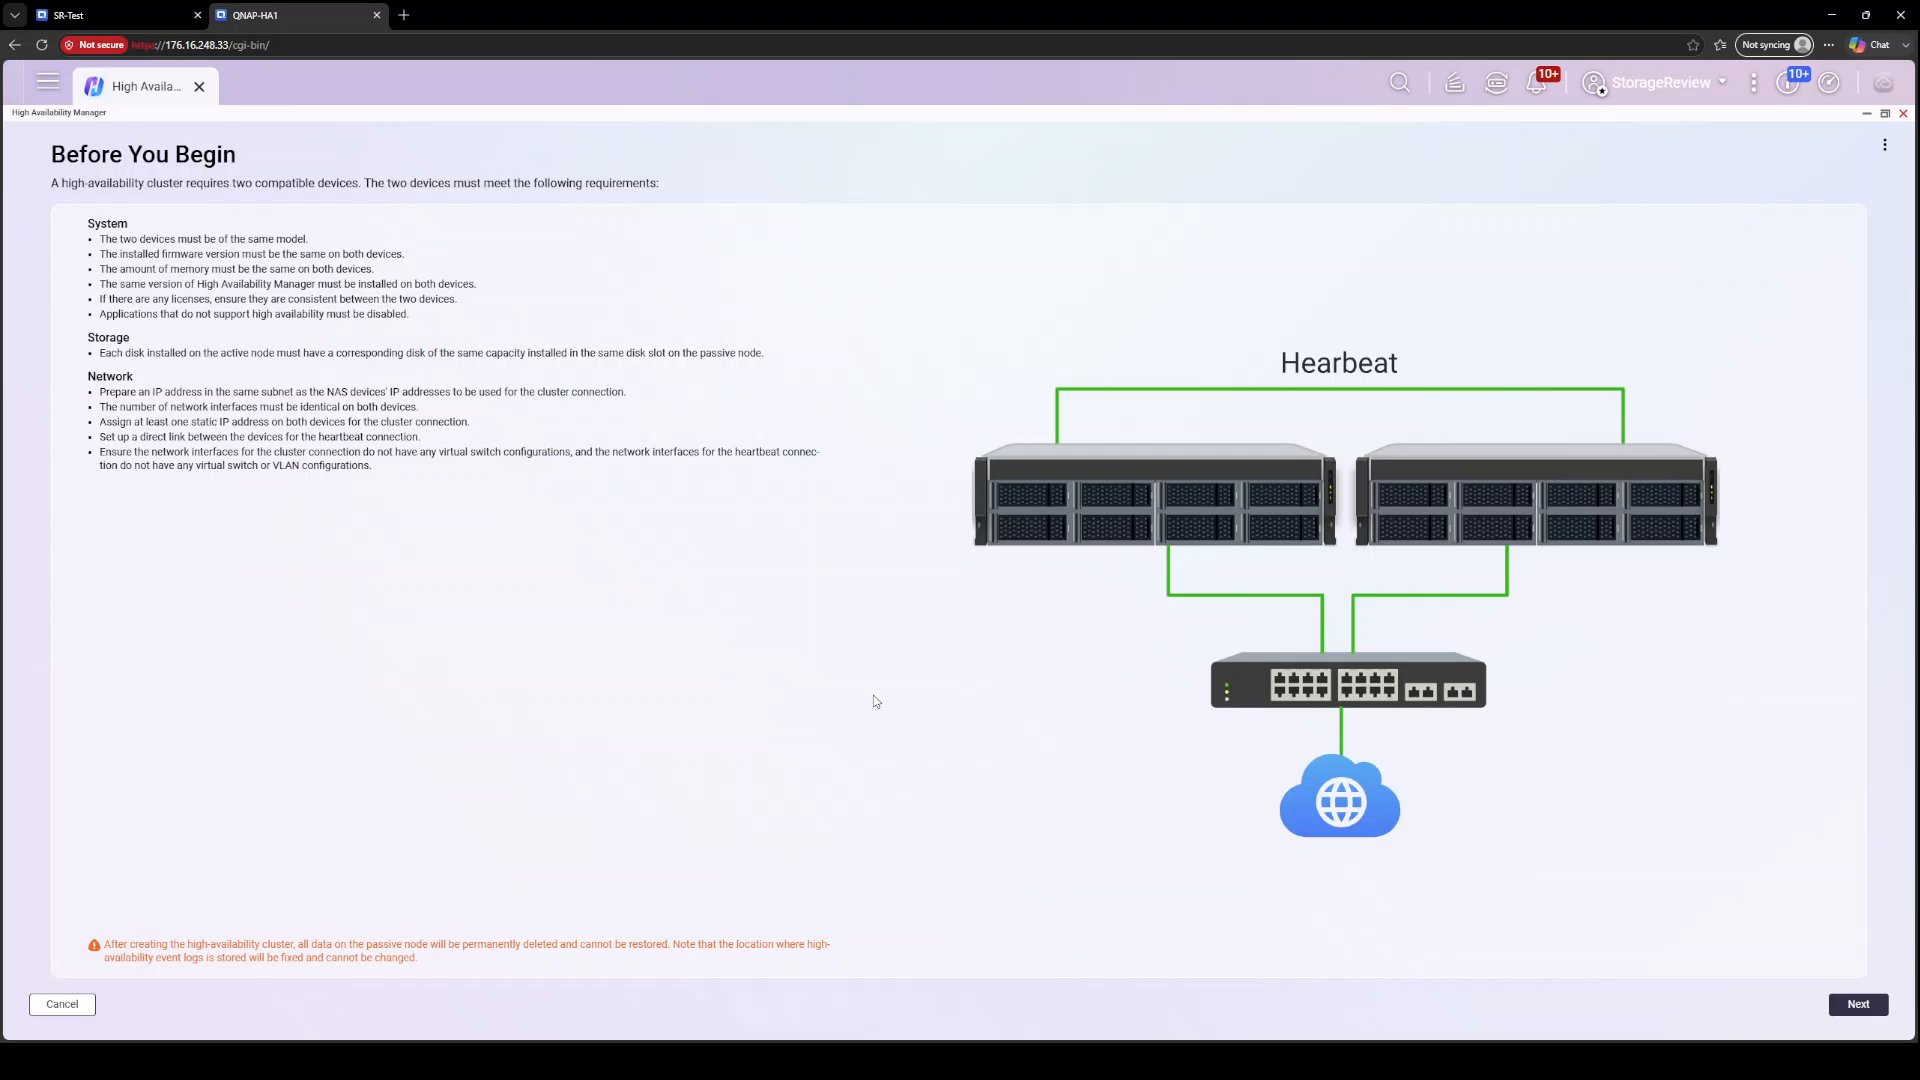
Łącze heartbeat stanowi podstawę projektu. QNAP wymaga bezpośredniego połączenia między dwoma jednostkami, bez przełączników na ścieżce, i obsługuje zarówno ruch związany z kontrolą stanu, jak i synchronizację danych na poziomie bloków między węzłami. Oddzielne połączenie klastra obsługuje ruch skierowany do klientów w sieci standardowej. Uzupełnieniem ochrony typu split-brain jest serwer kworum, trzeci świadek w sieci, który pomaga węzłowi określić, czy powinien się promować, gdy heartbeat ucichnie. Omówimy split-brain i topologię wdrożenia, która mu zapobiega, szczegółowo w dalszej części tego przeglądu.
Firma QNAP twierdzi, że ponad 90% usług NAS jest gotowych do obsługi technologii HA w h6.0, a klaster można rozszerzyć za pomocą obudów rozszerzających JBOD. Istnieją jednak pewne zastrzeżenia. Niezmienne migawki, kolejna kluczowa funkcja h6.0, nie są obecnie obsługiwane w klastrze HA, więc administratorzy będą musieli na razie wybrać między tymi dwoma zabezpieczeniami. HA wymaga również dwóch identycznych systemów, pasującego modelu i oprogramowania sprzętowego, co kreator parowania wymusza przed zezwoleniem na kontynuację.
Budowanie klastra QNAP HA
Tworzenie klastra rozpoczyna się od dwóch niezależnie skonfigurowanych jednostek TS-h765eU o identycznym sprzęcie. Począwszy od wyznaczonego węzła aktywnego, kreator High Availability Manager przeprowadza krótki proces parowania. Kreator wykrywa węzeł pasywny za pośrednictwem łącza Heartbeat, a następnie prosi o przypisanie ról interfejsom sieciowym: połączeniu klastra, które służy jako kanał komunikacyjny umożliwiający dostęp do klastra, oraz połączeniu Heartbeat, które, jak zauważa QNAP, jest dedykowane do synchronizacji danych i musi stanowić bezpośrednie łącze między urządzeniami. W naszej konfiguracji kreator przypisał Heartbeat do Adaptera 1, a połączenie klastra do Adaptera 2.
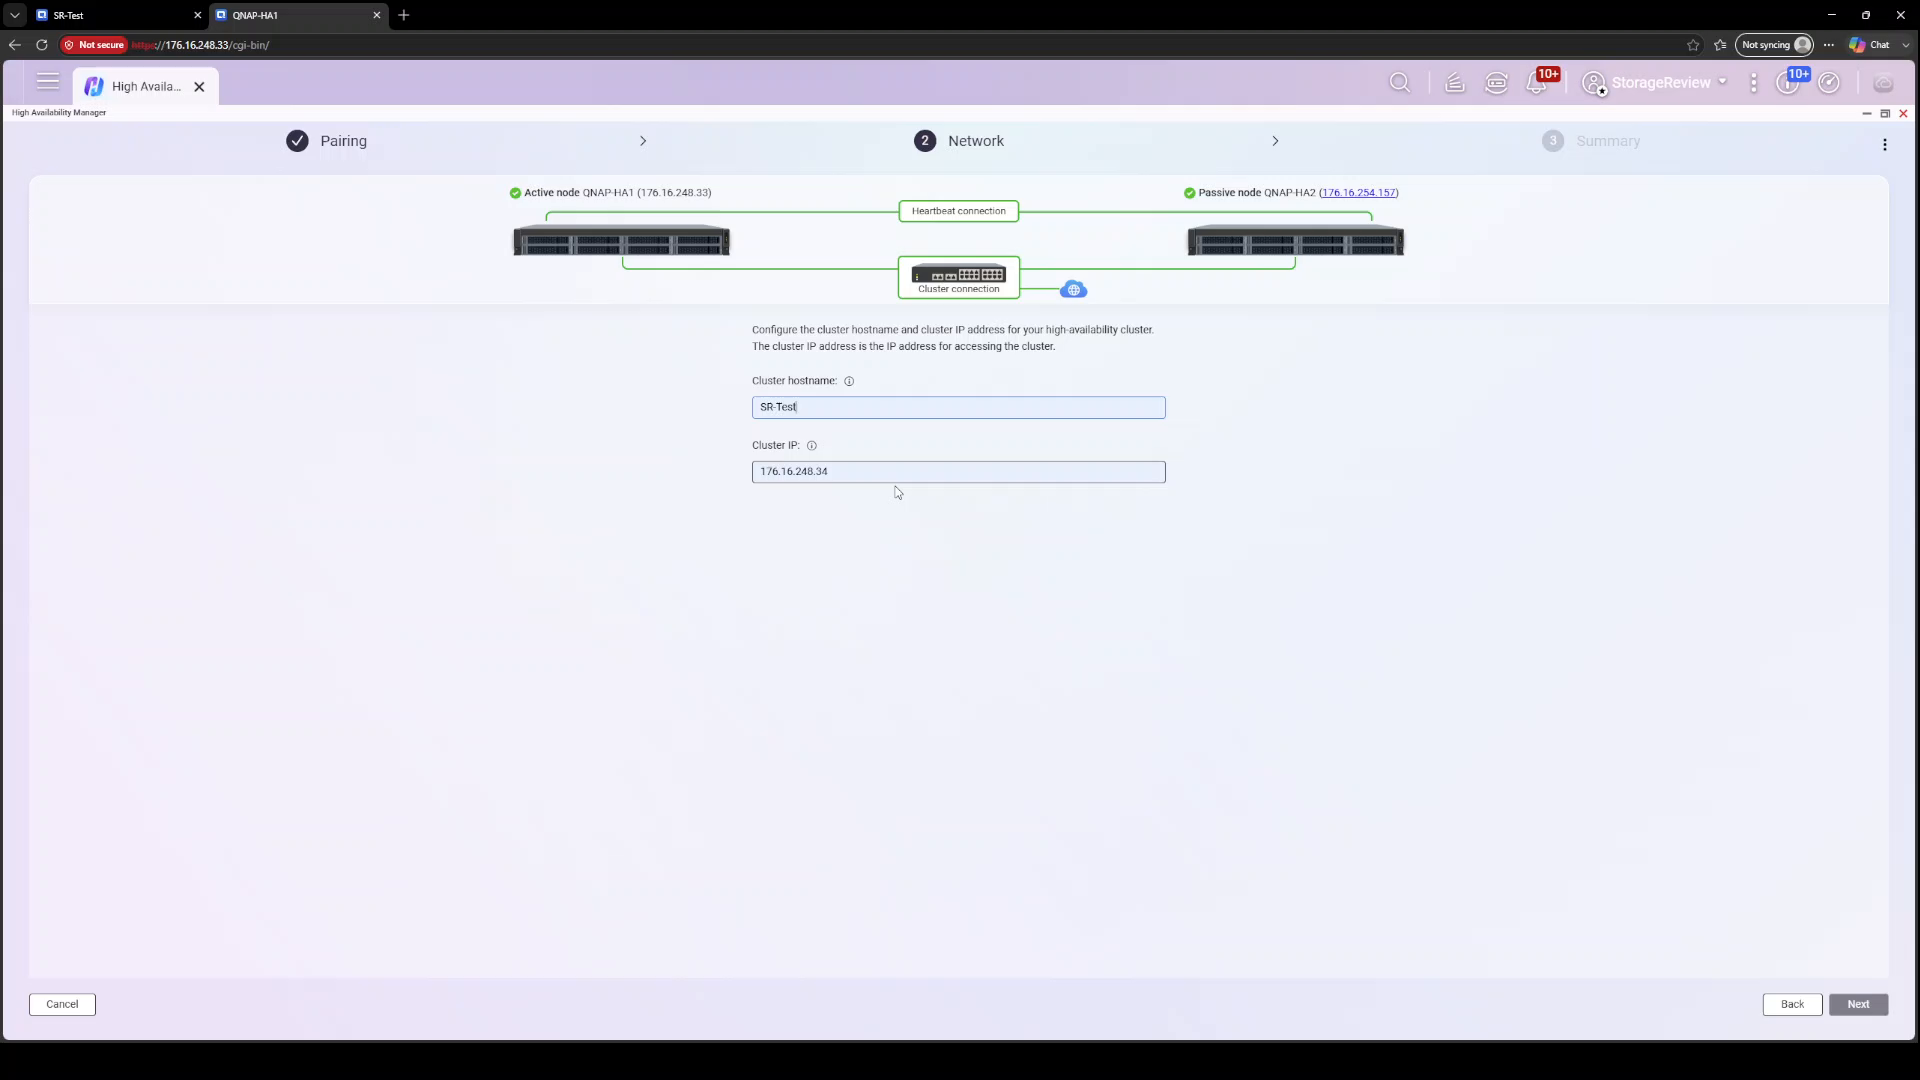
Następnie następuje identyfikacja klastra. Przypisujesz nazwę hosta i adres IP klastra, które stają się jedynym adresem używanym przez klientów od tego momentu. Nasz klaster otrzymał nazwę SR-Test i adres 176.16.248.34, a jego punktem odniesienia są węzły QNAP-HA1 (176.16.248.33) i QNAP-HA2 (176.16.254.157), znajdujące się w różnych podsieciach /24 w sieci laboratoryjnej; kreator sparował je bez problemu.
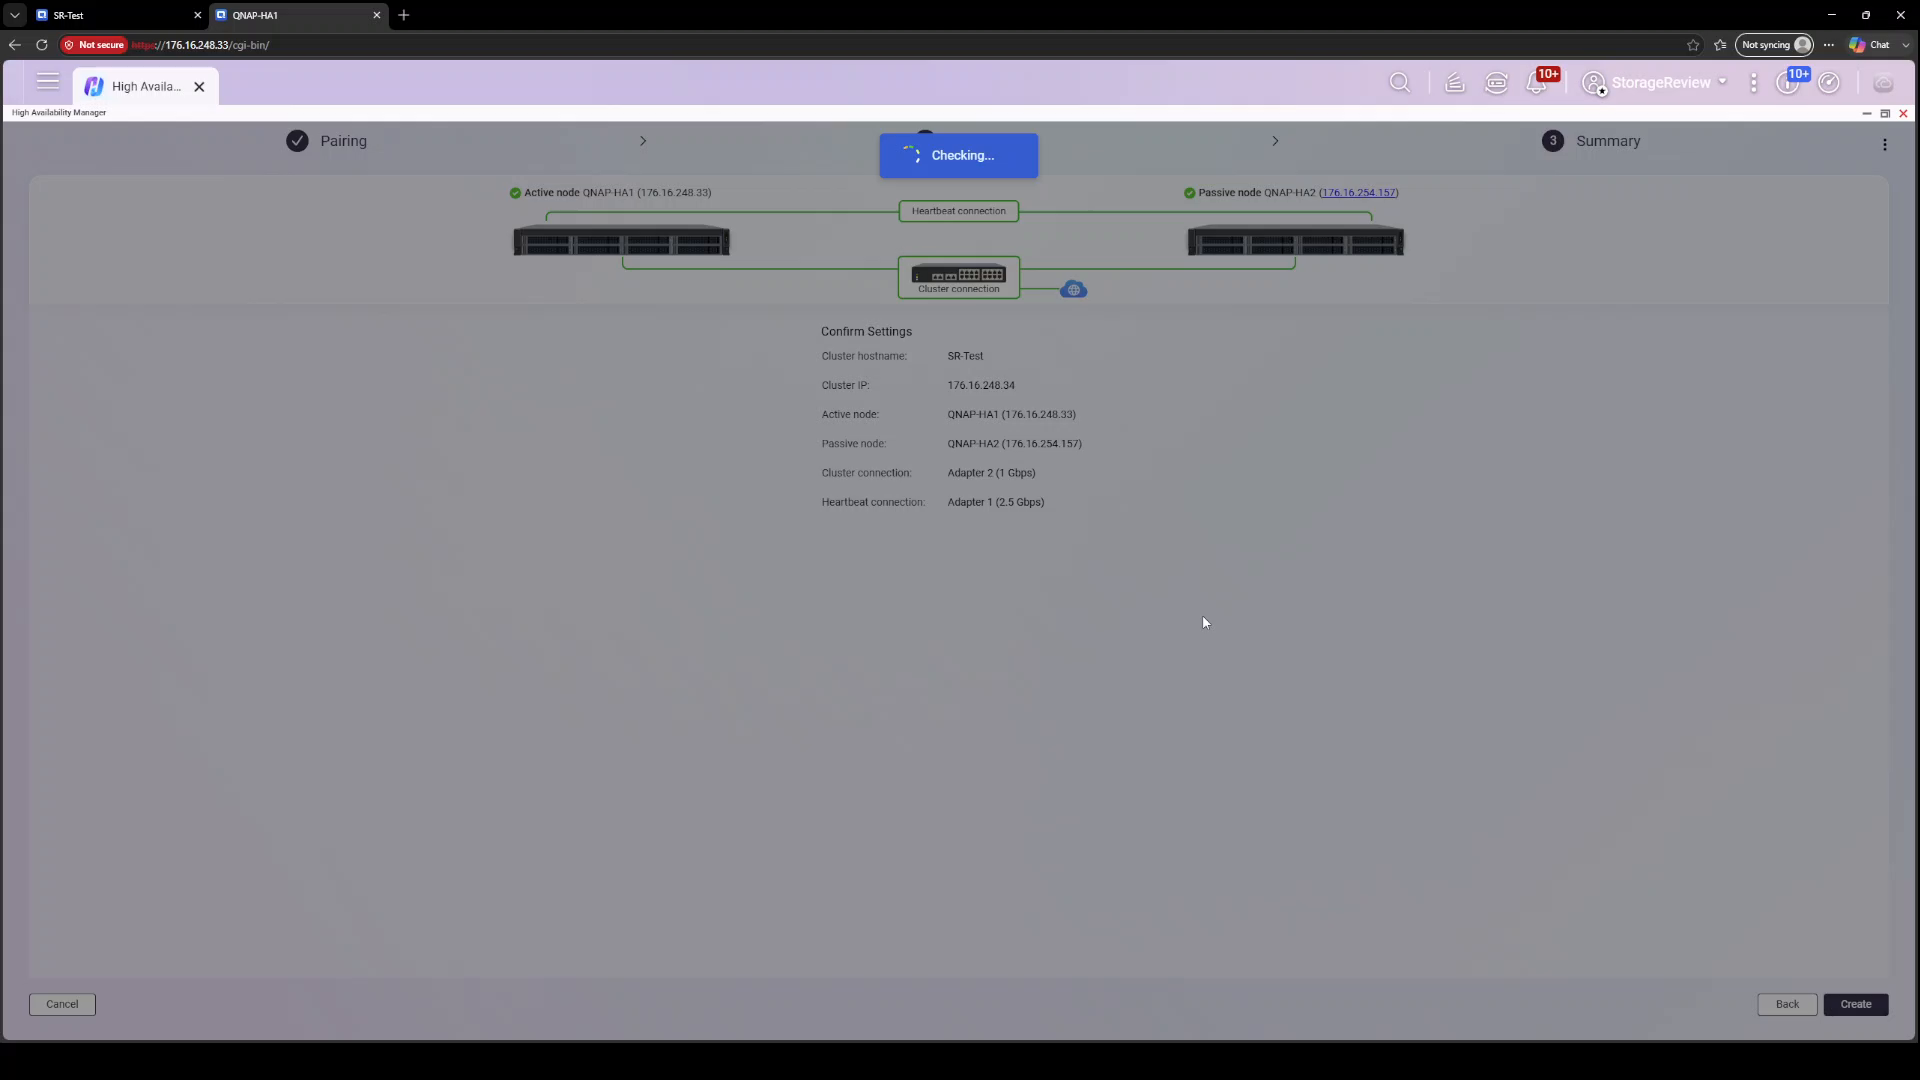
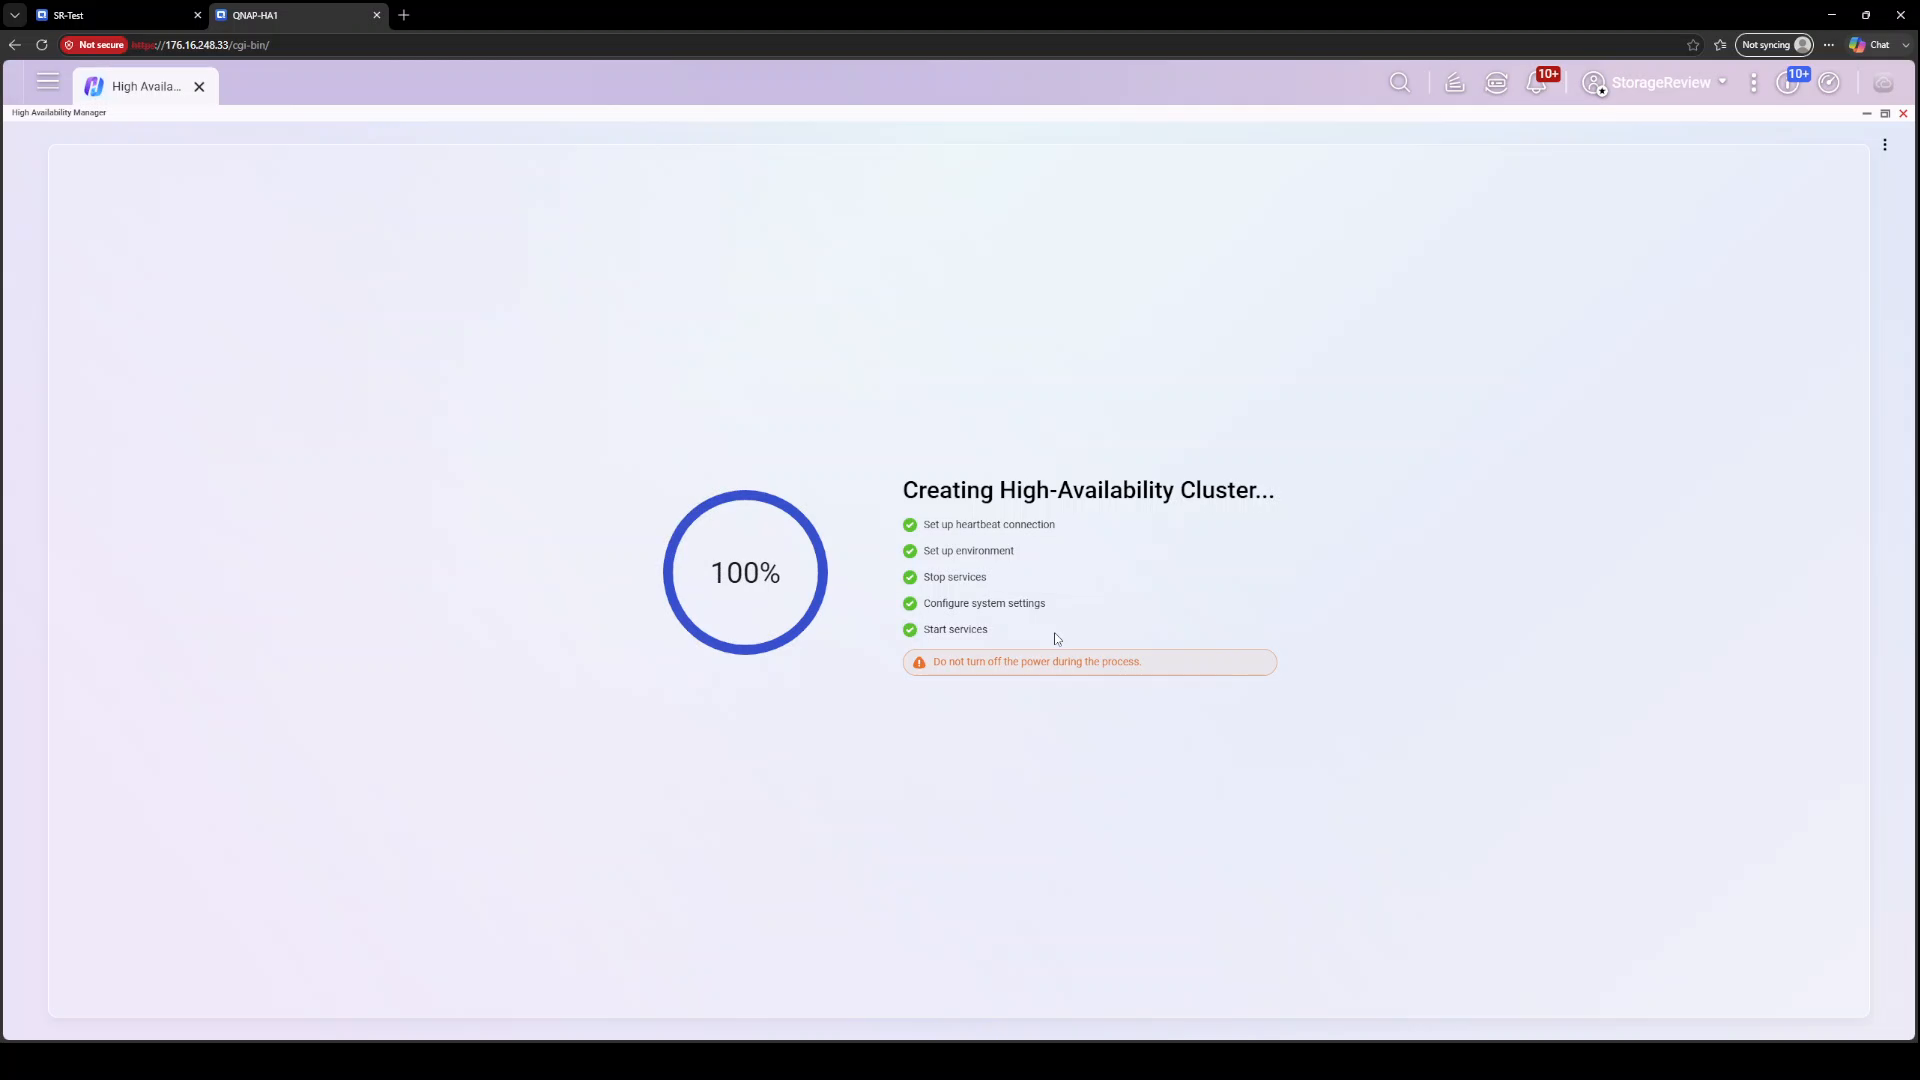
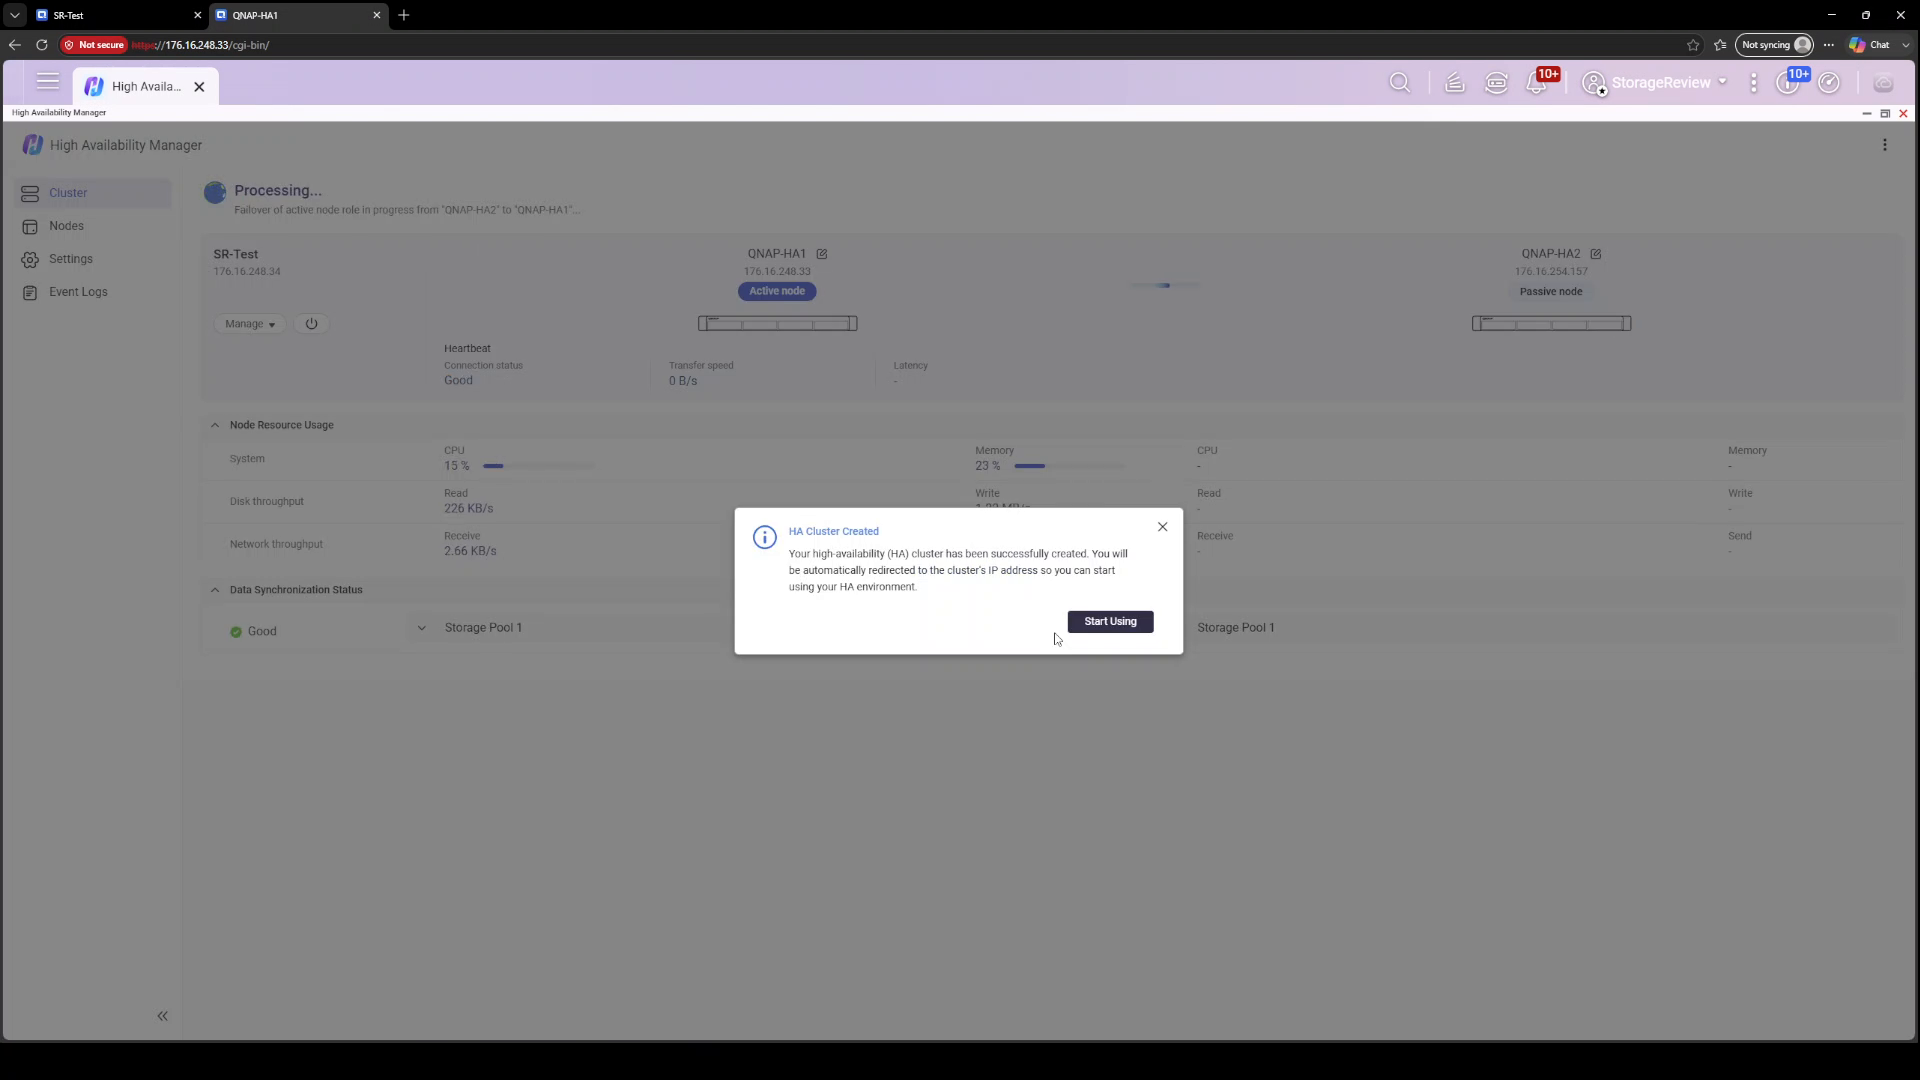
Po potwierdzeniu ustawień kreator uruchamia pięcioetapową kompilację: konfiguruje połączenie Heartbeat, konfiguruje środowisko, zatrzymuje usługi, konfiguruje ustawienia systemowe i uruchamia usługi. Interfejs użytkownika podkreśla, że w tym czasie nie należy niczego wyłączać. W naszych systemach sama kompilacja trwała około pięciu i pół minuty, po czym Menedżer HA poinformował o utworzeniu klastra i przekierował nas do adresu IP klastra. Przejście z dwóch niezależnych jednostek NAS do klastra obsługującego zajęło kreatorowi od początku do końca mniej niż dziesięć minut.
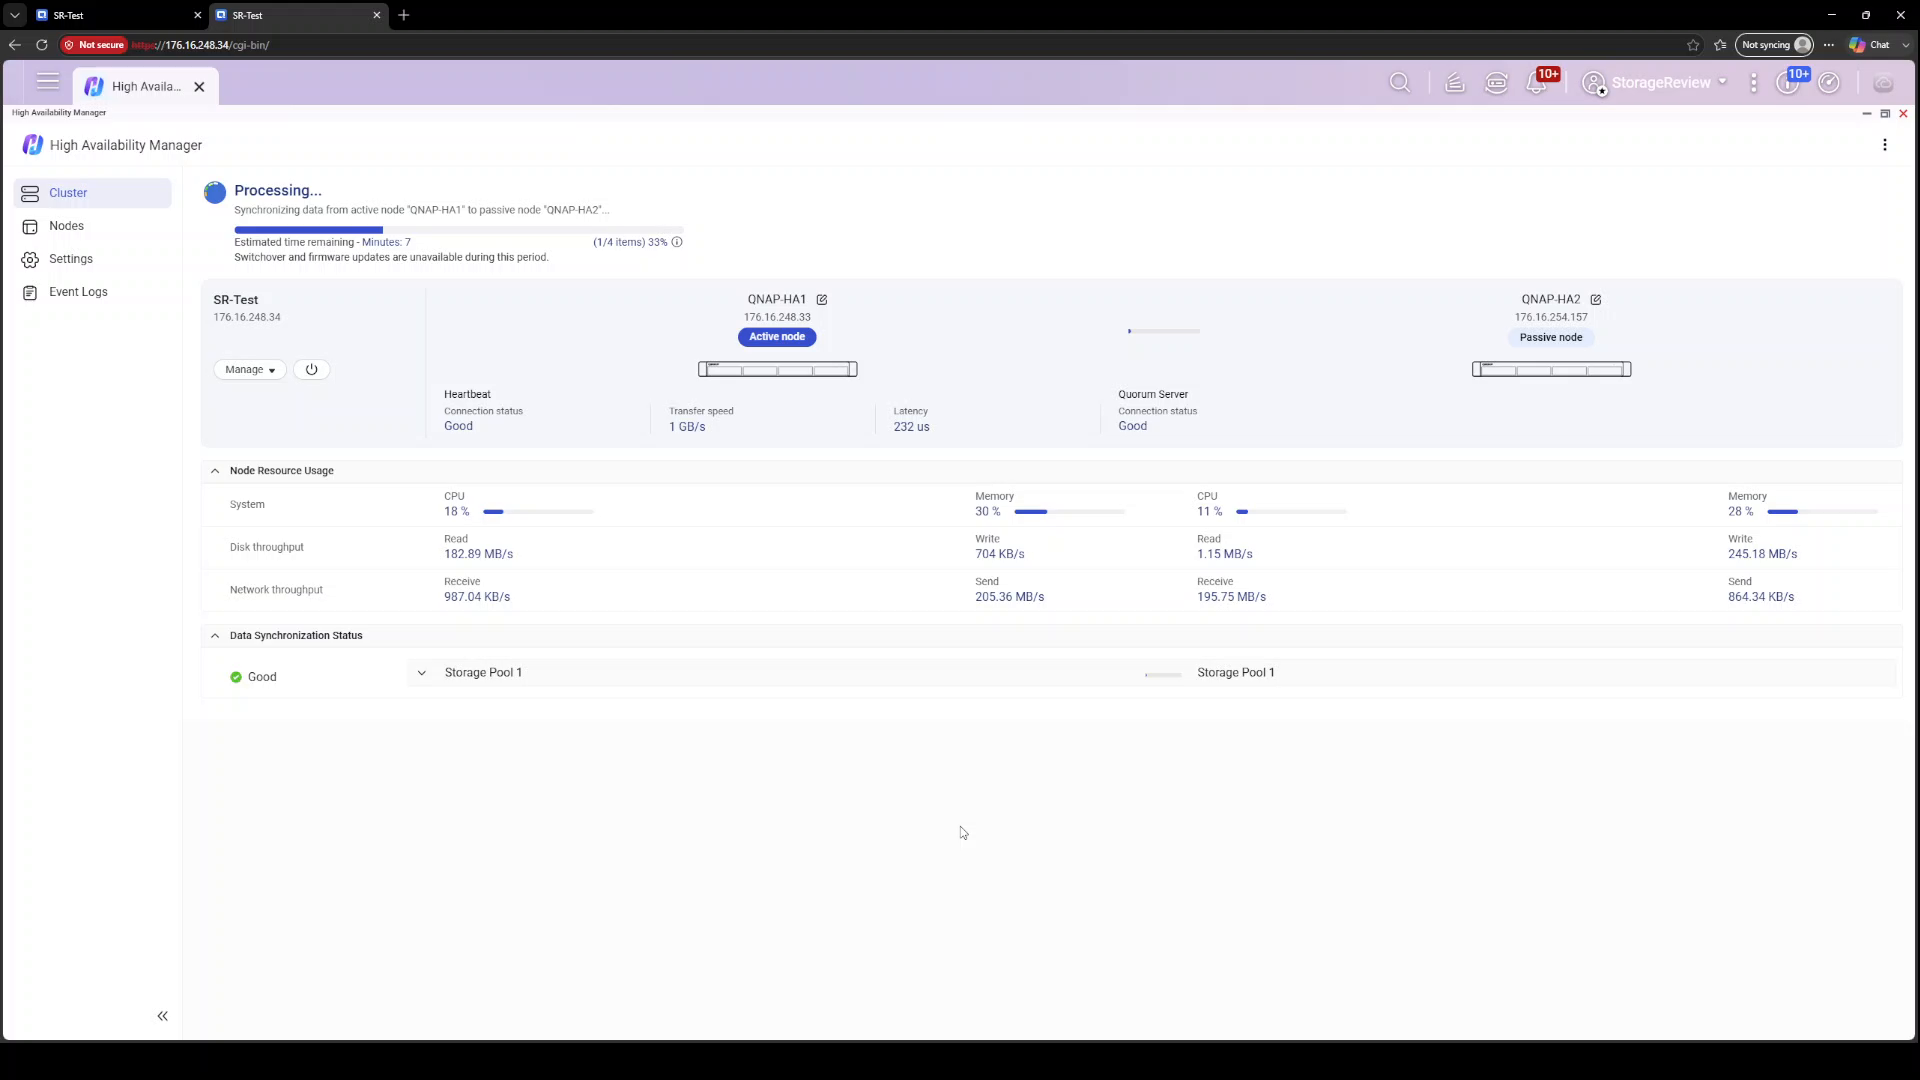
Większym wyzwaniem jest początkowa synchronizacja, w której węzeł aktywny replikuje swoją pulę pamięci masowej do węzła pasywnego, blok po bloku. Menedżer HA wyraźnie to pokazuje za pomocą paska postępu, liczby elementów i szacowanego czasu u góry pulpitu, wraz z ostrzeżeniem, że przełączanie i aktualizacje oprogramowania sprzętowego są niedostępne do czasu zakończenia synchronizacji. Obserwowanie statystyk pulsu w tej fazie było jednym z bardziej imponujących elementów procesu: prędkości transferu wahały się od około 900 MB/s do 1.2 GB/s, z opóźnieniem rzędu setek mikrosekund, w tym jednym reprezentatywnym odczytem 1 GB/s przy 232 mikrosekundach. Nasza początkowa synchronizacja zakończyła się w około dziesięć minut, co dokładnie pokrywa się z początkowym szacunkiem dziewięciu minut na pulpicie.
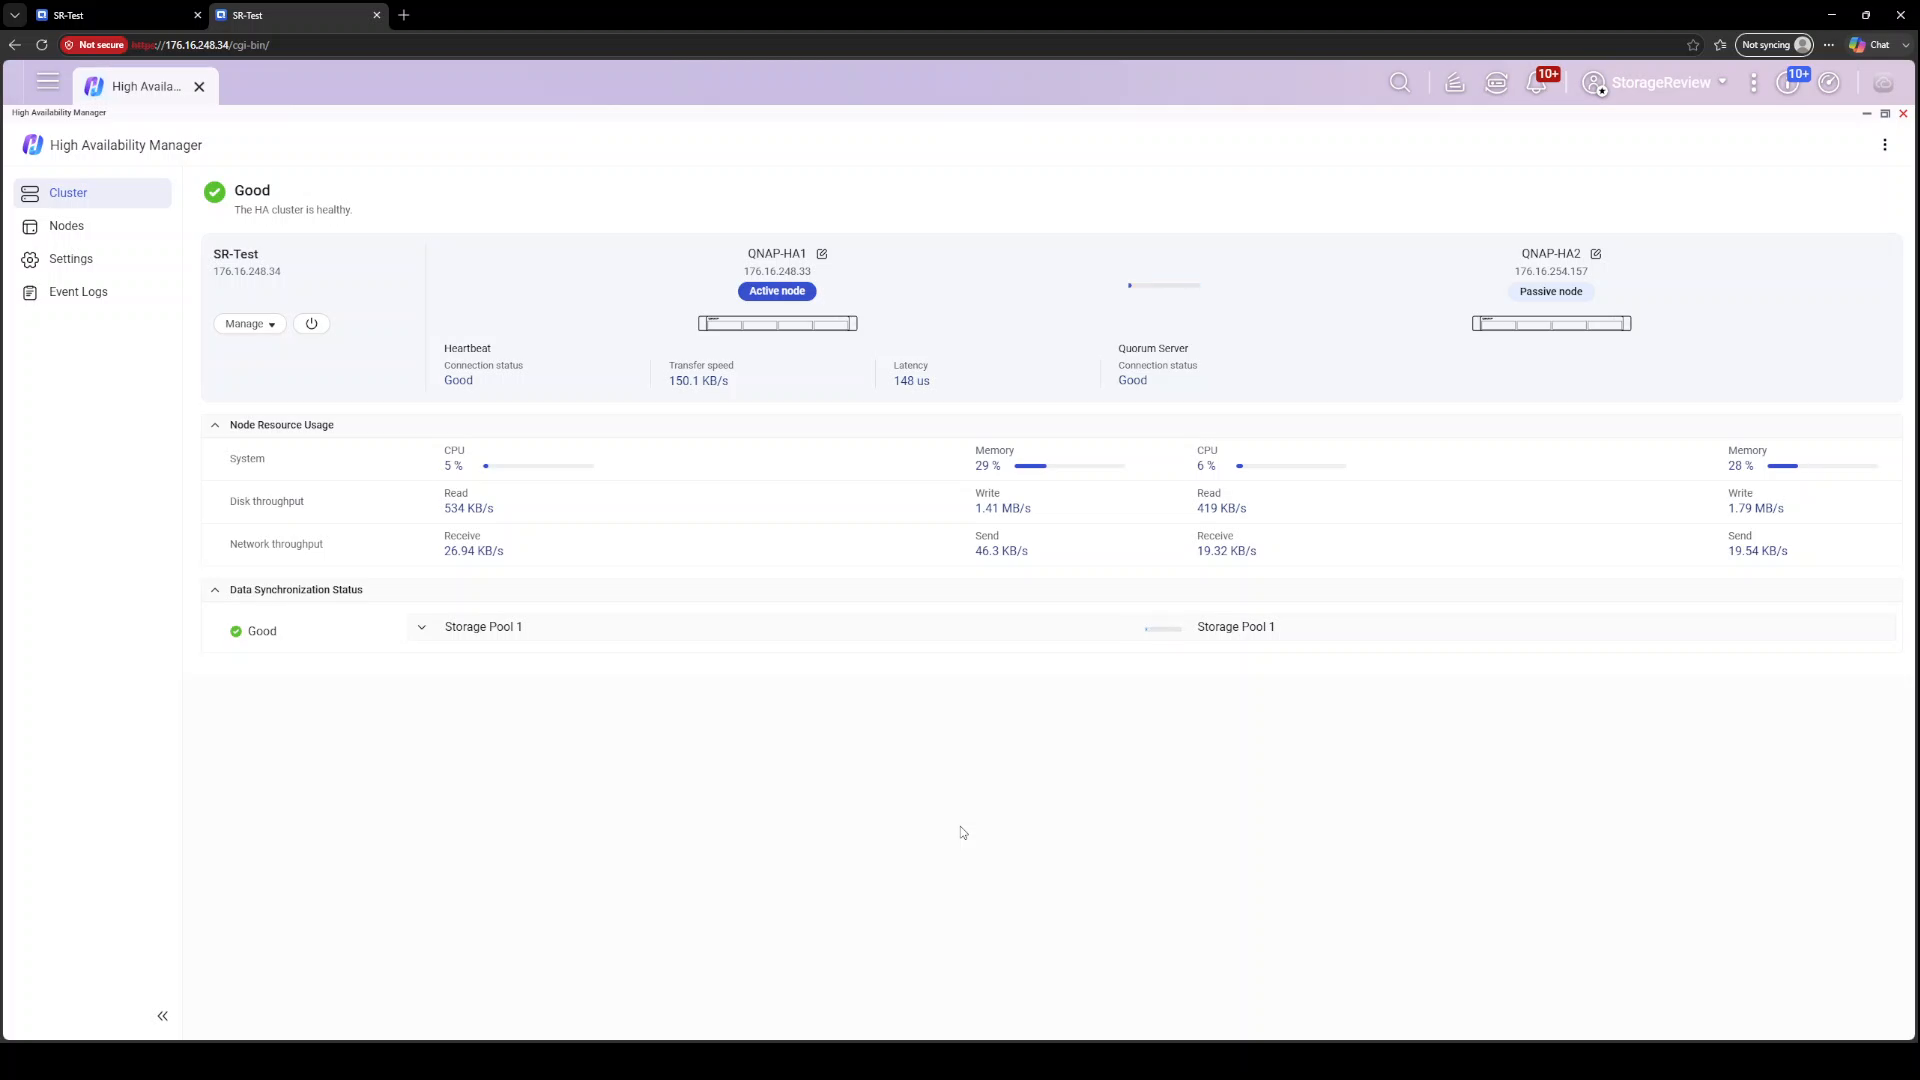
Po zakończeniu synchronizacji pulpit nawigacyjny przechodzi w stan „Dobry”: klaster jest sprawny, połączenie z pulsacją, oba węzły widoczne z aktualnymi statystykami procesora, pamięci, przepustowości dysku i sieci obok siebie, a poniżej status synchronizacji dla puli. To przejrzysty, bogaty w informacje widok, który odpowiada na dwa pytania administratora: czy klaster jest sprawny i czy moje dane są zsynchronizowane?
Test awaryjny 1: utrata zasilania na aktywnym węźle
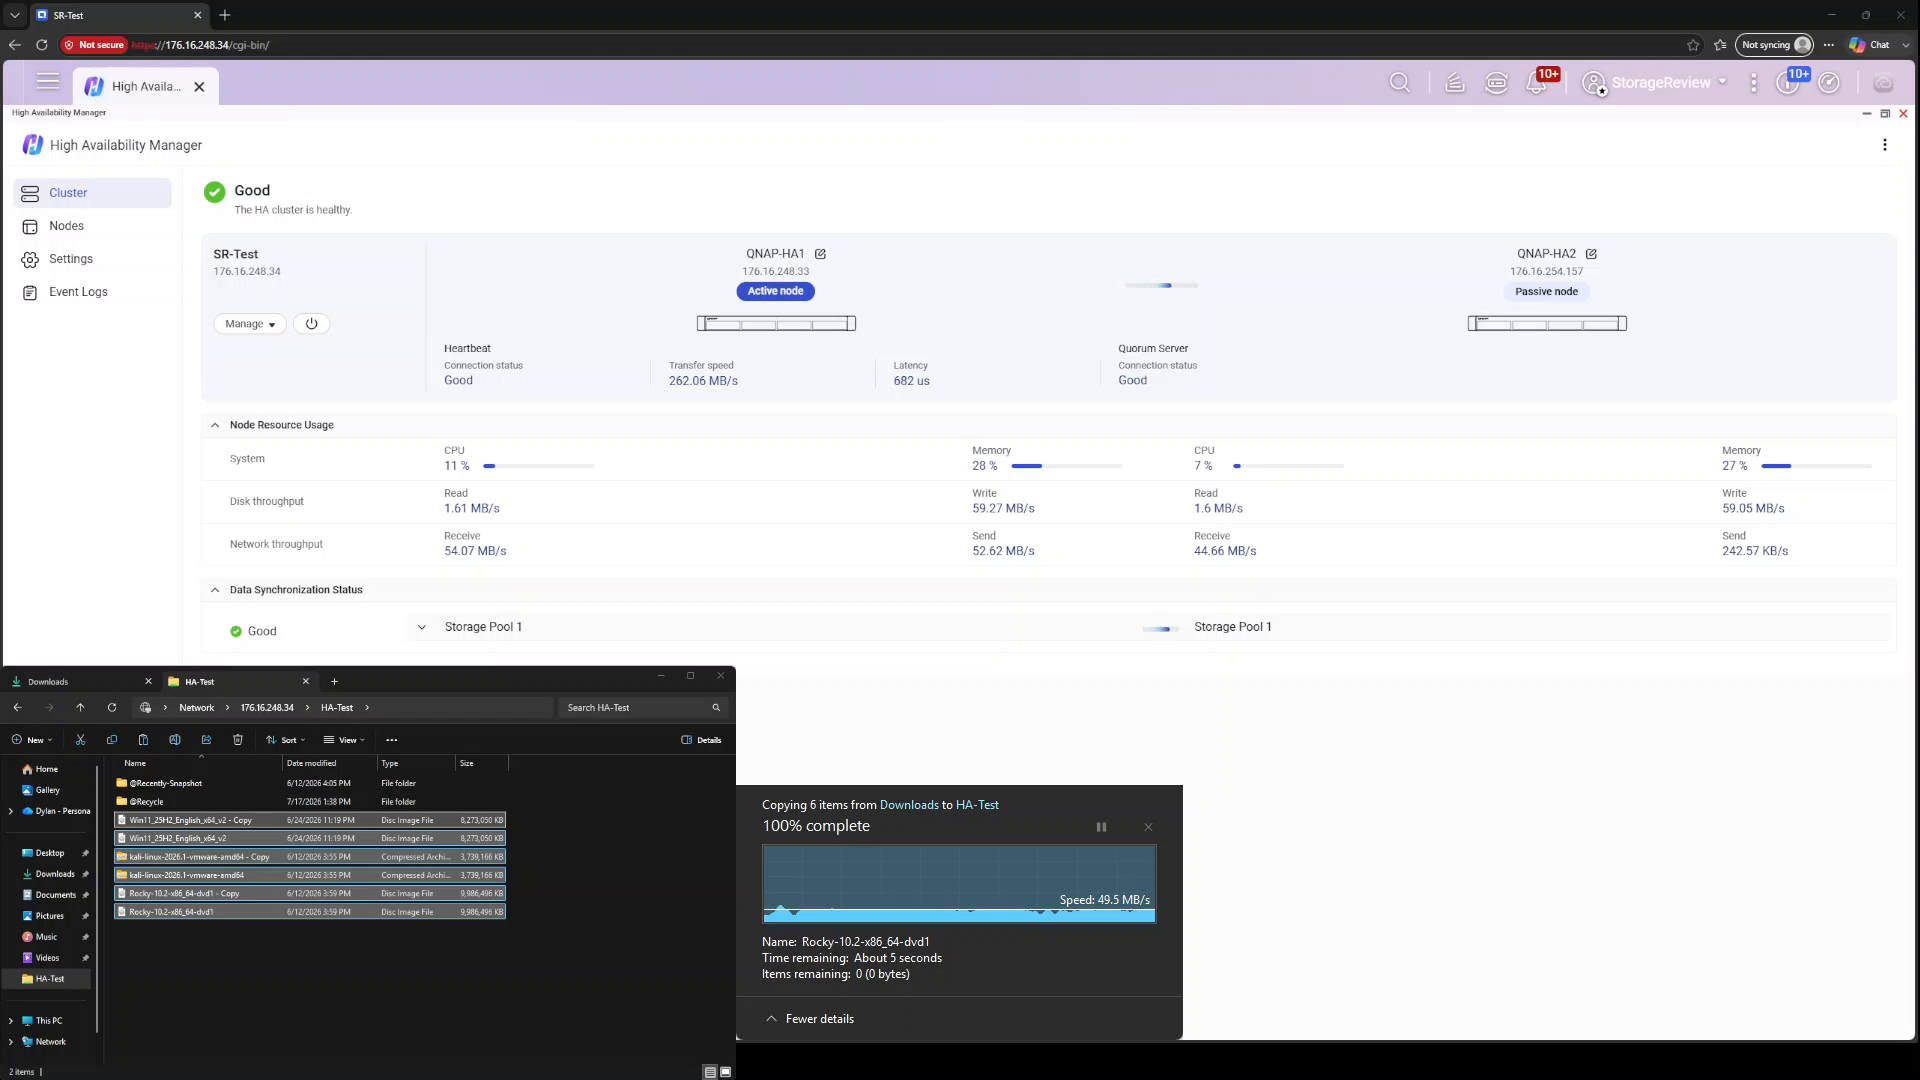
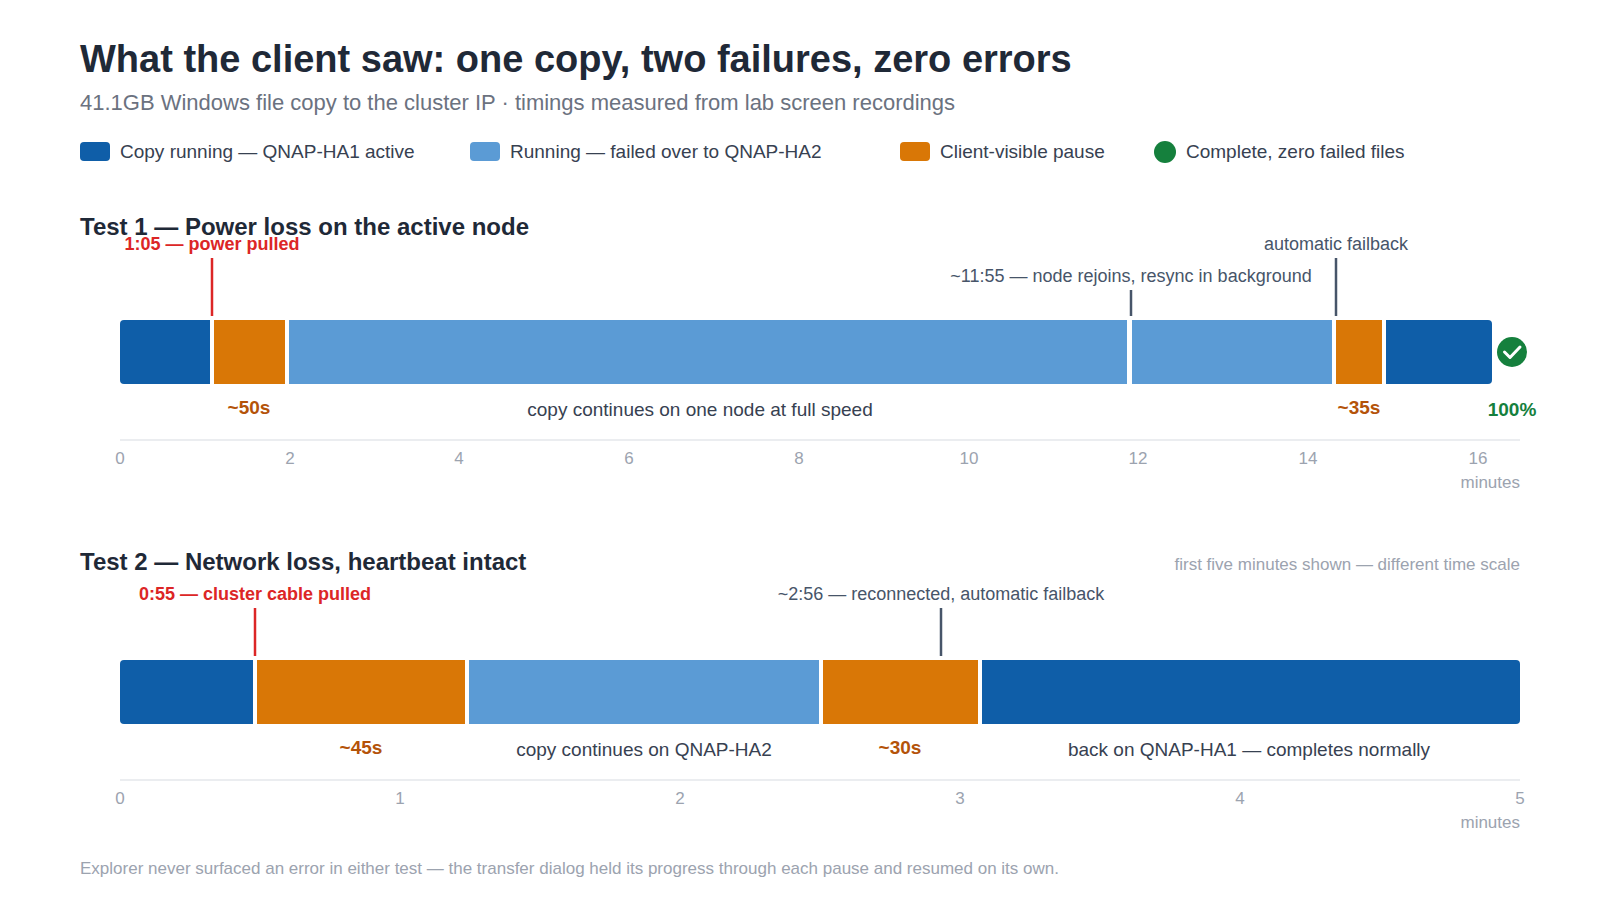
Nasz pierwszy scenariusz awarii jest najbardziej oczywisty: całkowita utrata zasilania na aktywnym węźle. Rozpoczęliśmy kopiowanie plików Windows z klienta do udziału SMB na adresie IP klastra, 41.1 GB pakietu sześciu plików, w tym obrazów ISO systemów Windows 11 i Rocky Linux oraz pary archiwów maszyn wirtualnych Kali Linux, a następnie w trakcie transferu wyłączyliśmy zasilanie serwera QNAP-HA1.
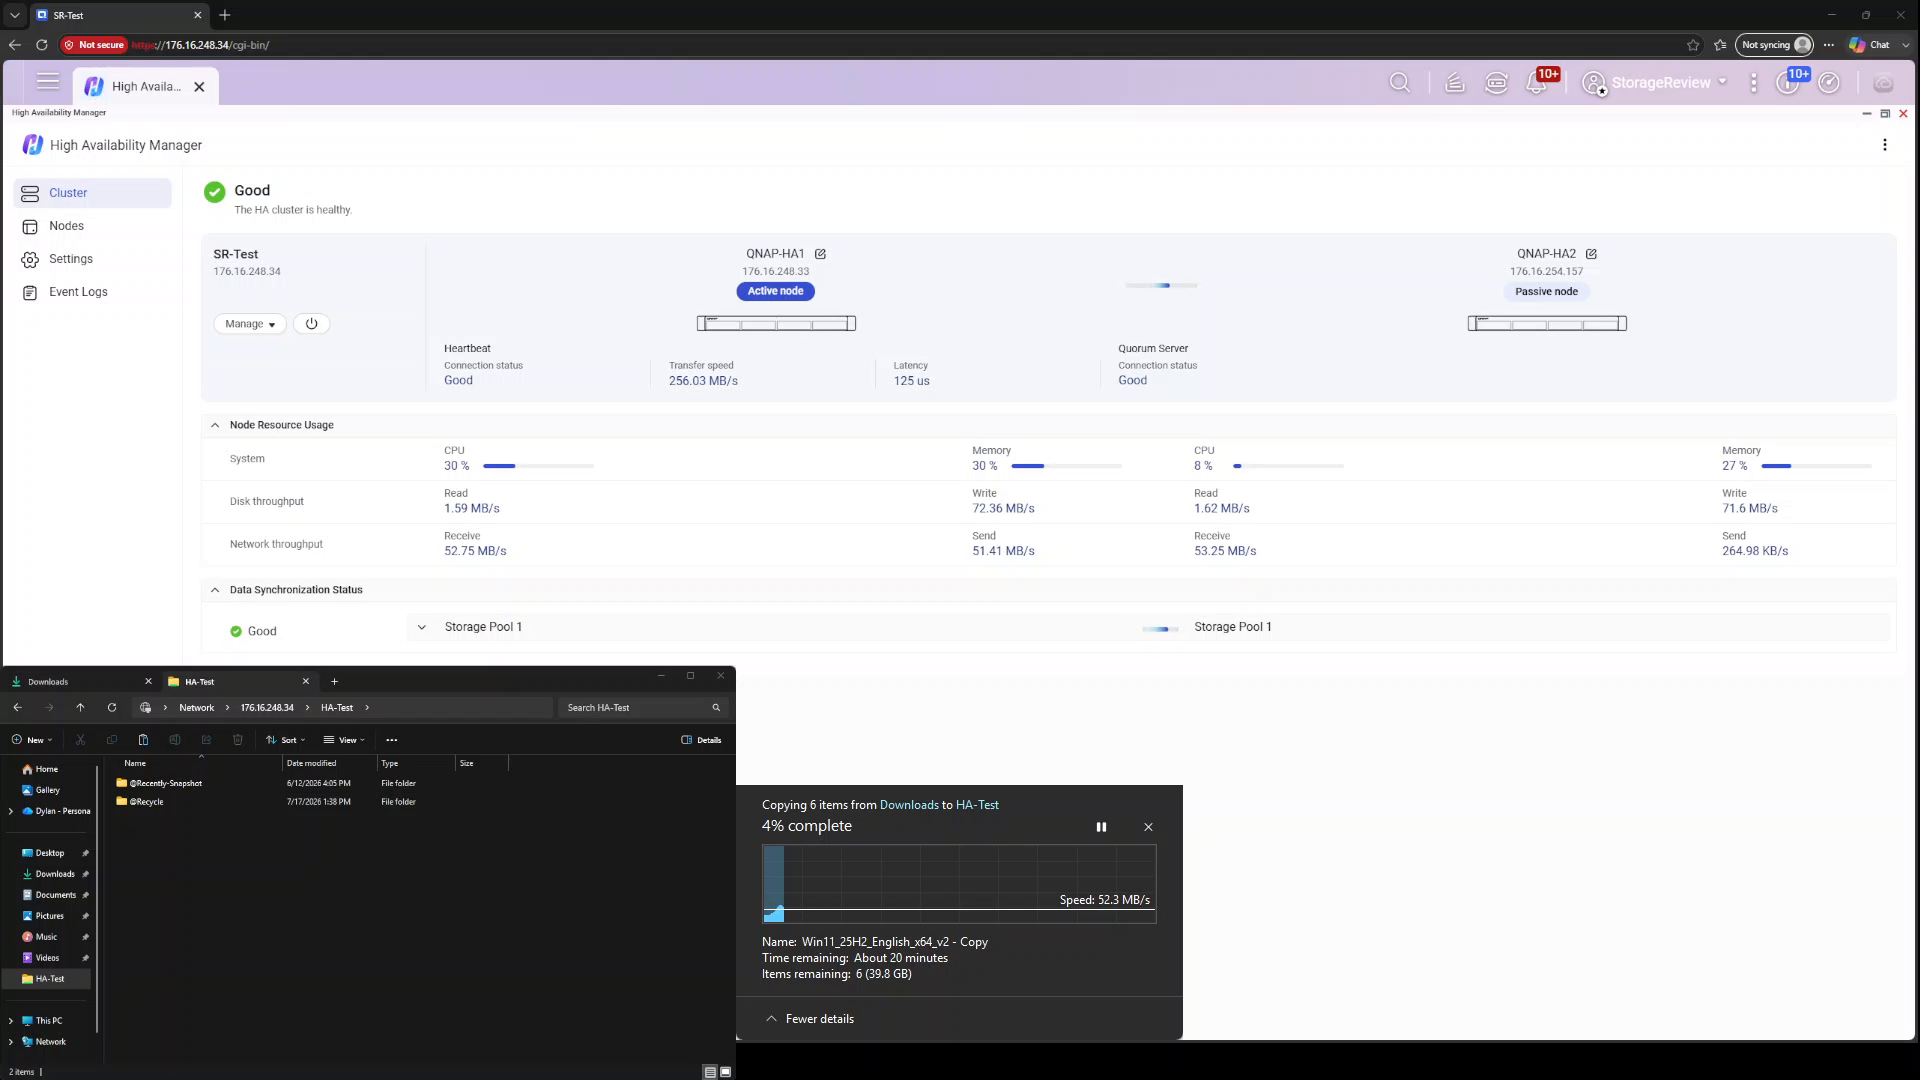
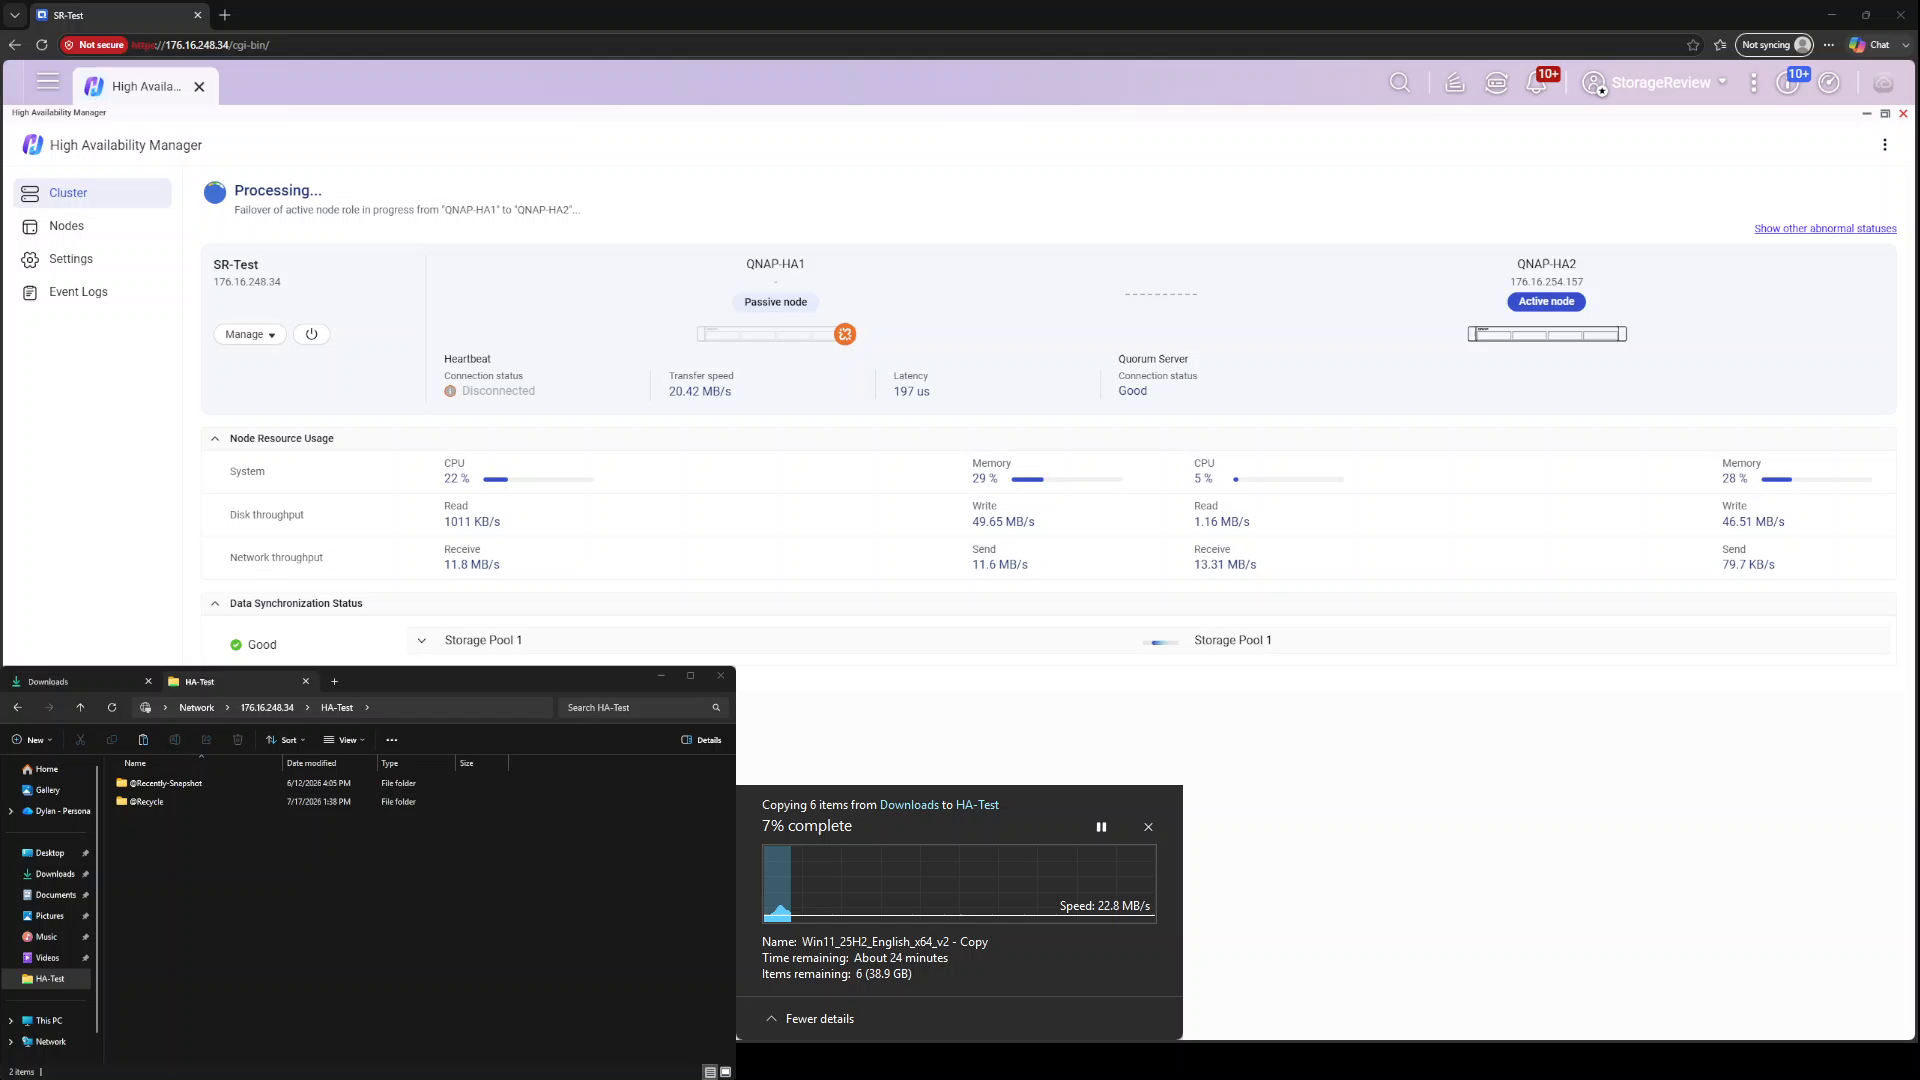
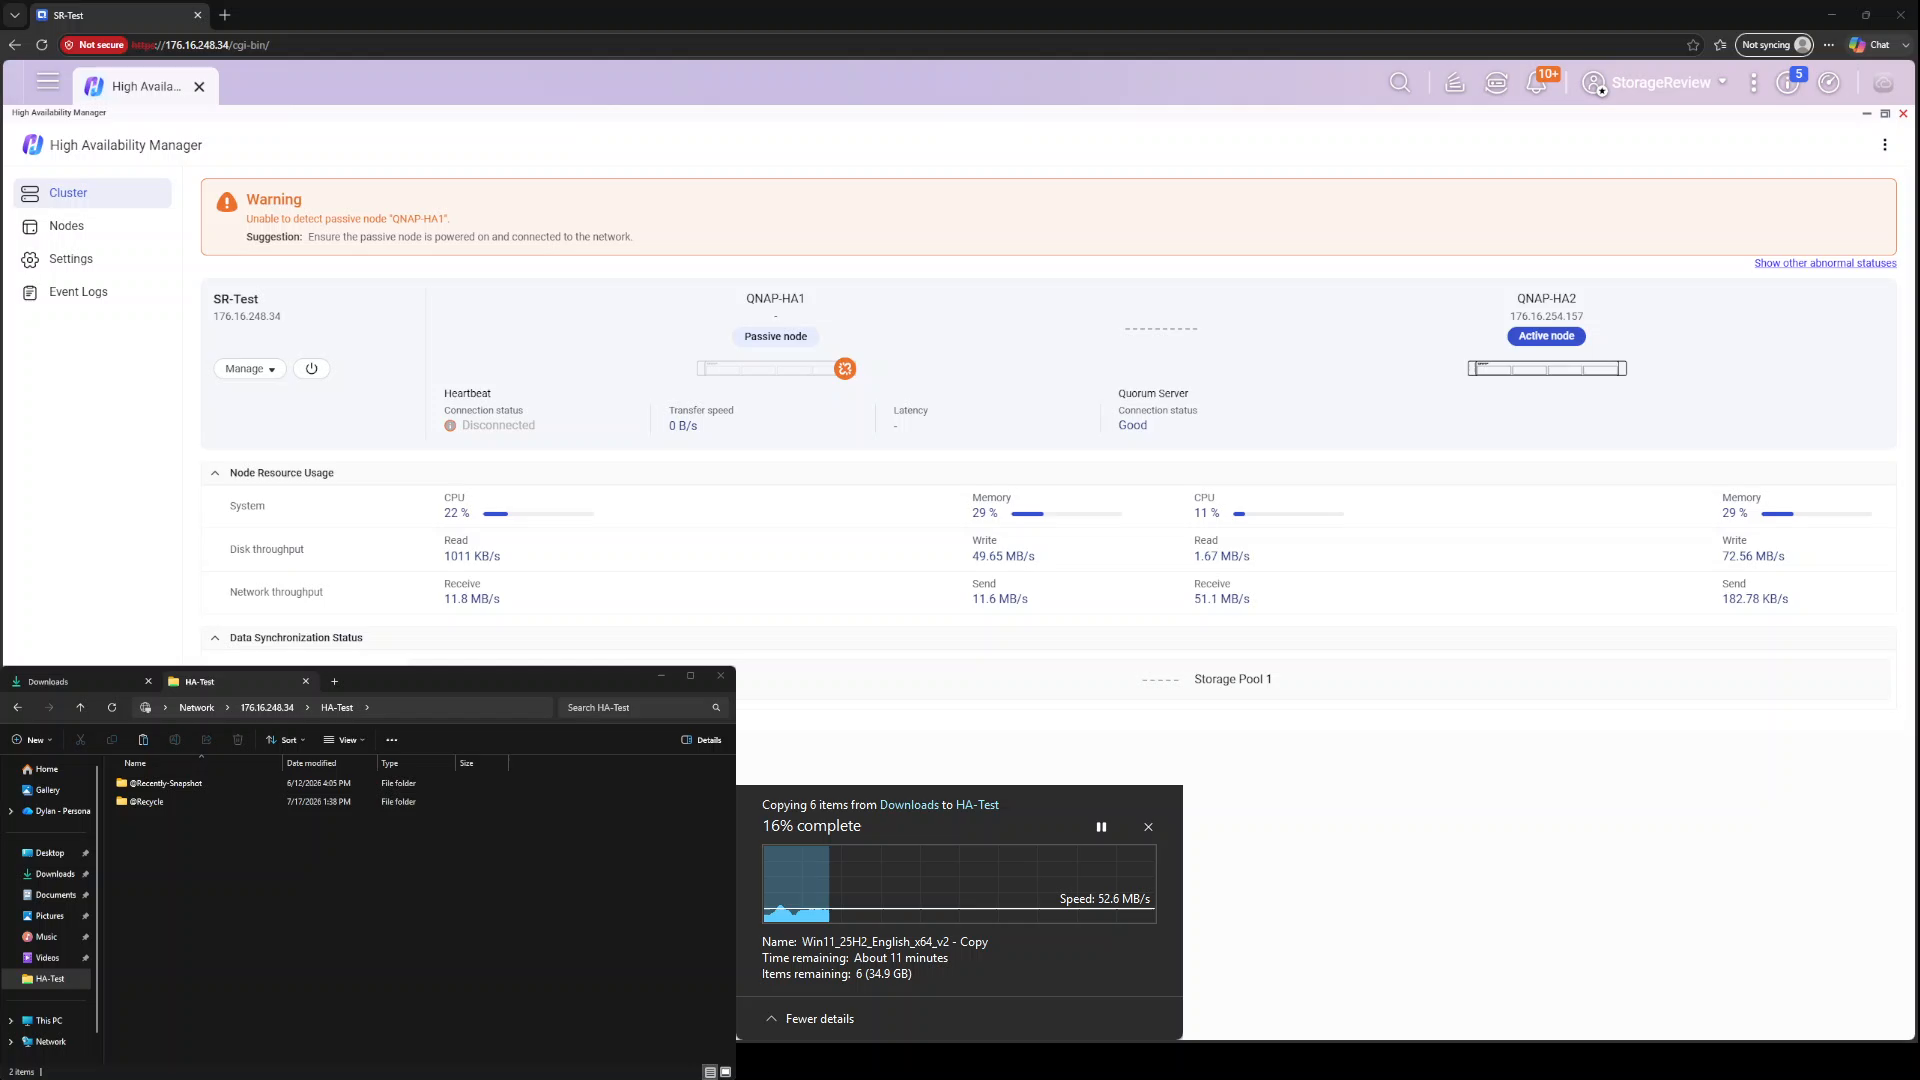
Z perspektywy klienta, kopiowanie zatrzymało się na niecałą minutę, około 50 sekund, od momentu odłączenia zasilania do ponownego przesłania danych, a Explorer nie zgłosił błędu; okno dialogowe transferu wstrzymało postęp, a następnie zostało wznowione, gdy QNAP-HA2 awansował się do stanu aktywnego. Menedżer HA krótko poinformował o trwającym przełączaniu awaryjnym roli aktywnego węzła, a następnie wyświetlił komunikat ostrzegawczy: nie można wykryć pasywnego węzła QNAP-HA1, z sugestią upewnienia się, że węzeł jest włączony i połączony z siecią. Transfer był kontynuowany z pełną prędkością do tego samego adresu IP klastra, podczas gdy klaster działał na jednym węźle, co jest dokładnie stanem zdegradowanym, ale sprawnym, obiecuje HA.
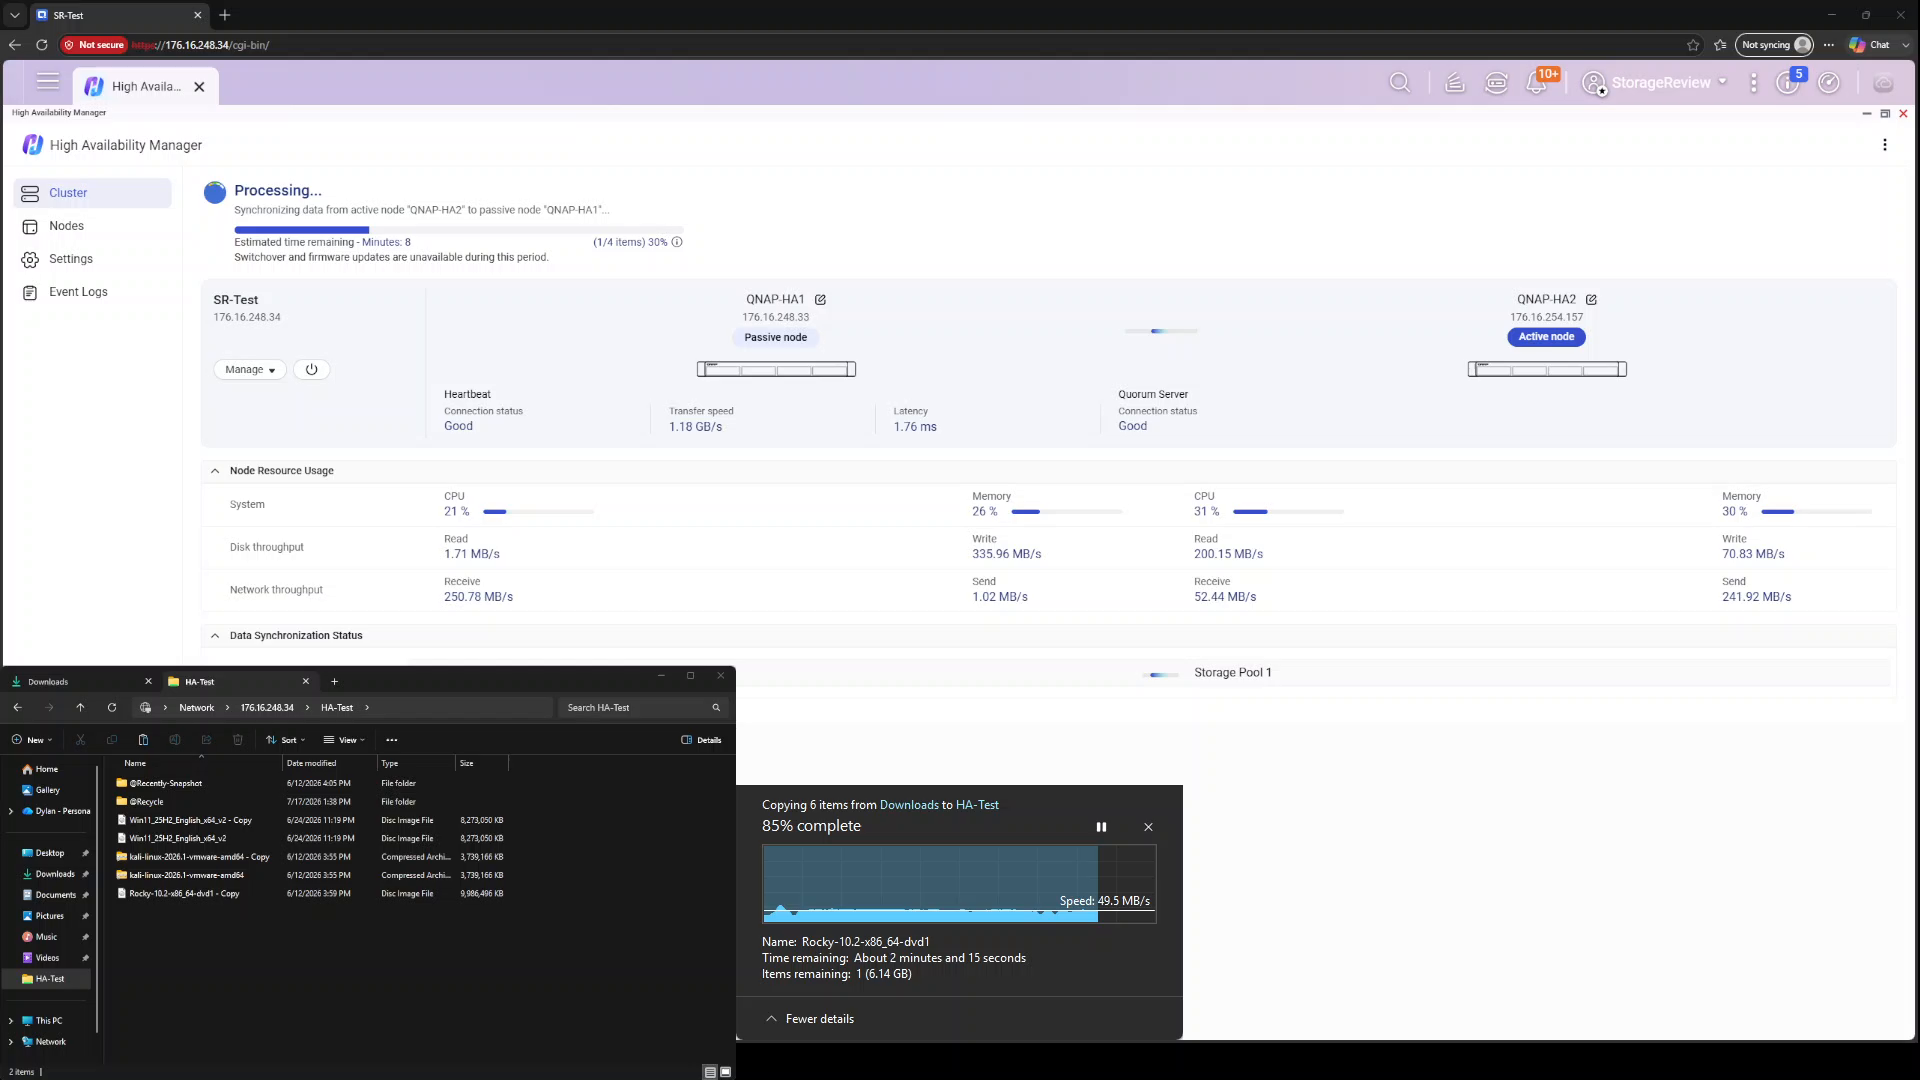
Przywrócenie zasilania serwera QNAP-HA1 automatycznie uruchomiło proces odwrotny. Węzeł uruchomił się i powrócił jako pasywny element około dziesięć minut po utracie zasilania, a Menedżer HA rozpoczął synchronizację danych z aktywnego węzła QNAP-HA2 z powrotem do QNAP-HA1, ponownie z postępem i szacunkowym czasem widocznym na pulpicie, podczas gdy kopiowanie plików przebiegało bez zakłóceń. Powrót awaryjny nie wymagał interwencji: po zakończeniu resynchronizacji klaster wstrzymał transfer na około 35 sekund, przywracając aktywną rolę do serwera QNAP-HA1, a następnie pozwolił na dokończenie kopiowania. Pod koniec synchronizacji klaster odzyskał status „Good” z transferem na poziomie 100%, przetrwawszy awarię zasilania, okres pojedynczego węzła, przywracanie węzła i powrót awaryjny w ramach jednego zadania kopiowania.
Test awaryjny 2: utrata sieci przy zachowanym sygnale Heartbeat
Drugi scenariusz jest subtelniejszy i prawdopodobnie częściej spotykany w świecie rzeczywistym: aktywny węzeł traci połączenie sieciowe skierowane do klienta (awaria portu przełącznika, zerwany kabel lub uszkodzony transceiver), podczas gdy sam węzeł nadal działa, a łącze Heartbeat pozostaje aktywne. W takim przypadku ochrona przed rozszczepieniem mózgu ma kluczowe znaczenie, ponieważ oba węzły są aktywne i mogą się wzajemnie widzieć, a klaster musi zdecydować, który węzeł powinien posiadać adres IP klastra.
Powtórzyliśmy tę samą kopię pliku Windows dla adresu IP klastra i rozłączyliśmy interfejs sieciowy klastra na aktywnym węźle. Transfer został wstrzymany na około 45 sekund, podczas gdy klaster przenosił usługi na drugi węzeł, a następnie wznowiony bez problemów. Menedżer HA precyzyjnie oznaczył błąd, ostrzegając, że interfejs sieciowy klastra Adapter 2 na węźle został odłączony i sugerując sprawdzenie połączenia z przełącznikiem, a następnie poszedł o krok dalej, zauważając, że odłączony węzeł nie może już połączyć się z serwerem kworum za pośrednictwem tego interfejsu. Ta specyfikacja, określająca dokładny interfejs, węzeł i konsekwencję, jest bardziej diagnostyczna niż ogólna flaga degradacji, na którą decydują się niektóre implementacje HA.
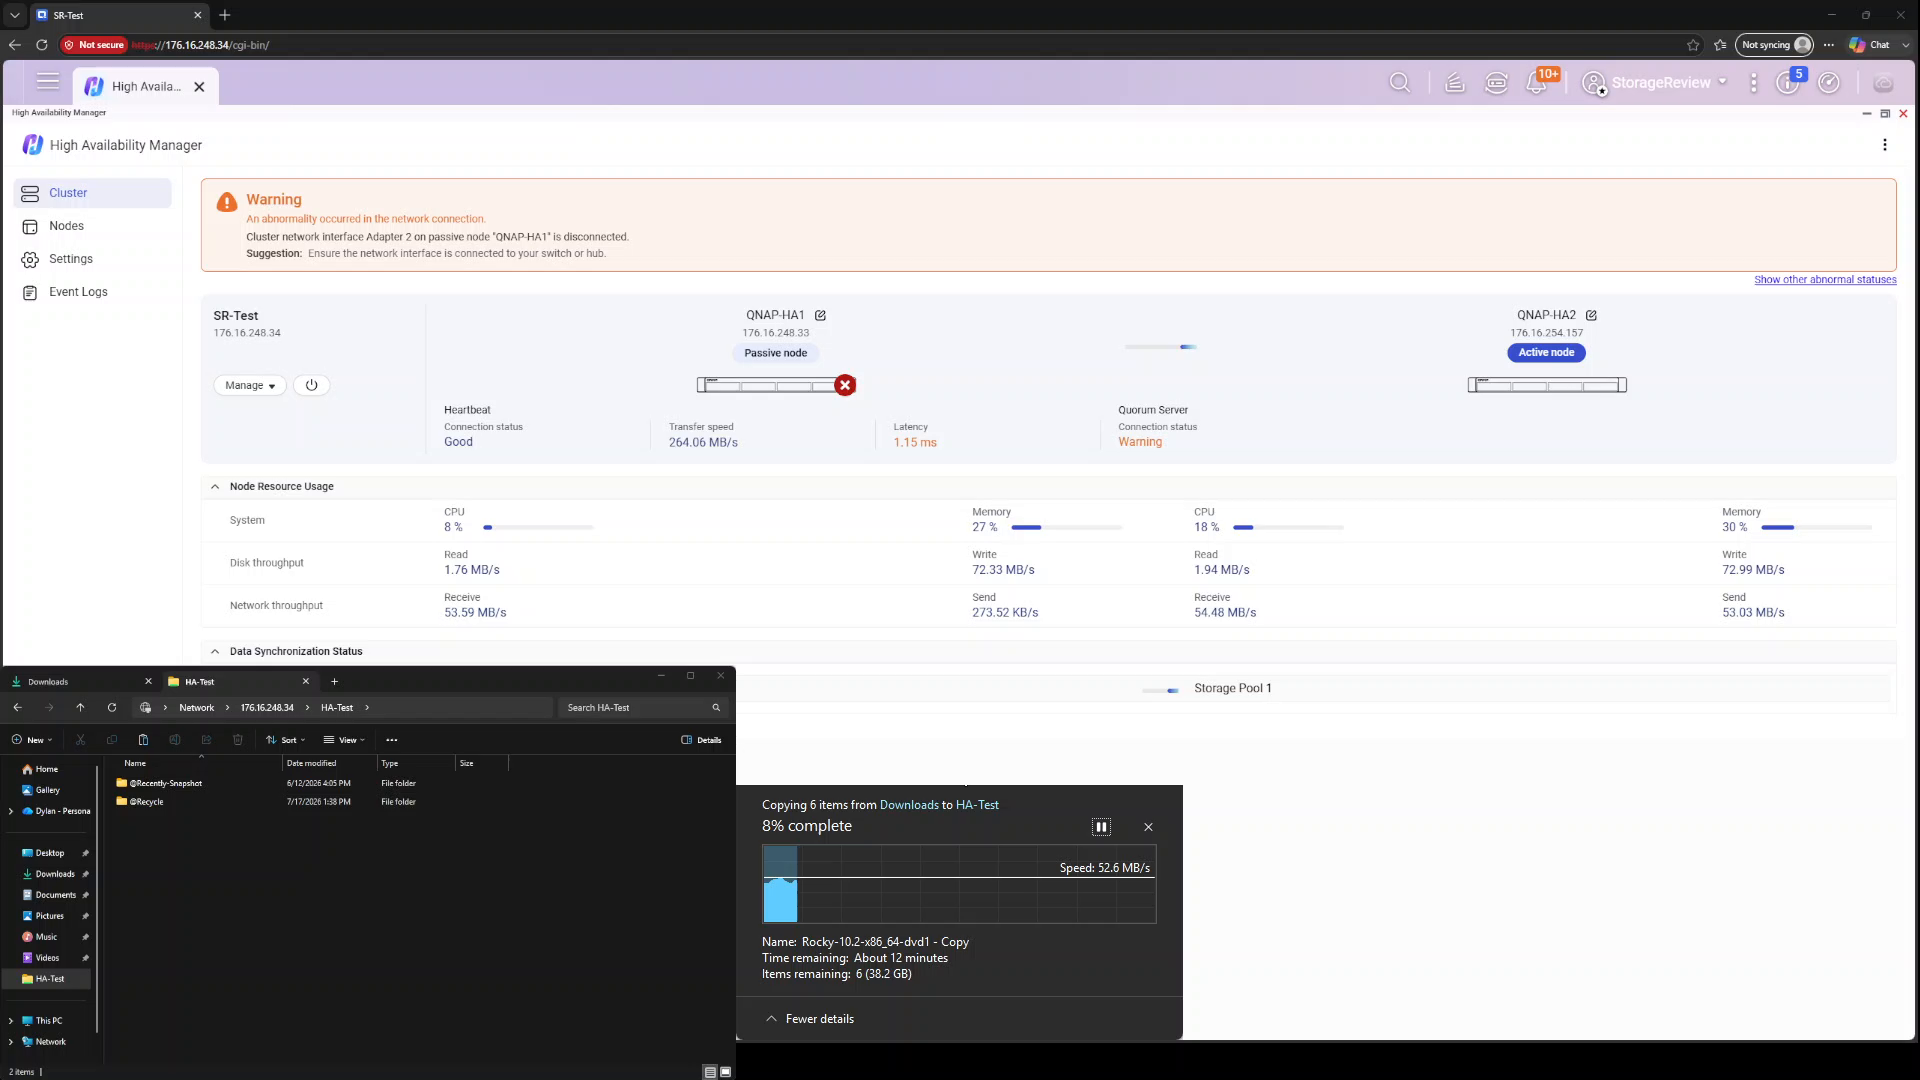
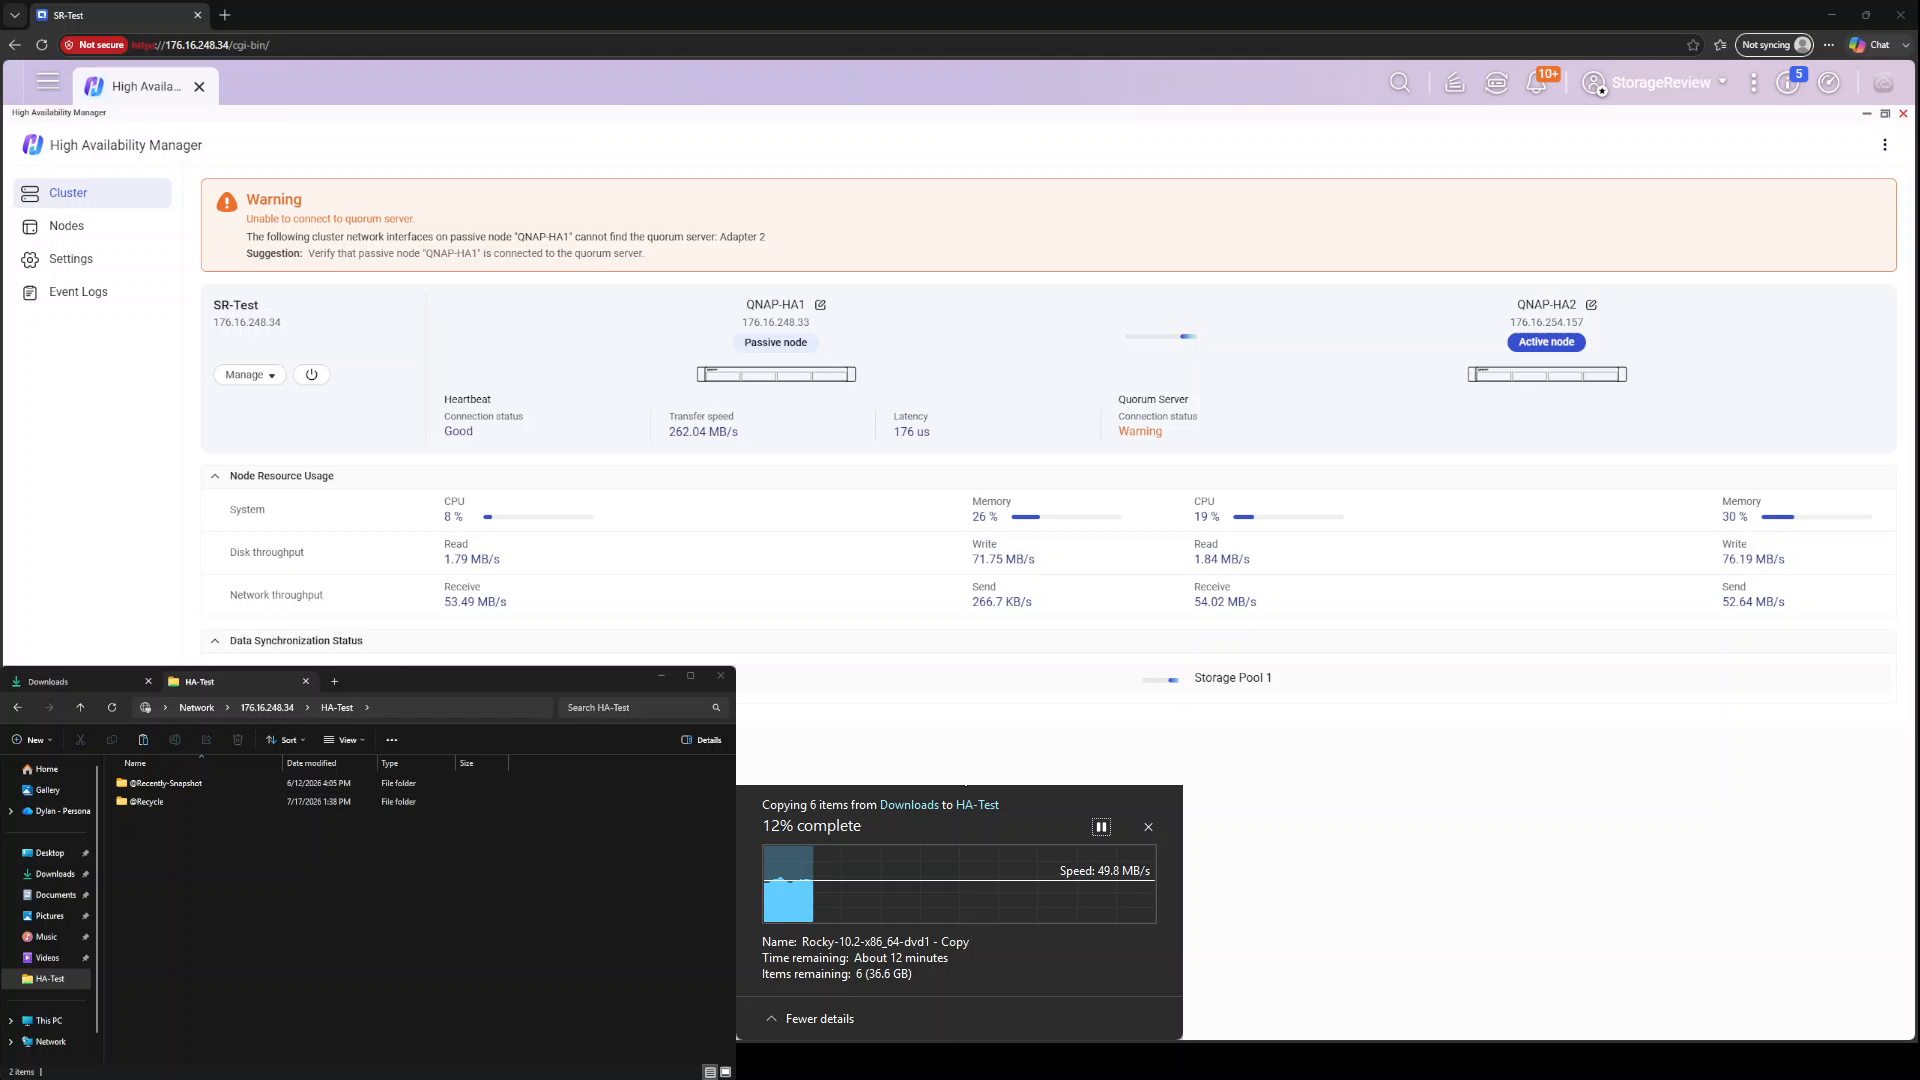
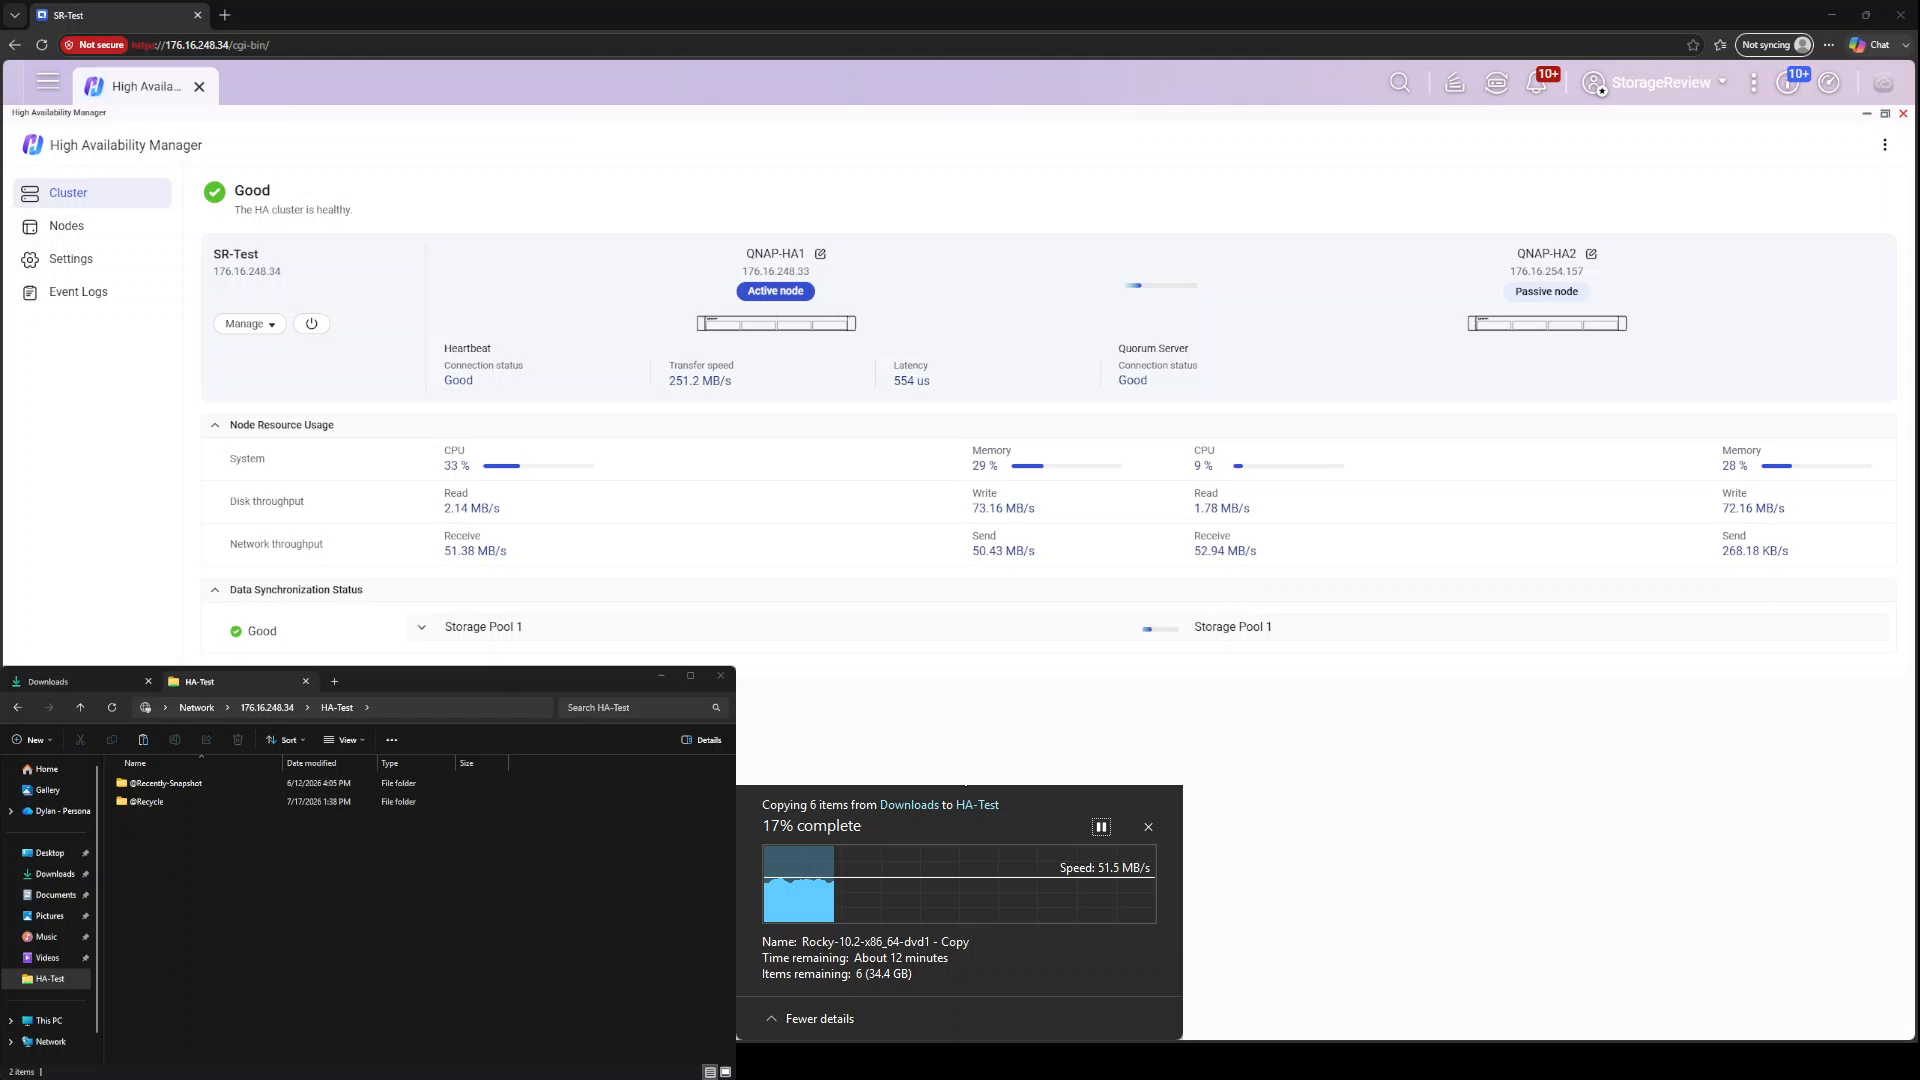
Ponowne podłączenie sieci przywróciło węzeł do klastra, a powrót do pracy po awarii nastąpił samoistnie w ciągu minuty: druga, około 30-sekundowa przerwa, podczas której aktywna rola powróciła do QNAP-HA1, była jedynym widocznym dla klienta dowodem na to, że cokolwiek się wydarzyło. To samo zadanie kopiowania przetrwało dwa przełączenia z rzędu bez ani jednego błędu pliku. Dla każdego, kto widział, jak sesja SMB zgasła z powodu znacznie mniejszej liczby błędów, jest to główny rezultat całego tego eksperymentu.
Właściwe wdrażanie HA: rozdwojony mózg i topologia sieci
Testy awaryjne, takie jak nasze, dowodzą, że klaster działa, ale to, jak dobrze para HA sprawdza się w środowisku produkcyjnym, zależy w równym stopniu od otaczającej sieci, co od samych jednostek NAS. Scenariusze, dla których zaprojektowano HA Manager (awaria węzła, niedziałający port przełącznika, zerwane łącze uplink), opierają się na jednym założeniu: co najmniej jedna ścieżka komunikacyjna między dwoma węzłami przetrwa awarię. Ochrona tego założenia jest najważniejszą decyzją we wdrożeniu HA, ponieważ alternatywą jest sytuacja, której każda architektura wysokiej dostępności powinna unikać: rozdwojenie jaźni.
Firma QNAP dokumentuje ten scenariusz. Problem z rozszczepieniem występuje, gdy oba węzły tracą ze sobą łączność, ale pozostają niezależnie sprawne, przyjmując rolę aktywną. Dwa węzły, z których każdy uważa się za właściciela klastra i akceptuje zapisy, są pretekstem do niespójności danych lub uszkodzenia pamięci masowej, ponieważ każdy z nich może próbować jednocześnie kontrolować współdzielone zasoby. Udokumentowane przyczyny są dokładnie takie, jakich można się spodziewać: rozłączenia sieci między węzłami, awarie pulsu i niestabilne ścieżki sieciowe. Zwróć uwagę na wspólne cechy tych problemów. Problem z rozszczepieniem nie jest aktywowany przez awarię pojedynczego węzła; jest aktywowany, gdy wszystkie ścieżki między dwoma sprawnymi węzłami ulegną jednoczesnej awarii. Jest to problem topologiczny i istnieje jego topologiczne rozwiązanie.
Zasady wdrażania są zgodne z oczekiwaniami:
Przeprowadź sygnał heartbeat jako bezpośredni kabel między dwoma węzłami. QNAP wymaga bezpośredniego łącza dla sygnału heartbeat i właśnie dlatego. Bez przełącznika, transceivera i współdzielonej infrastruktury na ścieżce, jedynym elementem, który może przerwać sygnał heartbeat, jest sam węzeł, a właśnie dla tego zdarzenia zaprojektowano funkcję przełączania awaryjnego. W przypadku instalacji w tej samej szafie, gdzie te jednostki TS-h765eU o małej głębokości prawdopodobnie będą umieszczone obok siebie, nie ma powodu, aby robić cokolwiek innego.
Jeśli węzły są oddzielone, należy utrzymywać ruch heartbeat i kliencki na fizycznie niezależnych ścieżkach. Tam, gdzie bezpośredni kabel jest niepraktyczny, należy kierować heartbeat przez przełączniki inne niż te używane do połączenia klastra. W momencie, gdy oba połączenia przechodzą przez ten sam przełącznik, staje się on pojedynczym punktem awarii, zdolnym do jednoczesnego odcięcia wszystkich ścieżek między węzłami, zmieniając zwykłą awarię przełącznika w potencjalny przypadek rozdwojenia jaźni. Cały sens zakupu dwóch jednostek NAS przepada, jeśli jeden element współdzielonej infrastruktury może je od siebie odizolować. Taka jest logika leżąca u podstaw naszej metodologii testowania przełączania awaryjnego sieci: odłączenie przewodu skierowanego do klienta, podczas gdy heartbeat pozostaje podłączony, symuluje awarię przełącznika lub okablowania, jakiej faktycznie doświadczyłaby prawidłowo oddzielona topologia, a heartbeat jest aktywny, aby móc bezproblemowo rozstrzygnąć przejęcie.
Włącz serwer kworum. Trzecim zabezpieczeniem QNAP jest świadek w sieci, skonfigurowany w obszarze High Availability Manager > Ustawienia > Zasady przełączania awaryjnego > Serwer kworum. Jeśli węzły utracą bezpośrednie połączenie, ale nadal będą miały dostęp do sieci, serwer kworum będzie kontynuował monitorowanie obu węzłów i przekazywał ich status, dając każdemu węzłowi niezależny punkt rozstrzygający remis przed jego awansem. Status połączenia serwera kworum jest stale wyświetlany na pulpicie nawigacyjnym HA Manager wraz z sygnałem pulsu, dzięki czemu jego stan jest widoczny na pierwszy rzut oka.
Gdyby jednak doszło do najgorszego, QuTS Hero radzi sobie z rozszczepieniem mózgu w sposób defensywny. Po przywróceniu łączności i ponownym nawiązaniu komunikacji przez węzły, wymieniają się informacjami o statusie, rozpoznają, że oba węzły pełniły rolę aktywną i celowo zatrzymują większość usług, w tym SMB i iSCSI, aby uniknąć scalenia dwóch rozbieżnych zestawów danych. Menedżer HA wyświetla następnie kreator odzyskiwania po rozszczepieniu mózgu z dwiema ścieżkami. Opcja pierwsza zachowuje dane na jednym wybranym węźle; drugi węzeł jest czyszczony, resetowany jako pasywny element i resynchronizowany – to najszybsza droga, gdy wiadomo, po której stronie znajdują się poprawne dane. Opcja druga zachowuje dane na obu węzłach, wznawiając usługi na jednym węźle, a jednocześnie całkowicie usuwając drugi z klastra, co pozwala na weryfikację i uzgodnienie danych przed ręcznym ponownym połączeniem. Jest to rozsądny model odzyskiwania, ale odzyskiwanie nadal oznacza przestoje i pełną resynchronizację. Rozszczepienie mózgu to stan, któremu zapobiega się poprzez projekt wdrożenia, a nie taki, po którym planuje się odzyskiwanie, a trzy powyższe reguły nie kosztują nic poza kablem i pięcioma minutami spędzonymi w panelu ustawień.
Monitorowanie i zarządzanie
Operacje drugiego dnia są już dostępne w aplikacji HA Manager, która konsoliduje stan klastra, wykorzystanie zasobów dla poszczególnych węzłów, dzienniki zdarzeń i zarządzanie węzłami, w tym ręczne przełączanie, w jednym panelu. Banery ostrzegawcze na pulpicie okazały się wystarczająco szczegółowe, aby służyć do celów diagnostycznych podczas naszych testów, wskazując konkretny interfejs i węzeł, który uległ awarii, zamiast ogólnej flagi degradacji.
QNAP wdrożył również świadomość HA w samym sprzęcie. W klastrze HA, panel LCD na każdym serwerze NAS może wyświetlać nazwę klastra, bieżącą rolę węzła oraz adres IP klastra, a dioda LED stanu sygnalizuje stan HA na pierwszy rzut oka: ciągłe zielone światło dla węzła aktywnego, migające zielone dla węzła pasywnego i ciągłe czerwone dla błędu HA. W szafie pełnej identycznych jednostek o małej głębokości, możliwość identyfikacji aktywnego węzła bez otwierania przeglądarki to drobna zaleta, którą docenią technicy. W przypadku wdrożeń flotowych, AMIZcloud dodaje scentralizowane monitorowanie w chmurze grup HA, wyświetlając stan klastra, opóźnienia i alerty w różnych lokalizacjach.
Uwagi końcowe
Menedżer wysokiej dostępności spełnił swoje podstawowe obietnice w obu trybach awarii, w których go testowaliśmy. Twarda utrata zasilania na aktywnym węźle kosztowała nas około 50 sekund wstrzymanego procesu kopiowania plików Windows i zero błędów; zerwane połączenie sieciowe klienta kosztowało około 45 sekund. W każdym przypadku to samo zadanie kopiowania przeszło przez proces przywracania węzła i automatycznego powrotu po awarii, z zaledwie drugą, trwającą mniej niż minutę przerwą. Klienci nigdy nie musieli niczego ponownie wskazywać. Aplikacje, udziały plików i przepływy pracy użytkowników nadal działały za pośrednictwem jednego adresu IP i nazwy hosta przed, w trakcie i po przełączeniu awaryjnym. Konfiguracja jest również łatwa; dwie niezależne jednostki stały się klastrem usług w mniej niż dziesięć minut pracy kreatora plus dziesięciominutowa synchronizacja początkowa, a pulpit nawigacyjny podpowiadał nam dokładnie, o który interfejs, węzeł i połączenie powinniśmy się martwić za każdym razem, gdy coś się zepsuło.
Pełny stos HA: dwie jednostki TS-h765eU i wypełniające je dyski IronWolf Pro.
Nie należy jednak ignorować kosztów HA. Kupujesz dwie sztuki wszystkiego, a pasywny węzeł pozostaje bezczynny do dnia, w którym przestanie. Niezmienne migawki, czyli druga podstawowa ochrona h6.0, są dziś niedostępne w klastrze HA, więc administratorzy muszą wybierać między nimi. Wymóg identycznego sprzętu oznacza, że aktualizacje odbywają się parami, co może ograniczać budżet.
W tym przypadku kluczowa jest kwestia odpowiedniego doboru rozmiaru, a HA Manager najlepiej sprawdza się w przypadku małych firm i wdrożeń brzegowych. W przypadku macierzy korporacyjnych z dwoma kontrolerami, para jednostek TS-h765eU o małej głębokości to zupełnie inna gra finansowa, ponieważ pokrywa ona scenariusz awarii, czyli utratę kontrolera, który jest głównym powodem zakupu podwójnych kontrolerów w segmencie MŚP. W przypadku schematów replikacji DIY, przesyłania migawek, zadań rsync oraz tworzenia kopii zapasowych i przywracania danych, różnica tkwi w czasie odzyskiwania: te schematy chronią dane, ale wymagają odbudowy połączeń klienckich przez wiele godzin, podczas gdy najgorszym zdarzeniem widocznym dla klienta w naszych testach w HA Manager była minutowa przerwa. Co równie ważne, awarii, której HA Manager nie jest w stanie zaabsorbować, czyli jednoczesnego zerwania wszystkich ścieżek międzywęzłowych, można zapobiec dzięki bezpośredniemu kablowi z sygnałem pulsu, oddzielnym ścieżkom sieciowym i włączonemu serwerowi kworum: rachunek za topologię wynosi łącznie jeden kabel i pięć minut w panelu ustawień.
Ostatnia kwestia dotycząca konstrukcji dwuwęzłowej: najbardziej podatnym na ataki oknem klastra jest resynchronizacja, gdy jeden węzeł przechowuje jedyną dobrą kopię danych, a dyski znajdujące się pod nim pracują najciężej. To argument za poważnym wyborem dysków w konfiguracji HA i dlatego dyski NAS, takie jak Seagate IronWolf Pro 30 TB w naszym systemie, mają tutaj większe znaczenie niż w przypadku samodzielnego urządzenia: ich zadaniem jest utrzymanie tego okna bez zakłóceń.
QNAP TS-h765eU i QuTS hero h6.0 są już dostępne. Więcej informacji można znaleźć na stronie produktu QNAP TS-h765eU.
Niniejszy raport jest sponsorowany przez firmę QNAP. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej opinii na temat rozpatrywanego produktu/produktów.


 Amazon