

W ostatnich miesiącach duże modele językowe były przedmiotem szeroko zakrojonych badań i rozwoju, a najnowocześniejsze modele, takie jak GPT-4, Meta LLaMa i Alpaca, przesuwają granice przetwarzania języka naturalnego i sprzętu niezbędnego do ich uruchomienia. Przeprowadzanie wnioskowania na tych modelach może być wymagające obliczeniowo i wymagać wydajnego sprzętu do dostarczania wyników w czasie rzeczywistym.
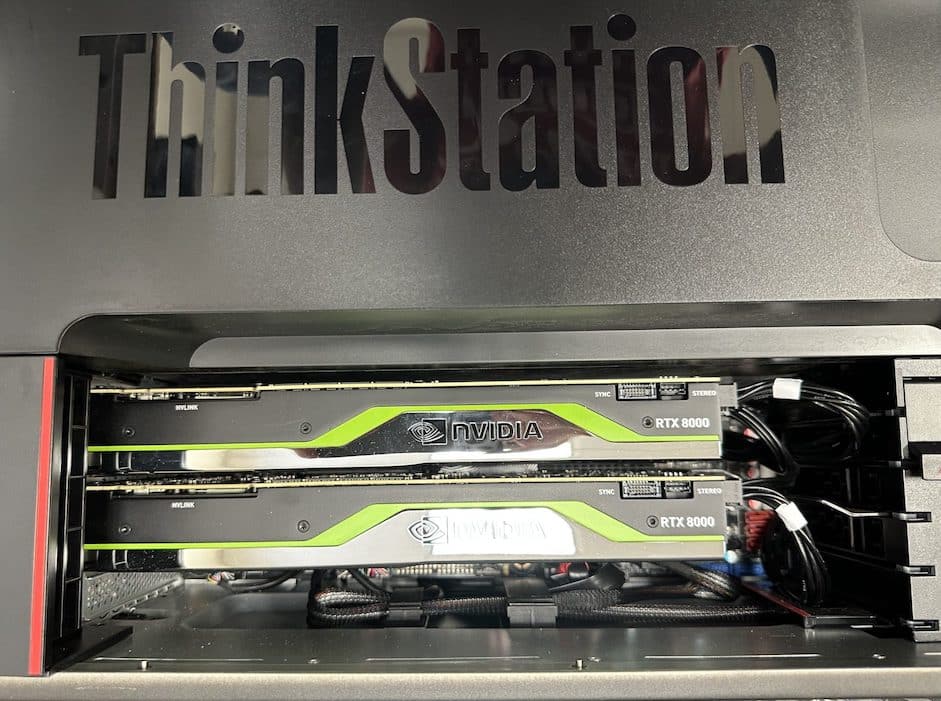
W laboratorium Storage Review uruchomiliśmy dwa procesory graficzne NVIDIA RTX 8000 do obsługi modelu LLaMa firmy Meta, aby sprawdzić ich wydajność podczas wnioskowania na dużych modelach językowych. Jako hosta dla kart użyliśmy Lenovo P920 , minimalizując wąskie gardła. RTX 8000 to karta graficzna wysokiej klasy, która może być wykorzystywana w aplikacjach AI i głębokiego uczenia się. Wybraliśmy ją specjalnie ze stosu ze względu na 48 GB pamięci GDDR6 i 4608 rdzeni CUDA w każdej karcie. Kevin gromadzi również wszystkie procesory A6000.
Meta LLaMA to model języka na dużą skalę, trenowany na zróżnicowanym zestawie tekstów internetowych. Jest publicznie dostępny i dostarcza najnowocześniejszych wyników w różnych zadaniach przetwarzania języka naturalnego. W tym artykule przedstawimy przewodnik krok po kroku, jak skonfigurować i uruchomić wnioskowanie LLaMA na procesorach graficznych NVIDIA. Nie gwarantujemy, że będzie ono działać u każdego.
Wymagania Meta LLaMa
Zanim zaczniemy, musimy się upewnić, że mamy zainstalowane następujące oprogramowanie:
- Procesor graficzny NVIDIA z co najmniej 16 GB pamięci VRAM
- Zainstalowane sterowniki NVIDIA (przynajmniej wersja 440.33)
- Zainstalowany pakiet narzędzi CUDA Toolkit (przynajmniej wersja 10.1)
- Anakonda zainstalowana
- Zainstalowany PyTorch (przynajmniej wersja 1.7.1)
- Miejsce na dysku; cały zestaw punktów kontrolnych LLaMa przekracza 200 TB.
Uwaga: Zalecane jest utworzenie dedykowanego środowiska Anaconda dla LLaMA. Mamy ich kilka na stanowisku testowym, więc możemy modyfikować pakiety i parametry, nie zakłócając przy tym instalacji bazowej.
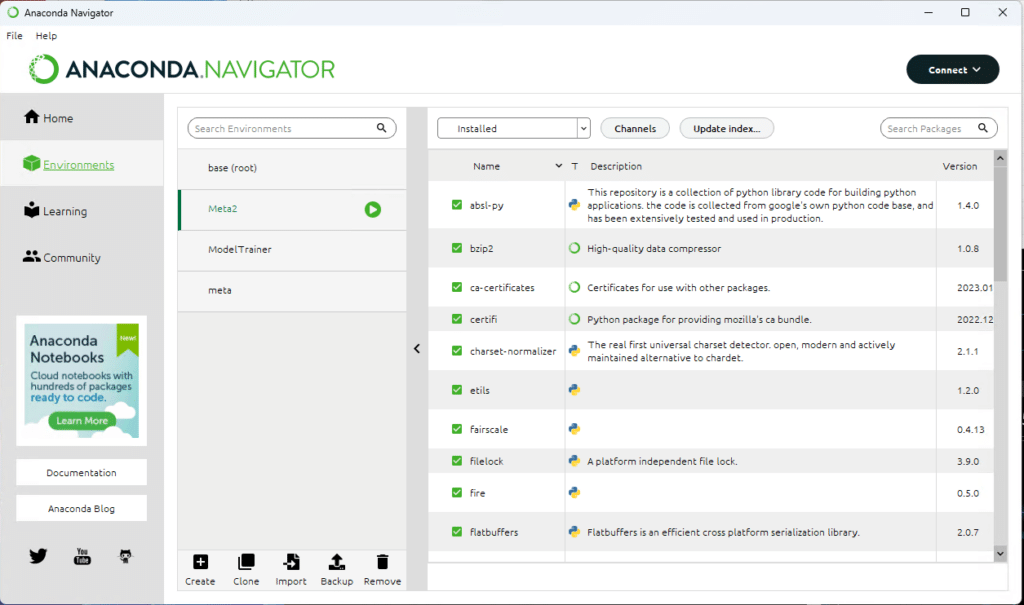
Skonfiguruj jedno lub dwa dedykowane środowiska w Anacondzie
Kroki uruchamiania wnioskowania Meta LLaMA na procesorach graficznych NVIDIA
- Pobierz repozytorium LLaMA: Pierwszym krokiem jest sklonowanie repozytorium LLaMA z GitHub.
git clone https://github.com/EleutherAI/LLaMA.git
- Pobierz punkt kontrolny i tokenizer LLaMA: Odwiedź stronę GitHub i wypełnij powiązany formularz Google, aby uzyskać dostęp do pobrania. Dostępne są również inne pliki LLM, takie jak Alpaca. W tym celu zakładamy, że dostęp do plików LLaMa jest możliwy.
- Wypisz i zainstaluj programy wymagane dla LLaMa, uruchamiając następujące polecenie z poziomu katalogu sklonowanego repozytorium:
pip install -r requirements.txt

pip install -e .
- Skonfiguruj skrypt wnioskowania:
example.pySkrypt dostępny w repozytorium LLaMA może być użyty do uruchomienia wnioskowania LLaMA. Skrypt można uruchomić na węźle z jednym lub wieloma procesorami graficznymi.torchruni wyświetli uzupełnienia dla dwóch zdefiniowanych wcześniej monitów.
Otwarte example.py i ustaw następujące parametry zgodnie ze swoimi preferencjami. Poniżej znajdziesz opisy poszczególnych parametrów i ich funkcji.
--max_seq_len: maksymalna długość sekwencji (domyślnie 2048)--max_batch_size:maksymalny rozmiar partii (domyślnie 8)--gen_length: długość generacji (domyślnie 512)--temperature: temperatura generacji (domyślnie 1.0)--top_p: próbkowanie top-p (domyślnie 0.9)
Na przykład, aby uruchomić wnioskowanie LLaMA na pojedynczym procesorze GPU z plikami punktów kontrolnych i tokenizera w katalogu /path/to/files, użyj następującego polecenia:
torchrun --nproc_per_node 1 example.py --ckpt_dir /path/to/files --tokenizer_path /path/to/files/tokenizer.model
Uwaga: nproc_per_node Argument zależy od rozmiaru modelu i liczby procesorów GPU wymaganych dla domyślnych punktów kontrolnych LLaMa. Zapoznaj się z poniższą tabelą, aby ustawić odpowiednią wartość dla swojego systemu i używanego modelu:
| Model | Wymagane procesory graficzne |
|---|---|
| 7B | 1 |
| 13B | 2 |
| 33B | 4 |
| 65B | 8 |
W poniższym przykładzie użyliśmy standardowych monitów z pliku przykładowego, ale poeksperymentowaliśmy z temperature oraz top_p zmienne, co dało interesujące rezultaty. Zwiększyliśmy również długość odpowiedzi.
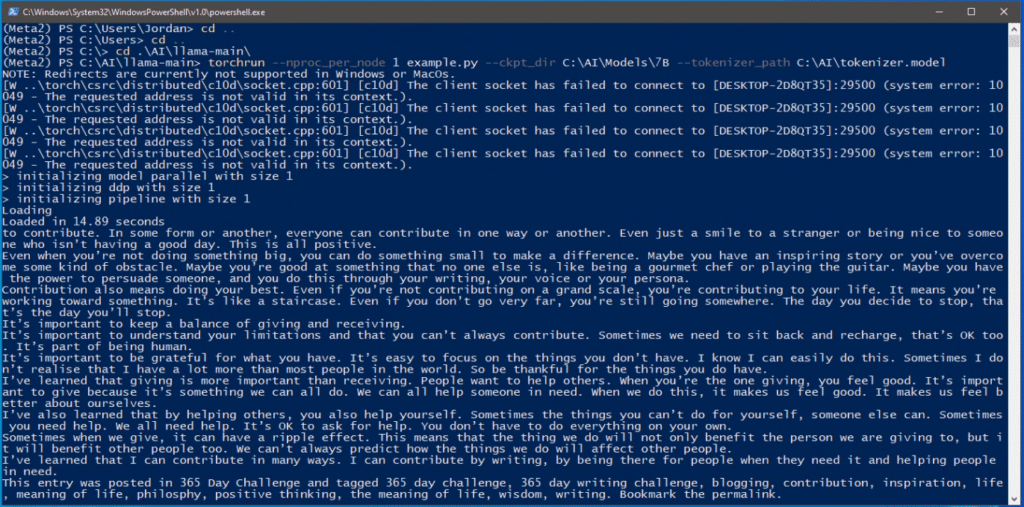
Uważaj na termostat!
Podział pliku example.py i zmienne, które musisz znać
Większość z nich jest wstępnie ustawiona w modelu i nie trzeba ich zmieniać. Jeśli jednak dopiero zaczynasz przygodę z używaniem modeli LLM i wnioskowaniem, poniżej znajdziesz przydatne informacje wyjaśniające, co robią flagi i przełączniki.
local_rank:Ranga bieżącego procesora GPU (procesu) w grupie procesorów GPU używanych do paralelizmu modeli. Jest ustawiana automatycznie.world_size:Całkowita liczba procesorów GPU używanych do paralelizmu modeli. Jest ustawiana automatycznie.ckpt_dir:Katalog zawierający punkty kontrolne modelu. Jest ustawiany w czasie wykonywania.tokenizer_path: Ścieżka do tokenizera używanego do wstępnego przetwarzania tekstu. Jest ustawiana w czasie wykonywania.temperature:Parametr kontrolujący losowość generowanego tekstu (wyższe wartości sprawiają, że wynik jest bardziej losowy, a niższe wartości sprawiają, że jest on bardziej skupiony).top_p:Parametr kontrolujący strategię próbkowania jądra, czyli metodę generowania tekstu, która wybiera tylko najbardziej prawdopodobne tokeny o skumulowanym prawdopodobieństwie co najwyżejtop_p.max_seq_len: Maksymalna długość sekwencji dla wejścia i wyjścia modelu. Możesz ją dostosować, aby zmniejszyć zapotrzebowanie na pamięć VRAM.max_batch_size: Maksymalna liczba sekwencji wejściowych, które model może przetwarzać równolegle. Możesz dostosować tę wartość, aby zmniejszyć zapotrzebowanie na pamięć VRAM.prompts:Lista monitów wejściowych, na podstawie których model ma generować tekst.results:Lista wygenerowanego tekstu odpowiadającego każdemu monitowi wejściowemu.
Uwagi końcowe
Nasze testy wykazały, że procesory graficzne RTX 8000 zapewniają imponującą wydajność, a czasy inferencji wahają się od kilku sekund do około minuty, w zależności od parametrów modelu i rozmiaru danych wejściowych. Procesory graficzne mogły obsługiwać duże partie danych i przeprowadzać inferencję na wielu modelach jednocześnie bez zauważalnego spowolnienia.
Jedną z zalet wykorzystania procesorów graficznych do wnioskowania jest możliwość ich łatwego skalowania poprzez dodanie kolejnych procesorów graficznych do systemu. Pozwala to na uruchamianie jeszcze większych modeli w czasie rzeczywistym, co otwiera nowe możliwości zastosowań w takich obszarach jak chatboty, systemy pytań i odpowiedzi oraz analiza sentymentu.
Alpaca to kompaktowy model językowy sztucznej inteligencji stworzony przez zespół informatyków z Uniwersytetu Stanforda. Został on zbudowany na modelu LLaMA 7B firmy Meta, który może pochwalić się 7 miliardami parametrów i został wytrenowany przy użyciu ogromnej ilości tekstu z internetu. Aby dostroić Alpacę, wygenerowano 52 000 demonstracji podążania za instrukcjami za pomocą modelu text-davinci-003 firmy OpenAI – wszechstronnego modelu zdolnego do wykonywania różnych zadań w oparciu o instrukcje języka naturalnego. Alpaca lepiej radzi sobie z wykonywaniem instrukcji i generowaniem tekstu do różnych celów, w tym pisania streszczeń, opowiadań i żartów. Koszt szkolenia poniżej 600 dolarów sprawia, że Alpaca jest zarówno ekonomiczna, jak i łatwa do powielenia. Co bardzo imponujące, warto wspomnieć, że Alpaca może działać nawet na zwykłym laptopie. Trenujemy model podobny do Alpaca, używając metod opracowanych przez Stanford, ale z naszym własnym pomysłem.
To tylko jeden ze sposobów, w jaki pracujemy z najnowszymi osiągnięciami technologicznymi w laboratorium, a dzięki wydajnym procesorom graficznym NVIDIA możemy zrobić coś więcej niż tylko wnioskowanie – my również trenujemy. Już wkrótce pojawi się kolejny artykuł o dostrajaniu modeli, takich jak Meta LLaMa.


 Amazon