

Dell har kvalificerat KIOXIAs 245.76 TB NVMe SSD-diskar för programvarudefinierad ObjectScale, vilket ger 9.83 PB rå flashminne i en enda 2U-server. Densitetsmilstolpen kommer utöver det datasökvägsarbete som Dell redogjorde för tidigare i år för ObjectScale 4.2 och 4.3, vilket syftar till AI-träning med hög genomströmning, effektivitet i pipelines för små objekt och inferensacceleration genom nativ S3 över RDMA, Key-Value (KV) Cache-avlastning för LLM:er , en omarbetad chunk-store-motor och direkt stöd för Apache Iceberg via S3-tabeller.
Densitetsmilstolpe: 9.83 PB i ett 2U-format via 245 TB KIOXIA SSD-diskar
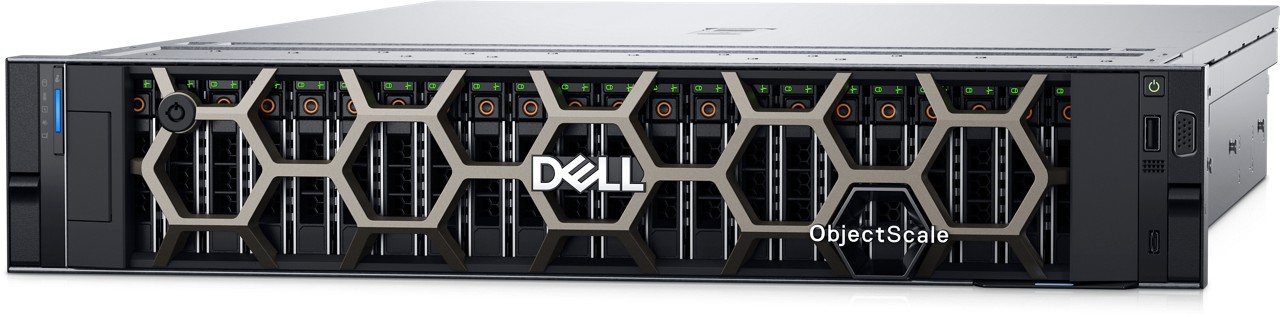
I takt med att företags AI-datasjöar expanderar över modellträning, finjustering och efterlevnadsnivåer har rackdensitet, hantering av termiskt hölje och begränsningar av golvyta blivit primära designvariabler. För att hantera råkapacitet per rackenhet har Dell kvalificerat KIOXIAs 245.76 TB NVMe SSD-diskar för programvarudefinierad ObjectScale som körs på Dell PowerEdge R7725- servrar.
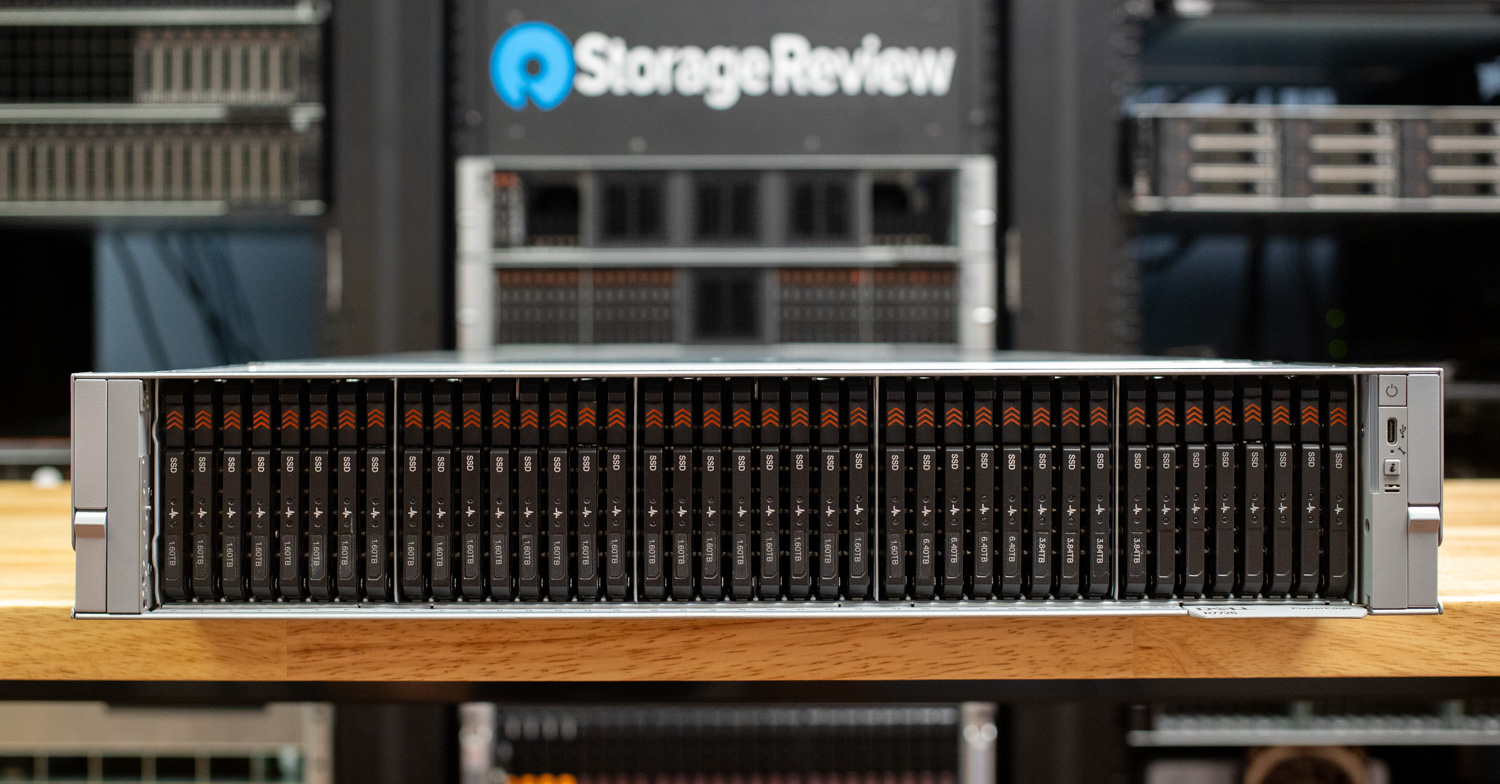
Genom att placera 40 av de 245.76 TB stora hårddiskarna i ett enda 2U-chassi når ObjectScale 9.83 PB rå all-flash-kapacitet; vi granskade plattformen förra sommaren. Denna densitet riktar sig direkt mot företags AI-fabriker, vektordatabaser, stora analysdatabaser och cybermotståndskraftiga plattformar som kräver ostrukturerad lagringsyta på flera petabyte samtidigt som strömförbrukning, kylbelastning och kabelkomplexitet minimeras. För uppmätta siffror om vad 245 TB flash gör för strömförsörjning och rackkapacitet jämfört med hårddiskar, se vår Micron 6600 ION-rapport.
Genomströmningsvinster och arkitektur för små objekt
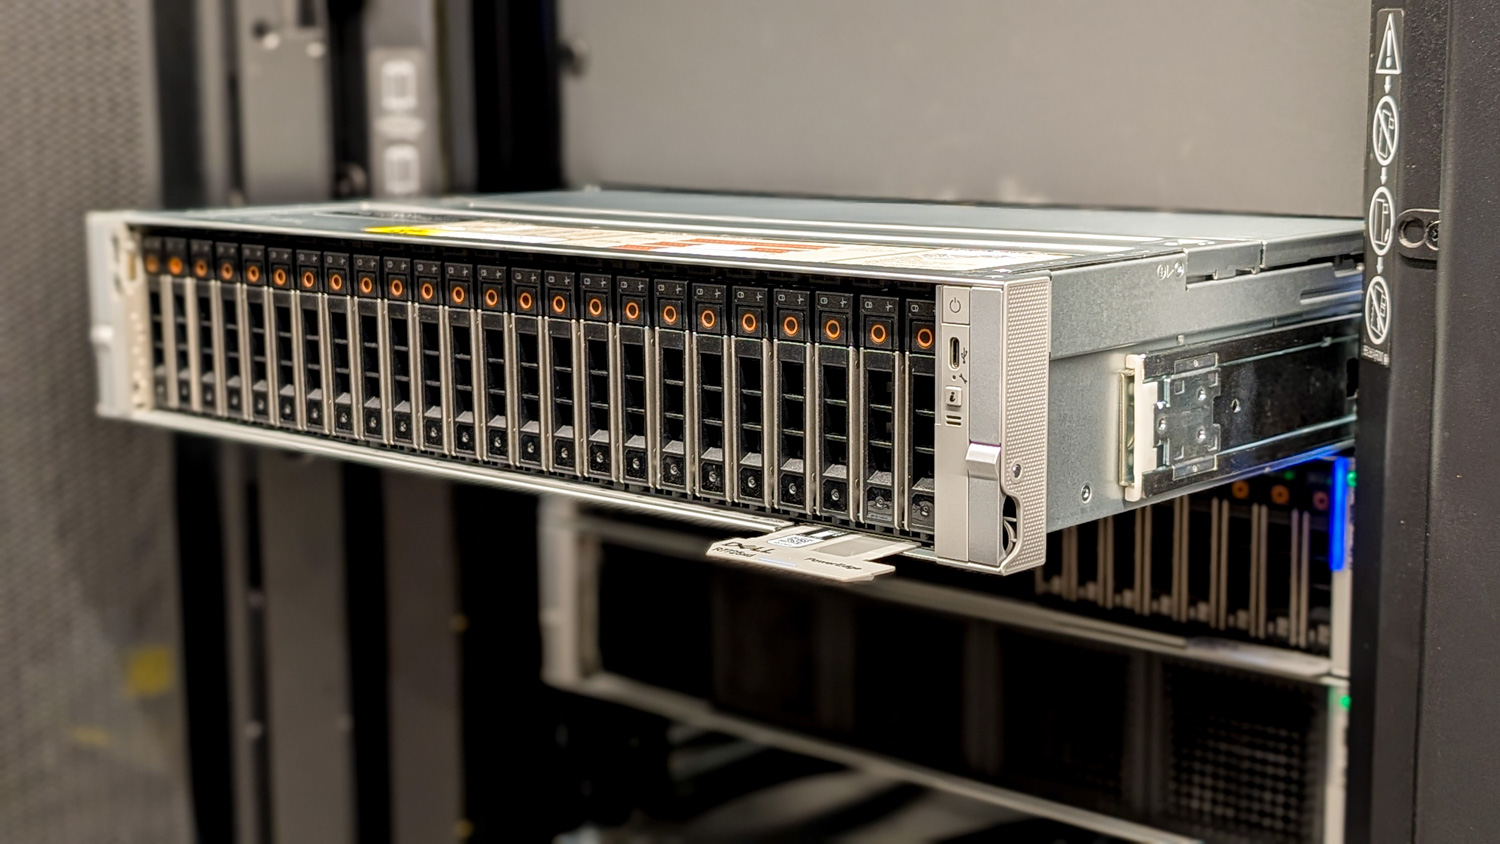
I programvarudefinierade distributioner på kvalificerade Dell PowerEdge-servrar indikerar Dells interna tester en läshastighet per nod på upp till 40 GB/s, en 8-faldig ökning jämfört med föregående generations all-flash objektplattformar. Dell pekar också på en brittisk högfrekvent handelskund som klarar ungefär 280 GB/s aggregerad läshastighet i produktion. Dessa siffror överensstämmer med vad vi har mätt på själva hårdvaran: i våra R7725xd-tester i november förra året klarade plattformen mer än 300 GB/s över den interna NVMe-poolen och 160 GB/s över NVMe-oF RDMA. Det arbetet karakteriserade servern direkt snarare än att köra ObjectScale ovanpå den, men det fastställer det tak som programvaran arbetar mot.
För att eliminera flaskhalsar i metadata som är vanliga i pipelines som hanterar miljontals små funktionsuppsättningar, vektorblock och telemetriloggar, använder ObjectScale en optimerad chunk-store-motor. Arkitekturen aggregerar små nyttolaster till enhetliga 128 MB-block innan raderingskodning tillämpas över noder. För typiska 10 KB-filer får mer än 10 000 objekt plats i en enda block, vilket avsevärt minskar metadata-overhead.
Denna chunking-metod omstrukturerar även återuppbyggnader av hårddiskfel genom att minska det totala antalet shards som måste återskapas från miljarder till miljontals, vilket minskar återställningstiderna för täta NVMe-hårddiskar från veckor till timmar. Inline-kontrollsummor verifierade på stripe-nivå minskar värdens CPU-cykler som läggs på bakgrundsintegritetsskanningar. Dessutom ger den omkonstruerade Key-Value Store i ObjectScale 4.2 ungefär 4 gånger bättre minneseffektivitet och minskar diskutrymmet för metadata med 30 % till 60 %.
S3 över RDMA och inferensacceleration
ObjectScale 4.3 utökar S3 över RDMA över Dells all-flash-portfölj, inklusive XF960- , EXF900- och programvarudefinierade PowerEdge R7725xd-distributioner. Genom att använda RoCEv2-nätverk och Dells S3-över-RDMA SDK kringgår plattformen kärnans TCP-overhead och CPU-avbrott för att etablera direkta minnesvägar mellan värd-GPU:er och backend-NVMe-media. Interna tester visar att detta ger upp till 230 % högre dataflöde, en 80 % minskning av latensen och upp till 98 % minskning av klientens CPU-användning jämfört med standard S3 över TCP.
För inferensarkitekturer fungerar ObjectScale som en extern nivå för KV Cache-offload . Eftersom långkontextinferens snabbt uttömmer HBM och VRAM på GPU:n, tillåter integration med vLLM, LMCache och NVIDIAs NIXL-bibliotek inferensramverk att spilla aktiva uppmärksamhetstillstånd direkt till ObjectScale över RDMA-accelererad S3. Dell rapporterar upp till en 19x förbättring av Time to First Token jämfört med standard vLLM utan cache-offload, tillsammans med upp till 5.3x högre token-genomströmning och nästan 3x högre multi-turn-genomströmning. Separat citerar Dell en TTFT på ungefär 0.86 sekunder i sina egna jämförande tester mot en konkurrerande objektplattform.
Inbyggda S3-tabeller och effektiv skalbarhet
ObjectScale 4.3 innehåller även inbyggda S3-tabeller, som Dell listar som en teknisk förhandsvisning, och bäddar in Apache Icebergs öppna tabellformat direkt i lagringsbucketlagret. Frågemotorer som Trino, Starburst , Spark och Flink kan köra analyser direkt mot S3-buckets utan att kräva dedikerad staging eller ETL-dataförflyttning till separata lager. Dell rapporterar att denna arkitektur ger upp till 2 gånger snabbare inmatning och upp till 4.5 gånger snabbare frågor jämfört med traditionella lagerkonfigurationer.
Underliggande lagringseffektivitet inkluderar raderingskodningsprofiler med 24+2 och 24+4, vilket enligt Dell minskar skrivförstärkningen med upp till 75 %. På hårddiskplattformar med hög kapacitet, som EX500, rapporterar företaget upp till 25 % snabbare inmatning av stora objekt och upp till 2 gånger högre skrivprestanda för medelstora objekt. Arbetsbelastningsspecifik bucketkomprimering stöder Snappy-, LZ4-, ZSTD- och Deflate-algoritmer med telemetri för FinOps-kostnadsspårning. Provisionering och orkestrering integreras direkt med molnbaserade verktyg, inklusive Kubernetes Container Object Storage Interface (COSI) och Terraform-leverantörer.


 Amazon