

MLCommons har publicerat MLPerf Inference v6.1, och omgången sätter ett deltagarrekord med 30 inskickade organisationer och 486 datacenter- och edge-resultat. Två nya tester ansluter sig till sviten: en End-to-End RAG-pipeline för datacentret och ett Edge Agentic Inference-benchmark för enanvändarenheter, och resultaten innehåller de första expertgranskade siffrorna för NVIDIAs Vera Rubin NVL72, AMDs Instinct MI350P, Intels Arc Pro B70 och AMDs Ryzen AI Max+ 395. När det gäller förbättringstakten säger MLCommons att det bästa resultatet per accelerator för DeepSeek-R1 i serverscenariot är 5.7 gånger bättre än i v5.1 för ett år sedan, och det bästa VLM-resultatet förbättrades 2.99 gånger under de sex månaderna sedan v6.0.
Två nya tester: End-to-End RAG och Edge Agentic Inference
End-to-End RAG-riktmärket mäter en komplett pipeline för frågesvar, flera modeller och en vektordatabas som arbetar tillsammans. Referensimplementeringen kör fyra modeller tillsammans: gpt-oss-120B hanterar frågeupplösning, tillräcklighetskontroll och svarsgenerering; gpt-oss-20B betygsätter hämtade dokument; e5-base-v2 producerar inbäddningar; och ColBERTv2 rankar om passager. Korpusen består av 107 484 passager, uppdelade från 2 515 HTML-filer; frågorna är 824 multi-hop-uppgifter från Googles FRAMES-dataset; och varje uppgift kan loopa igenom upp till 5 hämtningsrundor innan pipelinen bestämmer att den har tillräckligt med bevis. Två mätvärden kommer ut: dokument per sekund för att bygga FAISS HNSW-vektordatabasen och uppgifter per sekund för att besvara frågor mot den. En Llama 3.1-8B-bedömare betygsätter de slutliga svaren mot ett noggrannhetsmål på 97 %, och bedömningen är inte tidsbegränsad.
Edge Agentic Inference-benchmarket riktar sig mot kodningsassistentmönstret som har flyttats till arbetsstationer och stationära AI-boxar. Modellen är Qwen3.6-27B med thinking off, körs som en Q4_K_M GGUF under llama.cpp i referensen, med ett 32K kontextfönster per tur. Prestandabelastningen är en inspelad uppspelning av 20 agentiska kodningsbanor hämtade från SWE-bench Verified, totalt 1 007 turar, drivna i en enda ström med en begäran igång, på samma sätt som en utvecklare på en bärbar dator kör en agent. Det rapporterade måttet är genomsnittlig latens per tur, med tid-till-första-token och tid-per-utdata-token-distributioner bredvid, och noggrannheten begränsas separat av BFCL v4 vid 97 % av referenspoängen. MLCommons anpassade ramverket från sitt kommande MLPerf Agentic datacenterbenchmark.
”Vi lade till End-to-end RAG-testet eftersom det är tydligt att frågebesvarande har utvecklats bortom att bara vara en LLM tränad på en korpus; intressenter behöver förstå den verkliga prestandan hos de typer av flerstegs-, flerkomponentspipelines som byggs idag”, säger Miro Hodak, medordförande för MLPerf Inference-arbetsgruppen. ”På samma sätt lade vi till Edge Agentic Inference-testet eftersom komplexa inferenssystem med agentiska egenskaper i allt högre grad finns på edge computing-enheter, vilket skapar en ny uppsättning prestandautmaningar som våra kunder står inför idag.”
Rundan utökar också spekulativt avkodningsstöd, tidigare begränsat till DeepSeek-R1, till GPT-OSS-riktmärket i det interaktiva scenariot, och definierar ett nytt interaktivt scenario för VLM-testet med svar riktade till cirka 1.5 sekunder.
Nytt kisel från skrivbordet till racket
NVIDIAs Vera Rubin NVL72 gör sin MLPerf-debut i förhandsvisningskategorin, inskickat av NVIDIA och av Nebius på sin VR200 NVL72. NVIDIA rapporterar upp till 2.5 gånger högre token-genomströmning än GB300 NVL72 på DeepSeek-R1 i offline-, server- och interaktiva scenarier med TensorRT-LLM, och upp till 3.7 gånger på Qwen3-visionsspråksmodellen med vLLM med NVIDIA Dynamo. Det är NVIDIAs jämförelser mot sin egen tidigare generation, och förhandsvisningsbeteckningen innebär att plattformen förväntas vara kommersiellt tillgänglig vid nästa omgång.
AMD utökade sin MLPerf Inference 6.1-inlämning till sex modellfamiljer för språk, resonemang, text-till-video och rekommendationsuppgifter, och distribuerade Instinct MI355X, MI350X och det nya MI350P PCIe-kortet. 512-GPU Crusoe-klustret som är byggt på MI355X beskrivs nedan, tillsammans med AMDs egen genomgång av rundan.
Intels Arc Pro B70 visas i en nod med fyra grafikkort och 128 GB kombinerat VRAM, vilket Intel använde för Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper och det nya E2E-RAG-testet. Intel rapporterar att gpt-oss-120B förbättrades med 36 % på servernivå och 27 % offlinenivå jämfört med v6.0 på samma hårdvara. På CPU-sidan säger Intel att servergenomströmningen för Xeon 6980P Llama 3.1-8B ökade med 2.4 gånger jämfört med v6.0 på identiska kiselenheter, en förbättring endast i mjukvara.
Ryzen AI Max+ 395 dyker upp genom Atlas Inference, en förstagångsleverantör som körde den nya Edge Agentic-arbetsbelastningen på både en NVIDIA DGX Spark och en AMD Strix Halo-stationär dator med samma motor och kvantiseringsrecept. Atlas rapporterar 20.1 tokens per sekund på DGX Spark, där alla 1 007 varv slutförs på under 64 minuter, och 19.63 tokens per sekund på Strix Halo. Det är en mindre skillnad än vi mätte mellan de två plattformarna med standardkörtider i våra recensioner av Ryzen AI Halo och DGX Spark , och det är den typen av resultat som det nya riktmärket är utformat för att visa.
Större, mer mångsidig och mer distribuerad
Multinodsbidrag slog rekord den här omgången, upp från noll i v4.0, och tre sticker ut. Crusoe, en annan förstagångsbidragsgivare, körde det största systemet i MLPerf Inferences historia med AMD: 512 Instinct MI355X GPU:er över 64 noder på en standard RoCE Ethernet-struktur, inskickade för gpt-oss-120b och DeepSeek-R1. AMD rapporterar 5.75 miljoner tokens per sekund i offline-scenariot och 5.39 miljoner i server på gpt-oss-120b från det klustret, och 2.90 miljoner offline och 2.41 miljoner server på DeepSeek-R1, vilket AMD kallar den högsta aggregerade token-genomströmningen i MLPerfs historia, med en genomströmning som skalas nästan linjärt från 1 till 64 noder. Körningen med gpt-oss-120b fungerade som 512 oberoende replikor av en enda GPU i native MXFP4; DeepSeek-R1 använde SGLang med en replika med åtta GPU:er per nod. AMD citerar separat en GPT-OSS-120B-inlämning med 72 GPU:er med 95 % skalningseffektivitet och 1 miljon tokens per sekund, samma rubrik som de nådde på MI355X i v6.0.
Cisco presenterade riktmärkets första heterogena system från flera leverantörer, där de samlade åtta NVIDIA H200- och åtta AMD Instinct MI350X-grafikprocessorer i en enda inferenspool över en Cisco Silicon One G200-struktur, samma blandade acceleratormetod som de säljer genom sin Secure AI Factory. Det geografiskt distribuerade bidraget kom från MangoBoost med Dell: fyra anläggningar på två kontinenter, som drivs av MangoBoost, Dell, TensorWave och Microsoft Azure, som sträcker sig över Stilla havet och körs som en enda slutpunkt med vad MangoBoost rapporterar som 97 % skalningseffektivitet. MangoBoost hävdar också att de första resultaten, uppdelade i förfyllnings-/avkodningsformat, har uppnåtts på AMD Instinct-grafikprocessorer.
På andra ställen i resultaten rapporterar CoreWeave 1.16 miljoner tokens per sekund aggregerat på GB300 NVL72 med en offline-genomströmning per GPU som ökat med 17 % sedan v6.0, HPE citerar 8 500 tokens per sekund per GPU på DeepSeek-R1 över två Compute XD690-servrar med Blackwell Ultra, och Google fokuserade sin inlämning på DeepSeek-R1, med hänvisning till branschens övergång till stora modeller med en blandning av experter. gpt-oss-120b fick 112 inlämningar, det mesta av någon MLPerf-arbetsbelastning.
AMD:s två CDNA 4-formfaktorer: OAM och PCIe med dubbla kortplatser
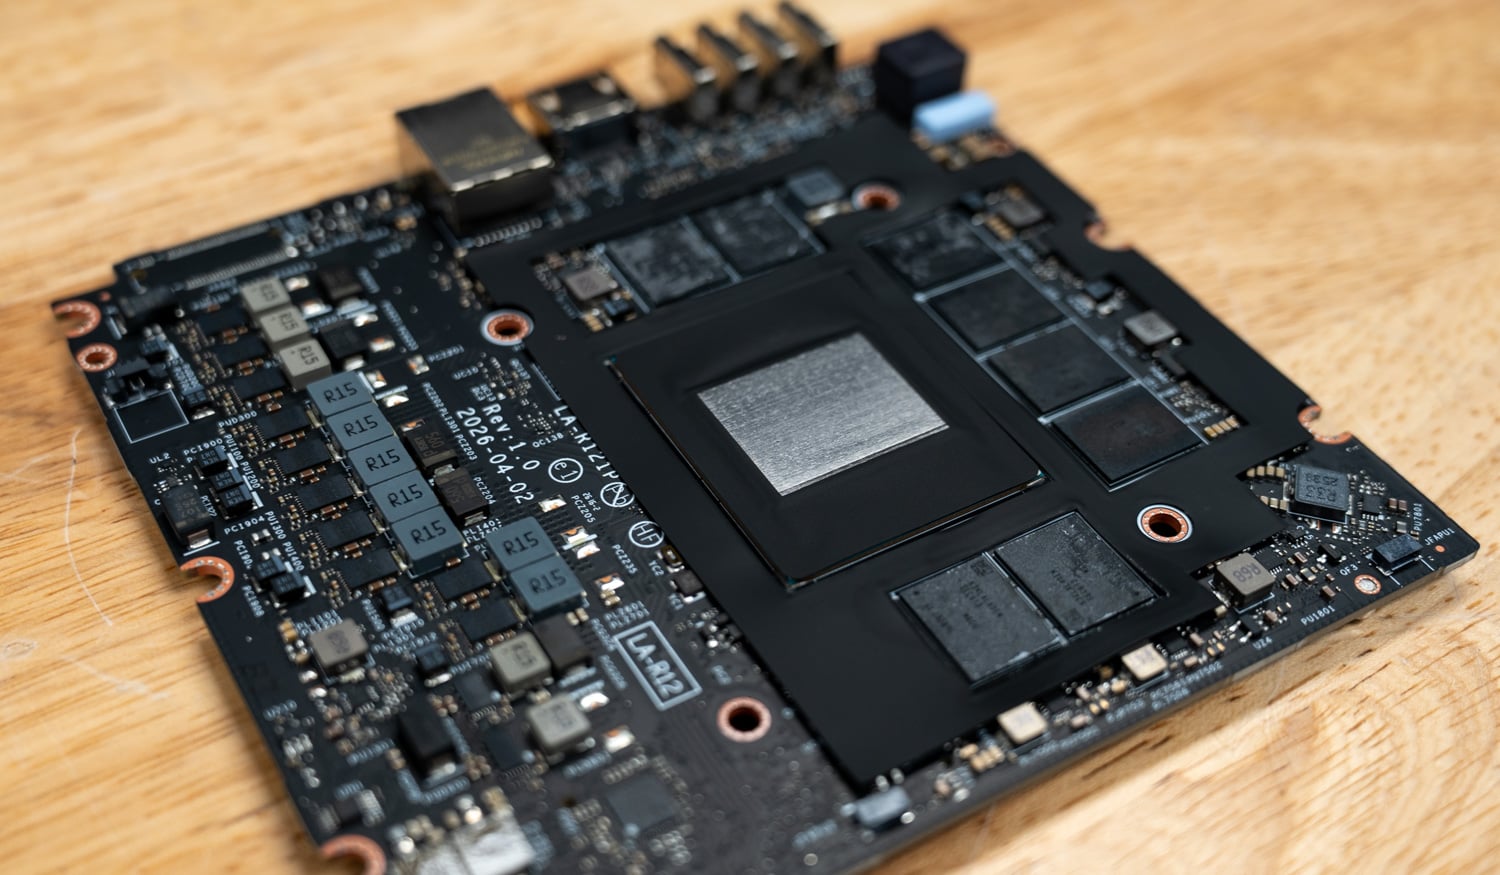
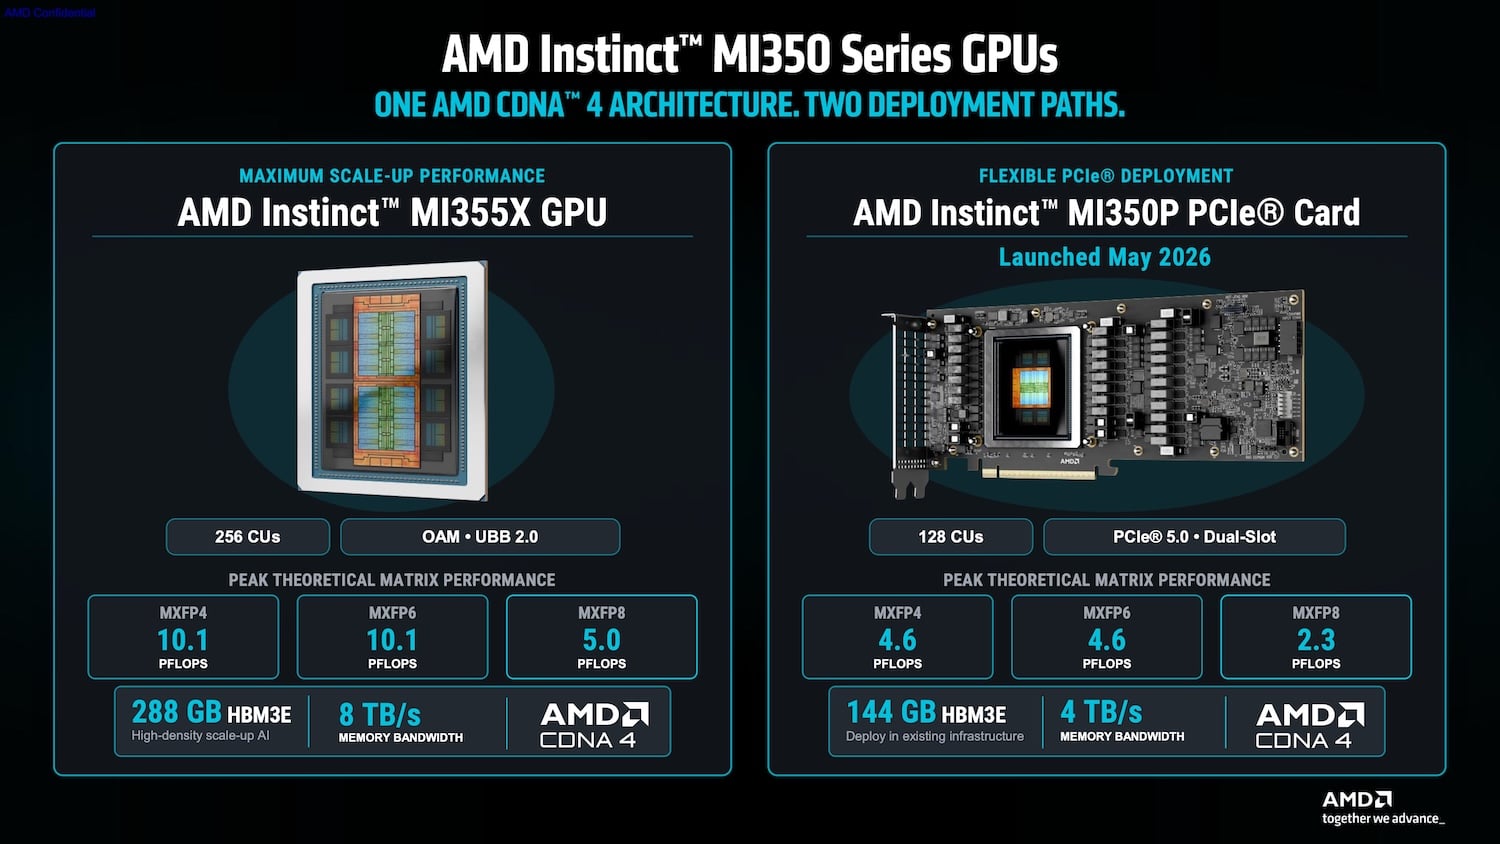
AMDs CDNA 4-arkitektur finns i två fysiska formfaktorer för att möta specifika begränsningar för datacenters strömförbrukning och kylning. Flaggskeppet Instinct MI355X riktar sig mot högdensitetsberäkningsnoder med hjälp av en OAM-formfaktor på en OCP Universal Baseboard (UBB 2.0)-plattform och tillhandahåller 256 beräkningsenheter, 288 GB HBM3E-minne och 8 TB/s aggregerad minnesbandbredd. Den levererar upp till 10.1 PFLOPS av maximal teoretisk MXFP4- och MXFP6-matrisprestanda. Den nyligen introducerade Instinct MI350P anpassar samma CDNA 4-kisel till ett PCIe 5.0-tilläggskort med dubbla kortplatser för standardchassier för företag, med 128 beräkningsenheter, 144 GB HBM3E-minne, 4 TB/s bandbredd och upp till 4.6 PFLOPS av maximal teoretisk MXFP4- och MXFP6-matrisprestanda.
Programvarudriven generationslyft på identiskt kisel
Programvaruoptimeringar i AMD ROCm v7 gav mätbara dataflödesökningar på identisk MI355X-hårdvara under en enda MLPerf-cykel. Testning på en MI355X-nod med åtta GPU:er visade att dataflödet för GPT-OSS-120B ökade med 28 % i offline-scenariot och 38 % i server-scenariot, medan Wan-2.2 SingleStream-prestanda förbättrades med 70 %. I klusterskala uppnådde 72 MI355X-acceleratorer i MLPerf 6.1 högre aggregerad GPT-OSS-120B-dataflöde än en 94-GPU-konfiguration som rapporterades i omgång 6.0. I konkurrensjämförelser publicerade av AMD, ledde MI355X med åtta GPU:er resultat mot NVIDIA B200 och B300 på GPT-OSS-120B, medan klustret med 72 GPU:er ledde NVIDIAs GB200-inlämning.
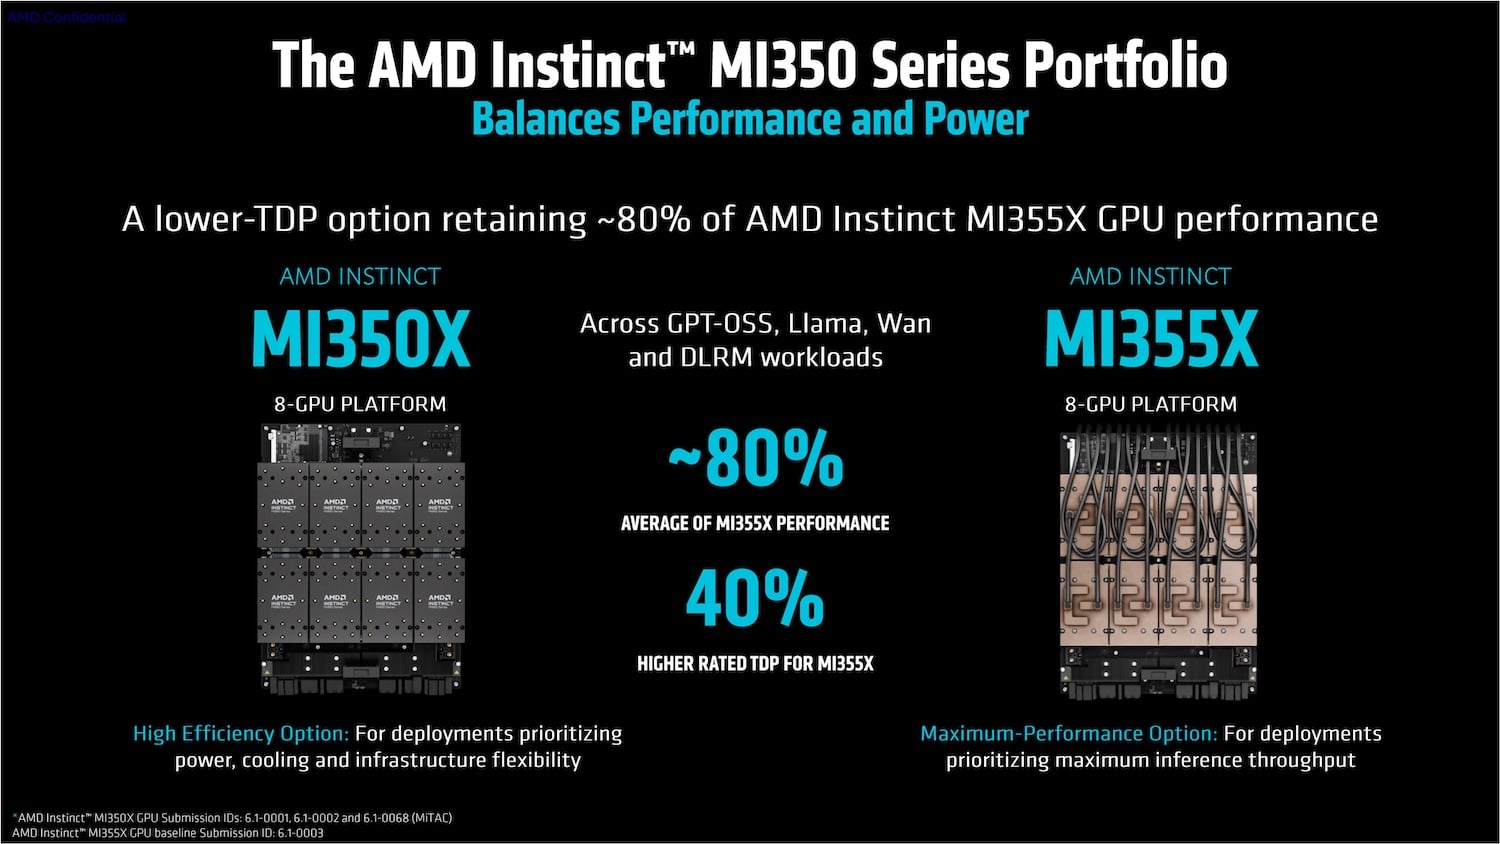
I sin första MLPerf-runda testade MI350P med dubbla slots fem stängda arbetsbelastningar och visade ledande resultat jämfört med utvalda bidrag av NVIDIA RTX PRO 6000 Server Edition och H200 NVL. För implementeringar som är känsliga för ström- och kylningsbudgetar bibehöll ett MI350X-system med åtta GPU:er cirka 80 % av MI355X-plattformens prestanda jämfört med GPT-OSS, Llama, Wan och DLRM-arbetsbelastningar, medan MI355X har en 40 % högre TDP. En beställd studie av Signal65 rapporterade att dessa dataflödessiffror resulterade i lägre driftskostnad per dokument och högre tokenutdata per dollar inom fasta latensgränser.
AMD-partnerresultat och Korea-till-USA-klustret
AMD säger att jämförbara MI355X-inlämningar från sju partners, Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe och MiTAC, låg i genomsnitt inom 4 % av deras referenssystemresultat, med vissa körningar som matchade eller överträffade dem något.
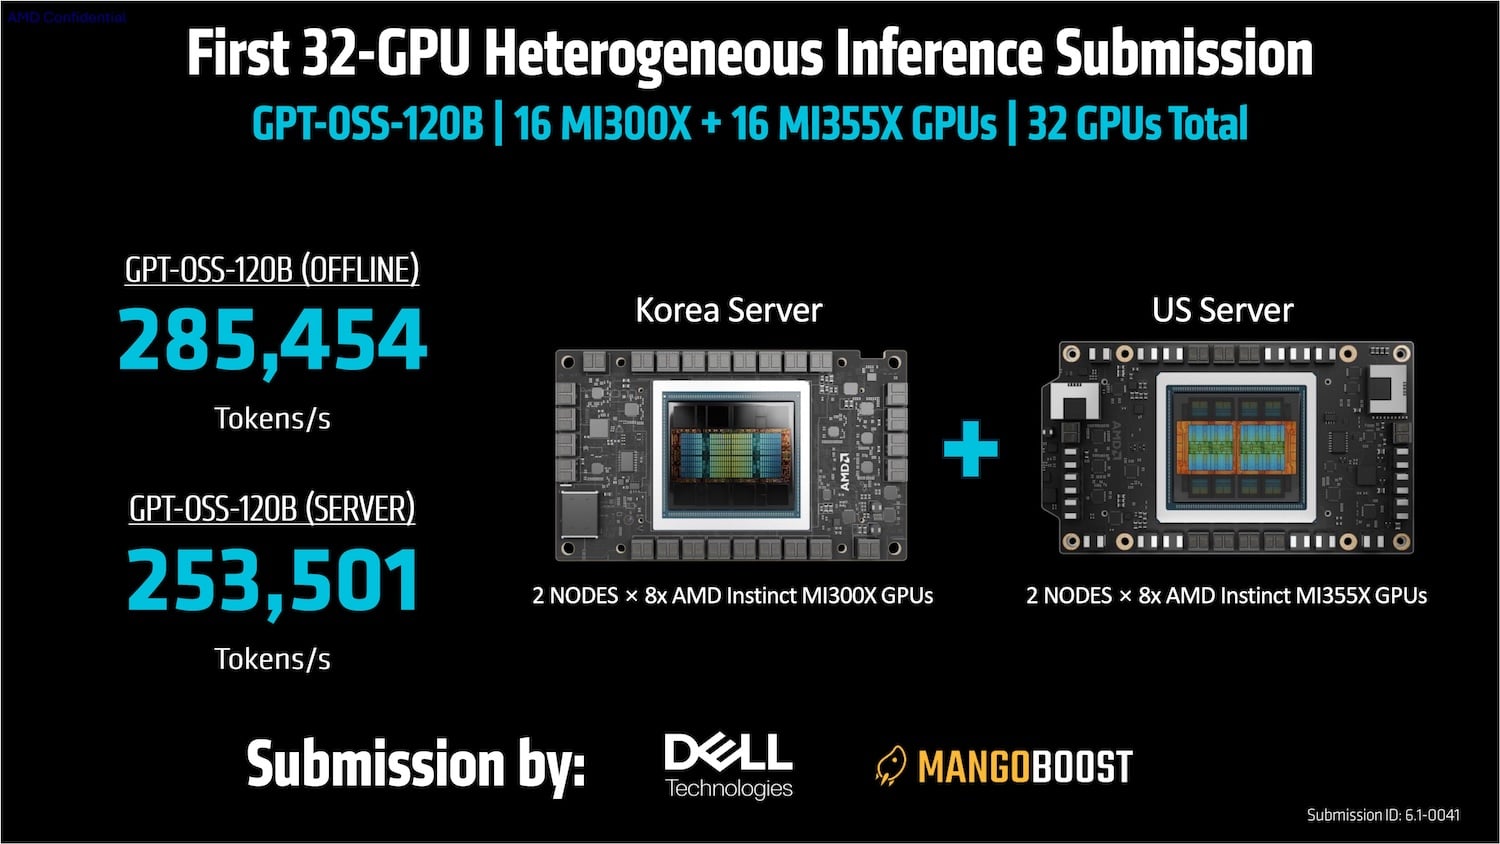
MangoBoost- och Dell-bidraget som nämns ovan är benchmarkens första heterogena 32-GPU-serverkonfiguration, som överbryggar 16 Instinct MI300X-GPU:er av föregående generation i Korea med 16 Instinct MI355X-GPU:er i USA till en enhetlig GPT-OSS-120B-slutpunkt. Konfigurationen med delat kluster levererade 285 454 offline-tokens per sekund och 253 501 server-tokens per sekund. Bidragen kördes på ROCm 7; AMD pekar på ROCm 10-utgåvan , med vLLM-, SGLang- och ROCm.AI-profileringsverktyg, som vägen framåt för den HBM4-baserade MI400-serien och den följande MI500-generationen.
Selen som ersätter MLPerf-inferens i datacentret
Sexton av de 30 inskickarna använde MLPerfs API-centrerade verktyg denna omgång, jämfört med en enda öppen inskickare i v6.0. Funktionen kör en sann klient/server-konfiguration över standard-API:er mot en hostad slutpunkt, vilket är hur datacenterinferens distribueras, och den har redan det nya Edge Agentic-testet, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B och text-till-video. Det är grunden för MLPerf Endpoints, som öppnar rullande inskickningar på begäran i oktober 2026 och ersätter MLPerf Inference som datacenterreferens 2027, med normaliserade resultat och utökade agentarbetsbelastningar planerade för Endpoints v1.0.
”Framöver kommer MLPerf Endpoints att ersätta Inference i vår familj av benchmarks för datacentret, och det snabba införandet av vår API-centrerade utrustning kommer att bidra till att göra den övergången smidig”, säger David Kanter, chef för MLPerf. De sex förstagångsbidragsgivarna i denna omgång är Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC och den individuella bidragsgivaren Naeem Khoshnevis från Harvards Kempner Institute, som skickade in ett enda H200 Llama 3.1-8B-resultat.
Inferensrundan följer MLPerf Storage v3.0-resultaten som publicerades för två veckor sedan, och fullständiga datacenter- och kanttabeller, tillsammans med tilläggsuppgifter för inskickare, finns tillgängliga på MLCommons resultatsidor.


 Amazon