

AMD-kisel kom förmodligen först: Strix Halo mini-datorer och bärbara datorer levererades med 128 GB enhetligt minne långt innan NVIDIA kom in i bilden. Men den lokalt AI-baserade stationära datorn som kategori är en som NVIDIA effektivt skapade när de placerade ett Grace Blackwell-superchip i en en-literslåda och kallade den DGX Spark . Presentationen var enkel: en maskin i utvecklarklass med tillräckligt med enhetligt minne för att hålla kapabla modeller, placerad på ett skrivbord istället för mätt i molnet. AMD Ryzen AI Halo är AMDs svar på den maskinen. AMD tillkännagav den tillsammans med Ryzen AI Max PRO 400-serien i maj 2026; förbeställningar öppnade i juni exklusivt via Micro Center , med tillgänglighet i butik den 10 juli. Ryzen AI Halo kommer med ett liknande format, 128 GB enhetligt minne, ett pris på 3 999 dollar och en kort lista med beslut som gör den till ett betydligt annorlunda förslag än Spark.
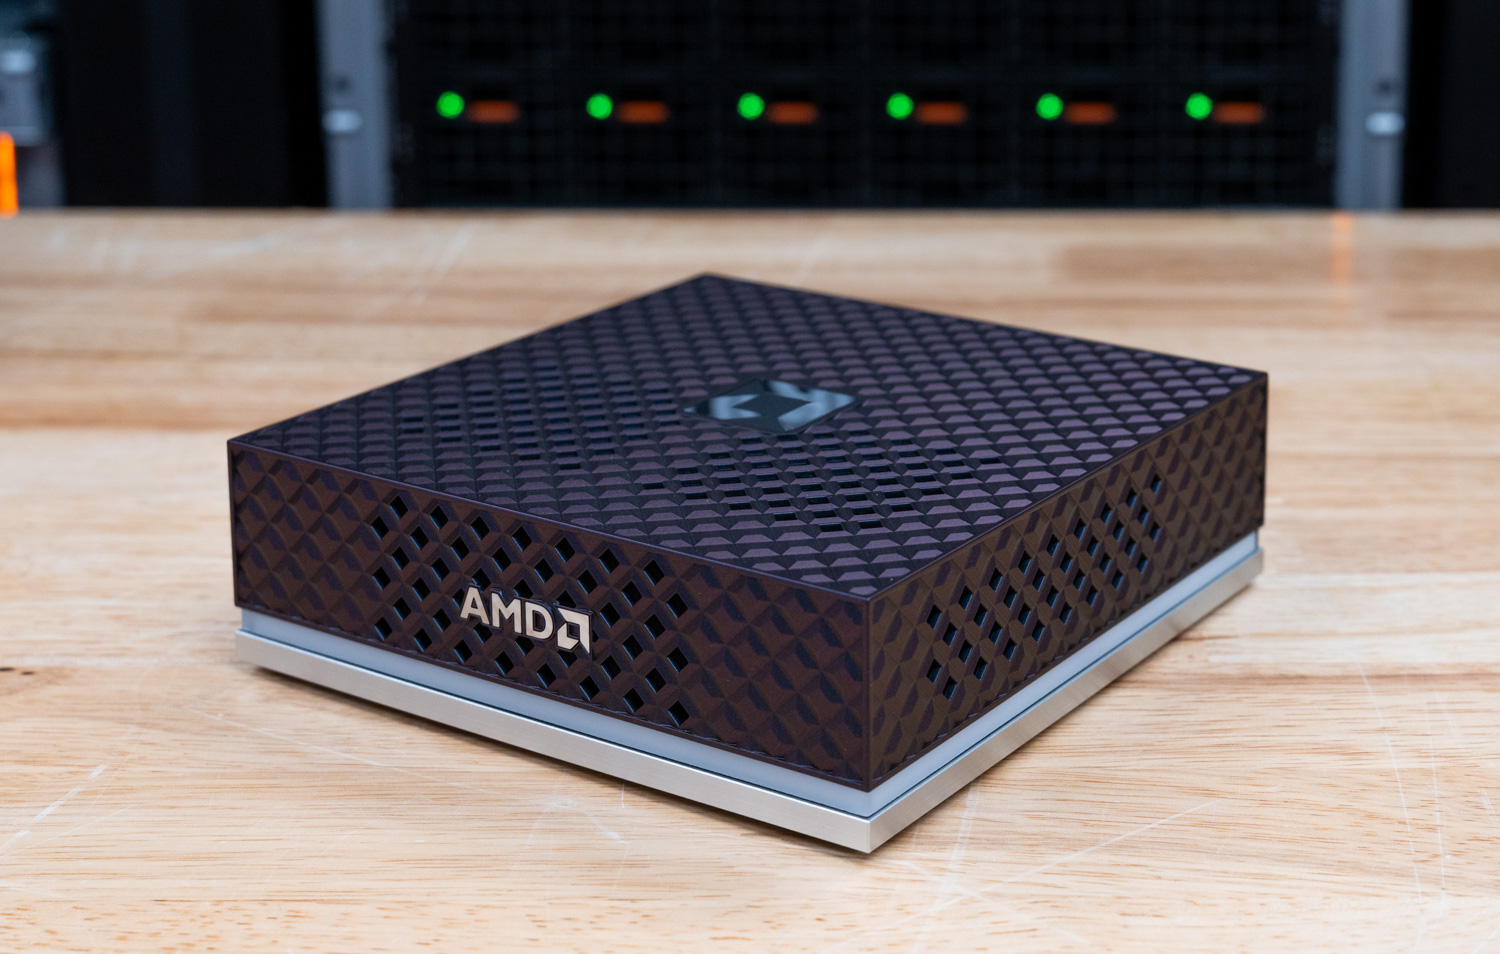
AMD marknadsför Halo som sin första AI-utvecklarplattform, vilket ger utvecklare en snabb och smidig väg att bygga och köra AI lokalt. Under huven finns Ryzen AI Max+ 395, en 16-kärnig, 32-trådig "Zen 5"-komponent med integrerad Radeon 8060S-grafik (40 RDNA 3.5-beräkningsenheter) och en XDNA 2 NPU klassad till 50 TOPS, allt inom en plattform som AMD marknadsför med upp till 126 TOPS kombinerad AI-genomströmning. 128 GB LPDDR5x körs med 8000 MT/s, vilket levererar 256 GB/s bandbredd, och hela plattformen drar ström från en enda USB-C-ingång klassad till 120W. AMD säger att minnespoolen är tillräcklig för att hålla modeller med upp till 200 miljarder parametrar i enhetsminne. Det är en komplett x86 mini-arbetsstation, vilket är roten till den skillnad som betyder mest.
Den skillnaden är Windows. Spark kör NVIDIAs Linux-baserade DGX OS och inget annat; Halo startar Windows 11 eller AMDs Linux-utvecklaravbildning på samma hårdvara. Inbyggt Windows-stöd var den vanligaste förfrågan vi hörde från folk som spanat in en Spark, och det förändrar vem lådan är till för. AMDs egen positionering gör samma poäng: Windows och Linux kontra Sparks Linux-baserade operativsystem ( i alla fall från och med idag ).
Tre ytterligare beslut skiljer Halo från Spark, och vart och ett tar upp ett klagomål vi har hört om den etablerade tillverkaren. Halo använder en standard M.2 2280 SSD snarare än den mindre vanliga 2242-hårddisken som Spark har plats för, vilket öppnar upp en mycket större pool av eftermarknadsalternativ, inklusive 8 TB kapacitet, för alla som vill byta ut hårddisken. Den levereras med variabelt grafikminne förinställt på maximal allokering på båda operativsystemen, så stora modeller laddas utan manuell justering. Den sveper också in chassit i en upplyst statusring, en liten korrigering av de mörka, ljuslösa Spark-enheter som vissa köpare fick, beroende på OEM. Kostnaden för AMDs tillvägagångssätt visas på baksidan av lådan, där det inte finns någon höghastighetsstruktur, bara 10 GbE, vilket begränsar vad du kan göra med klustring med flera noder. Det är avvägningarna, och de definierar de arbetsbelastningar som den här maskinen är byggd för innan någon benchmark körs.
Prismässigt spelar nyansen roll. Halo listas för 3 999 dollar med en 2 TB SSD, vilket placerar den precis vid rådande pris för ett bassystem i Spark-klassen. Jämförelsen beror på vilken Spark du menar. NVIDIAs egen DGX Spark med den större hårddisken kostar nu närmare 4 700 dollar, ett drag kopplat till utbudskrisen på LPDDR5X och NAND. Bassystemen Grace Blackwell från ASUS och andra säljer fortfarande runt 4 000 dollar och listas på Amazon idag (affiliate-länk). Jämfört med baslinjen i kategorin ligger Halo i paritet, och dess argument vilar på besluten ovan snarare än på att underprisa marknaden.
Vi körde Halo genom StorageReviews lokala AI-svit på både Windows och Linux, och resultaten presenteras tillsammans med design- och programvaruanalysen i hela den här recensionen.
Key Takeaways
- Alternativet med dubbla operativsystem x86: Ryzen AI Halo är den enda datorn i Sparks kategori som startar Windows 11 eller Linux på en fullständig x86-plattform, till ett pris av 3 999 dollar med en 2 TB SSD jämfört med DGX Spark Founders Editions 4 699 dollar.
- Minne för att hålla stora modeller: 128 GB LPDDR5x-8000 enhetligt minne med 256 GB/s stöder modeller upp till 200 miljarder parametrar lokalt, med variabelt grafikminne förinställt så att stora modeller laddas utan manuell konfiguration.
- Den starkaste Ryzen AI Max+ 395 vi testat: Halo toppade HP Z2 Mini G1a och ZBook Ultra G1a i nästan alla Windows-arbetsbelastningar, inklusive 37 316 i Cinebench R23 multi-core, 184.2 GIPS i 7-Zip och de ledande poängen för textgenerering (Phi 1 192) och bildgenerering (SD 1.5 FP16 937) i Procyon AI.
- CPU-vinster, inferensförluster vs. Spark: På Linux slog Halo DGX Spark direkt i CPU-arbete, med 11% snabbare komprimering och 38% snabbare dekomprimering i 7-Zip och 14% snabbare slutförande av LLVM-kompilering. Den låg dock efter 2x till 4x i de flesta vLLM-serverscenarier vid högre samtidighet, och sträckte sig till 8.8x i förfyllningsintensivt GPT OSS 120B-arbete.
- Servicevänlig lagring, blygsam nätverkshantering: Ett standard M.2 2280-fack öppnar upp för eftermarknadsuppgraderingar till 8 TB, även om plattformen förhandlar ner den medföljande Gen5 Micron 4600 till Gen4 genom designen, och den enda 10 GbE-porten utan höghastighetsstruktur utesluter den multinodklustring som Sparks 200G ConnectX-7 möjliggör.
Specifikationer
| Specifikation | AMD Ryzen AI Halo-system |
|---|---|
| Processorn | |
| CPU | AMD Ryzen™ AI Max+ 395-processor 16 kärnor / 32 trådar (Zen 5-arkitektur) |
| GPU | AMD Radeon™ 8060S integrerad grafik 40 beräkningsenheter (RDNA™ 3.5-arkitektur) |
| NPU | AMD XDNA™ 2 NPU |
| Minne | |
| Minnestyp | LPDDR5x |
| Minneskapacitet | 128GB |
| Minneshastighet | 8000MT / s |
| minnesbandbredd | 256GB / s |
| lagring | |
| lagring | 2TB M.2 NVMe SSD (SED) |
| Nätverk och anslutning | |
| ethernet | 1 × 10 GbE |
| Wi-Fi | Wi-Fi 7 |
| bluetooth | Bluetooth 5.4 |
| I / O | |
| USB | 3 × USB-C, 1 × USB-C (strömingång) |
| Display Output | 1 × HDMI 2.1b |
| Systemkrav | |
| TDP | 120W |
| Operativ system | Linux eller Windows 11 |
| Mått | 150 × 150 × 45.4 mm (5.9 × 5.9 × 1.79 tum) |
| Vikt | Mindre än 1.2 kg (2.65 lbs) |
AMD Ryzen AI Halo-konstruktion och design
AMD Ryzen AI Halo-systemet använder en kompakt formfaktor som liknar "NVIDIA Spark" och mäter bara 150 × 150 × 45.4 mm och väger mindre än 1.2 kg. Aluminiumchassit har ett aggressivt geometriskt ventilationsmönster över toppen och framsidan, vilket ger systemet ett distinkt utseende samtidigt som det maximerar luftflödet in i kylsystemet. Trots sin lilla storlek är plattformen utformad som en komplett stationär AI-arbetsstation som kan hantera arbetsstationsapplikationer, lokal LLM-inferens och AI-utvecklingsarbetsbelastningar.
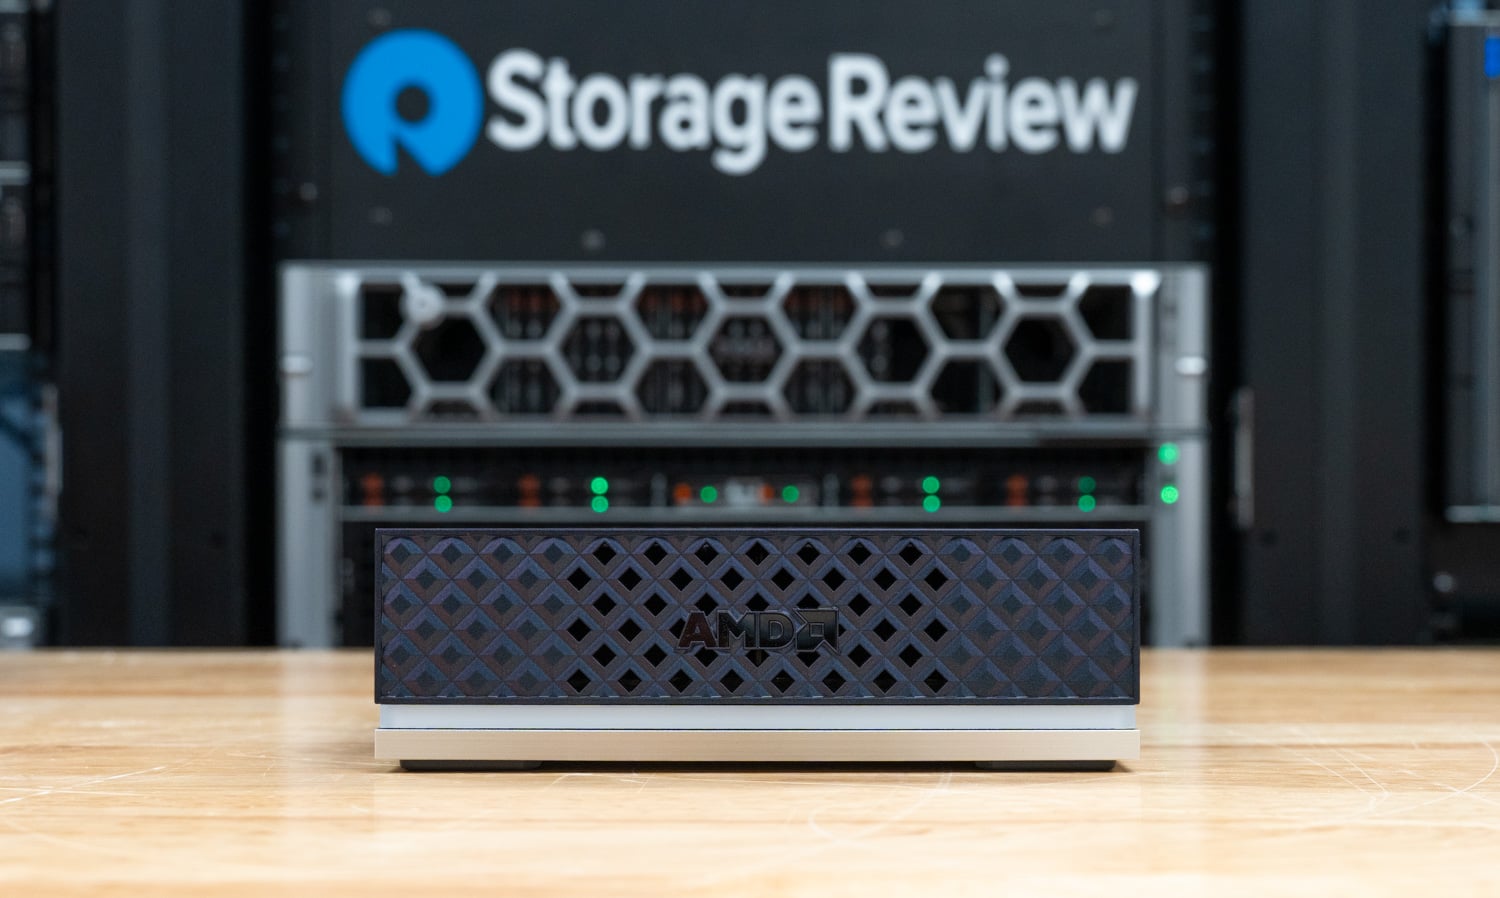
Front
Systemets framsida är avsiktligt ren och består nästan uteslutande av ett stort nätventilationsgaller som sträcker sig över hela chassits bredd. Istället för att placera portar på framsidan har AMD dedikerat detta område till luftflöde, vilket gör att kall luft kan komma in i systemet genom det stora mönstrade intaget samtidigt som fronten hålls ren. En silveraccent längs chassits undersida ger en subtil visuell kontrast till det annars mattsvarta höljet.
Bakre I / O
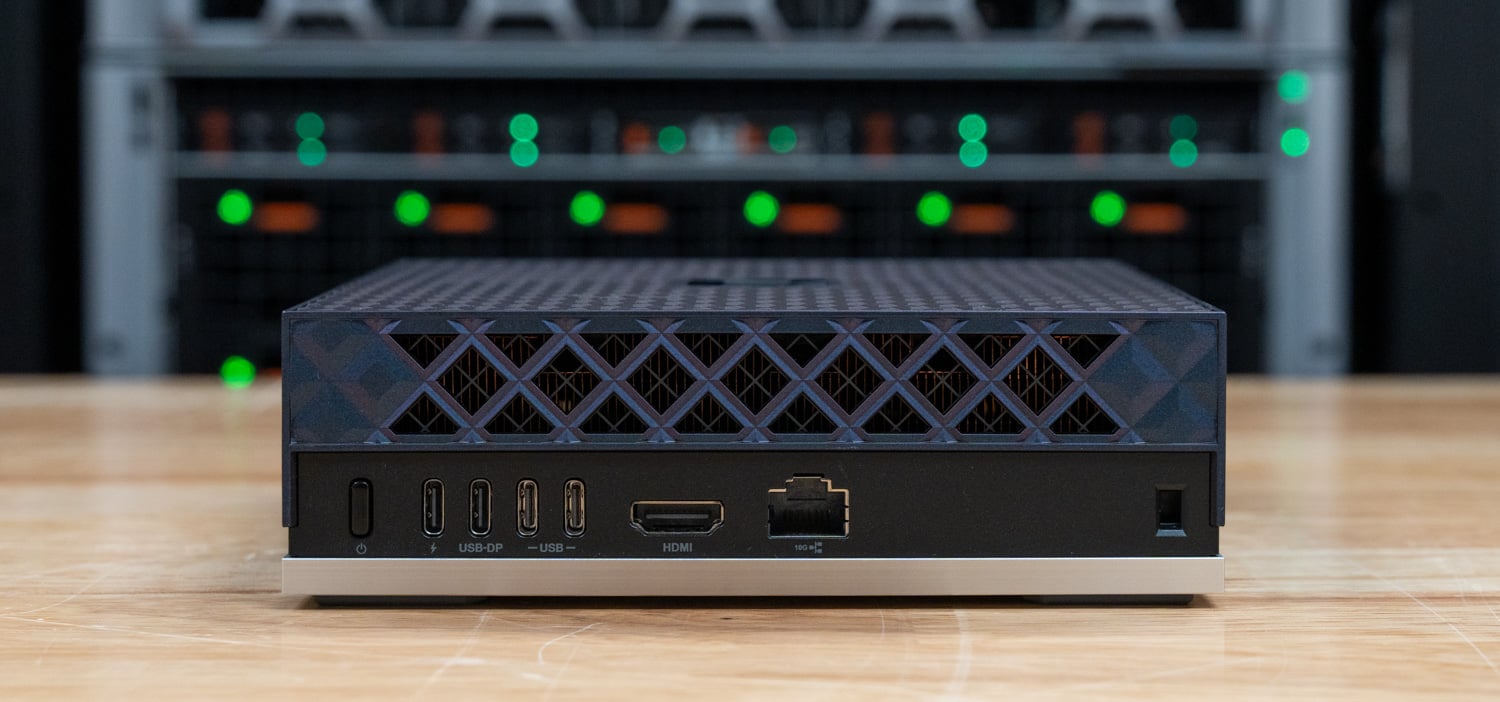
Alla externa anslutningar finns på systemets baksida. Från vänster till höger inkluderar bakpanelen följande:
- USB-C-strömingång
- USB-C-port med DisplayPort Alt-läge
- Två ytterligare USB-C-portar
- HDMI 2.1b-utgång
- 10 GbE RJ45 Ethernet
- Kensington säkerhetslåsplats
Systemet har tre USB-C-dataportar tillsammans med en dedikerad USB-C-strömkontakt, vilket gör det möjligt att ansluta flera höghastighetstillbehör och skärmar samtidigt. HDMI 2.1b ger inbyggd skärmutgång, medan det integrerade 10GbE Ethernet-gränssnittet gör plattformen väl lämpad för höghastighets-NAS-anslutning, överföring av AI-data och lokala utvecklingsmiljöer.
Intern design
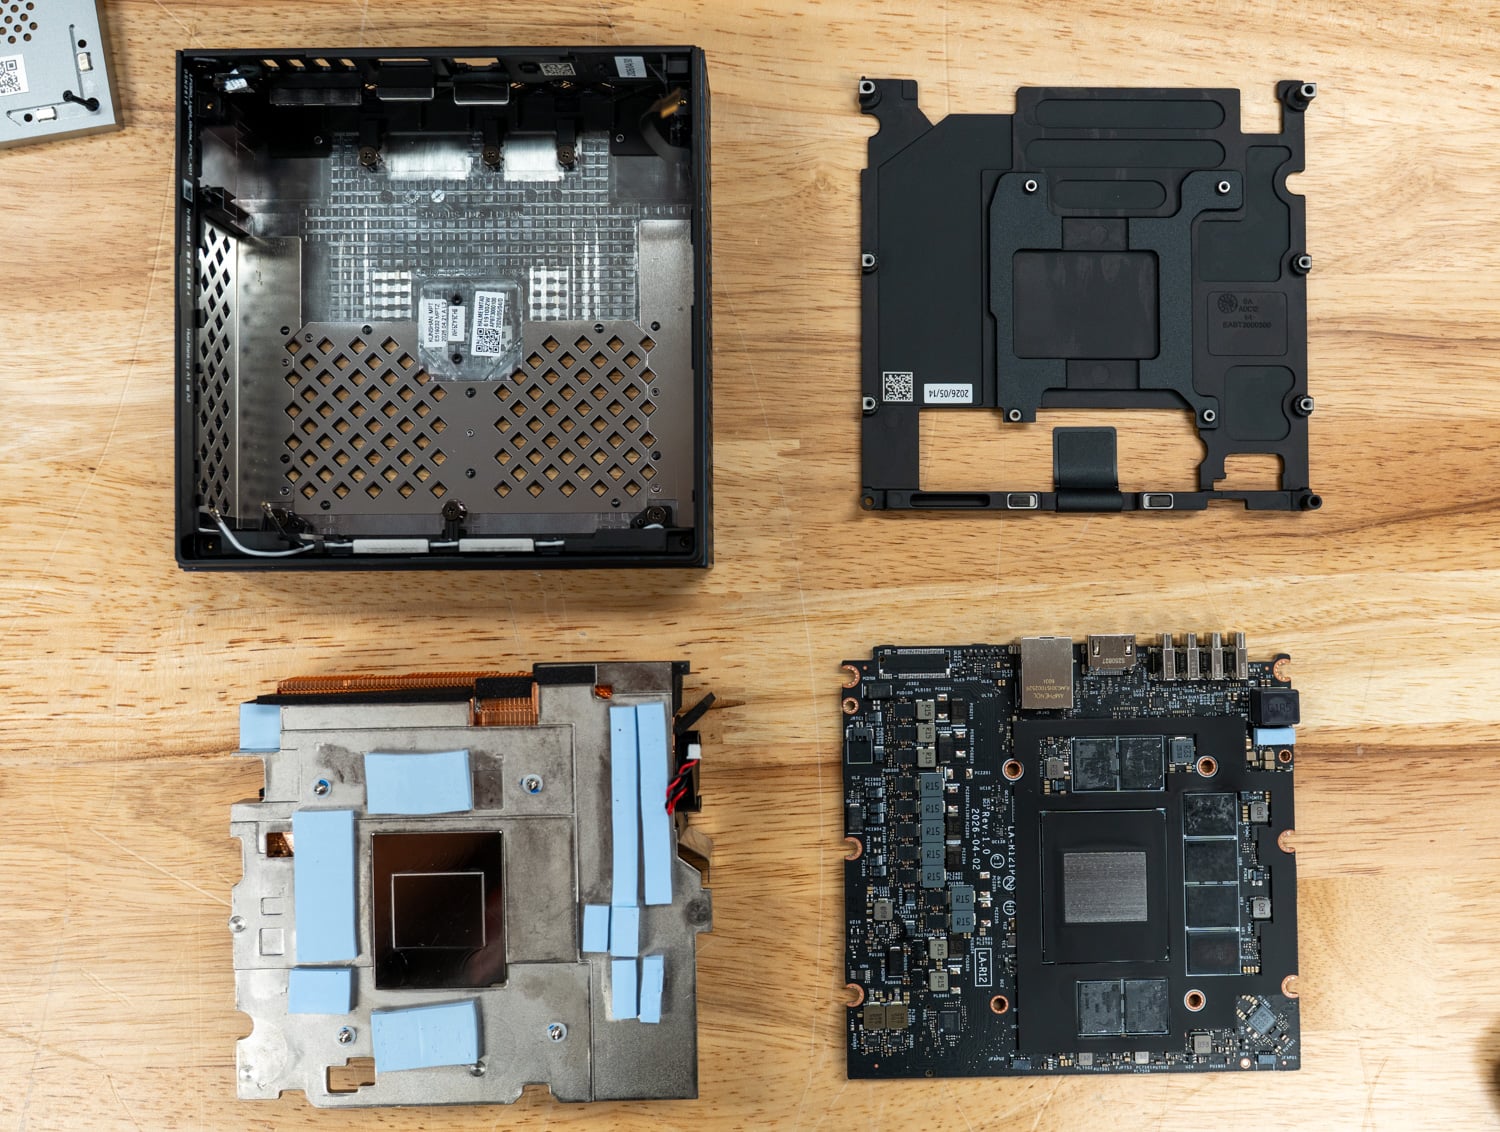
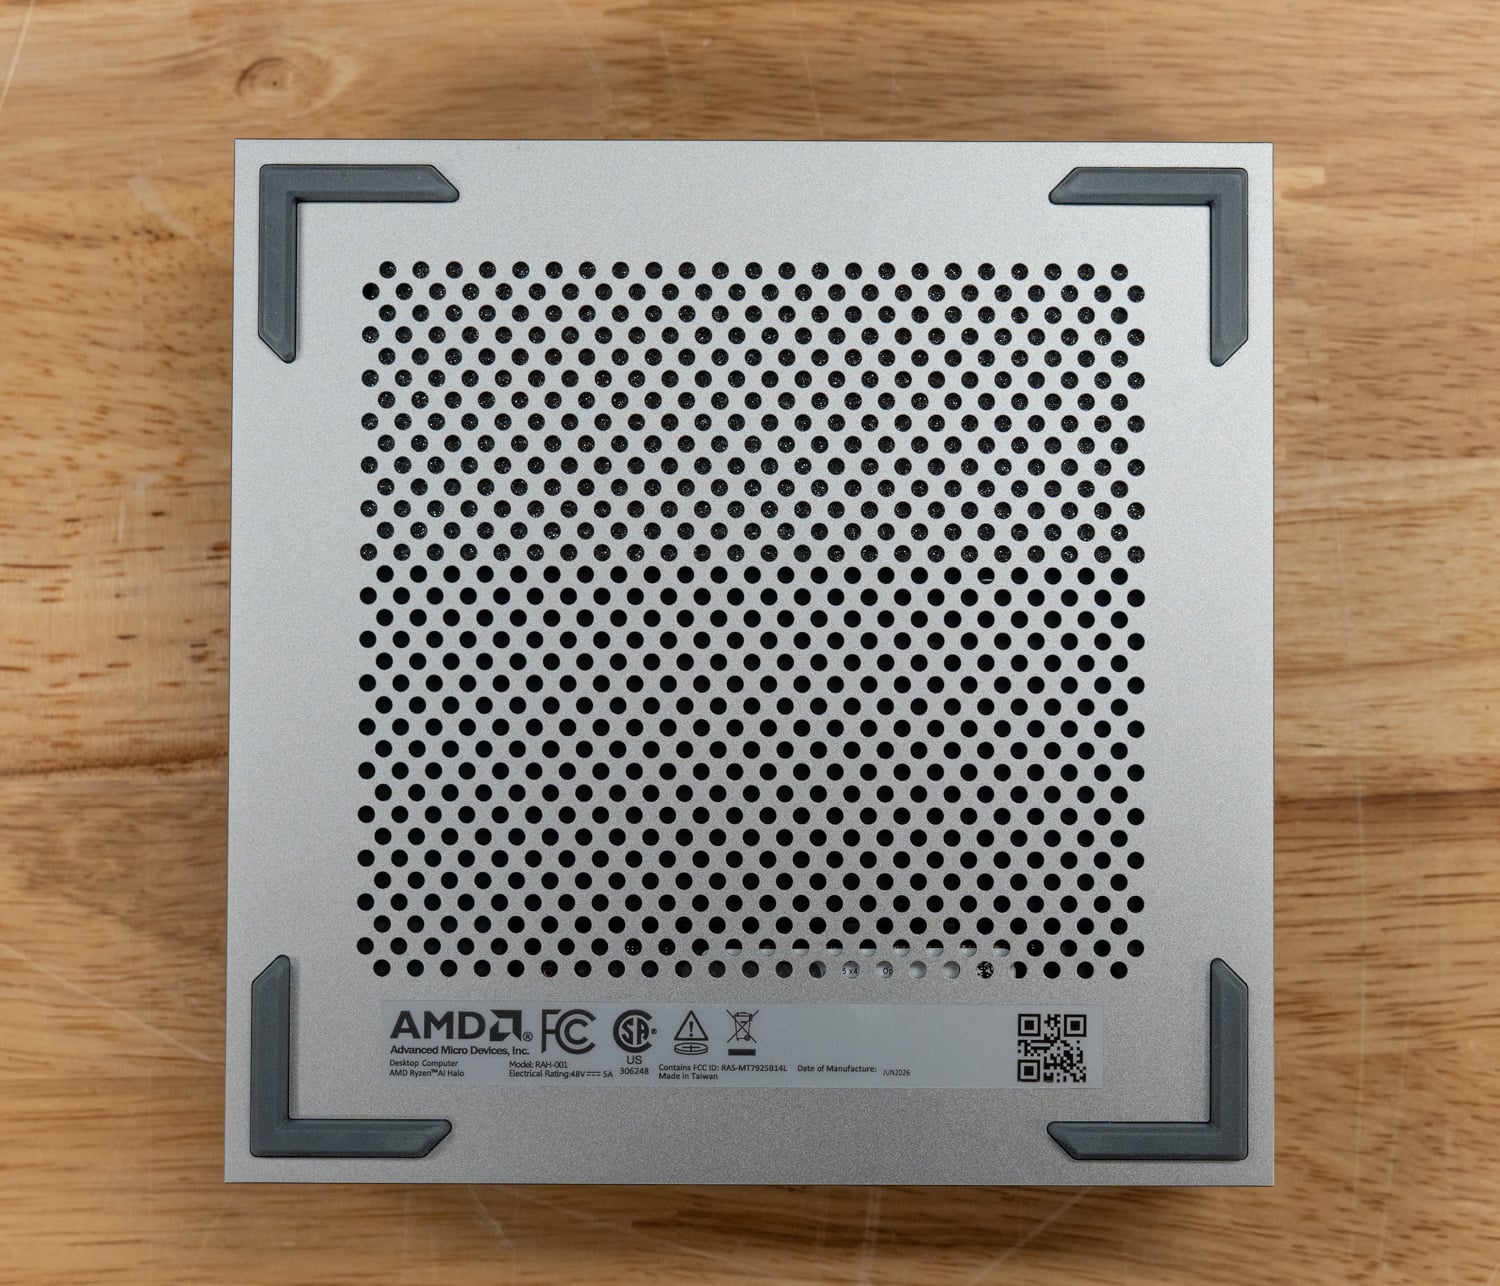
Undersidan av Ryzen AI Halo har en stor perforerad ventil som drar in luft för att kyla komponenterna som är monterade längs undersidan av kortet, och fyra gummifötter i hörnen håller enheten stabil på ett skrivbord eller en hylla.
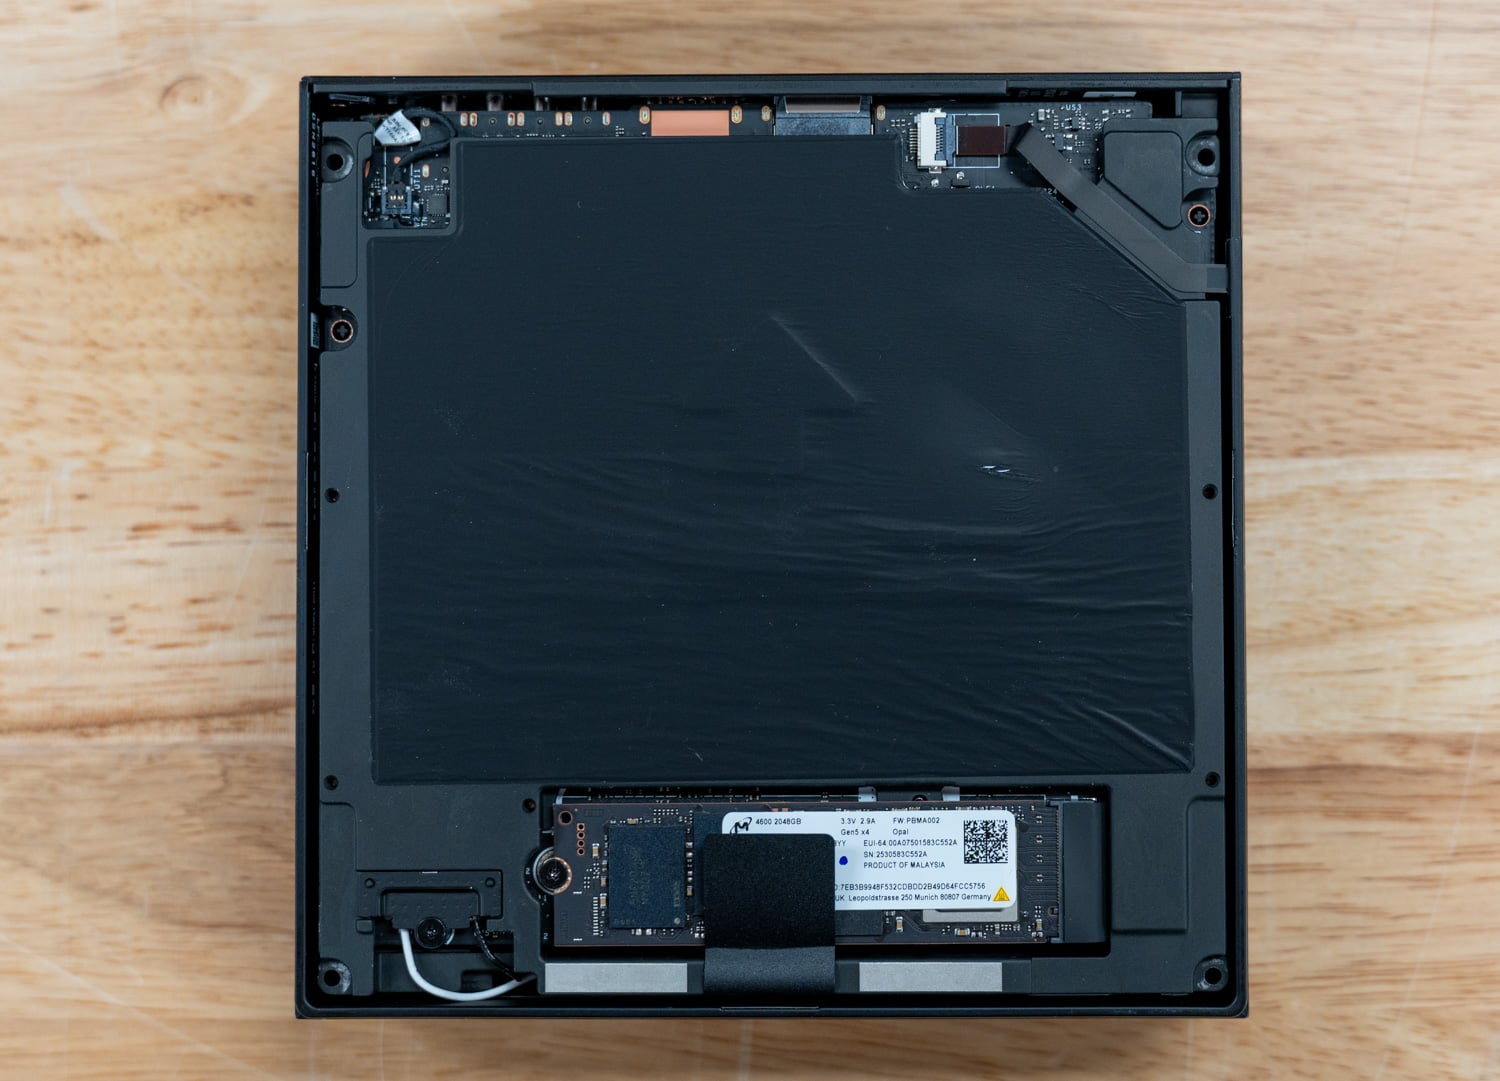
Genom att ta bort de fyra skruvarna som håller fast bottenpanelen visas M.2 SSD-facket och några av systemets komponenter på undersidan av kortet, inklusive Wi-Fi-kortkontakten. I vår testenhet rymmer den platsen en Micron 4600 2TB Gen5 x4 SSD, medan ett svart självhäftande ark skyddar resten av kortet från den exponerade undersidan.
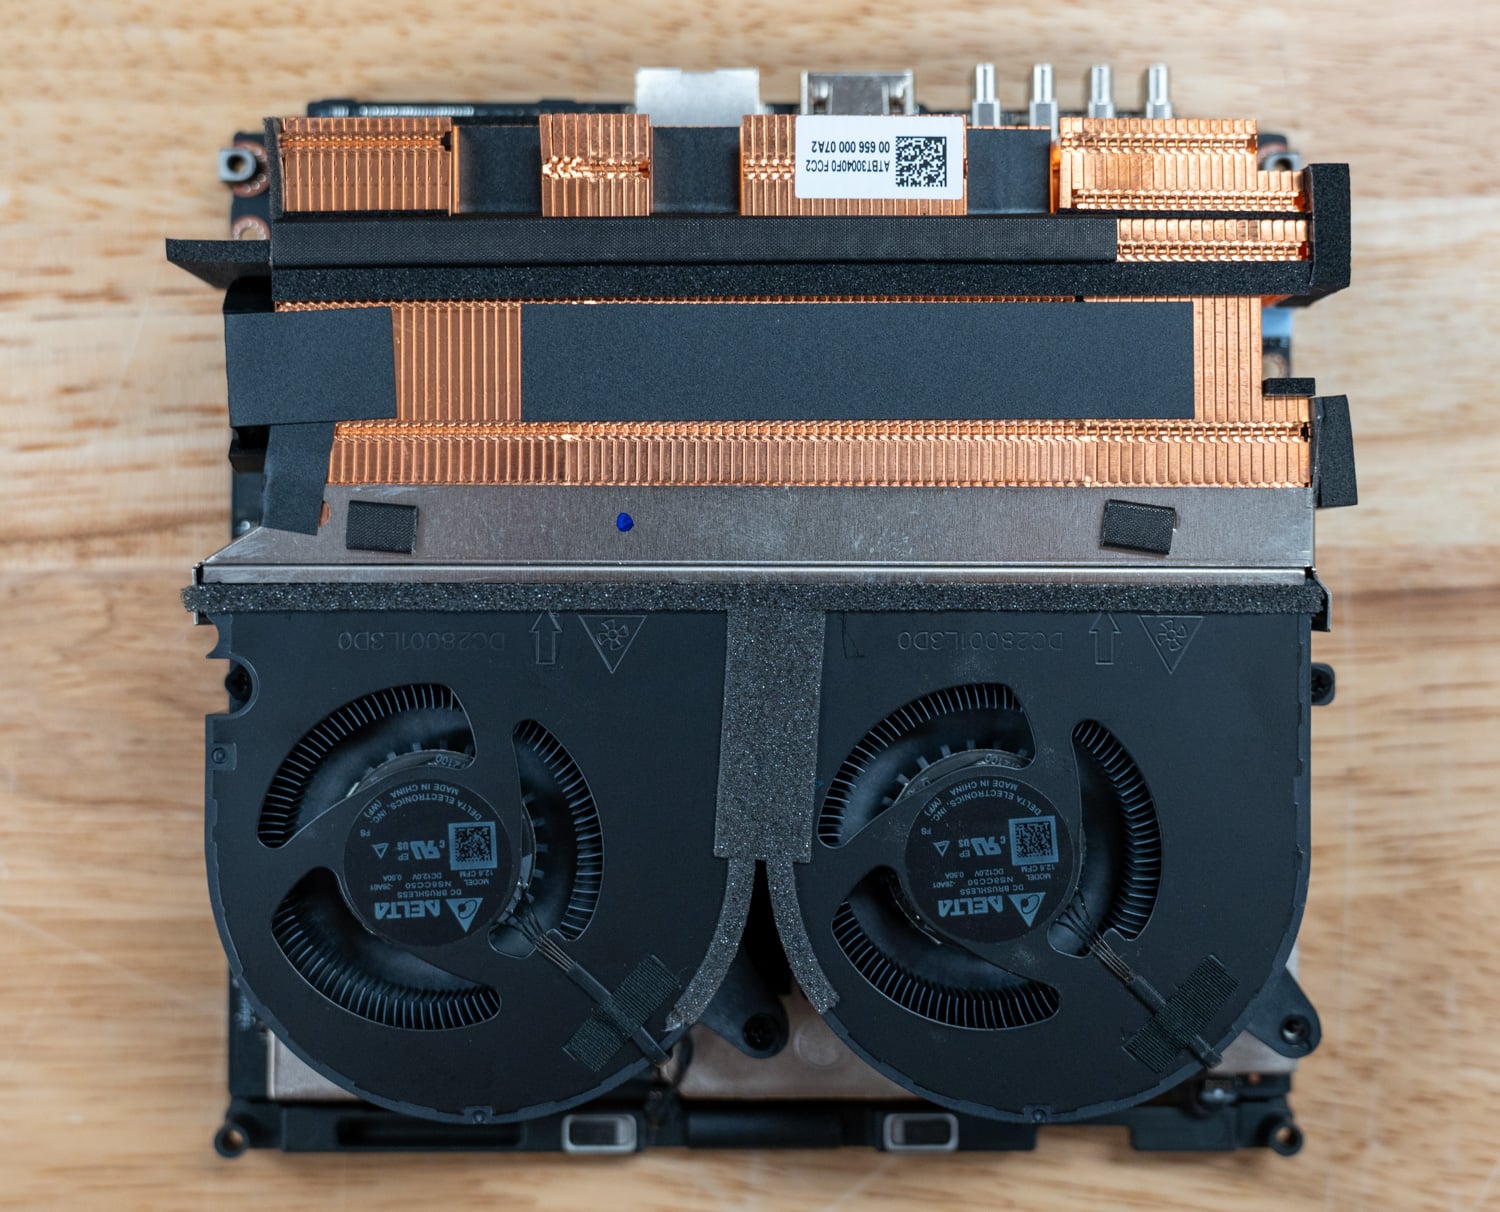
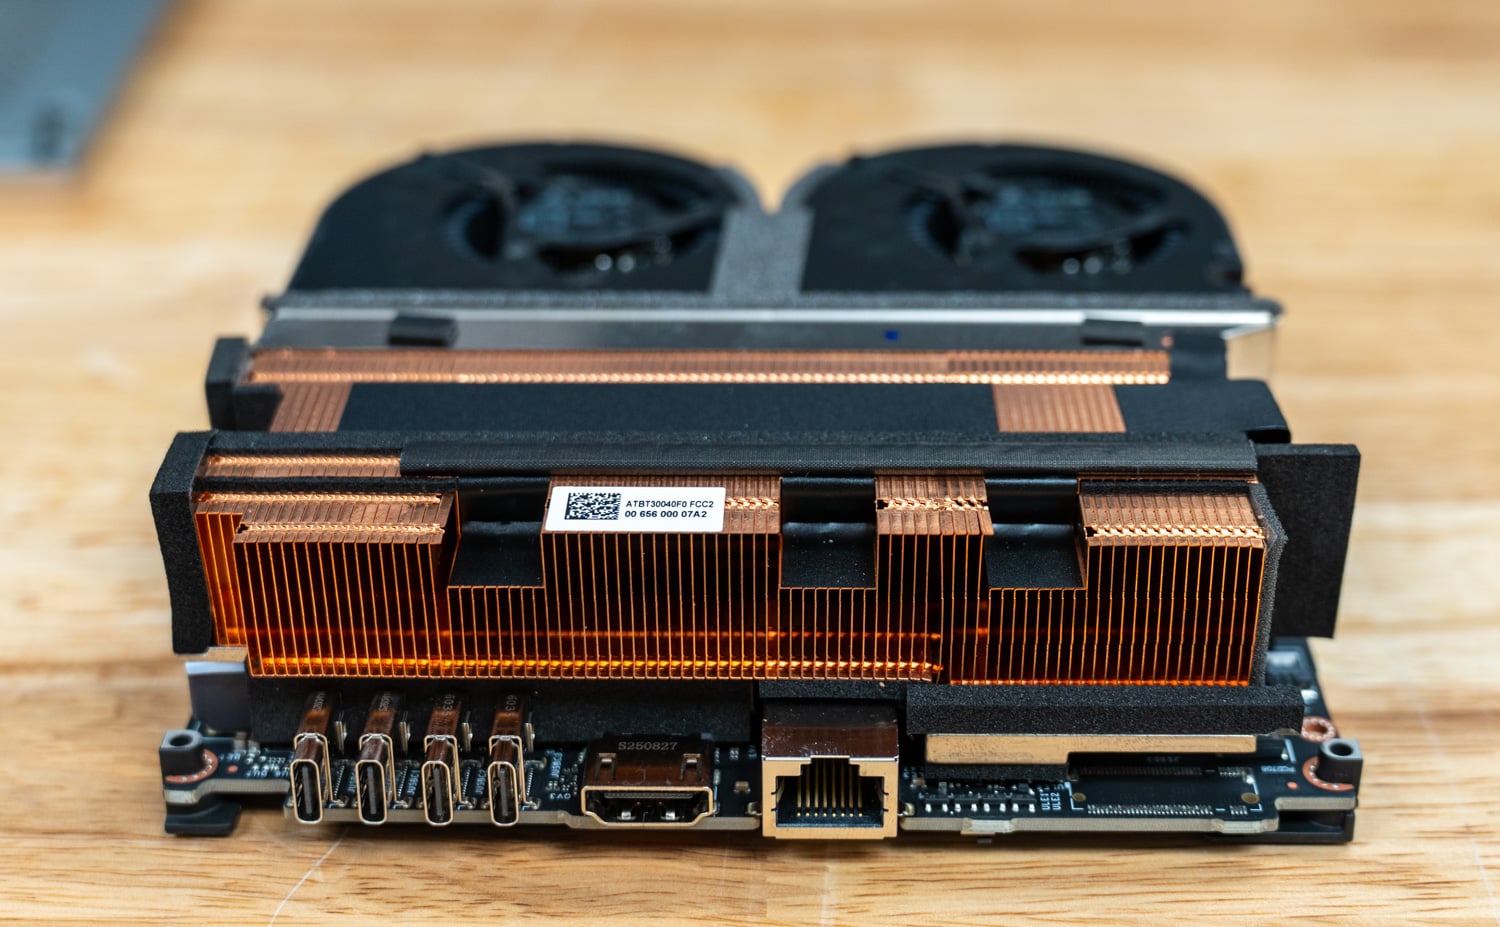
För kylning använde AMD en liknande metod som NVIDIAs DGX Spark, med dubbla fläktar som drar luft över en kylfläns med kylfläns och blåser ut den på baksidan av chassit.
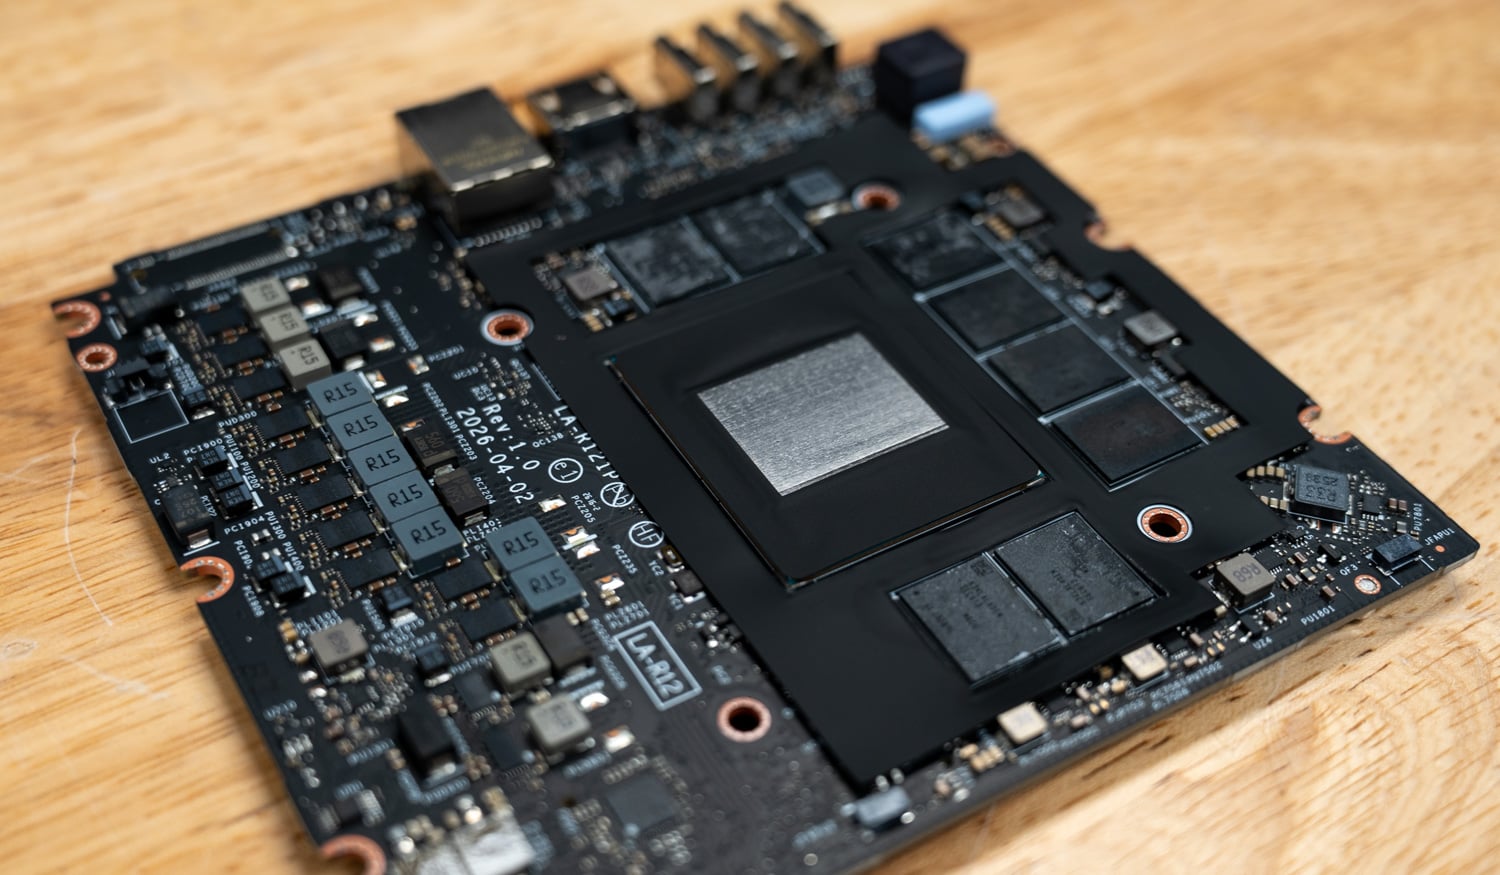
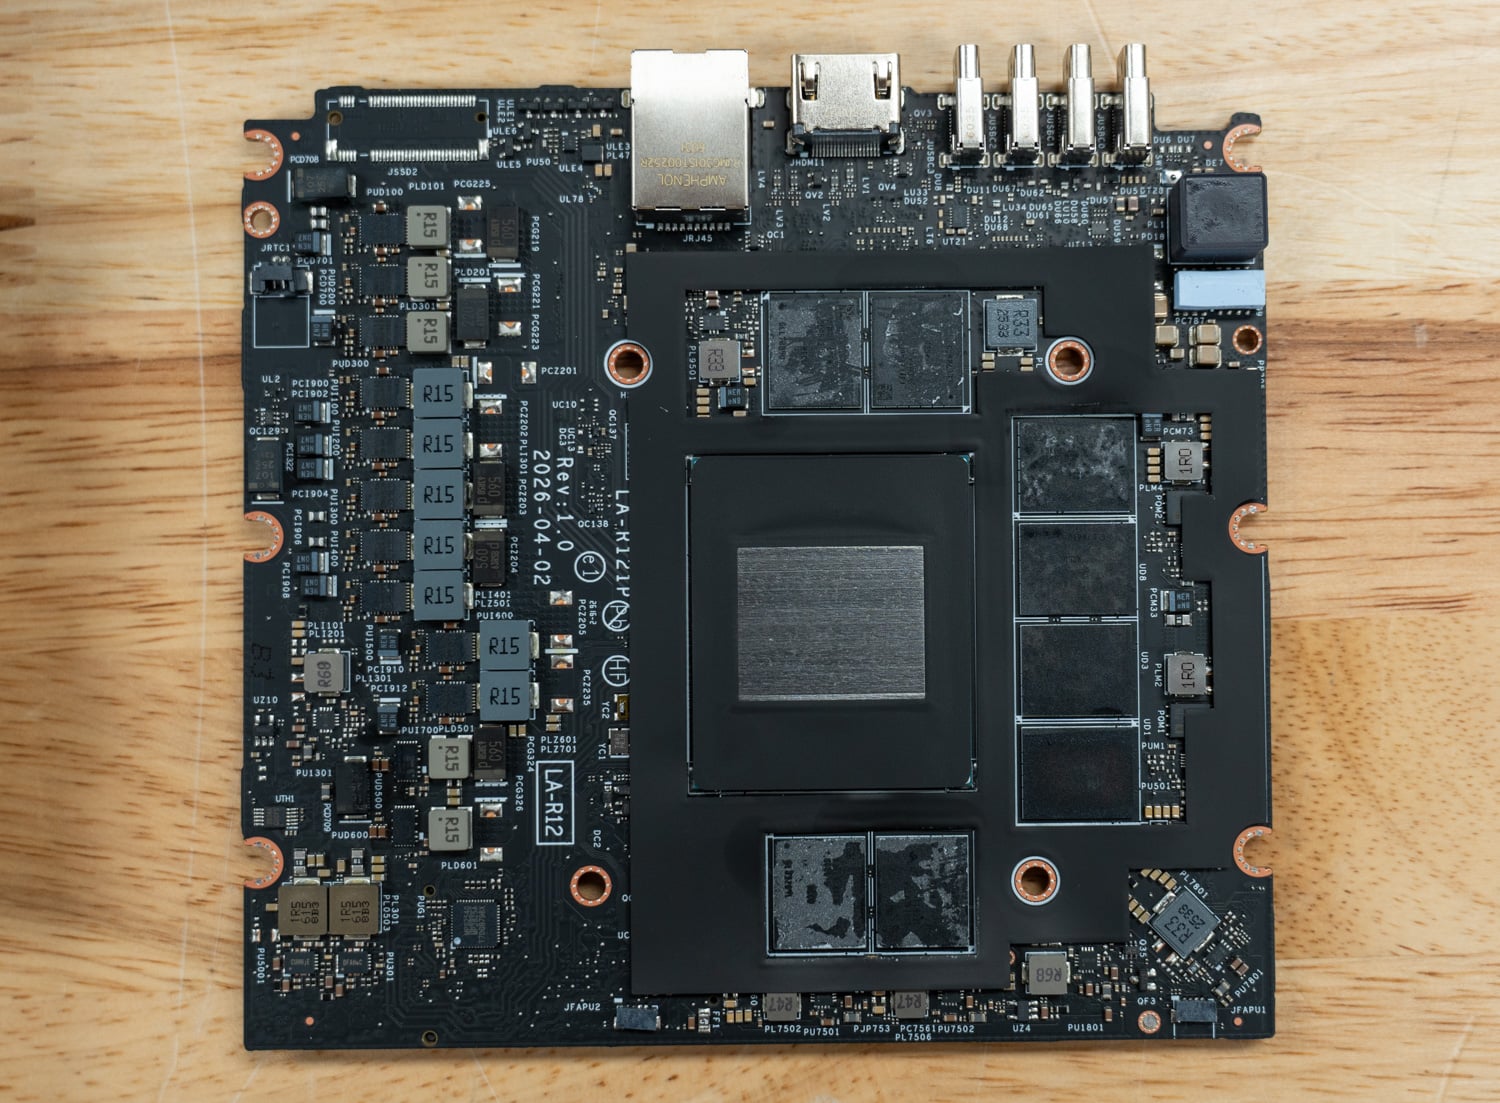
Med kylaggregatet bortlyft kommer moderkortet i sikte och avslöjar APU-chipet i mitten, flankerat av minnespaket på vardera sidan och VRM-kretsar som löper längs den vänstra kanten. Den silverfärgade fyrkanten som syns på chipet är inte flytande metall eller en pastabaserad förening; det är rester av en fast termisk kudde eller beläggning som AMD applicerat som gränssnitt mellan chipet och kylflänsen, vilket förklarar dess enhetliga, torra utseende snarare än det våta, utsmetade utseendet som pasta eller flytande metall vanligtvis lämnar efter sig.
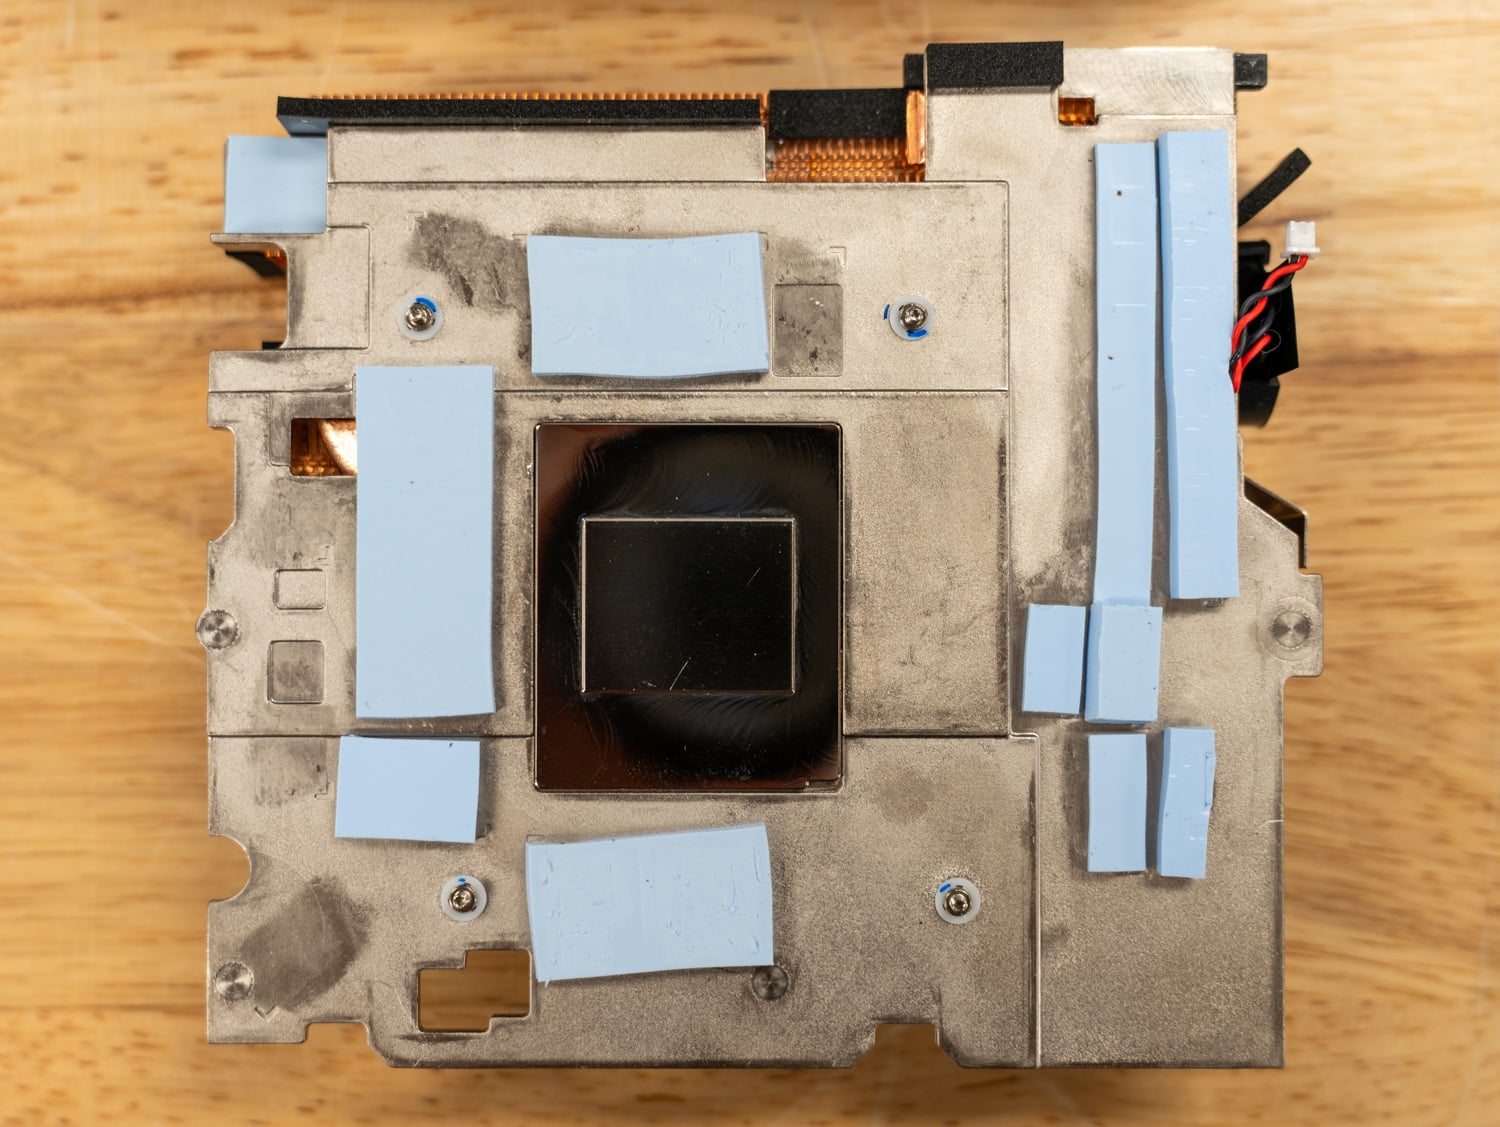
Genom att vända kylflänsen avslöjas undersidan av dess kalla platta, där en spegelblank sektion har direkt kontakt med chipet. Samtidigt är de omgivande minnes- och strömförsörjningszonerna täckta med förapplicerade termiska dynor av varierande tjocklek.
AMD Ryzen AI Halo prestandatestning
Vi utvärderade AMD Ryzen AI Halo-plattformen på Windows och Linux för att bedöma dess prestanda i arbetsstationsapplikationer och AI-fokuserade arbetsbelastningar. För Windows-tester jämfördes AMD Ryzen AI Halo-systemet med två kommersiellt tillgängliga system som drivs av Ryzen AI Max+ PRO 395: HP Z2 Mini G1a, en kompakt stationär arbetsstation, och HP ZBook Ultra G1a 14-tums, en mobil arbetsstation. Eftersom alla tre systemen delar samma underliggande processorarkitektur och integrerade Radeon 8060S-grafik, belyser dessa jämförelser hur Halo-plattformen presterar över olika termiska höljen och systemdesigner.
För Linux-testning övergick vi till AI-utveckling och lagringsarbetsbelastningar och jämförde Ryzen AI Halo-systemet med NVIDIA DGX Spark. Dessa tester fokuserade på FIO-lagringsbenchmarking och vLLM-inferensprestanda, och jämförde AMD:s Ryzen AI Halo-baserade utvecklarplattform med NVIDIA:s specialbyggda AI-utvecklingssystem för lokal storspråksmodellinferens.
Testade enheter
UL Procyon: AI-datorseende
Procyon AI Computer Vision Benchmark ger detaljerade insikter i hur AI-inferensmotorer presterar på professionell nivå. Genom att integrera motorer från flera leverantörer levereras prestandapoäng som korrekt återspeglar en enhets kapacitet. Benchmarken utvärderar toppmoderna neurala nätverksmodeller genom att jämföra deras AI-accelerationsprestanda över olika hårdvarutyper – inklusive CPU, GPU och NPU – vilket gör det möjligt för användare att bedöma relativ effektivitet över en rad olika arbetsbelastningar och förhållanden.
För att återspegla verkliga AI-arbetsbelastningar använder riktmärket sex olika neurala nätverksmodeller, var och en utvald för sin relevans för moderna datorseendeuppgifter. MobileNet V3 är en kompakt, mobilfokuserad modell designad för objektidentifiering i bilder, medan Inception V4 utför samma uppgift med en djupare, mer komplex arkitektur.
YOLO V3 (You Only Look Once) specialiserar sig på objektdetektering i realtid genom att uppskatta objektsannolikheter. DeepLab V3, byggt på MobileNet V2, fokuserar på semantisk bildsegmentering och pixelklustring. Real-ESRGAN, det mest beräkningskrävande testet, skalar upp bilder från 250×250 till 1 000×1 000 upplösning. Slutligen är ResNet 50 en robust klassificeringsmodell som möjliggör effektivare träning av djupa neurala nätverk.
Ryzen AI Halo-plattformen levererade genomgående stark AI-inferensprestanda över CPU- och GPU-arbetsbelastningar. I CPU-testerna uppnådde den en totalpoäng på 216, knappt efter HP Z2 Minis 227 och överträffade HP ZBook Ultras 186. GPU-inferensen var ännu mer imponerande, där Halo-systemet fick den högsta totalpoängen på 553, före ZBook Ultra (528) och Z2 Mini (528). Den registrerade också den snabbaste MobileNet V3-inferensen på 0.38 ms och slutförde den krävande REAL-ESRGAN-arbetsbelastningen på 185.08 ms, jämfört med 211.76 ms på Z2 Mini och 200.40 ms på ZBook Ultra.
| UL Procyon: AI-datorseendeinferens (ju lägre desto bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU-tider | |||
| AI-datorseendes totalpoäng (högre desto bättre) | 216 | 227 | 186 |
| MobileNet V3 | 0.73 ms | 0.75 ms | 1.09 ms |
| ResNet 50 | 6.02 ms | 5.99 ms | 6.84 ms |
| Inception V4 | 17.18 ms | 17.12 ms | 19.80 ms |
| DeepLab V3 | 29.21 ms | 21.20 ms | 28.27 ms |
| YOLO V3 | 35.60 ms | 36.58 ms | 41.64 ms |
| REAL-ESRGAN | 1,931.13 ms | 1,892.10 ms | 2,138.97 ms |
| GPU-tider | |||
| AI-datorseendes totalpoäng (högre desto bättre) | 553 | 528 | 583 |
| MobileNet V3 | 0.38 ms | 0.42 ms | 0.46 ms |
| ResNet 50 | 4.04 ms | 3.85 ms | 3.27 ms |
| Inception V4 | 13.26 ms | 15.15 ms | 11.62 ms |
| DeepLab V3 | 12.72 ms | 10.98 ms | 10.72 ms |
| YOLO V3 | 11.17 ms | 12.64 ms | 10.57 ms |
| REAL-ESRGAN | 185.08 ms | 211.76 ms | 200.40 ms |
UL Procyon: AI Text Generation
Procyon AI Text Generation Benchmark effektiviserar prestandatestning av AI LLM genom att tillhandahålla en koncis och konsekvent utvärderingsmetod. Den möjliggör upprepad testning över flera LLM-modeller samtidigt som den minimerar komplexiteten hos stora modellstorlekar och variabla faktorer. Utvecklad med ledande AI-hårdvara optimerar den användningen av lokala AI-acceleratorer för mer tillförlitliga och effektiva prestandabedömningar. Resultaten nedan mättes med TensorRT.
Referensplattformen Ryzen AI Halo ledde alla testade språkmodeller i Procyon AI Text Generation. Den uppnådde den högsta totala Phi-poängen på 1 192, jämfört med 965 för HP Z2 Mini och 922 för HP ZBook Ultra. Mistral följde en liknande trend med en poäng på 998, före 850 och 829, medan Llama3 slutade på 847 och överträffade konkurrerande system på 766 respektive 756. Halo-plattformen minskade också tiden till första token i alla modeller och producerade den första Phi-token på bara 0.996 sekunder, nästan hälften av latensen för HP-systemen. Även om tokengenereringshastigheten ibland gynnade Z2 Mini, resulterade Halo-plattformens betydligt lägre startlatens i de bästa totala benchmark-poängen.
| UL Procyon: AI Text Generation | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Phi totalpoäng | 1,192 | 965 | 922 |
| Phi-utgångstid till första token | 0.996 sekunder | 1.898 sekunder | 1.956 sekunder |
| Phi Output Tokens per sekund | 55.271 tokens/s | 68.967 tokens/s | 64.986 tokens/s |
| Phi total varaktighet | 56.237 sekunder | 52.666 sekunder | 55.501 sekunder |
| Mistral totalt resultat | 998 | 850 | 829 |
| Mistral-utgångstid till första token | 1.603 sekunder | 2.734 sekunder | 2.783 sekunder |
| Mistral Output Tokens per sekund | 35.027 tokens/s | 43.358 tokens/s | 41.992 tokens/s |
| Mistral total varaktighet | 88.582 sekunder | 81.716 sekunder | 84.065 sekunder |
| Llama3 Totalt resultat | 847 | 766 | 756 |
| Llama3-utgångstid till första token | 1.963 sekunder | 2.545 sekunder | 2.578 sekunder |
| Llama3 Output Tokens per sekund | 34.630 tokens/s | 36.752 tokens/s | 36.243 tokens/s |
| Llama3 Total Duration | 92.026 sekunder | 91.987 sekunder | 93.200 sekunder |
| Llama2 Totalt resultat | - | 936 | 929 |
| Llama2-utgångstid till första token | N/A sekunder | 3.813 sekunder | 3.860 sekunder |
| Llama2 Output Tokens per sekund | N/A tokens/s | 24.685 tokens/s | 24.619 tokens/s |
| Llama2 Total Duration | N/A sekunder | 136.077 sekunder | 136.720 sekunder |
UL Procyon: AI-bildgenerering
Procyon AI Image Generation Benchmark erbjuder ett konsekvent och noggrant sätt att mäta AI-inferensprestanda för hårdvara, från lågenergi-NPU:er till avancerade GPU:er. Det inkluderar tre tester: Stable Diffusion XL (FP16) för avancerade GPU:er, Stable Diffusion 1.5 (FP16) för måttligt kraftfulla GPU:er och Stable Diffusion 1.5 (INT8) för enheter med låg energi. Benchmarket använder den optimala inferensmotorn för varje system, vilket säkerställer rättvisa och jämförbara resultat.
Bildgenerering visade sig vara en av Ryzen AI Halos starkaste arbetsbelastningar. På Stable Diffusion 1.5 FP16 uppnådde Halo-plattformen en totalpoäng på 937, jämfört med 725 för Z2 Mini och 648 för ZBook Ultra, samtidigt som genereringstiden minskades till 106.7 sekunder, jämfört med 137.8 respektive 154.2 sekunder. Stable Diffusion XL visade en lika stark ledning, där Halo-systemet slutförde på 878.5 sekunder, cirka 174 sekunder snabbare än Z2 Mini och mer än 450 sekunder snabbare än ZBook Ultra. Plattformen slutförde också Stable Diffusion 1.5 INT8-riktmärket med en totalpoäng på 9 158, en arbetsbelastning som inte är tillgänglig på något av HP:s jämförelsesystem.
| UL Procyon: AI-bildgenerering | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Stabil Diffusion 1.5 (FP16) – Totalt resultat | 937 | 725 | 648 |
| Stabil Diffusion 1.5 (FP16) – Total tid | 106.7 sekunder | 137.815 sekunder | 154.203 sekunder |
| Stabil Diffusion 1.5 (FP16) – Bildgenereringshastighet | 6.670 s/bild | 8.613 s/bild | 9.638 s/bild |
| Stabil Diffusion 1.5 (INT8) – Totalt resultat | 9,158 | - | - |
| Stabil Diffusion 1.5 (INT8) – Total tid | 27.298 sekunder | - | - |
| Stable Diffusion 1.5 (INT8) – Bildgenereringshastighet | 3.412 s/bild | - | - |
| Stable Diffusion XL (FP16) – Totalt resultat | 682 | 570 | 451 |
| Stabil Diffusion XL (FP16) – Total tid | 878.493 sekunder | 1,052.468 sekunder | 1,329.592 sekunder |
| Stable Diffusion XL (FP16) – Bildgenereringshastighet | 54.906 s/bild | 65.779 s/bild | 83.100 s/bild |
SPECworkstation 4
SPECworkstation 4.0-benchmarket är ett omfattande verktyg för att utvärdera alla viktiga aspekter av arbetsstationers prestanda. Det ger ett verkligt mått på CPU-, grafik-, accelerator- och diskprestanda, vilket ger yrkesverksamma den data som behövs för att fatta välgrundade beslut om sina hårdvaruinvesteringar. Benchmarket inkluderar en dedikerad uppsättning tester inriktade på AI- och ML-arbetsbelastningar, såsom data science-uppgifter och ONNX Runtime-baserade inferenstester, vilket återspeglar den växande betydelsen av AI/ML i arbetsstationsmiljöer. Det täcker sju branschvertikaler och fyra hårdvaruundersystem och ger ett detaljerat och relevant mått på dagens arbetsstationers prestanda.
SPECworkstation 4 lyfte fram de balanserade arbetsstationsfunktionerna hos Ryzen AI Halo-plattformen. Den fick högsta poäng inom finansiella tjänster (2.92), media och underhållning (2.97), produktdesign (2.22) och produktivitet och utveckling (1.27), och överträffade både HP Z2 Mini och HP ZBook Ultra i dessa kategorier. Z2 Mini hade en liten ledning inom energi (2.50 vs. 2.35) och livsvetenskap (2.60 vs. 2.33). Sammantaget visade Halo-referensplattformen stark prestanda över riktmärkets professionella arbetsbelastningar och förblev konkurrenskraftig i alla testada kategorier.
| SPECworkstation 4.0.0 (Högre är bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Energi | 2.35 | 2.50 | 2.20 |
| Financial Services | 2.92 | 2.35 | 1.60 |
| Life Sciences | 2.33 | 2.60 | 2.20 |
| Media & underhållning | 2.97 | 2.22 | 1.90 |
| Produkt Design | 2.22 | 2.00 | 1.74 |
| Produktivitet & Utveckling | 1.27 | 1.00 | 1.03 |
Luxmark
Luxmark är ett GPU-riktmärke som använder LuxRender, en öppen källkod för strålspårningsrenderare, för att utvärdera ett systems prestanda med mycket detaljerade 3D-scener. Detta riktmärke är användbart för att bedöma de grafiska renderingsfunktionerna hos servrar och arbetsstationer, särskilt för visuella effekter och arkitektoniska visualiseringstillämpningar, där noggrann ljussimulering är avgörande.
Luxmarks resultat visade minimal skillnad mellan de tre Ryzen AI Max+ 395-plattformarna. Halo-referenssystemet hade den högsta Food-poängen på 4 158, och slog därmed Z2 Mini (3 943) och ZBook Ultra (3 915). I Hallbench-arbetsbelastningen fick den 8 014 poäng, något efter Z2 Minis 8 477 men före ZBook Ultras 7 833. Sammantaget tyder resultaten på att system byggda kring Radeon 8060S levererar mycket liknande strålspårningsprestanda oavsett formfaktor.
| Luxmark (Högre är bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Hallbänk | 8,014 | 8,477 | 7,833 |
| Tillsammans med | 4,158 | 3,943 | 3,915 |
7-zip-komprimering
7-Zip Compression Benchmark utvärderar CPU-prestanda under komprimering och dekomprimering, och mäter prestanda i GIPS (Giga Instructions Per Second) och CPU-användning. Högre GIPS och effektiv CPU-användning indikerar överlägsen prestanda.
Ryzen AI Halo-plattformen ledde alla större kategorier i 7-Zip-testet. Den uppnådde en komprimeringsgrad på 176.7 GIPS, jämfört med 139.3 GIPS på HP Z2 Mini och 139.6 GIPS på ZBook Ultra. Dekomprimeringsprestandan förblev lika stark på 191.6 GIPS, vilket överträffade Z2 Minis 164.0 GIPS och ZBook Ultras 174.0 GIPS. Tillsammans uppnådde Halo-plattformen den högsta totala bedömningen på 184.2 GIPS, vilket överträffade konkurrerande system med ungefär 20 % och visade utmärkt heltalsgenomströmning för arbetsbelastningar för att skapa och extrahera arkiv.
| 7-Zip Compression Benchmark (Högre är bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| komprimera | ||||||
| Aktuell CPU-användning | 2,741% | 2,734% | 2,868% | |||
| Aktuellt betyg/användning | 6.370 XNUMX GIPS | 5.136 XNUMX GIPS | 4.883 XNUMX GIPS | |||
| Ström | 174.589 XNUMX GIPS | 140.405 XNUMX GIPS | 140.061 XNUMX GIPS | |||
| Resulterande CPU-användning | 2,751% | 2,718% | 2,855% | |||
| Resulterande betyg/användning | 6.424 XNUMX GIPS | 5.126 XNUMX GIPS | 4.890 XNUMX GIPS | |||
| Resulterande betyg | 176.742 XNUMX GIPS | 139.298 XNUMX GIPS | 139.617 XNUMX GIPS | |||
| Dekomprimering | ||||||
| Aktuell CPU-användning | 2,568% | 2,343% | 2,904% | |||
| Aktuellt betyg/användning | 7.670 XNUMX GIPS | 6.805 XNUMX GIPS | 6.029 XNUMX GIPS | |||
| Ström | 196.986 XNUMX GIPS | 159.451 XNUMX GIPS | 175.104 XNUMX GIPS | |||
| Resulterande CPU-användning | 2,469% | 2,414% | 2,887% | |||
| Resulterande betyg/användning | 7.766 XNUMX GIPS | 6.793 XNUMX GIPS | 6.028 XNUMX GIPS | |||
| Resulterande betyg | 191.645 XNUMX GIPS | 163.969 XNUMX GIPS | 174.046 XNUMX GIPS | |||
| Totalt betyg | ||||||
| Total CPU-användning | 2,610% | 2,566% | 2,871% | |||
| Totalt betyg/användning | 7.095 XNUMX GIPS | 5.959 XNUMX GIPS | 5.459 XNUMX GIPS | |||
| Totalt betyg | 184.194 XNUMX GIPS | 151.634 XNUMX GIPS | 156.832 XNUMX GIPS | |||
Blender Benchmark
Blender är ett 3D-modelleringsprogram med öppen källkod. Detta benchmark kördes med Blender Benchmark-verktyget. Poängen mäts i samplingar per minut, där högre värden indikerar bättre prestanda.
CPU-rendering var ett annat område där Ryzen AI Halo utmärkte sig. I Monster-scenen uppnådde den 244.7 samplingar per minut, före HP Z2 Mini (224.3) och HP ZBook Ultra (189.3). Junkshop följde med 159.4 samplingar per minut, jämfört med 149.5 och 129.4, medan Classroom slutförde med 131.6 samplingar per minut, vilket överträffade Z2 Mini (116.3) med ungefär 13 % och ZBook Ultra (94.1) med nästan 40 %. Dessa resultat visar att Ryzen AI Max+ 395 levererar utmärkt flertrådad renderingsprestanda trots sin kompakta arbetsstationsstorlek.
| Blender Benchmark CPU (samplingar per minut, högre desto bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 244.7 prover/m² | 224.3 prover/m² | 189.29 prover/m² |
| Junkshop | 159.4 prover/m² | 149.5 prover/m² | 129.42 prover/m² |
| Klassrum | 131.6 prover/m² | 116.3 prover/m² | 94.14 prover/m² |
Resultaten för GPU-rendering var mycket mer jämförbara mellan systemen. Halo-referensplattformen renderade Monster-scenen med 704.2 samplingar per minut, vilket var efter Z2 Mini (745.6) men före ZBook Ultra (661.5). Junkshop låg effektivt mellan Halo-plattformen (366.6) och Z2 Mini (366.5). Samtidigt hade Halo-systemet den högsta Classroom-poängen med 361.5 samplingar per minut, vilket knappt översteg Z2 Mini (359.0) och ZBook Ultra (333.3). Resultaten indikerar att Radeon 8060S levererar anmärkningsvärt konsekvent GPU-renderingsprestanda över olika implementeringar.
| Blender Benchmark GPU (samplingar per minut, högre desto bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 704.2 prover/m² | 745.55 prover/m² | 661.50 prover/m² |
| Junkshop | 366.6 prover/m² | 366.54 prover/m² | 341.92 prover/m² |
| Klassrum | 361.51 prover/m² | 359.01 prover/m² | 333.26 prover/m² |
y-cruncher
y-cruncher är ett flertrådat, skalbart program som kan beräkna Pi och andra matematiska konstanter upp till biljoner siffror. Sedan lanseringen 2009 har det blivit ett populärt verktyg för benchmarking och stresstestning för överklockare och hårdvaruentusiaster.
Y-cruncher-resultaten fördelade sig längs beräkningsstorleken. Vid körningar på 1 miljard och 2.5 miljarder siffror avslutade alla tre systemen inom några tiondels sekunder från varandra, med HP-systemen något före. Allt eftersom arbetsbelastningen ökade drog Halo igång och slutförde beräkningen på 5 miljarder siffror på 71.948 sekunder, jämfört med 75.021 sekunder för Z2 Mini och 78.19 sekunder för ZBook Ultra. Vid 10 miljarder siffror avslutade Halo på 151.409 sekunder, ungefär 6 % före Z2 Mini och 12 % före ZBook Ultra, vilket tyder på att skrivbordschassit klarar tung flertrådad belastning bättre när körtiderna sträcker sig.
| Y-Cruncher (total beräkningstid) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 miljard | 13.193 sekunder | 12.965 sekunder | 12.93 sekunder |
| 2.5 miljard | 34.578 sekunder | 34.533 sekunder | 34.91 sekunder |
| 5 miljard | 71.948 sekunder | 75.021 sekunder | 78.19 sekunder |
| 10 miljard | 151.409 sekunder | 160.252 sekunder | 171.72 sekunder |
Geekbench 6
Geekbench 6 är ett plattformsoberoende benchmark som mäter systemets totala prestanda.
Geekbench 6 förstärkte Halo-plattformens balanserade prestandaprofil. Den uppnådde den högsta poängen för enkärnig processor på 2 986, före HP Z2 Mini (2 862) och ZBook Ultra (2 825). Flerkärnig prestanda ledde också jämförelsen med 18 068. Radeon 8060S noterade den högsta OpenCL GPU-poängen på 92 883, vilket knappt överträffade Z2 Mini (91 591) och överträffade ZBook Ultra (85 337) med god marginal. De konsekventa fördelarna i CPU- och GPU-tester illustrerar den väl avrundade prestandan hos Ryzen AI Max+ 395-plattformen.
| Geekbench 6 (Högre är bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU enkelkärnig | 2,986 | 2,862 | 2,825 |
| CPU Multi-Core | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 är ett allmänt erkänt riktmärke för att utvärdera CPU-prestanda i 3D-renderingsarbetsbelastningar. Drivs av Cinema 4D-motorn mäter den hur väl en processor hanterar enkeltrådade och flertrådade uppgifter, vilket ger insikt i övergripande respons och parallella bearbetningsmöjligheter.
Cinebench R23 visade en mycket jämn tävling mellan de två Ryzen AI Max+ 395-implementeringarna för stationära datorer. Halo-referensplattformen hade en flerkärnig poäng på 37 316, vilket överträffade HP Z2 Minis 37 156, medan båda enkelt överträffade HP ZBook Ultras 29 112. Prestandan för enkärnig processor följde samma mönster, med Halo-plattformen som fick 2 047 poäng, jämfört med 2 020 för Z2 Mini och 1 984 för ZBook Ultra. Även om marginalerna gentemot Z2 Mini var små, slutade Halo-systemet konsekvent i toppen av riktmärket.
| Cinebench R23 (Högre är bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Med flera kärnor | 37,316 | 37,156 | 29,112 |
| Single-core | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 bygger vidare på grunden från R23 genom att introducera GPU-baserade renderingstester samtidigt som fokus bibehålls på CPU-prestanda. För detta segment undersöker vi endast CPU-poängen, vilka ger uppdaterad insikt i hur väl varje system hanterar moderna 3D-renderinguppgifter.
Det nyare Cinebench 2024-riktmärket speglade R23-resultaten. Ryzen AI Halo noterade den högsta flerkärniga poängen på 1 916, knappt före HP Z2 Mini (1 906) och bibehöll en betydande ledning över HP ZBook Ultra (1 579). Prestanda med en enda kärna gynnade också Halo-plattformen, med 116 poäng jämfört med 112 för Z2 Mini och 111 för ZBook Ultra. Även om skillnaderna mellan stationära system förblev små, förstärker resultaten Ryzen AI Max+ 395:s förmåga att leverera konsekvent förstklassig CPU-renderingsprestanda.
| Cinebench 2024 (Högre är bättre) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Med flera kärnor | 1,916 | 1,906 | 1,579 |
| Single-core | 116 | 112 | 111 |
Phoronix-riktmärken
Phoronix Test Suite är en automatiserad benchmarkingplattform med öppen källkod som stöder över 450 testprofiler och mer än 100 testsviter via OpenBenchmarking.org. Den hanterar allt från att installera beroenden till att köra tester och samla in resultat, vilket gör den idealisk för prestandajämförelser, hårdvaruvalidering och kontinuerlig integration. Vi kommer att titta på prestanda i Stream-, 7-Zip- och LLVM-tester.
När vi tittade på Phoronix-benchmarksviten observerade vi en ganska jämn fördelning mellan AMD Ryzen AI Halo-plattformen och NVIDIA DGX Spark. Ryzen AI Halo-systemet ledde konsekvent CPU-centrerade arbetsbelastningar och överträffade DGX Spark med 11 % i 7-Zip-komprimering, 38 % i 7-Zip-dekomprimering och slutförde LLVM-kompileringstestet 14 % snabbare. DGX Spark, å andra sidan, visade starkare, ihållande minnesbandbredd och ledde STREAM Scale-, Triad- och Add-testerna med 17 %, 13 % respektive 15 %. Halo behöll en fördel på 18 % i STREAM Copy-benchmarket, vilket illustrerar att även om båda systemen är mycket kapabla, gynnar Ryzen AI Halo-plattformen generell beräkningsprestanda, medan DGX Spark uppvisar högre dataflöde i minnesbandbreddsfokuserade arbetsbelastningar.
| Testa | AMD Ryzen AI Halo | NVIDIA DGX Spark | Vinnare |
|---|---|---|---|
| 7-Zip-komprimering (MIPS) | 186,921 | 169,052 | Halo (+11%) |
| 7-Zip-dekompression (MIPS) | 146,109 | 106,084 | Halo (+38%) |
| STREAM-kopiering (MB/s) | 145,363 | 123,730 | Halo (+18%) |
| STREAM-skala (MB/s) | 110,611 | 128,970 | Gnista (+17%) |
| STREAM-triaden (MB/s) | 107,105 | 121,433 | Gnista (+13%) |
| STREAM Lägg till (MB/s) | 107,022 | 122,815 | Gnista (+15%) |
| LLVM-kompilering (märke, sekunder) | 431.8 | 504.3 | Halo (14 % snabbare) |
FIO-prestandamåttstock
För att mäta lagringsprestanda över vanliga branschmått använder vi fio. Vårt traditionella SSD-test förutsätter att varje hårddisk fylls två gånger som en sekundär hårddisk; här testade vi varje hårddisk i systemet, via filsystemet. Vi testade tidigare NVIDIA-systemen med GDSIO, men AMD erbjuder inte ett jämförbart GPU-direktlagringstest, så att köra fio på filsystemnivå på båda plattformarna ger dem lika villkor, vilket är viktigare än att jämföra hårddiskarna separat.
Både NVIDIA DGX Spark (Founders Edition) och AMD Ryzen AI Halo levereras med en PCIe Gen5-hårddisk, så på pappret har de två plattformarna identiska tak för rå bandbredd. I praktiken körs dock Halos hårddisk med PCIe Gen4-länkhastigheter i det här systemet, vilket begränsar den tillgängliga bandbredden långt under vad hårddisken själv klarar av. Den begränsningen i länkhastighet är värd att ha i åtanke genom hela det här avsnittet, eftersom den står för en betydande del av bandbreddsgapet mellan de två plattformarna.
I det här avsnittet fokuserar vi på följande FIO-riktmärken:
- 128K sekventiell
- 64K slumpmässigt
- 16K sekventiell
- 16K slumpmässigt
- 4K slumpmässigt
128K sekventiell läsning
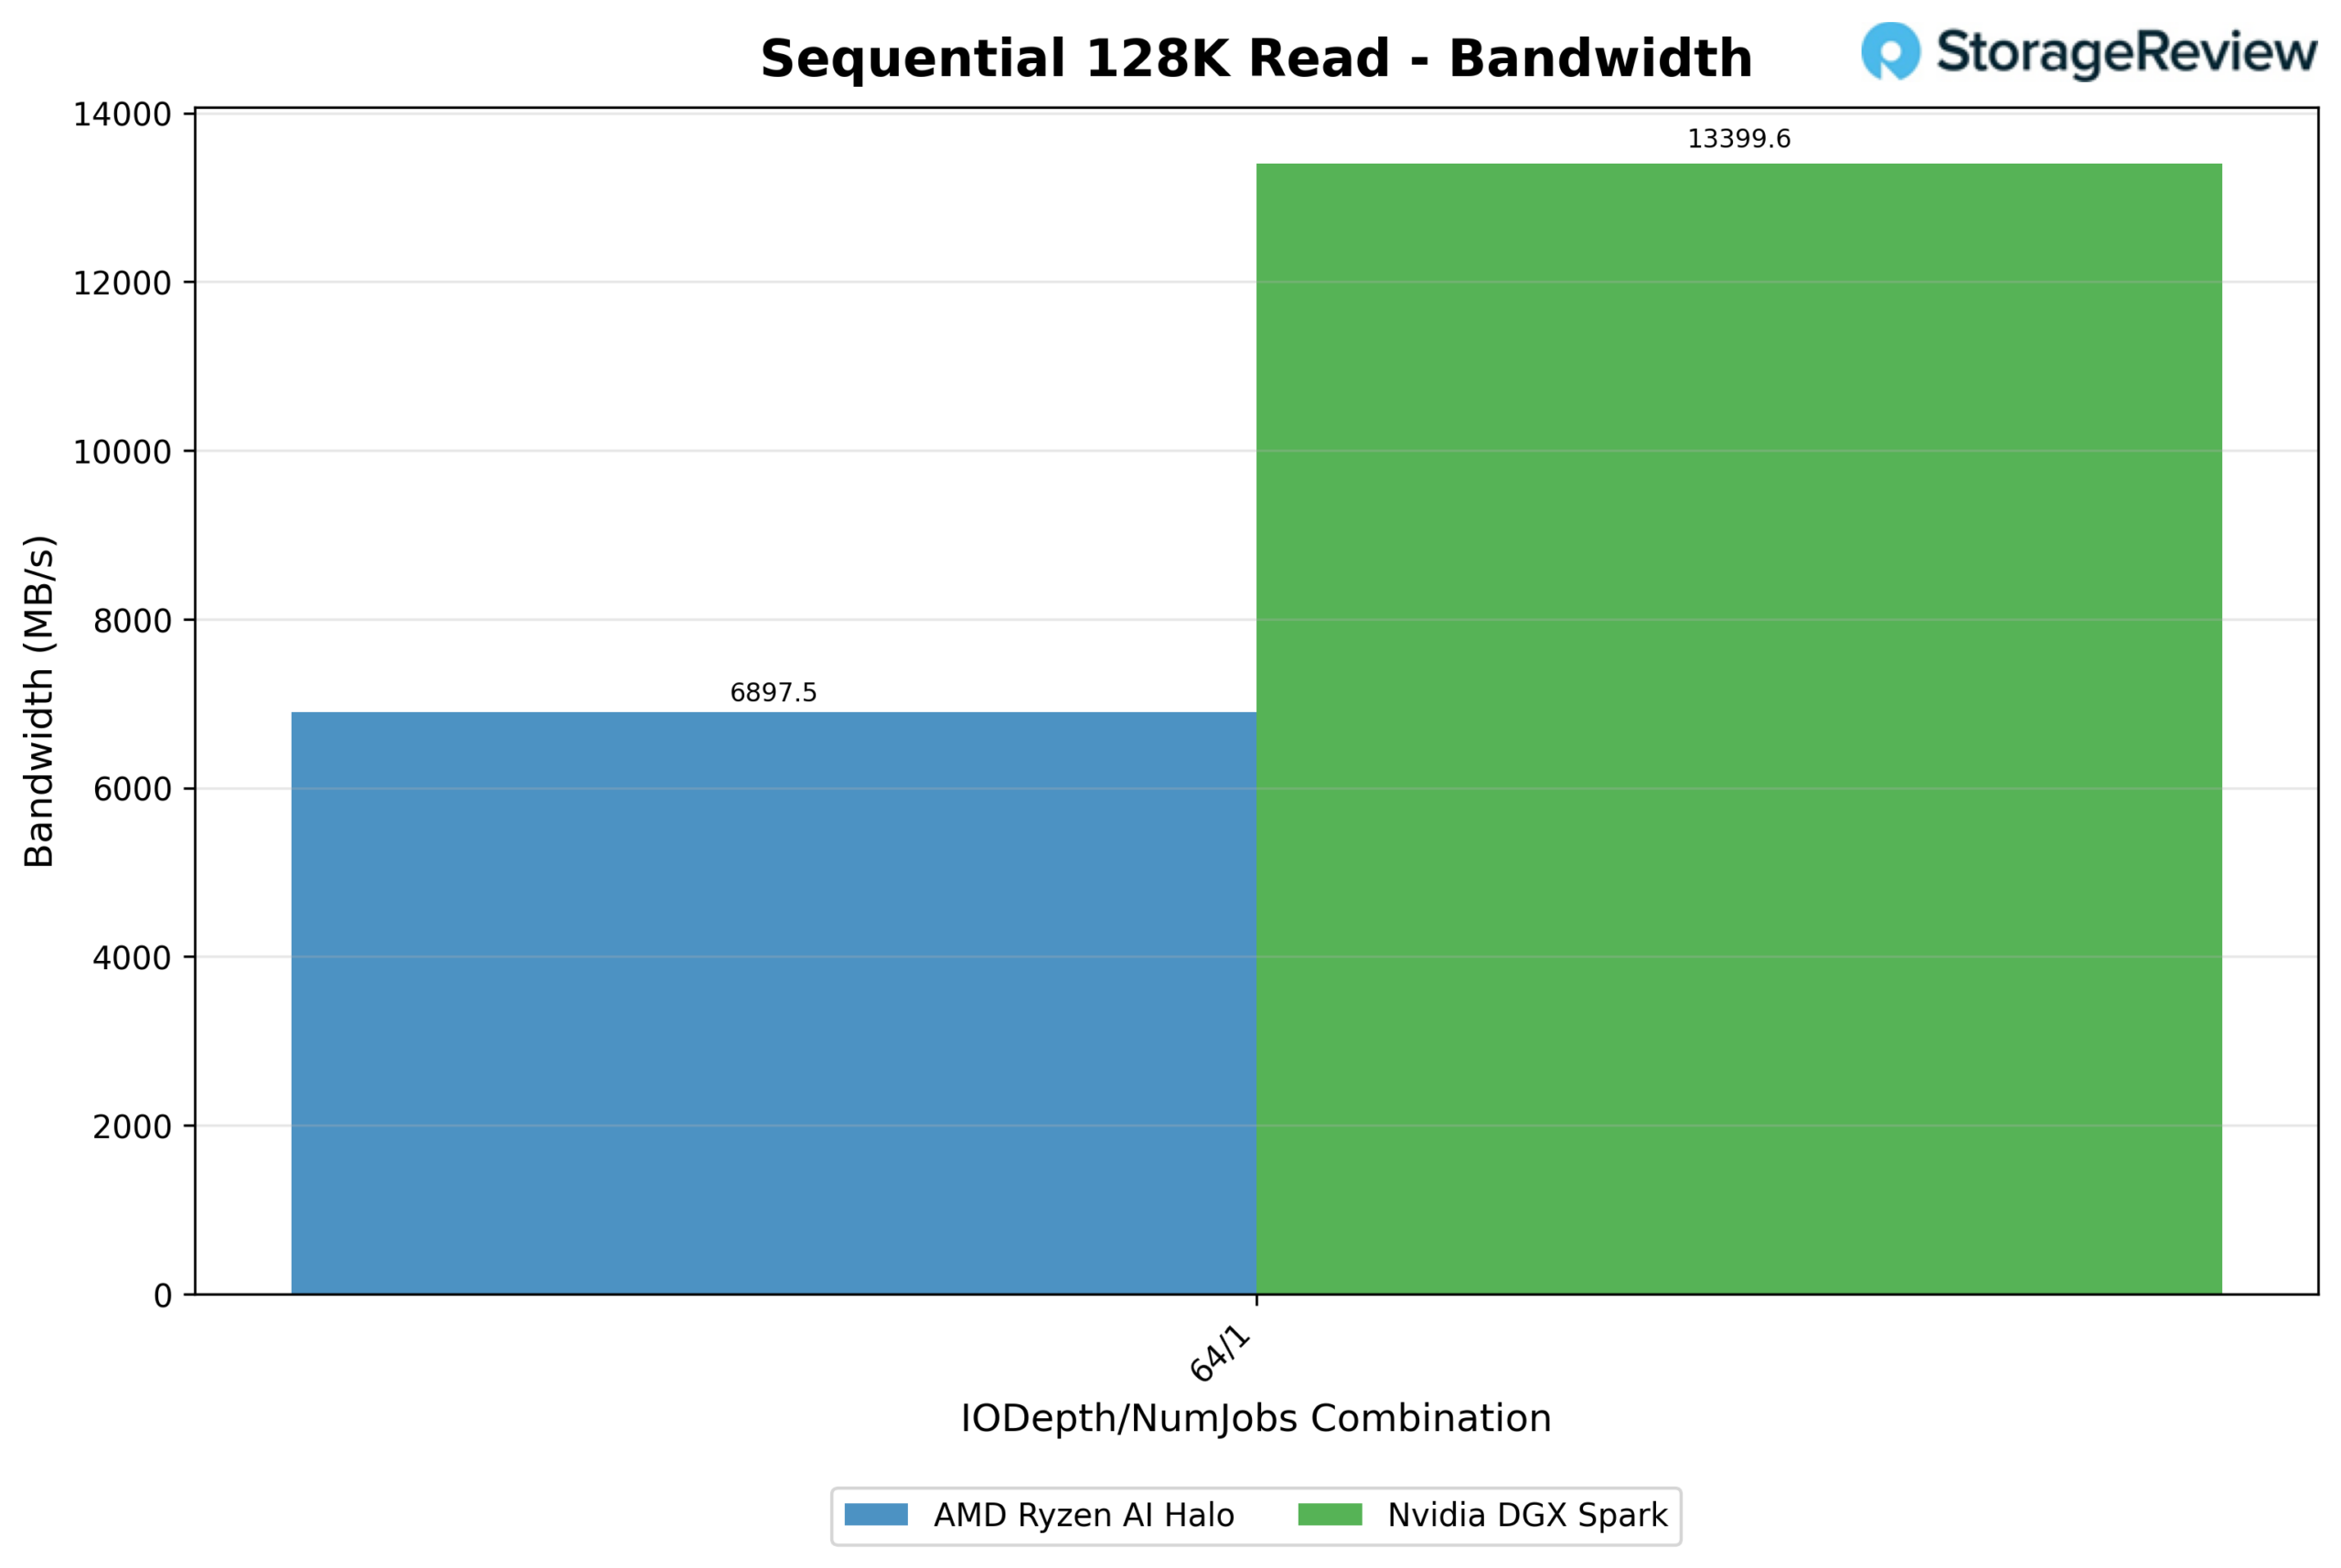
Vid en enkeltrådad, djup köbaserad 128K sekventiell läsning (64/1) hade NVIDIA DGX Spark 13 399,6 MB/s, nästan dubbelt så mycket som AMD Ryzen AI Halos 6 897,5 MB/s. Latensen följde samma mönster: Sparks genomsnittliga latens på detta djup var 0.597 ms, medan Halo låg efter på 1.159 ms, nästan dubbelt så långsamt per begäran trots att hälften av datan flyttades. Detta är det tydligaste gapet över hela svepningen, vilket tyder på att Sparks lagringsstack är byggd för högre, ihållande sekventiell dataflöde vid denna blockstorlek.
128K sekventiell skrivning
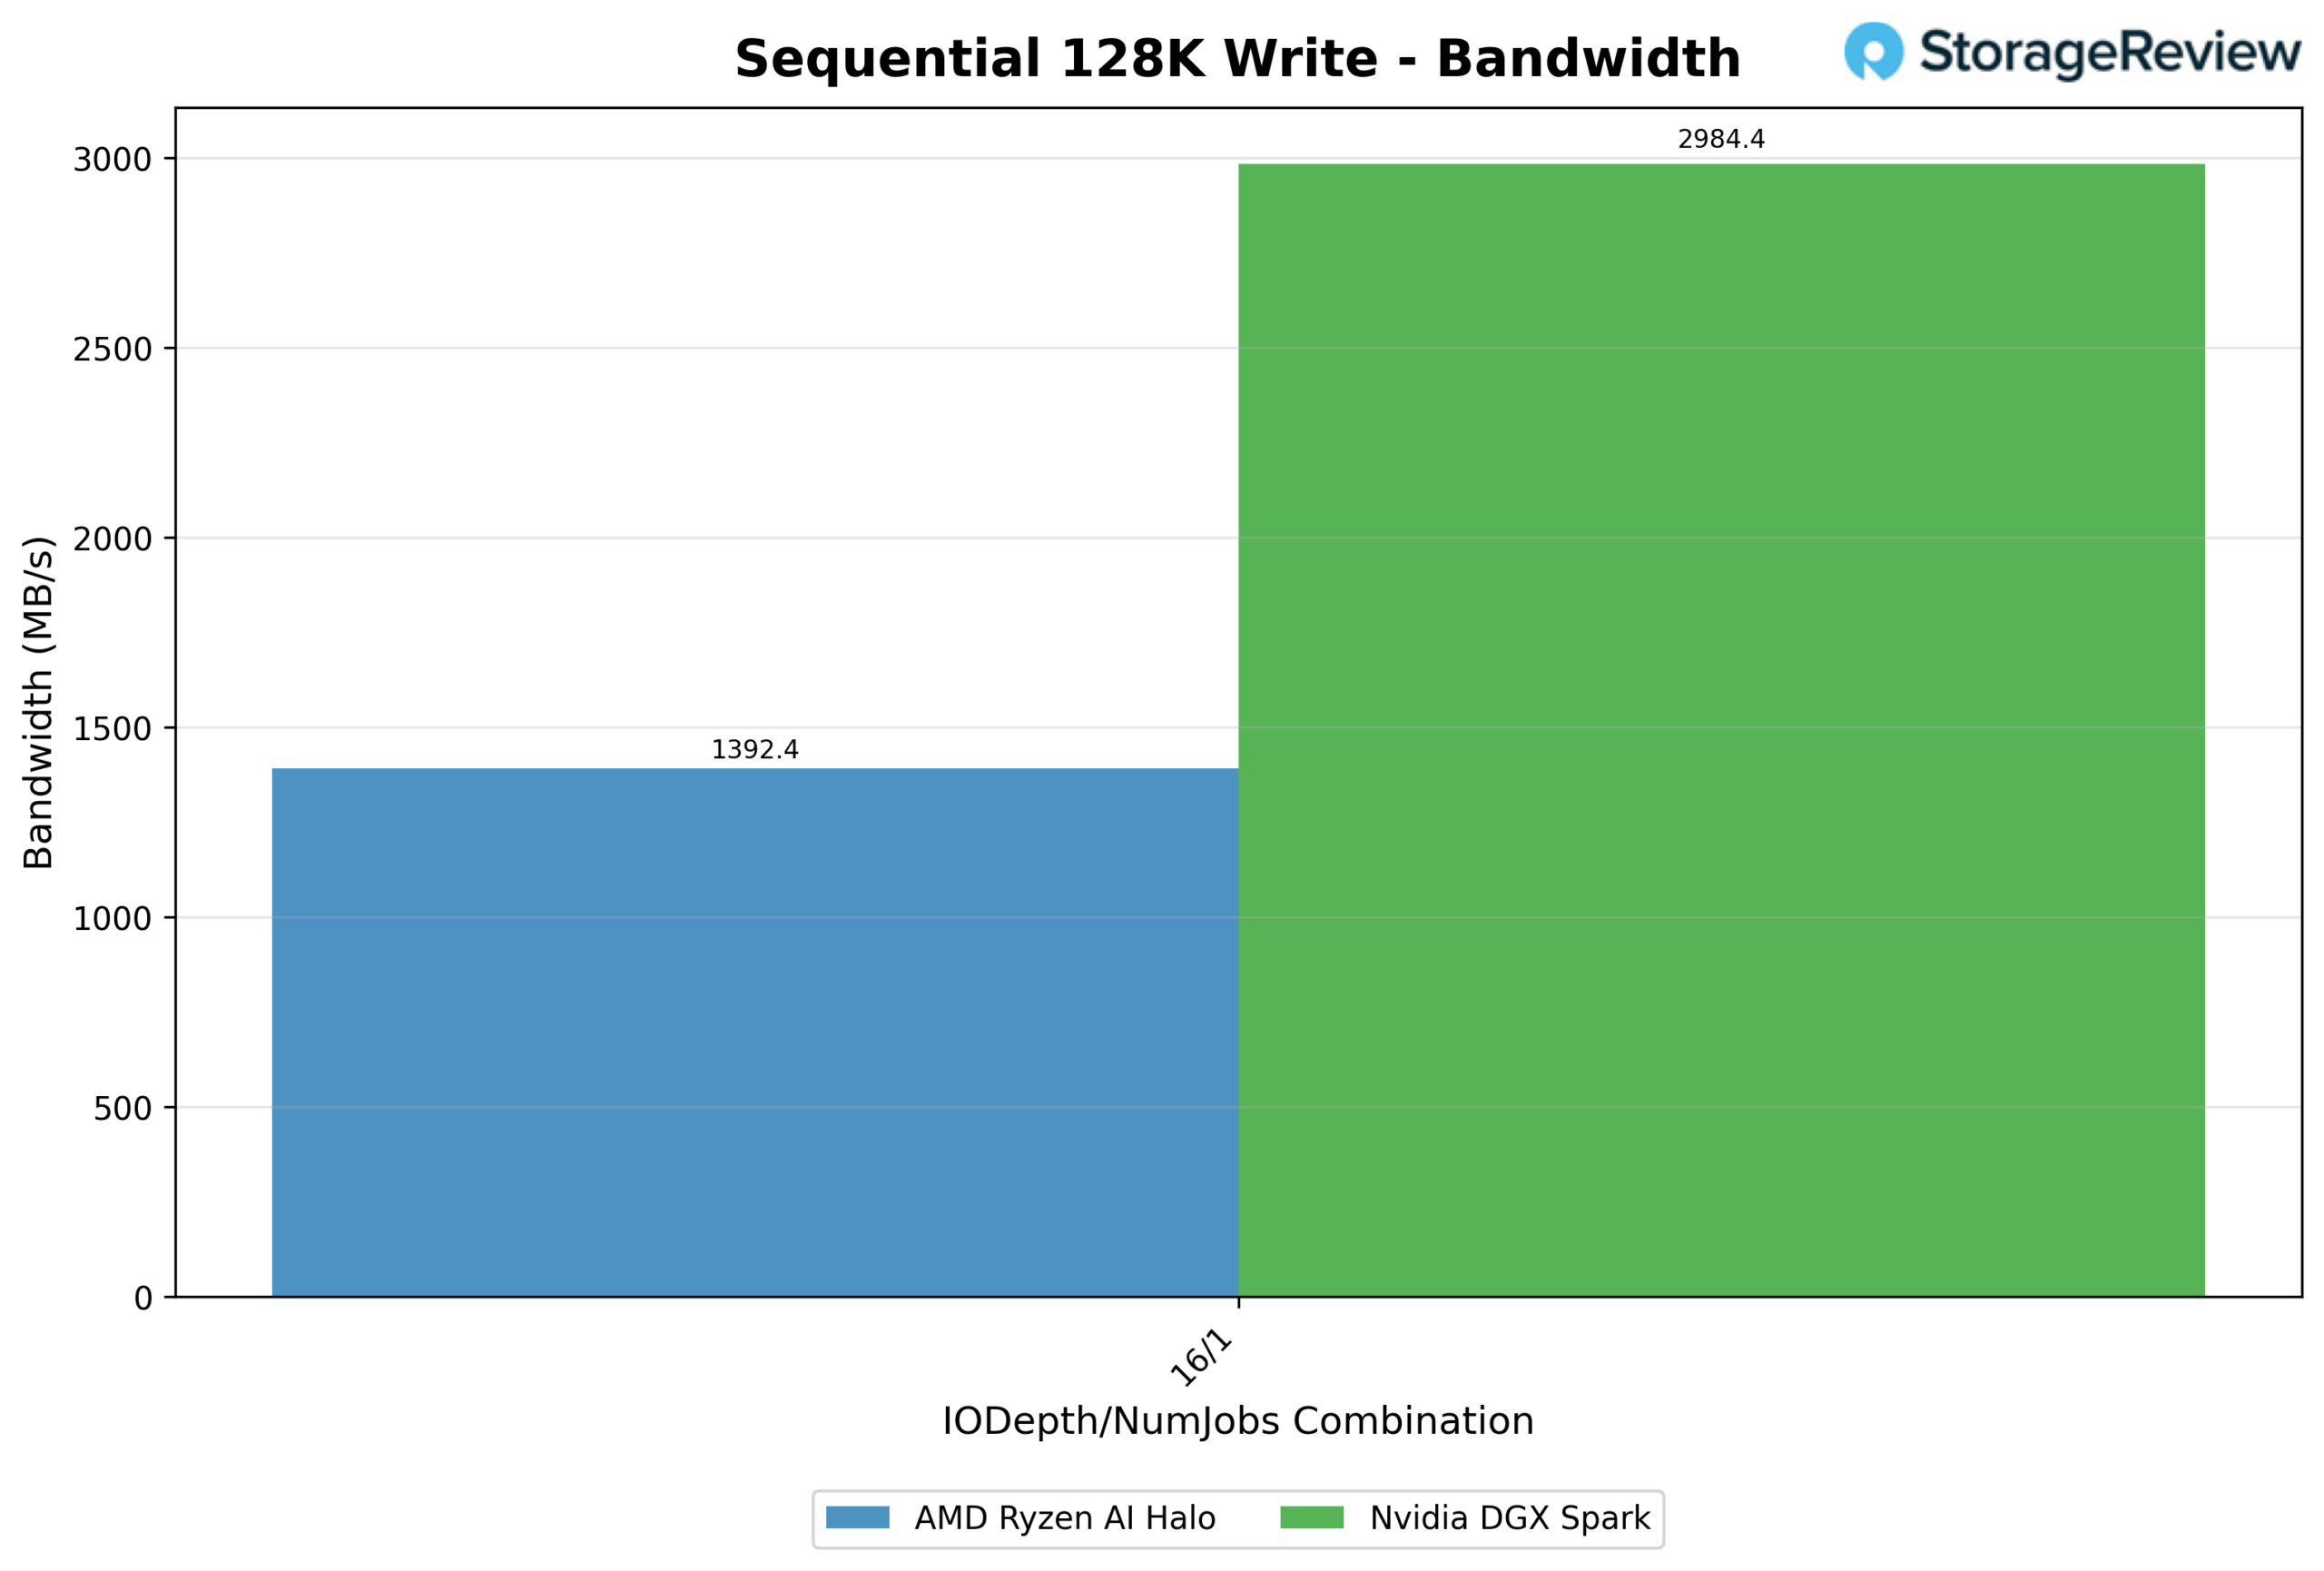
Skrivsidan berättar en liknande historia. Vid IODepth 16/1 nådde Spark 2 984,4 MB/s, jämfört med Halos 1 392,4 MB/s, en fördel på 114 % för NVIDIA. Latensen gynnade återigen Spark, på 0.67 ms jämfört med Halos 1.436 ms. Kombinerat med läsresultaten är 128K sekventiell Sparks starkaste resultat jämfört med Halo.
64K slumpmässig läsning
Det är här Halos fördel med låg ködjupslatens verkligen visar sig. Vid 1/1 svarade Halo på bara 0.051 ms, jämfört med Sparks 0.275 ms, över 5 gånger snabbare för en enda utestående förfrågan. Den skillnaden kvarstår över låga till medelhöga ködjup, där Halo ligger långt under 0.2 ms medan Spark ligger i intervallet 0.2–0.45 ms under större delen av svepningen.
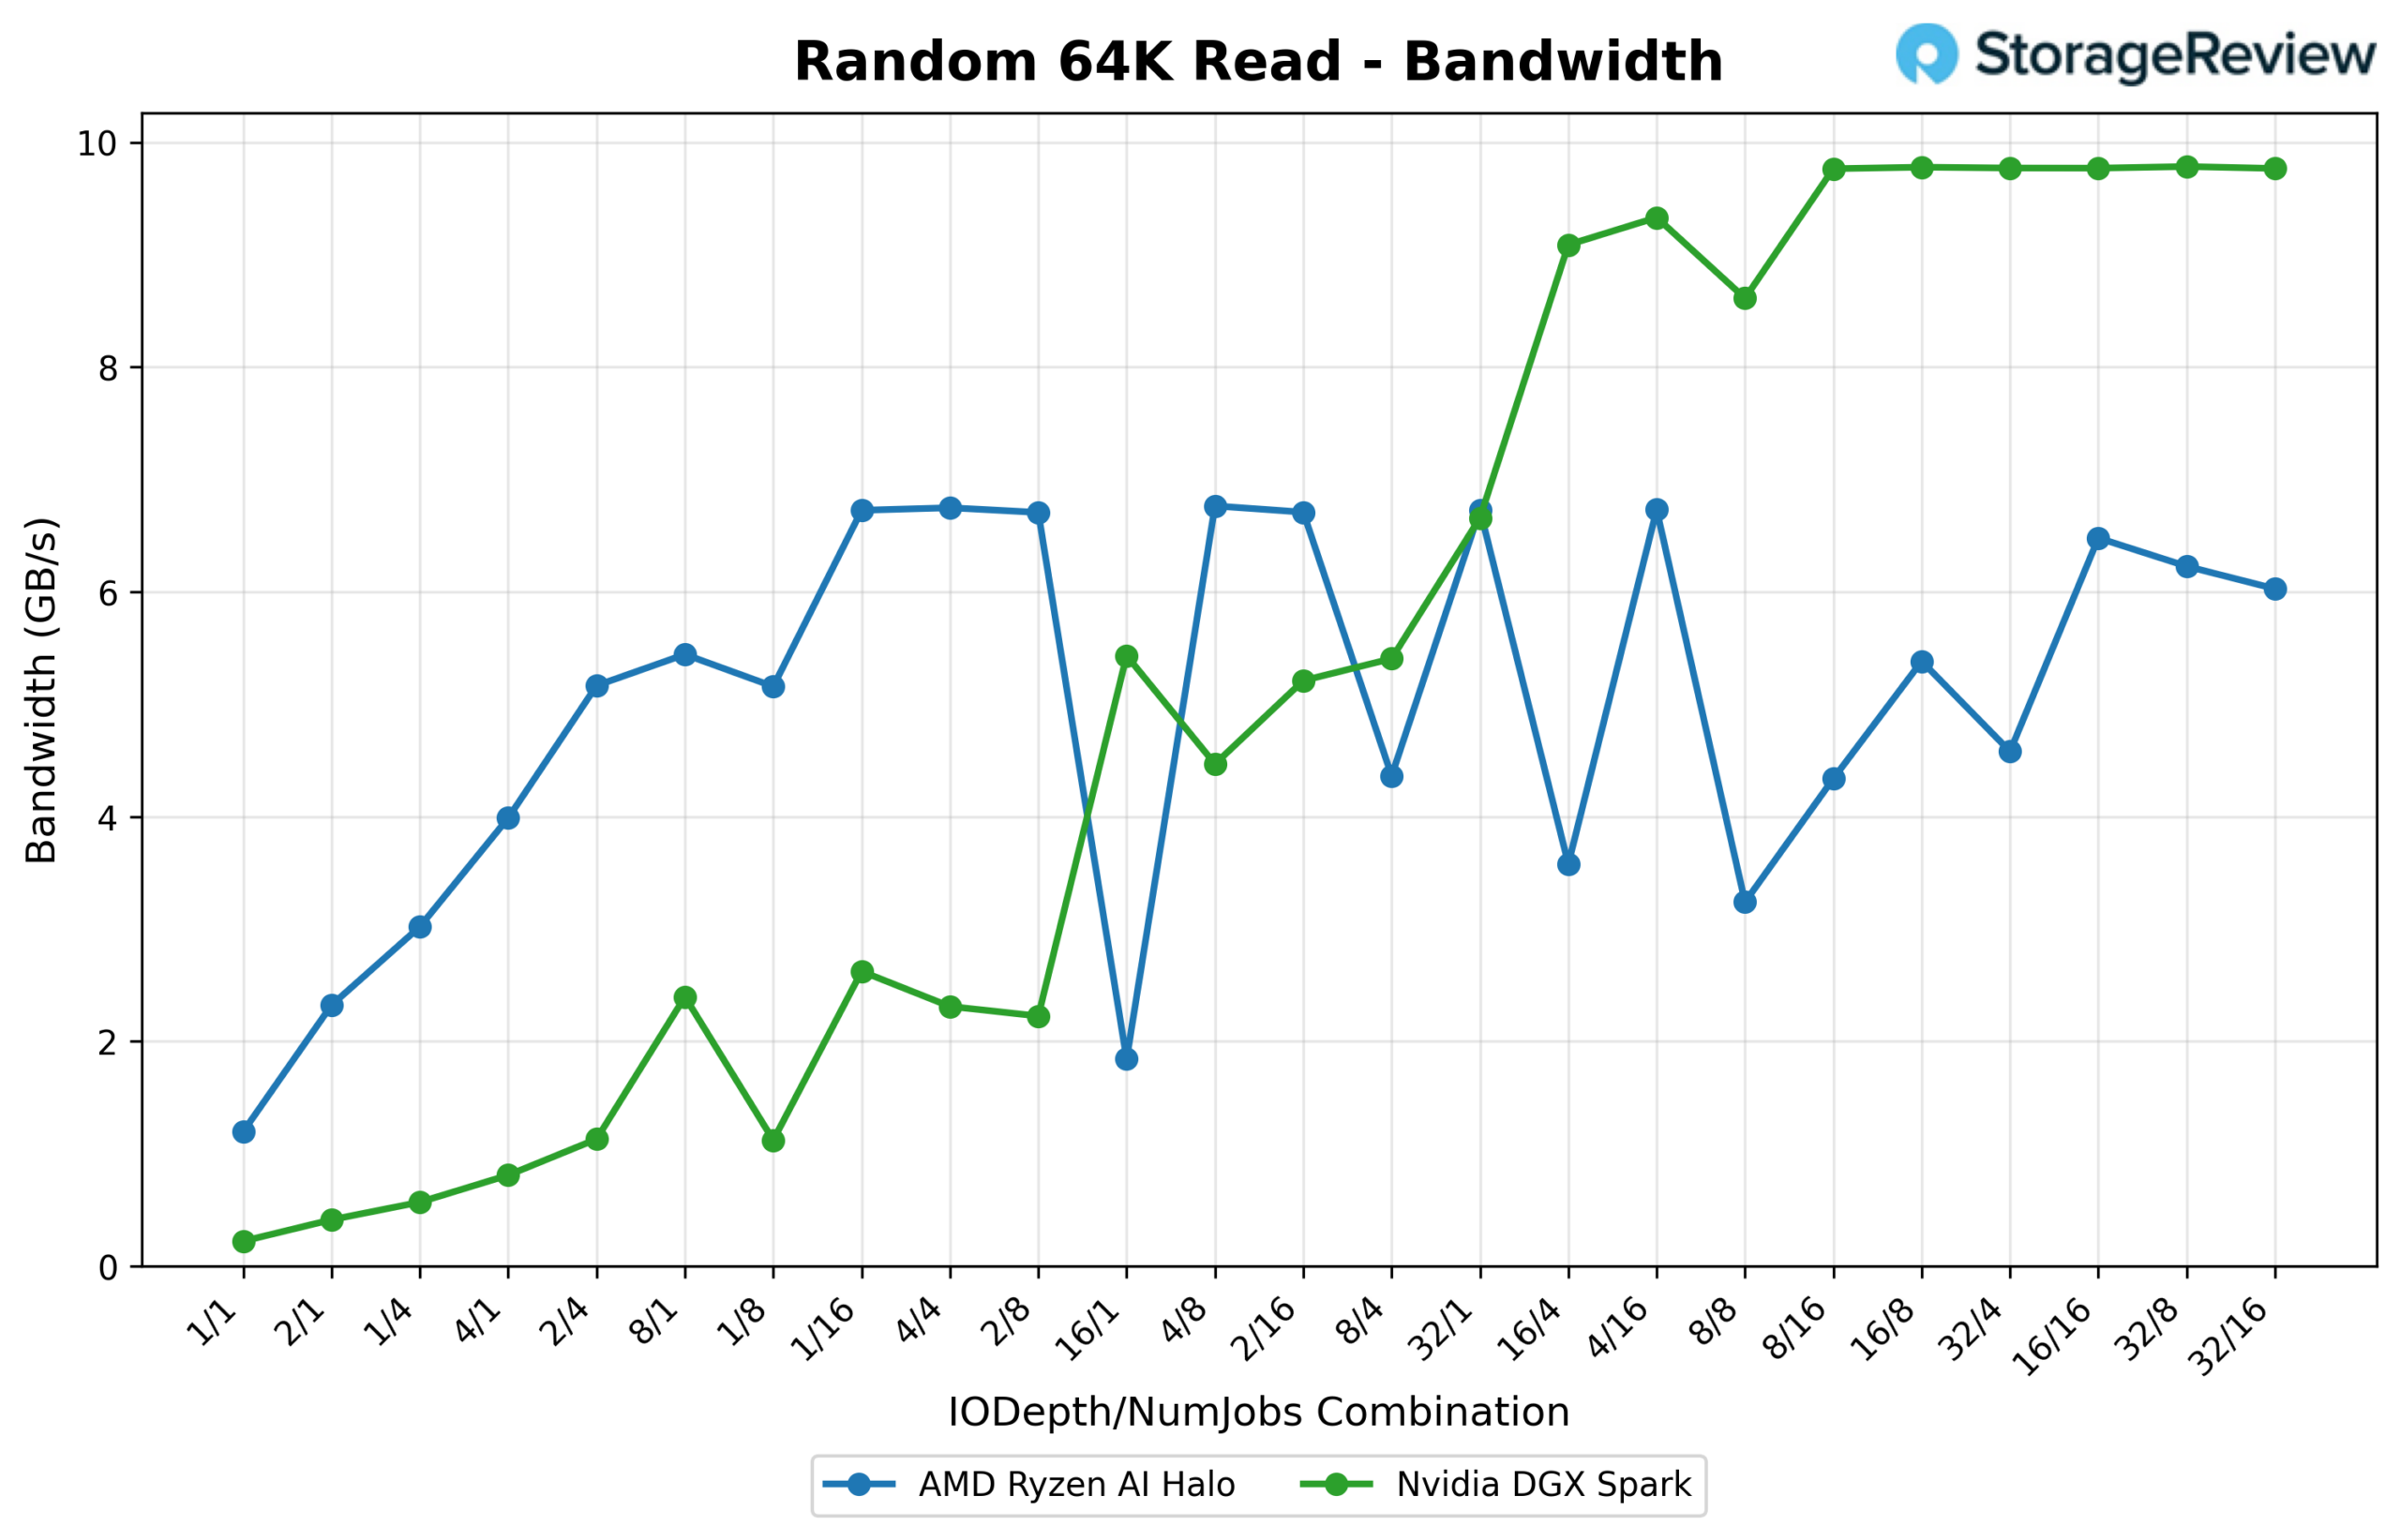
Storyn vänder dock på skalan. När ködjupet och trådantalet klättrar förbi ungefär 16/4, bryts Sparks bandbredd av och platåar runt 9.8 GB/s från och med 8/16, för att toppa på 10 019,1 MB/s (160.3K IOPS) vid 32/8. Halo når aldrig det taket: den mättar i intervallet 6.0–6.9 GB/s, och toppar på 6 926,5 MB/s (110.8K IOPS) vid 4/8. Dess bandbreddskurva är märkbart mer oregelbunden och växlar mellan ungefär 2 och 6.8 GB/s beroende på kombinationen av djup/tråd snarare än att klättra smidigt.
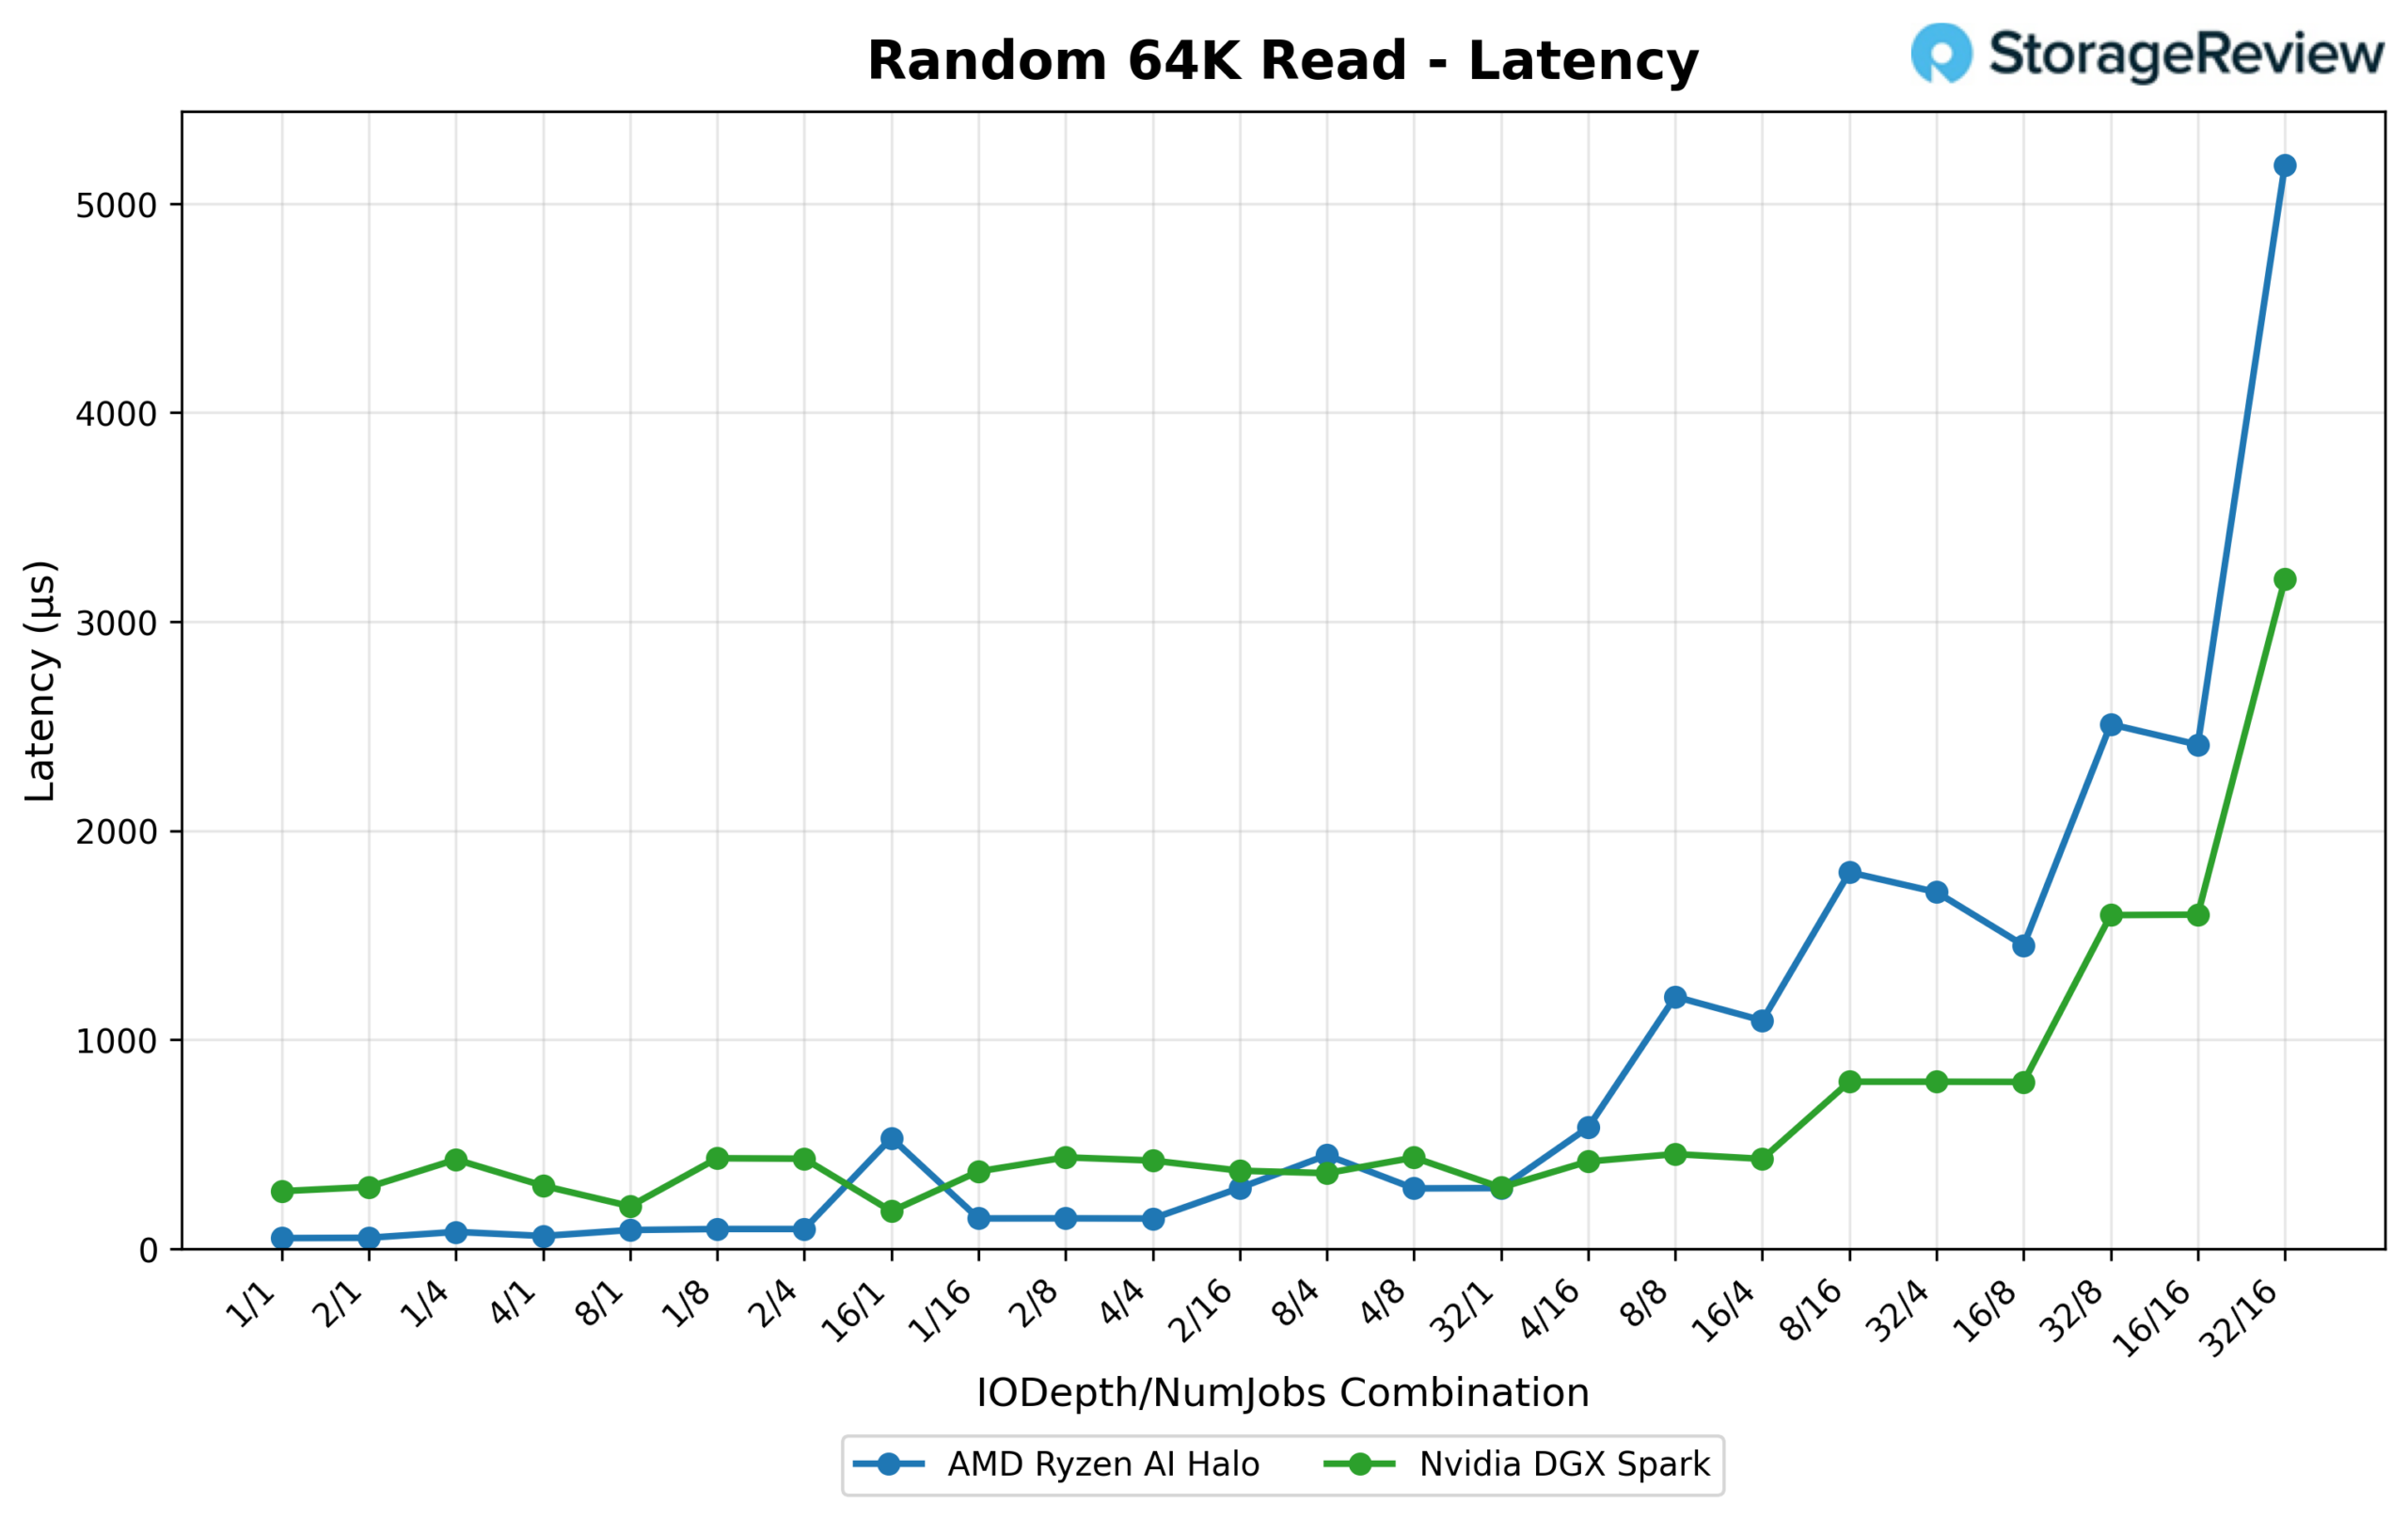
Latensen vid full mättnad svänger också till Sparks fördel: vid 32/16 ökar Halos genomsnittliga latens till 5.185 ms, jämfört med Sparks 3.204 ms, vilket innebär att Halo betalar för sin låga ködjupsrespons med sämre svansbeteende när kön är fulladdad.
64K slumpmässig skrivning
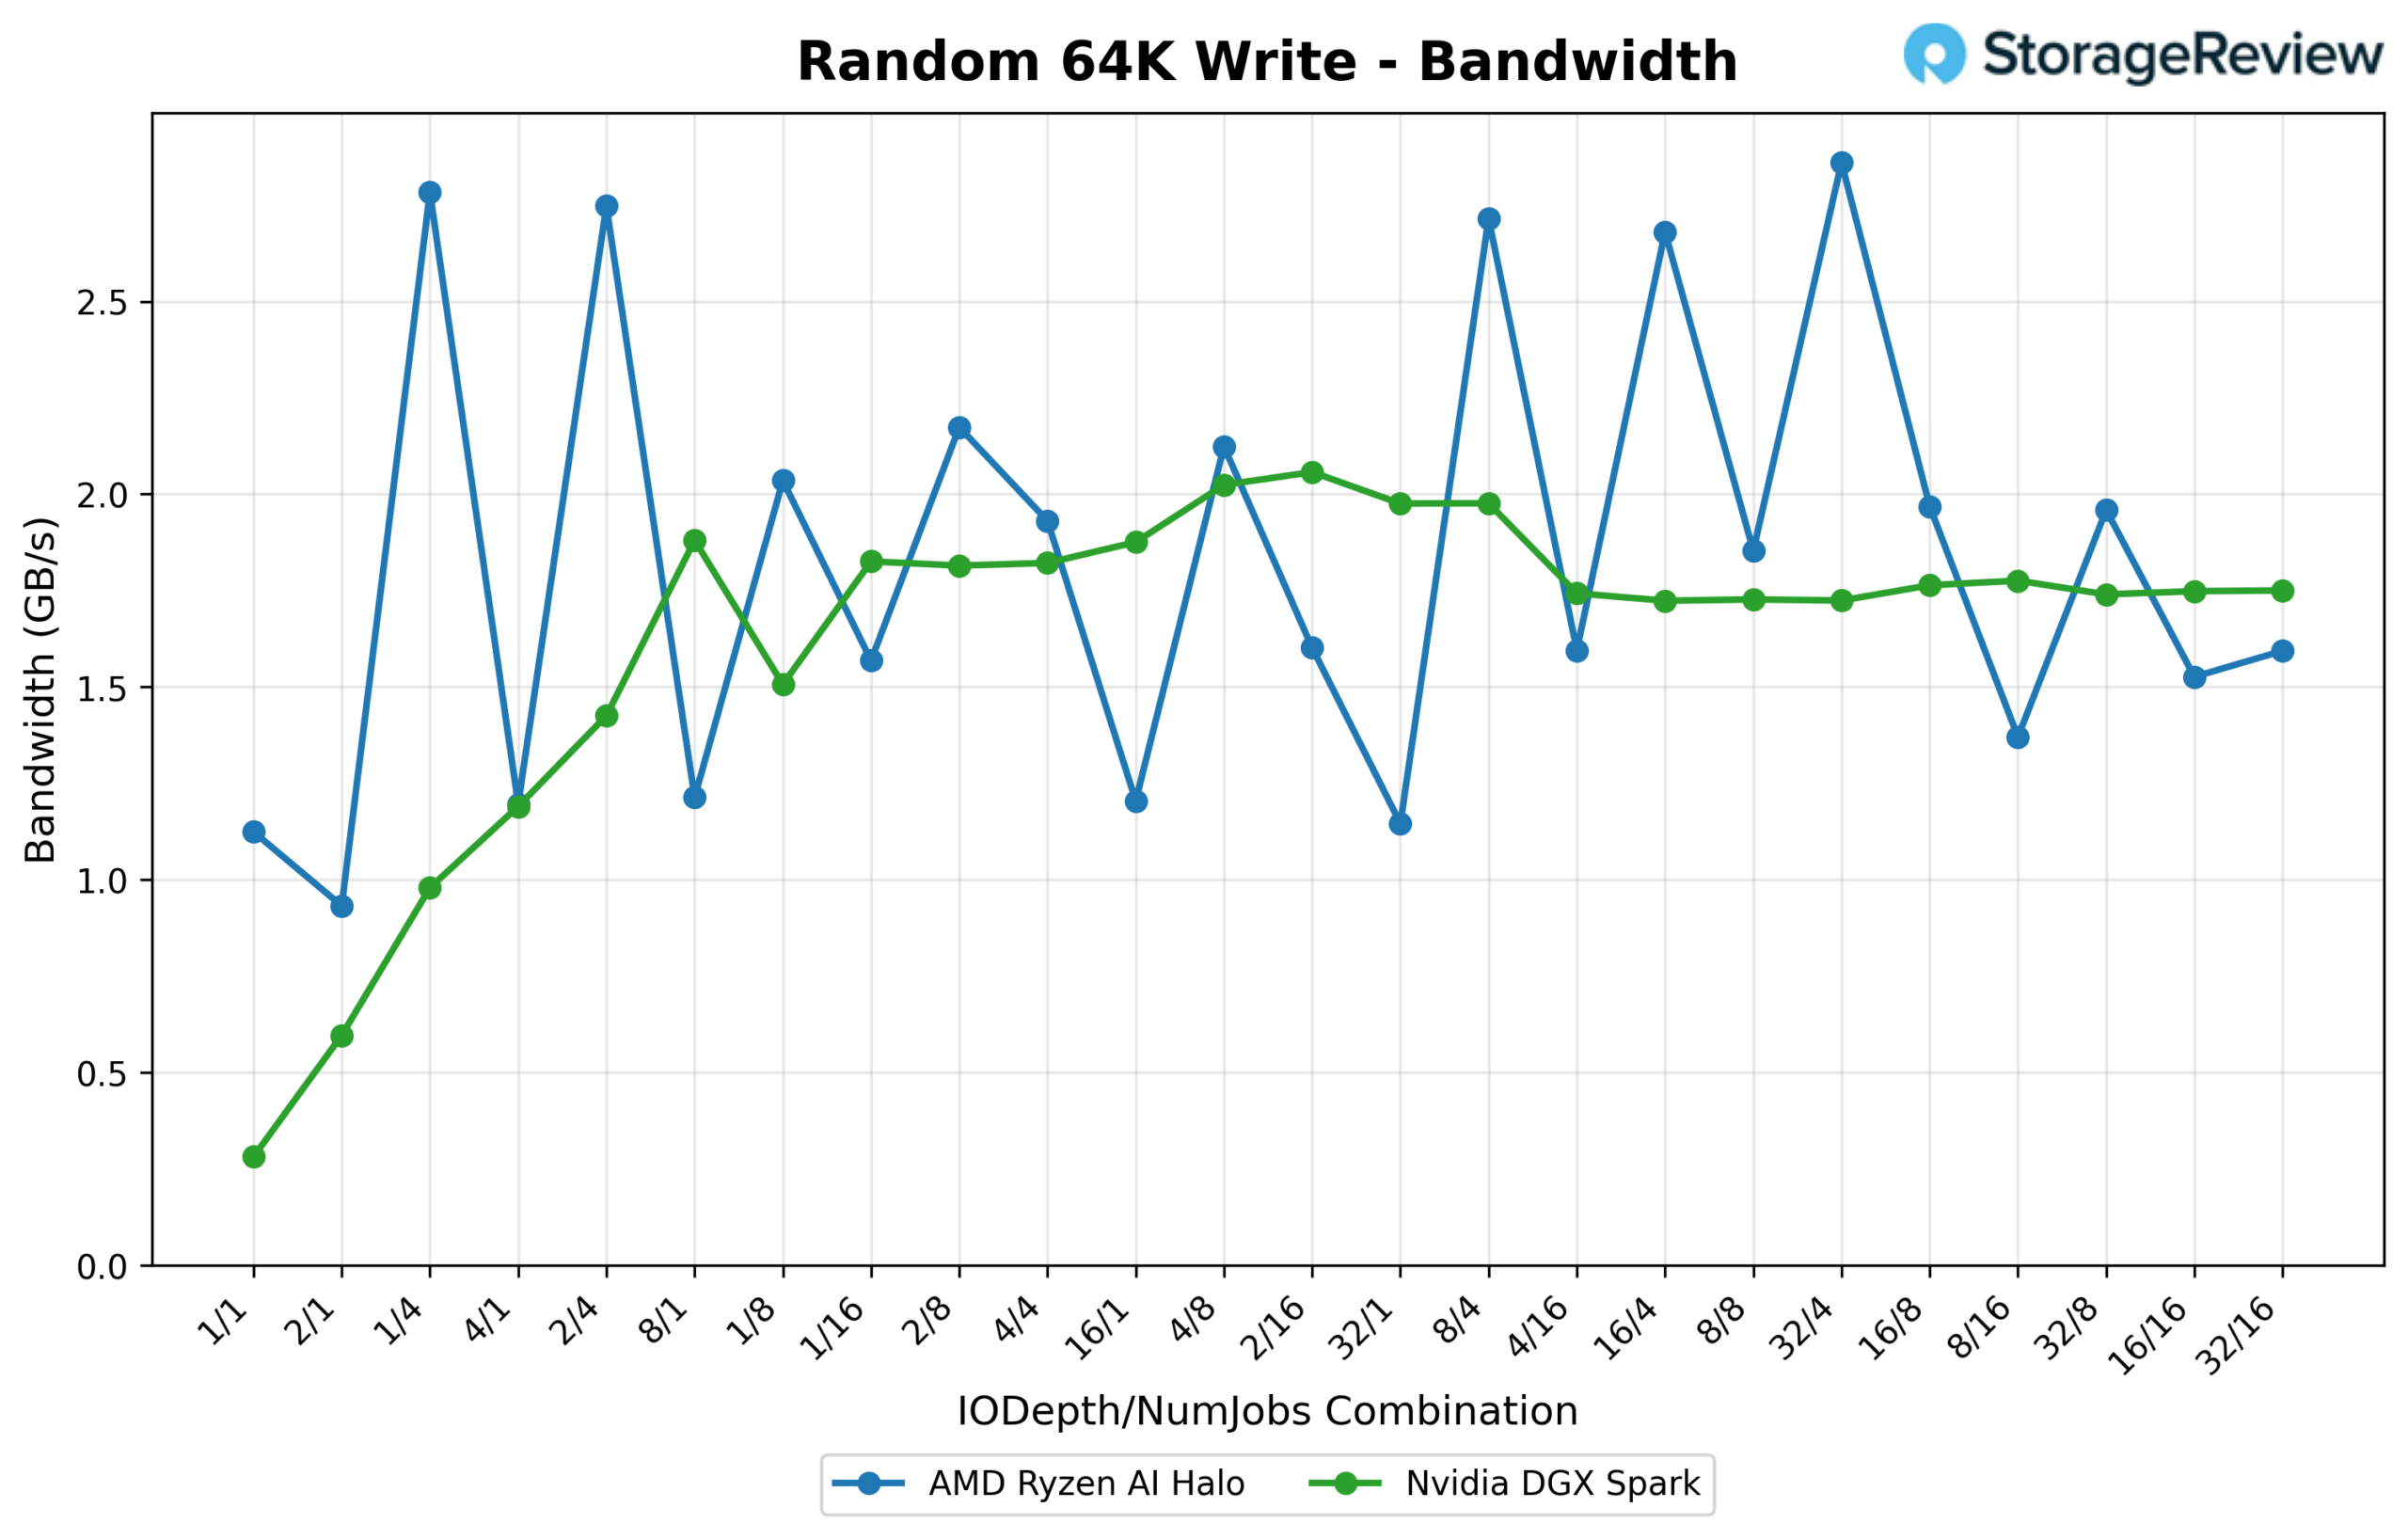
Slumpmässig 64K skrivbandbredd är närmare mellan de två plattformarna än läsbandbredden, även om kurvornas former skiljer sig mycket åt. Halos bandbredd är mer spikig: den hoppar upprepade gånger över 2.5 GB/s (med en topp på 2 929,1 MB/s / 46.9K IOPS vid 32/4) innan den faller tillbaka till intervallet 1.1–1.5 GB/s i angränsande kombinationer. Spark är jämförelsevis stabil, och ligger i ett band på 1.7–2.0 GB/s under större delen av svepningen och når en topp på 2 106,6 MB/s (33.7K IOPS) vid 2/16.
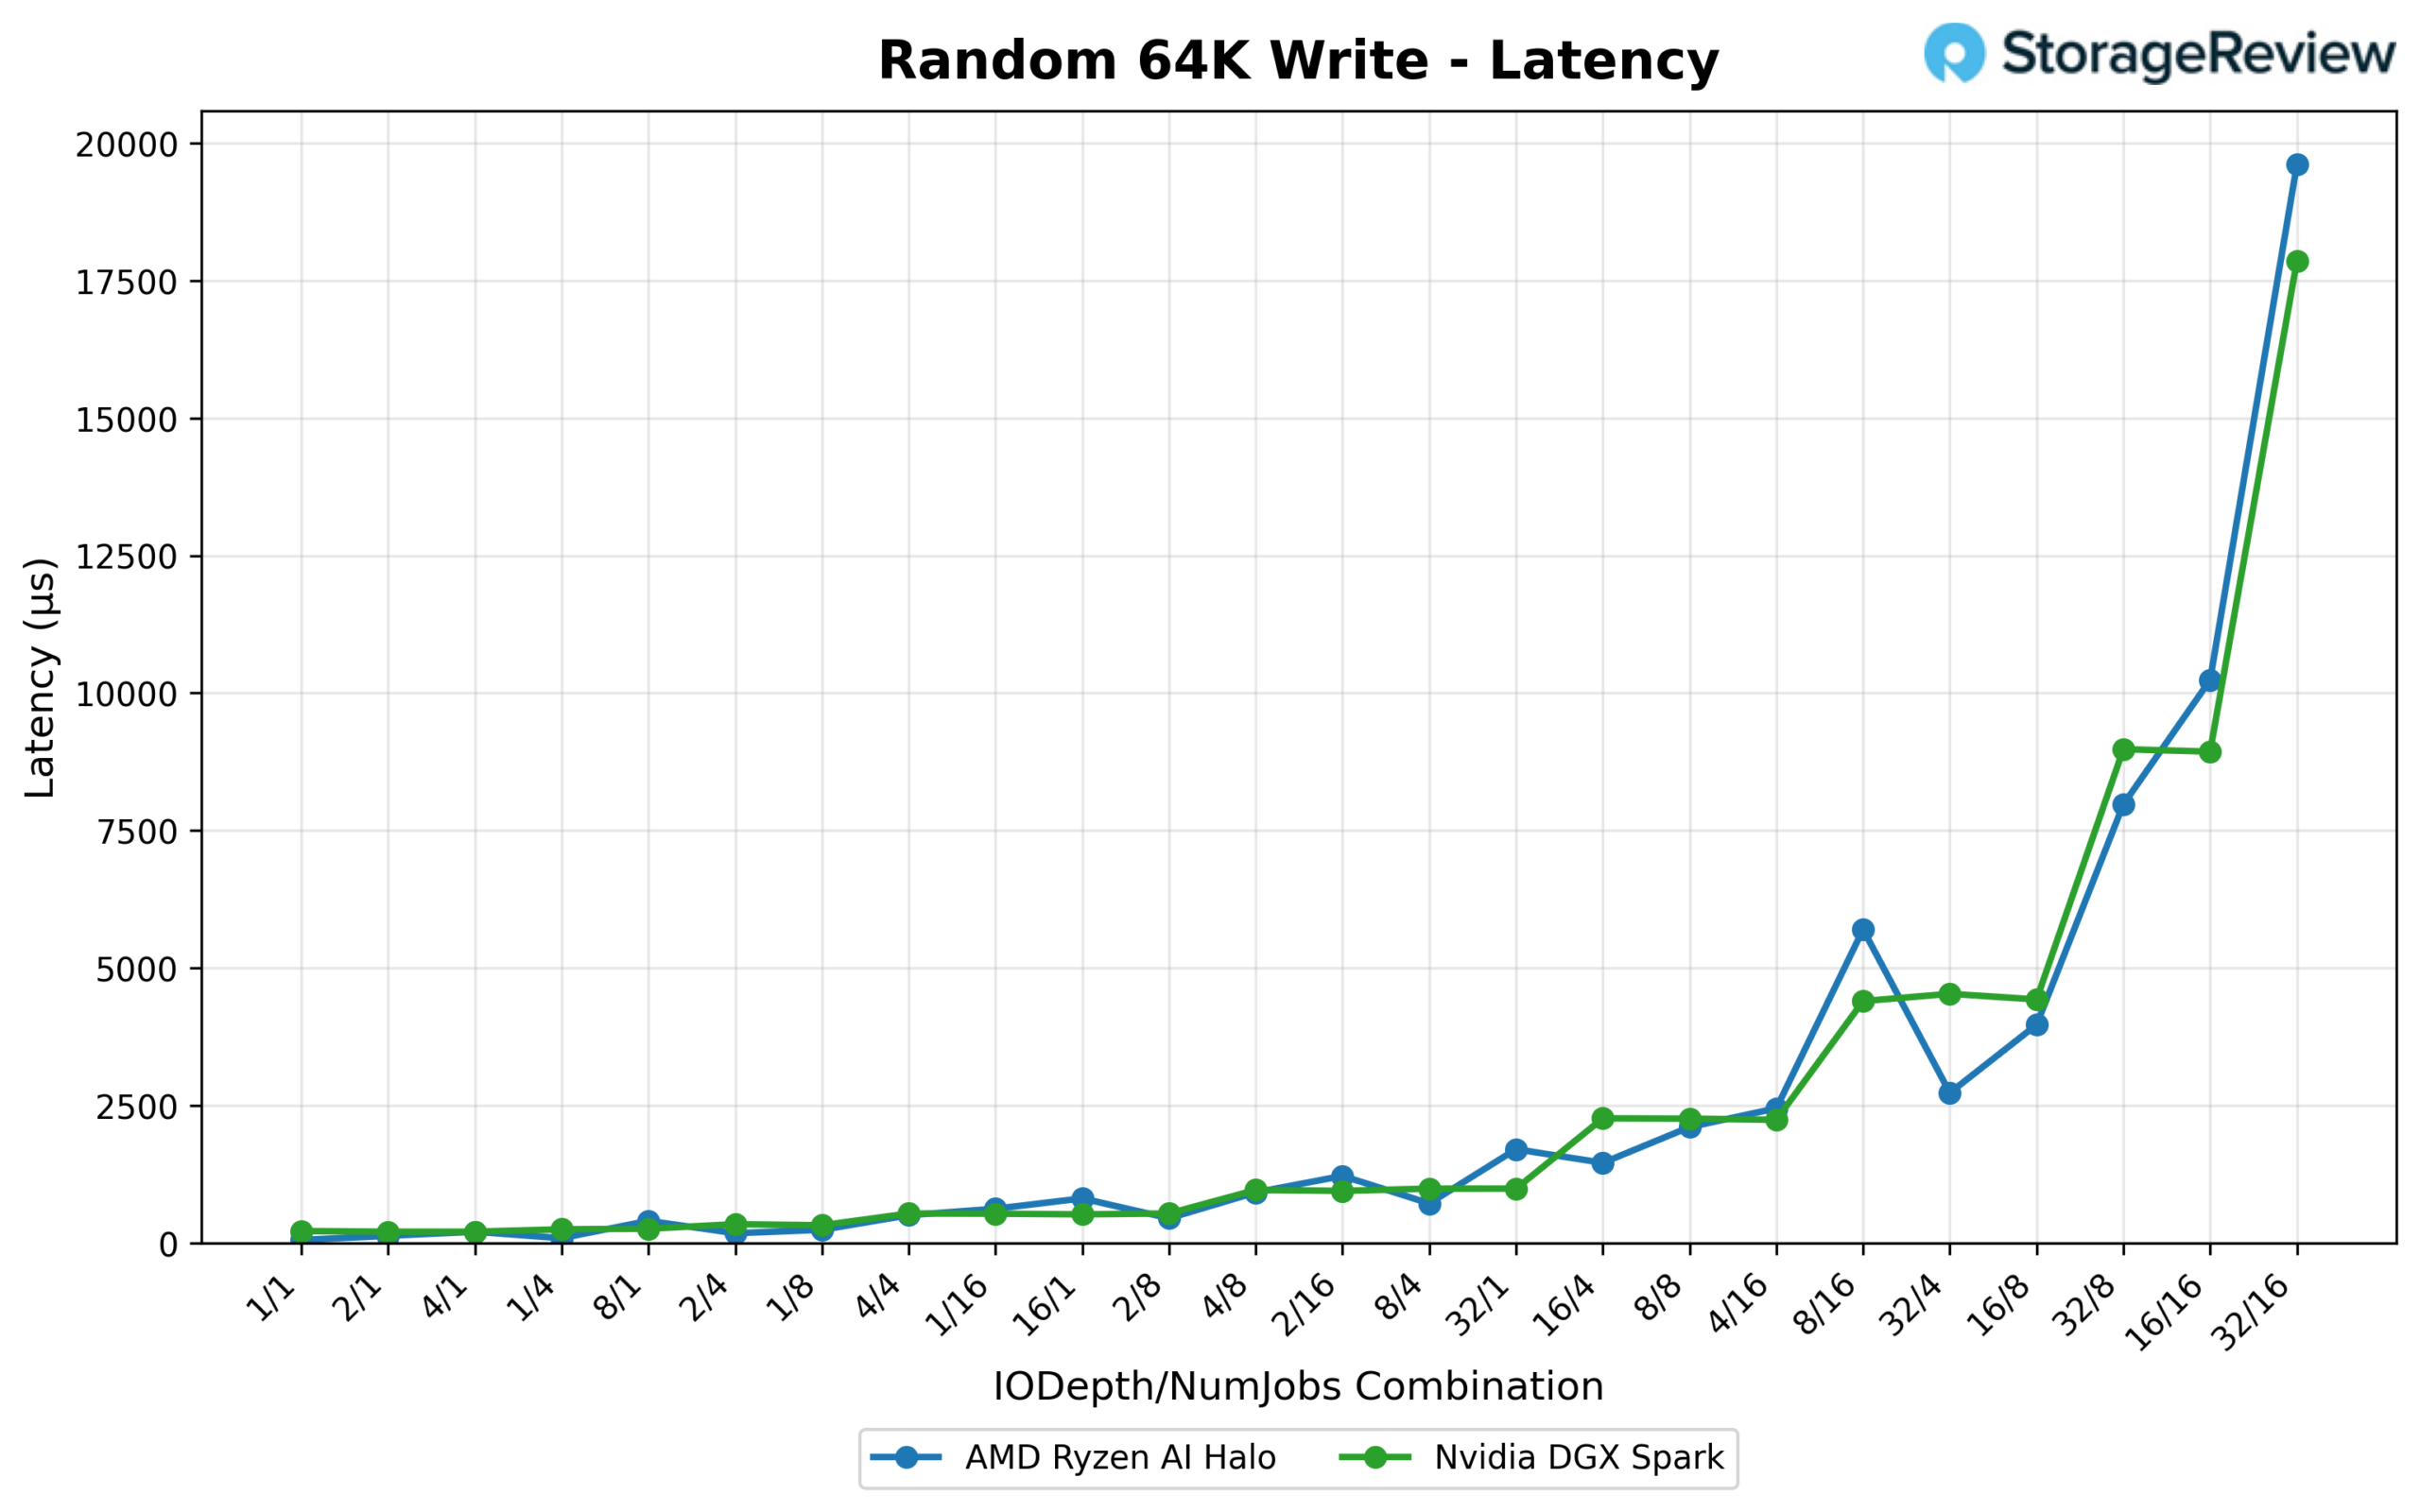
Latensen speglar 64K-läsmönstret: Halo är dramatiskt snabbare vid lågt ködjup (0.054 ms vid 1/1 jämfört med 0.217 ms för Spark), och båda hårddiskarna försämras kraftigt när ködjupet och trådantalet stiger till tvåsiffriga siffror. Vid full mättnad (32/16) når Halos latens 19.611 ms, jämfört med Sparks 17.857 ms. Båda hårddiskarna är tydligt under kraftig skrivförstärkningsbelastning vid denna tidpunkt, med Halo återigen något sämre högst upp på kurvan.
16K sekventiell läsning
Bandbredden förblir hög under större delen av svepningen, med båda hårddiskarna som växlar mellan ungefär 1–8 GB/s beroende på kombinationen av djup/tråd. Spark-processorn gränsar till den högre toppen och når 8 069,3 MB/s (516.4K IOPS) vid 32/1, medan Halo når sin topp på 6 715,8 MB/s (429.8K IOPS) vid 8/4.
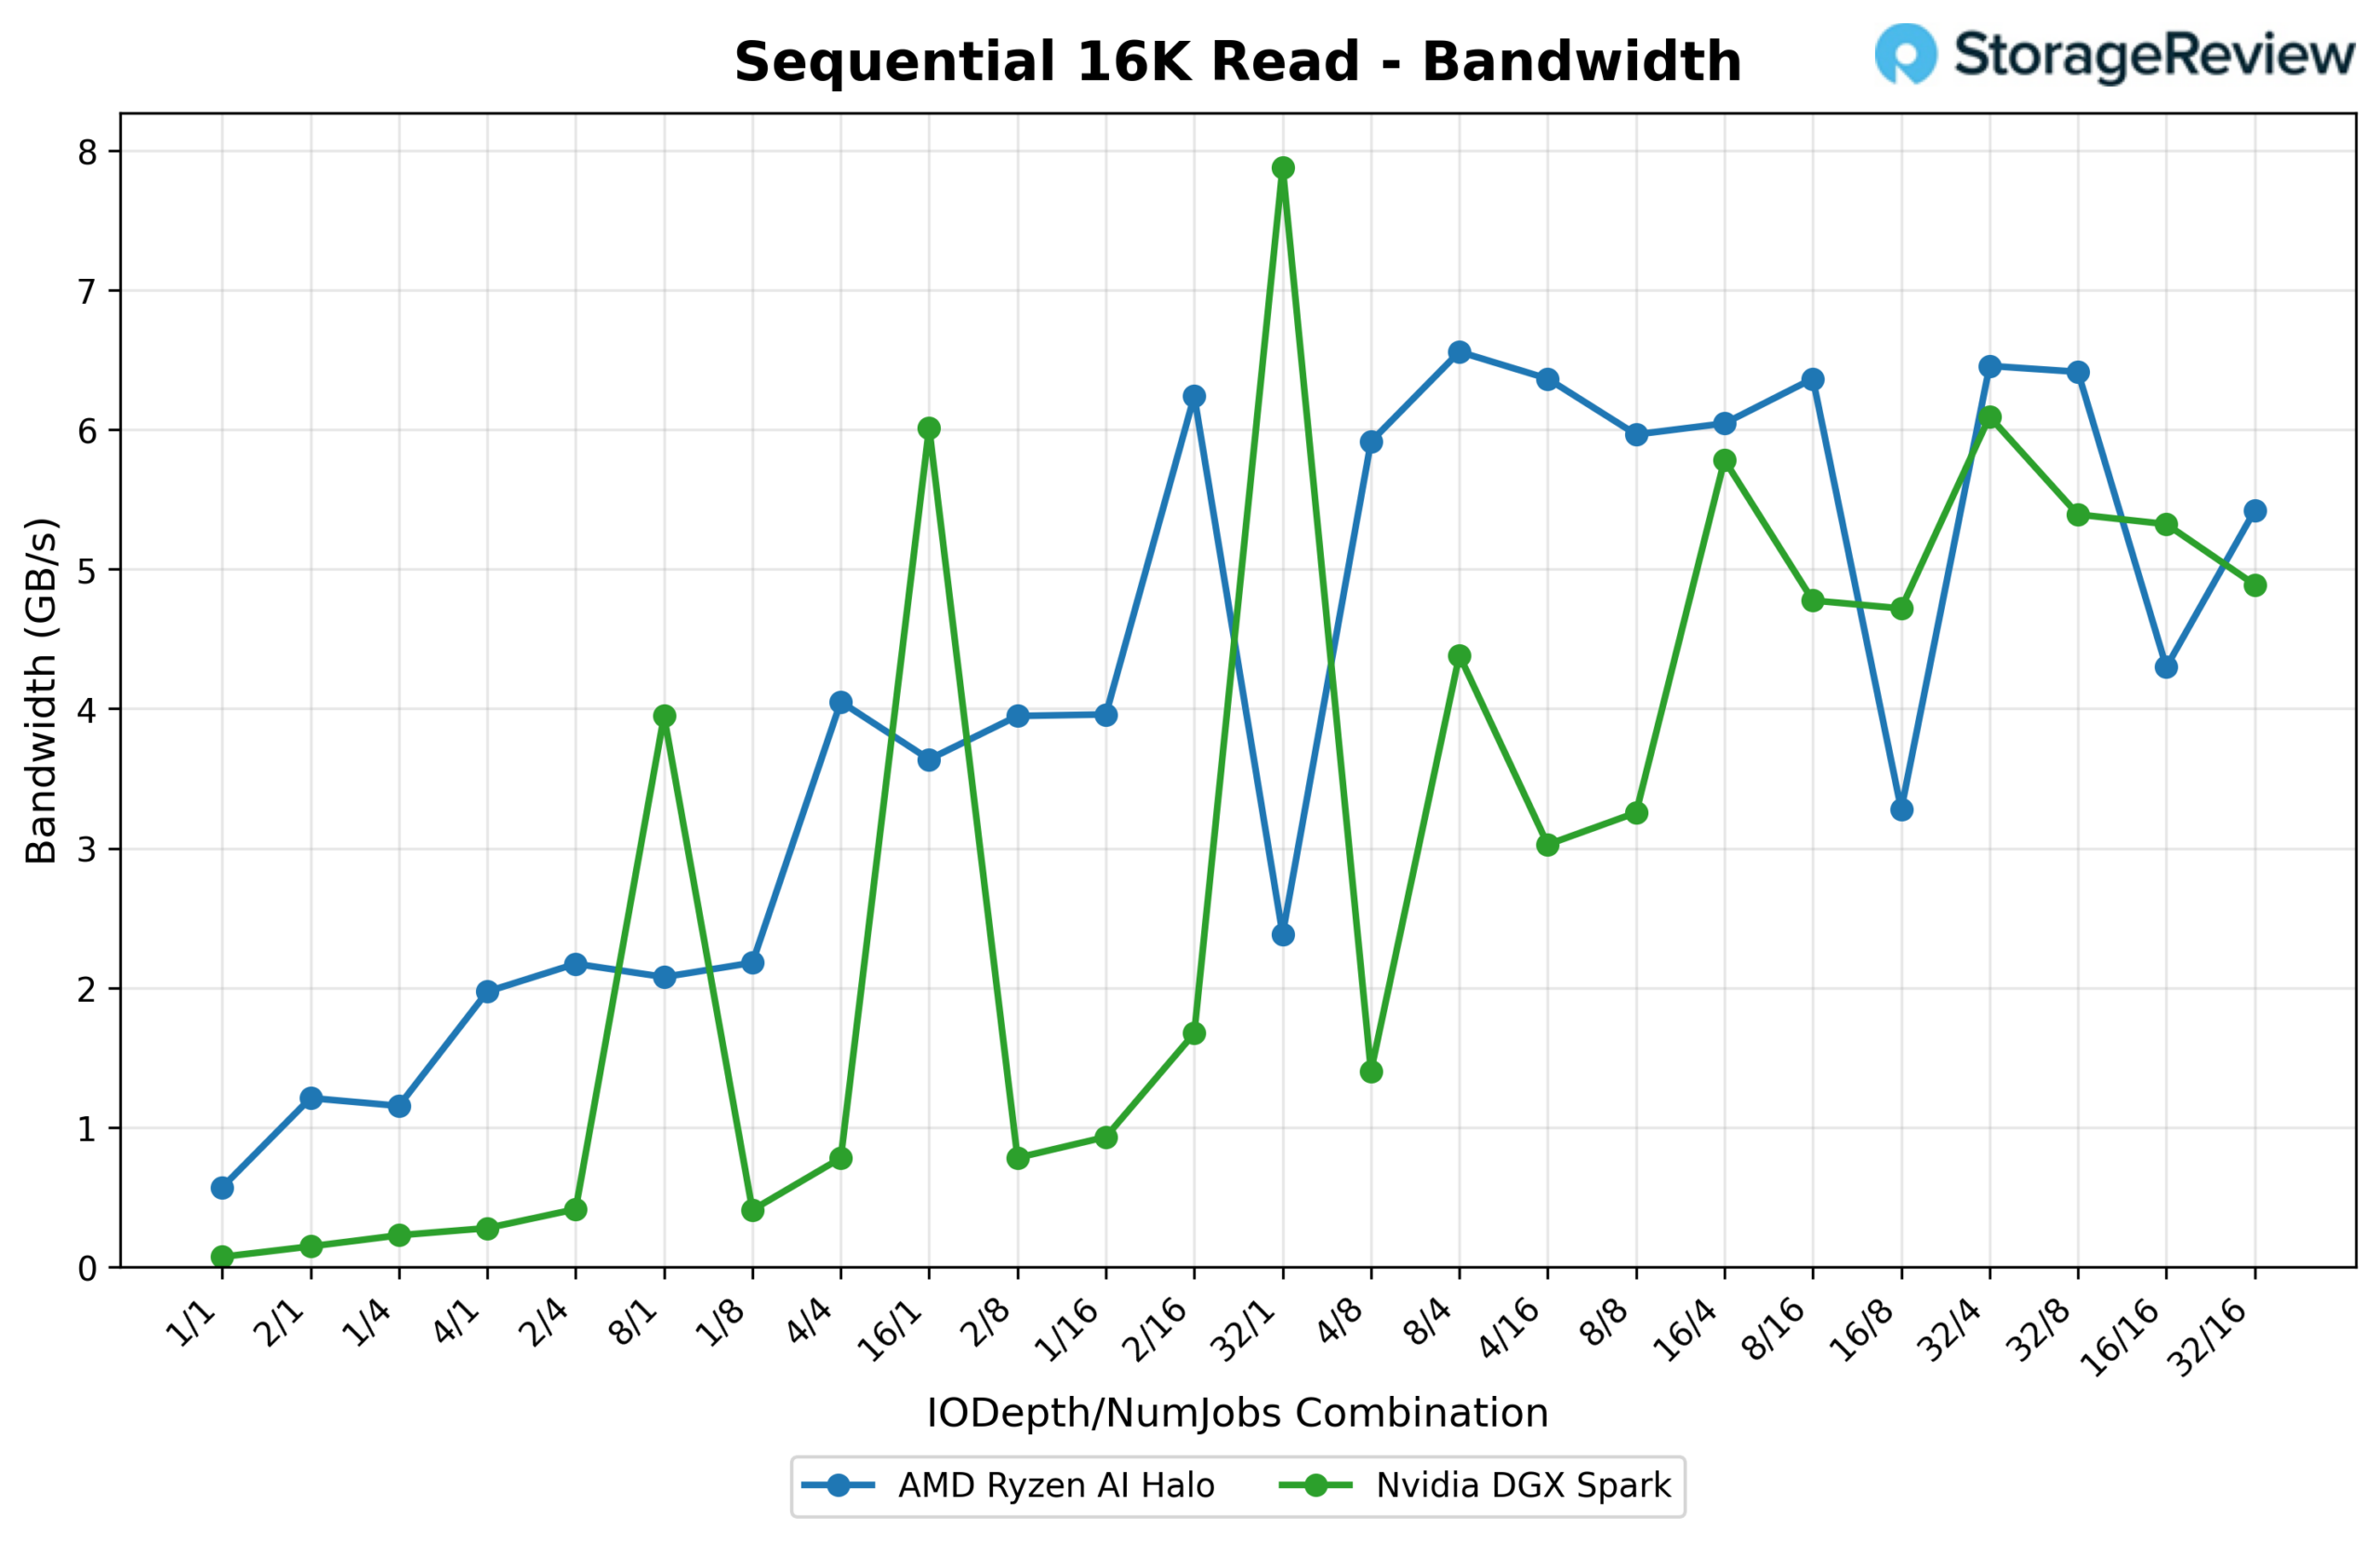
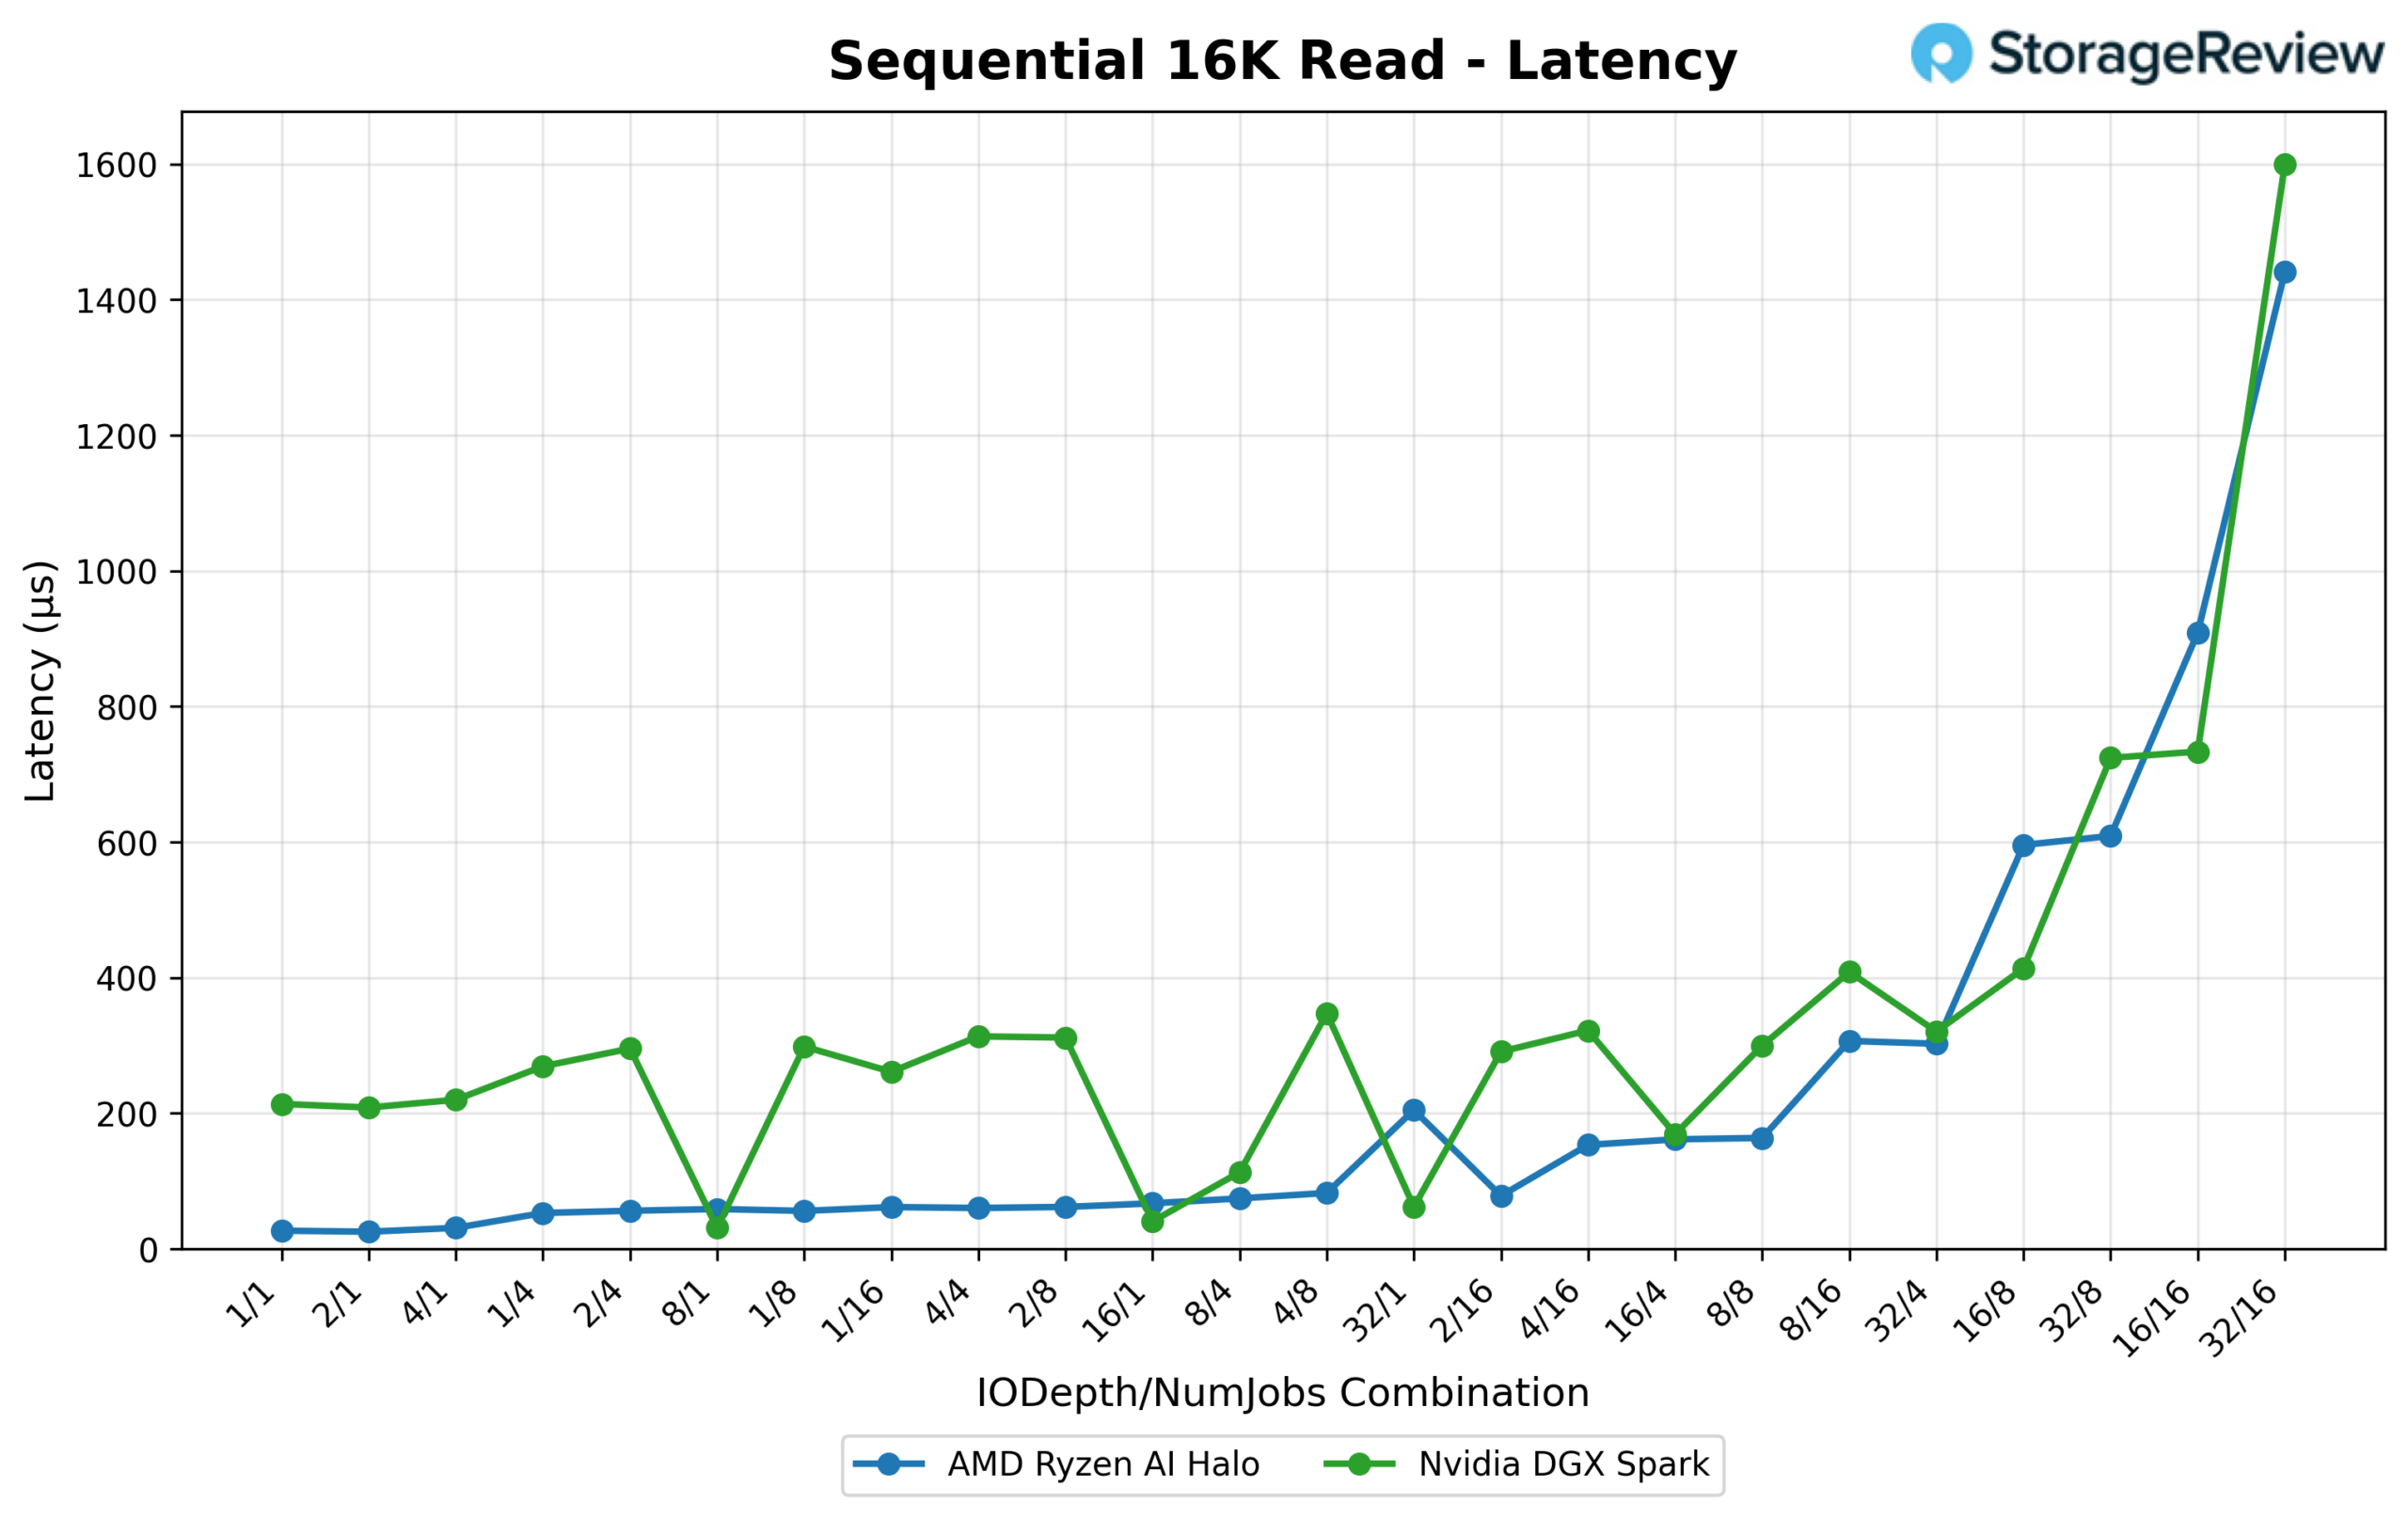
Latensen gynnar återigen Halo överallt utom allra högst upp i kön. Vid 1/1 svarar Halo på 0.027 ms jämfört med Sparks 0.214 ms, och Halo bibehåller lägre latens under större delen av svepningen. Endast vid de djupaste kombinationerna minskar gapet. Vid 32/16 landar Halos genomsnittliga latens på 1.441 ms strax under Sparks 1.599 ms, vilket gör detta till en av få punkter där Halos latenskurva inte överstiger Sparks vid mättnad.
16K sekventiell skrivning
Bandbredden är nära även här: Spark når en topp på 2 141,6 MB/s (137.1K IOPS) vid 16/1, och Halo ligger inte långt efter med 1 970,9 MB/s (126.1K IOPS) vid 1/8.
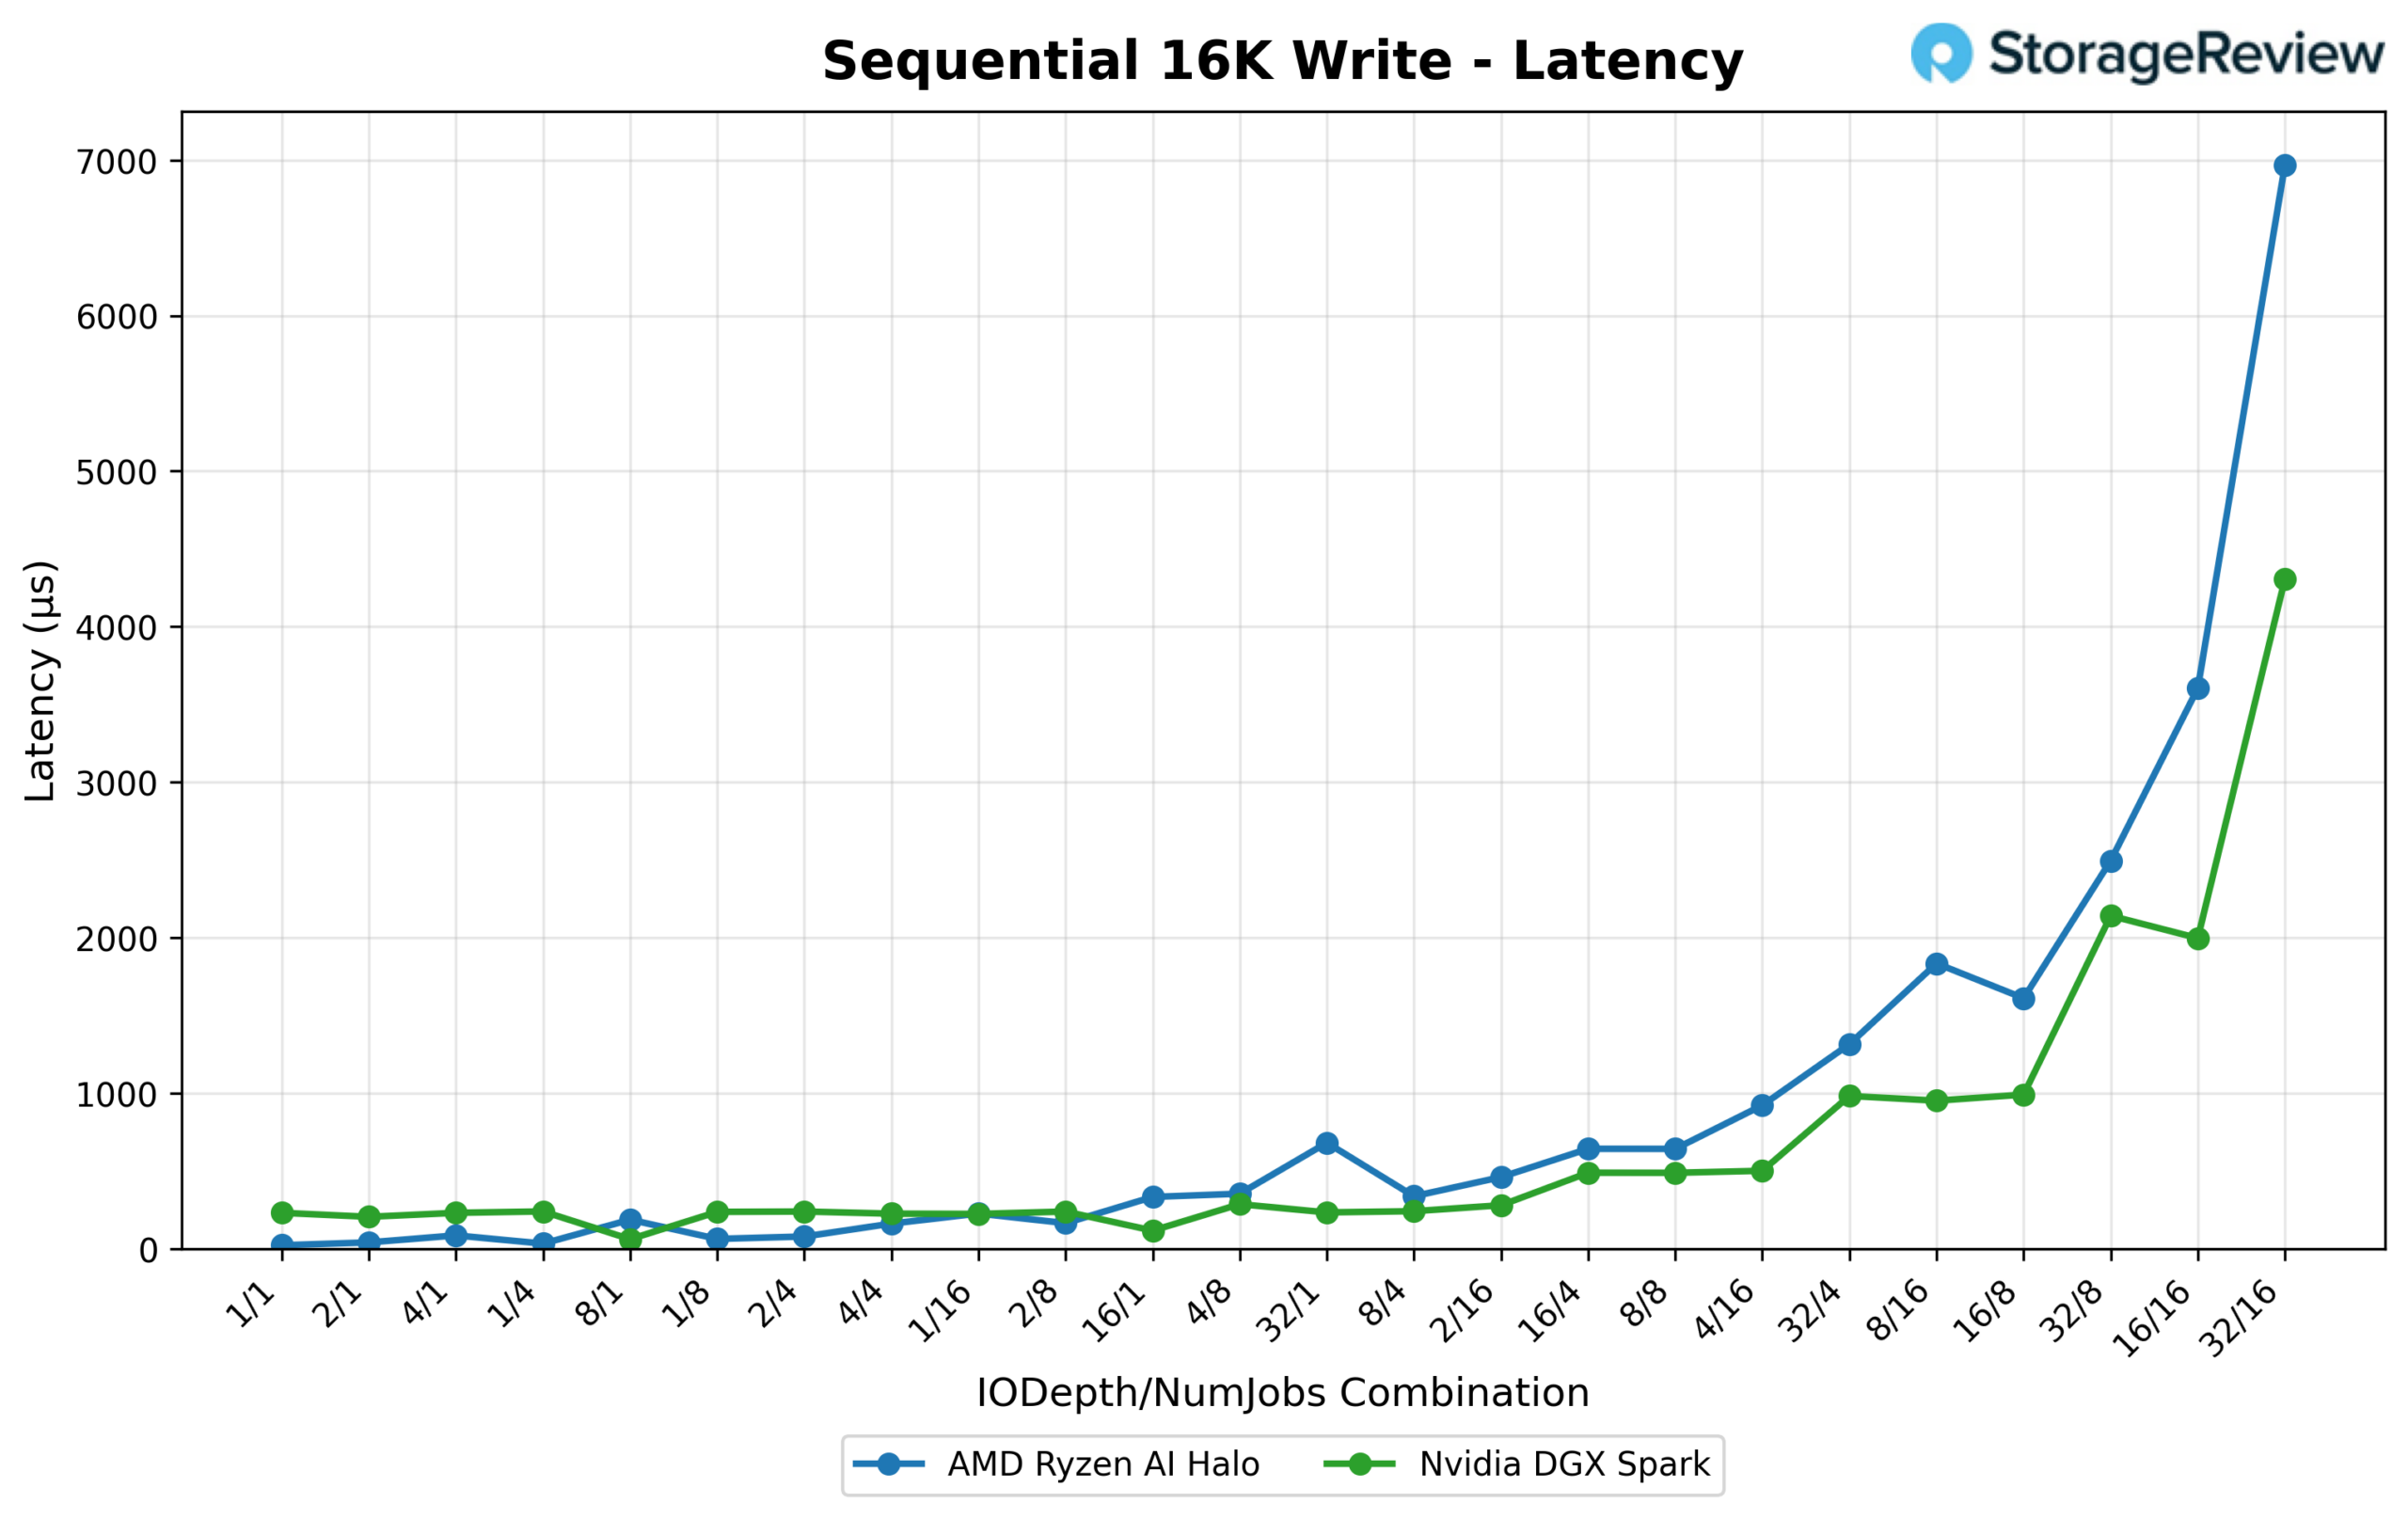
Det är vid latens som de två skiljer sig markant åt. Halo börjar långt före vid lågt ködjup (0.022 ms vid 1/1 jämfört med Sparks 0.231 ms), men dess latenskurva ökar kraftigt allt eftersom kön fylls. Vid 32/16 har Halos genomsnittliga latens klättrat till 6.967 ms, långt förbi Sparks 4.306 ms vid samma punkt. Halos kurva är också mycket mindre förutsägbar längs vägen, med skarpa toppar vid flera mellanregisterkombinationer där Spark förblir jämförelsevis platt.
16K slumpmässig läsning
Detta är en av Halos bättre prestationer. Den har faktiskt en högre toppbandbredd på 6 609,4 MB/s (423.0K IOPS) vid 32/16, jämfört med Sparks 6 082,6 MB/s (389.3K IOPS) vid samma kombination.
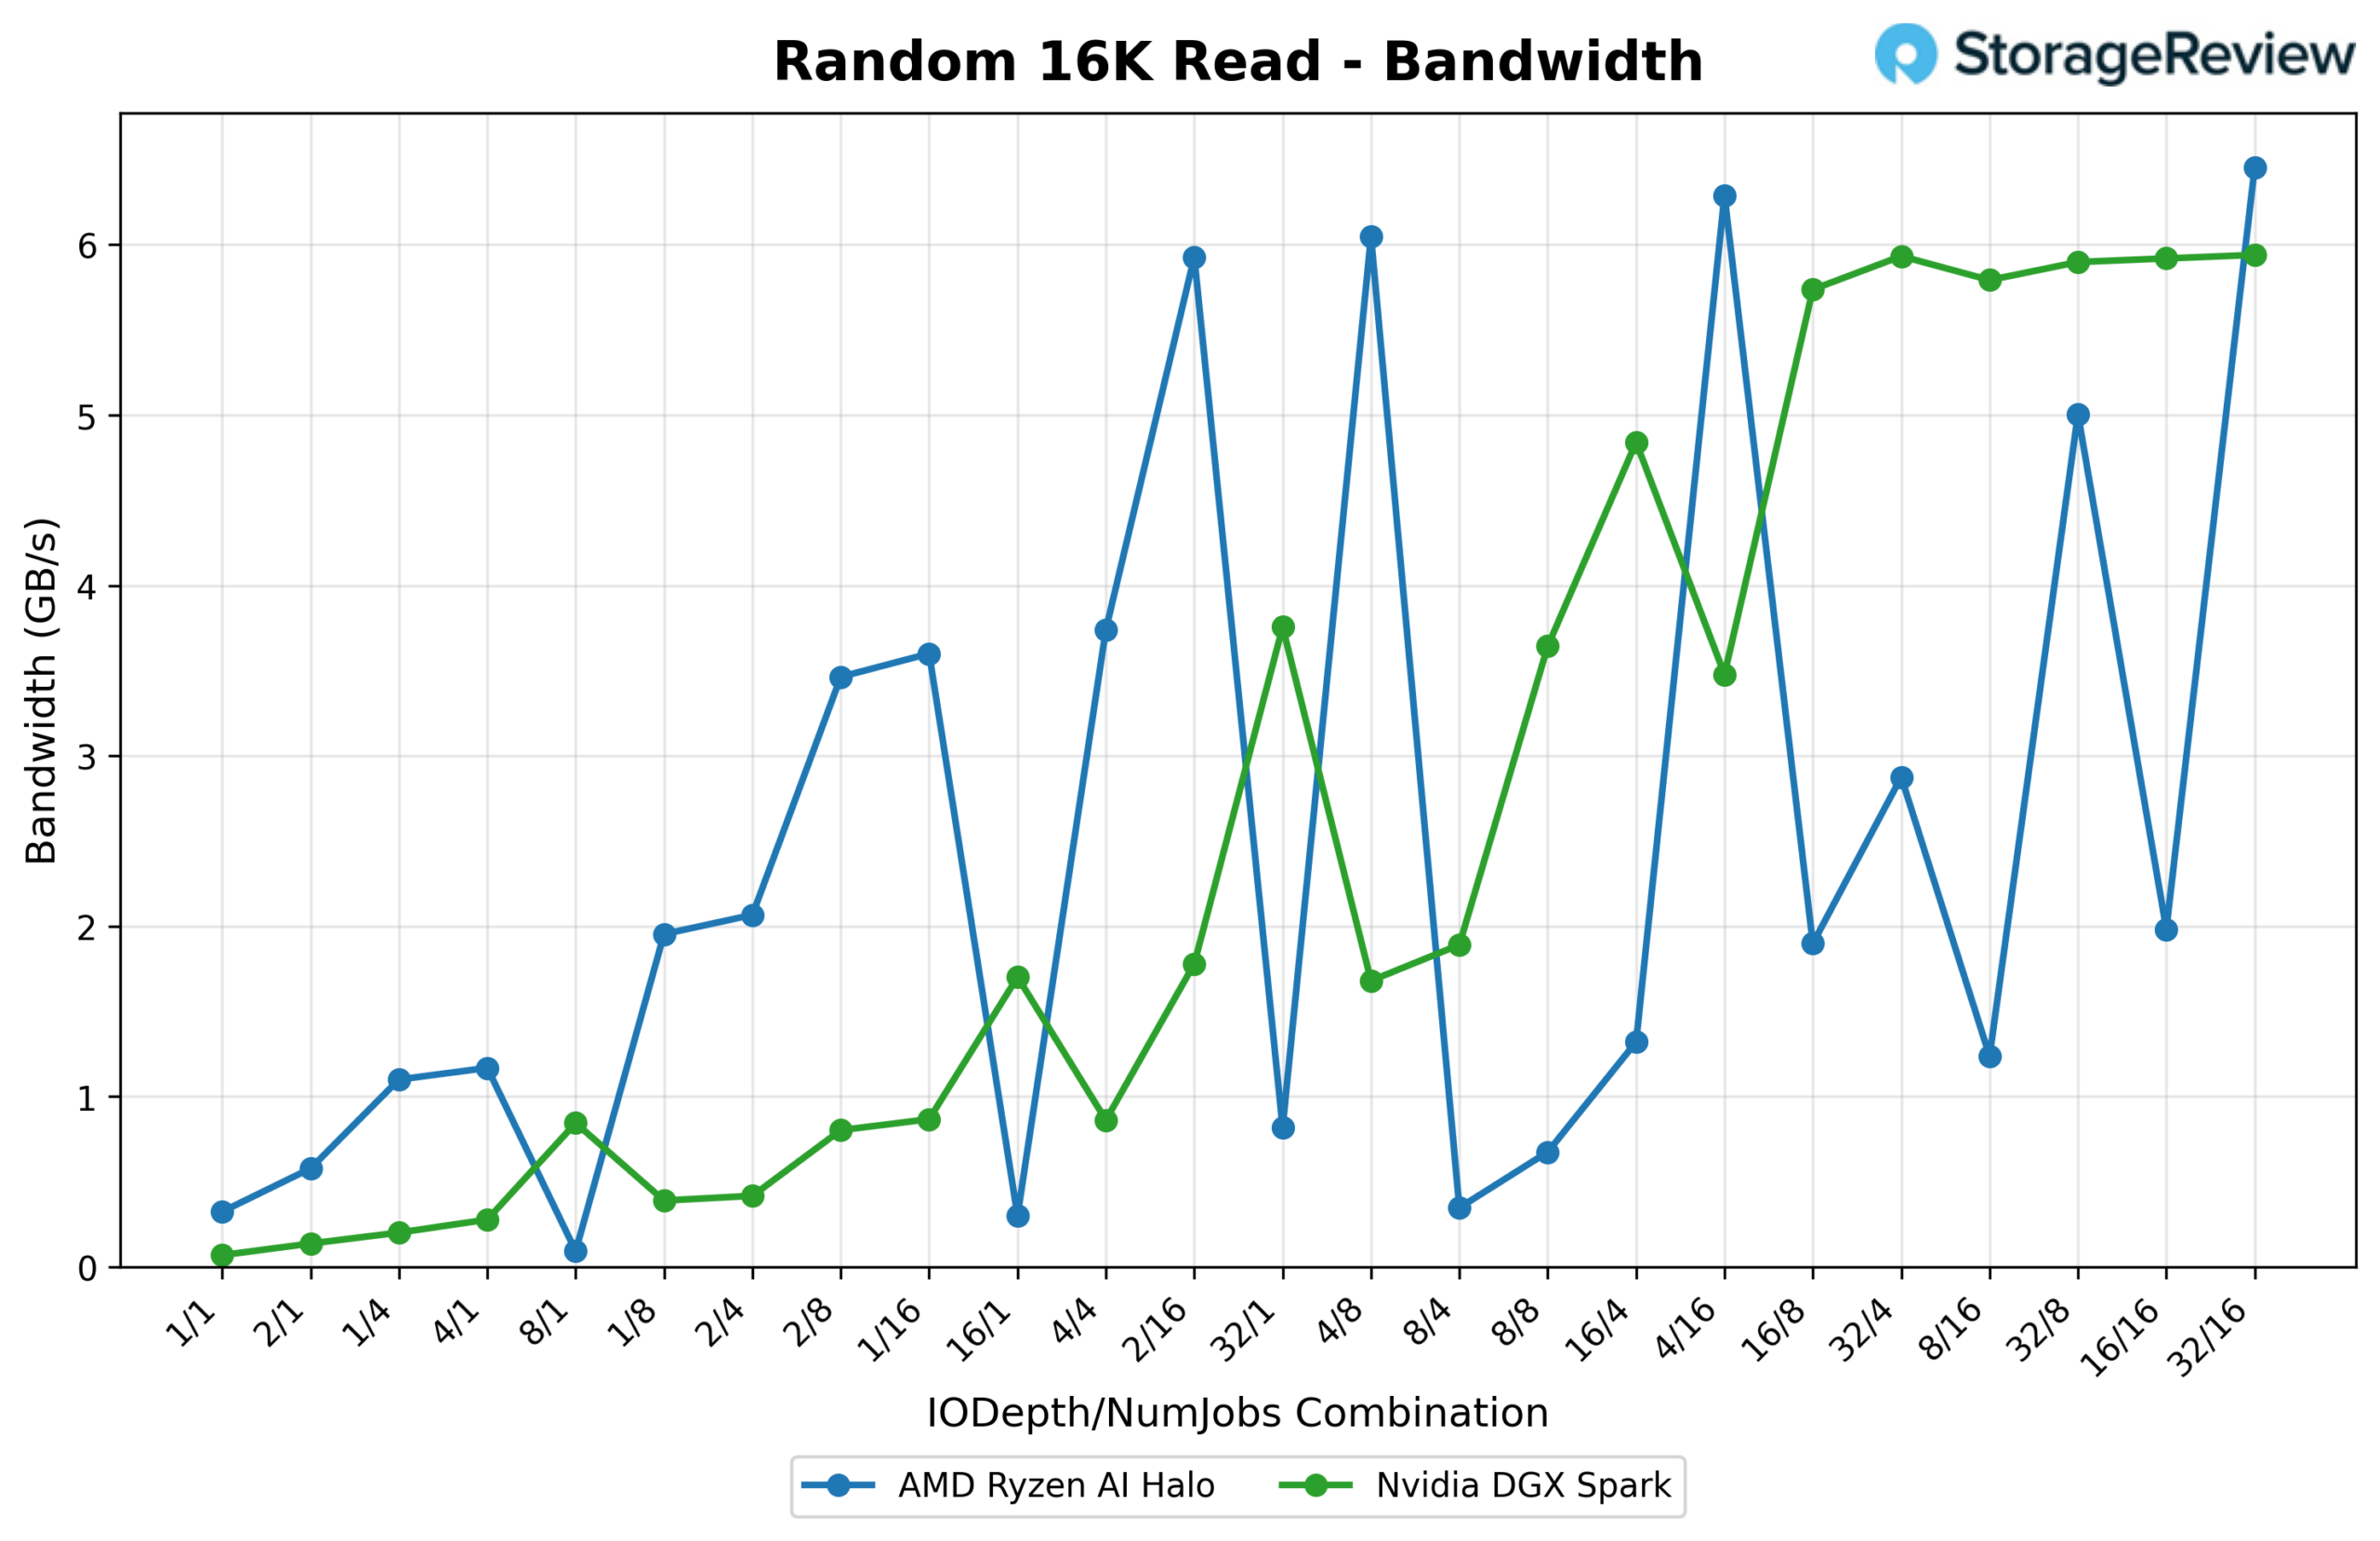
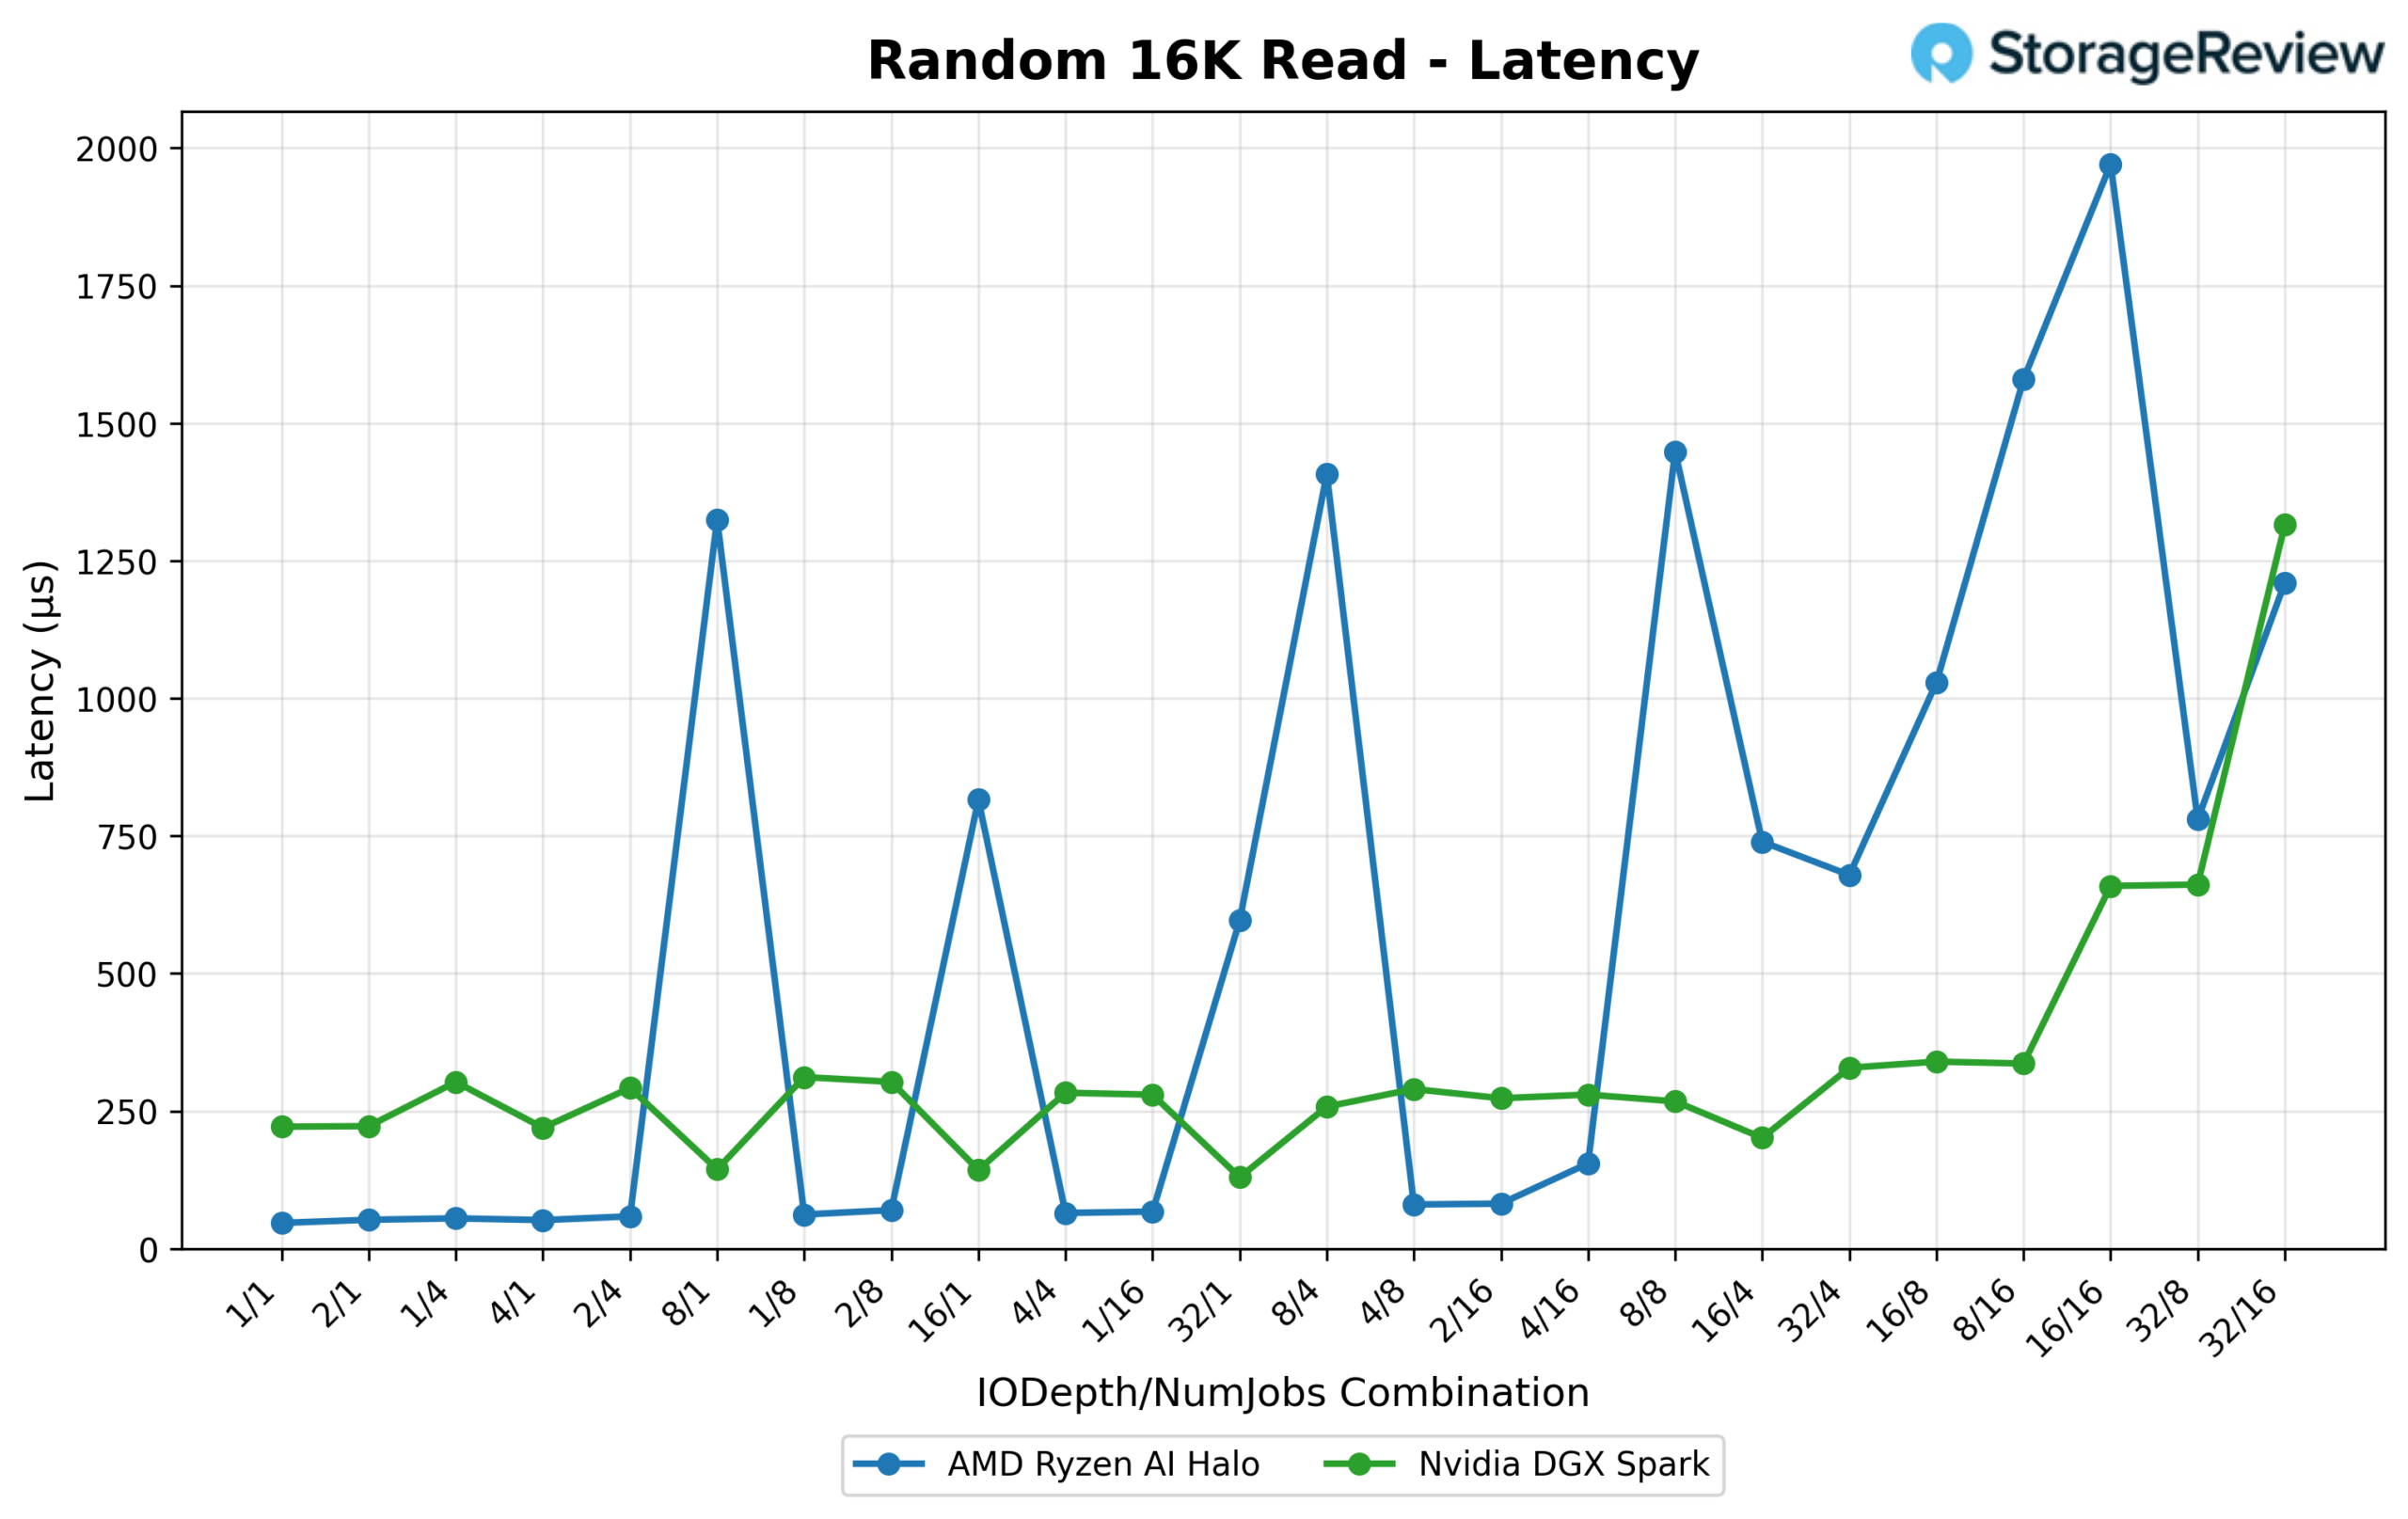
Latensen börjar återigen kraftigt till Halos fördel (0.047 ms vid 1/1 jämfört med 0.222 ms för Spark). Halos latenskurva är dock betydligt mer volatil över svepningen, med skarpa toppar vid 8/1, 16/1, 8/4 och 8/8 som skjuter långt över Sparks jämförelsevis jämna (om än högre baslinje) kurva. Högst upp i kön överstiger Halos maximala latens på 1.971 ms (vid 16/16) Sparks topp på 1.315 ms (vid 32/16), så Halo byter konsekvens mot rå hastighet med lågt ködjup.
16K slumpmässig skrivning
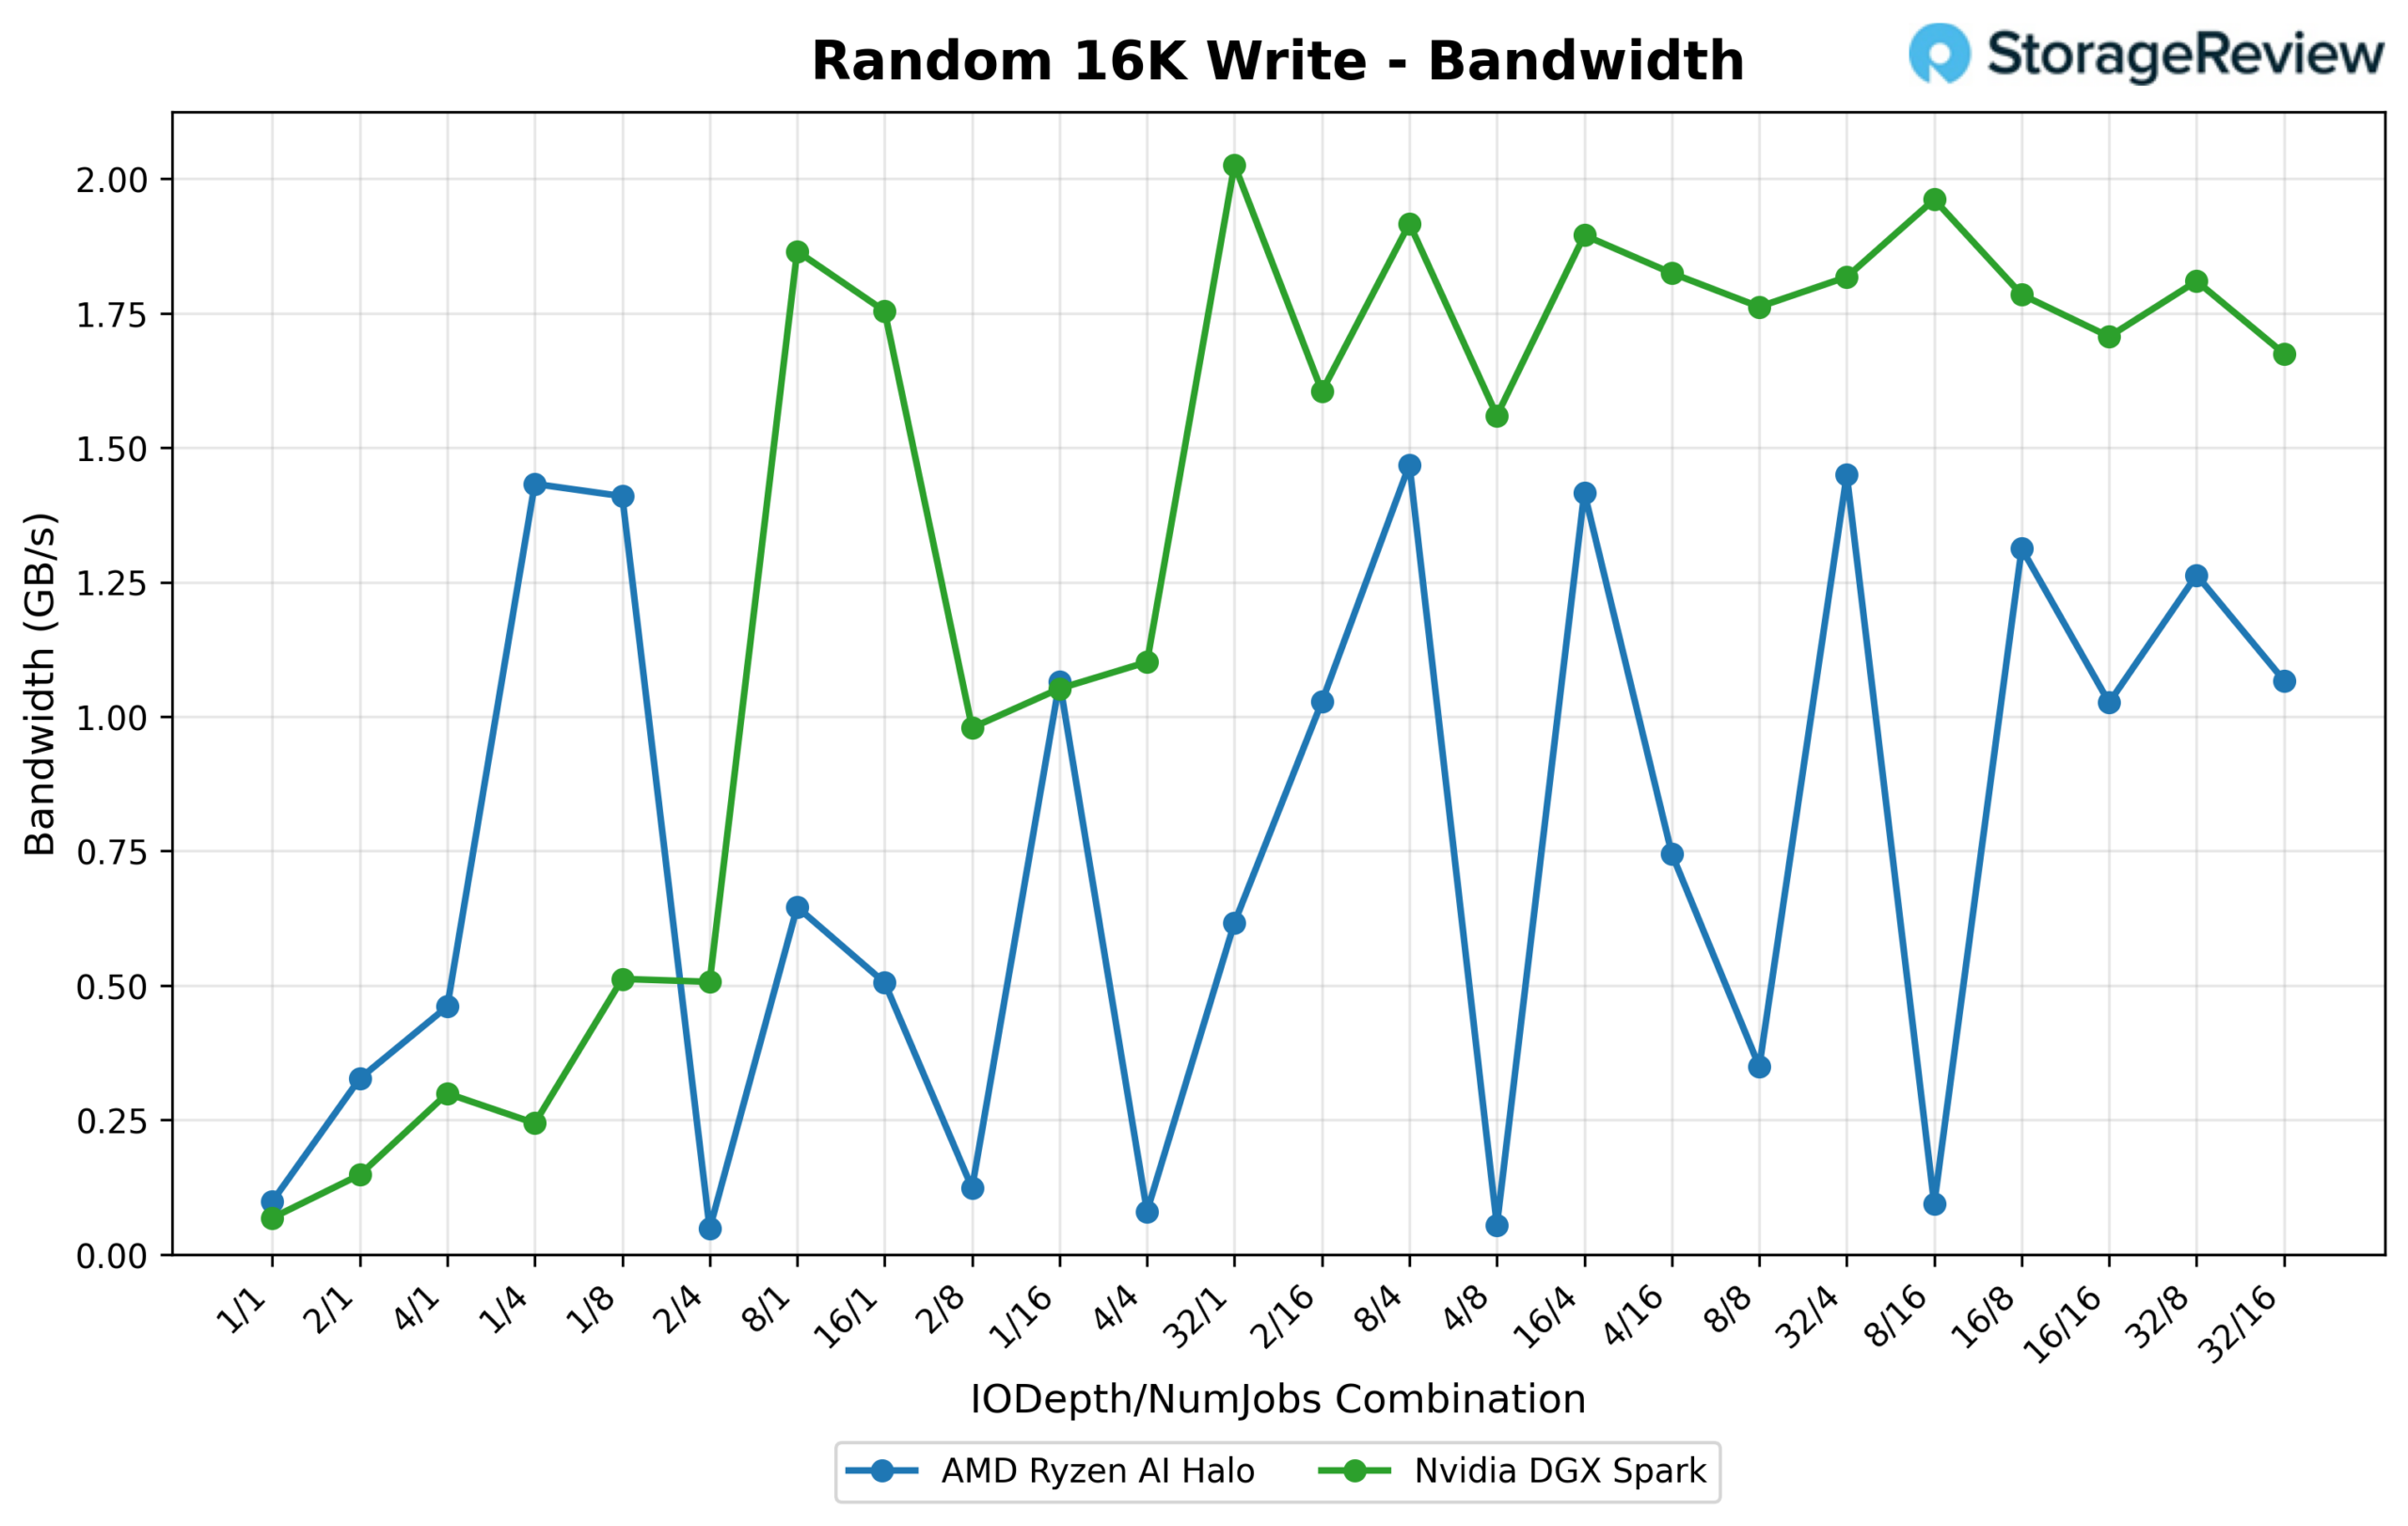
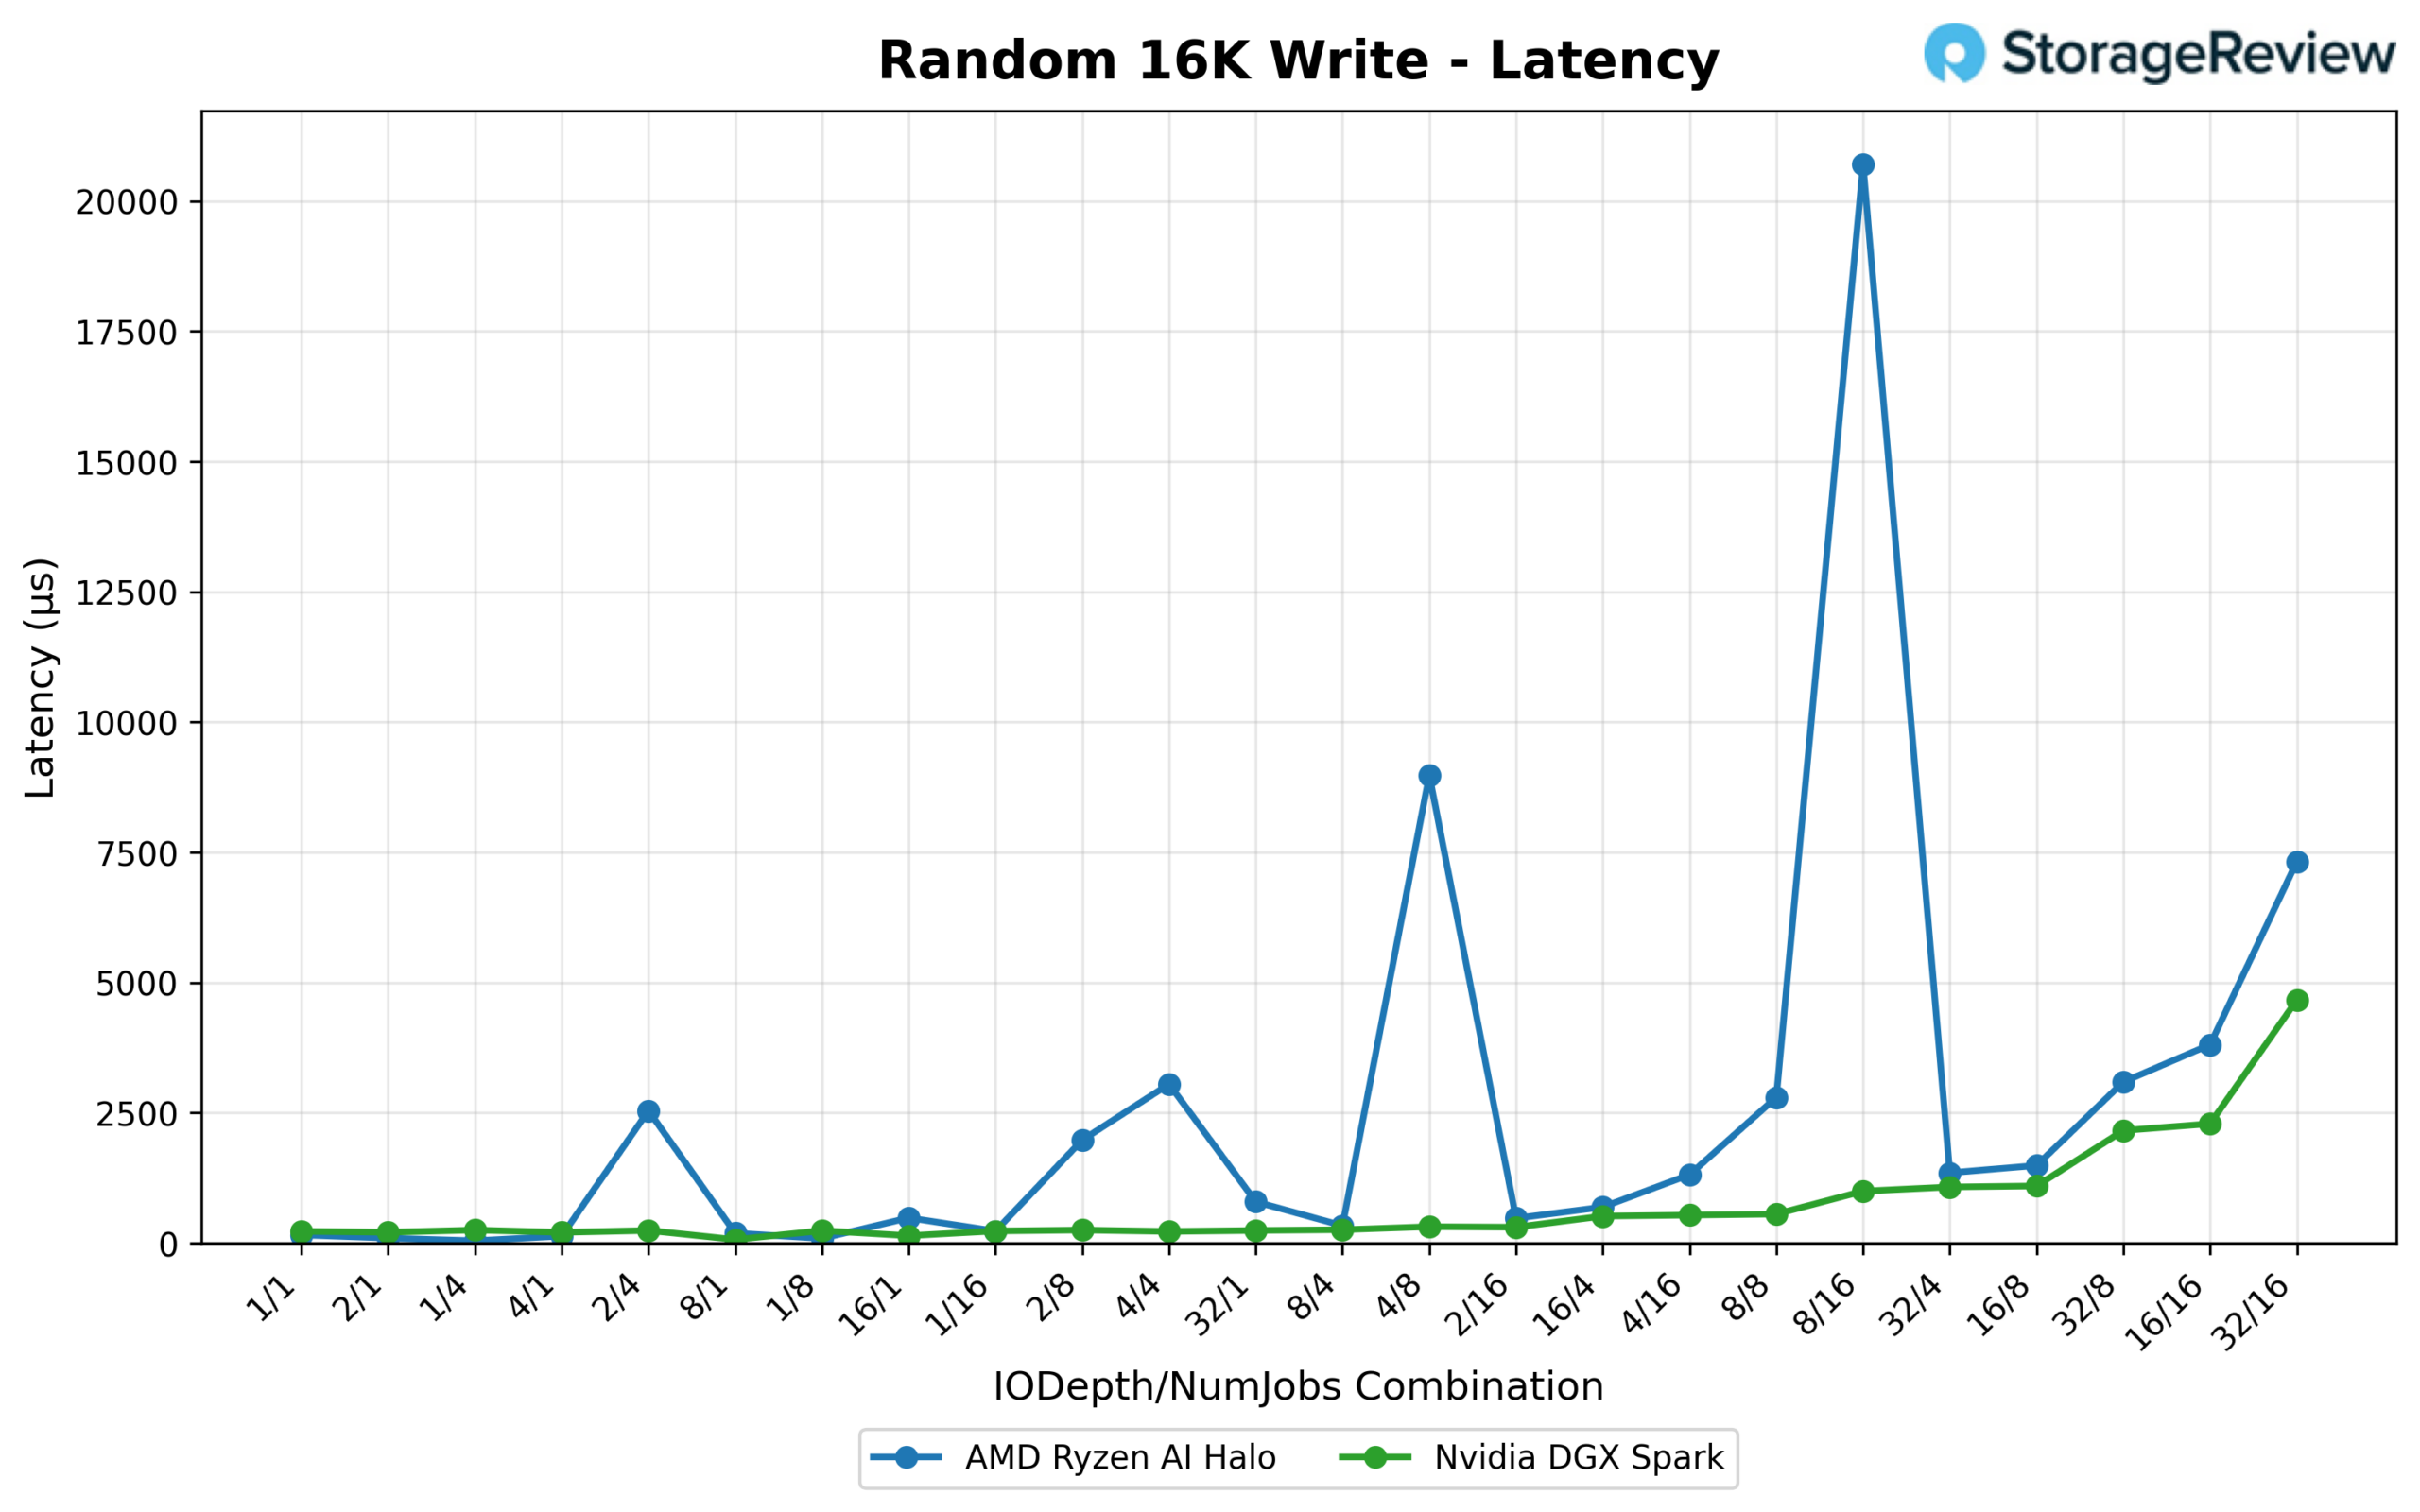
Bandbredden gynnar Sparks här, som når 2 074,1 MB/s (132.7K IOPS) vid 32/1, jämfört med Halos 1 503,5 MB/s (96.2K IOPS) vid 8/4. Sparks bandbreddskurva är också betydligt mer konsekvent och ligger inom intervallet 1.6–2.0 GB/s under större delen av svepningen efter den initiala rampen. Som jämförelse svänger Halos hastigheter vilt mellan ungefär 0.1 och 1.5 GB/s från en kombination till nästa.
Det är latensen som sticker ut i det här testet: Halo börjar lägre vid 1/1 (0.154 ms vs. 0.224 ms), men vid 8/16 stiger den genomsnittliga latensen till extrema 20.698 ms, nästan 4.5 gånger Sparks värsta tänkbara latens på 4.664 ms var som helst i svepningen. Bortsett från den enda toppen är Halos latens annars rimlig, men det är en betydande avvikelse värd att flagga för alla arbetsbelastningar som kan hamna på den specifika kombinationen av djup/tråd.
4K slumpmässig läsning
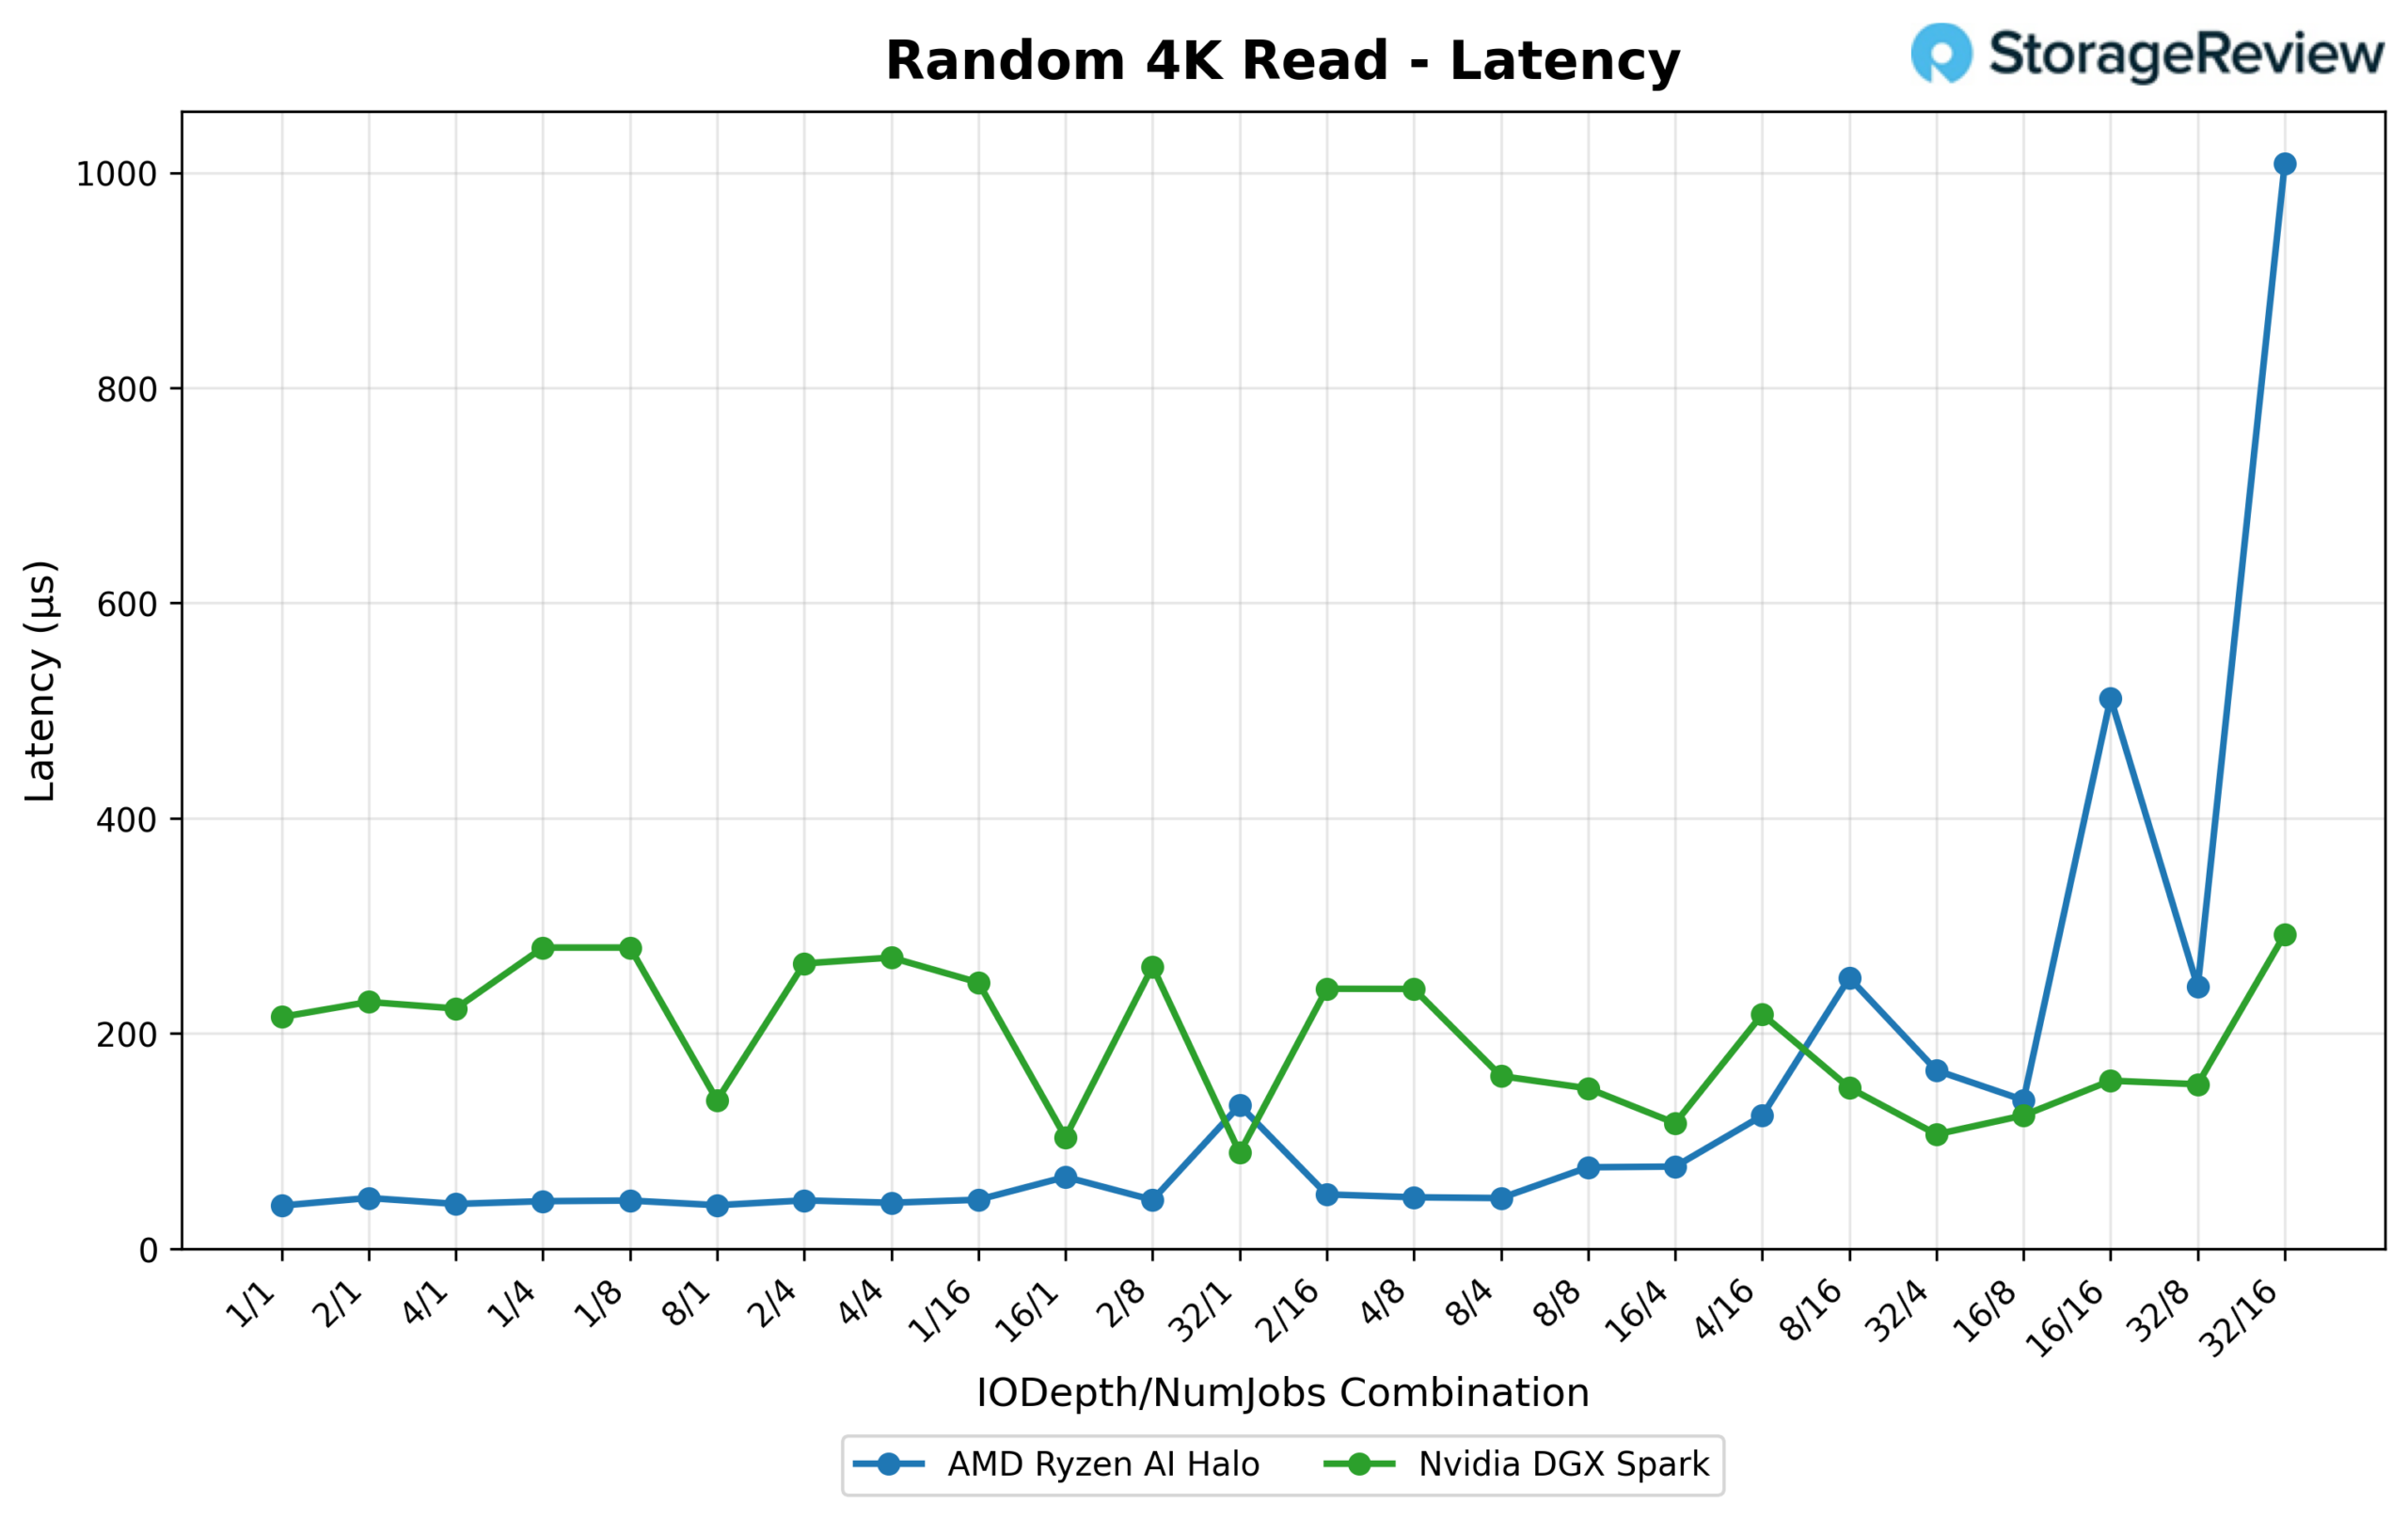
Vid låg ködjup svarar Halo dramatiskt snabbare (0.04 ms vid 1/1 jämfört med Sparks 0.215 ms), och den har en latensfördel genom större delen av det låga till mellersta intervallet av svepningen. Men Spark drar avgörande ledningen i dataflöde i stor skala: dess maximala IOPS når 1 750,7K (6 838,8 MB/s) vid 32/16, långt ifrån Halos topp på 1 050,4K IOPS (4 103,2 MB/s) vid 32/8.
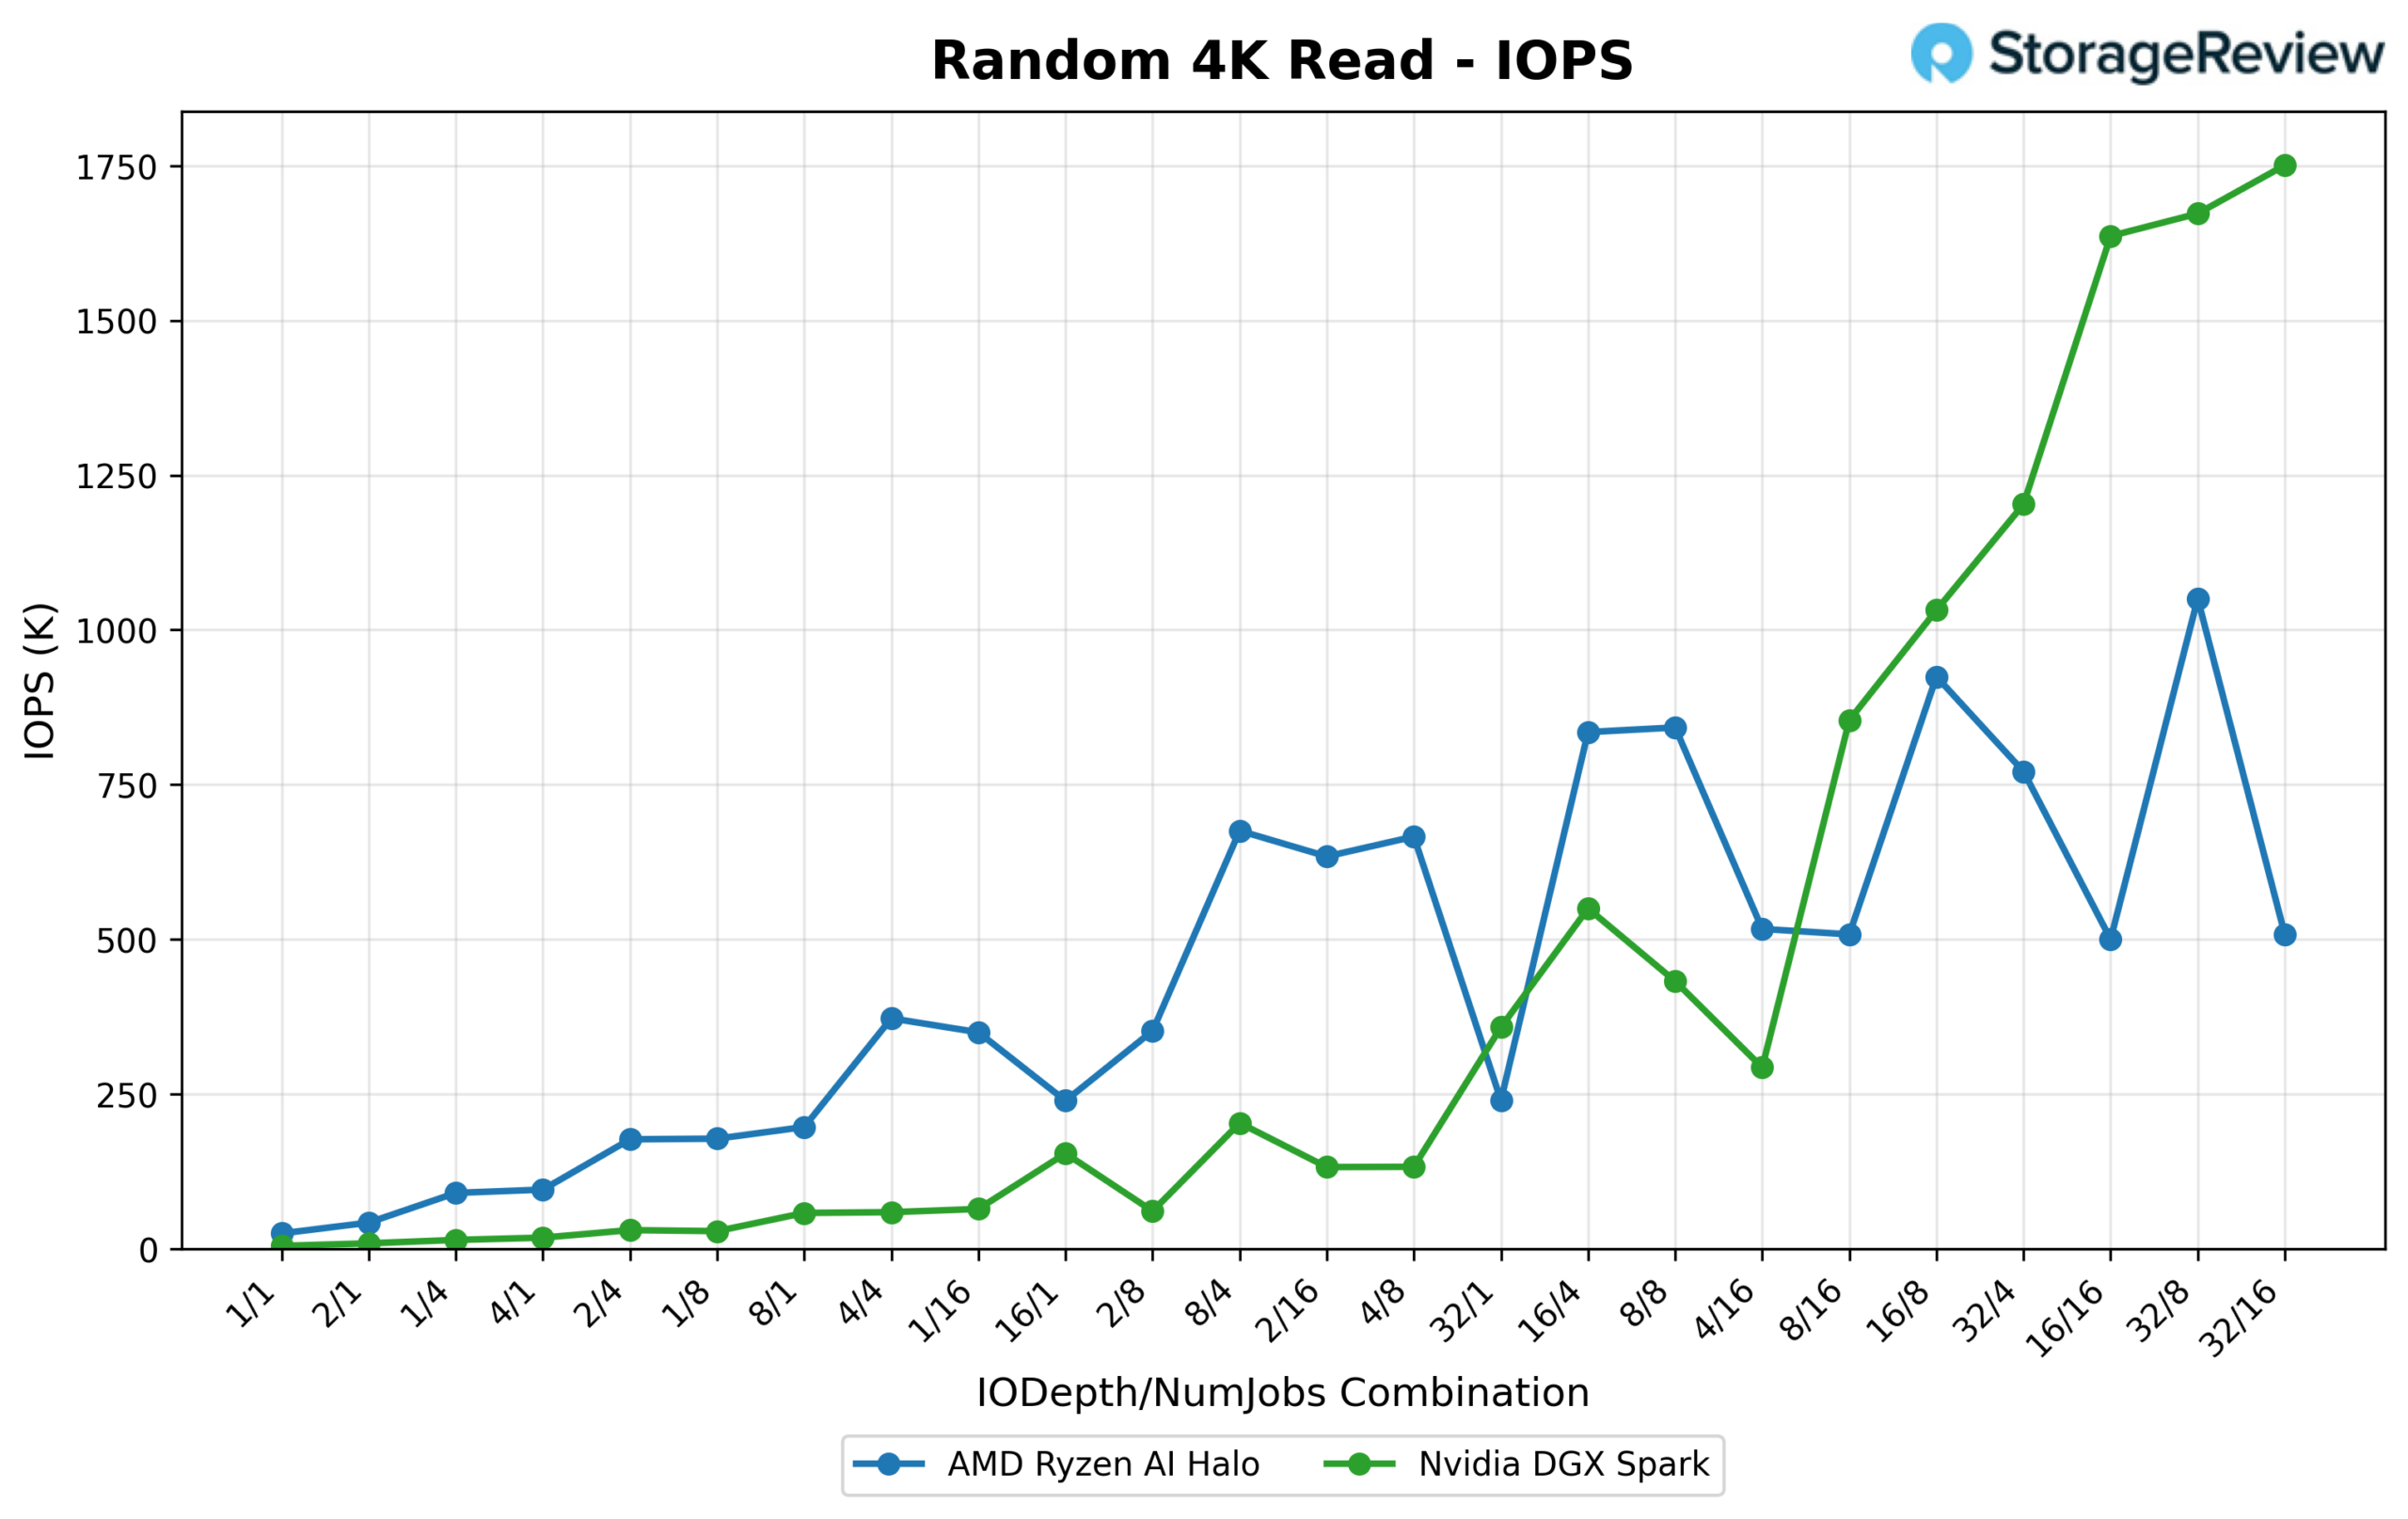
Intressant nog inverterar latensbilden vid högt ködjup. Sparks latenskurva förblir relativt begränsad även när djupet och trådarna stiger, och når en topp på bara 0.292 ms. Halo, däremot, ökar kraftigt vid 16/16 (0.513 ms) och igen vid 32/16 (1.009 ms), vilket överstiger dess baslinje i steady-state med över 3x, vilket innebär att dess utmärkta respons vid lågt ködjup inte fortsätter till full mättnad.
4K slumpmässig skrivning
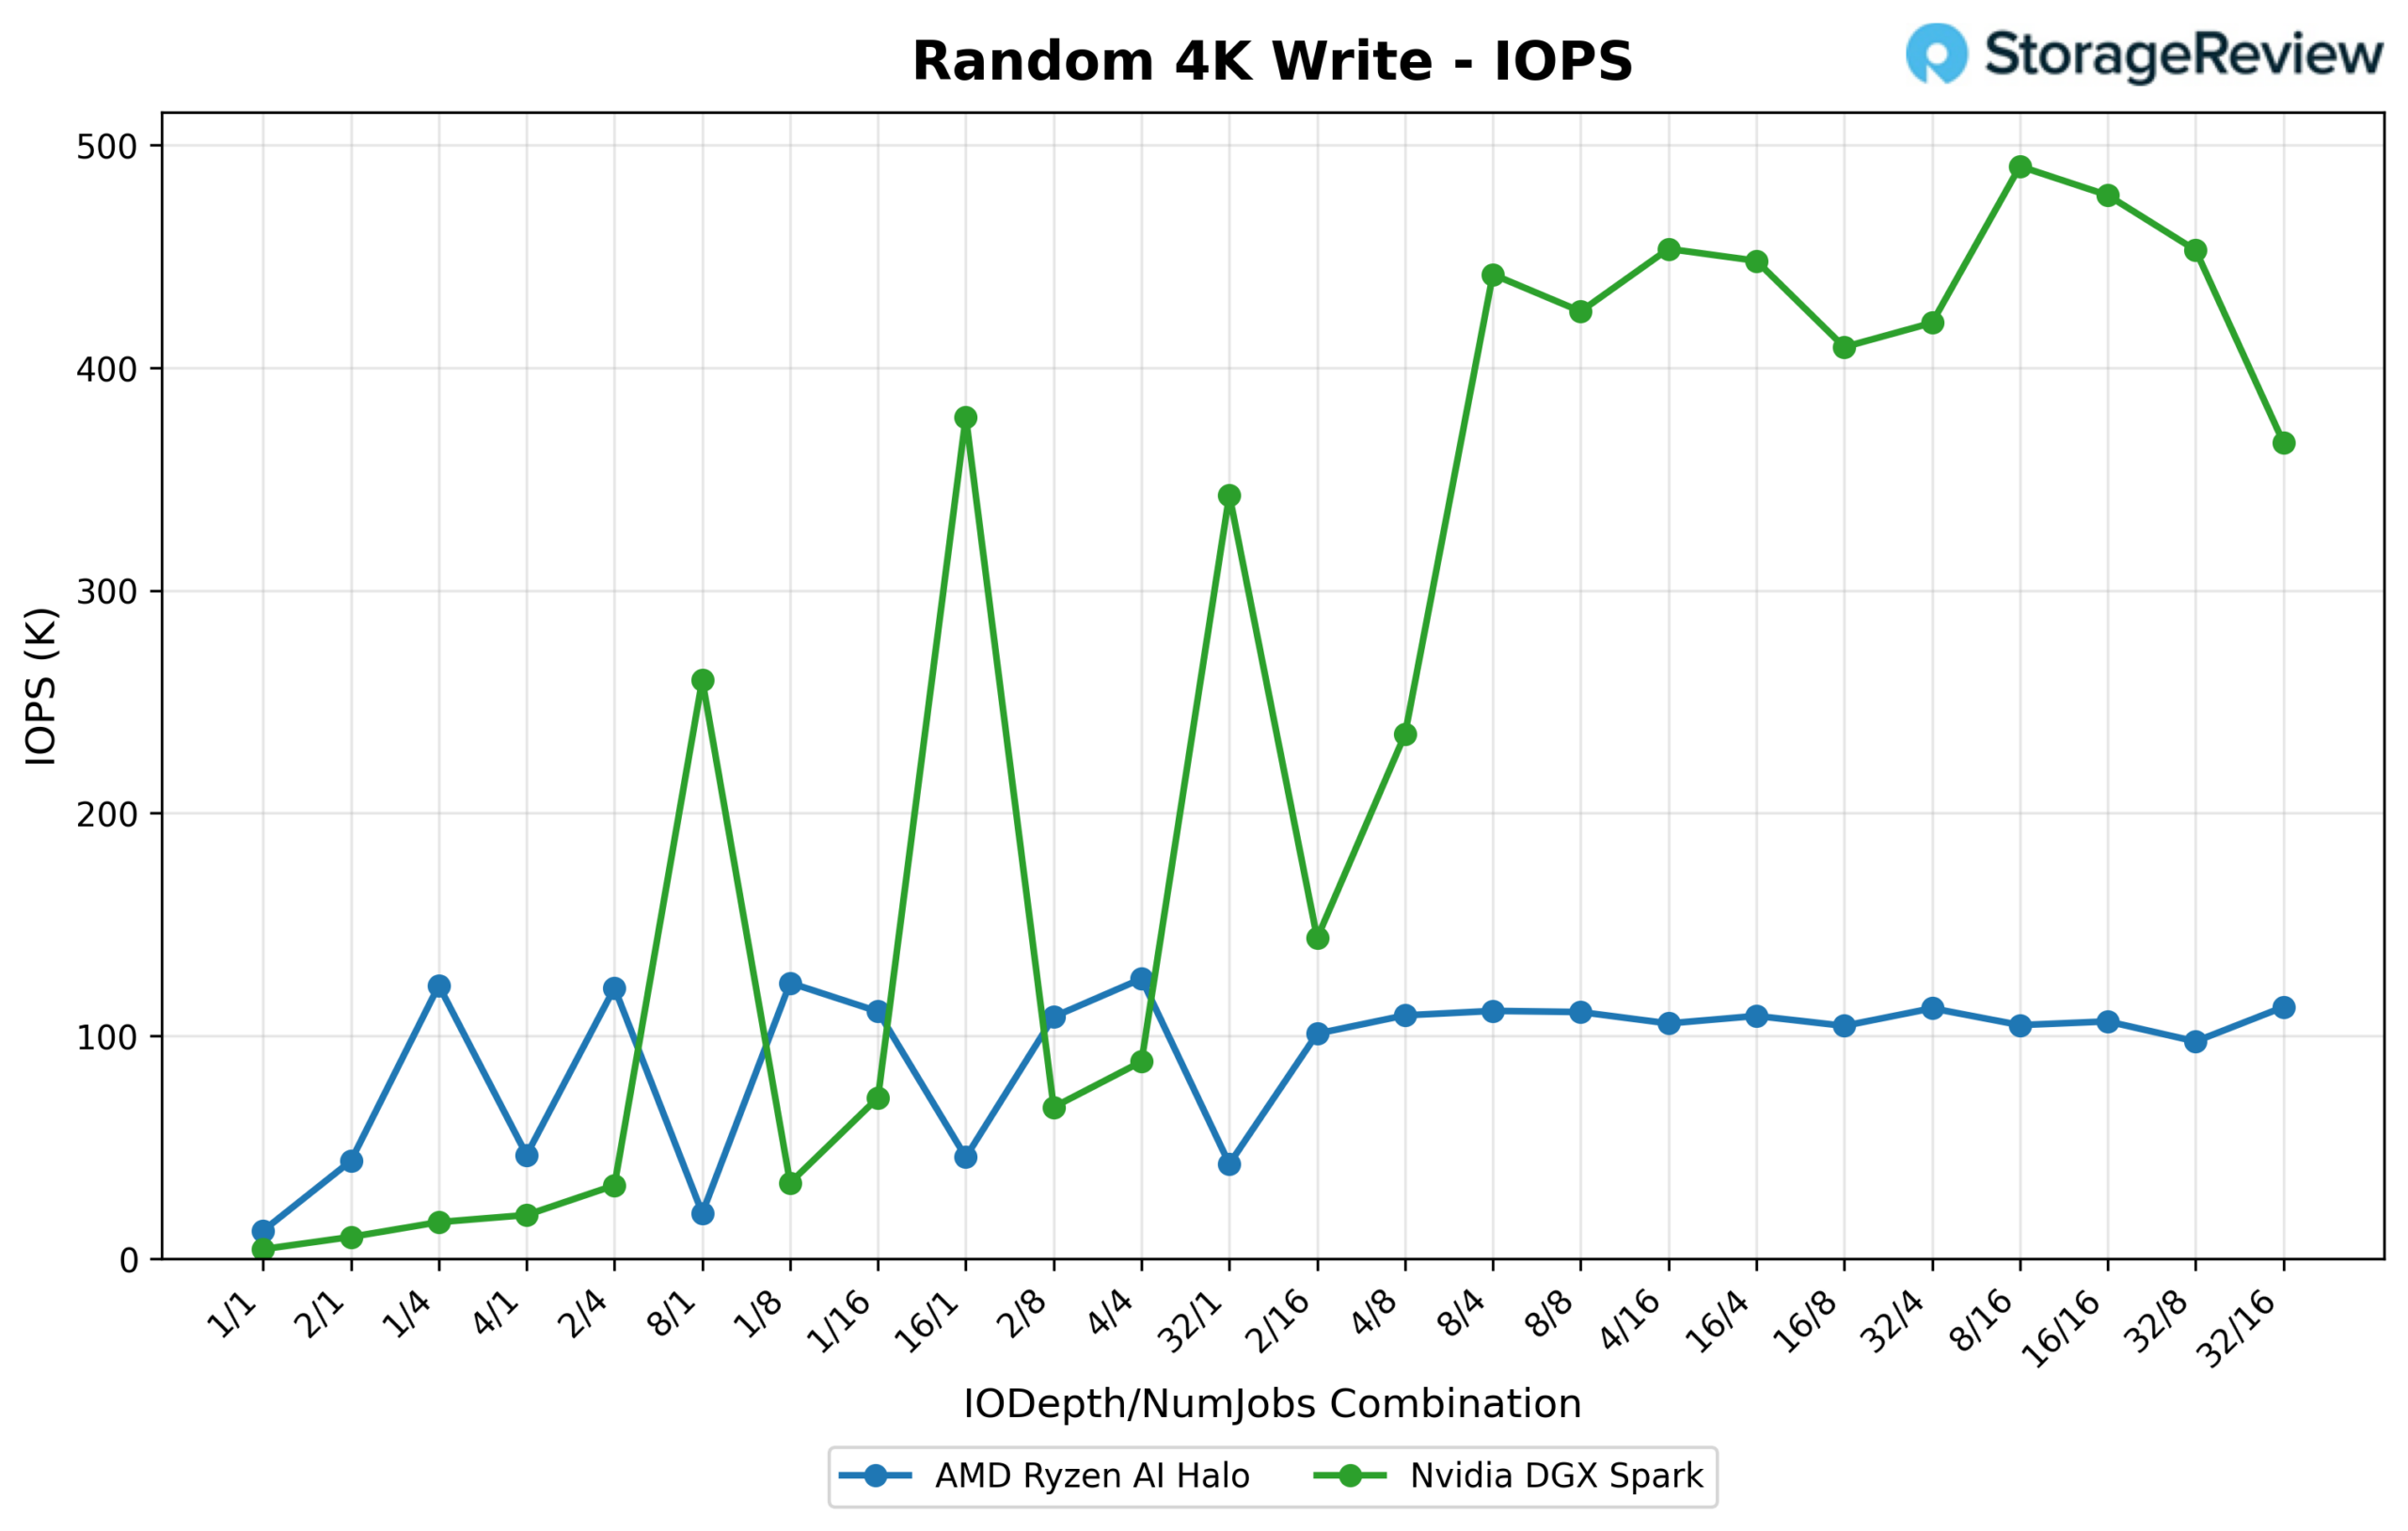
Detta är det största IOPS-gapet i svepningen. Sparks slumpmässiga 4K-skrivprestanda klättrar brant i takt med att ködjupet och trådantalet ökar och når 490.4K IOPS (1 915,6 MB/s) vid 8/16. Halo däremot planar ut mycket tidigare och på en mycket lägre nivå, och toppar vid 125.6K IOPS (490.7 MB/s) vid 4/4 och överstiger aldrig ungefär 110–115K IOPS under resten av svepningen. Spark körs på nästan 4x Halos maxhastighet här.
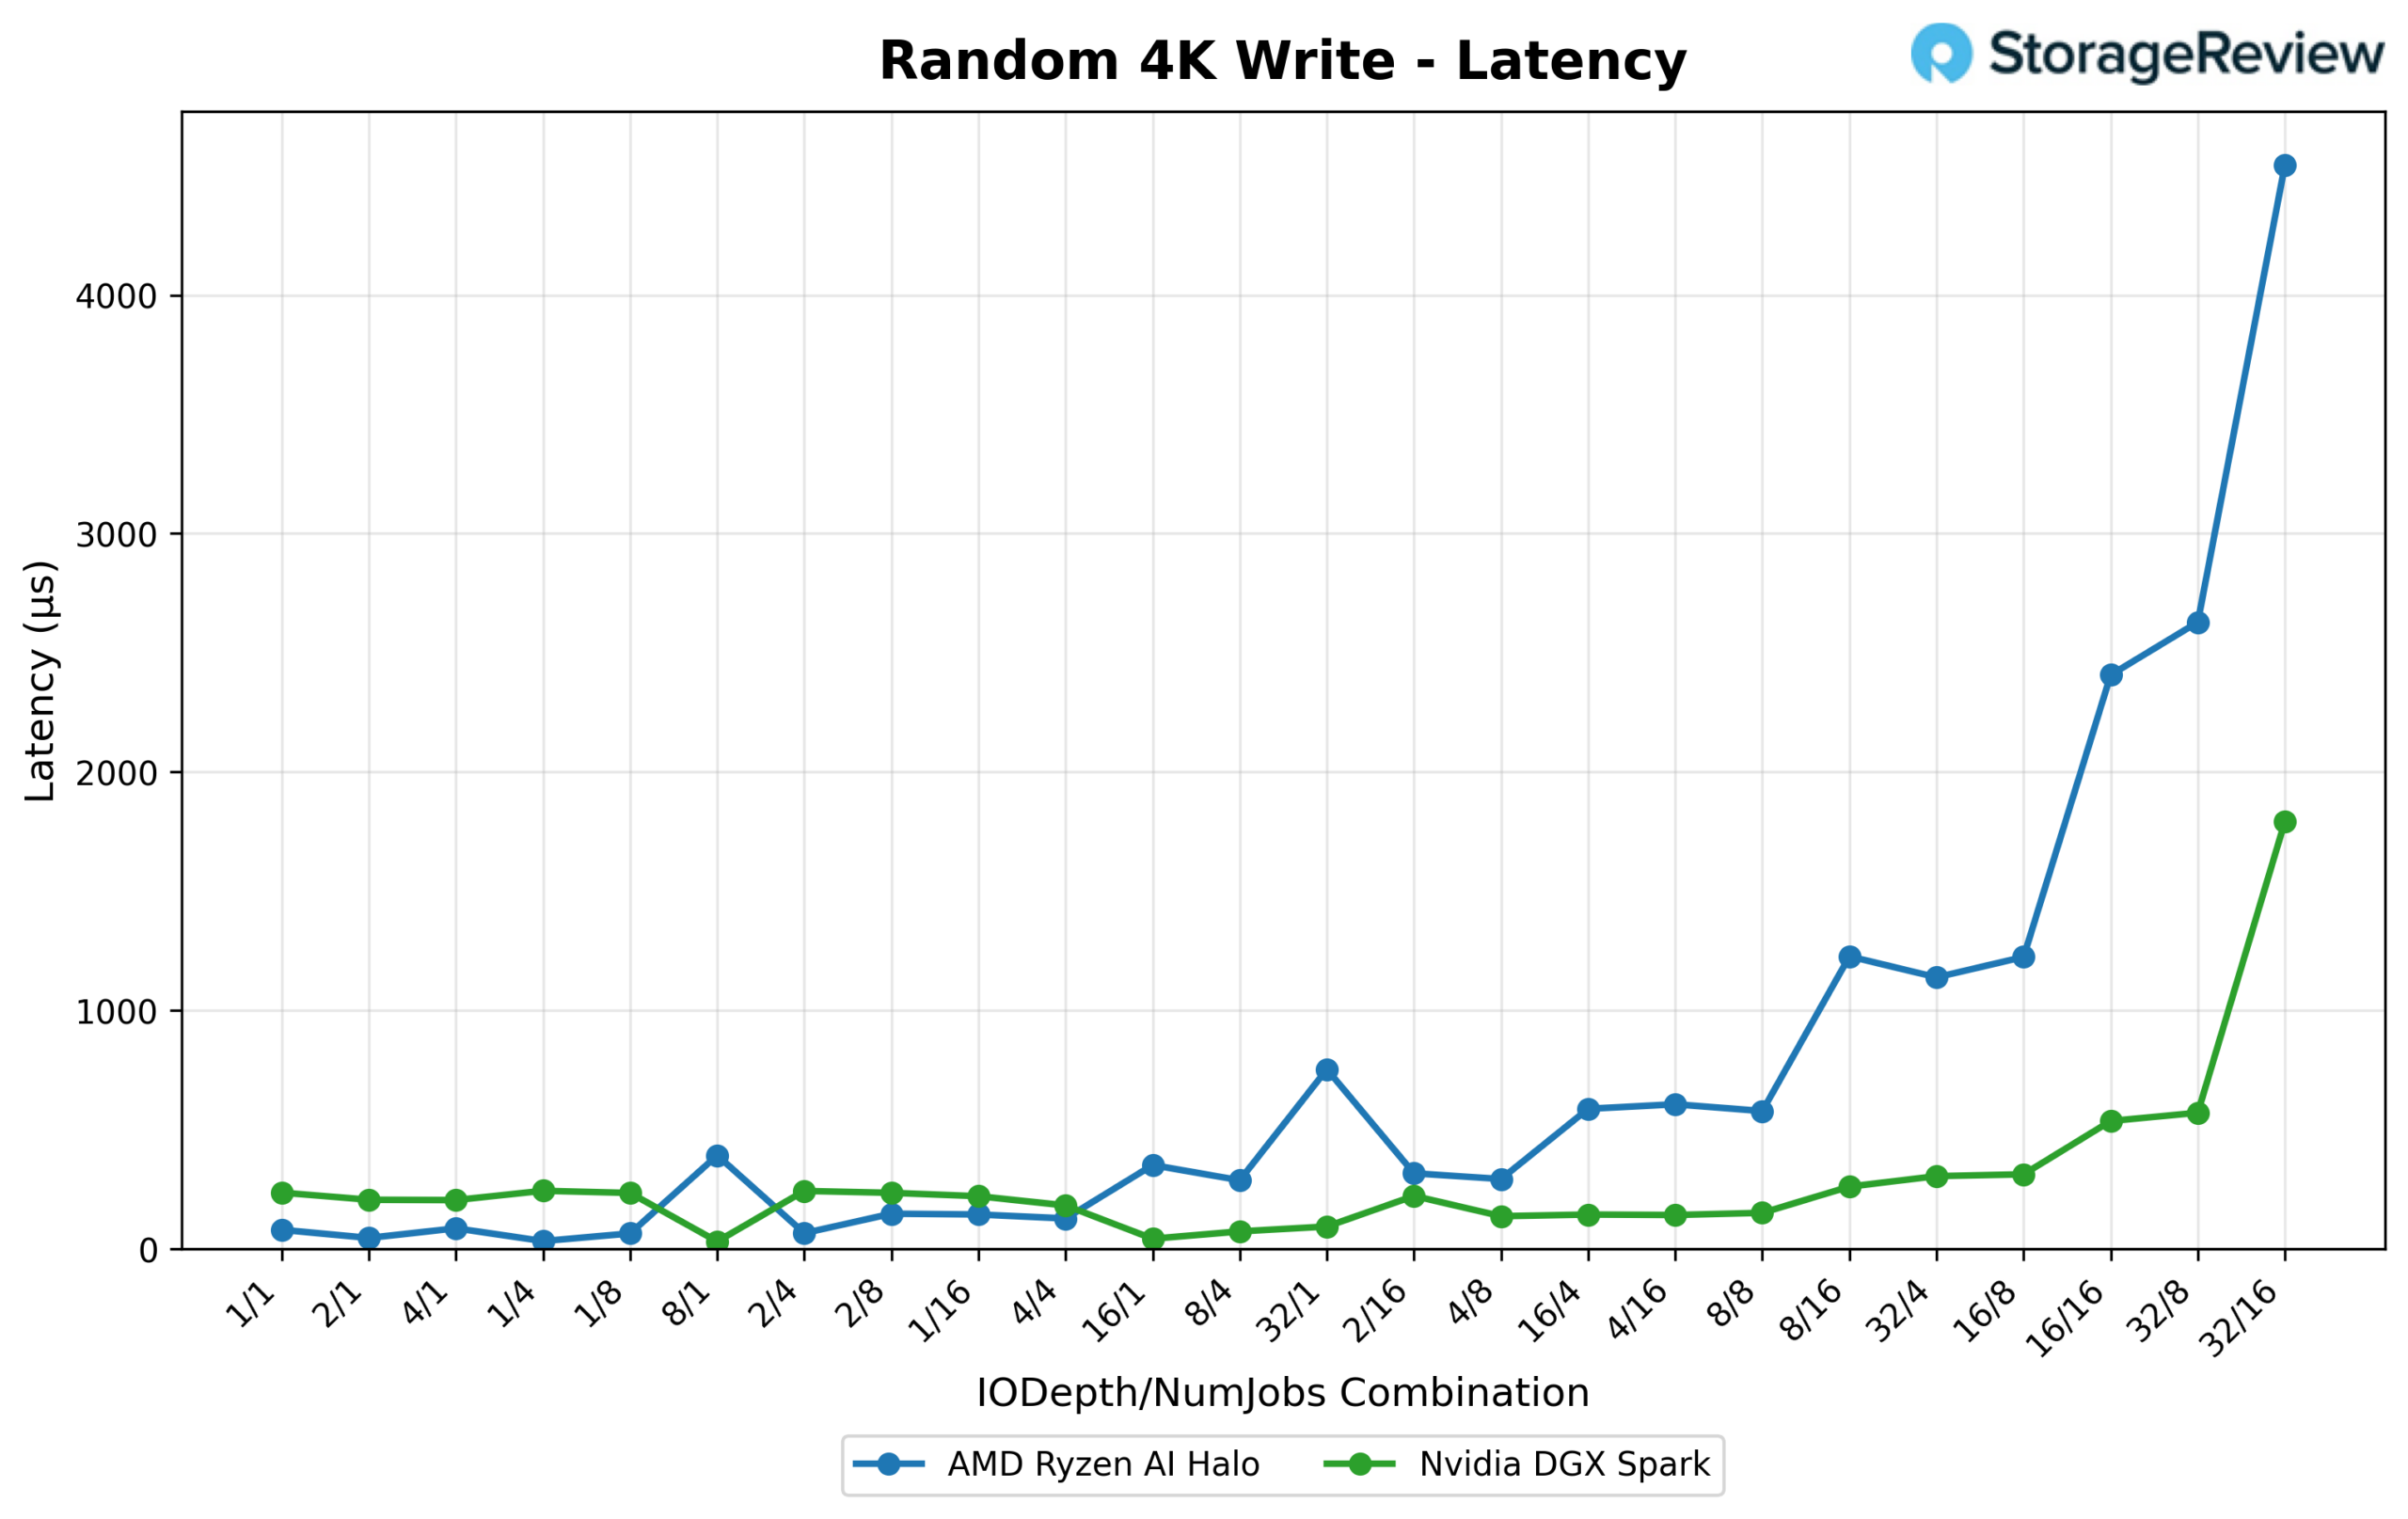
Latensen börjar återigen gynna Halo vid lågt ködjup (0.079 ms vs. 0.235 ms vid 1/1). Vid 32/16 har Halos genomsnittliga latens stigit till 4.546 ms, medan Sparks förblir jämförelsevis kontrollerad vid 1.792 ms. Kombinerat med IOPS-gapet är detta testet där Sparks fördel är mest uttalad och mest konsekvent över hela djupet/trådsvepet.
vLLM Online-servering – LLM-inferensprestanda
vLLM är en av de mest populära inferens- och serveringssystemen med hög genomströmning för LLM:er. vLLM:s online-serveringsbenchmark utvärderar den verkliga serveringsprestandan för denna inferensmotor under samtidiga förfrågningar. Den simulerar produktionsarbetsbelastningar genom att skicka förfrågningar till en aktiv vLLM-server, med konfigurerbara parametrar som förfrågningshastighet, in- och utmatningslängder och antalet samtidiga klienter. Benchmarket mäter viktiga mätvärden, inklusive genomströmning (tokens per sekund), tid till första token och tid per utmatningstoken (TPOT), vilket hjälper användare att förstå hur vLLM presterar under olika belastningsförhållanden.
Vi testade inferensprestanda över en omfattande uppsättning modeller som spänner över olika arkitekturer, parameterskalor och kvantiseringsstrategier för att utvärdera dataflödet över olika samtidighetsprofiler.
GPT OSS 120B
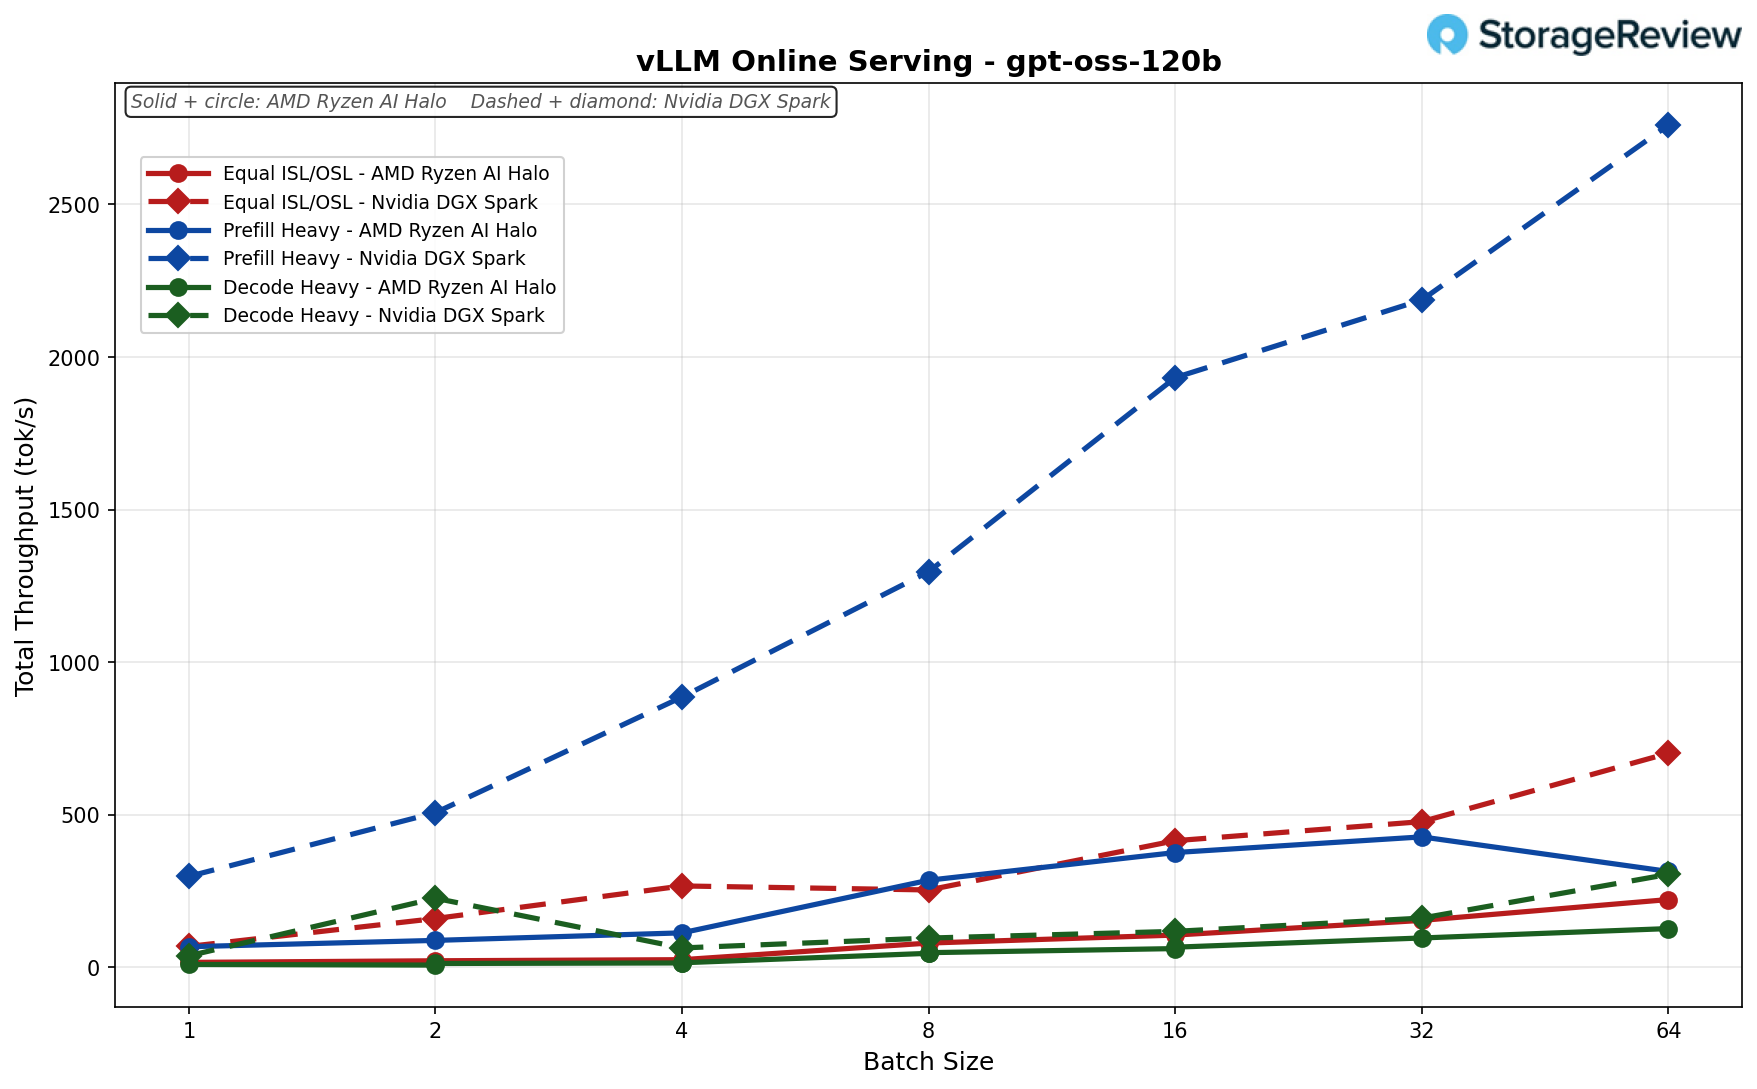
Lika ISL/OSL (256/256): Halo skalade till 222 tok/s vid batchstorlek 64, medan Spark nådde 701 (ungefär 3.2x efter).
Förfyllning Heavy (8k/1k): Halos dataflöde nådde sin topp vid batch 32 (427 tok/s), sjönk sedan till 314 vid batch 64, medan Spark steg till 2 760 (cirka 8.8x) – det största gapet i setet.
Avkoda tung (1k/8k): Halo nådde 127 tok/s, jämfört med Sparks 305 vid batchstorlek 64 (cirka 2.4x).
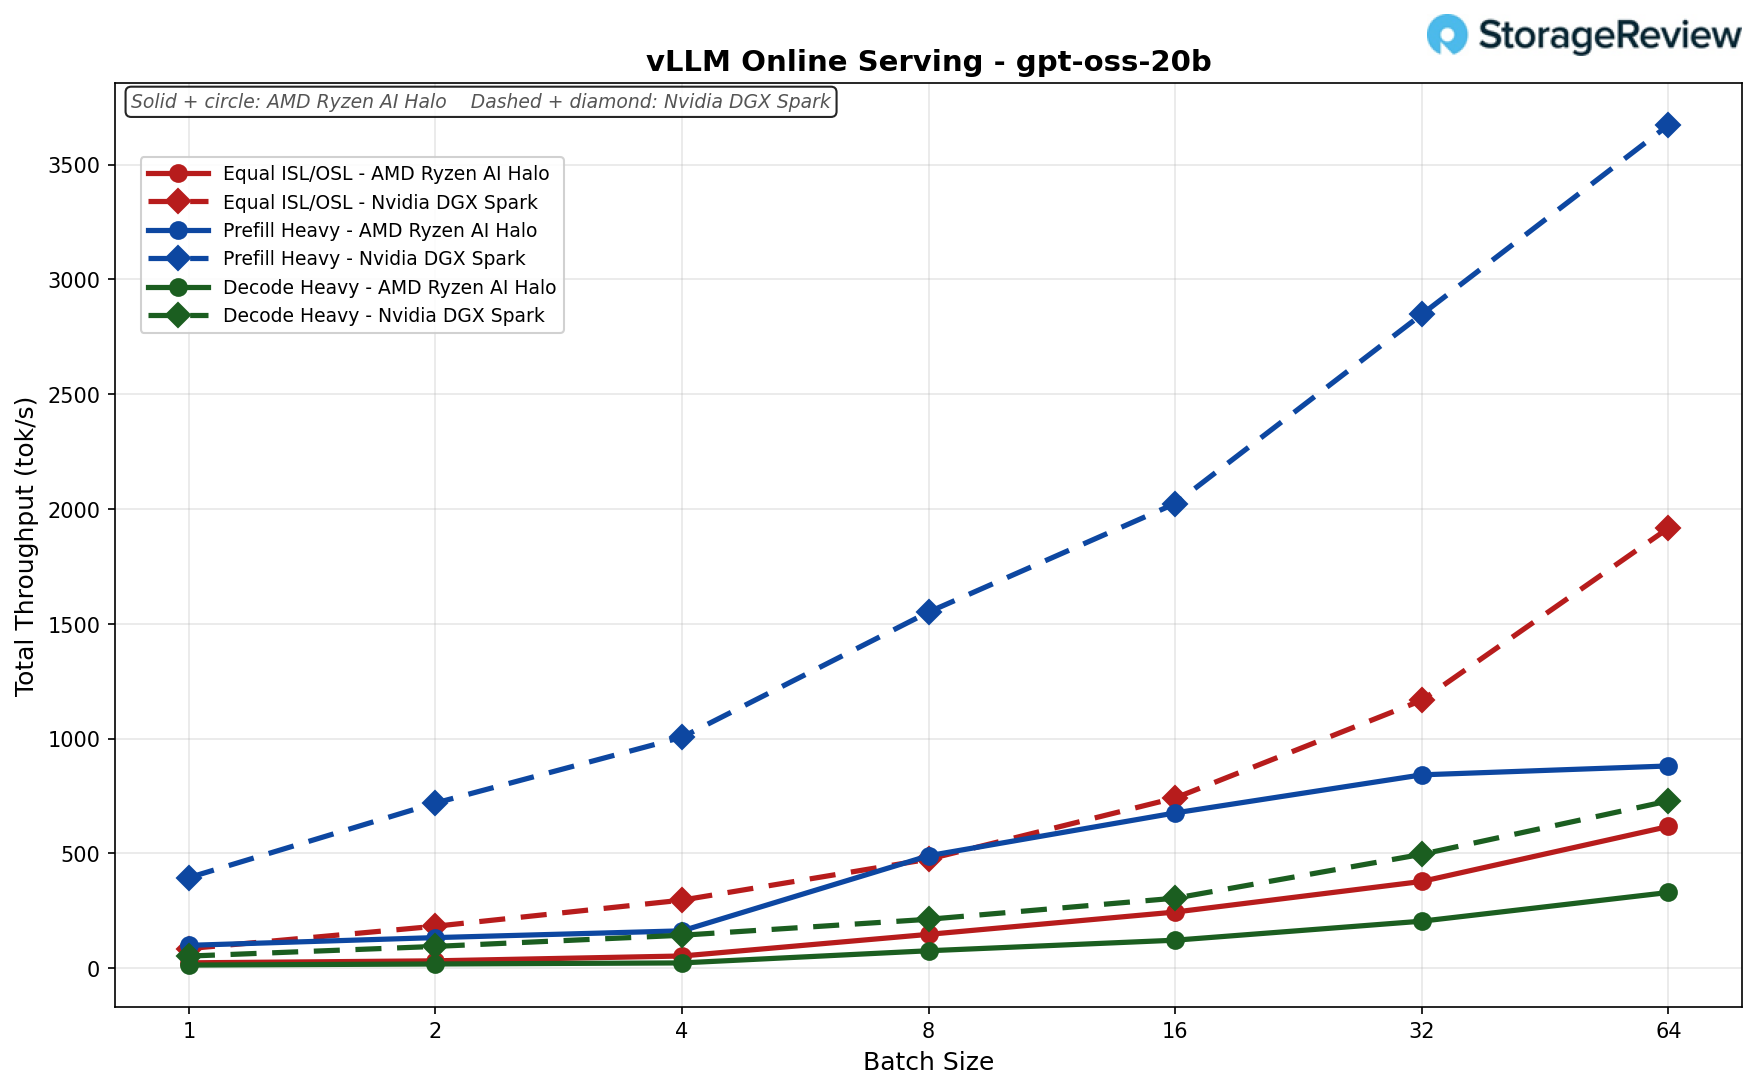
GPT OSS 20B
Lika ISL/OSL (256/256): Spark ledde i varje batch, skalande till 1 917 vs 617 tok/s vid batch 64 (Spark cirka 3.1x före).
Förfyllning Heavy (8k/1k): Sparks starkaste ledning, klättrar till 3 672 vs 881 tok/s vid batchstorlek 64 (Spark cirka 4.2x före).
Avkoda tung (1k/8k): Spark ligger före hela slaget och når 728 mot 330 tok/s vid batch 64 (Spark ligger cirka 2.2x före).
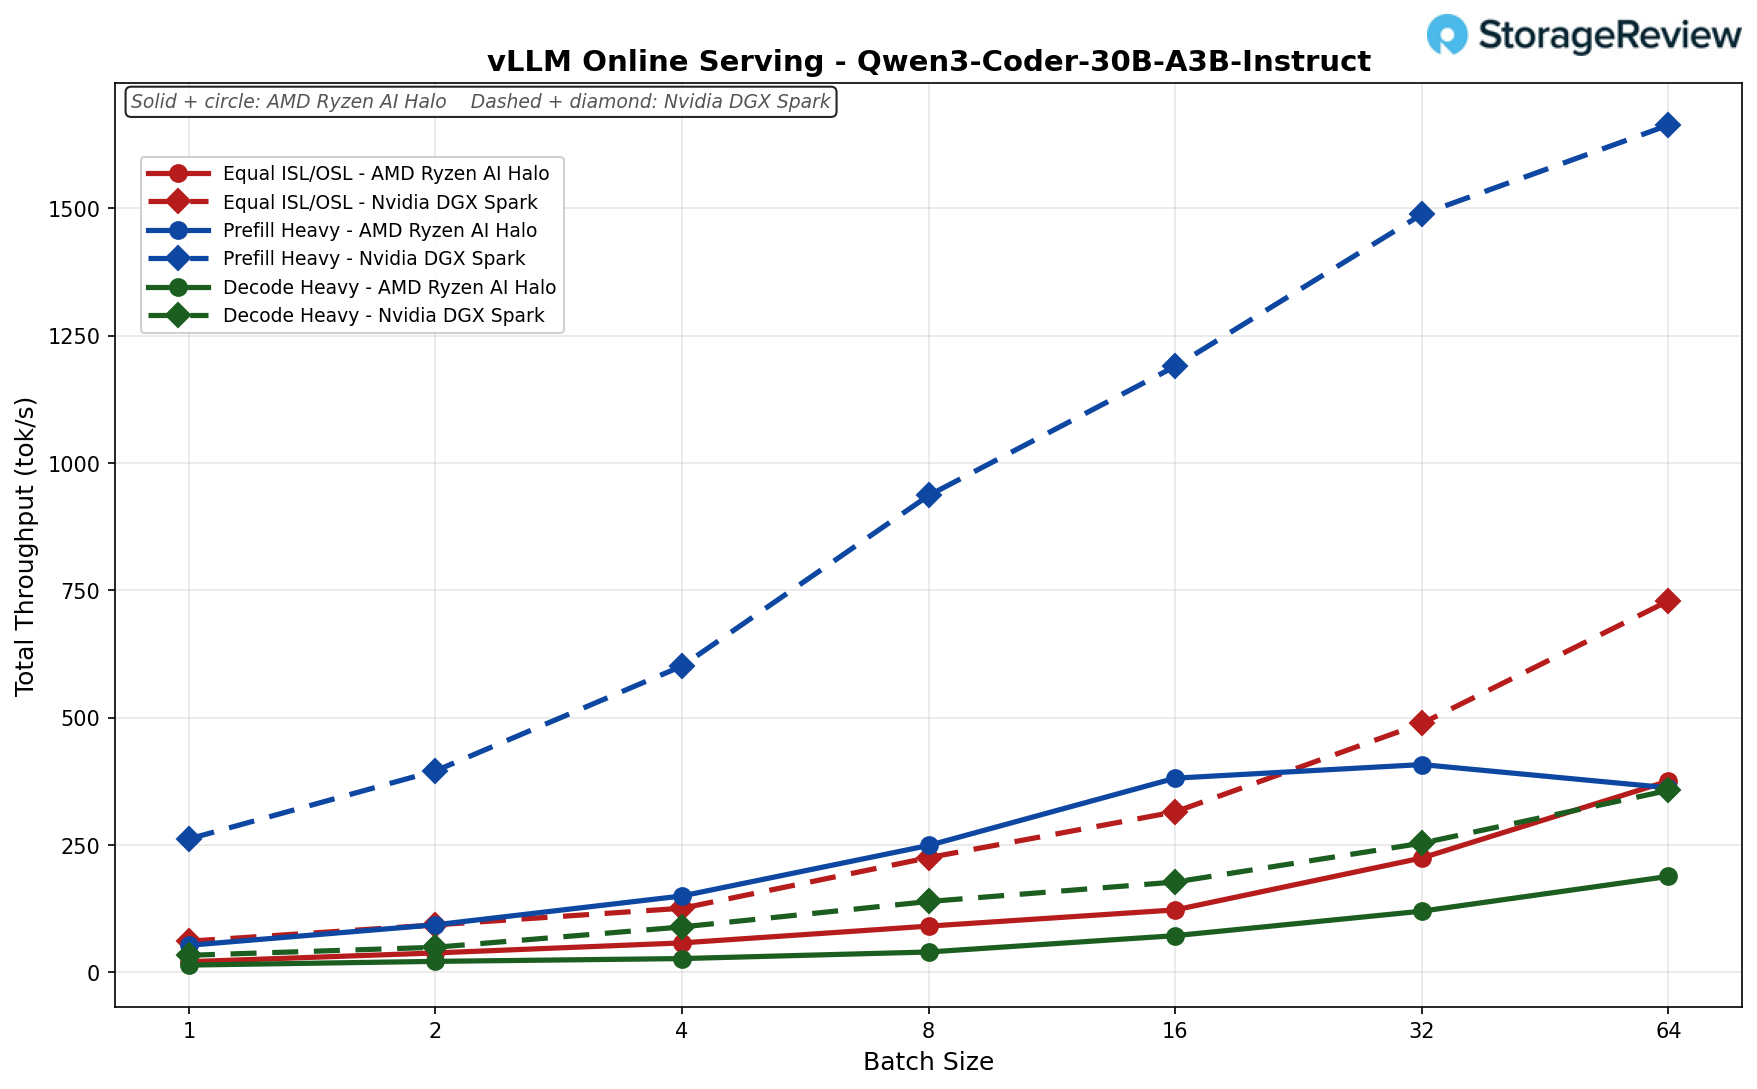
Qwen3-kodare 30B A3B-instruktion
Lika ISL/OSL (256/256): Halo skalade till 376 tok/s vid batchstorlek 64, ungefär hälften av Sparks 729 (cirka 1.9x) – ett av de strängare Equal ISL/OSL-resultaten.
Förfyllning Heavy (8k/1k): Halo nådde sin topp vid batch 32 (408 tok/s), sjönk sedan till 362 vid batch 64, efter Sparks 1 663 (cirka 4.6x).
Avkoda tung (1k/8k): Halo nådde 188 tok/s, jämfört med Sparks 357 vid batchstorlek 64 (cirka 1.9x).
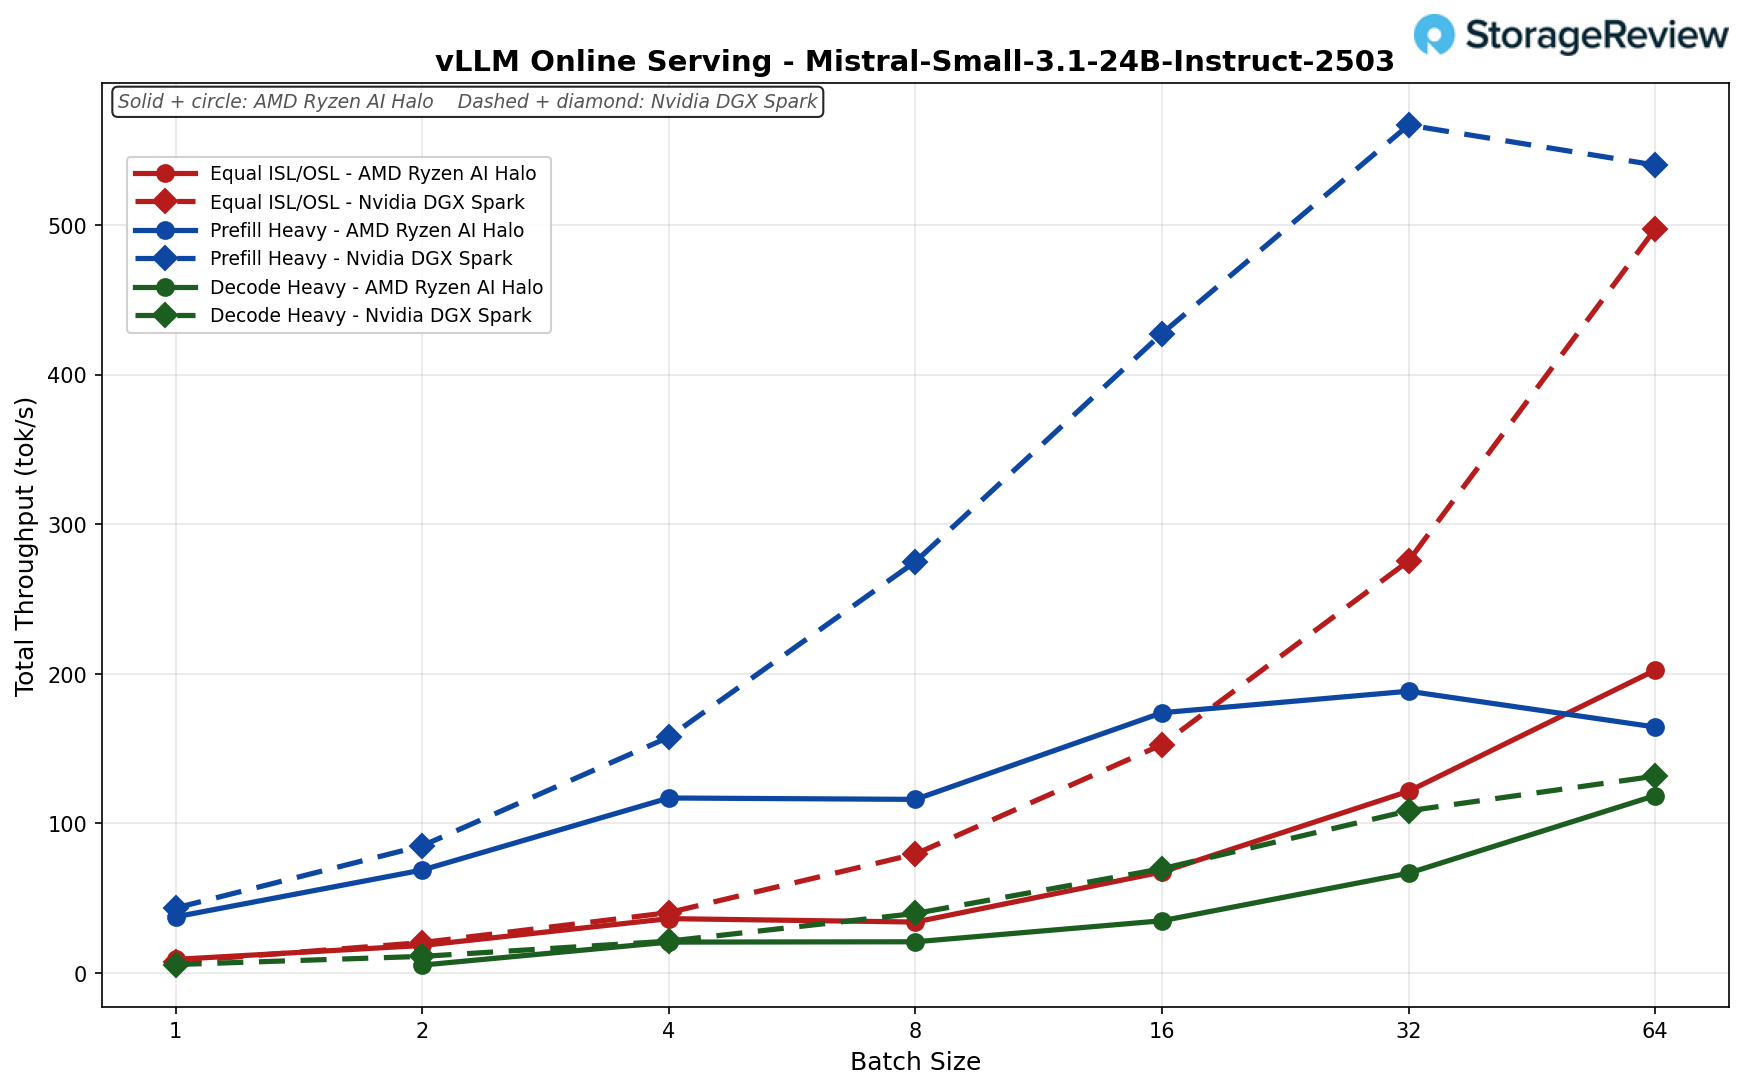
Mistral Small 3.1 24B Instruktion
Lika ISL/OSL (256/256): Halo ledde faktiskt i batch 1 (9 vs 8 tok/s), och stabiliserades sedan till 202 tok/s i batch 64, medan Spark låg på 498 (ungefär 2.5x efter).
Förfyllning Heavy (8k/1k): Halo nådde sin topp vid batch 32 (188 tok/s) och sjönk något till 164 vid batch 64, efter Sparks 540 (cirka 3.3x).
Decode Heavy (1k/8k): Nästan lika hela tiden, Halo nådde 119 tok/s mot Sparks 132 i batch 64 (inom cirka 11%).
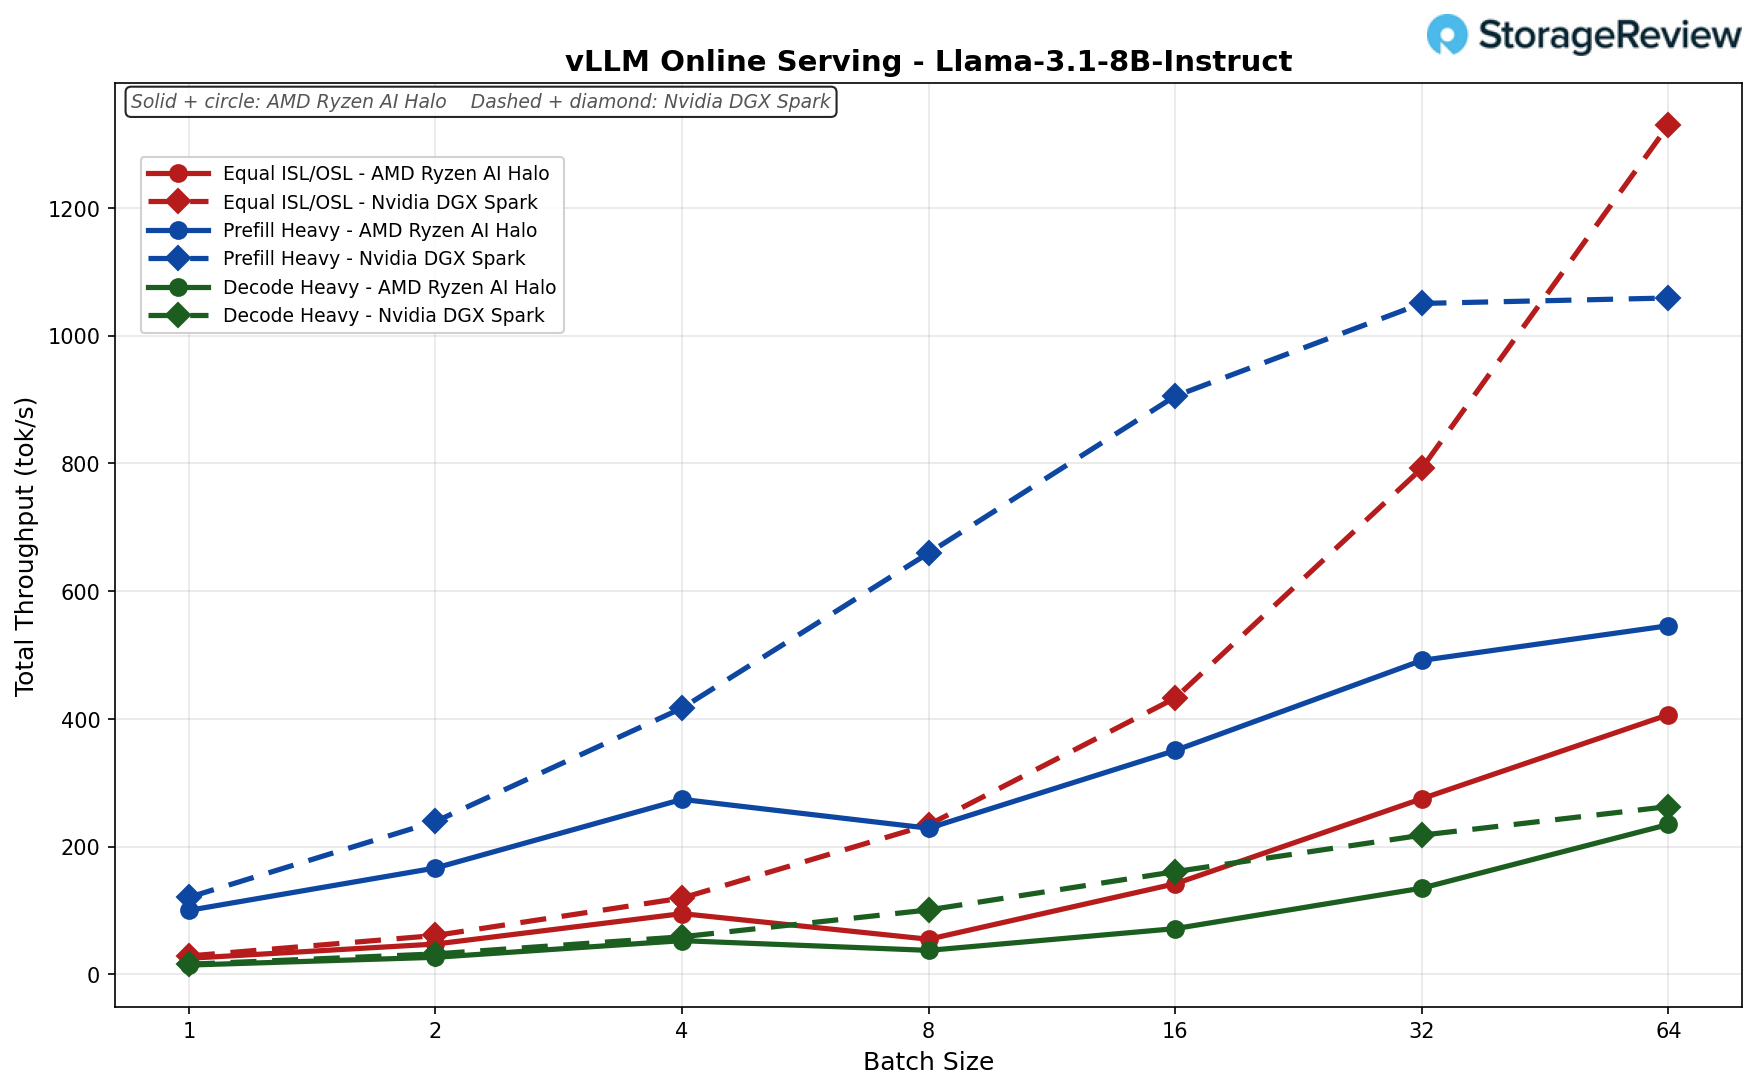
Llama 3.1 8B Instruktion
Lika ISL/OSL (256/256): Halo skalade rent från 25 tok/s vid batch 1 till 407 tok/s vid batch 64, och följde Spark noggrant genom batch 4, varefter Spark drog före till 1 330 (Halo låg efter med cirka 3.3x vid topp).
Förfyllning Heavy (8k/1k): Halo nådde 546 tok/s vid batchstorlek 64, och innehöll ungefär hälften av Sparks 1 059.
Decode Heavy (1k/8k): Halos mest konkurrenskraftiga scenario, som når 235 tok/s mot Sparks 263 vid en batchstorlek på 64 (inom cirka 12%).
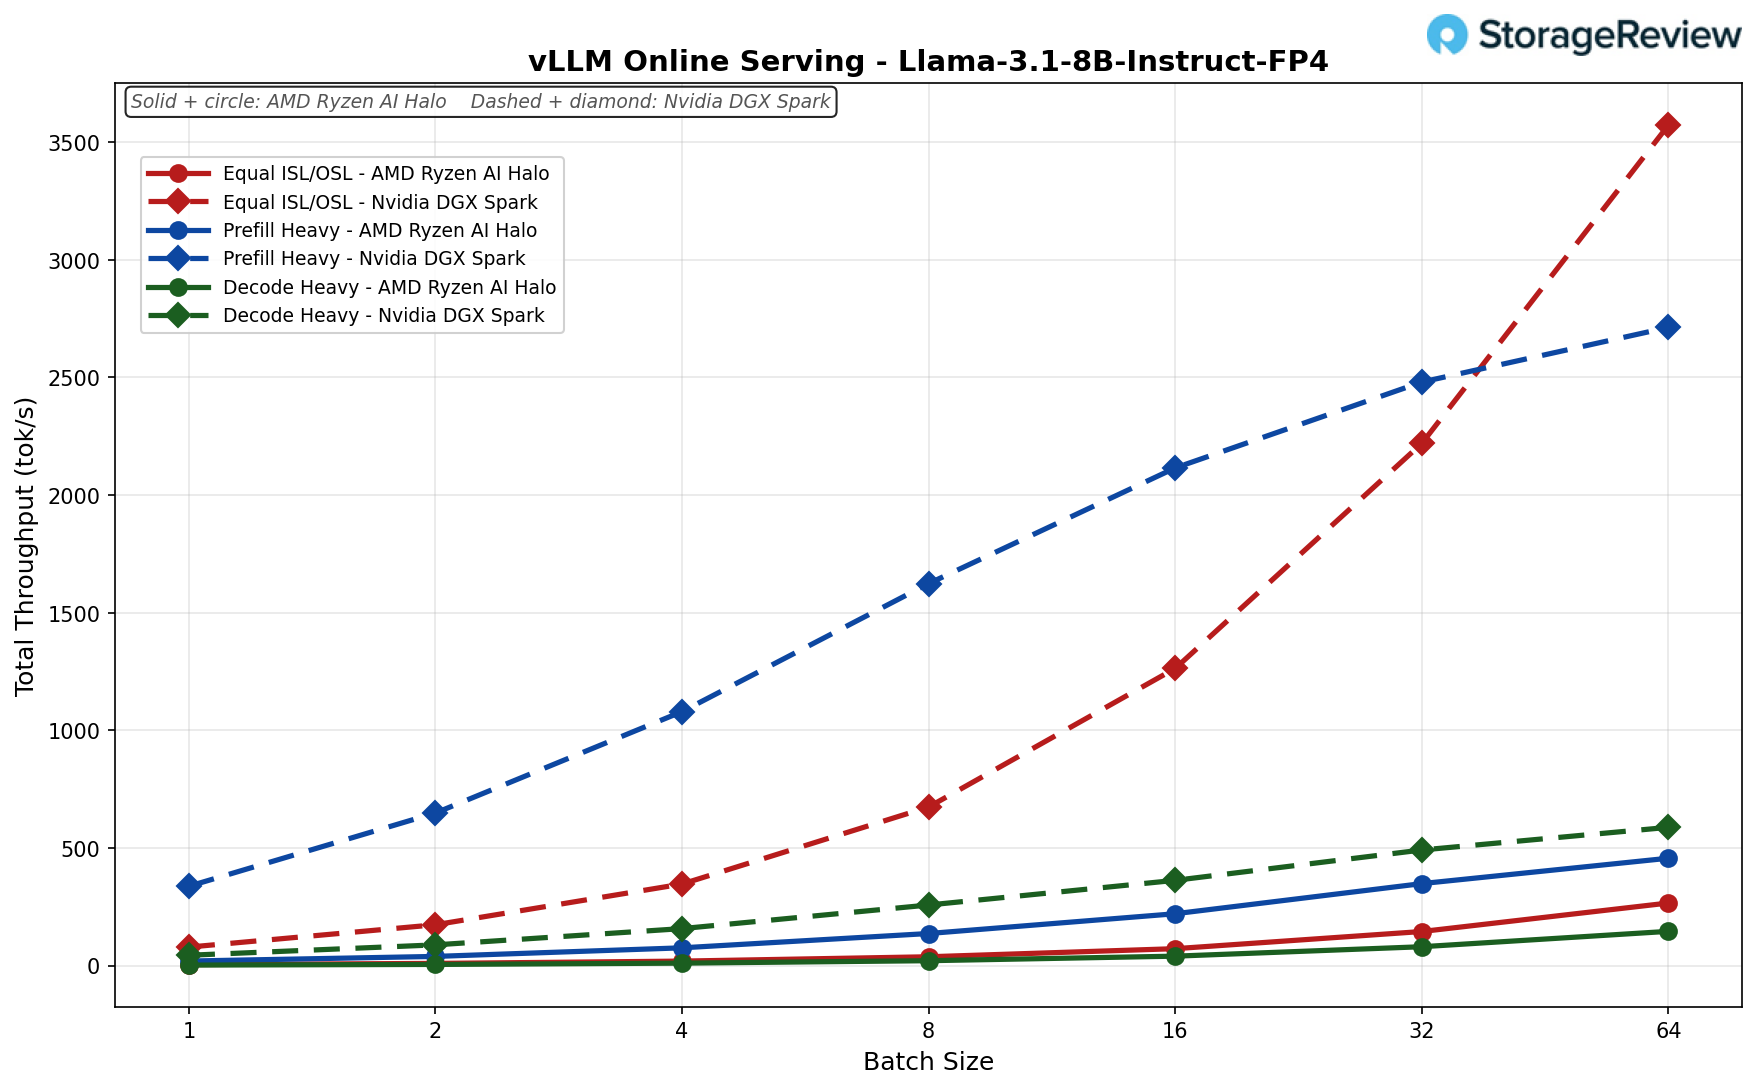
Llama 3.1 8B Instruktion FP4
Lika ISL/OSL (256/256): Halo nådde sin topp på 267 tok/s vid batchstorlek 64, långt efter Sparks 3 573 — FP4 visar det största gapet (cirka 13.4x).
Förfyllning Heavy (8k/1k): Halo nådde 457 tok/s vid batchstorlek 64, jämfört med Sparks 2 713 (cirka 5.9x).
Avkoda tungt (1k/8k): Halo skalade till 146 tok/s, jämfört med Sparks 588 tok/s vid en batchstorlek på 64 (ungefär 4x).
Slutsats
AMD Ryzen AI Halo går in i en kategori som NVIDIA effektivt skapade med DGX Spark, och den försöker inte slå Spark i sitt eget spel. I våra vLLM-tester hade Spark en 2x till 4x fördel i dataflödet i de flesta scenarier vid högre samtidighet, som sträckte sig till 8.8x i förfyllningsintensivt GPT OSS 120B-arbete och minskade till ungefär 10% endast i ett par avkodningsintensiva körningar, och dess lagringsundersystem vann nästan alla fio-test vid mättnad. Vad Halo istället erbjuder är samma 128 GB enhetligt minne och 200 miljarder parametrar i ett liknande format, till 3 999 dollar jämfört med Spark Founders Editions 4 699 dollar (även om vissa OEM-tillverkare har dem under 4 000 dollar), i en komplett x86-maskin som startar Windows 11 eller Linux snarare än enbart DGX OS.
Om man bortser från Spark, så är Halo den starkaste Ryzen AI Max+ 395-implementationen vi testat. Den fick toppbetyg mot HP Z2 Mini G1a och ZBook Ultra G1a i nästan alla Windows-arbetsbelastningar vi körde: 37 316 i Cinebench R23 multi-core, 184.2 GIPS i 7-Zip mot 151.6 och 156.8 för HP:erna, de högsta Procyon AI-text- och bildgenereringspoängen och de snabbaste y-cruncher-tiderna med 5 och 10 miljarder siffror. På Linux, mot Spark, vann den de CPU-bundna Phoronix-testerna direkt, komprimerade 11 % snabbare i 7-Zip och avslutade LLVM-kompileringen 14 % tidigare. Detta är först och främst en kompakt arbetsstation, där AI-utvecklarrollen läggs ovanpå snarare än att ersätta den.
Utvecklare som behöver maximalt antal lokala tokens per sekund, eller som planerar att klustra noder över höghastighetsstrukturer, bör fortfarande köpa Spark; Halos 10 GbE och dess vLLM-tak är inte i närheten. För utvecklare som bygger mot ROCm, team som behöver Windows i loopen, eller alla som vill ha en enda låda för att täcka professionella arbetsbelastningar och lokalt modellarbete, är Halo den bättre lämpade modellen, och standard M.2 2280-facket och det förinställda variabelgrafikminnet tar bort två av de vanligaste klagomålen som Spark-ägare har framfört. AMD har också sagt att plattformen kommer att köpa Ryzen AI Max PRO 400-seriens kisel med upp till 192 GB enhetligt minne under tredje kvartalet, så köpare som jagar större modeller har en tydlig väg framåt utan att byta plattform.
Produktsida – AMD Ryzen AI Halo
Topplista: AMD Ryzen AI Halo innehar platsen för bästa x86-alternativ på vår topplista över bästa stationära datorer för lokal AI .



 Amazon