
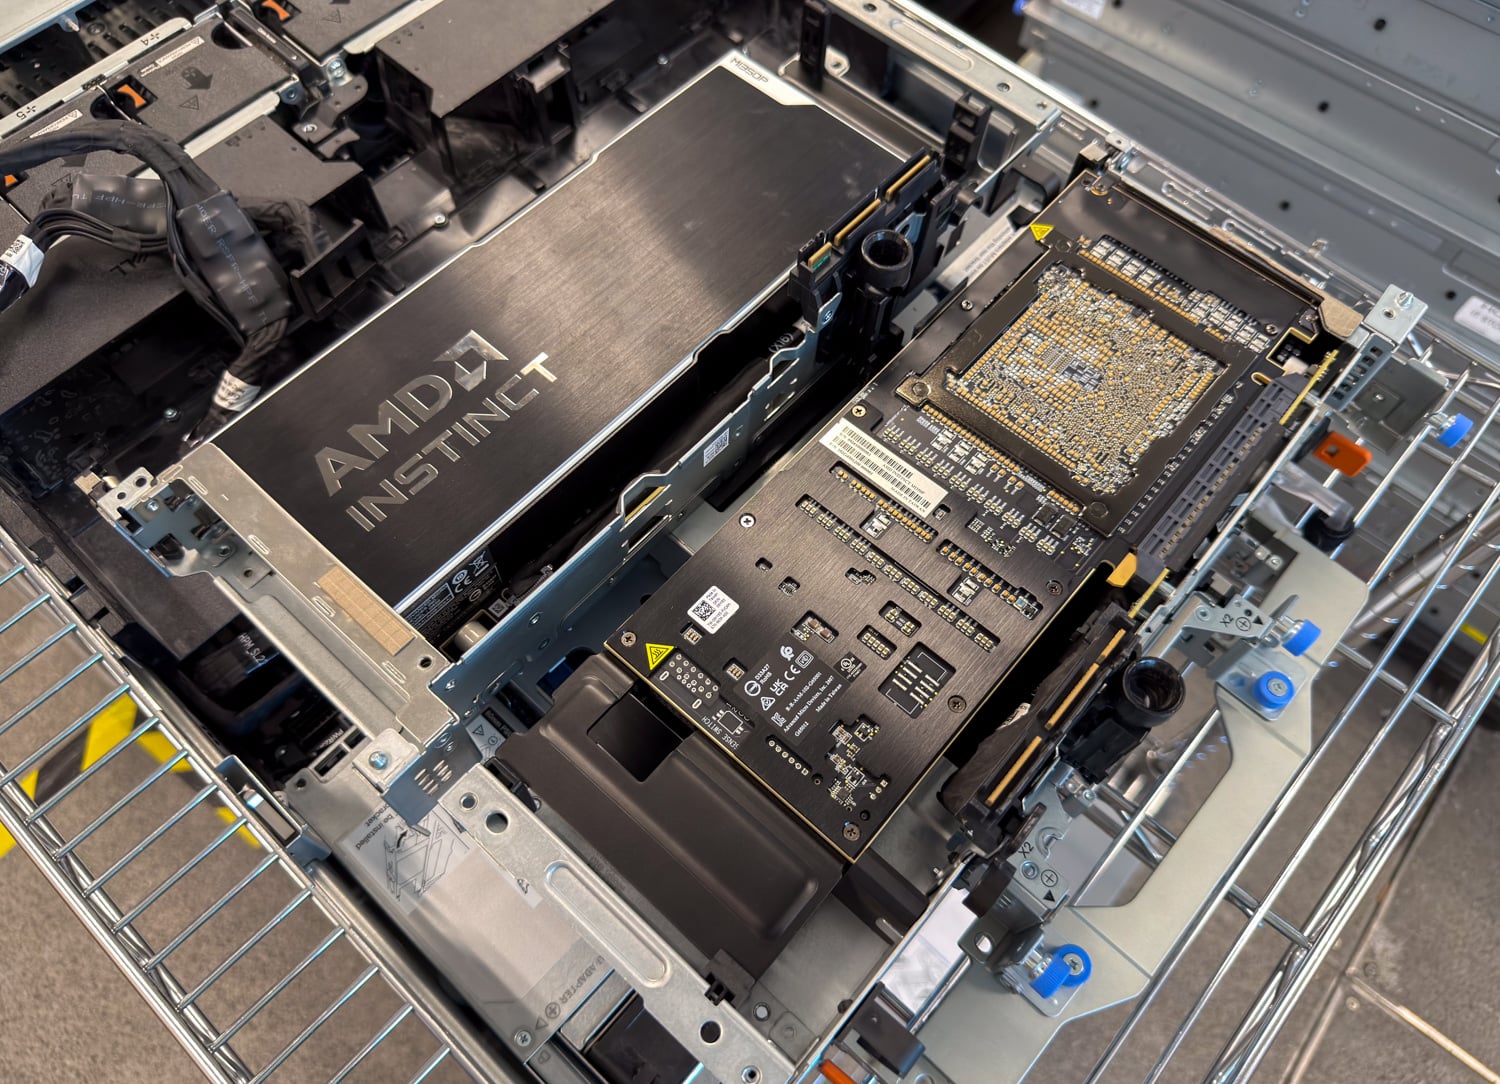
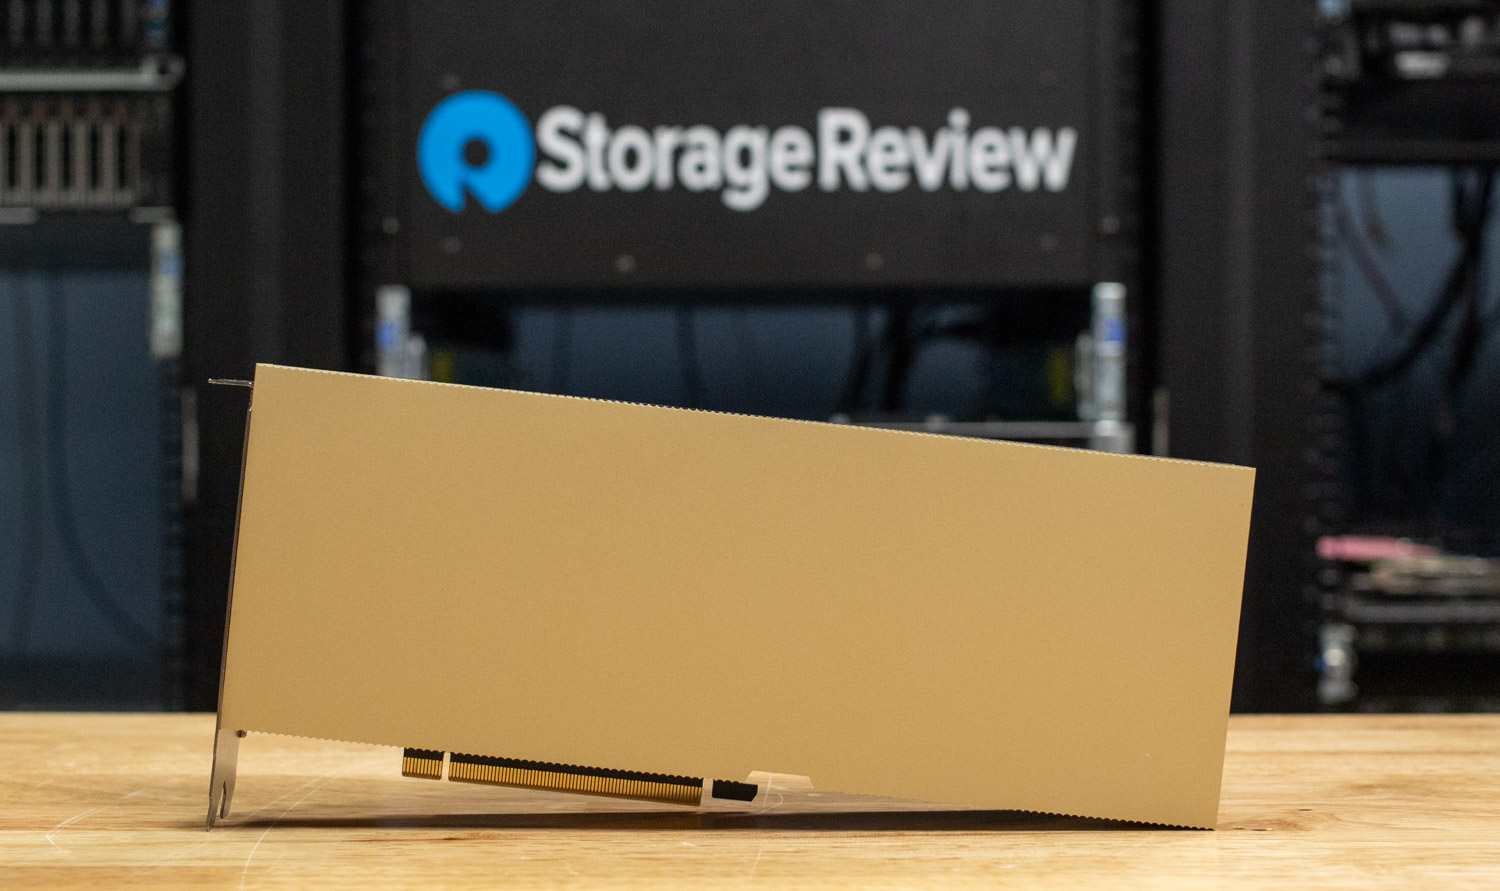
AMD Instinct MI350P 是 AMD 继 2022 年的 MI210 之后,四年来推出的首款全新 PCIe Instinct GPU。它将 AMD 的 CDNA 4 架构应用于传统的独立显卡,拥有高达 4.6 PFLOPS 的 MXFP4 性能、144GB 的 HBM3E 显存以及 4TB/s 的显存带宽。所有这些强大的性能都集成在一个双槽位、600W 的显卡中。

我们目前的AI系统评测主要集中在实验室环境下的推理服务,使用来自Llama、Qwen、DeepSeek和gpt-oss系列的开放权重模型,通过vLLM或SGLang运行,并测量其输出吞吐量和首令牌延迟。评测范围涵盖从边缘到完整GPU节点:NVIDIA RTX PRO 4500服务器版在HPE ProLiant DL145 Gen11服务器中,其输出令牌/秒的中位数是其所替代的L4缓存的2.7倍,功耗仅高出约105W;戴尔、技嘉和惠普的DGX Spark版本在200Gb网络架构上以双节点集群的形式运行分布式推理;Supermicro JumpStart项目则让我们有机会亲身体验NVIDIA HGX B200和AMD Instinct MI350X系统。存储也受到同样的对待,因为数据路径决定了这些 GPU 的繁忙程度,所以我们使用 GDSIO 测量 GPUDirect Storage 吞吐量,并测试KV 缓存卸载到闪存以处理长上下文和代理工作负载。
如果您正在为 AI 规划硬件规模,“最佳服务器”页面列出了我们根据这些评论数据挑选的当前 AI 推理和边缘服务器,“最佳企业级 SSD”页面涵盖了为 GPU 提供数据的驱动器,“最佳存储阵列”页面涵盖了训练集群和新云背后的 AI 存储平台。
AMD Instinct MI350P 是 AMD 继 2022 年的 MI210 之后,四年来推出的首款全新 PCIe Instinct GPU。它将 AMD 的 CDNA 4 架构应用于传统的独立显卡,拥有高达 4.6 PFLOPS 的 MXFP4 性能、144GB 的 HBM3E 显存以及 4TB/s 的显存带宽。所有这些强大的性能都集成在一个双槽位、600W 的显卡中。
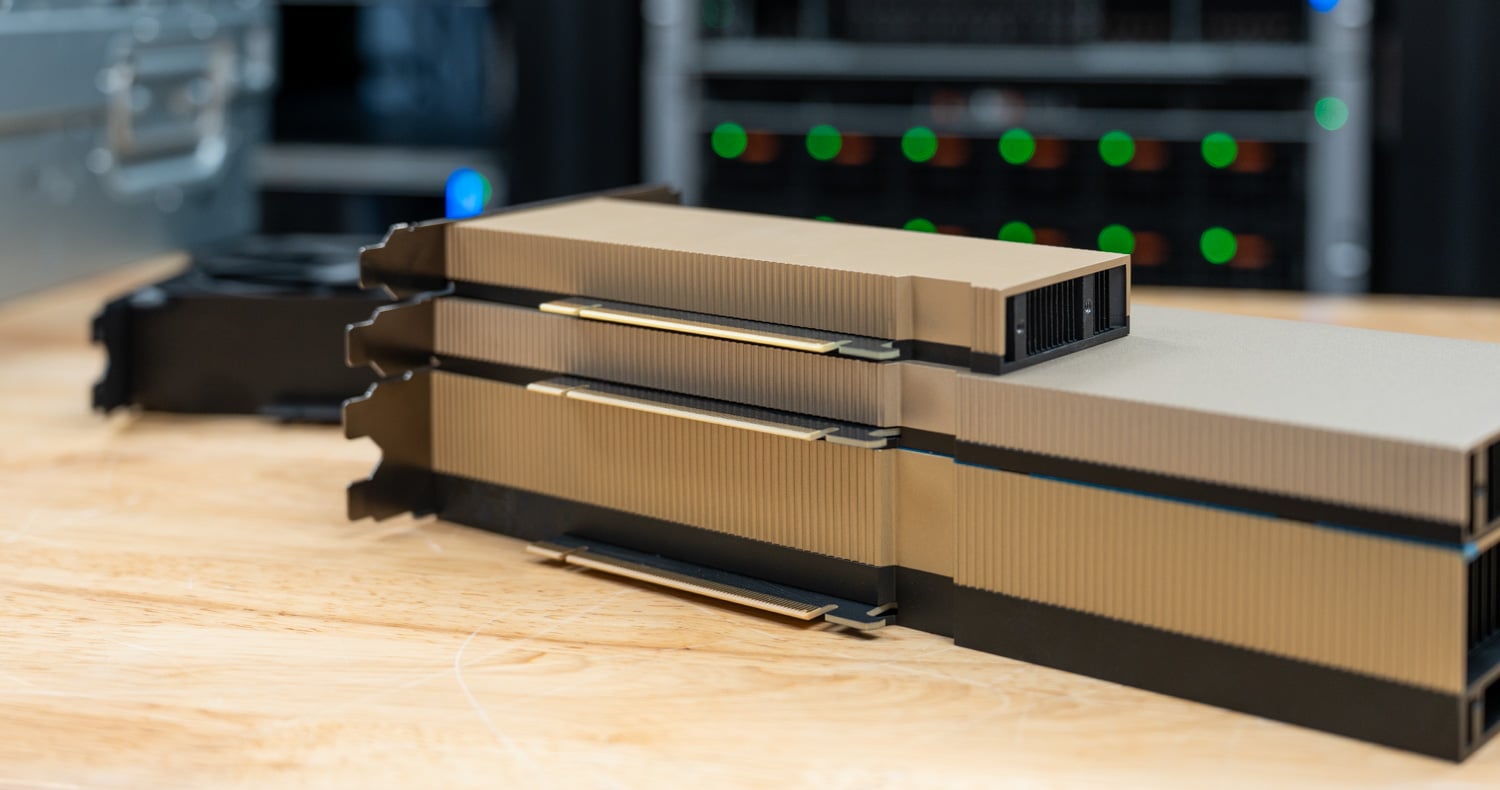
NVIDIA RTX PRO 4500 Blackwell 服务器版是 NVIDIA 专为大多数企业现有服务器打造的显卡。它是一款单槽被动散热的 165W 显卡,配备 32GB GDDR7 显存,并拥有完整的 Blackwell 功能集:第五代 Tensor Core(支持 FP4)、第四代 RT Core、三个编码器和三个解码器,以及多实例 GPU 支持。
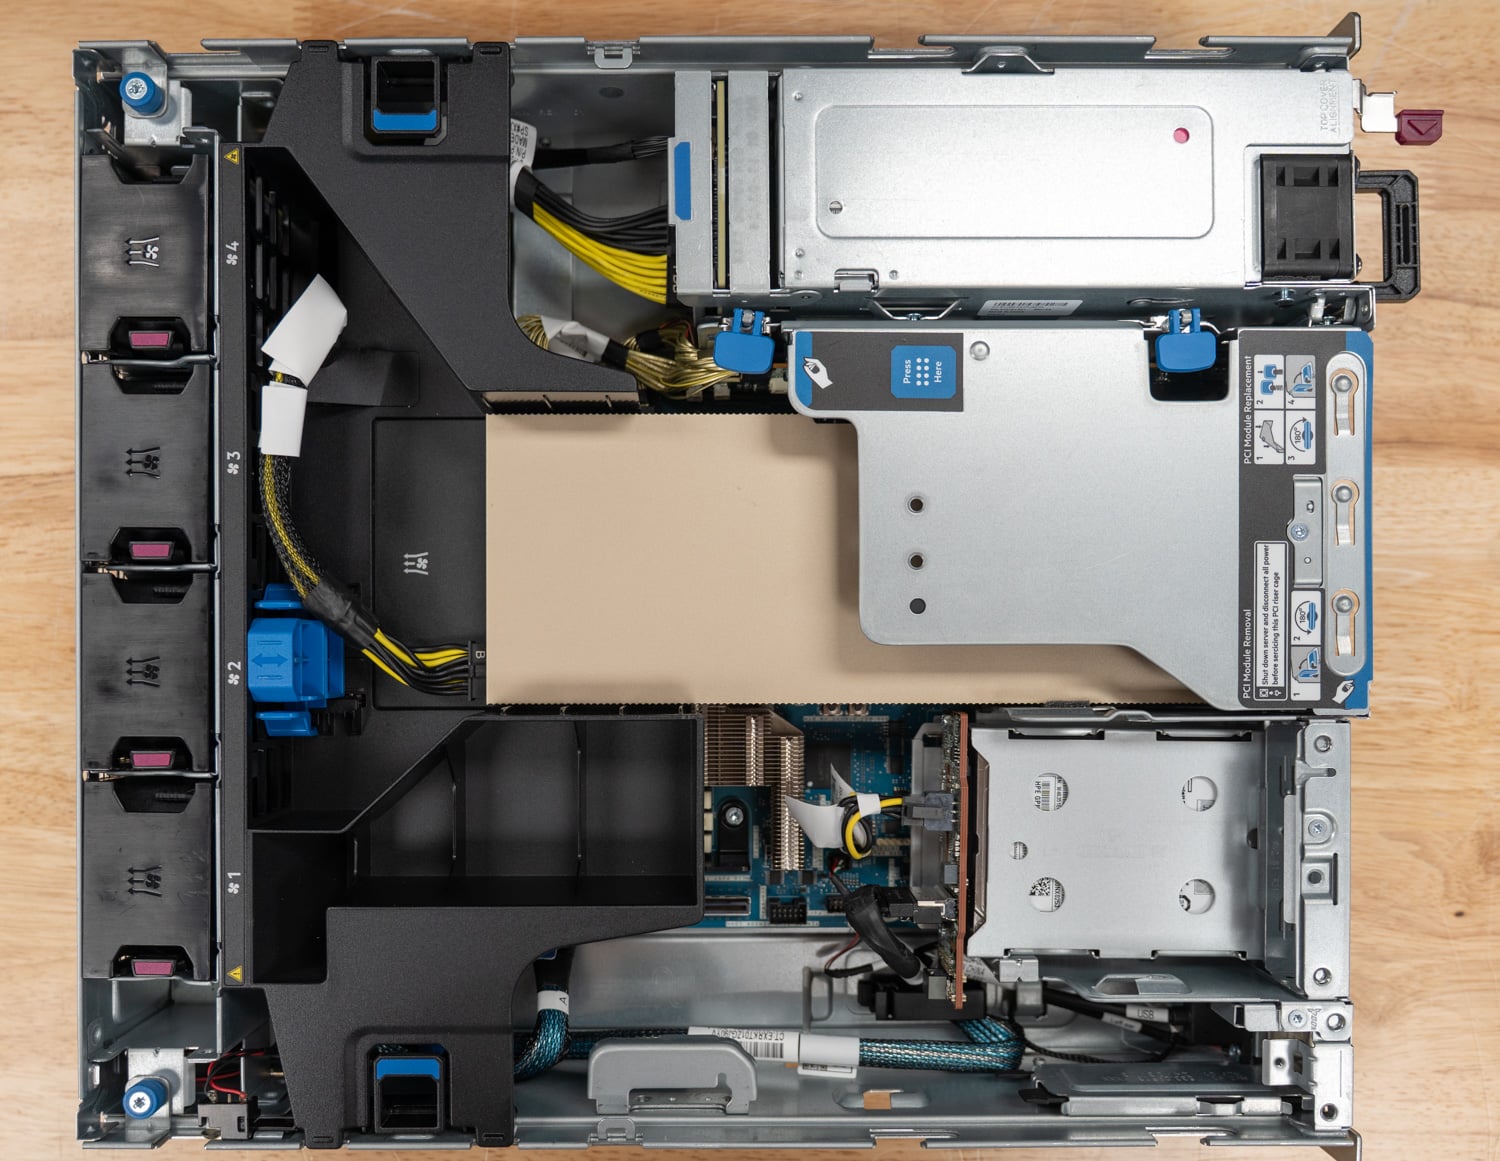
NVIDIA RTX PRO 4500 Blackwell 服务器版是 NVIDIA 专为替代数据中心外服务器中的 L4 缓存而设计的显卡:单槽设计,支持 PCIe Gen5,采用被动散热,功耗 165W,配备 32GB GDDR7 显存,并拥有完整的 Blackwell 功能集,包括 FP4 Tensor Core 和多实例 GPU。HPE 向我们寄送了一台 ProLiant DL145 服务器。
企业级人工智能基础设施已从优化训练模型转向服务于这些模型,这改变了其经济模式。训练是一项有终点的资本项目。推理则是一项生产工作负载,只要服务在线就会运行,其输出以代币衡量。这就是人工智能运营商目前面临的代币经济学问题:一旦
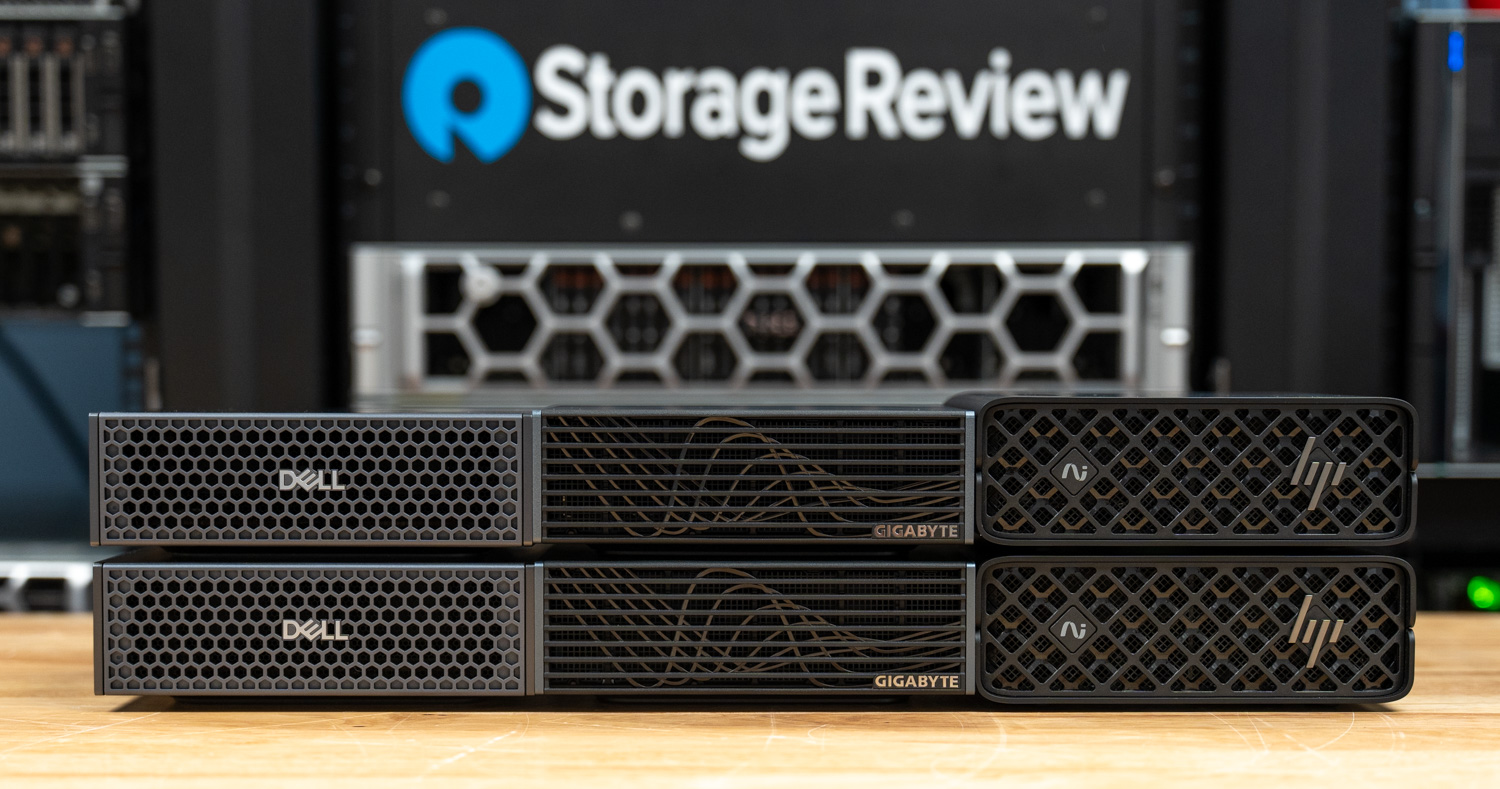
每当人们谈起NVIDIA DGX Spark显卡,首先想到的往往是两件事。第一是它最引人注目的规格:128GB统一内存,装在一台售价约4,000美元的台式机里,这个数字在两年前还很难想象会出现在工程师的办公桌上。第二是200
去年11月,我们发表了关于俄勒冈州立大学浮游生物成像研究的报道,标题聚焦于科学本身:研究船上搭载的人工智能加速基础设施,在船只抵达港口之前,就能近乎实时地处理数TB的海洋数据。但在接下来的几周里,一些其他的事情悄然发生。校园里开始流传着这样一个消息:
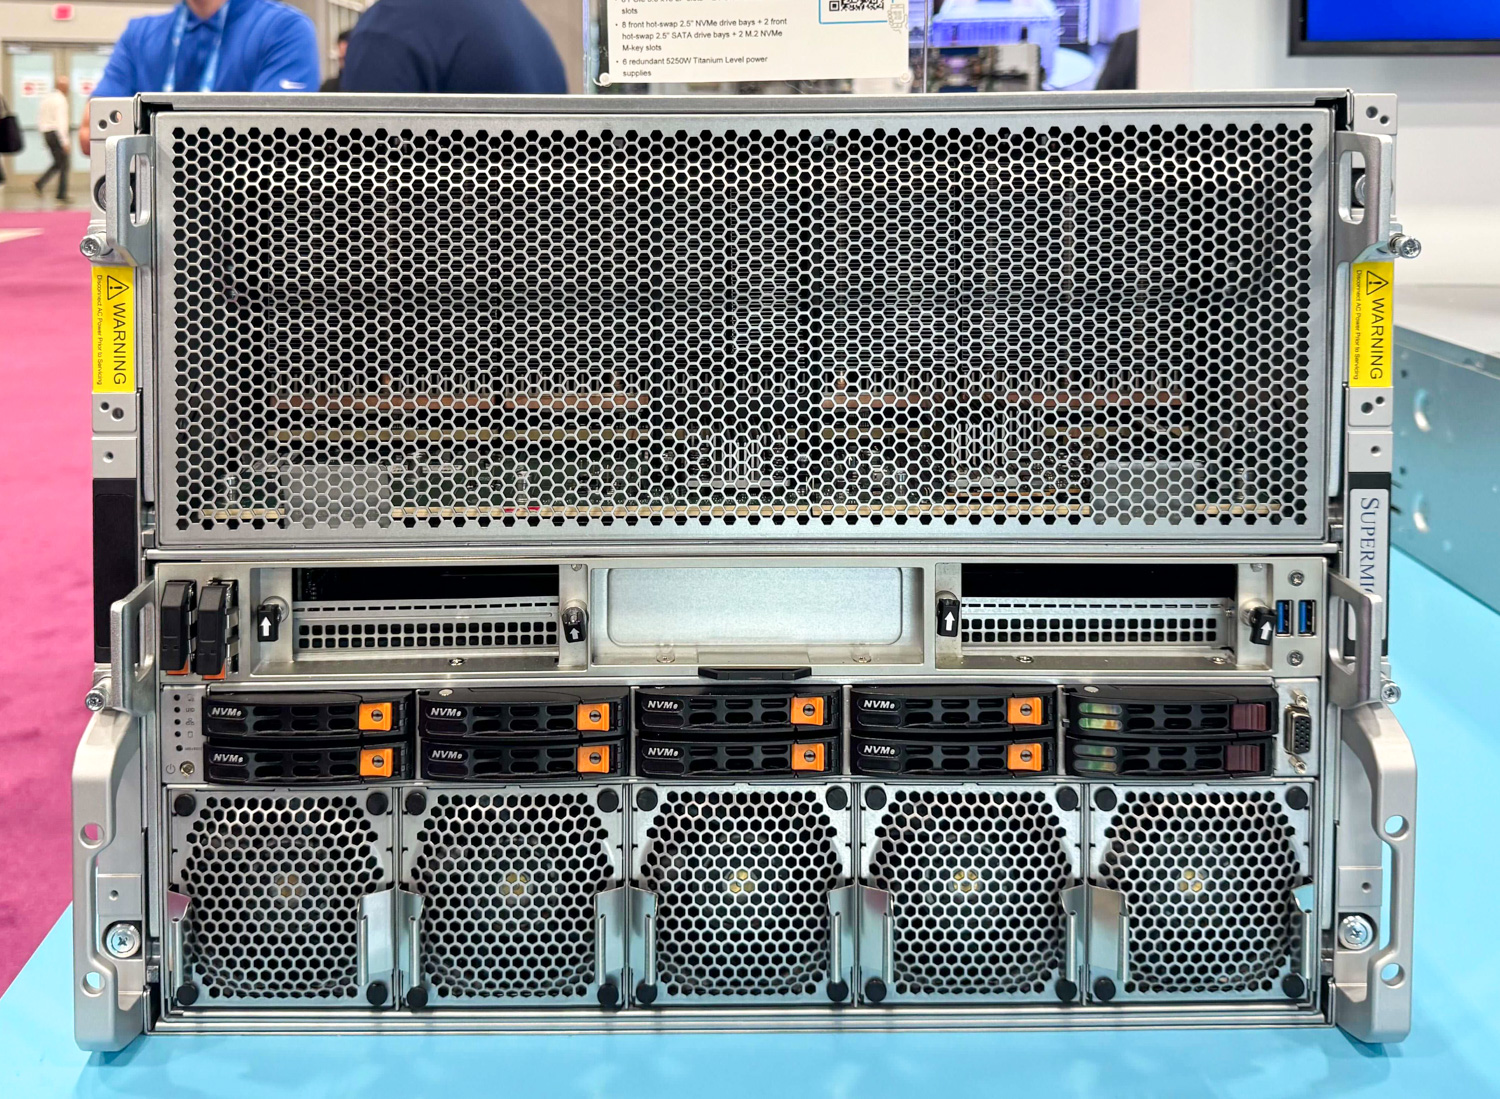
Supermicro 的 JumpStart 项目已成为 AI 基础设施采购前评估工具包中最实用的工具之一。与在共享环境中进行脚本演示不同,JumpStart 为符合条件的用户提供免费、限时、裸机访问权限,用户可以通过 SSH、IPMI 和 VNC 连接到真实的生产服务器,从而在实际硬件上运行工作负载。
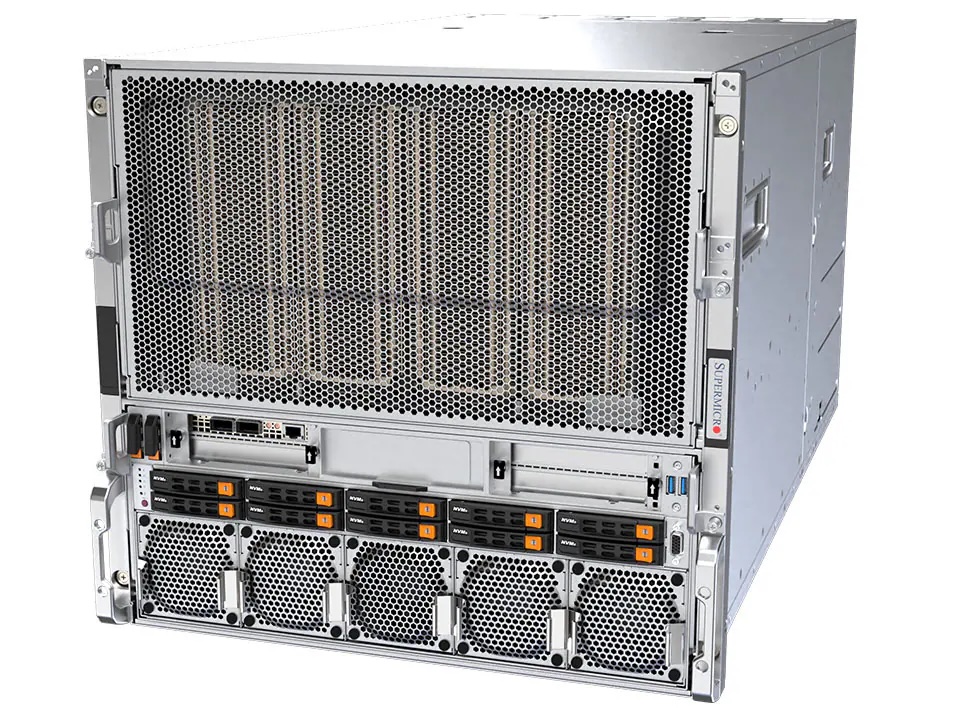
我们花了一周时间通过 Supermicro JumpStart 对 HGX B200 进行测试,以了解远程裸机访问如何加快 AI 平台决策速度。
L40S 对于需要计算和图形性能的合成数据生成、多模式 AI 开发和 Omniverse 应用程序尤其有价值。
我们的附属合作伙伴提供的产品和解决方案:


 Amazon