

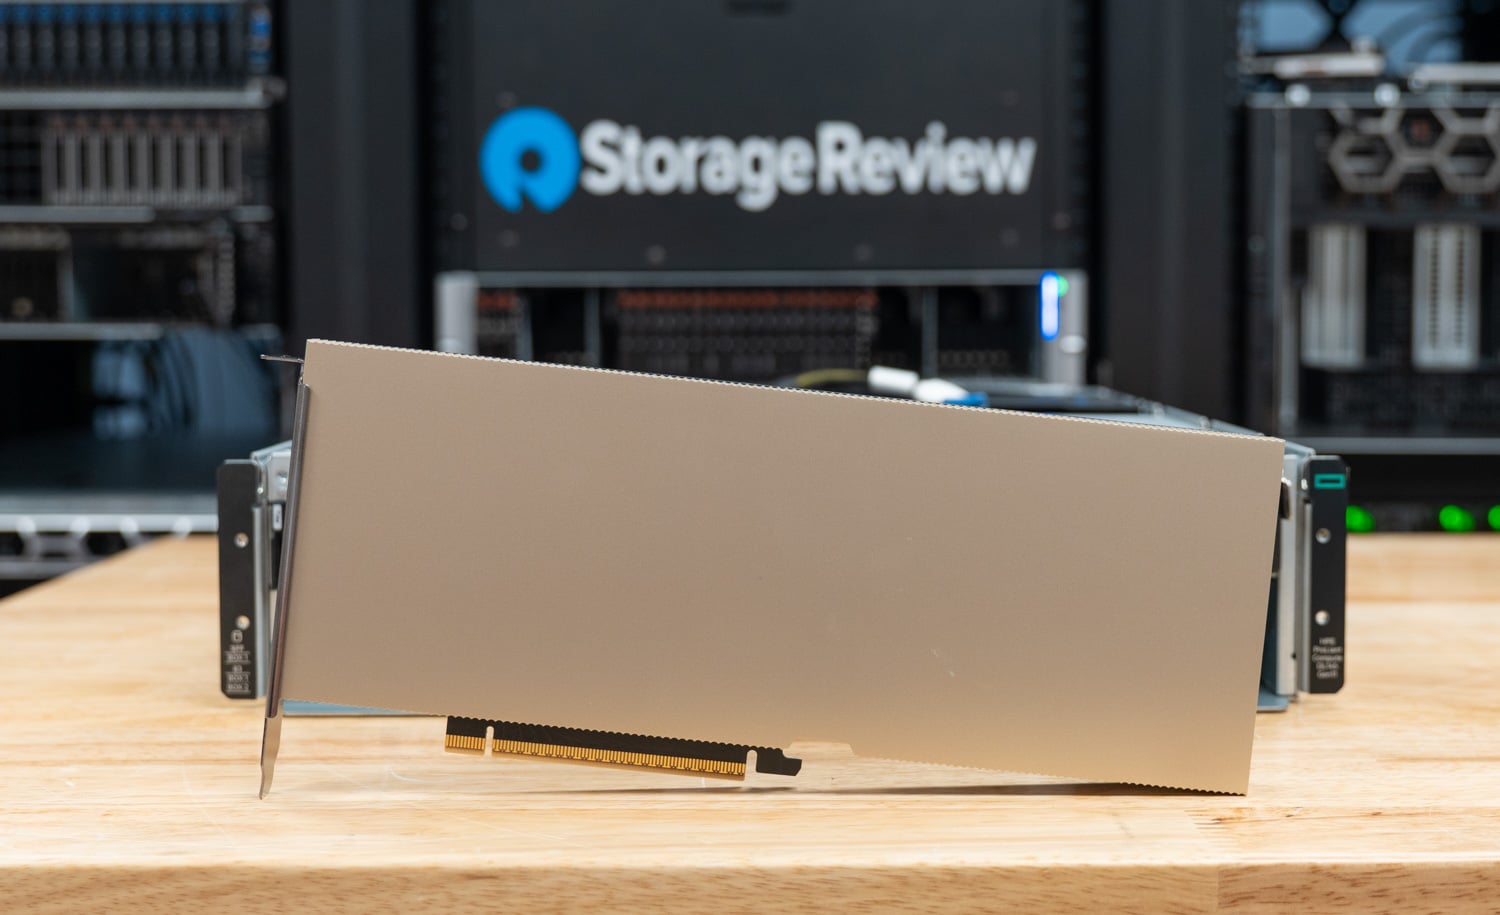
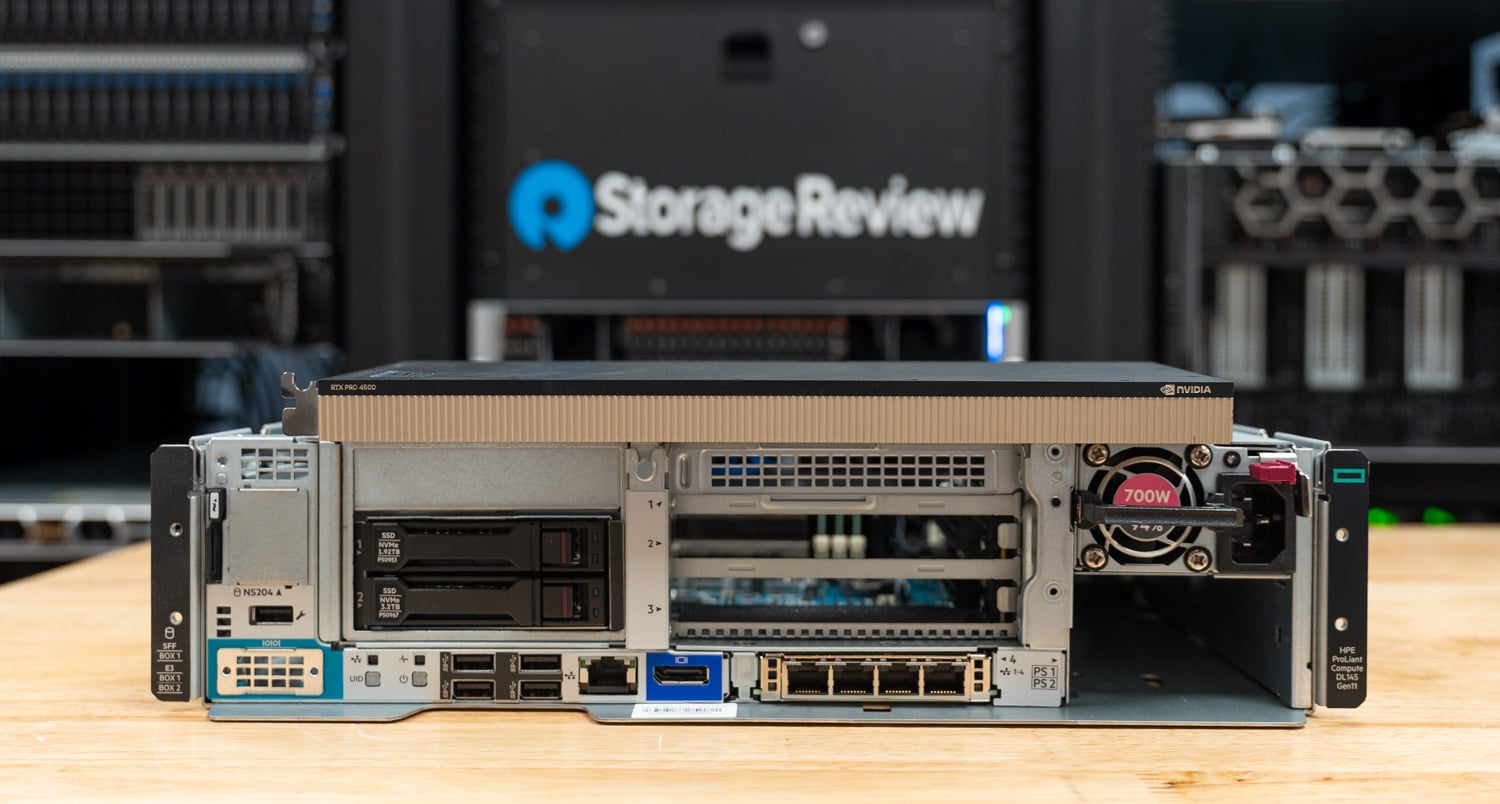
NVIDIA RTX PRO 4500 Blackwell 服务器版是 NVIDIA 专为替代数据中心外服务器中的 L4 缓存而设计的显卡:单槽设计,支持 PCIe Gen5,被动散热,功耗 165W,配备 32GB GDDR7 显存,并拥有完整的 Blackwell 功能集,包括 FP4 Tensor Core 和多实例 GPU。HPE 向我们提供了一台 ProLiant DL145 Gen11 服务器,这是一款短深度边缘服务器,HPE 将其与这款 GPU 搭配用于其 Nemotron 边缘解决方案。我们在同一机箱中,分别对 RTX PRO 4500 和 L4 缓存进行了相同的 vLLM 服务测试。这篇 RTX PRO 4500 边缘版评测正是围绕这一对比展开:对于已经在边缘服务器上运行 L4 缓存的站点而言,更换为 RTX PRO 4500 后,在令牌数量、延迟和功耗方面会有怎样的变化。
在两台小型 BF16 模型上,以实际并发情况测试,RTX PRO 4500 的输出吞吐量是 L4 缓存的 2.7 倍,即使在 L4 缓存已经进入队列的情况下,也能将首令牌延迟保持在 1 秒以内,但同时也使 DL145 服务器的整体功耗从约 196W 增加到约 301W。按 GPU 功耗计算,性能提升了 1.3 到 1.4 倍。对于每张显卡而言,这意味着并发聊天会话数量从 32 到 64 个增加到 256 个。每台 DL145 服务器最多可容纳三个 L4 缓存,而三个 L4 缓存同时处理 32 个会话的吞吐量接近于一张 RTX 4500 的吞吐量,因此,RTX 4500 在服务器层面的优势主要体现在单用户速度、低延迟、单个 32GB 内存池以及 FP4 性能上。
本文将针对边缘服务器,在 Metrum AI® 基准测试平台上,对比测试了 RTX PRO 4500 Server Edition 与其前代产品在 24GB 和 32GB 显存配置下的性能。RTX PRO 4500 Server Edition 也值得与 NVIDIA 的其他推理显卡进行更广泛的对比,我们正在进行相关测试,并将在另一篇文章中发布。本次对比主要关注 L4 缓存性能,我们添加了一个 RTX PRO 6000 Blackwell 数据集,仅用于展示在 26B 显存配置下,NVFP4 在更大显存显卡上的性能表现。RTX PRO 6000 不支持 HPE 边缘服务器。
关键精华
- 同一服务器上 L4 的 2.7 倍: 在 Qwen3.5-4B 和 Gemma 4 E4B 的 18 种输入和输出组合中,RTX PRO 4500 在 8 到 32 个并发请求时,每秒输出令牌数的中位数是 L4 的 2.7 倍;在 256 个并发请求时,中位数是 L4 的 3.0 倍到 3.2 倍。两张卡都安装在同一台 HPE ProLiant DL145 Gen11 服务器上。
- 延迟是更大的差距: 4500 生成每个令牌的时间为 12 至 15 毫秒,而 L4 为 35 至 40 毫秒;在 256 个并发请求的情况下,其首次生成令牌的平均时间保持在 264 毫秒至 650 毫秒之间,而 L4 则分别攀升至 9 秒和 39 秒。
- 墙面功率增加 105 瓦,代币数量增加 2.7 倍: DL145 在 L4 上运行时功耗约为 196W,在 4500 上运行时功耗约为 301W(32 个并发实例)。Qwen3.5-4B 的每系统瓦输出令牌数从 2.7 增加到 5.1,Gemma 4 E4B 的每系统瓦输出令牌数从 2.9 增加到 5.6。
- 每个用户在聊天提示模式下最多可进行 256 次会话: 将输出除以并发数,在 256 个并发会话的情况下,对于 256 个 Token 或更长的答案,4500 仍然能够为每个用户提供每秒 11 到 22 个 Token 的输出,而 L4 的输出已降至每秒 3.7 到 8.7 个 Token。在大多数题型中,当会话数在 32 到 256 之间时,L4 的输出低于每秒 10 个 Token 的下限;而在预填充较多的 1,024/32 题型中,其输出则在每秒 8 到 16 个 Token 之间;4500 的输出则高于此值,达到每秒 256 个 Token,但短答案题型和 1,024 Token 的提示题型除外。
- 32GB 和 FP4 打开了一个 L4 无法原生运行的模型类: 在配备 FP8 KV 缓存的 NVFP4 架构 Gemma 4 26B-A4B 处理器上,RTX 4500 在 32 个并发任务下,功耗为 165W,每秒可输出 1,613 个输出令牌,约为 RTX PRO 6000 Blackwell 在工作站上性能的一半(RTX PRO 6000 Blackwell 在 8 到 32 个并发任务下功耗为 266 到 471W)。在 256 个并发任务下,两者的差距扩大到约 2.5 倍。
RTX PRO 4500 服务器版是为什么而设计的?
NVIDIA 在 GTC 2026 大会上发布了 RTX PRO 4500 Blackwell 服务器版,作为其 RTX PRO 服务器系列的入门级产品,也是 L4 的继任者。它与 RTX PRO 4500 Blackwell 工作站显卡同名,两者共享芯片和 10,496 个 CUDA 核心,但它们是不同的产品。服务器版取消了显示输出和风扇,将板载功耗控制在 165W,并增加了数据中心功能集:支持最多两个 16GB 显存实例的 MIG、机密计算、第三个 NVENC 和 NVDEC 编码器,以及 vGPU 支持。NVIDIA 标称其显存速度为 800GB/s,FP4 Tensor 峰值性能为 1.6 PFLOPS(稀疏化),并将该显卡描述为“面向企业级 AI 的节能型 Blackwell GPU”,目标用户为“主流数据中心和边缘服务器”。我们在HPE GTC 2026 的报道中对此进行了详细介绍。
NVIDIA 也改变了显卡的外形尺寸:我们 2024 年评测的 L4显卡是半高半长、72W 的规格,配备 24GB GDDR6 显存,读写速度为 300GB/s;而 RTX PRO 4500 服务器版则是全高全长的单槽显卡,功耗为 165W,因此它仍然占用一个插槽,但需要使用全长转接卡和 16 针电源线。DL145 Gen11 的标准插槽是全高半长的规格,HPE 为我们提供的样机配备了全长转接卡和电源线。从纸面参数来看,4500 的显存带宽是 L4 的 2.7 倍,显存容量增加了 33%,FP8 Tensor 峰值性能是 L4 的 1.7 倍,功耗是 L4 的 2.3 倍,此外还增加了 L4 所没有的 FP4 通道。
| 规格 | RTX PRO 4500 Blackwell 服务器版 | 英伟达 L4 |
|---|---|---|
| 平台概述 | ||
| 卓越 | 布莱克威尔 | 阿达洛夫莱斯 |
| CUDA核心 | 10,496 | 7,424 |
| 内存 | 32GB GDDR7 带 ECC | 24GB GDDR6 |
| 记忆体频宽 | 800GB /秒 | 300GB /秒 |
| 性能(NVIDIA 峰值数据,考虑稀疏性) | ||
| FP32 | 51 TFLOPS | 30.3 TFLOPS |
| FP8张量 | 811 TFLOPS | 485 TFLOPS |
| FP4张量 | 1.6 浮点数 | 不支持 |
| 功率和外形尺寸 | ||
| 板电源 | 165W | 72W |
| 外形尺寸 | 单槽、全高、全长、被动式 | 单槽,半高,半长,被动式 |
| 电源连接器 | 1 个 PCIe CEM5 16 针 | 插槽动力 |
| 接口 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| 产品特性 | ||
| MIG | 最多 2 个实例,每个实例 16GB | 没有 |
| NVENC/NVDEC | 3 / 3 | 2 / 4 |
| 机密计算 | 能 | 没有 |
边缘服务器:HPE ProLiant DL145 Gen11
HPE 将 DL145 Gen11 定位为没有服务器机房的场所的理想选择。其针对 DL145 和 NVIDIA Nemotron 的解决方案简介中提到,这是一款可壁挂安装、近乎静音的服务器,工作温度范围为 -5°C 至 55°C,适用于通风不良、多尘以及温度较高或较低的场所。此外,它还配备了 iLO 和 Compute Ops Management 功能,可轻松部署数百个仅有电源和以太网接口的场所。HPE 建议零售、医疗保健、金融、制造和能源行业作为目标行业,并列出了本次评测所考察的工作负载:小型语言模型、RAG 和本地运行的向量搜索,从而确保对延迟敏感且受监管的数据始终保留在本地。我们曾在DL145 Gen11发布时对其进行过评测,因此本文不再赘述其平台特性。
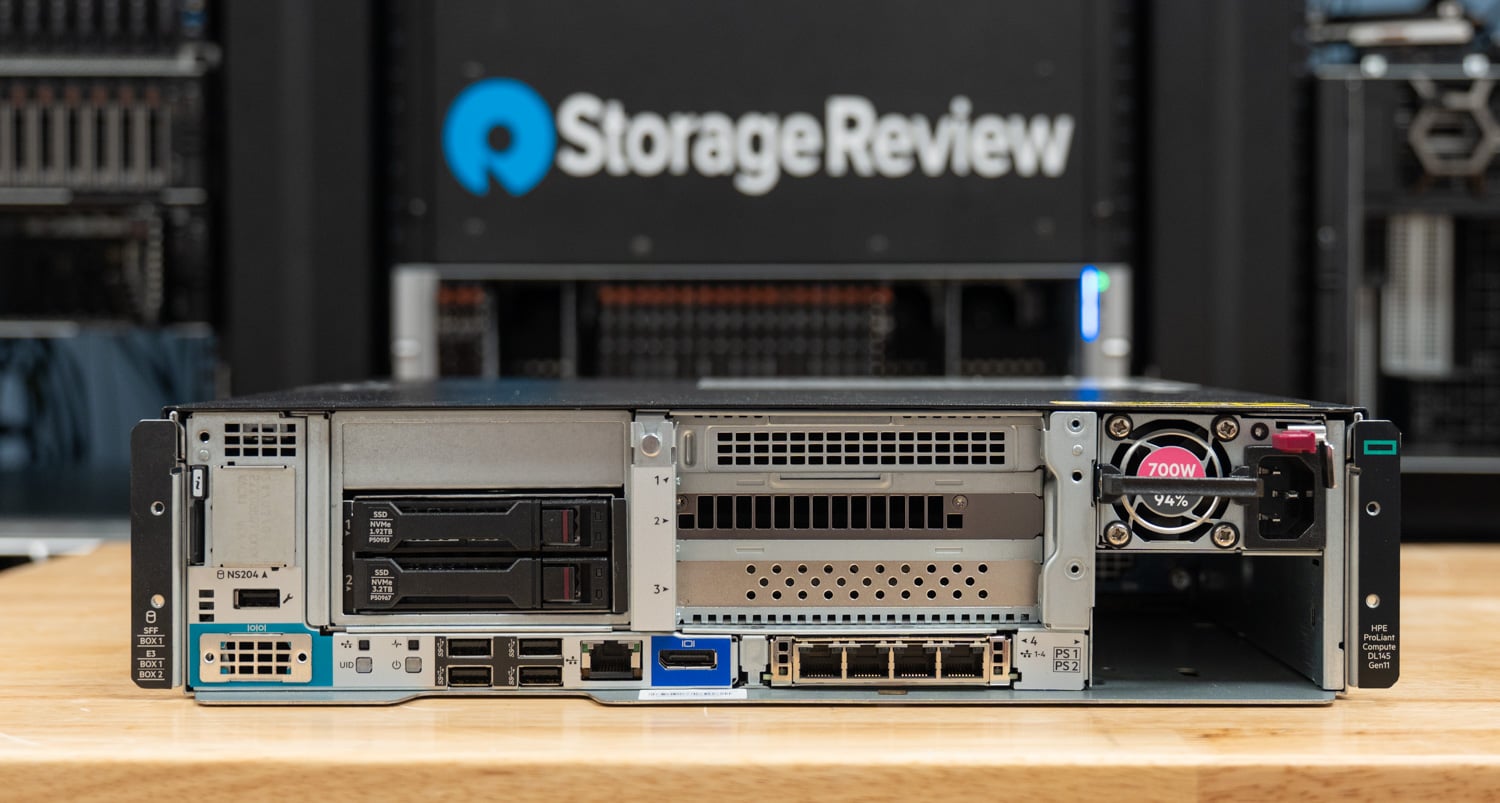
HPE 送测的这台服务器配置了一颗 AMD EPYC 8534P 处理器(64 核 128 线程 Siena 版本),96GB DDR5-4800 内存(六条 16GB DIMM 插槽),以及一块安装在全长转接卡上的 RTX PRO 4500 Blackwell 服务器版显卡。机箱配备了一个双盘位 U.3 背板;我们收到的这台服务器仅配备了 SATA 接口的背板线缆,因此我们使用了一块安装在 PCIe 硬盘托架上的 6.4TB Solidigm D7-P5620 NVMe SSD 启动,但这并不影响 GPU 的测试结果。L4 缓存的对比测试使用了完全相同的服务器配置。4500 是 HPE 为其 Nemotron 边缘计算解决方案在该平台上提供的显卡;L4 则是过去两年内 DL145 服务器用户目前很可能在该插槽中使用的显卡。
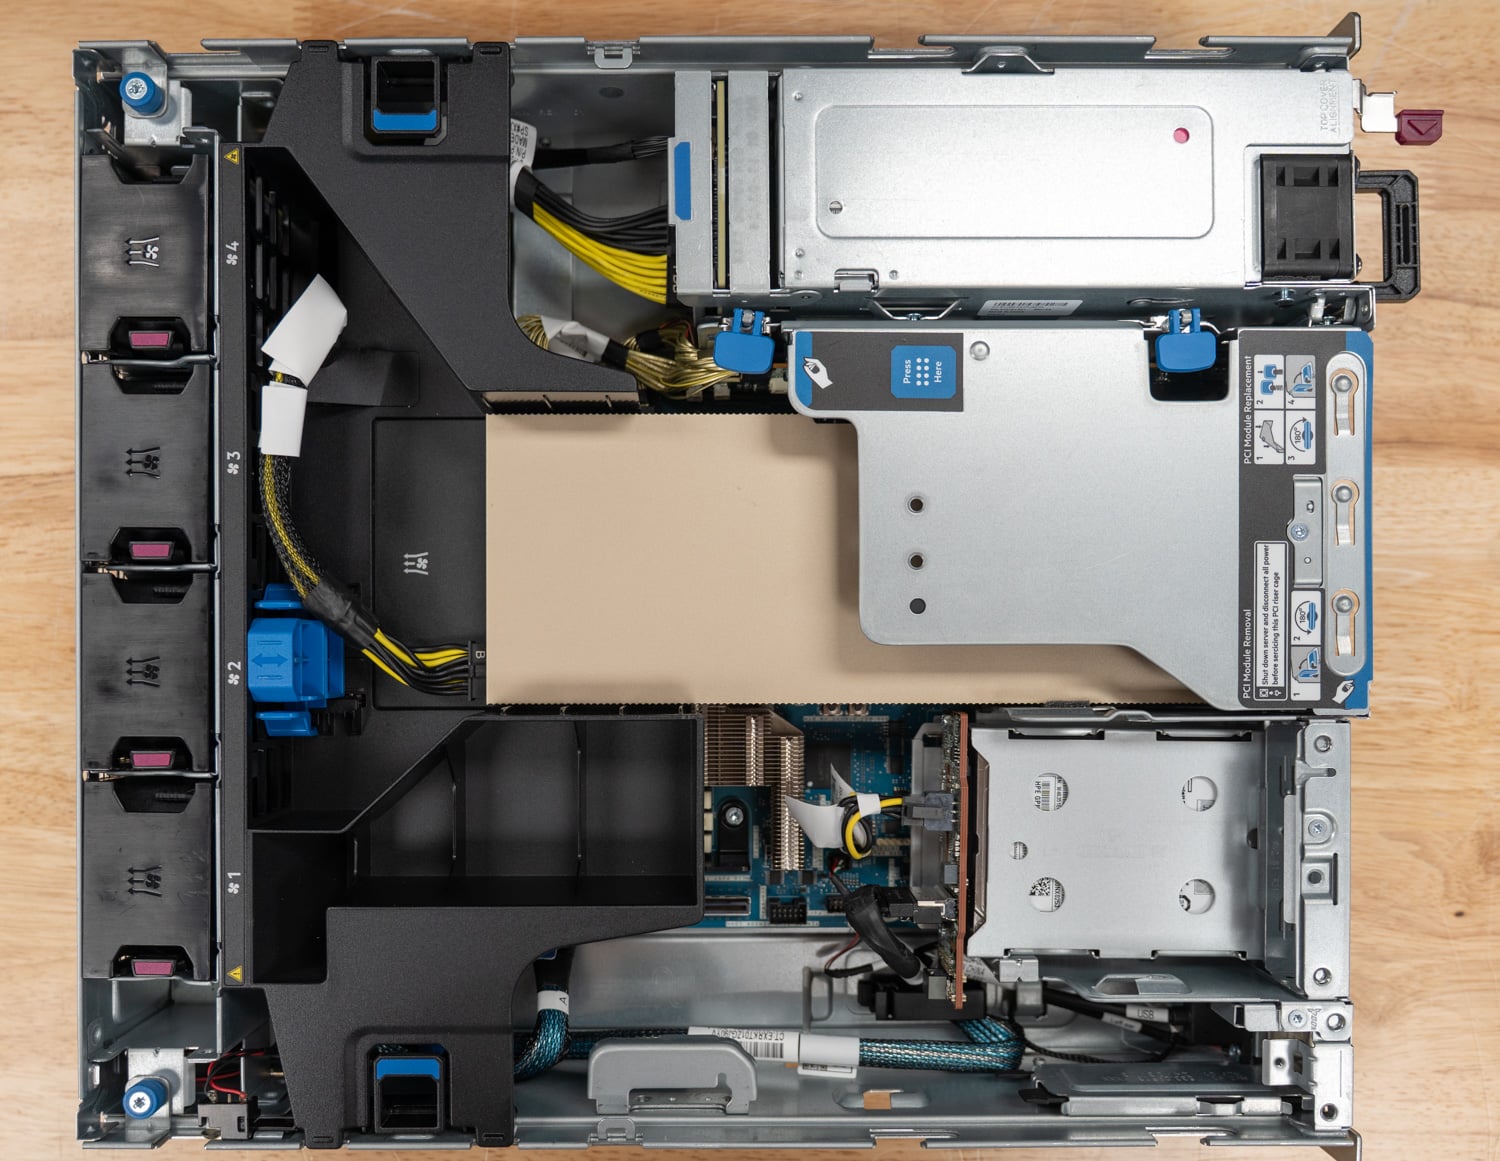
以下分析还参考了另外两个平台数据:DL145 通过 iLO 报告整机功耗,而基准测试平台在每次运行中都会记录整机功耗以及 GPU 板载功耗,因此我们可以比较墙插功耗和显卡功耗。此外,服务器的风道设计也确保了两张被动散热显卡的温度均在极限范围内:在 2U 短深度机箱中,4500 在最长运行时间内平均 GPU 温度最高达到 84°C,L4 最高达到 86°C,两者均在持续满功率推理负载下运行。
我们如何测试
本次评测中的所有推理数据均由Metrum AI Bench Platform (版本 3.9.2,运行文件中记录的版本号为 Metrum Insights)采集,该平台运行 vLLM 0.24.0 作为服务引擎。Bench Platform 针对每个系统运行一系列固定场景,记录每个场景的吞吐量、延迟百分位数、GPU 遥测数据和主机功耗,并将结果导出为每个作业的单个数据集。我们之前曾报道过 Metrum AI 与俄勒冈州立大学的合作,戴尔也曾使用同一平台发布其 R770AP 技术简报;这是我们首次使用该平台进行端到端的 GPU 对比测试。Metrum AI 的工程师和我们的实验室共同运行了这些作业,Bench Platform 负责数据采集,而我们的团队则负责设置硬件、模型和测试问题。
Metrum AI 还发布了一款开源配套工具Metrum AI Bench CLI,读者可以使用它在自己的系统上运行相同类型的测试。Metrum AI 是注册商标,Metrum AI Bench CLI 和 Metrum AI Bench Platform 是 Metrum AI, Inc. 的商标。使用 Metrum AI Bench 并不代表 Metrum AI 对其内容的认可。
网格包含九种提示形状:输入标记数分别为 32、256 和 1,024,最大输出标记数分别为 32、256 和 1,024 的所有组合,每次运行的并发请求数分别为 1、8、16、32 和 256,每个模型每个 GPU 运行 45 个场景。L4 的 Gemma 4 运行还包括 64 和 128 个并发请求,这对于找到其性能上限非常有用。每个场景在并发请求数为 1 到 32 时,每个流发送 15 个请求;在并发请求数为 256 时,发送 1,280 个请求。4500 的 Gemma 4 E4B 作业运行了三次;重复运行之间的场景间差异小于 2%,我们报告其中位数。 L4 和 4500 BF16 作业以及两个 Gemma 4 26B 作业(每张卡上一个)共计运行了 378 次场景,其中在一次 4500 场景的重复运行中出现了一次请求失败,我们提及此事只是为了披露信息。
本次测试涵盖三种模型:Qwen3.5-4B 和 Gemma 4 E4B,两者均在 BF16 环境下运行,并配备 BF16 KV 缓存。L4 和 4500 都能运行这两种模型,它们的大小也与目前 24GB 显卡上边缘部署实际运行的模型大小相当。Gemma 4 26B-A4B 是一个 26B 的混合专家模型,拥有约 4 亿个活跃参数,仅在 4500 上以 NVFP4 模式运行,并配备 FP8 KV 缓存。测试以搭载 RTX PRO 6000 Blackwell 工作站版(600W)的Dell Pro Max Tower T2工作站为参考。L4 本身不具备 FP4 计算能力,且在 BF16 环境下无法运行该模型,因此未参与这部分测试。
关于图表解读的三点说明:吞吐量曲线图的起始并发请求数为 8。单请求场景的持续时间较短(15 个请求,每个请求仅几秒),因此在 4500 显卡上,每个单用户 Qwen 场景的第一个请求(其首令牌延迟为 37 至 39 秒)会影响运行的吞吐量数据。所以,对于单用户场景,我们报告的是每个令牌的延迟和响应时间,这两项数据不受影响。GPU 功耗是采样平均值,因此我们仅计算运行时间足够长、平均值趋于稳定的每瓦令牌数,这在实际应用中意味着至少 16 个并发请求。当并发请求数达到 256 个且提示信息较长时,两张显卡的 KV 缓存都会耗尽,vLLM 会将请求排队;这些点仍然是真实的吞吐量数据,但该负载下的首令牌延迟描述的是一个队列,因此我们将 32 个并发请求视为对延迟敏感的应用场景的工作范围。
Qwen3.5-4B
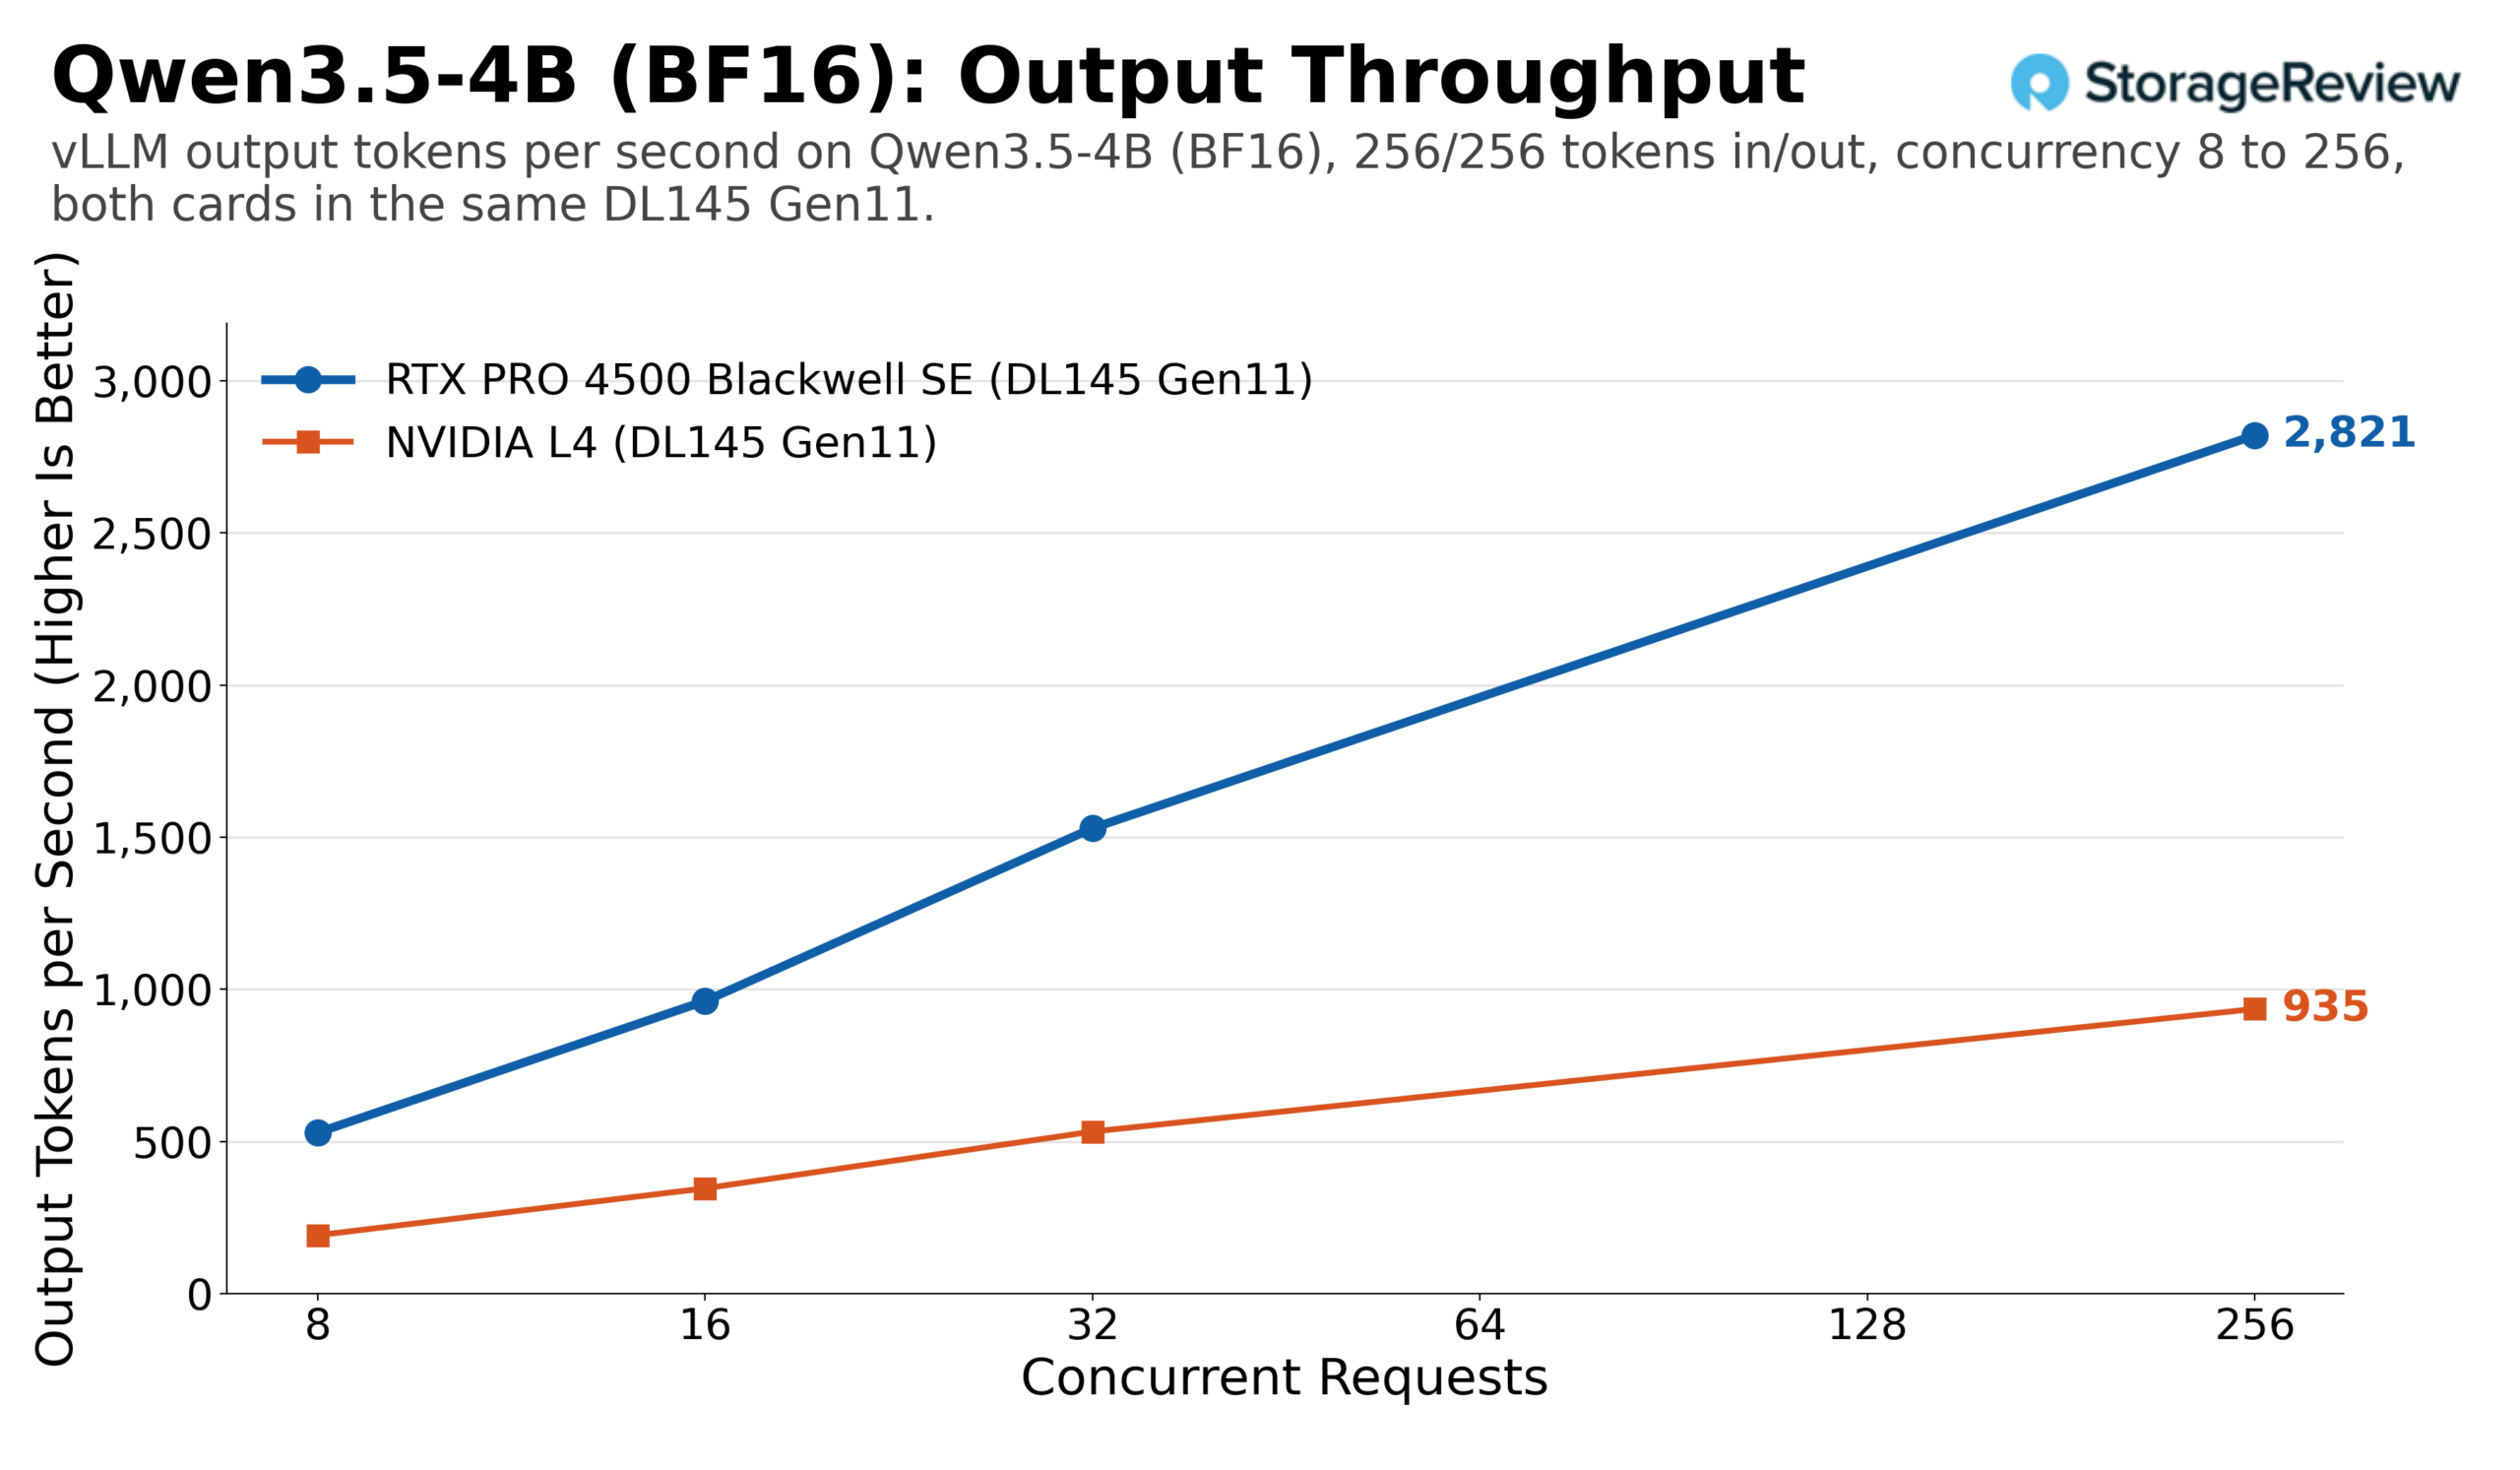
下图清晰地展示了 Qwen3.5 和 4B 的对比:在 8 到 256 个并发请求的各种提示形状下,两张卡片每秒输出的 token 数量。所有九个面板的曲线形状都相同,4500 在 8 个并发请求时约为 L4 的 2.5 到 2.8 倍,在 32 个并发请求时速度略有提升,并在 256 个并发请求时达到 2.4 到 3.2 倍。
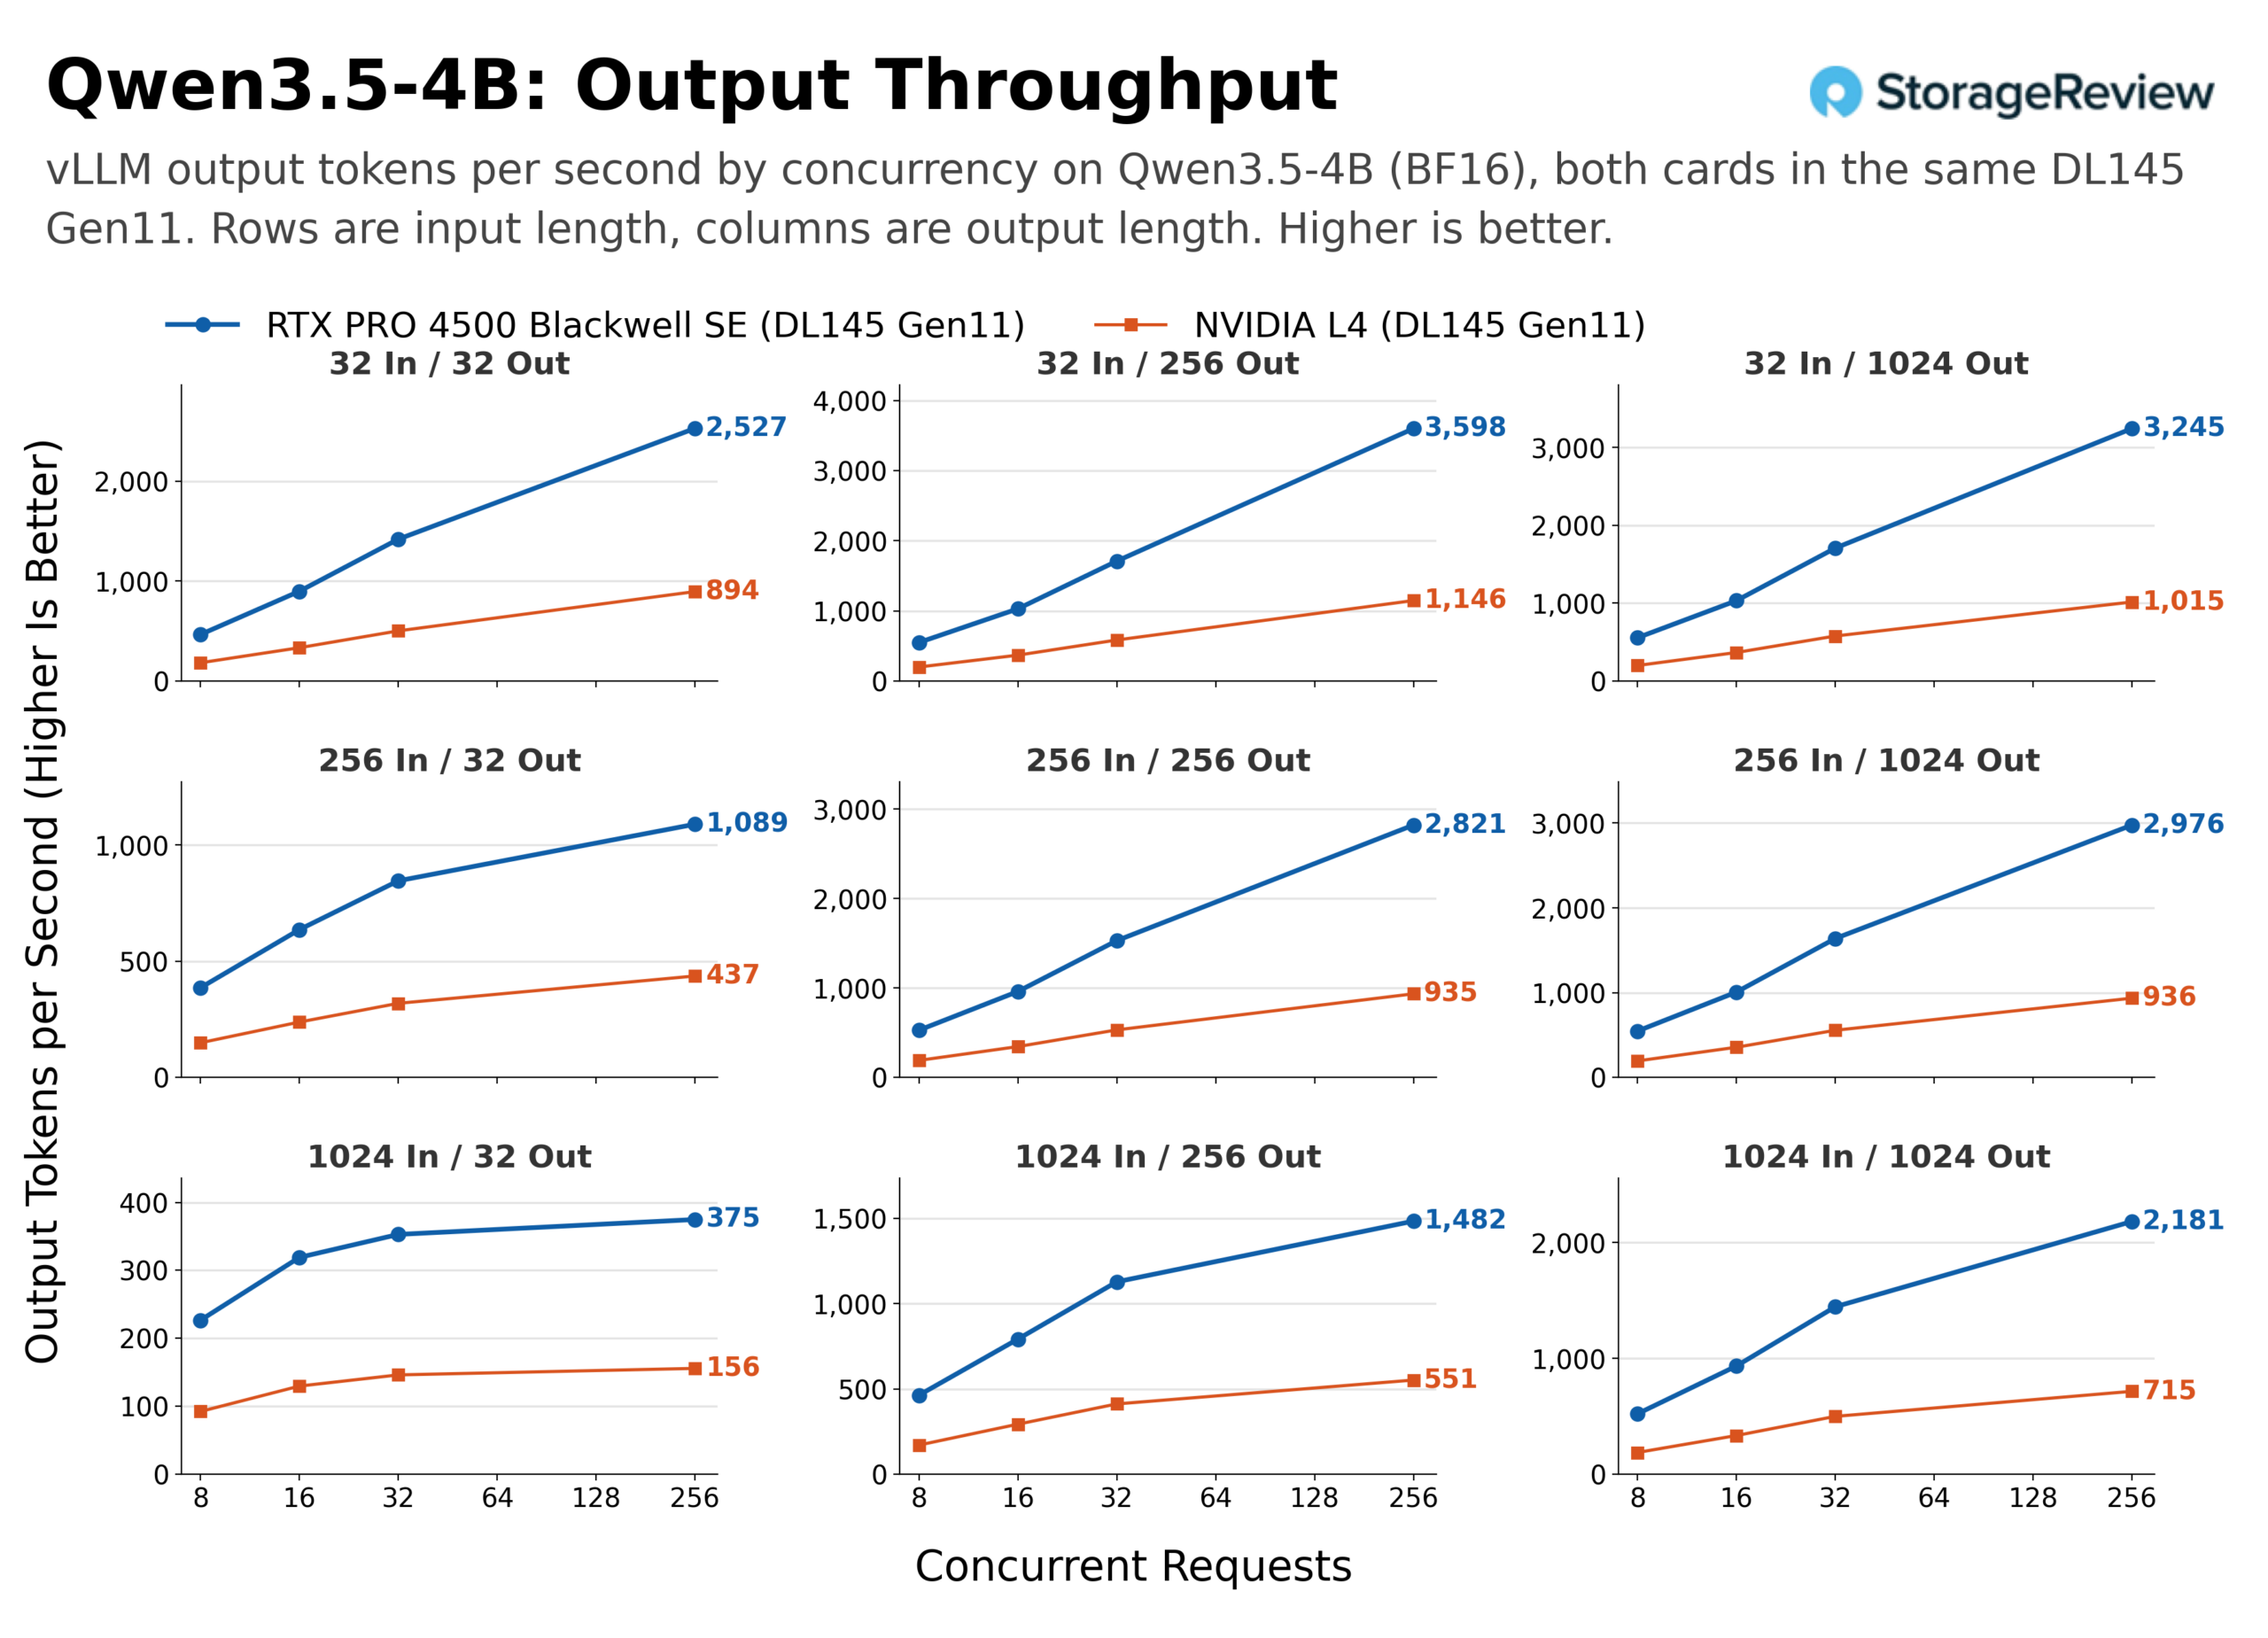
以 256 进 256 出的组合作为聊天规模的参考:在 8 个并发的情况下,L4 每秒产生 192 个输出令牌,而 4500 每秒产生 529 个(2.76 倍);在 32 个并发的情况下,L4 每秒产生 532 个输出令牌,而 4500 每秒产生 1,529 个(2.87 倍);在 256 个并发的情况下,L4 每秒产生 935 个输出令牌,而 4500 每秒产生 2,821 个(3.02 倍)。最长的组合(每个方向 1,024 个令牌)几乎完全符合上述情况:在 32 个并发的情况下,L4 每秒产生 499 个输出令牌,而 4500 每秒产生 1,445 个;在 256 个并发的情况下,L4 每秒产生 715 个输出令牌,而 4500 每秒产生 2,181 个。整个网格中差距最小的是预填充密集型的 1,024 进 32 出的组合,在这种情况下,从 8 个并发开始,4500 的性能就稳定地保持着 2.4 倍的优势,因为这种工作负载几乎完全是即时处理,并且两张卡从一开始就都处于计算密集型状态。 Qwen3.5-4B 在两张牌上都以这种形态稳步上升。BF16 网格中 16 个同时出现的下跌是 4500 运行的 Gemma 4 E4B,位于 1,024/32,这在所有三个重复中都出现过;我们尚未确定其原因。
对于单个用户而言,吞吐量比率低估了差异,因为用户实际感受到的是单词出现的快慢。在 256/256 的文本格式下,4500 处理器生成每个词元的平均时间为 12.4 毫秒,L4 处理器为 35.0 毫秒,因此,256 个词元的响应在 4500 处理器上大约需要 3.2 秒,在 L4 处理器上大约需要 9.0 秒。如果每个方向都生成 1,024 个词元,则耗时分别为 13.1 秒和 36.6 秒。对于该单个用户,在较短的提示音下,4500 处理器的首词延迟为 43 毫秒,L4 处理器为 81 毫秒;在较长的提示音下,4500 处理器的首词延迟为 99 毫秒,L4 处理器为 219 毫秒。
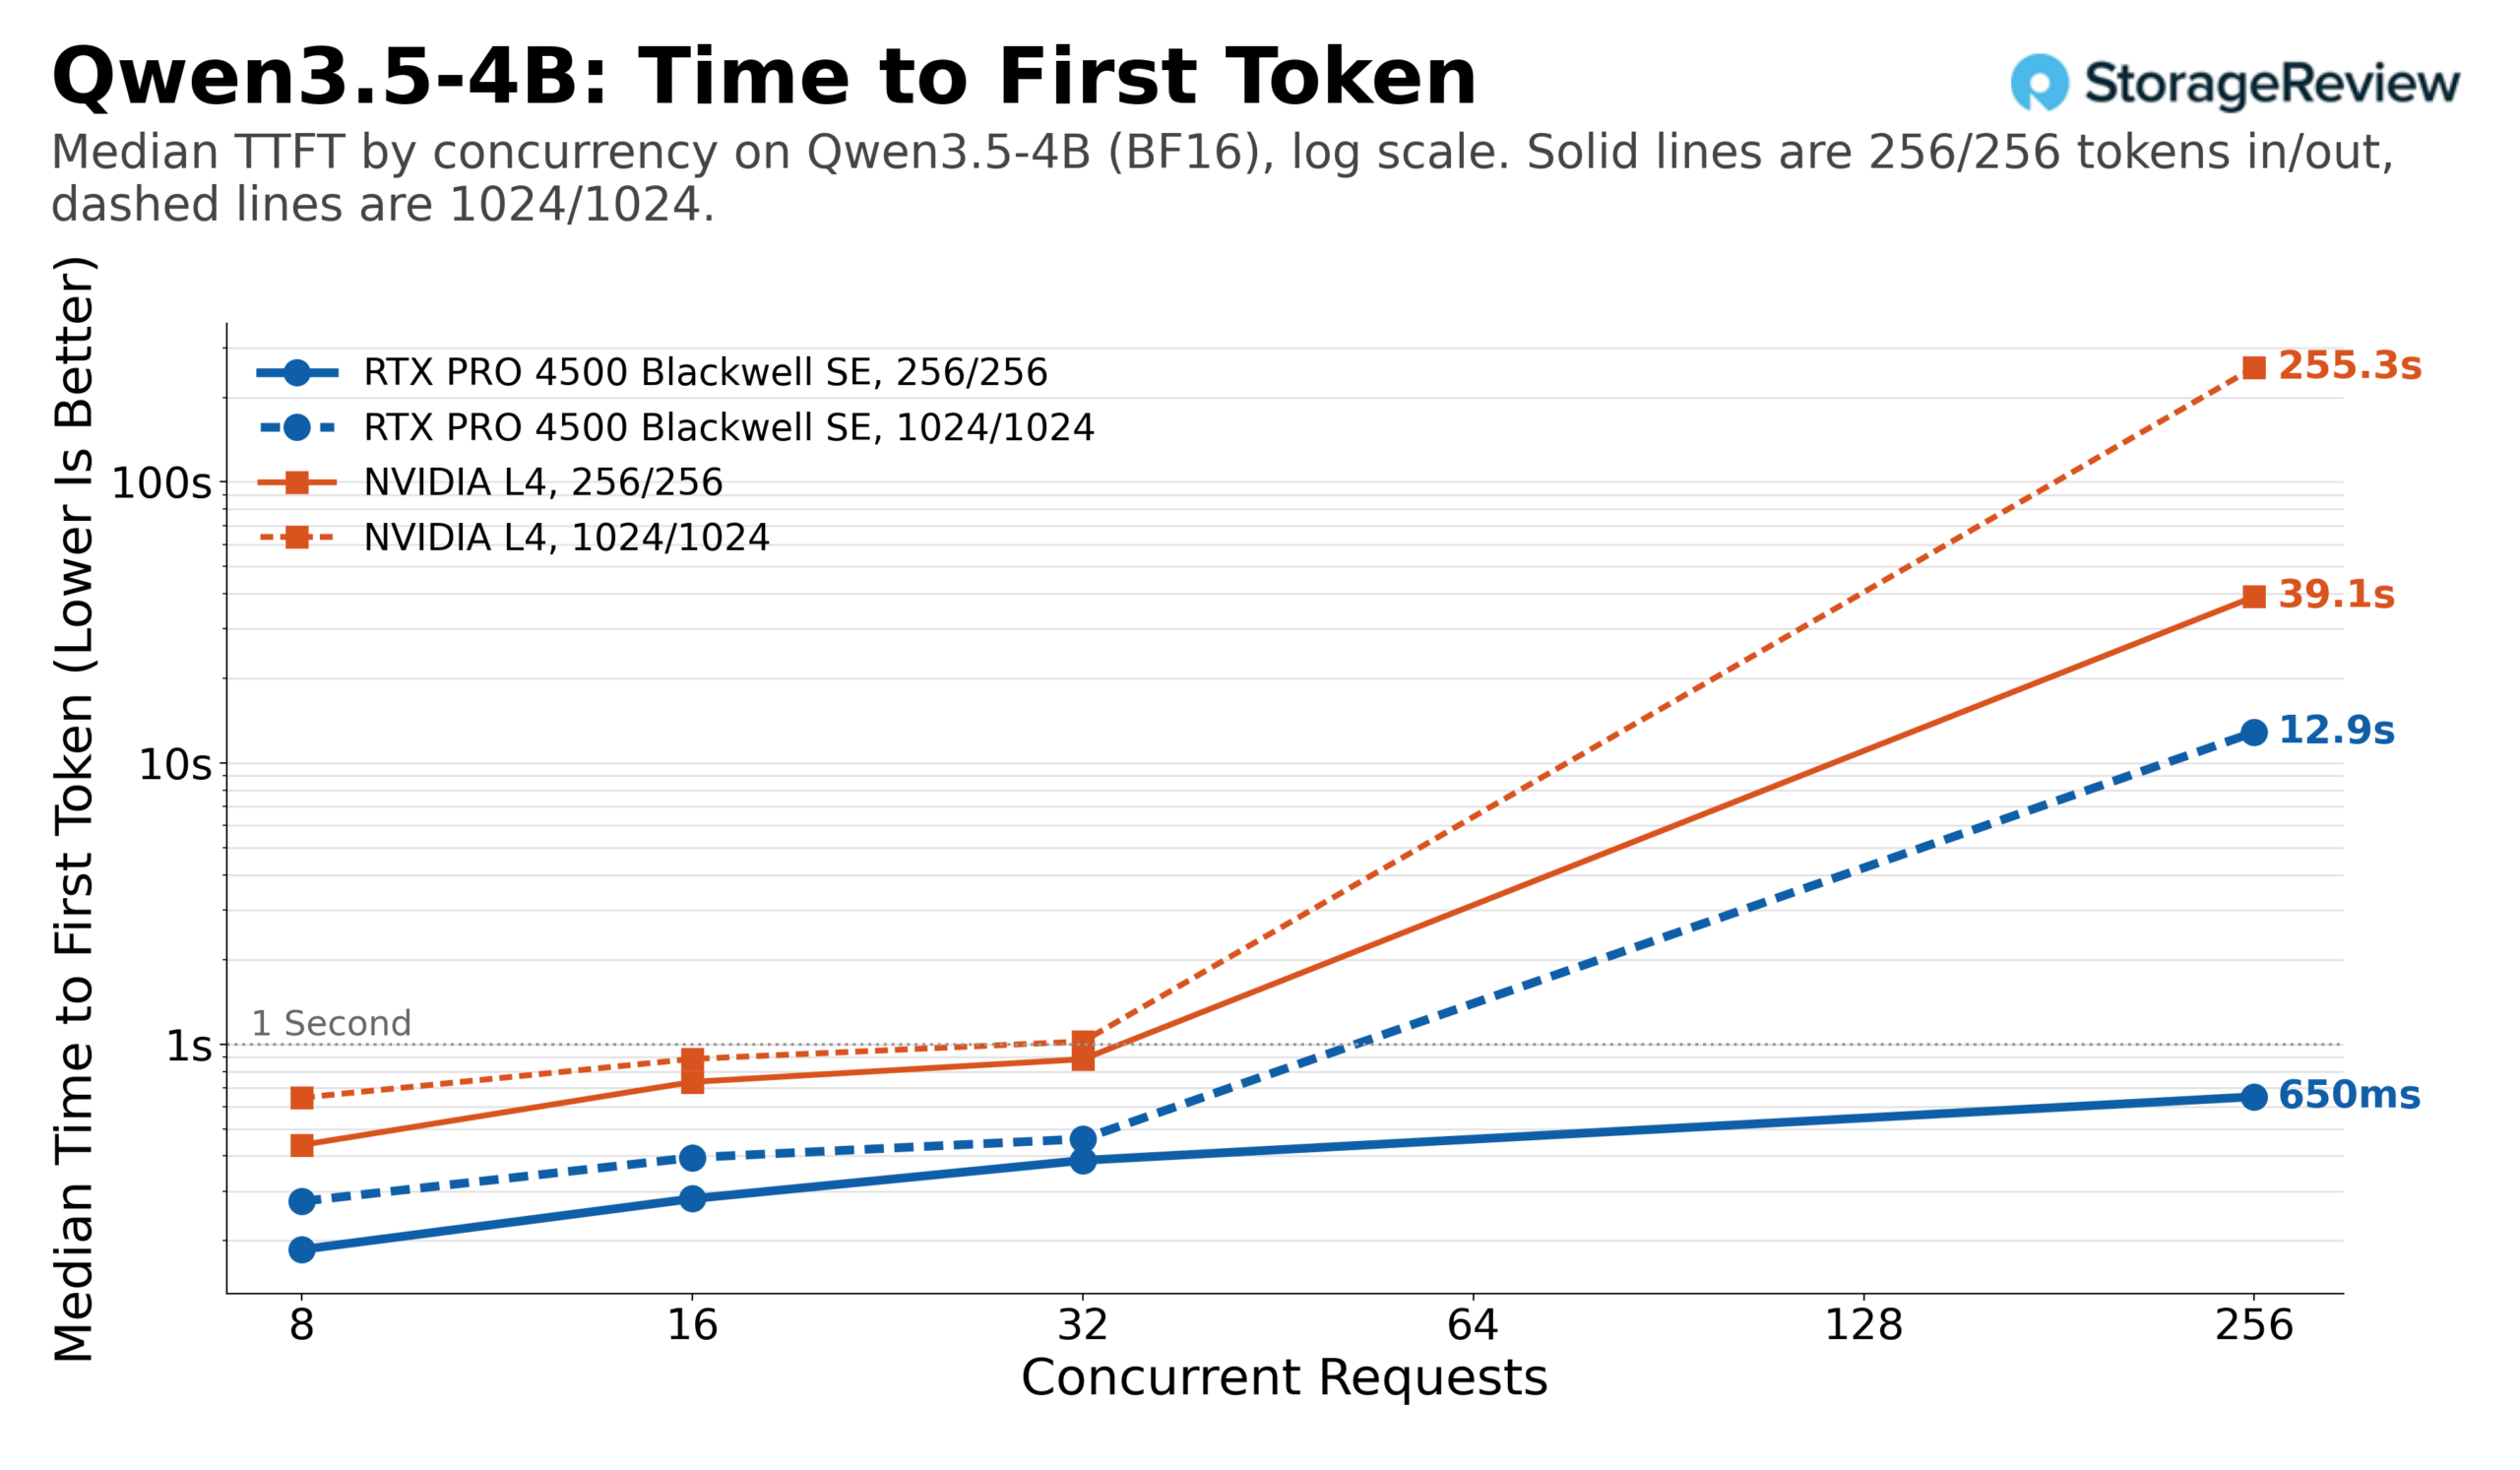
在负载较高的情况下,延迟差距进一步扩大:在 256/256 的并发场景下,32 个并发请求时,L4 的首令牌中位数为 884 毫秒,而 4500 的首令牌中位数为 386 毫秒。在 256 个并发请求时,L4 的首令牌中位数达到 39 秒,而 4500 则保持在 650 毫秒。在 1,024/1,024 的并发场景下,L4 在 32 个并发请求时就已经超过 1 秒(1,022 毫秒),在 256 个并发请求时达到 255 秒,这意味着请求在 vLLM 的队列中等待了 4 分钟,直到键值缓存释放。4500 在该场景下仅在 256 个并发请求时才超过 1 秒,为 12.9 秒。在下图中,L4 的首令牌中位数在 32 到 256 之间超出了图表范围;而 4500 在较短的并发场景下始终保持在 1 秒以内。
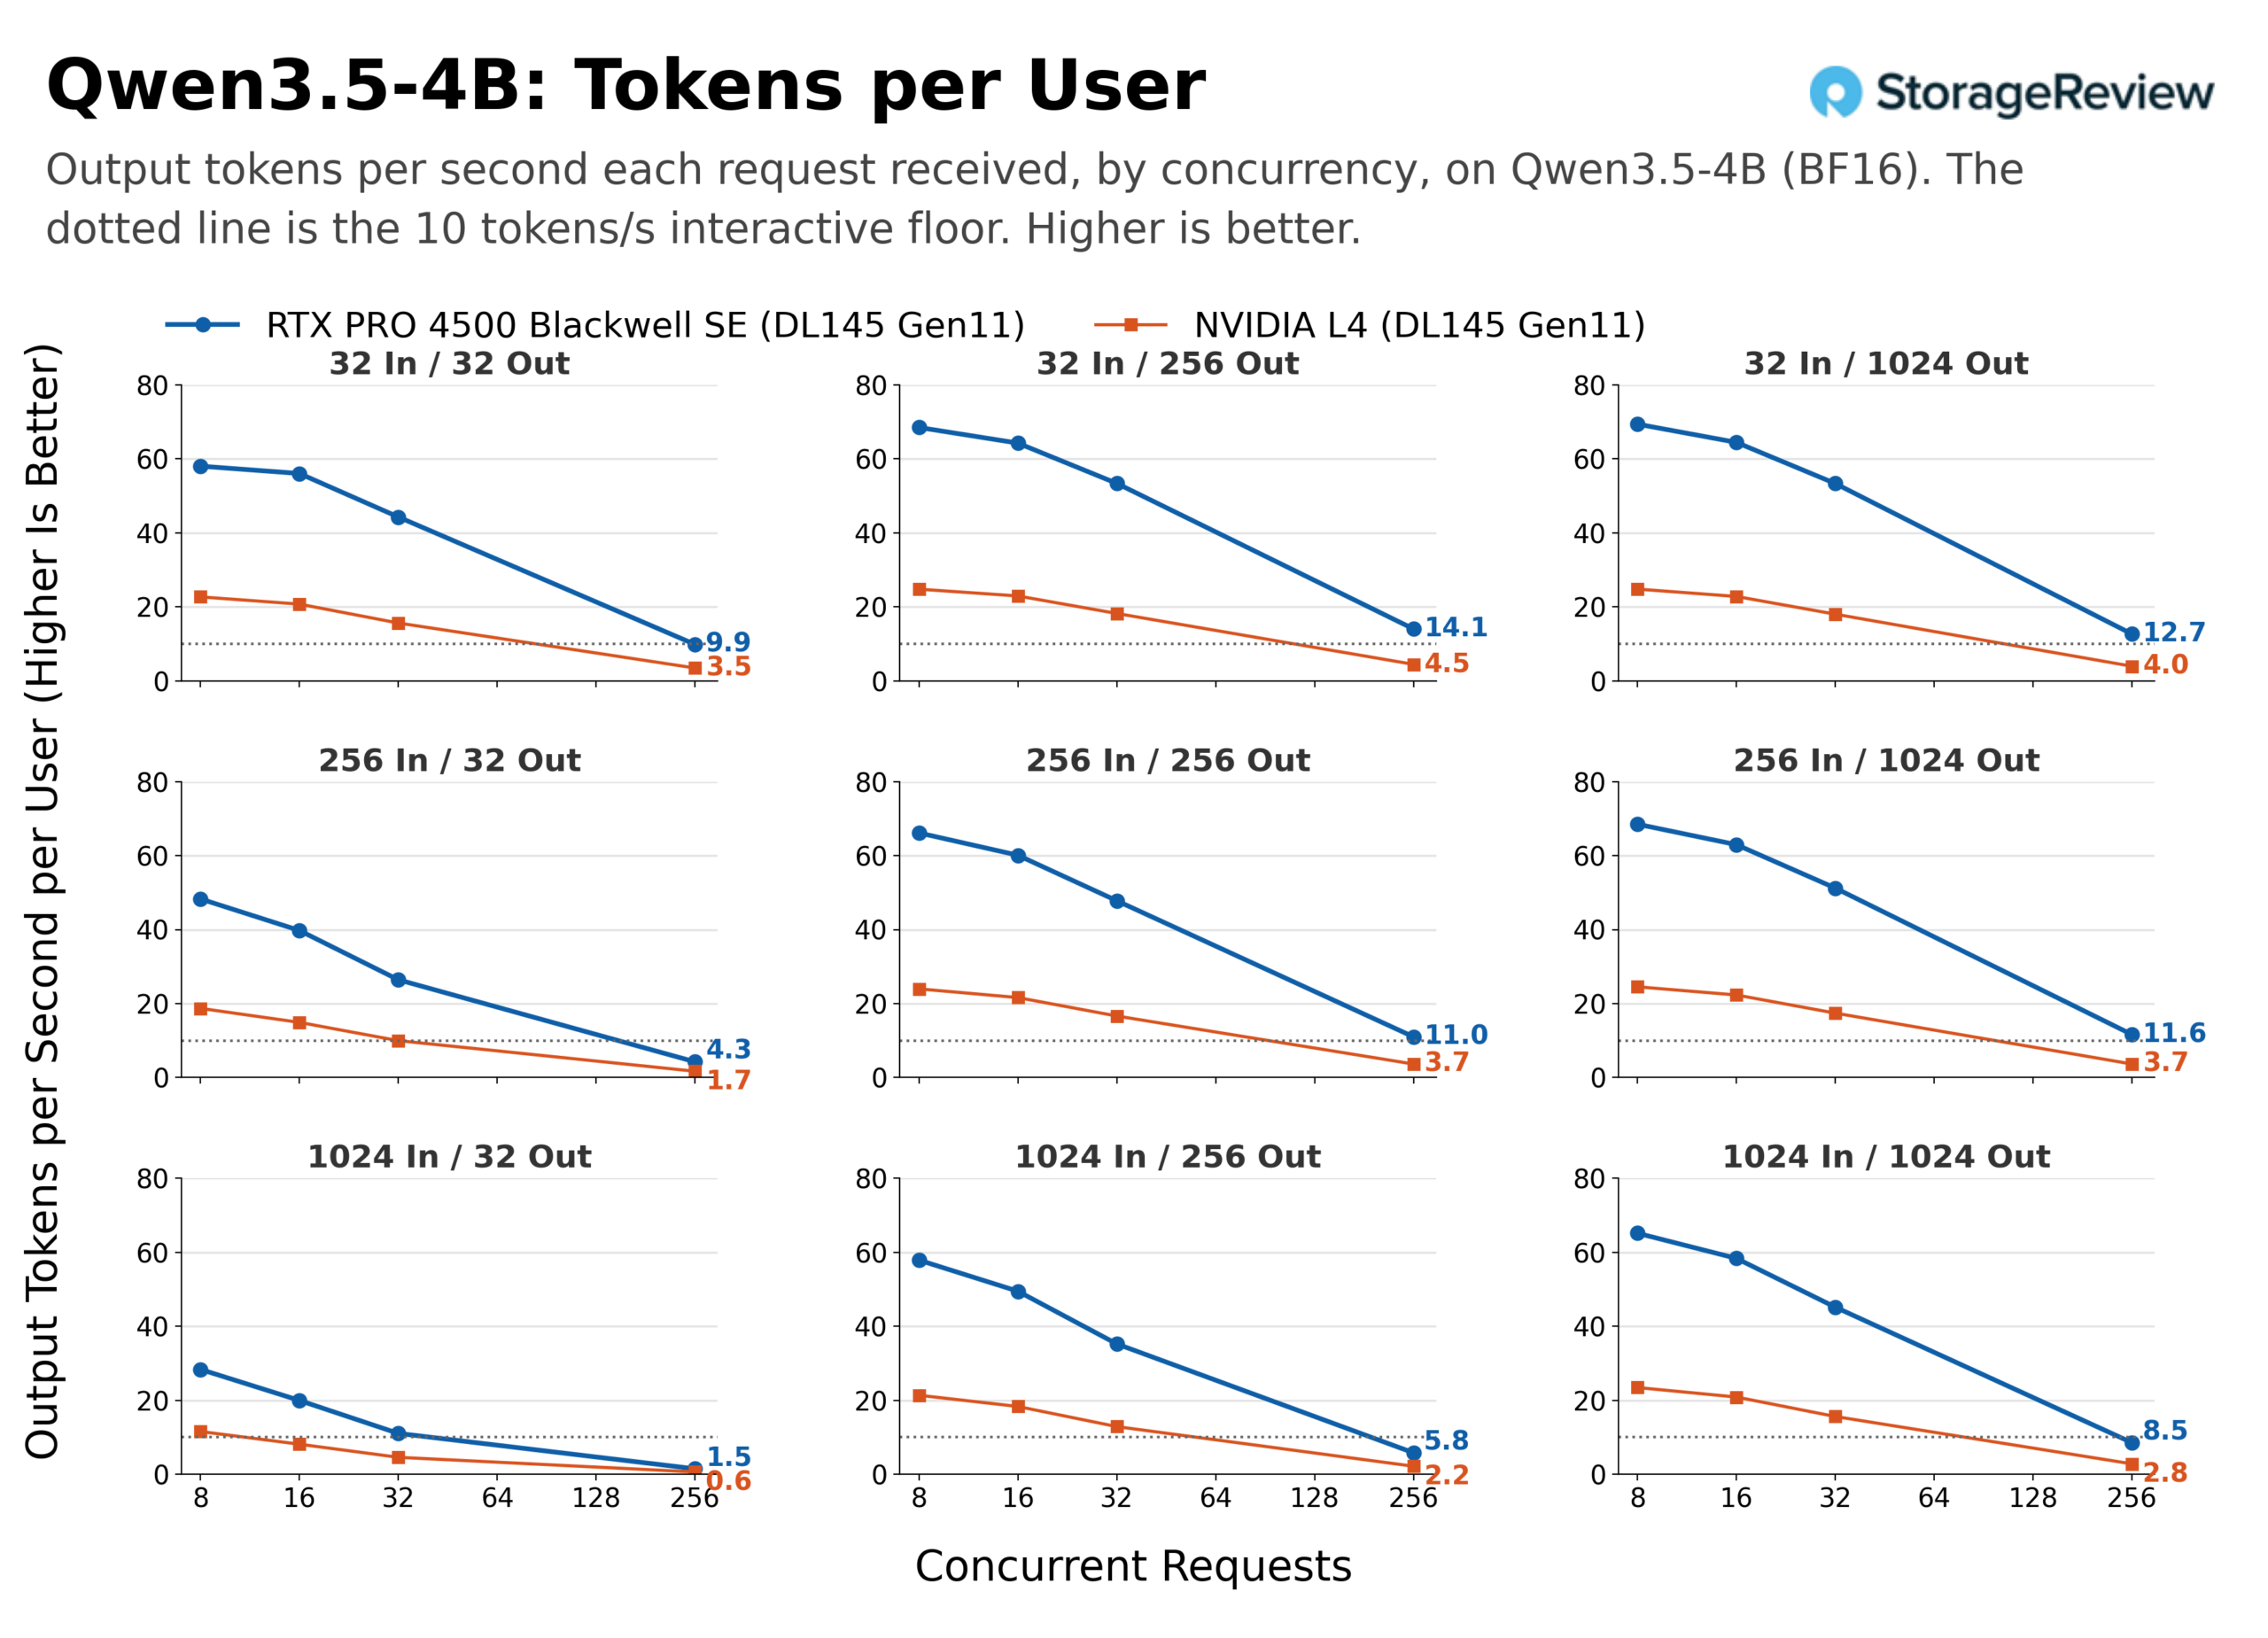
另一种解读相同数据的方法是按用户计算:每秒输出令牌数除以并发请求数,即队列中每个用户所看到的速率。下图网格中针对每种形状绘制了该速率,并以每秒 10 个令牌作为交互式使用的通用阈值。在 32 个并发请求的情况下,4500 型服务器在除 1,024 进 32 出之外的每种形状上,每个用户每秒可获得 44 到 53 个令牌,而在该形状上,该速率为 11 个令牌;L4 型服务器的速率为 10 到 18 个令牌,在该形状上已降至 4.6 个令牌。在 256 个并发输入时,4500 在四种聊天形状的组合中保持在最低限度之上(32/256 时为 14.1,32/1,024 时为 12.7,256/256 时为 11.0,256/1,024 时为 11.6),在 32/32 时达到最低限度(9.9),在 1,024 个标记的提示和简答题形状中低于最低限度,在 1,024/32 时降至 1.5,此时几乎所有工作都是预填充的。在 256 个并发输入时,L4 在所有形状中都低于最低限度,介于 0.6 和 4.5 之间。32 和 256 之间没有进行任何测试,因此每条线与虚线最低限度相交的点位于这两个并发输入之间;图表显示,L4 的交叉点在所有形态上都远早于 256,而 4500 的交叉点在聊天形态上位于 256 或接近 256。
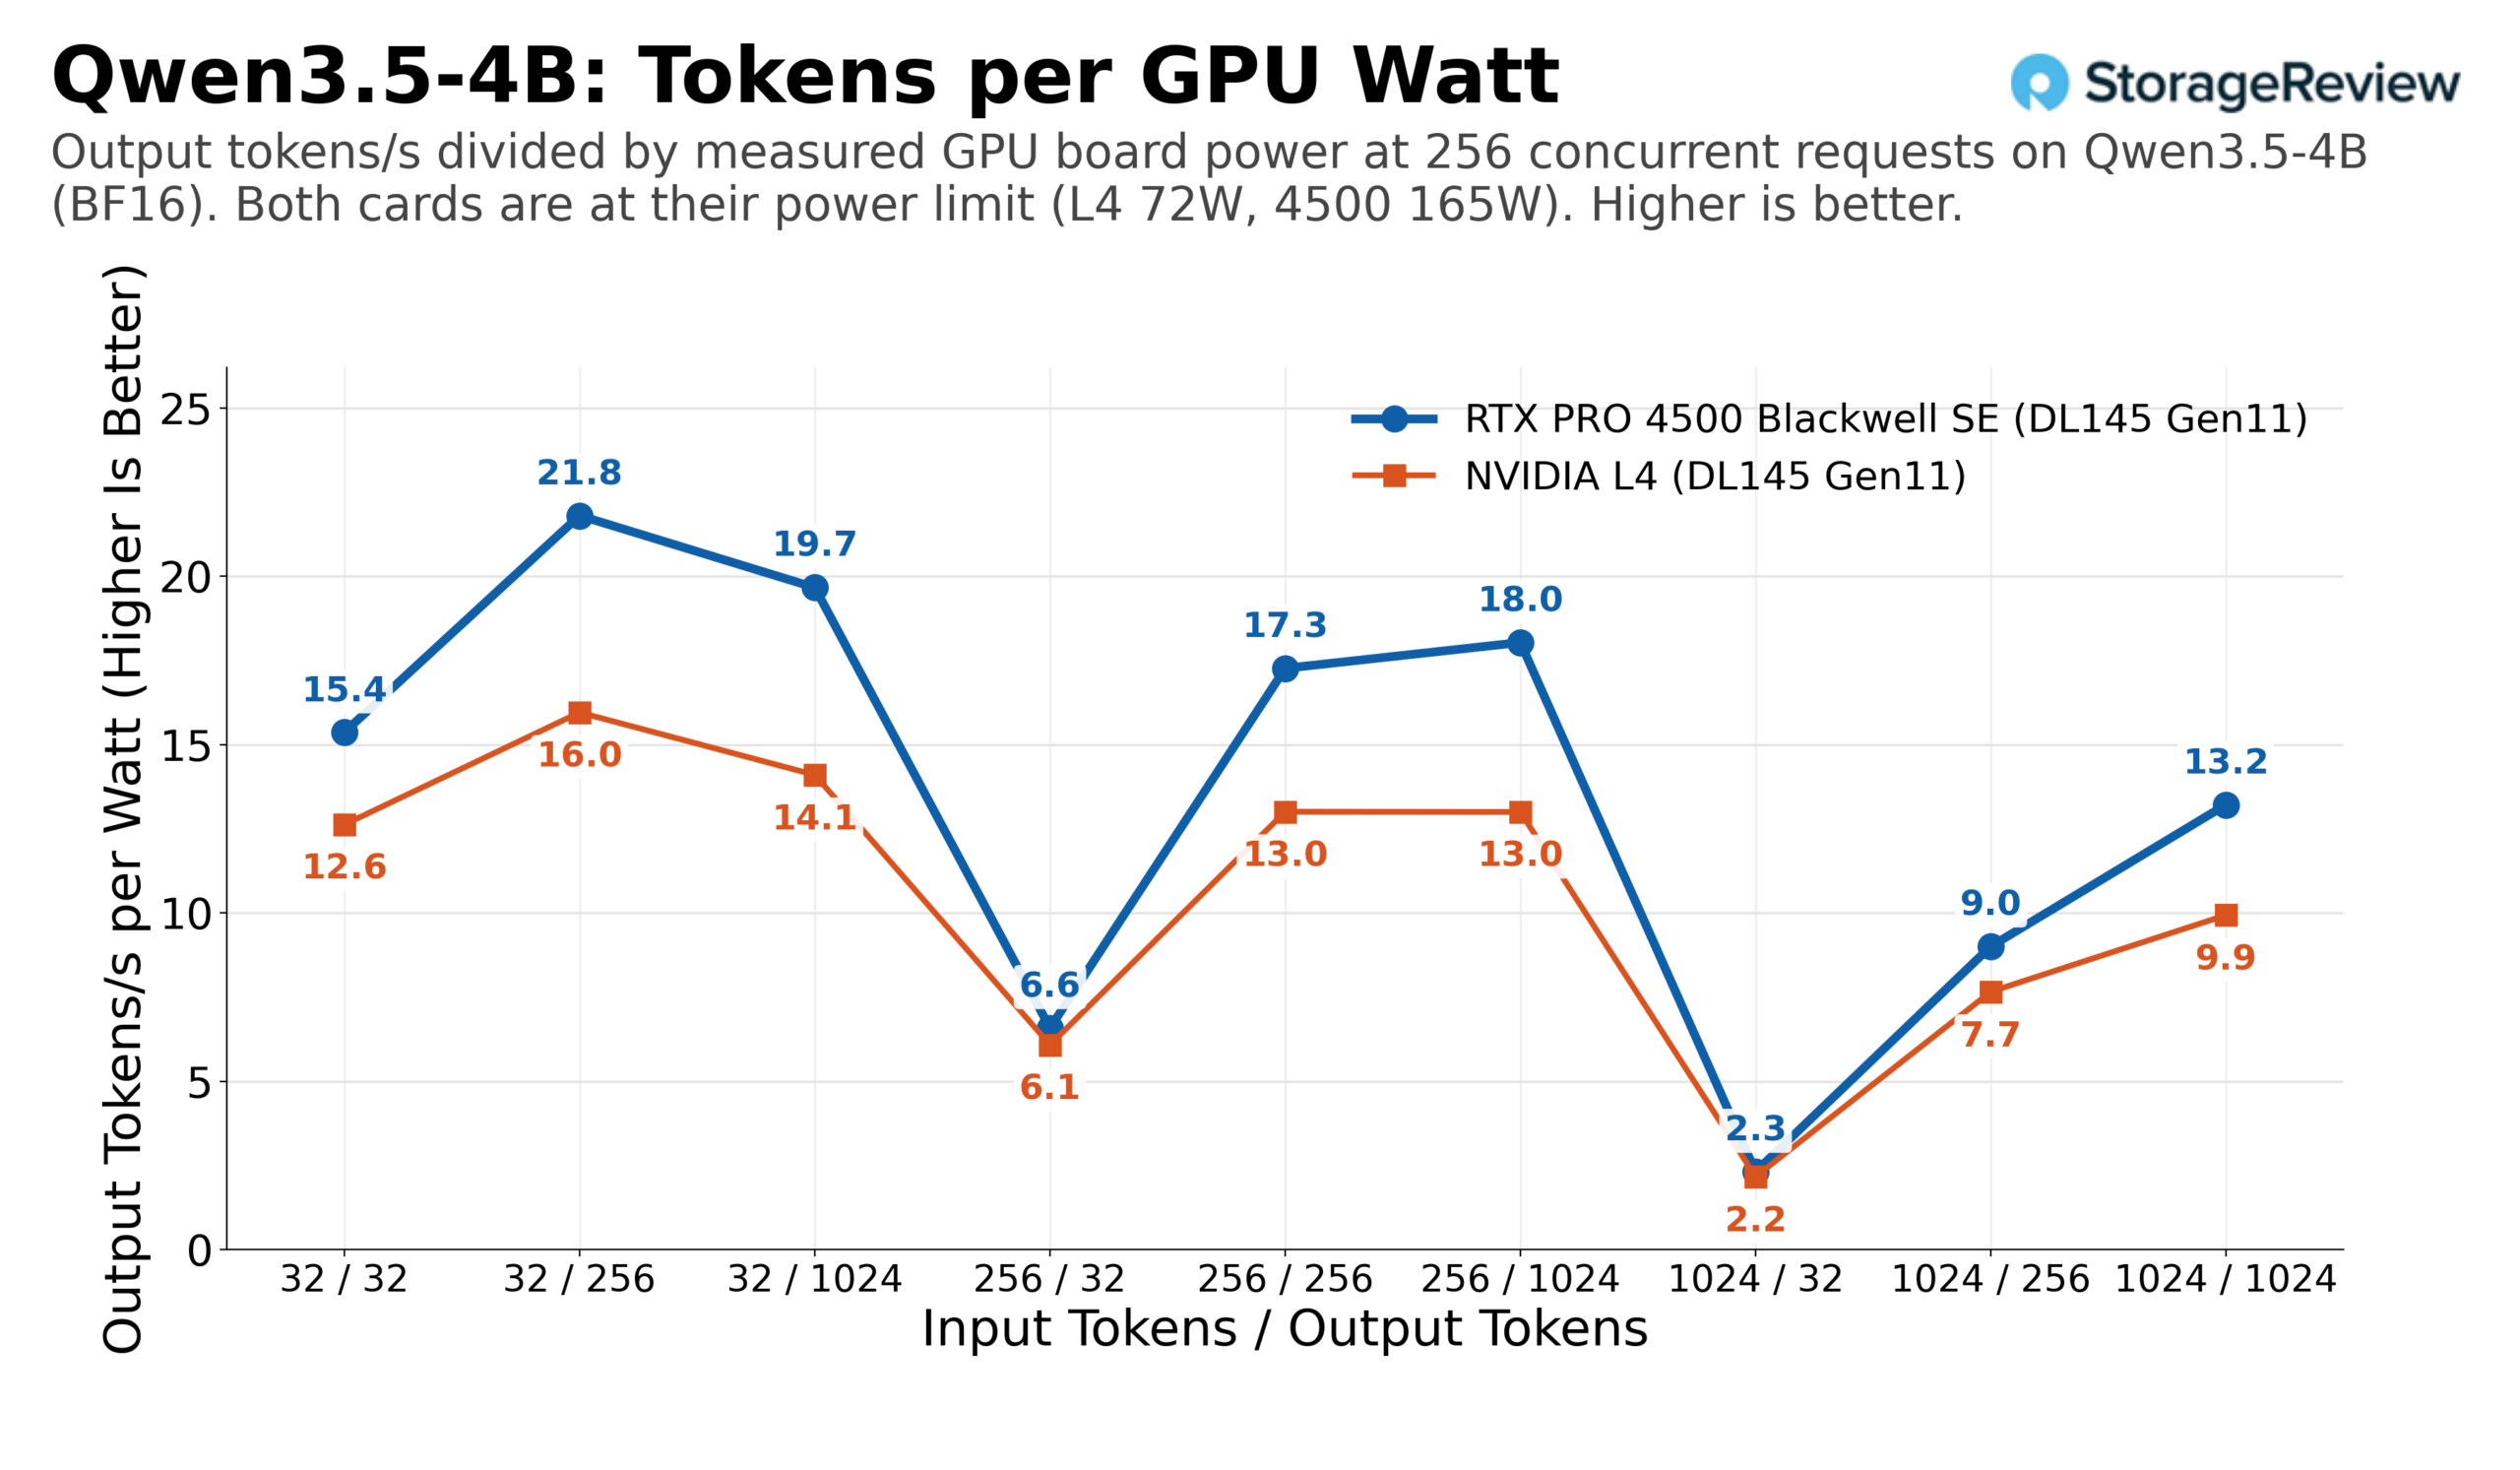
在大多数并发配置(16 个并发任务以上)下,两张显卡的功耗都接近或达到主板功耗上限,L4 为 72W,4500 为 165W。在输出功率较低的配置下,功耗则较低,例如在 Qwen3.5-4B 32/32 模式下,4500 在 32 个并发任务下的功耗为 125W,因此每 GPU 瓦特的令牌数与吞吐量密切相关。在 256 个并发任务下,4500 在九种配置下的每瓦特输出令牌数中位数是 L4 的 1.33 倍,从预填充限制的 1,024/32 模式的 1.07 倍到 256/1,024 模式的 1.39 倍。乘以 2.3 倍的功耗差异,即可得出 3 倍的吞吐量优势,其中 1.33 倍来自 Blackwell 更高的每瓦特性能,而 2.3 倍则来自 4500 更高的功耗。
Gemma 4 E4B
Gemma 4 E4B 是 Google Gemma 4 系列中性能较小的成员,其中的 E 代表有效 4B 参数。它在两张显卡上的表现都与 Qwen3.5-4B 类似,但在性能高峰期略有提升。在 8 到 32 个并发任务的情况下,平均吞吐量倍数为 2.67 倍(范围为 2.31 倍到 3.07 倍);在 256 个并发任务的情况下,吞吐量倍数为 3.20 倍。当并发任务数达到 1,024/1,024 时,由于 L4 缓存深度接近其键值缓存上限,吞吐量倍数达到了 3.82 倍。
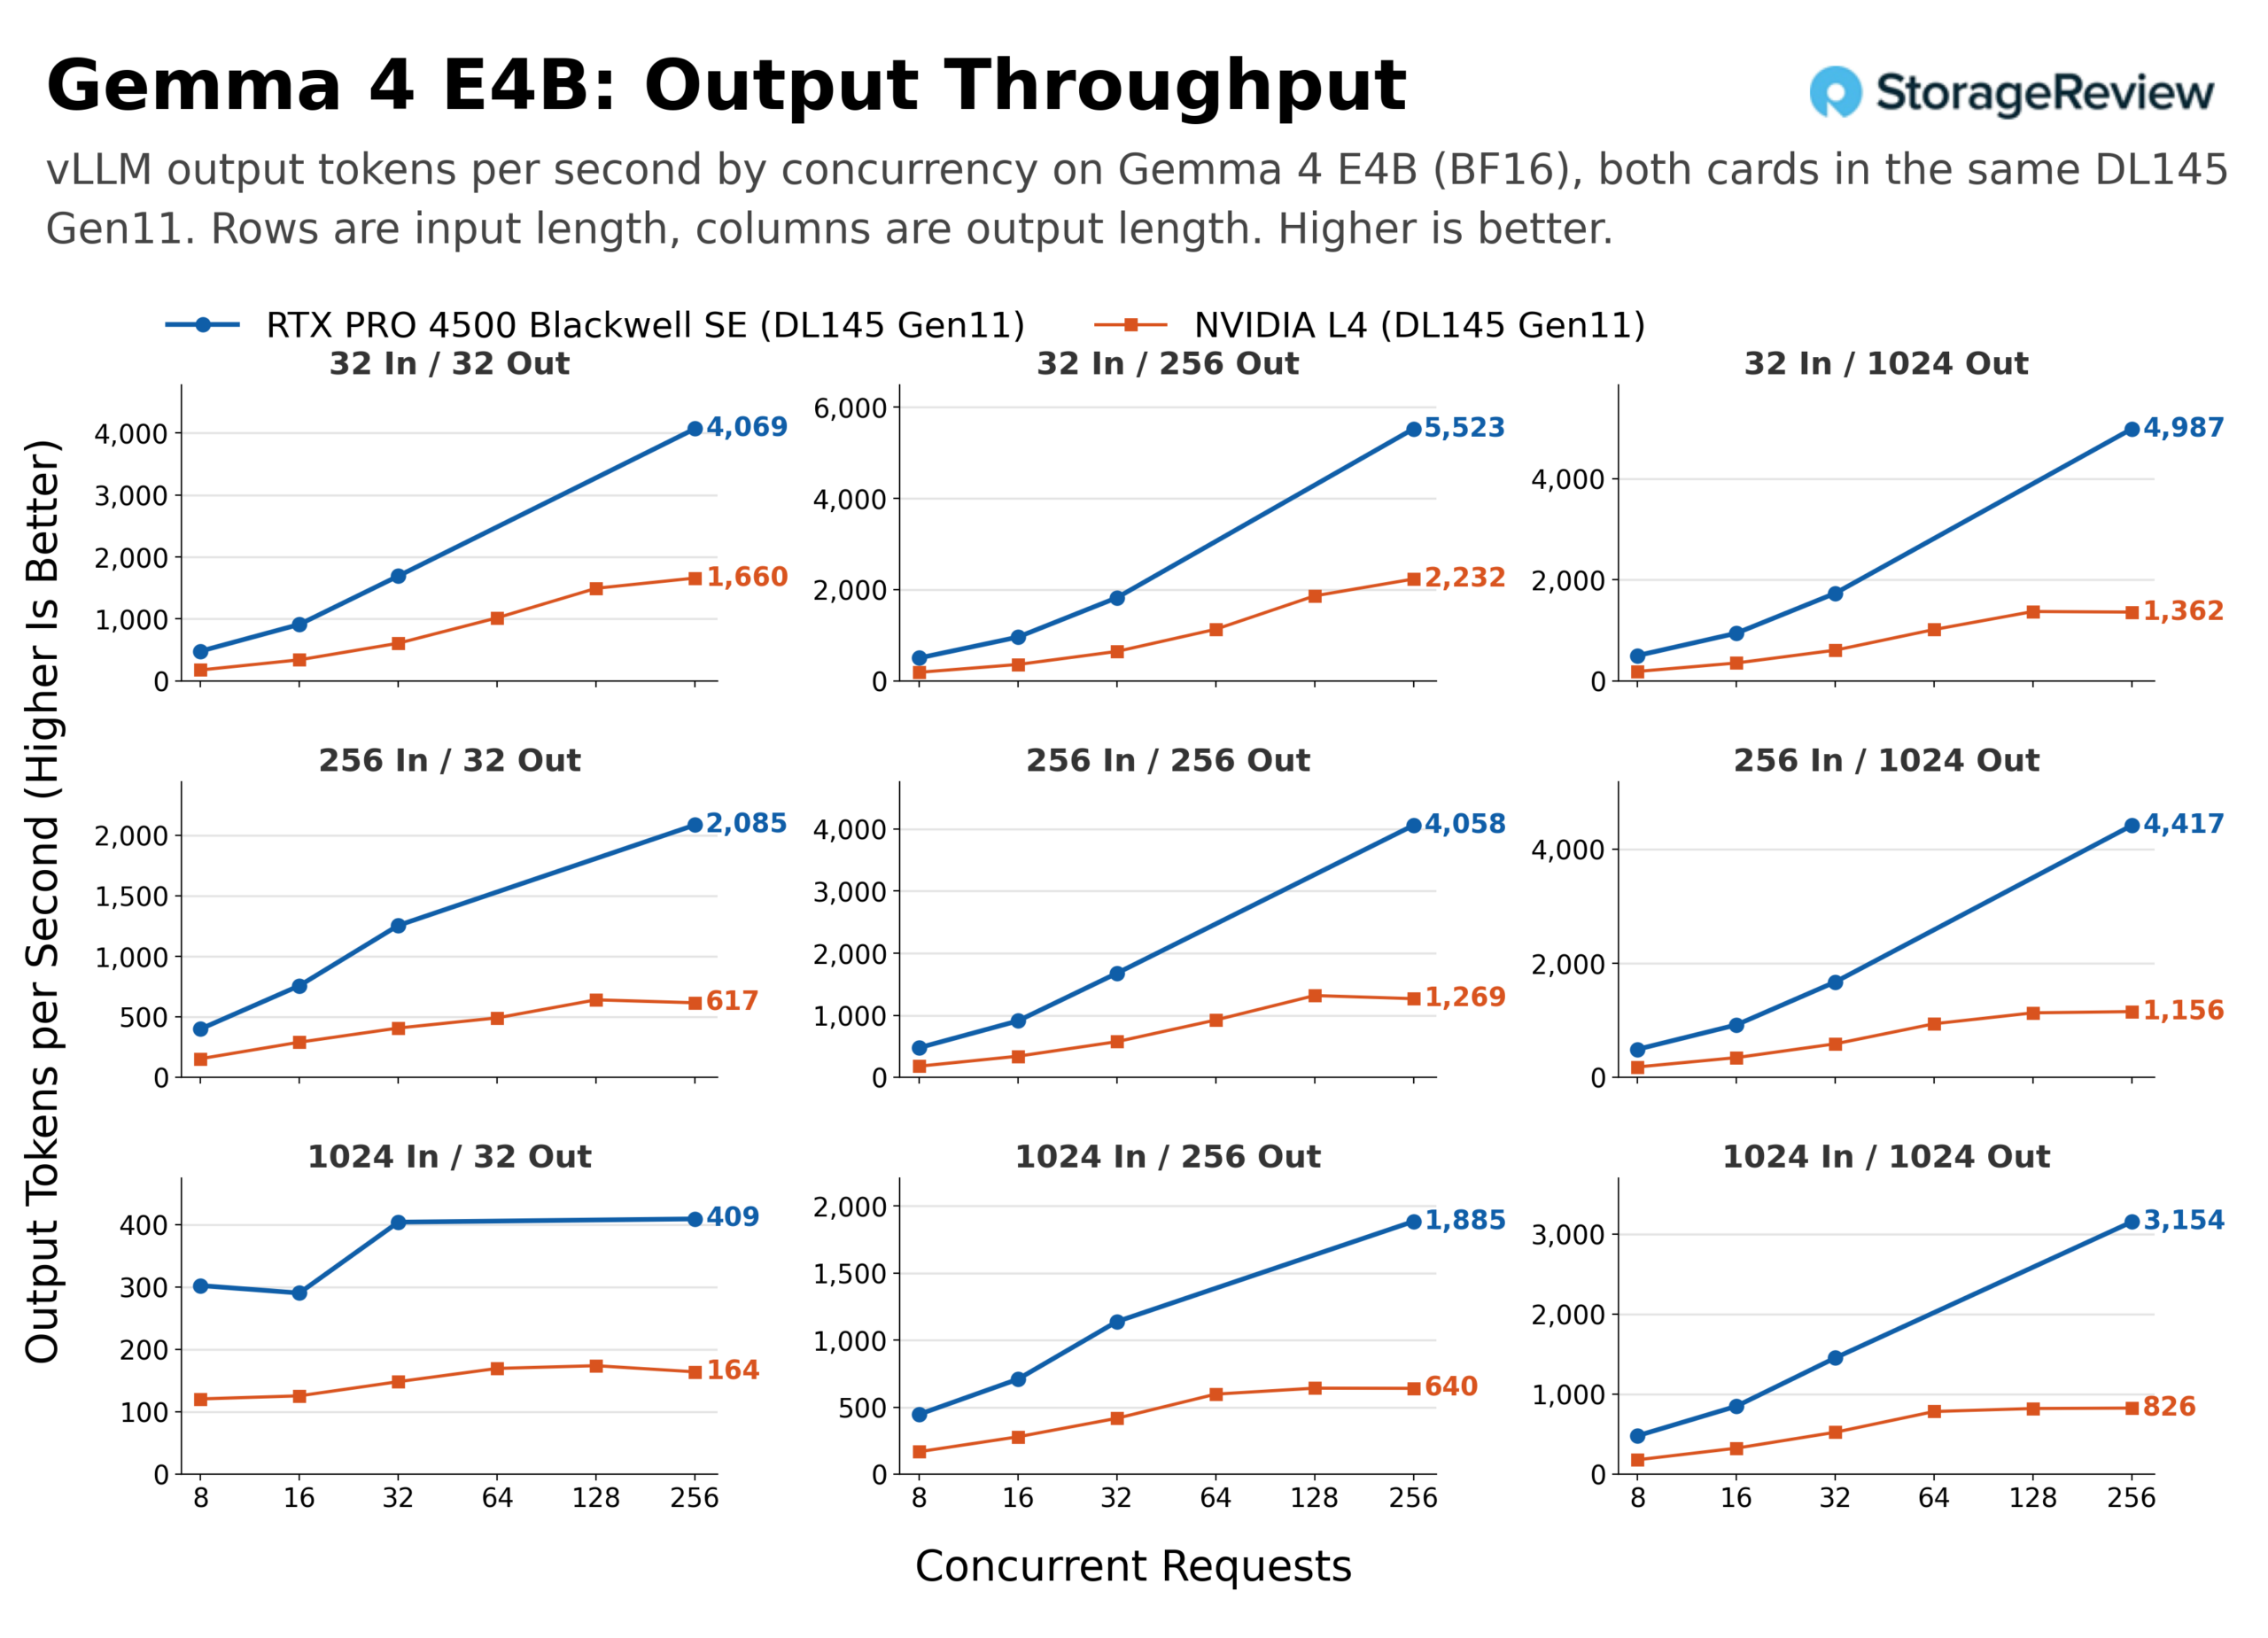
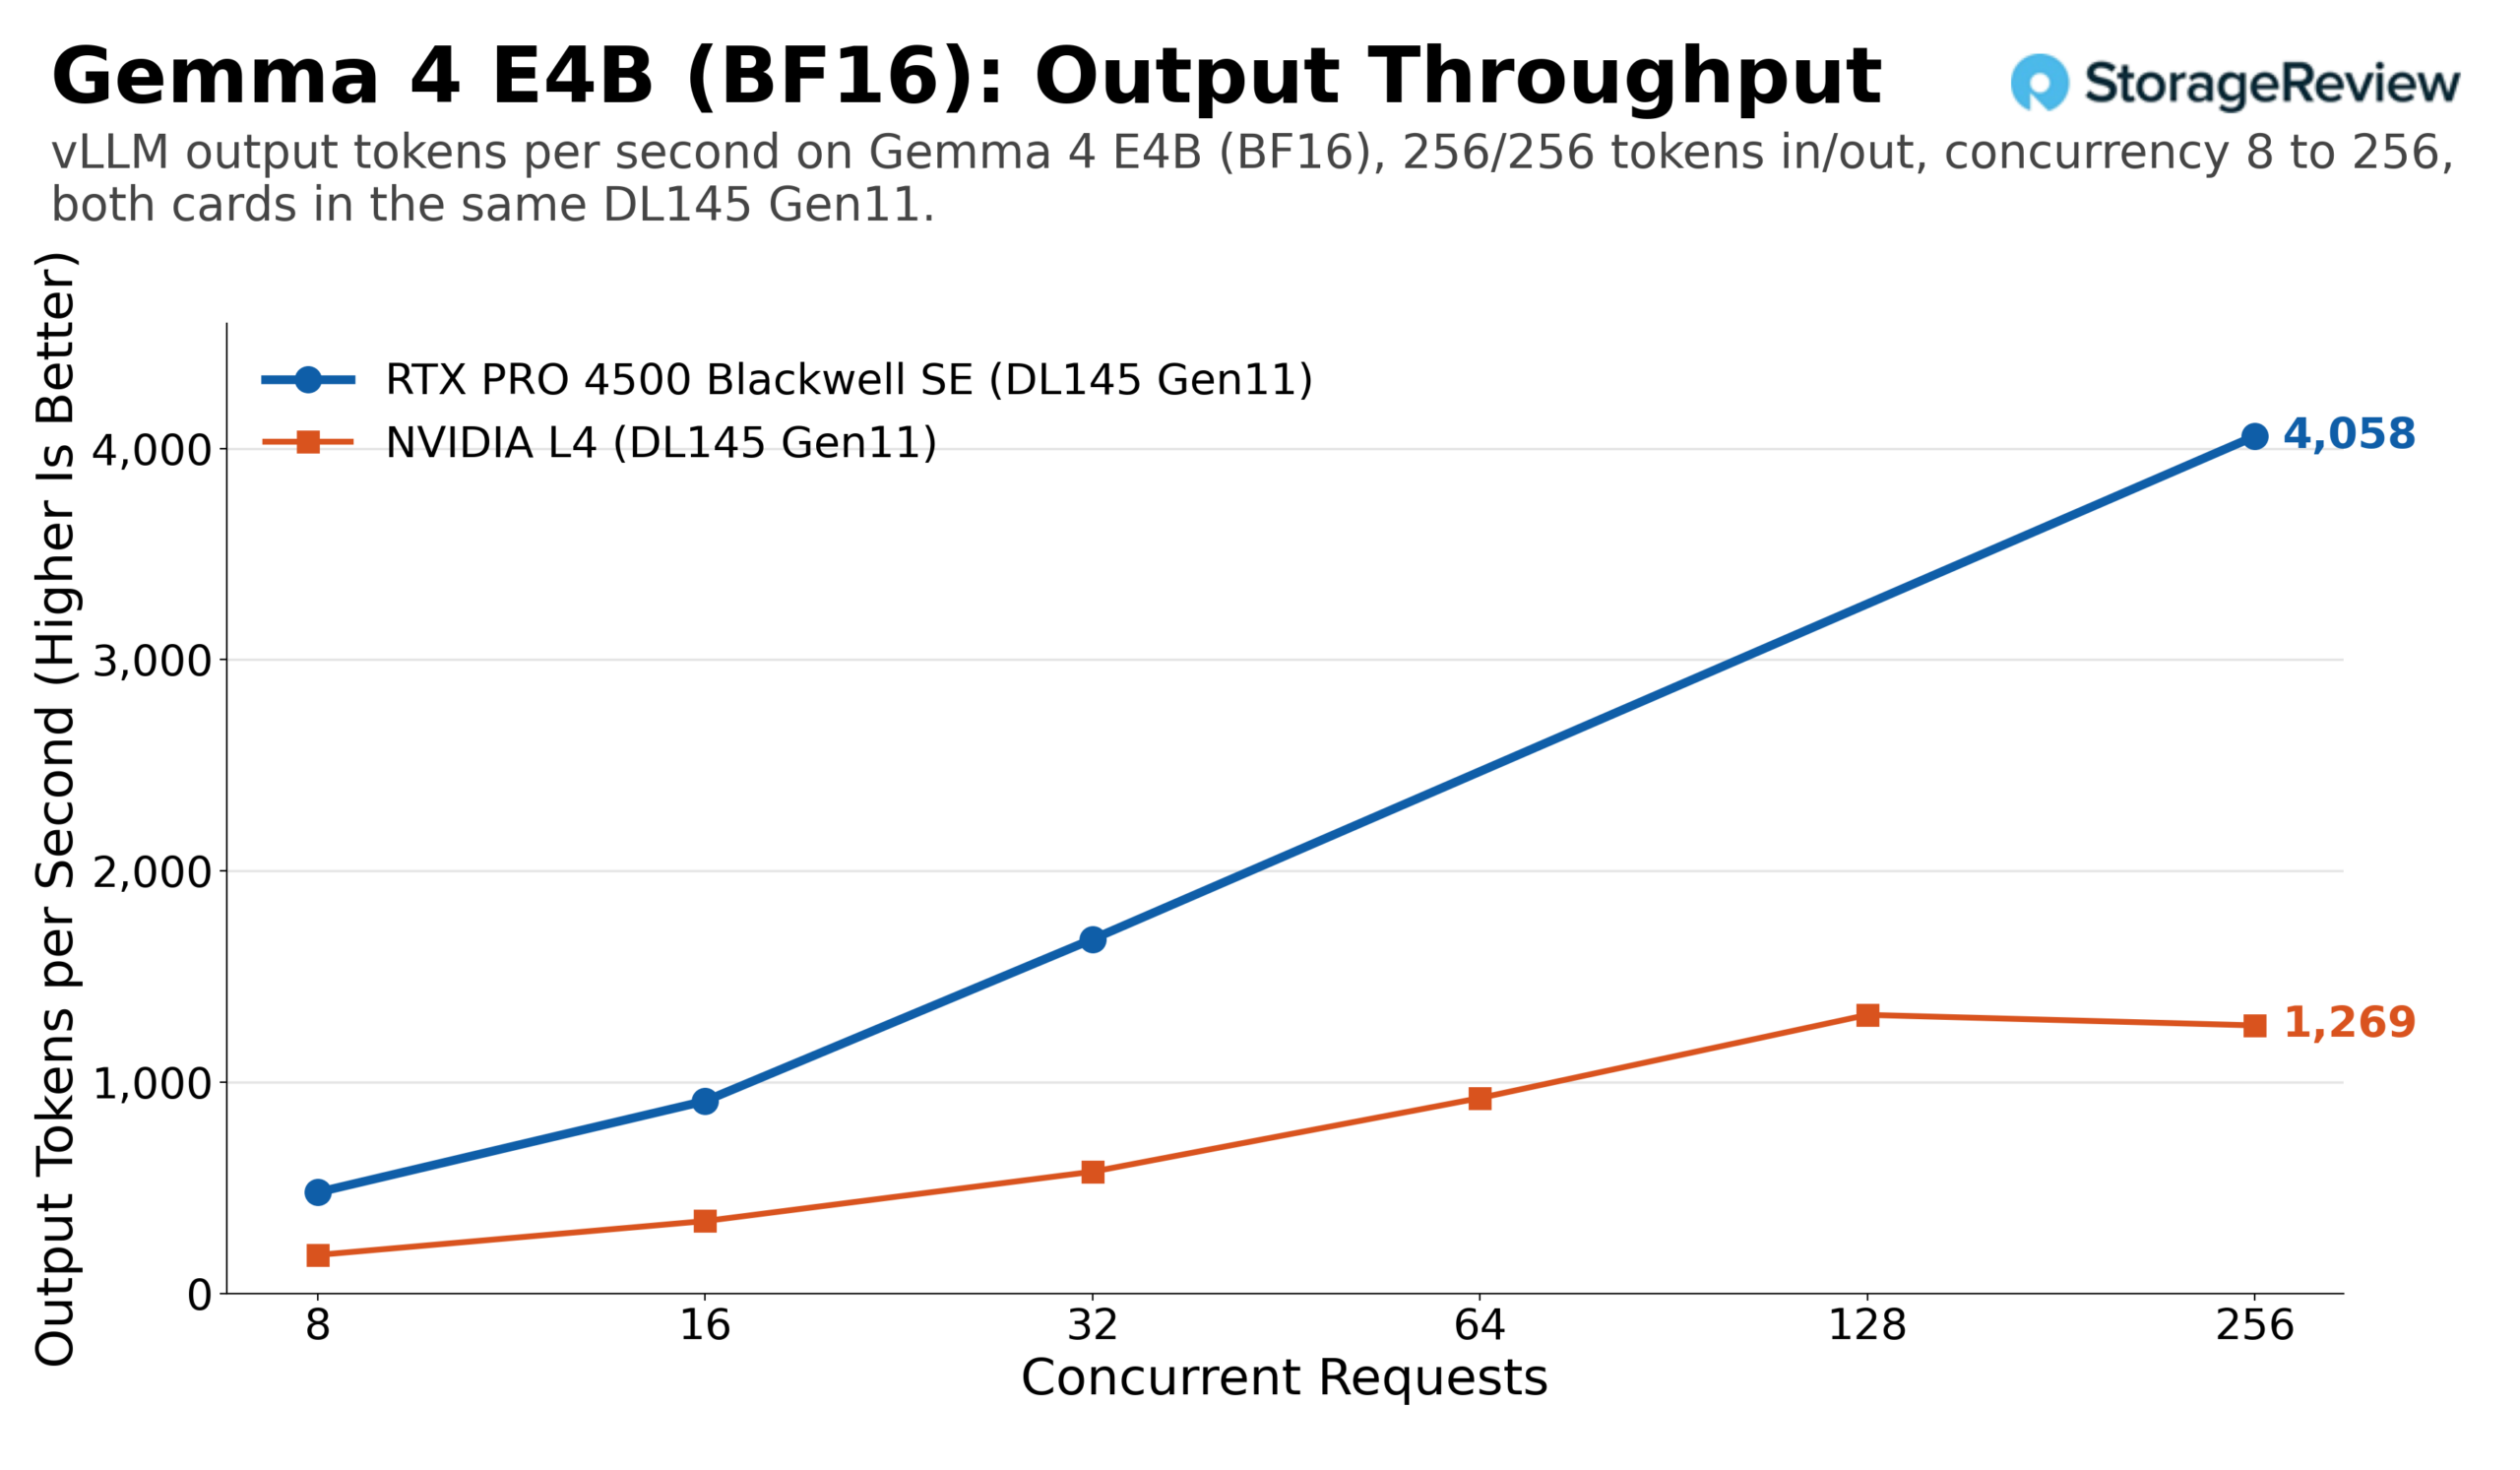
在 256/256 的并发场景下,L4 在 8 个并发会话时每秒产生 183 个输出令牌,32 个并发会话时每秒产生 577 个输出令牌,256 个并发会话时每秒产生 1,269 个输出令牌;4500 则分别为 479、1,678 和 4,058 个输出令牌。在 1,024/1,024 的并发场景下,L4 的并发场景分别为 180、524 和 826 个输出令牌,而 4500 则分别为 480、1,454 和 3,154 个输出令牌。4500 在 256 个并发会话下的性能是 L4 的 3.8 倍,原因可以从 L4 的性能曲线看出:从 32 个并发会话增加到 256 个并发会话时,L4 每秒仅增加了 302 个输出令牌,因为它没有足够的内存来添加会话。
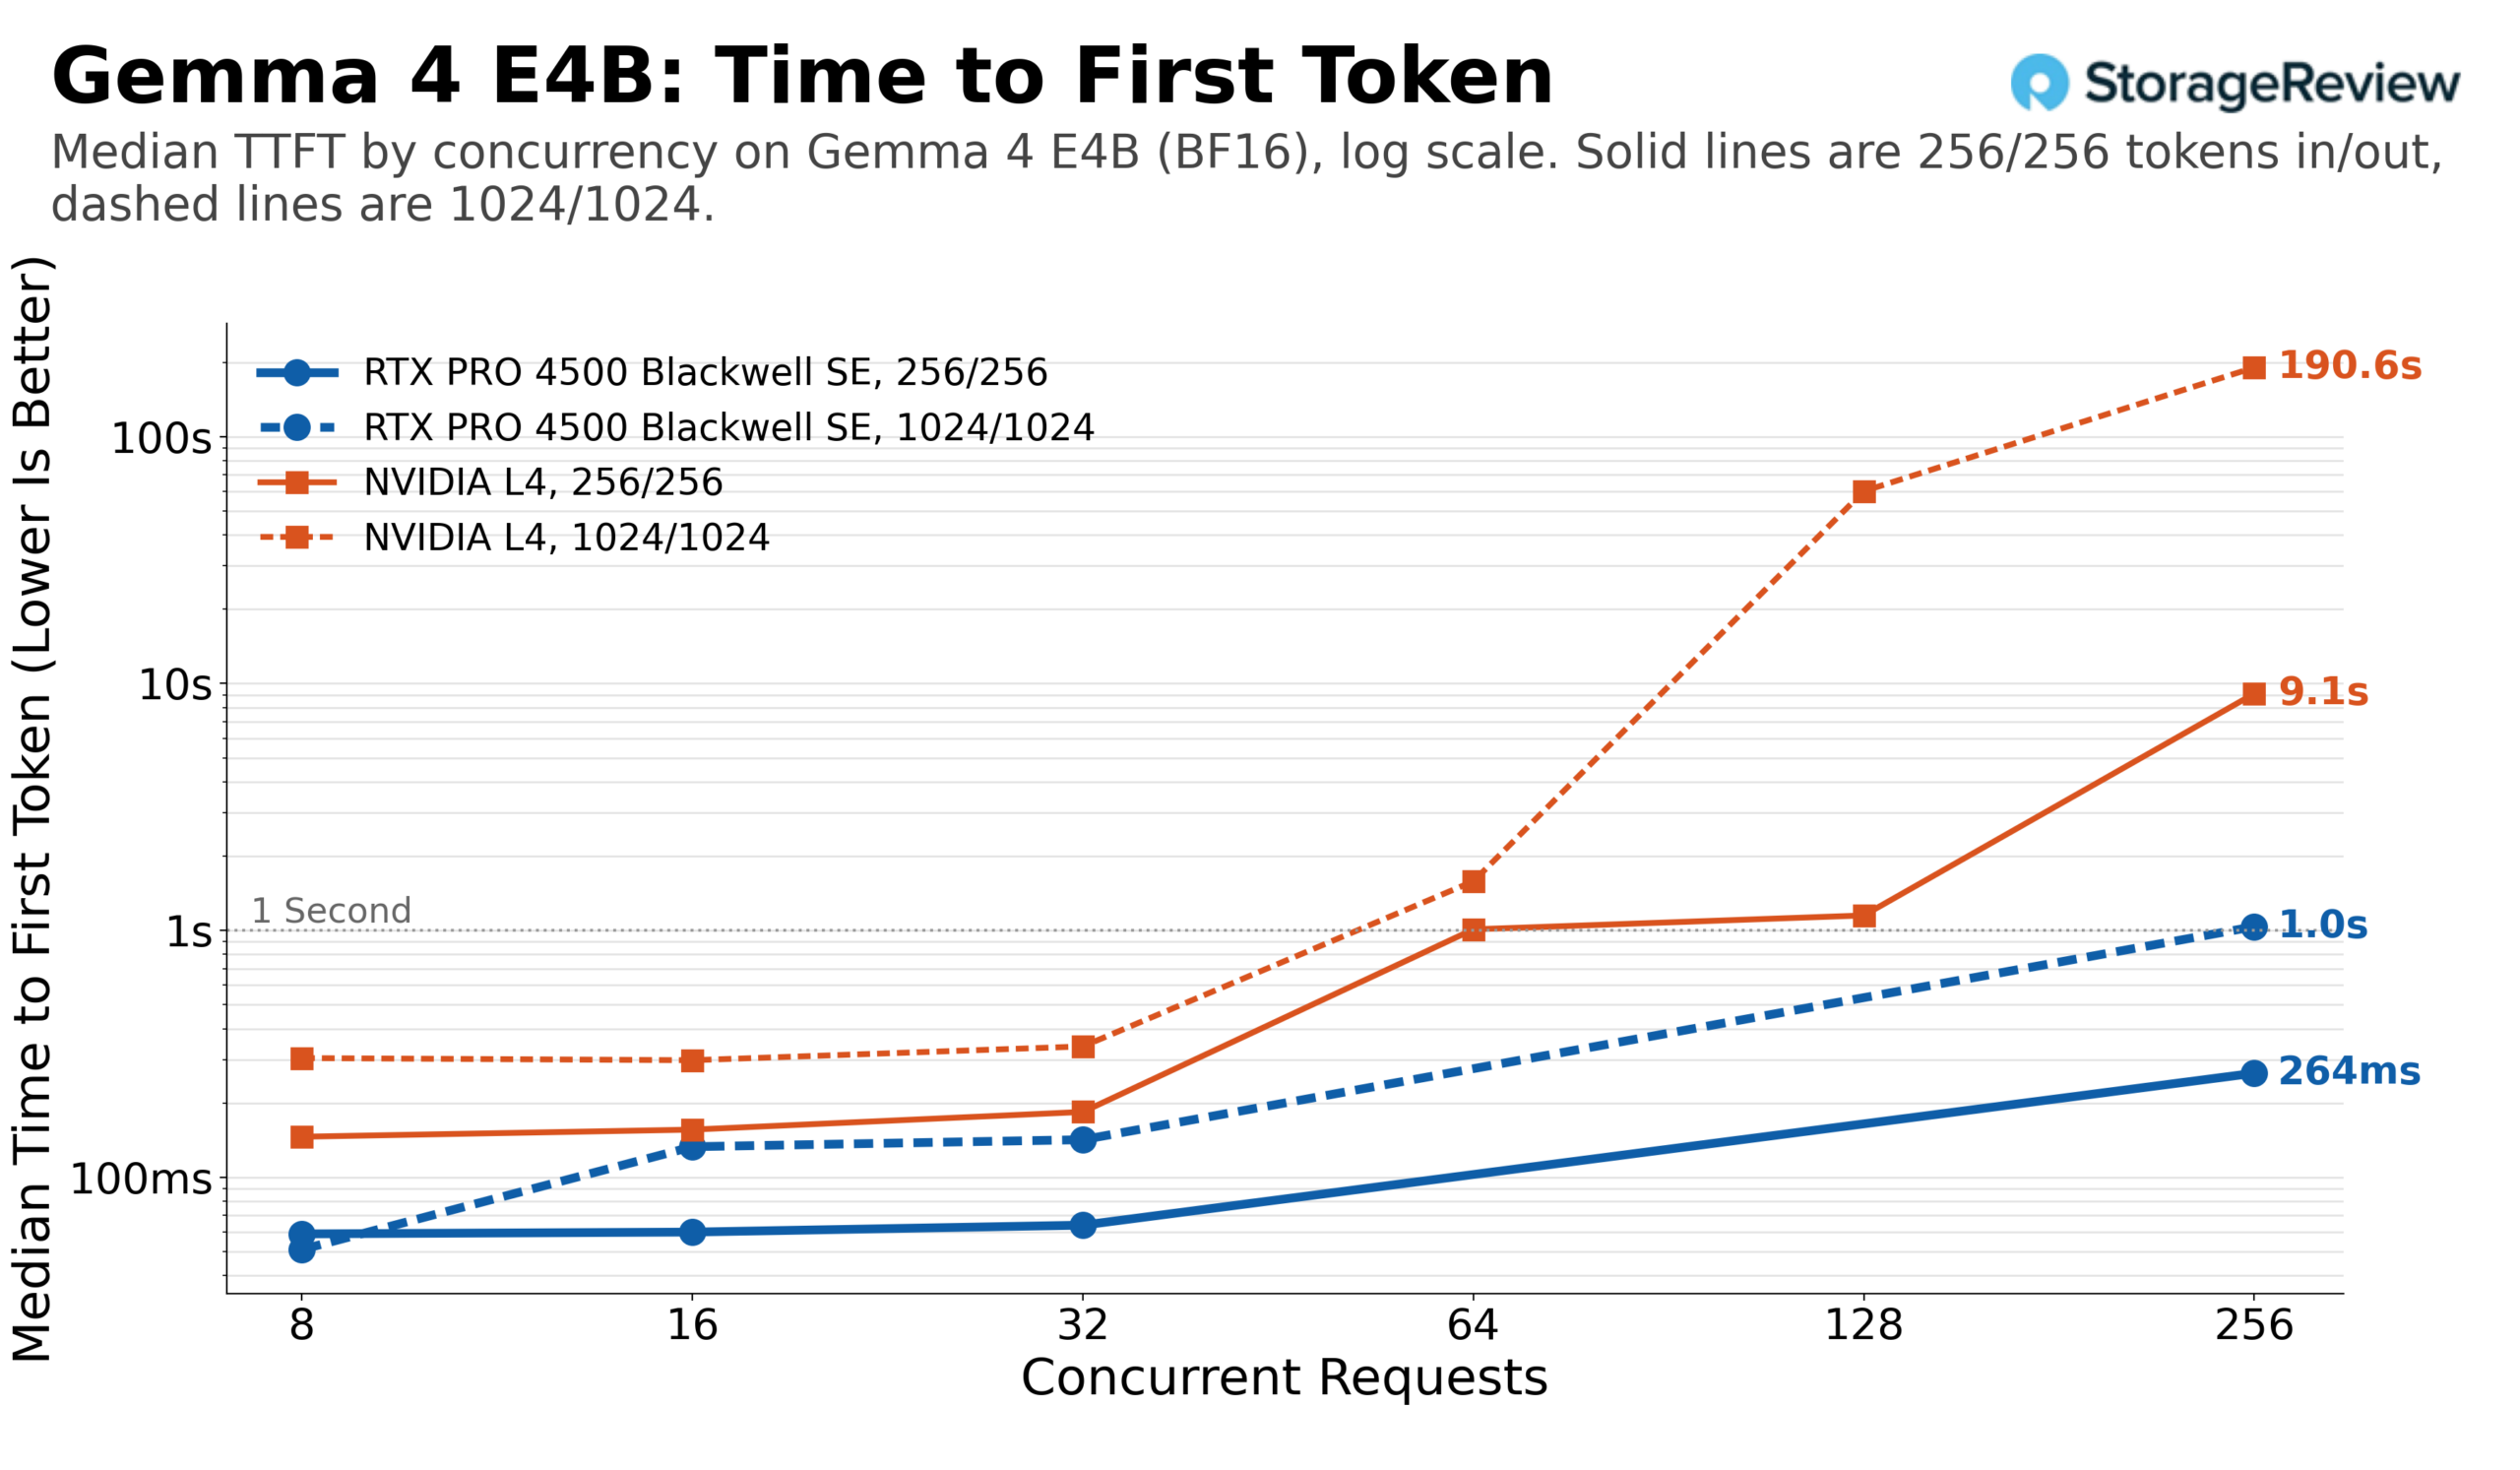
由于 L4 的 Gemma 4 作业同时包含 64 和 128 个并发线程,该模型准确地展示了 L4 的性能瓶颈所在。在 256/256 的线程形状上,其首次令牌到达时间的中位数在 32 个并发线程时为 184 毫秒,在 64 个并发线程时略超过 1 秒,在 256 个并发线程时为 9.1 秒。在 1,024/1,024 的线程形状上,其首次令牌到达时间的中位数在 32 个并发线程时为 339 毫秒,在 64 个并发线程时超过 1 秒,在 128 个并发线程时为 60 秒,在 256 个并发线程时为 191 秒。4500 在较短的线程形状上,在 32 个并发线程时保持在 64 毫秒,在 256 个并发线程时保持在 264 毫秒;在较长的线程形状上,其首次令牌到达时间的中位数在 32 个并发线程时为 142 毫秒,仅在 256 个并发线程时超过 1 秒,为 1,036 毫秒。因此,对于 Gemma 4 E4B 在聊天长度提示下,此服务器中的 L4 是一张 32 到 64 个会话的卡,而 4500 是一张 256 个会话的卡,并且延迟还有余量。
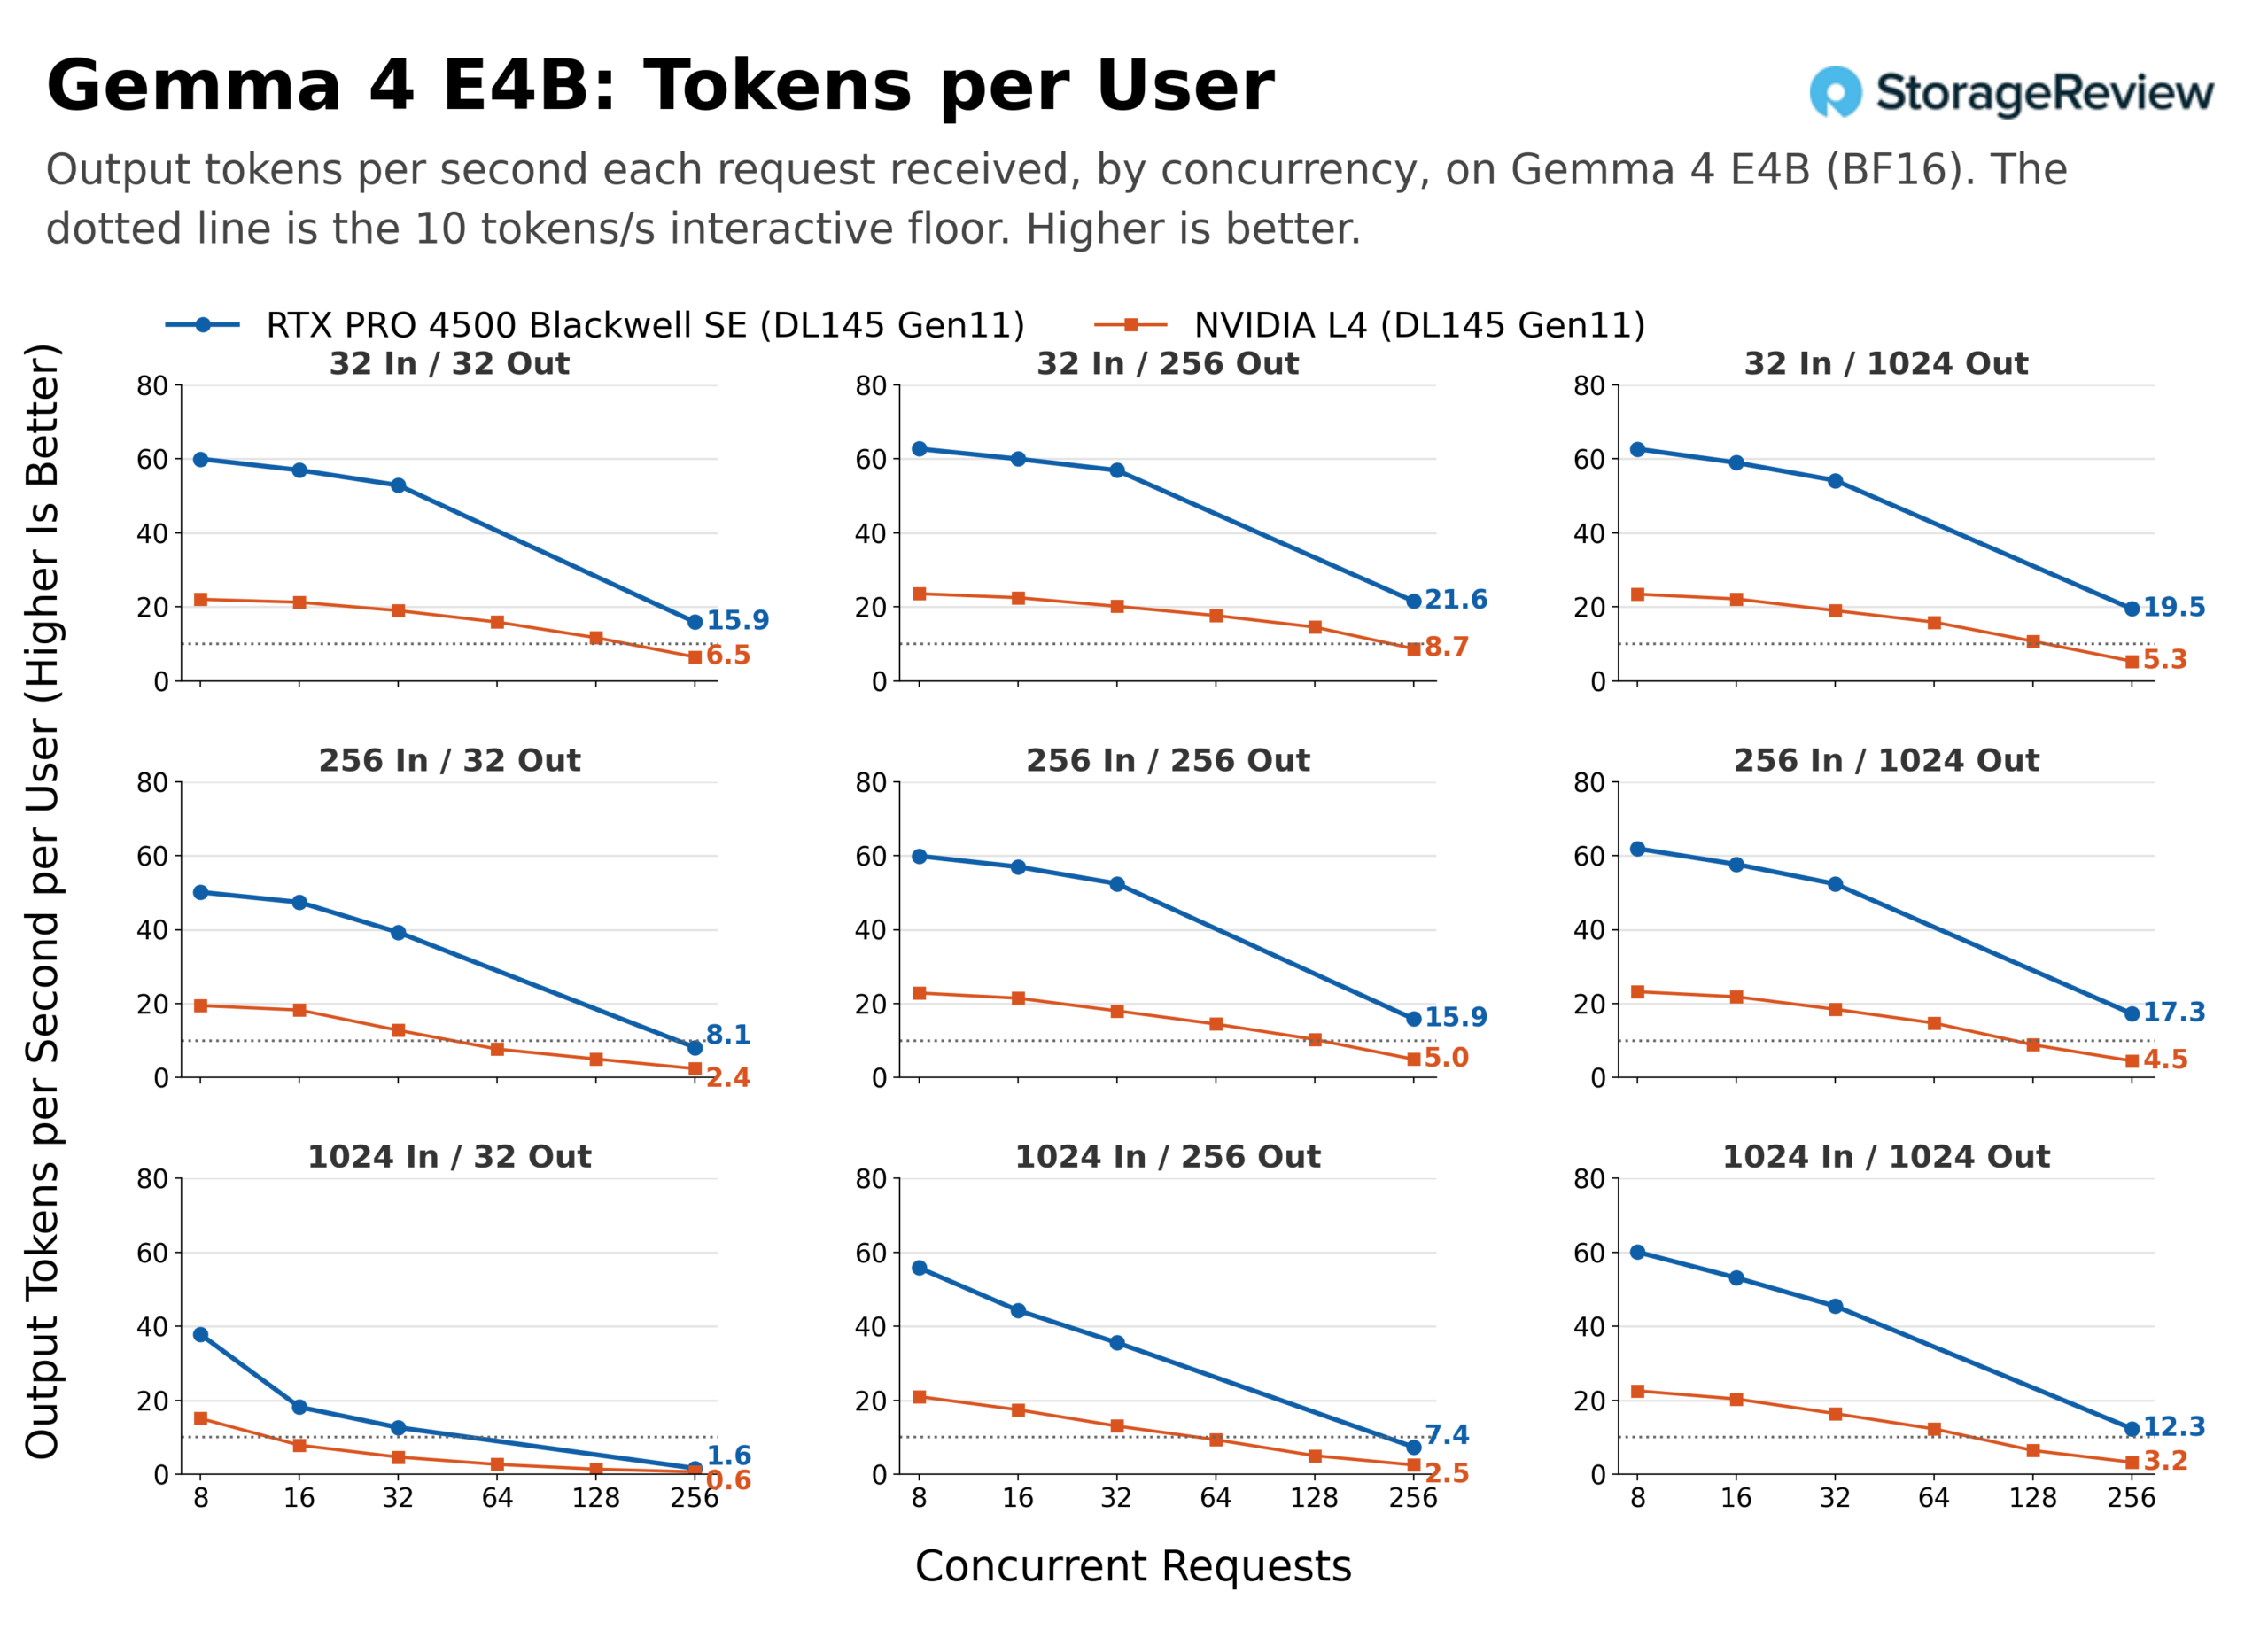
用户视图中,L4 的 64 和 128 个点已填充,显示了其性能下降的位置。在 256/256 的图形上,L4 在 32 个并发用户时,每个用户每秒可处理 18.0 个令牌;在 64 个并发用户时,每个用户每秒可处理 14.5 个令牌;在 128 个并发用户时,每个用户每秒可处理 10.3 个令牌;在 256 个并发用户时,每个用户每秒可处理 5.0 个令牌。因此,在该图形上,其性能在 128 到 256 个并发用户之间下降了每秒 10 个令牌。在 256/1,024 的图形上,其性能在 128 个并发用户时为 8.9 个并发用户;而在简答题和 1,024 个并发用户的情况下,其性能在 64 个并发用户时低于最低限值(在 256/32 时为 7.7 个并发用户,在 1,024/256 时为 9.3 个并发用户)。在 32 个并发用户的聊天形状中,4500 的每用户平均为 52 至 57 个字符,并且在九种形状中的六种形状中仍然高于最低值 256(在 32 和 256 个输入形状中,除 256/32 之外,为 15.9 至 21.6,在 1,024/1,024 中为 12.3),仅在三种简答题和长提示形状中低于最低值(在 256/32 中为 8.1,在 1,024/256 中为 7.4,在 1,024/32 中为 1.6)。
在256并发场景下,Gemma 4 E4B 算法使4500的L4缓存性能平均提升至1.39倍,其中在256/1,024场景下提升幅度最大,达到1.68倍;在其他L4缓存因键值缓存不足而无法充分利用的长负载场景下,提升幅度也达到1.6倍或更高;而在32/32场景下,由于工作负载过短,两张显卡都无法充分发挥性能,提升幅度最小,仅为1.07倍。在256/256场景下,4500的每瓦输出令牌数为24.6,而4500为17.7。
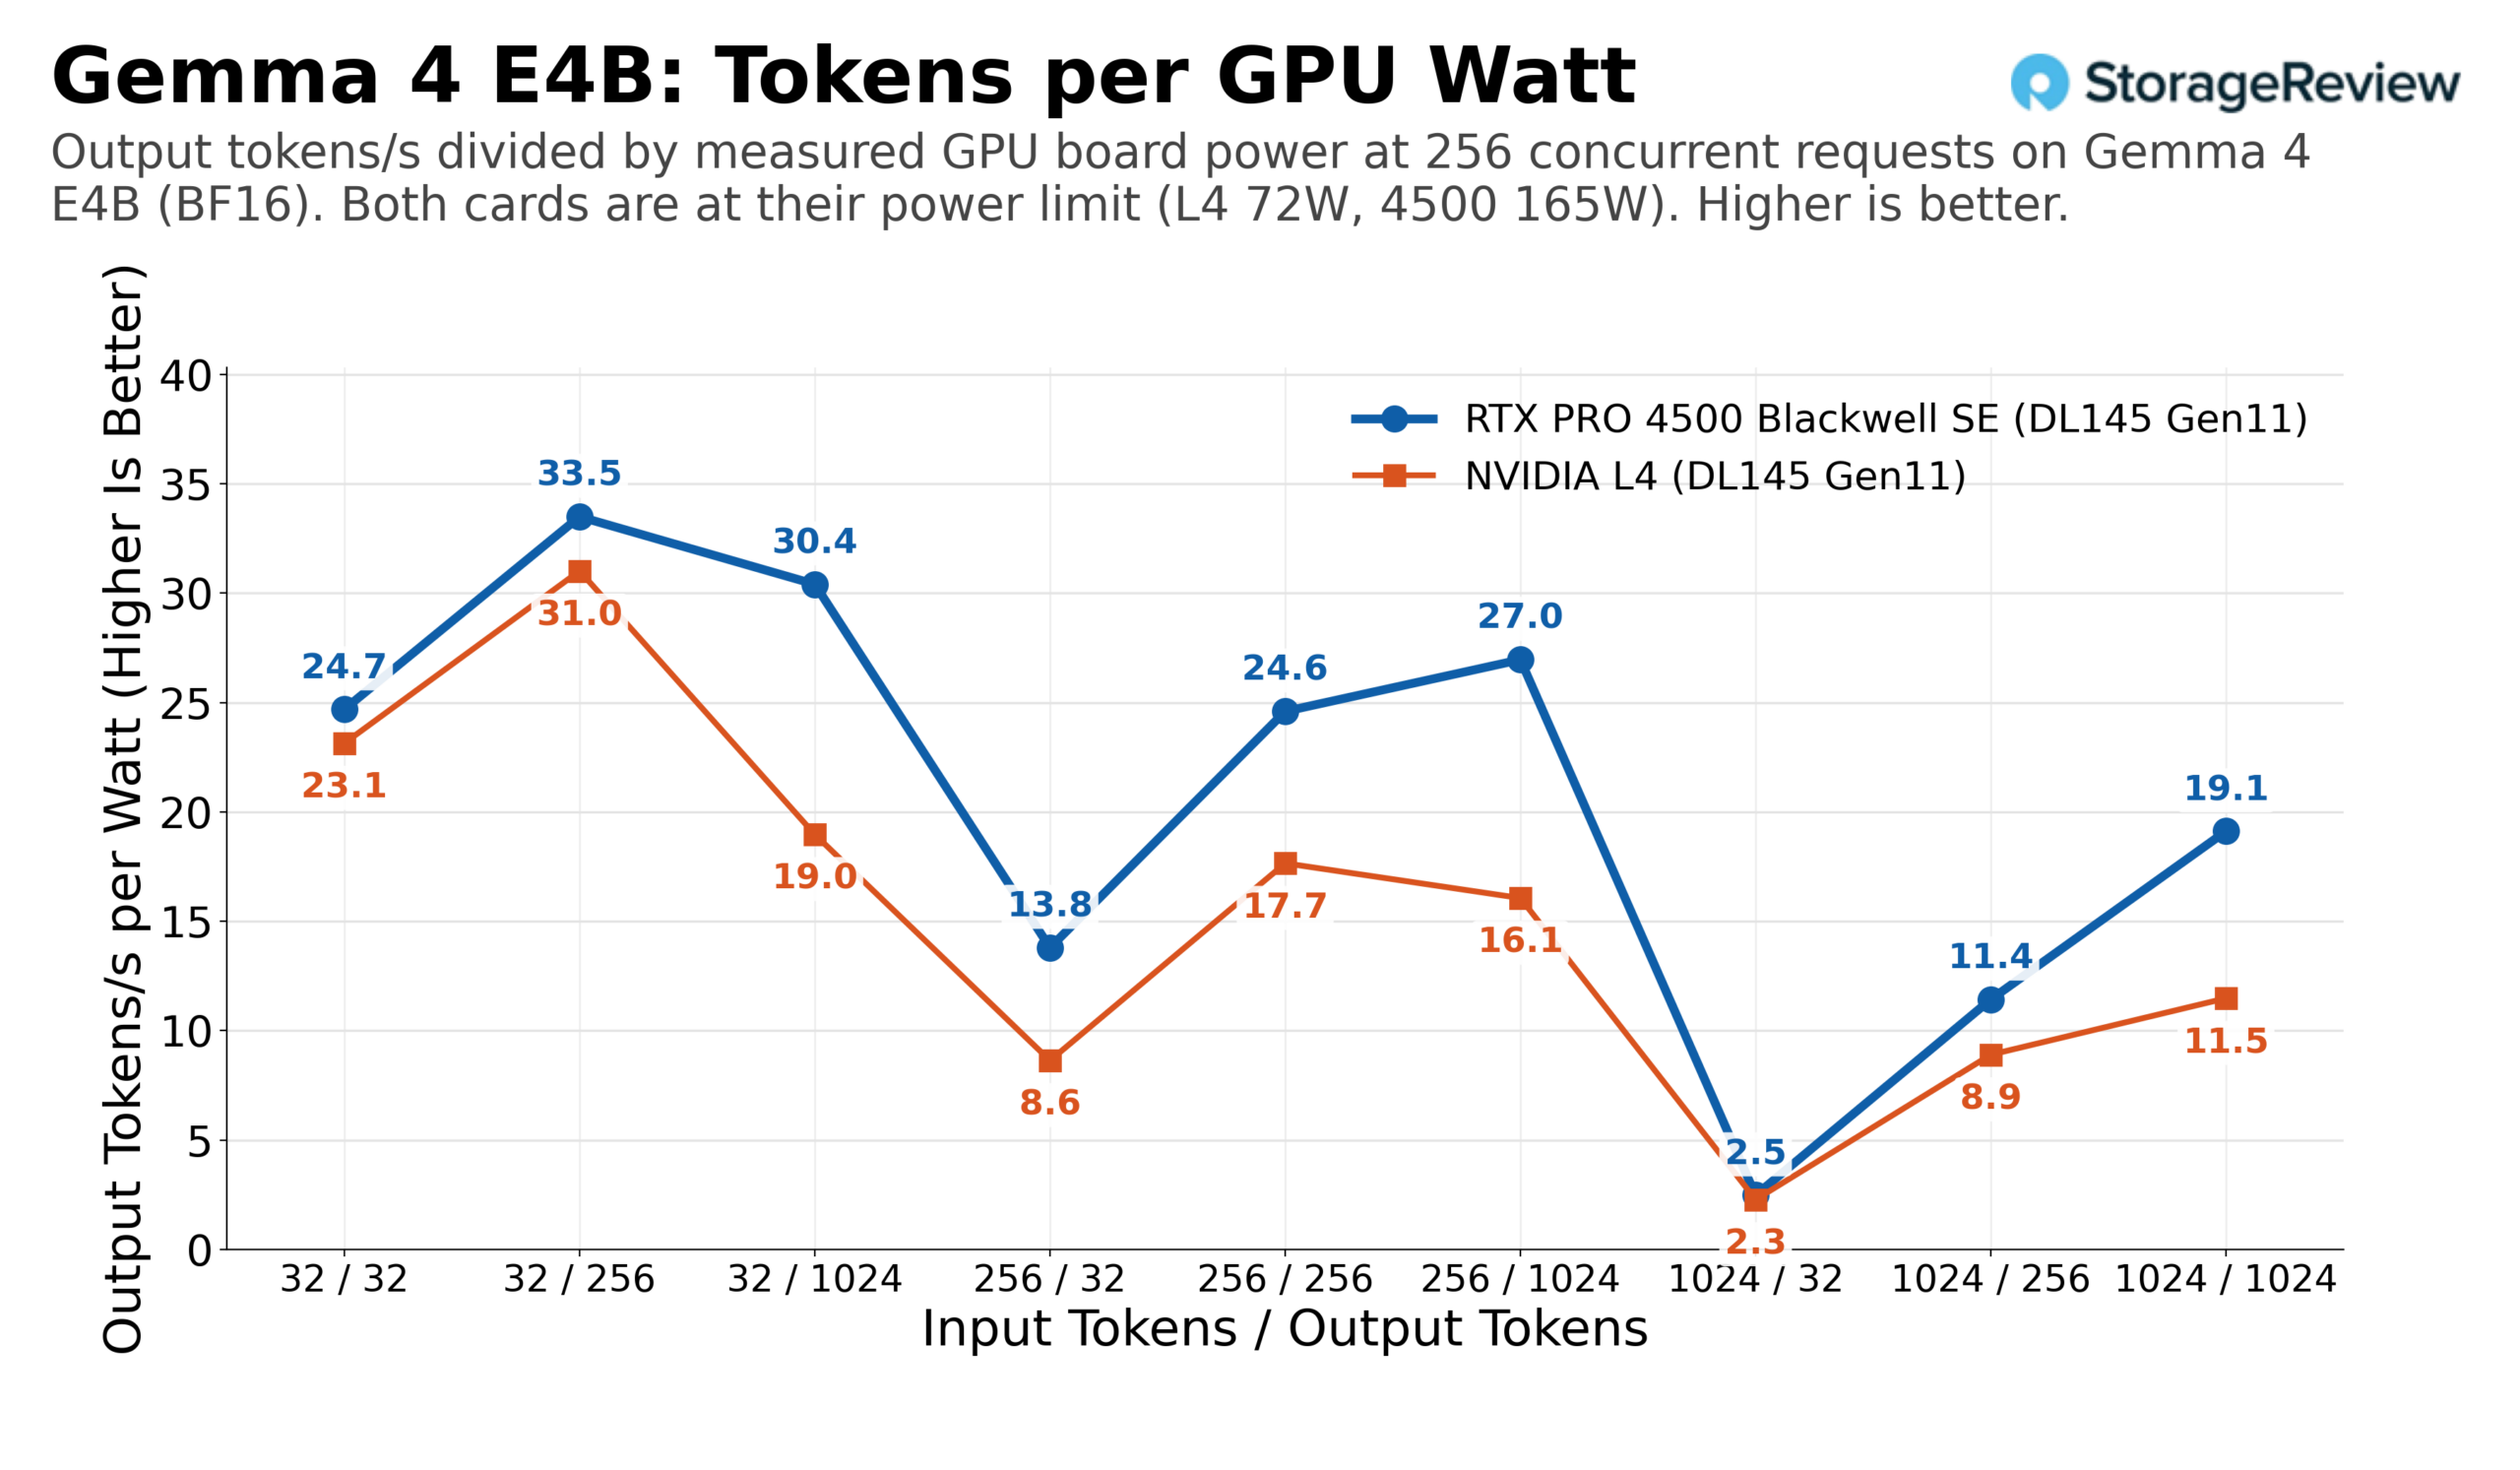
单个用户的单令牌延迟与 Qwen 的延迟相符:在 4500 上,256/256 时每个令牌的延迟为 14.1 毫秒,而 L4 上为 39.1 毫秒;在 1,024/1,024 时,每个令牌的延迟为 14.6 毫秒,而 L4 上为 39.8 毫秒。因此,在 4500 上处理 1,024 个令牌的响应大约需要 15 秒,而在 L4 上则需要 41 秒。
墙上的电源
边缘站点通常电力资源有限,因此我们在每次运行中都通过 DL145 的 iLO 跟踪了整台服务器的功耗。在轻负载下,单用户运行时,GPU 功耗在 43 到 65W 之间,无论安装哪张显卡,服务器功耗都约为 160W。在 256/256 的并发模式下,服务器同时运行 32 个进程时,使用 L4 显卡的功耗中位数为 196W,使用 RTX PRO 4500 显卡的功耗中位数为 301W,这两个中位数在两款 BF16 型号上都保持一致;我们记录到的最大功耗分别为:使用 L4 显卡时为 209W,使用 4500 显卡时为 308W。因此,升级显卡在负载下的功耗约为 105W,这与两张显卡额定功率 93W 的差距接近,再加上一些转换损耗和额外的风扇散热。
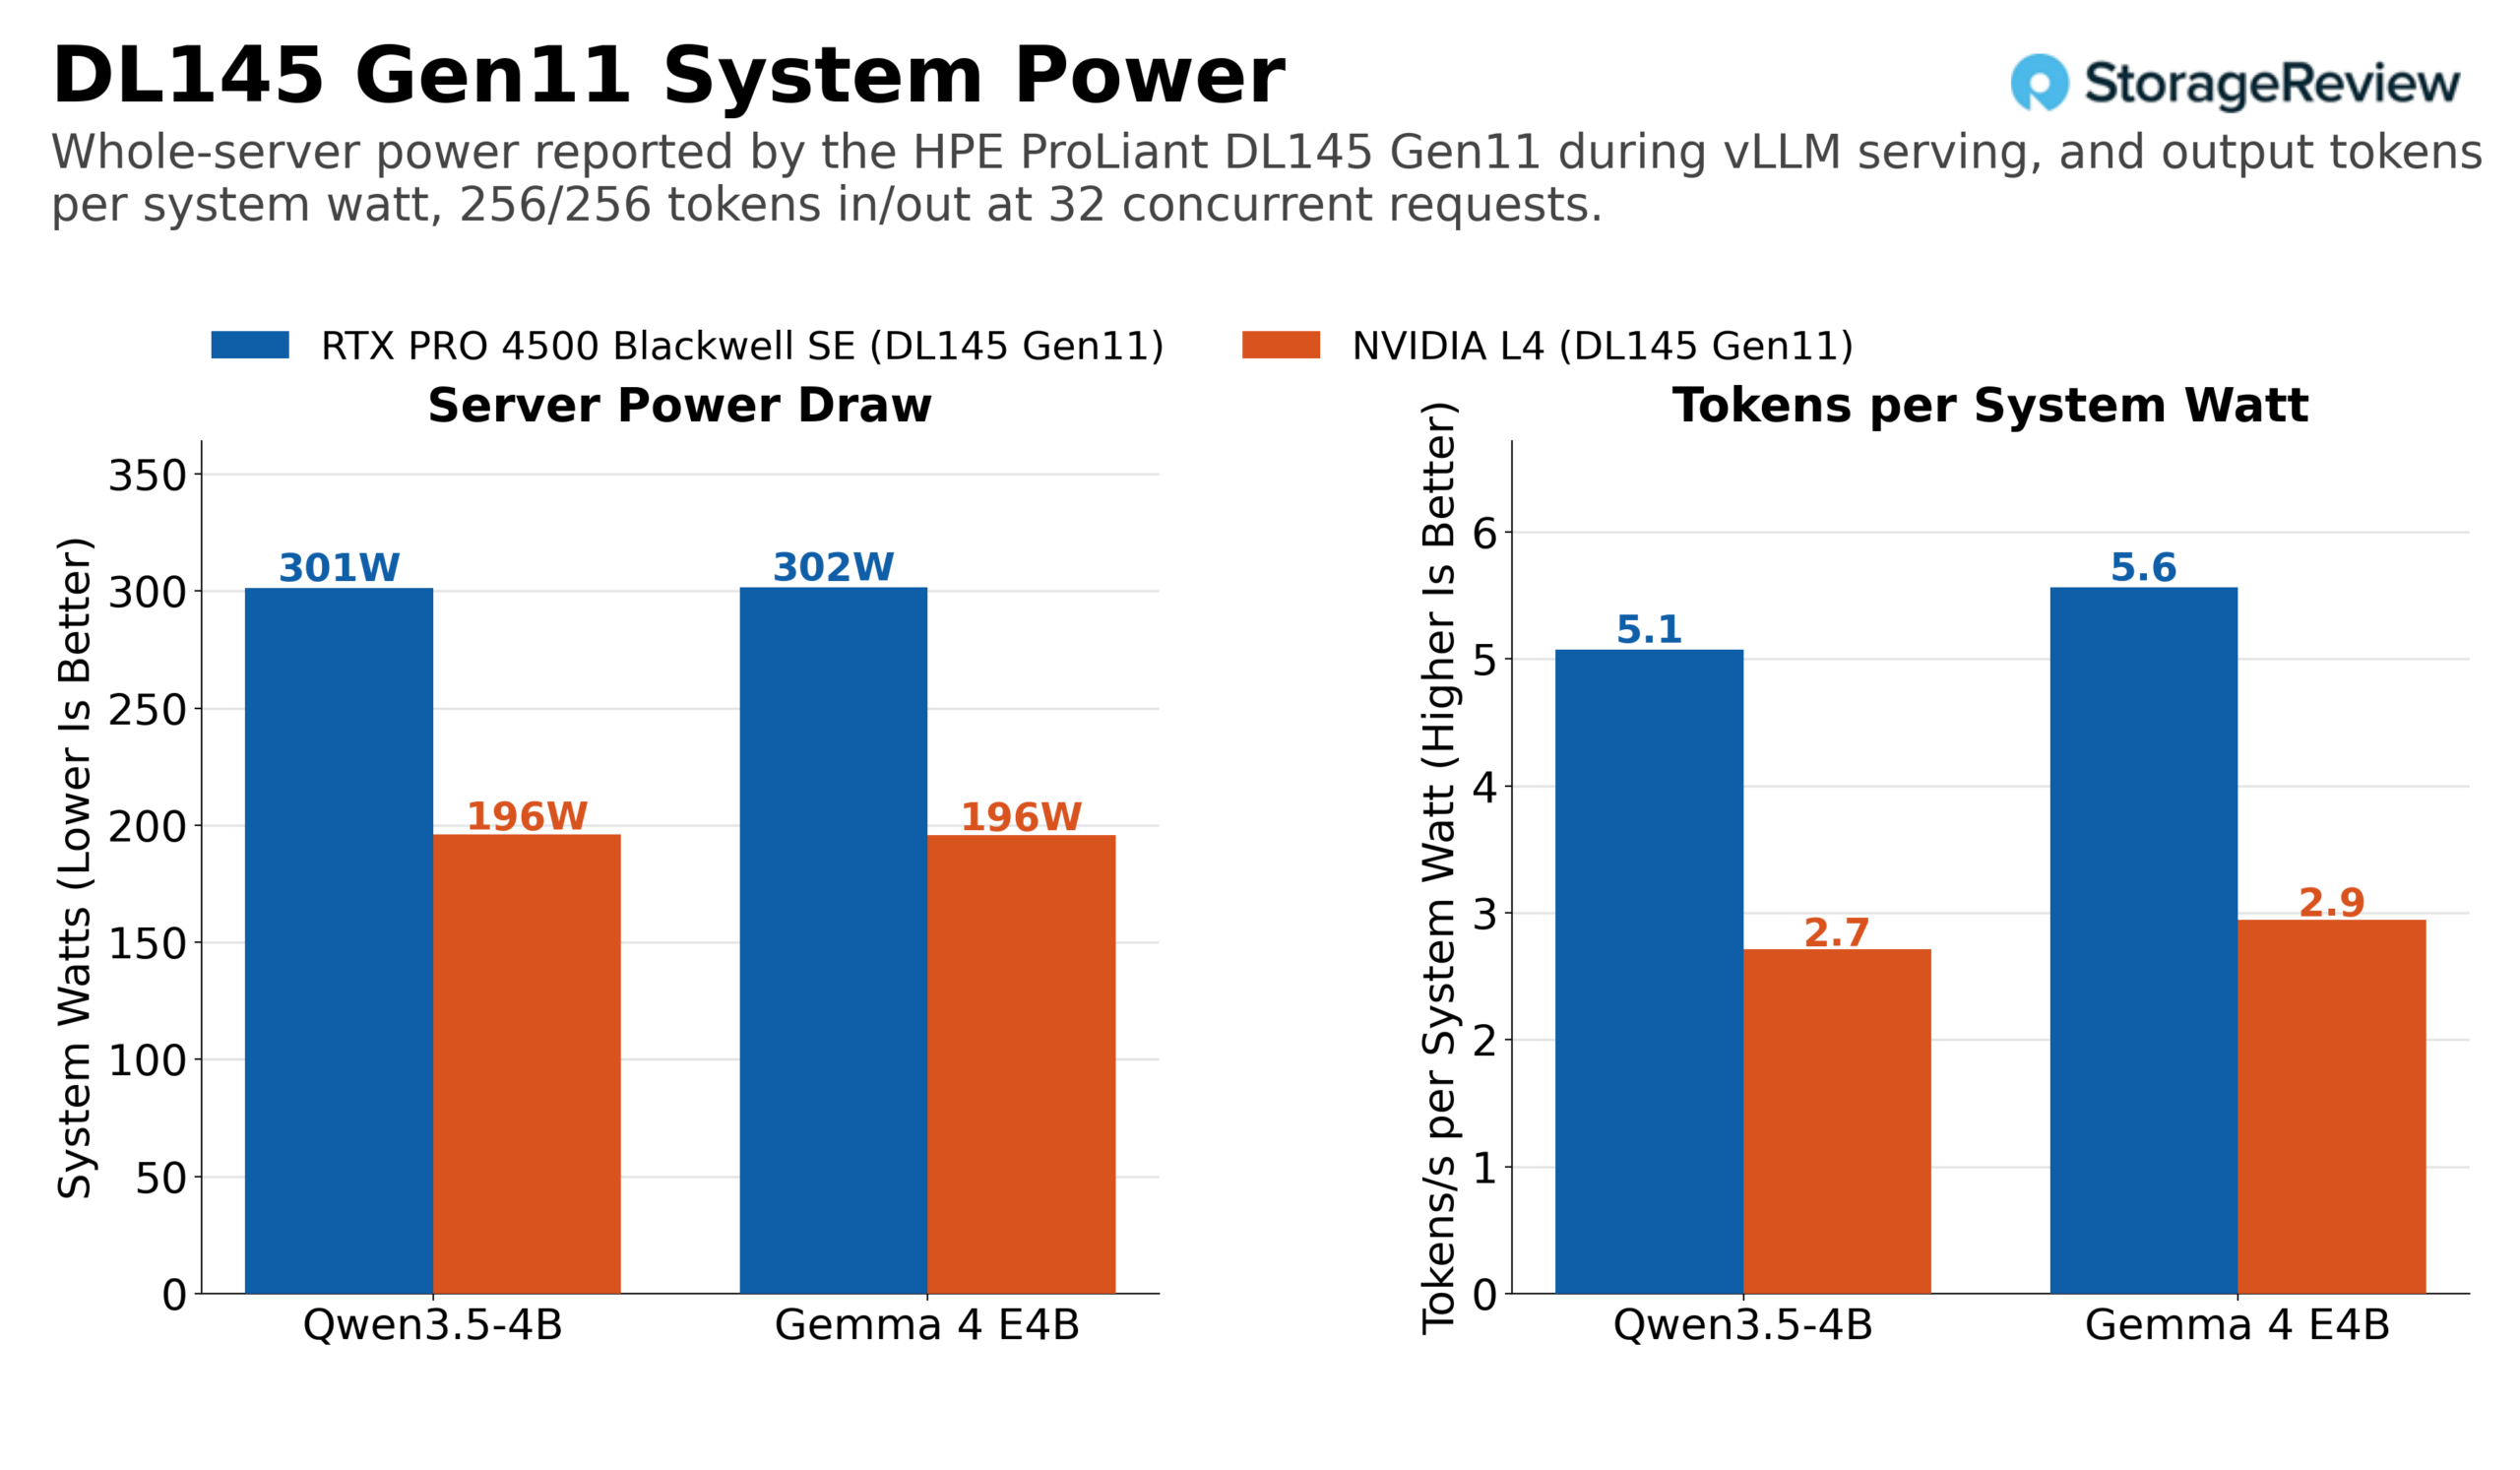
在 256/256 显存位宽下,32 个并发实例的情况下,服务器在 Qwen3.5-4B 平台上使用 L4 显卡时,每瓦系统每秒可产生 2.7 个输出令牌;使用 4500 显卡时,则为 5.1 个;在 Gemma 4 E4B 平台上,分别为 2.9 个和 5.6 个。系统级效率提升大于显卡级效率提升,因为 DL145 的大部分功耗都是固定成本:无论 GPU 每秒产生 532 个令牌还是 1,529 个令牌,CPU、内存、风扇和存储的功耗都大致相同。对于付费用户而言,通过交换机获得的每瓦输出令牌数已经是显卡级的 1.9 倍,而显卡级仅为 1.3 倍。对于按站点功率预算规划的服务器集群而言,这才是需要重点考虑的因素。
32GB 和 NVFP4 有什么用?
以上所有工作L4都能完成,只是速度较慢。4500的另一个优势在于L4无法原生支持的模型类:Gemma 4 26B-A4B(NVFP4格式),这是一个260亿位的混合专家模型,每个标记大约有40亿个活跃参数,使用FP8键值缓存。在BF16下,该模型的权重就超过24GB;而NVFP4格式的权重可以装入4500的32GB内存,并且还有空间容纳一个可用的键值缓存,Blackwell FP4张量核心可以原生运行这种格式。vLLM可以通过仅权重内核将NVFP4权重加载到L4的Ada架构上,4位权重大约14GB,可以装入24GB内存,但L4没有原生FP4计算能力,所以我们没有在L4上运行它。为了进行规模对比,我们在戴尔 Pro Max Tower T2 台式机中,使用 RTX PRO 6000 Blackwell 工作站版(96GB、600W 显卡)运行了相同的作业。这是不同的主机和不同级别的显卡,我们将其包含在内只是为了给 4500 的数据提供一个参考点。
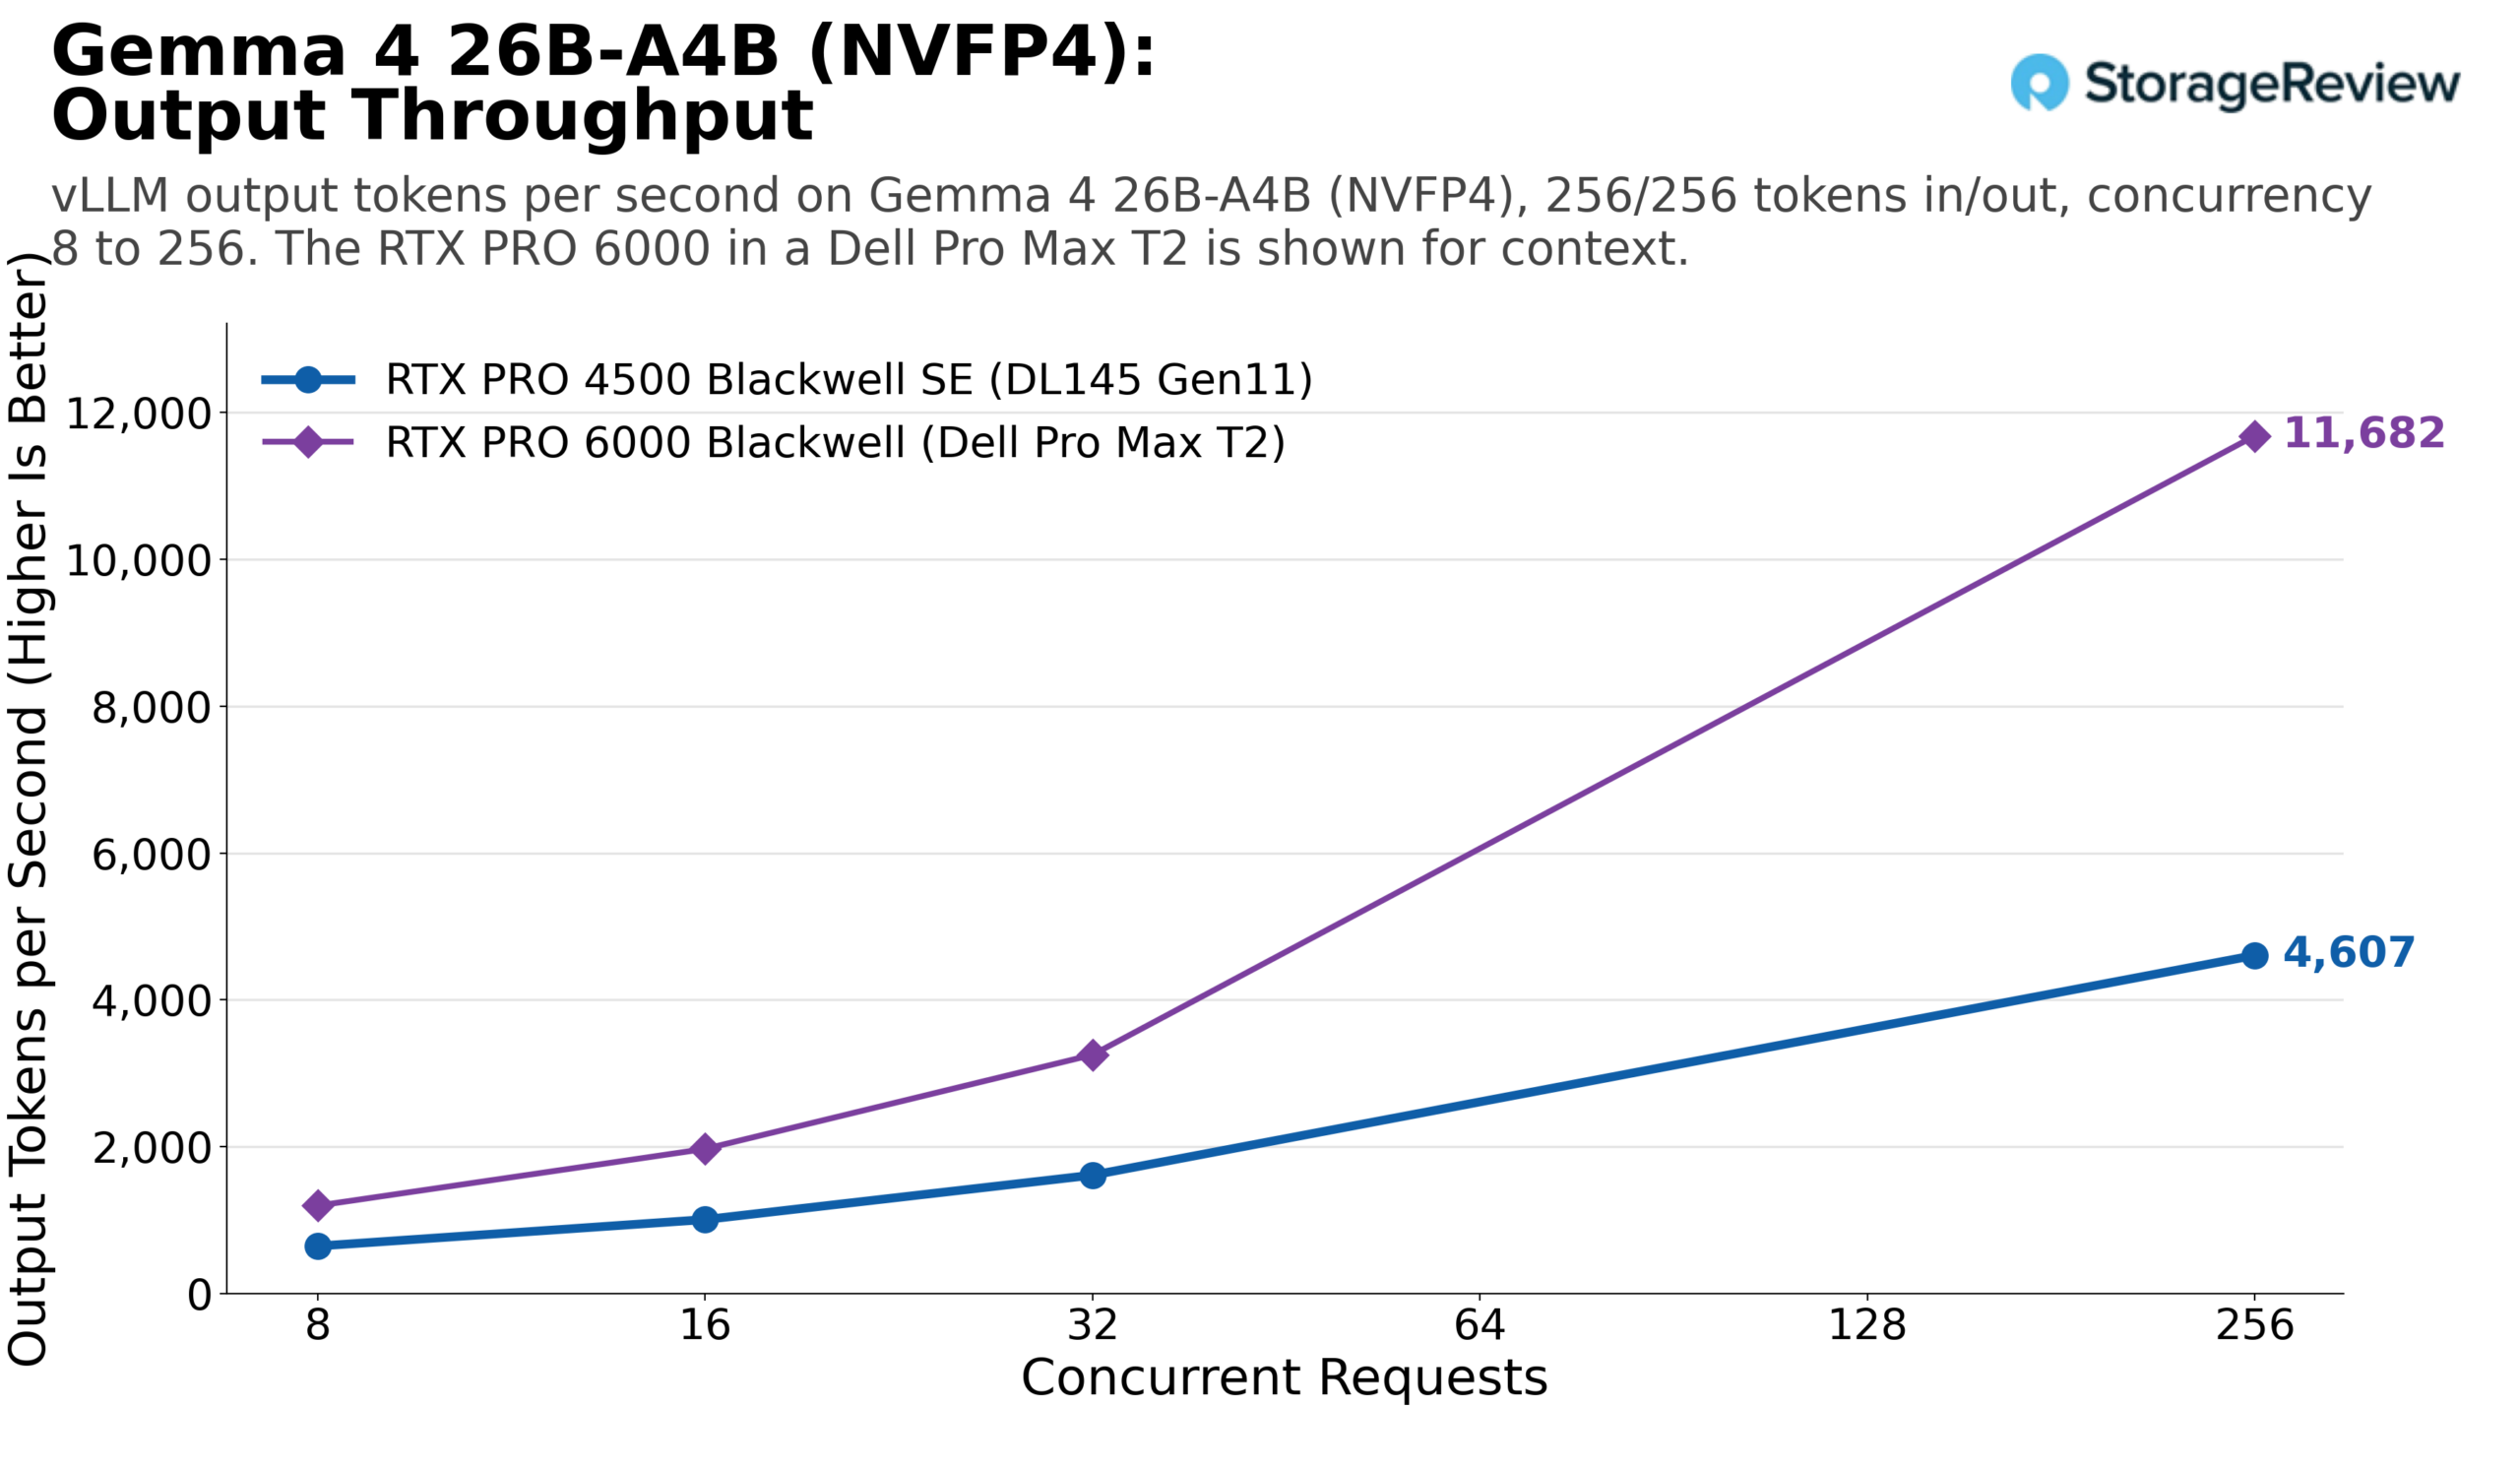
在 256/256 的配置下,RTX 4500 在 8 个并发线程时每秒产生 647 个输出令牌,32 个并发线程时每秒产生 1,613 个输出令牌,256 个并发线程时每秒产生 4,607 个输出令牌;RTX PRO 6000 的相应输出分别为 1,198、3,252 和 11,682 个。在 8 到 32 个并发线程的情况下,除了预填充的 1,024/32 配置外,RTX 4500 在所有配置下的性能都达到了 RTX 6000 的 48% 到 55%。在 1024/32 配置下,RTX 4500 在 32 个并发线程时的性能降至 RTX 6000 的 29%,功耗为 165W,而 RTX 6000 在上述配置下的功耗为 266W 到 471W。在 256 个并发线程的情况下,随着 32GB 内存的填充,RTX 4500 的性能降至 23% 到 42%。
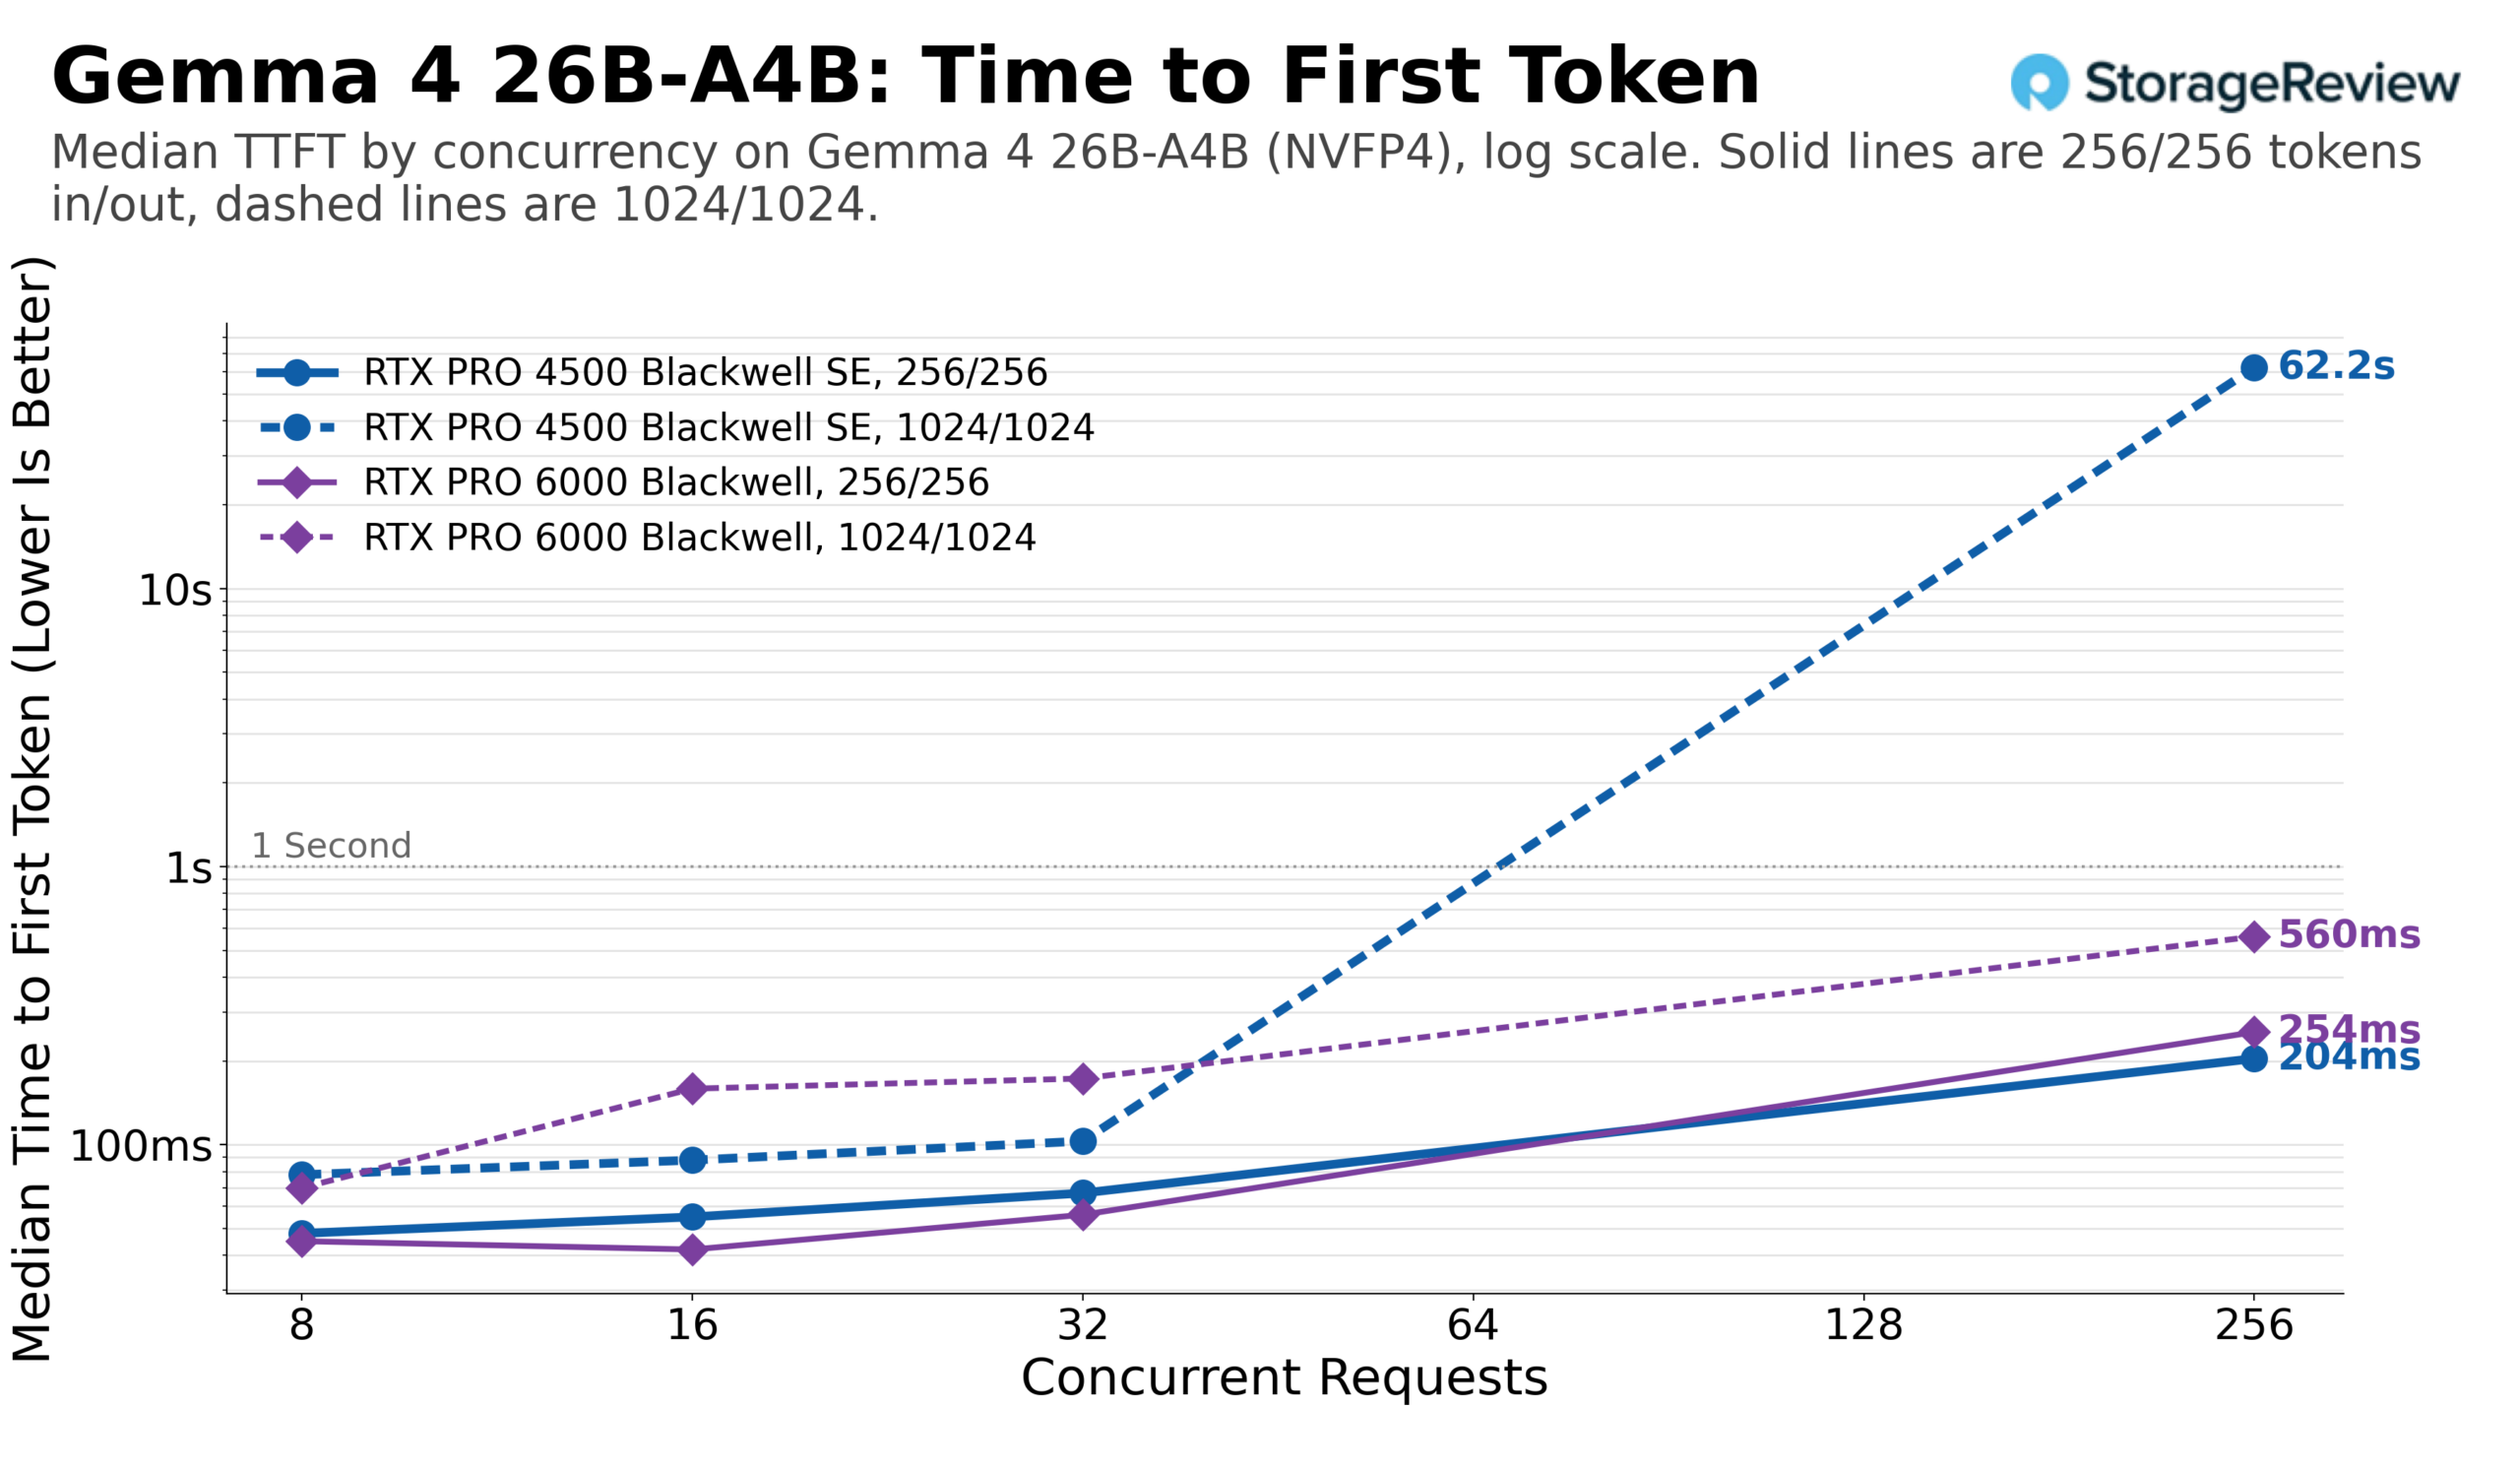
首令牌延迟与 BF16 模型的结果一致:在 32 个并发会话的情况下,4500 在 256/256 内存布局下的中位数为 67 毫秒,在 1,024/1,024 内存布局下的中位数为 103 毫秒,与 6000 的延迟相差仅几十毫秒;在 256 个并发会话的情况下,4500 的延迟保持在 204 毫秒。在 256 个并发会话的情况下,4500 的排队时间为 62 秒,而内存是其三倍的 6000 的排队时间为 560 毫秒。对于 26 亿 MoE 模型,4500 在长上下文中相当于 32 个会话,在聊天长度下相当于 256 个会话,并且它在 L4 所不具备的 FP4 硬件上运行该模型。
DL145显卡在为4500系列服务器的26B型号供电时,最大功耗为306W,而4B型号的峰值功耗为308W,因为该显卡本身的功耗均为165W。如果选择功率为300W的26B级显卡(安装在边缘机箱内),则可以实现性能升级,而且功耗并不比小型显卡更高。
结语
NVIDIA 官方宣称 RTX PRO 4500 Blackwell 服务器版的性能是 L4 的 5 倍以上,这一数据基于 FP4 和 NIM 协议。在同一台 DL145 Gen11 服务器上,我们进行了 BF16 的同等配置对比测试。在两个小型模型上,RTX PRO 4500 在正常工作并发状态下的输出吞吐量是 L4 的 2.7 倍,在饱和状态下更是达到了 L4 的 3.0 倍到 3.2 倍。对于单个用户,RTX PRO 4500 的令牌生成速度是 L4 的 2.8 倍,并且在 L4 需要排队数十秒的情况下,RTX PRO 4500 的首令牌延迟也保持在 1 秒以内。在大多数配置下,L4 能够保证每个用户每秒输出 10 个令牌,并支持 32 到 256 个会话;而在预填充数据较多的 1,024/32 配置下,会话数仅为 8 个;而 RTX PRO 4500 在聊天长度的提示信息下,能够支持 256 个会话。 4500 也为 NVFP4 中的 Gemma 4 26B-A4B 提供服务,而 L4 无法原生运行该型号。
该芯片在墙插上的功耗为 105W,整个服务器满载运行时的功耗约为 196W 至 301W,显卡功耗是主板功耗的 2.3 倍。以 GPU 为基准,4500 的单输出令牌效率是 L4 的 1.3 至 1.4 倍;以墙插功耗为基准(系统其余功耗均由墙插消耗),效率约为 L4 的 1.9 倍。对于按服务器功耗预算进行配置的网站来说,4500 能更好地利用现有功耗;而对于按插槽配置的网站来说,一台 4500 的吞吐量相当于三台 L4(每台服务器支持 32 个会话),并且每用户的缓存生成速度快 2.8 倍,只需一个 32GB 的缓存池即可满足需求。
评测开头提到的范围限制依然有效,因为本次评测仅针对三款小型边缘服务器中的一款显卡与其前代产品进行对比,而RTX PRO 4500 Server Edition在L40S、RTX PRO 6000 Server Edition以及其他现有推理产品线中的定位,则是另一个值得探讨的问题,我们将在后续文章中进行更深入的分析。对于拥有L4服务器的DL145用户而言,答案是:只要机箱配备全长转接卡和16针电源接口,4500显卡就是该平台的理想升级之选。此外,HPE将这款显卡与这款服务器搭配用于Nemotron边缘计算,也与硬件的实际性能完美契合。
DL145 Gen11 本身出现在我们边缘部分。 最佳服务器 排行榜上,这一结果现在成为了边缘推理故事的基石。
排行榜: RTX PRO 4500 Blackwell 服务器版是我们评测过的最佳单槽 GPU。 最佳企业级GPU leaderboard, and the L4 holds Best Slot-Powered Card for 1U and Edge.


 Amazon