
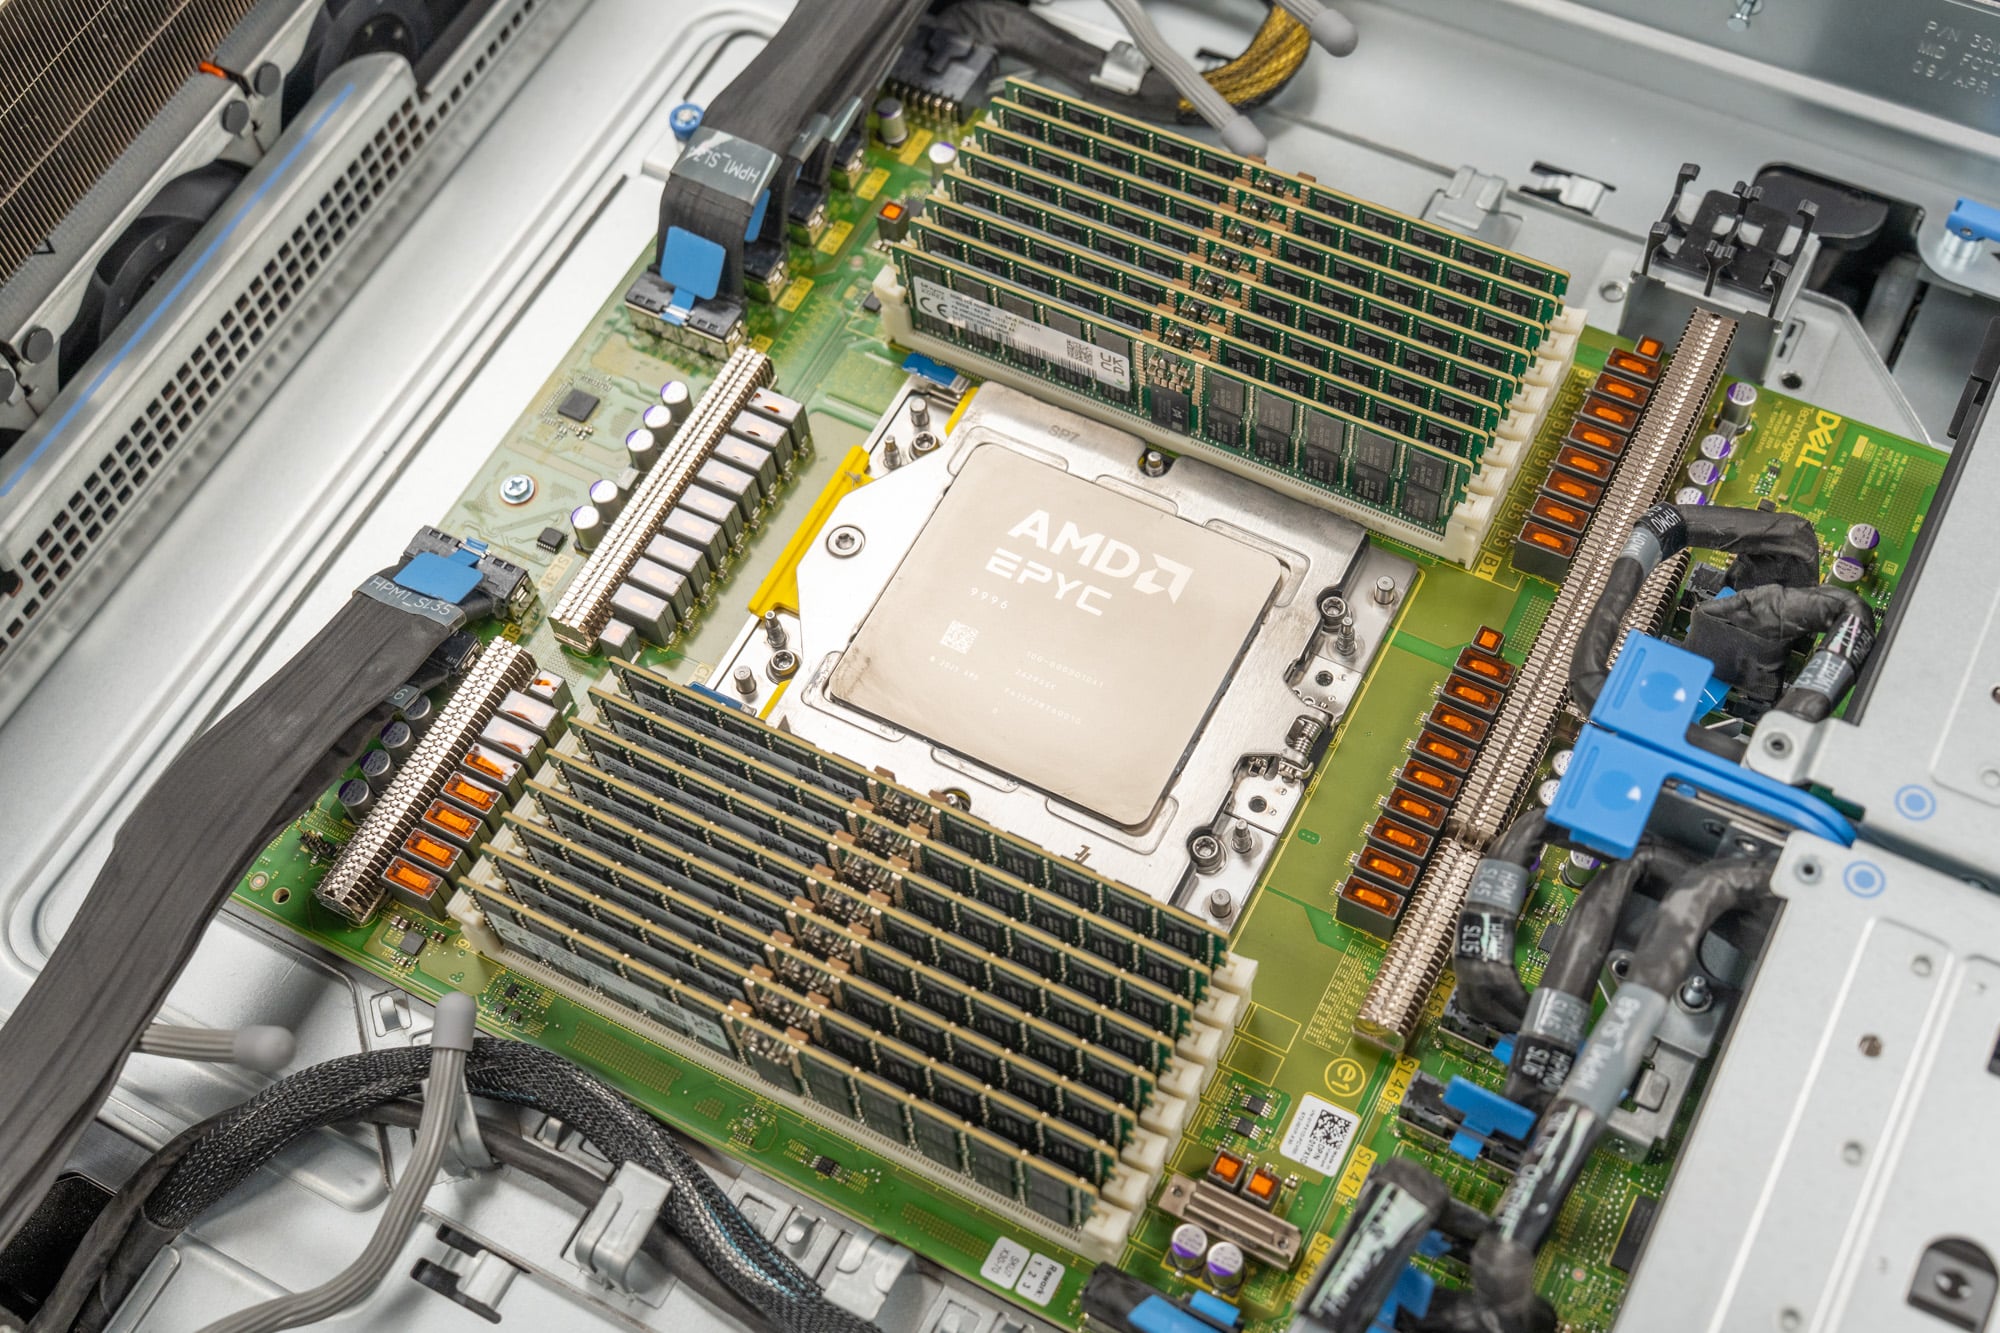
AMD第六代EPYC服务器CPU系列,代号Venice,采用Zen 6和Zen 6c核心,旨在覆盖服务器市场的各个领域。AMD通过更大的内存子系统,提高了核心数量和时钟频率,并为这些核心提供了更大的带宽。

本文的服务器评测侧重于机箱在负载下的实际性能,而非其配置表所列的参数。系统运行的是实际应用工作负载,而非单纯的模拟循环,例如基于 MariaDB 的 HammerDB TPC-C、Windows Server 共享存储、Proxmox 备份服务器,以及在 GPU 平台上运行的推理服务。近期评测涵盖了戴尔 PowerEdge 系列产品,从面向中小企业和中端市场的 1U R4715 和 2U R5715,到针对延迟优化的 R770AP 和 2U 存储带宽超过 300 GB/s 的 R7725xd,以及 Supermicro 的双 EPYC 9005 Turin 系统和联想 ThinkSystem SR650 V4,直至我们用于 AI 推理测试的 4U 及以上 GPU 系统。液冷和浸没式散热设计均采用相同的测试方法,功耗和散热性能均在实验室中实测,而非仅引用规格表数据。
如果您正在缩小候选名单,最佳服务器页面会根据这些评论的数据按角色对当前选择进行排名,而最佳存储阵列页面则会涵盖网络另一侧的系统。
AMD第六代EPYC服务器CPU系列,代号Venice,采用Zen 6和Zen 6c核心,旨在覆盖服务器市场的各个领域。AMD通过更大的内存子系统,提高了核心数量和时钟频率,并为这些核心提供了更大的带宽。
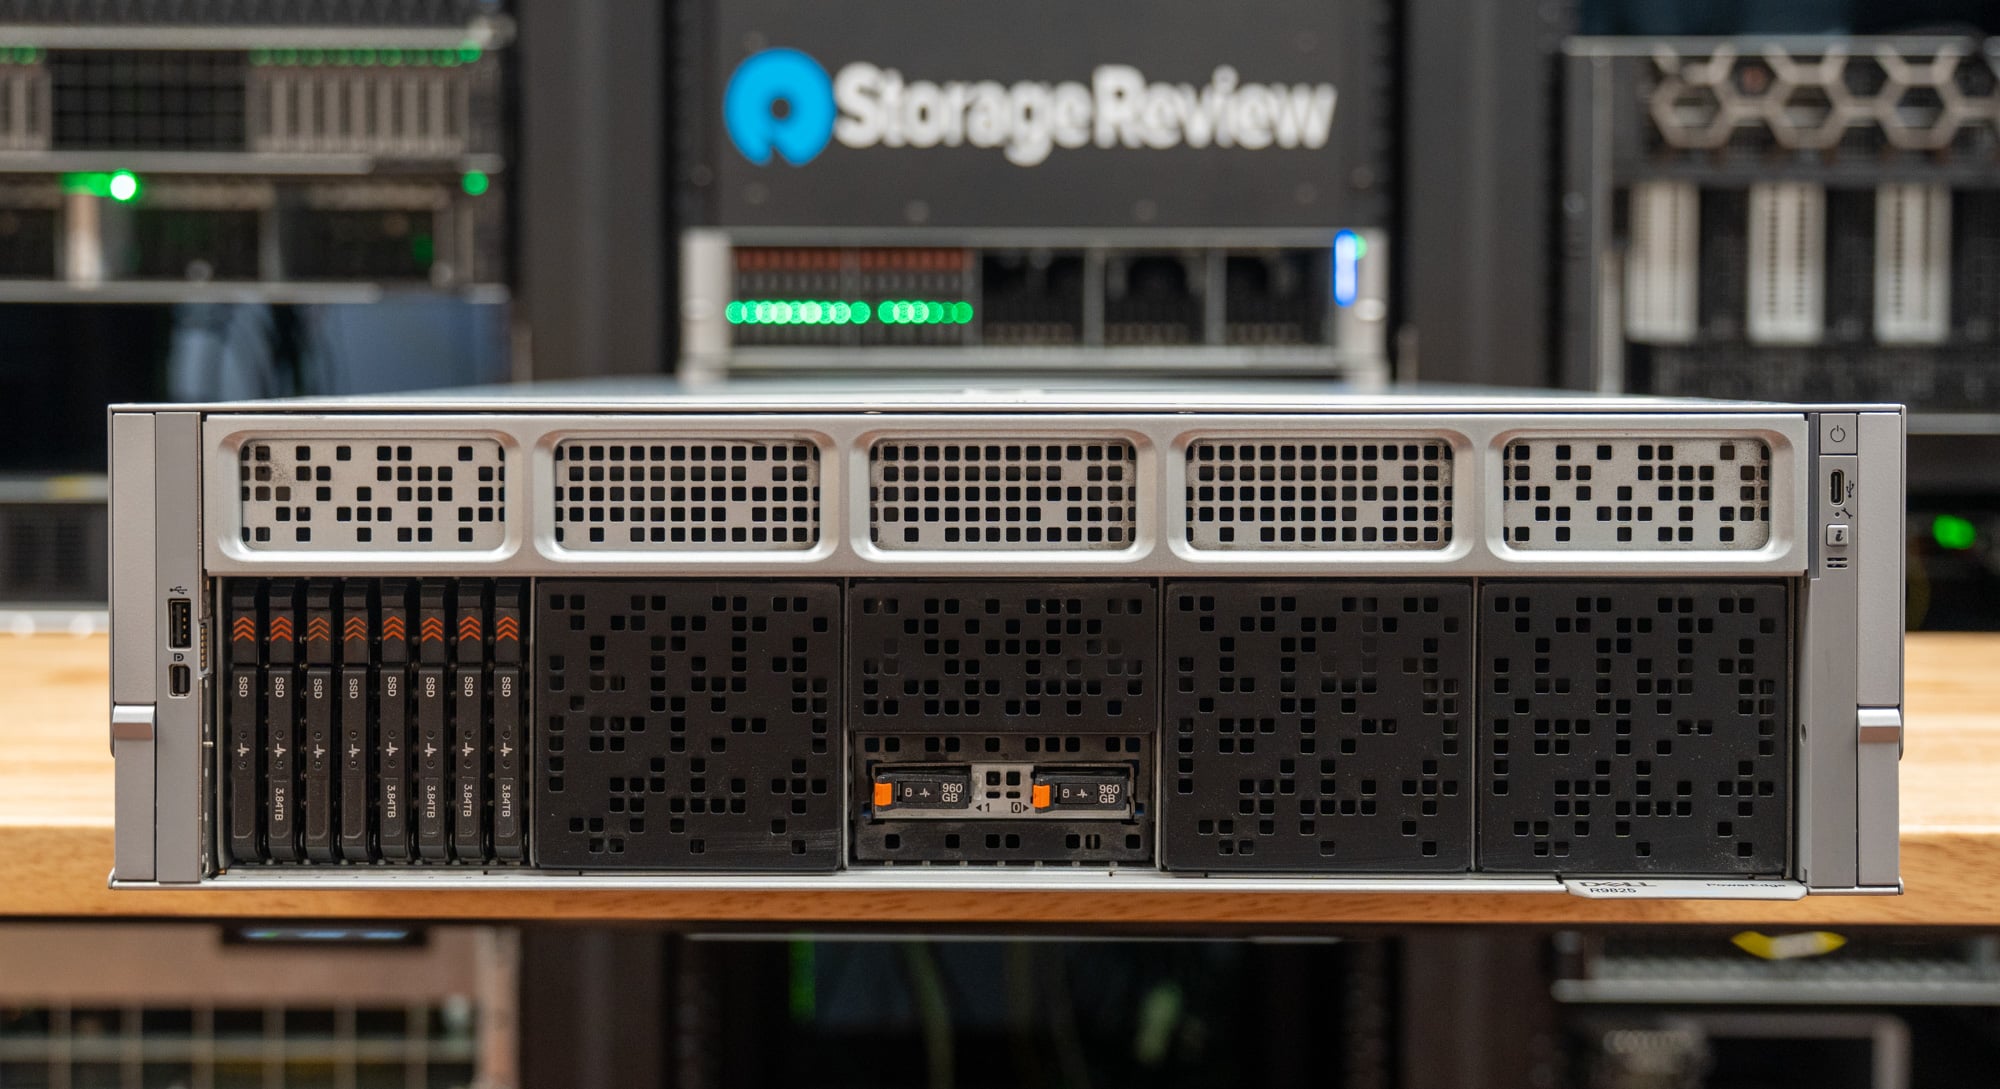
戴尔 PowerEdge R9825 是首款抵达我们实验室的基于 AMD 第六代 EPYC 处理器的服务器,也是戴尔第十八代 PowerEdge 系列的双路旗舰产品。它配备两颗 EPYC 9996 处理器,拥有 512 个 Zen 6c 核心和 1,024 个线程,32 个 DDR5 内存插槽最高可支持 8TB 内存,并且前面板……
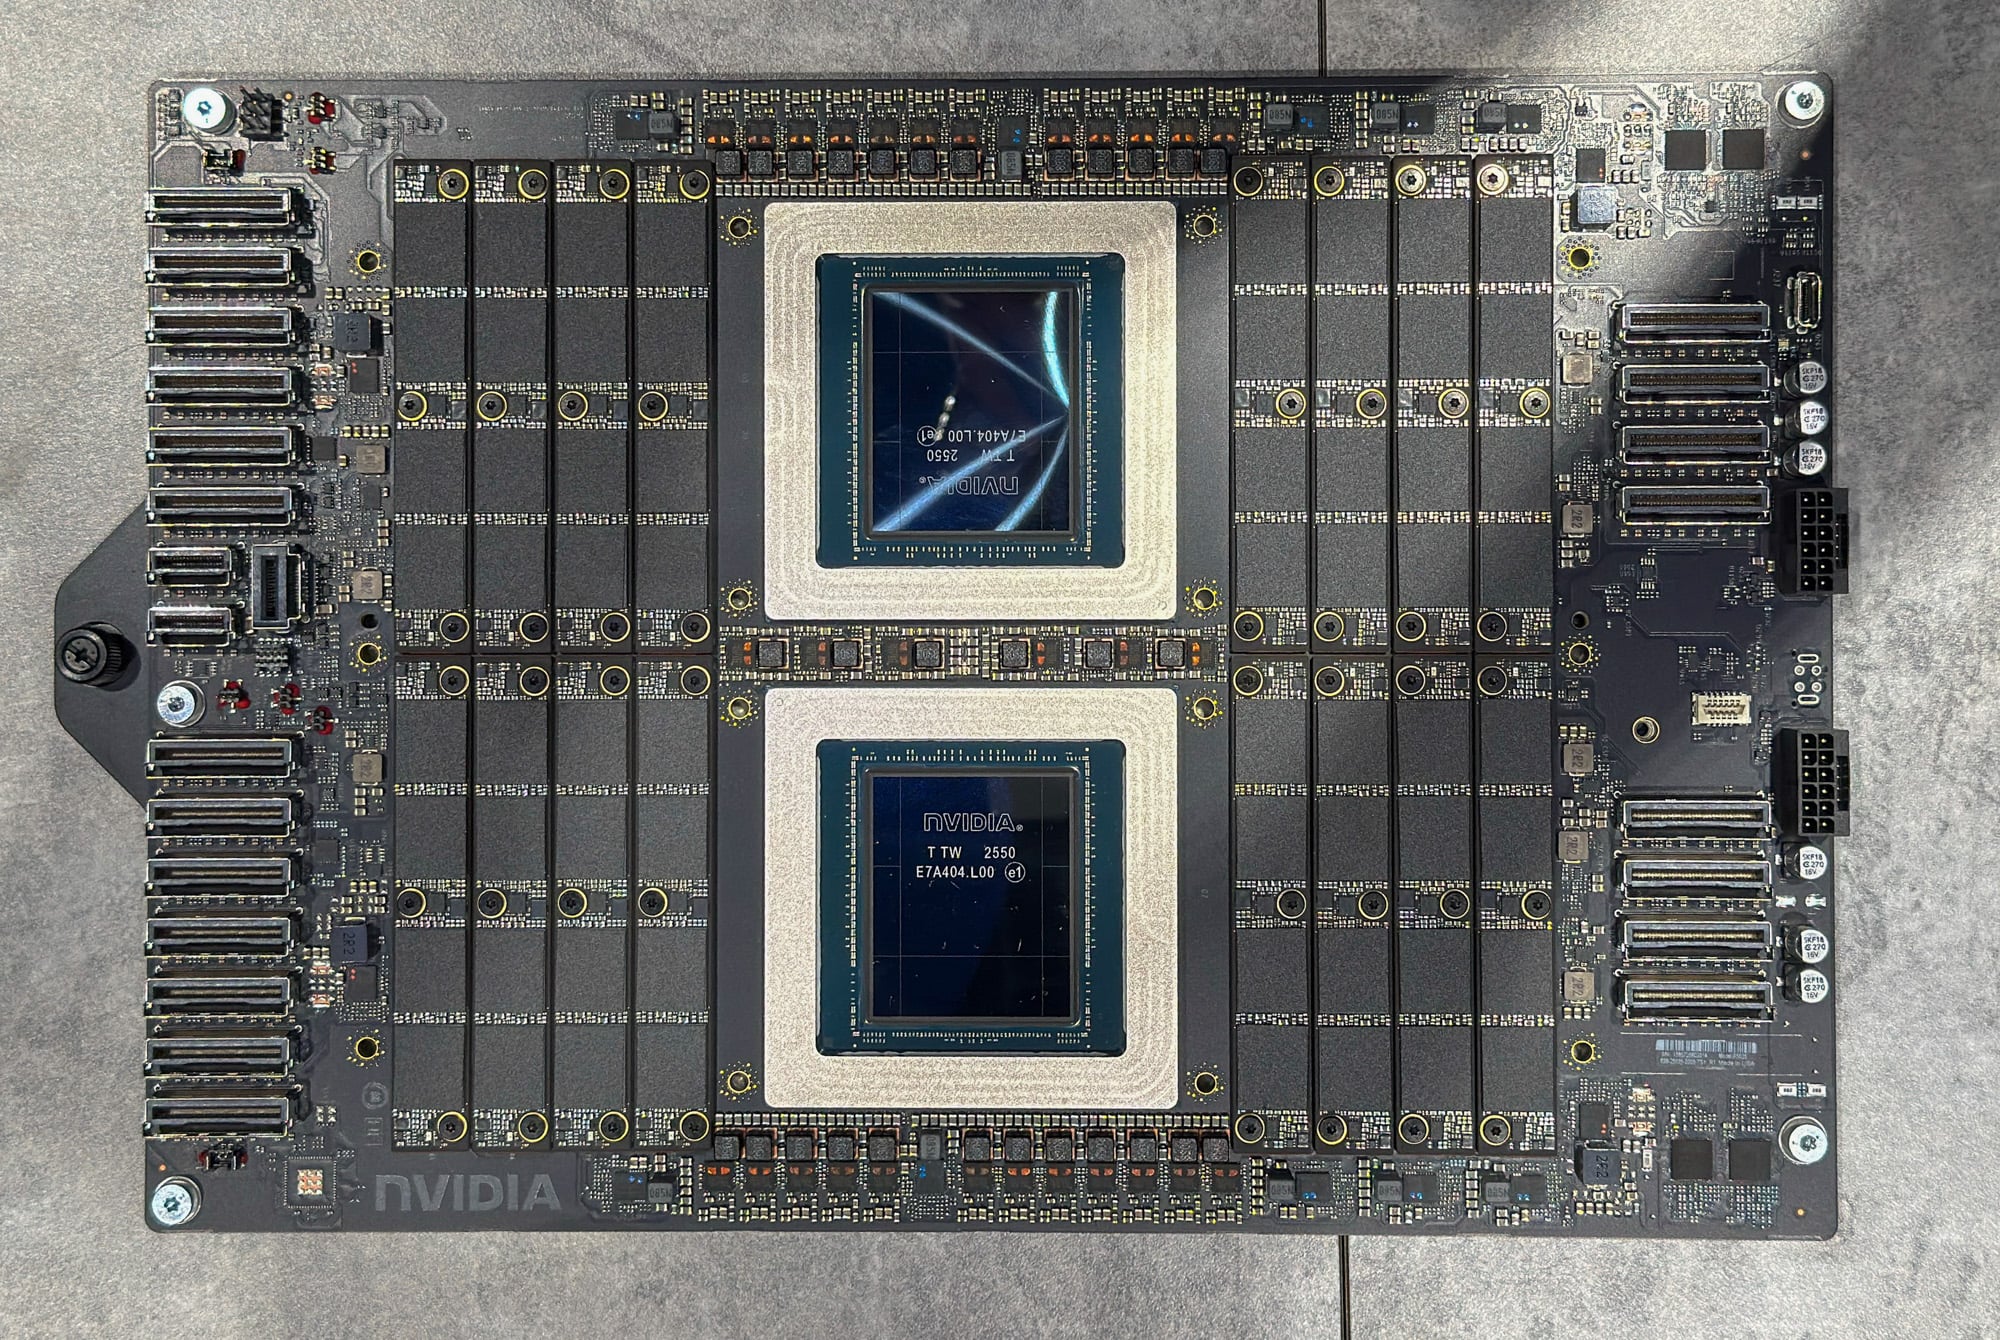
在数据中心的大部分发展历程中,NVIDIA 将 CPU 仅仅视为 GPU 的驱动芯片。其首款服务器处理器 Grace 也遵循了这一模式。它采用了 Arm 现成的 Neoverse V2 内核,主要作为 Grace Hopper 和 Grace Blackwell 超级芯片的 CPU 部分进行销售。这些超级芯片
基米·安东内利从杆位出发,凭借一停策略赢得了美国大奖赛冠军,领先查尔斯·勒克莱尔13.078秒,马克斯·维斯塔潘位列第三;维斯塔潘试图通过两停策略抢跑,但最终未能成功。此前,法拉利一直占据着计时榜的榜首位置,勒克莱尔在周五的第二次练习赛中速度最快,刘易斯·汉密尔顿则在周六的最后一次练习赛中速度最快,因此梅赛德斯车队最终赢得了比赛。
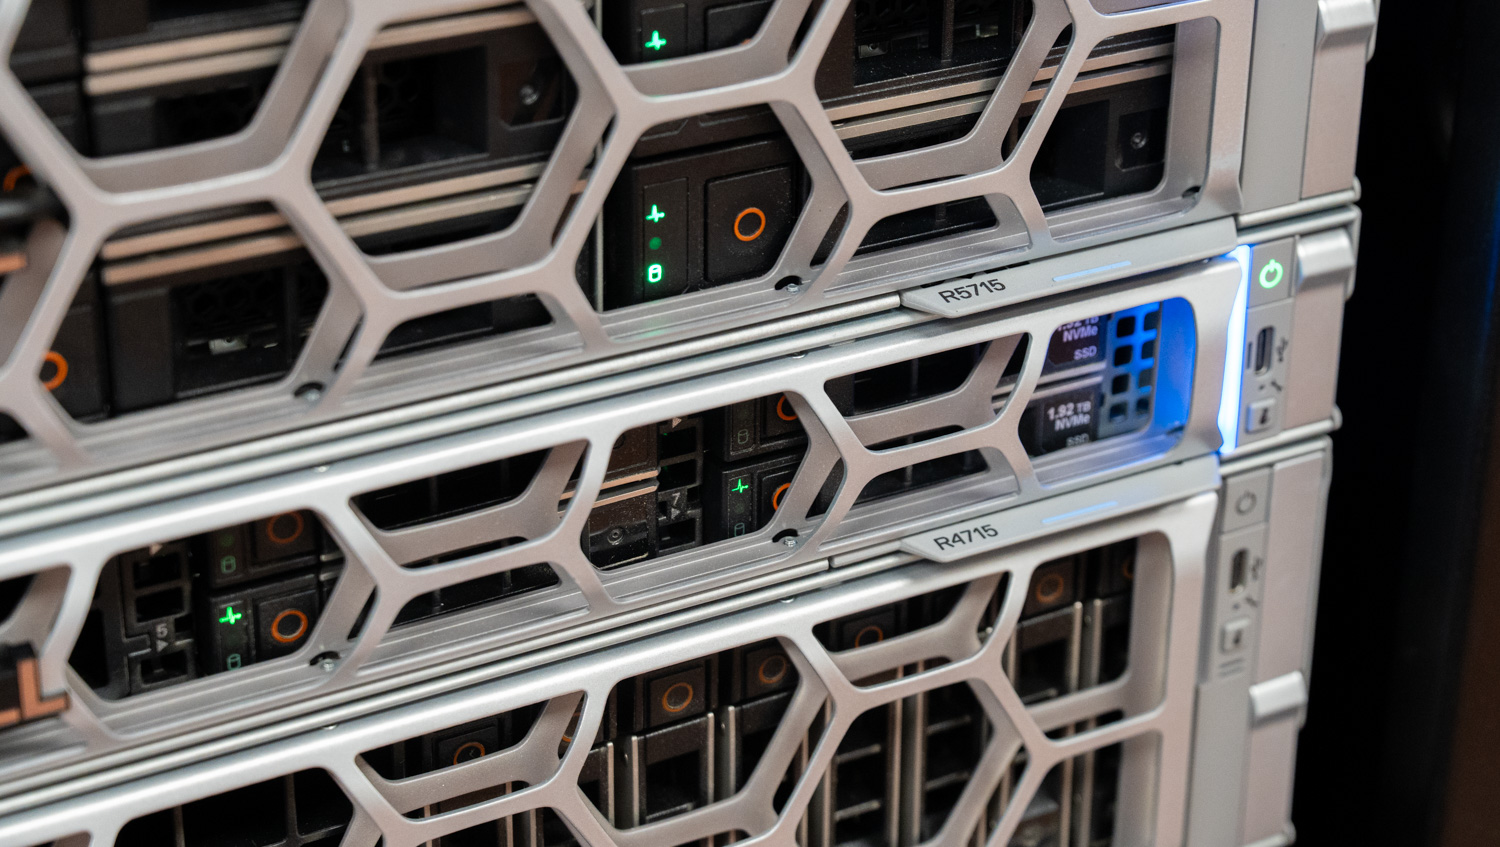
尽管戴尔 PowerEdge R4715 和 R5715 是两款独立的产品,但它们应该被视为一个可配置的矩阵。该矩阵包含两种机箱、四种 AMD EPYC 9005 系列 CPU 选项、多种存储配置以及完整的戴尔管理和支持生态系统。这种组合专为需要匹配的中小型企业而设计。
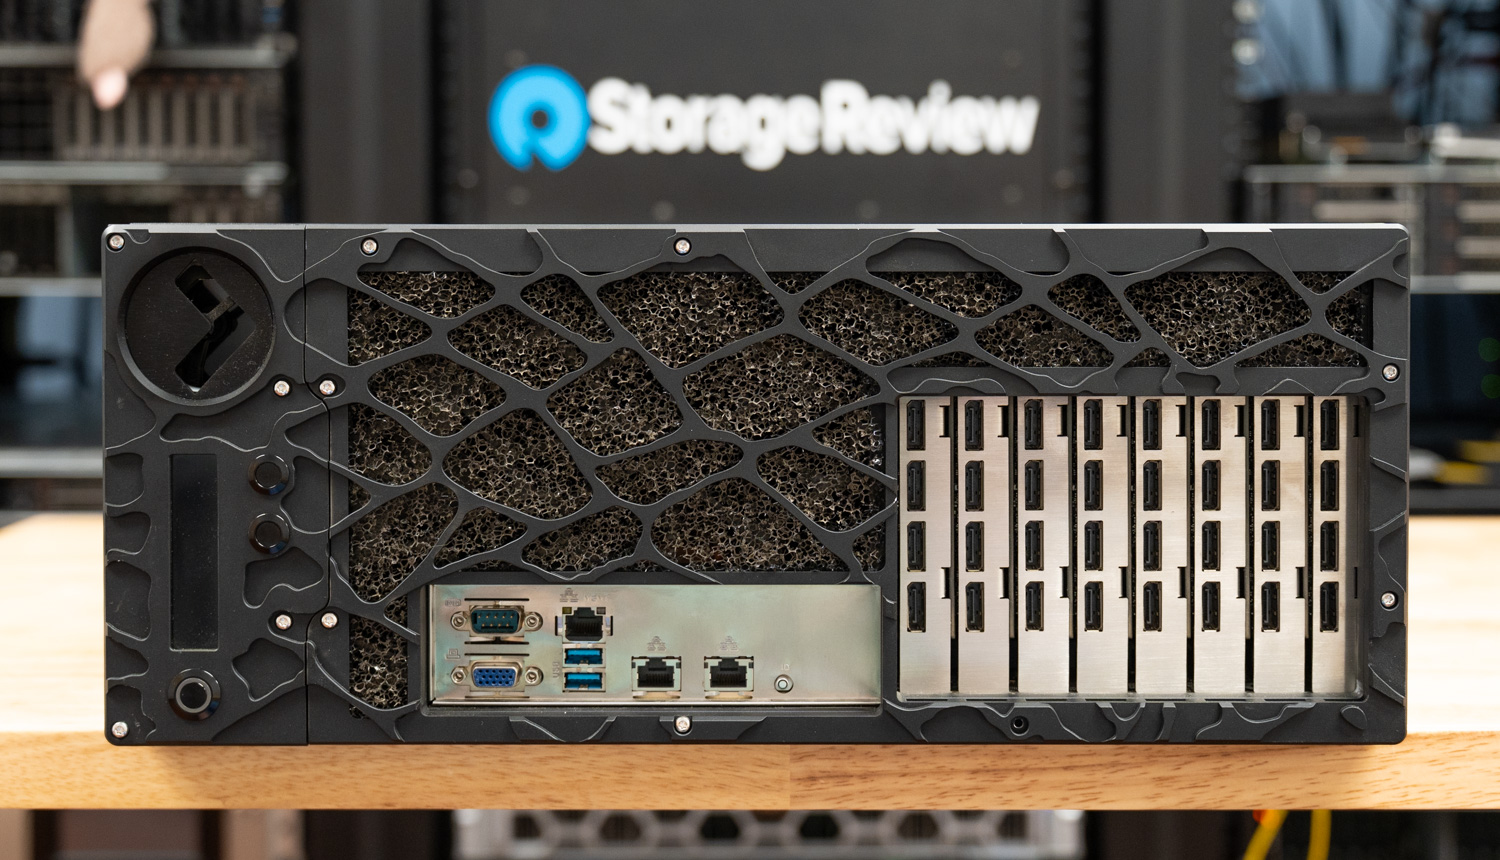
Comino 最近寄给我们最新款的 Comino Grando 进行评测,该机配置了八张 NVIDIA RTX PRO 6000 Blackwell 显卡,每张显卡配备 96GB 显存,总显存容量为 768GB。我们曾在 2024 年评测过 Comino,当时配置了六张 RTX 4090 显卡,总显存容量为 144GB。
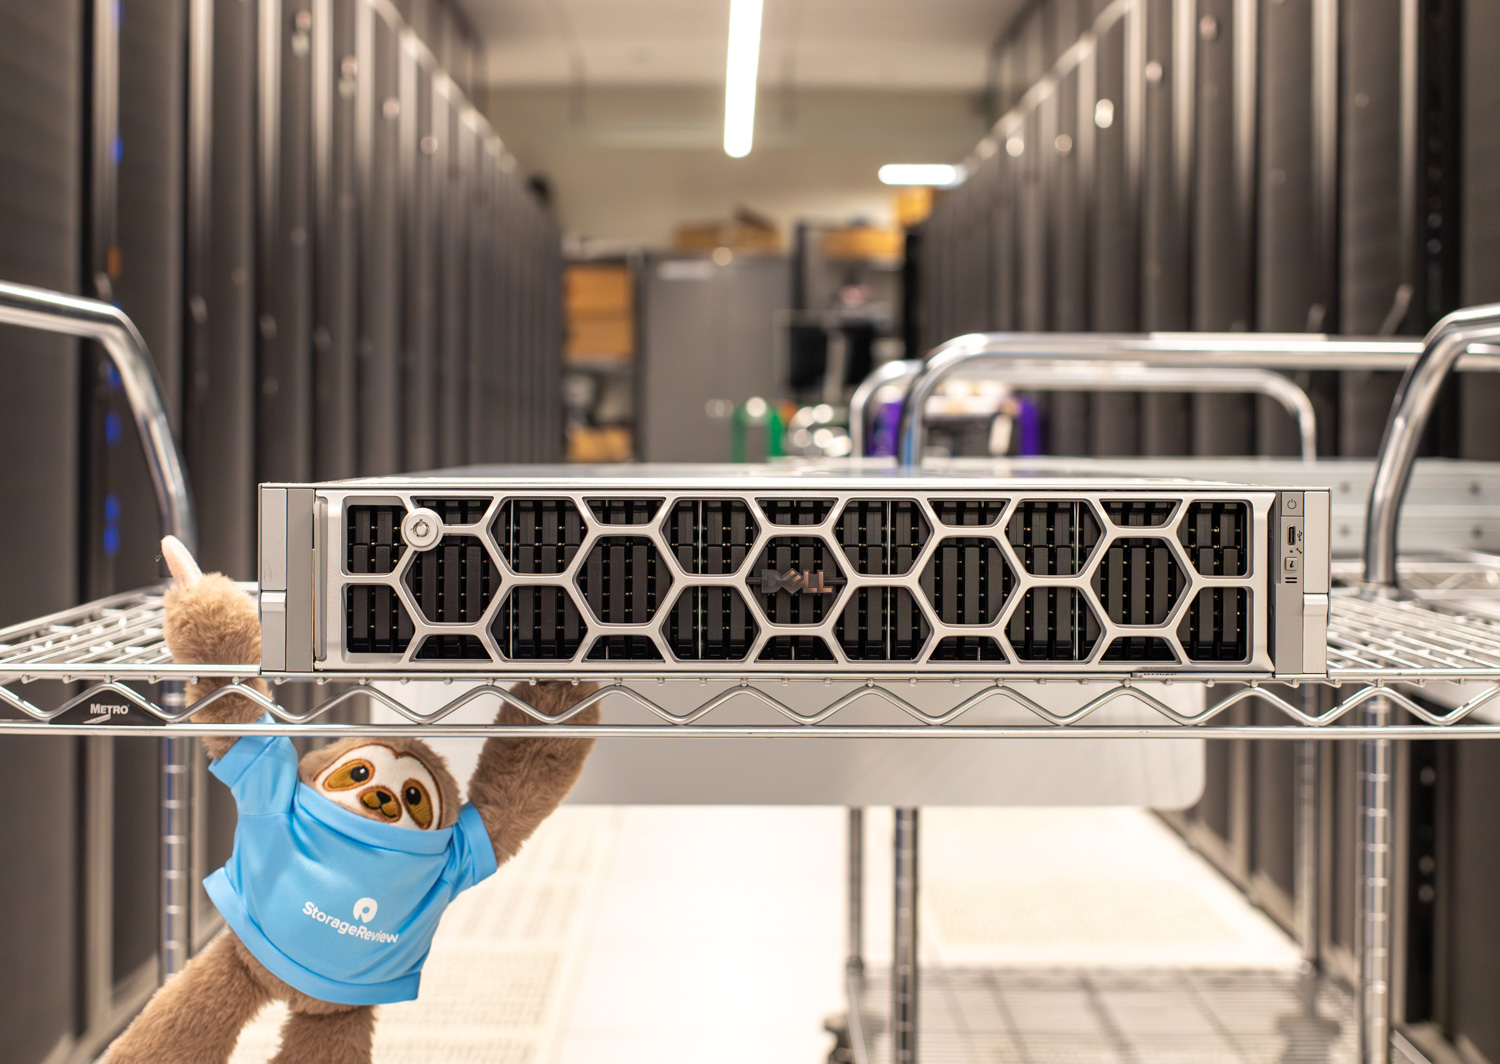
戴尔 PowerEdge R770AP 并非通用服务器,而这正是它的关键所在。大多数 2U 双路平台追求灵活性,而 R770AP 则反其道而行之,牺牲了 GPU 支持、混合存储选项和原始内存容量,换取了戴尔当前英特尔产品线中最高的核心密度、内存带宽和执行确定性。
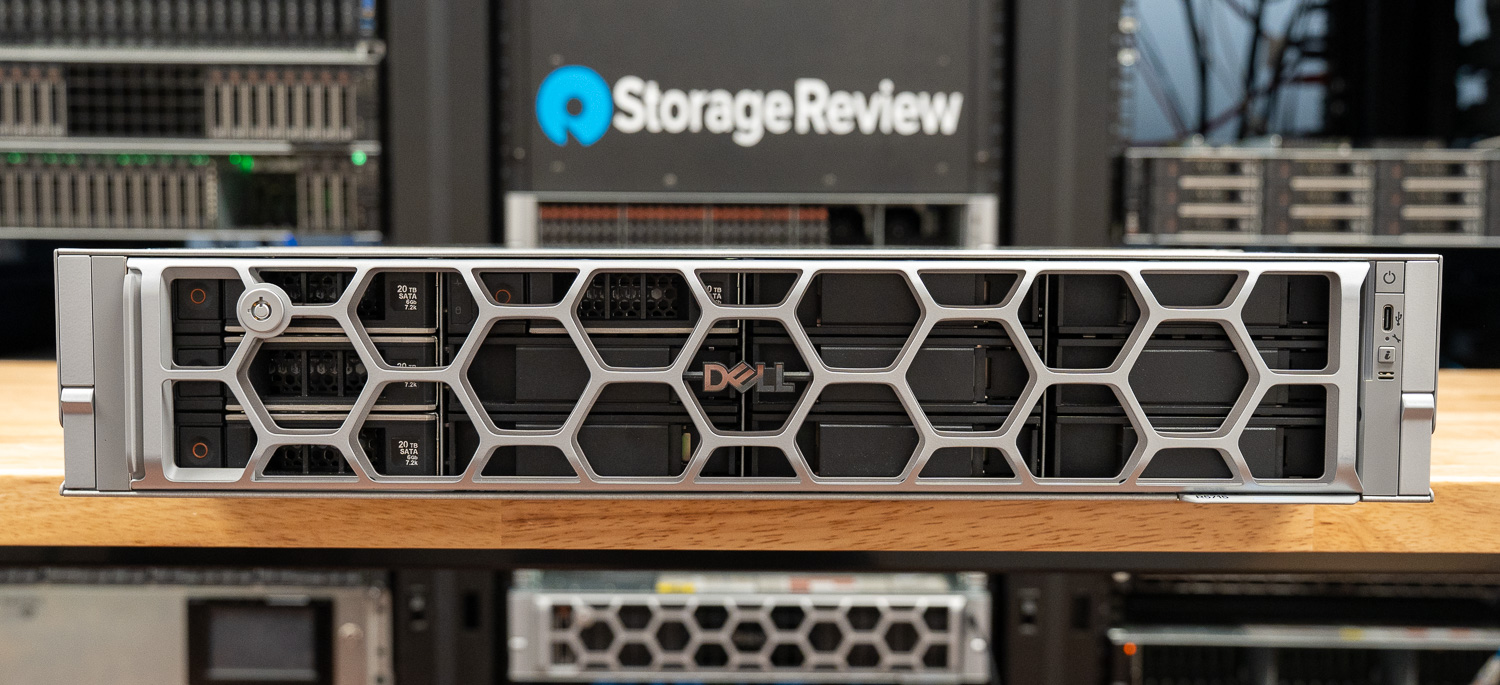
PowerEdge R5715 是戴尔面向中小企业推出的第 17 代 PowerEdge 系列服务器的第二款产品,其设计理念与 1U 同系列产品有所不同。R4715 侧重于计算密度和每机架单元核心数效率,而 R5715 则以 2U 单路机架式设计,围绕存储容量和 I/O 扩展性而打造。对于熟悉 R4715 的用户来说,R5715 的优势尤为突出。
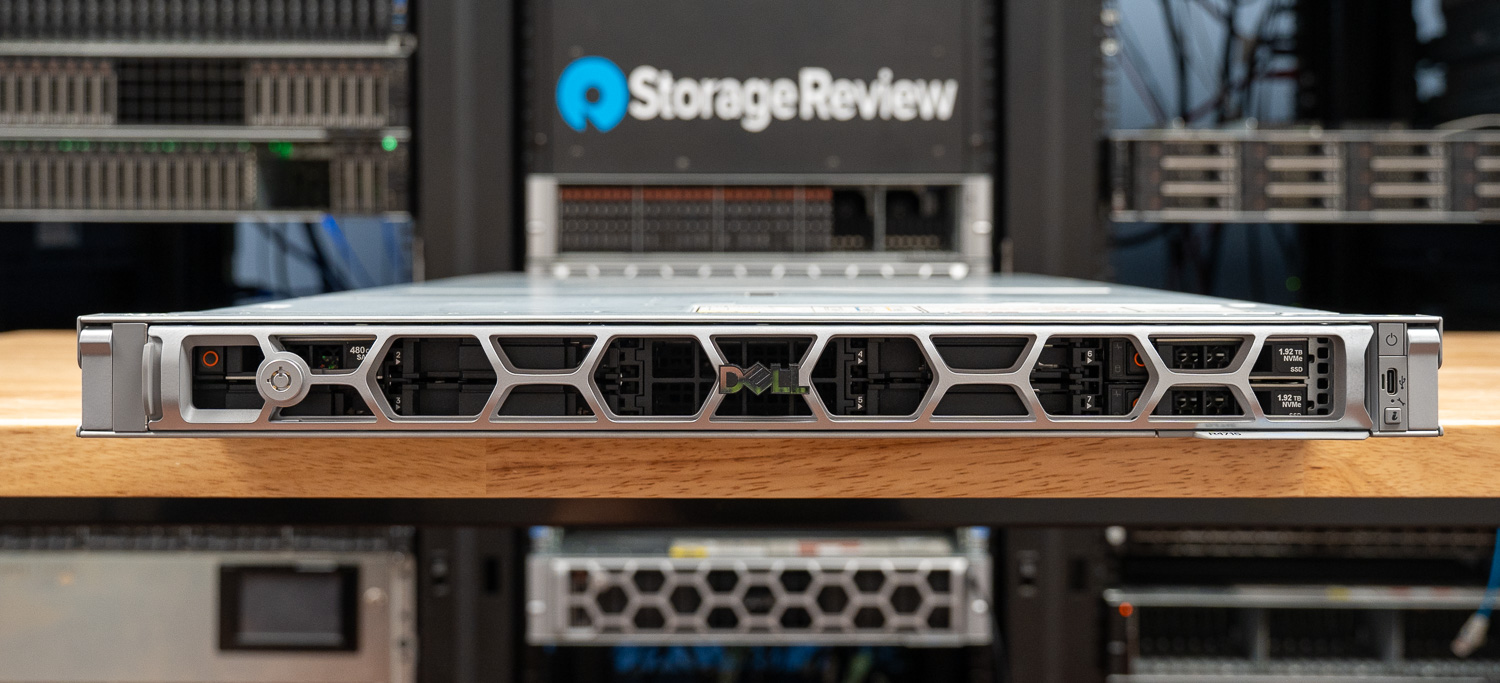
戴尔第 17 代 PowerEdge 系列服务器已相当成熟,而 R4715 和 R5715 的推出,则进一步明确了该系列的目标客户群体——中小企业和中端市场。这两款服务器均为单路平台,与第 17 代 PowerEdge 系列一样,均基于第五代 AMD EPYC 处理器。它们专为那些需要适量核心容量的企业而设计。
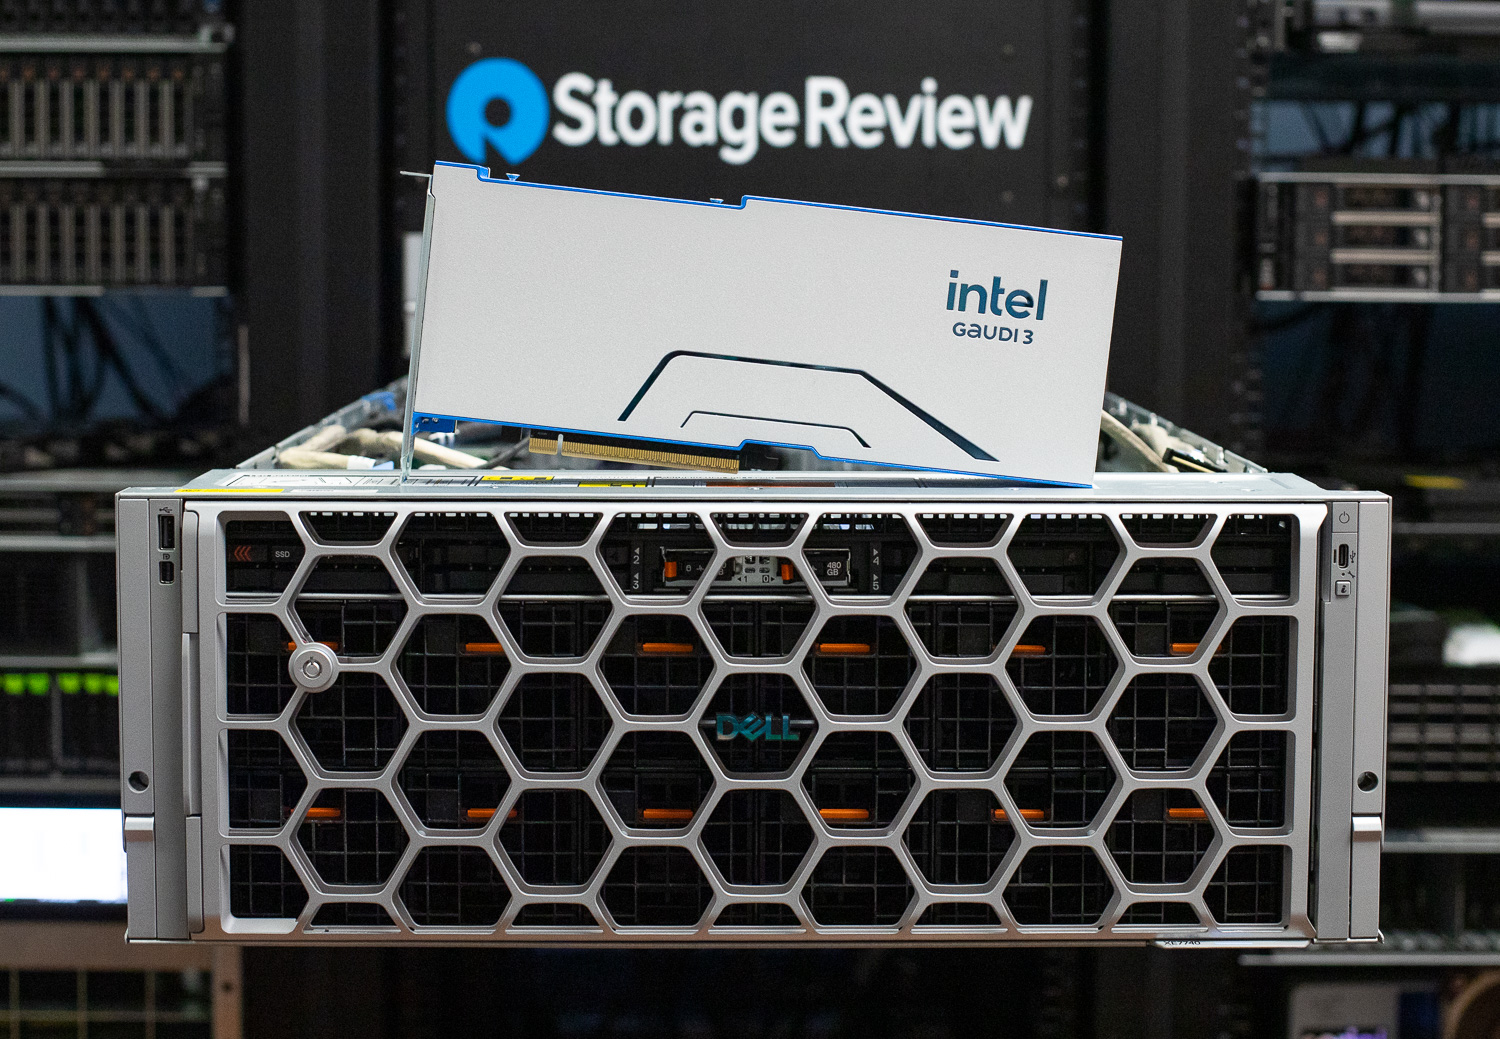
人工智能基础设施市场并非朝着单一方向发展,而是正在分裂成两个截然不同的世界。一方面是前沿训练集群,旨在大规模开发基础模型,与专有架构和少数加速器紧密耦合。另一方面是快速发展的企业推理应用。
我们的附属合作伙伴提供的产品和解决方案:


 Amazon