

2026年11月12日更新:联想ThinkPad T1g Gen 9和ThinkPad X9-15p Gen 1 Aura Edition携全新测试结果加入“其他测试产品”榜单;评选结果不变。10月29日,戴尔XPS 16 Creator Edition加入“其他测试产品”RTX Spark测试版块。
这里列出的每台笔记本电脑都经过了 StorageReview 实验室的测试。我们直接测量本地 AI 性能:UL Procyon AI 文本生成工具在所有支持该功能的系统上运行相同的模型;如果硬件配置足够,我们还会使用 LM Studio 和 Ollama 进行更深入的测试。本页所有排名均非基于规格表,每个选项都链接到包含相应数据的评测文章。
2026 年在笔记本电脑上运行 AI 模型有两种途径。独立显卡 NVIDIA RTX PRO 可提供最快的每秒令牌数,但模型必须能够容纳在显卡的显存容量中,该领域普遍采用 8GB 到 24GB 的显存容量。以 AMD 的 Ryzen AI Max+(Strix Halo)和 Intel 的 Core Ultra 共享 LPCAMM2 平台为代表的统一内存和共享内存设计,以牺牲原始速度为代价来换取更大的容量:GPU 可以借用大部分系统内存,因此可以加载更大的模型。以下推荐的产品涵盖了这两种途径,以及以 NPU 为先导的节能型产品。
一览
| 类别 | 系统 | AI引擎 | 主要结果 | 全部评论 |
|---|---|---|---|---|
| 最适合本地人工智能的笔记本电脑 | 戴尔 Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s(Phi,Procyon),我们测试过的速度最快的笔记本电脑 | Pro Max 18 Plus 评测 |
| 最适合大型模型 | 惠普 ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395,最高可分配 96GB 统一内存 | 已加载 DeepSeek-R1 70B;Gemma 3 27B,加载速度为 9 tok/s | ZBook Ultra G1a 评测 |
| 最佳 16 英寸平衡 | 戴尔 Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 179 tok/s (Phi),电池续航时间为 6 小时 21 分钟 | Pro Max 16 Plus 评测 |
| 最佳超便携 | 联想ThinkPad P14s第四代 | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | 55 tok/s (Phi),重量为 3.59 磅 | P14s 第七代评测 |
| 最好不要使用独立显卡 | 戴尔 Pro Precision 5 14s 英特尔 | Intel Arc Pro B390 集成显卡,64GB 共享 LPCAMM2 内存 | 运行的机型显存超过 8GB,电池续航时间 23 小时 50 分钟 | Pro Precision 5 14s 评测 |
| 最佳轻薄型NPU系统 | HP EliteBook 6 G1q | 骁龙 X Plus 处理器,45 TOPS 六边形 NPU,32GB 内存 | Llama 3.2 3B 在 LM Studio 中以 37 tok/s 的速度运行 | EliteBook 6 G1q 评测 |
| 最佳 RTX Spark 笔记本电脑 | HP OmniBook Ultra 16 | RTX Spark N1X,20 核 CPU / 6,144 核 Blackwell GPU,128GB(64GB 分配给 GPU) | 35B编码代理任务在72.0秒内完成,平均速度为89.5 tok/s,3次运行全部通过。 | OmniBook Ultra 16 评测 |
| 运行温度最低的 RTX Spark 笔记本电脑 | 联想 Yoga 9n 二合一笔记本电脑 16 | RTX Spark N1X,20 核 CPU / 6,144 核 Blackwell GPU,64GB(32GB 分配给 GPU) | 在持续负载下运行 30 分钟后,其峰值温度为 72°C,而 HP OmniBook Ultra 16 的峰值温度为 98°C。 | Yoga 9n 二合一 16 评测 |
精选推荐
最佳本地人工智能笔记本电脑:戴尔 Pro Max 18 Plus
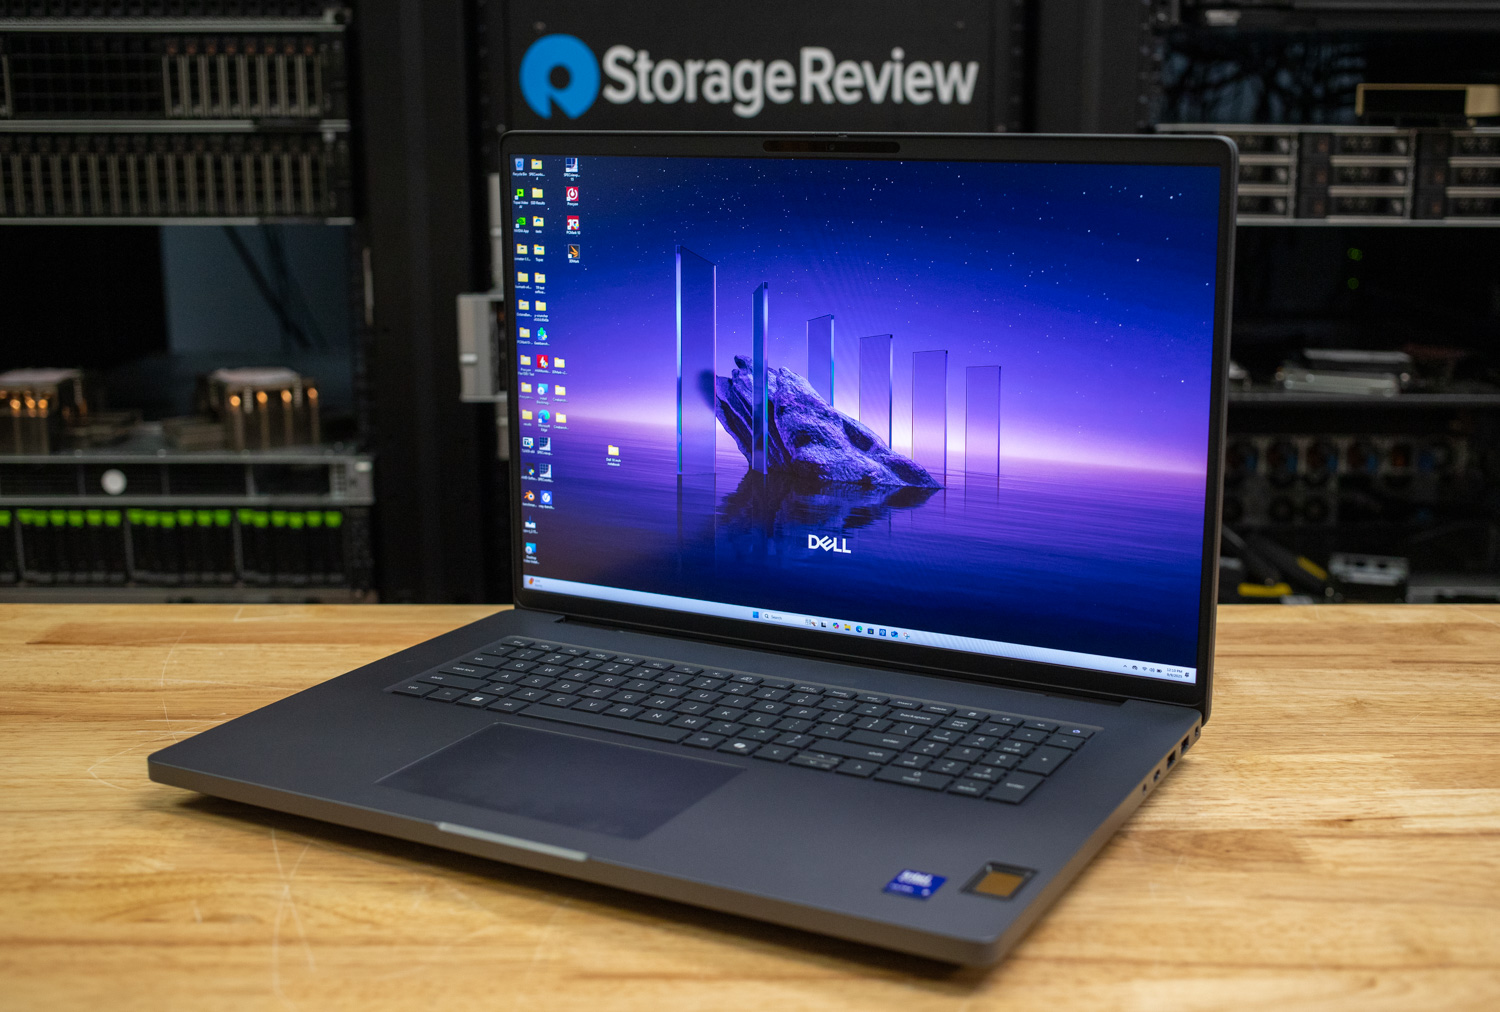
在 StorageReview 实验室的测试中,Pro Max 18 Plus 笔记本电脑的本地 AI 性能表现最佳。在 UL Procyon AI 文本生成测试中,其搭载的 RTX PRO 5000 Blackwell 显卡(24GB GDDR7 显存)将 Phi 的运算速度提升至每秒 185.1 个令牌,Mistral 为每秒 140.5 个令牌,Llama 3 为每秒 119.7 个令牌,所有模型的首令牌生成时间均低于 0.35 秒。Core Ultra 9 285HX 处理器和 128GB CAMM2 内存确保了其他组件的流畅运行,而 24GB 的显存足以轻松应对 20 亿级量化模型。
这款笔记本电脑的缺点正如其机身设计所示:重 7.17 磅,实测电池续航时间 3 小时 39 分钟,是我们笔记本电脑测试数据集中最短的续航时间。这是一款桌面级设备,恰好具备 Folding@home 功能。评测时,其标价为 9,245 美元。如果本地推理速度是关键所在,那么这就是答案。
评测:戴尔 Pro Max 18 Plus:Blackwell RTX PRO 5000 性能随身携带
最适合大尺寸机型:HP ZBook Ultra G1a 14
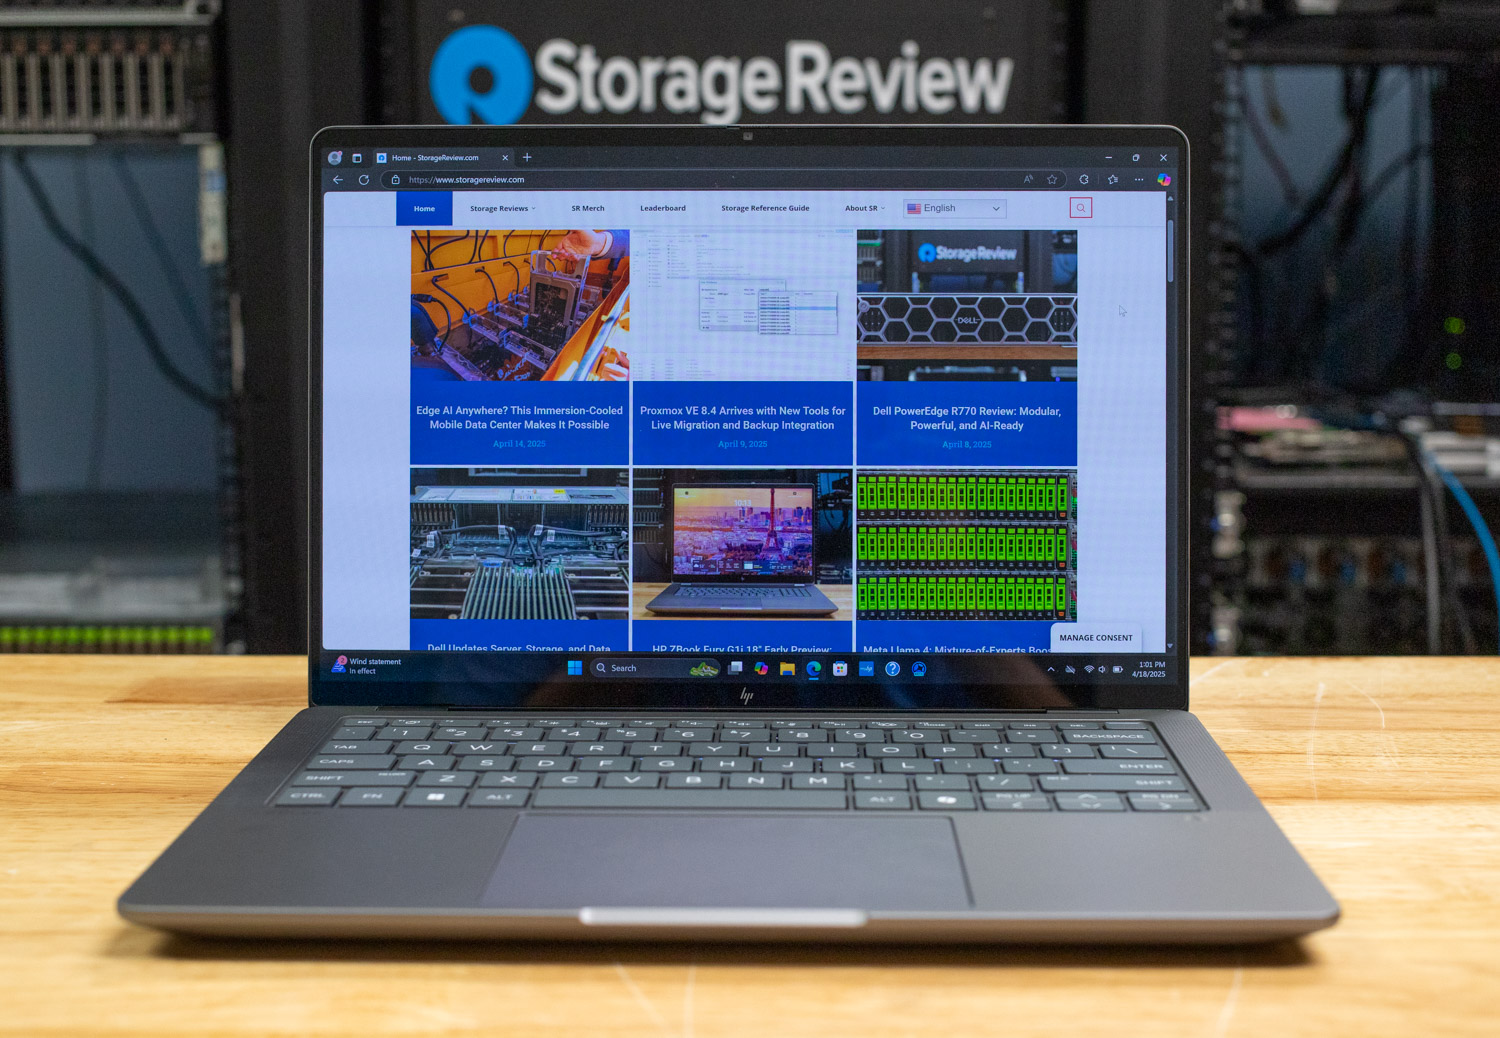
速度是一方面,容量是另一方面。ZBook Ultra G1a 搭载 AMD Ryzen AI Max+ PRO 395 处理器和 128GB LPDDR5X 统一内存,其中最多 96GB 可分配给 Radeon 8060S GPU。如此强大的内存配置让我们能够运行其他独立显卡笔记本电脑无法处理的模型:DeepSeek-R1 70B 和 QwQ 32B 均在 LM Studio 和 Ollama 中本地运行,而 Gemma 3 27B 的生成速度为每秒 8.96 个令牌,处理速度为每秒 73 个令牌。
它的Procyon性能落后于这里所有RTX PRO系列显卡(Phi每秒只能处理65个令牌),因此它并非小型机高速聊天的最佳选择。但如果重点在于机身本身的性能,那么它就是最佳选择,而且它仅重3.3磅,电池续航时间长达10小时35分钟。这与AMD桌面级的Strix Halo采用统一内存架构的设计理念如出一辙,只不过尺寸缩小到了14英寸。
即将上市:惠普 ZBook Ultra G3a 16
上文提到的“最佳大尺寸机型”可能即将被它的继任者取代。ZBook Ultra G3a 16 配备 192GB LPDDR5X-8533 统一内存,其中最高 160GB 可分配给 GPU(G1a 14 的最高内存容量为 128GB 和 96GB),搭载 Ryzen AI Max+ PRO 495 处理器,并采用重新设计的散热系统,功耗从 G1a 的 55W 提升至 100W。G1a 凭借大容量内存赢得该奖项,但功耗限制了它的性能;而 G3a 则在这两方面都表现出色。
惠普于10月在美国开启了G3a的预购,配置起价为3,149美元。待Procyon和LM Studio的完整测试结果出来后,G3a才会正式进入排名。我们之前的上手体验仅限于一台预生产样机,由于无法进行性能测试,因此无法进行硬件测试。待正式版样机送达实验室后,我们将发布完整的评测文章。
最佳 16 英寸均衡之选:戴尔 Pro Max 16 Plus
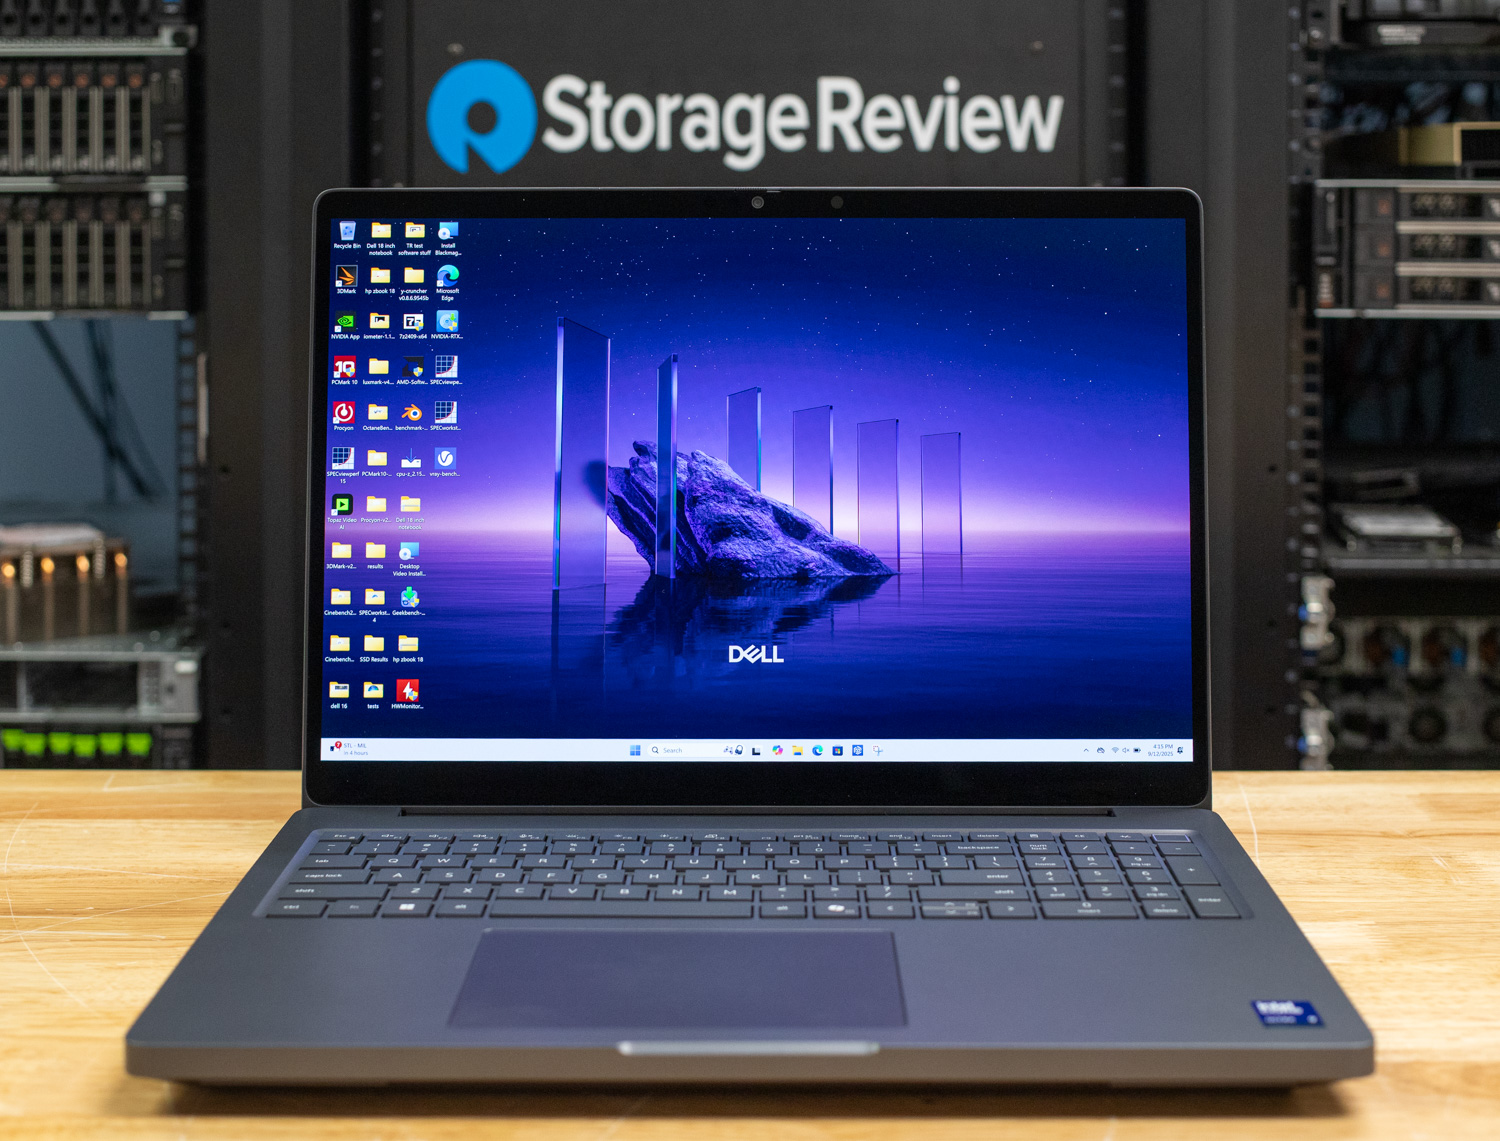
Pro Max 16 Plus 搭载了与 18 Plus 相同的 RTX PRO 5000 Blackwell 24GB 显卡,性能几乎没有差别:Phi 测试每秒可处理 178.6 个令牌,Mistral 测试每秒可处理 134.2 个令牌,Llama 3 测试每秒可处理 114.7 个令牌,大约是旗舰机型吞吐量的 96%。作为补偿,它的重量从 7.17 磅降至 5.63 磅,电池续航时间也几乎翻了一番,达到 6 小时 21 分钟。
对于大多数想要一款功能强大的本地推理设备的用户来说,这款产品比另一款更值得购买。它还荣登我们最佳移动工作站排行榜的“最佳综合移动工作站”榜首,这意味着其卓越的AI速度已与经过验证的完整专业应用套件完美结合。
评测:戴尔 Pro Max 16 Plus 评测:专为长时间工作和繁重任务而打造
最佳超便携笔记本电脑:联想ThinkPad P14s Gen 7
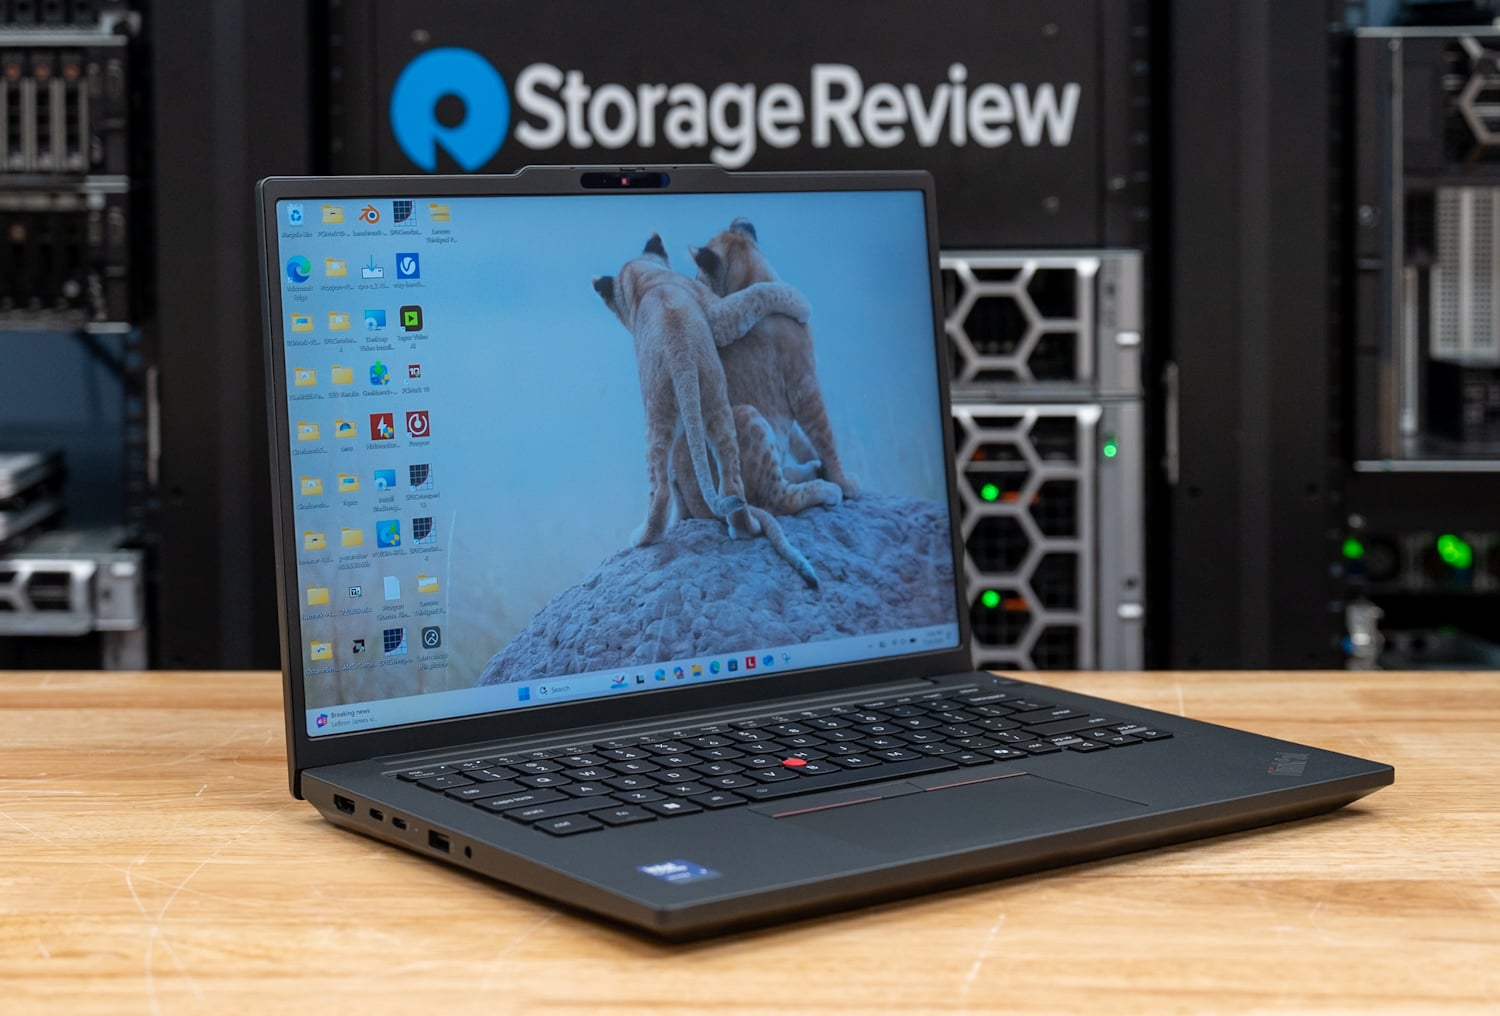
第七代奔腾14s重量仅为3.59磅,是本次评测中最轻的搭载独立Blackwell GPU的笔记本电脑。其RTX PRO 1000显卡(8GB GDDR7显存)在Phi测试中达到了每秒55.1个令牌,在Mistral测试中达到了每秒40.3个令牌,对于7B级机型而言,这样的实际交互速度相当出色。此外,Panther Lake处理器的50 TOPS NPU性能使其成为一台Copilot+智能助手。长达15小时52分钟的电池续航时间意味着,强大的AI功能不会影响您的工作效率。
购买前务必了解配置上限:我们的 Llama 2 13B 测试未能完成,因为该型号需要通过 Procyon 架构分配约 12GB 的显存,而其 GPU 本身只有 8GB。对于 7B 及以下的量化型号来说,这是一款非常不错的选择;对于更大的型号,请查看页面上方的相关说明。
不带独立显卡的最佳选择:戴尔 Pro Precision 5 14s 英特尔
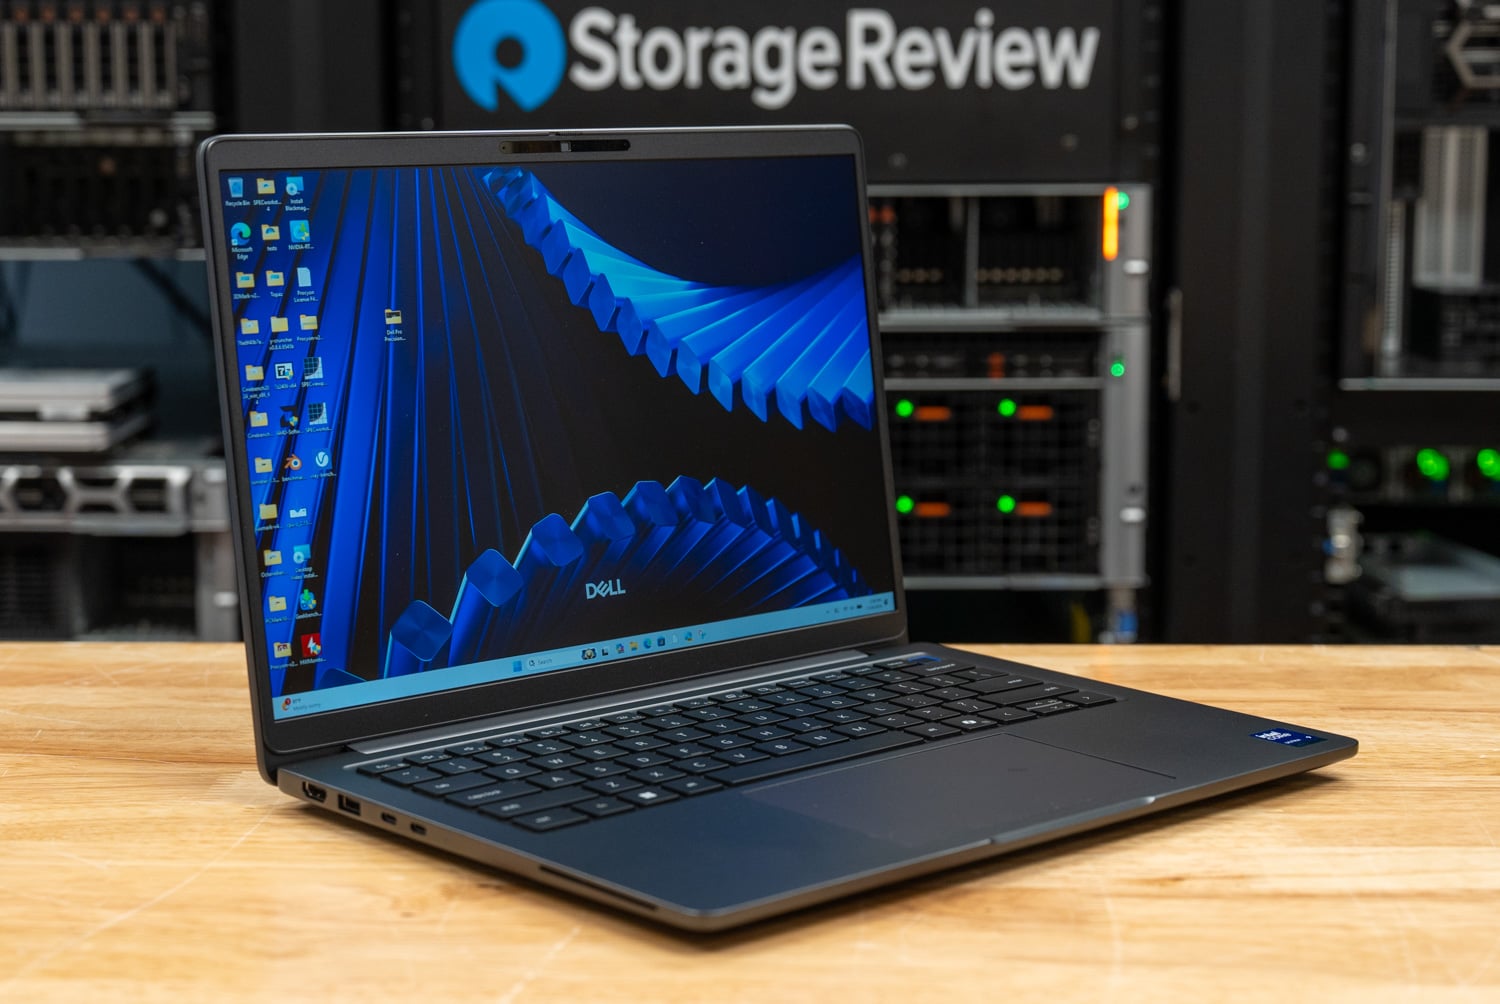
在合理范围内,没有独立显卡并非问题:英特尔 Pro Precision 5 14s 搭载了酷睿 Ultra X9 388H 处理器(50 TOPS NPU),并集成了英特尔 Arc Pro B390 显卡,使用 64GB 的 LPCAMM2 共享显存。在我们的测试中,该共享显存能够处理比 8GB 独立显卡更大的本地 AI 工作负载,并成功运行了完整的 Procyon AI 文本生成测试套件(在 Phi 测试中得分 887,在 Llama 2 测试中得分 786),而受显存限制的系统则未能完成测试。
与 RTX PRO 芯片相比,其运算速度较为一般,因此更适合后台辅助工作,而非高强度交互式会话。其他方面表现卓越:重量仅为 3.12 磅,实测续航时间长达 23 小时 50 分钟,在我们所有测试产品中排名第二。它还荣登我们“最佳移动工作站”榜单的“最佳超便携工作站”宝座。
评测:戴尔 Pro Precision 5 14s 英特尔版评测
最佳轻薄NPU系统:HP EliteBook 6 G1q
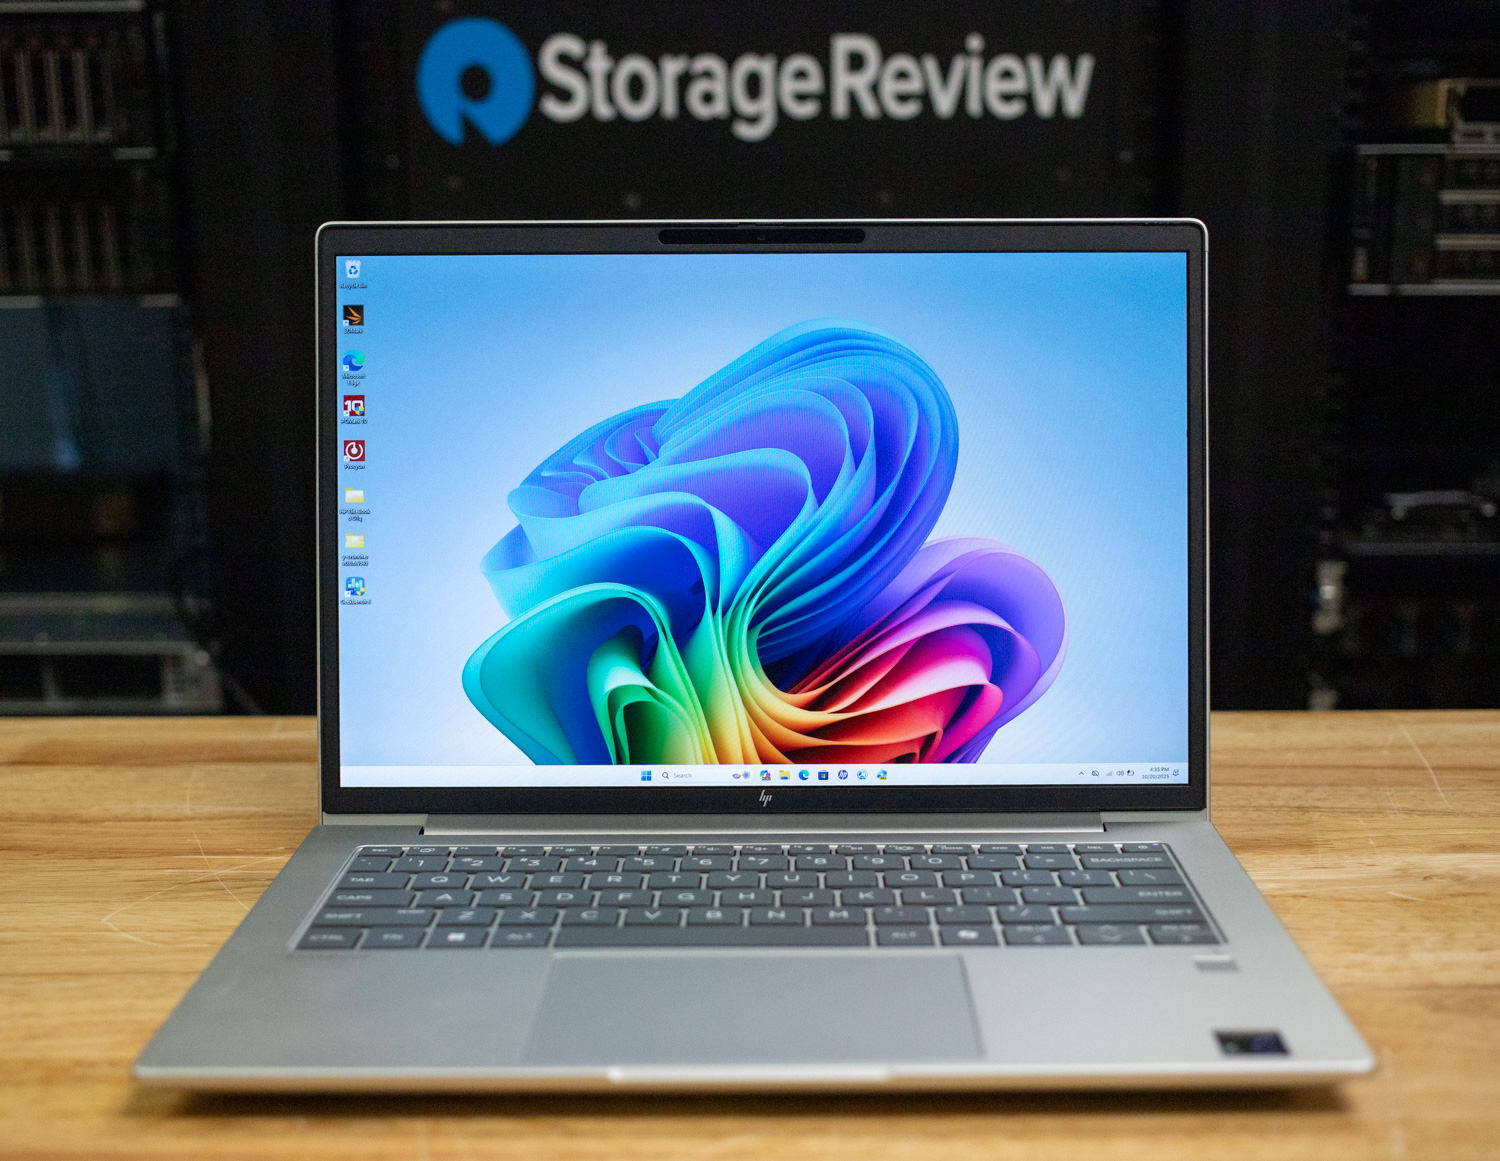
EliteBook 6 G1q 回答了另一个问题:你需要多小的机器才能实现实用的设备端 AI 功能?它搭载的骁龙 X Plus 处理器和 45 TOPS 的 Hexagon NPU,在 LM Studio 中运行 Llama 3.2 3B 的速度为每秒 36.7 个令牌,运行 Gemma 3 4B 的速度为每秒 29.3 个令牌,而 1B 型号的速度更是高达每秒 62 个令牌。对于一台仅重 3.17 磅(约 1.4 公斤)、续航时间长达 19 小时 35 分钟的机器来说,这样的聊天速度完全可以满足日常使用。
其性能上限较低,我们测试过的最大模型参数量为 4B,因此它适用于本地聊天、摘要和离线助手等应用,更复杂的模型则超出了我们的测试范围。评测时配置价格约为 3,100 美元,也是本页介绍的系统中最便宜的。
评测:惠普 EliteBook 6 G1q 评测:轻薄笔记本电脑,满足全天使用需求
RTX Spark 笔记本电脑:在我们的新客户端套件上进行了测试
NVIDIA 的 RTX Spark N1X 将 DGX Spark 的 GB10 超级芯片引入 Windows 笔记本电脑,其 Grace CPU 和 Blackwell GPU 共享一个 LPDDR5X 内存池。笔记本电脑提供两种配置,TDP 分别为 45W 和 80W:一种是 20 核 CPU 搭配 6,144 核 GPU,另一种是 18 核 CPU 搭配 5,120 核 GPU。我们使用全新的 Arm64 原生客户端套件 sr-client 1.2 对这些系统进行测试,因此其结果与上述 Procyon 平台的测试结果并不完全一致。我们的RTX Spark 发布报道中包含完整的平台详细信息。
内存决定了每种配置可以运行哪些模型。固件设置将内存池分配给 Windows 和 GPU,我们最小的本地 AI 模型层至少需要 16GB 的 GPU 可用内存,因此,一个 32GB 的系统如果只分配 12GB 给 GPU,就无法加载 12.8GB 的 gpt-oss:20b 模型。
最佳 RTX Spark 笔记本电脑:HP OmniBook Ultra 16
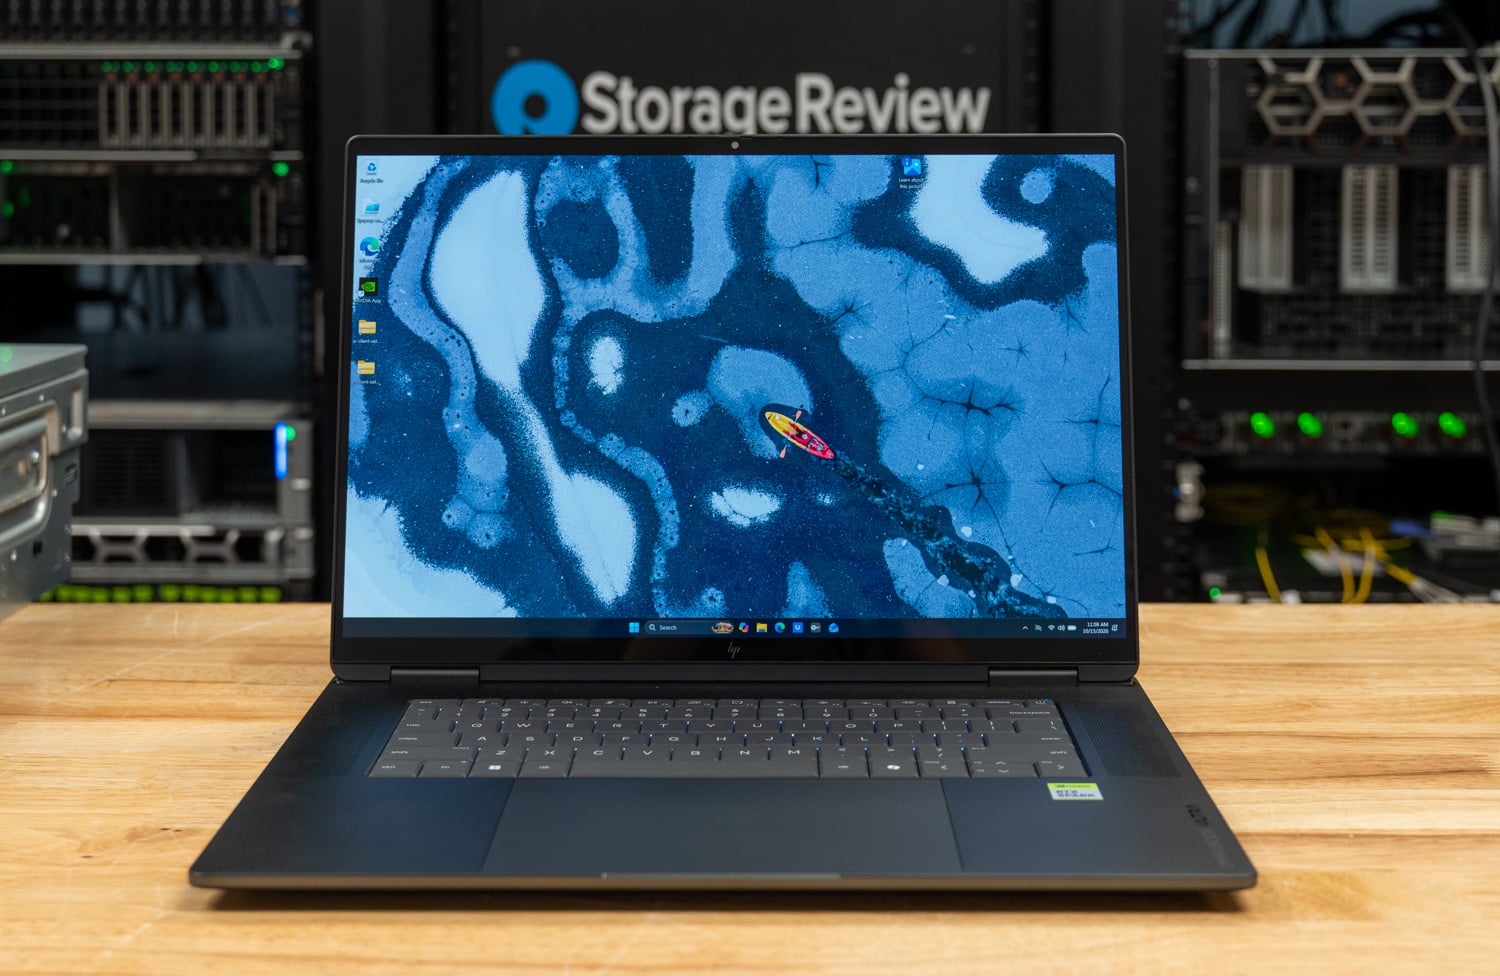
128GB 的 OmniBook Ultra 16 是我们测试过的最全面的 RTX Spark 笔记本电脑。它拥有 62.5GB 的 GPU 可用显存,能够运行我们本地的两个 AI 模型层级,分别以每秒 58.0 个 token 的速度生成 gpt-oss:20b 模型,以及以每秒 89.5 个 token 的速度生成 Qwen3.6-35B-A3B 模型。它通过了全部九项编码代理测试,并在 72.0 秒内完成了 Qwen3.6 任务,是同组测试中最快的。此外,它还以 98°C 的温度完成了全核 OpenBLAS 求解测试,该测试需要两台 Surface Laptop Ultra 才能完成。
在 Cinebench 2026 多核测试中,其 CPU 得分 7,004 分,是本次对比测试中 CPU 性能最高的,比 Razer Blade 16 高出 35%。Blade 的 RTX 5090 显卡在配备 24GB 内存的机型上生成代码的速度仍然比 OmniBook 快 2.3 倍,而 OmniBook 的浏览器在共享 GPU 上运行代码代理时速度慢了 1.73 倍。我们测试的 128GB 内存 + 2TB 硬盘版本仅在 HP.com 上销售,截至 10 月 14 日,HP 在该网站上的定价为 6,229.99 美元。售价 3,199.99 美元的 32GB 内存版本 CPU 速度与 OmniBook 相同,但无法加载我们测试的机型,电池续航测试结果尚未公布。
评测:惠普 OmniBook Ultra 16 评测:搭载 RTX Spark 显卡和 128GB 存储的机型在我们的本地编码代理测试中名列前茅
运行温度最低的 RTX Spark 笔记本电脑:联想 Yoga 9n 二合一 16
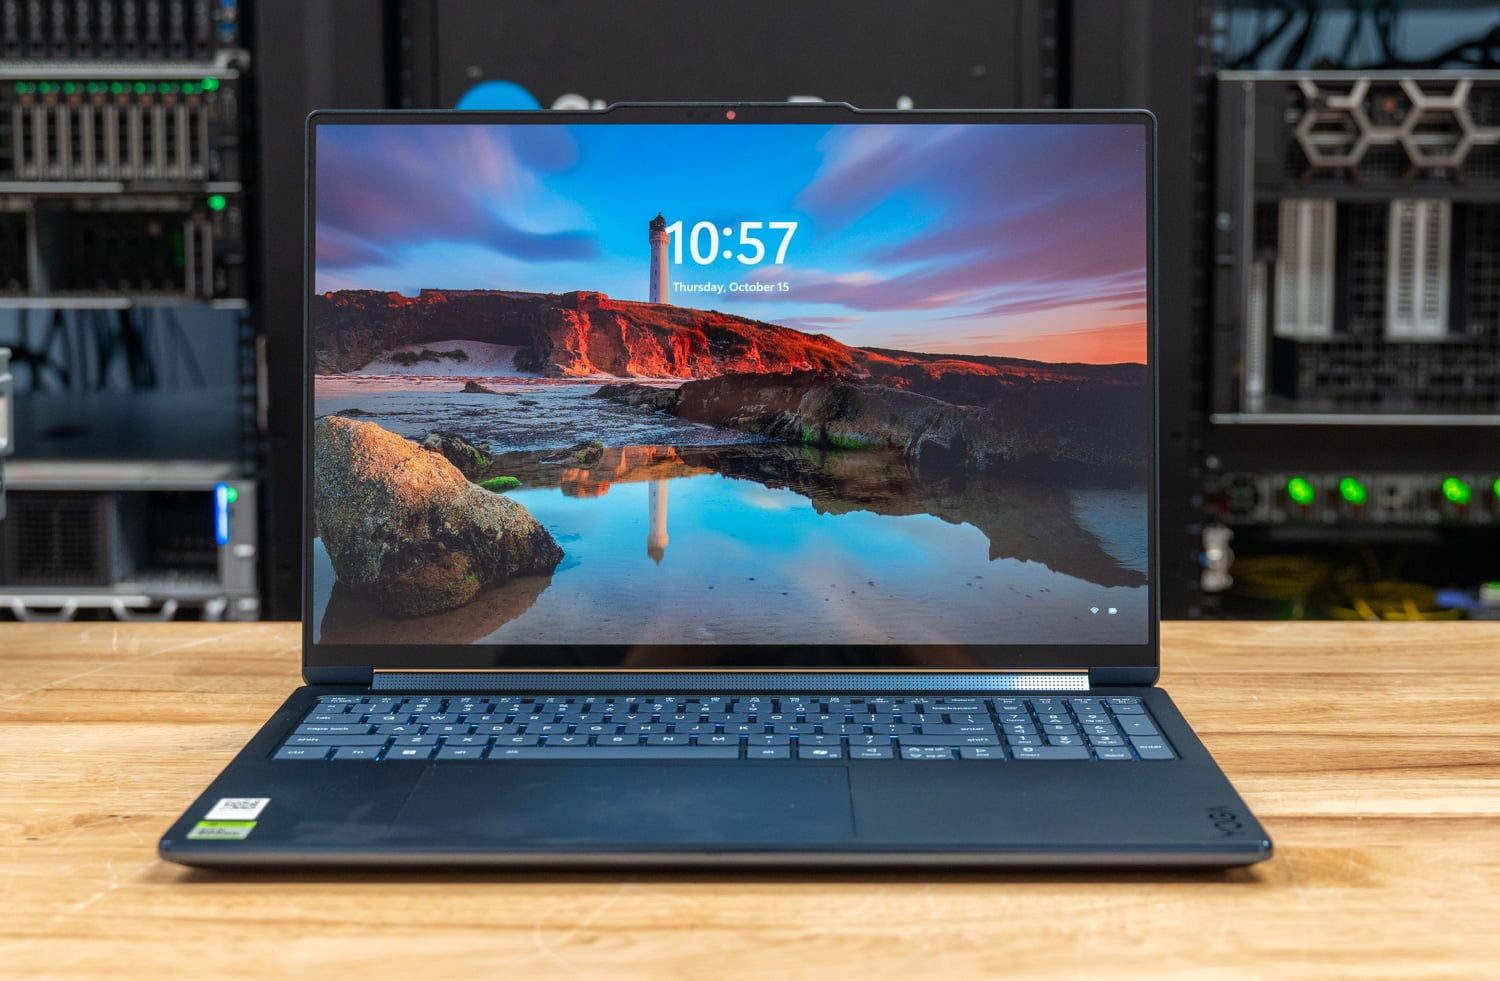
在我们测试过的所有 RTX Spark 笔记本电脑中,Yoga 9n 二合一 16 的 N1X 处理器运行温度最低。在 30 分钟的持续循环测试中,其 CPU 最高温度为 72 摄氏度,频率稳定在 3,015MHz,首次测试结果为 100.1%。HP OmniBook Ultra 16 和 Surface Laptop Ultra 的温度最高为 98 摄氏度,Lenovo Pro 9n 15 的最高温度为 92 摄氏度。所有温度均通过 Windows 散热区域测量,这是这些系统唯一暴露的 CPU 温度传感器。联想认为,这得益于更大的通风口、凸起的散热凸起以及可翻转铰链设计,该设计在通风口后方留出了空气流通的空间。
为了优化散热,Yoga 的全核性能略逊于 HP OmniBook。在大多数测试中,Yoga 的多线程性能比 OmniBook 慢 4% 到 10%,而且在运行代码代理程序时,Yoga 的浏览器速度比 HP OmniBook 慢 2.44 倍,而 HP OmniBook 仅为 1.73 倍。Yoga 配备 64GB 内存,其中 GPU 可获得 32GB 显存,足以以每秒 58.0 个令牌的速度运行 gpt-oss:20b 分区表,但低于我们 35B 的最低要求。对于一款经常用作平板电脑或放在腿上使用的 16 英寸二合一笔记本电脑来说,这样的性能取舍是合理的。测试机型的售价为 3,749.99 美元,电池续航测试结果待定。
评测:联想 Yoga 9n 二合一 16 评测:运行最凉爽的 RTX Spark 笔记本电脑
也在新套件上进行了测试:
- 戴尔 XPS 16 创意者版这款配备 20 核 N1X 处理器、64GB 内存和 32GB GPU 显存的笔记本电脑,在 MLPerf Client 测试中,以每秒 55.7 个 token 的速度生成了 80 亿个 Llama 3.1 数据;运行 gpt-oss:20b 编码代理的速度为每秒 58.5 个 token;同时,它还以每秒 31.9 个 token 的速度为 8 位用户提供了 270 亿个 Qwen3.8 数据,其性能与 128GB OmniBook 在本地 AI 测试中的表现相差不到 2% 到 8%。该电脑在 98°C 的温度下保持全速运行,没有出现降频现象,在 RTX Spark 系列显卡中单核性能和内存带宽表现最佳,并且维护起来也最方便。其 30.5GB 的 GPU 显存使其无法达到 350 亿次的代理处理能力。戴尔官方给出的这款配置售价为 4,799.99 美元。
- 联想Pro 9n 15这款N1X处理器拥有18核和32GB内存,机身重量仅为3.64磅(约1.6公斤)。在MLPerf客户端测试中,Llama 3.1 8B的运行速度为每秒55.1个令牌,与配备相同12GB GPU的20核N1X处理器相比,性能差距不到2%。其更高的全核频率使其在渲染和编译方面与20核版本保持8%到11%的差距,最高温度为93摄氏度。由于GPU仅配备12GB显存,因此它无法通过我们的模型加载和编码代理测试,本地AI用户应该配置更大的内存。联想官方公布的18核、32GB内存、512GB存储配置的起售价为2,999.99美元。
- 微软 Surface Laptop Ultra 商用版 (经测试):128GB 版本以每秒 58 至 89 个 token 的速度生成 gpt-oss:20b 和 Qwen3.6-35B-A3B 文件系统,并在 Cinebench 2026 多核测试中获得 6,963 分。此处仅显示“经测试”,因为有两台设备在我们的全核 OpenBLAS 负载测试中断电。
所有 RTX Spark 系统的电池续航测试结果都将在我们最新的跨平台电池测试中公布。
也进行了测试
这些系统都经过了相同的实验室流程,即使它们目前还没有占据任何类别地位,但对于合适的买家来说,它们仍然值得关注。
- 联想ThinkPad P16 Gen 3:这是该机队的第三台 RTX PRO 5000 机器(Phi 为 141.2 tok/s);我们的机器配备了 32GB 内存,这限制了后续工作流程的进行。
- HP ZBook Fury G1i 18:与 Pro Max 18 Plus 一样,采用 24GB Blackwell GPU,吞吐量稍逊一筹(Phi 为 157.4 tok/s),评测价格为 11,687 美元。
- 戴尔 Pro Precision 7 16 英特尔:RTX PRO 3000 Blackwell 配备 12GB 显存,是该领域最强的中端 GPU(通过 DirectML 在 Phi 上进行 Procyon 文本生成测试,得分为 2,244);其 12GB 显存使其达到了 8GB 显卡无法企及的 14B 级别。
- 联想ThinkPad P1 Gen 8:RTX PRO 2000 8GB,机身重量 4.06 磅,电池续航时间为 12 小时 59 分钟;Phi 为 77.3 tok/s。
- 联想ThinkPad P1 Gen 9:在我们新的客户端套件上进行了测试,其 50W RTX PRO 2000 在 MLPerf Client 中生成 Llama 3.1 8B 的速度为每秒 64.8 个令牌,是我们测试过的速度最快的 RTX PRO 2000,并且领先于 RTX Spark HP OmniBook Ultra 16 在该型号上的 56.5;其 8GB 显卡无法加载我们的 20B 及以上型号。
- 联想ThinkPad T1g Gen 9在我们的新客户端测试套件上,这款配备 12GB GeForce RTX 5070 显卡的笔记本电脑在 MLPerf Client 中以每秒 66.2 个令牌的速度运行了 Llama 3.1 8B 测试,并且能够运行 P1 Gen 9 的 8GB 显卡无法加载的 Ministral 3 8B 模型。其可用显存为 11.7GB,低于我们 20B 及以上型号 16GB 的最低要求。它荣获我们评选的“最佳独立显卡商用笔记本电脑”称号。 最佳商务笔记本电脑 排行榜。
- 联想ThinkPad X9-15p Gen 1 Aura版在我们的新客户端测试套件上,这款配备 18.1GB 可用共享内存的 Arc B390 处理器在我们的 gpt-oss:20b 编码代理测试中,三次运行全部通过,11 项测试全部合格。其令牌生成速度约为 NVIDIA 系统的一半甚至更低,而且板载的 32GB 内存配置无法达到我们的 27B 和 35B 性能等级,因此本地 AI 采购商应选择 64GB 内存版本。评测时,其标价为 2,629 美元。
- 戴尔 Pro Max 14 Premium: RTX PRO 2000 8GB 重 3.55 磅;Phi 运算速度为 54.1 tok/s。
- 戴尔 Pro Max 16(Ryzen):RTX PRO 1000 8GB 电池续航时间为 16 小时 2 分钟;Phi 为 61.9 tok/s。
- 联想ThinkPad P14s第四代:RTX PRO 500 6GB;入门级 Blackwell AI 在 Phi 上的速度为 45.7 tok/s。
- 戴尔 Pro Precision 5 16s 英特尔:与我们推荐的无独立显卡机型采用相同共享内存平台的 16 英寸版本,其工作站电池续航时间是我们测试过的最长的,为 24 小时 43 分钟。
- 戴尔 Pro Precision 5 14s AMD:配备 60 TOPS NPU 和 64GB 共享内存池;测试时 AMD 的 Procyon INT8 镜像路径尚未发布,因此比较受到限制。 戴尔 Pro Precision 5 16s AMD 它将 Ryzen AI 9 HX PRO 475 和 60 TOPS NPU 集成到 16 英寸机箱中,并在我们的测试中取得了 Pro Precision 系列中最强的本地 LLM 吞吐量,远远超过了其 Intel 同系列产品在 Llama3 和 Llama2 上的性能,使其成为该系列中本地推理工作的最佳选择。
- HP EliteBook X G1a:Ryzen AI 9 HX 375,配备 55 TOPS NPU;我们尚未在其上运行 LLM 套件。
我们如何排名
UL Procyon AI 文本生成是我们跨平台测试的标准:所有能够安装的笔记本电脑都运行相同的四款模型(Phi、Mistral、Llama 3 和 Llama 2,视情况而定),因此每秒生成的文本数量可以直接比较。如果硬件配置允许,我们会使用 LM Studio 和 Ollama 在更大的模型上运行更深入的测试。每台笔记本电脑在每个测试项目中仅排名一次,并且只有在我们实验室中生成可用本地 AI 结果的系统才会出现在此页面上。
RTX Spark 系统运行的是我们的新客户端套件 sr-client 1.2,因此本页上是将它们彼此比较,而不是与 Procyon 的结果进行比较。
在这个市场中,价格波动很快,因此本页上的所有美元价格均为评测发布时的测试价格。我们不会在未核实供应商当前配置器价格的情况下做出任何价值声明,并且在核实价格时会注明核实日期。
笔记本电脑本地人工智能常见问题解答
对于笔记本电脑上的本地人工智能来说,显存(VRAM)和总内存哪个更重要?
两者原因各不相同:模型必须能够加载到GPU可访问的内存中:对于独立显卡而言,这指的是显存(该领域通常为8GB至24GB),而我们的Llama 2 13B模型在8GB显存的显卡上无法运行,因为它需要大约12GB的显存。统一内存和共享内存设计则改变了这一局面:AMD的Ryzen AI Max+可以将高达96GB的系统内存分配给GPU,而Intel的共享LPCAMM2内存池可达64GB,因此更大的模型仍然可以加载,只是速度会降低。模型是否能够运行取决于其内存容量;而芯片的性能则决定了模型的运行速度。
StorageReview 在笔记本电脑上运行过的最大模型是什么?
DeepSeek-R1 70B 已通过其 96GB 可分配统一内存池本地加载到 HP ZBook Ultra G1a 14 上。在同一台机器上,我们测试了 Gemma 3 27B 的持续生成速度,结果为每秒 8.96 个令牌。桌面端的标准更高;“最佳本地 AI 桌面”排行榜涵盖了运行更大规模模型的系统。
NPU TOPS 评分对运行 LLM 有影响吗?
实际性能不如目前市场宣传的那样强劲,因为大多数本地LLM运行时都依赖于GPU,本页所有每秒令牌数的数据均来自GPU推理,只有骁龙EliteBook除外,因为该平台的AI堆栈才是重点。NPU目前主要体现在效率和INT8图像生成路径上,这也是为什么其中一些机器符合Copilot+ PC标准的原因,因此购买时应首先考虑GPU和内存。
在本地运行模型时,电池续航时间会发生什么变化?
推理是笔记本电脑持续运行的最繁重任务之一,因此在进行长时间推理时,请务必使用外接电源。本页显示的电池续航时间数据来自 PCMark 10 Modern Office 测试结果,这是一项生产力测试,各款笔记本电脑的续航时间差异巨大:我们速度最快的 AI 笔记本电脑续航时间为 3 小时 39 分钟,而共享内存的戴尔笔记本电脑续航时间接近 24 小时。我们的笔记本电脑电池续航时间排行榜对所有笔记本电脑进行了排名。
RTX Spark 笔记本电脑与这里排名的其他笔记本电脑相比如何?
RTX Spark 笔记本电脑搭载 NVIDIA 的 N1X 处理器,该处理器由一颗 Grace CPU 和一颗 Blackwell GPU 共享一个 LPDDR5X 内存池。我们使用新推出的客户端测试套件 sr-client 1.2 对其进行测试,因此其性能数据与本页推荐机型背后的 Procyon 测试结果并不完全一致。在 128GB 的 HP OmniBook Ultra 16 上,gpt-oss:20b 和 Qwen3.6-35B-A3B 算法的生成速度分别为每秒 58.0 和 89.5 个 token,而 35B 编码任务在 72.0 秒内三次运行全部通过。
内存分配决定了哪些机型能够加载:例如,32GB 的 Lenovo Pro 9n 15,如果只分配 12GB 内存给 GPU,则无法加载 12.8GB 的 gpt-oss:20b 镜像。Lenovo Yoga 9n 二合一 16 的运行温度最低,在持续 30 分钟的负载测试中最高温度仅为 72 摄氏度。Surface 仅被列入测试名单,因为有两台 Surface 在我们的全核 OpenBLAS 负载测试中关机了。
我是否应该直接购买一台台式机用于本地AI?
如果机器放在桌面上,那很可能是更好的选择。桌面系统性价比更高,散热性能更佳,而且电池续航时间也毫不逊色;我们“最佳本地AI台式机”排行榜上的产品起价与这里展示的中端笔记本电脑价格大致相同。本页的笔记本电脑则适用于那些需要携带外出进行AI工作负载的用户。
RTX Spark 与 DGX Spark:有什么区别?
它们采用的是同一款硅芯片,只是针对不同的平台进行了优化。RTX Spark N1X 笔记本电脑搭载了来自 DGX Spark 的 GB10 超级芯片,这是一款 Grace CPU 和 Blackwell GPU 共享同一 LPDDR5X 内存池的处理器,其 TDP 为 45 至 80W,而 NVIDIA 官方公布的 DGX Spark 中 GB10 的 TDP 为 140W。DGX Spark 运行的是 NVIDIA 的 Linux 操作系统,采用统一内存;RTX Spark 笔记本电脑运行的是基于 Arm 架构的 Windows 11 系统,其固件设置会预先划分内存池,而配备 128GB 内存的 HP OmniBook Ultra 16 则为其 GPU 分配了 62.5GB 的显存。我们使用不同的测试套件对这两款产品进行测试,因此不将它们进行直接比较;DGX Spark 系统在“最佳本地 AI 台式机”榜单中进行了排名。


 Amazon