

更新于 2026 年 10 月 13 日:1 月份的评测文章首次获得了实测结果(在 RTX 5000 Ada 基准测试中分别达到每秒 123 和 82 个令牌),“评测指南”栏目链接了 1 月份的上手体验文章,并且指南计划的范围与所选内容相符,其中应用内置的运行时环境将通过相应的应用指南进行介绍,而厂商的举措则无需应用指南即可追踪。最初发布于 2026 年 8 月 19 日。
在自有硬件上运行语言模型有四个原因,其中只有一点是出于理念上的考虑。隐私性:你交给本地模型的文档永远不会离开机器,这涵盖了客户端代码、合同、患者数据和未发布产品的全部通信过程。
成本结构:云端 AI 按量计费,代理工作负载的令牌数量增长速度极快,一台性能强大的工作站即可收回成本;而您拥有的硬件则按电费运行。可用性:无速率限制,无停机,也不会在周二收到弃用通知邮件,导致您的工作流程发生改变。控制权:您验证过的模型就是您运行的模型,直到您另行决定为止。
但另一方面,前沿的云模型仍然功能更强大,对于需要长期智能体处理的任务而言,这种差距是真实存在的。本地模型在有限任务方面已经达到了与云模型相当的水平,例如聊天、摘要、单文件代码和文档问答。而这些恰好涵盖了大多数人每天的大部分工作。如果您追求的是不惜一切代价实现最大功能,那么请使用云模型。如果您更注重隐私、成本或控制权,那么本地模型目前仍然可行,而本页面正是您了解本地模型的指南。
这种框架应该决定你的硬件预算,因为本地AI的投入首先取决于内存使用情况。16GB显存或32GB统一内存可以满足7亿到8亿级的模型需求,足以处理上述有限的工作量。24GB到32GB显存或48GB统一内存可以达到30亿级,此时智能体编码不再是演示。96GB到128GB统一内存可以运行100亿级以上的模型,接近前沿质量。过度购买内存可以提升你可能察觉不到的速度;而购买不足则意味着你想要的模型根本无法加载。
我们的“最佳本地AI笔记本电脑”和“最佳本地AI台式机”榜单按等级对机器进行了排名。本页将介绍在这些机器上运行哪些程序。
软件方面的发展远不如硬件成熟。如今,搜索结果中推荐的工具里,大约有三分之一已经失效,而推荐这些工具的大多数网站对此却浑然不觉。
本页面记录了截至 2026 年 10 月哪些工具可用以及它们支持哪些硬件。目前我们以 GitHub 星标数进行排名,因为这是一个中立且可验证的指标。我们会注明哪些工具是闭源的,没有星标数可供参考。表格中的每个工具名称都链接到其官方下载链接。随着每个工具经过实验室测试,“指南”列会更新,提供实际安装步骤和我们自己的测试数据,从 1 月份开始。
本页面遵循三条规则,首先是区分本地模型和本地代理。部分产品在您的计算机上运行,但每次推理调用都会发送到供应商的云端;这是为了保护隐私,而非提供离线功能,这些工具单独列在页面底部,以便区分。其次,每个条目都包含实际的最低硬件配置要求,因为如果没有内存信息,“它可以在笔记本电脑上运行”这样的描述毫无意义。第三,我们在常见问题解答中记录了哪些产品已停止服务,并附有停止服务的日期。
精选推荐
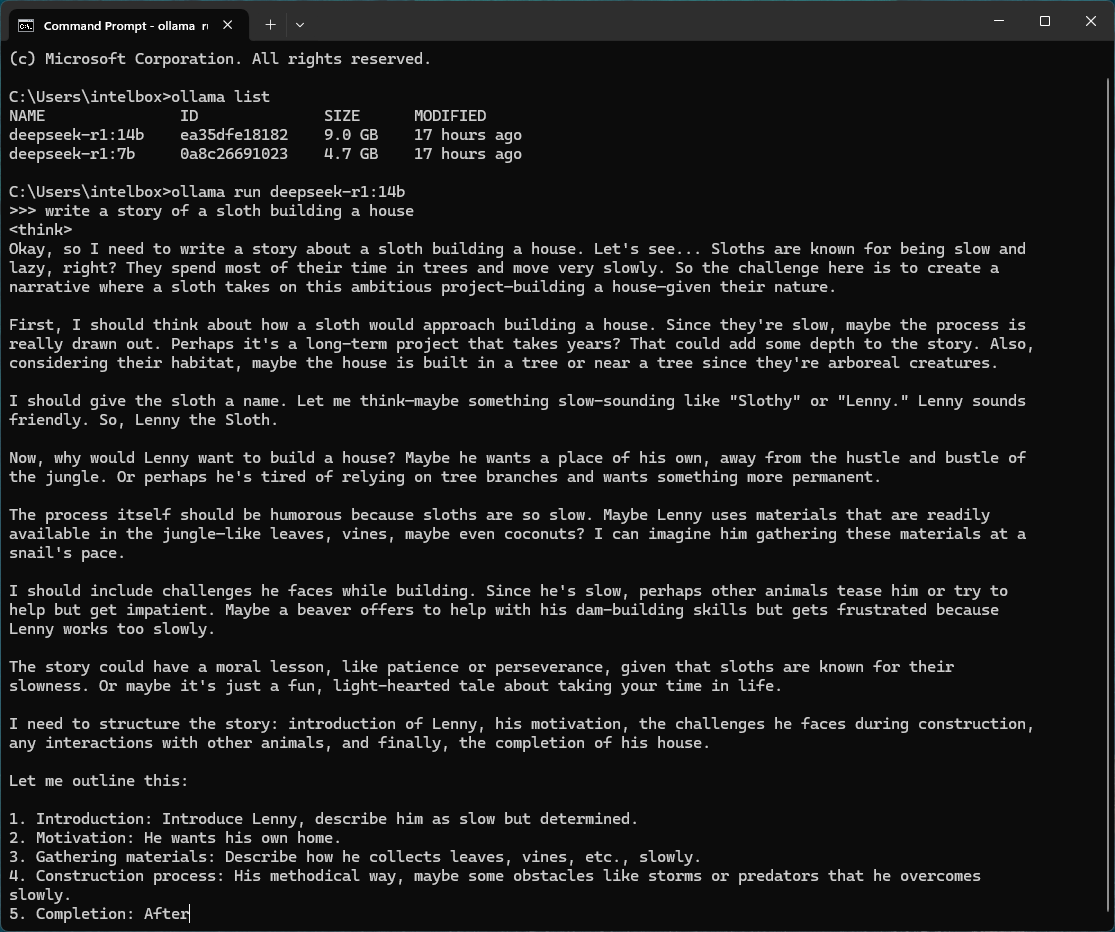
最佳本地LLM运行时间:奥拉玛
Ollama 是默认答案,也是大多数其他工具所依赖的。它采用 MIT 许可证,在 GitHub 上拥有约 17.9 万颗星,现在除了命令行界面 (CLI) 外,还提供桌面图形用户界面 (GUI)。它只需一条命令即可拉取模型,并在本地主机上提供一个与 OpenAI 兼容的端点。2026 年 1 月,它还增加了对 Anthropic Messages API 的兼容性,用户现在可以通过该 API 将 Claude Code 指向本地模型。最低配置: 3B 级模型需要 8GB 系统内存,7-8B 级模型需要 16GB 系统内存,30B 级模型需要 24GB 显存。
最适合硬件基准测试:LM Studio
由于是闭源软件,所以没有星级评分,但它依然名列前茅。LM Studio 捆绑了 llama.cpp 和 MLX,并公开了在测量机器性能而非实际使用机器时至关重要的各项控制功能:GPU 卸载层、量化选择、上下文长度和多 GPU 行为。自 2025 年 7 月起,它已免费用于商业用途。我们工作站和笔记本电脑测试板上的大多数每秒令牌数 (tokens per second) 数据都出自该工具。最低配置: 16GB 内存;若要获得更佳性能,建议使用 24GB 显存或 32GB 统一内存。
最佳底层引擎:llama.cpp
本页几乎所有其他内容都基于 llama.cpp。该项目采用 MIT 许可证,拥有约 124,700 个 star,并且每天都会发布多个带标签的构建版本。它对硬件用户来说意义重大,原因在于:其后端支持列表非常庞大,涵盖 CUDA、ROCm、Metal、Vulkan、SYCL、CANN 和 OpenCL,而且厂商工程师现在可以直接为其贡献优化。例如,在 8688 版本中对 Intel Arc 预填充的改进就带来了大约 5 倍的性能提升,而且所有 Ollama 和 LM Studio 用户无需安装任何软件即可获得此改进。最低配置:仅需 CPU 即可运行;8GB 内存即可流畅运行。
最佳本地优先桌面应用:Jan
Apache 2.0,约有 44,100 个 star,截至 2026 年 10 月版本为 v0.8.6。Jan 捆绑了 llama.cpp,因此无需安装其他任何软件,即使拔掉网线也能正常工作。乍一看这似乎要求不高,但当你查看该类别中有多少应用是带有 Ollama 字段的云客户端时,就会发现它远不止于此。这款应用非常适合推荐给那些永远不会打开终端的同事。
它也是本页上第一个拥有我们自身测试数据的平台:在我们的 RTX 5000 Ada 基准测试中,Jan V3.5 4B 的解码速度中位数为每秒 123 个 token,Jan V2 VL High 为每秒 82 个 token,分别使用了 4.8GB 和 8.2GB 的 GPU 显存,首次启动时启用了 GPU 加速,且未配置 CUDA。从安装到兼容 OpenAI 的 API 的完整教程,请参阅我们的Jan 上手指南;文档 RAG 是该指南未涵盖的应用程序部分。最低配置: 8GB 内存。
最佳本地文档 RAG:AnythingLLM
MIT 出品,拥有约 64,800 个 star。它内置矢量数据库,无需配置即可处理分块和嵌入,使其成为桌面级文档聊天工具中最开箱即用的软件。有两点需要注意:2026 年 3 月发现的一个 CVSS 9.6 级漏洞允许攻击者利用模型自身的流式响应触发远程代码执行,该漏洞已在 1.11.2 版本中修复,因此请在使用前更新。此外,该应用标榜本地优先,但默认开启遥测功能,您可以在设置中将其关闭。最低配置要求: 16GB 内存(用于文档处理)。
最佳自托管多用户解决方案:Open WebUI
拥有约 149,000 颗星,并提供最深度的检索配置,v0.11.0 版本将于 2026 年 7 月发布。它是一个自托管服务器,因此 Docker 是入门级工具。在基于它进行开发之前,需要注意一点:其许可证已于 2025 年 4 月从 BSD-3 更改为未经 OSI 认证的自定义许可证,新增了禁止移除 Open WebUI 品牌标识的条款,并规定在任何 30 天内用户数量低于 50 人时,不得移除该许可证。小规模运行且未做任何修改,对您而言不会有任何变化。最低配置:一个独立的运行时环境,外加 4GB 内存用于容器。
最佳本地编码代理:克莱恩
Apache 2.0,约有 63,900 个 star。Cline 在本地路径上投入的工程量比任何竞争对手都多,包括专为 Ollama 和 LM Studio 构建的简洁系统提示符,以及针对每个模型系列的本地工具调用。他们的文档异常坦诚地指出了云技术仍然胜出的方面。最低配置: 24GB 显存或 36GB 统一内存,并将上下文设置为 32K 或更高。
最佳离线终端编码:助手
Apache 2.0 认证,拥有约 48,300 个 star,其架构是本地最可靠的选择,原因值得理解。Aider 完全不使用 JSON 工具调用。它从纯文本中解析差异和整文件编辑格式,从而避免了大多数本地模型代理都会遇到的故障模式。但缺点是维护成本:96% 的代码提交都出自一位作者之手,发布频率已降至大约 2026 年才发布一个稳定版本。最低配置要求: 24GB 显存或 36GB 统一内存。
最佳自托管代理平台:OpenHands
OpenHands 是麻省理工学院 (MIT) 的项目,拥有约 84,500 个 star。它对本地模型进行了详尽的文档说明,更重要的是,它还能告诉你问题何时不在于你的配置:其文档指出,如果代理的行为像聊天机器人或工具频繁报错,则说明模型本身存在限制。它要求至少 22K 的上下文信息,并建议使用 32K。最低配置要求:量化模型需要 24GB 显存,统一内存需要 64GB。
最佳免费离线惊喜:GitHub Copilot CLI
自 2026 年 4 月起,Copilot CLI 可与 Ollama、vLLM 和 Foundry Local 配合使用。GitHub 身份验证是可选的,无需订阅 Copilot。设置 COPILOT_OFFLINE 会停止所有遥测和网络连接,其子代理将继承本地提供商。大多数对比文章仍然将其列为仅限云端使用。请注意,即使在自带密钥的情况下,IDE 扩展仍然会将内联补全发送到云端。最低配置要求: 128K 上下文窗口的机型,即 32GB 显存或 64GB 统一内存。
最佳厂商支持服务器:Lemonade
Apache 2.0,拥有约 5,400 个星标,是我们仅凭自身实力就推荐的唯一一款厂商相关工具。它由 AMD 工程师维护,支持 NVIDIA CUDA、Apple Metal、Vulkan 和普通 CPU,以及 Radeon 和 Ryzen AI NPU。它大约每两周发布一次,并于 2026 年 4 月将其桌面应用程序从 Electron 迁移到 Tauri。最低配置: 16GB 内存;NPU 版本需要 Ryzen AI 300 系列或更高版本。
最佳文件系统级本地 RAG:Nexa AI 超链接
Nexa AI Hyperlink 是一款闭源免费软件,它会对设备上的整个文件系统进行索引,并以内嵌引用的方式给出答案。它之所以出现在这份榜单上,是因为它是唯一一款在消费级硬件上公布了加速性能数据的全新本地 RAG 工具:在 RTX 5090 显卡上,索引速度提升约 3 倍,推理速度提升约 2 倍,处理 1GB 文件夹的时间从大约 15 分钟缩短到 4 到 5 分钟。最低配置要求:现代 RTX GPU;16GB 内存。
运行时间:模型由什么运行
这五个是引擎,接下来的两张表格中的所有内容都是与其中一个引擎通信的前端,因此表格像页面上的其余部分一样按 GitHub 星号排序。
此处的“指南”栏目与“应用”栏目有所重叠,因此其范围也相应调整:Ollama 单独成篇,因为它是首选方案,也是大多数其他工具所指向的后端;LM Studio 在两个表格中均有出现,并单独成篇;llama.cpp 的内容通过其捆绑的应用进行介绍,最早可参考一月份的实战教程;MLX 的内容则通过 Apple Silicon 上的 LM Studio 进行介绍。vLLM 是一个服务器引擎,其测试已包含在我们的双塔 GB300 集群评测中。
| 运行时 | 明星 | 执照 | 最低硬件 | 加速 | 产品指南 |
|---|---|---|---|---|---|
| 奥拉马 | 〜179,000 | 麻省理工学院简介 | 8GB 内存(3B 级),16GB 内存(7-8B 级),24GB 显存(30B 级) | CUDA、ROCm、Metal、Vulkan | 即将公开信息 |
| 美洲驼.cpp | 〜124,700 | 麻省理工学院简介 | 8GB 内存,仅 CPU 工作 | CUDA、ROCm、Metal、Vulkan、SYCL、CANN、OpenCL | 涵盖了 一月实践 |
| MLX / mlx-lm | 〜27,500 | 麻省理工学院简介 | 苹果芯片,16GB统一内存 | Metal;CUDA 后端于 2026 年新增 | 通过 LM Studio 指南(即将推出) |
| LM工作室 | 封闭源 | 专有技术,可免费用于商业用途 | 16GB 内存;24GB 显存或 32GB 统一存储 | 捆绑 llama.cpp 和 MLX | 即将公开信息 |
| 法学硕士 | 生产服务 | 阿帕奇2.0 | 24GB 显存 逼真地板 | CUDA、ROCm | 经我们测试 GB300集群评测 |
桌面应用程序和本地 RAG
这些是读者安装的应用程序,而“本地优先”一栏需要仔细阅读:它将在您的计算机上运行模型的软件与添加了 Ollama URL 字段的软件区分开来。
| 应用 | 明星 | 执照 | 本地优先 | 最低硬件 | 产品指南 |
|---|---|---|---|---|---|
| 打开 WebUI | 〜149,000 | 自定义,未经 OSI 认证 | 功能强大,服务器而非桌面版 | 单独的运行时内存 + 4GB 用于容器 | 即将公开信息 |
| 任何事法学硕士 | 〜64,800 | 麻省理工学院简介 | 已启用;遥测功能默认开启 | 16GB内存 | 即将公开信息 |
| 一月三十一日 | 〜44,100 | 阿帕奇2.0 | 是的,捆绑了 llama.cpp | 8GB内存 | 一月实战指南 |
| LM工作室 | 封闭源 | 所有权 | 是 | 16GB 内存;24GB 显存,这很有意思。 | 即将公开信息 |
| 米斯蒂 | 封闭源 | 专有免费层 | 是的,捆绑 Ollama、MLX、llama.cpp | 8GB内存 | 即将公开信息 |
| Nexa AI 超链接 | 封闭源 | 专有,免费 | 是的,设备端索引 | 现代 RTX 显卡,16GB 内存 | 即将公开信息 |
编码和代理工具
这些是页面上对硬件要求最高的条目,因为代理工作需要较大的上下文窗口和较长的会话时间。请将 32GB 显存或 64GB 统一内存视为演示程序的极限。
| 工具 | 明星 | 执照 | 本地路径 | 最低硬件 | 产品指南 |
|---|---|---|---|---|---|
| 开手 | 〜84,500 | 麻省理工学院简介 | LM Studio、Ollama、vLLM、SGLang | 24GB 显存或 64GB 统一显存;32K 上下文 | 即将公开信息 |
| 克莱因 | 〜63,900 | 阿帕奇2.0 | Ollama、LM Studio、OpenAI 兼容 | 24GB 显存或 36GB 统一内存 | 即将公开信息 |
| 鹅 | 〜52,900 | 阿帕奇2.0 | Ollama 一流;现在是 Linux 基金会 | 24GB 显存或 36GB 统一内存 | 即将公开信息 |
| 帮助 | 〜48,300 | 阿帕奇2.0 | Ollama,兼容 OpenAI;无需工具调用 | 24GB 显存或 36GB 统一内存 | 即将公开信息 |
| 捷思锐 | v1.0,2026年4月 | 阿帕奇2.0 | LM Studio、Ollama、llama.cpp | 24GB 显存或 36GB 统一内存 | 即将公开信息 |
| GitHub 副驾驶 CLI | 封闭源 | 专有软件,无需订阅 | Ollama、vLLM、Foundry Local | 32GB 显存或 64GB 统一显存;128K 上下文 | 即将公开信息 |
供应商倡议
几乎所有芯片和操作系统厂商都推出了本地AI产品,由于命名混乱且生命周期短,这个类别值得单独列出。2026年的趋势一致:厂商不再与第三方技术栈竞争,而是开始为其提供产品。NVIDIA终止了其两款本地AI产品,转而发布针对Ollama、llama.cpp和ComfyUI的优化方案。AMD与LM Studio合作推出联合品牌产品。高通则通过移植其他厂商的应用程序来发布其NPU功能。
厂商提供的工具能够做到 Ollama 和 LM Studio 做不到的一点是:它们可以访问 NPU。llama.cpp没有 NPU 后端,因此在骁龙或 Ryzen AI 机器上,这些工具会让神经网络引擎的利用率降至零。如果您购买了 40 到 60 TOPS 的性能,只有厂商提供的工具才能真正利用它。因此,请合理预期,因为 NPU 目前的模型处理能力上限约为 7 亿,其优势在于始终运行的小模型任务时可以延长电池续航时间,而不是提高吞吐量。在速度方面,独立 GPU 始终优于 NPU。
| 房屋出售 | 它是什么 | 类型 | 所需硬件 | 状态 | 产品指南 |
|---|---|---|---|---|---|
| AMD柠檬水 | 服务器、图形用户界面和软件开发工具包;约 5,400 个星标,Apache 2.0 版 | 应用 + 服务器 | 16GB 内存;Ryzen AI 300+ NPU。也支持 NVIDIA、Apple 和 CPU。 | 活跃,大约每两周发货 | 即将公开信息 |
| 英特尔 OpenVINO GenAI | 运行时和 SDK;约 10,700 颗星 | 软件开发套件(SDK) | Core Ultra、Arc A/B 系列;16GB 内存 | 活跃,2026.3(2026年8月) | 已追踪,无向导计划 |
| Apple 基础模型 | 操作系统公开的设备端模型 | 操作系统框架 | 苹果芯片;已安装 | 已激活;2026 年 WWDC 大会上向所有供应商开放 | 已追踪,无向导计划 |
| Microsoft Foundry Local | 本地推理 SDK 和 CLI;约 2,400 颗星 | 软件开发套件(SDK) | Windows、macOS、Linux;NPU/GPU/CPU | GA 2026年4月;精选模型目录 | 已追踪,无向导计划 |
| AMD 盖亚 | 适用于 Ryzen AI 的本地 LLM 应用;约 1,400 个星标,MIT 认证 | 应用 + SDK | 最低配置:Ryzen AI 300 系列处理器;16GB 内存,推荐 64GB 内存 | 已激活,版本 0.20.0,2026 年 6 月 | 已追踪,无向导计划 |
| 英特尔人工智能游乐场 | 桌面应用;约900颗星 | 应用 | Arc A 系列 8GB+、Arc B 系列、Core Ultra | 两年后仍处于活跃但测试阶段 | 已追踪,无向导计划 |
| 高通 GenieX | 骁龙NPU的设备端GGUF运行时 | 运行时 | 骁龙 X / X Elite,8 Elite | 开发者预览版,2026 年 7 月 | 已追踪,无向导计划 |
| NVIDIA 项目 G-Assist | 用于系统控制的设备端 8B 助手 | 应用 | RTX 20 系列或更新机型,6GB 显存 | 已发布但仍标记为预发布版 | 已追踪,无向导计划 |
这种命名方式加剧了混乱,因为NVIDIA的“RTX AI Garage”听起来像是一个产品,但实际上并非如此;它是一个博客系列。微软的技术栈也多次更名:Copilot Runtime API变成了Windows AI API,Azure AI Foundry变成了Microsoft Foundry,而DirectML现在处于维护模式,仅提供安全修复。Qualcomm AI Hub是一项云服务,用于远程配置物理设备,而不是在本地运行的服务。
通常会坏掉什么
大多数关于本地模型“无法正常工作”的报告都是配置问题,而非模型本身的问题。其中有四种情况尤为突出,而且这四种情况都是硬件用户在指责芯片之前应该了解的。
1. Ollama 默认使用 4,096 个 token 的上下文。超出此限制时,它不会报错,而是默默地截断上下文,导致代理循环悄然终止。但所有正规的框架都需要更大的上下文:OpenHands 至少需要 22 个 token,建议使用 32 个;Codex 需要 32 个 token;Copilot CLI 需要 128 个 token;Cline 则需要 262,144 个 token。这一个设置很可能是导致网上故障报告中最常见的原因。
2. KV 缓存量化会降低工具调用的性能,而且这种影响会在整体输出质量明显下降之前就出现。llama.cpp 文档对此有直接警告。如果您正在运行代理,请将其关闭。
3. 工具数量呈断崖式增长,而非平缓增长。当工具数量超过五六个左右时,某些模型会悄然停止发出有效的 JSON 工具调用,转而将 XML 嵌入响应体中,而框架会将其解读为“未使用任何工具”。一款流行的代理默认搭载了十一个工具,导致其自身推荐的模型在 2026 年初之前都无法正常运行。实际后果与直觉相悖:加载过多的 MCP 服务器会对本地模型造成损害,而对前沿模型则不会。
4. Q4_K_M 是实际的最低标准。低于此标准,工具调用可靠性下降速度比整体质量下降速度更快,因此模型听起来仍然正常,但实际上却无法正常工作。
内存是制约因素
本页所有工具的运行结果都取决于加速器能够识别的内存大小。以下是我们在智能体工作中经常看到的几种内存组合,也是我们计划在实验室中验证的组合。
| 硬件 | 型号 | Footprint | 报告吞吐量 |
|---|---|---|---|
| RTX 5090,32GB | Qwen3.6-35B-A3B Q4_K_M | 〜21GB | 160-180 tok/s,262K 上下文 |
| RTX 5090,32GB | Qwen3-Coder-30B-A3B Q4_K_M | 〜19GB | 24GB 内存容量下,速度为 50-90 tok/s |
| RTX 5090,32GB | Devstral Small 24B Q4_K_M | 〜14GB | 专为工具调用而设计 |
| RTX PRO 6000,96GB | GPT-OSS 120B MXFP4 | 〜63GB | 单张工作站显卡上的 100B 级性能;我们实验室评测中的 GPU |
| RTX PRO 5000 笔记本电脑,24GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | 〜19GB | 我们测试过的最大笔记本电脑GPU(ThinkPad P16 Gen 3);30B级性能绰绰有余。 |
| 96-128GB 统一存储,M 系列 | gpt-oss-120b Q6_K | 〜93GB | 14-20 tok/s;所有开放权重模型中最简洁的工具调用 JSON |
值得一提的是,因为市场宣传中并未提及:最大的开源模型并非工作站模型。GLM-5.2 的参数量约为 744 字节,在 FP8 模式下需要约 744GB 的内存,这相当于一个八 GPU 的数据中心节点。Kimi K2 和 DeepSeek V4 也属于同一级别。任何建议在台式机上运行这些模型的指南都是错误的。
以上吞吐量数据来自已发布的第三方测试和厂商资料,除上文提到的1月份解码数据外,尚未经过StorageReview实验室的验证。我们将随着每款产品进入评测指南流程,逐步用我们自己的数据替换这些数据。
云优先工具及其未在此排名的原因
本地代理不是本地模型,下面的工具显示了它们之间的区别:每个代理都在您的机器上运行,同时将每个推理调用发送到供应商云。
| 工具 | 本地模型支持 | 注意: |
|---|---|---|
| 光标 | 没有 | 官方文档指出,所有请求均通过 Cursor 服务器路由;自定义按键仅适用于主流云服务提供商,且 Tab 键自动补全始终使用 Cursor 模型。该公司于 2026 年被 SpaceX 收购。 |
| Devin Desktop(原名 Windsurf) | 没有 | 2026年6月更名。所有模型均托管于云端。 |
| Google Antigravity | 没有 | 文档明确指出它不能使用 Ollama、LM Studio 或自定义端点。 |
| Gemini 命令行界面 | 没有 | 本地支持仅存在于社区分支中。 |
| 科多 | 没有 | “本地部署”指的是自托管的基础设施,但仍然属于云模式。 |
| IDE 中的 GitHub Copilot | 局部的 | 聊天功能可以使用本地模型;即使在自带密钥的情况下,内联补全功能仍然基于云端。 |
| ChatGPT | 没有 | 桌面和移动应用是 OpenAI 云模型的客户端。OpenAI 的开源 GPT-OSS 模型虽然可以在本地运行,但并非通过 ChatGPT 应用,而是通过上述运行时环境运行。 |
| 克劳德 | 没有 | Claude 应用和 Cowork 运行在 Anthropic 的云模型上。Claude Code 可以通过 Ollama 的 Anthropic 兼容 API 指向本地模型,虽然这种方法可行,但目前尚未获得官方支持。 |
| 一般代理助理 | 没有 | 此类工具在您的计算机上运行,但依赖于云模型进行推理。 |
市面上有很多“如何将 Cursor 连接到 Ollama”的教程,但 Cursor 官方文档却与这些教程相矛盾。如果您需要离线操作,那么这种区别就至关重要了。
图像和视频生成方面呢?
本地图像生成是本地人工智能领域最大的社群之一。仅 ComfyUI 一个工具的 GitHub 星标数就超过了上面排名的绝大多数工具,而本地视频生成正逐渐成为最消耗显存的消费级工作负载。它值得拥有自己的排行榜,而且它也确实会拥有一个;在此页面上添加第四个类别会使其黯然失色。在此之前,本页的硬件逻辑可以直接应用:图像和视频处理比语言模型更依赖内存,并且同样的层级划分也适用。
本页面使用方法
排名遵循三条规则,第一条是目前暂以 GitHub 星标数为依据。这并非理想之选,但它中立、可验证,而且无需我们假装测试过实际上并未测试过的内容。闭源工具会被明确标记,且不会被赋予任何虚构的分数。随着我们自身测试结果的不断涌现,排名将根据实际测试结果进行调整,我们会对此进行说明;Jan 是第一个拥有实验室数据支持的条目,因此排名调整已经开始。第二条是每个条目都包含一个内存占用最小值,因为该数值决定了模型能否加载。
第三,“指南”栏目是对入选应用的专项承诺:每个上榜应用都会提供一份基于我们硬件的实际设置指南,其中包含我们的测试数据;应用内置的运行时环境也会在相应的应用指南中进行介绍;而厂商的各项举措则会在其对应的表格中进行记录。指南发布后,链接会在此处显示。
本地LLM工具常见问题解答
我应该从哪个本地LLM工具开始使用?
如果您习惯使用终端,可以选择 Ollama;如果您更喜欢带有控件的窗口,可以选择 LM Studio;如果您想要一款开箱即用、无需安装任何其他软件的程序,可以选择 Jan。这三款程序都是免费的,都完全离线运行,并且底层都使用 llama.cpp,因此模型行为相同。区别在于界面,而非速度。
NVIDIA ChatRTX、GPT4All 和 Continue.dev 发生了什么事?
它们已经消失了,还有相当一部分同类产品也随之消失。在采纳任何旧建议之前,了解这一点至关重要。NVIDIA ChatRTX已于 2026 年 1 月 21 日停止服务,其代码库已被存档,支持论坛也已关闭,目前尚未公布替代方案。
GPT4All 的情况最为棘手:它已经十二个月没有提交任何代码,最后一次发布是在 2025 年 2 月,但其代码库并未归档,且仍然拥有大量的 star 数,因此看起来仍然活跃。它仅支持少数几种量化格式,并且无法加载大多数最新的模型版本。
Continue.dev曾是本地模型编码的标准推荐平台,但两年后被 Cursor 收购,并于 2026 年 6 月停止运营。Roo Code于 2026 年 5 月关闭,Void于 2026 年 6 月归档,Twinny于 2025 年 11 月关闭,Reor于 2026 年 3 月关闭。Khoj的托管服务于 2026 年 4 月停止运营,但其自托管版本仍然可用。在厂商方面,Intel IPEX-LLM于 2026 年 1 月归档,并因已知安全问题而被标记,且未发布迁移方案;NVIDIA RTX AI Toolkit于 2025 年 11 月停止维护。
运行本地LLM需要多少显存?
对于聊天应用来说,8GB 系统内存可以运行 3B 级模型,而 16GB 内存仅靠 CPU 就能流畅运行 7 到 8B 级模型。为了获得更流畅的速度,你需要将模型集成到显存或统一内存中:16GB 内存可以处理 7 到 14B 级模型,24GB 内存在 Q4 时可以达到 30B 级,而 32GB 或以上的内存则能让智能编程工作不再令人沮丧。超过这个容量后,内存容量比带宽更重要,这就是为什么配备 96 到 128GB 统一内存的机器能够运行消费级显卡无法支持的模型。
本地LLM工具是否使用我的NPU?
通常情况下不会,因为 llama.cpp 没有 NPU 后端,所以 Ollama 和 LM Studio 在搭载骁龙或 Ryzen 处理器的 AI 机器上会将神经网络引擎的资源占用率设为 0%,转而使用 CPU 或 GPU 运行。目前,要调用 NPU 需要通过厂商提供的途径:高通 GenieX、AMD Lemonade(及其 NPU 运行时)、英特尔 OpenVINO,或者通过操作系统框架调用苹果的神经网络引擎。这样做的好处是延长电池续航时间并实现低功耗的持续运行,因为 NPU 的容量目前也只有大约 70 亿个,而且独立 GPU 的吞吐量始终优于 NPU。
我应该在Windows还是Linux系统上运行本地AI?
对于本页上的桌面应用程序,Windows 和 macOS 的体验更为流畅。LM Studio、Jan、AnythingLLM 和 Ollama 均可原生安装,GPU 驱动程序也来自常用渠道,无需任何终端操作。Linux 的优势则体现在更底层:生产级服务器引擎 vLLM 和 SGLang 优先支持 Linux,多 GPU 服务器也默认使用 Linux,一些最新的加速方案也率先登陆 Linux,例如 AMD 的 Ryzen AI NPU 支持,该支持已在 Linux 上推出,并且需要较新的内核版本。
如今两者之间的差距比以前小了很多。AMD 计划在 2026 年统一其 ROCm 在 Windows 和 Linux 上的发布版本,而 WSL2 则涵盖了大部分剩余的兼容性,这也是为什么像 Open WebUI 这样的基于 Docker 的工具能够在 Windows 机器上流畅运行的原因。实用原则是:如果您是从桌面应用程序列表中安装,请保持在您现有的操作系统上;如果您要构建专用服务器或寻求各种加速方案,请在 Linux 上构建。
本地模型是否足以替代云端模型进行编码?
这完全取决于具体任务,而且这种差异比大多数覆盖率报告所显示的要大得多。对于有限范围的工作、单文件生成、单元测试、样板代码和代码解释,目前在性能良好的工作站上运行的开源模型与前沿云模型大致相当。但对于长期代理工作、跨大型代码库的多文件重构,它们明显逊色,而且失败模式令人不快:静默无声的空操作和明明从未执行过却被自信地报告的工作。如果您选择本地部署的原因是出于隐私、物理隔离或成本考虑,那么目前是可行的。但如果您选择本地部署的原因是出于能力方面的考虑,那么目前还不可行。
在本地运行模型比使用云服务更安全吗?
就数据驻留而言,答案是肯定的,这也是大多数人选择本地部署的原因。但就软件安全而言,默认情况下答案是否定的:一个本地部署的 AI 应用,即使 CVSS 评分在 2026 年 3 月达到 9.6 分,也可能因为桌面应用打包时使用了不安全的默认设置,而被模型自身的流式输出驱动,在主机上执行代码。本地部署意味着数据不会迁移到本地,但这并不意味着软件本身就更安全,因为这类应用通常会部署大量快速迭代的代码。
什么是AI代理沙箱?我需要为本地AI创建一个沙箱吗?
沙箱是一个隔离环境,通常是容器或轻量级虚拟机,人工智能代理在其中执行其生成的命令和代码,从而避免错误或恶意指令影响宿主系统。沙箱的存在是因为代理的功能远不止回答问题:它们还会运行 shell 命令、编辑文件和浏览网页,而所有这些操作都由模型输出驱动,这些输出是可以被操纵的。在本地运行模型并不会改变这一本质。
沙箱机制旨在隔离代理程序的操作,而非模型所在的位置。上文所述的代码执行漏洞恰恰印证了这一点,尤其是在本地优先的应用程序中。本页介绍的部分工具内置了沙箱机制,而那些允许代理程序不受限制地访问主机的工具,在您将其部署到重要机器之前,更应仔细评估。随着代理程序在企业环境中的应用日益广泛,沙箱机制有望成为一项核心功能,我们也将开始在评估这些工具时将其纳入考量。
本地硬件能否运行包含数十个子代理的代理工作负载?
这是前沿领域,简而言之,单个工作站很快就会达到内存不足的极限。多智能体工作负载会生成子智能体,每个子智能体都携带自己的上下文,而在推理方面,每个活跃上下文都意味着内存中存在自己的键值缓存,因此内存占用会随着并发性和模型大小的增加而增加。当缓存超出内存容量时,这些缓存该如何处理,这本身就是一个工程问题;我们基于戴尔和Solidigm硬件构建的关于键值缓存卸载到闪存的深度研究,是我们迄今为止发表的关于该主题的最佳论述。
一台能够轻松处理一个 30B 级代理会话的机器,通常可以通过批处理服务器处理几个并行会话,延迟才会开始增加;而要处理数十个并发子代理,则需要服务器,它需要足够的内存来存储大量实时上下文,以及像 vLLM 这样专为连续批处理而设计的服务器引擎。此外,质量也存在上限,因为随着工具数量的增加,本地模型的可靠性会下降,而编排操作会增加工具数量和交接次数。
我们认为,单代理和少代理任务目前属于工作站的合理工作范畴,而大型子代理集群则属于基础设施任务。我们计划对这一界限以及跨越该界限所需的硬件进行更深入的研究。


 Amazon