

2026 年 10 月 13 日更新:复制通过公司风格;供应商简介、索赔跟踪器和数据保持不变。
各大存储厂商都声称自己销售最好的存储阵列,多年来,速度一直是衡量最佳性能的标准,但几乎没有厂商允许进行独立测试。戴尔、Everpure(前身为Pure Storage)、VAST、Weka、IBM、NetApp和华为都宣称自己拥有领先的性能,而这些宣称背后的几乎所有数据都来自厂商自身的内部测试,并附有“实际性能可能有所不同”的脚注。
本页面旨在梳理存储性能证据,因此我们将存储性能证据分为三类,并据此标注页面上的所有数据:经审核的基准测试提交结果(MLPerf Storage、IO500、SPC-1,厂商需按照公开规则提交结果)、厂商声明(规格表和发布数据,未经独立验证)以及StorageReview 实验室测试结果(我们自行测试的系统)。如果厂商拒绝我们测试其阵列,我们会明确说明;缺乏可验证数据也是事实。
人工智能存储领域的领导者
这些供应商会在构建人工智能训练集群或新云平台时出现。我们不对他们进行排名,因为目前还没有统一的衡量标准。我们能做的,是为每个供应商提供相同的信息:平台是什么,以客户名义部署在何处,NVIDIA 是否对其进行过验证,是否有经过审计的基准测试结果,以及哪些性能声明尚未得到证实。如果供应商在上述任何方面发布了新闻,我们会更新其资料。
前四家是人工智能原生存储专家,其余的是拥有人工智能产品线的成熟企业存储供应商。两组公司都赢得了实际部署项目;但他们所掌握的证据数量却截然不同。
VAST资料
平台: VAST AI 操作系统,基于 DASE(解耦式、共享一切)架构构建。无状态计算容器位于 NVMe-oF 协议下 NVMe 存储池的前端,并在文件、对象和数据库访问中呈现单一命名空间,所有存储介质均为 QLC,并配备存储级内存写入缓冲区。
VAST已与CoreWeave签署了一项价值1.17亿美元的多年期协议,该协议于2025年11月宣布,CoreWeave是VAST最大的客户。此外,VAST还参与了xAI Colossus Frontier AI Factory的扩展项目,并为运行在NVIDIA GB300 NVL72上的Mistral Compute AI工厂提供支持。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴,并通过 DGX SuperPOD 验证。
审计结果:无。VAST 从未向 MLPerf Storage 提交过数据。
公开声明: VAST 和 AMD 联合宣称,通过对 Instinct 进行 KV 缓存卸载,其首次令牌获取速度提升了 9 倍(基于厂商测试)。预计 2026 年 4 月的 F 轮融资,估值将达到 300 亿美元,这虽然设定了预期,但并非实际的性能数据。
我们过去一年的报道:
- VAST 和 AMD 声称,通过 KV 缓存卸载,首次令牌响应时间可提升 9 倍。 (Jul 2026)
- Cloudera 和 VAST 瞄准 GPU 资源匮乏问题 (Jul 2026)
- VAST 为 Mistral Compute 的 GB300 NVL72 人工智能工厂提供动力 (5月2026)
- VAST发布其智能体AI操作系统 (Feb 2026)
- VAST Amplify 旨在让现有 SSD 的性能提升 6 倍。 (Jan 2026)
- VAST引入了DPU原生推理架构 (Jan 2026)
WEKA
平台: NeuralMesh,这是一款软件定义的并行文件系统,前身为 WekaFS,以软件和 WEKApod 设备两种形式销售。NeuralMesh Axon 将相同的数据平面嵌入到 GPU 服务器中,因此本地 NVMe 可以加入集群,不再闲置。
已公布的部署案例: Nebius 将 NeuralMesh 作为其 AI 云的高级版本。Andromeda 于 2026 年 7 月在约 50 家 GPU 提供商中实现了 NeuralMesh 的标准化部署。WEKA 也是 CoreWeave 多厂商技术栈的一部分。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴,拥有 DGX SuperPOD 和 BasePOD 认证。
经审计的结果: WEKA 于 2024 年 9 月提交了 MLPerf Storage v1.0 版本,但未于 2025 年 8 月提交 v2.0 版本。其最近一次经审计的数据已过时一代。
公开宣称: WEKApod 3 搭载 NeuralMesh 6 技术,单机架容量可达 1.1 EB 和 10.2 TB/s。这些数据来自厂商,未经审计。
值得注意的是: HPE 于 2025 年 11 月终止了与 WEKA、Qumulo 和 Scality 的合作关系,因此 WEKA 不再通过 HPE 渠道接触买家。
我们过去一年的报道:
- Andromeda 在 50 多家 GPU 提供商中实现了 NeuralMesh 的标准化。 (Jul 2026)
- WEKApod 3 突破了单机架 EB 级存储的限制 (Jul 2026)
- NeuralMesh AIDP 正式发布 (Mar 2026)
- NeuralMesh 与 NVIDIA STX 集成,用于推理内存 (Mar 2026)
- WEKApod Prime 和 Nitro 下一代平台 (Nov 2025)
DDN
平台:两条产品线,其中EXAScaler是基于Lustre的并行文件系统,用于AI400X3和AI400X3M设备,负责训练任务。Infinia是一个键值对象平台,在2.4版本中增加了多租户和POSIX支持,主要面向推理和AI工厂工作负载。
已公布的部署项目包括: xAI Colossus,计划于 2024 年 11 月发布,将在 EXAScaler 和 Infinia 超级计算机上部署 20 万个 GPU。DDN 还拥有大量国家实验室和高性能计算 (HPC) 项目的部署记录,这些项目早于人工智能 (AI) 的发展周期。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴,并通过 DGX SuperPOD 认证。
经审核结果:是,且为最新结果。在 MLPerf Storage v2.0 测试中,AI400X3 在多节点 3D U-Net 环境下持续保持 120.68 GB/s 的吞吐量,并且在 2RU 机架式设备上处理 Llama3-8b 检查点时,读取速度达到 30.6 GB/s,写入速度达到 15.3 GB/s。由此可见,DDN 是此列表中性能最强的。
公开声明:通过 NVIDIA Dynamo 实现 KV 缓存加速,由 NVIDIA 与 Nebul 联合验证,而不是由独立机构验证。
我们过去一年的报道:
- DDN在2026年ISC展会上推出AI400X3M (2026 年 XNUMX 月)
- Infinia 2.4 新增了多租户和 POSIX 支持 (Jul 2026)
- DDN 和 Nebul 验证了 KV 缓存加速 (Jul 2026)
DDN 在性能密度方面领先于 MLPerf Storage v2.0,但没有参加 v3.0 轮比赛。
锤子空间
平台: Hammerspace 全球数据平台,以及 Tier 0 层,它将 GPU 服务器内部已有的本地 NVMe 存储转换为共享的、支持检查点功能的存储容量。该平台基于标准构建,采用并行 NFS(NFS 4.2 和 FlexFiles),运行在普通服务器上,无需任何专用设备,因此无需拍摄 Hammerspace 设备。
已公布的部署案例: Meta 在其工程博客上详细记录了 Hammerspace 在两个 24,576 个 GPU 的 H100 集群上的部署情况。这是本页所有厂商中,关于大规模 AI 存储部署的最具体的第一方案例,因为该案例是由运营商而非厂商撰写的。
NVIDIA 认证:无。Hammerspace 未获得 DGX SuperPOD、DGX BasePOD、NCP 参考架构或 NVIDIA 认证存储认证。
经审计结果:是,在 MLPerf Storage v1.0 和 v2.0 中均通过了审计。在 v2.0 中,Tier 0 在五个节点上使用 3D U-Net 协议实现了 420.8 GB/s 的吞吐量,加速器利用率达到 96.4%,同时为 140 个模拟的 H100 处理器提供数据。Hammerspace 在此列表中拥有最佳的审计参与记录,但其 NVIDIA 验证结果却最弱,这几乎与列表中其他所有公司的情况相反。
我们的报道: Hammerspace尚未经过StorageReview实验室的测试,我们近期的相关报道也比较少。这是我们自身的不足,并非对该平台的贬低。
Hammerspace 是 v2.0 版本的提交者,但也没有参加 v3.0 版本的评选。
戴尔技术
平台:包含三个产品,分别针对流水线的不同环节。PowerScale 是横向扩展的 NAS 产品线,采用全闪存 F 系列节点。ObjectScale 是 S3 层,于 2026 年实现了基于 RDMA 的 S3 和键值缓存卸载。Lightning 文件系统是一个全新的并行文件系统,于 2026 年 4 月正式发布,是戴尔用来对抗 DDN、VAST 和 WEKA 的产品。
已公布的部署案例:我们无法确认戴尔存储上是否存在已公布的大规模人工智能训练部署案例。目前最明确的公开案例是斯巴鲁,该公司在 PowerScale 上运行着一个驾驶安全人工智能实验室。对于这样规模的供应商而言,与那些人工智能原生供应商所宣称的云原生应用案例相比,这确实是一个显著的差距。
NVIDIA 认证: NVIDIA 认证存储启动合作伙伴,PowerScale 于 2025 年 7 月获得 NVIDIA 云合作伙伴计划认证。
审核结果:无。戴尔从未向 MLPerf Storage 提交过数据。
公开声明:戴尔声称 Lightning 是世界上速度最快的并行文件系统,其依据是内部分析,并宣称其 Exascale 存储能力可达每机架数 TB/s。这两项声明均列于下方的声明追踪表中。需要注意的是,Lightning 目前已正式发布,但其应用范围仅限于 AI 工厂构建,大多数用户在标准报价单中不会看到它。
我们过去一年的报道:
- 戴尔在 Gartner 2026 年企业存储魔力象限报告中继续保持领导者地位 (AUG 2026)
- ObjectScale 在 2U 机架式机箱内实现了 9.83PB 的存储容量,使用了 245TB 的 Kioxia SSD 和基于 RDMA 的 S3 服务。 (AUG 2026)
- 戴尔在第一季度外部存储产品的销量超过了IDC排名前五的其他厂商的总和。 (Jul 2026)
- PowerStore Gen 3 重置内部 (5月2026)
- PowerStoreOS 5.0 深度解析:第三代重置的软件部分 (Sep 2026)
- 2026 年 GTC 大会上的 Lightning 文件系统和百亿亿次级存储 (Mar 2026)
- 我们评测了 PowerEdge R5715,这是一款我们实际测试过的 2U 存储型服务器。 (Mar 2026)
HPE
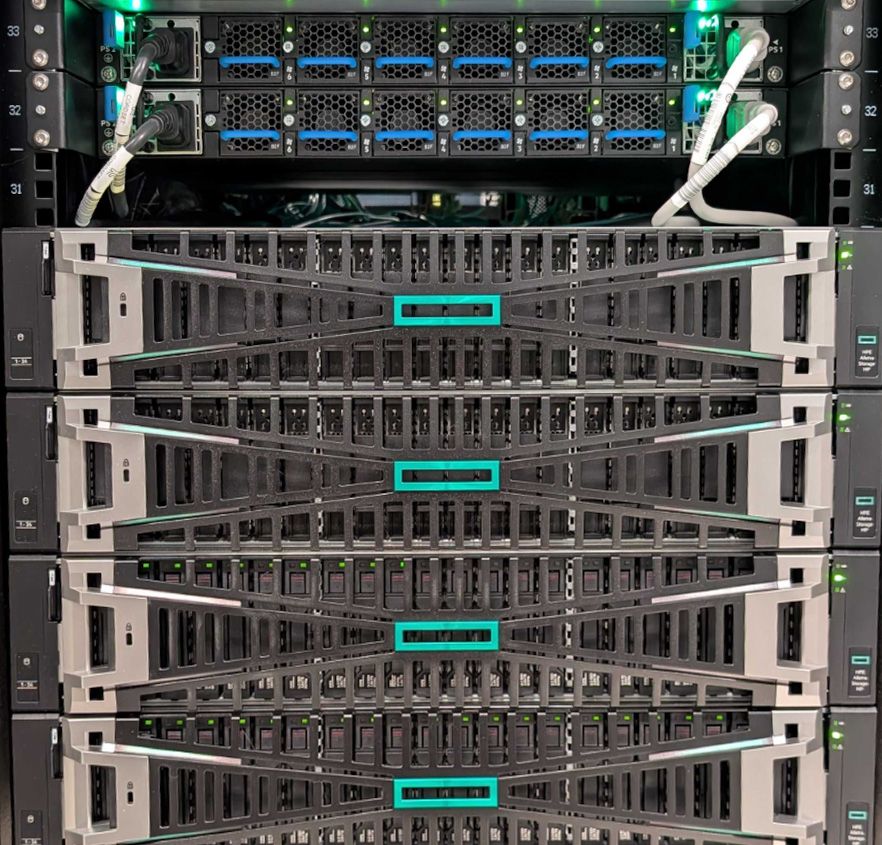
平台: Alletra Storage MP,分为用于块存储的 B10000 和用于对象存储的 X10000,以及用于文件存储的 GreenLake。HPE 还销售与之配套的计算和网络设备,其大部分 AI 存储产品都是通过这些设备交付的。
已命名的部署方案: Sovereign AI 和 AI 工厂构建,其中 HPE 提供全栈解决方案。没有像上述 VAST、WEKA 或 DDN 示例那样具有可比拟的已命名 NeoCloud 解决方案。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴,拥有 DGX BasePOD 和 SuperPOD 认证。
经审核结果显示: HPE 参与了 MLPerf Storage 的每一轮评测(从 v1.0 到 v3.0),在参与度方面领先于戴尔和 NetApp。不过,需要仔细阅读文件端的评测结果:HPE 最强的 AI 文件性能数据来自与 WEKA 的联合提交,但 HPE 已于 2025 年 11 月终止了与 WEKA、Qumulo 和 Scality 的合作关系。因此,这些评测结果已不再适用于 HPE 目前能够销售的产品。
我们过去一年的报道:我们已经对 Alletra 平台进行了实际测试。
- HPE 在 Gartner 2026 年企业存储魔力象限报告中继续保持领导者地位 (AUG 2026)
- Alletra Storage MP B10000 与 NIST CSF 2.0 的对比测试,我们的实际操作测试 (2026 年 XNUMX 月)
- Alletra Storage MP X10000 配备数据保护加速器节点 (Feb 2026)
- CloudCasa 为 B10000 添加了 Kubernetes 灾难恢复功能 (2026 年 XNUMX 月)
- MLPerf Storage v3.0:在 3D U-Net 上使用 K3000 时达到 345.8 GiB/s,K3000 是本页上仅有的两家提交此轮测试结果的供应商之一。
IBM
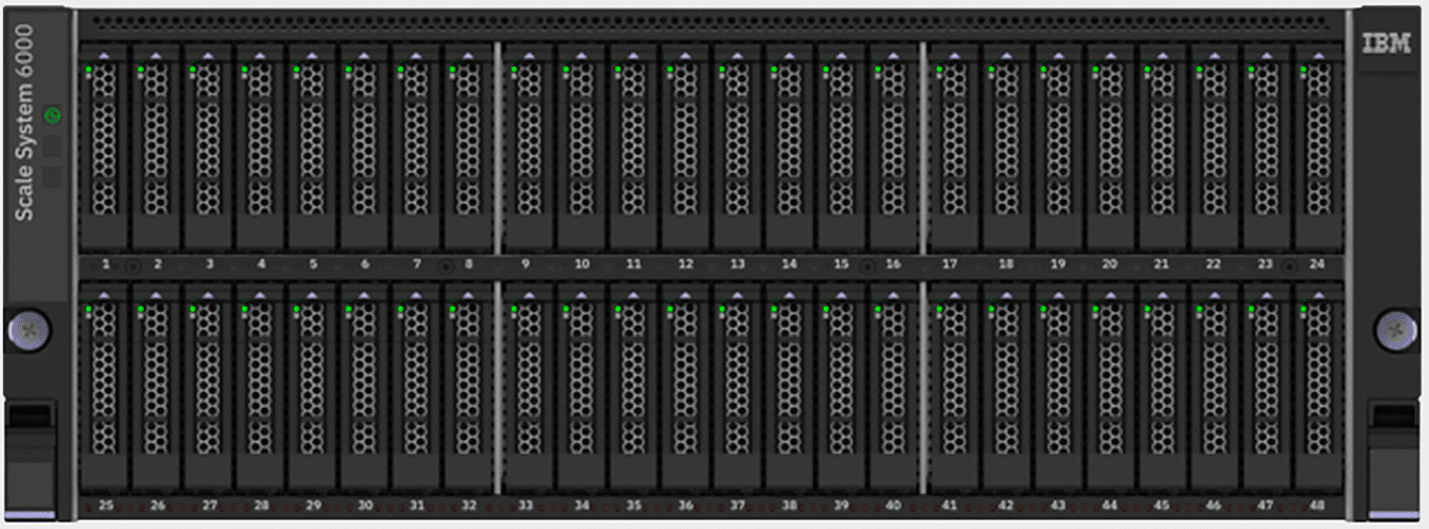
平台: IBM Storage Scale,具有 GPFS 血统的并行文件系统,以软件和 Storage Scale System 设备的形式销售,Fusion 将其打包用于 Kubernetes 和 AI 管道。
已公布的部署方案: CoreWeave 多厂商堆栈的一部分。IBM Cloud 还与 Together AI 合作,正在构建一个价值 2.4 亿美元的专用 HGX B300 推理集群,预计将于 2026 年 8 月发布,但存储层尚未公布。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴。
经审计的结果:是的,在 MLPerf Storage v2.0 中,包括检查点工作负载在内,Storage Scale 在 Llama 3.1 1T 型号上实现了 656.7 GiB/s 的读取速度。检查点恢复速度是衡量故障导致前沿训练运行损失的指标,而很少有厂商公布过这方面的审计数据。
公开声明:在最快阵列类别中并无突出表现。IBM Storage Scale 的市场定位侧重于规模和集成,而非惊人的吞吐量记录。
我们过去一年的报道:
- IBM 在 Gartner 2026 年企业存储魔力象限报告中继续保持领导者地位 (AUG 2026)
- IBM 和 Together AI 共同投资 240 亿美元,用于建设专用的 HGX B300 推理集群。 (AUG 2026)
- IBM推出面向RAG工作负载的内容感知存储 (Apr 2026)
- 具备智能体的下一代闪存系统 (Feb 2026)
- Storage Scale System 6000,面向人工智能和高性能计算的统一存储 (Nov 2025)
- 我们对 IBM FlashSystem 5300 进行了评测,实际体验了 IBM 的这款紧凑型阵列,并了解了它如何与更大型的系统进行对比。 (Sep 2024)
Everpure(原名 Pure Storage)
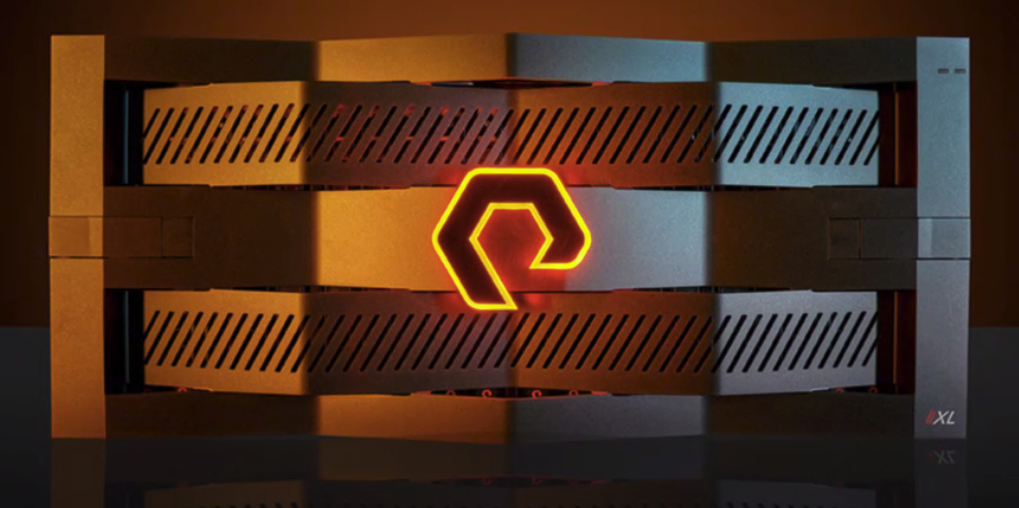
平台: FlashBlade//EXA 是面向人工智能的入门级产品,它将元数据和数据路径分离,从而使数据平面能够独立扩展。FlashBlade//S 和 FlashArray 则涵盖了其他方面。Everpure 自行生产 DirectFlash 模块,而不是购买成品 SSD,因此其密度和耐久性数据与市场上的其他产品有所不同。该公司于 2026 年 2 月 23 日正式更名为 Everpure。
已命名的部署:这是 CoreWeave 多厂商堆栈的一部分。我们无法确认 FlashBlade//EXA 上是否存在已命名的 AI 训练部署。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴。
经审核的结果: MLPerf Storage v3.0(2026 年 9 月),Everpure 的首次提交:在 30 个 FlashBlade//EXA 数据节点上实现了 877.5 GiB/s 的检查点写入速度和 833.0 GiB/s 的读取速度,均为该轮测试中最高的检查点写入速度,同时还创下了该轮测试中最高的键值缓存速度,达到 1,623.4 GiB/s。此外,它还保持着 SPECstorage Solution 2020_ai_image 的记录,AI 作业数达到 6,300 个,该记录于 2026 年 2 月 17 日发布。虽然基准测试和工作负载模型有所不同,但这是在已发布的规则集和审核流程下提交的真实案例,因此具有统计意义。
公开声明: FlashBlade//EXA 被宣传为业界性能最高的数据存储平台,预计单命名空间吞吐量超过 10 TB/s。此为预计值,未经实测。
我们过去一年的报道:
- Everpure连续第二年蝉联2026年Gartner魔力象限报告两大维度榜首 (AUG 2026)
- Everpure推出面向企业AI管道的数据流 (2026 年 XNUMX 月)
- 数据智能和企业数据云增强功能 (2026 年 XNUMX 月)
- 本次评测使用 Emulex SecureHBA 搭配 Everpure XL130 R5,并非 AI 基准测试,而是实际体验 Everpure 硬件。 (Mar 2026)
- MLPerf Storage v3.0(2026 年 9 月):首次提交,在 FlashBlade//EXA 上实现了 877.5 GiB/s 的检查点写入速度和 833 GiB/s 的读取速度,以及 1,623 GiB/s 的 KV 缓存读取速度,是本轮中最大的检查点和推理速度。 v3.0 版本全面覆盖.
NetApp的
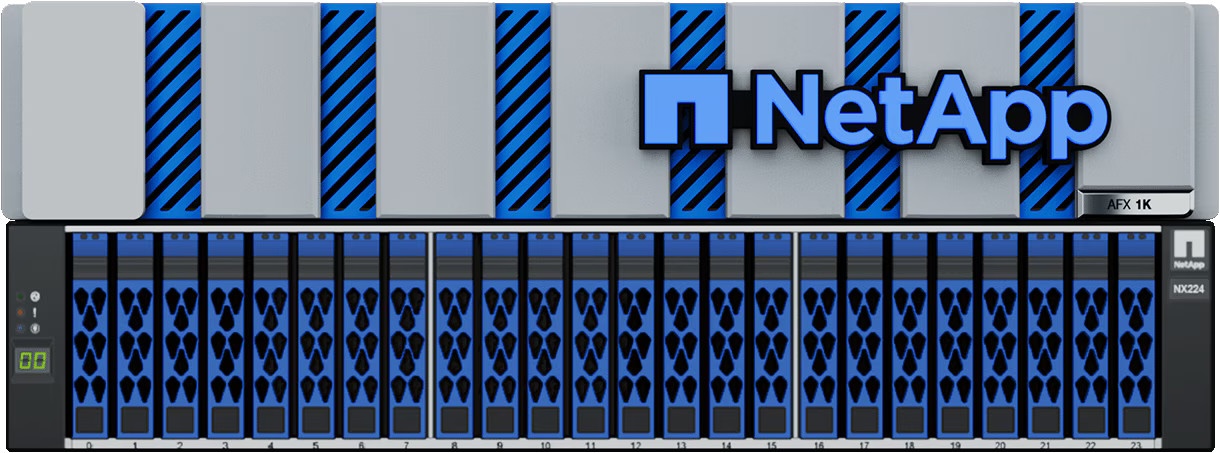
平台: AFX 于 2025 年 10 月发布,是一款专为 AI 数据管道构建的全闪存解耦式 ONTAP 系统,其上叠加了 AI 数据引擎。AIPod 是 NVIDIA 验证的参考设计。Novus 在 INSIGHT 2026 上发布,现已接受预订,其定位高于 AFX,专为 AI 工厂打造:pNFS 元数据传输到运行在经过认证的 Supermicro 服务器上的 Data Director 节点,而 AFF A90 HA 对则负责传输数据,客户端采用标准的 Linux pNFS 文件系统,GPU 服务器上无需任何专有代理。
已公布的部署案例:目前尚无任何大规模人工智能训练部署案例可供确认。最可靠的公开资料是经过验证的架构,而非客户名称,例如思科于 2026 年 6 月推出的 FlexPod 人工智能设计。
NVIDIA 认证: NVIDIA 认证存储产品发布合作伙伴,拥有 DGX SuperPOD 认证。
经审计的结果: MLPerf Storage 中未发现任何问题,NetApp 也从未参与过该项测试。在 Novus 之后,NetApp 引用了 Omdia 审计的一项测试,该测试表明,当 ONTAP 集群加入同一个命名空间时,扩展性接近线性;100 TB/s 的标题是 Omdia 基于该测试的建模结果,而非实际测量结果。
我们过去一年的报道:
- Novus 将 pNFS 元数据从 AFF A90 数据节点分离出来,目标吞吐量为 100 TB/s。 (十月2026)
- NetApp 在 Gartner 2026 年企业存储魔力象限报告中继续保持领导者地位 (AUG 2026)
- HCLTech 将 Keystone 与 U4X 结合,实现基于消费的 AI 存储。 (AUG 2026)
- NetApp 收购 DataPelago,用于 GPU 数据处理 (Jul 2026)
- StorageGRID 12.1 新增了联合命名空间,最高速度可达 12 TB/s。 (2026 年 XNUMX 月)
- FlexPod 与思科合作验证了 AI 架构。 (2026 年 XNUMX 月)
- AFX发布会 (十月2025)
关于华为的一点说明
华为在 MLPerf Storage v2.0 测试中取得了最高的绝对吞吐量,在 3D U-Net 测试中,一台 8U 双节点 OceanStor A800 存储设备同时为 255 个模拟 H100 设备提供数据,吞吐量高达 698 GiB/s,该数据已列入下方的审计表格。我们将其从领导者象限中移除,因为对于美国、欧洲以及本页面所涵盖的大多数市场而言,这并非一款实用型产品。吞吐量数据属实,但实际供货情况可能并非如此。2026 年 Gartner 魔力象限报告从另一个角度也得出了类似的结论,华为凭借 OceanStor 在北美以外市场的强劲表现,继续保持在领导者象限。
分析师怎么说
分析师排名本身就是一种独特的证据:它并非经过审计的基准,而是对执行力和愿景的独立评估,这更贴近这些系统的实际采购方式。在2026年Gartner企业存储平台魔力象限报告中,与去年一样,六家厂商依然占据领导者象限:Everpure、华为、HPE、NetApp、戴尔和IBM。其中,Everpure连续第二年在执行力方面排名第一,并在愿景完整性方面遥遥领先。
本页内容需注意两点:Gartner 对主存储市场和高性能文件及对象存储市场分别进行独立研究,后者正是上文提到的 AI 原生存储专家的领域,因此它们未出现在象限图中仅代表类别划分,而非最终结论。当八家受评厂商中有六家获得“领导者”称号时,称号本身对买家意义不大;相对排名才是关键所在。
什么会改变这份清单
以下四点按重要性排序:供应商允许我们按照我们的方法测试其平台,无论是我们可以自行托管的硬件,还是更大规模的部署。供应商提交了当前已审核的测试报告,例如 MLPerf Storage 或 SPECstorage。运营商(而非供应商)记录了部署情况,就像 Meta 对 Hammerspace 所做的那样。或者,供应商失去了其当前地位所依赖的认证或合作伙伴关系,例如 WEKA 和 HPE 的分拆改变了两家公司接触 AI 买家的方式。我们会根据这些情况更新相关资料。
经审计的基准结果显示
2026 年,人工智能训练及其所依托的新云服务提供商将成为存储性能竞争的焦点,而 MLCommons MLPerf Storage 正是这方面拥有完善的、经过审计的基准测试的领域。目前已发布的版本为 v3.0(2026 年 9 月),共有 19 家机构提交了测试结果,共计 143 个测试结果。该基准测试首次涵盖了完整的 AI 流水线:训练吞吐量、检查点机制以及两项新的推理测试(向量数据库和键值缓存),此外还支持 S3 对象存储,约有六分之一的提交结果使用了 S3 对象存储。
由于 v3.0 将模拟加速器从 H100 迁移到了 B200,因此结果与之前的版本不具可比性。MLPerf Storage 不会评选出唯一的赢家;不同的系统在不同的工作负载和指标上表现各异。
| 系统 | 审计结果(MLPerf 存储 v3.0) | 增益级 |
|---|---|---|
| Everpure FlashBlade//EXA | 30 个数据节点上的检查点写入速度为 877.5 GiB/s,读取速度为 833 GiB/s;键值缓存读取速度为 1,623 GiB/s | 检查点和推理领导者 |
| 炎荣科技 F9000X | 在 3D U-Net 上,数据传输速率为 543.9 GiB/s,用于连接 99 台模拟的 B200 加速器。 | 提交的最高训练吞吐量 |
| 图灵数据 F9200 | 在 3D U-Net 上,来自三个存储节点的读写速度为 541.5 GiB/s;Checkpoint-70B 的读取速度为 539.9 GiB/s,写入速度为 307.1 GiB/s。 | 性能密度新秀 |
| Azure 托管 Lustre | 从一个 4,096TiB 的托管云部署中以 642.2 GiB/s 的速度写入检查点 | 首个超大规模云服务提交 |
| NVIDIA AI商店 | 通过 OCI、AWS 和 GCP 上的 S3 对象存储提交了 20 个请求 | 并行文件系统领域的对象存储 |
在高性能计算 (HPC) 领域,IO500 榜单(ISC 2026 版)由 SCNet 的 Sugon ParaStor 领衔,其在 500 个客户端节点上测得的带宽为 26,888 GiB/s。英特尔 DAOS 系统(Argonne Aurora、LRZ)占据多个榜首位置,Weka 则通过三星 SSC-24 上榜。v3.0 的更迭与数据同样引人注目:v2.0 吞吐量领先者 DDN、华为、Hammerspace 和 Lightbits 均未参与本次评选,而 11 家首次提交榜单的公司上榜,其中包括 Azure 和 NVIDIA。完整分析请参见我们的MLPerf Storage v3.0 报道。
谁在为新云提供动力?
部署成功案例并非衡量标准,但它们真实反映了运营商在追求卓越性能时会选择哪些解决方案。值得注意的是,规模最大的AI工厂都是多供应商合作的;没有任何一家存储公司完全拥有这些站点。
| AI云 | 存放 | 信息 |
|---|---|---|
| 核心编织 | VAST Data(以及堆栈中的 WEKA、DDN、IBM Storage Scale 和 Everpure) | 一份价值1.17亿美元的多年期协议,将于2025年11月生效,VAST的最大客户 |
| xAI巨像 | DDN EXAScaler 和 Infinia,以及 Frontier AI Factory 扩展包中添加的 VAST 数据 | DDN于2024年11月宣布将推出10万个GPU;到2025年底将实现多厂商合作。 |
| 内比乌斯 | WEKA 神经网格 | Nebius AI Cloud 的高级版将于 2025 年 6 月发布。 |
| 一起人工智能 | IBM 云(HGX B300 系统) | 2.4亿美元的交易将于2026年8月宣布;存储层尚未披露。 |
理赔追踪器
这些是目前人工智能存储领域宣称的“最快”速度。但所有这些速度都未经独立机构在宣称的规模下进行验证;大多数厂商都在脚注中注明是内部测试,而表格中最有力的来源也只是分析师审核的一项测试,其背后却隐藏着一个预测性标题。
| 供应商索赔 | 联系电话 | 状态 |
|---|---|---|
| Everpure FlashBlade//EXA,“业界性能最高的数据存储平台”(2025年3月) | 预计单个命名空间内的读取速度将超过 10 TB/s | 供应商预测;未提交经审计的资料 |
| 戴尔 Lightning 文件系统,“世界上速度最快的并行文件系统”(2026 年 4 月正式发布) | 根据戴尔内部分析,每个机架单元最高可达 150 GB/s。 | 供应商声明;未提交经审计的资料 |
| 戴尔百亿亿次级存储(GTC 2026) | 每个机架最高可达 6 TB/s。 | 供应商声明;未提交经审计的资料 |
| 华为新一代 OceanStor Dorado(2024 年 9 月) | 规格表显示,其 IOPS 上限为 100 亿,延迟为 0.03 毫秒。 | 厂商规格;华为委托 Omdia 进行的测试在真实的 Oracle RAC 工作负载下,持续 IOPS 达到 2.58 万,延迟为 70 微秒,这对规格表上的最大数值进行了有用的实际检验。 |
| WEKA,WEKApod 3 搭载 NeuralMesh 6,单机架 EB 级容量宣称(2026 年 7 月) | 一个机架即可实现 1.1 EB 和 10.2 TB/s 的读写速度 | 厂商声明:WEKA 最后一次向 MLPerf Storage 提交数据是在 v1.0 版本,而跳过了 v2.0 版本。 |
| VAST Data 和 AMD,Instinct 上的 KV 缓存卸载(2026 年 7 月) | 首次令牌获取速度提升 9 倍 | 联合厂商测试;VAST从未向MLPerf Storage提交过测试结果。 |
| DDN 和 Nebul,利用 NVIDIA Dynamo 实现 KV 缓存加速(2026 年 7 月) | 厂商宣称推理工作负载速度提升 | 合作伙伴验证,而非独立审计;DDN 确实拥有最新的 MLPerf Storage v2.0 结果。 |
| NetApp Novus,“地球上速度最快的存储设备”(2026 年 10 月) | 预计单个 pNFS 命名空间内的顺序读取速度将达到 100 TB/s | Omdia 审计显示,在较小的集群上实现了近乎线性的扩展;100 TB/s 的数据是 Omdia 根据该测试得出的预测值,并非实际测量值。 |
SPC-1后来怎么样了?
SPC-1 曾是业界公认的块存储基准测试,如今已基本处于停滞状态:美国厂商在 2018 年左右就已基本放弃该测试,导致排行榜被中国厂商垄断。目前公认的最高纪录并非广为人知的华为成绩。ExponTech WDS V3 以 2720 万 SPC-1 IOPS 的成绩位居榜首(该成绩于 2023 年 11 月获得认可),领先于浪潮的 2300 万,而华为在 2020 年创下的 2100 万 IOPS 的成绩则位列第四。FlashNexus 提交的 3000 万 IOPS 的更高成绩自 2025 年 2 月以来一直处于审核阶段,尚未被认可,在存储性能委员会 (SPC) 正式认可之前,我们暂不将其视为纪录。
本页面使用方法
本页面遵循三条规则。第一,所有数据均标明其证据类别:经审核提交、厂商声明或 StorageReview 测量结果。第二,我们不会重复使用无法提供最新数据来源的最高级描述;本页面上一些著名的“最快”说法已过时多年,并已相应标记。第三,任何厂商均可通过以下方式进入本页面的验证页面:提交至 MLPerf Storage 或 IO500,或授权我们按照标准方法进行测试。
本页面仅涵盖人工智能和新云存储。主流企业级块存储和文件存储以及中小企业存储将另行创建页面,此处暂不赘述,因为各细分领域的证据有所不同。我们会根据最新动态更新领导者概况,并在新一轮审计结果发布时进行全面审核。
最快存储常见问题解答
世界上速度最快的存储阵列是什么?
目前尚无唯一经过验证的答案,任何给出答案的人都只是引用了厂商的说法。根据截至2026年9月的审计数据:Everpure的FlashBlade//EXA在MLPerf Storage v3.0测试中创下了877.5 GiB/s的写入速度纪录;YanRongTech的F9000X在训练吞吐量方面领先,达到543.9 GiB/s;Sugon ParaStor在IO500带宽榜单中名列前茅;ExponTech保持着公认的SPC-1 IOPS纪录。包括戴尔的单机架百亿亿次级存储预测在内的最高宣称数据,仍未经独立验证。
AI训练最快的存储方式是什么?
根据唯一经过审计的AI存储基准测试MLPerf Storage v3.0的评测,训练吞吐量领先的是YanRongTech、TuringData和UBIX,而Everpure在检查点和键值缓存推理方面领先,Azure则在云服务中拔得头筹。从最大的AI运营商的部署情况来看,VAST、DDN和WEKA在新型云服务领域占据主导地位,尽管这三家公司均未提交v3.0测试结果,但以上两种证据均已标注。
为什么针对企业级阵列的独立基准测试如此之少?
由于大多数企业级存储厂商在合同中禁止发布基准测试结果,而主流阵列厂商也于 2018 年左右放弃了他们曾经使用的公开基准测试(尤其是 SPC-1),因此面向人工智能领域的厂商在一定程度上扭转了这一趋势,因为参与 MLPerf Storage 已成为销售要求之一。我们会随着新的经审核结果的发布更新此页面。
在购买阵列时,是否应该考虑抗量子加密?
对于受监管行业而言,答案是肯定的,而且截止日期比看起来更近。美国国家安全局 (NSA) 的 CNSA 2.0 指南要求新建的国家安全系统必须在 2027 年 1 月前符合规定,不合规的系统必须在 2030 年底前退役;欧盟的 NIS2 和 DORA 框架也都有各自的加密要求。
FC-SP-3 标准的完善使得这不再是一个项目,而是一个采购细节:支持 FC-SP-3 的 HBA 卡采用后量子算法,以线速对传输中的 SAN 流量进行加密。由于加密发生在传输层,阵列仍然可以接收数据并进行压缩、去重和勒索软件异常扫描,从而绕过应用层加密。在正常的每三到五年一次的更新采购中指定 FC-SP-3 连接,即可在 2030 年前实现完全加密的 SAN。
硬件方面,中端产品已经可以出货:目前所有戴尔 PowerStore Gen 3 的 OCP 插槽都配备了支持 EDIF 的光纤通道卡,戴尔计划通过 PowerStoreOS 5.1 软件更新(不中断服务)来实现线路加密功能,相关内容已在我们的PowerStoreOS 5.0 深度评测文章中介绍。我们的FC-SP-3 深度评测文章则涵盖了该标准、截止日期和部署模式。


 Amazon