

更新于 2026 年 10 月 24 日:Mac Studio 的答案现已反映出苹果公司于 9 月开始发货的 M5 Max 和 M5 Ultra 机型,64GB DGX Spark 的说明也已更新至 10 月 23 日发布;推荐配置保持不变。10 月 20 日,入门标准变为:在 Linux 系统下使用 vLLM 内存,并配备两个或更多 GPU;或者拥有至少 96GB 的共享内存池。
本页排名的所有系统均经过 StorageReview 实验室的测试。我们直接对本地 AI 性能进行基准测试:vLLM 在线服务吞吐量、首次令牌获取时间以及每个输出令牌的计算时间,测试模型包括 GPT-OSS-120B、Llama 3.1 8B、Mistral Small 3.1 24B 和 Qwen3 Coder 30B,此外还包括 MAMF 计算效率和 GDSIO 存储测试。所有系统排名均非基于规格表。
2026 年本地 AI 桌面系统的关键问题在于统一内存与独立显存的选择。NVIDIA 基于 GB10 的 DGX Spark 和 AMD 的 Ryzen AI Max(Strix Halo)等桌面级设备,以设备的价格,将 128GB 的统一内存集成到单个芯片后,即可支持原本需要多个独立 GPU 才能实现的型号。
工作站塔式机凭借其强大的吞吐量脱颖而出:RTX PRO 6000 Blackwell 系列显卡每秒可处理更高的令牌数,但成本和功耗也高出数倍。本页面使用同一套测试套件,将两者分别进行分级排名,因为最终选择取决于您计划运行的最大型号以及您所需的响应速度。
一览
| 类别 | 系统 | 内存 | GPU(测试/最高) | 全部评论 |
|---|---|---|---|---|
| 最佳桌面人工智能系统 | NVIDIA DGX Spark | 128GB 统一 LPDDR5X | GB10集成(固定) | DGX Spark 评测 |
| 最佳 GB10 实现 | 宏碁Veriton GN100 | 128GB 统一 LPDDR5X | GB10集成(固定) | Veriton GN100 评测 |
| 最佳 x86 替代方案 | AMD 锐龙 AI Halo(Strix Halo) | 最高支持 128GB 统一 LPDDR5X 内存 | Radeon 8060S 集成显卡(固定) | Ryzen AI Halo 评测 |
| 最好不要使用独立显卡 | HP Z2 Mini G1a | 统一LPDDR5X(运行GPT-OSS 120B) | 集成显卡,无独立显卡(已修复) | Z2 Mini G1a 评测 |
| 最佳GB300系统 | MSI XpertStation WS300(替代产品:ASUS ET900N G3) | 748GB 一致性(252GB HBM3e + 496GB LPDDR5X) | GB300集成(固定) | XpertStation WS300 评测 |
| 本地人工智能的最佳塔 | 戴尔Precision 7875 | 192GB GDDR7 (2× 96GB) | 2× RTX PRO 6000 / 2 最大 | Precision 7875 评测 |
| 最佳多GPU平台 | HP Z8 Fury G6i | 经测试,最大支持 192GB GDDR7 显存 / 最高可达 384GB | 已测试 2 块 RTX PRO 6000 / 最多 4 块 | Z8 Fury G6i 评测 |
| 极致之选 | Comino Grando RTX PRO 6000 | 768GB GDDR7 (8× 96GB) | 8× RTX PRO 6000 / 8 最大 | Comino Grando 评论 |
桌面人工智能设备
戴尔称之为桌面AI、英伟达称之为个人AI超级计算机的设备层级,以牺牲峰值吞吐量为代价,换取更高的模型容量、能效和价格。这些系统配备128GB统一内存,能够轻松运行高量化的70B级模型,甚至可以扩展到120B级,而这些工作负载通常需要塔式计算机上配备多个独立GPU才能完成。
本级别必备实验室阅读材料:我们的DGX Spark 热测试对比了以下 GB10 系统中的 OEM 散热设计,该测试适用于此类中的所有设备,直到这些平台进行修订为止。
最佳桌面AI系统:NVIDIA DGX Spark
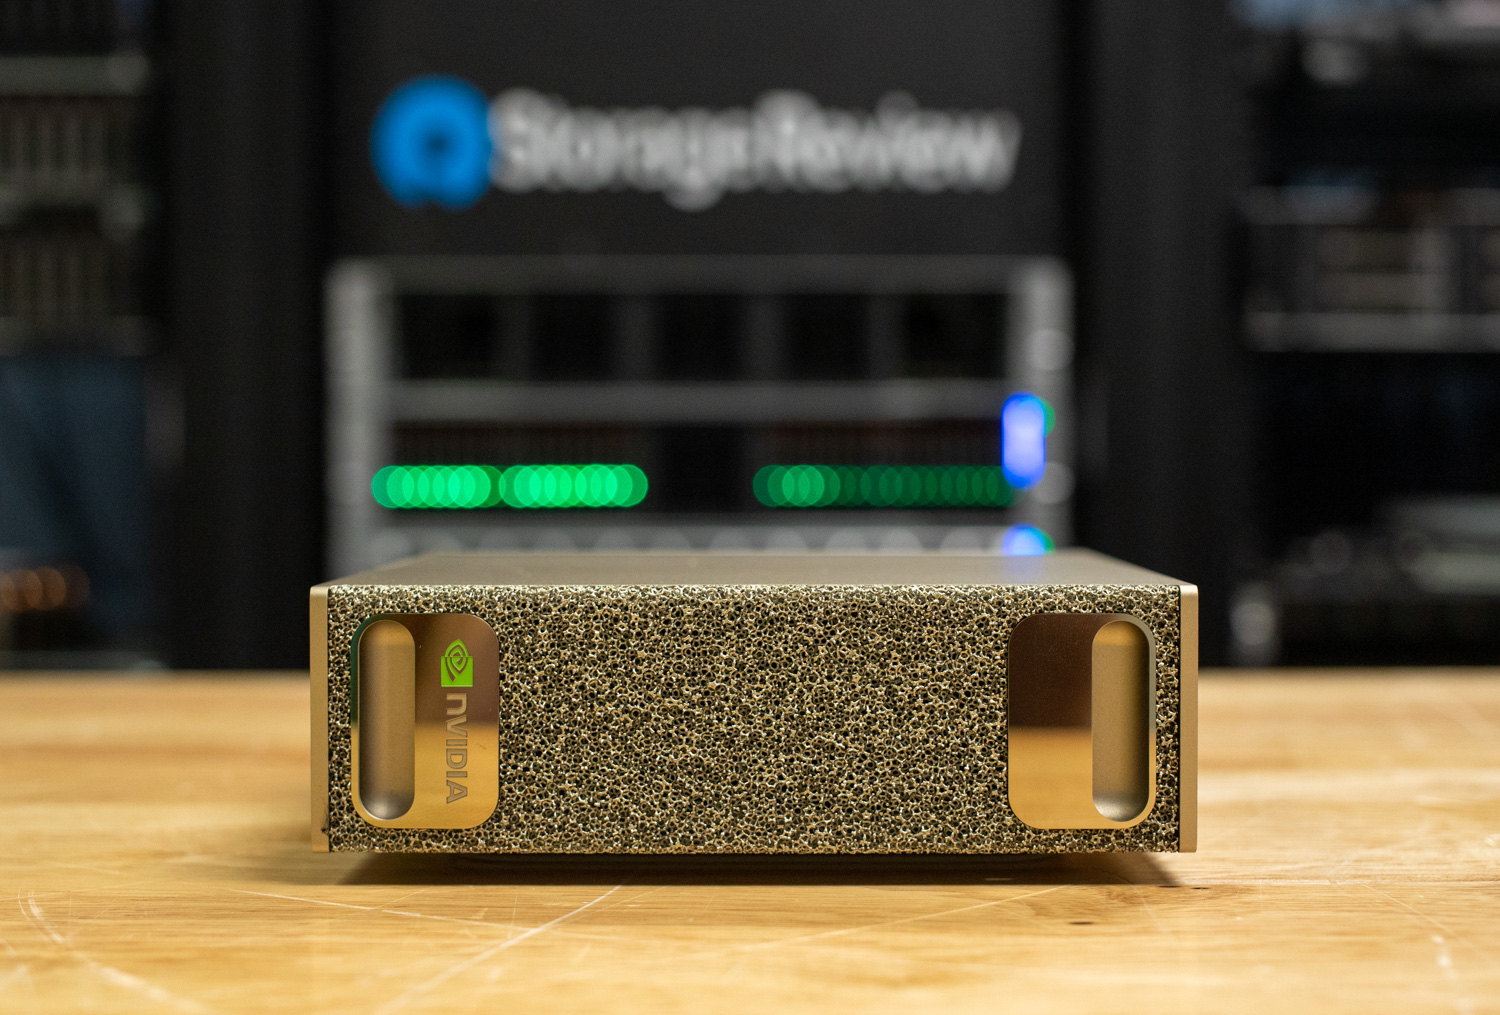
DGX Spark 是衡量其他所有桌面级 AI 设备的标杆。它搭载GB10 Grace Blackwell 超级芯片,配备 20 核 Arm CPU 和 128GB 统一 LPDDR5X 内存,以及双 ConnectX-7 200GbE 端口,是我们测试过的唯一一款开箱即用即可集群的设备:我们的双节点分布式推理测试在 Dell、GIGABYTE 和 HP 的节点上通过 200GbE 网络运行了流水线并行工作负载。
如今,集群存储方案有了更经济实惠的切入点:NVIDIA于 10 月 23 日发布了 64GB 的 DGX Spark SKU,售价 4,999 美元,通过相同的六家 OEM 厂商销售。两块 DGX Spark 可以通过一根 200GbE 网线连接,组成 128GB 的存储池;NVIDIA 声称,在 Qwen3.8 27B 测试中,集群存储的性能可达单块 128GB 存储的 1.7 倍,但我们尚未对此进行测试。其 CUDA 软件栈仍然是同类产品中最强大的。
该平台的唯一硬性限制是存储:每个 GB10 系统在单个短 M.2 插槽上的容量上限约为 4TB。我们采用八台 Spark 共享存储方案来解决这个问题:一个受控的 QLC 阵列通过每台 Spark 系统自带的 100GbE 端口提供服务,其中单个客户端的读取速度为 10.8GiB/s,与我们在 GB10 系统中测得的最快内部 M.2 固态硬盘速度相当;此外,集中托管的 78GB 固态硬盘的负载速度与本地 NVMe 固态硬盘的负载速度相差不到 13%。
最佳 GB10 实现方案:宏碁 Veriton GN100
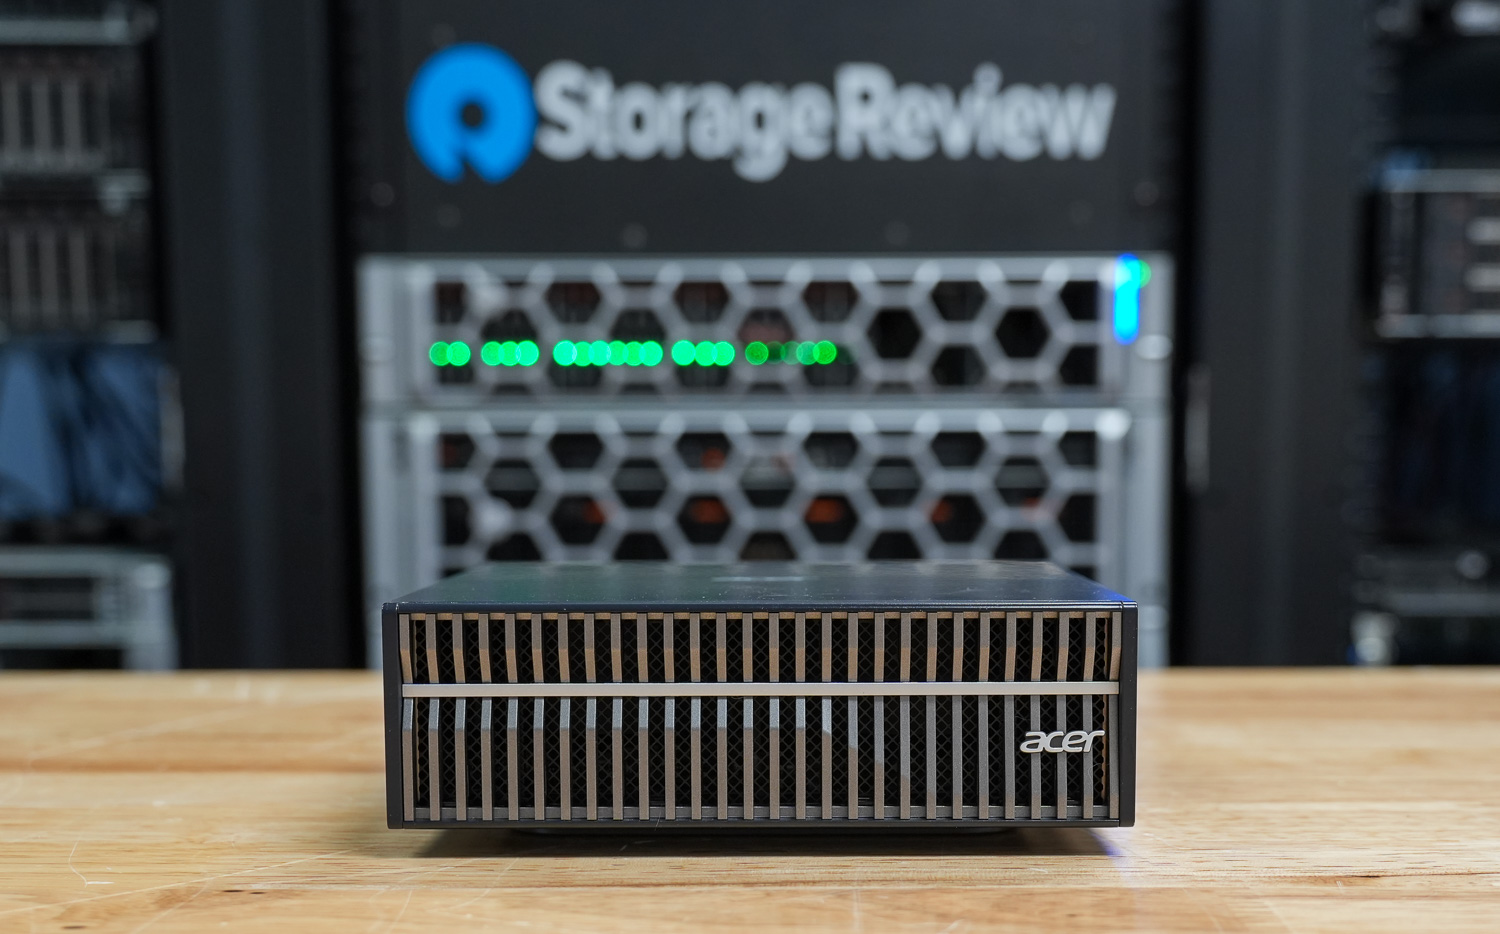
在GB10 OEM系统中,散热设计是真正的区别所在,而Veriton GN100在我们的测试中脱颖而出。所有GB10主机都采用相同的芯片和内存配置,因此持续性能取决于散热。据我们所知,我们此次对多厂商主机散热性能的对比测试是目前唯一公开发表的此类研究。
最佳 x86 替代方案:AMD Ryzen AI Halo
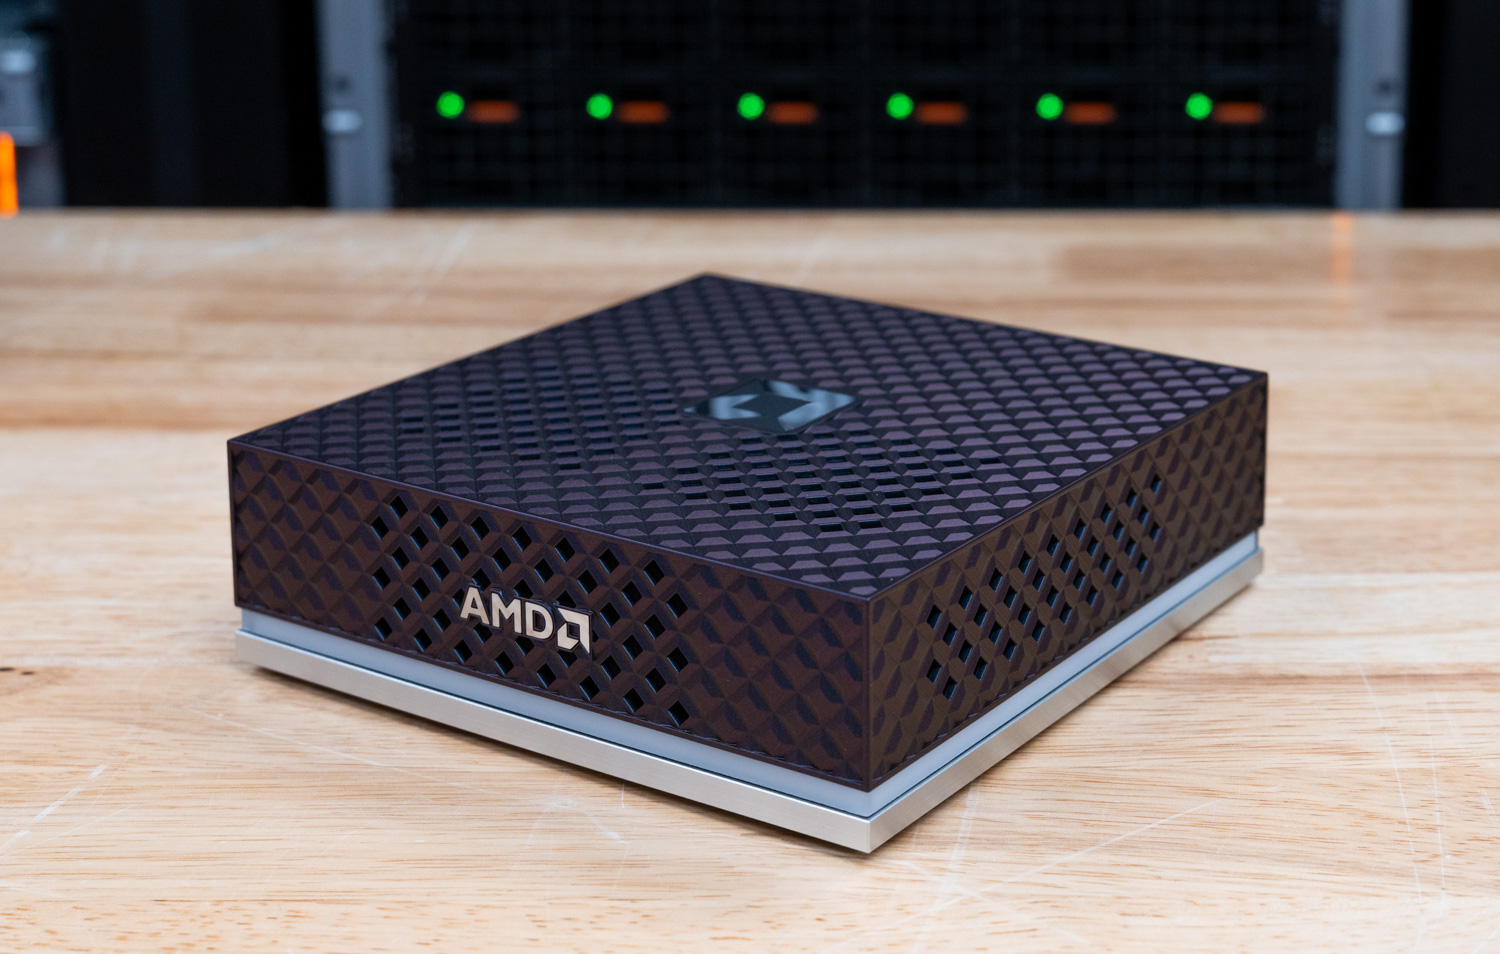
如果您需要 Windows 或标准的 x86 软件栈,Strix Halo 是桌面解决方案。AMD的 Ryzen AI Max+ 395 平台配备 128GB 统一内存和双操作系统配置,在我们的测试中,它能够处理 200 亿参数级别的模型,直接挑战 DGX Spark,而无需依赖 Arm/DGX 操作系统。
最佳无独立显卡机型:HP Z2 Mini G1a
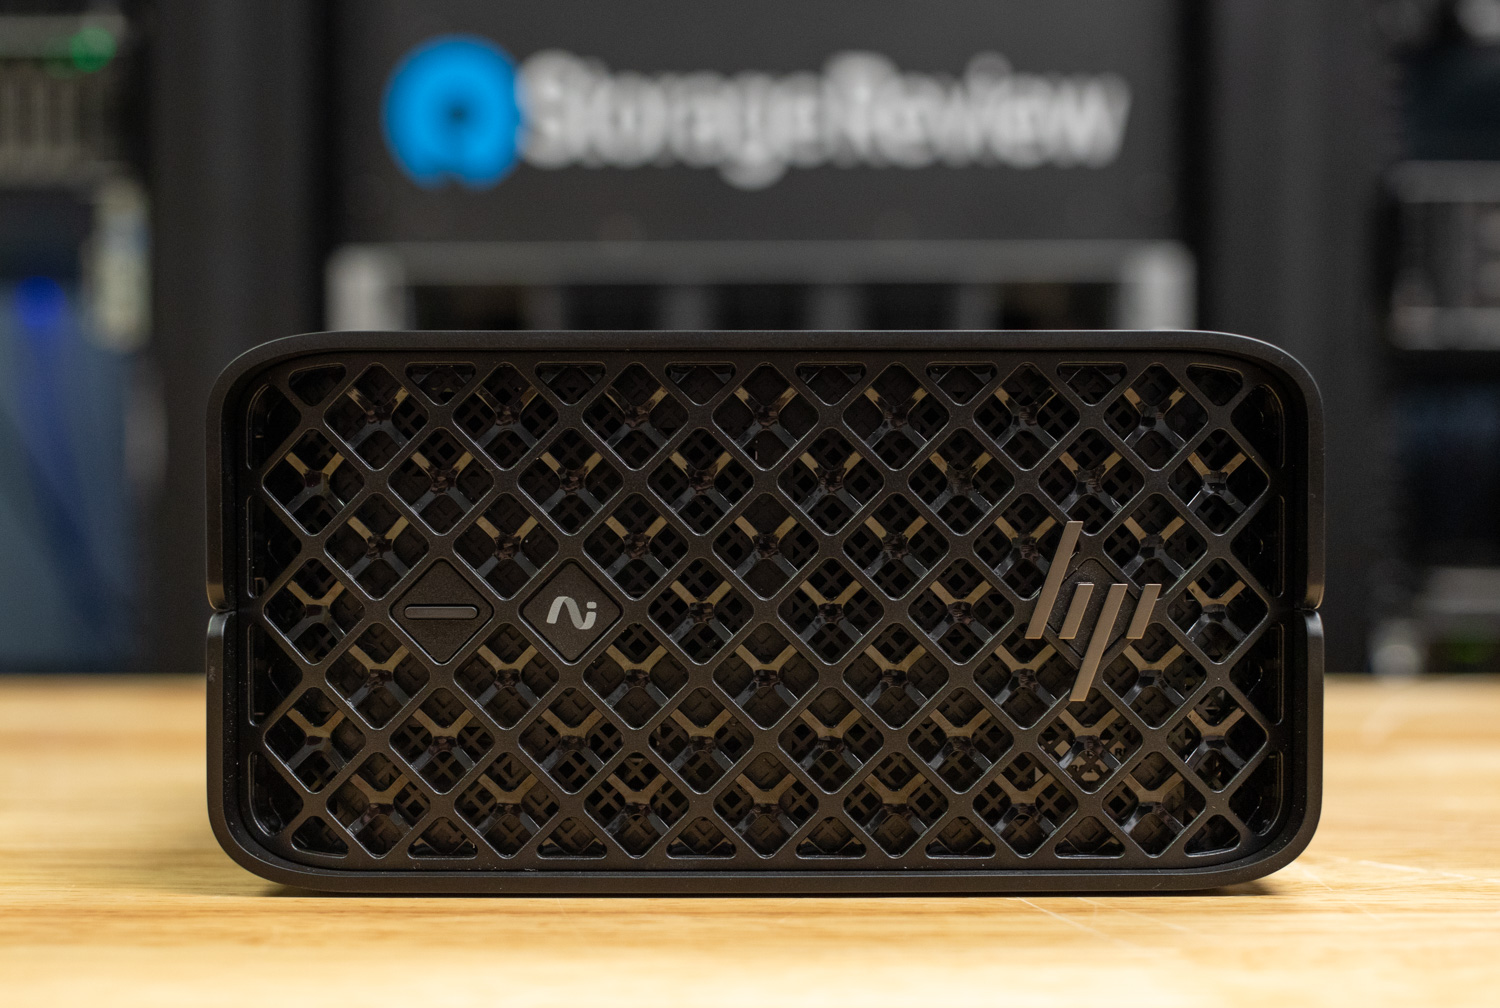
Z2 Mini G1a 运行的是 GPT-OSS 120B 分区表,完全没有配备独立显卡。惠普的这款迷你工作站将 AMD 的 Ryzen AI Max+ PRO 处理器装入紧凑、静音且对 IT 人员友好的机箱中,它仍然是统一内存 x86 系统如何改变小型办公电脑性能的最有力证明。
最佳 GB300 系统:MSI XpertStation WS300
WS300 是我们实验室测试的首台 GB300 DGX 工作站,它重新定义了设备级硬件的性能上限。Grace Blackwell Ultra 超级芯片拥有 748GB 的一致性内存,包括 252GB 的 HBM3e 和 496GB 的 LPDDR5X,支持 20 petaFLOPS 的 FP4 计算能力。在我们的测试中,它运行了一个 433GB 的 GLM-5.2 检查点,其中 216GB 的专家权重存储在 Grace 内存中。这样的配置显然不适合放在办公桌旁使用。与所有 DGX 系列系统一样,它运行的是 DGX 操作系统而非 Windows;如此庞大的内存容量需要相应的系统支持。
就价格和功耗而言,它更接近塔式机箱的高端产品,而非上一代GB10系列,但目前市面上还没有其他同类产品能与之匹敌。一个显而易见的问题——1,300W的功率在塔式机箱中是否会导致部分频率降低——现在有了确切的答案:我们对WS300进行了深入的散热测试,在2.8小时的持续运行中,Blackwell Ultra核心的温度保持在60℃,主频稳定在2.07GHz,没有出现任何温度波动,并且在满载情况下还留有大约20℃的散热余量。
GB300 的替代之选:华硕 ExpertCenter Pro ET900N G3 是我们测试过的第二款 GB300 DGX 工作站,它再次印证了该平台的卓越性能:在 14 款机型和两种工作负载下,28 项峰值吞吐量对比中有 24 项与 WS300 的差距在 2% 以内,而采用相干池的机型性能则达到或超过 WS300。华硕为这款 27 公斤重的机箱增加了提手,在 400G 光驱笼上方配备了专用风扇,并采用了 80 PLUS 钛金认证电源。两款机箱均能提供相同的平台性能;请阅读我们的ET900N G3 评测,了解两款机箱的对比详情。
集群扩展:现在对两座塔式服务器通过各自的 400G 端口连接在一起的情况进行了测量,而不是承诺:我们的GB300 集群测试将 ASUS 和 HP Station 与两个 DAC 配对,在 NCCL 集体测试中达到了 98% 的线路速率,并将 GLM-5.2(一个 433GB 的型号,单个 Station 只能通过将 215GB 的权重溢出到 Grace 内存中来提供服务)从 32 个流的每秒 139 个输出令牌增加到 1,525 个,并最终在 256 个流的情况下达到 3,141 个。
适合单个工作站的模型规模有所不同:预填充/解码分解使 GLM-5.3 Flash 短提示吞吐量增加了两倍,而 DeepSeek V4.1 Flash 每秒输出 5,248 个令牌,是该系列中最高的输出。
实验室:HP ZGX Fury AI工作站
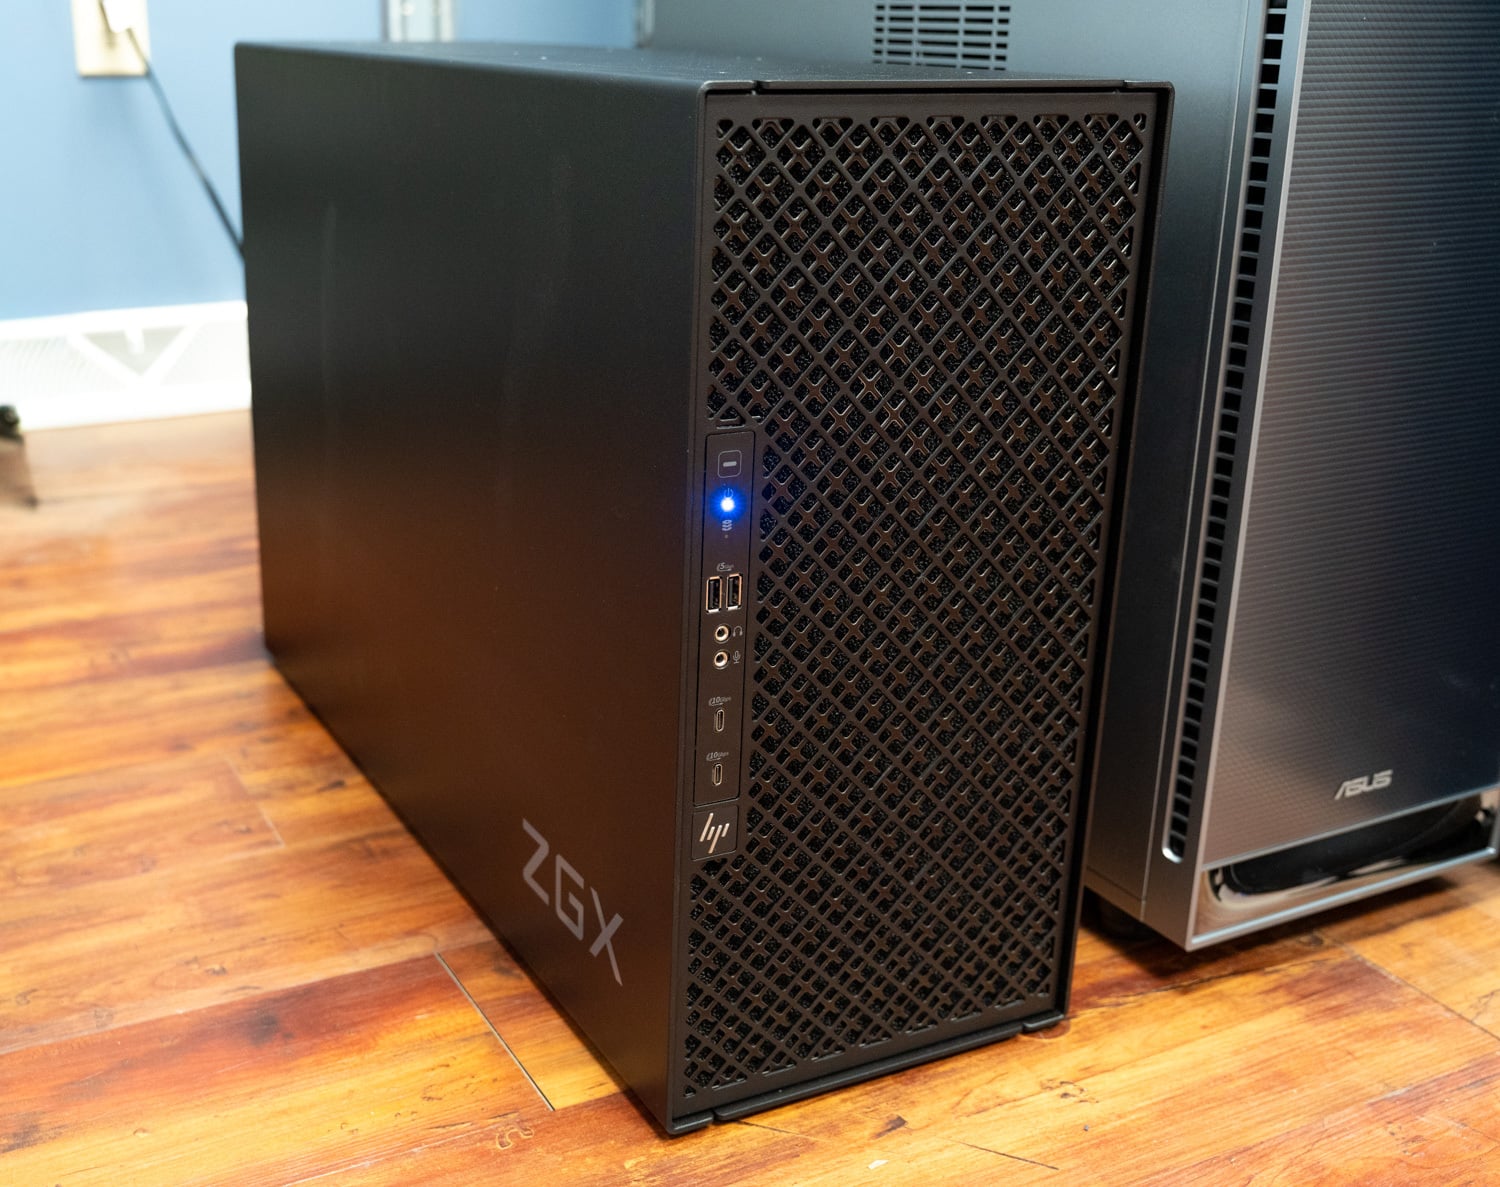
惠普 ZGX Fury AI Station 是继 MSI WS300 和华硕 ET900N G3 之后,第三款抵达我们实验室的 GB300 级系统。这两款双塔式机箱的性能测试结果相差不到 2%。
惠普的 ZGX Fury AI Station 现在已在我们的实验室中。它与上文提到的 MSI XpertStation WS300 一样,都基于 NVIDIA GB300 Grace Blackwell Ultra 平台,这使得我们有机会首次在同一测试平台上比较两家厂商对 DGX Station 架构的不同实现方式:散热、噪音、持续运行频率以及实际使用体验。
它的首批公开测试数据已经出炉:在我们的双站GB300集群测试中, ZGX Fury作为第二台服务器,负责执行GLM-5.3 Flash解耦配置的解码任务,以及所有张量并行测试的一半任务。目前,针对ZGX Fury的单独评测正在进行中,待其自身测试数据出炉后,我们将对其进行排名。
ZGX Fury 是微软首批以DGX Station for Windows命名的两款系统之一,另一款是搭载 GB300 显卡的戴尔 Pro Precision。NVIDIA 已将 Windows 版本列入第四季度上市计划。该硬件与我们在 Ubuntu 系统上测试过的 GB300 塔式机相同,但该版本的服务器堆栈是直接运行在 Windows 系统上还是在 WSL 环境下运行,目前尚无定论。
即将面世:AMD Threadripper Halo Station
AMD 的 Threadripper Halo Station 将于 2026 年 IFA 展会上发布,目前尚未进入任何实验室测试。它是针对 NVIDIA GB300 系列显卡的首款直接解决方案。AMD 的设计理念与 NVIDIA 截然不同:它没有采用单一的大型内存池,而是将一颗 96 核 Threadripper PRO 处理器搭载在一个配备高达 2TB 八通道 DDR5 内存和 128 条 PCIe 5.0 通道的平台上,并配备两块 600W 的 Instinct MI350P 加速卡,每块加速卡搭载 144GB HBM3E 显存,并且 AMD 还表示未来可扩展至四块加速卡和 576GB HBM 显存。整个系统采用液冷散热,并且这款 x86 主机避免了我们在 WS300 评测中提到的 Arm 工具链兼容性问题。
目前尚不清楚这些型号在 PCIe 连接显卡和 NVLink-C2C 连接方面的表现如何,AMD 尚未公布任何基准测试、定价或上市信息,因此目前只能作为观察对象,而非推荐产品。更多详情请参阅我们的发布报道;只有在硬件到货实验室后,我们才会将其纳入排名。
同时测试的产品:桌面人工智能设备
这些系统都经过了相同的实验室流程,是可靠的选择,但没有占据类别位置:戴尔 Pro Max with GB10、华硕 Ascent GX10、技嘉 AI TOP ATOM、惠普 ZGX Nano G1n和惠普 EliteDesk 8 Mini G1a。
用于本地人工智能的工作站塔
当响应时间比购置成本更重要时(例如交互式编码助手、多用户服务、具有长工具调用链的代理流水线),独立显存仍然是最佳选择。本文根据推理吞吐量和内存上限对这些台式机进行排名,并列出我们测试的GPU配置以及机箱最大容量,因为机箱的最终容量与我们测试的配置同样重要;台式机需要配备两个或更多GPU才能在此部分排名。单GPU台式机,包括配备96GB RTX PRO 6000的机型,在我们的Windows客户端套件的“最佳桌面工作站”页面上进行排名,因为它们回答的是不同的问题。
最适合本地AI的塔式机:戴尔Precision 7875
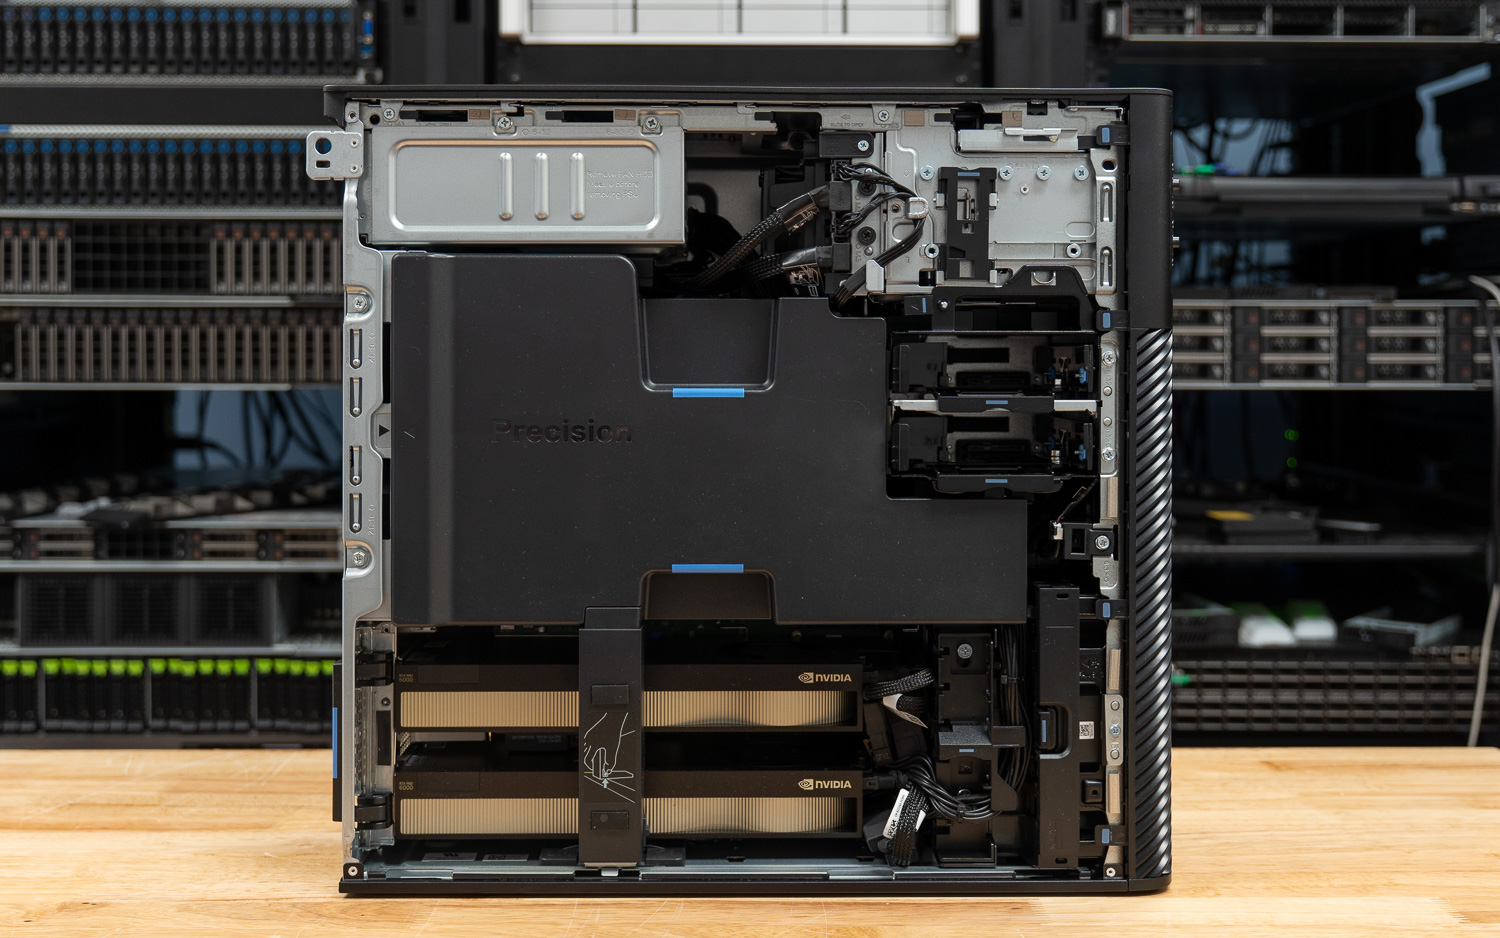
Precision 7875 搭载两块 RTX PRO 6000 Blackwell GPU,是我们测试过的速度最快的标准尺寸本地推理系统。它配备 Threadripper PRO 9995WX 处理器,两块显卡共计 192GB 显存,能够将 100B 级模型完全加载到 GPU 内存中,并提供交互式级别的首令牌响应时间,这是任何统一内存设备都无法企及的。不过,需要注意的是,7875 机箱最多支持两块双宽显卡,因此我们测试的双 GPU 配置已经是极限配置,无法再添加第三块显卡。
最佳多GPU平台:HP Z8 Fury G6i
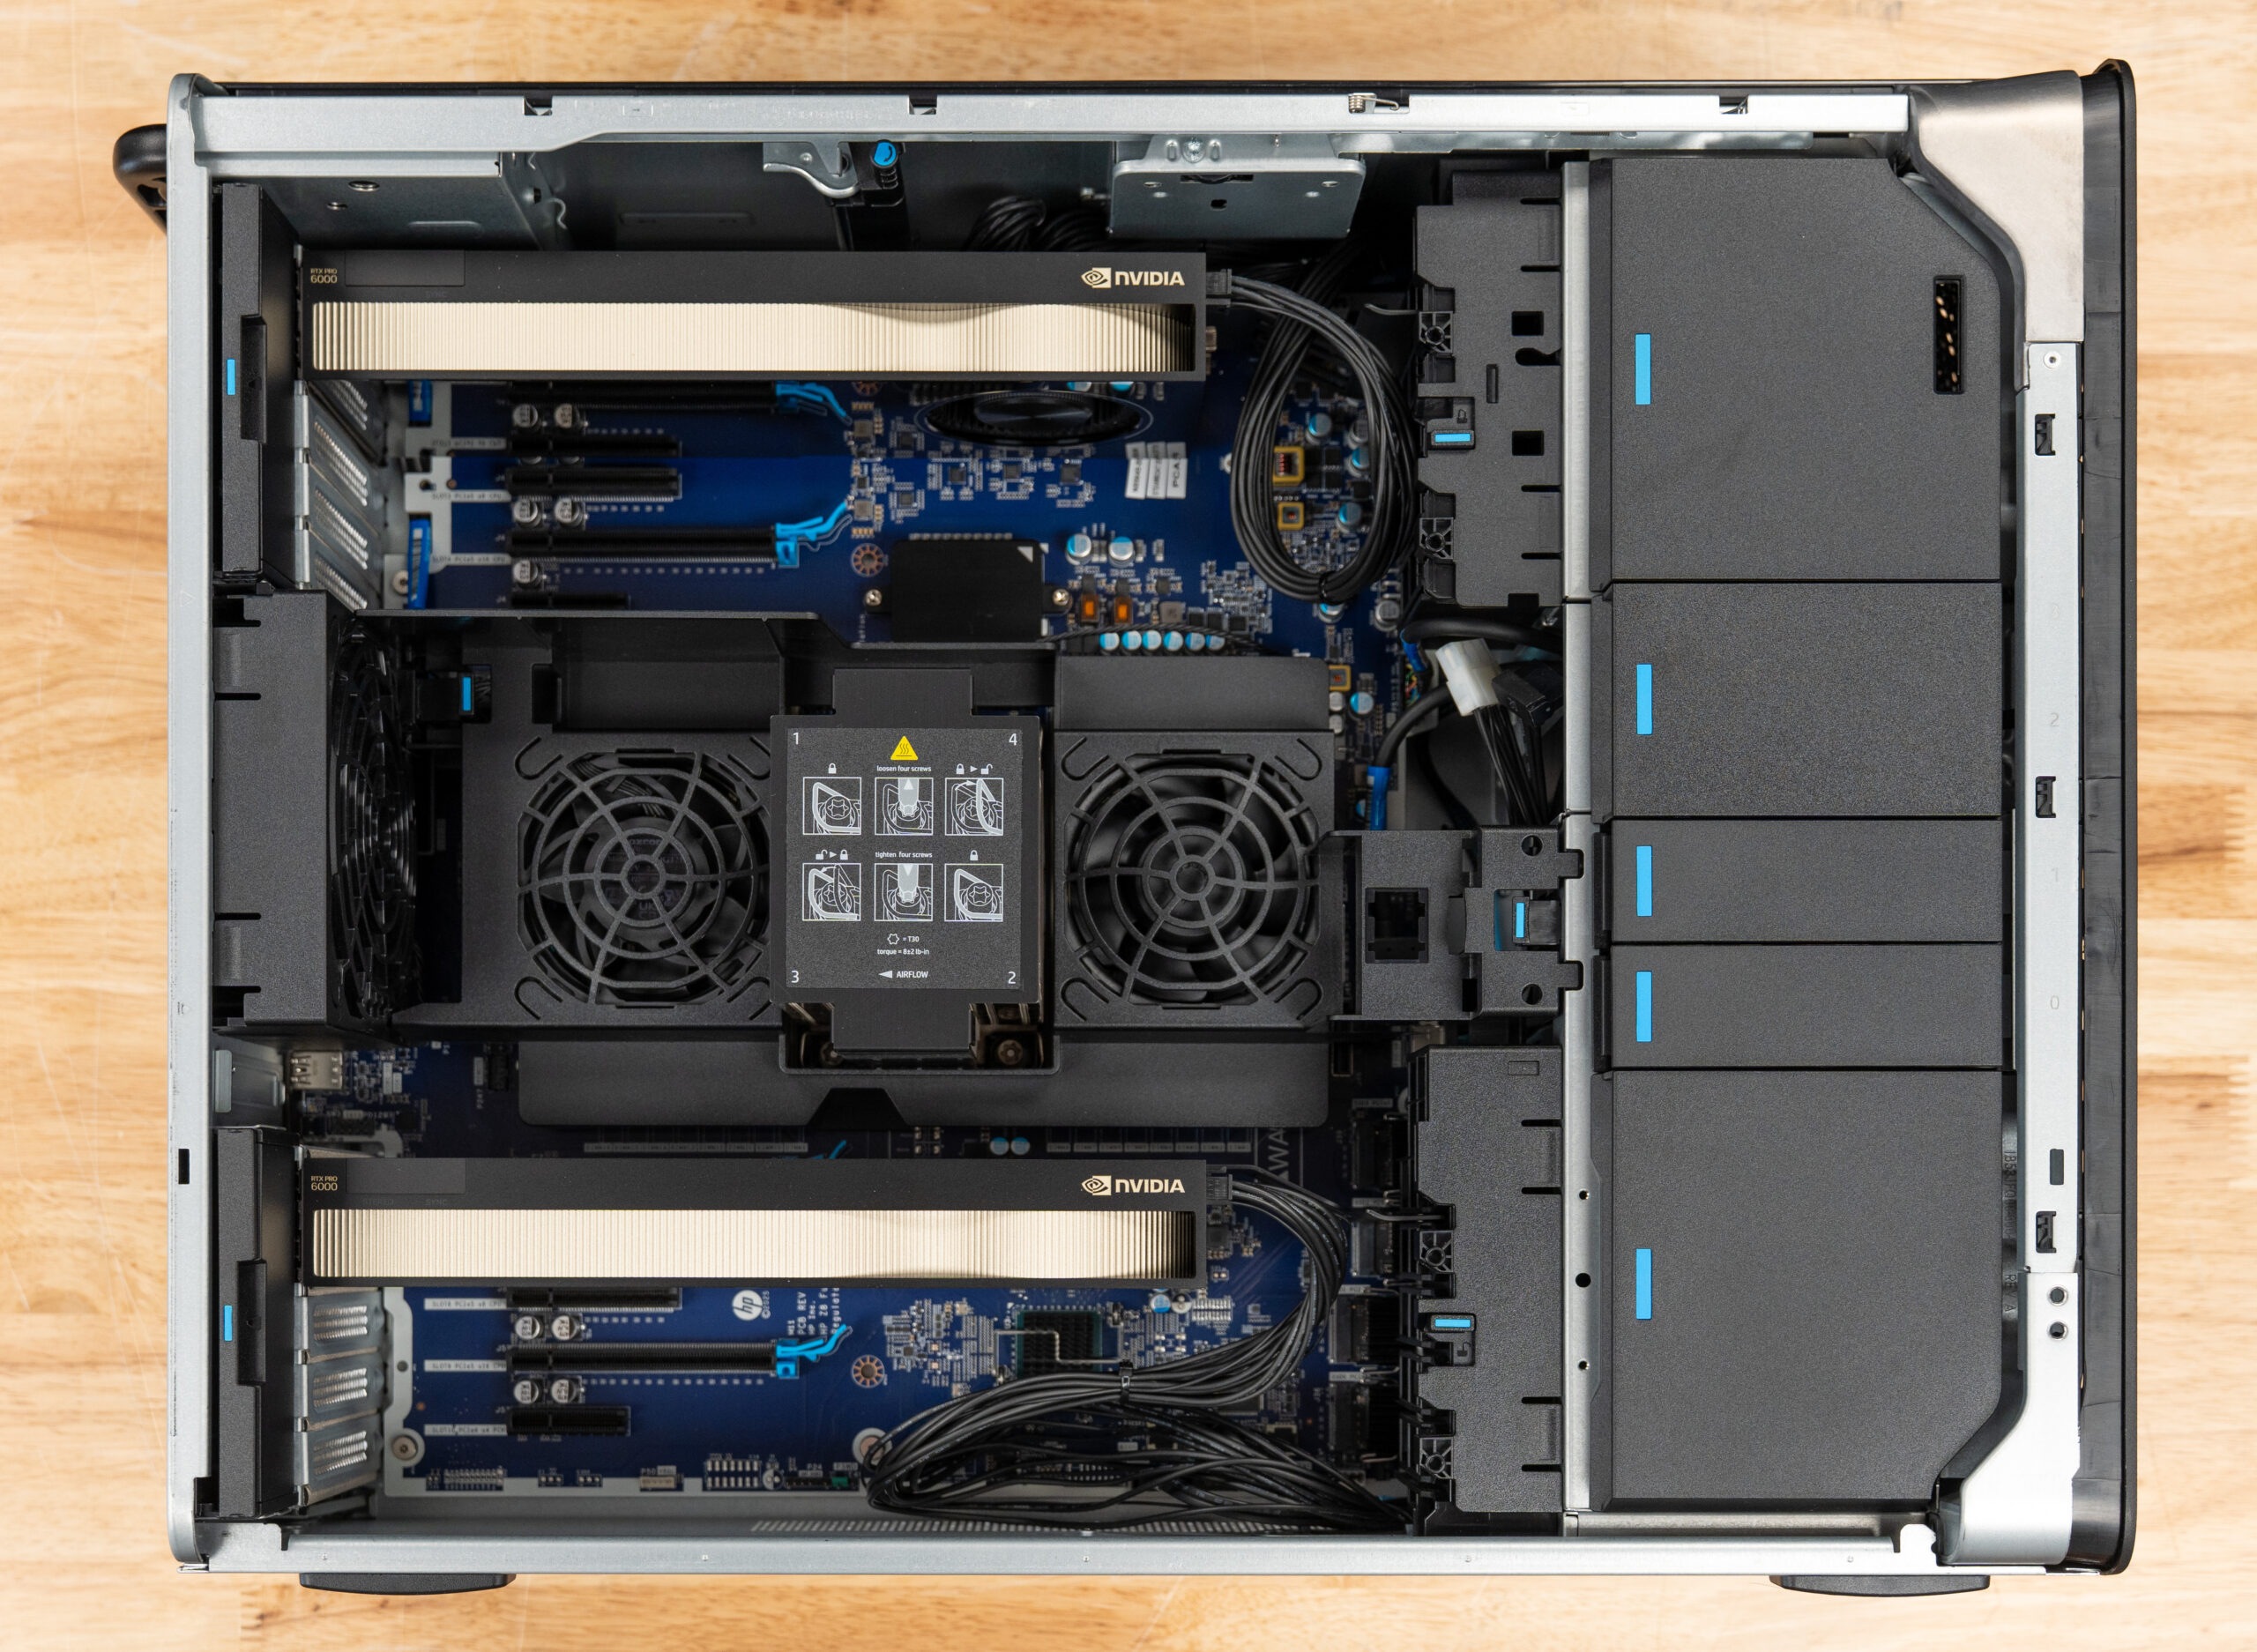
如果您计划升级到更多显卡,Z8 Fury G6i 就是您的理想之选。我们评测的这台主机搭载了两张 RTX PRO 6000 Max-Q 显卡,共计 192GB 显存。但这款机箱配备双电源,总功率高达 2700W,最多可支持四张 Blackwell 架构的显卡和 384GB 显存。测试配置与最大配置之间的差距正是关键所在:我们测试过的所有标准 OEM 机箱中,没有哪一款能提供如此大的显卡扩展空间,而且从两张显卡升级到四张显卡无需更换机箱。
终极选择:Comino Grando RTX PRO 6000
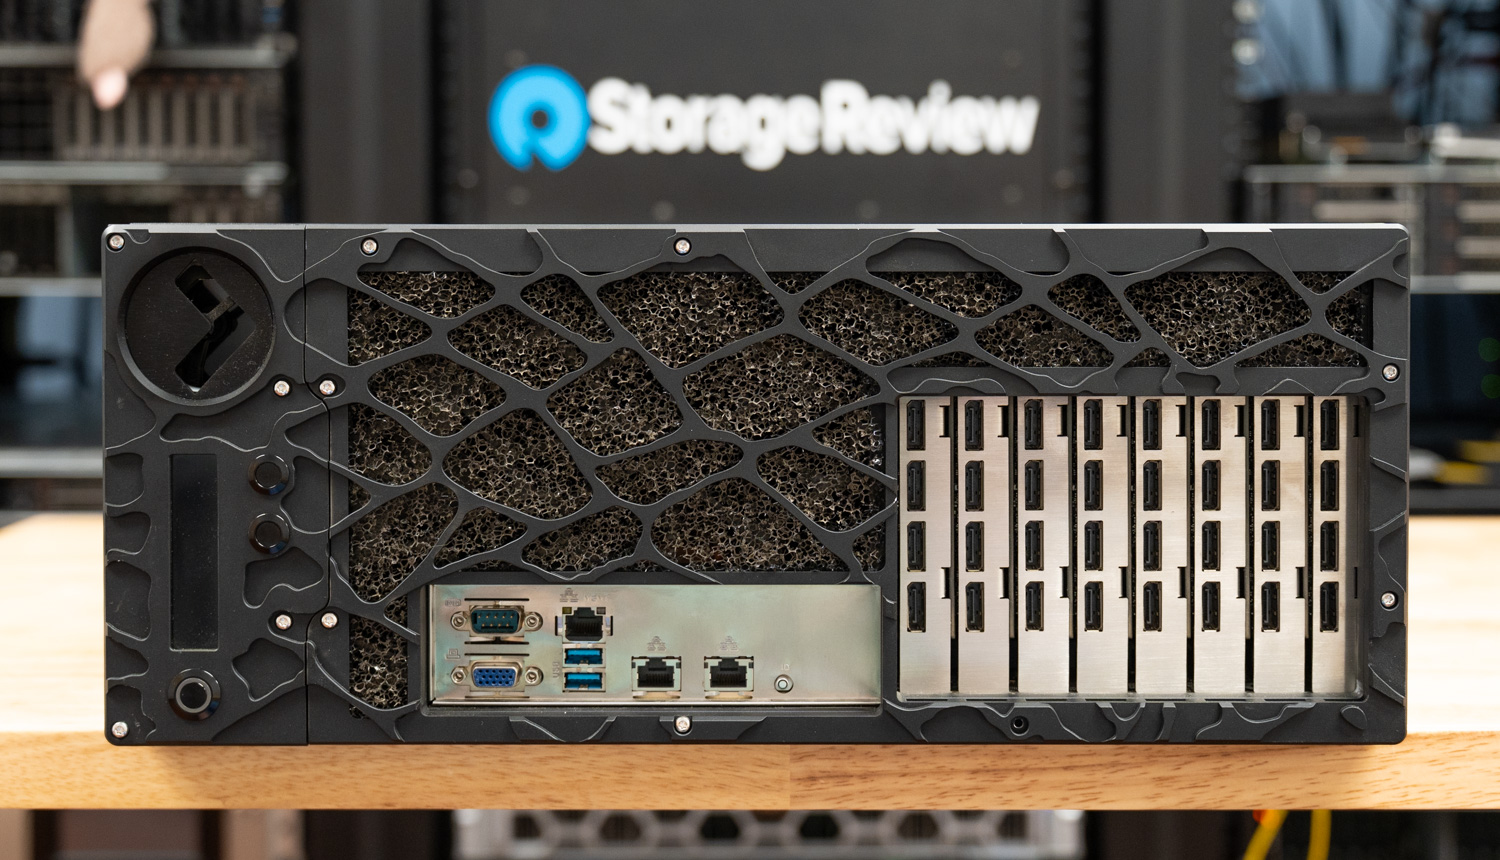
Grando 采用 4U 液冷机箱,配备 768GB 显存:专为那些找不到合适位置的用户而设计。我们评测的这台 Grando 搭载了八张 96GB 显存的 RTX PRO 6000 Blackwell 显卡,达到了机箱的最大容量。Comino 的液冷散热系统能够让这八张显卡全天候满负荷运行,而不会出现降频现象。这样的显存容量甚至超过了许多机架式服务器,而它却可以放在办公桌旁。它的价格确实不菲,但噪音控制却很出色。它特意出现在这份榜单上,是为了证明桌面级显卡的容量上限。
我们如何排名
StorageReview 排行榜遵循三条规则,第一条是只有经过实验室测试的系统才能上榜:如果我们没有对系统进行基准测试,可以提及,但不能将其列入类别。第二条是每个系统只能按一项测试指标排名一次。上述主机也曾出现在我们桌面工作站排行榜上,该排行榜基于 SPECworkstation 和渲染性能,直到 2026 年 10 月该页面迁移到单 GPU 系统;它们在该排行榜上的成绩仍保留在评测文章中,而在这里,它们则根据推理吞吐量和内存上限进行排名。
第三,存在准入门槛:系统需要两块或更多GPU(需在Linux下使用vLLM服务器进行测试),或者至少拥有96GB的共享内存池供各型号使用。即使配备96GB显卡,单GPU塔式机也能在我们的Windows客户端套件的“最佳桌面工作站”页面上获得排名。
排名综合考虑了vLLM在线服务吞吐量、首令牌响应时间、单次输出令牌响应时间、MAMF计算效率、GDSIO存储性能和市场价格。在同一评分区间内,由编辑团队进行评判以决定排名。供应商在排名发布前无法查看排名,且本页面排名不收取任何费用。
本地 AI 桌面常见问题解答
最适合智能体人工智能的桌面电脑是什么?
诸如编码代理、工具调用管道和多步骤自主任务等代理工作负载对吞吐量和延迟的敏感性远高于单次聊天应用,因为代理会将多个模型调用与庞大的上下文关联起来。这有利于塔式服务器:戴尔 Precision 7875 的独立显存可提供持续的首令牌响应时间,从而确保长代理链的响应速度。对于预算有限的代理实验,GB10 级设备可以以较低的速度运行相同的堆栈。我们完整的配置指南请参阅《面向代理 AI 的内存、GPU 和存储》。
本地运行70B模型需要多少内存?
一般来说,一个 4 位量化的 70 字节模型在上下文上下文之前大约需要 40-48GB 的模型可访问内存;而长时间的交互式使用则需要更多内存。这就是为什么 128GB 统一内存的设备能够很好地处理 70 字节级模型,以及为什么单 GPU 塔式机出现在我们“最佳桌面工作站”页面上的原因。
运行这些系统需要特殊权限吗?
对于设备层来说,答案是否定的:GB10 级机顶盒和 Strix Halo 系统都能在标准的办公电源插座上轻松运行。至于塔式机箱,则需要与大楼业主进行深入探讨。一台配置齐全的 HP Z8 Fury G6i 可以搭载两个总功率高达 2700W 的电源,这超过了标准 15 安培、120 伏电路的供电能力;而 Comino Grando 机箱则配备了 2000W 的热插拔电源,需要 180-264V 的输入电压,在 110V 电源下则只能使用 1000W 的电源。
在从本页顶部购买任何产品之前,请先检查墙壁插座的供电能力;专用电路或 208/240V 电源可能是全套 GPU 配置实际成本的一部分。散热也遵循同样的原理,因为每一瓦的功耗最终都会散发到房间内。
Mac 版 Studio 怎么样?
目前还没有,因为我们还没有进行实验室测试。苹果公司于9月22日开始发售搭载M5 Max和M5 Ultra处理器的Mac Studio,其中M5 Max最高配备128GB统一内存,起价2,499美元;M5 Ultra最高配备512GB内存,起价5,499美元。512GB配置(对于超大容量机型而言最为重要)预计将于10月下旬上市,苹果尚未公布价格。如果我们进行测试,将会像本页上的其他系统一样,根据测试结果进行排名。


 Amazon