
AMD 和英特尔宣布,他们将把各自针对 PyTorch 的 x86 CPU 优化工作整合到 oneDNN 中。oneDNN 是由统一加速基金会 (UXL) 管理的开源深度学习库,双方已达成一致,将 oneDNN 作为 PyTorch 内部 x86 加速的默认开源库。AMD 将其 ZenDNN 优化功能也整合到了 oneDNN 中,并加入了
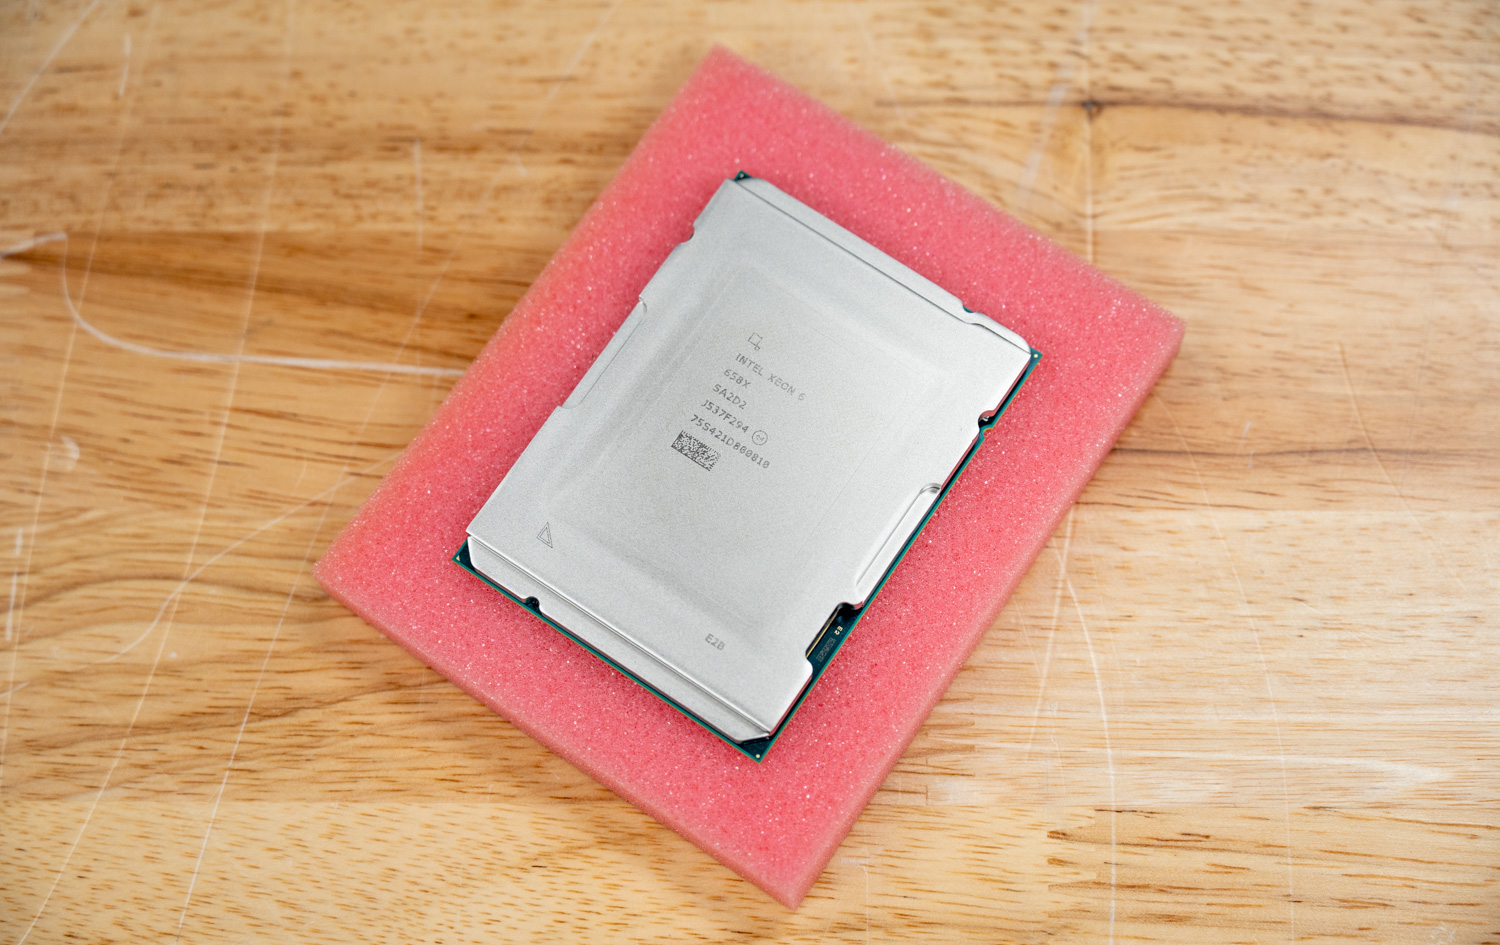

AMD 和英特尔宣布,他们将把各自针对 PyTorch 的 x86 CPU 优化工作整合到 oneDNN 中。oneDNN 是由统一加速基金会 (UXL) 管理的开源深度学习库,双方已达成一致,将 oneDNN 作为 PyTorch 内部 x86 加速的默认开源库。AMD 将其 ZenDNN 优化功能也整合到了 oneDNN 中,并加入了
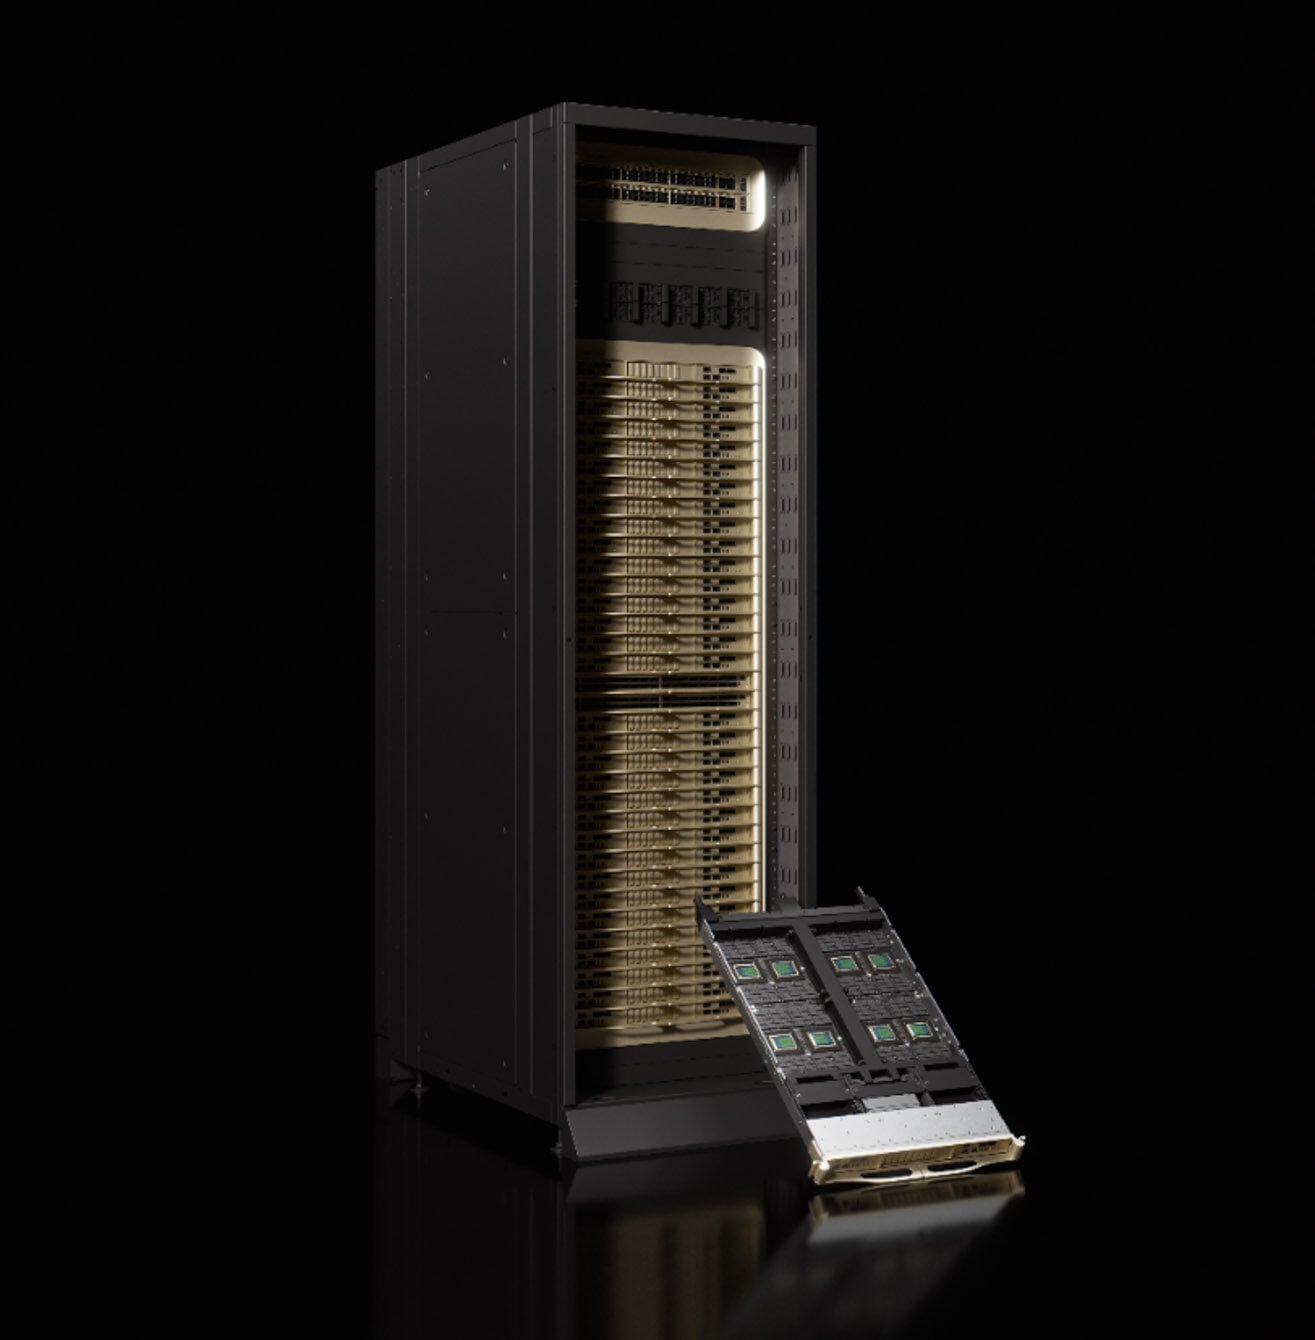
Supermicro 今日发布了 NVIDIA Vera CPU 机架,这是一款 48U 全液冷机架,可容纳 256 个 NVIDIA Vera CPU,共计 22,528 个核心和 45,056 个线程,Supermicro 宣称其最多可支持 22,500 个并发代理沙箱。它是数据中心构建模块解决方案 (DCBBS) 产品组合的最新成员,旨在与……配合使用。
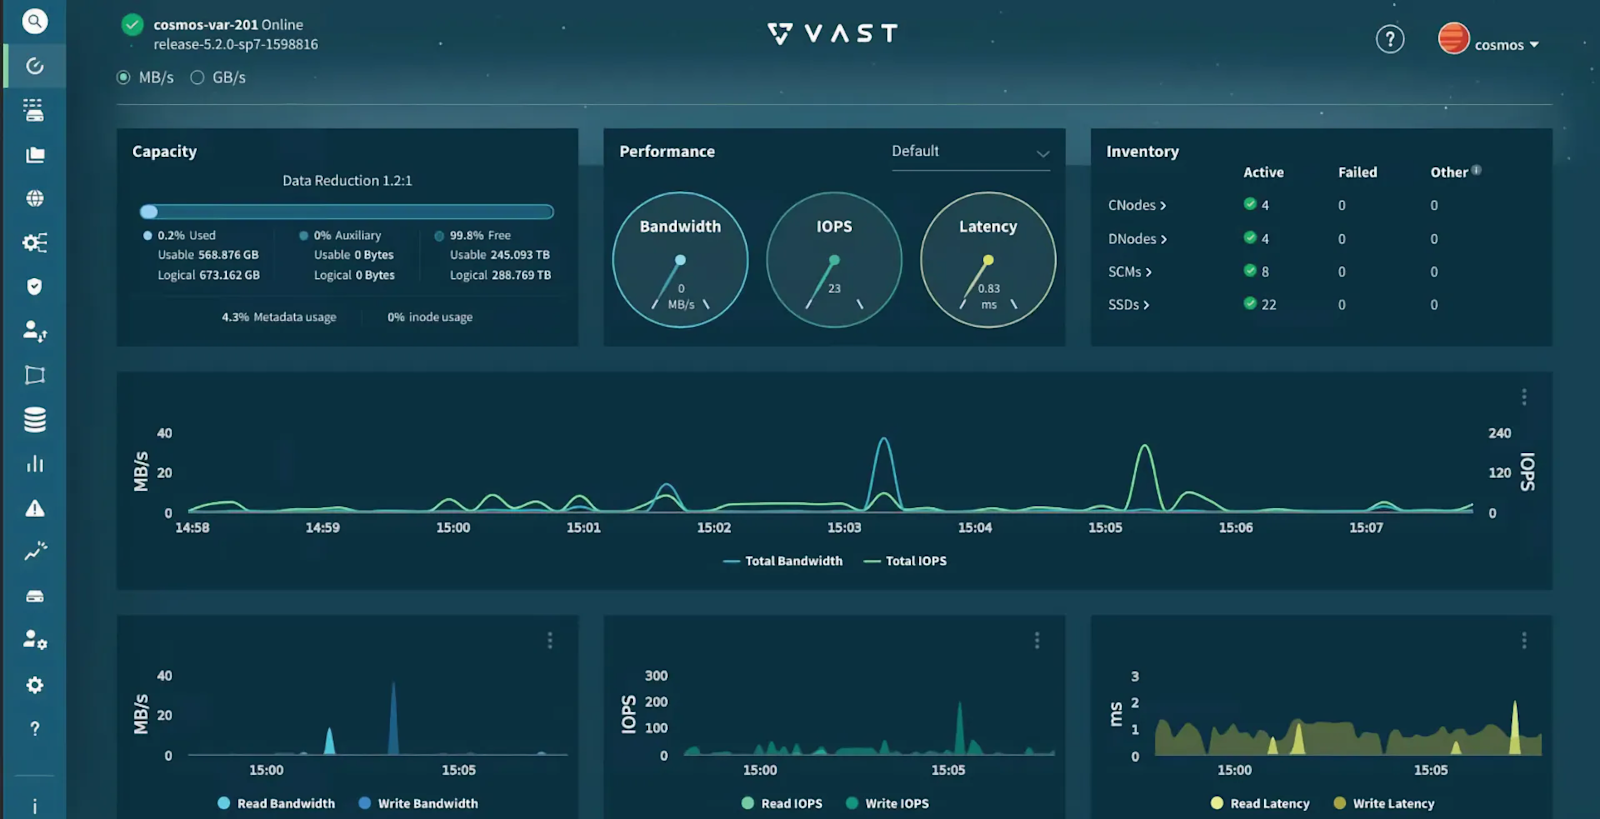
VAST Data 在 NVIDIA GTC 柏林大会上与 NVIDIA 联合发布了 Agent Sandbox Foundation Stack,这是一个参考架构,它在 VAST AI 操作系统上的 NVIDIA OpenShell 沙箱中运行 NVIDIA NemoClaw 代理。OpenShell 负责每个代理的隔离执行和策略执行,而 VAST 则负责那些需要在沙箱之外运行的部分:代理的……
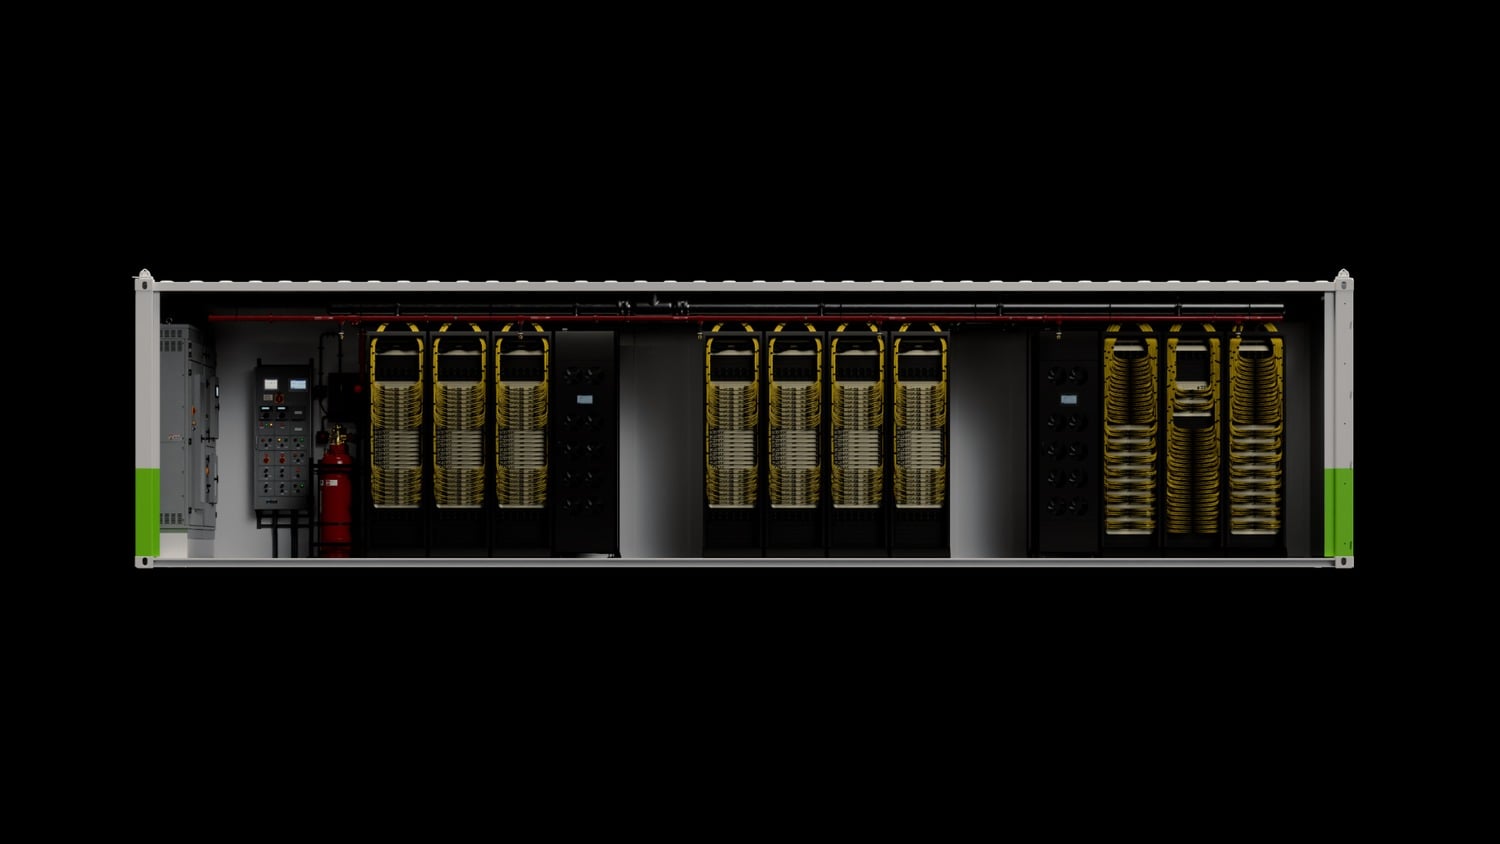
NVIDIA 今日在柏林 GTC 大会上发布了一系列重磅消息,涵盖容器化 Vera Rubin 基础设施、基板供应量扩大 2.5 倍、用于 AI 工厂电源管理和代理安全的软件,以及电信、自动驾驶汽车、机器人和医疗保健等领域的项目。其中最引人注目的是部署目标:NVIDIA 表示,其全新的 DSX POD 参考设计可降低 AI 工厂的功耗。
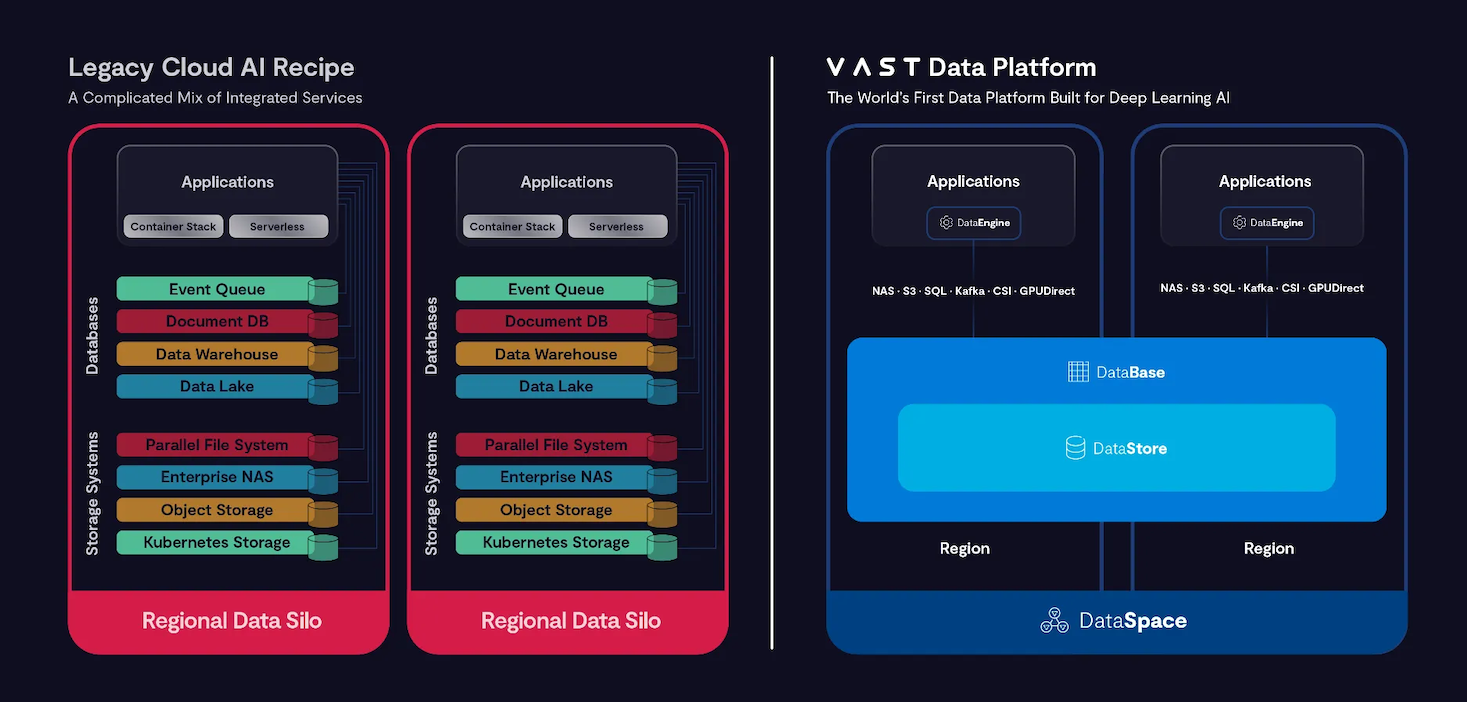
VAST Data宣布,DeepL正在部署VAST AI操作系统,作为其书面和实时语音翻译研究环境的数据基础。根据目前的部署计划,DeepL预计将获得其现有NVMe硬件存储容量的三倍左右,并将使用VAST的SyncEngine进行数据迁移。
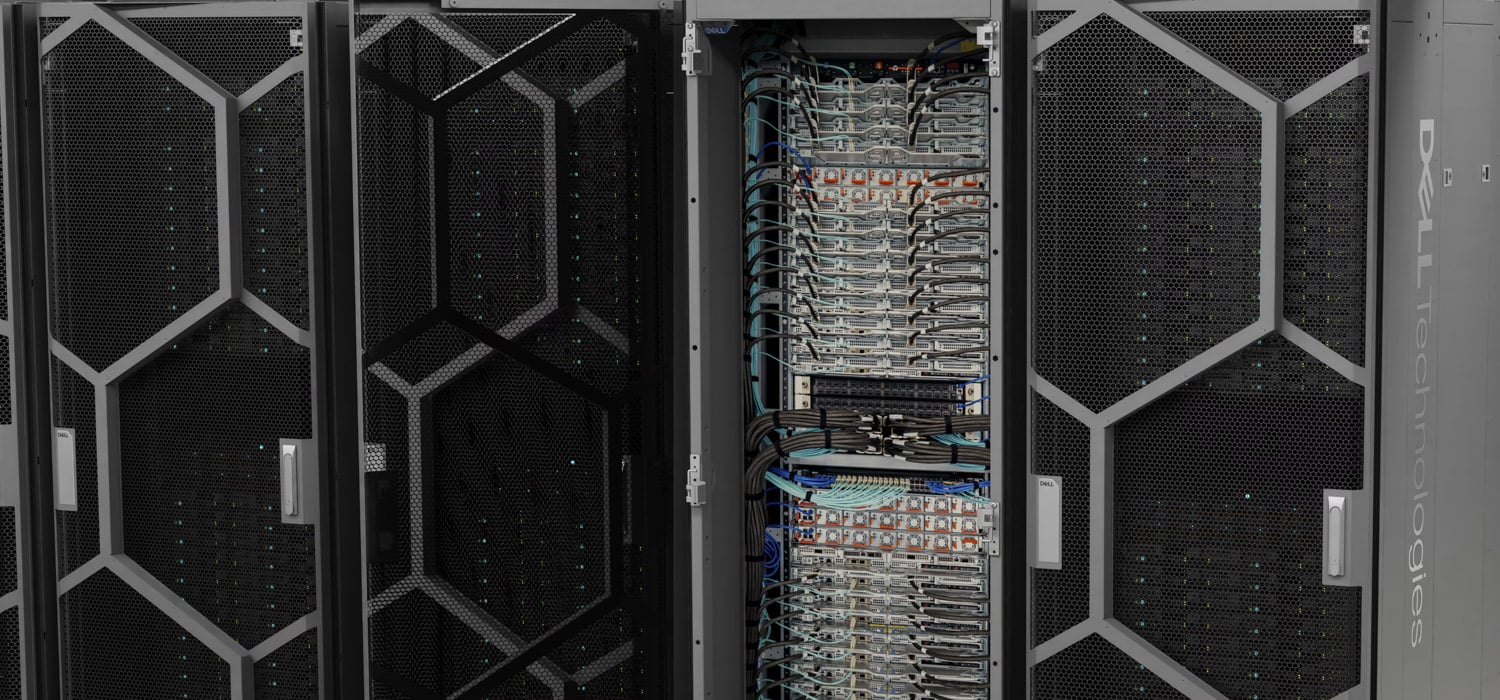
戴尔科技集团今天在柏林举行的 NVIDIA GTC 大会上扩展了其戴尔 AI 工厂,新增了一台 48U PowerEdge M9882 机架,该机架配备 256 个 NVIDIA Vera CPU,用于执行智能体工作负载;一台基于 Groq 3 LPU 的 PowerEdge XE9810 机架式推理系统;一台风冷双路 Vera 服务器;一台配备 GB10 的 64GB 戴尔 Pro Precision 工作站;以及一套
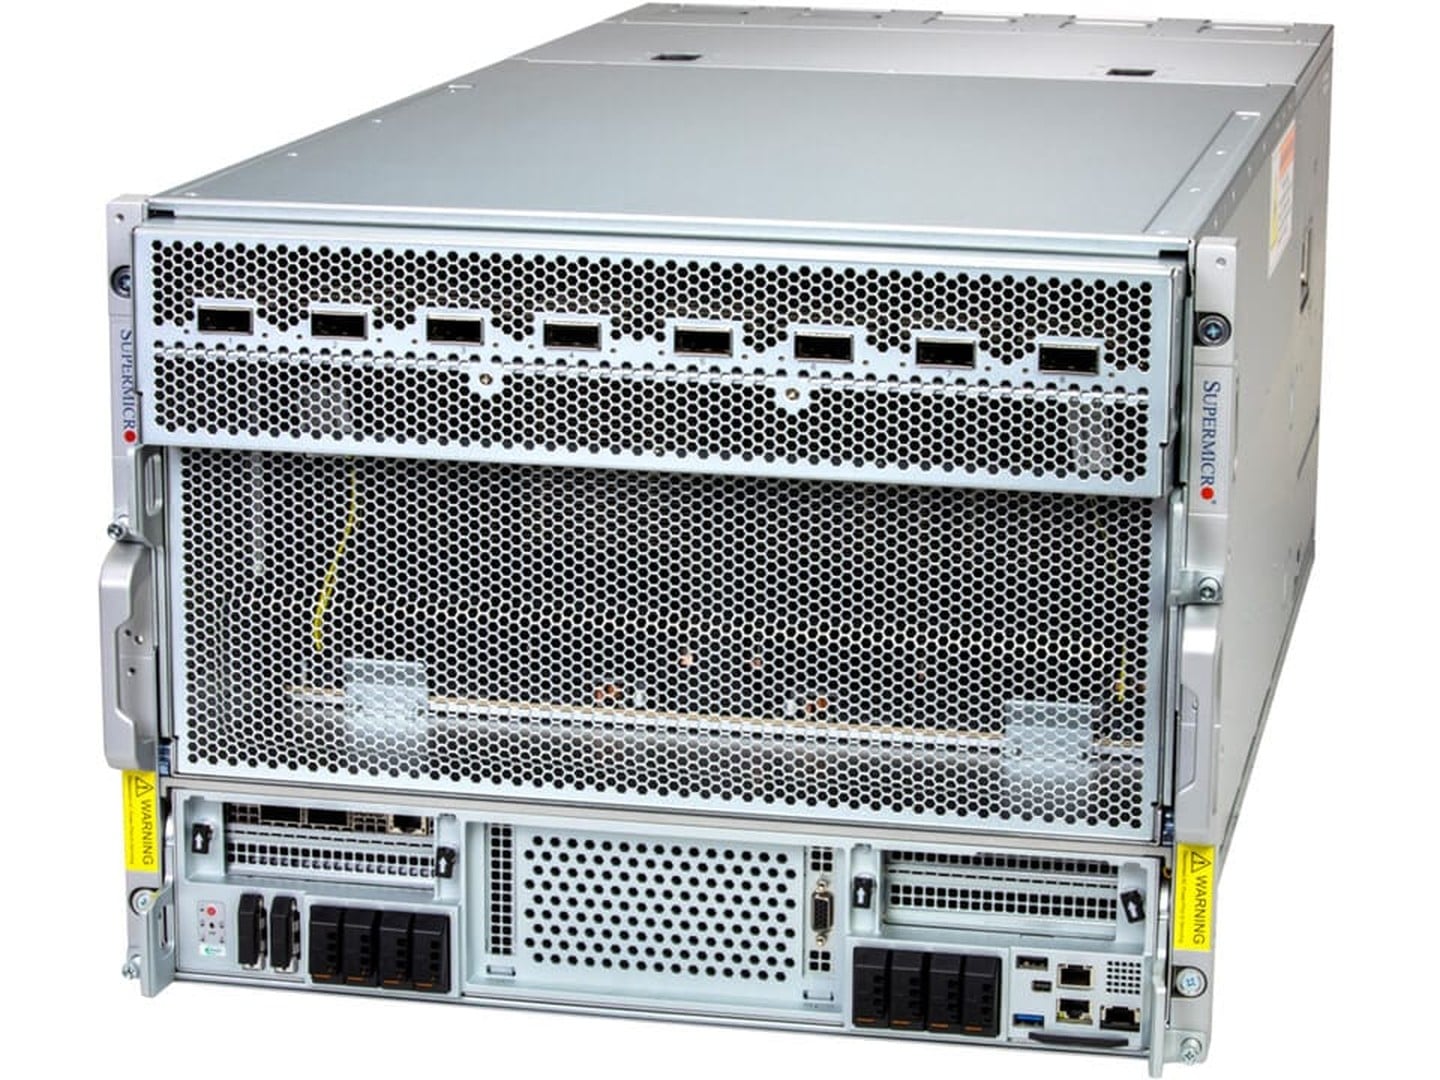
Nutanix 今天在 NVIDIA GTC 柏林大会上宣布了三项合作:与 Supermicro 联合设计私有推理系统,该系统基于每个节点配备 8 个 NVIDIA B300 Blackwell Ultra GPU 的服务器构建;从 NKP Bare Metal 开始对 NVIDIA Vera CPU 提供 Day Zero 支持;以及与 Netris 合作开发多租户堆栈,将租户隔离扩展到物理网络。
CoreWeave今天在NVIDIA GTC柏林大会上发布了Physical AI Launchables和CoreWeave零信任AI框架。Launchables是一个经过测试、可直接运行的机器人和自动驾驶工具模板目录,每个模板都只需一条命令即可启动,它将NVIDIA Isaac Sim、CARLA、MuJoCo、NVIDIA AlpaSim和NVIDIA Cosmos 3的环境与经过优化的编码代理技能相结合。
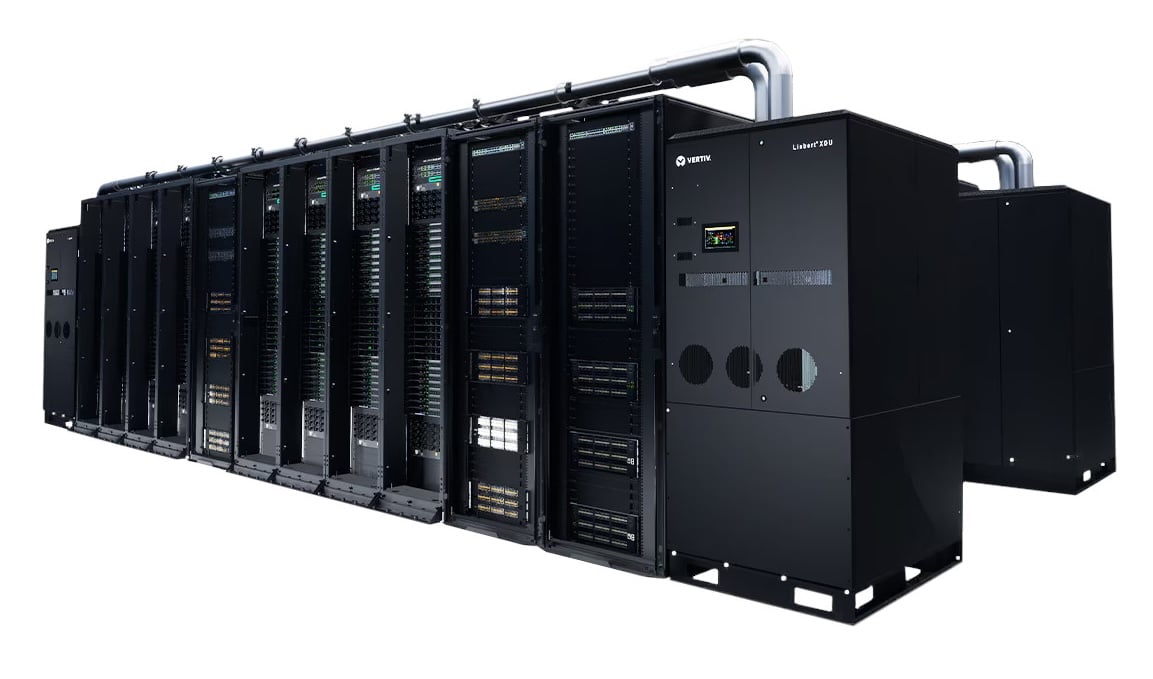
HPE今天在NVIDIA GTC柏林大会上宣布了HPE AI Factory与NVIDIA的更新,其中大部分更新都集中在HPE私有云AI领域。开发者、独立软件供应商和AI代理可以通过生产API和模型上下文协议(MCP)服务器,获得对平台推理、模型和管道的受控访问权限,集群现在可以混合使用。
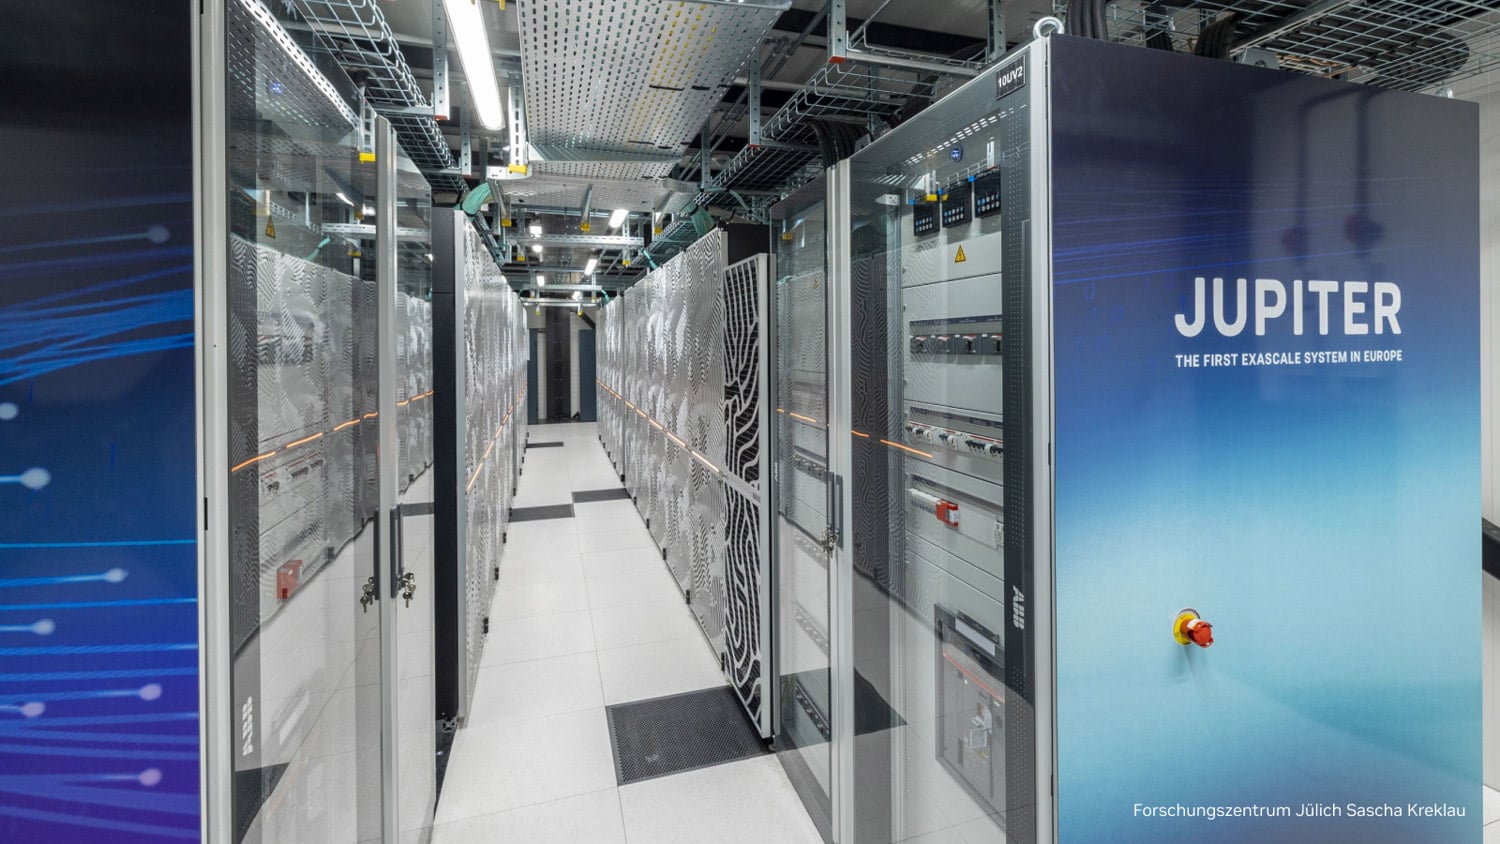
NVIDIA 在欧洲首台百亿亿次级超级计算机 JUPITER(位于于利希超级计算中心)上运行了 104 量子比特的容错量子处理器模拟,该模拟使用了 8,192 个 GH200 GPU。此次模拟在 GTC 柏林大会前夕发布,模拟了“魔态培养”过程,这是一种在实际硬件噪声条件下生成容错计算机在逻辑运算过程中消耗的非克利福德态的方法。
我们的附属合作伙伴提供的产品和解决方案:


 Amazon