

AMD 2026人工智能大会是迄今为止规模最大的发布会,内容之丰富,以至于我们不得不将其分为两篇进行报道。第一篇文章介绍了Instinct MI455X服务器和72GPU的Helios机架式服务器;而这篇姊妹篇则着重介绍那些无法与它们一同刊登的内容:代号为Venice的第六代EPYC服务器处理器和Verano主机处理器。这款CPU值得单独成篇。Venice每个插槽最多可拥有256个核心和512个线程,内存带宽高达1.6TB/s,是首款支持PCIe Gen 6的服务器处理器,其吞吐量更是2017年第一代EPYC的18倍。
Venice 也不是一颗芯片,而是一个产品组合,AMD 在每次发布会上都反复强调这一点:没有一种 CPU 能满足所有需求。同一代 Zen 6 架构衍生出了高密度处理器、企业级处理器、堆叠缓存高性能计算处理器以及低功耗 LPDDR 主机处理器。因此,在讨论速度和性能之前,让我们先来看看这个产品线。
威尼斯和维拉诺阵容
AMD 将现代数据中心服务器分为三类,其产品组合旨在满足所有这些需求。通用 CPU 服务器运行着 Web 网关、缓存、应用层、数据库和存储等所有组件,其他所有组件都依赖于这些组件。GPU 服务器需要一个主机 CPU 来为加速器提供数据,在这个过程中,单线程速度和 I/O 带宽比核心数量更重要。第三类是高密度 CPU 服务器,用于运行围绕 AI 服务发展起来的编排和工具执行代码;这类代码分支频繁且容易出现停顿,因此对线程的需求尤为迫切。
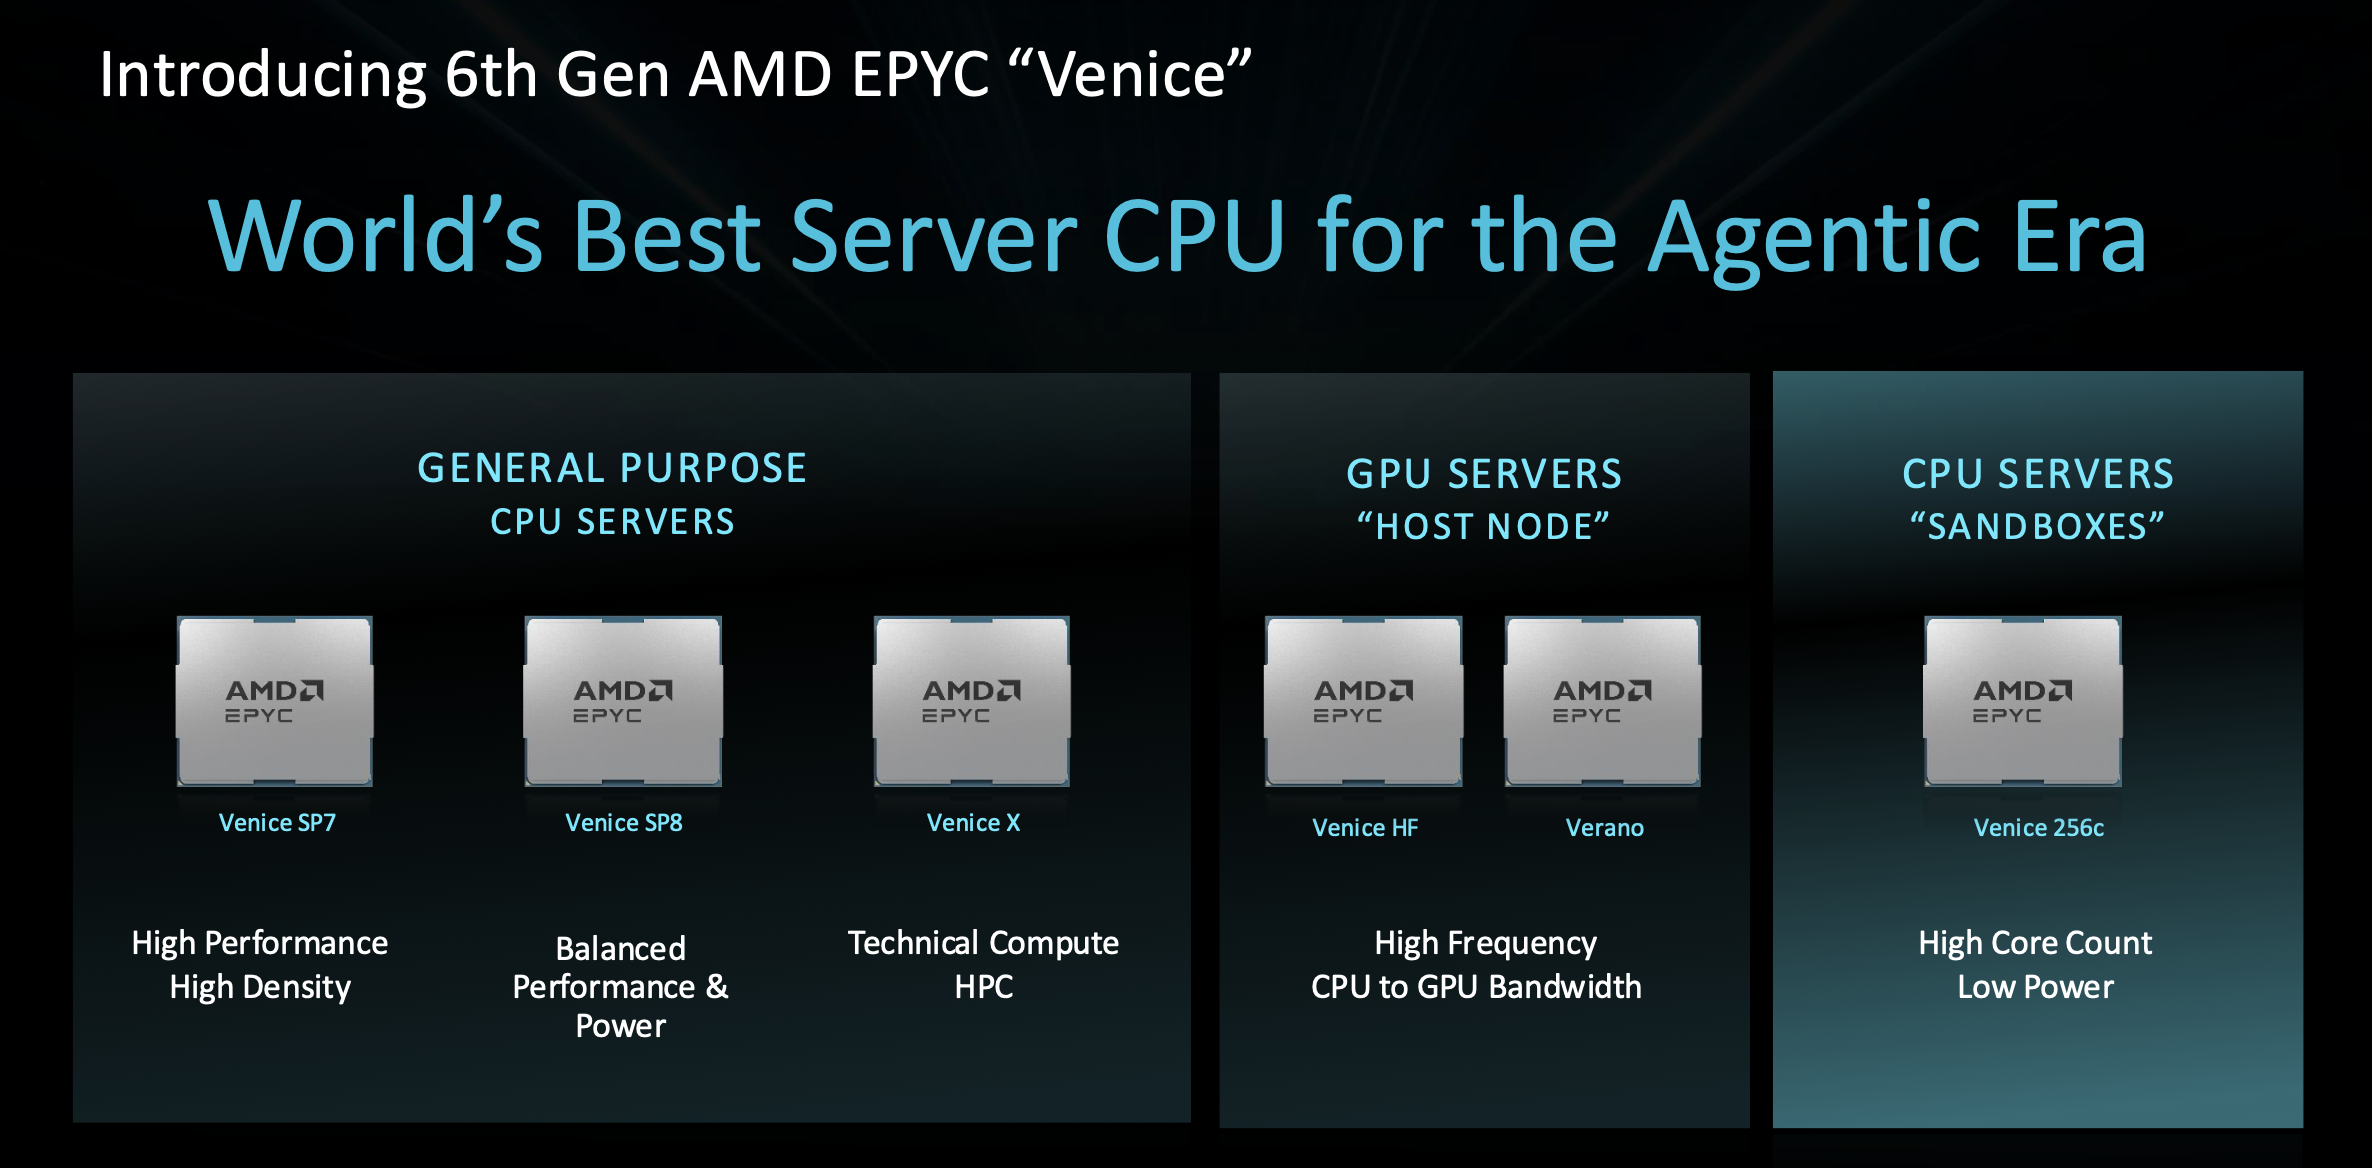
该产品线包含四款产品,平台分批推出:Venice SP7 将于 2026 年第四季度发布,Venice SP8 将于 2027 年上半年发布,Venice-X 和 Verano 将于下半年发布。AMD 将同一款芯片细分为六种不同的版本,更细致的划分直接对应三个层级。通用型处理器包括 Venice SP7、SP8 和 Venice-X。主机级处理器则将高频 Venice 芯片与 Verano 及其 LPDDR 内存相结合。高密度计算型处理器则被称为 Venice 256c:它拥有高核心数和低功耗,旨在尽可能在有限的功耗下将更多线程集成到机架中。Verano 也兼具多种功能:AMD 表示,部分客户将在每瓦性能是关键限制因素的场景下将其部署为通用处理器。
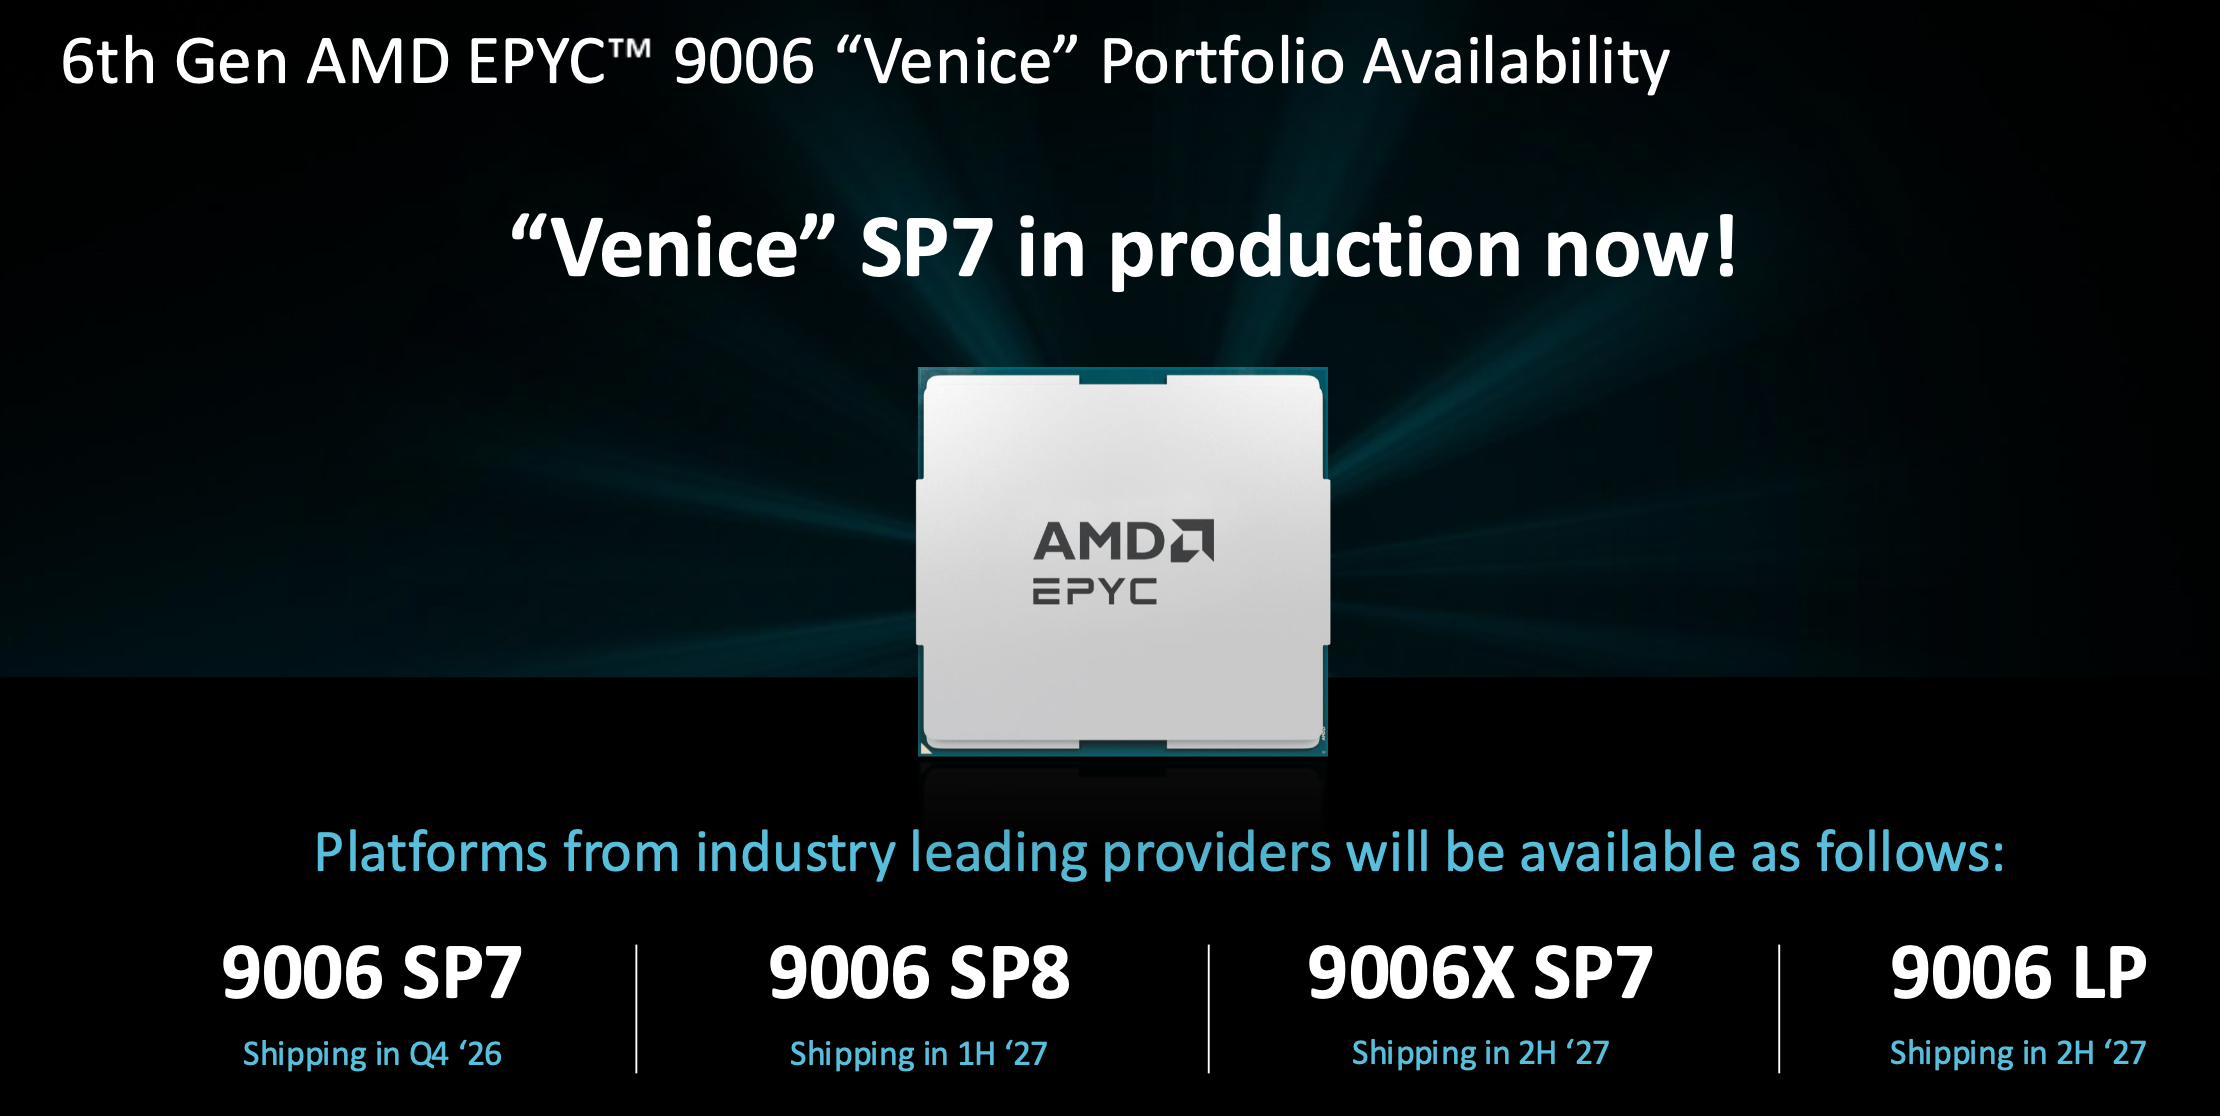
通过脚注,我们可以提前了解一下各款处理器的具体型号。256 核的 EPYC 9996 是该系列的主打产品,9956 拥有相同的核心数,功耗为 400W,而 96 核的 9686F 则是高频主机芯片。Helios 的每个计算托架都配备了其自家版本的主机芯片——EPYC 9G76。
不妥协层
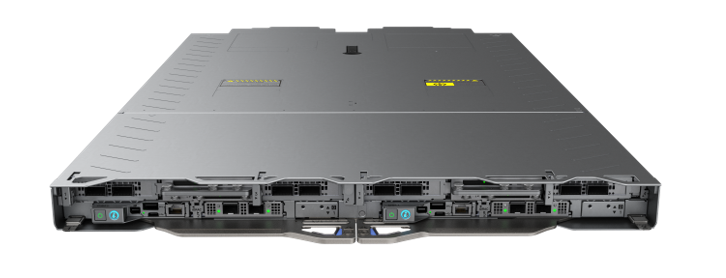
在介绍规格表之前,先简单说说这款大尺寸插槽的定位。Venice SP7 专为 AMD 最高端、性能毫不妥协的系列产品而设计:数据中心、超大规模数据中心和高性能计算 (HPC) 部署,在这些应用中,机架吞吐量是决定性因素,厂商们不惜一切代价。服务器厂商已经开始围绕它重新调整产品线。戴尔为了腾出空间,对其沿用多年的 PowerEdge 命名体系进行了拆分,并将这一级别的计算产品归入全新的 9000 系列,其中旗舰产品 PowerEdge R9825 和 Rack Scale M9825 均采用 3U 机箱,并搭载两颗 Venice 芯片。
主要规格
整个家族都建立在一个平台上,而且自都灵以来,几乎每个角落都是新的。
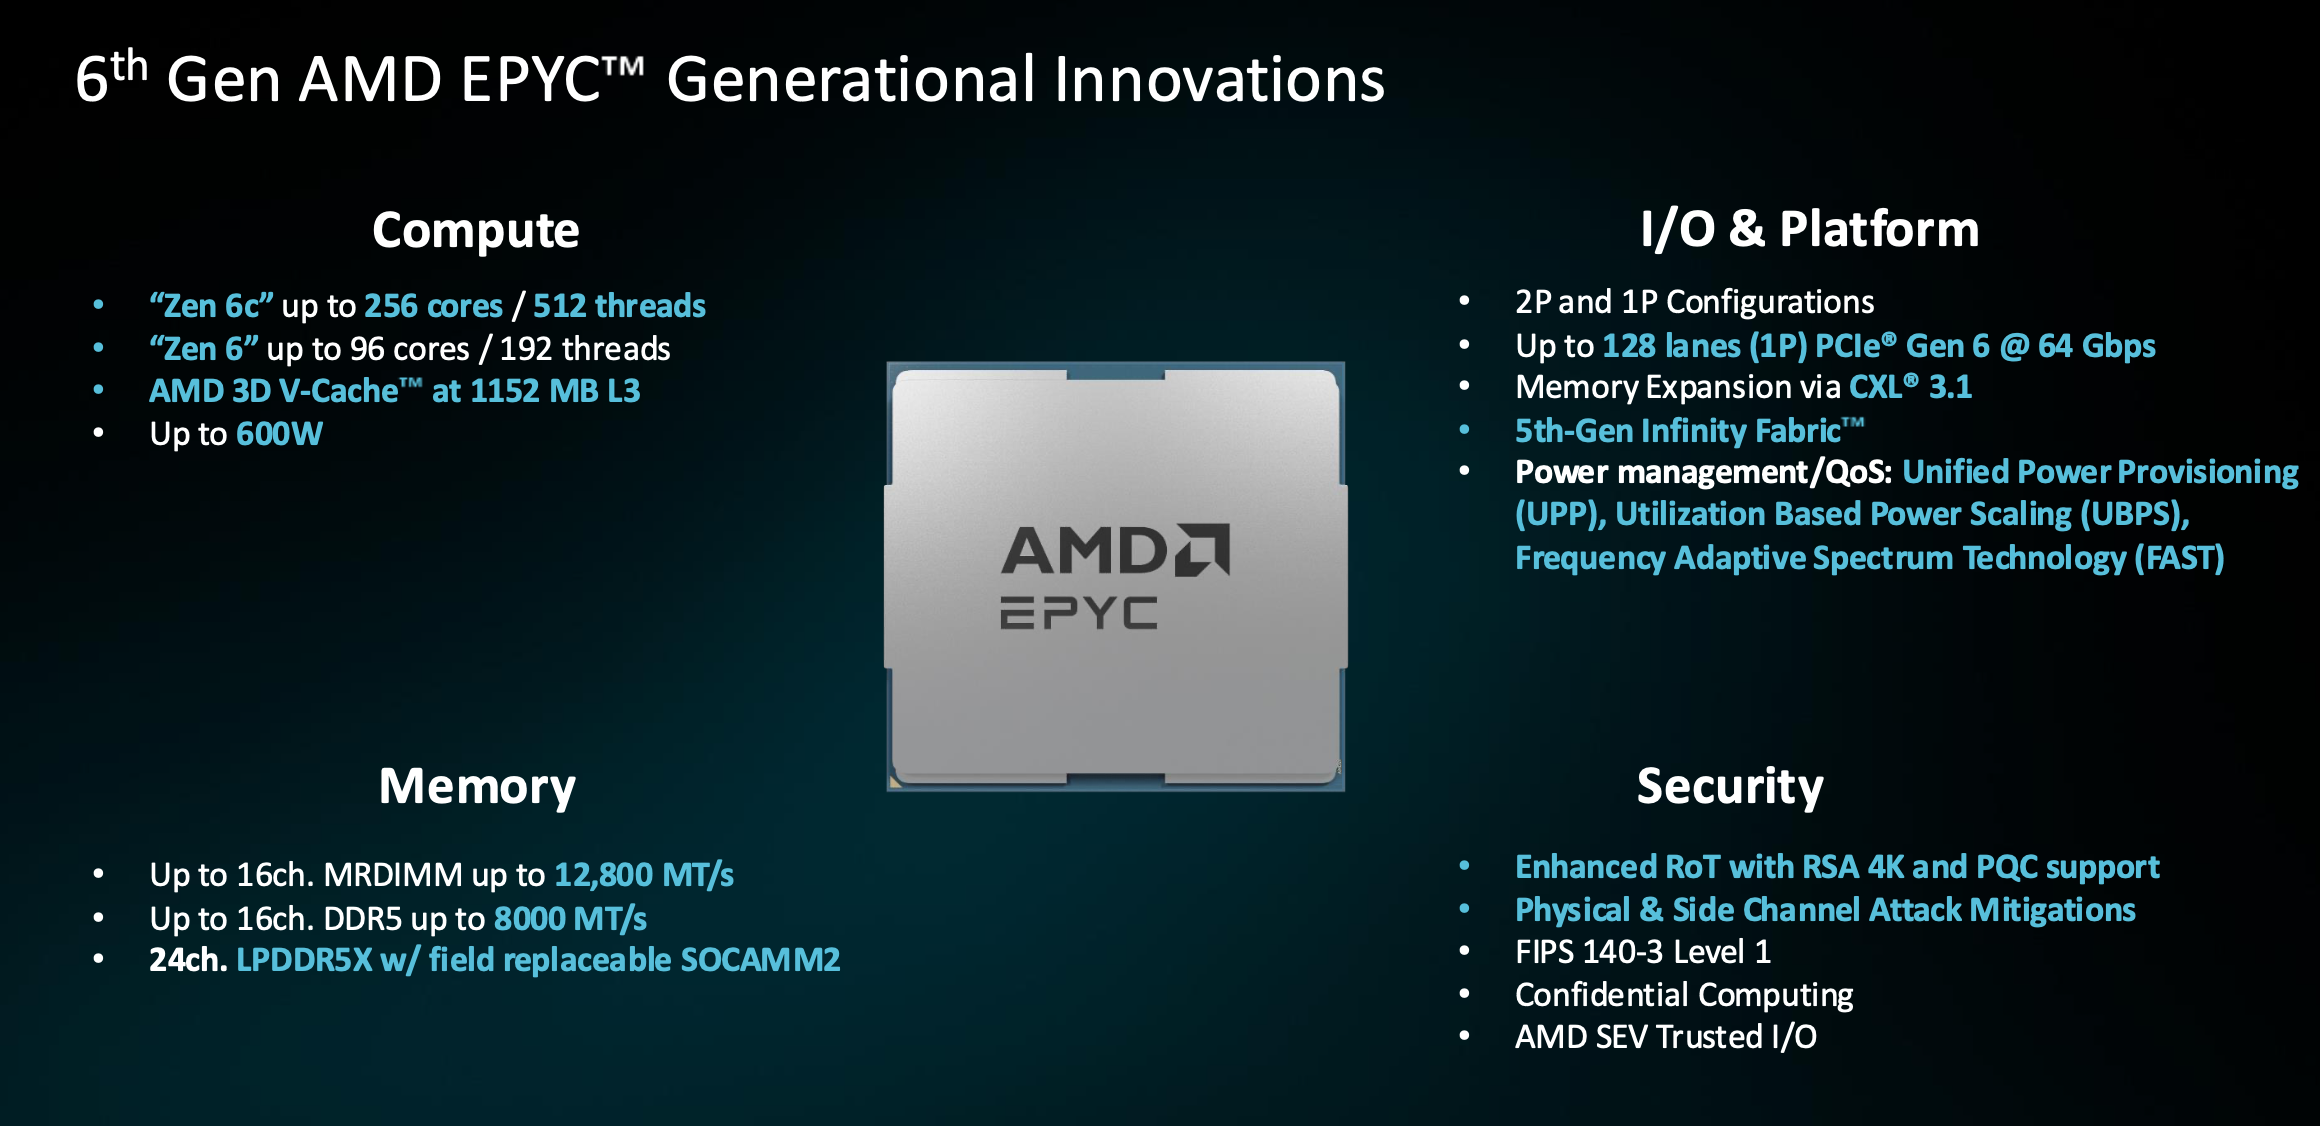
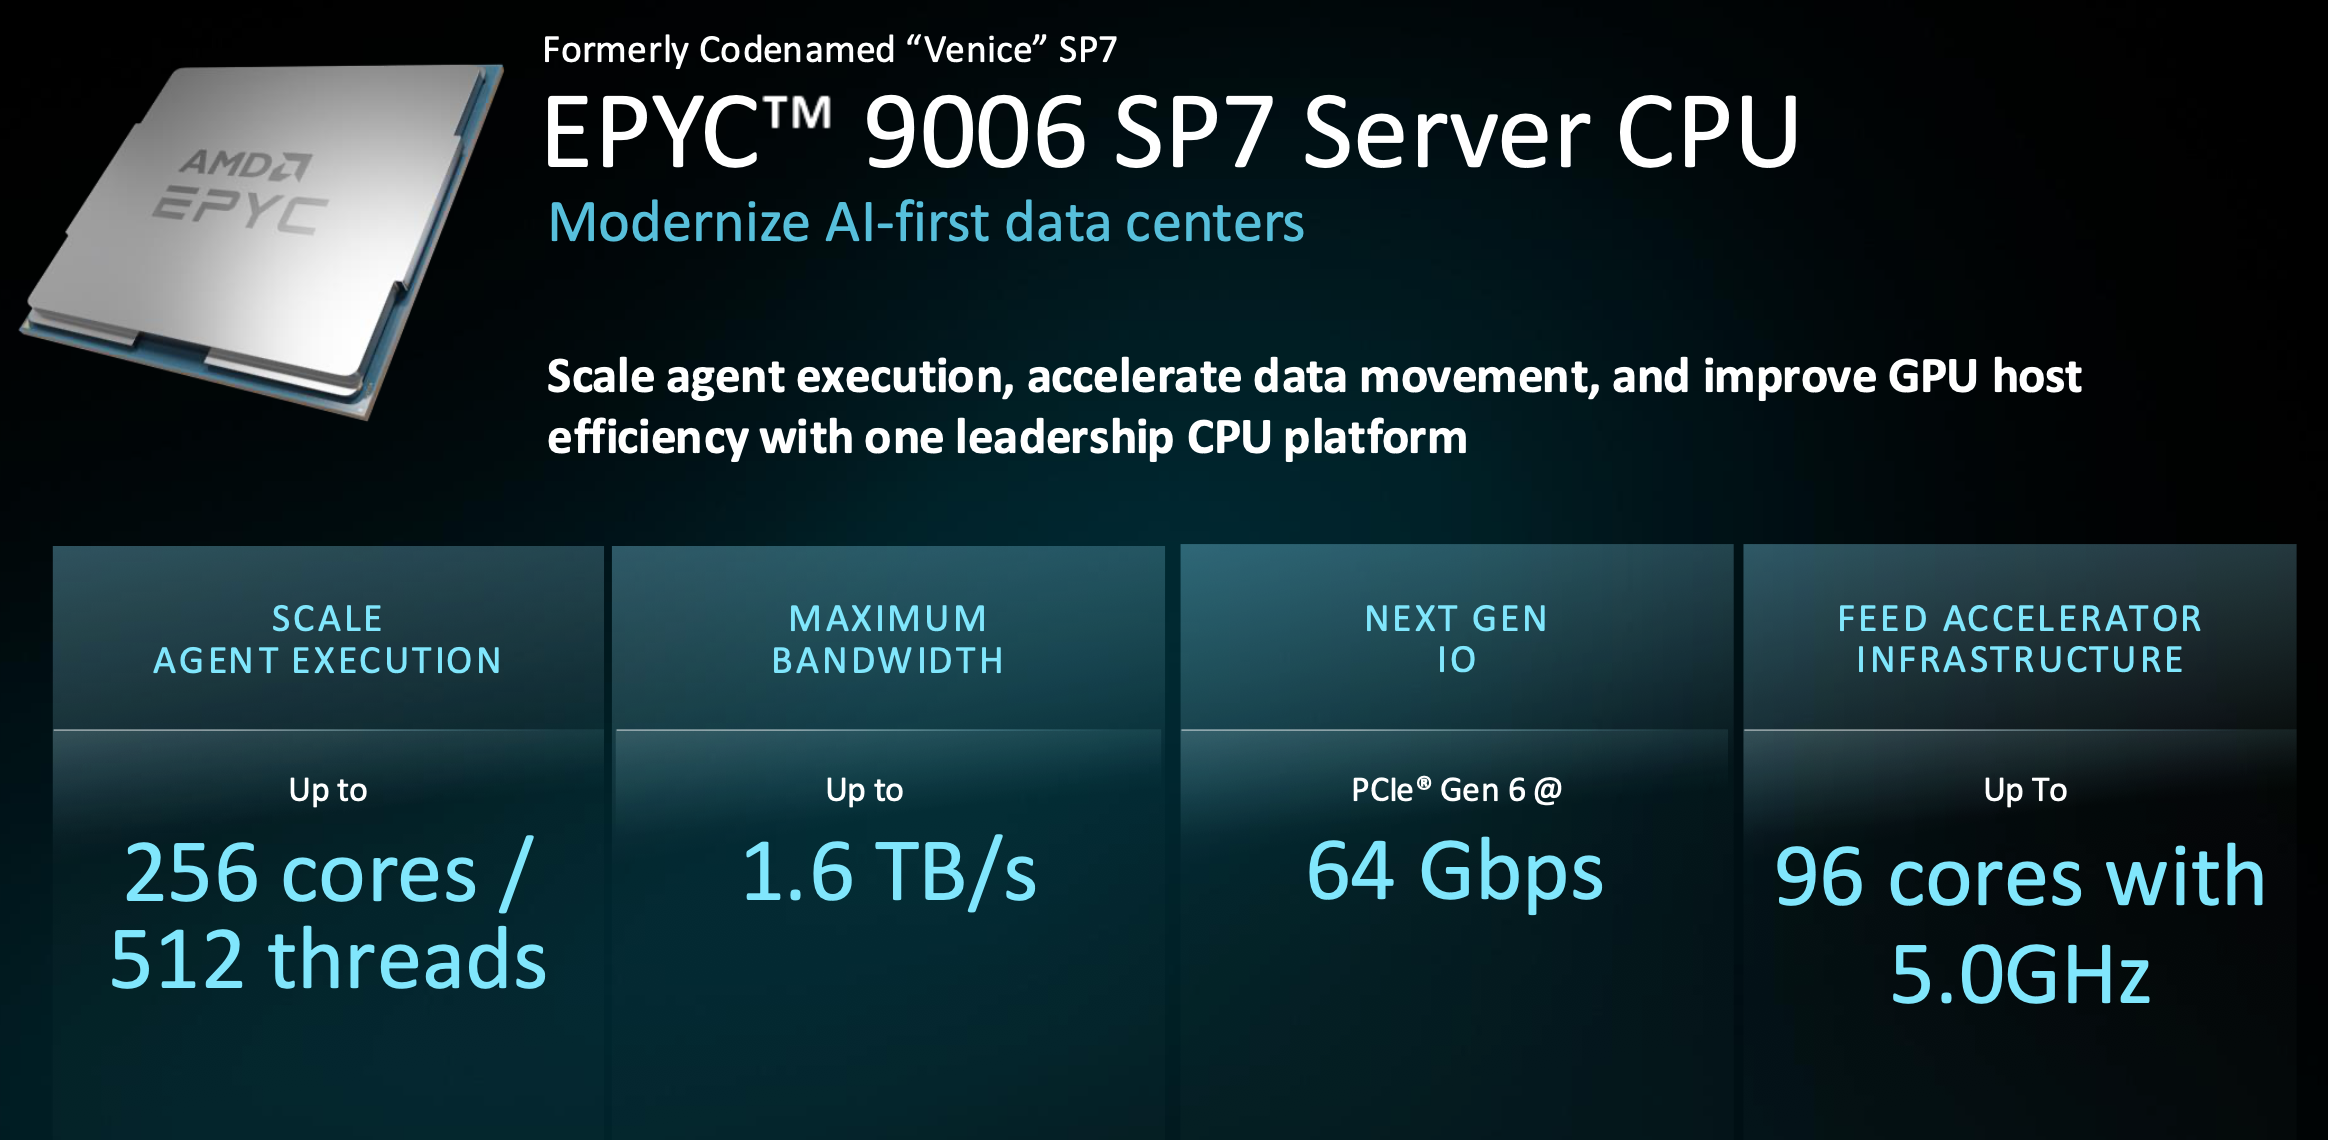
首先来看核心。Zen 6 有两种版本:紧凑型 Zen 6c 在一个插槽中集成了 256 个核心和 512 个线程,功耗最高可达 600W;而标准版的核心数为 96 个,但最高频率可达 5GHz。AMD 声称,在核心数量相同的情况下,Zen 6 的单核性能比竞争对手高出 20% 以上,而且高密度设计并没有减少缓存:即使是 256 核心的芯片,每个核心也保留了约 4MB 的 L3 缓存,旗舰版更是高达 1GB。AVX-512 指令集用于处理标记器和参数量在 30 亿到 80 亿之间的各种模型,这些模型越来越多地在 CPU 本身上运行。
为了满足这些核心的需求,需要更大的内存系统:16 通道 DDR5 内存,速度为 8,000MT/s,或者 MRDIMM 内存,速度为 12,800MT/s,每个插槽可提供 1.6TB/s 的带宽,而 Turin 仅使用 12 通道即可达到 614GB/s 的带宽。I/O 性能也实现了同样的飞跃。Venice 是首款采用 PCIe Gen 6 的服务器 CPU,拥有 128 条 PCIe 通道,每条通道的带宽高达 64 GT/s,是目前连接到加速器的其他任何产品的两倍,这也是我们稍后将详细阐述的主机节点概念的基础。CXL 3.1 利用这些通道进行内存扩展,而部分双路 AI 主机平台则牺牲了插槽间的 xGMI 带宽来换取 I/O 性能,从而达到 160 条可用通道。两项更安静的新增功能可在不占用核心的情况下移动数据:SDXI 卸载内存复制和相当于 30 到 50 个核心的加密任务,而智能数据缓存注入则将网络数据包直接放入缓存,而不是通过 DRAM 进行路由。
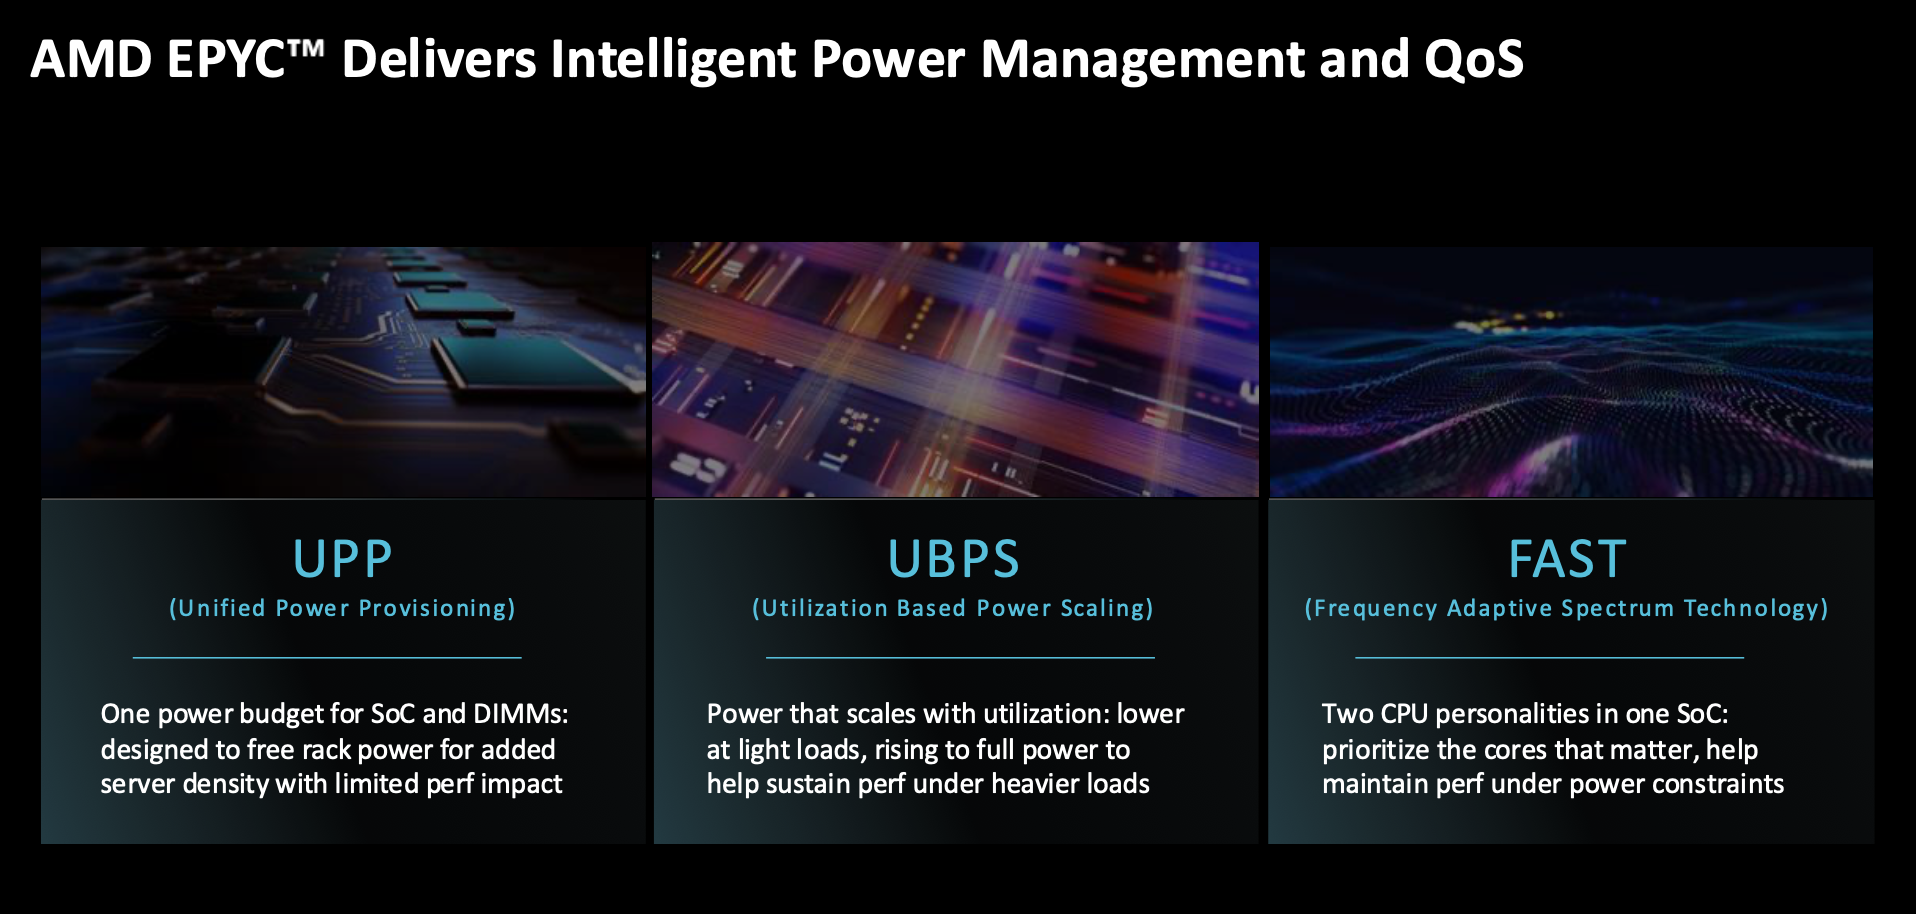
电源管理新增了三个控制选项,它们至关重要,因为AMD之后进行的所有机架式处理器性能对比都基于一定的功耗预算。UPP将SoC和DIMM的功耗预算合并为一个,因此,内存密集型工作负载会将部分功耗转移到DIMM,而计算密集型工作负载则会减少部分功耗,从而在固定预算内提升性能,或者释放机架电源以支持更多节点。UBPS在低负载时限制功耗,以牺牲通常的轻负载性能提升为代价,换取平稳、可预测的负载曲线;喜欢性能提升的用户可以将其关闭。FAST将一个SoC拆分为两个独立工作模式,保持优先级核心的高频运行,同时降低后台核心的运行速度,从而避免与批处理作业共享同一插槽的延迟敏感型任务受到影响。
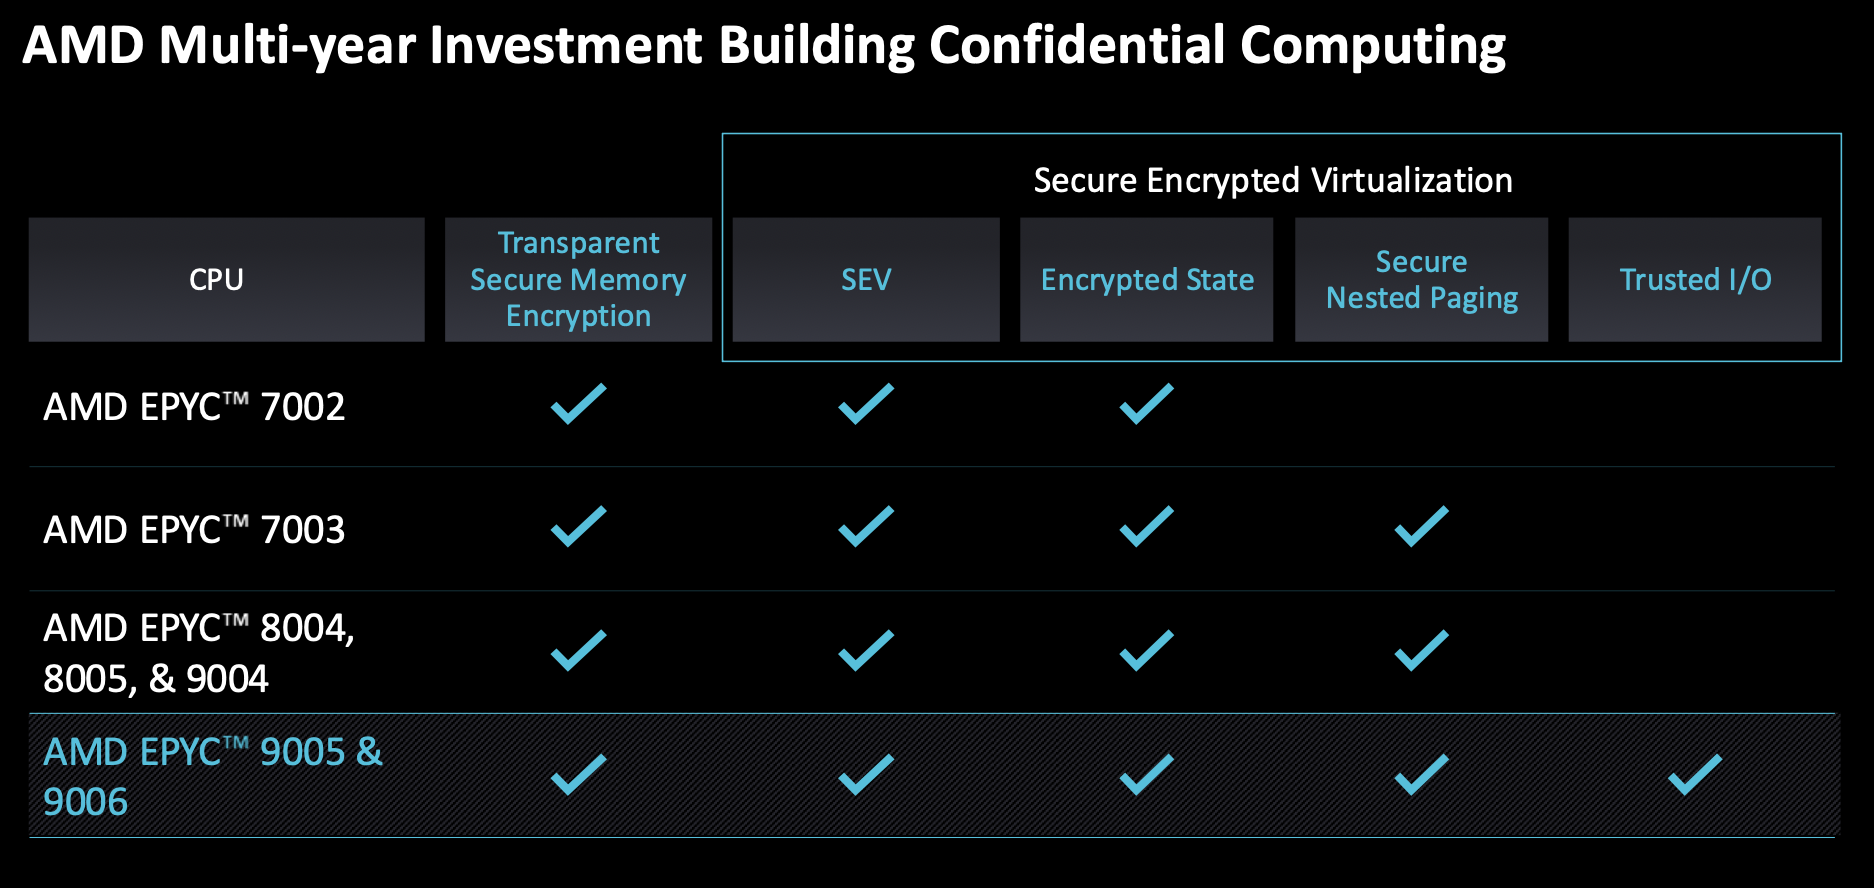
在安全性方面,Venice 延续了 AMD 机密计算技术的传统,其技术基础可追溯至 EPYC 7002 上的 SEV,并融合了加密状态、安全嵌套分页以及 Turin 架构引入的可信 I/O 等技术。本代产品新增了多项功能:采用 RSA-4K 和后量子算法的增强型信任根、物理攻击和侧信道攻击缓解措施、FIPS 140-3 1 级认证,以及设备溯源(Device Provenance)功能——Venice 将成为首批具备此功能的 AMD 产品之一,该功能可提供可验证的制造历史记录。
投资组合内部
这四个部分之间的差异比它们共同的名称所暗示的要大得多。
| 规格 | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP “Verano” |
|---|---|---|---|---|
| 颜色 | 最多 256(512 个线程) | 8到128 | 高达 96个 | 高达 72个 |
| 峰值频率 | 5.0GHz,96 核(HF) | 高频选项 | 〜5.15GHz | 高达5.0GHz |
| 内存 | 16通道,最高可达1.6TB/秒 | 8通道,每通道2个DIMM插槽 | 16通道MRDIMM,传输速率12,800 MT/s | 24通道LPDDR5X,SOCAMM2 |
| L3缓存 | 高达 1024MB | 核心数依赖性 | 1152MB(3D V-Cache) | 核心数依赖性 |
| I / O | PCIe Gen 6,128 通道 1P | 128 条 PCIe 通道,1P 和 2P | PCIe第6代 | 增强型 xGMI 为 112 GT/s |
| 目的是 | 超大规模密度,人工智能主机 | 企业级、边缘计算、NEBS友好型 | 高性能计算、人工智能预处理 | 机架级人工智能主机 |
EPYC 9006 SP7
SP7是旗舰级插槽,也是目前量产的插槽;合作伙伴平台将于第四季度跟进。其高频产品取代了AMD所说的Turin HF系列产品,后者是其产能爬坡最快的SKU之一,而其最大的应用场景是Helios服务器。在Helios中,每个计算托架上的主机CPU都通过Infinity Fabric连接到机架的统一内存域,并配备1TB的DDR5内存。由于该插槽是标准插槽,因此任何SP7 SKU,包括256核的旗舰级产品,都可以直接使用,这一点我们在之前的文章中已经介绍过。
EPYC 9006 SP8
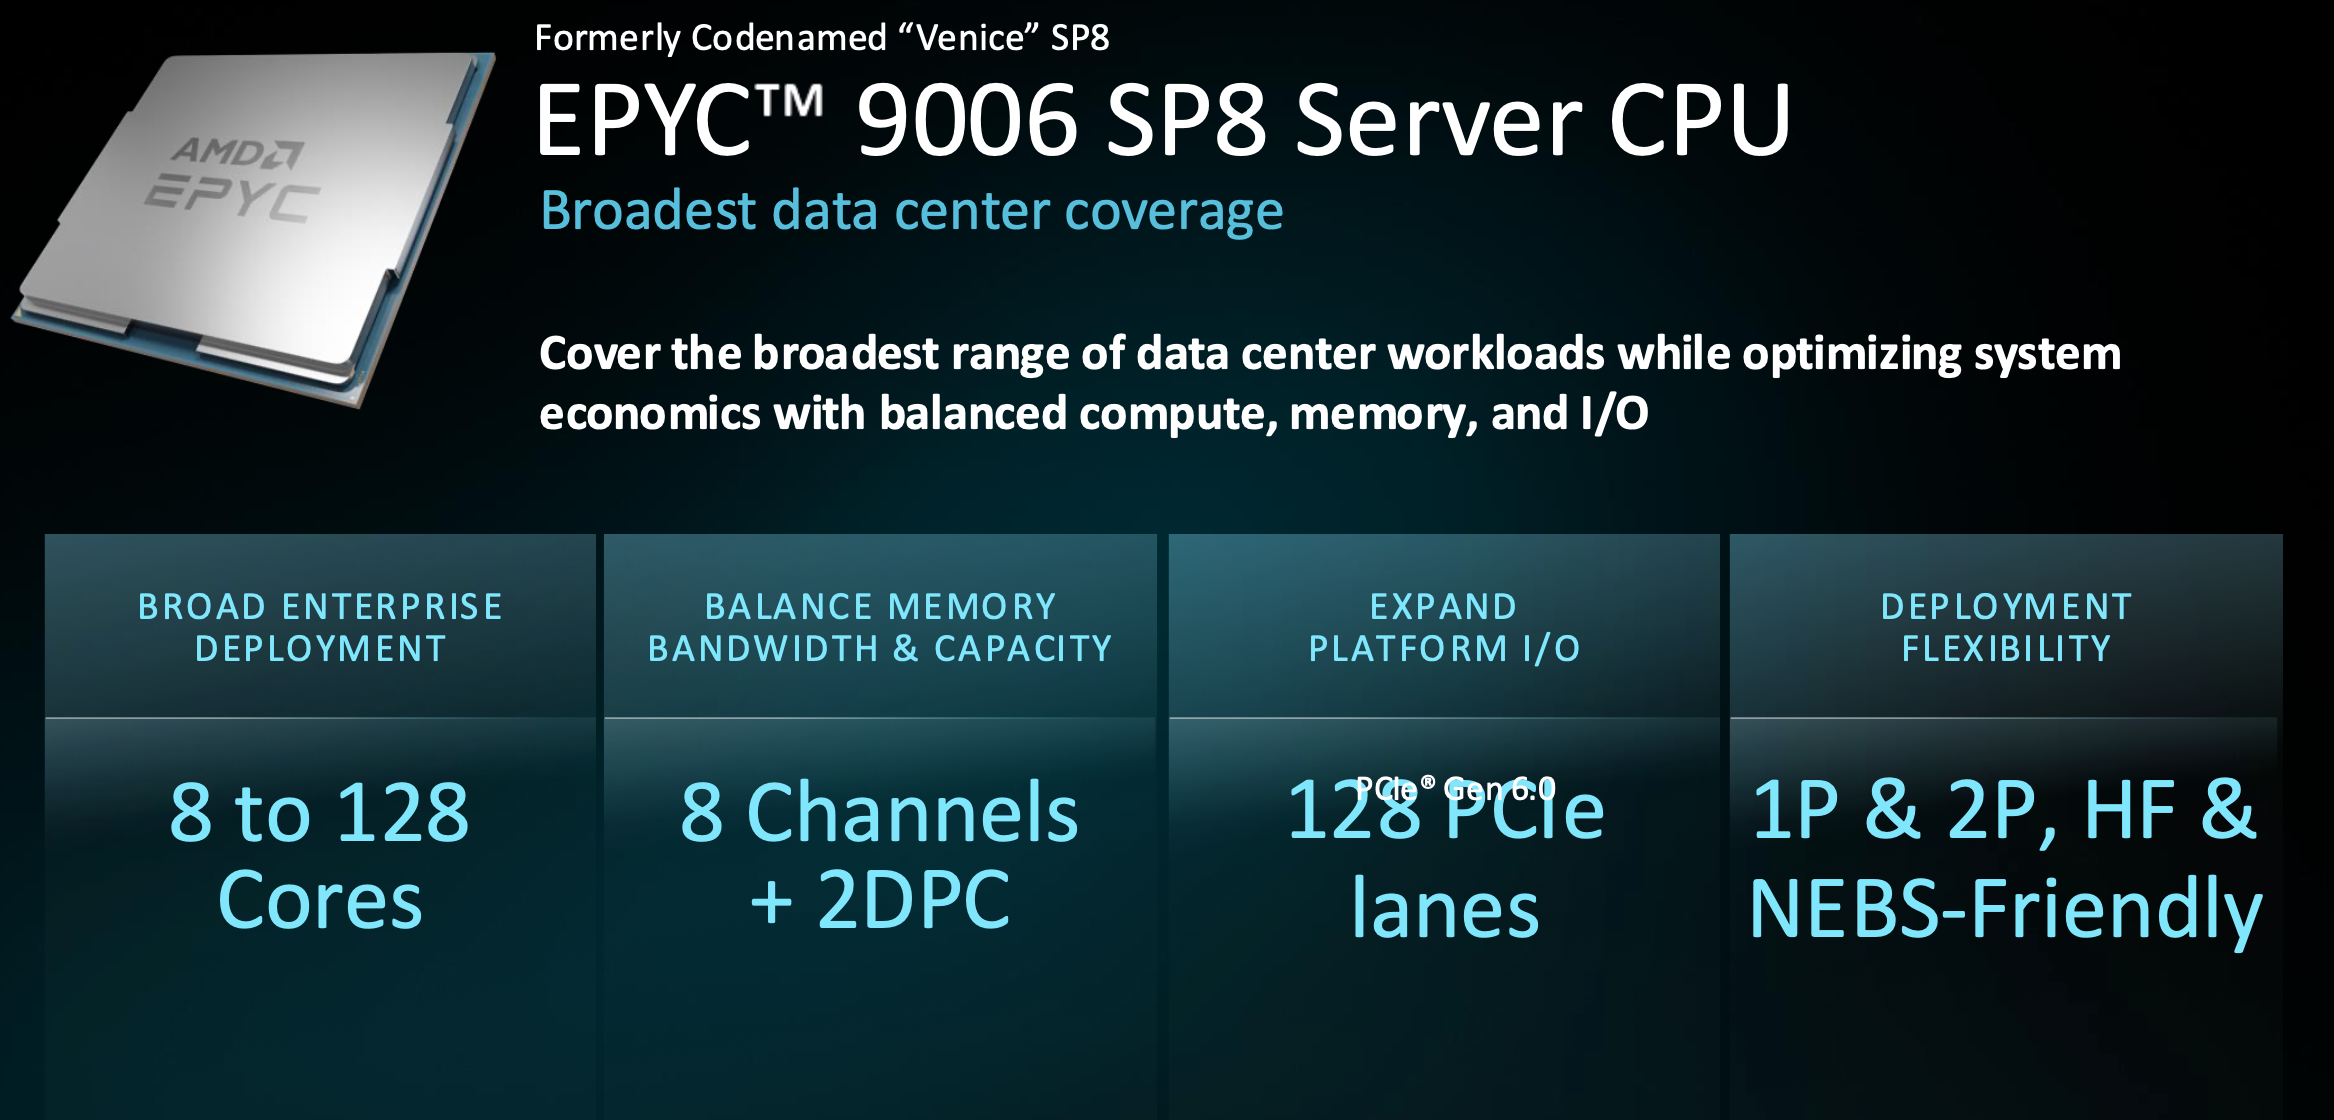
SP8 以牺牲系统经济性为代价,放弃了庞大的插槽。它支持 8 到 128 个核心,支持 8 个内存通道(每个通道 2 个 DIMM 插槽),保留了 128 条 PCIe 通道,并提供单路和双路两种版本,以及适用于电信和边缘部署的高频和 NEBS 兼容选项。AMD 的卖点是为企业提供适配的性能,在企业级应用中,决定交易成败的指标是每美元系统性能,而不是每个机架的性能。
EPYC 9006X “威尼斯-X”
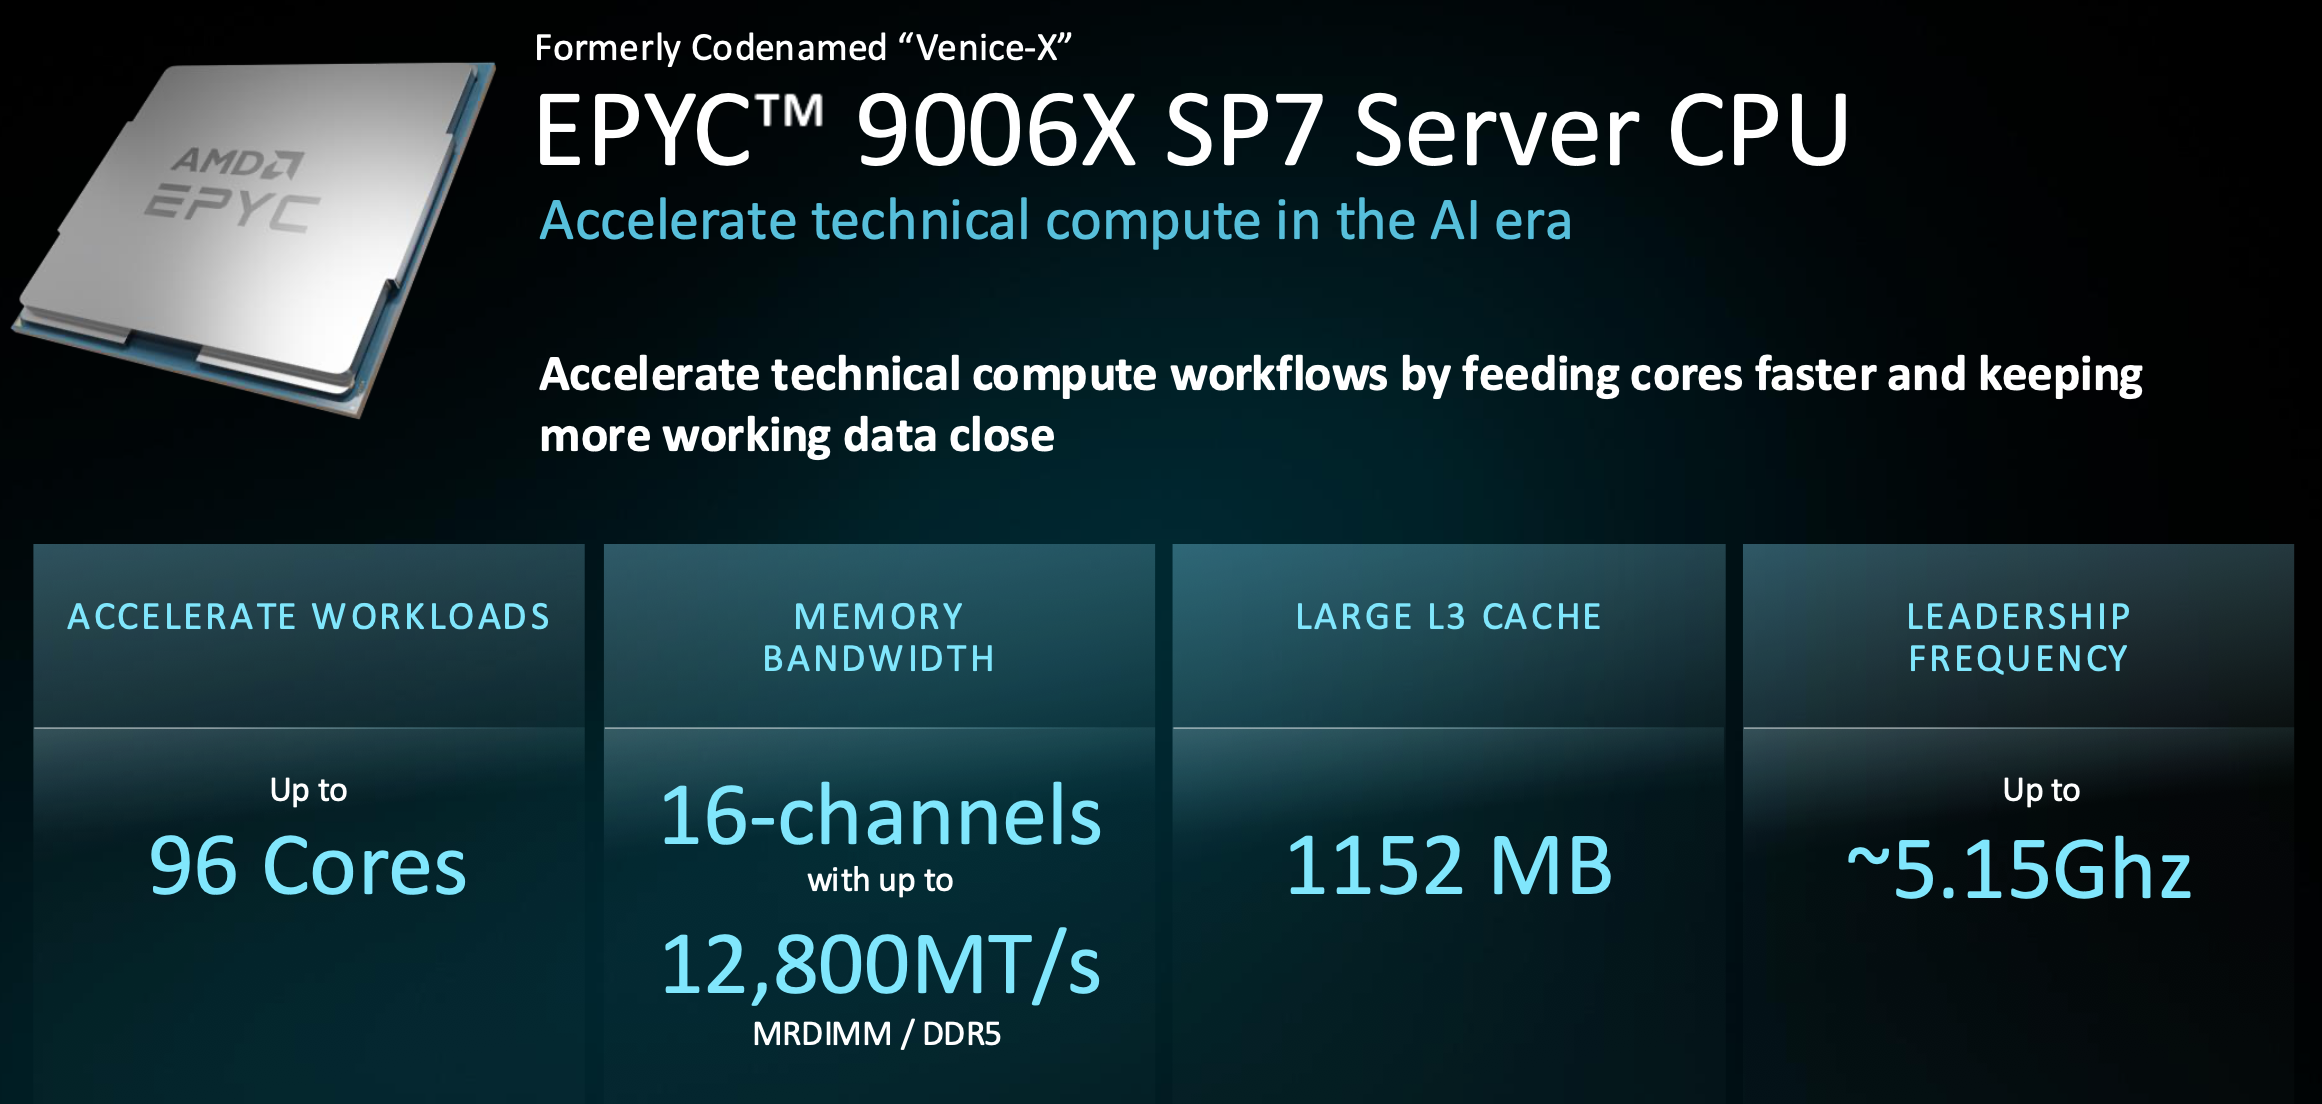
Venice-X 在 96 核高频配置上堆叠了 3D 垂直缓存,并将 L3 缓存提升至 1152MB,约为标准 SP7 处理器每个核心缓存容量的 3 倍。其时钟频率可达约 5.15GHz,并沿用了完整的 16 通道、12,800 MT/s 内存系统。其目标应用包括仿真和建模、大规模分析、内存数据库以及为训练流水线提供数据的 AI 预处理——在这些工作负载中,缓存中的工作集比额外的核心数更为重要。
EPYC 9006 LP “Verano”
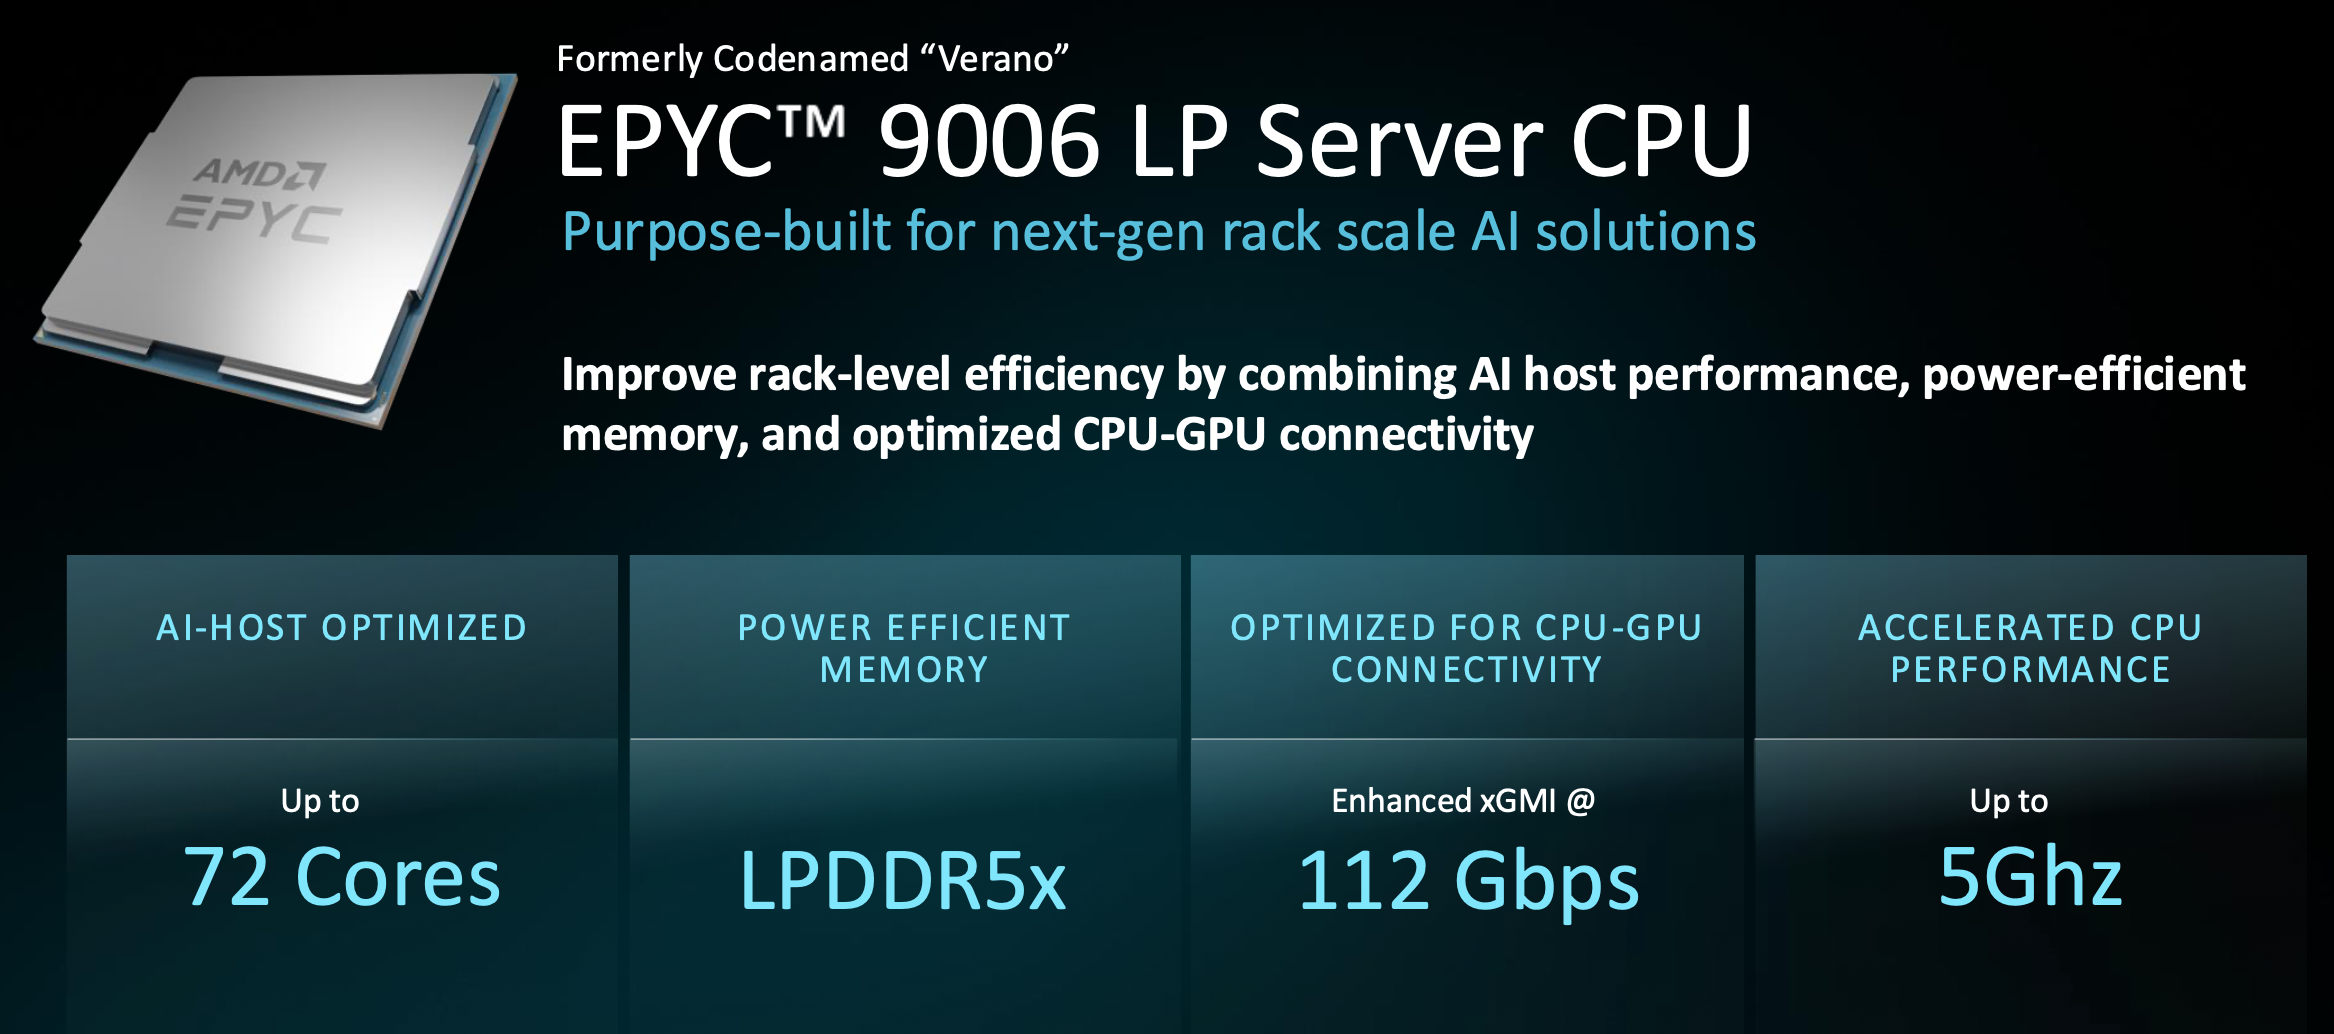
Verano是该系列中最专注的产品:首先,它是一款AI主机节点,拥有高达72个5GHz的核心、24通道LPDDR5X内存,以及用于CPU到GPU通信的增强型112 GT/s xGMI链路。LPDDR内存采用SOCAMM2模块,可在现场更换,这在大型系统中至关重要,因为如果内存条焊接在主板上发生故障,则整个主板都将报废。它也是AMD直接对抗NVIDIA Vera的产品,我们稍后会再次讨论这场对决,因为AMD确实进行了深入分析。
威尼斯排名如何
AMD分两轮比赛证明了自己的实力,先在都灵站展示了其已经取得的领先优势,然后在威尼斯站展示了其正在拉开的差距。
都灵队今天领先
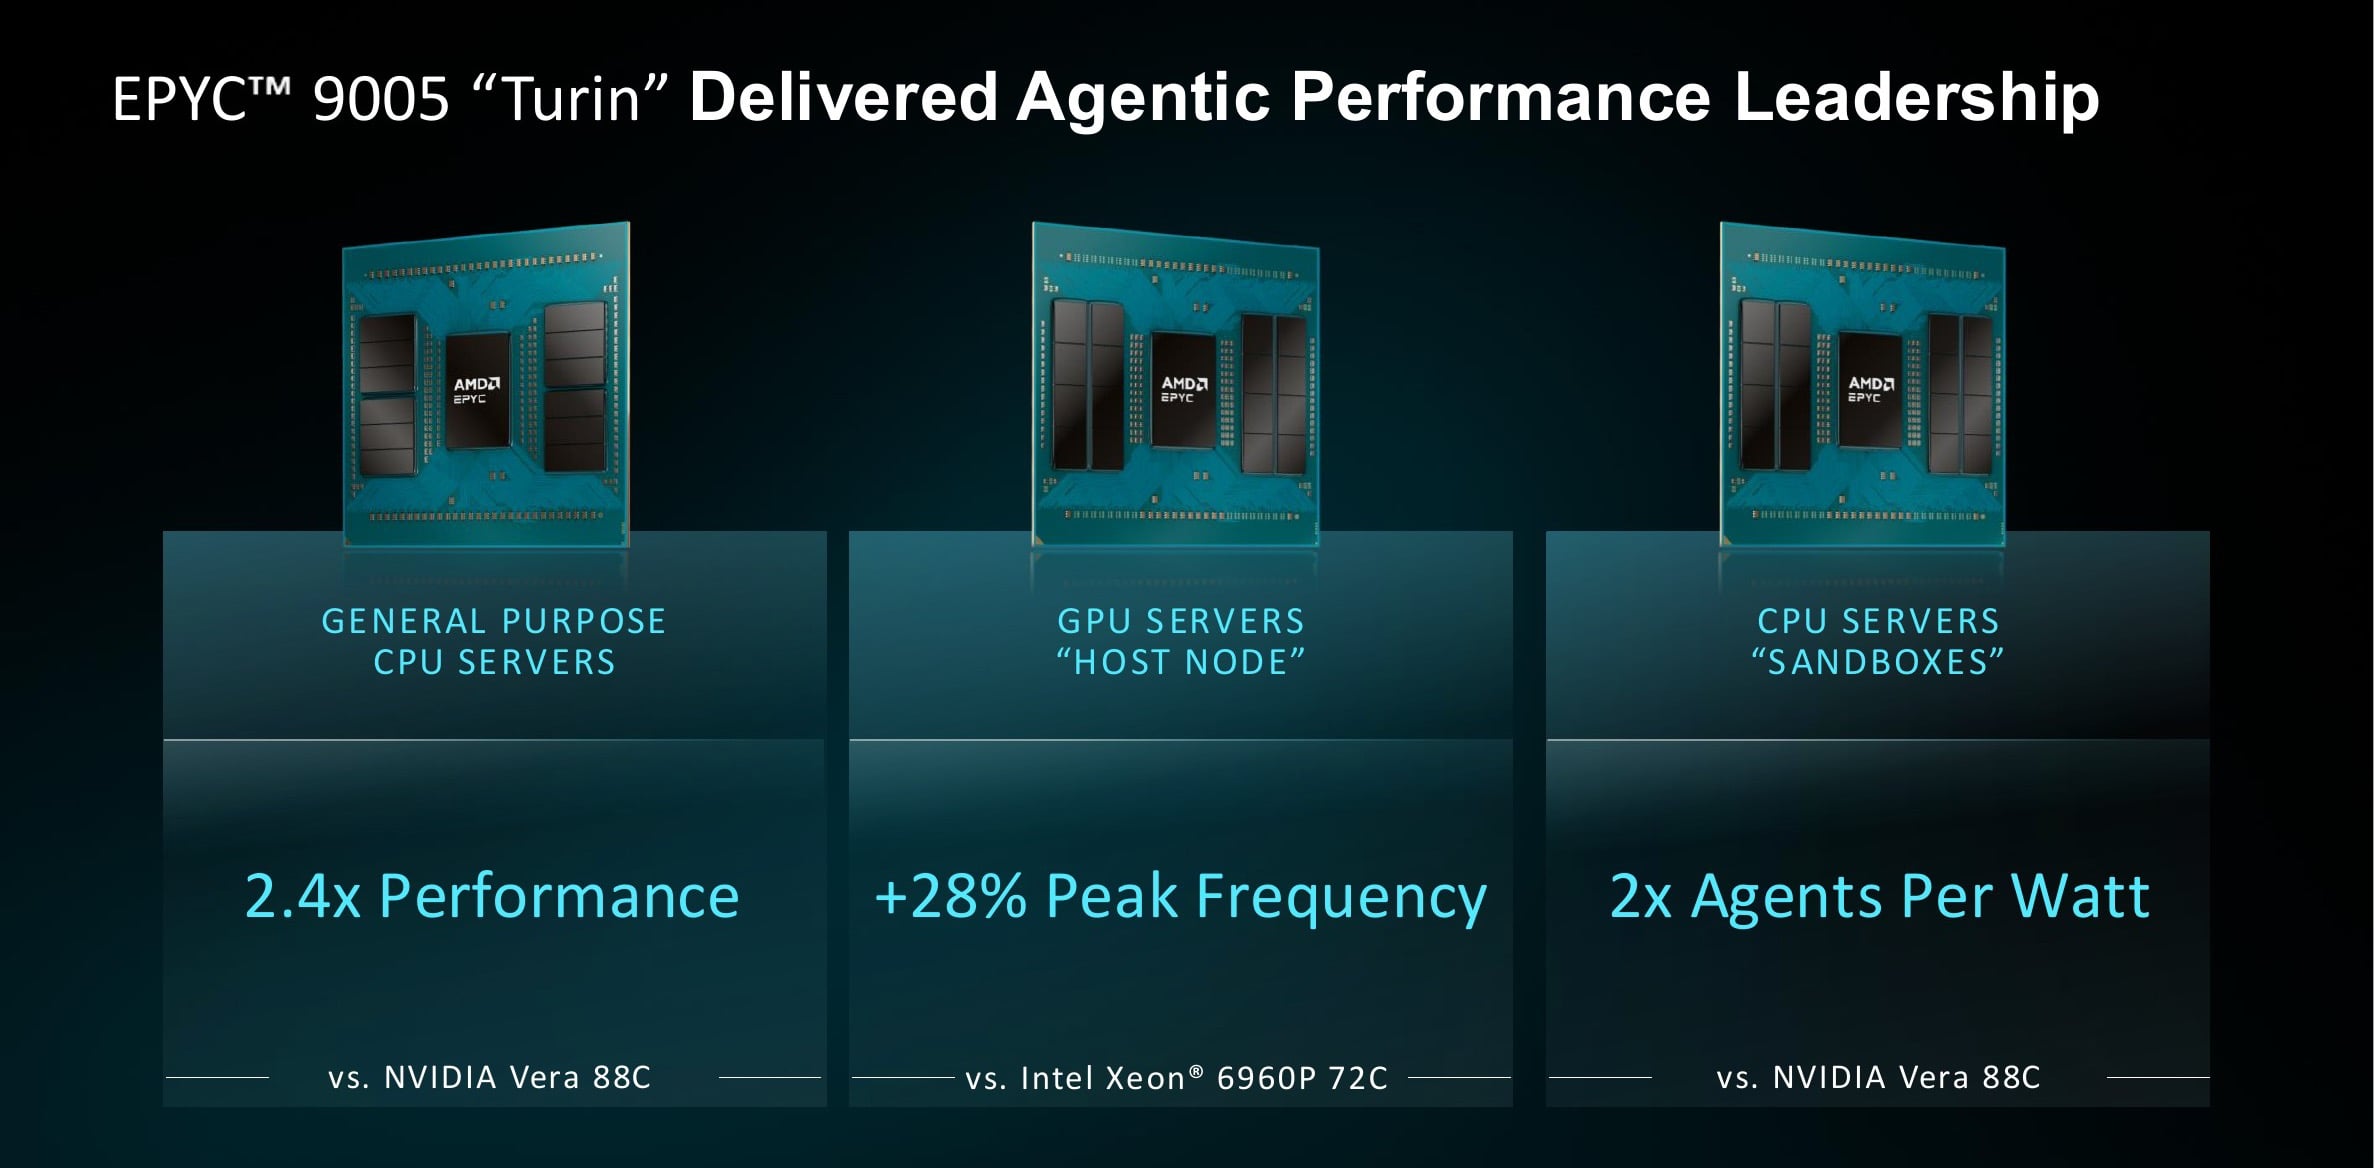
AMD 的大部分对比测试都以 NVIDIA 的 Vera(Vera Rubin 平台上的 Arm CPU)为基准,并首先对比了其已上市的一代产品。根据 AMD 的机架级建模,Turin 机架的通用吞吐量是 Vera 的 2.4 倍,每瓦代理数是 Vera 的两倍。该模型将两个机架的功耗预算都设定为 100kW,将拥有 384 个核心的双路 EPYC 9965 与拥有 176 个核心的双路 Vera 主板进行对比,并对六种工作负载的结果取平均值:SPECrate 2017 预估性能、服务器端 Java、NGINX、Redis、Memcached 以及 TPC-C 衍生产品。
本文及后续内容需注意两点。Vera 尚未正式发售,因此文中所有关于 Vera 的数据均为 AMD 对 NVIDIA 公开资料中描述的 88 核 450W 处理器的估算。此外,由于目前尚无针对代理工作负载的标准基准测试,AMD 在计算每瓦代理数时,会将硬件线程数作为代理数量的近似值。
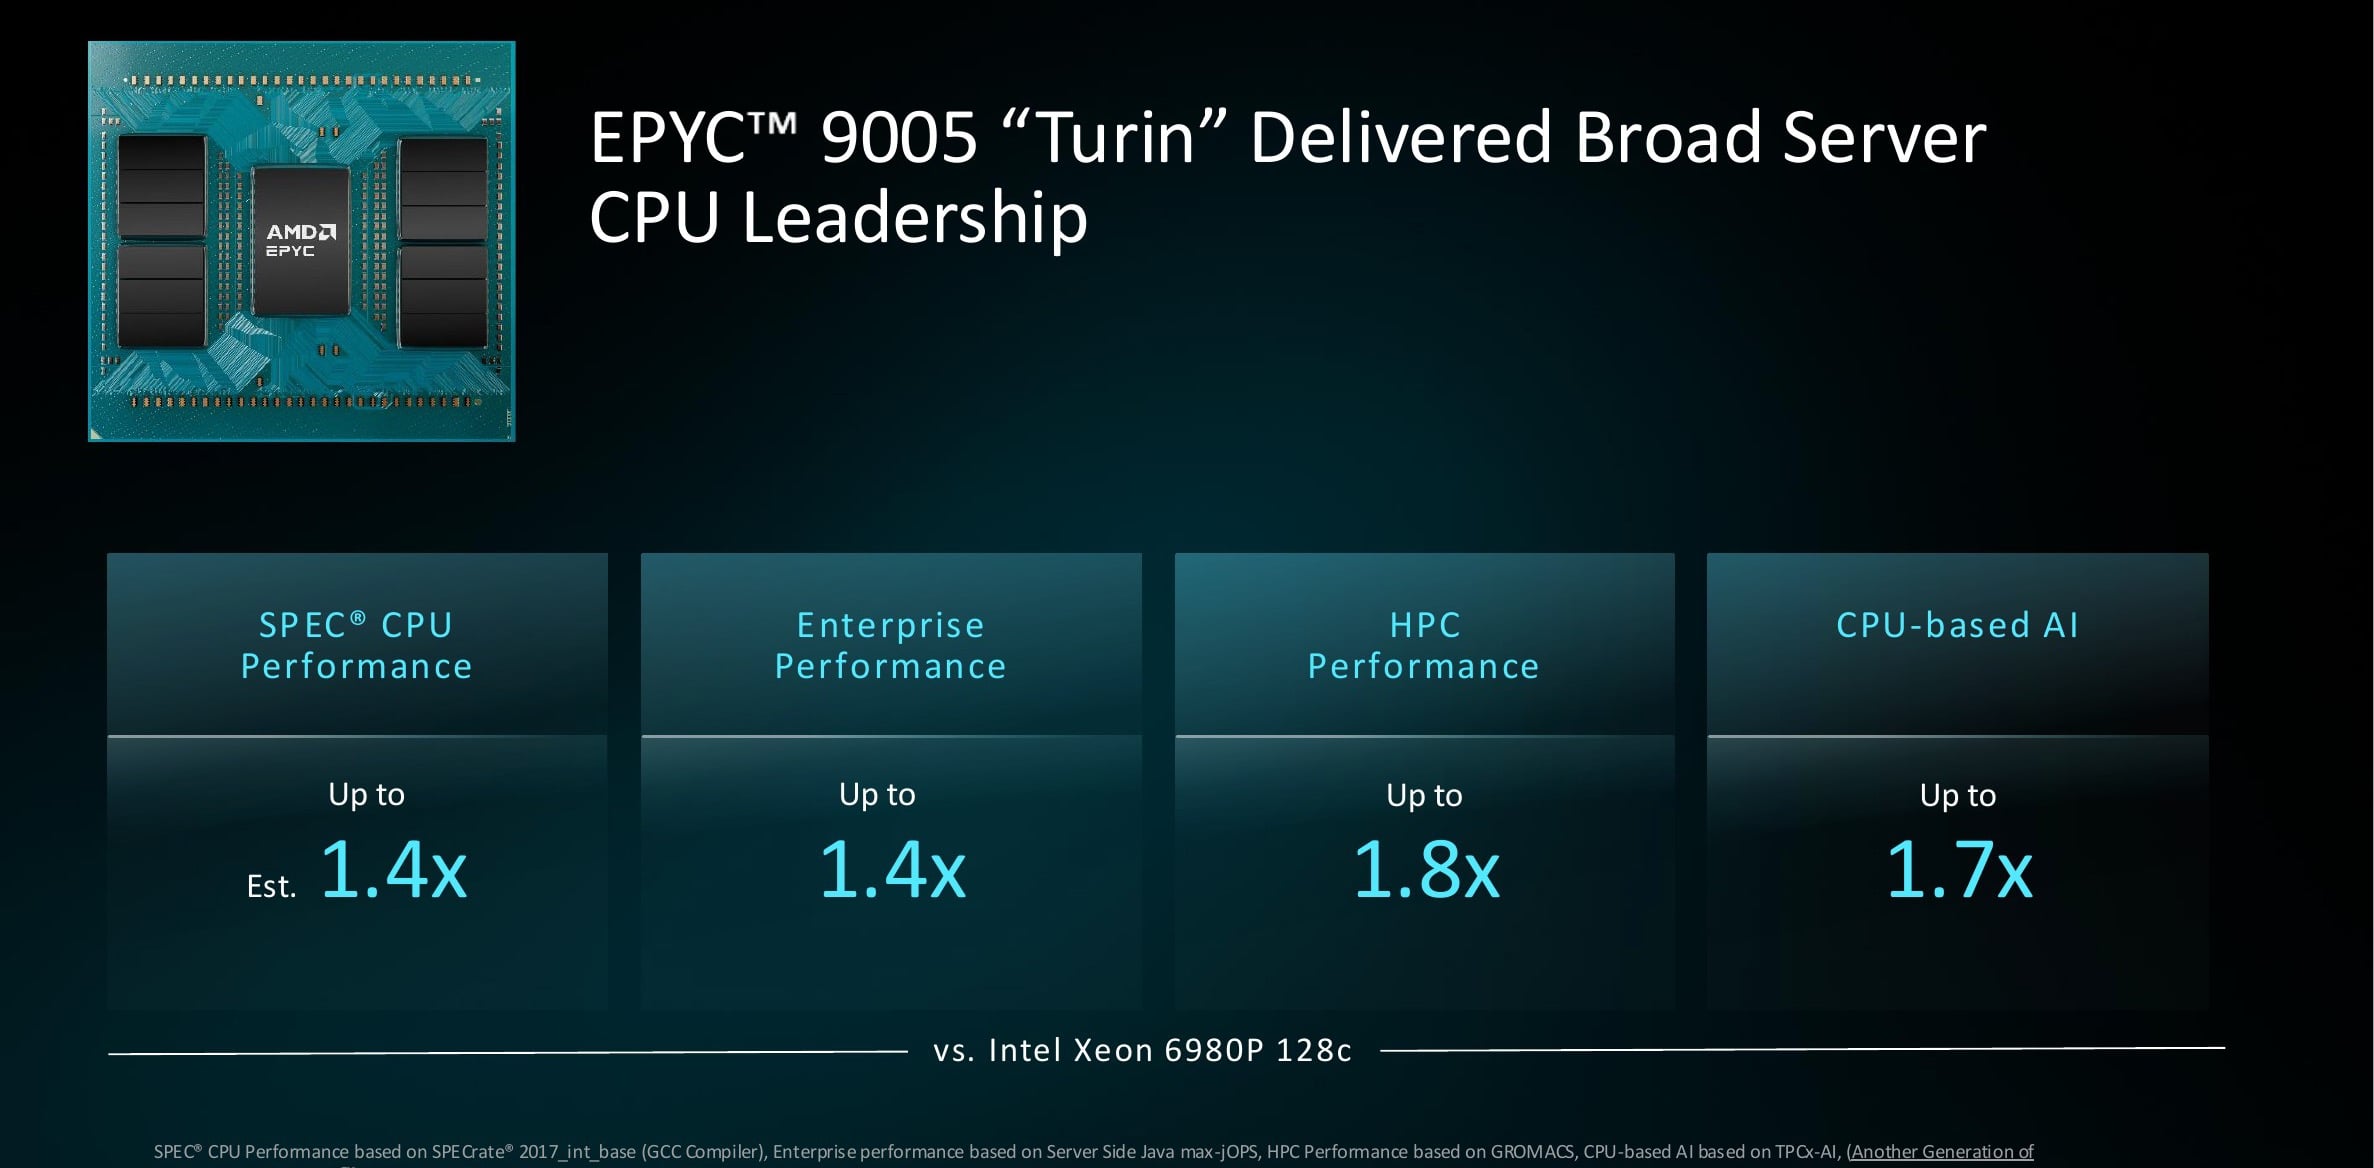
与英特尔的对比更有说服力,因为双方都在出货AMD可以直接进行基准测试的产品。Turin的主机CPU最高频率可达5.0GHz,而同级别的至强处理器最高频率仅为3.9GHz,28%的频率优势在单线程驱动GPU时至关重要。在同插槽配置下,AMD测试Turin与128核至强6980P的性能对比结果显示,Turin在SPEC CPU测试中最高可达1.4倍,企业级Java测试最高可达1.4倍,HPC测试最高可达1.8倍,基于CPU的AI测试最高可达1.7倍。
威尼斯扩大了每一个缝隙
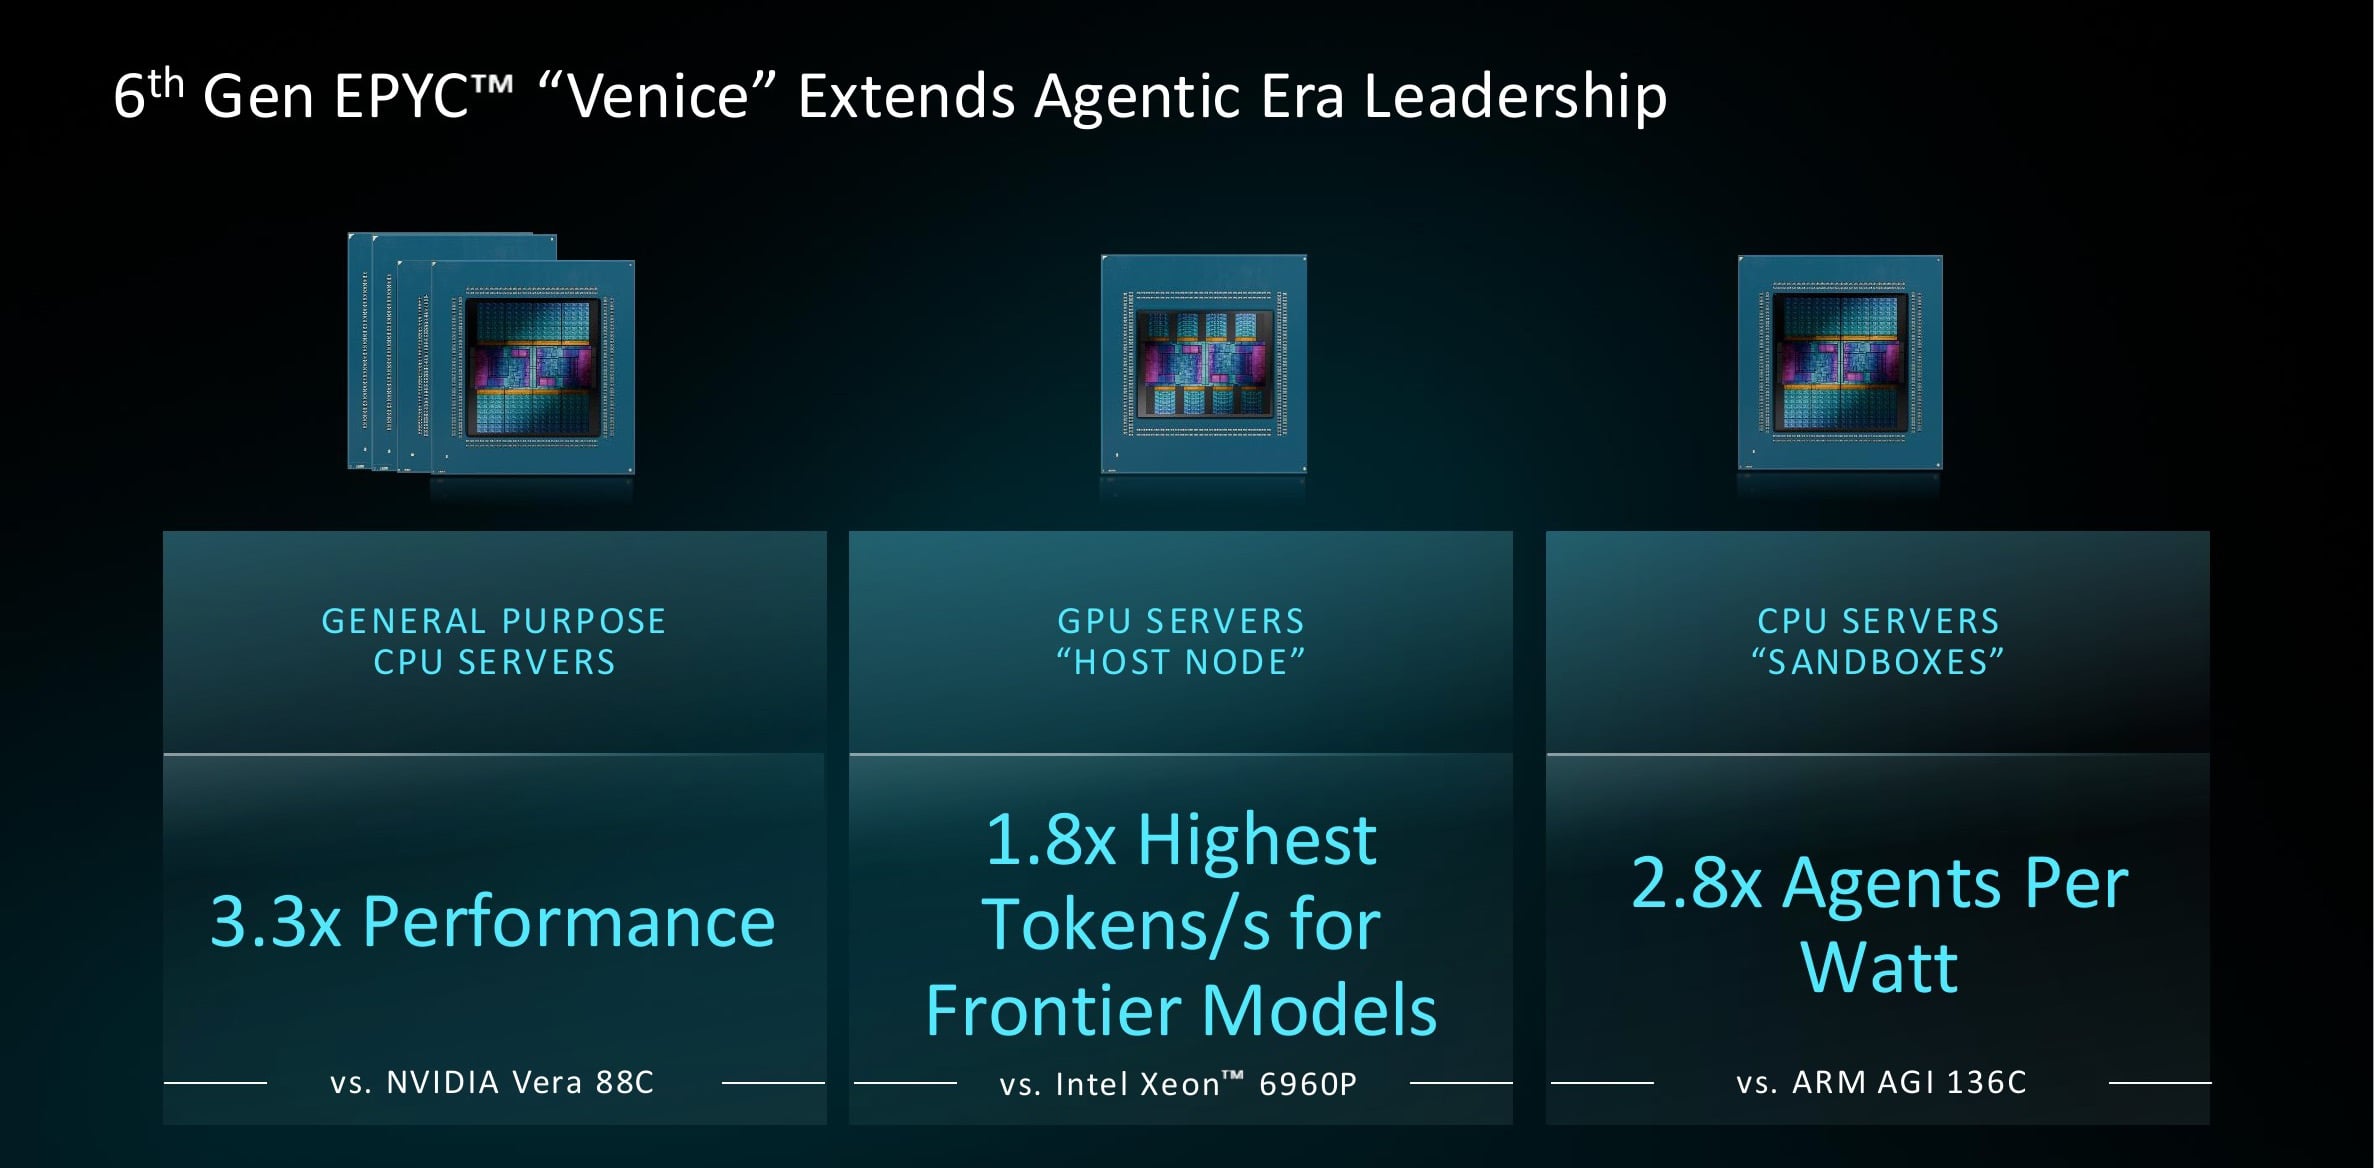
Venice 进一步扩大了这些优势。在相同的 100kW 机架模型下,Venice 拥有 512 个核心,而 Vera 只有 176 个,AMD 声称 Venice 的通用性能是 Vera 的 3.3 倍。Venice 的每瓦代理数是 136 核 Arm AGI 的 2.8 倍,并且在 Venice 搭载 GPU 的情况下,其在 frontier 模型上的每秒令牌数是 Vera 的 1.8 倍。需要注意的是,这 1.8 倍的倍数所衡量的应用场景比标题所暗示的要窄,我们将在下文的主机节点部分对此进行详细讨论。
与维拉正面交锋
在 SPECrate 2026 测试中,AMD 预计 2P Venice 9996 的性能将达到 2070 分,而 Vera 仅为 925 分,吞吐量优势高达 2.2 倍;此外,这款 96 核高频处理器的单核性能也比 Vera 高出约 1.2 倍。以上结果均使用 GCC 15.2 编译,NVIDIA 也曾使用相同的工具链测试 Vera 的性能。
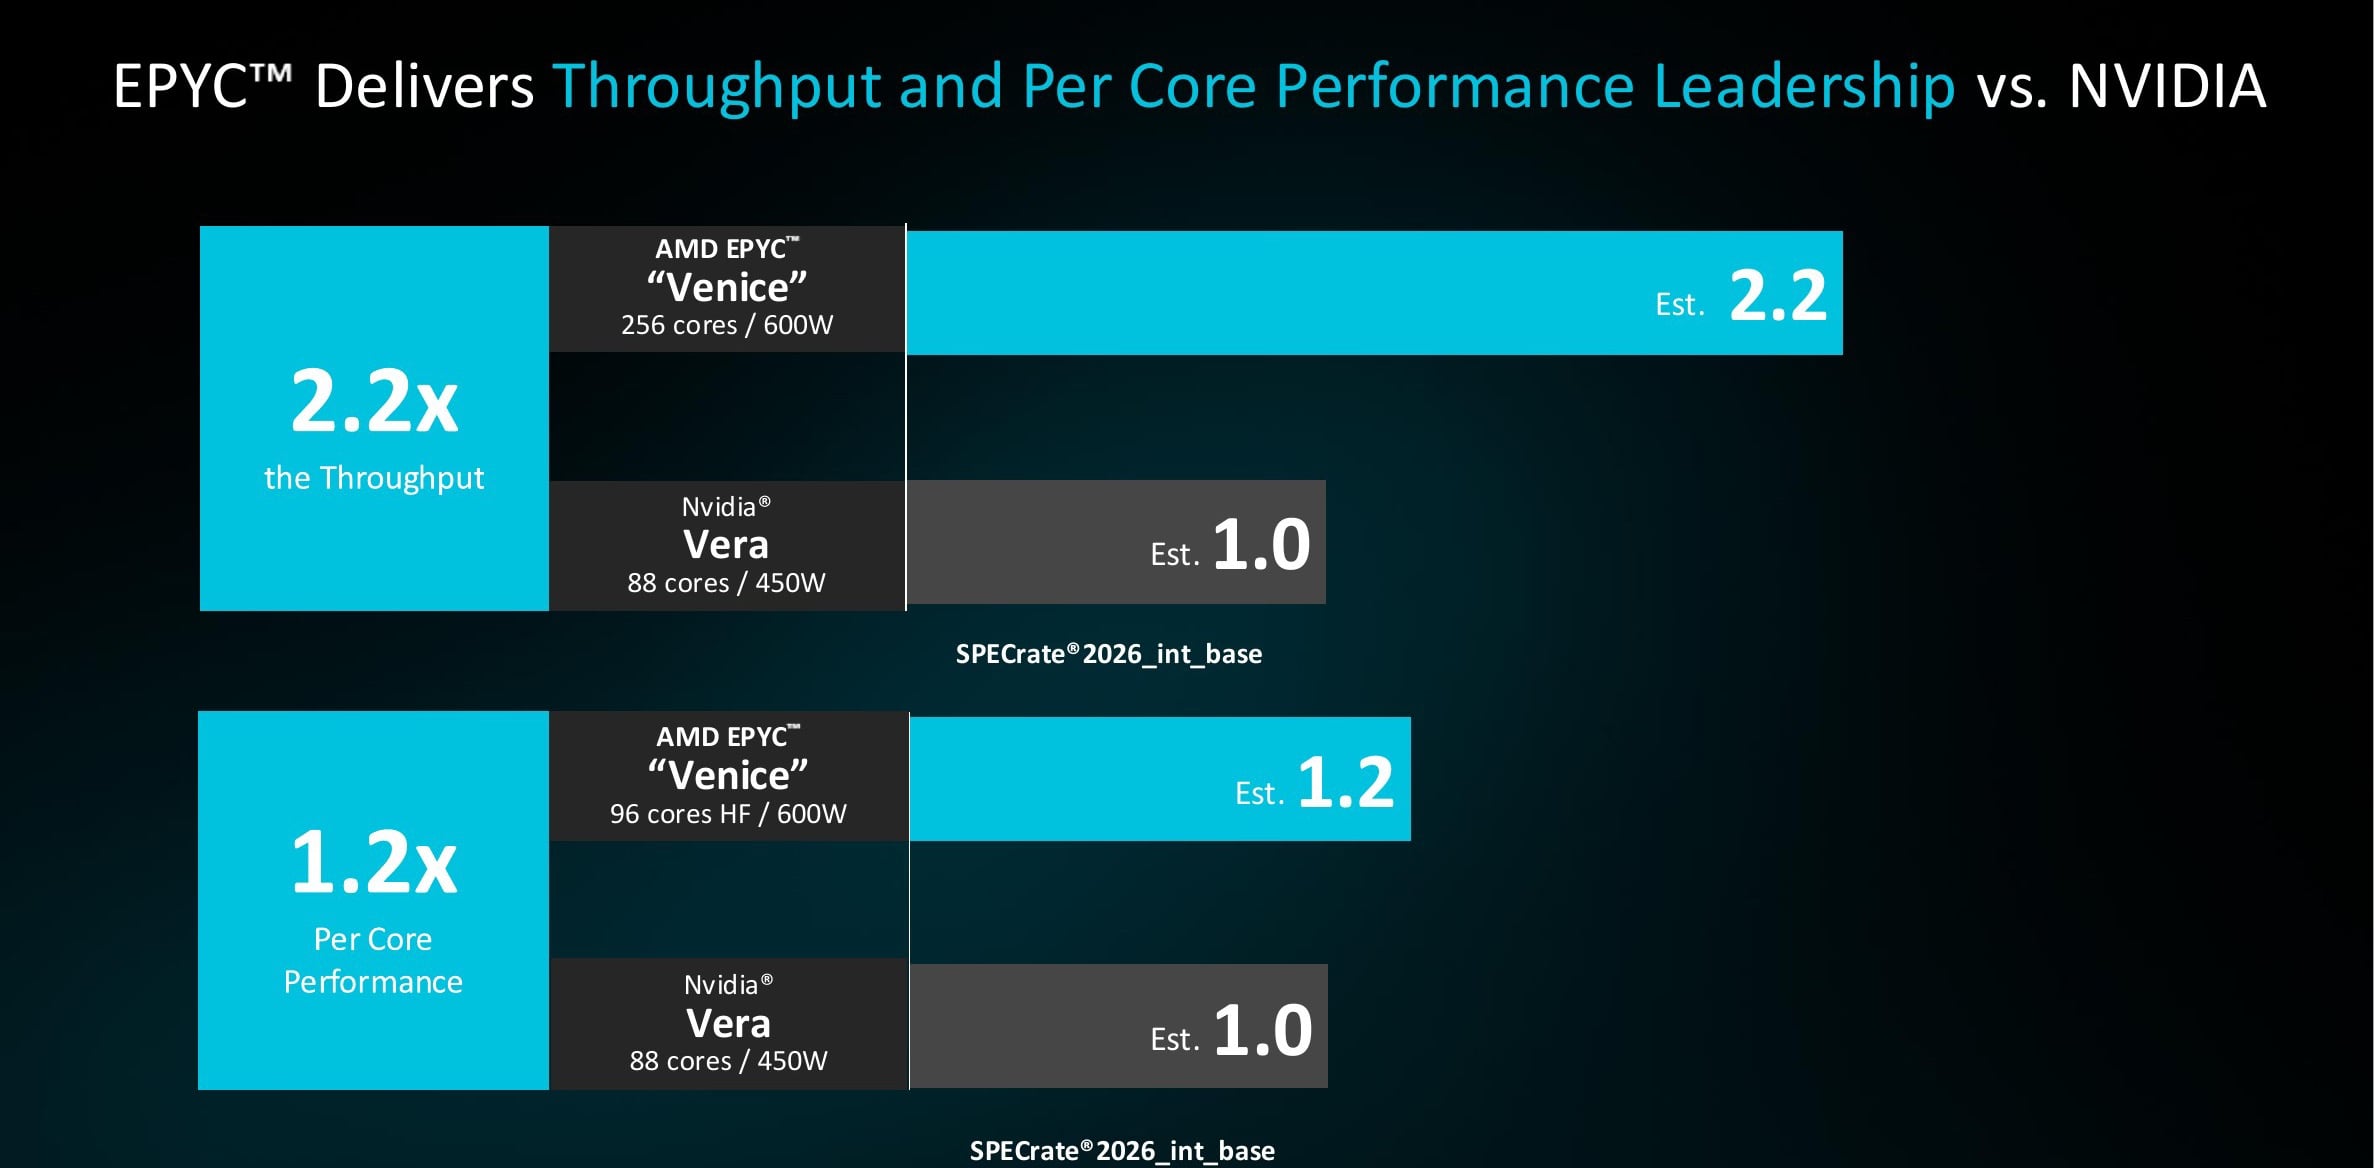
在发布周期间,AMD 宣称的单核性能优势实际上有所提升。AMD CPU 工程负责人 Ravi Kuppuswamy 告诉媒体,AMD 最初声称单核性能优势为 10%。本周早些时候,NVIDIA 公布了其 Vera 测试数据后,NVIDIA 团队使用相同的编译器和设置重新进行了对比,测得领先优势为 20%,而此时调优工作尚未完成。Kuppuswamy 表示,2.2 倍的吞吐量差距与 AMD 内部的预期一直相符。此外,AMD 还使用其自家的 AOCC 编译器,在 SPECrate 2017 测试中重新计算了单核性能,结果为 1.7 倍,因此 20% 的差距更为保守。
英特尔和Arm
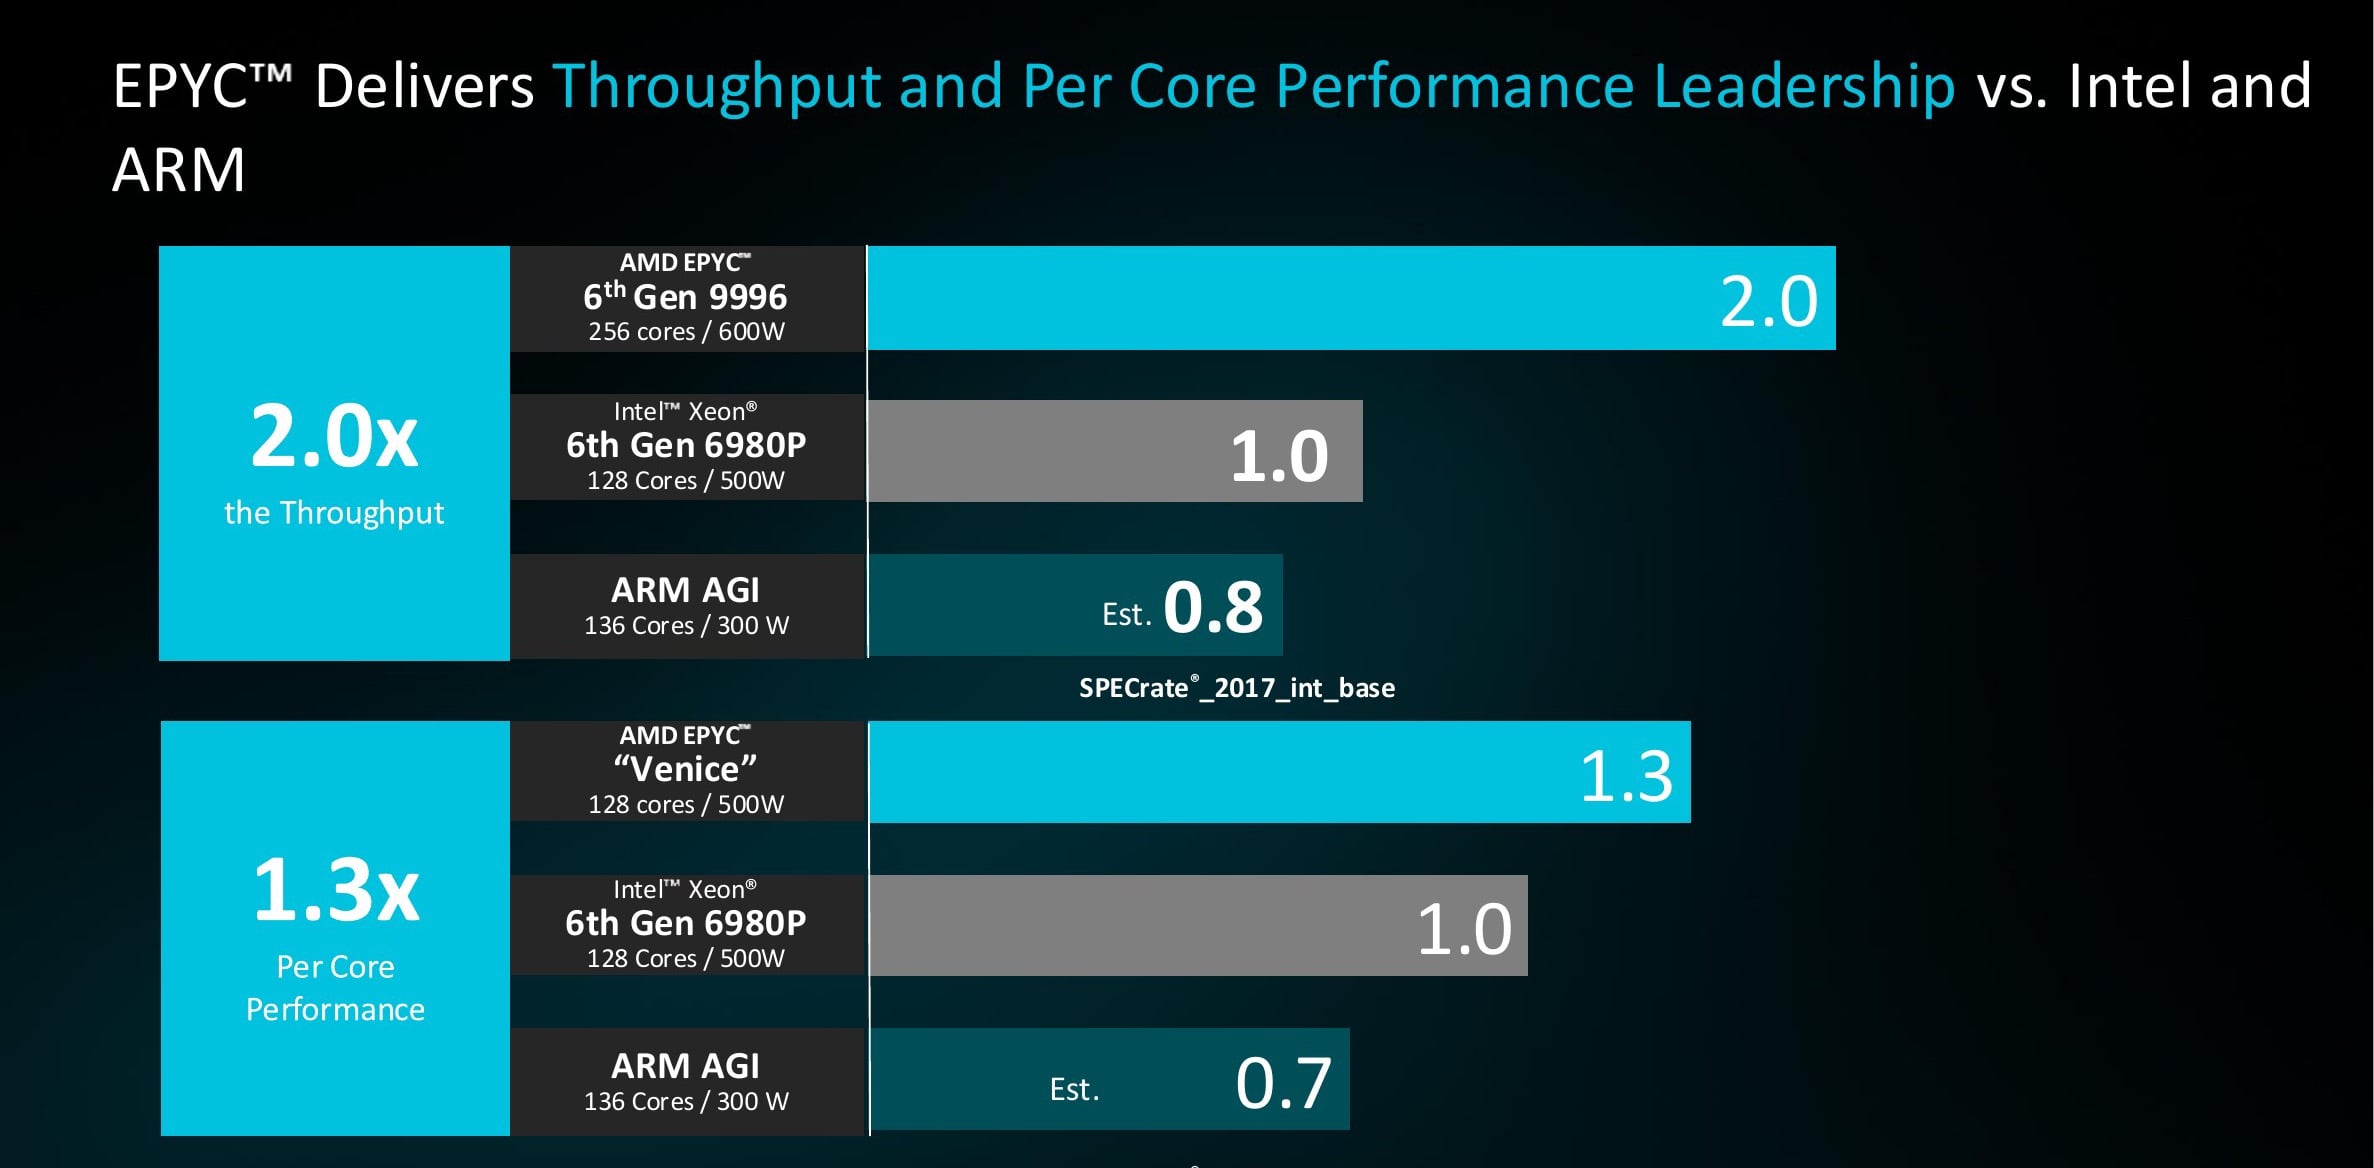
AMD 还公布了更广泛的 SPECrate 2017 排名。Venice 9996 以 4900 分位居榜首(256 核心,600W,1K 售价 14,904 美元),其次是 Turin 9965(3240 分)、Intel Xeon 6980P(2510 分,128 核心,500W,售价 13,955 美元)、Arm AGI(1944 分,136 核心,300W)和 Vera(1459 分)。9996、AGI 和 Vera 的数据为 AMD 预估值;Turin 和 Intel 的得分为已公布的测试结果。与 Intel 相比,在价格相近的情况下,Venice 9996 的吞吐量大约是 Intel 的两倍,或者说每美元的性能是 Intel 的两倍。按单核心计算,128 核心、500W 的 Venice 配置的得分是 6980P 的 1.3 倍,而 Arm AGI 的得分是 6980P 的 0.7 倍。与上面的 Vera 对比不同,这里每个厂商的得分都是用他们自己的最佳工具链生成的:AMD 使用 AOCC,Intel 使用 OneAPI,Arm 使用 GCC 13。
云原生和高性能计算
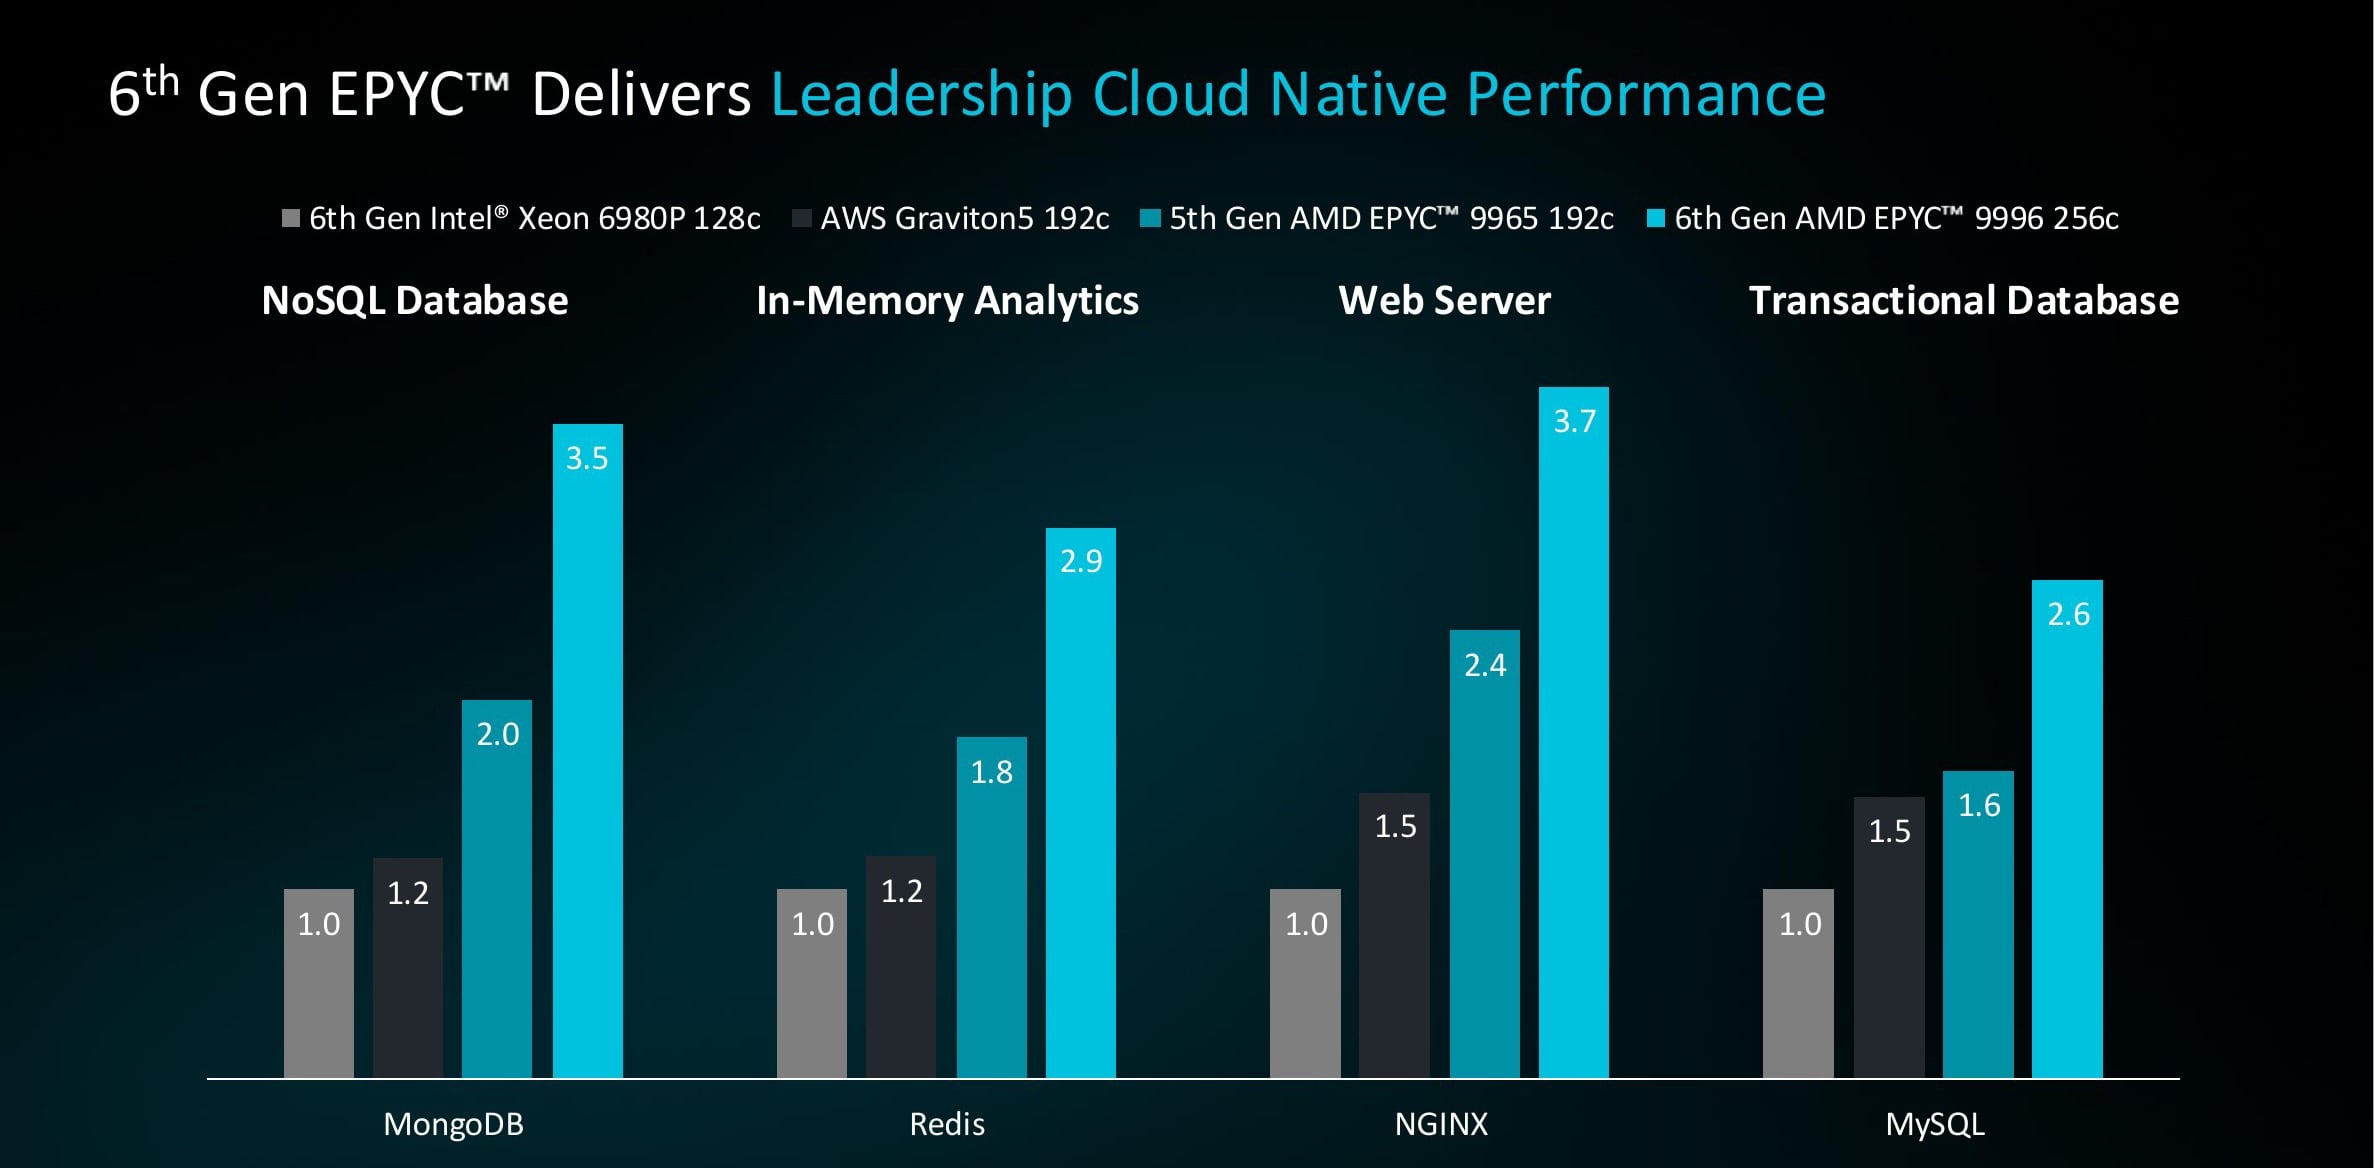
AMD 还按工作负载细分了对比结果,所有结果均以 Intel 6980P 为基准,设定为 1.0 倍。在云原生应用方面,拥有 256 核心的 Venice 9996 在 MongoDB 测试中性能提升 3.5 倍,在 Redis 测试中提升 2.9 倍,在 NGINX 测试中提升 3.7 倍,在 MySQL 测试中提升 2.6 倍。Turin 在相同测试中性能提升在 1.6 倍到 2.4 倍之间,Graviton5 的性能提升在 1.2 倍到 1.5 倍之间。
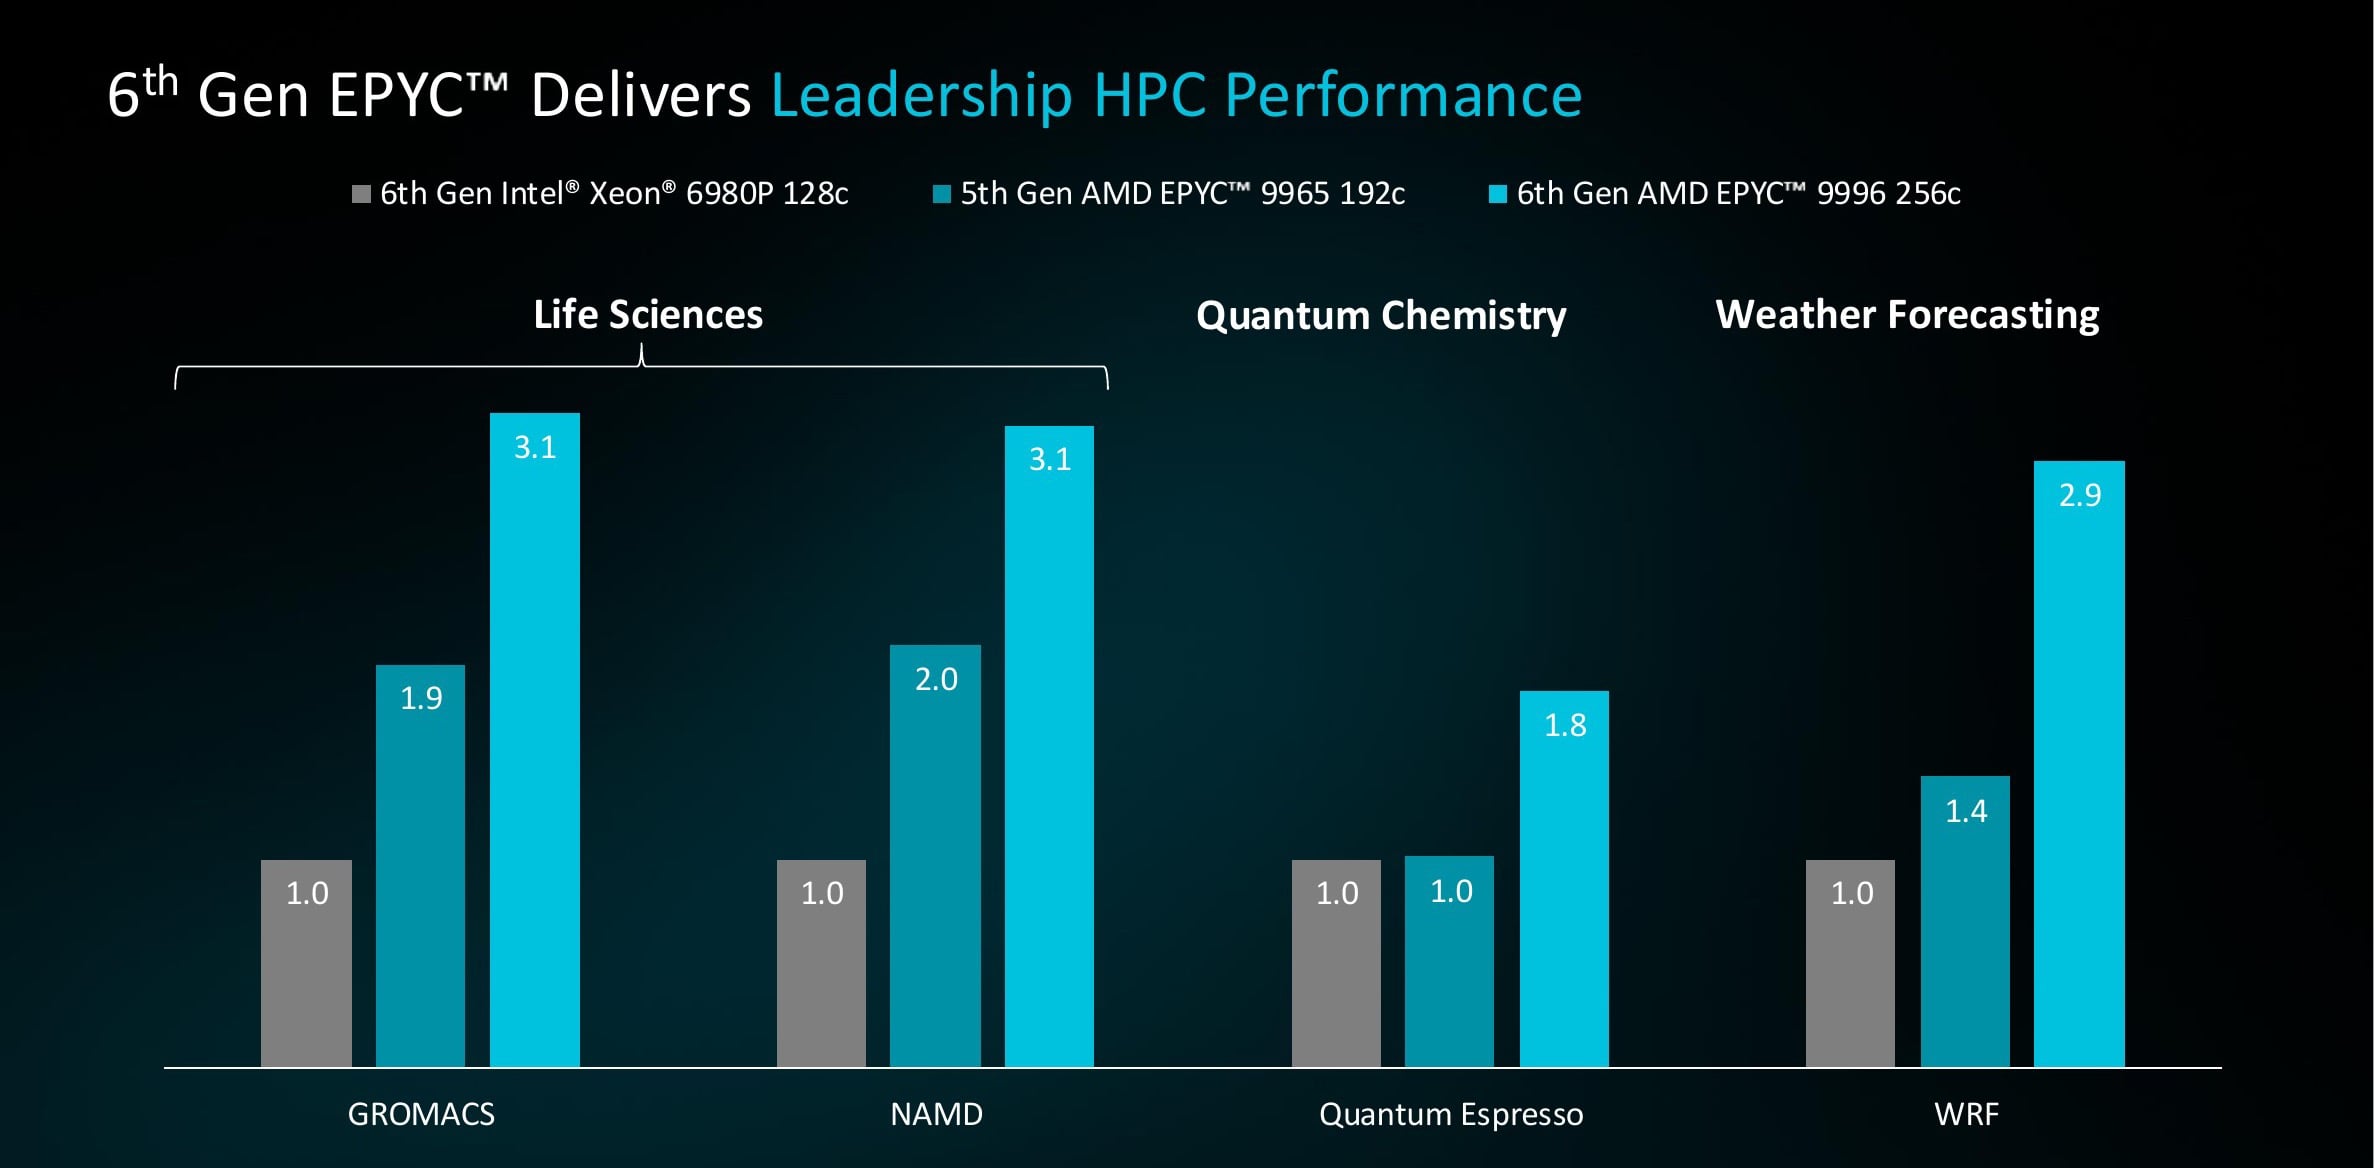
在高性能计算 (HPC) 领域,Venice 在 GROMACS 和 NAMD 测试中得分是 Xeon 的 3.1 倍,在 WRF 测试中是 2.9 倍,在 Quantum Espresso 测试中是 1.8 倍。内存配置对这些得分的影响非常显著。使用标准的 8,000 MT/s RDIMM 内存时,Venice 在 GROMACS 测试中的得分是 Xeon 基准测试的 2.81 倍;使用 12,800 MT/s MRDIMM 内存后,得分提升至 3.13 倍,同样的升级也使 WRF 测试的得分从 2.25 倍提升至 2.90 倍。AMD 将其在 HPC 领域的领先优势总结为 1.8 倍到 3.5 倍不等,具体取决于工作负载和内存配置。Intel 基准测试使用的是 8,800 MT/s MRDIMM 内存,因此差距并非源于 AMD 升级后的内存与 Intel 低速内存的对比。
主机节点和 1.8 倍声明
这就引出了每秒 1.8 倍令牌数的说法。其背后的硬件改进很容易列举:5GHz 的主机部分现在拥有 96 个核心而不是 64 个,主机内存带宽从 614GB/s 提升到 1.6TB/s,PCIe Gen 6 将 CPU 到 GPU 链路的带宽提高了一倍。
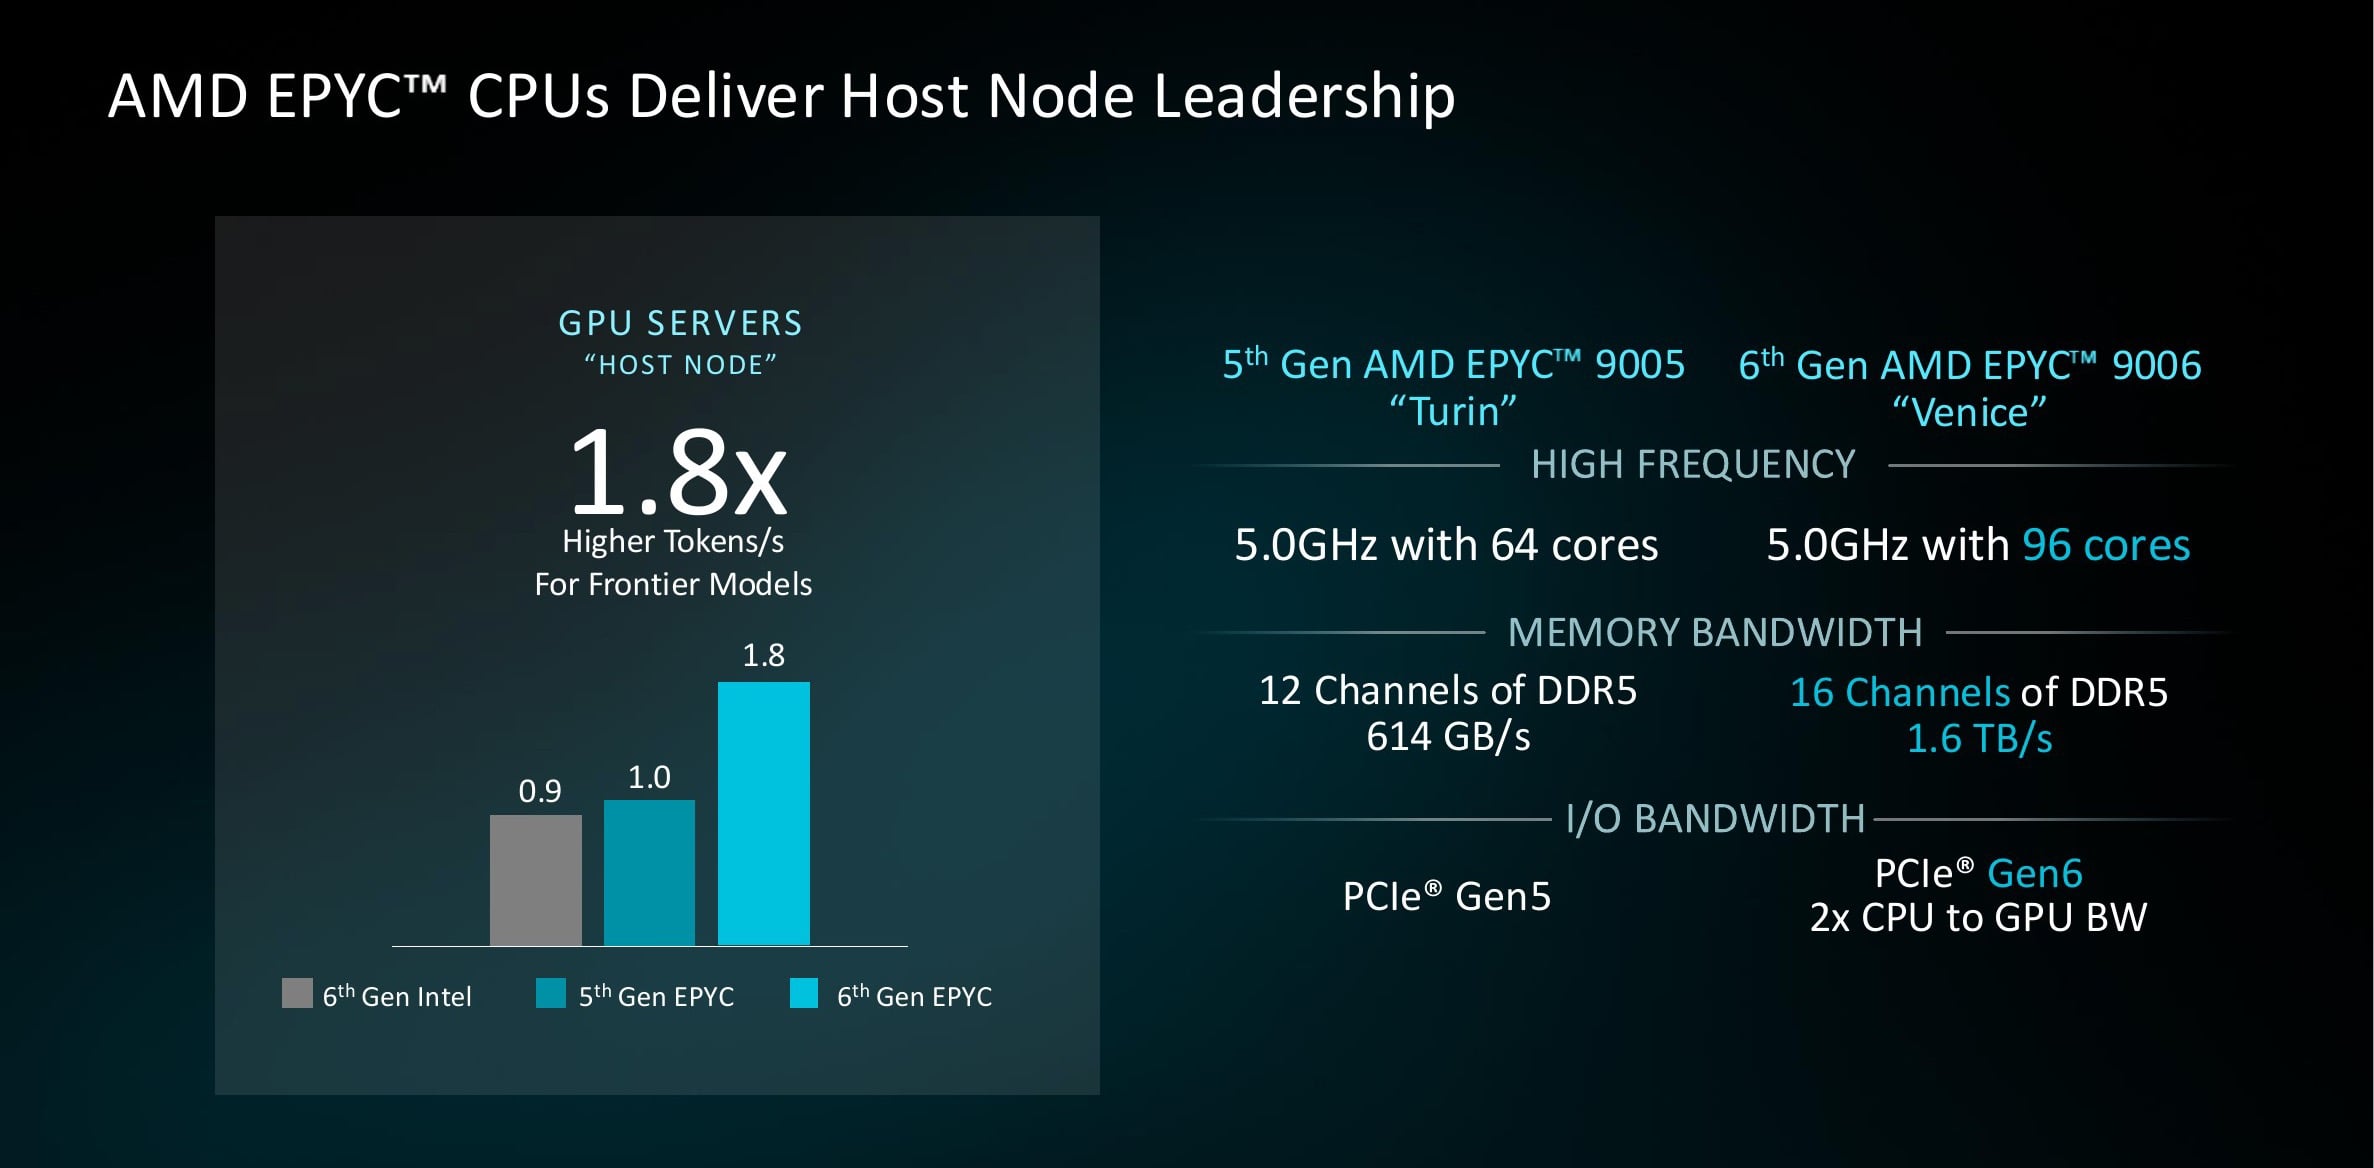
首先要检查的是基准线。AMD 将此图表的基准线设定为 Turin 1.0,而非 Intel,并将第六代至强处理器的基准线设定为 0.9,因此,当以至强 6960P 为基准线重新计算时,同样的性能提升接近 2 倍。预计的性能提升几乎完全来自 I/O 带宽。AMD 进行了一项 CPU 卸载测试,将 Qwen3-30B 的 BF16 权重数据从主机内存传输到 GPU,结果发现 PCIe Gen 5 x16 接收路径的运行速度达到了其理论上限的 89% 到 95%,而主机 DRAM 读取速度则低于其理论上限的 10%。解码速度受限于传输速度,因此,使用 PCIe Gen 6 将链路速度提升一倍,在此测试中可获得 1.8 倍到 1.9 倍的性能提升。Venice 目前是唯一一款为加速器提供 PCIe Gen 6 的服务器 CPU,因此这项优势是真实存在的,并且目前是独有的。不过,其适用范围有限:1.8 倍的性能提升仅描述了一种带宽受限的卸载模式,并不意味着在 Venice 主机上,GPU 处理所有模型的速度都能提升 1.8 倍。就目前出货的硬件而言,在同一台 8 核 B200 系统上,Turin 主机在 vLLM 和 NIM 工作负载的首次令牌处理时间方面,几何平均值比 Xeon 6960P 快 13%,最佳情况下提升幅度可达 36%。
机架密度
最后一项数据是密度:威尼斯卷轴每架有 49,152 个卷轴芯,而都灵卷轴为 36,864 个,维拉卷轴为 22,528 个,而且每部分卷轴的线数是卷轴芯数的两倍。在所有数据中,应用尾注后,这项数据的变化最大。
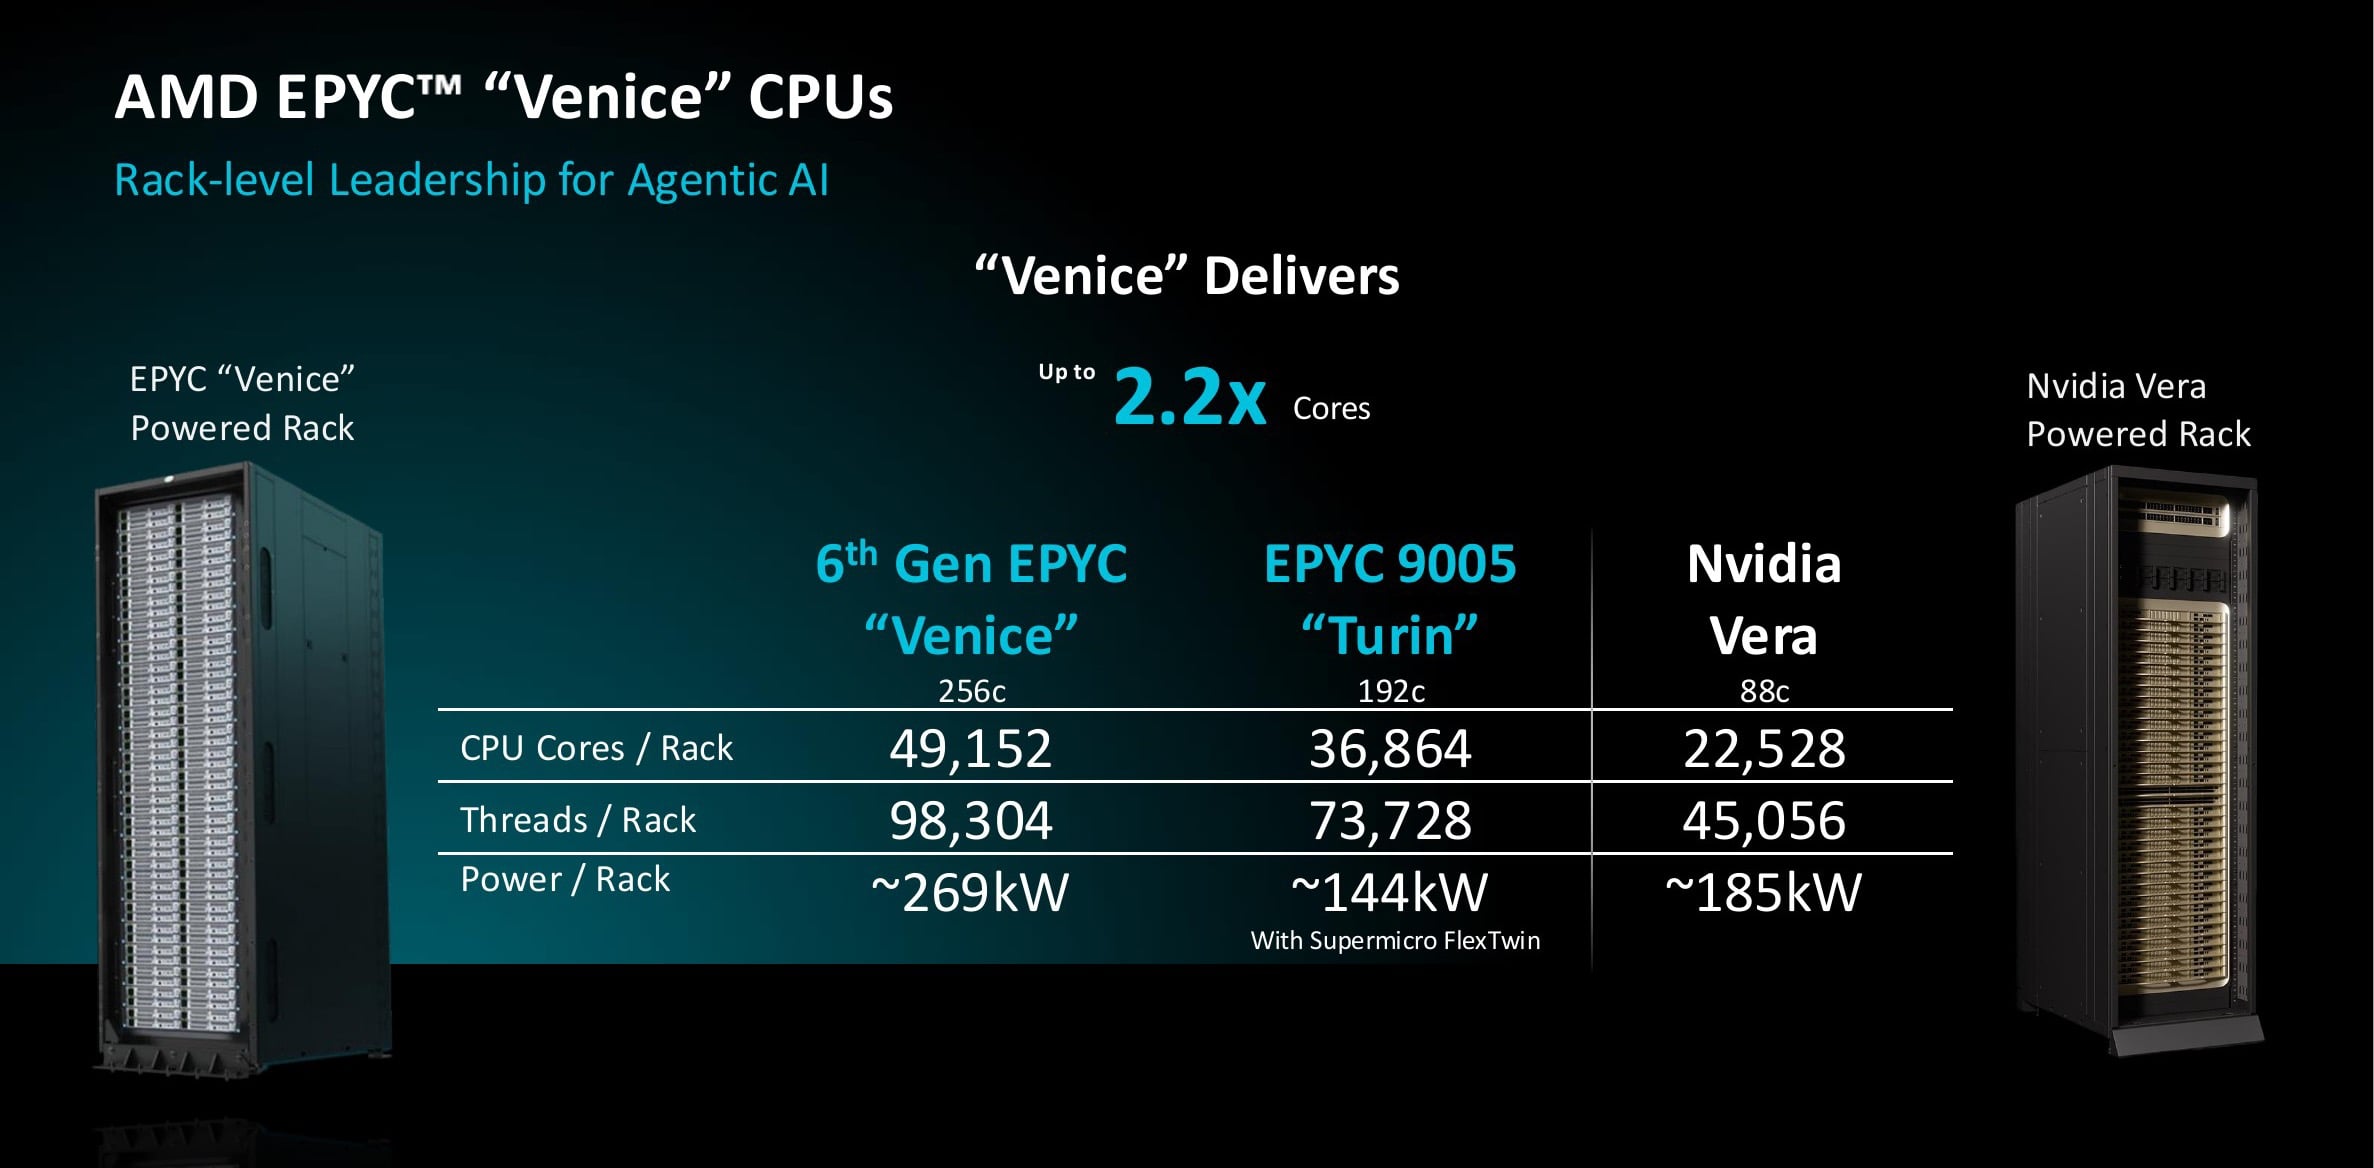
标题是核心数量是 Vera 的 2.2 倍,但 Venice 机架达到这一数字时功耗为 269kW,而 Vera 的功耗为 185kW,因此两款机架并非在相同功耗下进行比较。AMD 的注释提供了标准化版本。如果两款机架的功耗都控制在 100kW 以内,9996 的核心数量是 Vera 的 2.08 倍,是 Turin 的 1.86 倍,是 Intel 6980P 的 1.24 倍。如果用 400W 的 EPYC 9956 代替旗舰级处理器,AMD 估计其核心数量是 Vera 的 1.91 倍,功耗降低 26%,从而每机架瓦特核心数量是 Vera 的 2.57 倍。根据固定的功耗预算,领先优势在 1.9 倍到 2.2 倍之间。与本文中所有 Vera 的数据一样,NVIDIA 机架的数据是根据已公布的规格而非实际硬件测量数据估算的。密度优势在标准化后仍然存在;它只是比 2.2 倍的峰值要小。
大恶霸
暂且不谈个别数据:在服务器CPU市场的高端领域,AMD目前没有直接竞争对手。英特尔最好的产品落后于Turin,而AMD已经开始着手替换Turin这一代产品。在AMD公布的所有图表中,Arm的竞争对手都排在Turin之后。Vera尚未出货,AMD估计其吞吐量不到Turin 9965的一半(Turin 9965已经上市一年半了),而Venice的吞吐量大约是Turin的两倍。根据Mercury Research的数据,这一地位使AMD占据了服务器CPU收入的46%。市场证据也指向同样的方向。目前,高端EPYC处理器的需求超过了供应,导致交货周期延长。
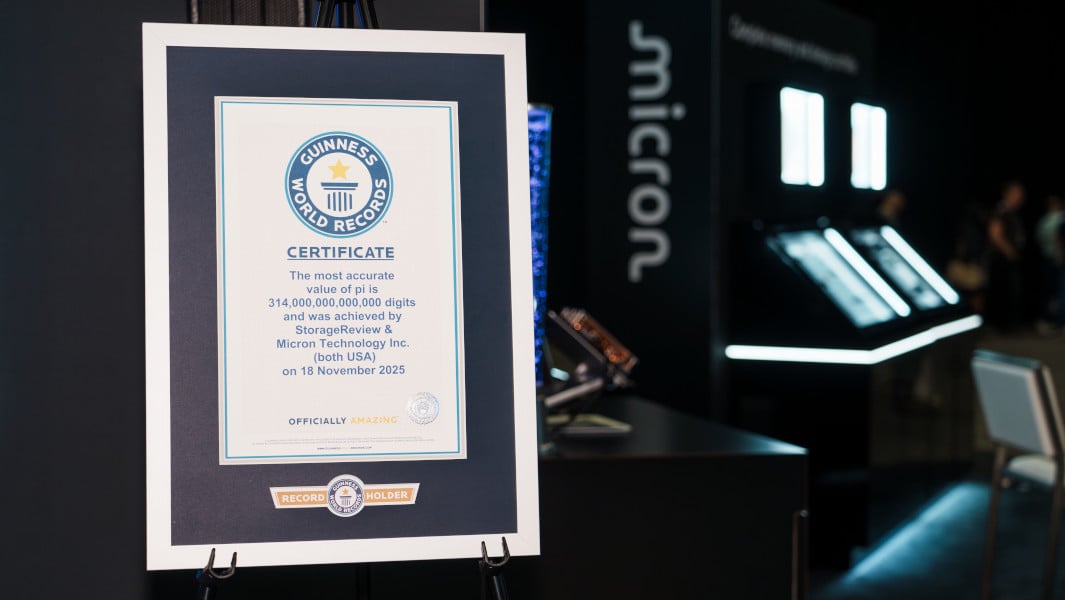
我们也可以补充一点数据。我们创造的314万亿位数π的世界纪录是在一台戴尔PowerEdge R7725服务器上完成的,该服务器配备两颗192核的EPYC 9965处理器和1.5TB的DDR5内存,与AMD Turin机架所采用的384核双路配置相同。计算过程中,所有核心都保持满负荷运行了110天,并且没有出现任何停机时间;任何内存错误或崩溃都会导致挑战失败。平均功耗约为1,600瓦,整个运行过程消耗了4,305千瓦时,即每万亿位数耗电13.7千瓦时,而此前300万亿位数的纪录估计耗电33,600千瓦时,运行时间约为225天。
结语
Venice 是 AMD 迄今为止最强大的服务器 CPU 发布会,其真正的亮点在于其产品覆盖面之广。Zen 6 架构涵盖了从 256 核心密度的处理器,到企业级插槽、配备 1152MB 堆叠缓存的高性能计算芯片,再到 LPDDR 主机节点,客户可以基于相同的架构和软件基础构建数据中心的各个层级。发布会上公布的数据在详细解读后依然令人信服:在相近的定价下,吞吐量约为英特尔的两倍;在相同的编译器下,单核性能比 Vera 高出 20%;机架密度是英伟达主机 CPU 的 1.9 倍到 2.2 倍(具体取决于功耗)。
商业方面无需预测。SP7 现已投产,合作伙伴平台将于第四季度上市;SP8 将于 2027 年上半年推出,Venice-X 和 Verano 则紧随其后。销售这些产品的公司已占据服务器 CPU 收入的 46%,其现有产品的需求远远超过供应,因此买家宁愿排队等待也不愿放弃。即使 Venice 的发布时间推迟一年,本文中的对比仍然会显示其领先地位,因为 Turin 的表现已经超越了图表上所有其他产品,无论是否已出货。AMD 的领先优势如此之大,以至于目前最接近的竞争对手竟然是其上一代产品。


 Amazon