

在巴黎举行的 RAISE 峰会上,DDN 重点介绍了其与欧洲主权混合云提供商 Nebul 的持续合作,旨在提升大规模 AI 推理部署的效率。这项上周宣布的合作项目结合了 Nebul 的推理平台、DDN 的 Infinia 数据智能架构以及 NVIDIA 的加速计算技术,以解决日益严峻的生产级 AI 瓶颈:推理过程中数据迁移带来的成本和性能问题。
DDN围绕关键生产指标展开工作,包括GPU利用率、令牌吞吐量、单令牌成本和延迟。其前提是,模型训练决定了AI资产的价值,而推理则决定了其运营和商业回报。随着智能体AI、检索增强生成和高并发推理的日益普及,存储和数据基础设施将直接影响加速器的利用率和响应时间。
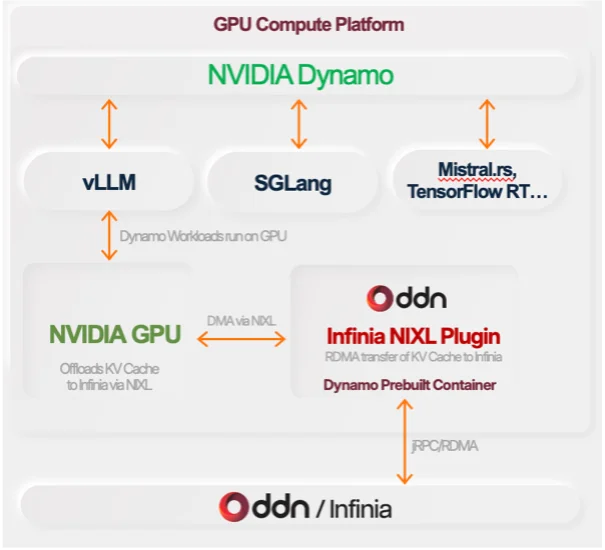
这项工作目前仍处于概念验证阶段,DDN 将迄今为止的成果描述为令人鼓舞的早期数据。两家公司报告称,启用键值缓存后,首次令牌生成时间得到了显著缩短,并且已完成基于 RoCE 的基础设施验证。随着他们在 Infinia 平台中发现更多优化机会,基准测试将在更长的推理序列长度上继续进行。该项目还扩展到与 NVIDIA 合作,共同开发基准测试方法、进行可扩展性验证并撰写未来的技术出版物。
该平台采用分布式键值缓存服务、GPU原生数据移动、数据编排和高性能存储架构。键值缓存加速对于推理尤为重要,因为它能够保存并快速检索先前计算的注意力状态,从而减少重复计算并降低数据传输延迟,避免GPU闲置。
DDN、Nebul 和 NVIDIA 的领导层标志着行业重心从 GPU 购置转向运营效率,重点在于最大化已部署加速器的价值。DDN 首席执行官 Alex Bouzari 和 Nebul 首席执行官 Arnold Juffer 都强调,虽然模型规模一直是过去的首要任务,但当前的挑战在于推理经济性,以及如何通过降低代币成本使生产级 AI 在商业上可行。NVIDIA 云基础设施副总裁 Rod Evans 补充道,随着企业向大规模智能体工作负载转型,衡量基础设施成功与否的标准越来越是 GPU 利用率和延迟,而不是原始计算能力。
DDN认为,人工智能基础设施必须超越传统的存储操作,积极参与人工智能的执行。该公司表示,其平台在全球范围内支持超过一百万个GPU,用户涵盖超大规模数据中心、云服务提供商、企业、政府机构和研究机构。
对于基础设施团队而言,相关的生产指标越来越多地包括:
- GPU利用率衡量昂贵的加速器在推理过程中保持活跃的有效程度。
- 每个代币的成本将基础设施效率与模型产出成本联系起来。
- 每瓦代币数量衡量输出效率与功耗的关系。
- 到达第一个代币的时间这会影响用户对交互式人工智能应用的感知响应能力。
- 投入生产所需时间反映了将人工智能服务从测试阶段过渡到生产阶段所需的运营工作量。 可扩展部署。
随着推理成为人工智能的主要运行工作负载,以低、可预测的延迟向 GPU 提供缓存的上下文和企业数据的能力对于维持利用率和控制成本将变得越来越重要。


 Amazon