

Equinix 扩大了与 NVIDIA 的合作关系,并与 Together AI 展开新的合作,共同推出 Equinix Inference Exchange。该平台旨在为企业部署提供分布式 AI 推理架构,将计算工作负载更靠近核心数据存储库、最终用户和运营应用程序。Equinix Inference Exchange 与 Equinix Fabric One 一同在 Equinix Horizon 大会上发布,该计划结合了 NVIDIA 的企业级硬件架构、Together AI 的开源模型平台以及 Equinix 的全球互连基础设施,旨在解决延迟、数据主权和网络瓶颈等问题。
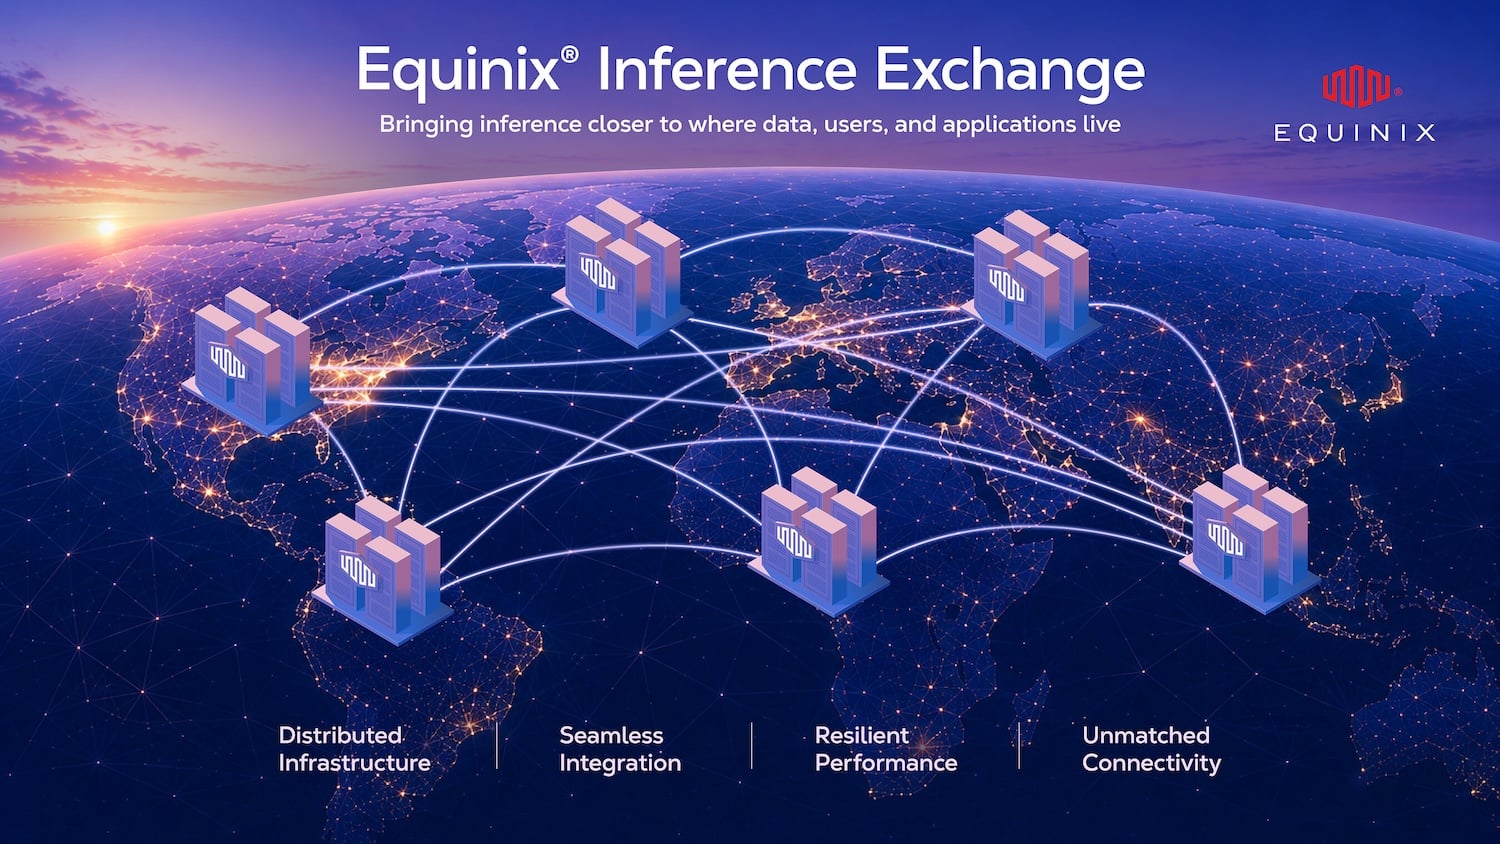
解决分布式推理和数据引力问题
随着企业人工智能项目从原型验证过渡到高吞吐量生产,推理部署位置决定了总体成本、响应延迟和合规性。将模型执行位置靠近数据源可以降低跨公有云回传数据的成本,同时提供确定性的延迟特性。然而,管理跨不同环境的分布式基础设施会带来运维开销和网络复杂性。
Equinix 利用其遍布 77 个大都市的 280 多个数据中心、230 个云接入点以及超过 10,500 家互联企业的网络,解决了这一运营难题。十大 AI 模型提供商中有八家以及十大 AI 云中有九家已在 Equinix 的数据中心内运行,该平台可作为分布式 AI 管道的中立聚合层。
架构和堆栈集成
Equinix推理交换平台由计算、软件和物理基础设施三个不同的层组成:
Equinix负责管理基础物理架构和互连架构。这包括电力供应、先进的液冷能力、日常设施运营,以及通过Equinix Fabric与网络、公有云和SaaS平台的私有互连。
NVIDIA 提供计算和参考验证层,提供专为高令牌吞吐量和降低每次查询推理成本而设计的企业级 AI 基础设施。
Together AI 提供推理服务软件层,支持超过 200 种开源模型。该平台既支持用于提升通用计算效率的共享多租户环境,也支持用于需要独立容量的工作负载的专用单租户拓扑结构。
通过 Equinix Fabric 路由流量,该平台可减少区域用户的首次令牌时间 (TTFT) 指标,同时在本地存储和模型端点之间建立私有对等路径。
企业部署目标和可用性
该平台主要面向三种部署拓扑结构。对于城域边缘推理,企业可以在本地城域中心运行模型,在保持集中管理和私有互连的同时,提供低延迟的 API 响应。对于开源模型迁移,该架构提供了一条从封闭的专有 API 迁移到开源基础模型的便捷路径,在利用现有网络架构的同时,降低了厂商锁定风险。对于自主人工智能和合规性要求,分布式布局使受监管行业的企业能够将推理执行和数据处理限制在特定的地理边界内,从而帮助满足严格的数据驻留和治理要求。
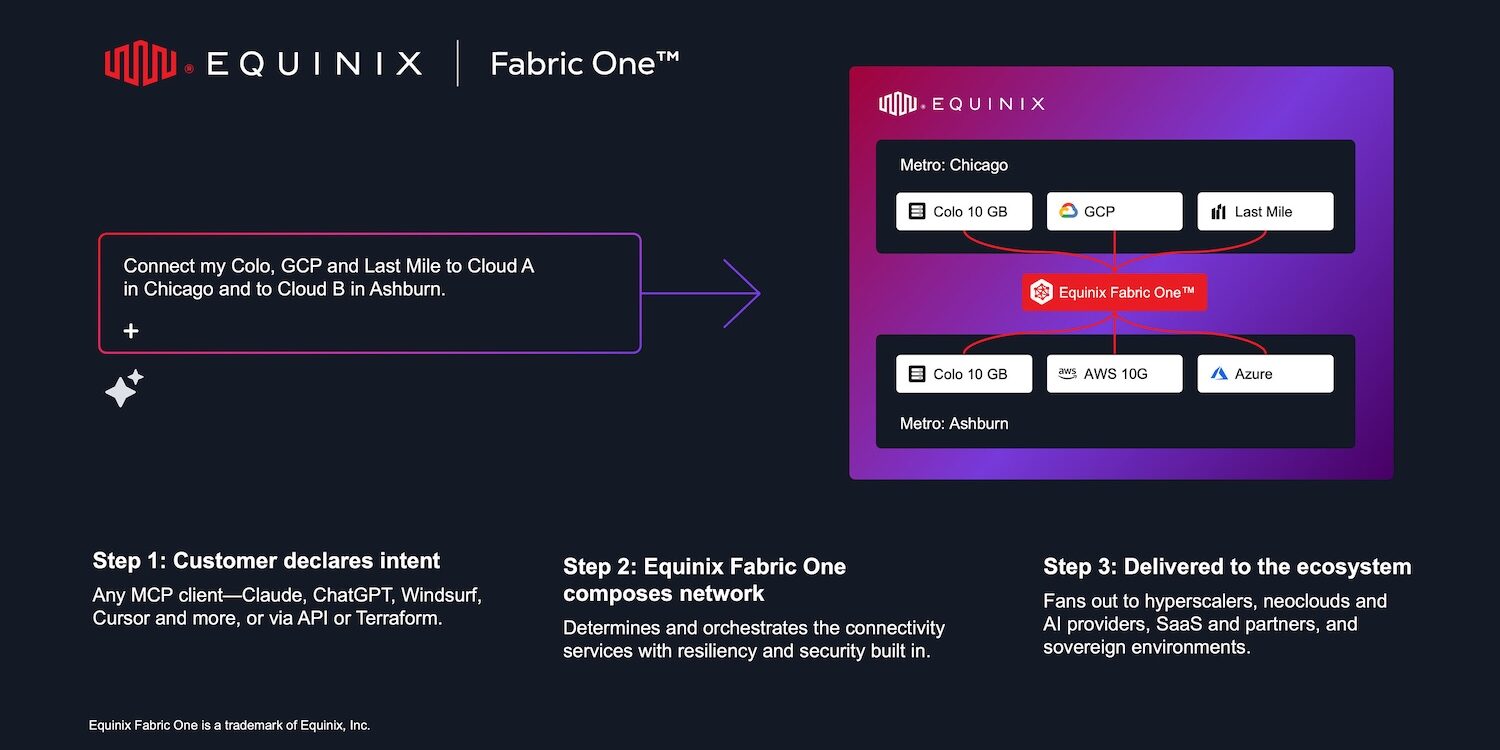
Equinix、NVIDIA 和 Together AI 的领导层指出,此次整合建立了一个厂商中立的高吞吐量推理架构,实现了计算性能与运营灵活性之间的平衡。
Equinix Inference Exchange 计划于 2027 年第一季度正式向企业用户开放。


 Amazon