

卡内基梅隆大学的研究人员发布了一项专注于 SSD 现场可靠性的研究,该研究的标题为“现场闪存故障的大规模研究”。 这项研究是在四年的时间里使用 Facebook 的数据中心进行的,运行时间达数百万小时。 该研究着眼于错误是如何表现出来的,旨在帮助其他人开发新颖的闪存可靠性解决方案。
正如我们在 StorageReview 上一段时间以来所说的那样,闪存提供了多项性能优势、密度优势和更低的功耗,最大的缺点是成本。 虽然许多 SSD 声称具有良好的使用寿命和可靠性,但直到现在还没有任何重大的现场研究。
虽然没有提到特定的供应商和特定的驱动器,但 Facebook 在他们的热数据层中使用了很多,该研究确实记录了使用 SSD 的平台类型(这被定义为系统中使用的设备容量的组合,所使用的 PCIe 技术,以及系统中 SSD 的数量),这些都是标签平台 AF。 这些平台容量从720GB到3.2TB不等,有两代PCIe(版本1和2),有的使用一个SSD,有的使用两个,运行时间从半年到两年多不等。
研究人员使用寄存器来跟踪类似于 SMART 数据的 SSD 操作。 每小时收集一次原始值,将其解析为可以整理到 Hive 表中的形式,然后一组机器使用 MapReduce 作业对存储在 Hive 中的数据执行并行聚合。 由此,研究人员能够监控误码率、SSD 故障率和错误计数、不同 SSD 之间的相关性(特别是在具有多个 SSD 的平台中)以及内部和外部因素的作用。
研究得出的结论包括:
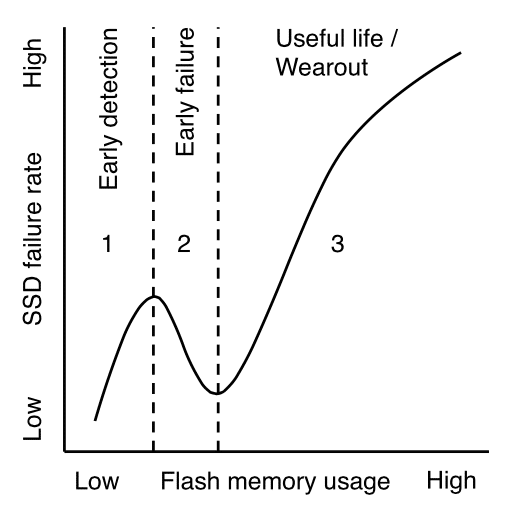
- SSD 在其生命周期中会经历几个不同的故障期——早期检测、早期故障、使用寿命和磨损,这与写入闪存芯片的数据量相对应。
- 读取干扰错误的影响并不是所检查的 SSD 中的主要错误来源。
- 跨 SSD 物理地址空间的稀疏数据布局(例如,非连续分配的数据)导致 SSD 故障率高; 密集的数据布局(例如,连续数据)在某些情况下也会对可靠性产生负面影响,这可能是由于对抗性访问模式。
- 更高的温度会导致故障率增加,但对于未采用节流技术的 SSD 来说,这种情况最为明显。
- 由于系统级缓冲和减少磨损技术,系统软件报告要写入的数据量可能会夸大实际写入闪存芯片的数据量。
虽然这项研究没有说明一种驱动器或一种驱动器比另一种更好,但它仍然是一个有趣的观察,看看 SSD 在大量使用的情况下在现实世界中的表现如何。 这项研究为未来研究 SSD 的使用以及可以使 SSD 更可靠或使用寿命更长的新技术打开了大门。
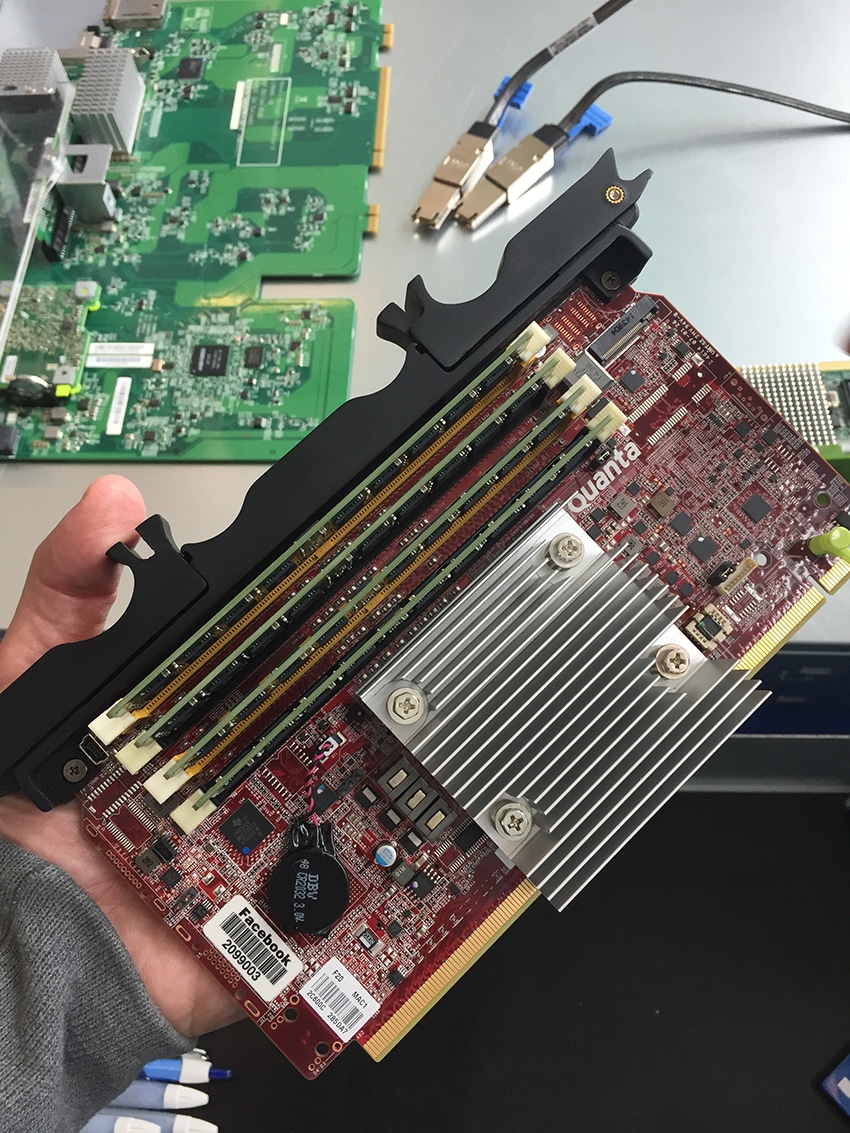
Facebook一直在不断改进其服务器设计,以适应卡内基梅隆大学研究等数据点。他们最近发布的Yosemite平台就是一个恰当的例子,它展示了Facebook如何利用非传统外形尺寸的Flash技术(至少在数据中心领域),以在高度重视总体拥有成本(TCO)的情况下获得最佳性能。


 Amazon