

微软推出了 Maia 200,这是一款全新的定制推理加速器,旨在提升大规模 AI 代币生成的经济效益。Maia 200 被定位为微软首个专为 AI 推理优化的芯片和系统平台。
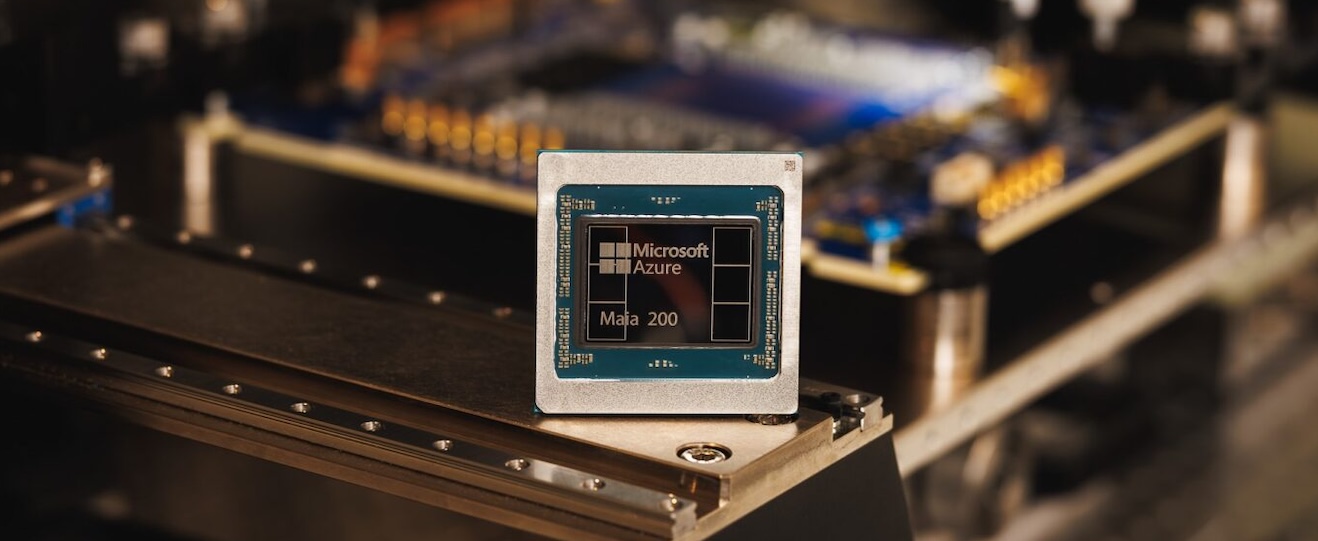
微软将人工智能推理构建为一个“高效前沿”,旨在平衡能力和准确性与成本、延迟和能耗。实际上,这个前沿会根据工作负载的不同而有所变化:交互式辅助驾驶优先考虑低延迟,批量摘要和搜索强调每美元的吞吐量,而高级推理则需要在较长的上下文窗口和多步骤执行下保持持续性能。微软传达的信息是,基础设施不能再千篇一律,Azure 需要提供一系列针对不同推理场景进行优化的服务选项。
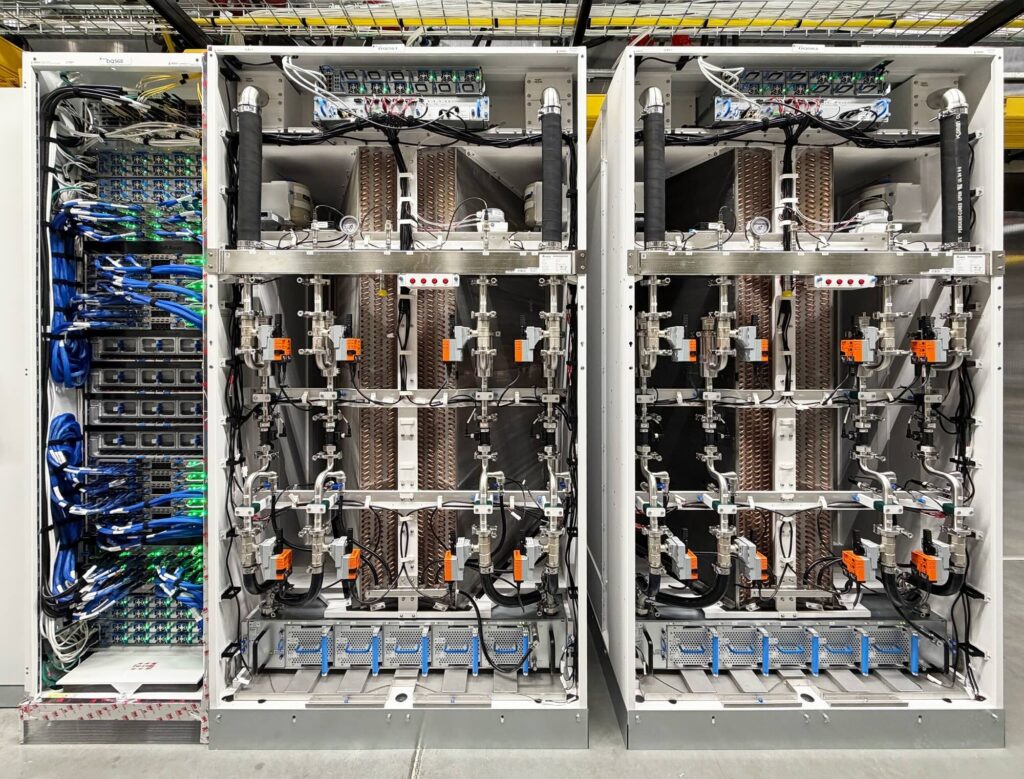
Microsoft Maia Rack
微软表示,Maia 体现了涵盖软件、芯片、系统和数据中心的全栈式解决方案,并声称与目前部署在其服务器上的最新一代硬件相比,每美元的性能提升了 30%。随着智能代理应用程序变得越来越复杂和应用越来越广泛,微软将这种集成式设计定位为一项基础性优势。
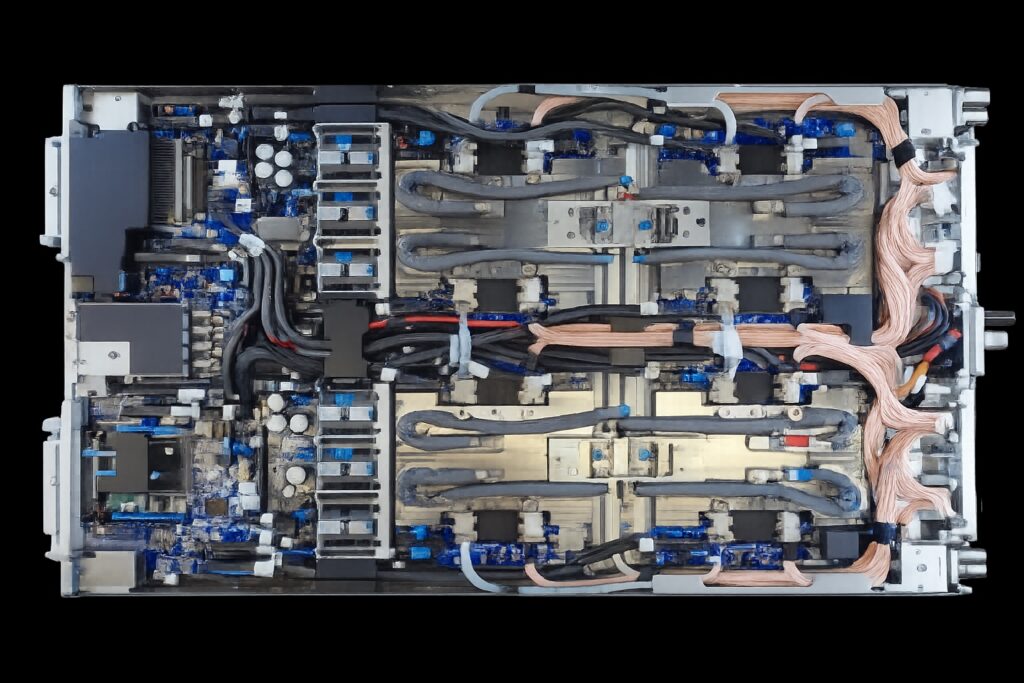
微软 Maia 200 服务器刀片
Maia 200:主要架构特点和峰值规格
Maia 围绕窄精度执行、旨在减少片外流量的内存层次结构以及旨在保持多加速器推理效率的以太网扩展设计而构建。
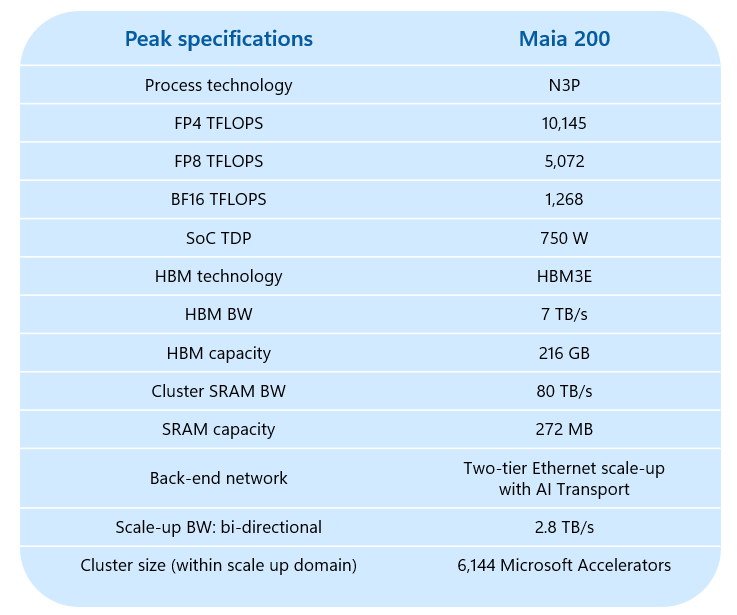
微软重点介绍了Maia的几项峰值规格和设计要点。Maia采用台积电N3工艺的优化窄精度数据通路,FP4峰值运算能力高达10.1 PetaOPS。微软正大力推广FP4这种成本效益高的推理格式,力求实现更高的每美元和每瓦功耗的代币产量。
内存是本次评测的重点。Maia 集成了 272MB 片上 SRAM 和 216GB HBM3e 显存,微软宣称其 HBM 带宽高达 7TB/s。其目标是将关键工作集保留在芯片内部,通过提高局部性降低 HBM 带宽需求,并通过减少片外数据传输来提升能效。
为了实现数据传输,Maia 将多级 DMA 子系统与分层片上网络相结合,从而为异构、内存密集型工作负载保持可预测的性能。微软强调数据传输和计算之间的重叠,以及对张量友好型布局的结构化支持。
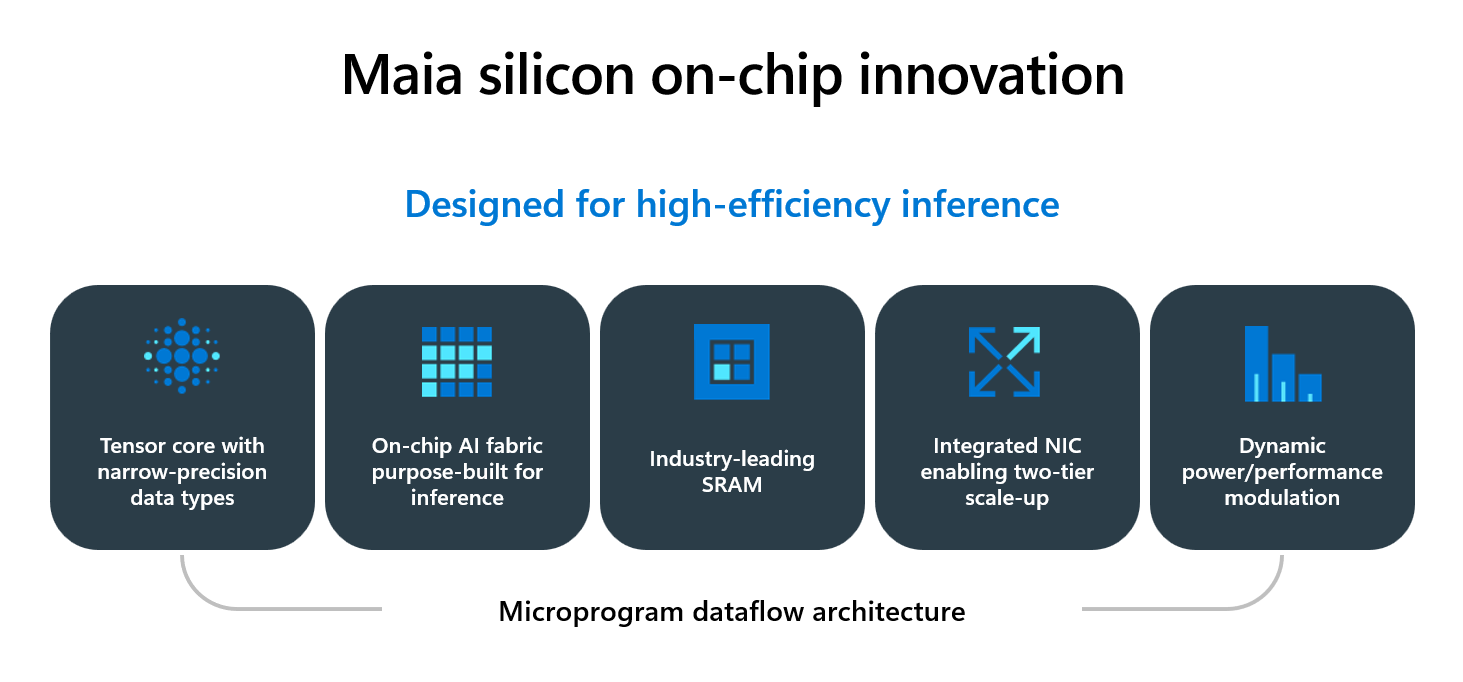
为了实现规模化扩展,Maia 集成了片上网卡和基于以太网的互连,双向带宽高达 2.8TB/s。微软表示,该设计支持最多 6,144 个加速器的两层规模化扩展架构,旨在为大型推理集群提供高带宽、低延迟的通信。
基于瓦片和集群的微架构
Maia 的计算设计采用分层结构。最小单元是 tile,它结合了用于矩阵运算和卷积的 Tile 张量单元 (TTU) 以及作为可编程 SIMD 引擎的 Tile 向量处理器 (TVP)。每个 tile 由多存储体 tile SRAM (TSRAM) 供电,并使用 tile 级 DMA 引擎来传输数据,而不会导致计算流水线停顿。一个轻量级控制处理器负责协调任务的分配,并利用硬件信号量来实现数据传输和计算之间的紧密同步。
Tile 组成集群,通过集群 SRAM (CSRAM) 实现共享局部性,并引入第二个 DMA 层,用于在 CSRAM 和共封装 HBM 之间暂存数据。微软还指出,Tile 和 SRAM 的冗余设计旨在提高良率和可制造性,同时保持编程模型的一致性。
窄幅精密对焦:FP4 和混合精度
微软正大力押注窄精度作为提升推理效率的关键,并援引业界经验表明,FP4 能够在保持推理精度的同时降低计算和内存成本。Maia 的 TTU 针对 FP8、FP6 和 FP4 进行了优化,并支持混合精度模式,例如 FP8 激活值乘以 FP4 权重。TVP 支持 FP8 以及 BF16、FP16 和 FP32,以满足那些受益于更高精度的算子的需求。集成的重塑器能够以线速将低精度格式上转换,从而避免在计算过程中出现瓶颈。
微软声称 Maia 上的 FP4 吞吐量是 FP8 的 2 倍,是 BF16 的 8 倍,这使得该架构能够在推理密集型部署中实现更高的每秒令牌数和更强的每瓦性能。
针对局部性和确定性进行调整的内存子系统
Maia 的片上 SRAM 分为集群级和 tile 级两个池,这两个层级都完全由软件管理。微软将此定位为对内存布局和局部性的确定性控制,这种控制既可以由开发人员直接完成,也可以通过编译器和运行时决策来实现。
该公司描述了几种预期模式:GEMM 内核可以将中间数据块保留在 TSRAM 中,以避免与 HBM 的往返通信;注意力内核可以将关键张量和部分积本地固定,以减少移动开销;集体通信可以在 CSRAM 中缓冲有效载荷,同时在 TSRAM 中进行累加,以避免多节点操作期间 HBM 压力过大。微软还强调 CSRAM 可用作跨内核流水线的瞬态缓冲区,旨在减少密集算子链和融合工作负载中的停顿。
数据传输:定制片上网络(NoC)加多层直接访问管理(DMA)。
微软认为,推理性能通常受限于数据传输而非峰值数学吞吐量,因此 Maia 在可预测的数据传输和低延迟控制信号方面投入了大量资源。片上互连被描述为一个跨越集群、瓦片、内存控制器和 I/O 单元的网状结构,并具有独立的逻辑平面,分别用于高带宽张量流量和对延迟敏感的控制流量。这种分离旨在防止同步、中断和小消息被大批量传输阻塞。
微软还提到,分层广播可以减少冗余的HBM读取,集群流量本地化可以确保热点数据在集群内部流动,Tile到Tile的SRAM访问可以在不调用HBM的情况下实现集群内数据共享,QoS机制可以优先处理紧急的控制和输出流量。DMA引擎按Tile、集群和网络角色分层,支持跨内存层和片外链路的并发传输,同时还能持续进行计算。
纵向扩展网络:片上网卡、以太网和ATL
为了实现多加速器推理,Maia 使用了集成网卡和基于以太网的纵向扩展架构,该架构围绕微软的 AI 传输层 (ATL) 构建。微软表示,ATL 可在标准以太网上进行端到端传输,旨在与通用的多厂商交换机配合使用,同时添加了数据包喷射、多路径路由和抗拥塞流量控制等传输特性。
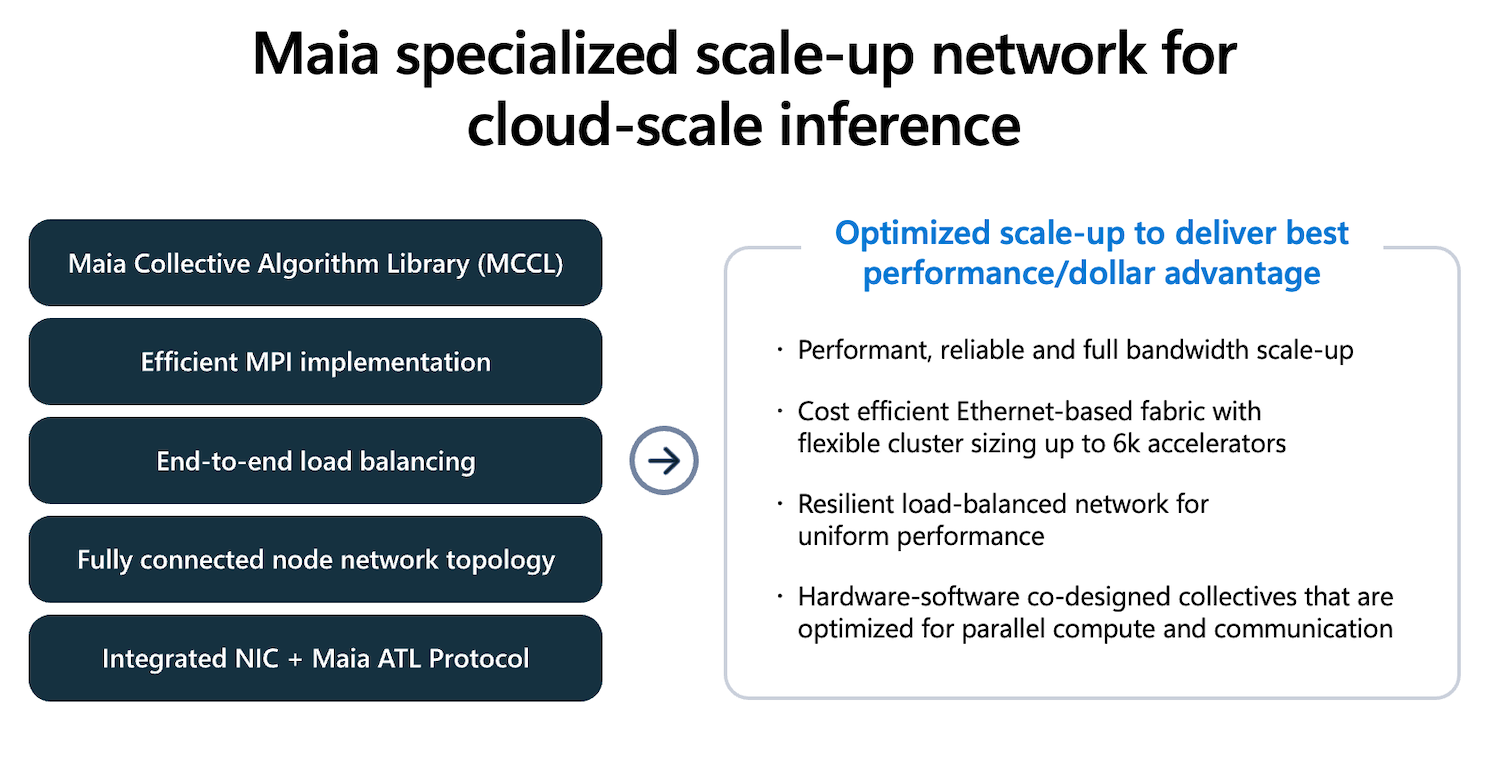
微软还描述了一种旨在减少对外部交换机依赖的本地张量并行流量的拓扑结构选择。该公司的全连接四路架构 (FCQ) 将四个加速器通过直接链路连接在一起,使高强度的本地集群无需使用交换式网络。第二层架构则扩展到 FCQ 范围之外的更大集群,微软认为这种规模的集群更适合推理同步模式,而非训练模式下的全连接行为。
在集群操作的软件方面,微软重点介绍了与硬件协同设计的微软集群通信库 (MCCL),旨在提升扩展效率。该公司指出,MCCL 通过计算和 I/O 重叠、分层集群、动态算法选择和流水线调度等方式来隐藏延迟并降低网络压力。
Azure 集成和部署模型
微软将 Maia 定位为 Azure 原生加速器,而非独立加速器。它的设计与 Azure 的机架、电源和机械标准保持一致,这些标准也适用于第三方 GPU 系统,从而简化部署和维护,并支持在同一数据中心内构建异构加速器集群。
Maia 平台同时适用于风冷和液冷环境,并配备了面向高密度机架的第二代液冷扩展模块。在运维方面,该平台与 Azure 控制平面集成,可实现生命周期管理、运行状况监控、固件部署和集群工作流,旨在减少升级和维护期间对服务的影响。
微软表示,Maia 将成为其异构 AI 基础设施的一部分,支持多种模型,包括 OpenAI 最新的 GPT-5.2 模型,并将用于为 Microsoft Foundry 和 Microsoft 365 Copilot 中的 AI 工作负载提供支持。该公司强调,可以使用与 Azure GPU 集群相同的工具来调度、分区和监控工作负载,旨在实现可移植性,并能够在不重新编排流程的情况下,针对每美元性能、延迟或容量进行优化。
开发者工具链:Maia 200 SDK、Triton Path 和底层控制
微软发布了 Maia 200 SDK,该 SDK 支持 PyTorch 等常用入口点,并提供多级控制。可选功能包括用于内核生成的 Maia Triton 编译器路径、针对 tile 和集群架构优化的内核库,以及用于显式管理数据移动、SRAM 放置和并行执行的微软嵌套并行语言 (NPL)。
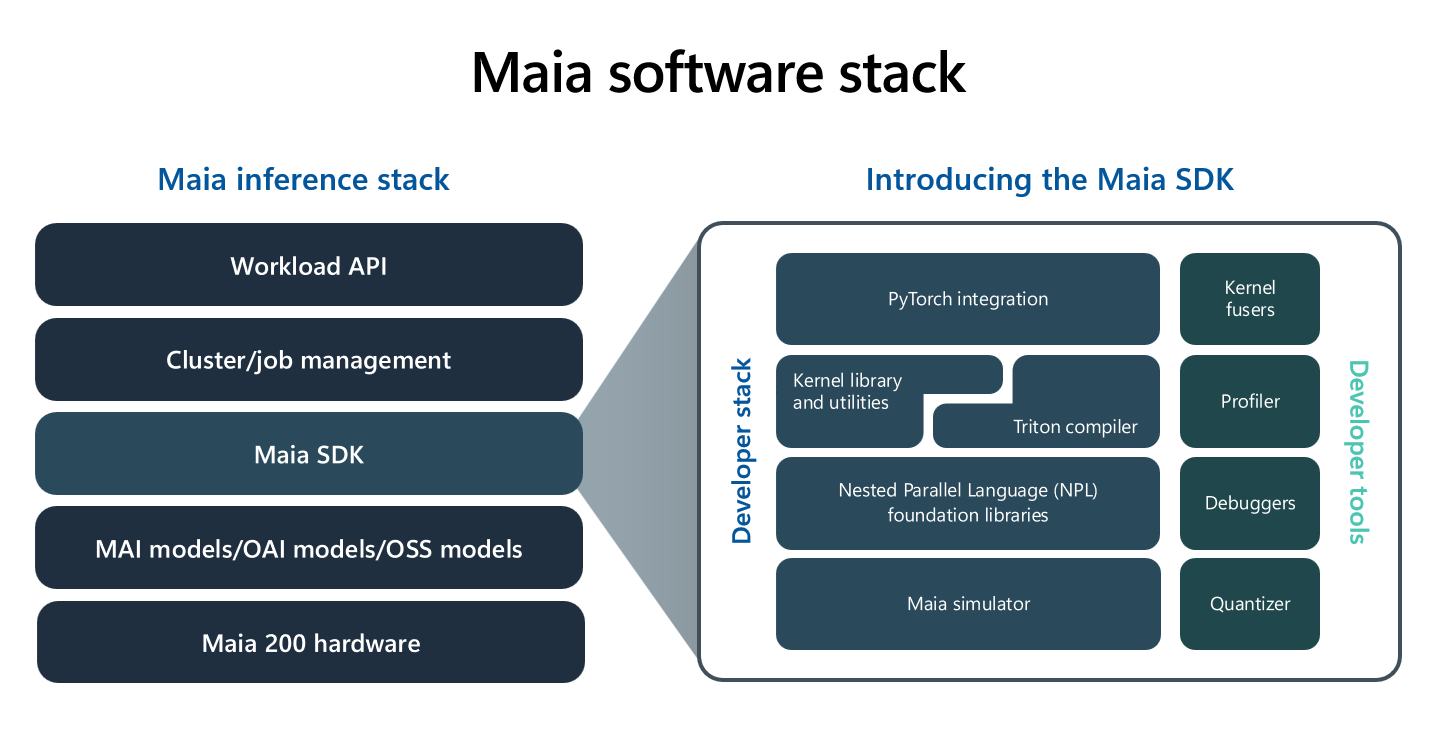
该SDK还包括模拟器、编译器流水线、性能分析器、调试器以及量化和验证工具。微软将其定位为一种尽早进行原型设计和性能调优、诊断瓶颈并提高整个技术栈利用率的方法。
底线
微软将 Maia 200 定位为一款专为推理而打造的平台,专注于每美元和每瓦的代币收益,其架构重点在于窄精度计算、软件管理的 SRAM 局部性以及直接集成在芯片上的基于以太网的扩展架构。该公司宣称,与现有硬件相比,Maia 200 的每美元性能提升了 30%,这得益于芯片、网络、系统和 Azure 运维之间的协同优化。


 Amazon