

在NVIDIA GTC 2026 大会上,英特尔宣布其至强 6 处理器将作为 NVIDIA DGX Rubin NVL8 系统的主机 CPU。此次设计合作进一步拓展了至强处理器在 NVIDIA GPU 平台中的应用,并凸显了该处理器在构建大规模 GPU 加速 AI 基础设施方面的重要作用。随着 AI 工作负载向大规模实时推理转型,主机 CPU 仍然是系统级可扩展性和架构连续性的关键组件。
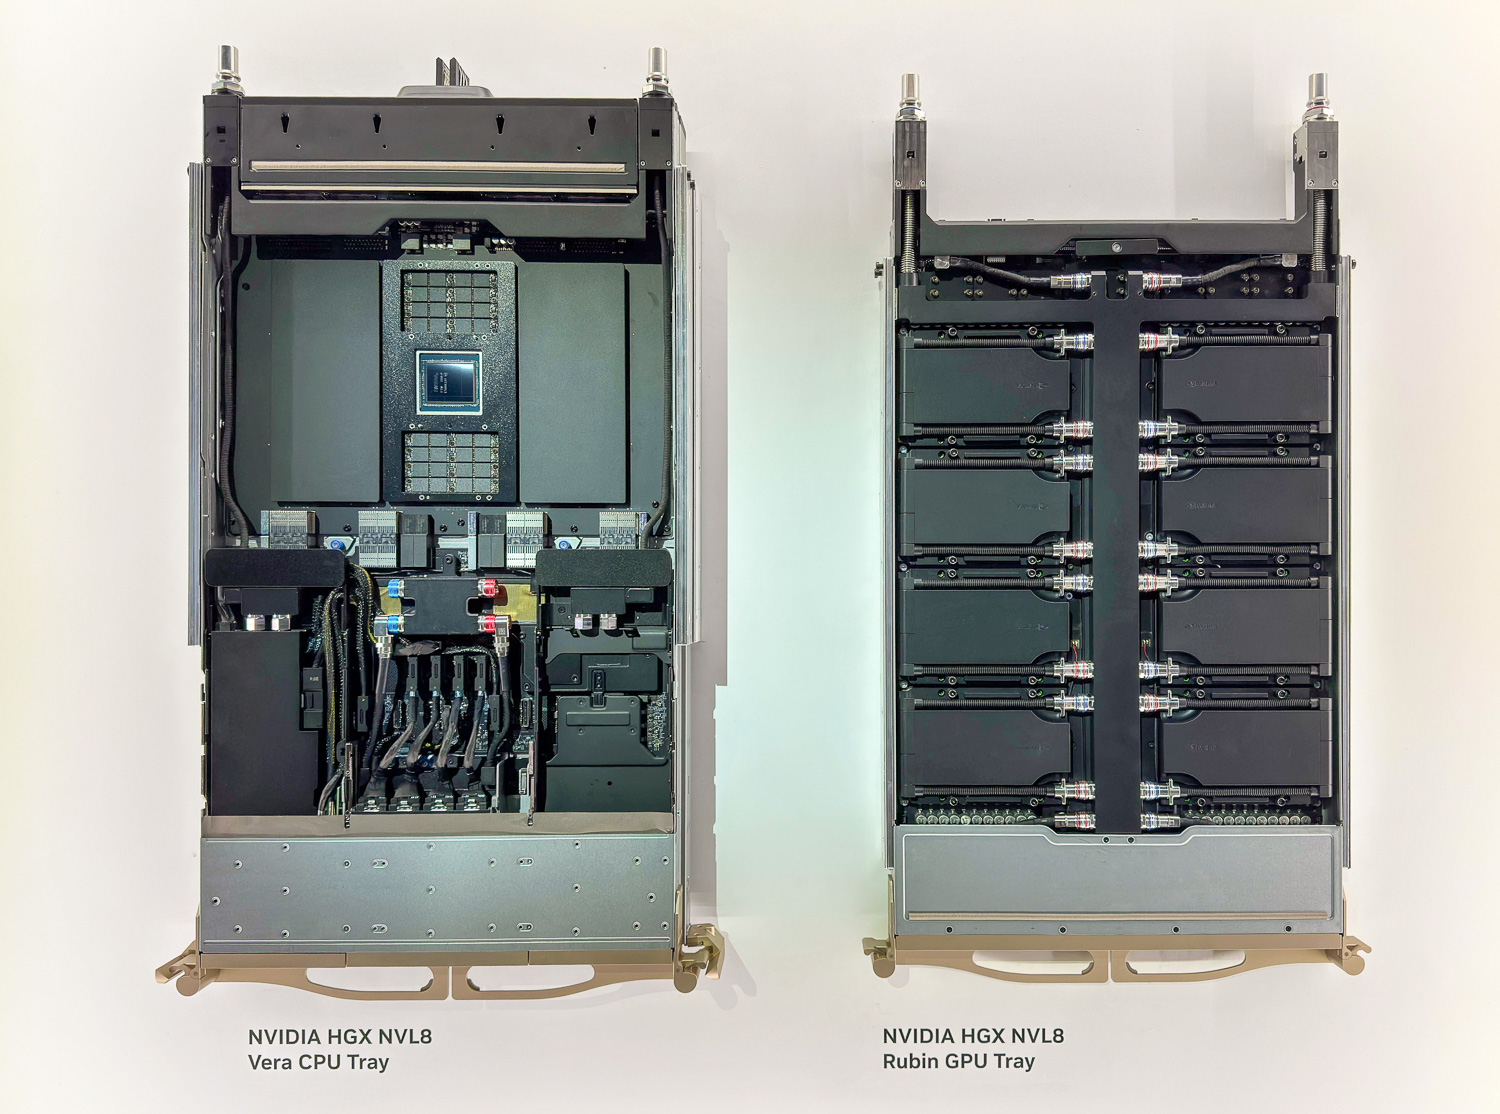
NVIDIA HGX NVL8 搭配 Vera 和 Xeon 6,并支持 DGX NVL8。
主机CPU在人工智能推理中不断演变的角色
从大规模模型训练到实时、智能AI和推理系统的转变,提升了主机CPU的重要性。在这些环境中,CPU不再是辅助组件,而是负责编排、内存访问和模型安全的关键引擎。英特尔表示,Xeon 6处理器旨在提供管理这些复杂的GPU加速系统所需的吞吐量和效率,同时保持与企业客户赖以扩展推理能力的庞大x86软件生态系统的兼容性。
推理性能越来越取决于以 CPU 为主导的系统编排,而不仅仅是 GPU 的原始吞吐量。主机 CPU 通过管理内存管理和工作负载调度等关键功能,直接影响集群的整体效率和总体拥有成本。Xeon 6 通过确保运行的连续性和可靠性,为数据中心、云和边缘环境中的现代 AI 基础设施奠定了必要的基础。
DGX Rubin Systems 中 Xeon 6 的技术优势
将英特尔® 至强® 6 处理器集成到DGX Rubin NVL8系统中,是基于当前 NVIDIA Blackwell 平台(包括 DGX B300 系统)中英特尔® 至强® 6776P 处理器所建立的架构基础。这种架构的延续性使得企业能够将现有的性能优化和系统级专业知识应用到下一代 AI 硬件中。据英特尔称,至强® 处理器经过精心设计,可通过诸如 Priority Core Turbo 等功能最大限度地提高 GPU 利用率,从而保持与加速器之间稳定的数据流。
内存容量和带宽是 Xeon 6 面向 AI 应用的核心价值所在。该平台支持高达 8 TB 的系统内存,足以容纳大型模型和不断扩展的键值缓存。此外,MRDIMM 技术的应用使内存带宽逐代提升 2.3 倍,显著提高了向 GPU 传输数据的速率。同时,大量的 PCIe 5.0 通道也提供了高带宽、低延迟的 I/O,足以支持多个 AI 加速器和高速网络连接。
安全与保密计算
随着人工智能推理规模的扩大,端到端保密计算对于保护敏感数据和专有模型至关重要。英特尔® 至强® 6 通过英特尔® 信任域扩展 (TDX) 满足这些需求,提供基于硬件的隔离和认证。这为现代人工智能集群构建了安全的基础,确保数据在系统中传输过程中始终受到保护。
CPU 到 GPU 数据路径的安全性得到进一步提升。诸如加密反弹缓冲区之类的功能,可在整个处理流程中实现机密计算,从而在使用过程中保护 AI 数据和模型。这种基于硬件的隔离对于维护关键任务环境的完整性以及在异构推理工作负载中保护知识产权至关重要。
生态系统整合与效率
英特尔® 至强® 6 处理器针对整个 AI 软件栈进行了优化支持,包括新增对 NVIDIA Dynamo 的兼容性。这使得 CPU 和 GPU 之间的异构推理更加高效,从而实现更优的资源分配。该平台专注于提升每瓦性能,帮助企业管理现代 AI 集群的功耗密度,在不牺牲有效编排和调度所需的单线程性能的前提下,降低长期总拥有成本 (TCO)。
通过对 GPU 加速系统的协调,英特尔® 至强® 6 处理器确保即使推理工作负载日益复杂,数据传输也能保持流畅高效。凭借久经考验的可靠性、成熟的软件支持和先进的 I/O 功能,至强® 巩固了其作为现代 AI 基础设施基石的地位,从而能够在全球范围内部署安全且可扩展的 AI 解决方案。


 Amazon