

NVIDIA宣布了两项旨在进军高性能计算和人工智能领域的重大举措:收购了Slurm工作负载管理器背后的公司SchedMD,以及推出面向多智能体人工智能的Nemotron 3系列开放模型、数据和工具。这两项举措将进一步巩固NVIDIA在高性能计算、生成式人工智能和企业级人工智能基础设施领域的地位,同时继续秉持开放、厂商中立软件的理念。
Slurm 和 SchedMD:加强开放、厂商中立的高性能计算调度
SchedMD 是 Slurm 的主要开发者,Slurm 是目前应用最广泛的开源高性能计算 (HPC) 和人工智能 (AI) 集群工作负载管理器之一。Slurm 用于在大规模集群中对运行紧密耦合并行工作负载的计算资源进行排队、调度和分配。随着集群规模和模型复杂性的增加,高效的调度对于维持资源利用率和吞吐量至关重要。
Slurm 在高性能计算 (HPC) 领域的应用十分广泛。在 TOP500 榜单的前 10 名和前 100 名系统中,超过一半都使用了 Slurm,这主要得益于其可扩展性、高吞吐量以及对复杂策略管理的支持。对于人工智能 (AI) 工作负载,Slurm 已成为基础模型开发者和 AI 构建者在 GPU 加速系统上协调大规模模型训练和推理的关键基础设施组件。
收购完成后,NVIDIA计划继续开发和分发Slurm,并将其作为开源、厂商中立的软件发布。该公司表示,Slurm将继续面向更广泛的高性能计算(HPC)和人工智能(AI)社区,并继续支持各种硬件和软件平台上的异构环境。NVIDIA与SchedMD已合作十余年,此次正式收购旨在加速双方的合作路线图,而非战略转型。
SchedMD管理层认为这笔交易是对Slurm在高性能计算和人工智能领域核心地位的认可。该公司指出,NVIDIA在加速计算方面的专业知识将有助于Slurm满足未来人工智能和超级计算的需求,同时保持其开源模式和社区参与度。
客户影响和平台支持
对于 SchedMD 的现有客户,NVIDIA 计划继续提供 Slurm 支持、培训和开发服务。目前,Slurm 的部署涵盖云服务提供商、制造商、人工智能公司和研究机构,涉及自动驾驶、医疗保健和生命科学、能源、金融服务、政府和一般制造业等多个行业。
NVIDIA 还希望加快 SchedMD 对新系统和架构的访问。对于采用 NVIDIA 加速计算平台的客户而言,这意味着对新一代 GPU 和系统配置的支持速度将更快。同时,NVIDIA 重申 Slurm 将继续支持各种异构环境,使混合厂商集群能够采用新的 Slurm 功能,而无需局限于单一硬件堆栈。
NVIDIA 和 SchedMD 的共同努力被视为加强高性能计算和人工智能领域开源软件生态系统的更广泛计划的一部分,旨在促进各行业和部署规模的创新。
Nemotron 3:面向多智能体、智能体的开放式 MoE 模型
与此同时,NVIDIA 推出了Nemotron 3 系列,这是一个开放的生态系统,包含模型、数据集和库,用于构建透明高效的智能体 AI 系统。随着企业从单模型聊天机器人转向更复杂的多智能体架构,他们面临着诸多挑战,例如智能体之间的通信开销、长时间工作流程中的上下文漂移以及不断攀升的推理成本。此外,企业对透明度的需求也日益增长,以便更好地理解和信任嵌入关键业务流程中的 AI 系统。
Nemotron 3 采用混合潜在专家混合 (MoE) 架构来满足这些需求,该架构专为大规模多智能体工作负载而设计。这些模型旨在支持智能体的协作行为、专业技能和高效的任务路由,同时保持可预测的性能和成本特性。
英伟达创始人兼首席执行官黄仁勋强调,开放式创新对人工智能的发展至关重要。他着重指出,Nemotron 将前沿人工智能转化为一个易于使用的平台,提升透明度和效率,从而支持大规模智能体的开发。
欧洲、韩国及其他地区的国家和地区人工智能计划已开始将Nemotron视为开放式、本地化人工智能开发的基础。包括埃森哲、Cadence、CrowdStrike、Cursor、德勤、Palantir、Perplexity等在内的早期采用者,正在将Nemotron模型融入到涵盖制造业、网络安全、软件工程、媒体和通信等领域的工作流程中。
型号系列:Nano、Super 和 Ultra
Nemotron 3 由三个主要的 MoE 模型层级组成,每个层级都针对不同类型的工作负载:
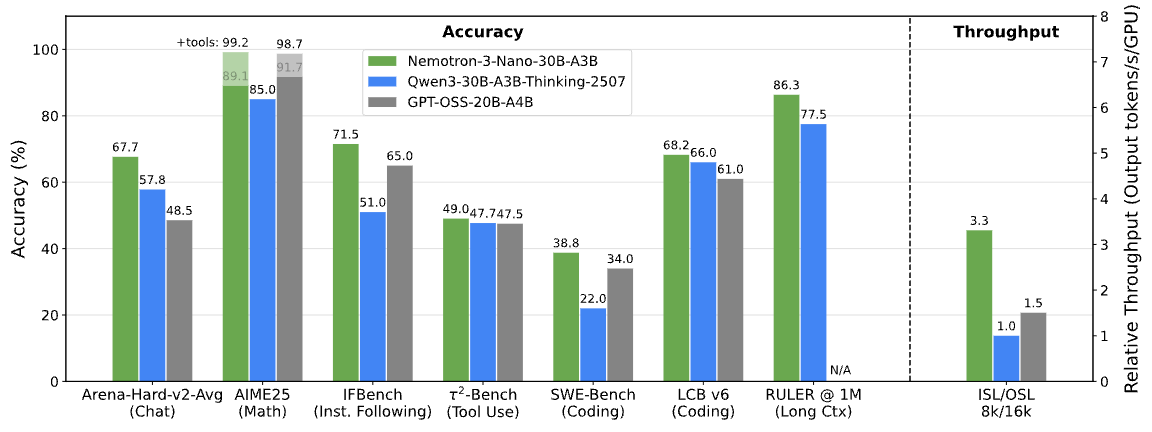
- 纳米 这是一个小型模型,大约有30亿个参数, 激活 每个代币最多可包含 3 亿个参数。 HPMC胶囊 高效推理。它是 合适的 对于任务 力e 调试, 摘要,人工智能 管道以及信息检索,其中低延迟和 成本 旨在 关键。 它的 混合式 MoE 设计可提供比 Nemotron 2 Nano 高达 4 倍的令牌吞吐量,并将推理成本降低高达 60%,从而降低整体推理成本。Nemotron 3 Nano 拥有 1 万个令牌的上下文窗口。 保持s 更多州 长 工作流程,提高准确性并连接远程上下文。 独立基准对其进行排名 它是最开放、最高效的模式之一。 程, 最佳 准确度 窥视s.
- Super 是一款高精度推理模型,拥有约 10 亿个参数,每个 token 最多可包含 100 亿个活跃参数。它专为多智能体应用而设计,在这些应用中,多个智能体协作以在低延迟要求下实现复杂目标。Super 适用于推理深度、工具使用和智能体间协作需要扩展,但又不希望像大型模型那样产生高昂成本的场景。
- Ultra 是顶级模型,它作为一个大型推理引擎,拥有约 50 亿个参数,每个 token 最多可激活 500 亿个参数。它专为要求最苛刻的 AI 工作流程而设计,包括深度研究、战略规划以及需要在超长上下文中进行高质量推理的复杂决策支持系统。
Nemotron 3 Super 和 Ultra 使用 NVIDIA 的 4 位 NVFP4 格式在 Blackwell 架构上进行训练。这种训练格式显著降低了内存占用,提高了训练吞吐量,同时保持了与更高精度格式相当的精度。对于企业和服务提供商而言,这使得他们能够在现有基础设施上训练更大的模型,或者减少特定规模所需的硬件资源。
通过这种分层式系列,开发人员可以根据特定的工作负载和成本目标来匹配模型大小和功能,从几十个代理扩展到几百个代理,同时在复杂的多步骤工作流程中保持更快、更准确的长期推理。
路由、代币经济学和混合模型策略
随着多智能体系统的日趋成熟,许多组织开始采用混合模型策略。Frontier 的专有模型用于处理最复杂的推理任务,而高效且可定制的开放模型则用于处理常规或特定领域的工作负载。Nemotron 3 正是专为这种基于路由的架构而设计的。
在典型的架构中,代理路由器实时分析任务。它会将任务分派给经过精细调优的 Nemotron 模型(例如 Nemotron 3 Ultra),或者在专有模型能够提供独特价值时将其分派给专有模型。这种方法通过为最苛刻的场景预留昂贵的前沿容量,并利用 Nemotron 处理高吞吐量、高效率的工作负载,从而优化代币经济。
构建 AI 助手和代理平台的合作伙伴表示,这种路由策略使他们能够提供更高的响应速度和更好的成本控制,同时保持灵活性,以便随着时间的推移集成不同的模型提供商和训练策略。
开放数据、库和安全工具
除了模型本身之外,NVIDIA 还发布了大量开放资源,以支持自定义代理的开发:
训练和强化学习数据集
NVIDIA 提供 3 万亿个 Nemotron 数据集,用于前期学习、后期学习和强化学习。这些数据集包含丰富的示例,涵盖推理、编码和多步骤工作流程,可用于训练或微调特定领域的智能体。Nemotron 智能体安全数据集提供真实世界的遥测数据,团队可利用这些数据评估和提升复杂自主系统的安全性。
NeMo Gym 和 NeMo RL
为了简化强化学习和训练后处理,NVIDIA 发布了 NeMo Gym 和 NeMo RL 这两个开源库。它们提供与 Nemotron 模型兼容的训练环境和训练后处理基础架构,并且可以扩展或适配其他架构。NeMo Evaluator 则用于评估模型在各种基准测试和用例中的安全性和性能。
所有这些工具和数据集都可以在 GitHub 和 Hugging Face 上找到,方便团队将其集成到现有的 MLOps 流水线和训练工作流程中。像 Prime Intellect 和 Unsloth 这样的生态系统参与者已经将 NeMo Gym 训练环境集成到他们的平台中,以简化企业用户的强化学习流程。
Nemotron 3 模型还兼容流行的推理和部署框架,包括 LM Studio、llama.cpp、SGLang 和 vLLM,这使得进行本地实验和部署到各种环境变得更加容易。
可用性
Nemotron 3 Nano 现已通过以下列出的多个分销渠道发售。
模型中心和推理提供商:Nemotron 3 Nano 模型可通过 Hugging Face 以及Baseten、DeepInfra、Fireworks、FriendliAI、OpenRouter 和 Together AI 等推理提供商获取。这些服务使团队能够快速评估模型并将其集成到现有应用程序中。
企业平台: Nemotron 模型正被集成到企业级 AI 和数据平台中,包括 Couchbase、DataRobot、H2O.ai、JFrog、Lambda 和 UiPath。这使得客户能够将 Nemotron 驱动的功能直接嵌入到他们的数据、编排和自动化堆栈中。
公有云和 NIM 微服务:对于公有云用户,Nemotron 3 Nano 将通过 Amazon Bedrock 在 AWS 上提供,用于无服务器推理,并且还将在 Google Cloud、CoreWeave、Crusoe、Microsoft Foundry、Nebius、Nscale 和 Yotta 上提供。
Nemotron 3 Nano 也可作为 NVIDIA NIM 微服务提供,以便在 NVIDIA 加速的基础架构上进行安全、可扩展的部署,使企业能够更好地控制隐私、数据本地性和性能。
Nemotron 3 Super 和 Ultra 预计将于 2026 年上半年上市,这将使各组织有时间在 Nano 层进行标准化,以满足早期代理用例的需求,并随着需求的增长计划未来迁移到更大的模型。


 Amazon