

NVIDIA GTC 2023 以推出新产品、合作伙伴、创新和软件拉开序幕。 为了让您了解公告的范围,主题演讲持续了 78 分钟。 宣布了四个新平台,每个平台都针对特定的生成式 AI 推理工作负载和专用软件进行了优化。
这些平台将 NVIDIA 的全套推理软件与最新的 NVIDIA Ada、Hopper 和 Grace Hopper 处理器相结合。 今天推出了两款新的 GPU,即 NVIDIA L4 Tensor Core GPU 和 H100 NVL GPU。
NVIDIA L4 AI 视频加速器在 AI视频处理方面比 CPU 的性能提升 120 倍,同时能效提升 99%。L4 可作为通用 GPU,几乎适用于任何工作负载,提供增强的视频解码和转码能力、视频流媒体播放、增强现实、生成式 AI 视频等功能。
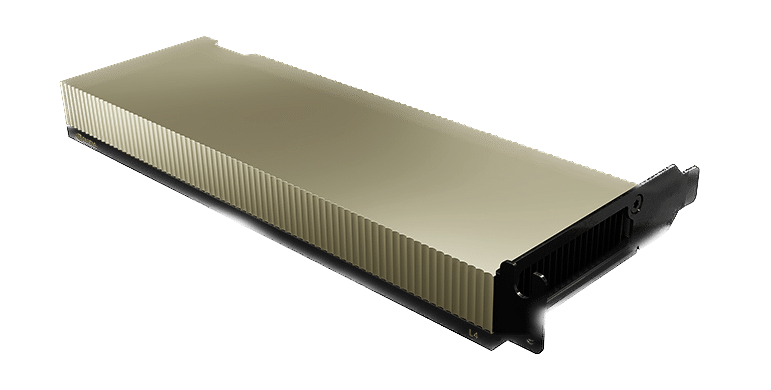
NVIDIA Ada Lovelace L4 Tensor Core GPU 为企业、云端和边缘的视频、人工智能、虚拟化桌面和图形应用程序提供通用加速和能效。 借助NVIDIA的AI平台和全栈
方法,L4 针对广泛的 AI 应用程序进行大规模推理进行了优化,包括推荐、基于语音的 AI 化身助手、生成 AI、视觉搜索和联络中心自动化。
L4 是最高效的主流 NVIDIA 加速器,配备 L4 的服务器比 CPU 解决方案高出 120 倍的 AI 视频性能和 2.7 倍的生成 AI 性能,以及比上一代 GPU 高出 4 倍的图形性能。 NVIDIA L4 是一种多功能、高能效、单插槽、薄型外形,非常适合大型部署和边缘位置。
NVIDIA L40 图像生成平台针对图形和 AI 赋能的 2D、视频和 3D 图像生成进行了优化。L40 平台是 NVIDIA Omniverse 的引擎,Omniverse 是一个用于在数据中心构建和运行元宇宙应用程序的平台,其稳定扩散推理性能比上一代产品提升了 7 倍,Omniverse 性能提升了 12 倍。
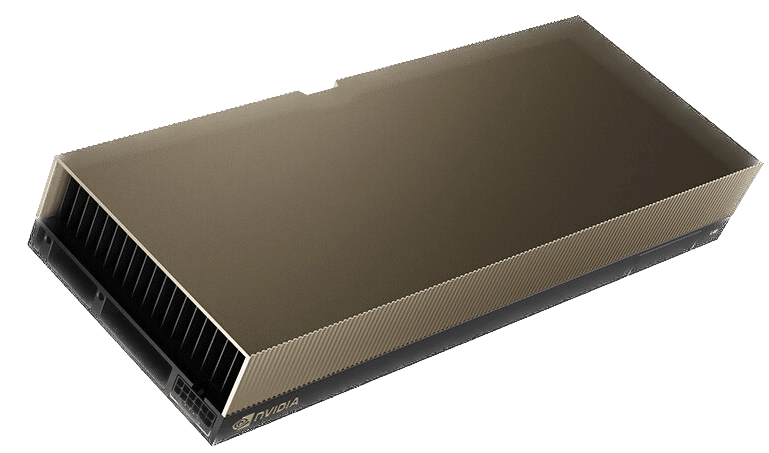
NVIDIA L40 GPU 为数据中心提供高性能视觉计算,具有下一代图形、计算和人工智能功能。 L40 基于 NVIDIA Ada Lovelace 架构构建,利用最新一代 RT、Tensor 和 CUDA 内核的强大功能,为要求苛刻的数据中心工作负载提供可视化和计算性能。
L40 提供增强的吞吐量和并发光线追踪和着色功能,可提高光线追踪性能并加速产品设计和架构、工程和施工工作流程的渲染。 L40 GPU 为结构稀疏性和优化的 TF32 格式提供硬件支持,以实现开箱即用的性能提升,从而实现更快的 AI 和数据科学模型训练。 加速的 AI 增强型图形功能(包括 DLSS)可在特定应用程序中提供更高的分辨率和更好的性能。
L40 的大型 GPU 内存可处理内存密集型应用程序和工作负载,例如数据科学、模拟、3D 建模和渲染,以及 48GB 的超快 GDDR6 内存。 使用 vGPU 软件将内存分配给多个用户,以在创意、数据科学和设计团队之间分配大量工作负载。
NVIDIA L24 专为具有节能硬件和组件的 7×40 企业数据中心运营而设计,经过优化可大规模部署并为各种数据中心工作负载提供最大性能。 L40 包括采用信任根技术的安全启动,提供额外的安全层,并且符合 NEBS Level 3 标准以满足数据中心标准。
NVIDIA H100 NVL 专为大规模部署大型语言模型而设计,是部署 ChatGPT 等大型语言模型的理想之选。新款 H100 NVL 配备 94GB 显存,并搭载 Transformer Engine 加速技术,在数据中心规模下,其 GPT-3 推理性能比上一代 A100 提升高达 12 倍。
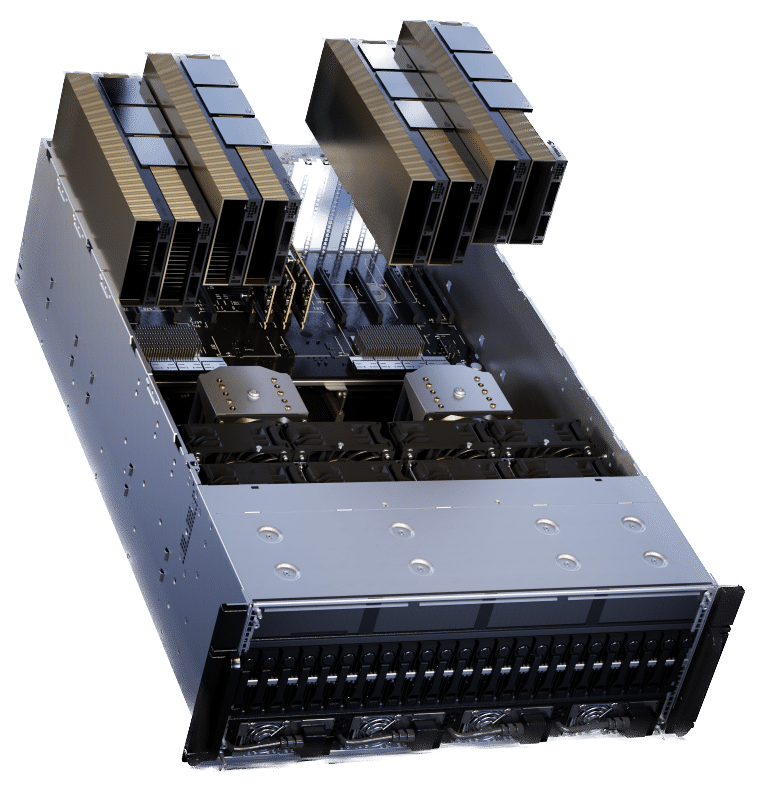
基于 PCIe 的 H100 NVL 和 NVLink 桥利用 Transformer Engine、NVLink 和 188GB HBM3 内存来提供最佳性能和跨数据中心的扩展。 H100 NVL 支持多达 175 亿个参数的大型语言模型。 配备 H100 NVL GPU 的服务器可将 GPT-175B 模型的性能提高至 NVIDIA DGX A12 系统的 100 倍,同时在功率受限的数据中心环境中保持低延迟。
NVIDIA Grace Hopper for Recommendation Models是图推荐模型、向量数据库和图神经网络的理想之选。凭借 CPU 和 GPU 之间 900 GB/s 的 NVLink-C2C 连接,Grace Hopper 的数据传输和查询速度比 PCIe Gen 5 快 7 倍。
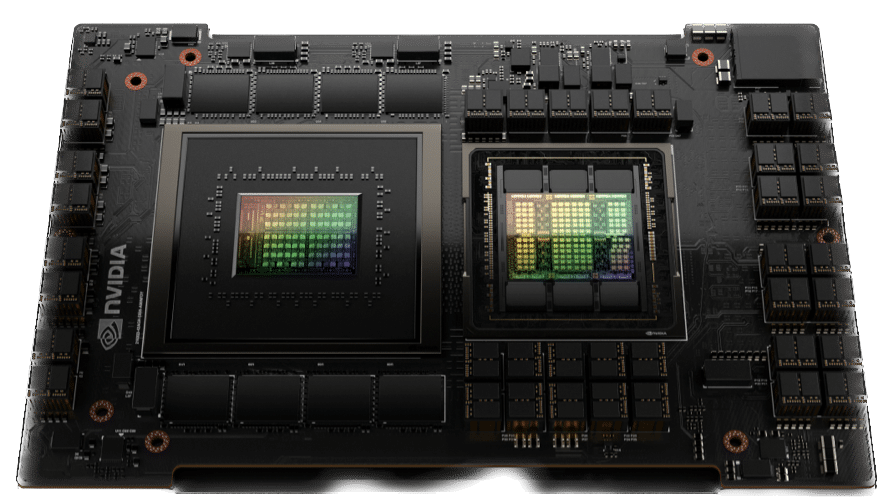
NVIDIA Grace Hopper Superchip 是一款突破性的加速 CPU,专为大规模人工智能和高性能计算 (HPC) 应用而设计。 该超级芯片将为运行 TB 级数据的应用程序提供高达 10 倍的性能提升,使科学家和研究人员能够为世界上最复杂的问题找到前所未有的解决方案。
NVIDIA Grace Hopper Superchip 结合使用 NVIDIA NVLink-C2C 的 Grace 和 Hopper 架构,为加速 AI 和 HPC 应用程序提供 CPU+GPU 一致性内存模型。 与 NVIDIA DGX A900 相比,Grace Hopper 包括每秒 7 GB (GB/s) 的一致接口,速度比 PCIe Gen5 快 30 倍,并为 GPU 提供高 100 倍的聚合系统内存带宽。 最重要的是,它运行所有 NVIDIA 软件堆栈和平台,包括 NVIDIA HPC SDK、NVIDIA AI 和 NVIDIA Omniverse。
现代推荐系统模型需要大量内存来存储嵌入表。 嵌入表包含项目和用户特征的语义表示,有助于向消费者提供更好的推荐。
通常,这些嵌入遵循使用频率的幂律分布,因为某些嵌入向量的访问频率高于其他向量。 NVIDIA Grace Hopper 支持高吞吐量推荐系统管道
将最常用的嵌入向量存储在 HBM3 内存中,将剩余的嵌入向量存储在更高容量的 LPDDR5X 内存中。 NVLink C2C 互连为 Hopper GPU 提供了对其本地 LPDDR5X 内存的高带宽访问。 同时,NVLink Switch System 扩展了这一点,为 Hopper GPU 提供了对 NVLink 网络中所有 Grace Hopper Superchip 的所有 LPDDR5X 内存的高带宽访问。


 Amazon