

人工智能基础设施历来资源消耗巨大,企业始终面临着如何优化GPU利用率的挑战。戴尔科技集团通过其AI Factory平台,整合了NVIDIA近期收购的编排解决方案Run:ai,从而有效应对这一挑战。在戴尔近期发布的一篇博客文章中,该公司重点介绍了Run:ai如何最大限度地提高资源利用率并加速人工智能成果的实现,从而彻底改变企业大规模部署和管理GPU资源的方式。
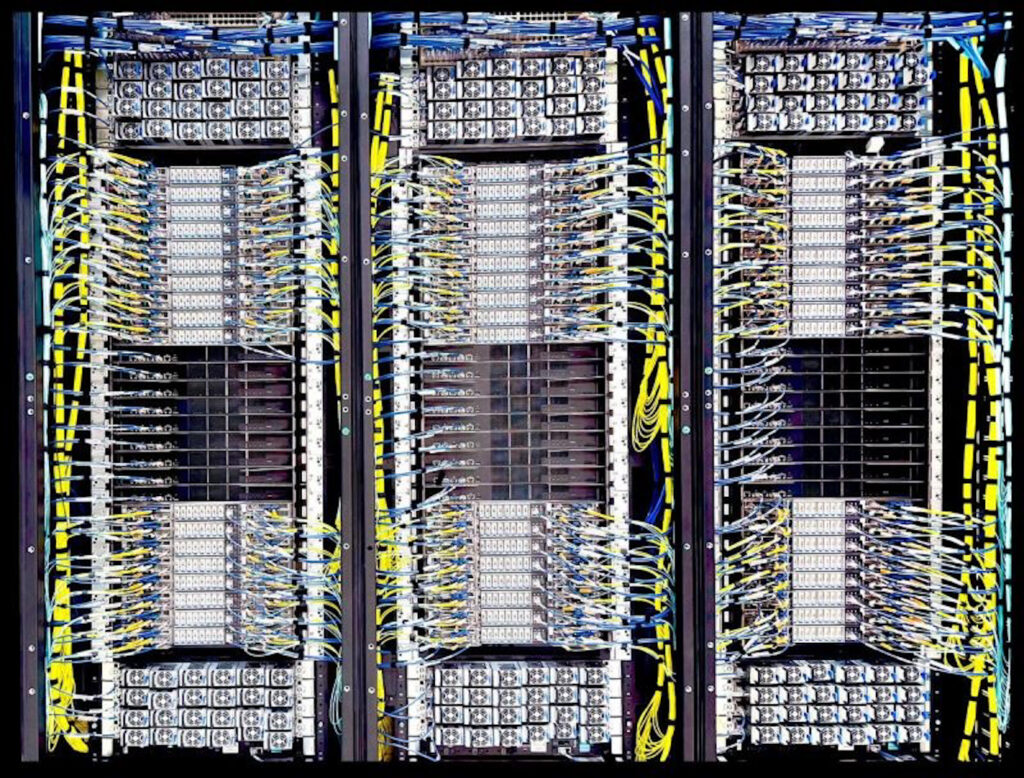
戴尔NVL72集群
Run:ai 到底是什么?
Run:ai 是一个基于 Kubernetes 构建的编排平台,专为以 GPU 为中心的工作负载而设计。Run:ai 成立于 2018 年,通过解决行业普遍存在的挑战——GPU 使用效率低下而获得关注。传统上,分配给 AI 工作负载的 GPU 通常处于闲置状态或未得到充分利用。Run:ai 通过动态池化和智能调度 GPU 资源解决了这一问题,实现了 GPU 的分级分配、高效的多 GPU 部署以及跨混合云、云和本地环境的无缝管理。
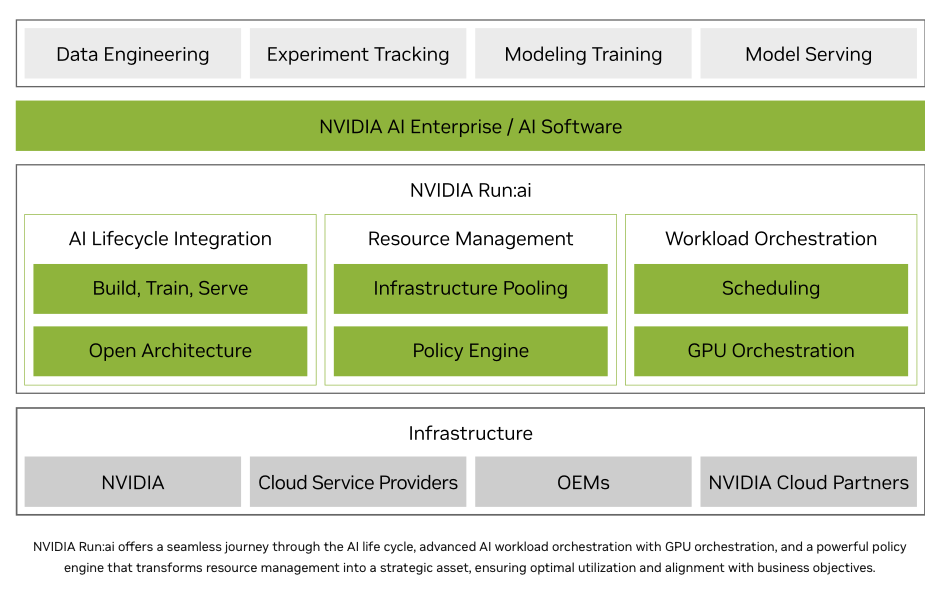
NVIDIA意识到 Run:ai 具有重塑 AI 基础设施的巨大潜力,于 2024 年 12 月以约 7 亿美元的价格完成了对该公司的收购。值得注意的是,NVIDIA 已承诺最终将 Run:ai 开源,这表明其有意推动 Run:ai 在其硬件平台之外的更广泛生态系统中得到应用。此举预计将进一步加速创新,并全面提升整个行业的效率。
对于那些希望深入了解资源管理技术的用户,NVIDIA 的文档详细介绍了Run:ai 如何对 GB200 NVL72 系统上的工作负载编排至关重要。该文档强调了一个关键缺陷:Kubernetes 本身无法识别 NVIDIA 的 MNNVL 架构,这使得跨这些高性能域管理和调度工作负载变得更加复杂。Run:ai 通过自动检测 NVLink 域并简化分布式工作负载的提交,消除了这种复杂性。这确保了 Pod 被正确放置在具有 NVLink 互连的节点上,从而无需深入了解硬件知识或为每个作业进行手动配置。这些功能展示了该平台如何简化密集型训练环境中的操作,使组织能够充分利用 GB200 NVL72 等高级硬件配置的强大功能。
为什么这对企业如此重要
对于运行 GPU 密集型工作负载(尤其是涉及生成式 AI 和大型语言模型的工作负载)的组织而言,GPU 利用率不足会带来重大风险:投资浪费。Run:ai 直接解决了这些效率低下的问题,NVIDIA 报告称,使用该平台的组织可以将 GPU 利用率提高多达五倍。
这种程度的优化不仅提升了投资回报率,还从根本上重塑了运营效率。此前受限于有限资源和复杂调度流程的团队,如今拥有了能够同时部署更多模型、快速扩展并更积极地进行实验的工具,所有这些都无需额外的硬件资本支出。虽然这些方法在大型 HPC 部署中很常见,但在企业中,最大化 GPU 利用率所需的效率水平却并不常见。
广阔的行业动力
几家主要的基础设施提供商正在采用该平台,这表明整个企业 IT 领域的发展势头正在增强。
戴尔持续扩展其 AI Factory 框架,该框架以 NVIDIA 技术为核心,其中包括 Run:ai。戴尔对 Run:ai 的应用展示了企业如何从孤立的手动资源分配模式转向更动态、更自动化的调度,从而在多租户环境中显著提升效率。
HPE将 Run:ai 作为其 GreenLake Marketplace 的一部分提供,并将其与 Ezmeral 平台集成,从而实现高级 GPU 调度、部分分配和混合基础架构编排。这使客户能够以更高的精度和可扩展性部署和管理 AI 工作负载。
思科将 Run:ai 与其 UCS X 系列服务器和 Intersight 云运维平台集成。该解决方案重点关注配额管理、GPU 部分共享和实时监控,以支持大规模本地 AI 部署。
我们仅重点介绍了 Run:ai 的部分合作伙伴。NVIDIA 拥有丰富的合作伙伴标识列表,如上所示。各大领先的 OEM 厂商和云平台提供商都在与 Run:ai 合作,致力于提供更具创新性和效率的 AI 基础架构解决方案。



 Amazon