

VAST Data 推出了一种全新的推理架构,该架构支持 NVIDIA 推理上下文内存存储平台。该系统专注于涉及持续、多轮代理驱动会话的 AI 应用。VAST 将此平台定位为专为 AI 设计的存储类别,可增强对键值 (KV) 缓存的访问,实现节点间推理上下文的快速共享,并提高能效。该设计采用 NVIDIA BlueField-4 DPU 和 Spectrum-X 以太网,而 VAST AI 操作系统 (AI OS) 则提供有效管理此共享基础架构资源所需的软件。
有关 KV 缓存的重要性的更多信息,请查看我们与 Pliops 合作完成的这篇深度分析。
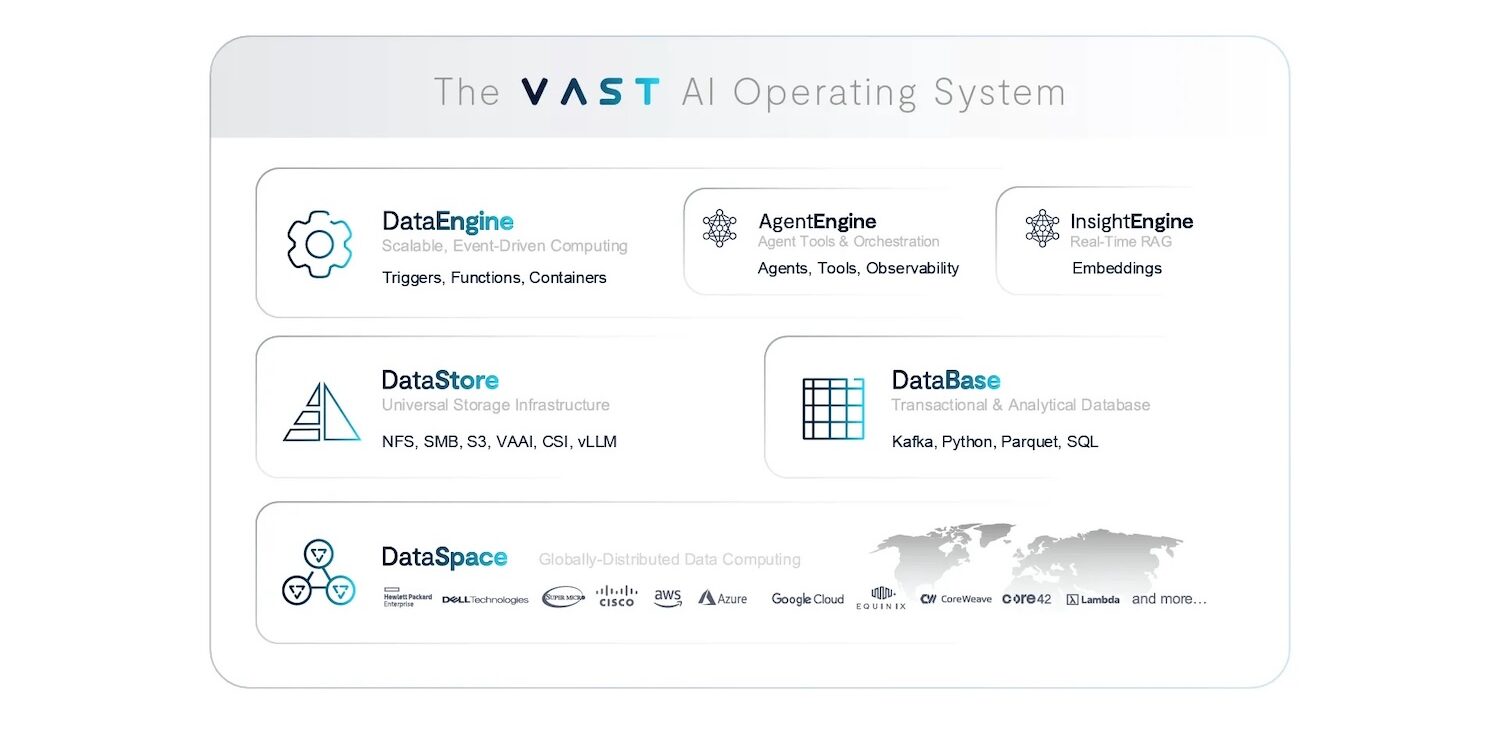
该公告标志着限制实际应用中推理性能的因素发生了变化。随着推理从简单的提示转向跨多个代理和用户的持续推理,上下文信息仅保留在单个GPU服务器上的理念已不再适用。在这种情况下,整体性能越来越依赖于推理历史记录在持续操作期间的存储、恢复、重用、扩展和共享效率。键值缓存(KV缓存)从内部优化机制演变为主要数据路径,从而影响首次令牌获取时间(TTFT)、GPU使用率和集群效率。
重建围绕DPU的推理数据路径
VAST 的策略是将 VAST AI OS 软件直接运行在 NVIDIA BlueField-4 DPU 上。与传统的客户端-服务器模式不同,VAST 架构将存储和上下文服务作为外部组件进行访问,而是将这些数据服务直接集成到 GPU 服务器(推理发生的地方),同时还支持专用数据节点配置。这种方法旨在最大限度地减少瓶颈,并消除不必要的复制和延迟,从而避免并发量增加时性能下降的问题。
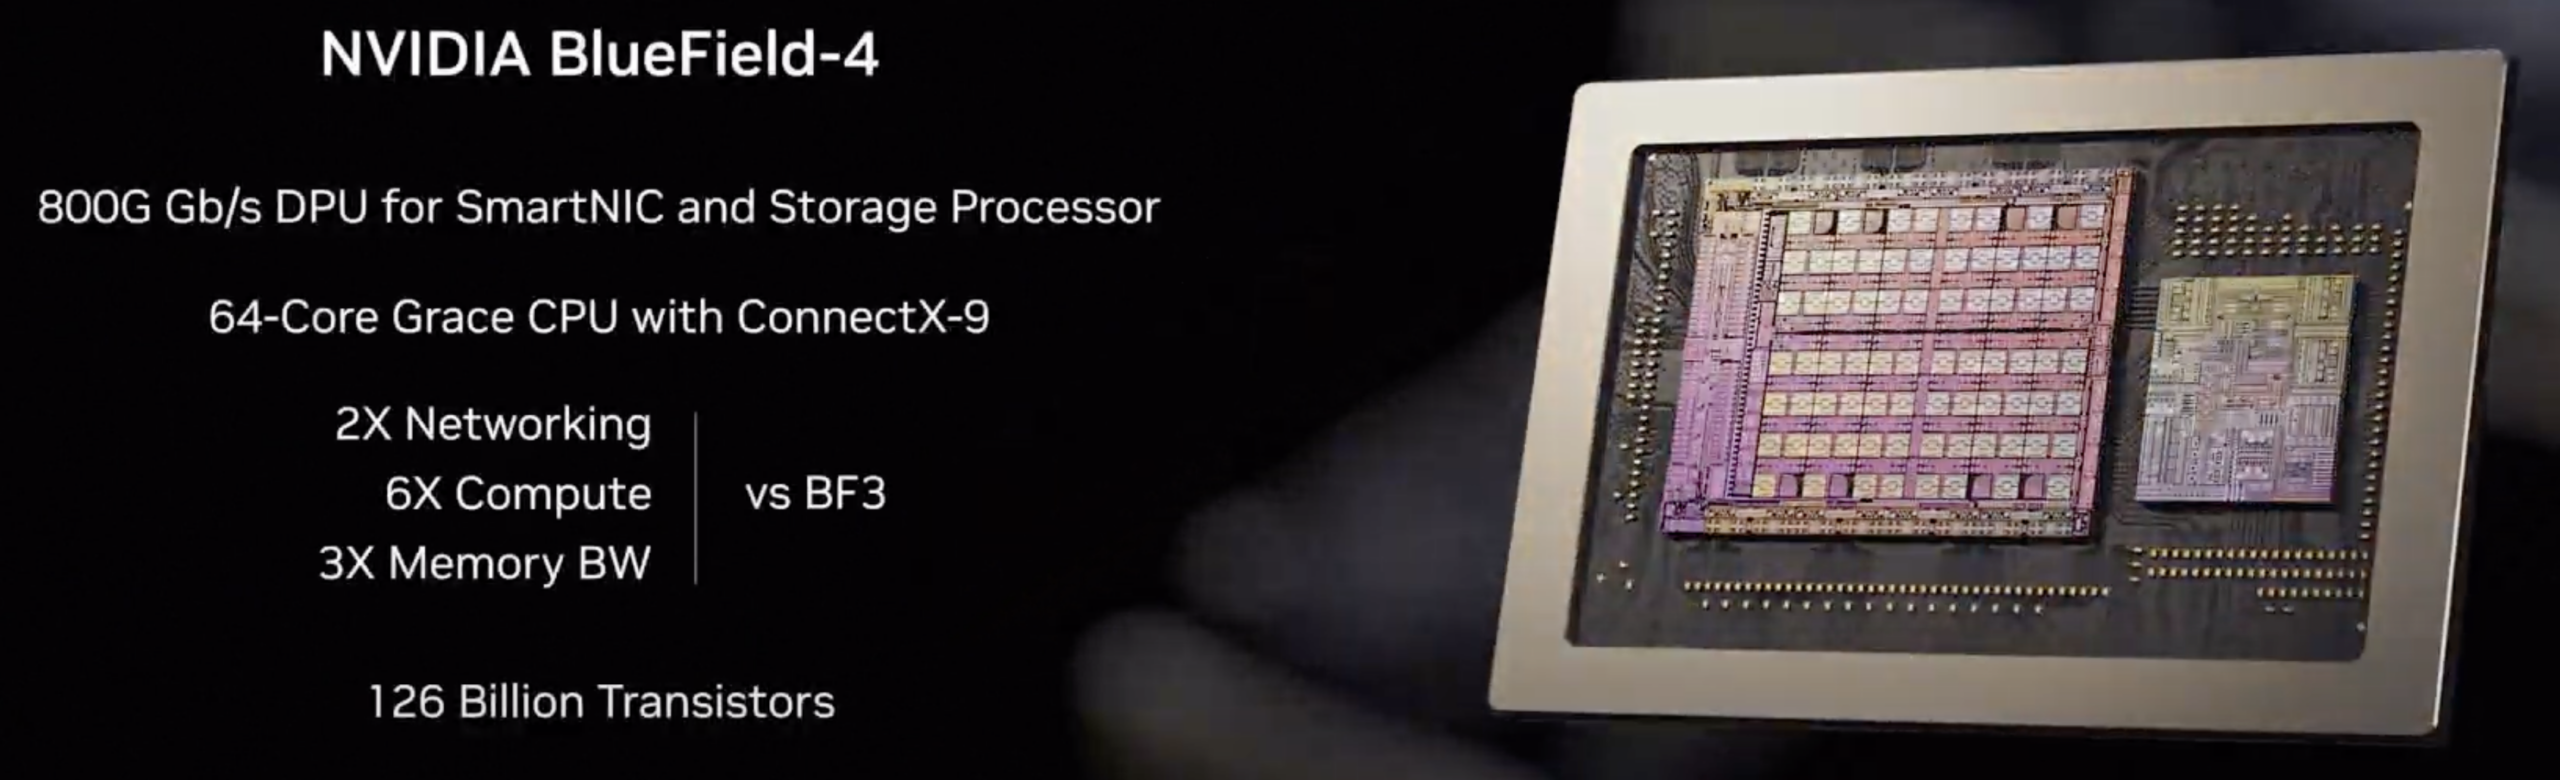
这种 DPU 原生设计明确针对大型推理系统的实际需求。当成百上千个会话同时运行时,管理键值缓存就变成了持续的输入/输出 (I/O) 工作。系统必须快速读取上下文以保持会话运行,将其存储以供长期使用,并在工作节点之间共享上下文,以防止在基础架构将操作引导至较慢的路径或需要大量协调时出现重复处理。TTFT 增加,导致 GPU 等待而非处理。VAST 断言,通过 BlueField-4 将数据平面移至服务器可以实现更高效的上下文流量、更高的吞吐量和更可靠的延迟,使其更接近 GPU 处理循环。
VAST 还强调使用 RDMA 架构实现从 GPU 内存到持久性 NVMe 存储的高效路径。这有效地实现了 GPU 服务器和存储之间的上下文平滑传输,减少了传统系统中常见的重复数据处理。其目标是确保上下文传输与高性能网络保持“带内”连接,同时最大限度地减少 CPU 参与和客户端开销。
大规模共享、连贯的背景
新架构与 VAST 的并行解耦共享一切 (DASE) 设计协同工作。VAST 解释说,这使得每个主机都能访问共享的、全局一致的上下文命名空间,而无需承担通常在大规模场景下产生的协调成本。在长时间运行的、由代理驱动的推理中,这一细节至关重要。上下文不仅规模庞大,而且共享程度也越来越高。
智能体系统通常需要同时使用多个工具,在多个智能体之间进行切换,并在交互过程中表现出类似记忆的行为。这就要求系统重用上下文而不是重新创建上下文,并在推理工作节点之间共享上下文而不是将其绑定到单个节点。如果系统由于调度、驱逐或故障恢复等原因无法维持上下文局部性,则必须快速恢复并继续会话,而无需重新处理冗长的提示历史记录。这样一来,键值缓存就成为集群中至关重要的资源,挑战在于如何使其广泛可用,同时避免成为同步瓶颈。
VAST 的观点是,将基于 DPU 的数据服务与共享存储架构相结合,可以创建一个全局可访问的上下文层,即使并发会话数量增加,也能保持高效运行。该平台并非通过添加独立的上下文单元来扩展,而是允许集群在扩展的同时,继续受益于资源的重用和共享。
语境即新的表现范围
VAST 执行官 John Mao 指出,大型推理系统的竞争优势正从单纯的计算能力转向内存和上下文系统。他总结道,最有效的集群并非仅仅是那些峰值浮点运算能力最高的集群,而是那些能够实时共享和管理上下文的集群。他还强调了即时按需访问上下文的重要性,并将其视为关键性能指标。他警告说,如果无法快速检索和重用上下文,GPU 将处于闲置状态,效率也会受到影响。
随着模型规模扩大和会话时长增加,许多运维人员的经验也印证了这一点。推理集群通常配置为最大程度地生成令牌,但实际体验会受到压力下的尾延迟和 TTFT 的影响。随着提示符的延长和会话的持续,上下文管理所花费的时间也会增加。如果上下文无法快速恢复或重用,GPU 周期就会浪费在重新建立状态或等待数据传输上。VAST 的架构方法将键值缓存视为共享基础设施,从而减少了这些问题并提高了集群的整体效率。
从实验到受控的生产推断
VAST 还将该平台定位为从实验性部署过渡到生产就绪型推理服务(包括在受监管环境下)的平台。随着推理成为一项具有特定安全性和合规性要求的盈利服务,管理键值缓存需要的不仅仅是速度,还需要监管。
在长时间会话中,上下文可能包含敏感提示、推理步骤、工具输出以及用户提供的信息。企业越来越需要针对此类上下文进行策略控制、隔离措施、审计跟踪和生命周期管理。VAST 声称,这些 AI 原生数据服务已内置于 AI 操作系统中,使组织能够将键值缓存视为可管理的资源,而非临时状态。
从运营角度来看,VAST 旨在解决大型推理环境中常见的挑战:缓存丢失或无法共享时发生的上下文重建风暴,以及上下文成为瓶颈而非计算瓶颈时造成的 GPU 时间浪费。该公司认为,增强上下文的持久性和重用性将减少重复计算并提高资源利用率,从而随着上下文规模和会话并发性的增加,提高每瓦吞吐量和每美元吞吐量。
英伟达:上下文管理驱动规模经济
NVIDIA网络高级副总裁Kevin Deierling强调了上下文在人工智能中的重要性,并将其比作人类记忆。他指出,有效管理上下文对于扩展多轮和多用户推理至关重要,这反过来又改变了大规模上下文内存的处理方式。他提到,VAST Data AI OS与NVIDIA BlueField-4相结合,能够随着工作负载的增加提供高吞吐量、稳定的数据路径,从而支持这一目标。这种合作意义重大,因为它将DPU和以太网架构集成到核心推理上下文中,而不仅仅用于主存储访问或网络连接。关键在于,上下文现在不仅对GPU构成挑战,也对网络和存储构成挑战,现代推理架构需要集中加速和可靠的数据传输,以确保GPU高效运行。
如果 VAST 的架构能够实现预期优势,那么其真正的影响将不在于峰值基准测试分数,而在于服务的稳定性能:在多个会话处于活动状态时降低 TTFT,随着上下文增加性能下降的幅度更小,通过减少上下文重建来提高资源利用率,以及更直接地实现多节点推理(此时上下文共享不再是劣势,而是优势)。此外,它还将推理基础设施推向更“原生于 AI”的模型,将键值缓存视为一个托管内存层,由持久性 NVMe 提供支持,并在节点间共享,同时严格限制延迟。
VAST前瞻会议
VAST Data 将在首届 VAST Forward 用户大会上公布其战略,该大会定于 2026 年 2 月 24 日至 26 日在犹他州盐湖城举行。公司计划在大会上举办详细的技术讲座、实践操作研讨会和认证项目,届时VAST 的领导层、客户和合作伙伴将出席。


 Amazon