

今年早些时候,我们计算出了圆周率π的314万亿位,创造了一项新纪录。这项计算在一台戴尔PowerEdge R7725服务器上运行了数月,将现代CPU和存储基础设施的性能发挥到了极致,同时也展现了企业级硬件的巨大进步。然而,当计算最终完成时,我们发现,这项纪录本身仅仅是故事的一部分。计算生成了一个庞大的数据集,包含628个文件,每个文件大约206GB,总计超过130TB。这些文件代表了计算的完整结果,通常也是此类项目中最为精彩的部分。数学家、开发人员和数据科学家经常希望进一步探索这类数据集,无论是为了验证部分计算结果、尝试新的分析方法,还是处理异常庞大的数值数据集。
这就产生了一个远超计算圆周率本身的实际问题。现代计算工作负载越来越多地产生海量输出数据集,这些数据集必须在计算任务完成后很长时间内保持可访问性。科学模拟、基因组分析和大规模人工智能训练运行都会产生数十甚至数百TB的数据。虽然实验室环境可能非常适合生成这些数据,但它很少是为全球用户长期托管这些数据的最佳场所。
对于我们的Pi项目而言,将超过130TB的数据集永久存储在StorageReview实验室并非最佳方案。研究人员已经开始申请访问权限,而要让数据集广泛可用,就需要能够可靠存储并高效分发数据集的基础设施。
正是在这种情况下,Backblaze 伸出了援手。该公司将整个 Pi 数据集托管在 Backblaze B2 云存储中,使研究人员和爱好者能够访问这些结果。为如此庞大的数据集提供持久存储和全球访问是一项意义重大的承诺,我们感谢 Backblaze 的帮助,确保这项创纪录的计算结果能够继续为更广泛的社区所用。
此次合作也体现了我们在现代基础设施领域日益看到的一个趋势:将本地计算与云端存储和分发相结合的混合工作流程所带来的实际优势。π 的计算本身完全在我们实验室的单个系统上运行,但计算完成后,云端自然而然地成为了托管和共享结果的最佳场所。
不过在此之前,数据必须先从我们的实验室传输到 Backblaze。传输超过 130 TB 的结果绝非易事,但凭借良好的网络带宽,传输在不到两周的时间内完成,并且在整个过程中大部分时间都保持了稳定的 2 Gbps 吞吐量。大型数据集仍然具有一定的复杂性,当一次性传输数百 GB 的数据时,带宽很快就会成为瓶颈。
现在,数据集已安全存储在 Backblaze B2 中,这 314 万亿位数字的计算结果不再局限于我们的实验室。研究人员可以下载这些文件,进行实验,验证计算结果,或将这些数字用于他们自己的项目。随着 2026 年圆周率日的临近,现在正是发布该数据集的最佳时机。
Backblaze B2:面向大规模数据的企业级云存储
要让 Pi 数据集广泛可用,需要能够可靠地存储和分发海量数据的基础设施。Backblaze B2 云存储是一个企业级对象存储平台,专为此类工作负载而设计。对象存储允许将海量文件存储在可扩展的对象存储桶中,而不是强制它们进入传统的文件层级结构,因此非常适合大型数据集、备份和现代数据管道。B2 还支持与 S3 兼容的 API,使组织能够使用熟悉的工具和工作流程与该服务交互,而无需重新设计现有应用程序或数据流程。
Backblaze 的平台专注于提供持久存储,同时兼顾经济性和易用性。其架构旨在实现 11 个 9 的数据持久性,并将数据分布在多个存储 pod 中,从而确保大规模的长期可靠性。该公司还以其透明度著称,定期发布详细的硬盘可靠性报告,并保持可预测的定价,这深受众多基础设施团队的青睐。在我们的案例中,B2 为托管实验室生成的大型数据集提供了一个切实可行的解决方案,确保任何有兴趣探索数据的人都能访问这些结果,同时也展示了云存储如何扩展本地计算环境的覆盖范围。除了标准的 Backblaze B2 云存储之外,B2 Overdrive 还支持高达 1 Tbps 的吞吐量。
在 Backblaze B2 中托管数据集
314万亿位数的π计算完成后,数据已从R7725服务器卸载到NAS存储设备。如何将数据集公开访问的问题需要仔细考虑。直接从实验室提供130TB的数据并不现实。我们的广域网连接最大上传和下载速度均为2Gbps,且供实验室所有用户共享。持续的、任何有意义的公开下载都会对日常工作造成干扰,而且仅带宽限制就会导致大量并发下载速度缓慢且不稳定,任何试图访问数据的用户都会遇到这个问题。
最初的想法是通过 BitTorrent 分发数据集。虽然技术上可行,但对大多数用户来说,这种方式并不方便。通过 BT 下载 130 TB 的数据集需要客户端,需要对 BT 下载的工作原理有一定的了解,并且需要耐心等待,因为整个过程不像直接下载那样简单直接。对于一个旨在广泛供研究人员和广大用户使用的数据集来说,避免这些不便之处是值得的。
Backblaze B2 完美地解决了这两个问题。数据集完全托管在云基础设施中,因此公开下载无需依赖实验室广域网,也不会给实验室运行带来任何负载。与 B2 的连接直接通过 HTTPS 由 Backblaze 基础设施提供,这意味着下载安全可靠、稳定一致,并且不受任何第三方种子服务器可用性的限制。完整的数据集现在存储在 pi-314-trillion 存储桶中,包含 628 个对象,总大小约为 132 TB,组织在单一数据路径下,任何人都可以访问,且不会对实验室造成任何影响。
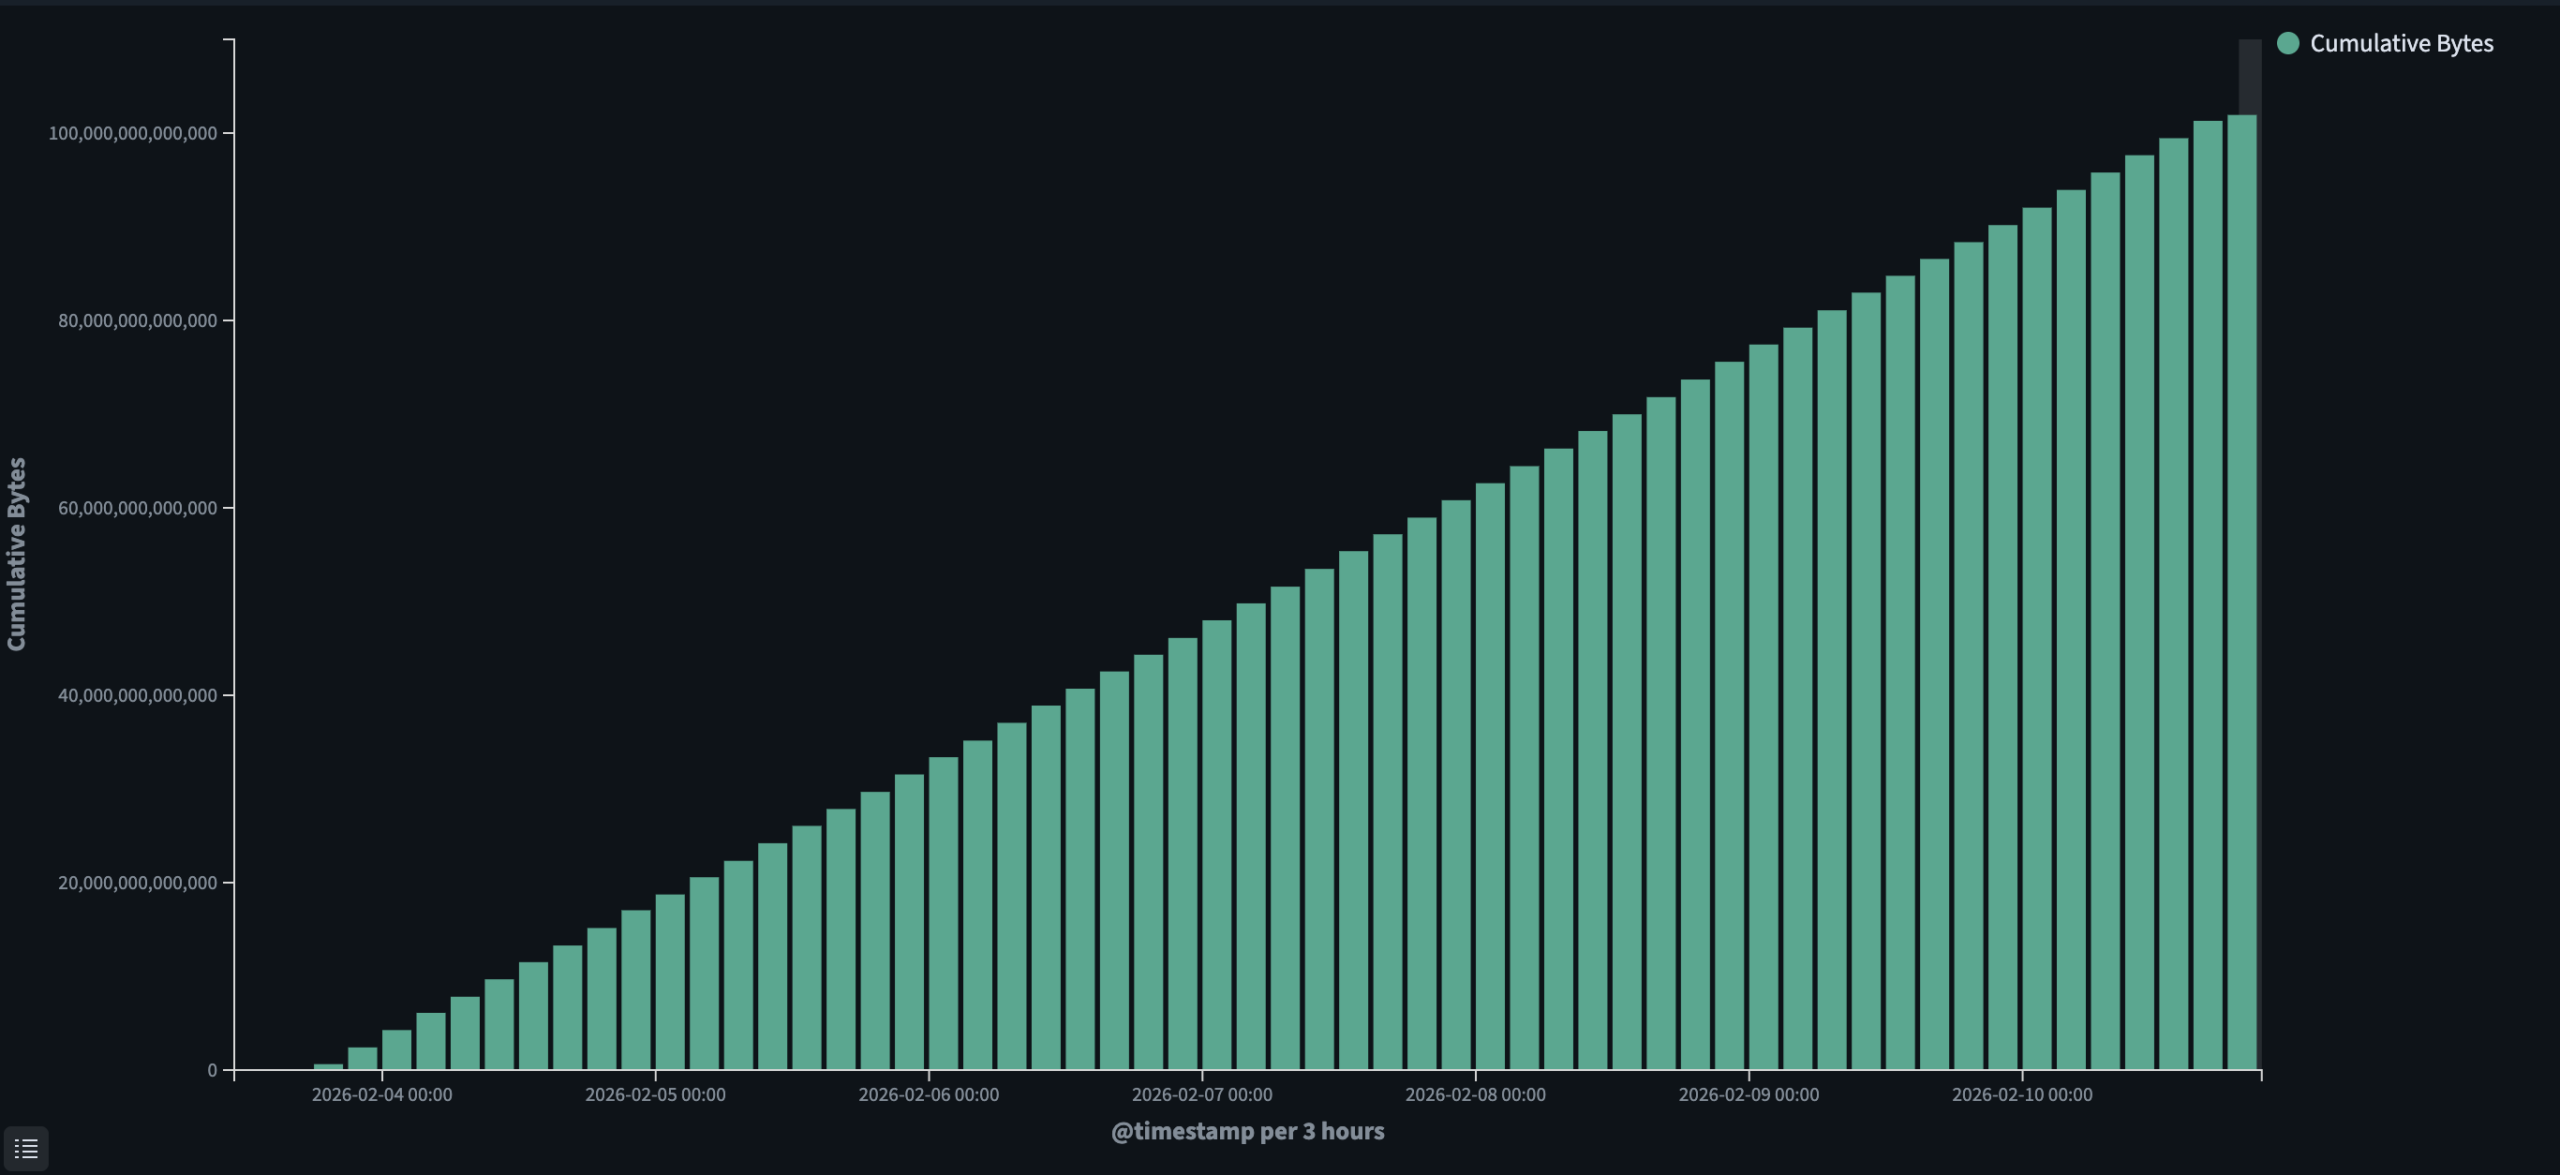
从实验室 NAS 传输数据是通过简单的 Rclone 配置完成的,数据传输经由我们的 UDM Pro Max(作为实验室网关)路由,上传速率在整个过程中保持在 2 Gbps 以上。按照这个吞吐量,传输 130 TB 的数据大约需要 10 天的连续传输时间。下图分别从每分钟和累计两个角度展示了传输情况。
传输期间的广域网利用率
实验室的 UniFi 网络控制面板证实了传输窗口期间的上传特性。广域网接口显示 Backblaze 是流量最大的应用,上传吞吐量为 2.27 Gbps,该期间的月度广域网数据使用量记录为 90.9 TB。传输过程中连接始终保持稳定,未发生明显的丢包事件。
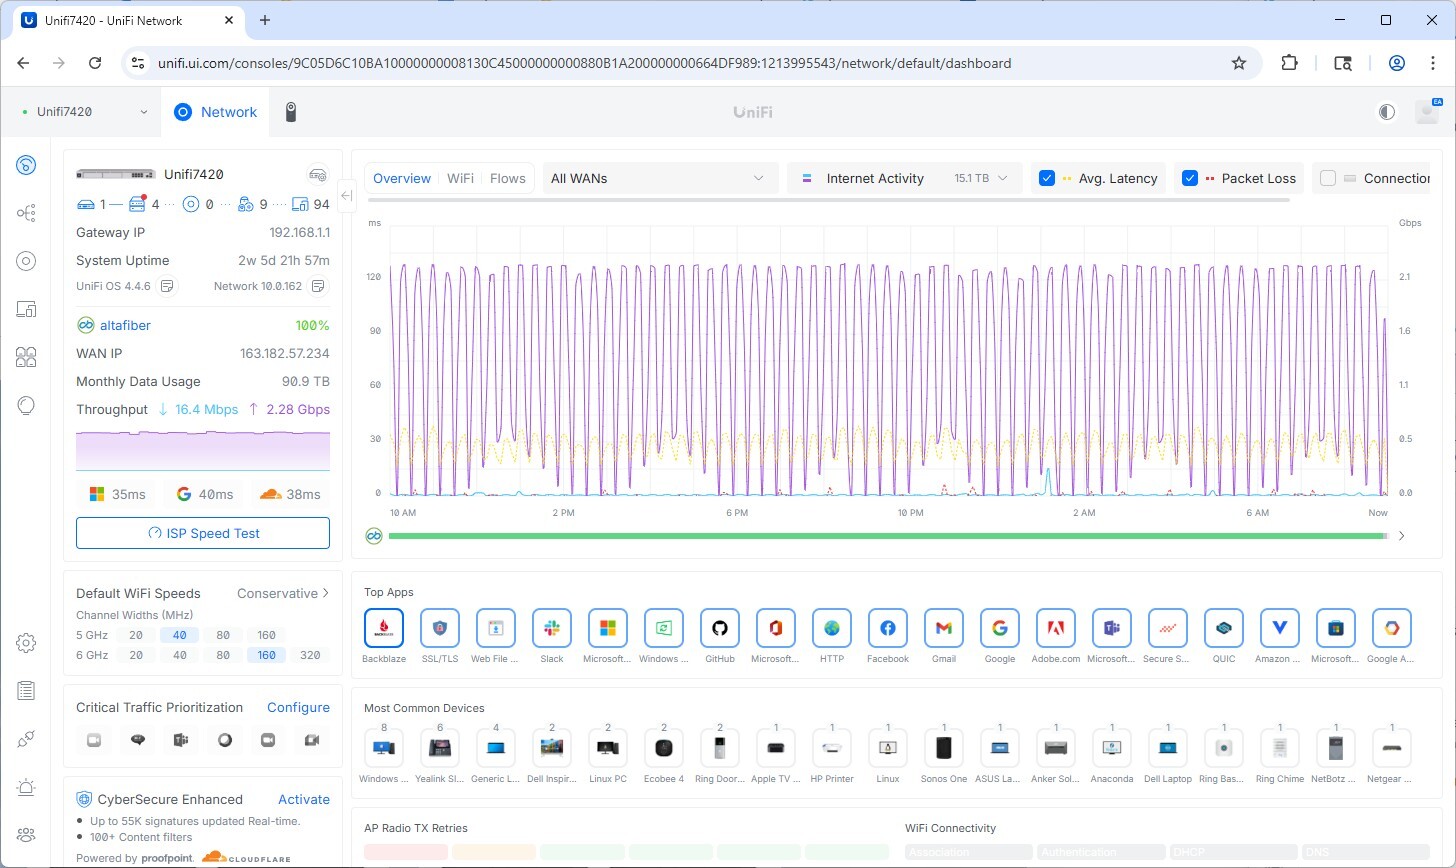
UniFi 控制面板显示,在传输期间,上传吞吐量持续保持在 2 Gbps 以上,其中 Backblaze 是 WAN 应用中的佼佼者。
每分钟传输吞吐量
下图显示了上传过程中一个典型窗口内每分钟的传输吞吐量。柱状图显示,吞吐量稳定在每分钟 15 至 16 GB 之间,这与持续约 2 Gbps 的线路速率相符。图中短暂的间隙对应于传输过程中周期性运行的校验和验证暂停,用于在继续传输前确认数据完整性。
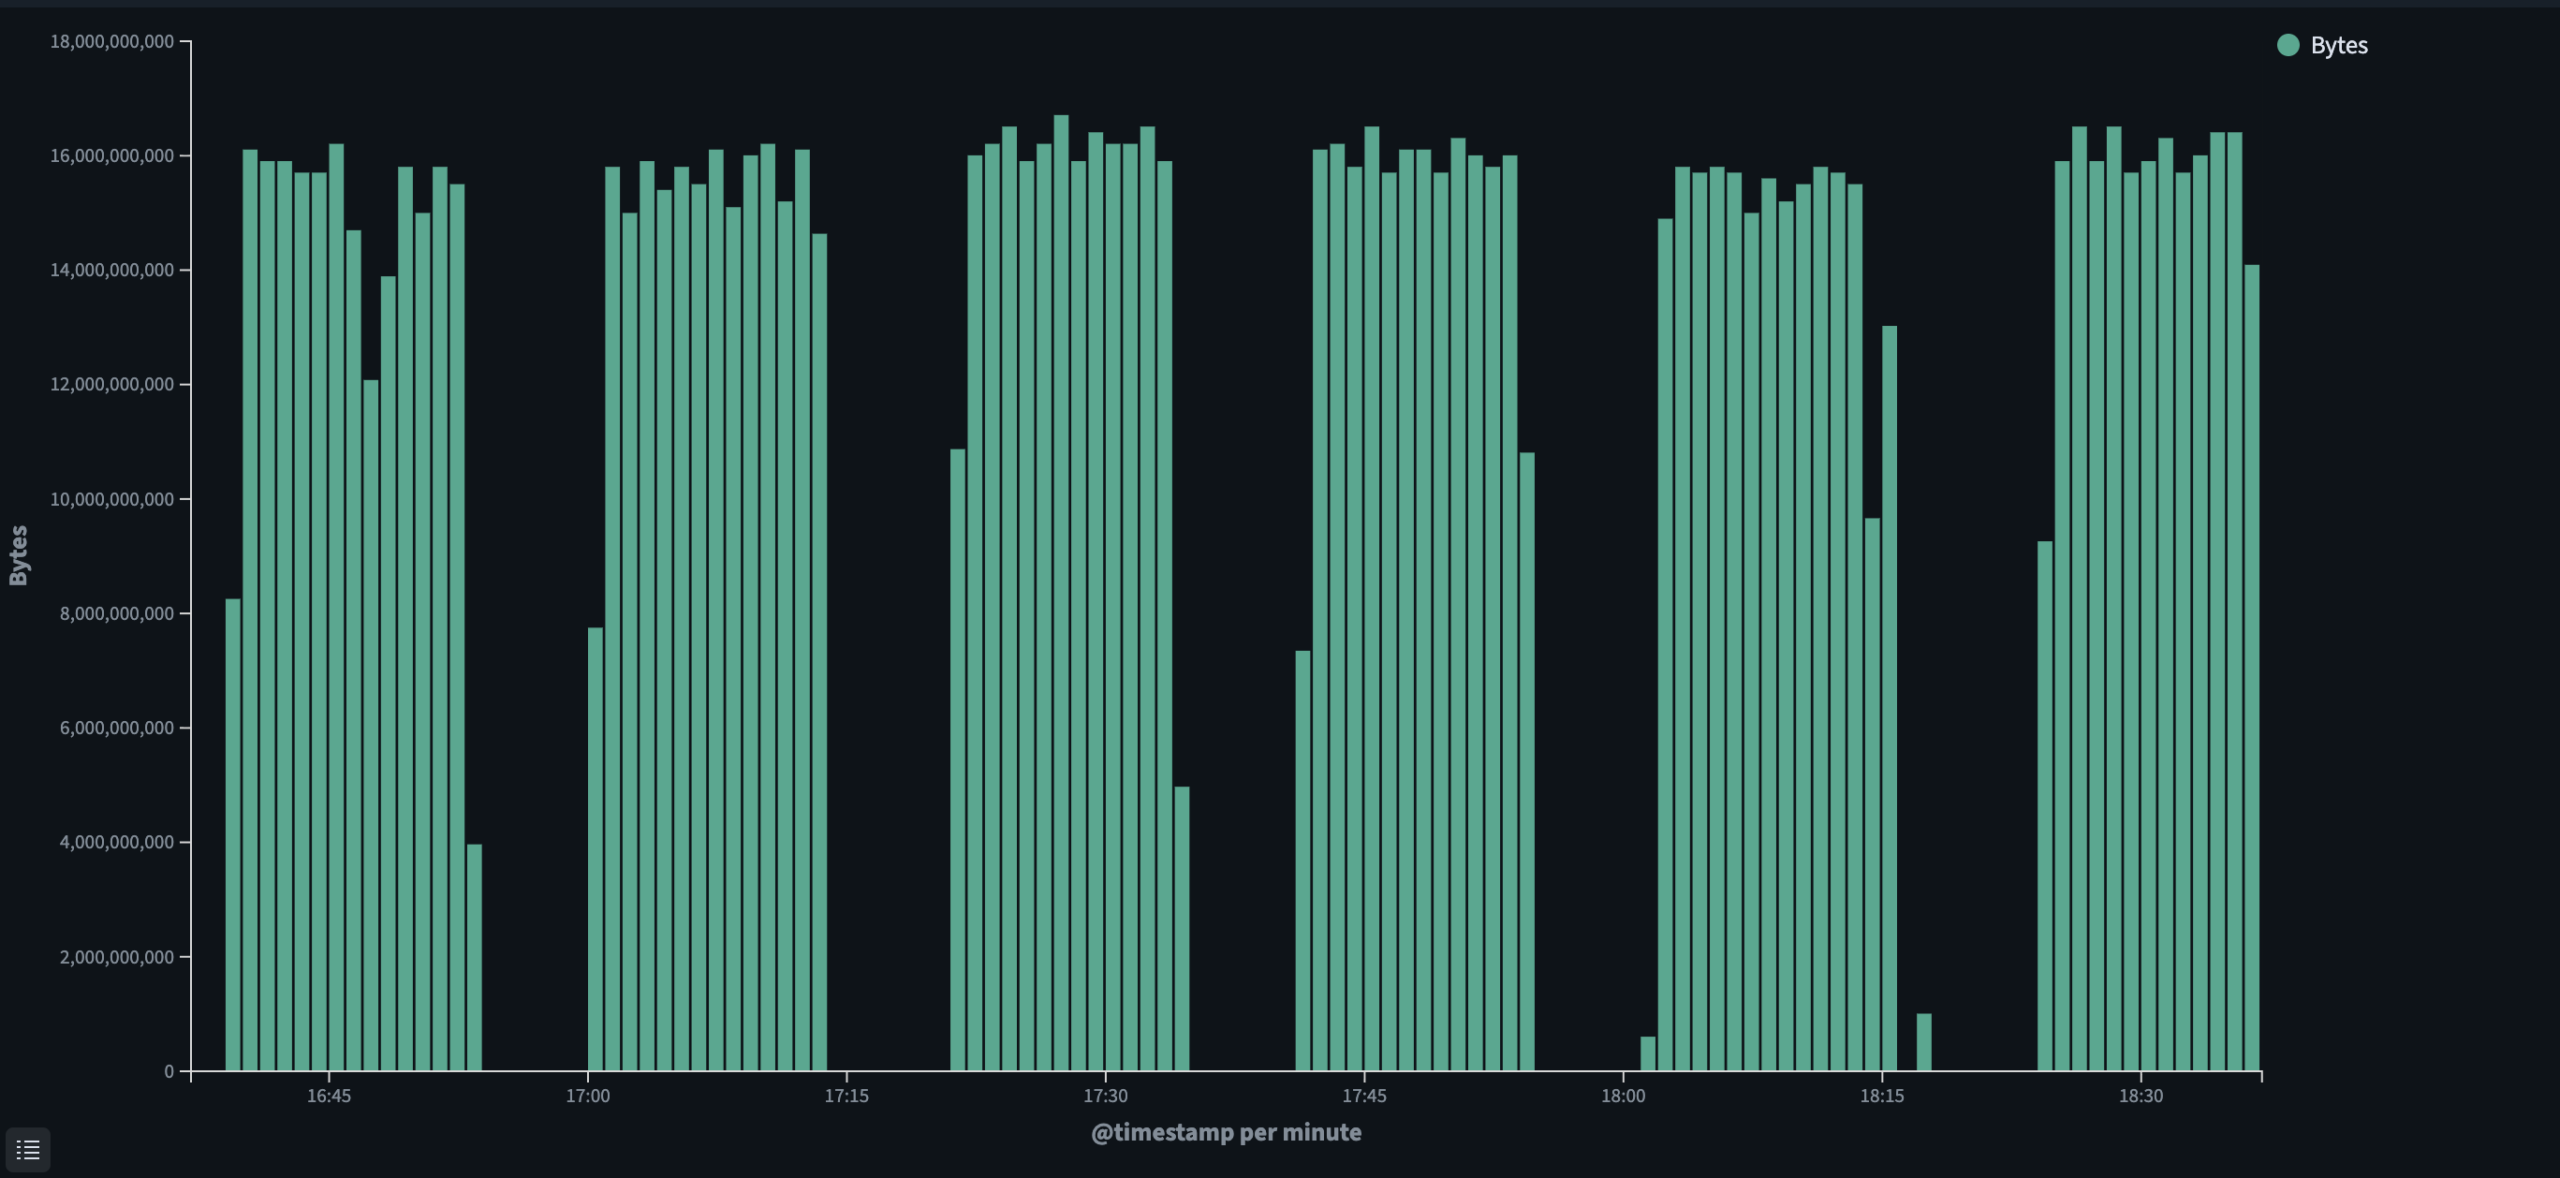
上传期间每分钟字节传输速率,在活动传输窗口内稳定达到每分钟 15 至 16 GB 的吞吐量。
累计转学进度
累计字节数图表追踪了2月4日至2月10日期间传输的总数据量,显示在此期间数据量从0持续线性增长至约100 TB。整个期间的稳定增长反映了传输的稳定性,没有出现重大中断或速率下降。
最终桶布局
Backblaze 创建了名为 pi-314-trillion 的存储桶,其中包含全部 628 个文件,确认大小为 132,210.5 GB。该存储桶配置为私有,保留所有文件版本,可通过 s3.us-west-004.backblazeb2.com 上的 S3 兼容端点访问。对象存储使得管理如此大规模的数据集变得非常简单。每个文件都可以单独寻址,可以通过编程方式检索完整的文件列表,并且无需考虑文件系统层次结构或卷限制。
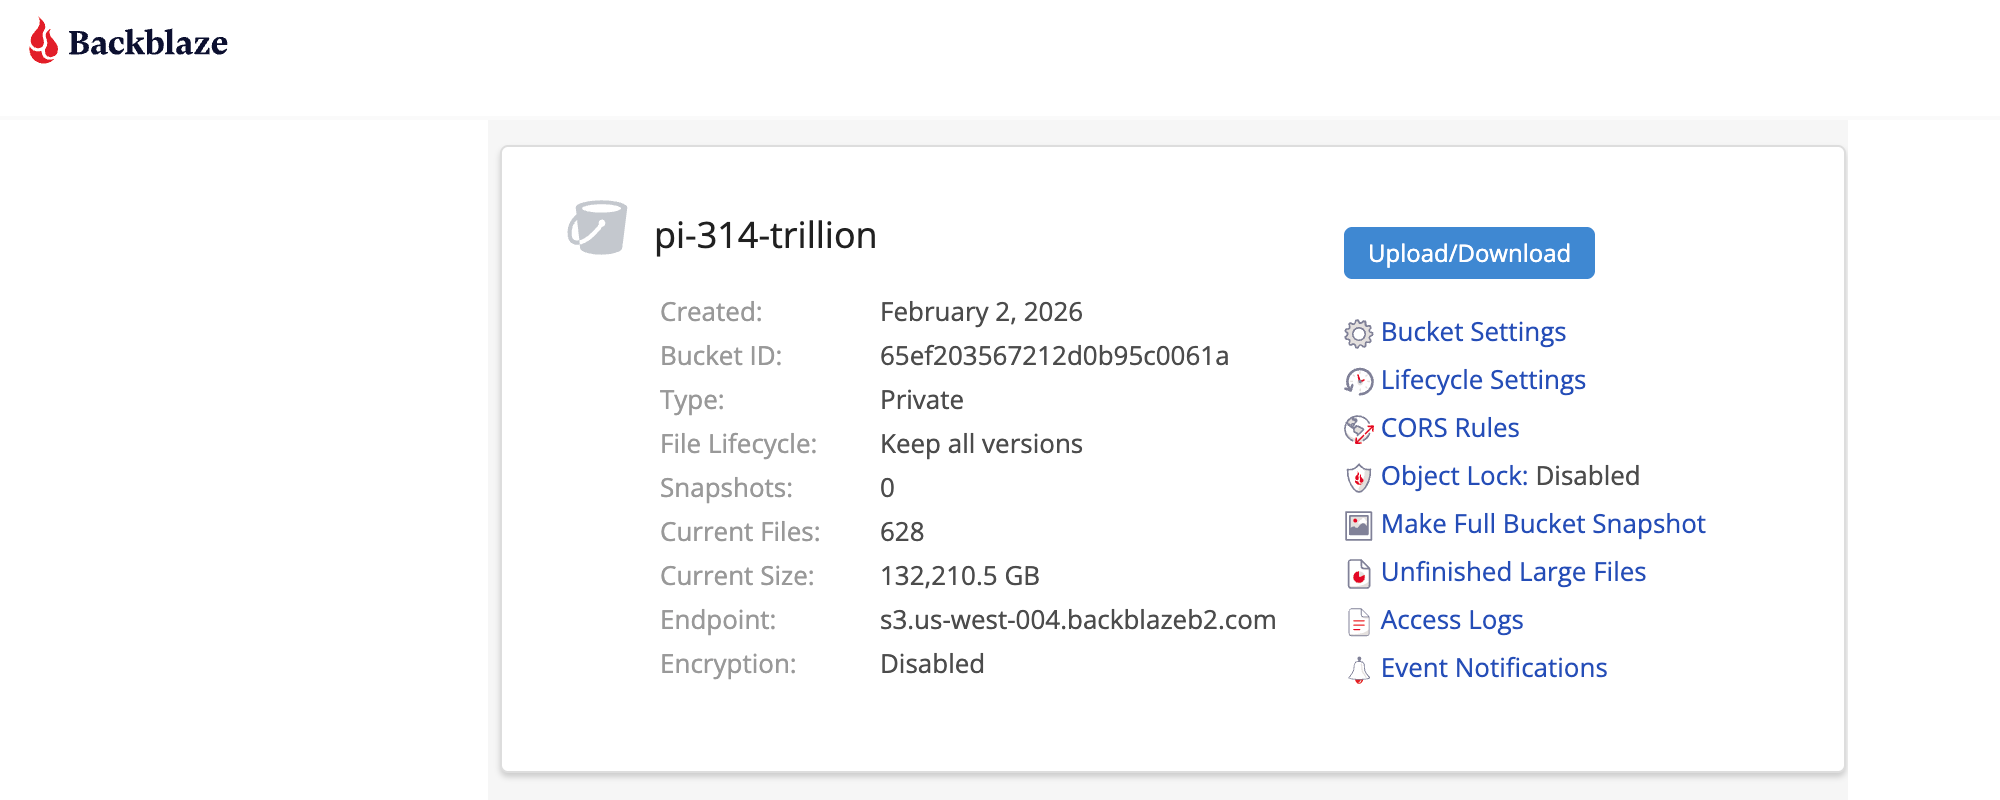
Backblaze B2 控制台显示 pi-314-trillion 存储桶,确认有 628 个文件,总大小为 132,210.5 GB,以及 S3 兼容端点。
访问数据集
研究人员一直要求我们提供这些数据;事实上,我们已经有一个项目正在进行中。迈克尔·克莱伯是谷歌的首席软件工程师,但他从1999年刚获得数学博士学位时就开始研究圆周率的数字。数学家们认为圆周率是一个正态数,因此可以合理地提出这样的问题:“在10^d个d位数的序列中,哪个序列最难出现在圆周率中,它需要多少位数字?”克莱伯将搜索范围扩展到了d=7,当法布里斯·贝拉尔在2009年计算出圆周率的2.7万亿位数字时,克莱伯鼓励他将范围扩展到d=11,这是当时计算能力的极限。“有了314万亿个随机数字,大约有79%的概率会看到所有长度为13的字符串,”克莱伯说,“所以我希望我们能走运!”既然 Backblaze 已经将数据向所有人开放,我们预计这种情况会更加普遍。
PI 数据集托管在 Backblaze B2 上,任何有兴趣使用该数据的人都可以下载。用户可通过请求链接访问该数据集,并可获取凭据或下载说明,以便从存储桶中检索文件。Backblaze 将托管该数据集,以确保在此期间数据始终可用于研究和验证。
下载选项
用户可以根据需要从数据集中检索单个文件,也可以检索完整的 130 TB 数据集。存储桶的结构允许直接访问和下载单个对象,而无需拉取整个数据集。如果想要检索所有内容,可以使用下文所述的工具对存储桶进行完全同步。建议使用此选项时预留 135 TB 的可用空间。
推荐工具
- Rclone 是访问该数据集的推荐工具。它与 Backblaze B2 无缝集成,并允许用户根据自身可用带宽需求调整下载过程。
- S3 兼容 API因此,任何具备 S3 功能的下载工具都可以用来检索数据。唯一的要求是,该工具必须允许覆盖默认的 S3 端点 URL,使其指向 B2 端点而不是 AWS 端点。
混合基础设施的实际案例
我们计算 314 万亿位数的圆周率,清晰地展现了混合基础设施在实践中的应用。该计算完全在 StorageReview 实验室的一台戴尔 PowerEdge R7725 服务器上完成,但由于运行完成后该系统需要重新分配给其他项目和任务,因此将 130 TB 的结果永久保存在实验室中始终是不可持续的。
无论是出于严谨的科学研究,还是仅仅出于对数据的好奇,我们都渴望将数据提供给需要的人。然而,在实验室内部托管如此庞大的数据集很快就会成为运营的负担。带宽被消耗殆尽,基础设施被占用,实验室的日常工作也与每一个下载请求争夺资源。
Backblaze B2 等解决方案消除了所有这些摩擦。数据存储在专为这种规模的数据集构建的云基础设施中,其吞吐量可随需求扩展,多重冗余确保数据不会丢失,并具备企业级存储平台所特有的安全性和运维专业知识。计算资源部署在本地是因为任务需要。而存储则部署在云端,因为对于后续的所有工作而言,云端无疑是更佳的选择。



 Amazon